نماذج حوسبة مكافئة { #chapequivalentmodels }
نماذج حوسبة مكافئة
- تعرَّف على آلات RAM وحساب لامدا.
- التكافؤ بين هذين النموذجين ونماذج أخرى وبين آلات تورينج.
- الآليات الخلوية وتكوينات آلات تورينج.
- افهم أطروحة Church-Turing.
"كل المشكلات في علم الحاسوب يمكن حلها بمستوى آخر من التوجيه غير المباشر", منسوب إلى ديفيد وي Wheeler.
"لأننا سنحسب لاحقًا بتعبيرات عن الدوال، نحتاج إلى تمييز بين الدوال والصيغ، وإلى رمز للتعبير عن هذا التمييز. هذا التمييز، والرموز التي تصفه، والتي نحيد عنها بشكل تافه، هو ما قدّمه Church.", جون ماكانتي، 1960 (في ورقة تصف لغة البرمجة LISP)
حتى الآن، عرّفنا مفهوم حساب دالة باستخدام آلات تورينج، وهي لا تطابق الطرق التي يجري بها الحساب في الممارسة العملية عن قرب. في هذا الفصل نبرر هذا الاختيار بإظهار أن تعريف الدوال القابلة للحساب سيبقى كما هو تحت مجموعة واسعة من نماذج الحوسبة. يُعرف هذا المفهوم بـ_اكتمال تورينج_ (Turing completeness) أو تكافؤ تورينج (Turing equivalence)، وهو إحدى أكثر حقائق علم الحاسوب جوهرية. في الواقع، هناك دعوى منتشرة الانتشار تُعرف بـ_أطروحة Church-Turing_ تقول إن كل تعريف "معقول" للدالة القابلة للحساب هو مكافئ لقابلية حسابها بآلة تورينج. نناقش أطروحة Church-Turing والتعريفات المحتملة لكلمة "معقول" في أطروحة Church-Turing (مناقشة).
تشمل بعض نماذج الحوسبة الرئيسية التي سنناقشها في هذا الفصل:
-
آلات RAM: لا تقابل آلات تورينج البنى المعمارية المعيارية للحاسوب التي تحتوي على ذاكرة عشوائية الوصول (Random Access Memory, RAM). فالنموذج الرياضي لآلات RAM أقرب بكثير إلى الحاسوب الفعلي، لكننا سنرى أنه مكافئ في القوة لآلات تورينج. كما سنناقش أيضًا متغيّرًا من لغات البرمجة لآلات RAM، نسميه NAND-RAM. والتكافؤ بين آلات تورينج وآلات RAM يتيح لنا إثبات تكافؤ تورينج للعديد من لغات البرمجة الشائعة، بما فيها جميع اللغات العامة المستخدمة عمليًا مثل C وPython وJavaScript وغيرها.
-
الآليات الخلوية (cellular automata): يمكن نمذجة كثير من الأنظمة الطبيعية والاصطناعية كمجموعات من مكوّنات بسيطة، كل منها يتطور وفق قواعد بسيطة تستند إلى حالته وحالة جيرانه (neighbors) المباشرين. ومن الأمثلة الشهيرة على ذلك لعبة حياة كونواي (Conway's Game of Life). ولإثبات أن الآليات الخلوية مكافئة لآلات تورينج، نقدّم أداة التكوينات (configurations) الخاصة بآلات تورينج. ولكل هذه الأدوات تطبيقات أخرى، وعلى الأخص تُستخدم في هل كل مبرهنة قابلة للإثبات؟ لإثبات نظرية عدم اكتمال غودل: نتيجة مركزية في الرياضيات.
-
حساب لامدا (lambda calculus): حساب لامدا هو نموذج للتعبير عن الحساب يعود أصله إلى ثلاثينيات القرن الماضي، وإن كان مرتبطًا عن قرب بلغات البرمجة الوظيفية المستخدمة على نطاق واسع اليوم. وإظهار تكافؤ حساب لامدا مع آلات تورينج يتطلب تقنية جميلة للتخلص من التهاكر تُعرف بـ"المُجمِّع Y" (Y Combinator).
في هذا الفصل ندرس التكافؤ بين النماذج. نقول إن نموذجَي حوسبة متكافئان (ويُعرفان أيضًا بـ_متكافئَي تورينج_) إذا كان بإمكانهما حساب المجموعة نفسها من الدوال. على سبيل المثال، رأينا أن آلات تورينج وبرامج NAND-TM متكافئة، لأننا نستطيع تحويل كل آلة تورينج إلى برنامج NAND-TM يحسب الدالة نفسها، وكذلك نستطيع تحويل كل برنامج NAND-TM إلى آلة تورينج تحسب الدالة نفسها.
في هذا الفصل نبيّن أن هذا يمتد إلى ما هو أبعد بكثير من آلات تورينج. والتقنيات التي سنطوّرها تتيح لنا أن نبيّن أن جميع لغات البرمجة العامة (أي Python وC وJava وغيرها) كاملة بحسب تورينج (Turing Complete)، بالمعنى أنها تستطيع محاكاة آلات تورينج، وبالتالي حساب جميع الدوال التي يمكن حسابها بآلة TM. وسنبيّن أيضًا الاتجاه الآخر - إذ يمكن استخدام آلات تورينج لمحاكاة برنامج بأي من هذه اللغات، وبالتالي حساب أي دالة يمكن حسابها بها. وهذا يعني أن جميع لغات البرمجة هذه متكافئة مع تورينج: فهي متكافئة في القوة مع آلات تورينج ومع بعضها البعض. وهذا مبدأ قوي يستند إليه المدى الواسع الذي بلغه علم الحاسوب. فضلا عن ذلك، فهو يتيح لنا أن «نأكل الكعكة ونحتفظ بها أيضًا» - فبما أن جميع هذه النماذج متكافئة، يمكننا اختيار النموذج الذي يناسبنا للمهمة قيد اليد. ولتحقيق هذا التكافؤ، نعرّف نموذج حوسبة جديدًا يُعرف بـ_آلات RAM_. تلتقط آلات RAM بنية الحاسوب الحديث عن قرب أكبر مما تفعل آلات تورينج، لكنها تظل مكافئة حسابيًا لآلات تورينج.
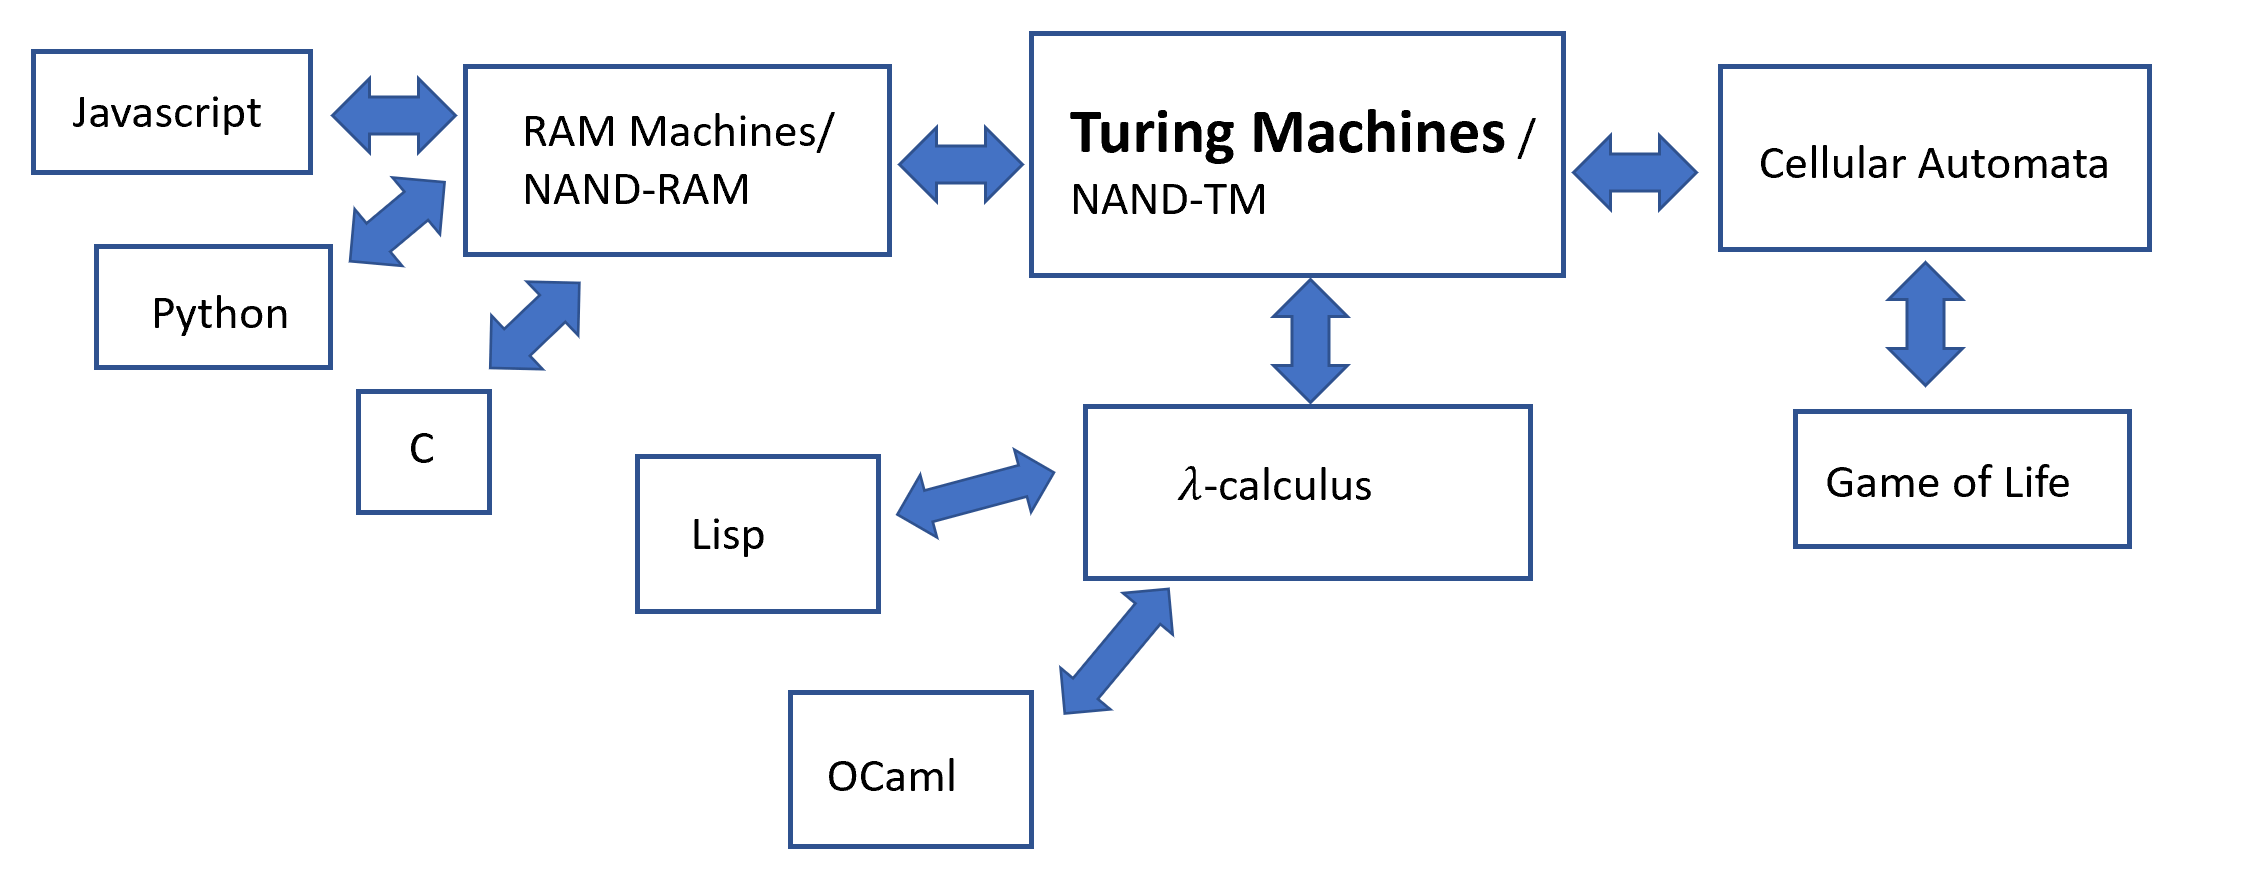
أخيرًا، سنبيّن أن تكافؤ تورينج يمتد إلى ما هو أبعد بكثير من لغات البرمجة التقليدية. سنرى أن الآليات الخلوية، وهي نموذج رياضي لأنظمة طبيعية بالغة البساطة، هي أيضًا مكافئة مع تورينج، وسنرى كذلك تكافؤ تورينج لحساب لامدا - وهو نظام منطقي للتعبير عن الدوال يشكّل أساس لغات البرمجة الوظيفية مثل Lisp وOCaml وغيرها.
انظر الشكل التوضيحي لمحة عامة عن نتائج هذا الفصل.
آلات RAM وNAND-RAM
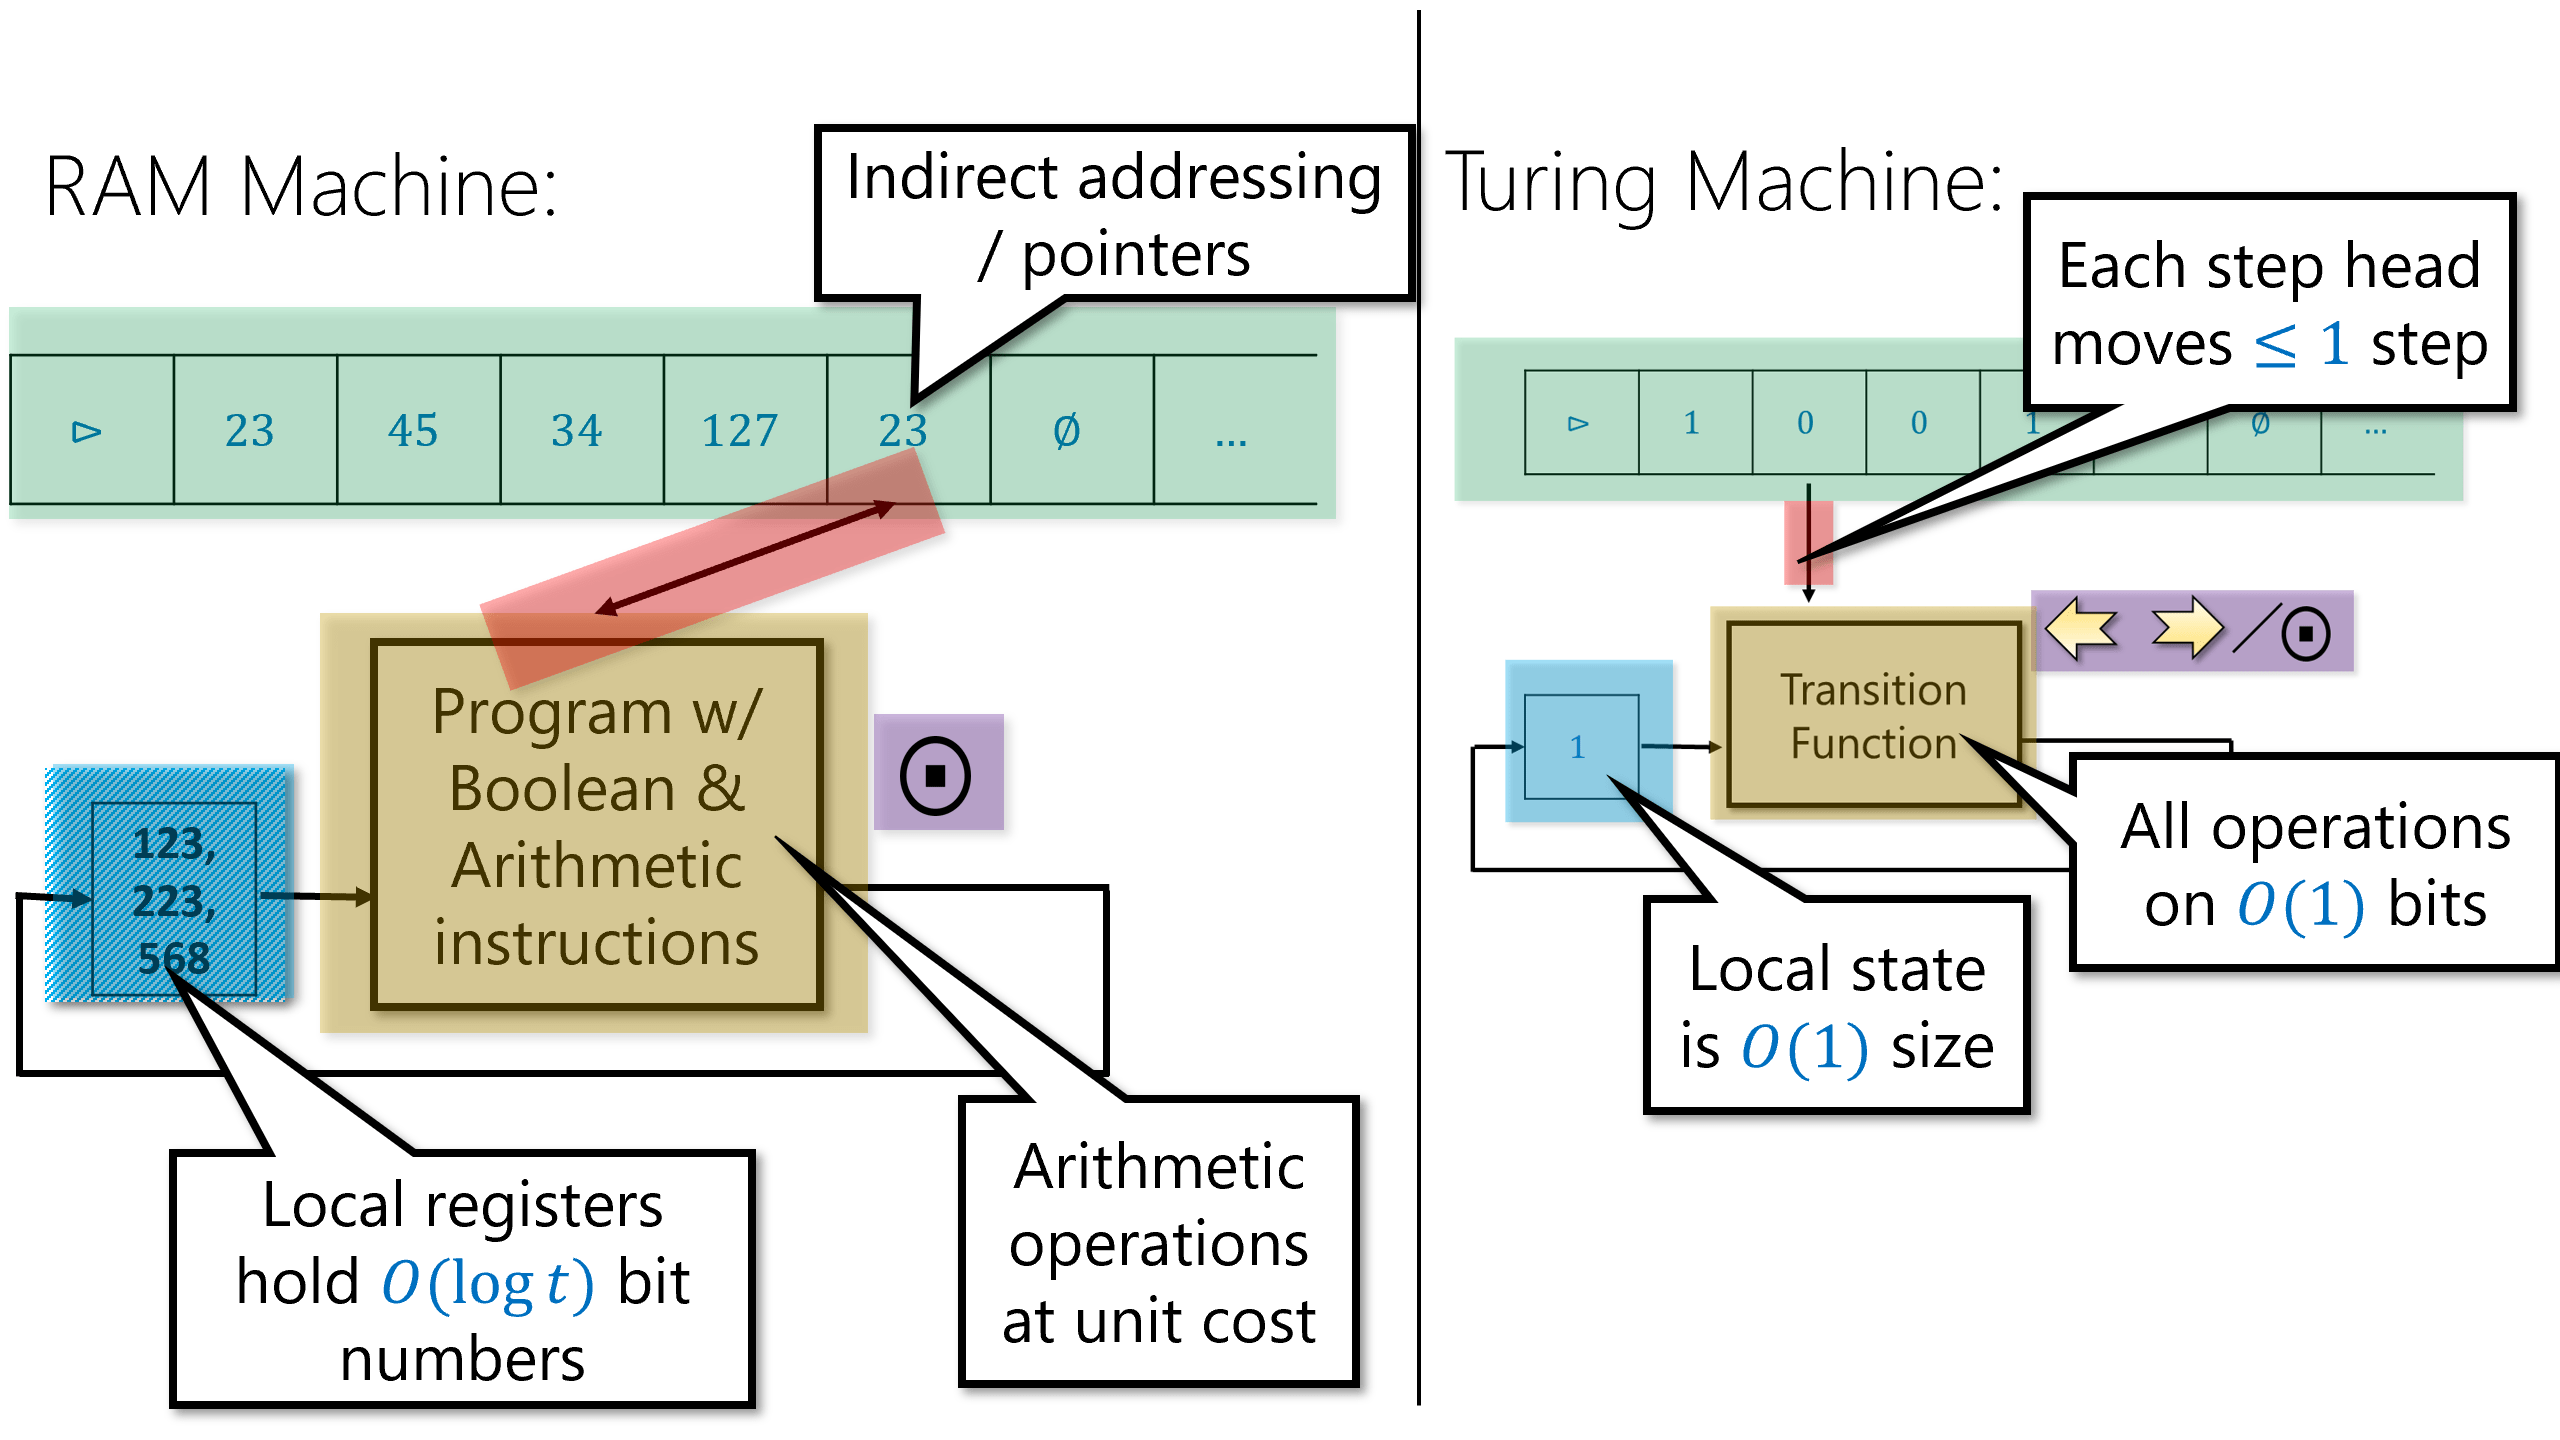
أحد قيود آلات تورينج (وبرامج NAND-TM) أننا لا نستطيع الوصول إلا إلى موقع واحد من مصفوفاتنا/شريطنا في كل مرة.
إذا كانت الرأس عند الموضع في الشريط وأردنا الوصول إلى الموضع ، فإن ذلك سيستغرق منّا 923 خطوة على الأقل.
في المقابل، تمتلك كل لغة برمجة تقريبًا صيغة رسمية (formalism) للوصول المباشر إلى مواقع الذاكرة.
كما توفّر الحواسيب الفيزيائية الفعلية ما يُعرف بـ_الذاكرة العشوائية الوصول (RAM)_، ويمكن التفكير فيها على أنها مصفوفة كبيرة اسمها Memory، بحيث إن أعطينا فهرسًا (أي عنوان ذاكرة، أو مؤشرًا pointer) استطعنا القراءة من الموضع في Memory والكتابة إليه.
("الذاكرة العشوائية الوصول" تسمية مضللة إلى حد بعيد إذ لا علاقة لها بالاحتمال، لكن بما أنها مصطلح معتمد في نظريّة الحوسبة وممارستها معًا، سنستخدمها نحن أيضًا.)
نموذج الحوسبة الذي يجسّد الوصول إلى ذاكرة من هذا النوع هو آلة RAM (ويُعرف أحيانًا أيضًا بـ_نموذج Word RAM_)، كما هو موضح في الشكل التوضيحي. ذاكرة آلة RAM هي مصفوفة ذات حجم غير محدود، يمكن لكل خلية فيها أن تخزّن كلمةً واحدة، نعتبرها سلسلة في ، وكذلك (بشكل مكافئ) عددًا في . على سبيل المثال، تستخدم كثير من البنى الحاسوبية الحديثة كلمات بطول بت، حيث يحمل كل موقع ذاكرة سلسلة في ، ويمكن أيضًا التفكير فيها على أنها عدد بين و. تُعرف المعامل بـ_حجم الكلمة_ (word size). في الممارسة غالبًا ما يكون عددًا ثابتًا مثل ، لكن عند تقديم النظرية نعتبر معاملًا قد يعتمد على طول المدخل أو على عدد الخطوات. (يمكنك التفكير في على أنها تقابل تقريبًا أكبر عنوان ذاكرة نستخدمه أثناء الحساب.) بالإضافة إلى مصفوفة الذاكرة، تحتوي آلة RAM أيضًا على عدد ثابت من السجلات (registers) ، يمكن لكل منها أن يحتوي كلمة واحدة أيضًا.
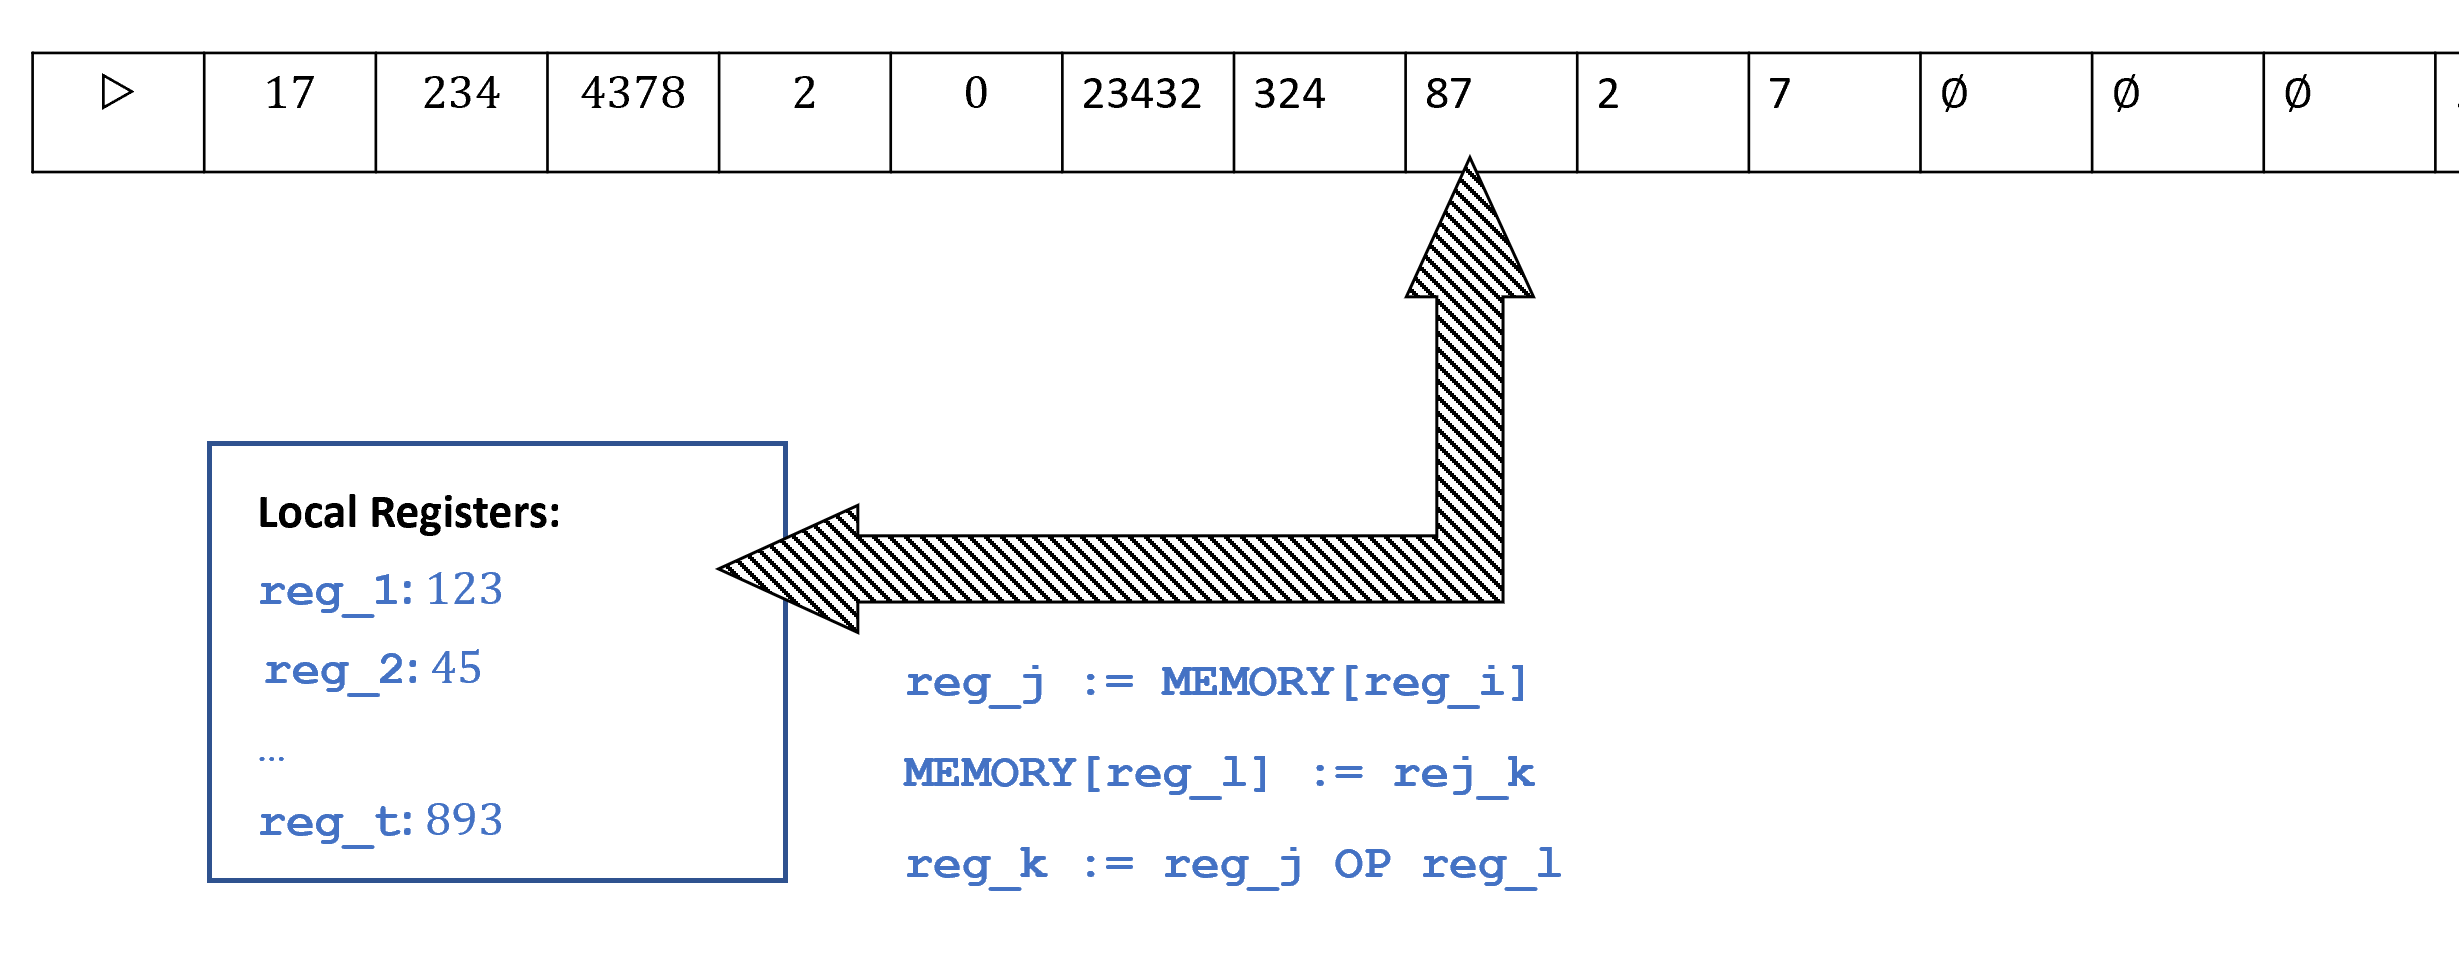
تشمل العمليات التي تستطيع آلة RAM تنفيذها:
-
نقل البيانات: تحميل بيانات من خلية معينة في الذاكرة إلى سجل، أو تخزين محتوى سجل في خلية معينة من الذاكرة. تستطيع آلة RAM الوصول إلى أي خلية في الذاكرة مباشرةً دون الحاجة إلى تحريك "الرأس" (كما تفعل آلات تورينج) إلى ذلك الموضع. أي أنه في خطوة واحدة تستطيع آلة RAM أن تحمّل في السجل محتوى خلية الذاكرة التي يفهرسها السجل ، أو أن تخزّن في خلية الذاكرة التي يفهرسها السجل محتوى السجل .
-
الحساب: تستطيع آلات RAM إجراء عمليات على السجلات مثل العمليات الحسابية، والعمليات المنطقية، والمقارنات.
-
مسار التنفيذ: كما في حالة آلات تورينج، يمكن أن يعتمد اختيار أمر التعليمات التالي على حالة آلة RAM، وهي محدَّدة بمحتوى سجلها.
لن نقدّم تعريفًا رسميًا لآلات RAM، وإن كان قسم ملاحظات المراجع (ملاحظات مرجعية) يحتوي على مصادر لمثل هذه التعريفات. تمامًا كما تُجسّد لغة البرمجة NAND-TM آلات تورينج، يمكننا أيضًا تعريف لغة برمجة NAND-RAM تُجسّد آلات RAM. توسّع لغة برمجة NAND-RAM لغة NAND-TM بإضافة الميزات التالية:
-
يُسمح لمتغيرات NAND-RAM بأن تكون ذات قيم صحيحة (غير سالبة) بدلًا من أن تكون بوليانية فقط كما في NAND-TM. أي أن المتغير العددي
fooيحمل عددًا صحيحًا غير سالب في (بدلًا من بت واحد في )، والمتغير المصفوفيBarيحمل مصفوفة من الأعداد الصحيحة. وكما في حالة آلات RAM، لن نسمح بأعداد صحيحة ذات حجم غير محدود. بشكل ملموس، يحمل كل متغير عددًا بين و، حيث هو عدد الخطوات التي نفّذها البرنامج حتى الآن. (يمكنك تجاهل هذا القيد الآن: إن أردنا حمل أعداد أكبر، يمكننا ببساطة تنفيذ تعليمات وهمية؛ وسيكون ذلك مفيدًا في الفصول اللاحقة.) -
نسمح بـ_الوصول المفهرس_ (indexed access) إلى المصفوفات. إذا كان
fooمتغيرًا عدديًا وBarمصفوفة، فإنBar[foo]تشير إلى الموضع فيBarالذي تفهرسه قيمةfoo. (لاحظ أن هذا يعني أننا لم نعد بحاجة إلى متغير فهرس خاصi.) -
كما هو شائع في لغات البرمجة، سنفترض أنه في العمليات البوليانية مثل
NAND، يُعتبر العدد الصحيح ذو القيمة صفرًا خطأً (false)، ويُعتبر العدد الصحيح غير الصفري صوابًا (true). -
بالإضافة إلى
NAND، تشمل NAND-RAM أيضًا جميع العمليات الحسابية الأساسية: الجمع، والطرح، والضرب، والقسمة (على الأعداد الصحيحة)، وكذلك المقارنات (التساوي، والأكبر، والأصغر، إلخ). -
تتضمن NAND-RAM عبارات شرطية
if/thenكجزء من اللغة. -
تحتوي NAND-RAM على بنيات تكرارية مثل
whileوdoكجزء من اللغة.
الوصف الكامل للغة برمجة NAND-RAM موجود في الملحق. لكن أهم ما تحتاج معرفته عن NAND-RAM هو أنك في الحقيقة لا تحتاج إلى معرفة الكثير عنها إطلاقًا، لأنها مكافئة في القوة لآلات تورينج:
مبرهنة — آلات تورينج (أي برامج NAND-TM) وآلات RAM (أي برامج NAND-RAM) متكافئة
لكل دالة ، تكون قابلة للحساب ببرنامج NAND-TM إذا وفقط إذا كانت قابلة للحساب ببرنامج NAND-RAM.
لأن برامج NAND-TM مكافئة لآلات تورينج، وبرامج NAND-RAM مكافئة لآلات RAM، فإن مبرهنة — آلات تورينج (أي برامج NAND-TM) وآلات RAM (أي برامج NAND-RAM) متكافئة تُظهر أن هذه النماذج الأربعة كلها متكافئة فيما بينها.
من الواضح أن NAND-RAM أقوى من NAND-TM فحسب، لذا إذا كانت دالة قابلة للحساب ببرنامج NAND-TM، فيمكن حسابها ببرنامج NAND-RAM. الاتجاه الصعب هو تحويل برنامج NAND-RAM إلى برنامج NAND-TM مكافئ له. ولوصف البرهان بالكامل، سنحتاج إلى تغطية المواصفة الرسمية الكاملة للغة NAND-RAM، وإظهار كيف يمكننا تنفيذ كل واحدة من ميزاتها كسكّر نحوي فوق NAND-TM.
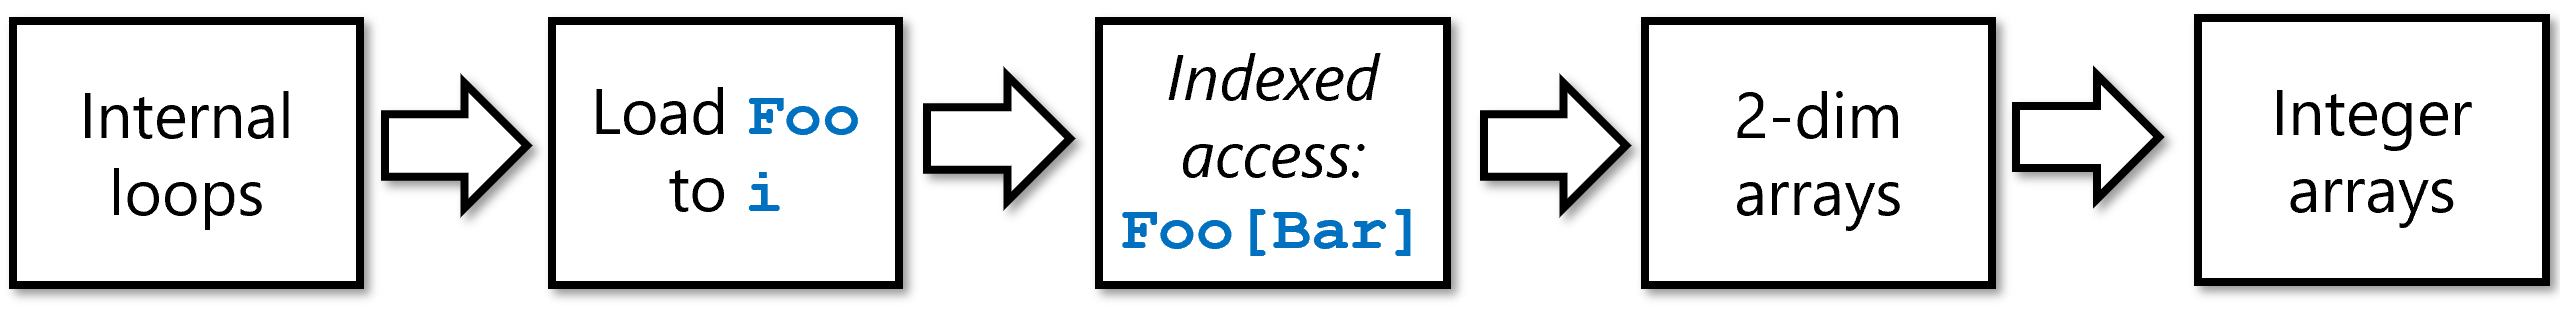
هذا ممكن، لكن المرور على جميع العمليات بالتفصيل ممل إلى حد ما. لذا سنركّز على وصف الأفكار الرئيسية وراء هذا التحويل. (انظر أيضًا الشكل التوضيحي.)
تعمّم NAND-RAM لغة NAND-TM بطريقتين رئيسيتين: (أ) بإضافة الوصول المفهرس إلى المصفوفات (أي صيغة Foo[bar])، و__(ب)__ بالانتقال من متغيرات ذات قيم بوليانية إلى متغيرات ذات قيم صحيحة.
يتكوّن التحويل من خطوتين:
-
الوصول المفهرس إلى مصفوفات البتات: نبدأ بإظهار كيف نتعامل مع (أ). أي أننا نبيّن كيف يمكننا تنفيذ العملية
Setindex(Bar)في NAND-TM بحيث إذا كانBarمصفوفة تُرمِّز لعدد صحيح ، فإن قيمةiبعد تنفيذSetindex(Bar)ستكون مساوية لـ. وسيتيح لنا هذا محاكاة الصيغةFoo[Bar]عبرSetindex(Bar)يتبعهاFoo[i]. -
مصفوفات البتات ثنائية البعد: ثم نبيّن كيف يمكننا استخدام "السكر النحوي" لإثراء NAND-TM بـ_مصفوفات ثنائية البعد_. أي أن لدينا فهرسين هما
iوjو_مصفوفات ثنائية البعد_، بحيث يمكننا استخدام الصيغةFoo[i][j]للوصول إلى الموضع (i,j) منFoo. -
مصفوفات الأعداد الصحيحة: وأخيرًا سنُرمِّز مصفوفة
Arrأحادية البعد من الأعداد الصحيحة عبر مصفوفةArrbinثنائية البعد من البتات. الفكرة بسيطة: إذا كانت تمثيلًا ثنائيًا (خالٍ من البادئة) لـArr[]، فإنArrbin[$i$][$j$]` سيكون مساويًا لـ .
وبعد أن تتوفر لدينا مصفوفات الأعداد الصحيحة، يمكننا استخدام سكرنا النحوي المعتاد للدوال وGOTO إلخ لتنفيذ عمليات الحساب ومسار التنفيذ في NAND-RAM.
النهج أعلاه ليس الطريقة الوحيدة لإثبات مبرهنة — آلات تورينج (أي برامج NAND-TM) وآلات RAM (أي برامج NAND-RAM) متكافئة، انظر على سبيل المثال تمرين — برهان بديل لتكافؤ TM/RAM
ملاحظة — آلات RAM / NAND-RAM ولغة التجميع (اختياري)
تقابل آلات RAM المعالجات الدقيقة الفعلية عن قرب كبير، مثل معالجات سلسلة Intel x86 التي تحتوي أيضًا على ذاكرة أولية (primary memory) كبيرة وعدد ثابت من السجلات الصغيرة. وهذا ليس مصادفة بالطبع: فهدف آلات RAM هو نمذجة بنية أنظمة الحوسبة الفعلية عن قرب أكبر مما تفعله آلات تورينج، وهي بنى تتبع إلى حد بعيد ما يُعرف بـبنية فون نيومان كما وصفها التقرير [@vonNeumann45]. ونتيجة لذلك، فإن NAND-RAM مشابهة في مخططها العام لغات التجميع مثل x86 أو NIPS. وتحتوي جميع لغات التجميع هذه على تعليمات (1) لنقل البيانات من السجلات إلى الذاكرة، (2) لإجراء عمليات حسابية أو منطقية على السجلات، و__(3)__ للتنفيذ الشرطي والحلقات ("if" و"goto"، وتُعرف عادة بـ"الفروع" و"القفزات" في سياق لغات التجميع).
الفرق الرئيسي بين آلات RAM والمعالجات الدقيقة الفعلية (وبالتالي بين NAND-RAM ولغات التجميع) أن المعالجات الدقيقة الفعلية لها حجم كلمة ثابت ، بحيث تحمل كل السجلات وخلايا الذاكرة أعدادًا في (أو ما يكافئ ذلك سلاسل في ). قد يختلف هذا العدد بين المعالجات المختلفة، لكن القيم الشائعة هي إما أو . وكنموذج نظري، لا تفتقر آلات RAM إلى هذا القيد، بل نجعل يكون لوغاريتم زمن التنفيذ لدينا (وهو ما يقابل قيمته في الممارسة أيضًا). للمعالجات الدقيقة الفعلية أيضًا عدد ثابت من السجلات (مثلًا 14 سجلًا للأغراض العامة في x86-64)، لكن هذا لا يحدث فرقًا كبيرًا مع آلات RAM. ويمكن إظهار أن آلات RAM التي لا تملك سوى سجلين فقط قوية بقدر آلات RAM الكاملة التي تملك عددًا ثابتًا كبيرًا من السجلات.
بالطبع، للمعالجات الدقيقة الفعلية كذلك كثير من الميزات التي لا تتشاركها مع آلات RAM، بما فيها التوازي، وتسلسلات الذاكرة، والعديد غيرها. لكن آلات RAM تلتقط بالفعل الحواسيب الفعلية تقريبًا، ولذلك (كما سترى) فإن زمن تشغيل خوارزمية على آلة RAM (مثل مقابل ) يرتبط ارتباطًا وثيقًا بكفاءتها العملية.
التفاصيل القبيحة (اختياري)
لن نعرض البرهان الرسمي الكامل لـ مبرهنة — آلات تورينج (أي برامج NAND-TM) وآلات RAM (أي برامج NAND-RAM) متكافئة، بل نركّز على أهم الأجزاء: تنفيذ الوصول المفهرس، ومحاكاة المصفوفات ثنائية البعد بالمصفوفات أحادية البعد. حتى هذين الجزءين مملة في وصفها، ولن يكون ذلك مفاجئًا لأي شخص كتب مترجمًا (compiler) من قبل. لذا يمكنك أن تتصفح هذا القسم قراءة سريعة دون عناء. النقطة المهمة ليست أن تحفظ كل التفاصيل عن ظهر قلب، بل أن تُقنع بأن من الممكن في المبدأ تحويل برنامج NAND-RAM إلى برنامج NAND-TM مكافئ، وأن تُقنع حتى بأنك أنت تستطيع فعل ذلك، لو أردت، مع وقت كافٍ وجهد كافٍ.
الوصول المفهرس في NAND-TM
في NAND-TM لا يمكننا الوصول إلى مصفوفاتنا إلا في موضع متغير الفهرس i، بينما لدى NAND-RAM متغيرات ذات قيم صحيحة يمكن استخدامها لـ_الوصول المفهرس_ إلى المصفوفات، من صيغة Foo[bar].
لتنفيذ الوصول المفهرس في NAND-TM، سنُرمِّز الأعداد الصحيحة في مصفوفاتنا باستخدام تمثيل ما (خالٍ من البادئة) (انظر الترميزُ الخالي من البادئات))، ثم نضع إجراءً Setindex(Bar) يضبط i على القيمة التي يرمّزها Bar.
يمكننا محاكاة أثر Foo[Bar] باستخدام Setindex(Bar) يتبعه Foo[i].
يمكن تنفيذ Setindex(Bar) على النحو التالي:
-
نهيّئ مصفوفة
Atzeroبحيث يكونAtzero[]وAtzero[]لكل . (يمكن dilakukan ذلك بسهولة في NAND-TM لأن كل المتغيرات غير المهيّأة تُعتبر صفرًا افتراضيًا.) -
نضبط
iعلى صفر، بأن نقصنه حتى نصل إلى النقطة التي يكون فيهاAtzero[i]. -
نجعل
Tempمصفوفة ترمِّز للعدد . -
نستخدم
GOTOلمحاكاة حلقة داخلية من الشكل: بينماTempBar، نزيدTemp. -
في نهاية الحلقة، تكون
iمساوية للقيمة التي يرمّزهاBar.
في شيفرة NAND-TM (باستخدام بعض السكر النحوي)، يمكننا تنفيذ العمليات أعلاه على النحو التالي:
# assume Atzero is an array such that Atzero[0]=1
# and Atzero[j]=0 for all j>0

# set i to 0.
LABEL("zero_idx")
dir0 = zero
dir1 = one
# corresponds to i <- i-1
GOTO("zero_idx",NOT(Atzero[i]))
...
# zero out temp
#(code below assumes a specific prefix-free encoding in which 10 is the "end marker")
Temp[0] = 1
Temp[1] = 0
# set i to Bar, assume we know how to increment, compare
LABEL("increment_temp")
cond = EQUAL(Temp,Bar)
dir0 = one
dir1 = one
# corresponds to i <- i+1
INC(Temp)
GOTO("increment_temp",cond)
# if we reach this point, i is number encoded by Bar
...
# final instruction of program
MODANDJUMP(dir0,dir1)
المصفوفات ثنائية البعد في NAND-TM
لتنفيذ المصفوفات ثنائية البعد، نريد أن نضمّها (نُدرجها) في مصفوفة أحادية البعد.
الفكرة أن نأتي بدالة واحد إلى واحد (one to one) ، وبذلك نضمّ الموضع من المصفوفة ثنائية البعد Two في الموضع من المصفوفة One.
نظرًا إلى أن المجموعة تبدو "أكبر بكثير" من المجموعة ، قد لا يكون من البديهي في البداية أن مثل هذا الوقوف الواحد إلى الواحد موجود. لكن بمجرد التفكير في الأمر أكثر، لا يكون بناؤه صعبًا إلى هذا الحد. على سبيل المثال، يمكنك أن تطلب من طفل أن يستخدم المقصّ واللصق ليحوّل قطعة ورق بمقاس 10" في 10" إلى شريط بمقاس 1" في 100". وهذا في جوهره وقوف واحد إلى واحد من إلى . ويمكننا تعميم ذلك للحصول على وقوف واحد إلى واحد من إلى ، وعمومًا من إلى . وبالتحديد، الوقوف التالي يكفي (انظر الشكل التوضيحي):
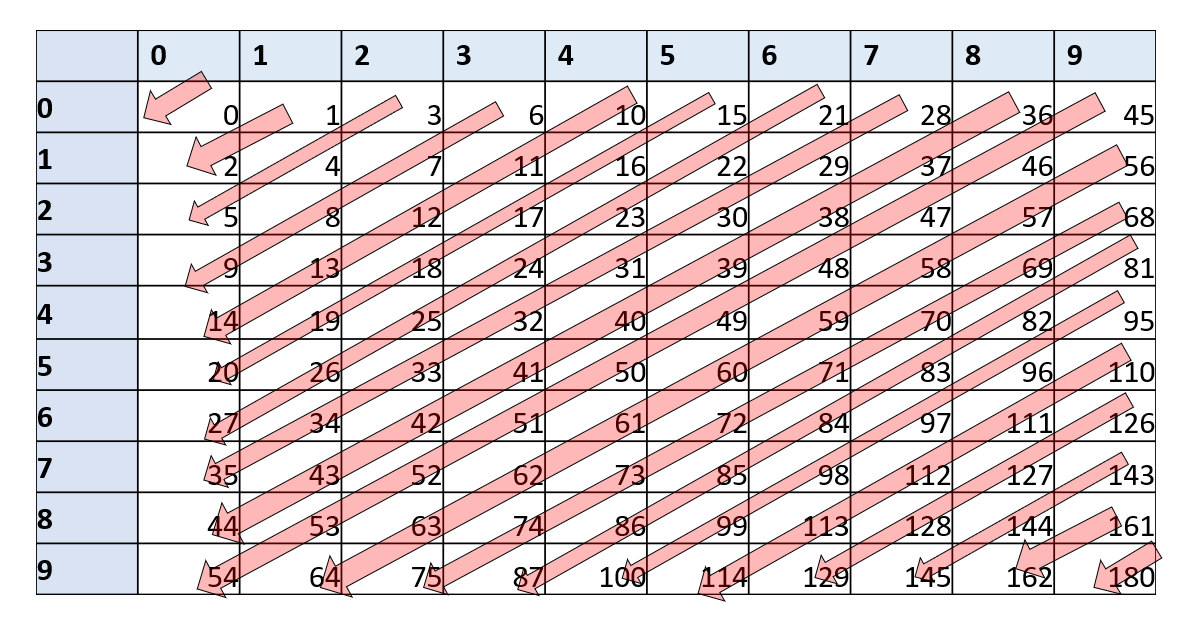
تمرين — الأزواج يطلب إليك أن تُثبت أن يق فعلًا واحدًا إلى واحد، وكذلك أن حسابه ممكن ببرنامج NAND-TM. (ويمكن للأخير أن يتم ببساطة باتباع خوارزميات المدرسة الابتدائية في الضرب والجمع والقسمة.)
وهذا يعني أننا نستطيع استبدال شيفرة من الشكل Two[Foo][Bar] = something (أي الوصول إلى المصفوفة ثنائية البعد Two عند الأعداد الصحيحة التي ترمّزها المصفوفتان أحاديتا البعد Foo وBar) بشيفرة من الشكل:
Blah = embed(Foo,Bar)
Setindex(Blah)
Two[i] = something
كل ما تبقّى
بعد أن تتوفر لدينا المصفوفات ثنائية البعد والوصول المفهرس، لا توجد محاكاة NAND-RAM بواسطة NAND-TM إلا مجرد مسألة تنفيذ الخوارزميات القياسية للعمليات الحسابية والمقارنات في NAND-TM. وإن كان هذا مرهقًا، فهو ليس صعبًا، والنتيجة النهائية هي إظهار أن كل برنامج NAND-RAM يمكن محاكاته ببرنامج NAND-TM مكافئ له، وبذلك يكتمل برهان مبرهنة — آلات تورينج (أي برامج NAND-TM) وآلات RAM (أي برامج NAND-RAM) متكافئة.
ملاحظة — التهاكر في NAND-RAM (متقدّم)
مفهوم يظهر في كثير من لغات البرمجة لكننا لم نُدرجه في برامج NAND-RAM هو التهاكر (recursion). غير أن التهاكر (والمكالمات بين الدوال عمومًا) يمكن تنفيذه في NAND-RAM باستخدام بنية بيانات المكدس (stack data structure). المكدس (stack) هو بنية بيانات تحتوي على سلسلة من العناصر، حيث يمكننا "دفع" العناصر إليها و"سحبها" منها بترتيب "الأول داخلًا الأخير خارجًا" (first in last out).
يمكننا تنفيذ مكدس باستخدام مصفوفة من الأعداد الصحيحة اسمها Stack ومتغير عددي stackpointer يمثل عدد العناصر الموجودة في المكدس.
وننفذ push(foo) mediante
Stack[stackpointer]=foo
stackpointer += one
وننفذ bar = pop() mediante
bar = Stack[stackpointer]
stackpointer -= one
وننفذ استدعاء دالة بدفع وسائط إلى المكدس. وستقوم شيفرة بـ"سحب" الوسائط من المكدس، وإجراء الحساب (والذي قد ينطوي على استدعاءات تهاكرية أو غير تهاكرية)، ثم "دفع" قيمة عائدها إلى المكدس. وبطبيعة المكدس "الأول داخلًا الأخير خارجًا"، فإننا لا نعيد التحكم إلى الإجراء المستدعي حتى تنتهي جميع الاستدعاءات التهاكرية.
الأمر أن بإمكاننا تنفيذ التهاكر باستخدام لغة غير تهاكرية ليس مثيرًا للدهشة.
فعلى سبيل المثال، لا تملك لغات الآلة (machine languages) عادةً تهاكرًا (ولا مكالمات بين الدوال عمومًا)، ومن ثمّ ينفّذ المترجم مكالمات الدوال باستخدام مكدس وGOTO.
يمكنك أن تجد على الإنترنت شروحات عن كيفية تنفيذ التهاكر عبر المكدس في لغة برمجة تحبها، سواء كانت Python أو JavaScript أو Lisp/Scheme.
تكافؤ تورينج (مناقشة)
أي من لغات البرمجة المعيارية مثل C وJava وPython وPascal وFortran لديها عمليات مشابهة جدًا لتلك في NAND-RAM.
(وفي الحقيقة، في النهاية يمكن تنفيذها جميعًا بآلات تملك عددًا ثابتًا من السجلات ومصفوفة ذاكرة كبيرة.)
لذلك، باستخدام مبرهنة — آلات تورينج (أي برامج NAND-TM) وآلات RAM (أي برامج NAND-RAM) متكافئة، يمكننا محاكاة أي برنامج في أي من لغات البرمجة هذه ببرنامج NAND-TM.
وفي الاتجاه المقابل، فإن كتابة مُفسِّر (interpreter) لـ NAND-TM بأي من لغات البرمجة أعلاه هي تمرين برمجي سهل إلى حد كبير.
لذلك يمكننا أيضًا محاكاة برامج NAND-TM (وبالتالي آلات تورينج بحسب مبرهنة — آلات تورينج وبرامج NAND-TM متكافئة) باستخدام لغات البرمجة هذه.
تُسمى هذه الخاصية، أي التكافؤ في القوة مع آلات تورينج / NAND-TM، بـ_التكافؤ مع تورينج_ (Turing Equivalent) (وتُسمى أحيانًا الاكتمال بحسب تورينج).
وعليه، فجميع لغات البرمجة التي نعرفها متكافئة مع تورينج.[1]
نموذج "أفضل الحلين"
التكافؤ بين آلات تورينج وآلات RAM يتيح لنا اختيار أنسب لغة للمهمة قيد اليد:
-
عندما نريد إثبات مبرهنة عن جميع البرامج/الخوارزميات، يمكننا استخدام آلات تورينج (أو NAND-TM) لأنها أبسط وأسهل في التحليل. وبشكل خاص، إذا أردنا إظهار أن دالة معينة لا يمكن حسابها، فإننا سنستخدم آلات تورينج.
-
عندما نريد إظهار أن دالة يمكن حسابها، يمكننا استخدام آلات RAM أو NAND-RAM، لأن البرمجة فيها أسهل، ولأنها تقابل عن قرب لغات البرمجة عالية المستوى التي اعتدنا عليها. وفي الواقع، كثيرًا ما سنصف برامج NAND-RAM بصيغة غير رسمية، واثقين من أن القارئ يستطيع ملء التفاصيل وترجمة الوصف عالي المستوى إلى البرنامج الدقيق. (وهذا مثل تمامًا الطريقة التي يستخدم بها الناس عادةً أوصافًا غير رسمية أو "شيفرة زائفة" (pseudocode) للخوارزميات، واثقين من أن جمهورهم سيعرف ترجمة هذه الأوصاف إلى شيفرة عند الحاجة.)
استخدامنا لآلات تورينج / NAND-TM وآلات RAM / NAND-RAM مشابه جدًا للطريقة التي يستخدم بها الناس في الممارسة لغات البرمجة عالية ومنخفضة المستوى. عندما يريد أحدهم إنتاج جهاز ينفّذ البرامج، يكون من الأنسب فعل ذلك بلغة برمجة بسيطة جدًا و"منخفضة المستوى". وعندما يريد أحدهم وصف خوارزمية، يكون من الأنسب استخدام أعلى صيغة رسمية ممكنة.
باستخدام نتائج التكافؤ مثل التكافؤ بين آلات تورينج وآلات RAM، يمكننا أن «نأكل الكعكة ونحتفظ بها أيضًا».
يمكننا استخدام نموذج أبسط مثل آلات تورينج عندما نريد إثبات أن شيئًا ما لا يمكن إنجازه، واستخدام نموذج غني بالميزات مثل آلات RAM عندما نريد إثبات أن شيئًا ما يمكن إنجازه.
لنتحدث عن التجريدات
"إن المبرمج في موقف فريد ... إذ عليه أن يكون قادرًا على التفكير وفق تسلسلات هرمية مفاهيمية أعمق بكثير مما واجهه أي عقل منفرد في أي وقت مضى."، إدسغر دايكسترا، "في قسوة تدريس علوم الحاسوب حقًا"، 1988.
في وقت ما من أي مقرر في نظريّة الحوسبة، يحتاج كلٌّ من المدرّس والطلاب إلى إجراء هذا الحديث. أي أننا نحتاج إلى مناقشة مستوى التجريد (level of abstraction) في وصف الخوارزميات. في مقرّرات الخوارزميات، يُكتب عادةً وصف الخوارزميات بالإنجليزية، مع الافتراض بأن القارئ يستطيع "ملء التفاصيل" وأنه قادر على تحويل تلك الخوارزمية إلى تنفيذ ملموس عند الحاجة. على سبيل المثال، خوارزمية — Breadth First Search هو وصف عالي المستوى لخوارزمية البحث بالعرض أولًا (breadth first search).
خوارزمية — Breadth First Search
Input: Graph $G$, vertices $u,v$
Output: "connected" when $u$ is connected to $v$ in $G$, "disconnected"


Initialize empty queue $Q$.
Put $u$ in $Q$
While{$Q$ is not empty}
   Remove top vertex $w$ from $Q$
   If{$w=v$} return "connected" endif
   Mark $w$
   Add all unmarked neighbors of $w$ to $Q$.
Endwhile
Return "disconnected"
لو أردنا إعطاء تفاصيل أكثر عن كيفية تنفيذ البحث بالعرض أولًا في لغة برمجة مثل Python أو C (أو NAND-RAM / NAND-TM على سبيل المثال)، لَوَصَفنا كيف ننفّذ بنية بيانات الطابور باستخدام مصفوفة، وكذلك كيف نستخدم المصفوفات لوضع علامات على الرؤوس. ونسمّي هذا الوصف "ذو المستوى الوسيط" وصفًا على مستوى التنفيذ (implementation level) أو وصفًا بالشيفرة الزائفة (pseudocode). وأخيرًا، إذا أردنا وصف التنفيذ بدقّة، لقَدّمنا الشيفرة الكاملة للبرنامج (أو تمثيلًا دقيقًا آخر تمامًا، مثلًا على شكل قائمة من الثنائيات (tuples)). ونسمّي هذا وصفًا رسميًا أو منخفض المستوى.
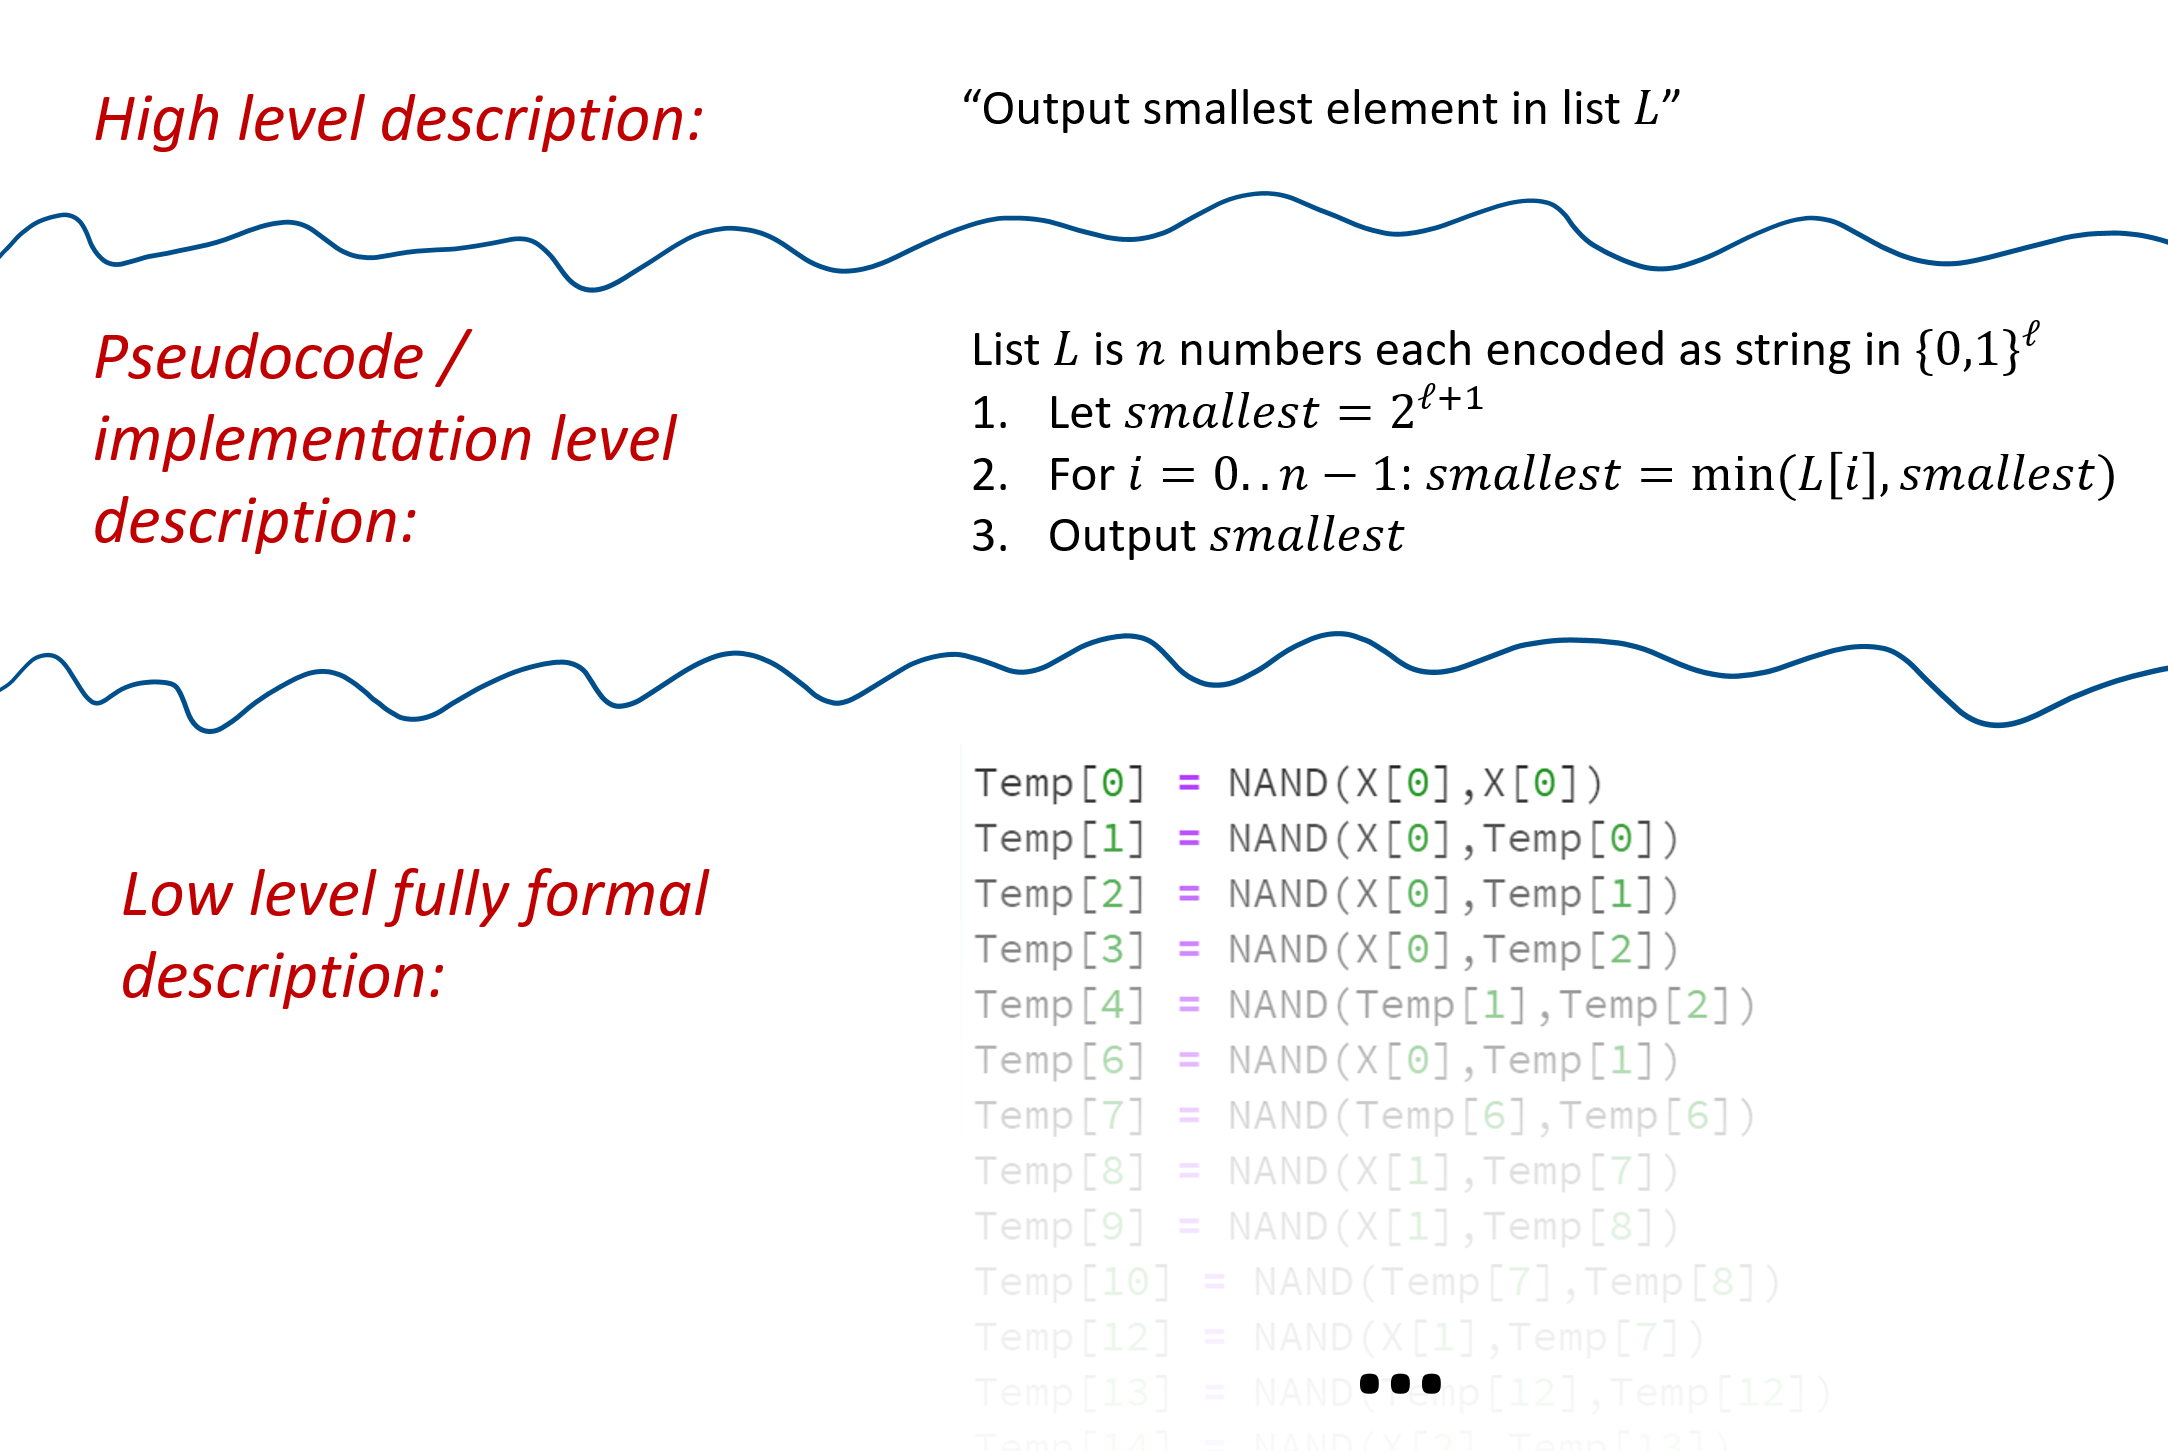
رغم أننا بدأنا بوصف برامج NAND-CIRC وNAND-TM وNAND-RAM على المستوى الرسمي الكامل، فإننا مع تقدّمنا في هذا الكتاب سننتقل إلى التنفيذ والوصف عالي المستوى. فهدفنا في النهاية ليس استخدام هذه النماذج في حساب فعلي، بل تحليل ظاهرة الحساب بصفة عامة. ومع ذلك، إن كنت لا تفهم كيف يُترجَم الوصف عالي المستوى إلى تنفيذ فعلي، فإن النزول "إلى المعدن" ("down to the metal") هو غالبًا تمرين ممتاز. ومن أهم المهارات التي يحتاجها عالم الحاسوب القدرة على الصعود والهبوط في التسلسلات الهرمية للتجريدات.
ينطبق تمييز مشابه على مفهوم التمثيل (representation) للأشياء بوصفها سلاسل. أحيانًا، من أجل الدقّة، نقدّم مواصفة منخفضة المستوى تصف بالضبط كيف يُرمَّز كائن ما في سلسلة ثنائية. على سبيل المثال، يمكننا وصف ترميز لرسوم بيانية ذات رأسًا كسلاسل ثنائية طولها ، بالقول إننا نرمّز رسمًا بيانيًا على الرؤوس إلى سلسلة بحيث يكون الإحداثي رقم في يساوي إذا وفقط إذا كان الضلع موجودًا في . ويمكننا أيضًا استخدام وصف وسيط أو على مستوى التنفيذ، بأن نقول ببساطة إننا نمثّل رسمًا بيانيًا باستخدام تمثيل مصفوفة التجاور (adjacency matrix).
وأخيرًا، بما أن الترجمة بين مختلف تمثيلات الرسوم البيانية (والأشياء عمومًا) يمكن إجراؤها عبر برنامج NAND-RAM (وبالتالي برنامج NAND-TM)، فإننا عند الحديث على مستوى عالٍ نكبّ أيضًا مناقشة التمثيل كليًا. على سبيل المثال، إن كانت حقيقة أن "ترابط" الرسم البياني دالة قابلة للحساب، فذلك صحيح بغضّ النظر عن كوننا نمثّل الرسوم البيانية كقوائم تجاور، أو مصفوفات تجاور، أو قوائم من أزواج الأضلاع، وهكذا وهكذا. ولذلك، في الحالات التي لا يُحدث فيها التمثيل الدقيق فرقًا، كثيرًا ما نتحدث عن خوارزمياتنا وكأنها تأخذ كمدخل كائنًا (قد يكون رسمًا بيانيًا أو متجهًا أو برنامجًا إلخ) دون تحديد كيفية ترميز كسلسلة.
تعريف "الخوارزميات". حتى الآن استخدمنا مصطلح "الخوارزمية" بشكل غير رسمي. غير أن آلات تورينج ومجموعة النماذج المكافئة لها تتيح لنا طريقة لتعريف الخوارزميات بدقّة وبشكل رسمي. ولذلك، كلما أشرنا في هذا الكتاب إلى خوارزمية، فإننا نعني أنها حالة من إحدى النماذج المكافئة مع تورينج، مثل آلات تورينج، وNAND-TM، وآلات RAM، إلخ. وبسبب تكافؤ جميع هذه النماذج، فلن يهم في كثير من السياقات أيًّا منها نستخدم.
اكتمال تورينج والتكافؤ، تعريف رسمي (اختياري)
النموذج الحوسبي (computational model) هو أي طريقة نعرّف بها معنى أن برنامج (يمثَّل بسلسلة) يحسب دالة (جزئية). إن النموذج الحوسبي هو كامل بحسب تورينج إذا استطاعنا أن نُسقط كل آلة تورينج (أو بما يكافئها برنامج NAND-TM) في برنامج لـ يحسب الدالة نفسها التي تحسبها . وهو متكافئ مع تورينج إذا كان الاتجاه الآخر قائمًا أيضًا (أي أننا نستطيع إسقاط كل برنامج في في آلة تورينج تحسب الدالة نفسها). ويمكننا تعريف هذا المفهوم رسميًا على النحو التالي. (هذا التعريف الرسمي ليس جوهريًا لبقية هذا الكتاب، فلا تتردد في تخطيه ما دمت تفهم المفهوم العام للتكافؤ مع تورينج؛ ويُشار إلى هذا المفهوم أحيانًا في الأدبيات بـترقيم غودل (Gödel numbering) أو الترقيم المقبول (admissible numbering).)
تعريف — اكتمال تورينج والتكافؤ (اختياري)
لنفترض أن هي مجموعة جميع الدوال الجزئية من إلى . النموذج الحوسبي هو دالة .
نقول إن برنامجًا يحسب بحسب إذا كان .
النموذج الحوسبي هو كامل بحسب تورينج إذا وُجدت دالة قابلة للحساب بحيث إن لكل آلة تورينج (مُمثَّلة كسلسلة) تكون مساوية للدالة الجزئية التي تحسبها .
النموذج الحوسبي هو متكافئ مع تورينج إذا كان كاملًا بحسب تورينج، ووُجدت دالة قابلة للحساب بحيث لكل سلسلة ، تكون تمثيلًا سلسلة لآلة تورينج تحسب الدالة .
من أمثلة النماذج المتكافئة مع تورينج (بعضها رأيناه بالفعل، وبعضها سنناقشه أدناه):
- آلات تورينج
- برامج NAND-TM
- برامج NAND-RAM
- حساب لامدا
- لعبة الحياة (إسقاط البرامج والمدخلات والمخرجات على تكوينات البداية والنهاية)
- لغات برمجة مثل Python/C/Javascript/OCaml... (مع السماح بتخزين غير محدود)
الآليات الخلوية
يمكن وصف كثير من الأنظمة الفيزيائية على أنها تتألف من عدد كبير من المكوّنات الأولية التي تتفاعل فيما بينها. إحدى طرق نمذجة مثل هذه الأنظمة هي استخدام الآليات الخلوية (cellular automata). وهذا نظام يتألف من عدد كبير (أو حتى لا نهائي) من الخلايا. لكل خلية عدد ثابت فقط من الحالات الممكنة. وفي كل خطوة زمنية، تحدّث الخلية حالتها إلى حالة جديدة بتطبيق قاعدة بسيطة على حالتها وعلى حالة جيرانها.
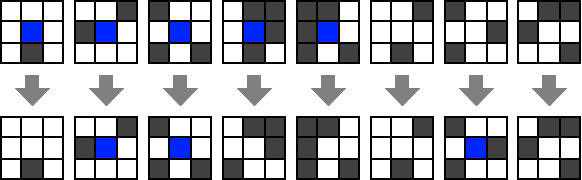
مثال نموذجي على آلية خلوية هو لعبة حياة كونواي (Conway's Game of Life). في هذه الآلية تُرتَّب الخلايا في شبكة ثنائية البعد لا نهائية. لكل خلية حالتان فقط: "ميتة" (يمكن ترميزها بـ والتعرّف عليها مع ) أو "حيّة" (يمكن ترميزها بـ ). تعتمد الحالة التالية للخلية على حالتها السابقة وعلى حالات جيرانها الثمانية الرأسية والأفقية والقطرية (انظر الشكل التوضيحي). تصبح الخلية الميتة حيّة فقط إذا كان ثلاثة من جيرانها بالضبط أحياء. وتبقى الخلية الحيّة على قيد الحياة إذا كان لديها جيران أحياء عددهما اثنان أو ثلاثة. على الرغم من أن عدد الخلايا قد يكون لا نهائيًا، يمكننا ترميز الحالة باستخدام سلسلة ذات طول متناهٍ عبر متابعة الخلايا الحيّة وحدها. فإذا هيّأنا النظام في تكوين يحوي عددًا متناهى من الخلايا الحيّة، فإن عدد الخلايا الحيّة سيبقى متناهى في جميع الخطوات اللاحقة. وتحتوي صفحة ويكيبيديا الخاصة بلعبة الحياة على بعض الأشكال والرسوم المتحركة الجميلة لتكوينات تنتج تطورات شديدة الإثارة.
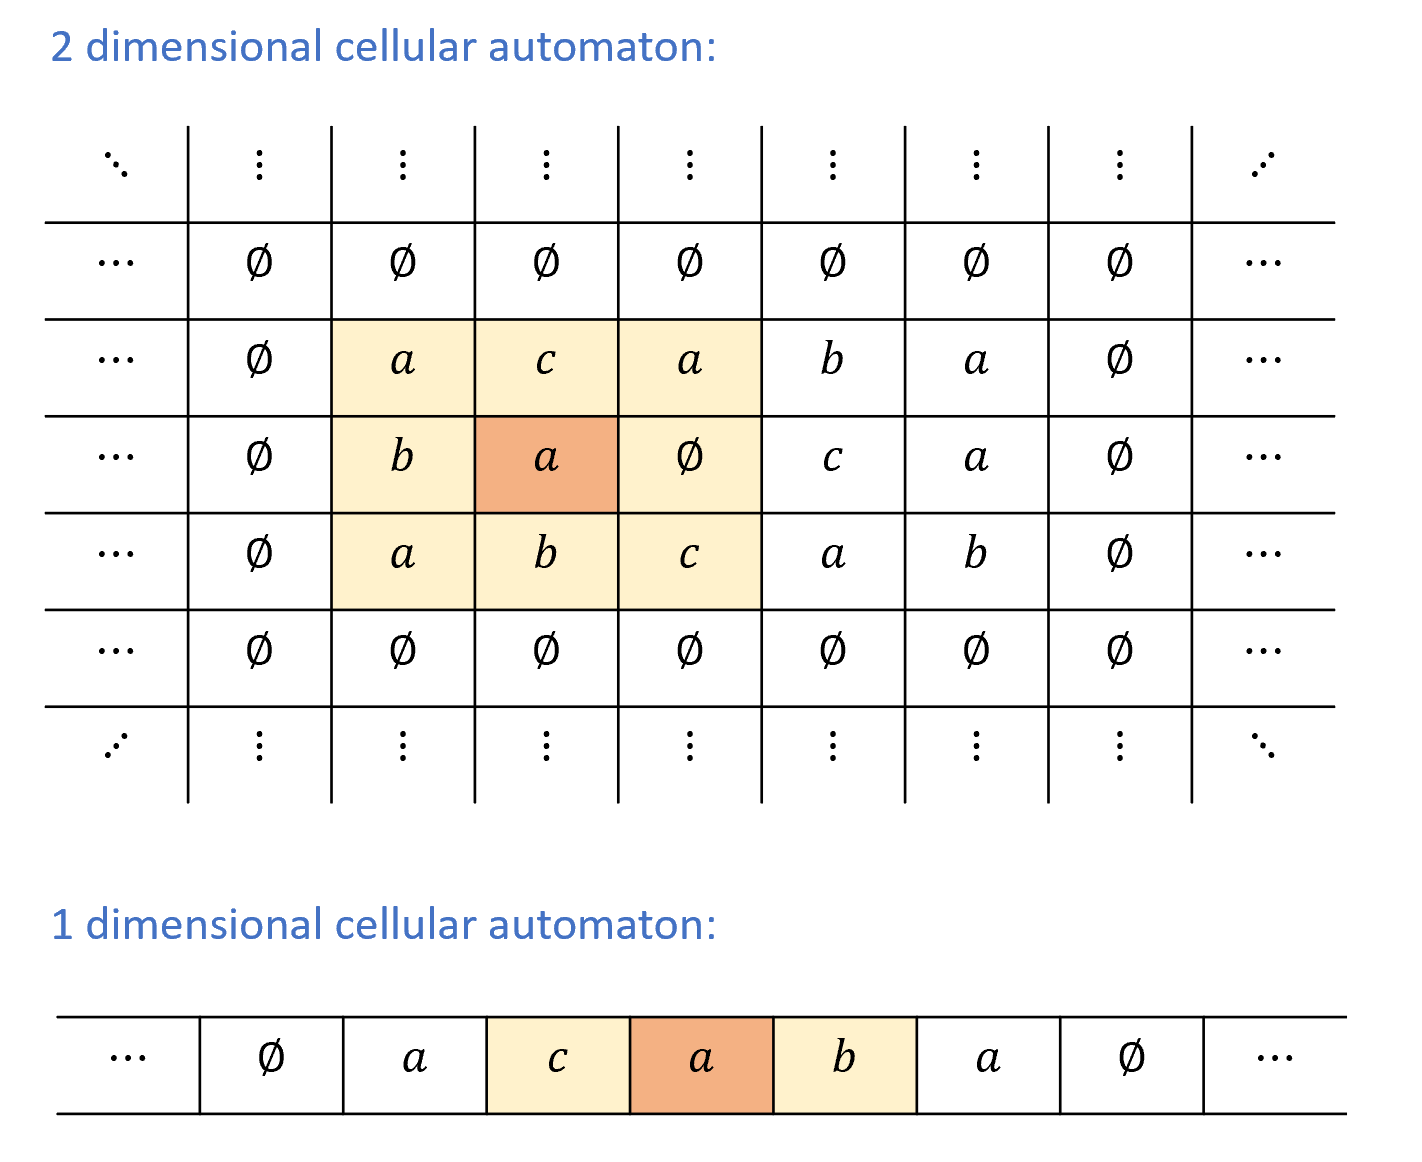
نظرًا لأن خلايا لعبة الحياة مرتَّبة في شبكة ثنائية البعد لا نهائية، فإنها مثال على آلية خلوية ثنائية البعد. ويمكننا أيضًا أن ندرس الحالة الأبسط هي حالة من آلية خلوية أحادية البعد، حيث تُرتَّب الخلايا في خط لا نهائي، انظر الشكل التوضيحي. ويبيّن أن هذا النموذج البسيط جدًا كافٍ أيضًا لتحقيق الاكتمال بحسب تورينج. وسنعرّف الآن رسميًا الآليات الخلوية أحادية البعد ثم نبيّن اكتمالها بحسب تورينج.
تعريف — الآليات الخلوية أحادية البعد
لنفترض أن مجموعة منتهية تحتوي على الرمز . آلية خلوية أحادية البعد (one dimensional cellular automaton) فوق أبجدية تُوصَف بـ_قاعدة انتقال_ (transition rule) ، تُحقّق .
تكوين (configuration) الآلية هو دالة . إذا كانت آلة ذات قاعدة في التكوين ، فإن تكوينها التالي، الذي نرمز له بـ ، هو الدالة بحيث لكل . بعبارة أخرى، تُحصل الحالة التالية للآلة عند النقطة بتطبيق القاعدة على قيم عند وعند جاريها.
التكوين المتناهي. نقول إن تكوينًا للآلة هو متناهٍ إذا كان هناك عدد متناهٍ فقط من الفهارس في بحيث . (أي أنه لكل ، يكون .) يمكن تمثيل مثل هذا التكوين بسلسلة متناهية تُرمِّز الفهارس والقيم . ولأن ، فإن كان تكوينًا متناهيًا فإن يكون متناهيًا أيضًا. ولن يهمّنا إلا دراسة الآليات الخلوية التي تُهيَّأ في تكوينات متناهية، وتبقى كذلك في تكوين متناهٍ طوال تطورها. ولن يهمّنا إلا دراسة الآليات الخلوية التي تُهيَّأ في تكوينات متناهية، ومن ثمّ تبقى في تكوين متناهٍ طوال تطورها.
الآليات الخلوية أحادية البعد كاملة بحسب تورينج
يمكننا كتابة برنامج (مثلًا باستخدام NAND-RAM) يحاكي تطوّر أي آلية خلوية انطلاقًا من تكوين متناهٍ أولي، بمجرد تخزين قيم الخلايا التي حالتها لا تساوي وتطبيق القاعدة تكرارًا. وعليه يمكن محاكاة الآليات الخلوية بآلات تورينج. والأمر الأكثر مدهشة هو أن الاتجاه الآخر قائم أيضًا. فعلى سبيل المثال، مهما بدت قواعد لعبة الحياة بسيطة، يمكننا محاكاة آلة تورينج باستخدامها (انظر الشكل التوضيحي).
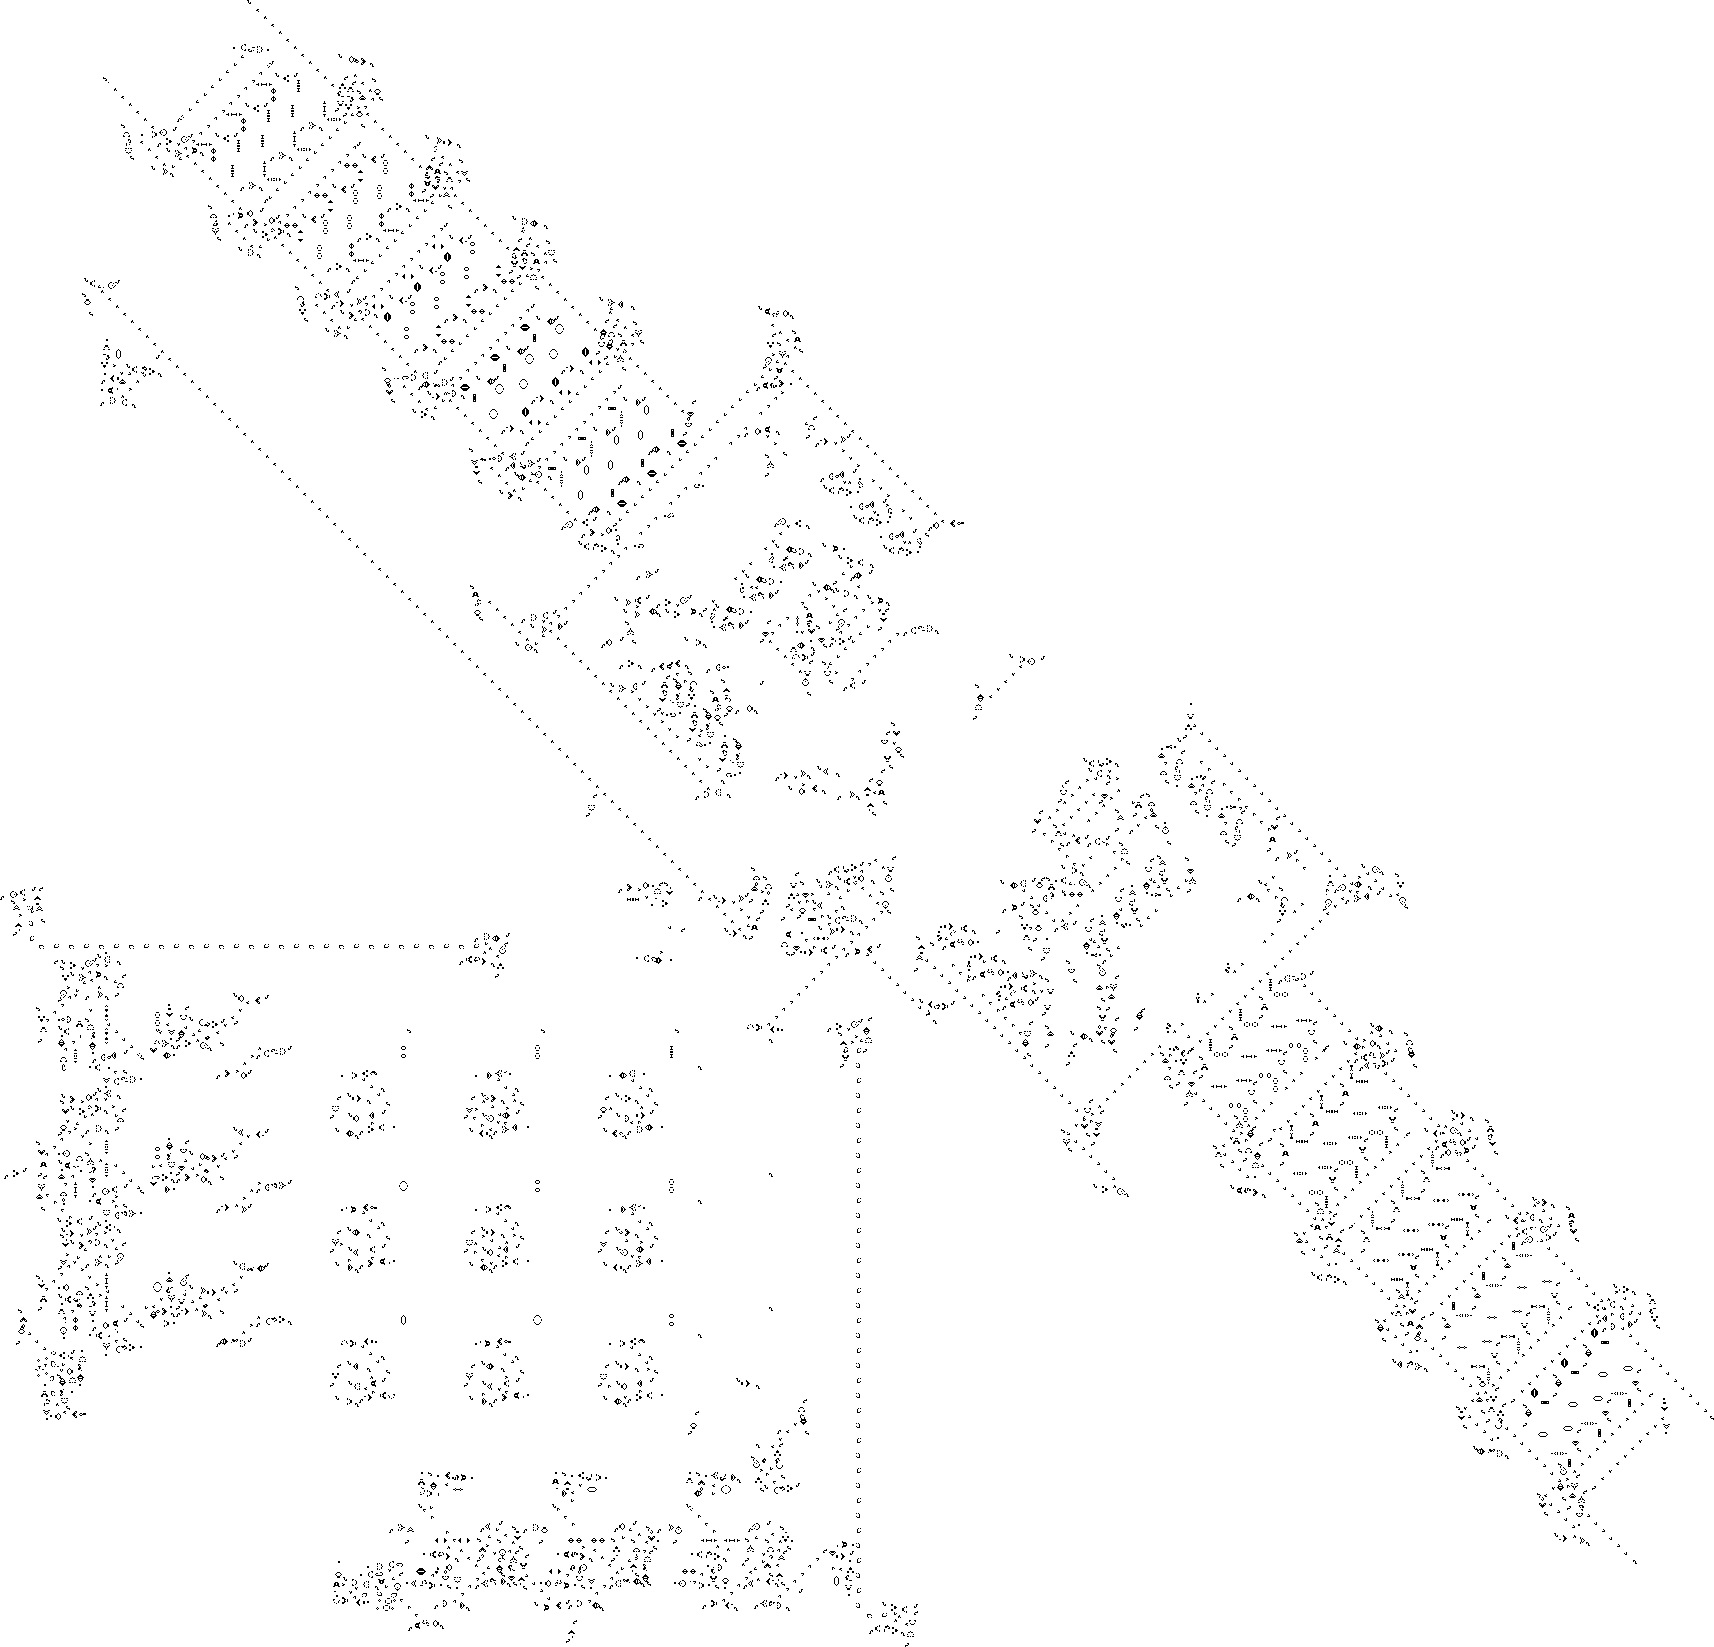
في الواقع، حتى الآليات الخلوية أحادية البعد يمكن أن تكون كاملة بحسب تورينج:
مبرهنة — الآليات أحادية البعد كاملة بحسب تورينج
لكل آلة تورينج ، هناك آلية خلوية أحادية البعد تستطيع محاكاة على كل مدخل .
لجعل مفهوم "محاكاة آلة تورينج" أكثر دقّة، سنحتاج إلى تعريف تكوينات آلات تورينج. وسنقوم بذلك في تكوينات آلات تورينج ودالة الخطوة التالية أدناه، لكن على مستوى عالٍ، التكوين لآلة تورينج هو سلسلة تُرمِّز حالتها الكاملة عند خطوة معيّنة من حسابها. أي محتويات جميع خلايا (شريطها) غير الفارغة، وحالتها الحالية، وكذلك موضع الرأس.
الفكرة المفتاحية في برهان مبرهنة — الآليات أحادية البعد كاملة بحسب تورينج هي أن الموضع الوحيد في شريط آلة تورينج الذي يمكن أن يتغيّر عند كل نقطة في الحساب هو الموضع الذي توجد فيه الرأس، والقيمة التي تتغيّر إليها هذه الخلية هي دالة لحالتها الحالية والحالة المتناهية لآلة . تتيح لنا هذه الملاحظة ترميز تكوين آلة تورينج على هيئة تكوين متناهٍ لآلية خلوية ، وضمان أن تطوّر هذا التكوين المرمَّز خطوة واحدة تحت قواعد يقابل خطوة واحدة في تنفيذ آلة تورينج .
تكوينات آلات تورينج ودالة الخطوة التالية
لتحويل الأفكار أعلاه إلى برهان صارم (بل حتى إلى صياغة صارمة!) لـ مبرهنة — الآليات أحادية البعد كاملة بحسب تورينج، سنحتاج إلى تعريف دقيق لمفهوم تكوينات آلات تورينج. وسيفيدنا هذا المفهوم أيضًا في الفصول اللاحقة.
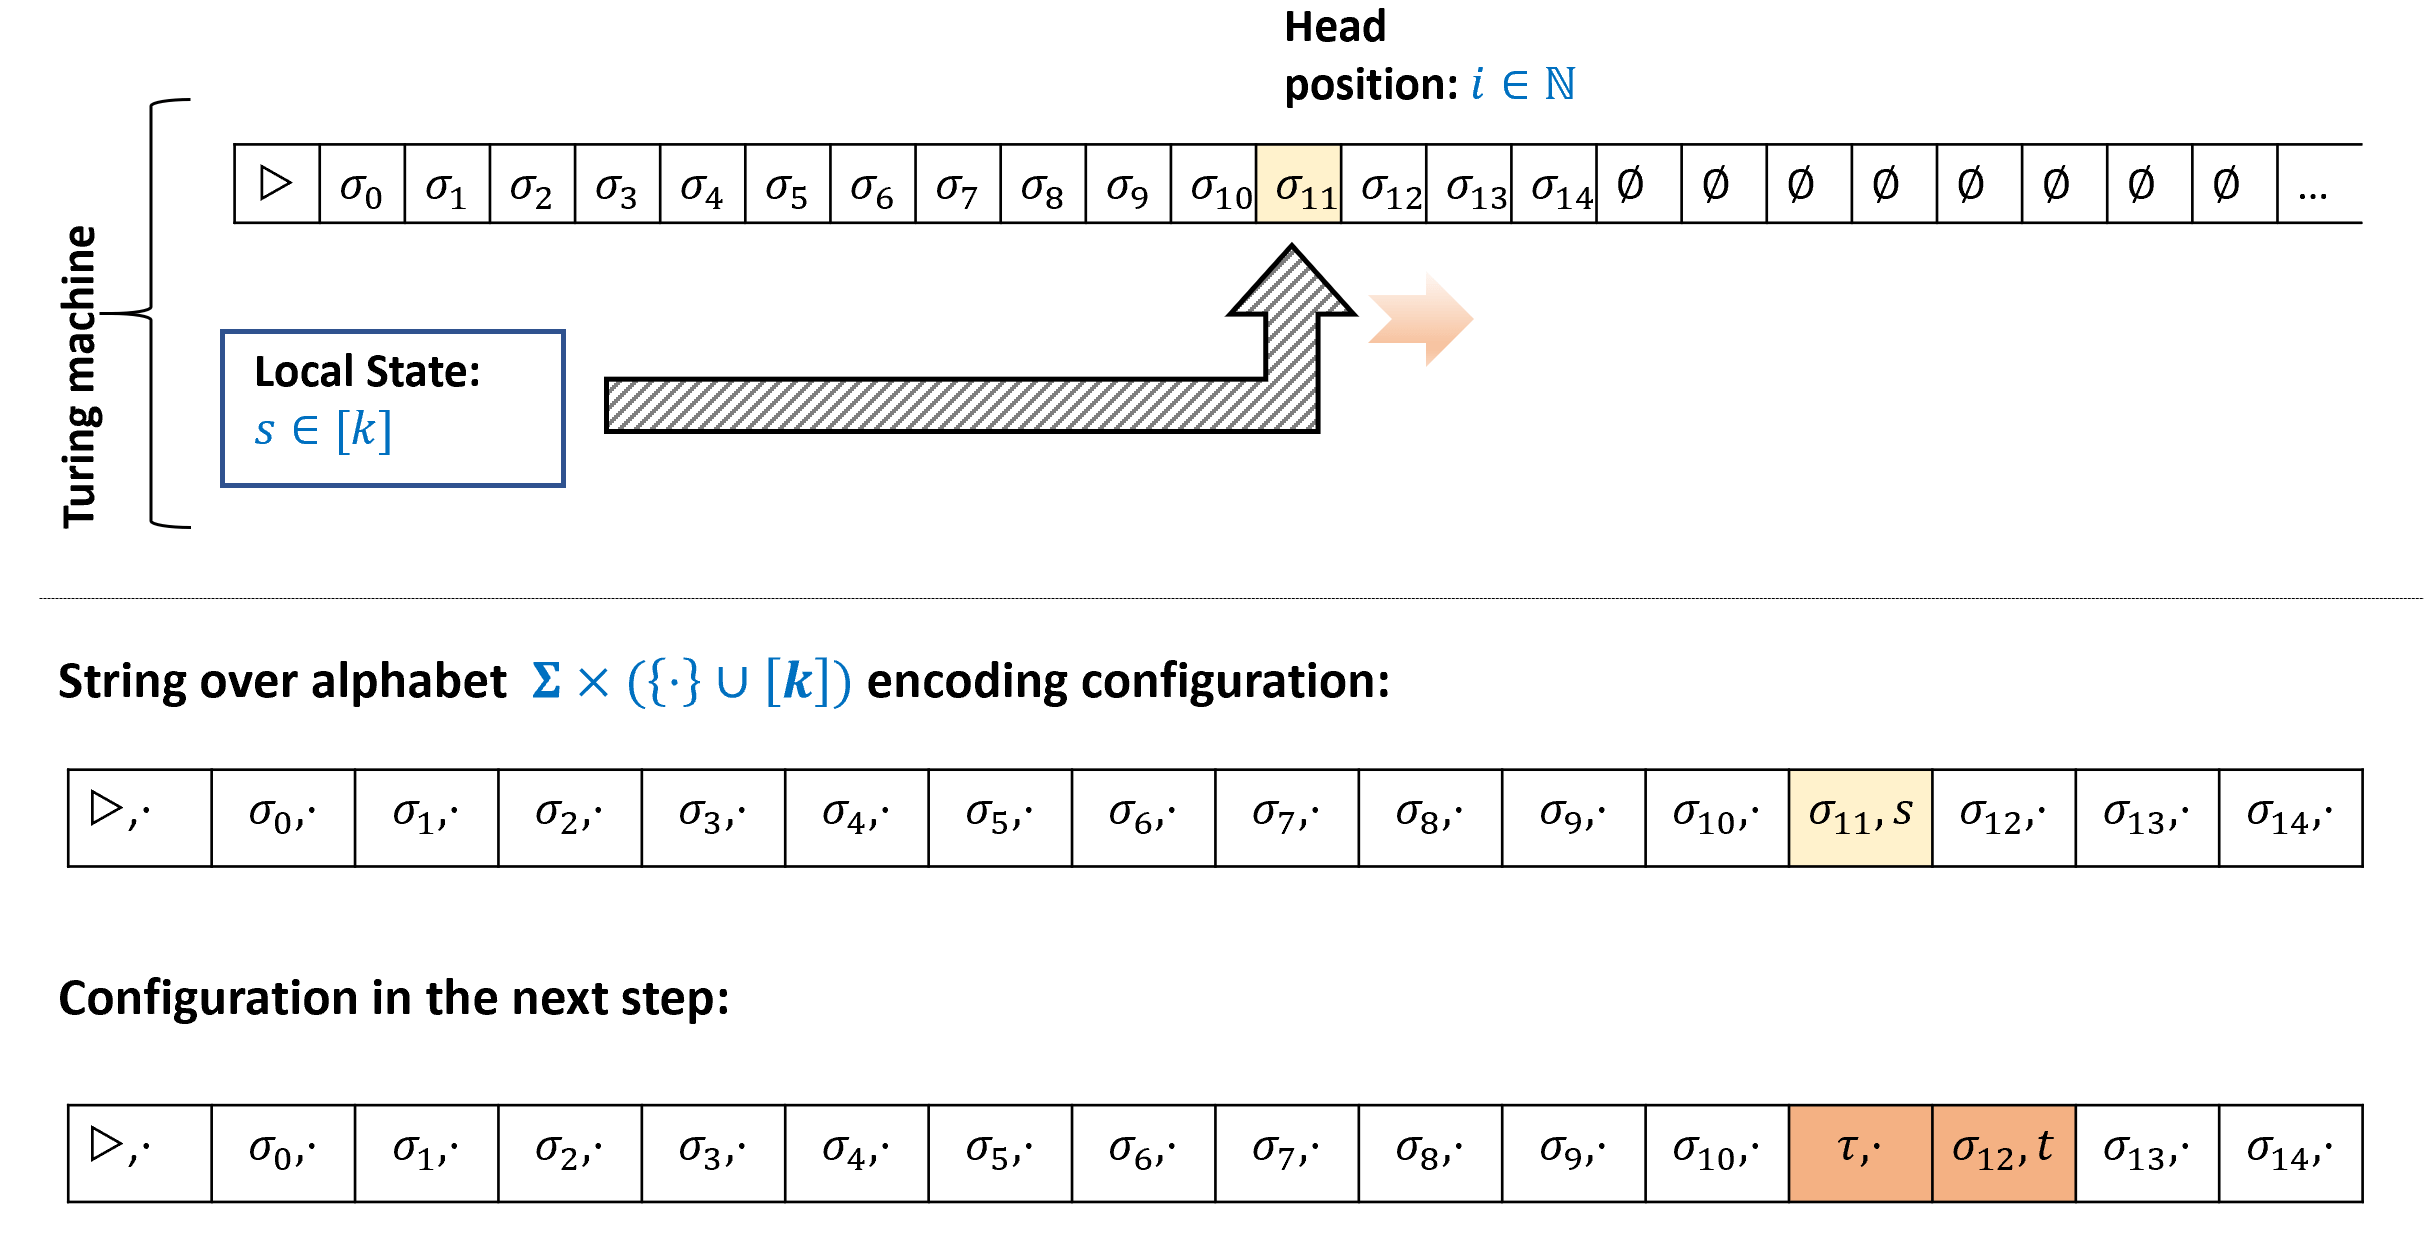
تعريف — تكوين آلة تورينج.
لنفترض أن آلة تورينج أبجديتها الشريطية ومجال حالاتها . تكوين هو سلسلة حيث ، تُحقِّق أنه يوجد إحداثي واحد بالضبط بحيث لبعض و. أما جميع الإحداثيات الأخرى فيكون لبعض .
يقابل تكوين لـ مع الحالة التالية لتنفيذه:
-
يحتوي شريط على لكل ، وعلى لكل المواضع التي تكون مساوية لـ أو أكبر، حيث نترك تكون القيمة بحيث مع و. (بعبارة أخرى، بما أن زوج من رمز أبجدية وإما حالة في أو الرمز ، فإن هو المكوّن الأول من هذا الزوج.)
-
رأس موجود في الموضع الفريد الذي يكون فيه على الشكل مع ، وحالة مساوية لـ .
توقّف وتأمّل
يحتوي تعريف — تكوين آلة تورينج. أدناه على بعض التفاصيل التقنية، لكنه ليس عميقًا أو معقّدًا إلى هذا الحد في الواقع. حاول أن تتوقف لحظة وتفكّر في كيفية ترميز حالة آلة تورينج عند نقطة معيّنة من التنفيذ في صورة سلسلة.
فكّر في جميع المكوّنات التي تحتاج إلى معرفتها لتتمكّن من متابعة التنفيذ من هذه النقطة فصاعدًا، وما هي طريقة بسيطة لترميزها باستخدام قائمة من رموز متناهية. وبشكل خاص، بالنظر إلى تطبيقاتنا المستقبلية، حاول أن تفكّر في ترميز يجعل إسقاط التكوين عند الخطوة على التكوين عند الخطوة بسيطًا قدر الإمكان.
تعريف — تكوين آلة تورينج. مُعقَّد بعض الشيء، لكن في النهاية التكوين هو مجرد سلسلة تُرمِّز لقطة (snapshot) لآلة تورينج عند نقطة معيّنة في التنفيذ. (بلغة أنظمة التشغيل، هذه "نسخة ذاكرة أساسية" (core dump).) يحتاج مثل هذه اللقطة أن تُرمِّز المكوّنات التالية:
-
موضع الرأس الحالي.
-
المحتويات الكاملة للذاكرة واسعة النطاق، أي الشريط.
-
محتويات "السجلات المحلية"، أي حالة الآلة.
التفاصيل الدقيقة لكيفية ترميز التكوين ليست مهمة، لكننا نودّ أن نُسجّل الحقيقة البسيطة التالية:
لمّة
لنفترض أن آلة تورينج، وأن هي الدالة التي تُسقط تكوينًا لـ على التكوين عند الخطوة التالية من التنفيذ. عندها لكل ، لا تعتمد قيمة إلا على الإحداثيات .
(لتبسيط الرمز، استخدمنا أعلاه الاصطلاح الذي إذا كان "خارج الحدود"، مثل أو ، فإننا نفترض أن .) نترك إثبات لمّة كتمرين في تمرين — دالة الخطوة التالية محلية. الفكرة وراء البرهان بسيطة: إذا لم تكن الرأس عند الموضع ولا عند المواضع و، فإن تكوين الخطوة التالية عند سيكون كما كان سابقًا. وإلا، يمكننا "قراءة" حالة آلة تورينج وقيمة الشريط عند موضع الرأس من التكوين عند أو عند أحد جيرانه، واستخدام ذلك لتحديث ما يجب أن تكون عليه الحالة الجديدة عند . إكمال البرهان الكامل ليس صعبًا، لكن فعله طريقة ممتازة للتأكد من أنك مرتاح لتعريف التكوينات.
إكمال برهان مبرهنة — الآليات أحادية البعد كاملة بحسب تورينج. يمكننا الآن إعادة صياغة مبرهنة — الآليات أحادية البعد كاملة بحسب تورينج بصورة أكثر رسمية، وإكمال برهانه:
مبرهنة — الآليات أحادية البعد كاملة بحسب تورينج (الصياغة الرسمية)
لكل آلة تورينج ، إذا رمزنا بـ أبجدية سلاسل تكويناتها، فإن هناك آلية خلوية أحادية البعد فوق الأبجدية بحيث لكل تكوين لـ (مع استخدام العرف نفسه الذي فيه نعتبر إذا كان "خارج الحدود").
برهان
نعتبر أن العنصر في يقابل العنصر في الآلية . وفي هذه الحالة، وبحسب لمّة، فإن الدالة التي تُسقط تكوينًا لـ على التالي هي في الواقع قاعدة صحيحة لآلية أحادية البعد.
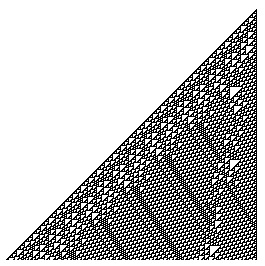
الآلية الناتجة عن برهان مبرهنة — الآليات أحادية البعد كاملة بحسب تورينج (الصياغة الرسمية) لها أبجدية كبيرة، وفوق ذلك حجمها يعتمد على الآلة التي يجري محاكاتها. ويبيّن أنه يمكن الحصول على آلية بأبجدية ذات حجم ثابت مستقل عن البرنامج الذي يُحاكى، بل يمكن أن تكون أبجدية الآلية هي المجموعة الدنيا ! انظر الشكل التوضيحي لمثال على مثل هذه الآلة الكاملة بحسب تورينج.
ملاحظة — تكوينات برامج NAND-TM
يمكننا استخدام الأسلوب نفسه في تعريف — تكوين آلة تورينج. لتعريف تكوينات برنامج NAND-TM. وسيحتاج مثل هذا التكوين أن يُرمِّز:
-
القيمة الحالية للمتغير
i. -
لكل متغير عددي
foo، قيمةfoo. -
لكل متغير مصفوفي
Bar، القيمةBar[]لكل حيث هي أكبر قيمة بلغها متغير الفهرسiفي الحساب.
حساب لامدا ولغات البرمجة الوظيفية
حساب لامدا (λ calculus) طريقة أخرى لتعريف الدوال القابلة للحساب. وقد اقترحه أوندزو تشُرْش (Alonzo Church) في ثلاثينيات القرن الماضي في وقت قريب جدًا من اقتراح آلان تورينج لآلة تورينج. ومن المثير للاهتمام أنه بينما لا تُستخدم آلات تورينج في الحساب العملي، إلا أن حساب لامدا ألهم لغات برمجة وظيفية مثل LISP وML وHaskell، وبدوره ألهم وغيرها من لغات البرمجة. وسنعرض في هذا القسم حساب لامدا ونبيّن أن قوته مكافئة لبرامج NAND-TM (وبالتالي أيضًا لآلات تورينج). ويحتوي مستودع Github لدينا على دفتر Jupyter فيه تنفيذ بلغة Python لحساب لامدا، يمكنك التجريب فيه لتكتسب إحساسًا أفضل بهذا الموضوع.
عامل .
جوهر حساب لامدا هو طريقة لتعريف دوال "مجهولة الاسم".
فعلى سبيل المثال، بدلًا من إعطاء اسم لدالة وتعريفها بأن
يمكننا كتابتها على أنها
وبالتالي .
أي أنك تستطيع التفكير في ، حيث هو تعبير ما، على أنها طريقة لتحديد الدالة المجهولة .
وتظهر الدوال المجهولة، باستخدام أو أو رموز أخرىمرتبط، في كثير من لغات البرمجة.
فعلى سبيل المثال، في Python يمكننا تعريف دالة التربيع باستخدام lambda x: x*x، بينما في JavaScript يمكننا استخدام x => x*x أو (x) => x*x. وفي Scheme سنعرّفها على أنها (lambda (x) (* x x)).
ومن الواضح أن اسم مُعامل الدالة لا يهم، ومن ثمّ فإن هو نفسه ، إذ يقابلان كلاهما دالة التربيع.
حذف الأقواس. لتقليل فوضى الرمز، فإننا عند كتابة تعبيرات حساب لامدا نُسقط غالبًا أقواس تقييم الدوال. فعوضًا عن كتابة لنتيجة تطبيق الدالة على المدخل ، يمكننا أيضًا كتابة ذلك ببساطة . ولذلك يمكننا كتابة . وسنستخدم في هذا الفصل كلَّيْ رمزي و لتطبيق الدوال. تطبيقات الدوال تجَمّعية وترتبط من اليسار إلى اليمين، ومن ثمّ فإن هو نفسه .
تطبيق الدوال على الدوال
من أهم سمات حساب لامدا أن الدوال "كائنات من الدرجة الأولى"، بمعنى أننا نستطيع استخدام الدوال كوسائط لدوال أخرى. فعلى سبيل المثال، هل تستطيع تخمين العدد الذي يساويه التعبير التالي؟
توقّف وتأمّل
قد يبدو التعبير المعادلة مرهقًا، لكن قبل أن تنظر إلى الحل أدناه، حاول تفكيكه إلى مكوّناته، وتقييم كل مكوّن على حدة. فالحصول على هذا المثال سيفيدك كثيرًا في فهم حساب لامدا.
لنقيّم المعادلة خطوة في كل مرة. ولئن كان السماح بالدوال المجهولة في حساب لامدا أمرًا لطيفًا، فإن إضافة الأسماء مفيدة جدًا لفهم التعبيرات المعقّدة. ولذلك، لنكتب و .
وعليه يصبح المعادلة
على مدخل دالة ، تُخرج الدالة ، أو بعبارة أخرى هي الدالة . ودالتنا هي ببساطة ، ومن ثمّ فإن هي الدالة التي تُسقط على . وعليه .
تمرين محلول
إلى أيّ عدد يُقيَّم التعبير التالي؟
الحل
الدالة هي الدالة التي على مدخل تتجاهل مدخلها وتُخرج . وعليه فإن تُنتج الدالة (أو، باستخدام رمز ، الدالة ). وعليه فإن المعادلة هو مكافئ لـ .
الحصول على دوال متعدّدة الوسائط عبر Curry
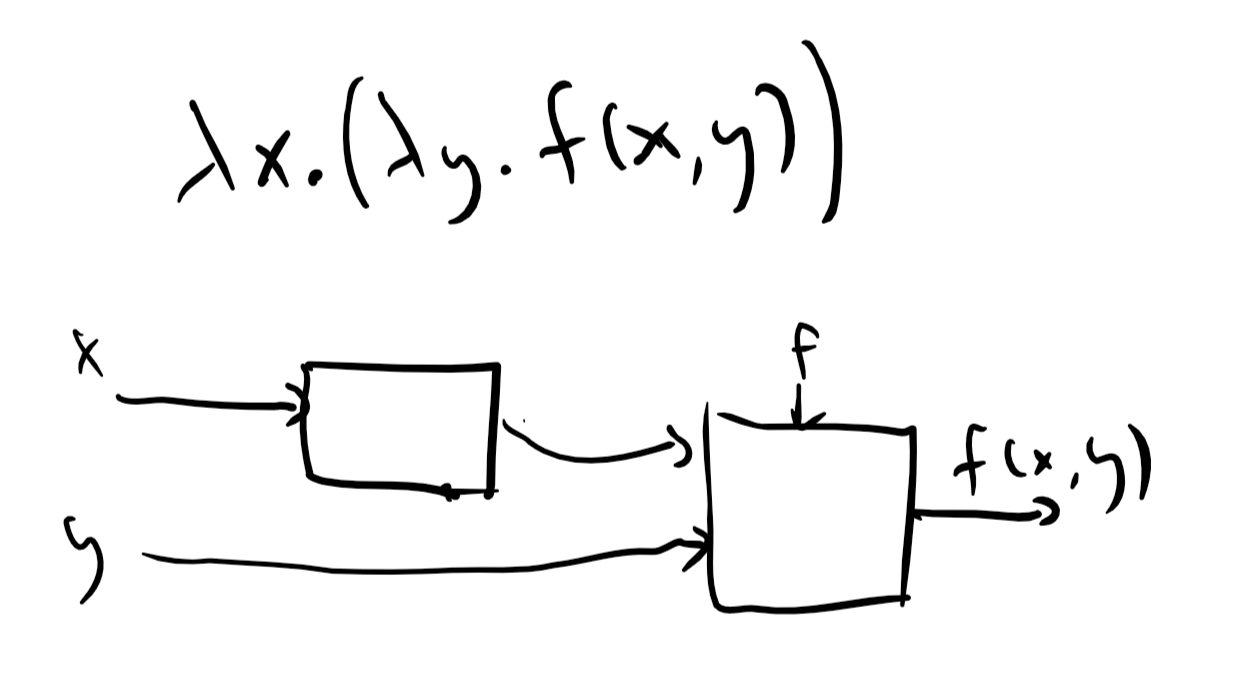
في تعبير من الشكل ، يمكن أن يأتي التعبير نفسه فيه معامل . إذن مثلًا الدالة تُسقط على الدالة .
وبشكل خاص، إذا استدعينا الدالة المعادلة على لنحصل على دالة ، ثم استدعينا على ، نحصل على القيمة . ونرى أن الدالة أحادية الوسيط المعادلة المقابلة لـ يمكن أيضًا التفكير فيها على أنها الدالة ثنائية الوسيط . وبشكل عام، يمكننا استخدام تعبير لمحاكاة أثر دالة ذات وسيطين . وتُعرف هذه التقنية بـCurrying (currying). وسنستخدم الاختصار من أجل . إذا كان عندها يقابل تطبيق ثم استدعاء الدالة الناتجة على ، مما ينتج عنه نتيجة استبدال مواضع في بـ . وبقواعد التجميع التي لدينا، فإن هذا هو نفسه ، وهو ما سنكتبه أحيانًا أيضًا .
الوصف الرسمي لحساب لامدا
نقدّم الآن وصفًا رسميًا لحساب لامدا. نبدأ بـ"تعبيرات أساسية" تحتوي على متغير واحد مثل أو ، ونبني منها تعبيرات أعقد من الشكل و، حيث تعبيران و مُعرِّف متغير. وتُعرَّف تعبيرات رسميًا على النحو التالي:
تعريف — تعبير .
تعبير هو إما مُعرِّف متغير واحد، أو تعبيرًا من أحد الشكلين التاليين:
-
التطبيق: ، حيث و تعبيرا .
-
التجريد: ، حيث تعبير .
تعريف — تعبير λ. هو تعريف تكراري (recursive definition) لأننا عرّفنا مفهوم تعبيرات في مصطلح نفسه. قد يبدو هذا محيّرًا في البداية، لكن في الحقيقة لقد اطلعت على التعريفات التكرارية منذ كنت تلميذًا في المدرسة الابتدائية. فكّر في كيفية تعريفنا لتعبير حسابي (arithmetic expression): إنه تعبير إما مجرد رقم، أو يأخذ أحد الأشكال أو أو أو ، حيث و تعبيرات حسابية أخرى.
المتغيرات الحرة والمربوطة. المتغيرات في تعبير تكون إما حرة (free) أو مربوطة (bound) بمعامل (بالمعنى الموضَّح في تحليل الصيغ: المتغيّرات المربوطة والحرّة). في تعبير أحادي المتغير ، المتغير حر. ومجموعة المتغيرات الحرة والمربوطة في تعبير تطبيق هي نفسها مجموعة المتغيرات في التعبيرين و الأساسيين. أما في تعبير تجريد ، فإن جميع المواضع الحرة لـ في تكون مربوطة بمعامل في . إن وجدتَ مفهوم المتغيرات الحرة والمربوطة محيّرًا، فيمكنك تفادي كل هذه القضايا باستخدام مُعرِّفات فريدة لكل المتغيرات.
الأولوية والأقواس. سنستخدم القواعد التالية التي تتيح لنا إسقاط بعض الأقواس. ترتبط تطبيقات الدوال من اليسار إلى اليمين، ومن ثمّ فإن هو نفسه . ولتطبيق الدوال أولوية أعلى من معامل ، ومن ثمّ فإن هو نفسه . وهذا مشابه لاستخدامنا قواعد الأولوية في العمليات الحسابية لنتمكن من استخدام أقواس أقل، ومن ثمّ كتابة التعبير على صورة . وكما ذُكر في الحصول على دوال متعدّدة الوسائط عبر Curry، فإننا نستخدم أيضًا الاختصار من أجل ، والاختصار من أجل . وهذا ينسجم جيدًا مع تحويل "Currying" الذي يحاكي الدوال متعددة المداخل بتعبيرات .
تكافؤ تعبيرات . كما رأينا في تمرين محلول، فإن القاعدة التي تقول إن مكافئة لـ تتيح لنا تعديل تعبيرات للحصول على صيغة مكافئة أبسط لها. ومن القواعد الأخرى التي نستطيع استخدامها أن المعامل لا يهم، ومن ثمّ فإن هو نفسه . ومعًا تعرّف هاتان القاعدتان مفهوم تكافؤ تعبيرات :
تعريف — تكافؤ تعبيرات
تعبيرا يكونان متكافئين إذا أمكِن تحويلهما إلى التعبير نفسه بتطبيقات متكررة للقواعد التالية:
-
التقييم (أو اختزال ): التعبير مكافئ لـ .
-
إعادة تسمية المتغيرات (أو التحويل ): التعبير مكافئ لـ .
إذا كان تعبير من الشكل ، فإنه يقابل بشكل طبيعي الدالة التي تُسقط أي مدخل على . وعليه فإن حساب لامدا يستلزم بشكل طبيعي نموذجًا حوسبيًا. وبما أن المداخل في حساب لامدا يمكن أن تكون بدورها دوالًا، فعلينا أن نقرّر بترتيب تقييم تعبير مثل وهناك عُرفان طبيعيان لهذا:
-
الاستدعاء بالاسم (أي "التقييم الكسول", lazy evaluation): نقيّم المعادلة بأن نُدخل أولًا التعبير في الطرف الأيسر كمدخل، فنحصل على ثم نكمل من هناك.
-
الاستدعاء بالقيمة (أي "التقييم النشِط", eager evaluation): نقيّم المعادلة بأن نقيّم أولًا الطرف الأيمن فنحصل على ، ثم نُدخل هذا في الطرف الأيسر لنحصل على .
ولأن حساب لامدا لا يحتوي إلا على دوال نقيّة (pure) لا تملك "آثارًا جانبية" (side effects)، فإن الترتيب لا يهم في كثير من الحالات. وفي الواقع، يمكن إظهار أن إن وصلنا إلى تعبير غير قابل للاختصار وحتم (مثلًا عدد) في كلا الاستراتيجيتين، فسيكون التعبير نفسه. غير أنه، ولأجل الوضوح، سنستخدم دائمًا ترتيب "الاستدعاء بالاسم" (أي التقييم الكسول). (الاختيار نفسه قائم في لغة البرمجة Haskell، وإن كانت كثير من لغات البرمجة الأخرى تستخدم التقييم النشِط.) (formally)، ويُرمَّز تقييم تعبير باستخدام "الاستدعاء بالاسم" بالعملية التالية:
تعريف — تبسيط تعبيرات
لنفترض أن تعبير . تبسيط هو ناتج العملية التكرارية التالية:
-
إذا كان متغيرًا واحدًا فإن تبسيط هو .
-
إذا كان على الشكل فإن تبسيط هو حيث هو تبسيط .
-
(التقييم / اختزال .) إذا كان على الشكل فإن تبسيط هو تبسيط ، الذي يعني استبدال جميع نسخ في المربوطة بمعامل بـ
-
(إعادة التسمية / التحويل .) يُحصل على التبسيط القياسي (canonical simplification) لـ بأخذ تبسيط وإعادة تسمية المتغيرات بحيث يكون أول متغير مربوط في التعبير هو ، والثاني هو ، وهكذا وهكذا.
نقول إن تعبيرَي هما و متكافئان، ويُرمَّز ذلك بـ ، إذا كان لهما التبسيط القياسي نفسه.
تمرين محلول — تكافؤ تعبيرات
أَثبِت أن التعبيرين و التاليين متكافئان:
الحل
التبسيط القياسي لـ هو ببساطة . ولإجراء التبسيط القياسي لـ نستخدم أولًا اختزال لنُدخل بدلًا من في ، لكن بما أن غير مستخدمة في هذه الدالة إطلاقًا، فإننا نحصل ببساطة على التي تختزل أيضًا إلى .
الحلقات اللانهائية في حساب لامدا
كما في آلات تورينج وبرامج NAND-TM، يمكن لعملية التبسيط في حساب لامدا أن تدخل أيضًا في حلقة لا نهائية. فعلى سبيل المثال، خذ التعبير التالي
إذا حاولنا تبسيط المعادلة باستدعاء الدالة الموجودة على اليسار على الموجودة على اليمين، فإننا نحصل على نسخة أخرى من المعادلة، ومن ثمّ فإن هذا لا ينتهي أبدًا. وهناك أمثلة قد يهمّ فيها ترتيب التقييم ما إذا كان بإمكان تعبير ما أن يُختزل أم لا، انظر تمرين — مثال على ترتيب التقييم في حساب لامدا.
حساب لامدا "المُعزَّز"
سنناقش الآن حساب لامدا بوصفه نموذجًا حوسبيًا. سنبدأ بوصف نسخة "معزّزة" من حساب لامدا تحتوي على بعض "الميزات الزائدة" لكنها أسهل في الفهم. سنبيّن أولًا كيف يكون حساب لامدا المعزّز مكافئًا لآلات تورينج في القوة الحاسوبية. ثم سنبيّن كيف يمكن تنفيذ جميع ميزات "حساب لامدا المعزّز" بوصفها "سكرًا نحويًا" فوق حساب لامدا "النقي" (أي غير المعزّز). وعليه فإن حساب لامدا النقي مكافئ في القوة لآلات تورينج (وبالتالي أيضًا لآلات RAM وكل النماذج الأخرى المتكافئة مع تورينج).
يتضمن حساب لامدا المعزّز مجموعة الكائنات والعمليات التالية:
-
الثوابت البوليانية ودالة IF: توجد تعبيرات هي و و تحقق الشروط التالية: لكل تعبيرَي هما و، لدينا و. أي أن هي الدالة التي تعطى ثلاثة وسائط فتُخرج إذا كان و إذا كان .
-
الأزواج: يوجد تعبير هو سنفكّر فيه على أنه دالة الأزواج (pairing). لكل تعبيرَي هما ، يكون هو الزوج الذي يحتوي كعضو أول و كعضو ثاني. ولدينا أيضًا تعبيرا هما و يستخرجان على التوالي عضو الأول والثاني من الزوج. وعليه، لكل تعبيرَي هما ، لدينا و.[2]
-
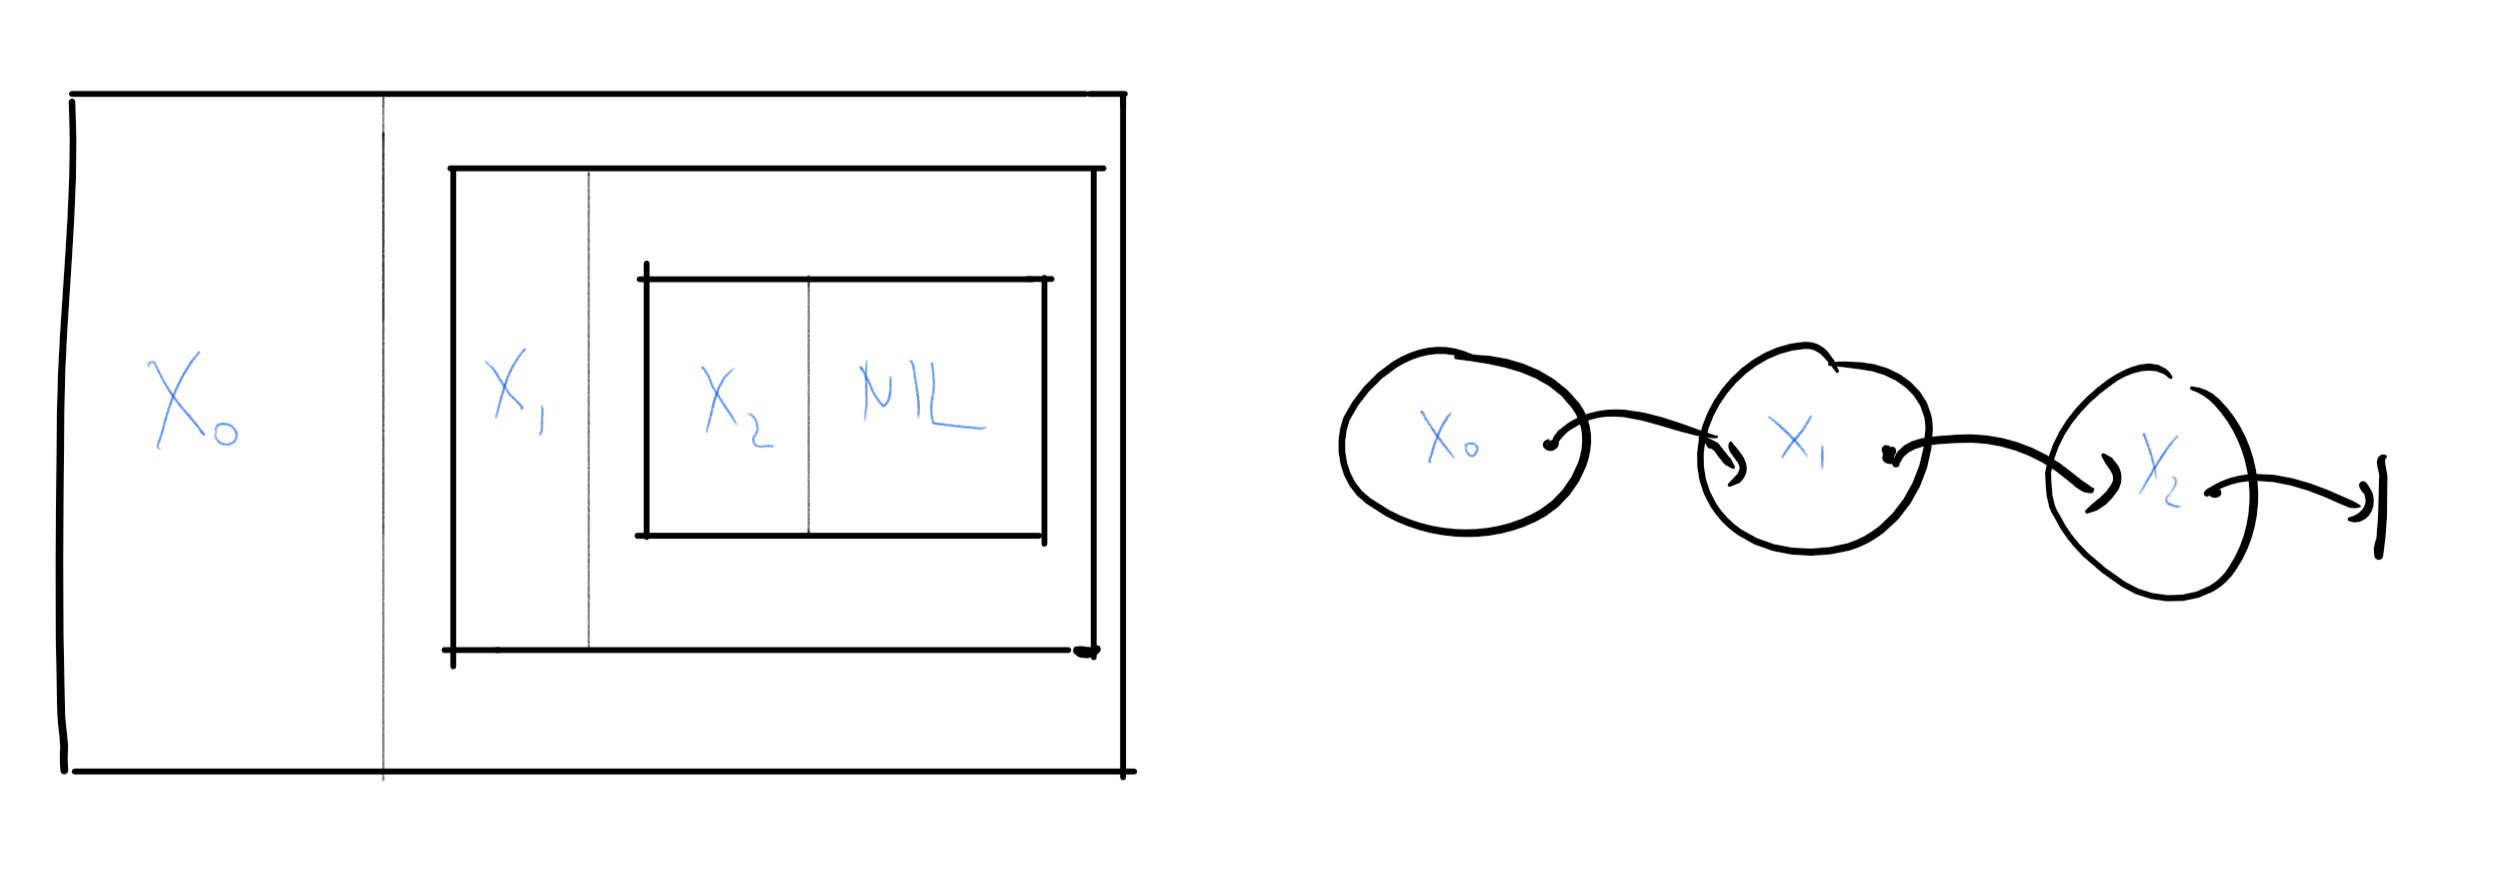
القوائم والسلاسل النصية: يوجد تعبير هو يقابل القائمة الفارغة، الذي نرمز له أيضًا بـ . باستخدام و نبني القوائم. الفكرة أنه إذا كان قائمة من عناصر على الشكل ، إذًا لكل تعبير هو يمكننا الحصول على قائمة من عناصر باستخدام التعبير . على سبيل المثال، لكل ثلاثة تعبيرات هي ، يقابل التالي قائمة من ثلاثة عناصر :
تعيد الدالة القيمة على وتُعيد على كل قائمة أخرى. و_السلسلة النصية_ (string) هي ببساطة قائمة من البتات.
-
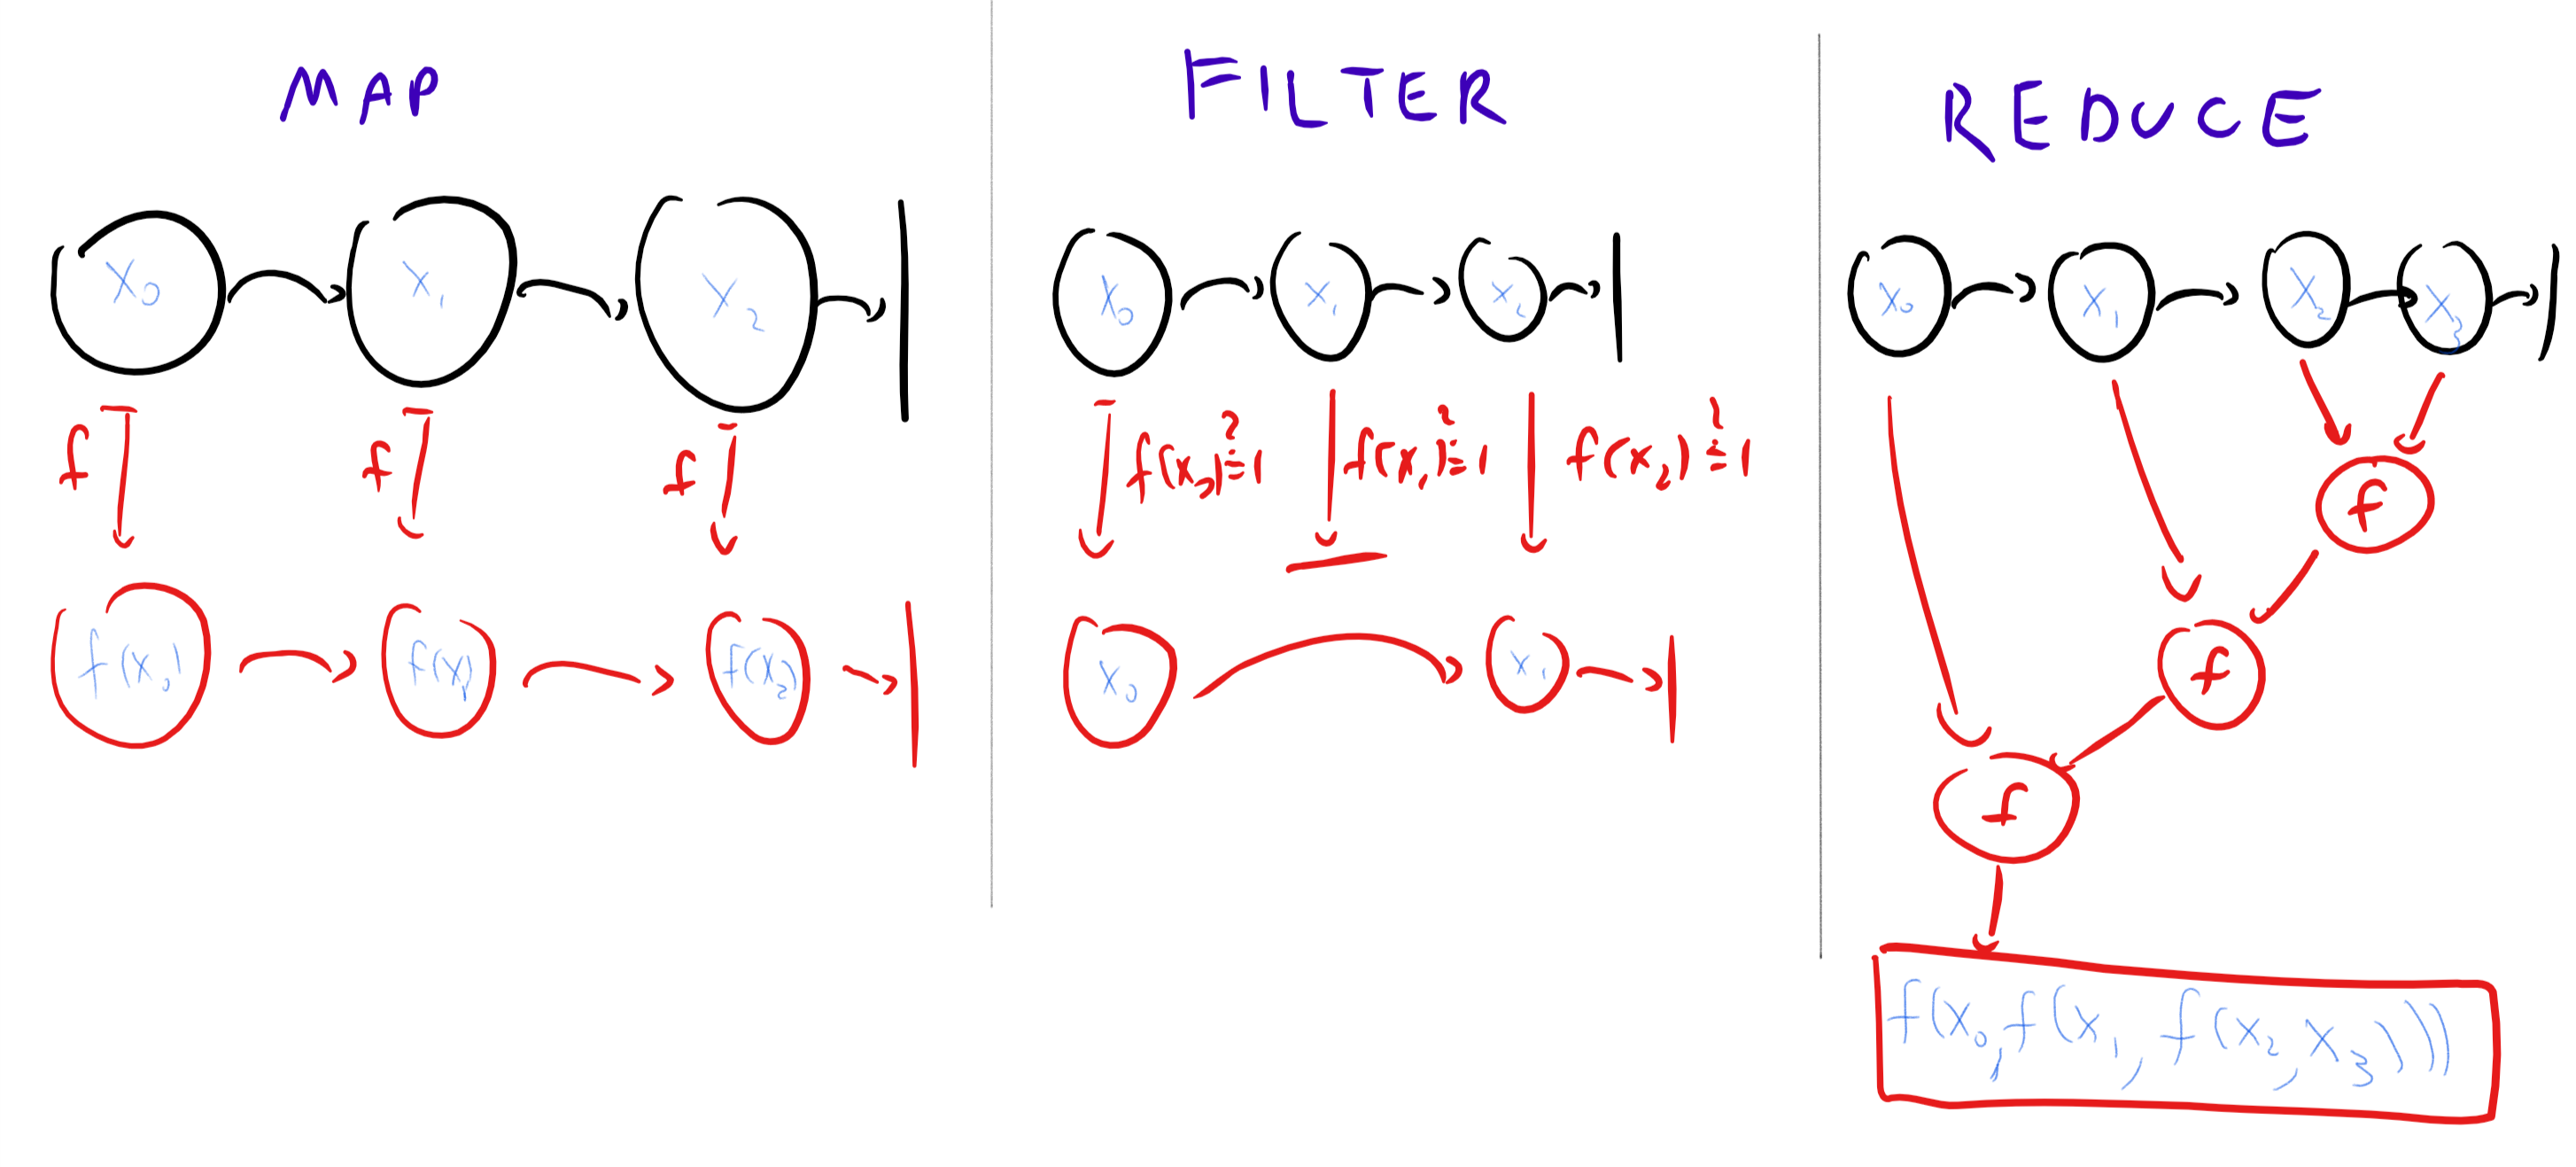
عمليات القوائم: يحتوي حساب لامدا المعزّز أيضًا على دوال معالجة القوائم وهي وFILTER. إذا أعطينا قائمة ودالة ، فإن تطبّق على كل عنصر في القائمة فتحصل على القائمة الجديدة . وإذا أعطينا قائمة على النحو أعلاه وتعبيرًا يكون ناتجه إما أو ، فإن تُعيد القائمة التي تحتوي كل عناصر التي تُخرج لها . وتطبّق الدالة REDUCE; L ; + ; 0L. وبشكل أكثر عمومية، تأخذ Lf\lambdazf$، مثل للجمع و للضرب). ويُعرَّف الناتج بـ انظر الشكل التوضيحي لتوضيح عمليات معالجة القوائم الثلاث.
-
التهاكر: وأخيرًا، نريد أن نتمكّن من تنفيذ دوال تهاكرية. ولأن الدوال في حساب لامدا مجهولة الاسم، فلا يمكننا كتابة تعريف من الشكل حيث يحتوي على استدعاءات إلى $f. بدلًا من ذلك نستخدم دوال me كوسيط. وسيأخذ المعامل f كمدخل ويُعيد "نسخة تهاكرية" من me باستدعاءات تهاكرية إلى هذه الدالة. أي أنه إذا كانت لدينا دالة me وRECURSE; F ستكون الدالة xf(x) = F(f,x)x$.
تمرين محلول — حساب NAND باستخدام حساب لامدا
أعطِ تعبير هو بحيث لكل .
الحل
قيمة لـ تساوي إلا إذا كان . وعليه يمكننا كتابة
تمرين محلول — حساب XOR باستخدام حساب لامدا
أعطِ تعبير هو بحيث لكل قائمة حيث لكل ، تُقيَّم إلى .
الحل
أولًا، نلاحظ أننا نستطيع حساب XOR لبتّين على النحو التالي: و
(نستخدم هنا قدرًا من السكر النحوي لوصف الدوال. وللحصول على تعبير الخاص بـ XOR، سنكتفي باستبدال التعبير المعادلة في المعادلة.) والآن يمكننا تعريف XOR لقائمة على النحو التكراري التالي:
وهذا يعني أن تساوي
أي أن تُحصل بتطبيق المعامل meL$ تُعيد إذا كان XOR_2HEAD(L)me(TAIL(L))$.
كان بإمكاننا أيضًا حساب REDUCE، وقد تركنا استخراج ذلك تمرينًا للقارئ.
حساب دالة في حساب لامدا المعزّز
يَنحصل على تعبير معزّز (enhanced λ expression) بتركيب الكائنات أعلاه مع قواعد التطبيق و_التجريد_. ونتيجة تبسيط تعبير هي تعبير مكافئ له، ومن ثمّ فإن كان لتعبيرين التبسيط نفسه فإنهما متكافئان.
تعريف — حساب دالة بواسطة حساب لامدا
لنفترض أن
نقول إن يحسب إذا كان لكل ، حيث و و، ومفهوم التكافؤ مُعرَّف بحسب تعريف — تبسيط تعبيرات λ.
حساب لامدا المعزّز كامل بحسب تورينج
العمليات الأساسية في حساب لامدا المعزّز تعادل إلى حد كبير لغتَي البرمجة Lisp أو Scheme. وبناءً على ذلك، ربما لا يكون مفاجئًا أن حساب لامدا المعزّز مكافئ لآلات تورينج:
مبرهنة — حساب لامدا وNAND-TM
لكل دالة ، تكون قابلة للحساب في حساب لامدا المعزّز إذا وفقط إذا كانت قابلة للحساب بآلة تورينج.
لإثبات المبرهنة، نحتاج إلى إظهار أن (1) إذا كانت قابلة للحساب بتعبير حساب لامدا فإنها قابلة للحساب بآلة تورينج، و__(2)__ إذا كانت قابلة للحساب بآلة تورينج فإنها قابلة للحساب بتعبير حساب لامدا معزّز.
إظهار (1) مباشر إلى حد كبير إلى حد كبير. فتطبيق قواعد التبسيط على تعبير يعادل في الأساس "ابحث واستبدل"، وهو ما يمكننا تنفيذه بسهولة في NAND-RAM، أو في Python على سبيل المثال (كلاهما مكافئ في القوة لآلات تورينج). أما إظهار (2) فيعادل في الأساس محاكاة آلة تورينج (أو كتابة مُفسِّر لـ NAND-TM) في لغة برمجة وظيفية مثل LISP أو Scheme. ونقدّم التفاصيل أدناه، لكن كيفية ذلك تمرين جيد في إتقان بعض تقنيات البرمجة الوظيفية المفيدة بذاتها.
برهان
سنكتفي برسم مخطط البرهان. اتجاه "إذا" بسيط. وكما ذُكر أعلاه، فإن تقييم تعبيرات يعادل في الأساس "ابحث واستبدل". كما أن تنفيذ جميع العمليات الأساسية أعلاه في لغة أمرية مثل Python أو C هو تمرين برمجي مباشر إلى حد كبير، وباستخدام الأفكار نفسها يمكننا فعل ذلك في NAND-RAM أيضًا، ثم نحوّله إلى برنامج NAND-TM.
وبالنسبة لاتجاه "فقط إذا" نحتاج إلى محاكاة آلة تورينج باستخدام تعبير $\lambda`. وسنقوم بذلك أولًا بإظهار أنه لكل آلة تورينج يوجد تعبير يحسب دالة الخطوة التالية التي تُسقط تكوينًا لـ على التالي (انظر تكوينات آلات تورينج ودالة الخطوة التالية).
تكوين هو سلسلة لمجموعة متناهية . يمكننا ترميز كل رمز بسلسلة متناهية ، وبذلك سنرمّز تكوينًا في حساب لامدا على هيئة قائمة حيث سلسلة طولها (أي قائمة طولها من الآصفار والواحدات) ترمّز رمزًا في .
بحسب لمّة، لكل ، تكون مساوية لـ لبعض الدالة المتناهية . وباستخدام ترميزنا لـ على هيئة ، يمكننا أيضًا التفكير في على أنها تُسقط على . وبحسب تمرين محلول — حساب NAND باستخدام حساب لامدا، يمكننا حساب الدالة ، وبالتالي كل دالة متناهية، بما فيها ، باستخدام حساب لامدا. وباستخدام هذه الفكرة، يمكننا حساب باستخدام حساب لامدا على النحو التالي. إذا أعطينا قائمة ترمّز التكوين ، فإننا نعرّف القائمتين و اللتين ترمّزان التكوين مُزاحًا خطوة واحدة إلى اليمين وإلى اليسار على التوالي. ويُعرَّف التكوين التالي على أنه حيث نترك تشير إلى العنصر رقم في . ويمكن حساب هذا بالتهاكر (وبالتالي باستخدام معامل في حساب لامدا المعزّز) على النحو التالي:
خوارزمية — using the λ calculus
INPUT: List $L = \langle \alpha_0,\alpha_1,\ldots, \alpha_{m-1}, \bot \rangle$ encoding a configuration $\alpha$.
OUTPUT: List $L'$ encoding $NEXT_M(\alpha)$

PROCEDURE{ComputeNext}{$L_{prev},L,L_{next}$}
If $ISEMPTY \; L_{prev}$
return $NIL$
Endif
$a \leftarrow HEAD \; L_{prev}$
If $ISEMPTY\; L$
$b \leftarrow \varnothing$ # Encoding of $\varnothing$ in $\{0,1\}^\ell$
Else
$b \leftarrow HEAD\;L$
Endif
If $ISEMPTY\; L_{next}$
$c \leftarrow \varnothing$
Else
$c \leftarrow HEAD \; L_{next}$
Endif
Return $PAIR \; r(a,b,c) \; ComputeNext(TAIL\; L_{prev}\;,\;TAIL\; L\;,\;TAIL\; L_{next})$
Endprocedure

$L_{prev} \leftarrow PAIR \; \varnothing \; L$ # $L_{prev} = \langle \varnothing , \alpha_0,\ldots, \alpha_{m-1},\bot \rangle$
$L_{next} \leftarrow  TAIL\; L$ # $L_{next} = \langle \alpha_1,\ldots,\alpha_{m-1}, \bot \}$
Return $ComputeNext(L_{prev},L,L_{next})$
وبعد أن نتمكن من حساب ، يمكننا محاكاة تنفيذ على المدخل باستخدام التهاكر التالي. نعرّف لتكون التكوين النهائي لـ عندما يُهيَّأ عند التكوين . ويمكن تعريف الدالة تكراريًا على النحو التالي:
والفحص هل كان تكوين ما هو تكوين توقف (i.e. هل كان تكوينًا تُخرج فيه دالة الانتقال alt) يمكن تنفيذه بسهولة في حساب ، ومن ثمّ يمكننا استخدام لحساب . وإذا تركنا لتكون التكوين الأولي لـ على المدخل ، فيمكننا الحصول على الناتج من ، وبذلك يكتمل البرهان.
من حساب لامدا المعزّز إلى حساب لامدا النقي
بينما مجموعة الدوال "الأساسية" التي سمحنا بها في حساب لامدا المعزّز أصغر مما توفره معظم لهجات Lisp، إلا أنها تبدو، على اعتبارنا قادمًا من NAND-TM، لا تزال منتفخة بعض الشيء. هل يمكننا الاكتفاء بأقل من ذلك؟ بعبارة أخرى، هل يمكننا إيجاد مجموعة جزئية من هذه العمليات الأساسية يمكنها تنفيذ الباقي؟
ويبيّن أنه يوجد بالفعل مجموعة جزئية فعلية من عمليات حساب لامدا المعزّز يمكن استخدامها لتنفيذ الباقي. تلك المجموعة الجزئية هي المجموعة الخالية. أي يمكننا تنفيذ جميع العمليات أعلاه باستخدام الصيغة وحدها، حتى من دون استخدام و. إنها λ حتى القاع!
توقّف وتأمّل
هذه نقطة جيدة للتوقف والتفكير في كيفية تنفيذك لهذه العمليات بنفسك. فعلى سبيل المثال، ابدأ بالتفكير في كيفية قدرتك على تنفيذ باستخدام ، ثم باستخدام مع . ويمكنك أيضًا تنفيذ و و بالاعتماد على . والجزء الأصعب هو تنفيذ باستخدام عمليات حساب لامدا النقي فقط.
مبرهنة — حساب لامدا المعزّز مكافئ لحساب لامدا النقي.
توجد تعبيرات تنفذ الدوال و و و و و و و و و و.
الفكرة الكامنة وراء مبرهنة — حساب لامدا المعزّز مكافئ لحساب لامدا النقي. هي أننا نرمّز و نفسهما على هيئة تعبيرات ، ونبني الأشياء انطلاقًا من هناك. ويُعرف هذا بـترميز Church (Church encoding)، لأنه نشأ عن Church في محاولته إظهار أن حساب لامدا يمكن أن يكون أساسًا لكل الحوسبة. ولن نكتب البرهان الرسمي الكامل لـ مبرهنة — حساب لامدا المعزّز مكافئ لحساب لامدا النقي.، بل سنعرض مخطط الأفكار المتضمَّنة فيه:
-
نعرّف لتكون الدالة التي على مدخلين تُخرج ، و لتكون الدالة التي على مدخلين تُخرج . ونستخدم Curry لتحقيق أثر دوال الإدخال، ومن ثمّ و. (نظام التمثيل هذا هو العُرف الشائع لتمثيل
falseوtrue، لكن هناك تمثيلات بديلة كثيرة أخرى لـ و لكنها كانت ستؤدي الغرض على الأرجح.) -
التنفيذ أعلاه يجعل الدالة تافهة: فـ هي ببساطة لأن و. يمكننا كتابة للحصول على .
-
لترميز زوج سننتج دالة يكون فيها و "في بطنها" وتُحقِّق لكل دالة . أي أن . ويمكننا استخراج العنصر الأول من زوج بكتابة والعنصر الثاني بكتابة ، ومن ثمّ و.
-
نعرّف لتكون الدالة التي تتجاهل مدخلها وتُخرج دائمًا . أي أن . ودالة تفحص، إذا أعطينا مدخلًا ، هل نحصل على عند تطبيق على الدالة التي تتجاهل كل مداخيلها وتُخرج دائمًا . لكل زوج صحيح على الشكل ، لدينا بينما . وبشكل رسمي، .
ملاحظة — أعداد Church (اختياري)
لا شيء خاص في القيم البوليانية. فبإمكانك استخدام حيل مشابهة لتنفيذ الأعداد الطبيعية باستخدام حدوس . والطريقة القياسية لذلك هي تمثيل العدد بالدالة التي على مدخل دالة تُخرج الدالة (بعدد مرة). أي أننا نمثّل العدد الطبيعي على هيئة ، والعدد على هيئة ، والعدد على هيئة ، وهكذا وهكذا. (لاحظ أن هذه ليست هي نفس التمثيل الذي استخدمناه للـ في السياق البولياني: لا بأس، فقد علمنا أن الشيء نفسه يمكن تمثيله بأكثر من طريقة واحدة.) ويُمثَّل العدد بالدالة التي تُسقط أي دالة على دالة الهوية . (أي أن .)
في هذا التمثيل، يمكننا حساب على هيئة و على هيئة . أما الطرح والقسمة فأكثر تعقيدًا، لكن يمكن تحقيقهما بالتهاكر. (استخراج ذلك تمرين ممتاز.)
معالجة القوائم
نصل الآن إلى عقبة أكبر، وهي كيفية تنفيذ و و و في حساب لامدا النقي. ويبيّن أنه يمكننا بناء و من ، و من . فعلى سبيل المثال، هو نفسه حيث هي العملية التي على مدخلين و تُخرج . (أترك لك، أيها القارئ، التحقق من ذلك كتمرين مُستحسن!)
ويمكننا تعريف تكراريًا، بأن نضع ونشترط أنه إذا أعطينا قائمة غير فارغة ، والتي نراها زوجًا ، فإن . وعليه، قد نحاول كتابة تعبير تكراري لـ على النحو التالي
العقبة الوحيدة في هذا كله هي أن حساب لامدا لا يملك مفهوم التهاكر، ومن ثمّ فإن هذا تعريف غير صالح. لكننا بالطبع يمكننا استخدام معامل لحل هذه المشكلة. سنستبدل الاستدعاء التكراري إلى "" باستدعاء دالة تُعطى كوسيط إضافي، ثم نطبّق عليها. وعليه حيث
مُجمِّع Y، أي التهاكر بلا تهاكر
المعادلة تعني أن تنفيذ و و ينحصر في تنفيذ معامل في حساب لامدا النقي. وهذا هو ما سنفعله الآن.
كيف يمكننا تنفيذ التهاكر بلا تهاكر؟ سنوضّح ذلك بمثال بسيط - دالة . وكما هو مبين في تمرين محلول — حساب XOR باستخدام حساب لامدا، يمكننا كتابة دالة لقائمة تكراريًا على النحو التالي:
حيث هي XOR على بتّين. وفي Python سنكتبها على النحو التالي
def xor2(a,b): return 1-b if a else b
def head(L): return L[0]
def tail(L): return L[1:]

def xor(L): return xor2(head(L),xor(tail(L))) if L else 0

print(xor([0,1,1,0,0,1]))
# 1
والآن، كيف يمكننا التخلص من هذا الاستدعاء التكراري؟
الفكرة الرئيسية هي أن بما أن الدوال تستطيع أن تأخذ دوالًا أخرى كمدخل، فإن إعطاء دالة نفسها كمدخل أمر مشروع تمامًا في Python (وفي حساب لامدا بالطبع).
إذن فكرتنا هي أن نحاول أن نجد دالة غير تكرارية هي tempxor تأخذ مدخلين: دالة وقائمة، بحيث تُخرج tempxor(tempxor,L) قيمة XOR لـ L!
توقّف وتأمّل
قد ترغب عند هذه النقطة في التوقف ومحاولة تنفيذ هذا بنفسك في Python أو أي لغة برمجة أخرى من اختيارك (ما دامت تسمح بدوال كمدخلات).
كانت محاولتنا الأولى هي ببساطة استخدام فكرة استبدال الاستدعاء التكراري بـ me.
لنعرّف هذه الدالة على اسم myxor
def myxor(me,L): return xor2(head(L),me(tail(L))) if L else 0
لنجرّب هذا:
myxor(myxor,[1,0,1])
إذا فعلت ذلك، ستحصل على الشكوى التالية من المُفسِّر:
TypeError: myxor() missing 1 required positional argument
المشكلة أن myxor تتوقع مدخلين - دالة وقائمة - بينما في الاستدعاء إلى me لم نقدّم سوى قائمة.
وللتصحيح، نعدّل الاستدعاء لنقدّم الدالة نفسها أيضًا:
def tempxor(me,L): return xor2(head(L),me(me,tail(L))) if L else 0
لاحظ الاستدعاء me(me,..) في تعريف tempxor: فإذا أعطينا tempxor دالة me كمدخل، فستستدعي tempxor فعليًا الدالة me وهي نفسها كأول مدخل.
وإذا جرّبنا ذلك الآن، سنرى أننا نحصل فعلًا على النتيجة الصحيحة!
tempxor(tempxor,[1,0,1])
# 0
tempxor(tempxor,[1,0,1,1])
# 1
وعليه يمكننا تعريف xor(L) ببساطة على أنها return tempxor(tempxor,L).
النهج أعلاه ليس خاصًا بـ XOR.
فإذا أعطينا دالة تكرارية f تأخذ مدخلًا x، يمكننا الحصول على نسخة غير تكرارية على النحو التالي:
-
أنشئ الدالة
myfالتي تأخذ زوج مدخلينmeوx، وتستبدل الاستدعاءات التكرارية إلىfباستدعاءات إلىme. -
أنشئ الدالة
tempfالتي تحوّل الاستدعاءات فيmyfمن الشكلme(x)إلى استدعاءات من الشكلme(me,x). -
تُعرَّف الدالة
f(x)على أنهاtempf(tempf,x)
وهذه هي الطريقة التي ننفّذ بها معامل RECURSE في Python. فهو سيأخذ دالة myf كما سبق، ويستبدلها بدالة بحيث لكل .
def RECURSE(myf):
    def tempf(me,x): return myf(lambda y: me(me,y),x)

    return lambda x: tempf(tempf,x)


xor = RECURSE(myxor)

print(xor([0,1,1,0,0,1]))
# 1

print(xor([1,1,0,0,1,1,1,1]))
# 0
من Python إلى حساب . في حساب لامدا، تُكتب الدالة ذات المدخلين التي تأخذ زوج مدخلين على هيئة . إذن الدالة تُكتب ببساطة ، وبالمثل الدالة تُكتب ببساطة . (هل ترى لماذا؟)
وعليه يمكن كتابة الدالة tempf المعرَّفة أعلاه على هيئة λ me. myf(me me).
وهذا يعني أن إذا رمزنا مدخل RECURSE بـ ، فإن حيث أو بعبارة أخرى
يحتوي الملحق الإلكتروني على تنفيذ لحساب لامدا باستخدام Python. وها هو تنفيذ لدالة XOR التكرارية من ذلك الملحق:[3]
# XOR of two bits
XOR2 = λ(a,b)(IF(a,IF(b,_0,_1),b))

# Recursive XOR with recursive calls replaced by m parameter
myXOR = λ(m,l)(IF(ISEMPTY(l),_0,XOR2(HEAD(l),m(TAIL(l)))))

# Recurse operator (aka Y combinator)
RECURSE = λf((λm(f(m*m)))(λm(f(m*m))))

# XOR function
XOR = RECURSE(myXOR)

#TESTING:

XOR(PAIR(_1,NIL)) # List [1]
# equals 1

XOR(PAIR(_1,PAIR(_0,PAIR(_1,NIL)))) # List [1,0,1]
# equals 0
ملاحظة — مُجمِّع Y
يُعرف المعامل أعلاه على نحو أفضل بأنه مُجمِّع Y (Y combinator).
وهو واحد من عائلة من معاملات النقطة الثابتة التي، إذا أعطيتها تعبير هو ، تجد نقطة ثابتة لـ بحيث . وإذا فكّرت في الأمر، فإن هي النقطة الثابتة لـ أعلاه. فـ هي الدالة بحيث لكل ، إن أدخلنا كأول وسيط في فإننا نحصل على من جديد، أو بعبارة أخرى . وعليه فإن إيجاد نقطة ثابتة لـ هو نفسه تطبيق عليها.
أطروحة Church-Turing (مناقشة)
"[في عام 1934]، كان تشُرْش قد وضع تخمينات، ثم اقترح على نحو قاطع أن الدوال القابلة للتعريف بـ λ هي جميع الدوال القابلة للحساب فعليًا .... وعندما اقترح تشُرْش هذه الأطروحة، جلست أنفي لإثباتها على بُعد ... لكن، بعد أن أدركت بسرعة أن [منهجي قد أخفق]، أصبحت بين ليلة وضحاها من أنصار الأطروحة."، ستيفن كلين، 1979.
"[الأطروحة ليست] تعريفًا فحسب ولا بديهية، بل ... قانون من قوانين الطبيعة."، إميل بوست، 1936.
لقد عرّفنا الدوال بأنها قابلة للحساب إذا أمكن حسابها ببرنامج NAND-TM، وقد رأينا أن التعريف سيبقى كما هو إذا استبدلنا برامج NAND-TM ببرامج Python، وبآلات تورينج، وبحساب لامدا، وبالآليات الخلوية (cellular automata)، وبنماذج حوسبة أخرى كثيرة. أما أطروحة Church-Turing فهي أن هذا هو التعريف الوحيد المعقول للدوال "القابلة للحساب". وخلافًا لـ"أطروحة Church-Turing الفيزيائية الممتدة" (PECTT) التي رأيناها من قبل، فإن أطروحة Church-Turing لا تقدّم تنبؤًا فيزيائيًا ملموسًا يمكن اختباره تجريبيًا، لكنها بلا شك تحفّز تنبؤات مثل PECTT. ويمكن النظر إلى أطروحة Church-Turing على أنها إما أنها دفاع عن اختيار تعريفي، أو أنها تقدّم تنبؤًا ما عن جميع أجهزة الحوسبة المحتملة، أو أنها تقترح قوانينَ طبيعة تقيّد العالم الطبيعي. وبعبارات سكوت آرونسون (Scott Aaronson)، "أيًّا كان ما هي، فلا يمكن إلا النظر إلى أطروحة Church-Turing على أنها ناجحة إلى حد بعيد". لم يطرح أي جهاز حوسبة مرشَّح (بما في ذلك الحواسيب الكمّية، وكذلك نماذج أقل عقلانية بكثير مثل الحواسيب الافتراضية ذات "منحنيات زمنية مغلقة" التي ذكرناها من قبل) تحديًا جادًّا لأطروحة Church-Turing حتى الآن. قد تجعل هذه الأجهزة بعض الحسابات أكثر كفاءة، لكنها لا تغيّر الفرق بين ما هو قابل للحساب وما ليس كذلك. (فـ_أطروحة Church-Turing الممتدة_، التي سنناقشها في أطروحة تورينج-تشرش الموسَّعة (نقاش)، تنص على أن آلات تورينج تلتقط أيضًا الحد لما يمكن حسابه بكفاءة. وكما في نسختها الفيزيائية، تُمثّل الحوسبة الكمّية التحدي الرئيسي لهذه الأطروحة.)
نماذج حوسبة مختلفة
يمكننا تلخيص النماذج التي رأيناها في الجدول التالي:
| المشكلات الحاسوبية | نوع النموذج | أمثلة |
|---|---|---|
| دوال متناهية | حوسبة غير منتظمة (الخوارزمية تعتمد على طول المدخل) | دوائر بوليانية، دوائر NAND، برامج مستقيمة (مثل NAND-CIRC) |
| دوال بمداخل غير محدودة | وصول تسلسلي إلى الذاكرة | آلات تورينج، برامج NAND-TM |
| -- | وصول مفهرس / RAM | آلات RAM، NAND-RAM، لغات البرمجة الحديثة |
| -- | أخرى | حساب لامدا، الآليات الخلوية |
الجدول: نماذج مختلفة لحساب الدوال المتناهية والدوال ذات الطول الاعتباري من المدخل.
لاحقًا، في الحساب المقيّد بالمساحة سندرس الحوسبة المحدودة بالذاكرة (memory bounded). ويبيّن أن برامج NAND-TM ذات كمية ثابتة من الذاكرة مكافئة لنموذج الآلات المتناهية (finite automata) (وتُضاف أحيانًا الصفتان "حتمي" أو "غير حتمي"، كما يُعرف هذا النموذج أيضًا بـ_آلات الحالات المنتهية_ (finite state machines))، وهو بدوره يلتقط مفهوم اللغات المنتظمة (regular languages) (التي يمكن وصفها بـتعبيرات نمطية)، وهو مفهوم سنراه في نماذج الحوسبة المقيَّدة.
خلاصة
- ورغم أننا عرّفنا الدوال القابلة للحساب باستخدام آلات تورينج، لكنا نستطيع أن نفعل ذلك بنماذج أخرى كثيرة، بما فيها برامج NAND-TM، وكذلك آلات RAM، وNAND-RAM، وحساب لامدا، والآليات الخلوية، ونماذج أخرى كثيرة.
- تبيّن أن النماذج البسيطة جدًا "كاملة بحسب تورينج" بالمعنى أنها تستطيع محاكاة حوسبة ذات تعقيد اعتباطي.
تمارين
تمرين — برهان بديل لتكافؤ TM/RAM
لنفترض أن هي الدالة التالية. المدخل هو زوج حيث ، و هو ترميز لقائمة من أزواج مفتاح-قيمة حيث و سلاسل ثنائية. المخرج هو لأصغر بحيث ، إذا وُجد مثل هذا ، وإلا فالسلسلة الفارغة.
-
أثبِت أن قابلة للحساب بآلة تورينج.
-
لنفترض أن هي الدالة التي مدخلها قائمة من الأزواج، ومخرجها هي القائمة المحصَّلة بإضافة الزوج في بداية . أثبِت أن قابلة للحساب بآلة تورينج.
-
لنفترض أننا نرمّز تكوين برنامج NAND-RAM بقائمة من أزواج مفتاح/قيمة، حيث المفتاح إما اسم متغير عددي
fooأو من الشكلBar[<num>]وبعض العدد<num>، ويحتوي على جميع قيم المتغيرات غير الصفرية. ولنفترض أن هي الدالة التي تُسقط تكوين برنامج NAND-RAM عند خطوة ما على التكوين في الخطوة التالية. أثبِت أن قابلة للحساب بآلة تورينج (لست مضطرًا لتنفيذ كل واحدة من العمليات الحسابية: يكفي تنفيذ الجمع والضرب). -
أثبِت أن لكل قابلة للحساب ببرنامج NAND-RAM، تكون قابلة للحساب بآلة تورينج.
تمرين — البحث في NAND-TM
يُظهر هذا التمرين جزءًا من برهان أن NAND-TM يستطيع محاكاة NAND-RAM. أنتج شيفرة برنامج NAND-TM يحسب الدالة المعرَّفة على النحو التالي.
على مدخل ، حيث تشير إلى ترميز خالٍ من البادئة للعدد الصحيح ، تكون إذا كان و وإلا. (لا يهمّنا ما تُخرجه LOOKUP على المداخل التي ليست من هذا الشكل.) ويمكنك اختيار أي ترميز خالٍ من البادئة تختاره، ويمكنك أيضًا استخدام لغة برمجة مفضّلة لديك لإنتاج هذه الشيفرة.
تمرين — الأزواج
لنفترض أن هي الدالة المعرَّفة على أنها . \
-
أثبِت أن هو بالفعل عدد طبيعي لكل . \
-
أثبِت أن واحد إلى واحد \
-
أنشئ برنامج NAND-TM هو بحيث لكل ، يكون ، حيث هي دالة الترميز الخالي من البادئة المعرَّفة أعلاه. ويمكنك استخدام السكر النحوي للحلقات الداخلية، والشروط، وزيادة/نقصان العدّاد. \
-
أنشئ برامج NAND-TM هي بحيث لكل و، يكون . ويمكنك استخدام السكر النحوي للحلقات الداخلية، والشروط، وزيادة/نقصان العدّاد.
تمرين — أقصر مسار
لنفترض أن هي الدالة التي على مدخل سلسلة ترمّز ثلاثيًا تُخرج سلسلة ترمّز إذا كان و غير متصلين في ، أو سلسلة ترمّز الطول لأقصر مسار من إلى . أثبِت أن قابلة للحساب بآلة تورينج. انظر الحاشية للتلميح.[4]
تمرين — أطول مسار
لنفترض أن هي الدالة التي على مدخل سلسلة ترمّز ثلاثيًا تُخرج سلسلة ترمّز إذا كان و غير متصلين في ، أو سلسلة ترمّز الطول لـ_أطول مسار بسيط_ (longest simple path) من إلى . أثبِت أن قابلة للحساب بآلة تورينج. انظر الحاشية للتلميح.[5]
تمرين — تعبير لأقصر مسار
لنفترض أن كما في تمرين — أقصر مسار. أثبِت أن يوجد تعبير يحسب . ويمكنك استخدام تمرين — أقصر مسار
تمرين — دالة الخطوة التالية محلية
أثبِت لمّة واستخدمه لإكمال برهان مبرهنة — الآليات أحادية البعد كاملة بحسب تورينج.
تمرين — حساب لامدا يحتاج إلى ثلاثة متغيرات على الأكثر
أثبِت أن لكل تعبير هو ولا يحتوي متغيرات حرة يوجد تعبير مكافئ هو لا يستخدم إلا المتغيرات و و.[6]
تمرين — مثال على ترتيب التقييم في حساب لامدا
-
لنفترض أن . أثبِت أن عملية تبسيط تنتهي إلى عدد متناهٍ إذا استخدمنا ترتيب التقييم "الاستدعاء بالاسم"، بينما لا تنتهي أبدًا إذا استخدمنا ترتيب "الاستدعاء بالقيمة".
-
(إضافي، متحدٍّ) لنفترض أن أي تعبير . أثبِت أن إذا انتهت عملية التبسيط إلى عدد متناهٍ إذا استخدمنا ترتيب "الاستدعاء بالقيمة" فإنها تنتهي أيضًا إلى عدد متناهٍ إذا استخدمنا ترتيب "الاستدعاء بالاسم". انظر الحاشية للتلميح.[7]
تمرين — دالة zip
أعطِ تعبيرًا في حساب لامدا المعزّز لحساب الدالة zip التي على مدخل زوج من القوائم و لهما الطول نفسه ، تُخرج قائمة من زوجًا هي بحيث العنصر رقم من (الذي نرمز له بـ ) هو الزوج .
وعليه فإن zip "تضمّ معًا" قائمتي العناصر هاتين في قائمة واحدة من الأزواج.[8]
تمرين — دالة الخطوة التالية بلا
لنفترض أن آلة تورينج. أعطِ تعبيرًا في حساب لامدا المعزّز لحساب دالة الخطوة التالية الخاصة بـ (كما في برهان مبرهنة — حساب لامدا وNAND-TM) دون استخدام . انظر الحاشية للتلميح.[9]
تمرين — مترجم من حساب لامدا إلى NAND-TM (متحدٍّ)
أعطِ برنامجًا بلغة البرمجة التي تختارها يأخذ كمدخل تعبير هو ويُخرج برنامج NAND-TM هو يحسب الدالة نفسها التي يحسبها . وللحصول على جزء من الدرجة يمكنك استخدام GOTO وكل السكر النحوي الخاص بـ NAND-CIRC في برنامج مُخرَجك. ويمكنك استخدام أي ترميز لتعبيرات كسلسلة ثنائية يناسبك. انظر الحاشية للتلميح.[10]
تمرين — اثنان على الأقل في حساب
لنفترض أن و كما قبل. عرّف
أثبِت أن هو تعبير يحسب دالة "اثنين على الأقل" (at least two). أي أنه لكل (كما رُمِّزت أعلاه) يكون إذا وفقط إذا كان عنصران على الأقل من يساويان .
تمرين — محلية دالة الخطوة التالية
سيساعدك هذا السؤال على اكتساب إحساس أفضل بمفهوم محلية دالة الخطوة التالية لآلات تورينج. وهذه المحلية تلعب دورًا مهمًا في نتائج مثل اكتمال حساب لامدا والآليات الخلوية أحادية البعد بحسب تورينج، وكذلك في نتائج مثل نظرية عدم اكتمال غودل ومبرهان Cook-Levin التي سنراها لاحقًا في هذا المقرر.
عرّف STRINGS لتكون لغة برمجة ذات الدلالات التالية:
-
برنامج
STRINGSهو له متغير سلسلة واحدstrهو في آنٍ واحد مدخل ومخرجها. ويمرّ البرنامج بلا حلقات وبلا متغيرات أخرى، بل يتألف من سلسلة عمليات بحث شرطية واستبدال تُعدِّلstr. -
عمليات برنامج
STRINGSهي:REPLACE(pattern1,pattern2)حيثpattern1وpattern2سلسلتان ثابتتان. يستبدل هذا أول ظهور لـpattern1فيstrبـpattern2if search(pattern) { code }ينفّذcodeإذا كانpatternسلسلة فرعية منstr. ويمكن أن يحتويcodeبدوره علىifمتداخلة. (ويمكن أيضًا إضافةelse { ... }للتنفيذ إذا لم يكنpatternسلسلة فرعية من الشرط.)- القيمة المُعادة هي
str
-
يحسب برنامج
STRINGهو دالة إذا كان لكل ، إذا هيّأناstrعلى ثم نفّذنا سلسلة التعليمات في ، فإنstrفي نهاية التنفيذ يساوي .
على سبيل المثال، فيما يلي برنامج STRINGS يحسب الدالة بحيث لكل ، إذا كان يحتوي على سلسلة فرعية من الشكل حيث ، فإن حيث يُحصل عليه باستبدال أول ظهور لـ في بـ 00.
if search('110011') {
    replace('110011','00')
} else if search('110111') {
    replace('110111','00')
} else if search('111011') {
    replace('111011','00')
} else if search('111111') {
    replace('1111111','00')
}
أثبِت أن لكل برنامج آلة تورينج هو ، يوجد برنامج STRINGS هو يحسب الدالة التي تُسقط كل سلسلة ترمّز تكوينًا صالحًا لـ على السلسلة التي ترمّز تكوين الخطوة التالية من حساب . (لا يهمّنا ما ستفعله الدالة على السلاسل التي لا ترمّز تكوينًا صالحًا.) ولست مضطرًا إلى كتابة برنامج STRINGS كاملًا، لكن عليك تقديم حجّة مقنعة بأن مثل هذا البرنامج موجود.
ملاحظات مرجعية
الفصل 7 في كتاب مور وميرتنز الرائع [@MooreMertens11] يحتوي على عرض ممتاز لكثير من هذه المادة. .
يمكن لنموذج RAM أن يكون مفيدًا جدًا في دراسة التعقيد الملموس للخوارزميات العملية. وقد بُدئ دراسته النظرية في [@cook1973time]. غير أن مجموعة العمليات المسموح بها تحديدًا في نموذج RAM وتكاليفها تختلف بين الكتب والسياقات. ينبغي توخّي الحذر في وضع مثل هذه التعريفات، خاصة إذا كان حجم الكلمة يكبر، كما أظهر شامير [@shamir1979] بالفعل. يحتوي الفصل 3 في كتاب سافج [@Savage1998models] على وصف أكثر رسمية لآلات RAM، انظر أيضًا الورقة [@hagerup1998]. وقد بُدئت دراسة خوارزميات RAM المستقلة عن حجم المدخل (المعروفة بنموذج "RAM ثنائي القطع" (transdichotomous RAM model)) في [@fredman1993]
نماذج الحوسبة التي نظرنا فيها حتى الآن هي تسلسلية بطبيعتها، لكن يجري الحساب هذه الأيام على نطاق واسع بالتوازي، سواء باستخدام معالجات متعددة النوى أو في حوسبة موزّعة موازية على نطاق هائل في مراكز البيانات أو عبر الإنترنت. والحوسبة المتوازية مهمة في الممارسة، لكنها لا تُحدث فرقًا كبيرًا فعليًا لسؤال ما يمكن وما لا يمكن حسابه. فبعد كل شيء، إذا أمكن إجراء حساب باستخدام آلة في زمن ، فيمكن حسابه بآلة واحدة في زمن .
صُف حساب لامدا في [@church1941]. وكتاب بيرس [@pierce2002types] هو كتاب مرجعي معياري، انظر أيضًا [@barendregt1984]. وتُسمّى "تقنية Curry" باسم المنطقي Haskell Curry (ولغة البرمجة Haskell مسمّاة أيضًا باسم هاسكل كوري). وقد نسب كوري نفسه هذا المفهوم إلى Moses Schönfinkel، وإن كان مصطلح "Schönfinkeling" لم ينتشر لسبب ما.
بخلاف معظم لغات البرمجة، لا يملك حساب لامدا النقي مفهوم الأنواع (types). فكل كائن في حساب لامدا يمكن أيضًا التفكير فيه على أنه تعبير ، ومن ثمّ على أنه دالة تأخذ مدخلًا واحدًا وتُخرج ناتجًا واحدًا. وجميع الدوال تأخذ مدخلًا واحدًا وتُخرج ناتجًا واحدًا، وإن أعطيتَ دالةً مدخلًا من شكل لم تتوقعه فإنها تظل تُقيّم تعبير عبر "ابحث واستبدل"، باستبدال جميع مواضع معاملها بنسخ من تعبير المدخل الذي أعطيته لها. وتُعدّ الصيغ المُنمَّطة من حساب لامدا موضوع بحث مكثّف، وهي ترتبط ارتباطًا وثيقًا بأنظمة الأنواع الخاصة بلغات البرمجة وبأنظمة البراهين القابلة للتحقق حاسوبيًا، انظر [@pierce2002types]. وبعض الصيغ المنمَّطة من حساب لامدا لا تملك حلقات لا نهائية، مما يجعلها مفيدة جدًا كطرق لتفعيل التحليل الساكن للبرامج وكذلك للبراهين القابلة للتحقق حاسوبيًا. وسنعود إلى هذه النقطة في نماذج الحوسبة المقيَّدة والبراهين والخوارزميات.
اقترح تاو طريقة تُظهر الاكتمال بحسب تورينج ديناميكا الموائع (حاسوبًا "مائيًا")، وذلك من أجل حسم مسألة سلوك معادلات نافير-ستوكس، انظر هذا المقال الشائع.
بعض لغات البرمجة لها حدود ثابتة (وإن كانت ضخمة جدًا) على حجم الذاكرة التي يمكنها الوصول إليها، وهي حدود تمنعها رسميًا من أن تصلح لحساب دوال لا نهائية، وبالتالي من محاكاة آلات تورينج. نحن نتجاهل مثل هذه القضايا في هذه المناقشة ونفترض إمكانية الوصول إلى جهاز تخزين بلا حد أعلى ثابت لسعته. ↩︎
نظرًا لمسائل بعينها في صياغة Python، فإننا في هذا التنفيذ نستخدم
f * gلتطبيقfعلىgبدلًا منfg، ونستخدمλx(exp)بدلًا منλx.expللتجريد. ونستخدم أيضًا_0و_1لحدوس الخاصة بـ و حتى لا تختلط مع ثوابت Python. ↩︎لست مضطرًا إلى إعطاء وصف كامل لآلة تورينج: استخدم نموذج "نأكل الكعكة ونحتفظ بها أيضًا" لإظهار وجود مثل هذه الآلة بالمحاجّة انطلاقًا من نماذج أكفأ ومكافئة. ↩︎
ينطبق نفس التلميح في تمرين — أطول مسار. لاحظ أنك لإظهار أن قابلة للحساب لست مضطرًا إلى إعطاء خوارزمية كفؤة. ↩︎
تلميح: يمكنك تقليل عدد المتغيرات التي تأخذها دالة بأن "تجمعها في أزواج". أي، عرّف تعبير هو بحيث لكل تكون هي دالة بحيث و. ثم استخدم لتقليل عدد المتغيرات المستخدمة تكراريًا. ↩︎
استخدم الاستدلال البنيوي على التعبير . ↩︎
اسم
zipهو اسم شائع لهذه العملية، على سبيل المثال في Python. ولا ينبغي خلطه بصيغة ضغط الملفاتzip. ↩︎استخدم و (وربما ). وستجد أن دالة
zipفي تمرين — دالة zip مفيدة أيضًا. ↩︎حاول أن تُنشئ إجراءً بحيث إذا احتوى المصفوفة
Leftعلى ترميز تعبير هو واحتوت المصفوفةRightعلى ترميز تعبير آخر هو ، فإن المصفوفةResultستحتوي على . ↩︎