الخلفية الرياضية
الخلفية الرياضية
- استعادة المفاهيم الرياضية الأساسية مثل المجموعات والدوال والأعداد والمشغّلات المنطقية والكمّاسات والسلاسل النصية والرسوم البيانية.
- تعريف ترميز الكبير (Big-) تعريفًا دقيقًّا.
- البراهين بالحَث.
- التدرّب على قراءة تعريفاتِ و_عباراتِ_ و_براهينَ_ رياضية.
- تحويل حجّة حدسية إلى برهان دقيق.
"وجدتُ أنّ كلّ عددٍ يمكن التعبير عنه من واحد إلى عشرة يتفوّق على سابقه بواحد: ثمّ يُضاعَف العشرة أو يُضاعَف ثلاثيًّا ... حتى المئة؛ ثمّ يُضاعَف المئة ويُضاعَف ثلاثيًّا بالطريقة ذاتها التي تُجمِع الآحاد والعشرات ... وهكذا إلى أقصى حدٍّ للعدّ."، محمّد بن موسى الخوارزمي، 820، ترجمة فريدريك روزن، 1831.
في هذا الفصل نراجع بعض المفاهيم الرياضية التي نستخدمها في هذا الكتاب. وتُغطَّى هذه المفاهيم عادةً في مساقات أو كتب دراسية في «الرياضيات لعلوم الحاسوب» أو «الرياضيات المتقطّعة»؛ راجع قسم «الملاحظات المرجعية» (ملاحظات مرجعية) لتجدّ عدة مصادر ممتازة في هذه المواضيع متاحة مجّانًا على الإنترنت.
اعتذار الرياضياتي. قد يتساءل بعض الطلاب لماذا يحتوي هذا الكتاب على هذا القدر الكبير من الرياضيات. والسبب هو أنّ الرياضيات هي ببساطة لغة لنمذجة المفاهيم بنية دقيقة وبلا التباس. في هذا الكتاب نستخدم الرياضيات لنمذجة مفهوم الحوسبة. على سبيل المثال، سندرس أسئلة مثل «هل هناك خوارزمية كفؤة لإيجاد العوامل الأولية لعدد صحيح معطى؟». (وسنرى أنّ هذا السؤال ممتع على نحو خاص، إذ يلمس مجالات متباعدة بينها كلٌّ كبير، مثل أمن الإنترنت وميكانيكا الكمّ!) فحتى مجرد صياغة مثل هذا السؤال، نحتاج إلى إعطاء تعريف دقيق لمفهوم الخوارزمية، ولمعنى أن تكون خوارزمية ما كفؤة. وكذلك، بما أنه لا توجد تجربة تجريبية لإثبات عدم وجود خوارزمية، فالطريقة الوحيدة لتثبيت مثل هذه النتيجة هي استخدام برهان رياضي.
دليل القارئ في هذا الفصل
حسب خلفيتك، يمكنك أن تتناول هذا الفصل بطريقتين مختلفتين:
-
إن كنت قد درست من قبل «الرياضيات المتقطّعة» أو «الرياضيات لعلوم الحاسوب» أو مساقات مشابهة، فلا تحتاج إلى قراءة الفصل كلّه. يكفي أن تُلقي نظرة سريعة على لمحة سريعة عن المتطلّبات الرياضية لترى الأدوات الرئيسية التي سنستخدمها، وعلى هذا الكتاب: الترميز والاصطلاحات لترى ترميزنا واصطلاحاتنا، ثمّ تقفز إلى بقية هذا الكتاب. أو يمكنك أن تجلس، وتُسترخي، وتقرأ هذا الفصل مجرّدًا لتعويد نفسك على ترميزنا، وكذلك للاستمتاع (أو عدم الاستمتاع) بتأمّلاتي الفلسفية ومحاولاتي الفكّهة.
-
إن كانت خلفيتك أقلّ اتّساعًا، فراجع ملاحظات مرجعية لتجدّ بعض المراجع في هذه المواضيع. يغطّي هذا الفصل بإيجاز المفاهيم التي نحتاجها، لكن قد يجد في قراءة معالجة أعمق للموضوع بعض الفائدة. وكما هو معتاد في الرياضيات، فأفضل طريقة للاستئناس بهذه المادة هي أن تحلّ التمارين بنفسك.
-
قد ترغب أيضًا في البدء بتنشيط معرفتك بـ_الاحتمالات المتقطّعة_، التي سنستخدمها لاحقًا في هذا الكتاب (راجع نظرية الاحتمالات 101).
لمحة سريعة عن المتطلّبات الرياضية
المفاهيم الرياضية الرئيسية التي سنستخدمها هي التالية. نكتفي بسرد هذه المفاهيم هنا، ونؤجّل تعريفاتها إلى بقية هذا الفصل. وإن كنت ملمًّا بكلّها، فيمكنك أن تقفز مباشرةً إلى هذا الكتاب: الترميز والاصطلاحات لترى القائمة الكاملة للترميز الذي نستخدمه.
-
البراهين: في المقام الأول والأخير، يتضمّن هذا الكتاب جرعةً ثقيلة من التفكير الرياضي الشكلي، ويشمل ذلك تعريفاتَ و_عباراتَ_ و_براهينَ_ رياضية.
-
المجموعات وعملياتها: سنستخدم على نطاق واسع المجموعات الرياضية. نستخدم علاقتَي الانتماء () والاحتواء () الأساسيتين، وعمليات المجموعات، وأهمّها الاتحاد () والتقاطع () وفرق المجموعتين ().
-
جداء ديكارتي وعملية نجمة كلييني: نستخدم أيضًا جداء ديكارتي لمجموعتَين و، ويُرمز إليه بـ (أي أنّ هي مجموعة الأزواج حيث و). ونرمز إلى جداء ديكارتي مع نفسها مرّات بـ (مثلًا )، وإلى (المعروفة بـ_نجمة كلييني_) الاتحادَ لـ لكلّ .
-
الدوال: المجال (domain) و_المدى_ (codomain) الدالة، وخصائص من كون الدالة حقنة (one-to-one، وتُعرف أيضًا بـ_الحقن_) أو مغطّية (onto، وتُعرف أيضًا بـ_التغطية_)، وكذلك الدوال الجزئية (partial functions) (التي، بخلاف الدوال القياسية أو «الكليّة»، ليست معرَّفة بالضرورة على كلّ عناصر مجالها).
-
العمليات المنطقية: عمليتا AND (و) وOR (أو)، اللتان يُرمز لهما بـ و، وNOT (لا) ويُرمز لها بـ ، إضافةً إلى الكمّاسين «يوجد» و«لكلّ» اللذين يُرمز لهما بـ و.
-
العدّاديات الأساسية (combinatorics): مفاهيم مثل (عدد المجموعات الجزئية ذات الحجم من مجموعة ذات حجم ).
-
الرسوم البيانية: رسوم بيانية غير موجّهة وموجّهة، والارتباط، والمسارات، والدورات.
-
ترميز الكبير: الترميز لتحليل النموّ المقارب للدوال.
-
الاحتمالات المتقطّعة: سنستخدم نظرية الاحتمال، وتحديدًا الاحتمال على فضاءات عيّنات منتهية مثل رمي عملة، بما في ذلك مفاهيم مثل المتغيّرات العشوائية و_التوقّع_ و_التركيز_. لن نستخدم نظرية الاحتمال إلا في النصف الثاني من هذا النص، وسنراجعها قبل ذلك في نظرية الاحتمالات 101. لكنّ التفكير الاحتمالي مهارة دقيقة (وفائقة النفع!)، ومن الأفضل دائمًا البدء في اكتسابها مبكرًا.
في بقية هذا الفصل نراجع بإيجاز المفاهيم أعلاه. فهذا جزئيًا لتذكير القارئ وتعزيز مادة قد لا تكون لا تزال حاضرة في ذهنه، وجزئيًا لتقديم ترميزنا واصطلاحاتنا التي قد تختلف أحيانًا عمّا واجهته من قبل.
قراءة النصوص الرياضية
يستخدم الرياضياتيون المصطلحات المتخصّصة (jargon) للسبب نفسه الذي تُستخدم به في مهن أخرى كثيرة، مثل الهندسة والقانون والطبّ وسواها. فنحن نريد أن نجعل المصطلحات دقيقة، وأن نقدّم اختصارات لمفاهيم يُعاد استخدامها كثيرًا. تميل النصوص الرياضية إلى أن «تحشو الكثير في كل جملة»، ولذلك فإنّ المفتاح هو أن تقرأها ببطء ودقّة، محلِّلًا كلّ رمز على حدة.
مع مرور الوقت والممارسة سترى أنّ قراءة النصوص الرياضية تصير أسهل، ولم تعد المصطلحات تمثّل مشكلة. والأهمّ من ذلك، فإنّ قراءة النصوص الرياضية إحدى أكثر المهارات قابليةً للنقل التي يمكنك أن تأخذها من هذا الكتاب. فَعالمنا يتغيّر بسرعة، ليس في مجال التقنية فحسب، بل في ميادين إنسانية أخرى كثيرة، سواء كانت الطبّ أو الاقتصاد أو القانون أو حتى الثقافة. أينما كانت طموحاتك المستقبلية، فمن المرجّح أن تصادف نصوصًا تستخدم مفاهيم جديدة لم ترها من قبل (راجع الشكل التوضيحي والشكل التوضيحي لمثالين حديثين من «المجالات الساخنة» الحالية). والقدرة على استيعاب تعريفات جديدة ثمّ تطبيقها قد تكون بالغة الأهمية. إنّها مهارة أسهل بكثير في الاكتساب داخل سياق مساق رياضي، وهو سياق آمن ومستقرّ نسبيًا، حيث تضمن لك على الأقلّ أنّ المفاهيم محدّدة بدقّة، وهنا يمكنك مراجعة أسئلتك مع هيئة التدريس.
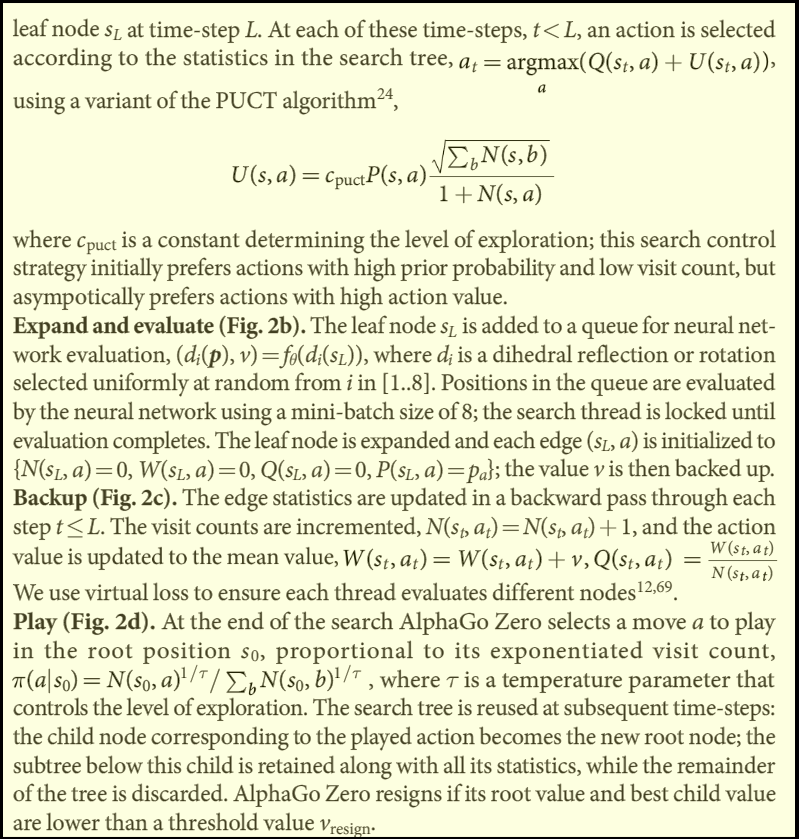
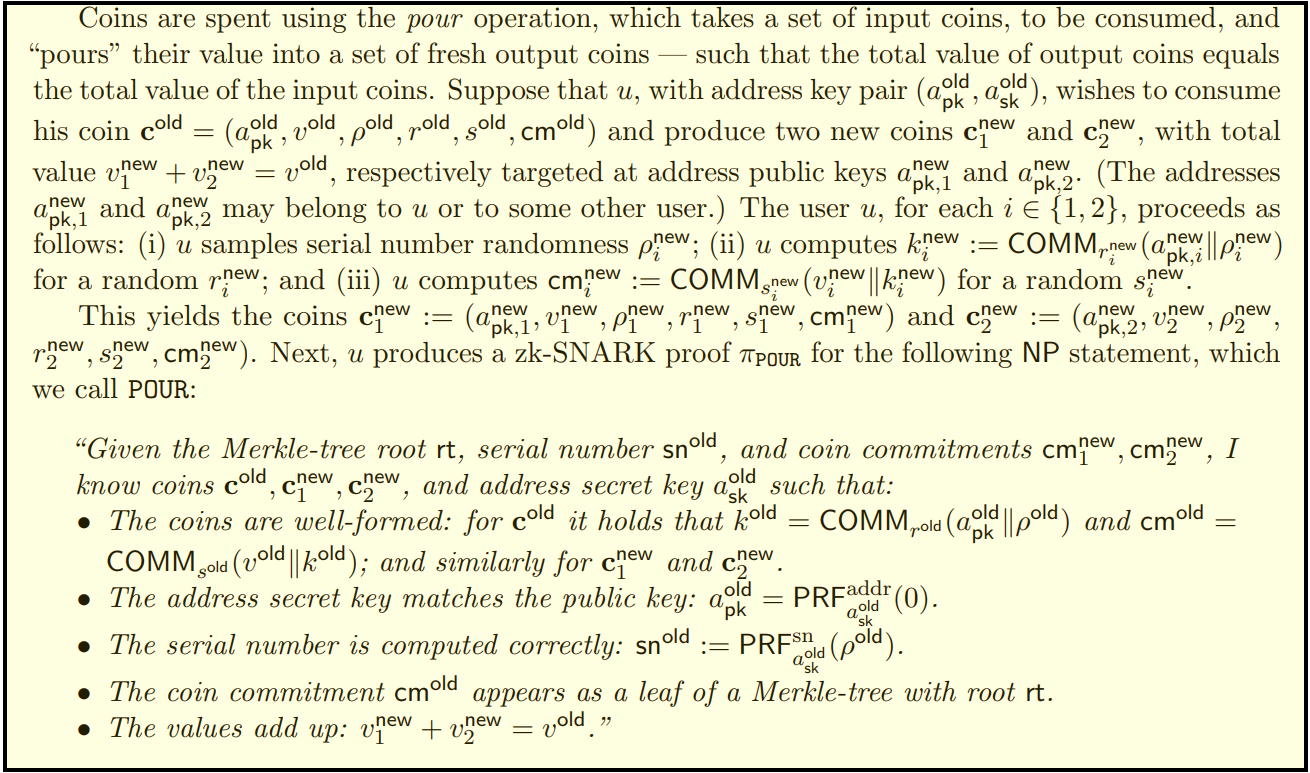
المكوّنات الأساسية لأي نص رياضي هي التعريفات و__الادّعاءات__ و__البراهين__.
التعريفات
يعرّف الرياضياتيون المفاهيم الجديدة غالبًا في ضوء مفاهيم قديمة. على سبيل المثال، إليك تعريفًا رياضيًا قد تكون صادفته في الماضي (وستجده مرّة أخرى بعد قليل):
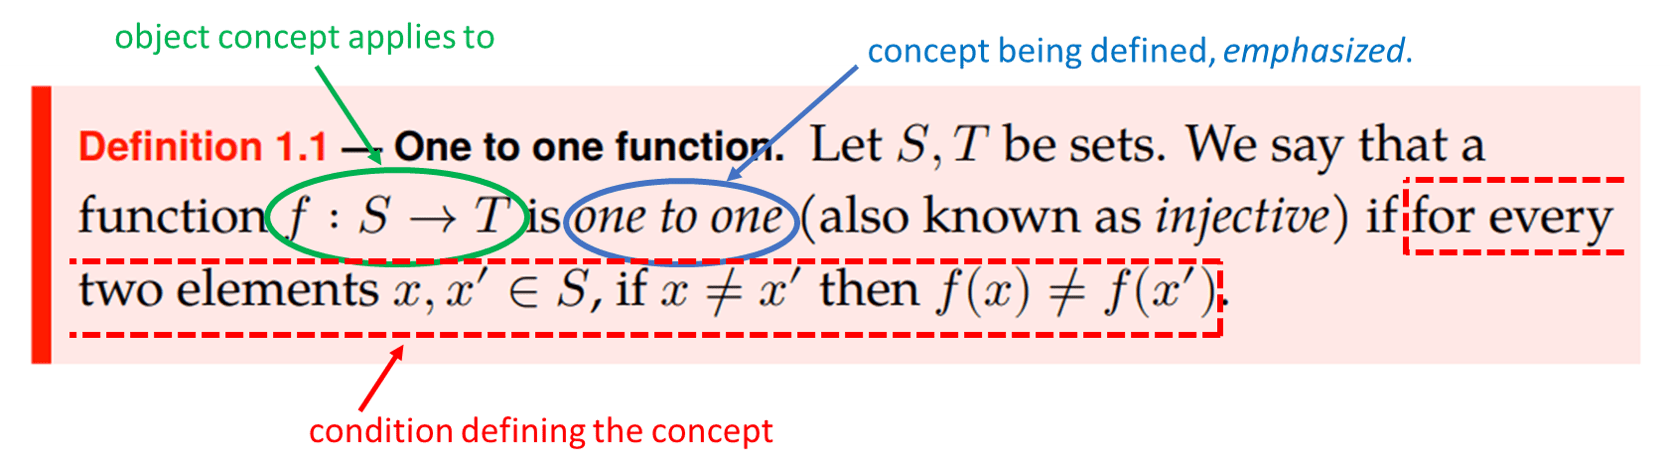
تعريف — دالة حقنة
لتكن مجموعتَين. نقول إنّ الدالة حقنة (one to one، وتُعرف أيضًا بـ_الحقن_) إذا كان لكلّ عنصرين ، متى كان ، فإنّ .
يلتقط تعريف — دالة حقنة مفهومًا بسيطًا، ومع ذلك فهو يستخدم قدرًا لا بأس به من الترميز. وعند قراءة تعريف كهذا، من المفيد عادةً أن تعلّمه بقلم أثناء مرورك به (راجع الشكل التوضيحي). على سبيل المثال، حين ترى مُعرِّفًا مثل أو أو ، فتأكّد من إدراكك لنوع الشيء الذي هو: هل هو مجموعة، أم دالة، أم عنصر، أم عدد، أم جنّ شيطان؟ قد تجد أيضًا مفيدًا أن تشرح التعريف بالكلمات لصديق (أو لنفسك).
الادّعاءات: المبرهنات والمُلمّات والمزاعم
المبرهنات والمُلمّات والمزاعم وما شابهها هي عبارات صحيحة عن المفاهيم التي عرّفناها. قرارُ تسمية عبارة ما «مبرهنة» أو «مُلمّة» أو «مزعم» مسألة تقدير، ولا تكتسب فرقًا رياضيًا. فالثلاثة جميعها تُقابل عبارات ثبت أنّها صحيحة. والفرق أنّ المبرهنة تشير إلى نتيجة مهمّة نودّ تذكّرها وإبرازها. أما المُلمّة فغالبًا ما تشير إلى نتيجة تقنية لا تهمّ بقدر ما هي مهمّة في ذاتها، لكنّها مفيدة جدًّا في إثبات مبرهنات أخرى. أما المزعم فهو عبارة «عابرة» نحتاج إلى استعمالها كي نُثبت نتائج أخرى أكبر، ولا نهتمّ بها كثيرًا بوحدها.
البراهين
البراهين (proofs) الرياضية هي الحجج التي نستعملها لنُظهر أنّ مبرهناتنا ومُلمّاتنا ومزاعمنا صحيحة فعلًا. نتناول البراهين في البراهين أدناه، لكنّ النقطة الجوهرية هي أنّ معيار البرهان الرياضي مرتفع جدًّا. وبخلاف بعض المجالات الأخرى، فإنّ البرهان في الرياضيات حجّة «لا ثغرة فيها» (airtight) تُظهر أنّ العبارة صحيحة دون أيّ ذرّة من الشكّ. ومن أمثلة البراهين الرياضية في هذا القسم ما ورد في تمرين محلول — للرؤوس المتّصلة مسارات بسيطة ومثال موسّع: الفرز الطوبولوجي. وكما ذُكر في المقدمة، فالقاعدة العامّة أنّ من المهمّ أن تفهم التعريفات أكثر من فهمك المبرهنات، وأنّ من المهمّ أن تفهم عبارة المبرهنة أكثر من فهمك برهانها.
الكائنات الرياضية المتقطّعة الأساسية
في هذا القسم نراجع سريعًا بعض الكائنات الرياضية (بمعنى «بنى البيانات الأساسية» في الرياضيات، إن صحّ التعبير) التي نستخدمها في هذا الكتاب.
المجموعات
_المجموعة_ (set) مجموعةٌ غير مرتّبة من الأشياء. مثلًا، حين نكتب ، فإنّنا نعني أنّ تشير إلى المجموعة التي تحتوي الأعداد و و. (ونستعمل التدوين «» للدلالة على أنّ عنصر في .) لاحظ أنّ المجموعة و متطابقتان، لأنّهما تحتويان العناصر نفسها. وكذلك، إمّا أن تحتوي المجموعة عنصرًا وإمّا ألّا تحتويه — إذ لا يوجد مفهوم لاحتوائها عليه «مرّتين» — ولذلك يمكننا حتى كتابة المجموعة نفسها على هيئة (مع أنّ ذلك سيكون غريبًا بعض الشيء). _عدد المجموعة_ (cardinality) المنتهية ، ويُرمز له بـ ، هو عدد عناصرها. (ويمكن تعريف العدد أيضًا للمجموعات لا نهائية؛ انظر المصادر في ملاحظات مرجعية.) ففي المثال أعلاه، . المجموعة هي مجموعة جزئية (subset) من مجموعة ، ويُرمز لذلك بـ ، إذا كان كلّ عنصر في هو أيضًا عنصر في . (ويمكن أيضًا وصف ذلك بالقول إنّ هي مجموعة شاملة (superset) لـ .) مثلًا، . المجموعة التي لا تحتوي أيّ عناصر تُعرف بـ_المجموعة الفارغة_ (empty set) ويُرمز لها بـ . إذا كانت مجموعة جزئية من غير مساوية لها، نقول إنّ مجموعة جزئية صارمة (strict subset) من ، ونرمز لذلك بـ .
يمكننا تعريف المجموعات إمّا بإدراج كلّ عناصرها، وإمّا بكتابة قاعدة تَحَقّقها مثل
بالطبع هناك أكثر من طريقة لكتابة المجموعة نفسها، وغالبًا ما سنستعمل تدوينًا حدسيًا يدرج بضعة أمثلة توضّح القاعدة. مثلًا، يمكننا أيضًا تعريف على أنه
لاحظ أنّ المجموعة إمّا منتهية (مثل المجموعة ) وإمّا لا نهائية (مثل المجموعة ).
وليس بالضروري أن تكون عناصر المجموعة أعدادًا.
فيمكننا الحديث عن مجموعات مثل المجموعة لكلّ حروف المدّ في اللغة الإنجليزية، أو المجموعة New York, Los Angeles, Chicago, Houston, Philadelphia, Phoenix, San Antonio, San Diego, Dallas لكلّ المدن في الولايات المتحدة التي يتجاوز عدد سكّانها المليون، وفق تعداد سنة 2010.
ويمكن حتى أن تكون عناصر المجموعة مجموعات أخرى، مثل المجموعة لكلّ المجموعات الجزئية ذات الحجم الزوجي من .
عمليات المجموعات: الاتحاد (union) لمجموعتَين ، ويُرمز له بـ ، هو المجموعة التي تحتوي كلّ العناصر الموجودة في أو في . أما التقاطع (intersection) لـ و، ويُرمز له بـ ، فهو مجموعة العناصر الموجودة في و في معًا. أما فرقّ المجموعتين (set difference) و، ويُرمز له بـ (وفي بعض النصوص أيضًا بـ )، فهو مجموعة العناصر الموجودة في لكن ليست في .
المعطوفات والقوائم والسلاسل النصية والمتتاليات: المعطوف (tuple) هو مجموعة مرتّبة من العناصر. مثلًا معطوف من أربعة عناصر (ويُعرف أيضًا بـ‑معطوف أو رباعي). ولأنّ الترتيب مهمّ، فهذا ليس المعطوف نفسه الذي هو ‑معطوف أو ‑معطوف . ويُعرف ‑معطوف أيضًا بـ_ثنائي_ (pair). ونحن نستعمل لفظتَي المعطوفات و_القوائم_ بالتبادل. والمعطوف الذي يأتي كلّ عنصره من مجموعة منتهية (مثل ) يُعرف أيضًا بـ_سلسلة نصية_ (string). على نحو مماثل للمجموعات، فإنّنا نرمز إلى الطول (length) المعطوف بـ . وكما في المجموعات تمامًا، يمكننا أيضًا التفكير في نظائر لا نهائية للمعطوفات، مثل المجموعة المرتّبة لكلّ المربّعات التامّة. وتُعرف المجموعات المرتّبة اللانهائية بـ_متتاليات_ (sequences)؛ وقد نستعمل أحيانًا لفظ «متتالية لا نهائية» للتأكيد على ذلك، ونستعمل «متتالية منتهية» مرادفًا للمعطوف. (ويمكننا التمييز بين متتالية من عناصر مجموعة ما وبين دالة (حيث لكلّ ). وعلى نحو مماثل، يمكننا التمييز بين ‑معطوف من عناصر وبين دالة .)
جداء ديكارتي: إذا كانت و مجموعتَين، فإنّ جداءَهما الديكارتي (Cartesian product)، ويُرمز له بـ ، هو مجموعة كلّ الأزواج المرتّبة حيث و. مثلًا، إذا كانت و، فإنّ يحتوي العناصر الستّة . وعلى نحو مماثل، إذا كانت مجموعات، فإنّ هو مجموعة كلّ الثلاثيات المرتّبة حيث و و. وأعمّ من ذلك، لكلّ عدد صحيح موجب ومجموعات ، فإننا نرمز إلى بالمجموعة المتكوّنة من المعطوفات ذات عنصرًا حيث لكلّ . ولكلّ مجموعة ، نرمز إلى المجموعة بـ ، وإلى بـ ، وإلى بـ ، وهكذا.
المجموعات الخاصّة
هناك عدّة مجموعات سنستعملها في هذا الكتاب مرّة بعد أخرى. المجموعة
تحتوي كلّ الأعداد الطبيعية (natural numbers)، أي الأعداد الصحيحة غير السالبة. ولكلّ عدد طبيعي ، نعرّف المجموعة بأنّها . (ونبدأ ترقيم و معًا من ، بينما ترقّم نصوصٌ كثيرة أخرى هذه المجموعات من . والبدء من الصفر أو من الواحد ليس سوى اصطلاح لا يهمّ كثيرًا، ما دام المرء متّسقًا معه.)
وسنستعمل أيضًا أحيانًا المجموعة من الأعداد الصحيحة (integers) (السالبة وغير السالبة)،[1] وكذلك المجموعة من الأعداد الحقيقية (real numbers). (وهي المجموعة التي لا تضمّ الأعداد الصحيحة فحسب، بل أيضًا الكسرية وغير الناطقة؛ مثلًا، تضمّ أعدادًا مثل و وغيرها.) ونرمز إلى المجموعة ، وهي من الأعداد الحقيقية الموجبة (positive). وتُرمز هذه المجموعة أحيانًا أيضًا بـ .
السلاسل النصية: مجموعة أخرى سنستعملها مرّة بعد أخرى هي
وهي مجموعة كلّ السلاسل النصية الثنائية ذات الطول ، بالنسبة إلى عدد طبيعي ما. أي أنّ هي مجموعة كلّ المعطوفات المكوّنة من من الأصفار والواحدات. وهذا يتّسق مع ترميزنا أعلاه: هو جداء ديكارتي ، و هو الجداء ، وهكذا.
سنكتب السلسلة النصية ببساطة على هيئة . مثلًا،
ولكلّ سلسلة نصية و، نكتب لعنصر ذي الترتيب .
وسنحدّث أيضًا كثيرًا عن مجموعة السلاسل النصية الثنائية بكلّ أطوالها، وهي
ويمكن كتابة هذه المجموعة بطريقة أخرى على هيئة أو، بإيجاز أكبر، على هيئة
تتضمّن المجموعة «السلسلة النصية ذات الطول » أو «السلسلة النصية الفارغة»، وسنرمز إليها بـ . (وفي استعمالنا لهذا التدوين نتبع اصطلاح كثير من لغات البرمجة. وتستعمل بعض النصوص الأخرى أو للدلالة على السلسلة النصية الفارغة.)
تعميم عملية النجمة: لكلّ مجموعة ، نعرّف
مثلًا، إذا كان فإنّ تشير إلى مجموعة كلّ السلاسل النصية المنتهية الطول فوق الأبجدية a‑z.
الدمج (concatenation): دمجُ سلسلتين نصيتين و هو السلسلة النصية ذات الطول التي نحصل عليها بكتابة بعد . أي أنّه، إذا كان و، فإنّ تساوي السلسلة النصية التي تتحقّق أنّه لكلّ لدينا ، ولكلّ لدينا .
الدوال
إذا كانت و مجموعتَين غير خاليتين، فإنّ دالةَ (function) تُسقِط على ، ويُرمز لها بـ ، تربط كلّ عنصر بعنصر . وتُعرف المجموعة بـ_مجال_ (domain) ، وتُعرف المجموعة بـ_مدى_ (codomain) . أما صورةُ (image) الدالة فهي المجموعة ، وهي المجموعة الجزئية من مدى المكوّنة من كلّ عناصر الخرج التي تُسقَط من عنصر دخل ما. (تستعمل بعض النصوص لفظَ المدى للدلالة على صورة الدالة، بينما تستعمل نصوصٌ أخرى لفظَ المدى للدلالة على مدى الدالة. ولذلك سنتجنّب استعمال لفظ «المدى» تمامًا.) وكما في حالة المجموعات، يمكننا كتابة الدالة إمّا بإدراج جدول كلّ القيم التي تعطيها لعناصر ، وإمّا باستعمال قاعدة. مثلًا، إذا كان و، فإنّ الجدول أدناه يعرّف دالة . لاحظ أنّ هذه الدالة هي نفسها الدالة المعرَّفة بالقاعدة .[2]
| المدخل | المخرج |
|---|---|
| 0 | 0 |
| 1 | 1 |
| 2 | 0 |
| 3 | 1 |
| 4 | 0 |
| 5 | 1 |
| 6 | 0 |
| 7 | 1 |
| 8 | 0 |
| 9 | 1 |
الجدول: مثال على دالة.
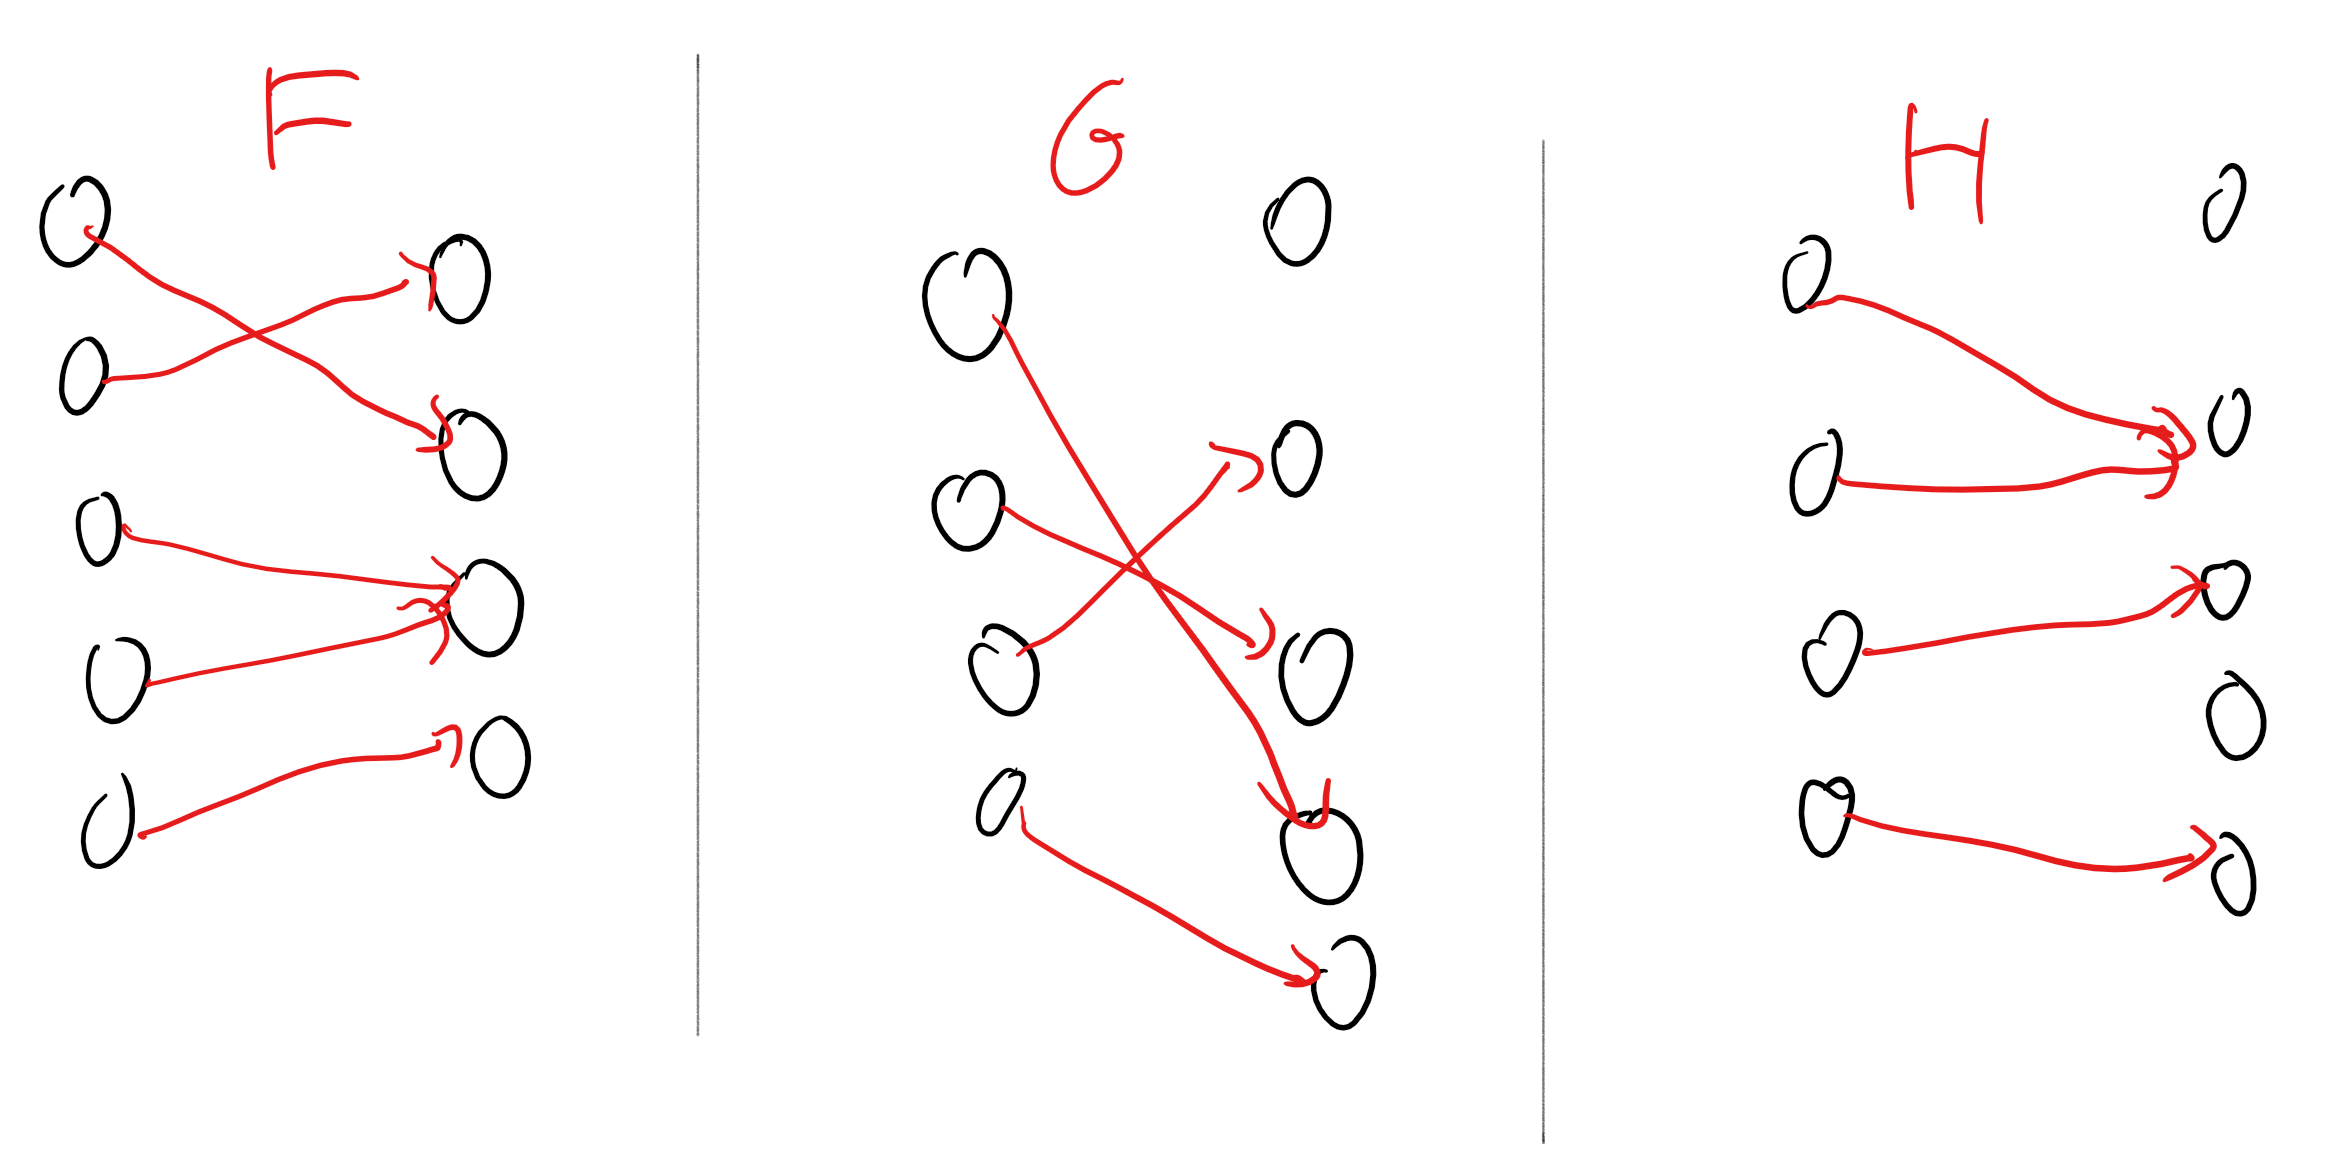
إذا كانت بحيث لكلّ ، فإنّنا نقول إنّ حقنة (one-to-one) (تعريف — دالة حقنة، وتُعرف أيضًا باسم الدالة الحقنة (injective) أو مجرّدًا حقنًا (injection)). وإذا كانت بحيث إنّ لكلّ يوجد بحيث ، فإنّنا نقول إنّ مغطّية (onto) (وتُعرف أيضًا باسم الدالة المغطّية (surjective) أو مجرّدًا تغطيةً (surjection)). والدالة التي هي حقنة ومغطّية معًا تُعرف باسم الدالة التقابلية (bijective) أو مجرّدًا تقابلًا (bijection). والتقابل من مجموعة إلى نفسها يُعرف أيضًا بـ_تبديلٍ_ (permutation) لـ . وإذا كان تقابلًا، فإنّ لكلّ يوجد وحيد بحيث . ونرمز إلى هذه القيمة بـ . لاحظ أنّ هو نفسه تقابل من إلى (هل ترى لماذا؟).
إعطاء تقابل بين مجموعتين طريقة جيّدة في كثير من الأحيان لإظهار أنّ لهما الحجم نفسه. والواقع أنّ التعريف الرياضي المعياري لفكرة «أنّ و لهما عدد العناصر نفسه» هو أنّ هناك تقابلًا . وعلاوة على ذلك، يُعرَّف عدد عناصر المجموعة بأنّه إذا كان هناك تقابل من إلى المجموعة . وكما سنرى لاحقًا في هذا الكتاب، فإنّ هذا التعريف يعمّم ليعرّف عدد عناصر المجموعات لا اللانهائية.
الدوال الجزئية: سنهتمّ أحيانًا بـ_الدوال الجزئية_ (partial functions) من إلى . يُسمح للدالة الجزئية بأن تكون غير معرَّفة على مجموعة جزئية ما من . أي أنّه، إذا كانت دالة جزئية من إلى ، فإنّ لكلّ ، إمّا يوجد عنصر في (كما في حالة الدوال القياسية)، وإمّا تكون غير معرَّفة. مثلًا، الدالة الجزئية معرَّفة فقط على الأعداد الحقيقية غير السالبة. وحين نريد أن نميّز بين الدوال الجزئية والدوال القياسية (أي غير الجزئية)، فإنّنا نسمّي الأخيرة دوالًا كليّة (total). وحين نقول «دالة» دون أيّ قيود، فإنّنا نعني دالةً كليّة.
مفهوم الدوال الجزئية هو تعميم صارم للدوال، ولذلك فإنّ كلّ دالة هي دالة جزئية، لكن ليس كلّ دالة جزئية هي دالة. (أي أنّه، لكلّ و غير خاليتين، تكون مجموعة الدوال الجزئية من إلى مجموعة شاملة صارمة لمجموعة الدوال الكليّة من إلى .) وحين نريد أن نؤكّد أنّ دالة من إلى قد لا تكون كليّة، فإنّنا سنكتب . كما يمكننا أن نفكّر في الدالة الجزئية من إلى على أنها دالة كليّة من إلى حيث هو «رمز فشل» خاص. فبدلًا من القول إنّ غير معرَّفة عند ، يمكننا القول إنّ .
حقائق أساسية عن الدوال: التحقّق من قدرتك على إثبات النتائج التالية طريقة ممتازة لتنشيط معلوماتك عن الدوال:
-
إذا كانت و دالتين حقنتين، فإنّ تركيبَهما (composition) المعرَّف بـ هو أيضًا حقنًا.
-
إذا كانت حقنة، فإنّ هناك دالة مغطّية بحيث لكلّ .
-
إذا كانت مغطّية، فإنّ هناك دالة حقنة بحيث لكلّ .
-
إذا كانت و مجموعتَين منتهيتين غير خاليتين، فإنّ الشروط التالية متكافئة فيما بينها: (a) ، (b) هناك دالة حقنة ، و__(c)__ هناك دالة مغطّية . وهذه التكافئات تتحقّق في الحقيقة حتى لو كانت و لا نهائيتين. وفي حالة المجموعات اللانهائية يكون الشرط (b) (أو بما يكافئه (c)) هو التعريفَ المقبول عادةً لعبارة .
توقّف وتأمّل
تجد براهين هذه النتائج في متون الرياضيات المتقطّعة، ومن بينها على سبيل المثال القسم 4.5 في ملاحظات Lehman-Leighton-Meyer. لكنّي أنصحك بشدّة بأن تحاول إثباتها بنفسك، أو على الأقلّ أن تقنع نفسك بأنّها صحيحة بإثبات حالات خاصة منها على أحجام صغيرة (مثلًا ).
لنُثبت إحدى هذه الحقائق كمثال:
لمّة
إذا كانت مجموعتَين غير خاليتين و حقنة، فإنّ هناك دالة مغطّية بحيث لكلّ .
برهان
اختر ما. سنعرّف الدالة على النحو التالي: لكلّ ، إذا وُجد بحيث ، فنضع (واختيار معرَّف جيدًا (well-defined) لأنّ خاصية الحقن في تمنع وجود مختلفين يقودان كلاهما إلى ). وفي غير ذلك، نضع . الآن، لكلّ ، وبحسب تعريف ، إذا كان فإنّ . وعلاوة على ذلك، فإنّ هذا يبيّن أيضًا أنّ هي مغطّية، لأنّ ذلك يعني أنّ لكلّ يوجد ما، وهو بالضبط ، بحيث .
الرسوم البيانية
الرسوم البيانية (graphs) حاضرة في كلّ مكان في علم الحاسوب، وفي حقول كثيرة أخرى كذلك. تُستعمل لنمذجة أنواع بيانات متنوّعة، منها الشبكات الاجتماعية، وقيود الجدولة الزمنية، وشبكات الطرق، والشبكات العصبية العميقة، والتفاعلات بين الجينات، والارتباطات بين الملاحظات، وكثير جدًّا غير ذلك. تأتي هنا تعريفات رسميّة لعدّة أنواع من الرسوم البيانية، لكن إن لم تكن قد رأيت الرسوم البيانية من قبل في مساق، فإنّني أحثّك على مطالعتها في أحد المصادر المذكورة في ملاحظات مرجعية.
للرسوم البيانية نوعان أساسيّان: غير موجّهة (undirected) و_موجّهة_ (directed).[3]
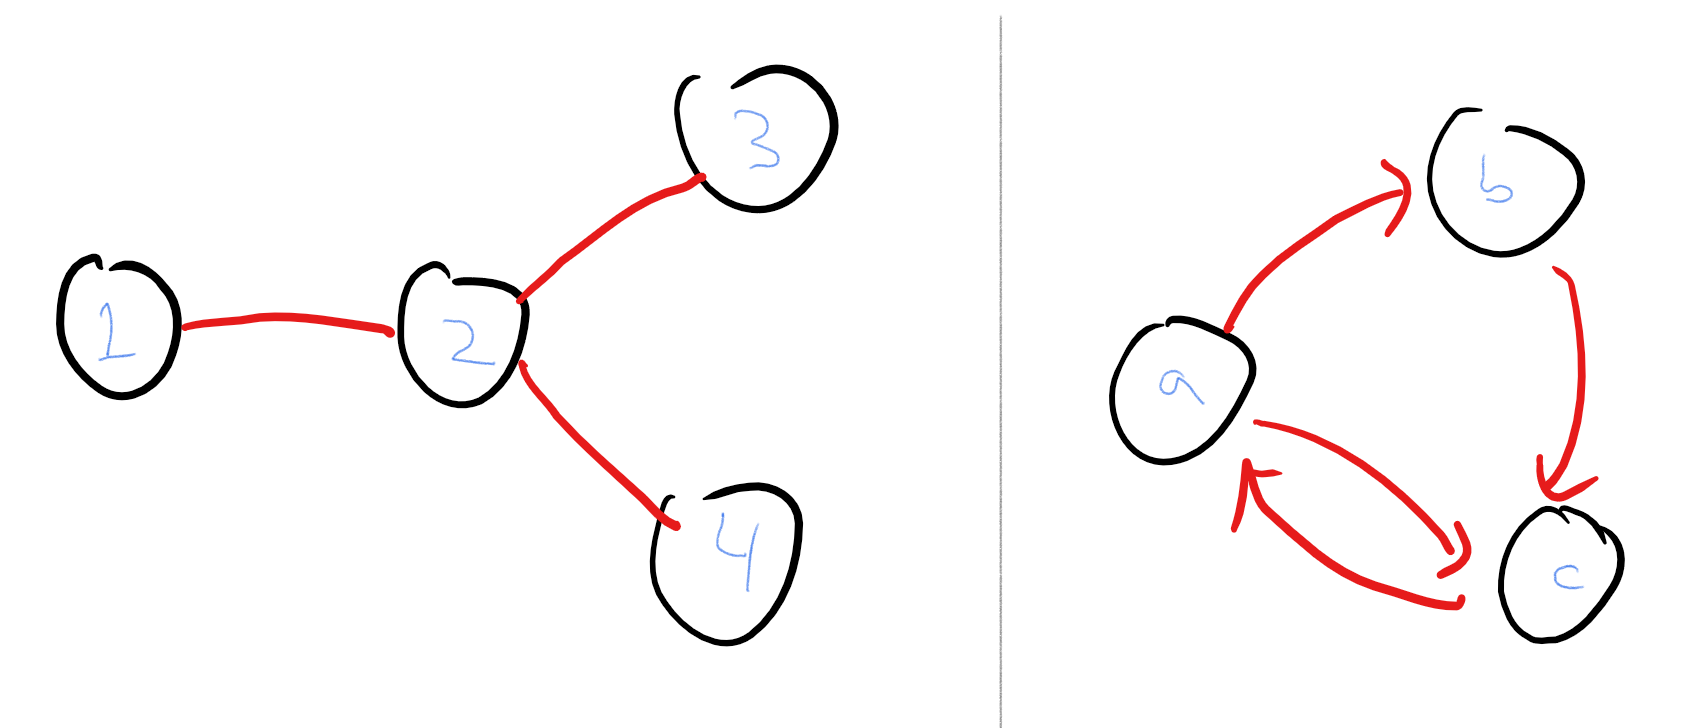 {#graphsexampefig .margin offset="1.5in"}
تعريف — الرسوم البيانية غير الموجّهة
يتكوّن الرسم البياني غير الموجّه (undirected graph) من مجموعة من الرؤوس (vertices) ومجموعة من الأضلاع. كلّ ضلع هو مجموعة جزئية من من عنصرين. ونقول إنّ رأسين متجاوران (neighbors) إذا كان الضلع في .
بالاعتماد على هذا التعريف، يمكننا تعريف خصائص أخرى عدّة للرسوم البيانية ورؤوسها. ونعرّف درجةَ (degree) بأنّها عدد الجيران الذين لـ . والمسار (path) في الرسم البياني هو معطوف ، لأجل ما، بحيث يكون جارًا لـ لكلّ . والمسار البسيط (simple path) هو مسار تكون فيه كلّ الـ متمايزة. والدورة (cycle) هي مسار بحيث . ونقول إنّ رأسين متّصلان (connected) إذا كان أو كان هناك مسار بحيث و. ونقول إنّ الرسم البياني متّصل (connected) إذا كان كلّ زوج من رؤوسه متّصلًا.
إليك بعض الحقائق الأساسية عن الرسوم البيانية غير الموجّهة. ونورد هنا بعض الحجج غير الرسميّة، لكنّنا نترك البراهين الكاملة تمارينًا (ويمكن العثور على هذه البراهين في كثير من الموارد المذكورة في ملاحظات مرجعية).
لمّة
في أيّ رسم بياني غير موجّه ، فإنّ مجموع درجات كلّ الرؤوس يساوي ضِعف عدد الأضلاع.
يمكن بيان لمّة بالملاحظة أنّ كلّ ضلع يساهم مرّتين في مجموع الدرجات (مرّة لـ ومرّة أخرى لـ ).
لمّة
علاقة الاتصال متعدّية (transitive)، بمعنى أنّه إذا كان متّصلًا بـ ، وكان متّصلًا بـ ، فإنّ متّصل بـ .
يمكن بيان لمّة ببساطة بلصق مسار من الشكل بمسار من الشكل للحصول على المسار الذي يربط بـ .
لمّة
لكلّ رسم بياني غير موجّه ولكلّ زوج متّصل ، فإنّ أقصر مسار من إلى بسيط. وبخاصة، فلكلّ زوج متّصل يوجد مسار بسيط يربط بينهما.
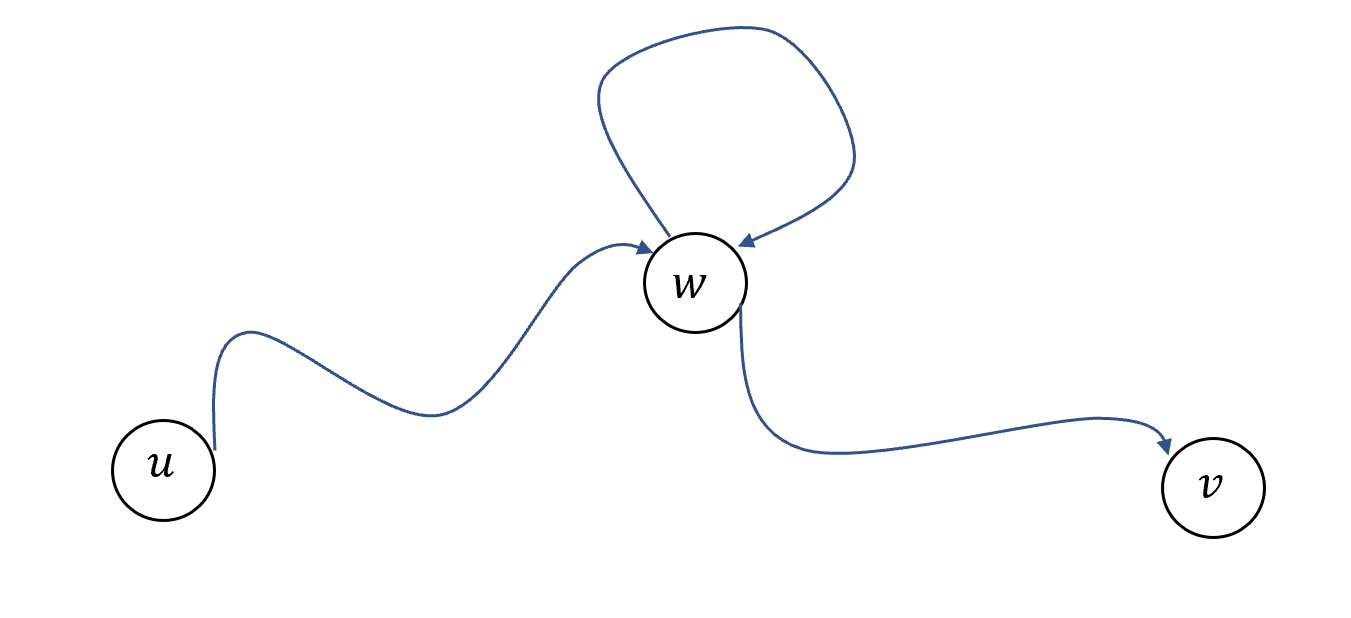
يمكن بيان لمّة بأنّنا «نختصر» أيّ مسار غير بسيط من إلى يتكرّر فيه الرأس نفسه مرّتين، فنزيل هذا التكرار (راجع الشكل التوضيحي). ويُعدّ تحويل هذا الاستدلال الحدسي إلى برهان رسميّ تمرينًا جيّدًا:
تمرين محلول — للرؤوس المتّصلة مسارات بسيطة
أثبت لمّة
الحل
يتبع البرهان الفكرة المبيّنة في الشكل التوضيحي. وهناك تعقيد واحد هو أنّ المسار قد يزور أكثر من رأس واحد مرّتين، ولذلك فإنّ «الاختصار» قد لا ينتج بالضرورة مسارًا بسيطًا؛ ونتعامل مع ذلك بالنظر إلى أقصر مسار بين و. وتفاصيل ذلك كالتالي.
لتكن رسمًا بيانيًا، وليكن و في رأسين متّصلين في . سنُثبت أنّ هناك مسارًا بسيطًا بين و. لتكن أقصر طول لمسار بين و، وليكن مسارًا ذا طول من إلى (قد يكون هناك أكثر من مسار واحد كهذا: وإنّ كان كذلك فاختر واحدًا منها فقط). (أي إنّ و، و لكلّ .) وندّعي أنّ بسيط. والحقّ، لنفترض خلاف ذلك، أي إنّ هناك رأسًا ما يتكرّر في المسار مرّتين: و لأجل ما. عندئذٍ يمكننا «اختصار» المسار والنظر إلى المسار ، الذي نحصل عليه بأخذ رؤوس الأولى (من إلى أول ظهور لـ ) وآخر منها (من الرأس الذي يلي ظهور الثاني إلى ). والمسار مسار صالح بين و، إذ إنّ كلّ زوج متتالٍ من الرؤوس فيه يربطه ضلع (وبخاصة، بما أنّ ، فإنّ و كلاهما ضلعان في )، لكنّ طول هو ، فهذا يناقض أنّ كان الأقصر.
ملاحظة — إيجاد البراهين
تمرين محلول — للرؤوس المتّصلة مسارات بسيطة مثال جيّد على عمليّة إيجاد برهان. تبدأ بالتأكّد من فهمك لما تعنيه العبارة، ثمّ تأتي بحجّة غير رسمية تشرح لماذا ينبغي أن تكون صحيحة. ثمّ تحوّل الحجّة غير الرسمية إلى برهان دقيق. ولا يلزم أن يكون هذا البرهان طويلًا جدًّا أو رسميًّا أكثر من اللازم، لكنّه ينبغي أن يبيّن بوضوح لماذا يتبع استنتاج العبارة من فروضها.
تتقدّم مفاهيم الدرجة والارتباط طبيعيًّا إلى الرسوم البيانية الموجّهة، المعرَّفة على النحو التالي.
تعريف — الرسوم البيانية الموجّهة
يتكوّن الرسم البياني الموجّه من مجموعة ومجموعة من أزواج مرتّبة (ordered pairs) عناصر . ونرمز أحيانًا إلى الضلع أيضًا على هيئة . إذا كان الضلع حاضرًا في الرسم البياني، فإنّنا نقول إنّ جيرًا صادرًا (out-neighbor) لـ ، وإنّ جارًا واردًا (in-neighbor) لـ .
قد يحتوي الرسم البياني الموجّه على و معًا، وعندئذٍ سيكون جيرًا واردًا وجيرًا صادرًا لـ ، والعكس أيضًا. و_درجةُ الدخول_ (in-degree) لـ هي عدد جيرانه الواردين، و_درجةُ الخروج_ (out-degree) لـ هي عدد جيرانه الصادرين. والمسار في الرسم البياني هو معطوف ، لأجل ما، بحيث يكون جيرًا صادرًا لـ لكلّ . وكما في الحالة غير الموجّهة، المسار البسيط هو مسار تكون فيه كلّ الـ متمايزة، والدورة هي مسار بحيث . وأحد أنواع الرسوم البيانية الموجّهة التي نهتمّ بها كثيرًا هو الرسوم البيانية الموجّهة غير الدورية (directed acyclic graphs) أو DAGs، وهي، كما يدلّ اسمها، رسوم بيانية موجّهة بلا أيّ دورات:
تعريف — الرسوم البيانية الموجّهة غير الدورية
نقول إنّ u_0,u_1,\ldots,u_k \in Vu_0=u_ki\in [k]u_i \rightarrow u_{i+1}E$.
للمُلمّات التي ذكرناها أعلاه نظائر في الرسوم البيانية الموجّهة. ونترك البراهين مرّة أخرى (وهي في جوهرها مطابقة لنظائرها غير الموجّهة) تمارينًا.
لمّة
في أيّ رسم بياني موجّه ، فإنّ مجموع درجات الدخول يساوي مجموع درجات الخروج، وهو يساوي عدد الأضلاع.
لمّة
في أيّ رسم بياني موجّه ، إذا كان هناك مسار من إلى ومسار من إلى ، فإنّ هناك مسارًا من إلى .
لمّة
لكلّ رسم بياني موجّه ولكلّ زوج بحيث يوجد مسار من إلى ، فإنّ أقصر مسار من إلى بسيط.
ملاحظة — الرسوم البيانية المُوسَمة
في بعض التطبيقات سننظر في الرسوم البيانية المُوسَمة (labeled graphs)، حيث يكون للرؤوس أو الأضلاع وسومُ (labels) مرتبطة بها (قد تكون أعدادًا أو سلاسل نصية أو عناصر مجموعة أخرى). ويمكننا التفكير في مثل هذا الرسم البياني على أنّ له دالةَ وسمٍ (labelling function) مرتبطة به (قد تكون جزئية) ، حيث هي مجموعة الوسوم المحتملة. غير أنّنا لن نشير عادةً صراحةً إلى دالة الوسم هذه، ونكتفي بأن نقول أمورًا مثل: «الرأس يحمل الوسم ».
المشغّلات المنطقية والكمّاسات
إذا كانت و عبارتين يمكن أن تكونا صادقتين أو خاطئتين، فإنّ AND (ويُرمز لها بـ ) عبارة تصدق إذا وفقط إذا كانت كلتا و صادقتين، و OR (ويُرمز لها بـ ) عبارة تصدق إذا وفقط إذا كانت أو صادقتان. و_نفيُ_ (negation)، ويُرمز له بـ أو ، يصدق إذا وفقط إذا كانت خاطئة.
لنفترض أنّ عبارة تعتمد على مُعامِلِ (parameter) ما (المعروف أيضًا أحيانًا باسم متغيّر غير مربوط (unbound variable))، بمعنى أنّه لكلّ إسناد لقيمة من مجموعة ما إلى ، تكون إمّا صادقة وإمّا خاطئة. مثلًا، عبارة ليست صادقة ولا خاطئة قبل كلّ نظر، لكنّها تصدق أو تخطئ متى أسنِدنا إلى عددًا حقيقيًا ما. ونرمز إلى بالعبارة التي تصدق إذا وفقط إذا كانت صادقة لكلّ .[4] ونرمز إلى بالعبارة التي تصدق إذا وفقط إذا وُجدَ ما بحيث صادقة.
مثلًا، ما يلي هو صياغة رسميّة للعبارة الصحيحة القائلة إنّ هناك عددًا طبيعيًا أكبر من لا يقبل القسمة على :
«من أجل كبير بما فيه الكفاية.» من التعبيرات التي سنراه يتكرّر مرّة بعد أخرى في هذا الكتاب هو الادّعاء بأنّ عبارة ما صادقة «من أجل كبير بما فيه الكفاية». ومعنى ذلك أنّ هناك عددًا صحيحًا بحيث تكون صادقة لكلّ . ويمكننا صياغة ذلك رسميًّا على هيئة .
كمّاسات المجموعيات والجداءات
الاختصارات التالية للجمع أو لأخذ جداء عدة أعداد تكون مفيدة في أحيان كثيرة. إذا كانت مجموعة منتهية و دالة، فإنّنا نكتب اختصارًا عن
ونكتب اختصارًا عن
مثلًا، يمكن كتابة مجموع مربّعات كلّ الأعداد من إلى على هيئة
ولأنّ الجمع على مدَيات (فترات) من الأعداد الصحيحة شائع جدًّا، فهناك تدوين خاصّ به. فلكلّ عددين صحيحين، ، تعني ما تعنيه حيث . ومن ثمّ يمكننا كتابة المجموع المعادلة على هيئة
تحليل الصيغ: المتغيّرات المربوطة والحرّة
في الرياضيات، كما في البرمجة، لدينا غالبًا «متغيّرات» أو «معاملات» رمزية. ومن المهمّ، إذا مُعطينا صيغة ما، أن نعرف ما إذا كان متغيّر ما مربوطًا (bound) أم حرًّا (free) في هذه الصيغة. مثلًا، في العبارة التالية يكون حرًّا، بينما يكون و مربوطين بالكمّاس :
ولأنّ حرّ، فيمكن أن يُسنَد إليه أيّ قيمة، وحقّية العبارة المعادلة تعتمد على قيمة . مثلًا، إذا كان تكون العبارة المعادلة صادقة، لكنّها خاطئة مع . (هل ترى لماذا؟)
ويظهر المسألة نفسها عند تحليل الشيفرة. مثلًا، في المقتطف التالي من لغة البرمجة C
for (int i=0 ; i<n ; i=i+1) {
    printf("*");
}
يكون المتغيّر i مربوطًا داخل كتلة for، بينما يكون المتغيّر n حرًّا.
والخاصّية الرئيسة للمتغيّرات المربوطة هي أنّه يمكننا إعادةَ تسميتها (rename) دون أن يتغيّر معنى العبارة (ما دام الاسم الجديد لا يتعارض مع متغيّر مستعمل آخر). ومثال ذلك أنّ العبارة
هي مكافئة (equivalent) لـالمعادلة بالمعنى أنّها صادقة لمجموعة نفسها بالضبط.
وبالمثل، فإنّ الشيفرة
for (int j=0 ; j<n ; j=j+1) {
    printf("*");
}
تعطي النتيجة نفسها التي تعطيها الشيفرة أعلاه التي استعملت i بدلًا من j.
ملاحظة — ملاحظة جانبية: الترميز الرياضي مقابل ترميز البرمجة
يتشابه الترميز الرياضي كثيرًا مع لغة البرمجة، وللسبب نفسه.
كلاهما نظامان صوريان يهدفان إلى نقل مفاهيم معقّدة بنية دقيقة.
غير أنّ هناك بعض الفروق الثقافية.
في لغات البرمجة، نحاول عادةً استعمال أسماء متغيّرات ذات معنى مثل NumberOfVertices، بينما نستعمل في الرياضيات معرّفات قصيرة مثل .
وربّما يعود جزءٌ من ذلك إلى سنّة كتابة البراهين الرياضية بخط اليد وتقديمها شفهيًا، في مقابل كتابتها على الآلة وصرافتها. وسببٌ آخر هو أنّه إذا استُعمل اسم المتغيّر الخطأ في برهان، فإنّ أقصى ما يحدث هو ارتباك القارئة؛ أمّا إذا استُعمل اسم المتغيّر الخطأ في برنامج، فقد تتحطّم الطائرات، وقد يموت المرضى، وقد تنفجر الصواريخ.
ومن نتائج ذلك أنّنا في الرياضيات نغدو في الغالب إلى إعادة استعمال المعرّفات، وإلى «نفاد» الحروف، فنستعمل الحروف اليونانية أيضًا، كما نميّز بين الحروف الصغيرة والكبيرة وبين مختلف أوجه الخط. وبالمثل، يميل الترميز الرياضي إلى استعمال قدر كبير من «الحِمل الزائد» (overloading)، إذ نستعمل مشغّلات مثل مع تنوّع عظيم من الأشياء (مثل الأعداد الحقيقية، والمصفوفات، وعناصر الحقول المنتهية، وغيرها)، مع افتراض أنّ المعنى يمكن استنتاجه من السياق.
ولكلا المجالين مفهوم «الأنواع»، وفي الرياضيات نحاول عادةً حجز حروف معيّنة لمتغيّرات من نوع بعينه. مثلًا، المتغيّرات مثل تدلّ كثيرًا على أعداد صحيحة، و تدلّ كثيرًا على عدد حقيقي موجب صغير (راجع هذا الكتاب: الترميز والاصطلاحات للمزيد عن هذه الاصطلاحات). وحين نقرأ أو نكتب نصوصًا رياضية، فلا نتمتع عادةً بميزة «مُصرِّف» يتحقّق من أمان الأنواع نيابةً عنّا. ولذلك من المهمّ أن نتعقّب نوع كلّ متغيّر، وأن نتأكّد من أنّ العمليات التي تُجرى عليه «منطقية».
يتضمّن كتاب Kun [@Kun18] نقاشًا وافيًا في أوجه التشابه والاختلاف بين ثقافتَي الرياضيات والبرمجة.
المقاربات وترميز الكبير
"أُثبت أنّ يذهب إلى ما لا نهاية، لكنّه لم يُرصد قطّ وهو يفعل ذلك."، مجهول، نقله كارل بوميرانس (2000)
غالبًا ما يكون وصف كميات مثل زمن التنفيذ بدقّة مرهقًا جدًّا، وليس هو مرغوبًا أيضًا، لأنّنا نهتمّ عادةً في المقام الأول بـ«حدود الرتبة الأعلى». أي أنّنا نريد أن نفهم سلوكَ التغيّر (scaling behavior) لتلك الكمية مع نموّ متغيّر الدخل. مثلًا، فيما يخصّ زمن التنفيذ، فإنّ الفرق بين خوارزمية زمنها وأخرى زمنها أهمّ بكثير من الفرق بين خوارزمية زمنها وأخرى زمنها . ولأجل هذا الغرض، فإنّ ترميز مفيد جدًّا بوصفه وسيلةً لـ«تنظيف» نصّنا وتشتيت انتباهنا على ما يهمّ حقًّا. مثلًا، باستعمال ترميز ، يمكننا القول إنّ و كلاهما ببساطة (وهذا يعني غير رسميًّا «أنّهما متساويان حتى ثوابت»)، بينما (وهذا يعني غير رسميًّا أنّ «أصغر بكثير من» ).
بوجه عام (وإن ظلّ ذلك غير رسمي)، إذا كانت دالتَين تُسقطان الأعداد الطبيعية على الأعداد الحقيقية غير السالبة، فإنّ «» تعني أنّ إن لم نكتبّ في الثوابت، بينما تعني «» أنّ أصغر بكثير من ، بمعنى أنّه مهما ضُربت في أيّ ثابت، فإنّ ستكون أكبر متى أخذنا كبيرًا بما فيه الكفاية (ولهذا السبب، أحيانًا نكتب على هيئة ). ونكتب إذا كانت و، ويمكن النظر إلى ذلك على أنّه القول إنّ هي نفسها إن لم نكتبّ في الثوابت. وبشكلٍ رسميّ أكثر، نعرّف ترميز الكبير على النحو التالي:
تعريف — ترميز الكبير
لتكن مجموعة الأعداد الحقيقية الموجبة. لدالتَين ، نقول إنّ إذا كان هناك عددان بحيث لكلّ . ونقول إنّ إذا كانت و. ونقول إنّ إذا كانت .
ونقول إنّ إذا كان لكلّ عدد ما بحيث لكلّ . ونقول إنّ إذا كانت .
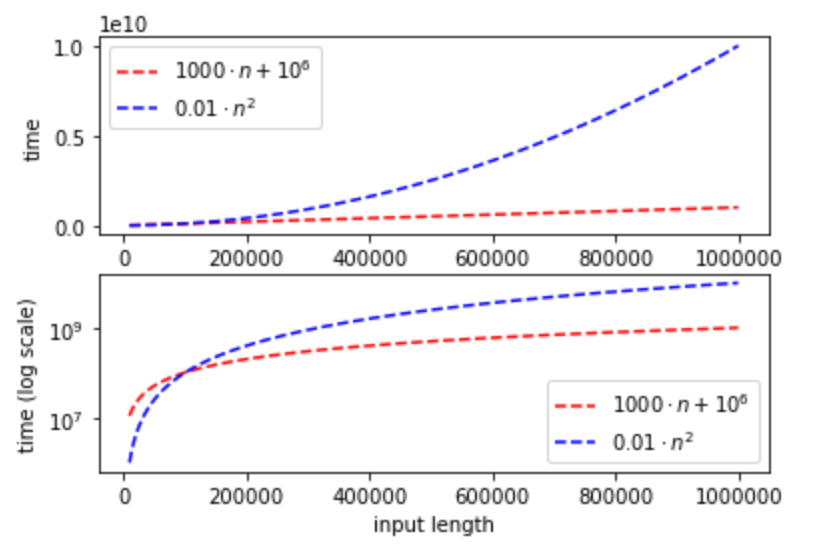
غالبًا ما يكون من الملائم استعمال «دوالّ مجهولة الاسم» في سياق ترميز . مثلًا، حين نكتب عبارة مثل ، فإنّنا نعني أنّ حيث هي الدالة المعرَّفة بـ . ويقدّم الفصل السابع في ملاحظات Jim Apsnes عن الرياضيات المتقطّعة ملخّصًا جيّدًا لترميز ؛ راجع أيضًا هذا الدليل مقدّمةً ألطف وأكثر اتّجاهًا إلى المبرمجين.
ليست مساواة. إن استعمال علامة المساواة في ترميز شائع جدًّا، لكنه تسمية غير دقيقة إلى حدٍّ ما، لأنّ عبارة مثل تعني في الحقيقة أنّ تنتمي إلى المجموعة . ولعلّ الأنسب هو استعمال متراجحات (inequalities) والكتابة و، وترك المساواة لـ ، ولذلك سنستعمل هذا التدوين أحيانًا أيضًا، لكنّ بما أنّ تدوين المساواة راسخ إلى حدٍّ بعيد، فإنّنا غالبًا ما نلجأ إليه هو الآخر أيضًا. (تكتب بعض النصوص بدلًا من ، لكنّنا لن نستعمل هذا التدوين.) ورغم علامة المساواة المضلِّلة، ينبغي أن تتذكّر أنّ عبارة مثل تعني أنّ هي «على الأكثر» بالمعنى التقريبي نفسه حين نتجاهل الثوابت، وأنّ عبارة مثل تعني أنّ هي «على الأقلّ» بالمعنى التقريبي نفسه.
بعض «قواعد الإرشاد» لترميز الكبير
هناك بعض القواعد الحدسية (heuristics) البسيطة التي قد تساعد عند محاولة مقارنة دالتَين و:
-
الثوابت الضربية لا تهمّ في ترميز ، ولذلك إذا كان فإنّ .
-
عند جمع دالتَين، لا يهمّنا إلّا الأكبر. مثلًا، لأغراض ترميز ، فإنّ هو نفسه ، وعلى نحو عام، في أيّ كثير حدود، لا يهمّنا إلّا الأسّ الأكبر.
-
لكلّ ثابتين ، لدينا إذا وفقط إذا كان ، و إذا وفقط إذا كان . مثلًا، بالجمع بين الملاحظتين السابقتين، .
-
متعدّد الحدود أصغر دائمًا من الأُسّي: لكلّ ثابتين و، حتى لو كان أصغر بكثير من . مثلًا، .
-
وبالمثل، اللوغاريتم أصغر دائمًا من متعدّد الحدود: (ونكتبه ) هو لكلّ ثابتين . مثلًا، بالجمع بين الملاحظات أعلاه، .
ملاحظة — ترميز الكبير في تطبيقات أخرى (اختياري)
على الرغم من أنّ ترميز الكبير يُستعمل غالبًا لتحليل زمن تنفيذ الخوارزميات، فإنّه ليس بالتأكيد التطبيق الوحيد. يمكننا استعمال ترميز لتقييد العلاقات المقاربة بين أيّ دوالّ تُسقط الأعداد الصحيحة على أعداد موجبة. ويمكن استعماله بصرف النظر عمّا إذا كانت هذه الدوال تقيس زمن التنفيذ، أو استهلاك الذاكرة، أو أيّ كمية أخرى قد لا علاقة لها بالحوسبة. وهنا مثال واحد لا علاقة له بهذا الكتاب (وعليه يمكنك بكلّ سرور تخطّيه): إحدى طرائق صياغة فرضية ريمان (وهي من أشهر المسائل المفتوحة في الرياضيات) هي أنّها تقابل التخمين القائل إنّ عدد الأعداد الأولية بين و يساوي حتى خطأ جمعّي مقداره على الأكثر .
البراهين
يعتقد كثيرون أنّ البراهين الرياضية سلسلة من الاستنتاجات المنطقية تبدأ من بعض البديهيات (axioms) وتصل في النهاية إلى استنتاج. وفي الواقع، تعرّف بعض المعاجم البراهين على هذا النحو. وهذا ليس خاطئًا تمامًا، لكنّ جوهر البرهان الرياضي لعبارة ليس سوى حجّة تُقنع القارئ بأنّ صحيحة دون أيّ ذرّة من الشكّ.
ولإنتاج برهان كهذا، تحتاج إلى:
-
أن تفهم بدقّة ما تعنيه .
-
أن تُقنع نفسك بأنّ صحيحة.
-
أن تكتب استدلالك بلغة إنشائية بسيطة ودقيقة ومُوجزة (لا تستعمل الصيغ أو الترميز إلّا حين يفيدان في الوضوح).
في كثير من الحالات، يكون الجزء الأول هو الأهمّ. ففهم ما تعنيه عبارة ما يمثّل في كثير من الأحيان أكثر من نصف الطريق إلى فهم لماذا هي صحيحة. وفي الجزء الثالث، لكي تُقنع القارئ دون أيّ ذرّة من الشكّ، سنرغب غالبًا في تفكيك الاستدلال إلى «خطوات أساسيّة»، بحيث تكون كلّ خطوة أساسيّة بسيطة بما يكفي لأن تكون «بديهية بحد ذاتها». ومجموع كلّ الخطوات ينتج العبارة المرغوبة.
البراهين والبرامج
هناك تشابه كبير بين عمليّة كتابة البراهين وعمليّة كتابة البرامج، وكلاهما يحتاج مجموعة مهارات متشابهة. ويستلزم كتابة برنامج ما:
-
فهم ما هي المهمّة التي نريد للبرنامج أن يحقّقها.
-
الإقناع نفسك بأنّ المهمّة يمكن إنجازها بواسطة حاسوب، ربما بالتخطيط على سبورة بيضاء أو على دفتر لكيفية تقسيمها إلى مهمّات أبسط.
-
تحويل هذه الخطة إلى شيفرة يفهمها مُصرِّف (compiler) أو مُفسِّر (interpreter)، بتقسيم كلّ مهمّة إلى تتابع من العمليات الأساسيّة لإحدى لغات البرمجة.
وكما في البرامج كذلك في البراهين، غالبًا ما تكون الخطوة 1 هي الأهمّ. والفرق الجوهري أنّ قارئ البرهان إنسان، وأنّ قارئ البرنامج حاسوب. (وهذا الفرق يزول مع الزمن كلّما كُتبت البراهين أكثر بصيغة قابلة للتحقّق آليًّا؛ إضافةً إلى ذلك، فإنّ ضمان صحّة البرامج وقابليتها للصيانة يتطلّبان أن يكون بالإمكان قراءتها وفهمها من البشر.) ولذلك فإنّ تركيزنا ينصبّ على قابلية القراءة وعلى وجود تسلسل منطقي واضح في برهاننا (وهذا ليس فكرة سيّئة بالنسبة للبرامج أيضًا). وحين تكتب برهانًا، ينبغي أن تنظر إلى جمهورك بوصفه قارئًا ذكيًّا جدًّا لكنّه شديد الشكّ وعضيلًا إلى حدٍّ ما، بحيث يصيح «مخالفة!» عند كلّ خطوة غير مبرَّرة بدقّة.
أسلوب كتابة البراهين
البرهان الرياضي قطعة كتابة، لكنّه نوع كتابة محدّد له اصطلاحات وأنماط تفضيليّة معيّنة. وكما في كلّ كتابة، فالمُمارسة تُجيد، ومن المهمّ أيضًا أن تنقّح مسودّاتك من أجل الوضوح.
في برهان العبارة ، ينبغي أن يكون كلّ النص بين الكلمتين «برهان:» و «انتهى البرهان» (QED) مُركَّزًا على إثبات أنّ صحيحة. وينبغي أن تُبقى الحواشي والأمثلة والتأمّلات خارج هاتين الكلمتين، حتى لا تربك القارئ. وينبغي أن يتّسم البرهان بتسلسل منطقي واضح، بمعنى أنّ كلّ جملة أو معادلة فيه ينبغي أن يكون لها غرض ما، وأن يكون هذا الغرض واضحًا كلّ الوضوح للقارئ. وحين تكتب برهانًا، فعن كلّ معادلة أو جملة تُدرِجها، اسأل نفسك:
-
هل تقول هذه الجملة أو المعادلة إنّ عبارة ما صحيحة؟
-
إن كان كذلك، فهل تترتّب هذه العبارة عن الخطوات السابقة، أم أننا سنُثبتها في الخطوة التالية؟
-
ما هو دورُ (role) هذه الجملة أو المعادلة؟ هل هي خطوة في اتجاه إثبات العبارة الأصلية، أم خطوة في اتجاه إثبات مزعَم وسيط سبق أن ذكرناه؟
-
وأخيرًا، هل تكون إجابات الأسئلة 1-3 واضحةً للقارئ؟ فإن لم تكن، فينبغي أن تعيد الترتيب، أو تعيد الصياغة، أو تضيف توضيحات.
من بين الموارد المفيدة في الكتابة الرياضية هذه النشرة لـ Lee، وهذه النشرة لـ Hutching، وكذلك عدة نشرات ممتازة في مساق Stanford CS 103.
أنماط البراهين
"لو كان هكذا لأمكن؛ ولو كان هكذا لكان؛ لكنّه ليس هكذا، فهو ليس كذلك. هذا هو المنطق."، لويس كارول، عبر المرآة.
وكما في البرمجة تمامًا، هناك عدّة أنماط شائعة من البراهين تتكرّر مرّة بعد أخرى. وهذه بعض الأمثلة:
البراهين بالتناقض: إحدى طرائق إثبات أنّ صحيحة هي أن نُبيّن أنّه لو كانت خاطئة لانتج تناقض. وغالبًا ما تبدأ هذه البراهين بجملة مثل «لنفرض، طلبًا للتناقض، أنّ خاطئة»، وتنتهي باستخراج تناقض ما (مثلًا إخلال أحد الفروض في عبارة المبرهنة). وهنا مثال:
لمّة
لا يوجد عددان طبيعيان بحيث .
برهان
لنفرض، طلبًا للتناقض، أنّ هذا خاطئ، وليكن أصغر عدد بحيث يوجد ما يحقّق . بتفريع هذه المعادلة نحصل على ، أي . لكنّ هذا يعني أنّ زوجيّ، وبما أنّ جداء عددين فرديّين فرديّ، فإنّه يعني أيضًا أنّ زوجيّ، أو بعبارة أخرى لأجل ما. غير أنّ إدخال هذا في يُظهر أنّ ، ما يعني أنّ هو أيضًا عدد زوجيّ. وباعتبارات مماثلة لما سبق نحصل على أنّ زوجيّ، وبالتالي يكون و عددين طبيعيين يحقّقان ، وهذا يناقض أصغرية .
براهين العبارة الكلّية: كثيرًا ما نريد إثبات عبارة من الشكل «كلّ كائن من النوع له الخاصّية .» وغالبًا ما تبدأ هذه البراهين بجملة مثل «ليكن كائنًا من النوع »، وتنتهي بإظهار أنّ لـ الخاصّية . وهنا مثال بسيط:
لمّة
لكلّ عدد طبيعي ، إمّا وإمّا زوجيّ.
برهان
لتكن عددًا ما. إذا كان عددًا صحيحًا فقد انتهينا، لأنّه عندئذٍ وبالتالي هو زوجيّ. وإلّا فإنّ عدد صحيح، وبالتالي فإنّ زوجيّ.
براهين اللّزوم (implication): حالة شائعة أخرى هي أن تكون العبارة من الشكل «من يلزم ». وغالبًا ما تبدأ هذه البراهين بجملة مثل «نفترض أنّ صادقة»، وتنتهي باستنتاج من . وهنا مثال بسيط:
لمّة
إذا كان فهناك حلّ للمعادلة التربيعية .
برهان
نفترض أنّ . عندئذٍ يكون عددًا غير سالب، وبالتالي له جذر تربيعي . وعليه فإنّ يحقّق
وإعادة ترتيب حدود المعادلة نحصل على
براهين التكافؤ: إذا كانت العبارة من الشكل « إذا وفقط إذا » (كثيرًا ما تُختصر إلى « إن وفقط إن » (iff))، فإنّنا نحتاج إلى إثبات أنّ تلزم منها ، وأنّ تلزم منها . ونسمّي اللّزَمَ بأنّ تلزم منها اتّجاه «فقط إذا» (only if)، واللّزَمَ بأنّ تلزم منها اتّجاه «إذا» (if).
براهين بدمج المزاعم الوسيطة: عندما يكون البرهان أعقد، فإنّ تفكيكه إلى عدّة خطوات يكون مفيدًا في كثير من الأحيان. أي أنّه، لإثبات العبارة ، قد نُثبت أوّلًا العبارات و و، ثمّ نُثبت أنّ تلزم منها . (وتذكّر أنّ تدلّ على المشغّل المنطقي AND.)
براهين بالتفريق بين الحالات: هذه حالة خاصّة ممّا سبق، إذ نقسّم، لإثبات عبارة ، إلى عدة حالات ، ونُثبت أنّ (a) الحالات حاصرة (exhaustive)، بمعنى أنّ إحدى الحالات يجب أن تقع، و (b) نمرّ على الحالات واحدةً واحدة ونُثبت أنّ كلّ حالة تلزم منها النتيجة التي نروم إليها.
البراهين بالحَث: نتناول الحَث ونعطي مثالًا في الحَث الرياضي أدناه. ويمكننا التفكير في هذه البراهين على أنّها صيغةٌ من الصيغ السابقة، حيث لدينا عدد غير محدود من المزاعم الوسيطة ، ونُثبت أنّ صادقة، وأنّ تلزم منها ، وأنّ تلزم منها ، وهكذا دواليًا. ويحتوي الموقع الخاص بمساق CMU 15-251 على نشرة مفيدة عن المحاذير المحتملة عند إجراء البراهين بالحَث.
«من دون خسارة عامّة» (w.l.o.g): قد يكون هذا المصطلح مربكًا في البداية. وهو في جوهره وسيلة لتبسيط البراهين بالتفريق بين الحالات. والفكرة أنّه إذا كانت الحالة 1 مساوية للحالة 2 بعد تغيير متغيّرات أو تحويل مشابه، فإنّ برهان الحالة 1 سيُلزم منه أيضًا برهان الحالة 2. وهذه دائمًا عبارة ينبغي النظر إليها بشكّ. فكلّما رأيتها في برهان، اسأل نفسك هل تفهم لماذا كان الافتراض المأخوذ بلا خسارة عامّة حقًّا، وحين تستعملها، حاول أن ترى هل الاستعمال مبرَّر فعلًا. وحين تكتب برهانًا، أحيانًا يكون الأسهل ببساطة أن تكرّر برهان الحالة الثانية (مع إضافة ملاحظة بأنّ البرهان قريب جدًّا من الأول).
ملاحظة — البراهين الهرمية (اختياري)
تُكتب البراهين الرياضية في النهاية نثرًا إنجليزيًّا. ويُجادل عالِم الحاسوب المعروف Leslie Lamport بأنّ هذه مسألة، وأنّ البراهين ينبغي أن تُكتب بطريقة أكثر رسمية ودقّة. ويقترح في مخطوطه منهجًا لـ_البراهين الهرمية المهيكلة_ (structured hierarchical proofs)، لها الصيغة التالية:
-
برهان عبارة من الشكل «إذا كانت فإنّ » هو تتابع من مزاعم مرقّمة، يبدأ بافتراض أنّ صادقة، وينتهي بالمزعم بأنّ صادقة.
-
يتبع كلّ مزعم برهان يوضّح كيف اشتُقّ من الافتراضات أو المزاعم السابقة.
-
برهان كلّ مزعم هو بدوره تتابع من مزاعم فرعية.
وممّنية صيغة Lamport أنّ دور كلّ جملة في البرهان يتّضح إلى حدٍّ كبير. كما أنّ تحويل هذه البراهين إلى صيغ قابلة للتحقّق آليًّا أصعب بكثير. أمّا العيب فهو أنّ قراءة هذه البراهين وكتابتها قد تكون مملّة، مع تمييز أقلّ بين الأجزاء المهمّة من الحجة والأجزاء الأكثر اعتياديّة.
مثال موسّع: الفرز الطوبولوجي
في هذا القسم سنُثبت ما يلي: كلّ رسم بياني موجّه غير دوريّ (DAG، راجع تعريف — الرسوم البيانية الموجّهة غير الدورية) يمكن ترتيبه في طبقات بحيث إنّ لكلّ ضلع موجّه ، تكون طبقة أكبر من طبقة . وتُعرف هذه النتيجة بـالفرز الطوبولوجي، وهي مستعملة في تطبيقات كثيرة، منها جدولة المهمّات، وأنظمة البناء، وإدارة حزم البرمجيات، وحسابات خلايا جداول البيانات، وكثير غيرها (راجع الشكل التوضيحي). والواقع أنّنا سنستعملها نحن أيضًا لاحقًا في هذا الكتاب.
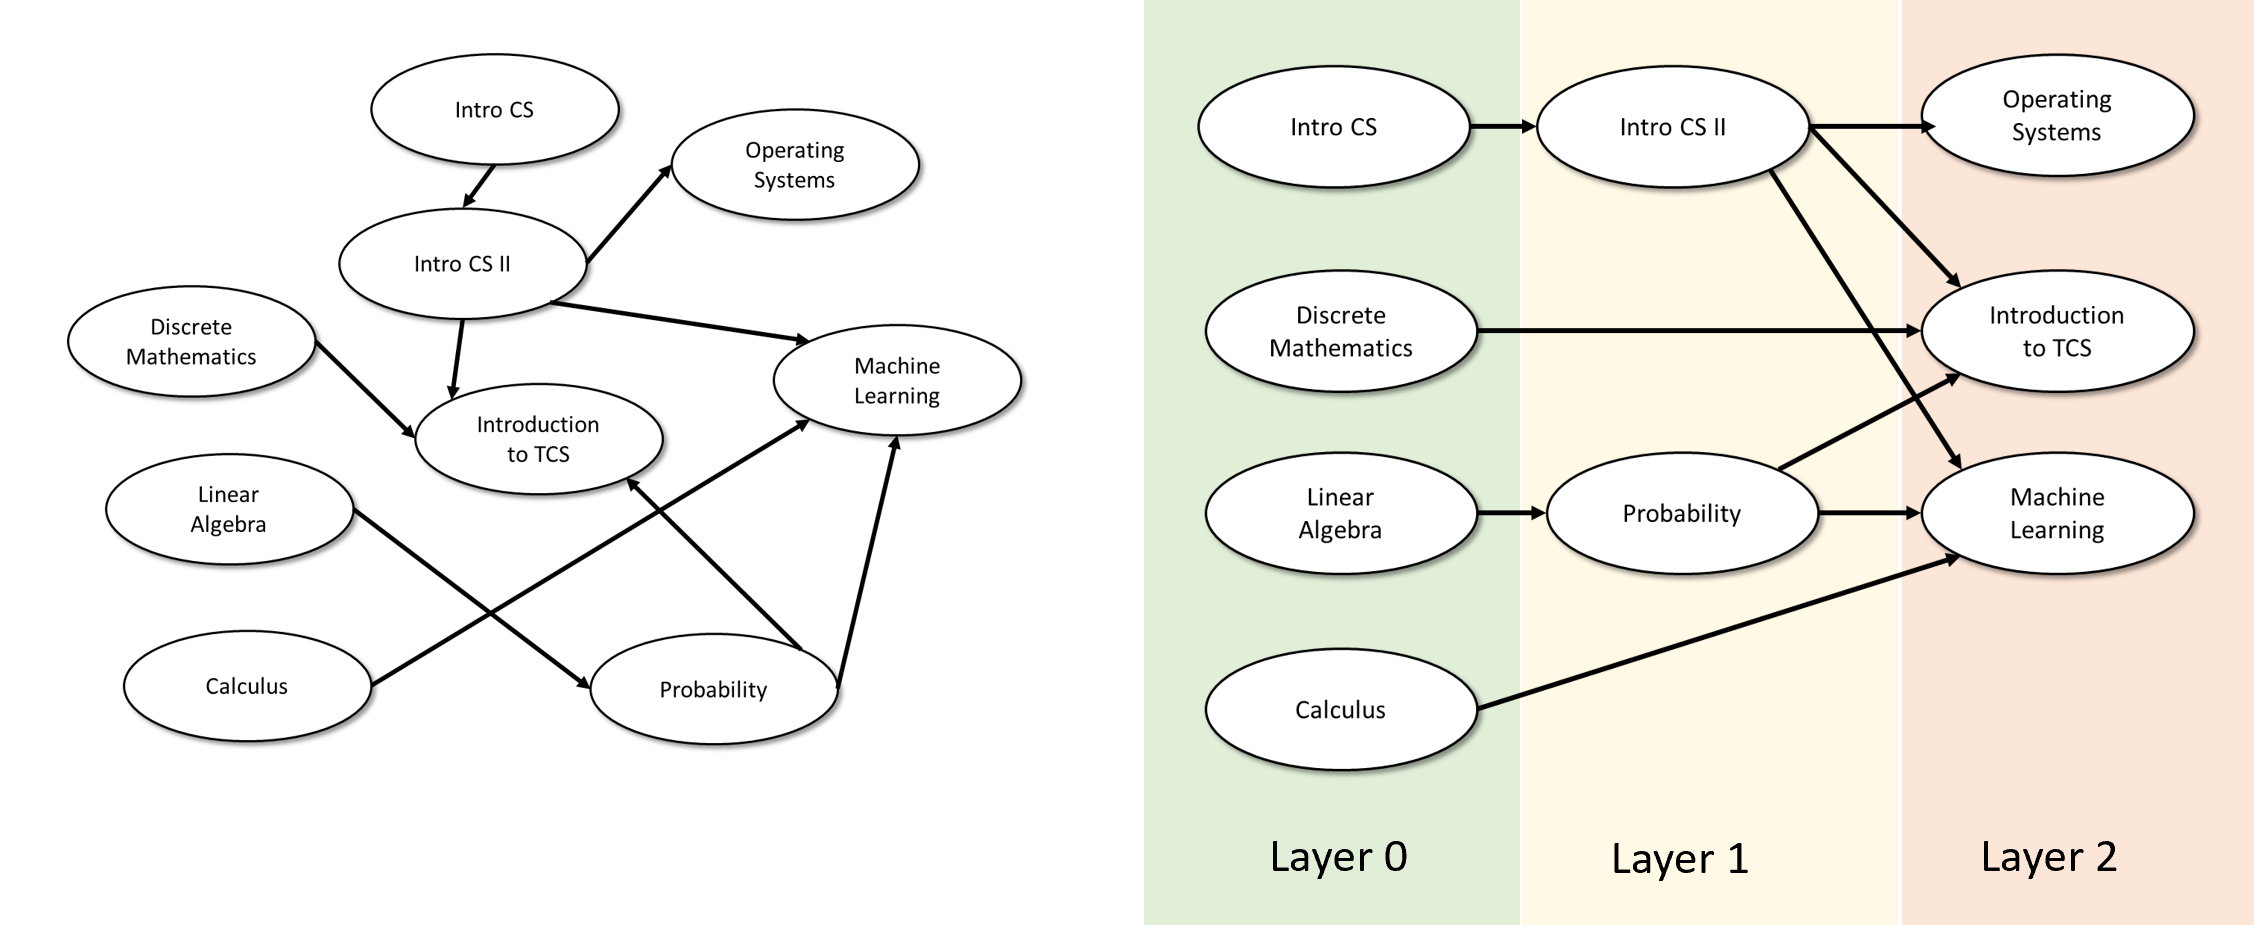
نبدأ بالتعريف التالي. الطبقيّة (layering) لرسم بياني موجّه هي وسيلة لإسناد كلّ رأس عددًا طبيعيًا (يقابل طبقته)، بحيث يكون جيران الواردون في طبقات ذات أرقام أصغر من طبقة ، ويكون جيران الصادرون في طبقات ذات أرقام أكبر. والتعريف الرسميّ هو على النحو التالي:
تعريف — طبقيّة رسم بياني موجّه غير دوريّ
لتكن رسمًا بيانيًا موجّهًا. الطبقيّة لـ هي دالة بحيث إنّ لكلّ ضلع في لدينا .
في هذا القسم نُثبت أنّ الرسم البياني الموجّه غير دوريّ إذا وفقط إذا كانت له طبقيّة صالحة.
مبرهنة — الفرز الطوبولوجي
لتكن رسمًا بيانيًا موجّهًا. عندئذٍ يكون غير دوريّ إذا وفقط إذا كانت هناك طبقيّة لـ .
لإثبات مبرهنة كهذه، نحتاج أوّلًا إلى فهم ما تعنيه. وبما أنّها عبارة «إذا وفقط إذا»، فإنّ مبرهنة — الفرز الطوبولوجي تقابل عبارتين:
لمّة
لكلّ رسم بياني موجّه ، إذا كان غير دوريّ فإنّ له طبقيّة.
لمّة
لكلّ رسم بياني موجّه ، إذا كان لـ طبقيّة، فإنّه غير دوريّ.
لإثبات مبرهنة — الفرز الطوبولوجي نحتاج إلى إثبات لمّة ولمّة معًا. ولمّة في الحقيقة ليس صعبًا جدًّا على الإثبات. فبحدس، إذا كان يحتوي على دورة، فإنّه لا يمكن أن تكون كلّ الأضلاع على الدورة ترتفع في رقم الطبقة، لأنّنا إذا سِرنا على الدورة فسنضطر عند نقطة ما إلى العودة إلى الموضع الذي بدأنا منه. والبرهان الرسميّ هو على النحو التالي:
برهان
لتكن رسمًا بيانيًا موجّهًا، وليكن طبقيّة لـ بحسب تعريف — طبقيّة رسم بياني موجّه غير دوريّ . ولنفرض، طلبًا للتناقض، أنّ ليس غير دوريّ، ومن ثمّ فهناك دورة ما بحيث ، ولكلّ يكون الضلع حاضرًا في . وبما أنّ طبقيّة، فإنّ لكلّ لدينا ، أي أنّ وهذا تناقض، لأنّ وبالتالي .
تقابل لمّة الاتّجاه الأصعب (والأنفع). ولإثباته نحتاج إلى أن نُبيّن كيف، معطى رسم بياني موجّه غير دوريّ ، يمكننا أن نأتي بطبقيّة لرؤوس بحيث تصعد كلّ الأضلاع «إلى أعلى».
توقّف وتأمّل
إن لم تكن قد رأيت برهان هذه المبرهنة من قبل (أو لم تكن تتذكّره)، فإنّ هذا مكان ممتاز للتوقّف ومحاولة إثباتها بنفسك. وإحدى طرق ذلك هي أن تصف خوارزمية (algorithm) تُعطى كدخل رسمًا بيانيًا موجّهًا غير دوريّ على رؤوس و أضلاع أو أقلّ، وتبني مصفوفة ذات الطول بحيث لكلّ ضلع في الرسم البياني يكون .
الحَث الرياضي
هناك عدة طرائق لإثبات لمّة. وإحدى طرائق ذلك هي البدء بإثباته لرسوم بيانية صغيرة، مثل الرسوم ذات 1 أو 2 أو 3 رؤوس (راجع الشكل التوضيحي، وهي رسوم يمكننا التحقّق من كلّ الحالات فيها)، ثمّ محاولة توسيع البرهان إلى رسوم بيانية أكبر. والمصطلح التقنيّ لهذا المنهج في الإثبات هو البرهان بالحَث.
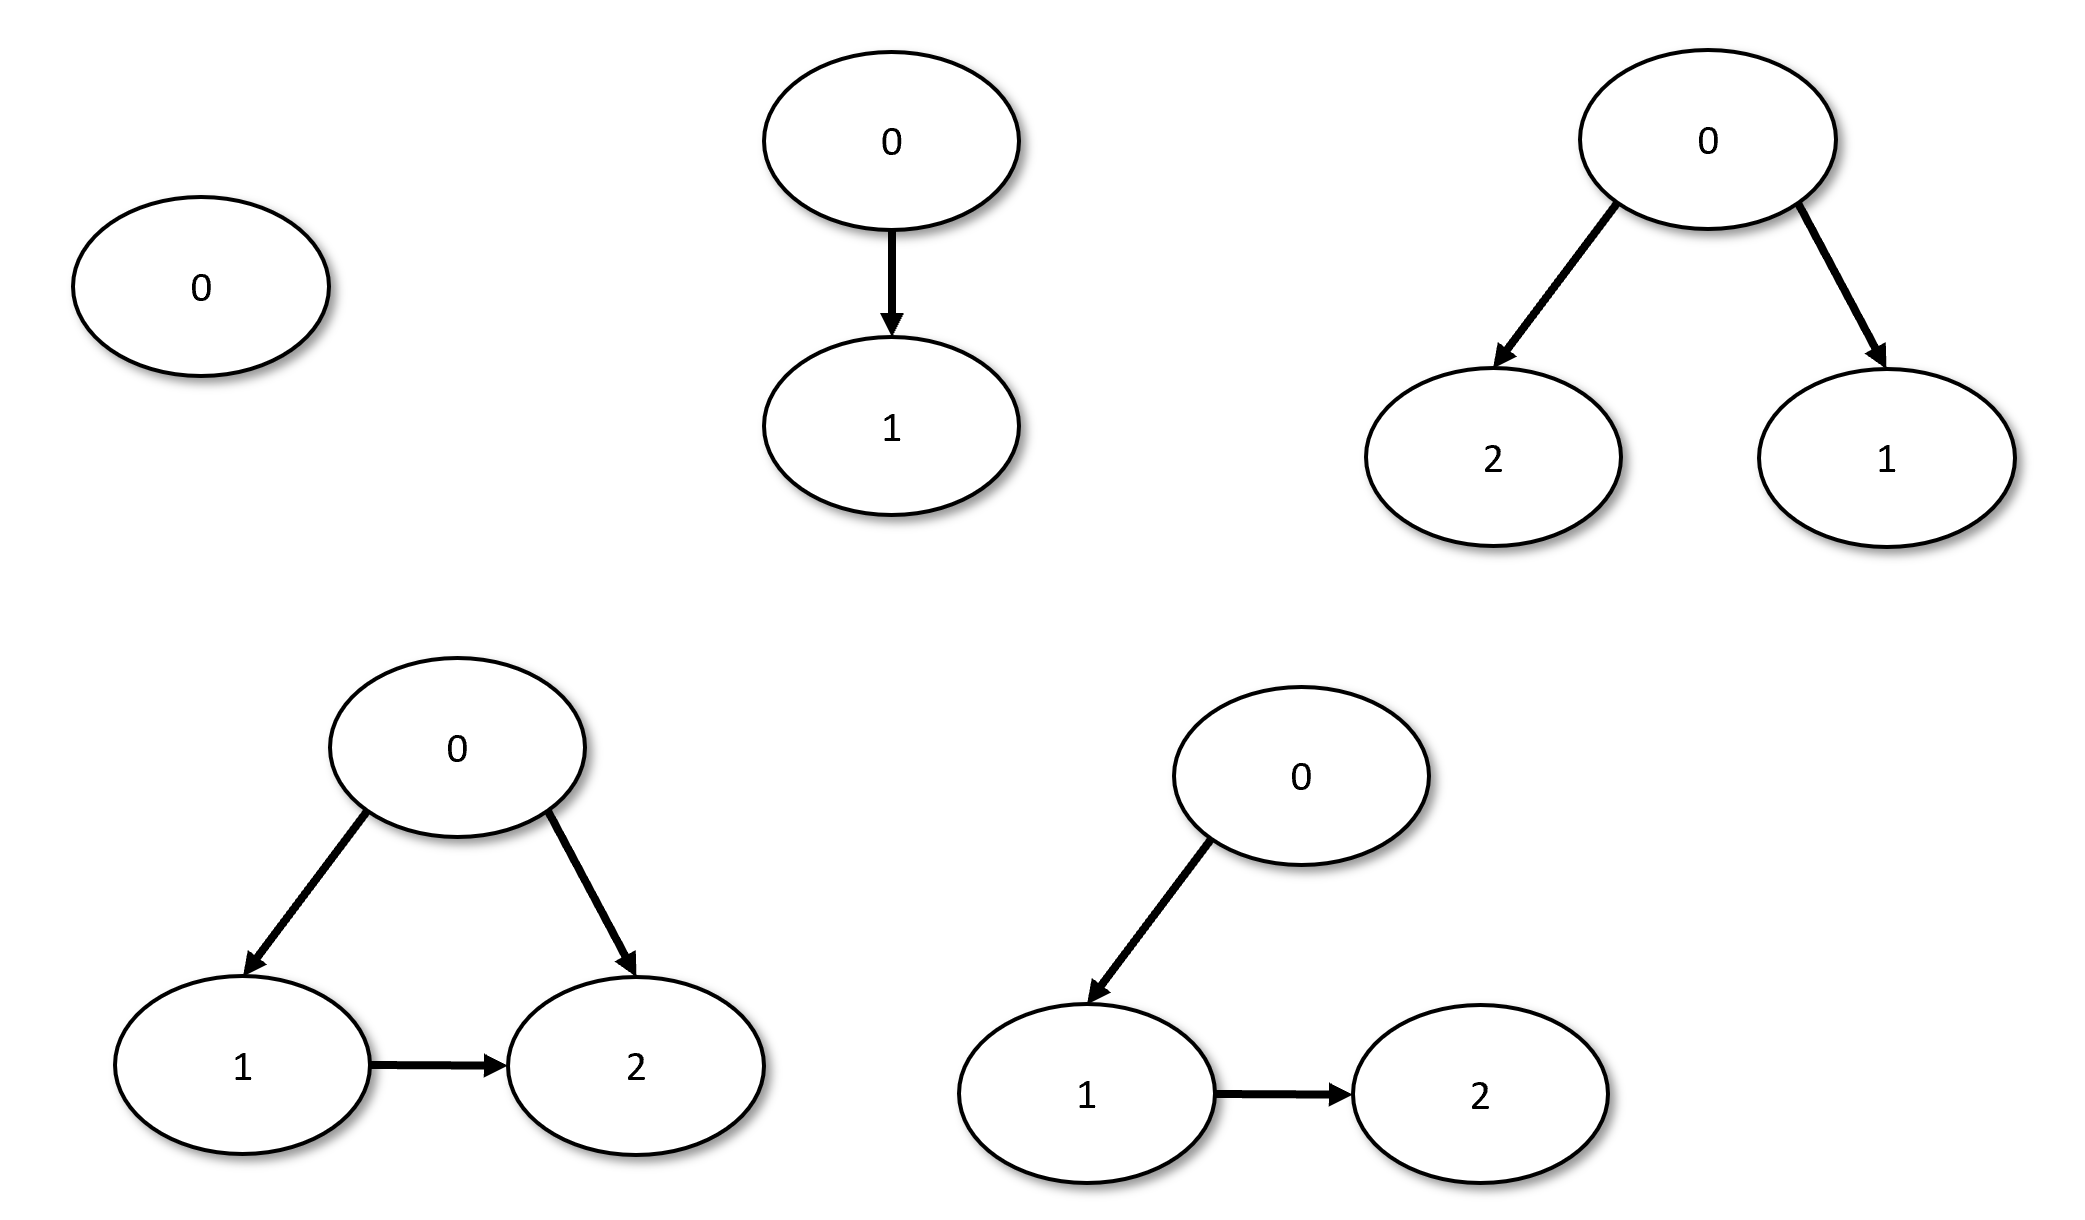
الحَث (induction) ليس سوى تطبيق قاعدة الاستدلال modus ponens البديهية، التي تقول إنّه إذا كان
(a) صادقة
و
(b) تلزم منها
فإنّ صادقة.
في سياق البراهين بالحَث، لدينا عادةً عبارة مُعامَلة بمُعامِل صحيح ما ، ونُثبت أنّ (a) صادقة، وأنّ (b) لكلّ ، إذا كانت صادقة كلّها فإنّ صادقة. (ومعهود أنّ إثبات (b) هو الجزء الصعب، وإنّ كانت هناك أمثلة تكون فيها «الحالة الأساس» (a) دقيقة إلى حدٍّ كبير.) وبتطبيق قاعدة الاستدلال modus ponens، يمكننا أن نستنتج من (a) و (b) أنّ صادقة. ومتى فعلنا ذلك، فبمجرّد أن نعرف الآن أنّ و كلتاهما صادقتان، يمكننا أن نستعمل ذلك مع (b) لنستنتج (مرّة أخرى بتطبيق قاعدة الاستدلال) أنّ صادقة. ويمكننا تكرار الاستدلال نفسه مرّة بعد مرّة للحصول على أنّ صادقة لكلّ . وتُسمّى العبارة (a) «الحالة الأساس» (base case)، بينما تُسمّى (b) «خطوة الحَث» (inductive step). ويسمّى الافتراض في (b) بأنّ تتحقّق لـ «فرضية الحَث» (inductive hypothesis). (والصورة الموصوفة هنا من الحَث تُسمّى أحيانًا «الحَث القوي» (strong induction) في مقابل «الحَث الضعيف» (weak induction) الذي نستبدل فيه (b) بالعبارة (b') القائلة إنّ إذا كانت صادقة فإنّ صادقة؛ ويمكن النظر إلى الحَث الضعيف بوصفه الحالة الخاصّة من الحَث القوي التي لا نستعمل فيها افتراض أنّ صادقة.)
ملاحظة — الحَث والتكرار
البراهين بالحَث ترتبط عن قرب بالخوارزميات التكرارية. وفي الحالتين نُقلّص حلّ مسألة أكبر إلى حلّ نسخة أصغر منها. وفي خوارزمية تكرارية لحلّ مسألة ما P على دخل طوله ، نسأل أنفسنا: «ماذا لو أعطاني أحدهم طريقة لحلّ P على نسخ أصغر من ؟». وفي برهان بالحَث لإثبات عبارة Q مُعامَلة بعدد ، نسأل أنفسنا: «ماذا لو كنتُ أعرف أصلًا أنّ صادقة لكلّ ؟». وكلا المفهومين، الحَث والتكرار، مفهومان جوهريان لهذا المساق ولمستوى علم الحاسوب ككلّ (وحتى لمجالات استقصائية أخرى، ومنها الرياضيات وسواها). وكلاهما قد يكون مربكًا في البداية، لكنّهما مع الوقت والممارسة يتّضحان. ولمزيد من البساطة في البراهين بالحَث والتكرار، قد تجد ما يلي مفيدًا: نشرة Stanford CS 103، وهذه المحاضرة من MIT 6.00، أو هذا المقتطف من كتاب Lehman-Leighton.
إثبات النتيجة بالحَث
هناك عدة طرائق لإثبات لمّة بالحَث. وسنستعمل الحَث على عدد الرؤوس ، ولذلك سنعرّف العبارة على النحو التالي:
هي : «لكلّ رسم بياني موجّه غير دوريّ ذو رأسًا، هناك طبقيّة لـ .»
العبارة الخاصّة بـ (حيث لا يحتوي الرسم البياني على أيّ رؤوس) بديهية. وعليه يكفي أن نُثبت ما يلي: لكلّ ، إذا كانت صادقة فإنّ صادقة.
ولننجز ذلك، نحتاج إلى أن نجد طريقة، معطى رسم بياني ذو رؤوس، تُحوّل مهمّة إيجاد طبقيّة لـ إلى مهمّة إيجاد طبقيّة لرسم بياني آخر ذو رأسًا. والفكرة أنّنا سنجد مصدرًا (source) لـ : أي رأسًا ليس له جيران واردون. يمكننا عندئذٍ إسناد الطبقة إلى ، ثمّ وضع بقية الرؤوس في طبقات باستعمال فرضية الحَث.
ما سبق هو الحدس وراء برهان لمّة، لكنّنا حين نكتب البرهان الرسميّ أدناه نستعمل ميزة النظر إلى الخلف، ونحاول أن نختصر رحلة كانت متعرّجة في تسلسل خطّي سهل الاتّباع من المنطق يبدأ بالكلمة «برهان:» وينتهي بـ «انتهى البرهان» (QED) أو بالرمز .[5] والمناقشات والأمثلة والاستطرادات قد تكون بليغة جدًّا، لكنّنا نُبقيها خارج المساحة المحدودة بين هاتين الكلمتين، حيث (بحسب ما تصفه هذه النشرة الممتازة) «يجب أن تتّكئ كلّ جملة على شيء ما». وكما نفعل في البرمجة، يمكننا تقسيم البرهان إلى «دوالّ فرعية» صغيرة (المعروفة في اللغة الرياضية باسم مُلمّات أو مزاعم)، وهي عبارات أصغر تساعدنا على إثبات النتيجة الرئيسة. غير أنّ البرهان ينبغي أن يُبنى على نحو يضمن أنّه يكون للقارئ في كلّ لحظة وبوضوح تامّ أيّ مرحلة نحن فيها من مراحل البرهان. وينبغي أن يستطيع القارئ تحديد دور كلّ جملة في البرهان وأيّ جزء تنتمي إليه. ونعرض الآن البرهان الرسميّ لـلمّة.
برهان
لتكن رسمًا بيانيًا موجّهًا غير دوريّ، و عدد رؤوسه. نُثبت المُلمّة بالحَث على . الحالة الأساس هي حيث لا توجد رؤوس، ولذلك تكون العبارة صحيحة بداهةً.[6] أمّا في حالة ، فإنّنا نفترض فرضية الحَث وهي أنّ كلّ رسم بياني موجّه غير دوريّ ذو عدد رؤوس لا يتجاوز له طبقيّة.
ونطرح المزعم التالي:
المزعم: يجب أن يحتوي على رأس درجته الداخلية صفر.
برهان المزعم: لنفرض خلاف ذلك، أي إنّ كلّ رأس له جار وارد. ليكن رأسًا ما من ، وليكن جيرًا واردًا لـ ، و جيرًا واردًا لـ ، وهكذا على هذا النحو خطوة حتى نبني قائمة بحيث لكلّ يكون جيرًا واردًا لـ ، أو بعبارة أخرى يكون الضلع حاضرًا في الرسم البياني. وبما أنّ في هذا الرسم البياني رؤوس فقط، فلا بدّ أن يتكرّر أحد الرؤوس الـ في هذا التسلسل، ومن ثمّ يوجد بحيث . لكنّ عندئذٍ يكون التسلسل دورة في ، وهذا يناقض افتراضنا بأنّه غير دوريّ. (انتهى برهان المزعم)
وبناءً على المزعم، يمكننا أن نأخذ رأسًا ما درجته الداخلية صفر في ، وليكن هو الرسم البياني الناتج عن إزالة من . ولدى عدد رؤوس يساوي ، ومن ثمّ فبحسب فرضية الحَث له طبقيّة . ونعرّف على النحو التالي:
وندّعي أنّ طبقيّة صالحة، أي أنّه لكلّ ضلع لدينا . ولإثبات ذلك نقسّم إلى حالات:
-
الحالة 1: ، . في هذه الحالة الضلع موجود في الرسم البياني ، ومن ثمّ ففي ضوء فرضية الحَث لدينا ، ما ينتج أنّ .
-
الحالة 2: ، . في هذه الحالة و .
-
الحالة 3: ، . لا يمكن أن تحدث هذه الحالة لأنّ ليس له جيران واردون.
-
الحالة 4: . ولا يمكن أن تحدث هذه الحالة مرّة أخرى لأنّها تعني أنّ جاره لنفسه — أي إنّ هذا ينطوي على حلقة ذاتية (self loop)، وهي دورة من نوعٍ محظور في الرسم البياني غير الدوريّ.
وعليه، فإنّ طبقيّة صالحة لـ ، وهذا يُتمّ البرهان.
توقّف وتأمّل
قراءة البرهان مهارة لا تقلّ أهمية عن كتابته. والواقع أنّها، كما تمامًا فهم الشيفرة، مهارة صعبة جدًّا بذاتها. ولذلك فإنّني أنصحك بشدّة بأن تعيد قراءة البرهان أعلاه، وتسأل نفسك عند كلّ جملة عمّا إذا كان الافتراض الذي تتضمّنه مبرَّرًا، وهل تُظهر هذه الجملة فعلًا ما تدّعي أنّه تُظهره. ومن العادات الجيّدة أيضًا أن تسأل نفسك، حين تقرأ برهانًا، عن كلّ متغيّر تصادفه (مثل و و و وغيرها في البرهان أعلاه) الأسئلة التالية: (1) ما نوعُ هذا المتغيّر؟ هل هو عدد؟ أم رسم بياني؟ أم رأس؟ أم دالة؟ و (2) ماذا نعرف عنه؟ هل هو عنصر اعتباطي في المجموعة؟ هل أثبتنا عنه بعض الحقائق؟، و (3) ما الذي نُحاول إثباته عنه؟.
الأصغرية والتفرّد
تكفل مبرهنة — الفرز الطوبولوجي بأنّ لكلّ رسم بياني موجّه غير دوريّ هناك طبقيّة ما ، لكنّ هذه الطبقيّة ليست بالضرورة متفرّدة (unique). مثلًا، إذا كانت طبقيّة صالحة للرسم البياني، فإنّ الدالة المعرَّفة بـ طبقيّة صالحة أيضًا. غير أنّ الأمر ينتهي إلى أنّ الطبقيّة الأصغرية (minimal) متفرّدة. والطبقيّة الأصغرية هي التي يُسنَد فيها كلّ رأس إلى أصغر رقم طبقة ممكن. ونعرّف الآن الأصغرية رسميًّا ونطرح مبرهنة التفرّد:
مبرهنة — الطبقيّة الأصغرية متفرّدة
لتكن رسمًا بيانيًا موجّهًا غير دوريّ. نقول إنّ طبقيّة أصغرية (minimal) إذا كان لكلّ رأس ، فإن كان ليس له جيران واردون فإنّ ، وإن كان لـ جيران واردون فإنّ هناك جيرًا واردًا لـ بحيث .
ولكلّ طبقيّتين لـ ، إذا كانت كلتا و أصغرية فإنّ .
يترتّب على تعريف الأصغرية في مبرهنة — الطبقيّة الأصغرية متفرّدة أنّنا لا نستطيع نقل أيّ رأس إلى طبقة أدنى دون أن تصبح الطبقيّة غير صالحة. فإذا كان مصدرًا (أي درجته الداخلية صفر)، فإنّ الطبقيّة الأصغرية لا بدّ أن تضعه في الطبقة ، وأمّا كلّ آخر، فإذا كان ، فلا نستطيع تعديل ذلك لوضع ، لأنّ هناك جيرًا واردًا لـ يحقّق . وتقول مبرهنة — الطبقيّة الأصغرية متفرّدة إنّ الطبقيّة الأصغرية متفرّدة بالمعنى أنّ كلّ طبقيّة أصغرية أخرى تساوي .
الفكرة هي إثبات المبرهنة بالحَث على الطبقات. إذا كانت و أصغرية، فيجب أن تتفقا على رؤوس المصدر، لأنّ كلًّا من و ينبغي أن تُسند هذه الرؤوس إلى الطبقة . ويمكننا بعدها أن نُبيّن أنّه إذا كانت و متفقتين حتى الطبقة ، فإنّ خاصّية الأصغرية تقتضي أن تتفقا أيضًا في الطبقة . وفي البرهان الفعلي نستعمل حيلة صغيرة لتوفير الكتابة. فبدلًا من إثبات العبارة (أو بعبارة أخرى أنّ لكلّ )، نُثبت العبارة الأضعف وهي أنّ لكلّ . (وهذه عبارة أضعف، لأنّ شرط أنّ أصغر من أو مساوٍ له ينتج عن شرط أنّ يساوي .) غير أنّه، بما أنّ و ليسا سوى اسمين نضعهما لطبقيّتين أصغرَيين، فإنّ تغيير الاسمين «» و«» وحده يجعل البرهان نفسه يُظهر أيضًا أنّ لكلّ ، ومن ثمّ أنّ .
برهان
لتكن رسمًا بيانيًا موجّهًا غير دوريّ، و طبقيّتين أصغرَيتين صالحتين لـ . سنُثبت أنّ لكلّ لدينا . ولأنّنا لم نفترض أيّ شيء في سوى أصغرّيتهما، فإنّ البرهان نفسه سيُبيّن أيضًا أنّ لكلّ لدينا ، ومن ثمّ أنّ لكلّ ، وهذا هو ما احتجنا إلى إظهاره.
سنُثبت أنّ لكلّ بالحَث على . الحالة بديهية: فبما أنّ في هذه الحالة، وجب أن تكون على الأقلّ . أمّا في حالة ، فبأصغرية ، إذا كان فيجب أن يوجد جار وارد ما لـ بحيث . ومن فرضية الحَث نحصل على ، وبما أنّ طبقيّة صالحة فيجب أن يكون ، ما يعني أنّ .
توقّف وتأمّل
برهان مبرهنة — الطبقيّة الأصغرية متفرّدة دقيق تمامًا، لكنه مكتوب بصيغة مختصرة إلى حدٍّ ما. تأكّد من قراءته كاملًا وفهم لماذا يُعدّ هذا برهانًا محكم الإغلاق لعبارة المبرهنة.
هذا الكتاب: الترميز والاصطلاحات
معظم الترميز الذي نستعمله في هذا الكتاب ترميز قياسي مستعمل في معظم النصوص الرياضية. أمّا النقاط الرئيسة التي نخالف فيها فهي:
-
نرقّم الأعداد الطبيعية بدءًا من (مع أنّ نصوصًا كثيرة أخرى، خاصّةً في علم الحاسوب، تفعل الشيء نفسه).
-
ونرقّم أيضًا المجموعة بدءًا من ، ومن ثمّ نعرّفها بأنّها . وفي نصوص أخرى تُعرّف غالبًا بأنّها . وعلى نحو مماثل، فإنّنا نرقّم سلاسلنا النصية بدءًا من ، ومن ثمّ تُكتب السلسلة النصية على هيئة .
-
إذا كان عددًا طبيعيًا فإنّ لا تساوي العدد ، بل إنّها سلسلة نصية من واحدًا: (أي سلسلة من من الرقم 1). وعلى نحو مماثل، فإنّ تشير إلى السلسلة النصية بطول .
-
الدوال الجزئية (partial) هي دوال ليست معرَّفة بالضرورة على كلّ المداخل. وحين نكتب فإنّ ذلك يعني أنّ دالة كليّة ما لم نُنوّه إلى خلاف ذلك. وحين نريد أن نؤكّد أنّ قد تكون دالة جزئية، فإنّنا سنكتب أحيانًا .
-
كما سنرى لاحقًا في المساق، فإنّنا سنصف مسائلنا الحوسبية غالبًا في إطار حساب دالةٍ منطقية (Boolean function) . وبالمقابل، تصف كتبٌ دراسيةٌ أخرى المهمّة نفسها بأنّها الحكم على لغةٍ ما (deciding a language) . وهذان المنظوران متكافئان، لأنّ لكلّ مجموعة توجد دالة مقابلة بحيث إذا وفقط إذا . وحساب الدوال الجزئية يقابل المهمّة المعروفة في الأدبيات بأنّها حلّ مسألة وعدٍ (promise problem). ولأنّ ترميز اللغات شائع جدًّا في الكتب الدراسية الأخرى، فإنّنا سنُذكّر القارئ من حين لآخر بهذا التطابق.
-
نستعمل و لمشغّلَي «السقف» (ceiling) و«الأرضية» (floor)، اللذين يقابلان «التقريب إلى الأعلى» أو «التقريب إلى الأسفل» لعدد إلى أقرب عدد صحيح. ونستعمل للدلالة على «باقي» قسمة على ، أي أنّ . وفي السياق الذي يُتوقّع فيه عدد صحيح، فإنّنا نُقرّب الكميات عادةً «بصمت» إلى عدد صحيح. مثلًا، إذا قلنا إنّ سلسلة نصية طولها ، فإنّ ذلك يعني أنّ طولها . (ونُقرّب إلى الأعلى التزامًا بالاصطلاح، لكنّ في معظم هذه الحالات لن يُحدث الفرق إن قرّبنا إلى الأعلى أم إلى الأسفل.)
-
كما في معظم نصوص علم الحاسوب، فإنّنا نُعتمِد اللوغاريتم بالأساس 2. ولذلك فإنّ هي نفسها .
-
سنستعمل أيضًا التدوين اختصارًا لـ (أي اختصارًا للقول إنّ هناك ثابتين بحيث لكلّ كبير بما فيه الكفاية). وعلى نحو مماثل، سنستعمل اختصارًا لـ (أي اختصارًا للقول إنّ هناك ثابتين بحيث لكلّ كبير بما فيه الكفاية).
-
كما هو شائع في الأدبيات الرياضية، فإنّنا نستعمل علامة النَّسْب (apostrophe) لإثراء مجموعتنا من المعرّفات. فعادةً إذا كان يشير إلى شيء ما، فإنّ و وغيرها تشير إلى أشياء أخرى من النوع نفسه.
-
ولتقليل «الحمل المعرفي» فإنّنا نستعمل كثيرًا ثوابت مستديرة مثل في عبارات المبرهنات وفي أسئلة مجموعة التمارين. وحين ترى مثل هذا الثابت «المستدير»، فيمكنك عادةً أن تفترض أنّه لا أهمية خاصّة له وأنّه اختير عشوائيًّا. مثلًا، إن رأيت مبرهنة من الشكل «الخوارزمية تحتاج إلى خطوة على الأكثر لحساب الدالة على مداخل طولها »، فمن المرجّح أنّ العدد ثابت اعتباطي كبير بما فيه الكفاية، ويمكن إثبات المبرهنة نفسها بحدٍّ من الشكل حيث ثابت أصغر من . وبالمثل، إذا طلبت منك مسألة إثبات أنّ كمية ما على الأقلّ ، فمن المرجّح تمامًا أنّ الكمية في الحقيقة على الأقلّ حيث ثابت أصغر من .
اصطلاحات أسماء المتغيّرات
كما في البرمجة، الرياضيات مليئة بـ_المتغيّرات_. وفي كلّ مرّة ترى فيها متغيّرًا، من المهمّ دائمًا أن تتعقّب ما نوعُه (مثلًا: هل المتغيّر عدد، أم سلسلة نصية، أم دالة، أم رسم بياني، إلخ). ولتسهيل ذلك، نحاول الالتزام باصطلاحات معيّنة، ونستعمل باتّساق معرّفات معيّنة للمتغيّرات من النوع نفسه. بعض هذه الاصطلاحات مدرجة في notationtable أدناه. وهذه الاصطلاحات ليست قوانين غير قابلة للتغيير، وقد نُخالفها أحيانًا من حين لآخر. كما أنّ هذه الاصطلاحات لا تُغني عن الحاجة إلى التصريح بنوع الشيء الذي يشيره كلّ متغيّر جديد صراحةً.
---
caption: 'Conventions for identifiers in this book'
alignment: LL
table-width: 1/3
id: notationtable
---
*Identifier*	*Often denotes object of type*
$i$,$j$,$k$,$\ell$,$m$,$n$	Natural numbers (i.e., in $\mathbb{N} = \{0,1,2,\ldots \}$)
$\epsilon,\delta$	Small positive real numbers  (very close to $0$)
$x,y,z,w$	Typically strings in $\{0,1\}^*$ though sometimes numbers or other objects. We often identify an object with its representation as a string.
$G$	A _graph_. The set of $G$'s vertices is typically denoted by $V$. Often $V=[n]$. The set of $G$'s edges is typically denoted by $E$.
$S$	Set
$f,g,h$	Functions. We often (though not always) use lowercase identifiers for _finite functions_, which map  $\{0,1\}^n$ to $\{0,1\}^m$ (often $m=1$).
$F,G,H$	Infinite (unbounded input) functions mapping $\{0,1\}^*$ to $\{0,1\}^*$ or $\{0,1\}^*$ to $\{0,1\}^m$ for some $m$. Based on context, the identifiers $G,H$ are sometimes used to denote functions and sometimes graphs.
$A,B,C$	Boolean circuits
$M,N$	Turing machines
$P,Q$	Programs
$T$	A function mapping $\mathbb{N}$ to $\mathbb{N}$ that corresponds to a time bound.
$c$	A positive number (often an unspecified constant; e.g.,  $T(n)=O(n)$ corresponds to the existence of $c$ s.t. $T(n) \leq c \cdot n$ every $n>0$). We sometimes use $a,b$ in a similar way.
$\Sigma$	Finite set (often used as the _alphabet_ for a set of strings).
بعض العادات اللفظية (idioms)
تستعمل النصوص الرياضية في كثير من الأحيان اصطلاحات أو «عادات لفظية» (idioms) معيّنة.
ومن أمثلة هذه العادات التي نستعملها في هذا النص ما يلي:
-
«ليكن ...»، أو «ليشرِف إلى ...»، أو «ليكن »:__ هذه كلّها طرائق مختلفة للقول إنّنا نُعرِّف الرمز ليشير إلى أيًّا كان التعبير الوارد في . وحين يكون خاصّيةً (property) لأشياء ما، فقد نعرّف بأن نكتب شيئًا من قبيل «نقول إنّ له الخاصّية إذا ...». ورغم أننا نحاول غالبًا تعريف المصطلحات قبل استعمالها، فإنّ جملة رياضية ما تكون أحيانًا أوضح إذا استعملنا مصطلحًا قبل تعريفه، وعندئذٍ نضيف «حيث هو ...» لتفسير كيفية تعريف في التعبير السابق.
-
الكمّاسات: تنطوي النصوص الرياضية على كمّاسات كثيرة مثل «لكلّ» و«يوجد». ونكتبها أحيانًا بالكلمات كما في «لكلّ » أو «يوجد »، وأحيانًا نستعمل الرموز الصوريّة و . ومن المهمّ أن تتعقّب أيّ متغيّر يُكمَّس وبأيّ طريقة تتبع الاعتماديات (dependencies) بين المتغيّرات. مثلًا، تعني قطعة الجملة مثل «لكلّ يوجد » أنّ يمكن اختياره بطريقة تعتمد على . وترتيب الكمّاسات مهمّ. مثلًا، العبارة التالية صحيحة: «لكلّ عدد طبيعي يوجد عدد أولي بحيث إنّ يقسم .» وبالمقابل، العبارة التالية خاطئة: «يوجد عدد أولي بحيث إنّ لكلّ عدد طبيعي يقسم العددَ .»
-
المعادلات والمبرهنات والتعريفات المرقّمة: لتعقّب كلّ المصطلحات التي نعرّفها والعبارات التي نُثبتها، فإنّنا نُسند إليها وسمًا (عدديًّا في الغالب)، ثمّ نُحيل إليه في أجزاء أخرى من النص.
-
(i.e.), (e.g.): تميل النصوص الرياضية إلى أن تحتوي على عدد كبير من هذه التعبيرات. فنستعمل (i.e., ) في الحالات التي تكون فيها مكافئةً لـ ، ونستعمل (e.g., ) في الحالات التي يكون فيها مثالًا على (مثلًا، يمكن استعمال عبارات مثل «عدد طبيعي (أي، عدد صحيح غير سالب)» أو «عدد طبيعي (مثالًا، )»).
-
«إذن»، «لذلك»، «نحصل على أنّ»: وهذا يعني أنّ الجملة التالية تنبع من الجملة السابقة، مثل «الرسم البياني ذو رأسًا متّصل. لذلك يحتوي على ضلعًا على الأقلّ.» ونستعمل أحيانًا «بالفعل» للدلالة على أنّ النص التالي يبرّر المزاعم الواردة في الجملة السابقة، مثل «للرسم البياني ذو رأسًا ضلعًا على الأقلّ. بالفعل، هذا يتبع لأنّ متّصل.»
-
الثوابت: في علم الحاسوب، نهتمّ عادةً بكيفية تغيّر (scales) استهلاك خوارزمياتنا للموارد (مثل زمن التنفيذ) مع كميات معيّنة (مثل طول الدخل). ونشير إلى الكميات التي لا تعتمد على طول الدخل بأنّها ثوابت (constants)، ولذلك نستعمل كثيرًا عبارات مثل «يوجد ثابت بحيث إنّ لكلّ تعمل الخوارزمية في خطوة على الأكثر على مداخل طولها .» واللفظ «ثابت» بالنسبة إلى ليس ضروريًا تمامًا، لكنّه يُضاف للتأكيد على أنّ هنا عدد ثابت مستقلّ عن . والواقع أنّنا أحيانًا، لتقليل الحمل المعرفي، نستبدل ببساطة بعدد مستدير كبير بما فيه الكفاية مثل أو أو ، أو نستعمل ترميز ونكتب «الخوارزمية تعمل في زمن .».
خلاصة
- «بنى البيانات الرياضية» الأساسية التي سنحتاجها هي الأعداد و_المجموعات_ و_المعطوفات_ و_السلاسل النصية_ و_الرسوم البيانية_ و_الدوال_.
- يمكننا استعمال الأشياء الأساسية لتعريف مفاهيم أعقد. مثلًا، يمكن تعريف الرسوم البيانية على أنها قائمة من الأزواج.
- بالاعتماد على تعريفاتٍ دقيقة للأشياء، يمكننا أن نصوغ عباراتٍ لا لبس فيها ودقيقة. ثمّ يمكننا استعمال البراهين الرياضية لتحديد ما إذا كانت هذه العبارات صادقة أم خاطئة.
- البرهان الرياضي ليس طقسًا صوريًّا، بل هو حجّة واضحة ودقيقة و«لا يمكن اختراقها» تُثبت صحّة عبارة معيّنة.
- ترميز الكبير نظام صوري مفيد جدًّا لحجب التفاصيل الأقلّ أهمية، ويسمح لنا بالتركيز على السلوك العامّ للكميات التي تهمّنا.
- الطريقة الوحيدة للاستئناس بالمفاهيم الرياضية هي تطبيقها في سياقات حلّ المسائل. ومن المتوقّع أن تحتاج إلى الرجوع مرّة بعد أخرى إلى التعريفات والترميز في هذا الفصل وأنت تعمل على مسائل هذا المساق.
التمارين
تمرين — التعبيرات المنطقية
a. اكتب تعبيرًا منطقيًّا يتضمّن المتغيّرات والمشغّلات (AND) و (OR) و (NOT)، بحيث يكون صادقًا إذا كانت أغلبية المداخل صادقة (True).
b. اكتب تعبيرًا منطقيًّا يتضمّن المتغيّرات والمشغّلات (AND) و (OR) و (NOT)، بحيث يكون صادقًا إذا كان المجموع (مع اعتبار «صادق» و«خاطئ» ) فرديًّا (odd).
تمرين — الكمّاسات
استعمل الكمّاسات المنطقية (لكلّ) و (يوجد)، وكذلك والعمليات الحسابية لكتابة ما يلي:
a. تعبير بحيث إنّ لكلّ الأعداد الطبيعية ، يكون صادقًا إذا وفقط إذا كان يقسم .
b. تعبير بحيث إنّ لكلّ عدد طبيعي ، يكون صادقًا إذا وفقط إذا كان قوةً للعدد ثلاثة.
تمرين
صِف العبارة التالية بالكلمات الإنجليزية: .
تمرين — تدوين بناء المجموعات
صِف المجموعات التالية بالكلمات:
a.
b.
تمرين — وجود دوالّ أحادية الحقن
لكلّ زوج من المجموعات الآتية ، أثبت أو أبطِل العبارة التالية: هناك دالة أحادية الحقن تُسقط على .
a. ليكن ، و و .
b. ليكن ، و هي مجموعة كلّ الدوال التي تُسقط على . و .
c. ليكن ، و ، و .
تمرين — مبدأ الاحتواء والطرد
a. لتكن مجموعتَين منتهيتين. أثبت أنّ .
b. لتكن مجموعات منتهية. أثبت أنّ .
c. لتكن مجموعات جزئية منتهية من ، بحيث لكلّ . أثبت أنّه إذا كان ، فإنّ هناك مجموعتَين متمايزتَين بحيث $.
تمرين
أثبت أنّه إذا كانت منتهيتين و حقنة، فإنّ .
تمرين
أثبت أنّه إذا كانت منتهيتين و مغطّية، فإنّ .
تمرين
أثبت أنّه لكلّ منتهيتين، هناك دالة جزئية من إلى .
تمرين
لنفترض أنّ متتالية بحيث ، وأنّ فإنّ . أثبت بالحَث أنّ لكلّ .
تمرين
أثبت أنّه لكلّ رسم بياني غير موجّه ذو رأس، إذا كانت درجة كلّ رأس لا تتجاوز ، فإنّ هناك مجموعة جزئية من رأسًا على الأقلّ بحيث لا يكون رأسان في متجاورَين.
تمرين — ترميز
لكلّ زوج من الدوالّ أدناه، حدّد أيّ العلاقات التالية تتحقّق: ، أو ، أو ، أو .
a. ، .
b. ، .
c. ، .
d. ، .
e. ، (حيث هو عدد المجموعات الجزئية ذات الحجم من مجموعة حجمها ). انظر الحاشية للتلميح.[7]
تمرين
اذكر مثالًا لزوج من الدوالّ بحيث لا تتحقّق ولا العلاقة ولا العلاقة .
تمرين
أثبت أنّه لكلّ رسم بياني غير موجّه على رؤوس، إذا كان لـ أضلاع على الأقلّ فإنّ يحتوي على دورة.
تمرين
أثبت أنّه لكلّ رسم بياني غير موجّه ذو رأس، إذا كانت درجة كلّ رأس لا تتجاوز ، فإنّ هناك مجموعة جزئية من رأس على الأقلّ بحيث لا يكون رأسان في متجاورَين.
ملاحظات مرجعية
يشير العنوان «اعتذار الرياضياتي» إلى كتاب هاردي الكلاسيكي [@Hardy41]. وحتى حين يكون هاردي مخطئًا، فإنّ قراءته تستحقّ القراءة إلى حدٍّ بعيد.
هناك مصادر كثيرة على الإنترنت للخلفية الرياضية التي يحتاجها هذا الكتاب. وبخاصة، فإنّ ملاحظات محاضرات MIT 6.042 «الرياضيات لعلوم الحاسوب» [@LehmanLeightonMeyer] وافية جدًّا، ومقاطع الفيديو والواجبات الخاصّة بهذا المساق متاحة على الإنترنت. وبالمثل، فإنّ مساق Berkeley CS 70: «الرياضيات المتقطّعة ونظرية الاحتمال» لديه ملاحظات محاضرات وافية على الإنترنت.
ومن المصادر الأخرى للرياضيات المتقطّعة كتاب Rosen [@Rosen19discrete] وكتاب Jim Apsnes الإلكتروني [@AspensDiscreteMath]. ويقدّم Lewis وZax [@LewisZax19]، وكذلك الكتاب الإلكتروني لـFleck [@Fleck]، عرضًا ألطف لكثير من المادة نفسها. ويُعدّ Solow [@Solow14] مقدّمة جيّدة لقراءة البراهين وكتابتها. ويقدّم Kun [@Kun18] مقدّمة في الرياضيات موجّهة إلى القرّاء ذوي الخلفيات البرمجية. ولدى Stanford مساق CS 103 مجموعة ممتازة من النشرات عن تقنيات البراهين الرياضية والرياضيات المتقطّعة.
ابتكر الرياضياتيّ Sylvester عام 1878 لفظَ رسم بياني بالمعنى الوارد في تعريف — الرسوم البيانية غير الموجّهة، تشبيهًا بالرسوم الكيميائية المستعملة لتصوير الجزيئات. وهناك خلط مؤسف بين هذا المصطلح والاستعمال الأكثر شيوعًا للفظ «رسم بياني» بمعنى رسم البيانات، وبخاصة رسم دالة ما بدلالة . وإحدى طرائق ربط هذين المفهومين هي التمييز بين كلّ دالة وبين الرسم البياني الموجّه على مجموعة الرؤوس بحيث إنّ يحتوي الضلع لكلّ . وفي الرسم البياني المبنيّ بهذه الطريقة، يكون لكلّ رأس في درجة خروج تساوي واحدًا. وإذا كانت الدالة أحادية الحقن فإنّ لكلّ رأس في تكون درجة الدخول على الأكثر واحدًا. وإذا كانت الدالة مغطّية فإنّ لكلّ رأس في تكون درجة الدخول على الأقلّ واحدًا. وإذا كانت تقابلًا فإنّ لكلّ رأس في تكون درجة الدخول مساوية تمامًا للواحد.
اقتباس كارل بوميرانس مأخوذ من الصفحة الرئيسية لـ Doron Zeilberger.
الحرف Z يرمز إلى الكلمة الألمانية «Zahlen» التي تعني «الأعداد». ↩︎
لعددين طبيعيين و، فإنّ (اختصارًا لـ"modulo") تدلّ على باقي (remainder) قسمة على . أي أنّها العدد في بحيث لأجل عدد صحيح . ونستعمل أحيانًا أيضًا التدوين للدلالة على أنّ تساوي . ↩︎
من الممكن، وأحيانًا مفيد، أن نفكّر في الرسم البياني غير الموجّه على أنه الحالة الخاصّة من الرسم البياني الموجّه التي تملك خاصّيةً خاصة، هي أنّه لكلّ زوج إمّا كان الضلعان و حاضرين معًا أو لم يكن أيٌّ منهما حاضرًا. غير أنّ هناك فرقًا جوهريًا في كثير من السياقات بين الرسوم البيانية غير الموجّهة والموجّهة، ولذلك فإنّ الأفضل عادةً التفكير فيها بوصفها فئتين منفصلتين. ↩︎
في هذا الكتاب نضع المتغيّر المربوط بالكمّاس في حاشية سفلية، ولذلك نكتب . أمّا نصوصٌ كثيرة أخرى فلا تستعمل تدوين الحاشية هذا، فتكتب العبارة نفسها على هيئة . ↩︎
اختصار QED هو من عبارة "quod erat demonstratum" اللاتينية، أي «ما كان ينبغي إثباته» أو «ذات الشيء الذي كان مطلوبًا بيانه». ↩︎
استعمال كحالة أساس صحيح منطقيًّا، لكنّه قد يكون مربكًا. إن وجدتَ حالة البديهية مربكة، فيمكنك دائمًا أن تتحقّق مباشرةً من العبارة عند ، ثمّ تستعمل و معًا كحالتَي أساس. ↩︎
إحدى طرائق ذلك هي استعمال تقريب ستيرلين لدالة مضروب المعامل. ↩︎