النصوص
«آه؟ كراهية بسيطة للعمل اليدوي؟» رفع الطبيب حاجبه. «وهذا مفهوم، لكنه في غير موضعه. ينبغي للمرء أن يقدّر تلك المهام الرتيبة التي تُشغل الجسد وتترك العقل والقلب طليقين.»
تاد ويليامز، كرسي عظمة التنين
بإمكان آلتنا الافتراضية الصغيرة أن تمثّل ثلاثة أنواع من القيم الآن: الأعداد
والقيم المنطقية وnil. ولهذه الأنواع صفتان مهمّتان مشتركتان: أنها غير قابلة
للتغيير وأنها صغيرة. الأعداد هي الأكبر، ومع ذلك ما زالت تتّسع في كلمتين بعرض
64 بت. هذا ثمن صغير بما يكفي يمكننا تحمّله لكل القيم، حتى القيم المنطقية والقيم
الـ nil التي لا تحتاج كل هذه المساحة.
النصوص، للأسف، ليست بهذه الصغر. فلا يوجد حدّ أقصى لطول نصّ. حتى لو اخترنا فسرياً له عند حدّ مصطنع مثل 255 محرفاً، فذلك يظلّ ذاكرة أكثر مما يُنفَق على كل قيمة على حدة.
نحتاج إلى وسيلة لدعم قيم أحجامها متفاوتة، أحياناً إلى حدٍّ كبير. وهذا بالضبط ما صُمّم له التخصيص الديناميكي في الكومة. يمكننا تخصيص عدد البايتات الذي نحتاجه. فنحصل على مؤشر سنستخدمه لتتبّع القيمة وهي تتدفّق في الآلة الافتراضية.
القيم والكائنات
استخدام الكومة للقيم الأكبر ذات الحجم المتغيّر، والمكدّس للقيم الصغيرة الذرّية، يؤدي إلى تمثيل على مستويين. كل قيمة Lox تستطيع تخزينها في متغيّر أو إرجاعها من تعبير ستكون Value. أما الأنواع الصغيرة ذات الحجم الثابت مثل الأعداد، فتُخزَّن حمولتها مباشرةً داخل بنية Value نفسها.
وإذا كان الكائن أكبر، فإن بياناته تعيش في الكومة. عندئذٍ تكون حمولة Value مؤشراً إلى تلك الكتلة من الذاكرة. وسنحصل في النهاية على حفنة من الأنواع المخصَّصة في الكومة داخل clox: النصوص، والنسخ، والدوال، تفهم الفكرة. ولكل نوع بياناته الفريدة، لكن هناك أيضاً حالة تشترك فيها جميعها سيستخدم [جامع القمامة المستقبلي][] لدينا لإدارة ذاكرتها.
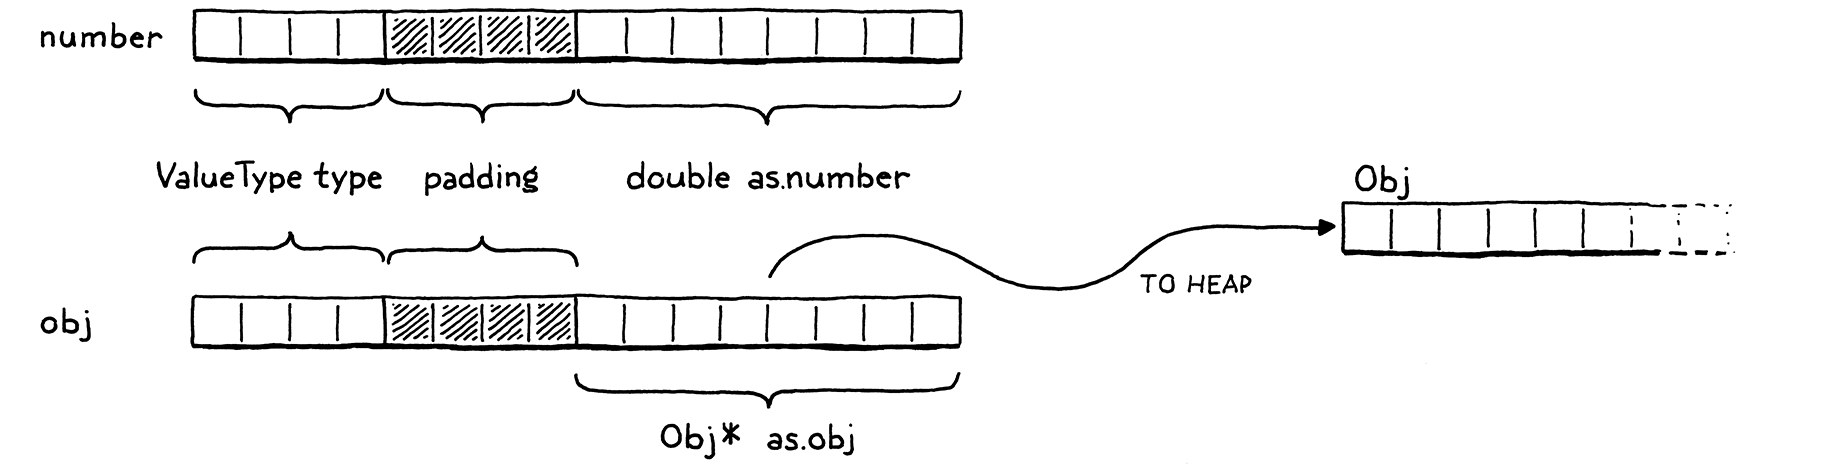
سنسمّي هذا التمثيل المشترك "Obj". كل قيمة Lox التي تعيش حالتها في الكومة هي Obj. وبذلك يمكننا استخدام حالة ValueType جديدة واحدة للإشارة إلى جميع الأنواع المخصَّصة في الكومة.
^code val-obj (1 before, 1 after)
وحين يكون نوع القيمة هو VAL_OBJ، تكون الحمولة مؤشراً إلى ذاكرة الكومة، لذا نضيف
حالة أخرى إلى الاتحاد من أجلها.
^code union-object (1 before, 1 after)
وكما فعلنا مع أنواع القيم الأخرى، نُخرج بضعة ماكروهات مفيدة للعمل مع قيم Obj.
^code is-obj (1 before, 2 after)
يُقيَّم هذا إلى true إذا كانت القيمة المعطاة هي Obj. وإن كان كذلك، يمكننا استخدام
هذا:
^code as-obj (2 before, 1 after)
وهو يستخرج مؤشر Obj من القيمة. ويمكننا أيضاً الذهاب في الاتجاه الآخر.
^code obj-val (1 before, 2 after)
يأخذ هذا مؤشر Obj مجرداً ويلفّه في قيمة Value كاملة.
وراث البنى
كل قيمة مخصَّصة في الكومة هي Obj، لكن Objs ليست كلها متساوية. فنحن نأحتاج للنصوص إلى مصفوفة المحارف. وعندما نصل إلى النسخ، ستحتاج إلى حقول بياناتها. وكائن الدالة سيحتاج إلى قطعة شيفرة البايت الخاصة به. كيف نتعامل مع حمولات وأحجام مختلفة؟ لا يمكننا استخدام اتحاد آخر كما فعلنا مع Value لأن الأحجام متباينة تماماً.
بدلاً من ذلك، سنستخدم تقنية أخرى. لقدت منذ زمن طويل، إلى حدّ أن مواصفة C تُفرد لها دعماً خاصاً، لكنني لا أعرف أن لها اسماً قانونياً. إنها مثال على التنميط الرقمي (type punning)، لكن ذلك المصطلح فضفاض إلى حدٍّ ما. وفي غياب أي أفكار أفضل، سأسميها وراثة البنى (struct inheritance)، لأنها تعتمد على البنى وتتبع بشكل تقريبي كيف تعمل الوراثة المفردة للحالة في اللغات الموجّهة للكائنات.
وكما في الاتحاد الموسوم، يبدأ كل Obj بحقل وسم يحدّد نوع الكائن الذي هو -- نصّ أو نسخة أو ما شابه. وبعد ذلك تأتي حقول الحمولة. بدلاً من اتحاد له حالات لكل نوع، يكون كل نوع بنيته الخاصة المنفصلة. الجزء الصعب هو كيفية معاملة هذه البنى بصورة موحّدة، إذ لا يوجد في C مفهوم للوراثة أو تعدّد الأشكال. سأشرح ذلك قريباً، لكن أولا، لنُخرج الأمور المخقّة من الطريق.
واسم "Obj" نفسه يشير إلى بنية تحوي الحالة المشتركة بين جميع أنواع الكائنات. فهي نوعاً ما مثل «الصنف الأساس» للكائنات. وبسبب بعض التبعيات الدورية بين القيم والكائنات، نُعلنها مسبقاً (forward-declare) في وحدة "value".
^code forward-declare-obj (2 before, 1 after)
والتعريف الفعلي في وحدة جديدة.
^code object-h
في الوقت الحالي، لا تحوي سوى وسم النوع. وقريباً سنضيف بعض معلومات الح الأخرى لإدارة الذاكرة. وتعداد الأنواع هو:
^code obj-type (1 before, 2 after)
من الواضح أن ذلك سيكون أكثر نفعاً في الفصول اللاحقة بعد أن نضيف أنواعاً مخصَّصة في الكومة أكثر. وبما أننا سنصل إلى أنواع الوسم هذه كثيراً،,it من ماكرو صغير يستخرج وسم نوع الكائن من قيمة معطاة.
^code obj-type-macro (1 before, 2 after)
هذه هي أسّاسنا.
الآن، لنبنِ النصوص فوقه. تُعرَّف حمولة النصوص في بنية منفصلة. ومرةً أخرى، نحتاج إلى إعلانها مسبقاً.
^code forward-declare-obj-string (1 before, 2 after)
ويعيش التعريف بجوار Obj.
^code obj-string (1 before, 2 after)
يحتوي كائن النصّ على مصفوفة محارف. وتُخزَّن تلك في مصفوفة منفصلة مخصَّصة في الكومة حتى لا نخصص إلا القدر الضروري من المساحة لكل نصّ. ونخزّن أيضاً عدد البايتات في المصفوفة. وهذا ليس ضرورياً تماماً لكنه يتيح لنا معرفة مقدار الذاكرة المخصَّصة للنصّ دون المرور على مصفوفة المحارف للعثور على بايت الإيقاف.
ولأن ObjString هو Obj، فإنه يحتاج أيضاً إلى الحالة التي تشترك فيها جميع Obj. وهو يحقق ذلك بجعل حقله الأول هو Obj. وتُنص C على أن حقول البنى تُرتَّب في الذاكرة حسب ترتيب التصريح بها. أيضاً، حين تتداخل البنى، تتوسّع حقول البنية الداخلية في المكان نفسه. لذا تبدو ذاكرة Obj و ObjString هكذا:
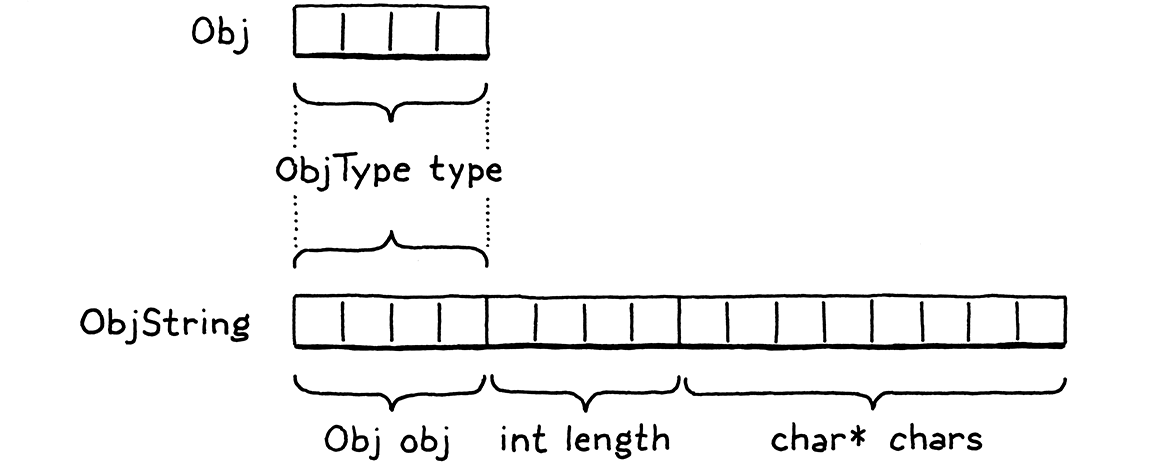
لاحظ كيف تصطف البايتات الأولى من ObjString تماماً مع Obj. مصادفة -- بل C تشترط ذلك. وهذا مصمَّم لتفعيل نمط ذكي: يمكنك أخذ مؤشر إلى بنية وتحويله بأمان إلى مؤشر إلى حقلها الأول ثم العودة.
معطى ObjString*، يمكنك تحويله بأمان إلى Obj* ثم الوصول إلى حقل type منه. كل
ObjString «هو» Obj بمعنى «is» في البرمجة الموجّهة للكائنات. وعندما نضيف لاحقاً
أنواع كائنات أخرى، سيكون لكل بنية حقل Obj أول. وأي شيفرة تريد العمل مع جميع
الكائنات تستطيع معاملتها بوصفها Obj* أساسية وتتجاهل أي حقول أخرى قد تأتي بعدها.
ويمكنك الذهاب في الاتجاه الآخر أيضاً. معطى Obj*، يمكنك «تحويله هابطاً» إلى
ObjString*. بالطبع، عليك أن تتأكّد من أن مؤشر Obj* الذي لديك يشير فعلاً إلى
حقل obj في ObjString حقيقي. وإلا فإنك تعيد تفسير بتات عشوائية من الذاكرة تفسيراً
غير آمن. وللكشف عن أن هذا التحويل آمن، نضيف ماكرواً آخر.
^code is-string (1 before, 2 after)
يأخذ هذا قيمة Value لا مؤشر Obj* خاماً لأن معظم شيفرة الآلة الافتراضية تعمل مع
القيم. ويعتمد على دالة سطرية هذه:
^code is-obj-type (2 before, 2 after)
اختبار سريع: لماذا لا نضع جسم هذه الدالة مباشرةً داخل الماكرو؟ ما الفرق بين هذه
وغيرها؟ حسناً، السبب أن الجسم يستخدم value مرتين. فالماكرو يُوسَّع بإدراج تعبير
الوسيط في كل موضع يظهر فيه اسم المعامل داخل الجسم. فإذا استخدم ماكرو معاملاً أكثر
من مرّة، فإن ذلك التعبير سيُقيَّم عدّة مرّات.
وهذا سيّئ إن كان التعبير له آثار جانبية. فإذا وضعنا جسم isObjType() في تعريف
الماكرو ثم فعلتَ، مثلاً:
IS_STRING(POP())
لسيسحب ذلك قيمتين من المكدّس! واستخدام دالة يحلّ تلك المشكلة.
طالما أننا نتأكّد من ضبط وسم النوع على نحو صحيح كلما أنشأنا Obj من نوع ما، فسيخبرنا هذا الماكرو متى يكون تحويل قيمة إلى نوع كائن معيّن آمناً. يمكننا فعل ذلك باستخدام هذين:
^code as-string (1 before, 2 after)
يأخذ هذان الماكروان قيمة Value متوقَّع أن تحوي مؤشراً إلى ObjString صالح في الكومة.
ويُعيد الأول مؤشر ObjString*. ويخطو الثاني فوق ذلك ليعيد مصفوفة المحارف نفسها،
لأنها غالباً ماسنحتاجها في النهاية.
النصوص
حسنا، بإمكاننا الآن أن تمثّل قيم النصوص. حان وقت إضافة النصوص إلى اللغة نفسها. وكالمعتاد، نبدأ في المقدّمة. فالمحلّل المعجمي (scanner) يُصدر رموزاً للنصوص الحرفية، لذا جاء دور المحلل النحوي (parser).
^code table-string (1 before, 1 after)
وحين يصطدم المحلل النحوي برمز نصّ، يستدعي دالة التحليل هذه:
^code parse-string
يأخذ هذا محارف النصّ مباشرةً من المُعرِّف (lexeme).
وأجزاء + 1 و - 2 تقتطع علامتَي الاقتباس الأولى والأخيرة. ثم ينشئ كائن نصّ،
ويلفّه في قيمة Value، ويحشره في جدول الثوابت.
ولإنشاء النصّ، نستخدم copyString() المعلَنة في object.h.
^code copy-string-h (2 before, 1 after)
ووحدة المصرّف تحتاج إلى تضمين ذلك.
^code compiler-include-object (2 before, 1 after)
وتحصل وحدة "object" لدينا على ملف تنفيذ نُعرّف فيه الدالة الجديدة.
^code object-c
أولاً، نخصص مصفوفة جديدة في الكومة، كبيرة بما يكفي لمحارف النصّ وللبايت الختام (terminator) في نهايته، باستخدام هذا الماكرو منخفض المستوى الذي يخصص مصفوفة بنوع عنصر وعدد معيّنين:
^code allocate (2 before, 1 after)
ومتى امتلاكنا المصفوفة، ننسخ المحارف من المُعرِّف وننهيها.
قد تتساءل لماذا لا يستطيع ObjString أن يشير ببساطة إلى المحارف الأصلية في شيفرة المصدر. فبعض ObjStrings ستُنشأ ديناميكياً في الزمن التشغيل نتيجة لعمليات على النصوص مثل الدمج. وواضح أن تلك النصوص تحتاج إلى تخصيص ذاكرة ديناميكياً للمحارف، ما يعني أن النصّ يحتاج إلى تحرير تلك الذاكرة عندما لم تعد هناك حاجة إليها.
ولو كان لدينا ObjString لنصّ حرفي، وحاولنا تحرير مصفوفة محارفه التي تشير إلى شيفرة المصدر الأصلية، لحدثت أشياء سيّئة. لذا، بالنسبة للنصوص الحرفية، ننسخ المحارف مسبقاً إلى الكومة. وبهذه الطريقة، يملك كل ObjString مصفوفة محارفه بموثوقية ويستطيع تحريرها.
والعمل الحقيقي لإنشاء كائن نصّ يحدث في هذه الدالة:
^code allocate-string (2 before)
فهي تنشئ ObjString جديداً في الكومة ثم تهيّئ حقوله. وهي نوعاً ما مثل مُنشئ في لغة موجّهة للكائنات. ولهذا فإنها أولاً تستدعي مُنشئ «الصنف الأساس» لتهيئة حالة Obj، باستخدام ماكرو جديد.
^code allocate-obj (1 before, 2 after)
مثل الماكرو السابق، فإن هذا موجود أساساً لتجنّب الحاجة
إلى تحويل void* زائداً إلى النوع المطلوب. والوظيفة الفعلية هنا:
^code allocate-object (2 before, 2 after)
فهو يخصص كائناً بالحجم المعطى في الكومة. ولاحظ أن الحجم ليس مجرد حجم Obj نفسه. فالمُنادي يمرّر عدد البايتات بحيث تتّسع المساحة لحقول الحمولة الإضافية التي يحتاج إليها نوع الكائن المحدد الجاري إنشاؤه.
ثم يهيّئ حالة Obj -- أي في الوقت الحالي وسم النوع فقط. وتعود هذه الدالة إلى
allocateString() التي تُكمل تهيئة حقول ObjString. Voilà،
صار بإمكاننا صرّف وتنفيذ النصوص الحرفية.
العمليات على النصوص
نصوصنا الأنيقة هنا، لكنها لا تفعل شيئاً تقريباً بعد. وخطوة أولى جيدة هي أن نجعل شيفرة الطباعة القائمة لا تتقيّأ على نوع القيمة الجديد.
^code call-print-object (1 before, 1 after)
إذا كانت القيمة كائناً مخصَّصاً في الكومة، فإنها تفوّض الأمر إلى دالة مساعدة في وحدة "object".
^code print-object-h (1 before, 2 after)
ويبدو التنفيذ هكذا:
^code print-object
لدينا الآن نوع كائن واحد فقط، لكن هذه الدالة ستنبت حالات switch إضافية في فصول لاحقة. وبالنسبة لكائنات النصوص، فإنها ببساطة تطبع مصفوفة المحارف كأنها نصّ C.
كما تحتاج مشغّلات المساواة إلى التعامل مع النصوص بأسلوب حسن. تأمّل:
"string" == "string"
هذان نصّان حرفان منفصلان. سيقوم المصرّف باستدعاءين منفصلين لـ copyString()،
وينشئ كائنين مختلفين من ObjString ويخزّنهما كثابتين في القطعة. إنهما كائنان مختلفان
في الكومة. لكن مستخدمينا (وبالتالي نحن) يتوقّعون أن تكون للنصوص مساواة بالقيمة. وينبغي
أن يُقيَّم التعبير أعلاه إلى true. وهذا يتطلّب بعض الدعم الخاص.
^code strings-equal (1 before, 1 after)
إذا كانت القيمتان نصّين، فإنهما متساويتان إذا كانت مصفوفتا محارفهما تحتويان على المحارف نفسها، بغضّ النظر عمّا إذا كانا كائنين منفصلين أو الكائن نفسه بالضبط. وهذا يعني فعلاً أن مساواة النصوص أبطأ من المساواة على أنواع أخرى لأنها تضطر إلى المرور على النصّ كله. سنُنقّح ذلك لاحقاً، لكن هذا يمنحنا الدلالات الصحيحة الآن.
وأخيراً، لكي نستخدم memcmp() والأشياء الجديدة في وحدة "object"، نحتاج إلى
بضعة تضمينات. هنا:
^code value-include-string (1 before, 2 after)
وهنا:
^code value-include-object (2 before, 1 after)
الدمج
توفّر اللغات الناضجة عمليات كثيرة للعمل مع النصوص -- الوصول إلى محارف مفردة، وطول النصّ، وتغيير حالة الأحرف، والتقسيم، والدمج، والبحث، إلخ. وحين تنفّذ لغتك، فمن المرجّح أن تريد كل ذلك. لكن في هذا الكتاب، نبقي الأمور دائماً في الحدّ الأدنى.
العملية الوحيدة المميزة التي ندعمها على النصوص هي +. فإذا استخدمتَ ذلك المشغّل على
كائنَي نصّ، فإنه ينتج نصّاً جديداً هو دمج المُعاملين. وبما أن Lox مكتوبة النوع
ديناميكياً، فلا يمكننا تحديد أيّ سلوك مطلوب وقت التصريف لأننا لا نعرف أنواع
المُعاملين حتى الزمن التشغيل. ولهذا، تفحص تعليمة OP_ADD المُعاملين ديناميكياً
وتختار العملية الصحيحة.
^code add-strings (1 before, 1 after)
إذا كان كلا المُعاملين نصّين، فسوندمجهما. وإذا كان كلاهما عددين، فسونجمعهما. وأي تركيبة أخرى لأنواع المُعاملات فهي خطأ زمني.
ولدمج النصوص، نُعرّف دالة جديدة.
^code concatenate
إنها مطوّلة إلى حدٍّ كبير، كما تميل شيفرة C التي تعمل مع النصوص أن تكون. أولاً، نحسب طول نصّ النتيجة بناءً على أطوال المُعاملين. ثم نخصص مصفوفة محارف للنتيجة وننسخ إليها النصفين. وكالمعتاد، نتأكّد بعناية من أن النصّ منهي.
ولكي نستدعي memcpy()، تحتاج الآلة الافتراضية إلى تضمين.
^code vm-include-string (1 before, 2 after)
وأخيراً، ننتج ObjString ليحتوي تلك المحارف. وهذه المرة نستخدم دالة جديدة، هي
takeString().
^code take-string-h (2 before, 1 after)
ويبدو التنفيذ هكذا:
^code take-string
تفترض دالة copyString() السابقة أنها لا تستطيع تملّك ملكية المحارف التي تمرّرها.
بدلاً من ذلك، تنشئ نسخة متحفّظة من المحارف في الكومة يملكها ObjString. وهذا هو
السلوك الصحيح للنصوص الحرفية حيث تكون المحارف المُمرَّرة في منتصف شيفرة المصدر.
لكن في حالة الدمج، كنا قد خصّصنا مصفوفة محارف ديناميكياً في الكومة. وصنع
نسخة أخرى منها سيكون تكراراً ( ويعني أن concatenate() يجب أن تتذكّر تحرير نسختها).
بدلاً من ذلك، تطالب هذه الدالة بملكية النصّ الذي تعطيها إياه.
وكالمعتاد، يتطلب تجميع هذه الوظيفة معاً بضعة تضمينات.
^code vm-include-object-memory (1 before, 1 after)
تحرير الكائنات
تأمّل هذا التعبير الذي يبدو بريئاً:
"st" + "ri" + "ng"
حين يمضغ المصرّف هذا، يخصص ObjString لكل من تلك النصوص الحرفية الثلاثة ويخزّنها في جدول ثوابت القطعة، ويولّد شيفرة البايت هذه:
0000    OP_CONSTANT         0 "st"
0002    OP_CONSTANT         1 "ri"
0004    OP_ADD
0005    OP_CONSTANT         2 "ng"
0007    OP_ADD
0008    OP_RETURN
تدفع التعليمتان الأوليان "st" و"ri" على المكدّس. ثم تُخرج OP_ADD تلك وتدمجها.
وهذا يخصص ديناميكياً نصّاً جديداً "stri" في الكومة. وتدفعه الآلة الافتراضية ثم
تدفع الثابت "ng". أما OP_ADD الأخيرة فتُخرج "stri" و"ng"، وتدمجهما، وتدفع
النتيجة: "string". رائع، هذا ما نتوقّعه.
لكن، انتظر. ما الذي حدث لنصّ "stri" ذاك؟ خصّصناه ديناميكياً، ثم تخلّصت منه الآلة
الافتراضية بعد دمجه مع "ng". فقد سحبناه من المكدّس ولم نعد نملك مرجعاً إليه، لكننا
لم نحرّر ذاكرته أبداً. لقد وقعنا في تسريب ذاكرة كلاسيكي.
بالطبع، منالمقبول تماماً أن ينسى برنامج Lox النصوص الوسيطة ولا يقلق بشأن تحريرها. فـ Lox تدير الذاكرة تلقائياً نيابةً عن المستخدم. لكن مسؤولية إدارة الذاكرة لا تختفي. بدلاً من ذلك، تقع على أكتافنا نحن منفّذي الآلة الافتراضية.
الحل الكامل هو جامع قمامة يستعيد الذاكرة غير المستخدمة أثناء تشغيل البرنامج. ولدينا أشياء أخرى نضعها في مكانها قبل أن نكون مستعدّين لمباشرة ذلك المشروع. إلى أن ذلك، نحن نعيش وقتاً مستعاراً. وكلما طال انتظارنا لإضافة الجامع، صعب تنفيذه.
اليوم، على الأقل علينا أن نفعل الحدّ الأدنى: نتجنّب تسريب الذاكرة بالتأكّد من أن الآلة الافتراضية تستطيع العثور على كل كائن مخصَّص حتى لو لم يعد برنامج Lox نفسه يشير إليها. وهناك تقنيات متطوّرة كثيرة تستخدم مديرو الذاكرة المتقدّمون لتخصيص ذاكرة الكائنات وتتبّعها. وسناخذ أبسط نهج عملي.
سننشئ قائمة مرتبطة (linked list) تخزّن كل Obj. وتستطيع الآلة الافتراضية المرور على تلك القائمة للعثور على كل كائن خُصِّص في الكومة، سواء أكان برنامج المستخدم أو مكدّس الآلة الافتراضية لا يزالان يشيران إليه أم لا.
يمكننا تعريف بنية عقدة قائمة مرتبطة منفصلة، لكننا عندئذٍ سنحتاج إلى تخصيص تلك أيضاً. بدلاً من ذلك، سنستخدم قائمة متغذّية داخلياً (intrusive list) -- إذ ستكون بنية Obj نفسها هي عقدة القائمة المرتبطة. ويحصل كل Obj على مؤشر إلى Obj التالي في السلسلة.
^code next-field (2 before, 1 after)
وتخزّن الآلة الافتراضية مؤشراً إلى رأس القائمة.
^code objects-root (1 before, 1 after)
وحين نهيّئ الآلة الافتراضية لأول مرة، لا توجد كائنات مخصَّصة.
^code init-objects-root (1 before, 1 after)
وكل مرة نخصّص Obj، ندخجه في القائمة.
^code add-to-list (1 before, 1 after)
وبما أن هذه قائمة مرتبطة بفرع واحد، فأسهل مكان لإدراجه هو الرأس. وبذلك لا نحتاج كذلك إلى تخزين مؤشر إلى الذيل والحفاظ على تحديثه.
وتستخدم وحدة "object" مباشرةً المتغيّر العام vm من وحدة "vm"، لذا نحتاج إلى
كشفه خارجياً.
^code extern-vm (2 before, 1 after)
وفي النهاية، سيحرّر جامع القمامة الذاكرة بينما تكون الآلة الافتراضية قيد التشغيل. لكن حتى عند ذلك، عادةً ما ستظلّ هناك كائنات غير مستخدمة باقية في الذاكرة عند اكتمال برنامج المستخدم. وينبغي للآلة الافتراضية أن تحرّر تلك أيضاً.
لا منطق معقّد لذلك. فبمجرد انتهاء البرنامج، يمكننا تحرير كل كائن. يمكننا ذلك وينبغي أن نفعله الآن.
^code call-free-objects (1 before, 1 after)
تلك الدالة الفارغة التي عرّفناها منذ زمن بعيد تفعل شيئاً أخيراً! فهي تستدعي هذه:
^code free-objects-h (1 before, 2 after)
وهكذا نحّرّر الكائنات:
^code free-objects
هذه تنفيذ من كتاب مقدمة في علوم الحاسوب (CS 101) للمرور على قائمة مرتبطة وتحرير عقدها. ولكل عقدة، نستدعي:
^code free-object
نحن لا نحرّر Obj نفسه فحسب. فبعض أنواع الكائنات تخصّص ذاكرة أخرى تملكها أيضاً، لذا نحتاج أيضاً إلى شيفرة صغيرة خاصّة بكل نوع للتعامل مع احتياجات كل نوع كائن. وهنا، يعني ذلك أننا نحرّر مصفوفة المحارف ثم نحرّر ObjString. وكلاهما يستخدم آخر ماكرو لإدارة الذاكرة.
^code free (1 before, 2 after)
إنه غلاف صغير حول reallocate() «يغيّر حجم» تخصيص
معين إلى صفر بايت.
وكالمعتاد، نحتاج إلى تضمين لربط كل شيء معاً.
^code memory-include-object (1 before, 2 after)
ثم في ملف التنفيذ:
^code memory-include-vm (1 before, 2 after)
بهذا لم تعد آلتنا الافتراضية تسرّب الذاكرة. تماماً Like برنامج C جيّد، فهي تنظّف فوضىها قبل الخروج. لكنها لا تحرّر أي كائنات أثناء تشغيل الآلة الافتراضية. لاحقاً، وحين يصبح من الممكن كتابة برامج Lox ذات زمن تشغيل أطول، ستأكل الآلة الافتراضية ذاكرة أكثر وأكثر مع تقدّمها، دون التنازل عن بايت واحد حتى ينتهي البرنامج كله.
لن نتناول ذلك حتى نضيف جامع قمامة حقيقياً، لكن هذه خطوة كبيرة. فلدينا الآن البنية التحتية لدعم مجموعة متنوعة من الأنواع المختلفة من الكائنات المخصَّصة ديناميكياً. وقد استخدمناها لإضافة النصوص إلى clox، وهي من أكثر الأنواع استعمالاً في معظم لغات البرمجة. وتتيح لنا النصوص بدورها بناء نوع بيانات أساسي آخر، خاصة في اللغات الديناميكية: [جدول التجزئة][]. لكن ذلك للفصل التالي...
التحديات
-
يتطلب كل نصّ تخصيصين ديناميكيين منفصلين -- واحد لـ ObjString وثانٍ لمصفوفة المحارف. والوصول إلى المحارف من قيمة يتطلب است indirections عبر المؤشرين، وقد يكون سيئاً للأداء. ويعتمد حلّ أكفأ على تقنية تُسمّى [الأعضاء المصفوفة المرنة][] (flexible array members). استخدمها لتخزين ObjString ومصفوفة محارفه في تخصيص واحد متّصل.
-
حين ننشئ ObjString لكل نصّ حرفي، فإننا ننسخ المحارف إلى الكومة. وبهذه الطريقة، حين يُحرَّر النصّ لاحقاً، نعرف أنه من الآمن تحرير المحارف أيضاً.
هذا نهج أبسط لكنه يهدر بعض الذاكرة، وقد يكون مشكلة على الأجهزة مقيّدة جداً. بدلاً من ذلك، يمكننا تتبّع أي ObjStrings تملك مصفوفة محارفها وأيها هي «نصوص ثابتة» تشير ببساطة إلى شيفرة المصدر الأصلية أو إلى موضع آخر غير قابل للتحرير. أضف دعماً لذلك.
-
لو كانت Lox لغتك، فماذا كنتَ ستفعل حين يحاول المستخدم استخدام
+مع مُعامل نصّي والآخر من نوع آخر؟ برّر اختيارك. ماذا تفعل اللغات الأخرى؟
ملاحظة تصميم: ترميز النصوص
في هذا الكتاب، أحاول ألا أتهرّب من المشاكل المعقّدة التي ستصطدم بها في تطبيق لغة حقيقي. قد لا نستخدم دائماً الحلّ الأكثر تطوّراً -- هذا كتاب تمهيدي -- لكنني لا أعتقد أن من الأمانة أن ندّعي أن المشكلة غير موجودة أصلاً. غير أنني مررت بجانب عقدة شديدة الطبع: تحديد كيفية تمثيل النصوص.
هناك جانبان لترميز النصّ:
-
ما «المحرف» الواحد في نصّ؟ كم قيمة مختلفة هناك وماذا تمثّل؟ أول إجابة معيارية الانتشار كانت ASCII. فقد أعطتك 127 قيمة محرف مختلفة وحدّدت ما هي. كانت رائعة... إن كنت لا تهتمّ إلا بالإنجليزية. ومع أنها تحوي محارف غريبة منسية إلى حدٍّ كبير مثل «فاصل السجلّ» و«الخامل المتزامن»، إلا أنها لا تحوي حرفاً واحداً بعلامة مزدوجة أو مدوّرة أو منقوطة. فهي لا تستطيع تمثيل "jalapeño" أو "naïve" أو "Gruyère" أو "Mötley Crüe".
ثم جاء Unicode. في البداية، كان يدعم 16,384 محرفاً مختلفاً (نقاط الشيفرة code points)، وقد استقرّت عناية في 16 بت مع بضعة بتات فائضة. ثم نما ونما، والآن There أكثر بكثير من 100,000 نقطة شيفرة مختلفة، بما في ذلك أدوات الاتصال الإنساني الحيوية مثل 💩 (Unicode Character 'PILE OF POO'،
U+1F4A9).وحتى تلك القائمة الطويلة من نقاط الشيفرة ليست كافية لتمثيل كل رسم محرف مرئي محتمل قد تدعمه اللغة. للتعامل مع ذلك، لدى Unicode أيضاً محارف مركّبة تعدّل نقطة شيفرة سابقة. فمثلاً، "a" يليها المحرف المركّب "¨" يعطيك "ä". (ولجعل الأمور أكثر التباساً، لدى Unicode أيضاً نقطة شيفرة واحدة تشبه "ä".)
إن وصل المستخدم إلى «المحرف» الرابع في "naïve"، فهل يتوقّع أن يستعيد "v" أم “¨”? الأولى تعني أنه يفكّر في كل نقطة شيفرة ومحرفها المركّب كوحدة واحدة -- وهو ما تسمّيه Unicode العقدة الرسومية الممتدة (extended grapheme cluster) -- والأخرى تعني أنه يفكّر في نقاط الشيفرة المفردة. أيّهما يتوقّعه مستخدموك؟
-
كيف تُمثَّل الوحدة الواحدة في الذاكرة؟ أعطت معظم الأنظمة التي تستخدم ASCII بايتاً واحداً لكل محرف وتركت البتّ غير مستخدَم. ولدى Unicode حفنة من الترميزات الشائعة. تحزم UTF-16 معظم نقاط الشيفرة في 16 بت. وكان ذلك رائعاً حين تناسب كل نقطة شيفرة ذلك الحجم. وحين تجاوز ذلك، أضافوا أزواج بديلة (surrogate pairs) تستخدم وحدات شيفرة 16 بتية متعددة لتمثيل نقطة شيفرة واحدة. وUTF-32 هو التطور التالي لـ UTF-16 -- فهو يعطي 32 بت كاملة لكل نقطة شيفرة على الإطلاق.
أما UTF-8 فأكثر تعقيداً من أيّ منهما. فهو يستخدم عدداً متغيّراً من البايتات لترميز نقطة شيفرة. ونقاط الشيفرة ذات القيم الأدنى تتّسع في بايتات أقلّ. وبما أن كل محرف قد يشغل عدداً مختلفاً من البايتات، فلا يمكنك الفهرسة المباشرة في النصّ لإيجاد نقطة شيفرة معيّنة. فإذا أردتَ، مثلاً، نقطة الشيفرة العاشرة، فلا تعرف كم بايتاً داخل النصّ هي دون المرور على جميع ما قبلها وفكّ ترميزه.
يتضمّن اختيار تمثيل المحرف والترميز مقايضات جوهرية. وكثير أشياء في الهندسة، لا توجد حلّ مثالي:
-
ASCII موفّر للذاكرة وسريع، لكنه يزيح اللغات غير اللاتينية إلى الهامش.
-
UTF-32 سريع ويدعم مدى Unicode كاملاً، لكنه يهدر ذاكرة كبيرة بالنظر إلى أن معظم نقاط الشيفرة تميل إلى أن تكون في النطاق الأدنى من القيم، حيث لا حاجة إلى 32 بت كاملة.
-
UTF-8 موفّر للذاكرة ويدعم مدى Unicode كاملاً، لكن ترميزه متغيّر الطول يجعل الوصول إلى نقاط الشيفرة التعسّفية بطيئاً.
-
UTF-16 أسوأ من جميعها -- نتيجة قبيحة لنمو Unicode خارج نطاقه السابق بعرض 16 بت. فهو أقلّ كفاءة في الذاكرة من UTF-8 لكنه يظلّ ترميزاً متغيّر الطول بفضل أزواج البديلة. تجنّبه إن استطعت. لكن للأسف، إذا كانت لغتك تحتاج إلى العمل على المتصفّح أو JVM أو CLR، فقد تكون محتجزاً عليه، لأن جميعها تستخدم UTF-16 لنصوصها ولا تريد أن إلى التحويل في كل مرة تمرّر فيها نصّاً إلى النظام الأساسي.
أحد الخيارات هو اتّخاذ المنهج الأقصى وفعل «الأنسب» شيء. أن تدعم كل نقاط شيفرة Unicode. وأن تختار داخلياً ترميزاً لكل نصّ بناءً على محتواه -- استخدم ASCII إذا استقرّت كل نقطة شيفرة في بايت، و UTF-16 إذا لم تكن هناك أزواج بديلة، إلخ. وقدّم واجهات برمجية (APIs) تتيح للمستخدمين المرور على نقاط الشيفرة وعلى العقد الرسومية الممتدة كليهما.
هذا يغطي كل الأساسيات لكنه معقّد حقاً. فهناك الكثير لتنفيذه وتنقيحه وتحسينه. وحين تسلسِل النصوص أو تتفاعل مع أنظمة أخرى، عليك التعامل مع جميع الترميزات. والمستخدمون بحاجة إلى فهم واجهتي الفهرسة ومعرفة أيّهما يستخدمون ومتى. وهذا هو المنهج الذي تميل إليه اللغات الأكبر والأحدث -- مثل Raku و Swift.
أما المقايضة الأبسط فهي أن تُرمّز دائماً باستخدام UTF-8 ولا تكشف سوى واجهة تعمل مع نقاط الشيفرة. أما المستخدمون الذين يريدون العمل مع العقد الرسومية الممتدة، فليترك لهم استخدام مكتبة طرف ثالث لذلك. فهذا أقلّ تّراً على اللاتينية من ASCII لكنه أكثر تعقيداً بقليل. فأنت تخسر الفهرسة السريعة المباشرة بنقطة الشيفرة، لكن يمكنك عادةً التعايش بدونها أو تحمّل جعلها O(n) بدلاً من O(1).
لو كنتُ أصمّم لغة عمل كبيرة لمن يكتبون تطبيقات ضخمة، فربما سأذهب بالمنهج الأقصى. لكن لغتي النصّية المدمجة الصغيرة Wren، ذهبتُ مع UTF-8 ونقاط الشيفرة.