جداول التجزئة
هاش، س. لا يوجد تعريف لهذه الكلمة -- لا أحد يعرف ما هو الهاش.
أمبروس بيرس، معجم الشيطان غير المختصر
قبل أن نتمكّن من إضافة متغيّرات إلى آلتنا الافتراضية النامية، نحتاج إلى وسيلة للبحث عن قيمة بمعطى اسم متغيّر. لاحقًا، حين نضيف أصنافًا، سنحتاج أيضًا إلى وسيلة لتخزين حقول على النسخ. وبنية البيانات المثالية لهاتين المسألتين وغيرها هي جدول التجزئة (hash table).
ربما تعرف أصلًا ما هو جدول التجزئة، وإن لم تكن تعرفه بهذا الاسم. فإن كنت مبرمج Java فإنّك تسمّيها "HashMaps". ومستخدمو C# وPython يسمّونها "dictionaries". وفي C++، هي "unordered map". أما "الكائنات" (objects) في JavaScript و"الجداول" (tables) في Lua فهي جداول تجزئة تحت الغطاء، وهو ما يمنحها مرونتها.
جدول التجزئة، مهما كانت لغتك تسمّيه، يربط مجموعة من المفاتيح (keys) بمجموعة من القيم (values). وكل زوج مفتاح/قيمة هو مُدخل (entry) في الجدول. وبمعطى مفتاح يمكنك البحث عن قيمته المقابلة. ويمكنك إضافة أزواج مفتاح/قيمة جديدة وحذف المُدخلات بالمفتاح. فإن أضفت قيمة جديدة لمفتاح قائم، فإنّها تحلّ محلّ المُدخل السابق.
تظهر جداول التجزئة في هذا العدد الكبير من اللغات لأنّها قوية إلى حدٍّ لا يصدّق. ويأتي الكثير من هذه القوة من مقياس واحد: معطى مفتاح، يعيد جدول التجزئة القيمة المقابلة في زمن ثابت (constant time)، بغضّ النظر عن كم مفتاح موجود في جدول التجزئة.
هذا مدهش إلى حدٍّ ما حين تفكّر فيه. تخيّل أنّ لديك كومة كبيرة من بطاقات الأعمال وأطلب منك العثور على شخص معيّن. وكلّما كانت الكومة أكبر، استغرق الأمر وقتًا أطول. حتى لو كانت الكومة مرتّبة بعناية وامتلاك الرشاقة اليدوية لإجراء بحث ثنائي يدويًا، فأنت لا تزال تتحدّث عن O(log n). لكن مع جدول تجزئة، يستغرق العثور على تلك بطاقة الأعمال الوقت نفسه سواء كانت الكومة عشر بطاقات أو مليونًا.
مصفوفة من الدلاء
لجدول تجزئة كامل وسريع عدّة أجزاء متحرّكة. وسأقدّمها واحدًا تلو الآخر من خلال العمل على مسألتين بسيطتين وحلولهما. وفي النهاية، سنبني بنية بيانات قادرة على ربط أيّ مجموعة من الأسماء بقيمها.
في الوقت الحالي، تخيّل لو كانت Lox أشدّ تقييدًا في أسماء المتغيّرات إلى حدٍّ كبير. ماذا لو كان اسم المتغيّر لا يمكن إلّا أن يكون حرفًا صغيرًا واحدًا؟ كيف يمكننا أن نمثّل مجموعة من أسماء المتغيّرات وقيمها بكفاءة عالية إلى حدٍّ ما؟
مع 26 متغيّرًا ممكنًا فقط (27 إن حسبت الشرطة السفلية "حرفًا"، على حدّ ظنّي)، تكون الإجابة سهلة.
نصرّح مصفوفة ذات حجم ثابت من 26 عنصرًا. وسنتبع التقليد في تسمية كل عنصر دلوًا (bucket).
وكل دلو يمثّل متغيّرًا يبدأ a عند الفهرس صفر. فإذا كانت هناك قيمة في المصفوفة عند فهرس حرف
ما، فإنّ ذلك المفتاح موجود بتلك القيمة. وإلا، فإنّ الدلو فارغ وذلك الزوج غير موجود في بنية
البيانات.
استهلاك الذاكرة جيّد -- مجرّد مصفوفة واحدة بحجم معقول. وهناك بعض الهدر من الدلاء الفارغة، لكنه ليس ضخمًا. ولا يوجد حِمل زائد لمؤشّرات العُقد، أو الحشو، أو أمور أخرى ستحصل عليها مع شيء كقائمة مرتبطة أو شجرة.
الأداء أفضل حتى. فمعطى اسم متغيّر -- أي محرفه -- يمكنك أن تطرح القيمة ASCII لـ a وتستخدم
النتيجة للفهرسة مباشرةً في المصفوفة. ثم يمكنك إمّا أن تبحث عن القيمة القائمة أو أن تخزّن قيمة
جديدة مباشرةً في تلك الخانة. ولا يمكن أن تكون أسرع من ذلك.
هذا نوعًا ما بنية بياناتنا المثالية الأفلاطونية. سريعة كالبرق، وبسيطة تمامًا، ومُدمَجة في الذاكرة. وحين نضيف دعمًا لمفاتيح أعقد، سنضطر إلى تقديم بعض التنازلات، لكنّ هذا هو ما نستهدفه. فحتى بعد أن تُضيف دوالّ التجزئة وإعادة التحجيم الديناميكية ومعالجة التصادمات (collisions)، يبقى هذا هو جوهر كل جدول تجزئة هناك -- مصفوفة متّصلة من الدلاء تفهرس إليها مباشرةً.
معامل الحشو والمفاتيح الملفوفة
حصر Lox في متغيّرات من حرف واحد يجعل مهمّتنا كمنفّذين أسهل، لكنّ البرمجة في لغة تمنحك 26 موضع تخزين فقط على الأرجح ليست ممتعة. ماذا لو خفّفنا القيد قليلًا وسمحنا بمتغيّرات يصل طولها إلى ثمانية محارف؟
هذا صغير بما يكفي حتى نتمكّن من حزم المحارف الثمانية كلها في عدد صحيح من 64 بتًّا وتحويل السلسلة بسهولة إلى عدد. يمكننا عندها استخدامه كفهرس للمصفوفة. أو، على الأقلّ، يمكننا لو استطعنا تخصيص مصفوفة من 295,148 بيتابايت. لقد أصبح الذاكرة أرخص مع الوقت، لكن ليس رخيصًا إلى هذا الحدّ. حتى لو استطعنا إنشاء مصفوفة بهذا الحجم، لكانت مهدورة بشكل فظيع. فدلو تقريبًا سيكون فارغًا ما لم يبدأ المستخدمون بكتابة برامج Lox أكبر بكثير مما توقّعناه.
رغم أنّ مفاتيح متغيّراتنا تغطّي المدى العددي الكامل من 64 بتًّا، فمن الواضح أننا لا نحتاج إلى مصفوفة بهذا الحجم. وبدلًا من ذلك، فإنّنا نخصّص مصفوفة بسعة أكبر بكثير ممّا نحتاج من المُدخلات، لكن ليست معقولةً إلى حدٍّ كبير. ونُسقط مفاتيح 64 بتًّا الكاملة إلى ذلك المدى الأصغر بأخذ القيمة بأخذ الباقي (modulo) على حجم المصفوفة. ويفعل ذلك في جوهره طيّ المدى العددي الأكبر على نفسه حتى يناسب مدى عناصر المصفوفة الأصغر.
على سبيل المثال، لنقل إنّنا نريد تخزين "bagel". فإنّنا نخصّص مصفوفة من ثمانية عناصر، وهو ما يكفي بكلّ راحة لتخزينه وأكثر لاحقًا. فإنّنا نتعامل مع سلسلة المفتاح على أنّها عدد صحيح من 64 بتًّا. وعلى آلة بترتيب البايتات الصغير مثل Intel، فإنّ حزم تلك المحارف في كلمة من 64 بتًّا يضع الحرف الأول، "b" (قيمته ASCII هي 98)، في البايت الأقلّ أهمية. ونأخذ باقي قسمة ذلك العدد على حجم المصفوفة (8) ليناسب الحدود فنحصل على فهرس دلو، 2. ثم نخزّن القيمة هناك كما هي العادة.
يسمح لنا استخدام حجم المصفوفة كمقسوم (modulus) بأن نُسقط المدى العددي للمفتاح ليناسب مصفوفة من أيّ حجم. ويمكننا بالتالي أن نتحكّم في عدد الدلاء باستقلال عن مدى المفاتيح. وهذا يحلّ مشكلة الهدر لدينا، لكنه يقدّم مشكلة جديدة. فأيّ متغيّرين يكون لرقمي مفتاحهما الباقي نفسه عند القسمة على حجم المصفوفة سينتهيان في الدلو نفسه. ويمكن أن تتصادم (collide) المفاتيح. فمثلًا، إن حاولنا إضافة "jam"، فإنّه سينتهي أيضًا في الدلو 2.
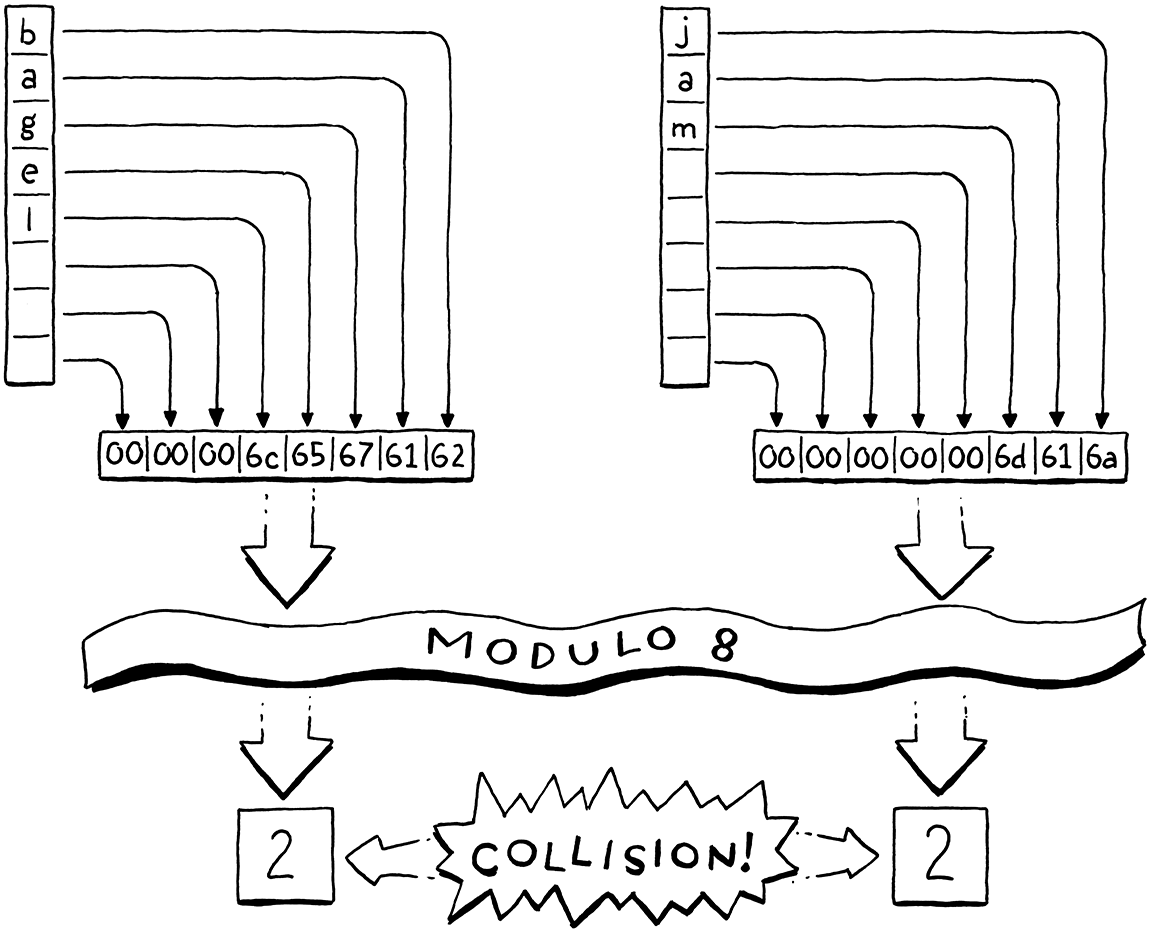
لدينا بعض التحكّم في هذا عبر ضبط حجم المصفوفة. فكلّما كانت المصفوفة أكبر، قلّ عدد الفهارس التي تُسقط إلى الدلو نفسه، وقلّ احتمال وقوع التصادمات. ويتتبّع منفّذو جداول التجزئة هذا الاحتمال بوصفه يقيس معامل الحشو (load factor) للجدول. وهو معرَّف بأنه عدد المُدخلات مقسومًا على عدد الدلاء. فجدول تجزئة فيه خمسة مُدخلات ومصفوفة من 16 عنصرًا يكون معامل حشوه 0.3125. وكلّما ارتفع معامل الحشو، زاد احتمال التصادمات.
إحدى الطرق التي نخفّف بها التصادمات هي إعادة تحجيم المصفوفة (resize). تماماً كما في المصفوفات الديناميكية التي نفّذناها سابقًا، فإنّنا نُعيد تخصيص مصفوفة جدول التجزئة وننمّيها كما تمتلئ. لكن بخلاف المصفوفة الديناميكية العادية، لن ننتظر حتى تمتلئ المصفوفة تمامًا. وبدلًا من ذلك، نختار معامل حشو مرغوبًا وننمّي المصفوفة حين يتجاوزه.
معالجة التصادمات
حتى مع معامل حشو منخفض جدًّا، يمكن أن تحدث التصادمات. فرمز مفارقة عيد الميلاد يخبرنا بأنّ احتمال التصادم يزداد بسرعة كبيرة كلّما زاد عدد المُدخلات في جدول التجزئة. يمكننا اختيار حجم مصفوفة كبير لتقليل ذلك، لكنّها معركة خاسرة. لنقل إنّنا أردنا تخزين مئة عنصر في جدول تجزئة. ولإبقاء احتمال التصادم دون 10% التي ما تزال مرتفعة نوعًا ما، نحتاج إلى مصفوفة فيها 47,015 عنصرًا على الأقلّ. ولإخفاء الاحتمال دون 1% نحتاج إلى مصفوفة من 492,555 عنصرًا، أي أكثر من 4,000 دلو فارغ لكلّ دلو مستخدَم.
يمكن لمعامل الحشو المنخفض أن يجعل التصادمات أندر، لكنّ مبدأ الحجيرة يخبرنا بأنّنا لا نستطيع التخلّص منها تمامًا. فإن كان لديك خمس حمامات وأربعة ثقوب لوضعها فيها، فإنّ على الأقلّ ثقبًا واحدًا سينتهي الأمر فيه إلى أكثر من حمامة. ومع 18,446,744,073,709,551,616 اسم متغيّر مختلف، يمكن لأيّ مصفوفة ذات حجم معقول أن تنتهي إلى مفاتيح متعدّدة في الدلو نفسه.
لذلك ما زال علينا أن نتعامل مع التصادمات برشاقة حين تحدث. فالمستخدمون لا يحبّون أن تكون لغتهم البرمجية قادرة على البحث عن المتغيّرات على نحو صحيح في معظم الأوقات فقط.
التسلسل المنفصل
تقع تقنيات معالجة التصادمات في فئتين واسعتين. الأولى هي التسلسل المنفصل (separate chaining). وبدلًا من أن يحتوي كل دلو على مُدخل واحد، نسمح له بأن يحتوي على مجموعة منها. وفي التنفيذ الكلاسيكي، يشير كل دلو إلى قائمة مرتبطة من المُدخلات. وللبحث عن مُدخل، تجد دلوه ثمّ تمشي في القائمة حتى تجد مُدخلًا بمفتاح مطابق.
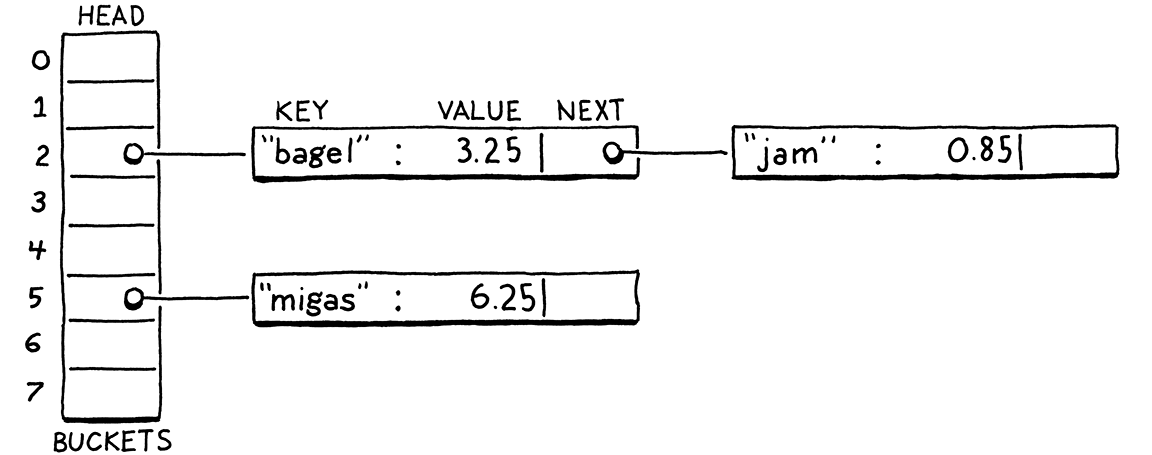
في الحالات الكارثية السيّئة حيث يصطدم كل مُدخل في الدلو نفسه، تتراجع بنية البيانات إلى قائمة واحدة مرتبطة غير مرتّبة ببحث من نوع O(n). وفي الممارسة، من السهل تفادي ذلك بالتحكّم في معامل الحشو وفي كيفية توزّع المُدخلات على الدلاء. ففي جداول التجزئة ذات التسلسل المنفصل المعتادة، من النادر أن يحتوي دلو على أكثر من مُدخل أو مُدخلَين.
التسلسل المنفصل بسيط مفاهيميًا -- إنّه حرفيًا مصفوفة من القوائم المرتبطة. معظم العمليات سهلة التنفيذ، حتى الحذف الذي، كما سنرى، قد يكون عبئًا. لكنه ليس مناسبًا إلى حدٍّ كبير للمعالجات الحديثة. فحمله الزائد كبير بسبب المؤشّرات، وهو يميل إلى تشتيت عقد القوائم المرتبطة الصغيرة العُقد في الذاكرة، وهذا ليس جيّدًا لاستخدام الذاكرة المخبّأة.
العنونة المفتوحة
التقنية الأخرى تُسمّى العنونة المفتوحة (open addressing) أو التجزئة المغلقة (closed hashing) (بشكل محيّر). بهذه التقنية، تعيش كل المُدخلات مباشرةً في مصفوفة الدلاء، بمُدخل واحد لكل دلو. فإن اصطدم مُدخلان في الدلو نفسه، فإنّنا نجد دلوًا فارغًا مختلفًا نستخدمه بدلًا منه.
تخزين كل المُدخلات في مصفوفة واحدة كبيرة متّصلة جيّد لإبقاء التمثيل الذاكراتي بسيطًا وسريعًا. لكنّه يجعل كل العمليات على جدول التجزئة أعقد. فحين نُدرج مُدخلًا، قد يكون دلوه ممتلئًا، فتُوجَّه إلى فحص دلو آخر. وقد يكون ذلك الدلو مشغولًا أيضًا، وهكذا. والعملية التي إيجاد دلو متاح تُسمّى السبر (probing)، والترتيب الذي تفحص به الدلاء يُسمّى تسلسل السبر (probe sequence).
هناك عدد من الخوارزميات لتحديد الدلاء التي يجب سبرها وكيف نقرّر أيّ مُدخل يذهب إلى أيّ دلو. وقد أُنجز الكثير من البحث هنا لأنّ حتى التعديلات الطفيفة يمكن أن يكون لها أثر كبير على الأداء. وعلى بنية بيانات مستخدَمة بكثافة مثل جداول التجزئة، فإنّ ذلك الأثر على الأداء يمسّ عددًا كبيرًا جدًّا من برامج العالم الحقيقي عبر مدى من قدرات العتاد.
وكما جرت العادة في هذا الكتاب، سنختار أبسطها الذي يُنجز العمل بكفاءة. وذلك السبر الخطّي القديم الطراز (linear probing). فحين نبحث عن مُدخل، نفحص أول دلو يُسقط إليه مفتاحه. فإن لم يكن موجودًا هناك، نفحص العنصر التالي مباشرةً في المصفوفة، وهكذا. فإن وصلنا إلى النهاية، نلتفّ عائدين إلى البداية.
الميزة الجيدة في السبر الخطّي هو أنّه صديق للذاكرة المخبّأة. فبما أنّنا نمشي في المصفوفة مباشرةً بترتيب الذاكرة، فإنّه يبقي أسطر ذاكرة المعالج المخبّأة ممتلئة ومرتاحة. والسيّئة هي أنّه عرضة يسبّب التكتّل (clustering). فإذا كان لديك كثير من المُدخلات ذات قيم مفاتيح متقاربة عدديًّا، فقد تنتهي إلى كثير من الدلاء المتصادمة والفيض المتجاورة لبعضها.
مقارنةً بالتسلسل المنفصل، قد يكون فهم العنونة المفتوحة أصعب. أظنّ العنونة المفتوحة شبيهة بالتسلسل المنفصل، إلا أنّ "قائمة" العُقد فيها مُشداة عبر مصفوفة الدلاء نفسها. فبدلًا من تخزين الروابط بينها في مؤشّرات، تُحتسب الاتصالات ضمنًا بترتيب الدلاء التي تفحصها.
الجزء الصعب هو أنّ أكثر من واحدة من تلك القوائم الضمنية قد تكون متشابكة معًا. لنمرّ على مثال يغطّي جميع الحالات المثيرة. سنتجاهل القيم الآن ونركّز على مجموعة مفاتيح. نبدأ بمصفوفة فارغة من 8 دلاء.

نقرّر إدراج "bagel". فالحرف الأول، "b" (قيمته ASCII هي 98)، فإنّ باقي القسمة على حجم المصفوفة (8) يضعه في الدلو 2.

ثمّ نُدرج "jam". فذاك أيضًا يريد الذهاب إلى الدلو 2 (106 mod 8 = 2)، لكنّ ذلك الدلو مشغول. فنواصل السبر إلى الدلو التالي. وهو فارغ، فنضعه هناك.
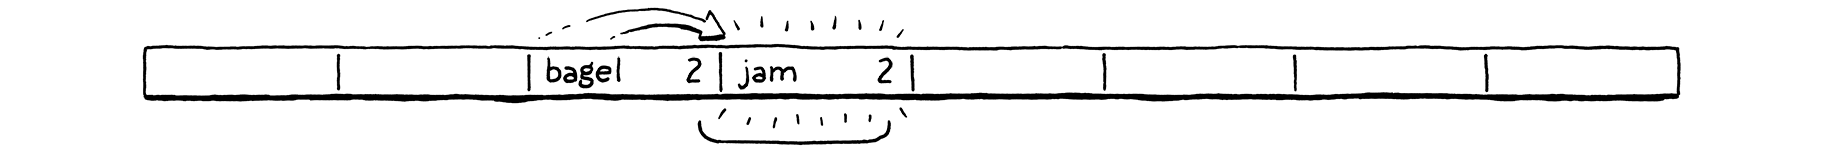
نُدرج "fruit"، الذي يقع بكلّ سرور في الدلو 6.

وكذلك، يمكن لـ "migas" أن تذهب إلى دلوها المفضّل 5.
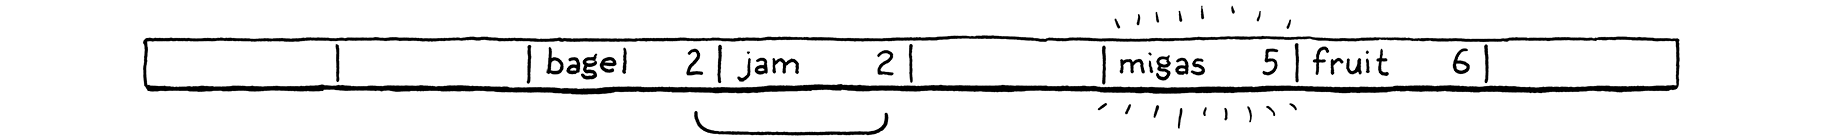
وحين نحاول إدراج "eggs"، فإنّه أيضًا يريد أن يكون في الدلو 5. ذلك الدلو ممتلئ، فنتخطّى إلى 6. والدلو 6 ممتلئ أيضًا. لاحظ أنّ المُدخل الموجود هناك ليس جزءًا من تسلسل السبر نفسه. فـ "Fruit" في دلوه المفضّل، 6. إذن فإنّ تسلسلي السبر 5 و6 قد اصطدما وشُبِّكا. فنتخطّى ذلك ونضع "eggs" في النهاية في الدلو 7.

نصطدم بمشكلة مشابهة مع "nuts". فلا يمكنه أن يقع في 6 كما يريد، ولا يمكنه أن يذهب إلى 7. فنواصل. لكنّنا وصلنا إلى نهاية المصفوفة، فنلتفّ عائدين إلى 0 ونضعه هناك.
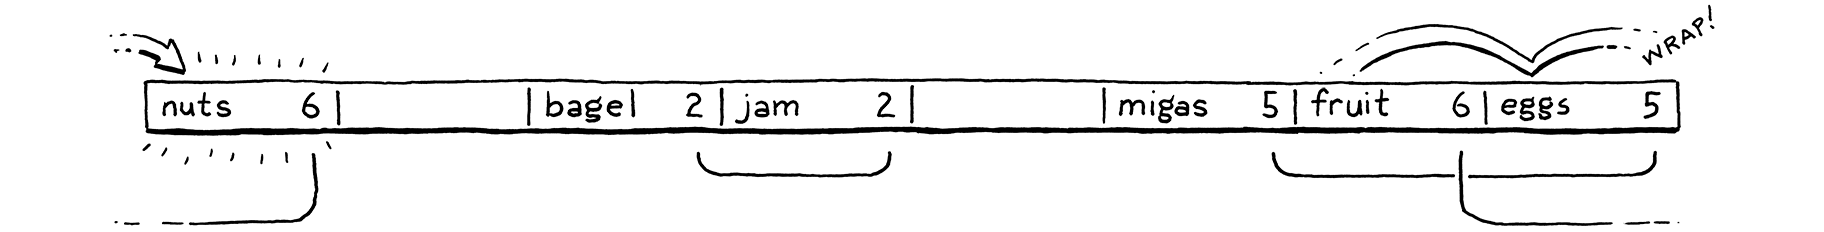
في الممارسة، يتبيّن أنّ التشابك ليس مشكلة كبيرة. فحتى في التسلسل المنفصل، نحتاج إلى المشي في القائمة للتحقّق من مفتاح كل مُدخل لأنّ مفاتيح متعدّدة يمكن أن تُسقط إلى الدلو نفسه. ومع العنونة المفتوحة، نحتاج إلى ذلك الفحص نفسه، وهو يغطّي أيضًا الحالة التي تكون فيها بصعد فوق مُدخلات "تنتمي" إلى دلو أصلي مختلف.
دوالّ التجزئة
أصبح بإمكاننا الآن أن نبني لأنفسنا جدولًا ذا كفاءة معقولة لتخزين أسماء متغيّرات يصل طولها إلى ثمانية محارف، لكنّ ذلك القيد ما زال مزعجًا. ولكي نخفّف القيد الأخير، نحتاج إلى وسيلة لأخذ سلسلة بأيّ طول وتحويلها إلى عدد ثابت الحجم.
أخيرًا، نصل إلى جزء "التجزئة" من "جدول التجزئة". فـ دالة التجزئة (hash function) تأخذ كُتلة بيانات أكبر و"تُجزّئها" لإنتاج رمز تجزئة (hash code) ثابت الحجم تتوقّف قيمته على كلّ بتات البيانات الأصلية. ودالة التجزئة الجيدة ثلاثة أهداف رئيسية:
-
يجب أن تكون حتمية (deterministic). يجب أن يجزّئ المُدخل نفسه دائمًا إلى العدد نفسه. فإذا انتهي المتغيّر نفسه إلى دلاء مختلفة في أوقات مختلفة، فسيصبح العثور عليه صعبًا حقًّا.
-
يجب أن تكون متجانسة (uniform). فمعطى مجموعة مُدخلات معتادة، ينبغي أن تنتج مدى واسعًا ومتجانس التوزيع من أرقام الخرج، بأقلّ عدد ممكن من التكتّلات أو الأنماط. ونريد منها أن تشتّت القيم عبر المدى العددي كلّه لتقليل التصادمات والتكتّل.
-
يجب أن تكون سريعة. كلّ عملية على جدول التجزئة تتطلّب أن نجزّئ المفتاح أولًا. فإذا كان التجزئة بطيئة، فقد يُلغي ذلك على نحو محتمل سرعة التخزين في المصفوفة الكامنة.
هناك كومة هائلة من دوالّ التجزئة هناك. فبعضها قديم ومُحسَّن لمعماريات لم يعد أحد يستخدمها. وبعضها مصمَّم ليكون سريعًا، وبعضها الآخر آمن تشفيريًّا. وبعضها يستغل تعليمات المتجهات وأحجام الذاكرة المخبّأة الخاصة بشرائح معيّنة، وبعضها الآخر يهدف إلى تعظيم قابلية النقل.
هناك أشخاصٌ يكون تصميم وتقييم دوالّ التجزئة هو مَهنتهم التي يعشقونها. وأنا أعجب بهم، لكنّني لستُ ماهرًا في الرياضيات بما يكفي لأكون واحدًا منهم. لذا اخترتُ لـ clox دالة تجزئة بسيطة ومجرَّبة اسمها FNV-1a، وقد خدمتني جيدًا على مدى السنين. فكّر في تجربة دوالّ أخرى في شيفرتك وشاهد إن كانت تصنع فرقًا.
حسنًا، تلك كانت جولة سريعة في الدلاء ومعاملات الحشو والعنونة المفتوحة ومعالجة التصادمات ودوالّ التجزئة. وذلك قدرٌ هائل من النص وبلا قدر يذكر من الشيفرة الحقيقية. لا تقلق إن بدا ذلك لا يزال غامضًا. فمتى ننتهي من برمجته، سيسقط كلّ شيء في موضعه.
بناء جدول تجزئة
الميزة الرائعة في جداول التجزئة مقارنةً بتقنيات كلاسيكية أخرى مثل أشجار البحث المتوازنة هي أنّ بنية البيانات الفعلية بسيطة إلى هذا الحدّ. وسـ clox يذهب إلى وحدة جديدة.
^code table-h
جدول التجزئة مصفوفة من المُدخلات. وكما في مصفوفتنا الديناميكية السابقة، فإنّنا نتتبّع حجم
المصفوفة المُخصَّص (capacity) وعدد أزواج المفتاح/القيمة المخزّنة فيها حاليًا (count). ونسبة
العدّ إلى السعة هي بالضبط معامل حشو جدول التجزئة.
كل مُدخل هو واحد من هذه:
^code entry (1 before, 2 after)
إنّه زوج مفتاح/قيمة بسيط. وبما أنّ المفتاح يكون دائمًا نصًّا، فإنّنا نخزّن مؤشّر ObjString مباشرةً بدلًا من تغليفه في Value. بهذه الطريقة يكون أسرع وأصغر قليلًا.
ولإنشاء جدول تجزئة جديد فارغ، نُعلن دالة تشبه المُنشئ.
^code init-table-h (2 before, 2 after)
نحتاج إلى ملف تنفيذ جديد لتعريف ذلك. وبما أنّنا هنا، فلنتخلّص من كل includeات المزعجة.
^code table-c
وكما في نوع مصفوفة القيم الديناميكي لدينا، يبدأ جدول التجزئة بسعة صفر ومصفوفة NULL. فنحن لا
نخصّص أيّ شيء حتى نحتاج إليه. وبافتراض أنّنا سنخصّص شيئًا في النهاية، نحتاج كذلك إلى القدرة على
تحريره.
^code free-table-h (1 before, 2 after)
وتنفيذها المبهج:
^code free-table
ومرّة أخرى، يبدو تمامًا كالمصفوفة الديناميكية.في الواقع يمكنك أن تفكّر في جدول التجزئة على أنّه
مجرد مصفوفة ديناميكية ذات سياسة غريبة حقًّا لإدراج العناصر. ولا نحتاج هنا إلى التحقّق من NULL
إذ إنّ FREE_ARRAY() يتعامل مع ذلك برشاقة أصلًا.
تجزئة النصوص
قبل أن نتمكّن من البدء في وضع مُدخلات في الجدول، نحتاج إلى... تجزئتها. ولضمان توزيع المُدخلات بشكل متجانس عبر المصفوفة، نريد دالة تجزئة جيّدة تنظر إلى كلّ بتات سلسلة المفتاح. فإن كانت تنظر مثلًا إلى أوّل بضعة محارف فقط، فإنّ سلسلة من النصوص تتشارك البادئة نفسها ستنتهي إلى التصادم في الدلو نفسه.
ومن جهة أخرى، فإنّ المشي على السلسلة كلّها لحساب التجزئة بطيء نوعًا ما. إذ سنفقد بعض فائدة الأداء الخاصة بجدول التجزئة لو اضطررنا إلى المشي على السلسلة في كل مرّة نبحث فيها عن مفتاح في الجدول. لذا سنفعل الأمر البديهي: نُخزّنها مؤقتًا (cache).
وهناك في وحدة "object" في ObjString، نضيف:
^code obj-string-hash (1 before, 1 after)
يخزّن كل ObjString رمز التجزئة لسلسلته. وبما أنّ النصوص غير قابلة للتغيير في Lox، يمكننا حساب رمز التجزئة مرّة واحدة في المقدمة، ونتيقّن من أنّه لن يُبطَل أبدًا. والتخزين المؤقّت له نوعٌ من المعقول: فاختيار السلسلة ونسخ محارفها عملية O(n) أصلًا، لذا فهذه وقتٌ جيّد أيضًا لإجراء حساب O(n) لتجزئة السلسلة.
كلّما استدعينا الدالة الداخلية لتخصيص سلسلة، نمرّر لها رمز تجزئتها.
^code allocate-string (1 after)
تكتفي تلك الدالة بتخزين التجزئة في البنية.
^code allocate-store-hash (1 before, 2 after)
الجزء المثير يحدث عند المستدعين. فـ allocateString() تُستدعى من موضعين: الدالة التي تنسخ سلسلة،
والتي تتولّى ملكية سلسلة ديناميكية التخصيص قائمة بالفعل. سنبدأ بالأولى.
^code copy-string-hash (1 before, 1 after)
لا سحر هنا. فإنّنا نحسب رمز التجزئة ثم نمرّره.
^code copy-string-allocate (2 before, 1 after)
دوالّ السلسلة الأخرى مشابهة.
^code take-string-hash (1 before, 1 after)
والشيفرة المثيرة هنا:
^code hash-string
هذه هي "دالة التجزئة" الحقيقية في clox. وتُسمّى الخوارزمية "FNV-1a"، وهي أقصر دالة تجزئة لائقة أعرفها. والإيجاز فضيلة بالتأكيد في كتاب يهدف إلى أن يريك كلّ سطر من الشيفرة.
الفكرة الأساسية بسيطة إلى حدٍّ ما، وكثير من دوالّ التجزئة تتبع النمط نفسه. فأنت تبدأ بقيمة تجزئة أوّلية، عادةً ما تكون ثابتًا له خصائص رياضية مختارة بعناية. ثمّ تمشي على البيانات المراد تجزئتها. ولكل بايت (أو أحيانًا كلمة)، فإنّك تخلط البتات في قيمة التجزئة بطريقة ما، ثمّ تبعثر البتات الناتجة قليلًا.
يمكن أن يصبح معنى "الخلط" و"التبعيثر" متطوّرًا إلى حدٍّ كبير. لكنّ الهدف الأساسي في النهاية هو التجانس -- نريد أن تكون قيم التجزئة الناتجة منتشرة على أوسع نطاق عددي ممكن تفاديًا للتصادمات والتكتّل.
إدراج المُدخلات
الآن وبعد أن أصبحت كائنات النصوص تعرف رمز تجزئتها، يمكننا البدء في وضعها في جداول التجزئة.
^code table-set-h (1 before, 2 after)
تضيف هذه الدالة زوج المفتاح/القيمة المُعطى إلى جدول التجزئة المُعطى. فإن كان هناك مُدخل لذلك
المفتاح بالفعل، فإنّ القيمة الجديدة تحلّ محلّ القيمة القديمة. وتُرجِع الدالة true إن أُضيف مُدخل
جديد. وهذا هو التنفيذ:
^code table-set
معظم المنطق المثير موجود في findEntry() التي سنصل إليها قريبًا. ومهمّة تلك الدالة هي أخذ مفتاح
والوقوف على الدلو في المصفوفة الذي ينبغي أن يذهب إليه. وتُرجِع مؤشّرًا إلى ذلك الدلو -- عنوان
Entry في المصفوفة.
وحين نحصل على دلو، يصبح الإدراج مباشرًا. فنحدّث حجم جدول التجزئة، مع الحرص على ألّا نزيد العدّ إذا كنا قد كتبنا فوق قيمة مفتاح موجود بالفعل. ثم ننسخ المفتاح والقيمة إلى الحقلين المقابلين في Entry.
لكنّنا نفتقد شيئًا صغيرًا هنا. فنحن لم نخصّص مصفوفة Entry بعد. أوه! قبل أن نتمكّن من إدراج أيّ شيء، نحتاج إلى التأكّد من أنّ لدينا مصفوفة وأنّها كبيرة بما يكفي.
^code table-set-grow (1 before, 1 after)
هذا مشابه للشيفرة التي كتبناها قبل وقت ليس ببعيد لنمّو مصفوفة ديناميكية. فإن لم تكن لدينا سعة كافية
لإدراج عنصر، فإنّنا نُعيد التخصيص وننمّي المصفوفة. ويأخذ الماكرو GROW_CAPACITY() سعة قائمة
وينمّيها بمعامل ما لضمان أن نحصل على أداء ثابت مُخمَّد (amortized) عبر سلسلة من عمليات الإدراج.
الفرق المثير هنا هو ذلك الثابت TABLE_MAX_LOAD.
^code max-load (2 before, 1 after)
هكذا نُدير معامل حشو الجدول. فنحن لا ننمو عندما تمتلئ السعة تمامًا. وبدلًا من ذلك، ننمّي المصفوفة قبل ذلك، حين تصبح ممتلئة بنسبة 75% على الأقلّ.
سنصل إلى تنفيذ adjustCapacity() قريبًا. أولًا، لننظر إلى تلك الدالة findEntry() التي كنت
تتساءل عنها.
^code find-entry
هذه الدالة هي قلب جدول التجزئة الحقيقي. فهي مسؤولة عن أخذ مفتاح ومصفوفة دلاء، والوقوف على الدلو
الذي ينتمي إليه المُدخل. وهناك أيضًا يأتي السبر الخطّي ومعالجة التصادمات إلى اللعب. وسنستخدم
findEntry() للبحث عن المُدخلات القائمة في جدول التجزئة، ولتحديد أين نُدرج مُدخلات جديدة.
ومع كل ذلك، فليس فيها الكثير. أولًا، نستخدم باقي القسمة (modulo) لإسقاط رمز تجزئة المفتاح إلى فهرس ضمن حدود المصفوفة. ويعطينا ذلك فهرس دلو نأمل أن نتمكّن عنده من العثور على المُدخل أو وضعه.
هناك بضع حالات للتحقّق منها:
-
إذا كان مفتاح Entry عند ذلك فهرس المصفوفة هو
NULL، فإنّ الدلو فارغ. فإن كنّا نستخدمfindEntry()للبحث عن شيء في جدول التجزئة، فهذا يعني أنّه ليس هناك. وإن كنّا نستخدمها للإدراج، فهذا يعني أنّنا وجدنا مكانًا نضيف إليه المُدخل الجديد. -
إذا كان المفتاح في الدلو مساويًا للمفتاح الذي نبحث عنه، فإنّ ذلك المفتاح موجود بالفعل في الجدول. فإن كنّا نبحث، فهذا جيّد -- لقد وجدنا المفتاح الذي نبحث عنه. وإن كنّا نُدرج، فهذا يعني أننا سنستبدل قيمة ذلك المفتاح بدلًا من إضافة مُدخل جديد.
- وإلا، فإنّ الدلو يحتوي على مُدخل لكن بمفتاح مختلف. وهذا تصادم. وفي تلك الحالة، نبدأ السبر.
وهذا ما تفعله حلقة
forتلك. نبدأ من الدلو الذي كان المُدخل سينتهي إليه على نحو مثالي. فإن كان ذلك الدلو فارغًا أو يحمل المفتاح نفسه، فقد انتهينا. وإلا، فإنّنا نتقدّم إلى العنصر التالي -- وهذا هو الجزء الخطّي من "السبر الخطّي" -- ونفحص هناك. فإن تجاوزنا نهاية المصفوفة، فإنّ مشغّل استخدام الباقي الثاني يعيدنا إلى البداية.
نخرج من الحلقة حين نجد إمّا دلوًا فارغًا أو دلوًا يحمل المفتاح نفسه الذي نبحث عنه. وقد تتساءل عن حلقة لا نهائية. ماذا لو اصطدمنا مع كل الدلاء؟ ولحسن الحظ، لا يمكن أن يحدث ذلك بفضل معامل الحشو. فنحن ننمّي المصفوفة بمجرّد أن تقترب من الامتلاء، لذا نعرف أنّ هناك دلاء فارغة دائمًا.
نُرجِع مباشرةً من داخل الحلقة، فينتج مؤشّر إلى Entry الموجود، ليتمكّن المستدعي من إدراج شيء فيه أو
القراءة منه. وفي tableSet() سابقًا، وهي الدالة التي افتتحت هذا كلّه، فإنّنا نخزّن المُدخل الجديد
في ذلك الدلو المُرجَع وننتهي.
التخصيص وإعادة التحجيم
قبل أن نتمكّن من وضع مُدخلات في جدول التجزئة، فعلينا فعلًا أن نملك مكانًا لتخزينها. فنحتاج إلى تخصيص مصفوفة من الدلاء. ويحدث ذلك في هذه الدالة:
^code table-adjust-capacity
ننشئ مصفوفة دلاء فيها capacity مُدخل. وبعد تخصيص المصفوفة، فإنّنا نهيّئ كل عنصر ليكون دلوًا فارغًا
ثمّ نخزّن المصفوفة (وسعتها) في البنية الرئيسة لجدول التجزئة. وهذه الشيفرة مناسبة حين نُدرج أوّل
مُدخل في الجدول، ونشترط أوّل تخصيص للمصفوفة. لكن ماذا عن حين يكون لدينا مصفوفة بالفعل ونحتاج إلى
نمّيتها؟
حين كنا نعمل على مصفوفة ديناميكية، كان بإمكاننا مجرّد استخدام realloc() وترك مكتبة C القياسية
تنسخ كل شيء. لكنّ ذلك لا ينفع مع جدول تجزئة. تذكّر أنّنا لاختيار دلو كل مُدخل نأخذ مفتاح تجزئته
بأخذ باقي القسمة على حجم المصفوفة. وهذا يعني أنّه حين يتغيّر حجم المصفوفة، قد تنتهي المُدخلات إلى دلاء
مختلفة.
وقد تكون لتلك الدلاء الجديدة تصادمات جديدة علينا معالجتها. لذا فأبسط طريقة لجعل كل مُدخل في مكانه الصحيح هي إعادة بناء الجدول من الصفر بإعادة إدراج كل مُدخل في المصفوفة الفارغة الجديدة.
^code re-hash (2 before, 2 after)
نمشي على المصفوفة القديمة من الأمام إلى الخلف. وكلّما وجدنا دلوًا غير فارغ، فإنّنا نُدرج ذلك المُدخل
في المصفوفة الجديدة. ونستخدم findEntry()، معطِين إياها المصفوفة الجديدة بدلًا من تلك المخزّنة
حاليًا في Table. (ولهذا تأخذ findEntry() مؤشّرًا مباشرًا إلى مصفوفة Entry بدلًا من بنية Table
كاملة. وبذلك يمكننا تمرير المصفوفة الجديدة وسعتها قبل أن نخزّنهما في البنية.)
بعد ذلك، يمكننا تحرير ذاكرة المصفوفة القديمة.
^code free-old-array (3 before, 1 after)
وبذلك، لدينا جدول تجزئة يمكننا أن نضع فيه ما نشاء من المُدخلات. فهو يتعامل مع الكتابة فوق المفاتيح القائمة وينمو عند الحاجة للحفاظ على سعة الحشو المرغوبة.
وبما أنّنا هنا، لنعرّف أيضًا دالة مساعِدة لنسخ كل مُدخلات جدول تجزئة إلى آخر.
^code table-add-all-h (1 before, 2 after)
لن نحتاج إلى هذا حتى وقت أبعد بكثير حين ندعم وراثة الطرق، لكنّنا قد ننفّذه الآن ما دمنا ما زلنا نحتفظ بكل أمور جدول التجزئة حديّة في أذهاننا.
^code table-add-all
ليس هناك الكثير لقوله عن هذا. فهو يمشي على مصفوفة الدلاء لجدول التجزئة المصدر. وكلّما وجد دلوًا غير
فارغ، يُضيف المُدخل إلى جدول التجزئة الهدف باستخدام الدالة tableSet() التي عرّفناها للتوّ.
استرجاع القيم
الآن وبعد أن صار جدول تجزئتنا يحتوي بعض الأشياء، لنبدأ بسحبها إلى الخارج. فمعطى مفتاح، يمكننا البحث عن القيمة المقابلة، إن وُجدت، بهذه الدالة:
^code table-get-h (1 before, 1 after)
تمرّر لها جدولًا ومفتاحًا. فإن وجدت مُدخلًا بذلك المفتاح، فإنّها تُرجِع true، وإلا فإنّها تُرجِع
false. وإن كان المُدخل موجودًا، فإنّ مُعامل الخرج value يشير إلى القيمة الناتجة.
وبما أنّ findEntry() تقوم بالعمل الصعب، فإنّ التنفيذ ليس سيئًا.
^code table-get
إن كان الجدول فارغًا تمامًا، فلا نجد المُدخل على الأرجح، لذا نتحقّق من ذلك أولًا. وهذا ليس تحسينًا
فحسب -- إنّه يضمن أيضًا ألّا نحاول الوصول إلى مصفوفة الدلاء حين تكون المصفوفة NULL. وإلا، فإنّنا
نترك findEntry() تعمل سحرها. فهي تُرجِع مؤشّرًا إلى دلو. فإن كان الدلو فارغًا -- ونكتشف ذلك
بمعرفة ما إذا كان المفتاح NULL -- فإنّنا لم نجد Entry بمفتاحنا. فإن أرجعت findEntry() فعلًا
Entry غير فارغًا، فذلك هو مطابقنا. فنأخذ قيمة Entry وننسخها إلى مُعامل الخرج ليتمكّن المستدعي من
الحصول عليها. قطعة كعككة.
حذف المُدخلات
هناك عملية أساسية أخرى تحتاج جدول تجزئة متكامل الميزات إلى دعمها: إزالة مُدخل. ويبدو هذا بديهيًّا إلى حدٍّ ما، فإذا استطعت إضافة الأشياء، فينبغي أن تستطيع إزالتها، صحيح؟ لكنّك ستندهش كمّ من أدلة جداول التجزئة تُغفل هذا.
كان بإمكاني سلوك هذا المسار أيضًا. وفي الحقيقة، فإنّنا نستخدم الحذف في clox فقط في حالة حدّية صغيرة في الآلة الافتراضية. لكن إن أردت أن تفهم فعلًا كيفية تنفيذ جدول تجزئة تنفيذًا كاملًا، فإنّ هذا يبدو مهمًّا. وأنا أتفهّم رغبتهم في تجاهله. وكما سنرى، فإنّ الحذف من جدول تجزئة يستخدم العنونة المفتوحة أمر صعب.
على الأقلّ التصريح بسيط.
^code table-delete-h (1 before, 1 after)
النهج البديهي هو عكس الإدراج. استخدم findEntry() للبحث عن دلو المُدخل. ثمّ أفرغ الدلو. انتهى!
في الحالات التي لا توجد فيها تصادمات، فإنّ ذلك يعمل على ما يرام. لكن إن وقع تصادم، فإنّ الدلو الذي يعيش فيه المُدخل قد يكون جزءًا من تسلسل سبر ضمني واحد أو أكثر. فمثلًا، إليك جدول تجزئة يحتوي ثلاثة مفاتيح كلّها لها الدلو المفضّل نفسه، 2:
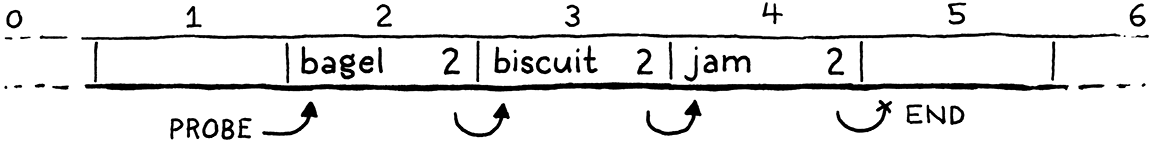
تذكّر أنّنا حين نمشي في تسلسل سبر للعثور على مُدخل، نعرف أنّنا بلغنا نهاية تسلسل وأنّ المُدخل غير موجود حين نصطدم بدلو فارغ. إنّه كأنّ تسلسل السبر قائمة مُدخلات والمُدخل الفارغ ينهي تلك القائمة.
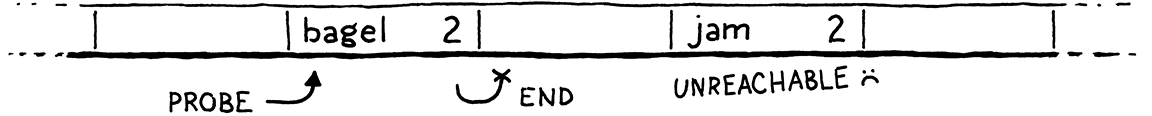
إن حذفنا "biscuit" بمجرّد تفريغ الـ Entry، فإنّنا نكسر ذلك تسلسل السبر في منتصفه، تاركةً المُدخلات التالية يتيمة وغير قابلة للوصول. شيءٌ يشبه إزالة عقدة من قائمة مرتبطة دون إعادة وصل المؤشّر من العقدة السابقة إلى التالية.
إن حاولنا لاحقًا البحث عن "jam"، فسنبدأ عند "bagel" ونتوقّف عند Entry فارغ تالٍ ولن نجده أبدًا.
ولحلّ ذلك، تستخدم معظم التنفيذات خدعة تُسمّى شواهد القبر (tombstones). فبدلًا من تفريغ المُدخل عند الحذف، فإنّنا نستبدله بمُدخل حارس خاصّ يُسمّى "شاهد قبر". وحين نتبع تسلسل سبر أثناء بحث، ونصطدم بشاهد قبر، فإنّنا لا نتعامل معه كخانة فارغة ونتوقّف عن التكرار. وبدلًا من ذلك، نواصل السير كي لا يكسر حذف مُدخل أيّ سلسلة تصادمات ضمنية، ولا يزال بإمكاننا العثور على مُدخلات بعده.
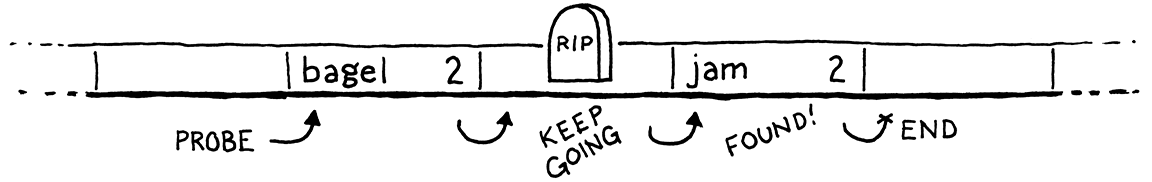
وتبدو الشيفرة هكذا:
^code table-delete
أولًا، نجد الدلو الذي يحتوي المُدخل الذي نريد حذفه. (فإن لم نجده، فلا شيء لحذفه، لذا نخرج.) ونستبدل
المُدخل بشاهد قبر. وفي clox، نستخدم مفتاحًا NULL وقيمة true لتمثيل ذلك، لكنّ أيّ تمثيل لا يمكن
الخلط بينه وبين دلو فارغ أو مُدخل صالح يفي بالغرض.
هذا كل ما نحتاج إلى فعله لحذف مُدخل. بسيط وسريع. لكنّ جميع العمليات الأخرى تحتاج أيضًا إلى التعامل الصحيح مع شواهد القبر. فشاهد القبر نوعٌ من المُدخل "النصفي". فلديه بعض خصائص المُدخل الحاضر وبعض خصائص المُدخل الفارغ.
حين نتبع تسلسل سبر أثناء بحث، ونصطدم بشاهد قبر، فإنّنا نلاحظه ونتابع السير.
^code find-tombstone (2 before, 2 after)
في المرّة الأولى التي نمرّ فيها بشاهد قبر، فإنّنا نخزّنه في هذا المتغيّر المحلّي:
^code find-entry-tombstone (1 before, 1 after)
إن وصلنا إلى مُدخل فارغ فعلًا، فإنّ المفتاح غير موجود. وفي تلك الحالة، إن كنّا قد مررنا بشاهد قبر،
نُرجِع دلوه بدلًا من المُدخل الفارغ اللاحق. وإن كنّا نستدعي findEntry() لإدراج عقدة، فإنّ ذلك
يسمح لنا بمعاملة دلو شاهد القبر على أنه فارغ وإعادة استخدامه للمُدخل الجديد.
إعادة استخدام خانات شواهد القبر تلقائيًّا بهذه الطريقة تساعد على تقليل عدد شواهد القبر التي تهدر المساحة في مصفوفة الدلاء. ففي حالات الاستخدام المعتادة التي فيها مزيج من الإدراجات والحذفات، ينمو عدد شواهد القبر فترةً ثمّ يميل إلى الاستقرار.
ومع ذلك، فلا ضمان ألّا تتسبّب دفعات كبيرة من عمليات الحذف تجعل المصفوفة ممتلئة بشواهد القبر. وفي أسوأ الحالات
على الإطلاق، يمكننا أن ننتهي إلى لا دلاء فارغة. وذلك سيكون سيئًا لأنّنا، تذكّر، الشيء الوحيد الذي
يمنع الحلقة اللانهائية في findEntry() هو الافتراض بأنّنا سنصطدم في النهاية بدلو فارغ.
لذا نحتاج إلى التفكير في كيفية تفاعل شواهد القبر مع معامل حشو الجدول وإعادة تحجيمه. والسؤال الرئيسي هو: حين نحسب معامل الحشو، هل ينبغي أن نتعامل مع شواهد القبر كدلاء ممتلئة أم كدلاء فارغة؟
عدّ شواهد القبر
إن تعاملنا مع شواهد القبر كدلاء ممتلئة، فقد ننتهي إلى مصفوفة أكبر ممّا نحتاجه على الأرجح لأنّها تُضخّم معامل الحشو زورًا. فهناك شواهد قبر يمكننا إعادة استخدامها، لكنّها لا تُعامَل على أنّها غير مستخدَمة، فننتهي إلى نموّ المصفوفة في وقت أبكر ممّا ينبغي.
لكن إن تعاملنا مع شواهد القبر كدلاء فارغة ولم ندرِجها في معامل الحشو، فإنّنا نخاطر بالانتهاء إلى لا دلاء فارغة فعلًا لإنهاء البحث. فالحلقة اللانهائية مشكلة أسوأ بكثير من خانات مصفوفة إضافية قليلة، لذا فإنّنا بالنسبة إلى معامل الحشو، نعتبر شواهد القبر دلاء ممتلئة.
ولهذا السبب فإنّنا لا نُنقص العدّ عند حذف مُدخل في الشيفرة السابقة. لم يعد العدّ عدد المُدخلات في جدول التجزئة، بل صار عدد المُدخلات زائدًا شواهد القبر. وهذا يعني أنّنا نزيد العدّ أثناء الإدراج فقط إن كان المُدخل الجديد يذهب إلى دلو فارغ تمامًا.
^code set-increment-count (1 before, 2 after)
إن كنّا نستبدل شاهد قبر بمُدخل جديد، فإنّ الدلو قد جُرِب في الحساب بالفعل ولا يتغيّر العدّ.
وحين نُعيد تحجيم المصفوفة، فإنّنا نخصّص مصفوفة جديدة ونُعيد إدراج كل المُدخلات القائمة فيها. وخلال تلك العملية، لا ننسخ شواهد القبر. فهي لا تضيف أيّ قيمة بما أنّنا نعيد بناء تسلسلات السبر على أيّ حال، وكانت ستحبط البحث فحسب. وهذا يعني أنّنا نحتاج إلى إعادة حساب العدّ لأنّه قد يتغيّر أثناء إعادة التحجيم. لذا نُفرغه:
^code resize-init-count (2 before, 1 after)
ثمّ كلّما وجدنا مُدخلًا ليس شاهد قبر، فإنّنا نزيده.
^code resize-increment-count (1 before, 1 after)
وهذا يعني أنّه حين نزيد السعة، قد ننتهي إلى عدد أقلّ من المُدخلات في المصفوفة الأكبر الناتجة، لأنّ كلّ شواهد القبر تُستبعد. وهذه هدرٌ قليل، لكنها ليست مشكلة عملية كبيرة.
أجد ممتعًا أنّ كثيرًا من العمل اللازم لدعم حذف المُدخلات يقع في findEntry() و
adjustCapacity(). فمنطق الحذف الفعلي بسيط إلى حدٍّ ما وسريع. وفي الممارسة، تميل الحذفات إلى
أن تكون نادرة، لذا كنتَ تتوقّع من جدول تجزئة أن يبذل أقصى جهده في دالة الحذف ويترك الدوالّ الأخرى
وحدها كي تبقى أسرع. ومع نهج شواهد القبر لدينا، تكون الحذفات سريعة، لكنّ عمليات البحث تتعرّض
للعقوبة.
أجريتُ بعض قياس الأداء لاختبار هذا في بضعة سيناريوهات حذف مختلفة. وفوجئت عند اكتشاف أنّ شواهد القبر انتهت إلى أن تكون أسرع إجمالًا مقارنةً بالقيام بكل العمل أثناء الحذف لإعادة إدراج المُدخلات المتأثّرة.
لكن إن فكّرت في الأمر، فالأمر ليس أنّ نهج شاهد القبر يدفع عمل الحذف الكامل لمُدخل إلى عمليات أخرى، بل بالأحرى إنّه يجعل الحذف كسولًا (lazy). في البداية، هو يقوم بأقلّ قدر من العمل لتحويل المُدخل إلى شاهد قبر. وهذا قد يسبّب عقوبة حين تحتاج عمليات البحث اللاحقة إلى تجاوزه. لكنّه يتيح أيضًا لدلو شاهد القبر أن يُعاد استخدامه من قبل إدراج لاحق أيضًا. وإعادة الاستخدام تلك طريقة فعّالة جدًّا لتجنّب تكلفة إعادة ترتيب كلّ المُدخلات المتأثّرة التالية. فأنت في الأساس تعيد تدوير عقدة في سلسلة المُدخلات المفحوصة. وهي خدعة أنيقة.
تدويل النصوص
لدينا الآن جدول تجزئة يعمل إلى حدٍّ كبير، لكنّ فيه عيبًا جوهريًّا في مركزه. كما أنّنا لا نستخدمه لشيء بعد. حان الوقت لمعالجة الأمرين معًا، ونتعلّم في أثناء ذلك تقنية كلاسيكية يستخدمها المفسّرات.
سبب عدم عمل جدول التجزئة تمامًا هو أنّ findEntry() تتحقّق ممّا إذا كان مفتاح قائم يطابق المفتاح
الذي تبحث عنه، فتستخدم == لمقارنة سلسلتين بالمساواة. ولا يُرجع ذلك true إلّا إذا كانت المفاتيح
الاثنان هما السلسلة نفسها بالضبط في الذاكرة. وسلّلتان منفصلتان بنفس المحارف ينبغي اعتبارهما
متساويتين، لكنّهما ليستا كذلك.
تذكّر، حين أضفنا النصوص في الفصل الماضي، أضفنا دعمًا صريحًا لمقارنة النصوص محرفًا بمحرف
من أجل الحصول على مساواة قيمة حقيقية. يمكننا أن نفعل ذلك في findEntry()، لكنّ ذلك بطيء.
وبدلًا من ذلك، سنستخدم تقنية تُسمّى تدويل النصوص (string interning). والمشكلة الأساسية هي أنّه من الممكن وجود سلاسل مختلفة في الذاكرة بنفس المحارف. وينبغي أن تتصرّف تلك كقيم متكافئة رغم أنّها كائنات متميّزة. فهي في الأساس نسخ مكرّرة، ويلزمنا مقارنة كلّ بايتاتهالكشف ذلك.
تدويل النصوص هو عملية إزالة التكرار. فإنّنا ننشئ مجموعة من النصوص "المُدوَّلة" (interned). وأيّ نصّ في تلك المجموعة مضمون أن يكون مختلفًا نصًّا عن كلّ النصوص الأخرى. وحين تُدوِّل نصًّا، فإنّك تبحث عن نصّ مطابق في المجموعة. فإن وُجد، فإنّك تستخدم ذلك الأصل. وإلا، فإنّ النصّ الذي لديك فريد، لذا تضيفه إلى المجموعة.
بهذه الطريقة، تعرف أنّ كلّ تسلسل من المحارف ممثَّل بسلسلة واحدة فقط في الذاكرة. وهذا يجعل مساواة القيمة أمرًا تافهًا. فإذا كان سلسلتان تشيران إلى العنوان نفسه في الذاكرة، فإنّهما بالطبع هما السلسلة نفسها ويجب أن تكونا متساويتين. وبما أنّنا نعرف أنّ النصوص فريدة، فإنّ سلسلتين تشيران إلى عنوانين مختلفين يجب أن تكونا سلسلتين مختلفتين.
إذن، مساواة المؤشّرات تطابق مساواة القيمة تمامًا. وهو بدوره يعني أنّ == القائمة لدينا في
findEntry() تفعل الشيء الصحيح. أو، على الأقلّ، سيفعل ذلك بمجرّد أن نُدوِّل كلّ النصوص. ولكي نزيل
تكرار كلّ النصوص على نحو موثوق، تحتاج الآلة الافتراضية إلى القدرة على العثور على كلّ نصّ يُنشأ.
ونفعل ذلك بمنحها جدول تجزئة لتخزينها كلّها.
^code vm-strings (1 before, 1 after)
وكما جرت العادة، نحتاج إلى include.
^code vm-include-table (1 before, 1 after)
حين نُشغّل آلة افتراضية جديدة، يكون جدول النصوص فارغًا.
^code init-strings (1 before, 1 after)
وحين نُطفئ الآلة الافتراضية، فإنّنا ننظّف أيّ موارد استخدمها الجدول.
^code free-strings (1 before, 1 after)
بعض اللغات تملك نوعًا منفصلًا أو خطوة صريحة لتدويل نصّ. أمّا clox، فسنُدوِّل كلّ نصّ تلقائيًّا. وهذا يعني أنّه كلّما أنشأنا نصًّا فريدًا جديدًا، فإنّنا نضيفه إلى الجدول.
^code allocate-store-string (1 before, 1 after)
ونحن نستخدم الجدول أشبه بمجموعة تجزئة (set) من بجدول تجزئة. فالمفاتيح هي النصوص، وليست هناك غيرها
ما يهمّنا، لذا نكتفي باستخدام nil للقيم.
هذا يُدخل النصّ في الجدول بافتراض أنّه فريد، لكنّنا نحتاج فعلًا إلى التحقّق من التكرار قبل أن نصل
إلى هنا. ونفعل ذلك في دالتَي المستوى الأعلى اللتين تستدعيان allocateString(). وهذه إحداهما:
^code copy-string-intern (1 before, 1 after)
حين ننسخ نصًّا إلى LoxString جديد، فإنّنا نبحث عنه في جدول النصوص أولًا. فإن وجدناه، فإنّنا بدلًا من "نسخه" نُرجع ببساطة إشارةً إلى ذلك النصّ. وإلا، فإنّنا نكمل فنخصّص نصًّا جديدًا ونخزّنه في جدول النصوص.
أما توليّ ملكية نصّ فهو مختلف قليلًا.
^code take-string-intern (1 before, 1 after)
ومرّة أخرى، فإنّنا نبحث عن النصّ في جدول النصوص أولًا. فإن وجدناه، فإنّنا قبل أن نُرجعه، نحرّر ذاكرة النصّ الذي مرَّر إلينا. وبما أنّ الملكية تُمرَّر إلى هذه الدالة ولم نعد بحاجة إلى النصّ المكرّر، فإنّ حرّره مسؤوليّتنا.
وقبل أن نصل إلى الدالة الجديدة التي سنكتبها، هناك include أخير.
^code object-include-table (1 before, 1 after)
وللبحث عن نصّ في الجدول، لا يمكننا استخدام الدالة المعتادة tableGet() لأنّها تستدعي
findEntry()، التي لديها المشكلة ذاتها مع السلاسل المكرّرة التي نحاول إصلاحها الآن. وبدلًا من
ذلك، نستخدم هذه الدالة الجديدة:
^code table-find-string-h (1 before, 2 after)
ويبدو التنفيذ هكذا:
^code table-find-string
يبدو أنّنا نسخنا findEntry() عبر اللصق. وهناك كثير من التكرار، لكن أيضًا اختلافان رئيسيان.
أولًا، نمرّر مصفوفة المحارف الخام للمفتاح الذي نبحث عنه بدلًا من ObjString. فحين نستدعي هذه الدالة،
لم ننشئ ObjString بعد.
ثانيًا، حين نتحقّق ممّا إذا وجدنا المفتاح، فإنّنا ننظر إلى النصوص نفسها. فنرى أولًا إن كان لهما أطوال وتجزئات متطابقة. وهذه سريعة الفحص، فإن لم تتطابق فإنّ النصوص بالتأكيد ليست هي نفسها.
وإن كان هناك تصادم في التجزئة، فإنّنا نقارن النصوص محرفًا بمحرف فعلًا. وهذه هي النقطة الوحيدة في الآلة الافتراضية التي نختبر فيها النصوص فعليًّا للمساواة النصّية. نفعل ذلك هنا لإزالة تكرار النصوص، ثمّ تستطيع بقية الآلة الافتراضية أن تأخذ على عاتقها أنّ أيّ سلسلتين في عنوانين مختلفين من الذاكرة يجب أن يكون لهما محتويات مختلفة.
وفي الحقيقة، الآن بعد أن دوّلنا كلّ النصوص، يمكننا الاستفادة من ذلك في مفسّر شيفرة البايت. فحين
يفعل مستخدم == على كائنين يحدث أن يكونا نصّين، لم نعد بحاجة إلى اختبار المحارف.
^code equal (1 before, 1 after)
لقد أضفنا حِملًا زائدًا صغيرًا عند إنشاء النصوص لتدويلها. لكن بالمقابل، وقت التشغيل، يكون معامل المساواة على النصوص أسرع بكثير. وبهذا، لدينا جدول تجزئة متكامل الميزات جاهز لتتبّع المتغيّرات أو النسخ أو أيّ أزواج مفتاح/قيمة أخرى قد تظهر.
كما سرّعنا أيضًا اختبار النصوص للمساواة. وهذا جيّد حين يفعل المستخدم == على نصوص. لكنّه
أهمّ كثيرًا في لغة مُنمَّطة ديناميكيًّا مثل Lox حيث يُبحث عن استدعاءات الطرق وحقول النسخ بالاسم وقت
التشغيل. فإن كان اختبار نصّ للمساواة بطيئًا، فإنّ ذلك يعني أنّ البحث عن طريقة بالاسم بطيء. وإن كان
ذلك بطيئًا في لغتك الكائنية التوجّه، فإنّ كل شيء بطيء.
التحدّيات
-
في clox، نحتاج بالمصادفة إلى مفاتيح تكون نصوصًا فحسب، لذا فإنّ جدول التجزئة الذي بنيناه مكتوب بشكل صريح لذلك النوع من المفاتيح. فإن كنا قد عرضنا جداول التجزئة على مستخدمي Lox كمجموعة من الدرجة الأولى، فسيكون من المفيد دعم أنواع مختلفة من المفاتيح.
أضف دعمًا لمفاتيح الأنواع الأولية الأخرى: الأعداد، والقيم المنطقية، و
nil. لاحقًا، سيدعم clox أصنافًا معرَّفة من المستخدم. فإن أردنا دعم مفاتيح تكون نسخًا من تلك الأصناف، فما نوع التعقيد الذي يضيفه ذلك؟ -
لجداول التجزئة كثير من المفاتيح التي يمكنك ضبطها وتؤثّر في أدائها. فأنت تقرّر ما إذا كنت ستستخدم التسلسل المنفصل أم العنونة المفتوحة. وبحسب أيّ طريق تسلك، يمكنك ضبط كم مُدخلًا يُخزَّن في كلّ عقدة، أو استراتيجية السبر التي تستخدمها. وأنت تتحكّم في دالة التجزئة ومعامل الحشو ومعدّل النموّ.
لم يُنشأ هذا التنوّع كلّه مجرّدًا ليمنح مرشّحي الدكتوراه في علوم الحاسوب ما ينشرون فيه أطروحات: لكلٍّ منها استخداماتها في المجالات المتنوّعة جدًّا وسيناريوهات العتاد حيث تظهر التجزئة. ابحث عن بضع تنفيذات لجداول التجزئة في أنظمة مفتوحة المصدر مختلفة، وابحث عن الخيارات التي اتّخذوها، وحاول أن تفهم لماذا فعلوا الأشياء بتلك الطريقة.
-
يشتهر بأنّ قياس أداء جدول تجزئة صعب إلى حدٍّ كبير. فقد يكون تنفيذ جدول تجزئة جيّدًا مع بعض مجموعات المفاتيح وسيّئًا مع غيرها. وقد يعمل جيّدًا عند الأحجام الصغيرة ويتدهور مع نموّه، أو العكس. وقد يختنق حين تكون الحذفات شائعة، لكنّه يطير حين لا تكون كذلك. وإنشاء مقاييس أداء تمثّل تمثيلًا دقيقًا لكيفية استخدام مستخدميك لجدول التجزئة هو تحدٍّ.
اكتب حفنة من برامج قياس الأداء المختلفة للتحقّق من تنفيذ جدول التجزئة لدينا. كيف يتغيّر الأداء بينها؟ ولماذا اخترت حالات الاختبار التي اخترتها؟