جمع النفايات
أريد، أريد،
أريد، أريد،
أريد أن أكون نفاية.The Whip, “Trash”
نقول إنّ Lox لغة "عالية المستوى" لأنّها تُحرّر المبرمجين من القلق بشأن تفاصيل لا علاقة لها بالمشكلة التي يحلّونها. يصبح المستخدم مديرًا تنفيذيًّا، يعطي الآلة أهدافًا مجرّدة ويترك للحاسوب الوضيع أن يجد طريقة للوصول إليها.
التخصيص الديناميكي للذاكرة مرشّح مثالي للأتمتة. فهو ضروري لبرنامج عامل، ومرهق إذا فُعل يدويًا، ومع ذلك يظلّ معرّضًا للخطأ. والأخطاء الحتميّة يمكن أن تكون كارثية، يؤدّيان إلى انهيارات أو فساد في الذاكرة أو انتهاكات أمنية. إنّه نوع من العمل الخطر المملّ الذي تتفوّق فيه الآلات على البشر.
ولهذا فإنّ Lox لغة مُدارة (managed language)، ما يعني أنّ تنفيذ اللغة يتولّى تخصيص الذاكرة وتحريرها نيابةً عن المستخدم. وحين ينفّذ المستخدم عملية تتطلّب ذاكرة ديناميكية، تخصّصها الآلة الافتراضية تلقائيًّا. ولا قلق المبرمج أبدًا من إلغاء تخصيص أيّ شيء. وتضمن الآلة أنّ أيّ ذاكرة يستخدمها البرنامج تبقى باقية طالما احتاج إليها.
تقدّم Lox وهمًا بأنّ الحاسوب لديه ذاكرة لا نهائية. يستطيع المستخدمون أن يخصّصوا ويخصّصوا ويخصّصوا ولا يفكّرون مرّة واحدة من أين تأتي كلّ تلك البايتات. وبالطبع، لا تمتلك الحواسيب بعد ذاكرة غير محدودة. لذا فإنّ طريقة اللغات المُدارة في الحفاظ على ذلك الوهم هي أن تتسلّل خلف ظهر المبرمج وتستعيد ذاكرة لم عد البرنامج بحاجة إليها. والمكوّن الذي يقوم بذلك يُسمّى جامع النفايات (collector).
إمكانية الوصول
يطرح هذا سؤالًا صعبًا بشكل مفاجئ: كيف تُخبر الآلة الافتراضية أيّ ذاكرة غير مطلوبة؟ فالذاكرة لا تُطلب إلّا إذا قُرئت في المستقبل، لكن كيف يمكن للتنفيذ، في غياب آلة زمنية، أن يعرف أيّ شيفرة سوف ينفّذها البرنامج وأيّ بيانات سوف يستخدمها؟ تحذير للمشاهدة المسبقة: الآلات الافتراضية لا تستطيع السفر إلى المستقبل. وبدلًا من ذلك، تتّخذ اللغة تقديرًا محافظًا (conservative): فهي تعتبر قطعة ذاكرة ما زالت مستخدَمة إذا كان من الممكن أن تُقرأ في المستقبل.
يبدو ذلك محافظًا إلى حدٍّ مفرط. ألا يمكن لأيّ بت من الذاكرة أن يُقرأ محتملًا؟ في الواقع لا، ليس على الأقلّ في لغة آمنة الذاكرة مثل Lox. وإليك مثالًا:
var a = "first value";
a = "updated";
// GC here.
print a;
لنفترض أنّنا نُشغّل الجامع بعد اكتمال الإسناد في السطر الثاني. فالسلسلة "first value" ما زالت
جالسة في الذاكرة، لكن لا سبيل لبرنامج المستخدم إلى الوصول إليها أبدًا. فبمجرد إعادة إسناد a، فقد
البرنامج أيّ إشارة إلى تلك السلسلة. ويمكننا تحريرها بأمان. وتكون القيمة قابلة للوصول
(reachable) إذا كان هناك بعض الطرق التي يقدر بها برنامج المستخدم على الإشارة إليها. وإلّا، فمثل
السلسلة "first value" هنا، فإنّها غير قابلة للوصول (unreachable).
يمكن للآلة الافتراضية الوصول مباشرةً إلى قيم كثيرة. تأمّل:
var global = "string";
{
  var local = "another";
  print global + local;
}
أوقف البرنامج مباشرةً بعد دمج السلسلتين وقبل أن ينفّذ تصريح print. تستطيع الآلة الافتراضية الوصول
إلى "string" بالنظر في جدول المتغيّرات العامة وإيجاد المدخل الخاص بـ global. وتستطيع أن تجد
"another" بالمشي في مكدّس القيم والوصول إلى الخانة الخاصّة بالمتغيّر المحلّي local. بل وتستطيع
حتى أن تجد السلسلة المدموجة "stringanother" لأنّ تلك القيمة المؤقّتة أيضًا تجلس على مكدّس الآلة
الافتراضية في اللحظة التي أوقفنا فيها برنامجنا.
تُسمّى كل هذه القيم الجذور (roots). والجذر هو أيّ كائن تستطيع الآلة الافتراضية الوصول إليه مباشرةً دون المرور عبر إشارة في كائن آخر. معظم الجذور هي متغيّرات عامة أو عناصر على المكدّس، لكن كما سنرى، هناك موضعان آخران تخزّن عندهما الآلة الافتراضية إشارات إلى كائنات تستطيع الوصول إليها.
ويمكن العثور على قيم أخرى عبر المرور عبر إشارة داخل قيمة أخرى. الحقول في نسخ الأصناف هي الحالة الأوضح، لكنّنا لا نملكها بعد. وحتى بدونها، ما زالت آلتنا الافتراضية تملك إشارات غير مباشرة. تأمّل:
fun makeClosure() {
  var a = "data";

  fun f() { print a; }
  return f;
}

{
  var closure = makeClosure();
  // GC here.
  closure();
}
لنفترض أنّنا نوقف البرنامج عند السطر المعلَّم ونُشغّل جامع النفايات. وحين ينتهي الجامع ويستأنف
البرنامج، فإنّه سيستدعي الإغلاق، الذي سيطبع بدوره "data". لذا يحتاج الجامع إلى ألّا يحرّر تلك
السلسلة. لكن إليك كيف يبدو المكدّس حين نوقف البرنامج:

سلسلة "data" ليست في أيّ موضع عليه. فقد رُفعت بالفعل من المكدّس ونُقلت إلى القيمة العليا المُغلَقة
التي يستخدمها الإغلاق. والإغلاق نفسه موجود على المكدّس. لكن للوصول إلى السلسلة، نحتاج إلى التتبّع عبر
الإغلاق ومصفوفة قيمه العليا. وبما أنّه من الممكن لبرنامج المستخدم أن يفعل ذلك، فإنّ كل هذه
الكائنات التي يمكن الوصول إليها بشكل غير مباشر تُعدّ كذلك قابلة للوصول.
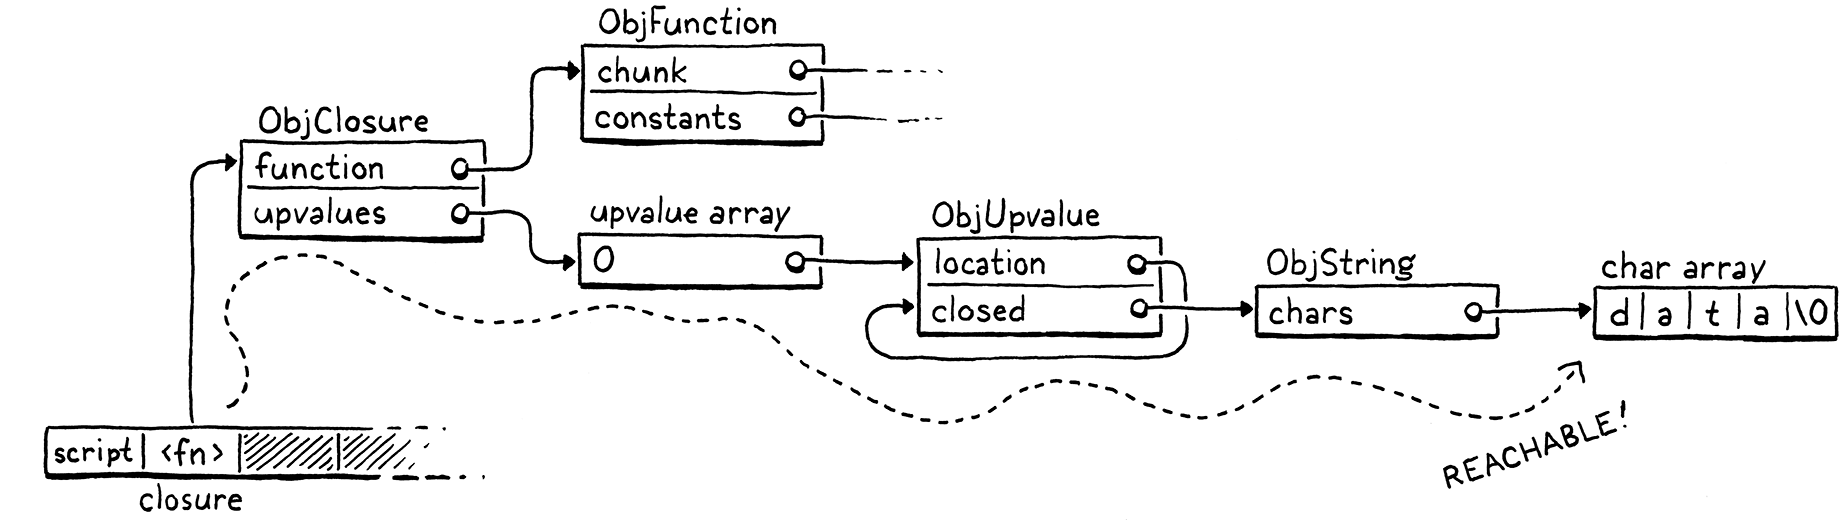
يعطينا هذا تعريفًا استقرائيًّا لإمكانية الوصول:
-
كل الجذور قابلة للوصول.
-
أيّ كائن يُشار إليه من كائن قابل للوصول هو نفسه قابل للوصول.
هذه هي القيم التي ما زالت "حيّة" وتحتاج إلى البقاء في الذاكرة. وأيّ قيمة لا تستوفي هذا التعريف هي فريسةً مشروعة للجامع. وتشير هذه القاعدة إلى خوارزمية عودية يمكننا استخدامها لتحرير الذاكرة غير المطلوبة:
-
ابتداءً من الجذور، اعبر عبر إشارات الكائنات لتجد المجموعة الكاملة للكائنات القابلة للوصول.
-
حرّر كل الكائنات التي ليست في تلك المجموعة.
كثير من خوارزميات جمع النفايات المختلفة مستخدَمة اليوم، لكنّها جميعًا تتبع تلك البنية نفسها تقريبًا. وقد يتداخل بعضها أو يخلط بين خطوتيها، لكنّ العمليتين الأساسيتين موجودتان. وهي تختلف غالبًا في كيفية أدائها لكل خطوة.
جمع النفايات بالتحديد والتسوي
كانت أول لغة مُدارة هي Lisp، أي ثاني لغة "عالية المستوى" بعد اختراع Fortran مباشرةً. وقد فكّر John McCarthy في استخدام إدارة ذاكرة يدوية أو عدّ المراجع، لكنّه في النهاية استقرّ على جمع النفايات (وصاغ المصطلح) -- فحين يكون البرنامج قد نفد من الذاكرة، فإنّه يعود ويجد تخزينًا غير مستخدم يمكنه استعادته.
صمّم أوّل خوارزمية لجمع النفايات وأبسطها، وتُسمّى بالتحديد والمسح (mark-and-sweep) أو ببساطة بالتحديد والتسوي (mark-sweep). يتّسع وصفها في ثلاث فقرات قصيرة في الورقة الأولى عن Lisp. ورغم قِدمها وبساطتها، فالخوارزمية الأساسية ذاتها تقوم مقوّمًا (underlying) مديرَي ذاكرة كثيرين اليوم. وبعض زوايا علوم الحاسوب تبدو خالدة.
وكما يوحي الاسم، يعمل التحديد والتسوي في مرحلتين:
-
التحديد: نبدأ من الجذور ونعبر أو نتتبّع كلّ الكائنات التي تشير إليها تلك الجذور. إنّها اجتياز رسومي كلاسيكي لكل الكائنات القابلة للوصول. وفي كلّ مرّة نزور فيها كائنًا، فإنّنا نحدّده بطريقة ما. (وتختلف التنفيذات في كيفية تسجيل علامة التحديد.)
-
التسوي: بمجرّد اكتمال مرحلة التحديد، يكون كل كائن قابل للوصول في الكومة قد حُدّد. وهذا يعني أنّ أيّ كائن غير محدَّد غير قابل للوصول وجاهز للاستعادة. نمرّ على كل الكائنات غير المحدَّدة ونحرّر كلًّا منها.
يبدو الأمر شيءًا كهذا:
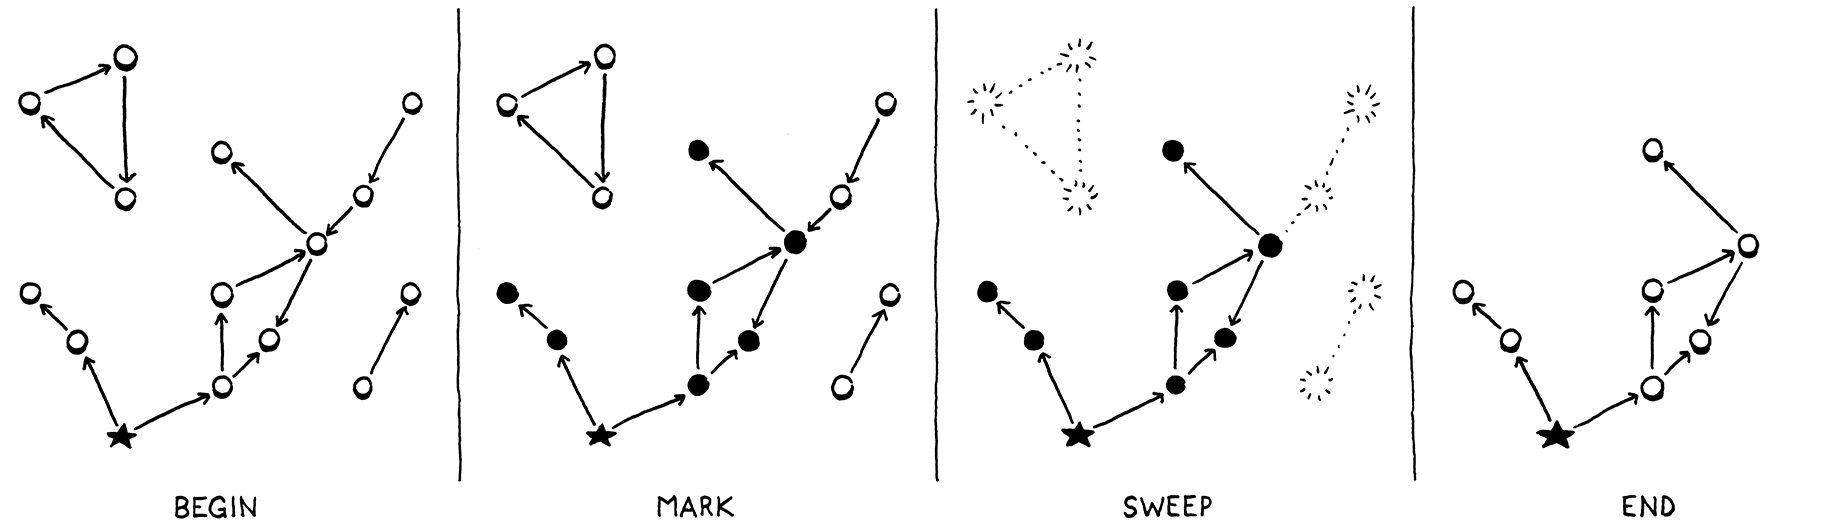
وهذا ما سننفّذه. فكلّما قرّرنا أنّ الوقت مناسب لاستعادة بعض البايتات، سنعبر عبر كل شيء ونحدّد كل الكائنات القابلة للوصول، ونحرّر ما لم يُحدَّد، ثمّ نستأنف برنامج المستخدم.
جمع النفايات
كل هذا الفصل يدور حول تنفيذ دالة واحدة (function):
^code collect-garbage-h (1 before, 1 after)
سنعمل على بلوغ تنفيذ كامل بدءًا من هذه القشرة الفارغة:
^code collect-garbage
السؤال الأول الذي قد تطرحه هو: متى تُستدعى هذه الدالة؟ كما يتبيّن، فذاك سؤال دقيقّ سنقضي بعض الوقت عليه لاحقًا في الفصل. أما الآن فسنتفادى المسألة ونبني لأنفسنا في أثناء ذلك أداة تشخيص مريحة.
^code define-stress-gc (1 before, 2 after)
سنضيف وضع "اختبار إجهاد" اختياريًّا لجامع النفايات. وحين يُعرَّف هذا العَلَم، يعمل الجامع في كلّ مرّة يستطيع. وهذا، بالطبع،فظيع بالنسبة للأداء. لكنه ممتاز لكشف أخطاء إدارة الذاكرة التي لا تحدث إلّا حين يُطلَق جامع في اللحظة المناسبة تمامًا. فإذا كان كلّ لحظة تُطلق جامعًا، فمن المرجّح أن تجد تلك الأخطاء.
^code call-collect (1 before, 1 after)
في كلّ مرّة نستدعي فيها reallocate() للحصول على ذاكرة إضافية، فإنّنا نُجبر عملية جمع على الحدوث. أمّا
فحص if فذلك لأنّ reallocate() تُستدعى أيضًا لتحرير تخصيص أو تصغيره. ولا نريد إطلاق جامع نفايات
لأجل ذلك -- ولا سيّما لأنّ الجامع نفسه سيستدعي reallocate() لتحرير الذاكرة.
الجمع قبل التخصيص مباشرةً هو الطريقة الكلاسيكية لربط جامع نفايات بآلة افتراضية. فأنت تستدعي مدير الذاكرة أصلًا، فيكون ذلك موضعًا سهلًا لربط الشيفرة به. كما أنّ التخصيص هو الوقت الوحيد الذي تكون فيه بحاجة فعلًا إلى ذاكرة محرَّرة كي تعيد استخدامها. فإذا لم تستخدم التخصيص لإطلاق جامع، فعليك أن تتأكّد من أنّ كلّ موضع ممكن في الشيفرة يمكنك أن تحلّق فيه وتخصّص ذاكرة لديه أيضًا وسيلة لإطلاق الجامع. وإلّا، فقد تدخل الآلة الافتراضية في حالة جوع تحتاج فيها إلى ذاكرة إضافية ولا تجمع أبدًا.
تسجيلات التصحيح
وبما أنّنا في موضوع التشخيص، فلنضف المزيد. فأحد التحديات الحقيقية التي واجهتني مع أجهزة جمع النفايات هو أنّها غامضة. لقد كنا نشغّل الكثير من برامج Lox على ما يرام دون أيّ جامع على الإطلاق حتى الآن. ومتى أضفنا واحدًا، فكيف نعرف ما إذا كان يفعل شيئًا مفيدًا؟ هل يمكننا أن نعرف إلّا إذا كتبنا برامج تقطع مساحات شاسعة من الذاكرة؟ وكيف نُصلح ذلك؟
ومن السهلّ إلقاء الضوء على ما يجري داخل الجامع عبر بعض التسجيلات.
^code define-log-gc (1 before, 2 after)
وحين يُفعَّل هذا، يطبع clox معلومات إلى الطرفية حين يفعل شيئًا بالذاكرة الديناميكية.
نحتاج إلى بضعة includeات.
^code debug-log-includes (1 before, 2 after)
ليس لدينا جامع بعد، لكن يمكننا أن نبدأ بإضافة بعض التسجيلات الآن. سنريد أن نعرف متى تبدأ عملية جمع.
^code log-before-collect (1 before, 1 after)
وفي النهاية سنُسجّل عمليات أخرى أثناء الجمع، لذا سنريد أيضًا أن نعرف متى ينتهي العرض.
^code log-after-collect (2 before, 1 after)
ليس لدينا أيّ شيفرة للجامع بعد، لكن لدينا دوالّ للتخصيص والتحرير، لذا يمكننا أن نجهّزها الآن.
^code debug-log-allocate (1 before, 1 after)
وعند نهاية عمر الكائن:
^code log-free-object (1 before, 1 after)
بهذين العَلَمين، ينبغي أن نتمكّن من رؤية أنّنا نتقدّم ونحن نكمل بقية الفصل.
تحديد الجذور
الكائنات موزّعة عبر الكومة كنجوم في سماء ليلية حالكة. والإشارة من كائن إلى آخر تشكّل وصلة، وتلك الأبراج هي الرسم البياني الذي تعبره مرحلة التحديد. ويبدأ التحديد من الجذور.
^code call-mark-roots (3 before, 2 after)
معظم الجذور هي متغيّرات محلّية أو قيم مؤقّتة جالسة في مكدّس الآلة الافتراضية نفسه، لذا نبدأ بالمشي فيه.
^code mark-roots
ولتحديد قيمة من Lox، نستخدم هذه الدالة الجديدة:
^code mark-value-h (1 before, 1 after)
وتنفيذها هنا:
^code mark-value
بعض قيم Lox -- الأعداد والقيم المنطقية وnil -- تُخزَّن مباشرةً داخل Value ولا تحتاج إلى تخصيص في
الكومة. ولا يحتاج جامع النفايات إلى القلق منها إطلاقًا، لذا فإنّ أول ما نفعله هو التأكّد من أنّ القيمة
كائن كومة فعلي. وإن كانت كذلك، فإنّ العمل الحقيقي يحدث في هذه الدالة:
^code mark-object-h (1 before, 1 after)
والتي تُعرَّف هنا:
^code mark-object
فحص NULL غير ضروري عند الاستدعاء من markValue(). فقيمة Lox التي تكون من نوع Obj ما سيكون لها
دائمًا مؤشّر صالح. لكن لاحقًا سنستدعي هذه الدالة مباشرةً من شيفرة أخرى، وفي بعض تلك المواضع يكون
الكائن المُشار إليه اختياريًّا.
ولنفترض أنّ لدينا كائنًا صالحًا فعلًا، فإنّنا نحدّده بضبط عَلَم. وهذا الحقل الجديد يعيش في بنية ترويسة Obj التي تشترك فيها كل الكائنات.
^code is-marked-field (1 before, 1 after)
يبدأ كل كائن جديد حياته غير محدَّد، لأنّنا لم نقرّر بعد إن كان قابلًا للوصول أم لا.
^code init-is-marked (1 before, 2 after)
وقبل أن نذهب أبعد، لنضف بعض التسجيلات إلى markObject().
^code log-mark-object (2 before, 1 after)
بهذه الطريقة يمكننا رؤية ما تفعله مرحلة التحديد. فتحديد المكدّس يعتني بالمتغيّرات المحلّية والقيم المؤقّتة. والمصدر الرئيس الآخر للجذور هو المتغيّرات العامة.
^code mark-globals (2 before, 1 after)
تعيش تلك في جدول تجزئة تملكه الآلة الافتراضية، لذا سنُعلن دالة مساعِدة أخرى لتحديد كل الكائنات في جدول.
^code mark-table-h (2 before, 2 after)
وننفّذ ذلك في وحدة "table" هنا:
^code mark-table
بسيط إلى حدٍّ ما. نمشي في مصفوفة المُدخلات. ولكلّ مُدخل، نحدّد قيمته. كما أنّنا نحدّد سلاسل المفاتيح لكلّ مُدخل، بما أنّ الجامع يدير تلك السلاسل أيضًا.
جذور أقلّ وضوحًا
تلك تغطّي الجذور التي نفكّر فيها عادةً -- القيم التي من الواضح أنّها قابلة للوصول لأنّها مخزّنة في متغيّرات يستطيع برنامج المستخدم رؤيتها. لكن للآلة الافتراضية بعض جيوبها الخفيّة التي تخبّئ فيها إشارات إلى قيم تصل إليها مباشرةً.
معظم حالة استدعاء الدوالّ تعيش في مكدّس القيم، لكن الآلة الافتراضية تحتفظ بمكدّس منفصل من CallFrames. ويحتوي كل CallFrame على مؤشّر إلى الإغلاق الجاري استدعاؤه. وتستخدم الآلة الافتراضية تلك المؤشّرات للوصول إلى الثوابت والقيم العليا، لذا يلزم الإبقاء على تلك الإغلقاقات أيضًا.
^code mark-closures (1 before, 2 after)
وبمناسبة الحديث عن القيم العليا، فإنّ قائمة القيم العليا المفتوحة مجموعة أخرى من القيم التي تستطيع الآلة الافتراضية الوصول إليها مباشرةً.
^code mark-open-upvalues (3 before, 2 after)
وتذكّر أيضًا أنّ عملية الجمع يمكن أن تبدأ أثناء أيّ تخصيص. وهذه التخصيصات لا تحدث فقط بينما يكون برنامج المستخدم قيد التشغيل. فالمصرّف نفسه يأخذ ذاكرة من الكومة على فترات للقيم الحرفية وجدول الثوابت. فإن عمل الجامع بينما نحن في منتصف الترجمة، فإنّ أيّ قيم يصل إليها المصرّف مباشرةً تحتاج إلى أن تُعامَل كجذور أيضًا.
ولنُبقِ وحدة المصرّف مفصولة بنظافة عن بقيّة الآلة الافتراضية، سنفعل ذلك في دالة منفصلة.
^code call-mark-compiler-roots (1 before, 1 after) وهي مُعلَنة هنا:
^code mark-compiler-roots-h (1 before, 2 after)
وهذا يعني أنّ وحدة "memory" تحتاج إلى include.
^code memory-include-compiler (2 before, 1 after)
والتعريف موجود في وحدة "compiler".
^code mark-compiler-roots
ولحسن الحظّ، لا يحتفظ المصرّف بكثير من القيم. فالكائن الوحيد الذي يستخدمه هو ObjFunction الذي يترجم إليه. وبما أنّ التصريحات الوظيفية يمكن أن تتداخل، فإنّ للمصرّف قائمة مرتبطة بتلك التصريحات، ونمشي في القائمة كلّها.
ولأنّ وحدة "compiler" تستدعي markObject()، فإنّها تحتاج أيضًا إلى include.
^code compiler-include-memory (1 before, 1 after)
تلك هي كل الجذور. وبعد تشغيل هذا، يكون كل كائن تستطيع الآلة الافتراضية -- وقت التشغيل والمصرّف -- الوصول إليه دون المرور عبر كائن آخر قد عُلِّم.
تتبّع إشارات الكائنات
الخطوة التالية في عملية التحديد هي العبور عبر رسم الإشارات بين الكائنات لإيجاد القيم القابلة للوصول بشكل غير مباشر. ليس لدينا نسخ بحقول بعد، لذا ليست هناك كائنات كثيرة تحتوي على إشارات، لكن لدينا بعضها (some). وبخاصة، فإنّ ObjClosure لديه قائمة ObjUpvalues التي يُغلقها، إلى جانب إشارة إلى ObjFunction الخام الذي يلتفّ به. وObjFunction بدوره لديه جدول ثوابت يحتوي على إشارات إلى كلّ القيم الحرفية المنشأة في جسم الدالة. وهذا يكفي لبناء شبكة من الكائنات معقّدة إلى حدٍّ ما يمكن لجامعنا أن يزحف عبرها.
حان وقت تنفيذ ذلك العبور. يمكننا أن نمشي بالعرض أولًا، أو بالعمق، أو بترتيب آخر. وبما أنّنا نريد فقط إيجاد مجموعة كل الكائنات القابلة للوصول، فإنّ ترتيب زيارتها لا يهمّنا في الغالب (mostly).
تجريد الألوان الثلاثة
بينما يتجوّل الجامع في رسم الكائنات، نحتاج إلى التأكّد من أنّه لا يفقد موضعه ولا يعلق ذهابًا وإيابًا. وهذا مصدر قلق خاصّ مع التنفيذات المتقدّمة مثل أجهزة الجمع التزايدي التي تتشابك مع تنفيذ أجزاء من برنامج المستخدم. إذ يحتاج الجامع إلى القدرة على التوقّف ثمّ استئناف ما توقّف عنده لاحقًا.
ولمساعدتنا كبشر ذوي عقول ضعيفة على التفكير في هذه العمليّة المعقّدة، ابتكر مخترعو الآلات الافتراضية استعارة تُسمّى تجريد الألوان الثلاثة (tricolor abstraction). لكلّ كائن "لون" مفاهيمي يتتبّع الحالة التي يكون فيها الكائن، والعمل المتبقّي ليده.
-
 الأبيض: في بداية جمع النفايات، كل الكائنات بيضاء. وهذا اللون يعني أنّنا لم نصل إلى
الكائن أو نعالجه إطلاقًا.
-
 الرمادي: أثناء التحديد، حين نصل إلى كائنٍ لأول مرّة، فإنّنا نُغمّقه فيصبح رماديًّا.
وهذا اللون يعني أنّنا نعرف أنّ الكائن نفسه قابل للوصول ولا ينبغي جمعه. لكنّنا لم نعبُر عبره
بعد لنرى ما هي الكائنات الأخرى التي يشير إليها. وبعبارات خوارزميات الرسوم البيانية، هذه هي
قائمة العمل (worklist) -- مجموعة الكائنات التي نعرف عنها لكن لم نعالجها بعد.
-
 الأسود: حين نأخذ كائنًا رماديًّا ونحدّد كلّ الكائنات التي يشير إليها، فإنّنا
نُحوّل عندئذٍ الكائن الرمادي إلى أسود. وهذا اللون يعني أنّ مرحلة التحديد انتهت من معالجة ذلك
الكائن.
ضمن حدود هذا التجريد، تبدو عملية التحديد الآن كالتالي:
-
نبدأ وكلّ الكائنات بيضاء.
-
نجد كل الجذور ونحدّدها بالرمادي.
-
نكرّر ما دام ما زالت هناك كائنات رمادية:
-
نختار كائنًا رماديًّا. ونحوّل أيّ كائنات بيضاء يشير إليها إلى الرمادي.
-
نحدّد الكائن الرمادي الأصلي أسود.
-
أجد أنّ تصوّر هذا يساعدني. لديك شبكة كائنات بإشارات بينها. وفي البداية، هي كلّها نقاط بيضاء صغيرة. وعلى جانب، هناك بعض الحوافّ الواردة من الآلة الافتراضية التي تشير إلى الجذور. يتحوّل تلك الجذور إلى الرمادي. ثمّ يتحوّل كل كائن رمادي وإخوتُه إلى الرمادي بينما يتحوّل الكائن نفسه إلى الأسود. والأثر الكامل هو جبهة موجية رمادية تعبر عبر الرسم البياني، تاركةً خلفها حقلًا من الكائنات السوداء القابلة للوصول. أما الكائنات غير القابلة للوصول فلا تمسّها الجبهة الموجية وتبقى بيضاء.
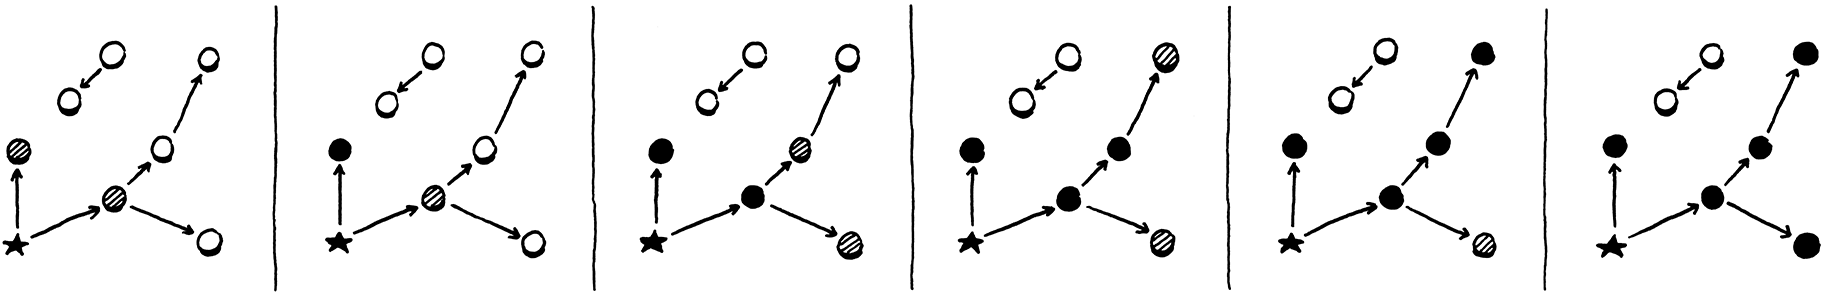
في النهاية (end)، يبقى لديك بحر من الكائنات السوداء التي تم الوصول إليها، منثرًا بجزر من الكائنات البيضاء التي يمكن كنسها وتحريرها. وبمجرد تحرير الكائنات غير القابلة للوصول، تُعاد الكائنات المتبقّية -- وكلّها سوداء -- إلى الأبيض استعدادًا لدورة جمع النفايات التالية.
قائمة عمل للكائنات الرمادية
في تنفيذنا، قمنا بتحديد الجذور بالفعل. إنّنها كلّها رمادية. والخطوة التالية هي أن نبدأ في انتقاء بعضها والعبور عبر إشاراتها. لكن ليس لدينا أيّ طريقة سهلة للعثور عليها. فنحن نضبط حقلًا على الكائن، وذلك كلّ شيء. ولا نريد أن نضطر إلى عبور قائمة الكائنات كلّها بحثًا عن الكائنات التي ضبط ذلك الحقل فيها.
بدلًا من ذلك، سننشئ قائمة عمل منفصلة لمتابعة كلّ الكائنات الرمادية. وحين يتحوّل كائن إلى الرمادي، فإنّنا، بالإضافة إلى ضبط حقل التحديد، سنضيفه أيضًا إلى قائمة العمل.
^code add-to-gray-stack (1 before, 1 after)
يمكننا استخدام أيّ نوع من بنى البيانات تتيح لنا وضع العناصر وإخراجها بسهولة. اخترتُ مكدّسًا لأنّه
أبسط ما يمكن تنفيذه بمصفوفة ديناميكية في C. وهو يعمل إلى حدٍّ كبير مثل المصفوفات الديناميكية الأخرى
التي بنيناها في Lox، إلّا أنّه يستدعي دالة realloc() في النظام لا غلافنا reallocate(). والذاكرة
المخصّصة لمكدّس الرمادي نفسه لا يديرها جامع النفايات. ولا نريد أن يؤدي نموّ مكدّس الرمادي أثناء
عملية جمع إلى أن يبدأ الجامع عملية جمع جديدة على نحو متكرّر. فقد يحدث ذلك ثقبًا في الاستمرارية
الزمانية-المكانية.
سندير ذاكرته بأنفسنا، على نحو صريح. فالآلة الافتراضية تملك مكدّس الرمادي.
^code vm-gray-stack (1 before, 1 after)
يبدأ فارغًا.
^code init-gray-stack (1 before, 2 after)
ونحتاج إلى تحريره عندما تُغلق الآلة الافتراضية.
^code free-gray-stack (2 before, 1 after)
نحن نتحمّل المسؤولية الكاملة عن هذه المصفوفة. ويشمل ذلك فشل التخصيص. فإذا لم نتمكن من إنشاء مكدّس الرمادي أو توسيعه، فلن نتمكّن من إنهاء جمع النفايات. وهذه أخبار سيّئة للآلة الافتراضية، لكنّها نادرة لحسن الحظّ لأنّ مكدّس الرمادي يميل إلى أن يكون صغيرًا جدًّا.وكان من الأجمل لو فعلنا شيئًا أكثر لباقة، لكنّنا لإبقاء الشيفرة في هذا الكتاب بسيطة، فإنّنا نتوقّف فحسب.
^code exit-gray-stack (2 before, 1 after)
معالجة الكائنات الرمادية
حسنًا، الآن حين ننتهي من تحديد الجذور، يكون علينا قد ضبطنا مجموعة من الحقول وملأتُ قائمة عملنا بكائنات علينا معالجتها. حان وقت المرحلة التالية.
^code call-trace-references (1 before, 2 after)
وهذا هو التنفيذ:
^code trace-references
إنّه قريب جدًّا من تلك الخوارزمية النصّية إلى حدّ ما. فطالما لم يفرغ المكدّس، فإنّنا نُخرج الكائنات الرمادية واحدةً تلو الأخرى، ونعبر عبر إشاراتها، ثمّ نحدّدها سوداء. وقد يُظهر العبور عبر إشارات كائن ما كائنات بيضاء جديدة تُحدَّد رمادية وتُضاف إلى المكدّس. لذا فإنّ هذه الدالة تتأرجح ذهابًا وإيابًا بين تحويل الكائنات البيضاء إلى رمادية وتحويل الكائنات الرمادية إلى سوداء، لتدفع الجبهة الموجية الكاملة إلى الأمام تدريجيًّا.
وهنا هو الموضع الذي نعبُر فيه عبر إشارات كائن واحد:
^code blacken-object
لكلّ نوع (kind) من الكائنات حقول مختلفة قد تشير إلى كائنات أخرى، لذا نحتاج إلى كتلة شيفرة خاصّة بكلّ نوع. نبدأ بالأنواع السهلة -- فكائنات السسلات والدوالّ الأصلية لا تحتوي على أيّ إشارات صادرة، فلا شيء نعبُر عبره.
لاحظ أنّنا لا نضبط أيّ حالة في الكائن المُعبر عنه نفسه. فلا يوجد ترميز مباشر لـ "الأسود" في حالة
الكائن. فالكائن الأسود هو أيّ كائن يكون حقل isMarked فيه مضبوطًا (set)
ولم يعد موجودًا في مكدّس الرمادي.
^code blacken-upvalue (2 before, 1 after)
وحين تُغلق قيمة عليا، فإنّها تحتوي على إشارة إلى القيمة المُغلَقة. وبما أنّ القيمة لم تعد على المكدّس، فإنّنا نضطر إلى التأكّد من أنّنا نتتبّع الإشارة إليها من القيمة العليا.
وفيما يلي الدوالّ.
^code blacken-function (1 before, 1 after)
لكلّ دالة إشارة إلى ObjString يحتوي اسم الدالة. والأهمّ من ذلك، أنّ للدالة جدول ثوابت مزدحم بالإشارات إلى كائنات أخرى. ونتتبّع جميعها باستخدام هذه الدالة المساعِدة:
^code mark-array
وآخر نوع كائن لدينا الآن -- وسنضيف المزيد في الفصول اللاحقة -- هو الإغلقاقات.
^code blacken-closure (1 before, 1 after)
لكلّ إغلاق إشارة إلى الدالة الخام التي يلتفّ بها، إلى جانب مصفوفة من المؤشّرات إلى القيم العليا التي التقطها. ونتتبّع جميعها.
تلك هي الآليّة الأساسية لمعالجة كائن رمادي، لكنّ هناك نهايتين مرصوصتين يجب ربطهما. الأولى، بعض التسجيلات.
^code log-blacken-object (1 before, 1 after)
بهذه الطريقة يمكننا أن نراقب التتبّع وهو يتسرّب عبر رسم الكائنات. وبمناسبة الحديث عن الرسم البياني، لاحظ أنّني قلت الرسم البياني. فالإشارات بين الكائنات موجّهة، لكنّ ذلك لا يعني أنّها لا تحتوي دورات! فمن الممكن تمامًا أن تكون هناك دورات من الكائنات. وحين يحدث ذلك، نحتاج إلى التأكّد من أنّ جامعنا لا يعلق في حلقة لا نهائية وهو يُعيد إضافة السلسلة نفسها من الكائنات إلى مكدّس الرمادي مرّة تلو الأخرى.
والحلّ سهل.
^code check-is-marked (1 before, 1 after)
إذا كان الكائن محدَّدًا بالفعل، فإنّنا لا نحدّده مرّة أخرى، وبالتالي لا نضيفه إلى مكدّس الرمادي. ويضمن هذا ألّا يُضاف كائن رمادي بالفعل بصورة زائدة، وألّا يُحوَّل كائن أسود إلى رمادي من غير قصد. وبعبارات أخرى، إنّه يبقي الجبهة الموجية تتحرّك إلى الأمام عبر الكائنات البيضاء فقط.
تسوية الكائنات غير المستخدمة
حين تخرج الحلقة في traceReferences()، تكون قد عالجنا كل الكائنات التي وقع في متناول أيدينا. يكون
مكدّس الرمادي فارغًا، ويكون كل كائن في الكومة إما أسود أو أبيض. الكائنات السوداء قابلة للوصول،
ونريد الاحتفاظ بها. وأيّ شيء ما زال أبيض لم يمسّه التتبّع، وبالتالي فهو نفاية. ولم يبقَ سوى استعادتها.
^code call-sweep (1 before, 2 after)
كل المنطق موجود في دالة واحدة.
^code sweep
أعرف أنّ ذلك مقدار كبير نوعًا ما من الشيفرة وألعاب المؤشّرات، لكنّ الأمر ليس أكثر من ذلك بمجرّد أن
تعمل عليه. فحلقة while الخارجية تمشي في القائمة المرتبطة لكلّ كائنات الكومة، وتتحقّق من بتّات التحديد
لديها. وإذا كان الكائن محدَّدًا (أسود)، فإنّنا نتركه وشأنه ونتجاوزه. وإذا كان غير محدَّد (أبيض)، فإنّنا
نفصله من القائمة ونحرّره باستخدام دالة freeObject() التي كتبناها من قبل.
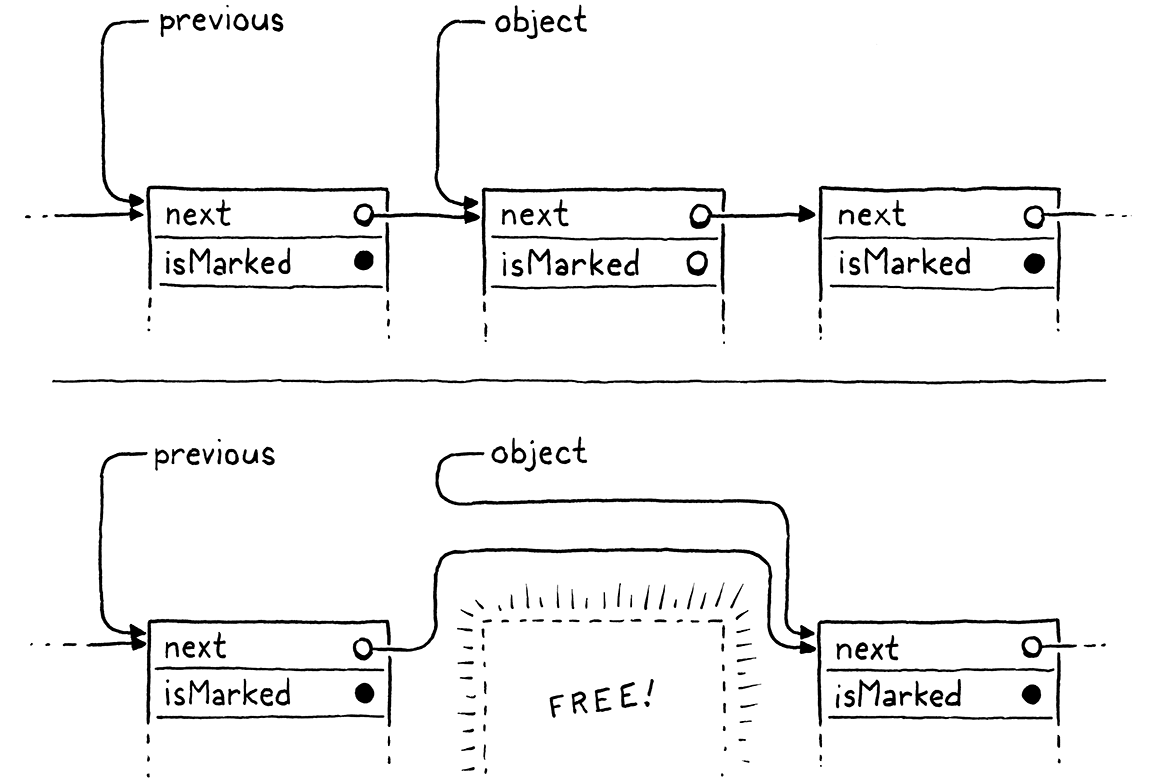
معظم الشيفرة الأخرى هنا تتناول حقيقة أنّ إزالة عقدة من قائمة مرتبطة في اتجاه واحد أمر مربك. علينا أن نتذكّر العقدة السابقة باستمرار كي نفصل مؤشّرها التالي، وعلينا أن نتعامل مع الحالة الحديّة التي نحرّر فيها العقدة الأولى. لكن، عدا ذلك، الأمر بسيط إلى حدٍّ ما -- احذف كل عقدة في قائمة مرتبطة لا يوجد فيها بتّ مضبوط.
وهناك إضافة صغيرة واحدة:
^code unmark (1 before, 1 after)
بعد أن يكتمل sweep()، لا تبقى سوى الكائنات السوداء الحيّة وقد ضبطت بتّات التحديد فيها. هذا صحيح، لكن
حين تبدأ دورة الجمع التالية، نحتاج إلى أن يكون كل كائن أبيض. لذا كلّما صادفنا كائنًا أسود، فإنّنا
نمسح البتّ الآن تحسّبًا للتشغيل التالي.
المراجع الضعيفة ومجمّع السلاسل
شبه انتهينا من الجمع. وهناك ركن آخر باقٍ في الآلة الافتراضية له متطلّبات غير اعتيادية بشأن الذاكرة. تذكّر أنّنا حين أضفنا السلاسل إلى clox جعلنا الآلة الافتراضية تُضمّنها كلّها (intern). وهذا يعني أنّ للآلة الافتراضية جدول تجزئة يحتوي مؤشّرًا إلى كلّ سلسلة في الكومة. وتستخدم الآلة الافتراضية ذلك لإزالة التكرار عن السلاسل.
أثناء مرحلة التحديد، تعمّدنا عدم اعتبار جدول سلاسل الآلة الافتراضية مصدرًا للجذور. ولو فعلنا ذلك، لما جُمع أيّ سلسلة (string) أبدًا. فجدول السلاسل سينمو وينمو دون أن يعيد بايتًا واحدًا إلى نظام التشغيل. وسيكون ذلك سيّئًا.
وفي الوقت نفسه، إذا سمحنا للجامع بأن يحرّر السلاسل، فإنّ جدول سلاسل الآلة الافتراضية سيبقى وفيه مؤشّرات معلّقة إلى ذاكرة محرَّرة. وسيكون ذلك أسوأ.
جدول السلاسل استثنائيّ ونحتاج إلى دعم استثنائيّ له. وبخاصة، فهو يحتاج إلى نوع خاصّ من المراجع. ينبغي أن يستطيع الجدول أن يشير إلى سلسلة، لكنّ هذا الرابط لا ينبغي أن يُعتبر جذرًا عند تحديد إمكانية الوصول. وهذا يعني أنّ الكائن المُشار إليه يمكن أن يُحرَّر. وحين يحدث ذلك، يجب إصلاح المرجع المعلّق أيضًا، على نوعٍ ما من السحر، كأنّه مؤشّر يصحّح نفسه. وهذه المجموعة بعينها من الدلالات تتكرّر بما يكفي لتُمنح اسمًا: مرجع ضعيف.
لقد نفّذنا نصف سلوك جدول السلاسل الفريد ضمنًا لمجرّد أنّنا لا نعبُر عبره أثناء التحديد. وهذا يعني أنّه لا يفرض جعل السلاسل قابلة للوصول. والجزء المتبقّي هو مسح أيّ مؤشّرات معلّقة تخصّ السلاسل التي حُرِّرت.
ولإزالة المراجع إلى السلاسل غير القابلة للوصول، نحتاج إلى معرفة السلاسل التي غير قابلة للوصول. ولا نعرف ذلك إلا بعد اكتمال مرحلة التحديد. لكن لا يمكننا الانتظار حتى بعد انتهاء مرحلة التسوي، لأنّ الكائنات -- وبتّات التحديد فيها -- لن تكون موجودة عندئذٍ لنتحقّق منها. لذا فالوقت المناسب هو بالتحديد بين مرحلتي التحديد والتسوي.
^code sweep-strings (1 before, 1 after)
منطق إزالة السلاسل التي ستُحذف قريبًا موجود في دالة جديدة في وحدة "table".
^code table-remove-white-h (2 before, 2 after)
والتنفيذ هنا:
^code table-remove-white
نمشي في كلّ مُدخل في الجدول. فجدول السلاسل المُضمّنة يستخدم مفتاح كلّ مُدخل فقط -- فهو في الأساس مجموعة تجزئة (hash set) لا خريطة تجزئة (hash map). فإذا لم يكن بتّ التحديد في كائن سلسلة المفتاح مضبوطًا، فإنّ ذلك كائن أبيض على وشك أن يُكنس بعيدًا. فنحذفه من جدول التجزئة أوّلًا، وبذلك نضمن ألّا نرى أيّ مؤشّرات معلّقة.
متى نجمع
لدينا الآن جامع نفايات يعمل تمامًا. وحين يُفعَّل عَلَم اختبار الإجهاد، يُستدعى في كلّ وقت، ومع تفعيل التسجيلات أيضًا يمكننا أن نراقبه وهو يؤدّي عمله ونرى أنّه يوفّر الذاكرة بالفعل. لكن حين يكون عَلَم اختبار الإجهاد مُطفأً، فهو لا يعمل إطلاقًا. حان وقت أن نقرّر متى ينبغي استدعاء الجامع أثناء التنفيذ الطبيعي للبرنامج.
على حدّ علمي، فإنّ الأدبيات تجيب عن هذا السؤال إجابة رديئة. فحين اخترعت أجهزة جمع النفايات أوّل مرّة، كانت الحواسيب تملك قدرًا ضئيلًا وثابتًا من الذاكرة. افترضت أوراق كثيرة من أبحاث الجمع الأولى أنّك تخصّص بضعة آلاف من الكلمات من الذاكرة -- بمعنى آخر، معظمها -- وتستدعي الجامع كلّما نفدت. بسيطة.
والآلات الحديثة تملك غيغابايت من الذاكرة الفيزيائية، مخفيّةً خلف تجريد الذاكرة الافتراضية الأكبر بكثير والذي تتشاركه عشرات البرامج الأخرى وجميعها تتنازع نصيبها من الذاكرة. وسيسمح نظام التشغيل برنامجك أن يطلب ما يريد، ثمّ يُدخل الصفحات من القرص ويُخرجها عندما تمتلئ الذاكرة الفيزيائية. أنت لا "تفقد" ذاكرة حقًّا قطّ، بل تصبح أبطأ وأبطأ.
الكمون والإنتاجية
لم يعد من المعنى انتظار اللحظة التي "يجب" فيها تشغيل الجامع، لذا نحتاج إلى استراتيجية توقيت أدقّ. وللتفكير في هذا بدقّة أكبر، حان وقت تقديم رقمين أساسيين يُستخدمان عند قياس أداء مدير ذاكرة: الإنتاجية (throughput) والكمون (latency).
تدفع كلّ لغة مُدارة ثمنًا في الأداء مقارنةً بالتحرير الصريح الذي يكتبه المستخدم. فالوقت المستغرق فعلًا في تحرير الذاكرة هو نفسه، لكنّ الجامع يقضي دورات في تحديد أيّ ذاكرة يُحرَّر. وهذا وقت لا يُنفق في تشغيل شيفرة المستخدم وإنجاز عمل مفيد. وفي تنفيذنا، هذه هي مرحلة التحديد بأكملها. والهدف من جامع نفايات متطوّر هو تقليل ذلك الحمل.
وهناك مقياسان رئيسيان يمكننا استخدامهما لفهم تلك التكلفة فهمًا أفضل:
-
الإنتاجية هي النسبة الكلية من الوقت التي قُضيت في تشغيل شيفرة المستخدم مقابل إنجاز عمل جمع النفايات. لنقل إنّك شغّلت برنامج clox لعشر ثوانٍ وأنفق منها ثانية واحدة داخل
collectGarbage(). هذا يعني أنّ الإنتاجية 90% -- قضى 90% من الوقت في تشغيل البرنامج و10% في الحمل الإضافي للجمع. -
الإنتاجية (throughput) هي النسبة الكلية من الوقت التي قُضيت في تشغيل شيفرة المستخدم مقابل إنجاز عمل جمع النفايات. لنقل إنّك شغّلت برنامج clox لعشر ثوانٍ وأنفق منها ثانية واحدة داخل
collectGarbage(). هذا يعني أنّ الإنتاجية 90% -- قضى 90% من الوقت في تشغيل البرنامج و10% في الحمل الإضافي للجمع.الإنتاجية هي المقياس الأساسيّ أكثر من غيره لأنّها تتتبّع التكلفة الكلية للحمل الإضافي للجمع. وعند تساوي كلّ شيء آخر، تريد أن تزيد الإنتاجية إلى أقصى حدّ. حتى هذا الفصل، لم يكن في clox أيّ جامع على الإطلاق، وبالتالي كانت 100% إنتاجية. وهذا من الصعب هزيمته. وبالطبع، جاء ذلك على حساب احتمال نفاد الذاكرة والانهيار إذا ظلّ برنامج المستخدم قيد التشغيل طويلًا بما يكفي. يمكنك النظر إلى هدف الجامع على أنه إصلاح ذلك "العيب" بأقلّ إنتاجية ممكنة.
-
الكمون (latency) هو أطول مقطع متّصل من الزمن يتوقّف فيه برنامج المستخدم تمامًا بينما يجري جمع النفايات. وهو مقياس لمدى "التكتّلية" التي يتميّز بها الجامع. والكمون مقياس مختلف تمامًا عن الإنتاجية.
فكّر في تشغيلين لبرنامج clox يستغرق كلٌّ منهما عشر ثوانٍ. في التشغيل الأول، يعمل الجامع مرّة واحدة ويقضي ثانية كاملة في
collectGarbage()في عملية جمع واحدة ضخمة. وفي التشغيل الثاني، يُستدعى الجامع خمس مرّات، كلّ مرّة لخُمس ثانية. وإجمالي الوقت المستغرق في الجمع لا يزال ثانية واحدة، فالإنتاجية 90% في الحالتين. لكن في التشغيل الثاني يكون الكمون خُمس ثانية فقط، أي خمس مرّات أقلّ ممّا في الأول.
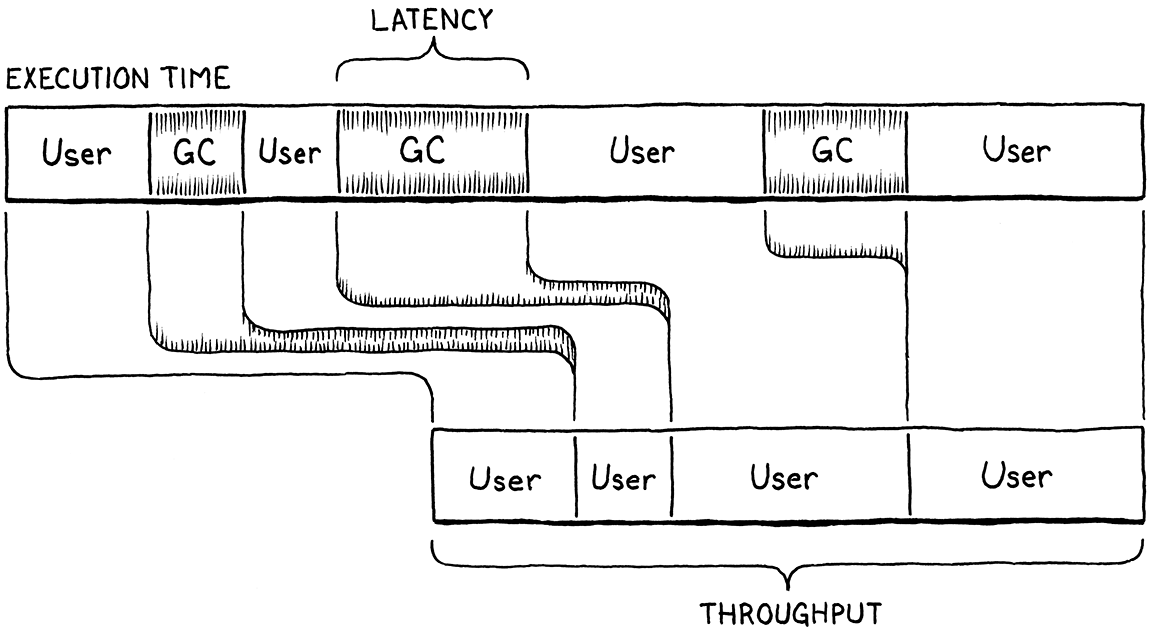
إن كنت تحبّ الاستعارات، فتخيّل أنّ برنامجك مخبز يبيع خبزًا طازجًا للزبائن. الإنتاجية هي إجمالي عدد أرغفة الباغيت الدافئة والقشرة القاسية التي تستطيع تقديمها للزبائن في يوم واحد. والكمون هو مدّة الانتظار التي يضطرّ إليها أتعس حظّ من الزبائن في الطابور قبل أن يُخدم.
تشغيل جامع النفايات يشبه إغلاق المخبز مؤقّتًا لمراجعة كلّ الأواني، وفصل المتسّخ من النظيف، ثمّ غسل المستخدم منها. وفي استعارتنا، لا لدينا غسّالات أوانٍ مخصّصة، لذا فبينما يجري ذلك لا يحدث أيّ خبز. الخبّاز هو من يغسل الأواني.
إنّ بيع أرغفة خبز أقلّ في اليوم أمر سيّئ، وجعل أيّ زبون معيّن يجلس وينتظر بينما تنظّف كلّ الأواني أمر سيّئ أيضًا. الهدف هو زيادة الإنتاجية إلى أقصى حدّ وتقليل الكمون، لكنّ لا وجبة مجّانية، ولا حتى داخل المخبز. فجامعات النفايات تتّخذ مقايضات مختلفة بين مقدار الإنتاجية الذي تتنازل عنه والكمون الذي تتحمّله.
والقدرة على اتّخاذ هذه المقايضات مفيدة لأنّ برامج المستخدم المختلفة لها احتياجات مختلفة. فمهمة دفعة ليلية تولّد تقريرًا من تيرابايت من البيانات لا تحتاج سوى إلى إنجاز أكبر قدر من العمل في أسرع وقت ممكن. هنا ملكةً الإنتاجية. وفي المقابل، يحتاج تطبيق يعمل على هاتف ذكي للمستخدم إلى أن يستجيب دائمًا فورًا لإدخال المستخدم، بحيث يبدو السحب على الشاشة ناعمًا كالزبدة. ولا يمكن للتطبيق أن يتجمّد لبضع ثوانٍ بينما يعبث الجامع في الكومة.
وكمؤلّف جامع نفايات، فإنّك تتحكّم ببعض المقايضة بين الإنتاجية والكمون عبر اختيارك لخوارزمية الجمع. لكن حتى داخل خوارزمية واحدة، لدينا تحكّم كبير في مدّة تكرار تشغيل الجامع.
جامعنا هو جامع يوقف العالم (stop-the-world GC)، ما يعني أنّ برنامج المستخدم موقوف حتى تكتمل عمليّة جمع النفايات بأكملها. فإذا انتظرنا وقتًا طويلًا قبل تشغيل الجامع، فسيتراكم عدد كبير من الكائنات الميتة. ويؤدي ذلك إلى وقفة طويلة جدًّا بينما يعمل الجامع، وبالتالي إلى كمون مرتفع. لذا، من الواضح أنّنا نريد تشغيل الجامع بدقّة تامّة.
لكن في كلّ مرّة يعمل فيها الجامع، فإنه يقضي بعض الوقت في زيارة الكائنات الحيّة. وذلك لا يفعل شيئًا مفيدًا حقًّا (خارجًا من ضمان ألّا تُحذف خطأً). فوقت زيارة الكائنات الحيّة هو وقت لا يُحرَّر فيه ذاكرة وأيضًا وقت لا تُشغَّل فيه شيفرة المستخدم. فإذا شغّلت الجامع بدقّة متناهية، فإنّ برنامج المستخدم لن يكون لديه وقت كافٍ حتى ليولّد نفايات جديدة تجمعها الآلة الافتراضية. وستقضي الآلة الافتراضية كلّ وقتها في إعادة زيارة المجموعة نفسها من الكائنات الحيّة مرّة تلو الأخرى، ية ستتضرّر. لذا، من الواضح أنّنا نريد تشغيل الجامع بقلّة التكرار إلى أقصى حدّ.
وفي الواقع، نريد شيئًا في المنتصف، وتكرار تشغيل الجامع هو إحدى مقابضنا الرئيسة لضبط المقايضة بين الكمون والإنتاجية.
كومة ذاتية الضبط
نريد أن يعمل جامعنا بمعدّل كافٍ لتقليل الكمون، لكن بمعدّل منخفض كفاية للحفاظ على إنتاجية لائقة. لكن كيف نجد التوازن بين ذلكين ونحن لا نعرف كم من الذاكرة يحتاجه برنامج المستخدم ولا كم مرة يخصّص؟ يمكننا أن نبرم القضيّة على المستخدم ونجبركم على الاختيار بأن نكشف معاملات ضبط الجامع. تفعل آلات افتراضية كثيرة هذا. لكن إذا لم نكن نحن مؤلّفي الجامع نعرف كيف نضبطه جيّدًا، فالأرجح ألّا يعرف معظم المستخدمين ذلك أيضًا. وهم يستحقّون سلوكًا افتراضيًّا معقولًا.
سأصارحك، فليس هذا مجال خبرتي. لقد تحدّثت إلى عدد من مهندسي جمع النفايات المحترفين -- فهذه مهنة يمكنك أن تبني عليها مسارك كاملًا -- وقرأت كثيرًا من الأدبيات، وكانت كلّ الإجابات التي حصلت عليها... غامضة. والاستراتيجية التي اخترتُها في النهاية شائعة، وبسيطة إلى حدٍّ ما، وكافية (وآمل ذلك) لأغلب الاستخدامات.
الفكرة هي أنّ تكرار تشغيل الجامع يُعدَّل تلقائيًّا بناءً على حجم الكومة الحيّ. فنحن نتتبّع إجمالي عدد بايتات الذاكرة المُدارة التي خصّصتها الآلة الافتراضية. وحين يتجاوز ذلك حدًّا معيّنًا، نُطلق عملية جمع. وبعد ذلك، نلاحظ كم بايتًا من الذاكرة بقي -- أي كم بايتًا لم يُحرَّر. ثمّ نعدّل الحدّ إلى قيمة أكبر من ذلك.
والنتيجة أنّه مع زيادة حجم الذاكرة الحيّة، فإنّنا نجمع أقلّ تكرارًا تفاديًا للتضحية بالإنتاجية عبر إعادة العبور في كومة الكائنات الحيّة المتنامية. ومع انخفاض حجم الذاكرة الحيّة، فإنّنا نجمع أكثر تكرارًا كي لا نفقد كمونًا أكثر ممّا ينبغي بسبب الانتظار طويلًا جدًّا.
يحتاج التنفيذ إلى حقلَي حسابات جديدين في الآلة الافتراضية.
^code vm-fields (1 before, 1 after)
الأول هو إجمالي متّصل لعدد بايتات الذاكرة المُدارة التي خصّصتها الآلة الافتراضية. والثاني هو الحدّ الذي يُطلق عملية الجمع التالية. ونُهيّئهما عند إقلاع الآلة الافتراضية.
^code init-gc-fields (1 before, 2 after)
والحدّ الابتدائي هنا اعتباطيّ (arbitrary). فهو يشبه السعة الابتدائية التي اخترناها لمصفوفاتنا الديناميكية المختلفة. والهدف ألّا نُطلق عمليات الجمع الأولى بسرعة بالغة لكن كذلك ألّا ننتظر طويلًا. ولو كان لدينا برامج Lox من العالم الحقيقي، لاستطعنا تحليلها لتحسين ضبط هذا. لكن بما أنّ كلّ ما لدينا هو برامج صغيرة، فقد اخترتُ رقمًا فحسب.
وفي كلّ مرّة نخصّص أو نحرّر بعض الذاكرة، فإنّنا نعدّل العدّاد بذلك المقدار.
^code updated-bytes-allocated (1 before, 1 after)
وحين يتجاوز الإجمالي الحدّ، فإنّنا نشغّل الجامع.
^code collect-on-next (2 before, 1 after)
والآن، أخيرًا، صار جامع النفايات لدينا يؤدّي شيئًا ما حين يشغّل المستخدم برنامجًا دون تفعيل عَلَم
التشخيص المخفيّ لدينا. فمرحلة التسوي تحرّر الكائنات بالاستدعاء reallocate()، وهو ما يخفض قيمة
bytesAllocated، لذا بعد اكتمال الجمع نعرف كم بايتًا حيًّا بقي. ونعدّل حدّ الجمع التالي بناءً على ذلك.
^code update-next-gc (1 before, 2 after)
والحدّ هو مضاعف لحجم الكومة. وبهذه الطريقة، ومع نموّ مقدار الذاكرة الذي يستخدمه البرنامج، يتحرّك الحدّ إلى أبعد كي يحدّ من إجمالي الوقت المستغرق في إعادة العبور عبر المجموعة الحيّة الأكبر. ومثل أرقام أخرى في هذا الفصل، فإنّ معامل التحجيم اعتباطيّ إلى حدٍّ ما.
^code heap-grow-factor (1 before, 2 after)
وستودّ ضبط هذا في تنفيذك بمجرّد أن تتوفّر لديك برامج حقيقية تقيسه عليها. في الوقت الحالي، يمكننا على الأقلّ تسجيل بعض الإحصاءات التي لدينا. ونلتقط حجم الكومة قبل الجمع.
^code log-before-size (1 before, 1 after)
ثمّ نطبع النتائج في النهاية.
^code log-collected-amount (1 before, 1 after)
بهذه الطريقة يمكننا أن نرى مقدار ما أنجزه جامع النفايات أثناء عمله.
أخطاء جمع النفايات
نظريًّا، فقد انتهينا من كلّ شيء الآن. لدينا جامع. يعمل دوريًّا، ويجمع ما يستطيع، ويترك الباقي. ولو كان هذا كتابًا دراسيًّا نموذجيًّا، لسحنا الغبار عن أيدينا واستمتعنا بالتوهّج الناعم للبنية الرخامية اللامع التي أنشأناها.
لكنّني أهدف إلى أن أعلّمك ليس نظريّة لغات البرمجة فحسب بل أحيانًا الواقع المؤلم الذي تعيش فيه. سأقلّب جذعًا متعفّنًا وأريك الأخطاء القبيحة التي تعيش تحته، وأخطاء جامع النفايات هي بالفعل من أقبح ما في البرية من البقايا اللافقريّة.
مهمّة الجامع هي تحرير الكائنات الميتة والحفاظ على الحيّة منها. والأخطاء سهلة الوقوع في كلا الاتجاهين. فإن أخفقت الآلة الافتراضية في تحرير كائنات غير لازمة، فإنّها تسرّب الذاكرة ببطء. وإن حرّرت كائنًا قيد الاستخدام، فيمكن لبرنامج المستخدم أن يصل إلى ذاكرة غير صالحة. وكثيرًا ما لا تسبّب هذه الأعطال انهيارًا فوريًّا، وهذا يجعل من الصعب بالنسبة لنا أن نرجع في الزمن المتتبّع لنجد العطب.
ويصعب الأمر أكثر بحكم أنّنا لا نعرف متى سيعمل الجامع. وأيّ استدعاء ينتهي إلى تخصيص بعض الذاكرة هو موضع في الآلة الافتراضية يمكن أن تحدث فيه عملية جمع. فالأمر يشبه لعبة "مقاعد الموسيقى". في أيّ لحظة قد يوقف الجامع الموسيقى. وكلّ كائن مخصَّص في الكومة نريد الاحتفاظ به يحتاج إلى إيجاد مقعد بسرعة -- أن يُحدَّد كجذر أو أن يُخزَّن كمرجع في كائن آخر -- قبل أن تأتي مرحلة التسوي لتطرده من اللعبة.
كيف يمكن للآلة الافتراضية أن تستخدم كائنًا لاحقًا -- كائنًا لا يراه الجامع نفسه؟ وكيف تجد الآلة الافتراضية ذلك؟ الإجابة الأكثر شيوعًا هي عبر مؤشّر مخزّن في متغيّر محلّي ما على مكدّس C. ويعبر الجامع عبر مكدّسَي قيم الآلة الافتراضية وإطارات الاستدعاء (CallFrame)، لكنّ مكدّس C مخفيّ (hidden) عنه.
وفي الفصول السابقة، كتبنا شيفرة تبدو عديمة الفوائد تدفع كائنًا إلى مكدّس قيم الآلة الافتراضية، ثمّ يؤدّي بعض العمل الصغير، ثمّ ينزعه منه فورًا. في معظم المرّات، كنت أقول إنّ ذلك لمصلحة الجامع. والآن ترى لماذا. فبين الدفع والنزع، يمكن أن يُخصَّص ذاكرة، وبالتالي يمكن أن يُطلق جامعًا. وكان علينا التأكّد من أنّ الكائن كان على مكدّس القيم كي تعثر عليه مرحلة التحديد في الجامع وتحتفظ به حيًّا.
كتبتُ تنفيذ clox كاملًا قبل تقسيمه إلى فصول وكتابة النصوص، لذا كان لديّ وقت وفير للعثور على كلّ هذه الزوايا وتنقية معظم هذه الأخطاء. وكان شيفرة اختبار الإجهاد التي أضفناها في بداية هذا الفصل وحزمة اختبارات جيدة إلى حدٍّ ما مفيدتان جدًّا.
لكنّني أصلحت معظمها فقط. وتركت اثنين عمدًا لأنّني أريد أن أعطيك لمحة عمّا يعنيه مصادفة هذه الأخطاء في البرية. فإذا فعّلت عَلَم اختبار الإجهاد وشغّلت بعض برامج Lox الصغيرة، فمن المرجّح أن تصادف بعضها. جرّب ذلك وانظر إن كنت تستطيع إصلاح أيّ منها بنفسك.
الإضافة إلى جدول الثوابت
من المرجّح جدًّا أن تصادف العطب الأوّل. فجدول الثوابت الذي تملكه كلّ قطعة هو مصفوفة ديناميكية. وحين يضيف المصرّف ثابتًا جديدًا إلى جدول الدالة الحالية، قد تحتاج تلك المصفوفة إلى النموّ. وقد يكون الثابت نفسه كائنًا مخصَّصًا في الكومة، مثل سلسلة أو دالة متداخلة.
يُمرَّر الكائن الجديد الذي يُضاف إلى جدول الثوابت إلى addConstant(). وفي تلك اللحظة، لا يمكن العثور
على الكائن إلّا في المُعامل لتلك الدالة على مكدّس C. وتضيف تلك الدالة الكائن إلى جدول الثوابت. فإذا لم
تكن في الجدول سعة كافية واحتاج إلى النموّ، فإنّه يستدعي reallocate(). وبدوره يُطلق ذلك جامعًا يفشل
في تحديد كائن الثابت الجديد، فيكنسها بعيدًا قبل أن تتّاح لنا فرصة إضافته إلى الجدول. انهيار.
والحلّ، كما رأيت في مواضع أخرى، هو دفع الثابت إلى المكدّس مؤقّتًا.
^code add-constant-push (1 before, 1 after)
ومتى يحتوي جدول الثوابت على الكائن، فإنّنا ننزعه من المكدّس.
^code add-constant-pop (1 before, 1 after)
وحين يكون الجامع يحدّد الجذور، فإنّه يمشي في سلسلة المصرّفين ويحدّد كلّ دوالّهم، لذا فقد أصبح الثابت الجديد قابلًا للوصول الآن. ونحتاج فعلًا إلى include لاستدعاء الآلة الافتراضية من وحدة "chunk".
^code chunk-include-vm (1 before, 2 after)
ضمّ السلاسل
وهذا مثال آخر مشابه. كلّ السلاسل في clox مُضمَّنة (interned)، لذا كلّما أنشأنا سلسلة جديدة، فإنّنا نضيفها أيضًا إلى جدول الضمّ. ويمكنك أن ترى إلى أين يتّجه هذا. فبما أنّ السلسلة جديدة تمامًا، فإنّها ليست قابلة للوصول من أيّ مكان. ويمكن أن يؤدي تغيير حجم مجمّع السلاسل إلى إطلاق عملية جمع. ومرة أخرى، فإنّنا نودع السلسلة على المكدّس أوّلًا.
^code push-string (2 before, 1 after)
ثمّ ننزعها مجدّدًا بمجرّد أن تستقرّ بأمان في الجدول.
^code pop-string (1 before, 2 after)
وهذا يضمن بقاء السلسلة آمنة بينما يجري تغيير حجم الجدول. وبعد أن تنجو من ذلك، ستعيد allocateString()
إعادتها إلى بعض المستدعين، الذين يمكنهم عندئذٍ تحمّل مسؤولية ضمان أنّ السلسلة ما زالت قابلة للوصول قبل
حدوث أيّ تخصيص آخر في الكومة.
دمج السلاسل
ومثال أخير: في المفسّر، يمكن استخدام التعليم OP_ADD لدمج سلسلتين. وكما يفعل مع الأعداد، فإنّه ينزع
المعاملين من المكدّس، ويحسب النتيجة، ويدفع تلك القيمة الجديدة إلى المكدّس. وبالنسبة للأعداد، فإنّ ذلك
آمن تمامًا.
لكنّ دمج سلسلتين يتطلّب تخصيص مصفوفة أحرف جديدة في الكومة، وهو بدوره يمكن أن يُطلق جامعًا. وبما أنّنا كنّا قد نزعنا سلسلتي المعاملين في تلك المرحلة، فقد يفوتهما مرحلة التحديد وتُكنس بعيدًا. وبدلًا من نزعهما من المكدّس على عجل، فإنّنا نتطلّع إليهما.
^code concatenate-peek (1 before, 2 after)
وهكذا، فإنّهما لا يزالان على المكدّس حين ننشئ سلسلة النتيجة. وبمجرد إنجاز ذلك، يمكننا أن ننزعهما بأمان ونستبدلهما بالنتيجة.
^code concatenate-pop (1 before, 1 after)
كانت تلك كلّها سهلة إلى حدٍّ ما، وبخاصة لأنّني أريتُك موضع الحلّ. لكن في الممارسة العملية، الجزء الصعب هو العثور عليها. فكلّ ما تراه هو كائن ينبغي أن يكون هناك وليس موجودًا. فالأمر ليس كالأخطاء الأخرى التي تبحث فيها عن الشيفرة التي تسبّب مشكلة ما. فأنت تبحث عن غياب شيفرة تفشل في منع مشكلة، وهذا بحث أصعب بكثير.
لكن، الآن على الأقلّ، يمكنك أن تطمئنّ. فعلى حدّ علمي، فقد وجدنا كل أخطاء الجمع في clox، والآن لدينا جامع نفايات عامل، متين، ذاتي الضبط، يحدّد ويكنس.
التحدّيات
-
بنية Obj في ترويسة كلّ كائن لها الآن ثلاثة حقول:
typeوisMarkedوnext. كم من الذاكرة تشغلها (على جهازك)؟ هل يمكنك ابتكار طريقة أكثر إحكامًا؟ وهل هناك تكلفة وقت تشغيل لفعل ذلك؟ -
حين تعبر مرحلة التسوي عبر كائن حيّ، فإنّها تمسح حقل
isMarkedتمهيدًا لدورة الجمع التالية. هل يمكنك ابتكار نهج أكثر كفاءة؟ -
التحديد والتسوي ليس سوى خوارزمية واحدة من مجموعة خوارزميات جمع النفايات الموجودة. استكشف تلك الخوارزميات باستبدال الجامع الحالي أو من خلال محسّنات له. والخيارات الجيّدة التي يمكن التفكير فيها هي عدّ المراجع، وخوارزمية Cheney، أو خوارزمية Lisp 2 للتحديد والضغط.
ملاحظة تصميم: جامعات الأجيال
يفقد الجامع إنتاجيته إن قضى وقتًا طويلًا في إعادة زيارة كائنات ما زالت حيّة. لكنّه يستطيع أن يزيد الكمون إن تجنّب الجمع وتراكم كومة كبيرة من النفايات ليشقّ طريقه فيها. لو كان هناك ما يخبرنا أيّ الكائنات من المرجّح أن تكون طويلة العمر وأيّها لا. عندئذٍ يمكن للجامع ألّا يعيد زيارة الكائنات طويلة العمر بقدر تكرار الكائنات قصيرة العمر وينظّف الأخيرة أكثر تكرارًا.
وتبيّن أنّ هناك طريقة من هذا النوع. قبل سنوات، جمع باحثو جمع النفايات مقاييس عن عمر الكائنات في برامج عالم حقيقي قيد التشغيل. فتتبّعوا كلّ كائن عند تخصيصه، ثمّ حين لم يعد لازمًا، ثمّ رسموا مخطّطات تبيّن كم من الوقت تميل الكائنات إلى العيش.
واكتشفوا شيئًا سمّوه فرضية الأجيال (generational hypothesis)، أو المصطلح الأقلّ لطفًا وفيات الرضّع (infant mortality). وكانت ملاحظتهم أنّ معظم الكائنات قصيرة العمر جدًّا، لكن بمجرّد أن تصمد بعد سن معيّن، فإنّها تميل إلى البقاء وقتًا طويلًا. وكلّما عاش كائن وقتًا أطول، كان من المرجّح أن يستمرّ في العيش وقتًا أطول. وهذه الملاحظة قويّة لأنّها منحتهم مقبضًا لتقسيم الكائنات إلى مجموعات تستفيد من عمليات جمع متكرّرة وتلك التي لا تستفيد منها.
وصمّموا تقنية تُسمّى جمع النفايات بالأجيال (generational garbage collection). وتعمل كالتالي: في كلّ مرّة يُخصَّص فيها كائن جديد، فإنّه يذهب إلى منطقة خاصة صغيرة نسبيًّا من الكومة تُسمّى "المشتل" (nursery). وبما أنّ الكائنات تميل إلى الموت في سنٍّ مبكّر، فإنّ جامع النفايات يُستدعى بشكل متكرّر (frequently) على الكائنات في هذه المنطقة تحديدًا.
وكلّ مرّة يعمل فيها الجامع على المشتل تُسمّى "جيلًا" (generation). وأيّ كائنات لم تعد لازمة تُحرَّر. وأمّا التي تصمد فإنّها تُعدّ الآن أقدم بجيل واحد، ويتتبّع الجامع ذلك لكلّ كائن. فإذا صمد كائن على مدى عدد معيّن من الأجيال -- وغالبًا ما يكون عملية جمع واحدة فقط -- فإنّه يرقى (tenured). وعند تلك النقطة، يُنسخ خارج المشتل إلى منطقة كومة أكبر بكثير مخصّصة للكائنات طويلة العمر. ويعمل جامع النفايات على تلك المنطقة أيضًا، لكن بمعدّل أقلّ بكثير لأنّ الأرجح أن معظم تلك الكائنات ما زالت حيّة.
وجامعات الأجيال هي زواج جميل بين البيانات التجريبية -- الملاحظة بأنّ أعمار الكائنات لا تتوزّع بالتساوي -- وبين تصميم خوارزمي ماكر يستغلّ تلك الحقيقة. وهي أيضًا بسيطة إلى حدٍّ كبير من حيث المفهوم. فبإمكانك أن تنظر إلى أحدها على أنه مجرّد جهازَي جمع نفايات مضبوطين على نحو منفصل مع سياسة بسيطة جدًّا لنقل الكائنات من أحدهما إلى الآخر.