آلة افتراضية
السحرة يحمون أسرارهم لا لأنّها كبيرة ومهمّة، بل لأنّها صغيرة وتافهة إلى هذا الحد. والآثار الرائعة التي تُحدث على المسرح غالبًا ما تكون نتيجة سرّ شديد العبث بحيث يُحرج الساحر أن يعترف بأنّه هكذا كانت الحيلة.
كريستوفر بريست، الهيبة
أمضينا وقتًا طويلًا في الحديث عن كيفية تمثيل برنامج كسلسلة من تعليمات شيفرة البايت (bytecode)، لكن ذلك يشبه تعلّم الأحياء باستخدام مجسّمات محشوّة ميتة فقط. نعرف ما هي التعليمات نظريًا، لكننا لم نرَها قطّ في العمل، لذا من الصعب أن نفهم حقًا ما الذي تفعله. سيكون من الصعب كتابة مصرّف يُخرج شيفرة بايت حين لا نملك فهمًا جيّدًا لكيفية تصرّف تلك الشيفرة البايت.
لذلك، وقبل أن نذهب ونبني واجهة المستخدم الأمامية (front end) لمفسّرنا الجديد، سنبدأ بالواجهة الخلفية (back end) -- الآلة الافتراضية (virtual machine) التي تنفّذ التعليمات. فهي تنفخ الحياة في شيفرة البايت. ومشاهدة التعليمات وهي ترقص تمنحنا صورة أوضح عن كيفية ترجمة مصرّفٍ ما لشيفرة المستخدم الأصلية إلى سلسلة منها.
آلة تنفيذ التعليمات
الآلة الافتراضية جزءٌ من البنية الداخلية لمفسّرنا. تعطيها قطعة من الشيفرة -- حرفيًا قطعة (Chunk) -- فتنفّذها. وتقع شيفرة الآلة الافتراضية وبنى بياناتها في وحدة جديدة.
^code vm-h
وكالمعتاد، نبدأ ببساطة. ستكتسب الآلة الافتراضية تدريجيًا كمًّا كبيرًا من الحالة التي تحتاج إلى تتبّعها، لذا نعرّف بنية الآن لوضع كل ذلك فيها. وكل ما نخزّنه حاليًا هو القطعة التي تنفّذها.
وكما نفعل مع معظم بنى البيانات التي ننشئها، فإنّنا نعرّف أيضًا دوالّ لإنشاء الآلة الافتراضية وتفكيكها. وهذا هو التنفيذ:
^code vm-c
حسنًا، تسمية تلك الدوالّ بـ"تنفيذات" هي مبالغة. لا توجد لدينا حالة مثيرة للاهتمام نُهيّئها أو نحرّرها بعد، لذا فالدوالّ فارغة. ثق بي، سنصل إلى هناك.
السطر الأكثر إثارة للاهتمام هنا هو تصريح vm. فهذه الوحدة ستحتوي في النهاية على كمّ
كبير من الدوالّ، وستكون تمرير مؤشّر إلى الآلة الافتراضية إليها جميعًا عبئًا. وبدلًا
من ذلك، نصرّح بكائن آلة افتراضية عامّ واحد. على أيّ حال، لا نحتاج سوى إلى واحد،
وهذا يخفّف الشيفرة في الكتاب قليلًا على الصفحة.
قبل أن نبدأ في ضخّ شيفرة ممتعة في آلتنا الافتراضية، فلنربطها بنقطة الدخول الرئيسية للمفسّر.
^code main-init-vm (1 before, 1 after)
نُشغّل الآلة الافتراضية حين يبدأ المفسّر أول مرة. ثم حين نوشك على الخروج، نوقفها.
^code main-free-vm (1 before, 1 after)
التزامٌ طقسي أخير:
^code main-include-vm (1 before, 2 after)
الآن حين تشغّل clox، فإنه يبدأ تشغيل الآلة الافتراضية قبل أن ينشئ تلك القطعة المكتوبة يدويًا من [الفصل الأخير][]. والآلة الافتراضية جاهزة وفي انتظار، فلنُعلّمها أن تفعل شيئًا.
تنفيذ التعليمات
تنشط الآلة الافتراضية حين نأمرها بتفسير قطعة من شيفرة البايت.
^code main-interpret (1 before, 1 after)
هذه الدالة هي نقطة الدخول الرئيسية إلى الآلة الافتراضية. وهي مُصرَّحة هكذا:
^code interpret-h (1 before, 2 after)
تنفّذ الآلة الافتراضية القطعة ثم تردّ بقيمة من هذا التعداد:
^code interpret-result (2 before, 2 after)
لا نستخدم النتيجة بعد، لكن حين يكون لدينا مصرّف يُبلّغ عن أخطاء ساكنة (static errors) وآلة افتراضية تكشف أخطاء وقت التشغيل، سيستخدم المفسّر هذا ليعرف كيف يضبط رمز خروج العملية.
نحن نتقدّم ببطء نحو بعض التنفيذ الفعلي.
^code interpret
أولًا، نخزّن القطعة الجاري تنفيذها في الآلة الافتراضية. ثم نستدعي run()، وهي دالة
مساعِدة داخلية تنفّذ تعليمات شيفرة البايت فعليًا. وبين هذين الجزءين يوجد سطر شيق.
فما هذا الأمر الخاص بـ ip؟
بينما تعمل الآلة الافتراضية عبر شيفرة البايت، فإنها تتتبّع أين هي -- أي موضع
التعليمة الجاري تنفيذها. لا نستخدم متغيّرًا محلّيًا داخل
run() لهذا الغرض لأنّ دوالّ أخرى ستحتاج في النهاية إلى الوصول إليه. وبدلًا من
ذلك، نخزّنه كحقل في الآلة الافتراضية.
^code ip (2 before, 1 after)
نوعه مؤشّر بايتات. ونستخدم مؤشّر C حقيقيًّا يشير إلى منتصف مصفوفة شيفرة البايت مباشرةً بدلًا من شيء مثل فهرس عدد صحيح، لأنّ فكّ مؤشّر أسرع من البحث عن عنصر في مصفوفة بالفهرس.
الاسم "IP" تقليدي، و— بخلاف كثير من الأسماء التقليدية في علوم الحاسوب — له في الواقع معنى: إنه مؤشّر تعليمات. فمعظم مجموعات التعليمات في العالم، الحقيقي والافتراضي، تملك سجلًّا أو متغيّرًا مثل هذا.
نُهيّئ ip بحيث يشير إلى أول بايت من الشيفرة في القطعة. لم ننفّذ تلك التعليمة بعد،
لذا يشير ip إلى التعليمة التي هو وشيك تنفيذها. وسيبقى هذا صحيحًا طوال وقت تشغيل
الآلة الافتراضية: فـ IP يشير دائمًا إلى التعليمة التالية، لا إلى التي يجري التعامل
معها حاليًا.
المتعة الحقيقية تحدث في run().
^code run
هذه هي أهمّ دالة على الإطلاق في كل clox، وبفارق كبير. حين ينفّذ المفسّر برنامج
مستخدم، فإنه سيقضي نحو 90% من وقته داخل run(). إنها القلب النابض للآلة
الافتراضية.
وعلى رغم مقدّمة الدراماتيكية هذه، فهي بسيطة إلى حدٍّ كبير من الناحية المفاهيمية. لدينا حلقة خارجية تمشي وتمرّ. في كل دور من أدوار تلك الحلقة، نقرأ تعليمة شيفرة بايت واحدة وننفّذها.
لمعالجة تعليمة، نحدّد أولًا نوع التعليمة التي نتعامل معها. يقرأ الماكرو READ_BYTE
البايت الذي يشير إليه ip حاليًا ثم يُقدّم مؤشّر التعليمات.
أول بايت من أي تعليمة هو رمز التشغيل (opcode). وبمجرّد أن نعرف رمز التشغيل، نحتاج
إلى الوصول إلى شيفرة C الصحيحة التي تطبّق دلالات تلك التعليمة. وتُسمّى هذه العملية
فكّ ترميز التعليمة أو توجيهها (dispatching).
نُجري تلك العملية لكل تعليمة على حدة، في كل مرّة تُنفَّذ فيها تعليمة، لذا فهذا هو أكثر أجزاء الآلة الافتراضية حساسيةً للأداء. وعلم لغات البرمجة مليء بالتقنيات الذكية لتوجيه شيفرة البايت بكفاءة، بدءًا من الأيام الأولى للحاسوب.
للأسف، تتطلّب أسرع الحلول إمّا امتدادات غير قياسية إلى C، أو شيفرة تجميع مكتوبة بخط
اليد. أمّا في clox، فسنبقي الأمر بسيطًا. تماماً كمفكّكنا، لدينا جملة switch واحدة
ضخمة ذات حالة لكل رمز تشغيل. ويطبّق جسم كل حالة سلوك ذلك الرمز.
حتى الآن، نتعامل مع تعليمة واحدة فقط، وهي OP_RETURN، وكل ما تفعله هو الخروج من
الحلقة كليًّا. في النهاية، ستُستخدم تلك التعليمة للعودة من دالة Lox الحالية، لكنّنا
لا نملك دوالّ بعد، لذا سنُعيد توظيفها مؤقتًا لإنهاء التنفيذ.
لندعم تعليمتنا الأخرى الوحيدة.
^code op-constant (1 before, 1 after)
لا تمتلك لدينا بعد آليات كافية لفعل أيّ شيء مفيد بثابت. سنطبعه في الوقت الحالي فقط
كي نتمكّن نحن مخترقي المفسّرات من رؤية ما يجري داخل آلتنا الافتراضية. ويتطلّب ذلك
الاستدعاء لـ printf() إضافة include.
^code vm-include-stdio (1 after)
ولدي أيضًا ماكرو جديد نعرّفه.
^code read-constant (1 before, 2 after)
يقرأ READ_CONSTANT() البايت التالي من شيفرة البايت، ويعامل الرقم الناتج كفهرس، ثم
يبحث عن الـ Value المقابلة في جدول ثوابت القطعة. وفي فصول لاحقة، سنضيف بضع تعليمات
أخرى ذات مُعاملات تشير إلى ثوابت، لذا نُهيّئ هذا الماكرو المساعِد الآن.
مثل الماكرو السابق READ_BYTE، لا يُستخدم READ_CONSTANT إلا داخل run(). ولجعل
هذا النطاق أكثر وضوحًا، تكون تعريفات الماكرو نفسها محصورة في تلك الدالة. نحن نعرّفها في البداية و— لأنّنا نهتمّ — نُلغي تعريفها في النهاية.
^code undef-read-constant (1 before, 1 after)
تتبّع التنفيذ
إن شغّلت clox الآن، فإنه ينفّذ القطعة التي كتبناها يدويًا في الفصل الأخير ويبصق
1.2 في طرفيتك. نرى أنّه يعمل، لكن ذلك فقط لأنّ تنفيذنا لـ OP_CONSTANT فيه شيفرة
مؤقتة تُسجّل القيمة. وحين تبدأ تلك التعليمة في فعل ما ينبغي فعله وتمرير ذلك الثابت
إلى العمليات الأخرى التي تريد استهلاكه، ستصبح الآلة الافتراضية صندوقًا أسود. وهذا
يجعل حياتنا بصفتنا مطوّري الآلة الافتراضية أصعب.
لمساعدتنا على ذلك، هذا وقت مناسب لإضافة بعض التسجيلات التشخيصية إلى الآلة الافتراضية كما فعلنا مع القطع نفسها. وفي الحقيقة، سنعيد استخدام الشيفرة نفسها. لا نريد أن يكون هذا التسجيل مفعّلًا في كل الأوقات -- فهو لنا نحن مخترقي الآلة الافتراضية، لا لمستخدمي Lox -- لذا نُنشئ أولًا عَلَمًا لنخفي خلفه.
^code define-debug-trace (1 before, 2 after)
حين يُعرَّف هذا العَلَم، تفكّك الآلة الافتراضية كل تعليمة وتطبعها قبيل تنفيذها مباشرةً. وحيث كان مفكّكنا السابق يمشي على قطعة كاملة مرّة واحدة بشكل ساكن، فإنّ هذا يفكّك التعليمات ديناميكيًا أثناء عملها.
^code trace-execution (1 before, 1 after)
بما أنّ disassembleInstruction() تأخذ إزاحة* بايت صحيحة، ونحن نخزّن مرجع التعليمة
الحالية كمؤشّر مباشر، فإنّنا نُجري أولًا بعض عمليات الحساب على المؤشّرات لتحويل
ip إلى إزاحة نسبة إلى بداية شيفرة البايت. ثم نفكّك التعليمة التي تبدأ عند ذلك
البايت.
وكما جرت العادة، نحتاج إلى إدخال تصريح الدالة قبل أن نستدعيها.
^code vm-include-debug (1 before, 1 after)
أعرف أنّ هذه الشيفرة ليست لافتة للنظر حتى الآن -- فهي حرفيًا جملة switch ملفوفة في
حلقة for -- لكن صدّقني أو لا تصدّق، هذه إحدى المكوّنات الرئيسة للآلة الافتراضية.
بها نستطيع تنفيذ التعليمات أسلوبًا إجرائيًّا. وبساطتها فضيلة -- فكلما قلّ العمل الذي
تنفذه، كان أسرع في تنفيذه. قارن ذلك بكل التعقيد والحِمل الزائد اللذين كان لدينا في
jlox مع نمط الزائر (Visitor) للمشي على شجرة التحليل المجرّد (AST).
مُتعامِل مكدّس القيم
إلى جانب التأثيرات الجانبية الإجرائية، تمتلك Lox تعبيرات تُنتج القيم وتعدّلها وتستهلكها. لذا، تحتاج شيفرتنا البايت المجمّعة إلى وسيلة تنقل القيم بين التعليمات المختلفة التي تحتاجها. مثلًا:
print 3 - 2;
نحتاج بوضوح إلى تعليمات للثابتين 3 و2، وإلى عبارة print، وإلى عملية الطرح. لكن
كيف تعرف تعليمة الطرح أنّ 3 هي المطرَح وأنّ 2 هي المطروح
منه؟ وكيف تعرف تعليمة الطباعة أن تطبع نتيجة ذلك؟
ولنضبط المسألة بشكل أدقّ، انظر إلى هذا الأمر بالضبط هنا:
fun echo(n) {
  print n;
  return n;
}

print echo(echo(1) + echo(2)) + echo(echo(4) + echo(5));
غلّفت كل تعبير جزئي باستدعاء لـ echo() يطبع مُعامله ويعيده. وهذا الأثر الجانبي
يتيح لنا رؤية ترتيب العمليات بالضبط.
لا تقلق بشأن الآلة الافتراضية لدقيقة. فكّر في دلالات Lox نفسها فقط. من الواضح أن
مُعاملي المعامل الحسابي يحتاجان إلى تقييمهما قبل أن نتمكّن من إجراء العملية نفسها.
(من الصعب جمع a + b إن كنت لا تعرف ما هما a وb.) كما، حين نفّذنا التعبيرات
في jlox، قرّرنا أن يكون المُعامل الأيسر هو المُقيَّم
قبل الأيمن.
إليك شجرة الصياغة لعبارة print:
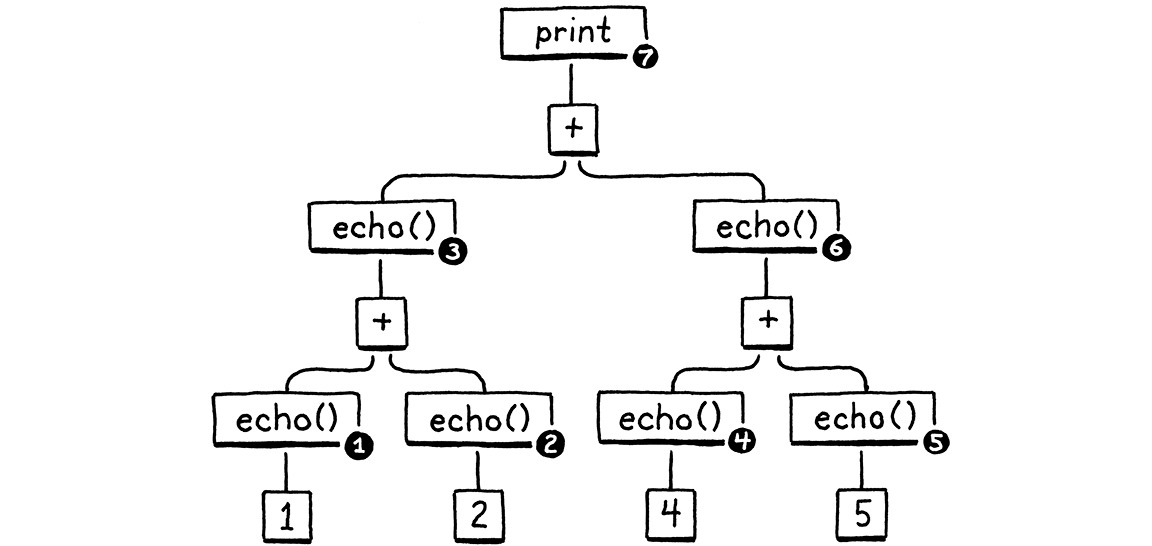
مع التقييم من اليسار إلى اليمين، وطريقة تداخل التعبيرات، يجب على أيّ تنفيذ صحيح لـ Lox أن يطبع هذه الأرقام بهذا الترتيب:
1  // from echo(1)
2  // from echo(2)
3  // from echo(1 + 2)
4  // from echo(4)
5  // from echo(5)
9  // from echo(4 + 5)
12 // from print 3 + 9
يحقق مفسّرنا القديم في jlox ذلك بالمشي المتكرر على شجرة التحليل المجرّد. فهو ينفّذ اجتيازًا لاحقًا (postorder traversal). يتكرّر أولًا في فرع المُعامل الأيسر، ثم الأيمن، ثم أخيرًا يقيّم العقدة نفسها.
بعد تقييم المُعامل الأيسر، يحتاج jlox إلى تخزين تلك النتيجة مؤقتًا في مكان ما بينما هو مشغول بالنزول عبر شجرة المُعامل الأيمن. ونستخدم لذلك متغيّرًا محلّيًا في Java. إذ يُنشئ مفسّرنا العودي الذي يمشي على الشجرة (tree-walk interpreter) إطار استدعاء Java فريدًا لكل عقدة يجري تقييمها، فيمكن أن نمتلك من تلك المتغيّرات المحلّية ما نحتاج.
في clox، دالتنا run() ليست عودية -- إذ تُسطَّح شجرة التعبيرات المتداخلة إلى سلسلة
خطّية من التعليمات. ولا نملك رفاهية استخدام متغيّرات محلّية في C، فكيف وأين ينبغي
أن نخزّن هذه القيم المؤقّتة؟ يمكنك على الأرجح أن تخمّن
بالفعل، لكنني أريد أن أتعمّق في هذا حقًّا لأنه جانب من البرمجة نأخذبه مسلّمات،
ونادرًا ما نتعلّم لماذا صُمّمت الحواسيب بهذا الشكل.
لنجرّب تمرينًا غريبًا. سنمشي على تنفيذ البرنامج أعلاه خطوةً خطوة:
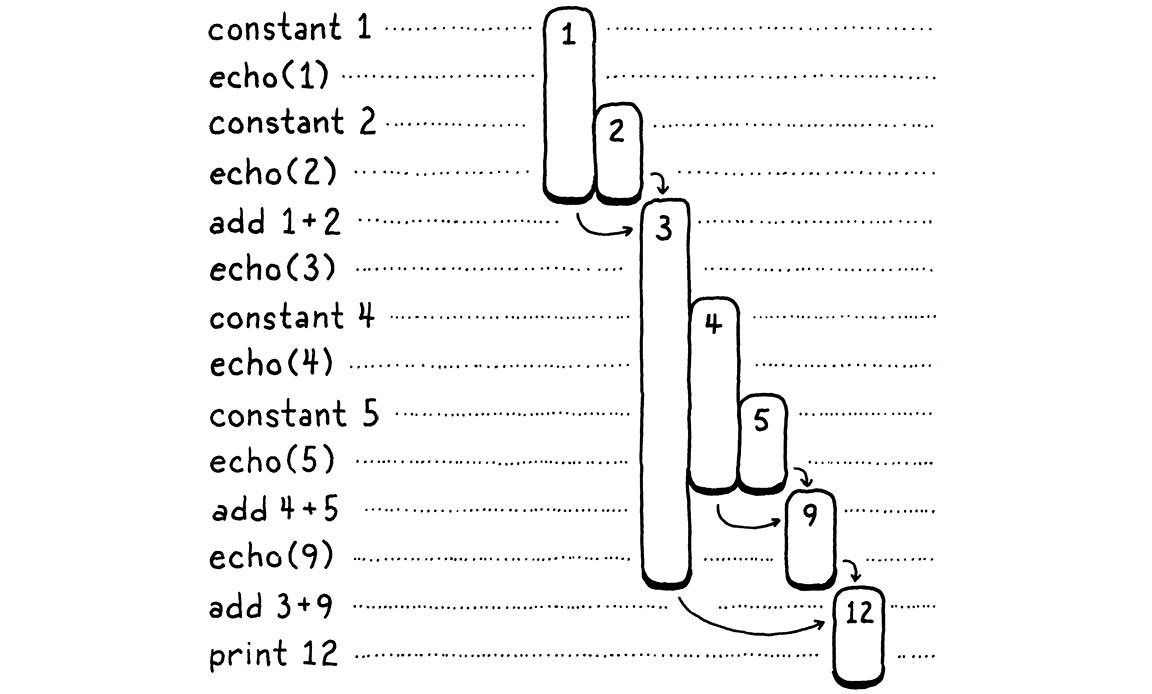
على اليسار خطوات الشيفرة. وعلى اليمين القيم التي نتتبّعها. يمثّل كل شريط رقمًا. يبدأ حين تُنتَج القيمة أول مرة -- إمّا ثابتًا وإمّا نتيجة جمع. ويتبّع طول الشريط الفترة التي يجب أن تبقى فيها قيمة منتَجة سابقًا، وينتهي حين تستهلك تلك القيمة عملية ما أخيرًا.
بينما تتقدّم، ترى قيمًا تظهر ثم تُؤكل لاحقًا. وأطولها عمرًا هي القيم المنتَجة من الجانب الأيسر من عملية جمع. وتبقى هناك بينما نعمل على تعبير المُعامل الأيمن.
في المخطّط أعلاه، أعطيت كل رقم فريد عموده البصري الخاص. لنكن أكثر وفورًا. بمجرّد أن يُستهلك رقم، نسمح بإعادة استخدام عموده لقيمة لاحقة أخرى. بمعنى آخر، نأخذ كل تلك الفجوات في الأعلى ونملؤها، بدفع الأرقام من اليمين:
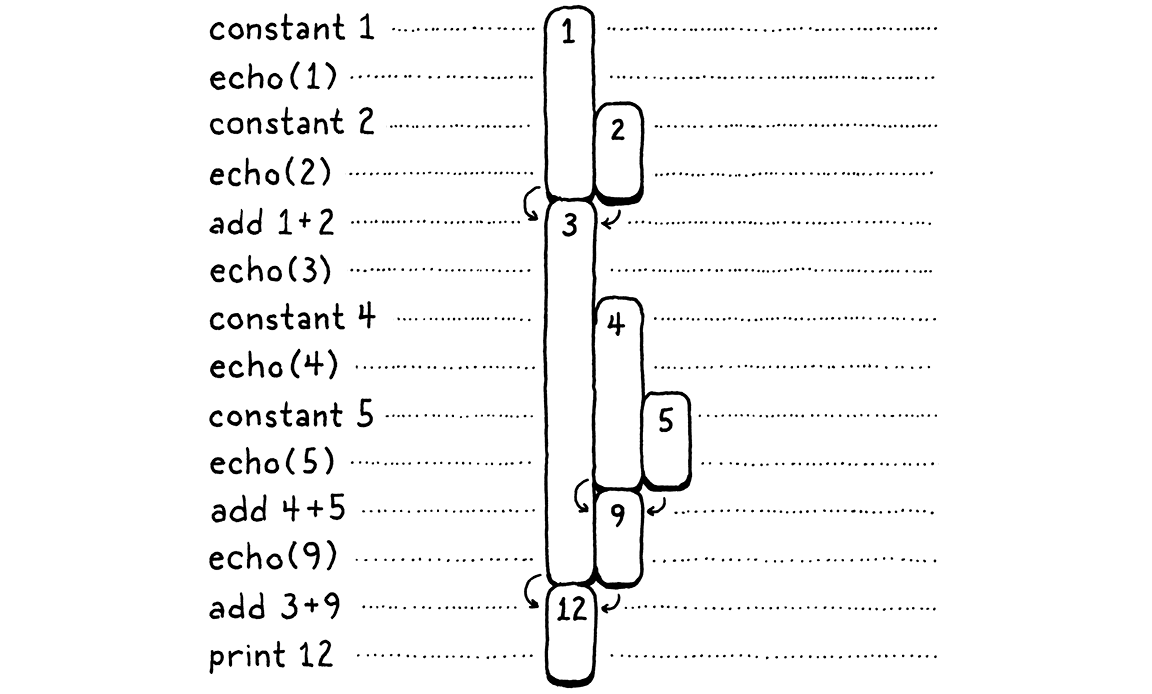
هناك أشياء مثيرة تحدث هنا. حين نزيح كل شيء إلى اليسار، يبقى كل رقم في عمود واحد طوال حياته. كما لا تتبقّى أيّ فجوات. بمعنى آخر، متى ظهر رقم أبكر من آخر، فسيعيش وقتًا لا يقلّ عن عمر ذاك الثاني. أول رقم يظهر هو آخر رقم يُستهلك. همم... آخر داخل، أول خارج... ولماذا، هذا مكدّس!
في المخطّط الثاني، في كل مرّة نُدخل رقمًا، ندفعه على المكدّس من اليمين. وحين تُستهلك الأرقام، فإنّها تُسقط دائمًا من الأيمن إلى الأيسر.
بما أنّ القيم المؤقّتة التي نحتاج إلى تتبّعها تتصرّف بشكل يشبه المكدّس طبيعةً، فإنّ آلتنا الافتراضية ستستخدم مكدّسًا لإدارتها. حين "تُنتج" تعليمة قيمة، فإنها تدفعها على المكدّس. وحين تحتاج إلى استهلاك قيمة أو أكثر، فإنها تحصل عليها بإسقاطها من المكدّس.
مكدّس الآلة الافتراضية
ربما لا يبدو هذا كشفًا مدهشًا، لكنني أحبّ الآلات الافتراضية القائمة على المكدّس. حين ترى خدعة سحرية أول مرة، تبدو كأنّها شيء سحريّ فعلًا. لكنك بعد ذلك تتعلّم كيف تعمل -- عادةً ما تكون حيلة ميكانيكية أو تمويه -- فيتبخّر الإحساس بالدهشة. وهناك بعض الأفكار في علوم الحاسوب التي بقي فيها بعض البريق الأوّل حتى بعد أن فكّكتها وتعلّمت كل تفاصيلها. والآلات الافتراضية القائمة على المكدّس إحدى تلك الأفكار.
كما سترى في هذا الفصل، فإنّ تنفيذ التعليمات في آلة افتراضية قائمة على المكدّس هو أمر بسيط تمامًا. وفي فصول لاحقة، سكتشف أيضًا أنّ ترجمة لغة مصدر إلى مجموعة تعليمات قائمة على المكدّس هو أمر هين. ومع ذلك، فإنّ هذه البنية سريعة بما يكفي لاستخدامها في تطبيقات لغويات إنتاجية. إنّه يكاد يبدو غشًّا في لعبة لغات البرمجة.
حسنًا، حان وقت الكتابة! وإليك المكدّس:
^code vm-stack (3 before, 1 after)
ننفّذ دلالة المكدّس بأنفسنا فوق مصفوفة C خام. قاع المكدّس -- أول قيمة تُدفع وآخر قيمة تُسقط -- هو العنصر صفر في المصفوفة، وتتبعه القيم المدفوعة لاحقًا. إن دفعنا حروف كلمة "crepe" -- فطورتي الصباحية المفضّلة القابلة للتكديس -- على المكدّس بالترتيب، بدت مصفوفة C الناتجة هكذا:
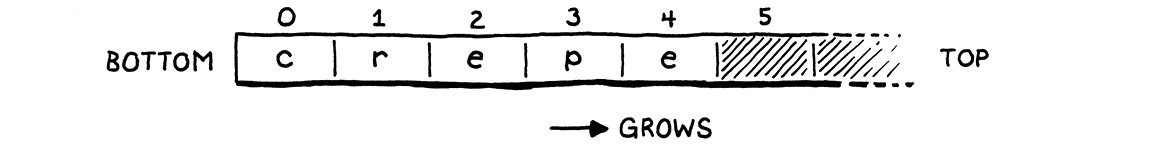
بما أنّ المكدّس ينمو ويتراجع مع دفع القيم وإسقاطها، فنحن نتاجع مكان أعلى المكدّس في
المصفوفة. وكما في ip، نستخدم مؤشّرًا مباشرًا بدلًا من فهرس عدد صحيح لأنّ فكّ
المؤشّر أسرع من حساب الإزاحة من الفهرس في كل مرّة نحتاج فيها إليها.
يشير المؤشّر إلى عنصر المصفوفة الواقع خلف العنصر الذي يحتوي على القيمة العليا في المكدّس. يبدو ذلك غريبًا قليلًا، لكن كل تنفيذ تقريبًا يفعل هذا. وهذا يعني أننا نستطيع الإشارة إلى أنّ المكدّس فارغ بأن يشير إلى العنصر صفر في المصفوفة.
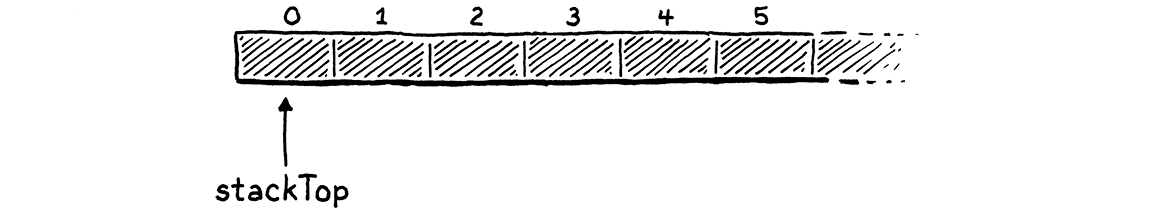
إن كان مؤشّرنا يشير إلى العنصر العلوي، فإنّ المكدّس الفارغ سيحتاج أن يشير إلى العنصر -1. وهذا غير معرَّف في C. وكما ندفع القيم على المكدّس...
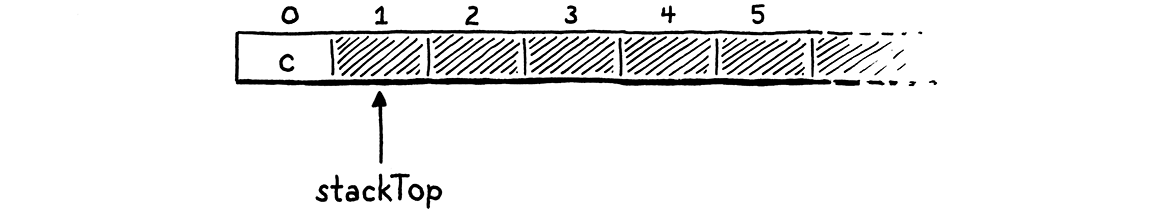
...يشير stackTop دائمًا إلى ما بعد آخر عنصر بقليل.
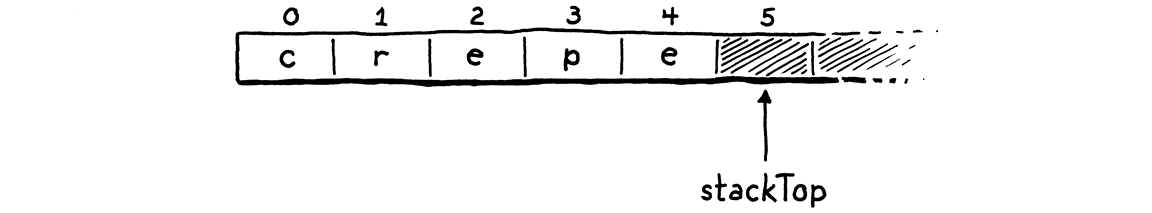
أتذكّرها هكذا: يشير stackTop إلى المكان الذي ستذهب إليه القيمة التالية التي
ستُدفع. وأقصى عدد قيم يمكننا تخزينها على المكدّس (على الأقلّ الآن) هو:
^code stack-max (1 before, 2 after)
منح آلتنا الافتراضية حجم مكدّس ثابتًا يعني أنّه من الممكن لسلسلة تعليمات ما أن تدفع قيمًا كثيرة جدًا وتنفد من مساحة المكدّس -- وهي "تجاوز المكدّس" الكلاسيكي. يمكننا أن ننمّي المكدّس ديناميكيًا حسب الحاجة، لكن سنبقي الأمر بسيطًا الآن. وبما أنّ VM تستخدم Value، نحتاج إلى include تصريحها.
^code vm-include-value (1 before, 2 after)
الآن وبعد أن ادّت الآلة الافتراضية بعض الحالة المثيرة، يمكننا تهيئتها.
^code call-reset-stack (1 before, 1 after)
وهي تستخدم دالة المساعِدة هذه:
^code reset-stack
بما أنّ مصفوفة المكدّس مُعلَنة مباشرةً داخل بنية VM، فلا نحتاج إلى تخصيصها. ولا
نحتاج حتى إلى مسح الخلايا غير المستخدَمة في المصفوفة -- فسن ببساطة لا نصل إليها قبل
أن تكون قيم قد خُزِّنت فيها. والتهيئة الوحيدة التي نحتاجها هي ضبط stackTop بحيث
يشير إلى بداية المصفوفة للدلالة على أنّ المكدّس فارغ.
يدعم بروتوكول المكدّس عمليتين:
^code push-pop (1 before, 2 after)
يمكنك دفع قيمة جديدة على أعلى المكدّس، ويمكنك إسقاط آخر قيمة دُفعت. وهذه هي الدالة الأولى:
^code push
إن كانت صياغة مؤشّرات C وعملياتها قد رثت عندك، فهذا تمرين إحماء جيّد. السطر الأول
يخزّن value في عنصر المصفوفة الموجود في أعلى المكدّس. تذكّر أنّ stackTop يشير
إلى ما بعد آخر عنصر مستخدَم، أي إلى العنصر التالي المتاح. هذا يخزّن القيمة في تلك
الخانة. ثم نزيد المؤشّر نفسه ليشير إلى الخانة التالية غير المستخدَمة في المصفوفة، الآن
بعد أن اصطفّت الخانة السابقة.
والإسقاط صورة معكوسة.
^code pop
أولًا، نحرّك مؤشّر المكدّس إلى الخلف للوصول إلى آخر خانة مستخدَمة في المصفوفة. ثم
ننظر إلى القيمة عند ذلك الفهرس ونعيدها. لا نحتاج إلى "إزالتها" صراحةً من المصفوفة
-- فتخفيض stackTop يكفي لوضع علامة على تلك الخانة بأنّها لم تعد مستخدَمة.
تتبّع المكدّس
لدينا مكدّس عامل، لكن من الصعب أن ترى أنّه يعمل. حين نبدأ بتنفيذ تعليمات أعقد وترجمة قطع أكبر من الشيفرة وتشغيلها، سننتهي إلى قيم كثيرة محشورة في تلك المصفوفة. ويسهّل ذلك حياتنا كمخترقي الآلة الافتراضية لو كان لدينا بعض القدرة على رؤية المكدّس.
ولهذا، متى كنّا نتبّع التنفيذ، فإنّنا سنعرض أيضًا محتوى المكدّس الحالي قبل تفسير كل تعليمة.
^code trace-stack (1 before, 1 after)
نمرّ في حلقة، ونطبع كل قيمة في المصفوفة، بدءًا من الأولى (قاع المكدّس) وانتهاءً عند بلوغ القمة. وهذا يتيح لنا ملاحظة أثر كل تعليمة في المكدّس. الخرج مطوّل إلى حدٍّ ما، لكنه مفيد حين نُشتّت الجرّاح لاستخراج خطأ عنيد من أمعاء المفسّر.
ومع المكدّس في اليد، فلنعد إلى تعليمتينا. أولًا:
^code push-constant (2 before, 1 after)
في الفصل الماضي، كنتُ تلوّح بيدك بشأن كيفية "يحمّل" تعليمة OP_CONSTANT ثابتًا.
والآن بعد أن صار لدينا مكدّس، تعرفون ما معنى أن تُنتج قيمة فعلًا: إنها تُدفع على
المكدّس.
^code print-return (1 before, 1 after)
ثم نجعل OP_RETURN يُسقط المكدّس ويطبع القيمة العليا قبل الخروج. وحين نضيف دعمًا
للدوالّ الحقيقية إلى clox، سنغيّر هذه الشيفرة. لكن، في الوقت الحالي، تعطينا وسيلة
لجعل الآلة الافتراضية تنفّذ سلاسل تعليمات بسيطة وتعرض النتيجة.
آلة حاسبة
القلب وروح آلتنا الافتراضية في مكانهما الآن. حلقة الشيفرة بايت توجّه التعليمات وتنفّذها. والمكدّس ينمو ويتراجع مع تدفّق القيم عبره. النصفان يعملان، لكن من الصعب أن تشعر بمدى ذكاء تفاعلهما ومع كل ما لدينا من تعليمتين أوّليتين فقط. فلنُعلّم مفسّرنا أن يقوم بالعمليات الحسابية.
سنبدأ بأبسط عملية حسابية: النفي أحادي المعامل.
var a = 1.2;
print -a; // -1.2.
يأخذ معامل النفي اللاحق - مُعاملًا واحدًا، وهي القيمة التي يجب نفيها. وهو يُنتج
نتيجة واحدة. لسنا نتعثّر في محلّل بعد، لكن يمكننا إضافة تعليمة الشيفرة بايت التي
ستُترجم إليها الصياغة أعلاه.
^code negate-op (1 before, 1 after)
وننفّذها هكذا:
^code op-negate (1 before, 1 after)
تحتاج التعليمة إلى قيمة تعمل عليها، تحصل عليها بالإسقاط من المكدّس. وهي تنفي تلك القيمة، ثم تدفع النتيجة من جديد لتستخدمها التعليمات اللاحقة. لا يمكن أن تكون أسهل من ذلك. ويمكننا أيضًا تفكيكها.
^code disassemble-negate (2 before, 1 after)
ويمكننا تجربتها في قطعتنا الاختبارية.
^code main-negate (1 before, 2 after)
بعد تحميل الثابت، وقبل الإرجاع، ننفّذ تعليمة النفي. وهي تستبدل الثابت على المكدّس بنفيه. ثم تطبع تعليمة الإرجاع ذلك:
-1.2
سحريّ!
المعاملات الثنائية
حسنًا، المعاملات أحادية المعامل ليست بهذا الإبهار. فلا يزال لدينا قيمة واحدة فقط على المكدّس في كل مرّة. ولكي نرى بعض العمق، نحتاج معاملات ثنائية. تمتلك Lox أربعة معاملات ثنائية حسابية: الجمع والطرح والضرب والقسمة. وسنُنفّذها جميعًا في الوقت نفسه.
^code binary-ops (1 before, 1 after)
عدنا إلى حلقة الشيفرة بايت، فهي تنفّذ هكذا:
^code op-binary (1 before, 1 after)
الفرق الوحيد بين هذه التعليمات الأربع هو معامل C الأساسي الذي تستخدمه في النهاية لدمج المُعاملين. وحول ذلك التعبير الحسابي الأساسي توجد شيفرة شكلية (boilerplate) تسحب القيم من المكدّس وتدفع النتيجة. وحين نضيف الأنواع الديناميكية لاحقًا، ستنمو تلك الشيفرة الشكلية. ولتجنّب تكرار تلك الشيفرة أربع مرات، لفّفتُها في ماكرو.
^code binary-op (1 before, 2 after)
أعترف بأنّ هذا استخدام مغامر إلى حدٍّ ما لـ C المُعالِج الأولي. تردّدت في فعل ذلك، لكنك ستكون شاكرًا في فصول لاحقة حين نحتاج إلى إضافة فحص النوع لكل مُعامل وأمورًا أخرى. سيكون عبئًا أن أمشي معك في الشيفرة نفسها أربع مرات.
إن لم تكن على دراية بالخدعة بالفعل، فإنّ حلقة do while الخارجية تلك تبدو غريبة
حقًّا. يحتاج هذا الماكرو إلى أن يتمدّد إلى سلسلة من التصريحات. ولكي نكون كتّاب ماكرو
حذرين، نريد أن نضمن أن تنتهي كل تلك التصريحات في النطاق نفسه عند تمدّد الماكرو.
تخيّل لو عرّفت:
#define WAKE_UP() makeCoffee(); drinkCoffee();
ثم استخدمته هكذا:
if (morning) WAKE_UP();
النيّة هي تنفيذ التصريحين في جسم الماكرو فقط إن كان morning صحيحًا. لكنه يتمدّد إلى:
if (morning) makeCoffee(); drinkCoffee();;
أوه. إنّ if لا يتعلّق إلا بالتصريح الأوّل. وقد تظنّ أنّ بإمكانك إصلاح ذلك باستخدام
كتلة.
#define WAKE_UP() { makeCoffee(); drinkCoffee(); }
هذا أفضل، لكنك تظلّ عرضة لـ:
if (morning)
  WAKE_UP();
else
  sleepIn();
الآن تحصل على خطأ تجميع على else بسبب ذلك ; الزائد بعد كتلة الماكرو. واستخدام
حلقة do while في الماكرو يبدو مضحكًا، لكنه يتيح لك وسيلة لاحتواء عدة تصريحات داخل
كتلة أيضًا تسمح بفاصلة منقوطة في النهاية.
أين كنّا؟ حسنًا، إذن ما يفعله جسم ذلك الماكرو هو أمر مباشر. يأخذ المعامل الثنائي مُعاملين، لذا يُسقط مرّتين. ويجري العملية على قيمتيه ثم يدفع النتيجة.
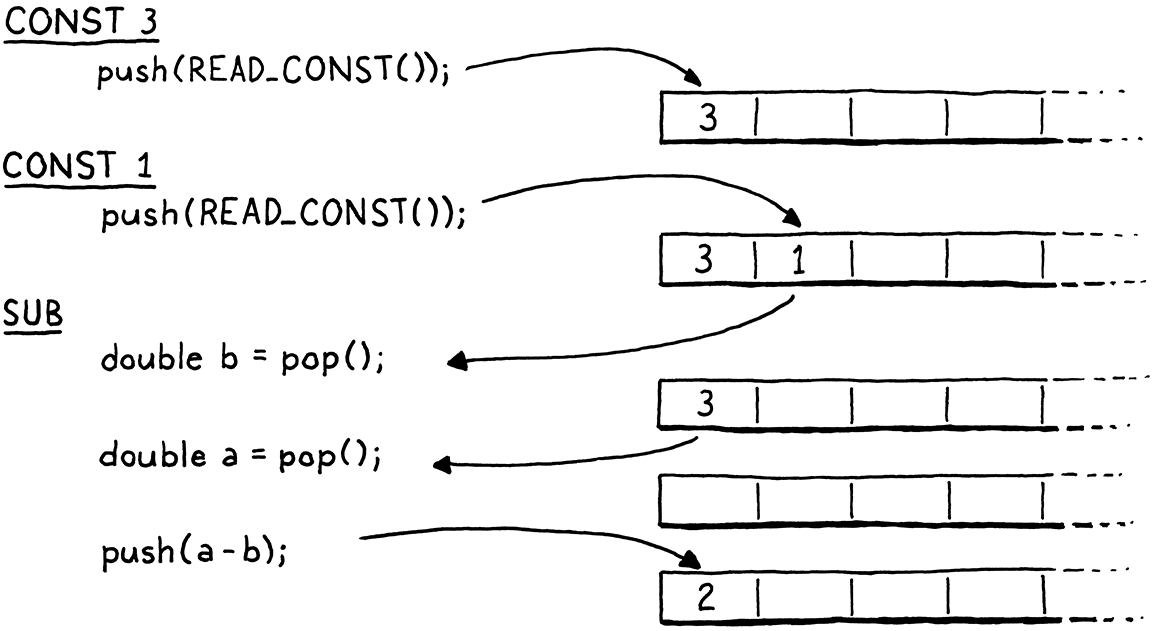
انتبه بشدّة إلى ترتيب عمليتي السقوط. لاحظ أنّنا نُسند المُعامل الأول المسقوط إلى
b لا إلى a. يبدو الأمر معكوسًا. حين تُحسب المُعاملات نفسها، يُقيَّم الأيسر أولًا
ثم الأيمن. هذا يعني أنّ المُعامل الأيسر يُدفع قبل المُعامل الأيمن. إذن يكون المُعامل
الأيمن في أعلى المكدّس. ومن ثمّ، القيمة الأولى التي نسقطها هي b.
مثلًا، إن ترجمنا 3 - 1، فإنّ تدفّق البيانات بين التعليمات يبدو هكذا:
وكما فعلنا مع الماكروهات الأخرى داخل run()، فإنّنا ننظّف خلفنا في نهاية الدالة.
^code undef-binary-op (1 before, 1 after)
والأخير هو دعم المفكّك.
^code disassemble-binary (2 before, 1 after)
تنسيقات التعليمات الحسابية بسيطة، مثل OP_RETURN. وبرغم أنّ المعاملات الحسابية
تأخذ مُعاملات -- تُوجد على المكدّس -- فإنّ تعليمات الشيفرة بايت الحسابية لا تأخذ.
لنُجرّب بعض تعليماتنا الجديدة على أرض الواقع بتقييم تعبير أكبر:
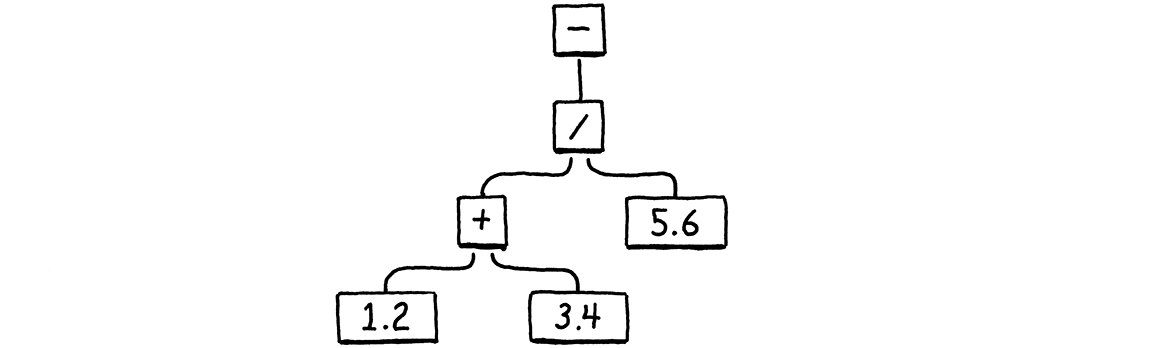
مبنيًا على قطعتنا المثال القائمة، إليك التعليمات الإضافية التي نحتاج إليها لتُترجَم تلك الشجرة يدويًا إلى شيفرة بايت.
^code main-chunk (3 before, 3 after)
يأتي الجمع أولًا. فتعليمة الثابت الأيسر، 1.2، موجودة بالفعل، لذا نضيف أخرى لـ 3.4. ثم
نجمع الاثنين باستخدام OP_ADD، تاركةً الناتج على المكدّس. هذا يغطي الجانب الأيسر من
القسمة. بعد ذلك ندفع 5.6، ونقسم ناتج الجمع عليه. وأخيرًا، نفني الناتج.
لاحظ كيف يتدفّق ناتج OP_ADD ضمنًا ليصبح مُعاملًا لـ OP_DIVIDE دون أن تكون أيّ من
التعليمتين مرتبطتين بالأخرى مباشرةً. هذا هو سحر المكدّس. فهو يتيح لنا أن نركّب
التعليمات بحرّية دون أن تحتاج أيّ منها إلى تعقيد أو وعي بتدفّق البيانات. ويتصرّف
المكدّس كمساحة عمل مشتركة يقرأ منها الجميع ويكتب فيها الجميع.
في هذه القطعة الصغيرة، لا يزال المكدّس يبلغ ارتفاع قيمتين فقط، لكن حين نبدأ بترجمة مصدر Lox إلى شيفرة بايت، سيكون لدينا قطع تستهلك المكدّس أكثر بكثير. وفي هذه الأثناء، حاول أن تلعب بهذه القطعة المكتوبة يدويًا لحساب تعبيرات حسابية متداخلة مختلفة وترى كيف تتدفّق القيم عبر التعليمات والمكدّس.
لماذا لا تُفرِغ هذا من نظامك الآن. هذه هي آخر قطعة سنبنيها يدويًا. وحين نعود إلى شيفرة البايت في المرة القادمة، سنكتب مصرّفًا يُولّدها نيابةً عنا.
التحدّيات
-
ما تسلسلات تعليمات شيفرة البايت التي كنت ستُولّدها للتعبيرات التالية:
1 * 2 + 3
1 + 2 * 3
3 - 2 - 1
1 + 2 * 3 - 4 / -5
(تذكّر أنّ Lox لا تملك صياغة للقيم الحرفية السالبة، لذا فإنّ
-5تنفي الرقم 5.) -
إن أردنا حقًّا مجموعة تعليمات دنياية، يمكننا إلغاء إمّا
OP_NEGATEأوOP_SUBTRACT. اعرض تسلسل تعليمات شيفرة البايت الذي كنت ستُولّده لـ:4 - 3 * -2أولًا، دون استخدام
OP_NEGATE. ثمّ، دون استخدامOP_SUBTRACT.بالنظر إلى ما سبق، هل ترى أنّ وجود كلتا التعليمتين منطقيّ؟ ولماذا أو لماذا لا؟ هل هناك تعليمات زائدة أخرى تودّ تضمينها؟
-
مكدّس آلتنا الافتراضية له حجم ثابت، ولا نتحقّق هل كان دفع قيمة يفيض فوقه. هذا يعني أنّ سلسلة التعليمات الخاطئة يمكن أن تُسقط مفسّرنا في انهيار أو سلوك غير معرَّف. تجنّب ذلك بنموّ المكدّس ديناميكيًا حسب الحاجة.
ما هي التكاليف والفوائد من فعل ذلك؟
-
لتفسير
OP_NEGATE، نُسقط المُعامل، ونفي القيمة، ثم ندفع النتيجة. هذه تنفيذ بسيط، لكنه يزيدstackTopويخفضه بلا داعٍ، لأنّ المكدّس ينتهي إلى الارتفاع نفسه في النهاية. قد يكون أسرع ببساطةً أن نفني القيمة في مكانها على المكدّس ونتركstackTopوشأنه. جرّب ذلك وانظر إن كنت تستطيع قياس فرق في الأداء.هل هناك تعليمات أخرى يمكنك إجراء تحسين مشابه فيها؟
ملاحظة تصميم: شيفرة بايت قائمة على السجلّات
طوال ما تبقّى من هذا الكتاب، سننفّذ بدقّة مفسّرًا حول مجموعة تعليمات شيفرة بايت قائمة على المكدّس. وهناك عائلة أخرى من بنيات الشيفرة بايت هناك -- قائمة على السجلّات. وعلى رغم الاسم، فهذه تعليمات الشيفرة بايت ليست صعبة العمل بالقدر الذي تبدو عليه السجلّات في شريحة فعلية مثل x64. ومع سجلّات العتاد الحقيقية، لا تملك عادةً سوى حفنة منها للبرنامج كلّه، لذا تكرّس جهدًا كبيرًا لـمحاولة استخدامها بكفاءة وتنقل الأشياء إليها ومنها.
في آلة افتراضية قائمة على السجلّات، ما زال لديك مكدّس. ولا تزال القيم المؤقّتة تُدفع عليه وتُسقط حين لم تعد هناك حاجة إليها. الفرق الرئيسي هو أنّ التعليمات تستطيع قراءة مُدخلاتها من أيّ موضع في المكدّس وأن تخزّن مُخرجاتها في خانات مكدّس محدّدة.
خذ هذا الملف الصغير بلغة Lox:
var a = 1;
var b = 2;
var c = a + b;
في آلتنا الافتراضية القائمة على المكدّس، سيُترجم التصريح الأخير إلى شيء كهذا:
load <a>  // Read local variable a and push onto stack.
load <b>  // Read local variable b and push onto stack.
add       // Pop two values, add, push result.
store <c> // Pop value and store in local variable c.
(لا تقلق إن لم تفهم تمامًا تعليمتي load وstore بعد. سنعود إليهما بتفصيل أكبر بكثير حين ننفّذ المتغيّرات.) لدينا أربع تعليمات منفصلة. وهذا يعني أربع مرّات عبر حلقة تفسير شيفرة البايت، وأربع تعليمات لفكّ الترميز والتوجيه. وهو سبعة بايتات على الأقلّ -- أربعة لرموز التشغيل وثلاثة أخرى للمُعاملات التي تحدّد أيّ المتغيّرات المحلّية نحمّل ونخزّن. وثلاث دفعات وثلاث عمليات إسقاط. عمل كثير!
في مجموعة تعليمات قائمة على السجلّات، تستطيع التعليمات القراءة من المتغيّرات المحلّية والكتابة إليها مباشرةً. وتبدو الشيفرة بايت للتصريح الأخير أعلاه هكذا:
add <a> <b> <c> // Read values from a and b, add, store in c.
تعليمة الجمع أكبر -- لديها ثلاثة مُعاملات تعليمات تحدّد أين في المكدّس تقرأ مُدخلاتها
وأين تكتب نتيجتها. لكن بما أنّ المتغيّرات المحلّية تعيش على المكدّس، تستطيع القراءة
مباشرةً من a وb ثم تخزّن الناتج في c مباشرةً.
هناك تعليمة واحدة فقط لفكّ الترميز والتوجيه، والأمر كله يتّسع في أربعة بايتات. ولفكّ الترميز أعقد بسبب المُعاملات الإضافية، لكنه لا يزال مكسبًا صافيًّا. فلا وجود لأيّ دفع أو إسقاط أو غيرها من عمليات التلاعب بالمكدّس.
كان التنفيذ الرئيسي لـ Lua في السابق قائمًا على المكدّس. ولكن مع Lua 5.0، انتقل المنفّذون إلى مجموعة تعليمات قائمة على السجلّات وسجّلوا تحسّنًا في السرعة. ومقدار التحسّن يعتمد بطبيعة الحال بشدّة على تفاصيل دلالات اللغة ومجموعة التعليمات تحديدًا ونضج المصرّف، لكن ذلك ينبغي أن يلفت انتباهك.
وهذا يطرح السؤال البديهي: لماذا سأقضي بقية الكتاب في شيفرة بايت قائمة على المكدّس؟ فآلات السجلّات أنيقة، لكنّ كتابة مصرّف لها أصعب بكثير. وبالنظر إلى أنّ هذا سيكون على الأرجح أوّل مصرّف تكتبه، أردت أن أتمسّك بمجموعة تعليمات سهلة التوليد وسهلة التنفيذ. فشيفرة البايت القائمة على المكدّس بسيطة إلى حدٍّ مذهل.
كما أنّها أكثر شيوعًا بكثير في الأدبيات والمجتمع. فرغم أنّك قد تنتقل في النهاية إلى شيء أكثر تقدّمًا، فإنّها أرضٌ مشتركة جيدة لمشاركتها مع بقية أقرانك من مهوسي لغات البرمجة.