المتغيّرات العامة
لو فقط لاخترع اختراعٌ يعبّئ ذاكرةً في زجاجة، كما يحدث مع الرائحة. وهي لا تبهت أبدًا، ولا تفسد. ثمّ، حين يريدها أحدهم، تُفتح الزجاجة، فيبدو الأمر كأنّك تعيش تلك اللحظة من جديد.
دافني دو موريه، ريبيكا
كان الفصل السابق استكشافًا طويلًا لبنية بيانات واحدة كبيرة وعميقة وأصلية في علوم الحاسوب. ثقيلٌ بالنظرية والمفاهيم. ولعلّ فيه بعض الحديث عن ترميز Big-O والخوارزميات. أمّا هذا الفصل فمتواضع فكريًّا أكثر. لا توجد أفكار كبيرة لتتعلّمها. وبدلًا من ذلك، فمجرّد بضعة مهام هندسية مباشرة. ومتى أكملناها، تدعم آلتنا الافتراضية المتغيّرات.
في الواقع، ستحعم فقط المتغيّرات العامة. أما المتغيّرات المحلّية فتأتي في [الفصل التالي][]. وفي jlox، تمكّنّا من حشرهما معًا في فصل واحد لأنّنا استخدمنا تقنية التنفيذ نفسها لكل المتغيّرات. لقد بنينا سلسلة من البيئات، واحدة لكل نطاق، وصولًا إلى الأعلى. كانت طريقة بسيطة ونظيفة لتعلّم كيفية إدارة الحالة.
لكنّها أيضًا بطيئة. فتخصيص جدول تجزئة جديد في كل مرّة تدخل فيها كتلة أو تستدعي دالة ليس هو الطريق إلى آلة افتراضية سريعة. ونظرًا لكثرة الشيفرة التي تتعلّق باستخدام المتغيّرات، فإنّ المتغيّرات إن بطئت بطئ كل شيء. أمّا في clox، فسنُحسّن ذلك باستخدام استراتيجية أكثر كفاءة بكثير للمتغيّرات المحلّية، لكنّ المتغيّرات العامة لا تُحسَّن بسهولة بهذا القدر.
مراجعة سريعة لدلالات Lox: المتغيّرات العامة في Lox "مرتبطة ربطًا متأخرًا" (late bound)، أو مُحلّة ديناميكيًّا. وهذا يعني أنّك تستطيع ترجمة قطعة شيفرة تشير إلى متغيّر عامّ قبل أن يُعرَّف. ما دامت الشيفرة لا تُنفَّذ قبل حدوث التعريف، فكل شيء على ما يرام. ومن الناحية العملية، يعني ذلك أنّك تستطيع الإشارة إلى متغيّرات لاحقة داخل أجسام الدوالّ.
fun showVariable() {
  print global;
}

var global = "after";
showVariable();
قد تبدو شيفرة كهذه غريبة، لكنّها مفيدة لتعريف دوالّ متكرّرة (recursive) تشير إلى بعضها. كما أنّها تتعامل بلطف أكبر مع الـ REPL. فبإمكانك كتابة دالة صغيرة في سطر واحد، ثمّ تعريف المتغيّر الذي تستخدمه في السطر التالي.
تعمل المتغيّرات المحلّية بطريقة مختلفة. ولأنّ تصريح المتغيّر المحلّي يحدث دائمًا قبل استخدامه، تستطيع الآلة الافتراضية حلّها وقت التجميع، حتى في مصرّف أحادي التمريرة بسيط. وسيتيح لنا ذلك استخدام تمثيل أذكى للمتغيّرات المحلّية. لكنّ ذلك للفصل التالي. الآن، لنركّز فحسب على المتغيّرات العامة.
التصاريح
تنشأ المتغيّرات باستخدام تصريحات متغيّرات، ما يعني أنّ هذا أيضًا الوقت المناسب لإضافة دعم التصاريح إلى مصرّفنا. إن كنت تتذكّر، فإنّ Lox تقسّم التصاريح إلى فئتين. "التصاريح" (declarations) هي تلك التصاريح التي تربط اسمًا جديدًا بقيمة. أمّا أنواع التصاريح الأخرى -- تدفّق التحكم، والطباعة، وهكذا -- فتُسمّى مجرّد "تصاريح". نحن نمنع التصاريح مباشرةً داخل تصاريح تدفّق التحكّم، مثل هذا:
if (monday) var croissant = "yes"; // Error.
السماح بذلك يطرح أسئلة مربكة حول نطاق المتغيّر. لذا، كما في اللغات الأخرى، نمنعه نحويًا بجعل قاعدة منفصلة للقواعد تخصّ مجموعة التصاريح التي يُسمح بها داخل جسم تدفّق تحكّم.
statement      → exprStmt
               | forStmt
               | ifStmt
               | printStmt
               | returnStmt
               | whileStmt
               | block ;
ثم نستخدم قاعدة منفصلة لأعلى مستوى ملف وداخل كتلة.
declaration    → classDecl
               | funDecl
               | varDecl
               | statement ;
تحتوي قاعدة declaration على التصاريح التي تُعلن أسماء، وتضمّ أيضًا statement بحيث يُسمح
بجميع أنواع التصاريح. وبما أنّ block نفسه موجود في statement، يمكنك وضع التصاريح داخل بناء لتدفّق التحكم بداخل كتلة.
في هذا الفصل، سنغطي تصريحين فقط وتصريحًا واحدًا معلِّنًا.
statement      → exprStmt
               | printStmt ;

declaration    → varDecl
               | statement ;
حتى الآن، كانت آلتنا الافتراضية تعتبر "البرنامج" تعبيرًا واحدًا، لأنّ ذلك كل ما كنا نستطيع تحليله وترجمته. وفي تنفيذ Lox الكامل، البرنامج هو تسلسل من التصاريح. ونحن الآن مستعدّون لدعم ذلك.
^code compile (1 before, 1 after)
نواصل ترجمة التصاريح حتى نصل إلى نهاية ملف المصدر. ونترجم تصريحًا واحدًا باستخدام هذه:
^code declaration
وسنصل إلى تصريحات المتغيّرات لاحقًا في الفصل، لذا فليسهل الآن أن نُحيل إلى statement().
^code statement
يمكن للكتل أن تحتوي على تصاريح، ويمكن لتصاريح تدفّق التحكم أن تحتوي على تصاريح أخرى. وهذا يعني أنّ هاتين الدالتين ستصبح عودية في النهاية. فلنكتب التصاريح المسبقة الآن.
^code forward-declarations (1 before, 1 after)
تصاريح الطباعة
لدينا نوعان من التصاريح ندعمهما في هذا الفصل. لنبدأ بتصاريح print، التي تبدأ بما يكفي
برمز print. ونكتشف ذلك باستخدام دالة المساعِدة هذه:
^code match
قد تتعرّف عليها من jlox. فإن كان الرمز الحالي من النوع المُعطى، فإنّنا نستهلك الرمز ونُرجِع
true. وإلا فإنّنا نترك الرمز وحده ونُرجِع false. وهذه دالة
مساعِدة مُنفَّذة بدلالة دالة مساعِدة أخرى:
^code check
تُرجِع الدالة check() قيمة true إن كان الرمز الحالي من النوع المُعطى. يبدو أنّ لفّ هذا في
دالة أمرٌ سخيف قليلًا، لكنّنا سنستخدمه أكثر لاحقًا، وأظنّ أنّ دوالّ
قصيرة الأسماء مثل هذه تجعل المحلّل أسهل في القراءة.
إن طابقنا رمز print، فإنّنا نترجم بقية التصريح هنا:
^code print-statement
يقيّم تصريح print تعبيرًا ويطبع النتيجة، لذا نبدأ بتحليل ذلك التعبير وترجمته. وتتوقّع
القواعد فاصلة منقوطة بعده، لذا نستهلكها. وأخيرًا، نُصدر تعليمة جديدة لطباعة النتيجة.
^code op-print (1 before, 1 after)
وقت التشغيل، ننفّذ هذه التعليمة هكذا:
^code interpret-print (1 before, 1 after)
حين يصل المفسّر إلى هذه التعليمة، يكون قد نفّذ بالفعل شيفرة التعبير، تاركةً قيمة النتيجة أعلى المكدّس. والآن نكتفي بالإسقاط والطباعة.
لاحظ أنّنا لا ندفع أيّ شيء آخر بعد ذلك. وهذا فرق جوهري بين التعبيرات والتصاريح في الآلة
الافتراضية. لكل تعليمة شيفرة بايت أثر على المكدّس (stack
effect) يصف كيف تعدّل التعليمة المكدّس. فمثلًا، تُسقط OP_ADD قيمتين وتدفع واحدة، تاركةً
المكدّس أصغر بعنصر واحد.
يمكنك جمع آثار المكدّس لسلسلة من التعليمات للحصول على أثرها الكلّي. فحين تجمع آثار سلسلة التعليمات المترجَمة من أيّ تعبير كامل، يكون المجموع واحدًا. فكل تعبير يترك قيمة نتيجة واحدة على المكدّس.
شيفرة البايت لتصريح كامل يكون أثرها الكلّي على المكدّس صفرًا. ولأنّ التصريح لا يُنتج قيمًا، فهو في النهاية يترك المكدّس دون تغيير، وإن كان بالطبع يستخدمه أثناء عمله. وهذا مهمّ لأنّه حين نصل إلى تدفّق التحكم والتكرار، قد ينفّذ البرنامج سلسلة طويلة من التصاريح. فإذا كان كل تصريح يُكبّر المكدّس أو يُصغّره، فقد يفيض في النهاية أو ينقص.
وبما أنّنا في حلقة المفسّر، ينبغي أن نحذف بعض الشيفرة.
^code op-return (1 before, 1 after)
حين كانت الآلة الافتراضية تترجم وتقيّم تعبيرًا واحدًا فقط، كان لدينا بعض الشيفرة المؤقّتة في
OP_RETURN لإخراج القيمة. والآن بعد أن لدينا التصاريح وprint، لم نعد نحتاج إلى ذلك. نحن على
بعد خطوة واحدة من التنفيذ الكامل لـ clox.
وكما جرت العادة، تحتاج التعليمة الجديدة إلى دعم في المفكّك.
^code disassemble-print (1 before, 1 after)
تلك هي عبارة print. وإن شئت، جرّبها:
print 1 + 2;
print 3 * 4;
مثير! حسنًا، ربما ليس مثيرًا للاضطراب، لكنّنا أستطيع الآن بناء ملفات نصّية تحوي ما نشاء من التصاريح، وهذا يبدو تقدّمًا.
التصاريح التعبيرية
انتظر حتى ترى التصريح التالي. إن لم نرَ الكلمة المفتاحية print، فلا بدّ أنّنا ننظر إلى تصريح
تعبيري.
^code parse-expressions-statement (1 before, 1 after)
يُحلَّل هكذا:
^code expression-statement
"التصريح التعبيري" هو ببساطة تعبيرٌ يليها فاصلة منقوطة. وهي الطريقة التي تكتب بها تعبيرًا في سياق يُتوقَّع فيه تصريح. وغالبًا ما يكون ذلك كي تتمكّن من استدعاء دالة أو تقييم إسناد لأثره الجانبي، مثل هذا:
brunch = "quiche";
eat(brunch);
دلاليًّا، يقيّم التصريح التعبيري التعبير ويتخلّص من النتيجة. والمصرّف يرمّز هذا السلوك مباشرةً.
فهو يترجم التعبير، ثم يُصدر تعليمة OP_POP.
^code pop-op (1 before, 1 after)
وكما يوحي الاسم، فإنّ تلك التعليمة تُسقط القيمة العليا من المكدّس وتنساها.
^code interpret-pop (1 before, 1 after)
ويمكننا أيضًا تفكيكها.
^code disassemble-pop (1 before, 1 after)
التصاريح التعبيرية ليست مفيدة جدًّا بعد لأنّنا لا نستطيع إنشاء أيّ تعبيرات ذات آثار جانبية، لكنّها ستكون أساسية حين نضيف الدوالّ لاحقًا. وأغلبية التصاريح في شيفرة العالم الحقيقي في لغات مثل C هي تصاريح تعبيرية.
مزامنة الأخطاء
بينما نُنجز هذا العمل الأوّلي في المصرّف، يمكننا أن نُغلق طرفًا خَلّيناه قبل عدة فصول. وكما في jlox، تستخدم clox وضع الهلع في استعادة الأخطاء (panic mode error recovery) لتقليل عدد أخطاء التجميع المتتالية التي تُبلّغ عنها. ويخرج المصرّف من وضع الهلع حين يبلغ نقطة تزامن. وبالنسبة إلى Lox، اخترنا حدود التصاريح لتكون تلك النقطة. والآن بعد أن لدينا التصاريح، يمكننا تنفيذ المزامنة.
^code call-synchronize (1 before, 1 after)
إن صادفنا خطأ تجميع أثناء تحليل التصريح السابق، فإنّنا ندخل وضع الهلع. وحين يحدث ذلك، نبدأ المزامنة بعد التصريح.
^code synchronize
نتخطّى الرموز بلا تمييز حتى نصل إلى ما يبدو حدًّا لتصريح. نتعرّف على الحدّ بالبحث عن رمز سابق يمكنه إنهاء تصريح، مثل فاصلة منقوطة. أو نبحث عن رمز لاحق يبدأ تصريحًا، وهو عادةً إحدى الكلمات المفتاحية الخاصة بتدفّق التحكم أو التصريح.
تصريحات المتغيّرات
مجرد القدرة على الطباعة لا تمنح لغتك أيّ جوائز في معرض لغات البرمجة (fair)، لذا فلننتقل إلى شيء أكثر طموحًا قليلًا ونُشغّل المتغيّرات. وهناك ثلاث عمليات نحتاج إلى دعمها:
- تصريح متغيّر جديد باستخدام تصريح
var. - الوصول إلى قيمة متغيّر باستخدام تعبير مُعرِّف.
- تخزين قيمة جديدة في متغيّر قائم باستخدام تعبير إسناد.
لا يمكننا فعل أيّ من الأخيرَين قبل أن نملك بعض المتغيّرات، لذا نبدأ بالتصاريح.
^code match-var (1 before, 2 after)
أصبح لدى دالة التحليل النائبة التي رسمناها لقاعدة التصاريح إنتاجٌ فعلي. فإن طابقنا رمز var،
نقفز إلى هنا:
^code var-declaration
يلي الكلمة المفتاحية اسم المتغيّر. وتُترجم ذلك باستخدام parseVariable()، وسنصل إليها بعد
لحظة. ثم نبحث عن = يليها تعبير مُهيّئ. فإن لم يُهيّئ المستخدم المتغيّر، فإنّ المصرّف يهيّئه
ضمنيًا إلى nil بإصدار تعليمة OP_NIL. وفي الحالتين، نتوقّع أن
يُنهي التصريح بفاصلة منقوطة.
هناك دالتان جديدتان هنا للعمل مع المتغيّرات والمُعرِّفات. وهذه هي الأولى:
^code parse-variable (2 before)
تتطلّب أن يكون الرمز التالي مُعرِّفًا، وهو تستهلكه وترسله إلى هنا:
^code identifier-constant (2 before)
تأخذ هذه الدالة الرمز المُعطى وتضيف لَمحته إلى جدول ثوابت القطعة كسلسلة. ثم تُرجِع فهرس ذلك الثابت في جدول الثوابت.
تُبحث المتغيّرات العامة بالاسم وقت التشغيل. وهذا يعني أنّ الآلة الافتراضية -- حلقة تفسير شيفرة البايت -- تحتاج إلى الوصول إلى الاسم. والسلسلة الكاملة كبيرة جدًّا على أن تُدسّ في تدفّق شيفرة البايت كمُعامل. وبدلًا من ذلك، فإنّنا نخزّن السلسلة في جدول الثوابت، ثمّ تشير التعليمة إلى الاسم بفهرسه في الجدول.
تُرجِع هذه الدالة ذلك الفهرس كلّ الطريق إلى varDeclaration()، التي تسلّمه لاحقًا إلى هنا:
^code define-variable
هذا يُخرج تعليمة الشيفرة بايت التي تُعرّف المتغيّر الجديد وتخزّن قيمته الأوّلية. ويكون فهرس اسم المتغيّر في جدول الثوابت هو مُعامل التعليمة. وكما هي العادة في الآلة الافتراضية القائمة على المكدّس، فإنّنا نُصدر هذه التعليمة أخيرًا. وقت التشغيل، ننفّذ شيفرة مُهيّئ المتغيّر أولًا. فيترك ذلك القيمة على المكدّس. ثم تأخذ هذه التعليمة تلك القيمة وتخزّنها لوقت اللاحق.
وهناك في وقت التشغيل، نبدأ بهذه التعليمة الجديدة:
^code define-global-op (1 before, 1 after)
وبفضل جدول تجزئتنا المفيد، ليس التنفيذ صعبًا جدًّا.
^code interpret-define-global (1 before, 1 after)
نحصل على اسم المتغيّر من جدول الثوابت. ثم نأخذ القيمة من أعلى المكدّس ونخزّنها في جدول تجزئة ذلك الاسم مفتاحًا له.
لا تتحقّق هذه الشيفرة ممّا إذا كان المفتاح موجودًا بالفعل في الجدول. وLox متساهلة نوعًا ما مع المتغيّرات العامة وتسمح لك بإعادة تعريفها دون خطأ. وذلك مفيد في جلسة REPL، لذا تدعم الآلة الافتراضية ذلك ببساطة عبر الكتابة فوق القيمة إن كان المفتاح موجودًا بالفعل في جدول التجزئة.
وهناك ماكرو مساعِد آخر صغير:
^code read-string (1 before, 1 after)
يقرأ مُعاملًا من بايت واحد من قطعة الشيفرة بايت. ويعامله كفهرس في جدول ثوابت القطعة ويُرجِع
السلسلة عند ذلك الفهرس. وهو لا يتحقّق من أنّ القيمة نصّ -- إنّه SimplyCast مجرّد من النوع (a mere type cast) يجرّدها ببساطة. وهذا آمن لأنّ
المصرّف لا يُصدر أبدًا تعليمة تشير إلى ثابت ليس نصًّا.
ولأنّنا نهتمّ بالنظافة المعجمية (lexical hygiene)، فإنّنا نُلغي أيضًا تعريف هذا الماكرو في نهاية دالة التفسير.
^code undef-read-string (1 before, 1 after)
أستمرّ في قول "جدول التجزئة"، لكنّنا ليس لدينا واحد فعليًا بعد. فنحن نحتاج مكانًا لتخزين هذه المتغيّرات العامة. وبما أنّنا نريدها أن تبقى ما دام clox يعمل، فإنّنا نخزّنها في الآلة الافتراضية نفسها.
^code vm-globals (1 before, 1 after)
وكما فعلنا مع جدول النصوص، نحتاج إلى تهيئة جدول التجزئة إلى حالة صالحة حين يقلع الآلة الافتراضية.
^code init-globals (1 before, 1 after)
ونُه فكّكه حين نخرج.
^code free-globals (1 before, 1 after)
وكما جرت العادة، نريد أن نستطيع تفكيك التعليمة الجديدة أيضًا.
^code disassemble-define-global (1 before, 1 after)
وبذلك، نستطيع تعريف متغيّرات عامة. ولا يستطيع المستخدمون أن يدركوا أنّهم فعلوا ذلك، لأنّهم لا يستطيعون فعليًا استخدامها. لذا لنُصلح ذلك تاليًا.
قراءة المتغيّرات
كما في كل لغة برمجة على الإطلاق، نصل إلى قيمة متغيّر باستخدام اسمه. وهنا نربط رموز المُعرِّفات بمحلّل التعابير:
^code table-identifier (1 before, 1 after)
وهذا يستدعي دالة التحليل الجديدة هذه:
^code variable-without-assign
وكما مع التصاريح، هناك بضع دوالّ مساعِدة صغيرة تبدو عديمة الفائدة الآن لكنّها ستصبح أكثر نفعًا في الفصول اللاحقة. وأعدك بذلك.
^code read-named-variable
يستدعي هذا دالة identifierConstant() نفسها التي سبق أن رأيناها، ليأخذ رمز المُعرِّف المُعطى
ويضيف لَمحته إلى جدول ثوابت القطعة كسلسلة. ولم يبقَ سوى إصدار تعليمة تحمّل المتغيّر العامّ بذلك
الاسم. وهذه هي التعليمة:
^code get-global-op (1 before, 1 after)
وهناك في المفسّر، يعكس التنفيذُ OP_DEFINE_GLOBAL.
^code interpret-get-global (1 before, 1 after)
نستخرج فهرس جدول الثوابت من مُعامل التعليمة ونحصل على اسم المتغيّر. ثم نستخدمه كمفتاح للبحث عن قيمة المتغيّر في جدول تجزئة المتغيّرات العامة.
إن لم يكن المفتاح موجودًا في جدول التجزئة، فهذا يعني أنّ ذلك المتغيّر العامّ لم يُعرَّف قطّ. وهذا خطأ وقت تشغيل في Lox، لذا نُبلّغ عنه ونخرج من حلقة المفسّر إن حدث ذلك. وإلا، فإنّنا نأخذ القيمة وندفعها على المكدّس.
^code disassemble-get-global (1 before, 1 after)
وقليلٌ من التفكيك، وانتهينا. مفسّرنا الآن قادر على تشغيل شيفرة كهذه:
var beverage = "cafe au lait";
var breakfast = "beignets with " + beverage;
print breakfast;
لم يبقَ سوى عملية واحدة.
الإسناد
طوال هذا الكتاب، حاولتُ أن أبقيك على طريق آمن وسهل إلى حدٍّ ما. فأنا لا أتجنّب المسائل الصعبة، لكنّي أحاول ألّا أجعل الحلول أعقد ممّا تحتاج. للأسف، فإنّ خيارات تصميم أخرى في مصرّف شيفرة البايت تجعل الإسناد مزعجًا في التنفيذ.
تستخدم آلتنا الافتراضية لشيفرة البايت مصرّفًا أحادي التمريرة. فهو يحلّل ويولّد شيفرة البايت على الفور دون أيّ شجرة تحليل مجرّد وسيطة. وما إن يتعرّف على قطعة صياغة، يُصدر شيفرة لها. والإسناد لا يناسب ذلك بشكل طبيعي. تأمّل:
menu.brunch(sunday).beverage = "mimosa";
في هذه الشيفرة، لا يدرك المحلّل أنّ menu.brunch(sunday).beverage هي هدف إسناد وليس تعبيرًا
عاديًّا إلا حين يصل إلى =، أي بعد رموز كثيرة بعد أول menu. وفي تلك اللحظة يكون المصرّف قد
أصدر بالفعل شيفرة بايت للجزء كلّه.
لكنّ المشكلة ليست بالوخامة التي قد تبدو. انظر إلى كيفية رؤية المحلّل لذلك المثال:
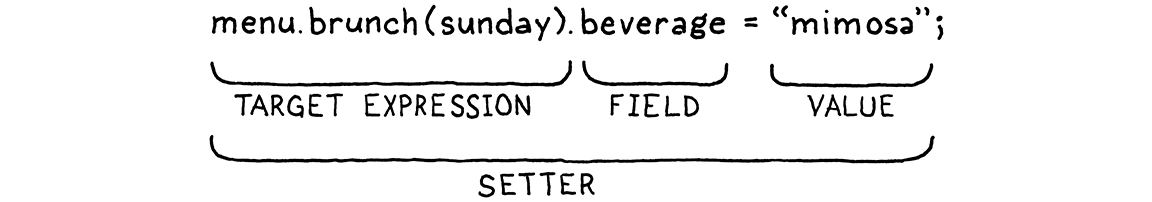
رغم أنّ جزء .beverage يجب ألّا يُترجم كتعبير قراءة، فإنّ كل ما إلى يسار . تعبيرٌ ذو دلالات
تعبيرية عادية. ويمكن ترجمة menu.brunch(sunday) وتنفيذه كما هي العادة.
ولحسن حظّنا، فإنّ فروق الدلالات الوحيدة على يسار الإسناد تظهر في أقصى يمين الرموز، قبيل =
مباشرةً. فحتى لو كان مُرسِل (receiver) دالةٍ معيّن (setter) تعبيرًا طويلًا بالقدر الذي
تشاءه، فإنّ الجزء الذي يختلف سلوكه عن تعبير القراءة ليس سوى المُعرِّف اللاحق، وهو مباشرةً قبل
=. ولا نحتاج إلى مقدار كبير من الاستباق لنُدرك أنّ beverage ينبغي أن يُترجم كتعبير تعيين لا
كتعبير قراءة.
المتغيّرات أسهل حتى من ذلك لأنّها مجرّد مُعرِّف مجرّد واحد قبل =. والفكرة عندئذٍ هي أنّنا
قبل ترجمة تعبير يمكن أن يُستخدم أيضًا كهدف إسناد، نبحث عن رمز = لاحق. فإن رأينا واحدًا،
ترجمناه كإسناد أو تعيين بدلًا من وصول إلى متغيّر أو قراءة.
ليس لدينا setters بعد، لذا كل ما نحتاج إلى معالجته هو المتغيّرات.
^code named-variable (1 before, 1 after)
في دالة تحليل تعبيرات المُعرِّفات، نبحث عن علامة يساوي بعد المُعرِّف. فإن وجدنا واحدة، فإنّنا بدلًا من إصدار شيفرة للوصول إلى متغيّر، نترجم القيمة المسنَدة ثم نُصدر تعليمة إسناد.
تلك هي التعليمة الأخيرة التي نحتاج إلى إضافتها في هذا الفصل.
^code set-global-op (1 before, 1 after)
وكما تتوقّع، فإنّ سلوكه وقت التشغيل يشبه تعريف متغيّر جديد.
^code interpret-set-global (1 before, 1 after)
الفرق الرئيسي هو ما يحدث حين لا يكون المفتاح موجودًا بالفعل في جدول تجزئة المتغيّرات العامة. إن لم يكن المتغيّر قد عُرِّف بعد، فإنّ محاولة الإسناد إليه خطأ وقت تشغيل. وLox لا تُصرّح بالمتغيّرات ضمنيًا.
الفرق الآخر هو أنّ تعيين متغيّر لا يُسقط القيمة من المكدّس. تذكّر، أنّ الإسناد تعبير، لذا يحتاج إلى ترك تلك القيمة هناك تحسّبًا لأن يكون الإسناد متداخلًا داخل تعبير أكبر ما.
أضف قليلًا من التفكيك:
^code disassemble-set-global (2 before, 1 after)
إذن انتهينا، صحيح؟ حسنًا... ليس تمامًا. لقد أخطأنا! تأمّل:
a * b = c + d;
وفقًا لقواعد Lox، فإنّ = له أدنى أسبقية، لذا ينبغي أن يُحلَّل هذا تقريبًا هكذا:
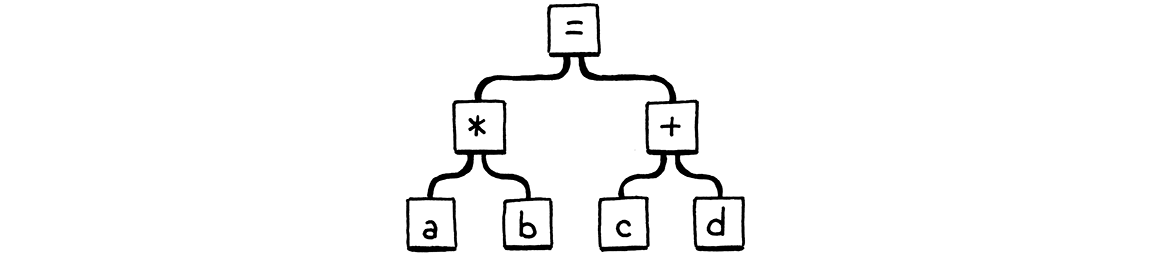
من البديهي أنّ a * b ليس هدف إسناد صالحًا، لذا ينبغي أن يكون هذا خطأ
صياغة. لكن إليك ما يفعله محلّلنا:
- أولًا، تحلّل
parsePrecedence()الرمزaباستخدام محلّل التحليل السابقvariable(). - بعد ذلك، تدخل حلقة التحليل الوسطي.
- تصل إلى
*وتستدعيbinary(). - يستدعي ذلك
parsePrecedence()عودًا لتحليل المُعامل الأيمن. - تستدعي تلك
variable()مجدّدًا لتحليلb. - داخل ذلك الاستدعاء لـ
variable()، تبحث عن=لاحقة. فترى واحدة وتُحلّل بذلك بقية السطر كإسناد.
بعبارة أخرى، يرى المحلّل الشيفرة أعلاه هكذا:
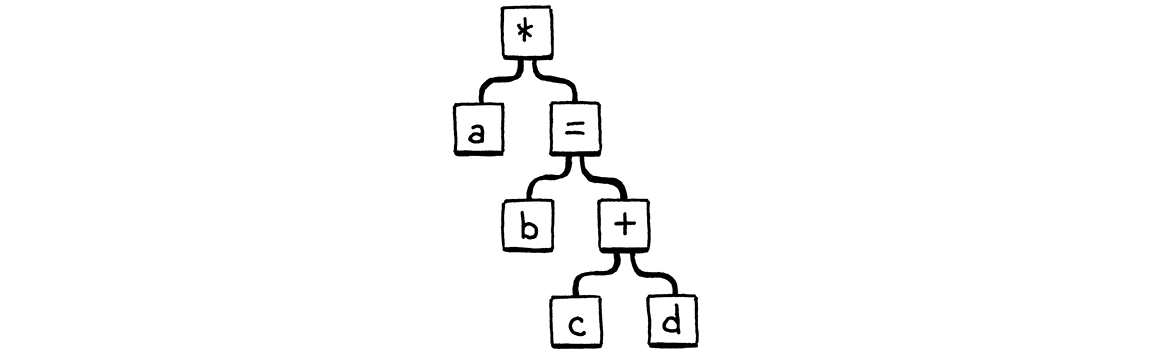
لقد أفسدنا معالجة الأسبقية لأنّ variable() لا تأخذ في الحسبان أسبقية التعبير المحيط الذي يحتوي
المتغيّر. فإن وقع المتغيّر صدفةً على يمين معامل وسطي، أو كمُعامل لمعامل أحادي، فإنّ ذلك التعبير
المحيط ذا أسبقية أعلى من أن تسمح بـ =.
ولإصلاح ذلك، ينبغي أن تبحث variable() عن = وتستهلكها فقط إن كانت في سياق تعبير ذي أسبقية
منخفضة. فالشيفرة التي تعرف الأسبقية الحالية هي، منطقيًّا، parsePrecedence(). ولا تحتاج دالة
variable() إلى معرفة المستوى الفعلي. إنّما يهمّها فقط أن تكون الأسبقية منخفضة بما يكفي
للسماح بالإسناد، لذا نمرّر تلك الحقيقة كمُعامل منطقي.
^code prefix-rule (4 before, 2 after)
ولأنّ الإسناد هو التعبير ذي أدنى أسبقية، فإنّ الوقت الوحيد الذي نسمح فيه بالإسناد هو حين نحلّل تعبير إسناد أو تعبيرًا في أعلى مستوى كما في تصريح تعبيري. ويصل ذلك العَلَم إلى دالة التحليل هنا:
^code variable
وهي تمرّره عبر مُعامل جديد:
^code named-variable-signature (1 after)
ثمّ تستخدمه أخيرًا هنا:
^code named-variable-can-assign (2 before, 1 after)
إنّ ذلك قدرٌ كبير من التوصيلات ليصل بتِت واحد من البيانات إلى الموضع الصحيح في المصرّف، لكنه
وصل. فإن كان المتغيّر متداخلًا داخل تعبير ذي أسبقية أعلى، فإنّ canAssign سيكون false وسيتجاهل
هذا الـ = حتى إن وُجد هناك. ثمّ تعود namedVariable()، وينفّذ التنفيذ في النهاية طريقه إلى
parsePrecedence().
وماذا بعد؟ ماذا يفعل المصرّف بمثالنا المعطوب السابق؟ الآن، لن تستهلك variable() رمز =، لذا
سيكون هو الرمز الحالي. ويعود المصرّف من محلّل التحليل السابق variable() إلى parsePrecedence()
ثم يحاول الدخول في حلقة التحليل الوسطي. ولا توجد دالة تحليل مرتبطة بـ =، لذا يتخطّى تلك الحلقة.
ثمّ تعود parsePrecedence() بهدوء إلى المستدعي. وذلك أيضًا غير صحيح. فإن لم تُستهلك = كجزء من
التعبير، فلا شيء آخر سيستهلكها. إنّه خطأ وينبغي أن نُبلّغ عنه.
^code invalid-assign (2 before, 1 after)
وبذلك، يتلقّى البرنامج السيئ السابق خطأً صحيحًا وقت التجميع. حسنًا، الآن هل انتهينا؟ ليس تمامًا بعد. انظر، إنّنا نمرّر مُعاملًا إلى إحدى دوالّ التحليل. لكنّ تلك الدوالّ مخزّنة في جدول من مؤشّرات الدوالّ، لذا تحتاج جميع دوالّ التحليل إلى أن تكون من النوع نفسه. فرغم أنّ معظم دوالّ التحليل لا تدعم أن تُستخدم كهدف إسناد -- فدوالّ setters هي الوحيدة الأخرى -- فإنّ مصرّفنا C الودود يطلب منها جميعًا أن تقبل ذلك المُعامل.
لذا سنُنهي هذا الفصل ببعض العمل الشاقّ. أولًا، لنمرّر العَلَم إلى دوالّ التحليل الوسطية.
^code infix-rule (1 before, 1 after)
وسنحتاج إلى ذلك للـ setters في النهاية. ثم نُصلح typedef لنوع الدالة.
^code parse-fn-type (2 before, 2 after)
وشيفرة مملة تمامًا لقبول هذا المُعامل في جميع دوالّ التحليل القائمة لدينا. هنا:
^code binary (1 after)
وهنا:
^code parse-literal (1 after)
وهنا:
^code grouping (1 after)
وهنا:
^code number (1 after)
وهنا أيضًا:
^code string (1 after)
وأخيرًا:
^code unary (1 after)
يا لها من راحة! عدنا إلى برنامج C يمكننا تجميعه. شغّله، والآن يمكنك تشغيل هذا:
var breakfast = "beignets";
var beverage = "cafe au lait";
breakfast = "beignets with " + beverage;

print breakfast;
يبدأ في أن يبدو كشيفرة حقيقية للغة فعلية!
التحدّيات
-
يضيف المصرّف اسم المتغيّر العامّ إلى جدول الثوابت كسلسلة في كل مرّة يُصادف فيها مُعرِّفًا. وهو ينشئ ثابتًا جديدًا في كل مرّة، حتى لو كان ذلك اسم المتغيّر موجودًا بالفعل في خانة سابقة في جدول الثوابت. وهذا مضيعةٌ في الحالات التي يُشير فيها الاستدعاء نفسه إلى المتغيّر نفسه عدّة مرّات. وبدورها يزيد ذلك احتمالات ملء جدول الثوابت ونفاد الخانات، بما أنّنا نسمح بـ 256 ثابتًا فقط في قطعة واحدة.
حسّن هذا. كيف يؤثّر تحسينك في أداء المصرّف مقارنةً بوقت التشغيل؟ هل هذه هي المقايضة الصحيحة؟
-
البحث عن متغيّر عامّ بالاسم في جدول تجزئة في كل مرّة يُستخدم فيها بطيء إلى حدٍّ ما، حتى مع وجود جدول تجزئة جيّد. هل يمكنك أن تجد طريقة أكثر كفاءة لتخزين المتغيّرات العامة والوصول إليها دون تغيير الدلالات؟
-
عند التشغيل في الـ REPL، قد يكتب المستخدم دالة تشير إلى متغيّر عامّ مجهول. ثمّ في السطر التالي، يصرّح بالمتغيّر. وينبغي أن تتعامل Lox مع هذا برشاقة بألا تُبلّغ عن خطأ تجميع "متغيّر مجهول" حين تُعرَّف الدالة أول مرّة.
لكن حين يشغّل المستخدم ملفًا نصّيًا بلغة Lox، يكون للمصرّف وصول إلى النصّ الكامل للبرنامج كلّه قبل تشغيل أيّ شيفرة. تأمّل هذا البرنامج:
fun useVar() {
  print oops;
}

var ooops = "too many o's!";
هنا، يمكننا أن نُدرك ساكنًا أنّ
oopsلن يُعرَّف لأنّه لا يوجد أيّ تصريح لذلك المتغيّر العامّ في أيّ موضع من البرنامج. ولاحظ أنّuseVar()لا تُستدعى أيضًا، لذا فرغم أنّ المتغيّر غير معرَّف، لن يقع خطأ وقت تشغيل لأنّه لا يُستخدم أيضًا.يمكننا أن نُبلّغ عن أخطاء كهذه كأخطاء تجميع، على الأقلّ عند التشغيل من ملف نصّي. هل تظنّ أنّنا ينبغي أن نفعل ذلك؟ برّر إجابتك. ماذا تفعل لغات البرمجة النصّية الأخرى التي تعرفها؟