الجمل والحالة
طوال حياتي، اشتاق قلبي لأمرٍ لا أستطيع تسمّيته. أندريه بريتون، الحبّ المجنون
المفسّر الذي لدينا حتى الآن يبدو أقرب إلى ضغط أزرار حاسبةٍ على برمجة لغةٍ حقيقية. و"البرمجة" بالنسبة لي تعني بناء نظامٍ من قطعٍ أصغر. ولا يمكننا فعل ذلك بعد لأنّنا لا نملك وسيلة لربط اسمٍ ببعض البيانات أو الدوالّ. ولا يمكننا تركيب برمجيات دون وسيلة للإشارة إلى القطع.
ولدعم الروابط، يحتاج مفسّرنا إلى حالةٍ داخليّة. فحين تعرّف متغيّراً في بداية البرنامج وتستعمله في نهايته، لا بدّ أن يحتفظ المفسّر بقيمة ذلك المتغيّر في الأثناء. لذا سنمنح مفسّرنا في هذا الفصل دماغاً لا يقدر على المعالجة فحسب بل على الذاكرة.
الحالة والجمل يمشيان جنباً إلى جنب. ولأنّ الجمل، بحكم تعريفها، لا تُقيَّم إلى قيمة، فإنّها تحتاج إلى فعل شيءٍ آخر كي تكون نافعة. وتُسمّى ذلك الفعل أثراً جانبياً (side effect). وقد يعني ذلك إنتاج مُخرَجٍ مرئيٍّ للمستخدم، أو تعديل حالةٍ في المفسّر يمكن اكتشافها لاحقاً. والأخير يجعلها ملائماً تماماً لتعريف المتغيّرات أو الكيانات المُسمّاة الأخرى.
في هذا الفصل، سنفعل كلّ ذلك. سنُعرّف جملاً تُنتج مُخرجات
(print) وتُنشئ حالة (var). سنضيف تعبيرات للوصول إلى المتغيّرات
وإسناد إليها. وأخيراً سنضيف الكتل والنطاق المحلّي. هذا كثيرٌ
لحشره في فصلٍ واحد، لكنّنا سنمضغه كلّه لقمةً لقمة.
الجمل
نبدأ بتوسيع قواعد Lox لتشمل الجمل. وهي ليست مختلفةٌ كثيراً عن التعبيرات. ونبدأ بأبسط نوعَين:
-
تتيح لك جملة التعبير وضع تعبيرٍ في موضعٍ يُتوقَّع فيه جملة. وهي موجودة لتقييم تعبيراتٍ ذات آثار جانبيّة. قد لا تلاحظها، لكنّك تستعملها طوال الوقت في C و Java ولغاتٍ أخرى. فكلّما رأيت استدعاء دالةٍ أو طريقةٍ يتبعه
;، فأنت تنظر إلى جملة تعبير. -
تُقيّم جملة
printتعبيراً وتعرض النتيجة على المستخدم. وأعترف بأنّ من الغريب أن ندمج الطباعة في اللّغة مباشرةً بدلاً من جعلها دالةً في مكتبة. وذلك تنازلٌ واقعيٌّ لأنّنا نبني هذا المفسّر فصلاً بعد فصل ونريد أن نتمكّن من اللعب به قبل أن يكتمل. ولو جعلنا print دالةً في مكتبة، لاضطررنا إلى الانتظار حتى تنفق كلّ آليّات تعريف الدوالّ واستدعائها قبل أن نشهد أيّ آثار جانبيّة.
صياغةٌ جديدة تعني قواعدَ جديدة. في هذا الفصل، نكتسب أخيراً القدرة على تحليل نصّ Lox برمجيّ كامل. ولأنّ Lox لغةٌ أمرية مُنمَّطة ديناميكياً، فإنّ "المستوى الأعلى" لنصٍّ برمجيّ هو ببساطة قائمةُ جمل. والقواعد الجديدة هي:
program        → statement* EOF ;

statement      → exprStmt
               | printStmt ;

exprStmt       → expression ";" ;
printStmt      → "print" expression ";" ;
القاعدة الأولى صارت الآن program، وهي نقطةُ البداية للقواعد
وتمثّل نصّ Lox برمجيّاً كاملاً أو مدخلاً واحداً في REPL.|Program
قائمةُ جملٍ يليها الرمز الخاصّ بـ"نهاية الملف". ورمزُ النهاية
الإلزامي يضمن أنّ المحلل النحوي يستهلك المُدخَل كلّه ولا يتجاهل
بصمت رموزاً خاطئة غير مُستهلَكة في نهاية النصّ.
RIGHT الآن، لا تحتوي statement إلّا على حالتين للنوعَين من الجمل
الذين وصفناهما. وسنملأ المزيد لاحقاً في هذا الفصل وفي الفصول
التالية. والخطوة التالية هي تحويل هذه القواعد إلى شيءٍ نستطيع
تخزينه في الذاكرة -- أشجارَ صياغة.
أشجار صياغة الجمل
لا يوجد موضعٌ في القواعد يُسمح فيه بتعبيرٍ وجملةٍ معاً. فمعاملات
+ مثلاً دائماً تعبيرات، وليست جملاً أبداً. وجسم حلقة while
دائماً جملة.
ولأنّ الصياغتَين منفصلتان، لا نحتاج إلى صنف أساسٍ واحد ترث منه كلّها. وتقسيم التعبيرات والجمل إلى تسلسلَين منفصلَين من الأصناف يمكّن مصرّف Java من مساعدتنا في كشف الأخطاء الغبيّة مثل تمرير جملة إلى دالة Java تتوقّع تعبيراً.
وهذا يعني صنف أساس جديداً للجمل. وكما فعل أسلافُنا قبلنا، سنستعمل
الاسم الغامض "Stmt". وبـاستبصار عظيم،
فقد صمّمت سكربت AST الصغير هذا تحسّباً لذلك. ولهذا مرّرنا "Expr"
كوسيط إلى defineAst(). والآن نضيف استدعاءً آخر لتعريف Stmt
وأصنافه الفرعية.
^code stmt-ast (2 before, 1 after)
شغّل سكربت مولّد AST وشاهد ملفّ "Stmt.java" الناتج وفيه أصناف
شجرة الصياغة التي نحتاجها لتعبيرات وجمل print. ولا تنسَ إضافة
الملفّ إلى مشروع محرّك البرمجة أو ملفّ make أو ما شابه.
تحليل الجمل
كانت دالة parse() في المحلل النحوي التي تحلل تعبيراً واحداً
وتُعيده حيلةً مؤقّتةً لتشغيل الفصل الأخير. والآن بما أنّ قواعدنا
لديها قاعدة البداية الصحيحة، وهي program، يمكننا أن نحوّل
parse() إلى الأمر الحقيقيّ.
^code parse
يحلّل هذا سلسلةً من الجمل، بعدد ما يستطيع العثور عليه حتى يبلغ
نهاية المُدخَل. وهذه ترجمةٌ مباشرّة إلى حدٍّ كبير لقاعدة
program إلى أسلوب النزول التكرّاري. ويجب أيضاً أن نرفع صلاةً
صغيرةً إلى آلهة Verbosity جافا بما أنّنا نستخدم ArrayList الآن.
^code parser-imports (2 before, 1 after)
البرنامج قائمةُ جمل، ونحلّل إحدى تلك الجمل باستعمال هذه الدالة:
^code parse-statement
إنّها عظميةٌ بعض الشيء، لكنّنا سنملؤها بأنواع جملٍ إضافية لاحقاً.
ونحدّد أيّ قاعدة جملٍ تحديداً طابقت بالنظر إلى الرمز الحالي.
ورمز print يعني بوضوح أنّها جملة print.
وإن لم يكن الرمز التالي يشبه أيّ نوعٍ معروف من الجمل، نفترض أنّه يجب أن يكون جملة تعبير. وهذه هي الحالة النهائية النموذجية عند تحليل جملة، لأنّ من الصعب التعرّف الاستباقي على تعبيرٍ من رمزه الأوّل.
لكلّ نوعٍ من الجمل دالته الخاصة. أوّلاً print:
^code parse-print-statement
وبما أنّنا طابقنا رمز print نفسه واستهلكناه، فلا نحتاج إلى فعل
ذلك هنا. نحن نحلّل التعبير التالي، ونستهلك الفاصلة المنقوطة
الخاتمة، ونُصدر شجرة الصياغة.
وإن لم نطابق جملة print، فلا بدّ أن يكون لدينا أحد هذه:
^code parse-expression-statement
على غرار الدالة السابقة، نحلّل تعبيراً يليه فاصلة منقوطة. ونلفّ ذلك Expr في Stmt من النوع المناسب ونُعيده.
تنفيذ الجمل
نمرّ الآن على الفصلين السابقين في صورة مصغّرة، نعمل طريقنا عبر الواجهة الأماميّة. فلمحلّلنا النحوي أن يُنتج الآن أشجار صياغة الجمل، فالخطوة التالية والأخيرة هي تفسيرها. وكما في التعبيرات، نستعمل نمط الزائر، لكن لدينا واجهة زائر جديدة، وهي Stmt.Visitor، لأنّها لتُنفَّذ إنّما كانت للجمل صنفُ أساس خاصّ بها.
نضيف ذلك إلى قائمة الواجهات التي ينفّذها Interpreter.
^code interpreter (1 after)
وبخلاف التعبيرات، لا تنتج الجمل قيماً، لذا فإنّ نوع إرجاع طُرق الزيارة هو Void لا Object. ولدينا نوعان من الجمل، ونحتاج إلى طريقة زيارة لكلٍّ منهما. وأسهلهما جمل التعبير.
^code visit-expression-stmt
نقيّم التعبير الداخلي باستعمال طريقتنا القائمة evaluate() ثمّ
نتخلّص من القيمة. ثمّ نُعيد null.
تطلب Java ذلك لتُرضي نوع الإرجاع Void الخاصّ المكتوب بحرفٍ
كبير. غريب، لكنّ ماذا نستطيع أن نفعل؟
طريقة زيارة جملة print لا تختلف كثيراً.
^code visit-print
قبل التخلّص من قيمة التعبير، نحوّلها إلى نصّ باستعمال دالة
stringify() التي قدّمنها في الفصل الأخير، ثمّ نُفرغها إلى
الإخراج القياسي.
أصبح مفسّرنا قادراً الآن على زيارة الجمل، لكن لدينا بعض العمل
لنُطعِمَه إياها. أوّلاً، عدّل دالة interpret() القديمة في صنف
Interpreter لتقبل قائمةَ جمل -- أي برنامجاً.
^code interpret
يحلّ هذا محلّ الشيفرة القديمة التي كانت تأخذ تعبيراً واحداً. وتَعوّذ الشيفرة الجديدة على طريقة المساعدة الصغيرة هذه:
^code execute
تلك هي نظيرةُ الجملة لدالة evaluate() التي لدينا للتعبيرات.
وبما أنّنا نعمل مع القوائم الآن، نحتاج إلى إخبار Java بذلك.
^code import-list (2 before, 2 after)
ما زال صنف Lox الرئيسي يحاول تحليل تعبير واحد وتمريره إلى المفسّر. ونُصلح سطر التحليل هكذا:
^code parse-statements (1 before, 2 after)
ثمّ نستبدل الاستدعاء إلى المفسّر بهذا:
^code interpret-statements (2 before, 1 after)
إنّه في الأساس مجرّد تمريرٌ للصياغة الجديدة عبر الأنابيب. حسناً، شغّل المفسّر وجرّبه. وفي هذه المرحلة، يجدرُ بك أن ترسم برنامج Lox صغيراً في ملفّ نصّي لتشغيله كسكربت. شيءٌ مثل:
print "one";
print true;
print 2 + 1;
يكاد يبدو برنامجاً حقيقياً! ولاحظ أنّ الـREPL أصبح أيضاً يطلب منك إدخال جملة كاملة بدلاً من تعبير بسيط. ولا تنسَ فواصلك المنقوطة.
المتغيّرات العامّة
الآن وقد أصبح لدينا جمل، يمكننا أن نبدأ في العمل على الحالة. وقبل أن نغوص في كلّ تعقيد النطاق المعجمي، سنبدأ بأبسط أنواع المتغيّرات -- المتغيّرات العامّة. ونحتاج إلى بناتَين جديدَتين.
-
تجلب جملة تصريح متغيّر متغيّراً جديداً إلى الوجود.
var beverage = "espresso";وهذا ينشئ رابطاً جديداً يربط اسماً (هنا "beverage") بقيمة (ه، النصّ
"espresso"). -
وبمجرد أن يتمّ ذلك، يصل تعبير المتغيّر إلى ذلك الرابط. فحين يُستعمل المعرّف "beverage" في صورة تعبير، فإنّه يبحث عن القيمة المربوطة بذلك الاسم ويُعيدها.
print beverage; // "espresso".
سنضيف الإسناد ونطاق الكتل لاحقاً، لكنّ ذلك يكفي للبداية.
صياغة المتغيّرات
وكما في السابق، سنعمل على التنفيذ من الأمام إلى الخلف، بادئين بالصياغة.aumeOyAgent وتصريحات المتغيّرات جمل، لكنّها مختلفة عن الجمل الأخرى، وسنقسم قواعد الجمل قسمَين للتعامل معها. والسبب أنّ القواعد تقيّد المواضع التي يُسمح فيها بأنواعٍ معيّنة من الجمل.
●
الأقسام في جمل التحكّم في التنفيذ -- فكّر في فرعي then و else في
جملة if أو في جسم while -- كلٌّ منها جملةٌ واحدة. لكنّ تلك
الجملة غير مسموح أن تكون جملة تصريح اسم. وهذا مقبول:
if (monday) print "Ugh, already?";
لكنّ هذا غير مقبول:
if (monday) var beverage = "espresso";
يمكننا السماح بالأخير، لكنّه مُربك. فما نطاق متغيّر
beverage هذا؟ هل يبقى بعد جملة if؟ وإن كان كذلك، فما قيمته في
الأيام غير الاثنين؟ وهل المتغيّر موجود أصلاً في تلك الأيام؟
الشيفرة كهذه غريبة، لذا فإنّ C و Java وأصدقاءها تمنعها. إنّه كأنّ هناك مستويَين من "الأسبقية" للجمل. فبعض المواضع التي يُسمح فيها بجملة -- مثل داخل كتلة أو في المستوى الأعلى -- تسمح بأيّ نوعٍ من الجمل، بما فيها التصاريح. وبعضها يسمح بالجمل ذات الأسبقية "الأعلى" فقط التي لا تصرّح بأسماء.
ولت accommodate هذا التمييز، نضيف قاعدةً أخرى لأنواع الجمل التي تصرّح بالأسماء.
program        → declaration* EOF ;

declaration    → varDecl
               | statement ;

statement      → exprStmt
               | printStmt ;
تذهب جمل التصريح تحت القاعدة الجديدة declaration. وهي الآن
المتغيّرات فقط، لكنّها ستشمل لاحقاً الدوالّ والأصناف. وأيّ موضعٍ
يُسمح فيه بتصريح يُسمح فيه أيضاً بجملٍ غير تصريحية، لذا تسقط قاعدة
declaration إلى statement. ومن البديهي أنّك تستطيع التصريح
بأشياء في المستوى الأعلى لنصٍّ برمجيّ، لذا يوجّه program إلى
القاعدة الجديدة.
وتبدو قاعدة تصريح متغيّر هكذا:
varDecl → "var" IDENTIFIER ( "=" expression )? ";" ;
وكمعظم الجمل، تبدأ بكلمة مفتاحيةٍ سابقة. وفي حالتنا، var. ثمّ
رمز معرّف لاسم المتغيّر المصرَّح به، يليه تعبير مُهيّئ اختياري.
وأخيراً، نضع فيراغاً على ذلك بالفاصلة المنقوطة.
وللوصول إلى متغيّر، نعرّف نوعاً جديداً من التعبيرات الأوليّة.
primary        → "true" | "false" | "nil"
               | NUMBER | STRING
               | "(" expression ")"
               | IDENTIFIER ;
يطابق بند IDENTIFIER ذاك رمز المعرّف الواحد، ويُفهم على أنّه اسم
المتغيّر الذي يجري الوصول إليه.
تحصل قواعد الصياغة الجديدة هذه على أشجار صياغةٍ مقابلة. وفي مولّد AST نضيف عقدة جملة جديدة لتصريح متغيّر.
^code var-stmt-ast (1 before, 1 after)
هي تخزّن رمز الاسم كي نعرف ما الذي تصرّح به، إضافةً إلى تعبير
المُهيّئ. (وإن لم يكن هناك مُهيّئ، فإنّ ذلك الحقل هو null.)
ثمّ نضيف عقدة تعبير للوصول إلى متغيّر.
^code var-expr (1 before, 1 after)
هي مجرّد غلافٍ حول رمز اسم المتغيّر. هذا كلّ شيء. وكما دائماً، لا تنسَ تشغيل سكربت مولّد AST كي تحصل على ملفّات "Expr.java" و "Stmt.java" المحدَّثة.
تحليل المتغيّرات
قبل أن نحلّل جمل المتغيّرات، نحتاج إلى نقل بعض الشيفرة لإفساح
المجال للقاعدة الجديدة declaration في القواعد. فالمستوى الأعلى
للبرنامج صار الآن قائمةَ تصريحات، لذا فإنّ دالة نقطة الدخول في
المحلّل النحوي تتغيّر.
^code parse-declaration (3 before, 4 after)
وهذا يستدعي هذه الدالة الجديدة:
^code declaration
مهلاً، أتذكر في ذلك الفصل الأسبق البعيد حين وضعنا البنية التحتية اللازمة للتعافي من الأخطاء؟ لقد أصبحنا أخيراً مستعدّين لربط ذلك.
هذه الدالة declaration() هي الدالة التي نستدعيها مراراً عند
تحليل سلسلة جمل في كتلة أو نصّ برمجيّ، لذا فهي الموضع المناسب
للمزامنة حين يدخل المحلل النحوي في وضع الذعر (panic mode). فجسم
هذه الدالة كلّه ملفوف في كتلة try لالتقاط الاستثناء الذي يُطلَق
حين يبدأ المحلل النحوي بالتعافي من الأخطاء. وهذا يعيده إلى
محاولة تحليل بداية الجملة أو التصريح التالي.
يحدث التحليل الحقيقي داخل كتلة try. أوّلاً، ينظر ليتأكّد ممّا إذا
كنا عند تصريح متغيّر بالبحث عن كلمة var السابقة. وإن لم يكن
كذلك، يسقط إلى دالة statement() القائمة التي تحلل جمل print
وجمل التعبير.
تذكّر كيف تحاول statement() تحليل جملة تعبير إن لم تطابق أيّ جملة
أخرى؟ وكيف يُبلّغ expression() عن خطأ صياغة إن لم يستطع تحليل
تعبير عند الرمز الحالي؟ فسلسلة الاستدعاءات تلك تضمن أنّنا نُبلّغ
عن خطأ إن لم يُحلَّل تصريحٌ أو جملة صالحة.
وحين يطابق المحلل النحوي رمز var، يفُرع إلى:
^code parse-var-declaration
وكما دائماً، تتبع شيفرة النزول التكرّاري قاعدة القواعد. فالمحلّل
النحوي طابق رمز var بالفعل، لذا يطلب بعد ذلك رمز معرّفٍ
ويستهلكه لاسم المتغيّر.
ثمّ إن رأى رمز = فإنّه يعلم أنّ هناك تعبير مُهيّئ فيحلّله. وإلّا
فيترك المُهيّئ null. وأخيراً، يستهلك الفاصلة المنقوطة الإلزامية
في نهاية الجملة. ويُلفّ كلّ هذا في عقدة شجرة صياغة Stmt.Var،
ونكون قد انتهينا.
وتحليل تعبير متغيّر أسهل Incl. في primary()، نبحث عن رمز معرّف.
^code parse-identifier (2 before, 2 after)
يعطينا ذلك واجهة أماميّة عامّة تعمل لتصريف المتغيّرات واستعمالها. ولم يبقَ سوى تغذيتها إلى المفسّر. وقبل أن نصل إلى ذلك، نحتاج إلى الحديث عن أين تقيم المتغيّرات في الذاكرة.
البيئات
الروابط التي تربط المتغيّرات بالقيم تحتاج إلى تخزين في مكانٍ ما. ومنذ اخترع أهل Lisp الأقواس، سُمّي بنية البيانات هذه بيئةً (environment).
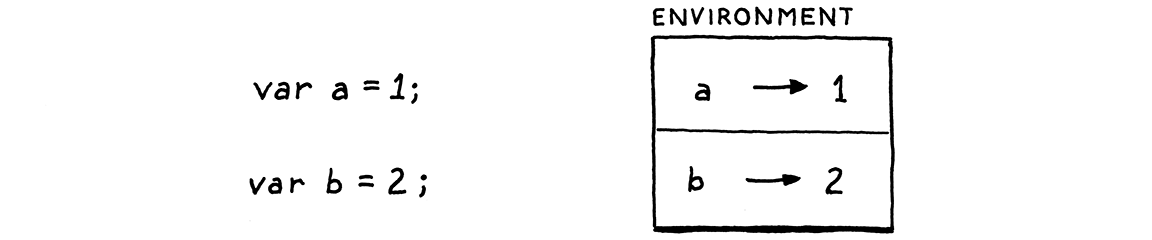
يمكنك أن تفكّر فيها كـخريطة مفاتيحها أسماء المتغيّرات وقيمها قيم المتغيّرات -- القيم بعينها. وفي الواقع، هكذا سننفّذها في Java. يمكننا أن نحشر تلك الخريطة والشيفرة الخاصة بإدارتها داخل Interpreter مباشرةً، لكنّها تشكّل مفهوماً محدَّداً بصورة جيّدة، لذا سنستخرجها إلى صنفها الخاصّ.
ابدأ ملفّاً جديداً وأضف:
^code environment-class
هناك خريطة Map من Java لتخزين الروابط. وهي تستعمل نصوصاً خاماً للمفاتيح، لا رموزاً. فالرمز يمثّل وحدة شيفرةٍ في موضعٍ محدّد في النصّ المصدر، لكن حين يأتي أمر البحث عن متغيّرات، ينبغي لكلّ رموز المعرّف التي تحمل الاسم نفسه أن تشير إلى المتغيّر نفسه (نتجاهل النطاق الآن). واستعمال النصّ الخام يضمن أن تشير كلّ تلك الرموز إلى مفتاح الخريطة نفسه.
لدينا عمليتان نحتاج إلى دعمهما. أوّلاً، تعريف متغيّر يربط اسماً جديداً بقيمة.
^code environment-define
ليس هذا جراحة دماغٍ بالضبط، لكنّنا اتّخذنا خياراً دلالياً مثيراً للاهتمام. فحين نضيف المفتاح إلى الخريطة، لا نفحص ما إذا كان موجوداً بالفعل. وهذا يعني أنّ هذا البرنامج يعمل:
var a = "before";
print a; // "before".
var a = "after";
print a; // "after".
جملة المتغيّر لا تعرّف متغيّراً جديداً فحسب، بل يمكن أن
تُستعمل أيضاً لإعادة تعريف متغيّرٍ قائم. يمكننا أن نختار جعل ذلك خطأً بدلاً من ذلك. فقد لا
ينوي المستخدم إعادة تعريف متغيّرٍ قائم. (وإن كان ينوي ذلك، فربما
كان سيستعمل الإسناد بدل var.) وسيُساعد جعل إعادة التعريف خطأً
على أن يجد ذلك الخلل.
د ذلك الخلل. لكنّ فعل ذلك يتفاعل بسوء مع الـREPL. ففي منتصف الجميل ألّا تضطر إلى تتبّع ذهنيّ للمتغيّرات التي عرّفتها بالفعل. ويمكننا السماح بإعادة التعريف في REPL لا في السكربتات، لكن حينها سيضطر المستخدمون إلى تعلّم مجموعتَين من القواعد، وقد لا تعمل الشيفرة المنسوخة من صيغةٍ إلى أخرى.
إذن، لإبقاء الوضعَين متّسقَين، سنسمح بذلك -- على الأقلّ للمتغيّرات العامّة. وبمجرد أن يصبح المتغيّر موجوداً، نحتاج إلى وسيلة للبحث عنه.
^code environment-get (2 before, 1 after)
هذا أكثر إثارةً للاهتمام دلالياً قليلاً. فإذا وُجد المتغيّر، فإنّها ببساطة تُعيد القيمة المربوطة به. لكن ماذا إن لم يُوجد؟ ومرةً أخرى، لدينا خيار:
-
اجعله خطأ صياغة.
-
اجعله خطأ وقت تشغيل.
-
اسمح به وأعد قيمةً افتراضيةً مثل
nil.
Lox متساهلةً إلى حدٍّ كبير، لكنّ الخيار الأخير يبدو لي متساهلاً أكثر من اللازم. وجعله خطأ صياغة -- خطأ وقت تصريف -- يبدو خياراً ذكياً. فاستعمال متغيّرٍ غير معرّف خطأ، وكلّما اكتشفته أبكر كان أفضل.
المشكلة أنّ استعمال متغيّر ليس هو الإشارة إليه. فبإمكانك أن تشير إلى متغيّر في قطعة شيفرة دون أن تقيّمها فوراً إن كانت تلك القطعة ملفوفة داخل دالة. فإذا جعلنا ذكر متغيّر قبل تصريحه خطأً ساكناً، تجعل تعريفَ دوالّ تعاودية أصعب بكثير.
ويمكننا استيعاب التعاود البسيط -- دالةً تستدعي نفسها -- بأن نصرّح باسم الدالة قبل أن نفحص جسمها. لكنّ ذلك لا ينفع مع الإجراءات المتبادلة التي تستدعي بعضها. فكّر في:
fun isOdd(n) {
  if (n == 0) return false;
  return isEven(n - 1);
}

fun isEven(n) {
  if (n == 0) return true;
  return isOdd(n - 1);
}
دالة isEven() ليست معرَّفةً في اللحظة التي ننظر فيها إلى
جسم isOdd() حيث تُستدعى. فإن عكسنا ترتيب الدالتَين، فإنّ
isOdd() ليست معرَّفةً حين ننظر إلى جسم isEven().
ولأنّ جعله خطأً ساكناً يجعل التصريحات التعاودية صعبةً جداً، سؤجّل الخطأ إلى وقت التشغيل. فمن Okay الإشارة إلى متغيّر قبل أن يُعرَّف ما دامت لا تقوّم ذلك الإشارة. وهذا يسمح لبرنامج الأعداد الزوجية والفردية بالعمل، لكنّك ستحصل على خطأ وقت تشغيل في:
print a;
var a = "too late!";
وكما في أخطاء الأنواع في شيفرة تقويم التعبيرات، نُبلّغ عن خطأ وقت التشغيل عبر إطلاق استثناء. ويحتوي الاستثناء على رمز المتغيّر كي نخبر المستخدم أين في شيفرته أخطأ.
تفسير المتغيّرات العامّة
يحصل صنف Interpreter على نسخة من صنف Environment الجديد.
^code environment-field (2 before, 1 after)
نخزّنها كحقل في Interpreter مباشرةً كي تبقى المتغيّرات في الذاكرة طالما كان المفسّر لا يزال يعمل.
لدينا شجرتا صياغة جديدتان، إذاً ف لدينا طريقتا زيارة جديدتان. الأولى لجمل التصريح.
^code visit-var
إذا كان للمتغيّر مُهيّئ، فإنّنا نقيّمه. وإن لم يكن، لدينا خيارٌ آخر نتخّذه. كان بإمكاننا جعل ذلك خطأ صياغة في المحلل النحوي بأن نطلب مُهيّئاً إلزامياً. لكنّ معظم اللّغات لا تفعل ذلك، لذا يبدو أمراً قاسياً قليلاً في Lox.
ويمكننا جعله خطأ وقت تشغيل. فسنسمح لك بتعريف متغيّر غير مهيّأ،
لكن إن كنتَ تصل إليه قبل إسناد قيمةٍ إليه لحدّث خطأ وقت التشغيل
حدث. وليست فكرةً سيّئة، لكنّ معظم اللّغات المُنمَّطة ديناميكياً لا
تفعل ذلك. وبدلاً من ذلك سنُبقي الأمر بسيطاً ونقول إنّ Lox تضبط
المتغيّر على nil إن لم يُهيّأ صراحةً.
var a;
print a; // "nil".
إذن، إن لم يكن هناك مُهيّئ، نضبط القيمة على null، وهو تمثيل
Java لقيمة nil في Lox. ثمّ نطلب من البيئة أن تربط المتغيّر بتلك
القيمة.
ثمّ نقيّم تعبير متغيّر.
^code visit-variable
وهذا ببساطة يحوّل الأمر إلى البيئة التي تقوم بالعمل الشاقّ للتأكّد من أنّ المتغيّر معرَّف. وبذلك نحصل على متغيّرات أوّلية تعمل. جرّب هذا:
var a = 1;
var b = 2;
print a + b;
لا يمكننا إعادة استعمال الشيفرة بعد، لكنّنا نستطيع أن نبدأ في بناء برامجٍ تُعيد استعمال البيانات.
الإسناد
من الممكن صنع لغةٍ فيها متغيّرات لكن لا تتيح لك إعادة إسنادها --
أو تغييرها --. وHaskell مثالٌ على ذلك. فSML تدعم المراجع
والمصفوفات القابلة للتغيير فقط -- ولا يمكن إعادة إسناد المتغيّرات.
وRust توجّهك بعيداً عن التغيير بأن تطلب مُعدِّل mut لتفعيل
الإسناد.
تغيير متغيّرٍ هو أثرٌ جانبي، وكما يوحي الاسم، يظنّ بعض أهل اللّغات أنّ الآثار الجانبيّة قذرة أو غير أنيقة. ينبغي أن تكون الشيفرة رياضياتٍ خالصة تُنتج قيماً -- بلّورية لا تتغيّر -- كأنّها فعلٌ من أفعال الخلق الإلهي. لا آلةٌ قذرة تضرب كتل البيانات في شكلها، أمرٌ بعد أمر.
Lox ليست قاسيةً إلى هذا الحدّ. فLox لغةٌ أمرية، والتغيير جزءٌ من الحزم. وإضافة دعم الإسناد لا تتطلّب جهداً كبيراً. فالمتغيّرات العامّة تدعم إعادة التعريف بالفعل، فمعظم الآليّات موجودة الآن. والناقص في الأثر الأساس هو اصطلاحيةُ إسنادٍ صريحة.
صياغة الإسناد
تلك الصيغة الصغيرة = أكثر تعقيداً ممّا قد يبدو. فمثل معظم اللّغات
المشتقّة من C، الإسناد تعبير وليس جملة.
وكما في C، إنّه أدنى أشكال التعبيرات أسبقيةً. وهذا يعني أنّ القاعدة
تقع بين expression و equality (التعبير ذي الأسبقية الأدنى التالي).
expression     → assignment ;
assignment     → IDENTIFIER "=" assignment
               | equality ;
هذا يقول إنّ assignment إمّا معرّفٌ يتبعه = وتعبيرٌ عن القيمة،
وإمّا equality (وبالتالي أيّ تعبيرٍ آخر). ولاحقاً، سيصبح
assignment أكثر تعقيداً حين نُضيف مخصِّصاتٍ للخصائص على الأشياء،
مثل:
instance.field = "value";
الجزء السهل هو إضافة عقدة شجرة الصياغة الجديدة.
^code assign-expr (1 before, 1 after)
لديها رمزٌ للمتغيّر المسنَد إليه، وتعبيرٌ للقيمة الجديدة. وبعد أن
تشغّل AstGenerator للحصول على صنف Expr.Assign الجديد، استبدل جسم
دالة expression() القائمة في المحلل النحوي لتطابق القاعدة
المحدَّثة.
^code expression (1 before, 1 after)
هنا تصبح الأمور صعبة. فالمحلّل النحوي النازل التكرّاري برمزٍ واحد
من النظرة التقدّمية لا يرى بُعيداً بما يكفي ليعرف أنّه يحلّل إسناداً
إلّا بعد أن يكون قد اجتاز الجانب الأيسر واصطدم بـ=. وقد تتساءل
لمَ يحتاج إلى ذلك أصلاً. فبعد كلّ شيء، لا نعرف أنّنا نحلّل تعبير +
إلّا بعد أن ننتهي من تحليل المعامل الأيسر.
الفرق هو أنّ الجانب الأيسر من الإسناد ليس تعبيراً يُقيَّم إلى قيمة. إنّه شيءٌ يشبه شبه تعبير يُقيَّم إلى "شيء" يمكنك الإسناد إليه. فكّر في:
var a = "before";
a = "value";
في السطر الثاني، نحن لا نقيّم a (وهو سيُعيد النصّ "before").
بل نحدّد أيّ متغيّرٍ يشير إليه a كي نعرف أين نخزّن قيمة تعبير
الجانب الأيمن. والمصطلحان الكلاسيكيان
لهذين البنيتين هما l-value و r-value. وكلّ التعبيرات التي
رأيناها حتى الآن والتي تنتج قيماً هي r-values. أمّا l-value
فيُقيَّم إلى "موقع تخزين" يمكنك الإسناد إليه.
نريد لشجرة الصياغة أن تعكس أنّ l-value لا يُقيَّم كالتعبير العادي.
ولهذا تحتوي عقدة Expr.Assign على Token للجانب الأيسر لا Expr.
والمشكلة أنّ المحلل النحوي لا يعرف أنّه يحلّل l-value حتى يصطدم
بـ=. وفي l-value معقّد، قد يحدث ذلك بعد
رموزٍ كثيرة.
makeList().head.next = node;
ولدينا رمزٌ واحد فقط من النظرة التقدّمية، فماذا نفعل؟ نستعمل حيلةً صغيرة، وتبدو هكذا:
^code parse-assignment
معظم شيفرة تحليل تعبير الإسناد تبدو شبيهةً بتلك الخاصة بالمعاملات
الثنائية الأخرى مثل +. نحن نحلّل الجانب الأيسر، الذي يمكن أن يكون
أيّ تعبيرٍ ذي أسبقية أعلى. فإذا وجدنا =، حلّلنا الجانب الأيمن ثمّ
لففناه كلّه في عقدة شجرة صياغة إسناد.
وهناك فرقٌ طفيف واحد عن المعاملات الثنائية: نحن لا ندور لبناء
تسلسلٍ من المعامل نفسه. ولأنّ الإسناد مقيَّدٌ إلى اليمين، فإنّنا
بدلاً من ذلك نستدعي assignment() تعاودياً لتحليل الجانب الأيمن.
والحيلة أنّنا، قبل إنشاء عقدة تعبير الإسناد مباشرةً، ننظر إلى تعبير الجانب الأيسر ونحدّد ما نوع هدف الإسناد الذي هو. فنحوّل عقدة تعبير r-value إلى تمثيل l-value.
وهذا التحويل يعمل لأنّه يتبيّن أنّ كلّ هدف إسنادٍ صالح يكون أيضاً صياغةً صالحة كتعبيرٍ عادي. فكّر في إسناد حقلٍ معقّدٍ مثل:
newPoint(x + 2, 0).y = 3;
والجانب الأيسر من ذلك الإسناد يمكن أن يعمل أيضاً كتعبيرٍ صالح.
newPoint(x + 2, 0).y;
المثال الأوّل يضبط الحقل، والثاني يقرأه.
وهذا يعني أنّنا نستطيع تحليل الجانب الأيسر كأنّه تعبير ثمّ إنتاج شجرة صياغة تحوّله بعد ذلك إلى هدف إسناد. فإذا لم يكن تعبير الجانب الأيسر هدفَ إسنادٍ صالحاً، نفشل بخطأ صياغة. وهذا يضمن أنّنا نُبلّغ عن خطأ في شيفرة كهذه:
a + b = c;
RIGHT الآن، الهدف الصالح الوحيد هو تعبير متغيّر بسيط، لكنّنا سنُضيف الحقول لاحقاً. والنتيجة النهائية لهذه الحيلة هي عقدة شجرة صياغة إسناد تعرف ما الذي تُسند إليه، ولها شجرة تعبير فرعية للقيمة المسنَدة. وكلّ ذلك برمزٍ واحدٍ فقط من النظرة التقدّمية ودون أيّ رجوع للخلف.
دلالة الإسناد
لدينا عقدة شجرة صياغة جديدة، لذا يحصل مفسّرنا على طريقة زيارة جديدة.
^code visit-assign
ولأسبابٍ واضحة، فإنّها مشابهة لتصريح المتغيّر. فهي تقيّم الجانب
الأيمن للحصول على القيمة، ثمّ تخزّنها في المتغيّر المُسمّى.
وبدلاً من استعمال define() على Environment، فإنّها تستدعي هذه
الطريقة الجديدة:
^code environment-assign
والفرق الجوهري بين الإسناد والتعريف هو أنّ الإسناد غير مسموح له أن يُنشئ متغيّراً جديداً. ومن ناحية تنفيذنا، يعني ذلك أنّه خطأ وقت تشغيل إن لم يكن المفتاح موجوداً بالفعل في خريطة متغيّرات البيئة.
والشيء الأخير الذي تفعله دالة visit() هو إعادة القيمة المسنَدة.
وذلك لأنّ الإسناد تعبيرٌ يمكن أن يتداخل داخل تعبيراتٍ أخرى،
مثل:
var a = 1;
print a = 2; // "2".
أصبح مفسّرنا الآن قادراً على إنشاء المتغيّرات وقراءتها وتعديلها. وهو بقدر ما كان لدى BASICs الأولى من تعقيد. فالمتغيّرات العامّة بسيطة، لكنّ كتابة برنامجٍ كبير حين يستطيع أيّ قطعتَي شيفرة أن تصطدما عمداً بحالة الأخرى ليست ممتعة. نحن نريد متغيّراتٍ محلّية، وهذا يعني أنّه حان وقت النطاق.
النطاق
يعرّف النطاق منطقةً يُطابَق فيها اسمٌ بكيانٍ معيّن. وتُتيح النطاقات المتعدّدة للاسم نفسه أن يشير إلى أشياءٍ مختلفة في سياقات مختلفة. في بيتي، يشير "بوب" عادةً إليّ. لكن ربما في مدينتك تعرف بوباً آخر. الاسم نفسه، لكنّ الشخصَين مختلفان بحسب أين تقله.
النطاق المعجمي (أو النطاق الساكن الأقلّ شيوعاً) هو نمطٌ خاصّ من النطاق يُظهر فيه نصّ البرنامج نفسه أين يبدأ النطاق وينتهي. وفي Lox، كما في معظم اللّغات الحديثة، المتغيّرات ذات نطاق معجمي. فحين ترى تعبيراً يستعمل متغيّراً معطًى، يمكنك تحديد أيّ تصريح متغيّر يشير إليه بمجرّد قراءة الشيفرة قراءةً ساكنة.
فمثلاً:
{
  var a = "first";
  print a; // "first".
}

{
  var a = "second";
  print a; // "second".
}
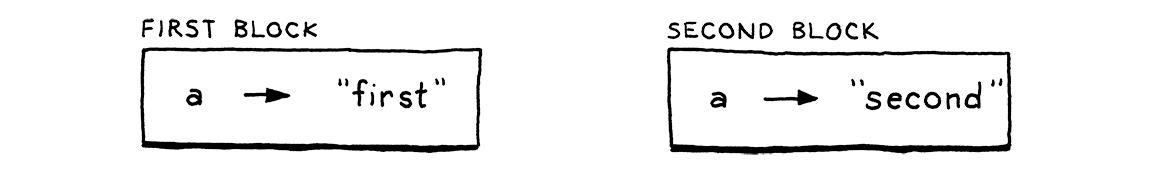
هنا، لدينا كتلتان مع متغيّر a مصرَّح به في كلٍّ منهما. وأنت
وأستطيع أن نلاحظ بمجرّد النظر إلى الشيفرة أنّ استعمال a في جملة
print الأولى يشير إلى a الأولى، والثانية تشير إلى الثانية.
وهذا على عكس النطاق الديناميكي حيث لا تعرف ما يشير إليه الاسم إلّا حين تنفّذ الشيفرة. وLox ليس لها متغيّرات ذات نطاق ديناميكي، لكنّ الدوالّ والخصائص على الأشياء ذات نطاق ديناميكي.
class Saxophone {
  play() {
    print "Careless Whisper";
  }
}

class GolfClub {
  play() {
    print "Fore!";
  }
}

fun playIt(thing) {
  thing.play();
}
حين تستدعي playIt() الدالة thing.play()، لا نعرف ما إذا كنا
على وشك سماع "Careless Whisper" أم "Fore!" فذلك يعتمد على ما إذا
مرّرتَ saxophone أو GolfClub إلى الدالة، ولا نعرف ذلك إلّا وقت
التشغيل.
والنطاق والبيئات أقاربٌ مقرّبون. فالأول هو المفهوم النظري، والثاني هو الآلية التي تنفّذه. ومتى عمل مفسّرنا طريقه في الشيفرة، فإنّ عُقد شجرة الصياغة التي تؤثّر في النطاق تغيّر البيئة. وفي صياغةٍ شبيهة بـC مثل صياغة Lox، يُتحكَّم في النطاق بكتلٍ محاطة بأقواسٍ معقوفة. (ولهذا نسمّيه نطاق الكتل.)
{
  var a = "in block";
}
print a; // Error! No more "a".
بداية الكتلة تُقدّم نطاقاً محلّياً جديداً، وينتهي ذلك النطاق حين
يجاوز التنفيذ } الختامية. وأي متغيّراتٍ مصرَّح بها داخل الكتلة
تختفي.
التعشيش والحجب
القصّة الأولى لتنفيذ نطاق الكتل قد تعمل هكذا:
-
أثناء زيارتنا لكلّ جملة داخل الكتلة، نتتبّع أيّ متغيّراتٍ صرِّح بها.
-
وبعد تنفيذ الجملة الأخيرة، نطلب من البيئة أن تحذف كلّ تلك المتغيّرات.
هذا سيعمل مع المثال السابق. لكنّ تذكّر، أحد دوافع النطاق المحلّي هو التغليف (encapsulation) -- يجب ألّا تؤثّر قطعة شيفرة في زاويةٍ من البرنامج في كتلةٍ أخرى. انظر إلى هذا:
// How loud?
var volume = 11;

// Silence.
volume = 0;

// Calculate size of 3x4x5 cuboid.
{
  var volume = 3 * 4 * 5;
  print volume;
}
انظر إلى الكتلة التي نحسب فيها حجم متوازي المستطيلات باستخدام
تصريحٍ محلّي لـvolume. وبعد خروج الكتلة، سيحذف المفسّر متغيّر
volume العامّ. وهذا ليس صحيحاً. فحين نخرج من الكتلة، ينبغي أن
نزيل أيّ متغيّراتٍ مصرَّح بها داخل الكتلة، لكن إن كان هناك متغيّرٌ
بالاسم نفسه مصرَّح به خارج الكتلة، فذلك متغيّرٌ آخر. ولا ينبغي
أن يُمسّ.
وحين يكون للمتغيّر المحلّي الاسم نفسه كمتغيّرٍ في نطاقٍ محيط، فإنّه يحجب الخارجيّ. فالشيفرة داخل الكتلة لم تعد تراه -- إنّه مختبئٌ في "الظلّ" الذي يلقيه الداخليّ -- لكنّه ما زال هناك.
وحين ندخل نطاق كتلة جديداً، نحتاج إلى حفظ المتغيّرات المعرَّفة في النطاقات الخارجية كي تكون لا تزال موجودة حين نخرج من الكتلة الداخلية. ونفعل ذلك بتعريف بيئةٍ جديدة لكل كتلة تحتوي على المتغيّرات المعرَّفة في ذلك النطاق فقط. وحين نخرج من الكتلة، نطرح بيئتها ونستعيد السابقة.
ونحتاج أيضاً إلى التعامل مع المتغيّرات المحيطة التي لا تُحجب.
var global = "outside";
{
  var local = "inside";
  print global + local;
}
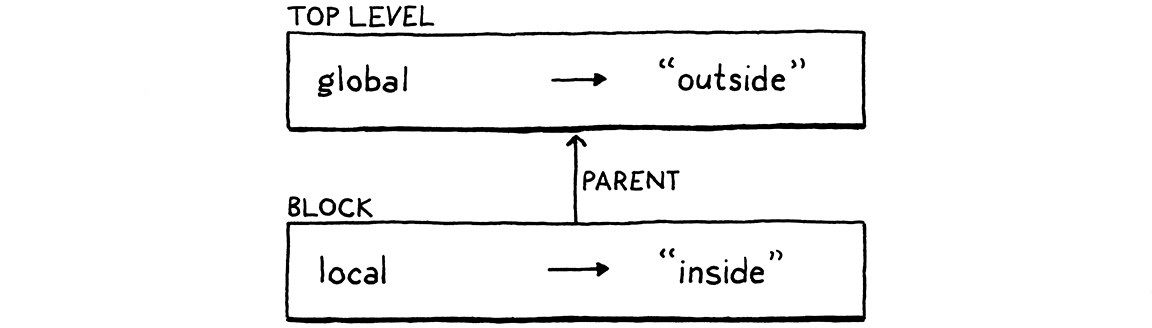
هنا، يعيش global في البيئة العامة الخارجية، و local معرَّفٌ
داخل بيئة الكتلة. وفي جملة print تلك، كلا المتغيّرَين في النطاق.
وللعثور عليهما، يجب على المفسّر أن يبحث ليس في البيئة الأعمق
الحالية فحسب، بل في أيّ بيئاتٍ محيطة أيضاً.
وننفّذ ذلك بـتسلسل البيئات معاً. فكلّ بيئة لديها مرجعٌ إلى بيئة النطاق المحيط مباشرةً. وحين نبحث عن متغيّر، نمشي على تلك السلسلة من الأعمق إلى الخارج حتى نجد المتغيّر. والبدء من النطاق الداخليّ هو ما يجعل المتغيّرات المحلّية تحجب الخارجيّة.
وقبل أن نضيف صياغة الكتل إلى القواعد، سنُقوّي صنف Environment لدينا بدعم هذا التعشيش. أوّلاً، نعطي كلّ بيئة مرجعاً إلى بيئتها المحيطة.
^code enclosing-field (1 before, 1 after)
يحتاج هذا الحقل إلى تهيئة، لذا نُضيف بضعة مُنشئَات.
^code environment-constructors
المُنشئ بلا معاملات هو لبيئة النطاق العامّ التي تُنهي السلسلة. أمّا المُنشئ الآخر فيُنشئ نطاقاً محلّياً جديداً متداخلاً داخل الخارجيّ المعطى.
لا نضطرّ إلى لمس دالة define() -- فالمتغيّر الجديد يُصرَّح به
دائماً في النطاق الأعمق الحالي. لكنّ البحث عن المتغيّرات والإسناد
إليها يتعاملان مع متغيّراتٍ قائمة وهما يحتاجان إلى يمشي السلسلة
للعثور عليها. أوّلاً، البحث:
^code environment-get-enclosing (2 before, 3 after)
إن لم يُعثر على المتغيّر في هذه البيئة، فإنّنا ببساطة نجرّب المحيطة. وهي بدورها تفعل الشيء ذاته تعاودياً، فهذا سيمشي في السلسلة كاملةً في النهاية. فإذا بلغنا بيئةً ليس لها محيطة ولم نجد المتغيّر بعد، فإنّنا نستسلم ونُبلّغ عن خطأ كما سابقاً.
والإسناد يعمل بالطريقة ذاتها.
^code environment-assign-enclosing (4 before, 1 after)
ومرةً أخرى، إن لم يكن المتغيّر في هذه البيئة، فإنّها تفحص الخارجيّة تعاودياً.
صياغة الكتل ودلالتها
الآن وبعد أن تداخلت البيئات، أصبحنا مستعدّين لإضافة الكتل إلى اللّغة. ها هي القواعد:
statement      → exprStmt
               | printStmt
               | block ;

block          → "{" declaration* "}" ;
الكتلة سلسلةٌ (ربما فارغة) من الجمل أو التصريحات محاطة بأقواسٍ معقوفة. والكتلة نفسها جملة، ويمكن أن تظهر في أيّ موضعٍ يُسمح فيه بجملة. وتبدو عقدة شجرة الصياغة هكذا:
^code block-ast (1 before, 1 after)
هي تحوي قائمةَ الجمل الموجودة داخل الكتلة.
والتحليل مباشر. فكما في الجمل الأخرى، نكتشف بداية الكتلة من رمزها
السابق -- في هذه الحالة {. وفي دالة statement() نضيف:
^code parse-block (1 before, 2 after)
كلّ العمل الحقيقي يقع هنا:
^code block
نحن نُنشئ قائمةً فارغة ثمّ نحلّل الجمل ونضيفها
إلى القائمة حتى نصل إلى نهاية الكتلة، التي يعلّمها } الختامية.
ولاحظ أنّ الحلقة فيها أيضاً فحصٌ صريح لـisAtEnd(). علينا أن نكون
حذرين لتفادي الحلقات اللانهائية، حتى عند تحليل شيفرةٍ غير صالحة.
فإن نسي المستخدم } ختاميةً، يجب ألّا يعلق المحلل النحوي.
هذا كلّ ما في الصياغة. أمّا في الدلالة، فنُضيف طريقةَ زيارةٍ أخرى إلى Interpreter.
^code visit-block
لتنفيذ كتلة، ننشئ بيئةً جديدة لنطاق الكتلة ونمرّرها إلى هذه الدالة الأخرى:
^code execute-block
وهي دالةٌ جديدة تنفّذ قائمةَ جمل في سياق بيئةٍ معطاة.
environment في Interpreter يشير دائماً إلى البيئة نفسها -- العامة
-- أمّا الآن فإنّ ذلك الحقل يمثّل البيئة الحالية. وهي البيئة
التي تقابل أعمق نطاقٍ يحتوي الشيفرة المطلوب تنفيذها.
ولتنفيذ الشيفرة ضمن نطاقٍ معطى، تُحدّث هذه الدالة حقل
environment في المفسّر، وتزور كلّ الجمل، ثمّ تستعيد القيمة
السابقة. وكما هو حسن الممارسة دائماً في Java، فإنّها تستعيد البيئة
السابقة باستخدام بند finally. وبهذه الطريقة تُستعاد حتى لو أُلقي
استثناء.
المفاجأة أنّ هذا كلّ ما نحتاج إليه لدعم كاملٍ للمتغيّرات المحلّية والتداخل والحجب. تفضّل وجرّب هذا:
var a = "global a";
var b = "global b";
var c = "global c";
{
  var a = "outer a";
  var b = "outer b";
  {
    var a = "inner a";
    print a;
    print b;
    print c;
  }
  print a;
  print b;
  print c;
}
print a;
print b;
print c;
أصبح مفسّرنا الصغير قادراً الآن على تذكّر الأشياء. ونحن نقترب ببطء من شيءٍ يشبه لغة برمجة كاملة المزايا.
التحديات
-
لم يعد الـREPL يدعم إدخال تعبير واحد وطباعة قيمة نتيجته تلقائياً. هذا مُزعج. أضف إلى REPL دعماً ليكتب المستخدمون جملاً وتعبيرات معاً. فإن أدخلوا جملة، فنفّذها. وإن أدخلوا تعبيراً، فقيّمه واعرض قيمة النتيجة.
-
ربما تريد أن تكون Lox أكثر وضوحاً قليلاً بشأن تهيئة المتغيّرات. بدلاً من تهيئة المتغيّرات ضمنياً إلى
nil، اجعل الوصول إلى متغيّرٍ لم يُهيّأ أو يُسنَد إليه خطأ وقت تشغيل، مثل:// No initializers. var a; var b; a = "assigned"; print a; // OK, was assigned first. print b; // Error! -
ماذا يفعل البرنامج التالي؟
var a = 1;
{
  var a = a + 2;
  print a;
}
ماذا كنت تتوقّع أن يفعل؟ هل هذا ما تظنّ أنّه ينبغي أن يفعله؟ ماذا تفعل الشيفرة المكافئة في اللغات الأخرى التي تعرفها؟ وما رأيك فيما سيتوقّعه المستخدمون من هذا؟
ملاحظة تصميم: التصريح الضمني بالمتغيّرات
تمتلك Lox صياغةً متمايزة للتصريح بمتغيّر جديد والإسناد إلى متغيّر قائم. وبعض اللّغات تدمج الاثنتين في صيغة الإسناد وحدها. فالإسناد إلى متغيّرٍ غير موجود يجلبه إلى الوجود تلقائياً. ويُسمّى هذا التصريح الضمني بالمتغيّرات (implicit variable declaration) وهو موجود في Python و Ruby و CoffeeScript وغيرها. أمّا JavaScript فلديها صيغةٌ صريحة للتصريح بالمتغيّرات، لكنّها تستطيع أيضاً إنشاء متغيّرات جديدة عند الإسناد. وVisual Basic لديه خيارٌ لتمكين المتغيّرات الضمنية أو تعطيلها.
وحين تستطيع الصيغةُ ذاتُها الإسنادَ أو الإنشاء، لا بدّ لكلّ لغةٍ من أن تقرّر ماذا يحدث حين لا يتّضح أيّ السلوكَين يقصده المستخدم. وعلى وجه الخصوص، لا بدّ لكلّ لغةٍ من أن تختار كيف يتفاعل التصريح الضمني مع الحجب، وأيّ نطاقٍ يذهب إليه المتغيّر المصرَّح ضمنياً.
-
في Python، ينشئ الإسناد دائماً متغيّراً في نطاق الدالة الحالية، حتى إن كان هناك متغيّرٌ بالاسم نفسه مصرَّح به خارج الدالة.
-
تتجنّب Ruby بعض الغموض بأنّ لها قواعدَ تسمية مختلفة للمتغيّرات المحلّية والعامّة. لكنّ كتل Ruby (وهي أقرب إلى الإغلاقات منها إلى "الكتل" في C) لها نطاقها الخاصّ، فهي تعاني المشكلة ذاتها. والإسناد في Ruby يُسند إلى متغيّرٍ قائمٍ خارج الكتلة الحالية إن وُجد واحدٌ بالاسم نفسه. وإلّا فأنشأ متغيّراً جديداً في نطاق الكتلة الحالية.
-
CoffeeScript، الذي يأخذ عن Ruby في جوانبَ كثيرة، مشابهة. فهو يمنع الحجب صراحةً بالقول إنّ الإسناد يُسند دائماً إلى متغيّرٍ في نطاقٍ خارجي إن وُجد، وصولاً إلى النطاق العامّ الخارجي. وإلّا فقد أنشأ المتغيّر في نطاق الدالة الحالية.
-
في JavaScript، يعدّل الإسناد متغيّراً قائماً في أيّ نطاقٍ محيط إن وُجد. وإن لم يوجد، فإنّه يُنشئ ضمنياً متغيّراً جديداً في النطاق العامّ.
والمزايا الرئيسية للتصريح الضمني هي البساطة. ف الصياغة أقلّ ولا مفهوم "تصريح" لتتعلّمه. ويستطيع المستخدمون ببساطة أن يبدؤوا في الإسناد وتكتشف اللّغة الأمرَ بنفسها.
واللّغات الأقدم المُنمَّطة ساكناً مثل C تستفيد من التصريح الصريح لأنّها توفّر للمستخدم موضعاً ليخبر المصرّف بما نوع كلّ متغيّر وكم من التخزين يخصّص له. وفي لغةٍ مُنمَّطة ديناميكياً ومُجمَّعة نفايات، ليست ذلك ضرورية حقّاً، لذا يمكنك أن تفلت من جعل التصاريح ضمنية. يبدو ذلك "نصّيّاً" أكثر، أقرب إلى "أنت تعرف ما أقصد".
لكنّ هل تلك فكرةٌ جيّدة؟ للتصريح الضمني بعض المشاكل.
-
قد ينوي المستخدم الإسناد إلى متغيّرٍ قائم، لكنّه يكون قد أخطأ في كتابته. ولا يعرف المفسّر ذلك، فيمضي ويخلق بصمت متغيّراً جديداً ما، ويبقى المتغيّر الذي أراد المستخدم الإسناد إليه على قيمته القديمة. وهذا سيّئٌ بشكلٍ خاص في JavaScript حيث يَنشئ الخطأ المطبعي متغيّراً عامّاً، وقد يتداخل بدوره مع شيفرةٍ أخرى.
-
تستعمل JS و Ruby و CoffeeScript وجود متغيّرٍ قائمٍ بالاسم نفسه -- حتى في نطاقٍ خارجي -- لتحديد ما إذا كان الإسناد يُنشئ متغيّراً جديداً أم يُسند إلى متغيّرٍ قائم. وهذا يعني أنّ إضافة متغيّرٍ جديدٍ في نطاقٍ محيط يمكن أن تغيّر معنى شيفرةٍ قائمة. فما كان متغيّراً محلّياً قد يتحوّل بصمت إلى إسنادٍ إلى ذلك المتغيّر الخارجي الجديد.
-
في Python، قد تريد الإسناد إلى متغيّرٍ خارج الدالة الحالية بدلاً من إنشاء متغيّر جديد فيها، لكنّك لا تستطيع.
ومرّ الوقت، أضافت اللغات التي أعرفها ذاتُ التصريح الضمني بالمتغيّرات ميزاتٍ وتعقيداً إضافيين للتعامل مع هذه المشاكل.
-
صار التصريح الضمني بالمتغيّرات العامّة في JavaScript يُعتبر خطأً على نطاقٍ عالمي. فـ"الوضع الصارم" يعطّله ويجعله خطأ تصريف.
-
أضافت Python جملة
globalلتتيح لك الإسناد صراحةً إلى متغيّرٍ عامّ من داخل دالة. ولاحقاً، ومع ازدياد شهرة البرمجة الوظيفية والدوالّ المتداخلة، أضافت جملةً مشابهةً اسمهاnonlocalللإسناد إلى المتغيّرات في الدوالّ المحيطة. -
وسّعت Ruby صياغة كتلها لتسمح بتصريح متغيّراتٍ معيّنة على أنّها محلّية صراحةً للكتلة حتى لو كان الاسم نفسه موجوداً في نطاقٍ خارجي.
وبالنظر إلى ذلك، أظنّ أنّ حجّة البساطة ضاعت إلى حدٍّ كبير. فهناك حجّة أنّ التصريح الضمني هو الافتراضي المناسب، لكنّني شخصياً أظنّ أنّها أقلّ إقناعاً.
ورأيي أنّ التصريح الضمني كان له معنى في سنينٍ مضت عندما كانت معظم ٍ مضت عندما كانت معظم لغات النصوص أمريةً إلى حدٍّ كبير وكانت حدٍّ كبير. ومع أكثر اطّلاع من المبرمجين على التعشيش العميق والبرمجة الوظيفية والإغلاقات، أصبح الوصول إلى متغيّرات النطاقات الخارجية أكثر رواجاً بكثير. ويجعل ذلك من المرجّح أكثر أن يصطدم المستخدمون بالحالات الصعبة حيث لا يتّضح ما يقصدونه في إسنادهم بين إنشاء متغيّر جديد وإعادة استعمال متغيّرٍ محيط.
لذلك أفضّل التصريح الصريح بالمتغيّرات، ولهذا تشترطه Lox.