ترجمة التعبيرات
في منتصف رحلة حياتي وجدتُ نفسي داخل غابة مظلمة ضاع فيها الطريق المستقيم.
دانتي أليغييري، الجحيم
هذا الفصل مثير لسببٍ واحد، لا اثنين، بل ثلاثة. أولًا، فهو يوفّر المقطع الأخير من مسار التنفيذ في آلتنا الافتراضية. وبمجرد وضعه في مكانه، نستطيع أن نوصّل شيفرة المستخدم الأصلية من المسح الضوئي وصولًا إلى تنفيذها.
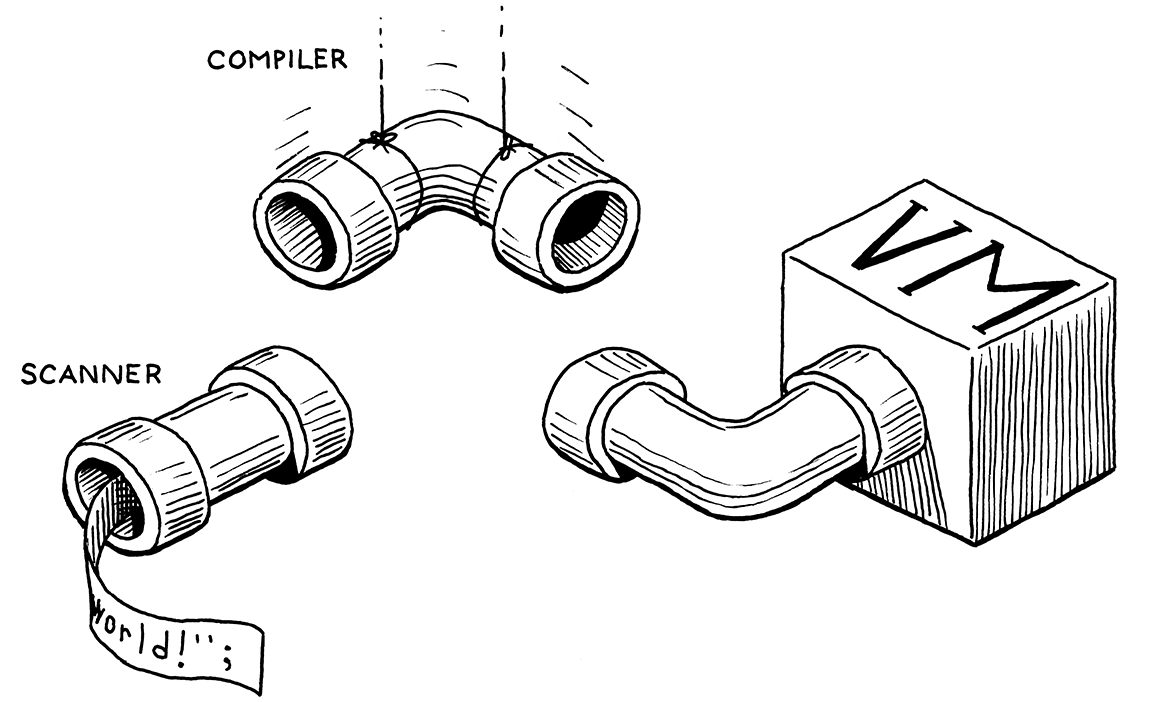
ثانيًا، سنحصل على كتابة مصرّف حقيقي، صادق تمامًا. فهو يحلّل شيفرة المصدر ويُخرج سلسلة منخفضة المستوى من التعليمات الثنائية. صحيح، إنّه شيفرة بايت (bytecode) وليست مجموعة تعليمات أصلية لإحدى الشرائح، لكنه أقرب كثيرًا إلى المعدن ممّا كان عليه jlox. نحن على وشك أن نصير مهوسي لغات برمجة حقيقيّين.
وثالثًا، وأخيرًا، بصفتي سأعرض عليكم واحدًا من خوارزميّاتي المفضّلة على الإطلاق: "تحليل تعابير أسبقية المعاملات التنازلي" لـ Vaughan Pratt. إنها أنيق طريقة أعرفها لتحليل التعابير. فهي تتعامل برشاقة مع المعاملات السابقة (prefix) واللاحقة (postfix) والوسطية (infix) والمختلطة (mixfix)، وأيّ شكل من أشكال اللاحقة تريده. وهي تتعامل مع الأسبقية والترابط (associativity) دون أيّ عناء. أحبّها.
وكما جرت العادة، قبل أن نصل إلى الأشياء الممتعة، لدينا بعض التهيّجات لنُنهيها. عليك أن تأكل الخضار قبل أن تحصل على الحلوى. أولًا، لنُلقِ تلك الهيكل المؤقّت الذي كتبناه لاختبار الماسح ونستبدله بشيء أكثر نفعًا.
^code interpret-chunk (1 before, 1 after)
ننشئ قطعة جديدة فارغة ونمرّرها إلى المصرّف. سيأخذ المصرّف برنامج المستخدم ويملأ
القطعة بشيفرة بايت. على الأقلّ، هذا ما سيفعله إن كان البرنامج خاليًا من أخطاء التجميع.
وإن صادف خطأ، فإنّ compile() تُرجِع false ونتخلّص من القطعة غير الصالحة.
وإلا، نُرسل القطعة المكتملة إلى الآلة الافتراضية لتُنفَّذ. وحين تنتهي الآلة الافتراضية،
نحرّر القطعة وننتهي. وكما ترى، فإنّ توقيع compile() أصبح مختلفًا الآن.
^code compile-h (2 before, 2 after)
نمرّر فيها القطعة التي سيكتب فيها المصرّف الشيفرة، ثم تُرجِع compile() ما إذا كان
التجميع قد نجح أم لا. ونجري التغيير نفسه في التوقيع داخل التنفيذ.
^code compile-signature (2 before, 1 after)
ذلك الاستدعاء لـ initScanner() هو السطر الوحيد الذي يبقى من هذا الفصل. انزع الشيفرة
المؤقّتة التي كتبناها لاختبار الماسح واستبدلها بهذه الأسطر الثلاثة:
^code compile-chunk (1 before, 1 after)
الاستدعاء لـ advance() يُشغّل "المضخة" في الماسح. سنرى ما يفعله قريبًا. ثم نحلّل
تعبيرًا واحدًا. لسنا سننفّذ التصريحات بعد، لذا فهذه هي المجموعة الوحيدة من القواعد
التي ندعمها. وسنعود إلى هذا حين نضيف التصريحات بعد فصول قليلة. وبعد أن
نترجم التعبير، ينبغي أن نكون عند نهاية شيفرة المصدر، لذا نتحقّق من رمز EOF الحارس.
سنقضي بقية الفصل في جعل هذه الدالة تعمل، وخاصة ذلك الاستدعاء الصغير لـ expression().
عادةً، لقفزنا مباشرةً إلى تعريف تلك الدالة ووشغّلنا التقدّم عبر التنفيذ عبر التنفيذ من الأعلى إلى الأسفل.
هذا الفصل مختلف. تقنية Pratt في التحليل بسيطة إلى حدٍّ لافت بمجرّد أن تحملها كلّها في ذهنك، لكنّ تقسيمها إلى قطع صغيرة الحجم هو مسألة دقيقة قليلًا. وهي عودية بالطبع، وهذا جزء من المشكلة. لكنها أيضًا تعتمد على جدول بيانات كبير. وبينما نبني الخوارزمية، ينمو ذلك الجدول بأعمدة إضافية.
لا أريد أن أعود إلى نحو أربعين سطرًا من الشيفرة في كل مرّة نوسّع فيها الجدول. لذا سنعمل على التقدّم نحو قلب المحلّل من الخارج ونغطي كل الأجزاء المحيطة قبل أن نصل إلى القلب اللذيذ. سيتطلّب هذا قدرًا أكبر من الصبر ومساحة ذهنية مؤقّتة مقارنةً بمعظم الفصول، لكنّه أفضل ما فعله.
التجميع أحادي التمريرة
لدى المصرّف عملان تقريبًا. فهو يحلّل شيفرة المستخدم الأصلية ليفهم معناها. ثم يأخذ تلك المعرفة ويُخرج تعليمات منخفضة المستوى تُنتج الدلالات نفسها. تقسّم كثير من اللغات هذين الدورين إلى تمريرتين منفصلتين في التنفيذ. فيُنتج المحلّل شجرة تحليل مجرّد (AST) -- تمامًا كما يفعل jlox -- ثم يعبر مولّد الشيفرة على تلك الشجرة ويُخرج شيفرة الهدف.
في clox، نتخذ نهجًا قديم الطراز وندمج هاتين التمريرتين في واحدة. في الزمن القديم، كان مخترقو اللغات يفعلون ذلك لأنّ الحواسيب لم تكن تملك ذاكرة كافية لتخزين شجرة تحليل كاملة لملف مصدر. ونحن نفعل ذلك لأنّه يبقي مصرّفنا أبسط، وهذا أصلٌ حقيقي عند البرمجة بلغة C.
المصرّفات أحادية التمريرة مثل التي سنبنيها لا تناسب كل اللغات. ولأنّ المصرّف يملك رؤية ضيّقة (peephole) لبرنامج المستخدم أثناء توليد الشيفرة، فلا بدّ أن تُصمَّم اللغة بحيث لا تحتاج إلى سياق محيط كبير لفهم قطعة صياغة بعينها. ولحسن الحظ، فإنّ Lox مناسبة تمامًا لذلك.
ما يعنيه هذا من الناحية العملية هو أنّ وحدة "المصرّف" في C لدينا تملك وظائف ستتعرّفها من jlox للتحليل -- استهلاك الرموز، ومطابقة أنواع الرموز المتوقّعة، وهكذا. كما أنّها تملك دوالّ لتوليد الشيفرة -- إصدار شيفرة البايت وإضافة الثوابت إلى القطعة الهدف. (وهذا يعني أنّني سأستخدم "التحليل" و"الترجمة" تبادليًا في هذا الفصل والفصول اللاحقة.)
سنبني أولًا نصفي التحليل وتوليد الشيفرة. ثم نخيطهما معًا بالشيفرة في الوسط التي تستخدم تقنية Pratt لتحليل قواعد Lox الخاصة وإخراج شيفرة البايت الصحيحة.
تحليل الرموز
أولًا، النصف الأمامي من المصرّف. ينبغي أن يبدو اسم هذه الدالة مألوفًا.
^code advance (1 before)
تمامًا كما في jlox، فهي تتقدّم خطوةً للأمام عبر تدفّق الرموز. تطلب من الماسح الرمز
التالي وتخزّنه لاستخدامه لاحقًا. وقبل ذلك، تأخذ الرمز current القديم وتخزّنه في حقل
previous. سيفيدنا ذلك لاحقًا كي نتمكّن من الوصول إلى اللمحة بعد أن نطابق رمزًا.
الشيفرة التي تقرأ الرمز التالي ملفوفة في حلقة. تذكّر أنّ ماسح clox لا يُبلّغ عن أخطاء معجمية. وبدلًا من ذلك، ينشئ رموز خطأ خاصة ويترك للمحلّل الإبلاغ عنها. نحن نفعل ذلك هنا.
نستمر في الحلقة، ونقرأ الرموز ونُبلّغ عن الأخطاء، حتى نصل إلى رمز ليس خطأً أو ننتهي. وبذلك يرى بقية المحلّل رموزًا صالحة فقط. ويُخزَّن الرمز الحالي والسابق في هذه البنية:
^code parser (1 before, 2 after)
وكما فعلنا في الوحدات الأخرى، لدينا متغيّر عامّ واحد من هذا النوع من البنى، لذا لا نحتاج إلى تمرير الحالة من دالة إلى أخرى في المصرّف.
معالجة أخطاء الصياغة
إن سلّمنا الماسح رمز خطأ، فنحتاج فعلًا إلى إبلاغ المستخدم. ويحدث ذلك باستخدام هذا:
^code error-at-current
نستخرج الموضع من الرمز الحالي كي نخبر المستخدم أين وقع الخطأ ونمرّره إلى errorAt().
وفي أغلب الأوقات، سنُبلّغ عن خطأ في موضع الرمز الذي استهلكناه للتوّ، لذا نمنح هذه
الدالة الأخرى الاسم الأقصر:
^code error
العمل الفعلي يحدث هنا:
^code error-at
أولًا، نطبع أين وقع الخطأ. نحاول أن نعرض اللمحة إن كانت مقروءة للإنسان. ثم نطبع رسالة
الخطأ نفسها. وبعد ذلك، نضبط عَلَم hadError هذا. وهو يسجّل ما إذا كان قد وقعت أيّ
أخطاء أثناء التجميع. وهذا الحقل يعيش أيضًا في بنية المحلّل.
^code had-error-field (1 before, 1 after)
ذكرتُ في وقت سابق أنّ compile() ينبغي أن تُرجِع false إن وقع خطأ. والآن يمكننا أن
نجعلها تفعل ذلك.
^code return-had-error (1 before, 1 after)
لديّ عَلَم آخر أُقدّمه لمعالجة الأخطاء. نريد تفادي ستوليد الأخطاء المتتالية. إن كان لدى المستخدم خطأ في شيفرته والمحلّل لا يعرف أين يقف في القواعد، فإنّنا لا نريده أن يقذف كومةً كاملة من أخطاء المتابعة عديمة المعنى بعد الخطأ الأوّل.
أصلحنا ذلك في jlox باستخدام وضع الهلع في استعادة الأخطاء (panic mode error recovery). وفي المفسّر المكتوب بلغة Java، كنا نُلقي استثناءً للخروج من كل شيفرة المحلّل حتى نصل إلى نقطة يمكننا عندها تخطّي الرموز وإعادة التزامن. ولا نملك استثناءات في C. وبدلًا من ذلك، سنقوم بشيء من "الدخان والمرايا" (smoke and mirrors). نضيف عَلَمًا نتتبّع به ما إذا كنّا حاليًا في وضع الهلع.
^code panic-mode-field (1 before, 1 after)
حين يقع خطأ، نضبطه.
^code set-panic-mode (1 before, 1 after)
بعد ذلك، نتابع الترجمة كالمعتاد وكأنّ الخطأ لم يقع قطّ. لن تُنفَّذ شيفرة البايت أبدًا، لذا فمتابعة العمل بلا ضرر. والحيلة أنّه ما دام عَلَم وضع الهلع مضبوطًا، فإنّنا نكتفي بكبْت أيّ أخطاء أخرى يُكتشف.
^code check-panic-mode (1 before, 1 after)
هناك احتمال كبير أن يخرج المحلّل عن المسار، لكنّ المستخدم لن يعلم لأنّ الأخطاء كلّها تُبتلع. وينتهي وضع الهلع حين يصل المحلّل إلى نقطة تزامن. بالنسبة إلى Lox، اخترنا حدود التصريحات، لذا حين نضيفها لاحقًا إلى مصرّفنا، سنمسح العَلَم هناك.
هذه الحقول الجديدة تحتاج إلى تهيئة.
^code init-parser-error (1 before, 1 after)
ولعرض الأخطاء، نحتاج إلى ترويسة معيارية.
^code compiler-include-stdlib (1 before, 2 after)
وهناك دالة تحليل أخيرة، صديق قديم آخر من jlox.
^code consume
هي مشابهة لـ advance() في أنّها تقرأ الرمز التالي. لكنها تتحقّق أيضًا من أنّ للرمز
نوعًا متوقَّعًا. فإن لم يكن كذلك، فإنّها تُبلّغ عن خطأ. وهذه الدالة هي أساس معظم أخطاء
الصياغة في المصرّف.
حسنًا، يكفي من الواجهة الأمامية الآن.
إصدار شيفرة البايت
بعد أن نحلّل جزءًا من برنامج المستخدم ونفهمه، تتمثّل الخطوة التالية في ترجمته إلى سلسلة من تعليمات شيفرة البايت. وتبدأ بأبسط خطوة ممكنة: إلحاق بايت واحد بالقطعة.
^code emit-byte
من الصعب تصديق أنّ أشياء عظيمة ستمرّ عبر دالة بهذه البساطة. فهي تكتب البايت المُعطى، الذي قد يكون رمز تشغيل أو مُعاملًا لتعليممة. وهي ترسل معلومات سطر الرمز السابق كي تُربط أخطاء وقت التشغيل بذلك السطر.
القطعة التي نكتب فيها تُمرَّر إلى compile()، لكنّها تحتاج إلى إيجاد طريقها إلى
emitByte(). ولهذا نعتمد على دالة وسيطة كهذه:
^code compiling-chunk (1 before, 1 after)
حاليًا، مؤشّر القطعة مخزّن في متغيّر على مستوى الوحدة كما نخزّن بقية الحالة العامة.
لاحقًا، حين نبدأ بترجمة الدوالّ المعرَّفة من المستخدم، ستصبح فكرة "القطعة الحالية"
أعقد قليلًا. ولكي نتجنّب العودة لتغيير شيفرة كثيرة، أُغلّف تلك المنطق في الدالة
currentChunk().
نُهيّئ هذا المتغيّر الجديد على مستوى الوحدة قبل أن نكتب أيّ شيفرة بايت:
^code init-compile-chunk (2 before, 2 after)
ثم، في النهاية تمامًا، حين ننتهي من ترجمة القطعة، نُنهي الأمور.
^code finish-compile (1 before, 1 after)
وهذا يستدعي هذا:
^code end-compiler
في هذا الفصل، تتعامل آلتنا الافتراضية مع التعبيرات فقط. حين تشغّل clox، فإنّه سيحلّل
تعبيرًا واحدًا ويترجمه وينفّذه، ثم يطبع النتيجة. ولطباعة تلك القيمة، نستخدم مؤقتًا
تعليمة OP_RETURN. لذا نجعل المصرّف يضيف واحدة منها إلى نهاية القطعة.
^code emit-return
وبما أنّنا هنا في الواجهة الخلفية، فلنُسهّل على أنفسنا.
^code emit-bytes
مع الوقت، سيكون لدينا ما يكفي من الحالات التي نحتاج فيها إلى كتابة رمز تشغيل يتبعه مُعامل من بايت واحد، فتستحقّ هذه الدالة المساعِدة أن نعرّفها.
تحليل التعبيرات السابقة
جمّعنا دوالّ التحليل وتوليد الشيفرة الخاصة بنا. والقطعة الناقصة هي الشيفرة في الوسط التي تربط تلك معًا.
الخطوة الوحيدة المتبقية في compile() التي علينا تنفيذها هي هذه الدالة:
^code expression
لسنا مستعدين بعد لتنفيذ كلّ أنواع التعبيرات في Lox. بصراحة، لا نملك حتى القيم المنطقية. في هذا الفصل، سنهتمّ بأربعة فقط:
- قيم عددية حرفية:
123 - أقواس للتجميع:
(123) - نفي أحادي المعامل:
-123 - فرسان الرياضيات الأربعة:
+و-و*و/
بينما نعمل على الدوالّ التي تترجم كلًّا من تلك الأنواع من التعبيرات، سنجمع أيضًا المتطلّبات الخاصة بالمحلّل المبني على جدول الذي يستدعيها.
محلّلات الرموز
في الوقت الحالي، لنركّز على تعبيرات Lox التي يتكوّن كلٌّ منها من رمز واحد فقط. في هذا الفصل، ليست سوى القيم العددية الحرفية، لكنّ هناك المزيد لاحقًا. وإليك كيف يمكننا ترجمتها:
نربط كل نوع رمز بنوع مختلف من التعبيرات. نعرّف دالة لكل تعبير تُخرج شيفرة البايت
المناسبة. ثم نبني مصفوفة من مؤشّرات الدوالّ. تقابل الفهارس في المصفوفة قيم تعداد
TokenType، والدالة عند كل فهرس هي شيفرة ترجمة تعبير من ذلك نوع الرمز.
لترجمة القيم العددية الحرفية، نخزّن مؤشّرًا إلى الدالة التالية عند الفهرس
TOKEN_NUMBER في المصفوفة.
^code number
نفترض أنّ رمز القيمة العددية الحرفية قد استُهلك بالفعل وهو مخزّن في previous. نأخذ
تلك اللمحة ونستخدم مكتبة C القياسية لتحويلها إلى قيمة من النوع double. ثم نولّد الشيفرة
التي تحمّل تلك القيمة باستخدام هذه الدالة:
^code emit-constant
أولًا، نضيف القيمة إلى جدول الثوابت، ثم نُصدر تعليمة OP_CONSTANT تدفعها على المكدّس
وقت التشغيل. ولإدراج مُدخل في جدول الثوابت، نعتمد على:
^code make-constant
معظم العمل يقع في addConstant()، التي عرّفناها في فصل سابق. فهي تضيف
القيمة المُعطاة إلى نهاية جدول ثوابت القطعة وتُرجِع فهرسها. ومهمّة الدالة الجديدة هي
في معظمها التأكّد من ألّا يكون لدينا ثوابت كثيرة أكثر من اللازم. وبما أنّ تعليمة
OP_CONSTANT تستخدم بايتًا واحدًا لمُعامل الفهرس، يمكننا تخزين وتحميل ما يصل إلى 256 ثابتًا في القطعة.
هذا كل ما يلزم في الأساس. شريطة وجود شيفرة مناسبة تستهلك رمز TOKEN_NUMBER، وتبحث
عن number() في مصفوفة مؤشّرات الدوالّ، ثم تستدعيها، نستطيع الآن ترجمة القيم العددية
الحرفية إلى شيفرة بايت.
الأقواس للتجميع
كان مصفوفة مؤشّرات دوالّ التحليل الخيالية لدينا رائعة لو كان كل تعبير بطول رمز واحد
فحسب. للأسف، معظمها أطول. لكنّ تعبيرات كثيرة تبدأ برمز معيّن. نسمّي هذه تعبيرات
سابقة (prefix). مثلًا، حين نحلّل تعبيرًا ويكون الرمز الحالي هو (، نعرف أنّنا ننظر
إلى تعبير تجميع بين قوسين.
يتبيّن أنّ مصفوفة مؤشّرات دوالّنا تتعامل مع تلك أيضًا. فدالة التحليل الخاصة بنوع تعبير يمكنها استهلاك أيّ رموز إضافية تشاء، تمامًا كما في المحلّل العودي النازل (recursive descent parser) المعتاد. وإليك كيف تعمل الأقواس:
^code grouping
مرّة أخرى، نفترض أنّ ( الافتتاحية قد استُهلكت بالفعل. ونستدعي بشكل عودي expression() لترجمة التعبير بين القوسين، ثم نحلّل
) الختامية في النهاية.
إلى جانب الواجهة الخلفية، لا شيء حرفيًّا في تعبير التجميع. وظيفته الوحيدة نحوية -- فهو
يتيح لك إدراج تعبير بأسبقية أقلّ حيث يُتوقَّع تعبير بأسبقية أعلى. إذن، لا دلالات وقت
تشغيل له بذاته، ومن ثمّ لا يُصدر أيّ شيفرة بايت. والاستدعاء الداخلي لـ expression()
يتولّى توليد شيفرة البايت للتعبير داخل الأقواس.
النفي الأحادي
الجمع الناقص الأحادي هو أيضًا تعبير سابق، لذا فهو يعمل مع نموذجنا أيضًا.
^code unary
استُهلك رمز - الأولي وهو جالس في parser.previous. نأخذ نوع الرمز من هناك لندوّن
أيّ معامل أحادي نتعامل معه. هذا غير ضروري الآن، لكنه سيجعل المعنى أوضح حين نستخدم هذه
الدالة نفسها لترجمة معامل ! في الفصل التالي.
كما في grouping()، نستدعي expression() عوديًا لترجمة المُعامل. وبعد ذلك، نُصدر شيفرة
البايت التي تنفّذ النفي. قد يبدو غريبًا قليلًا كتابة تعليمة النفي بعد شيفرة
مُعاملها لأنّ - تظهر على اليسار، لكن فكّر في الأمر من حيث ترتيب التنفيذ:
-
نقيّم المُعامل أولًا، فتترك قيمته على المكدّس.
-
ثم نُسقط تلك القيمة ونفيها وندفع النتيجة.
لذا ينبغي أن تُصدر تعليمة OP_NEGATE أخيرًا. وهذا جزء من
مهمّة المصرّف -- تحليل البرنامج بالترتيب الذي يظهر به في شيفرة المصدر وإعادة ترتيبه
إلى الترتيب الذي يحدث به التنفيذ.
هناك مشكلة واحدة في هذه الشيفرة مع ذلك. فدالة expression() التي تستدعيها ستحلّل أيّ
تعبير للمُعامل، بصرف النظر عن الأسبقية. وبمجرد أن نضيف المعاملات الثنائية وصياغات
أخرى، سيفعل ذلك الشيء الخطأ. تأمّل:
-a.b + c;
هنا، ينبغي أن يكون مُعامل - هو تعبير a.b فقط، لا تعبير a.b + c كاملًا. لكن إن
استدعت unary() expression()، فسيبتلع الأخير بكلّ بقية الشيفرة بما فيها +. وسيعامل
- على نحو خاطئ وكأنّ أسبقيته أقلّ من +.
حين نحلّل مُعامل النفي الأحادي -، نحتاج إلى ترجمة التعبيرات عند مستوى أسبقية معيّن أو
أعلى فقط. وفي محلّل jlox النازل العودي، كنا نحقق ذلك باستدعاء دالة التحليل الخاصة بأقلّ
تعبير بأسبقية نريد السماح به (وهي في هذه الحالة call()). وكل دالة تحلّل تعبيرًا
معيّنًا كانت تحلّل أيضًا أيّ تعبيرات ذات أسبقية أعلى، فشمل ذلك بقية جدول الأسبقيات.
دوالّ التحليل مثل number() وunary() هنا في clox مختلفة. فكل واحدة منها تحلّل نوعًا
واحدًا بالضبط من التعبيرات. وهي لا تتتالى لتشمل أنواع تعبيرات ذات أسبقية أعلى أيضًا.
فنحتاج إلى حلّ مختلف، وهكذا يبدو:
^code parse-precedence
هذه الدالة -- بمجرّد أن ننفّذها -- تبدأ من الرمز الحالي وتحلّل أيّ تعبير عند مستوى الأسبقية المُعطى أو أعلى. لدينا بعض التهيئة الأخرى لننهيها قبل أن نكتب جسم هذه الدالة، لكن يمكنك على الأرجح أن تخمّن أنّها ستستخدم ذلك الجدول من مؤشّرات دوالّ التحليل الذي كنت أستعرضه. في الوقت الحالي، لا تقلق كثيرًا بشأن كيفية عملها. ولأخذ "الأسبقية" كمُعامل، نعرّفها عدديًا.
^code precedence (1 before, 2 after)
هذه هي كل مستويات أسبقية Lox مرتّبة من الأدنى إلى الأعلى. وبما أنّ C تمنح قيم التعداد
أرقامًا متزايدة ضمنًا، فهذا يعني أنّ قيمة PREC_CALL أكبر عدديًا من PREC_UNARY.
مثلًا، لنقل إنّ المصرّف واقف على قطعة شيفرة كهذه:
-a.b + c
إن استدعينا parsePrecedence(PREC_ASSIGNMENT)، فإنّها ستحلّل التعبير كاملًا لأنّ + له
أسبقية أعلى من الإسناد. وإن استدعينا بدلًا من ذلك parsePrecedence(PREC_UNARY)، فستترجم
-a.b وتتوقف هناك. فهي لا تستمر عبر + لأنّ الجمع له أسبقية أقلّ من المعاملات
الأحادية.
ومع هذه الدالة في متناول اليد، يصبح ملء الجسم الناقص لـ expression() أمرًا تافهًا.
^code expression-body (1 before, 1 after)
نحلّل ببساطة أدنى مستوى أسبقية، وهو ما يشمل كل التعبيرات ذات الأسبقية الأعلى أيضًا. والآن، لترجمة مُعامل تعبير أحادي، نستدعي هذه الدالة الجديدة ونحدّها بالمستوى المناسب:
^code unary-operand (1 before, 2 after)
نستخدم أسبقية المعامل الأحادي PREC_UNARY الخاصة به للسماح بتعبيرات أحادية متداخلة مثل !!doubleNegative. وبما أنّ المعاملات الأحادية لها
أسبقية عالية إلى حدٍّ ما، فإنّ ذلك يستبعد على نحو صحيح أمورًا مثل المعاملات الثنائية.
وبمناسبة الحديث عنها...
تحليل التعبيرات الوسطية
المعاملات الثنائية تختلف عن التعبيرات السابقة لأنّها وسطية (infix). أمّا التعبيرات الأخرى، فنعرف ما نحلّله من أول رمز. أمّا التعبيرات الوسطية، فلا نعرف أنّنا في منتصف معامل ثنائي إلا بعد أن نحلّل مُعاملها الأيسر ثم نصطدم برمز المعامل في الوسط.
وإليك مثالًا:
1 + 2
لنمشي على محاولة ترجمته بما نعرفه حتى الآن:
-
نستدعي
expression(). وهي بدورها تستدعيparsePrecedence(PREC_ASSIGNMENT). -
تلك الدالة (بمجرد أن ننفّذها) ترى رمز العدد الأول وتُدرك أنّها تحلّل قيمة عددية حرفية. وهي تسلّم التحكّم إلى
number(). -
تنشئ
number()ثابتًا، وتُصدرOP_CONSTANT، ثم تعود إلىparsePrecedence().
وماذا بعد؟ ينبغي لاستدعاء parsePrecedence() أن يستهلك تعبير الجمع كاملًا، لذا يحتاج
إلى بطريقة ما أن يواصل. ولحسن الحظ، فإنّ المحلّل موجود حيث نحتاجه أن يكون. والآن بعد
أن ترجمنا تعبير العدد الأول، فالرمز التالي هو +. وهذا هو الرمز نفسه بالضبط الذي
تحتاجه parsePrecedence() لتُدرك أنّنا في منتصف تعبير وسطي، ولتستنتج أنّ التعبير الذي
ترجمناه بالفعل هو في الحقيقة مُعامل له.
إذن مصفوفة مؤشّرات الدوالّ الخيالية هذه لا تكتفي بسرد الدوالّ التي تحلّل تعبيرات تبدأ برمز معيّن. وبدلًا من ذلك، إنّها جدول من مؤشّرات الدوالّ. يرتبط عمود مع دوالّ التحليل السابقة بأنواع الرموز. ويرتبط العمود الثاني بدوالّ التحليل الوسطية بأنواع الرموز.
الدالة التي سنستخدمها كمحلّل وسطي لـ TOKEN_PLUS وTOKEN_MINUS وTOKEN_STAR و
TOKEN_SLASH هي هذه:
^code binary
حين تُستدعى دالة محلّل سابقة، يكون الرمز الأولي قد استُهلك بالفعل. أمّا دالة المحلّل الوسطية فحالتها أشدّ -- إذ يكون تعبير المُعامل الأيسر كاملًا قد رُجم بالفعل، ومعاملُه اللاحق قد استُهلك.
إنّ ترجمة المُعامل الأيسر أولًا ينتهي إلى نتيجة طيّبة. فهو يعني أنّه وقت التشغيل ستُنفَّذ تلك الشيفرة أولًا. وحين تعمل، تنتهي القيمة التي تُنتجها على المكدّس. وهناك بالضبط هو المكان الذي سيحتاج إليه المعامل الوسطي.
ثم نأتي إلى binary() هنا للتعامل مع بقية المعاملات الحسابية. وهذه الدالة تترجم
المُعامل الأيمن، تمامًا كما تترجم unary() مُعاملها اللاحق. وأخيرًا، تُصدر تعليمة
الشيفرة بايت التي تنفّذ العملية الثنائية.
عند التشغيل، ستنفّذ الآلة الافتراضية شيفرة المُعامل الأيسر والأيمن، بذلك الترتيب، تاركةً قيمهما على المكدّس. ثم تنفّذ تعليمة المعامل. وهي تُسقط القيمتين وتحسب العملية وتدفع النتيجة.
الشيفرة التي غالبًا ما لفتت انتباهك هنا هي سطر getRule() ذاك. حين نحلّل المُعامل
الأيمن، نحتاج إلى معالجة الأسبقية. خذ تعبيرًا كهذا:
2 * 3 + 4
حين نحلّل المُعامل الأيمن لتعبير *، نحتاج إلى التقاط 3 فقط، لا 3 + 4، لأنّ + له
أسبقية أقلّ من *. يمكننا أن نعرّف دالة منفصلة لكل معامل ثنائي. وكل منها تستدعي
parsePrecedence() وتمرّر مستوى الأسبقية الصحيح لمُعاملها.
لكنّ ذلك مملّ نوعًا ما. فمُعامل كل معامل ثنائي يدويّ له أسبقية أعلى بمستوى واحد من أسبقيته. يمكننا أن نبحث عن ذلك ديناميكيًا بأمر
getRule() هذا الذي سنصل إليه قريبًا. وباستخدامه، نستدعي parsePrecedence() بمستوى
أعلى بنسبة مستوى واحد من مستوى هذا المعامل.
بهذه الطريقة، يمكننا استخدام دالة binary() واحدة لكل المعاملات الثنائية رغم اختلاف
أسبقياتها.
محلّل Pratt
لدينا الآن جميع قطع وأجزاء المصرّف مرتّبة. لدينا دالة لكل إنتاج من إنتاجات القواعد:
number() وgrouping() وunary() وbinary(). ولا يزال علينا تنفيذ
parsePrecedence() وgetRule(). كما نعرف أنّنا نحتاج إلى جدول يتيح لنا، بناءً على نوع
الرمز، أن نجد
-
الدالة التي تترجم تعبيرًا سابقًا يبدأ برمز من ذلك النوع،
-
الدالة التي تترجم تعبيرًا وسطيًا يكون مُعامله الأيسر يليه رمز من ذلك النوع، و
-
أسبقية تعبير وسطي يستخدم ذلك الرمز معاملًا.
نغلّف هذه الخصائص الثلاث في بنية صغيرة تمثّل صفًّا واحدًا في جدول المحلّل.
^code parse-rule (1 before, 2 after)
نوع ParseFn هو تعريف نوع بسيط (typedef) لنوع دالة لا تأخذ مُعاملات ولا تُرجع شيئًا.
^code parse-fn-type (1 before, 2 after)
الجدول الذي يقود محلّلنا كله هو مصفوفة من ParseRules. لقد تحدّثنا عنه طوال الوقت، وأخيرًا ستحصل على رؤيته.
^code rules
يمكنك أن ترى كيف أُدرجت grouping وunary في عمود المحلّل السابق لأنواع رمزيها. وفي
العمود الثاني، سُلكت binary إلى معاملات الأسبقية الحسابية الأربعة. وللمعاملات
الوسطية تلك أيضًا أُحدِّدت أسبقيتها في العمود الأخير.
عدا ذلك، فإنّ بقية الجدول مليئة بـ NULL وPREC_NONE. معظم تلك الخلايا الفارغة موجودة
لأنّه لا يوجد تعبير مرتبط بتلك الرموز. فلا يمكنك بدء تعبير بـ else مثلًا، و}
ستكون معاملًا وسطيًا مربكًا إلى حدٍّ كبير.
لكنّنا لم نملأ القواعد بأكملها بعد. في الفصول اللاحقة، ومع إضافة أنواع جديدة من التعبيرات، ستُملأ بعض تلك الخانات بدوالّ. وأحد الأشياء التي أحبّها في هذا النهج في التحليل أنّه يجعل من السهل جدًّا أن ترى أيّ الرموز تستخدمه القواعد وأيّها متاح.
الآن وقد صار لدينا الجدول، فإنّنا مستعدّون أخيرًا لكتابة الشيفرة التي تستخدمه. وهنا
يأتي محلّل Pratt إلى الحياة. وأبسط دالة نعرّفها هي getRule().
^code get-rule
إنّها ببساطة تُرجِع القاعدة عند الفهرس المُعطى. وتستدعيها binary() للبحث عن أسبقية
المعامل الحالي. وتوجد هذه الدالة خصيصًا للتعامل مع دورة تصريح في شيفرة C. فتُعرَّف binary()
قبل جدول القواعد كي يتمكّن الجدول من تخزين مؤشّر إليها. وهذا يعني أنّ جسم binary() لا يستطيع
الوصول إلى الجدول مباشرةً.
وبدلًا من ذلك، نغلّف البحث في دالة. يتيح لنا ذلك أن نصرّح مسبقًا بـ getRule() قبل
تعريف binary()، ثمّ نعرّف getRule() بعد الجدول. وسنحتاج إلى بضع صرائح مسبقة أخرى
للتعامل مع كون قواعدنا عودية، لذا لنُخرجها جميعًا من الطريق.
^code forward-declarations (2 before, 1 after)
إن كنت تتابع معي وتنفّذ clox بنفسك، فانتبه جيدًا للتعليقات الصغيرة التي تخبرك أين تضع مقتطفات الشيفرة هذه. لكن لا تقلق إن أخطأت، فمصرّف C سيكون سعيدًا بإخبارك.
التحليل بالأسبقية
الآن أصبحنا نصل إلى الأشياء الممتعة. العازف الذي ينظّم جميع دوالّ التحليل التي عرّفناها
هو parsePrecedence(). لنبدأ بتحليل التعبيرات السابقة.
^code precedence-body (1 before, 1 after)
نقرأ الرمز التالي ونبحث عن ParseRule المقابلة. إن لم يكن هناك محلّل سابق، فلا بدّ أن يكون الرمز خطأ صياغة. نُبلّغ عن ذلك ونعود إلى المستدعي.
وإلا، فإنّنا نستدعي دالة التحليل السابقة تلك ونتركها تعمل. فذلك المحلّل السابق يترجم بقية التعبير السابق، مستهلكًا أيّ رموز أخرى يحتاجها، ثم يعود إلى هنا. التعبيرات الوسطية هي حيث تصبح الأمور مثيرة للاهتمام بما أنّ الأسبقية تدخل على المسرح. والتنفيذ بسيط إلى حدٍّ لافت.
^code infix (1 before, 1 after)
هذا كل شيء. حقًا. وإليك كيف تعمل الدالة بأكملها: في بداية parsePrecedence()، نبحث
عن محلّل سابق للرمز الحالي. والرمز الأول سيكون دائمًا حسب التعريف جزءًا من نوع ما من
التعبيرات السابقة. وقد يتبيّن أنّه متداخل كمُعامل داخل تعبير وسطي واحد أو أكثر، لكنّك
وأنت تقرأ الشيفرة من اليسار إلى اليمين، فإنّ أول رمز تصادفه يكون دائمًا جزءًا من تعبير
سابق.
بعد تحليل ذلك، والذي قد يستهلك رموزًا إضافية، يكون التعبير السابق قد انتهى. والآن نبحث
عن محلّل وسطي للرمز التالي. إن وجدنا واحدًا، فهذا يعني أنّ التعبير السابق الذي رجمناه
بالفعل قد يكون مُعاملًا له. لكن ذلك فقط إن كان استدعاء parsePrecedence() يحمل
precedence منخفضة بما يكفي للسماح بذلك المعامل الوسطي.
إن كان الرمز التالي ذا أسبقية منخفضة جدًّا، أو لم يكن معاملًا وسطيًا أصلًا، فقد انتهينا.
فقد حلّلنا أكبر قدر ممكن من التعبير. وإلا، نستهلك المعامل ونسلّم التحكّم إلى المحلّل
الوسطي الذي وجدناه. وهو يستهلك أيّ رموز أخرى يحتاجها (عادةً المُعامل الأيمن) ثم يعود
إلى parsePrecedence(). ثم نعود في الحلقة ونرى إن كان الرمز التالي هو أيضًا معامل
وسطي صالح يمكنه أن يأخذ التعبير السابق كاملًا كمُعامل له. نواصل الحلقة هكذا، نمضغ
المعاملات الوسطية ومُعاملاتها حتى نصل إلى رمز ليس معاملًا وسطيًا أو ذا أسبقية منخفضة
جدًّا فنتوقف.
هذا قدرٌ كبير من النثر، لكن إن كنت تريد أن تندمج عقلًا مع Vaughan Pratt وتفهم الخوارزمية فهمًا كاملًا، فتنقّل عبر المحلّل في مصحّحك وهو يعمل على بعض التعبيرات.ربما يساعدك رسمٌ بياني. ليس هناك سوى حفنة من الدوالّ، لكنها مترابطة بشكل مذهل:
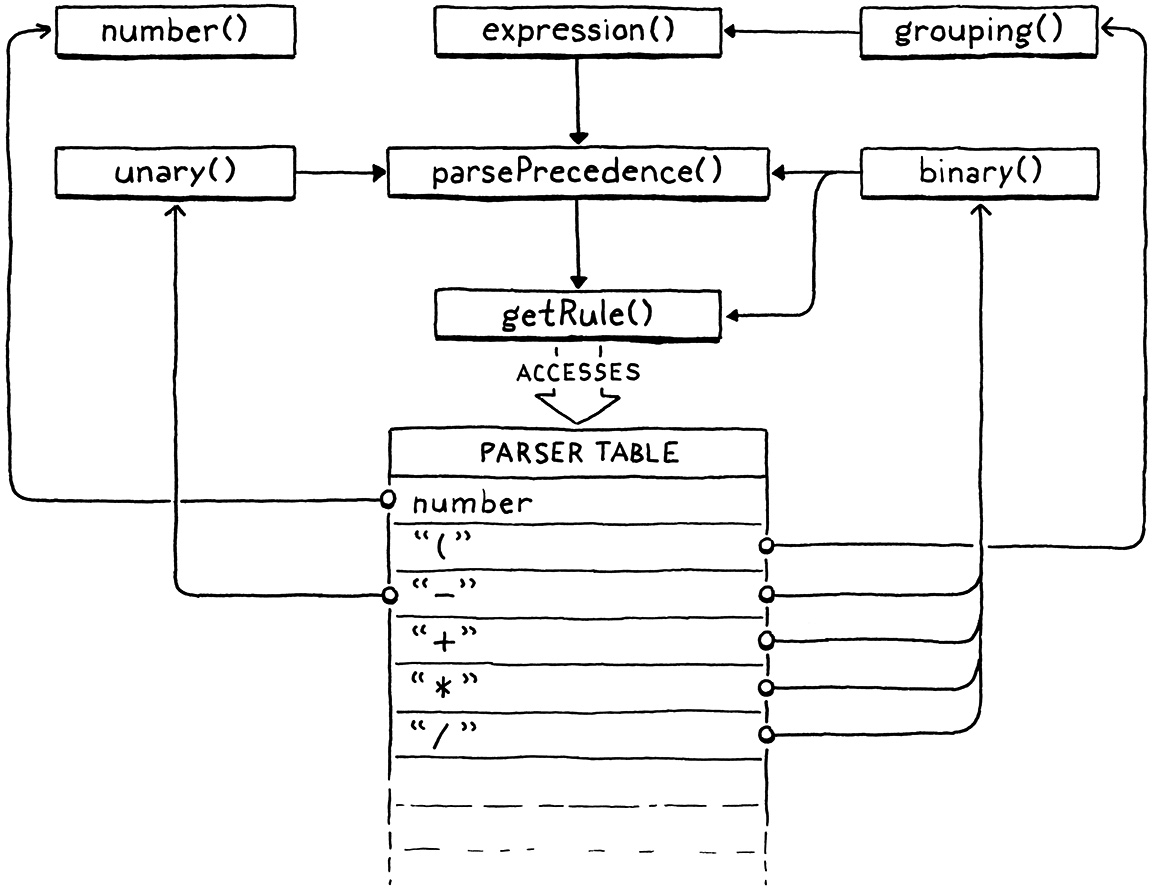
لاحقًا، سنحتاج إلى تعديل الشيفرة في هذا الفصل للتعامل مع الإسناد. لكن بخلاف ذلك، فإنّ
ما كتبناه يغطي كل احتياجاتنا لتجميع التعبيرات لبقية الكتاب. سنُدرج دوالّ تحليل إضافية في
الجدول حين نضيف أنواعًا جديدة من التعبيرات، لكنّ parsePrecedence() مكتملة.
تفريغ القطع
بما أنّنا هنا في قلب مصرّفنا، ينبغي أن نضيف بعض أدوات القياس. ولمساعدة تصحيح شيفرة البايت المولَّدة، سنضيف دعمًا لتفريغ القطعة بمجرّد أن ينتهي المصرّف. كان لدينا بعض التسجيل المؤقّت في وقت سابق حين كتبنا القطعة يدويًا. والآن سنضع شيفرة حقيقية كي نستطيع تفعيلها متى أردنا.
وبما أنّ هذا ليس للمستخدم النهائي، فإنّنا نخفيه خلف عَلَم.
^code define-debug-print-code (2 before, 1 after)
حين يُعرَّف ذلك العَلَم، نستخدم وحدتنا "debug" القائمة لطباعة شيفرة بايت القطعة.
^code dump-chunk (1 before, 1 after)
نحن نفعل ذلك فقط إن كانت الشيفرة خالية من الأخطاء. فبعد خطأ صياغة، يواصل المصرّف عمله لكنّه في حالة غريبة نوعًا ما وقد يُنتج شيفرة معطوبة. وهذا غير ضارّ لأنّها لن تُنفَّذ، لكنّنا سنربك أنفسنا فقط إن حاولنا قراءتها.
وأخيرًا، للوصول إلى disassembleChunk()، نحتاج إلى include لترويستها.
^code include-debug (1 before, 2 after)
نجحنا! كان هذا آخر قسم رئيسي نركّبه في مسار التجميع والتنفيذ في آلتنا الافتراضية. مفسّرنا لا يبدو كشيء كثير، لكنّ في داخله مسحٌ ضوئي، وتحليل، وترجمة إلى شيفرة بايت، وتنفيذ.
أشغّل الآلة الافتراضية واكتب تعبيرًا. إن فعلنا كل شيء على نحو صحيح، ينبغي أن تحسب النتيجة وتطبعها. لدينا الآن آلة حاسبة رياضية مفرطة في الهندسة. ولدينا الكثير من ميزات اللغة لنضيفها في الفصول القادمة، لكنّ الأساس في مكانه.
التحدّيات
-
لفهم المحلّل فهمًا حقيقيًّا، عليك أن ترى كيف ينفّذ المسار عبر دوالّ التحليل المثيرة للاهتمام --
parsePrecedence()ودوالّ المحلّل المخزّنة في الجدول. خذ تعبير (غريبًا) هذا:(-1 + 2) * 3 - -4اكتب تتبّعًا لكيفية استدعاء تلك الدوالّ. بيّن الترتيب الذي تُستدعى به، وأيّها تستدعي أيًّا، والمُعاملات المُمرَّرة إليها.
-
صفّ ParseRule الخاص بـ
TOKEN_MINUSيحتوي مؤشّري دالّتَي تحليل سابق ووسطي معًا. ذلك لأنّ-معاملٌ سابق (نفي أحادي) ومعاملٌ وسطي (طرح) في آنٍ واحد.في لغة Lox الكاملة، ما الرموز الأخرى التي يمكن استخدامها في موضعي السابق والوسيط؟ وماذا عن C أو أيّ لغة أخرى تختارها؟
-
ربما تفكّر في تعبيرات "مختلطة" معقّدة لها أكثر من مُعاملين يفصل بينها رموز. مشغّل الشرط أو المشغّل "الثلاثي" في C، وهو
?:، أحد الأمثلة المعروفة على نطاق واسع.أضف دعمًا لذلك المشغّل إلى المصرّف. لا يلزمك توليد أيّ شيفرة بايت، يكفي أن تُظهر كيف ستربطه بالمحلّل وتعالج المُعاملات.
ملاحظة تصميم: هذا تحليل فحسب
سأدّعي هنا أمرًا لن يكون محبوبًا لدى بعض أهل المصرّفات واللغات. لا بأس إن لم توافقني. أمّا أنا شخصيًّا، فأتعلّم أكثر من الآراء القوية التي لا أوافقها ممّا أتعلّمه من عدّة صفحات من التهوين والتلغيم. وادّعائي هو أنّ التحليل لا يهمّ.
على مدى السنين، انغمس كثير من أهل لغات البرمجة، ولا سيما في الأكاديمية، في المحلّلات وأخذوها على محمل الجدّ. في البداية، كان أهل المصرّفات هم من انغمسوا في مصرّفات المصرّفات وLALR وأمورًا من هذا القبيل. النصف الأول من كتاب التنين رسالة حبّ طويلة إلى عجائب مولّدات المحلّلات.
لاحقًا، انغمس أهل البرمجة الوظيفية في مُركِّبات المحلّل (parser combinators)، ومحلّلات packrat، وأمور من كلّ هذا النوع. لأنّ، واضحًا، إن أعطيت مبرمجًا وظيفيًّا مسألة، فأول ما سيفعله هو إخراج جيب مليء بدوالّ راقية الطرافة.
وفي عالم الرياضيات وتحليل الخوارزميات، هناك إرثٌ طويل من البحث في إثبات استهلاك الزمن والذاكرة لمختلف تقنيات التحليل، وتحويل مشكلات التحليل إلى مشكلات أخرى والعكس، وإسناد أصناف التعقيد إلى قواعد مختلفة.
على مستوى ما، هذا الأمر مهمّ. إن كنت تنفّذ لغة، فأنت تريد بعض الضمانة بأنّ محلّلك لن ينفجر أُسّيًا ويأخذ 7,000 سنة لتحليل حالة حدّية غريبة في القواعد. نظريّة المحلّلات تمنحك هذا الحدّ. وكتمرين ذهني، فإنّ تعلّم تقنيات التحليل ممتع ومجزي أيضًا.
لكن إن كان هدفك مجرّد تنفيذ لغة وإتاحتها للمستخدمين، فإنّ كلّ ذلك لا يهمّ تقريبًا. من السهل جدًّا أن تُحمّس بسبب شغف الذين يهتمّون به وتفكّر أنّ واجهتك الأمامية تحتاج إلى شيء من نوع مصنع المُركِّبات المولَّد الفاخر. لقد رأيت أشخاصًا يحرقون أوقاتًا هائلة في كتابة محلّلهم وإعادة كتابته باستخدام أيّ مكتبة أو تقنية رائجة اليوم.
هذا وقت لا يضيف أيّ قيمة لح حياة مستخدمك. إن كنت تحاول فقط إنجاز محلّلك، فاختر إحدى التقنيات المعيارية، واستخدمها، ثمّ انتقل إلى ما بعد ذلك. فنزول عودي، وتحليل Pratt، ومولّدات المحلّلات الشائعة مثل ANTLR أو Bison، كلّها خيارات صالحة.
خذ الوقت الإضافي الذي وفّرته عدم إعادة كتابة شيفرة التحليل الخاصة بك، وأنفقه على تحسين رسائل أخطاء التجميع التي يعرضها مصرّفك للمستخدمين. المعالجة الجيدة للأخطاء وإبلاغها أنفع للمستخدمين من أيّ شيء آخر تقريبًا يمكنك إنفاق وقتك عليه في الواجهة الأمامية.