تمثيل الشيفرة
لسكان الغابة، لكلّ نوعٍ من أنواع الأشجار صوته إضافةً إلى مميزاته. توماس هاردي، تحت شجرة الغابة
في الفصل الأخير، أخذنا الشيفرة المصدرية الخام في صورة سلسلة وحوّلناها إلى تمثيلٍ أعلى مستوى قليلاً: سلسلة من الرموز. أمّا المحلّل النحوي الذي سنكتبه في الفصل التالي فيأخذ تلك الرموز ويحوّلها مرّةً أخرى، إلى تمثيلٍ أغنى وأكثر تعقيداً.
قبل أن نتمكّن من إنتاج ذلك التمثيل، نحتاج إلى تعريفه. وهذا هو موضوع هذا الفصل. وفي الطريق سنُغطّي بعض النظرية حول القواعد الرسمية، ونشعر بالفرق بين البرمجة الوظيفية والبرمجة الموجّهة نحو الأشياء، ونمرّ على نمطَي تصميم، ونقوم ببعض البرمجة البينية (metaprogramming).
قبل أن نفعل كلّ ذلك، فلنركّز على الهدف الرئيسي -- تمثيلٌ للشيفرة. ينبغي أن يكون بسيطاً ينتجه المحلل النحوي، وسهلاً على المفسّر أن يستهلكه. إن لم تكن قد كتبت محلّلاً نحوياً أو مفسّراً من قبل، فهذه المتطلّبات ليست مُبهِرةً تماماً. ربما يساعدك حدسك. ماذا يفعل عقلك حين تلعب دور مفسّر بشريّ؟ كيف تُقيّم ذهنياً تعبيراً حسابياً مثل هذا:
1 + 2 * 3 - 4
ولأنّك تفهم ترتيب العمليات -- أمر "أعفني يا عمّتي سالي" القديم -- فأنت تعرف أنّ الضرب يُقيَّم قبل الجمع أو الطرح. وإحدى طرق تصوّر تلك الأسبقية هي باستعمال شجرة. العقد الورقية أعداد، والعقد الداخلية معاملاتٌ لها فروع لكلٍّ من معاملاتها.
ولتقييم عقدة حسابية، تحتاج إلى معرفة القيم العددية لشجاناتها الفرعية، لذا عليك تقييم تلك أوّلاً. يعني ذلك أن تعمل من الأوراق صعوداً إلى الجذر -- وهو اجتياز بترتيب لاحق (post-order):
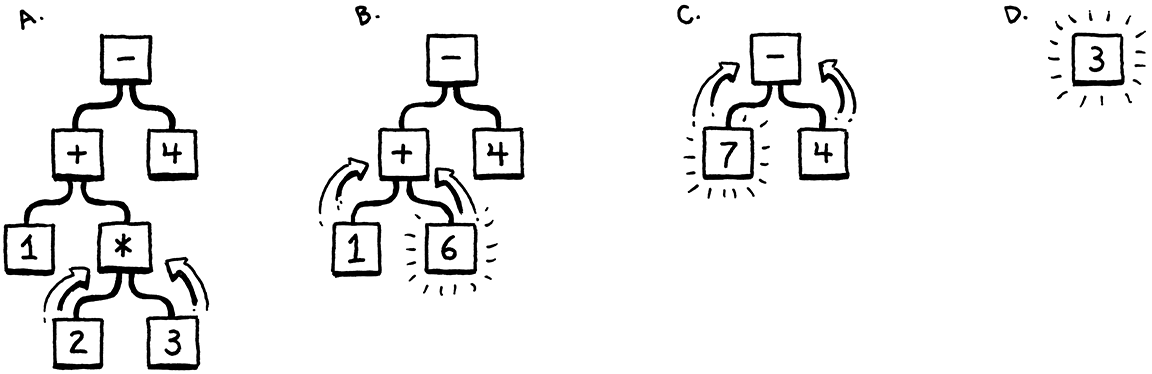
لو أعطيتك تعبيراً حسابياً، لاستطعت رسم إحدى هذه الأشجار بسهولة كبيرة.Sight وبالنظر إلى شجرة، تستطيع تقييمها دون أن تتعرّق. لذا يبدو حدسياً أنّ تمثيلاً قابلاً للاستخدام لشيفرتنا هو شجرة تطابق البنية النحوية -- أي تعشيش المعاملات -- للّغة.
إذن نحتاج إلى أن نكون أدقّ ممّا هي تلك القواعد. وكما في القواعد المعجمية في الفصل الأخير، هناك قدرٌ هائل من النظرية حول القواعد الصياغية. وسندخل في تلك النظرية أكثر قليلاً مما فعلنا عند المسح، لأنّها تتبيّن لتكون أداةً مفيدة في كلّ أنحاء المفسّر. نبدأ بالصعود مستوى في [تسلسل تشومسكي][]...
القواعد الخالية من السياق
في الفصل الأخير، سُمّي الشكل الرسمي الذي استعملناه لتعريف القواعد المعجمية -- أي القواعد التي تحدّد كيف تُجمَّع المحارف في رموز -- لغةً منظَّمة (regular language). وكان ذلك مناسباً لمُحلّلنا المعجمي الذي يُصدر تسلسلاً مسطّحاً من الرموز. لكنّ اللّغات المنظَّمة ليست قويةً بما يكفي للتعامل مع تعبيرات يمكن أن تتداخل بأيّ عمق.
نحتاج إلى مطرقةٍ أكبر، وتلك المطرقة هي قاعدةٍ خالية من السياق (context-free grammar) (CFG). وهي أثقل أداة في صندوق أدوات [القواعد الرسمية][] (formal grammars). فالقاعدة الرسمية تأخذ مجموعةً من القطع الذرّية تسمّيها "أبجديتها". ثمّ تعرّف مجموعةً (عادةً لا نهائية) من "النصوص" التي "تقع في" القاعدة. وكلّ نصّ هو تسلسلُ "حروف" في الأبجدية.
أستعمل كلّ تلك علامات التنصيص لأنّ المصطلحات تصبح مربكة قليلاً حين تنتقل من القواعد المعجمية إلى الصياغية. في قواعد مُحلّلنا المعجمي، تتكوّن الأبجدية من محارف مفردة، والنصوص هي الرموز النصّية الصالحة -- أي "الكلمات" تقريباً. أمّا في القواعد الصياغية التي نتحدّث عنها الآن، فنحن عند مستوى دقّةٍ مختلف. فكلّ "حرف" في الأبجدية أصبح رمزاً كاملاً، و"نصّ" هو تسلسل رموز -- أي تعبيراً كاملاً.
يا إلهي. ربما يساعدنا جدولٌ:
| المصطلح | القواعد المعجمية | القواعد الصياغية | |
| “الأبجدية” هي . . . | → | المحارف | الرموز |
| “نصّ” هو . . . | → | رمزٌ نصّي أو رمز | تعبير |
| ينفّذه . . . | → | المُحلِّل المعجمي | المحلّل النحوي |
مهمّة القاعدة الرسمية هي تحديد أيّ النصوص صالحة وأيّها غير صالح. فلو كنّا نعرّف قاعدةً لجمل إنجليزية، لكان "البيض لذيذ في الصباح" داخل القاعدة، لكن "لذيذ الصباح في هو البيض" على الأرجح لا.
قواعد القواعد
كيف نكتب قاعدةً تحوي عدداً لا نهائياً من النصوص الصالحة؟ لا يمكننا بالطبع أن نعدّدها كلّها. بدلاً من ذلك، ننشئ مجموعةً منتهية من القواعد. ويمكنك أن تفكّر فيها كأنّها لعبةٌ يمكنك "لعبها" في اتجاهَين.
إن بدأتَ بالقواعد، يمكنك استعمالها لتوليد نصوص داخلة في القاعدة. والنصوص المنشأة على هذا النحو تُسمّى مشتقّات (derivations) لأنّ كلّ منها مشتقّ من قواعد القاعدة. وفي كلّ خطوة من خطوات اللعبة، تختار قاعدةً وتتبع ما تخبرك به. معظم المصطلحات المحيطة بالقواعد الرسمية تأتي من لعبها بهذا الاتجاه. وتُسمّى القواعد إنتاجات (productions) لأنّها تنتج نصوصاً في القاعدة.
لكلّ إنتاجٍ في القاعدة الخالية من السياق رأس -- اسمه الاسم -- وجسم، يصف ما يولّده. وفي صورته الخالصة، الجسم مجرّد قائمة من الرموز. وتأتي الرموز بنوعَين واضحَين:
-
الرمز الختامي (terminal) هو حرفٌ من أبجدية القاعدة. ويمكنك أن تفكّر فيه كقيمة حرفية. في القواعد الصياغية التي نعرّفها، الرموز الختامية هي رموزٌ نصّية مفردة -- رموزٌ قادمة من المُحلِّل المعجمي مثل
ifأو1234.وتُسمّى هذه بـ"الرموز الختامية" بمعنى "نقطة النهاية" لأنّها لا تؤدّي إلى أيّ "حركات" إضافية في اللعبة. فأنت تُنتج ذلك الرمز فحسب.
-
الرمز اللا ختامي (nonterminal) هو مرجعٌ مُسمّى إلى قاعدةٍ أخرى في القاعدة. وهو يعني "العب تلك القاعدة وأدرج هنا كلّ ما تنتجه". وبهذه الطريقة تألّف القاعدة.
هناك تحسينٌ أخير: يمكنك أن يكون لديك عدّة قواعد بالاسم نفسه. فحين تصل إلى رمزٍ لا ختامي بهذا الاسم، يُسمح لك باختيار أيّ من تلك القواعد، أيّها يناسب مزاجك.
لنجعل هذا ملموساً، نحتاج إلى طريقة لكتابة قواعد الإنتاج هذه. وقد ظلّ الناس يحاولون تثبيت القواعد النحوية كلّ الطريق إلى _أشته ديَهيَ (Ashtadhyayi) لپانييني، التي رمّزت قواعد اللغة السنسكريتية قبل بضعة آلاف من السنين فقط. ولم يحصل تقدّمٌ يُذكر حتى احتاج جون بَكِس وزملاؤه إلى ترميز لتحديد ALGOL 58 فابتعدوا عن [صيغة بَكِس-ناور][] (BNF). ومنذ ذلك الحين، يستخدم كلٌّ تقريباً صورةً ما من BNF، معدَّلةً على ذوقه.
حاولتُ أن أأتي بشيءٍ نظيف. كلّ قاعدة اسمٌ يليه سهم (→) يليه
تسلسلٌ من الرموز، وينتهي أخيراً بفاصلة منقوطة (;). والرموز
الختامية نصوصٌ مقتبسة، والرموز اللا ختامية كلماتٌ صغيرة.
باستعمال ذلك، إليك قاعدةً لقوائم الفطور:
breakfast  → protein "with" breakfast "on the side" ;
breakfast  → protein ;
breakfast  → bread ;

protein    → crispiness "crispy" "bacon" ;
protein    → "sausage" ;
protein    → cooked "eggs" ;

crispiness → "really" ;
crispiness → "really" crispiness ;

cooked     → "scrambled" ;
cooked     → "poached" ;
cooked     → "fried" ;

bread      → "toast" ;
bread      → "biscuits" ;
bread      → "English muffin" ;
نستطيع استعمال هذه القاعدة لتوليد فطورٍ عشوائي. فلنلعب جولةً
ونرى كيف تعمل. وعرفاً قديماً، تبدأ اللعبة بالقاعدة
الأولى في القواعد، وهي هنا breakfast. ولديها ثلاثة
إنتاجات، ونختار الأوّل منها عشوائياً. تبدو النصّ الناتج هكذا:
protein "with" breakfast "on the side"
نحتاج إلى توسيع الرمز اللا الختامي الأوّل، وهو protein، لذا
نختار إنتاجاً له. فلنختار:
protein → cooked "eggs" ;
ثمّ نحتاج إلى إنتاج لـcooked، فنختار "poached". هذا رمزٌ
ختامي، لذا نضيفه. الآن يبدو نصّنا هكذا:
"poached" "eggs" "with" breakfast "on the side"
الرمز اللا الختامي التالي هو breakfast مرّةً أخرى. فإنّ إنتاج
breakfast الأول الذي اخترناه يشير تعاودياً إلى قاعدة breakfast.
والتعاود في القاعدة علامةٌ جيّدة على أنّ اللّغة المُعرَّفة خالية
من السياق وليست منظَّمة. وعلى وجه التحديد، التعاود الذي يكون فيه
الرمز اللا الختامي المتعاود له إنتاجات على كلا
الجانبين يعني أنّ اللّغة ليست منظَّمة.
كان بإمكاننا أن نواصل اختيار الإنتاج الأوّل لـbreakfast مرّةً
بعد مرّة، لننتج كلّ أنواع الفطور مثل "بيكون مع سجق مع بيض
مُقلّب مع بيكون..." لكنّنا لن نفعل. هذه المرّة سنختار bread.
ولها ثلاثة قواعد، كلٌّ منها يتضمّن رمزاً ختامياً فقط. سنختار
"English muffin".
وبهذا، جُوِّع كلّ رمزٍ لا ختامي في النصّ حتى لم يبقَ فيه إلّا رموز ختامية، فبقي لدينا:
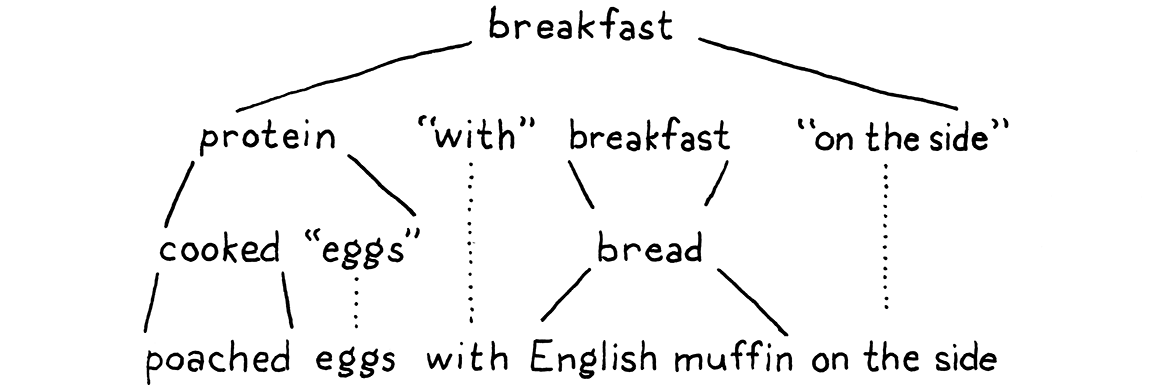
أضف قليلاً من الخبز المشوي وصلصة الهولندياز، وستحصل على بيض بينيديكت.
كلّما صادفنا قاعدة لها عدّة إنتاجات، اخترنا واحداً اعتباطياً. وهذه المرونة هي ما يسمح لعددٍ قليلٍ من قواعد اللغة بأن ترمّز مجموعةً أكبر بشكلٍ توافقي من النصوص. وأدخالُ أن تستدعي قاعدةٌ نفسها -- مباشرةً أو بشكلٍ غير مباشر -- يزيد الأمور أكثر، فيتيح لنا حشر عددٍ لا نهائيّ من النصوص في قاعدةٍ منتهية.
تحسين ترميزنا
حشر مجموعةٍ لا نهائية من النصوص في حفنةٍ من القواعد أمرٌ رائع، لكنّنا لنأخذها خطوةً أبعد. ترميزنا يعمل، لكنّه مُمل. لذا، مثل أيّ مصمّم لغاتٍ جيّد، سنرشّ بعض السكّر الصياغوي فوقه -- أي بعض الترميز الإضافي المريح. وإلى جانب الرموز الختامية واللا ختامية، سنسمح بأنواعٍ أخرى قليلة من التعبيرات في جسم القاعدة:
-
بدلاً من تكرار اسم القاعدة في كلّ مرّة نريد إضافة إنتاجٍ آخر لها، سنسمح بسلسلةِ إنتاجاتٍ يفصل بينها خطٌ رأسي (
|).bread → "toast" | "biscuits" | "English muffin" ; -
إضافةً إلى ذلك، سنسمح بالأقواس للتجميع ثمّ نسمح بـ
|في داخلها لاختيار واحدٍ من سلسلة خيارات في منتصف إنتاج.protein → ( "scrambled" | "poached" | "fried" ) "eggs" ; -
إنّ استعمال التعاود لدعم تسلسلاتٍ متكرّرة من الرموز له نقاوةquite آسِرة، لكنّه عبءٌ نوعاً ما أن نصنع قاعدةً فرعية مُسمّاة في كلّ مرّة نريد فيها حلقة. لذا نستعمل أيضاً لاحقة
*لتسمح بتكرار الرمز أو المجموعة السابقة صفر مرّات أو أكثر.crispiness → "really" "really"* ;
-
لاحقة
+مشابئة، لكنّها تتطلّب أن يظهر الإنتاج السابق مرّةً واحدة على الأقلّ.crispiness → "really"+ ; -
أمّا اللاحقة
?فهي لإنتاجٍ اختياري. فشيء ما قبلها يمكن أن يظهر صفر مرّة أو مرّةً واحدة، لا أكثر.breakfast → protein ( "with" breakfast "on the side" )? ;
مع كلّ تلك الرتوش الصياغية، تتقلّص قاعدة الفطور لدينا إلى:
breakfast → protein ( "with" breakfast "on the side" )?
          | bread ;

protein   → "really"+ "crispy" "bacon"
          | "sausage"
          | ( "scrambled" | "poached" | "fried" ) "eggs" ;

bread     → "toast" | "biscuits" | "English muffin" ;
أرجو ألّا يكون سيئاً إلى هذا الحدّ. إن كنتَ معتاداً على grep أو على استعمال التعبيرات المنظَّمة في محرّرك النصّي، فمعظم علامات الترقيم مألوفة. والفرق الرئيسي هو أنّ الرموز هنا تمثّل رموزاً كاملةً لا محارف مفردة.
سنستعمل هذا الترميز في بقيّة الكتاب لوصف قواعد Lox بدقّة. وحين تعمل على لغات البرمجة، ستجد أنّ القواعد الخالية من السياق (باستعمال هذا الترميز أو EBNF أو ترميزٍ آخر) تساعدك على تثبيت أفكار تصميم الصياغة غير الرسميّة. وهي أيضاً وسيطٌ مفيد للتواصل مع قراصنة اللغات الآخرين حول الصياغة.
والقواعد والإنتاجات التي نعرّفها لـLox هي أيضاً دليلنا إلى بنية البيانات التي سننفّذها لتمثيل الشيفرة في الذاكرة. وقبل أن نتمكّن من ذلك، نحتاج إلى قاعدةٍ فعلية لـLox، أو على الأقلّ إلى قدرٍ كافٍ منها لنبدأ.
قاعدةٌ لتعبيرات Lox
في الفصل السابق، أنجزنا قواعد Lox المعجمية كلّها بضربةٍ واحدة. فكلّ كلمة مفتاحية وكلّ علامة ترقيم موجودة. أمّا القواعد الصياغية فأكبر، وكان تدقيقها كلّها قبل أن نشغّل مفسّرنا فعلاً مملّاً بشكلٍ حقيقيّ.
بدلاً من ذلك، سنمضي بسرعة عبر مجموعةٍ فرعية من اللّغة في الفصلين التاليَين. وبعد أن نمثّل تلك اللّغة المصغّرة ونحلّلها ونفسّرها، ستضيف الفصول اللاحقة ميزاتٍ جديدة إليها تدريجياً، بما فيها الصياغة الجديدة. أمّا الآن فلن worrying إلاّ عن حفنةٍ صغيرة من التعبيرات:
-
القيم الحرفية. الأعداد والنصوص والقيم المنطقيّة و
nil. -
التعبيرات الأحادية. سابقة
!لإجراء النفي المنطقي، و-لنفي عدد. -
التعبيرات الثنائيّة. معاملات الحساب (
+و-و*و/) والمنطق (==و!=و<و<=و>و>=) التي نعرفها ونحبّها. -
الأقواس. زوجٌ من
(و)يلتفّ حول تعبير.
هذا يعطينا صياغةً كافية لتعبيراتٍ مثل:
1 - (2 * 3) < 4 == false
باستعمال ترميزنا الجديد اللطيف، إليك قاعدةً لتلك التعبيرات:
expression     → literal
               | unary
               | binary
               | grouping ;

literal        → NUMBER | STRING | "true" | "false" | "nil" ;
grouping       → "(" expression ")" ;
unary          → ( "-" | "!" ) expression ;
binary         → expression operator expression ;
operator       → "==" | "!=" | "<" | "<=" | ">" | ">="
               | "+"  | "-"  | "*" | "/" ;
هناك جزءٌ إضافي من الصياغة فوق الصياغة
هنا. فإلى جانب النصوص المقتبسة للرموز الختامية التي تطابق رموزاً
نصّيةً تامّة، فإنّنا نُضع CAPITALIZE على الرموز الختامية
التي هي رمزٌ نصّي واحدٌ قد يختلف تمثيلها النصّي. فـNUMBER أيّ
قيمة عددية حرفية، وSTRING أيّ قيمة نصّية حرفية. لاحقاً سنفعل
الشيء نفسه مع IDENTIFIER.
هذه القاعدة ملتبسة فعلاً، وسنرى ذلك حين نصل إلى تحليلها. لكنّها تكفي الآن.
تنفيذ أشجار الصياغة
أخيراً، نكتب بعض الشيفرة. تلك القاعدة التعبيرية الصغيرة هي
هيكلنا العظمي. وبما أنّ القاعدة متعاودة -- لاحظ كيف تعود
grouping و unary و binary كلّها إلى expression -- فإنّ بنية
بياناتنا ستشكّل شجرة. ولأنّ هذه البنية تمثّل صياغة لغتنا، فإنّها
تُسمّى شجرة صياغة.
استعمل مُحلّلنا المعجمي صنف Token واحداً لتمثيل كلّ أنواع
الرموز النصّية. وكي نميّز الأنواع المختلفة -- فكّر في العدد 123
مقابل النصّ "123" -- أضفنا تعداد TokenType بسيطاً. أمّا أشجار
الصياغة فليست متجانسة بهذا القدر.
فالتعبيرات الأحادية لها معاملٌ واحد، والتعبيرات الثنائيّة لها
اثنان، والقيم الحرفية لا شيء.
يسعنا أن ندمج ذلك كلّه في صنف Expression واحدٍ له قائمة أبناء
من حجمٍ اعتباطي. فبعض المصرّفات تفعل ذلك. لكنّي أحبّ أن أستثمر
أقصى ما في نظام أنواع Java. لذا سنعرّف صنف أساس للتعبيرات. ثمّ،
لكلّ نوعٍ من التعبيرات -- لكلّ إنتاجٍ تحت expression -- ننشئ
صنفاً فرعياً له حقولٌ للرموز اللا ختامية الخاصّة بتلك القاعدة.
وهكذا نحصل على خطأ تصريف إن حاولنا، مثلاً، الوصول إلى المعامل
الثاني لتعبيرٍ أحادي.
شيءٌ كهذا:
package com.craftinginterpreters.lox;

abstract class Expr { // [expr]
  static class Binary extends Expr {
    Binary(Expr left, Token operator, Expr right) {
      this.left = left;
      this.operator = operator;
      this.right = right;
    }

    final Expr left;
    final Token operator;
    final Expr right;
  }

  // Other expressions...
}
Expr هو صنف الأساس الذي ترث منه كلّ أصناف التعبيرات. وكما ترى
من Binary، فالأصناف الفرعية متداخلة داخله. ولا حاجة تقنية
إلى ذلك، لكنّه يتيح لنا حشر كلّ الأصناف في ملفّ Java واحد.
أشياء مربكة
لاحظ أنّه، مثل صنف Token تماماً، لا توجد هنا أيّ طُرق. إنّه بنيةٌ غبيّة. مصنّفة بأناقة، لكن مجرّدة كيسٍ من البيانات. وهذا يبدو غريباً في لغةٍ موجّهة نحو الأشياء مثل Java. ألّا يكون الصنف يفعل شيئاً؟
المشكلة أنّ أصناف هذه الأشجار لا يملكها أيّ مجالٍ واحد. فهل ينبغي أن يكون لها طُرقٌ للتحليل لأنّ الأشجار تُنشأ هناك؟ أم لتفسيرها لأنّها تُستهلك هناك؟ الأشجار تعبر الحدّ بين ذلك المجالين، مما يعني أنّها في الحقيقة مملوكةٌ لـلا مجال.
وفي الحقيقة إنّ هذه الأنواع موجودة لتتيح للمحلّل النحوي والمفسّر أن يتواصلا. وهذا يناسب أنواعاً مجرّد بياناتٍ بلا سلوك مرتبط. وهذا النمط طبيعيٌّ جداً في اللّغات الوظيفية مثل Lisp و ML حيث كل البيانات منفصلة عن السلوك، لكنّه يبدو غريباً في Java.
معجبو البرمجة الوظيفية الآن يقفزون ليصرخوا "انظر! اللّغات الموجّهة نحو الأشياء لا تناسب المفسّر!" ولن أذهب إلى هذا الحدّ. وتذكر أنّ المُحلِّل المعجمي نفسه كان ملائماً للتوجيه نحو الأشياء ب admirable شكل. فكان لديه كلّ الحالة القابلة للتغيير ليتتبّع أين يقع في الشيفرة المصدرية، ومجموعةٌ محدّدة تماماً من الطُرق العامة، حفنةٌ من المساعدات الخاصّة.
شعوري هو أنّ كلّ مرحلة أو جزءٍ من المفسّر يعمل على الوجه الجيّد في نمطٍ موجّه نحو الأشياء. إنّ بنى البيانات التي تجري بينها هي المجرّدة من السلوك.
البرمجة البينية للأشجار
تستطيع Java التعبير عن أصنافٍ بلا سلوك، لكنّني لا أقول إنّها جيّدةٌ في ذلك على وجهٍ particular. فإحدى عشرة أسطر شيفرة لحشو ثلاثة حقول في كائن أمرٌ مملّ إلى حدٍّ كبير، وحين ننتهي من كلّ شيء، سنملك 21 من هذه الأصناف.
لا أريد أن أُضيع وقتك أو حبري بكتابة كلّ ذلك. حقّاً، ما جوهر كلّ صنفٍ فرعي؟ اسمٌ وقائمة حقولٍ مُنمَّطة. هذا كلّ شيء. فنحن قراصنة لغاتٍ أذكياء، صحيح؟ فلنـنُؤتمت الأمر.
بدلاً من كتابة كلّ تعريف صنفٍ و تصريح حقلٍ ومُنشئٍ ومُهيّئٍ يدوياً بشقّة الونيس، سنُجمّع معاً سكربتاً يفعل ذلك نيابةً عنّا. فله وصفٌ لكلّ نوع شجرة -- اسمها وحقولها -- ويطبع شيفرة Java اللازمة لتعريف صنفٍ بذلك الاسم وتلك الحالة.
هذا السكربت تطبيقٌ صغير في Java لسطر الأوامر يُولّد ملفّاً باسم "Expr.java":
^code generate-ast
لاحظ أنّ هذا الملفّ في حزمةٍ مختلفة، .tool بدلاً من .lox.
هذا السكربت ليس جزءاً من المفسّر نفسه. إنّه أداةٌ نستخدمها
نحن، نحن الناس الذين نتلاعبون بالمفسّر، نشغّلها بأنفسنا لتوليد
أصناف شجرة الصياغة. وبعد انتهائها، نتعامل مع "Expr.java" كما
نتعامل مع أيّ ملفّ آخر في التنفيذ. إنّنا نُؤتمت فقط طريقة تأليف
ذلك الملفّ.
ولتوليد الأصناف، عليه أن يمتلك بعض الوصف لكلّ نوعٍ وحقوله.
^code call-define-ast (1 before, 1 after)
واختصاراً، حشمتُ أوصاف أنواع التعبيرات في نصوص. كلٌّ منها اسم
الصنف يليه : ثمّ قائمة الحقول مفصولةً بفواصل. ولكلّ حقل نوعٌ
واسم.
أوّل ما تحتاج إليه دالة defineAst() هو إخراج صنف Expr الأساس.
^code define-ast
وحين نستدعي هذا، فإنّ baseName هو "Expr"، وهو اسم الصنف واسم
الملفّ الذي يُخرجه معاً. نمرّره كوسيط بدلاً من تثبيت الاسم لأنّنا
سنضيف لاحقاً عائلةً منفصلة من الأصناف للجمل.
وداخل الصنف الأساس، نعرّف كلّ صنفٍ فرعي.
^code nested-classes (2 before, 1 after)
وهذه الشيفرة بدورها تستدعي:
^code define-type
وهكذا. كلّ ذلك الشيفرة الهيكلية المجيدة في Java قد أُنجزت. فهي تُعلن كلّ حقل في جسم الصنف. وتُعرّف مُنشئاً للصنف بمعاملات لكلّ حقل وتُهيّئها في الجسم.
صرّف هذا البرنامج وشغّله الآن فيُخرج دفعةً من
ملفّ .java جديد يحتوي بضعة عشرات من أسطر الشيفرة. وسيصير ذلك
الملفّ أطول قريباً.
العمل مع الأشجار
ارتّدِ خيمة خيالك لحظةً. فرغم أنّنا لم نصل إلى هناك بعد، فكّر فيما سيفعله المفسّر بأشجار الصياغة. كلّ نوعٍ من أنواع التعبيرات في Lox يتصرّف بشكلٍ مختلف وقت التشغيل. وهذا يعني أنّ المفسّر يحتاج إلى اختيار قطعة شيفرةٍ مختلفة للتعامل مع كلّ نوع تعبير. ومع الرموز يستطيع ببساطة أن يُبدّل على TokenType. لكنّنا لا نملك تعداد "نوع" لأشجار الصياغة، بل صنف Java منفصلاً لكلّ واحد منها.
كان بإمكاننا كتابة سلسلةٍ طويلة من فحوص الأنواع:
if (expr instanceof Expr.Binary) {
  // ...
} else if (expr instanceof Expr.Grouping) {
  // ...
} else // ...
لكنّ كلّ تلك فحوص الأنواع التسلسلية بطيئة. فأنواع التعبيرات التي
تأتي أسماؤها لاحقاً أبجدياً ستستغرق وقتاً أطول في التنفيذ، لأنّها
ستمرّ عبر حالات if أكثر قبل أن تجد النوع الصحيح. وهذا ليس
تصوّري لحلٍّ أنيق.
لدينا عائلةٌ من الأصناف ونحتاج إلى ربط قطعة سلوكٍ بكلّ واحدٍ منها.
والحلّ الطبيعي في لغةٍ موجّهة نحو الأشياء مثل Java هو أن نضع تلك
السلوكيات في طُرق على الأصناف نفسها. يمكننا إضافة طريقةٍ مجرّدة
interpret() على Expr
يطبّقها كلّ صنفٍ فرعي afterwards لفهم نفسه.
هذا يعمل إلى حدٍّ ما للمشاريع الصغيرة، لكنّه يتوسّع بشكلٍ سيّئ. وكما لاحظتُ من قبل، فهذه أصناف الأشجار تعبر بضعة مجالات. وعلى الأقلّ فالمحلّل النحوي والمفسّر كلاهما سيتدخّلان فيها. وكما سنرى لاحقاً، نحتاج إلى إجراء حلّ الأسماء عليها. ولو كانت لغتنا مُنمَّطة ساكناً، لكان لدينا مرحلة فحص أنواع.
لو أضفنا طُرقَ نسخ (instance methods) إلى أصناف التعبيرات لكلّ تلك العمليات، لسحقنا بذلك كومةً من المجالات المختلفة. وهذا يخالف [فصل المسؤوليات][] ويؤدي إلى شيفرةٍ يصعب صيانتها.
مسألة التعبير
هذه المشكلة أكثرُ جوهريّةً مما تبدو للوهلة الأولى. لدينا حفنةٌ من الأنواع، وحفنةٌ من العمليات عالية المستوى مثل "interpret". ولكلّ زوج من نوعٍ وعملية، نحتاج إلى تنفيذٍ محدّد. تخيّل جدولاً:
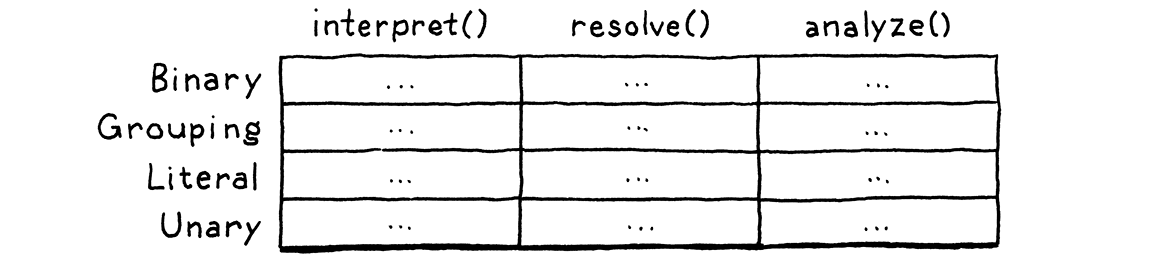
الصفوف أنواع، والأعمدة عمليات. وتمثّل كلّ خانة قطعةَ الشيفرة الفريدة التي تنفّذ تلك العملية على ذلك النوع.
تفترض اللّغة الموجّهة نحو الأشياء مثل Java أنّ كلّ الشيفرة في صفٍّ واحد تتجمّع بشكلٍ طبيعي. فهي تظنّ أنّ كلّ الأشياء التي تفعلها بنوعٍ ما يُرجَّح أن تكون مرتبطة ببعضها، واللّغة تجعل واللّغة تجعل من السهل تحديدها معاً كطُرق داخل الصنف نفسه.
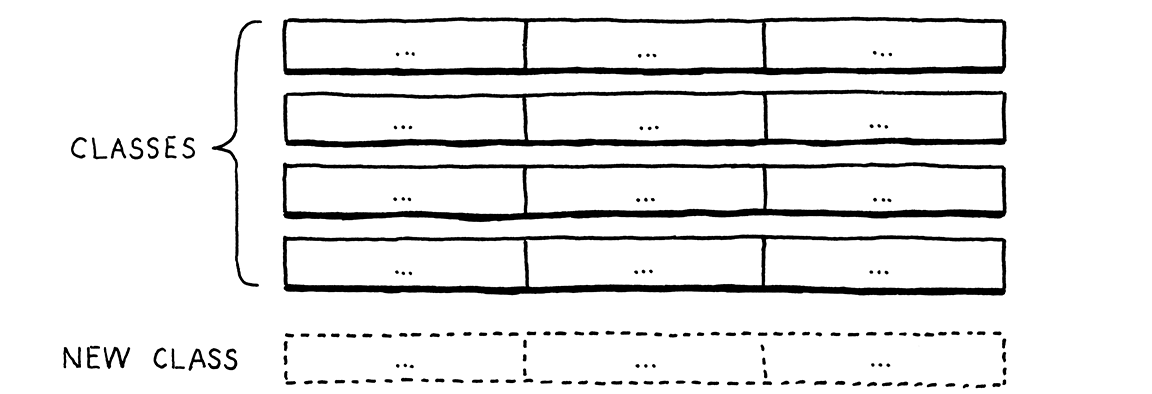
وهذا يجعل توسيع الجدول بإضافة صفوفٍ جديدة سهلاً. عرّف صنفاً جديداً فقط. لا شيفرةٍ قائمة تحتاج اللمس. لكنّ تخيّل ما لو أردت إضافة عملية جديدة -- عموداً جديداً. في Java، يعني ذلك فتح كلّ تلك الأصناف القائمة وإضافة طريقةٍ إليها.
وتقلب اللّغات المنتمية إلى عائلة ML
(Functional paradigm) ذلك. فهناك لا تملك أصنافاً بطُرق. والأنواع
والدوالّ منفصلةٌ تماماً. ولتنفيذ عمليةٍ على عددٍ من الأنواع
المختلفة، تُعرّف دالةً واحدة. وفي جسم تلك الدالة، تستعمل
مطابقة الأنماط (pattern matching) -- أي نوعاً من switch قائمٍ
على الأنواع لكنّه مُعزَّز -- لتنفيذ العملية على كلّ نوعٍ في مكانٍ
واحد.
وهذا يجعل إضافة عملياتٍ جديدة أمراً تافهاً -- عرّف دالةً أخرى يطابق الأنماط على كلّ الأنواع.
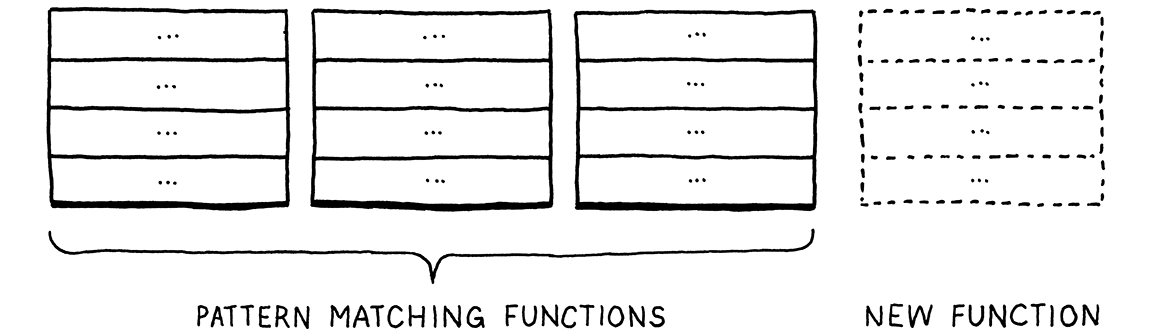
لكنّ العكس صحيح: إضافة نوعٍ جديد صعبة. عليك العودة وإضافة حالة جديدة إلى كلّ مطابقة أنماط في كلّ الدوالّ القائمة.
لكلّ نمطٍ من هذه الأنماط "حبيبات" خاصة به. هذا ما يعنيه اسم النموذج حرفياً -- فاللّغة الموجّهة نحو الأشياء تريدك أن توجّه شيفرتك على امتداد صفوف الأنواع. أمّا اللّغة الوظيفية فتشجّعك على حشد شيفرة كلّ عمودٍ معاً في دالة.
لاحظ مجموعةٌ من مهووسي اللّغات الأذكياء أنّ أيّاً من النمطين لا يجعل إضافة كلٍّ من الصفوف والأعمدة إلى الجدول سهلاً. وسمّوا هذه الصعوبة "مسألة التعبير" (expression problem) لأنّهم -- كما نحن الآن -- صادفوها أوّل مرّة حين حاولوا اكتشاف أفضل طريقة لنمذجة عقد شجرة الصياغة التعبيرية في مصرّف.
جرّب الناس رمي كلّ أنواع ميزات اللّغات وأنماط التصميم والحِيَل البرمجية لتلك المشكلة، لكنّ لغةً مثالية لم تنهيها بعد. وفي هذه الأثناء، أفضل ما نستطيع فعله هو أن نحاول اختيار لغةٍ يَتّفق توجيهها مع وصلات المعمارية الطبيعية في البرنامج الذي نكتبه.
والتوجيه نحو الأشياء يعمل على ما يرام في أجزاءٍ كثيرةٍ من مفسّرنا، لكنّ أصناف الأشجار هذه تحتكّ بحبيبات Java. ولحسن الحظّ، هناك نمط تصميم يمكننا تسخيرمه.
نمط الزائر
نمط الزائر (Visitor) هو أكثر الأنماط سوء فهمٍ في كتاب أنماط التصميم كلّه، وهذا في واقع الأمر يقول الكثير حين تنظر إلى مغالاة هندسة البرمجيات في العقود القليلة الماضية.
تبدأ المشكلة بالمصطلحات. فالنمط ليس عن "زيارة" شيء ما، وطريقة "accept" فيه لا تستحضر أيّ صورة مفيدة أيضاً. يظنّ كثيرون أنّ النمط له علاقة باجتياز الأشجار، والحال أنّه ليس كذلك على الإطلاق. سنستعمله على مجموعة أصنافٍ شبيهة بالأشجار، لكنّ ذلك مصادفة. وكما سترى، فإنّ النمط يعمل تماماً على كائنٍ واحد.
نمط الزائر في جوهره عن تقريب الأسلوب الوظيفي داخل لغة موجّهة نحو الأشياء. وهو يتيح لنا إضافة أعمدةٍ جديدة إلى ذلك الجدول بسهولة. يمكننا تعريف كلّ سلوك عمليةٍ جديدة على مجموعة أنواعٍ في مكانٍ واحد، دون الحاجة إلى لمس الأنواع نفسها. وهو يفعل ذلك بالطريقة نفسها التي نحلّ بها كلّ مشكلة تقريباً في علوم الحاسوب: بإضافة طبقةٍ من التوجيه غير المباشر.
قبل أن نطبّقها على أصناف Expr المولَّدة آلياً، فلنمرّ على مثالٍ أبسط. لنقل إنّ لدينا نوعَين من الحلويات: كرواصون وكرولات.
^code pastries (no location)
نريد أن نتمكّن من تعريف عمليات حلوى جديدة -- طهيها وأكلها وتزيينها، إلخ -- دون أن نضطرّ إلى إضافة طريقةٍ جديدة لكلّ صنفٍ في كلّ مرّة. إليك كيف نفعل ذلك. أوّلاً، نعرّف واجهةً منفصلة.
^code pastry-visitor (no location)
كلّ عمليةٍ يمكن أداؤها على الحلويات هي صنفٌ جديد يطبّق تلك الواجهة. ولكلّ صنف حلوى طريقةٌ ملموسة. وهذا يُبقي شيفرة العملية على النوعَين متجاورَين في comfort داخل صنفٍ واحد.
معطًى بعض الحلوى، كيف نوجّهها إلى الطريقة الصحيحة على الزائر بناءً على نوعها؟ إنما ينقذنا التعدّد الشكلّي (polymorphism)! نضيف هذه الطريقة إلى Pastry:
^code pastry-accept (1 before, 1 after, no location)
يطبّقها كلّ صنفٍ فرعي.
^code beignet-accept (1 before, 1 after, no location)
و:
^code cruller-accept (1 before, 1 after, no location)
ولتنفيذ عمليةٍ على حلوى، نستدعي طريقة accept() الخاصة بها
ونمرّر الزائر الذي يخصّ العملية التي نريد تنفيذها. فالحلوى --
أي تنفيذِ الصنف الفرعي المُحدّد لـaccept() -- تلتفت وتستدعي
طريقة الزيارة المناسبة على الزائر وتمرّر نفسها إليها.
هذه هي جوهر الحيلة بالضبط. فهي تتيح لنا استعمال التوجيه متعدّد الأشكال على أصناف الحلوى لاختيار الطريقة المناسبة على صنف الزائر. في الجدول، كلّ صنف حلوى هو صفٌّ، لكن إن نظرت إلى كلّ طرائق زائرٍ واحد فإنّها تشكّل عموداً.
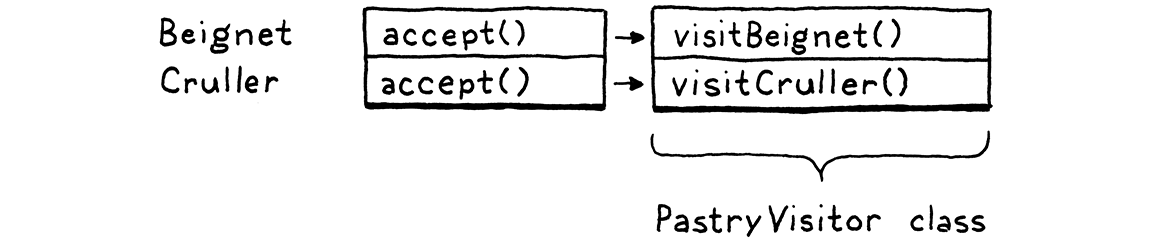
أضفنا طريقة accept() واحدةً إلى كلّ صنف، ويمكننا استعمالها مع
عددٍ غير محدود من الزوّار دون أن نلمس أصناف الحلوى مرّةً أخرى.
إنّه نمطٌ ذكيّ.
زوّار التعبيرات
حسناً، لندمجها في أصناف التعبيرات لدينا. وسنُحسّن النمط قليلاً أيضاً. في مثال الحلوى، لا تُعيد
طريقة visit ولا accept() أيّ شيء. لكنّ الزوّار في الممارسة
غالباً ما يريدون تعريف عملياتٍ تُنتج قيماً. لكنّ ما نوع الإرجاع
الذي ينبغي أن تكون له accept()؟ لا يمكننا افتراض أنّ كلّ صنف
زائر يريد إنتاج النوع نفسه، لذا نستعمل الأصناف العامة (generics)
ليملأ كلّ تنفيذ نوع إرجاعه.
أوّلاً، نعرّف واجهة الزائر. ومرةً أخرى، نضعها داخل الصنف الأساس كي نتمكّن من إبقاء كلّ شيءٍ في ملفٍ واحد.
^code call-define-visitor (2 before, 1 after)
تلك الدالة تولّد واجهة الزائر.
^code define-visitor
وهنا، نمرّ على كلّ الأصناف الفرعية ونُعلن طريقة زيارة لكلّ واحد منها. وحين نعرّف أنواع تعبيرات جديدة لاحقاً، سيتضمّنها هذا تلقائياً.
وداخل الصنف الأساس، نعرّف طريقة accept() المجرّدة.
^code base-accept-method (2 before, 1 after)
وأخيراً، يطبّق كلّ صنفٍ فرعي ذلك ويستدعي طريقة الزيارة الصحيحة لنوعه.
^code accept-method (1 before, 2 after)
وهكذا. يمكننا الآن تعريف عملياتٍ على التعبيرات دون أن نتدخّل في الأصناف أو في سكربت المولِّد لدينا. صرّف سكربت المولِّد هذا وشغّله لإخراج ملفّ "Expr.java" المحدَّث. فهو يحتوي واجهة Visitor مولَّدةً ومجموعةً من أصناف عُقد التعبير التي تدعم نمط الزائر باستعمالها.
قبل أن ننهي هذا الفصل الطويل، لننفّذ واجهة Visitor تلك ونرى النمط وهو يعمل.
طابعٌ جميل (إلى حدٍّ ما)
حين ننقّح محلّلنا النحوي ومفسّرنا، من المفيد غالباً أن ننظر إلى شجرة صياغةٍ محلّلة ونتأكّد من أنّ لها البنية التي نتوقّعها. يمكننا فحصها في المنقّح، لكنّ ذلك قد يكون عبئاً.
بدلاً من ذلك، نريد بعض الشيفرة التي-given شجرة صياغة تُنتج تمثيلاً نصّياً بلا التباس لها. وتحويل الشجرة إلى نصّ هو نوعٌ ما من عكس المحلّل النحوي، ويُسمّى غالباً "الطباعة الجميلة" (pretty printing) حين يكون الهدف إنتاج سلسلة نصّية صالحة الصياغة في اللّغة المصدرية.
وليست هذه هي هدفنا هنا. نريد للسلسلة أن تُظهر بنية التعشيش في
الشجرة بوضوحٍ تامّ. فطابعٌ يُعيد 1 + 2 * 3 ليس نافعاً إلى
حدٍّ كبير إن كان ما نحاول تنقيحه هو ما إذا كانت أسبقية المعاملات
تُعالَج على نحو صحيح. نريد أن نعرف ما إذا كان + أو * في
قمة الشجرة.
ولهذا الغرض، لن يكون التمثيل النصّي الذي نُنتجه صياغة Lox. بدلاً من ذلك، سيبدو كثيراً مثل -- حسناً -- Lisp. فكلّ تعبيرٍ محاطٌ بأقواس صراحةً، وكلّ تعبيراته الفرعية ورموزه مضمّنةٌ بداخله.
معطًى شجرة صياغةٍ مثل:
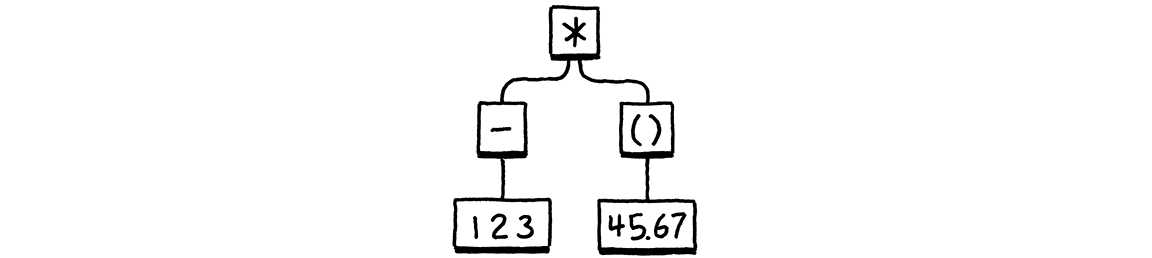
فإنّها تُنتج:
(* (- 123) (group 45.67))
ليست "جميلة" تماماً، لكنّها تُظهر التعشيش والتجميع صراحةً. ولتنفيذ ذلك، نعرّف صنفاً جديداً.
^code ast-printer
وكما ترى، فإنّها تطبّق واجهة الزائر. وهذا يعني أنّنا نحتاج إلى طرق زيارة لكلّ أنواع التعبيرات التي لدينا حتى الآن.
^code visit-methods (2 before, 1 after)
تعبيراتُ القيم الحرفية سهلة -- فهي تحوّل القيمة إلى نصّ مع فحصٍ
صغير للتعامل مع null في Java بدلاً من nil في Lox. أمّا بقية
التعبيرات فلديها تعبيرات فرعية، لذا تستعمل هذه الطريقة المساعدة
parenthesize():
^code print-utilities
وهي تأخذ اسماً وقائمة تعبيرات فرعية وتلُفّها كلّها في أقواس، فتُنتج نصّاً مثل:
(+ 1 2)
لاحظ أنّها تستدعي accept() على كلّ تعبيرٍ فرعي وتمرّر نفسها
إليه. وهذه هي الخطوة التعاودية التي تتيح
لنا طباعةَ شجرةٍ كاملة.
ليس لدينا محلّل نحوي بعد، لذا من الصعب رؤية هذا وهو يعمل. أمّا
الآن فسنُجمّع معاً طريقة main() صغيرة تُنشئ شجرةً يدوياً وتطبعها.
^code printer-main
وإنّ فعلنا كلّ شيءٍ على نحوٍ صحيح، فإنّها تطبع:
(* (- 123) (group 45.67))
يمكنك أن تحذف هذه الطريقة متى شئت. فلن نحتاجها. وأيضاً، حين نضيف أنواعاً جديدة لشجرة الصياغة، لن أُزعج نفسي بإعادة طرق الزيارة اللازمة لها في AstPrinter. إن أردت (وتريد ذلك كي لا يصيح مصرّف Java في وجهك)، فاذهب وأضفها بنفسك. وستكون مفيدةً في الفصل التالي حين نبدأ في تحليل شيفرة Lox إلى أشجار صياغة. أو إن لم تَرِب الحفاظ على AstPrinter، فلا تتردّد في حذفها. فلن نحتاجها مرّةً أخرى.
التحديات
-
قلتُ في وقتٍ سابق إنّ صيغ
|و*و+التي أضفناها إلى صياغتنا فوق الصياغة ليست سوى سكّرٍ صياغوي. خذ هذه القاعدة:expr → expr ( "(" ( expr ( "," expr )* )? ")" | "." IDENTIFIER )+ | IDENTIFIER | NUMBERأنتج قاعدة تطابق اللّغة نفسها لكن دون استعمال أيٍّ من ذلك السكّر الصياغوي.
مكافأة: ما نوع التعبير الذي يرمز له هذا الجزء من القاعدة؟
-
يتيح لك نمط الزائر محاكاة الأسلوب الوظيفي في لغةٍ موجّهة نحو الأشياء. صمّم نمطاً تكاملياً للّغة وظيفية. ينبغي أن يتيح لك حشد كلّ العمليات على نوعٍ واحد معاً وأن يتيح لك تعريف أنواعٍ جديدة بسهولة.
(ستكون SML أو Haskell مثاليتين لهذا التمرين، لكنّ Scheme أو Lisp أخرى تعمل أيضاً.)
-
في الترميز البولندي العكسي (RPN)، يوضع معاملا المعامل الحسابي كلاهما قبل المعامل، لذا يتحوّل
1 + 2إلى1 2 +. ويجري التقييم من اليسار إلى اليمين. تُدفع الأعداد على مكدّسٍ ضمني. ومُعاملٌ حسابيّ ينزع أعلى عددَين، ويجري العملية، ويدفع النتيجة. إذن، فإنّ هذا:(1 + 2) * (4 - 3)في RPN يصبح:
1 2 + 4 3 - *عرّف صنف زائر لأصناف شجرة الصياغة لدينا يأخذ تعبيراً، ويحوّله عرّف صنف زائر لأصناف شجرة الصياغة لدينا يأخذ تعبيراً، ويحوّله