تحليل التعبيرات
القواعد، التي تعرف كيف تتحكّم حتى في الملوك. مولير
هذا الفصل يمثّل أول محطة كبرى في الكتاب. لقد ركّع كثير منّا معاً خليطاً من تعبيرات نمطية (regular expressions) وعمليات على المقاطع الفرعية لاستخراج معنى ما من كومة نصّ. وكانت الشيفرة على الأرجح مليئة بالأخطاء ووحشاً في الصيانة. أما كتابة محلل حقيقي (parser) — واحد فيه معالجة جيدة للأخطاء، وبنية داخلية متماسكة، والقدرة على مضغ شيفرة نحوية متطوّرة بمتانة — فتُعدّ مهارة نادرة ومبهرّة. وفي هذا الفصل، سوف تتقنها.
إنها أسهل مما تظن، جزئياً لأننا جمعنا معاً نصيباً كبيراً من العمل الصعب مقدماً في [الفصل الأخير][]. فأنت تعرف بالفعل طريقك حول القواعد اللغوية الرسمية. وأنت على معرفة بأشجار التركيب (syntax trees)، ولدينا بعض أصناف Java لتمثيلها. والقطعة المتبقّية الوحيدة هي التحليل — تحويل تسلسل من الرموز (tokens) إلى إحدى تلك الأشجار.
تجعل بعض كتب علوم الحاسوب من المحلّلات موضوعاً كبيراً. في الستينيات، بدأ علماء الحاسوب — وهُم مُرهقون علىٍ من البرمجة بلغة التجميع — يصمّمون لغات أكثر تطوّراً وملائمة للبشر مثل Fortran وALGOL. لكن—for للأسف— لم تكن ملائمة للآلة بالنسبة لأجهزة ذلك العصر البدائية.
صمّم هؤلاء الرواد لغات لم يكونوا متأكّدين أصلاً كيف يكتبون المصرّفات لها، ثم أنجزوا عملاً رائداً باختراع تقنيات تحليل وتصريف قادرة على التعامل مع هذه اللغات الجديدة الكبيرة على تلك الأجهزة القديمة الصغيرة.
تكاد كتب المصرّفات الكلاسيكية تُقرأ كسِيَرٍ تمجيدية لهؤلاء الأبطال وأدواتهم. فغلاف Compilers: Principles, Techniques, and Tools يحمل حرفياً تنّيناً وسمّاه «تعقيد تصميم المصرّف» يفتك به فارس يحمل سيفاً وترساً مكتوباً عليهما «مولّد محلّلات LALR» و«الترجمة الموجَّهة بالصياغة». لقد بالغوا في مدح أنفسهم.
بعض التبجيل الذاتي هو أمر مستحق، لكن الحقيقة أنك لا تحتاج إلى معرفة معظم ذلك لتكتب محلّلاً عالي الجودة لجهاز حديث. وكالمعتاد، أحثّك على توسيع معرفتك وإلحاق ذلك لاحقاً، لكن هذا الكتاب يتخطّى خزانة الجوائز.
الغموض ولعبة التحليل
في الفصل الأخير، قلتُ إن بإمكانك «لعب» قواعد لغوية خالية من السياق كلعبة من أجل توليد نصوص. والمحللون يلعبون تلك اللعبة في الاتجاه المعاكس. فمعطى نصّ — أي سلسلة من الرموز — فإننا نسند تلك الرموز إلى أطراف القواعد اللغوية لنعرف أيّ القواعد كان يمكن أن تولّد ذلك النصّ.
جزء «كان يمكن» هذا مثير للاهتمام. فمن الممكن تماماً إنشاء قواعد لغوية ملتبسة (ambiguous)، حيث يمكن لخيارات مختلفة من الانتاجات يمكن أن تصل إلى النصّ نفسه. وحين تستخدم القواعد اللغوية لتوليد نصوص، فإن ذلك لا يهمّ كثيراً. فبمجرد أن يصبح لديك النصّ، فمين يهتمّ كيف وصلت إليه؟
أثناء التحليل، يعني الغموض أن المحلل قد يسوء فهم شيفرة المستخدم. فبينما نحلل، لا نكتفي بتحديد ما إذا كان النصّ شيفرة Lox صالحة، بل نتتبّع أيضاً أيّ القواعد تطابق أيّ أجزاء منه حتى نعرف أي جزء من اللغة ينتمي إليه كل رمز. وإليك قواعد Lox اللغوية للتعبيرات التي جمعناها في الفصل الأخير:
expression     → literal
               | unary
               | binary
               | grouping ;

literal        → NUMBER | STRING | "true" | "false" | "nil" ;
grouping       → "(" expression ")" ;
unary          → ( "-" | "!" ) expression ;
binary         → expression operator expression ;
operator       → "==" | "!=" | "<" | "<=" | ">" | ">="
               | "+"  | "-"  | "*" | "/" ;
هذا نصّ صالح في تلك القواعد اللغوية:

لكن هناك طريقتان يمكننا أن نولّد به. إحدى الطريقتين هي:
- انطلاقاً من
expression، اخترbinary. - لـ
expressionعلى اليسار، اخترNUMBER، واستخدم6. - للمشغّل، اختر
"/". - لـ
expressionعلى اليمين، اخترbinaryمرةً أخرى. - في ذلك تعبير
binaryالمتداخل، اختر3 - 1.
والأخرى هي:
- انطلاقاً من
expression، اخترbinary. - لـ
expressionعلى اليسار، اخترbinaryمرةً أخرى. - في ذلك تعبير
binaryالمتداخل، اختر6 / 3. - العودة إلى
binaryالخارجية، للمشغّل اختر"-". - لـ
expressionعلى اليمين، اخترNUMBER، واستخدم1.
إن الطريقتين تنتجان النصوصَ نفسها، لكن ليسا شجرتَي تركيب نفسهما:
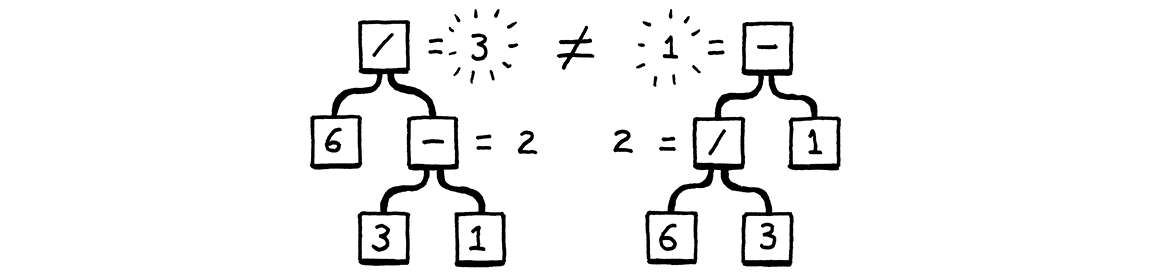
بمعنى آخر، تسمح القواعد اللغوية برؤية التعبير إما (6 / 3) - 1 أو 6 / (3 - 1).
فقاعدة binary تسمح للمُعاملات بالتداخل بأي ترتيب أردت. وبدورها يؤثر ذلك في
نتيجة تقييم الشجرة المحلَّلة. أما الطريقة التي عالج بها الرياضيون هذا الغموض منذ
اختراع السبورات أول مرة فهي تعريف قواعد للأولوية (precedence) والارتباطية
(associativity).
-
الأولوية تحدّد أيّ مشغّل يُقيَّم أولاً في تعبير يحتوي مزيجاً من مشغّلات مختلفة. فقواعد الأولوية تخبرنا أننا نقيّم
/قبل-في المثال أعلاه. والمشغّلات ذات الأولوية الأعلى تُقيَّم قبل المشغّلات ذات الأولوية الأدنى. وبعبارة مكافئة، يُقال إن المشغّلات ذات الأولوية الأعلى «ترتبط ارتباطاً أشدّ». -
الارتباطية تحدّد أيّ مشغّل يُقيَّم أولاً في سلسلة من المشغّل نفسه. وحين يكون المشغّل مرتبطاً يساراً (فكّر «من اليسار إلى اليمين»)، فإن المشغّلات على اليسار تُقيَّم قبل على اليمين. وبما أن
-مرتبط يساراً، فإن هذا التعبير:5 - 3 - 1يكافئ:
(5 - 3) - 1أما الإسناد فمرتبط يميناً. فهذا:
a = b = cيكافئ:
a = (b = c)
من دون أولوية وارتباطية محدَّدتين بإحكام، يكون التعبير الذي يستخدم مشغّلات متعددة ملتبساً — إذ يمكن تحليله إلى شجرات تركيب مختلفة، قد تُقيَّم بدورها إلى نتائج مختلفة. وسنُصلح ذلك في Lox بتطبيق قواعد الأولوية نفسها المستخدَمة في C، من الأدنى إلى الأعلى.
| الاسم | المشغّلات | الارتباط |
| Equality | == != |
يساراً |
| Comparison | > >=
< <= |
يساراً |
| Term | - + |
يساراً |
| Factor | / * |
يساراً |
| Unary | ! - |
يميناً |
في الوقت الحالي، تحشر القواعد اللغوية جميع أنواع التعبيرات في قاعدة expression
واحدة. وتُستخدم القاعدة نفسها بوصفها الطرف غير النهائي (non-terminal)
للمُعاملات، مما يسمح للقواعد اللغوية بقبول أي نوع من التعبيرات كتعبير فرعي، بغضّ
النظر عمّا إذا كانت قواعد الأولوية تسمح بذلك.
نُصلح ذلك بأن نُطبّع القواعد اللغوية. فنُعرّف قاعدة منفصلة لكل مستوى أولوية.
expression     → ...
equality       → ...
comparison     → ...
term           → ...
factor         → ...
unary          → ...
primary        → ...
كل قاعدة هنا لا تطابق إلا التعبيرات عند مستوى أولويتها أو أعلى. فمثلاً، تطابق
unary تعبيراً أحاديّاً مثل !negated أو تعبيراً أوّلياً مثل 1234. ويمكن لـ
term أن تطابق 1 + 2 لكن أيضاً 3 * 4 / 5. وتغطّي قاعدة primary الأخيرة
الأشكال الأعلى أولوية — الحرفية وتعبيرات التجميع.
كل ما نحتاجه هو ملء الانتاجات لكل تلك القواعد. سنبدأ بالقواعد السهلة. فقاعدة
expression العلوية تطابق أي تعبير عند أي مستوى أولوية. وبما أن
equality لها أدنى أولوية، فإن مطابقتها تغطّي كل
شيء.
expression → equality
وفي الطرف الآخر من جدول الأولويات، يحتوي التعبير الأوّلي على كل الحرفية وتعبيرات التجميع.
primary        → NUMBER | STRING | "true" | "false" | "nil"
               | "(" expression ")" ;
يبدأ التعبير الأحادي بمشغّل أحادي يليه المُعامل. وبما أن المشغّلات الأحادية يمكن
أن تتداخل — !!true تعبير صالح وإن كان غريباً — فإن المُعامل يمكن أن يكون مشغّلاً
أحادياً بدوره. وقاعدة متعاودة تتعامل مع ذلك بأناقة.
unary → ( "!" | "-" ) unary ;
لكن لهذه القاعدة مشكلة. فهي لا تتوقّف أبداً.
تذكّر، أن كل قاعدة تحتاج إلى مطابقة التعبيرات عند تلك الأولوية أو أعلى، لذا نحتاج أيضاً إلى أن نسمح لها بمطابقة تعبير أوّلي.
unary          → ( "!" | "-" ) unary
               | primary ;
هذا يعمل.
القواعد المتبقّية كلها مشغّلات ثنائية. سنبدأ بقاعدة الضرب والقسمة. وإليك محاولة أولى:
factor         → factor ( "/" | "*" ) unary
               | unary ;
القاعدة تتعاود لتطابق المُعامل الأيسر. وهذا يتيح للقاعدة مطابقة سلسلة من تعبيرات
الضرب والقسمة مثل 1 * 2 / 3. ووضع الانتاج المتعاود على اليسار وunary على
اليمين يجعل القاعدة مرتبطة يساراً وغير ملتبسة.
كل هذا صحيح، لكن كون الرمز الأول في جسم القاعدة هو نفسه رأس القاعدة يعني أن هذا
الإنتاج متعاود يساراً (left-recursive). وبعض تقنيات التحليل، بما فيها التقنية
التي سنستخدمها، تعاني مع التعاود في اليسار. (أما التعاود في مواضع أخرى، مثل ما
لدينا في unary والتعاود غير المباشر للتجميع في primary فلا يمثّل مشكلة.)
هناك قواعد لغوية كثيرة يمكنك تعريفها تطابق اللغة نفسها. واختيار كيفية نمذجة لغة معيّنة هو أمر جزئياً مسألة ذوق وجزئياً مسألة عملية. هذه القاعدة صحيحة، لكنها ليست مثلى لكيفية نيتّنا تحليلها. بدلاً من قاعدة متعاودة يساراً، سنستخدم قاعدة أخرى.
factor → unary ( ( "/" | "*" ) unary )* ;
نُعرّف تعبير العامل بأنه تسلسل مسطّح من عمليات الضرب والقسمة. وهذا يطابق الصياغة نفسها التي تطابقها القاعدة السابقة، لكنه يعكس على نحو أفضل الشيفرة التي سنكتبها لتحليل Lox. ونستخدم البنية نفسها لجميع مستويات أولوية المشغّلات الثنائية الأخرى، فتحصل على قواعد التعبيرات الكاملة هذه:
expression     → equality ;
equality       → comparison ( ( "!=" | "==" ) comparison )* ;
comparison     → term ( ( ">" | ">=" | "<" | "<=" ) term )* ;
term           → factor ( ( "-" | "+" ) factor )* ;
factor         → unary ( ( "/" | "*" ) unary )* ;
unary          → ( "!" | "-" ) unary
               | primary ;
primary        → NUMBER | STRING | "true" | "false" | "nil"
               | "(" expression ")" ;
هذه القواعد اللغوية أعقد مما كانت عليه قبل، لكننا مقابل ذلك تخلّصنا من غموض السابقة. وهي بالضبط ما نحتاجه لبناء محلّل.
التحليل بال descent التكراري
هناك حزمة كاملة من تقنيات التحليل التي تكون أسماؤها في معظمها تركيبات من «L» و «R» — LL(k) وLR(1) وLALR — إلى جانب مخلوقات أكثر غرابة مثل مُركّبات المحلّل و[محلّلات Earley][] وخوارزمية ساحة الفرز و[تحليل packrat][]. بالنسبة إلى أول مفسّر لدينا، فإن تقنية واحدة أكثر من كافية: التحليل بال descent التكراري (recursive descent).
التحليل بال descent التكراري هو أبسط طريقة لبناء محلّل، ولا يتطلّب استخدام أدوات مولّد محلّلات معقّدة مثل Yacc أو Bison أو ANTLR. كل ما تحتاجه هو شيفرة مكتوبة بيدك بشكل مباشر. لكن لا تخدعك بساطتها. فمحلّلات ال descent التكراري سريعة ومتينة، ويمكنها دعم معالجة أخطاء متطوّرة. وفي الواقع، تستخدم GCC وV8 (آلة JavaScript الافتراضية في Chrome) وRoslyn (مصرّف C# المكتوب بلغة C#) وتنفيذات لغارات إنتاجية ثقيلة أخرى كثيرة التحليل بال descent التكراري. إنه رائع.
يُعدّ التحليل بال descent التكراري محلّلاً من الأعلى إلى الأسفل لأنه يبدأ من
أعلى قاعدة لغوية أو أكثرها خارجية (هنا expression) ويشقّ طريقه نازلاً إلى التعبيرات الفرعية المتداخلة قبل أن يصل في
النهاية إلى أوراق شجرة التركيب. وهذا على النقيض من المحلّلات الصاعدة مثل LR التي
تبدأ بالتعبيرات الأولية وتُركّبها في قطع نحوية أكبر وأكبر.
محلّل ال descent التكراري هو ترجمة حرفية لقواعد اللغة مباشرةً إلى شيفرة أمرية. كل قاعدة تصبح دالة. وجسم القاعدة يُترجم إلى شيفرة تشبه ما يلي:
| تدوين القواعد اللغوية | التمثيل بالشيفرة |
| طرف (terminal) | شيفرة لمطابقة رمز واستهلاكه |
| طرف غير نهائي | استدعاء دالة تلك القاعدة |
| | جملة if أو switch |
* أو + | حلقة while أو for |
? | جملة if |
ووصف ال descent بأنه «تكراري» لأن قاعدة لغوية ما تشير إلى نفسها — بشكل مباشر أو غير مباشر — تنطوي على استدعاء دالة متكرر.
صنف المحلّل
كل قاعدة لغوية تصبح دالة داخل هذا الصنف الجديد:
^code parser
وكالمحلّل المعجمي (scanner)، يستهلك المحلّل تسلسل إدخال مسطّحاً، لكننا الآن نقرأ
الرموز بدلاً من المحارف. ونخزّن قائمة الرموز ونستخدم current للتأشير إلى الرمز
التالي بحماس منتظراً أن يُحلَّل.
سنمرّ الآن على قواعد التعبيرات بأكملها ونترجم كل قاعدة إلى شيفرة Java. فالقاعدة
الأولى، expression، تتوسّع ببساطة إلى قاعدة equality، لذا الأمر مباشر.
^code expression
كل دالة لتحليل قاعدة لغوية تنتج شجرة تركيب لتلك القاعدة وتُعيدها إلى المُنادي. وحين يحتوي جسم القاعدة على طرف غير نهائي — أي إشارة إلى قاعدة أخرى — فإننا نستدعي دالة تلك القاعدة الأخرى.
قاعدة المساواة أعقد قليلاً.
equality → comparison ( ( "!=" | "==" ) comparison )* ;
وفي Java، يصبح ذلك:
^code equality
لنمرّ عليه خطوةً خطوة. الطرف غير النهائي comparison الأول في الجسم يُترجم إلى
أول استدعاء لـcomparison() في الدالة. نأخذ تلك النتيجة ونخزّنها في متغيّر محلّي.
ثم حلقة ( ... )* في القاعدة تُقابل حلقة while. ونحتاج إلى معرفة متى نخرج من
تلك الحلقة. يمكننا أن نرى أننا داخل القاعدة يجب أولاً أن نجد رمز != أو ==. لذا
إن لم *نرَ أحدهما، فقّد انتهينا مع تسلسل مشغّلات المساواة. ونعبر عن ذلك الفحص
باستخدام طريقة match() الملائمة.
^code match
يتحقّق هذا ممّا إذا كان الرمز الحالي من أيّ من الأنواع المعطاة. إن كان كذلك، فإنه
يستهلك الرمز ويُعيد true. وإلا فيُعيد false ويترك الرمز الحالي على حاله. وطريقة
match() معرَّفة بمصطلحين عمليتين أكثر أساساً.
تعيد طريقة check() القيمة true إذا كان الرمز الحالي من النوع المعطى. وبخلاف
match()، لا تستهلك الرمز أبداً، إنها تنظر إليه فقط.
^code check
وتستهلك طريقة advance() الرمز الحالي وتُعيده، تماماً كما فعلت الطريقة المقابلة في
محلّلنا المعجمي وهي تزحف عبر المحارف.
^code advance
وتنتهي هذه الطرق عند آخر حفنة من العمليات الأوّلية.
^code utils
تفحص isAtEnd() ما إذا كنتَ قد نفدت من الرموز التي نحللها. وتُعيد peek() الرمز
الحالي الذي لم نستهلكه بعد، وتُعيد previous() آخر رمز استهلكناه. والأخيرة تجعل
استخدام match() ثم الوصول إلى الرمز المُطابَق حديثاً أسهل.
هذا معظم بنية التحليل التي نحتاجها. أين كنّا؟ حسناً، إذاً إن كنا داخل حلقة while
في equality()، فإننا نعرف أننا وجدنا مشغّل != أو == ويجب أن نحلّل تعبير مساواة.
نأخذ رمز المشغّل المُطابَق حتى نتتبّع أيّ نوع من تعبيرات المساواة لدينا. ثم نستدعي
comparison() مرةً أخرى لتحليل المُعامل الأيمن. وندمج المشغّل ومُعامليه في عقدة
شجرة تركيب Expr.Binary جديدة، ثم نعود إلى الحلقة. وفي كل دورة، نخزّن التعبير
الناتج في متغيّر expr المحلي نفسه. وبذلك، بينما نتقدّم عبر تسلسل تعبيرات
المساواة، ينشئ ذلك شجرة متداخلة مرتبطة يساراً من عقد المشغّلات الثنائية.
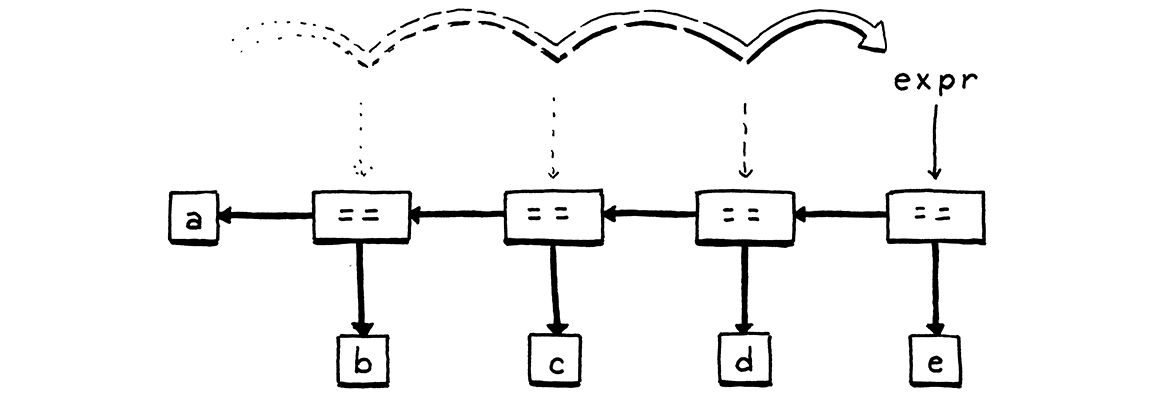
يخرج المحلّل من الحلقة حين يصطدم برمز ليس مشغّل مساواة. وأخيراً، يُعيد التعبير.
لاحظ أن إن لم يصادف المحلّل مشغّل مساواة أبداً، فإنه لن يدخل الحلقة أبداً. وفي تلك
الحالة، تستدعي دالة equality() وتُعيد comparison() عملياً. وبهذه الطريقة، تطابق
هذه الدالة مشغّل مساواة أو أيّ شيء ذي أولوية أعلى.
لننتقل إلى القاعدة التالية...
comparison → term ( ( ">" | ">=" | "<" | "<=" ) term )* ;
مترجَمةً إلى Java:
^code comparison
القاعدة اللغوية مطابقة عملياً تماماً لـequality،
وكذلك الشيفرة المقابلة. الفروق الوحيدة هي أنواع الرموز للمشغّلات التي نطابقها، والدالة
التي نستدعيها للمُعاملات — الآن term() بدلاً من comparison(). وقاعدتا المشغّلات
الثنائيتين المتبقّيتان تتبعان النمط نفسه.
حسب ترتيب الأولوية، أولاً الجمع والطرح:
^code term
وأخيراً، الضرب والقسمة:
^code factor
هذا كل المشغّلات الثنائية، محلَّلة بالأولوية والارتباطية الصحيحين. ونحن نتصاعد في تسلسل الأولوية، وقد وصلنا الآن إلى المشغّلات الأحادية.
unary          → ( "!" | "-" ) unary
               | primary ;
والشيفرة الخاصة بها مختلفة قليلاً.
^code unary
ومرةً أخرى، ننظر إلى الرمز الحالي لنرى كيف نحلل. إن كان
! أو -، فعلينا أن يكون لدينا تعبير أحادي. في تلك الحالة، نأخذ الرمز ثم نستدعي
unary() مرةً أخرى بشكل متكرر لتحليل المُعامل. نلفّ كل ذلك في شجرة تركيب تعبير
أحادي وننتهي.
وإلا، فلا بدّ أننا وصلنا إلى أعلى مستوى أولوية، أي التعبيرات الأولية.
primary        → NUMBER | STRING | "true" | "false" | "nil"
               | "(" expression ")" ;
معظم حالات القاعدة هي أطراف مفردة، لذا التحليل مباشر.
^code primary
والفرع المثير للاهتمام هو ذلك الذي يتعامل مع الأقواس. فبعد أن نطابق ( فتحاً
ونحلّل التعبير داخلها، يجب أن نجد رمز (). إن لم نفعل، فذلك خطأ.
أخطاء الصياغة
للمحلّل وظيفتان فعلاً:
-
معطى تسلسل صالح من الرموز، أن ينتج شجرة تركيب مقابلة.
-
معطى تسلسل غير صالح من الرموز، أن يكتشف أيّ أخطاء ويخبر المستخدم بأخطائهم.
لا تستهنّ بأهمية الوظيفة الثانية! في بيئات التطوير والمحرّرات الحديثة، يعيد المحلّل تحليل الشيفرة باستمرار — غالباً بينما لا يزال المستخدم يحرّرها — من أجل تلوين الصياغة ودعم أشياء مثل الإكمال التلقائي. وهذا يعني أنه سيصادف شيفرة في حالات ناقصة أو خاطئة نصفَ خطأ طوال الوقت.
حين لا يدرك المستخدم أن الصياغة خاطئة، فعلى المحلّل أن يساعده في العودة إلى المسار الصحيح. وطريقة الإبلاغ عن الأخطاء جزء كبير من واجهة المستخدم في لغتك. ومعالجة أخطاء الصياغة الجيدة صعبة. فبحكم التعريف، الشيفرة ليست في حالة محدَّدة بإحكام، لذا لا توجد طريقة لا تخطئ لمعرفة ما أراد المستخدم كتابته. فالمحلّل لا يستطيع قراءة ذهنك.
هناك متطلّبان صعبان حين يصطدم المحلّل بخطأ نحوي. فيجب على المحلّل أن:
-
يكتشف الخطأ ويبلّغ عنه. إن لم يكتشف الخطأ ومرّر شجرة التركيب المشوّهة الناتجة إلى المفسّر، فقد يُستدعى كل أنواع الرهائب.
-
يتجنّب الانهيار أو التعلّق. أخطاء الصياغة حقيقة من حقائق الحياة، ولا بدّ أن تكون أدوات اللغات متينة في مواجهتها. فحدوث انهيار في الذاكرة أو التعلّق في حلقة لا نهائية غير مسموح. قد لا يكون المصدر شيفرة صالحة، لكنه يظلّ إدخالاً صالحاً للمحلّل لأن المستخدمين يستخدمون المحلّل ليعرفوا ما الصياغة المسموح بها.
هذه هي الحدّ الأدنى إن أردت الدخول في لعبة التحليل أصلاً، لكنك على الأرجح تريد أن ترفع الرهان فوق ذلك. فينبغي أن يكون المحلّل الجيّد:
-
سريعاً. الحواسيب أسرع بآلاف المرّات مما كانت عندما اخترعت تقنية التحلل لأول مرة. لقد مضت الأيام التي كان عليك فيها أن تُحسّن محلّلك بحيث يمرّ على ملف مصدر كامل أثناء استراحة القهوة. لكن توقّعات المبرمجين ارتفعت بسرعة، إن لم تكن أسرع. إنهم يتوقّعون من محرّراتهم أن تُعيد تحليل الملفات خلال أجزاء من الألف من الثانية بعد كل ضغطة مفتاح.
-
أن يُبلّغ عن أكبر عدد من الأخطاء المتمايزة. الإنهاء بعد أول خطأ سهل التنفيذ، لكنه مزعج للمستخدمين إذا كان كلما أصلحوا ماون الخطأ الوحيد في الملف ظهر خطأ جديد. إنهم يريدون رؤيةها كلها.
-
أن يقلّل أخطاء المتسلسلة. بمجرد العثور على خطأ واحد، لا يعرف المحلّل حقّاً ما يجري. يحاول أن يعيد نفسه إلى مسارها ويستمر، لكن إن تلخبط فقد يُبلّغ عن سيل من أخطاء الأشباح التي لا تدلّ على مشاكل حقيقية أخرى في الشيفرة. وحين يُصلَح الخطأ الأول، تختفي تلك الأطياف، لأنها تعكس ارتباك المحلّل نفسه فقط. والأخطاء المتسلسلة مزعجة لأنها قد تُخيف المستخدم حتى يظنّ أن شيفرته في حالة أسوأ مما هي عليه فعلاً.
النقطتان الأخيرتان في tension مع بعضهما. نريد أن نُبلّغ عن أكبر عدد ممكن من الأخطاء المنفصلة، لكننا لا نريد أن نُبلّغ عن أخطاء هي مجرد آثار جانبية لخطأ سابق.
تُسمّى الطريقة التي يستجيب بها المحلّل للخطأ ويستمر في البحث عن أخطاء لاحقة استعادة الأخطاء (error recovery). وهذا كان موضوع بحث ساخن في الستينيات. في ذلك الحين، كنتَ تسلّم كومة من بطاقات مثقّبة إلى الأمينة وتعود في اليوم التالي لترى إن نجح المصرّف. ومع حلقة تكرار بطيئة إلى هذا الحدّ، كنتَ really تريد أن تجد كل خطأ في شيفرتك في مرور واحد.
اليوم، حين ينتهي المحلّلون قبل أن تنتهي حتى من الكتابة، فالمسألة أقلّ أهمية. فاستعادة الأخطاء البسيطة السريعة تكفي.
استعادة الأخطاء في وضع الذعر
من بين كل تقنيات الاستعادة التي اخترعت في الزمن الغابر، فإن التقنية التي صمدت أفضل في اختبار الزمن تُسمّى — بشكل مقلِق إلى حدٍّ ما — وضع الذعر (panic mode). ما إن يكتشف المحلّل خطأً حتى يدخل وضع الذعر. فهو يعرف أن رمزاً واحداً على الأقل لا يجعل معنى في ضوء حالته الحالية في منتصف مجموعة من القواعد اللغوية.
قبل أن يستطيع العودة إلى التحليل، يحتاج إلى محاذاة حالته وتسلسل الرموز القادمة بحيث يطابق الرمز التالي القاعدة الجاري تحليلها. وتُسمّى هذه العملية التزامن (synchronization).
ولتحقيق ذلك، نختار قاعدة ما في القواعد اللغويةستكون علامة على نقطة التزامن. فيُصلح المحلّل حالة تحليله by القفز خارج أي انتاجات متداخلة حتى يعود إلى تلك القاعدة. ثم يزامن تدفّق الرموز بحذف الرموز حتى يصل إلى رمز يمكن أن يظهر عند تلك النقطة في القاعدة.
أي أخطاء صياغة حقيقية إضافية مختبئة في تلك الرموز المحذوفة لن يُبلَّغ عنها، لكن ذلك يعني أيضاً أن أي أخطاء متسلسلة خاطئة كانت آثاراً جانبية للخطأ الأول لن يُبلَّغ عنها زوراً، وهذا مقايضة لائقة.
المكان التقليدي في القواعد اللغوية للالتزامن هو بين الجمل. وليس لدينا تلك بعد، لذا لن نزامن فعلياً في هذا الفصل، لكننا سنضع الآلية في مكانها للاستخدام لاحقاً.
الدخول في وضع الذعر
قبل أن ننتقل في هذه الرحلة الجانبية حول استعادة الأخطاء، كنا نكتب شيفرة تحليل تعبير
محاط بأقواس. وبعد تحليل التعبير، يبحث المحلّل عن قوس الإغلاق ) عبر استدعاء
consume(). وهنا، أخيراً، تلك الدالة:
^code consume
وهي مشابهة لـmatch() في أنها تتحقّق ممّا إذا كان الرمز التالي من النوع المتوقّع.
إن كان كذلك، فإنها تستهلك الرمز وكل شيء على ما يرام. وإن كان هناك رمز آخر، فقد
اصطدمنا بخطأ. ونبلّغ عنه باستدعاء هذا:
^code error
أولاً، يعرض ذلك الخطأ على المستخدم باستدعاء:
^code token-error
يبلّغ هذا عن خطأ عند رمز معطى. ويعرض موضع الرمز والرمز نفسه. وسيكون هذا مفيداً لاحقاً لأننا نستخدم الرموز في كل أنحاء المفسّر لتتبّع المواضع في الشيفرة.
وبعد أن نُبلّغ عن الخطأ، يعرف المستخدم عن خطئه، لكن ماذا يفعل المحلّل بعد ذلك؟
فعودةً إلى error()، ننشئ ParseError ونُعيده، وهو نسخة من هذا الصنف الجديد:
^code parse-error (1 before, 1 after)
هذا صنف بسيط يُستخدم كقيمة حارسة (sentinel) نستعمله لفكّ انحسار المحلّل. وطريقة
error() تُعيد الخطأ بدلاً من إطلاقه، لأننا نريد أن تتّخذ دالة الاستدعاء داخل
المحلّل قرار الانحلال أم لا. فبعض أخطاء التحليل تحدث في مواضع لا يُرجَّح أن يصل
فيها المحلّل إلى حالة غريبة، ولا نحتاج إلى مزامنة.
وفي تلك المواضع، نكتفي بإبلاغ عن الخطأ ونواصل العمل كأن شيئاً لم يكن.
مثلاً، تحدّ Lox عدد المعاملات التي يمكنك تمريرها إلى دالة. فإن مرّرتَ أكثر مما ينبغي، يحتاج المحلّل إلى الإبلاغ عن ذلك الخطأ، لكنّه يستطيع — بل ينبغي له — أن يواصل ببساطة تحليل المعاملات الزائدة بدلاً من الذعر والدخول في وضع الذعر.
لكن في حالتنا، خطأ الصياغة سيّئ بما يكفي دفعنا إلى الدخول في الذعر والمزامنة. فحذف الرموز سهل إلى حدٍّ ما، لكن كيف نزامن حالة المحلّل نفسها؟
مزامنة محلّل بال descent التكراري
مع التحليل بال descent التكراري، لا تُخزَّن حالة المحلّل — أي القواعد التي هو في وسط التعرّف عليها — صراحةً في حقول. بدلاً من ذلك، نستخدم مكدّس استدعاءات Java الخاص بنا لتتبّع ما يفعله المحلّل. فكل قاعدة يجري تحليلها هي إطار استدعاء على المكدّس. ولإعادة تعيين تلك الحالة، نحتاج إلى تفريغ إطارات الاستدعاء تلك.
الطريقة الطبيعية للقيام بذلك في Java هي الاستثناءات. فحين نريد أن نزامن، نحن رمي ذلك كائن ParseError. وفي مستوى أعلى، داخل دالة القاعدة اللغوية التي نزامن إليها، سنلتقطه. وبما أننا نزامن عند حدود الجمل، فسنلتقط الاستثناء هناك. وبعد التقاط الاستثناء، يكون المحلّل في الحالة الصحيحة. ولم يبقَ سوى مزامنة الرموز.
نريد أن نحذف الرموز حتى نكون في بداية الجملة التالية بالضبط. وهذا الحدّ سهل
التمييل -- وهو أحد الأسباب الرئيسية التي اخترناها. بعد الفاصلة المنقوطة، نكون
على الأرجح قد أنهينا جملة. ومعظم الجمل تبدأ بكلمة
مفتاحية -- for أو if أو return أو var إلخ. وحين يكون الرمز التالي أيّاً
من تلك، فنحن على الأرجح في طريقنا لبدء جملة.
تغلّف هذه الدالة ذلك المنطق:
^code synchronize
فهي تحذف الرموز حتى تظن أنها وجدت حدّ جملة. وبعد التقاط ParseError، سنستدعي هذه، ثم نكون متزامنين من جديد على الأرجح. وحين تعمل جيداً، تكون قد حذفت رموز كانت ستسبب أخطاء متسلسلة على الأرجح، والآن يمكننا تحليل بقية الملف بدءاً من الجملة التالية.
للأسف، لا ن نرى هذه الدالة في العمل، لأن ليس لدينا جمل بعد. سنصل إلى ذلك بعد فصلين. أما الآن، فإذا حدث خطأ، فسنُدخل في وضع الذعر ونحلّ كل الطريق إلى الأعلى ونتوقّف عن التحليل. وبما أننا نستطيع تحليل تعبير واحد فقط على أي حال، فلا كبيرة.
توصيل المحلّل
نحن في الغالب finished من تحليل التعبيرات الآن. وهناك مكان آخر نحتاج فيه إلى
إضافة بعض معالجة الأخطاء. فبينما ينزل المحلّل عبر دوال التحليل لكل قاعدة لغوية،
فإنه ينتهي به المطاب إلى primary(). إن لم تطابق أيّ من الحالات الموجودة هناك،
فهذا يعني أننا جالسون على رمز لا يستطيع بدء تعبير. ونحتاج إلى معالجة ذلك الخطأ
أيضاً.
^code primary-error (5 before, 1 after)
وبذلك، لم يبقَ في المحلّل سوى تعريف دالة ابتدائية تُشغّله. وتُسمّى تلك الدالة،
بشكل بديهي، parse().
^code parse
سنعود إلى هذه الدالة لاحقاً عندما نضيف جملاً إلى اللغة. أما الآن، فهي تحلّل تعبيراً واحداً وتُعيده. ولدينا أيضاً بعض الشيفرة المؤقتة للخروج من وضع الذعر. فاستعادة أخطاء الصياغة هي وظيفة المحلّل، لذا لا نريد أن يفلت استثناء ParseError إلى بقية المفسّر.
حين يحدث خطأ صياغة، تُعيد هذه الدالة null. وهذا مقبول. فالمحلّل يَعِدّ بألا ينهار
أو يتعلّق على صياغة غير صالحة، لكنه لا يَعِدّ بإعادة شجرة تركيب صالحة للاستخدام
إن وُجد خطأ. وما إن يُبلّغ المحلّل عن خطأ حتى يُضبط hadError، وتُتخطّى المراحل
التالية.
أخيراً، يمكننا توصيل محلّلنا الجديد بالصنف الرئيسي Lox وتجربته. ليس لدينا مفسّر بعد، لذا سنحلّل إلى شجرة تركيب ثم نستخدم صنف AstPrinter من الفصل الأخير لعرضها.
احذف الشيفرة القديمة التي تطبع الرموز الممسوحة بدلًا منها ضع هذه:
^code print-ast (1 before, 1 after)
تهانينا، لقد اجتزت العتبة! هذا فعلاً كل ما في كتابة محلل بخط اليد. سنوسّع القواعد اللغوية في فصول لاحقة بالإسناد والجمل وأشياء أخرى، لكن لا شيء منها أعقد من المشغّلات الثنائية التي تعاملنا معها هنا.
شغّل المفسّر واكتب بعض التعبيرات. انظر كيف يتعامل مع الأولوية والارتباطية على نحو صحيح؟ ليس سيئاً لأقل من 200 سطر من الشيفرة.
التحديات
-
في C، الكتلة هي صيغة جملة تتيح لك حزم سلسلة من الجمل في موضع يُتوقَّع فيه جملة واحدة. و[مشغّل الفاصلة][] هو صيغة مماثلة للتعبيرات. فسلسلة من التعبيرات مفصولة بفواصل يمكن إعطاؤها حيث يُتوقَّع تعبير واحد (عدا داخل قائمة معاملات استدعاء دالة). وفي الزمن التشغيلي، يقيّم مشغّل الفاصلة المُعامل الأيسر ويهمل النتيجة. ثم يُقيّم المُعامل الأيمن ويُعيده.
أضف دعماً لتعبيرات الفاصلة. امنحها الأولوية والارتباطية نفسها كما في C. اكتب القواعد اللغوية، ثم نفّذ شيفرة التحليل اللازمة.
-
وعلى النحو نفسه، أضف دعماً لمشغّل C الشرطي أو «الثلاثي»
?:. ما مستوى الأولوية المسموح به بين?و:؟ وهل المشغّل كامل مرتبط يساراً أم يميناً؟ -
أضف انتاجات أخطاء للتعامل مع ظهور كل مشغّل ثنائي دون مُعامل أيسر. بمعنى آخر، اكتشف ظهور مشغّل ثنائي في بداية تعبير. أبلغ عن ذلك كخطأ، لكن حلّل أيضاً مُعاملاً أيمناً بالأولوية المناسبة وتخلّص منه.
ملاحظة تصميم: المنطق مقابل التاريخ
لنفترض أننا قررنا إضافة مشغّلات & و | إلى Lox. أين ينبغي أن نضعها في
تسلسل الأولويات؟ ضع C — ومعظم اللغات التي تسير على نهج C — تضعهما دون ==.
ويُعدّ هذا خطأً شائعاً لأنه يعني أن عمليات شائعة مثل اختبار علم (flag) تتطلّب
أقواساً.
if (flags & FLAG_MASK == SOME_FLAG) { ... } // Wrong.
if ((flags & FLAG_MASK) == SOME_FLAG) { ... } // Right.
هل نُصلح هذا في Lox ونضع المشغّلات التشغيلية أعلى في جدول الأولوية مما تفعل C؟ هناك استراتيجيتان يمكننا اتّباعهما.
لا تكاد تريد أبداً استخدام نتيجة تعبير == كمُعامل لمشغّل ثنائي. فجعل المشغّلات
ترتبط ارتباطاً أشدّ يعني أن المستخدمين لا يحتاجون إلى الأقواس بقدر ما. فإذا
فعلنا ذلك، وكان المستخدمون يفترضون أن الأولوية اختيرت منطقياً لتقليل الأقواس،
فمن المرجّح أن يستنتجوها على نحو صحيح.
وهذا النوع من الاتّساق الداخلي يجعل اللغة أسهل في التعلّم لأن هناك حالات حدّية واستثناءات أقلّ يجب أن يصطدم بها المستخدم ثم يصحّحها. وهذا أمر جيد، لأن على المستخدمين قبل أن يستخدموا لغتنا أن يحمّلوا كل تلك الصياغة والدلالات في رؤوسهم. فاللغة الأبسط والأكثر عقلانية makes sense.
لكن بالنسبة لكثيرين من المستخدمين، هناك اختصار أسرع بكثير لنقل أفكار لغتنا إلى أدمغتهم -- استخدام مفاهيم يعرفونها بالفعل. فكثير من الوافدين الجدد إلى لغتنا سيأتون من لغة أو لغات أخرى. فإذا كانت لغتنا تستخدم بعض الصياغة أو الدلالات نفسها التي تستخدمها تلك اللغات، فسيكون على المستخدم أن يتعلّم أقل بكثير (وأن ينسى أقل بكثير).
وهذا مفيد بشكل خاص مع الصياغة. قد لا تتذكّرها جيداً اليوم، لكن حين تعلّمت أول لغة برمجة كانت لديك، كانت الشيفرة على الأرجح تبدو غريبة ودافعةً بعيدة المنال. ولم تتعلّم قراءتها وقبولها إلا بجهد شاقّ. فإذا صمّمتَ صياغة جديدة للغة جديدة، فأنت تجبر المستخدمين على بدء تلك العملية من جديد.
الاستفادة مما يعرفه المستخدمون بالفعل هي واحدة من أقوى الأدوات المتاحة لتسهيل تبنّي لغتك. من المستحيل تقريبًا أن نبالغ في تقدير قيمة ذلك. لكنها تضعك أمام مشكلة صعبة: ماذا يحدث حين يكون الشيء الذي يعرفه الجميع يعاني إلى حدٍّ ما؟ فأولوية المشغّل التشغيلي في C خطأ لا معنى له. لكنه خطأ مألوف، فقد تأقلم معه الملايين وتعلّموا التعايش معه.
هل تظلّ أميناً للمنطق الداخلي لغتك وتتجاهل التاريخ؟ هل تبدأ من لوح أبيض ومن المبادئ الأوّلية؟ أم هل تنسج لغتك في نسيج تاريخ البرمجة الغني وتمنح مستخدميك Advantage بالبدء من شيء يعرفونه بالفعل؟
لا توجد إجابة مثالية هنا، بل مقايضات فقط. فأنت وأنا نميلان إلى تفضيل اللغات الجديدة، لذا فإن ميولنا الطبيعية هي حرق كتب التاريخ وبدء قصتنا الخاصة.
في الممارسة، من الأفضل غالباً أن تستثمر ما يعرفه المستخدمون بالفعل. فإقناعهم بالقدوم إلى لغتك يتطلّب قفزة كبيرة. وكلما صغّرت تلك الهوّة، ازداد عدد من يكونون مستعدّين ليعبروها. لكن لا يمكنك دائماً التمسّك بالتاريخ، وإلا لن يكون في لغتك شيء جديد وجذاب تقدّمه للناس سبباً يقفزون من أجله.