الحَلّ والربط
كلّ فترةٍ ما تجد نفسك في موقفٍ غريب. تدخله تدريجياً وعلى أكثر الطرقّ طبيعيةً، لكن حين تكون في قلبه تماماً، تُصدم فجأةً وتسأل نفسك كيف توفّر كلّ هذا في العالم.
ثور هايردال، كون-تيكي
يا إلهي! تطبيق لغتنا يتسرّب الماء إلينا! في عهد بعيد حين أضفنا المتغيّرات والكتل، كان نطاقنا محكماً لنا. لكن حين أضفنا الإغلاقات لاحقاً، انفتح ثقبٌ في مفسّرنا الذي كان مانعاً للماء. من المرجّح ألّا تنزلق معظم البرامج الحقيقية من هذا الثقب، لكنّنا منفّذي لغات، ونقطع نذراً مقدّساً بأن نهتمّ بالصواب حتى في أعمق زوايا الدلالة وأرطِبها.
سنقضي الفصل كلّه في استكشاف ذلك التسريب، ثمّ نرقّعه بعناية. وفي العملية، سنكتسب فهماً أكثر صرامةً للنطاق المعجمي (lexical scoping) كما تستعمله Lox ولغاتٌ أخرى في عائلة C. وسنحصل أيضاً على فرصة لتعلّم التحليل الدلالي (semantic analysis) -- وهي تقنيّةٌ قويّة لاستخراج المعنى من شيفرة المستخدم المصدرية دون الحاجة إلى تشغيلها.
النطاق الساكن
تذكيرٌ سريع: تستخدم Lox، مثل معظم اللّغات الحديثة، نطاقاً معجميّاً (lexical). وهذا يعني أنّك تستطيع معرفة أيّ تصريحٍ يشير إليه اسمُ متغيّر بمجرّد قراءة نصّ البرنامج. فمثلاً:
var a = "outer";
{
  var a = "inner";
  print a;
}
هنا، نعرف أنّ a التي تُطبع هي المتغيّر المصرَّح عنه في السطر
السابق، وليست العامّة. وتشغيل البرنامج لا يؤثّر في ذلك -- ولا
يستطيع. قواعد النطاق جزءٌ من الدلالة الساكنة للّغة، ولهذا
تُسمّى أيضاً نطاقاً ساكناً.
لم أشرح تلك قواعد النطاق بالتفصيل، لكنّ الوقت الآن مناسبٌ لـالدقّة:
إنّ استعمال المتغيّر يشير إلى التصريح السابق بالاسم نفسه في أعمق نطاقٍ يحيط بالتعبير الذي استُعمل فيه المتغيّر.
هناك الكثير في ذلك لنفكّكه:
-
أقول "استعمال متغيّر" بدلاً من "تعبير متغيّر" لأشمل ذلك تعبيرات المتغيّرات والإسنادات معاً. وكذلك "التعبير الذي استُعمل فيه المتغيّر".
-
"السابق" يعني الظهور قبل ذلك في نصّ البرنامج.
var a = "outer";
{
  print a;
  var a = "inner";
}
هنا،
aالتي تُطبع هي الخارجيّة لأنّها تظهر قبل جملةprintالتي تستعملها. وفي معظم الحالات، في الشيفرة التسلسلية المباشرة، يسبق تصريحٌ ما نصّياً الاستعمالَ زمنياً أيضاً. لكنّ ذلك ليس صحيحاً دائماً. وكما سنرى، قد تؤجّل الدوالّ قطعةً من الشيفرة بحيث لا يعود تنفيذها الزمني الديناميكي يعكس الترتيب النصّي الساكن. -
و"الأعمق" موجودة بسبب صديقنا الذي يُسمّى الحجب (shadowing). فقد يوجد أكثر من متغيّر بالاسم نفسه في النطاقات المحيطة، كما في:
var a = "outer";
{
  var a = "inner";
  print a;
}
وقاعدتنا تحسم هذا التباس بالقول إنّ أعمق نطاقٍ هو الفائز.
ولأنّ هذه القاعدة لا تذكر أيّ سلوكٍ وقت التشغيل، فإنّها تعني أنّ تعبير المتغيّر يشير دائماً إلى التصريح نفسه طوال تنفيذ البرنامج. ومفسّرنا حتى الآن ينفّذ القاعدة على نحوٍ صحيحٍ في الغالب. لكن حين أضفنا الإغلاقات، تسلّل خطأ.
var a = "global";
{
  fun showA() {
    print a;
  }

  showA();
  var a = "block";
  showA();
}
قبل أن تكتب هذا وتشغّله، قرّر ما تظنّ أنّه سيطبعه.
حسناً... فهمتَ؟ إن كنتَ على اطّلاع بالإغلاقات في لغاتٍ أخرى،
فستتوقّع أن يطبع "global" مرّتين. فاستدعاء showA() الأوّل
سيطبع "global" بالتأكيد، إذ لم نصل حتى إلى تصريح a الداخلي
بعد. وبقاعدتنا أنّ تعبير المتغيّر يُحَلّ دائماً إلى المتغيّر نفسه،
فذلك يعني أنّ استدعاء showA() الثاني سيطبع الشيء ذاته.
للأسف، إنّه يطبع:
global
block
ولأُشدّد على أنّ هذا البرنامج لا يُعيد إسناد أيّ متغيّر ولا يحتوي
إلّا على جملة print واحدة. ومع ذلك، فجأةً، تطبع تلك الجملة
print لمتغيّرٍ لا يُعاد إسناده قوتين مختلفتين في لحظتين
مختلفتين. لقد كسرنا شيئاً ما في مكانٍ ما.
النطاقات والبيئات القابلة للتغيير
في مفسّرنا، البيئات هي التجسيد الديناميكي للنطاقات الساكنة. والاثنان يتبقيان في الغالب متزامنين -- ننشئ بيئةً جديدة حين ندخل نطاقاً جديداً، ونطرحها حين نغادر النطاق. وهناك عملية أخرى واحدة نُجريها على البيئات: ربط متغيّرٍ فيها. وهنا يقع خللنا.
لنمرّ على ذلك المثال المُشتبِه ونرى كيف تبدو البيئات في كلّ
خطوة. أوّلاً، نصرّح بـa في النطاق العام.
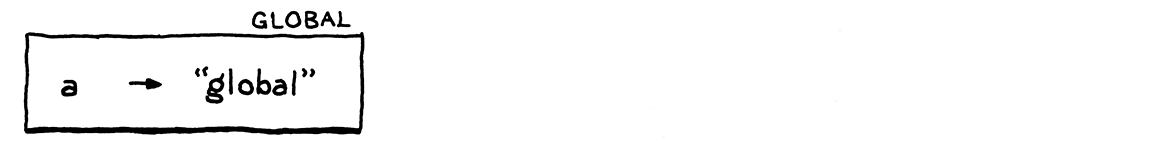
يمنحنا ذلك بيئةً واحدة فيها متغيّرٌ واحد. ثمّ ندخل الكتلة
ونُنفّذ تصريح showA().
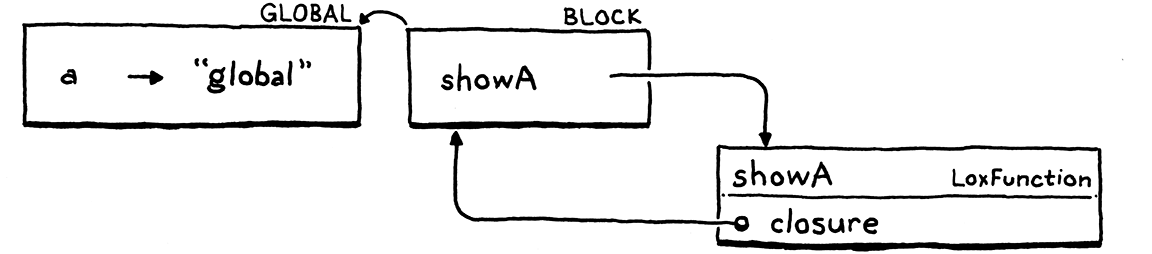
نحصل على بيئة جديدة للكتلة. وفيها نصرّح باسمٍ واحد، وهو
showA، المربوط بكائن LoxFunction الذي ننشئه لتمثيل الدالة. ولدى
ذلك الكائن حقل closure يلتقط البيئة التي صُرِّحت فيها الدالة،
لذا لديه مرجعٌ يعود إلى بيئة الكتلة.
الآن نستدعي showA().
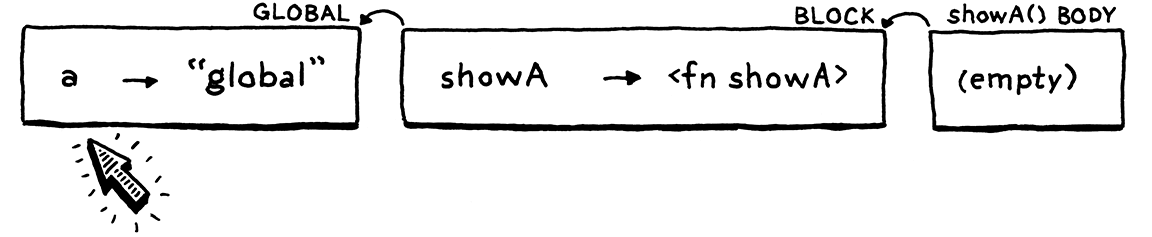
يُنشئ المفسّر ديناميكياً بيئةً جديدة لجسم دالة showA(). وهي
فارغة لأنّ تلك الدالة لا تصرّح بأيّ متغيّرات. وأمّ والد تلك
البيئة فهو إغلاقُ الدالة -- أي بيئة الكتلة الخارجية.
داخل جسم showA()، نطبع قيمة a. يبحث المفسّر عن هذه القيمة
بالمشي في سلسلة البيئات. ويصل كلّ الطريق إلى البيئة العامة قبل
أن يجدها هناك ويطبع "global". ممتاز.
ثمّ نصرّح بـa الثانية، هذه المرّة داخل الكتلة.
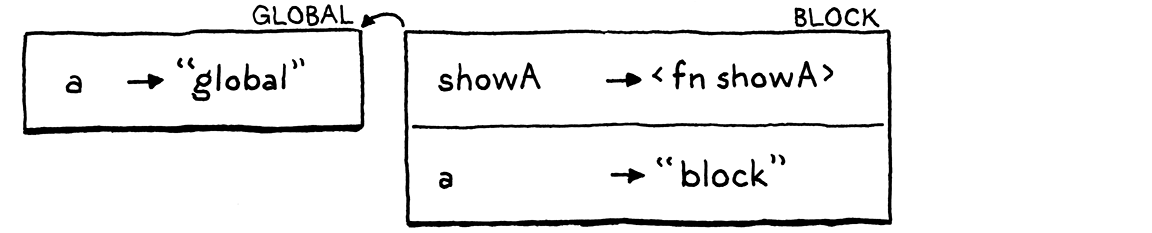
إنّها في الكتلة نفسها -- النطاق نفسه -- التي فيها showA()، لذا
تذهب إلى البيئة نفسها، وهي أيضاً البيئة التي يشير إليها إغلاقُ
showA(). وهنا يصبح الأمر مثيراً للاهتمام. نستدعي showA()
مرّةً أخرى.
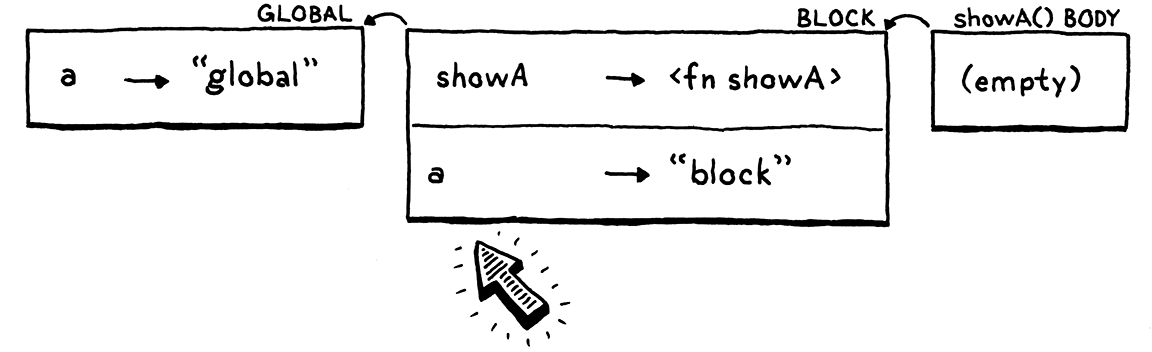
ننشئ بيئةً فارغة جديدة لجسم showA() مرّةً أخرى، ونربطها بذلك
الإغلاق، ونشغّل الجسم. وحين يمشي المفسّر في سلسلة البيئات
للعثور على a، يجد الآن a الجديدة في بيئة الكتلة. بوو.
اخترتُ أن أُنفّذ البيئات بطريقة آمل أن تتفق مع حدسك غير الرسمي حول النطاقات. فنحن نميل إلى اعتبار كلّ الشيفرة داخل كتلةٍ ما أنّها في النطاق نفسه، لذا يستخدم مفسّرنا بيئةً واحدةً لتمثيل ذلك. وكلّ بيئةٍ هي جدول تجزئة قابل للتغيير. وحين يُصرَّح بمتغيّرٍ محلّي جديد، يُضاف إلى البيئة القائمة لذلك النطاق.
وهذا الحدس، مثل حدوسٍ كثيرة في الحياة، ليس صحيحاً تماماً. فالكتلة ليست بالضرورة كلها النطاق نفسه. فكّر في:
{
  var a;
  // 1.
  var b;
  // 2.
}
عند السطر المُعلَّم الأوّل، المتغيّر a وحده في النطاق. وعند
السطر الثاني، كلٌّ من a و b. فإذا عرّفتَ "النطاق" بأنّه
مجموعة تصاريح، فإنّهما ليسا النطاق نفسه
بالتأكيد -- لأنّهما لا يحتويان التصاريح نفسها. إنّه أشبه بأنّ كلّ
جملة var تقسم الكتلة إلى نطاقَين
منفصلَين: النطاق قبل تصريح المتغيّر، والنطاق بعده الذي يشمل
المتغيّر الجديد.
لكن في تطبيقنا، تتصرّف البيئات فعلاً وكأنّ الكتلة كلّها نطاقٌ واحد، لكنّ نطاقاً يتغيّر مع الزمن. والإغلاقات لا تحبّ ذلك. فحين تُصرَّح دالةٌ، تلتقط مرجعاً إلى البيئة الحالية. وينبغي أن تلتقط الدالة لقطةً مجمّدةً من البيئة كما كانت لحظة تصريح الدالة. لكنّها بدلاً من ذلك، في شيفرة Java، لديها مرجعٌ إلى كائن البيئة القابل للتغيير نفسه. وحين يُصرَّح متغيّرٌ لاحقاً في النطاق الذي تقابله تلك البيئة، يرى الإغلاق المتغيّر الجديد، مع أنّ التصريح لا يسبق الدالة.
البيئات الدائمة
هناك نمطُ برمجةٍ يستعمل ما يُسمّى بنى البيانات الدائمة (persistent data structures). وخلافاً لبنى البيانات الليّنّة التي أنتَ معتاد عليها في البرمجة الأمرية، لا يمكن تعديل بنية بياناتٍ دائمة تعديلاً مباشراً أبداً. وبدلاً من ذلك، فإنّ أيّ "تعديل" على بنيةٍ قائمة يُنتج كائناً جديداً تماماً يحتوي كلَّ البيانات الأصلية مع التعديل الجديد. ويبقى الأصل دون تغيير.
لو طبّقنا تلك التقنية على Environment، لأعادت كلّ مرةٍ تصريحَ متغيّرٍ بيئةً جديدة تحتوي كلَّ المتغيّرات المصرَّحة سابقاً مع الاسم الجديد الواحد. وتصرّحُ متغيّرٍ سيُنجز التقسيمَ الضمني حيث تكون لديك بيئةٌ قبل تصريح المتغيّر وبيئةٌ بعده:
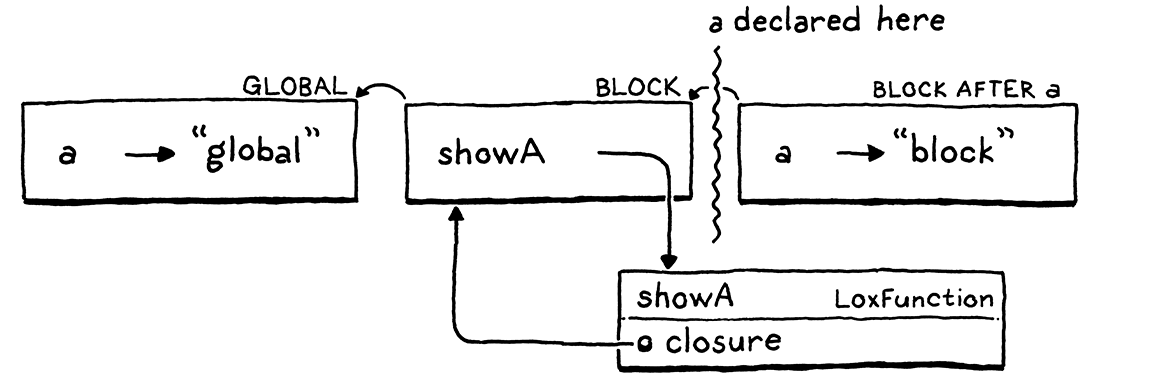
يحتفظ الإغلاق بمرجعٍ إلى كائن البيئة الجاري لحظة تصريح الدالة. وبما أنّ أيّ تصريحاتٍ لاحقة في تلك الكتلة ستُنتج كائنات Environment جديدة، فلن يرى الإغلاق المتغيّرات الجديدة وسيُصلَح خللنا.
هذه طريقةٌ مشروعة لحلّ المشكلة، وهي الطريقة الكلاسيكية لتنفيذ البيئات في مفسّرات Scheme. يمكننا أن نفعل ذلك لـLox، لكنّ ذلك يعني العودة وتغيير كومةٍ من الشيفرة القائمة.
لن أُرهقك بذلك. سنُبقي طريقة تمثيلنا للبيئات كما هي. وبدلاً من جعل البيانات أكثر بنيةً ساكنة، سنُدمج الحَلّ الساكن في عملية الوصول نفسها.
التحليل الدلالي
يقوم مفسّرنا بـحَلّ المتغيّر -- أي تتبّع التصريح الذي يشير إليه -- في كلّ مرّةٍ وفعل يُقيَّم فيها تعبير المتغيّر. فإذا كان ذلك المتغيّر ملفوفاً في حلقةٍ تعمل ألف مرّة، فإنّ المتغيّر يُحَلّ ألف مرّة.
نحن نعرف أنّ النطاق الساكن يعني أنّ استعمال المتغيّر يُحَلّ دائماً إلى التصريح نفسه، ويمكن تحديده بمجرّد النظر في النصّ. وبما أنّ ذلك كذلك، فلماذا نفعله ديناميكياً في كلّ مرّة؟ ففعله لا يفتح الثقب الذي يؤدي إلى خللنا المُزعج فحسب، بل هو بطيءٌ بلا داعٍ.
الحلّ الأفضل هو أن نُحلّ كلّ استعمالٍ للمتغيّر مرّةً واحدة. نكتب قطعةَ شيفرة تفحص برنامج المستخدم، وتجد كلّ متغيّرٍ مذكور، وتحدّد أيّ تصريحٍ يشير إليه. وهذه العملية مثالٌ على تحليلٍ دلاليّ (semantic analysis). فبينما يكتفي المحلل النحوي بمعرفة ما إذا كان البرنامج صحيحاً نحوياً (تحليلٌ صياغيّ)، فإنّ التحليل الدلالي يذهب أبعد ويبدأ في تحديد معنى أجزاء البرنامج فعلاً. وفي حالتنا، سيُحلّ تحليلنا روابط المتغيّرات. وسنعرف ليس فقط أنّ تعبيراً ما هو متغيّر، بل أيّ متغيّر هو.
هناك طرقٌ كثيرة يمكننا بها تخزين الربط بين متغيّر وتصريحه. وحين نصل إلى مفسّر C للّغة Lox، سيكون لدينا طريقةٌ أكثر كفاءة بكثير لتخزين المتغيّرات المحلّية والوصول إليها. لكن في jlox، أريد أن أُقلّل الضرر العرضي الذي نُلحقه بقاعدة شيفرتنا القائمة. ولا أريد أن أُطرح away كومةً من الشيفرة التي هي جيّدةٌ في معظمها.
بدلاً من ذلك، سنخزّن ناتج الحَلّ بطريقة تستثمر أقصى ما في صنف
Environment القائم. وتذكّر كيف كانت وصولاتُ a تُفسَّر في المثال
المُشتبِه.
في التقييم الأوّل (الصحيح)، ننظر في ثلاث بيئات في السلسلة قبل أن
نجد التصريح العامّ لـa. ثمّ حين يُصرَّح بـa الداخلي لاحقاً في
نطاق كتلة، يحجب العامّ.
والبحث التالي يمشي في السلسلة، ويجد a في البيئة الثانية
ويتوقّف هناك. ولكلّ بيئة نطاقٌ معجميٌّ واحد تُصرَّح فيه
المتغيّرات. فلو استطعنا ضمان أن بحثاً عن متغيّر يمشي دائماً
العدد نفسه من الروابط في سلسلة البيئات، لضَمن ذلك أنه يجد
المتغيّر نفسه في النطاق نفسه في كلّ مرّة.
و"حلّ" استعمال متغيّر لا يتطلّب سوى حساب كم "قفزة" ستُبقيه سيكون عنها المتغيّر المصرَّح في سلسلة البيئات. والسؤال المهمّ هو متى نُجري هذا الحساب -- أو بصيغةٍ أخرى، أين في تنفيذ مفسّرنا نضع شيفرته؟
وبما أنّنا نحسب خاصيةً ساكنةً بناءً على بنية الشيفرة المصدرية، فالجواب الواضح هو في المحلّل النحوي.(ISPR) ذلك هو موطنه التقليدي، وهو أين سنضعه لاحقاً في clox. وسيعمل هنا أيضاً، لكنّني أريد ذريعةً لأريك تقنيّةً أخرى. سنكتب الحالّ (resolver) كتبقيّةٍ مستقلّة.
بقيّةٌ لحلّ المتغيّرات
بعد أن يُنتج المحلل النحوي شجرة الصياغة، وقبل أن يبدأ المفسّر في تنفيذها، سنقوم بجولةٍ واحدة على الشجرة لنُحلّ كلّ المتغيّرات التي تحويها. والبقايا الإضافية بين التحليل النحوي والتنفيذ أمرٌ شائع. فلو كانت Lox مُنمَّطة ساكناً، لأمكننا إدراج فاحصِ أنواع هناك. وغالباً ما تُنفَّذ التحسينات أيضاً في بقايا منفصلة كهذه. وبالأساس، أيّ عملٍ لا يعتمد على حالةٍ لا تتوفّر إلّا وقت التشغيل يمكن إنجازه بهذه الطريقة.
تعمل بقيّة حلّ المتغيّرات لدينا نوعاً ما من المفسّر المصغّر. فهي تمشي على الشجرة، وتزور كلّ عقدة، لكنّ التحليل الساكن يختلف عن التنفيذ الديناميكي:
-
لا توجد آثار جانبيّة. حين يزور التحليل الساكن جملة print، فإنّه لا يطبع شيئاً فعلياً. وتُستبدَل الاستدعاءات إلى الدوالّ الأصلية أو العمليات الأخرى التي تمتدّ إلى العالم الخارجي بأشباكٍ فارغة ولا أثر لها.
-
لا يوجد تحكّم في التنفيذ. تُزور الحلقات مرّةً واحدة فقط. وكلا الفرعين في جمل
ifيُزوران. والمعاملات المنطقيّة لا تُحقِّق شرطاً وتقف مبكّراً.
صنف الحالّ
وكما في كلّ شيءٍ في Java، تتجسّد بقيّة حلّ المتغيّرات لدينا في صنف.
^code resolver
ولأنّ الحالّ يحتاج إلى زيارة كلّ عقدةٍ في شجرة الصياغة، فإنّه يطبّق تجريد الزائر الذي لدينا بالفعل. فليست سوى أنواع قليلةٍ من العُقد مهمّة حين يتعلّق الأمر بحلّ المتغيّرات:
-
تُقدّم جملة الكتلة نطاقاً جديداً للجمل التي تحويها.
-
يُقدّم تصريحُ الدالة نطاقاً جديداً لجسمها ويربط وسائطه في ذلك النطاق.
-
يضيف تصريحُ المتغيّر متغيّراً جديداً إلى النطاق الحالي.
-
تحتاج تعبيرات المتغيّرات والإسناد إلى حلّ متغيّراتها.
لا تفعل بقية العُقد شيئاً مميّزاً، لكنّنا ما زلنا بحاجة إلى
تنفيذ طُرق زيارة لها تعبر إلى أشجارها الفرعية. فرغم أنّ تعبير
+ لا يملك بنفسه أيّ متغيّرات نحلّها، فقد يملك أيٌّ من معامليه
بعضاً.
حلّ الكتل
نبدأ بالكتلات لأنّها تنشئ النطاقات المحلّية حيث يحدث كلّ السحر.
^code visit-block-stmt
يبدأ هذا نطاقاً جديداً، ويعبر إلى الجمل داخل الكتلة، ثمّ يطرح النطاق. والأشياء الطريفة تعيش في تلك الطرق المساعدة. نبدأ بال-simple منها.
^code resolve-statements
يمشي هذا على قائمة جمل ويُحلّ كلّ واحدة. وهو بدوره يستدعي:
^code resolve-stmt
وبما أنّنا في الموضوع، فدعنا نضيف حِملاً زائداً آخر سنحتاجه لاحقاً لحلّ تعبير.
^code resolve-expr
وهذه الطُرق مشابهة لطُرق evaluate() و execute() في
Interpreter -- فإنّها تلتفت وتطبّق نمط الزائر على عقدة شجرة
الصياغة المعطاة.
السلوك المهمّ حقّاً يدور حول النطاقات. ويُنشأ نطاق كتلة جديد هكذا:
^code begin-scope
وتتداخل النطاقات المعجمية في المفسّر وفي الحالّ معاً. فهي تتصرّف كالمكدّس. ويطبّق المفسّر ذلك المكدّس باستعمال قائمةٍ مترابطة -- سلسلة كائنات Environment. أمّا في الحالّ فنستعمل Stack أصلية في Java.
^code scopes-field (1 before, 2 after)
يتتبّع هذا الحقل مكدّس النطاقات الحالية -- أي التي "في النطاق". وكلّ عنصرٍ في المكدّس هو Map يمثّل نطاق كتلةٍ واحد. والمفاتيح، كما في Environment، هي أسماء المتغيّرات. أمّا القيم فقيمٌ منطقيّة، لسببٍ سأشرحه قريباً.
لا تُستخدم مكدّس النطاقات إلّا لنطاقات الكتل المحلّية. ولا يتتبّع الحالّ المتغيّرات المصرَّحة في المستوى الأعلى في النطاق العامّ، لأنّها أكثر ديناميكيّة في Lox. وحين نحلّ متغيّراً، فإن لم نجده في مكدّس النطاقات المحلّية، نفترض أنّه عامّ.
وبما أنّ النطاقات مخزَّنة في مكدّسٍ صريح، فإنّ الخروج منها أمرٌ مباشر.
^code end-scope
الآن يمكننا أن ندفع نطاقاً فارغاً على مكدّس وأن نسحبه. فلنضع أشياءً فيها.
حلّ تصريحات المتغيّرات
إنّ حلّ تصريح متغيّر يضيف مدخلاً جديداً إلى خريطة النطاق الأعمق الحالي. يبدو ذلك بسيطاً، لكنّ هناك رقصةً صغيرة نحتاج إلى أدائها.
^code visit-var-stmt
نقسم الربط إلى خطوتين: التصريح ثمّ التعريف، للتعامل مع الحالات الحدّية الغريبة مثل هذه:
var a = "outer";
{
  var a = a;
}
ماذا يحدث حين يشير مُهيّئ متغيّرٍ محلّي إلى متغيّرٍ بالاسم نفسه المصرَّح به؟ لدينا بضعة خيارات:
-
نفّذ المُهيّئ، ثمّ ضَع المتغيّر الجديد في النطاق. هنا، سيُهيَّأ
aالمحلّي الجديد بـ"outer"، أي قيمة العالمي. وبعبارةٍ أخرى، سيُفكَّ التصريح السابق إلى:var temp = a; // Run the initializer. var a; // Declare the variable. a = temp; // Initialize it. -
ضَع المتغيّر الجديد في النطاق، ثمّ نفّذ المُهيّئ. وهذا يعني أنّك تستطيع ملاحظة متغيّر قبل تهيئته، لذا نحتاج إلى تحديد ما ستكون قيمته عندئذٍ. ربّما
nil. أي إنّaالمحلّي الجديد سيُعاد تهيئته إلى قيمته المهيّأة ضمنياً، وهيnil. ويصبح تفكيك الشيفرة هكذا:var a; // Define the variable. a = a; // Run the initializer. -
اجعل الإشارة إلى متغيّرٍ في مُهيّئه خطأً. اجعل المفسّر يفشل وقت التصريف أو وقت التشغيل إذاذكر مُهيّئٌ المتغيّرَ الجاري تهيئته.
هل يبدو لك أيٌّ من الخيارَين الأوّلَين شيئاً يريده المستخدم فعلاً*؟ فالحجب نادرٌ وكثيراً ما يكون خطأً، لذا يبدو من المستبعد أن يكون تهيئةُ متغيّرٍ محجوب بناءً على قيمة المتغيّر المحجوب مقصوداً.
والخيار الثاني أقلّ نفعاً أيضاً. فالمتغيّر الجديد سيكون قيمته
nil دائماً. ولا يوجد أيّ اعتبار في ذكره باسمه أبداً. فبإمكانك
استعمال nil صريح بدلاً من ذلك.
ولأنّ الخيارَين الأوّلَين من المرجّح أن يخفيَا أخطاء المستخدم، سنأخذ الثالث. وفوق ذلك، سنجعله خطأ تصريفٍ بدلاً من خطأ وقت التشغيل. وبهذه الطريقة، يَنتبه المستخدم للمشكلة قبل تشغيل أيّ شيفرة.
ولكي نفعل ذلك، عند زيارتنا التعبيرات، نحتاج أن نعرف ما إذا كنّا داخل مُهيّئ متغيّرٍ ما. ونفعل ذلك بتقسيم الربط إلى خطوتين. والأولى هي التصريح به.
^code declare
يضيف التصريحُ المتغيّرَ إلى النطاق الأعمق بحيث يحجب أيّ متغيّرٍ
خارجي ونعرف أنّ المتغيّر موجود. ونضع عليه علامة "ليس جاهزاً بعد"
بربط اسمه بـfalse في خريطة النطاق. والقيمة المرتبطة بمفتاحٍ في
خريطة النطاق تمثّل ما إذا كنّا قد أنهينا حلّ مُهيّئ ذلك المتغيّر
أم لا.
وبعد تصريح المتغيّر، نحلّ تعبير مُهيّئه في النطاق نفسه حيث المتغيّر الجديد موجود الآن لكنّه غير متاح. وبمجرد انتهاء تعبير المُهيّئ، يكون المتغيّر جاهزاً تماماً. ونفعل ذلك بـتعريفه.
^code define
نضبط قيمة المتغيّر في خريطة النطاق على true لنضع عليه علامة
أنّه مُهيَّأٌ تماماً ومتاح للاستعمال. إنّه حيّ!
حلّ تعبيرات المتغيّرات
تصريحاتُ المتغيّرات -- وتصريحاتُ الدوالّ، التي سنصل إليها -- تكتب في خرائط النطاقات. وتُقرأ تلك الخرائط حين نحلّ تعبيرات المتغيّرات.
^code visit-variable-expr
أوّلاً، نفحص ما إذا كان المتغيّر يُستعمل داخل مُهيّئه. وهنا يأتي
دور القيم في خريطة النطاق. فإذا كان المتغيّر موجوداً في النطاق
الحالي لكنّ قيمته false، فذلك يعني أنّنا صرّحناه لكن لم
نُعرّفه بعد. ونُبلّغ عن ذلك الخطأ.
وبعد ذلك الفحص، نحلّ المتغيّر نفسه فعلياً باستعمال هذا المساعد:
^code resolve-local
يبدو هذا، ولسببٍ وجيهٍ جداً، مثل الشيفرة الموجودة في Environment لتقييم متغيّر. نبدأ من النطاق الأعمق ونعمل نحو الخارج، نبحث في كلّ خريطةٍ عن اسمٍ مطابق. فإذا وجدنا المتغيّر، حلّلناه مع تمرير عدد النطاقات بين النطاق الأعمق الحالي والنطاق الذي وُجد فيه المتغيّر. فإذا وُجد المتغيّر في النطاق الحالي نمرّر 0، وإذا كان في النطاق المحيط مباشرةً نمرّر 1. فهمتَ الفكرة.
إن مشينا عبر كلّ نطاقات الكتل ولم نجد المتغيّر أبداً، نتركه غير
محلول ونفترض أنّه عامّ. سنصل إلى تنفيذ تلك الدالة resolve()
بعد قليل. أمّا الآن فلنُواصل تقدّمِنا في عُقد الصياغة الأخرى.
حلّ تعبيرات الإسناد
التعبير الآخر الذي يشير إلى متغيّر هو الإسناد. وحلّ واحدٍ يبدو هكذا:
^code visit-assign-expr
أوّلاً، نحلّ تعبير القيمة المسنَدة تحسّباً لأنّه قد يحتوي أيضاً
إشارات إلى متغيّرات أخرى. ثمّ نستعمل دالتنا القائمة
resolveLocal() لحلّ المتغيّر المسنَد إليه.
حلّ تصريحات الدوالّ
وأخيراً، الدوالّ. فالدوالّ تربط أسماءً وتُقدّم نطاقاً. واسم الدالة نفسها مربوطٌ في النطاق المحيط حيث صُرِّحت الدالة. وحين ندخل إلى جسم الدالة، فإنّنا نربط وسائطها أيضاً في ذلك النطاق الداخلي للدالة.
^code visit-function-stmt
على غرار visitVariableStmt()، نصرّح باسم الدالة ونُعرّفه في
النطاق الحالي. لكنّ المتغيّرات، بخلاف ذلك، لا نُعرّف الاسم
بشكلٍ مُسبق أو بكثرة بل قبل حلّ جسم الدالة. وهذا يتيح للدالة أن
تشير إلى نفسها تعاودياً داخل جسمها.
ثمّ نحلّ جسم الدالة باستعمال هذا:
^code resolve-function
إنّه دالةٌ منفصلة لأنّنا سنستعملها أيضاً لحلّ دوالّ Lox حين نضيف الأصناف لاحقاً. فهي تنشئ نطاقاً جديداً للجسم ثمّ تربط متغيّرات لكلّ واحدٍ من وسائط الدالة.
ومتى أصبح ذلك جاهزاً، تحلّ جسم الدالة في ذلك النطاق. وهذا مختلفٌ عن الطريقة التي يتعامل بها المفسّر مع تصريحات الدوالّ. ففي وقت التشغيل، تصريحُ دالةٍ لا يفعل شيئاً بجسم الدالة. ولا يُلمس الجسم إلّا لاحقاً حين تُستدعى الدالة. أمّا في التحليل الساكن، فإنّنا ندخل إلى الجسم فوراً في الحال.
حلّ عُقد شجرة الصياغة الأخرى
هذا يغطّي الزوايا المهمّة في القواعد. فنحن نتعامل مع كلّ موضعٍ يُصرَّح فيه متغيّر أو يُقرأ أو يُكتب، وكلّ موضعٍ يُنشأ فيه نطاق أو يُدمَّر. ورغم أنّها لا تتأثّر بحلّ المتغيّرات، فنحن بحاجة أيضاً إلى طُرق زيارة لكلّ عُقد شجرة الصياغة الأخرى كي نُعِد دخولاً في أشجارها الفرعية. آسف، هذا الجزء مملّ، لكنّ اصبر عليّ. سنمشي نوعاً ما "من أعلى إلى أسفل" ونبدأ بالجمل.
جملة التعبير تحوي تعبيراً واحداً ليعبر إليه.
^code visit-expression-stmt
وجملة if لها تعبيرٌ بشرطها وجملةٌ أو جملتان لفروعها.
^code visit-if-stmt
وهنا نرى كيف يختلف الحَلّ عن التفسير. فحين نحلّ جملة if، لا
يوجد تحكّم في التنفيذ. نحلّ الشرط وكلا الفرعين. فبينما لا
يدخل التنفيذ الديناميكي إلّا في الفرع الذي يُنفَّذ فعلاً، فإنّ
التحليل الساكن متحفّظ -- فهو يحلّل أيّ فرعٍ يمكن أن يُنفَّذ.
ولأنّ أيّاً منهما يمكن بلوغه وقت التشغيل، فإنّنا نحلّ كليهما.
وكجمل التعبير، تحوي جملة print تعبيراً فرعياً واحداً.
^code visit-print-stmt
والمثل للإرجاع.
^code visit-return-stmt
وكما في جمل if، مع جملة while، نحلّ شرطها ونحلّ جسمها مرّةً
واحدة بالضبط.
^code visit-while-stmt
هذا يغطّي كلّ الجمل. ولننتقل إلى التعبيرات...
صديقنا القديم، التعبير الثنائي. ندخل إلى المعاملَين ونحلّهما.
^code visit-binary-expr
والاستدعاءات مشابهة -- نمشي على قائمة الوسائط ونحلّها كلّها. والشيءُ المُستدعى هو أيضاً تعبير (عادةً تعبير متغيّر)، فيُحلّ هو الآخر.
^code visit-call-expr
والأقواس سهلة.
^code visit-grouping-expr
والقيم الحرفية هي الأسهل على الإطلاق.
^code visit-literal-expr
تعبيرُ القيمة الحرفية لا يذكر أيّ متغيّرات ولا يحتوي أيّ تعبيرات فرعية، فلا عمل لدينا.
ولأنّ التحليل الساكن لا تحكّماً في التنفيذ ولا تحقّقاً شرطياً، فإنّ التعبيرات المنطقيّة تماماً كتعبيرات المعاملات الثنائية الأخرى.
^code visit-logical-expr
وأخيراً، العقدة الأخيرة. نحلّ معاملها الوحيد.
^code visit-unary-expr
ومع كلّ طرق الزيارة هذه، ينبغي أن يكون مصرّف Java راضياً بأنّ Resolver ينفّذ Stmt.Visitor و Expr.Visitor تنفيذاً كاملاً. والآن حان وقت استراحة: خذ شيئاً تأكله، ربّما قيلولةً صغيرة.
تفسير المتغيّرات المحلولة
لنرَ ما الذي ينفعنا فيه الحالّ. فكلّما زار متغيّراً، يخبر المفسّر بعدد النطاقات الفاصلة بين النطاق الحالي والنطاق الذي عُرِّف فيه المتغيّر. ووقت التشغيل، يقابل ذلك تماماً عددُ البيئات بين البيئة الحالية والبيئة المحيطة التي يستطيع عندها المفسّر العثور على قيمة المتغيّر. ويسلّم الحالّ ذلك العدد إلى المفسّر باستدعاء:
^code resolve
نريد تخزين معلومات الحَلّ في مكانٍ ما لنستعملها حين يُنفَّذ تعبير المتغيّر أو الإسناد لاحقاً، لكن أين؟ أحد المواضع الواضحة هو داخل عقدة شجرة الصياغة نفسها. وإنّه نهجٌ جيّد، وهناك تخزّن مصرّفاتٌ كثيرة نتائج تحليلاتٍ من هذا النوع.
يمكننا أن نفعل ذلك، لكنّه سيتطلّب العبث بمولّد شجرة الصياغة لدى. بدلاً من ذلك، سنأخذ نهجاً شائعاً آخر ونخزّنه بعيداً في جانب خريطةٍ تربط كلّ عقدة شجرة صياغة ببياناتها المحلولة.
كثيراً ما تعيد الأدوات التفاعلية مثل بيئات التطوير البرمجي تحليلَ أجزاءٍ من برنامج المستخدم وحلَّها على نحوٍ تدريجي. وقد يصعب العثور على كلّ قطع الحالة التي تحتاج إعادة حساب وهي مختبئة في أوراق شجرة الصياغة. ومن مزايا تخزين هذه البيانات خارج العُقد أنّه يجعل من السهل التخلّص منها -- ببساطة امسح الخريطة.
^code locals-field (1 before, 2 after)
قد تظنّ أنّنا نحتاج إلى نوعٍ ما من البنية الشجرية المتداخلة لتفادي الالتباس حين تكون هناك تعبيراتٌ متعدّدة تشير إلى المتغيّر نفسه، لكنّ كلّ عقدة تعبير هي كائن Java خاصٌّ بها بهويّةٍ فريدة. فخريطةٌ واحدة متماسكة لا تجد صعوبةً في إبقائها منفصلة.
وكالمعتاد، استعمال مجموعة يتطلّب استيراد بضعة أسماء.
^code import-hash-map (1 before, 1 after)
و:
^code import-map (1 before, 2 after)
الوصول إلى متغيّر محلول
أصبح لمفسّرنا الآن وصولٌ إلى موضع حلّ كلّ متغيّر. وأخيراً، نتمكّن من الاستفادة من ذلك. نستبدل طريقة زيارة تعبيرات المتغيّرات بهذه:
^code call-look-up-variable (1 before, 1 after)
وهذه تُفوّض إلى:
^code look-up-variable
وهناك أمورٌ paar تجري هنا. أوّلاً، نبحث عن المسافة المحلولة في
الخريطة. وتذكّر أنّنا لم نحلّ إلّا المتغيّرات المحلّية. فالمتغيّرات
العامّة تُعامَل بطريقة خاصة ولا تنتهي في الخريطة (ولذلك اسم
locals). لذا إن لم نجد مسافةً في الخريطة، فلا بدّ أنّه عامّ. وفي
تلك الحالة، نبحث عنه ديناميكياً، مباشرةً، في البيئة العامّة. وهذا
يُطلق خطأ وقت التشغيل إن لم يكن المتغيّر معرَّفاً.
وإن حصلنا على مسافة، فلدينا متغيّرٌ محلّي، ونتمكّن من الاستفادة
من نتائج تحليلنا الساكن. فبدلاً من استدعاء get()، نستعمل هذه
الطريقة الجديدة على Environment:
^code get-at
كانت طريقة get() القديمة تمشي ديناميكياً في سلسلة البيئات
المحيطة، وتفتّش كلّ واحدة منها لترى إن كان المتغيّر قداختبأ
في مكانٍ ما هناك. لكنّنا الآن نعرف تماماً أيّ بيئة في السلسلة
ستحتوي المتغيّر. ونصل إليها باستعمال هذه الطريقة المساعدة:
^code ancestor
تمشي هذه عدداً ثابتاً من القفزات إلى أعلى سلسلة الوالدين وتُعيد
البيئة هناك. وبمجرد أن نكون لدينا ذلك، تُعيد getAt() ببساطة
قيمة المتغيّر في خريطة تلك البيئة. بل إنّها لا تحتاج حتى إلى
الفحص للتأكّد من وجود المتغيّر هناك -- فنحن نعرف أنّه سيكون
موجوداً لأنّ الحالّ وجده قبل ذلك.
الإسناد إلى متغيّر محلول
يمكننا أيضاً استعمال متغيّر بالإسناد إليه. والتغييرات في زيارة تعبير الإسناد مشابهة.
^code resolved-assign (2 before, 1 after)
ومرةً أخرى، نبحث عن مسافة نطاق المتغيّر. فإن لم نجدها نفترض أنّه عامّ ونتعامل معه كما في السابق. وإلّا فنسنّدي هذه الطريقة الجديدة:
^code assign-at
وكما أنَّ getAt() بالنسبة إلى get()، كذلك assignAt() بالنسبة
إلى assign(). فهي تمشي عدداً ثابتاً من البيئات، ثمّ تحشو القيمة
الجديدة في تلك الخريطة.
هذه هي التغييرات الوحيدة في Interpreter. ولهذا اخترتُ تمثيلاً لبياناتنا المحلولة أقلّ ما يكون تدخّلاً. وبقية العُقد كلّها تواصل العمل كما كانت. بل إنّ شيفرة تعديل البيئات لم تتغيّر.
تشغيل الحالّ
لكنّنا بحاجة فعلاً إلى تشغيل الحالّ. ونُدرج البقيّة الجديدة بعد أن يضيع المحلل النحوي سحره.
^code create-resolver (3 before, 1 after)
لا نشغّل الحالّ إن وُجدت أيّ أخطاء تحليل نحوي. فإذا كانت الشيفرة تحوي خطأً نحوياً، فلن تُشغَّل أبداً، لذا فقيمة حلّها ضئيلة. وإن كانت الصياغة نظيفة، نطلب من الحالّ أن يفعل ما عليه. وللحالّ مرجعٌ إلى المفسّر، ويدفع بيانات الحَلّ إليه مباشرةً وهو يمشي على المتغيّرات. وحين يعمل المفسّر بعد ذلك، يكون لديه كلّ ما يحتاجه.
على الأقلّ، هذا صحيحٌ إن نجح الحالّ. لكنّ ماذا عن الأخطاء أثناء الحَلّ؟
أخطاء الحَلّ
ولأنّنا نقوم بمرورٍ تحليلٍ دلاليّ، لدينا فرصةٌ لجعل دلالة Lox أدقّ، ولمساعدة المستخدمين على التقاط الأخطاء مبكّراً قبل تشغيل شيفرتهم. انظر إلى هذا الشرّير:
fun bad() {
  var a = "first";
  var a = "second";
}
نحن نسمح فعلاً بتصريح عدّة متغيّرات بالاسم نفسه في النطاق
العامّ، لكنّ فعل ذلك في نطاقٍ محلّي هو خطأٌ على الأرجح. فإذا
كانوا يعرفون أنّ المتغيّر موجود بالفعل، لأسندوا إليه بدلاً من
استعمال var. وإن لم يكونوا يعرفون أنّه موجود، فعلى الأرجح لم
يكونوا ينوون الكتابة فوق السابق.
ويمكننا كشف هذا الخطأ ساكناً أثناء الحَلّ.
^code duplicate-variable (1 before, 1 after)
حين نصرّح بمتغيّر في نطاقٍ محلّي، نكون نعرف أصلاً أسماء كلّ متغيّرٍ صُرِّح سابقاً في ذلك النطاق نفسه. فإذا رأينا تصادماً، نُبلّغ عن خطأ.
أخطاء الإرجاع غير الصالحة
إليك سكربتاً آخر خبيثاً صغيراً:
return "at top level";
هذا يُنفّذ جملة return، لكنّه ليس داخل دالةٍ أصلاً. إنّه شيفرةٌ
على المستوى الأعلى. لا أعرف ما الذي يظنّ المستخدم أنّه سيحدث،
لكنّي لا أظنّ أنّنا نريد أن تسمح Lox بهذا.
ويمكننا توسيع الحالّ لكشف هذا ساكناً.-just كما نتتبّع النطاقات أثناء مشينا على الشجرة، يمكننا تتبّع ما إذا كانت الشيفرة التي نزورها حالياً داخل تصريح دالة.
^code function-type-field (1 before, 2 after)
وبدلاً من قيمة منطقيّةٍ مجرّدة، نستعمل هذا التعداد الطريف:
^code function-type
يبدو غبياً نوعاً ما الآن، لكنّنا سنضيف إليه بضع حالات أخرى لاحقاً وعندها سيصبح أكثر معنى. وحين نحلّ تصريح دالة، نمرّر ذلك.
^code pass-function-type (2 before, 1 after)
وفي resolveFunction() نأخذ ذلك الوسيط ونخزّنه في الحقل قبل حلّ
الجسم.
^code set-current-function (1 after)
نخزّن أوّلاً القيمة السابقة للحقل في متغيّرٍ محلّي. وتذكّر أنّ Lox لديها دوالّ محلّية، لذا يمكنك أن تتداخل تصريحات الدوالّ بأيّ عمق. ونحتاج إلى تتبّع ليس فقط أنّنا داخل دالة، بل كم دالةً نحن داخلها.
كان بإمكاننا استعمال مكدّسٍ صريح لقيم FunctionType لذلك، لكنّنا بدلاً من ذلك سنست piggyback على JVM. فنحن نخزّن القيمة السابقة في متغيّرٍ محلّي على مكدّس Java. وحين ننتهي من حلّ جسم الدالة، نُعيد الحقل إلى تلك القيمة.
^code restore-current-function (1 before, 1 after)
الآن، وبما أنّنا نستطيع دائماً معرفة ما إذا كنّا داخل تصريح دالة،
فنفحص ذلك حين نحلّ جملة return.
^code return-from-top (1 before, 1 after)
أنيق، صحيح؟
هناك قطعةٌ أخرى. فعوداً إلى صنف Lox الرئيسي الذي يجمع كلّ شيءٍ معاً، نحن حذرون من عدم تشغيل المفسّر إذا صودف أيّ أخطاء تحليل نحوي. ويجري ذلك الفحص قبل الحالّ كي لا نحاول حلّ شيفرةٍ غير صالحة نحوياً.
لكنّنا بحاجة أيضاً إلى تخطّي المفسّر إن وُجدت أخطاء حلّ، لذا نُضيف فحصاً آخر.
^code resolution-error (1 before, 2 after)
يمكنك أن تتخيّل إجراء الكثير من التحليلات الأخرى هنا. فمثلاً، لو
أضفنا جمل break إلى Lox، فعلى الأرجح نرغب في ضمان
أنّها لا تُستعمل إلّا داخل الحلقات.
ويمكننا أن نذهب أبعد ونُصدر تحذيراتٍ لشيفرةٍ ليست بالضرورة
خاطئة لكن على الأرجح غير مفيدة. فمثلاً، تحذّر بيئات التطوير
البرمجيّة العديدة إن كان لديك شيفرةٌ غير قابلة للوصول بعد جملة
return، أو متغيّرٌ محلّي لا تُقرأ قيمته أبداً. وكلّ ذلك كان
سهل الإضافة إلى مرورنا الزائر الساكن، أو كـبقايا منفصلة.
لكنّنا، في الوقت الحالي، سنلتزم بذلك القدر المحدود من التحليل. والجزء المهمّ أنّنا أصلحنا تلك الحالة الحدّية الغريبة المُزعجة الواحدة، مع أنّه قد يكون مُفاجئاً أنّ الأمر استغرق هذا القدر من العمل.
التحديات
-
لماذا من الآمن أن نُعرّف فوراً المتغيّر المربوط باسم دالة، بينما يجب على بقية المتغيّرات أن تنتظر حتى بعد تهيئتها قبل أن يمكن استعمالها؟
-
كيف تتعامل اللغات الأخرى التي تعرفها مع المتغيّرات المحلّية التي تشير إلى الاسم نفسه في مُهيّئها، مثل:
var a = "outer";
{
  var a = a;
}
هل هو خطأ وقت تشغيل؟ خطأ تصريف؟ مسموح به؟ هل تعامل المتغيّرات العامّة بطريقة مختلفة؟ هل توافق على اختياراتها؟ برّر إجابتك.
-
وسّع الحالّ ليُبلّغ عن خطأ إذا لم يُستعمل متغيّرٌ محلّي أبداً.
-
يحسب حالّنا أيّ بيئة وُجد فيها المتغيّر، لكنّ البحث يبقى يتمّ بالاسم في تلك الخريطة. ويمثّل تمثيلٌ أكفأ للبيئة المتغيّرات المحلّية في مصفوفة والبحث عنها بالفهرس.
وسّع الحالّ ليربط فهرساً فريداً بكلّ متغيّرٍ محلّي مصرَّح به في نطاق. وحين تحلّ وصولاً إلى متغيّر، ابحث عن النطاق الذي يقع فيه المتغيّر وعن فهرسه معاً وخزّن ذلك. وفي المفسّر، استعمل ذلك للوصول إلى متغيّرٍ بسرعة عبر فهرسه بدلاً من استعمال خريطة.