قطع الشيفرة بايت
إن وجدتَ أنّك تصرف كلّ وقتك تقريبًا على النظرية، فابدأ توجيه بعض الانتباه إلى الأمور العملية؛ فهي ستحسّن نظرياتك. وإن وجدتَ أنّك تصرف كلّ وقتك تقريبًا على الممارسة، فابدأ توجيه بعض الانتباه إلى الأمور النظرية؛ فهي ستحسّن ممارستك.
دونالد نوث
لدينا بالفعل تنفيذ كامل لـ Lox مع jlox، فلماذا لم ينته الكتاب بعد؟ جزءٌ من السبب هو أنّ jlox تعتمد على JVM لتفعل عنّا الكثير من الأمور. إن أردنا أن نفهم كيف يعمل المفسّر وصولًا إلى أعمق نقطة في المعدن، فعلينا أن نبني تلك القطع بأنفسنا.
وهناك سببٌ أكثر جوهريًا في أنّ jlox غير كافية: إنّها بطيئة إلى درجة موجعة. فالمفسّر الذي يتجوّل على الشجرة (tree-walk interpreter) جيّد لبعض أنواع اللغات عالية المستوى التوضيحية. لكنّه لا يصلح للغة إجرائية عامّة الغرض -- حتى لغة "برمجة نصّية" مثل Lox. خذ هذا الملف الصغير:
fun fib(n) {
  if (n < 2) return n;
  return fib(n - 1) + fib(n - 2); // [fib]
}

var before = clock();
print fib(40);
var after = clock();
print after - before;
على حاسوبي المحمول، يستغرق ذلك من jlox نحو 72 ثانية لينفّذ. وينهي برنامج C المكافئ المهمة في نصف ثانية. ولن تصل لغتنا النصّية المُنمَّطة ديناميكيًّا إلى سرعة لغة مُنمَّطة ساكنًا مع إدارة يدوية للذاكرة، لكنّنا لسنا بحاجة إلى القبول بأنها أبطأ بأكثر من رتبتَي قياس.
يمكن أن نأخذ jlox ونشغّلها في محلّل ملفات تعريف (profiler) ونبدأ في ضبط نقاط الاختناق وتحسينها، لكنّ ذلك لن يأخذنا بعيدًا. فنموذج التنفيذ -- التجوّل على شجرة التحليل المجرّد -- هو في جوهره التصميم الخاطئ. لا يمكننا تحسينه جزئيًّا لنصل إلى الأداء الذي نريده، تمامًا كما لا يمكنك صقل AMC Gremlin لتحويله إلى SR-71 Blackbird.
علينا أن نعيد التفكير في النموذج الأساسي. هذا الفصل يقدّم ذلك النموذج، وهو شيفرة البايت، ويبدأ مفسّرنا الجديد، clox.
شيفرة بايت؟
في الهندسة، قليلٌ من الخيارات خالية من المفاضلات. ولأفهم على نحو أفضل لماذا سنذهب مع شيفرة البايت، فلنقارنها ببعض الخيارات البديلة.
لماذا لا نتجوّل على شجرة التحليل المجرّد؟
لمفسّرنا القائم ميزتان:
-
حسنًا، أولًا، لقد كتبناه بالفعل. لقد اكتمل. والسبب الرئيسي في اكتماله هو أنّ هذا النمط من المفسّرات بسيط جدًّا في التنفيذ. فتمثيل وقت التشغيل للشيفرة يطابق الصياغة مباشرةً. فالانتقال من المحلّل إلى بنى البيانات التي نحتاجها وقت التشغيل يكاد لا يحتاج إلى أيّ جهد.
-
إنّه محمول (portable). فمفسّرنا الحالي مكتوب بلغة Java ويعمل على أيّ منصّة تدعمها Java. يمكننا كتابة تنفيذ جديد بلغة C باستخدام النهج نفسه، فنُصرّف لغتنا ونشغّلها على كل منصّة تقريبًا تحت الشمس.
تلك مزايا حقيقية. لكن، من ، هو غير كفؤ في الذاكرة. فكل قطعة صياغة تصبح عقدة
في شجرة التحليل المجرّد. تعبير Lox صغير مثل 1 + 2 يتحوّل إلى كومة من الكائنات ومؤشّرات
كثيرة بينها، شيء كهذا:
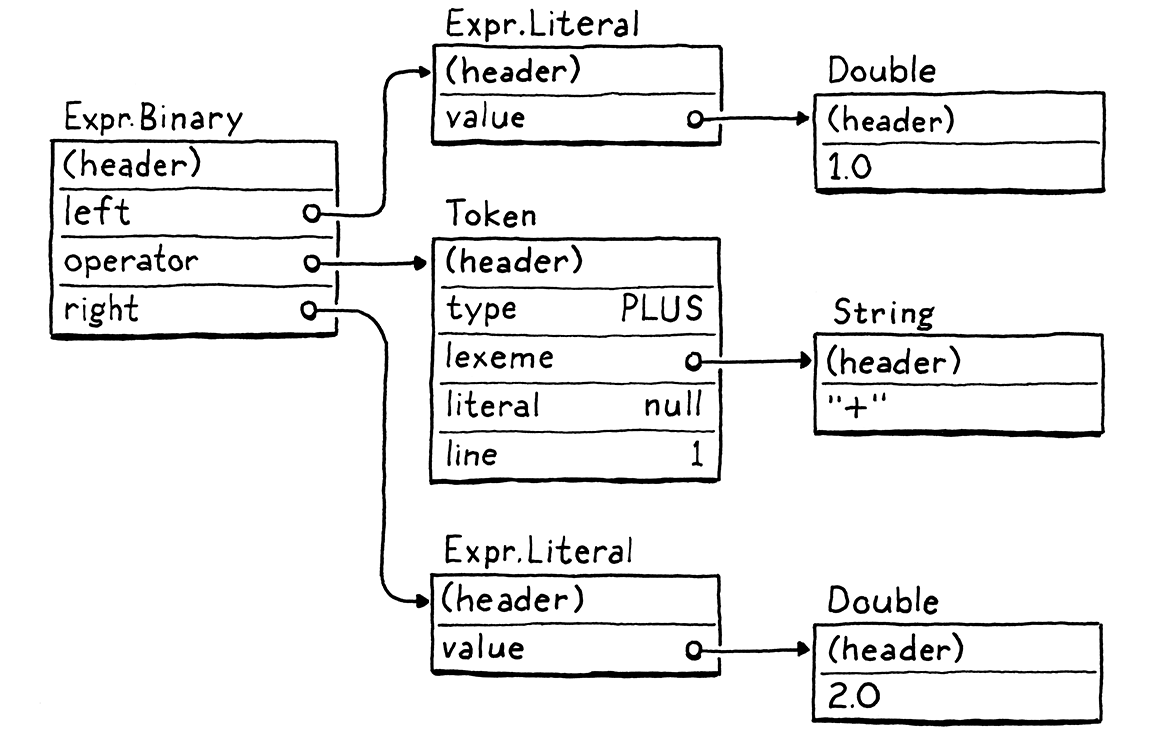
كل مؤشّر من تلك يضيف 32 أو 64 بتًّا إضافية من الحِمل الزائد إلى الكائن. والأسوأ، أنّ نثر بياناتنا عبر الكومة في شبكة متّصلة ترابطًا ضعيفًا يضرّ بـالمحلية المكانية.
تعالج المعالجات الحديثة البيانات أسرع بكثير ممّا تستطيع سحبه من الذاكرة العشوائية (RAM). ولتعويض ذلك، تمتلك الشرائح عدّة طبقات من الذاكرة المخبّأة (cache). إن كانت قطعة الذاكرة التي يحتاجها موجودة بالفعل في الذاكرة المخبّأة، فيمكن تحميلها بسرعة أكبر. ونحن نتكلّم عن أسرع بمئة ضعف.
كيف تدخل البيانات إلى تلك الذاكرة المخبّأة؟ فالآلة تضع الأشياء فيها لك بشكل استباقي. واستراتيجيتها التخمينية بسيطة إلى حدٍّ ما. فكلّما قرأ المعالج جزءًا من البيانات من الذاكرة العشوائية، جلب معه حزمة صغيرة كاملة من البايتات المجاورة ووضعها في الذاكرة المخبّأة.
إن طلب برنامجنا التالي بيانات قريبة بما يكفي لتكون داخل ذلك السطر المخبّأ، فإنّ معالجنا يعمل كسير ناقل مُشَحَّم في مصنع. ونحن نريد حقًا أن نستفيد من هذا. ولاستخدام الذاكرة المخبّأة بفاعلية، ينبغي أن تكون طريقة تمثيلنا للشيفرة في الذاكرة مُكثّفة ومرتّبة على النحو الذي تُقرأ به.
الآن انظر إلى تلك الشجرة. تلك الكائنات الفرعية يمكن أن تكون في أيّ مكان. كل خطوة يخطوها المتجوّل على الشجرة حيث يتبع إشارةً إلى عقدة فرعية قد تخرج عن حدود الذاكرة المخبّأة وتُجبر المعالج على التوقّف حتى يمكن ابتلاع كُتلة جديدة من البيانات من الذاكرة العشوائية. فـالحِمل الزائد لتلك العقد الشجرية بكل حقول المؤشّرات وترويستات الكائنات فيها يميل إلى دفع الكائنات بعيدًا عن بعضها وخارج الذاكرة المخبّأة.
لمتجوّل شجرة التحليل المجرّد لدينا حِمل زائد آخر أيضًا حول توجيه الواجهات ونمط الزائر (Visitor)، لكن مشكلات المحلية وحدها تكفي لتبرير تمثيل شيفرة أفضل.
لماذا لا نترجم إلى الشيفرة الأصلية؟
إن أردت أن تكون سريعًا حقًّا، فأنت تريد التخلّص من كل تلك الطبقات من الاستدلال. وصولًا إلى المعدن. شيفرة الآلة. حتى تبدو سريعة. شيفرة الآلة.
الترجمة مباشرةً إلى مجموعة التعليمات الأصلية التي تدعمها الشريحة هي ما تفعله أسرع اللغات. فاستهداف الشيفرة الأصلية كان الخيار الأكثر كفاءة منذ زمن بعيد في الأيام الأولى حين كان المهندسون يكتبون فعلاً بأيديهم البرامج في شيفرة الآلة.
إن لم تكتب شيفرة آلة من قبل، أو قريبتها الأكثر ألفةً للإنسان وهي شيفرة التجميع (assembly)، فسأقدّم لك ألطف مقدّمة ممكنة. فالشيفرة الأصلية سلسلة مُكثّفة من العمليات، مُرمَّزة مباشرةً بالثنائي. كل تعليمة يتراوح طولها بين بايت وبضعة بايتات، وهي منخفضة المستوى إلى درجة تصدم العقل. "انقل قيمةً من هذا العنوان إلى هذا السجلّ." "اجمع الأعداد الصحيحة في هذين السجلّين." وأمور من هذا القبيل.
يعالج المعالج التعليمات بسرعة، فيفكّ ترميز كل واحدة منها وينفّذها بالترتيب. لا توجد بنية شجرية مثل شجرة التحليل المجرّد لدينا، ويُعالَج تدفّق التحكم بالقفز من نقطة في الشيفرة مباشرةً إلى أخرى. لا استدلال، ولا حِمل زائد، ولا قفزات غير ضرورية ذهابًا وإيابًا ولا مطاردة مؤشّرات.
سريع كالبرق، لكنّ ذلك الأداء يأتي بثمن. أولًا، الترجمة إلى الشيفرة الأصلية ليست سهلة. فمعظم الشرائح المستخدمة على نطاق واسع اليوم لها بنيات بيزنطية شاملة مليئة بالكميات الهائلة من التعليمات التي تراكمت على مدى عقود. فهي تتطلّب تخصيصًا متطوّرًا للسجلّات، وخطوط أنابيب، وجدولة تعليمات.
وأيضًا، لقد تخلّيتَ عن قابلية النقل (portability). اقضِ بضع سنوات في إتقان معمارية ما، وستحصل على واحدة فقط من عدة مجموعات تعليمات رائجة هناك. ولجعل لغتك تعمل على جميعها، عليك تعلّم جميع مجموعات تعليماتها وكتابة واجهة خلفية منفصلة لكل واحدة.
ما هي شيفرة البايت؟
ثبِّت هاتين النقطتين في ذهنك. من جهة، المفسّر الذي يتجوّل على الشجرة بسيط ومحمول وبطيء. ومن الجهة الأخرى، الشيفرة الأصلية معقّدة وخاصّة بالمنصّة لكنّها سريعة. وتقف شيفرة البايت في المنتصف. فهي تحتفظ بقابلية نقل المتجوّل على الشجرة -- فلن نتّسخ أيدينا بالشيفرة التجميعية في هذا الكتاب. وهي تضخّي بـبعض البساطة مقابل دفعة أداء، لكن ليس بسرعة الوصول إلى الشيفرة الأصلية تمامًا.
بنيويًّا، تشبه شيفرة البايت شيفرة الآلة. فهي تسلسل خطّي مُكثّف من تعليمات ثنائية. وهذا يُبقي الحِمل الزائد منخفضًا ويتعامل بلطف مع الذاكرة المخبّأة. لكنّها مجموعة تعليمات أبسط وأعلى مستوى بكثير من أيّ شريحة حقيقية موجودة. (وفي صيغ شيفرة البايت كثيرة، لا تتجاوز كل تعليمة بايتًا واحدًا، ومن هنا اسم "شيفرة البايت".)
تخيّل أنّك تكتب مصرّفًا أصليًّا من لغة مصدر، وقد مُنحتَ صلاحية تامّة لتُعرّف أسهل معمارية ممكنة كنِهدف. شيفرة البايت شيءٌ من هذا القبيل. فهي مجموعة تعليمات متخيَّلة مثالية تجعل حياتك ككاتب مصرّف أسهل.
مشكلة البنية المتخيَّلة، بالطبع، هي أنّها غير موجودة. ونحن نحلّ ذلك بكتابة محاكي (emulator) -- شريحة مُحاكاة مكتوبة بالبرمجيات تفسّر شيفرة البايت تعليمةً تلو الأخرى. أي آلة افتراضية (VM) إن شئت.
تلك طبقة المحاكاة تضيف حِملًا زائدًا، وهو سبب رئيسي لكون شيفرة البايت أبطأ من الشيفرة الأصلية. لكنّها بالمقابل تمنحنا قابلية النقل. فاكتب آلتنا الافتراضية بلغة مثل C مدعومة بالفعل على كل الآلات التي نهتمّ بها، نستطيع عندها تشغيل محاكينا فوق أيّ عتاد نشاء.
هذا هو المسار الذي سنسلكه مع مفسّرنا الجديد، clox. وسنتبع آثار التنفيذات الرئيسة لـ Python وRuby وLua وOCaml وErlang وغيرها. وفي جوانب كثيرة، سيتوازى تصميم آلتنا الافتراضية مع بنية مفسّرنا السابق:
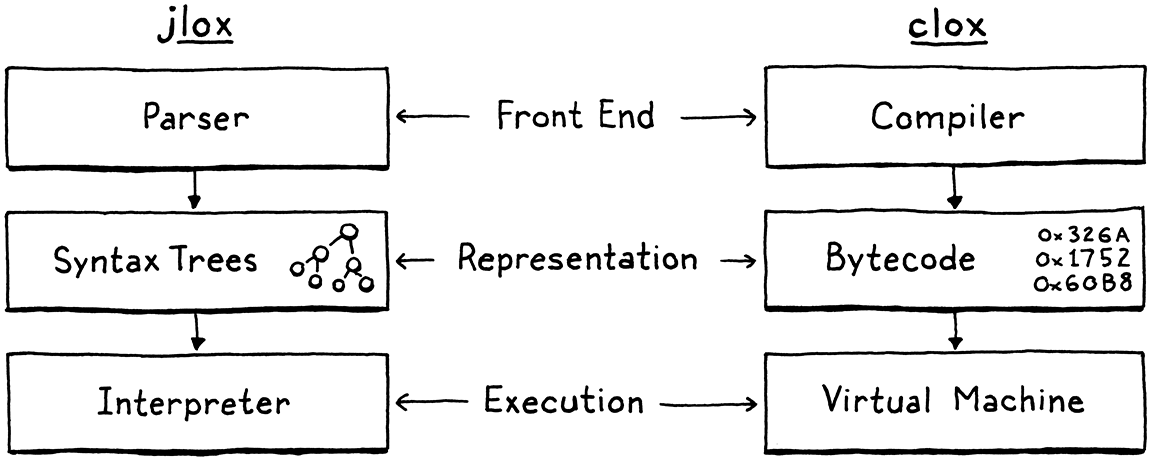
بالطبع، لن ننفّذ المراحل بالترتيب الصارم. تماماً كما في مفسّرنا السابق، سنتنقّل ذهابًا وإيابًا، ونبني التنفيذ ميزة لغة واحدة في كل مرّة. في هذا الفصل، سنضع هيكل التطبيق في مكانه وننشئ بنى البيانات اللازمة لتخزين قطعة شيفرة بايت وتمثيلها.
البداية
من أين نبدأ إذًا، إنْ من main()؟ شغّل محرّر النصوص المفضّل
لديك وابدأ الكتابة.
^code main-c
من هذه البذرة الصغيرة، سننمّي آلتنا الافتراضية كاملةً. وبما أنّ C توفّر لنا القليل جدًّا، فإنّنا نحتاج أولًا إلى قضاء بعض الوقت في تخصيب التربة. وبعض ذلك يذهب إلى هذا التروييسة:
^code common-h
هناك حفنة من الأنواع والثوابت التي سنستخدمها في المفسّر كلّه، وهذا مكان ملائم لوضعها.
وهي حاليًا NULL العتيق، وsize_t، ونوع bool المنطقي اللطيف في C99، وأنواع الأعداد
الصحيحة ذات الحجم الصريح -- uint8_t وأصدقاءه.
قطع التعليمات
بعد ذلك، نحتاج إلى وحدة تُعرّف تمثيل شيفرتنا. لقد كنتُ أستخدم "قطعة" (chunk) للإشارة إلى تسلسلات شيفرة البايت، فلنجعل ذلك الاسم الرسمي لتلك الوحدة.
^code chunk-h
في صيغة شيفرة البايت لدينا، لكل تعليمة رمز تشغيل (operation code) من بايت واحد (يُختصر عالميًّا إلى opcode). يتحكّم ذلك الرقم في نوع التعليمة التي نتعامل معها -- جمع، طرح، البحث عن متغيّر، وهكذا. نعرّفها هنا:
^code op-enum (1 before, 2 after)
حاليًا، نبدأ بتعليمة واحدة، وهي OP_RETURN. وحين نملك آلة افتراضية متكاملة الميزات،
ستعني هذه التعليمة "العودة من الدالة الحالية". وأقرّ بأنّ هذا ليس مفيدًا تمامًا بعد،
لكنّنا نضطر إلى البدء من مكان ما، وهذه تعليمة بسيطة بشكل خاص، لأسباب سنصل إليها لاحقًا.
مصفوفة ديناميكية من التعليمات
شيفرة البايت سلسلة من التعليمات. وفي النهاية، سنخزّن بعض البيانات الأخرى إلى جانب التعليمات، لذا لنُنشئ الآن بنيةً تحتفظ بها جميعًا.
^code chunk-struct (1 before, 2 after)
في الوقت الحالي، هذه مجرّد غلاف حول مصفوفة بايتات. وبما أنّنا لا نعرف حجم المصفوفة اللازم قبل أن نبدأ بترجمة قطعة، فلا بدّ أن تكون ديناميكية. والمصفوفات الديناميكية واحدة من بنى البيانات المفضّلة لديّ. يبدو هذا وكأنّني أدّعي أنّ الفانيلا هو نكهة المثلّجات المفضّلة لديّ نكهة، لكن اسمعني.
-
تخزين مُكثّف صديق للذاكرة المخبّأة
-
بحث مفهرس عن العنصر في زمن ثابت
-
إلحاق في نهاية المصفوفة في زمن ثابت
تلك المزايا هي بالضبط سبب استخدامنا للمصفوفات الديناميكية طوال الوقت في jlox تحت ستار صنف ArrayList في Java. والآن بعد أن صرنا في C، نحصل على صنع مصفوفاتنا الخاصة. إن كانت ذاكرتك تخانك في المصفوفات الديناميكية، فالفكرة بسيطة إلى حدٍّ ما. إلى جانب المصفوفة نفسها، نحتفظ برقمين: عدد العناصر في المصفوفة التي خصّصناها ("السعة" capacity) وكمّ من تلك المُدخلات المُخصَّصة مستخدَمة فعليًا ("العدّ" count).
^code count-and-capacity (1 before, 2 after)
حين نضيف عنصرًا، إن كان العدّ أقلّ من السعة، فهناك مساحة متاحة بالفعل في المصفوفة. نخزّن العنصر الجديد هناك مباشرةً ونرفع العدّ.
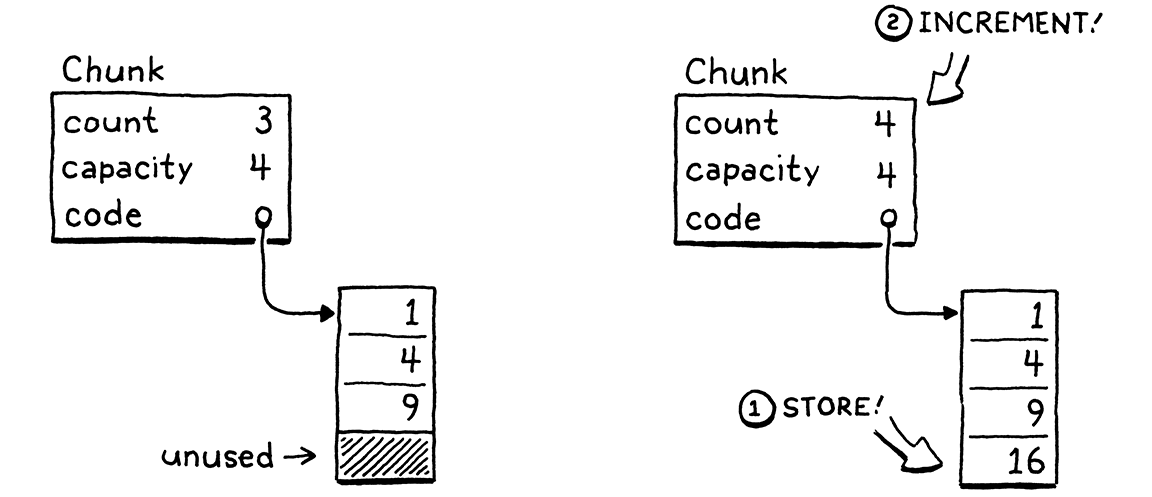
إن لم تكن لدينا سعة فائضة، فإنّ العملية أعقد قليلًا.
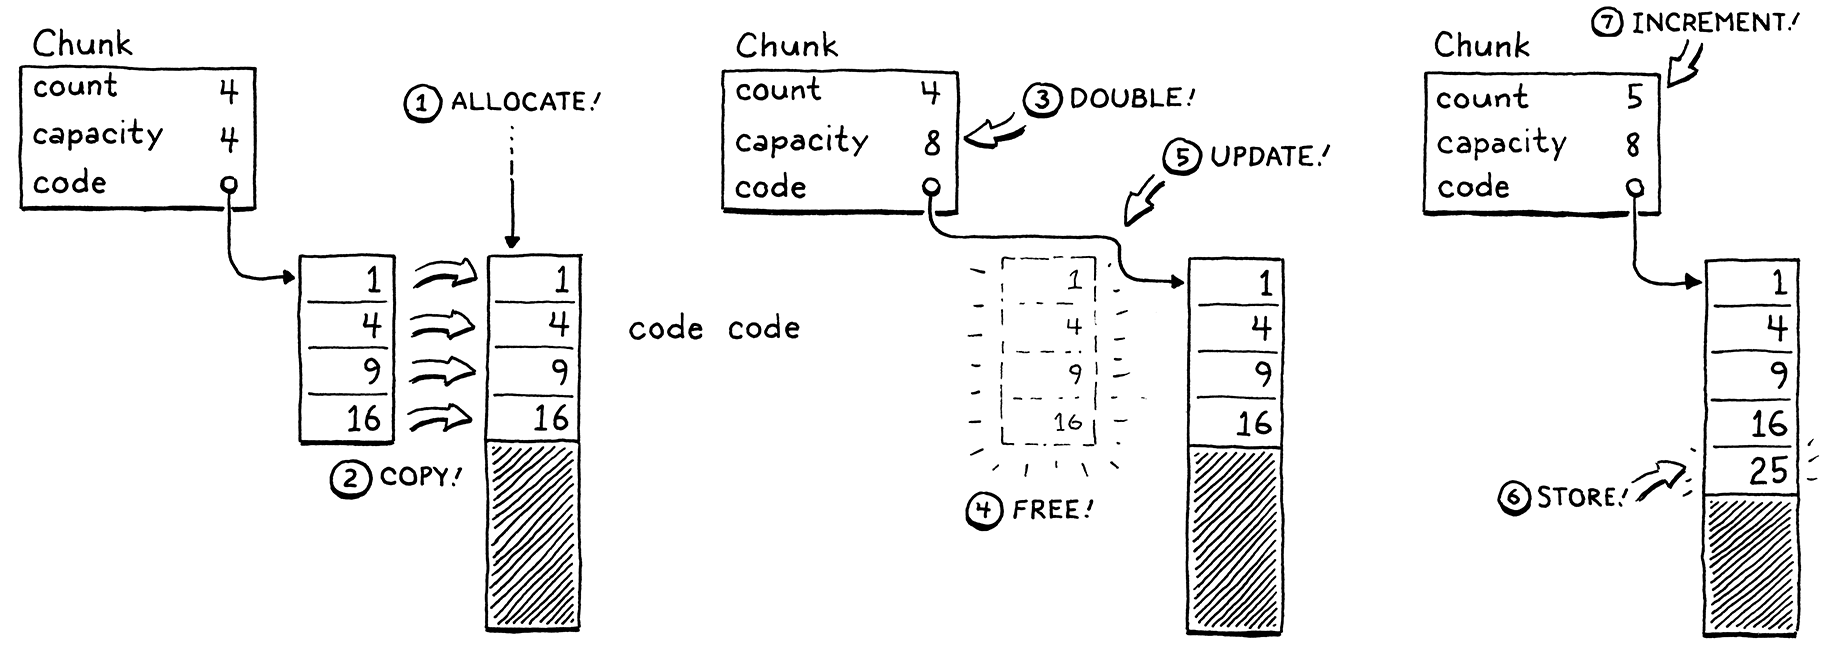
- نُخصّص مصفوفة جديدة بسعة أكبر.
- ننسخ العناصر القائمة من المصفوفة القديمة إلى الجديدة.
- نخزّن "السعة"
capacityالجديدة. - نُحذف المصفوفة القديمة.
- نُحدّث
codeليشير إلى المصفوفة الجديدة. - نخزّن العنصر في المصفوفة الجديدة الآن بعد أن توفّرت المساحة.
- نُحدّث
countالعدّ.
لدينا بنية جاهزة، فلننفّذ الدوالّ التي تعمل معها. لا تمتلك C امتلاك مُنشئات (constructors)، لذا نُعلن دالةً لتهيئة قطعة جديدة.
^code init-chunk-h (1 before, 2 after)
وننفّذها هكذا:
^code chunk-c
تبدأ المصفوفة الديناميكية فارغة تمامًا. فنحن لم نخصّص حتى الآن مصفوفة خام. ولإلحاق بايت إلى نهاية القطعة، نستخدم دالة جديدة.
^code write-chunk-h (1 before, 2 after)
هنا يحدث العمل المثير للاهتمام.
^code write-chunk
أول ما نحتاج إلى فعله هو التحقّق ممّا إذا كانت المصفوفة الحالية تملك بالفعل سعة للبايت
الجديد. وإن لم تكن كذلك، فإنّنا نضطر أولًا إلى نموّ المصفوفة لتوفير مساحة. (ونصطدم بهذه
الحالة أيضًا عند أول كتابة حين تكون المصفوفة NULL وcapacity صفرًا.)
لنموّ المصفوفة، نحدّد أولًا السعة الجديدة وننمّي المصفوفة إلى ذلك الحجم. وكلتا عمليتي الذاكرة منخفضتي المستوى معرّفتان في وحدة جديدة.
^code chunk-c-include-memory (1 before, 2 after)
هذا يكفينا لنبدأ.
^code memory-h
يحسب هذا الماكرو سعة جديدة بناءً على سعة حالية مُعطاة. ولتحقيق الأداء الذي نريده، فالجزء المهم هو أنّه يتناسب مع الحجم القديم. فننمو بمعامل اثنين، وهو أمر نموذجي إلى حدٍّ ما. و1.5× خيار شائع آخر.
كما نتعامل مع الحالة التي تكون فيها السعة الحالية صفرًا. في تلك الحالة، نقفز مباشرةً إلى ثمانية عناصر بدل البدء بواحد. وذلك يتجنّب بعض رفرفة الذاكرة الإضافية حين تكون المصفوفة صغيرة جدًّا، على حساب إهدار بضعة بايتات في القطع الصغيرة جدًّا.
ومتى عرفنا السعة المطلوبة، ننشئ المصفوفة أو ننمّيها إلى ذلك الحجم باستخدام GROW_ARRAY().
^code grow-array (2 before, 2 after)
يجعل هذا الماكرو استدعاء الدالة reallocate() أجمل، حيث يجري العمل الحقيقي. والماكرو نفسه
يتولّى الحصول على حجم نوع عنصر المصفوفة وتحويل void* الناتج مجددًا إلى مؤشّر من النوع
الصحيح.
هذه الدالة reallocate() هي الدالة الوحيدة التي سنستخدمها لكل عمليات إدارة الذاكرة
الديناميكية في clox -- تخصيص الذاكرة، وتحريرها، وتغيير حجم تخصيص قائم. وتوجيه كل تلك
العمليات عبر دالة واحدة سيكون مهمًّا لاحقًا حين نضيف جامع نفايات يحتاج إلى تتبّع مقدار
الذاكرة المستخدَمة.
مُعاملا الحجم الممرّران إلى reallocate() يحدّدان أيّ عملية نُنفّذ:
| oldSize | newSize | العملية |
| 0 | Non‑zero | تخصيص كتلة جديدة. |
| Non‑zero | 0 | تحرير التخصيص. |
| Non‑zero | Smaller than oldSize |
تصغير التخصيص القائم. |
| Non‑zero | Larger than oldSize |
تكبير التخصيص القائم. |
يبدو ذلك كمّ كبير من الحالات للتعامل معها، وهذه هي الشيفرة:
^code memory-c
حين يكون newSize صفرًا، نتولّى حالة إزالة التخصيص بأنفسنا باستدعاء free(). وإلا، فإنّنا
نعتمد على دالة realloc() في مكتبة C القياسية. وتلك الدالة تدعم الجوانب الثلاثة الأخرى
من سياستنا. وحين يكون oldSize صفرًا، فإنّ realloc() تعادل استدعاء malloc().
الحالات المثيرة للاهتمام هي حين يكون كلٌّ من oldSize وnewSize غير صفري. فهما يطلبان من
realloc() تغيير حجم الكتلة المخصَّصة سابقًا. إن كان الحجم الجديد أصغر من كتلة الذاكرة
القائمة، فإنّها ببساطة تُحدّث حجم الكتلة وتُرجع المؤشّر نفسه
الذي أعطيته لها. وإن كان الحجم الجديد أكبر، فإنّها تحاول نموّ كتلة الذاكرة القائمة.
وهي تستطيع ذلك فقط إن كانت الذاكرة التي تأتي بعد تلك الكتلة ليست مستخدَمة بالفعل. إن لم
يكن هناك متّسع لنموّ الكتلة، فإنّ realloc() تخصّص بدلًا من ذلك كتلة ذاكرة جديدة
بالحجم المطلوب، وتنسخ فوقها البايتات القديمة، وتحرّر الكتلة القديمة، ثم تُرجع مؤشّرًا إلى
الكتلة الجديدة. تذكّر، أنّ هذا بالضبط هو السلوك الذي نريده لمصفوفتنا الديناميكية.
ولأنّ الحواسيب كتل مادّية محدودة وليست تجريدات رياضية مثالية كما تريدنا نظريّة علوم
الحاسوب أن نؤمن، يمكن أن يفشل التخصيص إن لم تكن هناك ذاكرة كافية وتُرجع realloc() قيمة
NULL. وينبغي أن نتعامل مع ذلك.
^code out-of-memory (1 before, 1 after)
لا تستطيع آلتنا الافتراضية فعل أيّ شيء مفيد حقًّا إن لم تستطع الحصول على الذاكرة التي
تحتاجها، لكننا على الأقلّ نكتشف ذلك ونُنهي العملية فورًا بدلًا من إعادة مؤشّر NULL
والسماح لها بالانحراف لاحقًا.
حسنًا، يمكننا إنشاء قطع جديدة وكتابة تعليمات إليها. هل انتهينا؟ لا! فنحن في C الآن، تذكّر، علينا أن ندير الذاكرة بأنفسنا، كما في الأزمنة القديمة، وهذا يعني أيضًا تحريرها.
^code free-chunk-h (1 before, 1 after)
وهذا هو التنفيذ:
^code free-chunk
نُزيل تخصيص كل الذاكرة ثم نستدعي initChunk() لنصفّر الحقول تاركةً القطعة في حالة فارغة
محدَّدة جيدًا. ولتحرير الذاكرة، نضيف ماكرو آخر.
^code free-array (3 before, 2 after)
مثل GROW_ARRAY()، هذا غلاف حول استدعاء reallocate(). هذا يحرّر الذاكرة بتمرير صفر
كحجم جديد. أعرف، هذا قدرٌ كبير من الأمور منخفضة المستوى المملة. لا تقلق، سنستفيد كثيرًا
من هذه في الفصول اللاحقة وسنصل إلى البرمجة عند مستوى أعلى. لكن قبل أن نتمكّن من ذلك، علينا
أن نضع أساسنا الخاص.
تفكيك القطع
لدينا الآن وحدة صغيرة لإنشاء قطع شيفرة البايت. لنجرّبها ببناء قطعة عيّنة يدويًا.
^code main-chunk (1 before, 1 after)
لا تنسَ الـ include.
^code main-include-chunk (1 before, 2 after)
شغّل ذلك وجرّبه. هل نجح؟ إيه... من يعرف؟ كل ما فعلناه هو دفع بعض البايتات هنا وهناك في الذاكرة. وليس لدينا وسيلة صديقة للإنسان لرؤية ما بداخل تلك القطعة التي صنعناها.
ولإصلاح هذا، سننشئ مفكّكًا (disassembler). المُجمِّع (assembler) برنامجٌ قديم الطراز يأخذ ملفًا يحوي أسماء mnemonic مقروءة للإنسان لتعليمات المعالج مثل "ADD" و"MULT" ويترجمها إلى ما يقابلها من شيفرة آلة ثنائية. والمفكّك يسير في الاتجاه المعاكس -- فمعه كُتلة من شيفرة الآلة، يُخرج قائمةً نصّية بالتعليمات.
سننفّذ شيئًا شبيهًا بذلك. فمعطى قطعة، سيطبع كل التعليمات التي فيها. لن يستخدم مستخدم Lox هذا، لكنّنا نحن فريق صيانة Lox سنستفيد منه بالتأكيد، إذ يمنحنا نافذة على التمثيل الداخلي للشيفرة داخل المفسّر.
في main()، بعد أن ننشئ القطعة، نمرّرها إلى المفكّك.
^code main-disassemble-chunk (2 before, 1 after)
ومرّة أخرى، نُخرج وحدة أخرى.
^code main-include-debug (1 before, 2 after)
وهذا هو التروييسة:
^code debug-h
في main()، نستدعي disassembleChunk() لتفكيك كل التعليمات في القطعة بأكملها. وهذا مُنفَّذ
بدلالة الدالة الأخرى، التي تفكّك تعليمة واحدة فقط. وهي تظهر هنا في التروييسة لأنّنا سنتّصل
بها من الآلة الافتراضية في الفصول اللاحقة.
وهذه بداية ملف التنفيذ:
^code debug-c
لتفكيك قطعة، نطبع تروييسة صغيرة (كي نعرف أيّ قطعة ننظر إليها) ثم نمرّ عبر شيفرة البايت،
نفكّك كل تعليمة. وطريقة تكرّرنا عبر الشيفرة غريبة قليلًا. فبدلًا من زيادة offset في
الحلقة، نترك disassembleInstruction() يفعل ذلك عنّا. حين نستدعي تلك الدالة، بعد أن تفكّك
التعليمة عند الإزاحة المُعطاة، فإنّها تُرجع إزاحة التعليمة التالية. وذلك لأنّ التعليمات،
كما سنرى لاحقًا، قد تكون مختلفة الأحجام.
جوهر وحدة "debug" هو هذه الدالة:
^code disassemble-instruction
أولًا، تطبع إزاحة البايت للتعليمة المُعطاة -- وهذا يخبرنا أين في القطعة تقع هذه التعليمة. وسيكون علامة إرشاد مفيدة حين نبدأ في التعامل مع تدفّق التحكم والقفز داخل شيفرة البايت.
بعد ذلك، تقرأ بايتًا واحدًا من شيفرة البايت عند الإزاحة المُعطاة. هذا هو رمز التشغيل لدينا.
نحن نُبدّل عليه. لكل نوع من التعليمات، نوجّه إلى دالة مساعِدة صغيرة
لعرضها. وفي احتمال ضئيل أن لا يبدو البايت المُعطى كتعليمة إطلاقًا -- خطأ في مصرّفنا --
فإنّنا نطبع ذلك أيضًا. أمّا التعليمة الوحيدة التي لدينا، وهي OP_RETURN، فدالة العرض لها
هي:
^code simple-instruction
لا يوجد الكثير في تعليمة الإرجاع، لذا فإنّ كل ما تفعله هو طباعة اسم رمز التشغيل، ثم إرجاع إزاحة البايت التالية بعد هذه التعليمة. أما التعليمات الأخرى فستكون هناك أمور أكثر.
إن شغّلنا مفسّرنا الناشئ الآن، فإنه يطبع في الواقع شيئًا:
== test chunk ==
0000 OP_RETURN
نجح! هذا نوعٌ من "مرحبًا بالعالم!" الخاص بتمثيل شيفرتنا. يمكننا إنشاء قطعة، وكتابة تعليمة إليها، ثم استخراج تلك التعليمة منها. وترميزنا وفكّ ترميزنا لشيفرة البايت الثنائية يعملان.
الثوابت
الآن وبعد أن صار لدينا هيكل قطع أوّلي يعمل، لنبدأ جعله أكثر نفعًا. يمكننا تخزين الشيفرة في القطع، لكن ماذا عن البيانات؟ فالقيم كثيرة التي يعمل بها المفسّر تُنشأ وقت التشغيل كنتائج لعمليات.
1 + 2;
القيمة 3 لا تظهر في أيّ موضع من الشيفرة هنا. لكن قيمتَي 1 و2 الحرفيتين تظهران.
ولترجمة ذلك التصريح إلى شيفرة بايت، نحتاج إلى نوع ما من التعليمات يعني "أنتج ثابتًا"، وتحتاج
تلك القيم الحرفية إلى أن تُخزَّن في مكان ما داخل القطعة. في jlox، كانت عقدة Expr.Literal في
شجرة التحليل المجرّد تحمل القيمة. ونحتاج الآن إلى حلّ مختلف بعد أن لم تعد لدينا شجرة
صياغة.
تمثيل القيم
لن نُنفّذ أيّ شيفرة في هذا الفصل، لكن بما أنّ للثوابت قدمًا في عالمَي مفسّرنا الساكن والديناميكي معًا، فإنّها تُجبرنا على البدء في التفكير ولو قليلًا في كيفية تمثيل آلتنا الافتراضية للقيم.
في الوقت الحالي، سنبدأ بأبسط ما يمكن -- سنؤيّد فقط الأعداد العشرية (double) ذات الفاصلة العائمة. وهذا سيتّسع بوضوح مع الوقت، لذا سنُنشئ وحدة جديدة لنفسنا مساحةً للنموّ.
^code value-h
يُجريد هذا typedef كيفية تمثيل قيم Lox تمثيلًا ملموسًا في C. وبذلك يمكننا تغيير ذلك التمثيل دون الحاجة إلى العودة لإصلاح الشيفرة القائمة التي تمرّر القيم.
العودة إلى مسألة أين نخزّن الثوابت في قطعة. فبالنسبة للقيم الصغيرة ذات الحجم الثابت مثل الأعداد الصحيحة، تخزّن عديد من مجموعات التعليمات القيمة مباشرةً في تدفّق الشيفرة بعد رمز التشغيل مباشرةً. وتُسمّى هذه تعليمات فورية (immediate instructions) لأنّ بتات القيمة تقع مباشرةً بعد رمز التشغيل.
وهذا لا يناسب جيدًا الثوابت الكبيرة أو متغيّرة الحجم مثل النصوص. ففي مصرّف أصلي إلى شيفرة الآلة، تُخزَّن تلك الثوابت الأكبر في منطقة منفصلة من "بيانات الثوابت" في الملف التنفيذي الثنائي. ثم تحمل التعليمة التي تحمّل ثابتًا عنوانًا أو إزاحة تشير إلى أين تُخزَّن القيمة في ذلك القسم.
معظم الآلات الافتراضية تفعل شيئًا مشابهًا. على سبيل المثال، تُسند الآلة الافتراضية في Java مجمّع ثوابت (constant pool) لكل صنف مُصرَّف. يبدو ذلك جيّدًا بما يكفي بالنسبة إلى clox. ستحمل كل قطعة معها قائمة بالقيم التي تظهر كقيم حرفية في البرنامج. ولإبقاء الأمور أبسط، سنضع كل الثوابت فيها، حتى الأعداد الصحيحة البسيطة.
مصفوفات القيم
مجمّع الثوابت هو مصفوفة من القيم. وتعليمة تحميل ثابت تبحث عن القيمة بفهرسها في تلك المصفوفة. وكما مع مصفوفة شيفرة البايت لدينا، لا يعرف المصرّف حجم المصفوفة مسبقًا. لذا، نحتاج مرّة أخرى إلى مصفوفة ديناميكية. وبما أنّ C لا تملك بنى بيانات عامة، فسنكتب بنية بيانات مصفوفة ديناميكية أخرى، وهذه المرة من النوع Value.
^code value-array (1 before, 2 after)
وكما مع مصفوفة شيفرة البايت في Chunk، فإنّ هذه البنية تلتفّ حول مؤشّر إلى مصفوفة مع سعتها المُخصَّصة وعدد العناصر المستخدَمة. ونحتاج أيضًا إلى الدوالّ الثلاث نفسها للعمل مع مصفوفات القيم.
^code array-fns-h (1 before, 2 after)
من المرجّح أن تثير التنفيذات لديك شعور deja vu. أولًا، لإنشاء مصفوفة جديدة:
^code value-c
بمجرد أن تتوفّر لدينا مصفوفة مهيّأة، يمكننا البدء بـإضافة قيم إليها.
^code write-value-array
تتيح لنا ماكروهات إدارة الذاكرة التي كتبناها سابقًا إعادة استخدام بعض المنطق من مصفوفة الشيفرة، لذا ليس الأمر سيئًا إلى هذا الحدّ. وأخيرًا، لتحرير كل الذاكرة التي تستخدمها المصفوفة:
^code free-value-array
الآن وبعد أن لدينا مصفوفات قيم قابلة للنموّ، يمكننا إضافة واحدة إلى Chunk لتخزين ثوابت القطعة.
^code chunk-constants (1 before, 1 after)
لا تنسَ الـ include.
^code chunk-h-include-value (1 before, 2 after)
آه، C، وقصّة نمطيتها في العصر الحجري. أين كنّا؟ صحيح. حين نُهيّئ قطعة جديدة، فإنّنا نُهيّئ قائمة ثوابتها أيضًا.
^code chunk-init-constant-array (1 before, 1 after)
وكذلك، فإنّنا نحرّر الثوابت حين نحرّر القطعة.
^code chunk-free-constants (1 before, 1 after)
بعد ذلك، نعرّف دالة مساعِدة لإضافة ثابت جديد إلى القطعة. فمصرّفنا الذي لم يُكتب بعد كان يستطيع الكتابة إلى مصفوفة القيم داخل Chunk مباشرةً -- ليس الأمر أنّ C تملك حقولًا خاصة أو ما شابه -- لكن إضافة دالة صريحة أجمل قليلًا.
^code add-constant-h (1 before, 2 after)
ثم ننفّذها.
^code add-constant
بعد أن نضيف الثابت، نُرجِع الفهرس الذي أُلحق به الثابت كي نتمكّن من تحديد ذلك الثابت نفسه لاحقًا.
تعليمات الثوابت
نستطيع تخزين الثوابت في القطع، لكنّنا نحتاج أيضًا إلى تنفيذها. ففي قطعة شيفرة كهذه:
print 1;
print 2;
تحتاج القطعة المُصرَّفة إلى أن تحتوي ليس فقط على القيمتين 1 و2، بل أن تعرف متى تنتجهما كي تُطبعا بالترتيب الصحيح. إذن، نحتاج إلى تعليمة تنتج ثابتًا معيّنًا.
^code op-constant (1 before, 1 after)
حين تنفّذ الآلة الافتراضية تعليمة ثابت، فإنّها "تحمّل" الثابت
للاستخدام. وهذه التعليمة الجديدة أعقد قليلًا من OP_RETURN. ففي المثال أعلاه، نحمّل ثابتين
مختلفين. ورمز تشغيل مجرّد لا يكفي لمعرفة أيّ ثابت نحمّل.
للتعامل مع حالات مثل هذه، تسمح شيفرتنا البايت -- كما يسمح معظمها -- للتعليمات بأن تحمل مُعاملات. وتُخزَّن هذه كبيانات ثنائية مباشرةً بعد رمز التشغيل في تدفّق التعليمات، وتتيح لنا تخصيص ما تفعله التعليمة.
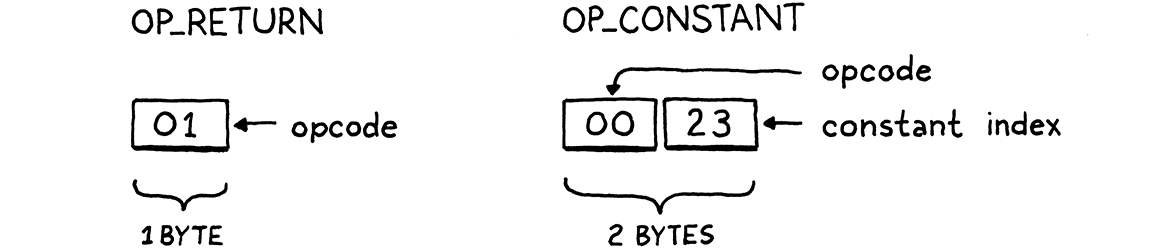
يحدّد كل رمز تشغيل كم بايتًا من مُعاملاته وما الذي تعنيه. فمثلًا، قد تكون عملية بسيطة مثل "الإرجاع" بلا مُعاملات، بينما تحتاج تعليمة "تحميل متغيّر محلّي" إلى مُعامل يحدّد أيّ متغيّر نحمّل. وفي كل مرّة نضيف رمز تشغيل جديدًا إلى clox، نحدّد كيف تبدو مُعاملاته -- أي صيغة التعليمات (instruction format) الخاصة به.
في هذه الحالة، تأخذ OP_CONSTANT مُعاملًا من بايت واحد يحدّد أيّ ثابت نحمّله من مصفوفة
ثوابت القطعة. وبما أنّ لدينا مصرّفًا بعد، فإنّنا "نترجم" تعليمة يدويًا في قطعتنا الاختبارية.
^code main-constant (1 before, 1 after)
نضيف قيمة الثابت نفسها إلى مجمّع ثوابت القطعة. وذلك يُرجِع فهرس الثابت في المصفوفة. ثم نكتب
تعليمة الثابت، بدءًا برمز التشغيل. وبعد ذلك، نكتب مُعامل فهرس الثابت الذي هو بايت واحد.
لاحظ أنّ writeChunk() يستطيع كتابة رموز تشغيل أو مُعاملات. كلّها بايتات خام بالنسبة لتلك
الدالة.
إن حاولنا تشغيل هذا الآن، فسيصرخ المفكّك في وجوهنا لأنّه لا يعرف كيف يفكّ ترميز التعليمة الجديدة. لنُصلح ذلك.
^code disassemble-constant (1 before, 1 after)
للهذه التعليمة صيغة تعليمات مختلفة، لذا نكتب دالة مساعِدة جديدة لتفكيكها.
^code constant-instruction
هناك أمور أكثر تجري هنا. فكما في OP_RETURN، نطبع اسم رمز التشغيل. ثم نستخرج فهرس
الثابت من البايت التالي في القطعة. نطبع ذلك الفهرس، لكنّه ليس مفيدًا جدًّا لنا القرّاء البشر.
لذا نبحث أيضًا عن قيمة الثابت الفعلية -- بما أنّ الثوابت معلومة وقت التجميع في النهاية
-- ونعرض القيمة نفسها أيضًا.
يتطلّب هذا وسيلة لطباعة قيمة من نوع clox. وستعيش تلك الدالة في وحدة "value"، لذا نُضيف include لها.
^code debug-include-value (1 before, 2 after)
وهناك في ذلك التروييسة، نُعلن:
^code print-value-h (1 before, 2 after)
وهذا تنفيذ:
^code print-value
رائع، صحيح؟ وكما يمكنك تخيّل، سيصبح هذا أعقد بمجرّد أن نضيف الأنواع الديناميكية إلى Lox ونحصل على قيم من أنواع مختلفة.
عدنا في constantInstruction()، والقطعة المتبقّية الوحيدة هي قيمة الإرجاع.
^code return-after-operand (1 before, 1 after)
تذكّر أنّ disassembleInstruction() تُرجع أيضًا رقمًا تخبر به المستدعيَ إزاحة بداية التعليمة
التالية. وحيث كان OP_RETURN بايتًا واحدًا فقط، فإنّ OP_CONSTANT بايتان -- واحد لرمز
التشغيل وواحد للمُعامل.
معلومات السطر
تحتوي القطع على كلّ تقريبًا المعلومات التي يحتاجها وقت التشغيل من شيفرة المستخدم الأصلية. من الغريب نوعًا ما أن نفكّر في إمكاننا اختصار كل أصناف شجرة التحليل المجرّد المختلفة التي أنشأناها في jlox في مصفوفة بايتات ومصفوفة ثوابت. هناك قطعة بيانات واحدة ناقصة فقط. نحتاجها، مع أنّ المستخدم يأمل ألّا يراها أبدًا.
حين يقع خطأ وقت التشغيل، نعرض للمستخدم رقم السطر الذي وقعت فيه شيفرة المصدر المخالفة. في jlox، تعيش تلك الأرقام في الرموز، التي نخزّنها بدورها في عقد شجرة التحليل المجرّد. ونحتاج إلى حلّ مختلف لـ clox الآن بعد أن تخلّينا من أشجار الصياغة لصالح شيفرة البايت. فمعطى أيّ تعليمة شيفرة بايت، نحتاج إلى القدرة على تحديد سطر برنامج المستخدم الذي تُرجمت منه.
هناك طرق ذكية كثيرة لترميز ذلك. لقد أخذت أبسط نهج ممكن على الإطلاق، مع أنّه غير كفؤ للذاكرة إلى درجة محرجة. فنحن نخزّن في القطعة مصفوفة منفصلة من الأعداد الصحيحة تواكب شيفرة البايت. كل عدد في المصفوفة هو رقم السطر المقابل للبايت المقابل في شيفرة البايت. وحين يقع خطأ وقت التشغيل، نبحث عن رقم السطر عند الفهرس نفسه الذي تقع فيه إزاحة التعليمة الحالية في مصفوفة الشيفرة.
لتنفيذ هذا، نضيف مصفوفة أخرى إلى Chunk.
^code chunk-lines (1 before, 1 after)
وبما أنّها تواكب مصفوفة شيفرة البايت تمامًا، فلا نحتاج إلى عدّ أو سعة منفصلة. وفي كل مرّة نلمس فيها مصفوفة الشيفرة، نجري تغييرًا مقابلًا على مصفوفة أرقام الأسطر، بدءًا من التهيئة.
^code chunk-null-lines (1 before, 1 after)
وكذلك إزالة التخصيص:
^code chunk-free-lines (1 before, 1 after)
حين نكتب بايت شيفرة إلى القطعة، نحتاج إلى معرفة سطر المصدر الذي جاء منه، لذا نضيف مُعاملًا
إضافيًا في تصريح writeChunk().
^code write-chunk-with-line-h (1 before, 1 after)
وفي التنفيذ:
^code write-chunk-with-line (1 after)
حين نخصّص مصفوفة الشيفرة أو ننمّيها، نفعل الشيء نفسه بمعلومات الأسطر أيضًا.
^code write-chunk-line (2 before, 1 after)
وأخيرًا، نخزّن رقم السطر في المصفوفة.
^code chunk-write-line (1 before, 1 after)
تفكيك معلومات السطر
حسنًا، لنجرّب ذلك مع قطعتنا الصغيرة، آه، اليدوية. أولًا، بما أنّنا أضفنا مُعاملًا جديدًا إلى
writeChunk()، نحتاج إلى إصلاح تلك الاستدعاءات لتمرير رقم سطر ما -- عشوائي في هذه المرحلة.
^code main-chunk-line (1 before, 2 after)
ومجرّد أن نملك واجهة أمامية حقيقية، سيتتبّع المصرّف السطر الحالي أثناء التحليل ويمرّره.
الآن وبعد أن لدينا معلومات سطر لكل تعليمة، لنضعها في محلّها. فالمفكّك يفيده أن يُظهر أيّ سطر مصدر صُرِّفت منه كل تعليمة. وهذا يعطينا وسيلة للعودة إلى الشيفرة الأصلية عند محاولة فهم ما يفترض أن تفعله كتلة ما من شيفرة البايت. وبعد طباعة إزاحة التعليمة -- أي عدد البايتات من بداية القطعة -- فإنّنا نُظهر سطر مصدرها.
^code show-location (2 before, 2 after)
تميل تعليمات شيفرة البايت إلى أن تكون دقيقة جدًّا. فسطر واحد من شيفرة المصدر غالبًا ما يترجم
إلى سلسلة كاملة من التعليمات. ولجعل ذلك أوضح بصريًا، فإنّنا نعرض | لأي تعليمة تأتي من سطر
المصدر نفسه التي قبلها. ويبدو الخرج الناتج لقطعتنا المكتوبة بخط اليد هكذا:
== test chunk ==
0000  123 OP_CONSTANT         0 '1.2'
0002    | OP_RETURN
لدينا قطعة من ثلاثة بايتات. أول بايتَين تعليمة ثابت تحمّل 1.2 من مجمّع ثوابت القطعة. البايت
الأول هو رمز التشغيل OP_CONSTANT والثاني هو الفهرس في مجمّع الثوابت. أمّا البايت الثالث
(عند الإزاحة 2) فهو تعليمة إرجاع من بايت واحد.
في الفصول المتبقّية، سنُكمل هذا بأنواع تعليمات كثيرة أكثر. لكنّ البنية الأساسية موجودة هنا، ولدينا الآن كل ما نحتاجه لتمثيل قطعة شيفرة قابلة للتنفيذ بالكامل وقت التشغيل في آلتنا الافتراضية. تذكّر تلك العائلة الكاملة من أصناف شجرة التحليل المجرّد التي عرّفناها في jlox؟ في clox، لقد اختزلنا ذلك في ثلاث مصفوفات: بايتات الشيفرة، وقيم الثوابت، ومعلومات الأسطر لأغراض التصحيح.
وهذا الاختصار هو سبب رئيسي لكون مفسّرنا الجديد سيكون أسرع من jlox. ويمكنك التفكير في شيفرة البايت على أنها نوعٌ من التسلسل المُكثَّف (compact serialization) لشجرة التحليل المجرّد، محسَّن إلى حدٍّ كبير لكيفية فكّ ترميزه من المفسّر بالترتيب الذي يحتاجه أثناء تنفيذه. وفي الفصل التالي، سنرى كيف تفعل الآلة الافتراضية ذلك بالضبط.
التحدّيات
-
ترميزنا لمعلومات السطر يهدر الذاكرة بطريقة مضحكة. وبما أنّ سلسلة من التعليمات غالبًا ما تقابل سطر مصدر واحدًا، فإنّ الحل الطبيعي هو شيء قريب من ترميز معدّل التشغيل لأرقام الأسطر.
ابتكر ترميزًا يضغط معلومات السطر لسلسلة من التعليمات على السطر نفسه. غيّر
writeChunk()ليكتب هذا الشكل المضغوط، ونفّذ دالةgetLine()تحدّد، بناءً على فهرس تعليمة، السطر الذي تقع فيه.تلميح: ليس من الضروري أن تكون
getLine()فعّالة بشكل خاص. وبما أنّها لا تُستدعى إلّا حين يقع خطأ وقت التشغيل، فإنّها بعيدة كلّ البعد عن المسار الحرج الذي تهمّ فيه الأداء. -
ولأنّ
OP_CONSTANTتستخدم بايتًا واحدًا فقط لمُعاملها، فلا يمكن أن تحتوي القطعة إلّا على 256 ثابتًا مختلفًا كحدٍّ أقصى. وهذا صغير بما يكفي كي يصطدم الناس الذين يكتبون شيفرة في العالم الحقيقي بهذا الحدّ. يمكننا استخدام بايتين أو أكثر لتخزين المُعامل، لكنّ ذلك يجعل كل تعليمة ثابت تشغل مساحة أكبر. معظم القطع لن تحتاج إلى ذلك العدد الكبير من الثوابت الفريدة، لذا فذلك يهدر المساحة ويضحي ببعض المحلية في الحالة الشائعة من أجل دعم الحالة النادرة.لموازنة هدفيين متعارضين كهذا، توفّر عديد من مجموعات التعليمات تعليمات متعدّدة تؤدّي العملية نفسها لكن بمُعاملات مختلفة الأحجام. اترك تعليمة
OP_CONSTANTالحالية ذات البايت الواحد كما هي، واعرّف تعليمة ثانيةOP_CONSTANT_LONG. فهي تخزّن المُعامل كعدد من 24 بتًّا، وهو ما ينبغي أن يكفي.نفّذ هذه الدالة:
void writeConstant(Chunk* chunk, Value value, int line) {
  // Implement me...
}
تضيف
valueإلى مصفوفة ثوابتchunkثم تكتب تعليمة مناسبة لتحميل الثابت. وأضف أيضًا دعمًا في المفكّك لتعليماتOP_CONSTANT_LONG.يبدو تعريف تعليمتين أفضل الحلين. فما الذي يُضطَر، إن وُجد، إلى التضحية به؟
-
تعتمد دالتنا
reallocate()على مكتبة C القياسية في تخصيص الذاكرة الديناميكية وتحريرها. فدالتاmalloc()وfree()ليستا سحرية. ابحث عن بضع تنفيذات مفتوحة المصدر لهما واشرح كيف تعملان. كيف تتتبّعان أيّ البايتات مُخصَّصة وأيّها حرّة؟ ما المطلوب لتخصيص كتلة ذاكرة؟ ولتحريرها؟ وكيف تجعلان ذلك فعّالًا؟ وماذا تفعلان بشأن التجزئة (fragmentation)؟وضع متشدّد: نفّذ
reallocate()دون استدعاءrealloc()أوmalloc()أوfree(). يُسمح لك باستدعاءmalloc()مرّة واحدة، في بداية تنفيذ المفسّر، لتخصيص كتلة ذاكرة كبيرة واحدة تكون دالتكreallocate()على علم بها. فهي توزّع كُتل الذاكرة من تلك المنطقة الواحدة، أي كومتك الخاصة. ومهمّتك أن تعرّف كيف تفعل ذلك.
ملاحظة تصميم: اختبر لغتك
نحن على وشك أن نصل إلى منتصف الكتاب تقريبًا، وأمرٌ واحد لم نتحدّث عنه هو اختبار تنفيذ لغتك. وليس ذلك لأنّ الاختبار غير مهم. ولا يمكنني أن أُشدّد بما يكفي على مدى حيويّة وجود مجموعة اختبارات جيّدة وشاملة للغةك.
كتبتُ مجموعة اختبارات لـ Lox (وأنت مرحّب باستخدامها في تنفيذك الخاص لـ Lox) قبل أن أكتب كلمةً واحدة في هذا الكتاب. وقد كشفت تلك الاختبارات عددًا لا يُحصى من الأخطاء في تنفيذاتي.
الاختبارات مهمة في كل برمجيات، لكنها أكثر أهمية بالنسبة إلى لغة برمجة، لسببين على الأقلّ:
-
يتوقّع المستخدمون أن تكون لغاتهم البرمجية صامدة كالصخر. اعتدنا إلى حدٍّ بعيد على المصرّفات والمفسّرات الناضجة المستقرّة، لدرجة أنّ "الخطأ في شيفرتك أنت، لا في المصرّف" أصبح جزءًا راسخًا من ثقافة البرمجيات. فإذا كانت هناك أخطاء في تنفيذ لغتك، سيرفض المستخدمون الخمسة وجوهًا للحزن كاملة قبل أن يتمكّنوا من فهم ما يجري، وأنت لا تريد أن تضعهم في ذلك كلّه.
-
تنفيذ اللغة قطعة برمجية مترابطة بعمق. فبعض قواعد الشيفرة واسعة وضيّقة. فإن كانت شيفرة تحميل الملف معطوبة في محرّرك النصّي، فإنّها -- نأمل ذلك! -- لن تسبّب إخفاقات في عرض النصّ على الشاشة. أما تنفيذات اللغات فهي أضيق وأعمق، ولا سيما قلب المفسّر الذي يعالج الدلالات الفعلية للغة. وهذا يجعل من السهل تسلّل أخطاء خفيّة بسبب تفاعلات غريبة بين أجزاء النظام المختلفة. ويحتاج ذلك إلى اختبارات جيّدة لطردها.
-
المُدخَل إلى تنفيذ اللغة، بحكم التصميم، توليديّ. فهناك عدد لا نهائي من البرامج الممكنة التي يمكن للمستخدم كتابتها، وينفّذك يجب أن تعمل جميعها على نحو صحيح. ومن البديهي أنّك لا تستطيع اختبار ذلك بشكل شامل، لكنّك تحتاج إلى العمل بجدّ لتغطية أكبر قدر ممكن من فضاء المُدخَلات.
-
تنفيذات اللغات غالبًا ما تكون معقّدة، وتتغيّر باستمرار، ومليئة بالتحسينات. ويؤدي ذلك إلى شيفرة متشابكة كثيرة الزوايا المظلمة حيث يمكن للأخطاء أن تختبئ.
كلّ ذلك يعني أنّك ستحتاج إلى كثير من الاختبارات. لكن أيّ اختبارات؟ فقد ركّزت المشاريع التي رأيتها في الغالب على "اختبارات لغوية" من الطرف إلى الطرف. كلّ اختبار هو برنامج مكتوب باللغة مع الخرج أو الأخطاء المتوقّعة أن ينتجها. ثم لديك مشغّل اختبارات يدفع برنامج الاختبار عبر تنفيذ لغتك ويتحقّق من أنّه يفعل ما يفترض به. ولكتابة اختباراتك باللغة نفسها مزايا جيّدة قليلة:
-
الاختبارات غير مقترنة بأيّ API معيّن أو بقرارات البنية الداخلية للتنفيذ. وهذا يحرّرك لإعادة تنظيم أجزاء من مفسّرك أو مصرّفك أو إعادة كتابتها دون الحاجة إلى تحديث كومة من الاختبارات.
-
يمكنك استخدام الاختبارات نفسها لتعدّد تنفيذات اللغة.
-
يمكن للاختبارات غالبًا أن تكون موجزة وسهلة القراءة والصيانة، بما أنّها مجرّد نصوص برمجية بلغتك.
لكن ليس كل شيء ورديًّا:
-
اختبارات الطرف إلى الطرف تساعدك على تحديد ما إذا كان هناك خطأ، لكن ليس أين الخطأ. فقد يكون كشف موضع الشيفرة الخاطئة في التنفيذ أصعب، لأنّ الاختبار لا يخبرك سوى أنّ الخرج الصحيح لم يظهر.
-
قد يكون إعداد برنامج صالح يُثير زاوية غامضة في التنفيذ عبئًا. وينطبق هذا على وجه الخصوص على المصرّفات المحسَّنة بدرجة عالية حيث قد تحتاج إلى كتابة شيفرة ملتوية أنّك تنتهي إلى مسار التحسين بالضبط حيث قد يختبئ خطأ.
-
قد تكون تكلفة تشغيل المفسّر وتحليل وترجمة وتشغيل كل نصّ اختبار مرتفعة. ومع مجموعة اختبارات كبيرة -- وأنت تريد واحدة ، تذكّر -- قد يعني ذلك وقتًا طويلًا في انتظار انتهاء الاختبارات.
يمكنني أن أُكمل، لكنني لا أريد أن يتحوّل هذا إلى وعظ. كما أنّني لا أدّعي أنّني خبير في كيفية اختبار اللغات. إنما أريد فقط أن تستوعب مدى أهمية أنّ تختبر لغتك. بجدّ. اختبر لغتك. وستشكرني على ذلك.