مدير المخزن المؤقت
8.1. نظرة عامة
يقدّم هذا القسم المفاهيم الأساسية اللازمة لفهم الأوصاف الواردة في الأقسام اللاحقة.
محتويات القسم
- 8.1.1. بنية مدير المخزن المؤقت
- 8.1.2. وسم المخزن المؤقت
- 8.1.3. كيف تقرأ العملية الخلفية الصفحات
- 8.1.4. خوارزمية استبدال الصفحات
- 8.1.5. إفراغ الصفحات المعدَّلة
8.1.1. بنية مدير المخزن المؤقت
يتكوّن مدير المخزن المؤقت (buffer manager) في PostgreSQL من جدول مخازن، وواصفات مخازن، ومجمّع مخازن. ويصف القسم التالي هذه المكوّنات.
تخزّن طبقة مجمّع المخازن (buffer pool) صفحات ملفات البيانات، مثل الجداول والفهارس، وكذلك خرائط المساحة الحرة وخرائط الظهور.
مجمّع المخازن مصفوفة تخزّن كل خانة فيها صفحة واحدة من ملف بيانات. ويُشار إلى فهارس مصفوفة مجمّع المخازن بـمعرّفات المخزن (buffer_ids).
يصف القسمان 8.2 و8.3 تفاصيل البنية الداخلية لمدير المخزن المؤقت. ويصف القسمان 8.2 و8.3 تفاصيل البنية الداخلية لمدير المخزن المؤقت.
8.1.2. وسم المخزن المؤقت
في PostgreSQL، يمكن إسناد وسم فريد لكل صفحة من جميع ملفات البيانات، أي وسم المخزن المؤقت (buffer tag). وعندما يتلقّى مدير المخزن المؤقت طلباً، يستخدم PostgreSQL قيمة buffer_tag الخاصة بالصفحة المطلوبة.
typedef struct buftag
{
	Oid			spcOid;			/* tablespace oid */
	Oid			dbOid;			/* database oid */
	RelFileNumber relNumber;	/* relation file number */
	ForkNumber	forkNum;		/* fork number */
	BlockNumber blockNum;		/* blknum relative to begin of reln */
} BufferTag;
يتكوّن buffer_tag من خمس قيم:
- specOid: معرّف OID لفضاء الجداول (tablespace) الذي تنتمي إليه العلاقة.
- dbOid: معرّف OID لقاعدة البيانات التي تنتمي إليها العلاقة.
- relNumber: رقم ملف العلاقة الذي يحتوي على الصفحة الهدف.
- blockNum: رقم الكتلة الخاص بالصفحة الهدف في العلاقة.
- forkNum: رقم التفرّع (fork number) للعلاقة التي تنتمي إليها الصفحة. وتُعرَّف أرقام التفرّع للجداول وخرائط المساحة الحرة وخرائط الظهور بالقيم 0 و1 و2 على الترتيب.
فمثلاً، يحدّد buffer_tag ‘{16821, 16384, 37721, 0, 7}’ الكتلة السابعة من الجدول الذي معرّفه OID هو 37721 ورقم تفرّعه 0. ويقع هذا الجدول في قاعدة البيانات ذات المعرّف 16384 ضمن فضاء الجداول ذي المعرّف 16821.
وبالمثل، يحدّد buffer_tag ‘{16821, 16384, 37721, 1, 3}’ الكتلة الثالثة من خريطة المساحة الحرة التي معرّفها OID هو 37721 ورقم تفرّعها 1.
8.1.3. كيف تقرأ العملية الخلفية الصفحات
يصف هذا القسم الفرعي كيف تقرأ عملية خلفية (backend process) صفحة من مدير المخزن المؤقت (الشكل 8.2).
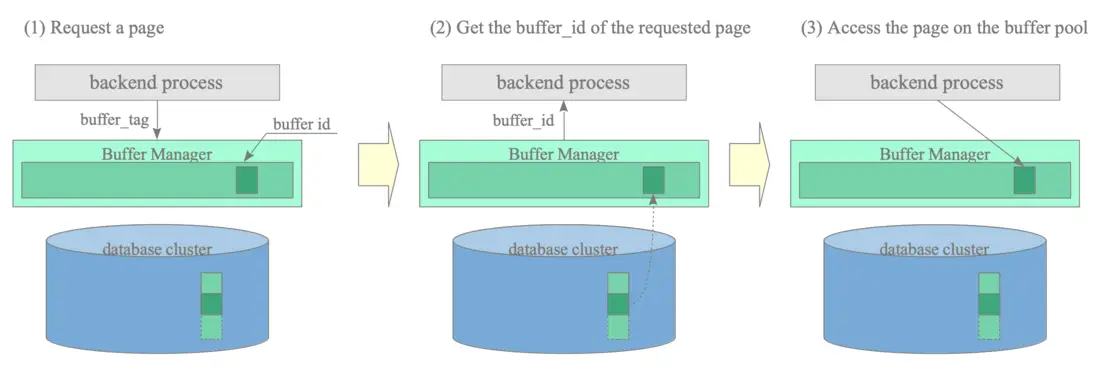
الشكل 8.2. كيف تقرأ العملية الخلفية صفحة من مدير المخزن المؤقت.
- (1) عند قراءة صفحة جدول أو فهرس، ترسل العملية الخلفية طلباً يتضمن قيمة buffer_tag الخاصة بالصفحة إلى مدير المخزن المؤقت.
- (2) يُعيد مدير المخزن المؤقت معرّف buffer_id للخانة التي تخزّن الصفحة المطلوبة. وإذا لم تكن الصفحة المطلوبة في مجمّع المخازن، يحمّل مدير المخزن المؤقت الصفحة من التخزين الدائم إلى إحدى خانات مجمّع المخازن ثم يُعيد buffer_id.
- (3) تصل العملية الخلفية إلى خانة buffer_id لقراءة الصفحة المطلوبة.
عندما تعدّل عملية خلفية صفحة في مجمّع المخازن (مثلاً بإدراج صفوف)، يُشار إلى الصفحة المعدَّلة بـالصفحة المعدَّلة (dirty page) لأنها لم تُفرَّغ بعد إلى التخزين.
ويصف القسم 8.4 عمليات مدير المخزن المؤقت بمزيد من التفصيل.
8.1.4. خوارزمية استبدال الصفحات
عندما تكون جميع خانات مجمّع المخازن مشغولة ولا تكون الصفحة المطلوبة مخزَّنة فيه، يجب على مدير المخزن المؤقت اختيار صفحة من مجمّع المخازن لاستبدالها. وفي علم الحاسوب، تُسمى خوارزميات الاختيار هذه خوارزميات استبدال الصفحات (page replacement algorithms)، وتُسمى الصفحة المختارة الصفحة الضحية (victim page).
ما زال البحث في خوارزميات استبدال الصفحات مستمراً منذ نشأة علم الحاسوب. وقد طُرحت خوارزميات كثيرة؛ ويستخدم PostgreSQL خوارزمية المسح الدوري (clock sweep) منذ الإصدار 8.1. والمسح الدوري أبسط وأكثر كفاءة من خوارزمية LRU المستخدمة في الإصدارات السابقة.
ويصف القسم 8.4.4 تفاصيل المسح الدوري.
8.1.4.1. معلومات تاريخية
اعتمد PostgreSQL على خوارزمية LRU بسيطة حتى الإصدار 7.4.
نفّذ الإصدار 8.0 (الصادر في 19 يناير 2005) ذاكرة الاستبدال التكيفية (Adaptive Replacement Cache) (ARC)، لكن ظهرت مخاوف من احتمال انتهاك براءة اختراع لشركة IBM.
ونتيجة لذلك، استبدل مجتمع PostgreSQL خوارزمية ARC بخوارزمية 2Q في الإصدار 8.0.2 (7 أبريل 2005)، قبل أن يتبنّى لاحقاً خوارزمية المسح الدوري في الإصدار 8.1 (8 نوفمبر 2005).
8.1.5. إفراغ الصفحات المعدَّلة
يجب في النهاية إفراغ الصفحات المعدَّلة إلى التخزين. غير أن مدير المخزن المؤقت يحتاج إلى مساعدة لتنفيذ هذه المهمة. وفي PostgreSQL، تتولّى عمليتان خلفيتان، هما كاتب نقاط التحقق (checkpointer) والكاتب الخلفي (background writer)، هذه المهمة.
ويصف القسم 8.6 كاتب نقاط التحقق والكاتب الخلفي.
** الإدخال/الإخراج المباشر (Direct I/O)
لا تدعم إصدارات PostgreSQL 15 وما قبلها الإدخال/الإخراج المباشر. راجع هذا المقال في قائمة pgsql-ML البريدية وهذا المقال.
وفي الإصدار 16، أُضيف الخيار debug_io_direct. ويتيح هذا الخيار للمطوّرين تحسين استخدام الإدخال/الإخراج المباشر في PostgreSQL. وإذا مضى التطوير بنجاح، فسيدعم PostgreSQL الإدخال/الإخراج المباشر رسمياً في المستقبل القريب.
8.2. بنية مدير المخزن المؤقت
يتكوّن مدير المخزن المؤقت في PostgreSQL من ثلاث طبقات: جدول المخازن، وواصفات المخازن، ومجمّع المخازن (الشكل 8.3).
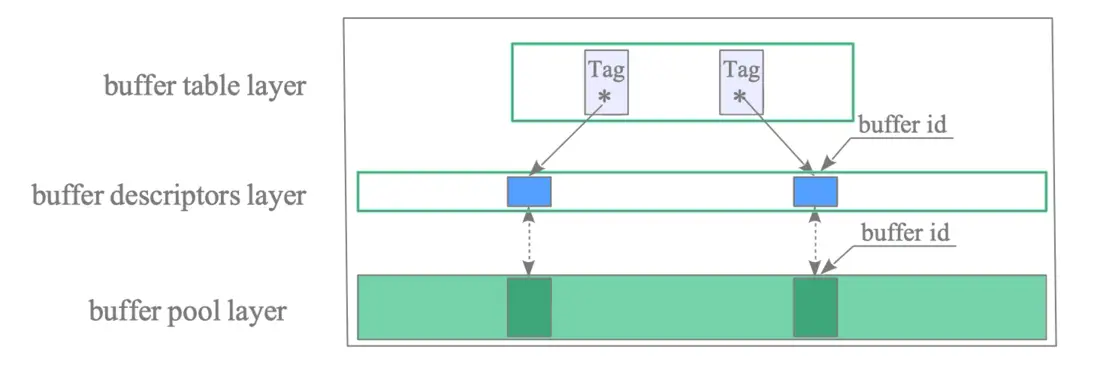
الشكل 8.3. البنية ثلاثية الطبقات لمدير المخزن المؤقت.
- مجمّع المخازن: مصفوفة تخزّن صفحات ملفات البيانات. وتُعرَّف كل خانة في المصفوفة بمعرّف buffer_id.
- واصفات المخازن: مصفوفة من واصفات المخازن. ولكل واصف تقابل واحد بواحد مع خانة في مجمّع المخازن، ويحمل البيانات الوصفية للصفحة المخزَّنة في تلك الخانة.
- جدول المخازن: جدول تجزئة يخزّن العلاقة بين قيم buffer_tag للصفحات المخزَّنة ومعرّفات buffer_id للواصفات التي تحمل بياناتها الوصفية.
ملاحظة: اعتمد هذا التوثيق مصطلح «طبقة واصفات المخازن» للتبسيط.
محتويات القسم
- 8.2.1. جدول المخازن
- 8.2.2. واصف المخزن
- 8.2.3. طبقة واصفات المخازن
- 8.2.4. مجمّع المخازن
8.2.1. جدول المخازن
ينقسم جدول المخازن منطقياً إلى ثلاثة أجزاء: دالة تجزئة، وخانات دلاء التجزئة، ومدخلات بيانات (الشكل 8.4).
تُسند دالة التجزئة المدمجة قيم buffer_tag إلى خانات دلاء التجزئة. ومع أن خانات دلاء التجزئة أكثر من خانات مجمّع المخازن، فقد تحدث تصادمات. لذلك يستخدم جدول المخازن التسلسل المنفصل بالقوائم المترابطة لحلّ التصادمات. فعندما تُسند مدخلات بيانات إلى دلو التجزئة نفسه، يخزّنها هذا الأسلوب في القائمة المترابطة نفسها (الشكل 8.4).
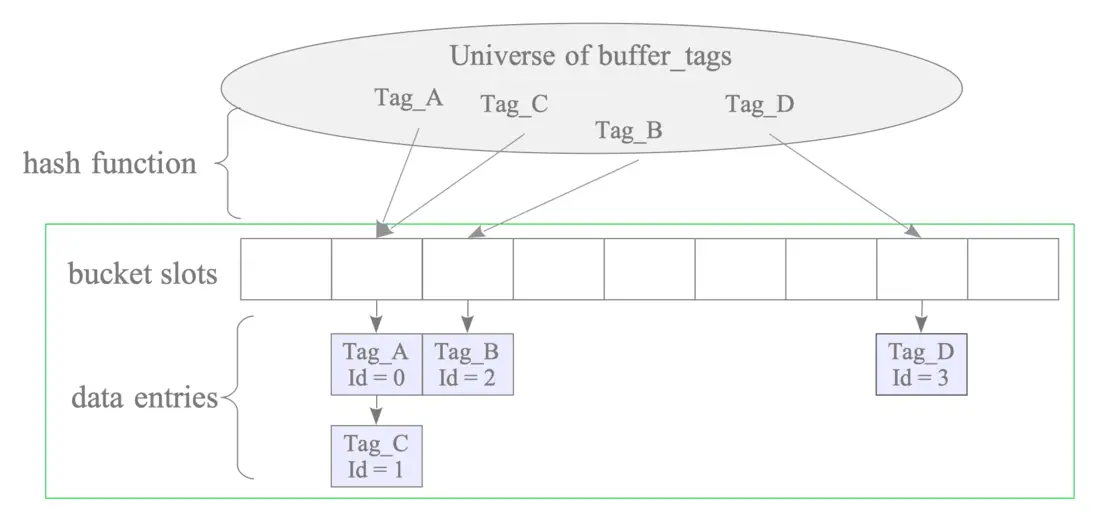
الشكل 8.4. جدول المخازن.
يتكوّن مدخل البيانات من قيمتين: قيمة buffer_tag الخاصة بصفحة، ومعرّف buffer_id للواصف الذي يحمل البيانات الوصفية لتلك الصفحة. فمثلاً، يدل المدخل ‘Tag_A, id=1’ على أن الواصف ذا المعرّف ‘1’ يخزّن البيانات الوصفية للصفحة الموسومة بـ Tag_A.
8.2.1.1. دالة التجزئة
دالة التجزئة تركيب من الدالتين calc_bucket() وhash().
وفيما يلي تمثيلها كدالة شبه برمجية:
uint32 bucket_slot = calc_bucket(unsigned hash(BufferTag buffer_tag), uint32 bucket_size)
8.2.2. واصف المخزن
يحمل واصف المخزن البيانات الوصفية للصفحة المخزَّنة في خانة مجمّع المخازن المقابلة. وتعرّف بنية BufferDesc هذا الواصف (انظر buf_internals.h).
/*
 * Flags for buffer descriptors
 */
#define BM_LOCKED		(1U << 22)	/* buffer header is locked */
#define BM_DIRTY		(1U << 23)	/* data needs writing */
#define BM_VALID		(1U << 24)	/* data is valid */
#define BM_TAG_VALID		(1U << 25)	/* tag is assigned */
#define BM_IO_IN_PROGRESS	(1U << 26)	/* read or write in progress */
#define BM_IO_ERROR		(1U << 27)	/* previous I/O failed */
#define BM_JUST_DIRTIED		(1U << 28)	/* dirtied since write started */
#define BM_PIN_COUNT_WAITER	(1U << 29)	/* have waiter for sole pin */
#define BM_CHECKPOINT_NEEDED	(1U << 30)	/* must write for checkpoint */
#define BM_PERMANENT		(1U << 31)	/* permanent buffer (not unlogged,
						 * or init fork) */

#define PG_HAVE_ATOMIC_U32_SUPPORT
typedef struct pg_atomic_uint32
{
	volatile uint32 value;
} pg_atomic_uint32;

typedef struct BufferDesc
{
	BufferTag	tag;			/* ID of page contained in buffer */
	int		buf_id;			/* buffer's index number (from 0) */

	/* state of the tag, containing flags, refcount and usagecount */
	pg_atomic_uint32 state;

	int		wait_backend_pgprocno;	/* backend of pin-count waiter */
	int		freeNext;		/* link in freelist chain */
	PgAioWaitRef	io_wref;		/* set iff AIO is in progress */
	LWLock		content_lock;	/* to lock access to buffer contents */
} BufferDesc;
وتشمل الحقول الرئيسية:
- tag: يحمل قيمة
buffer_tagالخاصة بالصفحة المخزَّنة. - buf_id: يحدّد الواصف.
- content_lock: قفل خفيف الوزن للوصول إلى الصفحة. راجع القسم 8.3.2 للتفاصيل.
- freeNext: مؤشر للقائمة الحرة.
- state: حقل واحد بعرض 32 بت يحمل ثلاثة متغيرات: flags وusage_count وrefcount.
ويوضّح الشكل 8.5 مكوّنات الحقل state: flags (10 بتّات)، وusage_count (4 بتّات)، وrefcount (18 بتّة).
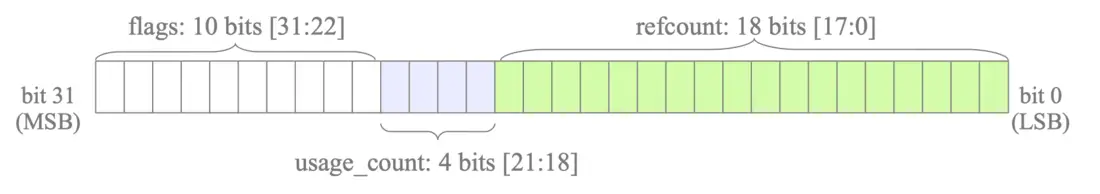
الشكل 8.5. بنية الحقل state في BufferDesc.
8.2.2.1. تفاصيل الحقل state
متغيرات الحقل state كما يلي:
-
flags: يخزّن عدة حالات للصفحة. والحالات الرئيسية كما يلي: بتّة المعدَّلة (dirty bit, BM_DIRTY): تدل على أن الصفحة معدَّلة.
-
بتّة الصلاحية (valid bit, BM_VALID): تدل على أن الصفحة صالحة ويمكن قراءتها أو الكتابة فيها.
-
بتّة io_in_progress (BM_IO_IN_PROGRESS): تدل على ما إذا كان مدير المخزن المؤقت يقرأ الصفحة من التخزين أو يكتبها إليه حالياً.
-
usage_count: يتتبّع عدد المرات التي وُصل فيها إلى الصفحة منذ تحميلها. وتستخدم خوارزمية استبدال الصفحات، الموضّحة في القسم 8.4.2، هذه القيمة. (تُقيَّد هذه القيمة عند (= ) لأن خوارزمية استبدال الصفحات تعمل على النحو الأمثل ضمن هذا النطاق.)
-
refcount (ويُسمى أيضاً عدّاد التثبيت): يحمل عدد عمليات PostgreSQL التي تصل إلى الصفحة حالياً. ويجب على العملية زيادة هذه القيمة (refcount++) عند الوصول إلى الصفحة وإنقاصها (refcount--) بعد ذلك. وتكون الصفحة غير مثبَّتة (unpinned) إذا كان refcount صفراً؛ وإلا فهي مثبَّتة (pinned).
8.2.2.2. العمليات على الحقل state
تحدّث عمليات CPU الذرّية هذه المتغيرات لضمان الكفاءة.
** العمليات الذرّية
تُنفَّذ العملية الذرّية كوحدة واحدة غير قابلة للتجزئة ودون انقطاع. ويضمن ذلك الاتساق عندما تصل عمليات متعددة إلى القيمة نفسها بالتزامن دون أقفال صريحة.
فمثلاً، لتغيير usage_count، يقنع النظام البتّات المعنية ويحدّث الحقل state بكامله (32 بت) دفعةً واحدة باستخدام عملية ذرّية. ويحسّن هذا النهج الأداء بتجنّب الحصول على قفل دوّار (spinlock) لهذه التحديثات.
ومن الآن فصاعداً، يعبّر هذا التوثيق عن العمليات على هذه المتغيرات بصيغة مبسّطة. فمثلاً، يُعبَّر عن زيادة refcount بـ “refcount++”، على غرار متغير C عادي.
** معلومات تاريخية
حتى الإصدار 9.5، كانت flags وusage_count وrefcount متغيرات منفصلة. وكانت العمليات تستخدم قفلاً دوّاراً لتجنّب التعارضات مع العمليات الأخرى.
فمثلاً، في كل مرة كانت usage_count تزداد، كان النظام يحصل على قفل دوّار كما يلي:
LockBufHdr(bufferdesc); /* Acquire a spinlock */
bufferdesc->usage_count++;
UnlockBufHdr(bufferdesc); /* Release the spinlock */
8.2.2.3. حالات الواصف
للتبسيط، يعرّف هذا التوثيق ثلاث حالات للواصف:
- فارغ (Empty): خانة مجمّع المخازن المقابلة لا تخزّن صفحة (refcount وusage_count يساويان 0).
- مثبَّت (Pinned): تخزّن الخانة صفحة وتصل إليها عملية واحدة على الأقل (refcount 1).
- غير مثبَّت (Unpinned): تخزّن الخانة صفحة لكن لا تصل إليها أي عملية حالياً (usage_count 1، لكن refcount يساوي 0).
وتمثّل المربّعات الملوّنة التالية هذه الحالات في الأشكال اللاحقة:
في الأشكال التالية، تُمثَّل حالات واصفات المخازن بمربّعات ملوّنة.
- (أبيض): فارغ
- (أزرق): مثبَّت
- (أزرق مائي): غير مثبَّت
بالإضافة إلى ذلك، تُرمز الصفحة المعدَّلة بالعلامة 'X'. فمثلاً، يُمثَّل الواصف غير المثبَّت المعدَّل بالرمز X.
8.2.3. طبقة واصفات المخازن
تشكّل مصفوفة واصفات المخازن طبقة واصفات المخازن.
عند بدء تشغيل خادم PostgreSQL، تكون جميع واصفات المخازن ’فارغة’. وتشكّل هذه الواصفات قائمة مترابطة تُسمى القائمة الحرة (freelist) (الشكل 8.6).
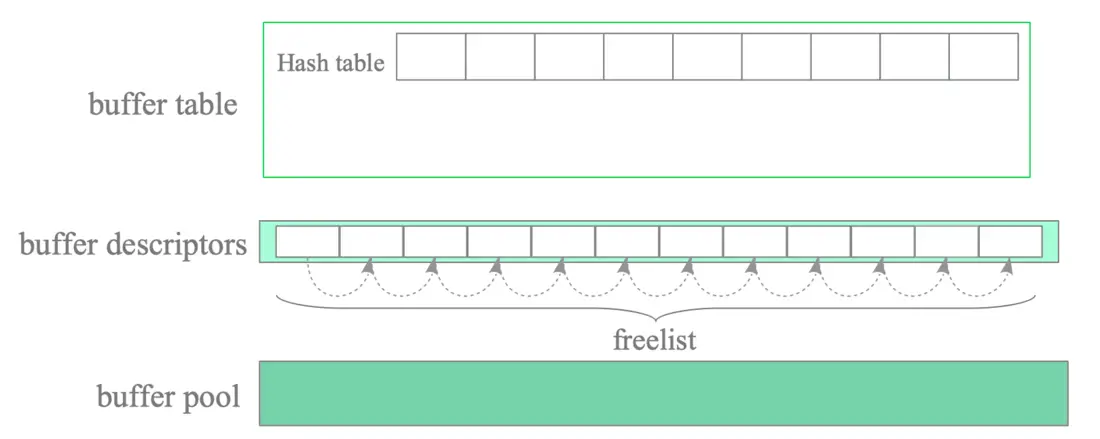
الشكل 8.6. الحالة الأولية لمدير المخزن المؤقت.
** ملاحظة
تختلف القائمة الحرة في PostgreSQL عن القوائم الحرة في Oracle.
فالقائمة الحرة في PostgreSQL مجرّد قائمة مترابطة من واصفات المخازن الفارغة. وفي PostgreSQL، تؤدي خرائط المساحة الحرة (FSM)، الموضّحة في القسم 5.3.4، الغرض نفسه الذي تؤديه القوائم الحرة في Oracle.
ويوضّح الشكل 8.7 كيفية تحميل الصفحة الأولى.
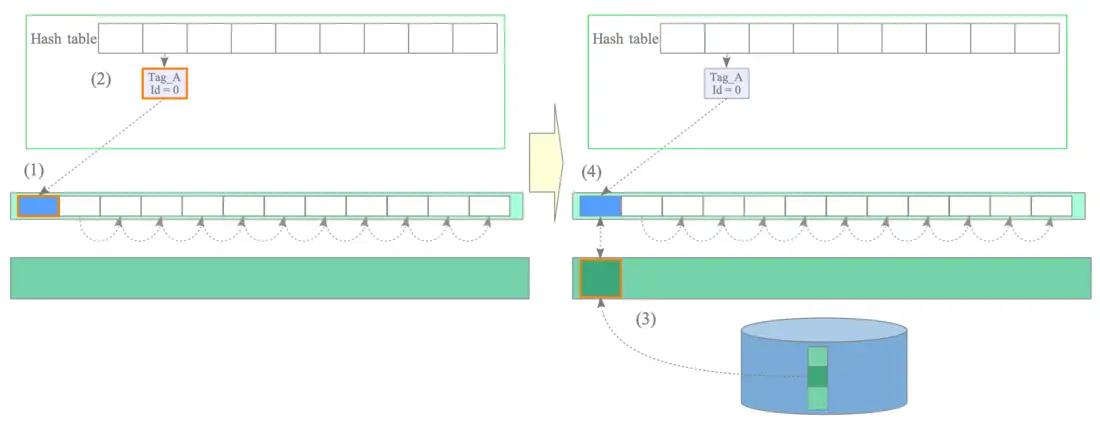
الشكل 8.7. تحميل الصفحة الأولى.
- (1) استرجاع واصف فارغ من أعلى القائمة الحرة وتثبيته (أي زيادة refcount وusage_count بمقدار 1).
- (2) إدراج مدخل جديد في جدول المخازن لإسناد وسم الصفحة الأولى إلى معرّف buffer_id الخاص بالواصف المسترجَع.
- (3) تحميل الصفحة الجديدة من التخزين إلى خانة مجمّع المخازن المقابلة.
- (4) حفظ البيانات الوصفية للصفحة الجديدة في الواصف المسترجَع.
وتُحمَّل الصفحة الثانية وما بعدها بطريقة مماثلة. ويقدّم القسم 8.4.1.2 تفاصيل إضافية.
الواصفات المسترجَعة من القائمة الحرة تحمل دائماً بيانات وصفية لصفحات. وهذه الواصفات غير الفارغة لا تعود إلى القائمة الحرة بمجرد استخدامها. غير أن الواصفات المقابلة تعود إلى القائمة الحرة وتُضبط حالتها على ’فارغ’ عند حدوث أحد ما يلي:
- إسقاط جداول أو فهارس.
- إسقاط قواعد بيانات.
- تنظيف جداول أو فهارس باستخدام الأمر VACUUM FULL.
** لماذا تتكوّن القائمة الحرة من الواصفات الفارغة؟
تتيح القائمة الحرة الاسترجاع الفوري للواصف الأول. وهذه ممارسة شائعة في التخصيص الديناميكي لموارد الذاكرة. ولمزيد من المعلومات، راجع هذا الشرح.
تحتوي طبقة واصفات المخازن على متغير صحيح غير سالب بعرض 32 بت هو nextVictimBuffer. ويُستخدم هذا المتغير في خوارزمية استبدال الصفحات الموضّحة في القسم 8.4.2.
8.2.4. مجمّع المخازن
مجمّع المخازن مصفوفة بسيطة تخزّن صفحات ملفات البيانات، مثل الجداول والفهارس. وتُسمى فهارس مصفوفة مجمّع المخازن buffer_ids.
حجم خانة مجمّع المخازن 8 كيلوبايت، وهو يساوي حجم الصفحة. لذلك يمكن لكل خانة أن تخزّن صفحة كاملة.
8.3. أقفال مدير المخزن المؤقت
يستخدم مدير المخزن المؤقت أقفالاً كثيرة لأغراض متنوعة. ويصف هذا القسم الأقفال اللازمة للشروح الواردة في الأقسام اللاحقة.
** ملاحظة
الأقفال الموصوفة في هذا القسم جزء من آلية مزامنة خاصة بمدير المخزن المؤقت. وهي لا تتعلق بأوامر SQL أو خيارات SQL.
محتويات القسم
- 8.3.1. أقفال جدول المخازن
- 8.3.2. content_lock
8.3.1. أقفال جدول المخازن
يحمي BufMappingLock سلامة بيانات جدول المخازن بأكمله. وهو قفل خفيف الوزن يمكن استخدامه في النمطين المشترك والحصري. وتحتفظ العملية الخلفية بقفل BufMappingLock مشترك عند البحث عن مدخل في جدول المخازن. أما عند إدراج المدخلات أو حذفها، فتحتفظ العملية بقفل حصري.
يُقسَّم BufMappingLock إلى أقسام لتقليل التنازع (القيمة الافتراضية 128 قسماً). ويحرس كل قسم من BufMappingLock جزءاً من خانات دلاء التجزئة.
ويوضّح الشكل 8.8 أثر تقسيم BufMappingLock. فبإمكان عمليتين خلفيتين أن تحتفظا في الوقت نفسه بقسمين مختلفين من BufMappingLock في النمط الحصري لإدراج مدخلات بيانات جديدة. ولو كان BufMappingLock قفلاً واحداً على مستوى النظام بأكمله، لاضطرّت إحدى العمليتين إلى انتظار الأخرى حتى تنتهي.
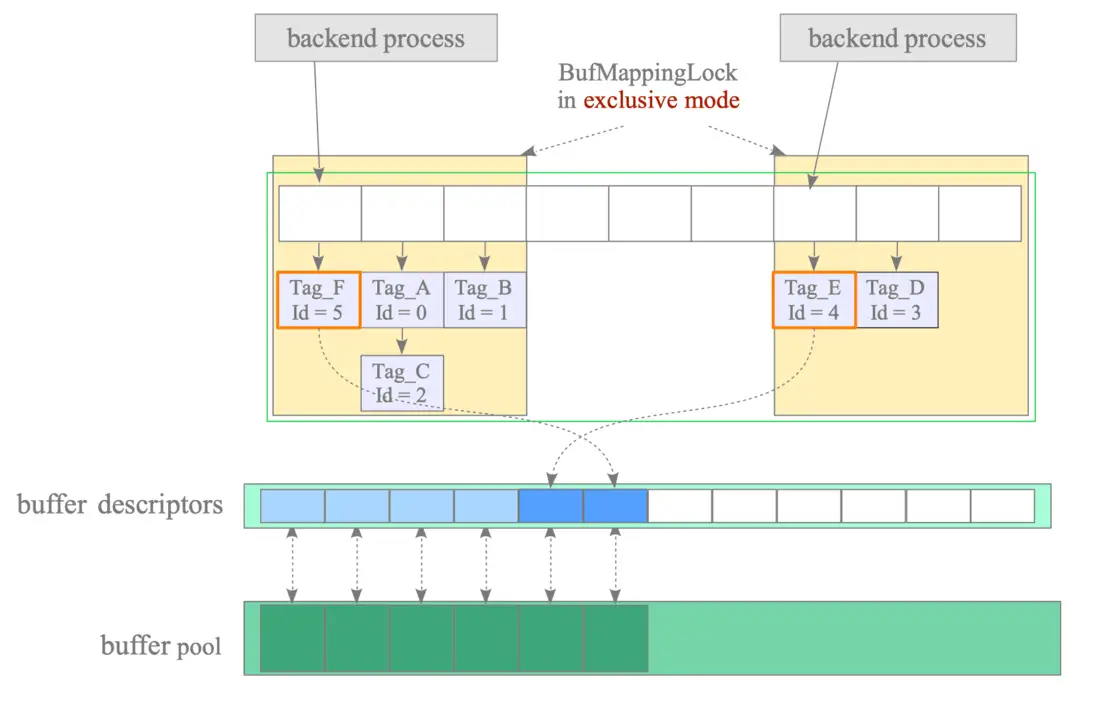
الشكل 8.8. عمليتان تحصلان في الوقت نفسه على قسمي BufMappingLock الخاصين بهما في النمط الحصري لإدراج مدخلات بيانات جديدة.
** معلومات تاريخية
أُدخل BufMappingLock في الإصدار 8.1 (عام 2005). وحتى الإصدار 9.4 (عام 2014)، كان BufMappingLock يُقسَّم افتراضياً إلى 16 قسماً.
قبل إدخال BufMappingLock، كان PostgreSQL يستخدم BufMgrLock. وكان لا بدّ من الحصول على هذا القفل العملاق كلما وُصل إلى المخزن المؤقت المشترك، ما أدّى إلى تزامن ضعيف.
8.3.2. قفل المحتوى content_lock
يستخدم كل واصف مخزن قفلاً خفيف الوزن، هو content_lock، للتحكّم في الوصول إلى الصفحة المخزَّنة في خانة مجمّع المخازن.
قفل content_lock قفل نمطي يفرض قيوداً على الوصول. ويمكن استخدامه في النمطين المشترك والحصري.
تحصل العملية الخلفية على قفل content_lock مشترك للواصف عند قراءة صفحة.
ويُحصَّل قفل content_lock حصري عند تنفيذ المهام التالية:
- إدراج أسطر (صفوف) في الصفحة المخزَّنة أو تغيير الحقلين t_xmin/t_xmax للصفوف داخل الصفحة.
- الإزالة الفيزيائية للصفوف أو ضغط المساحة الحرة في الصفحة المخزَّنة.
- تجميد الصفوف داخل الصفحة المخزَّنة.
ويقدّم ملف README الرسمي مزيداً من التفاصيل.
8.4. آليات إدارة المخازن المؤقتة
يجعل مدير المخزن المؤقت آلية قراءة بيانات الكتل من التخزين وكتابتها إليه مجرّدة، ما يتيح للمنفّذ الوصول إلى البيانات بسلاسة.
يشرح هذا القسم الآلية الداخلية، مع التركيز تحديداً على كيفية قراءة PostgreSQL صفحة هدف من جدول علاقة.
يصف القسم 8.4.1 العملية الأساسية لمدير المخزن المؤقت بمثال قراءة صفحة واحدة، ويشرح القسم 8.4.2 خوارزمية استبدال الصفحات (المسح الدوري). ويقدّم القسمان 8.4.3 و8.4.5 تفاصيل عن المخزن المؤقت الحلقي — المستخدم لقراءة جدول كبير أو الكتابة فيه — والمخزن المؤقت المحلي.
ولأن آلية المسح التسلسلي تغيّرت تغيّراً كبيراً مع إدخال الإدخال/الإخراج غير المتزامن (Asynchronous I/O, AIO)، يشرح القسم 8.5 تفاصيلها.
محتويات القسم
- 8.4.1. قراءة صفحة واحدة
- 8.4.2. خوارزمية استبدال الصفحات: المسح الدوري
- 8.4.3. المخزن المؤقت الحلقي
- 8.4.4. الجداول المؤقتة وإدارة المخزن المؤقت المحلي
8.4.1. قراءة صفحة واحدة
يتناول هذا القسم عملية قراءة صفحة واحدة.
في هذه الحالة، عندما تحتاج عملية خلفية إلى الوصول إلى صفحة محدّدة، فإنها تستدعي الدالة ReadBuffer().
ويعتمد سلوك ReadBuffer() على ثلاث حالات منطقية. وتصف الأقسام الفرعية التالية كل حالة.
8.4.1.1. الوصول إلى صفحة مخزَّنة في مجمّع المخازن
يصف هذا القسم الفرعي أبسط حالة: أن تكون الصفحة المطلوبة مخزَّنة بالفعل في مجمّع المخازن. في هذه الحالة، ينفّذ مدير المخزن المؤقت الخطوات التالية (راجع الشكل 8.9):
- (1) إنشاء قيمة buffer_tag للصفحة المطلوبة (مثلاً Tag_C) وحساب خانة دلو التجزئة.
- (2) الحصول على قسم BufMappingLock الذي يغطي خانة دلو التجزئة في النمط المشترك. ويُحرَّر هذا القفل في الخطوة (5).
- (3) البحث عن المدخل ذي الوسم Tag_C والحصول على buffer_id (مثلاً buffer_id 2) من ذلك المدخل.
- (4) تثبيت واصف المخزن الخاص بالمعرّف buffer_id 2 بزيادة refcount وusage_count بمقدار 1.
- (5) تحرير BufMappingLock.
- (6) الوصول إلى خانة مجمّع المخازن ذات المعرّف buffer_id 2.
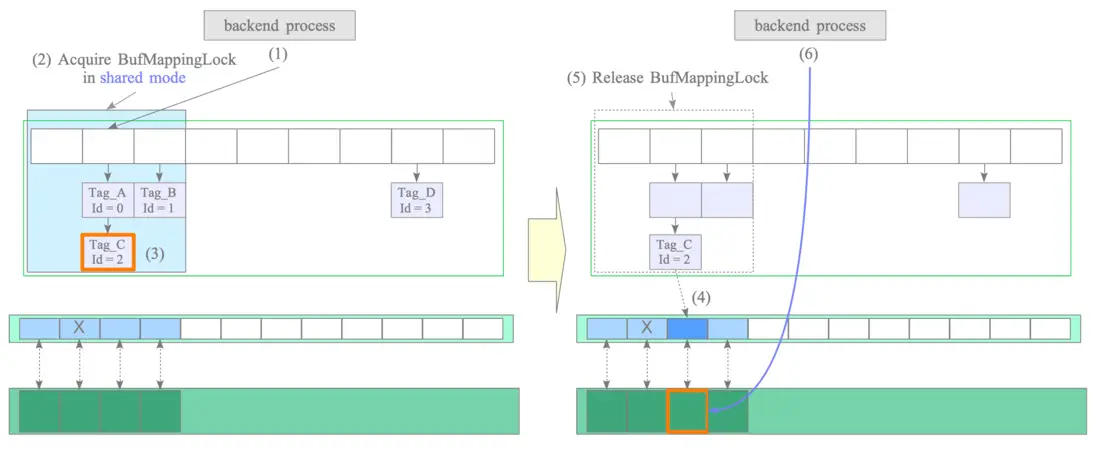
الشكل 8.9. الوصول إلى صفحة مخزَّنة في مجمّع المخازن.
عند قراءة أسطر من الصفحة، تحصل عملية PostgreSQL على قفل content_lock المشترك للواصف المقابل. ويتيح هذا القفل لعمليات متعددة قراءة خانة مجمّع المخازن في الوقت نفسه.
وعند إدراج أسطر أو تحديثها أو حذفها، تحصل عملية Postgres على قفل content_lock الحصري للواصف المقابل. ويجب على العملية أيضاً ضبط بتّة BM_DIRTY للصفحة على 1.
وبعد الوصول إلى الصفحة، تُنقص عملية PostgreSQL قيمة refcount للواصف المقابل بمقدار 1.
(لاحظ أن usage_count يبقى دون تغيير بمجرد بلوغه 15، لأنه مقيَّد بعرضه البالغ 4 بتّات.)
شبه الكود
يوضّح شبه الكود التالي هذه العملية:
ReadBuffer()
    StartReadBuffer()

        PinBufferForBlock()

            BufferAlloc(blockNum)
                /* (1) */
                buffer_tag = InitBufferTag(specOid, dbOid, relNumber, blockNum, forkNum);
                /* (2) */
                LWLockAcquire(partitionLock, LW_SHARED);
                /* (3) */
                buf_id = BufTableLookup(buffer_tag);
                bufDesc = GetBufferDescriptor(buf_id);
                /* (4) */
                PinBuffer(bufDesc);
                /* (5) */
                LWLockRelease(partitionLock);
                return bufDesc;

            return BufferDescriptorGetBuffer(bufDesc);

    return buf_id;
عند قراءة صفحة واحدة، يستدعي PostgreSQL الدالة ReadBuffer()، التي تستدعي بالتتابع StartReadBuffer() وPinBufferForBlock() وBufferAlloc().
وتنفّذ الدالة BufferAlloc() داخلياً العمليات على واصف المخزن (الخطوات (1) إلى (5)).
** الإصدار 16 وما قبله
قبل إدخال AIO، كانت الدالة ReadBuffer() أبسط، كما هو موضّح فيما يلي:
ReadBuffer()

    BufferAlloc(blockNum)
        /* (1) */
        buffer_tag = InitBufferTag(specOid, dbOid, relNumber, blockNum, forkNum);
        /* (2) */
        LWLockAcquire(partitionLock, LW_SHARED);
        /* (3) */
        buf_id = BufTableLookup(buffer_tag);
        bufDesc = GetBufferDescriptor(buf_id);
        /* (4) */
        PinBuffer(bufDesc);
        /* (5) */
        LWLockRelease(partitionLock);
        return bufDesc;

    return buf_id;
وينطبق الأمر نفسه على شبه الكود الواردة في هذا القسم من هنا فصاعداً؛ أي أن ReadBuffer() تستدعي BufferAlloc() مباشرةً دون المرور بـ StartReadBuffer() أو PinBufferForBlock().
8.4.1.2. تحميل صفحة من التخزين إلى خانة فارغة
في هذه الحالة الثانية، افترض أن مجمّع المخازن لا يحتوي على الصفحة المطلوبة وأن القائمة الحرة تضمّ عناصر حرة (واصفات فارغة).
وينفّذ مدير المخزن المؤقت الخطوات التالية (راجع الشكل 8.10):
- (1) البحث في جدول المخازن (افترض أن المدخل غير موجود). وإنشاء قيمة buffer_tag للصفحة المطلوبة (في هذا المثال، قيمة buffer_tag هي Tag_E) وحساب خانة دلو التجزئة.
- الحصول على قسم BufMappingLock في النمط المشترك.
- البحث في جدول المخازن. (غير موجود وفق الافتراض.)
- تحرير BufMappingLock.
- (2) الحصول على واصف مخزن فارغ من القائمة الحرة. في هذا المثال، معرّف buffer_id للواصف المُحصَّل هو 4.
- (3) الحصول على قسم BufMappingLock في النمط الحصري. (يُحرَّر هذا القفل في الخطوة (5).)
- (4) إنشاء مدخل بيانات جديد يتكوّن من buffer_tag بقيمة Tag_E وbuffer_id بالقيمة 4. وإدراج المدخل المُنشأ في جدول المخازن، وتثبيت واصف المخزن.
- (5) تحرير BufMappingLock.
- (6) تحميل بيانات الصفحة المطلوبة من التخزين إلى خانة مجمّع المخازن ذات المعرّف buffer_id 4 كما يلي: ضبط بتّة BM_IO_IN_PROGRESS للواصف المقابل على 1 لمنع وصول العمليات الأخرى.
- تحميل بيانات الصفحة المطلوبة من التخزين إلى خانة مجمّع المخازن.
- تحديث حالة الواصف المقابل: ضبط بتّة BM_IO_IN_PROGRESS على 0 وبتّة BM_VALID على 1.
- (7) الوصول إلى خانة مجمّع المخازن ذات المعرّف buffer_id 4.
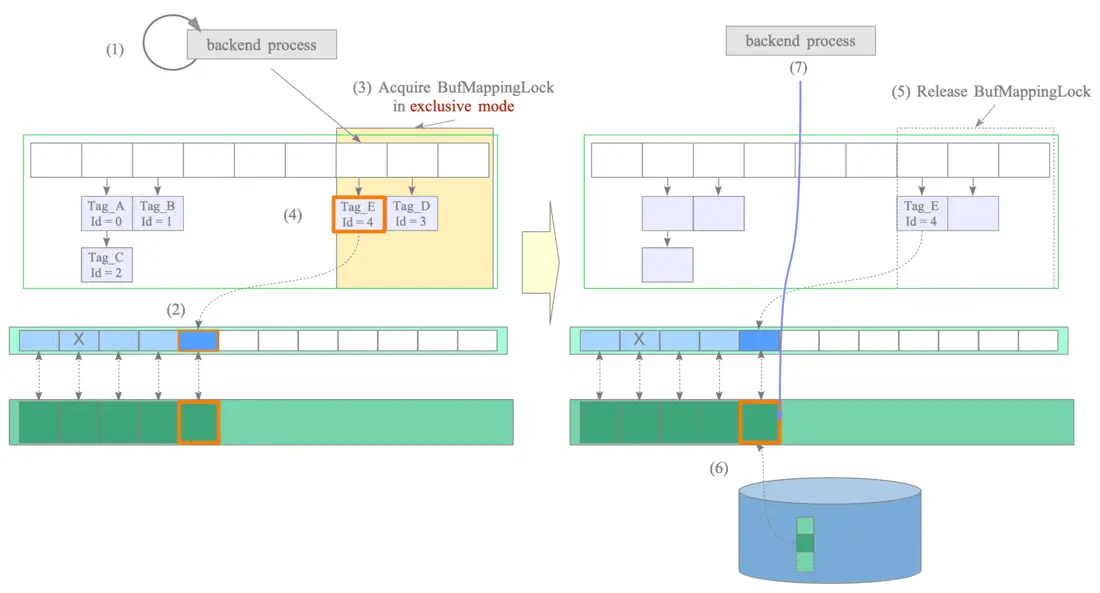
الشكل 8.10. تحميل صفحة من التخزين إلى خانة فارغة.
عند تحميل صفحة واحدة من التخزين، يقرأها PostgreSQL بشكل متزامن بصرف النظر عن معامل التهيئة io_method.
شبه الكود
يوضّح شبه الكود التالي هذه العملية.
ReadBuffer()
    StartReadBuffer()

        PinBufferForBlock()

            BufferAlloc(blockNum)

                /* (1) Lookup but not found */
                buffer_tag = InitBufferTag(specOid, dbOid, relNumber, blockNum, forkNum);
                LWLockAcquire(partitionLock, LW_SHARED);
                BufTableLookup(buffer_tag);
                LWLockRelease(partitionLock);

                /* (2) Get empty buffer */
                buf_id = GetVictimBuffer();
                bufDesc = GetBufferDescriptor(buf_id);

                /* (3) */
                LWLockAcquire(partitionLock, LW_EXCLUSIVE);

                /* (4) */
                BufTableInsert(buffer_tag, bufDesc->buf_id);
                PinBuffer(bufDesc);

                /* (5) */
                LWLockRelease(partitionLock);
                return bufDesc;

        /* (6) load page */
        AsyncReadBuffers()
            StartBufferIO()                 /* BM_IO_IN_PROGRESS = 1 */
	    pgaio_io_perform_synchronously()
                read()
                TerminateBufferIO(bufDesc); /* BM_IO_IN_PROGRESS = 0; BM_VALID = 1 */

    return bufDesc;
** الإصدار 16 وما قبله
ReadBuffer()

    BufferAlloc()
        /* (1) Lookup but not found */
        buffer_tag = InitBufferTag(specOid, dbOid, relNumber, blockNum, forkNum);
        LWLockAcquire(partitionLock, LW_SHARED);
        BufTableLookup(buffer_tag);
        LWLockRelease(partitionLock);

        /* (2) Get empty buffer */
        buf_id = GetVictimBuffer();
        bufDesc = GetBufferDescriptor(buf_id);

        /* (3) */
        LWLockAcquire(partitionLock, LW_EXCLUSIVE);

        /* (4) */
        BufTableInsert(buffer_tag, bufDesc->buf_id);
        PinBuffer(bufDesc);

        /* (5) */
        LWLockRelease(partitionLock);

        StartBufferIO(bufDesc);        /*  BM_IO_IN_PROGRESS = 1 */
        return bufDesc;

    /* (6) */
    read();                     /* e.g., preadv() on Linux */
    TerminateBufferIO(bufDesc); /*  BM_IO_IN_PROGRESS = 0; BM_VALID = 1 */

   return bufDesc;
8.4.1.3. تحميل صفحة من التخزين إلى خانة ضحية في مجمّع المخازن
افترض أن جميع خانات مجمّع المخازن مشغولة، لكن مجمّع المخازن لا يخزّن الصفحة المطلوبة. فينفّذ مدير المخزن المؤقت الخطوات التالية (راجع الشكلين 8.11 و8.12):
- (1) إنشاء قيمة buffer_tag للصفحة المطلوبة والبحث في جدول المخازن. في هذا المثال، قيمة buffer_tag هي Tag_M وهي غير موجودة في الجدول.
- (2) اختيار خانة ضحية في مجمّع المخازن باستخدام خوارزمية المسح الدوري. والحصول على المدخل القديم، الذي يحتوي على buffer_id الخاص بخانة الضحية، من جدول المخازن. وتثبيت خانة الضحية في طبقة واصفات المخازن. في هذا المثال، معرّف buffer_id لخانة الضحية هو 5 والمدخل القديم هو ‘Tag_F, id=5’.
- (3) إفراغ (كتابة وfsync) بيانات صفحة الضحية إذا كانت معدَّلة؛ وإلا فانتقل إلى الخطوة (4). ويجب كتابة الصفحة المعدَّلة إلى التخزين قبل الكتابة فوقها ببيانات جديدة. وتُنفَّذ عملية إفراغ الصفحة المعدَّلة بواسطة الدالة FlushBuffer() كما يلي: الحصول على قفل content_lock المشترك للواصف ذي المعرّف buffer_id 5 (يُحرَّر في الخطوة 6).
- تغيير حالات الواصف المقابل؛ إذ تُضبط بتّة BM_IO_IN_PROGRESS على 1 وبتّة BM_JUST_DIRTIED على 0.
- استدعاء الدالة XLogFlush() لكتابة بيانات WAL الموجودة في مخزن WAL المؤقت إلى ملف مقطع WAL الحالي (تُحذف التفاصيل؛ ويُوصف WAL والدالة XLogFlush() في الفصل 9.
- إفراغ بيانات صفحة الضحية إلى التخزين.
- تغيير حالات الواصف المقابل؛ إذ تُضبط بتّة BM_IO_IN_PROGRESS على 0 وبتّة BM_VALID على 1.
- تحرير قفل content_lock.
- (4) الحصول على قسم BufMappingLock القديم الذي يغطي الخانة التي تحتوي على المدخل القديم، في النمط الحصري.
- (5) الحصول على قسم BufMappingLock الجديد وإدراج المدخل الجديد في جدول المخازن: إنشاء المدخل الجديد المكوّن من buffer_tag الجديد Tag_M وbuffer_id الخاص بالضحية.
- الحصول على قسم BufMappingLock الجديد الذي يغطي الخانة التي تحتوي على المدخل الجديد في النمط الحصري.
- إدراج المدخل الجديد في جدول المخازن.
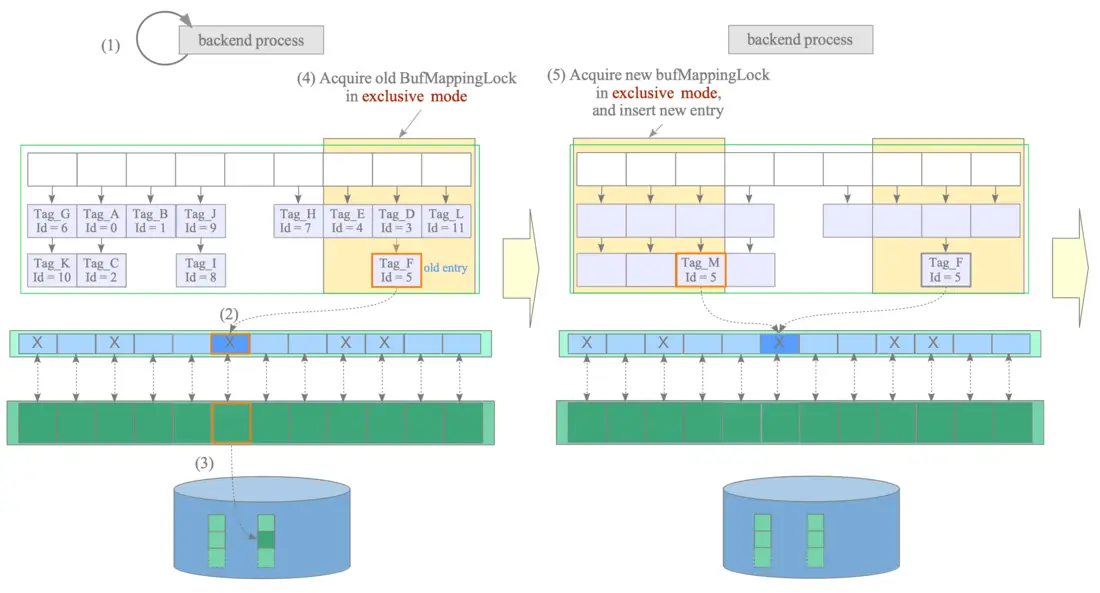
الشكل 8.11. تحميل صفحة من التخزين إلى خانة ضحية في مجمّع المخازن.
- (6) حذف المدخل القديم من جدول المخازن، وتحرير قسم BufMappingLock القديم.
- (7) تحميل بيانات الصفحة المطلوبة من التخزين إلى خانة الضحية. ثم تحديث رايات الواصف ذي المعرّف buffer_id 5؛ إذ تُضبط بتّة BM_DIRTY على 0 وتُهيَّأ البتّات الأخرى.
- (8) تحرير قسم BufMappingLock الجديد.
- (9) الوصول إلى خانة مجمّع المخازن ذات المعرّف buffer_id 5.
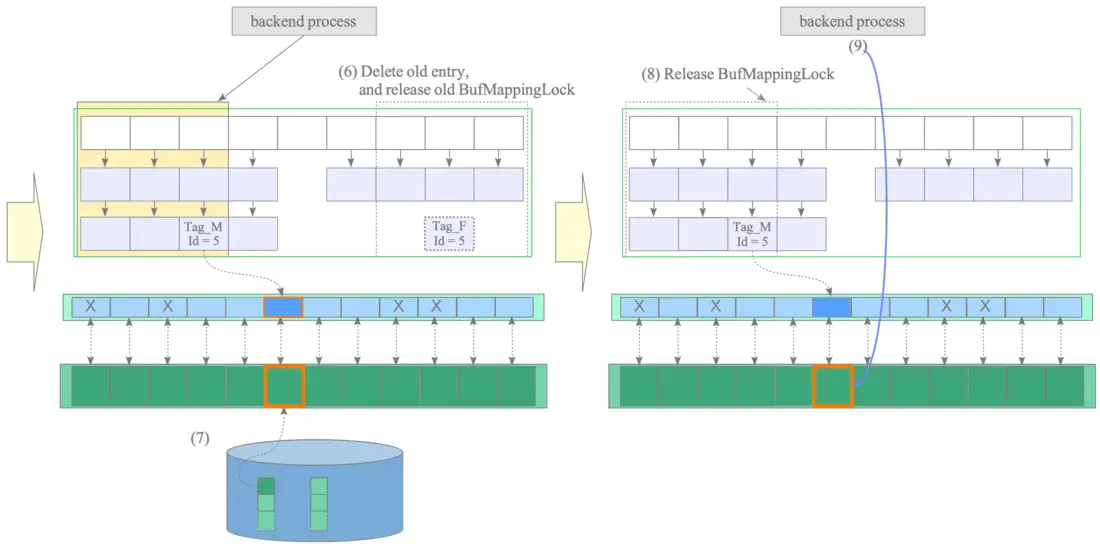
الشكل 8.12. تحميل صفحة من التخزين إلى خانة ضحية في مجمّع المخازن (تكملة للشكل 8.11).
8.4.2. خوارزمية استبدال الصفحات: المسح الدوري
يصف هذا القسم خوارزمية المسح الدوري (clock-sweep). وهذه الخوارزمية صيغة من NFU (Not Frequently Used) ذات كلفة منخفضة؛ وهي تختار الصفحات الأقل استخداماً بكفاءة.
تخيّل أن واصفات المخازن تشكّل قائمة دائرية (الشكل 8.13). ويشير المتغير nextVictimBuffer، وهو عدد صحيح غير سالب بعرض 32 بت، دائماً إلى أحد واصفات المخازن ويدور في اتجاه عقارب الساعة. وفيما يلي شبه الكود ووصف الخوارزمية:
شبه الكود: clock-sweep
    WHILE true
(1)    Obtain the candidate buffer descriptor pointed by the nextVictimBuffer
(2)    IF the candidate descriptor is 'unpinned' THEN
(3)       IF the candidate descriptor's usage_count == 0 THEN
             BREAK WHILE LOOP  /* the corresponding slot of this descriptor */
                               /* is victim slot.                           */
          ELSE
             Decrease the candidate descriptpor's usage_count by 1
          END IF
       END IF
(4)    Advance nextVictimBuffer to the next one
    END WHILE
(5) RETURN buffer_id of the victim
- (1) الحصول على واصف المخزن المرشّح الذي يشير إليه nextVictimBuffer.
- (2) إذا كان واصف المخزن المرشّح غير مثبَّت، فانتقل إلى الخطوة (3). وإلا فانتقل إلى الخطوة (4).
- (3) إذا كان usage_count للواصف المرشّح 0، فاختر الخانة المقابلة لهذا الواصف ضحيةً وانتقل إلى الخطوة (5). وإلا فأنقص usage_count لهذا الواصف بمقدار 1 وانتقل إلى الخطوة (4).
- (4) تقديم nextVictimBuffer إلى الواصف التالي (مع العودة إلى البداية عند بلوغ النهاية) والعودة إلى الخطوة (1). وكرّر حتى يُعثر على ضحية.
- (5) إعادة buffer_id الخاص بالضحية.
8.4.2.1. مثال
يوضّح الشكل 8.13 مثالاً محدّداً. واصفات المخازن مربّعات زرقاء أو سماوية، والأرقام داخل المربّعات تدل على usage_count لكل واصف.
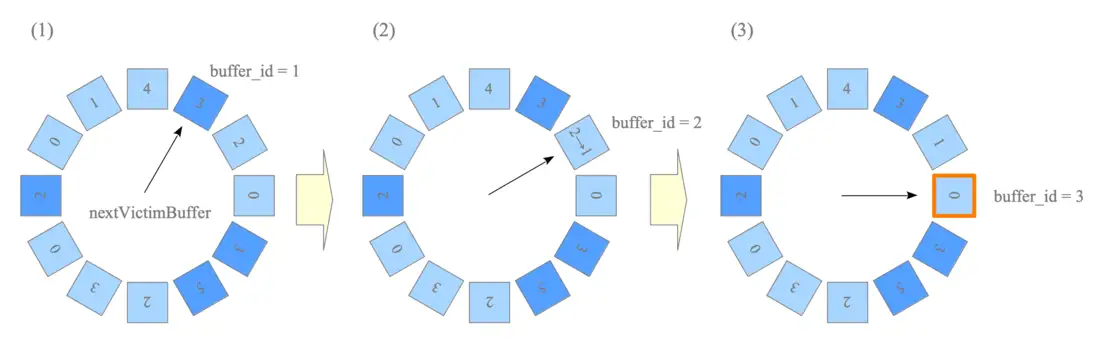
الشكل 8.13. المسح الدوري.
- (1) يشير nextVictimBuffer إلى الواصف الأول (buffer_id 1). ويُتخطّى هذا الواصف لأنه مثبَّت.
- (2) يشير nextVictimBuffer إلى الواصف الثاني (buffer_id 2). هذا الواصف غير مثبَّت، لكن usage_count الخاص به يساوي 2. لذلك ينخفض usage_count بمقدار 1، ويتقدّم nextVictimBuffer إلى المرشّح الثالث.
- (3) يشير nextVictimBuffer إلى الواصف الثالث (buffer_id 3). هذا الواصف غير مثبَّت وusage_count الخاص به يساوي 0. لذلك يصبح هذا الواصف هو الضحية في هذه الجولة.
كلما مسح nextVictimBuffer واصفاً غير مثبَّت، ينخفض usage_count بمقدار 1. لذلك، إذا وُجدت واصفات غير مثبَّتة في مجمّع المخازن، وجدت هذه الخوارزمية دائماً ضحية يكون usage_count فيها 0 عبر تدوير nextVictimBuffer.
8.4.3. المخزن المؤقت الحلقي
يستخدم PostgreSQL مخزناً مؤقتاً حلقياً بدلاً من مجمّع المخازن عند قراءة جدول كبير أو الكتابة فيه. والمخزن المؤقت الحلقي منطقة تخزين مؤقتة صغيرة.
ويُخصَّص في الذاكرة المشتركة عند تحقّق أيٍّ من الشروط التالية:
- القراءة بالجملة: عندما يتجاوز حجم العلاقة ربع حجم مجمّع المخازن (shared_buffers/4). في هذه الحالة، يكون حجم المخزن المؤقت الحلقي 256 كيلوبايت.
- الكتابة بالجملة: عند تنفيذ أوامر SQL التالية. في هذه الحالات، يكون حجم المخزن المؤقت الحلقي 16 ميجابايت: أمر COPY FROM.
- أمر CREATE TABLE AS.
- أمر CREATE MATERIALIZED VIEW أو REFRESH MATERIALIZED VIEW.
- أمر ALTER TABLE.
- معالجة التفريغ: عندما تنفّذ عملية تفريغ تلقائي عملية التفريغ. في هذه الحالة، يكون حجم المخزن المؤقت الحلقي 256 كيلوبايت.
ويحرّر PostgreSQL المخزن المؤقت الحلقي فور انتهاء استخدامه.
وفائدة المخزن المؤقت الحلقي واضحة. فإذا قرأت عملية خلفية جدولاً كبيراً دون مخزن مؤقت حلقي، فقد تُخرج العملية جميع الصفحات من مجمّع المخازن، ما يقلّل نسبة إصابة الذاكرة المؤقتة. ويمنع المخزن المؤقت الحلقي ذلك بتوفير منطقة مؤقتة مخصّصة للجداول الكبيرة.
** لماذا يكون الحجم الافتراضي للمخزن المؤقت الحلقي في القراءة بالجملة ومعالجة التفريغ 256 كيلوبايت؟
يشرح ملف README في دليل الشيفرة المصدرية لمدير المخزن المؤقت السبب:
تُستخدم حلقة بحجم 256 كيلوبايت في المسوح التسلسلية. وهذا الحجم صغير بما يكفي ليتّسع في ذاكرة L2 المؤقتة، ما يجعل نقل الصفحات من ذاكرة نظام التشغيل المؤقتة إلى ذاكرة المخازن المؤقتة المشتركة فعّالاً. وغالباً ما يكفي حجم أقل من ذلك، لكن يجب أن تكون الحلقة كبيرة بما يكفي لاستيعاب جميع الصفحات المثبَّتة بالتزامن أثناء المسح. (مقتطف)
وعندما تصل عمليات خلفية متعددة إلى العلاقة نفسها بالتزامن، فإنها تتشارك المخزن المؤقت الحلقي.
ويوضّح الشكل 8.14 كيف تصل عمليتان خلفيتان إلى مخزن مؤقت حلقي أثناء مسح تسلسلي:
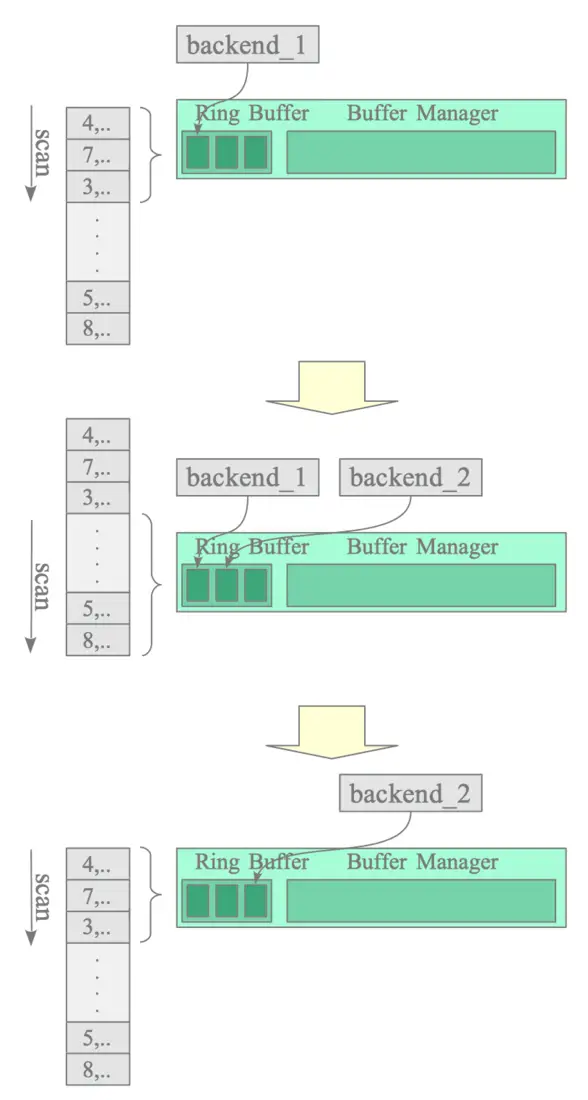
الشكل 8.14. مشاركة المخزن المؤقت الحلقي بين عمليتين خلفيتين.
- تُنشئ Backend_1 مخزناً مؤقتاً حلقياً وتصل إليه لقراءة جدول.
- تصل Backend_1 وBackend_2 إلى صفحات الجدول المحمَّلة في المخزن المؤقت الحلقي المشترك. وتبدأ Backend_2 مسحها التسلسلي من منتصف الجدول.
- بعد أن تكمل Backend_1 مسحها، تواصل Backend_2 مسح ما تبقّى من الجدول، بدءاً من البداية وحتى المنتصف.
8.4.4. الجداول المؤقتة وإدارة المخزن المؤقت المحلي
عندما تنشئ عملية خلفية جدولاً مؤقتاً، يخصّص مدير المخزن المؤقت منطقة ذاكرة خاصة وينشئ مخزناً مؤقتاً محلياً.
تستخدم خانات دلاء المخزن المؤقت المشترك أرقاماً موجبة. وفي المقابل، تستخدم خانات دلاء المخزن المؤقت المحلي أرقاماً سالبة (مثل -1 و-2). ويتيح هذا التمييز للعملية الخلفية الوصول إلى الجداول العادية والمؤقتة معاً بسلاسة.
لا تتطلّب إدارة المخازن المؤقتة المحلية أقفالاً لأن العملية الخلفية المالكة وحدها هي التي تصل إليها. علاوةً على ذلك، لا تتطلّب المخازن المؤقتة المحلية تسجيل WAL أو نقاط تحقق.
8.5. الإدخال/الإخراج غير المتزامن في PostgreSQL
قدّم PostgreSQL 18 (عام 2025) ميزة الإدخال/الإخراج غير المتزامن (AIO) لتحسين أداء القراءة.
ولذلك أُعيدت هيكلة مدير المخزن المؤقت، خصوصاً في الحالات التي ينفّذ فيها المنفّذ مسوحاً تسلسلية أو مسوحاً لكتل الخرائط النقطية (bitmap heap scans) أو عمليات تفريغ تقرأ صفحات الهدف بالتتابع. (ولا يدعم AIO في PostgreSQL الكتابة غير المتزامنة بعد.)
يشرح هذا القسم المفهوم الأساسي لـ AIO، ويصف تنفيذه، ويفصّل طريقة عمله، مع التركيز على المسح التسلسلي.
بالإضافة إلى ذلك، يقدّم الملحق 2 برامج io_uring نموذجية للقرّاء غير الملمّين بهذا الإطار.
محتويات القسم
- 8.5.1. الإدخال/الإخراج غير المتزامن
- 8.5.2. تنفيذ AIO في PostgreSQL
- 8.5.3. المفهوم الأساسي للمسح التسلسلي غير المتزامن
- 8.5.4. التنفيذ الفعلي للمسح التسلسلي غير المتزامن
** تقييم نتائج قياس أداء AIO
يُبرز عدد كبير من اختبارات الأداء والمقالات تحسينات الأداء التي حقّقها AIO بعد إدخاله في PostgreSQL.
غير أن تنفيذ AIO في PostgreSQL يحسّن أساساً قراءات الكتل التسلسلية للمسوح التسلسلية والعمليات المشابهة؛ ولا يُستخدم في مسوح الفهارس. وتكون فائدته أكبر عندما يكون مجمّع المخازن بارداً. ومع ارتفاع حرارة مجمّع المخازن وزيادة نسبة إصابة الذاكرة المؤقتة، تتضاءل الفائدة تدريجياً.
لذلك قد تبالغ نتائج قياس الأداء المحصَّلة في ظروف الذاكرة المؤقتة الباردة فقط في تقدير الأثر الفعلي لـ AIO بدرجة كبيرة.
8.5.1. الإدخال/الإخراج غير المتزامن
يقارن الشكل 8.15 مسار التنفيذ بين القراءات المتزامنة التقليدية والقراءات غير المتزامنة. (تُحذف ذاكرة الصفحات المؤقتة لتبسيط الشرح.)
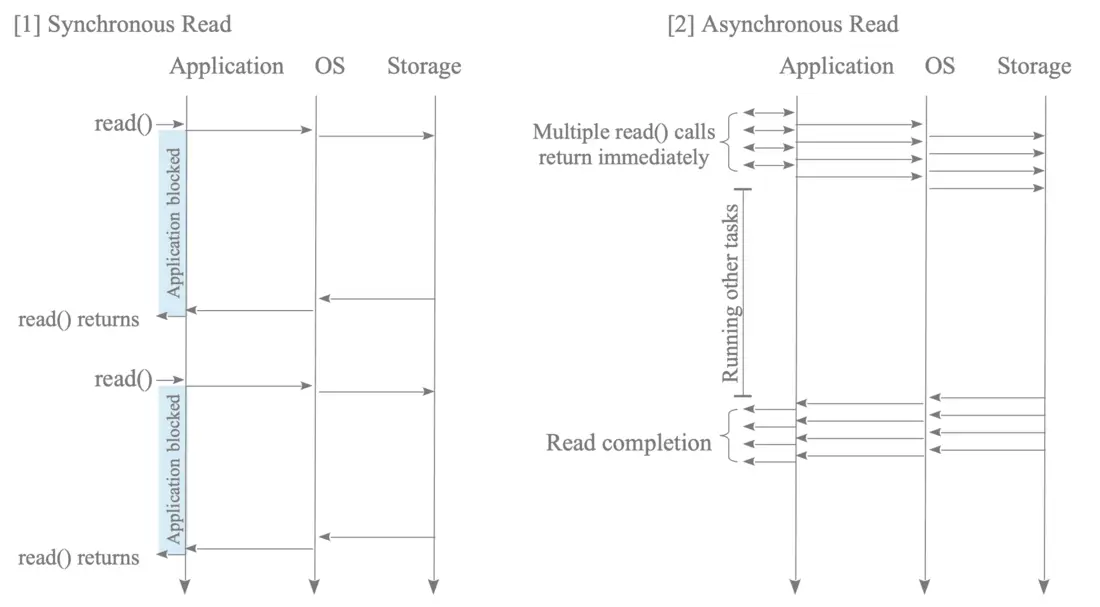
الشكل 8.15. القراءات المتزامنة وغير المتزامنة.
- القراءة المتزامنة: الشكل 8.15 [1] — يُصدر التطبيق نداء النظام read()، وينتظر حتى تنتهي العملية، ثم يُصدر الطلب التالي. وبالتالي تُنفَّذ عمليات قراءة متعددة بالتتابع.
- القراءة غير المتزامنة: الشكل 8.15 [2] — يمكن للتطبيق إرسال طلبات قراءة متعددة دون انتظار اكتمال كل طلب على حدة. ويعالج نظام التشغيل هذه الطلبات في الخلفية، ثم يجمع التطبيق النتائج لاحقاً.
8.5.1.1. فوائد AIO
يوفّر الإدخال/الإخراج غير المتزامن فوائد في الأداء للتطبيق وللتخزين معاً.
- التطبيق: يمكن للتطبيقات تنفيذ مهام أخرى أثناء انتظار اكتمال عمليات القراءة.
- التخزين: الأثر كبير في أقراص SSD. فبإمكان أقراص SSD معالجة طلبات إدخال/إخراج متعددة داخلياً على التوازي، محققةً إنتاجية عالية عند إصدار طلبات قراءة كثيرة في الوقت نفسه. وينبع هذا الأثر من الطوابير المتعددة والأعماق الطابورية الكبيرة في أقراص NVMe SSD.
وبفضل هذه الفوائد، يمكن لـPostgreSQL إصدار طلبات قراءة صفحات كثيرة دفعةً واحدة، ما يتيح لنظام التشغيل وأقراص SSD الحديثة استغلال توازيها الداخلي. ونتيجة لذلك، تحقّق عمليات تحميل مجمّع المخازن ومسوح الجداول الكبيرة إنتاجية أعلى بكثير.
8.5.2. تنفيذ AIO في PostgreSQL
يوفّر PostgreSQL تنفيذين للإدخال/الإخراج غير المتزامن: io_uring وعمال خلفيون io_worker.
ويمكن الاختيار بينهما عبر معامل التهيئة io_method. ولأن io_uring ميزة خاصة بنظام Linux، يجب على أنظمة التشغيل الأخرى، مثل macOS وBSD، اختيار io_worker.
8.5.2.1. io_uring
io_uring واجهة إدخال/إخراج غير متزامن أُدخلت في نواة Linux 5.1 (عام 2019).
عند استخدام io_uring، يُنشئ PostgreSQL زوجاً من المخازن المؤقتة الحلقية المشتركة يُسمى طابور الإرسال (Submission Queue, SQ) وطابور الاكتمال (Completion Queue, CQ). ويتشارك هذان الطابوران بين فضاء المستخدم والنواة.
وفيما يلي مسار عملية قراءة غير متزامنة باستخدام io_uring (الشكل 8.16 [1]):
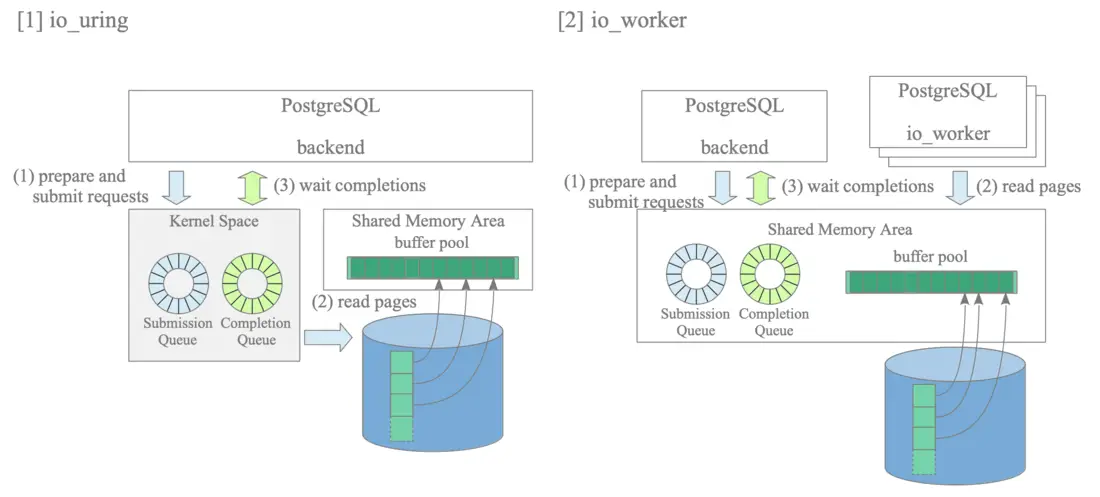
الشكل 8.16. مفاهيم io_uring وio_worker.
- (1) تجهيز الطلبات وإرسالها: يجهّز PostgreSQL طلب قراءة واحداً أو أكثر، كما هو موضّح أدناه، ويُدرجها في طابور SQ. ثم يرسل هذه الطلبات إلى النواة.
- (2) تنفيذ الطلب: تسترجع النواة الطلبات من طابور SQ وتنفّذ القراءات المطلوبة مستفيدةً من التوازي على مستوى التخزين. وتُنسخ البيانات المسترجَعة مباشرةً إلى خانة مجمّع المخازن المحدّدة عبر DMA (الوصول المباشر إلى الذاكرة). وعند اكتمال عملية قراءة، تُدرج النواة حدث اكتمال (CQE) في طابور CQ.
- (3) انتظار الاكتمالات: ينتظر PostgreSQL وصول الطلبات المكتملة إلى طابور CQ. وبمجرد العثور على حدث اكتمال، يمكن لـPostgreSQL قراءة الصفحة التي حُمِّلت في خانة مجمّع المخازن الهدف.
ويمكن للقرّاء غير الملمّين ببرمجة io_uring الرجوع إلى الملحق للاطلاع على أمثلة بسيطة.
طلب القراءة
من منظور PostgreSQL، طلب القراءة زوج يتكوّن من معرّف صفحة خاص بقاعدة البيانات (BufferTag) ومعرّف خانة في مجمّع المخازن (buffer_id).
وعند استخدام io_uring، يترجم PostgreSQL هذين المعرّفين إلى معاملات نظام التشغيل القياسية: واصف الملف الهدف (fd)، والإزاحة الفيزيائية بالبايت، وحجم القراءة (8 كيلوبايت)، وعنوان الذاكرة الهدف (خانة محدّدة في مجمّع المخازن).
الإدخال/الإخراج المتجهي (Scatter-Gather I/O)
يدعم Linux وUnix الإدخال/الإخراج المتجهي (عبر readv() وwritev())، ما يتيح قراءة كتل متجاورة متعددة من ملف أو كتابتها فيه باستخدام نداء نظام واحد.
ويدعم io_uring أيضاً الإدخال/الإخراج المتجهي، ما يتيح لـPostgreSQL قراءة كتل علاقة متجاورة متعددة بطلب قراءة واحد.
وكما هو موضّح في الشكل 8.17، عندما يقرأ PostgreSQL كتلاً متجاورة، فإنه يجهّز نداء نظام واحداً (io_uring_prep_readv()) بدلاً من تنفيذ نداء نظام منفصل لكل كتلة على حدة:
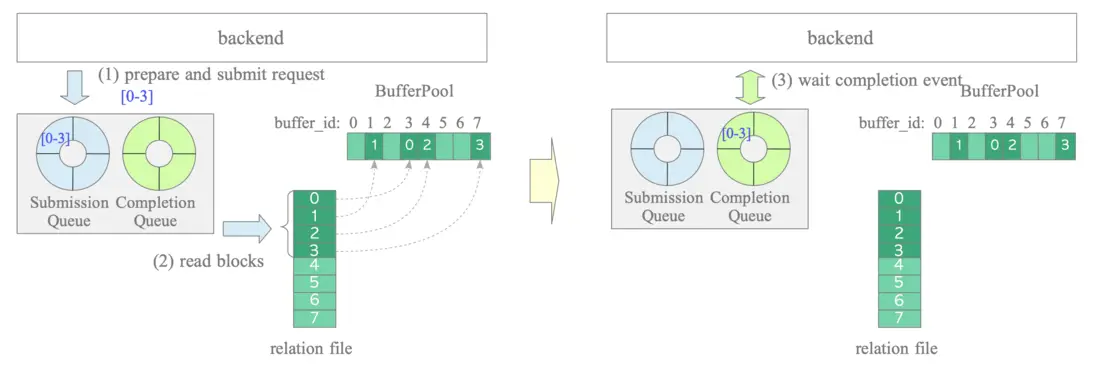
الشكل 8.17. io_uring مع الإدخال/الإخراج المتجهي (Scatter-Gather I/O).
- (1) التجهيز والإرسال: تجهّز العملية الخلفية طلب قراءة متجهياً واحداً للكتل 0-3 من العلاقة وترسله، مع تحديد خانات مجمّع المخازن الهدف (buffer_ids 3 و1 و4 و7).
- (2) تنفيذ الطلب: تقرأ النواة الكتل المطلوبة في خانات مجمّع المخازن المحدّدة.
- (3) انتظار الاكتمالات: ينتظر PostgreSQL حدث اكتمال واحداً قبل معالجة الصفحات المحمَّلة.
أثناء المسح التسلسلي، يقرأ PostgreSQL عادةً كتل علاقة متجاورة. ويجمع الإدخال/الإخراج المتجهي هذه الكتل في طلب قراءة واحد، ما يقلّل كلفة نداءات النظام ولا يتطلّب سوى حدث اكتمال واحد.
ويقدّم الملحق 2.2 برنامج io_uring بسيطاً يستخدم الإدخال/الإخراج المتجهي.
8.5.2.2. io_worker
لأنظمة التشغيل التي لا تدعم io_uring (مثل macOS وBSD وSolaris)، يوفّر PostgreSQL تنفيذاً بديلاً يُسمى io_worker (الشكل 8.16 [2]). وتنفّذ عملية خلفية واحدة أو أكثر من عمال io_worker طلبات الإدخال/الإخراج.
في نمط io_worker، ينشئ PostgreSQL بنيتي SQ وCQ خاصتين به في الذاكرة المشتركة.
وتجهّز العمليات الخلفية طلبات القراءة في طابور SQ وترسلها للتنفيذ. وتسترجع عمليات io_worker الخلفية هذه الطلبات وتنفّذ القراءات وتُدرج أحداث الاكتمال في طابور CQ.
وبالمقارنة مع io_uring:
- تنفّذ عمال io_worker الخلفيون طلبات الإدخال/الإخراج باستخدام نداءات نظام القراءة المتزامنة التقليدية. ومع أن عمالاً متعددين قد يعالجون الطلبات بالتزامن، فإن التوازي وقابلية التوسّع الممكنين أقل عموماً من io_uring.
- يتطلّب تنفيذ الطلبات تنسيقاً بين العمليات الخلفية وعمليات io_worker عبر طوابير الذاكرة المشتركة وإيقاظ العمليات. ونتيجة لذلك، تنشأ كلف إضافية للاتصال والجدولة.
** عدد عمال الإدخال/الإخراج
في الإصدار 18، كان عدد عمال الإدخال/الإخراج ثابتاً عند القيمة المحدّدة بمعامل io_workers.
وابتداءً من الإصدار 19، يمكن ضبط عدد عمال الإدخال/الإخراج ديناميكياً عبر المعاملات التالية: io_min_workers وio_max_workers وio_worker_idle_timeout وio_worker_launch_interval.
8.5.3. المفهوم الأساسي للمسح التسلسلي غير المتزامن
تشرح الأقسام الفرعية التالية المسح التسلسلي باستخدام AIO.
رغم أن هذه الآلية تعتمد على دوال بسيطة، فإن دمج مكوّنات متعددة لتحسين الأداء يجعلها معقّدة. لذلك يُقسَّم هذا الشرح إلى مرحلتين:
- يصف هذا القسم الفرعي السلوك الأساسي لمسح تسلسلي قائم على AIO في إعداد مبسّط إلى حد كبير. وللتركيز على الآلية الجوهرية، يفترض هذا النموذج سيناريو بداية باردة لا يخزّن فيه مجمّع المخازن أي صفحات ويحتوي فيه التخزين على كل البيانات المطلوب قراءتها.
- يبني القسم الفرعي التالي على هذه الأساس بدمج الميزات المحذوفة لعرض تفاصيل التنفيذ الكاملة.
وبينما ركّز شبه الكود في القسم 8.4 على المعالجة منخفضة المستوى لواصفات المخازن، يعمل الشرح التالي عند مستوى أعلى من التجريد:
- تجرّد BufferAlloc() كل إدارة واصفات المخازن باستثناء عملية القراءة الفيزيائية؛ وتُحذف الدوال الأدنى مستوى.
- تُحذف أيضاً تفاصيل مثل معالجة التثبيت (PIN).
- تجرّد do_exec(tuple) كل معالجة الصفوف، مثل تقييم مرشّح شرط WHERE والحساب التراكمي لدوال التجميع.
8.5.3.1. آلية ReadStream وتجريد stream_buffers
الاستراتيجية الأساسية للمسح التسلسلي القائم على AIO مباشرة:
- معالجة صفحات الجدول الهدف بالتتابع من البداية. والقراءة المسبقة لعدد معيّن من الكتل بشكل غير متزامن مقدماً.
ويتتبّع مدير المخزن المؤقت هذه الكتل المقروءة مسبقاً ويديرها باستخدام بنية بيانات مخصّصة تُسمى بنية ReadStream.
** ** ReadStream
typedef struct InProgressIO
{
    int16       buffer_index;
    ReadBuffersOperation op;
} InProgressIO;

/*
 * State for managing a stream of reads.
 */
struct ReadStream
{
    int16       max_ios;
    int16       io_combine_limit;
    int16       ios_in_progress;
    int16       queue_size;
    int16       max_pinned_buffers;
    int16       forwarded_buffers;
    int16       pinned_buffers;

    /*
     * Limit of how far, in blocks, to look-ahead for IO combining and for
     * read-ahead.
     *
     * The limits for read-ahead and combining are handled separately to allow
     * for IO combining even in cases where the I/O subsystem can keep up at a
     * low read-ahead distance, as doing larger IOs is more efficient.
     *
     * Set to 0 when the end of the stream is reached.
     */
    int16       combine_distance;
    int16       readahead_distance;
    uint16      distance_decay_holdoff;
    int16       initialized_buffers;
    int16       resume_readahead_distance;
    int16       resume_combine_distance;
    int         read_buffers_flags;
    bool        sync_mode;      /* using io_method=sync */
    bool        batch_mode;     /* READ_STREAM_USE_BATCHING */
    bool        advice_enabled;
    bool        temporary;

    /* scan stats counters */
    IOStats    *stats;

    /*
     * One-block buffer to support 'ungetting' a block number, to resolve flow
     * control problems when I/Os are split.
     */
    BlockNumber buffered_blocknum;

    /*
     * The callback that will tell us which block numbers to read, and an
     * opaque pointer that will be pass to it for its own purposes.
     */
    ReadStreamBlockNumberCB callback;
    void       *callback_private_data;

    /* Next expected block, for detecting sequential access. */
    BlockNumber seq_blocknum;
    BlockNumber seq_until_processed;

    /* The read operation we are currently preparing. */
    BlockNumber pending_read_blocknum;
    int16       pending_read_nblocks;

    /* Space for buffers and optional per-buffer private data. */
    size_t      per_buffer_data_size;
    void       *per_buffer_data;

    /* Read operations that have been started but not waited for yet. */
    InProgressIO *ios;
    int16       oldest_io_index;
    int16       next_io_index;

    bool        fast_path;

    /* Circular queue of buffers. */
    int16       oldest_buffer_index;    /* Next pinned buffer to return */
    int16       next_buffer_index;  /* Index of next buffer to pin */
    Buffer      buffers[FLEXIBLE_ARRAY_MEMBER];  /* typedef int Buffer;  */
};
يتكوّن ReadStream من مصفوفة تُسمى buffers[] وبيانات وصفية داخلية متنوعة. وتعمل هذه المصفوفة كطابور FIFO دائري بحجم نافذة نشطة يحدّده combine_distance، كما هو موضّح في الشكل 8.18 [1]. ويتتبّع فهرس مصفوفة يُسمى oldest_buffer_index رأس هذا الطابور، الذي يمثّل أقدم مخزن لم يُستهلك بعد.
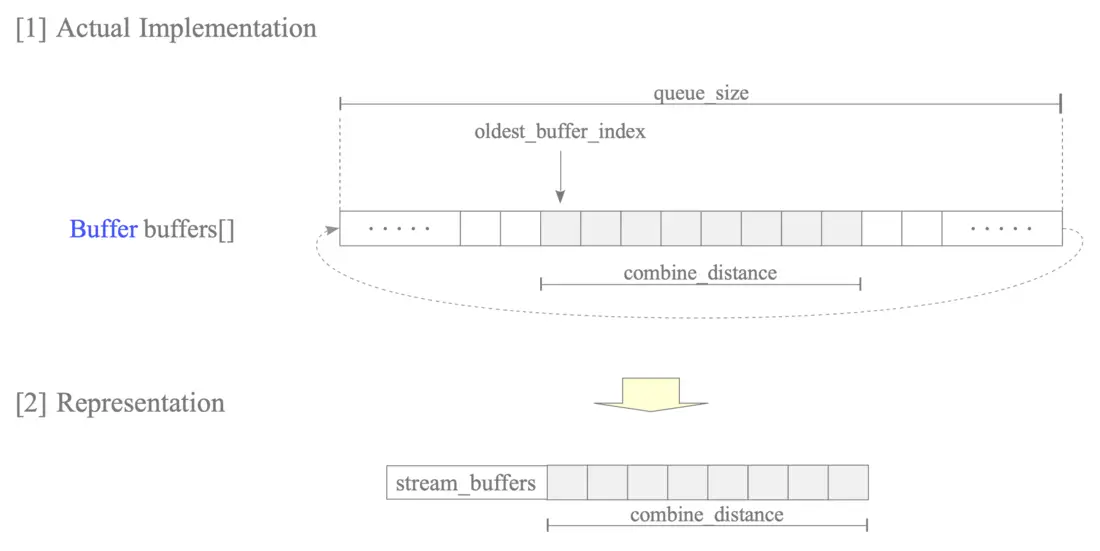
الشكل 8.18. التنفيذ الفعلي لمصفوفة مخازن ReadStream وتمثيلها المبسّط stream_buffers.
وفي هذا التوثيق كله، ولتجريد الحسابات منخفضة المستوى لمؤشرات المخزن المؤقت الحلقي، تُمثَّل آلية طابور FIFO هذه كلها ببساطة بـstream_buffers (الشكل 8.18 [2]).
عملية الإدراج في الطابور
يوضّح الشكل 8.19 عملية الإدراج، مقارناً تنفيذها منخفض المستوى بتمثيل stream_buffers عالي المستوى.
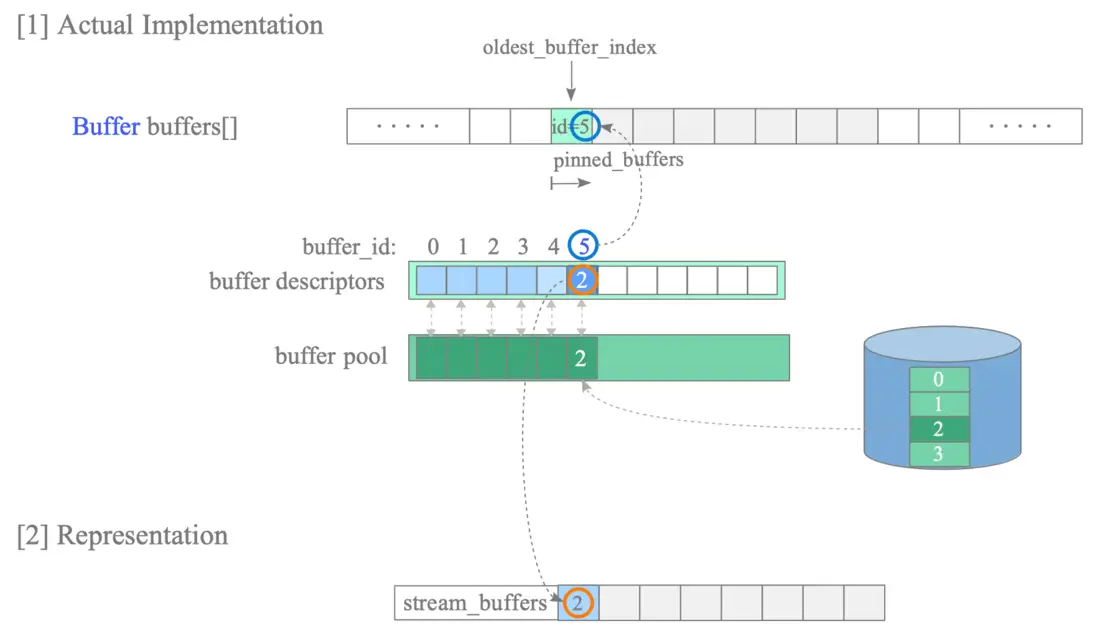
الشكل 8.19. عملية الإدراج في التنفيذ الفعلي وتمثيلها المبسّط.
لنتأمّل تحميل الكتلة الثانية (بالفهرسة من 0) من جدول علاقة في الخانة الخامسة من مجمّع المخازن.
في هذه الحالة، يُخصَّص واصف المخزن المقابل أيضاً في الخانة الخامسة من طبقة واصفات المخازن. وفي هذه اللحظة، يخزّن مدير المخزن المؤقت القيمة الصحيحة في مصفوفة buffers[] عند الموضع الذي يشير إليه oldest_buffer_index حالياً.
وفي تمثيل stream_buffers، يخزّن واصف المخزن نفسه (المشار إليه برقم الكتلة في الشكل 8.19 [2]).
عملية الإخراج من الطابور
يفصّل الشكل 8.20 عملية الإخراج من الطابور، موضّحاً كيف يُزال عنصر من كلٍّ من المخزن المؤقت الحلقي الفعلي والتمثيل المجرّد.
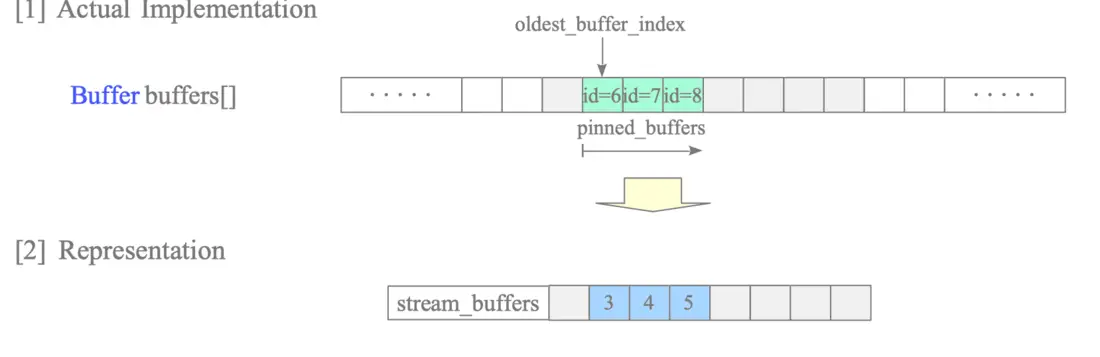
الشكل 8.20. عملية الإخراج من الطابور في التنفيذ الفعلي وتمثيلها المبسّط.
وكما هو موضّح في الشكل 8.20 [1]، عند إخراج معرّف المخزن في الرأس من الطابور، يتقدّم oldest_buffer_index خانة واحدة إلى اليمين. وينخفض وفقاً لذلك العدد الإجمالي للمخازن المتبقية التي يتتبّعها pinned_buffers.
وفي تمثيل stream_buffers (الشكل 8.20 [2])، تُمثَّل عملية الإخراج هذه بحذف العنصر الأيسر من القائمة.
** تحديد حجم الطابور
تحسب الدالة read_stream_begin_impl() قيمة queue_size بناءً على معاملات تهيئة مثل effective_io_concurrency وio_combine_limit.
ويبدأ حساب queue_size بالقيمة العظمى التالية:
حيث هو حجم الكتلة، وقيمته الافتراضية 8 كيلوبايت.
وقد تنخفض قيمة queue_size الفعلية تبعاً للظروف وسائر المعاملات.
8.5.3.2. عمليات AIO الجوهرية
يعرّف هذا القسم الفرعي دوالاً تغلّف عمليات AIO الأساسية.
تخصيص المخازن وإدراجها في الطابور
تخصّص الدالة read_ahead() واصفات مخازن لكتل العلاقة الهدف وتُدرجها في stream_buffers.
stream_buffers   = []
combine_distance = N

/* Simple Version */
read_ahead(stream_buffers, combine_distance, blockNum)
    offset = 0
    while stream_buffers.pinned_buffers < combine_distance
        bufDesc = BufferAlloc(blockNum + offset)
        offset += 1
        bufDesc.state.IO_IN_PROGRESS = 1
        stream_buffers.enqueue(bufDesc)
ولأن هذا القسم الفرعي يفترض أن على العملية الخلفية قراءة جميع الصفحات من التخزين، فُبسِّط المنطق:
- كرّر حتى يبلغ عدد pinned_buffers قيمة combine_distance: استدعِ BufferAlloc() للحصول على واصف مخزن مثبَّت.
- اضبط حالة واصف المخزن على IO_IN_PROGRESS وأدرجه في stream_buffers.
تجهيز طلبات القراءة غير المتزامنة وإرسالها
تجهّز الدالة prepare_and_submit() طلبات قراءة غير متزامنة لواصفات المخازن التي أدرجها read_ahead() حديثاً وترسلها.
ولأن المسح التسلسلي يقرأ كتلاً متجاورة، فإنه يستخدم الإدخال/الإخراج المتجهي (Scatter-Gather I/O) لدمج كتل متعددة في طلب قراءة واحد (راجع الملحق 2.2 للتفاصيل).
/* Simple Version */
prepare_and_submit(stream_buffers)
    /* submits a Vector I/O read for the newly added buffers */
    submit(stream_buffers)
انتظار اكتمال القراءة غير المتزامنة
تنتظر الدالة WaitReadBuffers() اكتمال عملية إدخال/إخراج محدّدة وتضع علامة الصلاحية على المخازن المقابلة.
/* Simple Version */
WaitReadBuffers(stream_buffers)
    wait_cqe(stream_buffers)       /* block until read completes */
    for each bufDesc in stream_buffers
        bufDesc.state.IO_IN_PROGRESS = 0
        bufDesc.state.VALID          = 1
8.5.3.3. المسح التسلسلي باستخدام AIO
وباستخدام الدوال المعرّفة أعلاه، يوضّح شبه الكود التالي السلوك الأساسي لمسح تسلسلي قائم على AIO.
ExecSeqScan()
    stream_buffers   = []
    combine_distance = 4
    blockNum         = 0
    /* Initialize stream_buffers and submit read request for the first round. */
(1) read_ahead(stream_buffers, combine_distance, blockNum)
    prepare_and_submit(stream_buffers)

(2) while blockNum <= last_block

        /* Dequeue the next buffer descriptor from stream_buffers */
(3)     current_buf = stream_buffers.dequeue()

(4)     if current_buf.state.IO_IN_PROGRESS == 1
            /* The buffer is still being read from storage. */
            WaitReadBuffers(stream_buffers)

        /* Read-ahead blocks and submit the read request if stream_buffers is empty. */
        if stream_buffers.pinned_buffers == 0
(5)         read_ahead(stream_buffers, combine_distance, blockNum)
            prepare_and_submit(stream_buffers)

        /* Process tuples of current_page */
(6)     for each tuple in current_buf
            do_exec(tuple)

        blockNum += 1
- (1) في الجولة الأولى، اقرأ مسبقاً combine_distance (= 4) صفحات، وأدرجها في stream_buffers، وأرسل طلب قراءة غير متزامن لتلك الصفحات.
- (2) عالج صفحات الجدول الهدف بالتتابع.
- (3) أخرِج واصف المخزن التالي من stream_buffers.
- (4) إذا كانت كتلة واصف المخزن الحالي ما زالت تُقرأ من التخزين، فاستدعِ WaitReadBuffers() وانتظر حتى تكتمل القراءة.
- (5) عندما يصبح stream_buffers فارغاً، اقرأ الدفعة التالية من الكتل مسبقاً وأرسل طلب القراءة. وهذا التوقيت هو ما يحقّق فائدة AIO: إذ ينفّذ نظام التشغيل القراءة التالية بشكل غير متزامن بينما تعالج العملية الخلفية صفوف الصفحة الحالية.
- (6) عالج جميع الصفوف الموجودة في current_buf.
ويوضّح الشكل 8.21 هذا التسلسل بافتراض قراءة جميع الصفحات من التخزين.
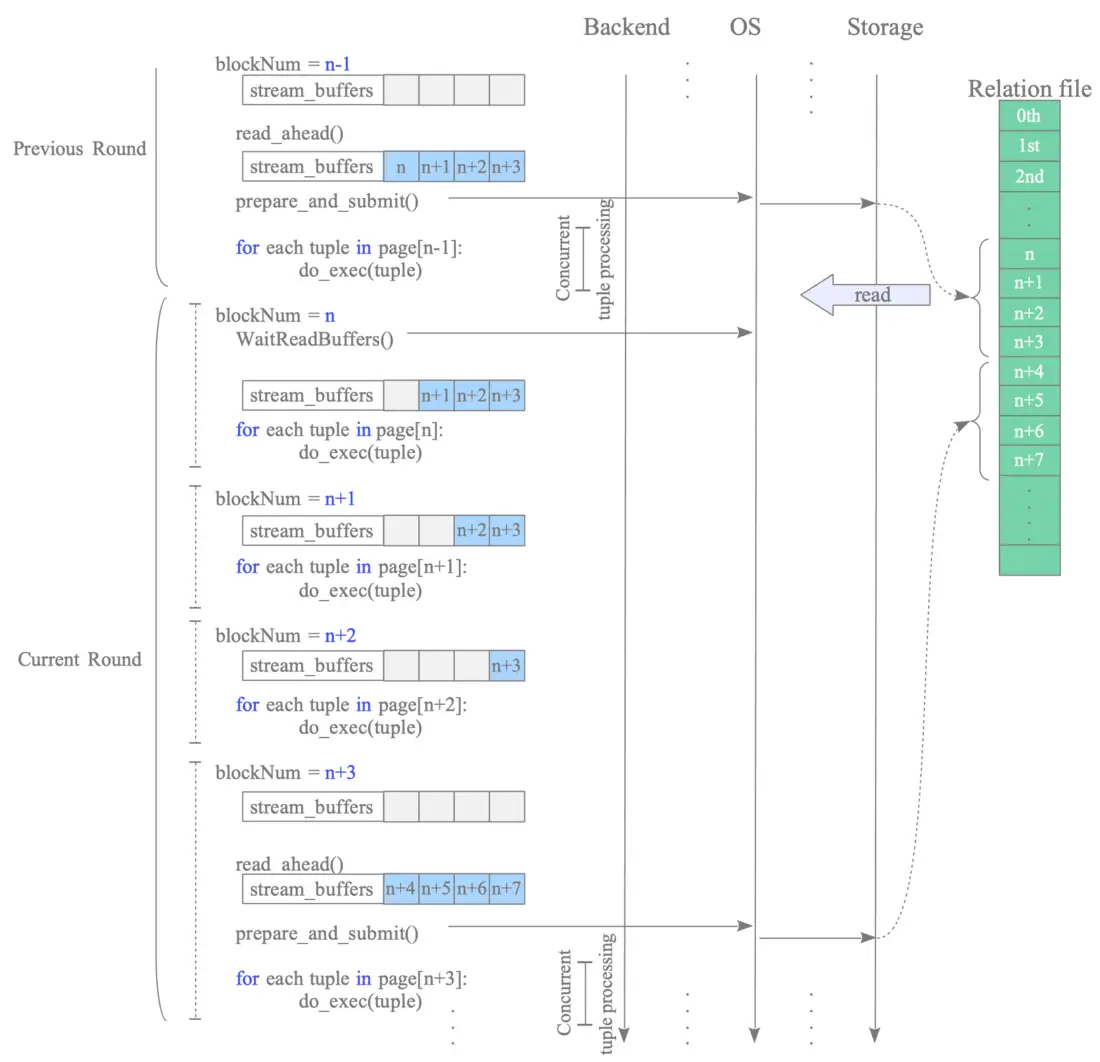
الشكل 8.21. نموذج مبسّط للمسح التسلسلي غير المتزامن.
- الجولة السابقة: في نهاية الجولة، يصبح stream_buffers فارغاً. لذلك يُدرج read_ahead() الكتل الأربع التالية ( و و و)، ويرسل prepare_and_submit() طلب القراءة غير المتزامن.
- وبعد الإرسال مباشرةً، تعالج العملية الخلفية صفوف الكتلة الأخيرة من الجولة السابقة (blockNum = ). وتجري معالجة الصفوف هذه بالتزامن مع عملية قراءة نظام التشغيل للكتل من إلى .
الجولة الحالية:
- معالجة blockNum = : تُعيد stream_buffers.dequeue() واصف المخزن الخاص بالكتلة ، الذي ما زال IO_IN_PROGRESS.
- ينتظر WaitReadBuffers() حتى تكتمل القراءة.
- عند الاكتمال، يضع WaitReadBuffers() علامة VALID على الكتل الأربع كلها ( و و و) في خطوة واحدة.
- ثم تعالج العملية الخلفية صفوف الكتلة .
- معالجة blockNum = و و: هذه المخازن صالحة بالفعل (وُضعت علامتها بواسطة استدعاء WaitReadBuffers() السابق)، لذلك تواصل المعالجة دون وقت انتظار إضافي.
- نهاية الجولة - stream_buffers فارغ: يُدرج read_ahead() الكتل من إلى ، ويرسل prepare_and_submit() طلب القراءة غير المتزامن التالي.
** المقارنة مع المسح التسلسلي المتزامن (الإصدار 16 وما قبله)
قبل إدخال AIO، كان PostgreSQL ينفّذ المسوح التسلسلية بطريقة متزامنة ومتسلسلة صارمة، كما هو موضّح في الشكل 8.22.
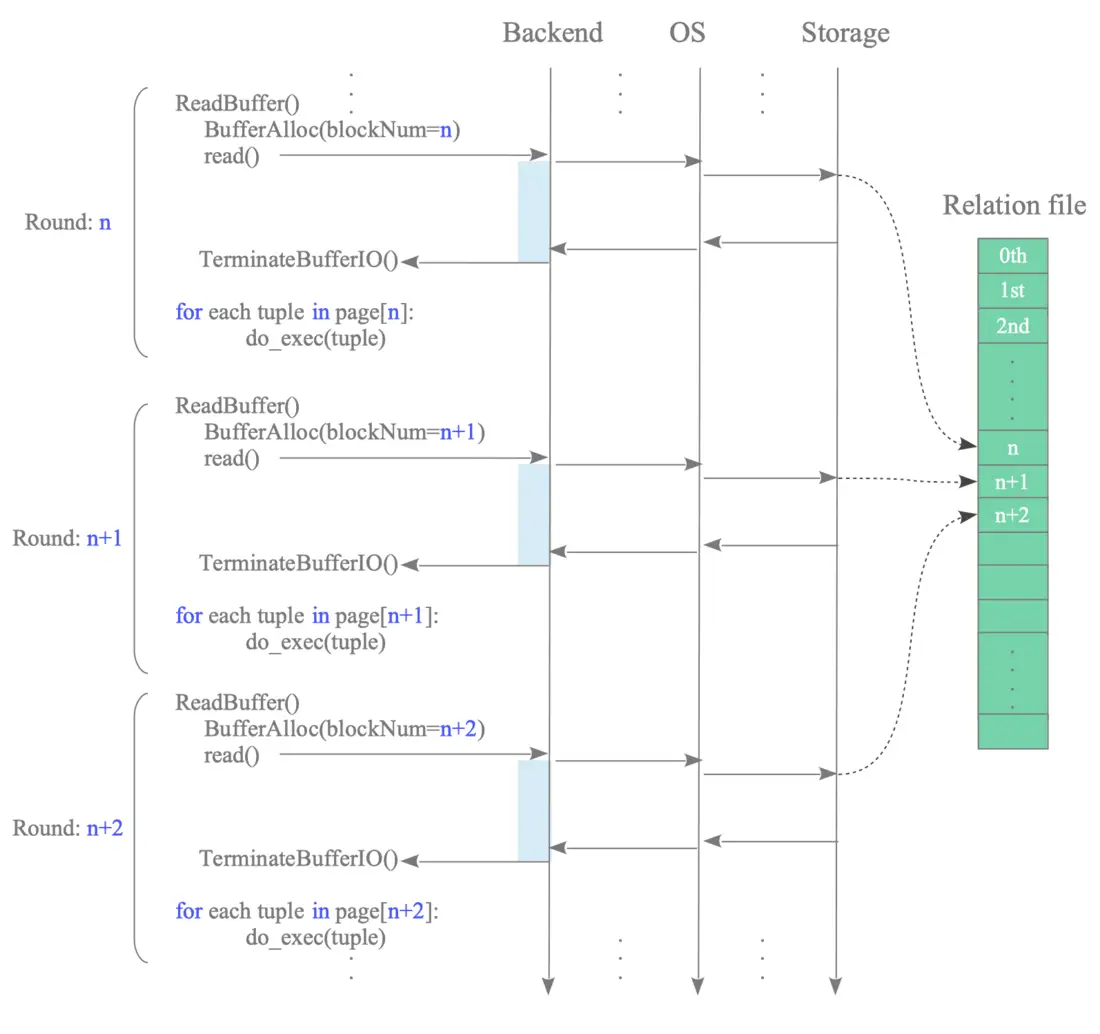
الشكل 8.22. مخطط تسلسلي لمسح تسلسلي متزامن تقليدي.
في هذا النموذج التقليدي، تكرّر العملية الخلفية دورة متسلسلة لكل كتلة (يُشار إليها هنا بـجولة):
- تخصيص المخزن: تستدعي الدالة ReadBuffer() الدالة BufferAlloc()، التي تبحث عن واصف المخزن المقابل للكتلة الهدف () أو تُنشئه.
- قراءة متزامنة من التخزين: تستدعي العملية الخلفية نداء نظام read() متزامناً قياسياً. وفي هذه اللحظة تكون العملية الخلفية محجوبة تماماً.
- انتهاء الإدخال/الإخراج ومعالجة الصفوف: بمجرد اكتمال الإدخال/الإخراج، تستيقظ العملية الخلفية وتحرّر القفل عن المخزن عبر TerminateBufferIO()، ثم تعالج الصفوف فوراً (do_exec()).
8.5.4. التنفيذ الفعلي للمسح التسلسلي غير المتزامن
مع بقاء خط المعالجة الأساسي كما وُصف في النموذج المبسّط السابق، يدمج مدير المخزن المؤقت عدة آليات واقعية لتحسين الكفاءة تحت أحمال العمل النشطة. وتحديداً، يقوم التنفيذ بما يلي:
- يتعامل مع إصابات الذاكرة المؤقتة أثناء القراءة المسبقة.
- يضبط نافذة القراءة المسبقة ديناميكياً بناءً على سلوك التنفيذ اللحظي.
- يتجاوز كلفة stream عبر نمط المسار السريع (Fast Path) عند اكتشاف تتابع من إصابات الذاكرة المؤقتة المتتالية.
وتفصّل الأقسام الفرعية التالية كل آلية من آليات الإنتاج هذه.
8.5.4.1. معالجة إصابة الذاكرة المؤقتة في القراءة المسبقة
عندما يصادف read_ahead() إصابة في الذاكرة المؤقتة، يتوقف عن مسح كتل إضافية ويجهّز طلب قراءة بالكتل المتجاورة التي لم تُصَب في الذاكرة المؤقتة والمتراكمة حتى تلك اللحظة فقط.
افترض أن الكتلة رقم (n+2) مخزَّنة بالفعل في مجمّع المخازن. ويوضّح الشكل 8.23 هذا السلوك.
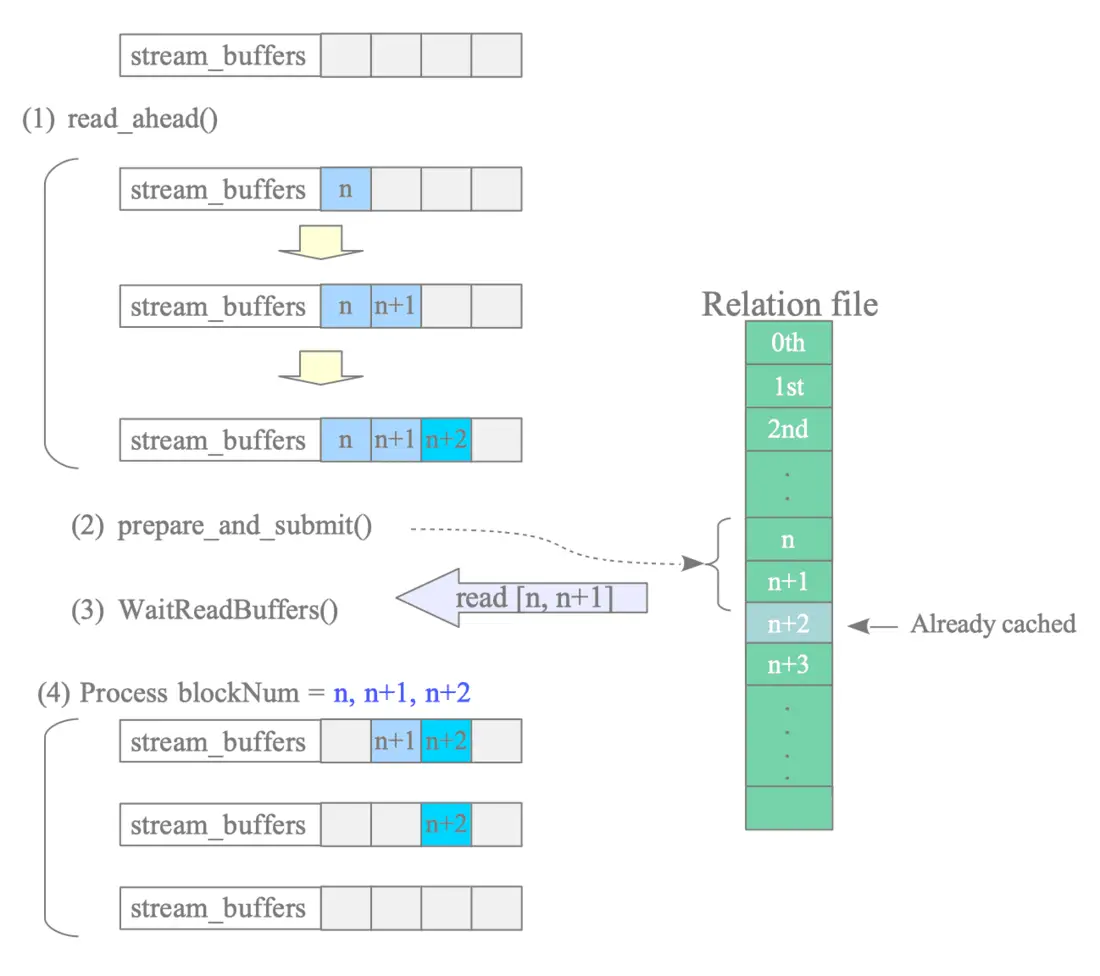
الشكل 8.23. سلوك القراءة المسبقة عند إصابة في الذاكرة المؤقتة.
- (1) بما أن stream_buffers فارغ، يحاول read_ahead() إعادة ملئه بالكتل التالية. ويبدأ read_ahead() من الكتلة رقم n ويُدرج الكتل في stream_buffers.
- وعندما يصادف إصابة في الذاكرة المؤقتة (في هذا المثال، الكتلة رقم (n+2))، يوقف عملية القراءة المسبقة.
(2) يجهّز prepare_and_submit() طلب قراءة متجهياً للكتلتين المتجاورتين (الكتلة رقم n والكتلة رقم (n+1)) ويرسله.
(3) ينتظر WaitReadBuffers() اكتمال طلب القراءة.
(4) يعالج المسح الكتل رقم n و(n+1) و(n+2). وتُحصَّل الكتلتان الأولىان من طلب الإدخال/الإخراج المكتمل، بينما تكون الكتلة رقم (n+2) متاحة بالفعل في مجمّع المخازن.
ويضمن إيقاف عملية القراءة المسبقة عند أول إصابة في الذاكرة المؤقتة أن تكون جميع الكتل المتراكمة في stream_buffers متجاورة فيزيائياً في ملف العلاقة. ونتيجة لذلك، يمكن لمدير المخزن المؤقت إرسالها كطلب إدخال/إخراج متجهي واحد (راجع الملحق 2.2 للتفاصيل)، ما يزيد كفاءة القراءة التسلسلية إلى أقصى حد.
ويوضّح الشكل 8.24 [1] السلوك عند قراءة كتل لاحقة من التخزين بعد معالجة إصابة في الذاكرة المؤقتة.
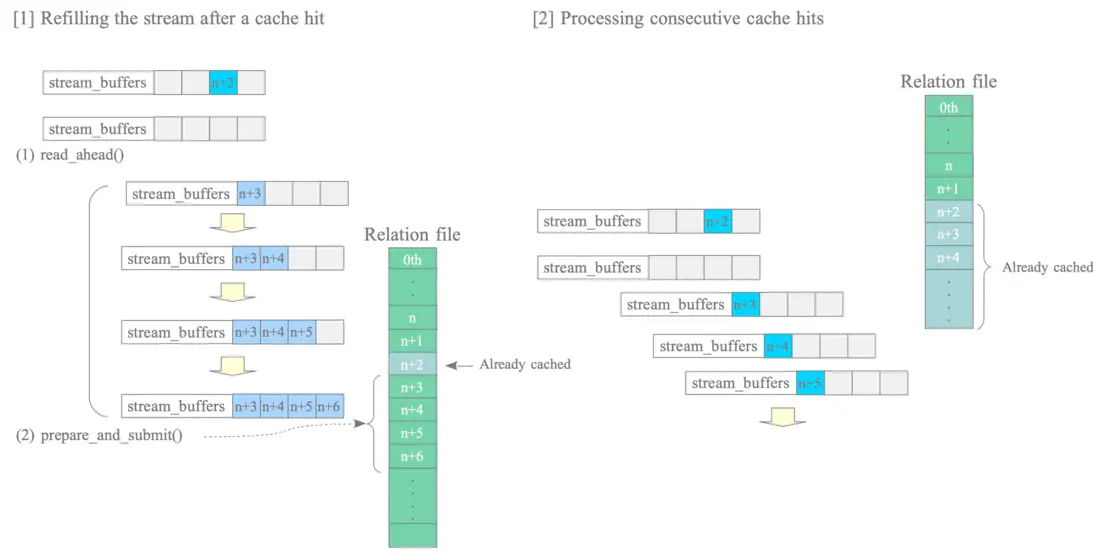
الشكل 8.24. سلوك stream في مراحل القراءة المسبقة اللاحقة بعد إصابات الذاكرة المؤقتة.
- (1) بعد معالجة الكتلة رقم (n+2)، يعيد read_ahead() ملء stream_buffers حتى عرض combine_distance، بدءاً من الكتلة رقم (n+3).
- (2) يجهّز prepare_and_submit() طلب قراءة متعدد الكتل من stream_buffers ويرسله.
وفي المقابل، يوضّح الشكل 8.24 [2] السلوك عندما تؤدي الكتل اللاحقة أيضاً إلى إصابات متتالية في الذاكرة المؤقتة. في هذا السيناريو، تُدرَج واصفات المخازن المخزَّنة مؤقتاً في stream_buffers واحداً تلو الآخر، وتُكرَّر جولة معالجة صفوف من كتلة واحدة.
8.5.4.2. آلية القراءة المسبقة التكيفية
يتغيّر طول combine_distance في stream_buffers تكيفياً.
في بداية المسح التسلسلي، تُهيَّأ combine_distance على 1. وخوارزمية التزايد كما يلي:
- التزايد: تتضاعف قيمة combine_distance مع كل جولة (مثلاً من 1 إلى 2، ومن 2 إلى 4، ومن 4 إلى 8، وهكذا). والقيمة العظمى لـ combine_distance هي الأصغر بين io_combine_limit/BLCKSZ و(queue_size - 1)، وتُحسب كما يلي:
ويوضّح الشكل 8.25 تغيّر حجم combine_distance عندما تُضبط io_combine_limit/BLCKSZ على 16.
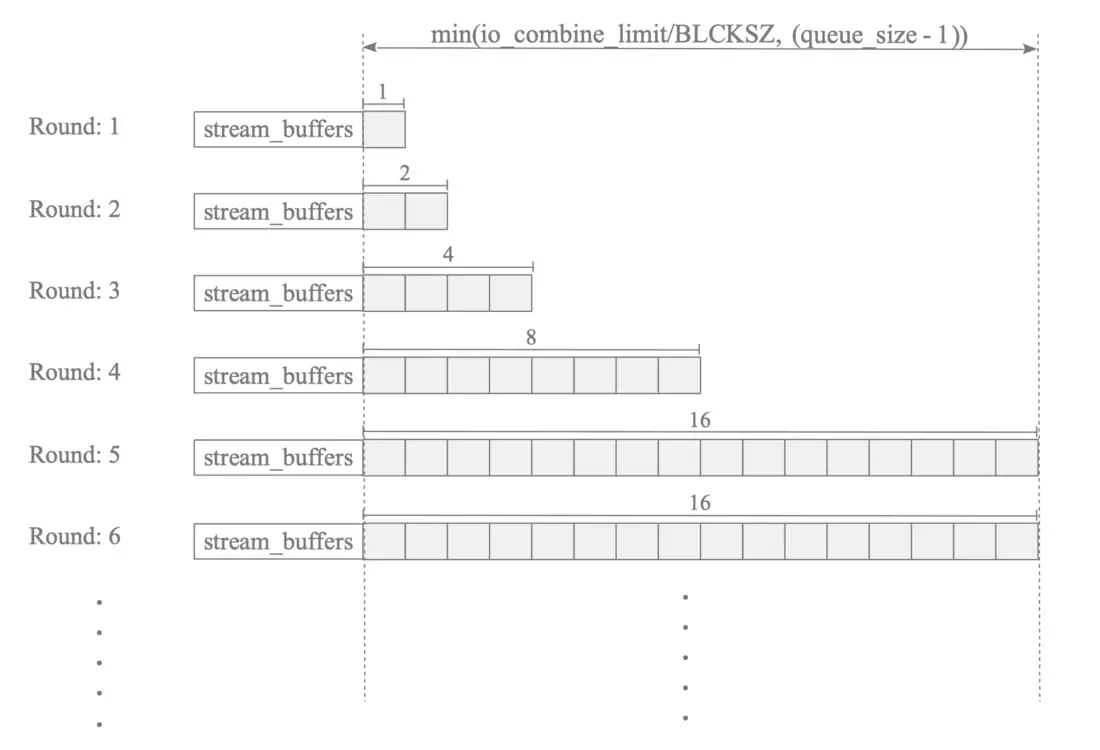
الشكل 8.25. نمو combine_distance أثناء القراءة التسلسلية المسبقة.
وبينما يزداد combine_distance بسرعة للوصول إلى حدّ التوازي الأقصى المحدّد في أسرع وقت ممكن، فإنه يتضاءل ببطء شديد.
- التضاؤل: عندما تستمر إصابات الذاكرة المؤقتة لأكثر من (queue_size - 1) كتلة، تنقص قيمة combine_distance بمقدار 1. وتؤدي استمرار الإصابات إلى نقص مقدارها 1 في كل مرة حتى تصل إلى 1.
- وتؤدي أي إصابة فائتة في الذاكرة المؤقتة إلى تفعيل نمط التزايد فوراً.
ويوضّح الشكل 8.26 تذبذب قيمة combine_distance. ويفترض هذا المثال أن ملف العلاقة مخزَّن مؤقتاً بالفعل في مجمّع المخازن بدءاً من الكتلة رقم n.
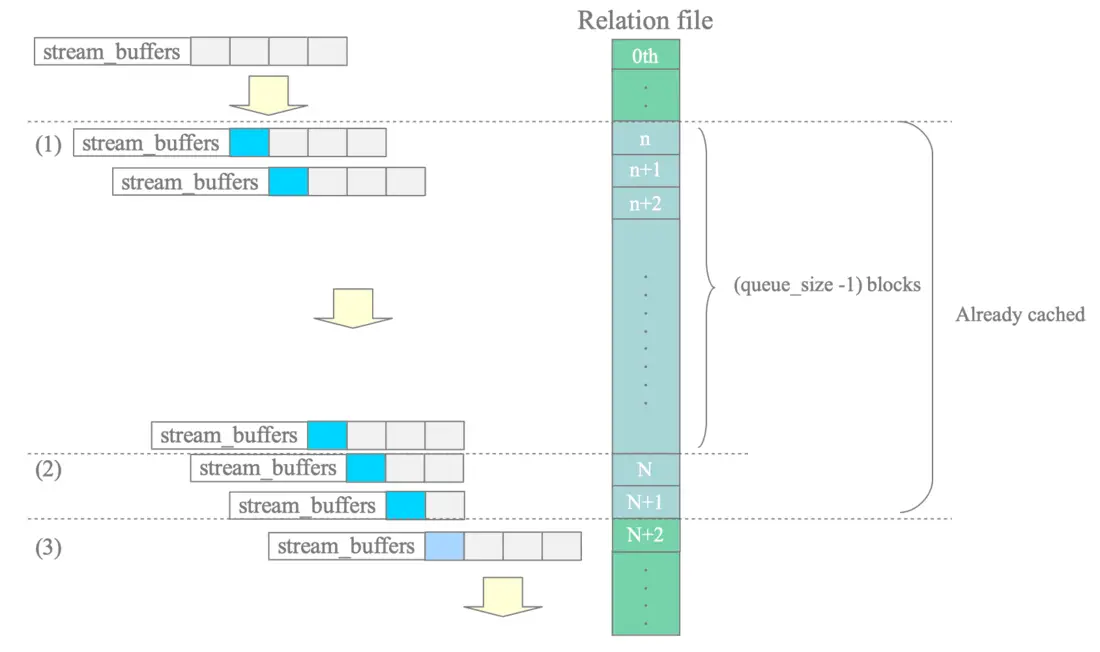
الشكل 8.26. تذبذب combine_distance بحسب إصابات الذاكرة المؤقتة والإصابات الفائتة.
- (1) إصابات أوّلية في الذاكرة المؤقتة: من الكتلة رقم n إلى الكتلة رقم (n + (queue_size -1))، ينفّذ مدير المخزن المؤقت معالجة إصابة الذاكرة المؤقتة الموضّحة في القسم الفرعي السابق. وأثناء هذه الفترة، يبقى طول combine_distance دون تغيير.
- (2) تضاؤل تدريجي: عندما تستمر إصابات الذاكرة المؤقتة إلى ما بعد حدّ (queue_size - 1)، تنقص قيمة combine_distance بمقدار 1 عند كل كتلة لاحقة.
- (3) التزايد: عند حدوث إصابة فائتة في الذاكرة المؤقتة ووجوب قراءة كتلة من التخزين، تعود الآلية فوراً إلى نمط التزايد. في هذا المثال، يتضاعف combine_distance من 2 إلى 4.
8.5.4.3. نمط المسار السريع: تجاوز stream_buffers
عندما تكون combine_distance تساوي 1 وتستمر إصابات الذاكرة المؤقتة، ينتقل مدير المخزن المؤقت إلى نمط المسار السريع (Fast Path)، الذي يقرأ خانات المخازن مباشرةً دون استخدام stream_buffers. ويهدف هذا النمط إلى تسريع المعالجة بتجاوز عملية إدارة stream_buffers كلها.
وإذا حدثت إصابة فائتة في الذاكرة المؤقتة أثناء نمط المسار السريع، ينتقل مدير المخزن المؤقت فوراً من نمط المسار السريع عائداً إلى نمط القراءة المسبقة العادي.
ويوضّح الشكل 8.27 [1] مثالاً على الدخول إلى نمط المسار السريع والخروج منه.
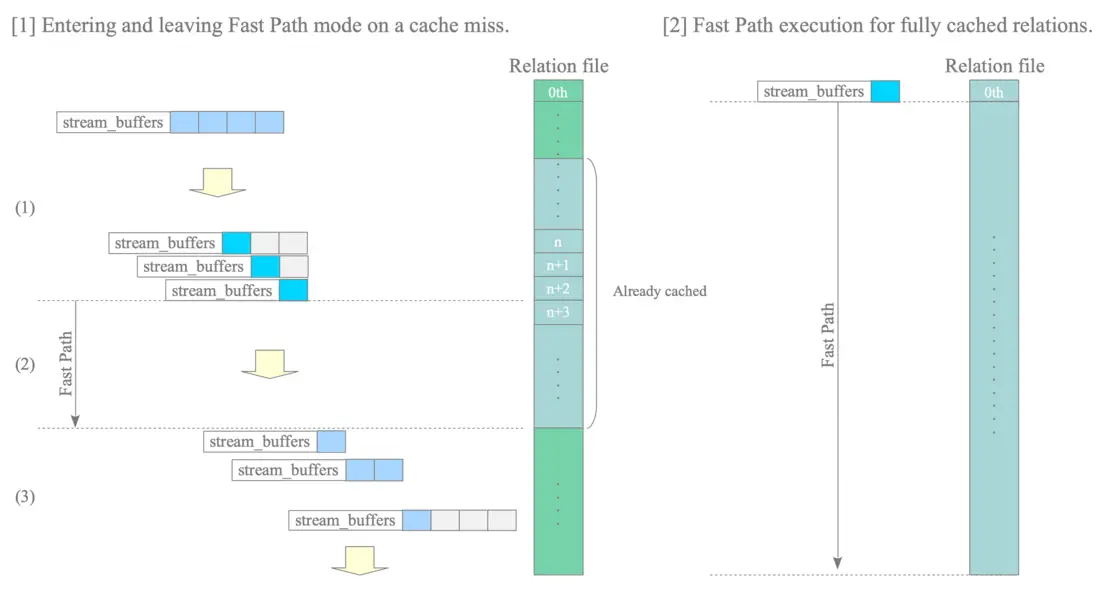
الشكل 8.27. سلوك نمط المسار السريع وانتقالاته.
عندما تكون جميع الكتل مخزَّنة مؤقتاً بالفعل في مجمّع المخازن (الشكل 8.26 [2])، يستخدم مدير المخزن المؤقت stream_buffers لمعالجة الكتلة رقم 0 فقط. وبعد ذلك، يعالج جميع الكتل اللاحقة في نمط المسار السريع.
8.6. إفراغ الصفحات المعدَّلة
بالإضافة إلى استبدال الصفحات الضحية، تُفرّغ عمليتا كاتب نقاط التحقق والكاتب الخلفي الصفحات المعدَّلة إلى التخزين.
تشترك العمليتان في الوظيفة نفسها، وهي إفراغ الصفحات المعدَّلة، لكنهما تؤدّيان أدواراً وسلوكات مختلفة.
8.6.1. كاتب نقاط التحقق
تكتب عملية كاتب نقاط التحقق سجل نقطة تحقق في ملف مقطع WAL وتُفرّغ الصفحات المعدَّلة كلما بدأت عملية نقطة التحقق.
ويصف القسم 9.7 نقاط التحقق ومحفّزاتها.
8.6.2. الكاتب الخلفي
يخفّف الكاتب الخلفي حمل الإدخال/الإخراج المكثّف المصاحب لنقاط التحقق. وتُفرّغ هذه العملية الصفحات المعدَّلة باستمرار وتدريجياً مع أقل تأثير ممكن على نشاط قاعدة البيانات ككل.
وبشكل افتراضي، يستيقظ الكاتب الخلفي كل 200 ملّي ثانية (وفق bgwriter_delay) ويُفرّغ بحدّ أقصى bgwriter_lru_maxpages (القيمة الافتراضية 100 صفحة).
ويتمثّل فرق رئيسي عن كاتب نقاط التحقق في اختيار الصفحات الهدف. فبينما يكتب كاتب نقاط التحقق جميع الصفحات المعدَّلة، يستهدف الكاتب الخلفي أساساً الصفحات التي يكون usage_count فيها 0. وتقلّل هذه الاستراتيجية حمل الكتابة بإبقاء الصفحات كثيرة الاستخدام، أو «الساخنة»، (تلك التي لها usage_count مرتفع) في الذاكرة، ما يقلّل احتمال تكرار عمليات الإدخال/الإخراج.
** لماذا فُصل كاتب نقاط التحقق عن الكاتب الخلفي؟
في الإصدار 9.1 وما قبله، كان الكاتب الخلفي ينفّذ معالجة نقاط التحقق بانتظام.
وفي الإصدار 9.2 (عام 2012)، فُصلت عملية كاتب نقاط التحقق عن عملية الكاتب الخلفي. ويشرح الاقتراح المعنون «Separating bgwriter and checkpointer» سبب ذلك. وفيما يلي مقتطفات ذات صلة:
حالياً (في عام 2011) تؤدي عملية bgwriter مهام الكتابة الخلفية ونقاط التحقق وبعض المهام الأخرى. وهذا يعني أننا لا نستطيع تنفيذ fsync النهائي لنقطة التحقق دون إيقاف الكتابة الخلفية، لذا يوجد أثر أداء سلبي من القيام بالأمرين في عملية واحدة. بالإضافة إلى ذلك، هدفنا في 9.2 هو استبدال حلقات الاستقصاء الدوري (polling loops) بالمزاليج (latches) لتقليل استهلاك الطاقة. وتعقيد حلقات bgwriter مرتفع ويبدو من غير المرجح التوصل إلى نهج نظيف باستخدام المزاليج. (مقتطف)