سجل ما قبل الكتابة (WAL)
9.1. نظرة عامة
يقدّم هذا القسم نظرة عامة على آلية التسجيل المسبق للكتابة (write-ahead logging, WAL).
يوضّح القسم الفرعي الأول مخاطر انهيار النظام في قاعدة بيانات لا تستخدم WAL. ويقدّم القسم الفرعي الثاني المفاهيم الأساسية، مثل كتابة بيانات WAL وعملية الاستعادة (recovery). ويصف القسم الفرعي الأخير كتابات الصفحة الكاملة (full-page writes)، وهو مفهوم بالغ الأهمية لسلامة البيانات.
في هذا القسم، تستخدم الأمثلة جدولًا باسم TABLE_A يحتوي على صفحة واحدة.
محتويات القسم
- 9.1.1. عمليات الإدراج دون WAL
- 9.1.2. عمليات الإدراج واستعادة قاعدة البيانات
- 9.1.3. كتابات الصفحة الكاملة
9.1.1. عمليات الإدراج دون WAL
تُنفّذ كل نظم إدارة قواعد البيانات (DBMS) تجمّع مخزن مؤقت مشتركًا (shared buffer pool) لتوفير وصول فعّال إلى صفحات العلاقات.
يوضّح الشكل 9.1 سيناريو تُدرَج فيه صفوف البيانات في الجدول TABLE_A على خادم PostgreSQL لا ينفّذ WAL.
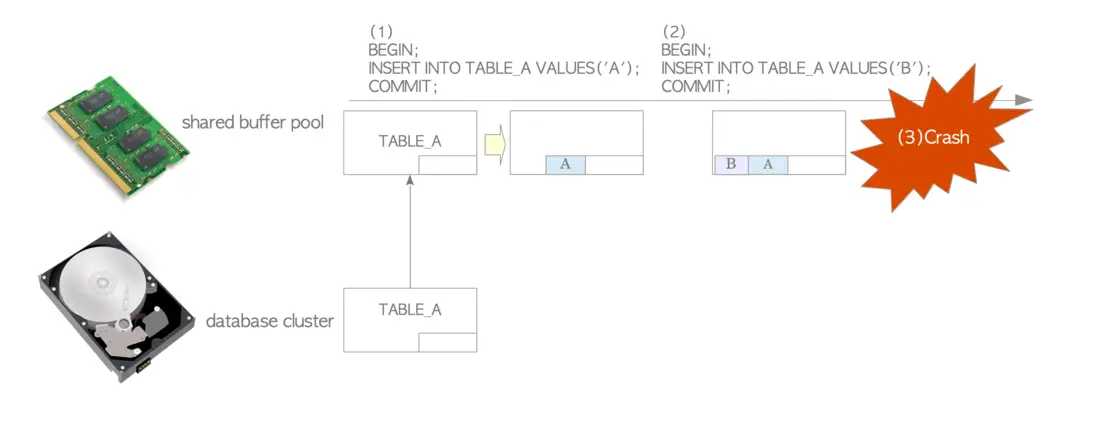
الشكل 9.1. عمليات الإدراج دون WAL.
- (1) عند تنفيذ عبارة INSERT الأولى، يحمّل PostgreSQL صفحة TABLE_A من تجمّع قاعدة البيانات إلى تجمّع المخزن المؤقت المشترك ويُدرج صفًّا. وتُسمى هذه الصفحة المعدَّلة صفحة قذرة (dirty page). ولا تُكتب الصفحة إلى وسيط التخزين فورًا.
- (2) عند تنفيذ عبارة INSERT الثانية، يُدرج PostgreSQL صفًّا جديدًا في الصفحة الموجودة في تجمّع المخزن المؤقت. وتظل الصفحة في الذاكرة فقط.
- (3) إذا تعطّل نظام التشغيل أو خادم PostgreSQL (مثلًا بسبب انقطاع التيار الكهربائي)، تُفقد كل البيانات المُدرَجة في الذاكرة.
لذلك فإن قاعدة بيانات بلا WAL معرّضة لأعطال النظام.
** معلومات تاريخية
قبل الإصدار 7.1، كان PostgreSQL ينفّذ كتابات متزامنة على القرص بإصدار استدعاء النظام sync كلما تغيّرت صفحة في الذاكرة.
ومع أن ذلك كان يضمن المتانة، فقد أدى إلى أداء ضعيف لأوامر التعديل مثل INSERT وUPDATE وDELETE.
9.1.2. عمليات الإدراج واستعادة قاعدة البيانات
يدعم PostgreSQL آلية WAL لمنع فقدان البيانات دون المساس بالأداء. ويصف هذا القسم الفرعي المفاهيم الأساسية، وكتابة بيانات WAL، واستعادة قاعدة البيانات.
يسجّل PostgreSQL جميع التعديلات كبيانات تاريخية في وسيط تخزين دائم. وتُعرف هذه البيانات التاريخية باسم سجلات XLOG أو بيانات WAL.
تكتب عمليات التغيير، مثل الإدراج أو الحذف أو الالتزام، سجلات XLOG في مخزن WAL المؤقت في الذاكرة. وتُدفع هذه السجلات إلى ملف قطعة WAL (WAL segment file) على وسيط التخزين عند الالتزام بالمعاملة أو إلغائها. (تُوصف مُطلِقات أخرى لكتابة سجلات XLOG في القسم 9.5.) ويمثّل رقم تسلسل السجل (LSN) المعرّف الفريد والموقع المحدد لسجل XLOG داخل سجل المعاملات.
عند التفكير في استعادة قاعدة البيانات، يتبادر إلى الذهن سؤال مباشر: من أين تبدأ الاستعادة بالضبط؟ الجواب هو نقطة إعادة التنفيذ (REDO point). ونقطة إعادة التنفيذ هي موقع سجل XLOG المكتوب في اللحظة التي بدأت فيها أحدث نقطة تفتيش (checkpoint). (تُوصف نقاط التفتيش في القسم 9.7.) ولا تنفصل عملية الاستعادة عن عملية نقطة التفتيش.
** معلومات
نُفِّذت آلية WAL وعملية نقطة التفتيش في الوقت نفسه في الإصدار 7.1.
يصف الشكل 9.2 والخطوات التالية إدراج صف باستخدام WAL.
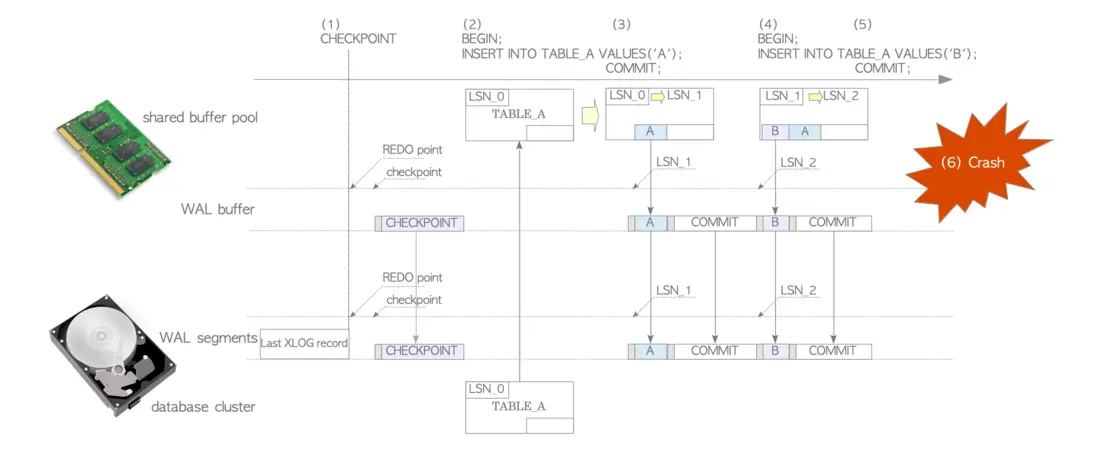
الشكل 9.2. عمليات الإدراج باستخدام WAL.
** إشارات
يوضّح «LSN الخاص بالجدول TABLE_A» قيمة 'pd_lsn' داخل ترويسة صفحة TABLE_A. ويُقصد بـ«LSN الخاص بالصفحة» الأمر نفسه.
- (1) تُجري عملية نقاط التفتيش (checkpointer) — وهي عملية خلفية — نقاط تفتيش دورية. وفي بداية نقطة التفتيش، تكتب سجل نقطة تفتيش يحتوي على أحدث نقطة إعادة تنفيذ إلى قطعة WAL.
- (2) عند تنفيذ عبارة INSERT الأولى، يحمّل PostgreSQL صفحة TABLE_A إلى تجمّع المخزن المؤقت المشترك ويُدرج صفًّا. ثم يكتب سجل XLOG لهذه العبارة في مخزن WAL المؤقت عند LSN_1 ويحدّث ترويسة الصفحة (pd_lsn) للجدول TABLE_A من LSN_0 إلى LSN_1.
- (3) عند الالتزام بالمعاملة، يكتب PostgreSQL سجل XLOG للالتزام في مخزن WAL المؤقت ويدفع جميع السجلات من LSN_1 إلى ملف قطعة WAL.
- (4) عند تنفيذ عبارة INSERT الثانية، يُدرج PostgreSQL صفًّا جديدًا، ويكتب سجل XLOG عند LSN_2، ويحدّث LSN الخاص بالجدول TABLE_A إلى LSN_2.
- (5) عند الالتزام بهذه المعاملة، يدفع PostgreSQL سجلات XLOG كما في الخطوة (3).
- (6) إذا حدث عطل في النظام، تُفقد البيانات الموجودة في تجمّع المخزن المؤقت المشترك. ومع ذلك، فقد حُفظت جميع التعديلات في ملفات قطع WAL.
عند إعادة التشغيل، يدخل PostgreSQL تلقائيًا في وضع الاستعادة. فيقرأ سجلات XLOG ويعيد تنفيذها بالتسلسل بدءًا من نقطة إعادة التنفيذ (الشكل 9.3).
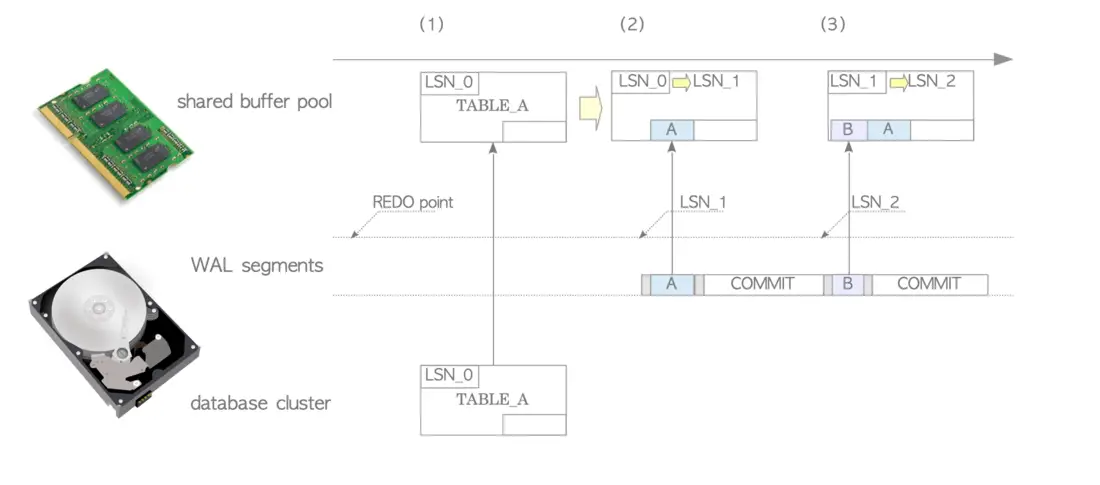
الشكل 9.3. استعادة قاعدة البيانات باستخدام WAL.
- (1) يقرأ PostgreSQL أول سجل XLOG للإدراج ويحمّل صفحة TABLE_A من وسيط التخزين إلى تجمّع المخزن المؤقت المشترك.
- (2) قبل إعادة التنفيذ، يقارن PostgreSQL بين LSN الخاص بسجل XLOG وLSN الخاص بالصفحة. وقواعد إعادة التنفيذ كما يلي: إذا كان LSN الخاص بسجل XLOG أحدث (أكبر) من LSN الخاص بالصفحة، يُدرَج الجزء الخاص بالبيانات من السجل في الصفحة، ويُحدَّث LSN الخاص بالصفحة.
- إذا كان LSN الخاص بسجل XLOG أقدم (أصغر)، يُتخطّى السجل.
(3) يعيد PostgreSQL تنفيذ جميع السجلات المتبقية بالترتيب الزمني.
على الرغم من أن كتابة سجلات XLOG تحمل بالتأكيد تكلفة طفيفة، فإنها تتضاءل أمام كلفة كتابة الصفحات المعدَّلة كاملة. ولا شك في أن قدرة تحمّل أعطال النظام المكتسبة تستحق هذه الكلفة.
9.1.3. كتابات الصفحة الكاملة
إذا تعطّل نظام التشغيل أثناء كتابة صفحة قذرة، فقد تتلف بيانات الصفحة على وسيط التخزين. ولا يمكن إعادة تنفيذ سجلات XLOG على صفحة تالفة.
لمعالجة ذلك، يستخدم PostgreSQL كتابات الصفحة الكاملة (full-page writes). وعند تفعيلها، يكتب PostgreSQL الصفحة كاملة كسجل XLOG خلال أول تعديل على تلك الصفحة بعد نقطة تفتيش. ويسمى هذا السجل كتلة احتياطية (backup block) أو صورة الصفحة الكاملة (full-page image).
يوضّح الشكل 9.4 عملية الإدراج مع تفعيل كتابات الصفحة الكاملة.
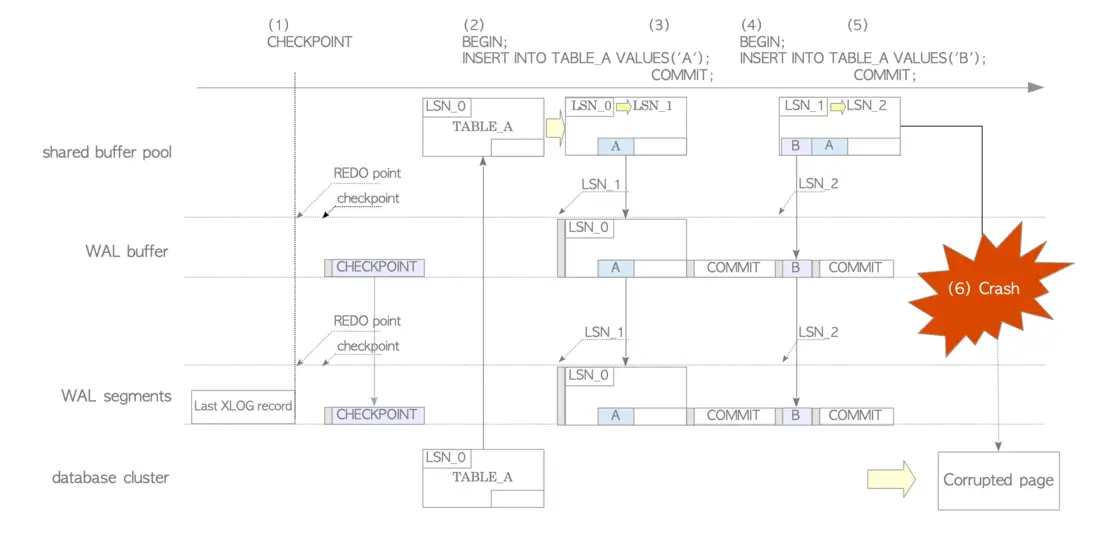
الشكل 9.4. كتابات الصفحة الكاملة.
- (1) تبدأ عملية نقاط التفتيش نقطة تفتيش.
- (2) تؤدي عبارة INSERT الأولى إلى إنشاء كتلة احتياطية لأنها أول تعديل على الصفحة منذ نقطة التفتيش.
- (3) تُلتزم المعاملة ويُدفع المخزن المؤقت كالمعتاد.
- (4) تنشئ عبارة INSERT الثانية سجل XLOG عاديًا (وليس كتلة احتياطية) لأن الصفحة عُدّلت مرة واحدة بالفعل منذ نقطة التفتيش.
- (5) تُلتزم المعاملة.
- (6) يحدث عطل في نظام التشغيل بينما تكتب عملية نقاط التفتيش صفحة TABLE_A المعدَّلة إلى وسيط التخزين، ما يؤدي إلى تلف الصفحة على قرص التخزين.
يوضّح الشكل 9.5 عملية الاستعادة.
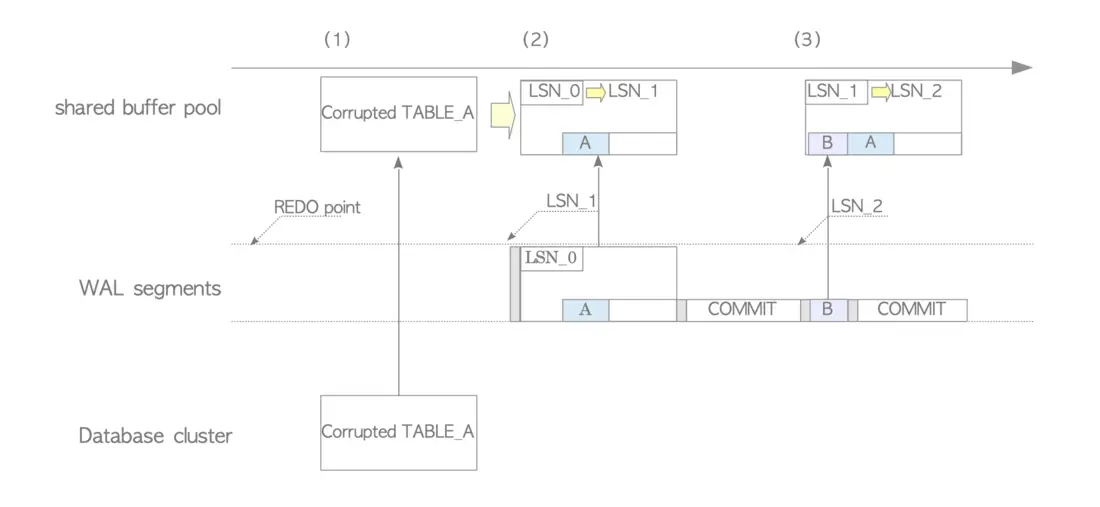
الشكل 9.5. استعادة قاعدة البيانات باستخدام الكتلة الاحتياطية.
- (1) يقرأ PostgreSQL أول سجل XLOG ويحمّل الصفحة التالفة إلى تجمّع المخزن المؤقت.
- (2) بما أن السجل كتلة احتياطية، يُكتب محتوى الصفحة كاملًا فوق الصفحة التالفة بصرف النظر عن قيم LSN. ويُحدَّث LSN الخاص بالصفحة إلى LSN_1. وبذلك تُستعاد الصفحة التالفة.
- (3) تُعاد بعد ذلك تنفيذ الكتل غير الاحتياطية باستخدام قاعدة مقارنة LSN المعتادة.
تضمن هذه الآلية استعادة قاعدة البيانات حتى إذا حدثت أخطاء في كتابة البيانات بسبب انهيار.
** WAL والنسخ الاحتياطي والنسخ المتماثل
كما ذُكر أعلاه، يمنع WAL فقدان البيانات بسبب انهيار العمليات أو نظام التشغيل. ومع ذلك، تُفقد البيانات إذا حدث عطل في نظام الملفات أو في وسيط التخزين. ولمعالجة مثل هذه الأعطال، يوفّر PostgreSQL ميزتي النسخ الاحتياطي المتصل والنسخ المتماثل.
- تتيح النسخ الاحتياطية المتصلة المنتظمة استعادة قاعدة البيانات من أحدث نسخة احتياطية حتى بعد عطل وسيط التخزين. ومع ذلك، لا يمكن استعادة التغييرات التي أُجريت بعد آخر نسخة احتياطية باستخدام تلك النسخة وحدها. فمثلًا، حتى مع نسخة احتياطية يومية تُؤخذ عند الساعة 0:00، إذا حدث عطل في نظام الملفات عند الساعة 8:00، فستُفقد كل التغييرات من 0:00 حتى لحظة العطل.
- تخزّن ميزة النسخ المتماثل المتزامن جميع التغييرات في وسيط تخزين أو مضيف آخر في الوقت الحقيقي. وإذا حدث عطل في وسيط التخزين على الخادم الأساسي، يمكن استعادة البيانات من الخادم الاحتياطي.
لمزيد من المعلومات، انظر الفصول 10 و11 و12 على الترتيب.
** هل يُغني النسخ المتماثل المتزامن عن النسخ الاحتياطي؟
لا. لا يُغني النسخ المتماثل المتزامن عن النسخ الاحتياطي.
يتطلب تشغيل نظام إدارة قواعد البيانات معالجة ليس فقط أعطال العتاد أو البرمجيات، بل أيضًا فقدان البيانات الناتج عن الخطأ البشري أو أخطاء البرمجيات.
فمثلًا، إذا حُذفت بيانات حساسة عن طريق الخطأ، ينعكس الحذف فورًا على الخادم الاحتياطي. وبالمثل، إذا كُتبت بيانات خاطئة بسبب خطأ ما، ينتشر الخطأ فورًا عبر جميع خوادم النسخ المتماثل.
في مثل هذه الحالات، لا يمكن للنسخ المتماثل استعادة البيانات المفقودة أو التالفة. وليس أمامك للتعافي من هذه الأعطال سوى استخدام بيانات النسخ الاحتياطي (+ سجلات الأرشيف).
9.2. سجل المعاملات وملفات قطع WAL
منطقيًا، يكتب PostgreSQL سجلات XLOG في ملف افتراضي بمساحة عناوين من 8 بايتات (16 إكسابايت).
سعة سجل المعاملات غير محدودة فعليًا. ومع أن مساحة عناوين من 8 بايتات هائلة، فإن إدارة ملف واحد بهذا الحجم مستحيلة. لذلك يقسّم PostgreSQL سجل المعاملات إلى ملفات أصغر، عادةً 16 ميغابايت لكل ملف. ويُعرف كل ملف باسم قطعة WAL (WAL segment). انظر الشكل 9.6.
** حجم ملف قطعة WAL
في الإصدار 11 أو أحدث، يمكن ضبط حجم ملف قطعة WAL عبر خيار –wal-segsize عند إنشاء تجمّع PostgreSQL باستخدام الأمر initdb.
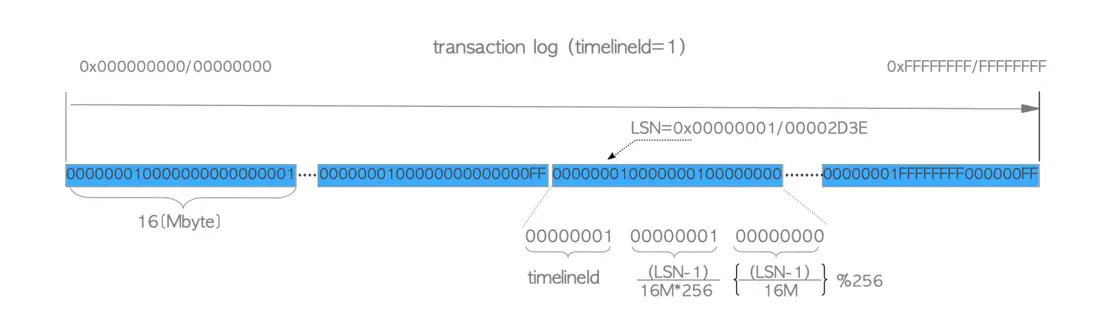
الشكل 9.6. سجل المعاملات وملفات قطع WAL
اسم ملف قطعة WAL عدد سداسي عشري من 24 خانة. وقاعدة التسمية كما يلي:
** timelineId
يستخدم WAL في PostgreSQL مفهوم timelineId (عدد صحيح غير مُوقَّع من 4 بايتات) من أجل الاستعادة الزمنية (PITR)، وهو ما يُوصف في الفصل 10.
ومع ذلك، يبقى timelineId ثابتًا عند 0x00000001 في هذا الفصل لتبسيط الأوصاف التالية.
أول ملف قطعة WAL هو 000000010000000000000001. وعندما تمتلئ سجلات XLOG الملف الأول، يوفّر PostgreSQL الملف الثاني: 000000010000000000000002. وتُستخدم الملفات بترتيب تصاعدي. وبعد امتلاء 0000000100000000000000FF، يكون الملف الموفَّر هو 000000010000000100000000. وبهذه الطريقة يزداد العدد المكوّن من 8 خانات في الوسط بمقدار واحد كلما حُملت الخانتان الأخيرتان.
وبالمثل، بعد امتلاء 0000000100000001000000FF، يوفّر PostgreSQL الملف 000000010000000200000000، وهكذا.
** pg_xlogfile_name / pg_walfile_name
تحدّد الدالة المدمجة pg_xlogfile_name (في الإصدار 9.6 أو أقدم) أو pg_walfile_name (في الإصدار 10 أو أحدث) اسم ملف قطعة WAL الذي يحتوي على LSN محدَّد.
وفيما يلي مثال:
testdb=# SELECT pg_xlogfile_name('1/00002D3E');  # In versions 10 or later, "SELECT pg_walfile_name('1/00002D3E');"
     pg_xlogfile_name
--------------------------
 000000010000000100000000
(1 row)
9.3. التخطيط الداخلي لقطعة WAL
قطعة WAL ملف بحجم 16 ميغابايت افتراضيًا. وهي مقسّمة داخليًا إلى صفحات من 8192 بايت (8 كيلوبايت). وتحتوي الصفحة الأولى على ترويسة معرّفة بالبنية XLogLongPageHeaderData.
في المقابل، تحتوي كل الصفحات التالية على معلومات صفحة معرّفة بالبنية XLogPageHeaderData. وبعد ترويسة الصفحة، تُكتب سجلات XLOG في كل صفحة بالتسلسل من البداية. انظر الشكل 9.7.
** ** XLogLongPageHeaderData
typedef XLogPageHeaderData *XLogPageHeader;

/*
 * When the XLP_LONG_HEADER flag is set, we store additional fields in the
 * page header.  (This is ordinarily done just in the first page of an
 * XLOG file.)	The additional fields serve to identify the file accurately.
 */
typedef struct XLogLongPageHeaderData
{
	XLogPageHeaderData std;		/* standard header fields */
	uint64		xlp_sysid;		/* system identifier from pg_control */
	uint32		xlp_seg_size;	/* just as a cross-check */
	uint32		xlp_xlog_blcksz;	/* just as a cross-check */
} XLogLongPageHeaderData;
** ** XLogPageHeaderData
/*
 * Each page of XLOG file has a header like this:
 */
#define XLOG_PAGE_MAGIC 0xD113	/* can be used as WAL version indicator */

typedef struct XLogPageHeaderData
{
	uint16		xlp_magic;		/* magic value for correctness checks */
	uint16		xlp_info;		/* flag bits, see below */
	TimeLineID	xlp_tli;		/* TimeLineID of first record on page */
	XLogRecPtr	xlp_pageaddr;	/* XLOG address of this page */

	/*
	 * When there is not enough space on current page for whole record, we
	 * continue on the next page.  xlp_rem_len is the number of bytes
	 * remaining from a previous page; it tracks xl_tot_len in the initial
	 * header.  Note that the continuation data isn't necessarily aligned.
	 */
	uint32		xlp_rem_len;	/* total len of remaining data for record */
} XLogPageHeaderData;
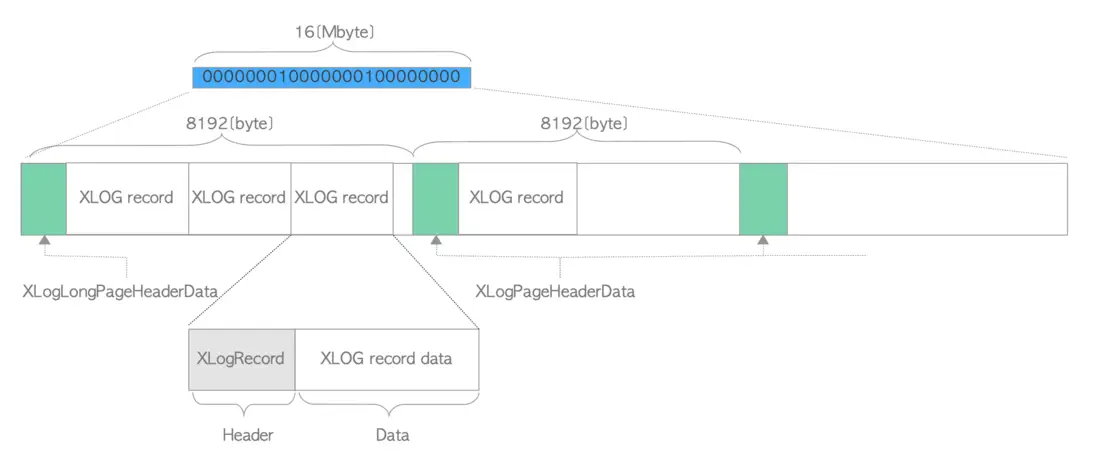
الشكل 9.7. التخطيط الداخلي لملف قطعة WAL.
البنيتان XLogLongPageHeaderData وXLogPageHeaderData معرّفتان في xlog_internal.h. وقد حُذف وصف هاتين البنيتين هنا لأنه غير مطلوب في الأقسام التالية.
9.4. التخطيط الداخلي لسجل XLOG
يتكوّن سجل XLOG من جزء ترويسة عامة وأجزاء بيانات مرتبطة به.
يصف القسم الفرعي الأول بنية الترويسة. ويشرح القسمان الفرعيان المتبقيان بنيتي جزء البيانات للإصدار 9.4 وما قبله، والإصدار 9.5 وما بعده على الترتيب. (تغيّر تنسيق البيانات في الإصدار 9.5 (2016).)
محتويات القسم
- 9.4.1. جزء الترويسة من سجل XLOG
- 9.4.2. جزء البيانات من سجل XLOG (الإصدار 9.4 أو أقدم)
- 9.4.3. جزء البيانات من سجل XLOG (الإصدار 9.5 أو أحدث)
9.4.1. جزء الترويسة من سجل XLOG
تحتوي جميع سجلات XLOG على جزء ترويسة عامة معرّف ببنية XLogRecord. وبنية الإصدار 9.4 وما قبله معروضة أدناه:
typedef struct XLogRecord
{
   uint32          xl_tot_len;   /* total len of entire record */
   TransactionId   xl_xid;       /* xact id */
   uint32          xl_len;       /* total len of rmgr data. This variable was removed in ver.9.5. */
   uint8           xl_info;      /* flag bits, see below */
   RmgrId          xl_rmid;      /* resource manager for this record */
   /* 2 bytes of padding here, initialize to zero */
   XLogRecPtr      xl_prev;      /* ptr to previous record in log */
   pg_crc32        xl_crc;       /* CRC for this record */
} XLogRecord;
** جزء الترويسة من سجل XLOG في الإصدار 9.5 أو أحدث.
في الإصدار 9.5 أو أحدث، حُذف المتغيّر xl_len من بنية XLogRecord لتحسين التنسيق وتقليل الحجم ببضعة بايتات.
** ** XLogRecord
typedef struct XLogRecord
{
        uint32          xl_tot_len;             /* total len of entire record */
        TransactionId 	xl_xid;           	/* xact id */
        XLogRecPtr      xl_prev;                /* ptr to previous record in log */
        uint8           xl_info;                /* flag bits, see below */
        RmgrId          xl_rmid;                /* resource manager for this record */
        /* 2 bytes of padding here, initialize to zero */
        pg_crc32c       xl_crc;                 /* CRC for this record */
        /* XLogRecordBlockHeaders and XLogRecordDataHeader follow, no padding */
} XLogRecord;
معظم المتغيّرات واضحة بذاتها.
يرتبط كل من xl_rmid وxl_info بـمديري الموارد (resource managers)، وهم مجموعات من العمليات الخاصة بميزة WAL، مثل كتابة سجلات XLOG وإعادة تنفيذها. ويميل عدد مديري الموارد إلى الازدياد مع كل إصدار من PostgreSQL.
يسرد الجدول 9.1 مديري الموارد:
| العملية | مدير الموارد |
|---|---|
| عمليات صفوف الكومة (heap) | RM_HEAP, RM_HEAP2 |
| عمليات الفهارس | RM_BTREE, RM_HASH, RM_GIN, RM_GIST, RM_SPGIST, RM_BRIN |
| عمليات المتسلسلات | RM_SEQ |
| عمليات المعاملات | RM_XACT, RM_MULTIXACT, RM_CLOG, RM_XLOG, RM_COMMIT_TS |
| عمليات فضاءات الجداول | RM_SMGR, RM_DBASE, RM_TBLSPC, RM_RELMAP |
| عمليات النسخ المتماثل | RM_STANDBY, RM_REPLORIGIN, RM_GENERIC_ID, RM_LOGICALMSG_ID |
وفيما يلي أمثلة تمثيلية على كيفية عمل مديري الموارد:
- عند تنفيذ عبارة INSERT، يُضبط المتغيّران xl_rmid وxl_info في الترويسة على RM_HEAP وXLOG_HEAP_INSERT على الترتيب. وأثناء استعادة قاعدة البيانات، يختار PostgreSQL الدالة heap_xlog_insert() من RM_HEAP بناءً على xl_info لإعادة تنفيذ السجل.
- في عبارة UPDATE، يُضبط xl_info على XLOG_HEAP_UPDATE. وتعيد الدالة heap_xlog_update() تنفيذ السجل أثناء الاستعادة.
- عند الالتزام بمعاملة، يُضبط xl_rmid وxl_info على RM_XACT وXLOG_XACT_COMMIT على الترتيب. وتعيد الدالة xact_redo_commit() تنفيذ هذا السجل أثناء الاستعادة.
** معلومات
بنية XLogRecord في الإصدار 9.4 أو أقدم معرّفة في xlog.h، وفي الإصدار 9.5 أو أحدث توجد في xlogrecord.h.
الدالتان heap_xlog_insert وheap_xlog_update معرّفتان في heapam.c؛ وxact_redo_commit معرّفة في xact.c.
9.4.2. جزء البيانات من سجل XLOG (الإصدار 9.4 أو أقدم)
يُصنَّف جزء البيانات من سجل XLOG إما ككتلة احتياطية (تحتوي على صفحة كاملة) أو ككتلة غير احتياطية (تحتوي على بيانات تختلف وفقًا للعملية).
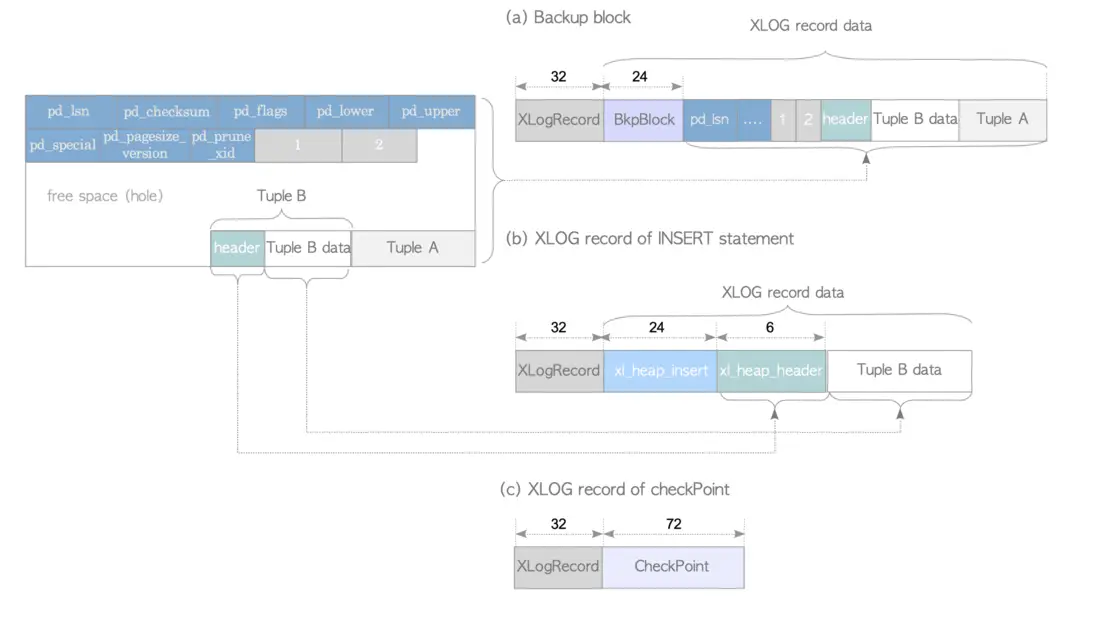
الشكل 9.8. أمثلة على سجلات XLOG (الإصدار 9.4 أو أقدم).
تُوصف التخطيطات الداخلية لسجلات XLOG أدناه باستخدام أمثلة محددة.
9.4.2.1. الكتلة الاحتياطية
تُعرض الكتلة الاحتياطية في الشكل 9.8(a). وهي تتكوّن من بنيتَي بيانات وكائن بيانات واحد:
- بنية XLogRecord (جزء الترويسة).
- بنية
BkpBlock. - الصفحة كاملة، باستثناء مساحتها الحرة.
تحتوي بنية BkpBlock على متغيّرات تحدّد الصفحة في تجمّع قاعدة البيانات (relfilenode، ورقم التفريعة (fork) للعلاقة، ورقم الكتلة). كما تخزّن موضع البداية وطول المساحة الحرة في الصفحة.
** ** BkpBlock
typedef struct BkpBlock @ include/access/xlog_internal.h
{
  RelFileNode node;        /* relation containing block */
  ForkNumber  fork;        /* fork within the relation */
  BlockNumber block;       /* block number */
  uint16      hole_offset; /* number of bytes before "hole" */
  uint16      hole_length; /* number of bytes in "hole" */

  /* ACTUAL BLOCK DATA FOLLOWS AT END OF STRUCT */
} BkpBlock;
9.4.2.2. الكتلة غير الاحتياطية
في الكتل غير الاحتياطية، يختلف تخطيط جزء البيانات وفقًا للعملية. ويُشرح هنا سجل XLOG الخاص بعبارة INSERT كمثال تمثيلي. انظر الشكل 9.8(b). وفي هذه الحالة، يتكوّن سجل XLOG من بنيتَي بيانات وكائن بيانات واحد:
- بنية XLogRecord (جزء الترويسة).
- بنية
xl_heap_insert. - الصف المُدرَج، بعد إزالة بضعة بايتات منه.
تحتوي بنية xl_heap_insert على متغيّرات تحدّد الصف المُدرَج في تجمّع قاعدة البيانات (relfilenode الخاص بالجدول وTID الخاص بالصف) وعلى علامة ظهور الصف.
** ** xl_heap_insert
typedef struct BlockIdData
{
   uint16          bi_hi;
   uint16          bi_lo;
} BlockIdData;

typedef uint16 OffsetNumber;

typedef struct ItemPointerData
{
   BlockIdData     ip_blkid;
   OffsetNumber    ip_posid;
}

typedef struct RelFileNode
{
   Oid             spcNode;             /* tablespace */
   Oid             dbNode;              /* database */
   Oid             relNode;             /* relation */
} RelFileNode;

typedef struct xl_heaptid
{
   RelFileNode     node;
   ItemPointerData tid;                 /* changed tuple id */
} xl_heaptid;

typedef struct xl_heap_insert
{
   xl_heaptid      target;              /* inserted tuple id */
   bool            all_visible_cleared; /* PD_ALL_VISIBLE was cleared */
} xl_heap_insert;
** معلومات
يرد سبب إزالة بضعة بايتات من الصف المُدرَج في تعليق الشيفرة المصدرية لبنية xl_heap_header:
لا نخزّن الجزء الثابت كاملًا (HeapTupleHeaderData) من الصف المُدرَج أو المُحدَّث في WAL؛ فيمكننا توفير بضعة بايتات بإعادة بناء الحقول المتاحة في مكان آخر من سجل WAL، أو التي لا حاجة أصلًا إلى إعادة بنائها.
وهناك مثال آخر معروض هنا. انظر الشكل 9.8(c).
سجل XLOG الخاص بنقطة تفتيش بسيط ويتكوّن من بنيتَي بيانات:
- بنية XLogRecord (جزء الترويسة).
- بنية CheckPoint، التي تحتوي على معلومات نقطة التفتيش (انظر القسم 9.7 للتفاصيل).
** معلومات
بنية xl_heap_header (الإصدار 9.4 أو أقدم) معرّفة في heapam_xlog.h، بينما بنية CheckPoint معرّفة في pg_control.h.
9.4.3. جزء البيانات من سجل XLOG (الإصدار 9.5 أو أحدث)
في الإصدار 9.4 أو أقدم، لم يكن لسجلات XLOG تنسيق موحّد، إذ كان كل مدير موارد يعرّف تنسيقه الخاص. وقد جعل ذلك صيانة الشيفرة المصدرية وتنفيذ ميزات WAL جديدة يتزايد صعوبة.
ولمعالجة هذه المشكلة، قدّم الإصدار 9.5 تنسيقًا موحّدًا منظّمًا مستقلًا عن مديري الموارد.
يتكوّن جزء البيانات من سجل XLOG من جزأين: الترويسة والبيانات. انظر الشكل 9.9.
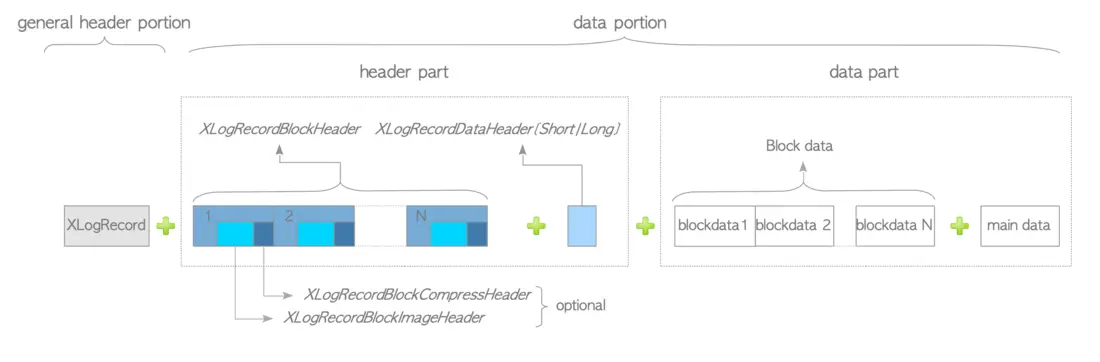
الشكل 9.9. التنسيق الموحّد لسجل XLOG.
يحتوي جزء الترويسة على صفر أو أكثر من XLogRecordBlockHeaders وصفر أو واحد من XLogRecordDataHeaderShort (أو XLogRecordDataHeaderLong). ويجب أن يحتوي على واحد منها على الأقل.
عندما يخزّن السجل صورة صفحة كاملة (FPI)، تتضمّن بنية XLogRecordBlockHeader البنية XLogRecordBlockImageHeader. كما تتضمّن البنية XLogRecordBlockCompressHeader إذا كانت الكتلة مضغوطة.
** ** XLogRecordBlockHeader
/*
 * Header info for block data appended to an XLOG record.
 *
 * 'data_length' is the length of the rmgr-specific payload data associated
 * with this block. It does not include the possible full page image, nor
 * XLogRecordBlockHeader struct itself.
 *
 * Note that we don't attempt to align the XLogRecordBlockHeader struct!
 * So, the struct must be copied to aligned local storage before use.
 */
typedef struct XLogRecordBlockHeader
{
	uint8		id;				/* block reference ID */
	uint8		fork_flags;		/* fork within the relation, and flags */
	uint16		data_length;	/* number of payload bytes (not including page
								 * image) */

	/* If BKPBLOCK_HAS_IMAGE, an XLogRecordBlockImageHeader struct follows */
	/* If BKPBLOCK_SAME_REL is not set, a RelFileLocator follows */
	/* BlockNumber follows */
} XLogRecordBlockHeader;

/*
 * The fork number fits in the lower 4 bits in the fork_flags field. The upper
 * bits are used for flags.
 */
#define BKPBLOCK_FORK_MASK	0x0F
#define BKPBLOCK_FLAG_MASK	0xF0
#define BKPBLOCK_HAS_IMAGE	0x10	/* block data is an XLogRecordBlockImage */
#define BKPBLOCK_HAS_DATA	0x20
#define BKPBLOCK_WILL_INIT	0x40	/* redo will re-init the page */
#define BKPBLOCK_SAME_REL	0x80	/* RelFileLocator omitted, same as
									 * previous */
** ** XLogRecordBlockImageHeader
/*
* Additional header information when a full-page image is included
* (i.e. when BKPBLOCK_HAS_IMAGE is set).
*
* The XLOG code is aware that PG data pages usually contain an unused "hole"
* in the middle, which contains only zero bytes. Since we know that the
* "hole" is all zeros, we remove it from the stored data (and it's not counted
* in the XLOG record's CRC, either). Hence, the amount of block data actually
* present is (BLCKSZ - <length of "hole" bytes>).
*
* Additionally, when wal_compression is enabled, we will try to compress full
* page images using one of the supported algorithms, after removing the
* "hole". This can reduce the WAL volume, but at some extra cost of CPU spent
* on the compression during WAL logging. In this case, since the "hole"
* length cannot be calculated by subtracting the number of page image bytes
* from BLCKSZ, basically it needs to be stored as an extra information.
* But when no "hole" exists, we can assume that the "hole" length is zero
* and no such an extra information needs to be stored. Note that
* the original version of page image is stored in WAL instead of the
* compressed one if the number of bytes saved by compression is less than
* the length of extra information. Hence, when a page image is successfully
* compressed, the amount of block data actually present is less than
* BLCKSZ - the length of "hole" bytes - the length of extra information.
*/
typedef struct XLogRecordBlockImageHeader
{
uint16 length; /* number of page image bytes */
uint16 hole_offset; /* number of bytes before "hole" */
uint8 bimg_info; /* flag bits, see below */
/*
* If BKPIMAGE_HAS_HOLE and BKPIMAGE_COMPRESSED(), an
* XLogRecordBlockCompressHeader struct follows.
*/
} XLogRecordBlockImageHeader;
/* Information stored in bimg_info */
#define BKPIMAGE_HAS_HOLE 0x01 /* page image has "hole" */
#define BKPIMAGE_APPLY 0x02 /* page image should be restored
* during replay */
/* compression methods supported */
#define BKPIMAGE_COMPRESS_PGLZ 0x04
#define BKPIMAGE_COMPRESS_LZ4 0x08
#define BKPIMAGE_COMPRESS_ZSTD 0x10
#define BKPIMAGE_COMPRESSED(info) \
((info & (BKPIMAGE_COMPRESS_PGLZ | BKPIMAGE_COMPRESS_LZ4 | \
BKPIMAGE_COMPRESS_ZSTD)) != 0)
** ** XLogRecordBlockCompressHeader
/*
 * Extra header information used when page image has "hole" and
 * is compressed.
 */
typedef struct XLogRecordBlockCompressHeader
{
	uint16		hole_length;	/* number of bytes in "hole" */
} XLogRecordBlockCompressHeader;
** ** XLogRecordDataHeader
/*
 * XLogRecordDataHeaderShort/Long are used for the "main data" portion of
 * the record. If the length of the data is less than 256 bytes, the short
 * form is used, with a single byte to hold the length. Otherwise the long
 * form is used.
 *
 * (These structs are currently not used in the code, they are here just for
 * documentation purposes).
 */
typedef struct XLogRecordDataHeaderShort
{
	uint8		id;				/* XLR_BLOCK_ID_DATA_SHORT */
	uint8		data_length;	/* number of payload bytes */
}			XLogRecordDataHeaderShort;

#define SizeOfXLogRecordDataHeaderShort (sizeof(uint8) * 2)

typedef struct XLogRecordDataHeaderLong
{
	uint8		id;				/* XLR_BLOCK_ID_DATA_LONG */
	/* followed by uint32 data_length, unaligned */
}			XLogRecordDataHeaderLong;

#define SizeOfXLogRecordDataHeaderLong (sizeof(uint8) + sizeof(uint32))
يتكوّن جزء البيانات من صفر أو أكثر من بيانات الكتل وصفر أو واحد من البيانات الرئيسية، وهما يقابلان XLogRecordBlockHeader (أو أكثر) وXLogRecordDataHeader على الترتيب.
** ضغط WAL
في الإصدار 9.5 أو أحدث، يمكن ضغط صور الصفحات الكاملة داخل سجلات XLOG بطريقة LZ عبر ضبط “wal_compression = enable”. وفي هذه الحالة تُضاف بنية XLogRecordBlockCompressHeader.
توفّر هذه الميزة ميزتين: تقليل كلفة الإدخال/الإخراج لكتابة السجلات، وكبح استهلاك ملفات قطع WAL.
أما العيب فهو زيادة استهلاك موارد المعالج اللازمة للضغط.
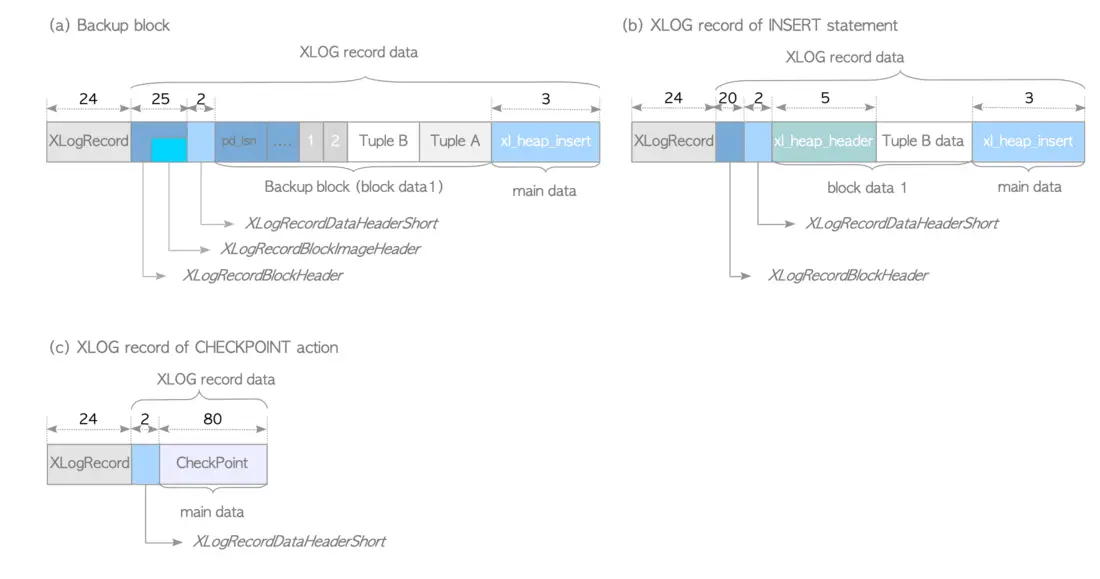
الشكل 9.10. أمثلة على سجلات XLOG (الإصدار 9.5 أو أحدث).
وفيما يلي بعض الأمثلة المحددة.
9.4.3.1. الكتلة الاحتياطية
تُعرض الكتلة الاحتياطية الناتجة عن عبارة INSERT في الشكل 9.10(a). وهي تتكوّن من أربع بنى بيانات وكائن بيانات واحد:
- بنية XLogRecord (جزء الترويسة).
- بنية XLogRecordBlockHeader، متضمنةً بنية XLogRecordBlockImageHeader واحدة.
- بنية XLogRecordDataHeaderShort.
- كتلة احتياطية (بيانات الكتلة).
- بنية xl_heap_insert (البيانات الرئيسية).
تحتوي بنية XLogRecordBlockHeader على متغيّرات تحدّد الكتلة في تجمّع قاعدة البيانات (relfilenode، ورقم التفريعة، ورقم الكتلة). وتحوي بنية XLogRecordBlockImageHeader طول هذه الكتلة ورقم إزاحتها.
وتخزّن بنيتا الترويسة هاتان معًا البيانات نفسها التي كانت تخزّنها بنية BkBlock المستخدمة حتى الإصدار 9.4.
قسم البيانات الرئيسية
تحوي بنية XLogRecordDataHeaderShort طول بنية xl_heap_insert، التي تعمل كبيانات رئيسية للسجل.
ويختلف محتوى قسم البيانات الرئيسية في سجل WAL الذي يحتوي على FPI وفقًا للعملية. فمثلًا، تضيف عبارة UPDATE بنى مثل xl_heap_lock أو xl_heap_update.
وفي سياق الاستعادة الفيزيائية المعتمدة على WAL، تكون البيانات في قسم البيانات الرئيسية للكتلة الاحتياطية زائدة عن الحاجة وتبقى غير مستخدمة، لأن FPI نفسها توفّر الحالة الكاملة للصفحة.
** النسخ المتماثل المنطقي
عندما يُضبط wal_level على logical، يتغيّر السلوك: فتُلحق بيانات الصف الفعلية صراحةً بقسم البيانات الرئيسية، حتى إذا كانت FPI موجودة. انظر الشكل 9.11.
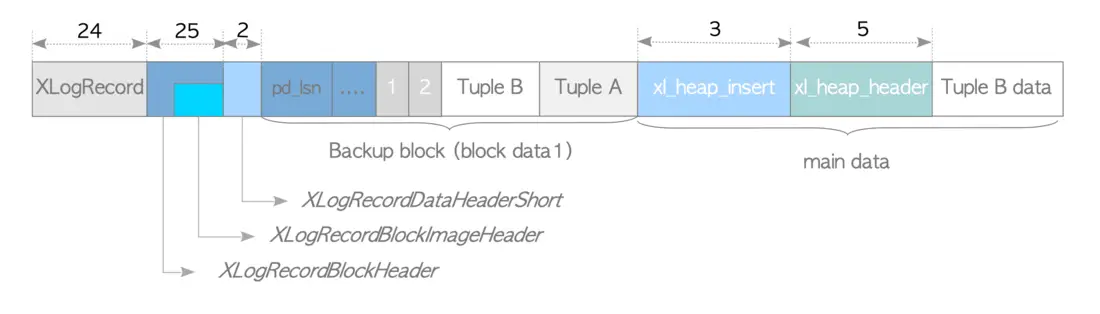
الشكل 9.11. سجل XLOG يحتوي على كتلة احتياطية (wal_level = logical).
هذا التصميم بالغ الأهمية من أجل النسخ المتماثل المنطقي. فهو يتيح لعملية walsender تجاوز FPI الفيزيائية وفكّ ترميز معلومات الصف المخزّنة في البيانات الرئيسية مباشرة. وبذلك يحقّق PostgreSQL عملية فكّ ترميز فعّالة مستقلة عن التخطيط الفيزيائي للصفحة.
ويضمن ذلك أداءً عاليًا وإنتاجية ثابتة حتى خلال «طفرة نقاط التفتيش» التي يتكرر فيها توليد FPI.
9.4.3.2. الكتلة غير الاحتياطية
يُعرض سجل الكتلة غير الاحتياطية الناتج عن عبارة INSERT في الشكل 9.10(b). وهو يتكوّن من أربع بنى بيانات وكائن بيانات واحد:
- بنية XLogRecord (جزء الترويسة).
- بنية XLogRecordBlockHeader.
- بنية XLogRecordDataHeaderShort.
- صف مُدرَج (تحديدًا بنية xl_heap_header وكامل البيانات المُدرَجة).
- بنية
xl_heap_insert(البيانات الرئيسية).
تحتوي بنية XLogRecordBlockHeader على ثلاث قيم (relfilenode، ورقم التفريعة، ورقم الكتلة) لتحديد الكتلة الهدف، وعلى طول جزء بيانات الصف المُدرَج.
وتحوي بنية XLogRecordDataHeaderShort طول بنية xl_heap_insert.
وتحوي بنية xl_heap_insert قيمتين فقط: رقم إزاحة الصف داخل الكتلة وعلامة الظهور. وقد بُسِّطت هذه البنية لأن بنية XLogRecordBlockHeader تخزّن الآن معظم البيانات التي كانت تحتوي عليها xl_heap_insert سابقًا.
** ** xl_heap_insert
typedef struct xl_heap_insert
{
        OffsetNumber	offnum;            /* inserted tuple's offset */
        uint8           flags;

        /* xl_heap_header & TUPLE DATA in backup block 0 */
} xl_heap_insert;
يُعرض سجل نقطة تفتيش في الشكل 9.10(c). وهو يتكوّن من ثلاث بنى بيانات:
- بنية XLogRecord (جزء الترويسة).
- بنية XLogRecordDataHeaderShort، التي تحوي طول البيانات الرئيسية.
- بنية CheckPoint (البيانات الرئيسية).
** معلومات
بنية xl_heap_header معرّفة في htup.h، وبنية CheckPoint معرّفة في pg_control.h.
تنسيق XLOG الجديد مُحسَّن لكفاءة التحليل، على الرغم من كونه أكثر تعقيدًا على الإنسان. وبالإضافة إلى ذلك، أصبحت أنواع كثيرة من سجلات XLOG الآن أصغر حجمًا.
يوضّح الشكلان 9.8 و9.10 أحجام البنى الرئيسية، ما يتيح حساب أحجام السجلات ومقارنتها[1].
9.5. كتابة سجلات XLOG
يقدّم هذا القسم نظرة شاملة على عملية كتابة سجلات XLOG.
أولًا، تأمّل العبارة التالية لاستكشاف داخليات PostgreSQL:
testdb=# INSERT INTO tbl VALUES ('A');
يستدعي تنفيذ هذه العبارة الدالة الداخلية exec_simple_query().
وفيما يلي الشيفرة الزائفة للدالة exec_simple_query():
exec_simple_query() @postgres.c

(1) ExtendCLOG() @clog.c                  /* Write the state of this transaction
                                           * "IN_PROGRESS" to the CLOG.
                                           */
(2) heap_insert()@heapam.c                /* Insert a tuple, creates a XLOG record,
                                           * and invoke the function XLogInsert.
                                           */
(3)   XLogInsert() @xloginsert.c (9.4 or earlier, xlog.c)
                                          /* Write the XLOG record of the inserted tuple
                                           *  to the WAL buffer, and update page's pd_lsn.
                                           */
(4) finish_xact_command() @postgres.c     /* Invoke commit action.*/
      XLogInsert() @xloginsert.c (9.4 or earlier, xlog.c)
                                          /* Write a XLOG record of this commit action
                                           * to the WAL buffer.
                                           */
(5)   XLogWrite() @xloginsert.c (9.4 or earlier, xlog.c)
                                          /* Write and flush all XLOG records on
                                           * the WAL buffer to WAL segment.
                                           */
(6) TransactionIdCommitTree() @transam.c  /* Change the state of this transaction
                                           * from "IN_PROGRESS" to "COMMITTED"
                                           * on the CLOG.
                                           */
تشرح الأوصاف التالية كل سطر من الشيفرة الزائفة لتوضيح كتابة سجل XLOG. ويقدّم الشكلان 9.12 و9.13 تمثيلين بصريين لهذه العملية.
- (1) تكتب الدالة ExtendCLOG() حالة المعاملة ‘IN_PROGRESS’ في CLOG (الموجود في الذاكرة).
- (2) تُدرج الدالة heap_insert() صف كومة في الصفحة الهدف في تجمّع المخزن المؤقت المشترك، وتنشئ سجل XLOG لتلك الصفحة، وتستدعي XLogInsert().
- (3) تكتب الدالة XLogInsert() سجل XLOG الذي أنشأته heap_insert() في مخزن WAL المؤقت عند LSN_1. ثم تحدّث pd_lsn الخاص بالصفحة المعدَّلة من LSN_0 إلى LSN_1.
- (4) تُنفَّذ الدالة finish_xact_command() للالتزام بهذه المعاملة. فتنشئ سجل XLOG الخاص بعملية الالتزام، ثم تكتب XLogInsert() هذا السجل في مخزن WAL المؤقت عند LSN_2.
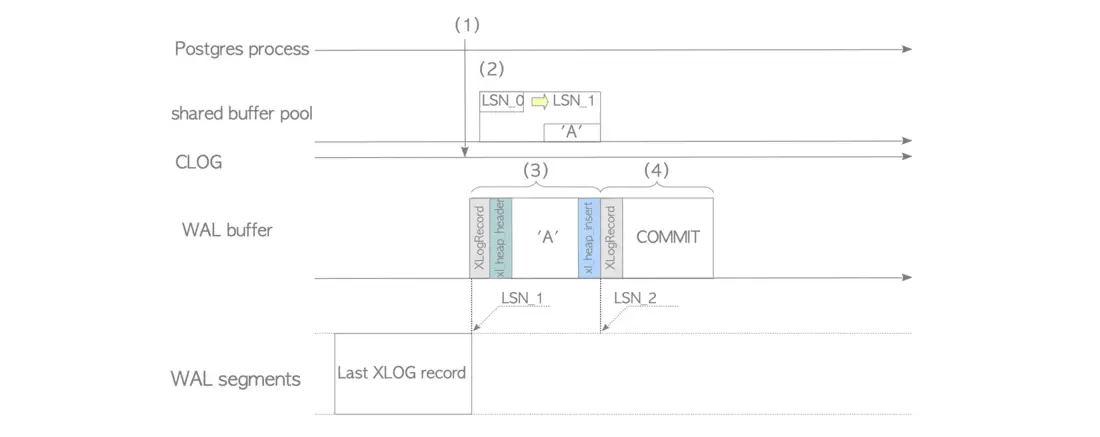
الشكل 9.12. تسلسل كتابة سجلات XLOG.
- (5) تكتب الدالة XLogWrite() جميع سجلات XLOG من مخزن WAL المؤقت وتدفعها إلى ملف قطعة WAL. وإذا كانت المعلمة wal_sync_method مضبوطة على ‘open_sync’ أو ‘open_datasync’، تُكتب السجلات تزامنيًا. وفي هذه الحالة، تكتب الدالة جميع السجلات باستدعاء النظام open() مع العلامة ‘O_SYNC’ أو ‘O_DSYNC’. وإذا كانت المعلمة مضبوطة على ‘fsync’ أو ‘fsync_writethrough’ أو ‘fdatasync’، ينفّذ النظام استدعاء النظام المقابل: fsync() أو fcntl() مع خيار F_FULLFSYNC أو fdatasync(). وتضمن هذه الاستدعاءات كتابة جميع سجلات XLOG إلى وسيط التخزين.
- (6) تغيّر الدالة TransactionIdCommitTree() حالة المعاملة من ‘IN_PROGRESS’ إلى ‘COMMITTED’ في CLOG.
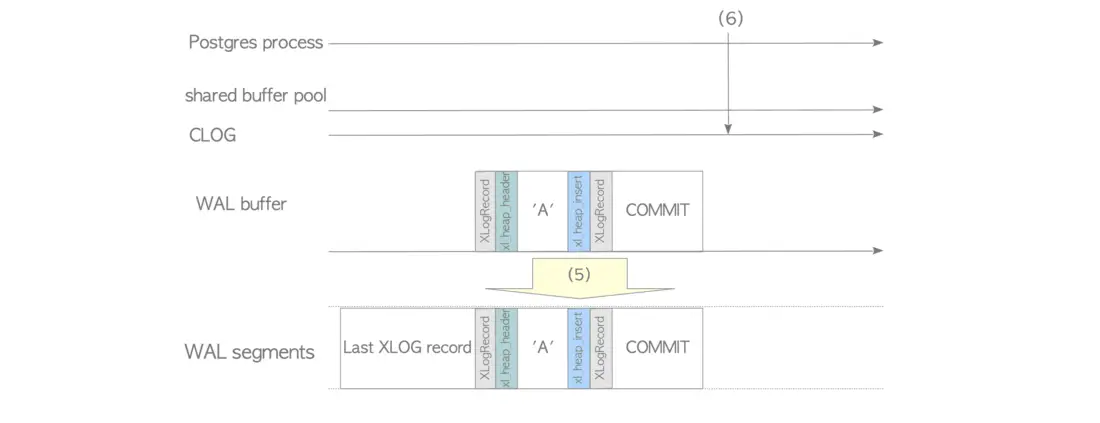
الشكل 9.13. تسلسل كتابة سجلات XLOG. (تابع من الشكل 9.12)
في المثال أعلاه، أدّى الالتزام إلى كتابة سجلات XLOG في قطعة WAL. ومع ذلك، تحدث هذه الكتابة في أي من الحالات التالية:
- التزام معاملة جارية أو إلغاؤها.
- امتلاء مخزن WAL المؤقت. (يعتمد حجم مخزن WAL المؤقت على المعلمة wal_buffers.)
- الكتابة الدورية لعملية كاتب WAL. (انظر القسم 9.6.1.)
وإذا حدث أي من ذلك، تُكتب جميع سجلات WAL الموجودة في مخزن WAL المؤقت إلى ملف قطعة WAL بصرف النظر عن حالة الالتزام الخاصة بمعاملاتها.
9.5.1. ملاحظة حول كتابة سجلات XLOG
تولّد عمليات لغة معالجة البيانات (DML) عادةً سجلات XLOG، لكن العمليات غير المتعلقة بـDML يمكنها أيضًا توليدها.
ومن الأمثلة:
- تكتب عملية الالتزام سجل XLOG يحتوي على معرّف المعاملة الملتزمة.
- تكتب عملية نقطة التفتيش سجل XLOG يحتوي على معلومات عامة عن نقطة التفتيش.
وفي حالات خاصة، تولّد حتى عبارات SELECT سجلات XLOG:
- تولّد عبارة SELECT FOR UPDATE سجلات XLOG لجميع أقفال الصفوف الهدف (ROW SHARE LOCK) [1:1].
- أثناء عمليات الصف فقط في الكومة (HOT)، يكتب النظام سجلات XLOG الخاصة بحذف الصفوف وإزالة تجزئة الصفحة إلى مخزن WAL المؤقت.
وبالإضافة إلى ذلك، إذا كانت المعلمة wal_level مضبوطة على ‘replica’ أو أعلى، يسجّل PostgreSQL أيضًا أقفال ACCESS EXCLUSIVE كسجلات XLOG. ويحدث ذلك عند الحصول صراحةً على قفل ACCESS EXCLUSIVE باستخدام الأمر LOCK، أو عند تنفيذ أوامر مثل DROP TABLE وTRUNCATE. راجع القسم 11.2.4 للتفاصيل.
9.6. عمليات WAL ذات الصلة
9.6.1. عملية كاتب WAL
كاتب WAL عملية خلفية تفحص مخزن WAL المؤقت دوريًا وتكتب جميع سجلات XLOG غير المكتوبة إلى قطع WAL. وتساعد هذه العملية على تجنّب اندفاعات كتابة XLOG. وإذا لم يكن كاتب WAL مفعّلًا، فقد تصبح كتابة XLOG عنق زجاجة عند الالتزام بكمية كبيرة من البيانات دفعة واحدة.
كاتب WAL مفعّل افتراضيًا ولا يمكن تعطيله. وتضبط معلمة الإعداد wal_writer_delay فترة الفحص، وقيمتها الافتراضية 200 ميلي ثانية.
9.6.2. عملية مُلخِّص WAL
أُدخلت في الإصدار 17 (2024) لدعم النسخ الاحتياطية التزايدية (الموصوفة في القسم 10.5)، وتتتبّع عملية مُلخِّص WAL التغييرات في جميع كتل قاعدة البيانات، بما فيها العلاقات وخرائط الظهور.
وتكتب هذه التعديلات في ملفات ملخّص WAL في الدليل $PGDATA/pg_wal/summaries/.
وتفعّل معلمة الإعداد summarize_wal هذه العملية؛ وهي معطّلة افتراضيًا.
لاحظ أن مُلخِّص WAL لا يتتبّع تفريعة خريطة المساحة الحرة لأنها لا تُسجَّل في WAL تسجيلًا سليمًا.
9.6.2.1. مخطط عمل عملية مُلخِّص WAL
تعمل عملية مُلخِّص WAL كما يلي:
- أثناء كل نقطة تفتيش، تقرأ العملية ملفات قطع WAL من نقطة إعادة التنفيذ السابقة إلى نقطة إعادة التنفيذ الحالية.
- تتتبّع العملية التغييرات في جميع كتل جميع العلاقات (بما فيها خرائط الظهور) باستخدام ملفات قطع WAL.
- تكتب العملية النتائج في ملفات ملخّص WAL في الدليل “pg_wal/summaries/”.
وفي هذا السياق، يُشار إلى «نقطة إعادة التنفيذ السابقة» و«نقطة إعادة التنفيذ الحالية» بـstart_lsn وend_lsn على الترتيب.
ونمط اسم ملف الملخّص كما يلي:
- نمط ملف الملخّص:
{Timeline}{start_lsn}{end_lsn}.summary
وفيما يلي مثال على ملفات الملخّص:
$ ls -1 $PGDATA/pg_wal/summaries/
00000001000000000100002800000000010B1D30.summary
0000000100000000010B1D300000000001473DE0.summary
000000010000000001473DE00000000001473EE0.summary
000000010000000001473EE0000000000147A8A8.summary
00000001000000000147A8A8000000000147A9A8.summary

... snip ...
تعرض الدالة pg_available_wal_summaries() ملخّصات WAL:
testdb=# SELECT tli, start_lsn, end_lsn FROM pg_available_wal_summaries() ORDER BY start_lsn;
 tli | start_lsn  |  end_lsn
-----+------------+------------
   1 | 0/1000028  | 0/10B1D30
   1 | 0/10B1D30  | 0/1473DE0
   1 | 0/1473DE0  | 0/1473EE0
   1 | 0/1473EE0  | 0/147A8A8
   1 | 0/147A8A8  | 0/147A9A8

... snip ...
يحذف PostgreSQL ملفات الملخّص تلقائيًا بعد مرور المدة التي تحدّدها wal_summary_keep_time (افتراضيًا 10 أيام) منذ إنشائها.
9.6.2.2. محتويات ملف الملخّص
لتوضيح محتوى ملف الملخّص، ينشئ المثال التالي أربعة جداول (t1 وt2 وt3 وt4)، يتكوّن كل منها من أربع كتل.
testdb=# CREATE TABLE t1 (id int);
CREATE TABLE
testdb=# INSERT INTO t1 SELECT  GENERATE_SERIES(1, 800);
INSERT 0 800
testdb=# SELECT * FROM pg_freespace('t1');
 blkno | avail
-------+-------
     0 |     0
     1 |     0
     2 |     0
     3 |     0
(4 rows)

testdb=# CREATE TABLE t2 (id int);
CREATE TABLE
testdb=# INSERT INTO t2 SELECT  GENERATE_SERIES(1, 800);
INSERT 0 800
testdb=# CREATE TABLE t3 (id int);
CREATE TABLE
testdb=# INSERT INTO t3 SELECT  GENERATE_SERIES(1, 800);
INSERT 0 800
testdb=# CREATE TABLE t4 (id int);
CREATE TABLE
testdb=# INSERT INTO t4 SELECT  GENERATE_SERIES(1, 800);
INSERT 0 800
testdb=# CHECKPOINT;
CHECKPOINT
وبعد تنفيذ CHECKPOINT، تُنفَّذ العمليات التالية:
- [1] تحديث صفّين في الجدول t1.
- [2] إدراج 150 صفًّا في الجدول t2.
- [3] حذف 300 صف من الجدول t3.
- [4] اقتطاع جميع الصفوف من الجدول t4.
- [5] إنشاء جدول جديد t5 وإدراج 800 صف فيه.
testdb=# -- [1] Update two rows to modify the blocks of t1
testdb=# UPDATE t1 SET id = id + 1000 WHERE id = 1 OR id = 200;
UPDATE 2
testdb=# -- [2] Insert 150 rows to modify the last block and add a new block
testdb=# INSERT INTO t2 SELECT GENERATE_SERIES(1, 150);
INSERT 0 150
testdb=# -- [3] Delete 500 rows to remove blocks
testdb=# DELETE FROM t3 WHERE id > 300;
DELETE 500
testdb=# -- [4] Truncate all blocks
testdb=# TRUNCATE t4;
TRUNCATE TABLE
testdb=# -- [5] Create new table
testdb=# CREATE TABLE t5 (id int);
CREATE TABLE
testdb=# INSERT INTO t5 SELECT  GENERATE_SERIES(1, 800);
INSERT 0 800
testdb=# CHECKPOINT;
CHECKPOINT
تعرض الدالة pg_wal_summary_contents(timeline, start_lsn, end_lsn) جميع الكتل المتغيّرة بين ‘start_lsn’ و’end_lsn’. ويتضمّن الخرج filenode (OID)، ورقم الكتلة، ورقم التفريعة، وعلامة ‘is_limit_block’.
[1] كتل معدَّلة
يُحدَّث صفّان في الجدول t1.
testdb=# UPDATE t1 SET id = id + 1000 WHERE id = 1 OR id = 200;
UPDATE 2
تسترجع الدالة pg_wal_summary_contents() بيانات الملخّص:
testdb=# SELECT p.relname, s.relforknumber, s.relblocknumber, s.is_limit_block
testdb-# 	FROM pg_wal_summary_contents(1, '0/1F4225F8', '0/1F476450') AS s, pg_class AS p
testdb-#  	WHERE s.relfilenode = p.oid AND p.relname = 't1';
 relname | relforknumber | relblocknumber | is_limit_block
---------+---------------+----------------+----------------
 t1      |             0 |              0 | f
 t1      |             0 |              3 | f
(2 rows)
يشير الخرج إلى أن الكتلتين رقم 0 ورقم 3 من الجدول t1 قد عُدِّلتا.
يوضّح الشكل 9.14 هذه التغييرات استنادًا إلى بيانات الملخّص.
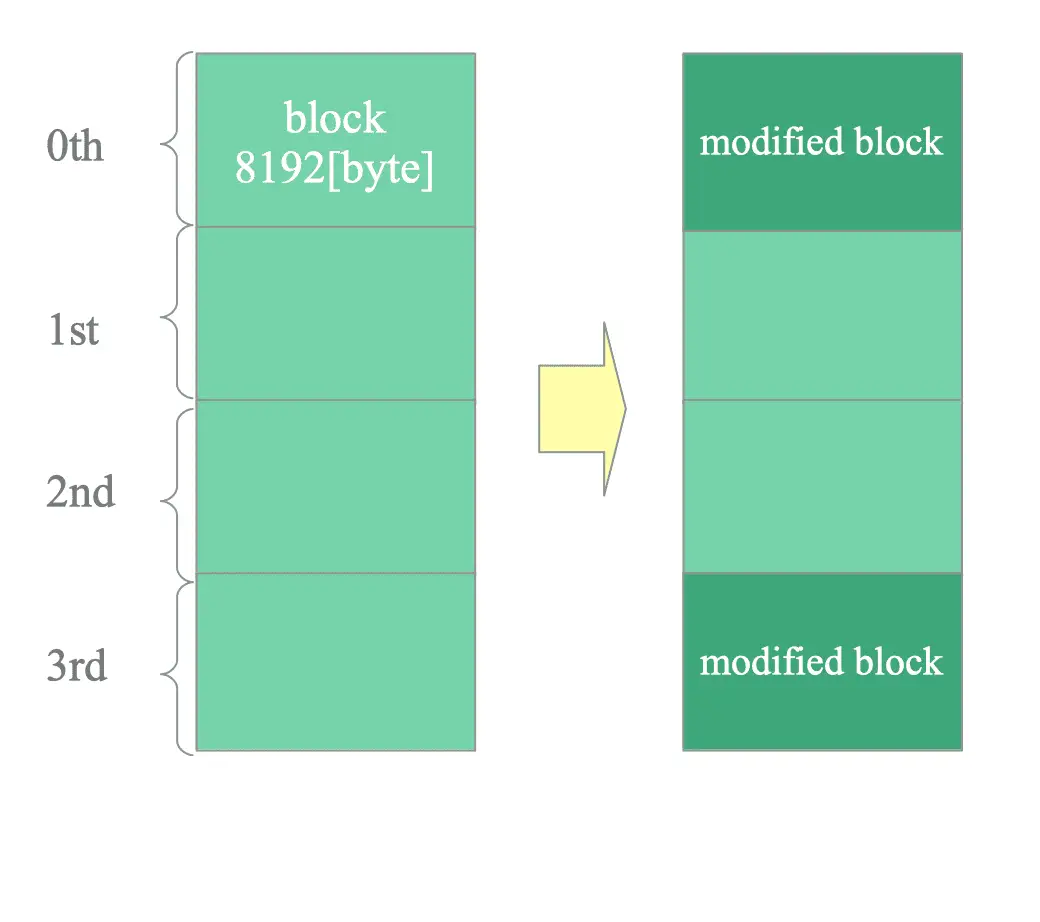
الشكل 9.14. تعديل الجدول t1.
[2] كتل مضافة
أُضيف 150 صفًّا جديدًا إلى الجدول t2.
عُدِّلت الكتلة الثالثة، وأُضيفت كتلة رابعة جديدة.
testdb=# SELECT p.relname, s.relforknumber, s.relblocknumber, s.is_limit_block
testdb-# 	FROM pg_wal_summary_contents(1, '0/1F4225F8', '0/1F476450') AS s, pg_class AS p
testdb-#  	WHERE s.relfilenode = p.oid AND p.relname = 't2';
 relname | relforknumber | relblocknumber | is_limit_block
---------+---------------+----------------+----------------
 t2      |             0 |              3 | f
 t2      |             0 |              4 | f
(2 rows)

testdb=# select * from pg_freespace('t2');
 blkno | avail
-------+-------
     0 |     0
     1 |     0
     2 |     0
     3 |     0
     4 |     0
(5 rows)
يوضّح الشكل 9.15 هذه الإضافات.
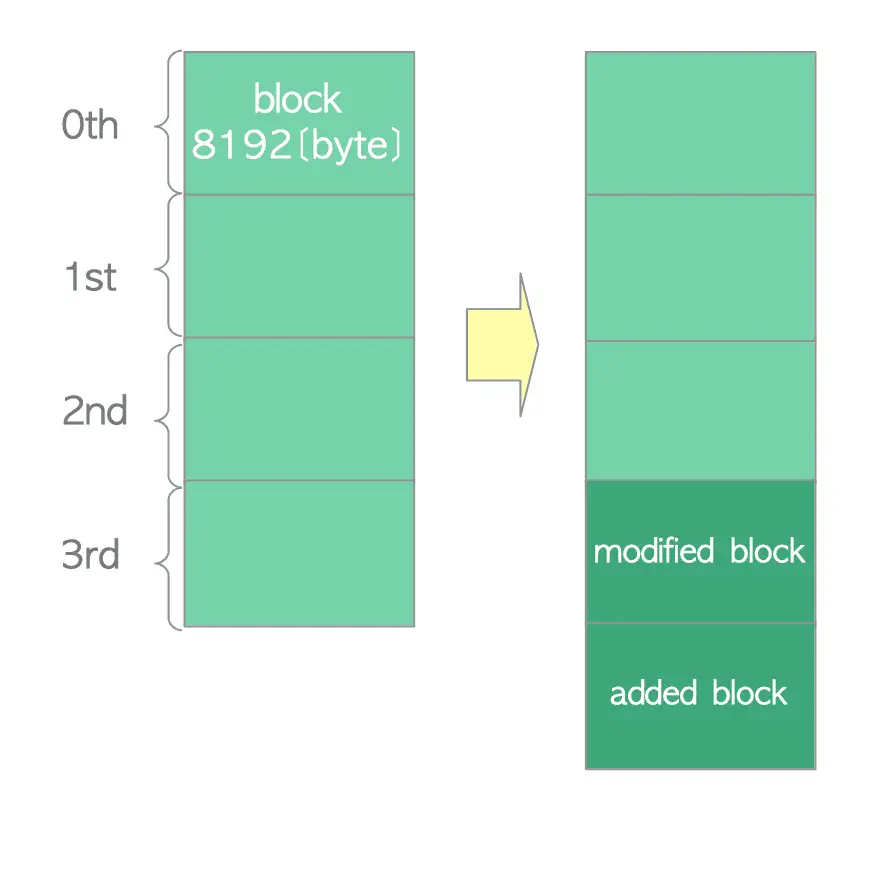
الشكل 9.15. تعديل الجدول t2.
[3] كتل مُزالة
عند حذف كتل بعد رقم كتلة معيّن، تسجّل العملية الكتلة الحدّية وتضبط is_limit_block على true. وتعمل هذه الكتلة الحدّية ككتلة إنهاء افتراضية.
في الجدول t3، حُذف 500 صف.
testdb=# SELECT p.relname, s.relforknumber, s.relblocknumber, s.is_limit_block
testdb-# 	FROM pg_wal_summary_contents(1, '0/1F4225F8', '0/1F476450') AS s, pg_class AS p
testdb-#  	WHERE s.relfilenode = p.oid AND p.relname = 't3';
 relname | relforknumber | relblocknumber | is_limit_block
---------+---------------+----------------+----------------
 t3      |             0 |              2 | t
 t3      |             0 |              1 | f
 t3      |             0 |              0 | f
 t3      |             2 |              2 | t
 t3      |             2 |              0 | f
(5 rows)

testdb=# select * from pg_freespace('t3');
 blkno | avail
-------+-------
     0 |     0
     1 |  5472
(2 rows)
في هذه الحالة، تُعلَّم الكتلة الثانية من الجدول t3 ككتلة حدّية بضبط is_limit_block على true؛ وتُحدَّث خريطة الظهور المقابلة (التفريعة 2) بالطريقة نفسها.
وبناءً على ذلك، يُظهر الخرج أن الكتلتين الثانية والثالثة قد أُزيلتا، وأن الكتلة الثانية من خريطة ظهور t3 قد أُزيلت، وأن الكتلتين المتبقيتين رقم 0 ورقم 1 قد عُدِّلتا.
يوضّح الشكل 9.16 هذه التعديلات.
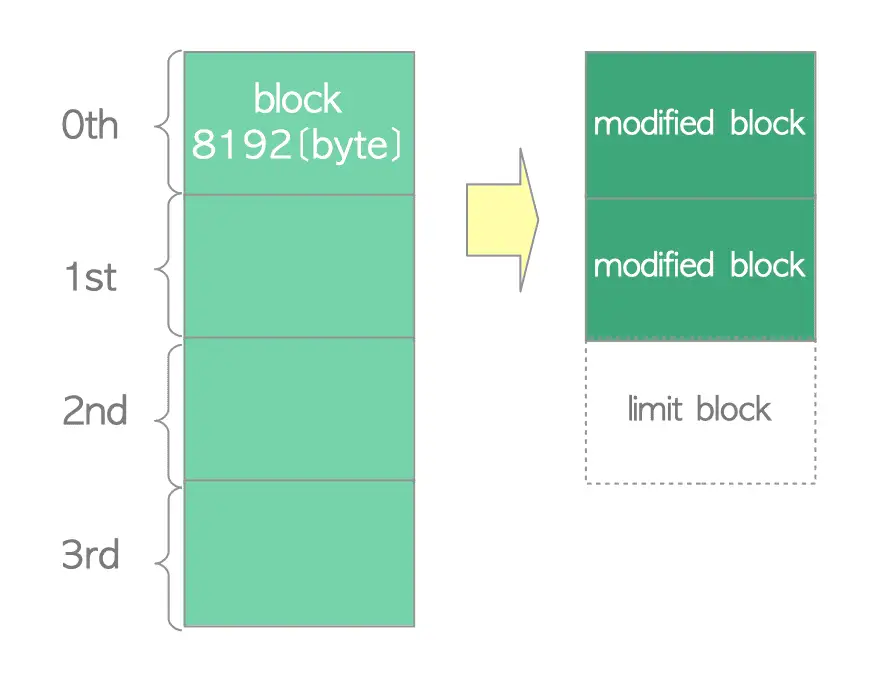
الشكل 9.16. تعديل الجدول t3.
[4] اقتطاع جميع الكتل
عند اقتطاع الجدول t4، يُضبط رقم الكتلة لجميع الكتل المرتبطة على 0، وتُضبط is_limit_block على true.
testdb=# SELECT p.relname, s.relforknumber, s.relblocknumber, s.is_limit_block
testdb-# 	FROM pg_wal_summary_contents(1, '0/1F4225F8', '0/1F476450') AS s, pg_class AS p
testdb-#  	WHERE s.relfilenode = p.oid AND p.relname = 't4';
 relname | relforknumber | relblocknumber | is_limit_block
---------+---------------+----------------+----------------
 t4      |             0 |              0 | t
 t4      |             2 |              0 | t
 t4      |             3 |              0 | t  <= fork_num 3 is a special number,
                                                  so the explanation is omitted here.
(3 rows)

testdb=# select * from pg_freespace('t4');
 blkno | avail
-------+-------
(0 rows)
يوضّح الشكل 9.17 عملية الاقتطاع.
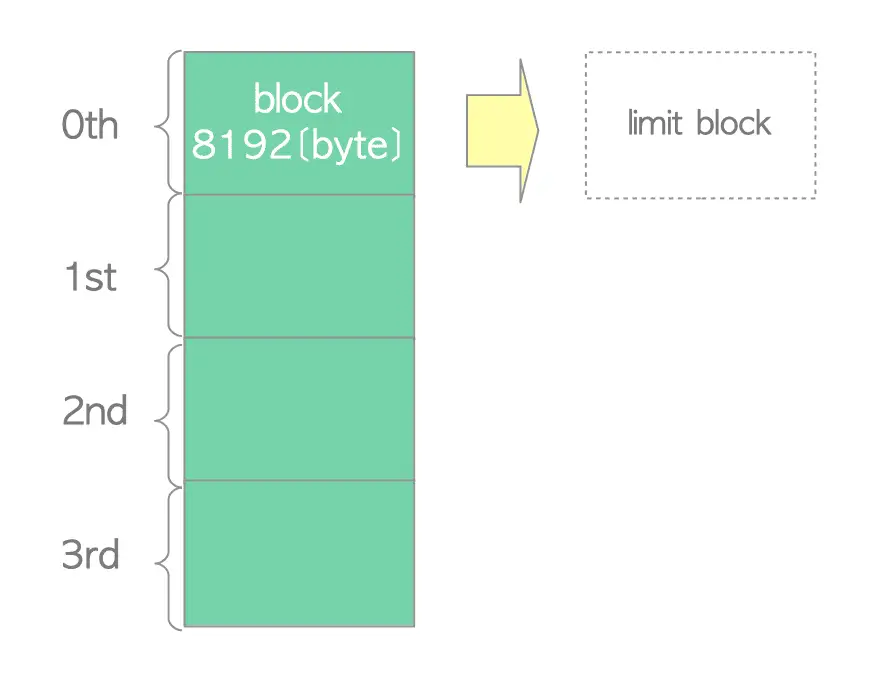
الشكل 9.17. تعديل الجدول t4.
وتحدث النتيجة نفسها عند تنفيذ أمر DROP TABLE.
[5] إنشاء جدول جديد
عند إنشاء جدول جديد، يُضبط رقم الكتلة على 0، وتُضبط is_limit_block على true.
بالنسبة إلى الجدول t5، يحتوي الملخّص في البداية على الكتلة رقم 0 مع ضبط is_limit_block على true. ثم تنشئ عمليات الإدراج اللاحقة الكتل من 0 إلى 3، مع ضبط is_limit_block على false.
testdb=# SELECT p.relname, s.relforknumber, s.relblocknumber, s.is_limit_block
testdb-# 	FROM pg_wal_summary_contents(1, '0/1F4225F8', '0/1F476450') AS s, pg_class AS p
testdb-#  	WHERE s.relfilenode = p.oid AND p.relname = 't5';
 relname | relforknumber | relblocknumber | is_limit_block
---------+---------------+----------------+----------------
 t5      |             0 |              0 | t
 t5      |             0 |              0 | f
 t5      |             0 |              1 | f
 t5      |             0 |              2 | f
 t5      |             0 |              3 | f
 t5      |             2 |              0 | f
(6 rows)
يوضّح الشكل 9.18 إنشاء الجدول t5 وتعبئته.
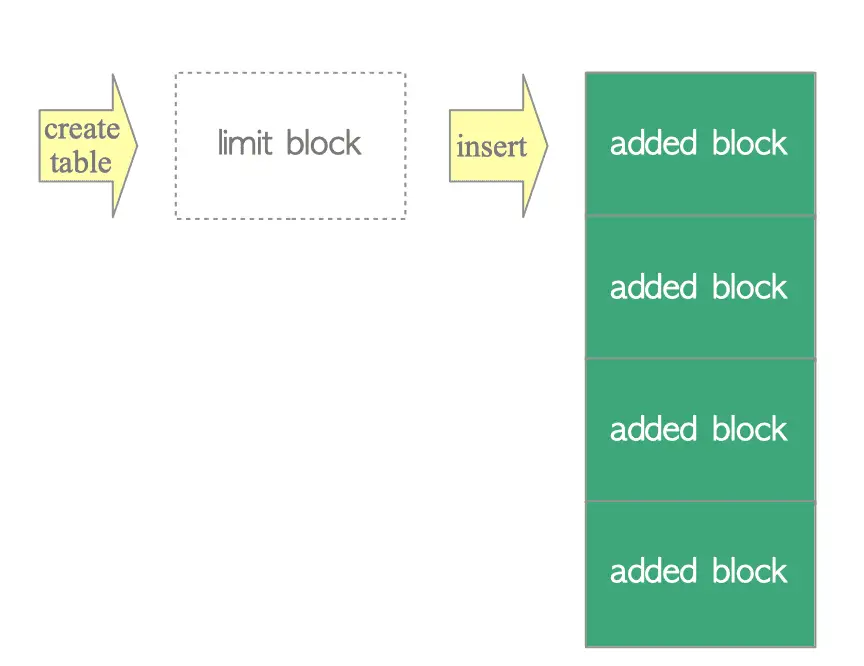
الشكل 9.18. تعديل الجدول t5.
9.7. معالجة نقاط التفتيش في PostgreSQL
في PostgreSQL، تنفّذ عملية نقاط التفتيش (الخلفية) نقاط التفتيش. وتبدأ هذه العملية عند حدوث أحد الأحداث التالية:
- انقضاء الفترة المضبوطة في checkpoint_timeout منذ نقطة التفتيش السابقة (القيمة الافتراضية 300 ثانية).
- في الإصدار 9.4 أو أقدم، استهلاك عدد ملفات قطع WAL المضبوط في checkpoint_segments منذ نقطة التفتيش السابقة (القيمة الافتراضية 3).
- في الإصدار 9.5 أو أحدث، تجاوز الحجم الكلي لملفات قطع WAL في الدليل
pg_wal(أوpg_xlogفي الإصدار 9.6 أو أقدم) لقيمة max_wal_size (القيمة الافتراضية 1 غيغابايت أو 64 ملفًا). - توقف خادم PostgreSQL في الوضع smart أو fast.
- إصدار مستخدم فائق الأمر CHECKPOINT يدويًا.
** معلومات
في الإصدار 9.1 أو أقدم، وكما ذُكر في القسم 8.6، كانت عملية الكاتب الخلفي تنفّذ كلًا من نقاط التفتيش وكتابة الصفحات القذرة.
تصف الأقسام الفرعية التالية مخطط نقاط التفتيش وملف pg_control، الذي يحتفظ بالبيانات الوصفية لنقطة التفتيش الحالية.
محتويات القسم
- 9.7.1. مخطط معالجة نقاط التفتيش
- 9.7.2. ملف pg_control
9.7.1. مخطط معالجة نقاط التفتيش
لمعالجة نقاط التفتيش جانبان: التحضير لاستعادة قاعدة البيانات، وتنظيف الصفحات القذرة في تجمّع المخزن المؤقت المشترك.
يوضّح الشكل 9.19 لمحة عامة عن المعالجة الداخلية.
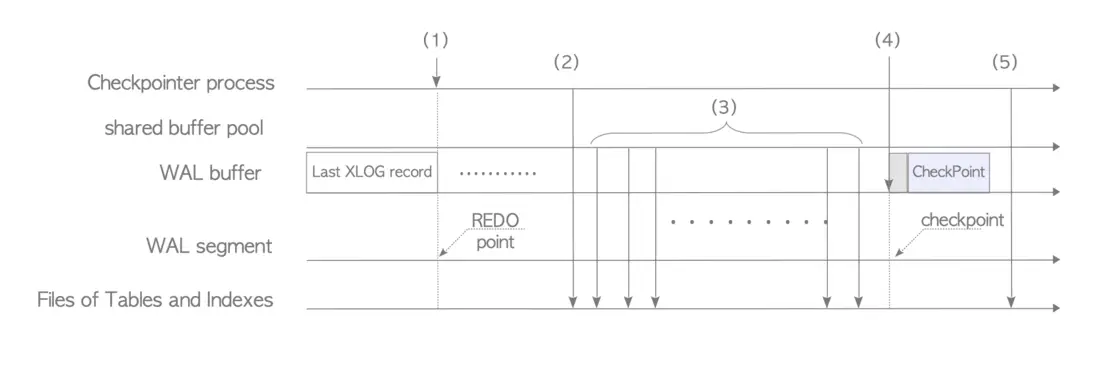
الشكل 9.19. المعالجة الداخلية لنقطة تفتيش PostgreSQL.
- (1) تخزين نقطة إعادة التنفيذ: عند بدء نقطة تفتيش، تخزّن عملية نقاط التفتيش نقطة إعادة التنفيذ في الذاكرة. ونقطة إعادة التنفيذ هي LSN الخاص بسجل XLOG المكتوب في لحظة بدء نقطة التفتيش. وتبدأ استعادة قاعدة البيانات من هذه النقطة.
- (2) دفع الذاكرة المشتركة: تدفع عملية نقاط التفتيش جميع البيانات الموجودة في الذاكرة المشتركة (مثل محتويات clog) إلى وسيط التخزين.
- (3) دفع الصفحات القذرة: تكتب عملية نقاط التفتيش تدريجيًا جميع الصفحات القذرة في تجمّع المخزن المؤقت المشترك وتدفعها إلى وسيط التخزين.
- (4) كتابة سجل نقطة التفتيش: تكتب عملية نقاط التفتيش سجل XLOG لنقطة التفتيش هذه في مخزن WAL المؤقت. وتعرّف بنية
CheckPointجزء البيانات من هذا السجل، وتحتوي على متغيّرات مثل نقطة إعادة التنفيذ. ويسمى موضع كتابة سجل نقطة التفتيش checkpoint. - (5) تحديث pg_control: تحدّث عملية نقاط التفتيش ملف pg_control. ويحتوي هذا الملف على معلومات أساسية، مثل موضع نقطة التفتيش.
** ** struct CheckPoint
typedef struct CheckPoint
{
  XLogRecPtr      redo;           /* next RecPtr available when we began to
                                   * create CheckPoint (i.e. REDO start point) */
  TimeLineID      ThisTimeLineID; /* current TLI */
  TimeLineID      PrevTimeLineID; /* previous TLI, if this record begins a new
                                   * timeline (equals ThisTimeLineID otherwise) */
  bool            fullPageWrites; /* current full_page_writes */
  uint32          nextXidEpoch;   /* higher-order bits of nextXid */
  TransactionId   nextXid;        /* next free XID */
  Oid             nextOid;        /* next free OID */
  MultiXactId     nextMulti;      /* next free MultiXactId */
  MultiXactOffset nextMultiOffset;/* next free MultiXact offset */
  TransactionId   oldestXid;      /* cluster-wide minimum datfrozenxid */
  Oid             oldestXidDB;    /* database with minimum datfrozenxid */
  MultiXactId     oldestMulti;    /* cluster-wide minimum datminmxid */
  Oid             oldestMultiDB;  /* database with minimum datminmxid */
  pg_time_t       time;           /* time stamp of checkpoint */

 /*
  * Oldest XID still running. This is only needed to initialize hot standby
  * mode from an online checkpoint, so we only bother calculating this for
  * online checkpoints and only when wal_level is hot_standby. Otherwise
  * it's set to InvalidTransactionId.
  */
  TransactionId oldestActiveXid;
} CheckPoint;
9.7.2. ملف pg_control
ملف pg_control ضروري لاستعادة قاعدة البيانات لأنه يحتوي على معلومات نقطة التفتيش الأساسية. وإذا تلف هذا الملف أو تعذّرت قراءته، فلا يمكن أن تبدأ عملية الاستعادة لأن نقطة البداية مفقودة.
ومع أن ملف pg_control يخزّن أكثر من 40 عنصرًا، فإن ثلاثة عناصر وثيقة الصلة بالقسم التالي معروضة أدناه:
- State: حالة خادم قاعدة البيانات عند بدء أحدث نقطة تفتيش. وتوجد سبع حالات إجمالًا، منها: start up: النظام قيد بدء التشغيل.
- shut down: النظام قيد الإيقاف الطبيعي.
- in production: النظام يعمل.
Latest checkpoint location: LSN الخاص بأحدث سجل نقطة تفتيش.
يُخزَّن ملف pg_control في الدليل الفرعي $PGDATA/global من الدليل الأساسي. وتعرض أداة pg_controldata محتوياته.
$ pg_controldata  $PGDATA
pg_control version number:            1300
Catalog version number:               202306141
Database system identifier:           7250496631638317596
Database cluster state:               in production
pg_control last modified:             Mon Jan 1 15:16:38 2024
Latest checkpoint location:           0/16AF0090
Latest checkpoint's REDO location:    0/16AF0090
Latest checkpoint's REDO WAL file:    000000010000000000000016

... snip ...
** إزالة نقطة التفتيش السابقة في PostgreSQL 11
حتى الإصدار 10، كان PostgreSQL يحتفظ بقطع WAL تحتوي على آخر نقطتَي إعادة تنفيذ — «نقطة إعادة التنفيذ لأحدث نقطة تفتيش» و«نقطة إعادة التنفيذ لنقطة التفتيش السابقة». وكان ذلك احتياطًا في حال تعذّر قراءة أحدث نقطة إعادة تنفيذ.
ومع ذلك، تخزّن الإصدارات 11 (2018) وما بعدها أحدث نقطة إعادة تنفيذ فقط لتوفير مساحة التخزين. ويعكس هذا التغيير تحسّن موثوقية التخزين.
انظر هذا الموضوع لمزيد من التفاصيل.
9.8. استعادة قاعدة البيانات في PostgreSQL
ينفّذ PostgreSQL استعادة قائمة على سجل إعادة التنفيذ. وإذا انهار خادم قاعدة البيانات، يستعيد PostgreSQL تجمّع قاعدة البيانات بإعادة تنفيذ سجلات XLOG في ملفات قطع WAL بالتسلسل بدءًا من نقطة إعادة التنفيذ.
نُوقشت استعادة قاعدة البيانات عدة مرات في الأقسام السابقة. ويغطي هذا القسم جانبين إضافيين من الاستعادة.
محتويات القسم
- 9.8.1. معالجة الاستعادة
- 9.8.2. مقارنة LSN وعدم التأثر بالتكرار
9.8.1. معالجة الاستعادة
يتعلق الجانب الأول ببدء عملية الاستعادة. فعند تشغيل PostgreSQL، يقرأ ملف pg_control. وتصف التفاصيل التالية عملية الاستعادة من تلك النقطة.
انظر الشكل 9.20 والوصف التالي.
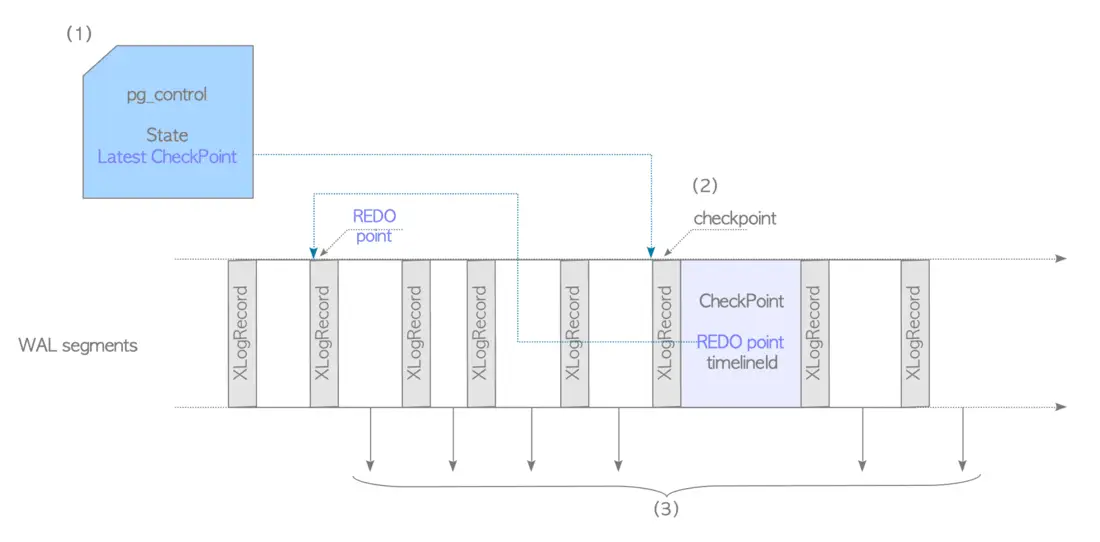
الشكل 9.20. تفاصيل عملية الاستعادة.
- (1) يقرأ PostgreSQL جميع العناصر في ملف pg_control عند بدء التشغيل. وإذا كان عنصر state هو ‘in production’، يدخل PostgreSQL في وضع الاستعادة لأن قاعدة البيانات لم تُوقف إيقافًا طبيعيًا.
- وإذا كانت الحالة ‘shut down’، يدخل PostgreSQL في وضع بدء التشغيل الطبيعي.
(2) يقرأ PostgreSQL أحدث سجل نقطة تفتيش من ملف قطعة WAL المناسب باستخدام الموقع المسجَّل في ملف pg_control. ثم يسترجع نقطة إعادة التنفيذ من ذلك السجل.
(3) يقرأ مديرو الموارد سجلات XLOG ويعيدون تنفيذها بالتسلسل من نقطة إعادة التنفيذ حتى نهاية أحدث قطعة WAL.
- إذا كان سجل XLOG المعاد تنفيذه كتلة احتياطية، يكتب المدير فوق صفحة الجدول المقابلة بصرف النظر عن LSN الخاص بها.
- وإلا، فلا يعيد المدير تنفيذ سجل XLOG غير الاحتياطي إلا إذا كان LSN الخاص بالسجل أكبر من pd_lsn الخاص بالصفحة المقابلة.
9.8.2. مقارنة LSN وعدم التأثر بالتكرار
تتعلق النقطة الثانية بمقارنة LSN: لماذا يجب مقارنة LSN الخاص بالكتلة غير الاحتياطية مع pd_lsn الخاص بالصفحة المقابلة.
ويُوضَّح ذلك بمثال محدد يبرز الحاجة إلى هذه المقارنة. انظر الشكلين 9.21 و9.22. (لاحظ أن مخزن WAL المؤقت محذوف لتبسيط الوصف.)
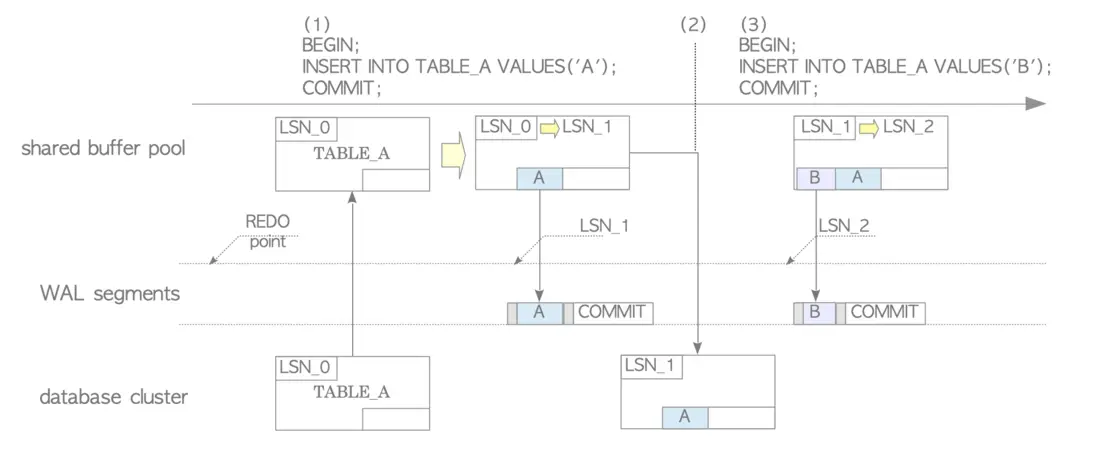
الشكل 9.21. عمليات الإدراج أثناء عمل الكاتب الخلفي.
- (1) يُدرج PostgreSQL صفًّا في الجدول TABLE_A ويكتب سجل XLOG عند LSN_1.
- (2) تكتب عملية نقاط التفتيش صفحة TABLE_A إلى وسيط التخزين. وعند هذه النقطة، يكون pd_lsn الخاص بالصفحة هو LSN_1.
- (3) يُدرج PostgreSQL صفًّا جديدًا في الجدول TABLE_A ويكتب سجل XLOG عند LSN_2. ولم تُكتب الصفحة المعدَّلة بعد إلى وسيط التخزين.
في هذا السيناريو، وخلافًا لأمثلة النظرة العامة السابقة، كُتبت صفحة TABLE_A إلى وسيط التخزين مرة واحدة.
وإذا أُوقفت قاعدة البيانات في الوضع الفوري ثم شُغّلت، تحدث الاستعادة التالية:
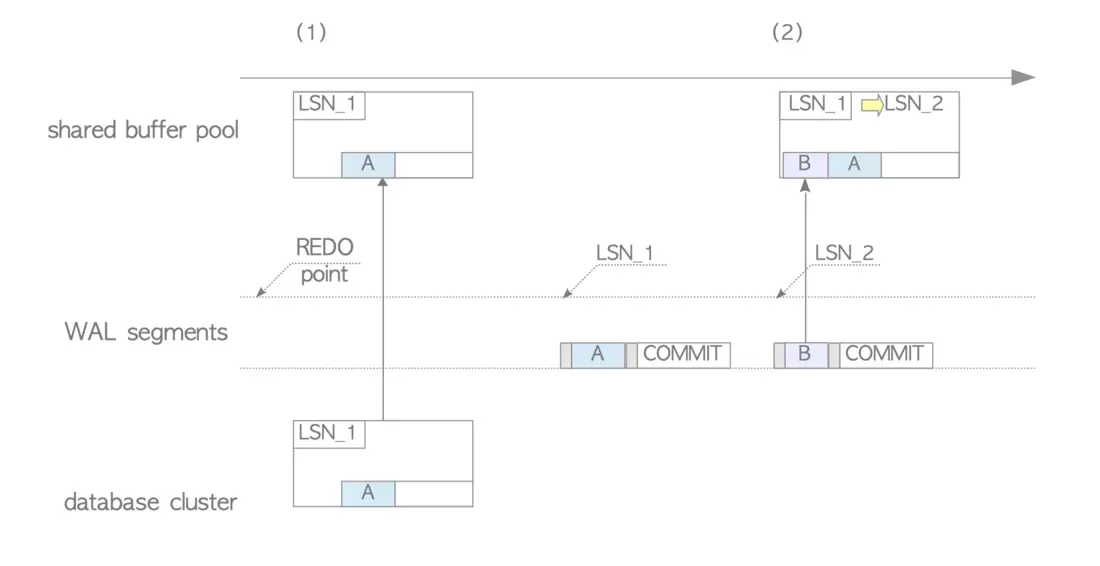
الشكل 9.22. استعادة قاعدة البيانات.
- (1) يحمّل PostgreSQL أول سجل XLOG وصفحة TABLE_A. ولا يعيد تنفيذ السجل لأن LSN الخاص بالسجل (LSN_1) ليس أكبر من LSN الخاص بالصفحة (وهو أيضًا LSN_1). فلا حاجة لإعادة تنفيذه.
- (2) بعد ذلك، يعيد PostgreSQL تنفيذ سجل XLOG الثاني لأن LSN الخاص بالسجل (LSN_2) أكبر من pd_lsn الحالي لصفحة TABLE_A (LSN_1).
إذا كان ترتيب إعادة تنفيذ الكتل غير الاحتياطية خاطئًا أو أُعيد تنفيذها أكثر من مرة، يصبح تجمّع قاعدة البيانات غير متسق. ويُظهر ذلك أن عملية إعادة التنفيذ للكتل غير الاحتياطية ليست عديمة التأثر بالتكرار (idempotent). ولضمان ترتيب إعادة التنفيذ الصحيح، ينبغي ألا يُعاد تنفيذ سجلات الكتل غير الاحتياطية إلا عندما يكون LSN الخاص بها أكبر من pd_lsn الخاص بالصفحة المقابلة.
في المقابل، فإن عملية إعادة التنفيذ للكتل الاحتياطية عديمة التأثر بالتكرار، أي يمكن إعادة تنفيذ هذه الكتل عدة مرات بصرف النظر عن LSN الخاص بها.
9.9. إدارة ملفات قطع WAL
يكتب PostgreSQL سجلات XLOG في ملفات قطع WAL المخزّنة في الدليل الفرعي pg_wal (المسمى pg_xlog في الإصدار 9.6 أو أقدم). ويُبدَّل إلى ملف قطعة WAL جديد كلما امتلأ الملف الحالي. ويتغيّر عدد ملفات WAL وفقًا لمعلمات الإعداد ونشاط الخادم.
وابتداءً من الإصدار 9.4، يمكن لـفتحات النسخ أيضًا التحكم في عدد ملفات WAL بناءً على حالة النسخ المتماثل. علاوة على ذلك، قدّم الإصدار 9.5 تحسينات على سياسة إدارة ملفات قطع WAL.
تصف الأقسام الفرعية التالية تبديل ملفات قطع WAL وطرق الإدارة الأساسية.
محتويات القسم
- 9.9.1. تبديل قطع WAL
- 9.9.2. إدارة قطع WAL
9.9.1. تبديل قطع WAL
تحدث عمليات تبديل قطع WAL عند حدوث أي من الأحداث التالية:
- امتلاء قطعة WAL.
- استدعاء الدالة pg_switch_wal() (أو pg_switch_xlog() في الإصدارات الأقدم).
- تفعيل المعلمة archive_mode وانقضاء مهلة archive_timeout.
عند تبديل ملف قطعة WAL، يعيد PostgreSQL تدويره عادةً (بإعادة تسميته وإعادة استخدامه) للاستخدام المستقبلي. ومع ذلك، قد يُحذف الملف لاحقًا إذا لم تعد هناك حاجة إليه.
9.9.2. إدارة قطع WAL
كلما بدأت نقطة تفتيش، يقدّر PostgreSQL عدد ملفات قطع WAL اللازمة لدورة نقطة التفتيش التالية ويجهّزها. ويستند هذا التقدير إلى استهلاك WAL في دورات نقاط التفتيش السابقة.
ويبدأ عدّ ملفات قطع WAL من القطعة التي تحتوي على نقطة إعادة التنفيذ. ويجب أن تكون هذه القيمة بين min_wal_size (افتراضيًا 80 ميغابايت، أو 5 ملفات) وmax_wal_size (افتراضيًا 1 غيغابايت، أو 64 ملفًا).
وعند بدء نقطة تفتيش، يحتفظ PostgreSQL بملفات قطع WAL اللازمة أو يعيد تدويرها، ويحذف غير اللازمة منها.
يوضّح الشكل 9.23 مثالًا محددًا.
لنفترض وجود ستة ملفات قطع WAL قبل بدء نقطة تفتيش، وأن WAL_3 يحتوي على نقطة إعادة التنفيذ. وإذا قدّر PostgreSQL أن خمسة ملفات مطلوبة، يُعاد تسمية WAL_1 إلى WAL_7 لإعادة تدويره، ويُحذف WAL_2.
** معلومات
يمكن حذف الملفات الأقدم من الملف الذي يحتوي على نقطة إعادة التنفيذ لأن آلية الاستعادة الموصوفة في القسم 9.8 لا تحتاج إليها أبدًا.
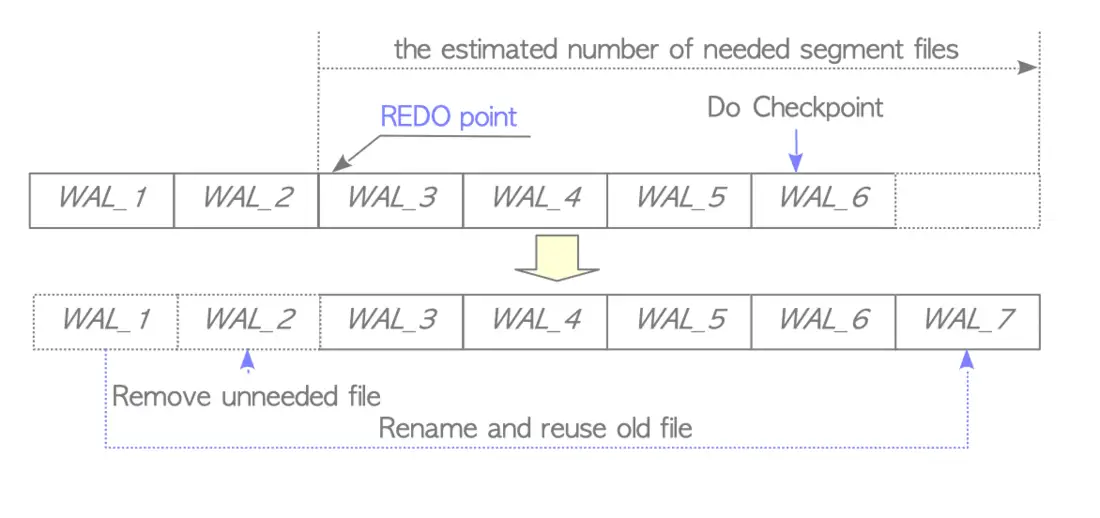
الشكل 9.23. إعادة تدوير ملفات قطع WAL وحذفها عند نقطة تفتيش.
وإذا تطلّب ارتفاع مفاجئ في نشاط WAL مزيدًا من القطع، ينشئ PostgreSQL ملفات قطع WAL جديدة ما دام الحجم الكلي يبقى دون max_wal_size.
فمثلًا، في الشكل 9.24، إذا امتلأ WAL_7، يُنشأ WAL_8 جديد.
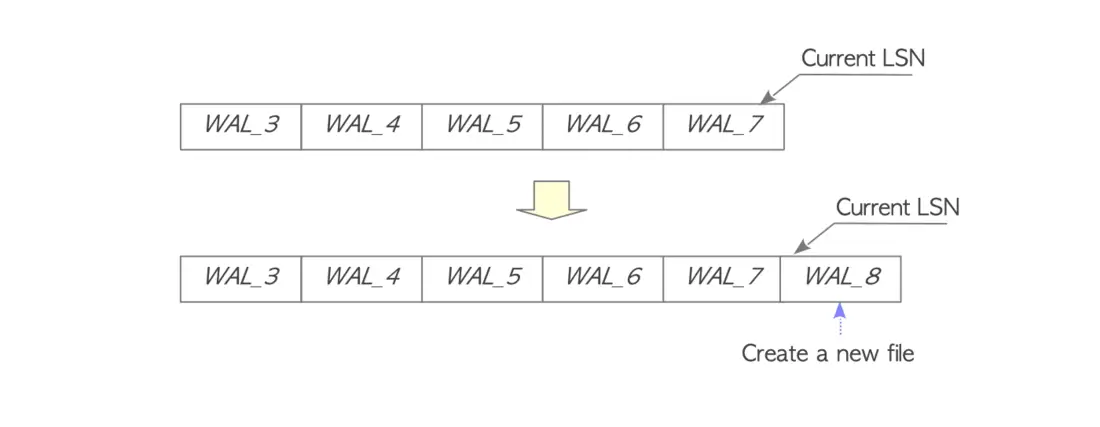
الشكل 9.24. إنشاء ملف قطعة WAL.
يتكيّف عدد ملفات قطع WAL مع نشاط الخادم. وإذا زاد معدل كتابة WAL باستمرار، يزداد العدد المقدَّر للملفات والحجم الكلي تدريجيًا. وبالعكس، إذا انخفض معدل الكتابة، تنخفض هذه القيم.
وإذا تجاوز الحجم الكلي لملفات قطع WAL قيمة max_wal_size، تبدأ نقطة تفتيش. ويوضّح الشكل 9.25 هذه الحالة. وأثناء نقطة التفتيش، تُنشأ نقطة إعادة تنفيذ جديدة وتُهمل نقطة إعادة التنفيذ القديمة؛ ثم يُعاد تدوير ملفات قطع WAL القديمة غير اللازمة. وبهذه الطريقة، يحتفظ PostgreSQL بملفات قطع WAL المطلوبة لاستعادة قاعدة البيانات فقط.
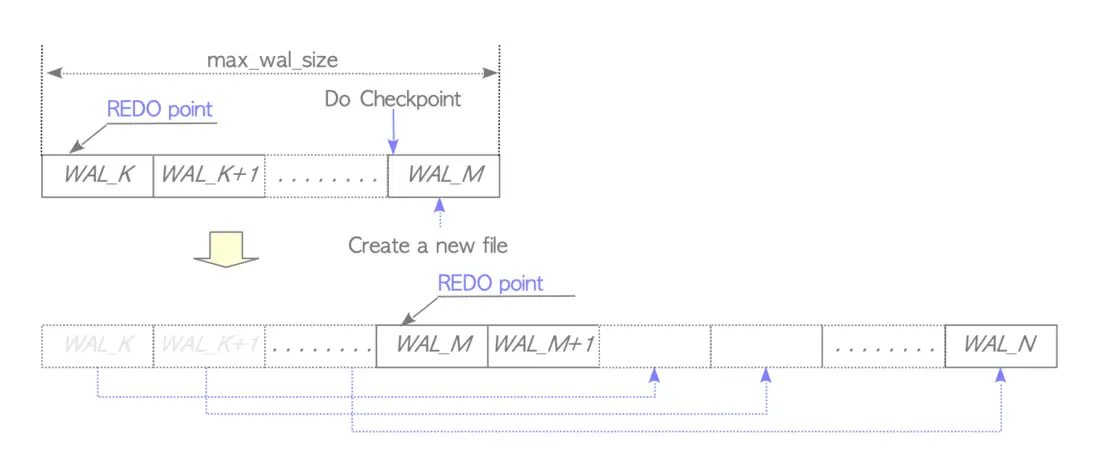
الشكل 9.25. نقاط التفتيش وإعادة تدوير ملفات قطع WAL.
9.9.2.1. عوامل أخرى
تؤثر المعلمة wal_keep_size (أو wal_keep_segments في الإصدار 12 أو أقدم) وميزة فتحة النسخ أيضًا في عدد ملفات قطع WAL.
9.10. الأرشفة المستمرة وسجلات الأرشيف
الأرشفة المستمرة ميزة تنسخ ملفات قطع WAL إلى منطقة أرشيف كلما حدث تبديل لقطعة WAL. وتؤدي عملية الأرشفة (الخلفية) هذه المهمة. ويُعرف الملف المنسوخ باسم سجل الأرشيف. وتُستخدم هذه الميزة عادةً من أجل النسخ الاحتياطي الفيزيائي الساخن والاستعادة الزمنية (PITR)، وهما موصوفان في الفصل 10.
وتحدّد معلمة الإعداد archive_command مسار منطقة الأرشيف. فمثلًا، ينسخ الإعداد التالي ملفات قطع WAL إلى الدليل /home/postgres/archives/ عند كل تبديل قطعة:
archive_command = 'cp %p /home/postgres/archives/%f'
وفي هذا الأمر، يمثّل العنصر النائب %p مسار قطعة WAL المصدر، ويمثّل العنصر النائب %f اسم ملف سجل الأرشيف.
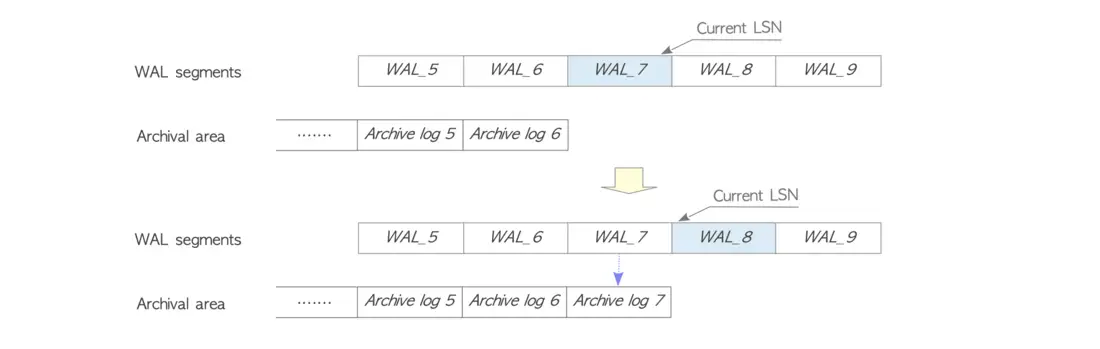
الشكل 9.26. الأرشفة المستمرة.
عند تبديل ملف قطعة WAL المسمى WAL_7، يُنسخ الملف إلى منطقة الأرشيف باسم Archive log 7.
تقبل المعلمة archive_command أي أمر أو أداة يونكس. ويتيح ذلك استخدام scp أو أدوات نسخ احتياطي أخرى لنقل سجلات الأرشيف إلى مضيفات بعيدة، بدلًا من الاعتماد على أوامر النسخ البسيطة.
** archive_library
اعتمدت إصدارات PostgreSQL 14 وما قبلها على أوامر الصدفة للأرشفة المستمرة. ومع ذلك، قدّم الإصدار 15 ميزة مكتبة قابلة للتحميل لتمكين الأرشفة المستمرة عبر آليات قائمة على المكتبات.
لمزيد من التفاصيل، راجع التوثيق الخاص بـarchive_library وbasic_archive.
** ملاحظة
لا ينظّف PostgreSQL سجلات الأرشيف تلقائيًا، لذا يجب على المسؤولين إدارة هذه الملفات. وبدون تدخّل، يتزايد عدد سجلات الأرشيف باستمرار.
وتُعدّ أداة pg_archivecleanup أداة مفيدة لإدارة ملفات سجل الأرشيف.
وبالإضافة إلى ذلك، يمكن لأمر find حذف سجلات الأرشيف القديمة. فمثلًا، يحذف الأمر التالي السجلات الأقدم من ثلاثة أيام:
$ find /home/postgres/archives -mtime +3d -exec rm -f {} \;