مغلّف البيانات الخارجية
4.1. نظرة عامة (Overview)
لاستخدام ميزة FDW (مغلّف البيانات الخارجية)، يجب تثبيت الإضافة المناسبة، وتنفيذ أوامر الإعداد مثل CREATE FOREIGN TABLE وCREATE SERVER وCREATE USER MAPPING. (لمزيد من التفاصيل، راجع التوثيق الرسمي.)
وبعد اكتمال التهيئة، تُستدعى الدوال المعرَّفة في الإضافة أثناء معالجة الاستعلامات للوصول إلى الجداول الخارجية.
ويصف الشكل 4.2 بإيجاز عملية تنفيذ FDW في PostgreSQL.
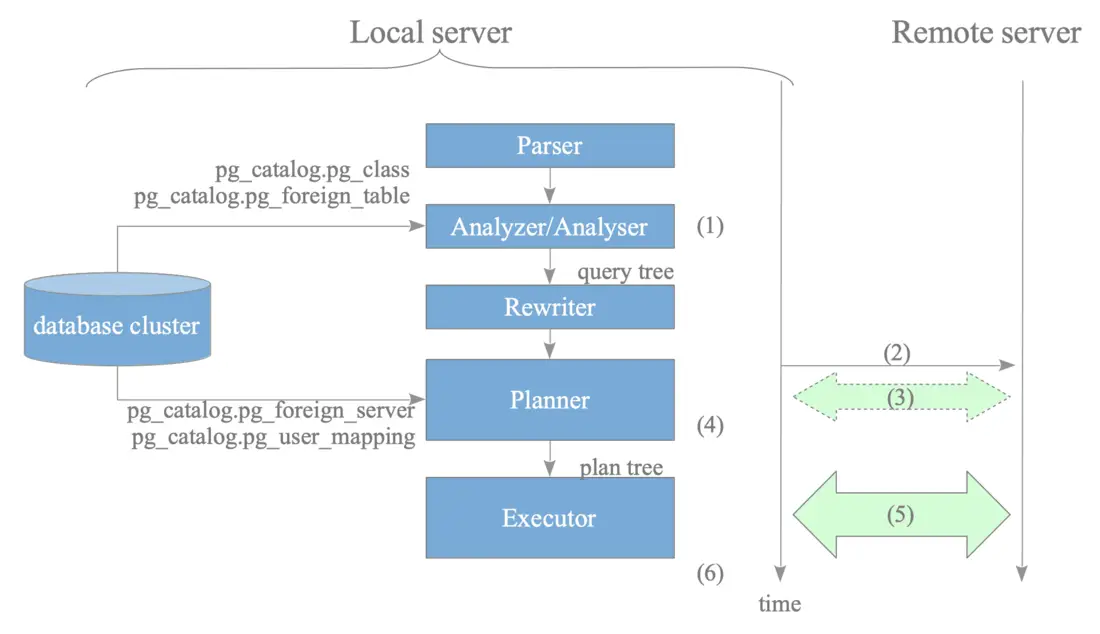
الشكل 4.2. كيفية تنفيذ مغلّفات البيانات الخارجية.
- (1) التحليل: يُنشئ المحلّل شجرة استعلام من SQL المُدخَل.
- (2) الاتصال: يُنشئ المخطِّط (أو المنفِّذ) اتصالًا بالخادم البعيد.
- (3) تقدير الكلفة: إذا كان الخيار use_remote_estimate مضبوطًا على ‘on’ (القيمة الافتراضية ‘off’)، ينفّذ المخطِّط أوامر EXPLAIN على الخادم البعيد لتقدير كلفة كل مسار خطة.
- (4) فك التحليل (Deparsing): يولّد المخطِّط عبارة SQL نصية من شجرة الخطة؛ وتُسمى هذه العملية داخليًا فك التحليل (deparsing).
- (5) التنفيذ: يرسل المنفِّذ عبارة SQL النصية إلى الخادم البعيد ويستقبل النتائج.
ثم يعالج المنفِّذ البيانات المستلمة حسب الحاجة. على سبيل المثال، إذا نُفِّذ استعلام متعدد الجداول، يُجري المنفِّذ معالجة ربط بين البيانات البعيدة المستلمة وجداول محلية أو خارجية أخرى.
وتُوصف تفاصيل هذه العمليات في الأقسام التالية.
محتويات القسم
- 4.1.1. إنشاء شجرة استعلام
- 4.1.2. إنشاء اتصال بالخادم البعيد
- 4.1.3. تقدير الكلفة عبر EXPLAIN البعيد (اختياري)
- 4.1.4. فك التحليل
- 4.1.5. التنفيذ واسترداد النتائج
4.1.1. إنشاء شجرة استعلام
يُنشئ المحلّل شجرة استعلام SQL المُدخَل بالاستفادة من تعريفات الجداول الخارجية. وتُخزَّن هذه التعريفات في كتالوجي pg_catalog.pg_class وpg_catalog.pg_foreign_table، وهما يُملَآن عبر الأمرين CREATE FOREIGN TABLE أو IMPORT FOREIGN SCHEMA.
4.1.2. إنشاء اتصال بالخادم البعيد
لإنشاء اتصال، يستخدم المخطِّط (أو المنفِّذ) مكتبة خاصة بنوع قاعدة البيانات البعيدة. على سبيل المثال، يستخدم postgres_fdw مكتبة libpq للاتصال بخوادم PostgreSQL البعيدة. وبالمثل، تستخدم إضافة mysql_fdw مكتبة libmysqlclient للاتصال بخوادم MySQL.
وتُخزَّن معاملات الاتصال — بما في ذلك اسم المستخدم وعنوان IP للخادم ورقم المنفذ — في كتالوجي pg_catalog.pg_user_mapping وpg_catalog.pg_foreign_server. وتُعرَّف هذه المعاملات باستخدام الأمرين CREATE USER MAPPING وCREATE SERVER.
4.1.3. تقدير الكلفة عبر EXPLAIN البعيد (اختياري)
تدعم ميزة FDW في PostgreSQL الحصول على إحصاءات من الجداول الخارجية لتحسين إنشاء خطة الاستعلام. وتستخدم عدة إضافات FDW، مثل postgres_fdw وmysql_fdw وtds_fdw وjdbc2_fdw، هذه الإحصاءات.
إذا ضُبِط الخيار ‘use_remote_estimate’ على ‘on’ عبر الأمر ALTER SERVER، يطلب المخطِّط كلف الخطط من الخادم البعيد بتنفيذ الأمر EXPLAIN. وإلا، يعتمد المخطِّط على قيم ثابتة مضمَّنة افتراضية لتقدير الكلفة.
localdb=# ALTER SERVER remote_server_name OPTIONS (use_remote_estimate 'on');
وبينما تحاول عدة إضافات استخدام قيم EXPLAIN البعيد، يمتاز postgres_fdw بقدرة فريدة على عكس هذه النتائج بدقة لأن أمر EXPLAIN في PostgreSQL يوفّر كلفة البدء والكلفة الإجمالية معًا.
في المقابل، غالبًا ما يفتقر مخرَج EXPLAIN من أنواع أنظمة إدارة قواعد البيانات الأخرى إلى التفصيل الكافي لمتطلبات التخطيط في PostgreSQL. على سبيل المثال، يُعيد أمر EXPLAIN في MySQL أساسًا العدد المقدَّر للصفوف، بينما يحتاج مخطِّط PostgreSQL إلى معلومات الكلفة الأشمل الموصوفة في الفصل 3.
4.1.4. فك التحليل
أثناء إنشاء شجرة الخطة، يُنشئ المخطِّط عبارة SQL نصية من مسارات المسح المرتبطة بالجداول الخارجية.
على سبيل المثال، يوضّح الشكل 4.3 شجرة الخطة لبيان SELECT التالي:
localdb=# SELECT * FROM tbl_a AS a WHERE a.id < 10;
وكما هو موضّح في الشكل 4.3، تخزّن عقدة ForeignScan — المرتبطة بشجرة خطة PlannedStmt — عبارة SELECT نصية.
في هذه العملية، يعيد postgres_fdw بناء نص SQL من شجرة الاستعلام المنشأة أثناء التحليل النحوي والتحليل الدلالي. وتُسمى عملية إعادة البناء هذه فك التحليل (deparsing) في PostgreSQL.
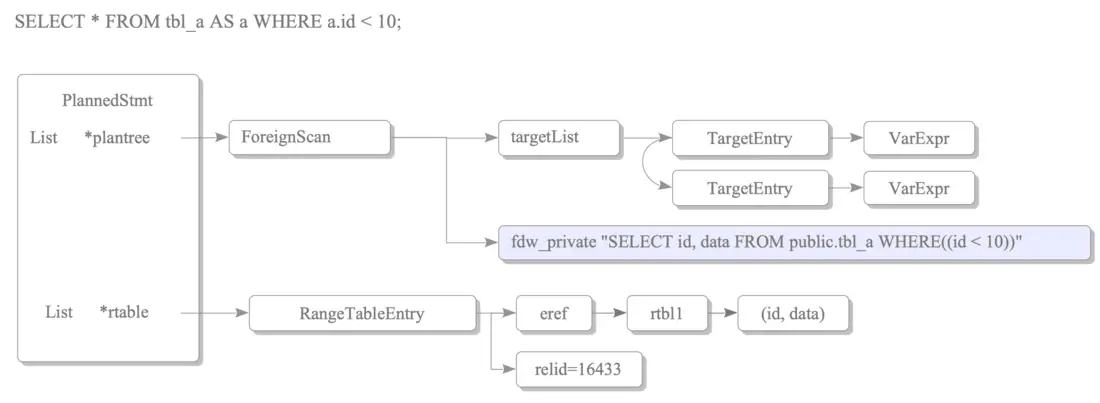
الشكل 4.3. مثال على شجرة الخطة التي تمسح جدولًا خارجيًا.
وبالمثل، ينشئ mysql_fdw عبارة SELECT متوافقة مع MySQL من شجرة الاستعلام. وعند استخدام redis_fdw أو rw_redis_fdw، تُنشئ العملية أمر SELECT خاصًا بـ Redis.
4.1.5. التنفيذ واسترداد النتائج
بعد عملية فك التحليل، يرسل المنفِّذ عبارات SQL المُفكَّكة إلى الخادم البعيد ويستقبل النتائج.
وتعتمد طريقة إرسال عبارات SQL على تنفيذ إضافة FDW المحددة. على سبيل المثال، يرسل mysql_fdw عبارات SQL دون بدء معاملة رسمية. ويوضّح الشكل 4.4 التسلسل النموذجي لتنفيذ استعلام SELECT في mysql_fdw.
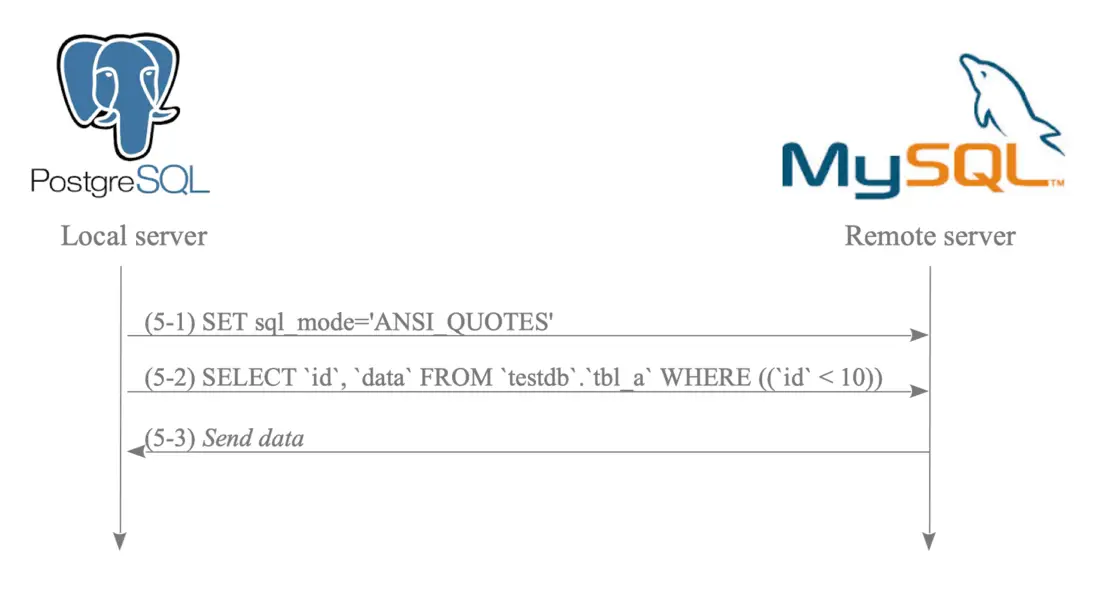
الشكل 4.4. التسلسل النموذجي لعبارات SQL لتنفيذ استعلام SELECT في mysql_fdw.
- (5-1) التهيئة: تضبط SQL_MODE على ‘ANSI_QUOTES’.
- (5-2) الإرسال: ترسل عبارة SELECT إلى الخادم البعيد.
- (5-3) الاسترداد والتحويل: تستقبل النتائج من الخادم البعيد. وفي هذه المرحلة، يحوّل mysql_fdw البيانات إلى صيغة يقرأها PostgreSQL.
وعلى جميع إضافات FDW تنفيذ ميزة تحويل لضمان توافق البيانات البعيدة مع منفِّذ PostgreSQL.
** ** السجل الفعلي للخادم البعيد
mysql> SELECT command_type,argument FROM mysql.general_log;
+--------------+-----------------------------------------------------------------------+
| command_type | argument                                                              |
+--------------+-----------------------------------------------------------------------+
... snip ...

| Query        | SET sql_mode='ANSI_QUOTES'                                            |
| Prepare      | SELECT `id`, `data` FROM `localdb`.`tbl_a` WHERE ((`id` < 10))        |
| Close stmt   |                                                                       |
+--------------+-----------------------------------------------------------------------+
في المقابل، يكون تسلسل التواصل في postgres_fdw أكثر تعقيدًا لأنه يتضمّن إدارة المعاملات والمؤشرات. ويظهر التسلسل النموذجي لاستعلام SELECT في postgres_fdw في الشكل 4.5.
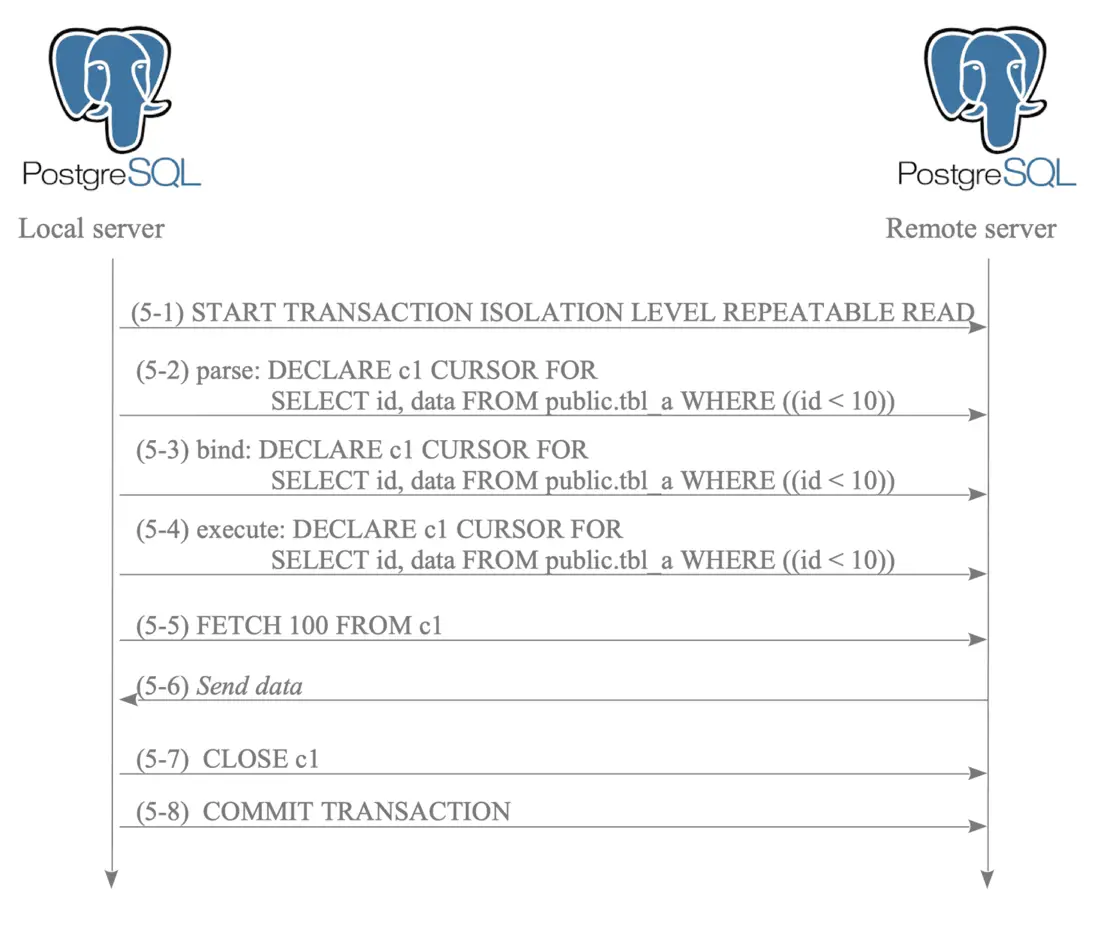
الشكل 4.5. التسلسل النموذجي لعبارات SQL لتنفيذ استعلام SELECT في postgres_fdw.
- (5-1) بدء المعاملة: تبدأ معاملة بعيدة. ومستوى العزل البعيد الافتراضي هو REPEATABLE READ. غير أنه إذا ضُبِط مستوى عزل المعاملة المحلية على SERIALIZABLE، تُضبَط المعاملة البعيدة أيضًا على SERIALIZABLE.
- (5-2)-(5-4) تعريف المؤشر: يُعرَّف مؤشر لعبارة SQL. وتُنفَّذ الاستعلامات البعيدة عمومًا عبر المؤشرات لإدارة تدفق البيانات بكفاءة.
- (5-5) الجلب: تُنفَّذ أوامر FETCH لاسترداد النتائج. ويُسترد افتراضيًا 100 صف لكل أمر FETCH.
- (5-6) الاسترداد: تُستقبل البيانات من الخادم البعيد.
- (5-7) إغلاق المؤشر: يُغلق المؤشر بعد استرداد جميع الصفوف المطلوبة.
- (5-8) الالتزام: تُلتزم المعاملة البعيدة.
** ** السجل الفعلي للخادم البعيد
LOG:  statement: START TRANSACTION ISOLATION LEVEL REPEATABLE READ
LOG:  parse <unnamed>: DECLARE c1 CURSOR FOR SELECT id, data FROM public.tbl_a WHERE ((id < 10))
LOG:  bind <unnamed>: DECLARE c1 CURSOR FOR SELECT id, data FROM public.tbl_a WHERE ((id < 10))
LOG:  execute <unnamed>: DECLARE c1 CURSOR FOR SELECT id, data FROM public.tbl_a WHERE ((id < 10))
LOG:  statement: FETCH 100 FROM c1
LOG:  statement: CLOSE c1
LOG:  statement: COMMIT TRANSACTION
** مستوى العزل الافتراضي للمعاملة البعيدة.
يشرح التوثيق الرسمي سبب كون REPEATABLE READ هو مستوى العزل الافتراضي للمعاملة البعيدة.
4.2. كيفية عمل إضافة Postgres_fdw
إضافة postgres_fdw وحدة متخصصة تصونها رسميًا مجموعة تطوير PostgreSQL العالمية. وشيفرتها المصدرية مدمجة مباشرةً في شجرة الشيفرة المصدرية لـ PostgreSQL.
وpostgres_fdw محلّ تحسين مستمر. ويلخّص الجدول 4.1 ملاحظات الإصدار المتعلقة بـ postgres_fdw من التوثيق الرسمي.
| الإصدار | سنة الإصدار | الوصف |
|---|---|---|
| 9.6 | 2016 | النظر في تنفيذ عمليات الفرز على الخادم البعيد. النظر في تنفيذ عمليات الربط على الخادم البعيد. تنفيذ UPDATE أو DELETE بالكامل على الخادم البعيد عند الإمكان. السماح بضبط حجم الجلب كخيار للخادم أو الجدول. |
| 10 | 2017 | دفع الدوال التجميعية إلى الخادم البعيد عند الإمكان. |
| 11 | 2018 | السماح بدفع التجميعات إلى الجداول الخارجية التي تكون أجزاءً. السماح بدفع أوامر UPDATE وDELETE باستخدام عمليات الربط إلى الخوادم الخارجية. |
| 12 | 2019 | السماح بدفع عمليات فرز ORDER BY وعبارات LIMIT في مزيد من الحالات. |
| 14 | 2021 | |
| 15 | 2022 | |
| 16 | 2023 | |
| 17 | 2024 |
وبينما فصّل القسم السابق كيفية معالجة postgres_fdw للاستعلامات ذات الجدول الواحد، تصف الأقسام الفرعية التالية معالجة الاستعلامات متعددة الجداول وعمليات الفرز والدوال التجميعية.
ورغم أن هذا القسم يركّز أساسًا على عبارات SELECT، فإن postgres_fdw يدعم أيضًا عمليات DML الأخرى، بما في ذلك INSERT وUPDATE وDELETE.
ملاحظة: لا يكتشف FDW في PostgreSQL الجمود
لا تدعم إضافة postgres_fdw وإطار FDW الأساسي إدارة الأقفال الموزَّعة واكتشاف الجمود الموزَّع. وبناءً على ذلك، قد يحدث جمود عبر الخوادم.
على سبيل المثال، لنتأمل سيناريو يحدّث فيه العميل A جدولًا محليًا tbl_local ثم جدولًا خارجيًا tbl_remote، بينما يحدّث العميل B الجدول tbl_remote ثم الجدول tbl_local بالترتيب المعاكس.
ورغم أن المعاملتين تدخلان في حالة جمود متبادل، لا يستطيع PostgreSQL اكتشاف الاعتماد عبر الحدود البعيدة. ونتيجةً لذلك، تظل المعاملتان متوقفتين إلى أجل غير مسمى ولا يمكن التزامهما.
localdb=# -- Client A
localdb=# BEGIN;
BEGIN
localdb=# UPDATE tbl_local SET data = 0 WHERE id = 1;
UPDATE 1
localdb=# UPDATE tbl_remote SET data = 0 WHERE id = 1;
UPDATE 1
localdb=# -- Client B
localdb=# BEGIN;
BEGIN
localdb=# UPDATE tbl_remote SET data = 0 WHERE id = 1;
UPDATE 1
localdb=# UPDATE tbl_local SET data = 0 WHERE id = 1;
UPDATE 1
محتويات القسم
- 4.2.1. استعلام متعدد الجداول
- 4.2.2. عمليات الفرز
- 4.2.3. الدوال التجميعية
4.2.1. استعلام متعدد الجداول
لتنفيذ استعلام متعدد الجداول، يجلب postgres_fdw عادةً كل جدول خارجي باستخدام عبارة SELECT أحادية الجدول ثم يُجري الربط على الخادم المحلي.
في الإصدار 9.5 والأقدم، يجلب postgres_fdw الجداول الخارجية فرادى حتى لو كانت مخزَّنة على الخادم البعيد نفسه. وتُنشأ عملية الربط وتُنفَّذ دائمًا محليًا.
وفي الإصدار 9.6 والأحدث، حُسِّن postgres_fdw لدعم عمليات الربط البعيدة. وعندما تقيم الجداول الخارجية على الخادم البعيد نفسه ويكون الخيار use_remote_estimate مفعَّلًا، يمكن للمخطِّط إنشاء مسار ربط يُنفَّذ مباشرةً على الخادم البعيد.
وتُوصف تفاصيل التنفيذ أدناه.
4.2.1.1. الإصدارات 9.5 أو أقدم
فيما يلي وصف لكيفية معالجة PostgreSQL لاستعلام يربط جدولين خارجيين، ’tbl_a’ و’tbl_b’.
localdb=# SELECT * FROM tbl_a AS a, tbl_b AS b WHERE a.id = b.id AND a.id < 200;
وتظهر نتيجة الأمر EXPLAIN لهذا الاستعلام أدناه:
 1
 2
 3
 4
 5
 6
 7
 8
 9
10
11
12
localdb=# EXPLAIN SELECT * FROM tbl_a AS a, tbl_b AS b WHERE a.id = b.id AND a.id < 200;
                                  QUERY PLAN
------------------------------------------------------------------------------
 Merge Join  (cost=532.31..700.34 rows=10918 width=16)
   Merge Cond: (a.id = b.id)
   ->  Sort  (cost=200.59..202.72 rows=853 width=8)
         Sort Key: a.id
         ->  Foreign Scan on tbl_a a  (cost=100.00..159.06 rows=853 width=8)
   ->  Sort  (cost=331.72..338.12 rows=2560 width=8)
         Sort Key: b.id
         ->  Foreign Scan on tbl_b b  (cost=100.00..186.80 rows=2560 width=8)
(8 rows)
يشير المخرَج إلى أن المنفِّذ يختار ربطًا بالدمج، يُعالَج عبر الخطوات التالية:
- السطر 8: يجلب المنفِّذ الصفوف من الجدول tbl_a باستخدام مسح خارجي.
- السطر 6: يفرز المنفِّذ الصفوف المجلوبة من tbl_a على الخادم المحلي.
- السطر 11: يجلب المنفِّذ الصفوف من الجدول tbl_b باستخدام مسح خارجي.
- السطر 9: يفرز المنفِّذ الصفوف المجلوبة من tbl_b على الخادم المحلي.
- السطر 4: ينفّذ المنفِّذ عملية ربط بالدمج على الخادم المحلي.
ويُوصف تسلسل استرداد الصفوف أدناه (راجع الشكل 4.6):
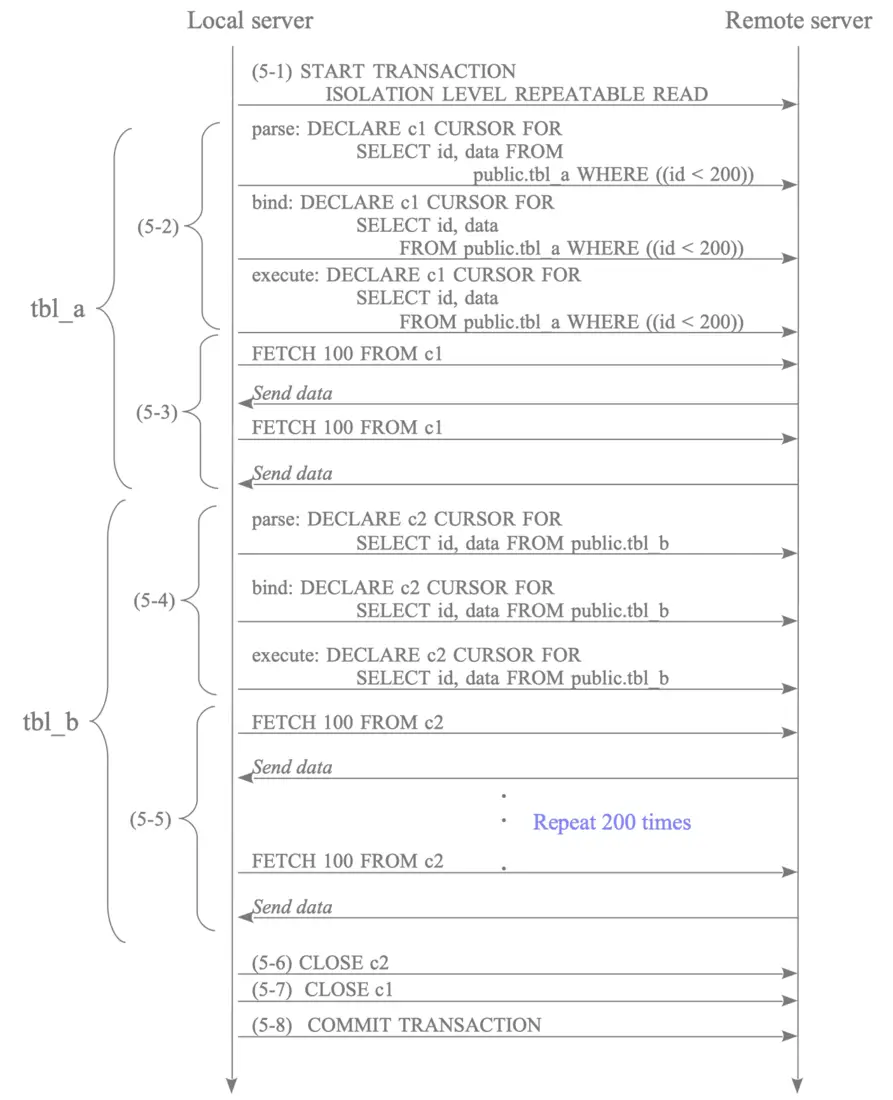
الشكل 4.6. تسلسل عبارات SQL لتنفيذ الاستعلام متعدد الجداول في الإصدارات 9.5 أو الأقدم.
(5-1) بدء المعاملة: تبدأ معاملة بعيدة.
(5-2) تعريف المؤشر (c1): يُعرَّف المؤشر c1 بعبارة SELECT التالية:
SELECT id, data FROM public.tbl_a WHERE (id < 200)
(5-3) الجلب (c1): تُنفَّذ أوامر FETCH لاسترداد نتائج المؤشر c1.
(5-4) تعريف المؤشر (c2): يُعرَّف المؤشر c2 بعبارة SELECT التالية:
SELECT id, data FROM public.tbl_b
ويتناول ما يلي تعريف المؤشر c2. فرغم أن عامل تصفية الاستعلام الأصلي هو tbl_a.id = tbl_b.id AND tbl_a.id < 200، وهو ما يستلزم منطقيًا قيد tbl_b.id < 200، لا يستطيع postgres_fdw في هذه الإصدارات إجراء هذا الاستنتاج. وبناءً على ذلك، ينفّذ المنفِّذ العبارة دون عبارة WHERE وعليه أن يسترد جميع الصفوف من الجدول الخارجي tbl_b. وهذا السلوك غير كفؤ لأن بيانات غير ضرورية تُنقَل من الخادم البعيد عبر الشبكة.
(5-5) الجلب (c2): تُنفَّذ أوامر FETCH لاسترداد نتائج المؤشر c2.
(5-6) إغلاق المؤشر (c1): يُغلق المؤشر c1.
(5-7) إغلاق المؤشر (c2): يُغلق المؤشر c2.
(5-8) الالتزام: تُلتزم المعاملة البعيدة.
بعد استقبال الصفوف، يفرز المنفِّذ البيانات من كل من tbl_a وtbl_b ثم يُكمل عملية الربط بالدمج باستخدام النتائج المفروزة.
** ** السجل الفعلي للخادم البعيد
LOG:  statement: START TRANSACTION ISOLATION LEVEL REPEATABLE READ
LOG:  parse <unnamed>: DECLARE c1 CURSOR FOR
      SELECT id, data FROM public.tbl_a WHERE ((id < 200))
LOG:  bind <unnamed>: DECLARE c1 CURSOR FOR
      SELECT id, data FROM public.tbl_a WHERE ((id < 200))
LOG:  execute <unnamed>: DECLARE c1 CURSOR FOR
      SELECT id, data FROM public.tbl_a WHERE ((id < 200))
LOG:  statement: FETCH 100 FROM c1
LOG:  statement: FETCH 100 FROM c1
LOG:  parse <unnamed>: DECLARE c2 CURSOR FOR
      SELECT id, data FROM public.tbl_b
LOG:  bind <unnamed>: DECLARE c2 CURSOR FOR
      SELECT id, data FROM public.tbl_b
LOG:  execute <unnamed>: DECLARE c2 CURSOR FOR
      SELECT id, data FROM public.tbl_b
LOG:  statement: FETCH 100 FROM c2
LOG:  statement: FETCH 100 FROM c2
LOG:  statement: FETCH 100 FROM c2
LOG:  statement: FETCH 100 FROM c2

... snip

LOG:  statement: FETCH 100 FROM c2
LOG:  statement: FETCH 100 FROM c2
LOG:  statement: FETCH 100 FROM c2
LOG:  statement: FETCH 100 FROM c2
LOG:  statement: CLOSE c2
LOG:  statement: CLOSE c1
LOG:  statement: COMMIT TRANSACTION
4.2.1.2. الإصدارات 9.6 أو أحدث
إذا ضُبِط خيار use_remote_estimate على ‘on’ (القيمة الافتراضية ‘off’)، يرسل postgres_fdw عدة أوامر EXPLAIN للحصول على تقديرات الكلفة لجميع مسارات الخطط المتعلقة بالجداول الخارجية.
ولتحقيق ذلك، يصدر postgres_fdw أوامر EXPLAIN لكل استعلام أحادي الجدول وكذلك لعبارات SELECT التي تمثّل عمليات ربط بعيدة محتملة.
وفي هذا المثال، تُرسَل الأوامر السبعة التالية من EXPLAIN إلى الخادم البعيد. ثم يستخدم المخطِّط هذه النتائج لاختيار الخطة الأقل كلفة.
(1) EXPLAIN SELECT id, data FROM public.tbl_a WHERE ((id < 200))
(2) EXPLAIN SELECT id, data FROM public.tbl_b
(3) EXPLAIN SELECT id, data FROM public.tbl_a WHERE ((id < 200)) ORDER BY id ASC NULLS LAST
(4) EXPLAIN SELECT id, data FROM public.tbl_a WHERE ((((SELECT null::integer)::integer) = id)) AND ((id < 200))
(5) EXPLAIN SELECT id, data FROM public.tbl_b ORDER BY id ASC NULLS LAST
(6) EXPLAIN SELECT id, data FROM public.tbl_b WHERE ((((SELECT null::integer)::integer) = id))
(7) EXPLAIN SELECT r1.id, r1.data, r2.id, r2.data FROM (public.tbl_a r1 INNER JOIN public.tbl_b r2 ON (((r1.id = r2.id)) AND ((r1.id < 200))))
ويُظهر EXPLAIN المحلي الخطة التي اختارها المخطِّط.
localdb=# EXPLAIN SELECT * FROM tbl_a AS a, tbl_b AS b WHERE a.id = b.id AND a.id < 200;
                        QUERY PLAN
-----------------------------------------------------------
 Foreign Scan  (cost=134.35..244.45 rows=80 width=16)
   Relations: (public.tbl_a a) INNER JOIN (public.tbl_b b)
(2 rows)
ويؤكد المخرَج أن المخطِّط يختار ربطًا داخليًا يُعالَج على الخادم البعيد، ما يحسّن الكفاءة تحسينًا كبيرًا بتقليل نقل البيانات.
ويُوصف تسلسل العمليات التي ينفّذها postgres_fdw أدناه (راجع الشكل 4.7):
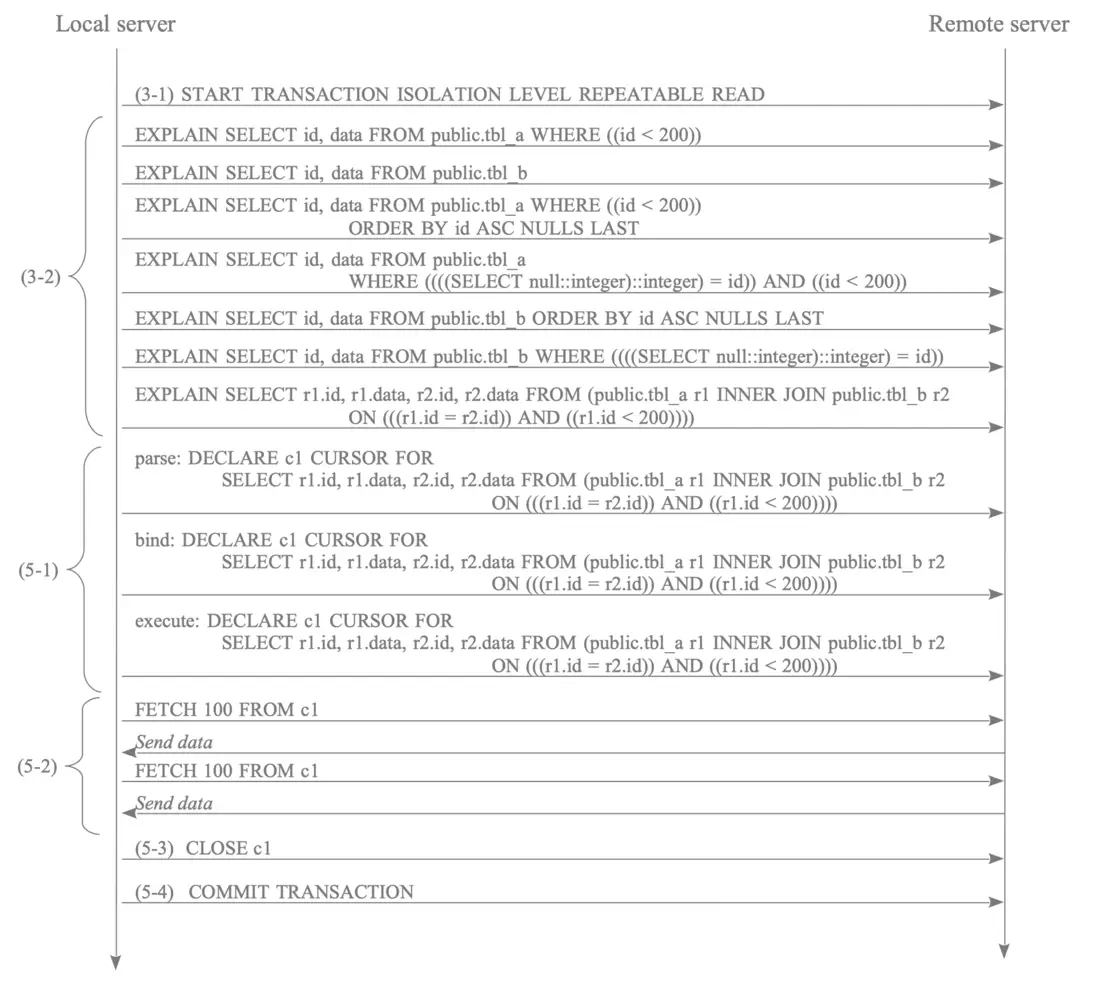
الشكل 4.7. تسلسل عبارات SQL لتنفيذ عملية الربط البعيد في الإصدارات 9.6 أو الأحدث.
- (3-1) بدء المعاملة: تبدأ معاملة بعيدة.
- (3-2) تقدير الكلفة: تُنفَّذ أوامر EXPLAIN لتقدير كلفة كل مسار خطة محتمل.
وفي هذه الحالة تحديدًا، تُنفَّذ سبعة أوامر EXPLAIN. ثم يحدّد المخطِّط استعلام SELECT الأقل كلفة بناءً على القيم المُعادة.
(5-1) تعريف المؤشر (c1): يُعرَّف المؤشر c1 بعبارة الربط البعيد التالية:
SELECT r1.id, r1.data, r2.id, r2.data FROM (public.tbl_a r1 INNER JOIN public.tbl_b r2
  ON (((r1.id = r2.id)) AND ((r1.id < 200))))
(5-2) استرداد النتائج: تُستقبل النتائج المربوطة من الخادم البعيد. (5-3) إغلاق المؤشر (c1): يُغلق المؤشر c1. (5-4) الالتزام: تُلتزم المعاملة البعيدة. ** ** السجل الفعلي للخادم البعيد
LOG:  statement: START TRANSACTION ISOLATION LEVEL REPEATABLE READ
LOG:  statement: EXPLAIN SELECT id, data FROM public.tbl_a WHERE ((id < 200))
LOG:  statement: EXPLAIN SELECT id, data FROM public.tbl_b
LOG:  statement: EXPLAIN SELECT id, data FROM public.tbl_a WHERE ((id < 200)) ORDER BY id ASC NULLS LAST
LOG:  statement: EXPLAIN SELECT id, data FROM public.tbl_a WHERE ((((SELECT null::integer)::integer) = id)) AND ((id < 200))
LOG:  statement: EXPLAIN SELECT id, data FROM public.tbl_b ORDER BY id ASC NULLS LAST
LOG:  statement: EXPLAIN SELECT id, data FROM public.tbl_b WHERE ((((SELECT null::integer)::integer) = id))
LOG:  statement: EXPLAIN SELECT r1.id, r1.data, r2.id, r2.data FROM (public.tbl_a r1 INNER JOIN public.tbl_b r2 ON (((r1.id = r2.id)) AND ((r1.id < 200))))
LOG:  parse: DECLARE c1 CURSOR FOR
	   SELECT r1.id, r1.data, r2.id, r2.data FROM (public.tbl_a r1 INNER JOIN public.tbl_b r2 ON (((r1.id = r2.id)) AND ((r1.id < 200))))
LOG:  bind: DECLARE c1 CURSOR FOR
	   SELECT r1.id, r1.data, r2.id, r2.data FROM (public.tbl_a r1 INNER JOIN public.tbl_b r2 ON (((r1.id = r2.id)) AND ((r1.id < 200))))
LOG:  execute: DECLARE c1 CURSOR FOR
	   SELECT r1.id, r1.data, r2.id, r2.data FROM (public.tbl_a r1 INNER JOIN public.tbl_b r2 ON (((r1.id = r2.id)) AND ((r1.id < 200))))
LOG:  statement: FETCH 100 FROM c1
LOG:  statement: FETCH 100 FROM c1
LOG:  statement: CLOSE c1
LOG:  statement: COMMIT TRANSACTION
ويجدر التنبيه إلى أنه إذا بقي خيار use_remote_estimate على ‘off’، فنادرًا ما يُختار استعلام ربط بعيد. لأن المخطِّط، دون تغذية راجعة من الخادم البعيد، يقدّر كلفة عمليات الربط البعيدة بقيمة ثابتة مضمَّنة كبيرة جدًا، ما يجعل عمليات الربط المحلية تبدو أفضل بالمقارنة.
4.2.2. عمليات الفرز
4.2.2.1. الإصدارات 9.5 أو أقدم
في هذه الإصدارات، تُعالَج عمليات الفرز — مثل تلك التي تُشغِّلها عبارة ORDER BY — حصريًا على الخادم المحلي. وبناءً على ذلك، على الخادم المحلي استرداد جميع الصفوف الهدف من الخادم البعيد قبل أن تبدأ عملية الفرز.
ويوضّح مخرَج EXPLAIN التالي كيفية معالجة استعلام بسيط يحتوي على عبارة ORDER BY:
1
2
3
4
5
6
7
localdb=# EXPLAIN SELECT * FROM tbl_a AS a WHERE a.id < 200 ORDER BY a.id;
                              QUERY PLAN
-----------------------------------------------------------------------
 Sort  (cost=200.59..202.72 rows=853 width=8)
   Sort Key: id
   ->  Foreign Scan on tbl_a a  (cost=100.00..159.06 rows=853 width=8)
(3 rows)
السطر 6: يرسل المنفِّذ الاستعلام التالي إلى الخادم البعيد ويسترد النتائج:
SELECT id, data FROM public.tbl_a WHERE ((id < 200))
السطر 4: ينفّذ المنفِّذ عملية الفرز على الصفوف المستردة من tbl_a محليًا. ** ** السجل الفعلي للخادم البعيد
LOG:  statement: START TRANSACTION ISOLATION LEVEL REPEATABLE READ
LOG:  parse <unnamed>: DECLARE c1 CURSOR FOR
      SELECT id, data FROM public.tbl_a WHERE ((id < 200))
LOG:  bind <unnamed>: DECLARE c1 CURSOR FOR
      SELECT id, data FROM public.tbl_a WHERE ((id < 200))
LOG:  execute <unnamed>: DECLARE c1 CURSOR FOR
      SELECT id, data FROM public.tbl_a WHERE ((id < 200))
LOG:  statement: FETCH 100 FROM c1
LOG:  statement: FETCH 100 FROM c1
LOG:  statement: CLOSE c1
LOG:  statement: COMMIT TRANSACTION
4.2.2.2. الإصدارات 9.6 أو أحدث
بدءًا من الإصدار 9.6، يمكن لـ postgres_fdw تنفيذ عبارات SELECT ذات عبارة ORDER BY مباشرةً على الخادم البعيد عند الإمكان.
1
2
3
4
5
localdb=# EXPLAIN SELECT * FROM tbl_a AS a WHERE a.id < 200 ORDER BY a.id;
                           QUERY PLAN
-----------------------------------------------------------------
 Foreign Scan on tbl_a a  (cost=100.00..167.46 rows=853 width=8)
(1 row)
السطر 4: يرسل المنفِّذ استعلامًا يحتوي على عبارة ORDER BY إلى الخادم البعيد. والنتائج المستردة مفروزة بالفعل، ما يغني عن الفرز المحلي:
SELECT id, data FROM public.tbl_a WHERE ((id < 200)) ORDER BY id ASC NULLS LAST
** ** السجل الفعلي للخادم البعيد
LOG:  statement: START TRANSACTION ISOLATION LEVEL REPEATABLE READ
LOG:  parse <unnamed>: DECLARE c1 CURSOR FOR
	   SELECT id, data FROM public.tbl_a WHERE ((id < 200)) ORDER BY id ASC NULLS LAST
LOG:  bind <unnamed>: DECLARE c1 CURSOR FOR
	   SELECT id, data FROM public.tbl_a WHERE ((id < 200)) ORDER BY id ASC NULLS LAST
LOG:  execute <unnamed>: DECLARE c1 CURSOR FOR
	   SELECT id, data FROM public.tbl_a WHERE ((id < 200)) ORDER BY id ASC NULLS LAST
LOG:  statement: FETCH 100 FROM c1
LOG:  statement: FETCH 100 FROM c1
LOG:  statement: CLOSE c1
LOG:  statement: COMMIT TRANSACTION
ويقلّل هذا التحسين عبء العمل الحسابي على الخادم المحلي وقد يقلّل زمن التنفيذ الإجمالي تقليلًا كبيرًا.
4.2.3. الدوال التجميعية
4.2.3.1. الإصدارات 9.6 أو أقدم
على غرار عمليات الفرز الموصوفة في القسم الفرعي السابق، تُعالَج الدوال التجميعية مثل AVG() وCOUNT() على الخادم المحلي. وتتكوّن العملية من الخطوات التالية:
1
2
3
4
5
6
localdb=# EXPLAIN SELECT AVG(data) FROM tbl_a AS a WHERE a.id < 200;
                              QUERY PLAN
-----------------------------------------------------------------------
 Aggregate  (cost=168.50..168.51 rows=1 width=4)
   ->  Foreign Scan on tbl_a a  (cost=100.00..166.06 rows=975 width=4)
(2 rows)
السطر 5: يسترد المنفِّذ جميع الصفوف الهدف من الخادم البعيد بإرسال الاستعلام التالي:
SELECT id, data FROM public.tbl_a WHERE ((id < 200))
السطر 4: يحسب المنفِّذ متوسط الصفوف المستردة على الخادم المحلي. ** ** السجل الفعلي للخادم البعيد
LOG:  statement: START TRANSACTION ISOLATION LEVEL REPEATABLE READ
LOG:  parse <unnamed>: DECLARE c1 CURSOR FOR
      SELECT data FROM public.tbl_a WHERE ((id < 200))
LOG:  bind <unnamed>: DECLARE c1 CURSOR FOR
      SELECT data FROM public.tbl_a WHERE ((id < 200))
LOG:  execute <unnamed>: DECLARE c1 CURSOR FOR
      SELECT data FROM public.tbl_a WHERE ((id < 200))
LOG:  statement: FETCH 100 FROM c1
LOG:  statement: FETCH 100 FROM c1
LOG:  statement: CLOSE c1
LOG:  statement: COMMIT TRANSACTION
وهذه المقاربة غير كفؤة عند التعامل مع مجموعات بيانات كبيرة، لأن نقل حجم كبير من الصفوف يستهلك عرض نطاق شبكيًا كبيرًا ويزيد زمن التنفيذ.
4.2.3.2. الإصدارات 10 أو أحدث
بدءًا من الإصدار 10، يمكن لـ postgres_fdw تنفيذ عبارات SELECT التي تحتوي على دوال تجميعية مباشرةً على الخادم البعيد عند الإمكان.
1
2
3
4
5
6
localdb=# EXPLAIN SELECT AVG(data) FROM tbl_a AS a WHERE a.id < 200;
                     QUERY PLAN
-----------------------------------------------------
 Foreign Scan  (cost=102.44..149.03 rows=1 width=32)
   Relations: Aggregate on (public.tbl_a a)
(2 rows)
السطر 4: يرسل المنفِّذ استعلامًا يحتوي على الدالة AVG() إلى الخادم البعيد ويسترد النتيجة النهائية فقط.
SELECT avg(data) FROM public.tbl_a WHERE ((id < 200))
** ** السجل الفعلي للخادم البعيد
LOG:  statement: START TRANSACTION ISOLATION LEVEL REPEATABLE READ
LOG:  parse <unnamed>: DECLARE c1 CURSOR FOR
	   SELECT avg(data) FROM public.tbl_a WHERE ((id < 200))
LOG:  bind <unnamed>: DECLARE c1 CURSOR FOR
	   SELECT avg(data) FROM public.tbl_a WHERE ((id < 200))
LOG:  execute <unnamed>: DECLARE c1 CURSOR FOR
	   SELECT avg(data) FROM public.tbl_a WHERE ((id < 200))
LOG:  statement: FETCH 100 FROM c1
LOG:  statement: CLOSE c1
LOG:  statement: COMMIT TRANSACTION
وهذه العملية أكثر كفاءة بكثير لأن الخادم البعيد يُجري الحساب ويرسل صفًا واحدًا فقط كنتيجة، ما يقلّل حركة الشبكة إلى الحد الأدنى.
** الدفع للأسفل (Push-Down)
الدفع للأسفل هو عملية تفويض مهام، مثل التجميع أو الفرز، إلى الخادم البعيد.