معالجة الاستعلامات
3.1. نظرة عامة (Overview)
في PostgreSQL، تتولى عملية خلفية واحدة عادةً معالجة جميع الاستعلامات التي يصدرها عميل متصل.
وتتكوّن الواجهة الخلفية من خمسة أنظمة فرعية رئيسية:
- المحلّل النحوي (Parser): يُنشئ شجرة تحليل من عبارة SQL نصية.
- المحلّل (Analyzer/Analyser): يجري تحليلًا دلاليًا لشجرة التحليل ويُنشئ شجرة استعلام.
- المُعيد الكتابة (Rewriter): يحوّل شجرة الاستعلام وفقًا للقواعد المخزَّنة في نظام القواعد، إن وُجدت مثل هذه القواعد.
- المخطِّط (Planner): يُنشئ شجرة خطة هي الأكثر كفاءة من شجرة الاستعلام.
- المنفِّذ (Executor): ينفّذ الاستعلام بالوصول إلى الجداول والفهارس بالترتيب المحدد في شجرة الخطة.
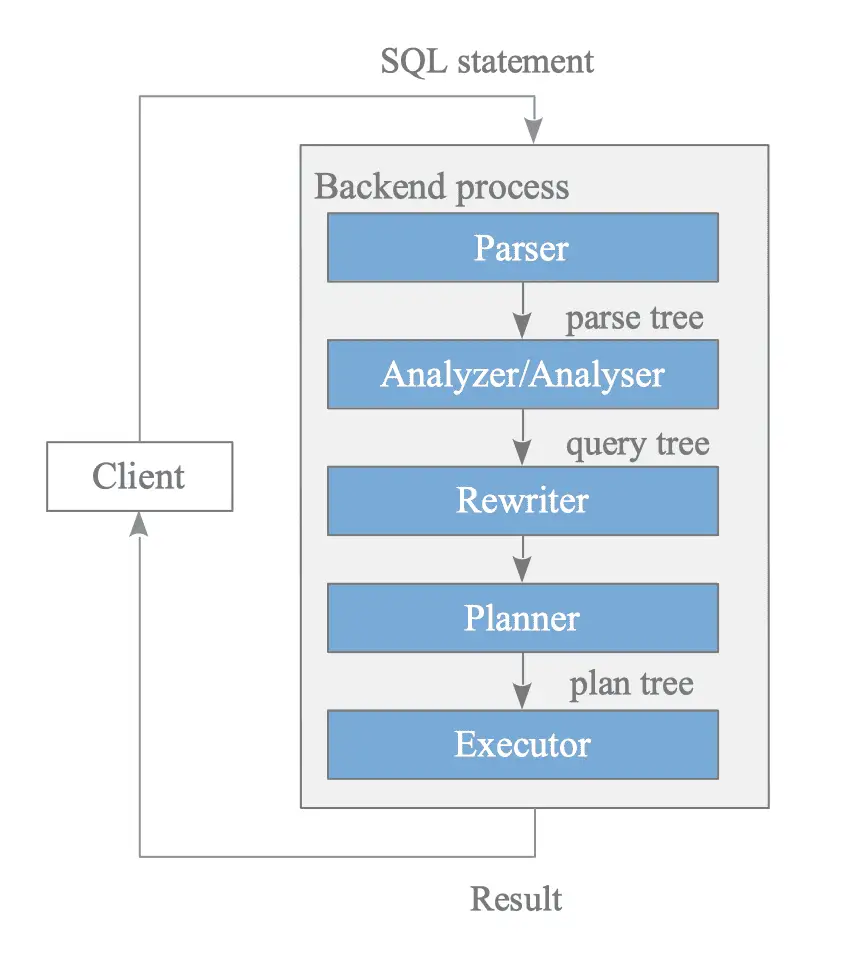
الشكل 3.1. معالجة الاستعلامات.
يقدّم هذا القسم نظرة عامة على هذه الأنظمة الفرعية. ولأن المخطِّط والمنفِّذ بالغي التعقيد، تُشرح وظائفهما بالتفصيل في الأقسام اللاحقة.
محتويات القسم
- 3.1.1. المحلّل النحوي
- 3.1.2. المحلّل (Analyzer/Analyser)
- 3.1.3. المُعيد الكتابة
- 3.1.4. المخطِّط والمنفِّذ
3.1.1. المحلّل النحوي
يُنشئ المحلّل النحوي شجرة تحليل من عبارة SQL نصية يمكن للأنظمة الفرعية اللاحقة معالجتها. وفيما يلي مثال محدد يوضّح هذه العملية.
لنتأمل الاستعلام التالي:
testdb=# SELECT id, data FROM tbl_a WHERE id < 300 ORDER BY data;
شجرة التحليل بنية بيانات جذرها بنية SelectStmt المعرَّفة في parsenodes.h.
ويوضّح الشكل 3.2(ب) شجرة التحليل للاستعلام الموضّح في الشكل 3.2(أ).
** ** SelectStmt
typedef struct SelectStmt
{
	NodeTag		type;

	/*
	 * These fields are used only in "leaf" SelectStmts.
	 */
	List	   *distinctClause; /* NULL, list of DISTINCT ON exprs, or
								 * lcons(NIL,NIL) for all (SELECT DISTINCT) */
	IntoClause *intoClause;		/* target for SELECT INTO */
	List	   *targetList;		/* the target list (of ResTarget) */
	List	   *fromClause;		/* the FROM clause */
	Node	   *whereClause;	/* WHERE qualification */
	List	   *groupClause;	/* GROUP BY clauses */
	bool		groupDistinct;	/* Is this GROUP BY DISTINCT? */
	Node	   *havingClause;	/* HAVING conditional-expression */
	List	   *windowClause;	/* WINDOW window_name AS (...), ... */

	/*
	 * In a "leaf" node representing a VALUES list, the above fields are all
	 * null, and instead this field is set.  Note that the elements of the
	 * sublists are just expressions, without ResTarget decoration. Also note
	 * that a list element can be DEFAULT (represented as a SetToDefault
	 * node), regardless of the context of the VALUES list. It's up to parse
	 * analysis to reject that where not valid.
	 */
	List	   *valuesLists;	/* untransformed list of expression lists */

	/*
	 * These fields are used in both "leaf" SelectStmts and upper-level
	 * SelectStmts.
	 */
	List	   *sortClause;		/* sort clause (a list of SortBy's) */
	Node	   *limitOffset;	/* # of result tuples to skip */
	Node	   *limitCount;		/* # of result tuples to return */
	LimitOption limitOption;	/* limit type */
	List	   *lockingClause;	/* FOR UPDATE (list of LockingClause's) */
	WithClause *withClause;		/* WITH clause */

	/*
	 * These fields are used only in upper-level SelectStmts.
	 */
	SetOperation op;			/* type of set op */
	bool		all;			/* ALL specified? */
	struct SelectStmt *larg;	/* left child */
	struct SelectStmt *rarg;	/* right child */
	/* Eventually add fields for CORRESPONDING spec here */
} SelectStmt;
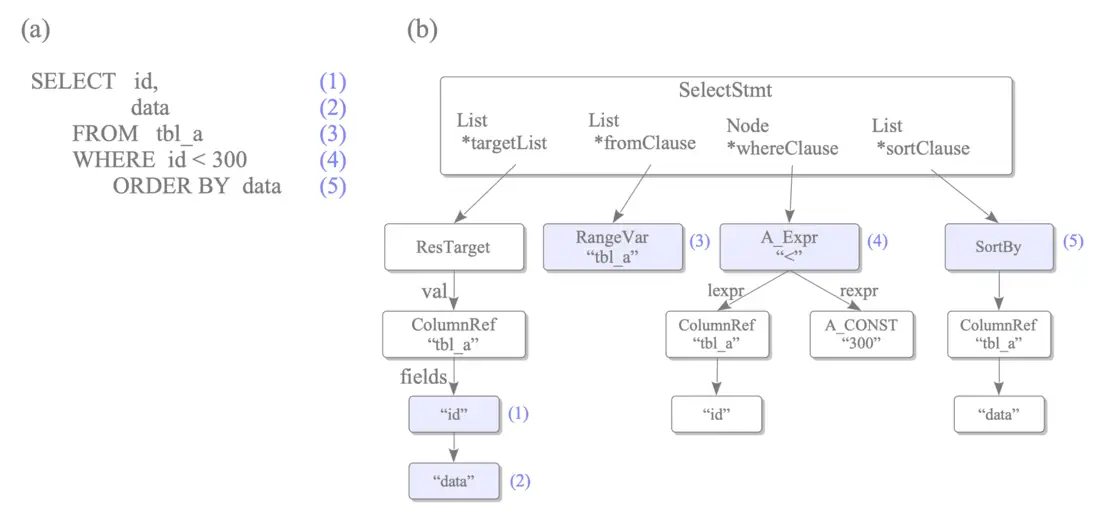
الشكل 3.2. مثال على شجرة تحليل.
تُقابل عناصر استعلام SELECT عُقدًا مقابلة في شجرة التحليل، ويُشار إليها بالأرقام المتطابقة في الشكل 3.2. على سبيل المثال:
- (1) عنصر في قائمة الأهداف، يمثّل العمود ‘id’.
- (4) يمثّل عبارة WHERE.
ويتحقق المحلّل النحوي من صحة بناء الجملة للاستعلام المُدخَل فقط. وبناءً على ذلك، لا يُعيد خطأً إلا إذا كان الاستعلام يحتوي على مخالفة نحوية.
ولا يجري المحلّل النحوي فحوصًا دلالية؛ فعلى سبيل المثال، لن يُعيد خطأً حتى إذا أشار الاستعلام إلى جدول غير موجود. وتتولى جميع عمليات التحقق الدلالي وظيفة المحلّل (analyzer/analyser).
3.1.2. المحلّل (Analyzer/Analyser)
يجري المحلّل تحليلًا دلاليًا لشجرة التحليل التي أنشأها المحلّل النحوي، ويُنتج شجرة استعلام.
وجذر شجرة الاستعلام هو بنية Query المعرَّفة في parsenodes.h. وتحتوي هذه البنية على بيانات وصفية للاستعلام — مثل نوع الأمر (SELECT وINSERT وغيرهما) — وعلى عدة أوراق. وتشكّل كل ورقة قائمة أو شجرة تحمل بيانات لعبارة محددة.
** ** Query
/*
 * Query -
 *	  Parse analysis turns all statements into a Query tree
 *	  for further processing by the rewriter and planner.
 *
 *	  Utility statements (i.e. non-optimizable statements) have the
 *	  utilityStmt field set, and the rest of the Query is mostly dummy.
 *
 *	  Planning converts a Query tree into a Plan tree headed by a PlannedStmt
 *	  node --- the Query structure is not used by the executor.
 *
 *	  All the fields ignored for the query jumbling are not semantically
 *	  significant (such as alias names), as is ignored anything that can
 *	  be deduced from child nodes (else we'd just be double-hashing that
 *	  piece of information).
 */
typedef struct Query
{
	NodeTag		type;

	CmdType		commandType;	/* select|insert|update|delete|merge|utility */

	/* where did I come from? */
	QuerySource querySource pg_node_attr(query_jumble_ignore);

	/*
	 * query identifier (can be set by plugins); ignored for equal, as it
	 * might not be set; also not stored.  This is the result of the query
	 * jumble, hence ignored.
	 *
	 * We store this as a signed value as this is the form it's displayed to
	 * users in places such as EXPLAIN and pg_stat_statements.  Primarily this
	 * is done due to lack of an SQL type to represent the full range of
	 * uint64.
	 */
	int64		queryId pg_node_attr(equal_ignore, query_jumble_ignore, read_write_ignore, read_as(0));

	/* do I set the command result tag? */
	bool		canSetTag pg_node_attr(query_jumble_ignore);

	Node	   *utilityStmt;	/* non-null if commandType == CMD_UTILITY */

	/*
	 * rtable index of target relation for INSERT/UPDATE/DELETE/MERGE; 0 for
	 * SELECT.  This is ignored in the query jumble as unrelated to the
	 * compilation of the query ID.
	 */
	int			resultRelation pg_node_attr(query_jumble_ignore);

	/* has aggregates in tlist or havingQual */
	bool		hasAggs pg_node_attr(query_jumble_ignore);
	/* has window functions in tlist */
	bool		hasWindowFuncs pg_node_attr(query_jumble_ignore);
	/* has set-returning functions in tlist */
	bool		hasTargetSRFs pg_node_attr(query_jumble_ignore);
	/* has subquery SubLink */
	bool		hasSubLinks pg_node_attr(query_jumble_ignore);
	/* distinctClause is from DISTINCT ON */
	bool		hasDistinctOn pg_node_attr(query_jumble_ignore);
	/* WITH RECURSIVE was specified */
	bool		hasRecursive pg_node_attr(query_jumble_ignore);
	/* has INSERT/UPDATE/DELETE/MERGE in WITH */
	bool		hasModifyingCTE pg_node_attr(query_jumble_ignore);
	/* FOR [KEY] UPDATE/SHARE was specified */
	bool		hasForUpdate pg_node_attr(query_jumble_ignore);
	/* rewriter has applied some RLS policy */
	bool		hasRowSecurity pg_node_attr(query_jumble_ignore);
	/* parser has added an RTE_GROUP RTE */
	bool		hasGroupRTE pg_node_attr(query_jumble_ignore);
	/* is a RETURN statement */
	bool		isReturn pg_node_attr(query_jumble_ignore);

	List	   *cteList;		/* WITH list (of CommonTableExpr's) */

	List	   *rtable;			/* list of range table entries */

	/*
	 * list of RTEPermissionInfo nodes for the rtable entries having
	 * perminfoindex > 0
	 */
	List	   *rteperminfos pg_node_attr(query_jumble_ignore);
	FromExpr   *jointree;		/* table join tree (FROM and WHERE clauses);
								 * also USING clause for MERGE */

	List	   *mergeActionList;	/* list of actions for MERGE (only) */

	/*
	 * rtable index of target relation for MERGE to pull data. Initially, this
	 * is the same as resultRelation, but after query rewriting, if the target
	 * relation is a trigger-updatable view, this is the index of the expanded
	 * view subquery, whereas resultRelation is the index of the target view.
	 */
	int			mergeTargetRelation pg_node_attr(query_jumble_ignore);

	/* join condition between source and target for MERGE */
	Node	   *mergeJoinCondition;

	List	   *targetList;		/* target list (of TargetEntry) */

	/* OVERRIDING clause */
	OverridingKind override pg_node_attr(query_jumble_ignore);

	OnConflictExpr *onConflict; /* ON CONFLICT DO [NOTHING | UPDATE] */

	/*
	 * The following three fields describe the contents of the RETURNING list
	 * for INSERT/UPDATE/DELETE/MERGE. returningOldAlias and returningNewAlias
	 * are the alias names for OLD and NEW, which may be user-supplied values,
	 * the defaults "old" and "new", or NULL (if the default "old"/"new" is
	 * already in use as the alias for some other relation).
	 */
	char	   *returningOldAlias pg_node_attr(query_jumble_ignore);
	char	   *returningNewAlias pg_node_attr(query_jumble_ignore);
	List	   *returningList;	/* return-values list (of TargetEntry) */

	List	   *groupClause;	/* a list of SortGroupClause's */
	bool		groupDistinct;	/* is the group by clause distinct? */

	List	   *groupingSets;	/* a list of GroupingSet's if present */

	Node	   *havingQual;		/* qualifications applied to groups */

	List	   *windowClause;	/* a list of WindowClause's */

	List	   *distinctClause; /* a list of SortGroupClause's */

	List	   *sortClause;		/* a list of SortGroupClause's */

	Node	   *limitOffset;	/* # of result tuples to skip (int8 expr) */
	Node	   *limitCount;		/* # of result tuples to return (int8 expr) */
	LimitOption limitOption;	/* limit type */

	List	   *rowMarks;		/* a list of RowMarkClause's */

	Node	   *setOperations;	/* set-operation tree if this is top level of
								 * a UNION/INTERSECT/EXCEPT query */

	/*
	 * A list of pg_constraint OIDs that the query depends on to be
	 * semantically valid
	 */
	List	   *constraintDeps pg_node_attr(query_jumble_ignore);

	/* a list of WithCheckOption's (added during rewrite) */
	List	   *withCheckOptions pg_node_attr(query_jumble_ignore);

	/*
	 * The following two fields identify the portion of the source text string
	 * containing this query.  They are typically only populated in top-level
	 * Queries, not in sub-queries.  When not set, they might both be zero, or
	 * both be -1 meaning "unknown".
	 */
	/* start location, or -1 if unknown */
	ParseLoc	stmt_location;
	/* length in bytes; 0 means "rest of string" */
	ParseLoc	stmt_len pg_node_attr(query_jumble_ignore);
} Query;
يوضّح الشكل 3.3 شجرة الاستعلام للاستعلام الموضّح في الشكل 3.2(أ) من القسم الفرعي السابق.
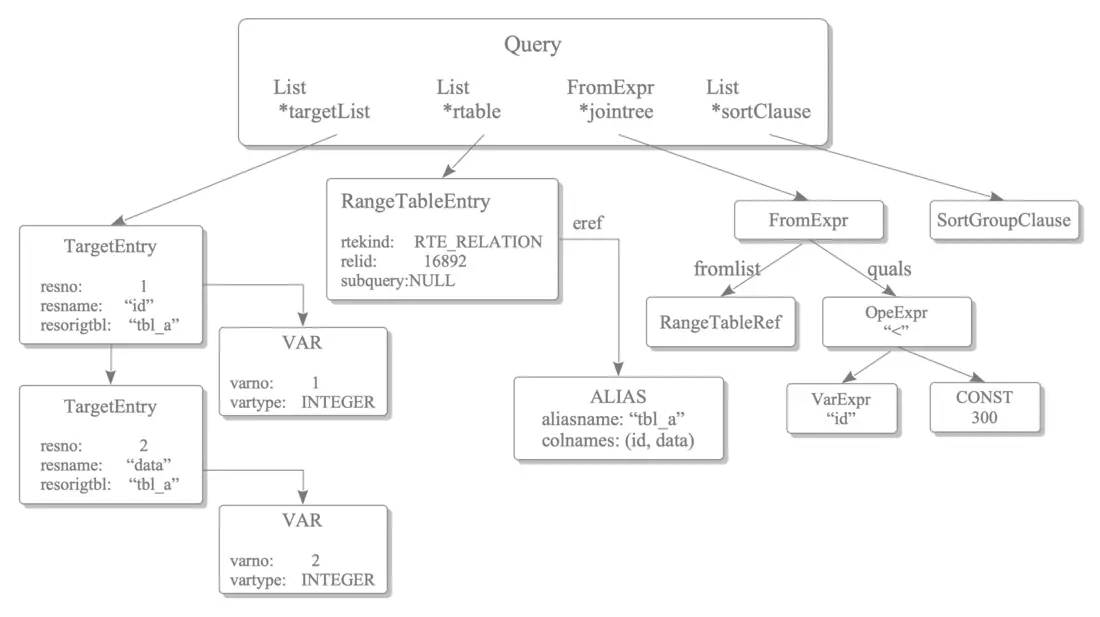
الشكل 3.3. شجرة استعلام استعلام SELECT في الشكل 3.2.
وتُلخَّص شجرة الاستعلام الموضّحة أعلاه كما يلي:
- targetlist: قائمة بالأعمدة التي تشكّل نتيجة الاستعلام. في هذا المثال، تحتوي القائمة على عمودين: ‘id’ و‘data’. وإذا استخدم الاستعلام المُدخَل نجمة (’*’), فإن المحلّل يوسّعها صراحةً إلى جميع الأعمدة المتاحة.
- range table: قائمة بالعلاقات (الجداول) المستخدمة في الاستعلام. في هذا المثال، يحمل جدول النطاق بيانات وصفية للجدول ’tbl_a’، مثل معرّف OID الخاص به واسمه.
- jointree: بنية تخزّن عبارتي FROM وWHERE.
- sortClause: قائمة ببنى
SortGroupClause.
ويصف التوثيق الرسمي تفاصيل أشجار الاستعلام بإيجاز.
3.1.3. المُعيد الكتابة
المُعيد الكتابة هو النظام الفرعي القائم على نظام القواعد. وهو يحوّل شجرة الاستعلام وفقًا للقواعد المخزَّنة في كتالوج النظام pg_rules، عند الاقتضاء.
ورغم أن المُعيد الكتابة ونظام القواعد ميزتان قويتان، يركّز هذا القسم على كيفية تنفيذهما لـ طرق العرض، باستخدام مثال محدد.
3.1.3.1. طرق العرض
عند تعريف طريقة عرض بالأمر CREATE VIEW، تُنشأ قاعدة مقابلة تلقائيًا وتُخزَّن في كتالوج النظام.
افترض أن طريقة العرض التالية قد عُرِّفت وأن قاعدتها المقابلة مخزَّنة في كتالوج النظام pg_rules:
sampledb=# CREATE VIEW employees_list
sampledb-#      AS SELECT e.id, e.name, d.name AS department
sampledb-#            FROM employees AS e, departments AS d WHERE e.department_id = d.id;
وعند إصدار الاستعلام الموضّح أدناه، يُنشئ المحلّل النحوي شجرة تحليل كما هو موضّح في الشكل 3.4(أ).
sampledb=# SELECT * FROM employees_list;
في هذه المرحلة، يحوّل المُعيد الكتابة عقدة جدول النطاق إلى شجرة تحليل استعلام فرعي بناءً على تعريف طريقة العرض المخزَّن في كتالوج النظام pg_rules.
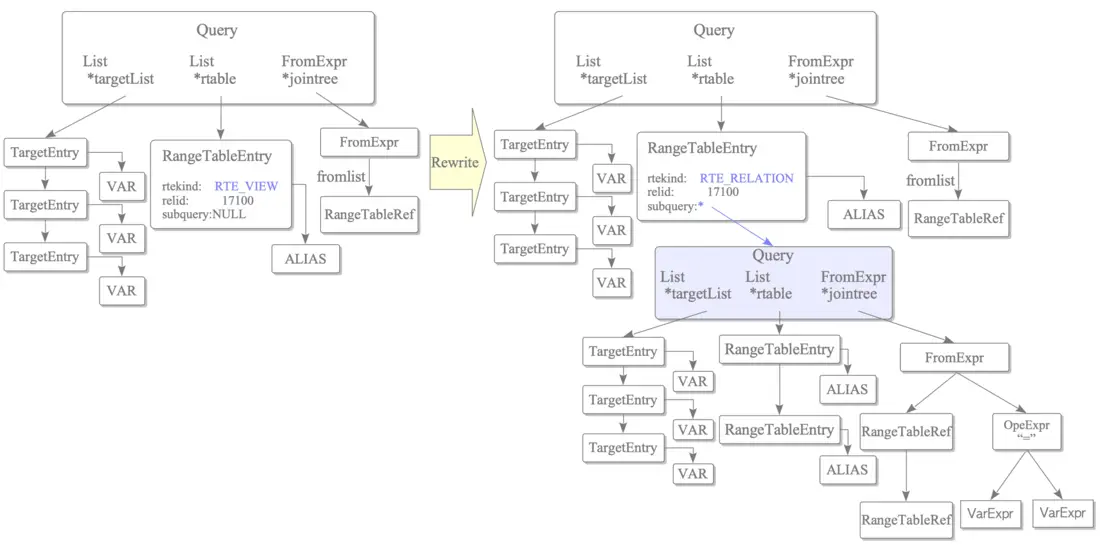
الشكل 3.4. مثال على مرحلة إعادة الكتابة.
** معلومة
ولأن PostgreSQL ينفّذ طرق العرض باستخدام هذه الآلية، لم تكن قابلة للتحديث قبل الإصدار 9.2 (عام 2012). ورغم أن طرق العرض القابلة للتحديث أُدخلت في الإصدار 9.3 (عام 2013)، فلا تزال هناك عدة قيود. لمزيد من التفاصيل، راجع التوثيق الرسمي.
3.1.4. المخطِّط والمنفِّذ
يستقبل المخطِّط شجرة استعلام من المُعيد الكتابة ويُنشئ شجرة خطة (استعلام) مُحسَّنة للتنفيذ الفعّال بواسطة المنفِّذ.
ويعتمد مخطِّط PostgreSQL على التحسين القائم على الكلفة المحض؛ فهو لا يدعم التحسين القائم على القواعد ولا التلميحات. وبوصفه أكثر النظام الفرعي تعقيدًا في PostgreSQL، تُقدَّم نظرة عامة مفصلة على المخطِّط في الأقسام اللاحقة من هذا الفصل.
** pg_hint_plan وpg_plan_advice
قبل الإصدار 19، لم يكن PostgreSQL يدعم أصليًا تلميحات المخطِّط في SQL الأساسية، ما جعل إضافة pg_hint_plan الخيار الأساسي للمطوّرين.
ويقدّم الإصدار 19 (عام 2026) pg_plan_advice كوحدة مساهمة، فتصبح تلميحات الاستعلام متاحة رسميًا.
وعلى غرار أنظمة إدارة قواعد البيانات العلائقية الأخرى، يعرض الأمر EXPLAIN في PostgreSQL شجرة الخطة. ويرد مثال محدد أدناه:
1
2
3
4
5
6
7
8
testdb=# EXPLAIN SELECT * FROM tbl_a WHERE id < 300 ORDER BY data;
                          QUERY PLAN
---------------------------------------------------------------
 Sort  (cost=182.34..183.09 rows=300 width=8)
   Sort Key: data
   ->  Seq Scan on tbl_a  (cost=0.00..170.00 rows=300 width=8)
         Filter: (id < 300)
(4 rows)
يمثّل هذا المخرَج شجرة الخطة الموضّحة في الشكل 3.5.
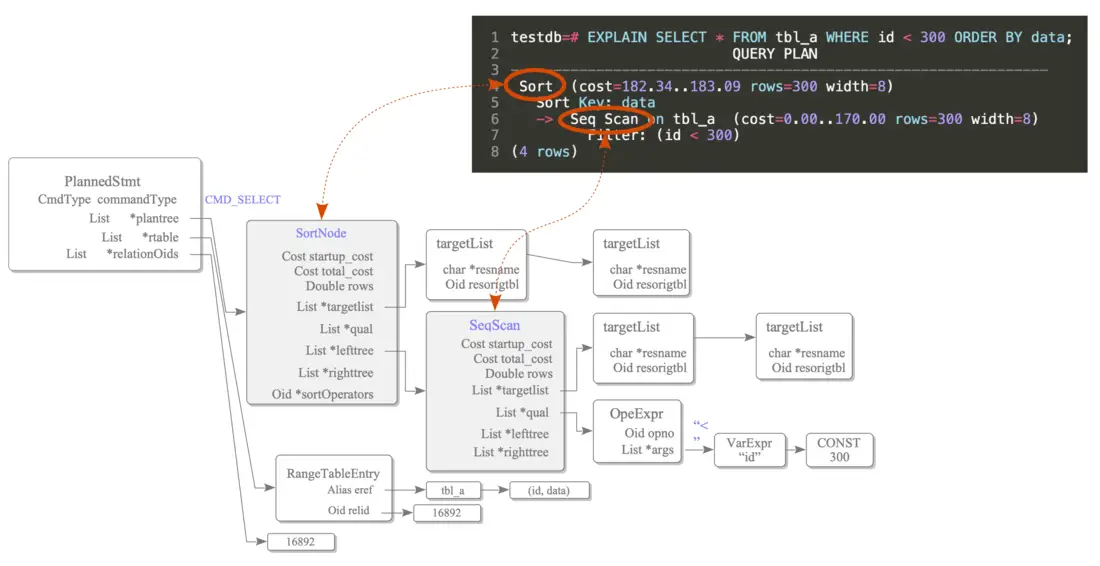
الشكل 3.5. شجرة خطة بسيطة والعلاقة بين شجرة الخطة ونتيجة الأمر EXPLAIN.
تتكوّن شجرة الخطة من عناصر تُسمى عُقد الخطة (plan nodes)، وهي مرتبطة بقائمة plantree في بنية PlannedStmt. وهذه العناصر معرَّفة في plannodes.h. لمزيد من التفاصيل، راجع القسم 3.3.3 والقسم 3.5.4.2.
وتحتوي كل عقدة خطة على البيانات الوصفية التي يحتاجها المنفِّذ. وفي استعلام ذي جدول واحد، تتدفق البيانات عبر شجرة الخطة من الأوراق (الأسفل) إلى الجذر. ويتبع هذا التنفيذ نموذج البركان (Volcano Model) (المعروف أيضًا باسم نموذج المكرِّر Iterator Model)، حيث تُعالَج الصفوف وتُمرَّر إلى الأعلى واحدًا واحدًا.
على سبيل المثال، تتكوّن شجرة الخطة في الشكل 3.5 من عقدة Sort وعقدة مسح تسلسلي. وبناءً على ذلك، ينفّذ المنفِّذ مسحًا تسلسليًا للجدول tbl_a ثم يفرز النتيجة المستردة[1].
ويتفاعل المنفِّذ مع الجداول والفهارس عبر مدير المخازن المؤقتة، كما هو موصوف في الفصل 8. وأثناء المعالجة، يستخدم المنفِّذ مناطق الذاكرة المخصَّصة مثل temp_buffers وwork_mem، ويُنشئ ملفات مؤقتة إذا تجاوزت البيانات الذاكرة المتاحة. انظر الشكل 3.6.
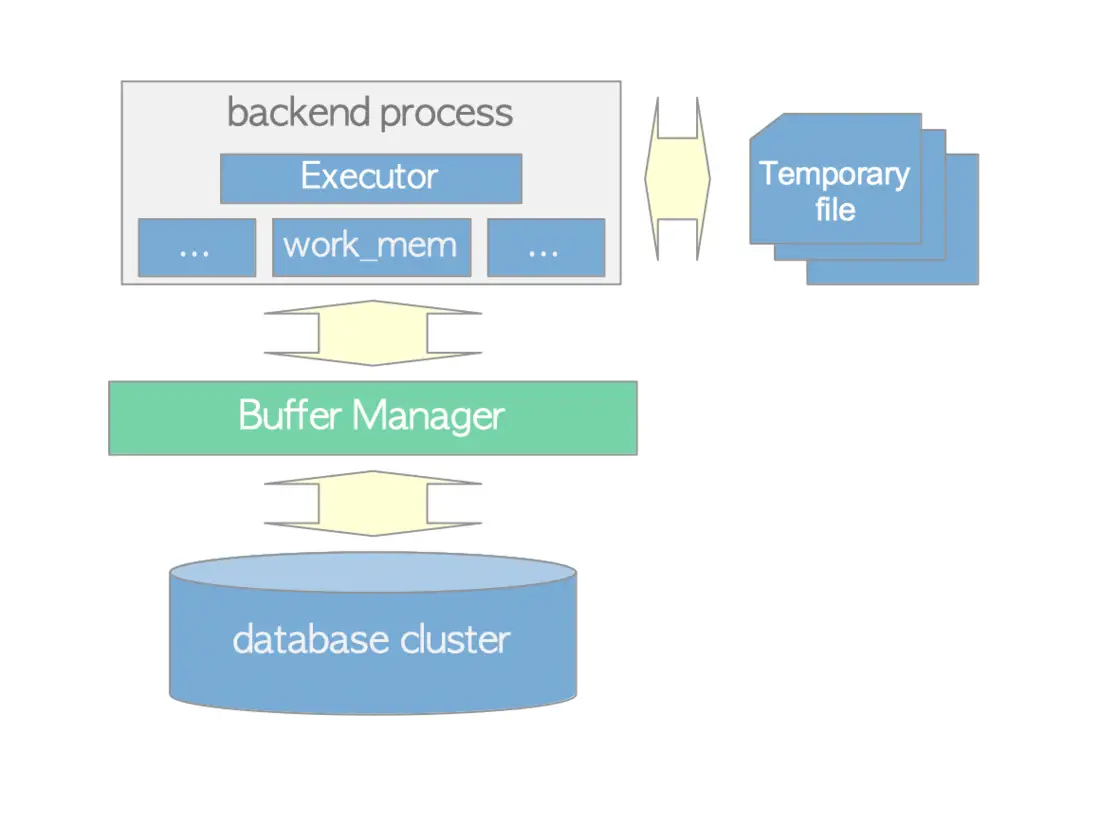
الشكل 3.6. العلاقة بين المنفِّذ ومدير المخازن المؤقتة والملفات المؤقتة.
علاوة على ذلك، عند الوصول إلى الصفوف، يستخدم PostgreSQL آلية تحكّم بالتزامن للحفاظ على ذرّية وعزل المعاملات النشطة. وتُفصَّل هذه الآلية في الفصل 5.
3.2. تقدير الكلفة في استعلام ذي جدول واحد
يستخدم PostgreSQL نموذج تحسين استعلامات قائمًا على الكلفة. والكلف قيم بلا أبعاد؛ فهي لا تعمل كمؤشرات أداء مطلقة، بل تُستخدم لمقارنة الأداء النسبي لعمليات مختلفة.
وتُقدَّر الكلف بواسطة الدوال المعرَّفة في costsize.c. ولكل عملية ينفّذها المنفِّذ دالة كلفة مقابلة. على سبيل المثال، تُحسَب كلفتا المسح التسلسلي ومسح الفهرس بواسطة cost_seqscan() وcost_index() على التوالي.
ويصنّف PostgreSQL الكلف إلى ثلاثة أنواع: كلفة البدء (start-up) وكلفة التشغيل (run) والكلفة الإجمالية (total). ولأن الكلفة الإجمالية هي مجموع كلفة البدء وكلفة التشغيل، فإن الكلفتين الأوليين فقط تُقدَّران بشكل مستقل.
- كلفة البدء (Start-up cost): الكلفة المتكبَّدة قبل جلب أول صف (tuple). وفي مسح الفهرس، تشمل هذه الكلفة كلفة قراءة صفحات الفهرس للوصول إلى أول صف في الجدول الهدف.
- كلفة التشغيل (Run cost): كلفة جلب جميع الصفوف.
- الكلفة الإجمالية (Total cost): الكلفة الكلية، وتُحسَب كمجموع كلفتي البدء والتشغيل.
ويعرض الأمر EXPLAIN كلفة البدء والكلفة الإجمالية لكل عملية. ويُعرض مثال أساسي أدناه:
1
2
3
4
5
testdb=# EXPLAIN SELECT * FROM tbl;
                       QUERY PLAN
---------------------------------------------------------
 Seq Scan on tbl  (cost=0.00..145.00 rows=10000 width=8)
(1 row)
في السطر 4، يقدّم المخرَج تفاصيل المسح التسلسلي. ويحتوي قسم الكلفة على قيمتين: و، تمثّلان كلفة البدء والكلفة الإجمالية على التوالي.
ويستكشف هذا القسم عمليات التقدير للمسح التسلسلي ومسح الفهرس وعمليات الفرز بالتفصيل.
وتستخدم الأمثلة التالية الجدول والفهرس المعرَّفين أدناه:
testdb=# CREATE TABLE tbl (id int PRIMARY KEY, data int);
testdb=# CREATE INDEX tbl_data_idx ON tbl (data);
testdb=# INSERT INTO tbl SELECT generate_series(1,10000),generate_series(1,10000);
testdb=# ANALYZE;
testdb=# \d tbl
      Table "public.tbl"
 Column |  Type   | Modifiers
--------+---------+-----------
 id     | integer | not null
 data   | integer |
Indexes:
    "tbl_pkey" PRIMARY KEY, btree (id)
    "tbl_data_idx" btree (data)
محتويات القسم
- 3.2.1. المسح التسلسلي
- 3.2.2. مسح الفهرس
- 3.2.3. الفرز
- 3.2.4. تقدير العدد الأساسي
3.2.1. المسح التسلسلي
تُقدَّر كلفة المسح التسلسلي بواسطة الدالة cost_seqscan(). ويستكشف هذا القسم الفرعي تقدير الكلفة للاستعلام التالي:
testdb=# SELECT * FROM tbl WHERE id <= 8000;
في المسح التسلسلي، تكون كلفة البدء . وتُعرَّف كلفة التشغيل بالمعادلة التالية:
حيث:
seq_page_cost وcpu_tuple_cost وcpu_operator_cost معاملات تُضبَط في ملف postgresql.conf. وقيمها الافتراضية و و على التوالي. و و هما عدد جميع صفوف هذا الجدول وجميع صفحاته على التوالي. ويمكن استرداد هاتين القيمتين باستخدام الاستعلام التالي:
testdb=# SELECT relpages, reltuples FROM pg_class WHERE relname = 'tbl';
 relpages | reltuples
----------+-----------
       45 |     10000
(1 row)
وبناءً على نتيجة الاستعلام:
لذلك،
وتؤكّد نتيجة الأمر EXPLAIN هذه التقديرات:
1
2
3
4
5
6
testdb=# EXPLAIN SELECT * FROM tbl WHERE id <= 8000;
                       QUERY PLAN
--------------------------------------------------------
 Seq Scan on tbl  (cost=0.00..170.00 rows=8000 width=8)
   Filter: (id <= 8000)
(2 rows)
في السطر 4، يُظهر المخرَج كلفة البدء والكلفة الإجمالية بالقيمتين و. ويقدّر المخطِّط أيضًا أن صف سيُختار.
ويعرض السطر 5 عامل التصفية: «»، المعروف رسميًا باسم مُسند تصفية على مستوى الجدول (table-level filter predicate).
ولاحظ أن هذا النوع من عوامل التصفية يُطبَّق بعد قراءة جميع الصفوف من الجدول؛ فهو لا يقلّل نطاق الصفحات الممسوحة على القرص.
** معلومة
كما يظهر في تقدير كلفة التشغيل، يفترض PostgreSQL أنه يجب قراءة جميع الصفحات من التخزين. ولا يأخذ المحسِّن في الاعتبار ما إذا كانت الصفحات الممسوحة مقيمة حاليًا في المخازن المؤقتة المشتركة.
3.2.2. مسح الفهرس
رغم أن PostgreSQL يدعم أساليب فهرسة متنوعة — مثل B-Tree وGiST وGIN وBRIN — فإن كلفة مسح الفهرس تُقدَّر باستخدام دالة الكلفة المشتركة cost_index().
ويشرح هذا القسم الفرعي عملية تقدير كلفة مسح الفهرس للاستعلام التالي:
testdb=# SELECT id, data FROM tbl WHERE data <= 240;
وقبل التقدير، يجب تحديد عدد صفحات الفهرس () وصفوف الفهرس ():
testdb=# SELECT relpages, reltuples FROM pg_class WHERE relname = 'tbl_data_idx';
 relpages | reltuples
----------+-----------
       30 |     10000
(1 row)
وبناءً على نتيجة الاستعلام:
3.2.2.1. كلفة البدء
تمثّل كلفة بدء مسح الفهرس الكلفة المتكبَّدة من قراءة صفحات الفهرس للوصول إلى أول صف في الجدول الهدف. وتُعرَّف بالمعادلة التالية:
في هذه المعادلة، هو ارتفاع شجرة الفهرس. وتُوثَّق تفاصيل هذا الحساب في تعليقات btcostestimate().
في هذا المثال، يساوي وفقًا للمعادلة (3-3)، و يساوي . وباستخدام القيمة الافتراضية لـ ، يكون الحساب كما يلي:
3.2.2.2. كلفة التشغيل
كلفة تشغيل مسح الفهرس هي مجموع كلفتي المعالج ومدخلات/مخرجات الجدول والفهرس معًا:
** معلومة
إذا طُبِّق المسح بالفهرس فقط (الموصوف في القسم 7.2)، فلا تُقدَّر و.
وتُحسَب المكوّنات الثلاثة الأولى كما يلي:
حيث:
- cpu_index_tuple_cost وrandom_page_cost معاملان يُضبَطان في postgresql.conf (القيمتان الافتراضيتان و على التوالي).
- يمثّل كلفة تقييم مُسند الفهرس (القيمة الافتراضية ).
- هي النسبة المقدَّرة لنطاق بحث الفهرس الذي يحقّق عبارة WHERE (قيمة عشرية بين و). و تمثّل عدد صفوف الجدول الواجب قراءتها.
- تمثّل عدد صفحات الفهرس الواجب قراءتها.
وتُوصف الانتقائية (Selectivity) بالتفصيل في ** التالي.
** الانتقائية (Selectivity)
تُقدَّر انتقائية مُسندات الاستعلام باستخدام إما القيم الأكثر شيوعًا (MCV) وإما حدود المدرج التكراري (histogram_bounds)، وكلاهما مخزَّن كإحصاءات في pg_stats.
وفيما يلي وصف موجز لحساب الانتقائية بأمثلة محددة. لمزيد من التفاصيل، راجع التوثيق الرسمي.
القيم الأكثر شيوعًا (MCV)
تُخزَّن قيم MCV لكل عمود في عرض pg_stats في عمودين مرتبطين:
- most_common_vals: قائمة بأكثر القيم تكرارًا في العمود.
- most_common_freqs: قائمة بتكرارات تلك القيم.
لنتأمل جدولًا باسم «countries» بالبنية التالية:
- country: اسم البلد.
- continent: القارة التي ينتمي إليها البلد.
** ** countries
  1
  2
  3
  4
  5
  6
  7
  8
  9
 10
 11
 12
 13
 14
 15
 16
 17
 18
 19
 20
 21
 22
 23
 24
 25
 26
 27
 28
 29
 30
 31
 32
 33
 34
 35
 36
 37
 38
 39
 40
 41
 42
 43
 44
 45
 46
 47
 48
 49
 50
 51
 52
 53
 54
 55
 56
 57
 58
 59
 60
 61
 62
 63
 64
 65
 66
 67
 68
 69
 70
 71
 72
 73
 74
 75
 76
 77
 78
 79
 80
 81
 82
 83
 84
 85
 86
 87
 88
 89
 90
 91
 92
 93
 94
 95
 96
 97
 98
 99
100
101
102
103
104
105
106
107
108
109
110
111
112
113
114
115
116
117
118
119
120
121
122
123
124
125
126
127
128
129
130
131
132
133
134
135
136
137
138
139
140
141
142
143
144
145
146
147
148
149
150
151
152
153
154
155
156
157
158
159
160
161
162
163
164
165
166
167
168
169
170
171
172
173
174
175
176
177
178
179
180
181
182
183
184
185
186
187
188
189
190
191
192
193
194
195
196
197
198
199
200
201
202
203
204
205
206
207
208
209
210
211
212
213
214
215
216
217
218
219
220
221
222
223
224
225
226
227
228
229
230
231
232
233
234
235
236
237
238
239
240
241
242
243
--
-- PostgreSQL database dump
--

-- Dumped from database version 9.6.0
-- Dumped by pg_dump version 9.6.0

SET statement_timeout = 0;
SET lock_timeout = 0;
SET idle_in_transaction_session_timeout = 0;
SET client_encoding = 'UTF8';
SET standard_conforming_strings = on;
SET check_function_bodies = false;
SET client_min_messages = warning;
SET row_security = off;

SET search_path = public, pg_catalog;

SET default_tablespace = '';

SET default_with_oids = false;

--
-- Name: countries; Type: TABLE; Schema: public; Owner: postgres
--

CREATE TABLE countries (
    continent text,
    country text
);

ALTER TABLE countries OWNER TO postgres;

--
-- Data for Name: countries; Type: TABLE DATA; Schema: public; Owner: postgres
--

COPY countries (continent, country) FROM stdin;
Africa	Algeria
Africa	Angola
Africa	Benin
Africa	Botswana
Africa	Burkina
Africa	Burundi
Africa	Cameroon
Africa	Cape Verde
Africa	Central African Republic
Africa	Chad
Africa	Comoros
Africa	Congo
Africa	Djibouti
Africa	Egypt
Africa	Equatorial Guinea
Africa	Eritrea
Africa	Ethiopia
Africa	Gabon
Africa	Gambia
Africa	Ghana
Africa	Guinea
Africa	Guinea-Bissau
Africa	Ivory Coast
Africa	Kenya
Africa	Lesotho
Africa	Liberia
Africa	Libya
Africa	Madagascar
Africa	Malawi
Africa	Mali
Africa	Mauritania
Africa	Mauritius
Africa	Morocco
Africa	Mozambique
Africa	Namibia
Africa	Niger
Africa	Nigeria
Africa	Rwanda
Africa	Sao Tome and Principe
Africa	Senegal
Africa	Seychelles
Africa	Sierra Leone
Africa	Somalia
Africa	South Africa
Africa	South Sudan
Africa	Sudan
Africa	Swaziland
Africa	Tanzania
Africa	Togo
Africa	Tunisia
Africa	Uganda
Africa	Zambia
Africa	Zimbabwe
Asia	Afghanistan
Asia	Bahrain
Asia	Bangladesh
Asia	Bhutan
Asia	Brunei
Asia	Burma (Myanmar)
Asia	Cambodia
Asia	China
Asia	East Timor
Asia	India
Asia	Indonesia
Asia	Iran
Asia	Iraq
Asia	Israel
Asia	Japan
Asia	Jordan
Asia	Kazakhstan
Asia	North Korea
Asia	South Korea
Asia	Kuwait
Asia	Kyrgyzstan
Asia	Laos
Asia	Lebanon
Asia	Malaysia
Asia	Maldives
Asia	Mongolia
Asia	Nepal
Asia	Oman
Asia	Pakistan
Asia	Philippines
Asia	Qatar
Asia	Russian Federation
Asia	Saudi Arabia
Asia	Singapore
Asia	Sri Lanka
Asia	Syria
Asia	Tajikistan
Asia	Thailand
Asia	Turkey
Asia	Turkmenistan
Asia	United Arab Emirates
Asia	Uzbekistan
Asia	Vietnam
Asia	Yemen
Europe	Albania
Europe	Andorra
Europe	Armenia
Europe	Austria
Europe	Azerbaijan
Europe	Belarus
Europe	Belgium
Europe	Bosnia and Herzegovina
Europe	Bulgaria
Europe	Croatia
Europe	Cyprus
Europe	Czech Republic
Europe	Denmark
Europe	Estonia
Europe	Finland
Europe	France
Europe	Georgia
Europe	Germany
Europe	Greece
Europe	Hungary
Europe	Iceland
Europe	Ireland
Europe	Italy
Europe	Latvia
Europe	Liechtenstein
Europe	Lithuania
Europe	Luxembourg
Europe	Macedonia
Europe	Malta
Europe	Moldova
Europe	Monaco
Europe	Montenegro
Europe	Netherlands
Europe	Norway
Europe	Poland
Europe	Portugal
Europe	Romania
Europe	San Marino
Europe	Serbia
Europe	Slovakia
Europe	Slovenia
Europe	Spain
Europe	Sweden
Europe	Switzerland
Europe	Ukraine
Europe	United Kingdom
Europe	Vatican City
North America	Antigua and Barbuda
North America	Bahamas
North America	Barbados
North America	Belize
North America	Canada
North America	Costa Rica
North America	Cuba
North America	Dominica
North America	Dominican Republic
North America	El Salvador
North America	Grenada
North America	Guatemala
North America	Haiti
North America	Honduras
North America	Jamaica
North America	Mexico
North America	Nicaragua
North America	Panama
North America	Saint Kitts and Nevis
North America	Saint Lucia
North America	Saint Vincent and the Grenadines
North America	Trinidad and Tobago
North America	United States
Oceania	Australia
Oceania	Fiji
Oceania	Kiribati
Oceania	Marshall Islands
Oceania	Micronesia
Oceania	Nauru
Oceania	New Zealand
Oceania	Palau
Oceania	Papua New Guinea
Oceania	Samoa
Oceania	Solomon Islands
Oceania	Tonga
Oceania	Tuvalu
Oceania	Vanuatu
South America	Argentina
South America	Bolivia
South America	Brazil
South America	Chile
South America	Colombia
South America	Ecuador
South America	Guyana
South America	Paraguay
South America	Peru
South America	Suriname
South America	Uruguay
South America	Venezuela
\.

--
-- Name: idx_continent; Type: INDEX; Schema: public; Owner: postgres
--

CREATE INDEX idx_continent ON countries USING btree (continent);

--
-- PostgreSQL database dump complete
--
testdb=# \d countries
   Table "public.countries"
  Column   | Type | Modifiers
-----------+------+-----------
 country   | text |
 continent | text |
Indexes:
    "continent_idx" btree (continent)

testdb=# SELECT continent, count(*) AS "number of countries",
testdb-#     (count(*)/(SELECT count(*) FROM countries)::real) AS "number of countries / all countries"
testdb-#       FROM countries GROUP BY continent ORDER BY "number of countries" DESC;
   continent   | number of countries | number of countries / all countries
---------------+---------------------+-------------------------------------
 Africa        |                  53 |                   0.274611398963731
 Europe        |                  47 |                   0.243523316062176
 Asia          |                  44 |                   0.227979274611399
 North America |                  23 |                   0.119170984455959
 Oceania       |                  14 |                  0.0725388601036269
 South America |                  12 |                  0.0621761658031088
(6 rows)
بالنسبة لاستعلام يحتوي على العبارة WHERE continent = ‘Asia’، يقدّر المخطِّط الكلفة باستخدام قيمة MCV للعمود ‘continent’:
testdb=# SELECT * FROM countries WHERE continent = 'Asia';
لإجراء هذا التقدير، يرجع المخطِّط إلى ‘most_common_vals’ و‘most_common_freqs’ في عرض pg_stats:
testdb=# \x
Expanded display is on.
testdb=# SELECT most_common_vals, most_common_freqs FROM pg_stats
testdb-#                  WHERE tablename = 'countries' AND attname='continent';
-[ RECORD 1 ]-----+-------------------------------------------------------------
most_common_vals  | {Africa,Europe,Asia,"North America",Oceania,"South America"}
most_common_freqs | {0.274611,0.243523,0.227979,0.119171,0.0725389,0.0621762}
وكما هو موضّح أعلاه، فإن التكرار في most_common_freqs المقابل لـ ‘Asia’ في most_common_vals هو . وبناءً على ذلك، تُعتمد هذه القيمة انتقائيةً لتقدير الكلفة.
حدود المدرج التكراري (histogram_bounds)
إذا لم تكن قيم MCV متاحة — على سبيل المثال، عند التعامل مع أنواع صحيحة أو عشرية مزدوجة الدقة فريدة أو شديدة التنوّع — تُستخدم حدود المدرج التكراري (histogram_bounds).
- histogram_bounds: قائمة بالقيم التي تقسم بيانات العمود إلى مجموعات (دِلاء) متساوية في السكان تقريبًا.
فيما يلي مثال على حدود المدرج التكراري للعمود ‘data’ في الجدول tbl:
testdb=# SELECT histogram_bounds FROM pg_stats WHERE tablename = 'tbl' AND attname = 'data';
				              histogram_bounds
----------------------------------------------------------------------------
 {1,100,200,300,400,500,600,700,800,900,1000,1100,1200,1300,1400,1500,1600,
 1700,1800,1900,2000,2100,2200,2300,2400,2500,2600,2700,2800,2900,3000,3100,
 3200,3300,3400,3500,3600,3700,3800,3900,4000,4100,4200,4300,4400,4500,4600,
 4700,4800,4900,5000,5100,5200,5300,5400,5500,5600,5700,5800,5900,6000,6100,
 6200,6300,6400,6500,6600,6700,6800,6900,7000,7100,7200,7300,7400,7500,7600,
 7700,7800,7900,8000,8100,8200,8300,8400,8500,8600,8700,8800,8900,9000,9100,
 9200,9300,9400,9500,9600,9700,9800,9900,10000}
(1 row)
بشكل افتراضي، يقسم histogram_bounds البيانات إلى 100 دلو. ويوضّح الشكل 3.7 هذه الدلاء وحدودها المقابلة.
وتُرقَّم الدلاء بدءًا من 0، وتحتوي كل دلو على العدد نفسه تقريبًا من الصفوف.
وتمثّل قيم histogram_bounds حدود هذه الدلاء. على سبيل المثال، إذا كانت القيمة رقم 0 من حدود المدرج هي والقيمة رقم 1 هي ، فإن الدلو[0] يحتوي على صفوف قيمها في النطاق (أي القيم الأكبر من أو المساوية لـ والأقل من ).

الشكل 3.7. الدلاء وhistogram_bounds.
يُحسَب انتقائية الاستعلام WHERE كما يلي. وبما أن القيمة تقع في الدلو الثاني (بين الحدين و)، يُطبَّق الاستقراء الخطي:
وبناءً على المعادلات (3-1) و(3-3) و(3-4) و(3-6)، تُحسَب الكلف كما يلي:
وتُعرَّف بالمعادلة التالية:
يمثّل أسوأ كلفة إدخال/إخراج، وتحدث عند مسح جميع صفحات الجدول عشوائيًا:
وباستخدام من المعادلة (3-2):
ويمثّل أفضل كلفة إدخال/إخراج، وتحدث عند مسح صفحات الجدول المختارة تسلسليًا:
في هذه الحالة،
تُناقَش بالتفصيل في ** التالي. وفي هذا المثال، الارتباط هو:
وبناءً على ذلك، وفقًا للمعادلات (3-10) و(3-11) و(3-12):
وأخيرًا، تُحدَّد كلفة التشغيل الإجمالية بدمج المعادلات (3-7) و(3-8) و(3-9) و(3-13):
** ارتباط الفهرس (Index Correlation)
ارتباط الفهرس (index correlation) هو الارتباط الإحصائي بين ترتيب الصفوف الفيزيائي والترتيب المنطقي لقيم العمود (كما هو معرَّف في التوثيق الرسمي). وتتراوح هذه القيمة بين و.
ويوضّح المثال التالي العلاقة بين مسح الفهرس وارتباط الفهرس.
يتكوّن الجدول tbl_corr من خمسة أعمدة: عمودان من نوع نصي وثلاثة من نوع صحيح.
وتخزّن الأعمدة الصحيحة قيمًا من إلى . ومن الناحية الفيزيائية، يتكوّن tbl_corr من ثلاث صفحات، وتحتوي كل صفحة على أربعة صفوف. ولكل عمود صحيح فهرس B-Tree مقابل.
testdb=# \d tbl_corr
    Table "public.tbl_corr"
  Column  |  Type   | Modifiers
----------+---------+-----------
 col      | text    |
 col_asc  | integer |
 col_desc | integer |
 col_rand | integer |
 data     | text    |
Indexes:
    "tbl_corr_asc_idx" btree (col_asc)
    "tbl_corr_desc_idx" btree (col_desc)
    "tbl_corr_rand_idx" btree (col_rand)
والتوزيع المنطقي للبيانات كما يلي:
testdb=# SELECT col,col_asc,col_desc,col_rand
testdb-#                         FROM tbl_corr;
   col    | col_asc | col_desc | col_rand
----------+---------+----------+----------
 Tuple_1  |       1 |       12 |        3
 Tuple_2  |       2 |       11 |        8
 Tuple_3  |       3 |       10 |        5
 Tuple_4  |       4 |        9 |        9
 Tuple_5  |       5 |        8 |        7
 Tuple_6  |       6 |        7 |        2
 Tuple_7  |       7 |        6 |       10
 Tuple_8  |       8 |        5 |       11
 Tuple_9  |       9 |        4 |        4
 Tuple_10 |      10 |        3 |        1
 Tuple_11 |      11 |        2 |       12
 Tuple_12 |      12 |        1 |        6
(12 rows)
ويُستردّ ارتباط الفهرس لهذه الأعمدة من عرض pg_stats:
testdb=# SELECT tablename,attname, correlation FROM pg_stats WHERE tablename = 'tbl_corr';
 tablename | attname  | correlation
-----------+----------+-------------
 tbl_corr  | col_asc  |           1
 tbl_corr  | col_desc |          -1
 tbl_corr  | col_rand |    0.125874
(3 rows)
لنتأمل استعلامًا يستهدف قيمًا بين و في ‘col_asc’:
testdb=# SELECT * FROM tbl_corr WHERE col_asc BETWEEN 2 AND 4;
ولأن ترتيب الصفوف الفيزيائي يطابق ترتيب الفهرس المنطقي (الارتباط = )، فإن جميع الصفوف الهدف مخزَّنة في الصفحة الأولى. وبناءً على ذلك، يحتاج المنفِّذ إلى قراءة صفحة واحدة فقط، كما هو موضّح في الشكل 3.8(أ).
وفي المقابل، لنتأمل استعلامًا مماثلًا على ‘col_rand’:
testdb=# SELECT * FROM tbl_corr WHERE col_rand BETWEEN 2 AND 4;
وبسبب الارتباط المنخفض ()، تتوزّع الصفوف الهدف على مواقع فيزيائية مختلفة. وهذا يتطلب من المنفِّذ قراءة جميع الصفحات، كما هو موضّح في الشكل 3.8(ب).
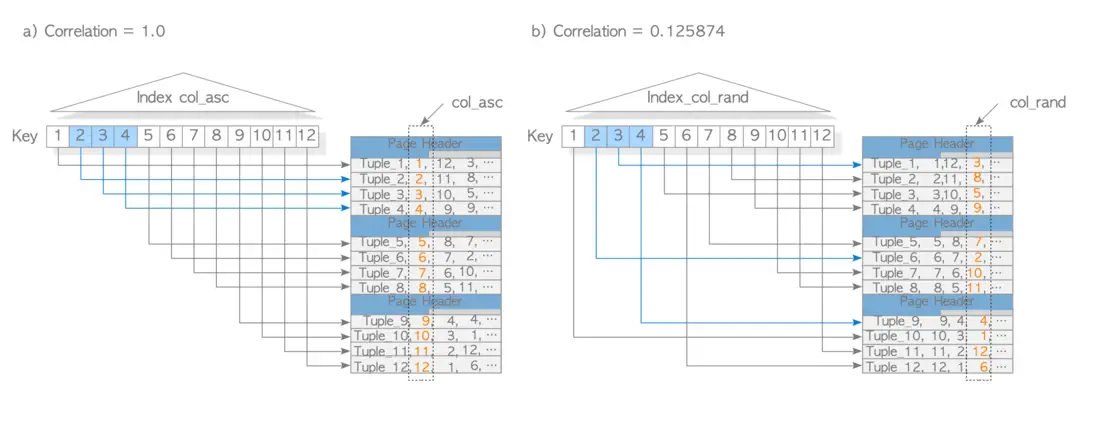
الشكل 3.8. مثالان على ارتباط الفهرس.
وفي النهاية، ارتباط الفهرس مقياس إحصائي يُستخدم أثناء تقدير الكلفة ليعكس تأثير الوصول العشوائي إلى الإدخال/الإخراج. وهو يراعي التباين بين ترتيب الفهرس والترتيب الفيزيائي للصفوف داخل الجدول.
3.2.2.3. الكلفة الإجمالية
بناءً على المعادلتين (3-5) و(3-14)، تُحسَب الكلفة الإجمالية كما يلي:
وتؤكّد نتيجة الأمر EXPLAIN هذه التقديرات:
1
2
3
4
5
6
testdb=# EXPLAIN SELECT id, data FROM tbl WHERE data <= 240;
                                QUERY PLAN
---------------------------------------------------------------------------
 Index Scan using tbl_data_idx on tbl  (cost=0.29..13.49 rows=240 width=8)
   Index Cond: (data <= 240)
(2 rows)
في السطر 4، تُعرض كلفة البدء والكلفة الإجمالية بالقيمتين و على التوالي (مقرَّبتين من القيم المحسوبة). ويقدّر المخطِّط أيضًا أن صفًا (tuple) سيُمسح.
ويعرض السطر 5 شرط الفهرس Index Cond: . وهذا رسميًا مُسند وصول (access predicate)، يحدّد شرطي البدء والتوقف لمسح الفهرس.
** seq_page_cost وrandom_page_cost
القيمتان الافتراضيتان لـ seq_page_cost وrandom_page_cost هما و على التوالي.
وتعني هاتان القيمتان الافتراضيتان أن PostgreSQL يفترض أن الإدخال/الإخراج العشوائي أبطأ أربع مرات من الإدخال/الإخراج التسلسلي، وهي نسبة نموذجية لأقراص التخزين المغناطيسية التقليدية (HDDs).
غير أنه في البيئات الحديثة التي صارت فيها أقراص الحالة الصلبة (SSDs) معيارًا، غالبًا ما تكون القيمة الافتراضية لـ random_page_cost مرتفعة بشكل مفرط. وإذا بقيت هذه القيمة على وضعها الافتراضي أثناء العمل على قرص SSD، فقد يفضّل المخطِّط عمليات المسح التسلسلي على مسح الفهرس حتى عندما يكون الفهرس أكثر كفاءة. ولذلك، يُوصى عمومًا بتقليل random_page_cost إلى في التخزين القائم على SSD.
وتُوثَّق آثار الإعدادات غير المناسبة لـ random_page_cost على أداء الاستعلام في هذه المدونة.
3.2.3. الفرز
يُستخدم مسار الفرز في عمليات مثل ORDER BY والمعالجة المسبقة لعمليات الربط بالدمج ووظائف داخلية أخرى. وتُقدَّر كلف الفرز بواسطة الدالة cost_sort().
وفي عملية الفرز، يعتمد اختيار الخوارزمية على حجم البيانات. فإذا اتسع جميع الصفوف الواجب فرزها للذاكرة المخصَّصة بواسطة work_mem، تُستخدم خوارزمية الفرز السريع (quicksort). وإلا، يُنشأ ملف مؤقت وتُستخدم خوارزمية الفرز الدمجي الخارجي (external merge sort).
وتمثّل كلفة بدء مسار الفرز كلفة عملية الفرز نفسها. ويُعبَّر عنها بالصيغة ، حيث هو عدد الصفوف الواجب فرزها.
وتمثّل كلفة التشغيل كلفة قراءة الصفوف المفروزة بالفعل، وهي .
ويستكشف هذا القسم الفرعي تقدير الكلفة للاستعلام التالي، بافتراض أن العملية تتسع في work_mem دون الحاجة إلى ملفات مؤقتة:
testdb=# SELECT id, data FROM tbl WHERE data <= 240 ORDER BY id;
في هذا السيناريو، تُعرَّف كلفة البدء بالمعادلة التالية:
حيث:
- هي الكلفة الإجمالية للعملية السابقة (في هذه الحالة، مسح الفهرس). ووفقًا للمعادلة (3-15)، فهي .
- هو عدد الصفوف الواجب فرزها، وهو .
- تُعرَّف بأنها .
وباستخدام القيمة الافتراضية البالغة ، تُحسَب كلفة البدء كما يلي:
و هي كلفة قراءة الصفوف المفروزة من الذاكرة:
وبناءً على ذلك، تكون :
ويؤكّد مخرَج الأمر EXPLAIN هذه التقديرات:
1
2
3
4
5
6
7
8
testdb=# EXPLAIN SELECT id, data FROM tbl WHERE data <= 240 ORDER BY id;
                                   QUERY PLAN
---------------------------------------------------------------------------------
 Sort  (cost=22.97..23.57 rows=240 width=8)
   Sort Key: id
   ->  Index Scan using tbl_data_idx on tbl  (cost=0.29..13.49 rows=240 width=8)
         Index Cond: (data <= 240)
(4 rows)
في السطر 4، تُعرض كلفة البدء والكلفة الإجمالية بالقيمتين و على التوالي.
3.2.4. تقدير العدد الأساسي (Cardinality Estimation)
افترضت المناقشات السابقة أن الانتقائية يمكن تحديدها بدقة مطلقة. لكن في الواقع، كان تقدير الانتقائية واحدًا من أكثر المشكلات إلحاحًا وصعوبة في أنظمة قواعد البيانات منذ نشأتها.
3.2.4.1. الانتقائية مقابل العدد الأساسي
بينما يستخدم PostgreSQL داخليًا الانتقائية، يركّز مجال قواعد البيانات الأوسع عمومًا على العدد الأساسي (Cardinality). ويُمثَّل العدد الأساسي بعدد صحيح، وتُعرَّف العلاقة بين الانتقائية والعدد الأساسي كما يلي:
حيث هو العدد الإجمالي للصفوف (rows) في الجدول. وسيُستخدم مصطلح العدد الأساسي في ما يلي بشكل أساسي.
3.2.4.2. بيان صعوبة تقدير العدد الأساسي
يوضّح مثال ملموس صعوبة تقدير العدد الأساسي.
لنتأمل قاعدة بيانات تمثّل 100 قروي. ويسجّل جدول residents فئة العمر (under18 وyoung وmiddle وelder) وحالة رخصة القيادة (none وstandard وgold). (وهنا، «رخصة gold» مصطلح يُستخدم في اليابان لرخصة تُمنح للسائقين الذين لم يتسبّبوا بحوادث أو مخالفات لمدة خمس سنوات.)
إعداد قاعدة البيانات
تُعرَّف بنية الجدول كما يلي:
testdb=# CREATE TYPE license AS ENUM ('none', 'standard', 'gold');
CREATE TYPE
testdb=# CREATE TYPE age AS ENUM ('under18', 'young', 'middle', 'elder');
CREATE TYPE

testdb=# CREATE TABLE residents (id int, name text, license license, age age);
CREATE TABLE

testdb=# \d residents
Table "public.residents"
 Column  |  Type   | Collation | Nullable | Default
---------+---------+-----------+----------+---------
 id      | integer |           |          |
 name    | text    |           |          |
 license | license |           |          |
 age     | age     |           |          |
ويتوفر ملف residents.csv هنا:
** ** residents.csv
$ cat residents.csv
0,,none,under18
1,,none,under18
2,,none,under18
3,,none,under18
4,,none,under18
5,,none,under18
6,,none,under18
7,,none,under18
8,,none,under18
9,,none,under18
10,,none,under18
11,,none,under18
12,,none,under18
13,,none,under18
14,,none,under18
15,,none,under18
16,,none,under18
17,,none,under18
18,,none,under18
19,,none,under18
20,,none,young
21,,none,young
22,,none,young
23,,none,young
24,,none,young
25,,none,young
26,,none,young
27,,standard,young
28,,standard,young
29,,standard,young
30,,standard,young
31,,standard,young
32,,standard,young
33,,standard,young
34,,standard,young
35,,standard,young
36,,standard,young
37,,standard,young
38,,standard,young
39,,standard,young
40,,standard,young
41,,standard,young
42,,standard,young
43,,gold,young
44,,gold,young
45,,none,middle
46,,none,middle
47,,none,middle
48,,none,middle
49,,none,middle
50,,none,middle
51,,none,middle
52,,none,middle
53,,standard,middle
54,,standard,middle
55,,standard,middle
56,,standard,middle
57,,standard,middle
58,,standard,middle
59,,standard,middle
60,,standard,middle
61,,standard,middle
62,,standard,middle
63,,standard,middle
64,,standard,middle
65,,standard,middle
66,,standard,middle
67,,standard,middle
68,,standard,middle
69,,standard,middle
70,,standard,middle
71,,standard,middle
72,,standard,middle
73,,standard,middle
74,,standard,middle
75,,standard,middle
76,,standard,middle
77,,standard,middle
78,,gold,middle
79,,gold,middle
80,,none,elder
81,,none,elder
82,,none,elder
83,,none,elder
84,,none,elder
85,,standard,elder
86,,standard,elder
87,,standard,elder
88,,standard,elder
89,,standard,elder
90,,standard,elder
91,,standard,elder
92,,standard,elder
93,,standard,elder
94,,standard,elder
95,,standard,elder
96,,standard,elder
97,,standard,elder
98,,standard,elder
99,,gold,elder
testdb=# COPY residents FROM '/usr/local/pgsql/residents.csv' (FORMAT csv);
COPY 100
testdb=# ANALYZE;
ANALYZE
توزيع التكرارات
تُستردّ القيم الأكثر شيوعًا (MCVs) وتكراراتها لعمودي age وlicense من pg_stats:
توزيع فئة العمر:
testdb=# SELECT most_common_vals, most_common_freqs FROM pg_stats WHERE tablename = 'residents' AND attname='age';
       most_common_vals       |  most_common_freqs
------------------------------+---------------------
 {middle,young,under18,elder} | {0.35,0.25,0.2,0.2}
(1 row)
| فئة العمر | التكرار | عدد القرويين المقابل (من أصل 100) |
|---|---|---|
| under18 | 0.2 | 20 شخصًا |
| young | 0.25 | 25 شخصًا |
| middle | 0.35 | 35 شخصًا |
| elder | 0.2 | 20 شخصًا |
توزيع حالة الرخصة:
testdb=# SELECT most_common_vals, most_common_freqs FROM pg_stats WHERE tablename = 'residents' AND attname='license';
   most_common_vals   | most_common_freqs
----------------------+-------------------
 {standard,none,gold} | {0.55,0.4,0.05}
(1 row)
| حالة الرخصة | التكرار | عدد القرويين المقابل (من أصل 100) |
|---|---|---|
| none | 0.4 | 40 شخصًا |
| standard | 0.55 | 55 شخصًا |
| gold | 0.05 | 5 أشخاص |
فشل التقدير الأولي (دون إدراك الارتباط)
يُنفَّذ بيان SELECT لاسترداد القرويين الذين تقل أعمارهم عن 18 عامًا ولا يمتلكون رخصة (none). ويقارن EXPLAIN ANALYZE القيمة المقدَّرة من المخطِّط بنتيجة التنفيذ الفعلية:
testdb=# EXPLAIN (ANALYZE TRUE, TIMING FALSE, BUFFERS FALSE)
testdb-# 	 	  SELECT * FROM residents WHERE age = 'under18' AND license = 'none';
                                      QUERY PLAN
--------------------------------------------------------------------------------------
 Seq Scan on residents  (cost=0.00..2.50 rows=8 width=18) (actual rows=20.00 loops=1)
   Filter: ((age = 'under18'::age) AND (license = 'none'::license))
   Rows Removed by Filter: 80
 Planning Time: 0.183 ms
 Execution Time: 0.048 ms
(8 rows)
العدد الأساسي المقدَّر هو ، بينما عدد الصفوف الفعلي هو .
وتعكس هذه القيمة الفعلية القيد الواقعي القائل إن من تقل أعمارهم عن 18 عامًا لا يمكنهم الحصول على رخصة قيادة (بموجب قانون هذه القرية أو القانون الياباني). وبناءً على ذلك، تنتمي مجموعة من تقل أعمارهم عن 18 عامًا بأكملها بالضرورة إلى فئة الرخصة «none»، ما يؤدي إلى صفًا مطابقًا بالضبط.
السبب الجذري: افتراض الاستقلال
يحسب مخطِّط PostgreSQL التقدير بضرب نسبة under18 () في نسبة none ()، بافتراض أن العمودين مستقلان: .
تحسب مخطِّطات معظم أنظمة إدارة قواعد البيانات العلائقية العدد الأساسي بافتراض أن الأعمدة مستقلة بعضها عن بعض ما لم يُنص على خلاف ذلك. وهذا يتجاهل الارتباطات المحتملة بين البيانات. وبناءً على ذلك، كلما قوي الارتباط بين الأعمدة، تراجعت دقة تقدير المخطِّط. ولا يزال تقدير العدد الأساسي مجال بحث نشطًا.
3.2.4.3. حل جزئي: الإحصاءات الموسَّعة
لمعالجة ذلك، أدخل PostgreSQL دعم الإحصاءات الموسَّعة في الإصدار 13. وباستخدام عبارة CREATE STATISTICS، يمكن التقاط الارتباط بين عمودي age وlicense في كائن إحصاءات جديد.
testdb=# CREATE STATISTICS stat_residents (mcv) ON license, age FROM residents;
CREATE STATISTICS
testdb=# ANALYZE;
ANALYZE
وبعد تحليل الإحصاءات الموسَّعة، تصبح نتائج التقدير لفئة العمر under18 أقرب إلى الواقع:
age = ‘under18’ وlicense = ’none’
testdb=# EXPLAIN (ANALYZE TRUE, TIMING FALSE, BUFFERS FALSE)
testdb-# 	 	  SELECT * FROM residents WHERE age = 'under18' AND license = 'none';
                                      QUERY PLAN
-------------------------------------------------------------------------------------
 Seq Scan on residents  (cost=0.00..2.50 rows=20 width=18) (actual rows=20.00 loops=1)
   Filter: ((age = 'under18'::age) AND (license = 'none'::license))
   Rows Removed by Filter: 80
 Planning Time: 0.515 ms
 Execution Time: 0.049 ms
(8 rows)
age = ‘under18’ وlicense = ‘standard’
testdb=# EXPLAIN (ANALYZE TRUE, TIMING FALSE, BUFFERS FALSE)
testdb-# 	 	  SELECT * FROM residents WHERE age = 'under18' AND license = 'standard';
                                     QUERY PLAN
-------------------------------------------------------------------------------------
 Seq Scan on residents  (cost=0.00..2.50 rows=1 width=18) (actual rows=0.00 loops=1)
   Filter: ((age = 'under18'::age) AND (license = 'standard'::license))
   Rows Removed by Filter: 100
 Planning Time: 0.538 ms
 Execution Time: 0.073 ms
(6 rows)
age = ‘under18’ وlicense = ‘gold’
testdb=# EXPLAIN (ANALYZE TRUE, TIMING FALSE, BUFFERS FALSE)
testdb-# 	 	  SELECT * FROM residents WHERE age = 'under18' AND license = 'gold';
                                     QUERY PLAN
-------------------------------------------------------------------------------------
 Seq Scan on residents  (cost=0.00..2.50 rows=1 width=18) (actual rows=0.00 loops=1)
   Filter: ((age = 'under18'::age) AND (license = 'gold'::license))
   Rows Removed by Filter: 100
 Planning Time: 0.112 ms
 Execution Time: 0.053 ms
(6 rows)
يُقدَّر حاملو رخصة «none» ضمن فئة under18 بـ ، وهو رقم دقيق.
أما القيمة المقدَّرة لحاملي رخصتي «standard» و«gold» ضمن فئة under18 فمن المرجّح أنها نتيجة تقريب أو منطق تنعيم، لكنها تمثّل تحسنًا كبيرًا مقارنةً بافتراض الاستقلال.
** حدود الإحصاءات الموسَّعة
يمكن ضبط الإحصاءات الموسَّعة في PostgreSQL للأعمدة ضمن جدول واحد فقط. ولا يمكن تطبيق هذه الميزة على عمليات الربط التي تشمل عدة جداول.
وبناءً على ذلك، لا يزال تقدير العدد الأساسي لعمليات JOIN يمثّل تحدّيًا كبيرًا. ورغم استمرار البحوث المكثفة، لم يتحقق بعد حل عملي قابل للتطبيق عالميًا لتقدير العدد الأساسي عبر الجداول.
3.3. إنشاء شجرة الخطة لاستعلام ذي جدول واحد
ولأن معالجة المخطِّط بالغة التعقيد، يوضّح هذا القسم الحالة الأكثر أساسية: إنشاء شجرة خطة لاستعلام ذي جدول واحد. وتُغطّى العملية الأكثر تعقيدًا لإنشاء أشجار الخطط للاستعلامات متعددة الجداول في القسم 3.6.
وينفّذ مخطِّط PostgreSQL الخطوات الثلاث التالية:
- المعالجة المسبقة (Preprocessing): يجري تحويلات وتبسيطات أولية على الاستعلام.
- إنشاء المسارات وتقدير الكلفة (Path Creation and Cost Estimation): يقدّر كلف جميع مسارات الوصول الممكنة لتحديد الخيار الأقل كلفة.
- إنشاء شجرة الخطة (Plan Tree Creation): يُنشئ شجرة الخطة النهائية بناءً على المسار الأقل كلفة الذي حُدِّد.
ومسار الوصول (access path) وحدة معالجة تُستخدم حصريًا أثناء مرحلة تقدير الكلفة. على سبيل المثال، للمسح التسلسلي ومسح الفهرس والفرز وعمليات الربط المتنوعة مسارات مقابلة لكل منها. وهذه المسارات توجد داخل المخطِّط فقط لتسهيل اختيار خطة مثالية؛ ولا تُستخدم أثناء التنفيذ الفعلي.
وأكثر بنية بيانات أساسية لمسارات الوصول هي بنية Path المعرَّفة في pathnodes.h، وهي تقابل المسح التسلسلي. وجميع مسارات الوصول الأخرى امتدادات أو تنويعات على هذه البنية الأساسية.
** ** Path
typedef struct PathKey
{
	pg_node_attr(no_read, no_query_jumble)

	NodeTag		type;

	/* the value that is ordered */
	EquivalenceClass *pk_eclass pg_node_attr(copy_as_scalar, equal_as_scalar);
	Oid			pk_opfamily;	/* index opfamily defining the ordering */
	CompareType pk_cmptype;		/* sort direction (ASC or DESC) */
	bool		pk_nulls_first; /* do NULLs come before normal values? */
} PathKey;

typedef struct Path
{
	pg_node_attr(no_copy_equal, no_read, no_query_jumble)

	NodeTag		type;

	/* tag identifying scan/join method */
	NodeTag		pathtype;

	/*
	 * the relation this path can build
	 *
	 * We do NOT print the parent, else we'd be in infinite recursion.  We can
	 * print the parent's relids for identification purposes, though.
	 */
	RelOptInfo *parent pg_node_attr(write_only_relids);

	/*
	 * list of Vars/Exprs, cost, width
	 *
	 * We print the pathtarget only if it's not the default one for the rel.
	 */
	PathTarget *pathtarget pg_node_attr(write_only_nondefault_pathtarget);

	/*
	 * parameterization info, or NULL if none
	 *
	 * We do not print the whole of param_info, since it's printed via
	 * RelOptInfo; it's sufficient and less cluttering to print just the
	 * required outer relids.
	 */
	ParamPathInfo *param_info pg_node_attr(write_only_req_outer);

	/* engage parallel-aware logic? */
	bool		parallel_aware;
	/* OK to use as part of parallel plan? */
	bool		parallel_safe;
	/* desired # of workers; 0 = not parallel */
	int			parallel_workers;

	/* estimated size/costs for path (see costsize.c for more info) */
	Cardinality rows;			/* estimated number of result tuples */
	int			disabled_nodes; /* count of disabled nodes */
	Cost		startup_cost;	/* cost expended before fetching any tuples */
	Cost		total_cost;		/* total cost (assuming all tuples fetched) */

	/* sort ordering of path's output; a List of PathKey nodes; see above */
	List	   *pathkeys;
} Path;
لإدارة هذه الخطوات، يحتفظ المخطِّط داخليًا ببنية PlannerInfo، التي تحمل شجرة الاستعلام وبيانات وصفية عن العلاقات المعنية ومسارات الوصول المرشَّحة.
** ** PlannerInfo
/*----------
 * PlannerInfo
 *		Per-query information for planning/optimization
 *
 * This struct is conventionally called "root" in all the planner routines.
 * It holds links to all of the planner's working state, in addition to the
 * original Query.  Note that at present the planner extensively modifies
 * the passed-in Query data structure; someday that should stop.
 *
 * For reasons explained in optimizer/optimizer.h, we define the typedef
 * either here or in that header, whichever is read first.
 *
 * Not all fields are printed.  (In some cases, there is no print support for
 * the field type; in others, doing so would lead to infinite recursion or
 * bloat dump output more than seems useful.)
 *
 * NOTE: When adding new entries containing relids and relid bitmapsets,
 * remember to check that they will be correctly processed by
 * the remove_self_join_rel function - relid of removing relation will be
 * correctly replaced with the keeping one.
 *----------
 */
#ifndef HAVE_PLANNERINFO_TYPEDEF
typedef struct PlannerInfo PlannerInfo;
#define HAVE_PLANNERINFO_TYPEDEF 1
#endif

struct PlannerInfo
{
	pg_node_attr(no_copy_equal, no_read, no_query_jumble)

	NodeTag		type;

	/* the Query being planned */
	Query	   *parse;

	/* global info for current planner run */
	PlannerGlobal *glob;

	/* 1 at the outermost Query */
	Index		query_level;

	/* NULL at outermost Query */
	PlannerInfo *parent_root pg_node_attr(read_write_ignore);

	/*
	 * plan_params contains the expressions that this query level needs to
	 * make available to a lower query level that is currently being planned.
	 * outer_params contains the paramIds of PARAM_EXEC Params that outer
	 * query levels will make available to this query level.
	 */
	/* list of PlannerParamItems, see below */
	List	   *plan_params;
	Bitmapset  *outer_params;

	/*
	 * simple_rel_array holds pointers to "base rels" and "other rels" (see
	 * comments for RelOptInfo for more info).  It is indexed by rangetable
	 * index (so entry 0 is always wasted).  Entries can be NULL when an RTE
	 * does not correspond to a base relation, such as a join RTE or an
	 * unreferenced view RTE; or if the RelOptInfo hasn't been made yet.
	 */
	struct RelOptInfo **simple_rel_array pg_node_attr(array_size(simple_rel_array_size));
	/* allocated size of array */
	int			simple_rel_array_size;

	/*
	 * simple_rte_array is the same length as simple_rel_array and holds
	 * pointers to the associated rangetable entries.  Using this is a shade
	 * faster than using rt_fetch(), mostly due to fewer indirections.  (Not
	 * printed because it'd be redundant with parse->rtable.)
	 */
	RangeTblEntry **simple_rte_array pg_node_attr(read_write_ignore);

	/*
	 * append_rel_array is the same length as the above arrays, and holds
	 * pointers to the corresponding AppendRelInfo entry indexed by
	 * child_relid, or NULL if the rel is not an appendrel child.  The array
	 * itself is not allocated if append_rel_list is empty.  (Not printed
	 * because it'd be redundant with append_rel_list.)
	 */
	struct AppendRelInfo **append_rel_array pg_node_attr(read_write_ignore);

	/*
	 * all_baserels is a Relids set of all base relids (but not joins or
	 * "other" rels) in the query.  This is computed in deconstruct_jointree.
	 */
	Relids		all_baserels;

	/*
	 * outer_join_rels is a Relids set of all outer-join relids in the query.
	 * This is computed in deconstruct_jointree.
	 */
	Relids		outer_join_rels;

	/*
	 * all_query_rels is a Relids set of all base relids and outer join relids
	 * (but not "other" relids) in the query.  This is the Relids identifier
	 * of the final join we need to form.  This is computed in
	 * deconstruct_jointree.
	 */
	Relids		all_query_rels;

	/*
	 * join_rel_list is a list of all join-relation RelOptInfos we have
	 * considered in this planning run.  For small problems we just scan the
	 * list to do lookups, but when there are many join relations we build a
	 * hash table for faster lookups.  The hash table is present and valid
	 * when join_rel_hash is not NULL.  Note that we still maintain the list
	 * even when using the hash table for lookups; this simplifies life for
	 * GEQO.
	 */
	List	   *join_rel_list;
	struct HTAB *join_rel_hash pg_node_attr(read_write_ignore);

	/*
	 * When doing a dynamic-programming-style join search, join_rel_level[k]
	 * is a list of all join-relation RelOptInfos of level k, and
	 * join_cur_level is the current level.  New join-relation RelOptInfos are
	 * automatically added to the join_rel_level[join_cur_level] list.
	 * join_rel_level is NULL if not in use.
	 *
	 * Note: we've already printed all baserel and joinrel RelOptInfos above,
	 * so we don't dump join_rel_level or other lists of RelOptInfos.
	 */
	/* lists of join-relation RelOptInfos */
	List	  **join_rel_level pg_node_attr(read_write_ignore);
	/* index of list being extended */
	int			join_cur_level;

	/* init SubPlans for query */
	List	   *init_plans;

	/*
	 * per-CTE-item list of subplan IDs (or -1 if no subplan was made for that
	 * CTE)
	 */
	List	   *cte_plan_ids;

	/* List of Lists of Params for MULTIEXPR subquery outputs */
	List	   *multiexpr_params;

	/* list of JoinDomains used in the query (higher ones first) */
	List	   *join_domains;

	/* list of active EquivalenceClasses */
	List	   *eq_classes;

	/* set true once ECs are canonical */
	bool		ec_merging_done;

	/* list of "canonical" PathKeys */
	List	   *canon_pathkeys;

	/*
	 * list of OuterJoinClauseInfos for mergejoinable outer join clauses
	 * w/nonnullable var on left
	 */
	List	   *left_join_clauses;

	/*
	 * list of OuterJoinClauseInfos for mergejoinable outer join clauses
	 * w/nonnullable var on right
	 */
	List	   *right_join_clauses;

	/*
	 * list of OuterJoinClauseInfos for mergejoinable full join clauses
	 */
	List	   *full_join_clauses;

	/* list of SpecialJoinInfos */
	List	   *join_info_list;

	/* counter for assigning RestrictInfo serial numbers */
	int			last_rinfo_serial;

	/*
	 * all_result_relids is empty for SELECT, otherwise it contains at least
	 * parse->resultRelation.  For UPDATE/DELETE/MERGE across an inheritance
	 * or partitioning tree, the result rel's child relids are added.  When
	 * using multi-level partitioning, intermediate partitioned rels are
	 * included. leaf_result_relids is similar except that only actual result
	 * tables, not partitioned tables, are included in it.
	 */
	/* set of all result relids */
	Relids		all_result_relids;
	/* set of all leaf relids */
	Relids		leaf_result_relids;

	/*
	 * list of AppendRelInfos
	 *
	 * Note: for AppendRelInfos describing partitions of a partitioned table,
	 * we guarantee that partitions that come earlier in the partitioned
	 * table's PartitionDesc will appear earlier in append_rel_list.
	 */
	List	   *append_rel_list;

	/* list of RowIdentityVarInfos */
	List	   *row_identity_vars;

	/* list of PlanRowMarks */
	List	   *rowMarks;

	/* list of PlaceHolderInfos */
	List	   *placeholder_list;

	/* array of PlaceHolderInfos indexed by phid */
	struct PlaceHolderInfo **placeholder_array pg_node_attr(read_write_ignore, array_size(placeholder_array_size));
	/* allocated size of array */
	int			placeholder_array_size pg_node_attr(read_write_ignore);

	/* list of ForeignKeyOptInfos */
	List	   *fkey_list;

	/* desired pathkeys for query_planner() */
	List	   *query_pathkeys;

	/* groupClause pathkeys, if any */
	List	   *group_pathkeys;

	/*
	 * The number of elements in the group_pathkeys list which belong to the
	 * GROUP BY clause.  Additional ones belong to ORDER BY / DISTINCT
	 * aggregates.
	 */
	int			num_groupby_pathkeys;

	/* pathkeys of bottom window, if any */
	List	   *window_pathkeys;
	/* distinctClause pathkeys, if any */
	List	   *distinct_pathkeys;
	/* sortClause pathkeys, if any */
	List	   *sort_pathkeys;
	/* set operator pathkeys, if any */
	List	   *setop_pathkeys;

	/* Canonicalised partition schemes used in the query. */
	List	   *part_schemes pg_node_attr(read_write_ignore);

	/* RelOptInfos we are now trying to join */
	List	   *initial_rels pg_node_attr(read_write_ignore);

	/*
	 * Upper-rel RelOptInfos. Use fetch_upper_rel() to get any particular
	 * upper rel.
	 */
	List	   *upper_rels[UPPERREL_FINAL + 1] pg_node_attr(read_write_ignore);

	/* Result tlists chosen by grouping_planner for upper-stage processing */
	struct PathTarget *upper_targets[UPPERREL_FINAL + 1] pg_node_attr(read_write_ignore);

	/*
	 * The fully-processed groupClause is kept here.  It differs from
	 * parse->groupClause in that we remove any items that we can prove
	 * redundant, so that only the columns named here actually need to be
	 * compared to determine grouping.  Note that it's possible for *all* the
	 * items to be proven redundant, implying that there is only one group
	 * containing all the query's rows.  Hence, if you want to check whether
	 * GROUP BY was specified, test for nonempty parse->groupClause, not for
	 * nonempty processed_groupClause.  Optimizer chooses specific order of
	 * group-by clauses during the upper paths generation process, attempting
	 * to use different strategies to minimize number of sorts or engage
	 * incremental sort.  See preprocess_groupclause() and
	 * get_useful_group_keys_orderings() for details.
	 *
	 * Currently, when grouping sets are specified we do not attempt to
	 * optimize the groupClause, so that processed_groupClause will be
	 * identical to parse->groupClause.
	 */
	List	   *processed_groupClause;

	/*
	 * The fully-processed distinctClause is kept here.  It differs from
	 * parse->distinctClause in that we remove any items that we can prove
	 * redundant, so that only the columns named here actually need to be
	 * compared to determine uniqueness.  Note that it's possible for *all*
	 * the items to be proven redundant, implying that there should be only
	 * one output row.  Hence, if you want to check whether DISTINCT was
	 * specified, test for nonempty parse->distinctClause, not for nonempty
	 * processed_distinctClause.
	 */
	List	   *processed_distinctClause;

	/*
	 * The fully-processed targetlist is kept here.  It differs from
	 * parse->targetList in that (for INSERT) it's been reordered to match the
	 * target table, and defaults have been filled in.  Also, additional
	 * resjunk targets may be present.  preprocess_targetlist() does most of
	 * that work, but note that more resjunk targets can get added during
	 * appendrel expansion.  (Hence, upper_targets mustn't get set up till
	 * after that.)
	 */
	List	   *processed_tlist;

	/*
	 * For UPDATE, this list contains the target table's attribute numbers to
	 * which the first N entries of processed_tlist are to be assigned.  (Any
	 * additional entries in processed_tlist must be resjunk.)  DO NOT use the
	 * resnos in processed_tlist to identify the UPDATE target columns.
	 */
	List	   *update_colnos;

	/*
	 * Fields filled during create_plan() for use in setrefs.c
	 */
	/* for GroupingFunc fixup (can't print: array length not known here) */
	AttrNumber *grouping_map pg_node_attr(read_write_ignore);
	/* List of MinMaxAggInfos */
	List	   *minmax_aggs;

	/* context holding PlannerInfo */
	MemoryContext planner_cxt pg_node_attr(read_write_ignore);

	/* # of pages in all non-dummy tables of query */
	Cardinality total_table_pages;

	/* tuple_fraction passed to query_planner */
	Selectivity tuple_fraction;
	/* limit_tuples passed to query_planner */
	Cardinality limit_tuples;

	/*
	 * Minimum security_level for quals. Note: qual_security_level is zero if
	 * there are no securityQuals.
	 */
	Index		qual_security_level;

	/* true if any RTEs are RTE_JOIN kind */
	bool		hasJoinRTEs;
	/* true if any RTEs are marked LATERAL */
	bool		hasLateralRTEs;
	/* true if havingQual was non-null */
	bool		hasHavingQual;
	/* true if any RestrictInfo has pseudoconstant = true */
	bool		hasPseudoConstantQuals;
	/* true if we've made any of those */
	bool		hasAlternativeSubPlans;
	/* true once we're no longer allowed to add PlaceHolderInfos */
	bool		placeholdersFrozen;
	/* true if planning a recursive WITH item */
	bool		hasRecursion;

	/*
	 * The rangetable index for the RTE_GROUP RTE, or 0 if there is no
	 * RTE_GROUP RTE.
	 */
	int			group_rtindex;

	/*
	 * Information about aggregates. Filled by preprocess_aggrefs().
	 */
	/* AggInfo structs */
	List	   *agginfos;
	/* AggTransInfo structs */
	List	   *aggtransinfos;
	/* number of aggs with DISTINCT/ORDER BY/WITHIN GROUP */
	int			numOrderedAggs;
	/* does any agg not support partial mode? */
	bool		hasNonPartialAggs;
	/* is any partial agg non-serializable? */
	bool		hasNonSerialAggs;

	/*
	 * These fields are used only when hasRecursion is true:
	 */
	/* PARAM_EXEC ID for the work table */
	int			wt_param_id;
	/* a path for non-recursive term */
	struct Path *non_recursive_path;

	/*
	 * These fields are workspace for createplan.c
	 */
	/* outer rels above current node */
	Relids		curOuterRels;
	/* not-yet-assigned NestLoopParams */
	List	   *curOuterParams;

	/*
	 * These fields are workspace for setrefs.c.  Each is an array
	 * corresponding to glob->subplans.  (We could probably teach
	 * gen_node_support.pl how to determine the array length, but it doesn't
	 * seem worth the trouble, so just mark them read_write_ignore.)
	 */
	bool	   *isAltSubplan pg_node_attr(read_write_ignore);
	bool	   *isUsedSubplan pg_node_attr(read_write_ignore);

	/* optional private data for join_search_hook, e.g., GEQO */
	void	   *join_search_private pg_node_attr(read_write_ignore);

	/* Does this query modify any partition key columns? */
	bool		partColsUpdated;

	/* PartitionPruneInfos added in this query's plan. */
	List	   *partPruneInfos;
};
توضّح الأمثلة التالية تحويل أشجار الاستعلام إلى أشجار خطط.
محتويات القسم
- 3.3.1. المعالجة المسبقة
- 3.3.2. تحديد مسار الوصول الأقل كلفة
- 3.3.3. إنشاء شجرة الخطة
3.3.1. المعالجة المسبقة
قبل إنشاء شجرة الخطة، يجري المخطِّط معالجة مسبقة لشجرة الاستعلام المخزَّنة في بنية PlannerInfo.
ورغم أن المعالجة المسبقة تشمل عمليات عديدة، يركّز هذا القسم الفرعي على الخطوات الرئيسية المتعلقة بالاستعلامات ذات الجدول الواحد. وتُفصَّل عمليات معالجة مسبقة إضافية، مثل تلك المتعلقة بعمليات الربط والاستعلامات الفرعية، في القسم 3.6.
وتشمل خطوات المعالجة المسبقة الجوهرية ما يلي:
- تبسيط قوائم الأهداف والعبارات (Simplifying Target Lists and Clauses): يبسّط المخطِّط قوائم الأهداف وعبارات LIMIT والتعبيرات الأخرى. على سبيل المثال، تُجري الدالة eval_const_expressions()، المعرَّفة في clauses.c، طيّ الثوابت بإعادة كتابة تعبيرات مثل «(1 + 2)» إلى «3».
- تطبيع التعبيرات المنطقية (Normalizing Boolean Expressions): يُبسَّط المنطق البولياني لأغراض الكفاءة؛ فعلى سبيل المثال، تُعاد كتابة النفي المزدوج «NOT(NOT a)» على صورة «a».
- تسطيح تعبيرات AND/OR (Flattening AND/OR Expressions): رغم أن معيار SQL يعرّف AND وOR كعوامل ثنائية، يتعامل PostgreSQL معهما داخليًا كعوامل متعددة المعاملات. ويفترض المخطِّط أن جميع تعبيرات AND وOR المتداخلة ينبغي تسطيحها لتقليل عمق الشجرة وتحسين سرعة التقييم.
وكمثال محدد، لنتأمل التعبير البولياني «(id = 1) OR (id = 2) OR (id = 3)». ويوضّح الشكل 3.9(أ) البنية الأولية لشجرة الاستعلام باستخدام عوامل ثنائية. ويبسّط المخطِّط هذه الشجرة بتسطيحها إلى عامل ثلاثي واحد، كما هو موضّح في الشكل 3.9(ب).
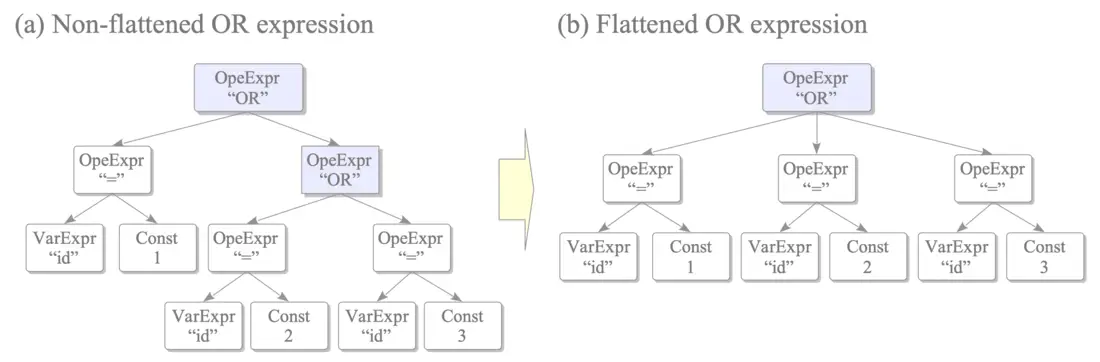
الشكل 3.9. مثال على تسطيح تعبيرات AND/OR.
3.3.2. تحديد مسار الوصول الأقل كلفة
لتحديد مسار الوصول الأقل كلفة، يقدّر المخطِّط كلف جميع مسارات الوصول الممكنة ويختار المسار ذا الكلفة الأدنى. وتحديدًا، ينفّذ المخطِّط العمليات التالية:
- إنشاء بنية RelOptInfo: تُنشأ بنية
RelOptInfoبواسطة الدالة make_one_rel() وتُخزَّن في simple_rel_array ضمن بنيةPlannerInfo(انظر الشكل 3.10). وفي حالتها الأولية، تحمل RelOptInfo العضو baserestrictinfo — الذي يحتوي على عبارات WHERE في الاستعلام — والعضو indexlist، الذي يخزّن البيانات الوصفية لأي فهارس مرتبطة بالجدول الهدف.
** ** RelOptInfo
typedef enum RelOptKind
{
RELOPT_BASEREL,
RELOPT_JOINREL,
RELOPT_OTHER_MEMBER_REL,
RELOPT_OTHER_JOINREL,
RELOPT_UPPER_REL,
RELOPT_OTHER_UPPER_REL
} RelOptKind;
/*
* Is the given relation a simple relation i.e a base or "other" member
* relation?
*/
#define IS_SIMPLE_REL(rel) \
((rel)->reloptkind == RELOPT_BASEREL || \
(rel)->reloptkind == RELOPT_OTHER_MEMBER_REL)
/* Is the given relation a join relation? */
#define IS_JOIN_REL(rel) \
((rel)->reloptkind == RELOPT_JOINREL || \
(rel)->reloptkind == RELOPT_OTHER_JOINREL)
/* Is the given relation an upper relation? */
#define IS_UPPER_REL(rel) \
((rel)->reloptkind == RELOPT_UPPER_REL || \
(rel)->reloptkind == RELOPT_OTHER_UPPER_REL)
/* Is the given relation an "other" relation? */
#define IS_OTHER_REL(rel) \
((rel)->reloptkind == RELOPT_OTHER_MEMBER_REL || \
(rel)->reloptkind == RELOPT_OTHER_JOINREL || \
(rel)->reloptkind == RELOPT_OTHER_UPPER_REL)
typedef struct RelOptInfo
{
pg_node_attr(no_copy_equal, no_read, no_query_jumble)
NodeTag type;
RelOptKind reloptkind;
/*
* all relations included in this RelOptInfo; set of base + OJ relids
* (rangetable indexes)
*/
Relids relids;
/*
* size estimates generated by planner
*/
/* estimated number of result tuples */
Cardinality rows;
/*
* per-relation planner control flags
*/
/* keep cheap-startup-cost paths? */
bool consider_startup;
/* ditto, for parameterized paths? */
bool consider_param_startup;
/* consider parallel paths? */
bool consider_parallel;
/*
* default result targetlist for Paths scanning this relation; list of
* Vars/Exprs, cost, width
*/
struct PathTarget *reltarget;
/*
* materialization information
*/
List *pathlist; /* Path structures */
List *ppilist; /* ParamPathInfos used in pathlist */
List *partial_pathlist; /* partial Paths */
struct Path *cheapest_startup_path;
struct Path *cheapest_total_path;
struct Path *cheapest_unique_path;
List *cheapest_parameterized_paths;
/*
* parameterization information needed for both base rels and join rels
* (see also lateral_vars and lateral_referencers)
*/
/* rels directly laterally referenced */
Relids direct_lateral_relids;
/* minimum parameterization of rel */
Relids lateral_relids;
/*
* information about a base rel (not set for join rels!)
*/
Index relid;
/* containing tablespace */
Oid reltablespace;
/* RELATION, SUBQUERY, FUNCTION, etc */
RTEKind rtekind;
/* smallest attrno of rel (often <0) */
AttrNumber min_attr;
/* largest attrno of rel */
AttrNumber max_attr;
/* array indexed [min_attr .. max_attr] */
Relids *attr_needed pg_node_attr(read_write_ignore);
/* array indexed [min_attr .. max_attr] */
int32 *attr_widths pg_node_attr(read_write_ignore);
/*
* Zero-based set containing attnums of NOT NULL columns. Not populated
* for rels corresponding to non-partitioned inh==true RTEs.
*/
Bitmapset *notnullattnums;
/* relids of outer joins that can null this baserel */
Relids nulling_relids;
/* LATERAL Vars and PHVs referenced by rel */
List *lateral_vars;
/* rels that reference this baserel laterally */
Relids lateral_referencers;
/* list of IndexOptInfo */
List *indexlist;
/* list of StatisticExtInfo */
List *statlist;
/* size estimates derived from pg_class */
BlockNumber pages;
Cardinality tuples;
double allvisfrac;
/* indexes in PlannerInfo's eq_classes list of ECs that mention this rel */
Bitmapset *eclass_indexes;
PlannerInfo *subroot; /* if subquery */
List *subplan_params; /* if subquery */
/* wanted number of parallel workers */
int rel_parallel_workers;
/* Bitmask of optional features supported by the table AM */
uint32 amflags;
/*
* Information about foreign tables and foreign joins
*/
/* identifies server for the table or join */
Oid serverid;
/* identifies user to check access as; 0 means to check as current user */
Oid userid;
/* join is only valid for current user */
bool useridiscurrent;
/* use "struct FdwRoutine" to avoid including fdwapi.h here */
struct FdwRoutine *fdwroutine pg_node_attr(read_write_ignore);
void *fdw_private pg_node_attr(read_write_ignore);
/*
* cache space for remembering if we have proven this relation unique
*/
/* known unique for these other relid set(s) given in UniqueRelInfo(s) */
List *unique_for_rels;
/* known not unique for these set(s) */
List *non_unique_for_rels;
/*
* used by various scans and joins:
*/
/* RestrictInfo structures (if base rel) */
List *baserestrictinfo;
/* cost of evaluating the above */
QualCost baserestrictcost;
/* min security_level found in baserestrictinfo */
Index baserestrict_min_security;
/* RestrictInfo structures for join clauses involving this rel */
List *joininfo;
/* T means joininfo is incomplete */
bool has_eclass_joins;
/*
* used by partitionwise joins:
*/
/* consider partitionwise join paths? (if partitioned rel) */
bool consider_partitionwise_join;
/*
* inheritance links, if this is an otherrel (otherwise NULL):
*/
/* Immediate parent relation (dumping it would be too verbose) */
struct RelOptInfo *parent pg_node_attr(read_write_ignore);
/* Topmost parent relation (dumping it would be too verbose) */
struct RelOptInfo *top_parent pg_node_attr(read_write_ignore);
/* Relids of topmost parent (redundant, but handy) */
Relids top_parent_relids;
/*
* used for partitioned relations:
*/
/* Partitioning scheme */
PartitionScheme part_scheme pg_node_attr(read_write_ignore);
/*
* Number of partitions; -1 if not yet set; in case of a join relation 0
* means it's considered unpartitioned
*/
int nparts;
/* Partition bounds */
struct PartitionBoundInfoData *boundinfo pg_node_attr(read_write_ignore);
/* True if partition bounds were created by partition_bounds_merge() */
bool partbounds_merged;
/* Partition constraint, if not the root */
List *partition_qual;
/*
* Array of RelOptInfos of partitions, stored in the same order as bounds
* (don't print, too bulky and duplicative)
*/
struct RelOptInfo **part_rels pg_node_attr(read_write_ignore);
/*
* Bitmap with members acting as indexes into the part_rels[] array to
* indicate which partitions survived partition pruning.
*/
Bitmapset *live_parts;
/* Relids set of all partition relids */
Relids all_partrels;
/*
* These arrays are of length partkey->partnatts, which we don't have at
* hand, so don't try to print
*/
/* Non-nullable partition key expressions */
List **partexprs pg_node_attr(read_write_ignore);
/* Nullable partition key expressions */
List **nullable_partexprs pg_node_attr(read_write_ignore);
} RelOptInfo;
- تقدير الكلف وإضافة مسارات الوصول: يقيّم المخطِّط جميع أساليب الوصول المحتملة عبر الخطوات الفرعية التالية: المسح التسلسلي: يُنشأ مسار للمسح التسلسلي، وتُقدَّر كلفته، ويُضاف المسار إلى قائمة pathlist في بنية RelOptInfo.
- مسح الفهرس: إذا وُجدت فهارس ملائمة، تُنشأ مسارات وصول للفهرس. ويقدّر المخطِّط كلف عمليات مسح الفهرس هذه ويضيف المسارات الناتجة إلى pathlist.
- المسح بخرائط البتات: إذا كان المسح بخرائط البتات ممكنًا، تُنشأ مسارات مقابلة. وتُقدَّر كلفها وتُضاف إلى pathlist.
اختيار المسار الأقل كلفة: يقارن المخطِّط جميع المدخلات في قائمة pathlist في بنية RelOptInfo ويختار المدخلة ذات الكلفة الإجمالية الأدنى.
تقدير الكلف المساعدة: إذا تضمّن الاستعلام دوال LIMIT أو ORDER BY أو AGGREGATE، يقدّر المخطِّط الكلف الإضافية المرتبطة بهذه العمليات ويحدّث الخطة وفقًا لذلك.
ويوضّح المثالان التاليان هذه العملية بالتفصيل.
3.3.2.1. المثال الأول
يستكشف هذا المثال استعلامًا بسيطًا ذا جدول واحد بلا فهارس. ويتضمّن الاستعلام عبارتي WHERE وORDER BY معًا:
testdb=# \d tbl_1
     Table "public.tbl_1"
 Column |  Type   | Modifiers
--------+---------+-----------
 id     | integer |
 data   | integer |

testdb=# SELECT * FROM tbl_1 WHERE id < 300 ORDER BY data;
ويوضّح الشكلان 3.10 و3.11 عمليات المخطِّط لهذا الاستعلام.
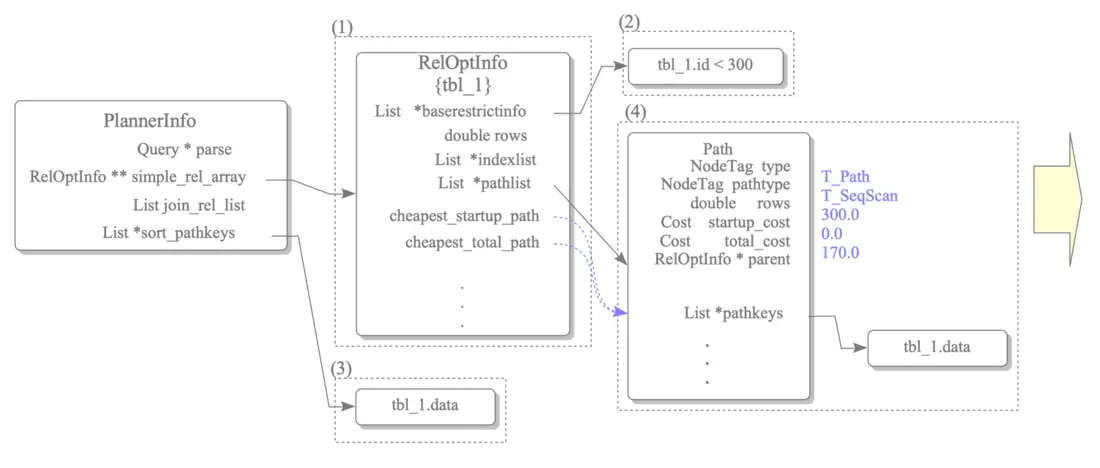
الشكل 3.10. كيفية تحديد المسار الأقل كلفة في المثال الأول
- (1) إنشاء بنية RelOptInfo: يُنشئ المخطِّط بنية RelOptInfo ويخزّنها في simple_rel_array ضمن PlannerInfo.
- (2) إضافة عبارة WHERE إلى baserestrictinfo: تُضاف العبارة «id < 300» إلى baserestrictinfo بواسطة الدالة distribute_restrictinfo_to_rels() (المعرَّفة في initsplan.c). ولأن الجدول الهدف لا يحتوي على فهارس، يبقى indexlist في RelOptInfo بالقيمة NULL.
- (3) إضافة مفتاح pathkey الخاص بالفرز إلى sort_pathkeys: تضيف الدالة standard_qp_callback() (المعرَّفة في planner.c) مفاتيح pathkey الملائمة إلى sort_pathkeys في PlannerInfo. ومفتاح pathkey بنية بيانات تمثّل ترتيب الفرز لمسار ما. وفي هذا المثال، يُضاف العمود ‘data’ كمفتاح pathkey بسبب عبارة ORDER BY.
- (4) تقدير كلفة المسح التسلسلي: يُنشئ المخطِّط بنية
Pathويقدّر كلفة المسح التسلسلي باستخدام الدالة cost_seqscan(). وتُكتب هذه الكلف المقدَّرة في المسار، الذي يُضاف بعد ذلك إلى RelOptInfo بواسطة الدالة add_path() (المعرَّفة في pathnode.c).
ولعدم وجود فهارس، يكون المسح التسلسلي أسلوب الوصول الوحيد المتاح، ما يجعله مسار الوصول الأقل كلفة المحدَّد تلقائيًا للعلاقة الأساسية.
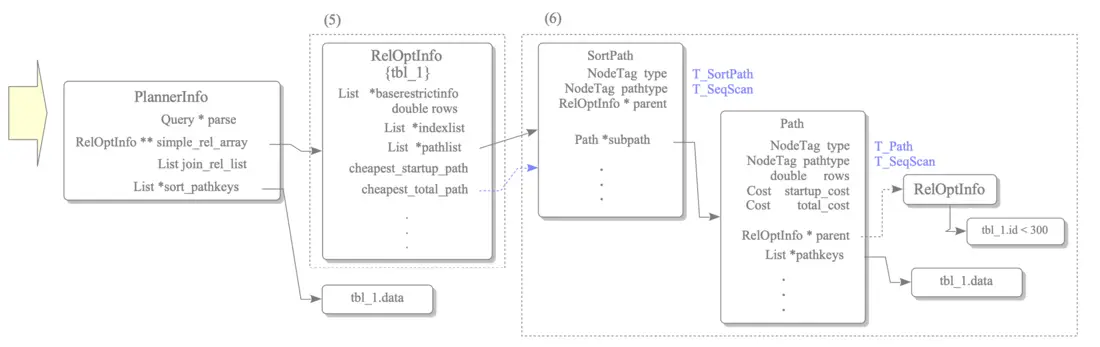
الشكل 3.11. كيفية تحديد المسار الأقل كلفة في المثال الأول. (تابع من الشكل 3.10)
- (5) إنشاء RelOptInfo جديدة للفرز: تُنشأ بنية RelOptInfo جديدة خصيصًا لمعالجة إجراء ORDER BY. ولاحظ أن هذه البنية الجديدة لا تحتوي على baserestrictinfo (معلومات عبارة WHERE).
- (6) إنشاء SortPath وربطه: تُنشأ بنية
SortPathوتُضاف إلى RelOptInfo الجديدة. ويتكوّن SortPath من مكوّنين رئيسيين: المسار نفسه (الذي يخزّن البيانات الوصفية لعملية الفرز) ومسار فرعي (يشير إلى مسار الوصول الأساسي الأقل كلفة).
** ** SortPath
typedef struct SortPath
{
	Path	path;
	Path	*subpath;		/* path representing input source */
} SortPath;
ورغم أن RelOptInfo الجديدة تفتقر إلى baserestrictinfo، فإن حقل parent في مسار المسح التسلسلي يحتفظ برابط إلى RelOptInfo الأصلية. وبناءً على ذلك، يمكن للمخطِّط أثناء مرحلة إنشاء شجرة الخطة (الموصوفة في القسم 3.3.3) أن يربط عبارة WHERE بشكل صحيح بعقدة المسح التسلسلي بوصفها «Filter».
وتُنشأ شجرة الخطة النهائية بناءً على مسار الوصول الأقل كلفة المحدَّد هنا. وتُقدَّم تفاصيل هذا التحويل في القسم 3.3.3.
3.3.2.2. المثال الثاني
يفحص هذا المثال استعلامًا ذا جدول واحد على جدول يحتوي على فهرسين. ويتضمّن الاستعلام عبارة WHERE:
testdb=# \d tbl_2
     Table "public.tbl_2"
 Column |  Type   | Modifiers
--------+---------+-----------
 id     | integer | not null
 data   | integer |
Indexes:
    "tbl_2_pkey" PRIMARY KEY, btree (id)
    "tbl_2_data_idx" btree (data)

testdb=# SELECT * FROM tbl_2 WHERE id < 240;
وتوضّح الأشكال 3.12 حتى 3.14 عمليات المخطِّط لهذا الاستعلام.
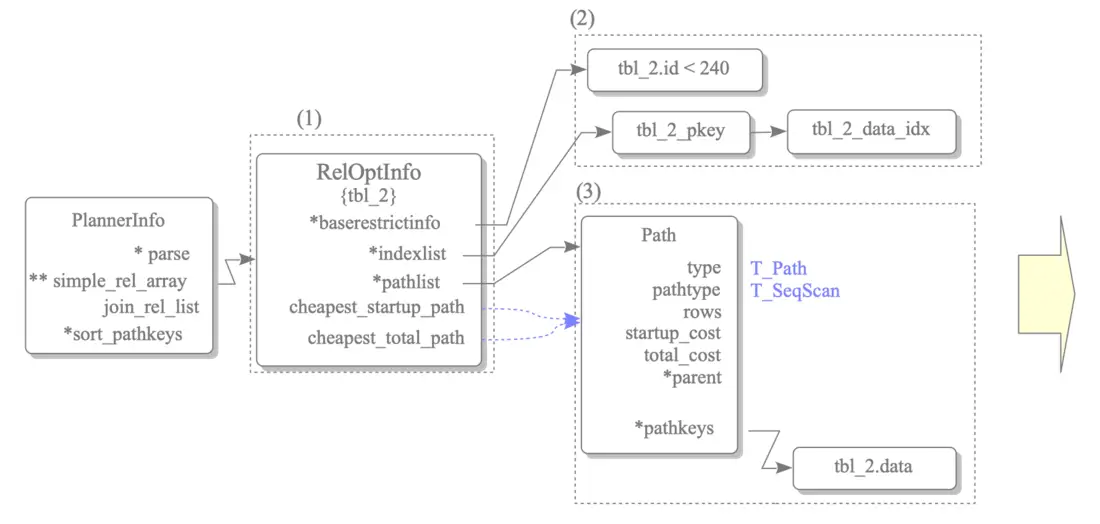
الشكل 3.12. كيفية تحديد المسار الأقل كلفة في المثال الثاني.
- (1) إنشاء بنية RelOptInfo: يهيّئ المخطِّط بنية RelOptInfo للجدول الهدف.
- (2) إضافة baserestrictinfo وindexlist: تُضاف عبارة WHERE «id < 240» إلى baserestrictinfo. وفي الوقت نفسه، تُضاف البيانات الوصفية للفهرسين – tbl_2_pkey وtbl_2_data_idx – إلى indexlist.
- (3) تقدير كلفة المسح التسلسلي: يُنشئ المخطِّط مسار Path للمسح التسلسلي، ويقدّر كلفته، ويضيفه إلى pathlist في RelOptInfo.
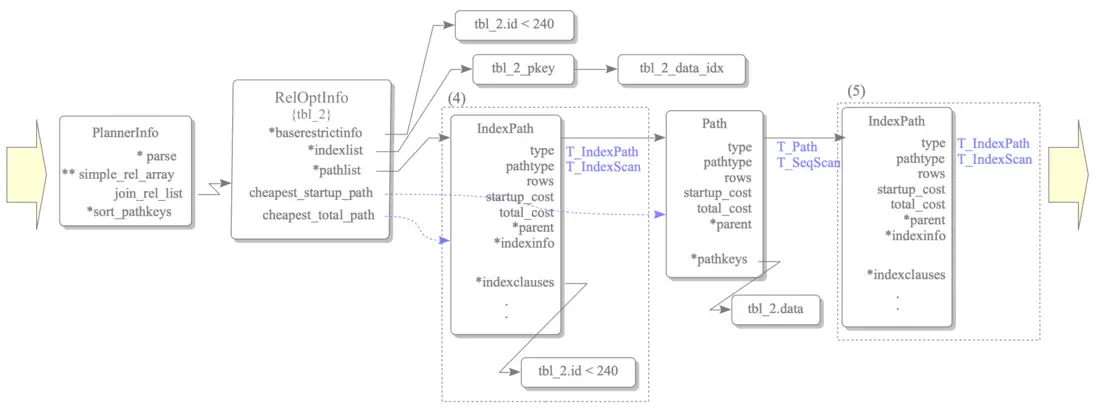
الشكل 3.13. كيفية تحديد المسار الأقل كلفة في المثال الثاني. (تابع من الشكل 3.12)
- (4) إنشاء أول IndexPath وتقييمه: يعالج المخطِّط الفهارس في indexlist تسلسليًا. أولًا، ينشئ
IndexPathالخاص بـ tbl_2_pkey. ولأن tbl_2_pkey معرَّف على العمود ‘id’ وتصفّي عبارة WHERE بواسطة العمود نفسه، تُخزَّن العبارة في حقل indexclauses في IndexPath. ثم تقيّم الدالة add_path() هذا المسار. وإذا كانت كلفته الإجمالية أقل من مسار المسح التسلسلي القائم، فإنه يُدرَج في بداية pathlist. - (5) إنشاء مسارات IndexPath اللاحقة وتقييمها: بعد ذلك، يُنشأ IndexPath الخاص بـ tbl_2_data_idx. غير أنه لأن الاستعلام لا يحتوي على عامل تصفية متعلق بالعمود ‘data’، يبقى indexclauses في هذا المسار بالقيمة NULL. وتُقدَّر الكلفة، ويُمرَّر المسار إلى add_path().
** ** IndexPath
typedef struct IndexPath
{
	Path		path;
	IndexOptInfo *indexinfo;
	List	   *indexclauses;
	List	   *indexorderbys;
	List	   *indexorderbycols;
	ScanDirection indexscandir;
	Cost		indextotalcost;
	Selectivity indexselectivity;
} IndexPath;

/*
 * IndexOptInfo
 *		Per-index information for planning/optimization
 *
 *		indexkeys[] and canreturn[] each have ncolumns entries.
 *
 *		indexcollations[], opfamily[], and opcintype[] each have nkeycolumns
 *		entries.  These don't contain any information about INCLUDE columns.
 *
 *		sortopfamily[], reverse_sort[], and nulls_first[] have
 *		nkeycolumns entries, if the index is ordered; but if it is unordered,
 *		those pointers are NULL.
 *
 *		Zeroes in the indexkeys[] array indicate index columns that are
 *		expressions; there is one element in indexprs for each such column.
 *
 *		For an ordered index, reverse_sort[] and nulls_first[] describe the
 *		sort ordering of a forward indexscan; we can also consider a backward
 *		indexscan, which will generate the reverse ordering.
 *
 *		The indexprs and indpred expressions have been run through
 *		prepqual.c and eval_const_expressions() for ease of matching to
 *		WHERE clauses. indpred is in implicit-AND form.
 *
 *		indextlist is a TargetEntry list representing the index columns.
 *		It provides an equivalent base-relation Var for each simple column,
 *		and links to the matching indexprs element for each expression column.
 *
 *		While most of these fields are filled when the IndexOptInfo is created
 *		(by plancat.c), indrestrictinfo and predOK are set later, in
 *		check_index_predicates().
 */
#ifndef HAVE_INDEXOPTINFO_TYPEDEF
typedef struct IndexOptInfo IndexOptInfo;
#define HAVE_INDEXOPTINFO_TYPEDEF 1
#endif

struct IndexPath;				/* forward declaration */

struct IndexOptInfo
{
	pg_node_attr(no_copy_equal, no_read, no_query_jumble)

	NodeTag		type;

	/* OID of the index relation */
	Oid			indexoid;
	/* tablespace of index (not table) */
	Oid			reltablespace;
	/* back-link to index's table; don't print, else infinite recursion */
	RelOptInfo *rel pg_node_attr(read_write_ignore);

	/*
	 * index-size statistics (from pg_class and elsewhere)
	 */
	/* number of disk pages in index */
	BlockNumber pages;
	/* number of index tuples in index */
	Cardinality tuples;
	/* index tree height, or -1 if unknown */
	int			tree_height;

	/*
	 * index descriptor information
	 */
	/* number of columns in index */
	int			ncolumns;
	/* number of key columns in index */
	int			nkeycolumns;

	/*
	 * table column numbers of index's columns (both key and included
	 * columns), or 0 for expression columns
	 */
	int		   *indexkeys pg_node_attr(array_size(ncolumns));
	/* OIDs of collations of index columns */
	Oid		   *indexcollations pg_node_attr(array_size(nkeycolumns));
	/* OIDs of operator families for columns */
	Oid		   *opfamily pg_node_attr(array_size(nkeycolumns));
	/* OIDs of opclass declared input data types */
	Oid		   *opcintype pg_node_attr(array_size(nkeycolumns));
	/* OIDs of btree opfamilies, if orderable.  NULL if partitioned index */
	Oid		   *sortopfamily pg_node_attr(array_size(nkeycolumns));
	/* is sort order descending? or NULL if partitioned index */
	bool	   *reverse_sort pg_node_attr(array_size(nkeycolumns));
	/* do NULLs come first in the sort order? or NULL if partitioned index */
	bool	   *nulls_first pg_node_attr(array_size(nkeycolumns));
	/* opclass-specific options for columns */
	bytea	  **opclassoptions pg_node_attr(read_write_ignore);
	/* which index cols can be returned in an index-only scan? */
	bool	   *canreturn pg_node_attr(array_size(ncolumns));
	/* OID of the access method (in pg_am) */
	Oid			relam;

	/*
	 * expressions for non-simple index columns; redundant to print since we
	 * print indextlist
	 */
	List	   *indexprs pg_node_attr(read_write_ignore);
	/* predicate if a partial index, else NIL */
	List	   *indpred;

	/* targetlist representing index columns */
	List	   *indextlist;

	/*
	 * parent relation's baserestrictinfo list, less any conditions implied by
	 * the index's predicate (unless it's a target rel, see comments in
	 * check_index_predicates())
	 */
	List	   *indrestrictinfo;

	/* true if index predicate matches query */
	bool		predOK;
	/* true if a unique index */
	bool		unique;
	/* true if the index was defined with NULLS NOT DISTINCT */
	bool		nullsnotdistinct;
	/* is uniqueness enforced immediately? */
	bool		immediate;
	/* true if index doesn't really exist */
	bool		hypothetical;

	/*
	 * Remaining fields are copied from the index AM's API struct
	 * (IndexAmRoutine).  These fields are not set for partitioned indexes.
	 */
	bool		amcanorderbyop;
	bool		amoptionalkey;
	bool		amsearcharray;
	bool		amsearchnulls;
	/* does AM have amgettuple interface? */
	bool		amhasgettuple;
	/* does AM have amgetbitmap interface? */
	bool		amhasgetbitmap;
	bool		amcanparallel;
	/* does AM have ammarkpos interface? */
	bool		amcanmarkpos;
	/* AM's cost estimator */
	/* Rather than include amapi.h here, we declare amcostestimate like this */
	void		(*amcostestimate) (struct PlannerInfo *, struct IndexPath *, double, Cost *, Cost *, Selectivity *, double *, double *) pg_node_attr(read_write_ignore);
};
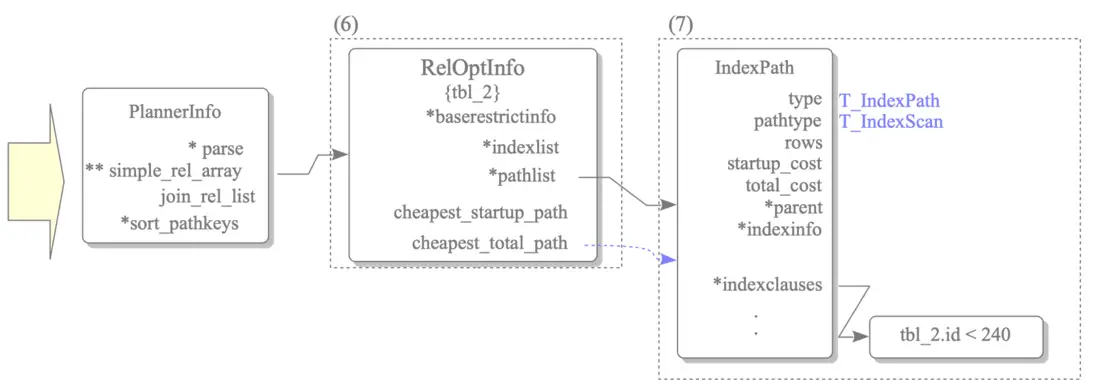
الشكل 3.14. كيفية تحديد المسار الأقل كلفة في المثال الثاني. (تابع من الشكل 3.13)
- (6) إنشاء بنية RelOptInfo جديدة: تُهيَّأ بنية RelOptInfo جديدة لإتمام عملية الاختيار.
- (7) اختيار المسار الأقل كلفة وتخزينه: في هذا المثال، يُختار مسح الفهرس باستخدام tbl_2_pkey بوصفه المسار الأقل كلفة. وبناءً على ذلك، يُضاف هذا المسار إلى pathlist في RelOptInfo الجديدة بوصفه الخطة المثلى.
** ملاحظة
لا تضيف الدالة add_path() بالضرورة كل مسار تستقبله. فقد تُهمل مسارًا جديدًا إذا كان أغلى بكثير من مسار قائم له ترتيب فرز (pathkeys) مماثل أو أفضل. ونظرًا لتعقيد منطق التقليم هذا، راجع تعليقات الشيفرة المصدرية الخاصة بالدالة add_path() لمزيد من التفاصيل.
3.3.3. إنشاء شجرة الخطة
في المرحلة الأخيرة، يُنشئ المخطِّط شجرة خطة بناءً على المسار الأقل كلفة المحدَّد.
وجذر شجرة الخطة بنية PlannedStmt، المعرَّفة في plannodes.h. ورغم أنها تحتوي على تسعة عشر حقلًا، تُوصف أربعة حقول تمثيلية أدناه:
- commandType يخزّن نوع العملية، مثل SELECT أو UPDATE أو INSERT.
- rtable يخزّن مدخلات جدول النطاق.
- relationOids يخزّن معرّفات OIDs للجداول المرتبطة بالاستعلام.
- plantree يخزّن شجرة الخطة الفعلية، وهي تتكوّن من عقد خطط متنوعة.
** ** PlannedStmt
typedef struct PlannedStmt
{
	pg_node_attr(no_equal, no_query_jumble)

	NodeTag		type;

	/* select|insert|update|delete|merge|utility */
	CmdType		commandType;

	/* query identifier (copied from Query) */
	int64		queryId;

	/* plan identifier (can be set by plugins) */
	int64		planId;

	/* is it insert|update|delete|merge RETURNING? */
	bool		hasReturning;

	/* has insert|update|delete|merge in WITH? */
	bool		hasModifyingCTE;

	/* do I set the command result tag? */
	bool		canSetTag;

	/* redo plan when TransactionXmin changes? */
	bool		transientPlan;

	/* is plan specific to current role? */
	bool		dependsOnRole;

	/* parallel mode required to execute? */
	bool		parallelModeNeeded;

	/* which forms of JIT should be performed */
	int			jitFlags;

	/* tree of Plan nodes */
	struct Plan *planTree;

	/*
	 * List of PartitionPruneInfo contained in the plan
	 */
	List	   *partPruneInfos;

	/* list of RangeTblEntry nodes */
	List	   *rtable;

	/*
	 * RT indexes of relations that are not subject to runtime pruning or are
	 * needed to perform runtime pruning
	 */
	Bitmapset  *unprunableRelids;

	/*
	 * list of RTEPermissionInfo nodes for rtable entries needing one
	 */
	List	   *permInfos;

	/* rtable indexes of target relations for INSERT/UPDATE/DELETE/MERGE */
	/* integer list of RT indexes, or NIL */
	List	   *resultRelations;

	/* list of AppendRelInfo nodes */
	List	   *appendRelations;

	/*
	 * Plan trees for SubPlan expressions; note that some could be NULL
	 */
	List	   *subplans;

	/* indices of subplans that require REWIND */
	Bitmapset  *rewindPlanIDs;

	/* a list of PlanRowMark's */
	List	   *rowMarks;

	/* OIDs of relations the plan depends on */
	List	   *relationOids;

	/* other dependencies, as PlanInvalItems */
	List	   *invalItems;

	/* type OIDs for PARAM_EXEC Params */
	List	   *paramExecTypes;

	/* non-null if this is utility stmt */
	Node	   *utilityStmt;

	/* statement location in source string (copied from Query) */
	/* start location, or -1 if unknown */
	ParseLoc	stmt_location;
	/* length in bytes; 0 means "rest of string" */
	ParseLoc	stmt_len;
} PlannedStmt;
وتقابل كل عقدة في شجرة الخطة عملية معينة، مثل مسح تسلسلي أو فرز أو مسح فهرس.
وتعمل بنية PlanNode كعقدة أساسية، وتبدأ جميع عقد الخطط المحددة الأخرى (مثل SeqScan أو Sort) بحقل Plan.
وعلى سبيل المثال، تتكوّن ScanNode، وهي نوع مجرّد ترث منه جميع أنواع خطط مسح العلاقات، من بنية Plan يتبعها المتغير الصحيح scanrelid.
وتحتوي بنية PlanNode على أربعة عشر حقلًا، منها الحقول السبعة التمثيلية التالية:
- startup_cost وtotal_cost تمثّلان الكلف المقدَّرة للعملية المقابلة للعقدة.
- plan_rows هو العدد المقدَّر للصفوف الواجب مسحها.
- targetlist يخزّن عناصر قائمة الأهداف المستردة من شجرة الاستعلام.
- qual قائمة بشروط التأهيل (عوامل التصفية) الواجب تطبيقها.
- lefttree وrighttree مؤشّران إلى العقد الفرعية، ما يتيح البنية الهرمية للشجرة.
** ** PlanNode
/* ----------------
 *		Plan node
 *
 * All plan nodes "derive" from the Plan structure by having the
 * Plan structure as the first field.  This ensures that everything works
 * when nodes are cast to Plan's.  (node pointers are frequently cast to Plan*
 * when passed around generically in the executor)
 *
 * We never actually instantiate any Plan nodes; this is just the common
 * abstract superclass for all Plan-type nodes.
 * ----------------
 */
typedef struct Plan
{
	pg_node_attr(abstract, no_equal, no_query_jumble)

	NodeTag		type;

	/*
	 * estimated execution costs for plan (see costsize.c for more info)
	 */
	/* count of disabled nodes */
	int			disabled_nodes;
	/* cost expended before fetching any tuples */
	Cost		startup_cost;
	/* total cost (assuming all tuples fetched) */
	Cost		total_cost;

	/*
	 * planner's estimate of result size of this plan step
	 */
	/* number of rows plan is expected to emit */
	Cardinality plan_rows;
	/* average row width in bytes */
	int			plan_width;

	/*
	 * information needed for parallel query
	 */
	/* engage parallel-aware logic? */
	bool		parallel_aware;
	/* OK to use as part of parallel plan? */
	bool		parallel_safe;

	/*
	 * information needed for asynchronous execution
	 */
	/* engage asynchronous-capable logic? */
	bool		async_capable;

	/*
	 * Common structural data for all Plan types.
	 */
	/* unique across entire final plan tree */
	int			plan_node_id;
	/* target list to be computed at this node */
	List	   *targetlist;
	/* implicitly-ANDed qual conditions */
	List	   *qual;
	/* input plan tree(s) */
	struct Plan *lefttree;
	struct Plan *righttree;
	/* Init Plan nodes (un-correlated expr subselects) */
	List	   *initPlan;

	/*
	 * Information for management of parameter-change-driven rescanning
	 *
	 * extParam includes the paramIDs of all external PARAM_EXEC params
	 * affecting this plan node or its children.  setParam params from the
	 * node's initPlans are not included, but their extParams are.
	 *
	 * allParam includes all the extParam paramIDs, plus the IDs of local
	 * params that affect the node (i.e., the setParams of its initplans).
	 * These are _all_ the PARAM_EXEC params that affect this node.
	 */
	Bitmapset  *extParam;
	Bitmapset  *allParam;
} Plan;
** ** ScanNode
/*
 * ==========
 * Scan nodes
 *
 * Scan is an abstract type that all relation scan plan types inherit from.
 * ==========
 */
typedef struct Scan
{
	pg_node_attr(abstract)

	Plan		plan;
	/* relid is index into the range table */
	Index		scanrelid;
} Scan;

/* ----------------
 *		sequential scan node
 * ----------------
 */
typedef struct SeqScan
{
	Scan		scan;
} SeqScan;
تصف الأقسام التالية شجرتي الخطة المنشأتين من المسارين الأقل كلفة المحدَّدين في المثالين السابقين.
3.3.3.1. المثال الأول
يصف هذا القسم شجرة الخطة المنشأة للاستعلام في القسم 3.3.2.1.
ويتكوّن المسار الأقل كلفة، الموضّح في الشكل 3.11، من SortPath كجذر ومسار مسح تسلسلي كابن له.
ورغم أن التفاصيل المعقّدة لعملية التحويل تُحذف هنا، فإن شجرة الخطة تُنشأ بشكل شبه مباشر من البنية الهرمية للمسار الأقل كلفة.
في هذا المثال، تُسنَد عقدة SortNode إلى حقل plantree في بنية PlannedStmt، وتُسنَد عقدة SeqScanNode إلى lefttree في عقدة Sort. وتظهر هذه البنية في الشكل 3.15(أ).
** ** SortNode
/* ----------------
 *		sort node
 * ----------------
 */
typedef struct Sort
{
	Plan		plan;

	/* number of sort-key columns */
	int			numCols;

	/* their indexes in the target list */
	AttrNumber *sortColIdx pg_node_attr(array_size(numCols));

	/* OIDs of operators to sort them by */
	Oid		   *sortOperators pg_node_attr(array_size(numCols));

	/* OIDs of collations */
	Oid		   *collations pg_node_attr(array_size(numCols));

	/* NULLS FIRST/LAST directions */
	bool	   *nullsFirst pg_node_attr(array_size(numCols));
} Sort;
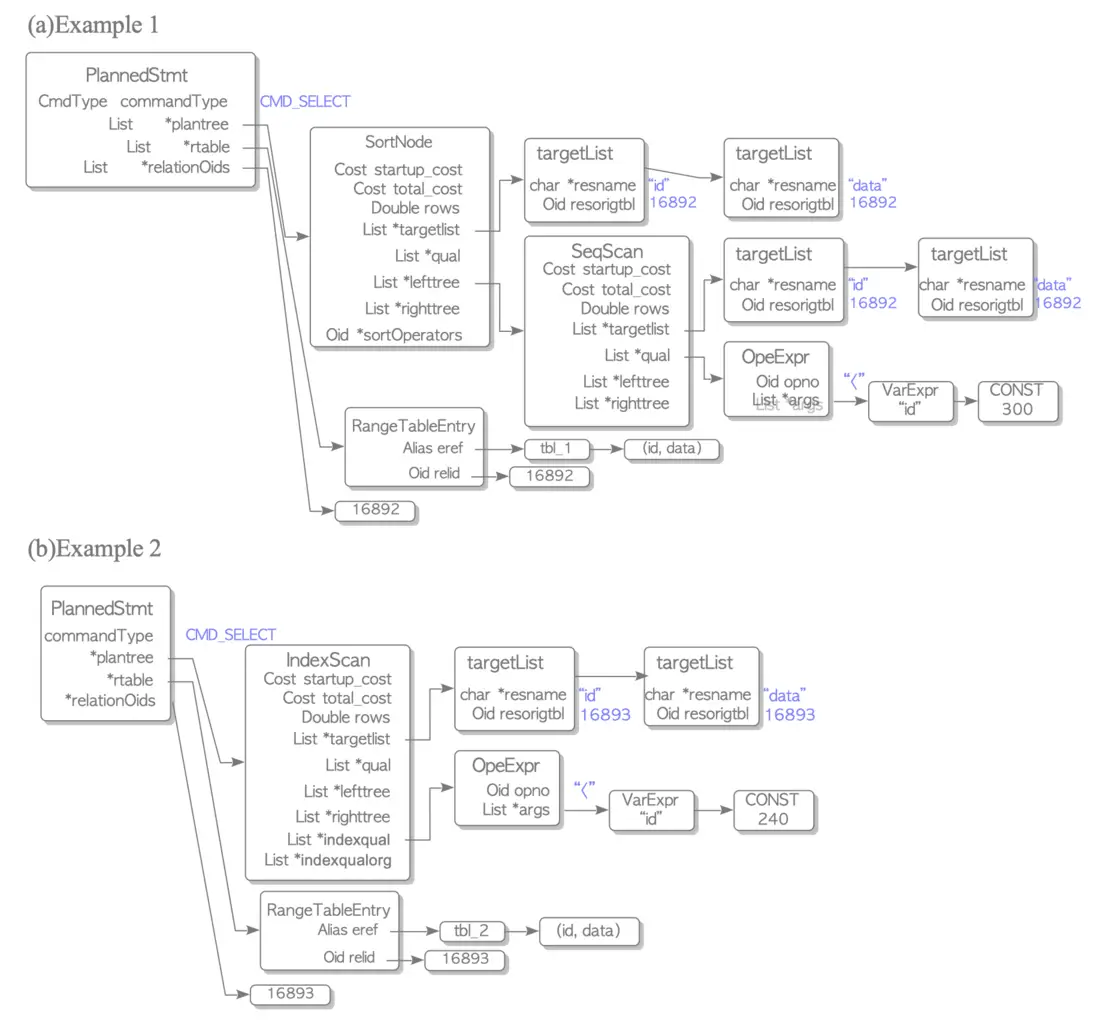
الشكل 3.15. أمثلة على أشجار الخطط.
3.3.3.2. المثال الثاني
يصف المثال الثاني شجرة الخطة للاستعلام في القسم 3.3.2.2.
وكما هو موضّح في الشكل 3.14، فإن المسار الأقل كلفة هو مسار مسح الفهرس؛ ولذلك تتكوّن شجرة الخطة الناتجة من IndexScanNode وحده. ويظهر ذلك في الشكل 3.15(ب).
** ** IndexScanNode
/* ----------------
 *		index scan node
 *
 * indexqualorig is an implicitly-ANDed list of index qual expressions, each
 * in the same form it appeared in the query WHERE condition.  Each should
 * be of the form (indexkey OP comparisonval) or (comparisonval OP indexkey).
 * The indexkey is a Var or expression referencing column(s) of the index's
 * base table.  The comparisonval might be any expression, but it won't use
 * any columns of the base table.  The expressions are ordered by index
 * column position (but items referencing the same index column can appear
 * in any order).  indexqualorig is used at runtime only if we have to recheck
 * a lossy indexqual.
 *
 * indexqual has the same form, but the expressions have been commuted if
 * necessary to put the indexkeys on the left, and the indexkeys are replaced
 * by Var nodes identifying the index columns (their varno is INDEX_VAR and
 * their varattno is the index column number).
 *
 * indexorderbyorig is similarly the original form of any ORDER BY expressions
 * that are being implemented by the index, while indexorderby is modified to
 * have index column Vars on the left-hand side.  Here, multiple expressions
 * must appear in exactly the ORDER BY order, and this is not necessarily the
 * index column order.  Only the expressions are provided, not the auxiliary
 * sort-order information from the ORDER BY SortGroupClauses; it's assumed
 * that the sort ordering is fully determinable from the top-level operators.
 * indexorderbyorig is used at runtime to recheck the ordering, if the index
 * cannot calculate an accurate ordering.  It is also needed for EXPLAIN.
 *
 * indexorderbyops is a list of the OIDs of the operators used to sort the
 * ORDER BY expressions.  This is used together with indexorderbyorig to
 * recheck ordering at run time.  (Note that indexorderby, indexorderbyorig,
 * and indexorderbyops are used for amcanorderbyop cases, not amcanorder.)
 *
 * indexorderdir specifies the scan ordering, for indexscans on amcanorder
 * indexes (for other indexes it should be "don't care").
 * ----------------
 */
typedef struct Scan
{
	pg_node_attr(abstract)

	Plan		plan;
	Index		scanrelid;		/* relid is index into the range table */
} Scan;

typedef struct IndexScan
{
	Scan		scan;
	/* OID of index to scan */
	Oid			indexid;
	/* list of index quals (usually OpExprs) */
	List	   *indexqual;
	/* the same in original form */
	List	   *indexqualorig;
	/* list of index ORDER BY exprs */
	List	   *indexorderby;
	/* the same in original form */
	List	   *indexorderbyorig;
	/* OIDs of sort ops for ORDER BY exprs */
	List	   *indexorderbyops;
	/* forward or backward or don't care */
	ScanDirection indexorderdir;
} IndexScan;
في هذا المثال، تعمل عبارة WHERE «id < 240» كمُسند وصول. وبناءً على ذلك، تُخزَّن في حقل indexqual في IndexScanNode، بدلًا من حقل qual العام.
3.4. أداء المنفِّذ
يصف هذا القسم العملية الأساسية للمنفِّذ أثناء معالجة الاستعلامات.
كما يصف معالجة الدوال التجميعية والمعالجة الداخلية لقيود الجداول، وكلاهما مهم للاستخدام العملي.
محتويات القسم
- 3.4.1. كيفية عمل المنفِّذ
- 3.4.2. الدوال التجميعية
- 3.4.3. القيود
3.4.1. كيفية عمل المنفِّذ
يستخدم PostgreSQL نموذج البركان (المعروف أيضًا بنموذج المكرِّر) لتنفيذ الاستعلامات.
وفي هذا النموذج، يعالج المنفِّذ شجرة الخطة باستدعاء الدوال المرتبطة بكل عقدة. ومن منظور تدفق البيانات، تنتقل الصفوف إلى الأعلى من العقد الورقية إلى الجذر.
ولكل عقدة خطة دوال محددة مسؤولة عن عملها، وتقع في الدليل src/backend/executor/. على سبيل المثال:
- المسح التسلسلي (SeqScan): معرَّف في nodeSeqscan.c.
- مسح الفهرس (IndexScan): معرَّف في nodeIndexscan.c.
- الفرز (Sort): معرَّف في nodeSort.c.
ويُفهَم عمل المنفِّذ بأفضل صورة من خلال فحص مخرَج الأمر EXPLAIN، الذي يعكس بنية شجرة الخطة. لنتأمل النتيجة التالية من المثال الأول (القسم 3.3.3.1):
1
2
3
4
5
6
7
8
testdb=# EXPLAIN SELECT * FROM tbl_1 WHERE id < 300 ORDER BY data;
                          QUERY PLAN
---------------------------------------------------------------
 Sort  (cost=182.34..183.09 rows=300 width=8)
   Sort Key: data
   ->  Seq Scan on tbl_1  (cost=0.00..170.00 rows=300 width=8)
         Filter: (id < 300)
(4 rows)
وعند تحليل مسار التنفيذ، يُقرأ مخرَج EXPLAIN عادةً من الأسفل إلى الأعلى:
- السطر 6 (SeqScan): تمسح عقدة SeqScan (المعرَّفة في nodeSeqscan.c) الجدول الهدف تسلسليًا، وتطبّق عامل التصفية «id < 300»، وتمرّر الصفوف الناتجة إلى الأعلى نحو SortNode.
- السطر 4 (Sort): تستقبل عقدة SortNode (المعرَّفة في nodeSort.c) الصفوف واحدًا واحدًا من عقدتها الفرعية (SeqScanNode) وتخزّنها في مخزن work_mem المؤقت. وبعد أن تنتهي العقدة الفرعية من تزويد الصفوف، تنفّذ SortNode عملية الفرز.
ومن منظور تدفق التحكّم، يبدأ المنفِّذ من SortNode. ثم تستدعي SortNode عقدة SeqScan مرارًا للحصول على الصفوف. وكما هو موضّح في الشكل 3.16، تُجمَع هذه الصفوف في الذاكرة قبل تنفيذ الفرز النهائي.
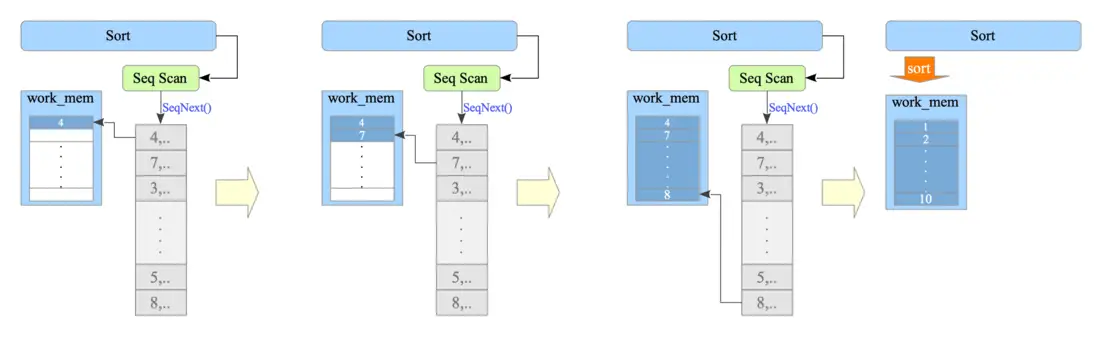
الشكل 3.16. معالجة الفرز في المنفِّذ.
3.4.1.1. دوال المسح
كما ذُكر في القسم 1.3، تُخزَّن صفوف البيانات في كتل فيزيائية بحجم 8 كيلوبايت. وللوصول إلى صف بيانات واحد، على المنفِّذ أن يجتاز طبقات عديدة، مثل مدير المخازن المؤقتة (انظر الفصل 8) والتحكّم بالتزامن (انظر الفصل 5). علاوة على ذلك، تختلف طريقة الوصول حسب ما إذا كانت كتلة البيانات تنتمي إلى جدول أو فهرس.
وطريقة وصول المنفِّذ إلى صف بيانات واحد مجرَّدة للغاية، وتُخفي تعقيد الطبقات الوسيطة.
فعلى سبيل المثال، في حالة المسح التسلسلي، يمكن الوصول إلى صفوف جدول تسلسليًا مع مراعاة المعاملات عبر استدعاء الدالة SeqNext() مرارًا. وفي حالة مسح الفهرس، يمكن تنفيذ مسح فهرس عبر استدعاء الدالة IndexNext() مرارًا.
3.4.1.2. الملفات المؤقتة
يستخدم المنفِّذ الذاكرة work_mem والمخازن المؤقتة temp_buffers المخصَّصة في الذاكرة لمعالجة الاستعلامات. غير أنه إذا تجاوزت مهمة – مثل الفرز أو التجميع بالتجزئة — الذاكرة المتاحة، يتحوّل المنفِّذ إلى ملفات مؤقتة على القرص.
وباستخدام خيار ANALYZE، ينفّذ الأمر EXPLAIN الاستعلام ويعرض أعداد الصفوف الفعلية وزمن التشغيل واستخدام الذاكرة أو القرص. ويُعرض مثال على ذلك أدناه:
 1
 2
 3
 4
 5
 6
 7
 8
 9
10
testdb=# EXPLAIN ANALYZE SELECT id, data FROM tbl_25m ORDER BY id;
                                                        QUERY PLAN
--------------------------------------------------------------------------------------------------------------------------
 Sort  (cost=3944070.01..3945895.01 rows=730000 width=4104) (actual time=885.648..1033.746 rows=730000 loops=1)
   Sort Key: id
   Sort Method: external sort  Disk: 10000kB
   ->  Seq Scan on tbl_25m  (cost=0.00..10531.00 rows=730000 width=4104) (actual time=0.024..102.548 rows=730000 loops=1)
 Planning time: 1.548 ms
 Execution time: 1109.571 ms
(6 rows)
في السطر 6، يشير مخرَج EXPLAIN ANALYZE إلى أن المنفِّذ أجرى «فرزًا خارجيًا» واستخدم ملفًا مؤقتًا بحجم 10,000 كيلوبايت.
وتُنشأ الملفات المؤقتة تحت الدليل الفرعي $PGDATA/base/pg_tmp. وهي تتبع قاعدة تسمية محددة:
- نمط الملف المؤقت:
pgsql_tmp[PID].[seq_number]
على سبيل المثال، ملف باسم ‘pgsql_tmp8903.5’ يمثّل الملف المؤقت السادس (لأن رقم التسلسل يبدأ من الصفر) الذي أنشأته عملية Postgres ذات المعرّف PID 8903.
$ ls -la $PGDATA/base/pgsql_tmp*
-rw-------  1 postgres  postgres  10240000 12  4 14:18 pgsql_tmp8903.5
3.4.2. الدوال التجميعية
عمليًا، يُعدّ الحساب الفعّال للدوال التجميعية دورًا حاسمًا لأنظمة قواعد البيانات. ويصف هذا القسم كيفية تعامل المنفِّذ مع الدوال التجميعية — مثل sum وaverage وvariance.
ويُستخدم الجدول التالي d في أمثلة هذا القسم:
testdb=# CREATE TABLE d (x DOUBLE PRECISION);
CREATE TABLE
testdb=# INSERT INTO d SELECT GENERATE_SERIES(1, 10);
INSERT 0 10
وعند إصدار دالة sum، تُنشأ شجرة خطة كما هو موضّح في الشكل 3.17.
testdb=# SELECT sum(x) FROM d;
 sum
-----
  55
(1 row)
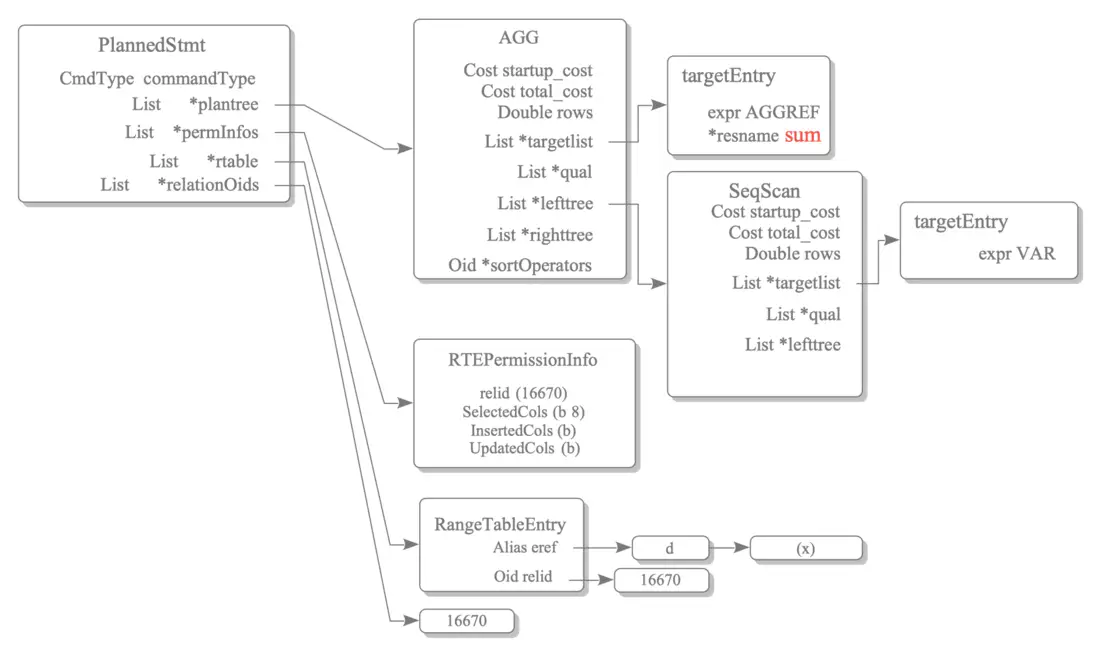
الشكل 3.17. شجرة خطة لدالة sum.
وتظهر نتيجة الأمر EXPLAIN لهذا الاستعلام أدناه:
1
2
3
4
5
6
testdb=# EXPLAIN SELECT sum(x) FROM d;
                       QUERY PLAN
--------------------------------------------------------
 Aggregate  (cost=38.25..38.26 rows=1 width=8)
   ->  Seq Scan on d  (cost=0.00..32.60 rows=2260 width=8)
(2 rows)
- السطر 5: تمسح عقدة SeqScan الجدول الهدف تسلسليًا وتمرّر قيم العمود الهدف ‘x’ إلى عقدة Aggregate.
- السطر 4: تستقبل عقدة Aggregate البيانات من عقدة SeqScan وتعالجها وفق الدالة التجميعية المحددة (مثل sum أو avg أو variance أو count).
ويقدّم الشكل 3.18 نظرة عامة على كيفية معالجة الدالة التجميعية داخل المنفِّذ.
الشكل 3.18. معالجة الدوال التجميعية في المنفِّذ.
وتستكشف الأقسام الفرعية التالية المعالجة الداخلية للدوال التجميعية بأمثلة محددة.
3.4.2.1. المجموع والمتوسط
صيغتا المجموع والمتوسط هما:
حيث يمثّل قيمة العمود الهدف في الصف رقم .
وكما يظهر في هاتين الصيغتين، فإن الفرق الأساسي بين المجموع والمتوسط هو القسمة النهائية على العدد الإجمالي للعناصر .
داخليًا، تُراكم عقدة Aggregate القيم الممسوحة تسلسليًا. وفي المرحلة النهائية من المعالجة، تُعيد العقدة المجموع المتراكم في عملية sum. وفي عملية avg، تُعيد المجموع المتراكم مقسومًا على عدد الصفوف المعالَجة ().
وتوضّح الشيفرة الزائفة التالية هذا المنطق:
d =[1.0, 2.0, 3.0, 4.0, 5.0, 6.0, 7.0, 8.0, 9.0, 10.0]

N = 0
S = 0

# Seq Scan
for x in d:

    # Aggregate: Sum
    N += 1
    S += x

print("Sum=", S)
print("Avg=", S/N)
3.4.2.2. التباين
لأغراض التبسيط، يُعرَّف التباين بناءً على مجموع مربعات الانحرافات عن المتوسط:
وبناءً على هذا التعريف، يوفّر PostgreSQL نوعين من التباين:
- تباين العيّنة (var_samp): . ويُستخدم عندما تمثّل البيانات عيّنة من مجتمع أكبر.
- تباين المجتمع (var_pop): . ويُستخدم عندما تمثّل البيانات المجتمع بأكمله.
وتعرض الأمثلة التالية مخرَج الدالتين:
testdb=# SELECT var_samp(x) FROM d;
     var_samp
-------------------
 9.166666666666666
(1 row)

testdb=# SELECT var_pop(x) FROM d;
 var_pop
---------
    8.25
(1 row)
3.4.2.2.1. حساب التباين بمرور واحد (الإصدارات 11 أو أقدم)
يتطلب التنفيذ الساذج لصيغة التباين (3-18) مرورين على البيانات: الأول لحساب المتوسط والثاني لحساب مجموع مربعات الفروق.
ولتحسين ذلك، يمكن اختصار الحساب إلى مرور واحد باستخدام الصيغة التالية:
وتتيح هذه المقاربة للمنفِّذ حساب التباين تكراريًا بالحفاظ على مجاميع جارية لكل من مجموع المربعات () ومجموع القيم ().
وتوضّح الشيفرة الزائفة التالية هذا المنطق:
d =[1.0, 2.0, 3.0, 4.0, 5.0, 6.0, 7.0, 8.0, 9.0, 10.0]

N = 0
S = 0
X2 = 0

# SeqScan
for x in d:

    # Aggregate: Variance
    N += 1
    S += x
    X2 += x**2

V = X2 - S**2/N

print("V=", V)
print("Var_samp=", V/(N-1))
print("Var_pop=", V/N)
** إعادة كتابة طريقة المرورين إلى طريقة المرور الواحد
3.4.2.2.2. طريقة Youngs وCramer (الإصدارات 12 أو أحدث)
في عام 2016، سلّطت ورقة بحثية بعنوان «A Closer Look at Variance ImplementationsIn Modern Database Systems» الضوء على قيود الدقة في حساب التباين في PostgreSQL.
ولمعالجة هذه المخاوف، طُوِّرت رقعة في نوفمبر 2018، ما أدى إلى تبنّي طريقة Youngs وCramer في الإصدار 12 من PostgreSQL. وتوفّر هذه الخوارزمية استقرارًا عدديًا ودقة أعلى بكثير من صيغة المرور الواحد القياسية[1:1].
وتوضّح الشيفرة الزائفة التالية تنفيذ طريقة Youngs وCramer (راجع الملحق 1.1 للتفاصيل.):
وفيما يلي الشيفرة الزائفة لطريقة Youngs وCramer:
d =[1.0, 2.0, 3.0, 4.0, 5.0, 6.0, 7.0, 8.0, 9.0, 10.0]
N = 0
S = 0
V = 0
# SeqScan
for x in d:
# Aggregate: Variance
N += 1
S += x
if 1 < N:
V += (x * N - S)**2 / (N * (N-1))
print("V=", V)
print("Var_samp=", V/(N-1))
print("Var_pop=", V/N)
3.4.3. القيود
عندما ينفّذ PostgreSQL عبارة INSERT أو UPDATE أو DELETE، يتحقق المنفِّذ من القيود المعرَّفة على الجدول الهدف.
ويركّز هذا القسم على الأنواع الثلاثة الشائعة التالية من القيود:
- قيود NOT NULL وCHECK
- قيود PRIMARY KEY وUNIQUE
- قيود FOREIGN KEY
ولتوضيح كيفية معالجة PostgreSQL لهذه القيود، لنتأمل إدراج صف واحد.
وتوضّح الشيفرة الزائفة أدناه التدفق الرئيسي للدالة ExecInsert():
ExecInsert() @ nodeModifyTable.c

/*
 * Block 1: Validate table constraints
 */
(1) ExecConstraints()@execMain.c       /* Check NOT NULL and CHECK constraints. */

/*
 * Block 2: Insert the heap tuple
 */
(2) table_tuple_insert()@tableam.c     /* Insert the target tuple into the heap table. */

/*
 * Block 3: Insert index tuples and enforce uniqueness
 */
(3) ExecInsertIndexTuples()@execIndexing.c
        for each index:
(4)         index_insert()@indexam.c   /* Insert the corresponding index tuple. */
            if (UNIQUE or PRIMARY KEY index)
(5)             _bt_check_unique()@nbtinsert.c
                                       /* Check whether a conflicting key already exists
                                        * in the B-tree index.
                                        */
/*
 * Block 4: Execute AFTER ROW INSERT triggers
 */
(6) ExecARInsertTriggers()@trigger.c
        for each AFTER INSERT trigger:
(7)         RI_FKey_check_ins()@ri_triggers.c /* Check FOREIGN KEY constraints. */
والخطوات الرئيسية هي:
الكتلة 1: التحقق من قيود الجدول
- (1) تتحقق ExecConstraints() من قيود NOT NULL وقيود CHECK.
الكتلة 2: إدراج صف الكومة
- (2) تُدرج table_tuple_insert() الصف في جدول الكومة.
الكتلة 3: إدراج صفوف الفهرس وفرض الفرادة
- (3) تعالج ExecInsertIndexTuples() جميع الفهارس التابعة للجدول.
- (4) تُدرج index_insert() صف الفهرس المقابل في كل فهرس.
- (5) تتحقق _bt_check_unique() مما إذا كان هناك مفتاح متعارض موجود بالفعل. وهنا تُفرَض قيود UNIQUE وPRIMARY KEY.
الكتلة 4: تنفيذ محفّزات AFTER ROW INSERT
- (6) تنفّذ ExecARInsertTriggers() محفّزات AFTER INSERT.
- (7) تتحقق RI_FKey_check_ins() من قيود FOREIGN KEY.
وتشرح الأقسام التالية كل نوع من أنواع القيود بمزيد من التفصيل.
3.4.3.1. قيود NOT NULL وCHECK
يتحقق PostgreSQL من هذين القيدين في الكتلة 1.
تتحقق الدالة ExecConstraints() من قيود NOT NULL وقيود CHECK. وبتعبير أدق، تقيّم الدالة ExecRelCheck() قيود CHECK.
ويخزّن PostgreSQL تعريفات قيود CHECK في كتالوج النظام pg_constraint. ويحمّل PostgreSQL هذه التعريفات في الذاكرة ويقيّم التعبيرات المقابلة لكل صف يُدرَج أو يُحدَّث.
وتنطبق الآلية نفسها على عبارات UPDATE.
3.4.3.2. قيود PRIMARY KEY وUNIQUE
يتحقق PostgreSQL من قيود PRIMARY KEY وUNIQUE في الكتلة 3.
عند إدراج صف فهرس في فهرس UNIQUE، يتحقق PostgreSQL مما إذا كان هناك مفتاح متعارض موجود بالفعل في الفهرس.
وتجري الدالة _bt_check_unique() هذا التحقق لفهارس B-tree. ولأن الدالة تفحص الفهرس مباشرةً، يجري التحقق في زمن يقارب ، حيث عدد مدخلات الفهرس.
وتنطبق الآلية نفسها على عبارات UPDATE.
3.4.3.3. قيود FOREIGN KEY
يتحقق PostgreSQL من قيود FOREIGN KEY في الكتلة 4.
تتطلب قيود FOREIGN KEY من PostgreSQL التحقق من صفوف في جدول آخر. لذلك يكون التنفيذ أكثر تعقيدًا من تنفيذ النوعين السابقين من القيود.
لنتأمل الجدولين التاليين:
CREATE TABLE tbl_parent (
    id int PRIMARY KEY,
    data text
);

CREATE TABLE tbl_child (
    cid int REFERENCES tbl_parent(id),
    data text
);
افترض أن PostgreSQL ينفّذ العبارة التالية:
INSERT INTO tbl_child VALUES (1, 'test');
أثناء الكتلة 4، ينفّذ PostgreSQL دالة محفّز FOREIGN KEY.
في الإصدارات 18 والأقدم، يولّد المحفّز استعلامًا مشابهًا لما يلي وينفّذه:
SELECT 1
FROM ONLY "public"."tbl_parent" x
WHERE "id" OPERATOR(pg_catalog.=) $1
FOR KEY SHARE OF x;
يستخدم بيان SELECT هذا FOR KEY SHARE لقفل الصف المُشار إليه. ويمنع هذا القفل المعاملات المتزامنة من حذف الصف أو تعديل المفتاح المُشار إليه أثناء تحقق PostgreSQL من قيد المفتاح الأجنبي.
وينفّذ PostgreSQL بيان SELECT هذا عبر واجهة برمجة الخادم (SPI).
ولأن SPI ينفّذ استعلام SQL داخليًا، يجب على PostgreSQL إجراء معالجة استعلام للاستعلام المولَّد. وتضيف هذه المعالجة كلفة إلى كل تحقق من مفتاح أجنبي.
وبناءً على ذلك، يؤدي إدراج صف واحد في الجدول الابن إلى تنفيذ استعلام SELECT داخلي إضافي.
التحقق المباشر من FOREIGN KEY في PostgreSQL 19
يقدّم الإصدار 19 من PostgreSQL (عام 2026) مسار تنفيذ جديدًا للتحقق من FOREIGN KEY.
عندما يدعم فهرس مناسب قيد PRIMARY KEY أو UNIQUE المُشار إليه، يمكن لـ PostgreSQL التحقق من FOREIGN KEY بفحص الفهرس المُشار إليه مباشرةً بدلًا من توليد استعلام SELECT داخلي وتنفيذه عبر SPI.
- يجري PostgreSQL بحثًا مباشرًا في فهرس PRIMARY KEY أو UNIQUE المُشار إليه.
- يتجنّب ذلك كلفة المخطِّط والمنفِّذ وSPI المرتبطة بتنفيذ عبارة SQL داخلية.
- لا يزال PostgreSQL يحصل على قفل الصف المطلوب على الصف المُشار إليه للحفاظ على دلالات FOREIGN KEY.
- إذا لم يتوفر بحث مباشر في الفهرس، يعود PostgreSQL إلى التنفيذ التقليدي القائم على SPI.
ولا يغيّر هذا التحسين سلوك فرض قيود FOREIGN KEY. بل يقلّل كلفة كل تحقق من قيد بإزالة مسار تنفيذ استعلام SPI الداخلي متى أمكن، ما يحسّن أداء INSERT وUPDATE لكثير من أحمال العمل.
3.5. عمليات الربط (Join Operations)
يدعم PostgreSQL ثلاث عمليات ربط: الربط بالحلقة المتداخلة، والربط بالدمج، والربط بالتجزئة. وللربط بالحلقة المتداخلة والربط بالدمج في PostgreSQL عدة صور مختلفة.
وفي ما يلي، نفترض أن القارئ على دراية بالسلوك الأساسي لهذه الأنواع الثلاثة من الربط.
وإذا لم تكن هذه المصطلحات مألوفة لديك، فراجع المراجع التالية:
** مراجع
- Abraham Silberschatz, Henry F. Korth, and S. Sudarshan, «Database System Concepts»، McGraw-Hill Education، ISBN-13: 978-0073523323
- Thomas M. Connolly, and Carolyn E. Begg, «Database Systems»، Pearson، ISBN-13: 978-0321523068
غير أنه لما كانت الشروح المتعلقة بالربط الهجين بالتجزئة مع الانحراف المدعوم في PostgreSQL قليلة، فسيُشرح هنا بمزيد من التفصيل.
محتويات القسم
- الربط بالحلقة المتداخلة
- الربط بالدمج
- الربط بالتجزئة
- مسارات الربط وعقده
لاحظ أن أساليب الربط الثلاثة المدعومة في PostgreSQL يمكنها تنفيذ جميع عمليات الربط، ليس INNER JOIN فقط، بل أيضًا LEFT/RIGHT OUTER JOIN وFULL OUTER JOIN وغيرها. غير أننا نركّز في هذا الفصل على NATURAL INNER JOIN لأغراض التبسيط.
3.6. إنشاء شجرة الخطة لاستعلام متعدد الجداول
يُشرح في هذا القسم عملية إنشاء شجرة خطة لاستعلام متعدد الجداول.
محتويات القسم
- 3.6.1. المعالجة المسبقة
- 3.6.2. تحديد المسار الأقل كلفة
- 3.6.3. تحديد المسار الأقل كلفة لاستعلام بثلاثة جداول
3.6.1. المعالجة المسبقة
تستدعي الدالة subquery_planner()، المعرَّفة في planner.c، مرحلة المعالجة المسبقة.
وبينما وُصفت المعالجة المسبقة للاستعلامات ذات الجدول الواحد في القسم 3.3.1، يركّز هذا القسم الفرعي على المعالجة المسبقة الخاصة بالاستعلامات متعددة الجداول.
ونظرًا للعدد الكبير من المهام المنفَّذة، تُوصف العمليات الأساسية فقط هنا.
معالجة تعبيرات الجداول الشائعة (CTEs) وتحويلها: إذا وُجدت قوائم WITH، يعالج المخطِّط كل تعبير جدول شائع (CTE) باستخدام الدالة SS_process_ctes().
رفع الاستعلامات الفرعية: إذا كان استعلام فرعي في عبارة FROM لا يحتوي على عبارات GROUP BY أو HAVING أو ORDER BY أو LIMIT أو DISTINCT، ولا يستخدم INTERSECT أو EXCEPT، يحوّله المخطِّط إلى صيغة ربط باستخدام الدالة pull_up_subqueries(). على سبيل المثال، يمكن تحويل استعلام يحتوي على استعلام فرعي في عبارة FROM إلى ربط طبيعي:
testdb=# SELECT * FROM tbl_a AS a, (SELECT * FROM tbl_b) as b WHERE a.id = b.id;
testdb=# SELECT * FROM tbl_a AS a, tbl_b as b WHERE a.id = b.id;
تحويل عمليات الربط الخارجي إلى ربط داخلي: يحوّل المخطِّط عملية ربط خارجي إلى ربط داخلي كلما سمحت شروط الربط أو قيود عبارة WHERE بتنفيذ ربط داخلي أكثر كفاءة دون تغيير مجموعة النتائج.
3.6.2. تحديد المسار الأقل كلفة
لتحديد شجرة الخطة المثلى، على المخطِّط أن ينظر في جميع توليفات الفهارس وأساليب الربط. وهذه عملية مكلفة للغاية وتصبح مستحيلة إذا زاد عدد الجداول بسبب الانفجار التوليفي.
وعندما يكون عدد جداول الربط صغيرًا نسبيًا (أقل من 12 عادةً)، يستخدم المخطِّط البرمجة الديناميكية لتحديد الخطة المثلى.
** محسِّن الاستعلام الجيني (GQO)
عند تنفيذ استعلام يربط جداول كثيرة، يُستغرَق وقت هائل لتحسين خطة الاستعلام. ولمعالجة هذه الحالة، ينفّذ PostgreSQL محسِّن الاستعلام الجيني (GQO).
وGQO خوارزمية تقريبية تُستخدم لتحديد خطة معقولة في زمن معقول. وإذا تجاوز عدد جداول الربط الحد المحدَّد بالمعامل geqo_threshold (القيمة الافتراضية 12)، ينشئ PostgreSQL خطة استعلام باستخدام هذه الخوارزمية الجينية بدلًا من البرمجة الديناميكية.
يتضمّن تحديد شجرة الخطة المثلى عبر البرمجة الديناميكية مستويات المعالجة التالية (راجع الشكل 3.34):
- المستوى 1: حدِّد المسار الأقل كلفة لكل جدول على حدة. ويُخزَّن المسار الأقل كلفة لكل جدول في بنية
RelOptInfoالخاصة به. - المستوى 2: في ما يلي، يُمثَّل RelOptInfo لمجموعة جداول بأقواس معقوصة، مثل {A, B}. وإذا وُجد جدولان A وB، يحدّد المخطِّط مسار الربط الأقل كلفة لـ {A, B}. وهذه النتيجة هي الجواب النهائي لربط جدولين. وإذا وُجدت ثلاثة جداول، يحدّد المخطِّط المسار الأقل كلفة لكل زوج ممكن: {A, B} و{A, C} و{B, C}.
- المستوى 3 وما فوق: واصل هذه العملية تدريجيًا. وتُستخدم نتائج توليفات الربط في المستويات الأدنى لتحديد المسارات الأقل كلفة لمجموعات أكبر (مثل {A, B, C}) حتى الوصول إلى مجموعة واحدة تحتوي على جميع الجداول.
الشكل 3.34. كيفية تحديد مسار الوصول الأقل كلفة باستخدام البرمجة الديناميكية.
وبإعادة استخدام المسارات الأقل كلفة للمسائل الجزئية في كل مستوى، يمكن للمخطِّط تحديد شجرة الخطة المثلى بكفاءة.
ويصف القسم التالي كيفية تحديد المخطِّط للخطة الأقل كلفة للاستعلام التالي:
testdb=# \d tbl_a
     Table "public.tbl_a"
 Column |  Type   | Modifiers
--------+---------+-----------
 id     | integer | not null
 data   | integer |
Indexes:
    "tbl_a_pkey" PRIMARY KEY, btree (id)

testdb=# \d tbl_b
     Table "public.tbl_b"
 Column |  Type   | Modifiers
--------+---------+-----------
 id     | integer |
 data   | integer |

testdb=# SELECT * FROM tbl_a AS a, tbl_b AS b WHERE a.id = b.id AND b.data < 400;
3.6.2.1. المعالجة في المستوى 1
في المستوى 1، يُنشئ المخطِّط بنية RelOptInfo ويقدّر أقل الكلف لكل علاقة في الاستعلام. وتُضاف بنى RelOptInfo هذه إلى simple_rel_array داخل بنية PlannerInfo الخاصة بالاستعلام (راجع الشكل 3.35).
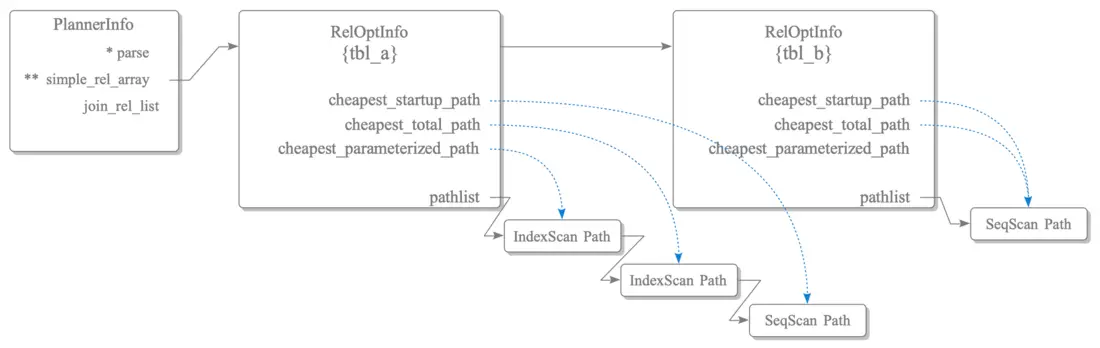
الشكل 3.35. PlannerInfo وRelOptInfo بعد المعالجة في المستوى 1.
يحتوي RelOptInfo الخاص بالجدول tbl_a على ثلاثة مسارات وصول، تُضاف إلى قائمة pathlist الخاصة به. وترتبط كل بنية RelOptInfo بأقل مسارات الكلف لديها:
- مسار كلفة البدء الأقل
- مسار الكلفة الإجمالية الأقل
- مسار الكلفة المُمَعمَلة (parameterized) الأقل (راجع القسم 3.5.1.3 لتفاصيل المسارات المُمَعمَلة)
وفي المقابل، لا يحتوي RelOptInfo الخاص بالجدول tbl_b إلا على مسار وصول واحد بالمسح التسلسلي لأن tbl_b لا يملك فهرسًا مرتبطًا به.
3.6.2.2. المعالجة في المستوى 2
في المستوى 2، تُنشأ بنية RelOptInfo لعلاقة الربط وتُضاف إلى join_rel_list في PlannerInfo (راجع الشكل 3.36 [1]).
الشكل 3.36. PlannerInfo وRelOptInfo بعد المعالجة في المستوى 2.
ثم يقدّر المخطِّط كلف جميع مسارات الربط الممكنة ويحدّد أفضل مسار وصول — ذاك ذا الكلفة الإجمالية الأقل. وتخزّن RelOptInfo هذه النتيجة كمسار الكلفة الإجمالية الأقل لديها.
ويعرض الجدول 3.3 جميع توليفات مسارات وصول الربط التي نُظر فيها في هذا المثال. ولأن الاستعلام ربط تساوٍ (equi-join)، يقدّر المخطِّط الكلف لأساليب الربط الثلاثة كلها (الحلقة المتداخلة والدمج والتجزئة). وللتوضيح، تُستخدم الترميزات التالية:
- SeqScanPath(table): مسار المسح التسلسلي للجدول.
- Materialized->SeqScanPath(table): مسار المسح التسلسلي المُجسَّد للجدول.
- IndexScanPath(table, attribute): مسار مسح الفهرس باستخدام السمة المحددة.
- ParameterizedIndexScanPath(table, attr1, attr2): مسار فهرس الجدول باستخدام attr1، مُمَعمَل بواسطة attr2 من الجدول الخارجي.
| المسار الخارجي | المسار الداخلي | ||
|---|---|---|---|
| الربط بالحلقة المتداخلة | |||
| 2 | SeqScanPath(tbl_a) | Materialized->SeqScanPath(tbl_b) | ربط حلقة متداخلة مُجسَّد |
| 3 | IndexScanPath(tbl_a,id) | SeqScanPath(tbl_b) | ربط حلقة متداخلة مع مسح فهرس خارجي |
| 4 | IndexScanPath(tbl_a,id) | Materialized->SeqScanPath(tbl_b) | ربط حلقة متداخلة مُجسَّد مع مسح فهرس خارجي |
| 5 | SeqScanPath(tbl_b) | SeqScanPath(tbl_a) | |
| 6 | SeqScanPath(tbl_b) | Materialized->SeqScanPath(tbl_a) | ربط حلقة متداخلة مُجسَّد |
| 7 | SeqScanPath(tbl_b) | ParametalizedIndexScanPath(tbl_a, id, tbl_b.id) | ربط حلقة متداخلة مفهرس |
| الربط بالدمج | |||
| 2 | IndexScanPath(tbl_a,id) | SeqScanPath(tbl_b) | ربط دمج مع مسح فهرس خارجي |
| 3 | SeqScanPath(tbl_b) | SeqScanPath(tbl_a) | |
| الربط بالتجزئة | |||
| 2 | SeqScanPath(tbl_b) | SeqScanPath(tbl_a) |
في فئة الربط بالحلقة المتداخلة، على سبيل المثال، تُقدَّر سبعة مسارات ربط. ويستخدم المسار الأول مسحًا تسلسليًا لكل من tbl_a (الخارجي) وtbl_b (الداخلي). ويستخدم المسار الثاني مسحًا تسلسليًا لـ tbl_a ومسحًا تسلسليًا مُجسَّدًا لـ tbl_b، وهكذا.
ويحدّد المخطِّط أخيرًا المسار الأقل كلفة بين جميع مسارات الربط المقدَّرة ويضيفه إلى pathlist في RelOptInfo الممثِّل للمجموعة {tbl_a, tbl_b} (راجع الشكل 3.36 [2]).
في هذا المثال، وكما يظهر في مخرَج EXPLAIN أدناه، يختار المخطِّط ربطًا بالتجزئة يكون فيه tbl_b الجدول الداخلي وtbl_a الجدول الخارجي.
testdb=# EXPLAIN  SELECT * FROM tbl_b AS b, tbl_c AS c WHERE c.id = b.id AND b.data < 400;
                              QUERY PLAN
----------------------------------------------------------------------
 Hash Join  (cost=90.50..277.00 rows=400 width=16)
   Hash Cond: (c.id = b.id)
   ->  Seq Scan on tbl_c c  (cost=0.00..145.00 rows=10000 width=8)
   ->  Hash  (cost=85.50..85.50 rows=400 width=8)
         ->  Seq Scan on tbl_b b  (cost=0.00..85.50 rows=400 width=8)
               Filter: (data < 400)
(6 rows)
3.6.3. تحديد المسار الأقل كلفة لاستعلام بثلاثة جداول
عملية تحديد المسار الأقل كلفة لاستعلام يشمل ثلاثة جداول هي كما يلي:
testdb=# \d tbl_a
     Table "public.tbl_a"
 Column |  Type   | Modifiers
--------+---------+-----------
 id     | integer |
 data   | integer |

testdb=# \d tbl_b
     Table "public.tbl_b"
 Column |  Type   | Modifiers
--------+---------+-----------
 id     | integer |
 data   | integer |

testdb=# \d tbl_c
     Table "public.tbl_c"
 Column |  Type   | Modifiers
--------+---------+-----------
 id     | integer | not null
 data   | integer |
Indexes:
    "tbl_c_pkey" PRIMARY KEY, btree (id)

testdb=# SELECT * FROM tbl_a AS a, tbl_b AS b, tbl_c AS c
testdb-#                WHERE a.id = b.id AND b.id = c.id AND a.data < 40;
- المستوى 1: يقدّر المخطِّط المسارات الأقل كلفة لجميع الجداول على حدة ويخزّن هذه المعلومات في كائنات RelOptInfo المقابلة: {tbl_a} و{tbl_b} و{tbl_c}.
- المستوى 2: يحدّد المخطِّط جميع الأزواج الممكنة من الجداول الثلاثة ويقدّر المسار الأقل كلفة لكل توليفة. وتُخزَّن النتائج في كائنات RelOptInfo المقابلة: {tbl_a, tbl_b} و{tbl_b, tbl_c} و{tbl_a, tbl_c}.
- المستوى 3: يحدّد المخطِّط أخيرًا المسار الأقل كلفة للاستعلام بأكمله باستخدام كائنات RelOptInfo التي حصل عليها سابقًا.
وفيما يلي وصف أكثر تفصيلًا لمعالجة المستوى 3 (راجع الشكل 3.34):
ينظر المخطِّط في ثلاث توليفات من كائنات RelOptInfo: {tbl_a, {tbl_b, tbl_c}} و{tbl_b, {tbl_a, tbl_c}} و{tbl_c, {tbl_a, tbl_b}}. ويُعبَّر عن ذلك كما يلي:
ثم يقدّر المخطِّط كلف جميع مسارات الربط الممكنة ضمن هذه التوليفات.
بالنسبة لكائن RelOptInfo الممثَّل بـ {tbl_c, {tbl_a, tbl_b}}، يقدّر المخطِّط جميع توليفات tbl_c والمسار الأقل كلفة لـ {tbl_a, tbl_b}. وفي هذا المثال، المسار الأقل كلفة لـ {tbl_a, tbl_b} هو ربط بالتجزئة يكون فيه tbl_a الجدول الخارجي وtbl_b الجدول الداخلي على التوالي.
وكما في المستوى 2، تشمل مسارات الربط المقدَّرة عمليات الربط بالحلقة المتداخلة والربط بالدمج والربط بالتجزئة وصورها المختلفة. ويعالج المخطِّط التوليفتين {tbl_a, {tbl_b, tbl_c}} و{tbl_b, {tbl_a, tbl_c}} بالطريقة نفسها، ثم يختار أخيرًا مسار الوصول الأقل كلفة إجمالًا.
ويظهر مخرَج EXPLAIN لهذا الاستعلام أدناه:
 1
 2
 3
 4
 5
 6
 7
 8
 9
10
11
12
13
14
15
testdb=# EXPLAIN SELECT * FROM tbl_a AS a, tbl_b AS b, tbl_c AS c
testdb-#                      WHERE a.id = b.id AND b.id = c.id AND a.data < 40;
                                   QUERY PLAN
--------------------------------------------------------------------------------
 Nested Loop  (cost=170.77..269.94 rows=20 width=24)
   Join Filter: (a.id = c.id)
   ->  Hash Join  (cost=170.49..262.44 rows=20 width=16)
         Hash Cond: (b.id = a.id)
         ->  Seq Scan on tbl_b b  (cost=0.00..73.00 rows=5000 width=8)
         ->  Hash  (cost=170.00..170.00 rows=39 width=8)
               ->  Seq Scan on tbl_a a  (cost=0.00..170.00 rows=39 width=8)
                     Filter: (data < 40)
   ->  Index Scan using tbl_c_pkey on tbl_c c  (cost=0.29..0.36 rows=1 width=8)
         Index Cond: (id = b.id)
(10 rows)
العلاقة الخارجية في الربط المفهرس بالحلقة المتداخلة. الربط الأقصى خارجية هو ربط مفهرس بالحلقة المتداخلة (السطر 5). والعلاقة الداخلية مسح فهرس مُمَعمَل (السطر 13)، بينما العلاقة الخارجية هي نتيجة الربط بالتجزئة بين tbl_b وtbl_a (الأسطر 7-12).
وبناءً على ذلك، ينفّذ المنفِّذ أولًا الربط بالتجزئة بين tbl_a وtbl_b ثم ينفّذ الربط المفهرس بالحلقة المتداخلة مع tbl_c.
3.7. الاستعلام المتوازي (Parallel Query)
الاستعلام المتوازي، الذي أُدخل في الإصدار 9.6 (عام 2016)، ميزة تعالج استعلامًا واحدًا باستخدام عدة عمليات عمال في الخلفية.
وعند تحقق شروط محددة، تعمل عملية PostgreSQL المنفِّذة للاستعلام كقائد (Leader). ويطلق القائد عددًا من عمليات العمال بحد أقصى يحدّده المعامل max_parallel_workers_per_gather. وتنفّذ كل عملية عامل جزءًا من معالجة المسح وتُعيد نتائجها إلى القائد، الذي يجمّعها لإنتاج المخرَج النهائي.
ويوضّح الشكل 3.37 مسحًا تسلسليًا متوازيًا تعالجه عمليتا عامل.
الشكل 3.37. مفهوم الاستعلام المتوازي.
والمعامل parallel_leader_participation، الذي أُدخل في الإصدار 11 (والمفعَّل افتراضيًا)، يتيح لعملية القائد المساعدة في تنفيذ الاستعلام أثناء انتظار ردود العمال. غير أنه لتبسيط الشروح والأشكال التالية، يُفترض أن عملية القائد تنتظر فقط (أي أن parallel_leader_participation معطَّل).
ويواصل PostgreSQL تحسين قدرات الاستعلام المتوازي في كل إصدار. ويسلّط الجدول 3.4 الضوء على تحديثات رئيسية من ملاحظات الإصدار الرسمية.
| الإصدار | سنة الإصدار | الوصف |
|---|---|---|
| 9.6 | 2016 | المسح التسلسلي. الربط بالحلقة المتداخلة والربط بالتجزئة. |
| 10 | 2017 | الربط بالدمج. مسح فهرس B-tree، ومسح الكومة بخرائط البتات. السماح بالاستعلامات الفرعية غير المترابطة. |
| 11 | 2018 | يمكن لأمر CREATE INDEX الآن استخدام المعالجة المتوازية أثناء بناء فهرس B-tree. السماح بتنفيذ عمليات الربط بالتجزئة على التوازي باستخدام جدول تجزئة مشترك. السماح بتنفيذ UNION لكل SELECT على التوازي إذا تعذّر توازي استعلامات SELECT الفردية. السماح بتوازي الأوامر CREATE TABLE ... AS وSELECT INTO وCREATE MATERIALIZED VIEW. |
| 12 | 2019 | السماح بالاستعلامات المتوازية في وضع العزل SERIALIZABLE. |
| 14 | 2021 | السماح لاستعلام يشير إلى عدة جداول خارجية بتنفيذ مسح الجداول الخارجية على التوازي. السماح لـ REFRESH MATERIALIZED VIEW باستخدام التوازي. |
| 15 | 2022 | السماح بتوازي SELECT DISTINCT. السماح لاستعلام يشير إلى عدة جداول خارجية بتنفيذ مسح متوازٍ للجداول الخارجية في مزيد من الحالات. السماح بالالتزام المتوازي على خوادم postgres_fdw. |
| 16 | 2023 | السماح بتوازي عمليات الربط بالتجزئة الخارجية FULL والخارجية اليمنى الداخلية. السماح لـ postgres_fdw بالإجهاض على التوازي. |
- ملاحظة: الاستعلام المتوازي ميزة للقراءة أساسًا ولا يدعم حاليًا عمليات المؤشر.
وتقدّم الأقسام التالية نظرة عامة على معمارية الاستعلام المتوازي، ثم تستكشف عمليات الربط المتوازية والتجميع المتوازي.
محتويات القسم
- 3.7.1. نظرة عامة
- 3.7.2. الربط المتوازي
- 3.7.3. التجميع المتوازي
3.7.1. نظرة عامة
يوضّح الشكل 3.38 مسار تنفيذ استعلام متوازٍ في PostgreSQL.
الشكل 3.38. كيفية تنفيذ الاستعلام المتوازي.
- (1) القائد ينشئ الخطة: ينشئ المحسِّن شجرة خطة تتضمّن عقدًا قادرة على التنفيذ المتوازي.
- (2) القائد يخزّن المعلومات المشتركة: لمزامنة التنفيذ بين عملية القائد وعمليات العمال، يخزّن القائد معلومات أساسية (مثل شجرة الخطة وحالة الجلسة) في منطقة الذاكرة المشتركة الديناميكية (DSM) الخاصة به.
- (3) القائد ينشئ العمال: يطلق القائد عمليات العمال في الخلفية.
- (4) العامل يهيّئ حالته: يقرأ كل عامل المعلومات المشتركة من DSM لتهيئة حالته الداخلية، بما يضمن بيئة تنفيذ متوافقة مع القائد.
- (5) العامل يمسح ويعيد النتائج: يسترجع كل عامل كتل البيانات ويمسحها عند الطلب بشكل نشط عبر تنفيذ دوال مثل SeqNext() أو IndexNext(). ثم تُعاد هذه النتائج إلى القائد.
- (6) القائد يجمع النتائج: يستقبل القائد النتائج من جميع العمال ويجمّعها.
- (7) التنظيف: بعد انتهاء الاستعلام، تُنهى عمليات العمال، ويحرّر القائد منطقة DSM.
أثناء معالجة الاستعلام المتوازي، تتواصل عملية القائد وعمليات العمال عبر منطقة DSM. وتخصّص عملية القائد مساحة الذاكرة عند الطلب، ما يتيح لعمليات العمال القراءة والكتابة في هذه المناطق المشتركة.
وتستخدم الأمثلة العملية التالية الجدول d، المنشأ كما يلي:
testdb=# CREATE TABLE d (id double precision, data int);
CREATE TABLE
testdb=# INSERT INTO d SELECT i::double precision, (random()*1000)::int FROM generate_series(1, 1000000) AS i;
INSERT 0 1000000
testdb=# ANALYZE;
ANALYZE
3.7.1.1. إنشاء الخطة المتوازية
لا ينظر المحسِّن في الاستعلام المتوازي دائمًا. فهو لا ينظر في التنفيذ المتوازي إلا عندما يكون حجم الجدول الواجب مسحه أكبر من أو يساوي min_parallel_table_scan_size (القيمة الافتراضية: 8 ميجابايت)، أو إذا كان حجم الفهرس أكبر من أو يساوي min_parallel_index_scan_size (القيمة الافتراضية: 512 كيلوبايت).
وفيما يلي أبسط خطة استعلام متوازٍ:
1
2
3
4
5
6
7
8
testdb=# EXPLAIN SELECT * FROM d WHERE id BETWEEN 1 AND 100;
                                     QUERY PLAN
-------------------------------------------------------------------------------------
 Gather  (cost=1000.00..16609.10 rows=1 width=12)
   Workers Planned: 2
   ->  Parallel Seq Scan on d  (cost=0.00..15609.00 rows=1 width=12)
         Filter: ((id >= '1'::double precision) AND (id <= '100'::double precision))
(4 rows)
وكما هو موضّح أعلاه، تتكوّن أبسط خطة متوازية من عقدة Gather وعقدة Parallel SeqScan. ويوضّح الشكل 3.39 شجرة الخطة لهذا الاستعلام.
الشكل 3.39. شجرة خطة القائد
عقدة Gather خاصة بالاستعلامات المتوازية وتجمع النتائج من عمليات العمال. وإضافة إلى Gather، تستخدم الاستعلامات المتوازية عقدًا متخصصة أخرى:
- Gather Merge: تجمع النتائج من العمال مع الحفاظ على ترتيبها المفروز.
- Parallel Append: تُستخدم لمسح الجداول المُجزَّأة أو استعلامات UNION ALL على التوازي (انظر التوثيق الرسمي).
- Finalize/Partial Aggregate: تُستخدم لتوازي الدوال التجميعية (انظر القسم 3.7.3).
وتنفّذ عمليات العمال شجرة الخطة الفرعية الواقعة تحت عقدة Gather. ولكي تُدرَج عقدة في هذه الخطة الفرعية، يجب أن تكون سمة ‘parallel_safe’ فيها مضبوطة على True. وفي المثال أعلاه، تنفّذ عمليات العمال عقدة Parallel Seq Scan وعوامل التصفية المرتبطة بها.
3.7.1.2. تخزين المعلومات المشتركة
لتنفيذ استعلام تعاونيًا، يخزّن القائد المعلومات التي تحتاجها عمليات العمال في منطقة الذاكرة المشتركة الديناميكية (DSM) الخاصة به.
وتُصنَّف المعلومات المشتركة بين القائد والعمال إلى نوعين رئيسيين: حالة التنفيذ والاستعلام.
- حالة التنفيذ: تشمل المعلومات البيئية اللازمة لتنفيذ القائد والعمال الاستعلام نفسه باتساق. (راجع README.parallel للحصول على قائمة شاملة). ومن مكوّناتها الرئيسية: جميع معاملات التهيئة (GUCs).
- لقطة المعاملة ومعرّف المعاملة الفرعية الحالية (انظر الفصل 5 للتفاصيل).
- مجموعة المكتبات المحمَّلة ديناميكيًا عبر dfmgr.c.
وتُخزَّن هذه الحالة بواسطة الدالة InitializeParallelDSM().
معلومات الاستعلام: تشمل بيانات خاصة بخطة التنفيذ وأساليب الوصول إلى البيانات:
- بنيتا PlannedStmt وParamListInfo.
- الواصفات المتخصصة للعقد التي ينفّذها العمال. على سبيل المثال، تستخدم عقدة Parallel Seq Scan الواصف ParallelTableScanDesc، بينما تستخدم عقدة Index Scan الواصف ParallelIndexScanDesc. وتُعالَج التهيئة التفصيلية بواسطة ExecParallelInitializeDSM().
- بنى القياس واستخدام الموارد لأغراض إعداد التقارير.
وتُخزَّن هذه المعلومات بواسطة الدالة ExecInitParallelPlan().
إضافة إلى ذلك، يخصّص القائد طابور TupleQueue (المعرَّف في tqueue.c) داخل DSM. ويعمل هذا الطابور كقناة التواصل التي يقرأ القائد عبرها النتائج التي يعيدها العمال.
3.7.1.3. إنشاء العمال
قد يختلف عدد العمال في خطة الاستعلام عن عدد العمال الذين أُطلقوا فعليًا. ويرجع ذلك إلى أن العدد الإجمالي للعمال محدود بالمعامل max_parallel_workers. كذلك قد لا تتوفر خانات عمال كافية إذا كانت استعلامات متوازية أخرى قيد التنفيذ في الوقت نفسه.
ويعرض الأمر EXPLAIN ANALYZE كلا العددين: العمال المخطَّط لهم (Planned) والعمال المُطلقين (Launched)، ما يتيح التحقق من تخصيص الموارد.
testdb=# EXPLAIN ANALYZE SELECT * FROM d WHERE id BETWEEN 1 AND 100;
                                                    QUERY PLAN
------------------------------------------------------------------------------------------------------------------
 Gather  (cost=1000.00..16609.10 rows=1 width=12) (actual time=60.035..60.994 rows=100 loops=1)
   Workers Planned: 2
   Workers Launched: 2
   ->  Parallel Seq Scan on d  (cost=0.00..15609.00 rows=1 width=12) (actual time=31.073..52.248 rows=50 loops=2)
         Filter: ((id >= '1'::double precision) AND (id <= '100'::double precision))
         Rows Removed by Filter: 499950
 Planning Time: 0.265 ms
 Execution Time: 61.012 ms
(8 rows)
3.7.1.4. تهيئة العمال
عند بدء التشغيل، يقرأ كل عامل معلومات حالة التنفيذ والاستعلام المشتركة التي أعدّها القائد في DSM.
وبتطبيق حالة التنفيذ، يهيّئ العامل بيئته لتطابق جلسة القائد بدقة. وهذا يضمن اتساق معاملات التهيئة ولقطات المعاملات والمكتبات المحمَّلة عبر جميع العمليات المشاركة في الاستعلام.
ولمعالجة الاستعلام، يعيد العامل بناء شجرة خطته من PlannedStmt المشترك. وتُستخدم الدالة ExecSerializePlan() (ونظيراتها) لإنشاء شجرة خطة فرعية تتكوّن من عقد parallel_safe فقط — وهي عادةً الجزء من شجرة خطة القائد الواقع تحت عقدة Gather.
ويوضّح الشكل 3.40 العلاقة بين شجرة خطة القائد وشجرة الخطة المنشأة للعامل.
الشكل 3.40. شجرة خطة العامل المنشأة من شجرة خطة القائد
3.7.1.5. مسح الصفوف وإعادة النتائج
كما نوقش في القسم 3.4.1.1، فإن طرائق المنفِّذ للوصول إلى صفوف البيانات مجرَّدة للغاية. وينطبق هذا المبدأ أيضًا على الاستعلامات المتوازية.
ولأن القائد والعمال يتشاركون بيئة تنفيذ الاستعلام عبر DSM، يمكن تنفيذ مسح تسلسلي واحد على التوازي. ويسترجع كل عملية كتل البيانات ويمسحها عند الطلب بشكل نشط عبر استدعاء الدالة SeqNext().
وبالمثل، تُعاد النتائج إلى عقدة Gather عبر طابور TupleQueue الموجود في DSM.
3.7.1.6. جمع النتائج
عقدة Gather عقدة خاصة بالاستعلامات المتوازية تجمع النتائج التي يعيدها العمال.
3.7.2. الربط المتوازي
تدعم الاستعلامات المتوازية في PostgreSQL الربط بالحلقة المتداخلة والربط بالدمج والربط بالتجزئة.
وتستخدم الأمثلة التالية الجدولين d وf.
testdb=# CREATE TABLE d (id double precision, data int);
CREATE TABLE
testdb=# INSERT INTO d SELECT i::double precision, (random()*1000)::int FROM generate_series(1, 1000000) AS i;
INSERT 0 1000000
testdb=# CREATE INDEX d_id_idx ON d (id);
CREATE INDEX
testdb=# CREATE TABLE f (id double precision, data int);
CREATE TABLE
testdb=# INSERT INTO f SELECT i::double precision, (random()*1000)::int FROM generate_series(1, 10000000) AS i;
INSERT 0 10000000
testdb=# \d d
                      Table "public.d"
 Column |       Type       | Collation | Nullable | Default
--------+------------------+-----------+----------+---------
 id     | double precision |           |          |
 data   | integer          |           |          |
Indexes:
    "d_id_idx" btree (id)

testdb=# \d f
                      Table "public.f"
 Column |       Type       | Collation | Nullable | Default
--------+------------------+-----------+----------+---------
 id     | double precision |           |          |
 data   | integer          |           |          |

testdb=# ANALYZE;
ANALYZE
3.7.2.1. الربط بالحلقة المتداخلة
في الربط المتوازي القياسي بالحلقة المتداخلة، لا يُعالَج الجدول الداخلي على التوازي. وبدلًا من ذلك، على كل عامل معالجة الجدول الداخلي بأكمله بشكل مستقل.
على سبيل المثال، في الربط المُجسَّد بالحلقة المتداخلة، يجسّد كل عامل نسخته الخاصة من الجدول الداخلي. وتجعل هذه التكرارية الربط أقل كفاءة مع زيادة عدد العمال.
testdb=# SET enable_nestloop = ON;
SET
testdb=# SET enable_mergejoin = OFF;
SET
testdb=# SET enable_hashjoin = OFF;
SET

testdb=# EXPLAIN SELECT * FROM d, f WHERE d.data = f.data AND f.id < 10000;
                                  QUERY PLAN
-------------------------------------------------------------------------------
 Gather  (cost=1000.00..97163469.29 rows=9651513 width=24)
   Workers Planned: 2
   ->  Nested Loop  (cost=0.00..96197317.99 rows=4825756 width=24)
         Join Filter: (d.data = f.data)
         ->  Parallel Seq Scan on f  (cost=0.00..121935.99 rows=4831 width=12)
               Filter: (id < '10000'::double precision)
         ->  Materialize  (cost=0.00..27992.00 rows=1000000 width=12)
               ->  Seq Scan on d  (cost=0.00..18109.00 rows=1000000 width=12)
(8 rows)
الشكل 3.41. الربط المُجسَّد بالحلقة المتداخلة في الاستعلام المتوازي.
في المقابل، يكون الربط المفهرس بالحلقة المتداخلة أكثر كفاءة بكثير. فرغم أن مسح الجدول الداخلي نفسه غير «مشترك»، يستخدم كل عامل الفهرس لاسترجاع الصفوف ذات الصلة فقط من الجدول الداخلي بسرعة.
testdb=# EXPLAIN SELECT * FROM d, f WHERE d.id = f.id AND f.id < 10000;
                                  QUERY PLAN
-------------------------------------------------------------------------------
 Gather  (cost=1000.42..142818.71 rows=967 width=24)
   Workers Planned: 2
   ->  Nested Loop  (cost=0.42..141722.01 rows=484 width=24)
         ->  Parallel Seq Scan on f  (cost=0.00..121935.99 rows=4831 width=12)
               Filter: (id < '10000'::double precision)
         ->  Index Scan using d_id_idx on d  (cost=0.42..4.09 rows=1 width=12)
               Index Cond: (id = f.id)
(7 rows)
الشكل 3.42. الربط المفهرس بالحلقة المتداخلة في الاستعلام المتوازي.
3.7.2.2. الربط بالدمج
على غرار الربط بالحلقة المتداخلة، يعالج الربط القياسي بالدمج الجدول الداخلي لجميع الصفوف. وبناءً على ذلك، على كل عامل تنفيذ عملية الفرز الخاصة به للجدول الداخلي بشكل مستقل.
غير أنه إذا وُصل إلى الجدول الداخلي باستخدام مسح فهرس، فيمكن تنفيذ عملية الربط بكفاءة، على غرار الربط المفهرس بالحلقة المتداخلة.
testdb=# SET enable_nestloop = OFF;
SET
testdb=# SET enable_mergejoin = ON;
SET
testdb=# SET enable_hashjoin = OFF;
SET
testdb=# EXPLAIN SELECT * FROM d, f WHERE d.id = f.id AND d.id < 100000;
                                       QUERY PLAN
----------------------------------------------------------------------------------------
 Gather  (cost=837387.83..853944.33 rows=97361 width=24)
   Workers Planned: 2
   ->  Merge Join  (cost=836387.83..843208.23 rows=48680 width=24)
         Merge Cond: (f.id = d.id)
         ->  Sort  (cost=836385.61..848880.80 rows=4998079 width=12)
               Sort Key: f.id
               ->  Parallel Seq Scan on f  (cost=0.00..109440.79 rows=4998079 width=12)
         ->  Index Scan using d_id_idx on d  (cost=0.42..3569.24 rows=97361 width=12)
               Index Cond: (id < '100000'::double precision)
(9 rows)
3.7.2.3. الربط بالتجزئة
في الإصدارين 9.6 و10 من PostgreSQL، يبني كل عامل مشارك في ربط متوازٍ بالتجزئة جدول تجزئة خاصًا به للجدول الداخلي. ويؤدي ذلك إلى استخدام مرتفع للذاكرة وعمل مكرّر.
testdb=# SET enable_nestloop = OFF;
SET
testdb=# SET enable_mergejoin = OFF;
SET
testdb=# SET enable_hashjoin = ON;
SET
testdb=# SET enable_parallel_hash = OFF;
SET
testdb=# EXPLAIN SELECT * FROM d, f WHERE d.id = f.id;
                                    QUERY PLAN
----------------------------------------------------------------------------------
 Gather  (cost=36492.00..323368.59 rows=1000000 width=24)
   Workers Planned: 2
   ->  Hash Join  (cost=35492.00..222368.59 rows=500000 width=24)
         Hash Cond: (f.id = d.id)
         ->  Parallel Seq Scan on f  (cost=0.00..109440.79 rows=4998079 width=12)
         ->  Hash  (cost=18109.00..18109.00 rows=1000000 width=12)
               ->  Seq Scan on d  (cost=0.00..18109.00 rows=1000000 width=12)
(7 rows)
أُدخل الربط المتوازي بالتجزئة في الإصدار 11 (ويتحكّم به المعامل enable_parallel_hash، وهو مفعَّل افتراضيًا). وبهذه الميزة، يتعاون جميع العمال لبناء جدول تجزئة مشترك في DSM. ويتيح ذلك مرحلة بناء أكثر كفاءة ويقلّل كلفة الذاكرة.
testdb=# SET enable_parallel_hash = ON;
SET
testdb=# EXPLAIN SELECT * FROM d, f WHERE d.id = f.id;
                                      QUERY PLAN
--------------------------------------------------------------------------------------
 Gather  (cost=22801.00..304736.59 rows=1000000 width=24)
   Workers Planned: 2
   ->  Parallel Hash Join  (cost=21801.00..203736.59 rows=500000 width=24)
         Hash Cond: (f.id = d.id)
         ->  Parallel Seq Scan on f  (cost=0.00..109440.79 rows=4998079 width=12)
         ->  Parallel Hash  (cost=13109.00..13109.00 rows=500000 width=12)
               ->  Parallel Seq Scan on d  (cost=0.00..13109.00 rows=500000 width=12)
(7 rows)
3.7.3. التجميع المتوازي
يمكن معالجة معظم الدوال التجميعية في PostgreSQL على التوازي. ويعتمد ما إذا كانت دالة معينة تدعم التوازي على ما إذا كان وضعها Partial Mode مضبوطًا على YES في التوثيق الرسمي.
ويختار المخطِّط بين استراتيجيتين رئيسيتين بناءً على العدد المقدَّر للصفوف الهدف.
3.7.3.1. الاستراتيجية 1: تجميع بسيط (عدد صفوف صغير)
عندما يكون العدد المتوقَّع للصفوف صغيرًا، ينفّذ العمال المسح، لكن التجميع الفعلي يحدث في عملية القائد:
- يمسح كل عامل الصفوف عبر عقدة Parallel Seq Scan.
- تستقبل عقدة Gather هذه الصفوف الخام من العمال.
- تحسب عقدة Aggregate النتيجة النهائية من الصفوف المجموعة.
testdb=# EXPLAIN SELECT avg(id) FROM d where id BETWEEN 1 AND 10;
                                        QUERY PLAN
------------------------------------------------------------------------------------------
 Aggregate  (cost=16609.10..16609.11 rows=1 width=8)
   ->  Gather  (cost=1000.00..16609.10 rows=1 width=8)
         Workers Planned: 2
         ->  Parallel Seq Scan on d  (cost=0.00..15609.00 rows=1 width=8)
               Filter: ((id >= '1'::double precision) AND (id <= '10'::double precision))
(5 rows)

testdb=# EXPLAIN SELECT var_pop(id) FROM d where id BETWEEN 1 AND 10;
                                        QUERY PLAN
------------------------------------------------------------------------------------------
 Aggregate  (cost=16609.10..16609.11 rows=1 width=8)
   ->  Gather  (cost=1000.00..16609.10 rows=1 width=8)
         Workers Planned: 2
         ->  Parallel Seq Scan on d  (cost=0.00..15609.00 rows=1 width=8)
               Filter: ((id >= '1'::double precision) AND (id <= '10'::double precision))
(5 rows)
3.7.3.2. الاستراتيجية 2: تجميع جزئي/نهائي (عدد صفوف كبير)
عندما يكون العدد المتوقَّع للصفوف كبيرًا، يكون تقليل حجم البيانات قبل إرسالها عبر DSM أكثر كفاءة:
- ينفّذ كل عامل تجميعًا جزئيًا (Partial Aggregate) على صفوفه الممسوحة محليًا.
- تجمع عقدة Gather هذه النتائج الوسيطة المجمَّعة جزئيًا (بدلًا من الصفوف الخام).
- تدمج عقدة Finalize Aggregate النتائج الوسيطة في جواب نهائي.
testdb=# EXPLAIN SELECT avg(id) FROM d where data > 100;
                                     QUERY PLAN
-------------------------------------------------------------------------------------
 Finalize Aggregate  (cost=16485.14..16485.15 rows=1 width=8)
   ->  Gather  (cost=16484.93..16485.14 rows=2 width=32)
         Workers Planned: 2
         ->  Partial Aggregate  (cost=15484.93..15484.94 rows=1 width=32)
               ->  Parallel Seq Scan on d  (cost=0.00..14359.00 rows=450371 width=8)
                     Filter: (data > 100)
(6 rows)

testdb=# EXPLAIN  SELECT var_pop(id) FROM d where data > 100;
                                     QUERY PLAN
-------------------------------------------------------------------------------------
 Finalize Aggregate  (cost=16485.14..16485.15 rows=1 width=8)
   ->  Gather  (cost=16484.93..16485.14 rows=2 width=32)
         Workers Planned: 2
         ->  Partial Aggregate  (cost=15484.93..15484.94 rows=1 width=32)
               ->  Parallel Seq Scan on d  (cost=0.00..14359.00 rows=450371 width=8)
                     Filter: (data > 100)
(6 rows)
3.7.3.3. المنطق الرياضي للتجميع المتوازي
لدمج النتائج من عمال مختلفين (مثل المجاميع والمتوسطات والتباينات)، يستخدم PostgreSQL الصيغ التالية (انظر الملحق 1.2 للتفاصيل):
وتستخدم عقدة Finalize Aggregate هذه الصيغ لدمج النتائج الجزئية. وفي الاستعلامات التي تشمل ثلاثة عمال أو أكثر، تُكرَّر هذه العملية تكراريًا للوصول إلى القيمة النهائية.