عنقود قواعد البيانات والجداول
1.1. البنية المنطقية لعنقود قواعد البيانات
عنقود قواعد البيانات (database cluster) هو مجموعة من قواعد البيانات (databases) التي يديرها خادم PostgreSQL. إذا كنت تسمع هذا التعريف لأول مرة، فربما تتساءل عمّا يعنيه. إن مصطلح «عنقود قواعد البيانات» في PostgreSQL لا يعني «مجموعة من خوادم قواعد البيانات». يعمل خادم PostgreSQL على مضيف واحد ويدير عنقود قواعد بيانات واحدًا.
يوضّح الشكل 1.1 البنية المنطقية لعنقود قواعد البيانات. قاعدة البيانات (database) هي مجموعة من كائنات قاعدة البيانات. في نظرية قواعد البيانات العلائقية، كائن قاعدة البيانات هو بنية بيانات تُستخدم لتخزين البيانات أو الإشارة إليها. والجدول (table) من نوع الكومة (heap table) هو المثال النموذجي؛ وتشمل الأمثلة الأخرى الفهارس (indexes) والتسلسلات (sequences) وطرق العرض (views) والدوال (functions). في PostgreSQL، تُعدّ قواعد البيانات نفسها أيضًا كائنات قاعدة بيانات ومعزولة منطقيًا بعضها عن بعض. وتنتمي جميع كائنات قاعدة البيانات الأخرى (مثل الجداول والفهارس) إلى قواعد بياناتها الخاصة.
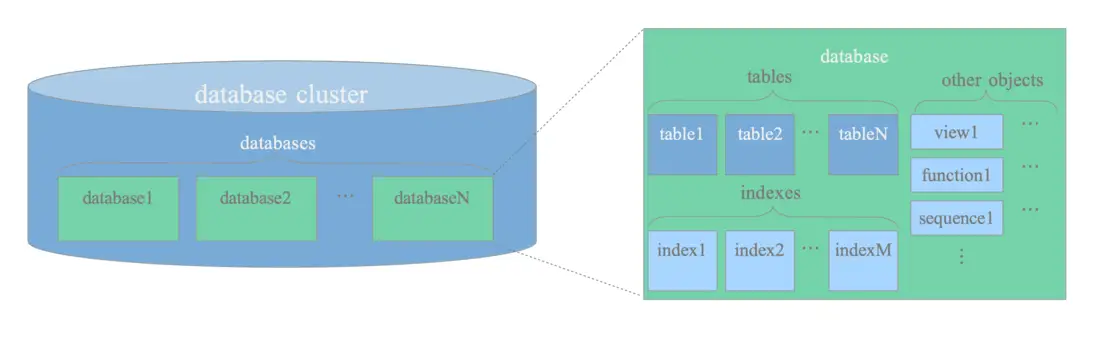
الشكل 1.1. البنية المنطقية لعنقود قواعد البيانات.
تُدار جميع كائنات قاعدة البيانات في PostgreSQL داخليًا بواسطة معرّفات الكائنات (OIDs) الخاصة بكل منها، وهي أعداد صحيحة غير مُوقَّعة بطول 4 بايت. وتُخزَّن العلاقات بين كائنات قاعدة البيانات ومعرّفات OIDs الخاصة بها في كتالوجات النظام المناسبة، حسب نوع الكائنات. على سبيل المثال، تُخزَّن معرّفات OIDs الخاصة بقواعد البيانات وجداول الكومة في pg_database وpg_class على التوالي.
للعثور على معرّفات OIDs المطلوبة، نفّذ الاستعلامات (queries) التالية:
sampledb=# SELECT datname, oid FROM pg_database WHERE datname = 'sampledb';
 datname  |  oid
----------+-------
 sampledb | 16384
(1 row)

sampledb=# SELECT relname, oid FROM pg_class WHERE relname = 'sampletbl';
  relname  |  oid
-----------+-------
 sampletbl | 18740
(1 row)
** معلومات تاريخية
حتى الإصدار 11 من PostgreSQL (عام 2018)، كانت قاعدة البيانات قادرة على إسناد معرّف كائن (OID) فريد تلقائيًا إلى كل صف (row) في جداول المستخدمين، تمامًا كما تفعل مع الجداول والفهارس.
وقد نشأت هذه الميزة من سلف PostgreSQL، وهو POSTGRES، الذي صُمِّم ليكون «قاعدة بيانات كائنية علائقية». وتحت تأثير المفاهيم الكائنية التوجه المتقدمة في ذلك الوقت، كانت الفلسفة الأساسية تقوم على معاملة كل شيء — ليس الجداول فحسب، بل البيانات المخزَّنة (tuples) نفسها أيضًا — بوصفه «كائنًا» له هويته الخاصة.
فيما يلي مثال على الإسناد الضمني لمعرّف OID في الإصدار 8.0:
testdb=# SELECT version();
                                     version
--------------------------------------------------------------------
 PostgreSQL 8.0.26 on arm-apple-darwin24.5.0, compiled by
                  GCC Apple clang version 17.0.0 (clang-1700.0.13.5)
(1 row)

testdb=# \d tbl
      Table "public.tbl"
 Column |  Type   | Modifiers
--------+---------+-----------
 id     | integer |
 data   | text    |

testdb=# SELECT * FROM tbl;
 id | data
----+------
  1 | a
  2 | b
  3 | c
(3 rows)

testdb=# SELECT oid, * FROM tbl;
  oid  | id | data
-------+----+------
 17236 |  1 | a
 17237 |  2 | b
 17238 |  3 | c
(3 rows)
وكما يظهر هنا، كان يُسنَد معرّف OID تلقائيًا إلى كل صف.
غير أن الوصول إلى البيانات باستخدام معرّفات OIDs الداخلية تعارض مع المبادئ الجوهرية لقواعد البيانات العلائقية (RDB)، التي تركّز على معالجة البيانات بناءً على قيمها الفعلية. وإلى جانب القيود الفيزيائية لصيغة OID ذات 32 بت، أصبحت هذه الميزة غير عملية لمعظم حالات الاستخدام في وقت مبكر نسبيًا.
ولفترة طويلة، أُبقِيَ عليها للتوافق مع الإصدارات السابقة فقط. وبعد فترة انتقالية طويلة، عُطِّلت معرّفات OIDs على مستوى الصف افتراضيًا في الإصدار 8.1 (عام 2005)، وأُزيلت نهائيًا في الإصدار 12 (عام 2019).
1.2. البنية الفيزيائية لعنقود قواعد البيانات
عنقود قواعد البيانات هو في الأساس دليل واحد يُشار إليه باسم الدليل الأساسي (base directory). ويحتوي على بعض الأدلة الفرعية والعديد من الملفات. عند تنفيذ أداة initdb لتهيئة عنقود قواعد بيانات جديد، سيُنشَأ دليل أساسي تحت الدليل المحدَّد. وعادةً ما يُضبَط مسار الدليل الأساسي في متغير البيئة PGDATA.
يوضّح الشكل 1.2 مثالًا لعنقود قواعد بيانات في PostgreSQL. قاعدة البيانات هي دليل فرعي تحت دليل base، وكل جدول أو فهرس هو (على الأقل) ملف واحد مخزَّن تحت الدليل الفرعي لقاعدة بياناته المعنية. وتحتوي عدة أدلة فرعية أخرى على بيانات وملفات تهيئة محدَّدة.
وبينما يدعم PostgreSQL فضاءات الجداول (tablespaces)، فإن معنى المصطلح يختلف عن أنظمة إدارة قواعد البيانات العلائقية الأخرى. ففضاء الجداول في PostgreSQL هو دليل واحد يحتوي على بعض البيانات خارج الدليل الأساسي.
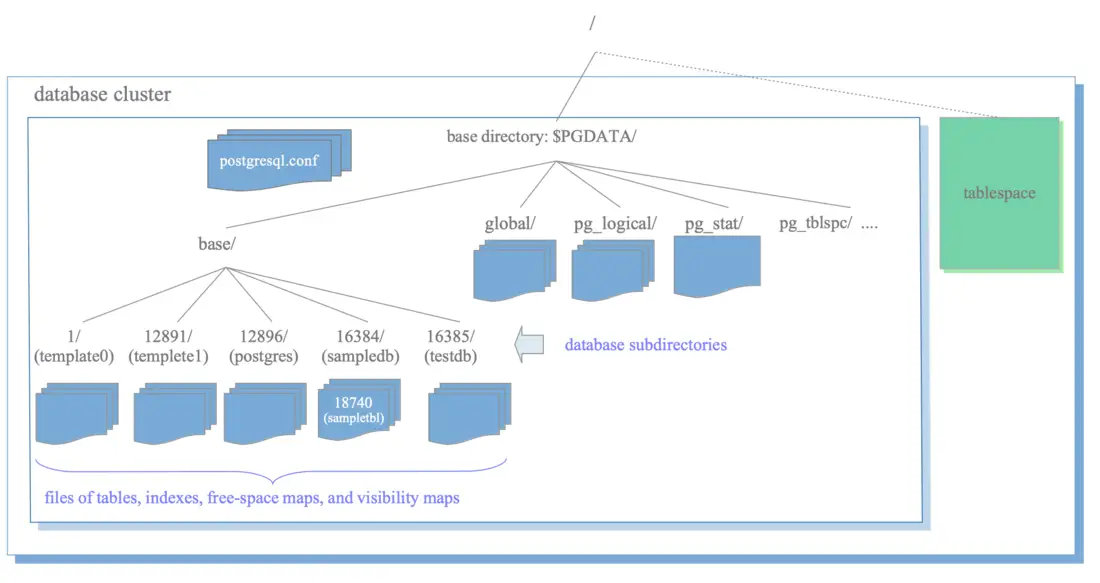
الشكل 1.2. مثال على عنقود قواعد البيانات.
تصف الأقسام الفرعية التالية تخطيط عنقود قواعد البيانات، وقواعد البيانات، والملفات المرتبطة بالجداول والفهارس، وفضاءات الجداول في PostgreSQL.
محتويات القسم
- 1.2.1. البنية المنطقية لعنقود قواعد البيانات
- 1.2.2. تخطيط قواعد البيانات
- 1.2.3. تخطيط الملفات المرتبطة بالجداول والفهارس
- 1.2.4. فضاءات الجداول
1.2.1. تخطيط عنقود قواعد البيانات
تخطيط عنقود قواعد البيانات موصوف في التوثيق الرسمي. ويسرد الجدول 1.1 الملفات والأدلة الفرعية الرئيسية التي يتناولها ذلك القسم:
| الملفات | الوصف |
|---|---|
| PG_VERSION | ملف يحتوي على رقم الإصدار الرئيسي لـ PostgreSQL. |
| current_logfiles | ملف يسجّل ملف (ملفات) السجل التي يكتب فيها جامع السجلات حاليًا. |
| pg_hba.conf | ملف للتحكم في مصادقة عملاء PostgreSQL. |
| pg_ident.conf | ملف للتحكم في تعيين أسماء المستخدمين في PostgreSQL. |
| postgresql.conf | ملف لضبط معاملات التهيئة. |
| postgresql.auto.conf | ملف يُستخدم لتخزين معاملات التهيئة التي تُضبَط في ALTER SYSTEM. (الإصدارات 9.4 أو أحدث) |
| postmaster.opts | ملف يسجّل خيارات سطر الأوامر التي بدأ بها الخادم آخر مرة. |
| الأدلة الفرعية | الوصف |
| base/ | دليل فرعي يحتوي على أدلة فرعية لكل قاعدة بيانات. |
| global/ | دليل فرعي يحتوي على جداول على مستوى العنقود، مثل pg_database وpg_control. |
| pg_commit_ts/ | دليل فرعي يحتوي على بيانات الطابع الزمني لالتزام المعاملات (transactions). (الإصدارات 9.5 أو أحدث) |
| pg_clog/ (الإصدارات 9.6 أو أقدم) | دليل فرعي يحتوي على بيانات حالة التزام المعاملات. أُعيدت تسميته إلى pg_xact في الإصدار 10. |
| pg_dynshmem/ | دليل فرعي يحتوي على ملفات يستخدمها النظام الفرعي للذاكرة المشتركة الديناميكية. (الإصدارات 9.4 أو أحدث) |
| pg_logical/ | دليل فرعي يحتوي على بيانات الحالة لفك الترميز المنطقي. (الإصدارات 9.4 أو أحدث) |
| pg_multixact/ | دليل فرعي يحتوي على بيانات حالة المعاملات المتعددة. (يُستخدم لأقفال الصفوف المشتركة) |
| pg_notify/ | دليل فرعي يحتوي على بيانات حالة LISTEN/NOTIFY. |
| pg_repslot/ | دليل فرعي يحتوي على بيانات فتحة النسخ المتماثل (replication slot). وسيُوصف النسخ المتماثل للفتحات في القسم 11.4. (الإصدارات 9.4 أو أحدث) |
| pg_serial/ | دليل فرعي يحتوي على معلومات حول المعاملات القابلة للتسلسل الملتزمة. (الإصدارات 9.1 أو أحدث) |
| pg_snapshots/ | دليل فرعي يحتوي على اللقطات المصدَّرة. تُنشئ دالة PostgreSQL المسماة pg_export_snapshot ملف معلومات لقطة في هذا الدليل الفرعي. (الإصدارات 9.2 أو أحدث) |
| pg_stat/ | دليل فرعي يحتوي على ملفات دائمة للنظام الفرعي للإحصاءات. |
| pg_stat_tmp/ | دليل فرعي يحتوي على ملفات مؤقتة للنظام الفرعي للإحصاءات. |
| pg_subtrans/ | دليل فرعي يحتوي على بيانات حالة المعاملات الفرعية. |
| pg_tblspc/ | دليل فرعي يحتوي على روابط رمزية إلى فضاءات الجداول. |
| pg_twophase/ | دليل فرعي يحتوي على ملفات الحالة للمعاملات المُعدَّة. |
| pg_wal/ (الإصدارات 10 أو أحدث) | دليل فرعي يحتوي على ملفات مقاطع سجل ما قبل الكتابة (WAL). أُعيدت تسميته من pg_xlog في الإصدار 10. وسيُوصف WAL في الفصل 9. |
| pg_xact/ (الإصدارات 10 أو أحدث) | دليل فرعي يحتوي على بيانات حالة التزام المعاملات. أُعيدت تسميته من pg_clog في الإصدار 10. وسيُوصف CLOG في القسم 5.4. |
| pg_xlog/ (الإصدارات 9.6 أو أقدم) | دليل فرعي يحتوي على ملفات مقاطع سجل ما قبل الكتابة (WAL). أُعيدت تسميته إلى pg_wal في الإصدار 10. |
** معلومات تاريخية
في الإصدار 10 (عام 2017)، أُعيدت تسمية الدليلين الفرعيين pg_xlog وpg_clog إلى pg_wal وpg_xact على التوالي.
وجرى هذا التغيير لأن المستخدمين غير المألوفين بـ PostgreSQL كانوا يحذفون هذه الأدلة أحيانًا، ظنًّا منهم أنها مجلدات تخزين سجلات عادية.
1.2.2. تخطيط قواعد البيانات
كل قاعدة بيانات هي دليل فرعي يقع تحت الدليل الأساسي. وأسماء هذه الأدلة الفرعية مطابقة لمعرّفات OIDs الخاصة بها. على سبيل المثال، إذا كانت قاعدة البيانات «sampledb» تحمل معرّف OID يساوي 16384، فسيكون اسم دليلها الفرعي أيضًا 16384.
$ cd $PGDATA
$ ls -ld base/16384
drwx------  213 postgres postgres  7242  8 26 16:33 16384
1.2.3. تخطيط الملفات المرتبطة بالجداول والفهارس
يُخزَّن كل جدول وفهرس في ملف واحد تحت دليل قاعدة بياناته إذا كان حجمه أقل من 1 جيجابايت. وتُدار الجداول والفهارس داخليًا بواسطة معرّفات OIDs الخاصة بها، بينما تُدار ملفات بياناتها الفيزيائية بواسطة معرّف يُسمى relfilenode. ورغم أن relfilenode يطابق عادةً معرّف OID المقابل له، فإن هذا ليس صحيحًا دائمًا؛ وتُوصف التفاصيل أدناه.
يوضّح المثال التالي معرّف OID وrelfilenode للجدول «sampletbl»:
sampledb=# SELECT relname, oid, relfilenode FROM pg_class WHERE relname = 'sampletbl';
  relname  |  oid  | relfilenode
-----------+-------+-------------
 sampletbl | 18740 |       18740
(1 row)
في هذه الحالة، قيمتا OID وrelfilenode متطابقتان. ومسار ملف البيانات الفيزيائي للجدول «sampletbl» هو $PGDATA/base/16384/18740.
$ cd $PGDATA
$ ls -la base/16384/18740
-rw------- 1 postgres postgres 8192 Apr 21 10:21 base/16384/18740
تتغيّر قيم relfilenode للجداول والفهارس عند إصدار أوامر معينة، مثل TRUNCATE وREINDEX وCLUSTER. على سبيل المثال، إذا نفّذنا الأمر TRUNCATE على الجدول «sampletbl»، فإن PostgreSQL يُسند إلى الجدول قيمة relfilenode جديدة (18812)، ويحذف ملف البيانات القديم (18740)، وينشئ ملفًا جديدًا (18812).
sampledb=# TRUNCATE sampletbl;
TRUNCATE TABLE

sampledb=# SELECT relname, oid, relfilenode FROM pg_class WHERE relname = 'sampletbl';
  relname  |  oid  | relfilenode
-----------+-------+-------------
 sampletbl | 18740 |       18812
(1 row)
** معلومة
في الإصدارات 9.0 أو أحدث، تكون الدالة المدمجة pg_relation_filepath() مفيدة بشكل خاص؛ فهي تُعيد مسار الملف النسبي للعلاقة (relation) المرتبطة بمعرّف OID أو باسم محدَّد.
sampledb=# SELECT pg_relation_filepath('sampletbl');
 pg_relation_filepath
----------------------
 base/16384/18812
(1 row)
عندما يتجاوز حجم ملف جدول أو فهرس 1 جيجابايت، ينشئ PostgreSQL ملف مقطع جديدًا باسم relfilenode.1. وإذا امتلأ ذلك الملف أيضًا، ينشئ PostgreSQL relfilenode.2، وهكذا.
$ cd $PGDATA
$ ls -la -h base/16384/19427*
-rw------- 1 postgres postgres 1.0G  Apr  21 11:16 data/base/16384/19427
-rw------- 1 postgres postgres  45M  Apr  21 11:20 data/base/16384/19427.1
** معلومة
يمكن تغيير الحد الأقصى لحجم ملف الجداول والفهارس باستخدام خيار التهيئة «–with-segsize» عند بناء PostgreSQL من المصدر.
ويكشف فحص الأدلة الفرعية لقواعد البيانات أن لكل جدول عادةً ملفين مساعدين مرتبطين به، بامتدادي «_fsm» و«_vm». وهما على التوالي خريطة المساحة الحرة (free space map) وخريطة الرؤية (visibility map).
تخزّن خريطة المساحة الحرة (FSM) معلومات تتعلق بالسعة المتاحة لكل صفحة (page) داخل ملف الجدول. وتتتبّع خريطة الرؤية (VM) حالة الرؤية لكل صفحة. (تتوفر تفاصيل إضافية في القسمين 5.3.4 و6.2.)
تمتلك الفهارس خرائط مساحة حرة فردية فقط، وليس لها خريطة رؤية.
ويرد مثال محدد على هذه الملفات أدناه:
$ cd $PGDATA
$ ls -la base/16384/18751*
-rw------- 1 postgres postgres  8192 Apr 21 10:21 base/16384/18751
-rw------- 1 postgres postgres 24576 Apr 21 10:18 base/16384/18751_fsm
-rw------- 1 postgres postgres  8192 Apr 21 10:18 base/16384/18751_vm
يُشار إلى خريطة المساحة الحرة وخريطة الرؤية داخليًا باسم تفريعات (forks) العلاقة. ويُسمّى ملف البيانات الرئيسي التفريع رقم 0. وخريطة المساحة الحرة هي التفريع الأول (رقم التفريع 1)، وخريطة الرؤية هي التفريع الثاني (رقم التفريع 2) لملف بيانات الجدول.
1.2.4. فضاءات الجداول
فضاء الجداول في PostgreSQL هو منطقة بيانات إضافية خارج الدليل الأساسي. وقد نُفِّذت هذه الوظيفة في الإصدار 8.0 (عام 2005).
يوضّح الشكل 1.3 التخطيط الداخلي لفضاء جداول وعلاقته بمنطقة البيانات الرئيسية.
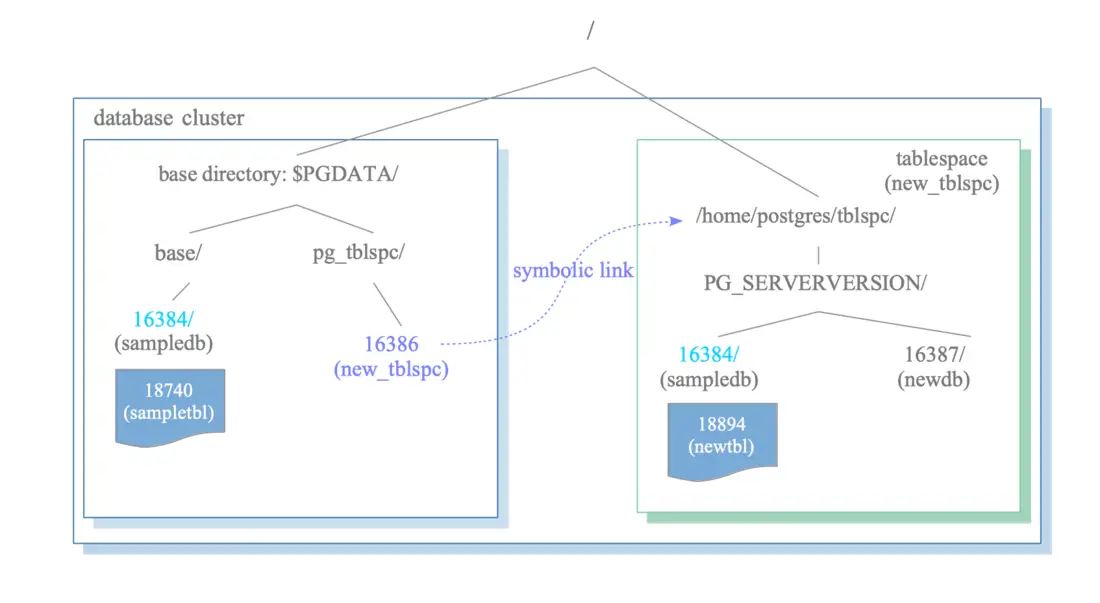
الشكل 1.3. فضاء جداول في عنقود قواعد البيانات.
يُهيَّأ فضاء الجداول داخل الدليل المحدَّد عند تنفيذ الأمر CREATE TABLESPACE.
وداخل ذلك الدليل المحدَّد، يُنشَأ تلقائيًا دليل فرعي خاص بالإصدار. وقاعدة تسمية هذا الدليل الفرعي كما يلي:
- قاعدة تسمية دليل فضاء الجداول:
PG_[Major version]_[Catalogue version number]
على سبيل المثال، إذا أُنشئ فضاء جداول باسم «new_tblspc» في المسار /home/postgres/tblspc بمعرّف OID يساوي 16386، فسيُنشَأ دليل فرعي مثل «PG_14_202011044» تحت ذلك المسار.
$ ls -l /home/postgres/tblspc/
total 4
drwx------ 2 postgres postgres 4096 Apr 21 10:08 PG_14_202011044
يرتبط دليل فضاء الجداول بعنقود قواعد البيانات عبر رابط رمزي يقع في الدليل الفرعي pg_tblspc. واسم هذا الرابط يطابق معرّف OID لفضاء الجداول.
$ ls -l $PGDATA/pg_tblspc/
total 0
lrwxrwxrwx 1 postgres postgres 21 Apr 21 10:08 16386 -> /home/postgres/tblspc
عند إنشاء قاعدة بيانات جديدة (بمعرّف OID 16387) داخل فضاء الجداول، يوضع دليلها المقابل تحت الدليل الفرعي الخاص بالإصدار:
$ ls -l /home/postgres/tblspc/PG_14_202011044/
total 4
drwx------ 2 postgres postgres 4096 Apr 21 10:10 16387
إذا أُنشئ جدول جديد داخل فضاء جداول تابع لقاعدة بيانات موجودة أصلًا في الدليل الأساسي، فيُنشَأ أولًا دليل باسم معرّف OID لقاعدة البيانات تحت الدليل الفرعي الخاص بالإصدار في فضاء الجداول ذلك. ثم يوضع ملف الجدول الجديد داخل هذا الدليل المُنشَأ حديثًا.
sampledb=# CREATE TABLE newtbl (.....) TABLESPACE new_tblspc;

sampledb=# SELECT pg_relation_filepath('newtbl');
             pg_relation_filepath
---------------------------------------------
 pg_tblspc/16386/PG_14_202011044/16384/18894
1.3. بنية جدول الكومة
يشرح هذا القسم التخطيط الداخلي لجدول الكومة وآلية TOAST (تقنية تخزين السمات الضخمة).
محتويات القسم
- 1.3.1. التخطيط الداخلي للصفحة
- 1.3.2. TOAST (تقنية تخزين السمات الضخمة)
1.3.1. التخطيط الداخلي للصفحة
تُقسَّم ملفات البيانات — بما في ذلك جداول الكومة والفهارس وخرائط المساحة الحرة وخرائط الرؤية — إلى صفحات (pages) أو كتل (blocks) ذات طول ثابت، يبلغ 8192 بايت (8 كيلوبايت) افتراضيًا. وتُرقَّم الصفحات داخل كل ملف تسلسليًا بدءًا من 0؛ وتُسمى هذه المعرّفات أرقام الكتل (block numbers). وعندما يبلغ الملف سعته القصوى، يضيف PostgreSQL صفحة فارغة جديدة إلى نهاية الملف لزيادة حجمه.
يعتمد التخطيط الداخلي للصفحة على النوع المحدَّد لملف البيانات. ويركّز هذا القسم على تخطيط جداول الكومة، لأن هذه المعلومات ضرورية لفهم المفاهيم التي تُناقَش في الفصول اللاحقة.
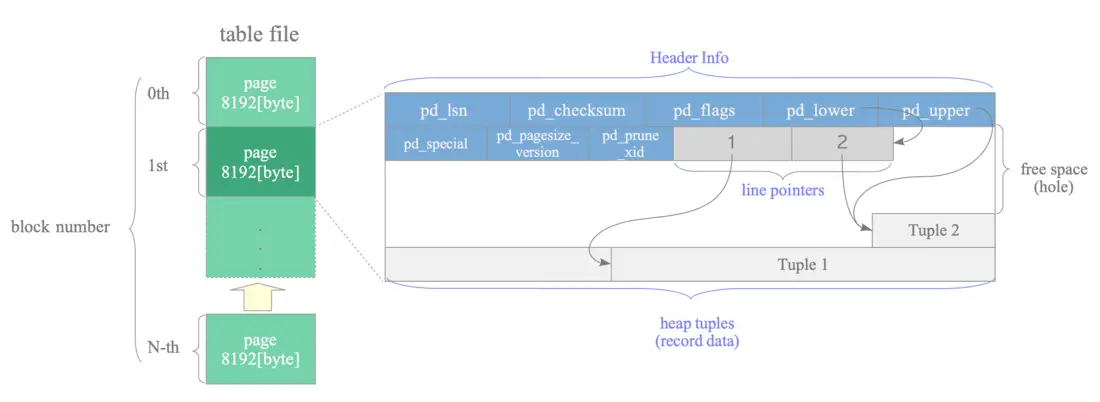
الشكل 1.4. تخطيط صفحة ملف جدول كومة.
تحتوي الصفحة داخل الجدول على ثلاثة أنواع من البيانات:
- صفوف الكومة (heap tuples): يمثّل صف الكومة بيانات السجل نفسه. وتُكدَّس الصفوف تسلسليًا من أسفل الصفحة. وتُوصف البنية الداخلية للصف في القسم 5.2 والفصل 9، إذ يتطلب فهمها معرفة مسبقة بكل من التحكّم بالتزامن (CC) وسجل ما قبل الكتابة (WAL).
- مؤشّرات السطر (line pointers): يبلغ طول كل مؤشّر سطر 4 بايت ويحمل مؤشّرًا إلى صف كومة محدد. ويُشار إليه أيضًا باسم مؤشّر العنصر (item pointer). وتشكّل مؤشّرات السطر مصفوفة بسيطة تعمل كفهرس للصفوف. ويُرقَّم كل عنصر في المصفوفة تسلسليًا بدءًا من 1، ويُشار إليه باسم رقم الإزاحة (offset number). وعند إضافة صف جديد إلى الصفحة، يُلحَق مؤشّر سطر مقابل بالمصفوفة للإشارة إلى الصف الجديد.
- بيانات الترويسة (header data): تُعرَّف ببنية
PageHeaderDataفي bufpage.h، وتُخصَّص بيانات الترويسة في بداية الصفحة. ويبلغ طولها 24 بايت وتحتوي على معلومات عامة عن الصفحة. وتشمل المتغيرات الرئيسية في البنية: pd_lsn: يخزّن هذا المتغير رقم تسلسل السجل (LSN) لسجل XLOG المرتبط بأحدث تغيير على هذه الصفحة. وهو عدد صحيح غير مُوقَّع بطول 8 بايت مرتبط بآلية WAL (سجل ما قبل الكتابة). وتتوفر تفاصيل إضافية في القسم 9.1.2. - pd_checksum: يخزّن هذا المتغير قيمة المجموع الاختباري (checksum) للصفحة. (ملاحظة: هذا المتغير مدعوم في الإصدارات 9.3 أو أحدث؛ وفي الإصدارات الأقدم كان هذا الحقل يخزّن pd_tli، وهو معرّف الخط الزمني (timelineId) للصفحة.)
- pd_lower, pd_upper: يشير pd_lower إلى نهاية مؤشّرات السطر، بينما يشير pd_upper إلى بداية أحدث صف كومة.
- pd_special: يُستخدم هذا المتغير للفهارس. وفي صفحات الجداول يشير إلى نهاية الصفحة. (وفي صفحات الفهارس يشير إلى بداية المساحة الخاصة، وهي منطقة بيانات خاصة بأنواع الفهارس مثل B-tree وGiST وGIN وغيرها.)
وتظهر بنية PageHeaderData أدناه:
typedef struct PageHeaderData
{
	/* XXX LSN is member of *any* block, not only page-organized ones */
	PageXLogRecPtr pd_lsn;		/* LSN: next byte after last byte of xlog
								 * record for last change to this page */
	uint16		pd_checksum;	/* checksum */
	uint16		pd_flags;		/* flag bits, see below */
	LocationIndex pd_lower;		/* offset to start of free space */
	LocationIndex pd_upper;		/* offset to end of free space */
	LocationIndex pd_special;	/* offset to start of special space */
	uint16		pd_pagesize_version;
	TransactionId pd_prune_xid; /* oldest prunable XID, or zero if none */
	ItemIdData	pd_linp[FLEXIBLE_ARRAY_MEMBER]; /* line pointer array */
} PageHeaderData;

typedef PageHeaderData *PageHeader;

typedef uint64 XLogRecPtr;
تُسمّى المساحة الفارغة بين نهاية مؤشّرات السطر وبداية أحدث صف المساحة الحرة (free space) أو الفتحة (the hole).
ولتحديد صف معين داخل جدول، يُستخدم داخليًا معرّف الصف (tuple identifier, TID). ويتكوّن معرّف TID من زوج من القيم: رقم الكتلة (block number) للصفحة التي تحتوي على الصف، ورقم الإزاحة (offset number) لمؤشّر السطر الذي يشير إلى ذلك الصف. وتُستخدم معرّفات TIDs عادةً في الفهارس؛ انظر القسم 1.4.2 لمزيد من التفاصيل.
1.3.2. TOAST (تقنية تخزين السمات الضخمة)
تُدار صفوف الكومة التي تتجاوز نحو 2 كيلوبايت — وتحديدًا القيمة الافتراضية TOAST_TUPLE_THRESHOLD البالغة 2,032 بايت — باستخدام آلية تُسمى TOAST.
إذا ظل عنصر بيانات يتجاوز عتبة الـ 2 كيلوبايت حتى بعد ضغطه، ينشئ PostgreSQL جدول TOAST مخصصًا وفهرس TOAST مقابلًا لذلك الجدول تحديدًا. وتُخزَّن البيانات الفعلية داخل جدول TOAST، بينما يخزّن الجدول الأصلي مؤشّرًا فقط يشير إلى مدخلة TOAST.
1.3.2.1. مثال عملي
لتجسيد هذه الآلية، يُنشأ جدول باسم tbl_toast.
testdb=# CREATE TABLE tbl_toast (id SERIAL PRIMARY KEY, data text);
testdb=# ALTER TABLE tbl_toast ALTER COLUMN data SET STORAGE EXTERNAL;
تُدرَج سلسلة صغيرة («abc») في الصف الأول، فتتسع داخل صفحة قياسية. وفي الصفين الثاني والثالث، تُدرَج بيانات بحجم 10 كيلوبايت تقريبًا في كل منهما.
testdb=# INSERT INTO tbl_toast (data) VALUES ('abc');
testdb=# INSERT INTO tbl_toast (data) SELECT repeat('abcdefghij', 1000) FROM generate_series(1, 2);
في هذه الحالة، يكون معرّف OID للجدول tbl_toast هو 16406.
testdb=# SELECT relname, oid, relfilenode FROM pg_class WHERE relname = 'tbl_toast';
  relname  |  oid  | relfilenode
-----------+-------+-------------
 tbl_toast | 16406 |       16406
(1 row)
وبناءً على ذلك، يُسمّى جدول TOAST المقابل وفهرسه pg_toast_16406 وpg_toast_16406_index على التوالي.
testdb=# SELECT relname, relpages FROM pg_class
    WHERE relname LIKE '%toast%16406%'
    	  AND relnamespace = (SELECT oid FROM pg_namespace WHERE nspname = 'pg_toast');
       relname        | relpages
----------------------+----------
 pg_toast_16406       |        0
 pg_toast_16406_index |        1
(2 rows)
يمكن استرداد معرّفات OIDs والمسارات الفيزيائية للملفات لهذه العلاقات باستخدام الاستعلام التالي. في هذا المثال، المساران هما base/16384/16411 وbase/16384/16412.
testdb=# \x
Expanded display is on.
testdb=# SELECT c.relname AS main_table, t.relname AS toast_table, t.oid AS toast_table_oid,
	 	pg_relation_filepath(t.oid) AS physical_path,
                i.relname AS toast_index, i.oid AS toast_index_oid,
		pg_relation_filepath(i.oid) AS index_path
         FROM pg_class c JOIN pg_class t ON c.reltoastrelid = t.oid
             JOIN pg_index idx ON idx.indrelid = t.oid
             JOIN pg_class i ON i.oid = idx.indexrelid WHERE c.relname = 'tbl_toast';
-[ RECORD 1 ]---+---------------------
main_table      | tbl_toast
toast_table     | pg_toast_16406
toast_table_oid | 16411
physical_path   | base/16384/16411
toast_index     | pg_toast_16406_index
toast_index_oid | 16412
index_path      | base/16384/16412
** ضغط الصفوف
لتوضيح آلية TOAST، يمنع هذا المثال ضغط البيانات عبر تعديل معاملات التخزين باستخدام الأمر ALTER TABLE.
يقوم PostgreSQL عادةً بضغط البيانات إذا تجاوز حجمها 2 كيلوبايت. وطريقة الضغط الافتراضية هي pglz (PostgreSQL Lempel-Ziv).
1.3.2.2. التحليل البنيوي
يوضّح الشكل 1.5 العلاقة بين الجدول الرئيسي tbl_toast وجدول TOAST pg_toast_16406.
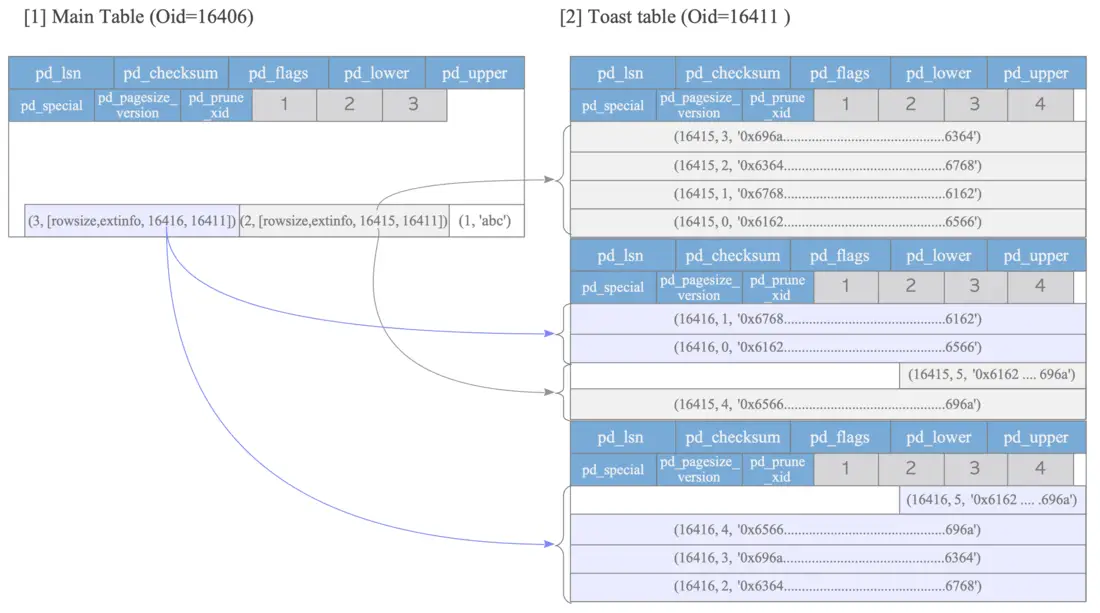
الشكل 1.5: التعيين البنيوي بين الجدول الرئيسي وجدول TOAST المرتبط به.
يشير مؤشّر TOAST واحد منطقيًا إلى عدة صفوف مقاطع (chunk_seq من 0 إلى 5) بوصفها عنصر «data» موحّدًا.
بما أن عناصر «data» في الصفين الثاني والثالث من tbl_toast يبلغ حجمها 10 كيلوبايت، فإنها تُخزَّن كمؤشّرات TOAST باستخدام بنية varatt_external بدلًا من البيانات الخام.
وتعريف بنية varatt_external كما يلي:
typedef struct varatt_external
{
    int32   va_rawsize;     /* Original data size (includes header) */
    uint32  va_extinfo;     /* External saved size (without header) and compression method */
    Oid     va_valueid;     /* Unique ID of value within TOAST table */
    Oid     va_toastrelid;  /* RelID of TOAST table containing it */
}   varatt_external;
وتُوصف هذه الحقول الأربعة أدناه:
- va_rawsize: حجم البيانات الأصلي، بما في ذلك الترويسة.
- va_extinfo: الحجم الفعلي المخزَّن خارجيًا (باستثناء الترويسة) وطريقة الضغط المستخدمة.
- va_valueid: معرّف فريد للقيمة داخل جدول TOAST، يُشار إليه داخليًا باسم chunk_id.
- va_toastrelid: معرّف OID لجدول TOAST الذي يحتوي على البيانات.
تعمل تركيبة va_valueid (chunk_id) وva_toastrelid كمؤشّر الفعلي إلى البيانات الخارجية. في هذا المثال، قيمتا va_valueid للصفين الثاني والثالث هما 16415 و16416 على التوالي، بينما va_toastrelid هو 16411 (معرّف OID لجدول TOAST).
1.3.2.3. محتوى جدول TOAST
يتكوّن جدول TOAST من ثلاثة أعمدة: chunk_id وchunk_seq وchunk_data.
- chunk_id: معرّف عنصر البيانات المخزَّن بتقنية TOAST من الجدول الأصلي.
- chunk_seq: رقم تسلسلي يُسنَد عند تقسيم عنصر «data» المخزَّن بتقنية TOAST إلى عدة مقاطع.
- chunk_data: مقطع البيانات الثنائية الفعلي.
يُعرض محتوى pg_toast_16406 أدناه:
testdb=# SELECT chunk_id, chunk_seq, chunk_data FROM pg_toast.pg_toast_16406;
 chunk_id | chunk_seq |        chunk_data
----------+-----------+-------------------------
    16415 |         0 | \x616263646566.....6566
    16415 |         1 | \x6768696a6162.....6162
    16415 |         2 | \x636465666768.....6768
    16415 |         3 | \x696a61626364.....6364
    16415 |         4 | \x65666768696a.....696a
    16415 |         5 | \x6162...696a
    16416 |         0 | \x616263646566.....6566
    16416 |         1 | \x6768696a6162.....6162
    16416 |         2 | \x636465666768.....6768
    16416 |         3 | \x696a61626364.....6364
    16416 |         4 | \x65666768696a.....696a
    16416 |         5 | \x6162...696a
(12 rows)
يستخدم فهرس TOAST العمودين chunk_id وchunk_seq كمفتاحين مركّبين. وعند استرداد بيانات مخزَّنة بتقنية TOAST، يُجري النظام مسحًا للفهرس (index scan) على فهرس TOAST لجلب مقاطع chunk_data المقابلة بالترتيب الصحيح.
1.4. طرائق كتابة الصفوف وقراءتها
يصف القسم الأخير من هذا الفصل طرائق كتابة صفوف الكومة وقراءتها.
محتويات القسم
- 1.4.1. كتابة صفوف الكومة
- 1.4.2. قراءة صفوف الكومة
1.4.1. كتابة صفوف الكومة
لنتأمل جدولًا يتكوّن من صفحة واحدة تحتوي على صف كومة واحد. في هذه الحالة، يشير pd_lower في الصفحة إلى مؤشّر السطر الأول، بينما يشير كل من مؤشّر السطر وpd_upper إلى أول صف كومة، كما هو موضّح في الشكل 1.6(أ).
وعند إدراج صف ثانٍ، يوضع قبل الصف الأول (يُكدَّس من الأسفل). ويُلحَق مؤشّر سطر ثانٍ بالأول ليشير إلى هذا الصف الجديد. وبناءً على ذلك، يُحدَّث pd_lower ليشير إلى نهاية مؤشّر السطر الثاني، ويُحدَّث pd_upper إلى بداية صف الكومة الثاني. انظر الشكل 1.6(ب). وتُحدَّث أيضًا بيانات ترويسة أخرى في هذه الصفحة (مثل pd_lsn وpd_checksum وpd_flags) إلى قيم مناسبة؛ وتُقدَّم تفاصيل إضافية في القسم 5.3 والقسم 9.4.
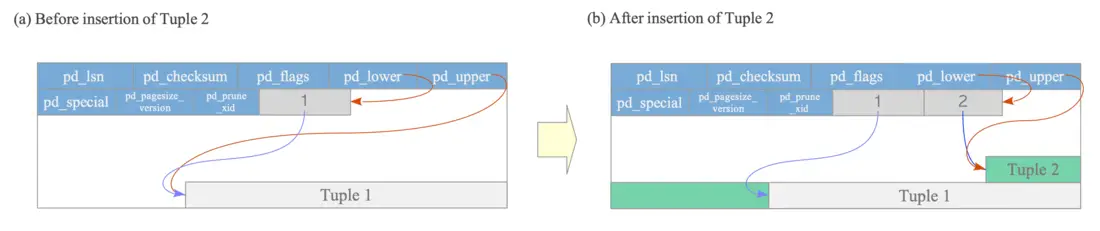
الشكل 1.6. كتابة صف كومة.
1.4.2. قراءة صفوف الكومة
فيما يلي عرض موجز لطريقتي وصول نموذجيتين: المسح التسلسلي ومسح فهرس B-tree:
- المسح التسلسلي: تقرأ هذه الطريقة جميع الصفوف في جميع الصفحات تسلسليًا عبر مسح كل مؤشّر سطر في كل صفحة. انظر الشكل 1.7(أ).
- مسح فهرس B-tree: تقرأ هذه الطريقة ملف فهرس يحتوي على صفوف فهرس. ويتكوّن كل صف فهرس من مفتاح فهرس ومعرّف TID يشير إلى صف الكومة الهدف. وعند تحديد صف فهرس يطابق مفتاح البحث[1]، يسترد PostgreSQL صف الكومة المقابل باستخدام معرّف TID الذي حصل عليه. على سبيل المثال، في الشكل 1.7(ب)، معرّف TID لصف الفهرس المسترد هو «(block = 7, offset = 2)». وهذا يدل على أن صف الكومة الهدف هو الصف الثاني في الصفحة السابعة من الجدول، ما يتيح لـ PostgreSQL الوصول إلى البيانات مباشرة دون مسح صفحات غير ضرورية.
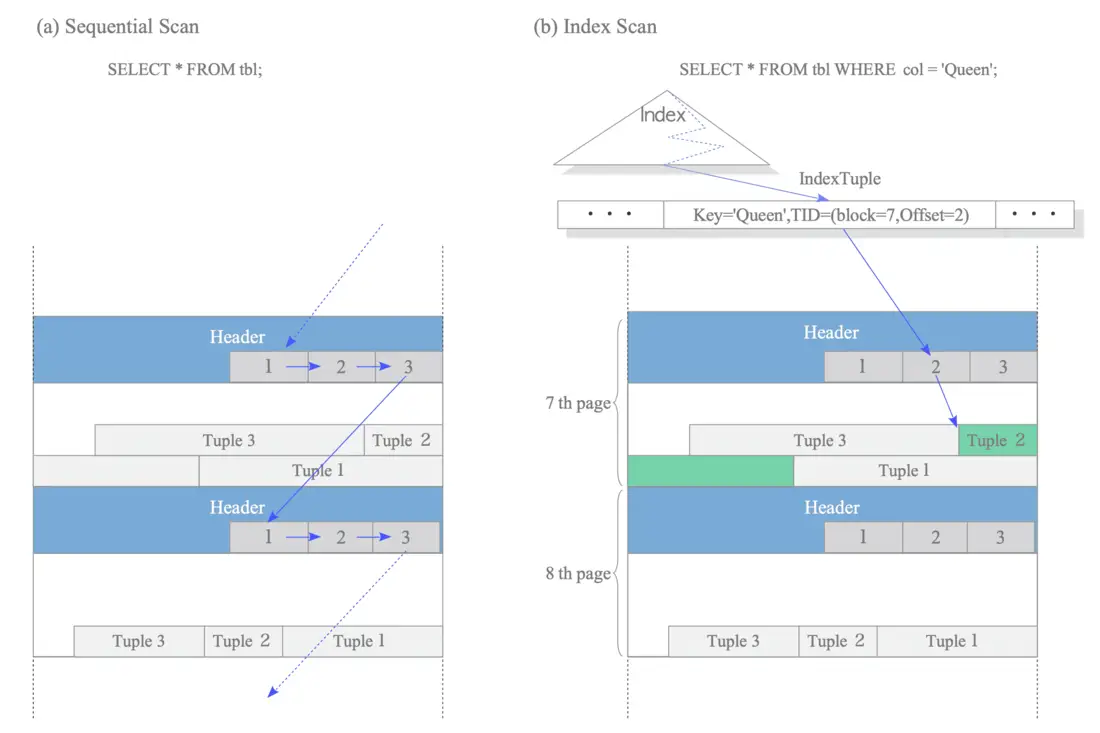
الشكل 1.7. المسح التسلسلي ومسح الفهرس.
تُوصف الآلية المحددة التي يستخدمها المنفِّذ (executor) للوصول إلى الجداول في القسم 3.4.1.
** معلومة
يدعم PostgreSQL أيضًا المسح بواسطة TID (TID-Scan)، والمسح بخرائط البتات (Bitmap-Scan)، والمسح بالفهرس فقط (Index-Only-Scan).
والمسح بواسطة TID طريقة تصل إلى صف مباشرةً باستخدام معرّف TID الخاص به. على سبيل المثال، لاسترداد الصف الأول في الصفحة رقم 0 من جدول ما، يمكن تنفيذ الاستعلام التالي:
sampledb=# SELECT ctid, data FROM sampletbl WHERE ctid = '(0,1)';
 ctid  |   data
-------+-----------
 (0,1) | AAAAAAAAA
(1 row)
وسيُوصف المسح بالفهرس فقط بالتفصيل في القسم 7.2.
حُذفت هنا إجراءات العثور على صفوف الفهرس داخل فهرس B-tree، لأنها مفهوم موثَّق على نطاق واسع والمساحة محدودة. يُرجى الرجوع إلى التوثيق التقني ذي الصلة لمزيد من التفاصيل. ↩︎