قراءة الملفات
أهداف التعلّم
بعد إتمام هذا القسم
- ستعرف كيف تقرأ محتويات الملفات باستخدام Python
- ستعرف ما المقصود بملف نصي وملف CSV
- ستتمكن من معالجة محتويات ملف CSV في برامجك
عن تمارين هذه الدورة
يتطلب أن تصير مبرمجًا ماهرًا الكثير من التدريب، بل أحيانًا تدريبًا ميكانيكيًّا في جوهره. كما أنه ينطوي على تنمية مهارات حلّ المشكلات وتطبيق الحدس. ولهذا تحتوي هذه الدورة على الكثير من التمارين بأنواع مختلفة. فبعضها يطلب منك تطبيق ما تعلّمته في المادة تطبيقًا مباشرًا إلى حدٍّ كبير، لكن بعضها الآخر متعمَّد أكثر ويتّسم بأنه مفتوح النهاية.
قد يبدو بعض التمارين مربكًا في البداية، لكن لا داعي للقلق. فليس أيٌّ من التمارين إلزاميًّا بشكل قاطع، وفي الحقيقة لا تحتاج سوى إلى 25 % من نقاط كل جزء لاجتياز الدورة. ويمكنك العثور على مزيد من التفاصيل حول اجتياز الدورة في صفحة الدرجات.
التمارين ليست مرتّبة بأي ترتيب معيّن من حيث الصعوبة. فكل قسم يقدّم عادةً بعض المفاهيم الجديدة في البرمجة، ثم تُمارَس هذه المفاهيم بتمارين أبسط وآخر أعقد. وإذا صادفتك تمرين يبدو صعبًا أكثر من اللازم، فانتقل إلى التمرين التالي. ويمكنك دائمًا العودة إلى التمارين الأصعب لاحقًا إن كان لديك الوقت.
وحين يصبح الأمر صعبًا حتمًا، فعليك بكلمة عزاء: فالمهمة التي تبدو صعبة إلى حدٍّ مستحيل هذا الأسبوع من المرجح أن تبدو سهلة إلى حدٍّ كبير بعد نحو أربعة أسابيع.
من الاستخدامات الشائعة جدًا في البرمجة التعامل مع البيانات المخزّنة في الملفات. فتستطيع البرامج قراءة البيانات من الملفات وكتابة النتائج المحسوبة في الملفات. وحتى كميات البيانات الكبيرة تصبح سهلة المعالجة تلقائيًّا عند استخدام الملفات.
في هذه الدورة نتعامل فقط مع الملفات النصية. فجميع الملفات المستخدَمة تتكوّن من أسطر نصية. ومثالًا على ذلك، محرّر Visual Studio Code الذي نستخدمه في هذه الدورة يعمل مع الملفات النصية. ملاحظة: رغم أن معالجات النصوص مثل Microsoft Word تُستخدم عادةً مع ملفات تحتوي على نص، فإن مستندات Word في ذاتها ليست ملفات نصية، إذ تحتوي أيضًا على معلومات التنسيق، وتُرمَّز بطريقة تجعل التعامل معها داخل برنامج أكثر تعقيدًا.
قراءة البيانات من ملف
لنعمل أولًا مع ملف اسمه example.txt، ذي المحتوى التالي:
Hello there!
This example file contains three lines of text.
This is the last line.
طريقة بسيطة لتضمين الملفات في برنامج Python هي استخدام جملة with. فسطر الترويسة يفتح الملف، ثم تأتي الكتلة التي يمكن الوصول إلى الملف من خلالها. وبعد الكتلة يُغلق الملف تلقائيًّا، ولا يمكن الوصول إليه بعد ذلك.
إذًا، تفتح الشيفرة التالية الملف، وتقرأ محتوياته، وتطبعه، ثم تغلق الملف:
with open("example.txt") as new_file:
    contents = new_file.read()
    print(contents)
Hello there!
This example file contains three lines of text.
This is the last line.
المتغيّر new_file أعلاه هو مقبض الملف (file handle). ومن خلاله يمكن الوصول إلى الملف وهو ما زال مفتوحًا. هنا استخدمنا التابع read، الذي يعيد محتويات الملف كسلسلة نصية واحدة. إذًا، في هذه الحالة تكون السلسلة النصية التي تعيدها read:
"Hello there!\nThis example file contains three lines of text.\nThis is the last line."
المرور على محتويات الملف
التابع read مفيد لطباعة محتويات الملف بأكمله، لكننا في الغالب نريد المرور على الملف سطرًا بسطر.
يمكن التفكير في الملفات النصية كقوائم من السلاسل النصية، تمثّل كل سلسلة نصية سطرًا واحدًا في الملف. ويمكننا المرور على القائمة بحلقة for.
المثال التالي يقرأ ملف المثال استخدامًا بحلقة for، ويزيل فواصل الأسطر من نهاية كل سطر، ويعدّ عدد الأسطر، ويطبع كل سطر مع رقم سطره. كما يتتبّع طول الأسطر:
with open("example.txt") as new_file:
    count = 0
    total_length = 0

    for line in new_file:
        line = line.replace("\n", "")
        count += 1
        print("Line", count, line)
        length = len(line)
        total_length += length

print("Total length of lines:", total_length)
Line 1 Hello there!
Line 2 This example file contains three lines of text.
Line 3 This is the last line.
Total length of lines: 81
يوجد فاصل سطر \n في نهاية كل سطر في الملف، لكن الدالة print تضيف هي أيضًا فاصل سطر افتراضيًّا. ولا توجد فواصل أسطر زائدة في المخرجات أعلاه، لأن فواصل الأطراف في نهايات الأسطر تُزال بالتابع replace، الذي يستبدل كل محرف فاصل سطر بسلسلة نصية فارغة. وبهذه الطريقة تُحسب أطوال الأسطر أيضًا بشكل صحيح.
تمرين برمجي: أكبر عدد
الملف
numbers.txtيحوي أعدادًا صحيحة، عدد واحد في كل سطر. وقد يبدو المحتوى هكذا:
2
45
108
3
-10
1100
...etc...
يُرجى كتابة دالة اسمها largest، تقرأ الملف وتعيد أكبر عدد فيه.
لاحظ أن الدالة لا تأخذ أي وسيط. فالملف الذي تعمل عليه اسمه دائمًا numbers.txt.
ملاحظة: إذا لم تستطع Visual Studio Code العثور على الملف وقد تأكّدت من عدم وجود أخطاء إملائية، فاطّلع على التعليمات الواردة بعد هذا التمرين.
ماذا أفعل إذا لم تستطع Visual Studio Code العثور على ملفي؟
عند تنفيذ شيفرتك، قد تشتكي Visual Studio Code من تعذّر العثور على الملف، رغم أنك قد تحقّقت وتأكّدت مرّتين من أن اسم الملف مكتوب بشكل صحيح وأن الملف موجود. فقد يعالج تغيير الإعداد التالي المشكلة:
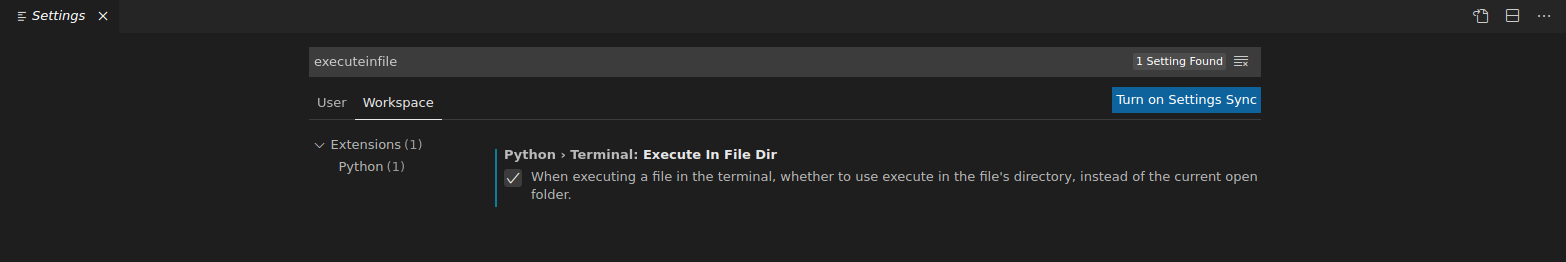
- افتح الإعدادات من شريط القوائم: File -> Preferences -> Settings
- ابحث عن الإعداد المعني باستخدام مصطلح البحث "executeinfile"
- اختر تبويب Workspace
- اختر الخيار أسفل Python -> Terminal -> Execute In File Dir
يجب أن يبدو نافذة الإعدادات لديك الآن بهذا الشكل تقريبًا:
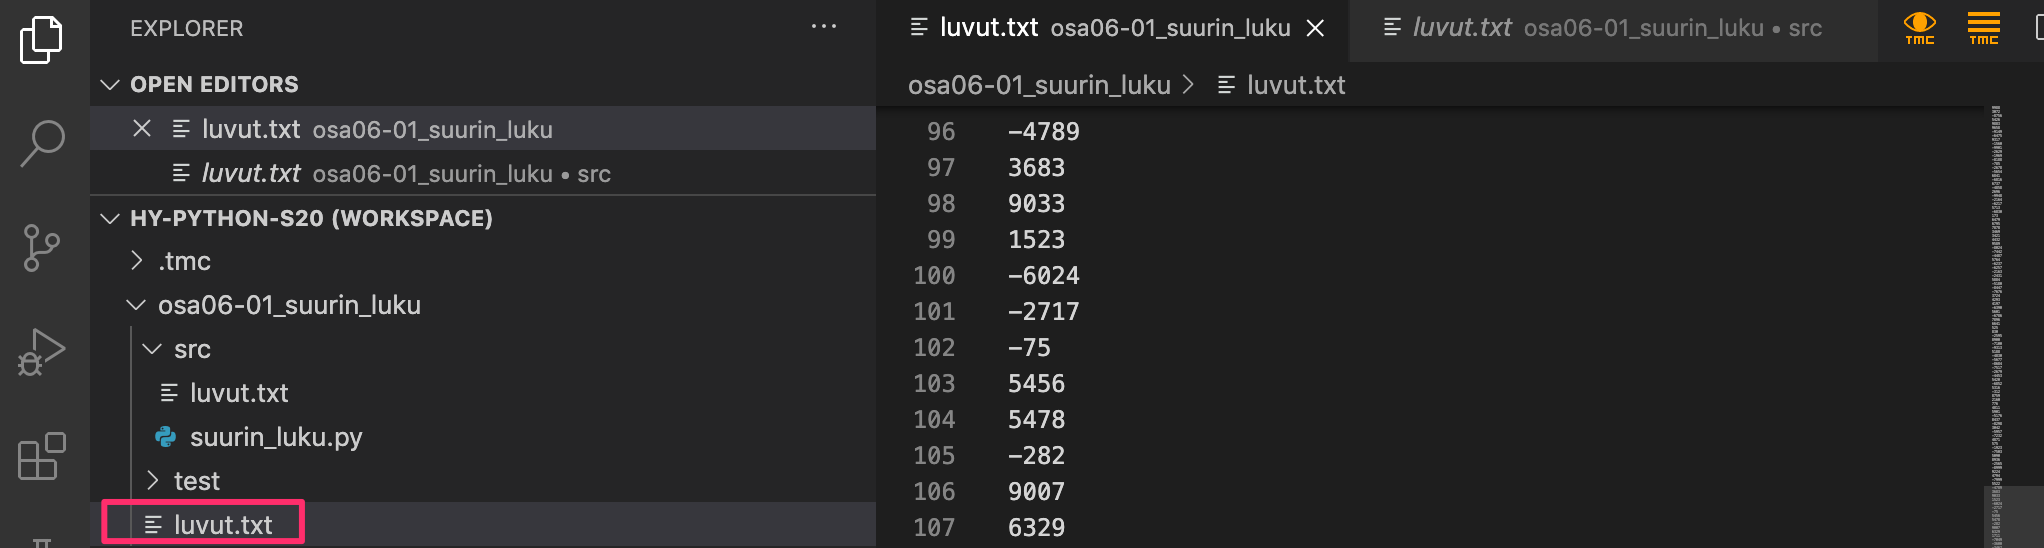
إذا لم يفد ذلك، فيمكنك نسخ الملف الموجود في دليل src
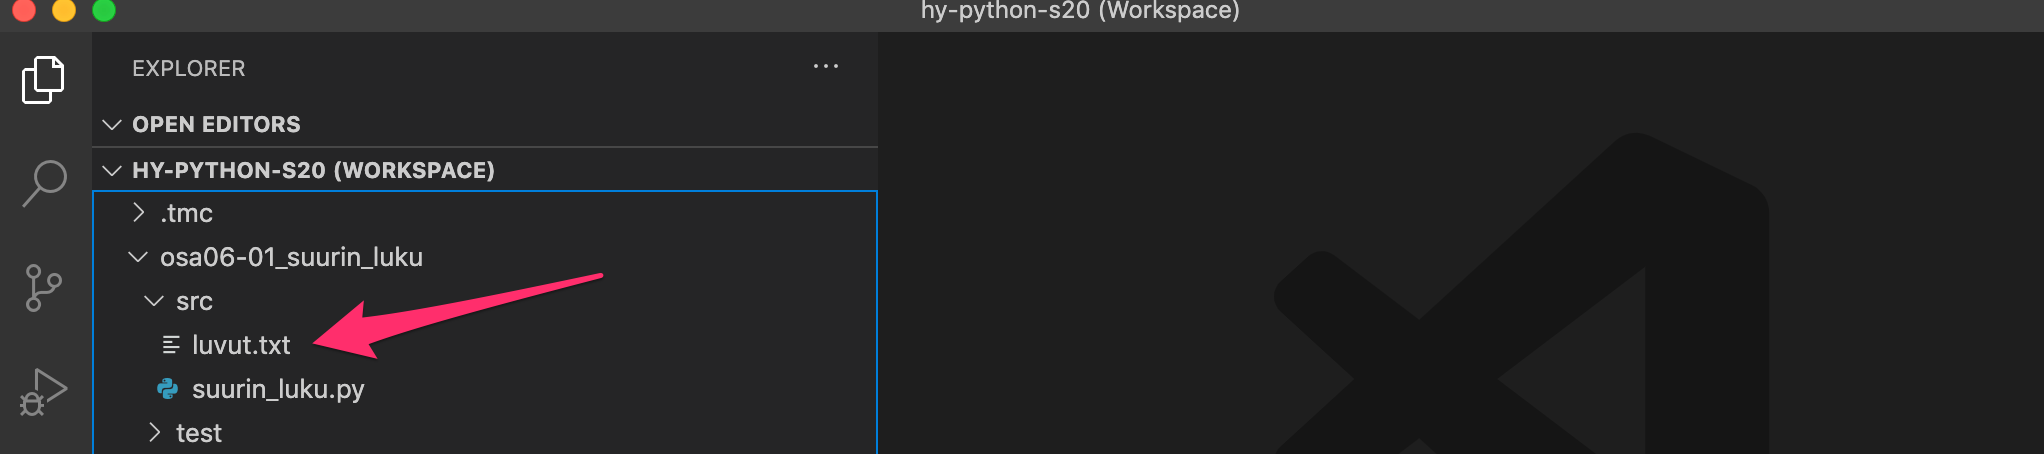
مباشرة إلى جذر دليل التمرين
تنقيح شيفرة تتعامل مع الملفات
يؤدي استخدام المنقّح المرئي في Visual Studio Code مع البرامج التي تتعامل مع الملفات غالبًا إلى رسالة خطأ قبيحة المظهر:
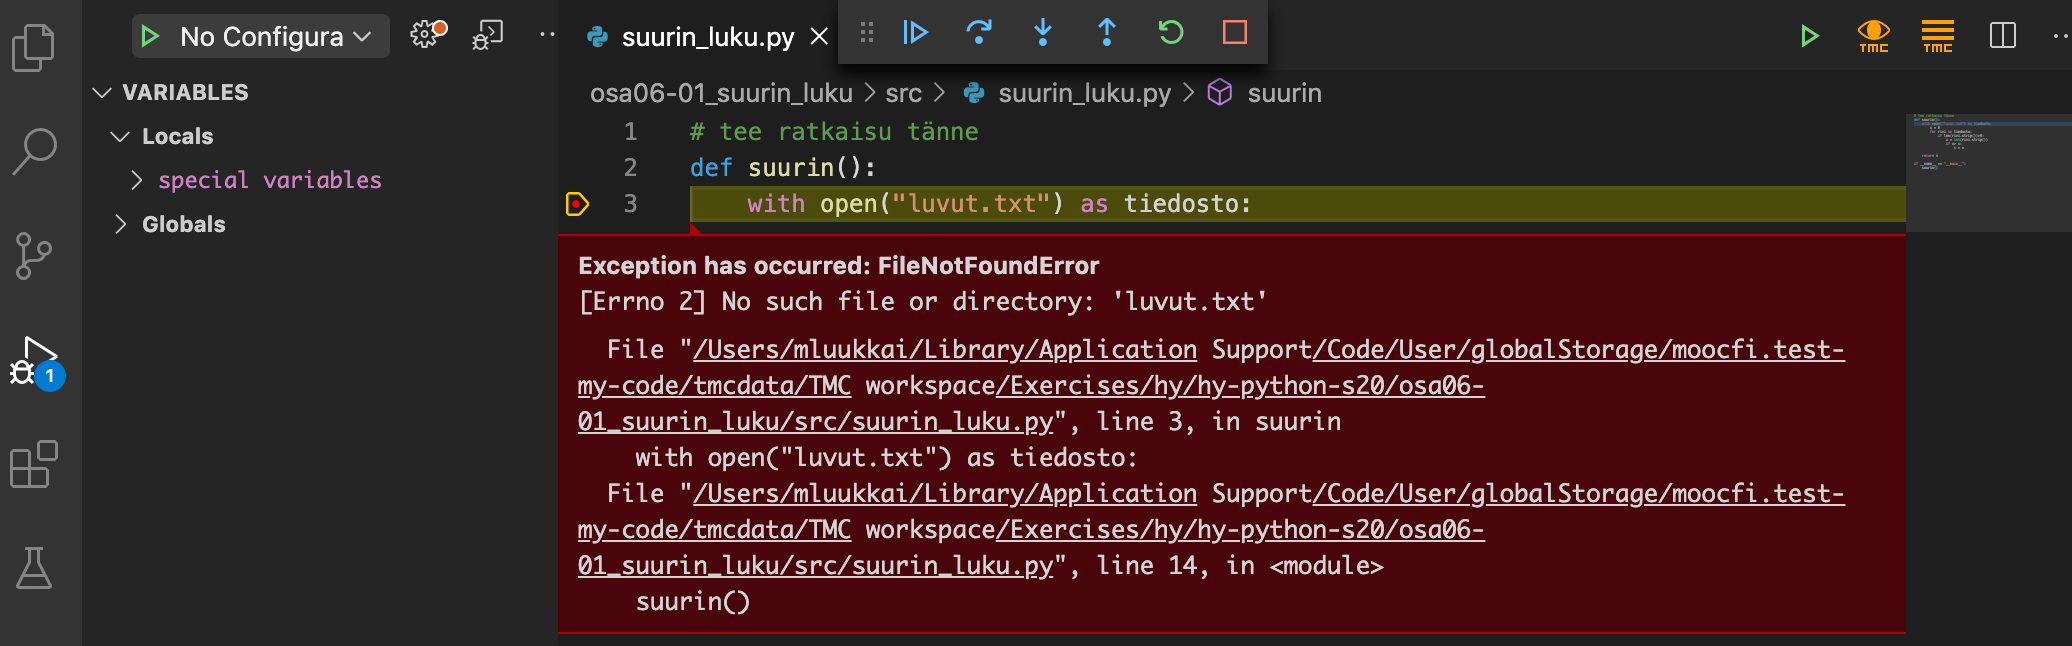
السبب أن المنقّح سيبحث دائمًا عن الملفات في جذر دليل التمرين. وإعداد Execute In File Dir المذكور أعلاه لن يكون له أي أثر في ذلك. وأسهل حل هو نسخ الملف إلى جذر الدليل ببساطة.
قد تحتاج إلى إعادة تشغيل Visual Studio Code بعد نسخ جميع الملفات الضرورية.
قراءة ملفات CSV
ملف CSV، وهو اختصار لـ_قيم مفصولة بفواصل_ (comma-separated Values)، هو ملف نصي يحوي بيانات مفصولة بمحرف محدَّد مسبقًا. والمحارف الأكثر استخدامًا لهذا الغرض هي الفاصلة , والفاصلة المنقوطة ;، لكن أي محرف ممكن على سبيل المبدأ.
تُستخدم ملفات CSV عادةً لتخزين سجلات من أنواع مختلفة. فكثير من برامج قواعد البيانات وجداول البيانات، مثل Excel، يمكنها استيراد البيانات وتصديرها بصيغة CSV، ما يجعل تبادل البيانات بين الأنظمة المختلفة سهلًا.
تعلّمنا بالفعل أنه يمكننا المرور على أسطر الملف بحلقة for، لكن كيف نفصل الحقول المختلفة في سطر واحد؟ تحتوي Python على تابع نصي split لهذا الغرض تحديدًا. يأخذ التابع محارف الفصل كوسيط نصي، ويعيد محتويات السلسلة النصية المستهدفة كقائمة من السلاسل النصية، مفصولة عند محارف الفصل.
مثال على عمل التابع:
text = "monkey,banana,harpsichord"
words = text.split(",")
for word in words:
    print(word)
monkey
banana
harpsichord
لنفترض أن لدينا ملف grades.csv يحوي أسماء طلاب والدرجات التي حصلوا عليها في بعض المقررات. فكل سطر يحوي بيانات طالب واحد، والبيانات مفصولة بفاصلة منقوطة.
Paul;5;4;5;3;4;5;5;4;2;4
Beth;3;4;2;4;4;2;3;1;3;3
Ruth;4;5;5;4;5;5;4;5;4;4
البرنامج التالي يمرّ على الملف سطرًا بسطر، ويقسم كل سطر إلى أجزائه المنفصلة، ويطبع اسم كل طالب ودرجاته.
with open("grades.csv") as new_file:
    for line in new_file:
        line = line.replace("\n", "")
        parts = line.split(";")
        name = parts[0]
        grades = parts[1:]
        print("Name:", name)
        print("Grades:", grades)
Name: Paul
Grades: ['5', '4', '5', '3', '4', '5', '5', '4', '2', '4']
Name: Beth
Grades: ['3', '4', '2', '4', '4', '2', '3', '1', '3', '3']
Name: Ruth
Grades: ['4', '5', '5', '4', '5', '5', '4', '5', '4', '4']
تمرين برمجي: سوق الفواكه
الملف
fruits.csvيحوي أسماء فواكه وأسعارها، بالصيغة المحدَّدة في هذا المثال:
banana;6.50
apple;4.95
orange;8.0
...etc...
يُرجى كتابة دالة اسمها read_fruits، تقرأ الملف وتعيد قاموسًا مبنيًّا على محتوياته. وفي القاموس ينبغي أن يكون اسم الفاكهة هو المفتاح، وأن تكون القيمة هي سعرها. ويجب أن تكون الأسعار من النوع float.
ملاحظة: الدالة لا تأخذ أي وسيط. فالملف الذي تعمل عليه اسمه دائمًا fruits.csv.
تمرين برمجي: المصفوفة
الملف
matrix.txtيحوي مصفوفة بالصيغة المحدَّدة في المثال أدناه:
1,0,2,8,2,1,3,2,5,2,2,2
9,2,4,5,2,4,2,4,1,10,4,2
...etc...
يُرجى كتابة دالتين، اسمهما matrix_sum وmatrix_max. فكلاهما يمرّ على المصفوفة في الملف، ثم يعيد مجموع عناصرها أو العنصر ذا القيمة الأكبر، كما يوحي اسم الدالتين.
يُرجى أيضًا كتابة الدالة row_sums، التي تعيد قائمة تحتوي على مجموع كل صف في المصفوفة. فمثلًا، عند استدعاء row_sums عندما تكون المصفوفة في الملف معرَّفة هكذا
1,2,3
2,3,4
ينبغي أن تعيد الدالة القائمة [6, 9].
تلميح: يمكنك أيضًا تضمين دوال مساعدة أخرى في برنامجك. ومن المفيد جدًا أن تخصّص لحظة للتفكير في الوظائف الثلاث التي تشترك فيها الدوال الثلاثة المطلوب منك كتابتها. لاحظ أن الدوال الثلاث المذكورة أعلاه لا تأخذ أي وسيط، لكن أي دوال مساعدة تكتبها قد تأخذ وسائط. والملف الذي تعمل عليه اسمه دائمًا matrix.txt.
ملاحظة: إذا لم تستطع Visual Studio Code العثور على الملف وقد تأكّدت من عدم وجود أخطاء إملائية، فاطّلع على التعليمات الواردة قبل هذا التمرين.
قراءة نفس الملف عدة مرات
أحيانًا ما يكون من الضروري معالجة محتويات الملف أكثر من مرة في برنامج واحد. لننظر إلى برنامج يعمل مع بعض البيانات الشخصية المخزّنة في ملف CSV:
Peter;40;Helsinki
Emily;34;Espoo
Eric;42;London
Adam;100;Amsterdam
Alice;58;Paris
with open("people.csv") as new_file:
    # print out the names
    for line in new_file:
        parts = line.split(";")
        print("Name:", parts[0])

    # find the oldest
    age_of_oldest = -1
    for line in new_file:
        parts = line.split(";")
        name = parts[0]
        age = int(parts[1])
        if age > age_of_oldest:
            age_of_oldest = age
            oldest = name
    print("the oldest is", oldest)
سيؤدي تشغيل هذا إلى رسالة خطأ غامضة بعض الشيء:
Traceback (most recent call last):
    print("the oldest is"; oldest)
UnboundLocalError: local variable 'oldest' referenced before assignment
السبب في حدوث ذلك أن حلقة for الثانية لا تُنفَّذ إطلاقًا، لأن الملف لا يمكن معالجته إلا مرة واحدة. فبمجرد قراءة السطر الأخير يستقرّ مقبض الملف في نهاية الملف، ولا يمكن الوصول إلى البيانات الموجودة فيه بعد ذلك.
إذا أردنا الوصول إلى المحتويات في حلقة for الثانية، فسيتعيّن علينا فتح الملف مرة ثانية باستخدام open:
with open("people.csv") as new_file:
    # print out the names
    for line in new_file:
        parts = line.split(";")
        print("Name:", parts[0])

with open("people.csv") as new_file:
    # find the oldest
    age_of_oldest = -1
    for line in new_file:
        parts = line.split(";")
        name = parts[0]
        age = int(parts[1])
        if age > age_of_oldest:
            age_of_oldest = age
            oldest = name
    print("the oldest is", oldest)
مع أن الشيفرة أعلاه ستعمل، فإنها تتضمن تكرارًا غير ضروري. فمن الأفضل عادةً قراءة الملف مرة واحدة فقط، وتخزين محتوياته في صيغة مناسبة للمعالجة اللاحقة:
people = []
# read the contents of the file and store it in a list
with open("people.csv") as new_file:
    for line in new_file:
        parts = line.split(";")
        people.append((parts[0], int(parts[1]), parts[2]))

# print out the names
for person in people:
    print("Name:", person[0])

# find the oldest
age_of_oldest = -1
for person in people:
    name = person[0]
    age = person[1]
    if age > age_of_oldest:
        age_of_oldest = age
        oldest = name
print("the oldest is", oldest)
المزيد من معالجة ملفات CSV
لنواصل مع الملف grades.csv، ذي المحتوى التالي:
Paul;5;4;5;3;4;5;5;4;2;4
Beth;3;4;2;4;4;2;3;1;3;3
Ruth;4;5;5;4;5;5;4;5;4;4
ينشئ البرنامج التالي قاموسًا اسمه grades مبنيًّا على محتوى الملف. فالمفاتيح هي أسماء الطلاب، والقيمة المرتبطة بكل مفتاح هي قائمة الدرجات التي حصل عليها الطالب. ويحوّل البرنامج الدرجات إلى قيم صحيحة لتسهيل معالجتها.
grades = {}
with open("grades.csv") as new_file:
    for line in new_file:
        line = line.replace("\n", "")
        parts = line.split(";")
        name = parts[0]
        grades[name] = []
        for grade in parts[1:]:
            grades[name].append(int(grade))

print(grades)
{'Paul': [5, 4, 5, 3, 4, 5, 5, 4, 2, 4], 'Beth': [3, 4, 2, 4, 4, 2, 3, 1, 3, 3], 'Ruth': [4, 5, 5, 4, 5, 5, 4, 5, 4, 4]}
الآن يمكننا طباعة بعض الإحصاءات عن كل طالب بناءً على محتويات القاموس grades:
for name, grade_list in grades.items():
    best = max(grade_list)
    average = sum(grade_list) / len(grade_list)
    print(f"{name}: best grade {best}, average {average:.2f}")
Paul: best grade 5, average 4.10
Beth: best grade 4, average 2.90
Ruth: best grade 5, average 4.50
يُرجى الاطلاع الدقيق على البرنامج في المثال أعلاه. فقد يبدو معقّدًا بعض الشيء في البداية، لكن يمكن استخدام هذه الطريقة مع ملفات تحوي أنواعًا مختلفة كثيرة من البيانات.
إزالة الأسطر والمسافات وفواصل الأسطر غير الضرورية
لنفترض أن لدينا ملف CSV يحوي بعض الأسماء، قد صُدِّر من Excel:
first; last
Paul; Python
Jean; Java
Harry; Haskell
اشتهر Excel بإضافة مسافات بيضاء زائدة. فهنا يوجد محرف مسافة زائد بين العناصر، بعد كل فاصلة منقوطة.
نودّ طباعة أسماء العائلة لكل شخص في القائمة. يحتوي السطر الأول على ترويسات البيانات، ويمكن تجاهله بأمان:
last_names = []
with open("people.csv") as new_file:
    for line in new_file:
        parts = line.split(";")
        # ignore the header line
        if parts[0] == "first":
            continue
        last_names.append(parts[1])

print(last_names)
سيؤدي تنفيذ هذا إلى طباعة
[' Python\n', ' Java\n', ' Haskell']
العنصران الأولان يحملان محرف فاصل سطر في نهايتهما، والثلاثة جميعًا تحوي محرف مسافة زائدًا في بدايتها.
لقد استخدمنا بالفعل التابع replace لإزالة المسافات البيضاء الزائدة، لكن الحل الأكثر كفاءة هو استخدام التابع النصي strip في Python، الذي يزيل المسافات البيضاء من بداية السلسلة النصية ونهايتها. فهو يزيل جميع المسافات وفواصل الأسطر وأحرف الجدولة وغيرها من المحارف التي لا تُطبع عادةً.
يمكنك تجربته في مفسّر Python:
>>> " tryout ".strip()
'tryout'
>>> "\n\ntest\n".strip()
'test'
>>>
إنزال المسافة البيضاء عن السلسلة النصية يتطلب تغييرًا بسيطًا فقط في البرنامج:
last_names = []
with open("people.csv") as new_file:
    for line in new_file:
        parts = line.split(';')
        if parts[0] == "first":
            continue # this was the header line, so it is ignored
        last_names.append(parts[1].strip())
print(last_names)
الآن حصلنا على المخرج المرغوب المرتب:
['Python', 'Java', 'Haskell']
هناك أيضًا التابعان المتماثلان lstrip وrstrip. فيزيلان المحارف غير القابلة للطباعة من البداية أو النهاية فقط، حيث تعني الحرف l الحافة اليسرى للسلسلة النصية ويعني الحرف r الحافة اليمنى:
>>> " teststring  ".rstrip()
' teststring'
>>> " teststring  ".lstrip()
'teststring  '
دمج البيانات من ملفات مختلفة
من الشائع جدًا أن تكون البيانات التي يعالجها برنامج متفرّقة في ملفات متعددة. لننظر إلى حالة تُخزَّن فيها تفاصيل موظفي شركة شخصية في ملف اسمه employees.csv:
pic;name;address;city
080488-123X;Pekka Mikkola;Vilppulantie 7;00700 Helsinki
290274-044S;Liisa Marttinen;Mannerheimintie 100 A 10;00100 Helsinki
010479-007Z;Arto Vihavainen;Pihapolku 4;01010 Kerava
010499-345K;Leevi Hellas;Tapiolantie 11 B;02000 Espoo
تُخزَّن الرواتب في ملف منفصل اسمه salaries.csv:
pic;salary;bonus
080488-123X;3300;0
290274-044S;4150;200
010479-007Z;1300;1200
يحتوي كل سطر بيانات في الملفين على رمز الهوية الشخصي (personal identity code)، الذي يحدّد لمن تعود البيانات التي نتعامل معها. وباستخدام رمز الهوية الشخصي كعامل مشترك، يسهل ربط اسم كل موظف براتبه. فمثلًا، يمكننا طباعة القائمة التالية للدخل الشهري:
incomes:
Pekka Mikkola    3300 euros
Liisa Marttinen  4350 euros
Arto Vihavainen  2500 euros
يستخدم هذا البرنامج قاموسين كهيكل بيانات مساعد: names وsalaries. ويستخدم كلاهما رمز الهوية الشخصي مفتاحًا:
names = {}

with open("employees.csv") as new_file:
    for line in new_file:
        parts = line.split(';')
        if parts[0] == "pic":
            continue
        names[parts[0]] = parts[1]

salaries = {}

with open("salaries.csv") as new_file:
    for line in new_file:
        parts = line.split(';')
        if parts[0] == "pic":
            continue
        salaries[parts[0]] = int(parts[1]) +int(parts[2])

print("incomes:")

for pic, name in names.items():
    if pic in salaries:
        salary = salaries[pic]
        print(f"{name:16} {salary} euros")
    else:
        print(f"{name:16} 0 euros")
ينشئ البرنامج أولًا القاموسين names وsalaries، وهما ذا المحتوى التالي:
{
    '080488-123X': 'Pekka Mikkola',
    '290274-044S': 'Liisa Marttinen',
    '010479-007Z': 'Arto Vihavainen',
    '010499-345K': 'Leevi Hellas'
}

{
    '080488-123X': 3300,
    '290274-044S': 4350,
    '010479-007Z': 2500
}
تمرّ حلقة for في نهاية البرنامج على أسماء الموظفين لدمجها مع رواتبهم المقابلة.
كما يعالج البرنامج الحالات التي لا يوجد فيها رمز الهوية الشخصي للموظف في ملف الرواتب.
تذكّر أن ترتيب تخزين العناصر في القاموس لا يهمّ، لأن المعالجة تتم على المفاتيح استنادًا إلى قيم التجزئة.
تمرين برمجي: تقييم الدورة، الجزء 1
هذا البرنامج يعمل مع ملفي CSV. أحدهما يحوي معلومات عن بعض الطلاب في الدورة:
id;first;last
12345678;peter;pythons
12345687;jean;javanese
12345699;alice;adder
والآخر يحوي عدد التمارين التي أكملها كل طالب في كل أسبوع:
id;e1;e2;e3;e4;e5;e6;e7
12345678;4;1;1;4;5;2;4
12345687;3;5;3;1;5;4;6
12345699;10;2;2;7;10;2;2
كما ترى أعلاه، يحتوي ملفا CSV أيضًا على سطر ترويسة يخبرك بما يحويه كل عمود.
يُرجى كتابة برنامج يطلب من المستخدم اسمي هذين الملفين، ثم يقرأ الملفين، ثم يطبع إجمالي عدد التمارين التي أكملها كل طالب. وإذا كان الملفان يحويان المحتوى الوارد في الأمثلة أعلاه، فينبغي أن يطبع البرنامج ما يلي:
Student information: **students1.csv**
Exercises completed: **exercises1.csv**
pekka peloton 21
jaana javanainen 27
liisa virtanen 35
تلميح: أثناء اختبار برنامجك، قد تنفد صبرك بسرعة إن كان عليك دائمًا كتابة أسماء الملفات عند المطالبة بالمُدخَل. قد تفضّل تثبيت مُدخَل المستخدم في الشيفرة هكذا:
if False:
    # this is never executed
    student_info = input("Student information: ")
    exercise_data = input("Exercises completed: ")
else:
    # hard-coded input
    student_info = "students1.csv"
    exercise_data = "exercises1.csv"
الوظيفة الفعلية للبرنامج أصبحت الآن «مخفيّة» في فرع False من جملة if. ولن تُنفَّذ أبدًا.
والآن، إذا أردت التحقق سريعًا من أن البرنامج يعمل بشكل صحيح مع مُدخَل المستخدم أيضًا، فيمكنك ببساطة استبدال False بـTrue:
if True:
    student_info = input("Student information: ")
    exercise_data = input("Exercises completed: ")
else:
    # now this is the False branch, and is never executed
    student_info = "students1.csv"
    exercise_data = "exercises1.csv"
وبعد التحقق من أن برنامجك يعمل بشكل صحيح، يمكنك إزالة بنية if مع الإبقاء على أوامر طلب المُدخَل.
ملاحظة: لا يطلب منك هذا التمرين كتابة أي دوال، لذا يجب أن لا تضع أي شيفرة داخل كتلة if __name__ == "__main__".
ملاحظة 2: إذا لم تستطع Visual Studio العثور على الملف وقد تأكّدت من عدم وجود أخطاء إملائية، فاطّلع على هذه التعليمات.
تمرين برمجي: تقييم الدورة، الجزء 2
لنوسِع البرنامج الذي أنشأناه في التمرين السابق. فصارت الآن نقاط الامتحان الممنوحة لكل طالب محفوظة هي أيضًا في ملف CSV. ويحوي الملف المحتوى بالصيغة التالية:
id;e1;e2;e3
12345678;4;1;4
12345687;3;5;3
12345699;10;2;2
في المثال أعلاه، حصل الطالب ذو الرقم الجامعي 12345678 على 4+1+4 نقاط في الامتحان، ما يعادل 9 نقاط إجمالًا.
ينبغي من جديد أن يطلب البرنامج من المستخدم أسماء الملفات. ثم يعالج البرنامج الملفين ويطبع درجة لكل طالب.
Student information: **students1.csv**
Exercises completed: **exercises1.csv**
Exam points: **exam_points1.csv**
pekka peloton 0
jaana javanainen 1
liisa virtanen 3
يُحتسب كل تمرين مكتمل ضمن نقاط التمارين، بحيث إن إكمال 10 % على الأقل من إجمالي التمارين يمنح نقطة واحدة، وإن إكمال 20 % على الأقل يمنح نقطتين، وهكذا. وإكمال التمارين الأربعين كلها يمنح 10 نقاط. وعدد النقاط الممنوحة دائمًا عدد صحيح.
تُحدَّد الدرجة النهائية للدورة بناءً على مجموع نقاط الامتحان ونقاط التمارين وفقًا للجدول التالي:
| نقاط الامتحان + نقاط التمارين | الدرجة |
|---|---|
| 0-14 | 0 (راسب) |
| 15-17 | 1 |
| 18-20 | 2 |
| 21-23 | 3 |
| 24-27 | 4 |
| 28- | 5 |
ملاحظة: لا يطلب منك هذا التمرين كتابة أي دوال، لذا يجب أن لا تضع أي شيفرة داخل كتلة if __name__ == "__main__".
تمرين برمجي: تقييم الدورة، الجزء 3
يستمر هذا التمرين من التمرين السابق. فسنطبع الآن بعض الإحصاءات بناءً على ملفات CSV.
name                          exec_nbr  exec_pts. exm_pts.  tot_pts.  grade
pekka peloton                 21        5         9         14        0
jaana javanainen              27        6         11        17        1
liisa virtanen                35        8         14        22        3
يحوي كل صف معلومات طالب واحد. فعدد التمارين المكتملة، وعدد نقاط التمارين الممنوحة، وعدد نقاط الامتحان الممنوحة، وعدد النقاط الممنوحة إجمالًا، والدرجة — كلها معروضة في أعمدة مرتبة. ويجب أن يكون عرض عمود الاسم 30 محرفًا، بينما يجب أن تكون عرض الأعمدة الأخرى 10 محارف.
قد تجد السلاسل النصية ذات البادئة f المشروحة في الجزء 4 مفيدة هنا.
تميّز السلاسل النصية ذات البادئة f بين السلاسل النصية والأعداد عندما يتعلق الأمر بمحاذاة الأعمدة:
word = "python"
print(f"{word:10}continues")
print(f"{word:>10}continues")
python    continues
    pythoncontinues
كما ترى أعلاه، تُحاذي السلاسل النصية افتراضيًّا إلى الحافة اليسرى للمنطقة المخصّصة لها. ويمكن استخدام الرمز > للمحاذاة إلى الحافة اليمنى.
أما مع قيم الأعداد فالتقنية معكوسة:
number = 42
print(f"{number:10}continues")
print(f"{number:<10}continues")
42continues
42        continues
أما مع الأعداد فالسلوك الافتراضي هو المحاذاة إلى الحافة اليمنى. ويمكن استخدام الرمز < للمحاذاة إلى الحافة اليسرى.
ملاحظة: لا يطلب منك هذا التمرين كتابة أي دوال، لذا يجب أن لا تضع أي شيفرة داخل كتلة if __name__ == "__main__".
تمرين برمجي: المدقّق الإملائي
يُرجى كتابة برنامج يطلب من المستخدم كتابة بعض النصوص. ثم يجري برنامجك فحصًا إملائيًّا، ويطبع للمستخدم ملاحظات تُحيط نجومًا بكل كلمة مكتوبة خطأً. يُرجى الاطلاع على المثالين أدناه:
We use *ptython* to make a spell checker
This is *acually* good and *usefull* program
لا ينبغي أن يؤثّر حالة المحارف في عمل برنامجك.
يضمّ قالب التمرين الملف wordlist.txt، الذي يحوي جميع الكلمات التي ينبغي أن يقبلها فحص الإملاء على أنها صحيحة.
ملاحظة: لا يطلب منك هذا التمرين كتابة أي دوال، لذا يجب أن لا تضع أي شيفرة داخل كتلة if __name__ == "__main__".
ملاحظة 2 إذا لم تستطع Visual Studio العثور على الملف وقد تأكّدت من عدم وجود أخطاء إملائية، فاطّلع على هذه التعليمات.
تمرين برمجي: البحث عن الوصفات
يتناول هذا التمرين إنشاء برنامج يتيح للمستخدم البحث عن الوصفات حسب أسمائها أو أوقات تحضيرها أو المكوّنات المستخدَمة. وينبغي أن يقرأ البرنامج الوصفات من ملف يقدّمه المستخدم.
تتكوّن كل وصفة من ثلاثة أسطر أو أكثر. فالسطر الأول يحوي اسم الوصفة، والسطر الثاني يحوي عددًا صحيحًا يمثّل وقت التحضير بالدقائق، والأسطر المتبقية تحوي المكوّنات المستخدَمة، مكوّن واحد في كل سطر. وتنتهي الوصفة بسطر فارغ، باستثناء الوصفة الأخيرة في الملف التي تنتهي عند نهاية الملف فحسب. إذ يمكن أن يحوي الملف الواحد أكثر من وصفة، كما في المثال أدناه.
Pancakes
15
milk
eggs
flour
sugar
salt
butter

Meatballs
45
mince
eggs
breadcrumbs

Tofu rolls
30
tofu
rice
water
carrot
cucumber
avocado
wasabi

Cake pops
60
milk
bicarbonate
eggs
salt
sugar
cardamom
butter
تلميح: قد يكون الأفضل أولًا قراءة جميع أسطر الملف ووضعها في قائمة، إذ يسهل بعدها التعامل معها بالطريقة المشروحة في التمرين.
البحث عن الوصفات حسب اسم الوصفة
يُرجى كتابة دالة اسمها search_by_name(filename: str, word: str)، تأخذ اسم ملف وسلسلة بحث كوسيطين لها. وينبغي للدالة أن تمرّ على الملف وتختار جميع الوصفات التي يحوي اسمها سلسلة البحث المعطاة. ثم تُعاد أسماء هذه الوصفات في قائمة.
مثال على الدالة أثناء عملها:
found_recipes = search_by_name("recipes1.txt", "cake")

for recipe in found_recipes:
    print(recipe)
Pancakes
Cake pops
كما ترى في المثال أعلاه، لا تؤثّر حالة المحارف. فمصطلح البحث cake يُعيد Pancakes و_Cake pops_ معًا، رغم أن الأخير يبدأ بحرف كبير.
ملاحظة: إذا لم تستطع Visual Studio العثور على الملف وقد تأكّدت من عدم وجود أخطاء إملائية، فاطّلع على هذه التعليمات.
البحث عن الوصفات حسب وقت التحضير
يُرجى كتابة دالة اسمها search_by_time(filename: str, prep_time: int)، تأخذ اسم ملف وعددًا صحيحًا كوسيطين لها. وينبغي للدالة أن تمرّ على الملف وتختار جميع الوصفات التي لا يزيد وقت تحضيرها عن العدد المعطى.
تُعاد أسماء هذه الوصفات في قائمة من جديد، لكن يُضاف وقت التحضير إلى كل اسم. يُرجى الاطلاع على المثال أدناه.
found_recipes = search_by_time("recipes1.txt", 20)

for recipe in found_recipes:
    print(recipe)
Pancakes, preparation time 15 min
البحث عن الوصفات حسب المكوّنات
كلمة تحذير: الجزء الثالث من هذا التمرين أصعب بكثير من الجزأين السابقين. إذا شعرت أنك لا تتقدّم، فقد يكون من الأفضل لك أن تنتقل إلى الأمام، وتُكمل التمارين الأخرى في هذا الجزء من المادة، ثم تعود إلى هذا التمرين لاحقًا إن كان لديك وقت. وتذكّر أن بإمكانك تقديم الجزأين الأولين من هذا التمرين والحصول عليهما من النقاط حتى لو لم تُكمل الجزء الثالث.
يُرجى كتابة دالة اسمها search_by_ingredient(filename: str, ingredient: str)، تأخذ اسم ملف وسلسلة بحث كوسيطين لها. وينبغي للدالة أن تمرّ على الملف وتختار جميع الوصفات التي تحوي مكوّناتها سلسلة البحث المعطاة.
تُعاد أسماء هذه الوصفات في قائمة تمامًا كما في الجزء الثاني، مع إضافة وقت التحضير إليها. يُرجى الاطلاع على المثال أدناه.
found_recipes = search_by_ingredient("recipes1.txt", "eggs")

for recipe in found_recipes:
    print(recipe)
Pancakes, preparation time 15 min
Meatballs, preparation time 45 min
Cake pops, preparation time 60 min
تمرين برمجي: دراجات المدينة
في هذا التمرين سنكتب بعض الدوال للتعامل مع ملف يحوي بيانات مواقع محطات الدراجات البلدية في هلسنكي.
يتبع كل ملف الصيغة التالية:
Longitude;Latitude;FID;name;total_slot;operative;id
24.950292890004903;60.155444793742276;1;Kaivopuisto;30;Yes;001
24.956347471358754;60.160959093887129;2;Laivasillankatu;12;Yes;002
24.944927399779715;60.158189199971673;3;Kapteeninpuistikko;16;Yes;003
لكل محطة سطر واحد في الملف. ويحوي السطر إحداثيات المحطة واسمها وغيرها من معلومات التعرّف عليها.
المسافة بين المحطات
أولًا، اكتب دالة اسمها get_station_data(filename: str). ينبغي لهذه الدالة أن تقرأ أسماء جميع المحطات ومواقعها في الملف، وتعيدها في قاموس ذو الصيغة التالية:
{
  "Kaivopuisto": (24.950292890004903, 60.155444793742276),
  "Laivasillankatu": (24.956347471358754, 60.160959093887129),
  "Kapteeninpuistikko": (24.944927399779715, 60.158189199971673)
}
مفاتيح القاموس هي أسماء المحطات، والقيمة المرتبطة بها صف (tuple) يحوي إحداثيات موقع المحطة. فالعنصر الأول في الصف هو حقل خط الطول (Longitude)، والعنصر الثاني هو حقل خط العرض (Latitude).
ثم اكتب دالة اسمها distance(stations: dict, station1: str, station2: str)، تعيد المسافة بين المحطتين المحدَّدتين في وسيطيها.
تُحسب المسافة باستخدام نظرية فيثاغورس. ومعاملات الضرب أدناه قيم تقريبية لتحويل خطوط الطول وخطوط العرض إلى مسافات بالكيلومترات في منطقة هلسنكي.
# we will need the function sqrt from the math module
import math

x_km = (longitude1 - longitude2) * 55.26
y_km = (latitude1 - latitude2) * 111.2
distance_km = math.sqrt(x_km**2 + y_km**2)
بعض الأمثلة على الدالة أثناء عملها:
stations = get_station_data('stations1.csv')
d = distance(stations, "Designmuseo", "Hietalahdentori")
print(d)
d = distance(stations, "Viiskulma", "Kaivopuisto")
print(d)
0.9032737292463177
0.7753594392019532
ملاحظة: إذا لم تستطع Visual Studio العثور على الملف وقد تأكّدت من عدم وجود أخطاء إملائية، فاطّلع على هذه التعليمات.
أكبر مسافة
يُرجى كتابة دالة اسمها greatest_distance(stations: dict)، تحدّد المحطتين في القائمة اللتين بينهما أكبر مسافة. ينبغي أن تعيد الدالة صفًا، يكون عنصره الأول والثاني اسمَي المحطتين، وعنصره الثالث المسافة بينهما.
stations = get_station_data('stations1.csv')
station1, station2, greatest = greatest_distance(stations)
print(station1, station2, greatest)
Laivasillankatu Hietalahdentori 1.478708873076181