شيفرة البايت
^title Bytecode ^section Behavioral Patterns
النية
امنح السلوك مرونة البيانات عبر ترميزه كتعليمات (instructions) لآلة افتراضية.
الدافع
قد تكون صناعة الألعاب ممتعة، لكنها بالتأكيد ليست سهلة. فالألعاب الحديثة تتطلّب قواعد شيفرة هائلة ومعقّدة. فمصنّعو المنصّات وبوّابات متاجر التطبيقات لديهم متطلّبات جودة صارمة، وخلل تعطّل واحد قد يمنع لعبتك من الإصدار.
وفي الوقت نفسه، يُتوقّع منا أن نستخرج كل قطرة أداء من المنصّة. فاللعاب تضغط على العتاد أكثر من أي شيء آخر، وعلينا أن نحسّن بلا كلل لمجرد أن نُبقي وتيرتنا مع المنافسين.
ولمواجهة متطلّبات الثبات والأداء العالية هذه، فإننا نلجأ إلى لغات ثقيلة الوزن مثل ++C التي تملك تعبيرية منخفضة المستوى تستخرج أقصى ما من العتاد، وأنظمة أنواع غنية تمنع الأخطاء أو على الأقل تحصرها.
ونفخر بمهاراتنا في هذا، لكن ذلك له ثمنه. فأن تكون مبرمجاً ماهراً يستغرق سنوات من التدريب المتخصّص، وبعدها عليك أن تنازع مع الحجم الهائل لقاعدة شيفرتك. وأزمنة بناء الألعاب الكبيرة قد تتراوح بين «اذهب واحصل على فنجان قهوة» و«اذهب وحمّص حبّوبك بنفسك، واطحنها يدوياً، واسحب إسبريسو، ورغِّ رغوة حليب، وتدرّب على فنون اللاتيه في الرغوة».
وفوق هذه التحديات كلّها، تملك الألعاب قيداً واحداً آخر مزعجاً: المرح. فاللاعبون يطالبون بتجربة لعب مبتكرة ومتوازنة بعناية في آن واحد. وهذا يتطلّب تكراراً مستمراً، لكن إذا كان كل تعديل صغير يتطلب استدعاء مهندس يتدخّل في أكوام من شيفرة منخفضة المستوى ثم انتظار إعادة ترجمة بطيئة كالجليد، فقد قتلت تدفّقك الإبداعي.
مواجهة سحرية!
لنقل إننا نعمل على لعبة قتال قائمة على السحر. فزوج من السحرة يواجه كلٌّ منهما الآخر ويلقي عليه التعاويذ حتى يُعلن عن فائز. يمكننا أن نعرّف هذه التعاويذ في الشيفرة، لكن ذلك يعني أن على مهندس أن يكون متورّطاً في كل مرة يُعدَّل فيها واحد منها. فحين يريد مصمّم أن يضبط بضعة أرقام ليحسّ بها، عليه أن يعيد ترجمة اللعبة كلها، ويعيد تشغيلها، ثم يعود إلى المعركة.
وكما في معظم ألعاب هذه الأيام، نحتاج أيضاً إلى القدرة على تحديث اللعبة بعد إصدارها، سواء لإصلاح الأخطاء أو لإضافة محتوى جديد. فإذا كانت كل هذه التعاويذ مكتوبة يدوياً في الشيفرة، فإن تحديثها يعني ترقيع الملف التنفيذي للعبة نفسه.
ولنُذهب خطوة أبعد، ولنفترض أننا نريد أيضاً دعم التعديل (modding). نريد أن يتمكّن المستخدمون من إنشاء تعاويذهم الخاصة. فإذا كانت تلك في الشيفرة، فهذا يعني أن كل معدِّل يحتاج إلى سلسلة أدوات ترجمة كاملة لبناء اللعبة، علينا أن نطلق الشيفرة المصدرية التحكّم في زمن التنفيذ ليس ضرورياً في عيّنتنا لأننا ليس لدينا أي تعليمات للتكرار. يمكننا
البيانات > الشيفرة
من الواضح تماماً أن لغة تنفيذ محرّكنا ليست الخيار المناسب. فنحن نحتاج إلى أن تكون التعاويذ معزولة بأمان عن جوهر اللعبة. ونريد أن يكون تعديلها سهلاً، وإعادة تحميلها سهلة، وأن تكون مفصولة فعلياً عن بقية الملف التنفيذي.
لا أعرف أمرك أنت، لكن هذا يبدو لي مثل البيانات إلى حد بعيد. فإذا استطعنا تعريف سلوكنا في ملفات بيانات منفصلة يحمّلها محرّك اللعبة و«ينفّذها» بطريقة ما، لاستطعنا تحقيق كل أهدافنا.
ولا يبقى سوى أن نكتشف ماذا يعني «التنفيذ» بالنسبة للبيانات. فكيف تجعل بعض البايتات في ملف ما يعبّر عن سلوك؟ وهناك بضع طرق لفعل ذلك. وأعتقد أن مقارنة هذا النمط بنمط آخر ستساعدك على تكوين صورة عن نقاط قوته وضعفه: نمط المُفسِّر (Interpreter).
نمط المُفسِّر
يمكنني كتابة فصل كامل عن هذا النمط، لكن أربعة رجال آخرين غطّوه نيابةً عني. بدلاً من ذلك، سأحشر هنا أبسط مقدّمة ممكنة. يبدأ الأمر بلغة — فكّر في لغة برمجة — تريد تنفيذها. ولنفترض مثلاً أنها تدعم تعبيرات حسابية كهذه:
(1 + 2) * (3 - 4)
ثم تأخذ كل قطعة من ذلك التعبير، كل قاعدة في قواعد اللغة، وتحولها إلى كائن. فالأعداد الحرفية ستكون كائنات:
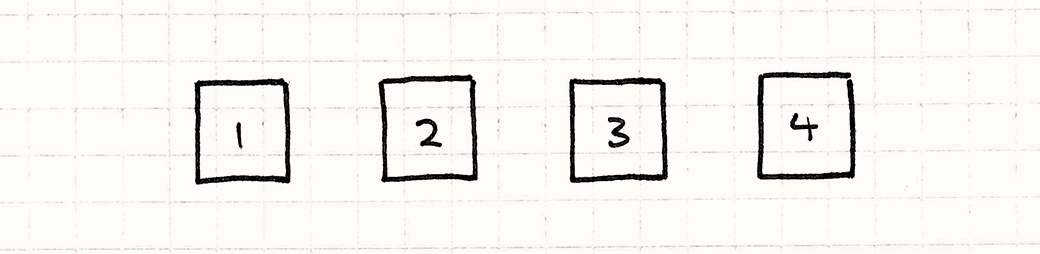
في الأساس، هي أغلفة صغيرة حول القيمة الخام. وسيكون المعامِلات كائنات أيضاً، وستحمل مراجع إلى معاملاتها. وإذا أخذت الأقواس والأسبقية في الحسبان، فإن ذلك التعبير كسحرٍ يتحوّل إلى شجرة صغيرة من الكائنات هكذا:
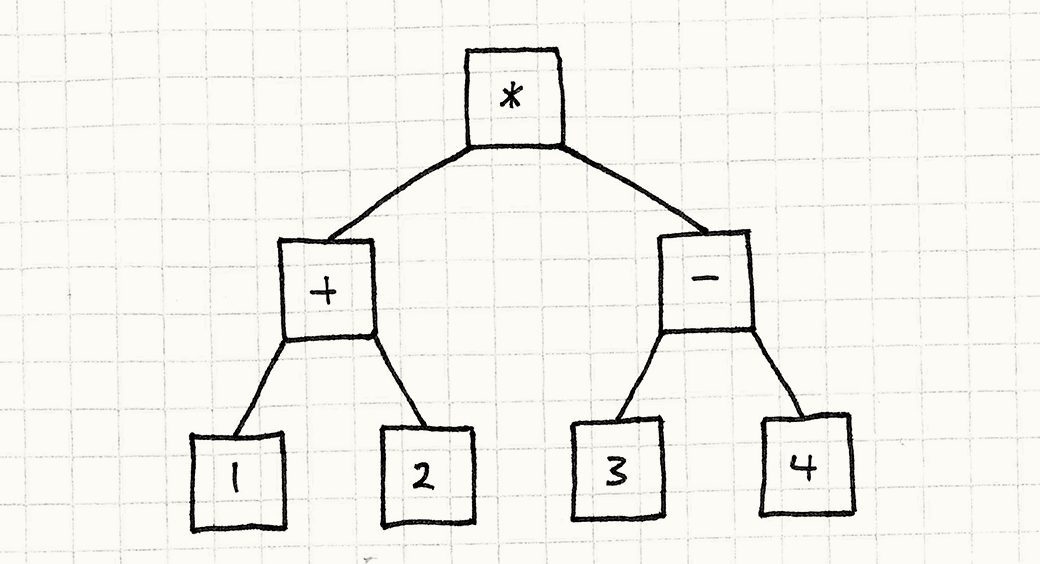
نمط المُفسِّر ليس عن إنشاء تلك الشجرة، بل عن تنفيذها. وطريقة عمله ذكية إلى حد ما. فكل كائن في الشجرة هو تعبير أو تعبير فرعي. وبأسلوب كينوني خالص، سنترك التعابير تقيّم نفسها.
أولاً، نعرّف واجهة أساس تطبّقها كل التعابير:
^code expression
ثم نعرّف صنفاً يطبّق هذه الواجهة لكل نوع من أنواع التعبير في قواعد لغتنا. وأبسطها هو الأعداد:
^code number
تعبير العدد الحرفي يقيّم نفسه فحسب إلى قيمته. أما الجمع والضرب فأكثر تعقيداً قليلاً لأنهما يحتويان تعبيرات فرعية. وقبل أن يقيّما نفسيهما، عليهما أن يقيّما تعبيراتهما الفرعية تقييماً متكرراً. هكذا:
^code addition
لطيف جداً، أليس كذلك؟ مجرد زوجين من الأصناف البسيطة، وأصبح بإمكاننا الآن تمثيل وتقييم تعبيرات حسابية معقّدة إلى أي حد. كل ما نحتاجه هو إنشاء الكائنات الصحيحة ووصلها ببعضها بشكل صحيح.
إنه نمط بديع وبسيط، لكن له بعض المشكلات. انظر إلى الرسم التوضيحي في الأعلى. ماذا ترى؟ صناديق صغيرة كثيرة، وأسهم كثيرة بينها. فالشيفرة مُمثَّلة في صورة شجرة كسورية هائلة من الكائنات الدقيقة. ولهذا نتائج غير سارة:
-
تحميلها من القرص يتطلّب إنشاء وحدات وأرباط كم هائلاً من هذه الكائنات الصغيرة.
-
تلك الكائنات والمؤشرات بينها تستهلك الكثير من الذاكرة (memory). وعلى آلة 32 بت، فإن ذلك التعبير الحسابي الصغير أعلاه يشغل 68 بايتاً على الأقل، دون احتساب الحشو.
-
اجتياز المؤشرات نحو التعبيرات الفرعية فتّاكٌ على ذاكرة التخزين المؤقت للبيانات (data cache). وفي الوقت نفسه، فإن كل تلك الاستدعاءات الافتراضية للدوال تُحدث مجزّة في ذاكرة التخزين المؤقت للتعليمات.
اجمع هذه النقاط معاً، وماذا تشكّل؟ ب-ط-ي-ء. فهناك سبب في أن معظم لغات البرمجة المتّسعة الاستخدام ليست قائمة على نمط المُفسِّر. فهو بطيء ببساطة، ويستهلك ذاكرة كثيرة أكثر من اللازم.
شيفرة الآلة، افتراضياً
لنعتبر لعبتنا. حين نشغّلها، لا يجتاز حاسوب اللاعب أيّ بنى شجرة لقواعد ++C وقت التشغيل. وبدلاً من ذلك، فإننا نترجمها مسبقاً إلى شيفرة آلة، وينفّذها المعالج. وما الذي تتفوّق به شيفرة الآلة؟
-
كثيفة. إنها كتلة صلبة متّصلة من البيانات الثنائية، ولا يذهب أي بت هدراً.
-
خطّية. التعليمات محشورة معاً وتُنفَّذ واحدة تلو الأخرى. لا قفز هنا وهناك في الذاكرة (إلا إذا كنت تفعل تحكّماً فعلياً بالتدفّق، بالطبع).
-
منخفضة المستوى. كل تعليمة تفعل شيئاً واحداً صغيراً نسبياً، والسلوك المثير يأتي من تركيبها معاً.
-
سريعة. كنتيجة لكل ذلك (حسناً، ولأنها منفّذة مباشرةً في العتاد)، فإن شيفرة الآلة تعمل كالريح.
يبدو هذا رائعاً، لكننا لا نريد شيفرة آلة حقيقية لتعاويذنا. فترك المستخدمين يقدّمون شيفرة آلة تنفّذها لعبتنا ليس سوى دعوة صريحة لـمشاكل أمنية (security problems). وما نحتاجه هو حل وسط بين أداء شيفرة الآلة وأمان نمط المُفسِّر.
فلماذا لا، بدلاً من تحميل شيفرة آلة حقيقية وتنفيذها مباشرةً، نعرّف شيفرة آلة افتراضية خاصة بنا؟ سنكتب عندئذٍ محاكياً صغيراً لها داخل لعبتنا. ستكون شبيهة بشيفرة الآلة — كثيفة، خطّية، منخفضة المستوى نسبياً — لكنها ستُدار بالكامل من لعبتنا أيضاً فنتمكّن من عزلها بأمان.
ولنسمّ محاكيّنا الصغير آلة افتراضية (virtual machine) أو «VM» اختصاراً، ونسمّي شيفرة الآلة الثنائية التخيلية التي ينفّذها شيفرة بايت (bytecode). فهي تملك مرونة وسهولة تعريف الأشياء في البيانات، لكن أداءها أفضل من التمثيلات الأعلى مستوى مثل نمط المُفسِّر.
يبدو هذا مخيفاً مع ذلك. فهدفي في بقية هذا الفصل هو أن أريك أن الأمر في متناول اليد إلى حد كبير إن أبقيت قائمة ميزاتك مختصرة. وحتى لو انتهيت في النهاية إلى عدم استخدام هذا النمط نفسك، فستكون على الأقل قد فهمت Lua ولغات أخرى كثيرة مُنفَّذة باستخدامه بصورة أفضل.
النمط
تعرّف مجموعة تعليمات (instruction set) العمليات منخفضة المستوى التي يمكن تنفيذها. وتُرمَّز سلسلة من التعليمات في صورة تسلسل بايتات. وتنفّذ آلة افتراضية (virtual machine) هذه التعليمات واحدة تلو الأخرى، مستخدمةً مكدّساً للقيم الوسيطة. وبدمج التعليمات، يمكن تعريف سلوك معقّد عالي المستوى.
متى تستخدمه
هذا هو أكثر الأنماط تعقيداً في هذا الكتاب، وليس شيئاً تُلقيه في لعبتك بخفة. استخدمه حين يكون لديك قدر كبير من السلوك تحتاج إلى تعريفه، وحين تكون لغة تنفيذ لعبتك غير مناسبة لأن:
-
إنها منخفضة المستوى أكثر من اللازم، فيصبح البرمجة فيها مملّة أو معرّضة للخطأ.
-
التكرار عليها يستغرق وقتاً طويلاً بسبب أزمنة ترجمة بطيئة أو مشكلات أخرى في الأدوات.
-
فيها ثقة أكثر من اللازم. فإذا أردت أن تضمن أن السلوك المُعرَّف لا يستطيع كسر اللعبة، فعليك عزله عن بقية قاعدة الشيفرة.
وبالطبع، فإن تلك القائمة تصف لعبتك إلى حد كبير. فمن لا يريد حلقة تكرار أسرع أو مزيداً من الأمان؟ غير أن ذلك لا يأتي مجاناً. فشيفرة البايت أبطأ من الشيفرة الأصلية، لذا فهي ليست مناسبة للأجزاء الحرجة من حيث الأداء في محرّكك.
ضع في اعتبارك
هناك شيء مغري في إنشاء لغتك الخاصة أو نظام داخل نظام. سأقدّم هنا مثالاً أدنى، لكن في العالم الحقيقي تميل هذه الأشياء إلى أن تنمو كما تنمو الكروم.
في كل مرة أرى فيها أحدهم يعرّف لغة صغيرة أو نظام سكربت، يقول: «لا تقلق، ستكون صغيرة». ثم يضيفون حتماً المزيد والمزيد من الميزات الصغيرة حتى تصبح لغةً كاملة
مكتملة. إلا أنها، بخلاف بعض اللغات الأخرى، نشأت بطريقة
عفوية عضوية، ولديها القليل من الأناقة المعمارية لقرية من الأكواخ.
وبالطبع، لا يوجد شيء خاطئ في صنع لغة كاملة. لكن تأكّد فقط من أنك تفعل ذلك بقصد. وإلا فكن حذراً جداً من ضبط نطاق ما يمكن أن تعبّر عنه شيفرة بايتك. ضَع لها حداً قصيراً قبل أن تنفلت من يدك.
ستحتاج إلى واجهة أمامية
تعليمات شيفرة البايت منخفضة المستوى ممتازة للأداء، لكن صيغة شيفرة البايت الثنائية ليست ما سيؤلّفه مستخدموك. وإحدى أسباب نقلنا السلوك خارج الشيفرة هو كي نستطيع التعبير عنه عند مستوى أعلى. فإذا كانت ++C منخفضة المستوى أكثر من اللازم، فإن جعل مستخدميك يكتبون فعلياً بـلغة تجميع (assembly language) — حتى لو كانت من تصميمك أنت — ليس تحسّناً!
وكما في نمط المُفسِّر لدى «الرباعية»، فإن المفترض أن لديك أيضاً طريقة لتوليد شيفرة البايت. عادةً، يؤلّف المستخدمون سلوكهم في صيغة أعلى مستوى، وتترجم أداة ما ذلك إلى شيفرة البايت التي تفهمها آلتنا الافتراضية. وبعبارة أخرى، مترجم.
أعرف، هذا يبدو مخيفاً. ولهذا ذكرته هنا. فإذا لم تكن لديك الموارد لبناء أداة تأليف، فشيفرة البايت ليست لك. لكن كما سنرى لاحقاً، فقد لا يكون الأمر بالسيئ الذي تظنّه.
ستفتقد مصحّح الأخطاء
البرمجة صعبة. نحن نعرف ما نريد من الآلة أن تفعله، لكننا لا نوصل ذلك صحيحاً دائماً — فنحن نكتب أخطاءً. ولمساعدتنا في العثور عليها وإصلاحها، جمعنا كومة من الأدوات لفهم ما تفعله شيفرتنا خطأً وكيف نصحّحه. لدينا مصحّحات أخطاء، ومحلّلات ساكنة، ومفكّكات ترجمة، إلخ. وكل تلك الأدوات مصمّمة للعمل مع لغة موجودة سلفاً: إما شيفرة آلة أو شيء أعلى مستوى.
وحين تعرّف آلة افتراضية خاصة بشيفرة البايت، فإنك تترك تلك الأدوات خلفك. صحيح أنك تستطيع أن تتنقّل خطوة خطوة داخل الآلة الافتراضية في مصحّح أخطاءك، لكن ذلك يخبرك بما تفعله الآلة الافتراضية نفسها، لا بما يفعله شيفرة البايت التي تفسّرها. وهو بالتأكيد لا يساعدك على ربط تلك الشيفرة بالشكل عالي المستوى التي رُجمت منها.
فإذا كان السلوك الذي تعرّفه بسيطاً، فبإمكانك أن تتدارك بأدوات مساعدة للتصحيح لا تكاد تذكر. لكن مع نموّ حجم محتواك، فخطّط لاستثمار وقت حقيقي في ميزات تساعد المستخدمين على رؤية ما تفعله شيفرة بايتهم. وقد لا تكون تلك الميزات في إصدار لعبتك، لكنها ستكون حاسمة للتأكد من أنك تستطيع فعلاً إصدار لعبتك.
شيفرة العيّنة
بعد القسمين السابقين، قد تندهش من بساطة التنفيذ. أولاً، نحتاج إلى صياغة مجموعة تعليمات لآلتنا الافتراضية. وقبل أن نبدأ التفكير في شيفرة البايت وما يتصل بها، دعنا نفكّر فيها على أنها واجهة برمجية (API) فحسب.
واجهة سحرية
لو كنا نعرّف التعاويذ في شيفرة ++C خالصة، فأي نوع من الواجهات البرمجية سنحتاج لكي تستدعيها تلك الشيفرة؟ وما العمليات الأساسية في محرّك اللعبة التي تُعرَّف التعاويذ؟
على أي حال، فإن معظم التعاويذ تنتهي في النهاية بتغيير إحدى إحصاءات الساحر، لذا لنبدأ ببضع منها:
^code magic-api
تحدّد المعامل الأول أي ساحر يتأثّر، فلتكن 0 للاعب و1 لمنافسه. وبهذه الطريقة،
تستطيع تعاويذ الشفاء أن تؤثّر في ساحر اللاعب نفسه، بينما تضرب هجمات الضرر عدوّه.
وتغطي هذه الدوال الصغيرة الثلاثة تنوّعاً مدهشاً من التأثيرات السحرية.
وإذا كانت التعاويذ تعدّل الإحصاءات في صمت، لكان منطق اللعبة بخير، لكن لعبها سيملّ اللاعبين حتى الدموع. لنصلح ذلك:
^code magic-api-fx
هذه لا تؤثّر في اللعب، لكنها ترفع حدّة تجربة اللعب. يمكننا إضافة المزيد منه لارتجاج الكاميرا، والحركة، إلخ، لكن هذا يكفي لنبدأ.
مجموعة تعليمات سحرية
الآن لنرَ كيف نحوّل هذه الواجهة البرمجية إلى شيء يمكن التحكّم فيه من البيانات. لنبدأ
صغيرين ثم نعمل طريقنا صعوداً حتى المشروع كلّه. في الوقت الحالي، سنتخلّص من كل
معاملات هذه الدوال. سنقول إن دوال set___() تؤثّر دائماً في ساحر اللاعب نفسه
وتضبط الإحصاء على أقصى قيمة دائماً. وبالمثل، فإن عمليات المؤثّرات تشغّل دائماً صوتاً
واحداً مكتوباً يدوياً وتأثير جزيئات واحداً.
ومع ذلك، فإن التعويذ ليس سوى سلسلة من التعليمات. كل واحدة منها تحدّد أي عملية تريد تنفيذها. يمكننا أن نعدّدها:
^code instruction-enum
ولترميز تعويذ في بيانات، فإننا نخزّن مصفوفة من قيم enum. ولدينا عدد قليل فقط من
الأوّليات المختلفة، لذا فإن نطاق قيم enum يتّسع بسهولة في بايت واحد. وهذا يعني أن
شيفرة التعويذ ليست سوى قائمة من بايتات (bytes) — أي «شيفرة البايت».
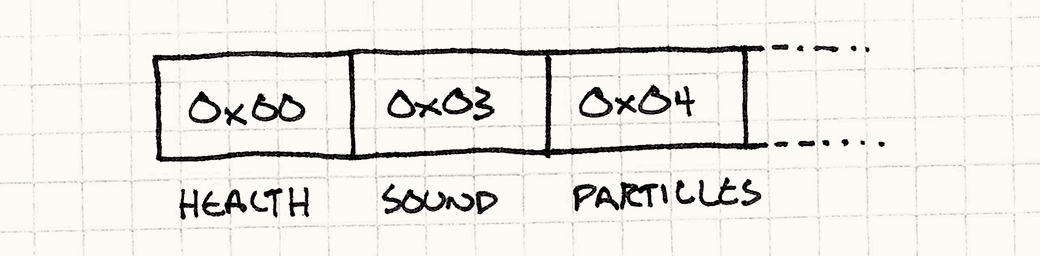
لتنفيذ تعليمة واحدة، فإننا ننظر إلى أيّ أوّلية هي ونوجّه التنفيذ إلى دالة الواجهة البرمجية المناسبة:
^code interpret-instruction
بهذه الطريقة، يشكّل مُفسّرنا جسراً بين عالم الشيفرة وعالم البيانات. ويمكننا أن نغلّف هذا في آلة افتراضية صغيرة تنفّذ تعويذاً كاملاً هكذا:
^code vm
اكتب ذلك وستكون قد كتبت أول آلة افتراضية لك. وللأسف، فهي ليست مرنة كثيراً. فنحن لا نستطيع تعريف تعويذ يلمس منافس اللاعب أو يخفض إحصاءً. كل ما نستطيعه هو تشغيل صوت واحد!
ولنحصل على شيء له الإحساس التعبيري الذي للغات الحقيقية، نحتاج إلى إدخال المعاملات هنا.
آلة مكدّس
لتنفيذ تعبير متداخل معقّد، تبدأ بأعمق التعبيرات الفرعية. فتحسبها، ثم تتدفّق النتائج إلى الخارج كوسائط للتعابير التي تحتويها حتى تُقيَّم في النهاية التعبير كله.
يُنمذج نمط المُفسِّر هذا صراحةً في صورة شجرة من كائنات متداخلة، لكننا نريد سرعة قائمة مسطّحة من التعليمات. وما زلنا بحاجة إلى ضمان تدفّق نتائج التعبيرات الفرعية إلى التعابير المحيطة بها الصحيحة. لكن، بما أن بياناتنا مسطّحة، سنضطر إلى استخدام ترتيب التعليمات للتحكّم في ذلك. وسنفعلها بالطريقة نفسها التي يفعلها معالجك — بمكدّس.
^code stack
تحافظ الآلة الافتراضية على مكدّس داخلي من القيم. وفي مثالنا، أنواع القيم الوحيدة
التي تعمل تعليماتنا معها هي الأعداد، لذا يمكننا استخدام مصفوفة بسيطة من int. وحين
تحتاج قطعة من البيانات إلى الانتقال من تعليمة إلى أخرى، فإنها تصل عبر المكدّس.
وكما يوحي الاسم، يمكن دفع القيم إلى المكدّس أو سحبها منه، لذا لنضف بضع دوال لذلك:
^code push-pop
وحين تحتاج تعليمة إلى تلقّي معاملات، فإنها تسحبها من المكدّس هكذا:
^code pop-instructions
وللحصول على بعض القيم داخل ذلك المكدّس، نحتاج إلى تعليمة أخرى: قيمة حرفية. فهي تمثّل قيمة عدد صحيح خام. لكن من أين تأتي هي قيمتها؟ وكيف نتجنّب هنا تراجعاً لا نهائياً من «السلحفاة حتى الأسفل»؟
والحيلة هي استغلال حقيقة أن تدفّق تعليماتنا هو تسلسل بايتات — يمكننا حشر الرقم مباشرةً في مصفوفة البايتات. ونعرّف نوع تعليمة آخر لقيمة عددية حرفية هكذا:
^code interpret-literal
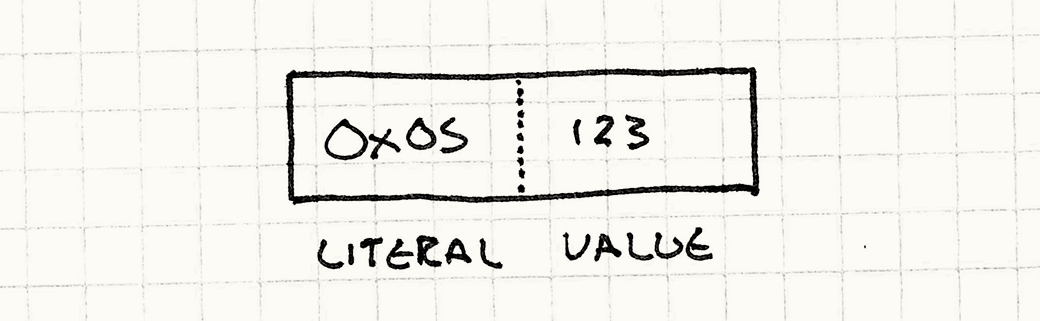
تقرأ البايت التالي في تدفّق شيفرة البايت كعدد وتدفعه إلى المكدّس. لننصّل بعض هذه التعليمات معاً ونراقب المُفسّر ينفّذها لتكتشف إحساس كيفية عمل المكدّس. نبدأ بمكدّس فارغ والمُفسّر يشير إلى أول تعليمة:
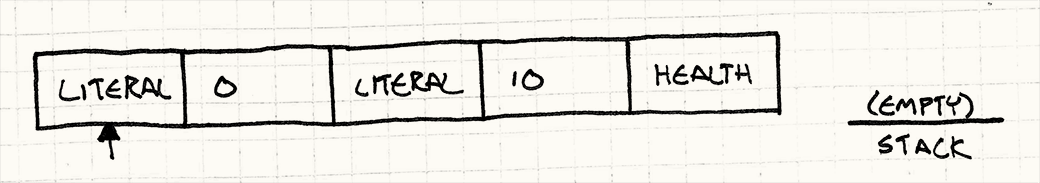
أولاً، ينفّذ أول INST_LITERAL. يقرأ البايت التالي من شيفرة البايت (0) ويدفعه إلى
المكدّس:
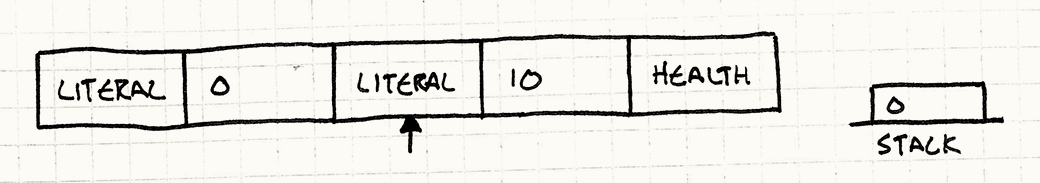
ثم ينفّذ INST_LITERAL الثانية. يقرأ 10 ويدفعه:
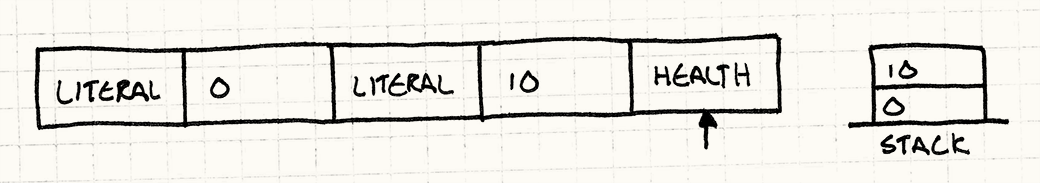
وأخيراً، ينفّذ INST_SET_HEALTH. يسحب 10 ويخزّنها في amount، ثم يسحب 0
ويخزّنها في wizard. ثم يستدعي setHealth() بتلك المعاملات.
ها هي! لقد حصلنا على تعويذ يضبط صحة ساحر اللاعب على عشر نقاط. الآن، لدينا مرونة كافية لأن نعرّف تعاويذ تضبط إحصاءات أي ساحر على أي المقادير نريدها. يمكننا أيضاً تشغيل أصوات مختلفة وإطلاق جزيئات.
لكن... هذا لا يزال يشبه تنسيق بيانات. فنحن لا نستطيع، على سبيل المثال، رفع صحة ساحر بمقدار نصف حكمته. يريد مصمّمونا أن يتمكّنوا من التعبير عن قواعد للتعاويذ، لا مجرد قيم.
السلوك = التركيب
إذا نظرنا إلى آلتنا الافتراضية الصغيرة كأنها لغة برمجة، فكل ما تدعمه الآن هو دالتان مدمجتان ومعاملات ثابتة لهما. ولجعل شيفرة البايت تشبه السلوك، فالأمر الذي ينقصنا هو التركيب (composition).
يحتاج مصمّمونا إلى أن يتمكّنوا من إنشاء تعبيرات تجمع قيماً مختلفة بطرق مثيرة. ولأبسط مثال، يريدون تعاويذ تعدّل إحصاءً بمقدار معيّن بدلاً من إلى مقدار معيّن.
وهذا يتطلّب أخذ القيمة الحالية للإحصاء في الحسبان. ولدينا تعليمات لـكتابة إحصاء، لكننا بحاجة إلى إضافة بضع تعليمات لـقراءة الإحصاءات:
^code read-stats
وكما ترى، فإن هذه تعمل مع المكدّس في الاتجاهين. فهي تسحب معاملاً لتحديد أي ساحر نقرأ الإحصاء له، ثم تبحث عن قيمة الإحصاء وتدفعها ثانيةً إلى المكدّس.
وهذا يتيح لنا كتابة تعاويذ تنسخ الإحصاءات هنا وهناك. يمكننا إنشاء تعويذ يضبط رشاقة ساحر إلى حكمته، أو تعويذة غريبة تجعل صحة ساحر تطابق صحة منافسه.
أفضل، لكن لا تزال محدودة إلى حد ما. بعد ذلك، نحتاج إلى العمليات الحسابية. حان وقت أن تتعلّم آلتنا الافتراضية كيف تجمع 1 + 1. سنضيف بضع تعليمات أخرى. وإلى الآن، من المفترض أنك فهمت الأمر وخمّنت شكلها. سأعرض الجمع فحسب:
^code add
وكما تعليماتنا الأخرى، فإنها تسحب بضع قيم، وتعمل قليلاً، ثم تدفع النتيجة ثانيةً. حتى الآن، كانت كل تعليمة جديدة تمنحنا تحسّناً تدريجياً في التعبير، لكننا جعلنا للتو قفزة كبيرة. وليس الأمر بديهياً، لكننا نستطيع الآن التعامل مع كل أصناف التعبيرات الحسابية المعقّدة والمتعمّقة في التداخل.
لنمرّ على مثال أعقد قليلاً. لنقل إننا نريد تعويذاً يزيد صحة ساحر اللاعب بمتوسط رشاقته وحكمته. وفي الشيفرة، يكون ذلك:
^code increase-health
قد تظن أننا بحاجة إلى تعليمات تتعامل مع التجميع الصريح الذي تمنحه الأقواس في التعبير هنا، لكن المكدّس يدعم ذلك ضمناً. إليك كيف يمكنك تقييم هذا يدوياً:
- خذ صحة الساحر الحالية واحفظها.
- خذ رشاقة الساحر واحفظها.
- افعل الشيء نفسه بحكمته.
- خذ آخر قيمتين، واجمعهما، واحفظ النتيجة.
- اقسم ذلك على اثنين واحفظ النتيجة.
- استدعِ صحة الساحر وأضفها إلى تلك النتيجة.
- خذ تلك النتيجة واضبط صحة الساحر على تلك القيمة.
أترى كل تلك «الحفظ» و«الاستدعاء»؟ كل «حفظ» يقابل دفعة، و«الاستدعاءات» هي عمليات سحب. وهذا يعني أننا نستطيع ترجمة ذلك إلى شيفرة بايت بسهولة تامة. فمثلاً، السطر الأول الذي يأخذ صحة الساحر الحالية هو:
:::text
LITERAL 0
GET_HEALTH
تدفع هذه القطعة من شيفرة البايت صحة الساحر إلى المكدّس. وإذا ترجمنا كل سطر على هذا النحو آلياً، سننتهي إلى قطعة من شيفرة البايت تقيّم تعبيرنا الأصلي. ولإعطائك إحساساً بكيفية تركيب التعليمات، فقد فعلت ذلك أدناه.
لإظهار كيف يتغيّر المكدّس مع الزمن، سنمرّ على تنفيذ نموذجي تكون فيه إحصاءات الساحر الحالية 45 صحة، و7 رشاقة، و11 حكمة. وبعد كل تعليمة مباشرةً يكتب ما يبدو عليه المكدّس بعد تنفيذها، ثم تعليق صغير يشرح غرض التعليمة:
:::text
LITERAL 0    [0]            # Wizard index
LITERAL 0    [0, 0]         # Wizard index
GET_HEALTH   [0, 45]        # getHealth()
LITERAL 0    [0, 45, 0]     # Wizard index
GET_AGILITY  [0, 45, 7]     # getAgility()
LITERAL 0    [0, 45, 7, 0]  # Wizard index
GET_WISDOM   [0, 45, 7, 11] # getWisdom()
ADD          [0, 45, 18]    # Add agility and wisdom
LITERAL 2    [0, 45, 18, 2] # Divisor
DIVIDE       [0, 45, 9]     # Average agility and wisdom
ADD          [0, 54]        # Add average to current health
SET_HEALTH   []             # Set health to result
إذا راقبت المكدّس في كل خطوة، يمكنك أن ترى كيف تتدفّق البيانات عبره كأنها سحر. فنحن ندفع 0 كفهرس الساحر في البداية، ويبقى معلّقاً في
قاع المكدّس حتى نحتاج إليه في النهاية لأجل SET_HEALTH الأخيرة.
آلة افتراضية
يمكنني أن أتابع، مضافاً المزيد والمزيد من التعليمات، لكن هذا موضع جيد للتوقف. كما
هي، لدينا آلة افتراضية صغيرة لطيفة تتيح لنا تعريف سلوك مفتوح إلى حد ما باستخدام تنسيق
بيانات بسيط ومدمج. ورغم أن «شيفرة البايت» و«الآلات الافتراضية» تبدوان مُرعبتين،
فأرى أنهما غالباً بسيطتان إلى حد مكدّس وحلقة وأمر switch.
تذكّر هدفنا الأصلي بأن يكون السلوك معزولاً بأمان؟ الآن وقد رأيت بالضبط كيف تُنفَّذ الآلة الافتراضية، فمن البديهي أننا نجحنا. لا يستطيع شيء في شيفرة البايت أن يفعل شيئاً خبيثاً أو يمدّ يده إلى أجزاء غريبة من محرّك اللعبة، لأننا عرّفنا بضع تعليمات فقط تلمس بقية اللعبة.
ونحن نتحكّم في مقدار الذاكرة التي تستخدمه بحجم المكدّس الذي ننشئه، ونحرص على التأكد من أنه لا يمكن أن يفيض. بل يمكننا حتى التحكّم في مقدار الوقت الذي تستخدمه. فحلقة التعليمات لدينا يمكننا فيها تتبّع عدد ما نفّذناه والخروج إن تجاوز حداً ما.
لم يبقَ سوى مشكلة واحدة: إنشاء شيفرة البايت فعلياً. فحتى الآن، أخذنا قطعاً من الشيفرة الزائفة وترجمناها إلى شيفرة بايت باليد. وإن لم يكن لديك الكثير من الوقت الحر، فلن ينجح هذا في الممارسة العملية.
أدوات رمي التعاويذ
كان أحد أهدافنا الأولى أن نتمكّن من طريقة أعلى مستوى لتأليف السلوك، لكننا بدلاً من ذلك أنشأنا شيئاً أدنى مستوى من ++C. فهو يملك أداء وقت التشغيل والأمان اللذين نريدهما، لكنه يفتقر تماماً إلى سهولة الاستخدام التي يبحث عنها المصمّمون.
ولملء هذه الفجوة، نحتاج إلى بعض الأدوات. فنحن بحاجة إلى برنامج يتيح للمستخدمين تعريف السلوك عالي المستوى لتعويذ ثم يأخذ ذلك ويولّد شيفرة بايت آلة المكدّس المناسبة.
وهذا على الأرجح يبدو أصعب بكثير من صنع الآلة الافتراضية. فقد أُجبر كثير من المبرمجين على حضور «المترجِّمات» في الجامعة ولم يخرجوا منها إلا اضطراب ما بعد الصدمة الناتج عن رؤية كتاب ذي تنين على غلافه أو كلمتَي «lex» و«yacc”.
وفي الحقيقة، فإن ترجمة لغة قائمة على النص ليست سيئة إلى هذا الحد، وإن كانت موضوعاً أوسع قليلاً مما يمكن حشره هنا. لكنك لست مضطراً إلى ذلك. فما قلته إننا بحاجة إليه هو أداة — ولا يلزم أن يكون مترجّماً تكون صيغة إدخاله ملف نصّي.
بل على العكس، أحثّك على أن تفكّر في بناء واجهة رسومية تتيح للمستخدمين تعريف سلوكهم، وخاصة إذا لم يكن الأشخاص الذين سيستخدمونها تقنيين بدرجة عالية. فكتابة نص خالٍ من أخطاء الصياغة صعبة بالنسبة لمن لم يقضِ سنوات معتادين على مترجِّم يصرخ في وجوههم.
وبدلاً من ذلك، يمكنك بناء تطبيق يتيح للمستخدمين «كتابة السكربت» بالنقر على صناديق صغيرة وسحبها، أو بسحب عناصر من القوائم، أو بأي شيء آخر منطقي يناسب نوع السلوك الذي تريدهم أن ينشئوه.
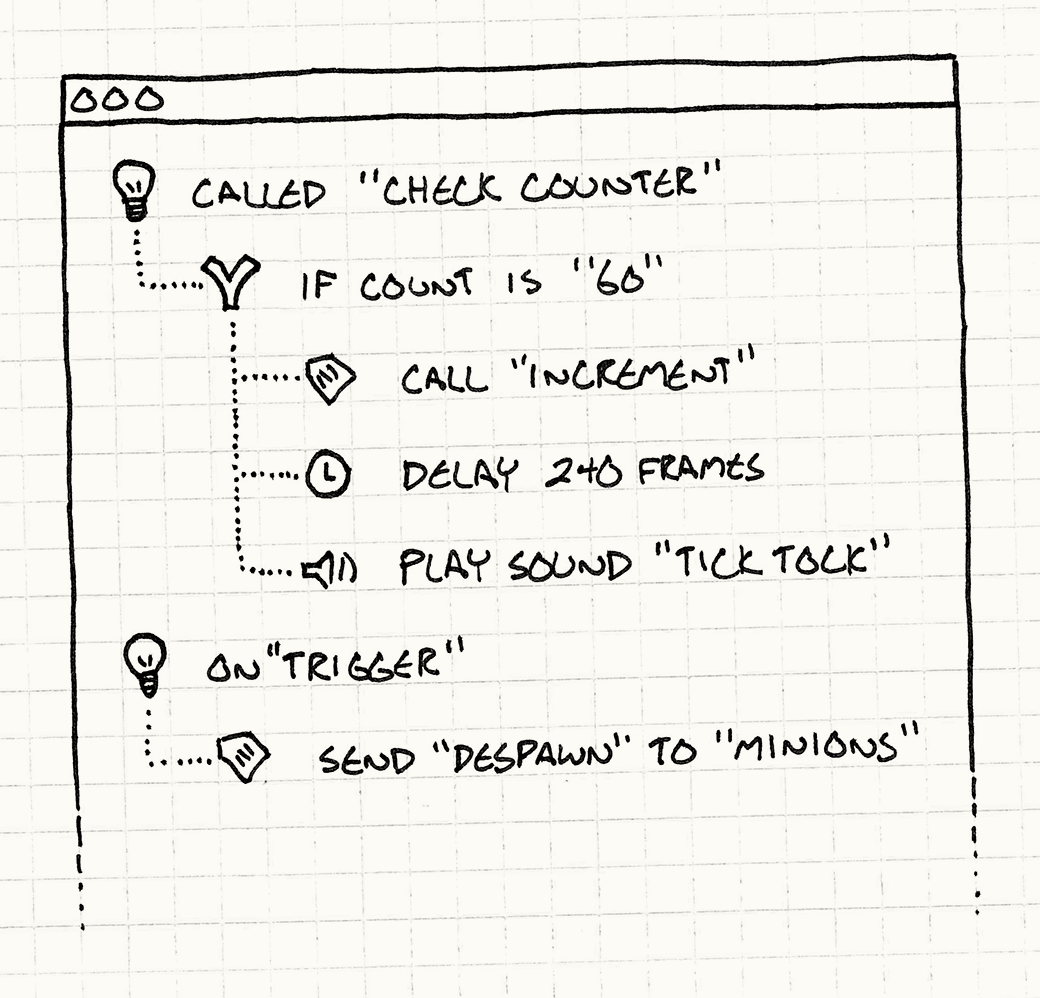
الشيء الجميل في هذا هو أن واجهتك يمكنها أن تجعل إنشاء برامج «غير صالحة» من قبل المستخدمين أمراً مستحيلاً. فبدلاً من أن تقذف رسائل خطأ في وجوههم، يمكنك أن تعطّل الأزرار استباقياً أو تقدّم قيماً افتراضية لضمان أن ما أنشأوه صالح في كل لحظة.
وهذا يوفّر عليك تصميم قواعد لغة وكتابة مُحلِّل لها. لكن، أعرف، يجد بعضكم برمجة واجهات المستخدم محبطة بقدر ما. حسناً، في هذه الحالة ليس لديّ أي أخبار جيدة لكم.
وفي نهاية المطاف، يتعلّق هذا النمط بالتعبير عن السلوك بطريقة صديقة للمستخدم وعالية المستوى. عليك أن تصنع تجربة المستخدم. ولنفّذ السلوك بكفاءة، تحتاج بعد ذلك إلى ترجمته إلى شكل أدنى مستوى. هذا عمل حقيقي، لكن إن كنت مستعداً للتحدّي فقد يعود عليك بالعائد.
القرارات التصميمية
حاولت أن أبقى هذا الفصل في أبسط صورة ممكنة، لكن ما نفعله في الواقع هو إنشاء لغة. وهذا فضاء تصميم مفتوح إلى حد كبير. واستكشافه قد يكون ممتعاً للغاية، لذا تأكّد من أنك لا تنسى إنهاء لعبتك.
كيف تصل التعليمات إلى المكدّس؟
تأتي الآلات الافتراضية لشيفرة البايت في نوعين رئيسيين: القائم على المكدّس والقائم
على السجلات. وفي الآلة القائمة على المكدّس، تعمل التعليمات دائماً من قمة المكدّس، كما
في شيفرة عيّنتنا. فمثلاً، يسحب INST_ADD قيمتين، ويجمعهما، ويدفع النتيجة.
ولا تزال الآلات القائمة على السجلات تملك مكدّساً. الفرق الوحيد هو أن التعليمات يمكنها
أن تقرأ مدخلاتها من عمق أكبر في المكدّس. فبدلاً من أن يسحب INST_ADD معاملاته
دائماً، لديه فهرسان مخزّنان في شيفرة البايت يحدّدان أين في المكدّس يقرأ المعاملات.
-
مع آلة افتراضية قائمة على المكدّس:
-
التعليمات صغيرة. وبما أن كل تعليمة تجد وسائطها ضمناً في قمة المكدّس، فلا تحتاج إلى ترميز أي بيانات لذلك. وهذا يعني أن كل تعليمة يمكن أن تكون صغيرة جداً، عادةً بايتاً واحداً.
-
توليد الشيفرة أبسط. فحين تصل إلى كتابة المترجِّم أو الأداة التي تُخرج شيفرة البايت، ستجد أن توليد شيفرة بايت قائمة على المكدّس أسهل. وبما أن كل تعليمة تعمل ضمناً من قمة المكدّس، فلا تحتاج سوى إلى إخراج التعليمات بالترتيب الصحيح لتمرير المعاملات بينها.
-
لديك تعليمات أكثر. فلا ترى كل تعليمة سوى قمة المكدّس تماماً. وهذا يعني أنك لتوليد شيفرة لشيء مثل
a = b + cتحتاج تعليمات منفصلة لنقلbوcإلى قمة المكدّس، وتنفيذ العملية، ثم نقل النتيجة إلىa.
-
-
مع آلة افتراضية قائمة على السجلات:
-
التعليمات أكبر. وبما أن التعليمات تحتاج وسائط لإزاحات المكدّس، فكل تعليمة تحتاج بتات أكثر. فمثلاً، تعليمة في Lua — على الأرجح أشهر آلة افتراضية قائمة على السجلات — يبلغ عرضها 32 بتاً كاملة. فهي تستخدم 6 بتات لنوع التعليمة، والباقي وسائط.
-
لديك تعليمات أقلّ. وبما أن كل تعليمة تستطيع أن تفعل عملاً أكثر، فلا تحتاج إلى هذا العدد الكبير منها. ويقول بعضهم إنك تحصل على تحسّن في الأداء لأنك لا تحتاج إلى خلط القيم داخل المكدّس كثيراً. فأيّهما ينبغي أن تفعل؟ توصيتي هي التمسّك بآلة افتراضية قائمة على المكدّس. فهي أبسط في التنفيذ وأبسط بكثير في توليد الشيفرة. وقد نالت الآلات القائمة على السجلات سمعة بأنها أسرع قليلاً بعد أن تحوّلت Lua إلى ذلك الأسلوب، لكن ذلك يعتمد بعمق على تعليماتك الفعليّة وعلى تفاصيل كثيرة أخرى في آلتك الافتراضية.
-
ما التعليمات التي لديك؟
تُعرّف مجموعة تعليماتك الحدود لما يمكن وما لا يمكن التعبير عنه في شيفرة البايت، كما أنها تؤثّر كثيراً في أداء آلتك الافتراضية. وهذه قائمة بأنواع التعليمات المختلفة التي قد ترغب فيها:
-
أوّليات خارجية. وهي تلك التي تمتدّ من الآلة الافتراضية إلى بقية محرّك اللعبة وتفعل أشياء يستطيع المستخدم رؤيتها. فهي تتحكّم في أنواع السلوك الحقيقي التي يمكن التعبير عنها في شيفرة البايت. وبدونها، لا تستطيع آلتك الافتراضية أن تفعل شيئاً أكثر من حرق دورات المعالج.
-
أوّليات داخلية. وهي التي تتعامل مع القيم داخل الآلة الافتراضية — أشياء مثل القيم الحرفية، والحساب، وعوامل المقارنة، والتعليمات التي تعبث بالمكدّس.
-
التحكّم في التدفّق. لم يغطّ مثالنا هذا، لكن حين تريد سلوكاً أمرياً ينفّذ التعليمات بشرط أو يكرّرها أكثر من مرة، فأنت بحاجة إلى التحكّم في التدفّق. وفي لغة شيفرة البايت منخفضة المستوى، فهي بسيطة إلى حدّ مفاجئ: القفزات.
وفي حلقة التعليمات لدينا، كان لدينا فهرس لتتبّع موضعنا في شيفرة البايت. وكل ما تفعله تعليمة قفز هو تعديل ذلك المتغيّر وتغيير موضعنا الحالي في التنفيذ. وبعبارة أخرى، إنها
goto. ويمكنك بناء كل أصناف التحكّم في التدفّق عالي المستوى باستخدامها. -
التجريد. إذا بدأ مستخدموك بتعريف الكثير من الأشياء في البيانات، فسينتهي بهم المطاف إلى الرغبة في إعادة استخدام قطع من شيفرة البايت بدلاً من نسخها واللصقها. وقد ترغب في شيء مثل الإجراءات القابلة للاستدعاء.
في أبسط أشكالها، لا تكون الإجراءات أعقد بكثير من قفزة. الفرق الوحيد هو أن الآلة الافتراضية تحتفظ بمكدّس إرجاع (return) ثانٍ. فحين تنفّذ تعليمة «استدعاء»، تدفع فهرس التعليمة الحالية إلى مكدّس الإرجاع ثم تقفز إلى شيفرة البايت المستدعاة. وحين تصادف «إرجاعاً»، يسحب الآلة الافتراضية الفهرس من مكدّس الإرجاع ويقفز إليه.
كيف تمثَّل القيم؟
تعمل آلتنا الافتراضية في العيّنة مع نوع واحد فقط من القيم، الأعداد الصحيحة. وهذا
يجعل الإجابة عن هذا السؤال سهلة — فالمكدّس ليس سوى مكدّس من int. وستدعم الآلة
الافتراضية الأكثر اكتمالاً أنواع بيانات مختلفة: سلاسل نصية، وكائنات، وقوائم، إلخ.
وستضطر إلى تحديد كيف تُخزَّن داخلياً.
-
نوع بيانات واحد:
-
الأمر بسيط. فلا تحتاج إلى القلق بشأن الوسوم، ولا التحويلات، ولا فحص الأنواع.
-
لا تستطيع العمل مع أنواع بيانات مختلفة. وهذه هي العيب الواضح. فحشر أنواع مختلفة في تمثيل واحد — فكّر في تخزين الأعداد كنصوص — هو دعوة للمعاناة.
-
-
متغيّر موسوم بنوع:
هذا هو التمثيل الشائع للغات ذات الأنواع الديناميكية. لكل قيمة قطعتان. الأولى هي وسم النوع — وهو
enum— الذي يحدّد ما نوع البيانات المخزّنة. ثم تُفسَّر بقية البتات بحسب ذلك النوع على النحو المناسب، مثل:^code tagged-value
-
القيم تعرف أنواعها. والشيء الجميل في هذا التمثيل أنك تستطيع فحص نوع القيمة وقت التشغيل. وهذا مهم للتوزيع الديناميكي (dynamic dispatch)، ولضمان أنك لا تحاول تنفيذ عمليات على أنواع لا تدعمها.
-
يستهلك ذاكرة أكبر. فكل قيمة عليها أن تحمل معها بضع بتات إضافية لتحديد نوعها. وفي شيء منخفض المستوى كآلة افتراضية، تتراكم هذه البتات هنا وهناك بسرعة.
-
-
اتحاد بلا وسم:
يستخدم هذا اتحاداً مثل الشكل السابق، لكنه لا يحمل وسم نوع معه. فلك كتلة صغيرة من البتات يمكن أن تمثّل أكثر من نوع، والمسؤولية عليك في التأكد من أنك لا تسيء تفسيرها.
وهذه هي الطريقة التي تمثّل بها اللغات ذات الأنواع الساكنة الأشياء في الذاكرة. وبما أن نظام الأنواع يضمن وقت الترجمة أنك لا تسيء تفسير القيم، فلا تحتاج إلى التحقّق منها وقت التشغيل.
-
مدمج. فلا يمكنك أن تكون أكثر كفاءة من تخزين البتات التي تحتاجها القيمة نفسها فحسب.
-
سريع. وغياب وسوم النوع يعني أنك لا تنفق دورات على فحصها وقت التشغيل أيضاً. وهذه إحدى الأسباب التي تميل اللغات ذات الأنواع الساكنة إلى أن تكون أسرع من الديناميكية.
-
غير آمن. هذا هو الثمن الحقيقي بالطبع. فقطعة سيّئة من شيفرة البايت تجعلك تسيء تفسير قيمة فتعامل رقماً كمؤشر أو العكس، يمكنها أن تنتهك أمان لعبتك أو تُسقطها.
-
-
واجهة:
الحل الكينوني لقيمة قد تكون أحد عدة أنواع مختلفة هو التعدّد الشكلية. توفر الواجهة دوال افتراضية لاختبارات الأنواع والتحويلات المختلفة، على النحو التالي:
^code value-interface
ثم لديك أصناف ملموسة لكل نوع بيانات بعينه، مثل:
^code int-value
-
مفتوح النهاية. يمكنك تعريف أنواع قيم جديدة خارج نواة الآلة الافتراضية ما دام أنها تطبّق الواجهة الأساس.
-
كينوني. فإذا التزمت بمبادئ البرمجة الكينونية، فإن هذا يفعل الأمور بالطريقة «الصحيحة» ويستخدم التوزيع متعدّد الأشكال للسلوك الخاص بالنوع بدلاً من أمر
switchعلى وسم نوع. -
مُفصّل. فعليك أن تعرّف صنفاً منفصلاً بكل الصياغة المرافقة لكل نوع بيانات. ولاحظ أن الأمثلة السابقة أظهرت التعريف الكامل لـكل أنواع القيم، بينما هنا نغطّي واحداً فقط!
-
غير كفؤ. فللحصول على التعدّد الشكلية، عليك المرور عبر مؤشر، ما يعني أن حتى القيم الصغيرة مثل القيم المنطقية والأعداد تُغلَّف في كائنات تُخصَّص على الكومة. وكلما لمست قيمة، عليك إجراء استدعاء دالة افتراضية.
وفي شيء مثل نواة آلة افتراضية، تتراكم الضربات الصغيرة من هذا النوع بسرعة. وفي الواقع، هذا يعاني من العديد من المشكلات التي جعلتنا نتجنّب نمط المُفسِّر، إلا أن المشكلة الآن في قِيمنا بدلاً من شيفرتنا. وتوصيتي هي أنك إذا استطعت الالتزام بنوع بيانات واحد، فافعل ذلك. وإلا فاستخدم اتحاداً موسوماً بنوع. هذا ما يفعله تقريباً كل مُفسّر لغة في العالم.
-
كيف تُولَّد شيفرة البايت؟
حفظت أهم سؤال للأخير. فقد مشيت معك عبر الشيفرة لاستهلاك شيفرة البايت وتفسيرها، لكن إنشاء شيء ينتج عنها متروك لك. والحل المعتاد هنا هو كتابة مترجِّم، لكنه ليس الخيار الوحيد.
-
إذا عرّفت لغة قائمة على النصوص:
-
عليك أن تعرّف صياغة. فمصمّمو اللغات الهاويون والمحترفون جميعاً يقلّلون تقديراً قاسياً لمدى صعوبة ذلك. فتعريف قواعد ترضي المحلّلات سهل. أما تعريف قواعد ترضي المستخدمين فهو صعب.
وتصميم الصياغة هو تصميم واجهة مستخدم، وهذه العملية لا تصبح أسهل عندما تقيّد واجهة المستخدم بسلسلة من المحارف.
-
عليك أن تنفّذ محلّلاً. فعلى عكس سمعتها، هذا الجزء سهل إلى حد ما. فإمّا أن تستخدم مولّد محلّلات مثل ANTLR أو Bison، أو — كما أفعل — أن تكتب محلّلاً صغيراً بالهبوط التكراري (recursive descent) بيدك، وستكون على خير.
-
عليك أن تتعامل مع أخطاء الصياغة. وهذه إحدى أهم أجزاء العملية وأكثرها صعوبة. فحين يرتكب المستخدمون أخطاء صياغة ودلالة — وستفعل ذلك باستمرار — فمهمتك هي إعادتهم إلى الطريق الصحيح. وتقديم تغذية راجعة مفيدة ليس سهلاً حين لا تعرف سوى أن محلّلك واقف على علامة ترقيم غير متوقّعة.
-
من المرجّح أن يثبّط المستخدمين غير التقنيين. نحن المبرمجون نحبّ ملفات النصوص. ومع أدوات سطر الأوامر القوية، ننظر إليها على أنها مكعبات ليغو في الحوسبة — بسيطة، لكن يسهل تركيبها بملايين الطرق.
معظم غير المبرمجين لا ينظرون إلى النص الصريح على هذا النحو. بالنسبة لهم، تبدو ملفات النصوص كتعبئة استمارات ضريبية لمدقّق آلي غاضب يصرخ في وجوههم إن نُسوا فاصلة منقوطة واحدة.
-
-
إذا عرّفت أداة تأليف رسومية:
-
عليك أن تنفّذ واجهة مستخدم. أزرار، ونقر، وسحب، وأشياء من هذا القبيل. بعضهم يشعر بالحساسية تجاه هذه الفكرة، لكنني أحبّها شخصياً. فإذا سلكت هذا الطريق، فمن المهم أن تتعامل مع تصميم واجهة المستخدم كجزء أساسي من أداء عملك جيداً — لا مجرّد مهمة ممصّة يجب أن تتخلّص منها.
وكل قطعة عمل إضافية صغيرة تقوم بها هنا ستجعل أداتك أسهل في الاستخدام وأكثر إمتاعاً، ويؤدي ذلك مباشرةً إلى محتوى أفضل في لعبتك. وإذا نظرت خلف كثير من الألعاب التي تحبّها، فستجد أن السر غالباً كان أدوات تأليف ممتعة.
-
لديك حالات خطأ أقلّ. ولأن المستخدم يبني السلوك تفاعلياً خطوة بخطوة، فإن تطبيقك يستطيع أن يوجّهه بعيداً عن الأخطاء بمجرد وقوعها.
ومع لغة قائمة على النصوص، لا يرى الأداة أيّ من محتوى المستخدم حتى يلقِ عليها ملفاً كاملاً. وهذا يجعل منع الأخطاء ومعالجتها أصعب.
-
قابلية النقل أصعب. فالشيء الجميل في المترجِّمات النصية أن ملفات النصوص
عالمية. فالمترجِّم البسيط يقرأ ملفاً واحداً ويكتب
ملفاً واحداً. ونقل ذلك بين أنظمة التشغيل أمر تافه.
وحين تبني واجهة مستخدم، عليك أن تختار إطار العمل الذي ستستخدمه، وكثير منها خاص بنظام تشغيل واحد. وهناك أيضاً مجموعات أدوات واجهة متعددة المنصّات، لكنها غالباً ما تنال انتشاراً على حساب المألوفية — فهي تبدو غريبة بالقدر نفسه على جميع المنصّات.
-
انظر أيضاً
-
الأخت القريبة لهذا النمط هي نمط المُفسِّر (Interpreter) لدى «الرباعية». وكلاهما يمنحك طريقة للتعبير عن سلوك قابل للتركيب في صورة بيانات.
وفي الواقع، ستنتهي غالباً إلى استخدام كلا النمطين. فالأداة التي تستخدمها لتوليد شيفرة البايت سيكون لديها شجرة داخلية من الكائنات تمثّل الشيفرة. وهذا هو تماماً ما يتوقّعه نمط المُفسِّر.
ولترجمة تلك الشجرة إلى شيفرة بايت، ستمشي عليها تكرارياً، تماماً كما تفعل لتفسيرها بنمط المُفسِّر. والفرق الوحيد هو أنك بدلاً من تنفيذ قطعة من السلوك فوراً، تُخرج تعليمة شيفرة البايت التي تؤدّيها لاحقاً.
-
لغة البرمجة Lua هي لغة السكربت الأكثر استخداماً في الألعاب. وهي منفَّذة داخلياً كآلة افتراضية لشيفرة بايت قائمة على السجلات ومُدمجة جداً.
-
Kismet هي أداة سكربت رسومية مدمجة في UnrealEd، محرّك المحرّر لمحرّك Unreal.
-
لغتي السكربتية الصغيرة الخاصة، Wren، هي مُفسّر بسيط لشيفرة بايت قائم على المكدّس.