محلية البيانات
^title محلية البيانات ^section أنماط التحسين
النية
سرّع الوصول إلى الذاكرة عبر ترتيب البيانات للاستفادة من الذاكرة المؤقتة في المعالج.
الدافع
لقد كُذِبنا. فهم يواصلون عرض رسوم بيانية يرتفع فيها سرعة المعالج المركزي سنة بعد سنة، كأن قانون مور ليس مجرد ملاحظة تاريخية بل نوعاً من الحق الإلهي. ودون أن نرفع إصبعاً واحداً، نراقب نحن أهل البرمجيات برامجنا تسرّع كما لو كان ذلك سحراً لمجرّد وجود عتاد جديد.
والشرائح قد أصبحت أسرع فعلاً (رغم أن ذلك بدأ يتباطأ الآن أيضاً)، لكن مهندسي العتاد أفلتوا من ذكر أمر ما. صحيح أننا نستطيع معالجة البيانات أسرع من أي وقت مضى، لكننا لا نستطيع الحصول عليها أسرع.
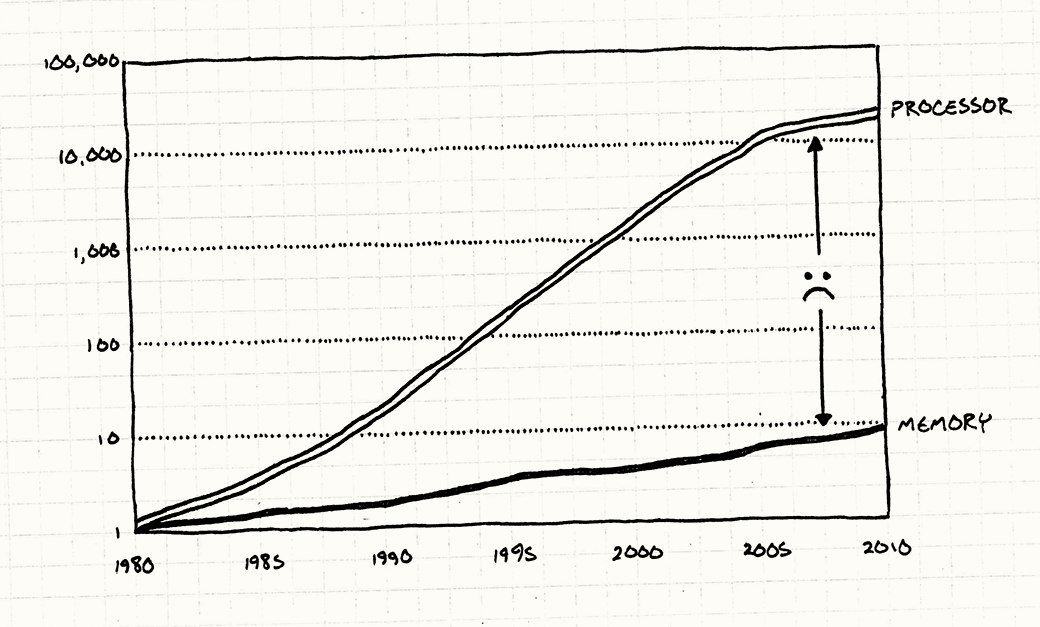 لكي يتجاوز معالجك فائق السرعة كومة من الحسابات، عليه في الواقع أن يُخرج البيانات من
الذاكرة الأساسية إلى السجلّات. وكما ترى، لم تُحافظ الذاكرة العشوائية على إيقاع مع
الزيادة في سرعات المعالج. ولا حتى عن بُعد.
مع عتاد اليوم، قد يستغرق جلب بايت واحد من الذاكرة العشوائية مئات الدورات. فإذا كانت معظم التعليمات تحتاج بيانات، واستغرق الحصول عليها مئات الدورات، فكيف لا تكون معالجاتنا عاطلة 99% من الوقت في انتظار البيانات؟
في الواقع، هي فعلاً عالقة في انتظار الذاكرة نسبة مدهشة من الوقت في هذه الأيام، لكنها ليست بالسوء الذي يمكن أن تكون عليه. ولشرح كيف يحدث ذلك، فلنأخذ رحلة إلى «أرض التشبيهات الطويلة»...
مستودع بيانات
تخيّل أنك محاسب في مكتب صغير ضيّق. ومهمّتك أن تطلب صندوقاً من الأوراق ثم تفعل بها شيئاً محاسبياً -- تجمع مجموعة من الأرقام أو شيء من هذا القبيل. وعليك أن تفعل ذلك مع صناديق موسومة معيّنة وفق منطق غامض لا يفهمه إلا المحاسبون الآخرون.
وبفضل مزيج من العمل الشاق والموهبة الطبيعية والمنشّطات، يمكنك أن تُنهي صندوقاً كاملاً في دقيقة مثلاً. لكن هناك مشكلة صغيرة. فكل تلك الصناديق مخزَّنة في مستودع في مبنى منفصل. ولأخذ صندوق، عليك أن تطلب من عامل المستودع أن يحضره إليك. فيذهب ويجلب رافعة شوكية ويقودها بين الممرات حتى يجد الصندوق الذي تريده.
يستغرقه ذلك، بجدّية، يوماً كاملاً. وعلى عكسك، فهو لن ينال جائزة «موظف الشهر» في أي وقت قريب. وهذا يعني أنه مهما كنت سريعاً، فأنت لا تحصل على أكثر من صندوق واحد في اليوم. وفي بقية الوقت، تجلس هناك وتتساءل عن قرارات الحياة التي أوصلك إلى هذه الوظيفة التي تمتصّ الروح.
وفي أحد الأيام، تظهر مجموعة من المصمّمين الصناعيين. ومهمّتهم تحسين كفاءة العمليات -- أشياء مثل جعل خطوط التجميع أسرع. وبعد أن شاهدوك تعمل بضعة أيام، لاحظوا بعض الأمور:
-
كثيراً ما، حين تنتهي من صندوق، يكون الصندوق التالي الذي تطلبه مجاوراً له مباشرةً على الرف نفسه في المستودع.
-
استخدام رافعة شوكية لحمل صندوق واحد من الأوراق أمر أحمق إلى حدٍّ ما.
-
هناك في الواقع القليل من المساحة الفارغة في زاوية مكتبك.
يأتون بحلّ مبدع. فمتى طلبت صندوقاً من عامل المستودع، فإنه يمسك بمنصّة كاملة منها. فهو يأخذ الصندوق الذي تريده ثم صناديق أخرى مجاورة له. وهو لا يعرف إن كنت تريد تلك الصناديق (وبالنظر إلى أخلاقياته المهنية، لا يهتمّ على أي حال)؛ بل ببساطة يأخذ أكبر عدد يمكن أن يتّسع على المنصّة.
يحميل المنصّة كاملةً ويأتي بك إليك. ومتجاوزاً مخاوف سلامة العمل، يقود الرافعة الشوكية إلى الداخل مباشرةً ويُسقط المنصّة في زاوية مكتبك.
وحين تحتاج إلى صندوق جديد، يكون أول ما تفعله هو النظر ما إن كان موجوداً أصلاً على المنصّة في مكتبك. فإن كان كذلك، رائع! لا يستغرق الأمر سوى ثانية للالتقاطه والعودة إلى تكديس الأرقام. وإذا كانت المنصّة تحمل خمسين صندوقاً وحظّيت بحظٍّ أن تكون كل الصناديق التي تحتاجها عليها، فبإمكانك إنجاز خمسين ضعف العمل الذي كنت تستطيعه قبلها.
لكن إن كنت تحتاج إلى صندوق ليس على المنصّة، فأنت تعود إلى نقطة الصفر. وبما أنه لا يتّسع في مكتبك أكثر من منصّة واحدة، سيضطر صديقك في المستودع إلى أخذها وإعادتها ثم أن يحضر لك منصّة جديدة تماماً.
منصّة لمعالجك
وطرافةً، هذا مشابه لكيفية عمل المعالجات في الحواسيب الحديثة. إن لم يكن الأمر واضحاً، فأنت تلعب دور المعالج المركزي. ومكتبك هو سجلّات المعالج، وصندوق الأوراق هو البيانات التي يمكن أن تتّسع لها. والمستودع هو الذاكرة العشوائية لجهازك، وعامل المستودع المزعج هو الناقل الذي يسحب البيانات من الذاكرة الأساسية إلى السجلّات.
لو كنت أكتب هذا الفصل قبل ثلاثين عاماً، لكان التشبيه ينتهي عند هنا. لكن مع أسرع الشرائح والذاكرة العشوائية، حسناً، لم تكن، بدأ مهندسو العتاد يبحثون عن حلول. وما وصلوا إليه كان الذاكرة المؤقتة للمعالج (CPU caching).
تملك الحواسيب الحديثة قطعة صغيرة من الذاكرة داخل الشريحة نفسها. ويستطيع المعالج سحب البيانات منها أسرع بكثير مما يستطيع من الذاكرة الأساسية. وهي صغيرة لأنها يجب أن تتّسع داخل الشريحة، ولأن نوع الذاكرة الأسرع الذي تستخدمه (الذاكرة العشوائية الساكنة أو «SRAM») أغلى بكثير.
تُسمّى هذه القطعة الصغيرة من الذاكرة ذاكرة مؤقتة (cache)، وتحديداً القطعة الموجودة على الشريحة هي ذاكرتك المؤقتة L1، وفي تشبيهي المُتعب هنا كان دورها لعبته المنصّة. فمتى احتاجت شريحتك إلى بايت من الذاكرة العشوائية، فإنها تلقائياً تلتقط قطعة كاملة من الذاكرة المتّصلة -- عادةً نحو 64 إلى 128 بايت -- وتضعها في الذاكرة المؤقتة. وتُسمّى هذه الكتلة الصغيرة من الذاكرة سطر ذاكرة مؤقتة (cache line).
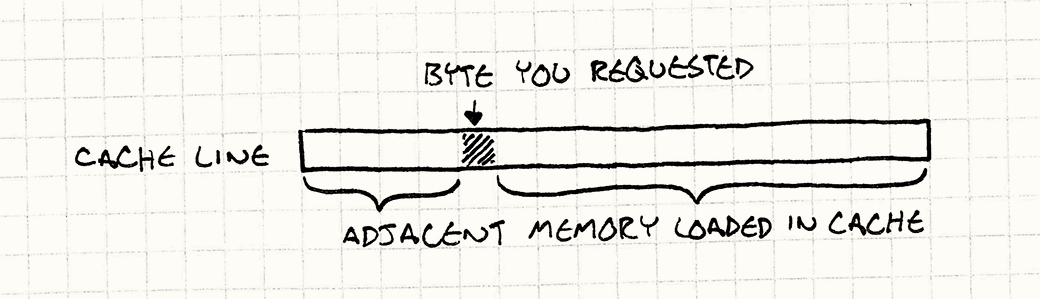
إذا كان البايت التالي الذي تحتاجه موجوداً في تلك القطعة، فإن المعالج يقرأه مباشرةً من الذاكرة المؤقتة، وهي أسرع بكثير من إصابة الذاكرة العشوائية. والعثور على بيانات في الذاكرة المؤقتة بنجاح يُسمّى إصابة ذاكرة مؤقتة (cache hit). وإذا لم يعثر عليها هناك واضطر إلى الذهاب إلى الذاكرة الأساسية، فذلك إخفاق ذاكرة مؤقتة (cache miss).
وحين يقع إخفاق ذاكرة مؤقتة، يتعطّل المعالج (stalls) -- فلا يستطيع تنفيذ التعليمات التالية لأنه يحتاج بيانات. فيجلس هناك ساقطاً في الملل لبضع مئات من الدورات حتى تكتمل جلب البيانات. ومهمّتنا هي تفادي ذلك. تخيّل أنك تحاول تحسين جزء حرجّ من شيفرة اللعبة من حيث الأداء، يبدو هكذا:
^code do-nothing
ما أول تغيير ستجريه على تلك الشيفرة؟ بلى. أزل ذلك الاستدعاء عديم الفائدة والمكلف. ذلك الاستدعاء يعادل كلفة إخفاق ذاكرة مؤقتة من حيث الأداء. فكلما قفزت إلى الذاكرة الأساسية، فالأمر كأنك تضع تأخيراً في شيفرتك.
انتظر، البيانات هي الأداء؟
حين بدأت العمل على هذا الفصل، قضيت بعض الوقت في تجميع برامج صغيرة شبيهة بالألعاب تستجيب لاستخدام الذاكرة المؤقتة في أفضل حالة وأسوأ حالة. وأردت مقاييس أداء تهزّ الذاكرة المؤقتة حتى أستطيع أن أرى بعيني كم من سفك الدماء يسبب ذلك.
وحين جعلت بعض الأمور تعمل، فوجئت. كنت أعرف أنه أمر كبير، لكن لا شيء يشبه رؤيته بعينيك لقد كتبتُ برنامجين يؤديان الحساب نفسه تماماً. وكل ما كان بينهما هو عدد إخفاقات الذاكرة المؤقتة التي يسبّبانها. وكان البطيء خمسين ضعفاً أبطأ من الآخر.
كان هذا مذهلاً بالنسبة لي. كنت معتاداً على اعتبار الأداء جانباً من الشيفرة لا من البيانات. فالبايت ليس بطيئاً ولا سريعاً، بل هو مجرّد شيء ساكن هناك. لكن بسبب الذاكرة المؤقتة، فطريقة تنظيمك للبيانات تؤثّر مباشرةً في الأداء.
والتحدّي الآن هو أن نلخّص ذلك في شيء يناسب فصلاً هنا. ف تحسين استخدام الذاكرة المؤقتة موضوع ضخم. ولم أذكر حتى الذاكرة المؤقتة للتعليمات (instruction caching). وتذكّر أن الشيفرة في الذاكرة أيضاً ولا بدّ من تحميلها على المعالج قبل أن يُنفَّذها. وهناك من هو أعلم بهذا الموضوع يستطيع أن يكتب كتاباً كاملاً عنه.
ولأنك تقرأ هذا الكتاب الآن، لدي بعض التقنيات الأساسية التي ستضعك على الطريق نحو التفكير في كيفية تأثير بنى البيانات في أدائك.
وتنحصر كلها في شيء بسيط إلى حدٍّ كبير: كلما قرأ الشريحة جزءاً من الذاكرة، فإنها تحصل على سطر ذاكرة مؤقتة كامل. وكلما استطعت استخدام ما في ذلك سطر الذاكرة المؤقتة، كنت أسرع. والهدف إذن هو تنظيم بنى بياناتك بحيث تكون الأشياء التي تعالجها متجاورة بعضها في الذاكرة.
بمعنى آخر، إذا كانت شيفرتك تعالج Thing ثم Another ثم Also، فيجب أن تكون
مرتّبة في الذاكرة هكذا:
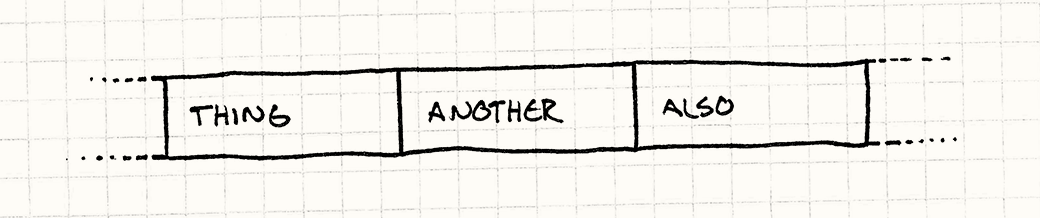
لاحظ أن هذه ليست مؤشرات إلى Thing وAnother وAlso. بل هي البيانات الفعلية
لها، في مواضعها، مرصوفة واحداً تلو الآخر. وحالما يقرأ المعالج Thing، فسيبدأ بالحصول
على Another وAlso أيضاً (حسب حجمهما وحجم سطر الذاكرة المؤقتة). وحين تبدأ في العمل
عليهما بعد ذلك، فسيكونان في الذاكرة المؤقتة مسبقاً. شريحتك سعيدة، وأنت سعيد.
النمط
تملك المعالجات الحديثة ذواكر مؤقتة لتسريع الوصول إلى الذاكرة. وهذه تستطيع الوصول إلى الذاكرة المجايدة للذاكرة التي تم الوصول إليها مؤخراً بسرعة أكبر بكثير. واستثمر ذلك لتحسين الأداء عبر زيادة محلية البيانات -- أي إبقاء البيانات في ذاكرة متّصلة بالترتيب الذي تعالجها به.
متى تستخدمه
مثل معظم عمليات التحسين، فإن أول إرشاد لاستخدام نمط محلية البيانات هو أن تكون لديك مشكلة أداء. لا تُضِع وقتك في تطبيقه على زاوية نادرة التنفيذ في قاعدة شيفرتك. فتحسين الشيفرة لا تحتاجه إنما يجعل حياتك أصعب فقط، لأن النتيجة تكون في أغلب الأحيان أكثر تعقيداً وأقل مرونة.
وبالنسبة إلى هذا النمط تحديداً، ستحتاج أيضاً إلى التأكّد من أن مشاكلك في الأداء سبّبها إخفاقات الذاكرة المؤقتة. فإذا كانت شيفرتك بطيئة لأسباب أخرى، فلن يفيدك هذا.
والطريقة الرخيصة للتوصيف (profiling) هي أن تضيف يدوياً قدراً من أدوات القياس التي تفحص كم من الوقت انقضى بين نقطتين في الشيفرة، على أن تأمل أن يكون المؤقّت دقيقاً. أما للكشف عن الاستخدام السيّئ للذاكرة المؤقتة، فستحتاج شيئاً أكثر تعقيداً قليلاً. فأنت تريد حقاً أن ترى كم إخفاق ذاكرة مؤقتة يقع وأين.
ولحسن الحظ، هناك أدوات توصيف في الخارج تُبلّغ عن هذا. فإن كان الأمر يستحق الوقت، فاحصل على واحدة منها تعمل وتأكّد أنك تفهم الأرقام (المعقّدة بشكل مفاجئ) التي ترميها بك قبل أن تُجري عملية جراحية كبرى على بنى بياناتك.
ومع ذلك، فإن إخفاقات الذاكرة المؤقتة ستؤثّر في أداء لعبتك. وبينما لا ينبغي أن تقضي وقتاً طويلاً في تحسين استخدام الذاكرة المؤقتة استباقاً، ففكّر طوال عملية التصميم فيما كانت بنى بياناتك
في بالك
إحدى علامات هندسة البرمجيات المميزة هي التجريد (abstraction). فجزء كبير من هذا الكتاب يدور حول أنماط تفصل قطع الشيفرة عن بعضها كي يسهل تغييرها أكثر. وفي اللغات المُوجَّهة بالكائنات، يعني هذا في كل الأحوال تقريباً الواجهات.
وفي C++، يعني استخدام الواجهات الوصول إلى الكائنات عبر مؤشرات أو مراجع. لكن المرور عبر مؤشر يعني القفز عبر الذاكرة، وهو ما يؤدي إلى إخفاقات الذاكرة المؤقتة التي يعمل هذا النمط على تفاديها.
ولأجل إرضاء هذا النمط، ستضطر إلى التضحية ببعض تجريداتك الثمينة. فكلما صمّمت برنامجك أكثر حول محليات البيانات، اضطررت أكثر للتخلّي عن الوراثة والواجهات والمزايا التي يمكن لتلك الأدوات أن توفّرها. ولا توجد طلقة فضضية هنا، بل فقط مقايضات صعبة. وهذا هو ما يجعل الأمر ممتعاً!
شيفرة نموذجية
إن سرت حقاً في جحر تحسين محليات البيانات، فسوف تكتشف طرقاً لا تُحصى لتقطيع بياناتك وتقطيعها إلى قطع يستطيع معالجك هضمّها بأقصى سهولة. وكي تبدأ، سأعرض مثالاً لكل واحدة من بعض أكثر الطرق شيوعاً لتنظيم بياناتك. وسنغطيها في سياق جزء معيّن من محرّك ألعاب، لكن (كما مع الأنماط الأخرى) تذكّر أن التقنية العامة يمكن تطبيقها في أي مكان يناسب.
المصفوفات المتّصلة
لنبدأ بـحلقة لعبة تعالج كومة من كيانات
اللعبة. وقد فُكّكت تلك الكيانات إلى مجالات مختلفة -- الذكاء الاصطناعي والفيزياء والعرض --
باستخدام نمط المكوّن. إليك صنف
GameEntity:
^code game-entity
لكل مكوّن كمية صغيرة نسبياً من الحالة، ربما لا تتجاوز بضعة متّجهات أو مصفوفة، ثم دالة لتحديثه. والتفاصيل ليست مهمّة هنا، لكن تخيّل شيئاً يشبه ذلك تقريباً:
^code components
تحتفظ اللعبة بمصفوفة كبيرة من المؤشرات إلى جميع الكيانات في العالم. وفي كل دورة من حلقة اللعبة، نحتاج إلى تنفيذ ما يلي:
-
تحديث مكوّنات الذكاء الاصطناعي لجميع الكيانات.
-
تحديث مكوّنات الفيزياء لها.
-
رسمها باستخدام مكوّنات العرض فيها.
وتنفّذ محرّكات الألعاب كثيرة ذلك على هذا النحو:
^code game-loop
وقبل أن تسمع عن ذاكرة المعالج المؤقتة أبداً، كان هذا يبدو بريئاً تماماً. لكنك الآن أصبحت لديك فكرة بأن أمراً ما غير صحيح هنا. فهذه الشيفرة لا تكتفي بهزّ الذاكرة المؤقتة، بل تأخذها وتديرها وتضربها حتى تصير ممزّقة. لاحظ ما تفعله:
-
مصفوفة كيانات اللعبة تخزّن مؤشرات إليها، فلكل عنصر في المصفوفة علينا المرور عبر ذلك المؤشر. وهذا إخفاق ذاكرة مؤقتة.
-
ثم يكون لكيان اللعبة مؤشر إلى المكوّن. إخفاق ذاكرة مؤقتة آخر.
-
ثم نحدّث المكوّن.
-
ثم نعود إلى الخطوة الأولى لكل مكوّن من كل كيان في اللعبة.
والجزء المُقلق هو أننا لا نعرف شيئاً عن كيفية ترتيب هذه الكائنات في الذاكرة. فنحن رهائن مدير الذاكرة تماماً. ومع تخصيص الكيانات وتحريرها عبر الزمن، من المرجّح أن تصبح الكومة منظَّمة بشكل عشوائي أكثر فأكثر.
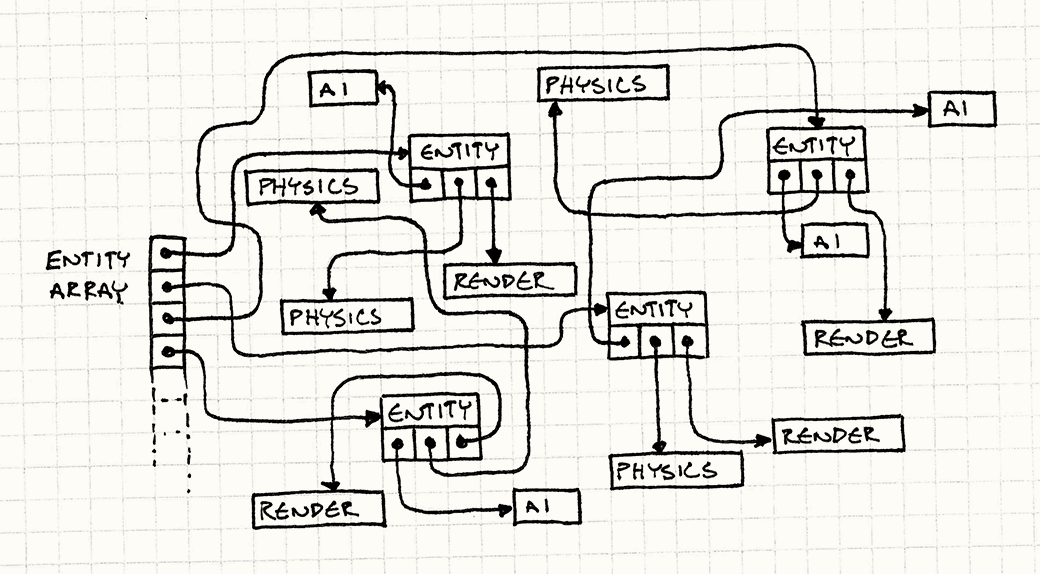
لو كان هدفنا أن نأخذ جولة عاصفة في فضاء عناوين اللعبة كأنها حزمة إجازة رخيصة من
«256 ميغابايت من الذاكرة العشوائية في أربع ليال!»، لكانت هذه صفقة رائعة. لكن هدفنا هو
تشغيل اللعبة بسرعة، والتجوّل في كل أنحاء الذاكرة الأساسية ليس
الطريق إلى ذلك. وتذكّر دالة sleepFor500Cycles() تلك؟ حسناً، هذه الشيفرة تستدعيها
فعلياً طوال الوقت.
لنفعل شيئاً أفضل. وملاحظتنا الأولى أن السبب الوحيد لتتبّع مؤشر للوصول إلى كيان اللعبة
هو كي نتمكّن فوراً من تتبّع مؤشر آخر للوصول إلى مكوّن. فـGameEntity نفسه لا يملك
حالة مثيرة ولا دوالاً مفيدة. فالمكوّنات هي ما تهتمّ به حلقة اللعبة.
وبدلاً من كوكبة ضخمة من كيانات اللعبة ومكوّناتها متناثرة في ظلام فضاء العناوين، سوف نعود إلى الأرض. سيكون لدينا مصفوفة كبيرة لكل نوع من المكوّنات: مصفوفة مسطّحة لمكوّنات الذكاء الاصطناعي، وأخرى للفيزياء، وأخرى للعرض.
كالتالي:
^code component-arrays
ولنشدّد على أن هذه مصفوفات من المكوّنات لا من المؤشرات إلى المكوّنات. فالبيانات كلها هناك، بايتاً بعد بايت. ويمكن لحلقة اللعبة أن تمشي عليها مباشرةً:
^code game-loop-arrays
لقد تخلّصنا من كل تلك مطاردة المؤشرات. وبدلاً من القفز هنا وهناك في الذاكرة، نقوم بزحف مستقيم عبر ثلاث مصفوفات متّصلة.
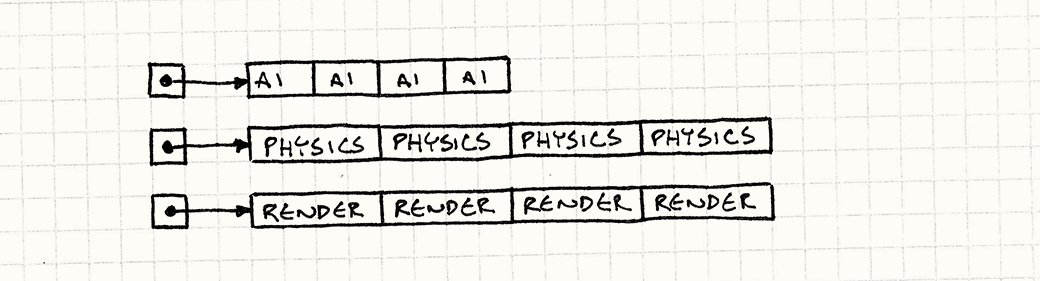
هذا يضخّ تدفّقاً ثابتاً من البايتات مباشرةً في فم المعالج الجائع. وفي اختباراتي، جعل هذا التغيير حلقة التحديث خمسين ضعفاً أسرع من النسخة السابقة.
ولطريف أن OSA لم نفقد كثيراً من التغليف هنا. صحيح أن حلقة اللعبة تحدّث المكوّنات مباشرةً بدلاً من المرور عبر كيانات اللعبة، لكنها كانت تفعل ذلك سابقاً أيضاً للتأكّد من معالجتها بالترتيب الصحيح. وحتى مع ذلك، فإن كل مكوّن ما زال مُغلفاً بشكل جيّد. فهو يملك بياناته ودواله الخاصة. وكل ما غيّرناه هو طريقة استخدامه.
وهذا لا يعني أننا بحاجة إلى التخلص من GameEntity أيضاً. يمكننا تركه كما هو مع مؤشرات
إلى مكوّناته. فستكون تلك المؤشرات تشير ببساطة إلى تلك المصفوفات. وهذا ما زال مفيداً في
أجزاء أخرى من اللعبة حيث تريد تمرير «كيان لعبة» مفهومي وكل ما يرافقه. والجزء المهم هو
أن حلقة اللعبة الحرجة للأداء تتجاوز ذلك وتذهب مباشرةً إلى البيانات.
بيانات محشورة
لنفترض أننا نبني نظام جسيمات. واتباعاً لنصيحة القسم السابق، لدينا جميع جسيماتنا في مصفوفة كبيرة متّصلة جميلة. فلنغلّفها أيضاً في صنف إدارة صغير:
^code particle-system
وتبدو دالة تحديث أوّلية للنظام كالتالي:
^code update-particle-system
لكن اتضح أننا لا نحتاج في الواقع إلى معالجة جميع الجسيمات في كل وقت. فإظام الجسيمات له مجمّع كائنات ثابت الحجم، لكنها ليست عادةً جميعها تلمع بنشاط عبر الشاشة. والجواب السهل هو شيء من هذا الشكل:
^code particles-is-active
نمنح Particle علماً لتتبّع ما إذا كان قيد الاستخدام أم لا. وفي حلقة التحديث، نفحص ذلك لكل جسيم. فذلك يُحمّل العلم إلى الذاكرة المؤقتة مع كل
بيانات ذلك الجسيم الأخرى. وإذا لم يكن الجسيم نشطاً، فإننا نتخطّاه إلى الجسيم التالي.
وأما بقية بيانات الجسيم التي حمّلناها في الذاكرة المؤقتة فهي إهدار.
وكلما قلّ عدد الجسيمات النشطة، زاد ما نتخطّاه عبر الذاكرة. وكلما أكثرنا من ذلك، زادت إخفاقات الذاكرة المؤقتة بين لحظات الفعل المفيد الفعلي في تحديث الجسيمات النشطة. فإذا كانت المصفوفة كبيرة وفيها الكثير من الجسيمات غير النشطة، فنحن نُفش الذاكرة المؤقتة مرة أخرى.
ووجود الكائنات في مصفوفة متّصلة لا يحلّ الكثير إن لم تكن الكائنات التي نعالجها فعلياً متّصلة فيها. فإذا كانت مرصوفة بكائنات غير نشطة علينا الرقص حولها، فنحن نعود إلى المشكلة الأصلية.
بالنظر إلى عنوان هذا القسم، يمكنك على الأرجح تخمين الجواب. بدلاً من فحص علم النشاط، سن رتّب بحسبه. سنُبقي جميع الجسيمات النشطة في مقدّمة القائمة. فإذا كنا نعرف أن جميع تلك الجسيمات نشطة، فلا نحتاج إلى فحص العلم إطلاقاً.
ويسهل أيضاً أن نتتبّع كم عدد الجسيمات النشطة. وبهذا، تتحوّل حلقة التحديث لدينا إلى شيء من الجمال:
^code update-particles
الآن نحن لا نتخطّى أي بيانات. فكل بايت يُشفط إلى الذاكرة المؤقتة هو جزء من جسيم نشط نعالجه فعلاً.
وبالطبع، لا أقصد أن ترتّب المجموعة الكاملة من الجسيمات بالفرز السريع (quicksort) في كل إطار. فذلك سيُلغي المكاسب هنا أكثر مما ينفع. والذي نريده هو إبقاء المصفوفة مرتّبة.
وافتراض أن المصفوفة مرتّبة بالفعل -- وهي كذلك في البداية حين تكون كل الجسيمات غير نشطة -- فإن الوقت الوحيد الذي يمكن أن تصبح فيه غير مرتّبة هو حين يُفعَّل جسيم أو يُعطَّل. ويمكننا التعامل مع هاتين الحالتين بسهولة. فحين يُفعَّل جسيم، ننقله إلى نهاية الجسيمات النشطة بتبديله مع أول جسيم غير نشط:
^code activate-particle
ولتعطيل جسيم، نفعل العكس تماماً:
^code deactivate-particle
طوّر كثير من المبرمجين (أنا من ضمنهم) حساسية تجاه نقل الأشياء في الذاكرة. فنقل كومة من البايتات يشعر بالثقل مقارنةً بإسناد مؤشر. لكن حين تضيف كلفة المرور عبر ذلك المؤشر، يتبيّن أن حدسنا أحياناً ما يكون خاطئاً. وفي بعض الحالات، يكون نقل الأشياء في الذاكرة أرخص إن ساعدك ذلك على إبقاء الذاكرة المؤقتة ممتلئة.
وهناك نتيجة أنيقة لإبقاء الجسيمات مرتّبة بحسب حالة نشاطها -- فنحن لا نحتاج إلى تخزين
علم نشاط في كل جسيم على الإطلاق. فحالته يمكن استنتاجها من موقعه في المصفوفة ومن عدّاد
numActive_. وهذا يجعل كائنات الجسيمات لدينا أصغر، أي أننا نستطيع حشر أكثر منها في
أسطر الذاكرة المؤقتة، وهذا يجعلها أسرع.
لكن الأمور ليست وردية بالكامل. فكما ترى من الواجهة البرمجية، فقد فقدنا هنا بعض موجّهية
الكائنات. فصنف Particle لم يعد يتحكّم في حالة نشاطه الخاصة. ولا يمكنك استدعاء دالة
activate() ما عليه لأنه لا يعرف فهرسه. بدلاً من ذلك، تحتاج أي شيفرة تريد تفعيل الجسيمات
إلى الوصول إلى نظام الجسيمات.
وهنا، أنا مرتاح للترابط القوي بين ParticleSystem وParticle. فأنا أنظر إليهما على
أنهما مفهوم واحد موزّع على صنفين فيزيائيين. فكل ما يعنيه ذلك هو قبول فكرة أن
الجسيمات لا تعني شيئاً إلا في سياق نظام جسيمات ما. وأيضاً، في هذه الحالة، من المرجّح
أن يكون نظام الجسيمات هو من يُنشئ الجسيمات ويقتلها على أي حال.
فصل الساخن/البارد
حسناً، هذا هو المثال الأخير على تقنية بسيطة تجعل ذاكرتك المؤقتة أكثر سعادة. لنفترض أن لدينا مكوّن ذكاء اصطناعي لكيان لعبة ما.-ITحتوي على بعض الحالة -- الحركة التي يعيدها حالياً، وموضع الهدف الذي يتّجه نحوه، ومستوى الطاقة، إلخ -- أشياء يفحصها ويعدّلها في كل إطار بلا استثناء. شيء من هذا الشكل:
^code ai-component
لكنه يحتوي أيضاً على بعض الحالة لظروف أندر. فهو يخزّن بعض البيانات التي تصف الغنائم التي يُسقطها حين يصادف النهاية الصاخبة لبندقية قصيرة. وبيانات السقوط هذه لا تُستخدم إلا مرّة واحدة في عمر الكيان، في نهايته المرّة:
^code loot-drop
وافتراضاً أننا اتّبعنا الأنماط السابقة، فعند تحديث مكوّنات الذكاء الاصطناعي هذه نمرّ على مصفوفة جميلة من بيانات محشورة ومتّصلة. لكن تلك البيانات تشمل جميع معلومات سقوط الغنائم. وهذا يجعل كل مكوّن أكبر، ما يقلّل عدد المكوّنات التي يمكن حشرها في سطر ذاكرة مؤقتة. فنحصل على مزيد من إخفاقات الذاكرة المؤقتة لأن مجموع الذاكرة التي نمرّ عليها أكبر. وتُسحب بيانات الغنائم إلى الذاكرة المؤقتة لكل مكوّن في كل إطار، رغم أننا لا نلمسها أصلاً.
والحلّ لذلك يُسمّى «فصل الساخن/البارد» (hot/cold splitting). والفكرة أن نقسّم بنية بياناتنا إلى قطعتين منفصلتين. فالأولى تحمل بيانات «الساخنة»، أي الحالة التي نحتاج إلى لمسها في كل إطار. والقطعة الأخرى هي بيانات «الباردة»، أي كل ما يُستخدم بتواتر أقل.
القطعة الساخنة هي مكوّن الذكاء الاصطناعي الرئيس. فهي التي نحتاج إلى استخدامها أكثر، فلا نريد أن نطارد مؤشراً للعثور عليها. ويمكن أن يكون المكوّن البارد بعيداً على الجانب، لكننا ما زلنا بحاجة إلى الوصول إليه، لذا نمنح المكوّن الساخن مؤشراً إليه، كالتالي:
^code hot-cold
والآن، حين نمرّ على مكوّنات الذكاء الاصطناعي في كل إطار، فإن البيانات الوحيدة التي تُحمَّل إلى الذاكرة المؤقتة هي ما نعالجه فعلاً (مع استثناء ذلك المؤشر الصغير الوحيد إلى البيانات الباردة).
لكنك ترى كيف تبدأ الأمور في غامضة. ففي مثالي هنا، من الواضح أي البيانات يجب أن تكون ساخنة وأيّها باردة، لكن في لعبة حقيقية نادراً ما يكون الحدّ واضحاً إلى هذا الحد.
وماذا لو كان لديك حقول تُستخدم حين يكون الكيان في وضع معيّن لا في غيره؟ وماذا لو كانت الكيانات تستخدم جزءاً معيّناً من البيانات فقط حين تكون في أجزاء معيّنة من المستوى؟
إنجاز هذا النوع من التحسين يقع في مكان بين الفنّ الأسود وجحر الفأر. فمن السهل أن تُستدرج وتقضي وقتاً لا ينتهي في نقل البيانات ذهاباً وإياباً لترى ما الذي يُحدثه ذلك من فرق في السرعة. ويحتاج الأمر إلى ممارسة لتعرف أين تبذل جهدك.
قرارات التصميم
هذا النمط يتعلق فعلياً بعقلية -- فهو يدفعك للتفكير في ترتيب بياناتك في الذاكرة كجزء رئيسي من قصّة أداء لعبتك. أما فضاء التصميم الملموس فعريض إلى حدٍّ كبير. يمكنك أن تدع محلية البيانات تؤثّر في معماريتك بأكملها، أو ربما تكون مجرد نمط موضعي تطبّقه على بضع بنى بيانات أساسية.
وأهم الأسئلة التي ستحتاج إلى الإجابة عنها هي متى وأين تطبّق هذا النمط، لكن إليك هنا بعض الأسئلة الأخرى التي قد تظهر.
كيف تتعامل مع تعدد الأشكال (polymorphism)؟
حتى هذه النقطة، تجنبنا الاشتقاق والدوال الافتراضية. لقد افترضنا لدينا مصفوفات جميلة محشورة من كائنات متجانسة (homogenous). وبهذا نعرف أنها كلّها بالحجم نفسه تماماً. لكن تعدّد الأشكال والإرسال الديناميكي أدوات مفيدة أيضاً. فكيف نوفّق بينهما؟
-
لا تفعل:
أبسط جواب هو تجنّب الاشتقاق، أو على الأقل تجنّبه في المواضع حيث تحسّن لأجل استخدام الذاكرة المؤقتة. ثقافة هندسة البرمجيات تتّجه أصلاً بعيداً عن الاستخدام الكثيف للوراثة.
-
آمن وسهل. فأنت تعرف تماماً أي صنف تتعامل معه، وجميع الكائنات بالحجم نفسه بالطبع.
-
أسرع. فالإرسال الديناميكي يعني البحث عن الدالة في جدول الدوال الافتراضية ثم المرور عبر ذلك المؤشر للوصول إلى الشيفرة الفعلية. وبينما تختلف كلفة هذا اختلافاً كبيراً بين العتاد المختلفة، فإن للإرسال الديناميكي بعض الكلفة.
- غير مرن. وبالطبع، فالسبب الذي نستخدم الإرسال الديناميكي من أجله هو أنه يمنحنا
طريقة قوية لتنويع السلوك بين الكائنات. فإذا أردت لكيانات مختلفة في لعبتك أن يكون
لكل منها أساليب عرض خاصة أو حركات وهجمات خاصة، فإن الدوال الافتراضية طريقة
مثبتة لنمذجة ذلك. أما إضطرارك إلى تحشيد كل تلك الشيفرة في دالة واحدة غير افتراضية
تفعل شيئاً كمفتاح
switchكبير، فسرعان ما تصبح فوضوية.
-
-
استخدم مصفوفات منفصلة لكل نوع:
نحن نستخدم تعدّد الأشكال كي نستطيع استدعاء سلوك على كائن لا نعرف نوعه. بمعنى آخر، لدينا كيس مختلط من الأشياء، ونريد كل كائن فيه أن يفعل شيئه الخاص حين نأمره.
لكن هذا يطرح السؤال: لماذا تخلط الكيس أصلاً؟ فلماذا لا نحتفظ بمجموعات منفصلة متجانسة لكل نوع؟
-
تُبقي الكائنات محشورة بإحكام. فبما أن كل مصفوفة تحتوي كائنات صنف واحد فقط، فلا حشو ولا غربلة أخرى.
-
يمكنك الإرسال بشكل ساكن. فبمجرد أن تقسّم كائناتك حسب النوع، لم تعد بحاجة إلى تعدّد الأشكال إطلاقاً. ويمكنك استخدام استدعاءات دوال عادية غير افتراضية.
-
عليك تتبّع مجموعة من المجموعات. فإذا كان لديك أنواع كثيرة مختلفة من الكائنات، فإن نفقة وتعقيد صيانة مصفوفة منفصلة لكل نوع يمكن أن يكون عبئاً.
-
عليك أن تكون واعياً بكل نوع. فبما أنك Must صيانة مجموعات منفصلة لكل نوع، فلا يمكنك أن تكون مفصولاً عن مجموعة الأصناف. وجزء من سحر تعدّد الأشكال هو أنه مفتوح النهاية -- فالشيفرة التي تعمل مع واجهة يمكن أن تكون مفصولة تماماً عن المجموعة المحتملة الكبيرة من الأنواع التي تطبّق تلك الواجهة.
-
-
استخدم مجموعة من المؤشرات:
إن لم تكن قلقاً بشأن الذاكرة المؤقتة، فهذه هي الحلّ الطبيعي. فاكتفِ بمصفوفة من المؤشرات إلى نوع أساس ما أو نوع واجهة. تحصل على كل تعدّد الأشكال الذي تريده، ويمكن أن تكون الكائنات بأي حجم تشاء.
-
مرن. فالشيفرة التي تستهلك المجموعة يمكن أن تعمل مع كائنات من أي نوع ما دام يدعم الواجهة التي تهمّك. فهو مفتوح النهاية تماماً.
-
أقل صديقة للذاكرة المؤقتة. وبالطبع، فالسبب كله.Skippingwhy الذي نتحدث هنا عن خيارات أخرى هو أن هذا يعني توجيه مؤشرات غير صديق للذاكرة المؤقتة. لكن تذكّر: إن لم تكن هذه الشيفرة حرجة للأداء، فالأمر على الأرجح مقبول.
-
كيف تُعرَّف كيانات اللعبة؟
إن استخدمت هذا النمط بالتوازي مع نمط المكوّن، فستحصل على مصفوفات متّصلة جميلة لكل المكوّنات التي تتكوّن منها كيانات لعبتك. وستمرّ حلقة اللعبة على تلك مباشرةً، لذا فكائن كيان اللعبة نفسه أقل أهمية، لكنه ما زال مفيداً في أجزاء أخرى من قاعدة الشيفرة حيث تريد العمل مع «كيان» مفهومي واحد.
والسؤال إذن هو كيف ينبغي أن يُمثَّل؟ وكيف يتتبّع مكوّناته؟
-
إذا كانت كيانات اللعبة أصنافاً تحوي مؤشرات إلى مكوّناتها:
هذا ما بدا عليه مثالنا الأول. وهو نوعاً ما حلّ البرمجة المُوجَّهة بالكائنات الافتراضي. ف لديك صنف لـ
GameEntity، وهو يحوي مؤشرات إلى المكوّنات التي يملكها. وبما أنها مؤشرات فحسب، فهو لا يبالى بمكان تلك المكوّنات في الذاكرة ولا بكيفية تنظيمها.-
يمكنك تخزين المكوّنات في مصفوفات متّصلة. وبما أن كيان اللعبة لا يهتمّ بمكان مكوّناته، يمكنك تنظيمها في مصفوفة جميلة محشورة لتحسين المرور عليها.
-
بمعلومية كيان، يمكنك بسهولة الوصول إلى مكوّناته. فهي على بُعد توجيه مؤشر واحد فحسب.
-
نقل المكوّنات في الذاكرة صعب. فحين تُفعَّل المكوّنات أو تُعطَّل، فقد ترغب في نقلها داخل المصفوفة لإبقاء النشطة في المقدّمة ومتّصلة. لكن إن نقلت مكوّناً بينما يحمل الكيان مؤشراً خاماً إليه، فإن ذلك المؤشر ينكسر إن لم تكن حذراً. عليك التأكّد من تحديث مؤشر الكيان في الوقت نفسه.
-
-
إذا كانت كيانات اللعبة أصنافاً لها مُعرِّفات لمكوّناتها:
التحدّي مع المؤشرات الخام إلى المكوّنات أنها تجعل نقلها في الذاكرة أصعب. ويمكنك معالجة ذلك باستخدام شيء أكثر تجريداً: مُعرِّف أو فهرس يمكن استخدام للوصول إلى مكوّن.
أما دلالات المُعرِّف وعملية الوصول فيعودان إليك. فيمكن أن يكون الأمر ببساطة تخزين مُعرِّف فريد في كل مكوّن والمرور على المصفوفة، أو أعقد من ذلك كجدول تجزئة يربط المُعرِّفات بفهارسها الحالية في مصفوفة المكوّنات.
-
أعقدcomplex. فليس على نظام المُعرِّفات الخاص بك أن يكون عملاً عبقرياً، لكنه يظل أكثر عملاً من مؤشر أساسي. فستضطر إلى تنفيذه وتنقيحه، وستكون هناك نفقة ذاكرة لبيانات الحفظ.
-
أبطأ. فصعب هزيمة المرور عبر مؤشر خام. وقد ينطوي الانتقال من كيان إلى أحد مكوّناته على بعض البحث أو التجزئة.
-
ستحتاج إلى الوصول إلى «مدير» المكوّنات. فالفكرة الأساسية أن لديك مُعرِّفاً تجريدياً يحدّد مكوّناً. يمكنك استخدامه للحصول على إشارة إلى كائن المكوّن الفعلي. لكن لكي تفعل ذلك، عليك تمرير ذلك المُعرِّف إلى شيء يمكنه فعلياً العثور على المكوّن. وستكون ذلك هو الصنف الذي يلتفّ حول مصفوفتك المتّصلة الخام من كائنات المكوّنات.
ومع المؤشرات الخام، فإن كان لديك كيان لعبة تستطيع العثور على مكوّناته. أما مع هذا، فأنت تحتاج كيان اللعبة وسجلّ المكوّنات أيضاً.
-
-
إذا كان كيان اللعبة هو نفسه مجرّد مُعرِّف:
هذا أسلوب أحدث تستخدمه بعض محرّكات الألعاب. فبمجرد أن تكون قد نقلت كل سلوك كيانك وحالته من الصنف الرئيس إلى المكوّنات، فماذا يبقى؟ اتضح أنه ليس الكثير. فكل ما يفعله الكيان هو ربط مجموعة من المكوّنات ببعضها. فهو موجود ليقول إن مكوّن الذكاء الاصطناعي هذا ومكوّن الفيزياء هذا ومكوّن العرض هذا تعرّف كياناً واحداً حيّاً في العالم.
وهذا مهمّ لأن المكوّنات تتفاعل. فمكوّن العرض يحتاج إلى معرفة أين الكائن، وقد تكون ذلك خاصية في مكوّن الفيزياء. ومكوّن الذكاء الاصطناعي يريد تحريك الكائن، لذا يحتاج إلى تطبيق قوة على مكوّن الفيزياء. ولكل مكوّن طريقة للوصول إلى المكوّنات الأشقاء الأخرى للكيان الذي هو جزء منه.
وأدرك بعض الناس الأذكياء أن كل ما تحتاج إليه لهذا هو مُعرِّف. فبدلاً من أن يعرف الكيان مكوّناته، تعرف المكوّنات كيانها. فكل مكوّن يعرف مُعرِّف الكيان الذي يملكه. وحين يحتاج مكوّن الذكاء الاصطناعي إلى مكوّن الفيزياء لكيانه، فإن كل ما عليه هو أن يطلب مكوّن الفيزياء ذو مُعرِّف الكيان نفسه الذي يحمله.
وتختفي أصناف الكيانات لديك تماماً، ويُستبدل-shebang بمغلّف مبسّط حول رقم.
-
الكيانات صغيرة جداً. فحين تريد تمرير إشارة إلى كيان لعبة، فهي مجرّد قيمة واحدة.
-
الكيانات فارغة. وبالطبع، فإن عيب نقل كل شيء خارج الكيانات هو أنك مضطر لنقل كل شيء خارجها. فلا يعود لديك مكان تضع فيه حالة أو سلوكاً غير خاص بالمكوّنات. وهذا الأسلوب يُضاعف الرهان على نمط المكوّن.
-
لست بحاجة إلى إدارة عمرها. فبما أن الكيانات مجرّد أنواع قيمية غبيّة، فلا تحتاج إلى تخصيصها وتحريرها صراحةً. فالكيان «يموت» ضمنياً حين تُدمَّر جميع مكوّناته.
-
العثور على مكوّن لكيان قد يكون بطيئاً. فهذه هي المشكلة نفسها التي في الجواب السابق، لكن في الاتجاه المعاكس. فللعثور على مكوّن ما لكيان ما، عليك تحويل مُعرِّف إلى كائن. وقد تكون هذه العملية مكلفة.
لكن هذه المرة، الأمر هو حرج للأداء. فالمكوّنات تتفاعل غالباً مع أشقائها أثناء التحديث، لذا ستحتاج إلى العثور على المكوّنات كثيراً. وأحد الحلول هو جعل «المُعرِّف» للكيان هو فهرس المكوّن في مصفوفته.
فإذا كان لكل كيان مجموعة المكوّنات ذاتها، فإن مصفوفات مكوّناتك متوازية تماماً. فالمكوّن في الخانة الثالثة من مصفوفة مكوّنات الذكاء الاصطناعي سيكون لنفس الكيان الذي يرتبط به مكوّن الفيزياء في الخانة الثالثة من مصفوفته هو.
لكن لاحظ أن هذا يفرض عليك إبقاء تلك المصفوفات متوازية. وهذا صعب إن أردت البدء في فرزها أو حشرها وفق معايير مختلفة. فقد تكون لديك بعض الكيانات التي تكون فيزياء معطّلة وآخرون غير مرئيين. ولا توجد طريقة لفرز مصفوفتي الفيزياء والعرض على نحو مثالي للحالتين معاً إن كان عليهما البقاء متزامنتين.
-
انظر أيضاً
-
يدور معظم هذا الفصل حول نمط المكوّن، وهذا النمط بالتأكيد أحد أكثر بنى البيانات شيوعاً التي يُحسَّن استخدامها لأجل الذاكرة المؤقتة. وفي الواقع، فإن استخدام نمط المكوّن يجعل هذا التحسين أسهل. فبما أن الكيانات تُحدَّث «مجالاً» واحداً (الذكاء الاصطناعي، الفيزياء، إلخ) في كل مرة، فإن تفصيلها إلى مكوّنات يتيح لك تقطيع كومة من الكيانات إلى القطع الصحيحة لتكون صديقة للذاكرة المؤقتة.
لكن هذا لا يعني أنك تستطيع استخدام هذا النمط مع المكوّنات وحدها! فكلما كانت لديك شيفرة حرجة للأداء تمسّ الكثير من البيانات، من المهم التفكير في المحلية.
-
مقال «مآخذ البرمجة المُوجَّهة بالكائنات» لطوني ألبريخت هو على الأرجح أوسع مدخل مقروء حول تصميم بنى بيانات لعبتك لتكون صديقة للذاكرة المؤقتة. فقد جعل عدداً أكبر بكثير من الناس (ومنهم أنا!) واعياً بك مدى أهمية هذا الأمر للأداء.
-
في الوقت نفسه تقريباً، كتب نويل لوبيس مقالاً على المدونة شديد التأثير في الموضوع نفسه.
-
يستفيد هذا النمط دائماً تقريباً من مصفوفة متّصلة من كائنات متجانسة. ومع مرور الوقت، من المرجّح جداً أن تضيف كائنات إلى تلك المصفوفة وتزيل منها. ونمط مجمّع الكائنات يتعلق بالأمر نفسه تماماً.
-
محرّك الألعاب Artemis هو أحد أوائل الأطرusage وأشهرها التي تستخدم مُعرِّفات بسيطة لكيانات اللعبة.