المسح عند الطلب
الأدب ترتيباتٌ خاصةٌ في أسطرٍ أفقية، من ستةٍ وعشرين رمزاً صوتياً، وعشرة أرقامٍ عربية، ونحو ثماني علامات ترقيم.
كورت فونيجوت، مثل مصافحة يدي الله: حوارٌ عن الكتابة
لمفسّرنا الثاني، clox، ثلاث مراحل -- المُحلِّل المعجمي، والمصرّف، والآلة الافتراضية. وبنية بيانات تربط كلَّ زوجٍ من المراحل. تنتقل الرموز من المُحلِّل المعجمي إلى المصرّف، وتنتقل قطع شيفرة البايت من المصرّف إلى الآلة الافتراضية. وقد بدأنا تنفيذنا من الطرف مع [قطع شيفرة البايت][] و[الآلة الافتراضية][]. والآن سنعود إلى البداية لنبني مُحلِّلاً معجمياً يُنتج الرموز. وفي [الفصل التالي][] سنربط الطرفين معاً بمصرّف شيفرة البايت.
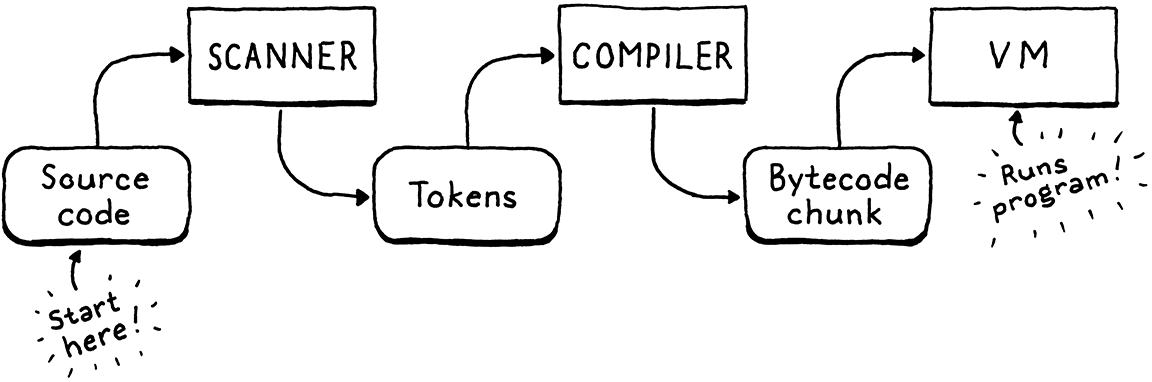
سأعترف بأنّ هذا ليس أكثر الفصول إثارةً في الكتاب. فمع وجود تنفيذين لنفس اللّغة، لا بدّ من بعض التكرار. لكنّني تسلّلت بالفعل إلى بعض الفروق المثيرة مقارنةً بمُحلِّل jlox المعجمي. تابع القراءة لتعرف ما هي.
تشغيل المفسّر
الآن بما أنّنا نبني الواجهة الأماميّة، يمكننا تشغيل clox
كمفسّرٍ حقيقيّ. لم يعد هناك قطعُ شيفرة بايت مكتوبةٌ بخطّ اليد.
حان وقت REPL وتحميل النصوص البرمجية. أزل معظم الشيفرة في
main() واستبدلها بـ:
^code args (3 before, 2 after)
إن مرّرتَ بلا وسائط إلى الملفّ التنفيذي، فستُلقى في REPL. أمّا وسيطٌ واحد في سطر الأوامر فيُفهم على أنّه مسار نصٍّ برمجيٍّ للتشغيل.
سنحتاج إلى بضعة ترويسات نظام، فلنتخلّص منها كلّها الآن.
^code main-includes (1 after)
ثمّ نشغّل REPL ونستخدمه.
^code repl (1 before)
الـREPL الجيّد يتعامل بلباقة مع مُدخَلات تمتدّ على عدّة أسطر ولا يملك حدّاً ثابتاً لطول السطر. والـREPL هنا أكثر تجريداً قليلاً -- آه -- لكنّه يكفي لأغراضنا.
العمل الحقيقيّ يقع في interpret(). سنصل إليه بعد قليل، لكنّنا
نتكفّل أولاً بتحميل النصوص البرمجية.
^code run-file
نقرأ الملفّ وننفّذ سلسلة شيفرة Lox الناتجة. ثمّ بناءً على نتيجة ذلك، نضبط رمز الخروج على الوجه الصحيح، لأنّنا بناة أدوات فِسِطون ونهتمّ بالتفاصيل الصغيرة كهذه.
نحتاج أيضاً إلى تحرير سلسلة الشيفرة المصدرية، لأنّ readFile()
يُخصّصها ديناميكياً ويحوّل الملكية إلى مستدعيها. وتبدو تلك الدالة
هكذا:
^code read-file
وكثيرٌ من شيفرة C، فإنّها تحتاج إلى جهدٍ أكبر ممّا يبدو أنّه ينبغي لها، وخاصةً أنّها صُمِّمت صراحةً لأنظمة التشغيل. الجزء الصعب هو أنّنا نريد تخصيص سلسلة كبيرة بما يكفي لقراءة الملفّ كاملاً، لكنّنا لا نعرف حجم الملفّ حتى نقرأه.
الشيفرة هنا هي الحيلة الكلاسيكية لحلّ ذلك. نفتح الملفّ، لكن قبل
قراءته ننتقل إلى نهايته تماماً باستعمال fseek(). ثمّ نستدعي
ftell() التي تخبرنا بعدد البتات التي نبعدها عن بداية الملفّ.
ولأنّنا انتقلنا (انتقلنا؟) إلى النهاية، فذاك هو الحجم. نُعيد
الانتقال إلى البداية، ونخصّص سلسلةً بذلك الحجم،
ونقرأ الملفّ كلّه في دفعةٍ واحدة.
إذن فلننتهِ، صحيح؟ ليس تماماً. فاستدعاءات الدوالّ هذه، مثل معظم الاستدعاءات في مكتبة C المعياريّة، يمكن أن تفشل. لو كان هذا Java، فإنّ الإخفاقات تُطلَق كاستثناءات وتفكّ المكدّس تلقائياً، فلا نحتاج حقّاً إلى معالجتها. أمّا في C، فإن لم نفحصها، فستُهمَل بصمت.
هذا ليس في الواقع كتاباً عن ممارسات C الجيّدة، لكنّني أكره أن أشجّع على أسلوبٍ سيّئ، فتعالَ نتعامل مع الأخطاء. فهو أمرٌ مفيدٌ لنا، مثل أكل الخضار أو تنظيف الأسنان.
ولحسن الحظّ، لا نحتاج إلى فعل أيّ شيءٍ ذكيّ بشكلٍ خاص إن حدث إخفاق. فإذا لم نتمكن من قراءة نصّ المستخدم البرمجيّ على الوجه الصحيح، فكلّ ما يمكننا فعله حقّاً هو أن نُخبر المستخدم ونخرج من المفسّر بلباقة. أوّلاً، قد يفشل فتح الملفّ.
^code no-file (1 before, 2 after)
يمكن أن يحدث هذا إن لم يكن الملفّ موجوداً أو لم يكن للمستخدم صلاحية الوصول إليه. وهو أمرٌ شائع إلى حدٍّ كبير -- فالناس يخطئون في كتابة المسارات طوال الوقت.
وهذا الإخفاق أندر بكثير:
^code no-buffer (1 before, 1 after)
إن لم نتمكّن حتى من تخصيص ذاكرة كافية لقراءة نصّ Lox البرمجيّ، فمستخدمنا على الأرجح لديه مشكلات أكبر جوهريّة، لكنّنا ينبغي أن نبذل أقصى جهدنا على الأقلّ كي نُعلمه.
وأخيراً، قد تفشل القراءة نفسها.
^code no-read (1 before, 1 after)
وهذا أيضاً غير مرجّح. وفي الواقع، قد تفشل استدعاءات
printf إلى fseek() و ftell()
و rewind() نظرياً أيضاً، لكنّنا لا نريد أن ندخل في تفاصيلٍ
أكثر من اللازم، أليس كذلك؟
فتح خطّ إنتاج التصريف
أصبح لدينا سلسلةٌ من شيفرة Lox المصدرية، فنحن الآن مستعدّون
لإقامة خطّ إنتاجٍ نمسحها ونصرّفها وننفّذها. وهو يقوده
interpret(). أمّا الآن فتلك الدالة تشغّل قطعةَ الاختبار
المكتوبة مسبقاً. فلنغيّرها إلى شيءٍ أقرب إلى صورتها النهائية.
^code vm-interpret-h (1 before, 1 after)
حيث كنّا سابقاً نمرّر Chunk، نمرّر الآن سلسلةَ الشيفرة المصدرية. وهذا هو التنفيذ الجديد:
^code vm-interpret-c (1 after)
لن نبني المصرّف الفعليّ في هذا الفصل، لكنّنا نستطيع أن نبدأ في تخطيط بنيته. وهو يعيش في وحدة جديدة.
^code vm-include-compiler (1 before, 1 after)
أمّا الآن فالدالة الوحيدة فيه مُصرَّح عنها هكذا:
^code compiler-h
وستتغيّر تلك التوقيع، لكنّها تُنشئنا على الطريق.
المرحلة الأولى من التصريف هي المسح -- وهو ما نفعله في هذا الفصل -- لذا فالمصرّف الآن لا يفعل سوى إعداد ذلك.
^code compiler-c
وسينمو هذا أيضاً في الفصول اللاحقة، بطبيعة الحال.
المُحلِّل المعجمي يمسح
ما زال أمامنا بضعة أقدامٍ أخرى من الهياكل الإنشائية لنقوم قبل أن نبدأ في كتابة شيفرةٍ نافعة. أوّلاً، ترويسة جديدة:
^code scanner-h
وتنفيذها المقابل:
^code scanner-c
بينما يمضغ مُحلِّلنا المعجمي شيفرة المستخدم المصدرية، فهو يتتبّع كم ابتعد فيها. وكما فعلنا مع الآلة الافتراضية، نلُفّ تلك الحالة في بنية (struct) ثمّ ننشئ متغيّر وحدةٍ من مستوى أعلى واحداً من ذلك النوع كي لا نضطرّ إلى تمريره حول كلّ الدوالّ المختلفة.
الحقول أقلّ ممّا تتوقّع. فمؤشّر start يعلّم بداية الرمز النصّي
الحاليّ الجاري مسحه، و current يشير إلى المحرف الجاري النظر
إليه.
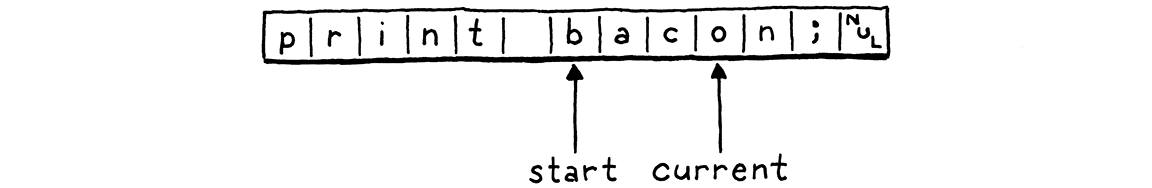
ولنا حقل line يتتبّع السطر الذي يقع فيه الرمز النصّي
الحالي لأغراض الإبلاغ عن الأخطاء. هذا كلّ شيء! نحن لا نحتفظ
حتى بمؤشّر إلى بداية سلسلة الشيفرة المصدرية. فالمُحلِّل المعجمي
يمضي في الشيفرة مرّة واحدة وينتهي بعدها.
وبما أنّ لدينا حالة، علينا تهيئتها.
^code init-scanner
نبدأ عند أوّل محرفٍ في أوّل سطر، كعدّاءٍ مُنبطحٍ عند خطّ الانطلاق.
رمزٌ في كلّ مرّة
في jlox، حين كان مسدس الانطلاق يُطلق، كان المُحلِّل المعجمي ينطلق بسرعةٍ ويَمسح البرنامج كلّه بحماس، مُعيداً قائمةً من الرموز. وسيكون هذا تحدياً في clox. فنحتاج إلى نوعٍ ما من المصفوفات أو القوائم القابلة للنمو لتخزين الرموز فيها. ونحتاج إلى إدارة تخصيص الرموز وتحريرها، وإلى المجموعة نفسها. تلك شيفرةٌ كثيرة، ومنكباتٌ ذاكرةٍ كثيرة.
في أيّ لحظة، لا يحتاج المصرّف إلّا إلى رمزٍ أو اثنين -- تذكّر أنّ قواعدنا تتطلّب رمزاً واحداً فقط من النظرة التقدّمية -- لذا لا نحتاج إلى الاحتفاظ بها كلّها في الوقت نفسه. بدلاً من ذلك، أبسط الحلول هو ألّا نمسح رمزاً حتى يحتاجه المصرّف. وحين يوفّره المُحلِّل المعجمي، يُعيده بالقيمة. وهو لا يحتاج إلى تخصيص أيّ شيء ديناميكياً -- بإمكانه ببساطة أن يمرّر الرموز على مكدّس C.
وللأسف، لا لدينا مصرّف بعد يستطيع أن يطلب الرموز من المُحلِّل المعجمي، لذا سيجلس المُحلِّل المعجمي هناك بلا عمل. ولِنُشغّل، سنكتب بعض الشيفرة المؤقّتة التي تقوده.
^code dump-tokens (1 before, 1 after)
هذه الحلقة تدور إلى ما لا نهاية. في كلّ دورة، تمسح رمزاً واحداً وتطبعه. وحين تصل إلى رمز "نهاية الملف" الخاصّ أو إلى خطأ، تتوقّف. فمثلاً، إن شغّلنا المفسّر على هذا البرنامج:
print 1 + 2;
فهو يطبع:
   1 31 'print'
   | 21 '1'
   |  7 '+'
   | 21 '2'
   |  8 ';'
   2 39 ''
العمود الأوّل هو رقم السطر، والثاني هو القيمة العددية لنوع الرمز type، وأخيراً الرمز النصّي نفسه. ذلك الرمز النصّي الفارغ الأخير في السطر الثاني هو رمز نهاية الملف.
هدفنا لبقية الفصل هو جعل تلك القطعة من الشيفرة تعمل بتنفيذ الدالة المفتاحية هذه:
^code scan-token-h (1 before, 2 after)
كلّ استدعاءٍ يمسح الرمز التالي في الشيفرة المصدرية ويعيده. ويبدو الرمز هكذا:
^code token-struct (1 before, 2 after)
إنّه مشابهٌ إلى حدٍّ كبير لصنف Token في jlox. ولدينا تعداد
يُحدّد ما نوع الرمز الذي هو -- عدد، أو معرّف، أو معامل +، إلخ.
والتعداد مطابقٌ تقريباً للذي في jlox، فدعنا ننجز الأمر كلّه.
^code token-type (2 before, 2 after)
باستثناء بادئة كلّ الأسماء بـTOKEN_ (لأنّ C ترمي بأسماء
التعدادات في فضاء الأسماء العام) فإنّ الفرق الوحيد هو نوع
TOKEN_ERROR الإضافي. فما قصته؟
لا يوجد سوى بضع أخطاءٍ يُكتشفها أثناء المسح: النصوص غير المنتهية، والمحارف غير المعروفة. في jlox، يُبلّغ المُحلِّل المعجمي عنهما بنفسه. أمّا في clox، فيُنتج المُحلِّل المعجمي رمز "خطأ" اصطناعياً لذلك الخطأ ويمرّره إلى المصرّف. وبهذه الطريقة يعرف المصرّف أنّ خطأً قد وقع ويمكنه بدء التعافي من الأخطاء قبل الإبلاغ عنه.
الجزء الجديد في نوع Token في clox هو كيفية تمثيله للرمز النصّي. في jlox، خزّن كلّ Token الرمزَ النصّيَ كنصّ Java صغيرٍ منفصل. ولو فعلنا ذلك في clox، لاضطررنا إلى اكتشاف كيفية إدارة ذاكرة تلك النصوص. وهو أمرٌ صعبٌ بصفةٍ خاصة لأنّنا نمرّر الرموز بالقيمة -- فقد تشير عدّة رموز إلى سلسلة الرمز النصّي ذاتها. فالملكية تصبح غريبة.
بدلاً من ذلك، نستعمل السلسلة المصدرية الأصلية كمخزنٍ للمحارف. نمثّل الرمز النصّي بمؤشّر إلى أوّل محرفٍ فيه وبعدد المحارف التي يحتويها. وهذا يعني أنّنا لا نحتاج إلى القلق بشأن إدارة ذاكرة الرموز النصّية إطلاقاً، وأنّنا نستطيع نسخ الرموز بحرّية. ما دامت سلسلة الشيفرة المصدرية الرئيسية تعيش أطول من جميع الرموز، فكلّ شيء يعمل على ما يرام.
مسح الرموز
نحن مستعدّون لمسح بعض الرموز. وسنعمل تدريجياً نحو التنفيذ الكامل، بدءاً من هذا:
^code scan-token
وبما أنّ كلّ استدعاء لهذه الدالة يمسح رمزاً كاملاً، فنحن نعرف
أنّنا عند بداية رمزٍ جديد لحظة دخولنا الدالة. لذا نضبط
scanner.start ليشير إلى المحرف الحالي كي نتذكّر أين يبدأ
الرمز النصّي الذي نحن على وشك مسحه.
ثمّ نفحص ما إذا كنتُ قد وصلتُ إلى نهاية الشيفرة المصدرية. فإن كان كذلك، نُعيد رمز EOF ونتوقّف. وهذه قيمةُ حارسٍ (sentinel) تُشير إلى المصرّف بأنّه يتوقّف عن طلب المزيد من الرموز.
وإن لم نكن عند النهاية، فإنّنا نفعل بعض... الأشياء... لمسح الرمز التالي. لكنّنا لم نكتب تلك الشيفرة بعد. سنصل إليها قريباً. فإذا لم تسح تلك الشيفرة رمزاً وتُعيده بنجاح، فإنّنا نصل إلى نهاية الدالة. ويجب أن يعني ذلك أنّنا عند محرفٍ لا يستطيع المُحلِّل المعجمي التعرّف عليه، لذا نُعيد رمز خطأ له.
تعتمد هذه الدالة على بضعة مساعدات، معظمها مألوف من jlox. أوّلاً:
^code is-at-end
نشترط أن تكون السلسلة المصدرية سلسلة C جيدة منتهية بـnull. فإن كان المحرف الحالي هو بايت الإنهاء، فقد وصلنا إلى النهاية.
ولإنشاء رمز، لدينا دالةٌ شبيهة بالمُنشئ:
^code make-token
تستعمل مؤشّرَي start و current في المُحلِّل المعجمي
لالتقاط الرمز النصّي للرمز. ثمّ تضبط حقولاً أخرى بديهية وتُعيد
الرمز. ولها دالةٌ شقيقة تُعيد أخطاء الرموز.
^code error-token
الفرق الوحيد هو أنّ "الرمز النصّي" يشير إلى سلسلة رسالة الخطأ بدلاً من أن يشير داخل شيفرة المستخدم المصدرية. ومرةً أخرى، نحتاج إلى التأكّد من بقاء رسالة الخطأ موجودة بالقدر الكافي كي يقرأها المصرّف. وعملياً، لا نستدعي هذه الدالة إلّا مع قيم نصوص C الحرفية. وهي ثابتةٌ وأبديّة، فحُسناً.
ما لدينا الآن هو في جوهره مُحلِّل معجمي عامل للّغة ذات قواعد معجمية فارغة. ولأنّ القواعد لا تحتوي إنتاجات، فكلّ محرف خطأ. وليس ذلك ممتعاً للبرمجة فيه، فدعنا نملأ القواعد.
قواعدٌ معجمية لـLox
أبسط الرموز هي محرفٌ واحدٌ فقط. ونتعرّف عليها هكذا:
^code scan-char (1 before, 2 after)
نقرأ المحرف التالي من الشيفرة المصدرية، ثمّ نفعل switch
مباشراً لنرى ما إذا كان يطابق أيّاً من رموز Lox النصّية ذات
المحرف الواحد. ولقراءة المحرف التالي، نستعمل مساعداً جديداً
يستهلك المحرف الحالي ويعيده.
^code advance
ثمّ تأتي رموزُ الترقيم ذات المحرفَين مثل != و >=. ولكلّ
منها أيضاً رمزٌ مقابلٌ ذو محرفٍ واحد. وهذا يعني أنّه حين نرى
محرفاً مثل !، لا نعرف ما إذا كنّا في رمز ! أم != حتى ننظر
أيضاً إلى المحرف التالي. ونتعامل مع ذلك هكذا:
^code two-char (1 before, 1 after)
بعد استهلاك المحرف الأوّل، نبحث عن =. فإن وجدتناه، نستهلكه
ونُعيد الرمزَ ذا المحرفَين المقابل. وإلّا فنترك المحرف الحالي
على حاله (كي يكون جزءاً من الرمز التالي) ونُعيد الرمزَ ذا
المحرف الواحد المناسب.
أما منطق استهلاك المحرف الثاني بشرط فيعيش هنا:
^code match
إذا كان المحرف الحالي هو المحرف المرغوب، نتقدّم ونُعيد true.
وإلّا نُعيد false للدلالة على عدم المطابقة.
يدعم مُحلِّلنا المعجمي الآن كلّ الرموز الشبيهة بالترقيم. وقبل أن نصل إلى الأطول منها، فلنُقم رحلةً جانبية قصيرة للتعامل مع المحارف التي ليست جزءاً من أيّ رمز أصلاً.
المسافات البيضاء
يحتاج مُحلِّلنا المعجمي إلى التعامل مع المسافات وعلامات التبويب
والأسطر الجديدة، لكنّ تلك المحارف لا تصبح جزءاً من الرمز النصّي
لأيّ رمز. يمكننا فحص ذلك داخل switch المحارف الرئيسي في
scanToken() لكنّ الأمر يصبح معقّداً قليلاً أن نتأكّد من أنّ
الدالة ما زالت تجد الرمز التالي بعد المسافات البيضاء عند
استدعائك لها. سنضطرّ إلى لفّ جسم الدالة كلّه في حلقةٍ أو ما
شابه.
بدلاً من ذلك، قبل بدء الرمز، ننتقل إلى دالةٍ منفصلة.
^code call-skip-whitespace (1 before, 1 after)
تقدّم هذه المُحلِّل المعجمي إلى ما بعد أيّ مسافاتٍ بيضاء سابقة. وبعد عودة هذا الاستدعاء، نعرف أنّ المحرف التالي ذو معنى (أو أنّنا عند نهاية الشيفرة المصدرية).
^code skip-whitespace
إنّه نوعٌ من المُحلِّل المعجمي المصغّر المنفصل. فهو يدور في حلقة يستهلك كلّ محرفِ مسافةٍ بيضاء يصادفه. ونحتاج إلى الحرص على ألّا يستهلك أيّ محارفٍ غير بيضاء. ولدعم ذلك، نستعمل هذا:
^code peek
وهذا ببساطة يُعيد المحرف الحالي دون استهلاكه. والشيفرة السابقة تتdeal مع كلّ محارف المسافات البيضاء ما عدا الأسطر الجديدة.
^code newline (1 before, 2 after)
وحين نستهلك أحدها، فإنّنا نزيد رقم السطر الحالي أيضاً.
التعليقات
التعليقات ليست تقنياً "مسافات بيضاء"، إن أردت أن تكون دقيقاً في مصطلحاتك، لكنّها بالنسبة إلى Lox يمكن أن تُعدّ كذلك، لذا نتخطّاها أيضاً.
^code comment (1 before, 2 after)
تبدأ التعليقات بـ// في Lox، لذا -- كما مع != وأصحابه -- نحتاج إلى
محرفٍ ثانٍ من النظرة التقدّمية. لكنّ الأمر يختلف مع !=: فهناك
كنا نريد استهلاك ! حتى لو لم يُعثر على =. أمّا التعليقات
فمختلفة. فإن لم نعثر على / ثانية، فلا بدّ ألّا تستهلك
skipWhitespace() الشرطةَ الأولى أيضاً.
ولمعالجة ذلك، نضيف:
^code peek-next
وهذا أشبه بـpeek() لكنّه يتجاوز المحرف الحالي بمحلرفٍ واحد.
فإن كان المحرف الحالي والمحرف التالي كلاهما /، فإنّنا نستهلكهما ثمّ
نستهلك أيّ محارف أخرى حتى السطر الجديد التالي أو نهاية الشيفرة المصدرية.
ونستعمل peek() للتحقّق من السطر الجديد دون استهلاكه. وبهذه
الطريقة، سيكون السطر الجديد هو المحرف الحالي في الدورة التالية
من الحلقة الخارجية في skipWhitespace() وسنتعرّف عليه ونزيد
scanner.line.
رموز القيم الحرفية
رموز الأعداد والنصوص خاصّة لأنّ لها قيمة وقتِ تشغيل مرتبطة بها. سنبدأ بالنصوص لأنّها سهلة التعرّف -- فهي تبدأ دائماً بعلامة تنصيص مزدوجة.
^code scan-string (1 before, 1 after)
وهذا يُنادي دالةً جديدة.
^code string
وكما في jlox، نستهلك المحارف حتى نصل إلى علامة التنصيص المغلقة. كما نتتبّع الأسطر الجديدة داخل القيمة النصّية الحرفية. (تدعم Lox نصوصاً متعدّدة الأسطر.) وكما دائماً، نتعامل بلباقة مع نفاد الشيفرة المصدرية قبل أن نجد علامة الإغلاق.
التغيير الرئيسي هنا في clox هو شيءٌ غير موجود. ومرةً أخرى، إنّه يتعلّق بإدارة الذاكرة. في jlox، كان لدى صنف Token حقلٌ من نوع Object لتخزين قيمة وقت التشغيل المحوَّلة من الرمز النصّي للقيمة الحرفية.
تنفيذ ذلك في C تطلّب الكثير من العمل. فسنحتاج إلى نوعٍ ما من الاتّحاد ووسم النوع لنعرف ما إذا كان الرمز يحتوي قيمةَ نصّية أم مزدوجة. وإن كان نصّاً، فسنحتاج إلى بعض الطريقة لإدارة ذاكرة مصفوفة محارف النصّ.
بدلاً من إضافة ذلك التعقيد إلى المُحلِّل المعجمي، فإنّنا تؤجّل تحويل الرمز النصّي للقيمة الحرفية إلى قيمة وقتِ تشغيل إلى وقتٍ لاحق. في clox، تخزّن الرموز الرمزَ النصّي فقط -- تسلسل المحارف كما يظهر تماماً في شيفرة المستخدم المصدرية. وفي المصرّف لاحقاً، سنحوّل ذلك الرمز النصّي إلى قيمة وقت التشغيل في اللحظة التي نكون فيها مستعدّين لتخزينه في جدول ثوابت القطعة.
ثمّ تأتي الأعداد. بدلاً من إضافة حالة switch لكلّ واحدٍ من
الأرقام العشرة التي قد تبدأ عدداً، نتعامل معها هنا:
^code scan-number (1 before, 2 after)
وهذا يستعمل دالةً بديهية:
^code is-digit
وننهي مسح العدد باستعمال هذا:
^code number
إنّه مطابقٌ تقريباً لنسخة jlox، لكنّنا مرةً أخرى لا نحوّل الرمز النصّي إلى عددٍ مزدوج بعد.
المعرّفات والكلمات المفتاحية
الدفعة الأخيرة من الرموز هي المعرّفات، المعرّفات المعرّفة من المستخدم والمحجوزة. يجب أن يكون هذا القسم ممتعاً -- فالطريقة التي نتعرّف بها على الكلمات المفتاحية في clox مختلفةٌ إلى حدٍّ كبير عن الطريقة التي فعلناها في jlox، وهي تمسّ بعض بنى البيانات المهمّة.
لكنّ علينا أوّلاً أن نمسح الرمز النصّي. فالأسماء تبدأ بحرفٍ أو بشرطة سفلية.
^code scan-identifier (1 before, 1 after)
ونتعرّف على تلك باستعمال هذا:
^code is-alpha
ومتى عثرنا على معرّف، فإنّنا نمسح بقيّته هنا:
^code identifier
بعد الحرف الأوّل، نسمح بالأرقام أيضاً، ونواصل استهلاك المحارف الأبجدية الرقمية حتى تنفد. ثمّ نُنتج رمزاً بالنوع الصحيح. وتحديد ذلك النوع "الصحيح" هو الجزء الفريد في هذا الفصل.
^code identifier-type
حسناً، أظنّ أنّ ذلك ليس ممتعاً إلى حدٍّ كبير بعد. هذا هو ما يبدو إن لم تكن لدينا كلمات محجوزة على الإطلاق. فكيف ينبغي أن نتعرّف على الكلمات المفتاحية؟ في jlox، كنا ن stuffingها كلّها في Map من Java ونبحث عنها بالاسم. ولا يوجد لدينا أيّ نوعٍ من بنية جدول تجزئة في clox، على الأقلّ ليس بعد.
وجدول التجزئة سيكون مبالغةً في كلّ حال. فالبحث عن نصّ في جدول تجزئة يتطلّب أن نمشي على النصّ لحساب شيفرة تجزئته، وإيجاد الحاوية (bucket) المقابلة في جدول التجزئة، ثمّ إجراء مقارنة تساوي محرفٍ بمحرفٍ مع أيّ نصّ يصادفه هناك.
لنفترض أنّنا مسحنا المعرّف "gorgonzola". كم من العمل ينبغي أن نقوم به لنعرف ما إذا كانت تلك كلمةً محجوزة؟ حسناً، لا كلمةَ مفتاحية في Lox تبدأ بـ"g"، بالنظر إلى أوّل محرفٍ تكفي للإجابة قاطعاً باللا. وهذا أبسط بكثير من البحث في جدول تجزئة.
وماذا عن "cardigan"؟ لدينا فعلاً كلمةٌ مفتاحية في Lox تبدأ بـ"c": وهي "class". لكنّ المحرف الثاني في "cardigan"، وهو "a"، يستبعد ذلك. وماذا عن "forest"؟ ولأنّ "for" كلمةٌ مفتاحية، علينا أن نذهب أبعد في النصّ قبل أن نؤكّد أنّنا لسنا أمام كلمة محجوزة. لكنّ الحالة في معظم الأحوال لا تكفي إلّا محرفاً أو اثنين لتخبرنا أنّ لدينا اسماً معرَّفاً من المستخدم بين أيدينا. وينبغي أن نتمكّن من التعرّف على ذلك والفشل سريعاً.
وهذا تمثيلٌ بصري لمنطق فحص المحارف المتفرّع:
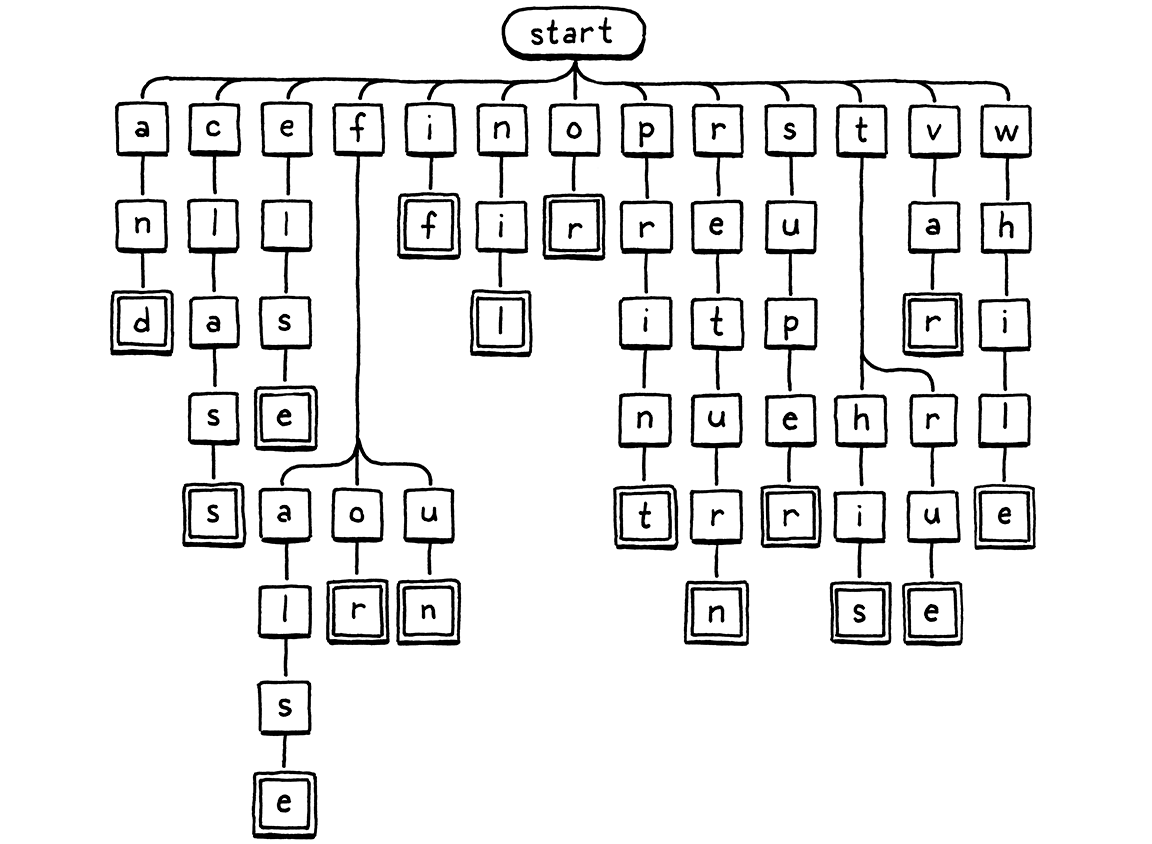
نبدأ من عقدة الجذر. فإذا وُجدت عقدةٌ ابنٌ حرفُها يطابق أوّل محرفٍ في الرمز النصّي، فإنّنا ننتقل إلى تلك العقدة. ثمّ نكرّر ذلك للحرف التالي في الرمز النصّي وهكذا. فإذا لم يطابق الحرف التالي في الرمز النصّي أيّ عقدةٍ ابن في أيّ لحظة، فلا بدّ أنّ المعرّف ليس كلمةً مفتاحية ونتوقّف. وإذا وصلنا إلى صندوقٍ ذو خطّين، وكنا عند آخر محرفٍ في الرمز النصّي، فقد وجدنا كلمةً مفتاحية.
الأشجار Trie وآلات الحالات
مخطّط الشجرة هذا مثالٌ على شيءٍ يُسمّى جذر شجري (trie). فشجرةُ trie تخزّن مجموعةً من النصوص. ومعظم بنى البيانات الأخرى لتخزين النصوص تحتوي على مصفوفات المحارف الخام ثمّ تلُفّها داخل بنيةٍ أكبر تساعدك على البحث بشكلٍ أسرع. أمّا trie فمختلفة. لن تجد في أيّ مكانٍ فيها نصّاً كاملاً.
بدلاً من ذلك، يُمثَّل كلّ نصٍّ "تحتويه" الـtrie في صورة مسار عبر شجرة عُقد المحارف، كما في اجتيازنا أعلاه. والعقد التي تطابق آخر محرفٍ في نصّ تحمل علامةً خاصة -- وهي الصناديق ذات الخطين المزدوجين في الرسم. وبهذه الطريقة، إذا كانت شجرة trie لديك تحتوي مثلاً على "banquet" و "ban"، فأنت قادر على معرفة أنّها لا تحتوي على "banque" -- فعقدة "e" لن تحمل تلك العلامة، بينما عُقد "n" و "t" ستحملها.
وتُعدّ أشجار trie حالةً خاصة من بنية بيانات أكثرُ أساساً: الآلة المحدّدة الحتمدية (DFA). ولربّما تعرف هذه أيضاً بأسماءٍ أخرى: آلة الحالات المنتهية، أو مجرّد آلة الحالات. آلات الحالات من الأشياء الرائعة! فهي تنفع في كلّ شيء من برمجة الألعاب إلى تنفيذ بروتوكولات الشبكات.
في الـDFA، لديك مجموعة حالات (states) مع انتقالات بينها، تشكّل رسماً بيانياً. في أيّ لحظة، تكون الآلة "في" حالةٍ واحدة تماماً. وتصل إلى الحالات الأخرى باتباع الانتقالات. وحين تستعمل DFA في التحليل المعجمي، فإنّ كلّ انتقالٍ هو محرفٌ يُطابَق من النصّ. وتمثّل كلّ حالة مجموعةَ المحارف المسموح بها.
شجرة كلماتنا المفتاحية هي بالضبط DFA يتعرّف على كلمات Lox المفتاحية. لكنّ DFAs أقوى من الأشجار البسيطة لأنّها تستطيع أن تكون رسوماً بيانيّة اعتباطية. فالانتقالات يمكن أن تشكّل دورات بين الحالات. وهذا يتيح لك التعرّف على نصوصٍ طويلةٍ بشكلٍ اعتباطي. فمثلاً، إليك DFA يتعرّف على القيم العددية الحرفية:
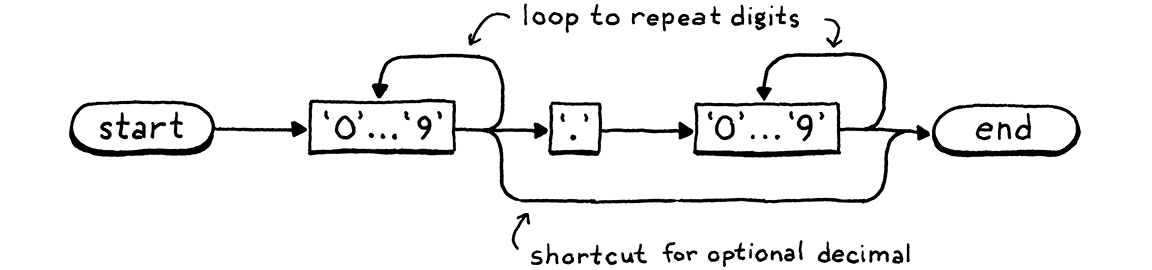
لقد جمعتُ عقد الأرقام العشرة معاً لجعلها أكثر قابلية للقراءة، لكنّ العملية الأساسية تعمل بالطريقة نفسها -- تمشي على المسار، وتدخل العقد كلّما استهلكت محرفاً مقابلاً في الرمز النصّي. ولو أردنا، لاستطعنا أن نبني DFA واحدةً ضخمة واحدةً يقوم بـكلّ التحليل المعجمي لـLox، آلةَ حالةٍ واحدة تتعرّف على جميع الرموز التي نحتاجها وتُخرجها.
غير أنّ صنع تلك الـDFa العملاقة يدوياً سيكون صعباً. ولهذا أُنشئت Lex. فتعطيها وصفاً نصّياً بسيطاً لقواعدك المعجمية -- حفنةً من التعبيرات المنظَّمة -- فتولّد لك DFA تلقائياً وتُنتج كومةً من شيفرة C تنفّذها.
لن نسلك ذلك الطريق. فلدينا بالفعل مُحلِّل معجمي مكتوبٌ بخطّ اليد وأكثر من كافٍ. ولا نحتاج سوى شجرة trie صغيرة للتعرّف على الكلمات المفتاحية. فكيف ينبغي أن نترجم ذلك إلى شيفرة؟
إنّ الحلّ الأبسط على الإطلاق هو استعمال
جملة switch لكلّ عقدة، مع حالات لكلّ فرع. وسنبدأ من عقدة الجذر
ونتعامل مع الكلمات المفتاحية السهلة.
^code keywords (1 before, 1 after)
هذه هي الحروف الأولى التي تقابل كلمةً مفتاحية واحدة. فإذا رأينا
"s"، فكلمة المعرّف المفتاحية الوحيدة الممكنة هي super. لكنّها
قد لا تكون كذلك، لذا ما زال علينا فحص بقيّة الحروف أيضاً. وفي
مخطّط الشجرة، هذا هو أساساً ذلك المسار المستقيم المتدلّي من
"s".
لن نلفّ switch لكلّ تلك العقد. بدلاً من ذلك، لدينا دالةٌ
مساعدة تختبر بقيّة الرمز النصّي لكلمةٍ مفتاحية محتملة.
^code check-keyword
نستعمل هذا لكلّ المسارات غير المتفرّعة في الشجرة. فبعد أن نجد بادئةً لا يمكن أن تكون إلّا كلمةً محجوزة واحدةً ممكنة، نحتاج إلى التحقّق من أمرين. يجب أن يكون الرمز النصّي بطول الكلمة المفتاحية تماماً. فإذا كان الحرف الأوّل "s"، فقد يبقى الرمز النصّي "sup" أو "superb". ويحتاج المحارف المتبقّية أن تطابق تماماً -- فـ"supar" لا تكفي.
وإن كان لدينا عددُ المحارف الصحيح، وكانت هي المحارف التي نريدها، فتلك كلمةٌ مفتاحية، ونُعيد نوع الرمز المرتبط بها. وإلّا فيجب أن يكون معرّفاً عادياً.
ولنا بضع كلمات مفتاحية تتفرّع فيها الشجرة من جديد بعد الحرف
الأوّل. فإذا بدأ الرمز النصّي بـ"f"، فقد يكون false أو for
أو fun. لذا نضيف switch آخر للفروع الخارجة من عقدة "f".
^code keyword-f (1 before, 1 after)
وقبل أن ننتقل، نحتاج إلى التحقّق من وجود حرفٍ ثانٍ أصلاً. فـ"f" وحدها معرّفٌ صالح أيضاً، في نهاية المطاف. والحرف الآخر الذي يتفرّع هو "t".
^code keyword-t (1 before, 1 after)
هذا كلّ شيء. بضعة جمل switch متداخلة. وهذا الشيفرة ليست
قصيرة فحسب بل سريعة جداً. فهي تقوم
بأقلّ قدرٍ من العمل الضروري لكشف الكلمة المفتاحية، وتخرج بمجرّد
أن تستطيع تحديد أنّ المعرّف لن يكون كلمةً محجوزة.
وبهذا يكتمل مُحلِّلنا المعجمي.
التحديات
-
تدعم لغاتٌ كثيرة حديثة استبدال النصوص (string interpolation). فداخل القيمة النصّية الحرفية، لديك بعض الفواصل الخاصة -- والأكثر شيوعاً
${في البداية و}في النهاية. وبين هذين الفاصلين، يمكن أن يظهر أيّ تعبير. وحين تُنفَّذ القيمة النصّية الحرفية، يُقيَّم التعبير الداخلي، ويُحوَّل إلى نصّ، ثمّ يُدمج مع القيمة النصّية الحرفية المحيطة.فمثلاً، لو كانت Lox تدعم استبدال النصوص، فإنّ هذا...
var drink = "Tea";
var steep = 4;
var cool = 2;
print "${drink} will be ready in ${steep + cool} minutes.";
...سيطبع:
Tea will be ready in 6 minutes.ما أنواع الرموز التي ستفرّفها لتنفيذ مُحلِّل معجمي لاستبدال النصوص؟ وما تسلسلُ الرموز الذي ستُصدره لتلك القيمة النصّية الحرفية أعلاه؟
وما الرموز التي ستُصدرها لما يلي:
"Nested ${"interpolation?! Are you ${"mad?!"}"}"فكّر في النظر إلى تطبيقات لغاتٍ أخرى تدعم الاستبدال لترى كيف تتعامل معه.
-
تستعمل عدة لغات أقواساً زاويةٍ للأنواع العامة (generics)، ولديها أيضاً معامل إزاحةٍ يميني
>>. وقد أدّى هذا إلى مشكلةٍ كلاسيكية في الإصدارات المبكّرة من C++:vector<vector<string>> nestedVectors;وسينتج خطأ تصريف، لأنّ
>>قد أُخذ كمُحرفٍ واحد يمين الإزاحة، لا كعلامتَي>. وأُجبر المستخدمون على تجنّب ذلك بوضع مسافة بين القوسين الزاويين المغلقَين.والإصدارات الأحدث من C++ أذكى ويمكنها التعامل مع الشيفرة أعلاه. أمّا Java و C# فلم يصيبهما المشكلة قطّ. فكيف تحدّد تلك اللّغات هذه القاعدة وتنفّذها؟
-
تعرّف لغاتٌ كثيرة، ولا سيّما في مراحل تطوّرها اللاحقة، "الكلمات المفتاحية السياقية". وهذه معرّفاتٌ تتصرّف كالكلمات المحجوزة في بعض السياقات لكن يمكن أن تكون معرّفاتٍ عادية يعرّفها المستخدم في سياقاتٍ أخرى.
فمثلاً،
awaitكلمةٌ مفتاحية داخل دالةasyncفي C#، لكنّك في الدوالّ الأخرى تستطيع استعمالawaitكمعرّفٍ خاص بك.اذكر بضع كلماتٍ مفتاحية سياقية من لغاتٍ أخرى، والسياق الذي تكون فيه ذات معنى. ما مزايا وعيوب الكلمات المفتاحية السياقية؟ وكيف كنت ستنفّذها في الواجهة الأماميّة للّغة لو احتجت إليها؟