القفز ذهابًا وإيابًا
الترتيب الذي يتخيّله عقلنا أشبه بشبكة، أو بسُلّم، يُبنى لنيل شيء ما. لكن بعد ذلك عليك أن ترمي السُلّم بعيدًا، لأنّك تكتشف أنّه، وإن كان مفيدًا، كان بلا معنى.
أومبرتو إيكو، اسم الوردة
استغرقنا وقتًا طويلًا حتى وصلنا إلى هنا، لكننا أصبحنا أخيرًا مستعدّين لإضافة تدفّق التحكم
(control flow) إلى آلتنا الافتراضية. في مفسّر التجوّل على الشجرة (tree-walk) الذي بنيناه
لـ jlox، نفّذنا تدفّق تحكم Lox بدلالة تدفّق تحكم Java. ولتنفيذ عبارة if في Lox،
استخدمنا عبارة if في Java لتشغيل الفرع المختار. هذا يعمل، لكنه ليس مُرضيًا تمامًا.
وبأيّ سحرٍ ينفّذ JVM نفسها أو معالج أصلي عبارات if؟ والآن بعد أن صار لدينا آلة
افتراضية خاصة بشيفرة البايت (bytecode VM) نمكّن من العبث بها، يمكننا الإجابة على ذلك.
حين نتحدّث عن "تدفّق التحكم"، إلى ماذا نُشير؟ بـ"التدفّق" نعني الطريقة التي يتحرّك بها التنفيذ عبر نصّ البرنامج. وكأنّ هناك روبوتًا صغيرًا داخل الحاسوب يتجوّل في شيفرتنا، ينفّذ أجزاء صغيرة هنا وهناك. التدفّق هو المسار الذي يسلكه ذلك الروبوت، وبـالتحكّم في الروبوت، فإنّنا نقود أيّ أجزاء من الشيفرة ينفّذها.
في jlox، كان موضع انتباه الروبوت -- أي الجزء الحالي من الشيفرة -- ضمنيًّا بناءً على
أيّ عقد شجرة التحليل المجرّد كانت مخزّنة في متغيّرات Java المختلفة وفي أيّ شيفرة Java كنا
في منتصف تنفيذها. أمّا في clox، فالموضوعية أوضح بكثير. يخزّن حقل ip في الآلة الافتراضية
عنوان تعليمة شيفرة البايت الحالية. وقيمة ذلك الحقل هي بالضبط "أين نحن" في البرنامج.
يتقدّم التنفيذ بصورة طبيعية بزيادة ip. لكن يمكننا تعديل ذلك المتغيّر كيفما نشاء. ولتنفيذ
تدفّق التحكم، كل ما يلزم هو تغيير ip بطرق أكثر إثارة للاهتمام. وأبسط بناء لتدفّق التحكم
هو عبارة if بلا بند else:
if (condition) print("condition was truthy");
تقيّم الآلة الافتراضية شيفرة البايت لتعبير الشرط. فإن كانت النتيجة صحيحة (truthy)، فإنّها
تتابع وتنفّذ عبارة print في الجسم. والحالة المثيرة للاهتمام هي حين يكون الشرط خاطئًا
(falsey). وحين يحدث ذلك، يتخطّى التنفيذ فرع then وينتقل إلى التصريح التالي.
لتخطّي كتلة من الشيفرة، نضبط حقل ip على عنوان تعليمة الشيفرة البايت التي تلي تلك
الشيفرة. أما لتخطّي شيفرة ما بشكل مشروط، فنحتاج إلى تعليمة تنظر إلى القيمة الموجودة
أعلى المكدّس. فإن كانت خاطئة، فإنّها تضيف إزاحة مُعطاة إلى ip لتقفز فوق مدى من
التعليمات. وإلا، فإنّها لا تفعل شيئًا وتترك التنفيذ يتابع كما هي العادة إلى التعليمة
التالية.
حين نترجم إلى شيفرة البايت، يتبخّر بنية الكتل المتداخلة الصريحة للشيفرة، ولا يترك خلفها سوى سلسلة مسطّحة من التعليمات. Lox لغة [برمجة مهيكلة][] (structured programming)، لكنّ شيفرة بايت clox ليست كذلك. المجموعة الصحيحة -- أو الخاطئة، حسب منظورك -- من تعليمات شيفرة البايت تستطيع أن تقفز إلى منتصف كتلة، أو من نطاق إلى آخر.
ستنفّذ الآلة الافتراضية ذلك بكل سرور، حتى لو تركت النتيجة المكدّس في حالة مجهولة وغير متّسقة. لذا، رغم أنّ شيفرة البايت غير مهيكلة، سنتأكّد من أنّ مصرّفنا لا يُنتج سوى شيفرة نظيفة تحافظ على البنية والتداخل نفسيهما اللذين تحافظ عليهما Lox نفسها.
وهذا بالضبط هو سلوك المعالجات الحقيقية. فرغم أنّنا قد نبرمجها بلغات أعلى مستوى تفرض تدفّق تحكّم مهيكلة، فإنّ المصرّف يخفض ذلك إلى قفزات خام. وفي القاع، تبيّن أنّ goto هو تدفّق التحكّم الحقيقي الوحيد.
على أيّ حال، لم أقصد أن أدخل في الفلسفة. الجزء المهم هو أنّ لدينا تلك التعليمة الوحيدة
للقفز الشرطي، وأنّ ذلك يكفي لتنفيذ عبارة if في Lox، ما دامت لا تملك بند else. فلنبدأ
في ذلك.
عبارات if
بعد هذا العدد من الفصول، أنت تعرف الإجراء. كل ميزة جديدة تبدأ في الواجهة الأمامية وتعمل
طريقها عبر المسار. وعبارة if هي، حسنًا، تصريح، فهذا هو الموضع الذي نربطها فيه بالمحلّل.
^code parse-if (2 before, 1 after)
حين نرى الكلمة المفتاحية if، نسلّم الترجمة إلى هذه الدالة:
^code if-statement
أولًا نترجم تعبير الشرط، محاطًا بأقواس. ووقت التشغيل، سيترك ذلك قيمة الشرط أعلى المكدّس. وسنستخدم ذلك لتحديد ما إذا كنّا سننفّذ فرع then أم نتخطّاه.
ثم نُصدر تعليمة OP_JUMP_IF_FALSE جديدة. ولها مُعامل يخصّ مقدار إزاحة ip -- أي عدد
بايتات الشيفرة التي نتخطّاها. فإن كان الشرط خاطئًا، فإنّها تضبط ip بذلك المقدار. شيء
كهذا:
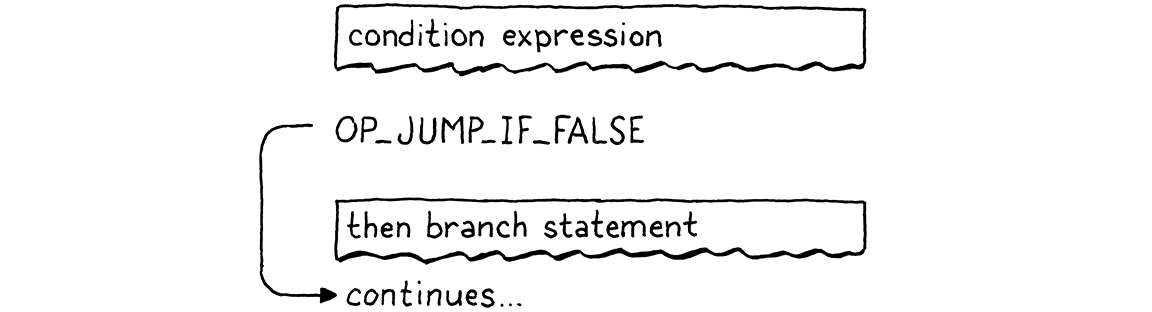
لكنّ لدينا مشكلة. حين نكتب مُعامل تعليمة OP_JUMP_IF_FALSE، كيف نعرف كم يجب أن نقفز؟
فنحن لم نترجم فرع then بعد، لذا لا نعرف كم من شيفرة البايت يحتوي.
لإصلاح ذلك، نستخدم خدعة كلاسيكية تُسمّى الترقيع الخلفي (backpatching). فنُصدر تعليمة القفز أولًا بمُعامل إزاحة نائبة. ونحتفظ بمكان تلك التعليمة نصف المكتملة. بعد ذلك، نترجم جسم then. وحين ننتهي من ذلك، نعرف كم يجب أن نقفز. فنعود ونستبدل تلك الإزاحة النائبة بالإزاحة الحقيقية الآن بعد أن صرنا قادرين على حسابها. شيءٌ كخياطة رقعة على نسيج الشيفرة المُصرَّفة القائم.
نرمّز هذه الخدعة في دالتَي مساعِدة.
^code emit-jump
تُصدر الأولى تعليمة شيفرة بايت وتكتب مُعاملًا نائبًا لإزاحة القفز. ونمرّر رمز التشغيل كمُعامل لأنّنا لاحقًا سيكون لدينا تعليمتان مختلفتان تستخدمان هذه الدالة المساعِدة. ونستخدم بايتين لمُعامل إزاحة القفز. فإزاحة 16 بتًّا تتيح لنا القفز فوق ما يصل إلى 65,535 بايتًا من الشيفرة، وهو ما ينبغي أن يكفي لاحتياجاتنا.
تُرجِع الدالة إزاحة التعليمة المُصدَرة في القطعة. وبعد ترجمة فرع then، نأخذ تلك الإزاحة ونمرّرها إلى هذه:
^code patch-jump
تعود إلى داخل شيفرة البايت وتستبدل المُعامل عند الموضع المُعطى بإزاحة القفز المحسوبة.
ونستدعي patchJump() قبل أن نُصدر مباشرةً التعليمة التالية التي نريد أن يهبط عليها القفز،
فتستخدم عدد البايتات الحالي للشيفرة بايت لتحديد كم يجب أن نقفز. وفي حالة عبارة if،
يعني ذلك مباشرةً بعد أن نترجم فرع then وقبل أن نترجم التصريح التالي.
هذا كل ما نحتاجه وقت التجميع. لنعرّف التعليمة الجديدة.
^code jump-if-false-op (1 before, 1 after)
وهناك في الآلة الافتراضية، نجعلها تعمل هكذا:
^code op-jump-if-false (2 before, 1 after)
هذه أول تعليمة نضيفها تأخذ مُعاملًا من 16 بتًّا. ولقراءته من القطعة، نستخدم ماكرو جديدًا.
^code read-short (1 before, 1 after)
يسحب البايتين التاليين من القطعة ويبني منهما عددًا صحيحًا غير سالب من 16 بتًّا. وكالمعتاد، ننظّف الماكرو عندما ننتهي من استخدامه.
^code undef-read-short (1 before, 1 after)
بعد قراءة الإزاحة، نتحقّق من قيمة الشرط الموجودة أعلى المكدّس. إن كانت
خاطئة، فإنّنا نطبّق إزاحة القفز هذه على ip. وإلا، فإنّنا نترك ip وحده ويستمر التنفيذ
تلقائيًّا إلى التعليمة التالية التي تلي تعليمة القفز.
في الحالة التي يكون فيها الشرط خاطئًا، لا نحتاج إلى أيّ عمل آخر. فقد أزحنا ip، لذا حين
تدور حلقة توجيه التعليمات الخارجية مرّة أخرى، فإنّها ستلتقط التنفيذ عند تلك التعليمة الجديدة،
بعد كلّ الشيفرة الموجودة في فرع then.
لاحظ أنّ تعليمة القفز لا تُسقط قيمة الشرط من المكدّس. لذا لسنا قد انتهينا تمامًا، لأنّ ذلك
يترك قيمة زائدة طافية على المكدّس. سنُنظّف ذلك قريبًا. متجاهلين ذلك في الوقت الحالي، لدينا
عبارة if عاملة في Lox الآن، ولا يحتاج دعمها وقت التشغيل في الآلة الافتراضية سوى تعليمة
صغيرة واحدة.
بنود else
عبارة if بلا دعم لبنود else هي مثل مورتيليا أدامز بلا غوميز. لذا، بعد أن نترجم فرع then،
نبحث عن كلمة مفتاحية else. فإن وجدنا واحدة، نترجم فرع else.
^code compile-else (1 before, 1 after)
حين يكون الشرط خاطئًا، سنقفز فوق فرع then. وإن وُجد فرع else، فإنّ ip ستهبط مباشرةً في
بداية شيفرته. لكنّ ذلك لا يكفي. وإليك التدفّق الذي يؤدي إلى:
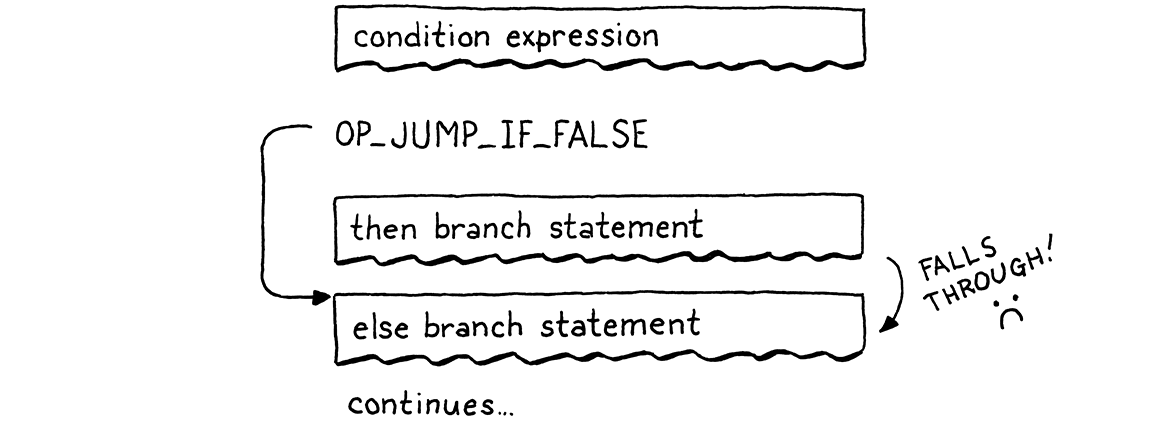
إن كان الشرط صحيحًا، فإنّنا ننفّذ فرع then كما نريد. لكن بعد ذلك، يستمر التنفيذ مباشرةً إلى داخل فرع else. أوه! وحين يكون الشرط صحيحًا، وبعد أن ننفّذ فرع then، نحتاج إلى القفز فوق فرع else. وبهذه الطريقة، في كلتا الحالتين، ننفّذ فرعًا واحدًا فقط، هكذا:
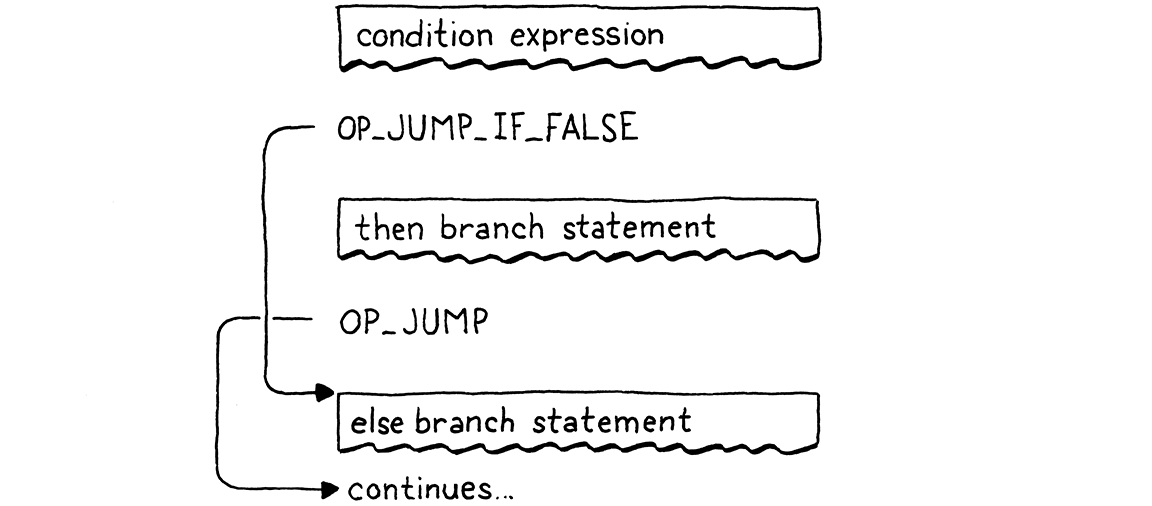
لتنفيذ ذلك، نحتاج إلى قفزة أخرى من نهاية فرع then.
^code jump-over-else (2 before, 1 after)
نرقّع تلك الإزاحة بعد نهاية جسم else.
^code patch-else (1 before, 1 after)
بعد تنفيذ فرع then، تقفز هذه إلى التصريح التالي بعد فرع else. وخلافًا للقفزة الأخرى، فإنّ هذه القفزة غير مشروطة. فنحن نأخذها دائمًا، لذا نحتاج إلى تعليمة أخرى تعبّر عن ذلك.
^code jump-op (1 before, 1 after)
ونفسّرها هكذا:
^code op-jump (2 before, 1 after)
لا شيء مدهش هنا حقًّا -- الفرق الوحيد هو أنّها لا تتحقّق من شرط وتطبّق الإزاحة دائمًا.
لدينا الآن فرع then وفرع else يعملان، لذا اقتربنا. والجزء الأخير هو تنظيف قيمة الشرط التي تركناها على المكدّس. تذكّر، أنّ كل تصريح مطلوب أن يكون له أثر صفري على المكدّس -- بعد انتهاء التصريح بالتنفيذ، ينبغي أن يكون المكدّس بارتفاع نفسه الذي كان عليه.
يمكن أن نجعل تعليمة OP_JUMP_IF_FALSE تُسقط الشرط نفسه، لكننا قريبًا سنستخدم تلك التعليمة
نفسها مع المعاملات المنطقية حيث لا نريد إسقاط الشرط. وبدلًا من ذلك، سنجعل المصرّف يُصدر بضع
تعليمات OP_POP صريحة عند ترجمة عبارة if. ونحتاج إلى التأكّد من أنّ كل مسار تنفيذ في
الشيفرة المولَّدة يُسقط الشرط.
حين يكون الشرط صحيحًا، نُسقطه مباشرةً قبل الشيفرة داخل فرع then.
^code pop-then (1 before, 1 after)
وإلا، فإنّنا نُسقطه في بداية فرع else.
^code pop-end (1 before, 2 after)
هذه التعليمة الصغيرة هنا تعني أيضًا أنّ كل عبارة if لها فرع else ضمنيّ حتى لو لم يكتب
المستخدم بند else. وفي الحالة التي تركها فيها، فإنّ كل ما يفعله الفرع هو التخلّص من قيمة
الشرط.
والتدفّق الصحيح الكامل يبدو هكذا:
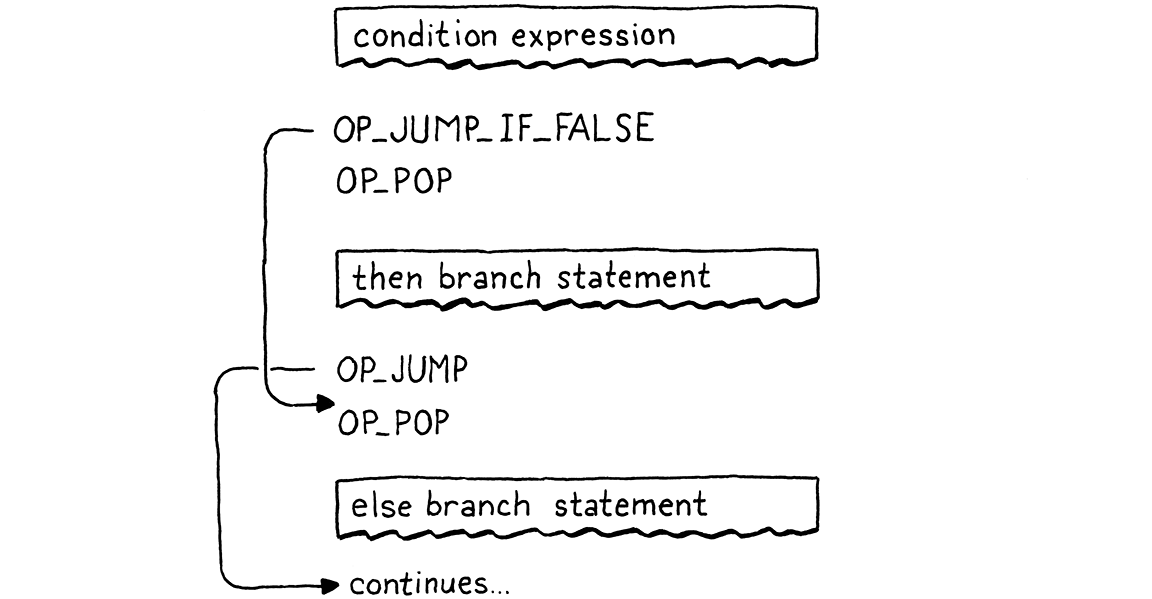
إن تتبّعت المسار، يمكنك أن ترى أنّه ينفّذ دائمًا فرعًا واحدًا ويضمن أُسقوط الشرط أولًا. ولم يبقَ سوى بعض دعم المفكّك.
^code disassemble-jump (1 before, 1 after)
للتعليمتين هذه صيغة جديدة بمُعامل من 16 بتًّا، لذا نضيف دالة مساعِدة جديدة لتفكيكهما.
^code jump-instruction
ها قد، هذا بناء واحد كامل لتدفّق التحكم. لو كان هذا فيلمًا من الثمانينيات، لانطلق موسيقى المونتاج وتتكفّل بقية صياغة تدفّق التحكم بنفسها. للأسف، فالثمانينيات قد مضت منذ زمن طويل، لذا علينا أن نشقّ طريقنا بأنفسنا.
المعاملات المنطقية
ربما تذكّر هذا من jlox، لكنّ المعاملات المنطقية and وor ليسا مجرد زوج آخر من المعاملات
الثنائية مثل + و-. ولأنّهما يتقاصران قصورًا (short-circuit) وقد لا يقيّمان مُعاملهما
الأيمن بحسب قيمة الأيسر، فإنّهما يعملان ًا من تعبيرات تدفّق التحكم.
هما في الأساس تنويعةٌ صغيرة على عبارة if ذات بند else. وأبسط طريقة لشرحهما هي أن أعرض
عليك شيفرة المصرّف وتدفّق التحكم الذي تنتجه في شيفرة البايت الناتجة. بدءًا بـ and، نربطه
في جدول تحليل التعابير هنا:
^code table-and (1 before, 1 after)
وهذا يسلّم الأمر إلى دالة تحليل جديدة.
^code and
في اللحظة التي يُستدعى فيها هذا، يكون تعبير الجهة اليسرى قد تُرجم بالفعل. وهذا يعني أنّ
قيمته وقت التشغيل ستكون أعلى المكدّس. فإن كانت تلك القيمة خاطئة، فإنّنا نعرف أنّ and
كاملًا يجب أن يكون خاطئًا، فنتخطّى المُعامل الأيمن ونترك قيمة الجهة اليسرى كنتيجة التعبير
كاملًا. وإلا، فإنّنا نتخلّص من قيمة اليسار ونقيّم المُعامل الأيمن الذي يصبح نتيجة تعبير and
كامل.
أربعة أسطر الشيفرة هناك تنتج ذلك بالضبط. يبدو التدفّق هكذا:
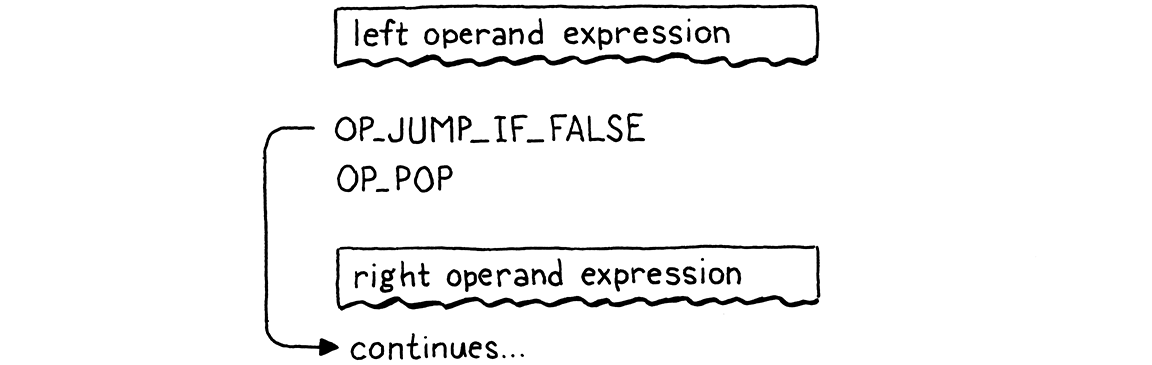
الآن ترى لماذا يُبقي OP_JUMP_IF_FALSE القيمة على المكدّس. فحين
تكون قيمة الجهة اليسرى من and خاطئة، تبقى تلك القيمة لتصبح نتيجة التعبير كاملًا.
المعامل المنطقي or
المعامل or أعقد قليلًا. أولًا نضيفه إلى جدول التحليل.
^code table-or (1 before, 1 after)
حين يستهلك ذلك المحلّل رمز or الوسطي، فإنّه يستدعي هذا:
^code or
في تعبير or، إن كانت الجهة اليسرى صحيحة، فإنّنا نتخطّى المُعامل الأيمن. إذن نحتاج إلى
القفز حين تكون القيمة صحيحة. يمكننا إضافة تعليمة منفصلة، لكنّني فقط لأُظهر كيف يكون مصرّفنا
حرًّا في ربط دلالات اللغة بأيّ تسلسل تعليمات يشاء، فقد نفّذته بدلالة تعليمات القفز التي
لدينا بالفعل.
حين تكون الجهة اليسرى خاطئة، فإنّها تقفز قفزة صغيرة فوق التصريح التالي. وذلك التصريح هو قفزة غير مشروطة فوق شيفرة المُعامل الأيمن. وهذه الرقصة الصغيرة تُنجز فعليًا قفزة حين تكون القيمة صحيحة. يبدو التدفّق هكذا:
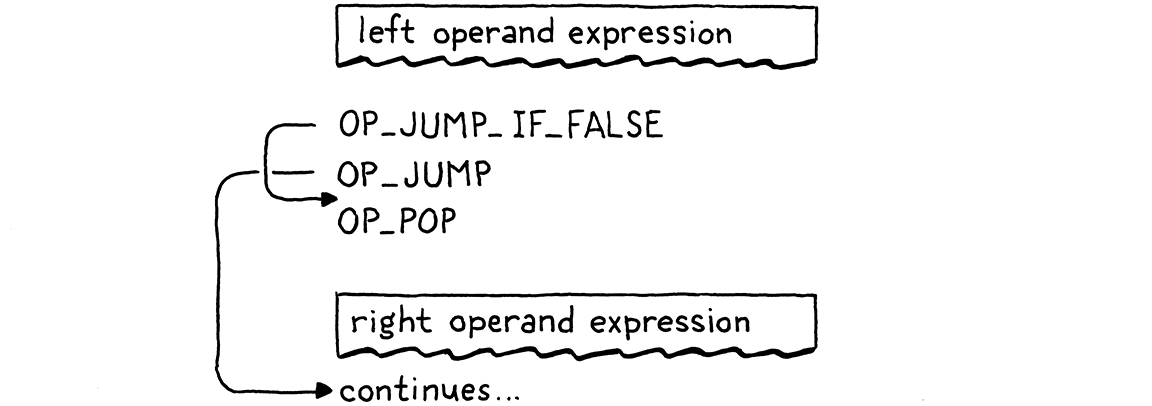
إن كنت صادقًا معك، فهذه ليست أفضل طريقة للقيام بذلك. فهناك تعليمات أكثر توجيهًا وحِمل
زائد أكثر. ولا يوجد سبب جيّد لماذا ينبغي أن يكون or أبطأ من and. لكنّ من الممتع أن ترى
أنّه من الممكن تنفيذ المعاملين دون إضافة أيّ تعليمات جديدة. سامحني على ترفّي.
حسنًا، تلك هي أبنية التفرّع (branching) الثلاثة في Lox. أي إنّها ميزات تدفّق التحكم التي
تقفز إلى الأمام فوق الشيفرة فقط. وكثير من اللغات تملك عادةً نوعًا ما من تصريح تفرّع متعدّد
الاتجاهات مثل switch، وربما تعبيرًا شرطيًّا مثل ?:، لكنّ Lox تُبقي الأمر بسيطًا.
عبارات while
يأخذنا ذلك إلى عبارات التكرار (looping)، التي تقفز إلى الخلف كي يمكن تنفيذ الشيفرة أكثر
من مرّة. وLox تملك بناءَي تكرار فقط، وهما while وfor. وحلقة while أبسط بكثير، لذا
نبدأ الاحتفال من هناك.
^code parse-while (1 before, 1 after)
حين نصل إلى رمز while، نستدعي:
^code while-statement
معظم هذا يعكس عبارات if -- نترجم تعبير الشرط محاطًا بأقواس إلزامية. يتبع ذلك تعليمة قفز
تتخطّى تصريح الجسم التالي إن كان الشرط خاطئًا.
نرقّع القفزة بعد ترجمة الجسم ونحرص على إسقاط قيمة الشرط من
المكدّس في كلا المسارين. والفرق الوحيد عن عبارة if هو الحلقة. وهي تبدو هكذا:
^code loop (1 before, 2 after)
بعد الجسم، نستدعي هذه الدالة لإصدار تعليمة "حلقة". وتلك التعليمة تحتاج إلى أن تعرف كم يجب أن تقفز إلى الخلف. وحين قفزنا إلى الأمام، اضطررنا إلى إصدار التعليمة على مرحلتين لأنّنا لم نكن نعرف كم سنقفز حتى بعد إصدار تعليمة القفز. ولا نواجه تلك المشكلة الآن. فنحن ترجمنا موضع الشيفرة الذي نريد القفز إليه -- وهو مباشرةً قبل تعبير الشرط.
كل ما نحتاج إلى فعله هو التقاط ذلك الموضع أثناء ترجمته.
^code loop-start (1 before, 1 after)
بعد تنفيذ جسم حلقة while، نقفز كلّ الطريق إلى الخلف إلى ما قبل الشرط. وبهذه الطريقة، نعيد
تقييم تعبير الشرط في كل دورة. ونخزّن عدد التعليمات الحالي للقطعة في loopStart لتسجيل
الإزاحة في شيفرة البايت مباشرةً قبل تعبير الشرط الذي نحن على وشك ترجمته. ثم نمرّر ذلك إلى
دالة المساعِدة هذه:
^code emit-loop
إنّها أشبه قليلًا بـ emitJump() وpatchJump() مجتمعتين. فهي تُصدر تعليمة حلقة جديدة تقفز
إلى الخلف بصورة غير مشروطة بمقدار إزاحة مُعطى. وكما في تعليمات القفز، لدينا بعدها مُعامل
من 16 بتًّا. ونحسب الإزاحة من التعليمة التي نحن عندها إلى نقطة loopStart التي نريد القفز
إليها. أمّا + 2 فتأخذ في الحسبان حجم مُعاملات تعليمة OP_LOOP نفسها التي نحتاج أيضًا إلى
القفز فوقها.
من منظور الآلة الافتراضية، لا فرق دلاليًا حقًّا بين OP_LOOP وOP_JUMP. فكلاهما يضيف
إزاحة إلى ip. كان بإمكاننا استخدام تعليمة واحدة للاثنين ومنحها مُعامل إزاحة مُوقَّعًا. لكنّي
ظننت أنّ تجنّب اللعب المحبط بالبتات المطلوب لتخمين عدد صحيح مُوقَّع من 16 بتًّا في بايتَين
أسهل قليلًا، ولدينا مساحة رموز تشغيل متاحة، فلمَ لا نستخدمها؟
التعليمة الجديدة هي هنا:
^code loop-op (1 before, 1 after)
وفي الآلة الافتراضية، ننفّذها هكذا:
^code op-loop (1 before, 1 after)
الفرق الوحيد عن OP_JUMP هو طرح بدل الجمع. والتفكيك مشابه أيضًا.
^code disassemble-loop (1 before, 1 after)
تلك هي عبارة while. وهي تحوي قفزتين -- قفزة أمامية مشروطة للخروج من الحلقة حين لا يتحقّق
الشرط، وقفزة حلقة غير مشروطة إلى الخلف بعد أن نفّذنا الجسم. يبدو التدفّق هكذا:
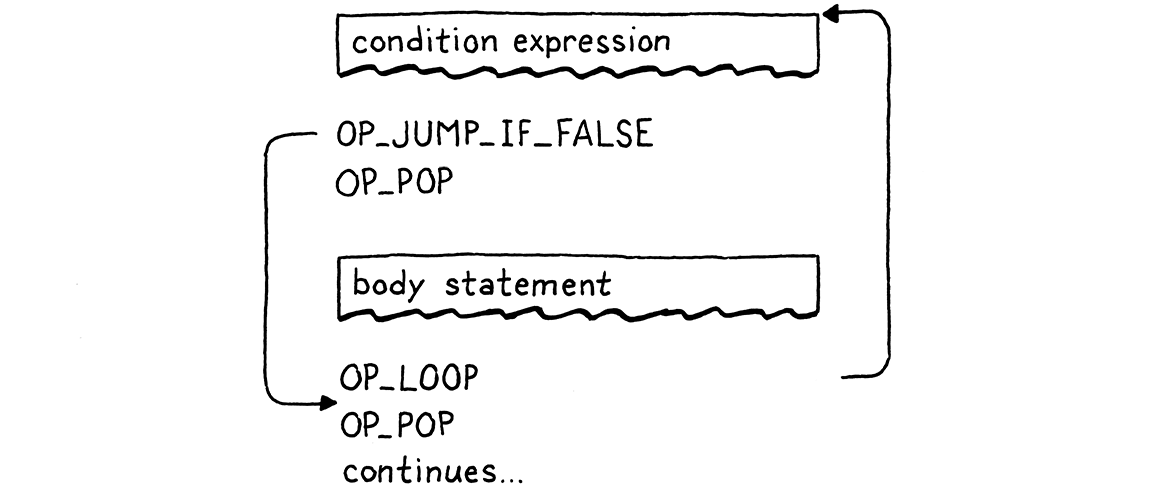
عبارات for
التصريح المتكرّر الآخر في Lox هو حلقة for العريقة الموروثة من C. ولديها أمور أكثر بكثير
مقارنةً بحلقة while. فهي تملك ثلاثة بنود، جميعها اختيارية:
-
قد يكون المُهيّئ تصريح متغيّر أو تعبيرًا. فهو يُنفَّذ مرّة واحدة في بداية التصريح.
-
بند الشرط تعبير. وكما في حلقة
while، نخرج من الحلقة حين يقيَّم إلى قيمة خاطئة. -
تعبير الزيادة يُنفَّذ مرّة واحدة في نهاية كل دورة من دورات الحلقة.
في jlox، كان المحلّل يحوّل حلقة for إلى شجرة تحليل مجرّد مُركَّبة لحلقة while مع أشياء
إضافية قبلها وفي نهاية جسمها. وسنفعل شيئًا مشابهًا، لكننا لن نمرّ على أيّ شجرة تحليل. وبدلًا
من ذلك، سيستخدم مصرّف شيفرة البايت لدينا تعليمات القفز والحلقة التي لدينا بالفعل.
سنعمل على التنفيذ قطعةً قطعة، بدءًا بالكلمة المفتاحية for.
^code parse-for (1 before, 1 after)
تستدعي دالة مساعِدة. إن كنا ندعم حلقات for ذات بنود فارغة مثل for (;;) فقط، لاستطعنا
تنفيذها هكذا:
^code for-statement
هناك كومة من علامات الترقيم الإلزامية في الأعلى. ثم نترجم الجسم. وكما فعلنا في حلقات
while، نسجّل إزاحة شيفرة البايت في أعلى الجسم ونُصدر حلقة للقفز إلى تلك النقطة بعده.
ولدينا الآن تنفيذ عامل لحلقات لا نهائية.
بند المُهيّئ
الآن سنضيف البند الأول، وهو المُهيّئ. فهو يُنفَّذ مرّة واحدة فقط، قبل الجسم، لذا فترجمته مباشرة.
^code for-initializer (1 before, 2 after)
الصياغة أعقد قليلًا لأنّنا نسمح إمّا بتصريح متغيّر وإمّا بتعبير. ونستخدم وجود الكلمة المفتاحية
var لنعرف أيّهما لدينا. وفي حالة التعبير، نستدعي expressionStatement() بدلًا من
expression(). وهي تبحث عن فاصلة منقوطة، وهو ما نحتاجه هنا أيضًا، كما تُصدر تعليمة
OP_POP للتخلّص من القيمة. ولا نريد للمُهيّئ أن يترك أيّ شيء على المكدّس.
إن صرّحت عبارة for بمتغيّر، فينبغي أن يكون نطاق ذلك المتغيّر محصورًا في جسم الحلقة. ونضمن
ذلك بلفّ التصريح كله في نطاق.
^code for-begin-scope (1 before, 1 after)
ثم نغلقه في النهاية.
^code for-end-scope (1 before, 1 after)
بند الشرط
التالي هو تعبير الشرط الذي يمكن استخدامه للخروج من الحلقة.
^code for-exit (1 before, 1 after)
وبما أنّ البند اختياري، نحتاج إلى معرفة ما إذا كان موجودًا فعلًا. فإن حُذف البند، فيجب أن يكون الرمز التالي فاصلة منقوطة، لذا نبحث عن ذلك لنعرف. وإن لم تكن هناك فاصلة منقوطة، فلا بدّ من وجود تعبير شرط.
في تلك الحالة، نترجمه. ثم، تمامًا كما مع while، نُصدر قفزة مشروطة تخرج من الحلقة إن كان الشرط خاطئًا. وبما أنّ القفزة تترك القيمة على المكدّس، فإنّنا نُسقطها قبل تنفيذ الجسم. وهذا يضمن تخلّصنا من القيمة حين يكون الشرط صحيحًا.
بعد جسم الحلقة، نحتاج إلى أن نرقّع تلك القفزة.
^code exit-jump (1 before, 2 after)
نفعل ذلك فقط حين يكون هناك بند شرط. فإن لم يكن، فلا قفزة لنرقّعها ولا قيمة شرط على المكدّس نُسقطها.
بند الزيادة
حفظت الأفضل للأخير، وهو بند الزيادة. فهو ملتويّ إلى حدٍّ ما. يظهر نصًّا قبل الجسم، لكنّه
يُنفَّذ بعده. لو كنّا حلّلنا إلى شجرة تحليل مجرّد وولّدنا الشيفرة في تمريرة منفصلة،
لاستطعنا بمجرّد الدخول إلى حقل الجسم في تصريح for وترجمته قبل بند الزيادة.
للأسف، لا يمكننا ترجمة بند الزيادة لاحقًا، لأنّ مصرّفنا يمرّ على الشيفرة في تمريرة واحدة فقط. وبدلًا من ذلك، سنقفز فوق الزيادة، وننفّذ الجسم، ثم نقفز إلى الأعلى إلى الزيادة، وننفّذها، ثم ننتقل إلى الدورة التالية.
أعرف، هذا غريب قليلًا، لكنّها تتفوّق على إدارة أشجار التحليل المجرّد يدويًّا في الذاكرة بلغة C، أليس كذلك؟ وإليك الشيفرة:
^code for-increment (2 before, 2 after)
ومرّة أخرى، هو اختياري. وبما أنّ هذا هو البند الأخير، فإنّه عند حذفه سيكون الرمز التالي القوس الختامي. وعندما تكون هناك زيادة، نحتاج إلى ترجمتها الآن، لكنّها لا ينبغي أن تُنفَّذ بعد. لذا أولًا، نُصدر قفزة غير مشروطة تتخطّى شيفرة بند الزيادة إلى جسم الحلقة.
بعد ذلك، نترجم تعبير الزيادة نفسه. وهذا عادةً إسناد. وأيًّا كان ما هو، فإنّنا لا نفّذه إلّا لأثره الجانبي، لذا نُصدر أيضًا إيقاطًا للتخلّص من قيمته.
الجزء الأخير معقّد قليلًا. أولًا، نُصدر تعليمة حلقة. وهذه هي الحلقة الرئيسة التي تعيدنا إلى
أعلى حلقة for -- مباشرةً قبل تعبير الشرط إن وُجد. وتحدث تلك الحلقة مباشرةً بعد الزيادة،
إذ إنّ الزيادة تُنفَّذ في نهاية كل دورة من دورات الحلقة.
ثم نغيّر loopStart ليشير إلى الإزاحة التي يبدأ عندها تعبير الزيادة. لاحقًا، حين نُصدر تعليمة
الحلقة بعد تصريح الجسم، سيؤدي ذلك إلى قفزها إلى الأعلى إلى تعبير الزيادة بدلًا من أعلى
الحلقة كما تفعل حين لا توجد زيادة. وهكذا ننسج الزيادة لتُنفَّذ بعد الجسم.
إنّه ملتوٍّ، لكن كل شيء يعمل في النهاية. حلقة كاملة بجميع بنودها تُترجم إلى تدفّق كهذا:
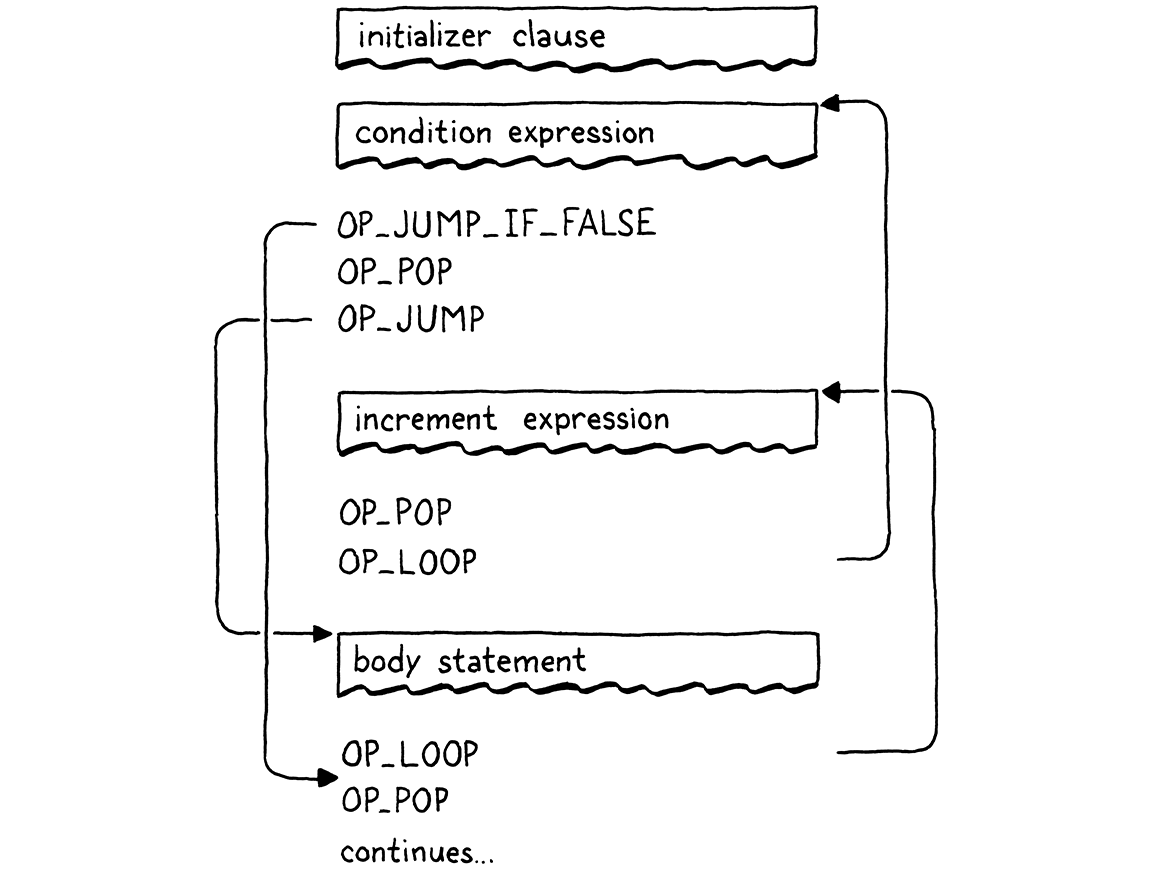
وكما عند تنفيذ حلقات for في jlox، لم نضطر إلى لمس وقت التشغيل. فكل ذلك يُترجم إلى عمليات
تدفّق تحكّم أوّلية تدعمها الآلة الافتراضية بالفعل. وفي هذا الفصل، أخذنا قفزة كبيرة إلى الأمام -- أصبحت clox الآن مكتملة تورينغ. وقد غطّينا قدرًا كبيرًا
من الصياغة الجديدة: ثلاثة تصاريح وصيغتَي تعبير. ومع ذلك، لم يستغرق ذلك سوى ثلاث تعليمات
جديدة بسيطة. فهذه نسبة مجهود إلى عائد جيّدة إلى حدٍّ ما لبنية آلتنا الافتراضية.
التحدّيات
-
إلى جانب عبارات
if، تملك معظم لغات عائلة C تصريحswitchمتعدّد الاتجاهات. أضف واحدًا إلى clox. القواعد هي:switchStmt → "switch" "(" expression ")" "{" switchCase* defaultCase? "}" ; switchCase → "case" expression ":" statement* ; defaultCase → "default" ":" statement* ;لتنفيذ عبارة
switch، نقيّم أولًا تعبير قيمةswitchبين الأقواس. ثم نمرّ على الحالات. لكل حالة، نقيّم تعبير قيمتها. إن كانت قيمة الحالة مساوية لقيمةswitch، فإنّنا ننفّذ التصاريح الواقعة تحت تلك الحالة ثم نخرج من تصريحswitch. وإلا، نجرب الحالة التالية. فإن لم تطابق أيّ حالة وكان هناك بندdefault، فإنّنا ننفّذ تصاريحه.ولتبسيط الأمور، فإنّنا نُسقط السقوط التسلسلي (fallthrough) وعبارات
break. فكل حالة تقفز تلقائيًّا إلى نهاية تصريح switch بعد انتهاء تصاريحها. -
في jlox، كان لدينا تحدٍّ بإضافة دعم لعبارات
break. فلنَفعلcontinueهذه المرّة:continueStmt → "continue" ";" ;تقفز عبارة
continueمباشرةً إلى أعلى أقرب حلقة محيطة، متخطّيةً بقية جسم الحلقة. وداخل حلقةfor، تقفزcontinueإلى بند الزيادة، إن وُجد. ويكون وجود عبارةcontinueغير محاطة بحلقة خطأً وقت التجميع.تأكّد من التفكير في النطاق. فماذا ينبغي أن يحدث للمتغيّرات المحلّية المُعلَنة داخل جسم الحلقة أو في كتل متداخلة داخل الحلقة حين يُنفَّذ
continue؟ -
لم تتغيّر أبنية تدفّق التحكم كثيرًا منذ Algol 68. فقد ركّزت تطوّر اللغات منذ ذلك الحين على جعل الشيفرة أكثر توضيحية وعالية المستوى، فلم يحظ تدفّق التحكم الإجرائي بكثير من الاهتمام.
للمتعة، حاول أن تخترع ميزة تدفّق تحكّم جديدة ومفيدة لـ Lox. يمكن أن يكون تحسينًا لشكل قائم أو شيئًا جديدًا تمامًا. من الناحية العملية، يصعب إيجاد شيء مفيد بما يكفي عند مستوى التعبيرية المنخفض هذا ليُعوَّض تكلفة إجبار المستخدم على تعلّم ترميز وسلوك غير مألوفين، لكنّها فرصة جيّدة لتدريب مهاراتك في التصميم.
ملاحظة تصميم: اعتبار goto ضارًّا
أن تكتشف أنّ كل تدفّق التحكم المهيكل الجميل لدينا في Lox يترجَم في الواقع إلى قفزات خام غير مهيكلة يشبه تلك اللحظة في Scooby Doo حين ينزع الوحش القناع عن وجهه. لقد كان الأمر goto طوال الوقت! لكن في هذه الحالة، الوحش تحت القناع. جميعنا نعرف أنّ goto شرّ. لكن... لماذا؟
من الصحيح أنّه يمكنك كتابة شيفرة غير قابلة للصيانة إلى حدٍّ فظيع باستخدام goto. لكنني لا أعتقد أنّ معظم المبرمجين اليوم رأوا ذلك بأعينهم. لقد مضى وقت طويل منذ كان ذلك النمط شائعًا. وفي هذه الأيام، هو شرّيرٌ نستدعيه في قصص الرعب حول نار المخيّم.
السبب في ندرة مواجهة ذلك الوحش وجهاً لوجه هو أنّ Edsger Dijkstra قتله برسالته الشهيرة "اعتبار عبارة Go To ضارّة"، المنشورة في Communications of the ACM (مارس 1968). كان الجدل حول البرمجة المهيكلة شديدًا منذ بعض الوقت مع مؤيّدين على الجانبين، لكنّي أظنّ أنّ Dijkstra يستحقّ أكبر قدر من الفضل في إنهائها فعليًا. فمعظم اللغات الجديدة اليوم لا تملك عبارات قفز غير مهيكلة.
رسالة من صفحة ونصف دمرت تقريبًا بمفردها ميزة من ميزات اللغة -- لا بدّ أنّها شيء مبهر حقًّا. إن لم تقرأها، فأشجّعك على فعل ذلك. فهي قطعة فارقة في تراث علوم الحاسوب، إحدى الأغاني التأسيسية لقبيلتنا. كما أنّها تمرين قصير ولطيف على قراءة الكتابة الأكاديمية في علوم الحاسوب الأكاديمية، وهي مهارة مفيدة للتطوير.
قرأتها عدّة مرات، مع بضع نقدات وردود وشروح. وانتهيت إلى مشاعر مختلطة، في أفضل الأحوال. وعلى مستوى عالٍ جدًّا، فإنّني معه. حجّته العامّة شيء كهذا:
-
بصفتنا مبرمجين، نكتب برامج -- نصًّا ساكنًا -- لكن ما يهمّنا هو البرنامج الفعلي الذي يعمل -- سلوكه الديناميكي.
-
نحن أفضل في التفكير في الأشياء الساكنة ممّا نحن في الأشياء الديناميكية. (هو لا يقدّم أيّ دليل لدعم هذا الادّعاء، لكنّني أصدّقه.)
-
إذن، كلما أمكننا جعل التنفيذ الديناميكي للبرنامج يعكس بنيته النصّية، كان ذلك أفضل.
هذه بداية جيّدة. فجذب انتباهنا إلى الفصل بين الشيفرة التي نكتبها والشيفرة كما تعمل داخل الآلة هو ملاحظة مثيرة للاهتمام. ثم يحاول أن يعرّف "توافقًا" (correspondence) بين نصّ البرنامج والتنفيذ. وبالنسبة لمن أمضى حياته المهنية كاملة يدعو إلى صرامة أكبر في البرمجة، فإنّ تعريفه إبهار إلى حدٍّ ما. فهو يقول:
لننظر الآن في كيفية مَيزنا لتقدّم عملية ما. (يمكنك التفكير في هذا السؤال بصيغة ملموسة جدًّا: لنفترض أنّ عملية ما، منظورة على أنّها تعاقب زمني من الأفعال، تتوقّف بعد فعل اعتباطي، فما البيانات التي لدينا من أجلها لنعيد تنفيذ العملية حتى النقطة نفسها بالضبط؟)
تخيّل الأمر هكذا. لديك حاسوبان يعمل عليهما البرنامج نفسه على المُدخَلات نفسها تمامًا -- أي حتمية تامّة. فتقوم بإيقاف أحدهما عند نقطة اعتباطية في تنفيذه. فما البيانات التي ستحتاج إلى إرسالها إلى الحاسوب الآخر كي توقفه عند النقطة نفسها التي بلغها الأول بالضبط؟
إن كان برنامجك يسمح فقط بتصريحات بسيطة كالإسناد، فالأمر سهل. فأنت تحتاج فقط إلى معرفة
النقطة بعد آخر تصريح نفّذته. أي نقطة توقّف في الأساس، أي ip في آلتنا الافتراضية، أو رقم
السطر في رسالة خطأ. وإضافة تدفّق تحكّم تفريعي مثل if وswitch لا تضيف شيئًا فوق ذلك.
فحتى إن كانت العلامة تشير إلى داخل فرع، ما زلنا نستطيع معرفة أين نحن.
وبمجرد أن تضيف استدعاءات الدوالّ، تحتاج إلى شيء أكثر. فكان بإمكانك إيقاف الحاسوب الأول في منتصف دالة، لكنّ تلك الدالة قد تُستدعى من عدّة أماكن. ولإيقاف الآلة الثانية عند النقطة نفسها بالضبط في تنفيذ البرنامج بأكمله، عليك إيقافها عند الاستدعاء الصحيح لتلك الدالة.
إذن عليك أن تعرف ليس التصريح الحالي فحسب، بل، وبالنسبة لاستدعاءات الدوالّ التي لم تعد بعد، عليك أن تعرف مواقع الاستدعاءات (callsites). بمعنى آخر، مكدّس استدعاءات (call stack)، وإن كنت لا أظنّ أنّ هذا المصطلح كان موجودًا حين كتب ديكسترا هذا. يا سلام.
يشير إلى أن الحلقات تجعل الأمور أصعب. فإذا أوقفتَ التنفيذ في منتصف جسم حلقة، فلا تعرف كم دورة قد نُفِّذت. فيقول إنّ عليك كذلك الاحتفاظ بعدّاد دورات. وبما أنّ الحلقات يمكن أن تتداخل، فأنت تحتاج إلى مكدّس لتلك العدّادات (على الأرجح متشابكًا مع مؤشّرات مكدّس الاستدعاءات، إذ يمكنك أن تكون في حلقات داخل استدعاءات خارجية أيضًا).
هنا تصبح الأمور غريبة. فنحن الآن نبني فعلًا نحو شيء ما، وتنتظر منه أن يشرح كيف يكسر goto كلّ هذا. وبدلًا من ذلك، فإنّه يقول ببساطة:
الاستخدام غير المقيَّد لعبارة go to له نتيجة فورية وهي أنّه يصبح من الصعب جدًا العثور على مجموعة ذات معنى من الإحداثيات لوصف تقدّم العملية.
لا يثبت أنّ هذا صعب، ولا يقول لماذا. إنّه يقول ذلك فحسب. لكنّه يذكر أنّ أحد النهج غير مُرضٍ:
بعبارة go to، يمكننا بالطبع أن نصف التقدّم على نحو فريد بعدّاد يعدّ الأفعال التي نُفِّذت منذ بدء البرنامج (أي، نوعٌ من الساعة المُطبَّعة). والصعوبة أنّ هذا الإحداثي، وإن كان فريدًا، فلا فائدة منه على الإطلاق.
لكن... هذا إلى حدٍّ ما هو بالضبط ما تفعله عدّادات الحلقات، وهو لم يمانعها. وليس الأمر أنّ
كل حلقة هي "لكل عدد صحيح من 0 إلى 10" بعدّاد يزداد. فكثير منها حلقات while بشروط معقّدة.
لنأخذ مثالًا قريبًا إلينا، فتأمّل حلقة تنفيذ شيفرة البايت الأساسية في قلب clox. يجادل ديكسترا بأنّ تلك الحلقة قابلة للتدبّر لأنّنا نستطيع ببساطة أن نعدّ كم مرّة دارت الحلقة والبرهنة على تقدّمها. لكنّ تلك الحلقة تدور مرّة لكل تعليمة مُنفَّذة في برنامج Lox مُصرَّف لمستخدم ما. فهل يخبرك أنّها نفّذت 6,201 تعليمة شيفرة بايت فعلًا بأيّ شيء مفيد عن حالة المفسّر؟
في الحقيقة، يشير هذا المثال بعينه إلى حقيقة أعمق. فقد [أثبت][] Böhm وJacopini أنّ أيّ تدفّق تحكّم يستخدم goto يمكن تحويله إلى تدفّق يستخدم التسلسل والحلقات والتفرّعات فقط. وحلقة مفسّر شيفرة البايت لدينا مثال حيّ على ذلك البرهان: فهي تنفّذ تدفّق التحكم غير المهيكل لمجموعة تعليمات شيفرة البايت في clox دون استخدام أيّ goto بنفسها.
يبدو أنّ ذلك يقدّم حجّة مضادّة لادّعاء ديكسترا: يمكنك تعريف توافق لبرنامج يستخدم goto عبر تحويله إلى برنامج لا يستخدمه ثم استخدام التوافق الخاص بذلك البرنامج، وهو -- بحسب كلامه -- مقبول لأنّه يستخدم التفريعات والحلقات فقط.
لكن، بصراحة، حجّتي هنا ضعيفة أيضًا. فأنا أظنّ أنّنا كلّنا نمارس رياضيات وهمية ونستعمل منطقًا زائفًا لنصنع ما ينبغي أن يكون حجّة تجريبية تتمحور حول الإنسان. وديكسترا محقّ في أنّ بعض الشيفرة التي تستخدم goto سيّئة حقًّا. والكثير من ذلك يمكن ويُستحسن أن يتحوّل إلى شيفرة أوضح باستخدام تدفّق تحكّم مهيكل.
بإزالة goto بالكامل من اللغات، فأنت تمنع نفسك من كتابة شيفرة سيّئة باستخدام goto. ولعلّ إجبار المستخدمين على استخدام تدفّق تحكّم مهيكل وجعل كتابة شيفرة شبيهة بـ goto بتلك البنى صعبةً هو مكسب صافٍ لإنتاجيتنا جميعًا.
لكنني أتساءل أحيانًا إن كنّا قد رَمَينا بالطفل مع ماء الحمّام. ففي غياب goto، نلجأ غالبًا إلى أنماط مهيكلة أعقد. و"switch داخل حلقة" مثال كلاسيكي. وآخر هو استخدام متغيّر حارس للخروج من سلسلة حلقات متداخلة:
// See if the matrix contains a zero.
bool found = false;
for (int x = 0; x < xSize; x++) {
  for (int y = 0; y < ySize; y++) {
    for (int z = 0; z < zSize; z++) {
      if (matrix[x][y][z] == 0) {
        printf("found");
        found = true;
        break;
      }
    }
    if (found) break;
  }
  if (found) break;
}
هل هذا فعلًا أفضل من:
for (int x = 0; x < xSize; x++) {
  for (int y = 0; y < ySize; y++) {
    for (int z = 0; z < zSize; z++) {
      if (matrix[x][y][z] == 0) {
        printf("found");
        goto done;
      }
    }
  }
}
done:
أظنّ ما لا أحبّه حقًّا هو أنّنا نتّخذ اليوم قرارات تصميم اللغة والهندسة على أساس الخوف. فقلّة من الناس اليوم لديهم فهم دقيق للمشكلات والفوائد الخاصة بـ goto. وبدلًا من ذلك، فإنّنا نفكّر مجرّدًا أنّه "مُعتبر ضارًّا". شخصيًّا، لم أجد العقيدة نقطة انطلاق جيّدة للعمل الإبداعي المبدئي.