التحكّم في المسار
المنطق، مثل الويسكي، يفقد أثره النافع إذا أُخذ بكميات كبيرة جداً.
إدوارد جون مورتون دراكس بلانكيت، اللورد دانساني
مقارنةً بماراثون الفصل الماضي الشاقّ، فإن اليوم نزهةً خفيفة عبر مروج الأقحوان. لكن العمل سهل، والمكافأة مدهشة في حجمها.
في الوقت الحالي، مفسّرنا لا هو إلا آلة حاسبة. لا يستطيع برنامج Lox أن يفعل سوى قدر ثابت من العمل قبل أن ينتهي. ولمضاعفة زمن تشغيله، عليك أن تضاعف طول شيفرته المصدرية. نحن على وشك إصلاح ذلك. وفي هذا الفصل، يتّخذ مفسّرنا خطوة كبيرة نحو دوريات لغة البرمجة الكبار: اكتمال تورنغ.
آلات تورنغ (باختصار)
في الجزء الأول من القرن الماضي، تعثّر الرياضيون في سلسلة من تناقضات مُربكة دفعتهم للشك في متانة الأساس الذي بنوا عليه أعمالهم. ولمعالجة تلك [الأزمة][]، عادوا إلى نقطة الصفر. انطلاقاً من حفنة بديهيات ومن المنطق ونظرية المجموعات، رجوا إعادة بناء الرياضيات على أساس منيع.
أرادوا أن يجيبوا بدقّة عن أسئلة مثل: «هل يمكن إثبات كل الجمل الصحيحة؟» و«هل يمكننا [حساب][] كل الدوال التي نستطيع تعريفها؟» بل وحتى السؤال الأعمّ: «ماذا نعني حين نزعم أن دالة ما قابلة للحساب؟»
افترضوا أن إجابة السؤالين الأولين ستكون «نعم». وكل ما تبقّى هو إثبات ذلك. وإلى أن الإجابة عن كليهما «لا»، والأمر المدهش أن السؤالين متشابكان بعمق. هذه زاوية م fascinating في الرياضيات تمسّ أسئلة جوهرية حول ما تستطيع العقول فعله وكيف يعمل الكون. ولا أستطيع أن أعطيها حقّها هنا.
لكن ما أريد أن أشير إليه هو أن Alan Turing وAlonzo Church، في أثناء إثباتهما أن إجابة السؤالين الأولين هي «لا»، صاغا إجابة دقيقة عن السؤال الأخير -- تعريفاً لأنواع الدوال القابلة للحساب. فقد صاغ كلٌّ منهما نظاماً صغيراً جداً بمجموعة دنيا من الآليات، لكنه يظلّ قوياً بما يكفي لحساب أي دالة من (صفّ كبير جداً من) الدوال.
تُعدّ هذه الآن «الدوال القابلة للحساب». أما نظام تورنغ فيُسمّى آلة تورنغ. ونظام Church هو حساب لامدا (lambda calculus). ولا يزال كلاهما مستخدماً على نطاق واسع كأساس لنماذج الحوسبة، وبل إن كثيراً من لغات البرمجة الوظيفية الحديثة تستخدم حساب لامدا في جوهرها.
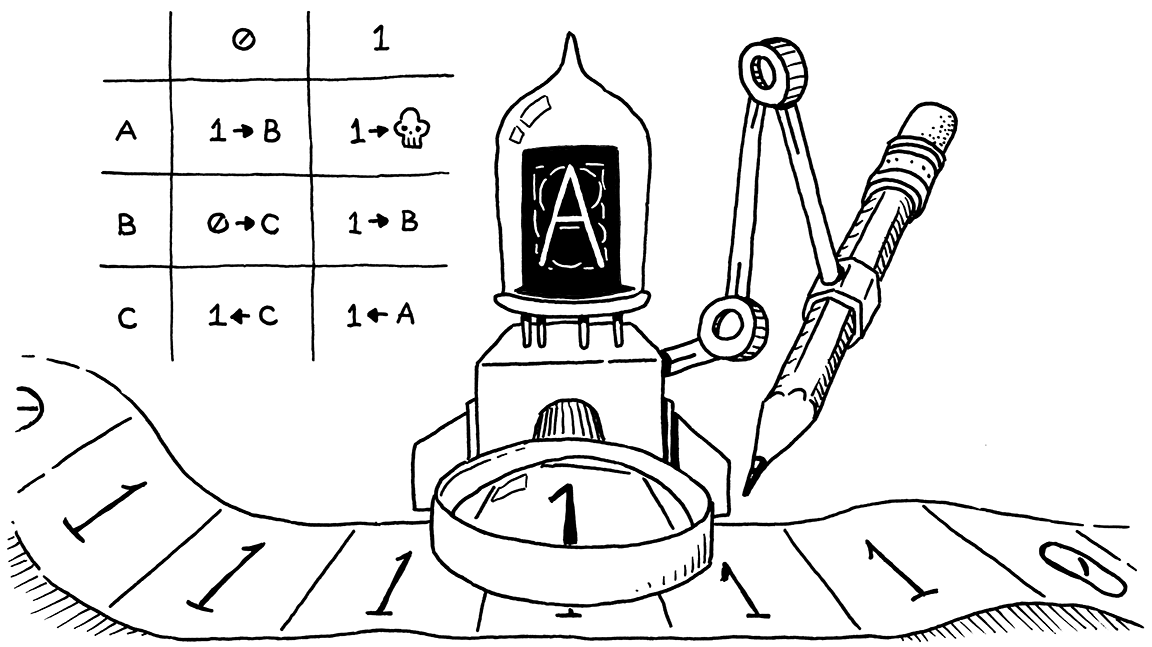
لآلات تورنغ شهرة اسم أفضل -- فليس هناك فيلم هوليوودي عن Alonzo Church بعد -- لكن الصيغتين متكافئتان في القوّة. وفي الواقع، أي لغة برمجة تملك حداً أدنى معيناً من التعبيرية قوية بما يكفي لحساب أي دالة قابلة للحساب.
يمكنك إثبات ذلك بكتابة محاكٍ لآلة تورنغ بلغتك. وبما أن تورنغ أثبت أن آلة يمكنه حساب أي دالة قابلة للحساب، فإن ذلك بالمعلومية يعني أن لغتك تستطيع أيضاً. كل ما تحتاج إليه هو ترجمة الدالة إلى آلة تورنغ، ثم تشغيل تلك الآلة على محاكيك.
إذا كانت لغتك تعبيرية بما يكفين للقيام بذلك، فإنها تُعدّ كاملة تورنغ. وآلات تورنغ بسيطة إلى حدٍّ كبير، لذا لا يلزم قدر كبير من القوّة للقيام بذلك. فأنت تحتاج أساساً إلى عمليات حسابية، وقليل من التحكّم في المسار، والقدرة على تخصيص واستخدام كميات ذاكرة عشوائية (نظرياً). لدينا الأول. وفي نهاية هذا الفصل، سيكون لدينا الثاني.
التنفيذ الشرطي
كفى من التاريخ، لنُحيِّ لغتنا قليلاً. يمكننا تقسيم التحكّم في المسار إلى نوعين تقريباً:
-
التحكّم الشرطي أو المتفرّع (branching) يُستخدم لـعدم تنفيذ جزء من الشيفرة. بشكل أمرّي، يمكنك أن تفكّر فيه كأنك تقفز إلى الأمام فوق منطقة من الشيفرة.
-
التحكّم الحلقوي ينفّذ قطعة من الشيفرة أكثر من مرّة. فهو يقفز إلى الخلف حتى تفعل شيئاً من جديد. وبما أنك لا تريد عادةً حلقات لا نهائية، فإن هناك عادةً منطقاً شرطياً ليعرف متى يتوقّف الحلقة أيضاً.
التفرّع أبسط، لذا سنبدأ به. للغلات المشتقّة من C ميزتان رئيسيّتان في التنفيذ
الشرطي: جملة if والمشغّل «الشرطي» الذي يحمل اسماً
واضحاً (?:). تسمح لك جملة if بتنفيذ جمل بشكل شرطي، ويسمح لك المشغّل
الشرطي بتنفيذ تعبيرات بشكل شرطي.
لأغراض البساطة، لا تملك Lox مشغّلاً شرطياً، فلنُشغّل جملة if عندنا. تتلقّى
قواعدنا اللغويةللجمل إنتاجاً جديداً.
statement      → exprStmt
               | ifStmt
               | printStmt
               | block ;

ifStmt         → "if" "(" expression ")" statement
               ( "else" statement )? ;
لجملة if تعبير للشرط، ثم جملة تُنفَّذ إذا كان الشرط truthy. واختيارياً، قد يكون
لها أيضاً كلمة else وجملة تُنفَّذ إذا كان الشرط falsey. وعقدة شجرة التركيب لها حقول لكل واحدة من هذه القطع الثلاث.
^code if-ast (1 before, 1 after)
مثل الجمل الأخرى، يتعرّف المحلل النحوي على جملة if بالكلمة المفتاحية if
السابقة لها.
^code match-if (1 before, 1 after)
وحين يجدها، يستدعي هذه الدالة الجديدة لتحليل الباقي:
^code if-statement
وكالمعتاد، تتبع شيفرة التحليل القواعد اللغوية عن قرب. فهي تكتشف بند else بالبحث
عن كلمة else السابقة. إن لم تكن هناك، يكون حقل elseBranch في شجرة التركيب هو
null.
ذلك else الاختياري الذي يبدو بريئاً فتح في الواقع لغموضاً في قواعدنا اللغوية. تأمّل:
if (first) if (second) whenTrue(); else whenFalse();
إليك اللغز: لأي جملة if ينتمي بند else ذلك؟ وهذا ليس مجرد سؤال نظري عن كيفية
تدوين قواعدنا اللغوية. بل يؤثر فعلياً في كيفية تنفيذ الشيفرة:
-
إن أرفقنا else بجملة
ifالأولى، فإنwhenFalse()تُستدعى إذا كانfirstfalsey، بغضّ النظر عن قيمةsecond. -
إن أرفقناه بجملة
ifالثانية، فإنwhenFalse()لا تُستدعى إلا إذا كانfirsttruthy وكانsecondfalsey.
ولأن بنود else اختيارية، ولأنه لا يوجد فاصل صريح يحدّد نهاية جملة if، فإن
القواعد اللغوية تكون ملتبسة عند تداخل if بهذه الطريقة. وهذه المشكلة النحوية
الكلاسيكية تُسمّى مشكلة [الـ else المعلَّق][] (dangling else).
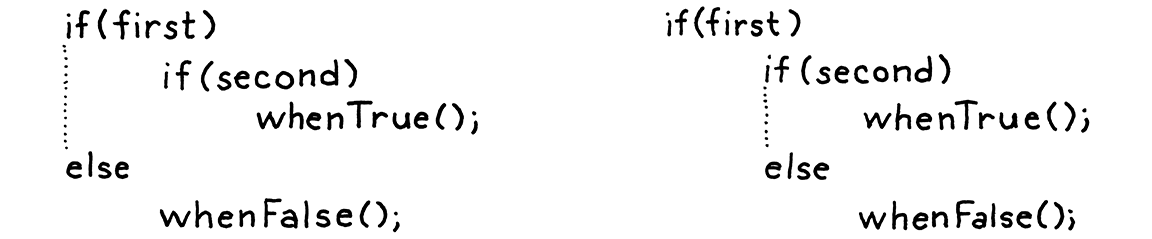
من الممكن فعلاً تعريف قواعد لغوية خالية من السياق تتجنّب هذا الالتباس مباشرةً،
لكن ذلك يتطلّب تقسيم معظم قواعد الجمل إلى أزواج: واحدة تسمح بـif مع else
وأخرى لا تسمح. وهو أمر مزعج.
بدلاً من ذلك، تتجنّب معظم اللغات والمحللات النحوية المشكلة بطريقة ارتجالية. فمهما
كانت الحيلة التي يبتذرونها لتخلّص أنفسهم منها، فإنهم يختارون دائماً التفسير نفسه --
يرتبط else بأقرب if يسبقه.
ومحللنا النحوي يفعل ذلك بالفعل. فبما أن ifStatement() يبحث ب المدرّية عن else
قبل أن يُرجع، فإنّ innermost استدعاء في سلسلة متداخلة سيطالب ببند else لنفسه قبل
العودة إلى جمل if الخارجية.
والآن، مع الصياغة، نحن مستعدّون للتفسير.
^code visit-if
تنفيذ المفسّر هو غلاف رقيق حول شيفرة Java نفسها ذاتها. فهو يقيّم الشرط. إن كان truthy، ينفّذ فرع then. وإلا، إن كان هناك فرع else، ينفّذ ذلك.
إن قارنتَ هذه الشيفرة بكيفية تعامل المفسّر مع الصياغات الأخرى التي نفّذناها، فجزء
جملة if في Java هو ما يجعل التحكّم في المسار خاصّاً. فمعظم أشجار التركيب الأخرى
تقيّم أشجارها الفرعية دائماً. أما هنا، فقد لا نقيّم جملة then أو else. وإن كان أيٌّ
منهما له أثر جانبي، فإن خيار عدم تقييمه يصبح مرئياً للمستخدم.
المشغّلات المنطقية
بما أننا لا نملك المشغّل الشرطي، فقد تظنّ أننا انتهينا من التفرّع، لكن لا. فحتى بدون
المشغّل الثلاثي، هناك مشغّلان آخران تقنياً من باني التحكّم في المسار --
والمشغّلان المنطقيان and وor.
هذان ليسا كالمشغّلات الثنائية الأخرى لأنهما يتجاهلان قصير الدائرة (short-circuit). فإذا، بعد تقييم المُعامل الأيسر، عرفنا ما يجب أن تكون عليه نتيجة التعبير المنطقي، فلا نقيّم المُعامل الأيمن. مثلاً:
false and sideEffect();
لكي يُقيَّم تعبير and إلى شيء truthy، يجب أن يكون كلا المُعاملين truthy. وبمجرد
أن نقيّم المُعامل الأيسر false نرى أن الأمر لن يكون كذلك، فلا حاجة إلى تقييم
sideEffect() ويُتخطّى.
هذا هو سبب عدم تنفيذنا للمشغّلات المنطقية مع المشغّلات الثنائية الأخرى. والآن
نحن مستعدّون. فالمشغّلان الجديدان منخفضان في جدول الأولويات. ومثل || و&& في
C، لكل منهما أولويته الخاصة معكون or أدنى من
and. ونُدخلهما بينهما تماماً بين assignment وequality.
expression     → assignment ;
assignment     → IDENTIFIER "=" assignment
               | logic_or ;
logic_or       → logic_and ( "or" logic_and )* ;
logic_and      → equality ( "and" equality )* ;
بدلاً من الرجوع إلى equality، تتتالى assignment الآن إلى logic_or. والقاعدتان
الجديدتان، logic_or وlogic_and، شبيهتان ومشغّلات
ثنائية أخرى. ثم تستدعي logic_and الدالة equality لمُعامليها، Returning
إلى بقية قواعد التعبير.
يمكننا إعادة استخدام صنف Expr.Binary الموجود لهذين التعبيرين الجديدين لأن حقولهما
متطابقة. لكن عندئذٍ سيضطر visitBinaryExpr() إلى التحقّق ممّا إذا كان المشغّل
أحد المشغّلات المنطقية واستخدام مسار شيفرة مختلف للتعامل مع التجاهل القصير. أرى أن
الأنظف أن نعرّف صنفاً جديداً لهذين المشغّلين حتى
يحصلا على دالة زيارة خاصة بهما.
^code logical-ast (1 before, 1 after)
لنسج التعبيرات الجديدة في المحلل النحوي، نغيّر أولاً شيفرة تحليل الإسناد لتستدعي
or().
^code or-in-assignment (1 before, 2 after)
شيفرة تحليل سلسلة تعبيرات or تحاكي المشغّلات الثنائية الأخرى.
^code or
ومُعاملاها هما مستوى الأولوية الأعلى التالي، أي تعبير and الجديد.
^code and
وهي تستدعي equality() لمُعامليها، وبذلك يعود محلّل التعبيرات إلى ما كان عليه
تماماً. نحن مستعدّون للتفسير.
^code visit-logical
إن قارنتَ هذا بدالة visitBinaryExpr() في الفصل الأسبق، فسترى
الفرق. هنا، نقيّم المُعامل الأيسر أولاً. ننظر إلى قيمته لنرى إن كنا نستطيع التجاهل
القصير. وإن لم نتمكن، وعندئذٍ فقط، نقيّم المُعامل الأيمن.
الجزء اللافت الآخر هنا هو تحديد القيمة الفعلية التي نُعيدها. وبما أن Lox مكتوبة
النوع ديناميكياً، نسمح بمُعاملات من أي نوع ونستخدم truthiness لتحديد ما يمثّله كل
مُعامل. ونطبّق تفكيراً مشابهاً على النتيجة. بدلاً من الوعد بأن نُعيد حرفياً true أو
false، فإن مشغّلاً منطقياً يضمن فقط أنه سيُعيد قيمة ذات truthiness مناسبة.
ولحسن الحظ، لدينا قيم ذات truthiness صحيحة في المتناول -- نتائج المُعاملات نفسها. لذا نستخدمها. مثلاً:
print "hi" or 2; // "hi".
print nil or "yes"; // "yes".
في السطر الأول، "hi" هي truthy، لذا يتجاهل or قصير الدائرة ويُعيدها. وفي
السطر الثاني، nil هي falsey، لذا يُقيّم ويُعيد المُعامل الثاني، "yes".
هذا يغطّي جميع أواصر التفرّع في Lox. نحن مستعدّون للقفز إلى الأمام نحو الحلقات. أترى ما فعلتُه هناك؟ قفز. إلى الأمام. أدركتَ؟ انظر،إنه مثل إشارة إلى... أوه، انسَ ذلك.
حلقات While
تقدّم Lox جملتَي تحكّم حلقويتين: while وfor. حلقة while هي الأبسط، لذا
سنبدأ بها. قواعدها اللغوية نفسها كما في C.
statement      → exprStmt
               | ifStmt
               | printStmt
               | whileStmt
               | block ;

whileStmt      → "while" "(" expression ")" statement ;
نضيف بنداً آخر إلى قاعدة statement يشير إلى القاعدة الجديدة لحلقة while. فهي تأخذ
كلمة while مفتاحية، يليها تعبير شرط محاط بأقواس، ثم جملة تكون الجسم. وتحصل قاعدة
القواعد اللغوية الجديدة هذه على عقدة شجرة تركيب.
^code while-ast (1 before, 1 after)
تخزّن العقدة الشرط والجسم. وهنا يمكنك أن ترى لماذا من الجميل أن تكون لدينا أصناف أساسية منفصلة للتعبيرات والجمل. فإعلانات الحقول توضّح أن الشرط تعبير وأن الجسم جملة.
وفي المحلل النحوي، نتبع العملية نفسها التي استخدمناها لجمل if. أولاً، نضيف حالة
أخرى في statement() لاكتشاف الكلمة المفتاحية السابقة ومطابقتها.
^code match-while (1 before, 1 after)
وهذا يفوّض العمل الفعلي إلى هذه الدالة:
^code while-statement
القواعد اللغوية بسيطة جداً وهذا ترجمة حرفيّة لها إلى Java. وبمناسبة الحديث عن الترجمة الحرفية إلى Java، إليك كيف نُنفّذ الصياغة الجديدة:
^code visit-while
مثل دالة الزيارة الخاصة بـif، يستخدم هذا الزائر ميزة Java المقابلة. هذه الدالة
ليست معقّدة، لكنها تجعل Lox أقوى بكثير. يمكننا أخيراً كتابة برنامج زمن تشغيله غير
مقيّد تماماً بطول شيفرته المصدرية.
حلقات For
بقي لنا آخر باني تحكّم في المسار، حلقة for بنمط C القديم. ولستُ بحاجة على الأرجح إلى تذكيرك، لكنها تبدو هكذا:
for (var i = 0; i < 10; i = i + 1) print i;
بلغة القواعد اللغوية، هذا:
statement      → exprStmt
               | forStmt
               | ifStmt
               | printStmt
               | whileStmt
               | block ;

forStmt        → "for" "(" ( varDecl | exprStmt | ";" )
                 expression? ";"
                 expression? ")" statement ;
داخل الأقواس، لديك ثلاثة بنود تفصلها فواصل منقوطة:
-
البند الأول هو المُهيّئ. يُنفَّذ مرّة واحدة بالضبط، قبل أي شيء آخر. وهو عادةً تعبير، لكن من باب الراحة نسمح أيضاً بإعلان متغيّر. وفي تلك الحالة، يكون نطاق المتغيّر محصوراً ببقية حلقة
for-- البندين الآخرين والجسم. -
التالي هو الشرط. كما في حلقة
while، يتحكّم هذا التعبير في متى نخرج من الحلقة. ويُقيَّم مرّة واحدة في بداية كل دورة، بما في ذلك الأولى. إن كانت النتيجة truthy، ينفّذ جسم الحلقة. وإلا، فيخرج. -
البند الأخير هو الزيادة. إنه تعبير حرّ يقوم ببعض العمل في نهاية كل دورة من دورات الحلقة. وتُهمَل نتيجة التعبير، لذا يجب أن يكون له أثر جانبي ليكون نافعاً. في الممارسة، هو عادةً يزيد متغيّراً.
ويمكن حذف أيّ من هذه البنود. وبعد قوس الإغلاق تأتي جملة الجسم، وهي عادةً كتلة.
نزع السكر
هذا كثير من الآليات، لكن لاحظ أن منها لا شيء يفعل ما لا تستطيع فعله بالجمل التي
لديك بالفعل. فإذا لم تكن حلقات for تدعم بنود المهيّئ، لاستطعت ببساطة وضع تعبير
المهيّئ قبل جملة for. وبدون بند الزيادة، لاستطعت ببساطة وضع تعبير الزيادة في
نهاية الجسم بنفسك.
بمعنى آخر، لا تحتاج Lox إلى حلقات for، وإنما هي تجعل بعض أنماط الشيفرة
الشائعة أكثر متعة في الكتابة. وتُسمّى هذه النوعية من الميزات سكراً نحوياً (syntactic sugar). فمثلاً، يمكن إعادة كتابة
حلقة for السابقة هكذا:
{
  var i = 0;
  while (i < 10) {
    print i;
    i = i + 1;
  }
}
هذا السكربت له الدلالات نفسها تماماً كما كان قبله، لكنه أقلّ راحةً للعين. وميزات
السكر النحوي مثل حلقة for في Lox تجعل اللغة أكثر متعةً وإنتاجية في العمل. لكن،
وخاصة في تطبيقات اللغات المتطوّرة، فإن كل ميزة لغة تتطلّب دعم طرف خلفي وتحسيناً
تكلّفتها باهظة.
يمكننا أن نأكل الكعكة ونأخذها أيضاً بواسطة نزع السكر (desugaring). وتصف تلك الكلمة الغريبة عملية يأخذ فيها المقدّم الأمامي شيفرة تستخدم السكر النحوي ويترجمها إلى شكل أوّلي أكثر يعرف كيف ينفّذه الطرف الخلفي أصلاً.
سننزع سكر حلقات for إلى حلقات while وإلى الجمل الأخرى التي يتعامل معها
المفسّر بالفعل. وفي مفسّرنا البسيط، لا يوفّر لنا نزع السفر حقاً الكثير من العمل،
لكنه يتيح لي فرصة أن أقدّم لك هذه التقنية. إذن، بخلاف الجمل السابقة، لن نضيف
عقدة شجرة تركيب جديدة. بدلاً من ذلك، ننتقل مباشرةً إلى التحليل. أولاً، أضف import
سنحتاجه قريباً.
^code import-arrays (1 before, 1 after)
وكما في كل جملة، نبدأ تحليل حلقة for بمطابقة كلمتها المفتاحية.
^code match-for (1 before, 1 after)
وهنا تصبح الأمور مثيرة. فنزع السكر سيحدث هنا، لذا سنبني هذه الدالة قطعةً قطعة، بدءاً بقوس الفتح السابق للبنود.
^code for-statement
البند الأول التالي لذلك هو المُهيّئ.
^code for-initializer (2 before, 1 after)
إن كان الرمز التالي لـ( هو فاصلة منقوطة، فالمُهيّئ قد حُذف. وإلا، فإننا نتحقّق من
كلمة var لنرى إن كانت إعلاناً لـمتغيّر. وإن لم
يطابق أيٌّ منهما، فلا بدّ أنه تعبير. نحلّله ونلفّه في جملة تعبير حتى يكون المُهيّئ
دائماً من نوع Stmt.
التالي هو الشرط.
^code for-condition (2 before, 1 after)
ومرةً أخرى، نبحث عن فاصلة منقوطة لنرى إن كان البند قد حُذف. والبند الأخير هو الزيادة.
^code for-increment (1 before, 1 after)
إنه مشبه ببند الشرط، لكن هذا البند ينتهي بقوس الإغلاق. ولم يبقَ سوى الجسم.
^code for-body (1 before, 1 after)
لقد حلّلنا جميع قطع حلقة for المختلفة، وعُقد AST الناتجة جالسة في حفنة من
المتغيّرات المحلّية في Java. وهنا يأتي نزع السكر. نأخذ تلك ونستخدمها لتركيب عقد
شجرة تركيب تعبّر عن دلالات حلقة for، مثل مثال النزع اليدوي الذي عرضته عليك
سابقاً.
تصبح الشيفرة أبسط قليلاً إن عملنا من الخلف، لذا نبدأ ببند الزيادة.
^code for-desugar-increment (2 before, 1 after)
الزيادة، إن وُجدت، تُنفَّذ بعد الجسم في كل دورة من دورات الحلقة. ونفعل ذلك باستبدال الجسم بكتلة صغيرة تحتوي الجسم الأصلي يليها جملة تعبير تقيّم الزيادة.
^code for-desugar-condition (2 before, 1 after)
ثم نأخذ الشرط والجسم ونبني الحلقة باستخدام حلقة while أوّلية. وإن حُذف الشرط،
فندفع true لنحصل على حلقة لا نهائية.
^code for-desugar-initializer (2 before, 1 after)
وأخيراً، إن وُجد مُهيّئ، فإنه ينفَّذ مرّة واحدة قبل الحلقة بأكملها. ونفعل ذلك أيضاً باستبدال الجملة كاملةً بكتلة تشغّل المُهيّئ ثم تنفّذ الحلقة.
هذا كل شيء. صار مفسّرنا الآن يدعم حلقات for بنمط C ولم نضطر إلى لمس صنف
Interpreter إطلاقاً. ولأننا نزعنا السكر إلى عقد يعرف المفسّر كيفية زيارتها بالفعل،
فلم يبقَ المزيد من العمل.
أخيراً، صارت Lox قوية بما يكفي لتسليتنا، ولو لبضع دقائق على الأقل. إليك برنامجاً صغيراً يطبع أول 21 عنصراً في متتالية فيبوناتشي:
var a = 0;
var temp;

for (var b = 1; a < 10000; b = temp + b) {
  print a;
  temp = a;
  a = b;
}
التحديات
-
بعد بضعة فصول من الآن، حين تدعم Lox دوالاً من الدرجة الأولى وتوجيهاً ديناميكياً، فلن نحتاج تقنياً إلى جمل تفرّع مدمجة في اللغة. بيّن كيف يمكن تنفيذ التنفيذ الشرطي بواسطة هذه الأدوات. وسمّ لغة تستخدم هذه التقنية في تحكّمها في المسار.
-
وعلى النحو نفسه، يمكن تنفيذ التكرار باستخدام تلك الأدوات نفسها، شريطة أن يدعم مفسّرنا تحسيناً مهماً. ما هو، ولماذا هو ضروري؟ وسمّ لغة تستخدم هذه التقنية في تكرارها.
-
بخلاف Lox، تدعم معظم اللغات الأخرى بنمط C أيضاً جملتَي
breakوcontinueداخل الحلقات. أضف دعماً لجملbreak.الصياغة هي كلمة
breakمفتاحية يليها فاصلة منقوطة. وينبغي أن يكون ظهور جملةbreakخارج أي حلقة محيطة خطأً نحوياً. في الزمن التشغيلي، تتسبب جملةbreakفي قفز التنفيذ إلى نهاية أقرب حلقة محيطة والمتابعة من هناك. لاحظ أنbreakقد تكون متداخلة داخل كتل وجملifأخرى تحتاج هي أيضاً إلى الخروج منها.
ملاحظة تصميم: ملاعق من السكر النحوي
حين تصمّم لغتك الخاصة، فأنت تختار مقدار السكر النحوي الذي تصبّه في القواعد اللغوية. فهل تصنع طعاماً صحياً بلا سكّر تُقابل فيه كل عملية دلالية وحدة نحوية واحدة، أمحلوى فاخرة فاخرة حيث يمكن التعبير عن كل ذرّة سلوك بعشر طرق مختلفة؟ أما اللغات الناجحة فتقيم في كل نقاط هذا الطيف.
وفي الطرف اللاذع الحادّ توجد لغات ذات صياغة دنيا بلا رحمة مثل Lisp وForth وSmalltalk. فمشترو Lisp المشهورون يدّعون أن لغتهم «لا صياغة لها»، بينما يتباهى أهل Smalltalk بأنك تستطيع أن تضع القواعد اللغوية كاملةً على بطاقة فهرس. ولهذه العائلة فلسفة أن اللغة لا تحتاج سكراً نحوياً. بدلاً من ذلك، فالصياغة والدلالات الدنيا التي تقدّمها قوية بما يكفي لتتيح لشيفرة المكتبات أن تكون تعبيرية كما لو كانت جزءاً من اللغة نفسها.
قريباً من هذه توجد لغات مثل C وLua وGo. فهي تسعى إلى البساطة والوضوح أكثر من التقليص. وبعضها، مثل Go، يتجنّب عمداً كلاً من السكر النحوي وقابلية التوسّع النحوي من الفئة السابقة. إنهم يريدون للصياغة أن تزيح نفسها عن طريق الدلالات، لذا يركّزون على إبقاء القواعد اللغوية والمكتبات بسيطة. ينبغي أن تكون الشيفرة واضحة أكثر منها جميلة.
وفي المنتصف تجد لغات مثل Java وC# وPython. وفي النهاية تصل إلى Ruby وC++ وPerl و D -- لغات حشمت القواعد اللغوية فيها قدراً كبيراً من الصياغة حتى بدأت تنفد منها محارف الترقيم على لوحة المفاتيح.
إلى حدٍّ ما، فإن الموقع على الطيف correlates مع العمر. فإضافة قطع من السكر النحوي في الإصدارات اللاحقة أمر سهل نسبياً. ف الصياغة الجديدة تُبهر الجماهير، وهي أقلّ احتمالاً لكسر البرامج القائمة من العبث بالدلالات. وبمجرد إضافتها، لا يمكنك سحبها أبداً، لذا تميل اللغات إلى التحلية مع مرور الوقت. ومن أبرز فوائد إنشاء لغة جديدة من الصفر أنه يتيح لك فرصة كشط تلك الطبقات المتراكمة من الك frosting وتبدأ من جديد.
للسكر النحوي سمعة سيئة لدى نخبة لغات البرمجة. فهناك هوس حقيقي بالتقليص في تلك الدائرة. وهناك ما يبرّر ذلك إلى حدٍّ ما. فالصياغة سيّئة التصميم وغير الضرورية ترفع العبء المعرفي دون أن تضيف تعبيرية كافية تبرّر ثقلها. ولأنهناك ضغطاً دائماً لإدخال ميزات جديدة إلى اللغة،,it takes انضباط وتركيز على البساطة لتجنّب الانتفاخ. وبمجرد أن تضيف بعض الصياغة، فأنت محتجز لها، لذا من الحكمة أن تكون مقتصداً.
وفي الوقت نفسه، فإن معظم اللغات الناجحة لديها قواعد لغوية معقّدة إلى حدٍّ لا بأس به، على الأقل في الوقت الذي تصبح فيه مستخدَمة على نطاق واسع. فالمبرمجون يقضون وقتاً طويلاً في لغتهم المفضّلة، وبعض اللمسات هنا وهناك يمكنها حقّاً أن تحسّن راحة عملهم وكفاءتهم.
وهذا يتطلّب أن تضبط التوازن الصحيح -- أن تختار مستوى الحلاوة المناسب للغةك -- وهو ما يعتمد على ذوقك الخاص.