القفل
7. القفل
تشغل معظم النوى، ومنها xv6، تنفيذ أنشطة متعددة تشابكًا. ومصدرٌ من مصادر هذا التشابك هو العتاد متعدد المعالجات: حواسيب تضمّ معالجات مركزية عدّة تنفّذ كلٌّ منها باستقلالية، مثل معالج RISC-V الذي يعمل عليه xv6. وهذه المعالجات تتشارك ذاكرة RAM الفيزيائية، ويستغلّ xv6 هذا التشارك للمحافظة على بنى بيانات في النواة تقرؤها جميع المعالجات وتكتب فيها. وهذا التشارك يفتح المجال أمام احتمال أن تقرأ معالجةٌ بنيةَ بيانات في اللحظة التي تكون معالجةٌ أخرى قد شرعت في تحديثها، أو حتى أن تُحدّث معالجات متعددة البيانات نفسها معًا؛ ودون تصميمٍ واعٍ، فمن المرجّح أن يُفضي هذا الوصول المتوازي إلى نتائج خاطئة أو إلى بنية بياناتٍ معطوبة. حتى على معالجٍ وحيد أيضًا، قد تبدّل النواة المعالج بين عدد من الخيوط، فيتشابك تنفيذها. وأخيرًا، فإنّ مُعالج مقاطعة جهازٍ يُعدّل البيانات نفسها التي تُعدّلها شيفرةٌ قابلة للمقاطعة قد يتلف تلك البيانات إن وقعت المقاطعة في اللحظة التي تكون الشيفرة المُقاطعة قد شرعت في تعديل البيانات فيها أيضًا. وتُشير كلمة التزامن إلى المواقف التي تتشابك فيها تدفقات تعليماتٍ متعددة، سواءً بسبب التوازي متعدد المعالجات أو تبديل الخيوط أو المقاطعات.
وتمتلئ النوى ببيانات يُنال منها تزامنيًا. فمثلًا، قد تستدعي معالجتان kalloc في الوقت نفسه، فتستخرجان من رأس القائمة الحرّة معًا. ويحبّ مصمّمو النوى أن يتركوا متّسعًا واسعًا للتزامن، إذ يمكنه أن يزيد الأداء والاستجابة. لكنّهم يلزمهم بعدئذٍ أن يُقنعوا أنفسهم بالصحّة رغم التزامن. وتُسمّى الاستراتيجيّات الموجّهة إلى الصحّة في ظلّ التزامن، والتجريدات التي تدعمها، تقنيّات تحكّم التزامن (concurrency control).
ويركّز هذا الفصل على تقنيّةٍ شائعة الاستخدام للتحكّم في التزامن، وهي القفل (lock). ولكي نقدّم لمحةً استباقية، إليك كيف يبدو استخدام القفل في نواة xv6:
struct spinlock lk;
...;
acquire(&lk);
... read or write some shared data ...
release(&lk);
ويوفّر القفل استبعادًا متبادلًا، يضمن أنّ معالجةً واحدةً فقط في كل مرة تستطيع حيازة القفل. فإن ربط المبرمج قفلًا بكل عنصر بياناتٍ مشترك، وحازت الشيفرة القفل المرتبط به دائمًا عند استخدام العنصر، فسيستخدم العنصرَ معالجةٌ واحدةٌ فقط في كل مرة. وفي هذا الوضع، نقول إنّ القفل يحمي عنصر البيانات. ومع أنّ القفل آليّةٌ سهلة الفهم للتحكّم في التزامن، فإنّه قد يحدّ من الأداء بتسلسله العمليّات المتزامنة على البيانات التي يحميها.
ويشرح ما بقي من هذا الفصل لماذا يحتاج xv6 إلى الأقفال، وكيف ينفّذها، وكيف يستخدمها.
7.1 حالات التسابق
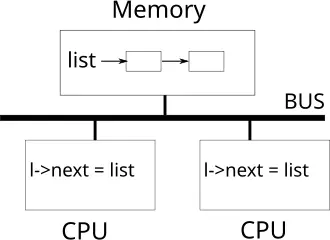
الشكل 7.1: معمارية SMP مبسّطة
ومثلًا على سبب حاجتنا إلى الأقفال، لنأخذ عمليتين لهما أولادٌ قد خرجوا، وتستدعيان نداء النظام wait على معالجتين مختلفتين. فـwait يحرّر ذاكرة الولد. وعليه، على كلّ معالجة، ستستدعي النواة kfree لتحرير صفحات ذاكرة الولدين. ويحتفظ مخصّص النواة بقائمةٍ مترابطةٍ من الصفحات الحرّة: يستخرج kalloc() صفحةً من القائمة، ويدفع kfree() صفحةً إليها. ولكي نحصل على أفضل أداء، قد نأمل أن تُنفّذ نداءات kfree للعمليتين الأبَويتين على التوازي دون أن تنتظر إحداهما الأخرى، لكنّ ذلك لن يكون صحيحًا نظرًا إلى تنفيذ kfree في xv6.
يفصّل الشكل 7.1 هذا السياق تفصيلًا أوسع: فقائمة الصفحات الحرّة المترابطة موجودةٌ في ذاكرةٍ تتشاركها المعالجتان، وهما تتعاملان مع القائمة باستخدام تعليمات التحميل والتخزين. (وفي الواقع، تملك المعالجات مخابئ، لكنّ نظم تعدد المعالجات تتصرف من ناحية المفهوم كما لو كانت هناك ذاكرة واحدة مشتركة.) فلو لم تكن هناك طلبات متزامنة، فلربما نفّذت عمليةَ الدفع push إلى قائمةٍ على النحو التالي:
    struct element {
      int data;
      struct element *next;
    };

    struct element *list = 0;

    void
    push(int data)
    {
      struct element *l;

      l = malloc(sizeof *l);
      l->data = data;
      l->next = list;
      list = l;
   }
** 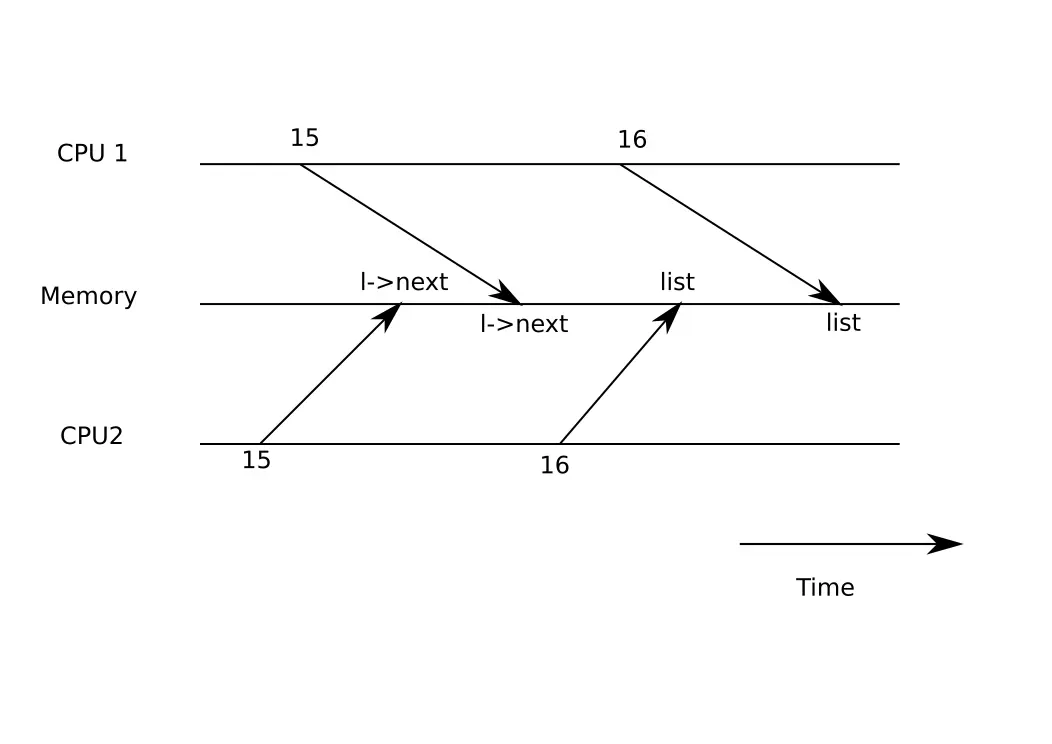
الشكل 7.2: مثال على تسابق
هذا التنفيذ صحيح إذا نُفّذ منفردًا. أمّا الشيفرة فليست صحيحة إذا نُفّذت أكثر من نسخةٍ منها تزامنيًا. فإن نفّذت معالجتان push في الوقت نفسه، فقد تنفّذ كلتاهما السطر 15 كما هو موضّح في الشكل 7.1، قبل أن تنفّذ أيّهما السطر 16، مما ينتج عنه نتيجة خاطئة كما يوضّحه الشكل 7.2. سيكون هناك عندئذٍ عنصران في القائمة قيمة next فيهما هي القيمة السابقة نفسها لـlist. وحين يحدث إسنادان إلى list في السطر 16، فسيطغى الثاني على الأول؛ وسيضيع العنصر الذي أتمّ الإسناد الأول.
إنّ التحديث الضائع في السطر 16 مثالٌ على حالة التسابق (race). وحالة التسابق وضعٌ يُنال فيه موضع ذاكرة تزامنيًا، ويكون أحد الوصولين فيه كتابةً على الأقلّ. وكثيرًا ما تكون حالة التسابق علامةً على علة: إمّا تحديث ضائع (إذا كانت عمليات الوصول كتابات) أو قراءة بنية بياناتٍ لم تكتمل تحديثاتها. وتعتمد نتيجة حالة التسابق على الشيفرة الآلية التي يُنشئها المصرّف، وعلى توقيت المعالجتين المعنيتين، وعلى كيفية ترتيب نظام الذاكرة لعملياتهما، وكلّ ذلك قد يجعل الأخطاء الناجمة عن التسابق صعبة الإعادة والتنقيح. فمثلًا، قد تُغيّر إضافة عبارات الطباعة أثناء تنقيح push توقيت التنفيذ بما يكفي لإخفاء التسابق.
والطريقة المعتادة لتجنّب التسابق هي استخدام قفل. وتضمن الأقفال استبعادًا متبادلًا (mutual exclusion)، فلا تستطيع معالجةٌ واحدةٌ في كل مرة سوى تنفيذ الأسطر الحسّاسة من push؛ وهذا يجعل السيناريو أعلاه مستحيلًا. والإصدار المُقفَل الصحيح من الشيفرة أعلاه يضيف بضعة أسطر فقط (المُظلّلة بالأصفر):
   struct element *list = 0;
   struct lock listlock;

   void
   push(int data)
   {
     struct element *l;
     l = malloc(sizeof *l);
     l->data = data;

     acquire(&listlock);
     l->next = list;
     list = l;
     release(&listlock);
   }
**
ويُسمّى تتابع التعليمات الواقع بين acquire وrelease غالبًا القسم الحرج (critical section). ويُقال إنّ القفل يحمي list.
وحين نقول إنّ قفلًا يحمي بيانات، فإنّنا نعني في الحقيقة أنّ القفل يحمي مجموعةً من الثوابت التي تنطبق على البيانات. والثوابت خصائص بنى البيانات التي تُصان على مرّ العمليات. وعادةً ما يعتمد السلوك الصحيح لعمليّةٍ ما على تحقّق الثوابت عند بدء العمليّة. وقد تخالف العمليّة الثوابت مؤقتًا، لكنّها ينبغي أن تُعيد ترسيخها قبل أن تتم. فمثلًا، في حالة القائمة المترابطة، الثابت هو أنّ list تشير إلى أوّل عنصرٍ في القائمة، وأنّ حقل next في كلّ عنصرٍ يشير إلى العنصر التالي. وتنفيذ push يخالف هذا الثابت مؤقتًا: في السطر 17، تشير l إلى عنصر القائمة التالي، لكنّ list لا تشير إلى l بعد (ويُعاد ترسيخ الثابت في السطر 18). وحدث التسابق الذي فحصناه أعلاه لأنّ معالجةً ثانيةً نفّذت شيفرةً تعتمد على ثوابت القائمة في حين كانت مخالَفةً (مؤقتًا). والاستخدام السليم للقفل يضمن أنّ معالجةً واحدةً فقط في كل مرة تستطيع العمل على بنية البيانات داخل القسم الحرج، فلا تنفّذ أيّ معالجة عمليّةً على بنية البيانات حين لا تصدق ثوابتها.
ويمكنك النظر إلى القفل بوصفه مُسلسِلًا للأقسام الحرجة المتزامنة بحيث تعمل قسمًا بعد آخر، فتصان بذلك الثوابت (على افتراض أنّ الأقسام الحرجة صحيحةٌ منفردةً). ويمكنك أيضًا النظر إلى الأقسام الحرجة التي يحرسها القفل نفسه بوصفها ذرّيةً نسبةً إلى بعضها، فيرى كلٌّ منها المجموعة الكاملة من تغييرات الأقسام الحرجة السابقة فقط، ولا يرى أبدًا تحديثاتٍ لم تكتمل.
ومع أنّ الأقفال مفيدةٌ للصحّة، فإنّها تحدّ من الأداء بطبيعتها. فمثلًا، إذا استدعيت عمليتان kfree تزامنيًا، فإنّ الأقفال ستُسلسل القسمين الحرجين، فلا فائدة من تشغيلهما على معالجتين مختلفتين. ونقول إنّ عملياتٍ متعددة تتعارض إن أرادت القفل نفسه في الوقت نفسه، أو إنّ القفل يعاني تنازعًا. وأحد التحدّيات الكبرى في تصميم النوى هو تجنّب تنازع الأقفال سعيًا إلى التوازي. وxv6 لا يفعل من ذلك إلّا قليلًا، أمّا النوى المتطوّرة فتنظّم بنى البيانات والخوارزميّات بصورةٍ خاصّةٍ لتجنّب تنازع الأقفال. وفي مثال القائمة، قد تحتفظ النواة بقائمة حرّة منفصلة لكلّ معالجة، ولا تمسّ قائمة معالجةٍ أخرى إلّا إذا كانت قائمة المعالجة الحالية فارغة واضطرّت إلى سرقة ذاكرةٍ من معالجةٍ أخرى. وقد تتطلّب حالات الاستخدام الأخرى تصاميمَ أكثر تعقيدًا.
وموضع الأقفال مهمٌّ أيضًا للأداء. فمثلًا، سيكون صحيحًا تقديم acquire في push إلى ما قبل السطر 13. لكنّ ذلك سيقلّل الأداء على الأرجح، إذ ستُسلسل عندئذٍ نداءات malloc. ويقدّم القسم «استخدام الأقفال» أدناه بعض الإرشادات حول مواضع إدراج نداءات acquire وrelease.
7.2 الشيفرة: الأقفال
يُرجى قراءة kernel/spinlock.h وkernel/spinlock.c.
يملك xv6 نوعين من الأقفال: الأقفال الدورانية (spinlocks) وأقفال النوم (sleep-locks). وسنبدأ بالأقفال الدورانية. ويمثّل xv6 القفل الدوراني بـstruct spinlock. والحقل المهمّ في البنية هو locked، وهو كلمةٌ تكون صفرًا عندما يكون القفل متاحًا، وغير صفرية عندما يكون محوزًا. فلو لم يكن هناك تزامن، لاستطاع xv6 حيازة قفلٍ بشيفرةٍ على الشكل التالي:
   void
   acquire(struct spinlock *lk) // does not work!
   {
     for(;;) {
       if(lk->locked == 0) {
         lk->locked = 1;
         break;
       }
     }
   }
**
للأسف، لا يضمن هذا التنفيذ استبعادًا متبادلًا في وجه التزامن. فقد تصل معالجتان إلى السطر 25 في الوقت نفسه، وترى أنّ lk->locked صفر، ثم تحوزان القفل معًا بتنفيذ السطر 26. وعند تلك النقطة، تحوز القفل معالجتان مختلفتان، وهو ما يخالف خاصيّة الاستبعاد المتبادل. وما نحتاجه هو طريقةٌ تجعل السطرين 25 و26 يُنفّذان كخطوةٍ ذرّية (atomic) غير قابلة للانقسام.
ولأنّ الأقفال تُستخدم على نطاقٍ واسع، فإنّ المعالجات متعدّدة الأنوية توفّر عادةً تعليمةً يمكن استخدامها لجعل السطرين 25 و26 ذرّيّين. وفي RISC-V هذه التعليمة هي amoswap r, r, a. فتعليمة amoswap تقرأ القيمة عند عنوان الذاكرة a، وتكتب محتويات المسجّل r في ذلك العنوان، وتضع ما قرأته في r. أي أنّها تبدّل محتويات المسجّل وموضع الذاكرة المُعنون. وهي تؤدّي هذا التتابع ذرّيًا، مستخدمةً عتادًا خاصًّا لمنع أيّ معالجةٍ أخرى من استخدام عنوان الذاكرة بين القراءة والكتابة.
ويوفّر مصرف C عائلةً من الدوالّ المدمجة «الذرّية» التي تُنشئ تعليماتٍ ذرّية. وتستخدم acquire() في xv6 الدالّة __atomic_exchange_n(addr, value, ...) التي تنزل إلى تعليمة amoswap؛ وتُعيد الدالّة المحتويات القديمة (المبدّلة) للعنوان addr. وهذه طريقةٌ جيّدةٌ لكتابة الحلقة في acquire:
  while (__atomic_exchange_n(&lk->locked, 1, __ATOMIC_ACQUIRE) != 0)
    ;
تستخدم acquire في xv6 الحلقة أعلاه (وسيشرح القسم 7.6 معنى __ATOMIC_ACQUIRE). ففي كلّ تكرار، تتبادل الحلقة الواحد في lk->locked وتتحقّق من القيمة السابقة؛ فإن كانت القيمة السابقة صفرًا، فقد حزنا القفل، وسيكون التبديل قد ضبط lk->locked على الواحد. وإن كانت القيمة السابقة واحدًا، فمعالجةٌ أخرى تحوز القفل، وحقيقة أنّنا بدّلنا الواحد ذرّيًا في lk->locked لم تُغيّر قيمته.
وبعد حيازة القفل، تسجّل acquire، لأغراض التنقيح، المعالجة التي حازت القفل. وحقل lk->cpu يحميه القفل، ولا يجوز تغييره إلّا أثناء حيازة القفل.
والدالّة release هي عكس acquire: فهي تمسح حقل lk->cpu ثمّ تحرّر القفل. ومن ناحية المفهوم، فإنّ التحرير يُسنِد صفرًا إلى lk->locked إسنادًا مجرّدًا. ويسمح معيار C للمصرّفات بأن تنفّذ الإسناد بعدّة تعليمات تخزين، فقد يكون إسناد C غير ذرّي بالنسبة إلى شيفرةٍ متزامنة. وبدلًا من ذلك، تستخدم release الدالّة الذرّية في C التي هي __atomic_store_n(addr, 0, ...) والتي تخزّن الصفر في العنوان في عمليّةٍ واحدةٍ غير قابلةٍ للانقسام.
7.3 الشيفرة: استخدام الأقفال
يستخدم xv6 الأقفال في أماكن كثيرة لتجنّب التسابق. وكما ذُكر أعلاه، تُشكّل kalloc وkfree مثالًا جيّدًا على ذلك. فجرّب التمرينين 1 و2 لترى ما يحدث إذا ما أغفلت هاتان الدالّتان الأقفال. ومن المرجّح أن تجد صعوبةً في إثارة السلوك الخاطئ، ممّا يوحي بأنّ اختبار خلوّ الشيفرة من أخطاء الإقفال والتسابق اختبارٌ عسيرٌ على نحوٍ موثوق. وقد يكون في xv6 تسابقاتٌ لم تُكتشف بعد.
من العسير في استخدام الأقفال قرارُ عدد الأقفال التي ينبغي استخدامها وأيّ البيانات والثوابت التي ينبغي لكلّ قفلٍ حمايتها. وهناك بعض المبادئ الأساسيّة. أوّلًا، في أيّ شيفرةٍ قد تُسبّب كتابةً في موضع ذاكرةٍ من قِبل معالجةٍ واحدة في الوقت نفسه الذي تقرأ فيه معالجةٌ أخرى ذلك الموضع أو تكتب فيه، ينبغي استخدام قفلٍ لمنع تداخل العمليّتين. وثانيًا، تذكّر أنّ الأقفال تحمي الثوابت: فإن تعلّق ثابتٌ بمواضع ذاكرةٍ متعددة، فعادةً ما يلزم أن تحميها كلّها قفلٌ واحدٌ لضمان صيانة الثابت.
تقول القواعد أعلاه متى تكون الأقفال ضروريّة، لكنّها لا تقول شيئًا عن متى تكون غير ضروريّة، ومن المهمّ من أجل الكفاءة ألّا يُبالغ في الإقفال، لأنّ الأقفال تُنقص التوازي. فإن لم يكن التوازي مهمًّا، فبالإمكان ترتيب الأمور بحيث لا وجود لخيطٍ إلّا واحدٌ، وألّا يُعير القفل أيّ اهتمام. ويستطيع نواةٌ بسيطةٌ أن تفعل ذلك على متعدّد المعالجات بوجود قفلٍ وحيد؛ تحوز النواة القفل في كلّ مرةٍ تُدخل فيها النواة من فضاء المستخدم، لنداء نظامٍ أو مقاطعة؛ وتحرّر النواة القفل عند عودتها إلى فضاء المستخدم. وقد حُوّلت أنظمةُ تشغيلٍ عديدةٌ ذات معالجٍ واحد لتعمل على متعدّدات المعالجات باستخدام هذا المنهج، الذي يُسمّى أحيانًا «قفل النواة الكبير»، لكنّ المنهج يُضحّي بالتوازي: فلا تستطيع إلّا معالجةٌ واحدة في كل مرة أن تنفّذ في النواة. فإن استهلكت النواة وقتًا مركزيًا ذا شأن، فبالإمكان الحصول على مزيدٍ من التوازي بحماية كائنات أو وحداتٍ مختلفةٍ بأقفال مختلفة، حتّى تستطيع معالجاتٌ مختلفة أن تنفّذ في أجزاء مختلفة من النواة في الوقت نفسه.
ومثالٌ على الإقفال خشن الحُبيبات، فإنّ مخصّص xv6 في kalloc.c يملك قائمةً حرّةً واحدةً يحميها قفلٌ وحيد. فإن حاولت عمليّات متعددة على معالجات مختلفة أن تُخصّص صفحات في الوقت نفسه، فسيلزم كلٌّ منها أن ينتظر دوره بالدوران في acquire. والدوران يُهدر وقت المعالج، إذ ليس عملًا نافعًا. فإن أهدر تنازع القفل جزءًا ذا شأنٍ من وقت المعالج، فلربّما تحسّن الأداء بتغيير المخصّص ليكون له قائمة حرّة منفصلة لكلّ معالجة، لكلٍّ منها قفلها الخاصّ، بما يسمح بتخصيصٍ متوازيٍّ حقيقيّ.
ومثالٌ على الإقفال دقيق الحُبيبات، فإنّ xv6 يملك قفلًا منفصلًا لكلّ ملفٍ، حتّى تستطيع العمليّات التي تُعالج ملفّات مختلفة أن تمضي غالبًا دون انتظار أقفال بعضها بعضًا. ويمكن جعل نظام إقفال الملفّات أدقّ حُبيباتٍ إن أراد المرء أن يسمح للعمليّات بالكتابة في مناطق مختلفة من الملفّ نفسه تزامنيًا. وفي نهاية المطاف، يلزم أن تستند قرارات حُبيبات الإقفال إلى متطلّبات الأداء وكذلك إلى اعتبارات التعقيد.
وبينما تشرح الفصول اللاحقة كلّ جزءٍ من xv6، فإنّها ستذكر أمثلةً على استخدام xv6 الأقفال للتعامل مع التزامن. ولمحةً استباقية، يسرد الشكل 7.3 جميع الأقفال في xv6.
الشكل 7.3: الأقفال في xv6
| القفل | الوصف |
|---|---|
| bcache.lock | يحمي تخصيص مدخلات مخبأ الكتل المؤقّت |
| cons.lock | يُسلسل معالجة قراءة دخل الطرفيّة |
| tx_lock | يُسلسل الوصول إلى عتاد خرج الطرفيّة (uart) |
| ftable.lock | يُسلسل تخصيص struct file في جدول الملفّات |
| itable.lock | يحمي تخصيص مدخلات inode في الذاكرة |
| vdisk_lock | يُسلسل الوصول إلى عتاد القرص وطابور واصفات DMA |
| kmem.lock | يُسلسل تخصيص الذاكرة |
| log.lock | يُسلسل العمليّات على سجلّ المعاملات |
| pipe’s pi->lock | يُسلسل العمليّات على كلّ أنبوب |
| pid_lock | يُسلسل زيادات next_pid |
| proc’s p->lock | يُسلسل تغييرات حالة كلّ عمليّة |
| wait_lock | يساعد wait على تجنّب الإيقاظات المفقودة |
| tickslock | يُسلسل العمليّات على عدّاد ticks |
| inode’s ip->lock | يُسلسل العمليّات على كلّ inode ومحتواه |
| buf’s b->lock | يُسلسل العمليّات على كلّ كتلة مخزّنة مؤقّتة |
7.4 الجمود الميت وترتيب الأقفال
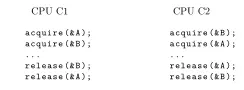
لنفترض أنّ الدالّات التي تعمل على المعالجين C1 وC2 كلتيهما عندها نقطةٍ يحتاج كلٌّ منها فيها إلى حيازة القفلين A وB معًا، وهما تحوزهما بترتيبين مختلفين:
صورة
وبقدرٍ من الحظّ العاثر، قد ينفّذ C1 وC2 نداء الحيازة الأوّل لكلٍّ منهما في اللحظة نفسها تمامًا؛ ويمكن لكليهما أن ينجح، إذ يطلبان قفلين مختلفين. لكنّ C1 وC2 سيضطرّان بعدئذٍ إلى الانتظار في نداءيهما الثانيين إلى acquire()، إذ إنّ كلاّ القفلين محوزٌ أصلًا من المعالج الآخر. ولأنّ كلاّ المعالجين ينتظر الآخر، فلن يحرّر أيٌّ منهما قفلًا أبدًا، وسينتظران إلى الأبد. وتُسمّى هذه الحالة الجمود الميت (deadlock).
إنّ المشكلة الجوهريّة في مثال C1/C2 هي أنّ المعالجين حازا القفلين بترتيبٍ مختلف. فلو حاول كلاهما حيازة A أوّلًا، لحاز أحدهما A ثمّ B ثمّ أحرّر القفلين معًا، ثمّ استطاع المعالج الآخر المضي قدمًا. وبشكلٍ أعمّ، يلزم أن تتبع شيفرة الإقفال هذه القاعدة لتجنّب الجمود الميت: فإنّ جميع مسارات الشيفرة التي تحوز أقفالًا متعدّدة يلزمها حيازة الأقفال بالترتيب نفسه. والحاجة إلى هذا الترتيب العالمي لحيازة الأقفال تعني أنّ الأقفال جزءٌ فعليًّا من مواصفات كلّ دالّة: فيلزم أن يستدعي المستدعون الدالّات بصورةٍ تُسبّب حيازة الأقفال بالترتيب المتّفق عليه.
ويملك xv6 سلاسلَ ترتيبِ أقفالٍ كثيرةً من طولِ اثنين تُضمّ أقفالًا خاصّةً بكلّ عمليّة (القفل في كلّ struct proc) بسبب طريقة عمل آليّة sleep/wakeup (انظر الفصل 9). فمثلًا، consoleintr هي روتين المقاطعة الذي يعالج المحارف المكتوبة. وحين يصل سطر جديد، فيلزم إيقاظ أيّ عمليّةٍ تنتظر دخل الطرفيّة. ولفعل ذلك، يحوز consoleintr القفل cons.lock أثناء ندائه wakeup، الذي يحوز قفل العمليّة المنتظرة لإيقاظها. ونتيجةً لذلك، يضمّ ترتيب الأقفال العالمي المتجنّب للجمود الميت القاعدة التي تنصّ على أنّ cons.lock يلزم حيازته قبل أيّ قفل عمليّة. وشيفرة نظام الملفّات تحتوي أطول سلاسل أقفال في xv6. فمثلًا، فإنّ إنشاء ملفٍ يلزمه حيازة قفل الدليل وقفل inode الملفّ الجديد وقفل كتلة قرصٍ مخزّنة مؤقّتة وvdisk_lock مُشغّل القرص وp->lock العمليّة المستدعية معًا. ولتجنّب الجمود الميت، تحوز شيفرة نظام الملفّات الأقفال دائمًا بالترتيب المذكور في الجملة السابقة.
وقد يكون احترام ترتيبٍ عالميّ يتجنّب الجمود الميت عسيرًا على نحوٍ مفاجئ. فأحيانًا يتعارض ترتيب الأقفال مع البنية المنطقيّة للبرنامج، مثلًا، إذ قد تستدعي وحدة شيفرة M1 الوحدة M2، لكنّ ترتيب الأقفال يقتضي حيازة قفلٍ في M2 قبل قفلٍ في M1. وأحيانًا لا تكون هويّات الأقفال معلومةً مسبقًا، ربّما لأنّ قفلًا يلزم حيازته لكي تُكتشف هويّة القفل التالي الذي يُحاز. وينشأ هذا النوع من المواقف في نظام الملفّات حين يبحث عن المكوّنات المتتالية في اسم مسارٍ، وفي شيفرة نداءَي النظام wait وexit حين يبحثان في جدول العمليّات عن العمليّات الأولاد. وأخيرًا، فإنّ خطر الجمود الميت كثيرًا ما يكون قيدًا على مدى ما يمكن جعل نظام الإقفال دقيق الحُبيبات، إذ إنّ المزيد من الأقفال كثيرًا ما يعني مزيدًا من الفرص للجمود الميت. والحاجة إلى تجنّب الجمود الميت كثيرًا ما تكون عاملًا رئيسًا في تنفيذ النواة.
والسؤال الذي ينشأ أحيانًا هو ما ينبغي أن يحدث إذا حاولت معالجةٌ حيازة قفلٍ تحوزه المعالجة نفسها أصلًا. وأحد مسالك الاستدلال أنّ ذلك ينبغي أن يُسمح به: فلا تستطيع أيّ معالجةٍ أخرى حيازة القفل، فلا حاجة إلى القلق من تدخّل المعالجات في استخدام بعضها بعضًا للبيانات المحميّة. وتُسمّى أنظمة الأقفال التي تسمح لمعالجةٍ بأن تحوز من جديد قفلًا تحوزه أصلًا قابلةً لإعادة الدخول (re-entrant) أو تعاوديّة (recursive). ومن ناحية أخرى، فإن كان القفل محوزًا أصلًا، حتى لو كان على المعالج نفسها، فذلك يعني أنّ عمليّةً ما قد تكون خالفت بعض الثوابت مؤقتًا ولم تُعدها بعد؛ والسماح لعمليّةٍ جديدة بالبدء حين لا تصدق الثوابت يبدو دعوةً إلى العلل. ويتّخذ xv6 هذا الرأي الأخير، ويمنع معالجةً تحوز قفلًا حاليًا من إعادة حيازته. والكشف عن هذا الموقف هو غرض نداء holding في acquire.
7.5 الأقفال والمقاطعات
تحمي بعض الأقفال الدورانية في xv6 بياناتٍ تستخدمها كلٌّ من الخيوط ومُعالجات المقاطعات. فمثلًا، قد يزيد مُعالج مقاطعة المؤقّت clockintr القيمة ticks في الوقت نفسه تقريبًا الذي يقرأ فيه خيطٌ في النواة ticks في sys_pause. والقفل tickslock يُسلسل الوصولين.
ويثير تفاعل الأقفال الدورانية مع المقاطعات خطرًا محتملًا. فلنفترض أنّ sys_pause يحوز tickslock، وأنّ معالجته قُوطعت بمقاطعة مؤقّت. سيحاول clockintr حيازة tickslock، فيراه محوزًا، وينتظر تحريره. وفي هذا الموقف، فلن يُحرَّر tickslock أبدًا: إذ لا يستطيع تحريرَه إلّا sys_pause، لكنّ sys_pause لن يواصل العمل حتّى يعود clockintr. وهكذا سيقع المعالج في جمودٍ ميت، وستتجمّد أيضًا أيّ شيفرةٍ تحتاج أيًّا من القفلين.
ولتجنّب هذا الموقف، إن استُخدم قفلٌ دورانيّ من قِبل مُعالج مقاطعة، فيلزم ألّا تحوز معالجةٌ ذلك القفل أبدًا والمقاطعات مُمكّنة. وأمّا xv6 فأكثر تحفّظًا: فحين تحوز معالجةٌ أيّ قفل، يعطّل xv6 المقاطعات دائمًا على تلك المعالجة. وقد تقع المقاطعات بعد على معالجات أخرى، فيمكن أن ينتظر acquire التابع لمقاطعةٍ حتّى يحرّر خيطٌ قفلًا دورانيًا؛ لكن ليس على المعالج نفسها.
ويعيد xv6 تمكين المقاطعات حين لا تحوز معالجةٌ أيّ قفلٍ دورانيّ؛ وعليه أن يُجري القليل من مسك الدفاتر للتعامل مع الأقسام الحرجة المتداخلة. فـacquire ينادي push_off، وrelease ينادي pop_off، لتتبّع مستوى تداخل الأقفال على المعالجة الحاليّة. وحين يبلغ ذلك العدّاد الصفر، يُعيد pop_off حالة تمكين المقاطعات التي كانت قائمةً في بداية القسم الحرج الأبعد. ويأمر push_off وpop_off المعالج بتمكين المقاطعات وتعطيلها بتغيير البِتّ SIE (تمكين مقاطعات المشرف) في السجلّ sstatus (حالة المشرف)، باستخدام intr_on وrc_sstatus(SSTATUS_SIE)؛ وهذا الأخير يمسح البِتّ SIE.
ومن المهمّ أن ينادي acquire الدالّة push_off قبيل ضبط lk->locked ضبطًا صارم. فلو عُكس الأمران، لكانت هناك نافذةٌ وجيزةٌ يكون القفل فيها محوزًا والمقاطعات مُمكّنة، ولأدّت مقاطعةٌ ذات توقيتٍ مؤسفٍ إلى جمودٍ ميتٍ في النظام. وبالشكل نفسه، من المهمّ ألّا ينادي release الدالّة pop_off إلّا بعد تحرير القفل (spinlock.c:73).
7.6 ترتيب التعليمات والذاكرة
من الطبيعي أن نتصوّر البرامج وهي تنفّذ بالترتيب الذي تظهر به عبارات الشيفرة المصدريّة. وهذا نموذجٌ ذهنيٌّ معقولٌ للشيفرة أحاديّة الخيط، لكنّه ليس ما يحدث فعلًا.
وأحد السببين أنّ المصرّفات تُنبِق تعليمات التحميل والتخزين بترتيبٍ مختلفٍ عمّا تنصّ عليه الشيفرة المصدريّة، وقد تحذفها كلّيًّا (كتخزينها البيانات في مسجّلات مثلًا). وسببٌ آخر أنّ المعالج قد ينفّذ التعليمات خارج ترتيبها زيادةً في الأداء. فمثلًا، قد تلاحظ معالجةٌ أنّ تعليمتين A وB في تتابعٍ متسلسلٍ غير معتمدتين إحداهما على الأخرى. وقد تبدأ المعالجةُ التعليمةَ B أوّلًا، إمّا لأنّ مدخلاتها صارت جاهزةً قبل مدخلات A، أو من أجل تراكب تنفيذ A وB.
وقد تُسبّب إعادة ترتيب الوصول إلى الذاكرة من قِبل المعالج والمصرّف مشكلاتٍ حين تتفاعل خيوطٌ متعددة عبر ذاكرةٍ مشتركة (وترمان وأسانوفيتش 2024; بوهم 2005). ومثالٌ على ما قد يسوء، فإنّه في هذه الشيفرة الخاصّة بـpush، سيكون كارثةً لو نقل المصرّف أو المعالج التخزين الموافق للسطر 4 إلى نقطةٍ بعد release في السطر 6:
      l = malloc(sizeof *l);
      l->data = data;
      acquire(&listlock);
      l->next = list;
      list = l;
      release(&listlock);
**
فلو وقعت مثل هذه إعادة الترتيب، لكانت هناك نافذةٌ يستطيع معالجٌ آخر فيها أن يحوز القفل فيرى list المُحدَّثة، لكنّه يرى list->next غير مُهيّأ.
والخبر السارّ أنّ المصرّفات والمعالجات توفّر للمبرمجين وسائلَ لمنع إعادة الترتيب. وتظهر هذه في xv6 في الوسيطين __ATOMIC_ACQUIRE و__ATOMIC_RELEASE للدالّات الذرّيّة في C المستخدمة في acquire وrelease. ولكلٍّ من الوسيطين تأثيران. أوّلًا، يطلب كلٌّ منهما من المصرّف ألّا ينقل مراجع الذاكرة إلى ما بعد النداء الذرّي. وثانيًا، يطلب كلٌّ منهما من المصرّف أن يُنبِق تعليماتٍ تأمر المعالج بألّا ينقل مراجع الذاكرة زمن التنفيذ إلى ما بعد التعليمات المُنبَقة عن النداء الذرّي. وتُسمّى مثل هذه النقطة «لا تتجاوزني» حاجز ذاكرة (memory barrier) أو سيّاج (fence).
وللحواجز في دالّات الأقفال الدورانية في xv6 تأثيران مهمّان على الشيفرة التي تستخدم الأقفال. أوّلًا، جميع مراجع الذاكرة (القراءات والكتابات) التي تقع في شيفرة C قبل release() مضمونٌ أن تؤثّر في نظام الذاكرة قبل إتمام release(). ويشمل ذلك مراجع الذاكرة في القسم الحرج ومراجع الذاكرة التي قبله على حدّ سواء. وثانيًا، جميع مراجع الذاكرة في شيفرة C بعد acquire مضمونٌ ألّا تؤثّر قبل أن تُكمل amoswap في acquire() عملها بنجاح. ومرّة أخرى، يشمل ذلك المراجع الواقعة داخل القسم الحرج والمراجع التي بعد release على حدّ سواء.
وتُنتج هذه الحواجز تأثيرًا تعدّديًا مهمًّا. فمثلًا، إذا كتبت معالجةٌ في كائن بياناتٍ مُخصَّصٍ حديثًا (دون حيازة أقفال) ثمّ ربطت - في قسمٍ حرجٍ - ذلك الكائن بقائمة، فأيّ معالجةٍ تحوز قفلًا بعد ذلك وتحصل على مؤشّر إلى الكائن من القائمة، مضمونٌ لها أن تلاحظ كتابات المعالجة الأولى.
وإنّ الحواجز في acquire وrelease تفرض الترتيب في جميع الحالات تقريبًا حيث يكون ذلك مهمًّا، إذ يستخدم xv6 الأقفال حول الوصولات إلى البيانات المشتركة. ويناقش الفصل 12 بعض الاستثناءات.
7.7 البرمجة بالعمليّات الذرّيّة
وبينما لا يفعل xv6 ذلك، فمن الممكن أحيانًا تحديث البيانات المشتركة مع تجنّب التسابق بالاستخدام المباشر للتعليمات الذرّيّة، دون استخدام الأقفال. وتوفّر معظم المعالجات عشرات التعليمات الذرّيّة على نحوٍ ملائم، بأنماطٍ نموذجيّةٍ تقرأ موضع ذاكرةٍ، وتُعدّل القيمة، وتكتب القيمة الجديدة في موضع الذاكرة نفسه، ذرّيًا. وتعليمة amoadd في RISC-V مثالٌ على ذلك: فهي تُضيف ذرّيًا محتويات مسجّلٍ إلى موضعٍ في الذاكرة. ويوفّر مصرف C أغلفةً «ذرّيّة» لهذه التعليمات.[1] وبذلك، تستطيع الشيفرة زيادة عدّادٍ مشتركٍ دون أقفال باستخدام
__atomic_fetch_add(&counter, 1, __ATOMIC_SEQ_CST);
وقد يكون تجنّب الأقفال نافعًا لأنّها تستهلك وقت المعالج، أو بسببٍ بنيويّ كتجنّب الجمود الميت يجعل استخدام الأقفال عسيرًا.
7.8 أقفال النوم
أحيانًا يلزم xv6 أن يحوز قفلًا لمدّةٍ طويلة. فمثلًا، يُبقي نظام الملفّات (الفصل 10) الملفّ مقفلًا أثناء قراءة محتواه وكتابته على القرص، وهذه العمليّات القرصيّة قد تستغرق عشرات الملّي ثوان. وإنّ حيازة قفلٍ دورانيّ كلّ تلك المدّة ستؤدّي إلى إهدار إن أرادت عمليّةٌ أخرى حيازته، إذ ستُهدر العمليّةُ الحاززةُ المعالجَ لمدّةٍ طويلةٍ أثناء دورانها. ومساوئٌ أخرى للأقفال الدورانية أنّ العمليّة لا تستطيع التنازل عن المعالج مع الاحتفاظ بقفلٍ دورانيّ؛ ونحبّ ذلك حتّى تستطيع عمليّاتٌ أخرى استخدام المعالج بينما تنتظر العمليّةُ الحاززةُ للقفلِ القرصَ. وإنّ التنازل أثناء حيازة قفلٍ دورانيّ عملٌ غير مشروع لأنّه قد يؤدّي إلى جمودٍ ميت إن حاول خيطٌ ثانٍ حيازة القفل الدورانيّ بعدئذٍ؛ وبما أنّ acquire لا يتنازل عن المعالج، فربّما منع دوران الخيط الثاني الخيطَ الأوّل من العمل وتحرير القفل. وإنّ التنازل أثناء حيازة قفلٍ سيخالف أيضًا شرط أن تكون المقاطعات معطّلةً أثناء حيازة قفلٍ دورانيّ. ولذلك، نودّ نوعًا من الأقفال يتنازل عن المعالج أثناء انتظار الحيازة، ويسمح بالتنازل (وبالمقاطعات) أثناء حيازة القفل.
ويوفّر xv6 مثل هذه الأقفال في صورة أقفال النوم (sleep-locks). وacquiresleep يتنازل عن المعالج أثناء الانتظار، باستخدام تقنيّاتٍ سيشرحها الفصل 9. وعلى مستوىً عالٍ، يملك قفل النوم حقل locked يحميه قفلٌ دورانيّ. فإن كان قفل النوم محوزًا، أحرّر acquiresleep القفل الدورانيّ ونادى sleep، الذي يتنازل عن المعالج حتّى ينادي releasesleep الدالّة wakeup. والنتيجة أنّ خيوطًا أخرى تستطيع أن تنفّذ أثناء انتظار acquiresleep.
ولأنّ أقفال النوم تُبقي المقاطعات مُمكّنة، فلا يمكن استخدامها في مُعالجات المقاطعات. ولأنّ acquiresleep قد يتنازل عن المعالج، فلا يمكن استخدام أقفال النوم داخل الأقسام الحرجة للأقفال الدورانية (وإن كان يمكن استخدام الأقفال الدورانية داخل الأقسام الحرجة لأقفال النوم).
تُلائم الأقفال الدورانية الأقسام الحرجة القصيرة خيرًا، إذ إنّ انتظارها يُهدر وقت المعالج؛ أمّا أقفال النوم فتُجيد العمل مع العمليّات الطويلة.
7.9 العالم الواقعي
ويبقى البرمجة بالأقفال تحديًّا رغم سنوات البحث في أوّليّات التزامن والتوازي. وكثيرًا ما يكون الأفضل إخفاء الأقفال داخل بنياتٍ من مستوىً أعلى، كالطوابير المتزامنة، وإن كان xv6 لا يفعل ذلك. فإن كنت تبرمج بالأقفال، فمن الحكمة استخدام أداةٍ تحاول تحديد التسابقات، لأنّه من السهل إغفال ثابتٍ يلزمه قفل.
وتدعم معظم أنظمة التشغيل خيوط POSIX (Pthreads)، التي تسمح لعمليّة المستخدم بأن يكون لها عدّة خيوط تعمل تزامنيًا على معالجات مختلفة. ويدعم Pthreads الأقفال على مستوى المستخدم والحواجز وغيرها. ويسمح Pthreads أيضًا للمبرمج أن يحدّد على سبيل الاختيار أنّ القفل ينبغي أن يكون قابلاً لإعادة الدخول.
ويتطلّب دعم Pthreads على مستوى المستخدم دعمًا من نظام التشغيل. فمثلًا، يلزم أن يكون الأمر كالتالي: فإن توقّف خيط pthread في نداء نظام، فينبغي أن يستطيع خيط pthread آخر من العمليّة نفسها العمل على تلك المعالجة. ومثالٌ آخر، فإن غيّر خيط pthread فضاء عناوين عمليّته (بربط ذاكرةٍ بها أو فكّ ربطها مثلًا)، فيلزم أن ترتّب النواة لأن تُحدّث المعالجات الأخرى التي تُشغّل خيوط العمليّة نفسها جداول صفحاتها العتاديّة لتعكس التغيير في فضاء العناوين.
ومن الممكن تنفيذ الأقفال دون تعليمات ذرّيّة (لامبورت 1974)، لكنّ ذلك مكلف، لذا تستخدم معظم أنظمة التشغيل تعليمات ذرّيّة.
وقد تكون الأقفال مكلفة إن حاولت معالجاتٌ كثيرة حيازة القفل نفسه في الوقت نفسه. فإن كان القفل موجودًا في مخبأ معالجةٍ المحلّي، ولزم لمعالجةٍ أخرى أن تحوز القفل، فإنّ التعليمة الذرّيّة المُحدِّثة لسطر المخبأ (cache line) الحامل للقفل يلزمها أن تنقل السطر من مخبأ المعالجة الأولى إلى مخبأ المعالجة الأخرى، وربّما أن تُبطِل أيّ نسخٍ أخرى من سطر المخبأ. وإنّ جلب سطر مخبأ من مخبأ معالجةٍ أخرى قد يكون أغلى بمراتب من جلب سطرٍ من مخبأ محلّيّ.
ولتجنّب النفقات المرتبطة بالأقفال، تستخدم كثيرٌ من أنظمة التشغيل بنى بياناتٍ وخوارزميّات خالية من الأقفال (lock-free) (هيرلي وشافيت 2012; مكّيني وآخرون 2013). فمثلًا، من الممكن تنفيذ قائمةٍ مترابطةٍ كالتي في بداية الفصل لا تلزمها أقفالٌ خلال البحث في القائمة، ولا تلزمها إلّا تعليمةً ذرّيّةً واحدةً لإدراج عنصرٍ في القائمة. غير أنّ البرمجة الخالية من الأقفال أعقد من البرمجة بالأقفال؛ فعلى المرء مثلًا أن يقلق بشأن إعادة ترتيب التعليمات والذاكرة. والبرمجة بالأقفال عصيّةٌ أصلًا، لذا يجنّب xv6 التعقيد الإضافي للبرمجة الخالية من الأقفال.
7.10 التمارين
- علّق على النداءات إلى
acquireوreleaseفيkalloc. يبدو أنّ ذلك ينبغي أن يُسبّب مشكلات لشيفرة النواة التي تناديkalloc؛ فما الأعراض التي تتوقّع رؤيتها؟ وحين تُشغّل xv6، أترى هذه الأعراض؟ وماذا عن تشغيلusertests؟ فإن لم ترَ مشكلة، فلماذا لا؟ وانظر إن كنت تستطيع إثارة مشكلةٍ بإدراج حلقاتٍ وهميّة في القسم الحرج لـkalloc. - لنفترض أنّك علّقت بدلًا من ذلك على الإقفال في
kfree(بعد استعادة الإقفال فيkalloc). فما الذي قد يسوء الآن؟ أهو انعدام الأقفال فيkfreeأقلّ ضررًا من انعدام الأقفال فيkalloc؟ - إذا نادت معالجتان
kallocفي الوقت نفسه، فسيلزم إحداهما أن تنتظر الأخرى، وهذا سيّئٌ للأداء. عدّلkalloc.cليكون فيه مزيدٌ من التوازي، حتّى تستطيع نداءاتkallocالمتزامنة من معالجات مختلفة أن تمضي دون أن ينتظر بعضها بعضًا. - اكتب برنامجًا متوازيًا باستخدام خيوط POSIX، وهي مدعومةٌ على معظم أنظمة التشغيل. فمثلًا، نفّذ جدول تجزئة متوازيًا وقِس إن كان عدد عمليات puts/gets يتوسّع مع تزايد عدد المعالجات.
- نفّذ مجموعةً جزئيّةً من Pthreads في xv6. أي نفّذ مكتبة خيوط على مستوى المستخدم حتّى تستطيع عمليّة مستخدمٍ أن يكون لها أكثر من خيطٍ واحد، وارتّب الأمر حتّى تستطيع هذه الخيوط العمل متوازيةً على معالجات مختلفة. وضع تصميمًا يتعامل تعاملًا صحيحًا مع خيطٍ يُجري نداء نظامٍ حاجبًا ويغيّر فضاء عناوينه المشترك.
https://gcc.gnu.org/onlinedocs/gcc/_005f_005fatomic-Builtins.html ↩︎