آثار حجم البيانات في الأداء
لحجم البيانات المخزنة في قاعدة البيانات أثر كبير في أدائها. ومن المقبول عادةً أن الاستعلام يبطؤ مع إضافة بيانات إلى قاعدة البيانات. لكن ما مقدار أثر الأداء إذا تضاعف حجم البيانات؟ وكيف يمكننا تحسين هذه النسبة؟ هذه هي الأسئلة المفتاحية عند مناقشة قابلية توسع قواعد البيانات.
وكمثال، نحلل زمن استجابة الاستعلام التالي عند استخدام فهرسين مختلفين. وسيبقى تعريفا الفهرس مجهولين في الوقت الحالي — وسيُكشف عنهما في سياق المناقشة.
SELECT count(*)
  FROM scale_data
 WHERE section = ?
   AND id2 = ?
للعمود SECTION غرض خاص في هذا الاستعلام: فهو يتحكم في حجم البيانات. وكلما كبر رقم SECTION، زاد عدد الصفوف التي يختارها الاستعلام. ويعرض الشكل 3.1 زمن الاستجابة لقيمة SECTION صغيرة.
الشكل 3.1 مقارنة الأداء
هناك فرق كبير في الأداء بين صيغتَي الفهرسة. وما زال زمن الاستجابة في الحالتين أقل بكثير من عُشر ثانية، لذا فالاستعلام الأبطأ على الأرجح سريع بما يكفي في معظم الحالات. غير أن مخطط الأداء يعرض نقطة اختبار واحدة فقط. ومناقشة قابلية التوسع تعني النظر في أثر الأداء عند تغيير المعاملات البيئية — مثل حجم البيانات.
مهم
تُظهر قابلية التوسع اعتماد الأداء على عوامل مثل حجم البيانات.
وقيمة الأداء مجرد نقطة بيانات واحدة على مخطط قابلية التوسع.
ويعرض الشكل 3.2 زمن الاستجابة بدلالة رقم SECTION — أي مع حجم بيانات متنامٍ.
الشكل 3.2 قابلية التوسع حسب حجم البيانات
يُظهر المخطط نمو زمن الاستجابة في الفهرسين. وفي الجهة اليمنى من المخطط، عندما يصبح حجم البيانات مئة ضعف، يحتاج الاستعلام الأسرع أكثر من ضعف زمنه الأصلي، بينما ارتفع زمن استجابة الاستعلام الأبطأ بمقدار 20 ضعفاً إلى أكثر من ثانية.
نصيحة
في الملحق ج، «المخطط التوضيحي» السكربتات اللازمة لتكرار هذا الاختبار في قاعدة بيانات Oracle أو PostgreSQL أو SQL Server.
يعتمد زمن استجابة استعلام SQL على عوامل كثيرة، وحجم البيانات أحدها. وإذا كان الاستعلام سريعاً بما يكفي في شروط اختبار معينة، فهذا لا يعني أنه سيكون سريعاً بما يكفي في الإنتاج، وبخاصة في بيئات التطوير التي لا تملك سوى جزء صغير من بيانات نظام الإنتاج.
غير أنه لا عجب أن تبطؤ الاستعلامات مع نمو حجم البيانات. لكن الفجوة اللافتة بين الفهرسين غير متوقعة إلى حد ما. فما سبب معدلَي النمو المختلفين؟
ينبغي أن يسهل العثور على السبب بمقارنة خطتي التنفيذ.
Db2 (LUW)
-------------------------------------------------------------
ID | Operation           |                        Rows | Cost
 1 | RETURN              |                             |  208
 2 |  GRPBY (COMPLETE)   |         1 of 4456 (   .02%) |  208
 3 |   IXSCAN SCALE_SLOW | 4456 of 135449700 (   .00%) |  208
Explain Plan
-------------------------------------------------------------
ID | Operation           |                        Rows | Cost
 1 | RETURN              |                             |  296
 2 |  GRPBY (COMPLETE)   |         1 of 4456 (   .02%) |  296
 3 |   IXSCAN SCALE_FAST | 4456 of 135449700 (   .00%) |  296
MySQL
+------+------------+---------+-------+------+-----------------------+
| type | key        | key_len | ref   | rows | Extra                 |
+------+------------+---------+-------+------+-----------------------+
| ref  | scale_slow | 6       | const |    1 | Using index condition |
+------+------------+---------+-------+------+-----------------------+
+------+------------+---------+-------------+------+-------+
| type | key        | key_len | ref         | rows | Extra |
+------+------------+---------+-------------+------+-------+
| ref  | scale_fast | 12      | const,const |    1 |       |
+------+------------+---------+-------------+------+-------+
Oracle
------------------------------------------------------
| Id | Operation         | Name       | Rows  | Cost |
------------------------------------------------------
|  0 | SELECT STATEMENT  |            |     1 |  972 |
|  1 |  SORT AGGREGATE   |            |     1 |      |
|* 2 |   INDEX RANGE SCAN| SCALE_SLOW |  3000 |  972 |
------------------------------------------------------
------------------------------------------------------
| Id   Operation         | Name       | Rows  | Cost |
------------------------------------------------------
|  0 | SELECT STATEMENT  |            |     1 |   13 |
|  1 |  SORT AGGREGATE   |            |     1 |      |
|* 2 |   INDEX RANGE SCAN| SCALE_FAST |  3000 |   13 |
------------------------------------------------------
SQL Server 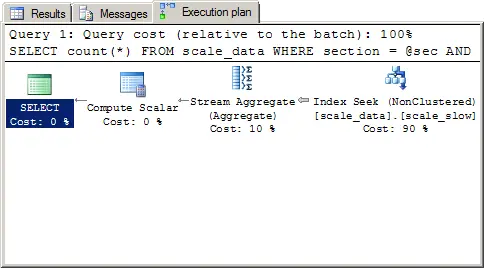
تستخدم خطة التنفيذ أعلاه الفهرس scale_slow، بينما تستخدم الخطة التالية الفهرس scale_fast. يرجى ملاحظة أن كلتيهما تستخدمان عملية Index Seek — فلا تعطيان أي تلميح إلى سبب كون إحداهما أبطأ من الأخرى.
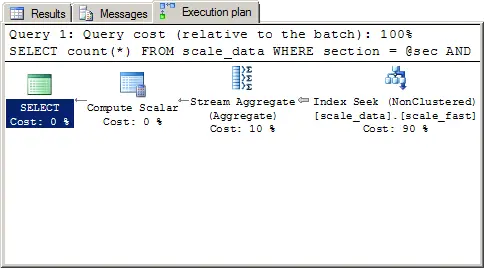
غير أننا نرى فرقاً باستخدام STATISTICS PROFILE ON:
|--Compute Scalar
   |--Stream Aggregate(Count(*))
      |--Index Seek(OBJECT:scale_slow),
         SEEK:(scale_data.section=2),
         WHERE:(scale_data.id2=1234) ORDERED FORWARD)
|--Compute Scalar
   |--Stream Aggregate(Count(*))
      |--Index Seek(OBJECT:(scale_data.scale_fast),
         SEEK:(scale_data.section=1)
          AND  scale_data.id2=1234) ORDERED FORWARD)
خطتا التنفيذ متطابقتان تقريباً — إنهما تستخدمان فهرساً مختلفاً فقط. ومع أن قيم التكلفة تعكس فرق السرعة، فالسبب غير ظاهر في خطة التنفيذ.
يبدو أننا نواجه «تجربة الفهرس البطيء»: فالاستعلام بطيء رغم استخدامه فهرساً. ومع ذلك لم نعد نصدّق خرافة «الفهرس المتدهور». وبدلاً من ذلك نتذكر المكوّنين اللذين يجعلان البحث في الفهرس بطيئاً: (1) الوصول إلى الجدول، (2) ومسح نطاق فهرس واسع.
إن أعجبك هذا الموضوع، قد يعجبك أيضاً…
… أن تشترك في القوائم البريدية، وتحصل على ملصقات مجانية، وتشتري كتابي، أو تنضم إلى دورة تدريبية.
ولا تُظهر أي من خطتي التنفيذ عملية TABLE ACCESS BY INDEX ROWID، لذا لا بد أن إحداهما تمسح نطاق فهرس أوسع من الأخرى. فأين تُظهر خطة التنفيذ نطاق الفهرس الممسوح؟ في معلومات المُسندات طبعاً!
نصيحة
انتبه إلى معلومات المُسندات.
ومعلومات المُسندات ليست بأي حال تفصيلة غير ضرورية يمكن إغفالها كما فُعل أعلاه؛ فخطة تنفيذ بلا معلومات مُسندات ناقصة. ويعني ذلك أنك لا تستطيع رؤية سبب فرق الأداء في الخطتين المعروضتين أعلاه. وإذا نظرنا إلى خطتي التنفيذ الكاملتين، رأينا الفرق.
Db2 (LUW)
Explain Plan
-------------------------------------------------------------
ID | Operation           |                        Rows | Cost
 1 | RETURN              |                             |  208
 2 |  GRPBY (COMPLETE)   |         1 of 4456 (   .02%) |  208
 3 |   IXSCAN SCALE_SLOW | 4456 of 135449700 (   .00%) |  208

Predicate Information
 3 - START (Q1.SECTION = ?)
      STOP (Q1.SECTION = ?)
      SARG (Q1.ID2 = ?)
Explain Plan
-------------------------------------------------------------
ID | Operation           |                        Rows | Cost
 1 | RETURN              |                             |  296
 2 |  GRPBY (COMPLETE)   |         1 of 4456 (   .02%) |  296
 3 |   IXSCAN SCALE_FAST | 4456 of 135449700 (   .00%) |  296

Predicate Information
 3 - START (Q1.SECTION = ?)
     START (Q1.ID2 = ?)
      STOP (Q1.SECTION = ?)
      STOP (Q1.ID2 = ?)
لاحظ أيضاً قيم التكلفة: فمع أن الفهرس الثاني أكفأ، للأول تكلفة أقل، ما يحمل المُحسِّن على اختيار الأسوأ إذا وُجد كلاهما.
MySQL
+------+------------+---------+-------+------+-----------------------+
| type | key        | key_len | ref   | rows | Extra                 |
+------+------------+---------+-------+------+-----------------------+
| ref  | scale_slow | 6       | const |    1 | Using index condition |
+------+------------+---------+-------+------+-----------------------+
+------+------------+---------+-------------+------+-------+
| type | key        | key_len | ref         | rows | Extra |
+------+------------+---------+-------------+------+-------+
| ref  | scale_fast | 12      | const,const |    1 |       |
+------+------------+---------+-------------+------+-------+
Oracle
------------------------------------------------------
| Id | Operation         | Name       | Rows  | Cost |
------------------------------------------------------
|  0 | SELECT STATEMENT  |            |     1 |  972 |
|  1 |  SORT AGGREGATE   |            |     1 |      |
|* 2 |   INDEX RANGE SCAN| SCALE_SLOW |  3000 |  972 |
------------------------------------------------------

Predicate Information (identified by operation id):
   2 - access("SECTION"=TO_NUMBER(:A))
       filter("ID2"=TO_NUMBER(:B))
------------------------------------------------------
| Id   Operation         | Name       | Rows  | Cost |
------------------------------------------------------
|  0 | SELECT STATEMENT  |            |     1 |   13 |
|  1 |  SORT AGGREGATE   |            |     1 |      |
|* 2 |   INDEX RANGE SCAN| SCALE_FAST |  3000 |   13 |
------------------------------------------------------

Predicate Information (identified by operation id):
   2 - access("SECTION"=TO_NUMBER(:A) AND "ID2"=TO_NUMBER(:B))
SQL Server 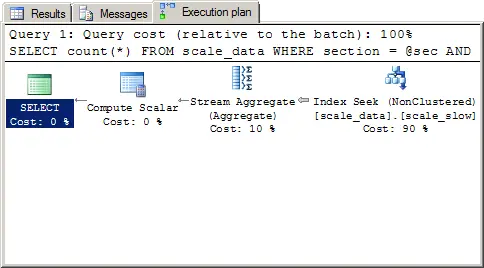
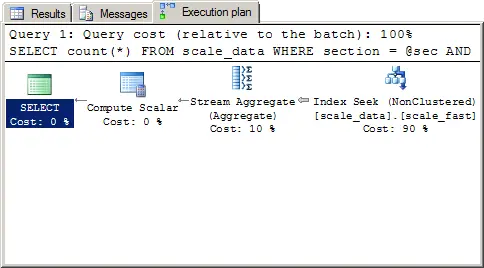
لرؤية الفرق في خطة التنفيذ الرسومية، يجب تمرير الفأرة فوق عملية Index Seek وفحص «Predicate» مقابل «Seek Perdicates».
|--Compute Scalar
   |--Stream Aggregate(Count(*))
      |--Index Seek(OBJECT:scale_slow),
         SEEK:(scale_data.section=2),
         WHERE:(scale_data.id2=1234) ORDERED FORWARD)
|--Compute Scalar
   |--Stream Aggregate(Count(*))
      |--Index Seek(OBJECT:(scale_data.scale_fast),
         SEEK:(scale_data.section=1)
          AND  scale_data.id2=1234) ORDERED FORWARD)
تشير مُسندات WHERE في خطة التنفيذ الأولى إلى مُسندات ترشيح الفهرس — فهي لا تضيّق نطاق الفهرس الممسوح. وتعرض خطة التنفيذ الثانية المُسندين معاً تحت SEEK، وهو مصطلح SQL Server لمُسندات الوصول.
ملاحظة
بُسِّطت خطة التنفيذ للوضوح. ويشرح الملحق تفاصيل قسم «Predicate Information» في خطة تنفيذ Oracle.
والفرق واضح الآن: لا يُعدّ من الشروط إلا الشرط على SECTION مُسند وصول عند استخدام فهرس SCALE_SLOW. وتقرأ قاعدة البيانات جميع صفوف القسم وتستبعد ما لا يطابق مُسند الترشيح على ID2، فينمو زمن الاستجابة مع عدد صفوف القسم. أما مع فهرس SCALE_FAST فتستخدم قاعدة البيانات جميع الشروط كمُسندات وصول، فينمو زمن الاستجابة مع عدد الصفوف المختارة.
مهم
مُسندات الترشيح كأجهزة ذخيرة غير منفجرة؛ يمكن أن تنفجر في أي وقت.
والقطع الأخيرة الناقصة في أحجيتنا هي تعريفا الفهرس. فهل نستطيع إعادة بناء تعريفَي الفهرس من خطتي التنفيذ؟
يجب أن يبدأ تعريف فهرس SCALE_SLOW بالعمود SECTION — وإلا لما أمكن استخدامه كمُسند وصول. والشرط على ID2 ليس مُسند وصول، فلا يمكن أن يلي SECTION في تعريف الفهرس. ويعني ذلك أن فهرس SCALE_SLOW يجب أن يضم ثلاثة أعمدة على الأقل، يكون SECTION فيها الأول وID2 غير الثاني. وهذا بالضبط ما في تعريف الفهرس المستخدم في هذا الاختبار:
CREATE INDEX scale_slow ON scale_data (section, id1, id2)
لا تستطيع قاعدة البيانات استخدام ID2 كمُسند وصول بسبب وجود العمود ID1 في الموضع الثاني.
ويجب أن يضم تعريف فهرس SCALE_FAST العمودين SECTION وID2 في الموضعين الأولين لأن كليهما يُستخدم في مُسندات الوصول. ومع ذلك لا يمكننا قول شيء عن ترتيبهما. والفهرس المستخدم في الاختبار يبدأ بالعمود SECTION وله عمود إضافي هو ID1 في الموضع الثالث:
CREATE INDEX scale_fast ON scale_data (section, id2, id1)
أُضيف العمود ID1 فقط ليكون لهذا الفهرس الحجم نفسه الذي لـSCALE_SLOW — وإلا فقد يخطر لك أن الحجم هو سبب الفرق.
روابط
-
شرح مُسندات ترشيح الفهرس: شروط أكبر من وأصغر من وBetween
-
العثور على مُسندات ترشيح الفهرس في قاعدة بيانات Oracle وPostgreSQL وSQL Server.
-
فهرسة مرشّحات LIKE: مُسندات الوصول والترشيح في تعبير واحد.
-
ترميز Big-O: النهج الرياضي لقابلية التوسع.