الوحدانية والكائنات والحالة
Mεταβάλλον ὰναπαύεται (حتّى وهي تتغيّر، تبقى ثابتةً.) —هيراقليطس Plus ça change, plus c’est la même chose. —ألفونس كار
قدّمت الفصول السابقة العناصر الأساسيّة التي تُبنى منها البرامج. فرأينا كيف تُجمَع الإجراءات الأوّليّة والبيانات الأوّليّة لتكوين كائناتٍ مركّبة، وتعلّمنا أنّ التجريد أمرٌ حيويٌّ في مساعدتنا على مواجهة تعقيد النظم الكبيرة. غير أنّ هذه الأدوات غير كافيّةٍ لتصميم البرامج. فإنّ تركيب البرامج تركيبًا فعّالًا يتطلّب أيضًا مبادئ تنظيميّةً قادرةً على إرشادنا في صياغة التصميم الكلّيّ لبرنامجٍ ما. فنحن نحتاج، على وجه الخصوص، إلى استراتيجيّاتٍ تساعدنا على بناء النظم الكبيرة بحيث تكون وحدانيّةً (modular)، أي بحيث يمكن تقسيمها تقسيمًا «طبيعيًّا» إلى أجزاءٍ متماسكةٍ يمكن تطويرها وصيانتها كلًّا على حدة.
وإحدى استراتيجيّات التصميم القويّة، التي تلائم على وجه الخصوص بناء البرامج المخصّصة لنمذجة النظم المادّية، هي أن نبني بنية برامجنا على بنية النّظام المُمثَّل. فنحن نبني، مقابل كلّ كائنٍ في النّظام، كائنًا حسابيًّا مقابلًا. ونُعرّف، مقابل كلّ فعلٍ في النّظام، عمليّةً رمزيّةً في نموذجنا الحسابيّ. وأملنا في استخدام هذه الاستراتيجيّة هو أنّ توسيع النموذج لاستيعاب كائناتٍ جديدةٍ أو أفعالٍ جديدةٍ لن يتطلّب أيّ تغييرات استراتيجيّةٍ في البرنامج، بل إضافة الأمثال الرمزيّة الجديدة لتلك الكائنات أو الأفعال فقط. فإذا كنّا قد نجحنا في تنظيم نظامنا، فسنحتاج - لإضافة ميزةٍ جديدةٍ أو لتصحيح علةٍ قديمةٍ - إلى العمل على جزءٍ موضعيٍّ واحدٍ من النّظام فقط.
فإذن، وإلى مدًى كبير، فإنّ الطريقة التي نُنظّم بها برنامجًا كبيرًا تُحدَّد بإدراكنا للنّظام المطلوب نمذجته. وسنبحث في هذا الفصل في استراتيجيّتَي تنظيمٍ بارزتين، تنشآن من «نظرةٍ إلى العالم» إلى بنية النظم نظرةً مختلفة إلى حدٍّ بعيد. فتركّز استراتيجيّة التنظيم الأولى على الكائنات (objects)، بنظرها إلى النّظام الكبير بوصفه مجموعةً من الكائنات المتميّزة التي قد تتغيّر سلوكيّاتها بمرور الزمن. وأمّا استراتيجيّة التنظيم البديلة فتركّز على المجاري (streams) من المعلومات التي تجري في النّظام، إلى حدٍّ كبيرٍ كما يرى المهندس الكهربائيّ نظام معالجة الإشارات.
وكلٌّ من المقاربة القائمة على الكائنات ومقاربة معالجة المجاري تُثير قضايا لغويّةً مهمّةً في البرمجة. ففي ما يتعلّق بالكائنات، يجب أن نُعني بالسؤال عن كيفيّة تغيّر كائنٍ حسابيٍّ مع احتفاظه بهويّته. وهذا سيُجبرنا على التخلّي عن نموذج الاستبدال القديم للاحتساب (1.1.5) لصالح نموذج البيئة (environment model) للاحتساب، الذي هو أكثر آليّةً لكنّه أقلّ قابليةً للمعالجة النظريّة. وصعوبات التعامل مع الكائنات والتغيّر والهويّة نتيجةٌ أساسيّةٌ للضرورة التي تُلزمنا بمواجهة الزمن في نماذجنا الحسابيّة. وهذه الصعوبات تزداد تفاقمًا حين نسمح بإمكان التنفيذ المتزامن للبرامج. ويمكن استثمار مقاربة المجاري أتمّ استثمارٍ حين نفصل الزمن المُحاكى في نموذجنا عن ترتيب الأحداث التي تقع في الحاسوب أثناء التقييم. وسنحقّق هذا بتقنيّةٍ تُعرف بـالتقييم المتأخّر (delayed evaluation).
3.1 الإحلال والحالة المحليّة
نحن نرى العالم عادةً وهو مأهولٌ بكائناتٍ مستقلّة، لكلٍّ منها حالةٌ تتغيّر بمرور الزمن. ويُقال عن كائنٍ إنّه «له حالة» إذا كان سلوكه متأثّرًا بتاريخه. فإنّ الحساب المصرفيّ، مثلًا، له حالةٌ من حيث أنّ الجواب عن سؤال «هل يمكنني سحب $100؟» يعتمد على تاريخ معاملات الإيداع والسحب. ويمكننا توصيف حالة كائنٍ ما بمتغيّر حالةٍ واحدٍ أو أكثر، وهي التي تحتفظ معًا بمعلوماتٍ كافيةٍ عن التاريخ لتحديد السلوك الحاليّ للكائن. ففي نظامٍ مصرفيٍّ بسيطٍ، يمكننا توصيف حالة حسابٍ برصيدٍ حاليّ، بدلًا من تذكّر تاريخ معاملات الحساب بأكمله.
وفي نظامٍ متكوّنٍ من كائناتٍ كثيرةٍ، نادرًا ما تكون الكائنات مستقلّةً استقلالًا تامًّا. فقد يؤثّر كلٌّ منها في حالات الآخرين عبر التفاعلات، وهي التي تعمل على ربط متغيّرات حالة كائنٍ ما بمتغيّرات حالة كائناتٍ أخرى. والواقع أنّ النظرة إلى النّظام بوصفه متكوّنًا من كائنات منفصلةٍ تكون نافعةً جدًّا حين يمكن تجميع متغيّرات حالة النّظام في نظمٍ جزئيّةٍ مترابطةٍ ترابطًا وثيقًا، لا ترتبط إلّا ارتباطًا فضفاضًا بالنظم الجزئيّة الأخرى.
وهذه النظرة إلى النّظام قد تكون إطارًا قويًّا لتنظيم النماذج الحسابيّة له. وحتّى يكون نموذجٌ كهذا وحدانيًّا، ينبغي أن يُفكَّك إلى كائناتٍ حسابيّةٍ تمثّل الكائنات الفعليّة في النّظام. ويجب أن يكون لكلّ كائنٍ حسابيٍّ متغيّرات حالة محلّيّة (local state variables) خاصّةٌ به، تصف حالة الكائن الفعليّ. وحيث إنّ حالات الكائنات في النّظام المُمثَّل تتغيّر بمرور الزمن، فإنّ متغيّرات حالة الكائنات الحسابيّة المقابلة يجب أن تتغيّر هي أيضًا. فإذا اخترنا نمذجة جريان الزمن في النّظام بالزمن المنقضي في الحاسوب، فعلينا أن نجد طريقةً لبناء كائناتٍ حسابيّةٍ تتغيّر سلوكيّاتها مع تشغيل برامجنا. وعلى وجه الخصوص، إذا أردنا نمذجة متغيّرات الحالة بأسماء رمزيّةٍ اعتياديّةٍ في لغة البرمجة، فيجب أن توفّر اللغة مشغّل إحلال (assignment operator) يمكننا من تغيير القيمة المرتبطة باسم.
3.1.1 متغيّرات الحالة المحليّة
ولتوضيح ما نعنيه بامتلاك كائنٍ حسابيٍّ حالةً متغيّرةً مع الزمن، فلنُمثّل حالة سحب المال من حساب مصرفيّ. وسنفعل ذلك باستخدام إجراءٍ withdraw، يأخذ كمُعطى amount المطلوب سحبه. فإذا كان في الحساب مالٌ يكفي لتغطية السحب، فيجب أن يعيد withdraw الرصيد الباقي بعد السحب. وإلّا، فيجب أن يعيد withdraw الرسالة رصيد غير كافٍ. فمثلًا، إذا بدأنا بـ$100 في الحساب، فينبغي أن نحصل على تتالي الاستجابات الآتي باستخدام withdraw:
(withdraw 25)
75

(withdraw 25)
50

(withdraw 60)
"Insufficient funds"

(withdraw 15)
35
لاحِظ أنّ التعبير (withdraw 25)، حين يُقيَّم مرّتين، يُعطي قيمتين مختلفتين. وهذا نوعٌ جديدٌ من السلوك بالنسبة إلى إجراء. فحتّى الآن، كان يمكن النظر إلى جميع إجراءاتنا بوصفها مواصفاتٍ لاحتساب دوالّ رياضيّة. فإنّ نداء إجراءٍ كان يحسب قيمة الدالّة مطبَّقةً على المعطيات المعطاة، وكان نداءان للإجراء ذاته بالمعطيات ذاتها يُنتجان النتيجة نفسها دائمًا.[1]
ولتنفيذ withdraw، يمكننا استخدام متغيّر balance للإشارة إلى رصيد المال في الحساب، وتعريف withdraw بوصفه إجراءٍ يصل إلى balance. ويفحص الإجراء withdraw ما إذا كان balance أكبر من amount المطلوب أو مساويًا له. فإن كان الأمر كذلك، فإنّ withdraw يُنقص balance بمقدار amount ويعيد القيمة الجديدة لـbalance. وإلّا، فإنّ withdraw يعيد رسالة رصيد غير كافٍ. وهذه هي تعاريف balance وwithdraw:
(define balance 100)

(define (withdraw amount)
  (if (>= balance amount)
      (begin (set! balance (- balance amount))
             balance)
      "Insufficient funds"))
ويُنجَز إنقاص balance بالتعبير
(set! balance (- balance amount))
وهذا يستخدم الصيغة الخاصّة set!، التي صياغتها هي
(set! ⟨name⟩ ⟨new-value⟩)
هنا ⟨name⟩ رمزٌ و⟨new-value⟩ هو أيّ تعبير. وSet! يُغيّر ⟨name⟩ بحيث تصبح قيمته هي الناتج المتحصّل من تقييم ⟨new-value⟩. وفي الحالة المعروضة، نُغيِّر balance بحيث تصبح قيمته الجديدة هي ناتج طرح amount من القيمة السابقة لـbalance.[2]
كما يستخدم Withdraw الصيغة الخاصّة begin لإحداث تقييم تعبيرين في الحالة التي يكون فيها اختبار if صحيحًا: بأن يُنقص balance أوّلًا ثم يُعاد قيمة balance. وبصورةٍ عامّة، فإنّ تقييم التعبير
(begin ⟨exp₁⟩ ⟨exp₂⟩ … ⟨expₖ⟩)
يؤدّي إلى تقييم التعبيرات إلى بالتتالي، وإعادة قيمة التعبير النهائيّ قيمةً لصيغة begin برمّتها.[3]
وبالرغم من أنّ withdraw يعمل كما هو مطلوب، إلّا أنّ المتغيّر balance يمثّل مشكلة. فكما حُدِّد أعلاه، فإنّ balance اسمٌ معرَّفٌ في البيئة العامّة ويمكن الوصول إليه بحريّةٍ لفحصه أو تعديله من قبل أيّ إجراء. لَكان أفضلَ بكثيرٍ لو استطعنا، بطريقةٍ أو بأخرى، جعل balance داخليًّا بالنسبة إلى withdraw، بحيث يكون withdraw الإجراء الوحيد القادر على الوصول إلى balance مباشرةً، وحيث لا يستطيع أيّ إجراءٍ آخر الوصول إلى balance إلّا بصورةٍ غير مباشرةٍ (عبر نداءات withdraw). وكان هذا سيمثّل مفهوم كون balance متغيّر حالة محلّيًّا يستخدمه withdraw لتتبّع حالة الحساب تمثيلًا أكثر دقّة.
ويمكننا جعل balance داخليًّا بالنسبة إلى withdraw بإعادة كتابة التعريف على النحو الآتي:
(define new-withdraw
  (let ((balance 100))
    (lambda (amount)
      (if (>= balance amount)
          (begin (set! balance
                       (- balance amount))
                 balance)
          "Insufficient funds"))))
وما فعلناه هنا هو استخدام let لإقامة بيئةٍ ذات متغيّر محلّيّ balance، مربوطٍ بالقيمة الأوّليّة 100. وداخل هذه البيئة المحليّة، نستخدم lambda لإنشاء إجراءٍ يأخذ amount كمُعطى ويتصرّف كإجراء withdraw السابق. وهذا الإجراء - الذي يُعاد كنتيجةٍ لتقييم تعبير let - هو new-withdraw، الذي يتصرّف بالطريقة ذاتها تمامًا كـwithdraw، لكن متغيّره balance لا يمكن الوصول إليه من قبل أيّ إجراءٍ آخر.[4]
والجمع بين set! والمتغيّرات المحليّة هو التقنيّة البرمجيّة العامّة التي سنستخدمها لبناء كائناتٍ حسابيّةٍ ذات حالة محلّيّة. ولسوء الحظّ، فإنّ استخدام هذه التقنيّة يُثير مشكلةً خطيرة: فإنّا عندما قدّمنا الإجراءات أوّل مرّة، قدّمنا أيضًا نموذج الاستبدال للتقييم (1.1.5) لتوفير تفسيرٍ لمعنى تطبيق الإجراء. وقد قلنا إنّه ينبغي تفسير تطبيق إجراءٍ على أنّه تقييم جسم الإجراء مع استبدال الوسائط الشكليّة بقيمها. وتكمن المشكلة في أنّ الاستبدال، بمجرّد إدخال الإحلال إلى لغتنا، لم يعد نموذجًا كافيًا لتطبيق الإجراء. (وسنرى سبب ذلك في 3.1.3.) ونتيجةً لذلك، فإنّه ليس لدينا - من الوجهة التقنيّة - في هذه النقطة أيّ طريقةٍ لفهم سبب تصرّف إجراء new-withdraw على النحو المزعوم أعلاه. ولكي نفهم فعلًا إجراءً مثل new-withdraw، سنحتاج إلى تطوير نموذجٍ جديدٍ لتطبيق الإجراء. وسنُقدّم في 3.2 نموذجًا كهذا، مع شرحٍ لـset! والمتغيّرات المحليّة. غير أنّنا، أوّلًا، نفحص بعض التنويعات على الموضوع الذي رسّخه new-withdraw.
والإجراء الآتي، make-withdraw، يُنشئ «معالجات سحب». وقد يُحدِّد الوسيط الشكليّ balance في make-withdraw المبلغ الأوّل من المال في الحساب.[5]
(define (make-withdraw balance)
  (lambda (amount)
    (if (>= balance amount)
        (begin (set! balance
                     (- balance amount))
               balance)
        "Insufficient funds")))
ويمكن استخدام Make-withdraw على النحو الآتي لإنشاء كائنين W1 وW2:
(define W1 (make-withdraw 100))
(define W2 (make-withdraw 100))

(W1 50)
50

(W2 70)
30

(W2 40)
"Insufficient funds"

(W1 40)
10
لاحِظ أنّ W1 وW2 كائنان مستقلّان تمامًا، لكلٍّ منهما متغيّر حالة محلّيّ balance خاصٌّ به. والسحوبات من أحدهما لا تؤثّر في الآخر.
ويمكننا أيضًا إنشاء كائناتٍ تتناول الإيداعات إضافةً إلى السحوبات، وبذلك يمكننا تمثيل حسابات مصرفيّةٍ بسيطة. وهناك إجراءٌ يعيد «كائن حساب مصرفيّ» برصيد أوّليّ محدَّد:
(define (make-account balance)
  (define (withdraw amount)
    (if (>= balance amount)
        (begin (set! balance
                     (- balance amount))
               balance)
        "Insufficient funds"))
  (define (deposit amount)
    (set! balance (+ balance amount))
    balance)
  (define (dispatch m)
    (cond ((eq? m 'withdraw) withdraw)
          ((eq? m 'deposit) deposit)
          (else (error "Unknown request:
                 MAKE-ACCOUNT" m))))
  dispatch)
وكلّ نداء لـmake-account يُقيم بيئةً ذات متغيّر حالة محلّيّ balance. وداخل هذه البيئة، يُعرّف make-account الإجراءين deposit وwithdraw اللذين يصلان إلى balance، وإجراءً إضافيًّا dispatch يأخذ «رسالةً» كمدخل ويعيد أحد الإجراءين المحليّين. والإجراء dispatch ذاته هو ما يُعاد قيمةً تمثّل كائن الحساب المصرفيّ. وهذا هو بالضبط أسلوب تمرير الرسائل (message passing) في البرمجة الذي رأيناه في 2.4.3، وإن كنّا نستخدمه هنا مقترنًا بالقدرة على تعديل المتغيّرات المحليّة.
ويمكن استخدام Make-account على النحو الآتي:
(define acc (make-account 100))

((acc 'withdraw) 50)
50

((acc 'withdraw) 60)
"Insufficient funds"

((acc 'deposit) 40)
90

((acc 'withdraw) 60)
30
وكلّ نداء لـacc يعيد الإجراء deposit أو withdraw المعرَّف محلّيًّا، والذي يُطبَّق بعد ذلك على amount المحدَّد. وكما كان الحال مع make-withdraw، فإنّ نداءً آخر لـmake-account
(define acc2 (make-account 100))
سيُنتج كائن حسابٍ منفصلًا تمامًا، يحتفظ بـbalance محلّيًّا خاصًّا به.
التمرين 3.1: المُجمِّع (accumulator) هو إجراءٌ يُنادى مرارًا بمعطًى عدديًّا واحد ويُجمِّع معطياته في مجموع. وفي كلّ مرّةٍ يُنادى فيها، يعيد المجموع المُجمَّع حاليًّا. اكتب إجراءَ make-accumulator يُنشئ مُجمِّعات، يحتفظ كلٌّ منها بمجموعٍ مستقلٍّ خاصٍّ به. وينبغي أن يُحدِّد مدخل make-accumulator القيمة الأوّليّة للمجموع؛ فمثلًا
(define A (make-accumulator 5))

(A 10)
15

(A 10)
25
التمرين 3.2: في تطبيقات اختبار البرمجيّات، من المفيد أن نكون قادرين على عدّ عدد المرّات التي يُنادى فيها إجراءٌ معيّنٌ في أثناء عمليّةٍ حسابيّةٍ ما. اكتب إجراءَ make-monitored يأخذ كمدخلٍ إجراءً، f، يأخذ هو ذاته مدخلًا واحدًا. والنتيجة التي يعيدها make-monitored هي إجراءٌ ثالث، لنسمّه mf، يتتبّع عدد مرّات ندائه بالاحتفاظ بعدّادٍ داخليّ. فإذا كان مدخل mf هو الرمز الخاصّ how-many-calls?، فإنّ mf يعيد قيمة العدّاد. وإذا كان المدخل هو الرمز الخاصّ reset-count، فإنّ mf يُصفّر العدّاد. ولكلّ مدخلٍ آخر، يعيد mf نتيجة نداء f على ذلك المدخل ويزيد العدّاد. فنحن نستطيع مثلًا إنشاء نسخةٍ مُراقَبةٍ من إجراء sqrt:
(define s (make-monitored sqrt))

(s 100)
10

(s 'how-many-calls?)
1
التمرين 3.3: عدّل إجراء make-account بحيث يُنشئ حساباتٍ محميّةً بكلمة مرور. أي أنّ make-account ينبغي أن يأخذ رمزًا كوسيطٍ إضافيٍّ، كما في
(define acc
  (make-account 100 'secret-password))
ويجب أن يعالج كائن الحساب الناتج طلبًا ما فقط إذا كان مصحوبًا بكلمة المرور التي أُنشئ الحساب بها، وأن يعيد - فيما عدا ذلك - شكوى:
((acc 'secret-password 'withdraw) 40)
60

((acc 'some-other-password 'deposit) 50)
"Incorrect password"
التمرين 3.4: عدّل إجراء
make-accountالوارد في التمرين 3.3 بإضافة متغيّر حالة محلّيٍّ آخر، بحيث يستدعي الإجراءcall-the-copsإذا وُصل إلى الحساب أكثر من سبع مرّاتٍ متتاليةٍ بكلمة مرورٍ خاطئة.
3.1.2 فوائد إدخال الإحلال
كما سنرى، فإنّ إدخال الإحلال إلى لغة البرمجة لدينا يُدخلنا في متاهةٍ من القضايا المفاهيميّة العصيبة. ومع ذلك، فإنّ النظرة إلى النظم بوصفها مجموعاتٍ من الكائنات ذات الحالة المحليّة تقنيّةٌ قويّةٌ للحفاظ على تصميمٍ وحدانيّ. فتأمّل - وبصفتها مثالًا بسيطًا - تصميم إجراء rand يعيد، كلّما نُودي، عددًا صحيحًا مُختارًا عشوائيًّا.
ومن غير الواضح تمامًا ما يعنيه «مُختارٌ عشوائيًّا». وما نريده على الأرجح هو أن تُنتج نداءات rand المتعاقبة تتاليًا من الأعداد له الخصائص الإحصائيّة للتوزيع المنتظم. ولن نناقش هنا طرائق توليد تتالياتٍ ملائمةٍ لهذا الغرض. بل دعنا نفترض أنّ لدينا إجراءً rand-update له الخاصّيّة أنّنا إذا بدأنا بعددٍ معطًى وشكّلنا
x₂ = (rand-update x₁)
x₃ = (rand-update x₂)
فإنّ تتالي القيم ، ، ، … سيكون له الخصائص الإحصائيّة المرغوبة.[6]
ويمكننا تنفيذ rand بوصفه إجراءً ذا متغيّر حالة محلّيّ x تُهيَّأ قيمته الأوّليّة إلى قيمةٍ ثابتةٍ random-init. وكلّ نداء لـrand يحسب rand-update للقيمة الحاليّة لـx، ويعيد هذا بوصفه العدد العشوائيّ، ويخزّنه أيضًا بوصفه القيمة الجديدة لـx.
(define rand
  (let ((x random-init))
    (lambda () (set! x (rand-update x)) x)))
وبالطبع، يمكننا توليد تتالي الأعداد العشوائيّة ذاته دون استخدام الإحلال، بمجرّد نداء rand-update مباشرةً. غير أنّ هذا كان سيَعني أنّ أيّ جزءٍ من برنامجنا يستخدم أعدادًا عشوائيّةً سيتحيّن عليه أن يتذكّر صراحةً القيمة الحاليّة لـx ليُمرَّر كوسيطٍ إلى rand-update. ولنُدرك كم كان هذا ليُسبّب إزعاجًا، تأمّل استخدام الأعداد العشوائيّة في تنفيذ تقنيّةٌ تُسمّى محاكاة مونت كارلو (Monte Carlo simulation).
وتتكوّن طريقة مونت كارلو من اختيار تجاربٍ عيّنيّةٍ عشوائيًّا من مجموعةٍ كبيرة، ثمّ استخلاص استدلالاتٍ على أساس الاحتمالات المُقدَّرة من تبويب نتائج تلك التجارب. فنستطيع مثلًا تقريب باستخدام الحقيقة أنّ هو احتمال أنّ عددين صحيحين مُختارين عشوائيًّا لا يشتركان في أيّ عاملٍ مشترك؛ أي أنّ أكبر قاسمٍ مشتركٍ لهما سيكون 1.[7] ولكي نحصل على التقريب لـ، نُجري عددًا كبيرًا من التجارب. وفي كلّ تجربةٍ نختار عددين صحيحين عشوائيًّا ونجري اختبارًا لنرى ما إذا كان أكبر قاسمٍ مشتركٍ لهما هو 1. والكسر من المرّات التي ينجح فيها الاختبار يُعطينا تقديرنا لـ، ومنه نحصل على تقريبنا لـ.
وقلب برنامجنا هو إجراءٌ monte-carlo، يأخذ كوسيطين عدد مرّات محاولة التجربة، مع التجربة ذاتها، الممثَّلة بإجراءٍ لا يأخذ وسائط والذي يعيد القيمة صحيح أو خاطئة في كلّ مرّةٍ يُشغَّل فيها. وMonte-carlo يُشغّل التجربة لعدد المحاولات المعيَّن ويعيد عددًا يبيّن كسر المحاولات التي وُجد أنّ التجربة صحيحةٌ فيها.
(define (estimate-pi trials)
  (sqrt (/ 6 (monte-carlo trials
                          cesaro-test))))
(define (cesaro-test)
   (= (gcd (rand) (rand)) 1))

(define (monte-carlo trials experiment)
  (define (iter trials-remaining trials-passed)
    (cond ((= trials-remaining 0)
           (/ trials-passed trials))
          ((experiment)
           (iter (- trials-remaining 1)
                 (+ trials-passed 1)))
          (else
           (iter (- trials-remaining 1)
                 trials-passed))))
  (iter trials 0))
والآن، لنجرّب الاحتساب ذاته باستخدام rand-update مباشرةً بدلًا من rand، بالطريقة التي كنا سنُجبر على اتّباعها لو لم نستخدم الإحلال لنمذجة الحالة المحليّة:
(define (estimate-pi trials)
  (sqrt (/ 6 (random-gcd-test trials
                              random-init))))

(define (random-gcd-test trials initial-x)
  (define (iter trials-remaining
                trials-passed
                x)
    (let ((x1 (rand-update x)))
      (let ((x2 (rand-update x1)))
        (cond ((= trials-remaining 0)
               (/ trials-passed trials))
              ((= (gcd x1 x2) 1)
               (iter (- trials-remaining 1)
                     (+ trials-passed 1)
                     x2))
              (else
               (iter (- trials-remaining 1)
                     trials-passed
                     x2))))))
  (iter trials 0 initial-x))
وبينما لا يزال البرنامج بسيطًا، فإنّه يُظهر بعض الخروقات المؤلمة على الوحدانيّة. ففي نسختنا الأولى من البرنامج، باستخدام rand، يمكننا التعبير عن طريقة مونت كارلو مباشرةً بوصفها إجراءً monte-carlo عامًّا يأخذ كوسيطٍ إجراء experiment اعتباطيًّا. وأمّا في نسختنا الثانية من البرنامج، فحيث لا توجد حالة محلّيّة لمولّد الأعداد العشوائيّة، فإنّ random-gcd-test مضطرٌّ إلى التلاعب صراحةً بالعددين العشوائيين x1 وx2 وإعادة تدوير x2 عبر حلقة التكرار بوصفه المدخل الجديد إلى rand-update. فهذا التناول الصريح للأعداد العشوائيّة يشبك بنية تجميع نتائج الاختبار بحقيقة أنّ تجربتنا الخاصّة تستخدم عددين عشوائيين، بخلاف تجارب مونت كارلو الأخرى التي قد تستخدم عددًا عشوائيًّا واحدًا أو ثلاثة. حتّى الإجراء الأعلى مستوىً estimate-pi يضطرّ إلى الاهتمام بتزويد عددٍ عشوائيٍّ أوّليّ. وحقيقة أنّ تفاصيل مولّد الأعداد العشوائيّة الداخليّة تتسرّب إلى أجزاء أخرى من البرنامج تجعل من الصعب علينا عزل فكرة مونت كارلو بحيث يمكن تطبيقها على مهامّ أخرى. وأمّا في النسخة الأولى من البرنامج، فإنّ الإحلال يُغلّف حالة مولّد الأعداد العشوائيّة داخل الإجراء rand، بحيث تبقى تفاصيل توليد الأعداد العشوائيّة مستقلّةً عن بقيّة البرنامج.
والظاهرة العامّة التي يُوضيحها مثال مونت كارلو هي هذه: من وجهة نظر جزءٍ واحدٍ من عمليّةٍ معقّدةٍ، تبدو الأجزاء الأخرى وكأنّها تتغيّر مع الزمن. ولديها حالة محلّيّةٌ مخفيّةٌ متغيّرةٌ مع الزمن. فإذا أردنا كتابة برامج حاسوبيّةٍ تُعبِّر بنيتُها عن هذا التفكيك، فإنّنا نُنشئ كائناتٍ حسابيّةً (كالحسابات المصرفيّة ومولّدات الأعداد العشوائيّة) تتغيّر سلوكيّاتها مع الزمن. ونحن نمثّل الحالة بمتغيّرات حالة محلّيّة، ونمثّل تغيّرات الحالة بإحلالاتٍ لتلك المتغيّرات.
ومن المغري أن نُنهي هذه المناقشة بالقول إنّه، بإدخال الإحلال وأسلوب إخفاء الحالة في متغيّرات محلّيّة، نُصبح قادرين على بناء النظم بناءً أكثر وحدانيّةً ممّا لو كان لا بدّ من التلاعب بجميع الحالات صراحةً، بتمرير وسائط إضافيّة. ولكن، للأسف، كما سنرى، الأمر ليس بهذه البساطة.
التمرين 3.5: التكامل بطريقة مونت كارلو (Monte Carlo integration) هو طريقة لتقدير التكاملات المحدَّدة بمحاكاة مونت كارلو. تأمّل احتساب مساحة منطقةٍ من الفضاء موصوفةٌ بمُسَيِّم يكون صحيحًا للنقاط الواقعة في المنطقة، وخاطئًا للنقاط التي لا تقع فيها. فمثلًا، المنطقة الواقعة داخل دائرةٍ نصف قطرها 3 ومركزها (5, 7) موصوفةٌ بالمُسَيِّم الذي يختبر ما إذا كان . ولكي نقدّر مساحة المنطقة الموصوفة بمُسَيِّمٍ كهذا، ابدأ باختيار مستطيلٍ يحتوي المنطقة. فمثلًا، فإنّ مستطيلًا رأساه المتقابلان قطريًّا هما (2, 4) و(8, 10) يحتوي الدائرة أعلاه. والتكامل المطلوب هو مساحة الجزء من المستطيل الواقع داخل المنطقة. ويمكننا تقدير التكامل بانتقاء نقاط تقع في المستطيل عشوائيًّا، واختبار لكلّ نقطةٍ لتحديد ما إذا كانت النقطة تقع في المنطقة. فإذا جرّبنا هذا بعددٍ كبيرٍ من النقاط، فإنّ كسر النقاط التي تقع في المنطقة ينبغي أن يُعطينا تقديرًا لنسبة المستطيل الواقعة داخل المنطقة. ومن ثمّ، فإنّ ضرب هذا الكسر في مساحة المستطيل بأكملهٍ ينبغي أن يُنتج تقديرًا للتكامل.
نفّذ تكامل مونت كارلو بوصفه إجراءَ estimate-integral يأخذ كوسائط مُسَيِّمًا P، وحدًّا عليويًا وسفليًّا x1 وx2 وy1 وy2 للمستطيل، وعدد المحاولات التي ينبغي إجراؤها لإنتاج التقدير. وينبغي أن يستخدم إجراءُك الإجراء monte-carlo ذاته الذي استُخدم أعلاه لتقدير . واستخدم estimate-integral لديك لإنتاج تقديرٍ لـ بقياس مساحة دائرة الوحدة.
وستجد أنه من المفيد أن تتوفر لديك دالّةٌ تعيد عددًا مُختارًا عشوائيًّا من مدىً معطًى. والإجراء random-in-range الآتي يُنفّذ هذا بدلالة الإجراء random المستخدم في 1.2.6، والذي يعيد عددًا غير سالبٍ أصغر من مدخله.[8]
(define (random-in-range low high)
  (let ((range (- high low)))
    (+ low (random range))))
التمرين 3.6: من المفيد أن نكون قادرين على إعادة ضبط مولّد أعدادٍ عشوائيّةٍ بحيث يُنتج تتاليًا يبدأ من قيمةٍ معطاة. صمّم إجراء
randجديدًا يُنادى بوسيطٍ يكون إمّا الرمزgenerateأو الرمزresetويتصرّف على النحو الآتي: فإنّ(rand 'generate)يُنتج عددًا عشوائيًّا جديدًا؛ و((rand 'reset) ⟨new-value⟩)يُعيد ضبط متغيّر الحالة الداخليّ إلى⟨new-value⟩المعيَّن. وبذلك، فبإعادة ضبط الحالة، يمكننا توليد تتاليات قابلةٍ للتكرار. وهذه أمورٌ بالغة الفائدة حين نختبر برامجنا التي تستخدم أعدادًا عشوائيّةً ونصحّح عللها.
3.1.3 تكاليف إدخال الإحلال
وكما رأينا، فإنّ العمليّة set! تُمكنّنا من نمذجة كائناتٍ لها حالة محلّيّة. غير أنّ هذه الميزة تأتي بثمن. فإنّ لغة البرمجة لدينا لم يعد ممكنًا تفسيرها من حيث نموذج الاستبدال لتطبيق الإجراء الذي قدّمناه في 1.1.5. وفوق ذلك، فإنّه لا يمكن لأيّ نموذجٍ بسيطٍ ذي خصائص رياضيّةٍ «جميلة» أن يكون إطارًا كافيًا للتعامل مع الكائنات والإحلال في لغات البرمجة.
فما دمّا لا نستخدم الإحالات، فإنّ تقييمين للإجراء ذاته بالمعطيات ذاتها سيُنتجان النتيجة نفسها، بحيث يمكن النظر إلى الإجراءات بوصفها تحسب دوالّ رياضيّة. والبرمجة دون أيّ استخدامٍ للإحالات، كما فعلنا في الفصلين الأوّلين من هذا الكتاب، تُعرَف بالتالي بـالبرمجة الدالّيّة (functional programming).
ولفهم كيف يعقّد الإحلال الأمور، تأمّل نسخةً مبسّطةً من إجراء make-withdraw الوارد في 3.1.1 لا تتعبّ نفسها بالتحقّق من عدم كفاية المبلغ:
(define (make-simplified-withdraw balance)
  (lambda (amount)
    (set! balance (- balance amount))
    balance))

(define W (make-simplified-withdraw 25))

(W 20)
5

(W 10)
-5
وقارن هذا الإجراء بالإجراء make-decrementer الآتي، الذي لا يستخدم set!:
(define (make-decrementer balance)
  (lambda (amount)
    (- balance amount)))
ويعيد Make-decrementer إجراءً يطرح مدخله من مبلغٍ معيَّنٍ balance، لكن لا يوجد هناك أثرٌ مُتراكمٌ على النداءات المتعاقبة، كما هو الحال مع make-simplified-withdraw:
(define D (make-decrementer 25))

(D 20)
5

(D 10)
15
ويمكننا استخدام نموذج الاستبدال لشرح كيف يعمل make-decrementer. فلنحلّل مثلًا تقييم التعبير
((make-decrementer 25) 20)
نبدأ ببساطة مشغّل التركيب باستبدال 25 مكان balance في جسم make-decrementer. وهذا يُختزل التعبير إلى
((lambda (amount) (- 25 amount)) 20)
والآن نُطبّق المشغّل باستبدال 20 مكان amount في جسم تعبير lambda:
(- 25 20)
والجواب النهائيّ هو 5.
ولكن، لاحِظ ما يحدث إذا حاولنا تحليلًا بالاستبدال شبيهًا بـmake-simplified-withdraw:
((make-simplified-withdraw 25) 20)
نبدأ ببساطة المشغّل باستبدال 25 مكان balance في جسم make-simplified-withdraw. وهذا يُختزل التعبير إلى[9]
((lambda (amount)
   (set! balance (- 25 amount)) 25)
 20)
والآن نُطبّق المشغّل باستبدال 20 مكان amount في جسم تعبير lambda:
(set! balance (- 25 20)) 25
فإذا تمسّكنا بنموذج الاستبدال، لَوجب علينا أن نقول إنّ معنى تطبيق الإجراء هو أن نُعيّن balance أوّلًا إلى 5 ثم نُعيد 25 قيمةً للتعبير. وهذا يُعطي الجواب الخاطئ. ولكي نحصل على الجواب الصحيح، كان يتحتّم علينا، بطريقةٍ أو بأخرى، تمييز أوّل ظهور لـbalance (قبل أثر set!) من ظهور balance الثاني (بعد أثر set!)، ونموذج الاستبدال لا يقدر على هذا.
والمشكلة هنا أنّ الاستبدال يقوم في نهاية الأمر على فكرة أنّ الرموز في لغتنا هي في أساسها أسماءٌ للقيم. لكن بمجرّد إدخالنا set! وفكرة أنّ قيمة متغيّرٍ يمكن أن تتغيّر، لم يعد المتغيّر مجرّد اسم. فالآن، يشير المتغيّر - بطريقةٍ ما - إلى موضعٍ يمكن تخزين قيمةٍ فيه، والقيمة المخزّنة في هذا الموضع يمكن أن تتغيّر. وسنرى في 3.2 كيف تؤدّي البيئات دورَ هذا «الموضع» في نموذجنا الحسابيّ.
التماثل والتغيّر
والقضية التي تطفو إلى السطح هنا أعمق من مجرّد انهيار نموذجٍ معيّنٍ للاحتساب. فبمجرّد إدخالنا التغيّر إلى نماذجنا الحسابيّة، تصير مفاهيمُ كثيرةٌ كانت مباشرةً سابقًا إشكاليّة. وتأمّل مفهوم كون شيئين «متماثلين».
فلنفترض أنّنا نادينا make-decrementer مرّتين بالمُعطى ذاته لإنشاء إجراءين:
(define D1 (make-decrementer 25))
(define D2 (make-decrementer 25))
أفـD1 وD2 متتماثلان؟ والجواب المقبول هو نعم، لأنّ D1 وD2 لهما السلوك الحسابيّ ذاته - كلٌّ منهما إجراءٌ يطرح مُدخله من 25. والواقع أنّ D1 يمكن أن يُستبدل مكان D2 في أيّ احتسابٍ دون تغيير النتيجة.
وقارن هذا بنداءين لـmake-simplified-withdraw:
(define W1 (make-simplified-withdraw 25))
(define W2 (make-simplified-withdraw 25))
أفـW1 وW2 متتماثلان؟ بالتأكيد لا، لأنّ نداءات W1 وW2 لها آثار متمايزة، كما يُظهرها تتالي التفاعلات الآتي:
(W1 20)
5

(W1 20)
-15

(W2 20)
5
وبالرغم من أنّ W1 وW2 «متساويان» بمعنى أنّهما كلاهما أُنشئ بتقييم التعبير ذاته، (make-simplified-withdraw 25)، فليس صحيحًا أنّ W1 يمكن أن يُستبدل مكان W2 في أيّ تعبيرٍ دون تغيير نتيجة تقييم التعبير.
ويُقال عن لغةٍ تدعم مفهوم «المتساويات يمكن أن تُستبدل مكان المتساويات» في تعبيرٍ دون تغيير قيمة التعبير إنّها شفّافة بالرجوع (referentially transparent). وإنّ الشفافيّة بالرجوع تُخرق عندما نُدرج set! في لغة الحاسوب لدينا. وهذا يجعل من الصعب تحديد متى يمكننا تبسيط التعبيرات باستبدال تعابيرَ مكافئةٍ بها. ونتيجةً لذلك، فإنّ الاستدلال على البرامج التي تستخدم الإحلال يصبح أصعبَ بكثيرٍ.
فبمجرّد أن نتنازل عن الشفافيّة بالرجوع، يصبح مفهوم معنى كون الكائنات الحسابيّة «متماثلة» عسيرًا على الإحاطة به بصورةٍ رسميّة. والواقع أنّ معنى «التماثل» في العالم الحقيقيّ الذي تمثّله برامجنا ليس واضحًا في ذاته. وبصورةٍ عامّة، لا نستطيع تحديد أنّ كائنين ظاهريًّا متماثلين هما حقًّا «الكائن ذاته» إلّا بتعديل أحد الكائنين ثمّ ملاحظة ما إذا كان الكائن الآخر قد تغيّر بالطريقة ذاتها. لكن كيف نستطيع أن نعرف ما إذا كان كائنٌ ما قد «تغيّر» بطريقةٍ أخرى غير ملاحظة «الكائن ذاته» مرّتين ورؤية ما إذا كانت خاصّيّةٌ ما للكائن تختلف من ملاحظةٍ إلى أخرى؟ وهكذا، فإنّا لا نستطيع تحديد «التغيّر» دون مفهومٍ قبليّ (a priori) عن «التماثل»، ولا نستطيع تحديد التماثل دون ملاحظة آثار التغيّر.
ومثالٌ على كيف تنشأ هذه القضية في البرمجة، تأمّل الحالة التي يكون لبطرس وبولس حساب مصرفيّ فيه $100. وهناك فرقٌ كبيرٌ بين نمذجة هذا على الشكل
(define peter-acc (make-account 100))
(define paul-acc (make-account 100))
ونمذجته على الشكل
(define peter-acc (make-account 100))
(define paul-acc peter-acc)
في الحالة الأولى، الحسابان المصرفيّان متمايزان. فإنّ المعاملات التي يجريها بطرس لن تؤثّر في حساب بولس، والعكس بالعكس. وأمّا في الحالة الثانية، فقد عرّفنا paul-acc بوصفه الشيء ذاته كـpeter-acc. وفي الواقع، صار لبطرس وبولس الآن حساب مصرفيّ مشترك، وإذا سحب بطرس من peter-acc فسيلاحظ بولس مالًا أقلّ في paul-acc. وهاتان الحالتان المتشابهتان لكنهما متمايزتان قد تُسبّبان بلبلةً في بناء النماذج الحسابيّة. فعلى الحساب المشترك على وجه الخصوص، قد يكون الأمر مُحيّرًا بصفةٍ خاصّةٍ من حيث أنّ هناك كائنًا واحدًا (الحساب المصرفيّ) له اسمان مختلفان (peter-acc وpaul-acc)؛ فإذا كنّا نبحث عن جميع الأماكن في برنامجنا حيث يمكن تغيير paul-acc، فعلينا أن نتذكّر أن ننظر أيضًا إلى الأشياء التي تُغيّر peter-acc.[10]
وبالإشارة إلى الملاحظات الواردة أعلاه عن «التماثل» و«التغيّر»، لاحِظ أنّ بطرس وبولس، لو كانا لا يقدران إلّا على فحص رصيديهما المصرفيّين، ولم يستطيعا أداء عمليّاتٍ تُغيّر الرصيد، لكانت مسألة ما إذا كان الحسابان متمايزين مسألةً خاليةً من الأهمّيّة. وبصورةٍ عامّة، فما دمّا لا نُعدّل كائنات البيانات قطّ، فيمكننا اعتبار كائن بياناتٍ مركّبًا هو مجموع أجزائه بالضبط. فمثلًا، فإنّ العدد الكسريّ يُحدَّد بإعطاء بسطه ومقامه. لكن هذه النظرة لم تبقَ صالحةً بحضور التغيّر، حيث يكون لكائن البيانات المركّب «هويّةٌ» هي شيءٌ مختلفٌ عن الأجزاء التي يتكوّن منها. فإنّ الحساب المصرفيّ يبقى «الحساب المصرفيّ ذاته» حتّى لو غيّرنا الرصيد بإجراء سحب؛ وبالعكس، كان بإمكاننا أن نملك حسابين مصرفيّين مختلفين لهما المعلومات ذاتها عن الحالة. وهذا التعقيد نتيجة، لا للغة البرمجة لدينا، بل لإدراكنا للحساب المصرفيّ بوصفه كائنًا. فنحن لا نعتبر مثلًا - بصورةٍ اعتياديّةٍ - العدد الكسريّ كائنًا قابلًا للتغيّر وله هويّةٌ، بحيث نستطيع تغيير البسط ولا يزال «العدد الكسريّ ذاته».
مزالق البرمجة الأمرة
وبالمقارنة مع البرمجة الدالّيّة، فإنّ البرمجة التي تُكثر من استخدام الإحلال تُعرَف بـالبرمجة الأمرة (imperative programming). فبالإضافة إلى إثارة تعقيداتٍ حول النماذج الحسابيّة، فإنّ البرامج المكتوبة بالأسلوب الأمر عُرضةٌ لعللٍ لا يمكن أن تحدث في البرامج الدالّيّة. فمثلًا، تذكّر برنامج العامليّة التكراريّ الوارد في 1.2.1:
(define (factorial n)
  (define (iter product counter)
    (if (> counter n)
        product
        (iter (* counter product)
              (+ counter 1))))
  (iter 1 1))
وبدلًا من تمرير المعطيات في الحلقة التكراريّة الداخليّة، يمكننا اتباع أسلوبٍ أمريّ (imperative) أكثر باستخدام الإحلال الصريح لتحديث قيمتَي المتغيّرين product وcounter:
(define (factorial n)
  (let ((product 1)
        (counter 1))
    (define (iter)
      (if (> counter n)
          product
          (begin (set! product (* counter
                                  product))
                 (set! counter (+ counter 1))
                 (iter))))
    (iter)))
وهذا لا يُغيّر النتائج التي يُنتجها البرنامج، لكنّه يُدخل فخًّا خفيًّا. فكيف نقرّر ترتيب عمليّات الإحلال؟ والحال أنّ البرنامج صحيحٌ كما هو مكتوب. لكنّ كتابة عمليّات الإحلال بالترتيب المعاكس
(set! counter (+ counter 1))
(set! product (* counter product))
كانت ستُنتج نتيجةً مختلفةً وخاطئة. وبصورةٍ عامّة، فإنّ البرمجة بالإحلال تُجبرنا على النظر بعنايةٍ في الترتيبات النسبيّة لعمليّات الإحلال للتأكّد من أنّ كلّ عبارةٍ تستخدم الإصدار الصحيح من المتغيّرات التي تغيّرت. وهذه المسألة لا تنشأ إطلاقًا في البرامج الوظيفيّة (functional programs).[11]
وتزداد تعقيد البرامج الأمريّة سوءًا إذا نظرنا في تطبيقاتٍ تنفّذ فيها عدّة عمليّاتٍ في الوقت ذاته. وسنعود إلى هذا في 3.4. لكن قبل ذلك، سنتناول مسألة توفير نموذجٍ حسابيٍّ للتعبيرات التي تشمل الإحلال، وسنستكشف استخدامات الكائنات ذات الحالة المحليّة في تصميم المحاكاة.
التمرين 3.7: فكِّر في كائنات الحساب المصرفيّ المُنشأة بـmake-account، مع تعديل كلمة المرور الموصوف في التمرين 3.3. فلنفترض أنّ نظامنا المصرفيّ يتطلّب القدرة على إنشاء حساباتٍ مشتركة. عرّف إجراءً make-joint يُنجز ذلك. وينبغي أن يأخذ make-joint ثلاثة معطيات. الأوّل هو حسابٌ محميٌّ بكلمة مرور. ويجب أن يطابق المعطى الثاني كلمة المرور التي عُرِّف بها الحساب لكي تُجرى عمليّة make-joint. والمعطى الثالث هو كلمة مرورٌ جديدة. وmake-joint يُنشئ وصولًا إضافيًّا إلى الحساب الأصليّ باستخدام كلمة المرور الجديدة. فمثلًا، إذا كان peter-acc حسابًا مصرفيًّا بكلمة المرور open-sesame، فإنّ
(define paul-acc
  (make-joint peter-acc
              'open-sesame
              'rosebud))
سيسمح للمرء بإجراء تعاملاتٍ على peter-acc باستخدام الاسم paul-acc وكلمة المرور rosebud. وقد ترغب في تعديل حلك للـالتمرين 3.3 لاستيعاب هذه الميزة الجديدة.
التمرين 3.8: حين عرّفنا نموذج التقييم في 1.1.3، قلنا إنّ الخطوة الأولى في تقييم تعبيرٍ ما هي تقييم تعابيره الجزئيّة. لكنّنا لم نُحدّد قطّ الترتيب الذي يُقيَّم به التعبير الجزئيّ (مثلًا، من اليسار إلى اليمين أو من اليمين إلى اليسار). وحين نُدخل الإحلال، فإنّ الترتيب الذي تُقيَّم به معطيات إجراءٍ ما قد يُحدث فرقًا في النتيجة. عرّف إجراءً بسيطًا f بحيث يُنتج تقييم
(+ (f 0) (f 1))
القيمة 0 إذا قُيِّمت معطيات + من اليسار إلى اليمين، لكنّه يُعيد 1 إذا قُيِّمت المعطيات من اليمين إلى اليسار.
3.2 نموذج البيئة للتقييم
حين قدّمنا الإجراءات المركّبة في الفصل 1، استخدمنا نموذج الاستبدال للتقييم (1.1.5) لتحديد معنى تطبيق إجراءٍ على معطيات:
- ولتطبيق إجراءٍ مركّبٍ على معطياتٍ، قيّم جسم الإجراء باستبدال كلّ وسيطٍ شكليّ بالمعطى المطابق له.
وحين نُدخل الإحلال في لغة البرمجة خاصّتنا، فإنّ مثل هذا التعريف لم يبقَ كافيًا. فبالأخصّ، أظهر 3.1.3 أنّه في وجود الإحلال، لم يعد من الممكن اعتبار المتغيّر اسمًا لقيمةٍ فحسب. بل ينبغي للمتغيّر أن يُشير بطريقةٍ ما إلى «مكانٍ» تُخزَّن فيه القيم. وفي نموذجنا الجديد للتقييم، ستُحفَظ هذه الأماكن في بنىً تُسمّى بيئات (environments).
والبيئة تسلسلٌ من الأُطُر (frames). وكلّ إطارٍ هو جدول (قد يكون فارغًا) من الروابط (bindings)، التي تربط أسماء المتغيّرات بقيمها المقابلة. (والإطار الواحد قد يحتوي على ربطٍ واحدٍ على الأكثرّ لأيّ متغيّر.) ولكلّ إطارٍ أيضًا مؤشّر إلى بيئته المحيطة (enclosing environment)، إلّا إذا اعتُبر الإطار، لأغراض المناقشة، عامًّا (global). وقيمة متغيّرٍ بالنسبة إلى بيئةٍ ما هي القيمة التي يُعطيها ربط المتغيّر في أوّل إطارٍ في البيئة يحتوي على ربطٍ لذلك المتغيّر. فإن لم يُحدّد أيّ إطارٍ في التسلسل ربطًا للمتغيّر، قيل إنّ المتغيّر غير مربوط (unbound) في البيئة.
يُظهر الشكل 3.1 بنية بيئةٍ بسيطةٍ تتكوّن من ثلاثة أُطُر، موسومةً بـI وII وIII. وفي الرسم، A وB وC وD هي مؤشّرات إلى بيئات. ويشير C وD إلى البيئة نفسها. والمتغيّران z وx مربوطان في الإطار II، بينما y وx مربوطان في الإطار I. وقيمة x في البيئة D هي 3. وقيمة x بالنسبة إلى البيئة B هي 3 أيضًا. ويُحدَّد ذلك كما يلي: نفحص أوّل إطارٍ في التسلسل (الإطار III) فلا نجد ربطًا لـx، فننتقل إلى البيئة المحيطة D ونجد الربط في الإطار I. ومن جانبٍ آخر، قيمة x في البيئة A هي 7، لأنّ أوّل إطارٍ في التسلسل (الإطار II) يحتوي على ربط x بـ7. وبالنسبة إلى البيئة A، يُقال إنّ ربط x بـ7 في الإطار II يحجب (shadow) ربط x بـ3 في الإطار I.
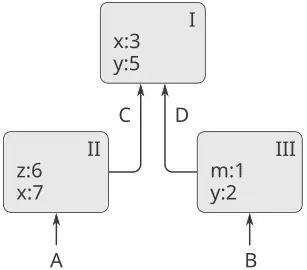
الشكل 3.1: بنية بيئةٍ بسيطة.
والبيئة حاسمةُ الأهمّيّة في عمليّة التقييم، لأنّها تُحدّد السياق الذي يُقيَّم فيه التعبير. ففي الحقيقة، يمكن القول إنّ التعابير في لغة البرمجة ليست لها بذاتها أيّ معنى. بل إنّ التعبير يكتسب معناه فقط بالنسبة إلى بعض البيئة التي يُقيَّم فيها. حتّى تفسير تعبيرٍ مباشرٍ كـ(+ 1 1) يعتمد على فهم أنّنا نعمل في سياقٍ يكون فيه + الرمز الدالّ على الجمع. وهكذا، في نموذجنا للتقييم سنتحدّث دائمًا عن تقييم تعبيرٍ بالنسبة إلى بيئةٍ ما. ولكي نصف التفاعلات مع المفسّر، سنفترض وجود بيئةٍ عامّة، تتكوّن من إطارٍ واحد (ليس له بيئة محيطة) يتضمّن القيم المرتبطة بالرموز المرتبطة بالإجراءات الأوّليّة. فمثلًا، فكرة أنّ + هو الرمز الدالّ على الجمع تُجسَّد بالقول إنّ الرمز + مربوطٌ في البيئة العامّة بإجراء الجمع الأوّليّ.
3.2.1 قواعد التقييم
ويظلّ المواصفة الكلّيّة لكيفيّة تقييم المفسّر للتركيبات كما كانت حين قدّمناها أوّل مرّةٍ في 1.1.3:
- ولتقييم تركيبةٍ:
- قيّم التعابير الجزئيّة للتركيبة.[12]
- طبّق قيمة التعبير الجزئيّ المشغّل على قيم التعبيرات الجزئيّة العوامل.
ويحلّ نموذج البيئة للتقييم محلّ نموذج الاستبدال في تحديد معنى تطبيق إجراءٍ مركّبٍ على معطيات.
في نموذج البيئة للتقييم، الإجراء هو دائمًا زوجٌ يتكوّن من بعض الشيفرة ومؤشّر إلى بيئة. والإجراءات لا تُنشَأ إلّا بطريقةٍ واحدة: بتقييم تعبير λ. وهذا يُنتج إجراءً تُستمَدّ شيفرته من نصّ تعبير λ وتكون بيئته هي البيئة التي قُيِّم فيها تعبير λ لإنتاج الإجراء. فمثلًا، تأمّل تعريف الإجراء
(define (square x)
  (* x x))
المقيَّم في البيئة العامّة. وإنّ صياغة تعريف الإجراء هي مجرّد سُكْرٌ صياغيّ (syntactic sugar) لتعبير λ ضمنيّ كامن. وكان يمكن الاكتفاء باستخدام
(define square
  (lambda (x) (* x x)))
والذي يُقيّم (lambda (x) (* x x)) ويربط square بالقيمة الناتجة، كلّ ذلك في البيئة العامّة.
يُظهر الشكل 3.2 نتيجة تقييم تعبير define هذا. وكائن الإجراء زوجٌ تُحدّد شيفرته أنّ للإجراء وسيطًا شكليًّا واحدًا، هو x، وجسم إجراءٍ هو (* x x). وجزء البيئة في الإجراء مؤشّر إلى البيئة العامّة، لأنّها البيئة التي قُيِّم فيها تعبير λ لإنتاج الإجراء. وأُضيف رابطٌ جديد، يربط كائن الإجراء بالرمز square، إلى الإطار العامّ. وبصورةٍ عامّة، يُنشئ define التعريفات بإضافة روابط إلى الأُطُر.
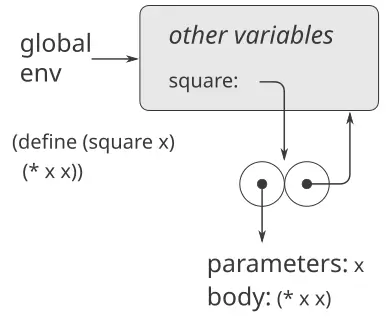
الشكل 3.2: بنية البيئة الناتجة عن تقييم (define (square x) (* x x)) في البيئة العامّة.
والآن بعد أن رأينا كيف تُنشَأ الإجراءات، نستطيع وصف كيف تُطبَّق الإجراءات. ويُحدّد نموذج البيئة ما يلي: لتطبيق إجراءٍ على معطيات، أنشئ بيئةً جديدةً تحتوي إطارًا يربط الوسائط بقيم المعطيات. وبيئة هذا الإطار المحيطة هي البيئة التي يُحدّدها الإجراء. والآن، داخل هذه البيئة الجديدة، قيّم جسم الإجراء.
ولإظهار كيف يُتّبع هذا القانون، يُوضّح الشكل 3.3 بنية البيئة المُنشأة بتقييم التعبير (square 5) في البيئة العامّة، حيث square هو الإجراء المُولَّد في الشكل 3.2. ويُنتج تطبيق الإجراء بيئةً جديدةً، موسومةً بـE1 في الشكل، تبدأ بإطارٍ يكون x، الوسيط الشكليّ للإجراء، مربوطًا فيه بالمعطى 5. والمؤشّر الصاعد من هذا الإطار يُظهر أنّ بيئته المحيطة هي البيئة العامّة. وقد اختيرت البيئة العامّة هنا، لأنّها البيئة المُشار إليها كجزءٍ من كائن الإجراء square. وداخل E1، نُقيّم جسم الإجراء، (* x x). وبما أنّ قيمة x في E1 هي 5، فالنتيجة هي (* 5 5)، أي 25.
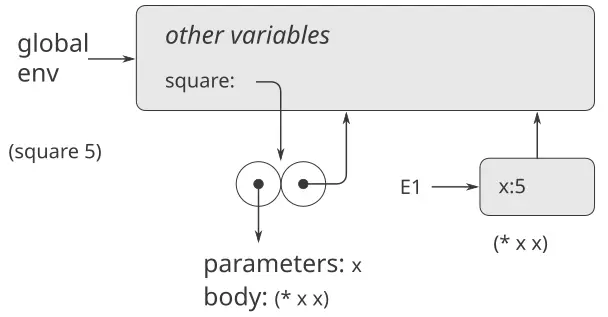
الشكل 3.3: البيئة المُنشأة بتقييم (square 5) في البيئة العامّة.
ويمكن تلخيص نموذج البيئة لتطبيق الإجراءات بقانونين:
- يُطبَّق كائن الإجراء على مجموعةٍ من المعطيات ببناء إطار، يربط الوسائط الشكليّة للإجراء بمعطيات النداء، ثمّ بتقييم جسم الإجراء في سياق البيئة الجديدة المبنيّة. وبيئة الإطار الجديد المحيطة هي جزء البيئة من كائن الإجراء المطبَّق.
- يُنشَأ الإجراء بتقييم تعبير λ بالنسبة إلى بيئةٍ معيّنة. وكائن الإجراء الناتج زوجٌ يتكوّن من نصّ تعبير λ ومؤشّر إلى البيئة التي أُنشئ فيها الإجراء.
ونُحدّد أيضًا أنّ تعريف رمزٍ باستخدام define يُنشئ رابطًا في إطار البيئة الحاليّة ويسند إلى الرمز القيمة المُشار إليها.[13] وأخيرًا، نُحدّد سلوك set!، العمليّة التي أَجبرتنا على تقديم نموذج البيئة في المقام الأوّل. فإنّ تقييم التعبير (set! ⟨variable⟩ ⟨value⟩) في بيئةٍ ما يجد ربط المتغيّر في البيئة ويغيّر ذلك الربط ليشير إلى القيمة الجديدة. أي أنّه يُعثَر على أوّل إطارٍ في البيئة يحتوي على ربطٍ للمتغيّر ويُعدَّل ذلك الإطار. فإن كان المتغيّر غير مربوطٍ في البيئة، فإنّ set! يُشير إلى خطأ.
وهذه قواعد التقييم، وإن كانت أعقدَ كثيرًا من نموذج الاستبدال، فهي لا تزال مباشرةً إلى حدٍّ معقول. وفوق ذلك، فإنّ نموذج التقييم، وإن كان مجرّدًا، فهو يوفّر وصفًا صحيحًا لكيفيّة تقييم المفسّر للتعابير. في الفصل 4 سنرى كيف يستطيع هذا النموذج أن يخدم بوصفه مخططًا لتنفيذ مفسّرٍ عامل. وتُطوّل الأقسام التالية شرح تفاصيل النموذج بتحليل بعض البرامج التوضيحيّة.
3.2.2 تطبيق الإجراءات البسيطة
حين قدّمنا نموذج الاستبدال في 1.1.5، أظهرنا كيف يُقيَّم التركيب (f 5) إلى 136، بالتعريفات الإجرائيّة التالية:
(define (square x)
  (* x x))
(define (sum-of-squares x y)
  (+ (square x) (square y)))
(define (f a)
  (sum-of-squares (+ a 1) (* a 2)))
نستطيع تحليل المثال نفسه باستخدام نموذج البيئة. يُظهر الشكل 3.4 كائنات الإجراءات الثلاثة المُنشأة بتقييم تعريفات f وsquare وsum-of-squares في البيئة العامّة. ويتكوّن كلّ كائن إجراءٍ من بعض الشيفرة، مع مؤشّر إلى البيئة العامّة.
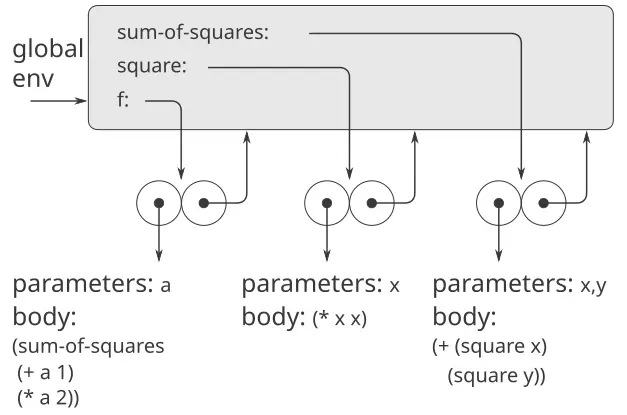
الشكل 3.4: كائنات الإجراءات في الإطار العامّ.
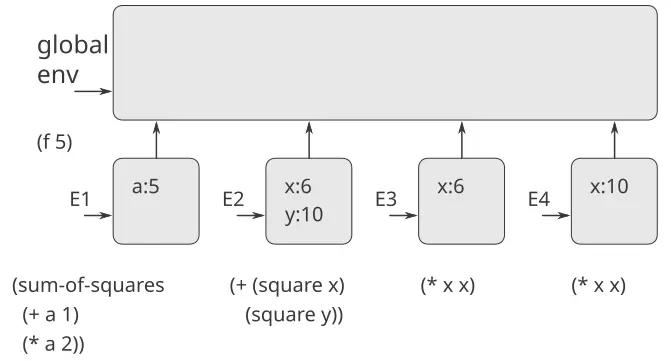
في الشكل 3.5 نرى بنية البيئة المُنشأة بتقييم التعبير (f 5). فإنّ نداء f يُنشئ بيئةً جديدةً E1 تبدأ بإطارٍ يكون فيه a، الوسيط الشكليّ لـf، مربوطًا بالمعطى 5. وداخل E1، نُقيّم جسم f:
(sum-of-squares (+ a 1) (* a 2))
الشكل 3.5: البيئات المُنشأة بتقييم (f 5) باستخدام الإجراءات الواردة في الشكل 3.4.
ولتقييم هذا التركيب، نُقيّم أوّلًا التعابير الجزئيّة. فالتعبير الجزئيّ الأوّل، sum-of-squares، له قيمةٌ هي كائن إجراء. (ولاحِظ كيف تُحصَل على هذه القيمة: ننظر أوّلًا في أوّل إطارٍ من E1، وهو لا يحتوي على ربطٍ لـsum-of-squares. ثمّ ننتقل إلى البيئة المحيطة، أي البيئة العامّة، ونجد الربط المبيَّن في الشكل 3.4.) أمّا التعبيران الجزئيّان الآخران فيُقيَّمان بتطبيق العمليّتين الأوّليّتين + و* لتقييم التركيبين (+ a 1) و(* a 2) للحصول على 6 و10 على التوالي.
والآن نطبّق كائن الإجراء sum-of-squares على المعطيين 6 و10. ويُنتج ذلك بيئةً جديدةً E2 يُربَط فيها الوسيطان الشكليّان x وy بالمعطيات. وداخل E2 نُقيّم التركيب (+ (square x) (square y)). وهذا يُفضي بنا إلى تقييم (square x)، حيث square موجودٌ في الإطار العامّ وx هو 6. ومرةً أخرى، نُنشئ بيئةً جديدةً، E3، يكون x مرتبطًا فيها بـ6، وداخلها نُقيّم جسم square، وهو (* x x). وأيضًا كجزءٍ من تطبيق sum-of-squares، يجب أن نُقيّم التعبير الجزئيّ (square y)، حيث y هو 10. وهذا النداء الثاني لـsquare يُنشئ بيئةً أخرى، E4، يكون فيها x، الوسيط الشكليّ لـsquare، مربوطًا بـ10. وداخل E4 يجب أن نُقيّم (* x x).
والنقطة المهمّة التي ينبغي ملاحظتها هي أنّ كلّ نداءٍ لـsquare يُنشئ بيئةً جديدةً تحتوي على ربطٍ لـx. ونستطيع أن نرى هنا كيف تخدم الأُطُر المختلفة في إبقاء المتغيّرات المحليّة المختلفة المسمّاة جميعًا x منفصلة. ولاحِظ أنّ كلّ إطارٍ يُنشئه square يُشير إلى البيئة العامّة، لأنّها البيئة المُشار إليها في كائن الإجراء square.
وبعد تقييم التعابير الجزئيّة، تُعاد النتائج. فالقيم المُولَّدة بالنداءين إلى square تُجمَع بـsum-of-squares، وهذه النتيجة يُعيدها f. وبما أنّ تركيزنا هنا على بنى البيئة، فلن نُطِل الشرح في كيفيّة تمرير هذه القيم المُعادة من نداءٍ إلى نداء؛ غير أنّ هذا أيضًا جانبٌ مهمّ من عمليّة التقييم، وسنعود إليه بتفصيلٍ في الفصل 5.
التمرين 3.9: في 1.2.1 استخدمنا نموذج الاستبدال لتحليل إجراءين لاحتساب المضروب، إصدارٌ تعاوديّ
(define (factorial n)
  (if (= n 1)
      1
      (* n (factorial (- n 1)))))
وإصدارٌ تكراريّ
(define (factorial n)
  (fact-iter 1 1 n))

(define (fact-iter product
                   counter
                   max-count)
  (if (> counter max-count)
      product
      (fact-iter (* counter product)
                 (+ counter 1)
                 max-count)))
أظهِر بنى البيئات المُنشأة بتقييم (factorial 6) باستخدام كلّ إصدارٍ من إجراء factorial.[14]
3.2.3 الأُطُر بوصفها مستودع الحالة المحليّة
نستطيع اللجوء إلى نموذج البيئة لنرى كيف يمكن استخدام الإجراءات والإحلال لتمثيل كائناتٍ ذات حالةٍ محليّة. فمثلًا، تأمّل «معالج السحب» الوارد في 3.1.1 والمُنشَأ بنداء الإجراء
(define (make-withdraw balance)
  (lambda (amount)
    (if (>= balance amount)
        (begin (set! balance
                     (- balance amount))
               balance)
        "Insufficient funds")))
فلْنَصِف تقييم
(define W1 (make-withdraw 100))
تتبعه
(W1 50)
50
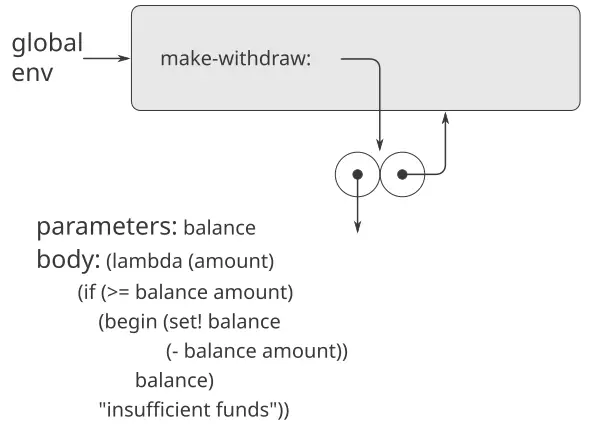
يُظهر الشكل 3.6 نتيجة تعريف إجراء make-withdraw في البيئة العامّة. وهذا يُنتج كائن إجراءٍ يحتوي على مؤشّر إلى البيئة العامّة. وحتّى الآن، لا يختلف هذا عن الأمثلة التي رأيناها سلفًا، إلّا في أنّ جسم الإجراء هو نفسه تعبير λ.
الشكل 3.6: نتيجة تعريف make-withdraw في البيئة العامّة.
ويقع الجزء المثير للاهتمام في الاحتساب حين نطبّق الإجراء make-withdraw على معطى:
(define W1 (make-withdraw 100))
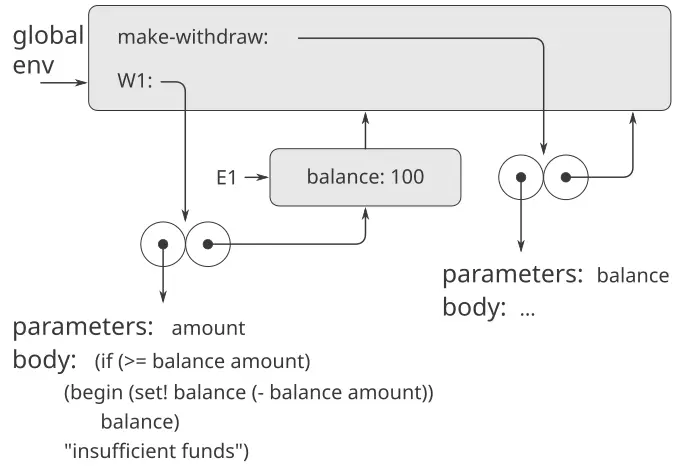
نبدأ، كالعادة، بإنشاء بيئةٍ E1 يكون فيها الوسيط الشكليّ balance مرتبطًا بالمعطى 100. وداخل هذه البيئة، نُقيّم جسم make-withdraw، أي تعبير λ. وهذا يُنشئ كائن إجراءٍ جديد، شيفرته كما يُحدّدها lambda وبيئته هي E1، البيئة التي قُيِّم فيها lambda لإنتاج الإجراء. وكائن الإجراء الناتج هو القيمة المُعادة من نداء make-withdraw. وهذا يُربط بـW1 في البيئة العامّة، إذ إنّ define نفسه يُقيَّم في البيئة العامّة. يُظهر الشكل 3.7 بنية البيئة الناتجة.
الشكل 3.7: نتيجة تقييم (define W1 (make-withdraw 100)).
والآن نستطيع تحليل ما يحدث حين يُطبَّق W1 على معطى:
(W1 50)
50
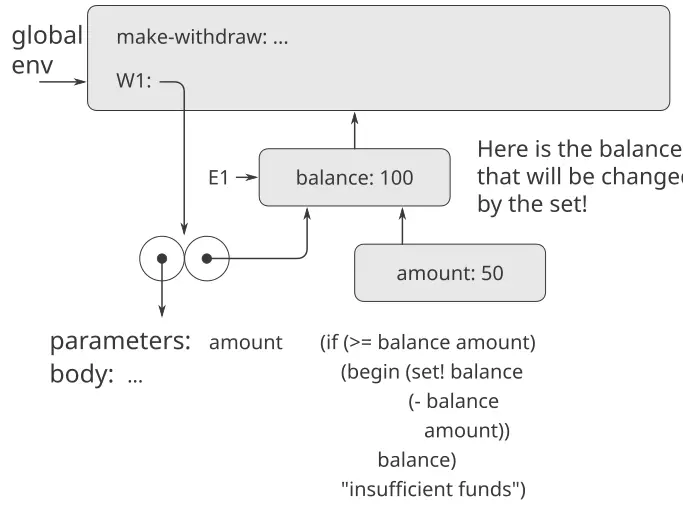
نبدأ ببناء إطارٍ يكون فيه amount، الوسيط الشكليّ لـW1، مربوطًا بالمعطى 50. والنقطة الحاسمة التي ينبغي ملاحظتها هي أنّ بيئة هذا الإطار المحيطة ليست البيئة العامّة، بل البيئة E1، لأنّها البيئة التي يُحدّدها كائن الإجراء W1. وداخل هذه البيئة الجديدة، نُقيّم جسم الإجراء:
(if (>= balance amount)
    (begin (set! balance (- balance amount))
           balance)
    "Insufficient funds")
وتُعرَض بنية البيئة الناتجة في الشكل 3.8. والتعبير الذي يُقيَّم يُشير إلى كلٍّ من amount وbalance. وسيُعثَر على amount في أوّل إطارٍ في البيئة، بينما سيُعثَر على balance باتّباع مؤشّر البيئة المحيطة إلى E1.
الشكل 3.8: البيئات المُنشأة بتطبيق كائن الإجراء W1.
وحين يُنفَّذ set!، فإنّ ربط balance في E1 يتغيّر. وعند انتهاء نداء W1، يكون balance هو 50، والإطار الذي يحتوي على balance لا يزال كائن الإجراء W1 يُشير إليه. أمّا الإطار الذي يربط amount (والذي نفّذنا فيه الشيفرة التي غيّرت balance) فلم يبقَ ذا صلة، لأنّ نداء الإجراء الذي بناه قد انتهى، ولا توجد مؤشّرات إلى ذلك الإطار من أجزاء البيئة الأخرى. وفي المرّة التالية التي يُندى فيها W1، سيُبنى إطارٌ جديد يربط amount وبيئته المحيطة هي E1. ونرى أنّ E1 يخدم بوصفه «المكان» الذي يحتفظ بمتغيّر الحالة المحليّة لكائن الإجراء W1. يُظهر الشكل 3.9 الوضع بعد نداء W1.
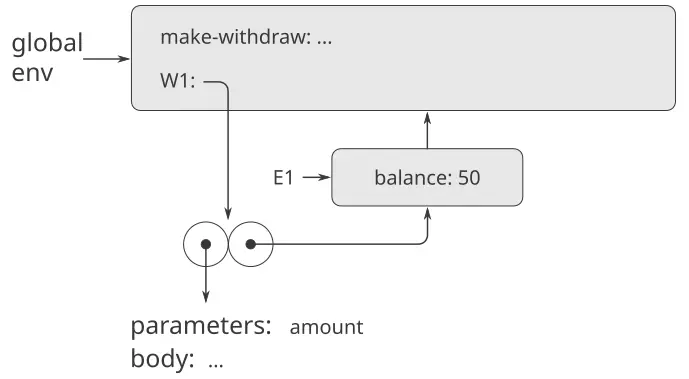
الشكل 3.9: البيئات بعد نداء W1.
ولاحِظ ما يحدث حين نُنشئ كائن «سحب» ثانيًا بإجراء نداءٍ آخر إلى make-withdraw:
(define W2 (make-withdraw 100))
ويُنتج ذلك بنية البيئة الواردة في الشكل 3.10، التي تُظهر أنّ W2 كائنُ إجراء، أي زوجٌ فيه بعض الشيفرة وبيئة. وقد أُنشئت البيئة E2 الخاصّة بـW2 بنداء make-withdraw. وهي تحتوي على إطارٍ له ربطه المحليّ الخاصّ بـbalance. ومن جانبٍ آخر، فإنّ W1 وW2 لهما الشيفرة نفسها: الشيفرة التي يُحدّدها تعبير λ في جسم make-withdraw.[15] ونرى هنا لماذا يتصرّف W1 وW2 بوصفهما كائنين مستقلّين. فإنّ نداءات W1 تُشير إلى متغيّر الحالة balance المخزون في E1، بينما نداءات W2 تُشير إلى balance المخزون في E2. وهكذا، فإنّ تغييرات الحالة المحليّة لأحد الكائنين لا تؤثّر في الكائن الآخر.
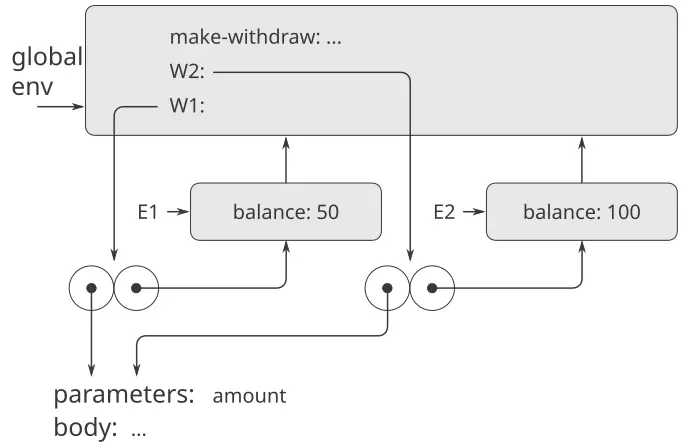
الشكل 3.10: استخدام (define W2 (make-withdraw 100)) لإنشاء كائنٍ ثانٍ.
التمرين 3.10: في إجراء make-withdraw، يُنشَأ المتغيّر المحليّ balance بوصفه وسيطًا لـmake-withdraw. ونستطيع أيضًا إنشاء متغيّر الحالة المحليّة صراحةً، باستخدام let، كما يلي:
(define (make-withdraw initial-amount)
  (let ((balance initial-amount))
    (lambda (amount)
      (if (>= balance amount)
          (begin (set! balance
                       (- balance amount))
                 balance)
          "Insufficient funds"))))
وتذكّر من 1.3.2 أنّ let هو مجرّد سُكْرٌ صياغيّ لنداء إجراء:
(let ((⟨var⟩ ⟨exp⟩)) ⟨body⟩)
يُفسَّر بوصفه صياغةً بديلةً لـ
((lambda (⟨var⟩) ⟨body⟩) ⟨exp⟩)
استخدم نموذج البيئة لتحليل هذا الإصدار البديل من make-withdraw، رسمًا أشكالًا شبيهةً بالأشكال أعلاه لتوضيح التفاعلات
(define W1 (make-withdraw 100))
(W1 50)
(define W2 (make-withdraw 100))
أظهِر أنّ الإصدَرين من make-withdraw يُنشئان كائناتٍ لها السلوك نفسه. وكيف تختلف بنى البيئة بين الإصدَرين؟
3.2.4 التعريفات الداخليّة
عرّف القسم 1.1.8 بفكرة أنّ الإجراءات يمكن أن يكون لها تعريفاتٌ داخليّة، الأمر الذي يؤدّي إلى بنيةٍ كتليّة (block structure) كما في الإجراء التالي لاحتساب الجذور التربيعيّة:
(define (sqrt x)
  (define (good-enough? guess)
    (< (abs (- (square guess) x)) 0.001))
  (define (improve guess)
    (average guess (/ x guess)))
  (define (sqrt-iter guess)
    (if (good-enough? guess)
        guess
        (sqrt-iter (improve guess))))
  (sqrt-iter 1.0))
والآن نستطيع استخدام نموذج البيئة لنرى لماذا تتصرّف هذه التعريفات الداخليّة كما هو مطلوب. يُظهر الشكل 3.11 النقطة في تقييم التعبير (sqrt 2) حيث نُودي الإجراء الداخليّ good-enough? للمرّة الأولى وguess مساوٍ لـ1.
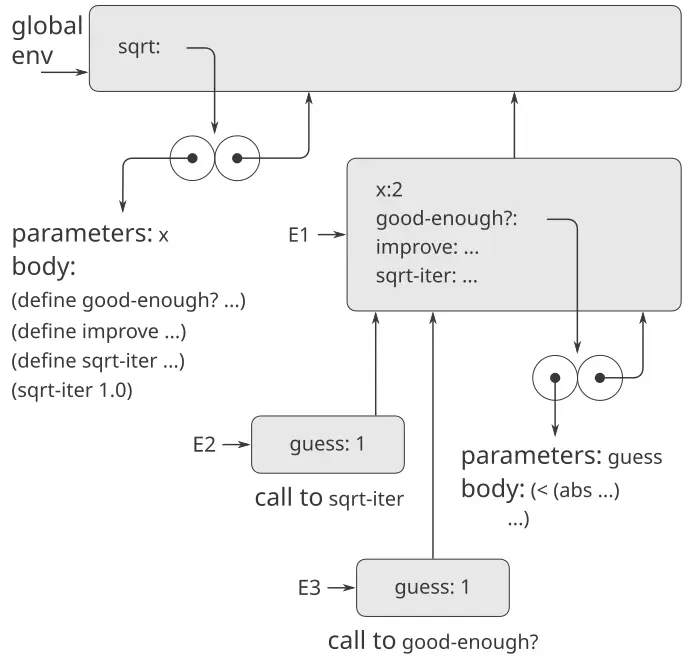
الشكل 3.11: إجراء sqrt ذو تعريفاتٍ داخليّة.
لاحِظ بنية البيئة. فإنّ sqrt رمزٌ في البيئة العامّة مربوطٌ بكائن إجراءٍ بيئته المرتبطة به هي البيئة العامّة. وحين نُودي sqrt، تكوّنت بيئةٌ جديدة E1 تابعةٌ للبيئة العامّة، يكون فيها الوسيط x مرتبطًا بـ2. ثمّ قُيِّم جسم sqrt في E1. وبما أنّ التعبير الأوّل في جسم sqrt هو
(define (good-enough? guess)
  (< (abs (- (square guess) x)) 0.001))
فإنّ تقييم هذا التعبير عرّف الإجراء good-enough? في البيئة E1. وبأكثر دقّة، أُضيف الرمز good-enough? إلى أوّل إطارٍ من E1، مربوطًا بكائن إجراءٍ بيئته المرتبطة به هي E1. وبالمثل، عُرِّف improve وsqrt-iter بوصفهما إجراءين في E1. وللإيجاز، يُظهر الشكل 3.11 كائن الإجراء الخاصّ بـgood-enough? فقط.
وبعد تعريف الإجراءات المحليّة، قُيِّم التعبير (sqrt-iter 1.0)، لا يزال في البيئة E1. فقد نُودي كائن الإجراء المربوط بـsqrt-iter في E1 بالمعطى 1. وخَلَق هذا بيئةً جديدةً E2 يكون فيها guess، وسيط sqrt-iter، مرتبطًا بـ1. وsqrt-iter بدوره نادى good-enough? بقيمة guess (من E2) بوصفها المعطى لـgood-enough?. وخَلَق هذا بيئةً أخرى، E3، يكون فيها guess (وسيط good-enough?) مرتبطًا بـ1. ومع أنّ sqrt-iter وgood-enough? كلاهما له وسيطٌ اسمه guess، فهذان متغيّران محليّان متمايزان يقعان في إطارين مختلفين. وكذلك، فإنّ E2 وE3 كلتيهما لهما E1 بوصفها بيئتهما المحيطة، لأنّ إجراءَي sqrt-iter وgood-enough? كلاهما له E1 بوصفها جزء بيئته. وإحدى نتائج ذلك أنّ الرمز x الذي يظهر في جسم good-enough? سيُشير إلى ربط x الظاهر في E1، أي قيمة x التي نُودي بها إجراء sqrt الأصليّ.
وهكذا، يفسّر نموذج البيئة الخاصّيتين الأساسّيتين اللتين تجعلان تعريفات الإجراءات المحليّة تقنيّةً مفيدةً لوحدنة البرامج:
- إنّ أسماء الإجراءات المحليّة لا تتداخل مع الأسماء الخارجيّة للإجراء المحيط، لأنّ أسماء الإجراءات المحليّة ستُربط في الإطار الذي يُنشئه الإجراء عند تشغيله، لا في البيئة العامّة.
- إنّ الإجراءات المحليّة تستطيع الوصول إلى وسائط الإجراء المحيط، بمجرّد استخدام أسماء الوسائط بوصفها متغيّراتٍ حُرّة (free variables). ويعود ذلك إلى أنّ جسم الإجراء المحليّ يُقيَّم في بيئةٍ تابعةٍ لبيئة التقييم الخاصّة بالإجراء المحيط.
التمرين 3.11: في 3.2.3 رأينا كيف وصف نموذج البيئة سلوك الإجراءات ذات الحالة المحليّة. والآن رأينا كيف تعمل التعريفات الداخليّة. فإنّ إجراء تمرير الرسائل النموذجيّ يحتوي على هذين الجانبين معًا. تأمّل إجراء الحساب المصرفيّ الوارد في 3.1.1:
(define (make-account balance)
  (define (withdraw amount)
    (if (>= balance amount)
        (begin (set! balance
                     (- balance
                        amount))
               balance)
        "Insufficient funds"))
  (define (deposit amount)
    (set! balance (+ balance amount))
    balance)
  (define (dispatch m)
    (cond ((eq? m 'withdraw) withdraw)
          ((eq? m 'deposit) deposit)
          (else (error "Unknown request:
                        MAKE-ACCOUNT"
                       m))))
  dispatch)
أظهِر بنية البيئة المُولَّدة من تتالي التفاعلات
(define acc (make-account 50))

((acc 'deposit) 40)
90

((acc 'withdraw) 60)
30
فأين تُحفَظ الحالة المحليّة الخاصّة بـacc؟ فلنفترض أنّنا نُعرّف حسابًا آخر
(define acc2 (make-account 100))
وكيف تُحفَظ الحالة المحليّة للحسابين منفصلة؟ وأيّ أجزاء بنية البيئة مُشترَكة بين acc وacc2؟
3.3 النمذجة بالبيانات القابلة للتغيير
تناول الفصل 2 البيانات المركّبة بوصفها وسيلةً لبناء كائناتٍ حسابيّةٍ لها عدّة أجزاء، بغية نمذجة كائنات العالم الواقعيّ التي لها عدّة جهات. وفي ذلك الفصل، قدّمنا انضباط تجريد البيانات، الذي بموجبه تُحدَّد بنى البيانات بدلالة البنّاءات (constructors)، التي تُنشئ كائنات البيانات، والمُحدِّدات (selectors)، التي تصل إلى أجزاء كائنات البيانات المركّبة. لكنّنا نعلم الآن أنّ هناك جانبًا آخر من البيانات لم يتناوله الفصل 2. فإنّ الرغبة في نمذجة أنظمةٍ مركّبةٍ من كائناتٍ لها حالة متغيّرة تدفعنا إلى الحاجة إلى تعديل كائنات البيانات المركّبة، إضافةً إلى بنائها والانتقاء منها. ولكي نمثّل الكائنات المركّبة ذات الحالة المتغيّرة، سنصمّم تجريدات بياناتٍ تتضمّن، إضافةً إلى المُحدِّدات والبنّاءات، عمليّاتٍ تُسمّى مُبدِّلات (mutators)، تُعدّل كائنات البيانات. فمثلًا، فإنّ نمذجة نظامٍ مصرفيّ تتطلّب منّا تغيير أرصدة الحسابات. وهكذا، فقد تقبل بنية بياناتٍ لتمثيل الحسابات المصرفيّة عمليّةً من شكل
(set-balance! ⟨account⟩ ⟨new-value⟩)
تُغيِّر رصيد الحساب المُعيّن إلى القيمة الجديدة المُعيّنة. وكائنات البيانات التي تُعرّف لها مُبدِّلات تُعرف بـكائنات البيانات القابلة للتغيير (mutable data objects).
قدّم الفصل 2 الأزواج بوصفها «صمغًا» عامّ الغرض لتوليف البيانات المركّبة. ونبدأ هذا القسم بتعريف مُبدِّلات أساسيّة للأزواج، حتّى تستطيع الأزواج أن تخدم بوصفها كتل بناءٍ لإنشاء كائنات بياناتٍ قابلةٍ للتغيير. وهذه المُبدِّلات تعزّز القدرة التمثيليّة للأزواج تعزيزًا كبيرًا، ممّا يتيح لنا بناء بنى بياناتٍ غير السلاسل والأشجار التي عملنا معها في 2.2. ونُقدّم أيضًا بعض الأمثلة على المحاكاة التي تمثَّلت فيها الأنظمة المعقّدة بوصفها مجموعاتٍ من الكائنات ذات الحالة المحليّة.
3.3.1 بنية القائمة القابلة للتغيير
إنّ العمليّات الأساسيّة على الأزواج —cons وcar وcdr— يمكن استخدامها لبناء بنية القائمة ولانتقاء أجزاءً من بنية القائمة، لكنّها عاجزةٌ عن تعديل بنية القائمة. والشيء نفسه صحيحٌ بشأن عمليّات القوائم التي استخدمناها حتّى الآن، مثل append وlist، إذ يمكن تعريف هذه بدلالة cons وcar وcdr. ولكي نُعدّل بنى القوائم، نحتاج إلى عمليّاتٍ جديدة.
والمُبدِّلات الأوّليّة للأزواج هي set-car! وset-cdr!. وset-car! تأخذ معطيين، يجب أن يكون الأوّل منهما زوجًا. وهي تُعدّل هذا الزوج، بتحويل مؤشّر car إلى مؤشّرٍ إلى المعطى الثاني لـset-car!.[16]
فمثلًا، لنفترض أنّ x مرتبطٌ بالقائمة ((a b) c d) وy بالقائمة (e f) كما هو موضّح في الشكل 3.12. فإنّ تقييم التعبير (set-car! x y) يُعدّل الزوج الذي x مرتبطٌ به، فيحلّ محلّ car فيه قيمة y. وتُعرَض نتيجة العمليّة في الشكل 3.13. وقد عُدّلت البنية x وستُطبَع الآن بالشكل ((e f) c d). أمّا الأزواج التي تمثّل القائمة (a b)، والتي يُعرَف بها بالمؤشّر الذي استُبدل، فهي مفصولةٌ الآن عن البنية الأصليّة.[17]
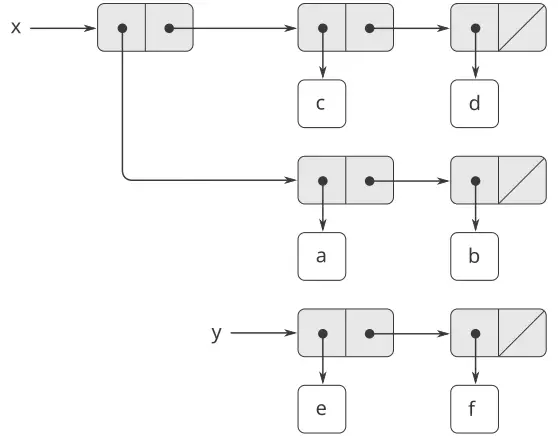
الشكل 3.12: القائمتان x: ((a b) c d) وy: (e f).
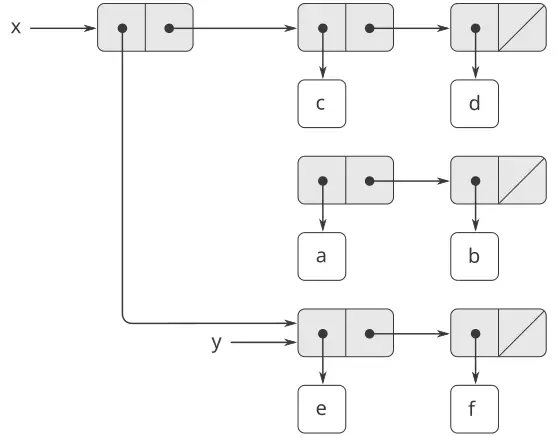
الشكل 3.13: أثر (set-car! x y) على القائمتين في الشكل 3.12.
قارِن الشكل 3.13 بـالشكل 3.14، الذي يُوضّح نتيجة تنفيذ (define z (cons y (cdr x))) وx وy مرتبطتين بالقائمتين الأصليّتين الواردتين في الشكل 3.12. والمتغيّر z مرتبطٌ الآن بزوجٍ جديد أنشأته عمليّة cons؛ والقائمة التي x مرتبطٌ بها لم تتغيّر.
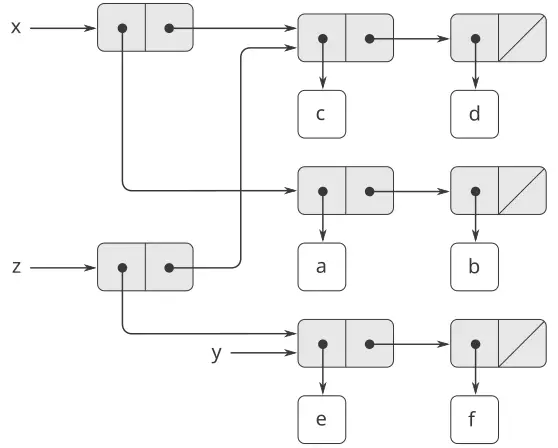
الشكل 3.14: أثر (define z (cons y (cdr x))) على القائمتين في الشكل 3.12.
إنّ عمليّة set-cdr! شبيهةٌ بـset-car!. والفرق الوحيد هو أنّ مؤشّر cdr للزوج، لا مؤشّر car، هو الذي يُستبدل. ويُعرَض أثر تنفيذ (set-cdr! x y) على قائمتَي الشكل 3.12 في الشكل 3.15. وهنا، استُبدل مؤشّر cdr الخاصّ بـx بالمؤشّر إلى (e f). وكذلك، فإنّ القائمة (c d)، التي كانت cdr الخاصّة بـx، صارت مفصولةً عن البنية.
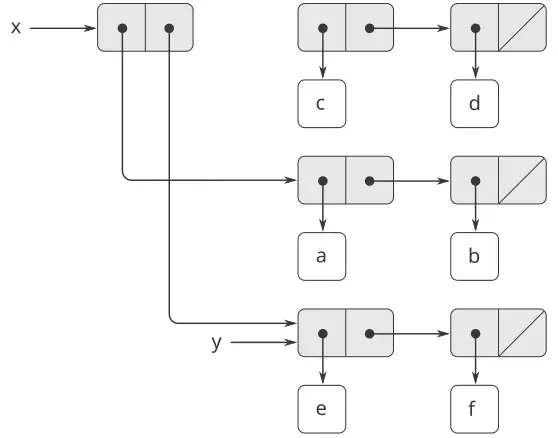
الشكل 3.15: أثر (set-cdr! x y) على قائمتَي الشكل 3.12.
يُبنِي cons بنية قائمةٍ جديدةً بإنشاء أزواجٍ جديدة، بينما set-car! وset-cdr! تُعدّلان الأزواج القائمة. ففي الحقيقة، نستطيع تنفيذ cons بدلالة المُبدِّلتين، مع إجراء get-new-pair يُعيد زوجًا جديدًا ليس جزءًا من أيّ بنية قائمةٍ قائمة. فنحن نحصُل على الزوج الجديد، ونضبط مؤشّرَي car وcdr فيه ليشيرا إلى الكائنات المُعيّنة، ونُعيد الزوج الجديد نتيجةً لـcons.[18]
(define (cons x y)
  (let ((new (get-new-pair)))
    (set-car! new x)
    (set-cdr! new y)
    new))
التمرين 3.12: عُرِّف الإجراء التالي لإلحاق القوائم في 2.2.1:
(define (append x y)
  (if (null? x)
      y
      (cons (car x) (append (cdr x) y))))
يُشكّل append قائمةً جديدةً بإجراء cons لعناصر x على y تباعًا. وإجراء append! شبيهٌ بـappend، لكنّه مُبدِّلٌ لا بانٍّ. وهو يُلحق القوائم بوصلها معًا، مُعدِّلًا الزوج الأخير من x بحيث يصير cdr فيه هو y. (واستدعاء append! بـx فارغة خطأ.)
(define (append! x y)
  (set-cdr! (last-pair x) y)
  x)
وهنا last-pair إجراءٌ يُعيد الزوج الأخير في معطاه:
(define (last-pair x)
  (if (null? (cdr x))
      x
      (last-pair (cdr x))))
تأمّل التفاعل
(define x (list 'a 'b))
(define y (list 'c 'd))
(define z (append x y))

z
(a b c d)

(cdr x)
⟨response⟩

(define w (append! x y))

w
(a b c d)

(cdr x)
⟨response⟩
ما هما الـ⟨response⟩ان الناقصان؟ ارسم مخطّطات الصناديق والمؤشّرات لتوضيح إجابتك.
التمرين 3.13: انظر في الإجراء make-cycle الآتي، الذي يستخدم الإجراء last-pair المعرَّف في التمرين 3.12:
(define (make-cycle x)
  (set-cdr! (last-pair x) x)
  x)
ارسم مخطّط صناديق ومؤشّراتٍ يُظهر البنية z المُنشَأة بالتعريف الآتي
(define z (make-cycle (list 'a 'b 'c)))
ماذا يحدث إذا حاولنا احتساب (last-pair z)؟
التمرين 3.14: الإجراء الآتي مفيدٌ للغاية، وإن كان غامضًا:
(define (mystery x)
  (define (loop x y)
    (if (null? x)
        y
        (let ((temp (cdr x)))
          (set-cdr! x y)
          (loop temp x))))
  (loop x '()))
يستخدم Loop المتغيّر «المؤقّت» temp لحفظ القيمة القديمة للـcdr الخاصّ بـx، إذ إنّ set-cdr! في السطر التالي يُدمّر الـcdr. اشرح ما يفعله mystery بصورةٍ عامّة. لنفترض أنّ v معرَّفٌ بـ(define v (list 'a 'b 'c 'd)). ارسم مخطّط الصناديق والمؤشّرات الذي يمثّل القائمة المربوطة بـv. ولنفترض أنّنا قيّنّا الآن (define w (mystery v)). ارسم مخطّطات الصناديق والمؤشّرات التي تُظهر البنيتين v وw بعد تقييم هذا التعبير. فما الذي سيُطبَع كقيمتَي v وw؟
المشاركة والهويّة
ذكرنا في 3.1.3 المسائل النظريّة لـ«التماثل» و«التغيير» التي أثارها إدخال الإحلال. وهذه المسائل تنشأ عمليًّا حين تُشارَك أزواجٌ فرديّةٌ بين كائنات بياناتٍ مختلفة. فمثلًا، انظر في البنية المتشكّلة بـ
(define x (list 'a 'b))
(define z1 (cons x x))
كما هو موضّح في الشكل 3.16، فإنّ z1 زوجٌ يشير كلٌّ من car وcdr فيه إلى الزوج ذاته x. وهذه المشاركة لـx من قِبَل car وcdr الخاصّين بـz1 نتيجةٌ للطريقة المباشرة التي يُنفَّذ بها cons. وبصورةٍ عامّة، فإنّ استخدام cons لبناء القوائم سيُنتج بنيةً متشابكةً من الأزواج تتشارك فيها بنياتٌ كثيرةٌ مختلفةٌ في أزواجٍ فرديّةٍ كثيرة.
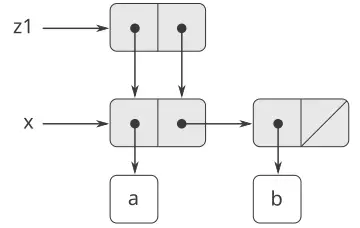
الشكل 3.16: القائمة z1 المتشكّلة بـ(cons x x).
وبخلاف الشكل 3.16، يُظهر الشكل 3.17 البنية المُنشَأة بالتعريف الآتي
(define z2
  (cons (list 'a 'b) (list 'a 'b)))
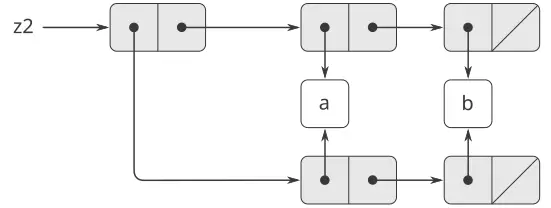
الشكل 3.17: القائمة z2 المتشكّلة بـ(cons (list 'a 'b) (list 'a 'b)).
في هذه البنية، الأزواجُ في القائمتين (a b) متمايزةٌ، وإن كانت الرموزُ الفعليّةُ مُشارَكة.[19]
فكلا z1 وz2 يمثّل «القائمة ذاتها»، ((a b) a b)، إذا فكّرنا فيهما بوصفهما قائمة. وبصورةٍ عامّة، فإنّ المشاركة غيرُ قابلةٍ للكشف إطلاقًا إذا عملنا على القوائم باستخدام cons وcar وcdr وحدها. غير أنّها تصبح ذا أهمّيّةٍ إذا سمحنا بمغيّراتٍ على بنية القائمة. ومثالٌ على الفرق الذي يمكن أن تُحدِثه المشاركة، انظر في الإجراء الآتي، الذي يُعدّل car البنية التي تُطبَّق عليها:
(define (set-to-wow! x)
  (set-car! (car x) 'wow)
  x)
حتّى وإن كانت z1 وz2 «البنية ذاتها»، فإنّ تطبيق set-to-wow! عليهما يُنتج نتائجَ مختلفة. فمع z1، يُغيّر تعديل car الـcdr أيضًا، لأنّ z1 يتّحد فيه car وcdr في الزوج ذاته. وأمّا مع z2، فإنّ car وcdr متمايزان، لذا يُعدّل set-to-wow! الـcar فقط:
z1
((a b) a b)

(set-to-wow! z1)
((wow b) wow b)

z2
((a b) a b)

(set-to-wow! z2)
((wow b) a b)
إحدى طرائق كشف المشاركة في بنى القوائم هي استخدام المُسَيِّم eq?، الذي عرّفناه في 2.3.1 بوصفه طريقةً لاختبار تساوي رمزين. وبأكثر عموميّةٍ، يختبر (eq? x y) ما إذا كان x وy هما الكائن ذاته (أي ما إذا كان x وy متساويين بوصفهما مؤشّرين). وهكذا، فبـz1 وz2 المعرَّفين في الشكل 3.16 والشكل 3.17، فإنّ (eq? (car z1) (cdr z1)) صحيحة و(eq? (car z2) (cdr z2)) خاطئة.
وكما سنرى في الأقسام التالية، يمكننا استغلال المشاركة لتوسيع ذخيرة بنيات البيانات التي يمكن تمثيلها بالأزواج توسيعًا كبيرًا. ومن جانبٍ آخر، فإنّ المشاركة يمكن أن تكون خطيرةً أيضًا، إذ إنّ التعديلات المُجرَاة على البنيات ستؤثّر في بنياتٍ أخرى تتشارك الأجزاء المُعدَّلة صدفةً. وينبغي استخدام عمليّات التغيير set-car! وset-cdr! بحذر؛ فما لم يكن لدينا فهمٌ جيّدٌ لكيفيّة مشاركة كائنات بياناتنا، فقد يؤدّي التغيير إلى نتائجَ غير متوقّعة.[20]
التمرين 3.15: ارسم مخطّطات الصناديق والمؤشّرات لتوضيح أثر
set-to-wow!على البنيتينz1وz2أعلاه.
التمرين 3.16: يقرّر بن بيتدِل كتابة إجراءٍ لعدّ عدد الأزواج في أيّ بنية قوائم. «إنّه يسير»، يعلّل. «عدد الأزواج في أيّ بنيةٍ هو العدد في car زائد العدد في cdr زائد واحدٌ آخرُ لعدّ الزوج الحاليّ.» فيكتب بن الإجراء الآتي:
(define (count-pairs x)
  (if (not (pair? x))
      0
      (+ (count-pairs (car x))
         (count-pairs (cdr x))
         1)))
أظهِر أنّ هذا الإجراء غيرُ صحيح. وبالتحديد، ارسم مخطّطات صناديق ومؤشّراتٍ تمثّل بنى قوائمٍ متكوّنةً من ثلاثة أزواجٍ بالضبط، يعيد إجراء بن بالنسبة إليها 3؛ ويعيد 4؛ ويعيد 7؛ ولا يعيد إطلاقًا.
التمرين 3.17: ابتكر نسخةً صحيحةً من الإجراء
count-pairsالوارد في التمرين 3.16، يعيد عدد الأزواج المتمايزة في أيّ بنية. (تلميح: اجتلِ البنية، محتفظًا ببنية بياناتٍ مساعِدةٍ تُستخدم لتتبّع الأزواج التي تمّ عدُّها سلفًا.)
التمرين 3.18: اكتب إجراءً يفحص قائمةً ويحدّد ما إذا كانت تحتوي دورةً، أي ما إذا كان برنامجٌ يحاول إيجاد نهاية القائمة بأخذ
cdrاتٍ متعاقبة سيدخل في حلقةٍ لا نهائيّة. وقد بنَت مثل هذه القوائم التمرين 3.13.
التمرين 3.19: أعِد التمرين 3.18 باستخدام خوارزميّةٍ لا تتطلّب إلّا مقدارًا ثابتًا من المكان. (وهذا يستلزم فكرةً ذكيّةً للغاية.)
التغيير ليس سوى إحلال
حين عرّفنا البيانات المركّبة، لاحظنا في 2.1.3 أنّ الأزواج يمكن تمثيلها بدلالة الإجراءات تمثيلًا محضًا:
(define (cons x y)
  (define (dispatch m)
    (cond ((eq? m 'car) x)
          ((eq? m 'cdr) y)
          (else (error "Undefined
                 operation: CONS" m))))
  dispatch)

(define (car z) (z 'car))
(define (cdr z) (z 'cdr))
والملاحظة ذاتها صحيحةٌ بالنسبة للبيانات القابلة للتغيير. فيمكننا تنفيذ كائنات البيانات القابلة للتغيير بوصفها إجراءاتٍ باستخدام الإحلال والحالة المحليّة. فمثلًا، يمكننا توسيع تنفيذ الأزواج المعطى أعلاه لمعالجة set-car! وset-cdr! بأسلوبٍ نظيرٍ للأسلوب الذي نفّذنا به الحسابات المصرفيّة باستخدام make-account في 3.1.1:
(define (cons x y)
  (define (set-x! v) (set! x v))
  (define (set-y! v) (set! y v))
  (define (dispatch m)
    (cond ((eq? m 'car) x)
          ((eq? m 'cdr) y)
          ((eq? m 'set-car!) set-x!)
          ((eq? m 'set-cdr!) set-y!)
          (else (error "Undefined
                 operation: CONS" m))))
  dispatch)

(define (car z) (z 'car))
(define (cdr z) (z 'cdr))

(define (set-car! z new-value)
  ((z 'set-car!) new-value)
  z)

(define (set-cdr! z new-value)
  ((z 'set-cdr!) new-value)
  z)
إنّ الإحلال هو كلّ ما يلزم، نظريًّا، لتفسير سلوك البيانات القابلة للتغيير. فمجرّد أن نُدخل set! إلى لغتنا، نُثير جميع المسائل، لا مسائل الإحلال فحسب، بل مسائل البيانات القابلة للتغيير عمومًا.[21]
التمرين 3.20: ارسم مخطّطات البيئات لتوضيح تقييم تتالي التعابير
(define x (cons 1 2))
(define z (cons x x))

(set-car! (cdr z) 17)

(car x)
17
باستخدام تنفيذ الأزواج الإجرائيّ المعطى أعلاه. (قارن التمرين 3.11.)
3.3.2 تمثيل الطوابير
إنّ المغيّرين set-car! وset-cdr! يمكّناننا من استخدام الأزواج لبناء بنيات بياناتٍ لا يمكن تشييدها بـcons وcar وcdr وحدها. ويُظهر هذا القسم كيف نستخدم الأزواج لتمثيل بنية بياناتٍ تُسمّى الطابور. وسيُظهر القسم 3.3.3 كيف نُمثّل بنيات بياناتٍ تُسمّى الجداول.
الطابور (queue) هو تسلسلٌ تُدرَج العناصر في أحد طرفيه (الذي يُسمّى الخلفيّة للطابور) وتُحذَف من الطرف الآخر (الذي يُسمّى المقدّمة). ويُظهر الشكل 3.18 طابورًا خاليًا في بادئ الأمر تُدرَج فيه العنصران a وb. ثمّ يُحذَف a، ويُدرَج c وd، ويُحذَف b. ولأنّ العناصر تُحذَف دائمًا بالترتيب الذي أُدرِجت به، فإنّ الطابور يُسمّى أحيانًا مِخزَن FIFO (أي «الأوّل داخلًا هو الأوّل خارجًا»).
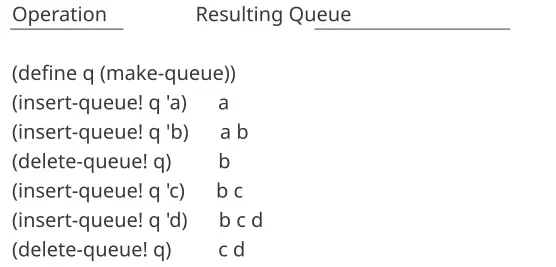
الشكل 3.18: عمليّات الطابور.
من حيث تجريد البيانات، يمكننا اعتبار الطابور معرَّفًا بمجموعة العمليّات الآتية:
بانٍ: (make-queue) يعيد طابورًا خاليًا (طابورًا لا يحتوي أيّ عناصر). محدِّدان:
(empty-queue? ⟨queue⟩)
يختبر ما إذا كان الطابور خاليًا.
(front-queue ⟨queue⟩)
يعيد الكائن الموجود في مقدّمة الطابور، مُعلنًا خطأً إذا كان خاليًا؛ ولا يُعدّل الطابور.
مغيّران:
(insert-queue! ⟨queue⟩ ⟨item⟩)
يُدرِج العنصر في خلفيّة الطابور ويعيد الطابور المُعدَّل قيمةً له.
(delete-queue! ⟨queue⟩)
يحذف العنصر الموجود في مقدّمة الطابور ويعيد الطابور المُعدَّل قيمةً له، مُعلنًا خطأً إذا كان الطابور خاليًا قبل الحذف.
ولأنّ الطابور تسلسلٌ من العناصر، فيمكننا بكلّ تأكيدٍ تمثيله بقائمةٍ اعتياديّة؛ فمقدّمة الطابور هي car القائمة، وإدراج عنصرٍ في الطابور يعني إلحاق عنصرٍ جديدٍ في نهاية القائمة، وحذف عنصرٍ من الطابور ليس سوى أخذ cdr القائمة. غير أنّ هذا التمثيل غيرُ كفؤ، لأنّ إدراج عنصرٍ يتطلّب منّا مسح القائمة حتّى نبلغ نهايتها. وبما أنّ الطريقة الوحيدة المتاحة لمسح القائمة هي بعمليّات cdr متعاقبة، فإنّ هذا المسح يتطلّب خطوةً لقائمةٍ من عنصرًا. ويغلُب تعديلٌ بسيطٌ لتمثيل القائمة على هذا العيب بالسماح بتنفيذ عمليّات الطابور بحيث تتطلّب خطوة؛ أي بحيث يكون عدد الخطوات اللازم مستقلًّا عن طول الطابور.
ينشأ الصّعب في تمثيل القائمة من الحاجة إلى المسح لإيجاد نهاية القائمة. وسبب حاجتنا إلى المسح هو أنّ الطريقة القياسيّة لتمثيل قائمةٍ بسلسلةٍ من الأزواج تُتيح لنا بسهولةٍ مؤشّرًا إلى بداية القائمة، لكنّها لا تُعطينا مؤشّرًا يسهل الوصولُ إليه إلى نهايتها. والتعديل الذي يتفادى هذا العيب هو تمثيل الطابور بقائمةٍ، مع مؤشّرٍ إضافيٍّ يُشير إلى الزوج الأخير في القائمة. وبذلك، حين نُدرِج عنصرًا، يمكننا الرجوع إلى مؤشّر الخلفيّة وتفادي مسح القائمة.
يُمثَّل الطابور، إذن، بزوجٍ من المؤشّرات، front-ptr وrear-ptr، التي تُشير، على التوالي، إلى الزوج الأوّل والزوج الأخير في قائمةٍ اعتياديّة. وبما أنّنا نودّ أن يكون الطابور كائنًا قابلًا للتمييز، فيمكننا استخدام cons لدمج المؤشّرين. وهكذا، سيكون الطابور نفسُه هو cons المؤشّرين. ويُوضيّح الشكل 3.19 هذا التمثيل.
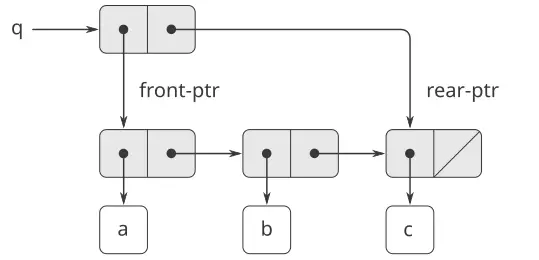
الشكل 3.19: تنفيذ طابورٍ بوصفه قائمةً ذات مؤشّري مقدّمةٍ وخلفيّة.
لتعريف عمليّات الطابور نستخدم الإجراءات الآتية، التي تُمكّننا من تحديد مؤشّري المقدّمة والخلفيّة للطابور وتعديلهما:
(define (front-ptr queue) (car queue))
(define (rear-ptr queue) (cdr queue))
(define (set-front-ptr! queue item)
  (set-car! queue item))
(define (set-rear-ptr! queue item)
  (set-cdr! queue item))
يمكننا الآن تنفيذ عمليّات الطابور الفعليّة. وسنعتبر الطابور خاليًا إذا كان مؤشّر مقدّمتِه هو القائمة الخالية:
(define (empty-queue? queue)
  (null? (front-ptr queue)))
يُعيد الباني make-queue، بوصفه طابورًا خاليًا في بادئ الأمر، زوجًا كلٌّ من car وcdr فيه هو القائمة الخالية:
(define (make-queue) (cons '() '()))
لاتّخاذ العنصر الموجود في مقدّمة الطابور، نُعيد car الزوج الذي يُشير إليه مؤشّر المقدّمة:
(define (front-queue queue)
  (if (empty-queue? queue)
      (error "FRONT called with an
              empty queue" queue)
      (car (front-ptr queue))))
لإدراج عنصرٍ في طابور، نتبع الطريقة التي تُشير نتيجتها في الشكل 3.20. فنبدأ بإنشاء زوجٍ جديد، car فيه هو العنصر المُراد إدراجه وcdr فيه هو القائمة الخالية. فإن كان الطابور خاليًا في بادئ الأمر، نُعيّن مؤشّري مقدّمة الطابور وخلفيّته إلى هذا الزوج الجديد. وإلّا، نُعدّل الزوج الأخير في الطابور ليشير إلى الزوج الجديد، ونُعيّن مؤشّر الخلفيّة أيضًا إلى الزوج الجديد.
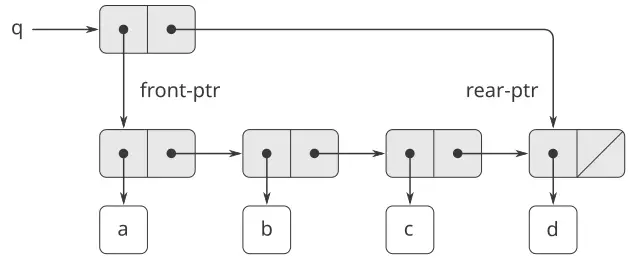
الشكل 3.20: نتيجة استخدام (insert-queue! q 'd) على الطابور في الشكل 3.19.
(define (insert-queue! queue item)
  (let ((new-pair (cons item '())))
    (cond ((empty-queue? queue)
           (set-front-ptr! queue new-pair)
           (set-rear-ptr! queue new-pair)
           queue)
          (else (set-cdr! (rear-ptr queue)
                          new-pair)
                (set-rear-ptr! queue new-pair)
                queue))))
ولحذف العنصر الموجود في مقدّمة الطابور، نُعدّل مؤشّر المقدّمة فحسب بحيث يُشير الآن إلى العنصر الثاني في الطابور، والذي يمكن إيجاده باتباع مؤشّر cdr للعنصر الأوّل (انظر الشكل 3.21):[22]
(define (delete-queue! queue)
  (cond ((empty-queue? queue)
         (error "DELETE! called with
                 an empty queue" queue))
        (else (set-front-ptr!
               queue
               (cdr (front-ptr queue)))
              queue)))
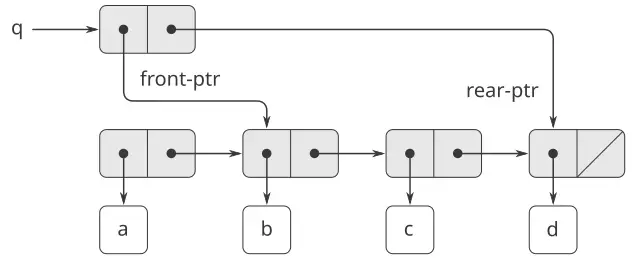
الشكل 3.21: نتيجة استخدام (delete-queue! q) على الطابور في الشكل 3.20.
التمرين 3.21: يقرّر بن بيتدِل اختبار تنفيذ الطابور الموصوف أعلاه. فيُدخل الإجراءات إلى مفسّر Lisp ويبدأ بتجربتها:
(define q1 (make-queue))

(insert-queue! q1 'a)
((a) a)

(insert-queue! q1 'b)
((a b) b)

(delete-queue! q1)
((b) b)

(delete-queue! q1)
(() b)
«كلّه خاطئ!» يشكو. «يُظهر ردّ المفسّر أنّ العنصر الأخير يُدرَج في الطابور مرّتين. وحين أحذف العنصرين كلَيهما، يبقى b الثاني موجودًا، فالطابور ليس خاليًا، مع أنّه من المفترض أن يكون كذلك.» وتقترح إيفا لو آتر أنّ بن قد أساء فهم ما يجري. «ليس الأمر أنّ العناصر تدخل الطابور مرّتين،» تشرح. «إنّه فقط أنّ الطابعة القياسيّة في Lisp لا تعرف كيف تُفسّر تمثيل الطابور. فإن أردت رؤية الطابور مطبوعًا بصورةٍ صحيحة، فسيلزمك تعريف إجراء طباعةٍ خاصّ بك للطوابير.» اشرح عمّا تتكلّم إيفا لو. وبالتحديد، أظهِر لماذا تُنتج أمثلة بن النتائج المطبوعة التي تُنتجها. وعرّف إجراءً print-queue يأخذ طابورًا مُدخَلًا ويطبع تسلسل العناصر في الطابور.
التمرين 3.22: بدلًا من تمثيل الطابور بزوجٍ من المؤشّرات، يمكننا بناء طابورٍ بوصفه إجراءً ذا حالةٍ محلّيّة. وستتكوّن الحالة المحليّة من مؤشّرين إلى بداية قائمةٍ اعتياديّةٍ ونهايتها. وهكذا، سيكون الإجراء make-queue على الصورة
(define (make-queue)
  (let ((front-ptr … )
        (rear-ptr … ))
    ⟨definitions of internal procedures⟩
    (define (dispatch m) …)
    dispatch))
أكمل تعريف make-queue وأعطِ تنفيذ عمليّات الطابور باستخدام هذا التمثيل.
التمرين 3.23: الطابور ذو الطرفين (deque) هو تسلسلٌ يمكن إدراج العناصر فيه وحذفها من المقدّمة أو من الخلفيّة. وعمليّات الطوابير ذوات الأطراف هي الباني
make-deque، والمُسَيِّمempty-deque?، والمحدِّداتfront-dequeوrear-deque، والمغيّراتfront-insert-deque!وrear-insert-deque!وfront-delete-deque!وrear-delete-deque!. أظهِر كيف نُمثّل الطوابير ذوات الأطراف باستخدام الأزواج، وأعطِ تنفيذ العمليّات.[23] وينبغي أن تُنجَز جميع العمليّات في خطوة.
3.3.3 تمثيل الجداول
حين درسنا طرائق مختلفةً لتمثيل المجموعات في الفصل 2، ذكرنا في 2.3.3 مهمّة صون جدولٍ من السجلّات مُفهرَسًا بمفاتيح تمييزٍ. وفي تنفيذ البرمجة الموجَّهة بالبيانات في 2.4.3، استخدمنا جداول ثنائيّة الأبعاد استخدامًا واسعًا، تُخزَّن المعلومات فيها وتُستخرَجُ باستخدام مفتاحين. وهنا نرى كيف نبني الجداول بوصفها بنى قوائمَ قابلةً للتغيير.
نبدأ بالنظر في جدولٍ أحاديّ الأبعاد، تُخزَّن فيه كلّ قيمةٍ تحت مفتاحٍ واحدٍ. ونُنفّذ الجدول بوصفه قائمةً من السجلّات، يُنفَّذ كلٌّ منها بوصفه زوجٍ متكوّنٍ من مفتاحٍ ومن القيمة المرتبطة به. وتُلصَق السجلّات معًا لتشكيل قائمةٍ بأزواجٍ لاصقةٍ يشير car كلٍّ منها إلى السجلّ الذي يليه. وتُسمّى هذه الأزواج اللاصقة العمود الفقريّ (backbone) للجدول. ولكي يكون لدينا موضعٌ يمكننا تغييره حين نُضيف سجلًّا جديدًا إلى الجدول، نبني الجدول بوصفه قائمةً مُترَأَسة (headed list). وللقائمة المُترَأَسة زوجٌ خاصٌّ في رأس عمودها الفقريّ يحمل «سجلًّا» وهميًّا - وهو في هذه الحالة الرمز *table* المُختار اعتباطيًّا. ويُظهر الشكل 3.22 مخطّط الصناديق والمؤشّرات للجدول
a:  1
b:  2
c:  3
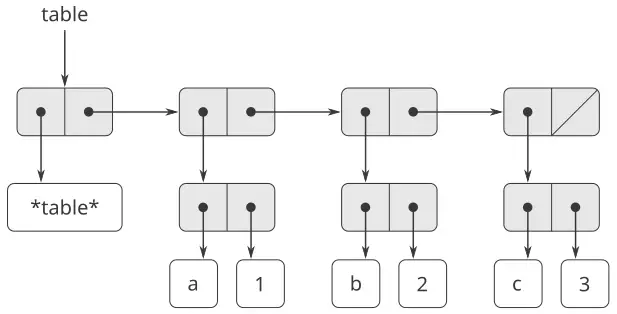
الشكل 3.22: جدولٌ مُمثَّلٌ بقائمةٍ مُترَأَسة.
لاستخراج المعلومات من جدولٍ نستخدم الإجراء lookup، الذي يأخذ مفتاحًا معطًى ويعيد القيمة المرتبطة به (أو القيمة false إن لم تُخزَّن أيّ قيمةٍ تحت ذلك المفتاح). ويُعرَّف Lookup بدلالة العمليّة assoc، التي تتوقّع مفتاحًا وقائمة سجلّاتٍ كمعطيّين. ولاحِظ أنّ assoc لا ترى السجلّ الوهميّ إطلاقًا. ويُعيد Assoc السجلّ الذي يكون المفتاح المعطى car فيه.[24] ثمّ يتحقّق Lookup من أنّ السجلّ الناتج من assoc ليس false، ويعيد قيمة السجلّ (أي cdr فيه).
(define (lookup key table)
  (let ((record (assoc key (cdr table))))
    (if record
        (cdr record)
        false)))

(define (assoc key records)
  (cond ((null? records) false)
        ((equal? key (caar records))
         (car records))
        (else (assoc key (cdr records)))))
لإدراج قيمةٍ في جدول تحت مفتاحٍ محدَّد، نستخدم assoc أوّلًا لنرى ما إذا كان هناك سجلٌّ في الجدول بهذا المفتاح سلفًا. فإن لم يكن، نُشكّل سجلًّا جديدًا بِـcons المفتاح مع القيمة، ونُدرِج هذا في رأس قائمة سجلّات الجدول، بعد السجلّ الوهميّ. فإن كان هناك سجلٌّ بهذا المفتاح سلفًا، نُعيّن cdr هذا السجلّ إلى القيمة الجديدة المعيَّنة. ويُتيح لنا ترويسة الجدول موضعًا ثابتًا نُعدّله لإدراج السجلّ الجديد.[25]
(define (insert! key value table)
  (let ((record (assoc key (cdr table))))
    (if record
        (set-cdr! record value)
        (set-cdr! table
                  (cons (cons key value)
                        (cdr table)))))
  'ok)
لبناء جدول جديد، نُنشئ ببساطةٍ قائمةً تحتوي الرمز *table*:
(define (make-table)
  (list '*table*))
الجداول ثنائيّة الأبعاد
في الجدول ثنائيّ الأبعاد، تُفهرَس كلّ قيمةٍ بمفتاحين. فيمكننا تشييد جدولٍ كهذا بوصفه جدولًا أحاديّ الأبعاد يُحدّد كلّ مفتاحٍ فيه جدولًا فرعيًّا. ويُظهر الشكل 3.23 مخطّط الصناديق والمؤشّرات للجدول
math:  +: 43    letters:  a: 97
       -: 45              b: 98
       *: 42
الذي يحتوي على جدولين فرعيّين. (ولا تحتاج الجداول الفرعيّة إلى رمز ترويسةٍ خاصّ، إذ إنّ المفتاح الذي يُحدّد الجدول الفرعيّ يؤدّي هذا الغرض.)
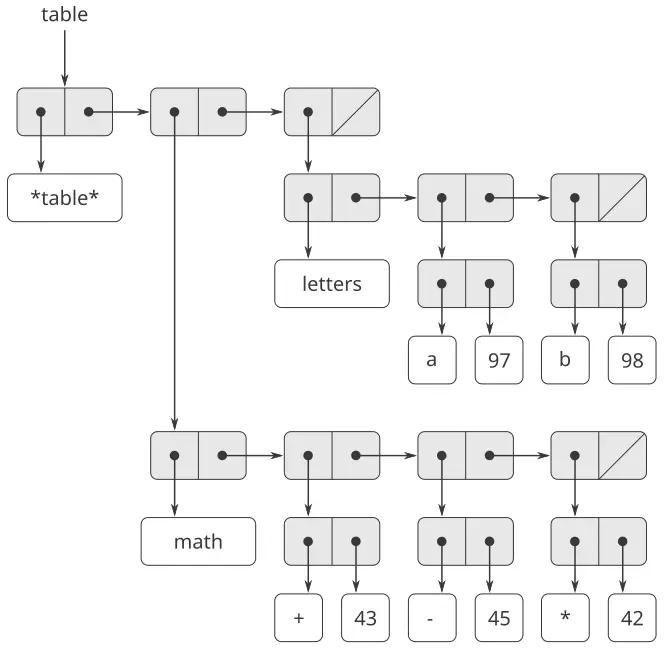
الشكل 3.23: جدولٌ ثنائيّ الأبعاد.
حين نبحث عن عنصر، نستخدم المفتاح الأوّل لتحديد الجدول الفرعيّ الصحيح. ثمّ نستخدم المفتاح الثاني لتحديد السجلّ داخل الجدول الفرعيّ.
(define (lookup key-1 key-2 table)
  (let ((subtable (assoc key-1 (cdr table))))
    (if subtable
        (let ((record
               (assoc key-2 (cdr subtable))))
          (if record (cdr record) false))
        false)))
لإدراج عنصرٍ جديدٍ تحت زوجٍ من المفاتيح، نستخدم assoc لمعرفة ما إذا كان هناك جدولٌ فرعيٌّ مخزَّنٌ تحت المفتاح الأوّل. فإن لم يكن، نبني جدولًا فرعيًّا جديدًا يحتوي السجلّ الوحيد (key-2، value) ونُدرِجه في الجدول تحت المفتاح الأوّل. فإن كان هناك جدولٌ فرعيٌّ للمفتاح الأوّل سلفًا، نُدرِج السجلّ الجديد في هذا الجدول الفرعيّ، باستخدام طريقة الإدراج للجداول أحاديّة الأبعاد الموصوفة أعلاه:
(define (insert! key-1 key-2 value table)
  (let ((subtable (assoc key-1 (cdr table))))
    (if subtable
        (let ((record
               (assoc key-2 (cdr subtable))))
          (if record
              (set-cdr! record value)
              (set-cdr!
               subtable
               (cons (cons key-2 value)
                     (cdr subtable)))))
        (set-cdr!
         table
         (cons (list key-1 (cons key-2 value))
               (cdr table)))))
  'ok)
إنشاء جداول محلّيّة
تأخذ العمليّتان lookup وinsert! المعرَّفتان أعلاه الجدول معطًى. وهذا يمكّننا من استخدام برامج تصل إلى أكثر من جدول. وهناك طريقة أخرى للتعامل مع عدّة جداول، وهي تخصيص إجراءَي lookup وinsert! منفصلين لكلّ جدول. ويمكننا فعل ذلك بتمثيل الجدول إجرائيًّا، بوصفه كائنًا يحافظ على جدول داخليّ كجزءٍ من حالته المحليّة. وحين يُرسَل إليه رسالةٌ مناسبة، يُتيح «كائن الجدول» هذا الإجراء الذي يُعمل به على الجدول الداخليّ. وفيما يلي مولِّدٌ للجداول ثنائيّة الأبعاد المُمثَّلة بهذه الطريقة:
(define (make-table)
  (let ((local-table (list '*table*)))
    (define (lookup key-1 key-2)
      (let ((subtable
             (assoc key-1 (cdr local-table))))
        (if subtable
            (let ((record
                   (assoc key-2
                          (cdr subtable))))
              (if record (cdr record) false))
            false)))
    (define (insert! key-1 key-2 value)
      (let ((subtable
             (assoc key-1 (cdr local-table))))
        (if subtable
            (let ((record
                   (assoc key-2
                          (cdr subtable))))
              (if record
                  (set-cdr! record value)
                  (set-cdr!
                   subtable
                   (cons (cons key-2 value)
                         (cdr subtable)))))
            (set-cdr!
             local-table
             (cons (list key-1
                         (cons key-2 value))
                   (cdr local-table)))))
      'ok)
    (define (dispatch m)
      (cond ((eq? m 'lookup-proc) lookup)
            ((eq? m 'insert-proc!) insert!)
            (else (error "Unknown operation:
                          TABLE" m))))
    dispatch))
وباستخدام make-table، يمكننا تنفيذ عمليّتَي get وput المستخدمتين في 2.4.3 لأجل البرمجة الموجَّهة بالبيانات، كما يلي:
(define operation-table (make-table))
(define get (operation-table 'lookup-proc))
(define put (operation-table 'insert-proc!))
يأخذ Get كمعطياتٍ مفتاحين، ويأخذ put كمعطياتٍ مفتاحين وقيمة. وتصل العمليّتان إلى الجدول المحلّيّ نفسه، المُحاط داخل الكائن المنشأ بنداء make-table.
التمرين 3.24: في تنفيذَي الجدول المذكورين أعلاه، تُختبر مفاتيح التساوي باستخدام
equal?(التي يناديهاassoc). وهذا ليس الاختبار الملائم دائمًا. فإنّه قد يكون لدينا جدولٌ ذو مفاتيح عدديّة لا نحتاج فيه إلى مطابقة تامّة للعدد الذي نبحث عنه، بل فقط عددٌ يقع ضمن نطاق تحمّلٍ معيّن منه. صمّم بانِي جداولmake-tableيأخذ كمعطىً إجراءsame-key?سيُستخدم لاختبار «تساوي» المفاتيح. وينبغي أن يُعيدMake-tableإجراءdispatchيمكن استخدامه للوصول إلى إجراءَيlookupوinsert!الملائمين لجدولٍ محلّيّ.
التمرين 3.25: بتعميم الجداول أحاديّة وثنائيّة الأبعاد، أظهِر كيف يمكن تنفيذ جدولٍ تُخزَّن فيه القيم تحت عددٍ اعتباطيّ من المفاتيح، وقد تُخزَّن قيمٌ مختلفة تحت أعدادٍ مختلفة من المفاتيح. وينبغي أن يأخذ إجراءَا
lookupوinsert!كمدخلٍ قائمةً من المفاتيح تُستخدم للوصول إلى الجدول.
التمرين 3.26: للبحث في جدولٍ منفَّذٍ كما هو أعلاه، يلزم المرء أن يمسح قائمة السجلّات. وهذا أساسًا هو تمثيل القائمة غير المرتّبة الوارد في 2.3.3. فإنّ من الأنفع للجداول الكبيرة أن تُبنى بصيغةٍ مختلفة. صِف تنفيذًا لجدولٍ تُنظَّم فيه سجلّات (المفتاح، القيمة) باستخدام شجرةٍ ثنائيّة، بافتراض أنّ المفاتيح يمكن ترتيبها بطريقةٍ ما (عدديًّا أو أبجديًّا مثلًا). (قارن التمرين 2.66 من الفصل 2.)
التمرين 3.27: حفظ النتائج (والمسمّى أيضًا الجدولة) تقنيّةٌ تمكّن إجراءً من تسجيل قيمٍ حُسبت سلفًا في جدولٍ محلّيّ. وهذه التقنيّة قادرةٌ على إحداث فرقٍ هائل في أداء البرنامج. فالإجراء ذو النتائج المحفوظة يحتفظ بجدولٍ تُخزَّن فيه قيم النداءات السابقة، مستخدمًا المعطيات التي أنتجت تلك القيم كمفاتيح لها. وحين يُطلَب من الإجراء ذي النتائج المحفوظة أن يحسب قيمةً، فإنّه يتحقّق أوّلًا من الجدول ليرى ما إذا كانت القيمة موجودةً فيه سلفًا، فإن كانت كذلك أعاد تلك القيمة فحسب. وإلّا، فإنّه يحسب القيمة الجديدة بالطريقة المعتادة ويخزّنها في الجدول. ومن أمثلة حفظ النتائج، تذكّر - من 1.2.2 - العمليّة الأسّيّة لاحتساب أعداد فيبوناتشي:
(define (fib n)
  (cond ((= n 0) 0)
        ((= n 1) 1)
        (else (+ (fib (- n 1))
                 (fib (- n 2))))))
والنسخة ذات النتائج المحفوظة من الإجراء نفسه هي
(define memo-fib
  (memoize
   (lambda (n)
     (cond ((= n 0) 0)
           ((= n 1) 1)
           (else
            (+ (memo-fib (- n 1))
               (memo-fib (- n 2))))))))
وحيث إنّ مُحفِظ النتائج معرَّفٌ كما يلي:
(define (memoize f)
  (let ((table (make-table)))
    (lambda (x)
      (let ((previously-computed-result
             (lookup x table)))
        (or previously-computed-result
            (let ((result (f x)))
              (insert! x result table)
              result))))))
ارسم مخطط البيئة لتحليل احتساب (memo-fib 3). فسّر لماذا يحسب memo-fib العدد الفيبوناتشيّ الـ بعددٍ من الخطوات يتناسب مع . فهل كان هذا المخطّط لا يزال يعمل لو كنّا قد عرّفنا memo-fib ببساطةٍ على أنّه (memoize fib)؟
3.3.4 محاكي الدوائر الرقميّة
تصميم النظم الرقميّة المعقّدة، كالحواسيب مثلًا، نشاطٌ هندسيٌّ مهمّ. وتُبنى النظم الرقميّة بربط عناصر بسيطة بعضها ببعض. وعلى رغم أنّ سلوك هذه العناصر الفرديّة بسيط، فإنّ الشبكات المكوّنة منها قد يكون لها سلوكٌ معقّدٌ جدًّا. ومحاكاة تصاميم الدوائر المقترحة بالحاسوب أداةٌ مهمّةٌ يستخدمها مهندسو النظم الرقميّة. وفي هذا القسم نصمّم نظامًا لأداء محاكاة المنطق الرقميّ. وهذا النظام يمثّل نموذجًا لنوعٍ من البرامج يُسمّى محاكاة موجَّهة بالأحداث (event-driven simulation)، وفيه تُطلق الأفعال («الأحداث») أحداثًا أخرى تجري في وقتٍ لاحق، وهي التي تُطلق بدورها أحداثًا أكثر، وهكذا دواليك.
سيتكوّن نموذجنا الحسابيّ للدائرة من كائناتٍ تقابل المكوّنات الأوّليّة التي تُبنى منها الدائرة. فهناك الأسلاك (wires)، التي تحمل الإشارات الرقميّة (digital signals). وقد تحمل الإشارة الرقميّة في أيّ لحظةٍ إحدى قيمتين محتملتين فقط، هما 0 و1. وهناك أيضًا أنواعٌ متعدّدةٌ من صناديق الدوالّ (function boxes) الرقميّة، التي تربط الأسلاك الحاملة لإشارات الدخل بأسلاك أخرى حاملة لإشارات الخرج. وهذه الصناديق تُنتج إشارات خرجٍ محسوبةً من إشارات دخلها. وتتأخّر إشارة الخرج زمنًا يعتمد على نوع صندوق الدالّة. فإنّ العاكس (inverter) صندوقُ دالّةٍ أوّليّ يعكس مدخله. فإن تغيّرت إشارة دخل عاكسٍ إلى 0، فإنّه - بعد تأخير عاكسٍ واحد (inverter-delay) - سيغيّر العاكس إشارة خرجه إلى 1. وإن تغيّرت إشارة دخل عاكسٍ إلى 1، فإنّه - بعد تأخير عاكسٍ واحد - سيغيّر العاكس إشارة خرجه إلى 0. ونحن نرسم العاكس رمزيًّا كما في الشكل 3.24. أمّا بوابة و (and-gate)، الموضّحة أيضًا في الشكل 3.24، فهي صندوق دالّةٍ أوّليّ له مدخلان وخرجٌ واحد. فإنّها تضبط إشارة خرجها على قيمةٍ هي الو المنطقيّ (logical and) للمدخلين. أي أنّه إذا صارت إشارتا دخلها كلتاهما 1، فإنّها - بعد تأخير بوابة وٍ واحد (and-gate-delay) - ستُجبر إشارة خرجها على أن تصير 1؛ وإلّا فسيكون الخرج 0. وبوابة أو (or-gate) صندوق دالّةٍ أوّليّ مشابه ذو مدخلين يضبط إشارة خرجها على قيمةٍ هي أو المنطقيّ للمدخلين. أي أنّ الخرج سيصير 1 إذا كانت إحدى إشارتَي الدخل - على الأقلّ - تساوي 1؛ وإلّا فسيكون الخرج 0.
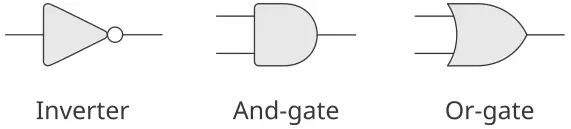
الشكل 3.24: الدوالّ الأوّليّة في محاكي المنطق الرقميّ.
يمكننا وصل الدوالّ الأوّليّة بعضها ببعضٍ لبناء دوالّ أكثر تعقيدًا. ولإنجاز ذلك، نوصِل مخارج بعض صناديق الدوالّ بمداخلات صناديق أخرى. فإنّ دائرة جامع النصف (half-adder) - مثلًا - الموضّحة في الشكل 3.25 تتكوّن من بوابة أو وبوابتَي و وعاكس. وهي تأخذ إشارتَي دخل، A وB، ولها إشارتا خرج، S وC. وستصير S تساوي 1 متى كان واحدٌ فقط من A وB يساوي 1، وستصير C تساوي 1 متى كان A وB كلاهما يساوي 1. ونستطيع أن نرى من الشكل أنّ المخارج - بسبب التأخيرات الداخلة في الأمر - قد تُولَّد في أزمنةٍ مختلفة. والعديد من صعوبات تصميم الدوائر الرقميّة ينشأ من هذه الحقيقة.
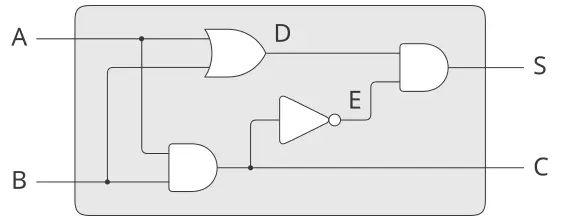
الشكل 3.25: دائرة جامع النصف.
سنبني الآن برنامجًا لنمذجة دوائر المنطق الرقميّ التي نريد دراستها. وسينشئ البرنامج كائناتٍ حسابيّةً تنمذج الأسلاك، وهي التي ستـ«تحتفظ» بالإشارات. وستُنمذج صناديق الدوالّ بإجراءاتٍ تفرض العلاقات الصحيحة بين الإشارات.
سيكون أحد العناصر الأساسيّة في محاكاتنا إجراءً اسمه make-wire، وهو الذي يبني الأسلاك. فإنّه يمكننا - مثلًا - بناء ستّة أسلاك كما يلي:
(define a (make-wire))
(define b (make-wire))
(define c (make-wire))
(define d (make-wire))
(define e (make-wire))
(define s (make-wire))
نحن نُرفِق صندوق دالّةٍ بمجموعةٍ من الأسلاك بنداء إجراءٍ يبني ذلك النوع من الصناديق. ومعطيات إجراء الباني هي الأسلاك التي ستُرفَق بالصندوق. فإنّه إذا افترضنا أنّنا نستطيع بناء بوابات و وبوابات أو وعواكس، فيمكننا توصيل مكوّنات نصف الجامع الموضّح في الشكل 3.25 بعضها ببعض كما يلي:
(or-gate a b d)
ok

(and-gate a b c)
ok

(inverter c e)
ok

(and-gate d e s)
ok
والأفضل من ذلك، أنّنا نستطيع تسمية هذه العمليّة صراحةً بتعريف إجراءٍ اسمه half-adder يبني هذه الدائرة، إذا أُعطي الأسلاك الخارجيّة الأربعة التي ستُرفَق بنصف الجامع:
(define (half-adder a b s c)
  (let ((d (make-wire)) (e (make-wire)))
    (or-gate a b d)
    (and-gate a b c)
    (inverter c e)
    (and-gate d e s)
    'ok))
وفائدة هذا التعريف أنّنا نستطيع استخدام half-adder ذاته كوحدة بناءٍ في إنشاء دوائر أكثر تعقيدًا. فإنّ الشكل 3.26 - مثلًا - يُظهر جامعًا كاملًا (full-adder) مؤلّفًا من نصفَي جامعٍ وبوابة أو.[26] ونستطيع بناء جامعٍ كاملٍ كما يلي:
(define (full-adder a b c-in sum c-out)
  (let ((c1 (make-wire))
        (c2 (make-wire))
        (s  (make-wire)))
    (half-adder b c-in s c1)
    (half-adder a s sum c2)
    (or-gate c1 c2 c-out)
    'ok))
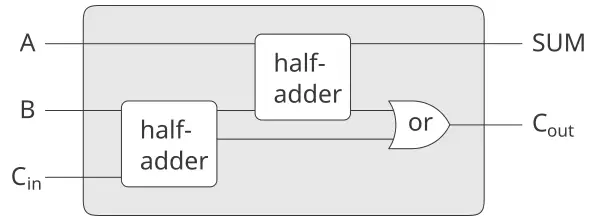
الشكل 3.26: دائرة جامع كامل.
وبعد أن عرّفنا full-adder كإجراءٍ، يمكننا الآن استخدامه كوحدة بناءٍ لإنشاء دوائر أكثر تعقيدًا بعد. (انظر التمرين 3.30 مثلًا.)
في الجوهر، يزوّدنا محاكينا بالأدوات اللازمة لبناء لغة الدوائر. فإذا تبنّينا المنظور العامّ على اللغات الذي تناولنا به دراسة Lisp في 1.1، فإنّنا نستطيع القول إنّ صناديق الدوالّ الأوّليّة تُشكّل العناصر الأوّليّة للغة، وإنّ توصيل الصناديق بعضها ببعضٍ يُوفّر وسيلة تركيب، وإنّ تحديد أنماط التوصيل كإجراءاتٍ يؤدّي دور وسيلة تجريد.
صناديق الدوالّ الأوّليّة
تُنفّذ صناديق الدوالّ الأوّليّة «القوى» التي يؤثّر بوساطتها تغيّر الإشارة على سلكٍ واحدٍ في إشارات الأسلاك الأخرى. ولبناء صناديق الدوالّ، نستخدم العمليّات الآتية على الأسلاك:
(get-signal ⟨wire⟩)يعيد القيمة الحاليّة للإشارة على السلك.(set-signal! ⟨wire⟩ ⟨new value⟩)يغيّر قيمة الإشارة على السلك إلى القيمة الجديدة.(add-action! ⟨wire⟩ ⟨procedure of no arguments⟩)يُقرّر أنّ الإجراء المحدَّد ينبغي أن يُنفَّذ كلّما تغيّرت قيمة الإشارة على السلك. وهذه الإجراءات هي الوسيلة التي تُنقل بها تغيّرات قيمة الإشارة على السلك إلى الأسلاك الأخرى.
وبالإضافة إلى ذلك، سنستفيد من إجراءٍ اسمه after-delay يأخذ تأخيرًا زمنيًّا وإجراءً يُنفَّذ، ثمّ ينفّذ الإجراء المعطى بعد التأخير المعطى.
وباستخدام هذه الإجراءات، يمكننا تعريف الدوالّ الأوّليّة للمنطق الرقميّ. ولوصْل مدخلٍ بخرجٍ بواسطة عاكس، نستخدم add-action! لربط سلك الدخل بإجراءٍ سيُنفَّذ كلّما تغيّرت قيمة الإشارة على سلك الدخل. وهذا الإجراء يحسب logical-not لإشارة الدخل، ثمّ - بعد تأخير عاكس واحد (inverter-delay) - يضبط إشارة الخرج لتكون هذه القيمة الجديدة:
(define (inverter input output)
  (define (invert-input)
    (let ((new-value
           (logical-not (get-signal input))))
      (after-delay
       inverter-delay
       (lambda ()
         (set-signal! output new-value)))))
  (add-action! input invert-input)
  'ok)

(define (logical-not s)
  (cond ((= s 0) 1)
        ((= s 1) 0)
        (else (error "Invalid signal" s))))
أمّا بوابة و فأكثر تعقيدًا بعض الشيء. فينبغي أن يُنفَّذ إجراء الفعل إذا تغيّر أيٌّ من مدخلي البوابة. وهو يحسب logical-and (باستخدام إجراءٍ نظير logical-not) قيمتَي الإشارتين على سلكَي الدخل، ويُعِدّ تغيّرًا إلى القيمة الجديدة ليجري على سلك الخرج بعد تأخير بوابة وٍ واحد (and-gate-delay).
(define (and-gate a1 a2 output)
  (define (and-action-procedure)
    (let ((new-value
           (logical-and (get-signal a1)
                        (get-signal a2))))
      (after-delay
       and-gate-delay
       (lambda ()
         (set-signal! output new-value)))))
  (add-action! a1 and-action-procedure)
  (add-action! a2 and-action-procedure)
  'ok)
التمرين 3.28: عرّف بوابة أو كصندوق دالّةٍ أوّليّ. وينبغي أن يكون باني
or-gateخاصّتك شبيهًا بـand-gate.
التمرين 3.29: ثمّة طريقةٌ أخرى لبناء بوابة أو، وهي كجهاز منطقٍ رقميّ مركّب مبنيٍّ من بوابات و وعواكس. عرّف إجراءً
or-gateيُنجز ذلك. فما مدّة تأخير بوابة أو بدلالةand-gate-delayوinverter-delay؟
التمرين 3.30: يُظهر الشكل 3.27 جامعًا تراكميّ الانتشار (ripple-carry adder) متشكّلًا من ربط من الجامعات الكاملة بعضها في إثر بعض. وهذه هي أبسط صيغةٍ من الجامع المتوازي لجمع عددين ثنائيَّين كلٌّ منهما بِتّ. والمدخلان و و و… و و و و و… و هما العددان الثنائيّان اللذان يُجمعان (وكلٌّ من و هو 0 أو 1). والدائرة تُنتج و و و… و ، وهي بِتّات الخاصة بالمجموع، و ، وهي الحاملة الناتجة عن الجمع. اكتب إجراءً
ripple-carry-adderيُولّد هذه الدائرة. وينبغي أن يأخذ الإجراء كمعطياتٍ ثلاث قوائم من سلكًا لكلٍّ منها - الـ والـ والـ - وسلكًا آخر . والعائق الرئيسيّ في الجامع التراكميّ الانتشار هو ضرورة انتظار انتشار إشارات الحمل. فما التأخير اللازم للحصول على الخرج الكامل من جامع تراكميّ الانتشار ذي بِتّ، معبَّرًا عنه بدلالة تأخيرات بوابات و وبوابات أو والعواكس؟
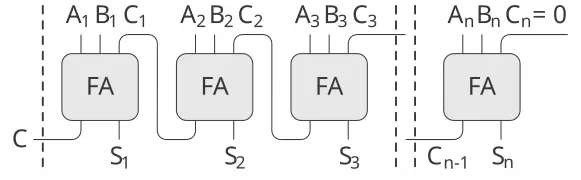
الشكل 3.27: جامع تراكميّ الانتشار للأعداد ذات الـ بِتّ.
تمثيل الأسلاك
سيكون السلك في محاكاتنا كائنًا حسابيًّا له متغيّرا حالة محلّيّان: signal-value (يُفترض مبدئيًّا أنّه 0) ومجموعةٌ من action-procedures تُنفَّذ متى تغيّرت قيمة الإشارة. ونحن نُنفّذ السلك - مستخدمين أسلوب تمرير الرسائل - كمجموعةٍ من الإجراءات المحلّيّة إلى جانب إجراء dispatch ينتخب العمليّة المحلّيّة الملائمة، تمامًا كما فعلنا مع كائن الحساب المصرفيّ البسيط في 3.1.1:
(define (make-wire)
  (let ((signal-value 0)
        (action-procedures '()))
    (define (set-my-signal! new-value)
      (if (not (= signal-value new-value))
          (begin (set! signal-value new-value)
                 (call-each
                  action-procedures))
          'done))
    (define (accept-action-procedure! proc)
      (set! action-procedures
            (cons proc action-procedures))
      (proc))
    (define (dispatch m)
      (cond ((eq? m 'get-signal)
             signal-value)
            ((eq? m 'set-signal!)
             set-my-signal!)
            ((eq? m 'add-action!)
             accept-action-procedure!)
            (else (error "Unknown operation:
                          WIRE" m))))
    dispatch))
يختبر الإجراء المحلّيّ set-my-signal! ما إذا كانت قيمة الإشارة الجديدة تُغيّر الإشارة على السلك. فإن كان الأمر كذلك، فإنّه ينفّذ كلّ إجراءٍ من إجراءات الفعل، باستخدام الإجراء call-each الآتي، الذي ينادي كلّ عنصرٍ في قائمةٍ من الإجراءات عديمة المعطيات:
(define (call-each procedures)
  (if (null? procedures)
      'done
      (begin ((car procedures))
             (call-each (cdr procedures)))))
والإجراء المحلّيّ accept-action-procedure! يُضيف الإجراء المعطى إلى قائمة الإجراءات التي ستُنفَّذ، ثمّ ينفّذ الإجراء الجديد مرّةً واحدة. (انظر التمرين 3.31.)
وبعد إعداد إجراء dispatch المحلّيّ كما حُدِّد، فإنّنا نستطيع توفير الإجراءات الآتية للوصول إلى العمليّات المحلّيّة على الأسلاك:[27]
(define (get-signal wire)
  (wire 'get-signal))
(define (set-signal! wire new-value)
  ((wire 'set-signal!) new-value))
(define (add-action! wire action-procedure)
  ((wire 'add-action!) action-procedure))
والأسلاك - التي لها إشارات متغيّرة مع الزمن، وقد تُرفَق بالأجهزة تزايديًّا - نموذجيّة للكائنات القابلة للتغيير. ونحن نمذجناها كإجراءاتٍ ذات متغيّرات حالةٍ محلّيّةٍ تُعدَّل بالإحلال. وحين يُنشَأ سلكٌ جديد، فإنّ مجموعةً جديدةً من متغيّرات الحالة تُخصَّص (بتعبير let في make-wire)، ويُبنى إجراء dispatch جديد ويُعاد، ملتقطًا البيئة التي تحوي متغيّرات الحالة الجديدة.
والأسلاك مشتركةٌ بين الأجهزة المتعدّدة التي رُبِطت بها. وهكذا، فإنّ التغيّر الذي يُحدثه تفاعلٌ مع جهازٍ واحدٍ سيؤثّر في جميع الأجهزة الأخرى الموصولة بالسلك. والسلك يُبلّغ التغيّر إلى جيرانه بنداء إجراءات الفعل المزوَّدة به عند إنشاء الوصلات.
جدول الأعمال
الشيء الوحيد اللازم لإكمال المحاكي هو after-delay. والفكرة هنا هي أنّنا نحفظ بنية بياناتٍ، تُسمّى جدول الأعمال (agenda)، تحتوي جدولًا بما ينبغي أداؤه. والعمليّات الآتية معرَّفةٌ لجداول الأعمال:
(make-agenda)يعيد جدول أعمالٍ جديدًا خاليًا.(empty-agenda? ⟨agenda⟩)يكون صادقًا إذا كان جدول الأعمال المحدَّد خاليًا.(first-agenda-item ⟨agenda⟩)يعيد أوّل عنصرٍ في جدول الأعمال.(remove-first-agenda-item! ⟨agenda⟩)يُعدّل جدول الأعمال بحذف أوّل عنصرٍ فيه.(add-to-agenda! ⟨time⟩ ⟨action⟩ ⟨agenda⟩)يُعدّل جدول الأعمال بإضافة إجراء الفعل المعطى ليجري في الزمن المحدَّد.(current-time ⟨agenda⟩)يعيد زمن المحاكاة الحاليّ.
وجدول الأعمال الخاصّ الذي نستخدمه يُشار إليه بـthe-agenda. والإجراء after-delay يُضيف عناصر جديدة إلى the-agenda:
(define (after-delay delay action)
  (add-to-agenda!
   (+ delay (current-time the-agenda))
   action
   the-agenda))
وتقود المحاكاة الإجراء propagate، الذي يعمل على the-agenda منفّذًا كلّ إجراءٍ في جدول الأعمال بالتتابع. وعمومًا، وبينما تجري المحاكاة، ستُضاف عناصر جديدة إلى جدول الأعمال، وسيواصل propagate المحاكاة ما دامت هناك عناصر في جدول الأعمال:
(define (propagate)
  (if (empty-agenda? the-agenda)
      'done
      (let ((first-item
             (first-agenda-item the-agenda)))
        (first-item)
        (remove-first-agenda-item! the-agenda)
        (propagate))))
محاكاة نموذجيّة
والإجراء الآتي، الذي يضع «مسبارًا» على سلكٍ، يُظهر المحاكي في العمل. فالمسبار يخبر السلك بأنّه - كلّما تغيّرت قيمة إشارته - ينبغي أن يطبع قيمة الإشارة الجديدة، مع الزمن الحاليّ واسمٍ يُحدِّد السلك:
(define (probe name wire)
  (add-action!
   wire
   (lambda ()
     (newline)
     (display name)
     (display " ")
     (display (current-time the-agenda))
     (display "  New-value = ")
     (display (get-signal wire)))))
نبدأ بتهيئة جدول الأعمال وتحديد التأخيرات الخاصة بصناديق الدوالّ الأوّليّة:
(define the-agenda (make-agenda))
(define inverter-delay 2)
(define and-gate-delay 3)
(define or-gate-delay 5)
والآن نُعرّف أربعة أسلاك، موضعين مسابير على اثنين منها:
(define input-1 (make-wire))
(define input-2 (make-wire))
(define sum (make-wire))
(define carry (make-wire))

(probe 'sum sum)
sum 0  New-value = 0

(probe 'carry carry)
carry 0  New-value = 0
ثمّ نوصّل الأسلاك في دائرة نصف جامع (كما في الشكل 3.25)، ونضبط الإشارة على input-1 لتكون 1، ثمّ نشغّل المحاكاة:
(half-adder input-1 input-2 sum carry)
ok

(set-signal! input-1 1)
done

(propagate)
sum 8  New-value = 1
done
وتتغيّر إشارة sum إلى 1 في الزمن 8. ونكون الآن على مباعدة ثماني وحدات زمنيّة من بداية المحاكاة. وعند هذه النقطة، يمكننا ضبط الإشارة على input-2 لتكون 1 والسماح للقيم بالانتشار:
(set-signal! input-2 1)
done

(propagate)
carry 11  New-value = 1
sum 16  New-value = 0
done
ويتغيّر carry إلى 1 في الزمن 11، وتتغيّر sum إلى 0 في الزمن 16.
التمرين 3.31: الإجراء الداخليّ accept-action-procedure! المعرَّف في make-wire ينصّ على أنّه - متى أُضيف إجراء فعلٍ جديد إلى سلكٍ - فإنّ الإجراء يُنفَّذ فورًا. فسّر لماذا هذه التهيئة ضروريّة. وخاصّةً، تتبّع مثال نصف الجامع في الفقرات أعلاه، وقل كيف كان ردّ النظام سيختلف لو كنّا قد عرّفنا accept-action-procedure! كما يلي:
(define (accept-action-procedure! proc)
  (set! action-procedures
        (cons proc action-procedures)))
تنفيذ جدول الأعمال
وأخيرًا، نُقدّم تفاصيل بنية بيانات جدول الأعمال، التي تحتفظ بالإجراءات المُقرَّر تنفيذها مستقبلًا.
ويتكوّن جدول الأعمال من قطاعاتٍ زمنيّة (time segments). وكلّ قطاعٍ زمنيٍّ زوجٌ يتألّف من عدد (الزمن) وطابور (انظر التمرين 3.32) يحتفظ بالإجراءات التي حُدِّد تنفيذها خلال ذلك القطاع الزمنيّ.
(define (make-time-segment time queue)
  (cons time queue))
(define (segment-time s) (car s))
(define (segment-queue s) (cdr s))
وسنعمل على طوابير القطاعات الزمنيّة باستخدام عمليّات الطابور الموصوفة في 3.3.2.
وجدول الأعمال ذاته جدولٌ أحاديّ الأبعاد من القطاعات الزمنيّة. وهو يختلف عن الجداول الموصوفة في 3.3.3 في أنّ القطاعات ستكون مرتّبةً بترتيبٍ تصاعديّ للزمن. وبالإضافة إلى ذلك، نخزّن الزمن الحاليّ (أي زمن آخر فعلٍ جرىت معالجته) في رأس جدول الأعمال. وجدول الأعمال المُنشأ حديثًا لا يحتوي قطاعاتٍ زمنيّةً، وزمنه الحاليّ 0:[28]
(define (make-agenda) (list 0))
(define (current-time agenda) (car agenda))
(define (set-current-time! agenda time)
  (set-car! agenda time))
(define (segments agenda) (cdr agenda))
(define (set-segments! agenda segments)
  (set-cdr! agenda segments))
(define (first-segment agenda)
  (car (segments agenda)))
(define (rest-segments agenda)
  (cdr (segments agenda)))
ويكون جدول الأعمال خاليًا إذا لم يكن فيه قطاعاتٌ زمنيّة:
(define (empty-agenda? agenda)
  (null? (segments agenda)))
ولإضافة فعلٍ إلى جدول أعمالٍ، نتحقّق أوّلًا مما إذا كان جدول الأعمال خاليًا. فإن كان كذلك، نُنشئ قطاعًا زمنيًّا للفعل ونُثبّته في جدول الأعمال. وإلّا، فنحن نمسح جدول الأعمال، فاحصين زمن كلّ قطاع. فإن وجدنا قطاعًا للزمن الذي حُدِّد لنا، أضفنا الفعل إلى الطابور المرتبط به. وإذا وصلنا إلى زمنٍ متأخّرٍ عن الزمن الذي حُدِّد لنا، نُدرج قطاعًا زمنيًّا جديدًا في جدول الأعمال قبله مباشرة. وإذا وصلنا إلى نهاية جدول الأعمال، فيجب أن نُنشئ قطاعًا زمنيًّا جديدًا في نهايته.
(define (add-to-agenda! time action agenda)
  (define (belongs-before? segments)
    (or (null? segments)
        (< time
           (segment-time (car segments)))))
  (define (make-new-time-segment time action)
    (let ((q (make-queue)))
      (insert-queue! q action)
      (make-time-segment time q)))
  (define (add-to-segments! segments)
    (if (= (segment-time (car segments)) time)
        (insert-queue!
         (segment-queue (car segments))
         action)
        (let ((rest (cdr segments)))
          (if (belongs-before? rest)
              (set-cdr!
               segments
               (cons (make-new-time-segment
                      time
                      action)
                     (cdr segments)))
              (add-to-segments! rest)))))
  (let ((segments (segments agenda)))
    (if (belongs-before? segments)
        (set-segments!
         agenda
         (cons (make-new-time-segment
                time
                action)
               segments))
        (add-to-segments! segments))))
والإجراء الذي يحذف أوّل بندٍ من جدول المواعيد يحذف البند الموجود في مقدّمة الطابور في المقطع الزمنيّ الأوّل. فإن جعل هذا الحذف المقطع الزمنيّ فارغًا، أزِلْناه من قائمة المقاطع:[29]
(define (remove-first-agenda-item! agenda)
  (let ((q (segment-queue
            (first-segment agenda))))
    (delete-queue! q)
    (if (empty-queue? q)
        (set-segments!
         agenda
         (rest-segments agenda)))))
ويُعثَر على أوّل بندٍ في جدول المواعيد في رأس الطابور في المقطع الزمنيّ الأوّل. وكلّما استخرجنا بندًا، نُحدّث أيضًا الزمن الحاليّ:[30]
(define (first-agenda-item agenda)
  (if (empty-agenda? agenda)
      (error "Agenda is empty:
              FIRST-AGENDA-ITEM")
      (let ((first-seg
             (first-segment agenda)))
        (set-current-time!
         agenda
         (segment-time first-seg))
        (front-queue
         (segment-queue first-seg)))))
التمرين 3.32: الإجراءات التي ينبغي تنفيذها خلال كلّ مقطعٍ زمنيٍّ من جدول المواعيد محفوظةٌ في طابور. وبالتالي، فإنّ إجراءات كلّ مقطعٍ تُنادى بالترتيب الذي أُضيفت به إلى جدول المواعيد (الأوّل دخولًا أوّل خروجًا). فسّر لماذا ينبغي استخدام هذا الترتيب. وعلى وجه الخصوص، تتبّع سلوك بوابة and تتغيّر معطياتها من 0, 1 إلى 1, 0 في المقطع نفسه، وقُل كيف كان السلوك ليختلف لو كنّا خزّنّا إجراءات المقطع في قائمةٍ اعتياديّةٍ، نُضيف الإجراءات إليها ونحذفها من المقدّمة فقط (الأخير دخولًا أوّل خروجًا).
3.3.5 انتشار القيود
تُنظَّم البرامج الحاسوبيّة تقليديًّا في صورة عمليّاتٍ حسابيّةٍ أحاديّة الاتجاه، تؤدّي عمليّاتٍ على معطياتٍ محدَّدةٍ سلفًا لإنتاج المخرجات المرغوبة. ومن جانبٍ آخر، فإنّنا نمثّل النظم غالبًا بدلالة العلاقات بين الكميّات. فمثلًا، قد يتضمّن نموذجٌ رياضيٌّ لبنيةٍ ميكانيكيّةٍ المعلومات القائلة إنّ الانحراف لقضيبٍ معدنيٍّ مرتبطٌ بالقوة على القضيب، والطول للقضيب، ومساحة المقطع العرضيّ ، ومعامل المرونة ، وذلك عبر المعادلة ومثل هذه المعادلة ليست أحاديّة الاتجاه. فبمعلوميّة أيّ أربعٍ من الكميّات، يمكننا استخدامها لاحتساب الخامسة. غير أنّ ترجمة المعادلة إلى لغة حاسوبٍ تقليديّةٍ ستُلزمنا باختيار واحدةٍ من الكميّات لتُحتسب بدلالة الأربع الأخرى. وبالتالي، فلن يكون إجراءٌ لاحتساب المساحة قابلًا للاستخدام في احتساب الانحراف ، رغم أنّ احتساب و ينبعان من المعادلة ذاتها.[31]
في هذا القسم، نرسم ملامح تصميم لغةٍ تُمكّننا من العمل بدلالة العلاقات ذاتها. فالعناصر الأوّليّة للغة هي القيود الأوّليّة (primitive constraints)، التي تنصّ على أنّ علاقاتٍ معيّنةٍ قائمةٌ بين الكميّات. فمثلًا، يحدّد (adder a b c) أنّ الكميّات و و ينبغي أن تكون مرتبطةً بالمعادلة ، ويعبّر (multiplier x y z) عن القيد ، ويقول (constant 3.14 x) إنّ قيمة ينبغي أن تكون 3.14.
تُوفّر لغتنا وسيلةً لدمج القيود الأوّليّة للتعبير عن علاقاتٍ أكثر تعقيدًا. فنحن ندمج القيود ببناء شبكات القيود (constraint networks)، التي تُوصَل فيها القيود بـالموصّلات (connectors). والموصّل كائنٌ «يحتفظ» بقيمةٍ قد تشارك في قيدٍ واحدٍ أو أكثر. فمثلًا، نعلم أنّ العلاقة بين درجتَي الحرارة بالسيلسيوس وبالفهرنهايت هي ويمكن النظر إلى مثل هذا القيد على أنّه شبكةٌ متألّفةٌ من قيود جامعٍ ومضاعفٍ وثابتٍ أوّليّة (الشكل 3.28). ففي الشكل، نرى على اليسار صندوق مضاعفةٍ له ثلاثة أطراف، موسومةً بـ و و . وهذه توصِل المضاعف ببقيّة الشبكة على النحو الآتي: الطرف مرتبطٌ بموصّل ، الذي سيحتفظ بدرجة الحرارة بالسيلسيوس. والطرف مرتبطٌ بموصّل ، وهو مرتبطٌ كذلك بصندوق ثابتٍ يحتفظ بالعدد 9. والطرف ، الذي يقيّده صندوق المضاعفة بأن يكون حاصل ضرب و ، مرتبطٌ بالطرف لصندوق مضاعفةٍ آخر، فيه موصولٌ بثابتٍ هو 5 و فيه موصولٌ بأحد حدَّي مجموعٍ.
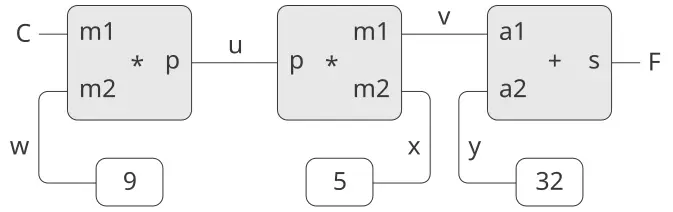
الشكل 3.28: العلاقة معبَّرًا عنها كشبكة قيود.
يجري الاحتساب بمثل هذه الشبكة على النحو الآتي: حين يُعطى موصّلٌ قيمةً (من المستخدم أو من صندوق قيدٍ مرتبطٍ به)، فإنّه يُنبّه جميع القيود المرتبطة به (باستثناء القيد الذي أنبّهه للتوّ) ليُخبرها بأنّ له قيمة. ثمّ يستطلع كلّ صندوق قيدٍ مُنبَّهٍ موصّلاته ليرى ما إذا كانت هناك معلوماتٌ كافيّةٌ لتحديد قيمةٍ لأحد الموصّلات. فإن كان الأمر كذلك، ضبط الصندوق ذلك الموصّل، الذي يُنبّه بدوره جميع القيود المرتبطة به، وهكذا دواليْك. فمثلًا، في التحويل بين السيلسيوس والفهرنهايت، تُضبط و و فورًا بصناديق الثوابت على 9 و5 و32 على الترتيب. فتنبّه الموصّلات المضاعفات والجامع، التي تحدّد أنّه لا توجد معلوماتٌ كافيّةٍ للمضيّ قدمًا. فإن ضبط المستخدم (أو جزءٌ آخر من الشبكة) على قيمةٍ (25 مثلًا)، انبعث المضاعف الأيسر، فضبط على . ثمّ أنبّه المضاعف الثاني، فضبط على 45، وأنبّه الجامع، فضبط على 77.
استخدام نظام القيود
لاستخدام نظام القيود لأداء العمليّة الحسابيّة لدرجات الحرارة الموصوفة أعلاه، نُنشئ أوّلًا موصّلين، C وF ، بمناداة البانيّ make-connector ، ونربط C وF في شبكةٍ مناسبةٍ:
(define C (make-connector))
(define F (make-connector))
(celsius-fahrenheit-converter C F)
ok
والإجراء الذي يُنشئ الشبكة معرَّفٌ كما يلي:
(define (celsius-fahrenheit-converter c f)
  (let ((u (make-connector))
        (v (make-connector))
        (w (make-connector))
        (x (make-connector))
        (y (make-connector)))
    (multiplier c w u)
    (multiplier v x u)
    (adder v y f)
    (constant 9 w)
    (constant 5 x)
    (constant 32 y)
    'ok))
ويُنشئ هذا الإجراء الموصّلات الداخليّة u وv وw وx وy ، ويربطها كما هو موضّح في الشكل 3.28 باستخدام بانيات القيود الأوّليّة adder وmultiplier وconstant . فكما هو الحال في محاكي الدارات الرقميّة في 3.3.4، فإنّ التعبير عن هذه التركيبات من العناصر الأوّليّة بدلالة الإجراءات يُوفّر تلقائيًّا للغتنا وسيلةَ تجريدٍ للكائنات المركّبة.
ولمراقبة الشبكة وهي تعمل، يمكننا وضع مسابير على الموصّلين C وF باستخدام إجراء probe شبيهٍ بالذي استخدمناه لمراقبة الأسلاك في 3.3.4. فإنّ وضع مِسبارٍ على موصّلٍ سيُسبّب طباعة رسالةٍ كلّما أُعطي الموصّل قيمةً:
(probe "Celsius temp" C)
(probe "Fahrenheit temp" F)
ثمّ نضبط قيمة C على 25. (والمعطى الثالث لـset-value! يخبر C بأنّ هذا التوجيه قادم من user .)
(set-value! C 25 'user)
Probe: Celsius temp = 25
Probe: Fahrenheit temp = 77
done
فينبعث المِسبار على C ويُبلّغ عن القيمة. وينتشر C بقيمته عبر الشبكة كما وُصف أعلاه. وهذا يضبط F على 77، وهو ما يُبلّغ عنه المِسبار على F .
ويمكننا الآن أن نحاول ضبط F على قيمةٍ جديدة، 212 مثلًا:
(set-value! F 212 'user)
Error! Contradiction (77 212)
ويشتكي الموصّل من أنّه أحسّ بتناقض: قيمته 77، وأحدهم يحاول ضبطها على 212. فإذا أردنا حقًّا إعادة استخدام الشبكة بقيمٍ جديدة، فيمكننا أن نطلب من C أن ينسى قيمته القديمة:
(forget-value! C 'user)
Probe: Celsius temp = ?
Probe: Fahrenheit temp = ?
done
فيجد C أنّ user ، الذي ضبط قيمته في الأصل، يسحبها الآن، فيوافق C على فقدان قيمته، كما يُظهره المِسبار، ويُخبر بقيّة الشبكة بهذه الحقيقة. وهذه المعلومة تنتشر في النهاية إلى F ، الذي يجد الآن أنّ ليس لديه سببٌ للاستمرار في الاعتقاد بأنّ قيمته 77. وبالتالي، يتخلّى F أيضًا عن قيمته، كما يُظهره المِسبار.
وحيث إنّ F لم يعد له قيمةٌ الآن، صرنا أحرارًا في ضبطها على 212:
(set-value! F 212 'user)
Probe: Fahrenheit temp = 212
Probe: Celsius temp = 100
done
وهذه القيمة الجديدة، حين تنتشر عبر الشبكة، تُلزم C بأن تكون له قيمة 100، وهذا ما يُسجّله المِسبار على C . ولاحِظ أنّ الشبكة ذاتها بالضبط تُستخدم لاحتساب C بمعلوميّة F ولاحتساب F بمعلوميّة C . وهذه اللّا اتجاهيّة للاحتساب هي السمة المميّزة للنظم المبنيّة على القيود.
تنفيذ نظام القيود
ويُنفَّذ نظام القيود بكائناتٍ إجرائيّةٍ ذات حالةٍ محلّيّةٍ، على نسقٍ يشبه إلى حدٍّ بعيدٍ محاكي الدارات الرقميّة في 3.3.4. فرغم أنّ الكائنات الأوّليّة لنظام القيود أكثر تعقيدًا بعض الشيء، فإنّ النظام الكلّيّ أبسط، إذ لا يوجد همٌّ بشأن جداول المواعيد وتأخيرات المنطق.
والعمليّات الأساسيّة على الموصّلات هي الآتية:
(has-value? ⟨connector⟩)يقول ما إذا كان الموصّل يملك قيمةً.(get-value ⟨connector⟩)يعيد القيمة الحاليّة للموصّل.(set-value! ⟨connector⟩ ⟨new-value⟩ ⟨informant⟩)يشير إلى أنّ المُبلِّغ يطلب من الموصّل ضبط قيمته على القيمة الجديدة.(forget-value! ⟨connector⟩ ⟨retractor⟩)يقول للموصّل إنّ الساحب يطلب منه نسيان قيمته.(connect ⟨connector⟩ ⟨new-constraint⟩)يقول للموصّل أن يشارك في القيد الجديد.
وتتّصل الموصّلات بالقيود بواسطة الإجراءَين inform-about-value ، الذي يقول للقيد المعطى إنّ الموصّل يملك قيمةً، وinform-about-no-value ، الذي يقول للقيد إنّ الموصّل فقد قيمته.
ويُنشئ Adder قيدَ جمعٍ بين موصّلي حدَّي الجمع a1 وa2 وموصّل المجموع sum . ويُنفَّذ الجامع كإجراءٍ ذي حالةٍ محلّيّةٍ (الإجراء me أدناه):
(define (adder a1 a2 sum)
  (define (process-new-value)
    (cond ((and (has-value? a1)
                (has-value? a2))
           (set-value! sum
                       (+ (get-value a1)
                          (get-value a2))
                       me))
          ((and (has-value? a1)
                (has-value? sum))
           (set-value! a2
                       (- (get-value sum)
                          (get-value a1))
                       me))
          ((and (has-value? a2)
                (has-value? sum))
           (set-value! a1
                       (- (get-value sum)
                          (get-value a2))
                       me))))
  (define (process-forget-value)
    (forget-value! sum me)
    (forget-value! a1 me)
    (forget-value! a2 me)
    (process-new-value))
  (define (me request)
    (cond ((eq? request 'I-have-a-value)
           (process-new-value))
          ((eq? request 'I-lost-my-value)
           (process-forget-value))
          (else (error "Unknown request:
                        ADDER" request))))
  (connect a1 me)
  (connect a2 me)
  (connect sum me)
  me)
ويربط Adder الجامع الجديد بالموصّلات المعيَّنة ويعيده قيمةً له. والإجراء me ، الذي يمثّل الجامع، يعمل بوصفه موزّعًا إلى الإجراءات المحليّة. وتُستخدم «واجهات الصياغة» (syntax interfaces) الآتية (انظر الحاشية 155 في 3.3.4) اقترانًا مع الموزّع:
(define (inform-about-value constraint)
  (constraint 'I-have-a-value))
(define (inform-about-no-value constraint)
  (constraint 'I-lost-my-value))
يُنادى الإجراء المحليّ process-new-value حين يُبلَّغ الجامع بأنّ أحد موصّلاته يملك قيمةً. فيتحقّق الجامع أوّلًا من كون a1 وa2 يملكان قيمة. فإن كانا كذلك، طلب من sum ضبط قيمته على مجموع الحدَّين. والمعطى informant لـset-value! هو me ، وهو كائن الجامع ذاته. فإن لم يكن a1 وa2 يملكان كلاهما قيمة، تحقّق الجامع حينئذٍ من كون a1 وsum يملكان قيمة. فإن كانا كذلك، ضبط a2 على فرق بين هذين. وأخيرًا، إذا كان a2 وsum يملكان قيمة، أعطى هذا الجامع معلوماتٍ كافيّةً لضبط a1 . وإذا قيل للجامع إنّ أحد موصّلاته فقد قيمته، فإنّه يطلب من جميع موصّلاته أن تفقد قيمتها الآن. (والقيم التي تُفقَد فعليًّا هي تلك التي ضبطها هذا الجامع فقط.) ثمّ يُشغّل process-new-value . وسبب هذه الخطوة الأخيرة أنّ موصّلًا واحدًا أو أكثر قد يزال يملك قيمة (أي أنّ موصّلًا قد تكون له قيمة لم يضبطها الجامع في الأصل)، وهذه القيم قد تحتاج إلى أن تنتشر رجعةً عبر الجامع.
أمّا المضاعف فيشبه الجامع إلى حدٍّ بعيدٍ. وسيضبط حاصل الضرب product على 0 إذا كان أحد العاملين 0، حتّى لو كان العامل الآخر غير معروف.
(define (multiplier m1 m2 product)
  (define (process-new-value)
    (cond ((or (and (has-value? m1)
                    (= (get-value m1) 0))
               (and (has-value? m2)
                    (= (get-value m2) 0)))
           (set-value! product 0 me))
          ((and (has-value? m1)
                (has-value? m2))
           (set-value! product
                       (* (get-value m1)
                          (get-value m2))
                       me))
          ((and (has-value? product)
                (has-value? m1))
           (set-value! m2
                       (/ (get-value product)
                          (get-value m1))
                       me))
          ((and (has-value? product)
                (has-value? m2))
           (set-value! m1
                       (/ (get-value product)
                          (get-value m2))
                       me))))
  (define (process-forget-value)
    (forget-value! product me)
    (forget-value! m1 me)
    (forget-value! m2 me)
    (process-new-value))
  (define (me request)
    (cond ((eq? request 'I-have-a-value)
           (process-new-value))
          ((eq? request 'I-lost-my-value)
           (process-forget-value))
          (else
           (error "Unknown request:
                   MULTIPLIER"
                  request))))
  (connect m1 me)
  (connect m2 me)
  (connect product me)
  me)
أمّا بانيّ constant فيضبط ببساطةٍ قيمة الموصّل المعيَّن. وستُنتج أيّ رسالة I-have-a-value أو I-lost-my-value تُرسَل إلى صندوق الثابت خطأً.
(define (constant value connector)
  (define (me request)
    (error "Unknown request: CONSTANT"
           request))
  (connect connector me)
  (set-value! connector value me)
  me)
وأخيرًا، يطبع المِسبار رسالةً عن ضبط الموصّل المعيَّن أو إلغاء ضبطه:
(define (probe name connector)
  (define (print-probe value)
    (newline) (display "Probe: ")
    (display name) (display " = ")
    (display value))
  (define (process-new-value)
    (print-probe (get-value connector)))
  (define (process-forget-value)
    (print-probe "?"))
  (define (me request)
    (cond ((eq? request 'I-have-a-value)
           (process-new-value))
          ((eq? request 'I-lost-my-value)
           (process-forget-value))
          (else (error "Unknown request:
                        PROBE" request))))
  (connect connector me)
  me)
تمثيل الموصّلات
ويُُمثَّل الموصّل بكائنٍ إجرائيٍّ ذي متغيّرات حالةٍ محلّيّةٍ هي value ، القيمة الحاليّة للموصّل؛ وinformant ، الكائن الذي ضبط قيمة الموصّل؛ وconstraints ، قائمة القيود التي يشارك فيها الموصّل.
(define (make-connector)
  (let ((value false)
        (informant false)
        (constraints '()))
    (define (set-my-value newval setter)
      (cond ((not (has-value? me))
             (set! value newval)
             (set! informant setter)
             (for-each-except
              setter
              inform-about-value
              constraints))
            ((not (= value newval))
             (error "Contradiction"
                    (list value newval)))
            (else 'ignored)))
    (define (forget-my-value retractor)
      (if (eq? retractor informant)
          (begin (set! informant false)
                 (for-each-except
                  retractor
                  inform-about-no-value
                  constraints))
          'ignored))
    (define (connect new-constraint)
      (if (not (memq new-constraint
                     constraints))
          (set! constraints
                (cons new-constraint
                      constraints)))
      (if (has-value? me)
          (inform-about-value new-constraint))
      'done)
    (define (me request)
      (cond ((eq? request 'has-value?)
             (if informant true false))
            ((eq? request 'value) value)
            ((eq? request 'set-value!)
             set-my-value)
            ((eq? request 'forget)
             forget-my-value)
            ((eq? request 'connect) connect)
            (else (error "Unknown operation:
                          CONNECTOR"
                         request))))
    me))
ويُنادى الإجراء المحليّ الخاصّ بالموصّل set-my-value حين يأتي طلبٌ لضبط قيمة الموصّل. فإن لم يكن الموصّل يملك قيمةً حاليًّا، فسيضبط قيمته ويتذكّر informant بوصفه القيد الذي طلب ضبط القيمة.[32] ثمّ يُخطِر الموصّل جميع القيود المشاركة له، باستثناء القيد الذي طلب ضبط القيمة. ويُنجَز هذا باستخدام المُكَرِّر (iterator) الآتي، الذي يُطبّق إجراءً معيَّنًا على جميع بنود قائمةٍ باستثناء بندٍ معطًى واحدٍ:
(define (for-each-except exception
                         procedure
                         list)
  (define (loop items)
    (cond ((null? items) 'done)
          ((eq? (car items) exception)
           (loop (cdr items)))
          (else (procedure (car items))
                (loop (cdr items)))))
  (loop list))
وإذا طُلب من موصّلٍ أن ينسى قيمته، فإنّه يُشغّل الإجراء المحليّ forget-my-value ، الذي يتحقّق أوّلًا من أنّ الطلب قادم من الكائن ذاته الذي ضبط القيمة في الأصل. فإن كان الأمر كذلك، أَخْطَر الموصّل القيود المرتبطة به بفقدان القيمة.
ويُضيف الإجراء المحليّ connect القيد الجديد المعيَّن إلى قائمة القيود إذا لم يكن موجودًا فيها من قبل. ثمّ، إذا كان الموصّل يملك قيمةً، يُخطِر القيد الجديد بهذه الحقيقة.
ويعمل إجراء الموصّل me بوصفه موزّعًا إلى الإجراءات الداخليّة الأخرى، ويمثّل الموصّل أيضًا ككائن. والإجراءات الآتية تُوفّر واجهة صياغةٍ للموزّع:
(define (has-value? connector)
  (connector 'has-value?))
(define (get-value connector)
  (connector 'value))
(define (set-value! connector
                    new-value
                    informant)
  ((connector 'set-value!)
   new-value
   informant))
(define (forget-value! connector retractor)
  ((connector 'forget) retractor))
(define (connect connector new-constraint)
  ((connector 'connect) new-constraint))
التمرين 3.33: باستخدام قيود المضاعف والجامع والثابت الأوّليّة، عرّف إجراءً
averagerيأخذ ثلاثة موصّلاتaوbوcكمعطياتٍ ويُرسّخ القيد القاضي بأنّ قيمةcهي متوسّط قيمتَيaوb.
التمرين 3.34: يريد لويس ريزَنر أن يبني مربِّعًا، وهو جهاز قيدٍ ذو طرفين تتحقّق فيه أنّ قيمة الموصّل b على الطرف الثاني ستكون دائمًا مربّع القيمة a على الطرف الأوّل. وهو يقترح الجهاز البسيط الآتي المبنيّ على مضاعفٍ:
(define (squarer a b) (multiplier a a b))
وهناك خللٌ خطيرٌ في هذه الفكرة. فسّره.
التمرين 3.35: يخبر بن بيتدِل لويس أنّ إحدى طرائق تجنّب المتعلّة الواردة في التمرين 3.34 هي تعريف المربّع كقيدٍ أوّليٍّ جديد. فأكمل الأجزاء الناقصة في المخطّط الذي رسمه بن لإجراءٍ يُنفّذ مثل هذا القيد:
(define (squarer a b)
  (define (process-new-value)
    (if (has-value? b)
        (if (< (get-value b) 0)
            (error "square less than 0:
                    SQUARER"
                   (get-value b))
            ⟨alternative1⟩)
        ⟨alternative2⟩))
  (define (process-forget-value) ⟨body1⟩)
  (define (me request) ⟨body2⟩)
  ⟨rest of definition⟩
  me)
فلنفترض أنّنا قيّمنا التتالي الآتي من التعابير في البيئة العامّة:
(define a (make-connector))
(define b (make-connector))
(set-value! a 10 'user)
في وقتٍ ما أثناء تقييم set-value!، يُقيَّم التعبير الآتي الوارد في الإجراء المحليّ الخاصّ بالموصّل:
(for-each-except
  setter inform-about-value constraints)
ارسم مخطّطًا للبيئة يُظهر البيئة التي يُقيَّم فيها التعبير الوارد أعلاه.
التمرين 3.37: إنّ إجراء celsius-fahrenheit-converter ثقيلُ الاستعمال بالمقارنة مع أسلوب تعريفٍ أكثر توجهًا نحو التعابير، مثل
(define (celsius-fahrenheit-converter x)
  (c+ (c* (c/ (cv 9) (cv 5))
          x)
      (cv 32)))

(define C (make-connector))
(define F (celsius-fahrenheit-converter C))
ها هنا c+ وc* وهكذا هي صيغ «القيد» من العمليّات الحسابيّة. فمثلًا، يأخذ c+ موصّلين كمعطيين ويعيد موصّلًا مرتبطًا بهذين بقيد جامع:
(define (c+ x y)
  (let ((z (make-connector)))
    (adder x y z)
    z))
عرِّف إجراءاتٍ نظيرةً c-، وc*، وc/، وcv (قيمة ثابتة) تُمكّننا من تعريف قيودَ مركّبةٍ كما في مثال المحوِّل أعلاه.[33]
3.4 التزامن: الزمن أمرٌ جوهريّ
لقد رأينا قوّة الكائنات الحسابيّة ذات الحالة المحليّة بوصفها أدواتٍ للنمذجة. لكنّ هذه القوّة تُجبى بثمن، كما حذّر 3.1.3: فقدان الشفافيّة بالرجوع، وما ينجم عن ذلك من أسئلةٍ كثيفةٍ حول التماثل والتغيّر، والحاجة إلى التخلّي عن نموذج الاستبدال للتقييم لصالح نموذج البيئة الأشدّ تعقيدًا.
والمسألة المركزيّة الكامنة خلف تعقيد الحالة والتماثل والتغيّر هي أنّ إدخال الإحلال يُجبرنا على إدخال الزمن إلى نماذجنا الحسابيّة. فمن قبل أن نُدخل الإحلال، كانت جميع برامجنا بلا زمن، بمعنى أنّ أيّ تعبيرٍ له قيمة له دائمًا القيمة ذاتها. وعلى النقيض من ذلك، تذكّر مثال نمذجة السحب من حسابٍ مصرفيّ وإعادة الرصيد الناتج، المقدَّم في بداية 3.1.1:
(withdraw 25)
75

(withdraw 25)
50
فإنّ التقييمات المتعاقبة للتعبير ذاته تُنتج هنا قيمًا مختلفة. وهذا السلوك ناجمٌ عن أنّ تنفيذ عبارات الإحلال (في هذه الحالة، الإحلالات على المتغيّر balance) يُرسّم لحظاتٍ في الزمن تتغيّر عندها القيم. فإنّ نتيجة تقييم تعبيرٍ ما لا تتوقّف على التعبير ذاته فحسب، بل تتوقّف أيضًا على ما إذا كان التقييم يقع قبل هذه اللحظات أم بعدها. وبناءُ النماذج بدلالة كائناتٍ حسابيّةٍ ذات حالة محلّيّة يُجبرنا على مواجهة الزمن بوصفه مفهومًا جوهريًّا في البرمجة.
ويمكننا أن نمضي أبعد من ذلك في بناء النماذج الحسابيّة بحيث تُطابق إدراكنا للعالم الماديّ. فإنّ الكائنات في العالم لا تتغيّر واحدًا تلو الآخر في تسلسل. بل نحن ندركها على أنّها تعمل تزامنًا — جميعها في وقتٍ واحد. ومن ثمّ، فكثيرًا ما يكون من الطبيعيّ نمذجة النظم بوصفها مجموعاتٍ من العمليّات الحسابيّة التي تُنفَّذ تزامنًا. فكما نستطيع أن نُزيد وحدانيّة برامجنا بتنظيم النماذج بدلالة كائناتٍ لها حالة محلّيّة منفصلة، فكثيرًا ما يكون من الملائم تقسيم النماذج الحسابيّة إلى أجزاءٍ تتطوّر كلٌّ على حدةٍ وتزامنًا. وحتّى لو كان مقدرًا للبرامج أن تُنفَّذ على حاسوبٍ تسلسليّ، فإنّ ممارسة كتابة البرامج كأنّها ستُنفَّذ تزامنًا تُجبر المبرمج على تجنّب القيود الزمنيّة غير الجوهريّة، وبذلك تجعل البرامج أكثر وحدانيّة.
فبالإضافة إلى زيادة وحدانيّة البرامج، فإنّ الاحتساب المتزامن قد يُوفّر ميزةً في السرعة على الاحتساب التسلسليّ. فإنّ الحواسيب التسلسليّة تُنفّذ عمليّةً واحدةً فقط في كلّ مرّة، وبذلك فإنّ مقدار الوقت الذي يتطلّبه أداء مهمّةٍ ما يتناسب مع العدد الكلّيّ للعمليّات المُنفَّذة.[34] لكن إذا أمكن تفكيك مسألةٍ إلى أجزاءٍ مستقلّةٍ نسبيًّا ولا تحتاج إلى التواصل إلّا نادرًا، فقد يكون من الممكن تخصيص الأجزاء لمعالجات حسابيّةٍ منفصلة، مما يُنتج ميزةً في السرعة تتناسب مع عدد المعالجات المتاحة.
وللأسف، فإنّ التعقيدات التي يُدخلها الإحلال تصير أكثر إشكاليّةً بحضور التزامن. فإنّ واقع التنفيذ المتزامن، سواءً لأنّ العالم يعمل بالتوازي أو لأنّ حواسيبنا تفعل ذلك، يستتبع تعقيدًا إضافيًّا في فهمنا للزمن.
3.4.1 طبيعة الزمن في النظم المتزامنة
على السطح، يبدو الزمن واضحًا ومباشرًا. فهو ترتيبٌ مفروضٌ على الأحداث.[35] فبالنسبة لأيّ حدثين و ، إمّا أن يقع قبل ، أو يكون و متزامنين، أو يقع بعد . فمثلًا، وبعودة إلى مثال الحساب المصرفيّ، لنفترض أنّ بيتر يسحب $10 وبول يسحب $25 من حسابٍ مشتركٍ يحتوي أوّلًا على $100، فيبقى في الحساب $65. وتبعًا لترتيب السحبين، يكون تتالي الأرصدة في الحساب إمّا →$ →$ $65 وإمّا →$ →$ $65. وفي تنفيذ حاسوبيٍّ للنظام المصرفيّ، يمكن نمذجة تتالي الأرصدة المتغيّر هذا بإحلالاتٍ متعاقبةٍ على متغيّر balance.
غير أنّ مثل هذا النظر قد يكون مُشكِلًا في الحالات المعقّدة. فلنفترض أنّ بيتر وبول، وأناسًا آخرين كذلك، ينفذون إلى الحساب المصرفيّ ذاته عبر شبكةٍ من الأجهزة المصرفيّة الموزّعة في جميع أنحاء العالم. فإنّ تتالي الأرصدة الفعليّ في الحساب سيتوقّف بشكلٍ حاسمٍ على التوقيت المفصّل للنفاذ وعلى تفاصيل التواصل بين الأجهزة.
وإنّ عدم الحتميّة هذا في ترتيب الأحداث قد يُثير مسائل خطيرة في تصميم النظم المتزامنة. فمثلًا، لنفترض أنّ السحبين اللذين أجراهما بيتر وبول مُنفَّذان كعمليّتين منفصلتين تتشاركان متغيّرًا مشتركًا balance، وكلٌّ منهما محدَّدةٌ بالإجراء الوارد في 3.1.1:
(define (withdraw amount)
  (if (>= balance amount)
      (begin
        (set! balance
              (- balance amount))
        balance)
      "Insufficient funds"))
فإذا عملت العمليّتان باستقلالٍ إحداهما عن الأخرى، فقد يختبر بيتر الرصيد ويحاول سحب مبلغٍ مشروع. غير أنّ بول قد يسحب بعض المال في الفترة بين زمن فحص بيتر للرصيد وزمن إتمام بيتر للسحب، مما يُبطِل اختبار بيتر.
وقد تكون الأمور أسوأ من ذلك. تأمّل التعبير
(set! balance (- balance amount))
الذي يُنفَّذ كجزءٍ من كلّ عمليّة سحب. وهذا يتكوّن من ثلاث خطوات: (1) النفاذ إلى قيمة متغيّر balance؛ (2) احتساب الرصيد الجديد؛ (3) ضبط balance على هذه القيمة الجديدة. فإذا نفّذ سحبا بيتر وبول هذه العبارة تزامنًا، فإنّ السحبين قد يُشابكان الترتيب الذي ينفذان به إلى balance ويضبطانه على القيمة الجديدة.
يُصوّر المخطّط الزمنيّ الوارد في الشكل 3.29 ترتيبًا للأحداث يبدأ فيه balance من 100، ويسحب بيتر 10، ويسحب بول 25، ومع ذلك تكون القيمة النهائيّة لـbalance هي 75. وكما يظهر المخطّط، فإنّ سبب هذه الشاذّة هو أنّ إحلال بول القيمة 75 إلى balance يقع على افتراض أنّ قيمة balance التي سيُنقَص منها هي 100. غير أنّ هذا الافتراض أصبح باطلًا حين غيّر بيتر balance إلى 90. وهذا فشلٌ كارثيّ للنظام المصرفيّ، لأنّ المبلغ الكلّيّ للمال في النظام غير محفوظ. فقبل المعاملات، كان المبلغ الكلّيّ للمال $100. وبعدها، كان لدى بيتر $10، ولدى بول $25، ولدى المصرف $75.[36]
الشكل 3.29: مخطّط زمنيّ يُظهر كيف يمكن أن يُؤدّي تشابك ترتيب الأحداث في سحبين مصرفيّين إلى رصيدٍ نهائيٍّ غير صحيح.
والظاهرة العامّة التي يُوضيحها المثال هذا هي أنّ عدّة عمليّاتٍ قد تتشارك متغيّر حالةٍ مشتركًا. وما يجعل هذا معقّدًا هو أنّ أكثر من عمليّةٍ قد تحاول التلاعب بالحالة المشتركة في الوقت ذاته. فمثلًا في مثال الحساب المصرفيّ، ينبغي أثناء كلّ معاملةٍ أن يكون كلّ زبونٍ قادرًا على التصرّف كأنّ الزبائن الآخرين غير موجودين. وحين يُبدّل زبونٌ الرصيد بطريقةٍ تتوقّف على الرصيد، ينبغي أن يكون قادرًا على افتراض أنّ الرصيد، في اللحظة السابقة للتغيير مباشرةً، لا يزال على ما كان يعتقده.
السلوك الصحيح للبرامج المتزامنة
إنّ المثال الوارد أعلاه نموذجٌ للعلل الخفيّة التي يمكن أن تتسرّب إلى البرامج المتزامنة. وجذر هذا التعقيد كائنٌ في الإحلالات على المتغيّرات المشتركة بين العمليّات المختلفة. ونحن نعلم بالفعل أنّ علينا أن نكون حذرين في كتابة البرامج التي تستخدم set!، لأنّ نتائج الاحتساب تتوقّف على الترتيب الذي تقع به الإحلالات.[37] ومع العمليّات المتزامنة، ينبغي أن نكون حذرين على نحوٍ خاصّ حيال الإحلالات، لأنّنا قد لا نكون قادرين على التحكّم في ترتيب الإحلالات التي تجريها العمليّات المختلفة. فإذا كان من الممكن أن تقع عدّة تغييراتٍ كهذه تزامنًا (كما في حال مُودِعين ينفذان إلى حسابٍ مشترك)، فنحتاج إلى طريقةٍ ما لضمان أنّ نظامنا يسلك السلوك الصحيح. فمثلًا، في حال السحب من حسابٍ مصرفيٍّ مشترك، يجب أن نضمن حفظ المال. وحتّى تجعل البرامج المتزامنة تسلك السلوك الصحيح، قد يلزمنا أن نضع بعض القيود على التنفيذ المتزامن.
أحد القيود الممكنة على التزامن يُقرّر أنّ لا عمليّتين تُبدّلان متغيّرات حالةٍ مشتركةٍ يمكن أن تقعا في الوقت ذاته. وهذا شرطٌ صارمٌ للغاية. فبالنسبة للمصرفيّة الموزّعة، فإنّه سيلزم مُصمّم النظام بضمان ألّا تسير إلّا معاملةٌ واحدة في كلّ مرّة. وهذا سيكون غير كفؤٍ ومتحفّظًا أكثر من اللازم على حدّ سواء. يُظهر الشكل 3.30 بيتر وبول يتشاركان حسابًا مصرفيًّا، حيث لدى بول أيضًا حسابٌ خاصّ. ويُوضيح المخطّط سحبين من الحساب المشترك (أحدهما لبيتر والآخر لبول) وإيداعًا في حساب بول الخاصّ.[38] ولا يجوز أن يكون السحبان من الحساب المشترك متزامنين (إذ كلًّا منهما ينفذ إلى الحساب ذاته ويُحدّثه)، ولا يجوز أن يكون إيداع بول وسحبه متزامنين (إذ كلًّا منهما ينفذ إلى المبلغ في محفظة بول ويُحدّثه). لكن لا ينبغي أن تكون هناك مشكلة في السماح لإيداع بول في حسابه الخاصّ بأن يسير تزامنًا مع سحب بيتر من الحساب المشترك.
الشكل 3.30: إيداعاتٌ وسحوباتٌ متزامنة من حسابٍ مشتركٍ في Bank1 وحسابٍ خاصٍّ في Bank2.
أمّا القيد الأقلّ صرامةً على التزامن فيضمن أنّ النظام المتزامن يُنتج النتيجة ذاتها كما لو كانت العمليّات قد سارت تسلسليًّا في ترتيبٍ ما. ولهذا الشرط جانبان مهمّان. أوّلًا، هو لا يشترط أن تسير العمليّات تسلسليًّا فعلًا، بل أن تُنتج نتيجةً هي ذاتها كأنّما كانت قد سارت تسلسليًّا. فمثلًا في المثال الوارد في الشكل 3.30، يستطيع مُصمّم نظام الحساب المصرفيّ أن يسمح بأمانٍ بوقوع إيداع بول وسحب بيتر تزامنًا، لأنّ النتيجة الصافية ستكون هي ذاتها كما لو أنّ العمليّتين وقعتا تسلسليًّا. وثانيًا، قد يكون هناك أكثر من نتيجةٍ «صحيحة»ٍ واحدةٍ يُنتجها برنامجٌ متزامن، لأنّنا لا نشترط إلّا أن تكون النتيجة هي ذاتها كما لـترتيبٍ تسلسليٍّ ما. فمثلًا، لنفترض أنّ الحساب المشترك لبيتر وبول يبدأ بـ$100، وأنّ بيتر يُودع $40 بينما يسحب بول تزامنًا نصف المال في الحساب. فإنّ التنفيذ التسلسليّ قد يُنتج رصيدًا للحساب إمّا $70 وإمّا $90 (انظر التمرين 3.38).[39]
وهناك شروطٌ أضعفُ بعدُ للتنفيذ الصحيح للبرامج المتزامنة. فبرنامجٌ لمحاكاة الانتشار (كجريان الحرارة في جسمٍ مثلًا) قد يتكوّن من عددٍ كبيرٍ من العمليّات، تمثّل كلٌّ منها حجمًا صغيرًا من المكان، وتُحدّث قيمها تزامنًا. وكلّ عمليّةٍ تُغيَّر قيمتها مرارًا إلى متوسّط قيمتها وقيم جيرانها. وهذه الخوارزميّة تتقارب نحو الجواب الصحيح مستقلًّا عن الترتيب الذي تُنفَّذ به العمليّات؛ فلا حاجة إلى أيّ قيودٍ على الاستخدام المتزامن للقيم المشتركة.
التمرين 3.38: لنفترض أنّ بيتر وبول وماري يتشاركون حسابًا مصرفيًّا مشتركًا يحتوي أوّلًا على $100. فتزامنًا، يُودع بيتر $10، ويسحب بول $20، وتسحب ماري نصف المال في الحساب، بتنفيذ الأوامر الآتية:
Peter: (set! balance (+ balance 10))
Paul:  (set! balance (- balance 20))
Mary:  (set! balance (- balance
                        (/ balance 2)))
- اذكر جميع القيم الممكنة المختلفة لـ
balanceبعد إتمام هذه المعاملات الثلاث، بافتراض أنّ النظام المصرفيّ يُجبر العمليّات الثلاث على السير تسلسليًّا في ترتيبٍ ما. - ما بعض القيم الأخرى التي يمكن أن تُنتَج إذا سمح النظام بتشابك العمليّات؟ ارسم مخطّطاتٍ زمنيّةً شبيهةً بالواردة في الشكل 3.29 لتشرح كيف يمكن أن تقع هذه القيم.
3.4.2 آليّات التحكّم في التزامن
لقد رأينا أنّ الصعوبة في التعامل مع العمليّات المتزامنة متأصّلةٌ في الحاجة إلى النظر في تشابك ترتيب الأحداث في العمليّات المختلفة. فمثلًا، لنفترض أنّ لدينا عمليّتين، إحداهما بثلاثة أحداثٍ مرتّبة والأخرى بثلاثة أحداثٍ مرتّبة . فإذا سارت العمليّتان تزامنًا، دون قيودٍ على كيفيّة تشابك تنفيذهما، فهناك 20 ترتيبًا ممكنًا مختلفًا للأحداث تتّسق مع الترتيبات الفرديّة للعمليّتين:
(a,b,c,x,y,z)  (a,x,b,y,c,z)  (x,a,b,c,y,z)
(x,a,y,z,b,c)  (a,b,x,c,y,z)  (a,x,b,y,z,c)
(x,a,b,y,c,z)  (x,y,a,b,c,z)  (a,b,x,y,c,z)
(a,x,y,b,c,z)  (x,a,b,y,z,c)  (x,y,a,b,z,c)
(a,b,x,y,z,c)  (a,x,y,b,z,c)  (x,a,y,b,c,z)
(x,y,a,z,b,c)  (a,x,b,c,y,z)  (a,x,y,z,b,c)
(x,a,y,b,z,c)  (x,y,z,a,b,c)
وبصفتنا مبرمجين يُصمّمون هذا النظام، سيتعيّن علينا النظر في آثار كلّ واحدٍ من هذه الترتيبات العشرين والتحقّق من أنّ كلّ سلوكٍ منها مقبول. ومثل هذا المنهج يصير سريعًا عسيرَ التداول بازدياد أعداد العمليّات والأحداث.
وأمّا المنهج الأكثر عمليّةً لتصميم النظم المتزامنة فهو ابتكار آليّاتٍ عامّة تسمح لنا بإخضاع تشابك العمليّات المتزامنة للقيود، حتّى نستطيع أن نكون على يقينٍ من أنّ سلوك البرنامج صحيح. وقد طُوّرت آليّاتٌ كثيرةٌ لهذا الغرض. وفي هذا القسم نصف واحدةً منها، وهي المسلسل (serializer).
تسلسل النفاذ إلى الحالة المشتركة
يُحقّق التسلسُل (serialization) الفكرة الآتية: ستُنفَّذ العمليّات تزامنًا، لكن ستكون هناك مجموعاتٌ معيّنةٌ من الإجراءات لا يمكن تنفيذها تزامنًا. وبأكثر دقّة، يُنشئ التسلسُل مجموعاتٍ مميّزةً من الإجراءات بحيث لا يُسمح إلّا بتنفيذٍ واحدٍ لإجراءٍ في كلّ مجموعةٍ مسلسَلةٍ في كلّ مرّة. فإذا كان إجراءٌ ما في المجموعة قيد التنفيذ، فإنّ عمليّةً تحاول تنفيذ أيّ إجراءٍ في المجموعة ستُجبر على الانتظار حتّى ينتهي التنفيذ الأوّل.
ويمكننا استخدام التسلسُل للتحكّم في النفاذ إلى المتغيّرات المشتركة. فمثلًا، إذا أردنا تحديث متغيّرٍ مشتركٍ بناءً على القيمة السابقة لذلك المتغيّر، فإنّا نضع النفاذ إلى القيمة السابقة للمتغيّر وإحلال القيمة الجديدة إلى المتغيّر في الإجراء ذاته. ثمّ نضمن أنّ لا إجراءً آخر يُحيل إلى المتغيّر يمكن أن يسير تزامنًا مع هذا الإجراء، بتسلسُل جميع هذه الإجراءات بالمسلسل ذاته. وهذا يضمن أنّ قيمة المتغيّر لا يمكن أن تُغيَّر بين نفاذٍ وإحلالٍ يقابله.
المسلسلات في Scheme
ولنجعل الآليّة الواردة أعلاه أكثر تحديدًا، لنفترض أنّنا مددنا Scheme لتشمل إجراءً يُسمّى parallel-execute:
(parallel-execute ⟨p₁⟩
                  ⟨p₂⟩
                  …
                  ⟨pₖ⟩)
ينبغي أن يكون كلّ ⟨p⟩ إجراءً بلا معطيات. يُنشئ parallel-execute عمليّةً منفصلةً لكلّ ⟨p⟩، تُطبّق ⟨p⟩ (بلا معطيات). وتسير جميع هذه العمليّات تزامنًا.[40]
وكمثالٍ على كيفيّة استخدام ذلك، تأمّل
(define x 10)
(parallel-execute (lambda () (set! x (* x x)))
                  (lambda () (set! x (+ x 1))))
وهذا يُنشئ عمليّتين متزامنتين— ، التي تضبط x على x مضروبًا في x، و ، التي تزيد x بواحد. وبعد تمام التنفيذ، سيبقى x بأحد خمس قيمٍ ممكنة، تبعًا لتشابك أحداث و :
101:  $P_{1}$  sets x to 100 and then  $P_{2}$  increments
     x to 101.
121:  $P_{2}$  increments x to 11 and then  $P_{1}$  sets
     x to x times x.
110:  $P_{2}$  changes x from 10 to 11 between the
     two times that  $P_{1}$  accesses the value of
     x during the evaluation of (* x x).
 11:  $P_{2}$  accesses x, then  $P_{1}$  sets x to 100,
     then  $P_{2}$  sets x.
100:  $P_{1}$  accesses x (twice), then  $P_{2}$  sets
     x to 11, then  $P_{1}$  sets x.
ويمكننا إخضاع التزامن للقيود باستخدام إجراءاتٍ مسلسَلة، وهي التي تُنشَأ بواسطة المسلسلات. وتُبنى المسلسلات بـmake-serializer، الذي تنفيذه معطىٌ أدناه. ويأخذ المسلسل إجراءً كمعطىً ويعيد إجراءً مسلسَلًا يتصرّف كالإجراء الأصليّ. وجميع النداءات لمسلسلٍ معطًى تُعيد إجراءاتٍ مسلسَلةً في المجموعة ذاتها.
وبذلك، وعلى خلاف المثال الوارد أعلاه، فإنّ تنفيذ
(define x 10)
(define s (make-serializer))
(parallel-execute
 (s (lambda () (set! x (* x x))))
 (s (lambda () (set! x (+ x 1)))))
لا يُنتج إلّا قيمتين ممكنتين لـx، هما 101 أو 121. أمّا الاحتمالات الأخرى فمُستَبعدة، لأنّ تنفيذ و لا يمكن تشابكه.
وها هو ذا إصدارٌ من إجراء make-account الوارد في 3.1.1، حيث الإيداعات والسحوبات مُسلسَلة:
(define (make-account balance)
  (define (withdraw amount)
    (if (>= balance amount)
        (begin (set! balance
                     (- balance amount))
               balance)
        "Insufficient funds"))
  (define (deposit amount)
    (set! balance (+ balance amount))
    balance)
  (let ((protected (make-serializer)))
    (define (dispatch m)
      (cond ((eq? m 'withdraw)
             (protected withdraw))
            ((eq? m 'deposit)
             (protected deposit))
            ((eq? m 'balance)
             balance)
            (else (error "Unknown request:
                          MAKE-ACCOUNT"
                         m))))
    dispatch))
وبهذا التنفيذ، لا يمكن لعمليّتين أن تسحبا من حسابٍ واحدٍ أو تُودعا فيه تزامنًا. وهذا يُستبعد مصدر الخطأ الموضّح في الشكل 3.29، حيث يُغيِّر بيتر رصيد الحساب بين الحين الذي ينفذ فيه بول إلى الرصيد لاحتساب القيمة الجديدة والحين الذي يُجري فيه بول الإحلال فعلًا. ومن جهةٍ أخرى، فإنّ لكلّ حسابٍ مسلسلَه الخاصّ، بحيث يمكن للإيداعات والسحوبات في حساباتٍ مختلفةٍ أن تسير تزامنًا.
التمرين 3.39: أيّ الاحتمالات الخمسة الواردة في التنفيذ بالتوازي الموضّح أعلاه تبقى إذا سلّسنا التنفيذ على النحو الآتي:
(define x 10)
(define s (make-serializer))
(parallel-execute
  (lambda ()
    (set! x ((s (lambda () (* x x))))))
  (s (lambda () (set! x (+ x 1)))))
التمرين 3.40: أعطِ جميع القيم الممكنة لـx التي يمكن أن تنتج عن تنفيذ
(define x 10)
(parallel-execute
 (lambda () (set! x (* x x)))
 (lambda () (set! x (* x x x))))
أيّ هذه الاحتمالات يبقى إذا استخدمنا بدلًا من ذلك إجراءاتٍ مسلسَلة:
(define x 10)
(define s (make-serializer))
(parallel-execute
 (s (lambda () (set! x (* x x))))
 (s (lambda () (set! x (* x x x)))))
التمرين 3.41: يقلق بن بيتدِل من أنّ تنفيذ الحساب المصرفيّ على النحو الآتي (حيث السطر المُعلَّق عليه قد تغيّر) سيكون أفضل:
(define (make-account balance)
  (define (withdraw amount)
    (if (>= balance amount)
        (begin
          (set! balance
                (- balance amount))
          balance)
        "Insufficient funds"))
  (define (deposit amount)
    (set! balance (+ balance amount))
    balance)
  (let ((protected (make-serializer)))
    (define (dispatch m)
      (cond ((eq? m 'withdraw)
             (protected withdraw))
            ((eq? m 'deposit)
             (protected deposit))
            ((eq? m 'balance)
             ((protected
                (lambda ()
                  balance)))) ; serialized
            (else
             (error
              "Unknown request:
               MAKE-ACCOUNT"
              m))))
    dispatch))
لأنّ السماح بنفاذٍ غير مسلسَلٍ إلى رصيد الحساب يمكن أن يُؤدّي إلى سلوكٍ شاذّ. فهل توافق على ذلك؟ وهل هناك أيّ سيناريو يُظهر قلق بن؟
التمرين 3.42: يقترح بن بيتدِل أنّ إنشاء إجراءٍ مسلسَلٍ جديدٍ استجابةً لكلّ رسالة withdraw وdeposit مضيعةٌ للوقت. وهو يقول إنّه يمكن تعديل make-account بحيث تُجرى نداءات protected خارج إجراء dispatch. أي أنّ الحساب سيُعيد الإجراء المسلسَل ذاته (الذي أُنشئ في الوقت ذاته مع الحساب) في كلّ مرّةٍ يُطلب منه فيها إجراء السحب.
(define (make-account balance)
  (define (withdraw amount)
    (if (>= balance amount)
        (begin (set! balance
                     (- balance amount))
               balance)
        "Insufficient funds"))
  (define (deposit amount)
    (set! balance (+ balance amount))
    balance)
  (let ((protected (make-serializer)))
    (let ((protected-withdraw
           (protected withdraw))
          (protected-deposit
           (protected deposit)))
      (define (dispatch m)
        (cond ((eq? m 'withdraw)
               protected-withdraw)
              ((eq? m 'deposit)
               protected-deposit)
              ((eq? m 'balance)
               balance)
              (else
               (error "Unknown request:
                       MAKE-ACCOUNT"
                      m))))
      dispatch)))
فهل هذا تغييرٌ آمن؟ وعلى وجه الخصوص، فهل هناك أيّ فرقٍ في التزامن الذي تسمح به هاتان النسختان من make-account؟
تعقيد استخدام موارد مشتركةٍ متعدّدة
تُوفّر المسلسلات تجريدًا قويًّا يساعد على عزل تعقيدات البرامج المتزامنة بحيث يمكن التعامل معها بحذرٍ و(نأمل) بصورةٍ صحيحة. لكن، مع أنّ استخدام المسلسلات مباشرٌ نسبيًّا حين لا يكون هناك إلّا موردٌ مشتركٌ واحد (كحسابٍ مصرفيٍّ واحد)، فإنّ برمجة التزامن قد تكون صعبةً بصورةٍ خادعةٍ حين تكون هناك مواردٌ مشتركةٌ متعدّدة.
ولتوضيح إحدى الصعوبات التي يمكن أن تنشأ، لنفترض أنّنا نرغب في مبادلة رصيدَي حسابين مصرفيّين. فنحن ننفذ إلى كلّ حسابٍ لإيجاد الرصيد، ونحتسب الفرق بين الرصيدين، ونسحب هذا الفرق من أحد الحسابين، ونُودعه في الحساب الآخر. ويمكننا تنفيذ ذلك على النحو الآتي:[41]
(define (exchange account1 account2)
  (let ((difference (- (account1 'balance)
                       (account2 'balance))))
    ((account1 'withdraw) difference)
    ((account2 'deposit) difference)))
يعمل هذا الإجراء حسنًا حين لا تكون إلّا عمليّةٌ واحدةٌ تحاول أداء المبادلة. لكن لنفترض أنّ بيتر وبول كلًّا منهما يستطيع النفاذ إلى الحسابات و و ، وأنّ بيتر يبادل و بينما يبادل بول و تزامنًا. فحتّى مع تسلسُل إيداعات الحسابات وسحوباتها للحسابات الفرديّة (كما في إجراء make-account الموضّح أعلاه في هذا القسم)، فإنّ exchange لا يزال يستطيع أن يُنتج نتائج غير صحيحة. فمثلًا، قد يحتسب بيتر الفرق بين رصيدَي و ، لكنّ بول قد يُغيّر الرصيد في قبل أن يتمكّن بيتر من إتمام المبادلة.[42] ومن أجل السلوك الصحيح، يجب أن نُرتّب لأن يُقصيَ إجراءُ exchange أيّ نفاذٍ متزامنٍ آخر إلى الحسابات طيلة مدّة المبادلة.
إحدى الطرائق التي نستطيع بها تحقيق ذلك هي استخدام مسلسَلَي الحسابين لتسلسُل إجراء exchange بأكمله. ولفعل ذلك، سنُرتّب لإتاحة النفاذ إلى مسلسل الحساب. ولاحِظ أنّنا نكسر وحدانيّة كائن الحساب المصرفيّ بشكلٍ مقصودٍ بالكشف عن المسلسل. فإنّ النسخة الآتية من make-account مطابقةٌ للنسخة الأصليّة الواردة في 3.1.1، إلّا أنّ هنا يُوفَّر مسلسلٌ لحماية متغيّر الرصيد، ويُصدَّر المسلسل عبر تمرير الرسائل:
(define (make-account-and-serializer balance)
  (define (withdraw amount)
    (if (>= balance amount)
        (begin
          (set! balance (- balance amount))
          balance)
        "Insufficient funds"))
  (define (deposit amount)
    (set! balance (+ balance amount))
    balance)
  (let ((balance-serializer
         (make-serializer)))
    (define (dispatch m)
      (cond ((eq? m 'withdraw) withdraw)
            ((eq? m 'deposit) deposit)
            ((eq? m 'balance) balance)
            ((eq? m 'serializer)
             balance-serializer)
            (else (error "Unknown request:
                          MAKE-ACCOUNT"
                         m))))
    dispatch))
يمكننا استخدام ذلك لأداء إيداعاتٍ وسحوباتٍ مسلسَلة. لكن، وعلى خلاف حسابنا المسلسَل السابق، فإنّ مسؤوليّة إدارة التسلسُل صراحةً تقع الآن على عاتق كلّ مستخدمٍ لكائنات الحساب المصرفيّ، كما يلي مثلًا:[43]
(define (deposit account amount)
  (let ((s (account 'serializer))
        (d (account 'deposit)))
    ((s d) amount)))
إنّ تصدير المسلسل بهذه الطريقة يمنحنا مرونةً كافيةً لتنفيذ برنامج مبادلةٍ مسلسَل. فنحن ببساطةٍ نُسلْسِل إجراء exchange الأصليّ بمسلسَلَي الحسابين:
(define (serialized-exchange account1 account2)
  (let ((serializer1 (account1 'serializer))
        (serializer2 (account2 'serializer)))
    ((serializer1 (serializer2 exchange))
     account1
     account2)))
التمرين 3.43: لنفترض أنّ أرصدة ثلاثة حسابات تبدأ بقيم $10 و$20 و$30، وأنّ عمليّاتٍ متعدّدةً تسير، مبادلةً أرصدة الحسابات. ناقش أنّ العمليّات إذا سارت تسلسليًّا، فإنّه بعد أيّ عددٍ من المبادلات المتزامنة، ينبغي أن تكون أرصدة الحسابات $10 و$20 و$30 بترتيبٍ ما. وارسم مخطّطًا زمنيًّا شبيهًا بالوارد في الشكل 3.29 لتُظهر كيف يمكن أن يُخالَف هذا الشرط إذا نُفّذت المبادلات باستخدام النسخة الأولى من برنامج مبادلة الحسابات الوارد في هذا القسم. ومن جهةٍ أخرى، ناقش أنّ حتّى مع برنامج
exchangeهذا، فإنّ مجموع أرصدة الحسابات سيبقى محفوظًا. وارسم مخطّطًا زمنيًّا لتُظهر كيف يمكن أن يُخالَف حتّى هذا الشرط لو أنّنا لم نُسلْسِل المعاملات على الحسابات الفرديّة.
التمرين 3.44: تأمّل مسألة تحويل مبلغٍ من حسابٍ إلى آخر. يدّعي بن بيتدِل أنّ ذلك يمكن إنجازه بالإجراء الآتي، حتّى إذا كان هناك أشخاصٌ متعدّدون ينقلون مالًا بين حساباتٍ متعدّدةٍ تزامنًا، باستخدام أيّ آليّة حسابٍ تُسلْسِل معاملات الإيداع والسحب، مثل إصدار make-account الوارد في النصّ أعلاه.
(define
  (transfer from-account to-account amount)
  ((from-account 'withdraw) amount)
  ((to-account 'deposit) amount))
يدّعي لويس ريزنر أنّ هناك مشكلةً هنا، وأنّنا نحتاج إلى استخدام منهجٍ أكثر تطوّرًا، كالذي يلزم للتعامل مع مسألة المبادلة. فهل لويس محقّ؟ وإذا لم يكن كذلك، فما الفرق الجوهريّ بين مسألة التحويل ومسألة المبادلة؟ (وعليك أن تفترض أنّ الرصيد في from-account لا يقلّ عن amount.)
التمرين 3.45: يعتقد لويس ريزنر أنّ نظامنا المصرفيّ معقّدٌ وعرضةٌ للأخطاء بلا داعٍ الآن، بما أنّ الإيداعات والسحوبات لم تبقَ مُسلسَلةً تلقائيًّا. وهو يقترح أنّ make-account-and-serializer كان ينبغي أن يُصدّر المسلسل (لاستخدامه في إجراءاتٍ مثل serialized-exchange) بالإضافة إلى (بدلًا من) استخدامه لتسلسُل الحسابات والإيداعات كما فعل make-account. وهو يقترح إعادة تعريف الحسابات على النحو الآتي:
(define
  (make-account-and-serializer balance)
  (define (withdraw amount)
    (if (>= balance amount)
        (begin (set! balance
                     (- balance amount))
               balance)
        "Insufficient funds"))
  (define (deposit amount)
    (set! balance (+ balance amount))
    balance)
  (let ((balance-serializer
         (make-serializer)))
    (define (dispatch m)
      (cond ((eq? m 'withdraw)
             (balance-serializer withdraw))
            ((eq? m 'deposit)
             (balance-serializer deposit))
            ((eq? m 'balance)
             balance)
            ((eq? m 'serializer)
             balance-serializer)
            (else (error "Unknown request:
                          MAKE-ACCOUNT"
                         m))))
    dispatch))
ثمّ تُعالَج الإيداعات كما في make-account الأصليّ:
(define (deposit account amount)
  ((account 'deposit) amount))
اشرح ما الخطأ في استدلال لويس. وعلى وجه الخصوص، تأمّل ما يقع حين يُنادى serialized-exchange.
تنفيذ المسلسلات
نحن نُنفّذ المسلسلات بدلالة آليّة مزامنةٍ أوّليّةٍ أكثر تُسمّى القفل الثنائيّ (mutex). والقفل الثنائيّ كائنٌ يدعم عمليّتين— يمكن اكتساب (acquired) القفل الثنائيّ، ويمكن إطلاقه (released). ومتى اكتُسب قفلٌ ثنائيّ، فلا يجوز لأيّ عمليّات اكتسابٍ أخرى على ذلك القفل أن تُواصل حتّى يُطلَق القفل.[44] وفي تنفيذنا، لكلّ مسلسلٍ قفلٌ ثنائيّ مرافق له. وبإعطائنا إجراءً p، يُعيد المسلسل إجراءً يكتسب القفل الثنائيّ، ويُشغّل p، ثمّ يُطلق القفل. وهذا يضمن أنّ إجراءً واحدًا فقط من الإجراءات التي يُنتجها المسلسل يمكن أن يكون قيد التشغيل في مرّةٍ واحدة، وهو بالضبط خاصّيّة التسلسُل التي يلزمنا أن نضمنها.
(define (make-serializer)
  (let ((mutex (make-mutex)))
    (lambda (p)
      (define (serialized-p . args)
        (mutex 'acquire)
        (let ((val (apply p args)))
          (mutex 'release)
          val))
      serialized-p)))
والقفل الثنائيّ كائنٌ قابلٌ للتغيير (ها هنا سنستخدم قائمةً ذات عنصرٍ واحد، سنُشير إليها بـخليّة) يمكن أن تحتفظ بالقيمة true أو false. وحين تكون القيمة false، يكون القفل الثنائيّ متاحًا لاكتسابه. وحين تكون القيمة true، يكون القفل الثنائيّ غير متاح، وأيّ عمليّةٍ تحاول اكتساب القفل يجب أن تنتظر.
يبدأ بانٍ القفل الثنائيّ make-mutex بتهيئة محتويات الخليّة إلى false. ولاكتساب القفل الثنائيّ، نختبر الخليّة. فإذا كان القفل الثنائيّ متاحًا، نضبط محتويات الخليّة على true ونواصل. وإلّا، فنحن ننتظر في حلقة، محاولين الاكتساب مرارًا وتكرارًا، حتّى نجد أنّ القفل الثنائيّ متاح.[45] ولإطلاق القفل الثنائيّ، نضبط محتويات الخليّة على false.
(define (make-mutex)
  (let ((cell (list false)))
    (define (the-mutex m)
      (cond ((eq? m 'acquire)
             (if (test-and-set! cell)
                 (the-mutex 'acquire))) ; retry
            ((eq? m 'release) (clear! cell))))
    the-mutex))
(define (clear! cell) (set-car! cell false))
تختبر الدالّة test-and-set! الخليّة وتُعيد نتيجة الاختبار. فضلًا عن ذلك، إذا كان الاختبار خاطئًا، تضبط test-and-set! محتويات الخليّة على القيمة true قبل إعادة القيمة false. ويمكننا التعبير عن هذا السلوك بالإجراء الآتي:
(define (test-and-set! cell)
  (if (car cell)
      true
      (begin (set-car! cell true)
             false)))
غير أنّ هذا التنفيذ لـtest-and-set! لا يكفي كما هو. فهناك دقّةٌ حاسمةٌ هنا، وهي الموضع الجوهريّ الذي يدخل منه التحكّم في التزامن إلى النظام: ينبغي أن تُنفَّذ العمليّة test-and-set! ذرّيًّا. أي أنّه ينبغي لنا أن نضمن أنّ الخليّة، متى اختبرتها عمليّةٌ ما فوجدتها false، ستُضبط محتوياتها فعلًا على true قبل أن تستطيع أيّ عمليّةٍ أخرى اختبارها. فإن لم نتّخذ هذا الضمان، فقد يفشل القفل الثنائيّ (mutex) على نحوٍ مشابهٍ لفشل الحساب المصرفيّ الوارد في الشكل 3.29. (انظر التمرين 3.46.)
إنّ التنفيذ الفعليّ لـtest-and-set! يعتمد على تفاصيل كيفيّة تشغيل نظامنا للعمليّات المتزامنة. فقد نكون، مثلًا، نُنفّذ عمليّاتٍ متزامنةً على معالجٍ تسلسليّ باستخدام آليّة تقسيمٍ زمنيّ تتداور بين العمليّات، فتسمح لكلّ عمليّةٍ بالعمل مدّةً قصيرة قبل مقاطعتها والانتقال إلى العمليّة التالية. وفي هذه الحالة، يستطيع test-and-set! أن يعمل بتعطيل تقسيم الوقت أثناء الاختبار والضبط.[46] وعلى البديل، توفّر الحواسيب متعدّدة المعالجات تعليماتٍ تدعم العمليّات الذرّيّة مباشرةً في العتاد.[47]
التمرين 3.46: لنفترض أنّنا نفّذنا
test-and-set!بإجراءٍ اعتياديٍّ كما هو موضّح في النصّ، دون محاولةٍ لجعل العمليّة ذرّيّة. فارسم مخطّطًا زمنيًّا شبيهًا بالوارد في الشكل 3.29 لتُبيّن كيف يمكن أن يفشل تنفيذ القفل الثنائيّ (mutex) بالسماح لعمليّتين باكتساب القفل في الوقت ذاته.
التمرين 3.47: السيمانة (semaphore) التي حجمها تعميمٌ للقفل الثنائيّ. فمثل القفل الثنائيّ، تدعم السيمانة عمليّتَي الاكتساب والإطلاق، لكنّها أعمّ من حيث أنّ حتّى عمليّةً تستطيع اكتسابها تزامنًا. والعمليّات الإضافيّة التي تحاول اكتساب السيمانة ينبغي أن تنتظر عمليّات الإطلاق. أعطِ تنفيذاتٍ للسيمانات بدلالة الأقفال الثنائيّة
وبدلالة عمليّات
test-and-set!الذرّيّة.
الجمود (deadlock)
والآن، بعد أن رأينا كيف تُنفَّذ المسلسلات (serializers)، نستطيع أن نرى أنّ تبادل الحسابات لا يزال يعاني من مشكلةٍ، حتّى مع الإجراء serialized-exchange أعلاه. فتخيّل أنّ بيتر يحاول مبادلة بـ بينما يحاول بول تزامنًا مبادلة بـ . ولنفترض أنّ عمليّة بيتر تبلغ النقطة التي تكون قد دخلت فيها إجراءً مسلسَلًا يحمي وأنّ عمليّة بول، عقب ذلك على الفور، تدخل إجراءً مسلسَلًا يحمي . فبيتر الآن لا يستطيع المواصلة (بدخول إجراءٍ مسلسَلٍ يحمي ) حتّى يخرج بول من الإجراء المسلسل الذي يحمي . وبالمثل، لا يستطيع بول المواصلة حتّى يخرج بيتر من الإجراء المسلسل الذي يحمي . فكلّ عمليّةٍ متوقّفةٌ إلى الأبد، تنتظر الأخرى. وتُسمّى هذه الحالَة جمودًا. والجمود خطرٌ دائمٌ في النظم التي تتيح وصولًا متزامنًا إلى موارد مشتركةٍ متعدّدة.
وإحدى طرائق تجنّب الجمود في هذه الحالة هي إعطاء كلّ حسابٍ رقم تعريفٍ فريدٍ وإعادة كتابة serialized-exchange بحيث تحاول كلّ عمليّةٍ دائمًا دخول إجراءٍ يحمي الحساب ذا الرقم الأدنى أوّلًا. وعلى الرغم من أنّ هذه الطريقة تعمل حسنًا في مسألة التبادل، فهناك حالاتٌ أخرى تتطلّب تقنيّاتٍ أكثر تطوّرًا لتجنّب الجمود، أو حيث لا يمكن تجنّب الجمود إطلاقًا. (انظر التمرين 3.48 والتمرين 3.49.)[48]
التمرين 3.48: اشرح بتفصيلٍ لماذا يتجنّب أسلوب تجنّب الجمود الموصوف أعلاه (أي أنّ الحسابات مُرقَّمة، وأنّ كلّ عمليّةٍ تحاول اكتساب الحساب ذي الرقم الأصغر أوّلًا) الجمودَ في مسألة التبادل. وأعِد كتابة
serialized-exchangeلتُدرج هذه الفكرة. (وأنت أيضًا محتاجٌ إلى تعديلmake-accountبحيث يُنشأ كلّ حسابٍ برقمٍ يمكن النفاذ إليه بإرسال رسالةٍ مناسبة.)
التمرين 3.49: أعطِ سيناريو حيث لا تعمل آليّة تجنّب الجمود الموصوفة أعلاه. (تلميح: في مسألة التبادل، تعرف كلّ عمليّةٍ مسبقًا الحساباتَ التي سيَلزمها النفاذ إليها. فتأمّل حالَة يجب أن تنال فيها عمليّةٌ النفاذ إلى بعض الموارد المشتركة قبل أن تستطيع معرفة أيّ موارد مشتركةٍ إضافيّةٍ ستلزمها.)
التزامن والزمن والتواصل
لقد رأينا كيف أنّ برمجة النظم المتزامنة تتطلّب ضبط ترتيب الأحداث حين تصل عمليّاتٌ مختلفة إلى حالةٍ مشتركة، ورأينا كيف يمكن تحقيق هذا الضبط باستخدامٍ حصيفٍ للمسلسلات (serializers). لكنّ مشاكل التزامن أعمق من ذلك، لأنّه - من وجهة نظرٍ أساسيّةٍ - ليس واضحًا دائمًا ما يُقصد بـ«الحالة المشتركة».
تتطلّب آليّاتٌ مثل test-and-set! أن تفحص العمليّات رايةً (flag) مشتركةً عامّةً في أزمنةٍ اعتباطيّة. وهذا مُشكِلٌ وغير كفؤٍ في التنفيذ في المعالجات الحديثة السريعة، حيث - بسبب تقنيّات التحسين كالتقسيم إلى مراحل (pipelining) والذاكرة المخبئيّة (cached memory) - قد لا تكون محتويات الذاكرة في حالةٍ متّسقةٍ في كلّ لحظة. ولذلك، في النظم متعدّدة المعالجات المعاصرة، يحلّ نموذج المسلسلات بديلًا عنها مقارباتٌ جديدة للتحكّم في التزامن.[49]
وتنشأ الجوانب المُشكِلة للحالة المشتركة أيضًا في النظم الموزعة الكبيرة. فتخيّل، مثلًا، نظامًا مصرفيًّا موزّعًا تحفظ فيه المصارف الفرعيّة الفرديّة قيمًا محلّيّةً للأرصدة وتقارنها دوريًّا بالقيم التي تحفظها الفروع الأخرى. في مثل هذا النظام، ستكون قيمة «رصيد الحساب» غير محدّدة، إلّا في الحال التي تلي المزامنة مباشرةً. فإن أودع بيتر مالًا في حسابٍ يملكه مشتركًا مع بول، فمتى ينبغي لنا أن نقول إنّ رصيد الحساب قد تغيّر — عندما يتغيّر الرصيد في الفرع المحلّيّ، أم لا إلّا بعد المزامنة؟ وإذا نال بول الحساب من فرعٍ مختلف، فما القيود المعقولة التي يلزم فرضها على النظام المصرفيّ بحيث يكون السلوك «صحيحًا»؟ والشيء الوحيد الذي قد يهمّ في الصحّة هو السلوك الذي يرصده بيتر وبول كلٌّ على حدة، و«حالة» الحساب في الحال التي تلي المزامنة مباشرةً. أمّا الأسئلة عن رصيد الحساب «الحقيقيّ» أو عن ترتيب الأحداث بين المزامنات فقد تكون بلا صلةٍ أو بلا معنى.[50]
والظاهرة الأساسيّة هنا هي أنّ مزامنة العمليّات المختلفة، أو إقامة حالةٍ مشتركة، أو فرض ترتيبٍ على الأحداث، تتطلّب تواصلًا بين العمليّات. وفي الجوهر، ينبغي أن يكون أيّ مفهومٍ للزمن في التحكّم في التزامن مرتبطًا ارتباطًا وثيقًا بالتواصل.[51] ومن المثير للإعجاب أنّ ارتباطًا مماثلاً بين الزمن والتواصل ينشأ أيضًا في النظريّة النسبيّة، حيث سرعة الضوء (أسرع إشارةٍ يمكن استخدامها لمزامنة الأحداث) ثابتٌ أساسيٌّ يربط الزمن بالمكان. والتعقيدات التي نواجهها في التعامل مع الزمن والحالة في نماذجنا الحسابيّة قد تعكس في الواقع تعقيدًا أساسيًّا في الكون الفيزيائيّ.
3.5 المجاري
لقد اكتسبنا فهمًا حسنًا للإحلال بوصفه أداةً في النمذجة، وإدراكًا للمشاكل المعقّدة التي يُثيرها الإحلال. وحان وقت التساؤل عمّا إذا كان في وسعنا أن نسير في الأمور سيرًا مختلفًا، حتّى نتجنّب بعض هذه المشاكل. وفي هذا القسم، نستكشف مقاربةً بديلةً لنمذجة الحالة، قائمةً على بنى بياناتٍ تُسمّى المجاري (streams). وكما سنرى، فالمجاري قادرةٌ على تخفيف بعض تعقيد نمذجة الحالة.
دعنا نتراجع خطوةً ولنراجع من أين يأتي هذا التعقيد. ففي محاولتنا نمذجة ظواهر العالم الواقعيّ، اتّخذنا بعض القرارات التي تبدو معقولةً ظاهريًّا: فنمذّينا الأشياء الواقعيّة ذات الحالة المحلّيّة بكائناتٍ حسابيّةٍ محلّيّة المتغيّرات. وربطنا التغيّر الزمنيّ في العالم الواقعيّ بالتغيّر الزمنيّ في الحاسوب. ونفّذنا التغيّر الزمنيّ لحالات الكائنات النموذجيّة في الحاسوب بإحلالاتٍ على المتغيّرات المحلّيّة للكائنات النموذجيّة.
أهناك مقاربةٌ أخرى؟ أفيمكننا تجنّب ربط الزمن في الحاسوب بالزمن في العالم النموذجيّ؟ أينبغي لنا أن نجعل النموذج يتغيّر مع الزمن حتّى نمذّج ظواهرَ في عالمٍ متغيّر؟ فكّر في المسألة بدلالة الدوالّ الرياضيّة. فيمكننا وصف السلوك المتغيّر زمنيًّا لكمّيّةٍ كدالّ في الزمن . فإن تركّزنا على لحظةً بلحظة، فإنّا نعتبرها كمّيّةً متغيّرة. لكنّنا إن تركّزنا على التاريخ الزمنيّ الكامل للقيم، فإنّا لا نُبرز التغيّر — فإنّ الدالّ ذاتها لا تتغيّر.[52]
فإن قُيس الزمن بخطواتٍ منفصلة، أمكننا نمذجة دالّ الزمن كتسلسلٍ (قد يكون غير منتهٍ). وفي هذا القسم، سنرى كيف ننمذج التغيّر بدلالة تسلسلاتٍ تمثّل التواريخ الزمنيّة للنظم التي نمذّجها. ولإنجاز ذلك، نُقدّم بنى بياناتٍ جديدةً تُسمّى المجاري. فمن وجهة نظرٍ مجرّدة، إنّ المجرى تسلسلٌ لا غير. لكنّنا سنجد أنّ التنفيذ المباشر للمجاري كقوائمَ (كما في 2.2.1) لا يكشف كاملًا عن قوّة معالجة المجاري. وكبديل، نُقدّم تقنيّة التقييم المتأخّر (delayed evaluation)، التي تُمكّننا من تمثيل تسلسلاتٍ ضخمةٍ جدًّا (حتّى غير منتهية) كمجاري.
تُتيح لنا معالجة المجاري نمذجة نظمٍ لها حالةٌ دون استخدام الإحلال أو البيانات القابلة للتغيير مطلقًا. ولهذا تبعاتٌ مهمّة، نظريّةٌ وعمليّةٌ، إذ نستطيع بناء نماذج تتجنّب العيوب الكامنة في إدخال الإحلال. ومن الجهة الأخرى، يُثير إطار المجاري صعوباتٍ خاصّةً به، والمسألةُ القائلة بأيّ تقنيّة نمذجةٍ تؤدّي إلى نظمٍ أكثر وحدانيّةً وأسهل صيانةً لا تزال مفتوحة.
3.5.1 المجاري قوائمٌ متأخّرة
وكما رأينا في 2.2.3، فإنّ التسلسلات يمكن أن تخدم بوصفها واجهاتٍ متعارف عليها لجمع وحدات البرنامج. وقد صغنا تجريداتٍ قويّةً للتلاعب بالتسلسلات، مثل map وfilter وaccumulate، التي تستوعب تنوّعًا واسعًا من العمليّات بصورةٍ موجزةٍ وأنيقةٍ معًا.
وللأسف، فإن مثّلنا التسلسلات كقوائمَ، فإنّ هذه الأناقة تُشترى بثمن اللّاكفاءة الشديدة، فيما يتعلّق بالزمن والمكان اللذين تتطلّبهما احتساباتنا. فحين نمثّل التلاعبات على التسلسلات كتحويلاتٍ للقوائم، ينبغي لبرامجنا أن تبني بنى بياناتٍ (قد تكون ضخمة) وتنسخها عند كلّ خطوةٍ من العمليّة.
ولنرَ لماذا هذا صحيح، دعنا نقارن برنامجين لاحتساب مجموع جميع الأعداد الأوّليّة في فاصلٍ. والبرنامج الأوّل مكتوبٌ بالأسلوب التكراريّ المعياريّ:[53]
(define (sum-primes a b)
  (define (iter count accum)
    (cond ((> count b) accum)
          ((prime? count)
           (iter (+ count 1)
                 (+ count accum)))
          (else (iter (+ count 1) accum))))
  (iter a 0))
وأمّا البرنامج الثاني فيؤدّي الاحتساب نفسه باستخدام عمليّات التسلسل الواردة في 2.2.3:
(define (sum-primes a b)
  (accumulate
   +
   0
   (filter prime? (enumerate-interval a b))))
وفي أثناء أداء الاحتساب، لا يحتاج البرنامج الأوّل إلّا إلى تخزين المجموع المتراكم. وعلى النقيض، لا يستطيع المُرَشِّح (filter) في البرنامج الثاني إجراء أيّ اختبارٍ حتّى يكون enumerate-interval قد بنى قائمةً كاملةً بأعداد الفاصل. ويُنتج المُرَشِّح قائمةً أخرى، تُمرَّر بدورها إلى accumulate قبل أن تُختزل لتكوين مجموع. ومثل هذا التخزين الوسيط الضخم غير مطلوبٍ للبرنامج الأوّل، الذي يمكننا اعتباره يعدّد الفاصل تزايديًّا، مضيفًا كلّ عددٍ أوّليّ إلى المجموع حالما يُولَّد.
وإنّ ظهور اللّاكفاءة في استخدام القوائم يصير بيّنًا بمقدارٍ مؤلمٍ إن استخدمنا نموذج التسلسل لاحتساب العدد الأوّليّ الثاني في الفاصل من 10,000 إلى 1,000,000 بتقييم التعبير
(car (cdr
      (filter
       prime?
       (enumerate-interval 10000 1000000))))
وهذا التعبير يجد العدد الأوّليّ الثاني فعلًا، لكنّ عبء الاحتساب فادح. فنحن نبني قائمةً بما يقارب مليون عددٍ صحيحٍ، ونُرَشِّح هذه القائمة باختبار كلّ عنصرٍ لأوّليّته، ثمّ نتجاهل كلّ النتيجة تقريبًا. وفي أسلوب برمجةٍ أكثر تقليديّةً، كنّا سنُشابك العدّ بالترشيح، ونتوقّف عند بلوغ العدد الأوّليّ الثاني.
والمجاري فكرةٌ بارعةٌ تتيح للمرء أن يستخدم التلاعبات التسلسليّة دون تحمّل تكاليف التلاعب بالتسلسلات كقوائمَ. فبالمجاري نستطيع إحراز أفضل ما في العالمين: فيمكننا صياغة البرامج صياغةً أنيقةً كتلاعباتٍ تسلسليّة، مع بلوغ كفاءة الاحتساب التزايديّ. والفكرة الأساسيّة هي الترتيب لبناء المجرى بناءً جزئيًّا فقط، وتمرير البناء الجزئيّ إلى البرنامج الذي يستهلك المجرى. فإن حاول المستهلك الوصول إلى جزءٍ من المجرى لم يُبنَ بعد، فإنّ المجرى يبني تلقائيًّا ما يكفي من نفسه زيادةً على ذلك لإنتاج الجزء المطلوب، محافظًا بذلك على الوهم بأنّ المجرى كلّه موجود. وبعبارة أخرى، وعلى الرغم من أنّنا سنكتب البرامج كأنّا نعالج تسلسلاتٍ كاملةً، فإنّا نُصمّم تنفيذ المجاري بحيث يُشابك تلقائيًّا وبشفافيّةٍ بناء المجرى مع استخدامه.
وعلى السطح، إنّ المجاري مجرّد قوائمَ بأسماءٍ مختلفةٍ للإجراءات التي تتلاعب بها. فهناك بانٍ، cons-stream، ومحدِّدان، stream-car وstream-cdr، يحقّقان القيود
(stream-car (cons-stream x y)) = x
(stream-cdr (cons-stream x y)) = y
وهناك كائنٌ قابلٌ للتمييز، the-empty-stream، لا يمكن أن يكون نتيجة أيّ عمليّة cons-stream، ويمكن التعرّف عليه بالمسيّم stream-null?.[54] وبذلك نستطيع صنع المجاري واستخدامها، بالطريقة ذاتها التي نستطيع بها صنع القوائم واستخدامها، لتمثيل بياناتٍ مجمّعةٍ مرتّبةٍ في تسلسل. وعلى وجه الخصوص، نستطيع بناء نظائر مجاري لعمليّات القوائم الواردة في الفصل 2، مثل list-ref وmap وfor-each:[55]
(define (stream-ref s n)
  (if (= n 0)
      (stream-car s)
      (stream-ref (stream-cdr s) (- n 1))))

(define (stream-map proc s)
  (if (stream-null? s)
      the-empty-stream
      (cons-stream
       (proc (stream-car s))
       (stream-map proc (stream-cdr s)))))

(define (stream-for-each proc s)
  (if (stream-null? s)
      'done
      (begin
        (proc (stream-car s))
        (stream-for-each proc
                         (stream-cdr s)))))
Stream-for-each مفيدٌ لعرض المجاري:
(define (display-stream s)
  (stream-for-each display-line s))

(define (display-line x)
  (newline)
  (display x))
ولجعل تنفيذ المجاري يُشابك تلقائيًّا وبشفافيّةٍ بناء المجرى مع استخدامه، سنرَتّب لأن يُقيَّم cdr المجرى حين يُنال به بواسطة الإجراء stream-cdr بدلًا من حين يُبنى المجرى بـcons-stream. وهذا الخيار التنفيذيّ يذكّرنا بمناقشتنا للأعداد الكسريّة في 2.1.2، حيث رأينا أنّنا نستطيع أن نختار تنفيذ الأعداد الكسريّة بحيث يُجرى اختزال البسط والمقام إلى أبسط صورهما إمّا في وقت البناء وإمّا في وقت التحديد. وإنّ التنفيذين للأعداد الكسريّة يُنتجان تجريد البيانات ذاته، لكنّ الخيار يؤثّر في الكفاءة. وهناك علاقةٌ مماثلةٌ بين المجاري والقوائم الاعتياديّة. فبوصفها تجريد بيانات، إنّ المجاري هي القوائم عينها. والفرق هو الوقت الذي تُقيَّم فيه العناصر. ففي القوائم الاعتياديّة، يُقيَّم كلٌّ من car وcdr في وقت البناء. وفي المجاري، يُقيَّم cdr في وقت التحديد.
وسيستند تنفيذنا للمجاري إلى صيغةٍ خاصّةٍ تُسمّى delay. فإنّ تقييم (delay ⟨exp⟩) لا يُقيّم التعبير ⟨exp⟩، بل يُعيد ما يُسمّى كائنًا متأخّرًا، نستطيع اعتباره «وعدًا» بتقييم ⟨exp⟩ في وقتٍ مستقبليّ. وكرفيقٍ لـdelay، هناك إجراءٌ يُسمّى force يأخذ كائنًا متأخّرًا كمعطىً ويؤدّي التقييم — مُجبرًا في الفعل delay على الوفاء بوعده. وسنرى أدناه كيف يمكن تنفيذ delay وforce، لكنّ دعنا أوّلًا نستخدمهما في بناء المجاري.
Cons-stream صيغةٌ خاصّةٌ مُعرَّفةٌ بحيث
(cons-stream ⟨a⟩ ⟨b⟩)
فهي مكافئةٌ لـ
(cons ⟨a⟩ (delay ⟨b⟩))
ومعنى هذا أنّنا سنبني المجاري باستخدام الأزواج. لكنّنا، بدلًا من وضع قيمة بقيّة المجرى في cdr الزوج، سنضع هناك وعدًا باحتساب البقيّة إن طُلبت يومًا. ويمكن الآن تعريف stream-car وstream-cdr كإجراءين:
(define (stream-car stream)
  (car stream))

(define (stream-cdr stream)
  (force (cdr stream)))
يختار stream-car الجزء car من الزوج، وstream-cdr يختار الجزء cdr من الزوج ويُقيّم التعبير المتأخّر الموجود هناك للحصول على بقيّة المجرى.[56]
تنفيذ المجاري أثناء العمل
ولنرى كيف يسلك هذا التنفيذ، دعنا نحلّل الاحتساب الأوّليّ «الفادح» الذي رأيناه أعلاه، مُعادًا صياغته بدلالة المجاري:
(stream-car
 (stream-cdr
  (stream-filter
   prime? (stream-enumerate-interval
           10000 1000000))))
وسنرى أنّه يعمل بكفاءةٍ فعلًا.
نبدأ بنداء stream-enumerate-interval بالمعطيين 10,000 و1,000,000. فـstream-enumerate-interval نظير enumerate-interval في المجاري (2.2.3):
(define (stream-enumerate-interval low high)
  (if (> low high)
      the-empty-stream
      (cons-stream
       low
       (stream-enumerate-interval (+ low 1)
                                  high))))
وبذلك، فإنّ النتيجة التي يُعيدها stream-enumerate-interval، والمكوَّنة بـcons-stream، هي[57]
(cons 10000
      (delay
        (stream-enumerate-interval
         10001
         1000000)))
أي أنّ stream-enumerate-interval يُعيد مجرى ممثَّلًا بزوجٍ car هو 10,000 وcdr هو وعدٌ بعدّ المزيد من الفاصل إن طُلب ذلك. وهذا المجرى يُرشَّح الآن للأوليّين، باستخدام نظير الإجراء filter في المجاري (2.2.3):
(define (stream-filter pred stream)
  (cond ((stream-null? stream)
         the-empty-stream)
        ((pred (stream-car stream))
         (cons-stream
          (stream-car stream)
          (stream-filter
           pred
           (stream-cdr stream))))
        (else (stream-filter
               pred
               (stream-cdr stream)))))
يختبر stream-filter الجزء stream-car من المجرى (أي car الزوج، وهو 10,000). وبما أنّ هذا ليس أوّليًّا، فإنّ stream-filter يفحص الجزء stream-cdr من مجرى دخلته. ونداء stream-cdr يُجبر تقييم stream-enumerate-interval المتأخّر، الذي يُعيد الآن
(cons 10001
      (delay
        (stream-enumerate-interval
         10002
         1000000)))
ينظر stream-filter الآن إلى stream-car هذا المجرى، 10,001، فيرى أنّه ليس أوّليًّا هو الآخر، فيُجبر stream-cdr آخر، وهكذا، حتّى يُنتج stream-enumerate-interval العدد الأوّليّ 10,007، وعندها يُعيد stream-filter، وفقًا لتعريفه،
(cons-stream
 (stream-car stream)
 (stream-filter pred (stream-cdr stream)))
وهو في هذه الحالة
(cons 10007
      (delay
        (stream-filter
         prime?
         (cons 10008
               (delay
                 (stream-enumerate-interval
                  10009 1000000))))))
وهذه النتيجة تُمرَّر الآن إلى stream-cdr في تعبيرنا الأصليّ. وهذا يُجبر stream-filter المتأخّر، الذي يُجبر بدوره باستمرار stream-enumerate-interval المتأخّر حتّى يجد العدد الأوّليّ التالي، وهو 10,009. وأخيرًا، فإنّ النتيجة الممرَّرة إلى stream-car في تعبيرنا الأصليّ هي
(cons 10009
      (delay
        (stream-filter
         prime?
         (cons 10010
               (delay
                 (stream-enumerate-interval
                  10011 1000000))))))
يُعيد stream-car العدد 10,009، والاحتساب يكتمل. وقد اختُبر من الأعداد الصحيحة عددٌ لا يزيد على الضروريّ لإيجاد العدد الأوّليّ الثاني، وأُعدّد الفاصل بقدر ما لا يزيد على الضروريّ لإطعام المُرَشِّح الأوّليّ.
وبصورةٍ عامّة، نستطيع اعتبار التقييم المتأخّر برمجةً «مدفوعة بالطلب»، بحيث تُنشَّط كلّ مرحلةٍ في عمليّة المجرى بقدر ما يكفي لإشباع المرحلة التالية فقط. وما فعلناه هو فصل الترتيب الفعليّ للأحداث في الاحتساب عن البنية الظاهرة لإجراءاتنا. فنحن نكتب الإجراءات كأنّ المجاري موجودة «كلّها في وقتٍ واحد»، بينما يُؤدّى الاحتساب في الواقع تزايديًّا، كما في أساليب البرمجة التقليديّة.
تنفيذ delay وforce
وعلى الرغم من أنّ delay وforce قد يبدوان عمليّتين غامضتين، فإنّ تنفيذهما واضحٌ ومباشرٌ حقًّا. فينبغي لـdelay أن يحزّم تعبيرًا بحيث يمكن تقييمه لاحقًا عند الطلب، ونستطيع إنجاز ذلك ببساطةٍ بمعاملة التعبير كجسمٍ لإجراء. ويمكن أن تكون delay صيغةً خاصّةً بحيث
(delay ⟨exp⟩)
فهي سكّر نحويّ لـ
(lambda () ⟨exp⟩)
يستدعي force ببساطةٍ الإجراء (الخالي من الوسائط) الذي يُنتجه delay، فيمكننا تنفيذ force كإجراءٍ:
(define (force delayed-object)
  (delayed-object))
وهذا التنفيذ يكفي لعمل delay وforce كما هو معلن، لكنّ هناك تحسينًا مهمًّا يمكننا إدراجه. ففي تطبيقاتٍ كثيرة، ننتهي إلى إجبار الكائن المتأخّر عينه مرّاتٍ كثيرة. وهذا يمكن أن يؤدّي إلى لّاكفاءةٍ خطيرةٍ في البرامج التعاوديّة التي تشتمل على مجاري. (انظر التمرين 3.57.) والحلّ هو بناء الكائنات المتأخّرة بحيث تخزّن، في أوّل مرّةٍ تُجبر فيها، القيمة التي تُحتسب. فإنّ الإجبارات اللاحقة ستُعيد ببساطةٍ القيمة المخزّنة دون إعادة الاحتساب. وبعبارة أخرى، ننفّذ delay كإجراءٍ مُحفَّظ النتائج (memoized) ذي غرضٍ خاصّ، شبيهٌ بالوارد في التمرين 3.27. وإحدى طرائق إنجاز ذلك هي استخدام الإجراء الآتي، الذي يأخذ كمعطىً إجراءً (خاليًا من الوسائط) ويُعيد نسخةً مُحفَّظة النتائج منه. فحين يُشغَّل الإجراء المُحفَّظ النتائج أوّل مرّةٍ، يحفظ النتيجة المحسوبة. وفي التقييمات اللاحقة، يُعيدها ببساطةٍ.
(define (memo-proc proc)
  (let ((already-run? false) (result false))
    (lambda ()
      (if (not already-run?)
          (begin (set! result (proc))
                 (set! already-run? true)
                 result)
          result))))
ثمّ تُعرَّف delay بحيث يكون (delay ⟨exp⟩) مكافئًا لـ
(memo-proc (lambda () ⟨exp⟩))
وforce كما عُرِّف سابقًا.[58]
التمرين 3.50: أكمل التعريف الآتي، الذي يُعمّم stream-map للسماح بإجراءاتٍ تأخذ معطياتٍ متعدّدة، على غرار map في 2.2.1، حاشية 78.
(define (stream-map proc . argstreams)
  (if (⟨??⟩ (car argstreams))
      the-empty-stream
      (⟨??⟩
       (apply proc (map ⟨??⟩ argstreams))
       (apply stream-map
              (cons proc
                    (map ⟨??⟩
                         argstreams))))))
التمرين 3.51: ولإلقاء نظرةٍ أدقّ على التقييم المتأخّر، سنستخدم الإجراء الآتي، الذي يُعيد معطاه ببساطةٍ بعد طبعه:
(define (show x)
  (display-line x)
  x)
فماذا يطبع المفسّر استجابةً لتقييم كلّ تعبيرٍ في التتالي الآتي؟[59]
(define x
  (stream-map
   show
   (stream-enumerate-interval 0 10)))

(stream-ref x 5)
(stream-ref x 7)
التمرين 3.52: تأمّل تتاليَ التعبيرات
(define sum 0)

(define (accum x)
  (set! sum (+ x sum))
  sum)

(define seq
  (stream-map
   accum
   (stream-enumerate-interval 1 20)))

(define y (stream-filter even? seq))

(define z
  (stream-filter
   (lambda (x)
     (= (remainder x 5) 0)) seq))

(stream-ref y 7)
(display-stream z)
فما قيمة sum بعد تقييم كلّ واحدٍ من التعبيرات أعلاه؟ وما الاستجابة المطبوعة لتقييم تعبيرَي stream-ref وdisplay-stream؟ أفكانت هذه الاستجابات ستختلف لو كنّا نفّذنا (delay ⟨exp⟩) ببساطةٍ كـ(lambda () ⟨exp⟩) دون استخدام التحسين الذي يوفّره memo-proc؟ فسّر.
3.5.2 المجاري غير المنتهية
لقد رأينا كيف ندعم وهم التلاعب بالمجاري ككياناتٍ كاملةٍ، مع أنّنا في الحقيقة لا نحتسب من المجرى إلّا بقدر ما نحتاج إليه للوصول. ونستطيع استثمار هذه التقنيّة لتمثيل التسلسلات بكفاءةٍ على هيئة مجارٍ، حتّى إن كانت التسلسلات طويلةً جدًّا. والأكثر إثارةً للإعجاب أنّنا نستطيع استخدام المجاري لتمثيل تسلسلاتٍ غير منتهية الطول. فتأمّل، مثلًا، التعريف الآتي لمجرى الأعداد الصحيحة الموجبة:
(define (integers-starting-from n)
  (cons-stream
   n (integers-starting-from (+ n 1))))
(define integers (integers-starting-from 1))
وهذا ذو معنىً لأنّ integers سيكون زوجًا car هو 1 وcdr هو وعدٌ بإنتاج الأعداد الصحيحة ابتداءً من 2. وهذا مجرى غير منتهي الطول، لكنّا في أيّ وقتٍ معطًى نستطيع فحص جزءٍ منتهٍ منه فقط. ولذلك، فلن تعرف برامجنا يومًا أنّ المجرى اللانهائيّ كلّه غير موجود.
وباستخدام integers نستطيع تعريف مجاري غير منتهيةٍ أخرى، مثل مجرى الأعداد الصحيحة غير القابلة للقسمة على 7:
(define (divisible? x y) (= (remainder x y) 0))
(define no-sevens
  (stream-filter (lambda (x)
                   (not (divisible? x 7)))
                 integers))
فيمكننا إيجاد الأعداد غير القابلة للقسمة على 7 بمجرّد النفاذ إلى عناصر هذا المجرى:
(stream-ref no-sevens 100)
117
وبتناظرٍ مع integers، نستطيع تعريف المجرى غير المنتهيّ لأعداد فيبوناتشي:
(define (fibgen a b)
  (cons-stream a (fibgen b (+ a b))))
(define fibs (fibgen 0 1))
إنّ fibs زوجٌ car هو 0 وcdr هو وعدٌ بتقييم (fibgen 1 1). وحين نُقيّم هذا (fibgen 1 1) المتأخّر، فإنّه سيُنتج زوجًا car هو 1 وcdr هو وعدٌ بتقييم (fibgen 1 2)، وهكذا.
ولنُلْقِ نظرةً على مجرى غير منتهٍ أكثر إثارةً، نستطيع تعميم مثال no-sevens لبناء المجرى غير المنتهيّ للأعداد الأوّليّة، باستخدام طريقةٍ تُعرف بـغربال إراتوستينس.[60] نبدأ بالأعداد الصحيحة ابتداءً من 2، وهو أوّل عددٍ أوّليّ. وللباقي من الأعداد الأوّليّة، نبدأ بترشيح مضاعفات 2 من بقيّة الأعداد الصحيحة. وهذا يُخلي مجرى يبدأ بـ3، وهو العدد الأوّليّ التالي. والآن نُرَشِّح مضاعفات 3 من بقيّة هذا المجرى. وهذا يُخلي مجرى يبدأ بـ5، وهو العدد الأوّليّ التالي، وهكذا. وبعبارة أخرى، نبني الأعداد الأوّليّة بعمليّة غربلةٍ، موصوفةٍ على النحو الآتي: لغربلة مجرى S، شكّل مجرى أوّلُ عنصرٍ فيه هو أوّل عنصرٍ من S وبقيّته مُحصَلةٌ بترشيح جميع مضاعفات أوّل عنصرٍ من S خارجًا من بقيّة S ثمّ غربلة النتيجة. وهذه العمليّة تُوصف بسهولةٍ بدلالة عمليّات المجاري:
(define (sieve stream)
  (cons-stream
   (stream-car stream)
   (sieve (stream-filter
           (lambda (x)
             (not (divisible?
                   x (stream-car stream))))
           (stream-cdr stream)))))

(define primes
  (sieve (integers-starting-from 2)))
والآن، لإيجاد عددٍ أوّليّ معيّن، لا يحتاج الأمر إلّا إلى طلبه:
(stream-ref primes 50)
233
من المثير للتأمّل نظام معالجة الإشارات الذي يُنشئه sieve، الموضّح في «مخطّط هندرسون» في الشكل 3.31.[61] إنّ مجرى الدخل يغذّي مُفَكِّكَ cons الذي يفصل أوّل عنصرٍ من المجرى عن بقيّة المجرى. وأوّل عنصرٍ يُستخدم لبناء مُرَشِّح قابلية قسمةٍ، يُمرَّر من خلاله الباقي، ومُخرَج المُرَشِّح يُغذّي صندوق غربلةٍ آخر. ثمّ يُركَّب أوّل عنصرٍ الأصليّ (cons) على مُخرَج الغربلة الداخليّة لتكوين مجرى المُخرَج. وهكذا، فليس المجرى وحده غير منتهٍ، بل معالج الإشارات غير منتهيّ أيضًا، لأنّ الغربال يحتوي غربالًا داخله.
الشكل 3.31: الغربال الأوّليّ منظورًا إليه كنظامٍ لمعالجة الإشارات.
تعريف المجاري ضمنيًّا
إنّ مجرْيَي integers وfibs أعلاه عُرِّفا بتحديد إجراءاتٍ «مولِّدة» تحتسب عناصر المجرى واحدًا واحدًا صراحةً. وطريقةٌ بديلةٌ لتحديد المجاري هي استغلال التقييم المتأخّر لتعريف المجاري ضمنيًّا. فالمثال الآتي، مثلًا، يعرّف المجرى ones كمجرى غير منتهٍ من الآحاد:
(define ones (cons-stream 1 ones))
وهذا يعمل كثيرًا مثل تعريف إجراءٍ تعاوديّ: فـones زوجٌ car هو 1 وcdr هو وعدٌ بتقييم ones. وتقييم cdr يُعطينا من جديد 1 ووعدًا بتقييم ones، وهكذا.
ونستطيع فعل أشياء أكثر إثارةً للاهتمام بالتلاعب بالمجاري بعمليّاتٍ مثل add-streams، التي تُنتج مجموعًا عنصرًا بعنصرٍ لمجرَيين معطيين:[62]
(define (add-streams s1 s2)
  (stream-map + s1 s2))
ويمكننا الآن تعريف مجرى (stream) الأعداد الصحيحة كما يلي:
(define integers
  (cons-stream 1 (add-streams ones integers)))
يعرّف هذا integers بوصفه مجرىً أوّله هو 1 وبقيّته هي مجموع ones وintegers. وعليه، فإنّ العنصر الثاني من integers هو 1 زائد أوّل عنصر من integers، أي 2؛ والعنصر الثالث من integers هو 1 زائد العنصر الثاني من integers، أي 3؛ وهكذا. ويعمل هذا التعريف لأنّه، في أيّ نقطةٍ، قد أُنشئ من مجرى integers ما يكفي حتّى نتمكّن من إعادة إدخاله في التعريف لإنتاج العدد الصحيح التالي.
ويمكننا تعريف أعداد فيبوناتشي بالنمط نفسه:
(define fibs
  (cons-stream
   0 (cons-stream
      1 (add-streams
         (stream-cdr fibs) fibs))))
يقول هذا التعريف إنّ fibs مجرىٌ يبدأ بـ0 و1، بحيث يمكن توليد بقيّة المجرى بجمع fibs إلى نفسه بعد إزاحته بمقدار مكانٍ واحد:
    1 1 2 3 5  8 13 21 … = (stream-cdr fibs)
    0 1 1 2 3  5  8 13 … = fibs
0 1 1 2 3 5 8 13 21 34 … = fibs
Scale-stream إجراءٌ مفيدٌ آخر في صياغة تعريفات المجرى كهذه. وهو يضرب كلّ عنصرٍ في مجرىً بثابتٍ معطًى:
(define (scale-stream stream factor)
  (stream-map
   (lambda (x) (* x factor))
   stream))
فعلى سبيل المثال،
(define double
  (cons-stream 1 (scale-stream double 2)))
يُنتج مجرى قوى العدد 2: 1، 2، 4، 8، 16، 32، ....
ويمكن إعطاء تعريفٍ بديلٍ لمجرى الأعداد الأوّليّة بالبدء بالأعداد الصحيحة وتصفيتها باختبار كونها أوّليّة. وسنحتاج إلى أوّل عددٍ أوّليّ، وهو 2، للانطلاق:
(define primes
  (cons-stream
   2 (stream-filter
      prime? (integers-starting-from 3))))
وهذا التعريف ليس مباشرًا إلى الحدّ الذي يبدو عليه، لأنّنا سنختبر ما إذا كان عددٌ أوّليًّا بفحص ما إذا كان قابلًا للقسمة على عددٍ أوّليّ (لا على أيّ عددٍ صحيحٍ فحسب) أصغر من أو يساوي :
(define (prime? n)
  (define (iter ps)
    (cond ((> (square (stream-car ps)) n) true)
          ((divisible? n (stream-car ps)) false)
          (else (iter (stream-cdr ps)))))
  (iter primes))
هذا تعريفٌ تعاوديّ، إذ يُعرَّف primes من حيث المُسَيِّم prime?، الذي يستخدم هو نفسه مجرى primes. وسبب عمل هذا الإجراء أنّه، في أيّ نقطةٍ، قد أُنشئ من مجرى primes ما يكفي لاختبار أوّليّة الأعداد التي نحتاج إلى فحصها تاليًا. أي أنّك، لكلّ نختبر أوّليّته، إمّا أن غير أوّليّ (وفي هذه الحالة هناك عددٌ أوّليّ أُنشئ سابقًا يقسمه) أو أنّ أوّليّ (وفي هذه الحالة هناك عددٌ أوّليّ أُنشئ سابقًا — أي عددٌ أوّليّ أصغر من — أكبر من ).[63]
التمرين 3.53: دون تشغيل البرنامج، صِف عناصر المجرى المعرَّف بـ
(define s (cons-stream 1 (add-streams s s)))
التمرين 3.54: عرّف إجراءً mul-streams، مماثلًا لـadd-streams، يُنتج الجداء العنصريّ لمجريي مدخليه. واستخدم هذا مع مجرى integers لإتمام التعريف الآتي للمجرى الذي عنصره (بحساب البداية من 0) هو مضروبًا:
(define factorials
  (cons-stream 1 (mul-streams ⟨??⟩ ⟨??⟩)))
التمرين 3.55: عرّف إجراءً
partial-sumsيأخذ مجرىً معطًى ويعيد المجرى الذي عناصره هي ، ، . فعلى سبيل المثال، ينبغي أن يكون(partial-sums integers)هو المجرى 1، 3، 6، 10، 15، ....
التمرين 3.56: مسألةٌ شهيرةٌ، طرحها أوّلًا ر. هامينغ، هي عدّ جميع الأعداد الصحيحة الموجبة التي لا عوامل أوّليّة لها غير 2، و3، و5، بترتيبٍ تصاعديٍّ ودون تكرار. وإحدى الطرق الواضحة لفعل ذلك هي ببساطةٍ اختبار كلّ عددٍ صحيحٍ بدوره لمعرفة ما إذا كان له أيّ عوامل غير 2، و3، و5. لكنّ هذا غير كفؤٍ على الإطلاق، إذ إنّه، مع كبر الأعداد الصحيحة، يقلّ عدد تلك التي تستوفيّ الشرط تدريجيًّا. وكبديلٍ، فلنُسمّ مجرى الأعداد المطلوب S ولنلاحِظ الحقائق الآتية عنه:
Sيبدأ بالعدد 1.- عناصر
(scale-stream S 2)هي أيضًا عناصر منS. - والأمر ذاته صحيح بالنسبة إلى
(scale-stream S 3)و(scale-stream S 5). - وهذه هي جميع عناصر
S.
وكلّ ما علينا فعله الآن هو دمج العناصر القادمة من هذه المصادر. ولهذا الغرض نُعرّف إجراءً merge يدمج مجريين مرتّبين في مجرى نتائجٍ مرتّبٍ واحد، مُقصِيًا التكرارات:
(define (merge s1 s2)
  (cond ((stream-null? s1) s2)
        ((stream-null? s2) s1)
        (else
         (let ((s1car (stream-car s1))
               (s2car (stream-car s2)))
           (cond ((< s1car s2car)
                  (cons-stream
                   s1car
                   (merge (stream-cdr s1)
                          s2)))
                 ((> s1car s2car)
                  (cons-stream
                   s2car
                   (merge s1
                          (stream-cdr s2))))
                 (else
                  (cons-stream
                   s1car
                   (merge
                    (stream-cdr s1)
                    (stream-cdr s2)))))))))
ثمّ يمكن بناء المجرى (stream) المطلوب بـmerge، كما يلي:
(define S (cons-stream 1 (merge ⟨??⟩ ⟨??⟩)))
املأ التعابير الناقصة في المواضع المشار إليها بـ⟨??⟩ أعلاه.
التمرين 3.57: كم عمليّة جمع تُجرى حين نحتسب العدد من أعداد فيبوناتشي باستخدام تعريف
fibsالمستند إلى الإجراءadd-streams؟ أظهر أنّ عدد عمليّات الجمع سيكون أكبر أسّيًّا لو كنّا قد نفّذنا(delay ⟨exp⟩)ببساطةٍ كـ(lambda () ⟨exp⟩)، دون استخدام التحسين الذي يوفّره الإجراءmemo-procالموصوف في 3.5.1.[64]
التمرين 3.58: أعطِ تفسيرًا للمجرى الذي يحسبه الإجراء الآتي:
(define (expand num den radix)
  (cons-stream
   (quotient (* num radix) den)
   (expand (remainder (* num radix) den)
           den
           radix)))
(Quotient أوّليّ يُعيد ناتج القسمة الصحيح لعددين صحيحين.) فما العناصر المتعاقبة التي يُنتجها (expand 1 7 10)؟ وما الذي يُنتجه (expand 3 8 10)؟
التمرين 3.59: في 2.5.3 رأينا كيف نُنفّئ نظامًا للحساب على كثيرات الحدود يمثّل كثيرات الحدود كقوائم من الحدود. وبطريقةٍ مشابهة، يمكننا العمل مع متسلسلات القوى (power series)، مثل الممثّلة كمجاري لا نهائيّة. وسنمثّل المتسلسلة بالمجرى الذي عناصره هي المعاملات ، ، ، ، ....
تكامل المتسلسلة هو المتسلسلة حيث ثابتٌ اعتباطيّ. عرّف إجراءً integrate-series يأخذ مدخلًا مجرىً ، ، ، … يمثّل متسلسلة قوى، ويعيد المجرى ، ، ، … من معاملات الحدود غير الثابتة لتكامل المتسلسلة. (وحيث أنّ النتيجة لا حدّ ثابت لها، فإنّها لا تمثّل متسلسلة قوى؛ وحين نستخدم integrate-series، فإنّنا سنُلحق (cons) بالثابت المناسب.) الدالّة هي مشتقّها نفسها. وهذا يعني أنّ وتكامل هما المتسلسلة ذاتها، عدا الحدّ الثابت، وهو . وبناءً على ذلك، فيمكننا توليد المتسلسلة الخاصة بـ كما يلي
(define exp-series
  (cons-stream
   1 (integrate-series exp-series)))
أظهر كيف نولّد متسلسلتي الجيب وجيب التمام، بدءًا من الحقيقة القائلة إنّ مشتقّ الجيب هو جيب التمام وإنّ مشتقّ جيب التمام هو سالب الجيب:
(define cosine-series
  (cons-stream 1 ⟨??⟩))

(define sine-series
  (cons-stream 0 ⟨??⟩))
التمرين 3.60: بتمثيل متسلسلات القوى كمجاري من المعاملات كما في التمرين 3.59، فإنّ جمع المتسلسلات يُنفَّذ بـadd-streams. أكمل تعريف الإجراء الآتي لضرب المتسلسلات:
(define (mul-series s1 s2)
  (cons-stream ⟨??⟩ (add-streams ⟨??⟩ ⟨??⟩)))
يمكنك اختبار إجارتك بالتحقّق من أنّ باستخدام المتسلسلتين من التمرين 3.59.
التمرين 3.61: لتكن متسلسلة قوى (التمرين 3.59) حدّها الثابت هو 1. ولنفترض أنّنا نريد إيجاد متسلسلة القوى ، أي المتسلسلة بحيث . اكتب حيث هو الجزء من الواقع بعد الحدّ الثابت. وبعد ذلك يمكننا حلّ المعادلة لإيجاد كما يلي: وبعبارةٍ أخرى، فإنّ هي متسلسلة القوى التي حدّها الثابت هو 1 وحدودها من الرتب الأعلى تساوي سالب مضروبًا في . استخدم هذه الفكرة لكتابة إجراءٍ
invert-unit-seriesيحسب لمتسلسلة قوى حدّها الثابت هو 1. وسوف تحتاج إلى استخدامmul-seriesمن التمرين 3.60.
التمرين 3.62: استخدم نتائج التمرين 3.60 والتمرين 3.61 لتعريف إجراءٍ
div-seriesيقسم متسلسلتي قوى. وينبغي أن يعملdiv-seriesمع أيّ متسلسلتين، شريطة أن تبدأ متسلسلة المقام بحدٍّ ثابتٍ لا يساوي صفرًا. (وإذا كان للمقام حدٌّ ثابتٌ يساوي صفرًا، فإنّdiv-seriesينبغي أن يُشير إلى خطأ.) وأظهر كيف تستخدمdiv-seriesمع نتيجة التمرين 3.59 لتوليد متسلسلة قوى الدالّة المماسيّة (tangent).
3.5.3 استثمار نمط المجاري
ويمكن أن تكون المجاري (streams) المزوّدة بالتقييم المتأخّر أداةَ نمذجةٍ قويّة، إذ توفّر العديد من فوائد الحالة المحليّة والإحلال. وهي تتجنّب، فضلًا عن ذلك، بعض التعقيدات النظريّة التي ترافق إدخال الإحلال إلى لغة البرمجة.
ويمكن أن يكون منهج المجاري مُفصِحًا لأنّه يتيح لنا بناء أنظمةٍ بحدود وحداتٍ مختلفةٍ عن تلك التي تقيمها الأنظمة المنظّمة حول إحلال القيم في متغيّرات الحالة. فنحن نستطيع مثلًا اعتبار متسلسلةً زمنيّةً كاملة (أو إشارة) محطّ اهتمامنا، بدلًا من قيم متغيّرات الحالة في لحظاتٍ مفردة. وهذا يجعل من المناسب جمع مكوّنات الحالة من لحظاتٍ مختلفةٍ ومقارنتها.
صياغة التكرارات كعمليّات مجاري
في القسم 1.2.1، عرّفنا العمليّات التكراريّة، التي تسير بتحديث متغيّرات الحالة. ونحن نعلم الآن أنّنا نستطيع تمثيل الحالة كمجرى قيمٍ «خالٍ من الزمن» بدلًا من تمثيلها كمجموعةٍ من المتغيّرات التي يُحدَّث قيمها. فلتكن لنا هذه النظرة في إعادة النظر في إجراء الجذر التربيعيّ من 1.1.7. واذكر أنّ الفكرة هي توليد تسلسلٍ من التخمينات الأفضل فأفضل للجذر التربيعيّ لـ بتطبيق الإجراء الذي يحسّن التخمينات مرّةً بعد مرّة:
(define (sqrt-improve guess x)
  (average guess (/ x guess)))
في إجراء sqrt الأصليّ لدينا، جعلنا هذه التخمينات هي القيم المتعاقبة لمتغيّر حالةٍ واحد. وبدلًا من ذلك، فيمكننا توليد مجرى التخمينات اللا نهائيّ، بدءًا بتخمينٍ أوّليٍّ قيمته 1:[65]
(define (sqrt-stream x)
  (define guesses
    (cons-stream
     1.0 (stream-map
          (lambda (guess)
            (sqrt-improve guess x))
          guesses)))
  guesses)

(display-stream (sqrt-stream 2))
1.
1.5
1.4166666666666665
1.4142156862745097
1.4142135623746899
…
ويمكننا توليد المزيد من حدود المجرى للحصول على تخميناتٍ أفضل فأفضل. وإن شئنا، فيمكننا كتابة إجراءٍ يتواصل في توليد الحدود حتّى تصبح الإجابة جيّدةً بما يكفي. (انظر التمرين 3.64.)
وهناك تكرارٌ آخر يمكننا معالجته بالطريقة ذاتها، وهو توليد تقريبٍ لـ ، استنادًا إلى المتسلسلة المتبادلة الإشارات التي رأيناها في 1.3.1: فنولّد أوّلًا مجرى حدود المتسلسلة (مقلوب الأعداد الفرديّة، بإشاراتٍ متبادلة). ثمّ نأخذ مجرى مجاميع عددٍ متزايدٍ من الحدود (باستخدام الإجراء partial-sums من التمرين 3.55) ونضرب النتيجة في 4:
(define (pi-summands n)
  (cons-stream
   (/ 1.0 n)
   (stream-map - (pi-summands (+ n 2)))))

(define pi-stream
  (scale-stream
   (partial-sums (pi-summands 1)) 4))

(display-stream pi-stream)
4.
2.666666666666667
3.466666666666667
2.8952380952380956
3.3396825396825403
2.9760461760461765
3.2837384837384844
3.017071817071818
…
وهذا يعطينا مجرى تقريباتٍ أفضل فأفضل لـ ، مع أنّ التقريبات تتقارب ببطءٍ شديد. إنّ ثمانية حدودٍ من التسلسل تحدّ قيمة بين 3.284 و3.017.
حتّى الآن، فإنّ استخدامنا لمنهج مجرى (stream) الحالات لا يختلف كثيرًا عن تحديث متغيّرات الحالة. لكنّ المجاري تُتيح لنا فرصةَ أداء بعض الحيل الممتعة. فنحن نستطيع مثلًا تحويل مجرىٍ بـمسرّع تسلسلٍ (sequence accelerator) يحوّل تسلسل التقريبات إلى تسلسلٍ جديدٍ يتقارب إلى القيمة ذاتها التي يتقارب إليها التسلسل الأصليّ، لكن بسرعةٍ أكبر.
وأحد هذه المسرّعات، الذي يعود إلى الرياضيّ السويسري ليونهارت أويلر في القرن الثامن عشر، يعمل حسنًا مع التسلسلات التي هي مجاميع جزئيّة لمتسلسلاتٍ متبادلة الإشارات (أي متسلسلات حدودها بإشاراتٍ متبادلة). وفي تقنيّة أويلر، إذا كان هو الحدّ من تسلسل المجموع الأصليّ، فإنّ التسلسل المسرَّع حدودُه هي وعليه، إذا مُثِّل التسلسل الأصليّ كمجرى من القيم، فإنّ التسلسل المتحوَّل يُعطى بـ
(define (euler-transform s)
  (let ((s0 (stream-ref s 0))     ; Sₙ₋₁
        (s1 (stream-ref s 1))     ; Sₙ
        (s2 (stream-ref s 2)))    ; Sₙ₊₁
    (cons-stream
     (- s2 (/ (square (- s2 s1))
              (+ s0 (* -2 s1) s2)))
     (euler-transform (stream-cdr s)))))
ويمكننا إيضاح تسريع أويلر بتسلسل تقريباتنا لـ :
(display-stream
 (euler-transform pi-stream))
3.166666666666667
3.1333333333333337
3.1452380952380956
3.13968253968254
3.1427128427128435
3.1408813408813416
3.142071817071818
3.1412548236077655
…
والأفضل من ذلك، أنّنا نستطيع تسريع التسلسل المسرَّع، ومن ثمّ تسريع المسرَّع تسريعًا تعاوديًّا، وهكذا. أي أنّنا نُنشئ مجرى مجاري (بنيةً سنُسمّيها جدولًا (tableau)) كلّ مجرىٍ منها هو تحوّل الذي يسبقه:
(define (make-tableau transform s)
  (cons-stream
   s
   (make-tableau
    transform
    (transform s))))
وللجدول الشكل وأخيرًا، نُشكّل تسلسلًا بأخذ الحدّ الأوّل في كلّ صفٍّ من الجدول:
(define (accelerated-sequence transform s)
  (stream-map stream-car
              (make-tableau transform s)))
ويمكننا إيضاح هذا النوع من «التسريع الفائق» لتسلسل :
(display-stream
 (accelerated-sequence euler-transform
                       pi-stream))
4.
3.166666666666667
3.142105263157895
3.141599357319005
3.1415927140337785
3.1415926539752927
3.1415926535911765
3.141592653589778
…
والنتيجة مذهلة. فإنّ أخذ ثمانية حدودٍ من التسلسل يُعطي القيمة الصحيحة لـ حتّى 14 منزلةً عشريّة. ولو كنّا قد استخدمنا تسلسل الأصليّ وحده، لكنّا بحاجةٍ إلى احتساب حوالي حدًّا (أي توسيع المتسلسلة إلى المدى الكافي لجعل الحدود المفردة أصغرّ من ) للحصول على هذا القدر من الدقّة!
وكان يمكننا تنفيذ تقنيّات التسريع هذه دون استخدام المجاري. لكنّ الصياغة بصيغة المجاري أنيقة ومناسبة على وجه الخصوص، لأنّ تسلسل الحالات بكامله يصبح متاحًا لنا بوصفه بنية بياناتٍ يمكن التلاعب بها بمجموعةٍ موحّدةٍ من العمليّات.
التمرين 3.63: يسأل لويس ريزنر لماذا لم يُكتَب الإجراء sqrt-stream بالطريقة الأكثر مباشرةً الآتية، دون المتغيّر المحليّ guesses:
(define (sqrt-stream x)
  (cons-stream
   1.0
   (stream-map (lambda (guess)
                 (sqrt-improve guess x))
               (sqrt-stream x))))
تردّ أليسّا هاكر بأنّ هذه النسخة من الإجراء أقلّ كفاءةً بدرجةٍ ملحوظةٍ لأنّها تؤدّي احتسابًا زائدًا. اشرح جواب أليسّا. فهل كانت النسختان ستختلفان في الكفاءة لو كان تنفيذنا لـdelay يستخدم (lambda () ⟨exp⟩) وحده دون استخدام التحسين الذي يوفّره memo-proc (3.5.1)؟
التمرين 3.64: اكتب إجراءً stream-limit يأخذ معطيين هما مجرى وعدد (التسامح). وينبغي له أن يفحص المجرى حتّى يجد عنصرين متعاقبين يختلفان في القيمة المطلقة بأقلّ من التسامح، وأن يعيد الثاني منهما. وباستخدام هذا، يمكننا احتساب الجذور التربيعيّة حتّى تسامحٍ معطًى بـ
(define (sqrt x tolerance)
  (stream-limit (sqrt-stream x) tolerance))
التمرين 3.65: استخدم المتسلسلة لاحتساب ثلاثة تسلسلاتٍ من التقريبات للوغاريتم الطبيعيّ للعدد 2، بالطريقة ذاتها التي فعلناها أعلاه لـ . فما سرعة تقارب هذه التسلسلات؟
مجاري الأزواج اللانهائيّة
في 2.2.3، رأينا كيف يتعامل نمط التسلسل مع حلقات التكرار المتداخلة التقليديّة بوصفها عمليّاتٍ معرَّفةً على تسلسلاتٍ من الأزواج. فإن عمّمنا هذه التقنيّة على مجاري لا نهائيّة، أمكننا إذن كتابة برامجٍ لا يسهل تمثيلها كحلقات تكرار، لأنّ «الحلقة» ينبغي أن تمتدّ على مجموعةٍ لا نهائيّة.
فمثلًا، لنفترض أنّنا نرغب في تعميم الإجراء prime-sum-pairs من 2.2.3 لإنتاج مجرى أزواج جميع الأعداد الصحيحة حيث بحيث يكون أوّليًّا. فإذا كان int-pairs هو تسلسل جميع أزواج الأعداد الصحيحة حيث ، فإنّ مجرنا المطلوب هو ببساطةٍ[66]
(stream-filter
 (lambda (pair)
   (prime? (+ (car pair) (cadr pair))))
 int-pairs)
ومشكلتنا إذن هي إنتاج المجرى int-pairs. وبصورةٍ أعمّ، لنفترض أنّ لدينا مجريين و ، وتخيّل المصفوفة المستطيلة اللانهائيّة ونرغب في توليد مجرى يحتوي جميع الأزواج في المصفوفة الواقعة على القطر أو فوقه، أي الأزواج (وإذا أخذنا كلًّا من و مجرى الأعداد الصحيحة، فإنّ ذلك سيُعطينا المجرى int-pairs المطلوب.)
وسمّ مجرى الأزواج العامّ (pairs S T)، واعتبره مؤلفًا من ثلاثة أجزاء: الزوج ، وبقيّة الأزواج في الصفّ الأوّل، والأزواج الباقية:[67] لاحِظ أنّ الجزء الثالث في هذا التفكيك (الأزواج التي ليست في الصفّ الأوّل) هو (تعاوديًّا) الأزواج المتكوّنة من (stream-cdr S) و(stream-cdr T). ولاحِظ أيضًا أنّ الجزء الثاني (بقيّة الصفّ الأوّل) هو
(stream-map (lambda (x)
              (list (stream-car s) x))
            (stream-cdr t))
وهكذا يمكننا تشكيل مجرى الأزواج خاصّتنا كما يلي
(define (pairs s t)
  (cons-stream
   (list (stream-car s) (stream-car t))
   (⟨combine-in-some-way⟩
    (stream-map (lambda (x)
                  (list (stream-car s) x))
                (stream-cdr t))
    (pairs (stream-cdr s)
           (stream-cdr t)))))
ولإتمام الإجراء، ينبغي أن نختار نوعًا ما لدمج المجريين (streams) الداخليّين. وإحدى الأفكار هي استخدام مقابِل المجرى للإجراء append من 2.2.1:
(define (stream-append s1 s2)
  (if (stream-null? s1)
      s2
      (cons-stream
       (stream-car s1)
       (stream-append (stream-cdr s1) s2))))
لكن هذا غير ملائمٍ للمجاري اللا نهائيّة، لأنّه يأخذ جميع العناصر من المجرى الأوّل قبل إدماج المجرى الثاني. وعلى وجه الخصوص، إذا حاولنا توليد جميع أزواج الأعداد الصحيحة الموجبة بـ
(pairs integers integers)
فإنّ مجرى نتائجنا سيحاول أوّلًا أن يمرّ بجميع الأزواج التي أوّل عددٍ صحيحٍ فيها يساوي 1، ومن ثمّ فلن يُنتج أبدًا أزواجًا بأيّ قيمةٍ أخرى للعدد الأوّل.
ولمعالجة المجاري اللا نهائيّة، ينبغي أن نبتكر ترتيبًا للدمج يضمن أنّ كلّ عنصرٍ سيُبلَغ في النهاية إذا تركنّا برنامجنا يعمل مدّةً طويلةً كافية. وطريقةٌ أنيقةٌ لتحقيق ذلك هي بالإجراء interleave الآتي:[68]
(define (interleave s1 s2)
(if (stream-null? s1)
s2
(cons-stream
(stream-car s1)
(interleave s2 (stream-cdr s1)))))
وحيث إنّ interleave يأخذ العناصر بالتبادل من المجريين، فإنّ كلّ عنصرٍ من المجرى الثاني سيصل في النهاية إلى المجرى المدموج، حتّى لو كان المجرى الأوّل لا نهائيًّا.
وهكذا يمكننا توليد مجرى الأزواج المطلوب كما يلي
(define (pairs s t)
(cons-stream
(list (stream-car s) (stream-car t))
(interleave
(stream-map (lambda (x)
(list (stream-car s) x))
(stream-cdr t))
(pairs (stream-cdr s) (stream-cdr t)))))
التمرين 3.66: افحص المجرى
(pairs integers integers). فهل يمكنك إبداء أيّ ملاحظاتٍ عامّة عن الترتيب الذي تُوضَع به الأزواج في المجرى؟ فعلى سبيل المثال، كم زوجًا تقريبًا يسبق الزوج (1, 100)؟ والزوج (99, 100)؟ والزوج (100, 100)؟ (وإذا استطعت إبداء عباراتٍ رياضيّةٍ دقيقة هنا، فذلك أفضل. لكن لا تتردّد في إعطاء إجاباتٍ أكثر كيفيّةً إذا وجدت نفسك متورّطًا في التفاصيل.)
التمرين 3.67: عدّل الإجراء
pairsحتّى يُنتج(pairs integers integers)مجرى جميع أزواج الأعداد الصحيحة (دون شرط ). تلميح: سوف تحتاج إلى مزج مجرى إضافيّ.
التمرين 3.68: يظنّ لويس ريزنر أنّ بناء مجرى الأزواج من ثلاثة أجزاء أمرٌ معقّدٌ بلا داعٍ. فبدلًا من فصل الزوج عن بقيّة أزواج الصفّ الأوّل، يقترح العمل مع الصفّ الأوّل بكامله، كما يلي:
(define (pairs s t)
(interleave
(stream-map
(lambda (x)
(list (stream-car s) x))
t)
(pairs (stream-cdr s)
(stream-cdr t))))
أفيعمل هذا؟ فكّر في ما يحدث إذا قيّمنا (pairs integers integers) باستخدام تعريف لويس لـpairs.
التمرين 3.69: اكتب إجراءً
triplesيأخذ ثلاثة مجاري لا نهائيّة، و و ، ويُنتج مجرى الثلاثيّات بحيث . واستخدمtriplesلتوليد مجرى جميع الثلاثيّات الفيثاغورسيّة من الأعداد الصحيحة الموجبة، أي الثلاثيّات بحيث و .
التمرين 3.70: لَكان من الجميل أن نكون قادرين على توليد مجاري تظهر فيها الأزواج بترتيبٍ مفيدٍ ما، بدلًا من الترتيب الناتج عن عمليّة تشبيكٍ ارتجاليّة (ad hoc) . ونحن نستطيع استخدام تقنيّةٍ مشابهة للإجراء
mergeمن التمرين 3.56، إذا عرّفنا طريقةً للقول إنّ زوجًا من الأعداد الصحيحة «أصغرّ» من آخر. وإحدى طرائق فعل ذلك هي تعريف «دالّاة وزن» والنصّ على أنّ أصغرّ من إذا كان . اكتب إجراءًmerge-weightedشبيهًا بـmerge، باستثناء أنّmerge-weightedيأخذ معطًى إضافيًّا هوweight، وهو إجراءٌ يحسب وزن الزوج، ويُستخدم لتحديد الترتيب الذي ينبغي أن تظهر به العناصر في المجرى المدموج الناتج.[69] وباستخدام هذا، عُمّمpairsإلى إجراءٍweighted-pairsيأخذ مجريين، مع إجراءٍ يحسب دالّاة الأوزان، ويولّد مجرى الأزواج، مرتّبًا تبعًا للوزن. واستخدم إجارتك لتوليد مجرى جميع أزواج الأعداد الصحيحة الموجبة حيث مرتّبةً تبعًا للمجموع ،ومجرى جميع أزواج الأعداد الصحيحة الموجبة حيث ، حيث لا ولا قابلٌ للقسمة على 2، أو 3، أو 5، والأزواج مرتّبةٌ تبعًا للمجموع .
التمرين 3.71: الأعداد التي يمكن التعبير عنها بمجموع مكعّبين بأكثر من طريقةٍ واحدة تُسمّى أحيانًا أعداد رامانوجان (Ramanujan numbers)، تكريمًا للرياضيّ سرينيفاسا رامانوجان.[70] وإنّ مجاري الأزواج المرتّبة تُوفّر حلًّا أنيقًا لمسألة احتساب هذه الأعداد. فلكي نجد عددًا يمكن كتابته مجموع مكعّبين بطريقتين مختلفتين، لا نحتاج إلّا إلى توليد مجرى أزواج الأعداد الصحيحة موزونًا تبعًا للمجموع (انظر التمرين 3.70)، ثمّ البحث في المجرى عن زوجين متعاقبين بالوزن ذاته. اكتب إجراءً لتوليد أعداد رامانوجان. أوّل هذه الأعداد هو 1,729. فما الأعداد الخمسة التالية؟
التمرين 3.72: بطريقةٍ مشابهة لـالتمرين 3.71، ولّد مجرى جميع الأعداد التي يمكن كتابتها مجموع مربّعين بثلاث طرائق مختلفة (مُظهرًا كيف يمكن كتابتها كذلك).
المجاري كإشارات
بدأنا مناقشتنا للمجاري بوصفها مقابِلاتٍ حسابيّةٍ لـ«الإشارات» في نظم معالجة الإشارات. وفي الحقيقة، فإنّنا نستطيع استخدام المجاري لنمذجة نظم معالجة الإشارات بطريقةٍ مباشرةٍ جدًّا، بتمثيل قيم إشارةٍ في فتراتٍ زمنيّةٍ متعاقبة كعناصر متتاليّةٍ في مجرى. فنحن نستطيع مثلًا تنفيذ مُكامِل (integrator) أو جامع (summer) يُجمِّع، لمجرى مدخل وقيمة أوّليّة ، وزيادةً صغيرة ، المجموع ويعيد مجرى القيم . والإجراء integral الآتي يُذكّرنا بتعريف مجرى الأعداد الصحيحة «بالنمط الضمنيّ» (3.5.2):
(define (integral integrand initial-value dt)
(define int
(cons-stream
initial-value
(add-streams (scale-stream integrand dt)
int)))
int)
الشكل 3.32 صورةٌ لنظام معالجة إشاراتٍ يقابل الإجراء integral. ويُضرب مجرى الدخل في ويمرّ عبر جامعٍ، يُغذّى خرجه مرجعيًّا إلى الجامع ذاته. والمرجعيّة الذاتيّة في تعريف int تنعكس في الشكل بحلقة التغذية الراجعة التي تصل خرج الجامع بأحد مدخليه.
الشكل 3.32: الإجراء integral منظورًا إليه بوصفه نظام معالجة إشارات.
التمرين 3.73: نستطيع نمذجة الدوائر الكهربائيّة باستخدام المجاري لتمثيل قيم التيّارات أو الجهود في تسلسلٍ من الأزمنة. فمثلًا، لنفترض أنّ لدينا دائرة RC تتكوّن من مقاومةٍ مقاومتُها ومكثّفٍ سعتُه على التوالي. وتُحدَّد استجابة الجهد للدائرة تجاه تيّارٍ محقون بالصيغة الواردة في الشكل 3.33، التي تُظهر بنيتها المخطّط المصاحب لتدفّق الإشارات.
الشكل 3.33: دائرة RC ومخطّط تدفّق الإشارات المرافق. اكتب إجراءً
RCيُمثّل هذه الدائرة. وينبغي أن يأخذRCمدخلاتٍ هي قيم و و وأن يعيد إجراءً يأخذ مدخلاتٍ هي مجرىٌ يمثّل التيّار وقيمة أوّليّة لجهد المكثّف ويُنتج مخرجًا مجرى الجهود . فعلى سبيل المثال، ينبغي أن تكون قادرًا على استخدامRCلنمذجة دائرة RC بمقدار = 5 أوم، و = 1 فاراد، وخطوةٍ زمنيّةٍ قيمتها 0.5 ثانيةٍ بتقييم(define RC1 (RC 5 1 0.5)). وهذا يُعرّفRC1بوصفه إجراءً يأخذ مجرىً يمثّل التسلسل الزمنيّ للتيّارات وجهد مكثّفٍ أوّليٍّ ويُنتج مجرى خرج الجهود.
التمرين 3.74: تُصمّم أليسّا هاكر نظامًا لمعالجة الإشارات الواردة من مستشعراتٍ فيزيائيّة. والميزة المهمّة التي ترغب في إنتاجها هي إشارةٌ تصف تقاطعات الصفر (zero crossings) لإشارة الدخل. أي أنّ الإشارة الناتجة ينبغي أن تكون كلّما انتقلت إشارة الدخل من السالب إلى الموجب، و كلّما انتقلت من الموجب إلى السالب، و فيما عدا ذلك. (وافترض أنّ إشارة الدخل موجبة.) فمثلًا، ستبدو إشارة دخلٍ نموذجيّة مع إشارة تقاطعات الصفر المرافقة لها كما يلي
… 1 2 1.5 1 0.5 -0.1 -2 -3 -2 -0.5 0.2 3 4 …
… 0 0 0 0 0 -1 0 0 0 0 1 0 0 …
وفي نظام أليسّا، تُُمثَّل الإشارة القادمة من المستشعر كمجرى sense-data ، ومجرى zero-crossings هو مجرى تقاطعات الصفر المقابل. وتكتب أليسّا أوّلًا إجراءً sign-change-detector يأخذ قيمتين كمعطيين ويقارن إشارات القيمتين لإنتاج ، أو ، أو المناسب. ثمّ تبني مجرى تقاطعات الصفر خاصّتها كما يلي
(define (make-zero-crossings
input-stream last-value)
(cons-stream
(sign-change-detector
(stream-car input-stream)
last-value)
(make-zero-crossings
(stream-cdr input-stream)
(stream-car input-stream))))
(define zero-crossings
(make-zero-crossings sense-data 0))
يمرّ رئيس أليسا في العمل، إيفا لو أتور، ويقترح أنّ هذا البرنامج مكافئٌ تقريبًا للبرنامج التالي، الذي يستخدم النسخة المعمّمة من stream-map الواردة في التمرين 3.50:
(define zero-crossings
(stream-map sign-change-detector
sense-data
⟨expression⟩))
أكمل البرنامج بتزويد ⟨التعبير⟩ المُشار إليه.
التمرين 3.75: للأسف، يتبيّن أنّ كاشف عبور الصفر الذي كتبته أليسا في التمرين 3.74 غير كافٍ، لأنّ الإشارة المزعجة القادمة من المستشعر تُفضي إلى عبورٍ زائف للصفر. يقترح ليم إي. تويكيت، المتخصّص في العتاد، أن تُنعّم أليسا الإشارة لترشيح الضجيج قبل استخلاص مواضع عبور الصفر. تأخذ أليسا بنصيحته وتقرّر استخلاص عبور الصفر من الإشارة المبنيّة على حساب متوسّط كل قيمة من بيانات الاستشعار مع القيمة السابقة لها. تشرح المشكلة للويReasonير مساعدها، لويس ريزنر، الذي يحاول تنفيذ الفكرة معدِّلًا برنامج أليسا كما يلي:
(define (make-zero-crossings
input-stream last-value)
(let ((avpt
(/ (+ (stream-car input-stream)
last-value)
2)))
(cons-stream
(sign-change-detector avpt last-value)
(make-zero-crossings
(stream-cdr input-stream) avpt))))
لا ينفّذ هذا خطّة أليسا على نحوٍ صحيح. اعثر على الخلل الذي أدخله لويس وأصلحه دون تغيير بنية البرنامج. (تلميح: ستحتاج إلى زيادة عدد وسطاء make-zero-crossings.)
التمرين 3.76: لدى إيفا لو أتور ملاحظة على أسلوب لويس في التمرين 3.75. البرنامج الذي كتبه غير وحدانيّ، لأنّه يمزج عملية التنعيم مع عملية استخلاص عبور الصفر. فعلى سبيل المثال، لا ينبغي أن يضطرّ المُستخرِج إلى التغيير إذا وجدت أليسا طريقة أفضل لتحسين إشارة دخلها. ساعد لويس بكتابة إجراء
smoothيأخذ مجرىً كدخل وينتج مجرىً يكون كل عنصر فيه متوسّط عنصرين متتاليين من مجرى الدخل. ثم استخدمsmoothكمكوّنٍ لتنفيذ كاشف عبور الصفر بأسلوبٍ أكثر وحدانيةً.
3.5.4 المجاري والتقييم المؤجَّل
يُظهر إجراء integral في نهاية القسم السابق كيف يمكننا استخدام المجاري لنمذجة أنظمة معالجة الإشارات التي تحتوي حلقات ارتجاع. حَلْقة الارتجاع الخاصة بالجامع والمُجمِّع المُبيَّنة في الشكل 3.32 مُنمذَجة بحقيقة أنّ مجرى integral الداخلي int مُعرَّفٌ بدلالة نفسه:
(define int
(cons-stream
initial-value
(add-streams
(scale-stream integrand dt) int)))
تعتمد قدرة المفسّر على التصرّف مع تعريفٍ ضمنيّ من هذا القبيل على التأخير delay المُدمَج في cons-stream. فبدون هذا delay، لم يكن المفسّر ليتمكّن من بناء int قبل تقييم كلا وسطي cons-stream، وهو ما كان سيستلزم أن يكون int مُعرَّفًا مسبقًا. وبشكلٍ عام، فإنّ التأخير delay حاسمٌ لاستخدام المجاري في نمذجة أنظمة معالجة الإشارات التي تحتوي حلقات. وبدون التأخير delay، لاضطرّت نماذجنا إلى الصياغة بحيث تُقيَّم مُدخلات أي مكوّن معالجة إشارات تقييمًا كاملًا قبل إمكان إنتاج المُخرج. وهذا يعني منع الحلقات.
للأسف، قد تستلزم نماذج المجاري للأنظمة ذات الحلقات استخدامات للتأخير delay تتجاووز التأخير delay «المُخفِي» الذي يُوفّره cons-stream. فعلى سبيل المثال، يُظهر الشكل 3.34 نظام معالجة إشارات لحلّ المعادلة التفاضلية حيث دالّة معطاة. يُظهر الشكل مكوّن تعيين يُطبّق على إشارة دخله، موصولًا في حَلْقة ارتجاع بمُكمِّل تكامليّ بطريقة تشبه إلى حدٍّ كبير دوائر الحاسوب التناظريّة (analog computer) التي تُستخدم فعلًا لحلّ مثل هذه المعادلات.
الشكل 3.34: «دائرة حاسوب تناظريّة» تحلّ المعادلة .
إذا افترضنا أنّنا أُعطينا قيمةً أوّليّة لـ ، فيمكننا أن نحاول نمذجة هذا النظام باستخدام الإجراء
(define (solve f y0 dt)
(define y (integral dy y0 dt))
(define dy (stream-map f y))
y)
لا يعمل هذا الإجراء، لأنّه في السطر الأوّل من solve يتطلّب النداء إلى integral أن يكون الدخل dy مُعرَّفًا، وهذا لا يحدث إلّا في السطر الثاني من solve.
من ناحية أخرى، فإنّ مقصد تعريفنا وجيهٌ في الحقيقة، لأنّنا نستطيع، مبدئيًا، البدء في توليد مجرى y دون معرفة dy. وبالفعل، فإنّ integral وكثيرًا من عمليّات المجاري الأخرى تتمتّع بخصائص تشبه خصائص cons-stream، إذ نُمكنها توليد جزءٍ من الإجابة بمُجرّد معرفة جزئيّة عن الوسطاء. أمّا integral، فأوّل عنصر في مجرى الخرج هو initial-value المُحدَّد. بالتالي، نستطيع توليد أوّل عنصر من مجرى الخرج دون تقييم المكمّم dy. وما إن نعرف أوّل عنصر من y، حتّى يتمكّن stream-map في السطر الثاني من solve من البدء في العمل لتوليد أوّل عنصر من dy، وهو ما سيُنتج العنصر التالي من y، وهكذا.
للانتفاع من هذه الفكرة، سنُعيد تعريف integral ليتوقّع أن يكون مكمّم المجرى وسيطًا مؤجَّلًا. وسيقوم integral بإجبار force تقييم المكمّم فقط عندما يُطلَب توليد أكثر من أوّل عنصر من مجرى الخرج:
(define (integral
delayed-integrand initial-value dt)
(define int
(cons-stream
initial-value
(let ((integrand
(force delayed-integrand)))
(add-streams
(scale-stream integrand dt)
int))))
int)
صار بوسعنا الآن تنفيذ إجراء solve بتأخير تقييم dy في تعريف y:[71]
(define (solve f y0 dt)
(define y (integral (delay dy) y0 dt))
(define dy (stream-map f y))
y)
وبشكلٍ عام، يجب على كل مُنادٍ لـ integral الآن أن يُؤخّر delay وسيط المكمّم. ونستطيع إثبات أنّ إجراء solve يعمل بتقريب عبر حساب القيمة عند من حلّ المعادلة التفاضلية بالشرط الأوّلي :
(stream-ref
(solve (lambda (y) y) 1 0.001) 1000)
2.716924
التمرين 3.77: كان إجراء integral المُستخدم أعلاه مُشابهًا للتعريف «الضمنيّ» لمجرى الأعداد الصحيحة اللانهائيّ في 3.5.2. وبدلًا من ذلك، نستطيع إعطاء تعريف لـ integral أقرب إلى integers-starting-from (أيضًا في 3.5.2):
(define (integral
integrand initial-value dt)
(cons-stream
initial-value
(if (stream-null? integrand)
the-empty-stream
(integral
(stream-cdr integrand)
(+ (* dt (stream-car integrand))
initial-value)
dt))))
عند استخدام هذا الإجراء في أنظمة ذات حلقات، يعاني من المشكلة ذاتها التي يعاني منها إصدارنا الأصلي من integral. عدّل الإجراء ليصبح توقّعه integrand كوسيطٍ مؤجَّل، ليُمكن استخدامه بالتالي في إجراء solve المُبيَّن أعلاه.
التمرين 3.78: تأمّل مشكلة تصميم نظام معالجة إشارات لدراسة المعادلة التفاضلية الخطية المتجانسة من الرتبة الثانية يُولَّد مجرى الخرج، الذي ينمذج ، بواسطة شبكة تحتوي حَلْقة. وسبب ذلك أنّ قيمة تعتمد على قيمتي و ، وكلٌّ منهما تتحدّد بالتكامل على . والمخطّط الذي نودّ ترميزه مُبيَّنٌ في الشكل 3.35. اكتب إجراء
solve-2ndيأخذ كوسطاء الثوابت و و والقيم الأوّليّة و لـ و ، ويُولّد مجرى القيم المتعاقبة لـ .
الشكل 3.35: مخطّط سريان الإشارات لحلّ معادلة تفاضلية خطية من الرتبة الثانية.
التمرين 3.79: عمّم إجراء
solve-2ndمن التمرين 3.78 ليُمكن استخدامه في حلّ المعادلات التفاضلية العامة من الرتبة الثانية .
الشكل 3.36: دائرة RLC على التسلسل.
التمرين 3.80: تتألّف دائرة RLC على التسلسل من مقاومة ومكثّف ومُحثٍّ موصولين على التسلسل، كما هو مُبيَّنٌ في الشكل 3.36. فإذا كانت و و هي المقاومة والحَثّ والسعة على التوالي، فإنّ العلاقات بين الجهد والتيّار في المكوّنات الثلاثة توصف بالمعادلات كما تفرض أوصال الدائرة العلاقات ويُظهر الجمع بين هذه المعادلات أنّ حالة الدائرة (المتلخّصة في ، الجهد عبر المكثّف، و ، التيّار في المُحثِّ) توصف بزوج المعادلات التفاضلية ومخطّط سريان الإشارات الذي يمثّل هذا النظام من المعادلات التفاضلية مُبيَّنٌ في الشكل 3.37.
الشكل 3.37: مخطّط سريان إشارات لحلّ دائرة RLC على التسلسل.
اكتب إجراء
RLCيأخذ كوسطاء مُعامِلات الدائرة و و وفرق الزمن . وعلى غرار ما فعله إجراءRCفي التمرين 3.73، يجب أن يُنتجRLCإجراءً يأخذ القيم الأوّليّة لمتغيّرات الحالة، و ، ويُنتاج زوجًا (باستخدامcons) من مجرىَي الحالتين و . وباستخدامRLC، ولّد زوج المجاري الذي ينمذج سلوك دائرة RLC على التسلسل بـ = 1 أوم، و = 0.2 فاراد، و = 1 هنري، و = 0.1 ثانية، وقيمتين أوّليّتين = 0 أمبير و = 10 فولت.
التقييم بالترتيب الاعتيادي
تُبيّن الأمثلة في هذا القسم كيف أنّ الاستخدام الصريح للتأخير delay والإجبار force يُوفّر مرونةً كبيرة في البرمجة، لكنّ الأمثلة نفسها تُظهر أيضًا كيف يُمكن أن يُزيد هذا من تعقيد برامجنا. فإجراءنا الجديد integral، على سبيل المثال، يمنحنا القدرة على نمذجة أنظمة ذات حلقات، لكن يتعيّن علينا الآن أن نتذكّر أنّ integral يجب أن يُنادى بمكمّمٍ مؤجَّل، وأنّ كل إجراء يستخدم integral يجب أن يكون عالمًا بذلك. في الواقع، لقد أنشأنا صِنفين من الإجراءات: الإجراءات الاعتيادية والإجراءات التي تأخذ وسطاء مؤجَّلين. وبشكلٍ عام، فإنّ إنشاء أصناف منفصلة من الإجراءات يُرغمنا على إنشاء أصناف منفصلة من الإجراءات ذات الرتبة العليا أيضًا.[72]
إحدى طرق تجنّب الحاجة إلى صِنفين مختلفين من الإجراءات هي جعل جميع الإجراءات تأخذ وسطاء مؤجَّلين. فيُمكننا اعتماد نموذج تقييم تُؤخَّل فيه جميع وسطاء الإجراءات تلقائيًا، ولا تُجبَر إلّا عند الحاجة الفعلية إليها (على سبيل المثال، عندما تشترطها عملية أوّليّة). وهذا من شأنه تحويل لغتنا إلى استخدام التقييم بالترتيب الاعتيادي (normal-order evaluation)، الذي وصفناه أوّل مرّة عندما عرّفنا نموذج الإحلال للتقييم في 1.1.5. والتحوّل إلى التقييم بالترتيب الاعتيادي يُوفّر طريقةً موحّدة وأنيقة لتبسيط استخدام التقييم المؤجَّل، وكانت هذه لتكون استراتيجيّة طبيعية نعتمدها لو كانت همّنا معالجة المجاري وحدها. وفي 4.2، بعد أن ندرس المقيّم، سنرى كيف نحوّل لغتنا بهذه الطريقة بالضبط. وللأسف، فإنّ إدراج التأجيلات في نداءات الإجراءات يُحدث فوضى عارمة في قدرتنا على تصميم برامج تعتمد على ترتيب الأحداث، كالبرامج التي تستخدم الإحلال، أو تُغيّر بيانات، أو تُنفّذ إدخالًا أو إخراجًا. وحتّى التأخير delay الوحيد في cons-stream يُمكن أن يُحدث بلبلةً كبيرة، كما تُوضّح التمرين 3.51 والتمرين 3.52. وعلى حدّ علم أيّ إنسان، فإنّ القابلية للتغيير والتقييم المؤجَّل لا يتناغمان جيّدًا في لغات البرمجة، وإنّ ابتكار سُبل للتصرّف معهما معًا في وقتٍ واحد مجالٌ بحثيّ نشط.
3.5.5 وحدانية البرامج الوظيفية ووحدانية الكائنات
كما رأينا في 3.1.2، فإنّ إحدى الفوائد الكبرى لإدخال الإحلال هي قدرتنا على زيادة وحدانية أنظمتنا بتغليف أجزاء من حالة نظام كبير، أو «إخفائها»، داخل متغيّرات محلّية. وتستطيع نماذج المجاري أن تُوفّر وحدانيةً مكافئة دون استخدام الإحلال. وللتوضيح، يُمكننا إعادة تنفيذ تقدير مونت كارلو لـ ، الذي فحصناه في 3.1.2، من منظور معالجة المجاري.
تكمن مسألة الوحدانية الجوهريّة في أنّنا أردنا إخفاء الحالة الداخلية لمُولِّد الأعداد العشوائية عن البرامج التي تستخدم الأعداد العشوائية. بدأنا بإجراء rand-update، الذي كانت قيمته المتعاقبة تُزوّدنا بمخزوننا من الأعداد العشوائية، واستخدمناه لإنتاج مُولِّد أعداد عشوائية:
(define rand
(let ((x random-init))
(lambda ()
(set! x (rand-update x))
x)))
في الصياغة المجريّة لا يوجد مُولِّد أعداد عشوائية في ذاته، بل مجرّد مجرى من الأعداد العشوائية يُنتَج بنداءات متعاقبة إلى rand-update:
(define random-numbers
(cons-stream random-init
(stream-map rand-update
random-numbers)))
نستخدم هذا لبناء مجرى نتائج تجربة تشيزارو (Cesàro) المُنفَّذة على الأزواج المتتالية في مجرى random-numbers:
(define cesaro-stream
(map-successive-pairs
(lambda (r1 r2) (= (gcd r1 r2) 1))
random-numbers))
(define (map-successive-pairs f s)
(cons-stream
(f (stream-car s)
(stream-car (stream-cdr s)))
(map-successive-pairs
f (stream-cdr (stream-cdr s)))))
يُغذّى الآن مجرى cesaro-stream إلى إجراء monte-carlo، الذي يُنتج مجرى تقديرات للاحتمالات. ثم تُحوَّل النتائج إلى مجرى تقديرات لـ . ولا يحتاج هذا الإصدار من البرنامج إلى وسيط يُخبره بعدد التجارب التي يجب تنفيذها. إذ تُحصَل على تقديرات أفضل لـ (من تنفيذ تجارب أكثر) بالنظر أبعد في مجرى pi :
(define (monte-carlo experiment-stream
passed
failed)
(define (next passed failed)
(cons-stream
(/ passed (+ passed failed))
(monte-carlo
(stream-cdr experiment-stream)
passed
failed)))
(if (stream-car experiment-stream)
(next (+ passed 1) failed)
(next passed (+ failed 1))))
(define pi
(stream-map
(lambda (p) (sqrt (/ 6 p)))
(monte-carlo cesaro-stream 0 0)))
هناك وحدانيةٌ معتبَرة في هذا الأسلوب، لأنّنا نستطيع مع ذلك صياغة إجراء monte-carlo عامّ يُمكنه التصرّف مع تجارب اعتباطيّة. ومع ذلك، لا يوجد إحلالٌ ولا حالة محلّية.
التمرين 3.81: ناقش التمرين 3.6 تعميم مُولِّد الأعداد العشوائية للسماح بإعادة ضبط تسلسل الأعداد العشوائية لإنتاج تسلسلات قابلة للتكرار من الأعداد «العشوائية». أنتج صياغةً مجريّة لهذا المولّد نفسه تعمل على مجرى دخل من الطلبات لـ
generateعدد عشوائي جديد أو لـresetالتسلسل إلى قيمة مُحدَّدة، والتي تُنتج مجرى الأعداد العشوائية المرغوب. لا تستخدم الإحلال في حلّك.
التمرين 3.82: أعد تنفيذ التمرين 3.5 حول تكامل مونت كارلو بدلالة المجاري. فلن يحتوي إصدار
estimate-integralالمجريّ إلى وسيط يُخبره بعدد التجارب التي يجب تنفيذها. وبدلًا من ذلك، سيُنتج مجرى تقديرات قائمة على تجارب أكثر تباعًا.
منظور البرمجة الوظيفية للزمن
لنَعُد الآن إلى مسائل الكائنات والحالة التي طُرحت في بداية هذا الفصل ونفحصها في ضوءٍ جديد. لقد أدخلنا الإحلال والكائنات القابلة للتغيير لتوفير آلية للبناء الوحدانيّ للبرامج التي تنمذج أنظمة ذات حالة. وبنينا كائنات حسابيّة بمتغيّرات حالة محلّية، واستخدمنا الإحلال لتعديل هذه المتغيّرات. ونمذجنا السلوك الزمانيّ للكائنات في العالم بالسلوك الزمانيّ للكائنات الحسابيّة المقابلة لها.
والآن قد رأينا أنّ المجاري تُوفّر سبيلًا بديلًا لنمذجة الكائنات ذات الحالة المحلّية. فيُمكننا نمذجة كمّيّة متغيّرة، كالحالة المحلّية لبعض الكائنات، باستخدام مجرى يمثّل التاريخ الزمانيّ للحالات المتعاقبة. في الجوهر، نحن نمثّل الزمن صراحةً، باستخدام المجاري، بحيث نفصل الزمن في عالمنا المُحاكى عن تسلسل الأحداث التي تقع أثناء التقييم. وبالفعل، فبسبب وجود التأخير delay، قد تكون هناك علاقة ضئيلة بين الزمن المُحاكى في النموذج وبين ترتيب الأحداث أثناء التقييم.
وللمقارنة بين هذين الأسلوبين في النمذجة، لِنُعد النظر في تنفيذ «معالج سحب» يراقب الرصيد في حساب مصرفيّ. ففي 3.1.3 نفّذنا نسخةً مبسّطة من such a processor:
(define (make-simplified-withdraw balance)
(lambda (amount)
(set! balance (- balance amount))
balance))
تُنتج نداءات make-simplified-withdraw كائنات حسابيّة، لكلٍّ منها متغيّر حالة محلّي balance يتمّ إنقاصه بنداءات متعاقبة على الكائن. يأخذ الكائن وسيط amount ويُعيد الرصيد الجديد. ويُمكننا تخيّل مُستخدِم حساب مصرفيّ يطبع تسلسلًا من المُدخلات إلى مثل هذا الكائن، ويراقب تسلسل القيم المُعادة المُبيَّن على شاشة العرض.
و بدلًا من ذلك، يُمكننا نمذجة معالج سحب كإجراء يأخذ كدخل رصيدًا ومجرى من المبالغ المطلوب سحبها، ويُنتج مجرى الأرصدة المتعاقبة في الحساب:
(define (stream-withdraw balance amount-stream)
(cons-stream
balance
(stream-withdraw
(- balance (stream-car amount-stream))
(stream-cdr amount-stream))))
يُنفّذ stream-withdraw دالّة رياضية محدَّدة تعريفًا جيّدًا، يَتْبَعُ ناتجها كليًّا من دخلها. لكن افترض، مع ذلك، أنّ الدخل amount-stream هو مجرى القيم المتعاقبة التي يطبعها المُستخدِم، وأنّ مجرى الأرصدة الناتج يُعرَض. فمن منظور المُستخدِم الذي يطبع القيم ويراقب النتائج، تكون للعمليّة المجريّة السلوك عينه الذي للكائن المُنشَأ بواسطة make-simplified-withdraw. غير أنّ في الإصدار المجريّ لا يوجد إحلال، ولا متغيّر حالة محلّي، ومن ثمّ لا شيء من الصعوبات النظريّة التي واجهناها في 3.1.3. ومع ذلك، فللنظام حالة!
هذا لأمرٌ يُثير الدهشة حقًا. فمع أنّ stream-withdraw يُنفّذ دالّة رياضية محدَّدة تعريفًا جيّدًا لا يتغيّر سلوكها، فإنّ إدراك المُستخدِم هنا هو إدراك مُتفاعل مع نظام ذي حالة متغيّرة. وإحدى طرق حلّ هذا التناقض هي إدراك أنّ الوجود الزمانيّ للمُستخدِم هو الذي يفرض الحالة على النظام. فلو أمكن المُستخدِم أن يتراجع عن التفاعل ويفكّر بدلالة مجاري الأرصدة بدلًا من المعاملات الفرديّة، لبدا النظام بلا حالة.[73]
ومن وجهة نظر جزءٍ واحد من عمليّة معقّدة، تبدو الأجزاء الأخرى وكأنّها تتغيّر مع الزمن. فلديها حالة محلّية زمنيّة متغيّرة مخفيّة. وإذا أردنا كتابة برامج تنمذج هذا النوع من التفكيك الطبيعيّ في عالمنا (كما نراه من منظورنا بوصفنا جزءًا من ذلك العالم) ببُنى في حاسوبنا، فإنّنا نُنشئ كائنات حسابيّة غير وظيفيّة — إذ لا بدّ لها أن تتغيّر مع الزمن. فنحن نمثّل الحالة بمتغيّرات حالة محلّية، ونمثّل تغيّرات الحالة بإحلالاتٍ على تلك المتغيّرات. وبفعلنا هذا، نجعل زمن تنفيذ حسبةٍ ما ينمذج الزمن في العالم الذي نحن جزء منه، ونحصل بذلك على «كائنات» في حاسوبنا.
إنّ النمذجة بالكائنات قويّة وبديهيّة، إلى حدٍّ كبير لأنّها تُطابق إدراكنا للتفاعل مع عالمٍ نحن جزء منه. لكن كما رأينا مرارًا طوال هذا الفصل، فإنّ هذه النماذج تُثير مشكلات شائكة في تقييد ترتيب الأحداث ومزامنة عمليّات متعدّدة. وقد حفّزت إمكانيّة تجنّب هذه المشكلات تطوير لغات البرمجة الوظيفيّة، التي لا تتضمّن أيّ إمكان للإحلال أو البيانات القابلة للتغيير. وفي مثل هذه اللغة، تُنفّذ جميع الإجراءات دوالّ رياضية محدَّدة تعريفًا جيّدًا لوسطائها، لا يتغيّر سلوكها. والأسلوب الوظيفيّ جذّاب للغاية للتصرّف مع الأنظمة المتزامنة.[74]
من ناحية أخرى، إذا نظرنا عن كثب، نستطيع أن نرى مشكلات مرتبطة بالزمن تتسرّب إلى النماذج الوظيفيّة أيضًا. ومجالٌ مُسبِّب للمتاعب بشكل خاص يظهر عندما نرغب في تصميم أنظمة تفاعليّة، لا سيّما تلك التي تنمذج التفاعلات بين كيانات مستقلّة. فعلى سبيل المثال، تأمّل مرّة أخرى تنفيذ نظام مصرفيّ يسمح بالحسابات المصرفيّة المشتركة. ففي نظام تقليديّ يستخدم الإحلال والكائنات، كنّا لننمذج حقيقة أنّ بطرس وبولس يتشاركان حسابًا بدفع كلٍّ منهما طلبات معاملاته إلى كائن الحساب المصرفيّ نفسه، كما رأينا في 3.1.3. أمّا من منظور المجاري، حيث لا توجد «كائنات» في ذاتها، فقد أشرنا سابقًا إلى أنّ الحساب المصرفيّ يُمكن نمذجته كعمليّة تعمل على مجرى طلبات المعاملات لإنتاج مجرى الاستجابات. وتبعًا لذلك، يُمكننا نمذجة حقيقة أنّ لبطرس وبولس حسابًا مصرفيًّا مشتركًا بدمج مجرى طلبات معاملات بطرس مع مجرى طلبات بولس، وتغذية الناتج إلى عمليّة مجرى الحساب المصرفيّ، كما هو مُبيَّنٌ في الشكل 3.38.
الشكل 3.38: حساب مصرفيّ مشترك، مُنمذَج بدمج مجرىَي طلبات معاملات.
تكمُن مشكلة هذه الصياغة في فكرة الدمج. فلن يصلح الأمر بدمج المجريَيْن بأخذ طلب من بطرس وطلب من بولس بالتبادل ببساطة. فلنفترض أنّ بولس يصل إلى الحساب نادرًا جدًا. فهل يُعقل أن نُحتّم على بطرس الانتظار حتّى يصل بولس إلى الحساب قبل أن يُصدر معاملته الثانية؟ ومع ذلك، فأيًّا كانت طريقة تنفيذ هذا الدمج، فلا بدّ أن يشابك مجرىَي المعاملات بطريقةٍ ما مُقيَّدةٍ بـ«الزمن الحقيقيّ» كما يُدركه بطرس وبولس، بمعنى أنّ بطرس وبولس، إذا التقيا، يستطيعان الاتّفاق على أنّ معاملات مُعيَّنة عُنِيَ بمعالجتها قبل اللقاء، ومعاملات أخرى عُنِيَ بمعالجتها بعد اللقاء.[75] وهذا هو عينُ ذلك القيد الذي اضطررنا إلى التصرّف معه في 3.4.1، حيث وجدنا الحاجة إلى إدخال مزامنة صريحة لضمان ترتيب «صحيح» للأحداث في المعالجة المتزامنة للكائنات ذات الحالة. وهكذا، ومحاولةً لدعم الأسلوب الوظيفيّ، فإنّ الحاجة إلى دمج المُدخلات القادمة من عملاء مختلفين تُعيد إحداث المشكلات عينها التي قصد الأسلوب الوظيفيّ إزالتها.
بدأنا هذا الفصل بهدف بناء نماذج حسابيّة تُطابق بنيتها إدراكنا للعالم الحقيقيّ الذي نحاول نمذجته. فيُمكننا نمذجة العالم كمُجمَّع من كائنات منفصلة، مُقيَّدةٍ بالزمن، متفاعلة وذات حالة، أو يُمكننا نمذجة العالم كوحدة واحدة، خالدة، بلا حالة. ولكلّ من المنظورين مزايا قويّة، لكن لا يكفي أيٌّ منهما وحده إرضاءً تامًا. ولم يظهر بعد توحيدٌ كبرى.[76]
Actually, this is not quite true. One exception was the random-number generator in 1.2.6. Another exception involved the operation/type tables we introduced in 2.4.3, where the values of two calls to
getwith the same arguments depended on intervening calls toput. On the other hand, until we introduce assignment, we have no way to create such procedures ourselves. ↩︎The value of a
set!expression is implementation-dependent.Set!should be used only for its effect, not for its value. The nameset!reflects a naming convention used in Scheme: Operations that change the values of variables (or that change data structures, as we will see in 3.3) are given names that end with an exclamation point. This is similar to the convention of designating predicates by names that end with a question mark. ↩︎We have already used
beginimplicitly in our programs, because in Scheme the body of a procedure can be a sequence of expressions. Also, the⟨consequent⟩part of each clause in acondexpression can be a sequence of expressions rather than a single expression. ↩︎In programming-language jargon, the variable
balanceis said to be encapsulated within thenew-withdrawprocedure. Encapsulation reflects the general system-design principle known as the hiding principle: One can make a system more modular and robust by protecting parts of the system from each other; that is, by providing information access only to those parts of the system that have a “need to know.” ↩︎In contrast with
new-withdrawabove, we do not have to useletto makebalancea local variable, since formal parameters are already local. This will be clearer after the discussion of the environment model of evaluation in 3.2. (See also Exercise 3.10.) ↩︎One common way to implement
rand-updateis to use the rule that is updated to modulo , where , , and are appropriately chosen integers. Chapter 3 of Knuth 1981 includes an extensive discussion of techniques for generating sequences of random numbers and establishing their statistical properties. Notice that therand-updateprocedure computes a mathematical function: Given the same input twice, it produces the same output. Therefore, the number sequence produced byrand-updatecertainly is not “random,” if by “random” we insist that each number in the sequence is unrelated to the preceding number. The relation between “real randomness” and so-called pseudo-random sequences, which are produced by well-determined computations and yet have suitable statistical properties, is a complex question involving difficult issues in mathematics and philosophy. Kolmogorov, Solomonoff, and Chaitin have made great progress in clarifying these issues; a discussion can be found in Chaitin 1975. ↩︎This theorem is due to E. Cesàro. See section 4.5.2 of Knuth 1981 for a discussion and a proof. ↩︎
MIT Scheme provides such a procedure. If
randomis given an exact integer (as in 1.2.6) it returns an exact integer, but if it is given a decimal value (as in this exercise) it returns a decimal value. ↩︎We don’t substitute for the occurrence of
balancein theset!expression because the⟨name⟩in aset!is not evaluated. If we did substitute for it, we would get(set! 25 (- 25 amount)), which makes no sense. ↩︎The phenomenon of a single computational object being accessed by more than one name is known as aliasing. The joint bank account situation illustrates a very simple example of an alias. In 3.3 we will see much more complex examples, such as “distinct” compound data structures that share parts. Bugs can occur in our programs if we forget that a change to an object may also, as a “side effect,” change a “different” object because the two “different” objects are actually a single object appearing under different aliases. These so-called side-effect bugs are so difficult to locate and to analyze that some people have proposed that programming languages be designed in such a way as to not allow side effects or aliasing (Lampson et al. 1981; Morris et al. 1980). ↩︎
In view of this, it is ironic that introductory programming is most often taught in a highly imperative style. This may be a vestige of a belief, common throughout the 1960s and 1970s, that programs that call procedures must inherently be less efficient than programs that perform assignments. (Steele 1977 debunks this argument.) Alternatively it may reflect a view that step-by-step assignment is easier for beginners to visualize than procedure call. Whatever the reason, it often saddles beginning programmers with “should I set this variable before or after that one” concerns that can complicate programming and obscure the important ideas. ↩︎
Assignment introduces a subtlety into step 1 of the evaluation rule. As shown in Exercise 3.8, the presence of assignment allows us to write expressions that will produce different values depending on the order in which the subexpressions in a combination are evaluated. Thus, to be precise, we should specify an evaluation order in step 1 (e.g., left to right or right to left). However, this order should always be considered to be an implementation detail, and one should never write programs that depend on some particular order. For instance, a sophisticated compiler might optimize a program by varying the order in which subexpressions are evaluated. ↩︎
If there is already a binding for the variable in the current frame, then the binding is changed. This is convenient because it allows redefinition of symbols; however, it also means that
definecan be used to change values, and this brings up the issues of assignment without explicitly usingset!. Because of this, some people prefer redefinitions of existing symbols to signal errors or warnings. ↩︎The environment model will not clarify our claim in 1.2.1 that the interpreter can execute a procedure such as
fact-iterin a constant amount of space using tail recursion. We will discuss tail recursion when we deal with the control structure of the interpreter in 5.4. ↩︎Whether
W1andW2share the same physical code stored in the computer, or whether they each keep a copy of the code, is a detail of the implementation. For the interpreter we implement in Chapter 4, the code is in fact shared. ↩︎Set-car!andset-cdr!return implementation-dependent values. Likeset!, they should be used only for their effect. ↩︎We see from this that mutation operations on lists can create “garbage” that is not part of any accessible structure. We will see in 5.3.2 that Lisp memory-management systems include a garbage collector, which identifies and recycles the memory space used by unneeded pairs. ↩︎
Get-new-pairis one of the operations that must be implemented as part of the memory management required by a Lisp implementation. We will discuss this in 5.3.1. ↩︎The two pairs are distinct because each call to
consreturns a new pair. The symbols are shared; in Scheme there is a unique symbol with any given name. Since Scheme provides no way to mutate a symbol, this sharing is undetectable. Note also that the sharing is what enables us to compare symbols usingeq?, which simply checks equality of pointers. ↩︎The subtleties of dealing with sharing of mutable data objects reflect the underlying issues of “sameness” and “change” that were raised in 3.1.3. We mentioned there that admitting change to our language requires that a compound object must have an “identity” that is something different from the pieces from which it is composed. In Lisp, we consider this “identity” to be the quality that is tested by
eq?, i.e., by equality of pointers. Since in most Lisp implementations a pointer is essentially a memory address, we are “solving the problem” of defining the identity of objects by stipulating that a data object “itself” is the information stored in some particular set of memory locations in the computer. This suffices for simple Lisp programs, but is hardly a general way to resolve the issue of “sameness” in computational models. ↩︎On the other hand, from the viewpoint of implementation, assignment requires us to modify the environment, which is itself a mutable data structure. Thus, assignment and mutation are equipotent: Each can be implemented in terms of the other. ↩︎
If the first item is the final item in the queue, the front pointer will be the empty list after the deletion, which will mark the queue as empty; we needn’t worry about updating the rear pointer, which will still point to the deleted item, because
empty-queue?looks only at the front pointer. ↩︎Be careful not to make the interpreter try to print a structure that contains cycles. (See Exercise 3.13.) ↩︎
Because
assocusesequal?, it can recognize keys that are symbols, numbers, or list structure. ↩︎Thus, the first backbone pair is the object that represents the table “itself”; that is, a pointer to the table is a pointer to this pair. This same backbone pair always starts the table. If we did not arrange things in this way,
insert!would have to return a new value for the start of the table when it added a new record. ↩︎A full-adder is a basic circuit element used in adding two binary numbers. Here A and B are the bits at corresponding positions in the two numbers to be added, and is the carry bit from the addition one place to the right. The circuit generates SUM, which is the sum bit in the corresponding position, and , which is the carry bit to be propagated to the left. ↩︎
These procedures are simply syntactic sugar that allow us to use ordinary procedural syntax to access the local procedures of objects. It is striking that we can interchange the role of “procedures” and “data” in such a simple way. For example, if we write
(wire 'get-signal)we think ofwireas a procedure that is called with the messageget-signalas input. Alternatively, writing(get-signal wire)encourages us to think ofwireas a data object that is the input to a procedureget-signal. The truth of the matter is that, in a language in which we can deal with procedures as objects, there is no fundamental difference between “procedures” and “data,” and we can choose our syntactic sugar to allow us to program in whatever style we choose. ↩︎The agenda is a headed list, like the tables in 3.3.3, but since the list is headed by the time, we do not need an additional dummy header (such as the
*table*symbol used with tables). ↩︎Observe that the
ifexpression in this procedure has no⟨alternative⟩expression. Such a “one-armedifstatement” is used to decide whether to do something, rather than to select between two expressions. Anifexpression returns an unspecified value if the predicate is false and there is no⟨alternative⟩. ↩︎In this way, the current time will always be the time of the action most recently processed. Storing this time at the head of the agenda ensures that it will still be available even if the associated time segment has been deleted. ↩︎
Constraint propagation first appeared in the incredibly forward-looking SKETCHPAD system of Ivan Sutherland (1963). A beautiful constraint-propagation system based on the Smalltalk language was developed by Alan Borning (1977) at Xerox Palo Alto Research Center. Sussman, Stallman, and Steele applied constraint propagation to electrical circuit analysis (Sussman and Stallman 1975; Sussman and Steele 1980). TK!Solver (Konopasek and Jayaraman 1984) is an extensive modeling environment based on constraints. ↩︎
The
settermight not be a constraint. In our temperature example, we useduseras thesetter. ↩︎The expression-oriented format is convenient because it avoids the need to name the intermediate expressions in a computation. Our original formulation of the constraint language is cumbersome in the same way that many languages are cumbersome when dealing with operations on compound data. For example, if we wanted to compute the product , where the variables represent vectors, we could work in “imperative style,” using procedures that set the values of designated vector arguments but do not themselves return vectors as values:
scheme (v-sum a b temp1) (v-sum c d temp2) (v-prod temp1 temp2 answer)↩︎Most real processors actually execute a few operations at a time, following a strategy called pipelining. Although this technique greatly improves the effective utilization of the hardware, it is used only to speed up the execution of a sequential instruction stream, while retaining the behavior of the sequential program. ↩︎
To quote some graffiti seen on a Cambridge building wall: “Time is a device that was invented to keep everything from happening at once.” ↩︎
An even worse failure for this system could occur if the two
set!operations attempt to change the balance simultaneously, in which case the actual data appearing in memory might end up being a random combination of the information being written by the two processes. Most computers have interlocks on the primitive memory-write operations, which protect against such simultaneous access. Even this seemingly simple kind of protection, however, raises implementation challenges in the design of multiprocessing computers, where elaborate cache-coherence protocols are required to ensure that the various processors will maintain a consistent view of memory contents, despite the fact that data may be replicated (“cached”) among the different processors to increase the speed of memory access. ↩︎The factorial program in 3.1.3 illustrates this for a single sequential process. ↩︎
The columns show the contents of Peter’s wallet, the joint account (in Bank1), Paul’s wallet, and Paul’s private account (in Bank2), before and after each withdrawal (W) and deposit (D). Peter withdraws $10 from Bank1; Paul deposits $5 in Bank2, then withdraws $25 from Bank1. ↩︎
A more formal way to express this idea is to say that concurrent programs are inherently nondeterministic. That is, they are described not by single-valued functions, but by functions whose results are sets of possible values. In 4.3 we will study a language for expressing nondeterministic computations. ↩︎
Parallel-executeis not part of standard Scheme, but it can be implemented in MIT Scheme. In our implementation, the new concurrent processes also run concurrently with the original Scheme process. Also, in our implementation, the value returned byparallel-executeis a special control object that can be used to halt the newly created processes. ↩︎We have simplified
exchangeby exploiting the fact that ourdepositmessage accepts negative amounts. (This is a serious bug in our banking system!) ↩︎إذا كانت أرصدة الحساب في البداية $10 و $20 و $30، فبعد أي عدد من عمليات التبادل المتزامنة، يجب أن تبقى الأرصدة $10 و $20 و $30 بترتيبٍ ما. وترتيب إيداعات الحسابات الفرديّة على التسلسل لا يكفي لضمان ذلك. انظر التمرين 3.43. ↩︎
يفحص التمرين 3.45 سبب عدم ترتيب الإيداعات والسحوبات تلقائيًا على التسلسل بواسطة الحساب. ↩︎
مصطلح «mutex» اختصارٌ لـ mutual exclusion (الإقصاء المتبادل). وتُسمّى المسألة العامّة المتمثّلة في ترتيب آليّة تسمح للعمليّات المتزامنة بمشاركة الموارد بأمان مسألة الإقصاء المتبادل. ومِرفَقُنا نسخةٌ بسيطة من آليّة semaphore (العَلَم) (انظر التمرين 3.47)، التي طُرِحَت في نظام التعدّد البرمجيّ «THE» المُطوَّر في الجامعة التقنيّة في أيندهوفن وسُمّي بأحرف أوّل اسم الجامعة بالهولنديّة (Dijkstra 1968a). وكانت عمليّتا الاكتساب والإطلاق تُسمّيان أصلاً P وV، من الكلمتين الهولنديّتين passeren (عبور) و vrijgeven (إطلاق)، إشارةً إلى الأعلام المُستخدمة في منظومات السكك الحديديّة. وكان عرض ديكسترا الكلاسيكيّ (1968b) من أوائل ما عرض مسائل التحكّم في التزامن عرضًا واضحًا، وأظهر كيف يُمكن استخدام الأعلام للتصرّف مع مجموعة متنوّعة من مشكلات التزامن. ↩︎
في معظم منظومات التشغيل مُقسَّمة الزمن، لا تُهدر العمليّات التي يحجبها مِرفَق وقتًا في «الانتظار المشغول» كما سبق. وبدلًا من ذلك، يجعل النظام عمليّة أخرى تعمل في أثناء انتظار الأولى، وتُوقَظ العمليّة المحجوبة عندما يصبح المِرفَق متاحًا. ↩︎
في MIT Scheme على معالج واحد، الذي يستخدم نموذج تقطيع الوقت، يُمكن تنفيذ
test-and-set!كما يلي:scheme (define (test-and-set! cell) (without-interrupts (lambda () (if (car cell) true (begin (set-car! cell true) false)))))↩︎هناك تنويعات عديدة لمثل هذه التعليمات — منها test-and-set و test-and-clear و swap و compare-and-exchange و load-reserve و store-conditional — يجب مواءمة تصميمها بعناية مع واجهة المعالج–الذاكرة في الآلة. وإحدى المسائل التي تظهر هنا هي تحديد ما يحدث إذا حاولت عمليّتان اكتساب المورد نفسه في اللحظة ذاتها بالضبط باستخدام مثل هذا التعليم. وهذا يستلزم آليةً ما لاتّخاذ قرار بشأن العمليّة التي تحصل على التحكّم. وتُسمّى مثل هذه الآليّة arbiter (حَكَم). والحُكّام تُختصر عادةً في نوعٍ من جهاز عتاديّ. وللأسف، يُمكن إثبات استحالة بناء حَكَمٍ عادل فيزيائيًا يعمل 100% من الوقت، إلّا إذا سمحنا للحَكَم بوقت طويل اعتباطيًّا لاتّخاذ قراره. وقد لُوحظت الظاهرة الأساسيّة هنا أوّل مرّة على يد الفيلسوف الفرنسيّ في القرن الرابع عشر جان بوريدان في تعليقه على كتاب أرسطو De caelo. وقد argued بوريدان أنّ أنّ كلبًا عاقلًا تمامًا موضوع بين مصدرين للطعام جذّابين بالقدر نفسه سيموت جوعًا، لأنّه عاجز عن تقرير أيّهما يتوجّه إليه أوّلًا. ↩︎
تعود التقنيّة العامّة لتجنّب الجمود بترقيم الموارد المشتركة واكتسابها بالترتيب إلى Havender (1968). والحالات التي لا يُمكن فيها تجنّب الجمود تستلزم طرائق استعادة من الجمود، التي تقتضي أن تتراجع العمليّات «خلفًا» عن حالة الجمود وتحاول مرّة أخرى. وآليّات الاستعادة من الجمود مُستخدمة على نطاق واسع في منظومات إدارة قواعد البيانات، وهو موضوع يُعالَج بالتفصيل في Gray and Reuter 1993. ↩︎
إحدى هذه البدائل عن الترتيب على التسلسل تُسمّى مزامنة الحواجز. إذ يُتيح المبرمج للعمليّات المتزامنة أن تنفّذ كما تشاء، لكنّه يُنشئ نقاط مزامنة مُعيَّنة («حواجز») لا تستطيع أيّ عمليّة العبور عبرها حتّى تكون جميع العمليّات قد وصلت إلى الحاجز. وتُوفّر المعالجات الحديثة تعليمات آليّة تسمح للمبرمجين بإنشاء نقاط مزامنة في الأماكن التي تكون فيها الاتّساقيّة مطلوبة. فـ PowerPC مثلًا يتضمّن لهذا الغرض تعليمين يُسمّيان SYNC و EIEIO (Enforced In-order Execution of Input/Output). ↩︎
قد يبدو هذا وجهة نظر غريبة، لكن هناك منظومات تعمل بهذه الطريقة. فالرسوم الدوليّة على حسابات بطاقات الائتمان، على سبيل المثال، تُسوّى عادةً على أساس كل دولة، وتُطابَق الرسوم المُسجَّلة في الدول المختلفة دوريًّا. بالتالي، قد يختلف رصيد الحساب من دولة إلى أخرى. ↩︎
بالنسبة للأنظمة الموزّعة، دُفِعَ بهذا المنظور على يد Lamport (1978)، الذي أظهر كيف يُمكن استخدام الاتّصال لإنشاء «ساعات عالميّة» يُمكن استخدامها لإقامة ترتيبات على الأحداث في الأنظمة الموزّعة. ↩︎
يتبنّى الفيزيائيّون هذه النظرة أحيانًا بإدخال «خطوط العالم» للجسيمات كوسيلة للاستدلال على الحركة. وقد ذكرنا أيضًا (2.2.3) أنّ هذه هي الطريقة الطبيعيّة للتفكير في أنظمة معالجة الإشارات. وسنستكشف تطبيقات المجاري في معالجة الإشارات في 3.5.3. ↩︎
افترض أنّ لدينا مُسَيِّمًا
prime?(مثلًا كما في 1.2.6) يختبر الأوليّة. ↩︎في تنفيذ MIT، يكون
the-empty-streamهو القائمة الفارغة'()عينها، ويكونstream-null?هوnull?عينه. ↩︎لا بدّ أن يُزعجك هذا. فحقيقة أنّنا نُعرّف إجراءات بهذه الشبهة لتعمل على المجاري والقوائم تدلّ على أنّنا نفتقر إلى تجريدٍ أساسيّ. وللأسف، ولكي نستغلّ هذا التجريد، سنحتاج إلى ممارسة تحكّم أدقّ في عمليّة التقييم ممّا يُمكننا فعله الآن. وسنناقش هذه النقطة أكثر في نهاية 3.5.4. وفي 4.2، سنُطوّر إطارًا يُوحّد القوائم والمجاري. ↩︎
مع أنّ
stream-carوstream-cdrيُمكن تعريفهما كإجراءات، فلا بدّ أن تكونcons-streamصيغةً خاصّة. فلو كانتcons-streamإجراءً، لكان تقييم(cons-stream ⟨a⟩ ⟨b⟩)⟨b⟩وفقًا لنموذج تقييمنا سيُسبّب تلقائيًا تقييم ⟨b⟩، وهو عين ما لا نرغب في حدوثه. وللسبب عينه، يجب أن يكونdelayصيغةً خاصّة، مع أنّforceيُمكن أن يكون إجراءً اعتياديًّا. ↩︎الأرقام المُبيَّنة هنا لا تظهر فعلًا في التعبير المؤجَّل. وما يظهر فعلًا هو التعبير الأصليّ، في بيئةٍ تكون فيها المتغيّرات مربوطة بالأرقام المناسبة. فعلى سبيل المثال،
(+ low 1)مع ربطlowبـ 10,000 يظهر فعلًا في الموضع الذي يظهر فيه10001. ↩︎هناك تنفيذات كثيرة ممكنة للمجاري بخلاف الذي وُصف في هذا القسم. فالتقييم المؤجَّل، الذي هو مفتاح جعل المجاري عمليّة، كان كامنًا في طريقة تمرير المُعامِلات بالاسم call-by-name في Algol 60. وقد وُصِف استخدام هذه الآليّة لتنفيذ المجاري أوّل مرّة على يد Landin (1965). وأُدخِل التقييم المؤجَّل للمجاري إلى Lisp على يد Friedman and Wise (1976). ففي تنفيذهما، يؤخّر
consتقييم وسيطه دائمًا، بحيث تتحوّل القوائم تلقائيًا إلى مجاري. ويُعرَف تحسين حفظ النتائج أيضًا بـ call-by-need. وكان مُجتمَع Algol سيُطلِق على كائناتنا المؤجَّلة الأصليّة اسم call-by-name thunks وعلى الإصدارات المُحسَّنة اسم call-by-need thunks. ↩︎تمرينات مثل التمرين 3.51 والتمرين 3.52 قيّمة لاختبار فهمنا لكيف عمل
delay. من ناحية أخرى، فإنّ خلط التقييم المؤجَّل بالطباعة — والأسوأ من ذلك، بالإحلال — مُربِك للغاية، وقد تعوّد مُعلّمو مقرّرات لغات الحاسوب تعذيب طلّابهم بأسئلة امتحانيّة مثل الأسئلة الواردة في هذا القسم. وحاجةً للقول، فإنّ كتابة برامج تعتمد على مثل هذه الفروق الدقيقة أسلوبٌ بغيض في البرمجة. وجزء من قوة معالجة المجاري هو أنّها تسمح لنا بتجاهل الترتيب الذي تحدث فيه الأحداث فعلًا في برامجنا. وللأسف، هذا هو precisely ما لا يُمكننا تحمّل تجاوزه في وجود الإحلال، الذي يُرغمنا على الاهتمام بالزمن والتغيّر. ↩︎إراتوستينس، الفيلسوف اليونانيّ الإسكندريّ في القرن الثالث قبل الميلاد، مشهور بتقديمه أوّل تقدير دقيق لمحيط الأرض، والذي حسبه بمراقبة الظلال المُسقَطة في الظهيرة في يوم الانقلاب الصيفيّ. وعلى الرغم من قِدَم طريقة إراتوستينس للمناخل، فقد شكّلت الأساس لأجهزة «مناخل» عتاديّة خاصّة بالأغراض، كانت حتّى وقت قريب أقوى الأدوات الموجودة لتحديد الأعداد الأوّليّة الكبيرة. غير أنّ هذه الطرق قد تجاوزتها منذ السبعينيّات نتائج التقنيّات الاحتماليّة المناقَشة في 1.2.6. ↩︎
لقد سمّينا هذه الأشكال على اسم بيتر هندرسون، الذي كان أوّل من يُظهر لنا مخطّطات من هذا النوع كطريقة للتفكير في معالجة المجاري. وكل خطٍّ متصل يمثّل مجرى قيمٍ يُرسَل. والخطّ المتقطّع الممتدّ من
carإلىconsوfilterيدلّ على أنّ هذه قيمة واحدة لا مجرى. ↩︎يستخدم هذا النسخة المعمّمة من
stream-mapالواردة في التمرين 3.50. ↩︎هذه النقطة الأخيرة بالغة الدقّة وتعتمد على حقيقة أنّ (هنا، يَدُلّ على العدد الأوّليّ .) وتقديرات من هذا القبيل بالغة الصعوبة في الإثبات. ويُظهر البرهان القديم لأقليدس على لانهائيّة عدد الأعداد الأوّليّة أنّ ، ولم يُثبَت نتيجة أفضل جوهريًّا حتّى عام 1851، عندما أثبت الرياضيّ الروسيّ ب. ل. تشيبيشيف أنّ لجميع . وهذه النتيجة، التي خُمِنَت أصلًا في عام 1845، تُعرَف بـ فرضية برتراند. ويُمكن العثور على برهان لها في القسم 22.3 من Hardy and Wright 1960. ↩︎
يُظهر هذا التمرين كيف يرتبط الاستدعاء بالحاجة ارتباطًا وثيقًا بالحفظ الاعتياديّ للنتائج كما وُصِف في التمرين 3.27. ففي ذلك التمرين، استخدمنا الإحلال لبناء جدول محلّي صراحةً. أمّا تحسيننا المجريّ بالاستدعاء بالحاجة، فيبني مثل هذا الجدول تلقائيًا، إذ يخزّن القيم في أجزاء المجرى التي أُجبِرت سابقًا. ↩︎
لا يُمكننا استخدام
letلربط المتغيّر المحلّيguesses، لأنّ قيمةguessesتعتمد علىguessesنفسها. ويتناول التمرين 3.63 سبب رغبتنا في متغيّر محلّي هنا. ↩︎كما في 2.2.3، نمثّل زوجًا من عددين صحيحين كقائمة لا كزوج Lisp. ↩︎
انظر التمرين 3.68 لبعض الإفهام عن سبب اختيارنا هذا التفكيك. ↩︎
الصياغة الدقيقة للخاصيّة المطلوبة على ترتيب الدمج هي كما يلي: يجب أن تكون هناك دالّة لوسيطين، بحيث يظهر الزوج المُقابِل للعنصر من المجرى الأوّل والعنصر من المجرى الثاني كعنصر رقم في مجرى الخرج. وقد أُوحيَت إلينا خدعة استخدام
interleaveلإنجاز هذا على يد ديفيد تيرنر، الذي استخدمها في لغة KRC (Turner 1981). ↩︎سنشترط أن تكون دالّة الترجيح بحيث يزيد وزن الزوج كلما تحرّكنا خارجًا على طول صفٍّ أو أسفل عمود في مصفوفة الأزواج. ↩︎
نقلاً عن نعي ج. ه. هاردي لرامانجن (Hardy 1921): «كان السيد ليتلوود (على ما أعتقد) هو من لاحظ أنّ "كل عدد صحيح موجب كان أحد أصدقائه." وأتذكّر مرّة ذهابي لزيارته حين كان مريضًا في پوتني. وقد ركبتُ في سيارة أجرة رقم 1729، ولاحظتُ أنّ العدد بدا لي مملًا إلى حدٍّ ما، ورجوتُ أن لا يكون نذيرَ شؤم. "لا،" أجاب، "إنّه عدد بالغ الأهمّيّة؛ إنّه أصغر عدد يُمكن التعبير عنه بصورتَي مجموع مكعّبين مختلفتين." » وقد أُوحيَت إلينا خدعة استخدام الأزواج الموزونة لتوليد أعداد رامانجن على يد تشارلز ليسيرسون. ↩︎
هذا الإجراء غير مضمون العمل في جميع تنفيذات Scheme، مع أنّ في أي تنفيذ ثمة تنويعة بسيطة ستعمل. وتتعلّق المشكلة بفروق دقيقة في الطرق التي تتصرّف بها تنفيذات Scheme مع التعريفات الداخليّة. (انظر 4.1.6.) ↩︎
هذه انعكاسٌ صغير، في Lisp، للصعوبات التي تجدها اللغات التقليديّة شديدة التصنيع مثل باسكال في التعامل مع الإجراءات ذات الرتبة العليا. ففي مثل هذه اللغات، يجب على المبرمج أن يُحدّد أنواع بيانات وسطاء كل إجراء وناتجه: عدد، قيمة منطقيّة، تسلسل، وهكذا. وبالتالي، لم نكن لنُعبّر عن تجريدٍ مثل «طبّق إجراءً معطى
procعلى جميع العناصر في تسلسل» بإجراء واحد ذي رتبة عليا مثلstream-map. بل كنّا سنحتاج إلى إجراء تعيين مختلف لكل توليفة مختلفة من أنواع بيانات الوسيط والناتج التي يُمكن تحديدها لـproc. وإنّ الحفاظ على مفهوم عمليّيّ لـ«نوع البيانات» في وجود الإجراءات ذات الرتبة العليا يُثير مسائل عديدة صعبة. وإحدى طرق التصرّف مع هذه المشكلة توضّحها لغة ML (Gordon et al. 1979)، التي تتضمّن «أنواع بيانات متعدّدة الأشكال» تشمل قوالب للتحوّلات ذات الرتبة العليا بين أنواع البيانات. بل إنّ أنواع بيانات معظم الإجراءات في ML لا يُصرّح عنها المبرمج صراحةً أبدًا. وبدلًا من ذلك، تتضمّن ML آليّة استنتاج الأنواع تستخدم المعلومات في البيئة لاستنتاج أنواع بيانات الإجراءات المُعرَّفة حديثًا. ↩︎وبالمثل في الفيزياء، عندما نُلاحظ جسيمًا متحرّكًا، نقول إنّ موضع (حالة) الجسيم تتغيّر. غير أنه من منظور خطّ العالم للجسيم في الزمكان، لا يوجد تغيّر مُشار إليه. ↩︎
جون باكوس، مُخترِع فورتران، أعطى البرمجة الوظيفيّة ظهورًا بارزًا عندما مُنِح جائزة ACM تورينغ عام 1978. وقد دَعَم خطاب قبوله (Backus 1978) الأسلوب الوظيفيّ دعمةً قويّة. ويُوجد عرضٌ جيّد للبرمجة الوظيفيّة في Henderson 1980 و في Darlington et al. 1982. ↩︎
لاحِظ أنّ لأيّ مجريَيْن، هناك عمومًا أكثر من ترتيب تشابكٍ مقبول. بالتالي، من الناحية التقنيّة، «الدمج» علاقة لا دالّة — فالجواب ليس دالّة محدَّدة من المُدخلات. وقد ذكرنا سابقًا (الحاشية 167) أنّ عدم الحتميّة جوهريّ عند التصرّف مع التزامن. وعلاقة الدمج تُوضيح عدم الحتميّة الأساسيّ عينه، من المنظور الوظيفيّ. وفي 4.3، سننظر إلى عدم الحتميّة من وجهة نظر أخرى أيضًا. ↩︎
نموذج الكائنات يقارب العالم بتقسيمه إلى قطع منفصلة. أمّا النموذج الوظيفيّ فلا يُوحد على حدود الكائنات. ونموذج الكائنات مفيد عندما تكون الحالة غير المشتركة «للكائنات» أكبر بكثير من الحالة التي تتقاسمها. ومثال على مكان تسقط فيه وجهة نظر الكائنات هو ميكانيكا الكمّ، حيث يُفضي التفكير في الأشياء كجسيمات فرديّة إلى تناقضات والتباسات. وقد يكون توحيد وجهة نظر الكائنات مع وجهة نظر الوظيفيّة لا علاقة له بالبرمجة، بل يتعلّق بمسائل إبستيمولوجيّة أساسيّة. ↩︎