بناء التجريدات بالبيانات
نأتي الآن إلى الخطوة الحاسمة في التجريد الرياضيّ: ننسى ما ترمز إليه الرموز. … [الرياضيّ] لا يلزم أن يبقى عاطلًا؛ فهناك عمليّاتٌ كثيرةٌ قد يجريها على هذه الرموز، دون أن ينظر قطّ إلى الأشياء التي ترمز إليها. —هرمان فايل، طريقة التفكير الرياضيّة
تركّزنا في الفصل 1 على العمليّات الحسابيّة وعلى دور الإجراءات في تصميم البرامج. فرأينا كيف نستخدم البيانات الأوّليّة (الأعداد) والعمليّات الأوّليّة (العمليّات الحسابيّة)، وكيف نُركّب الإجراءات لتكوين إجراءاتٍ مركّبةٍ عبر التركيب والتعبيرات الشرطيّة واستخدام الوسائط، وكيف نُجرّد الإجراءات باستخدام define. ورأينا أنّ الإجراء يمكن اعتباره نمطًا للتطوّر المحليّ لعمليّة، وصنّفنا بعض الأنماط الشائعة للعمليّات كما تتجسّد في الإجراءات، وتفكّرنا فيها، وأجرينا تحليلاتٍ خوارزميّةً بسيطةً لها. ورأينا أيضًا أنّ الإجراءات من الرتبة العليا تعزّز قوّة لغتنا بتمكيننا من التلاعب بالطرق العامّة للاحتساب، ومن التفكير من خلالها. وهذا كثيرٌ من جوهر البرمجة.
سوف ننظر في هذا الفصل إلى بياناتٍ أكثر تعقيدًا. فجميع الإجراءات في الفصل 1 تعمل على بياناتٍ عدديّةٍ بسيطة، والبيانات البسيطة غير كافيّة للعديد من المسائل التي نرغب في معالجتها بالاحتساب. والبرامج تُصمَّم عادةً لنمذجة ظواهر معقّدة، وأكثر ما يكون المرء مضطرًّا إلى بناء كائناتٍ حسابيّةٍ لها عدّة أجزاء، وذلك لنمذجة ظواهر العالم الواقعيّ التي لها عدّة جوانب. وبذلك، فإنّا حيث كان تركيزنا في الفصل 1 على بناء التجريدات بتركيب الإجراءات لتكوين إجراءاتٍ مركّبة، فإنّنا نتوجّه في هذا الفصل إلى جانبٍ رئيسيّ آخر لأيّ لغة برمجة: الوسيلة التي توفّرها لبناء التجريدات بتركيب كائنات البيانات لتكوين بياناتٍ مركّبة (compound data).
لماذا نريد البيانات المركّبة في لغة برمجةٍ؟ لنحو السبب ذاتها التي تجعلنا نريد الإجراءات المركّبة: لنرفع المستوى المفاهيميّ الذي نُصمّم عنده برامجنا، ولنزيد وحدانيّة تصميماتنا، ولنعزّز القوّة التعبيريّة للغتنا. فكما أنّ القدرة على تعريف الإجراءات تُمكّننا من التعامل مع العمليّات على مستوى مفاهيميّ أعلى من مستوى العمليّات الأوّليّة للغة، فإنّ القدرة على بناء كائنات البيانات المركّبة تُمكّننا من التعامل مع البيانات على مستوى مفاهيميّ أعلى من مستوى كائنات البيانات الأوّليّة للغة.
تأمّل مهمّة تصميم نظامٍ لأداء العمليّات الحسابيّة على الأعداد الكسريّة. يمكننا أن نتخيّل عمليّةً add-rat تأخذ عددين كسريّين وتُنتج مجموعهما. ومن منظور البيانات البسيطة، يمكن النظر إلى العدد الكسريّ كعددين صحيحين: بسطٌ ومقام. وبذلك، يمكننا تصميم برنامجٍ يُعبَّر فيه عن كلّ عددٍ كسريّ بعددين صحيحين (بسطٌ ومقام)، وحيث يُنفَّذ add-rat بإجراءين (أحدهما يُنتج بسط المجموع والآخر يُنتج مقامه). لكنّ ذلك سيكون أمرًا عسيرًا، لأنّنا سنحتاج إذن إلى تتبّع أيّ بسطٍ يقابل أيّ مقامٍ صراحةً. ففي نظامٍ يُقصد به أداء عمليّاتٍ كثيرةٍ على أعدادٍ كسريّةٍ كثيرة، فإنّ تفاصيل مسك الدفاتر كهذه ستُشوّش البرامج تشويشًا كبيرًا، فضلًا عمّا ستفعله بعقولنا. لَكان أفضلَ كثيرًا لو استطعنا «لصق» بسطٍ ومقامٍ معًا لتكوين زوجٍ - وهو كائن بيانات مركّب - تستطيع برامجنا التلاعب به بطريقةٍ متّسقةٍ مع اعتبار العدد الكسريّ وحدةً مفاهيميّةً واحدة.
واستخدام البيانات المركّبة يُمكّننا أيضًا من زيادة وحدانيّة برامجنا. فإذا استطعنا التلاعب بالأعداد الكسريّة مباشرةً بوصفها كائناتٍ بحقّة ذاتها، فسنقدر على فصل الجزء من برنامجنا الذي يعنى بالأعداد الكسريّة في ذاتها عن تفاصيل كيفيّة تمثيل الأعداد الكسريّة بأزواجٍ من الأعداد الصحيحة. وأمّا التقنيّة العامّة في عزل أجزاء البرنامج التي تعنى بكيفيّة تمثيل كائنات البيانات عن أجزاء البرنامج التي تعنى بكيفيّة استخدام كائنات البيانات، فهي منهجيّة تصميمٍ قويّةٌ تُسمّى تجريد البيانات (data abstraction). وسنرى كيف يجعل تجريد البيانات تصميم البرامج وصيانتها وتعديلها أسهلَ بكثيرٍ.
ويؤدّي استخدام البيانات المركّبة إلى زيادةٍ حقيقيّةٍ في القوّة التعبيريّة للغة البرمجة لدينا. تأمّل فكرة تكوين «تركيب خطّيّ» . فقد نرغب في كتابة إجراءٍ يقبل و و و كمعطياتٍ ويعيد قيمة . ولا يطرح هذا أيّ صعوبةٍ إذا كان على المعطيات أن تكون أعدادًا، لأنّنا نستطيع بسهولةٍ تعريف الإجراء
(define (linear-combination a b x y)
  (+ (* a x) (* b y)))
لكن افترض أنّنا لا نعني بالأعداد فقط. افترض أنّنا نرغب في التعبير، من حيث الإجراءات، عن الفكرة القائلة إنّه يمكن تكوين تركيباتٍ خطّيّةٍ كلّما عُرِّف الجمع والضرب - للأعداد الكسريّة، أو الأعداد المركّبة، أو كثيرات الحدود، أو أيّ شيءٍ آخر. ويمكننا التعبير عن هذا كإجراءٍ على الصيغة
(define (linear-combination a b x y)
  (add (mul a x) (mul b y)))
حيث add وmul ليسا الإجراءين الأوّليّين + و*، بل شيئان أكثر تعقيدًا سيؤدّيان العمليّات المناسبة لأيّ أنواع بياناتٍ نمرّرها كمعطيات a وb وx وy. والنقطة الجوهريّة هي أنّ الشيء الوحيد الذي ينبغي أن يعرفه linear-combination عن a وb وx وy هو أنّ الإجراءين add وmul سيؤدّيان التلاعبات المناسبة. فمن منظور الإجراء linear-combination، لا صلة لما هي a وb وx وy، وأقلّ صلةً بعدُ بكيفيّة تمثيلها من حيث بياناتٍ أكثر أوّليّة. ويُظهر هذا المثال ذاته أهمّيّة أن توفّر لغة البرمجة لدينا القدرة على التلاعب بالكائنات المركّبة مباشرةً: فدون ذلك، لا سبيل لإجراءٍ كـlinear-combination لتمرير معطياته إلى add وmul دون أن يضطرّ إلى معرفة بنيتها المفصّلة.[1]
نبدأ هذا الفصل بتنفيذ نظام العمليّات الحسابيّة للأعداد الكسريّة المذكور أعلاه. وسيشكّل هذا الخلفيّة لمناقشتنا للبيانات المركّبة وتجريد البيانات. وكما هو الحال مع الإجراءات المركّبة، فإنّ المسألة الرئيسيّة الواجب معالجتها هي التجريد كتقنيّةٍ لمواجهة التعقيد، وسنرى كيف يمكّننا تجريد البيانات من إقامة حواجز تجريد (abstraction barriers) مناسبةٍ بين أجزاء البرنامج المختلفة.
وسنرى أنّ مفتاح تكوين البيانات المركّبة هو أنّ لغة البرمجة ينبغي أن توفّر نوعًا من «اللصق» بحيث يمكن جمع كائنات البيانات معًا لتكوين كائنات بياناتٍ أكثر تعقيدًا. وهناك أنواعٌ كثيرةٌ ممكنةٌ من اللصق. فإنّا سنكتشف كيف نُكوّن بياناتٍ مركّبةً دون أيّ عمليّاتٍ خاصّةٍ «للبيانات» على الإطلاق، بل باستخدام الإجراءات فقط. وسيطمس هذا التمييز بين «الإجراء» و«البيانات» تطميسًا أكبر، وهو الذي كان قد بدأ يتضعضع نحو نهاية الفصل 1. وسنستكشف أيضًا بعض التقنيّات المتعارف عليها لتمثيل التسلسلات والأشجار. وإحدى الأفكار الرئيسيّة في التعامل مع البيانات المركّبة هي مفهوم الإغلاق (closure) - وهو أنّ اللصق الذي نستخدمه لجمع كائنات البيانات ينبغي أن يسمح لنا بجمع كائنات البيانات الأوّليّة لا فحسب، بل كائنات البيانات المركّبة كذلك. وفكرة رئيسيّة أخرى أنّ كائنات البيانات المركّبة يمكن أن تخدم بوصفها واجهاتٍ متعارف عليها (conventional interfaces) لجمع وحدات البرنامج بطرائق التجميع والتبادل. ونوضّح بعض هذه الأفكار بتقديم لغة رسوميّات بسيطةٍ تستثمر الإغلاق.
ثم سنزيد القوّة التمثيليّة للغتنا بإدخال تعبيراتٍ رمزيّة (symbolic expressions) - أي بياناتٍ يمكن أن تكون أجزاؤها الأوّليّة رموزًا اعتراضيّةً بدلًا من الأعداد فقط. ونحن نستكشف بدائل مختلفة لتمثيل مجموعات الكائنات. وسنجد أنّّه، كما أنّ دالّةً عدديّةً معيّنةً يمكن احتسابها بعديدٍ من العمليّات الحسابيّة المختلفة، فهناك طرائق كثيرة يمكن أن تُعبَّر بها بنية بياناتٍ معيّنةً من حيث كائناتٍ أبسط منها، وأنّ اختيار التمثيل يمكن أن يكون له أثرٌ مهمٌّ على المتطلّبات الزمنيّة والمكانيّة للعمليّات التي تتلاعب بالبيانات. وسنبحث هذه الأفكار في سياق التفاضل الرمزيّ، وتمثيل المجموعات، وترميز المعلومات.
وسنتناول تاليًا مسألة العمل مع بياناتٍ قد تُمثَّل بطرائق مختلفة في أجزاء مختلفة من البرنامج. وهذا يستدعي الحاجة إلى تنفيذ عمليّاتٍ عامّة (generic operations)، وهي التي ينبغي لها أن تتعامل مع أنواعٍ كثيرةٍ مختلفةٍ من البيانات. والحفاظ على الوحدانيّة بحضور العمليّات العامّة يتطلّب حواجز تجريدٍ أقوى ممّا يمكن إقامته بتجريد البيانات البسيط وحده. وعلى وجه الخصوص، فإنّا نُقدّم البرمجة الموجَّهة بالبيانات (data-directed programming) كتقنيّةٍ تسمح بأن يُصمَّم التمثيل الفرديّ للبيانات على انفراد، ثم تُجمع التمثيلات جمعًا إضافيًّا (additively) (أي دون تعديل). ولتوضيح قوّة هذا المنهج في تصميم النظم، نُغلق الفصل بتطبيق ما تعلّمناه على تنفيذ حزمةٍ لأداء العمليّات الحسابيّة الرمزيّة على كثيرات الحدود، والتي يمكن أن تكون معاملاتها أعدادًا صحيحة، أو أعدادًا كسريّة، أو أعدادًا مركّبة، أو حتّى كثيرات حدودٍ أخرى.
2.1 مقدّمة في تجريد البيانات
لقد لاحظنا في 1.1.8 أنّ الإجراء المستخدم كعنصرٍ في إنشاء إجراءٍ أكثر تعقيدًا يمكن اعتباره لا مجرّد مجموعةٍ من العمليّات الخاصّة فحسب، بل تجريدًا إجرائيًّا أيضًا. أي أنّ تفاصيل كيفيّة تنفيذ الإجراء يمكن إخفاؤها، ويمكن استبدال الإجراء نفسه بأيّ إجراءٍ آخر ذي سلوكٍ كلّيٍّ مماثل. وبعبارة أخرى، فبوسعنا أن نُجرّد بحيث نفصل الطريقة التي سيُستخدم فيها الإجراء عن تفاصيل كيفيّة تنفيذه من حيث إجراءاتٍ أكثر أوّليّة. والمفهوم الموازي للبيانات المركّبة يُسمّى تجريد البيانات (data abstraction). وتجريد البيانات منهجيّةٌ تُمكّننا من عزل كيفيّة استخدام كائن بيانات مركّب عن تفاصيل كيفيّة بنائه من كائنات بياناتٍ أكثر أوّليّة.
والفكرة الأساسيّة في تجريد البيانات هي بناءة البرامج التي ستستخدم كائنات البيانات المركّبة بحيث تعمل على «بياناتٍ مجرّدة». أي أنّ برامجنا ينبغي أن تستخدم البيانات على نحوٍ لا يفترض عنها شيئًا ليس ضروريًّا على نحوٍ حتميّ لأداء المهمّة بين اليدين. وفي الوقت نفسه، يُعرَّف تمثيلٌ «ملموس» للبيانات مستقلًّا عن البرامج التي تستخدم البيانات. والواجهة بين هذين الجزأين من نظامنا ستكون مجموعةً من الإجراءات، تُسمّى المحدِّدات (selectors) والبانيّات (constructors)، والتي تنفّذ البيانات المجرّدة من حيث التمثيل الملموس. ولتوضيح هذه التقنيّة، سنُفكّر في كيفيّة تصميم مجموعةٍ من الإجراءات للتلاعب بالأعداد الكسريّة.
2.1.1 مثال: العمليّات الحسابيّة للأعداد الكسريّة
لنفترض أنّنا نريد أداء العمليّات الحسابيّة على الأعداد الكسريّة. ونريد أن نكون قادرين على جمعها وطرحها وضربها وقسمتها، وعلى اختبار ما إذا كان عددان كسريّان متساويين.
لنبدأ بافتراض أنّ لدينا بالفعل طريقةً لبناء عددٍ كسريّ من بسطٍ ومقام. ونفترض أيضًا أنّّه، إذا أُعطي عددٌ كسريّ، فلدينا طريقةٌ لاستخراج (أو تحديد) بسطه ومقامه. ولنفترض أيضًا أنّ البانيّ والمحدِّدات متاحةٌ بوصفها إجراءات:
- يُعيد
(make-rat ⟨n⟩ ⟨d⟩)العددَ الكسريّ الذي بسطه هو العدد الصحيح⟨n⟩ومقامه هو العدد الصحيح⟨d⟩. - يُعيد
(numer ⟨x⟩)بسط العدد الكسريّ⟨x⟩. - يُعيد
(denom ⟨x⟩)مقام العدد الكسريّ⟨x⟩.
نحن نستخدم هنا استراتيجيّة قويّة في التركيب: التفكير الأمنيويّ (wishful thinking). فنحن لم نقل بعد كيف يُعبَّر عن العدد الكسريّ، أو كيف ينبغي تنفيذ الإجراءين numer وdenom والبانيّ make-rat. ومع ذلك، فلو كان لدينا هذه الإجراءات الثلاثة، لاستطعنا آنذاك أن نجمع ونطرح ونضرب ونقسم ونختبر التساوي باستخدام العلاقات التالية: ونستطيع التعبير عن هذه القواعد كإجراءات:
(define (add-rat x y)
  (make-rat (+ (* (numer x) (denom y))
               (* (numer y) (denom x)))
            (* (denom x) (denom y))))

(define (sub-rat x y)
  (make-rat (- (* (numer x) (denom y))
               (* (numer y) (denom x)))
            (* (denom x) (denom y))))

(define (mul-rat x y)
  (make-rat (* (numer x) (numer y))
            (* (denom x) (denom y))))

(define (div-rat x y)
  (make-rat (* (numer x) (denom y))
            (* (denom x) (numer y))))

(define (equal-rat? x y)
  (= (* (numer x) (denom y))
     (* (numer y) (denom x))))
صار لدينا الآن العمليّات على الأعداد الكسريّة معرَّفةً من حيث إجراءات التحديد والبناء numer وdenom وmake-rat. لكننا لم نُعرّفها بعد. وما نحتاجه هو طريقةٌ ما للصق بسطٍ ومقامٍ معًا لتكوين عددٍ كسريّ.
الأزواج
وليتيح لنا تنفيذ المستوى الملموس من تجريد البيانات، توفّر لغتنا بنيةً مركّبةً تُسمّى زوجًا (pair)، والتي يمكن بناؤها بالإجراء الأوّليّ cons. وهذا الإجراء يأخذ معطيين ويعيد كائن بياناتٍ مركّبًا يحتوي المعطيين كجزأين. وبإعطائنا زوجًا، نستطيع استخراج جزأيه باستخدام الإجراءين الأوّليّين car وcdr.[2] وهكذا، فيمكننا استخدام cons وcar وcdr كما يلي:
(define x (cons 1 2))

(car x)
1

(cdr x)
2
لاحِظ أنّ الزوج كائن بياناتٍ يمكن إعطاؤه اسمٌ ثم التلاعب به، تمامًا مثل كائن البيانات الأوّليّ. فضلًا عن ذلك، فيمكن استخدام cons لتكوين أزواجٍ عناصرها أزواج، وهكذا:
(define x (cons 1 2))
(define y (cons 3 4))
(define z (cons x y))

(car (car z))
1

(car (cdr z))
3
سنرى في 2.2 كيف تعني هذه القدرة على جمع الأزواج أنّ الأزواج يمكن استخدامها وحداتِ بناءٍ عامّة الغرض لإنشاء جميع أنواع بنيات البيانات المعقّدة. فالأوّليّة الوحيدة للبيانات المركّبة، وهي الزوج، المنفّذة بالإجراءات cons وcar وcdr، هي اللصق الوحيد الذي نحتاجه. وتُسمّى كائنات البيانات المبنية من الأزواج بياناتٍ مبنيّة على القوائم (list-structured).
تمثيل الأعداد الكسريّة
تُتيح الأزواج طريقةً طبيعيّةً لإتمام نظام الأعداد الكسريّة. فما عليك إلّا أن تمثّل العدد الكسريّ بزوجٍ من عددين صحيحين: بسطٌ ومقام. وحينئذٍ يُنفَّذ make-rat وnumer وdenom بسهولةٍ كما يلي:[3]
(define (make-rat n d) (cons n d))
(define (numer x) (car x))
(define (denom x) (cdr x))
وكذلك، فإنّه لعرض نتائج احتساباتنا، يمكننا طباعة الأعداد الكسريّة بطباعة البسط، ثم شرطة مائلة، ثم المقام:[4]
(define (print-rat x)
  (newline)
  (display (numer x))
  (display "/")
  (display (denom x)))
يمكننا الآن تجربة إجراءاتنا للأعداد الكسريّة:
(define one-half (make-rat 1 2))
(print-rat one-half)
1/2

(define one-third (make-rat 1 3))
(print-rat
 (add-rat one-half one-third))
5/6

(print-rat
 (mul-rat one-half one-third))
1/6

(print-rat
 (add-rat one-third one-third))
6/9
كما يُظهر المثال الأخير، فإنّ تنفيذنا لا يُختزل الأعداد الكسريّة إلى أبسط صورة. ونستطيع معالجة هذا بتغيير make-rat. فإذا كان لدينا إجراءٌ gcd مثل الإجراء الوارد في 1.2.5 والذي يُنتج القاسم المشترك الأكبر لعددين صحيحين، فنستطيع استخدام gcd لاختزال البسط والمقام إلى أبسط صورهما قبل بناء الزوج:
(define (make-rat n d)
  (let ((g (gcd n d)))
    (cons (/ n g)
          (/ d g))))
فإنّا نحصل الآن على
(print-rat
 (add-rat one-third one-third))
2/3
كما هو مطلوب. وقد أُنجز هذا التعديل بتغيير البانيّ make-rat دون تغيير أيّ من الإجراءات (مثل add-rat وmul-rat) التي تنفّذ العمليّات الفعليّة.
التمرين 2.1: عرّف نسخةً أفضل من
make-ratتتعامل مع المعطيات الموجبة والسالبة جميعًا. وينبغي لـMake-ratأن يُوحّد الإشارة بحيث إن كان العدد الكسريّ موجبًا، فالبسط والمقام كلاهما موجب، وإن كان العدد الكسريّ سالبًا، فالبسط وحده هو السالب.
2.1.2 حواجز التجريد
وقبل المواصلة بمزيدٍ من الأمثلة على البيانات المركّبة وتجريد البيانات، دعنا ننظر في بعض القضايا التي أثارها مثال العدد الكسريّ. فقد عرّفنا العمليّات على الأعداد الكسريّة من حيث بانيّ make-rat ومحدِّدين numer وdenom. وبصورةٍ عامّة، فإنّ الفكرة الكامنة في تجريد البيانات هي تحديد مجموعةٍ أساسيّةٍ من العمليّات لكلّ نوعٍ من كائنات البيانات، والتي ستُعبَّر بها جميع التلاعبات بكائنات البيانات من ذلك النوع، ثم استخدام تلك العمليّات وحدها في التلاعب بالبيانات.
يمكننا تصوّر بنية نظام الأعداد الكسريّة كما هو موضّح في الشكل 2.1. فالخطوط الأفقيّة تمثّل حواجز تجريد تعزل «مستويات» مختلفة للنظام. فعند كلّ مستوىٍ، يفصل الحاجز البرامج (أعلاه) التي تستخدم تجريد البيانات عن البرامج (أسفله) التي تنفّذ تجريد البيانات. والبرامج التي تستخدم الأعداد الكسريّة تتلاعب بها حصريًّا من حيث الإجراءات التي تُوفّرها حزمة العدد الكسريّ «للاستخدام العامّ»: add-rat وsub-rat وmul-rat وdiv-rat وequal-rat?. وهذه، بدورها، تُنفَّذ حصريًّا من حيث البانيّ والمحدِّدين make-rat وnumer وdenom، والذين يُنفَّذون بدورهم من حيث الأزواج. وتفاصيل كيفيّة تنفيذ الأزواج لا صلة لها ببقيّة حزمة العدد الكسريّ ما دام يمكن التلاعب بالأزواج باستخدام cons وcar وcdr. وفي الواقع، فإنّ الإجراءات عند كلّ مستوىٍ هي الواجهات التي تُعرِّف حواجز التجريد وتصل المستويات المختلفة.
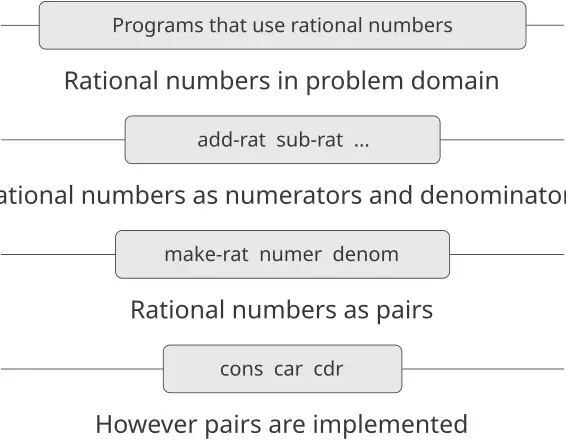
الشكل 2.1: حواجز تجريد البيانات في حزمة العدد الكسريّ.
ولهذه الفكرة البسيطة مزايا كثيرة. ومن مزاياها أنّها تجعل البرامج أسهلَ بكثيرٍ في الصيانة والتعديل. فأيّ بنية بياناتٍ معقّدةٍ يمكن تمثيلها بطرائق متنوّعة باستخدام بنيات البيانات الأوّليّة التي توفّرها لغة البرمجة. وبالطبع، فإنّ اختيار التمثيل يؤثّر في البرامج التي تعمل عليه؛ وبذلك، فلو كان التمثيل سيُغيَّر في وقتٍ لاحقٍ، فقد تضطرّ جميع تلك البرامج إلى التعديل وفقًا لذلك. وقد تكون هذه المهمّة مستهلكةً للوقت ومكلفةً في البرامج الكبيرة، ما لم يُحْبَس الاعتماد على التمثيل بحكم التصميم في وحداتِ برنامجٍ قليلةٍ جدًّا.
فمثلًا، فإنّ طريقةً بديلةً لمعالجة مسألة اختزال الأعداد الكسريّة إلى أبسط صورة هي أداء الاختزال كلّما نصل إلى أجزاء عددٍ كسريّ، بدلًا من حين نبنيه. وهذا يؤدّي إلى إجراءات بناءٍ وتحديدٍ مختلفة:
(define (make-rat n d)
  (cons n d))

(define (numer x)
  (let ((g (gcd (car x) (cdr x))))
    (/ (car x) g)))

(define (denom x)
  (let ((g (gcd (car x) (cdr x))))
    (/ (cdr x) g)))
يكمن الفرق بين هذا التنفيذ والتنفيذ السابق في وقت احتسابنا لـgcd. فإذا كنّا في استخدامنا المعتاد للأعداد الكسريّة نصل إلى بسط الأعداد الكسريّة ذاتها ومقاماتها مرّاتٍ كثيرة، فسيكون الأفضل احتساب gcd حين تُبنى الأعداد الكسريّة. وإلّا، فقد نكون أحسنَ حالًا بأن ننتظر حتّى وقت الوصول لاحتساب gcd. وعلى أيّ حال، فإنّا حين ننتقل من تمثيلٍ إلى آخر، لا يتحتّم تعديل الإجراءات add-rat وsub-rat وما شابهها إطلاقًا.
وقصر الاعتماد على التمثيل على بضعة إجراءاتِ واجهةٍ يساعدنا على تصميم البرامج كما يساعدنا على تعديلها، لأنّه يسمح لنا بالمحافظة على المرونة اللازمة للنظر في تنفيذاتٍ بديلة. ولمواصلة مثالنا البسيط، لنفترض أنّنا نُصمّم حزمة عددٍ كسريّ ولا نستطيع في البادئ حسم ما إذا كنّا سنؤدّي الـgcd في وقت البناء أم في وقت التحديد. فإنّ منهجيّة تجريد البيانات تعطينا طريقةً لتأخير ذلك القرار دون فقدان القدرة على إحراز التقدّم في بقيّة النظام.
التمرين 2.2: فكّر في مسألة تمثيل قطع المستقيم في مستوًى. يُعبَّر عن كلّ قطعةٍ بزوجٍ من النقاط: نقطة بدايةٍ ونقطة نهاية. عرّف بانيًّا make-segment ومحدِّدين start-segment وend-segment يُعرِّفان تمثيل القطع من حيث النقاط. فضلًا عن ذلك، يمكن تمثيل النقطة بزوجٍ من الأعداد: الإحداثيّ والإحداثيّ . ووفقًا لذلك، حدّد بانيًّا make-point ومحدِّدين x-point وy-point يُعرِّفان هذا التمثيل. وأخيرًا، باستخدام محدِّديك وبانيّيك، عرّف إجراءً midpoint-segment يأخذ قطعةَ مستقيمٍ كمعطىً ويعيد نقطة منتصفها (أي النقطة التي إحداثيّاها متوسّط إحداثيّي طرفيها). ولتجربة إجراءاتك، ستحتاج إلى طريقةٍ لطباعة النقاط:
(define (print-point p)
  (newline)
  (display "(")
  (display (x-point p))
  (display ",")
  (display (y-point p))
  (display ")"))
التمرين 2.3: نفّذ تمثيلًا للمستطيلات في مستوًى. (تلميح: قد ترغب في الاستعانة بـالتمرين 2.2.) وبناءً على بانيّيك ومحدِّديك، أنشئ إجراءاتٍ تحسب محيط مستطيلٍ معطىً ومساحته. ثم نفّذ تمثيلًا مختلفًا للمستطيلات. فهل تستطيع تصميم نظامك بحواجز تجريدٍ مناسبة، بحيث تعمل الإجراءات ذاتها للمحيط والمساحة باستخدام أيّ التمثيلين؟
2.1.3 ما المقصود بالبيانات؟
بدأنا تنفيذ العدد الكسريّ في 2.1.1 بتنفيذ العمليّات على الأعداد الكسريّة add-rat وsub-rat وما شابهها من حيث ثلاثة إجراءاتٍ غير محدّدةٍ: make-rat وnumer وdenom. وعند تلك النقطة، كان بإمكاننا أن نفكّر في العمليّات بوصفها معرَّفةً من حيث كائنات بيانات - أعداد كسريّة وبسط ومقام - كان سلوكها محدَّدًا بالإجراءات الثلاثة الأخيرة.
لكن ما المقصود بالبيانات (data) بالضبط؟ ولا يكفي القول إنّها «كلّ ما يُنفَّذ بالمحدِّدات والبانيّات المعطاة». فمن الواضح أنّ ليس كلّ مجموعة اعتراضيّة من ثلاثة إجراءاتٍ يمكن أن تخدم أساسًا مناسبًا لتنفيذ العدد الكسريّ. فنحن نحتاج إلى ضمان أنّّه، إذا بنينا عددًا كسريًّا x من زوجٍ من الأعداد الصحيحة n وd، فإنّ استخراج numer وdenom من x وقسمتهما ينبغي أن يُنتج النتيجة ذاتها التي تُنتجها قسمة n على d. وبعبارة أخرى، ينبغي لـmake-rat وnumer وdenom أن تُحقّق الشرط القائم بأنّه، لأيّ عددٍ صحيح n وأيّ عددٍ صحيح غير صفريّ d، إذا كان x هو (make-rat n d)، فإنّ وفي الحقيقة، فإنّ هذا هو الشرط الوحيد الذي ينبغي لـmake-rat وnumer وdenom أن تفي به لتشكيل أساسٍ مناسبٍ لتمثيل العدد الكسريّ. وبصورةٍ عامّة، فيمكننا أن نفكّر في البيانات بوصفها معرَّفةً بمجموعةٍ ما من محدِّداتٍ وبانيّات، جنبًا إلى جنبٍ مع شروطٍ محدَّدةٍ ينبغي لهذه الإجراءات أن تفي بها لتكون تمثيلًا صالحًا.[5]
وهذا المنظور يمكن أن يخدم لا لتعريف كائنات بياناتٍ «عالية المستوى» فقط، كالأعداد الكسريّة، بل أيضًا كائناتٍ أدنى مستوىً. فتأمّل مفهوم الزوج، الذي استخدمناه لتعريف أعدادنا الكسريّة. فنحن لم نقل قطّ ما الزوج فعلًا، بل قلنا فقط إنّ اللغة توفّر الإجراءات cons وcar وcdr للتلاعب بالأزواج. لكن الشيء الوحيد الذي نحتاج إلى معرفته عن هذه العمليّات الثلاث هو أنّنا إذا لصقنا كائنين معًا باستخدام cons، فسنستطيع استرجاع الكائنين باستخدام car وcdr. أي أنّ العمليّات تُحقّق الشرط القائم بأنّه، لأيّ كائنين x وy، إذا كان z هو (cons x y) فإنّ (car z) هو x و(cdr z) هو y. فإنّا ذكرنا أنّ هذه الإجراءات الثلاثة مُدرجةٌ كأوّليّاتٍ في لغتنا. ومع ذلك، فإنّ أيّ ثلاثيّةٍ من الإجراءات تُحقّق الشرط الوارد أعلاه يمكن استخدامها أساسًا لتنفيذ الأزواج. ويوضّح هذا بشكلٍ لافتٍ أنّنا نستطيع تنفيذ cons وcar وcdr دون استخدام أيّ بنيات بياناتٍ إطلاقًا، بل باستخدام الإجراءات فقط. وها هي التعريفات:
(define (cons x y)
  (define (dispatch m)
    (cond ((= m 0) x)
          ((= m 1) y)
          (else
           (error "Argument not 0 or 1:
                   CONS" m))))
  dispatch)

(define (car z) (z 0))
(define (cdr z) (z 1))
وهذا الاستخدام للإجراءات لا يقابل شيئًا يشبه مفهومنا البديهيّ عمّا ينبغي أن تكون عليه البيانات. ومع ذلك، فكلّ ما يلزمنا لإظهار أنّ هذه طريقةٌ صالحةٌ لتمثيل الأزواج هو أن نتحقّق من أنّ هذه الإجراءات تُحقّق الشرط المعطى أعلاه.
والنقطة الدقيقة التي يلزم ملاحظتها هي أنّ القيمة التي يُعيدها (cons x y) هي إجراء - أي الإجراء المعرَّف داخليًّا dispatch، الذي يأخذ معطىً واحدًا ويُعيد إمّا x وإمّا y بحسب ما إذا كان المعطى 0 أو 1. وعلى النحو المقابل، فإنّ (car z) مُعرَّفٌ بأنّه يُطبّق z على 0. ومن ثمّ، فإن كان z هو الإجراء المُكّون بـ(cons x y)، فإنّ تطبيق z على 0 سيُعطي x. وهكذا، فقد أظهرنا أنّ (car (cons x y)) يُعطي x كما هو مطلوب. وبالطريقة ذاتها، فإنّ (cdr (cons x y)) يُطبّق الإجراء الذي يُعيده (cons x y) على 1، وهو ما يُعيد y. وبالتالي، فإنّ هذا التنفيذ الإجرائيّ للأزواج تنفيذٌ صالح، وإذا كنّا نصل إلى الأزواج باستخدام cons وcar وcdr وحدها، فلن نستطيع التمييز بين هذا التنفيذ وتنفيذٍ يستخدم بنيات بياناتٍ «حقيقيّة».
وقصدي من عرض التمثيل الإجرائيّ للأزواج ليس أنّ لغتنا تعمل على هذا النحو (فإنّ Scheme، ونظم Lisp بصفةٍ عامّة، تُنفّذ الأزواج مباشرةً، لأسباب تعلّق بالكفاءة)، بل إنّها تستطيع أن تعمل على هذا النحو. فالتمثيل الإجرائيّ، على الرغم من غموضه، طريقةٌ ملائمةٌ تمامًا لتمثيل الأزواج، بما أنّه يفي بالشروط الوحيدة التي يلزم للأزواج أن تفي بها. ويُظهر هذا المثال أيضًا أنّ القدرة على التلاعب بالإجراءات بوصفها كائناتٍ تُوفّر تلقائيًّا القدرة على تمثيل البيانات المركّبة. وقد يبدو هذا غرابةً الآن، لكن تمثيلات البيانات الإجرائيّة ستلعب دورًا مركزيًّا في ذخيرتنا البرمجيّة. ويُسمّى هذا الأسلوب من البرمجة تمرير الرسائل (message passing)، وسنستخدمه أداةً أساسيّةً في الفصل 3 حين نعالج قضايا النمذجة والمحاكاة.
التمرين 2.4: ها هو تمثيلٌ إجرائيٌّ بديلٌ للأزواج. وبالنسبة لهذا التمثيل، تحقّق من أنّ (car (cons x y)) يُعطي x لأيّ كائنين x وy.
(define (cons x y)
  (lambda (m) (m x y)))

(define (car z)
  (z (lambda (p q) p)))
وما التعريف المقابل لـcdr؟ (تلميح: للتحقّق من أنّ هذا يعمل، استعن بنموذج الاستبدال الوارد في 1.1.5.)
التمرين 2.5: أظهر أنّنا نستطيع تمثيل أزواج الأعداد الصحيحة غير السالبة باستخدام الأعداد والعمليّات الحسابيّة فقط، إذا مثّلنا الزوج و بالعدد الصحيح الذي هو الجداء . وأعطِ التعريفات المقابلة للإجراءات
consوcarوcdr.
التمرين 2.6: وفي حالة أنّ تمثيل الأزواج كإجراءاتٍ لم يكن مُحيِّرًا بما يكفي، فكّر في أنّنا، في لغةٍ قادرةٍ على التلاعب بالإجراءات، نستطيع أن نتدبّر أمرنا دون أعدادٍ (على الأقلّ بقدر ما يتعلّق بالأعداد الصحيحة غير السالبة) بتنفيذ 0 وعمليّة إضافة 1 كما يلي
(define zero (lambda (f) (lambda (x) x)))

(define (add-1 n)
  (lambda (f) (lambda (x) (f ((n f) x)))))
ويُعرف هذا التمثيل بـأعداد تشرتش (Church numerals)، نسبةً إلى مُخترعه، ألونزو تشرتش، المنطقيّ الذي اخترع حساب λ.
عرِّف one وtwo مباشرةً (لا من حيث zero وadd-1). (تلميح: استخدم الاستبدال لتقييم (add-1 zero).) وأعطِ تعريفًا مباشرًا لإجراء الجمع + (لا من حيث التطبيق المتكرّر لـadd-1).
2.1.4 تمرين ممتدّ: حساب الفواصل
أليسا ب. هاكر تُصمّم نظامًا لمساعدة الناس على حلّ مسائل الهندسة. وإحدى الميزات التي تريد توفيرها في نظامها هي القدرة على التعامل مع الكمّيّات غير الدقيقة (كالمعطيات المقيسة للأجهزة الفيزيائيّة) بدقّةٍ معروفة، بحيث إنّه حين تُجرى الاحتسابات بكمّيّاتٍ تقريبيّةٍ كهذه، فإنّ النتائج ستكون أعدادًا ذات دقّةٍ معروفة.
سيستخدم مهندسو الكهرباء نظام أليسا لاحتساب الكمّيّات الكهربائيّة. وفبعض الأحيان يلزمهم أن يحسبوا قيمة مقاومة مكافئة توازيّة لمقاومتين و باستخدام الصيغة وقيم المقاومة تُعرف عادةً فقط حتّى قدرٍ من التفاوت يضمنه مُصنّع المقاومة. فمثلًا، إذا اشتريت مقاومةً موسومةً بـ«6.8 أوم بتفاوت 10%»، فلن تستطيع أن تكون واثقًا إلّا من أنّ المقاومة لها مقاومةٌ كهربائيّةٌ بين 6.8 0.68 = 6.12 و6.8 + 0.68 = 7.48 أوم. وهكذا، فإذا كان لديك مقاومةٌ 6.8 أوم بتفاوت 10% على التوازي مع مقاومةٍ 4.7 أوم بتفاوت 5%، فإنّ مقاومة التوليفة يمكن أن تتراوح من نحو 2.58 أوم (إذا كانت المقاومتان عند الحدّين الأدنيين) إلى نحو 2.97 أوم (إذا كانت المقاومتان عند الحدّين العلويّين).
وفكرة أليسا هي تنفيذ «حساب الفواصل» كمجموعةٍ من العمليّات الحسابيّة لجمع «فواصل» (كائناتٌ تمثّل مدى القيم الممكنة لكمّيّةٍ غير دقيقة). ونتيجة جمع فاصلين أو طرحهما أو ضربهما أو قسمتهما هي فاصلٌ بدروها، يمثّل مدى النتيجة.
تفترض أليسا وجود كائنٍ مجرّدٍ يُسمّى «فاصلًا» له طرفان: حدٌّ أدنى وحدٌّ أعلى. وتفترض أيضًا أنّّه، بإعطائها طرفي فاصلٍ، فهي قادرةٌ على بناء الفاصل باستخدام بانيّ البيانات make-interval. وتكتب أليسا أوّلًا إجراءً لجمع فاصلين. فإنّها تستنبط أنّ القيمة الأدنى التي يمكن أن يكون عليها المجموع هي مجموع الحدّين الأدنيين، وأنّ القيمة العظمى التي يمكن أن يكون عليها هي مجموع الحدّين العلويّين:
(define (add-interval x y)
  (make-interval (+ (lower-bound x)
                    (lower-bound y))
                 (+ (upper-bound x)
                    (upper-bound y))))
وتستنبط أليسا أيضًا جداء فاصلين بإيجاد الأدنى والأعلى من جداءات الحدود، وباستخدامهما كحدّي الفاصل الناتج. (وmin وmax أوّليّتان تجدان الأدنى أو الأعلى من أيّ عددٍ من المعطيات.)
(define (mul-interval x y)
  (let ((p1 (* (lower-bound x)
               (lower-bound y)))
        (p2 (* (lower-bound x)
               (upper-bound y)))
        (p3 (* (upper-bound x)
               (lower-bound y)))
        (p4 (* (upper-bound x)
               (upper-bound y))))
    (make-interval (min p1 p2 p3 p4)
                   (max p1 p2 p3 p4))))
ولقسمة فاصلين، تضرب أليسا الأوّل في مقلوب الثاني. ولاحِظ أنّ حدّي الفاصل المقلوب هما مقلوب الحدّ الأعلى ومقلوب الحدّ الأدنى، بهذا الترتيب.
(define (div-interval x y)
  (mul-interval x
                (make-interval
                 (/ 1.0 (upper-bound y))
                 (/ 1.0 (lower-bound y)))))
التمرين 2.7: برنامج أليسا غير مكتملٍ لأنّها لم تُحدّد تنفيذ تجريد الفاصل. وإليك تعريفُ بانيّ الفاصل:
(define (make-interval a b) (cons a b))
عرِّف محدِّدي upper-bound وlower-bound لإتمام التنفيذ.
التمرين 2.8: باستخدام استنباطٍ مماثلٍ لاستنباط أليسا، صِف كيف يمكن احتساب الفرق بين فاصلين. عرّف إجراءَ طرحٍ مقابلًا، يُسمّى
sub-interval.
التمرين 2.9: عرض الفاصل هو نصف الفرق بين حدّيه الأعلى والأدنى. والعرض مقياسٌ لعدم التيقّن من العدد الذي يُحدّده الفاصل. فبالنسبة لبعض العمليّات الحسابيّة، فإنّ عرض نتيجة دمج فاصلين هو دالّةٌ في عروضي الفاصلين المعطيين فقط، بينما بالنسبة لبعضها الآخر، فإنّ عرض التوليفة ليس دالّةً في عروضي الفاصلين المعطيين. أظهر أنّ عرض المجموع (أو الفرق) بين فاصلين هو دالّةٌ في عروضي الفاصلين المُجمعين (أو المطروحين) فقط. وأعطِ أمثلةً تُظهر أنّ هذا لا يصدق في الضرب أو القسمة.
التمرين 2.10: ينظر بن بِتدل، مبرمج النُظم الخبيرة، من فوق كتف أليسا ويعلّق بأنّه ليس واضحًا ما معنى القسمة على فاصلٍ يمتدّ على الصفر. عدّل شيفرة أليسا لتفحص هذه الحالة ولتُشير إلى خطأٍ إذا وقعت.
التمرين 2.11: وعلى سبيل الاستطراد، يعلّق بن أيضًا بعبارةٍ غامضة: «بفحص إشارات طرفي الفواصل، فإنّ من الممكن تفكيك mul-interval إلى تسع حالات، حالةٌ واحدةٌ فقط منها تتطلّب أكثر من عمليّتي ضرب.» أعد كتابة هذا الإجراء باستخدام اقتراح بن.
وبعد تصحيح برنامجها، تعرضه أليسا على مستخدمٍ محتمل، فيشتكي أنّ برنامجها يحلّ المسألة الخطأ. وهو يريد برنامجًا قادرًا على التعامل مع أعدادٍ مُعبَّرًا عنها كقيمةٍ مركزيّةٍ وتفاوتٍ مضاف؛ فهو يريد، مثلًا، أن يعمل مع فواصلَ مثل 3.5 0.15 بدلًا من [3.35, 3.65]. فتعود أليسا إلى مكتبها وتُصلح هذه المسألة بتوفير بانيّ بديلٍ ومحدِّدين بديلين:
(define (make-center-width c w)
  (make-interval (- c w) (+ c w)))

(define (center i)
  (/ (+ (lower-bound i)
        (upper-bound i))
     2))

(define (width i)
  (/ (- (upper-bound i)
        (lower-bound i))
     2))
للأسف، معظم مستخدمي أليسا مهندسون. فإنّ مواقف الهندسة الحقيقيّة تتضمّن عادةً قياساتٍ عدمُ يقينها صغيرٌ فقط، ويُقاس ذلك بنسبة عرض الفترة إلى منتصف الفترة. وعادةً ما يحدّد المهندسون تفاوتاتٍ مئويّةً على مُعطيات الأجهزة، كما في مواصفات المقاومات الواردة أعلاه.
التمرين 2.12: عرّف بانيًا (constructor) باسم
make-center-percentيأخذ مركزًا ونسبة تفاوتٍ مئويّةً وينتج الفترة المطلوبة. ويجب أن تعرّف أيضًا منتقيًا (selector) باسمpercentيُنتج نسبة التفاوت المئويّة لفترةٍ معطاة. أمّا المنتقيcenterفهو ذاته المبيَّن أعلاه.
التمرين 2.13: أظهر أنّه تحت افتراض تفاوتاتٍ مئويّةٍ صغيرة، ثمّة صيغةٌ بسيطةٌ لنسبة التفاوت المئويّة التقريبيّة لحاصل ضرب فترتين بدلالة تفاوتي العاملين. ويجوز لك تبسيط المسألة بافتراض أنّ جميع الأعداد موجبة.
بعد جهدٍ جهيد، تُسلّم أليسا بي. هاكر نظامها المنتهي. وبعد سنواتٍ عدّة، وبعد أن تكون قد نسيت الأمر كلَّه، تتلقّى اتصالًا هيجانًا من مستخدمٍ غاضبٍ يُدعى ليم إي. تويكيت. ويبدو أنّ ليم قد لاحظ أنّ صيغة المقاومات المتوازية يمكن كتابتها بطريقتين متكافئتين جبريًّا: و وقد كتب البرنامجين الآتيين، كلٌّ منهما يحتسب صيغة المقاومات المتوازية بطريقةٍ مختلفة:
(define (par1 r1 r2)
  (div-interval
   (mul-interval r1 r2)
   (add-interval r1 r2)))

(define (par2 r1 r2)
  (let ((one (make-interval 1 1)))
    (div-interval
     one
     (add-interval
      (div-interval one r1)
      (div-interval one r2)))))
يشتكي ليم من أنّ برنامج أليسا يُعطي جوابين مختلفين للطريقتين في الاحتساب. وهذه شكوى جديّة.
التمرين 2.14: بيّن أنّ ليم على حقّ. افحص سلوك النظام على مجموعةٍ متنوّعةٍ من التعابير الحسابيّة. أنشئ بعض الفترات و ، واستخدمها في احتساب التعبيرين و . وستحصل على أعمق إدراكٍ باستخدام فتراتٍ عرضُها نسبةٌ صغيرةٌ من قيمة المركز. وافحص نتائج الاحتساب في صيغة المركز والنسبة (انظر التمرين 2.12).
التمرين 2.15: لاحظت إيفا لو أتور، وهي مستخدمة أخرى، الفترات المختلفة التي تحتسبها تعابيرُ متكافئةٌ جبريًّا لكنّها مختلفة. وهي تقول إنّ صيغةً للاحتساب بالفترات باستخدام نظام أليسا ستُنتج حدودًا أضيقَ للخطأ إذا أمكن كتابتها بشكلٍ لا يتكرّر فيه أيّ متغيّرٍ يمثّل عددًا غير أكيد. وبالتالي - كما تقول - فإنّ
par2برنامجٌ «أفضل» للمقاومات المتوازية منpar1. فهل هي محقّة؟ ولماذا؟
التمرين 2.16: اشرح، بصورةٍ عامّة، لماذا قد تؤدّي التعابير الجبريّة المتكافئة إلى أجوبةٍ مختلفة. فهل تستطيع ابتكار حزمةٍ للحساب بالفترات خاليةٍ من هذا القصور، أم أنّ هذه المهمّة مستحيلة؟ (تحذير: هذه المسألة في غاية الصعوبة.)
2.2 البيانات الهرميّة وخاصّيّة الإغلاق
كما رأينا، توفّر الأزواج (pairs) مادّةَ لصقٍ أوّليّةً يمكننا استخدامها لبناء كائنات بياناتٍ مركّبة. ويُظهر الشكل 2.2 طريقةً قياسيّةً لتصوّر زوجٍ — في هذه الحالة، الزوج المتشكّل بـ(cons 1 2). في هذا التمثيل، الذي يُسمّى ترميز الصناديق والمؤشّرات (box-and-pointer notation)، يُعرَض كلّ كائنٍ بمثابة مؤشّر (pointer) إلى صندوق. وصندوق الكائن الأوّليّ يحتوي تمثيلًا للكائن. فمثلًا، صندوق العدد يحتوي رقمًا. وأمّا صندوق الزوج فهو صندوقٌ مزدوجٌ في الحقيقة، جزءه الأيسر يحتوي (مؤشّرًا إلى) car الزوج وجزؤه الأيمن يحتوي cdr.
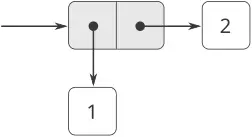
الشكل 2.2: تمثيل (cons 1 2) بالصناديق والمؤشّرات.
وقد رأينا بالفعل أنّ cons يمكن استخدامه لدمج لا الأعداد فحسب بل الأزواج أيضًا. (وأنت قد استفدت من هذه الحقيقة، أو كان ينبغي لك ذلك، عند أداء التمرين 2.2 والتمرين 2.3.) ونتيجةً لذلك، توفّر الأزواج لبنةَ بناءٍ عامّةً نستطيع بها تشييد جميع أنواع بنيات البيانات. ويُظهر الشكل 2.3 طريقتين لاستخدام الأزواج في دمج الأعداد 1، و2، و3، و4.
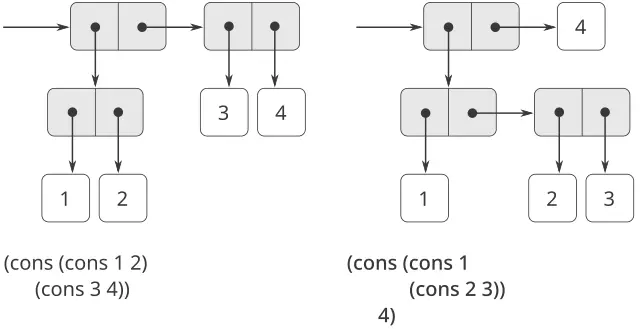
الشكل 2.3: طريقتان لدمج الأعداد 1، و2، و3، و4 باستخدام الأزواج.
إنّ القدرة على إنشاء أزواجٍ عناصرها أزواجٌ هي جوهر أهمّيّة بنية القائمة بوصفها أداةً تمثيليّة. ونحن نشير إلى هذه القدرة بـخاصّيّة الإغلاق (closure property) لـcons. وبصورةٍ عامّة، فإنّ عمليّةً لدمج كائنات البيانات تُحقّق خاصّيّة الإغلاق إذا كانت نتائج دمج الأشياء بتلك العمليّة قابلةً بذاتها للدمج باستخدام العمليّة ذاتها.[6] والإغلاق هو مفتاح القوّة في أيّ وسيلةِ دمجٍ لأنّه يسمح لنا بإنشاء بنى هرميّة — بنىً مركّبةٍ من أجزاء، هي بذاتها مركّبةٌ من أجزاء، وهكذا.
فمنذ بداية الفصل 1، استخدمنا الإغلاق استخدامًا جوهريًّا في تعاملنا مع الإجراءات، لأنّ جميع البرامج إلّا أبسطها تعتمد على حقيقة أنّ عناصر التركيب يمكن أن تكون تركيبًا بذاتها. وفي هذا القسم نتناول تبعات الإغلاق بالنسبة للبيانات المركّبة. فنحن نصف بعض التقنيّات المتعارَف عليها لاستخدام الأزواج في تمثيل التسلسلات والأشجار، ونعرض لغةً رسوميّةً تُجسّد الإغلاق بطريقةٍ بالغة الوضوح.[7]
2.2.1 تمثيل التسلسلات
إحدى البنيات المفيدة التي نستطيع تشييدها بالأزواج هي التسلسل (sequence) — مجموعةٌ مرتَّبةٌ من كائنات البيانات. ثمّة، بالطبع، طرائقُ كثيرةٌ لتمثيل التسلسلات بدلالة الأزواج. وأحد التمثيلات المباشرة على نحوٍ خاصّ موضَّحٌ في الشكل 2.4، حيث يُتمثَّل التسلسل 1، و2، و3، و4 سلسلةً من الأزواج. فالـcar لكلّ زوجٍ هو العنصر المقابل له في السلسلة، والـcdr للزوج هو الزوج التالي في السلسلة. والـcdr للزوج الأخير يُشير إلى نهاية التسلسل بالإشارة إلى قيمةٍ مميّزةٍ ليست زوجًا، وهي مُتمثَّلة في مخطّطات الصناديق والمؤشّرات بخطٍّ قطريّ وفي البرامج بقيمة المتغيّر nil. ويُبنى التسلسل كلُّه بعمليّات cons متداخلة:
(cons 1
      (cons 2
            (cons 3
                  (cons 4 nil))))
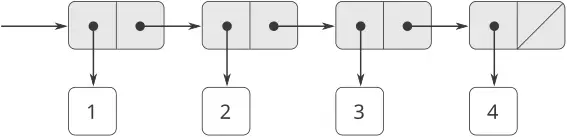
الشكل 2.4: التسلسل 1، و2، و3، و4 مُمثَّلًا سلسلةً من الأزواج.
إنّ تسلسلًا كهذا من الأزواج، المتشكّل بعمليّات cons متداخلة، يُسمّى قائمة (list)، وتوفّر Scheme أوّليًّا يُسمّى list للمساعدة في بناء القوائم.[8] ويمكن إنتاج التسلسل أعلاه بـ(list 1 2 3 4). وبصورةٍ عامّة،
(list ⟨a₁⟩ ⟨a₂⟩ … ⟨aₙ⟩)
وهو مكافئٌ لـ
(cons ⟨a₁⟩
      (cons ⟨a₂⟩
            (cons …
                  (cons ⟨aₙ⟩
                        nil)…)))
تطبع نظم Lisp القوائم اصطلاحًا بطباعة تسلسل العناصر محاطًا بأقواس. وبذلك، فإنّ كائن البيانات في الشكل 2.4 يُطبع بالشكل (1 2 3 4):
(define one-through-four (list 1 2 3 4))

one-through-four
(1 2 3 4)
احرص على ألّا تخلط بين التعبير (list 1 2 3 4) والقائمة (1 2 3 4)، وهي النتيجة المتحصّلة عند تقييم التعبير. فإنّ محاولة تقييم التعبير (1 2 3 4) ستُطلق إشارة خطأٍ عندما يحاول المفسّر تطبيق الإجراء 1 على المعطيات 2، و3، و4.
يمكننا النظر إلى car على أنّه ينتقي أوّل عنصر في القائمة، وإلى cdr على أنّه ينتقي القائمة الفرعيّة المكوّنة من جميع العناصر عدا الأوّل. ويمكن استخدام تطبيقات car وcdr المتداخلة لاستخراج العنصر الثاني، والثالث، والعناصر اللاحقة في القائمة.[9] والباني cons يُنتج قائمةً شبيهة بالأصليّة، لكن مع عنصرٍ إضافيّ في البداية.
(car one-through-four)
1

(cdr one-through-four)
(2 3 4)

(car (cdr one-through-four))
2

(cons 10 one-through-four)
(10 1 2 3 4)

(cons 5 one-through-four)
(5 1 2 3 4)
قيمة nil، المستخدمة لإنهاء سلسلة الأزواج، يمكن النظر إليها بوصفها تسلسلًا لا عناصر له، وهو القائمة الفارغة (empty list). وكلمة nil اختصارٌ للكلمة اللاتينيّة nihil، التي تعني «لا شيء».[10]
عمليّات القوائم
يُرافق استخدام الأزواج في تمثيل تسلسلات العناصر كقوائم تقنيّاتٌ برمجةٍ متعارَف عليها لمعالجة القوائم بالتنزّل المتتالي بـcdr عبرها. فمثلًا، يأخذ الإجراء list-ref كمعطياتٍ قائمةً وعددًا ويُعيد العنصر من القائمة. ومن المتعارف عليه ترقيم عناصر القائمة ابتداءً من 0. وطريقة احتساب list-ref هي الآتية:
- من أجل ، ينبغي أن يُعيد
list-refالـcarللقائمة. - وإلّا، فينبغي أن يُعيد
list-refالعنصر -st منcdrالقائمة.
(define (list-ref items n)
  (if (= n 0)
      (car items)
      (list-ref (cdr items)
                (- n 1))))

(define squares
  (list 1 4 9 16 25))

(list-ref squares 3)
16
غالبًا ما نتنزّل بـcdr عبر القائمة كلّها. ولمساعدتنا في ذلك، تتضمّن Scheme مُسَيِّمًا أوّليًّا يُسمّى null?، يختبر ما إذا كان معطاه هو القائمة الفارغة. والإجراء length، الذي يُعيد عدد العناصر في قائمةٍ، يُجسّد هذا النمط الاستخداميّ النموذجيّ:
(define (length items)
  (if (null? items)
      0
      (+ 1 (length (cdr items)))))

(define odds
  (list 1 3 5 7))

(length odds)
4
يُنفّذ الإجراء length خطةً تعاوديّةً بسيطة. وخطوة الاختزال هي:
- إنّ
lengthأيّ قائمةٍ يساوي 1 زائدlengthالـcdrمنها.
وهذا يُطبَّق تتاليًّا حتّى نصل إلى الحالة الأساسيّة:
- إنّ
lengthالقائمة الفارغة هو 0.
ويمكننا أيضًا احتساب length بأسلوبٍ تكراريّ:
(define (length items)
  (define (length-iter a count)
    (if (null? a)
        count
        (length-iter (cdr a)
                     (+ 1 count))))
  (length-iter items 0))
وثمّة تقنيّةٌ برمجةٍ متعارَف عليها أخرى، وهي «تجميع قائمة الجواب بـcons» أثناء التنزّل بـcdr عبر قائمةٍ، كما في الإجراء append، الذي يأخذ قائمتين كمعطياتٍ ويدمج عناصرهما لإنتاج قائمةٍ جديدة:
(append squares odds)
(1 4 9 16 25 1 3 5 7)

(append odds squares)
(1 3 5 7 1 4 9 16 25)
يُنفّذ Append أيضًا باستخدام خطةٍ تعاوديّة. ولدمج (append) القائمتين list1 وlist2، افعل الآتي:
- إذا كانت
list1هي القائمة الفارغة، فالنتيجة هيlist2فحسب. - وإلّا، فادمج (
append) الـcdrلـlist1معlist2، وثبّت (cons) الـcarلـlist1في رأس النتيجة:
(define (append list1 list2)
  (if (null? list1)
      list2
      (cons (car list1)
            (append (cdr list1)
                    list2))))
التمرين 2.17: عرّف إجراءً last-pair يُعيد القائمة التي تحتوي العنصر الأخير لقائمةٍ معطاةٍ (غير فارغة) فقط:
(last-pair (list 23 72 149 34))
(34)
التمرين 2.18: عرّف إجراءً reverse يأخذ قائمةً كمعطى ويُعيد قائمةً بالعناصر ذاتها بترتيبٍ معكوس:
(reverse (list 1 4 9 16 25))
(25 16 9 4 1)
التمرين 2.19: تأمّل برنامج عدّ النقود الوارد في 1.2.2. سيكون من الجميل أن نتمكّن من تغيير العملة التي يستخدمها البرنامج بسهولة، حتّى نتمكّن من احتساب عدد طرائق صرف جنيه إسترليني مثلًا. فبالبرنامج مكتوبًا كما هو، فإنّ المعرفة بالعملة موزّعةٌ جزئيًّا في الإجراء first-denomination وجزئيًّا في الإجراء count-change (الذي يعلم أنّ ثمّة خمسة أنواعٍ من عملات الولايات المتّحدة). وسيكون من الأجمل أن نتمكّن من تزويد البرنامج بقائمة العملات التي تُستخدم في الصرف.
نريد إعادة كتابة الإجراء cc بحيث يكون معطاه الثاني قائمةً بقيم العملات التي ستُستخدم بدلًا من عددٍ صحيحٍ يحدّد أيّ العملات تُستخدم. وحينها يمكن أن تكون لدينا قوائم تُعرّف كلّ نوعٍ من العملات:
(define us-coins
  (list 50 25 10 5 1))

(define uk-coins
  (list 100 50 20 10 5 2 1 0.5))
ويمكننا حينها مناداة cc على النحو الآتي:
(cc 100 us-coins)
292
سيتطلّب القيام بذلك تغيير برنامج cc إلى حدٍّ ما. فسيظلّ بالشكل ذاته، لكنّه سيصل إلى معطاه الثاني بطريقةٍ مختلفة، كما يلي:
(define (cc amount coin-values)
  (cond ((= amount 0)
         1)
        ((or (< amount 0)
             (no-more? coin-values))
         0)
        (else
         (+ (cc
             amount
             (except-first-denomination
              coin-values))
            (cc
             (- amount
                (first-denomination
                 coin-values))
             coin-values)))))
عرّف الإجراءات first-denomination، وexcept-first-denomination، وno-more? بدلالة عمليّاتٍ أوّليّةٍ على بنيات القوائم. فهل يؤثّر ترتيب القائمة coin-values في الجواب الذي يُنتجه cc؟ ولماذا أو لماذا لا؟
التمرين 2.20: تأخذ الإجراءات +، و*، وlist أعدادًا اعتباطيّةً من المعطيات. وإحدى طرائق تعريف إجراءاتٍ كهذا هي استخدام define مع الترميز ذي النقطة في الذيل (dotted-tail notation). ففي تعريف الإجراء، فإنّ قائمة الوسائط التي تحتوي نقطةً قبل اسم الوسيط الأخير تُشير إلى أنّه حين يُنادى الإجراء، فإنّ الوسائط الأوّليّة (إن وُجِدت) ستكون لها المعطيات الأوّليّة قيمًا، كالمعتاد، لكنّ قيمة الوسيط الأخير ستكون قائمةً بأيّ معطياتٍ متبقّية. فمثلًا، إذا كان لدينا التعريف
(define (f x y . z) ⟨body⟩)
فإنّ الإجراء f يمكن مناداته بمعطيين أو أكثر. فإن قيّمنا
(f 1 2 3 4 5 6)
فإنّه في جسم f، سيكون x هو 1، وy هو 2، وz هو القائمة (3 4 5 6). وبالنظر إلى التعريف
(define (g . w) ⟨body⟩)
فإنّ الإجراء g يمكن مناداته بصفر من المعطيات أو أكثر. فإن قيّمنا
(g 1 2 3 4 5 6)
فإنّه في جسم g، سيكون w هو القائمة (1 2 3 4 5 6).[11]
استخدم هذا الترميز لكتابة إجراءٍ same-parity يأخذ عددًا صحيحًا أو أكثر ويُعيد قائمةً بجميع المعطيات التي تتّسم بالتكافؤ نفسه (زوجيّةً أو فرديّةً) كما المعطى الأوّل. فمثلًا،
(same-parity 1 2 3 4 5 6 7)
(1 3 5 7)

(same-parity 2 3 4 5 6 7)
(2 4 6)
الرسم الخرائطي على القوائم
إحدى العمليّات المفيدة للغاية هي تطبيق تحويلٍ ما على كلّ عنصرٍ في قائمةٍ وإنتاج قائمة النتائج. فمثلًا، يضرب الإجراء الآتي كلّ عددٍ في قائمةٍ في معاملٍ معطًى:
(define (scale-list items factor)
  (if (null? items)
      nil
      (cons (* (car items) factor)
            (scale-list (cdr items)
                        factor))))

(scale-list (list 1 2 3 4 5) 10)
(10 20 30 40 50)
يمكننا تجريد هذه الفكرة العامّة والتقاطها بوصفها نمطًا مشتركًا مُعبَّرًا عنه بإجراءٍ من رتبةٍ عليا، تمامًا كما في 1.3. والإجراء عليا الرتبة هنا يُسمّى map. وMap يأخذ كمعطياتٍ إجراءً ذا معطى واحد وقائمةً، ويُعيد قائمةَ النتائج الناتجة عن تطبيق الإجراء على كلّ عنصرٍ في القائمة:[12]
(define (map proc items)
  (if (null? items)
      nil
      (cons (proc (car items))
            (map proc (cdr items)))))

(map abs (list -10 2.5 -11.6 17))
(10 2.5 11.6 17)

(map (lambda (x) (* x x)) (list 1 2 3 4))
(1 4 9 16)
والآن يمكننا إعطاء تعريفٍ جديد لـscale-list بدلالة map:
(define (scale-list items factor)
  (map (lambda (x) (* x factor))
       items))
إنّ Map بناءٌ مهمّ، لا لأنه يلتقط نمطًا مشتركًا فحسب، بل لأنه يُرسّي مستوىً أعلى من التجريد في التعامل مع القوائم. ففي تعريف scale-list الأصليّ، تجذب بنية البرنامج التعاوديّة الانتباه إلى المعالجة العنصريّة للقائمة. أمّا تعريف scale-list بدلالة map فيحجب ذلك المستوى من التفصيل ويُبرز أنّ الضرب في معاملٍ يحوّل قائمةَ عناصرٍ إلى قائمة نتائج. والفرق بين التعريفين ليس أنّ الحاسوب يؤدّي عمليّةً مختلفة (فهو لا يفعل ذلك)، بل أنّنا نفكّر في العمليّة تفكيرًا مختلفًا. وفي الواقع، يساعد map في إرساء حاجز تجريدٍ يعزل تنفيذ الإجراءات التي تحوّل القوائم عن تفاصيل كيفيّة استخراج عناصر القائمة ودمجها. ومثل الحواجز المبيّنة في الشكل 2.1، يمنحنا هذا التجريد مرونةَ تغيير التفاصيل منخفضة المستوى لكيفيّة تنفيذ التسلسلات، مع الحفاظ على الإطار المفاهيميّ للعمليّات التي تحوّل التسلسلات إلى تسلسلات. ويوسّع القسم 2.2.3 هذا الاستخدام للتسلسلات بوصفها إطارًا لتنظيم البرامج.
التمرين 2.21: يأخذ الإجراء square-list قائمة أعداد كمعطى ويُعيد قائمةً بمربّعات تلك الأعداد.
(square-list (list 1 2 3 4))
(1 4 9 16)
إليك تعريفان مختلفان لـsquare-list. أكمل كليهما بسدّ التعابير الناقصة:
(define (square-list items)
  (if (null? items)
      nil
      (cons ⟨??⟩ ⟨??⟩)))

(define (square-list items)
  (map ⟨??⟩ ⟨??⟩))
التمرين 2.22: يحاول لويس ريزنر إعادة كتابة إجراء square-list الأوّل في التمرين 2.21 بحيث يولّد عمليّةً تكراريّة:
(define (square-list items)
  (define (iter things answer)
    (if (null? things)
        answer
        (iter (cdr things)
              (cons (square (car things))
                    answer))))
  (iter items nil))
للأسف، إنّ تعريف square-list بهذه الطريقة يُنتج قائمة الإجابة بترتيبٍ معكوسٍ عن المراد. لماذا؟
ثم يحاول لويس إصلاح علّته بتبادل الوسيطين إلى cons:
(define (square-list items)
  (define (iter things answer)
    (if (null? things)
        answer
        (iter (cdr things)
              (cons answer
                    (square
                     (car things))))))
  (iter items nil))
وهذا لا ينجح أيضًا. فسّر.
التمرين 2.23: الإجراء for-each شبيهٌ بـmap. وهو يأخذ كوسائطَ إجراءً وقائمةَ عناصر. غير أنّه، بدلًا من تكوين قائمةٍ بالنتائج، يُطبّق for-each الإجراء على كلّ عنصرٍ بدوره، من اليسار إلى اليمين. والقيم المُعادة من تطبيق الإجراء على العناصر لا تُستخدم إطلاقًا—يُستخدم for-each مع إجراءاتٍ تؤدّي فعلًا، كالطبع. فعلى سبيل المثال،
(for-each
 (lambda (x) (newline) (display x))
 (list 57 321 88))

57
321
88
والقيمة المُعادة من نداء for-each (غير موضّحةٍ أعلاه) يمكن أن تكون شيئًا اعتباطيًّا، مثل true. فأعطِ تنفيذًا لـfor-each.
2.2.2 البنى الهرميّة
إنّ تمثيل التسلسلات بدلالة القوائم يتعمّم تعمّمًا طبيعيًّا لتمثيل تسلسلاتٍ قد تكون عناصرها هي نفسها تسلسلات. فعلى سبيل المثال، يمكننا اعتبار الكائن ((1 2) 3 4) المُنشأ بـ
(cons (list 1 2) (list 3 4))
قائمةً من ثلاثة عناصر، أوّلُها قائمةٌ بذاته، (1 2). وإنّ ذلك لمُستفادٌ من الصورة التي تُطبع بها النتيجة بواسطة المفسّر. ويُظهر الشكل 2.5 تمثيل هذه البنية بدلالة الأزواج.
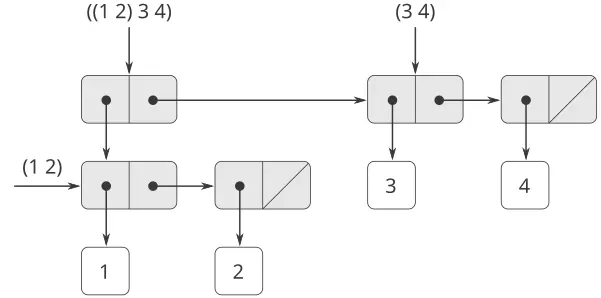
الشكل 2.5: بنيةٌ مُشكَّلةٌ بـ(cons (list 1 2) (list 3 4)).
وثمّة طريقةٌ أخرى للنظر إلى التسلسلات التي عناصرها تسلسلات، وهي اعتبارها أشجارًا (trees). فعناصر التسلسل هي فروع الشجرة، والعناصر التي هي تسلسلاتٌ بذاتها هي أشجارٌ فرعيّة. ويُظهر الشكل 2.6 البنية في الشكل 2.5 من منظور الشجرة.
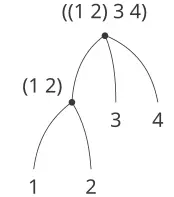
الشكل 2.6: بنية القائمة في الشكل 2.5 من منظور الشجرة.
والتعاود أداةٌ طبيعيّةٌ للتعامل مع بنى الأشجار، إذ يمكننا غالبًا اختزال العمليّات على الأشجار إلى عمليّاتٍ على فروعها، التي تختزل بدورها إلى عمليّاتٍ على فروع الفروع، وهكذا، حتّى نصل إلى أوراق الشجرة. فكمثالٍ على ذلك، قارن الإجراء length في 2.2.1 بالإجراء count-leaves، الذي يُعيد العدد الكلّي لأوراق شجرة:
(define x (cons (list 1 2) (list 3 4)))
(length x)
3
(count-leaves x)
4

(list x x)
(((1 2) 3 4) ((1 2) 3 4))

(length (list x x))
2

(count-leaves (list x x))
8
ولتنفيذ count-leaves، تذكّر الخطة التعاوديّة لاحتساب length:
Lengthقائمةxهو 1 زائدlengthالـcdrلـx.Lengthالقائمة الفارغة هو 0.
أمّا count-leaves فهو شبيه. وأمّا القيمة من أجل القائمة الفارغة فهي نفسها:
count-leavesالقائمة الفارغة يساوي 0.
لكن في خطوة الاختزال، حيث نُزيل الـcar من القائمة، ينبغي أن نأخذ في الحسبان أنّ الـcar قد يكون هو نفسه شجرةً نحتاج إلى إحصاء أوراقها. وبالتالي، فإنّ خطوة الاختزال الملائمة هي
count-leavesشجرةxيساويcount-leavesالـcarلـxزائدcount-leavesالـcdrلـx.
وأخيرًا، فبأخذ cars نصل إلى أوراقَ فعليّة، لذا نحتاج إلى حالة أساسٍ أخرى:
count-leavesورقةٍ هو 1.
ومعاونةً في كتابة الإجراءات التعاوديّة على الأشجار، توفّر Scheme المسيّم الأوّلي pair?، الذي يختبر ما إذا كان مُدخله زوجًا. وإليك الإجراء الكامل:[13]
(define (count-leaves x)
  (cond ((null? x) 0)
        ((not (pair? x)) 1)
        (else (+ (count-leaves (car x))
                 (count-leaves (cdr x))))))
التمرين 2.24: لنفترض أنّنا قيّمنا التعبير
(list 1 (list 2 (list 3 4))). فأعطِ النتيجة التي يطبعها المفسّر، وبنية الصناديق والمؤشّرات المقابلة، وتأويل هذا بوصفه شجرةً (كما في الشكل 2.6).
التمرين 2.25: أعطِ تركيباتٍ من cars وcdrs ستنتزع 7 من كلّ واحدة من القوائم التالية:
(1 3 (5 7) 9)
((7))
(1 (2 (3 (4 (5 (6 7))))))
التمرين 2.26: لنفترض أنّنا عرّفنا x وy ليكونا قائمتين:
(define x (list 1 2 3))
(define y (list 4 5 6))
فما النتيجة التي يطبعها المفسّر استجابةً لتقييم كلّ واحدٍ من التعابير التالية:
(append x y)
(cons x y)
(list x y)
التمرين 2.27: عدّل إجراءك reverse من التمرين 2.18 لتُنتج إجراءً هو deep-reverse يأخذ قائمةً كمعطىً ويُعيد قيمته قائمةً عناصرها معكوسةٌ وجميع قوائمها الفرعيّة معكوسةٌ عكسًا عميقًا كذلك. فعلى سبيل المثال،
(define x
  (list (list 1 2) (list 3 4)))

x
((1 2) (3 4))

(reverse x)
((3 4) (1 2))

(deep-reverse x)
((4 3) (2 1))
التمرين 2.28: اكتب إجراءً هو fringe يأخذ كمعطىً شجرةً (ممثَّلةً كقائمة) ويُعيد قائمةً عناصرها هي جميع أوراق الشجرة مرتَّبةً من اليسار إلى اليمين. فعلى سبيل المثال،
(define x
  (list (list 1 2) (list 3 4)))

(fringe x)
(1 2 3 4)

(fringe (list x x))
(1 2 3 4 1 2 3 4)
التمرين 2.29: يتكوّن المِهْبَل الثنائيّ من فرعين، فرعٍ أيسر وفرعٍ أيمن. وكلّ فرعٍ هو قضيبٌ ذو طولٍ معيّن، يتدلّى منه إمّا ثقلٌ وإمّا مِهْبَلٌ ثنائيٌّ آخر. ويمكننا تمثيل المِهْبَل الثنائيّ باستخدام بياناتٍ مركّبةٍ وذلك بإنشائه من فرعين (فعلى سبيل المثال، باستخدام list):
(define (make-mobile left right)
  (list left right))
أمّا الفرع فيُبنى من length (الذي ينبغي أن يكون عددًا) مع structure، الذي قد يكون إمّا عددًا (يمثّل ثقلًا بسيطًا) وإمّا مِهْبَلًا آخر:
(define (make-branch length structure)
  (list length structure))
فاكتب المُنَتقيات المُقابلة left-branch وright-branch، التي تُعيد فروض المِهْبَل، وbranch-length وbranch-structure، التي تُعيد مكوّنات الفرع. وباستخدام مُنَتقياتك، عرّف إجراءً هو total-weight يُعيد الثقل الكلّي لمِهْبَلٍ ما. ويُقال عن مِهْبَلٍ إنّه متوازنٌ إذا كان عزم الالتواء الذي يُطبّقه فرعه الأيسر العلويّ مساويًا لذاك الذي يُطبّقه فرعه الأيمن العلويّ (أي إذا كان طول القضيب الأيسر مضروبًا في الثقل المتدلّي من ذاك القضيب مساويًا للجداء المقابل من الجهة اليمنى) وإذا كان كلٌّ من المِهْبَلات الفرعيّة المتدلّية من فروضه متوازنًا. فصمّم مسيّمًا يختبر ما إذا كان المِهْبَل الثنائيّ متوازنًا. ولنفترض أنّنا غيّرنا تمثيل المِهْبَلات بحيث تصير البواني هي
(define (make-mobile left right)
  (cons left right))

(define (make-branch length structure)
  (cons length structure))
فما القدر الذي يتعيّن عليك تغييره في برامجك للتحوّل إلى التمثيل الجديد؟
الإسناد على الأشجار
فكما أنّ map تجريدٌ قويٌّ للتعامل مع التسلسلات، فإنّ map مع التعاوب تجريدٌ قويٌّ للتعامل مع الأشجار. فعلى سبيل المثال، يأخذ الإجراء scale-tree، النظير لـscale-list في 2.2.1، كوسائطَ معاملًا عدديًّا وشجرةً أوراقها أعداد. وهو يُعيد شجرةً بالشكل نفسه، حيث يُضرب كلّ عددٍ في المعامل. والخطة التعاوديّة لـscale-tree شبيهةٌ بتلك الخاصّة بـcount-leaves:
(define (scale-tree tree factor)
  (cond ((null? tree) nil)
        ((not (pair? tree))
         (* tree factor))
        (else
         (cons (scale-tree (car tree)
                           factor)
               (scale-tree (cdr tree)
                           factor)))))

(scale-tree (list 1
                  (list 2 (list 3 4) 5)
                  (list 6 7))
            10)

(10 (20 (30 40) 50) (60 70))
وثمّة طريقةٌ أخرى لتنفيذ scale-tree، وهي اعتبار الشجرة تسلسلًا من الأشجار الفرعيّة واستخدام map. فنُسند على التسلسل، مُكبّرين كلّ شجرةٍ فرعيّةٍ بدورها، ونُعيد قائمة النتائج. وفي الحالة الأساسّة، حيث تكون الشجرة ورقةً، نضرب ببساطةٍ في المعامل:
(define (scale-tree tree factor)
  (map (lambda (sub-tree)
         (if (pair? sub-tree)
             (scale-tree sub-tree factor)
             (* sub-tree factor)))
       tree))
ويمكن تنفيذ كثيرٍ من عمليّات الأشجار بتركيباتٍ مشابهةٍ من عمليّات التسلسلات والتعاوب.
التمرين 2.30: عرّف إجراءً هو square-tree نظيرًا لإجراء square-list في التمرين 2.21. أي أنّ square-tree ينبغي أن يسلك سلوكًا كما يلي:
(square-tree
 (list 1
       (list 2 (list 3 4) 5)
       (list 6 7)))
(1 (4 (9 16) 25) (36 49))
فعرّف square-tree مباشرةً (أي دون استخدام أيّ إجراءاتٍ عليا الرتبة) وكذلك باستخدام map والتعاوب.
التمرين 2.31: جرّد إجابتك على التمرين 2.30 لتُنتج إجراءً هو tree-map بالخاصّيّة أنّ square-tree يمكن تعريفه كـ
(define (square-tree tree)
  (tree-map square tree))
التمرين 2.32: يمكننا تمثيل مجموعةٍ كقائمةٍ من عناصرٍ متمايزة، ويمكننا تمثيل مجموعة جميع المجموعات الفرعيّة للمجموعة كقائمةٍ من القوائم. فعلى سبيل المثال، إذا كانت المجموعة هي (1 2 3)، فإنّ مجموعة جميع المجموعات الفرعيّة هي (() (3) (2) (2 3) (1) (1 3) (1 2) (1 2 3)). فأكمل التعريف التالي لإجراءٍ يولّد مجموعة المجموعات الفرعيّة لمجموعةٍ ما، وأعطِ تفسيرًا واضحًا لسبب نجاحه:
(define (subsets s)
  (if (null? s)
      (list nil)
      (let ((rest (subsets (cdr s))))
        (append rest (map ⟨??⟩ rest)))))
2.2.3 التسلسلات كَوَاجهاتٍ اعتياديّة
وفي العمل مع البيانات المركّبة، أكّدنا كيف يسمح لنا تجريد البيانات بتصميم برامجٍ دون أن نتشابك في تفاصيل تمثيلات البيانات، وكيف يحفظ لنا التجريد المرونة اللازمة لتجربة تمثيلاتٍ بديلة. وفي هذا القسم، نستعرض مبدأً تصميميًّا قويًّا آخر للعمل مع بنى البيانات—ألا وهو استخدام الوَاجهات الاعتياديّة.
في 1.3 رأينا كيف يمكن لتجريدات البرامج، المنفَّذةً كإجراءاتٍ عليا الرتبة، أن تلتقط الأنماط الشائعة في البرامج التي تتعامل مع بياناتٍ عدديّة. وإنّ قدرتنا على صياغة عمليّاتٍ نظيرةٍ للعمل مع بياناتٍ مركّبةٍ تعتمد اعتمادًا حاسمًا على الأسلوب الذي نعالج به بنى بياناتنا. فتأمّل مثلًا الإجراء التالي، النظير لإجراء count-leaves في 2.2.2، الذي يأخذ شجرةً كمعطىً ويحتسب مجموع مربّعات الأوراق الفرديّة:
(define (sum-odd-squares tree)
  (cond ((null? tree) 0)
        ((not (pair? tree))
         (if (odd? tree) (square tree) 0))
        (else (+ (sum-odd-squares
                  (car tree))
                 (sum-odd-squares
                  (cdr tree))))))
أمّا في الظّاهر، فهذا الإجراء مختلفٌ كلّ الاختلاف عن الإجراء التالي، الذي يبني قائمةً بجميع أعداد فيبوناتشي الزوجيّة ، حيث لا تزيد على عددٍ صحيحٍ معطىً :
(define (even-fibs n)
  (define (next k)
    (if (> k n)
        nil
        (let ((f (fib k)))
          (if (even? f)
              (cons f (next (+ k 1)))
              (next (+ k 1))))))
  (next 0))
وعلى الرغم من أنّ هذين الإجراءين مختلفان بنيويًّا اختلافًا كبيرًا، فإنّ وصفًا أكثر تجريدًا للاحتسابين يكشف عن قدرٍ كبيرٍ من التشابه. فالبرنامج الأوّل
- يُعدّد أوراق شجرة؛
- يرشّحها، منتقيًا الفرديّة منها؛
- يُربّع كلّ واحدٍ من المُنتقى؛ و
- يُراكم النتائج باستخدام
+، بدءًا من 0.
أمّا البرنامج الثاني
- يُعدّد الأعداد الصحيحة من 0 إلى ؛
- يحتسب عدد فيبوناتشي لكلّ عددٍ صحيح؛
- يرشّحها، منتقيًا الزوجيّة منها؛ و
- يُراكم النتائج باستخدام
cons، بدءًا من القائمة الفارغة.
سيجد مهندسُ معالجة الإشارات من الطبيعيّ أن يُصوّر هذه العمليّات بدلالة إشاراتٍ تتدفّق عبر تتابعٍ من المراحل، كلٌّ منها ينفّذ جزءًا من خطة البرنامج، كما هو موضّح في الشكل 2.7. ففي sum-odd-squares، نبدأ بـmُعَدِّد (enumerator)، الذي يُولّد «إشارة» تتكوّن من أوراق شجرةٍ معطاة. وهذه الإشارة تُمرَّر عبر مرشّح (filter)، يُقصي جميع العناصر عدا الفرديّة. ثمّ تُمرَّر الإشارة الناتجة بدورها عبر إسناد (map)، وهو «محوّلٌ» يُطبّق الإجراء square على كلّ عنصر. ثمّ يُغذّى خرج الإسناد إلى مُراكم (accumulator)، الذي يجمع العناصر باستخدام +، بدءًا من 0 أوّليّة. أمّا خطة even-fibs فهي نظيرة.
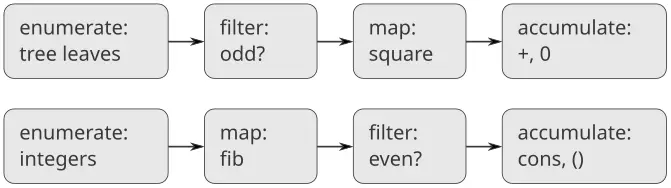
الشكل 2.7: تكشف خطط تدفّق الإشارة الخاصّة بالإجراءين sum-odd-squares (أعلى) وeven-fibs (أسفل) عن القاسم المشترك بين البرنامجين.
وللأسف، فإنّ تعريفَي الإجراءين المذكورين أعلاه لا يُظهران بنية تدفّق الإشارة هذه. فعلى سبيل المثال، إذا فحصنا الإجراء sum-odd-squares، نجد أنّ الإعداد منفَّذٌ جزئيًّا باختبارَي null? وpair? وجزئيًّا بالبنية التعاوديّة الشجريّة للإجراء. وبشكلٍ مماثل، نجد التراكم جزءًا منه في الاختبارات وجزءًا منه في الجمع المستخدم في التعاوب. وبصورةٍ عامّة، ليس ثمّة أجزاءٌ متمايزةٌ في أيّ من الإجراءين تقابل العناصر في وصف تدفّق الإشارة. فإجراءانا يُفكّكان الاحتساب بطريقةٍ مختلفة، يبثّان الإعداد في البرنامج كله ويمزجانه بالإسناد والترشيح والتراكم. ولو كنّا قادرين على تنظيم برامجنا بحيث تصير بنية تدفّق الإشارة ظاهرةً في الإجراءات التي نكتبها، لَزاد ذلك وضوح الشيفرة الناتجة مفهوميًّا.
عمليّات التسلسلات
ومفتاح تنظيم البرامج بحيث تعكس بنية تدفّق الإشارة على نحوٍ أوضح هو التركيز على «الإشارات» التي تتدفّق من مرحلةٍ في العمليّة إلى المرحلة التالية. فإذا مثّلنا هذه الإشارات كقوائم، أمكننا استخدام عمليّات القوائم لتنفيذ المعالجة في كلّ مرحلة. فعلى سبيل المثال، يمكننا تنفيذ مراحل الإسناد في مخطّطات تدفّق الإشارة باستخدام الإجراء map من 2.2.1:
(map square (list 1 2 3 4 5))
(1 4 9 16 25)
وأمّا ترشيح تسلسلٍ لانتقاء العناصر التي تحقّق مسيّمًا معيَّنًا فقط فيُنجَز بـ
(define (filter predicate sequence)
  (cond ((null? sequence) nil)
        ((predicate (car sequence))
         (cons (car sequence)
               (filter predicate
                       (cdr sequence))))
        (else  (filter predicate
                       (cdr sequence)))))
فعلى سبيل المثال،
(filter odd? (list 1 2 3 4 5))
(1 3 5)
ويمكن تنفيذ التراكمات (accumulations) بالإجراء
(define (accumulate op initial sequence)
  (if (null? sequence)
      initial
      (op (car sequence)
          (accumulate op
                      initial
                      (cdr sequence)))))

(accumulate + 0 (list 1 2 3 4 5))
15
(accumulate * 1 (list 1 2 3 4 5))
120
(accumulate cons nil (list 1 2 3 4 5))
(1 2 3 4 5)
وكلّ ما يبقى لتنفيذ مخططات تدفق الإشارة (signal-flow diagrams) هو تعداد التسلسل من العناصر التي ستُعالَج. وبالنسبة إلى even-fibs، نحتاج إلى توليد تسلسل الأعداد الصحيحة في مدىً معطًى، وهو ما يمكننا فعله كما يلي:
(define (enumerate-interval low high)
  (if (> low high)
      nil
      (cons low
            (enumerate-interval
             (+ low 1)
             high))))

(enumerate-interval 2 7)
(2 3 4 5 6 7)
ولتعداد (enumerate) أوراق شجرةٍ، يمكننا استخدام[14]
(define (enumerate-tree tree)
  (cond ((null? tree) nil)
        ((not (pair? tree)) (list tree))
        (else (append
               (enumerate-tree (car tree))
               (enumerate-tree (cdr tree))))))

(enumerate-tree (list 1 (list 2 (list 3 4)) 5))
(1 2 3 4 5)
ويمكننا الآن إعادة صياغة sum-odd-squares وeven-fibs كما في مخططات تدفق الإشارة. فبالنسبة إلى sum-odd-squares، نُعدِّد (enumerate) تسلسل أوراق الشجرة، ونُرَشِّحه (filter) لنحتفظ بالأعداد الفرديّة وحدها في التسلسل، ونُربّع كلّ عنصر، ونجمع النتائج:
(define (sum-odd-squares tree)
  (accumulate
   +
   0
   (map square
        (filter odd?
                (enumerate-tree tree)))))
وبالنسبة إلى even-fibs، نُعدِّد الأعداد الصحيحة من 0 إلى ، ونُولِّد عدد فيبوناتشي لكلّ عددٍ من هذه الأعداد، ونُرَشِّح التسلسل الناتج لنحتفظ بالعناصر الزوجيّة وحدها، ونُتراكِم النتائج (accumulate) في قائمة:
(define (even-fibs n)
  (accumulate
   cons
   nil
   (filter even?
           (map fib
                (enumerate-interval 0 n)))))
وقيمة التعبير عن البرامج كعمليّاتٍ تسلسليّةٍ هي أنّ ذلك يساعدنا على جعل تصاميم برامجنا وحدانيّةً (modular)، أي مبنيّةً بدمج أجزاءٍ مستقلّةٍ نسبيًّا. ويمكننا تشجيع التصميم الوحدانيّ بتوفير مكتبة (library) من المكوّنات المعياريّة إلى جانب واجهةٍ اعتياديّةٍ (conventional interface) لربط المكوّنات بطرائقٍ مرنةٍ.
والبناء الوحدانيّ استراتيجيّةٌ قويّةٌ للتحكّم في التعقيد في التصميم الهندسيّ. ففي تطبيقات معالجة الإشارة (signal processing) الواقعيّة، مثلًا، يبني المصمّمون بانتظامٍ أنظمةً بربط عناصرَ متتاليةٍ منتقاةٍ من عائلاتٍ معياريّةٍ من المرشّحات (filters) والمحوّلات (transducers). وعلى نحوٍ مماثل، تُوفّر عمليّات التسلسل مكتبةً من عناصر البرامج المعياريّة التي يمكننا مزجها ومطابقتها. فعلى سبيل المثال، يمكننا إعادة استخدام أجزاءٍ من الإجراءين sum-odd-squares وeven-fibs في برنامجٍ يبني قائمةً بمربّعات أوّل عدد فيبوناتشي:
(define (list-fib-squares n)
  (accumulate
   cons
   nil
   (map square
        (map fib
             (enumerate-interval 0 n)))))

(list-fib-squares 10)
(0 1 1 4 9 25 64 169 441 1156 3025)
ويمكننا إعادة ترتيب الأجزاء واستخدامها في احتساب حاصل ضرب مربّعات الأعداد الصحيحة الفرديّة في تسلسلٍ ما:
(define
  (product-of-squares-of-odd-elements
   sequence)
  (accumulate
   *
   1
   (map square (filter odd? sequence))))

(product-of-squares-of-odd-elements
 (list 1 2 3 4 5))
225
ويمكننا أيضًا صياغة تطبيقات معالجة البيانات (data processing) الاعتياديّة بدلالة عمليّات التسلسل. فلنفترض أنّ لدينا تسلسلًا من سجلّات الموظفين (personnel records) ونريد إيجاد راتب المبرمج الأعلى أجرًا (highest-paid programmer). ولنفترض أنّ لدينا منتقيًّا (selector) اسمه salary يُعيد راتب سجلّ، ومسيِّمًا (predicate) اسمه programmer? يختبر فيما إذا كان السجلّ لمبرمجٍ. فيمكننا حينئذٍ الكتابة
(define
  (salary-of-highest-paid-programmer
   records)
  (accumulate
   max
   0
   (map salary
        (filter programmer? records))))
وهذه الأمثلة لا تُعطي سوى لمحةٍ عن المدى الواسع من العمليّات التي يمكن التعبير عنها كعمليّاتٍ تسلسليّةٍ.[15]
والتسلسلات، المنفَّذة هنا كقوائم، تعمل كواجهةٍ اعتياديّةٍ (conventional interface) تسمح لنا بدمج وحدات المعالجة. وإضافةً إلى ذلك، حين نمثّل البنى تمثيلًا موحّدًا كتسلسلاتٍ، فإنّنا نُركّز اعتماديات بنية البيانات في برامجنا على عددٍ قليلٍ من عمليّات التسلسل. وبتغيير هذه، يمكننا تجربة تمثيلاتٍ بديلةٍ للتسلسلات، دون المساس بالتصميم الكلّيّ لبرامجنا. وسنستغلّ هذه القدرة في 3.5، حين نُعمّم نمط معالجة التسلسلات ليقرّ بتسلسلاتٍ لا نهائيّةٍ (infinite sequences).
التمرين 2.33: أكمل التعابير الناقصة لإتمام التعريفات الآتية لبعض عمليّات التلاعب الأساسيّة بالقوائم، على هيئة تراكماتٍ:
(define (map p sequence)
  (accumulate (lambda (x y) ⟨??⟩)
              nil sequence))

(define (append seq1 seq2)
  (accumulate cons ⟨??⟩ ⟨??⟩))

(define (length sequence)
  (accumulate ⟨??⟩ 0 sequence))
التمرين 2.34: يمكن صياغة تقييم كثير حدودٍ في عند قيمةٍ معطاةٍ من كتراكمٍ. فنُقيّم كثير الحدود باستخدام خوارزميّةٍ معروفةٍ تُسمّى قاعدة هورنر (Horner’s rule)، وهي تبني الاحتساب على الشكل وبعبارةٍ أخرى، نبدأ من ، ونضرب في ، ونضيف ، ونضرب في ، وهكذا، حتّى نبلغ .[16]
وأكمل القالب الآتي لإنتاج إجراءٍ يُقيّم كثير حدودٍ باستخدام قاعدة هورنر. وافترض أنّ معاملات كثير الحدود مرتّبةٌ في تسلسلٍ، من إلى .
(define
  (horner-eval x coefficient-sequence)
  (accumulate
   (lambda (this-coeff higher-terms)
     ⟨??⟩)
   0
   coefficient-sequence))
فعلى سبيل المثال، لاحتساب عند ستُقيّم
(horner-eval 2 (list 1 3 0 5 0 1))
التمرين 2.35: أعِد تعريف count-leaves الوارد في 2.2.2 كتراكمٍ:
(define (count-leaves t)
  (accumulate ⟨??⟩ ⟨??⟩ (map ⟨??⟩ ⟨??⟩)))
التمرين 2.36: الإجراء accumulate-n شبيهٌ بـaccumulate، إلّا أنّه يأخذ كمعطاه الثالث تسلسلًا من التسلسلات، ويُفترض أنّ جميعها تملك العدد نفسه من العناصر. وهو يُطبّق إجراء التراكم المعيَّن لدمج جميع العناصر الأوّلة من التسلسلات، وجميع العناصر الثانية من التسلسلات، وهكذا، ويُعيد تسلسلًا من النتائج. فعلى سبيل المثال، إذا كان s تسلسلًا يحتوي على أربعة تسلسلاتٍ، ((1 2 3) (4 5 6) (7 8 9) (10 11 12)), فينبغي أن تكون قيمة (accumulate-n + 0 s) هي التسلسل (22 26 30). وأكمل التعابير الناقصة في التعريف الآتي لـaccumulate-n:
(define (accumulate-n op init seqs)
  (if (null? (car seqs))
      nil
      (cons (accumulate op init ⟨??⟩)
            (accumulate-n op init ⟨??⟩))))
التمرين 2.37: لنفترض أنّنا نمثّل المتجهات (vectors) v = كتسلسلاتٍ من الأعداد، والمصفوفات (matrices) m = كتسلسلاتٍ من المتجهات (صفوف المصفوفة). فعلى سبيل المثال، المصفوفة ممثَّلةٌ بالتسلسل ((1 2 3 4) (4 5 6 6) (6 7 8 9)). وبهذا التمثيل، يمكننا استخدام عمليّات التسلسل للتعبير موجزٍ عن عمليّات المتجهات والمصفوفات الأساسيّة. وهذه العمليّات (الموصوفة في أيّ كتابٍ عن جبر المصفوفات) هي الآتية: ويمكننا تعريف الجداء القياسيّ (dot product) كالآتي[17]
(define (dot-product v w)
  (accumulate + 0 (map * v w)))
وأكمل التعابير الناقصة في الإجراءات الآتية لاحتساب عمليّات المصفوفات الأخرى. (والإجراء accumulate-n معرَّفٌ في التمرين 2.36.)
(define (matrix-*-vector m v)
  (map ⟨??⟩ m))

(define (transpose mat)
  (accumulate-n ⟨??⟩ ⟨??⟩ mat))

(define (matrix-*-matrix m n)
  (let ((cols (transpose n)))
    (map ⟨??⟩ m)))
التمرين 2.38: الإجراء accumulate يُعرَف أيضًا باسم fold-right، لأنّه يدمج العنصر الأوّل من التسلسل مع نتيجة دمج جميع العناصر الواقعة إلى اليمين. وهناك أيضًا fold-left، وهو شبيهٌ بـfold-right، إلّا أنّه يدمج العناصر عاملًا في الاتجاه المعاكس:
(define (fold-left op initial sequence)
  (define (iter result rest)
    (if (null? rest)
        result
        (iter (op result (car rest))
              (cdr rest))))
  (iter initial sequence))
ما هي قيم
(fold-right / 1 (list 1 2 3))
(fold-left  / 1 (list 1 2 3))
(fold-right list nil (list 1 2 3))
(fold-left  list nil (list 1 2 3))
اذكر خاصّيّةً ينبغي أن يحقّقها op لضمان أن يُنتج fold-right وfold-left القيمَ نفسها لأيّ تسلسلٍ.
التمرين 2.39: أكمل التعريفات الآتية للإجراء reverse (التمرين 2.18) بدلالة fold-right وfold-left الواردين في التمرين 2.38:
(define (reverse sequence)
  (fold-right
   (lambda (x y) ⟨??⟩) nil sequence))

(define (reverse sequence)
  (fold-left
   (lambda (x y) ⟨??⟩) nil sequence))
التعيينات المتداخلة
ويمكننا توسيع نمط التسلسل ليشمل احتساباتٍ كثيرةً تُعبَّر عنها عادةً باستخدام حلقاتٍ متداخلةٍ (nested loops).[18] وانظر هذه المسألة: إذا أُعطي عددٌ صحيحٌ موجب ، فأوجد جميع الأزواج المرتّبة (ordered pairs) من الأعداد الصحيحة الموجبة المتمايزة و ، حيث ، بحيث يكون المجموع أوّليًّا (prime). فعلى سبيل المثال، إذا كان هو 6، فإنّ الأزواج هي الآتية: والطريقة الطبيعيّة لتنظيم هذا الاحتساب هي توليد تسلسل جميع الأزواج المرتّبة من الأعداد الصحيحة الموجبة الأصغر من أو المساوية لـ ، ثمّ الترشيح لاختيار تلك الأزواج التي يكون مجموعها أوّليًّا، ثمّ - لكلّ زوجٍ يجتاز المرشّح - إنتاج الثلاثيّة .
وهذه طريقةٌ لتوليد تسلسل الأزواج: لكلّ عددٍ صحيحٍ ، عُدِّد الأعداد ، ولكلّ و هكذا وُلِّد الزوج . وبدلالة عمليّات التسلسل، نعيّن (map) على التسلسل (enumerate-interval 1 n). ولكلّ في هذا التسلسل، نعيّن على التسلسل (enumerate-interval 1 (- i 1)). ولكلّ في هذا التسلسل الأخير، نُولِّد الزوج (list i j). وهذا يُعطينا تسلسلًا من الأزواج لكلّ . ودمج جميع التسلسلات لجميع قيم (بالتراكم باستخدام append) يُنتج التسلسل المطلوب من الأزواج:[19]
(accumulate
 append
 nil
 (map (lambda (i)
        (map (lambda (j)
               (list i j))
             (enumerate-interval 1 (- i 1))))
      (enumerate-interval 1 n)))
إنّ تركيب التعيين والتراكم بـappend شائعٌ إلى هذا الحدّ في هذا النوع من البرامج، حتّى إنّنا سنعزله كإجراءٍ منفصل:
(define (flatmap proc seq)
  (accumulate append nil (map proc seq)))
والآن رُشِّح تسلسل الأزواج هذا لإيجاد تلك التي يكون مجموعها أوّليًّا. فمسيِّم الترشيح يُنادى لكلّ عنصرٍ من التسلسل، ومعطاه زوجٌ ينبغي أن يستخرج منه العددين الصحيحين. ومن ثمّ، المسيِّم الذي يُطبَّق على كلّ عنصر في التسلسل هو
(define (prime-sum? pair)
  (prime? (+ (car pair) (cadr pair))))
وأخيرًا، وُلِّد تسلسل النتائج بالتعيين على الأزواج المُرَشَّحة باستخدام الإجراء الآتي، الذي يبني ثلاثيّةً تتألّف من عنصري الزوج إلى جانب مجموعهما:
(define (make-pair-sum pair)
  (list (car pair)
        (cadr pair)
        (+ (car pair) (cadr pair))))
وجميع هذه الخطوات مجتمعةً تُعطي الإجراء الكامل:
(define (prime-sum-pairs n)
  (map make-pair-sum
       (filter
        prime-sum?
        (flatmap
         (lambda (i)
           (map (lambda (j)
                  (list i j))
                (enumerate-interval
                 1
                 (- i 1))))
         (enumerate-interval 1 n)))))
والتعيينات المتداخلة مفيدةٌ أيضًا للتسلسلات الأخرى غير تلك التي تُعدِّد المديات. فلنفترض أنّنا نريد توليد جميع تبديلات (permutations) مجموعةٍ أي جميع طرق ترتيب عناصر المجموعة. فعلى سبيل المثال، تبديلات هي ، ، ، ، ، و . وهذه خطّةٌ لتوليد تبديلات : لكلّ عنصرٍ في ، وُلِّد تعاوديًّا تسلسل تبديلات المجموعة ،[20] وألحِق بمقدّمة كلٍّ منها. وهذا يُعطي، لكلّ في ، تسلسل تبديلات التي تبدأ بـ . ودمج هذه التسلسلات لجميع قيم يُعطي جميع تبديلات :[21]
(define (permutations s)
  (if (null? s)   ; empty set?
      (list nil)  ; sequence containing empty set
      (flatmap (lambda (x)
                 (map (lambda (p)
                        (cons x p))
                      (permutations
                       (remove x s))))
               s)))
لاحِظ كيف تُرجِع هذه الاستراتيجيّة مسألة توليد تبديلات إلى مسألة توليد تبديلات مجموعاتٍ ذات عناصرَ أقلّ من . وفي الحالة النهائيّة، نهبط إلى القائمة الخالية، التي تمثّل مجموعةً لا عناصر لها. ومن أجل ذلك، نُولِّد (list nil)، وهو تسلسلٌ ذو عنصرٍ واحد، هو المجموعة الخالية. والإجراء remove المستخدم في permutations يُعيد جميع العناصر في تسلسلٍ معطًى فيما عدا عنصرًا معطًى. ويمكن التعبير عن ذلك بترشيحٍ بسيط:
(define (remove item sequence)
  (filter (lambda (x) (not (= x item)))
          sequence))
التمرين 2.40: عرّف إجراءً
unique-pairsيُولِّد، إذا أُعطي عددٌ صحيحٌ ، تسلسل الأزواج حيث . واستخدمunique-pairsلتبسيط تعريفprime-sum-pairsالمعطى أعلاه.
التمرين 2.41: اكتب إجراءً لإيجاد جميع الثلاثيّات المرتّبة من الأعداد الصحيحة الموجبة المتمايزة و و الأصغر من أو المساوية لعددٍ صحيحٍ معطًى والتي يساوي مجموعها عددًا صحيحًا معطًى .
التمرين 2.42: تسأل «أحجية الملكات الثماني» كيف يمكن وضع ثماني ملكات على رقعة الشطرنج بحيث لا تكون أيّ ملكةٍ تحت الكشّ من أيٍّ منهنّ (أي أنّه لا توجد ملكتان في الصفّ نفسه أو العمود نفسه أو القطر نفسه). وحلٌّ ممكنٌ موضّحٌ في الشكل 2.8. وإحدى طرق حلّ الأحجية هي العمل على امتداد الرقعة، بوضع ملكةٍ في كلّ عمود. فمتى وضعنا ملكة، يجب أن نضع الملكة الـ في موضعٍ لا تتعارض فيه مع أيٍّ من الملكات الموجودة أصلًا على الرقعة. ويمكننا صياغة هذا المنهج تعاوديًّا: افترض أنّنا قد ولّدنا بالفعل تسلسل جميع الطرق الممكنة لوضع ملكة في أوّل عمودًا من الرقعة. ولكلّ من هذه الطرق، وُلِّد مجموعةً موسّعةً من المواضع بوضع ملكةٍ في كلّ صفٍّ من العمود الـ. والآن رُشِّح هذه المواضع، مُبقيًا فقط تلك التي تكون الملكة في العمود الـ آمنةً فيها بالنسبة إلى الملكات الأخرى. وهذا يُنتج تسلسل جميع الطرق لوضع ملكة في أوّل عمودًا. وبمواصلة هذا الإجراء، فلن نُنتج حلًّا واحدًا فحسب، بل جميع حلول الأحجية.
الشكل 2.8: حلٌّ ممكنٌ لأحجية الملكات الثماني.
ونُنفّذ هذا الحلّ كإجراءٍ queens، يُعيد تسلسل جميع حلول مسألة وضع ملكة على رقعة شطرنجٍ . وQueens له إجراءٌ داخليٌّ queen-cols يُعيد تسلسل جميع الطرق لوضع الملكات في أوّل عمودًا من الرقعة.
(define (queens board-size)
  (define (queen-cols k)
    (if (= k 0)
        (list empty-board)
        (filter
         (lambda (positions)
           (safe? k positions))
         (flatmap
          (lambda (rest-of-queens)
            (map (lambda (new-row)
                   (adjoin-position
                    new-row
                    k
                    rest-of-queens))
                 (enumerate-interval
                  1
                  board-size)))
          (queen-cols (- k 1))))))
  (queen-cols board-size))
في هذا الإجراء، يمثّل rest-of-queens طريقةً لتموضع من الملكات في الأعمدة الـ الأولى، ويمثّل new-row صفًّا مقترحًا لوضع ملكة العمود الـ. أكمل البرنامج بتنفيذ التمثيل الخاصّ بمجموعات مواضع الرقعة، بما في ذلك الإجراء adjoin-position، الذي يُضيف موضع صفّ-عمود جديد إلى مجموعة من المواضع، وempty-board، الذي يمثّل مجموعةً خاليةً من المواضع. وعليك أيضًا كتابة الإجراء safe?، الذي يحدّد، من أجل مجموعة من المواضع، ما إذا كانت ملكة العمود الـ في مأمنٍ من الأخريات. (ولاحِظ أنّنا نحتاج فقط إلى التحقّق ممّا إذا كانت الملكة الجديدة في مأمنٍ، أمّا الملكات الأخرى فمضمونٌ بالفعل أنّها في مأمنٍ من بعضها بعضًا.)
التمرين 2.43: يمرّ لويس ريزنر بوقتٍ عصيبٍ للغاية في أداء التمرين 2.42. فإجراء queens الخاصّ به يبدو أنه يعمل، لكنّه يعمل ببطءٍ بالغ. (ولم يتمكّن لويس قطّ من الانتظار طويلًا بما يكفي لأن يحلّه حتّى حالة .) وحين سأل لويس إيفا لو أتور طالبًا المساعدة، أشارت إلى أنّه بدّل ترتيب التعيينات المتداخلة في flatmap، كاتبةً إيّاه على الصورة
(flatmap
 (lambda (new-row)
   (map (lambda (rest-of-queens)
          (adjoin-position
           new-row k rest-of-queens))
        (queen-cols (- k 1))))
 (enumerate-interval 1 board-size))
اشرح لماذا يؤدّي هذا التبديل إلى جعل البرنامج يعمل ببطء. وقدّر كم من الوقت سيستغرقه برنامج لويس لحلّ أحجية الملكات الثماني، بافتراض أنّ البرنامج في التمرين 2.42 يحلّ الأحجية في زمنٍ قدره .
2.2.4 مثال: لغة رسم الصور
يقدّم هذا القسم لغةً بسيطةً لرسم الصور توضّح قوّة تجريد البيانات والإغلاق، وتستثمر أيضًا الإجراءات ذات الرتبة العليا على نحوٍ جوهريّ. وقد صُمّمت اللغة لتسهيل التجريب بأنماطٍ كالتي في الشكل 2.9، وهي مركّبةٌ من عناصر مُكرَّرةٍ مُزاحةٍ ومُكبَّرةٍ.[22] ففي هذه اللغة، تُُمثَّل كائنات البيانات التي تُدمَج بوصفها إجراءاتٍ لا ببنيةٍ قائمةٍ على القوائم. فكما أنّ cons، الذي يحقّق خاصّيّة الإغلاق، أتاح لنا بناء بنية قوائم معقّدةٍ تعسّفيًّا بسهولة، فإنّ عمليّات هذه اللغة، التي تحقّق هي أيضًا خاصّيّة الإغلاق، تتيح لنا بناء أنماطٍ معقّدةٍ تعسّفيًّا بسهولة.
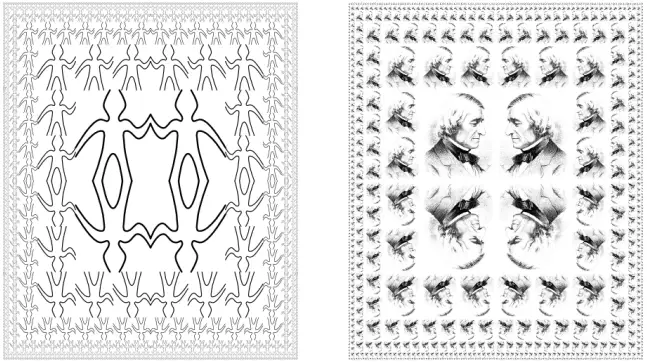
الشكل 2.9: تصاميم أُنشئت بلغة الرسم.
لغة الرسم
حين بدأنا دراسة البرمجة في 1.1، أكّدنا على أهمّيّة وصف لغةٍ بالتركيز على أوّليّات اللغة ووسائل تركيبها ووسائل تجريدها. وسنتبع هذا الإطار هنا.
وجزءٌ من أناقة لغة الرسم هذه أنّ هناك نوعًا واحدًا فقط من العناصر، يُسمّى الرسّام (painter). فالرسّام يرسم صورةً تُزاح وتُكبَّر لتتناسب مع إطارٍ مُعيَّنٍ على شكل متوازي أضلاع. فمثلًا، هناك رسّامٌ أوّليٌّ سنُسمّيه wave يرسم رسمًا خطّيًّا بدائيًّا، كما في الشكل 2.10. وشكل الرسم الفعليّ يعتمد على الإطار، فالصور الأربع كلّها في الشكل 2.10 أُنتجت بالرسّام wave عينه، لكن بالنسبة إلى أربعة إطاراتٍ مختلفةٍ. ويمكن أن تكون الرسّامون أكثر تعقيدًا من هذا: فالرسّام الأوّلي المسمّى rogers يرسم صورةً لمؤسّس MIT، وليام بارتون روجرز، كما في الشكل 2.11.[23] والصور الأربع في الشكل 2.11 مرسومةٌ بالنسبة إلى الإطارات الأربعة عينها التي رُسمت بها صور wave في الشكل 2.10.
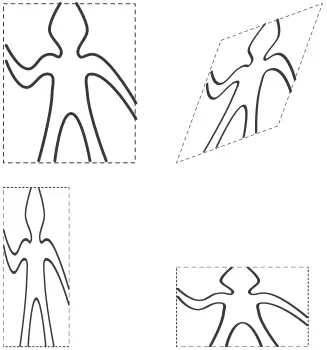
الشكل 2.10: صور أُنتجت بالرسّام wave، بالنسبة إلى أربعة إطاراتٍ مختلفةٍ. والإطارات، الموضّحة بخطوطٍ منقّطةٍ، ليست جزءًا من الصور.
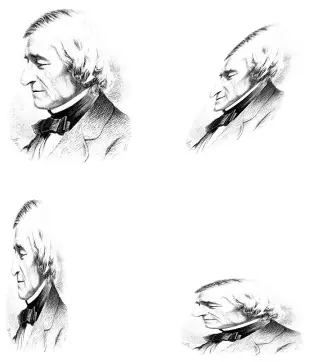
الشكل 2.11: صور وليام بارتون روجرز، المؤسّس والرئيس الأوّل لـMIT، مرسومةً بالنسبة إلى الإطارات الأربعة عينها كما في الشكل 2.10 (الصورة الأصليّة من ويكيميديا كومنز).
ولدمج الصور، نستخدم عمليّاتٍ متنوّعةً تبني رسّامين جديدين من رسّامين مُعطَيين. فمثلًا، تأخذ العمليّة beside رسّامين وتُنتج رسّامًا مركّبًا جديدًا يرسم صورة الرسّام الأوّل في النصف الأيسر للإطار وصورة الرسّام الثاني في النصف الأيمن للإطار. وبالمثل، تأخذ below رسّامين وتُنتج رسّامًا مركّبًا يرسم صورة الرسّام الأوّل تحت صورة الرسّام الثاني. وبعض العمليّات تحوّل رسّامًا واحدًا لإنتاج رسّامٍ جديد. فمثلًا، تأخذ flip-vert رسّامًا وتُنتج رسّامًا يرسم صورته مقلوبةً رأسيًّا، وتُنتج flip-horiz رسّامًا يرسم صورة الرسّام الأصليّ معكوسةً من اليسار إلى اليمين.
يُظهر الشكل 2.12 رسم رسّامٍ يُسمّى wave4 بُني على مرحلتين بالانطلاق من wave:
(define wave2 (beside wave (flip-vert wave)))
(define wave4 (below wave2 wave2))
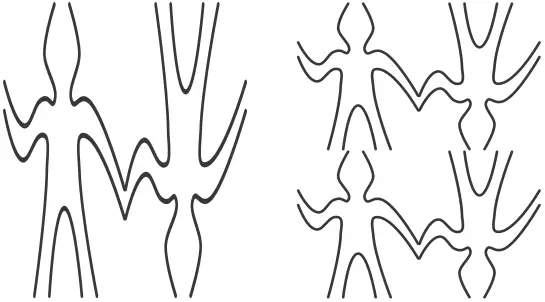
الشكل 2.12: إنشاء شكلٍ معقّد، بالانطلاق من الرسّام wave في الشكل 2.10.
عند بناء صورةٍ معقّدةٍ على هذا النحو، نستثمر حقيقة أنّ الرسّامين منغلقون بالنسبة إلى وسائل تركيب اللغة. فـbeside أو below لرّسّامين هي نفسها رسّام؛ وبالتالي، يمكننا استخدامها كعنصرٍ في صنع رسّامين أكثر تعقيدًا. وكما هو الحال في بناء بنية القوائم باستخدام cons، فإنّ انغلاق بياناتنا بالنسبة إلى وسائل التركيب أمرٌ حاسمٌ في القدرة على إنشاء بنياتٍ معقّدةٍ باستخدام عمليّاتٍ قليلةٍ فقط.
حين نتمكّن من دمج الرسّامين، نودّ أن نكون قادرين على تجريد أنماطٍ نموذجيّةٍ لدمج الرسّامين. وسنُنفّذ عمليّات الرسم كإجراءات Scheme. وهذا يعني أنّنا لا نحتاج إلى آليّة تجريدٍ خاصّةٍ في لغة الرسم: فبما أنّ وسائل التركيب إجراءات Scheme اعتياديّة، فإنّنا نمتلك تلقائيًّا القدرة على فعل أيّ شيءٍ بعمليّات الرسم يمكننا فعله بالإجراءات. فمثلًا، يمكننا تجريد النمط في wave4 كالآتي
(define (flipped-pairs painter)
  (let ((painter2
         (beside painter
                 (flip-vert painter))))
    (below painter2 painter2)))
وتعريف wave4 بوصفه حالةً من هذا النمط:
(define wave4 (flipped-pairs wave))
ويمكننا تعريف عمليّاتٍ تعاوديّةٍ أيضًا. وهذه واحدةٌ تجعل الرسّامين ينقسمون ويتفرّعون نحو اليمين كما في الشكل 2.13 والشكل 2.14:
(define (right-split painter n)
  (if (= n 0)
      painter
      (let ((smaller (right-split painter
                                  (- n 1))))
        (beside painter
                (below smaller smaller)))))
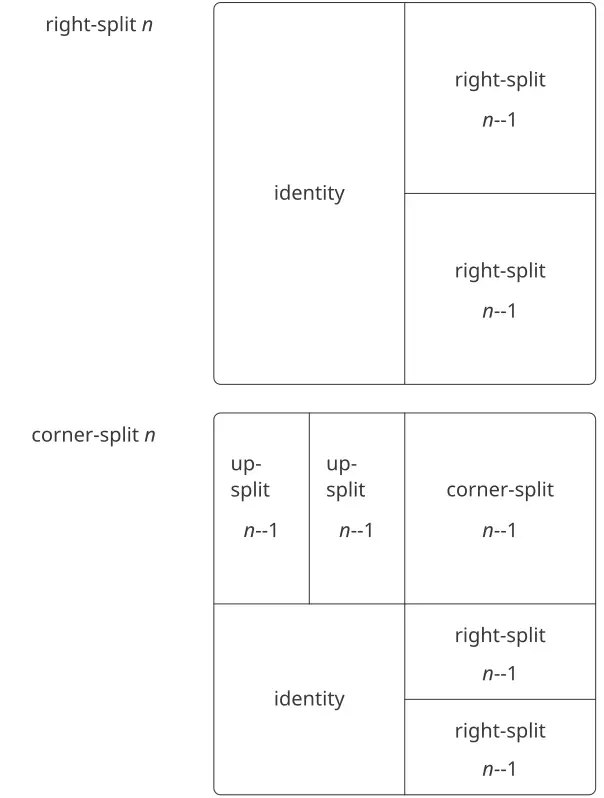
الشكل 2.13: مخطّطات تعاوديّة لـright-split وcorner-split.
ويمكننا إنتاج أنماطٍ متوازنةٍ بالتفرّع نحو الأعلى فضلًا عن التفرّع نحو اليمين (انظر التمرين 2.44 والشكل 2.13 والشكل 2.14):
(define (corner-split painter n)
  (if (= n 0)
      painter
      (let ((up (up-split painter (- n 1)))
            (right (right-split painter
                                (- n 1))))
        (let ((top-left (beside up up))
              (bottom-right (below right
                                   right))
              (corner (corner-split painter
                                    (- n 1))))
          (beside (below painter top-left)
                  (below bottom-right
                         corner))))))
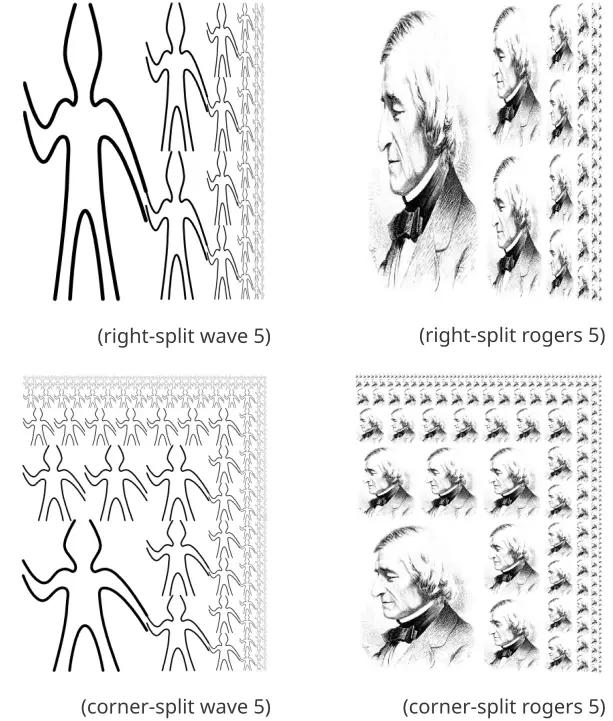
الشكل 2.14: العمليّتان التعاوديتان right-split وcorner-split مطبَّقتين على الرسّامين wave وrogers. ودمج أربع رَسومات corner-split يُنتج تصاميم square-limit متناظرةً كما في الشكل 2.9.
بوضع أربع نسخٍ من corner-split على النحو الملائم، نحصل على نمطٍ يُسمّى square-limit، تطبيقه على wave وrogers موضّحٌ في الشكل 2.9:
(define (square-limit painter n)
  (let ((quarter (corner-split painter n)))
    (let ((half (beside (flip-horiz quarter)
                        quarter)))
      (below (flip-vert half) half))))
التمرين 2.44: عرّف الإجراء
up-splitالذي يستخدمهcorner-split. فهو شبيهٌ بـright-split، إلّا أنّه يبدّل أدوارbelowوbeside.
عمليّات ذات رتبةٍ عليا
فضلًا عن تجريد أنماط دمج الرسّامين، يمكننا العمل في مستوى أعلى، مُجَرِّدين أنماط دمج عمليّات الرسم. أي أنّه يمكننا اعتبار عمليّات الرسم عناصرَ للتلاعب بها، وكتابة وسائل تركيبٍ لهذه العناصر، وهي إجراءاتٌ تأخذ عمليّات رسمٍ كمعطياتٍ وتُنشئ عمليّات رسمٍ جديدة.
فمثلًا، يُنظّم كلٌّ من flipped-pairs وsquare-limit أربع نسخٍ من صورة رسّامٍ في نمطٍ مربّعيّ؛ وهما لا يختلفان إلّا في كيفيّة توجيه النسخ. وإحدى طرائق تجريد نمط دمج الرسّامين هي بالإجراء الآتي، الذي يأخذ أربع عمليّات رسمٍ أحاديّة المعطى ويُنتج عمليّة رسمٍ تحوّل رسّامًا مُعطًى بتلك العمليّات الأربع وتُنظّم النتائج في مربّع. والتحويلات Tl وtr وbl وbr هي التحويلات التي تُطبَّق على النسخة العلوية اليسرى والنسخة العلوية اليمنى والنسخة السفلية اليسرى والنسخة السفلية اليمنى، على الترتيب.
(define (square-of-four tl tr bl br)
  (lambda (painter)
    (let ((top (beside (tl painter)
                       (tr painter)))
          (bottom (beside (bl painter)
                          (br painter))))
      (below bottom top))))
وبعدئذٍ يمكن تعريف flipped-pairs بدلالة square-of-four كالآتي:[24]
(define (flipped-pairs painter)
  (let ((combine4
         (square-of-four identity
                         flip-vert
                         identity
                         flip-vert)))
    (combine4 painter)))
ويمكن التعبير عن square-limit كالآتي:[25]
(define (square-limit painter n)
  (let ((combine4
         (square-of-four flip-horiz
                         identity
                         rotate180
                         flip-vert)))
    (combine4 (corner-split painter n))))
التمرين 2.45: يمكن التعبير عن Right-split وup-split كحالتين من عمليّة تقسيمٍ عامّة. عرّف إجراءً split بالخاصّيّة أنّ تقييم
(define right-split (split beside below))
(define up-split (split below beside))
يُنتج الإجراءين right-split وup-split بالسلوك نفسه الذي للإجراءين المعرَّفين سابقًا.
الإطارات
قبل أن نُبيّن كيف تُنفَّذ الرسّامون ووسائل تركيبهم، ينبغي أن نُفكّر أوّلًا في الإطارات. ويمكن وصف الإطار بثلاثة متجهات، متجه أصلٍ ومتجهي حافتَين. ومتجه الأصل يحدّد إزاحة أصل الإطار عن أصلٍ مطلقٍ معيّنٍ في المستوى، ومتجها الحافتين يحدّدان إزاحتي زاويتي الإطار عن أصله. فإذا كانت الحافتان متعامدتين، سيكون الإطار مستطيلًا. وإلّا فسيكون الإطار متوازي أضلاعٍ أكثر عمومًا.
يُظهر الشكل 2.15 إطارًا ومتجهاته المرتبطة به. وتماشيًا مع تجريد البيانات، لا يلزم أن نُحدّد بعد كيف تُُمثَّل الإطارات، عدا أن نقول إنّ هناك بانِيًا make-frame يأخذ ثلاثة متجهاتٍ ويُنتج إطارًا، وثلاثة مُنتَقٍيات مناظرة origin-frame وedge1-frame وedge2-frame (انظر التمرين 2.47).
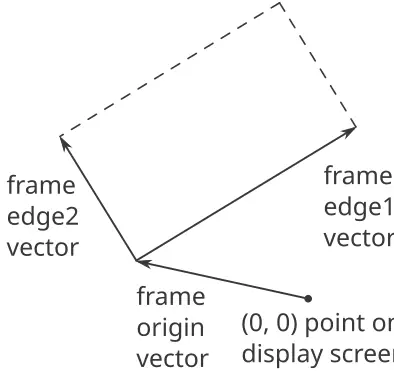
الشكل 2.15: يُوصَف الإطار بثلاثة متجهات: أصلٌ وحافتان.
سنستخدم الإحداثيّات في المربّع الوحدويّ لتحديد الصور. ومع كلّ إطارٍ، نربط خريطة إحداثيّات الإطار (frame coordinate map)، التي ستُستخدم لإزاحة الصور وتكبيرها لتتناسب مع الإطار. وتُحوّل الخريطة المربّع الوحدويّ إلى الإطار بربط المتجه بالمجموع المتجهيّ فمثلًا، يُربط (0, 0) بأصل الإطار، و(1, 1) بالرأس القُطريّ المقابل للأصل، و(0.5, 0.5) بمركز الإطار. ويمكننا إنشاء خريطة إحداثيّات إطارٍ بالإجراء الآتي:[26]
(define (frame-coord-map frame)
  (lambda (v)
    (add-vect
     (origin-frame frame)
     (add-vect
      (scale-vect (xcor-vect v)
                  (edge1-frame frame))
      (scale-vect (ycor-vect v)
                  (edge2-frame frame))))))
لاحِظ أنّ تطبيق frame-coord-map على إطارٍ يُعيد إجراءً يُعيد، حين يُعطى متجهًا، متجهًا. فإذا كان المتجه المعطى في المربّع الوحدويّ، فإنّ المتجه الناتج سيكون في الإطار. فمثلًا،
((frame-coord-map a-frame) (make-vect 0 0))
يُعيد المتجه نفسه الذي تُعيده
(origin-frame a-frame)
التمرين 2.46: يمكن تمثيل المتجه الثنائيّ الأبعاد الممتدّ من الأصل إلى نقطةٍ بزوجٍ يتألّف من إحداثي وإحداثي . نَفِّذ تجريد بياناتٍ للمتجهات بتقديم بانٍ
make-vectومُنتَقٍيات مناظرةxcor-vectوycor-vect. وبدلالة مُنتَقٍياتك وبانيك، نَفِّذ الإجراءاتadd-vectوsub-vectوscale-vectالتي تؤدّي عمليّات جمع المتجهات وطرحها وضرب متجهٍ في مقدارٍ قياسيّ:
التمرين 2.47: في ما يلي بانِيان محتملان للإطارات:
(define (make-frame origin edge1 edge2)
  (list origin edge1 edge2))

(define (make-frame origin edge1 edge2)
  (cons origin (cons edge1 edge2)))
من أجل كلّ بانٍ، قدّم المُنتَقِيات الملائمة لإنتاج تنفيذٍ للإطارات.
الرسّامون
يُُمثَّل الرسّام بإجراءٍ يرسم، حين يُعطى إطارًا كمعطى، صورةً معيّنةً مُزاحةً ومُكبَّرةً لتتناسب مع الإطار. أي أنّنا إذا كان p رسّامًا وf إطارًا، فإنّنا نُنتج صورة p في f بنداء p وإعطائها f كمعطى.
وتفاصيل كيفيّة تنفيذ الرسّامين الأوّليّين تعتمد على الخصائص الخاصّة لنظام الرسوميّات ونوع الصورة المطلوب رسمها. فمثلًا، لنفترض أنّ لدينا إجراءً draw-line يرسم خطًّا على الشاشة بين نقطتين محدَّدتين. فحينئذٍ يمكننا إنشاء رسّامين للرسوم الخطّيّة، كالرسّام wave في الشكل 2.10، من قوائم قطعٍ خطّيّةٍ كالآتي:[27]
(define (segments->painter segment-list)
  (lambda (frame)
    (for-each
     (lambda (segment)
       (draw-line
        ((frame-coord-map frame)
         (start-segment segment))
        ((frame-coord-map frame)
         (end-segment segment))))
     segment-list)))
والقطع مُعطاةٌ باستخدام إحداثيّاتٍ بالنسبة إلى المربّع الوحدويّ. ومن أجل كلّ قطعٍ في القائمة، يحوّل الرسّام نهايتَي القطع بخريطة إحداثيّات الإطار ويرسم خطًّا بين النقطتين المحوَّلتين.
إنّ تمثيل الرسّامين بإجراءاتٍ يُقيم حاجز تجريدٍ قويًّا في لغة الرسم. فيمكننا إنشاء جميع أنواع الرسّامين الأوّليّين ومزجها، بناءً على مجموعةٍ متنوّعةٍ من قدرات الرسوميّات. وتفاصيل تنفيذهم لا تهمّ. فأيّ إجراءٍ يمكن أن يقوم مقام رسّامٍ، شريطة أن يأخذ إطارًا كمعطى ويرسم شيئًا مُكبَّرًا ليتناسب مع الإطار.[28]
التمرين 2.48: يمكن تمثيل قطعةٍ خطّيّةٍ موجّهةٍ في المستوى بزوجٍ من المتجهات، المتجه الممتدّ من الأصل إلى نقطة بداية القطعة، والمتجه الممتدّ من الأصل إلى نقطة نهايتها. واستخدم تمثيلك للمتجهات من التمرين 2.46 لتعريف تمثيلٍ للقطع ببانٍ
make-segmentومُنتَقٍياتstart-segmentوend-segment.
التمرين 2.49: استخدم
segments->painterلتعريف الرسّامين الأوّليّين الآتيين: الرسّام الذي يرسم المحيط الخارجيّ للإطار المُعيَّن.الرسّام الذي يرسم شكل «X» بوصل الزوايا المتقابلة للإطار. الرسّام الذي يرسم شكلًا ماسيًّا بوصل نقاط منتصف أضلاع الإطار. الرسّام
wave.
تحويل الرسّامين ودمجهم
والعمليّة على الرسّامين (كـflip-vert أو beside) تعمل بإنشاء رسّامٍ ينادي الرسّامين الأصليّين بالنسبة إلى إطاراتٍ مُستنبطةٍ من الإطار المعطى. وهكذا، مثلًا، لا يلزم أن يعرف flip-vert كيف يعمل رسّامٌ ما لكي يقلبه، بل يلزمه فقط أن يعرف كيف يقلب إطارًا رأسًا على عقب: فالرسّام المقلوب يستخدم الرسّام الأصليّ فحسب، لكن في إطارٍ مقلوب.
وتقوم عمليّات الرسم على الإجراء transform-painter، الذي يأخذ كمعطياتٍ رسّامًا ومعلوماتٍ عن كيفيّة تحويل إطارٍ ويُنتج رسّامًا جديدًا. فالرسّام المحوَّل، حين يُنادى على إطارٍ، يحوّل الإطار ثم ينادي الرسّام الأصليّ على الإطار المحوَّل. ومعطيات transform-painter هي نقاطٌ (مُمثَّلةٌ كمتجهاتٍ) تُحدّد زوايا الإطار الجديد: فعند ربطها في الإطار، تحدّد النقطة الأولى أصل الإطار الجديد، وتحدّد النقطتان الأخريان نهايتي متجهي حافتيه. وبالتالي، فإنّ المعطيات الواقعة داخل المربّع الوحدويّ تُحدّد إطارًا محتوىً داخل الإطار الأصليّ.
(define (transform-painter
         painter origin corner1 corner2)
  (lambda (frame)
    (let ((m (frame-coord-map frame)))
      (let ((new-origin (m origin)))
        (painter (make-frame new-origin
                  (sub-vect (m corner1)
                            new-origin)
                  (sub-vect (m corner2)
                            new-origin)))))))
وهذه هي كيفيّة قلب صور الرسّامين رأسيًّا:
(define (flip-vert painter)
  (transform-painter
   painter
   (make-vect 0.0 1.0)   ; new origin
   (make-vect 1.0 1.0)   ; new end of edge1
   (make-vect 0.0 0.0))) ; new end of edge2
وباستخدام transform-painter، يمكننا تعريف تحويلاتٍ جديدةٍ بسهولة. فمثلًا، يمكننا تعريف رسّامٍ يُصغّر صورته إلى الربع العلوي الأيمن من الإطار المُعطى له:
(define (shrink-to-upper-right painter)
  (transform-painter painter
                     (make-vect 0.5 0.5)
                     (make-vect 1.0 0.5)
                     (make-vect 0.5 1.0)))
وتحويلاتٌ أخرى تُدوّر الصور عكس عقارب الساعة 90 درجةً[29]
(define (rotate90 painter)
  (transform-painter painter
                     (make-vect 1.0 0.0)
                     (make-vect 1.0 1.0)
                     (make-vect 0.0 0.0)))
أو تُضغط الصور نحو مركز الإطار:[30]
(define (squash-inwards painter)
  (transform-painter painter
                     (make-vect 0.0 0.0)
                     (make-vect 0.65 0.35)
                     (make-vect 0.35 0.65)))
وتحويل الإطار هو أيضًا مفتاح تعريف وسائل دمج رسّامين أو أكثر. فالإجراء beside، مثلًا، يأخذ رسّامين، ويحوّلهما ليرسما في النصفين الأيسر والأيمن من إطارٍ معطى على الترتيب، ويُنتج رسّامًا مركّبًا جديدًا. وحين يُعطى الرسّام المركّب إطارًا، ينادي الرسّام المحوَّل الأوّل ليرسم في النصف الأيسر للإطار، وينادي الرسّام المحوَّل الثاني ليرسم في النصف الأيمن للإطار:
(define (beside painter1 painter2)
  (let ((split-point (make-vect 0.5 0.0)))
    (let ((paint-left  (transform-painter
                        painter1
                        (make-vect 0.0 0.0)
                        split-point
                        (make-vect 0.0 1.0)))
          (paint-right (transform-painter
                        painter2
                        split-point
                        (make-vect 1.0 0.0)
                        (make-vect 0.5 1.0))))
      (lambda (frame)
        (paint-left frame)
        (paint-right frame)))))
لاحِظ كيف يجعل تجريد بيانات الرسّامين (painter data abstraction)، ولا سيّما تمثيل الرسّامين بوصفهم إجراءات، تنفيذ beside سهلًا. فالإجراء beside لا يحتاج إلى معرفة أيّ شيءٍ عن تفاصيل الرسّامين المكوّنين سوى أنّ كلّ رسّامٍ سيرسم شيئًا ما في إطاره المخصّص.
تمرين 2.50: عرّف التحويل
flip-horiz، الذي يقلب الرسّامين أفقيًّا، وتحويلاتٍ تُدوّر الرسّامين عكس اتجاه عقارب الساعة بمقدار 180 درجة و270 درجة.
تمرين 2.51: عرّف عمليّة
belowمن أجل الرسّامين. تأخذbelowرسّامين كمعطيات. والرسّام الناتج، إذا أُعطي إطارًا، يرسم بالرسّام الأوّل في أسفل الإطار وبالرسّام الثاني في أعلاه. عرّفbelowبطريقتين مختلفتين—أوّلًا بكتابة إجراءٍ مماثلٍ لإجراءbesideالمعطى أعلاه، وثانيًا بدلالةbesideوعمليّات تدويرٍ ملائمةٍ (من التمرين 2.50).
مستويات اللغة من أجل تصميم متين
إنّ لغة الصورة تطبّق بعضَ الأفكار الحاسمة التي استعرضناها عن التجريد بالإجراءات والبيانات. فالتجاريد الأساسيّة للبيانات، أي الرسّامين، مُنفَّذةٌ باستخدام تمثيلاتٍ إجرائيّة، وهذا ما يمكّن اللغة من معالجة قدرات الرسم الأساسيّة المختلفة معاملةً موحّدة. ووسائل التركيب تحقّق خاصّيّة الإغلاق، وهو ما يسمح لنا ببناء تصاميمَ معقّدةٍ بسهولة. وأخيرًا، فإنّ جميع أدوات تجريد الإجراءات مُتاحةٌ لنا لأجل تجريد وسائل تركيب الرسّامين.
وقد ألقينا أيضًا لمحةً عن فكرةٍ حاسمةٍ أخرى عن اللغات وتصميم البرامج. وهي مقاربة التصميم الطبقيّ (stratified design)، أي المفهوم القائل بأنّ النظم المعقّدة ينبغي أن تُبنى على هيئة تسلسلٍ من المستويات الموصوفة باستخدام تسلسلٍ من اللغات. فكلّ مستوىٍ يُبنَى بتركيب أجزاءَ تُعتبر أوّليّةً على ذلك المستوى، والأجزاء المبنيّة على كلّ مستوىٍ تُستخدم كأوّليّاتٍ على المستوى التالي. واللغة المستخدمة على كلّ مستوىٍ من التصميم الطبقيّ لها أوّليّات، ووسائل تركيب، ووسائل تجريدٍ ملائمةً لذلك المستوى من التفصيل.
والتصميم الطبقيّ سائدٌ في هندسة النظم المعقّدة. فمثلًا، في هندسة الحاسوب، تُركَّب المقاومات والترانزستورات (وتُوصَف بلغة الدارات التناظريّة) لإنتاج أجزاءَ كبوابات AND وبوابات OR، وهي التي تشكّل أوّليّات لغة تصميم الدارات الرقميّة.[31] وهذه الأجزاء تُركَّب لبناء المعالجات، وبنى النواقل (bus)، وأنظمة الذاكرة، التي تُركَّب بدورها لتشكيل الحواسيب، باستخدام لغاتٍ ملائمةٍ لهندسة الحاسوب. والحواسيب تُركَّب لتشكيل أنظمةٍ موزّعة، باستخدام لغاتٍ ملائمةٍ لوصف ترابط الشبكات، وهكذا.
وكمثالٍ صغيرٍ على التصميم الطبقيّ، فإنّ لغة الصورة التي نعمل بها تستخدم عناصرَ أوّليّةً (رسّامين أوّليّين) تُنشأ باستخدام لغةٍ تحدّد النقاط والخطوط لتوفير قوائم مقاطع الخطوط من أجل segments->painter، أو تفاصيل التظليل من أجل رسّامٍ كـrogers. وقد ركّز الجزء الأكبر من وصفنا للغة الصورة على تركيب هذه الأوّليّات، باستخدام مزيّجاتٍ هندسيّةٍ كـbeside وbelow. وقد عملنا أيضًا على مستوى أعلى، باعتبار beside وbelow أوّليّاتٍ تُعالَج في لغةٍ عمليّاتها، كـsquare-of-four مثلًا، تصوّر أنماطًا شائعةً لتركيب المزيّجات الهندسيّة.
والتصميم الطبقيّ يساعد على جعل البرامج متينة (robust)، أي أنّه يجعل من المرجّح أن تستدعي التغييرات الصغيرة في المواصفة تغييراتٍ صغيرةً مقابلةً في البرنامج. فمثلًا، لنفترض أنّنا أردنا تغيير الصورة المبنيّة على wave والمبيّنة في الشكل 2.9. فيمكننا العمل على المستوى الأدنى لتغيير المظهر التفصيليّ لعنصر wave؛ ويمكننا العمل على المستوى الأوسط لتغيير الطريقة التي يُكرّر بها corner-split العنصر wave؛ ويمكننا العمل على المستوى الأعلى لتغيير الطريقة التي يرتّب بها square-limit النسخ الأربع من الزاوية. وبصورةٍ عامّة، فإنّ كلّ مستوىٍ من التصميم الطبقيّ يوفّر معجمًا مختلفًا للتعبير عن خصائص النظام، ونوعًا مختلفًا من القدرة على تغييره.
تمرين 2.52: أجرِ تغييراتٍ على حدود المربّع الخاص بـ
waveالمبيّن في الشكل 2.9 بالعمل على كلّ من المستويات الموصوفة أعلاه. وبالأخصّ: أضف بعض المقاطع إلى رسّامwaveالأوّل في التمرين 2.49 (لإضافة ابتسامةٍ مثلًا).غيّر النمط الذي يبنيه
corner-split(مثلًا، باستخدام نسخةٍ واحدة فقط من صورتَيup-splitوright-splitبدلًا من نسختين). عَدّل النسخة منsquare-limitالتي تستخدمsquare-of-fourبحيث تُجمّع الزوايا في نمطٍ مختلف. (مثلًا، يمكنك أن تجعل مستر روجرز الكبير ينظر إلى الخارج من كلّ زاويةٍ من زوايا المربّع.)
2.3 البيانات الرمزيّة
جميع كائنات البيانات المركّبة التي استخدمناها حتّى الآن كانت مبنيةً في نهاية المطاف من الأعداد. وفي هذا القسم نوسّع القدرة التمثيليّة للغتنا بإدخال القدرة على العمل مع رموزٍ اعتباطيّةٍ بوصفها بيانات.
2.3.1 الاقتباس
إذا أمكننا تشكيل بياناتٍ مركّبةٍ باستخدام الرموز، فيمكننا أن نحصل على قوائمَ مثل
(a b c d)
(23 45 17)
((Norah 12)
 (Molly 9)
 (Anna 7)
 (Lauren 6)
 (Charlotte 4))
ويمكن أن تبدو القوائم التي تحتوي على رموزٍ تمامًا كتعبيرات لغتنا:
(* (+ 23 45) (+ x 9))
(define (fact n)
  (if (= n 1)
      1
      (* n (fact (- n 1)))))
ومن أجل معالجة الرموز نحتاج إلى عنصرٍ جديدٍ في لغتنا: القدرة على اقتباس (quote) كائن بيانات. فلنفترض أنّنا نريد بناء القائمة (a b). فلا يمكننا تحقيق ذلك بـ(list a b)، لأنّ هذا التعبير يبني قائمةً من قيم a وb بدلًا من الرموز ذاتها. وهذه المسألة معروفةٌ جيّدًا في سياق اللغات الطبيعيّة، حيث يمكن اعتبار الكلمات والجُمل إمّا كياناتٍ دلاليّةٍ وإمّا كسلاسلَ محرفيّةٍ (كياناتٍ صياغيّة). والممارسة الشائعة في اللغات الطبيعيّة هي استخدام علامات التنصيص للإشارة إلى أنّ كلمةً أو جملةً يُتعامل معها حرفيًّا بوصفها سلسلةً من المحارف. فعلى سبيل المثال، فإنّ الحرف الأوّل من «جون» هو «ج» بيّنًا. فإن قلنا لشخصٍ ما «قل اسمك بصوت عالٍ»، فنتوقّع أن نسمع اسم ذلك الشخص. ولكن إن قلنا لشخصٍ ما «قل ‹اسمك› بصوت عالٍ»، فنتوقّع أن نسمع الكلمتين «اسمك». ولاحِظ أنّنا مُلزَمون بتداخل علامات التنصيص لوصف ما قد يقوله شخصٌ آخر.[32]
ويمكننا اتّباع الممارسة ذاتها لتحديد القوائم والرموز التي يُتعامل معها بوصفها كائنات بيانات لا تعبيراتٍ يُقيَّم. غير أنّ صيغة الاقتباس التي نستخدمها تختلف عن صيغة اللغات الطبيعيّة في أنّنا نضع علامة تنصيص (وتقليديًّا، رمز التنصيص المفرد ') في بداية الكائن المُراد اقتباسه فقط. ويمكننا الاكتفاء بذلك في صياغة Scheme لأنّنا نعتمد على الفراغات والأقواس في تحديد حدود الكائنات. وهكذا، فإنّ معنى محرف التنصيص المفرد هو اقتباس الكائن التالي.[33]
يمكننا الآن التمييز بين الرموز وقيمها:
(define a 1)
(define b 2)

(list a b)
(1 2)

(list 'a 'b)
(a b)

(list 'a b)
(a 2)
ويسمح الاقتباس أيضًا بكتابة كائناتٍ مركّبةٍ باستخدام التمثيل المطبوع المعتاد للقوائم:[34]
(car '(a b c))
a

(cdr '(a b c))
(b c)
واتّفاقًا مع هذا، يمكننا الحصول على القائمة الفارغة بتقييم '()، وبالتّالي الاستغناء عن المتغيّر nil.
وهناك أوّليّةٌ إضافيّةٌ تُستخدم في معالجة الرموز، وهي eq?، التي تأخذ رمزين كمعطيات وتختبر كونَهما الرمز نفسه.[35] وباستخدام eq?، نستطيع تنفيذ إجراءٍ مفيدٍ يُسمّى memq. ويأخذ هذا معطيين، رمزًا وقائمةً. فإن لم يكن الرمز محتوىً في القائمة (أي أنّه ليس eq? لأيّ عنصرٍ فيها)، فإنّ memq يُعيد false. وإلّا، فإنّه يُعيد القائمة الجزئيّة من القائمة بدءًا من أوّل ظهورٍ للرمز:
(define (memq item x)
  (cond ((null? x) false)
        ((eq? item (car x)) x)
        (else (memq item (cdr x)))))
فعلى سبيل المثال، قيمة
(memq 'apple '(pear banana prune))
هي false، بينما قيمة
(memq 'apple '(x (apple sauce) y apple pear))
هو (apple pear).
تمرين 2.53: ماذا سيطبعه المفسّر استجابةً لتقييم كلّ من التعبيرات التالية؟
(list 'a 'b 'c)
(list (list 'george))
(cdr '((x1 x2) (y1 y2)))
(cadr '((x1 x2) (y1 y2)))
(pair? (car '(a short list)))
(memq 'red '((red shoes) (blue socks)))
(memq 'red '(red shoes blue socks))
تمرين 2.54: يُقال عن قائمتين إنّهما equal? إذا احتوتا على عناصرَ متساويةٍ مرتّبةٍ في الترتيب نفسه. فمثلًا،
(equal? '(this is a list)
        '(this is a list))
فالقيمة true، لكن
(equal? '(this is a list)
        '(this (is a) list))
أمّا القيمة فهي false. وبصورةٍ أدقّ، يمكننا تعريف equal? بشكلٍ تعاوديٍّ بدلالة مساواة الرموز الأساسيّة eq?، بقولنا إنّ a وb هما equal? إذا كانا رمزين والرمزان eq?، أو إذا كانا قائمتين بحيث يكون (car a) بـequal? مساويًا لـ(car b) ويكون (cdr a) بـequal? مساويًا لـ(cdr b). وباستخدام هذه الفكرة، نُفِّذ equal? بوصفه إجراءً.[36]
تمرين 2.55: تكتب إيفا لو أتور إلى المفسّر التعبير
(car ''abracadabra)
ولدهشتها، يطبعه المفسّر من جديد quote. اشرح.
2.3.2 مثال: التفاضل الرمزيّ
وكتوضيحٍ على معالجة الرموز، وتوضيحٍ إضافيٍّ على تجريد البيانات، تأمّل تصميم إجراءٍ يؤدي التفاضل الرمزيّ للتعبيرات الجبريّة. فنحن نريد من الإجراء أن يأخذ تعبيرًا جبريًّا ومتغيّرًا كمعطيات ويعيد مشتقّة التعبير بدلالة المتغيّر. فمثلًا، إذا كانت معطيات الإجراء هي و ، فينبغي أن يعيد الإجراء . والتفاضل الرمزيّ ذو أهمّيّة تاريخيّة خاصّة في Lisp. فقد كان أحد الأمثلة المحرّضة وراء تطوير لغة حاسوبٍ لمعالجة الرموز. وبالإضافة إلى ذلك، فقد مثّل بداية خطّ البحث الذي أدّى إلى تطوير نظمٍ قويّةٍ للعمل الرياضيّ الرمزيّ، التي يستخدمها حاليًّا عددٌ متزايدٌ من الرياضياتيّين التطبيقيّين والفيزيائيّين.
وعند تطوير برنامج التفاضل الرمزيّ، سنتبع استراتيجيّة تجريد البيانات ذاتها التي اتبعناها عند تطوير نظام الأعداد الكسريّة في 2.1.1. أي أنّنا سنعرّف أوّلًا خوارزميّة تفاضلٍ تعمل على كائناتٍ مجرّدةٍ كـ«المجاميع»، و«المضروبات»، و«المتغيّرات» دون القلق بشأن كيف سيُمثَّل أيٌّ منها. وبعد ذلك فقط سنتناول مسألة التمثيل.
برنامج التفاضل ببيانات مجرّدة
ومن أجل إبقاء الأمور بسيطة، سننظر في برنامج تفاضلٍ رمزيّ بسيطٍ للغاية يعالج تعبيراتٍ مبنيةً باستخدام عمليّتَي الجمع والضرب فقط وبمعطيين. ويمكن أداء تفاضل أيّ تعبيرٍ كهذا بتطبيق قواعد الاختزال التالية: ولاحِظ أنّ القاعدتين الأخيرتين تعاوديّتان بطبيعتهما. أي أنّنا للحصول على مشتقّة مجموعٍ نجد أوّلًا مشتقّات الحدود ثمّ نجمعها. وكلّ حدٍّ من الحدود قد يكون بدوره تعبيرًا يحتاج إلى التفكيك. وتفكيك الأجزاء إلى أجزاءَ أصغر فأصغر سيُنتج في النهاية أجزاءً إمّا ثوابتَ وإمّا متغيّرات، ومشقّاتها ستكون إمّا 0 وإمّا 1.
ولتجسيد هذه القواعد في إجراءٍ ننغمس في قليلٍ من التفكير بالأمانيّ، كما فعلنا عند تصميم تنفيذ الأعداد الكسريّة. فلو كانت لدينا وسيلةٌ لتمثيل التعبيرات الجبريّة، لأمكننا أن نقول ما إذا كان التعبير مجموعًا، أم مضروبًا، أم ثابتًا، أم متغيّرًا. وأمكننا استخلاص أجزاء التعبير. فمن أجل المجموع مثلًا، نريد أن نكون قادرين على استخلاص المُضَاف (addend) والمُضَاف إليه (augend). وينبغي أيضًا أن نكون قادرين على بناء تعبيراتٍ من أجزاء. فلنفترض أنّ لدينا سلفًا إجراءاتٍ تُنفّذ المُحدِّدات (selectors) والبنّاءات (constructors) والمسيّمات (predicates) التالية:
(variable? e)          Is e a variable?
(same-variable? v1 v2) Are v1 and v2 the same variable?
(sum? e)               Is e a sum?
(addend e)             Addend of the sum e.
(augend e)             Augend of the sum e.
(make-sum a1 a2)       Construct the sum of a1 and a2.
(product? e)           Is e a product?
(multiplier e)         Multiplier of the product e.
(multiplicand e)       Multiplicand of the product e.
(make-product m1 m2)   Construct the product of m1 and m2.
وباستخدام هذه، ومع المسيّم الأوّليّ number? الذي يحدّد الأعداد، نستطيع التعبير عن قواعد التفاضل بالإجراء التالي:
(define (deriv exp var)
  (cond ((number? exp) 0)
        ((variable? exp)
         (if (same-variable? exp var) 1 0))
        ((sum? exp)
         (make-sum (deriv (addend exp) var)
                   (deriv (augend exp) var)))
        ((product? exp)
         (make-sum
          (make-product
           (multiplier exp)
           (deriv (multiplicand exp) var))
          (make-product
           (deriv (multiplier exp) var)
           (multiplicand exp))))
        (else (error "unknown expression
                      type: DERIV" exp))))
والإجراء deriv هذا يتضمّن خوارزميّة التفاضل كاملةً. وبما أنّه معبَّرٌ عنه بدلالة بياناتٍ مجرّدة، فإنّه سيعمل مهما اختَرنا كيف نمثّل التعبيرات الجبريّة، طالما نصمّم مجموعةً ملائمةً من المُحدِّدات والبنّاءات. وهذه هي المسألة التي ينبغي أن نتناولها تاليًا.
تمثيل التعبيرات الجبريّة
يمكننا تصوّر طرائقَ كثيرةً لاستخدام بنية القوائم لتمثيل التعبيرات الجبريّة. فمثلًا، يمكننا استخدام قوائمَ من الرموز تعكس الترميز الجبريّ المعتاد، فنمثّل بالقائمة (a * x + b). غير أنّ أحد الخيارات المباشرة بصورةٍ خاصّةٍ هو استخدام الترميز البادئ ذي الأقواس نفسه الذي تستخدمه Lisp للتركيبات؛ أي أن نمثّل بـ(+ (* a x) b). وحينئذٍ يكون تمثيل البيانات الخاصّ بمسألة التفاضل كما يلي:
والمتغيّرات هي رموز. وهي تُعرَّف بالمسيّم الأوّل symbol?:
(define (variable? x) (symbol? x))
والمتغيّران متساويان إذا كانت الرموز التي تمثّلهما eq?:
(define (same-variable? v1 v2)
  (and (variable? v1)
       (variable? v2)
       (eq? v1 v2)))
والمجاميع والمضروبات تُبنى كقوائم:
(define (make-sum a1 a2) (list '+ a1 a2))
(define (make-product m1 m2) (list '* m1 m2))
والمجموع قائمةٌ أوّل عنصرٍ فيها هو الرمز +:
(define (sum? x)
  (and (pair? x) (eq? (car x) '+)))
والمُضَاف هو العنصر الثاني من قائمة المجموع:
(define (addend s) (cadr s))
والمُضَاف إليه هو العنصر الثالث من قائمة المجموع:
(define (augend s) (caddr s))
والمضروب قائمةٌ أوّل عنصرها هو الرمز *:
(define (product? x)
  (and (pair? x) (eq? (car x) '*)))
والمضروب هو العنصر الثاني من قائمة الضرب:
(define (multiplier p) (cadr p))
والمضروب فيه هو العنصر الثالث من قائمة الضرب:
(define (multiplicand p) (caddr p))
وهكذا، لا نحتاج إلّا إلى الجمع بين هذه وبين الخوارزميّة كما تجسّدها deriv كي نحصل على برنامج تفاضلٍ رمزيّ يعمل. فلننظر في بعض الأمثلة على سلوكه:
(deriv '(+ x 3) 'x)
(+ 1 0)

(deriv '(* x y) 'x)
(+ (* x 0) (* 1 y))

(deriv '(* (* x y) (+ x 3)) 'x)
(+ (* (* x y) (+ 1 0))
   (* (+ (* x 0) (* 1 y))
      (+  x 3)))
وإنّ البرنامج يُنتج إجاباتٍ صحيحة؛ غير أنّها غير مُبسَّطة. من الصحيح أنّ ولكنّنا نريد من البرنامج أن يعلم أنّ ، و ، و . وكان ينبغي أن تكون الإجابة عن المثال الثاني هي y ببساطة. وكما يُظهر المثال الثالث، فإنّ هذه تصير مسألةً جسيمة عندما تكون التعابير معقّدة.
وصعوبتنا تشبه إلى حدٍّ كبيرٍ تلك التي واجهناها مع تنفيذ الأعداد الكسريّة: فنحن لم نُبسّط الإجابات إلى أبسط صورة. ولتحقيق تبسيط الأعداد الكسريّة، احتجنا إلى تغيير البنّاءات والمُحدِّدات في التنفيذ فقط. ويمكننا اتّباع استراتيجيّة مشابهة هنا. فلن نُغيّر deriv إطلاقًا. وبدلًا من ذلك، سنُغيّر make-sum بحيث إذا كان كلٌّ من الحدّين عددًا، فإنّ make-sum يجمعهما ويعيد مجموعهما. وأيضًا، إذا كان أحد الحدّين 0، فإنّ make-sum يعيد الحدّ الآخر:
(define (make-sum a1 a2)
  (cond ((=number? a1 0) a2)
        ((=number? a2 0) a1)
        ((and (number? a1) (number? a2))
         (+ a1 a2))
        (else (list '+ a1 a2))))
وهذا يستخدم الإجراء =number?، الذي يتحقّق ممّا إذا كان تعبيرٌ ما مساويًا لعددٍ معطى:
(define (=number? exp num)
  (and (number? exp) (= exp num)))
وبالمثل، سنُغيّر make-product ليدمج القاعدتين بأنّ صفرًا مضروبًا في أيّ شيءٍ يساوي 0، وأنّ واحدًا مضروبًا في أيّ شيءٍ يساوي ذلك الشيء نفسه:
(define (make-product m1 m2)
  (cond ((or (=number? m1 0)
             (=number? m2 0))
         0)
        ((=number? m1 1) m2)
        ((=number? m2 1) m1)
        ((and (number? m1) (number? m2))
         (* m1 m2))
        (else (list '* m1 m2))))
وإليك كيف تعمل هذه النسخة على أمثلتنا الثلاثة:
(deriv '(+ x 3) 'x)
1

(deriv '(* x y) 'x)
y

(deriv '(* (* x y) (+ x 3)) 'x)
(+ (* x y) (* y (+ x 3)))
وعلى الرغم من أنّ هذا تحسينٌ كبير، إلّا أنّ المثال الثالث يُظهر أنّ الطريق لا يزال طويلًا قبل أن نحصل على برنامجٍ يضع التعابير في صورةٍ قد نتفّق على أنّها «الأبسط». ومسألة التبسيط الجبريّ معقّدةٌ لأنّه، من بين أسبابٍ أخرى، قد تكون صورةٌ ما أبسطَ صورةٍ لغرضٍ ما وغيرَ أبسطِ صورةٍ لغرضٍ آخر.
تمرين 2.56: أظهِر كيف نُوسّع المُفاضِلَ الأساسيّ ليتعامل مع أنواعٍ أكثر من التعبيرات. فنفّذ مثلًا قاعدة التفاضل بإضافة بندٍ جديد إلى برنامج
derivوتعريف الإجراءات الملائمةexponentiation?، وbase، وexponent، وmake-exponentiation. (يمكنك استخدام الرمز**للدلالة على الأُسّ.) وادمج القاعدتين بأنّ أيّ شيءٍ مرفوع إلى الأُسّ 0 يساوي 1، وأنّ أيّ شيءٍ مرفوع إلى الأُسّ 1 يساوي ذلك الشيء نفسه.
تمرين 2.57: وسّع برنامج التفاضل ليتعامل مع مجاميعَ ومضروباتٍ لها عددٌ اعتراضيٌّ (اثنان أو أكثر) من الحدود. وحينئذٍ يمكن التعبير عن المثال الأخير أعلاه كما يلي:
(deriv '(* x y (+ x 3)) 'x)
حاول فعل ذلك بتغيير تمثيل المجاميع والمضروبات فقط، دون تغيير الإجراء deriv إطلاقًا. فإنّ addend المجموع مثلًا هو الحدّ الأوّل، وaugend هو مجموع بقيّة الحدود.
تمرين 2.58: لنفترض أنّنا نريد تعديل برنامج التفاضل بحيث يعمل بالترميز الرياضيّ المعتاد، حيث يكون
+و*مشغّلين داخلين (infix) لا بادئين (prefix). وبما أنّ برنامج التفاضل معرَّفٌ بدلالة بياناتٍ مجرّدة، فيمكننا تعديله ليعمل مع تمثيلاتٍ مختلفةٍ للتعبيرات بتغيير المسيّمات والمُحدِّدات والبنّاءات التي تُحدّد تمثيل التعبيرات الجبريّة التي سيعمل عليها المُفاضِل فقط. أظهِر كيف نفعل ذلك كي نُفاضل تعبيراتٍ جبريّةً مقدَّمةً بالصيغة الداخلية، مثل(x + (3 * (x + (y + 2)))). ولتبسيط المهمّة، افترض أنّ+و*يأخذان معطيين دائمًا، وأنّ التعابير مُحاطةٌ بالأقواس بالكامل.وتصير المسألة أصعبَ بكثيرٍ إذا سمحنا بالترميز الجبريّ المعياريّ، مثل
(x + 3 * (x + y + 2))، الذي يُسقط الأقواس غير الضروريّة ويفترض أنّ الضرب يُنجَز قبل الجمع. فهل يمكنك تصميم مسيّماتٍ ومُحدِّداتٍ وبنّاءاتٍ ملائمةٍ لهذا الترميز بحيث يظلّ برنامج المشتقّات لدينا يعمل؟
2.3.3 مثال: تمثيل المجموعات
في الأمثلة السابقة بنينا تمثيلاتٍ لنوعين من كائنات البيانات المركّبة: الأعداد الكسريّة والتعبيرات الجبريّة. وفي أحد هذه الأمثلة كان لدينا الخيار بين تبسيط (اختزال) التعبيرات إمّا وقت البناء وإمّا وقت الانتقاء، لكن بخلاف ذلك كان اختيار تمثيل هذه البنى من حيث القوائم مباشرًا. وحين ننتقل إلى تمثيل المجموعات، لا يكون اختيار التمثيل بهذه الوضوح. فإنّ هناك عددًا من التمثيلات الممكنة، وهي تختلف اختلافًا جوهريًّا عن بعضها البعض في عدّة نواحٍ.
وبصورةٍ غير رسميّة، فإنّ المجموعة هي مجرّد تجميعٍ لكائناتٍ متمايزة. ولإعطاء تعريفٍ أدقّ يمكننا استخدام منهج تجريد البيانات. أي أنّنا نعرّف «المجموعة» بتحديد العمليّات التي ستُستخدم على المجموعات. وهذه هي union-set، وintersection-set، وelement-of-set?، وadjoin-set. وelement-of-set? مسيّمٌ يحدّد ما إذا كان عنصرٌ معطى ما عضوًا في مجموعة. وadjoin-set يأخذ كائنًا ومجموعةً كمعطيات ويعيد مجموعةً تحتوي على عناصر المجموعة الأصليّة والعنصر الملاحَق أيضًا. وunion-set يحسب اتحاد مجموعتين، وهو المجموعة التي تحتوي على كلّ عنصرٍ يظهر في أيّ من المعطيين. وintersection-set يحسب تقاطع مجموعتين، وهو المجموعة التي تحتوي فقط على العناصر التي تظهر في كلا المعطيين. ومن وجهة نظر تجريد البيانات، فنحن أحرارٌ في تصميم أيّ تمثيلٍ يُنفّذ هذه العمليّات بما يتّفق مع التأويلات المعطاة أعلاه.[37]
المجموعات كقوائم غير مرتّبة
إحدى طرق تمثيل المجموعة (set) هي قائمةٌ بعناصرها لا يظهر فيها أيّ عنصرٍ أكثر من مرّة. والمجموعة الخالية تُعبَّر عنها بالقائمة الخالية. وفي هذا التمثيل، الإجراء element-of-set? شبيهٌ بالإجراء memq المذكور في 2.3.1. وهو يستخدم equal? بدلًا من eq? حتّى لا يلزم أن تكون عناصر المجموعة رموزًا:
(define (element-of-set? x set)
  (cond ((null? set) false)
        ((equal? x (car set)) true)
        (else (element-of-set? x (cdr set)))))
وباستخدامه، يمكننا كتابة adjoin-set. فإن كان الكائن المطلوب إضافته موجودًا في المجموعة فعلًا، فإنّنا نُعيد المجموعة كما هي. وإلّا، فإنّنا نستخدم cons لإضافة الكائن إلى القائمة التي تمثّل المجموعة:
(define (adjoin-set x set)
  (if (element-of-set? x set)
      set
      (cons x set)))
ومن أجل intersection-set، يمكننا استخدام استراتيجيّة تعاوديّة. فإن كنّا نعرف كيف نُشكّل تقاطع set2 مع cdr الخاصّ بـset1، فلا يبقى علينا إلّا أن نُقرّر ما إذا كنّا سنُضمّن car الخاصّ بـset1 في هذا التقاطع. لكنّ ذلك مرتهنٌ بكون (car set1) موجودًا في set2 أيضًا. وهذا هو الإجراء الناتج:
(define (intersection-set set1 set2)
  (cond ((or (null? set1) (null? set2))
         '())
        ((element-of-set? (car set1) set2)
         (cons (car set1)
               (intersection-set (cdr set1)
                                 set2)))
        (else (intersection-set (cdr set1)
                                set2))))
وفي تصميم التمثيل، إحدى المسائل التي ينبغي أن نُعيرها اهتمامنا هي الكفاءة. فتأمّل عدد الخطوات التي تتطلّبها عمليّاتنا على المجموعات. فبما أنّها جميعًا تستخدم element-of-set?، فإنّ سرعة هذه العمليّة تؤثّر تأثيرًا كبيرًا على كفاءة تنفيذ المجموعة ككلّ. والآن، من أجل التحقّق ممّا إذا كان كائنٌ ما عضوًا في مجموعة، قد يضطرّ element-of-set? إلى تمشيط المجموعة برمّتها. (وفي أسوأ الحالات، يتبيّن أنّ الكائن ليس في المجموعة.) وبالتالي، فإن كانت المجموعة تضمّ عنصرًا، فإنّ element-of-set? قد يستغرق حتّى خطوة. وهكذا، فإنّ عدد الخطوات المطلوبة ينمو نموًّا يقابل . وعدد الخطوات التي يتطلّبها adjoin-set، الذي يستخدم هذه العمليّة، ينمو كذلك نحو . وأمّا intersection-set، الذي يُجري فحص element-of-set? لكلّ عنصرٍ من عناصر set1، فإنّ عدد الخطوات المطلوب ينمو بجداء حجمَي المجموعتين المعنيّتين، أي من أجل مجموعتين حجم كلٍّ منهما . والشيء نفسه سيصدق على union-set.
التمرين 2.59: نفّذ عمليّة
union-setمن أجل تمثيل المجموعات بالقوائم غير المرتّبة.
التمرين 2.60: حدّدنا أنّ المجموعة ستُمثَّل بقائمةٍ خالية من التكرار. والآن، افترض أنّنا نسمح بالتكرار. فمثلًا، يمكن تمثيل المجموعة بالقائمة
(2 3 2 1 3 2 2). صمّم إجراءاتelement-of-set?وadjoin-setوunion-setوintersection-setتعمل على هذا التمثيل. فكيف تُقارن كفاءة كلٍّ منها بكفاءة الإجراء المقابل في التمثيل الخالي من التكرار؟ وهل ثمّة تطبيقاتٌ كنتَ ستستخدم فيها هذا التمثيل تفضيلًا له على التمثيل الخالي من التكرار؟
المجموعات كقوائم مرتّبة
إحدى طرائق تسريع عمليّاتنا على المجموعات هي تغيير التمثيل بحيث تُدرَج عناصر المجموعة بترتيبٍ تصاعديّ. ولكي نفعل ذلك، نحتاج إلى طريقةٍ ما لمقارنة كائنين بحيث نستطيع القول أيّهما أكبر. فمثلًا، يمكننا مقارنة الرموز ترتيبًا معجميًّا، أو يمكننا الاتّفاق على طريقةٍ ما لإسناد عددٍ فريدٍ إلى كائنٍ ثمّ مقارنة العناصر بمقارنة الأعداد المقابلة لها. ولكي تبقي مناقشتنا بسيطة، سنقتصر على الحالة التي تكون فيها عناصر المجموعة أعدادًا، حتّى نستطيع مقارنة العناصر باستخدام > و<. وسنُمثّل مجموعة الأعداد بإدراج عناصرها بترتيبٍ تصاعديّ. فبينما كان تمثيلنا الأوّل أعلاه يسمح لنا بتمثيل المجموعة بإدراج العناصر بأيّ ترتيبٍ، فإنّ تمثيلنا الجديد لا يسمح إلّا بالقائمة (1 3 6 10).
تظهر إحدى مزايا الترتيب في element-of-set?: فعند التحقّق من وجود عنصرٍ ما، لم نعد مضطرّين إلى تمشيط المجموعة برمّتها. فإن وصلنا إلى عنصرٍ من المجموعة أكبر من العنصر الذي نبحث عنه، فإنّنا نعلم أنّ العنصر ليس في المجموعة:
(define (element-of-set? x set)
  (cond ((null? set) false)
        ((= x (car set)) true)
        ((< x (car set)) false)
        (else (element-of-set? x (cdr set)))))
فكم خطوةً يُوفّرها هذا؟ في أسوأ الحالات، قد يكون العنصر الذي نبحث عنه هو أكبر عنصرٍ في المجموعة، فيكون عدد الخطوات هو نفسُه كما في التمثيل غير المرتّب. ومن جانبٍ آخر، فإن كنّا نبحث عن عناصرَ كثيرةٍ مختلفة الأحجام، فيمكننا أن نتوقّع أنّنا سنكون قادرين أحيانًا على إيقاف البحث عند نقطةٍ قريبةٍ من بداية القائمة، وأنّنا سنكون في أحيانٍ أخرى مضطرّين إلى فحص معظم القائمة. وفي المتوسّط، ينبغي أن نتوقّع فحص نحو نصف عناصر المجموعة. وهكذا، فإنّ متوسّط عدد الخطوات المطلوبة سيكون قرابة . وهذا لا يزال نموًّا من رتبة ، لكنّه يُوفّر علينا، في المتوسّط، عامل 2 في عدد الخطوات مُقارنةً بالتنفيذ السابق.
ونحصل على تسريعٍ أكثر إذهالًا مع intersection-set. ففي التمثيل غير المرتّب، تطلّبت هذه العمليّة خطوة، لأنّنا كنّا نُجري تمشيطًا كاملًا لـset2 من أجل كلّ عنصرٍ من عناصر set1. لكنّ مع التمثيل المرتّب، يمكننا استخدام طريقةٍ أُذكى. ابدأ بمقارنة العنصرين الأوّلين، x1 وx2، في المجموعتين. فإن كان x1 مساويًا لـx2، فإنّ ذلك يُعطينا عنصرًا من التقاطع، وبقيّة التقاطع هي تقاطع cdr كلٍّ من المجموعتين. وأمّا إن كان x1 أصغر من x2، فبما أنّ x2 هو أصغر عنصرٍ في set2، فيمكننا أن نستنتج مباشرةً أنّ x1 لا يمكن أن يظهر في أيّ موضعٍ من set2، وبالتالي فهو ليس في التقاطع. وعليه، فإنّ التقاطع يساوي تقاطع set2 مع cdr الخاصّ بـset1. وبطريقةٍ مشابهة، فإن كان x2 أصغر من x1، فإنّ التقاطع يُعطى بتقاطع set1 مع cdr الخاصّ بـset2. وهذا هو الإجراء:
(define (intersection-set set1 set2)
  (if (or (null? set1) (null? set2))
      '()
      (let ((x1 (car set1)) (x2 (car set2)))
        (cond ((= x1 x2)
               (cons x1 (intersection-set
                         (cdr set1)
                         (cdr set2))))
              ((< x1 x2) (intersection-set
                          (cdr set1)
                          set2))
              ((< x2 x1) (intersection-set
                          set1
                          (cdr set2)))))))
ولتقدير عدد الخطوات التي تتطلّبها هذه العمليّة، لاحِظ أنّنا في كلّ خطوةٍ نُخفّض مسألة التقاطع إلى احتساب تقاطعات مجموعاتٍ أصغر — بإزالة أوّل عنصرٍ من set1 أو set2 أو من كليهما. وهكذا، فإنّ عدد الخطوات المطلوب هو على الأكثر مجموع حجمَي set1 وset2، بدلًا من جداء الحجمين كما في التمثيل غير المرتّب. وهذا نموٌّ من رتبة بدلًا من — تسريعٌ كبير، حتّى من أجل مجموعاتٍ متوسّطة الحجم.
التمرين 2.61: أعطِ تنفيذًا لـ
adjoin-setباستخدام التمثيل المرتّب. وبتحليلٍ مشابهٍ للتحليل المتعلّق بـelement-of-set?، أظهِر كيف نستفيد من الترتيب لإنتاج إجراءٍ يتطلّب، في المتوسّط، قرابة نصف عدد الخطوات التي يتطلّبها التمثيل غير المرتّب.
التمرين 2.62: أعطِ تنفيذًا رتبة نموّه لـ
union-setمن أجل المجموعات الممثّلة كقوائمَ مرتّبة.
المجموعات كأشجار ثنائيّة
يمكننا فعل ما هو أفضل من تمثيل القوائم المرتّبة بترتيب عناصر المجموعة في صورة شجرة. فكلّ عقدةٍ في الشجرة تحمل عنصرًا واحدًا من المجموعة، يُسمّى «المُدخَل» (entry) في تلك العقدة، ورابطًا إلى كلٍّ من عقدتين أُخريين (قد تكونان خاليتين). والرابط «الأيسر» يُشير إلى العناصر الأصغر من العنصر الموجود في العقدة، والرابط «الأيمن» يُشير إلى العناصر الأكبر منه. ويُظهر الشكل 2.16 بعض الأشجار التي تمثّل المجموعة . والمجموعة نفسها قد تُُمثَّل بشجرةٍ بعدّة طرقٍ مختلفة. والشرط الوحيد الذي نُلزم به أنفسنا من أجل تمثيلٍ صحيحٍ هو أن تكون جميع العناصر في الشجرة الفرعيّة اليسرى أصغر من مُدخَل العقدة، وأن تكون جميع العناصر في الشجرة الفرعيّة اليمنى أكبر منه.
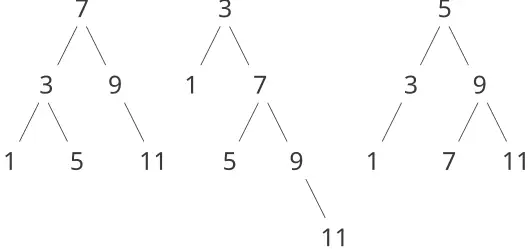
الشكل 2.16: أشجارٌ ثنائيّةٌ مختلفة تمثّل المجموعة .
وميزة تمثيل الأشجار هي هذه: افترض أنّنا نريد التحقّق ممّا إذا كان عددٌ موجودًا في مجموعة. فنبدأ بمقارنة بالمُدخَل الموجود في العقدة العليا. فإن كان أصغر منه، فإنّنا نعلم أنّنا لا نحتاج إلّا إلى البحث في الشجرة الفرعيّة اليسرى؛ وإن كان أكبر، فإنّنا لا نحتاج إلّا إلى البحث في الشجرة الفرعيّة اليمنى. والآن، فإن كانت الشجرة «متوازنة»، فإنّ كلًّا من هاتين الشجرتين الفرعيّتين سيكون قرابة نصف حجم الشجرة الأصليّة. وهكذا، فقد خفّضنا في خطوةٍ واحدة مسألة البحث في شجرةٍ حجمها إلى البحث في شجرةٍ حجمها . وبما أنّ حجم الشجرة يتنصف في كلّ خطوةٍ، فينبغي أن نتوقّع أنّ عدد الخطوات اللازم للبحث في شجرةٍ حجمها ينمو نموًّا يقابل .[38] ومن أجل المجموعات الكبيرة، سيكون هذا تسريعًا مهمًّا مُقارنةً بالتمثيلات السابقة.
يمكننا تمثيل الأشجار باستخدام القوائم. فكلّ عقدةٍ ستكون قائمةً من ثلاثة بنود: مُدخَل العقدة، والشجرة الفرعيّة اليسرى، والشجرة الفرعيّة اليمنى. وأمّا إذا كانت الشجرة الفرعيّة اليسرى أو اليمنى هي القائمة الخالية، فذلك يُشير إلى عدم وجود شجرةٍ فرعيّةٍ موصولة في ذلك الموضع. ويمكننا وصف هذا التمثيل بالإجراءات الآتية:[39]
(define (entry tree) (car tree))
(define (left-branch tree) (cadr tree))
(define (right-branch tree) (caddr tree))
(define (make-tree entry left right)
  (list entry left right))
والآن يمكننا كتابة إجراء element-of-set? باستخدام الاستراتيجيّة الموصوفة أعلاه:
(define (element-of-set? x set)
  (cond ((null? set) false)
        ((= x (entry set)) true)
        ((< x (entry set))
         (element-of-set?
          x
          (left-branch set)))
        ((> x (entry set))
         (element-of-set?
          x
          (right-branch set)))))
وإضافة عنصرٍ إلى مجموعةٍ تُنفَّذ بطريقةٍ مشابهة، وهي تتطلّب كذلك خطوة. فلكي نُضيف عنصرًا x، نقارن x بمُدخَل العقدة لتحديد ما إذا كان ينبغي إضافة x إلى الفرع الأيمن أم إلى الفرع الأيسر، وبعد إضافة x إلى الفرع المناسب، نُعيد تجميع هذا الفرع المُنشأ حديثًا مع المُدخَل الأصليّ والفرع الآخر. فإن كان x مساويًا للمُدخَل، فإنّنا نُعيد العقدة كما هي. وإن طُلِب منّا إضافة x إلى شجرةٍ خالية، فإنّنا نُنشئ شجرةً يكون x فيها هو المُدخَل ويكون فرعاها الأيمن والأيسر خاليين. وهذا هو الإجراء:
(define (adjoin-set x set)
  (cond ((null? set) (make-tree x '() '()))
        ((= x (entry set)) set)
        ((< x (entry set))
         (make-tree
          (entry set)
          (adjoin-set x (left-branch set))
          (right-branch set)))
        ((> x (entry set))
         (make-tree
          (entry set)
          (left-branch set)
          (adjoin-set x (right-branch set))))))
إنّ الادّعاء السابق بأنّ البحث في الشجرة يمكن أداؤه بعددٍ لوغاريتميٍّ من الخطوات يقوم على افتراض أنّ الشجرة «متوازنة»، أي أنّ الشجرة الفرعيّة اليسرى والشجرة الفرعيّة اليمنى لكلّ شجرةٍ تضمّان العدد نفسه من العناصر تقريبًا، بحيث تحتوي كلّ شجرةٍ فرعيّةٍ على قرابة نصف عناصر الشجرة الأمّ. ولكن كيف يمكننا أن نتيقّن من أنّ الأشجار التي نُنشئها ستكون متوازنة؟ فحتّى إن كنّا بدأنا بشجرةٍ متوازنة، فإنّ إضافة عناصرٍ بـadjoin-set قد تُنتج نتيجةً غير متوازنة. وبما أنّ موضع العنصر المُضاف حديثًا مرتهنٌ بكيفيّة مقارنة العنصر بالبنود الموجودة في المجموعة فعلًا، فيمكننا أن نتوقّع أنّه إن أضفنا عناصرٍ «عشوائيًّا» فإنّ الشجرة ستُميل إلى التوازن في المتوسّط. ولكنّ هذا ليس ضمانًا. فمثلًا، إن بدأنا بمجموعةٍ خاليةٍ وأضفنا الأعداد من 1 إلى 7 بالتتالي، فإنّنا ننتهي بالشجرة غير المتوازنة إلى حدٍّ كبير الموضّحة في الشكل 2.17. ففي هذه الشجرة، جميع الأشجار الفرعيّة اليسرى خالية، وليس لها بذلك أيّ ميزةٍ على قائمةٍ مرتّبةٍ بسيطة. وإحدى طرائق حلّ هذه المسألة هي تعريف عمليّةٍ تُحوّل شجرةً اعتباطيّةً إلى شجرةٍ متوازنةٍ بالعناصر نفسها. وبعدها يمكننا أداء هذا التحويل بعد كلّ بضع عمليّات adjoin-set لكي نُبقي مجموعتنا متوازنة. وثمّة طرائق أُخرى لحلّ هذه المسألة، أكثرها يتضمّن تصميم بنى بياناتٍ جديدة يمكن أداء البحث والإدخال فيها كلاهما بـ خطوة.[40]
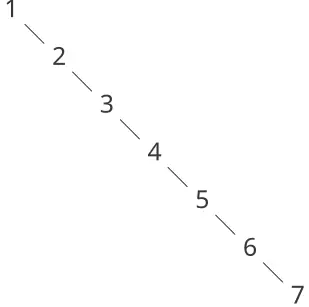
الشكل 2.17: شجرةٌ غير متوازنةٍ ناتجةٌ عن إضافة الأعداد من 1 إلى 7 بالتتالي.
التمرين 2.63: كلٌّ من الإجراءين الآتيين يُحوّل شجرةً ثنائيّةً إلى قائمة.
(define (tree->list-1 tree)
  (if (null? tree)
      '()
      (append
       (tree->list-1
        (left-branch tree))
       (cons (entry tree)
             (tree->list-1
              (right-branch tree))))))

(define (tree->list-2 tree)
  (define (copy-to-list tree result-list)
    (if (null? tree)
        result-list
        (copy-to-list
         (left-branch tree)
         (cons (entry tree)
               (copy-to-list
                (right-branch tree)
                result-list)))))
  (copy-to-list tree '()))
- فهل يُنتج الإجراءان النتيجة نفسها من أجل كلّ شجرة؟ فإن لم يكونا كذلك، فكيف تختلف النتائج؟ وأيّ قوائم يُنتجها الإجراءان من أجل الأشجار في الشكل 2.16؟
- فهل للإجراءين رتبة النموّ نفسها في عدد الخطوات اللازم لتحويل شجرةٍ متوازنةٍ لها عنصرًا إلى قائمة؟ فإن لم تكونا متساويتين، فأيّهما ينمو أبطأ؟
التمرين 2.64: الإجراء list->tree الآتي يُحوّل قائمةً مرتّبةً إلى شجرةٍ ثنائيّةٍ متوازنة. والإجراء المساعد partial-tree يأخذ كمعطيين عددًا صحيحًا وقائمةً من عنصرٍ على الأقلّ، ويُنشئ شجرةً متوازنةً تحتوي أوّل عنصرًا من القائمة. والنتيجة التي يُعيدها partial-tree هي زوجٌ (مُشكَّلٌ بـcons) car الخاصّ به هو الشجرة المُنشأة، وcdr الخاصّ به هو قائمة العناصر غير المُضمَّنة في الشجرة.
(define (list->tree elements)
  (car (partial-tree
        elements (length elements))))

(define (partial-tree elts n)
  (if (= n 0)
      (cons '() elts)
      (let ((left-size
             (quotient (- n 1) 2)))
        (let ((left-result
               (partial-tree
                elts left-size)))
          (let ((left-tree
                 (car left-result))
                (non-left-elts
                 (cdr left-result))
                (right-size
                 (- n (+ left-size 1))))
            (let ((this-entry
                   (car non-left-elts))
                  (right-result
                   (partial-tree
                    (cdr non-left-elts)
                    right-size)))
              (let ((right-tree
                     (car right-result))
                    (remaining-elts
                     (cdr right-result)))
                (cons (make-tree this-entry
                                 left-tree
                                 right-tree)
                      remaining-elts))))))))
- اكتب فقرةً قصيرةً تُفسّر بأوضح ما تستطيع كيف يعمل
partial-tree. وارسم الشجرة التي يُنتجهاlist->treeمن أجل القائمة(1 3 5 7 9 11). - فما رتبة النموّ في عدد الخطوات التي يتطلّبها
list->treeلتحويل قائمةٍ من عنصر؟
التمرين 2.65: استخدم نتائج التمرين 2.63 والتمرين 2.64 لإعطاء تنفيذاتٍ رتبة نموّها لـ
union-setوintersection-setمن أجل المجموعات المُنفَّذة كأشجارٍ ثنائيّةٍ (متوازنة).[41]
المجموعات واسترجاع المعلومات
لقد فحصنا خيارات استخدام القوائم لتمثيل المجموعات، ورأينا كيف يمكن أن يكون لاختيار تمثيلٍ ما لكائن بياناتٍ أثرٌ كبيرٌ على أداء البرامج التي تستخدم تلك البيانات. وهناك سببٌ آخر للتركيز على المجموعات هو أنّ التقنيّات المناقشة هنا تظهر مرّةً بعد أخرى في التطبيقات التي تتضمّن استرجاع المعلومات.
تأمّل قاعدة بياناتٍ تحتوي عددًا كبيرًا من السجلّات الفرديّة، كملفّات العاملين في شركةٍ أو العمليات الماليّة في نظامٍ محاسبيّ. فإنّ نظام إدارة البيانات النموذجيّ يقضي قدرًا كبيرًا من الوقت في الوصول إلى البيانات في السجلّات أو تعديلها، ولذلك يتطلّب طريقةً فعّالةً للوصول إلى السجلّات. ويُنجَز ذلك بتحديد جزءٍ من كلّ سجلٍّ ليقوم بدور مفتاح تعريفيّ. ويمكن أن يكون المفتاح أيّ شيءٍ يُعرِّف السجلّ تعريفًا فريدًا. فمن أجل ملفّ عامل، قد يكون رقم هويّة الموظّف. ومن أجل نظامٍ محاسبيّ، قد يكون رقم العمليّة الماليّة. وأيًّا كان المفتاح، فإنّنا حين نُعرّف السجلّ كبنية بياناتٍ، ينبغي أن نُضمّن إجراءً مُنتقِيًا key يُسترجِع المفتاح المرتبط بسجلٍّ معطًى.
والآن نُمثّل قاعدة البيانات كمجموعةٍ من السجلّات. ولكي نُحدّد موضع السجلّ ذي مفتاحٍ معطًى، نستخدم إجراءً lookup يأخذ كمعطيين مفتاحًا وقاعدة بياناتٍ، ويُعيد السجلّ الذي يحمل ذلك المفتاح، أو القيمة false إن لم يكن هناك سجلٌّ كهذا. والإجراء lookup مُنفَّذٌ بالطريقة نفسها تقريبًا كـelement-of-set?. فمثلًا، إن كانت مجموعة السجلّات مُنفَّذةً كقائمةٍ غير مرتّبة، فقد نستخدم
(define (lookup given-key set-of-records)
  (cond ((null? set-of-records) false)
        ((equal? given-key
                 (key (car set-of-records)))
         (car set-of-records))
        (else
         (lookup given-key
                 (cdr set-of-records)))))
وبالطبع، ثمّة طرائق أفضل لتمثيل المجموعات الكبيرة من تمثيلها كقوائمَ غير مرتّبةٍ. فإنّ أنظمة استرجاع المعلومات التي يجب الوصول إلى السجلّات فيها وصولًا «عشوائيًّا» تُنفَّذ عادةً بطريقةٍ تعتمد على الأشجار، كتمثيل الأشجار الثنائيّة المناقَش سابقًا. ومن أجل تصميم نظامٍ كهذا، يمكن أن تكون منهجيّة تجريد البيانات عونًا كبيرًا. فيستطيع المصمّم أن يُنشئ تنفيذًا أوّليًّا باستخدام تمثيلٍ بسيطٍ مباشرٍ كالقوائم غير المرتّبة. وهذا سيكون غير ملائمٍ للنظام النهائيّ، لكنّه قد يكون مفيدًا في توفير قاعدة بياناتٍ «سريعةٍ وخشنة» يُختبر بها بقيّة النظام. ولاحقًا، يمكن تعديل تمثيل البيانات ليصبح أكثر تطورًا. فإن كانت قاعدة البيانات تُستخدَم بدلالة المُنتقِيَات والبانيات المجرّدة، فإنّ هذا التغيير في التمثيل لن يفرض أيّ تغييراتٍ على بقيّة النظام.
التمرين 2.66: نفّذ إجراء
lookupمن أجل الحالة التي تكون فيها مجموعة السجلّات مبنيّةً كشجرةٍ ثنائيّةٍ مرتّبةٍ وفقًا للقيم العدديّة للمفاتيح.
2.3.4 مثال: أشجار ترميز هافمان
يُوفّر هذا القسم تدريبًا على استخدام بنية القوائم وتجريد البيانات للتلاعب بالمجموعات والأشجار. والتطبيق هنا هو على طرائق تمثيل البيانات كتسلسلاتٍ من الآحاد والأصفار (البتّات). فمثلًا، تُشفّر الشيفرة المعياريّة ASCII المستخدمة لتمثيل النصوص في الحواسيب كلّ حرفٍ كتسلسلٍ من سبع بتّات. ويسمح لنا استخدام سبع بتّات بالتمييز بين ، أو 128، من الحروف المختلفة الممكنة. وبصورةٍ عامّة، إن كنّا نريد التمييز بين رمزًا مختلفًا، فسنحتاج إلى استخدام بِتّة لكلّ رمز. فإن كانت جميع رسائلنا مُكوَّنةً من الرموز الثمانية A، وB، وC، وD، وE، وF، وG، وH، فيمكننا اختيار شيفرةٍ بثلاث بتّات لكلّ حرف، مثلًا:
A 000  C 010  E 100  G 110
B 001  D 011  F 101  H 111
وباستخدام هذه الشيفرة، فإنّ الرسالة
BACADAEAFABBAAAGAH
تُشفَّر كسلسلةٍ من 54 بِتّة
001000010000011000100000101
000001001000000000110000111
وتُعرَف الشيفرات كـASCII والشيفرة الخاصّة بالحروف من A إلى H أعلاه بأنّها شيفرات ثابتة الطول، لأنّها تمثّل كلّ رمزٍ في الرسالة بالعدد نفسه من البتّات. ومن المفيد أحيانًا استخدام شيفرات متغيّرة الطول، التي قد تُُمثَّل فيها رموزٌ مختلفة بأعدادٍ مختلفةٍ من البتّات. فمثلًا، لا تستخدم شيفرة مورس العدد نفسه من النقاط والشرطات لكلّ حرفٍ من حروف الأبجديّة. وعلى وجه الخصوص، فإنّ الحرف E، وهو الحرف الأكثر تكرارًا، يُمثَّل بنقطةٍ واحدة. وبصورةٍ عامّة، إن كانت رسائلنا على نحوٍ تظهر فيه بعض الرموز بتكرارٍ كبيرٍ جدًّا وبعضها بتكرارٍ نادرٍ جدًّا، فيمكننا ترميز البيانات بكفاءةٍ أكبر (أي باستخدام عددٍ أقلّ من البتّات لكلّ رسالة) إن أسندنا شيفراتٍ أقصر إلى الرموز المتكرّرة. فتأمّل شيفرة الحروف من A إلى H البديلة الآتية:
A 0    C 1010  E 1100  G 1110
B 100  D 1011  F 1101  H 1111
وباستخدام هذه الشيفرة، فإنّ الرسالة نفسها المذكورة أعلاه تُشفَّر كالسلسلة
100010100101101100011
010100100000111001111
تحتوي هذه السلسلة 42 بِتّة، وبذلك تُوفّر أكثر من 20% من المساحة مُقارنةً بالشيفرة ثابتة الطول الموضّحة أعلاه.
إحدى صعوبات استخدام شيفرةٍ متغيّرة الطول هي معرفة متى تكون قد وصلت إلى نهاية رمزٍ أثناء قراءة تسلسلٍ من الأصفار والآحاد. وتحلّ شيفرة مورس هذه المسألة باستخدام شيفرة فواصل خاصّة (وهي في هذه الحالة وقفةٌ زمنيّة) بعد تسلسل النقاط والشرطات الخاصّ بكلّ حرف. والحلّ الآخر هو تصميم الشيفرة على نحوٍ لا تكون فيه الشيفرة الكاملة لأيّ رمزٍ بدايةً (أي بادئة) لشيفرة رمزٍ آخر. وتُسمّى الشيفرة كهذه شيفرة بادئة. ففي المثال أعلاه، يُشفَّر الحرف A بـ0 ويُشفَّر الحرف B بـ100، فلا يمكن لأيّ رمزٍ آخر أن يملك شيفرةً تبدأ بـ0 أو بـ100.
وبصورةٍ عامّة، يمكننا تحقيق توفيراتٍ كبيرةٍ إن استخدمنا شيفرات بادئة متغيّرة الطول تستفيد من التردّدات النسبيّة للرموز في الرسائل المطلوب ترميزها. وتُسمّى إحدى الطرائق الخاصّة لفعل ذلك طريقة ترميز هافمان، نسبةً إلى مكتشفها، دافيد هافمان. ويمكن تمثيل شيفرة هافمان كشجرةٍ ثنائيّةٍ أوراقها هي الرموز المُرَمَّزة. وعند كلّ عقدةٍ غير طرفيّةٍ من الشجرة، توجد مجموعةٌ تحتوي جميع الرموز الموجودة في الأوراق الكائنة أسفل العقدة. وبالإضافة إلى ذلك، يُسنَد إلى كلّ رمزٍ في ورقةٍ وزنٌ (وهو تردّده النسبيّ)، وتحتوي كلّ عقدةٍ غير طرفيّةٍ على وزنٍ هو مجموع أوزان جميع الأوراق الكائنة أسفلها. والأوزان لا تُستخدم في عمليّة الترميز أو فكّ الترميز. وسنرى أدناه كيف تُستخدم للمساعدة في بناء الشجرة.
ويُظهر الشكل 2.18 شجرة هافمان الخاصّة بشيفرة الحروف من A إلى H المُعطاة أعلاه. وتُشير الأوزان في الأوراق إلى أنّ الشجرة صُمّمت من أجل رسائلٍ يظهر فيها الحرف A بتردّدٍ نسبيٍّ قدره 8، ويظهر فيها الحرف B بتردّدٍ نسبيٍّ قدره 3، ويظهر كلٌّ من الحروف الأخرى بتردّدٍ نسبيٍّ قدره 1.
الشكل 2.18: شجرة ترميز هافمان.
وبإعطائنا شجرة هافمان، يمكننا إيجاد ترميز أيّ رمزٍ بالانطلاق من الجذر والنزول حتّى نصل إلى الورقة التي تحمل الرمز. ففي كلّ مرّةٍ ننزل فيها عبر فرعٍ أيسر نُضيف 0 إلى الشيفرة، وفي كلّ مرّةٍ ننزل فيها عبر فرعٍ أيمن نُضيف 1. (ونحن نُقرّر أيّ فرعٍ نتّبعه بفحص أيّ الفرعين هو إمّا عقدة ورقة الرمز وإمّا يحتوي الرمز في مجموعةٍ.) فمثلًا، فإنّنا بالانطلاق من جذر الشجرة في الشكل 2.18، نصل إلى ورقة الحرف D باتّباع فرعٍ أيمن، ثمّ فرعٍ أيسر، ثمّ فرعٍ أيمن، ثمّ فرعٍ أيمن؛ وبذلك، فإنّ شيفرة الحرف D هي 1011.
ولفكّ ترميز تسلسلٍ من البتّات باستخدام شجرة هافمان، نبدأ من الجذر ونستخدم الأصفار والآحاد المتعاقبة في تسلسل البتّات لتحديد ما إذا كنّا سننزل عبر الفرع الأيسر أم الفرع الأيمن. ففي كلّ مرّةٍ نصل فيها إلى ورقةٍ، نكون قد أنشأنا رمزًا جديدًا في الرسالة، وعند تلك النقطة نبدأ من جديدٍ من جذر الشجرة لإيجاد الرمز التالي. فمثلًا، لنفترض أنّنا أُعطينا الشجرة أعلاه والتسلسل 10001010. فإنّنا بالانطلاق من الجذر ننزل عبر الفرع الأيمن (إذ أوّل بِتّة في السلسلة هي 1)، ثمّ عبر الفرع الأيسر (إذ البِتّة الثانية هي 0)، ثمّ عبر الفرع الأيسر (إذ البِتّة الثالثة هي 0 كذلك). وهذا يصل بنا إلى ورقة الحرف B، وبذلك يكون أوّل رمزٍ في الرسالة المفكوكة الترميز هو B. والآن نبدأ مرّةً أخرى من الجذر، ونُحرّك يسارًا لأنّ البِتّة التالية في السلسلة هي 0. وهذا يصل بنا إلى ورقة الحرف A. ثمّ نبدأ مرّةً أخرى من الجذر مع بقيّة السلسلة 1010، فنُحرّك يمينًا، ويسارًا، ويمينًا، ويسارًا، ونصل إلى C. وهكذا، فإنّ الرسالة بأكملها هي BAC.
توليد أشجار هافمان
وبإعطائنا «أبجديّة» من الرموز وتردّداتها النسبيّة، فكيف نُنشئ الشيفرة «الأفضل»؟ (وبعبارةٍ أُخرى، أيّ شجرةٍ ستُرمِّز الرسائل بأقلّ عددٍ من البتّات؟) لقد أعطانا هافمان خوارزميّةً لفعل ذلك، وأظهر أنّ الشيفرة الناتجة هي فعلًا أفضل شيفرةٍ متغيّرة الطول من أجل الرسائل التي تطابق فيها التردّدات النسبيّة للرموز التردّدات التي بُنيت الشيفرة وفقًا لها. ولن نُثبت هنا أمثليّة شيفرات هافمان، لكنّنا سنُبيّن كيف تُبنى أشجار هافمان.[42]
إنّ خوارزميّة توليد شجرة هافمان بسيطةٌ جدًّا. والفكرة هي ترتيب الشجرة بحيث تظهر الرموز ذات التردّد الأدنى في أقصى بُعدٍ عن الجذر. ابدأ بمجموعة عُقَد الأوراق، التي تحتوي الرموز وتردّداتها، كما تحدّدها البيانات الأوّليّة التي يُفترض بناء الشيفرة منها. والآن ابحث عن ورقتين ذواتَي أقلّ وزنين، وادمجهما لإنتاج عقدةٍ تكون هاتان العقدتان فرعيها الأيسر والأيمن. ووزن العقدة الجديدة هو مجموع الوزنين. وأزِل الورقتين من المجموعة الأصليّة وعوّضهما بهذه العقدة الجديدة. والآن تابع هذه العمليّة. ففي كلّ خطوةٍ، ادمج عقدتين ذواتَي أصغر وزنين، بإزالتهما من المجموعة وعوّضهما بعقدةٍ تكون هاتان فرعيها الأيسر والأيمن. وتتوقّف العمليّة عندما لا يبقى إلّا عقدةٌ واحدة، وهي جذر الشجرة بأكملها. وهذه هي الطريقة التي وُلِّدت بها شجرة هافمان الخاصّة بـالشكل 2.18:
Initial {(A 8) (B 3) (C 1) (D 1)
leaves   (E 1) (F 1) (G 1) (H 1)}

Merge   {(A 8) (B 3) ({C D} 2)
         (E 1) (F 1) (G 1) (H 1)}

Merge   {(A 8) (B 3) ({C D} 2)
         ({E F} 2) (G 1) (H 1)}

Merge   {(A 8) (B 3) ({C D} 2)
         ({E F} 2) ({G H} 2)}

Merge   {(A 8) (B 3) ({C D} 2)
         ({E F G H} 4)}

Merge   {(A 8) ({B C D} 5)
         ({E F G H} 4)}

Merge   {(A 8) ({B C D E F G H} 9)}

Final   {({A B C D E F G H} 17)}
merge
فالخوارزميّة لا تحدّد شجرةً فريدةً دائمًا، لأنّه قد لا تكون هناك عقدٌ فريدةٌ ذات أقلّ وزنٍ في كلّ خطوةٍ. وكذلك، فإنّ اختيار الترتيب الذي تُدمَج به العقدتان (أيّهما سيكون الفرع الأيمن وأيّهما سيكون الفرع الأيسر) اعتباطيّ.
تمثيل أشجار هافمان
وفي التمارين أدناه، سنعمل مع نظامٍ يستخدم أشجار هافمان لترميز الرسائل وفكّ ترميزها، ويُولّد أشجار هافمان وفقًا للخوارزميّة الموصوفة إجمالًا أعلاه. وسنبدأ بمناقشة كيف تُُمثَّل الأشجار.
وتُُمثَّل أوراق الشجرة بقائمةٍ تتكوّن من الرمز leaf، والرمز الموجود في الورقة، والوزن:
(define (make-leaf symbol weight)
  (list 'leaf symbol weight))
(define (leaf? object)
  (eq? (car object) 'leaf))
(define (symbol-leaf x) (cadr x))
(define (weight-leaf x) (caddr x))
وأمّا الشجرة العامّة فستكون قائمةً تتضمّن فرعًا أيسر، وفرعًا أيمن، ومجموعة رموز، ووزنًا. ومجموعة الرموز ستكون ببساطةٍ قائمةً بالرموز، لا بعض تمثيلات المجموعات الأكثر تطورًا. وحين نُنشئ شجرةً بدمج عقدتين، فإنّنا نحصل على وزن الشجرة كمجموع أوزان العقدتين، وعلى مجموعة الرموز كاتّحاد مجموعة الرموز الخاصّتين بالعقدتين. وبما أنّ مجموعات الرموز عندنا ممثّلةٌ كقوائم، فيمكننا تكوين الاتّحاد باستخدام الإجراء append الذي عرّفناه في 2.2.1:
(define (make-code-tree left right)
  (list left
        right
        (append (symbols left)
                (symbols right))
        (+ (weight left) (weight right))))
فإن أنشأنا شجرةً بهذه الطريقة، فإنّنا نملك المُنتقِيَات الآتية:
(define (left-branch tree) (car tree))
(define (right-branch tree) (cadr tree))

(define (symbols tree)
  (if (leaf? tree)
      (list (symbol-leaf tree))
      (caddr tree)))

(define (weight tree)
  (if (leaf? tree)
      (weight-leaf tree)
      (cadddr tree)))
ينبغي أن يفعل الإجراءان symbols وweight شيئًا مختلفًا بعض الشيء بحسب ما إذا كانا قد دُعيا بورقةٍ أو بشجرةٍ عامّة. وهذان مثالان بسيطان على الإجراءات العامّة (generic procedures) (أي الإجراءات التي تستطيع معالجة أكثر من نوعٍ واحدٍ من البيانات)، وسيكون لنا الكثير لنتحدّث عنه بشأنها في 2.4 و2.5.
إجراء فكّ الترميز
يُنفّذ الإجراء الآتي خوارزميّة فكّ الترميز. وهو يأخذ كمعطياتٍ قائمةً من الأصفار والآحاد، بالإضافة إلى شجرة هافمان.
(define (decode bits tree)
  (define (decode-1 bits current-branch)
    (if (null? bits)
        '()
        (let ((next-branch
               (choose-branch
                (car bits)
                current-branch)))
          (if (leaf? next-branch)
              (cons
               (symbol-leaf next-branch)
               (decode-1 (cdr bits) tree))
              (decode-1 (cdr bits)
                        next-branch)))))
  (decode-1 bits tree))

(define (choose-branch bit branch)
  (cond ((= bit 0) (left-branch branch))
        ((= bit 1) (right-branch branch))
        (else (error "bad bit:
               CHOOSE-BRANCH" bit))))
يأخذ الإجراء decode-1 معطيين: قائمة البتّات المتبقّية والموضع الحاليّ في الشجرة. وهو يواصل التحرّك «نزولًا» في الشجرة، فيختار فرعًا أيسر أو أيمن بحسب ما إذا كانت البِتّة التالية في القائمة صفرًا أو واحدًا. (ويتحقّق ذلك بالإجراء choose-branch.) وحين يصل إلى ورقةٍ، يُعيد الرمز الموجود في تلك الورقة بوصفه الرمز التالي في الرسالة، عن طريق إلحاقه (cons) بنتيجة فكّ ترميز بقيّة الرسالة، منطلقًا من جذر الشجرة. لاحِظ فحص الخطأ في البند الأخير من choose-branch، الذي يحتجّ إذا وجد الإجراء شيئًا آخر غير الصفر أو الواحد في بيانات الدخل.
مجموعات العناصر الموزونة
في تمثيلنا للأشجار، تحتوي كلّ عقدةٍ غير طرفيّةٍ على مجموعةٍ من الرموز، وقد مثّلناها كقائمةٍ بسيطة. غير أنّ خوارزميّة توليد الأشجار المناقشة أعلاه تتطلّب منّا أيضًا أن نعمل مع مجموعاتٍ من الأوراق والأشجار، بدمج العنصرين الأصغرين تباعًا. وبما أنّنا سنُطالب بإيجاد العنصر الأصغر في مجموعةٍ بشكلٍ متكرّر، فمن الملائم استخدام تمثيلٍ مرتّبٍ لهذا النوع من المجموعات.
سنُمثّل مجموعةً من الأوراق والأشجار كقائمةٍ من العناصر، مرتّبةً بترتيبٍ متزايدٍ بحسب الوزن. وإنّ الإجراء adjoin-set الآتي لبناء المجموعات شبيهٌ بالذي وُصف في Exercise 2.61؛ غير أنّ العناصر تُقارَن بأوزانها، وأنّ العنصر الذي يُضاف إلى المجموعة ليس موجودًا فيها أصلًا.
(define (adjoin-set x set)
  (cond ((null? set) (list x))
        ((< (weight x) (weight (car set)))
         (cons x set))
        (else
         (cons (car set)
               (adjoin-set x (cdr set))))))
يأخذ الإجراء الآتي قائمةً من أزواج الرمز والتردّد مثل ((A 4) (B 2) (C 1) (D 1)) ويبني مجموعةً أوّليّةً مرتّبةً من الأوراق، جاهزةً للدمج وفقًا لخوارزميّة هافمان:
(define (make-leaf-set pairs)
  (if (null? pairs)
      '()
      (let ((pair (car pairs)))
        (adjoin-set
         (make-leaf (car pair)    ; symbol
                    (cadr pair))  ; frequency
         (make-leaf-set (cdr pairs))))))
التمرين 2.67: عرّف شجرة ترميزٍ ورسالةً نموذجيّةً:
(define sample-tree
  (make-code-tree
   (make-leaf 'A 4)
   (make-code-tree
    (make-leaf 'B 2)
    (make-code-tree
     (make-leaf 'D 1)
     (make-leaf 'C 1)))))

(define sample-message
  '(0 1 1 0 0 1 0 1 0 1 1 1 0))
استخدم الإجراء decode لفكّ ترميز الرسالة، وأعطِ النتيجة.
التمرين 2.68: يأخذ الإجراء encode كمعطياتٍ رسالةً وشجرةً، ويُنتج قائمة البتّات التي تُعطي الرسالة المرمّزة.
(define (encode message tree)
  (if (null? message)
      '()
      (append
       (encode-symbol (car message)
                      tree)
       (encode (cdr message) tree))))
إنّ encode-symbol إجراءٌ عليك أنت كتابته، يُعيد قائمة البتّات التي تُشفّر رمزًا معطًى وفقًا لشجرةٍ معطاة. وعليك أن تُصمّم encode-symbol بحيث يُشير إلى خطأٍ إذا لم يكن الرمز موجودًا في الشجرة أصلًا. اختبر إجراءك بترميز النتيجة التي حصلت عليها في Exercise 2.67 بشجرة النموذج، وانظر هل هي مطابقةٌ لرسالة النموذج الأصليّة أم لا.
التمرين 2.69: يأخذ الإجراء الآتي كمعطاه قائمةً من أزواج الرمز والتردّد (حيث لا يظهر أيّ رمزٍ في أكثر من زوجٍ واحدٍ) ويُولّد شجرة ترميز هافمان وفقًا لخوارزميّة هافمان.
(define (generate-huffman-tree pairs)
  (successive-merge
   (make-leaf-set pairs)))
إنّ make-leaf-set هو الإجراء المُعطى أعلاه الذي يحوّل قائمة الأزواج إلى مجموعةٍ مرتّبةٍ من الأوراق. وsuccessive-merge هو الإجراء الذي عليك كتابته، باستخدام make-code-tree لدمج عناصر المجموعة الأقلّ وزنًا تباعًا حتّى لا يبقى إلّا عنصرٌ واحد، وهو شجرة هافمان المطلوبة. (وهذا الإجراء يحتاج إلى بعض الحذر بعض الشيء، لكنّه ليس معقّدًا حقًّا. فإن وجدت نفسك تُصمّم إجراءً معقّدًا، فأنت تُخطئ على الأرجح. ويمكنك أن تستفيد استفادةً كبيرةً من حقيقة أنّنا نستخدم تمثيلًا لمجموعةٍ مرتّبة.)
التمرين 2.70: صُمّم أبجديّةٌ من ثمانية رموزٍ بالتردّدات النسبيّة المرافقة لها لترميز كلمات أغاني الروك الخمسينيّة بكفاءة. (ولاحِظ أنّ «رموز» «الأبجديّة» لا يلزم أن تكون حروفًا فرديّة.)
A    2    NA  16
BOOM 1    SHA  3
GET  2    YIP  9
JOB  2    WAH  1
استخدم generate-huffman-tree (التمرين 2.69) لتوليد شجرة هافمان مناظرة، واستخدم encode (التمرين 2.68) لترميز الرسالة الآتية:
Get a job
Sha na na na na na na na na

Get a job
Sha na na na na na na na na

Wah yip yip yip yip
yip yip yip yip yip
Sha boom
كم بِتّة يلزم للترميز؟ وما هو أصغر عددٍ من البتّات يكون لازمًا لترميز هذا اللحن لو استخدمنا شيفرةً ثابتة الطول لأبجديّة الرموز الثمانية؟
التمرين 2.71: لنفترض أنّ لدينا شجرة هافمان لأبجديّةٍ تحتوي رمزًا، وأنّ التردّدات النسبيّة للرموز هي . ارسم الشجرة من أجل ؛ ومن أجل . في شجرةٍ كهذه (من أجل عامّة) فكم بِتّة يلزم لترميز الرمز الأكثر تكرارًا؟ والرمز الأقلّ تكرارًا؟
التمرين 2.72: تأمّل إجراء الترميز الذي صمّمته في التمرين 2.68. ما هو رتبة النمو في عدد الخطوات اللازمة لترميز رمزٍ واحد؟ تأكّد من إدراج عدد الخطوات اللازمة للبحث في قائمة الرموز عند كلّ عقدةٍ تُصادَف. والإجابة عن هذا السؤال بصورةٍ عامّة صعبة. فتأمّل الحالة الخاصّة التي تكون فيها التردّدات النسبيّة للرموز كما هي موصوفة في التمرين 2.71، وأعطِ رتبة النمو (كدالّةٍ في ) لعدد الخطوات اللازمة لترميز الرمزين الأكثر تكرارًا والأقلّ تكرارًا في الأبجديّة.
2.4 تمثيلات متعدّدة للبيانات المجرّدة
لقد عرّفنا تجريد البيانات (data abstraction)، وهو منهجيّةٌ لبناء النظم بحيث يمكن تحديد الكثير من البرنامج بشكلٍ مستقلّ عن الخيارات الداخلة في تنفيذ كائنات البيانات التي يعالجها البرنامج. فمثلًا، رأينا في 2.1.1 كيف نفصل بين مهمّة تصميم برنامجٍ يستخدم الأعداد النسبيّة وبين مهمّة تنفيذ الأعداد النسبيّة بدلالة الآليّات الأوّليّة للغة الحاسوب في بناء البيانات المركّبة. وكانت الفكرة الجوهريّة هي إقامة حاجز تجريدٍ (abstraction barrier) - وهو في هذه الحالة المُنتقِيّات والبواني الخاصّة بالأعداد النسبيّة (make-rat وnumer وdenom) - يعزل طريقة استخدام الأعداد النسبيّة عن تمثيلها الأساسيّ بدلالة بنية القوائم. ويقوم حاجز تجريدٍ شبيهٌ يعزل تفاصيل الإجراءات التي تؤدّي الحساب على الأعداد النسبيّة (add-rat وsub-rat وmul-rat وdiv-rat) عن الإجراءات ذات «المستوى الأعلى» التي تستخدم الأعداد النسبيّة. وللبرنامج الناتج البنية الموضّحة في الشكل 2.1.
وحواجز تجريد البيانات هذه أدواتٌ قويّةٌ للتحكّم في التعقيد. فبعزل التمثيلات الأساسيّة لكائنات البيانات، يمكننا تقسيم مهمّة تصميم برنامجٍ كبيرٍ إلى مهامّ أصغر يمكن أداؤها كلٌّ على حدة. غير أنّ هذا النوع من تجريد البيانات ليس قويًّا بما يكفي بعد، لأنّه قد لا يكون من المنطقيّ دائمًا الكلام عن «التمثيل الأساسيّ» لكائن بياناتٍ ما.
فمن ناحية، قد يوجد أكثر من تمثيلٍ مفيدٍ لكائن بياناتٍ واحد، وقد نرغب في تصميم نظمٍ قادرةٍ على التعامل مع تمثيلاتٍ متعدّدة. ولنأخذ مثالًا بسيطًا، قد تُُمثَّل الأعداد المركّبة بطريقتين شبه مكافئتين: بالتمثيل المستطيل (جزء حقيقيّ وجزء تخيّليّ) وبالتمثيل القطريّ (مقدار وزاوية). فأحيانًا يكون التمثيل المستطيل أنسب، وأحيانًا يكون التمثيل القطريّ أنسب. وفي الحقيقة، إنّه من المنطقيّ تمامًا تخيّل نظامٍ تُُمثَّل فيه الأعداد المركّبة بطريقتي التمثيل هاتين، وتعمل فيه الإجراءات المعالجة للأعداد المركّبة مع أيّ من التمثيلين.
والأهمّ من ذلك، أنّ نظم البرمجة تُصمَّم غالبًا على يد أشخاصٍ كثيرين يعملون على مدى فتراتٍ زمنيّةٍ ممتدّة، وتخضع لمتطلّباتٍ تتغيّر مع مرور الوقت. وفي بيئةٍ كهذه، ليس ممكنًا ببساطةٍ أن يتّفق الجميع مسبقًا على خيارات تمثيل البيانات. ولذلك، بالإضافة إلى حواجز تجريد البيانات التي تعزل التمثيل عن الاستخدام، نحتاج إلى حواجز تجريدٍ تعزل خيارات التصميم المختلفة بعضها عن بعض وتسمح للخيارات المختلفة بالتعايش في برنامجٍ واحد. وفوق ذلك، وبما أنّ البرامج الكبيرة تُنشأ غالبًا بدمج وحداتٍ قائمةٍ مسبقًا صُمّمت كلٌّ على حدة، فنحن نحتاج إلى اصطلاحاتٍ تسمح للمبرمجين بإدماج الوحدات في نظمٍ أكبر إدماجًا جمعيًّا (additive)، أي دون الحاجة إلى إعادة تصميم هذه الوحدات أو إعادة تنفيذها.
في هذا القسم، سنتعلّم كيف نتعامل مع بياناتٍ قد تُنمَّم بطرائق مختلفةٍ من قِبل أجزاء مختلفةٍ من البرنامج. وهذا يتطلّب بناء إجراءات عامّة (generic procedures) - أي الإجراءات التي تستطيع العمل على بياناتٍ قد تُنمَّم بأكثر من طريقةٍ واحدة. وإنّ تقنيّتنا الرئيسيّة لبناء الإجراءات العامّة ستكون العمل بدلالة كائنات بياناتٍ ذات أوسمة أنواع (type tags)، أي كائنات بياناتٍ تتضمّن معلوماتٍ صريحةً عن كيفيّة معالجتها. وسنناقش أيضًا البرمجة الموجَّهة بالبيانات (data-directed programming)، وهي استراتيجيّة تنفيذٍ قويّةٌ وملائمةٌ لتجميع النظم التي لها عمليّات عامّة إدماجًا جمعيًّا.
نبدأ بمثال الأعداد المركّبة البسيط. وسنرى كيف تُتيح لنا أوسمة الأنواع وأسلوب البرمجة الموجَّهة بالبيانات تصميم تمثيلين منفصلين - مستطيل وقطريّ - للأعداد المركّبة مع الحفاظ على مفهوم كائن بياناتٍ «عدد مركّب» مجرّد. وسنُحقّق ذلك بتعريف إجراءات للحساب على الأعداد المركّبة (add-complex وsub-complex وmul-complex وdiv-complex) بدلالة مُنتقِيّات عامّة تنفذ إلى أجزاء العدد المركّب بصورةٍ مستقلّةٍ عن كيفيّة تمثيل العدد. ونظام الأعداد المركّبة الناتج، كما هو موضّح في الشكل 2.19، يحتوي على نوعين مختلفين من حواجز التجريد. وحواجز التجريد «الأفقيّة» تؤدّي الدور نفسه الذي تؤدّيه الحواجز في الشكل 2.1. فهي تعزل العمليّات «ذات المستوى الأعلى» عن التمثيلات «ذات المستوى الأدنى». وبالإضافة إلى ذلك، هناك حاجزٌ «عموديّ» يمنحنا القدرة على تصميم تمثيلات بديلةٍ وتثبيتها كلٌّ على حدة.
الشكل 2.19: حواجز تجريد البيانات في نظام الأعداد المركّبة.
في 2.5 سنُبيّن كيف نستخدم أوسمة الأنواع وأسلوب البرمجة الموجَّهة بالبيانات لتطوير حزمة حسابٍ عامّة. وهذه تُوفّر إجراءات (add وmul وغيرها) يمكن استخدامها للتلاعب بجميع أنواع «الأعداد»، ويمكن توسعتها بسهولةٍ حين يلزم نوعٌ جديدٌ من الأعداد. وفي 2.5.3، سنُبيّن كيف نستخدم الحساب العامّ في نظامٍ يؤدّي الجبر الرمزيّ.
2.4.1 تمثيلات الأعداد المركّبة
سنُطوّر نظامًا يؤدّي عمليّات الحساب على الأعداد المركّبة، بوصفه مثالًا بسيطًا لكنّه غير واقعيٍّ على برنامجٍ يستخدم عمليّاتٍ عامّة. ونبدأ بمناقشة تمثيلين معقولين للأعداد المركّبة كأزواجٍ مرتّبة: التمثيل المستطيل (جزء حقيقيّ وجزء تخيّليّ) والتمثيل القطريّ (مقدار وزاوية).[43] وسيُظهر القسم 2.4.2 كيف يمكن جعل التمثيلين يتعايشان في نظامٍ واحدٍ باستخدام أوسمة الأنواع والعمليّات العامّة.
مثلها مثل الأعداد النسبيّة، تُنمَّم الأعداد المركّبة بصورةٍ طبيعيّةٍ كأزواجٍ مرتّبة. ويمكن النظر إلى مجموعة الأعداد المركّبة بوصفها فضاءً ثنائيّ الأبعاد له محوران متعامدان، المحور «الحقيقيّ» والمحور «التخيّليّ». (انظر الشكل 2.20.) ومن هذا المنظور، يمكن النظر إلى العدد المركّب (حيث ) بوصفه النقطة في المستوى التي إحداثيّها الحقيقيّ هو وإحداثيّها التخيّليّ هو . وجمع الأعداد المركّبة ينحلّ في هذا التمثيل إلى جمع الإحداثيّات:
الشكل 2.20: الأعداد المركّبة كنقاطٍ في المستوى.
وعند ضرب الأعداد المركّبة، يكون من الأنسب التفكير بدلالة تمثيل العدد المركّب بالتمثيل القطريّ، كمقدارٍ وزاوية ( و في الشكل 2.20). وحاصل ضرب عددين مركّبين هو المتجه الناتج عن تمديد أحد العددين المركّبين بطول الآخر ثمّ تدويره بالزاوية الخاصّة بالآخر:
وبذلك، فهناك تمثيلان مختلفان للأعداد المركّبة، كلٌّ منهما مناسبٌ لعمليّاتٍ مختلفة. ومع ذلك، فمن وجهة نظر شخصٍ يكتب برنامجًا يستخدم الأعداد المركّبة، فإنّ مبدأ تجريد البيانات يقترح أن تتوفّر جميع العمليّات المعالجة للأعداد المركّبة بغضّ النظر عن التمثيل الذي يستخدمه الحاسوب. فمثلًا، كثيرًا ما يكون من المفيد القدرة على إيجاد مقدار عددٍ مركّبٍ محدَّدٍ بإحداثيّاتٍ مستطيلة. وبالمثل، كثيرًا ما يكون من المفيد القدرة على تحديد الجزء الحقيقيّ لعددٍ مركّبٍ محدَّدٍ بإحداثيّاتٍ قطبيّة.
لتصميم نظامٍ كهذا، يمكننا اتّباع الاستراتيجيّة نفسها لتجريد البيانات التي اتّبعناها في تصميم حزمة الأعداد النسبيّة في 2.1.1. افترض أنّ العمليّات على الأعداد المركّبة مُنفَّذة بدلالة أربعة مُنتقِيّات: real-part وimag-part وmagnitude وangle. وافترض أيضًا أنّ لدينا إجراءين لبناء الأعداد المركّبة: يُعيد make-from-real-imag عددًا مركّبًا بجزءٍ حقيقيّ وجزءٍ تخيّليّ محدَّدين، ويُعيد make-from-mag-ang عددًا مركّبًا بمقدارٍ وزاويةٍ محدَّدين. وهذه الإجراءات لها الخاصّيّة أنّّه، لأيّ عددٍ مركّبٍ z، كلٌّ من
(make-from-real-imag (real-part z)
                     (imag-part z))
و
(make-from-mag-ang (magnitude z)
                   (angle z))
تُنتج أعدادًا مركّبةً مساويةً لـz.
باستخدام هذه البواني وهذه المُنتقِيّات، يمكننا تنفيذ الحساب على الأعداد المركّبة باستخدام «البيانات المجرّدة» التي يحدّدها البواني والمُنتقِيّات، تمامًا كما فعلنا مع الأعداد النسبيّة في 2.1.1. وكما هو موضّح في الصيغ أعلاه، فيمكننا جمع الأعداد المركّبة وطرحها بدلالة الجزأين الحقيقيّ والتخيّليّ، بينما نضرب الأعداد المركّبة ونقسمها بدلالة المقدارين والزاويتين:
(define (add-complex z1 z2)
  (make-from-real-imag
   (+ (real-part z1) (real-part z2))
   (+ (imag-part z1) (imag-part z2))))

(define (sub-complex z1 z2)
  (make-from-real-imag
   (- (real-part z1) (real-part z2))
   (- (imag-part z1) (imag-part z2))))

(define (mul-complex z1 z2)
  (make-from-mag-ang
   (* (magnitude z1) (magnitude z2))
   (+ (angle z1) (angle z2))))

(define (div-complex z1 z2)
  (make-from-mag-ang
   (/ (magnitude z1) (magnitude z2))
   (- (angle z1) (angle z2))))
لاكتمال حزمة الأعداد المركّبة، يجب أن نختار تمثيلًا، وأن نُنفّذ البواني والمُنتقِيّات بدلالة الأعداد الأوّليّة وبنية القوائم الأوّليّة. وهناك طريقتان واضحتان لفعل ذلك: فيمكننا تمثيل العدد المركّب «بالتمثيل المستطيل» كزوجٍ (جزء حقيقيّ، جزء تخيّليّ) أو «بالتمثيل القطريّ» كزوجٍ (مقدار، زاوية). فأيّهما نختار؟
حتّى نجعل الخيارات المختلفة ملموسة، تخيّل أنّ هناك مبرمجَين، بن بيتدِل وأليسا بي. هاكر، يُصمّم كلٌّ منهما على حدةٍ تمثيلًا لنظام الأعداد المركّبة. فيختار بن تمثيل الأعداد المركّبة بالتمثيل المستطيل. وبهذا الخيار، يكون انتقاء الجزأين الحقيقيّ والتخيّليّ لعددٍ مركّبٍ مباشرًا، تمامًا كبناء عددٍ مركّبٍ بجزءٍ حقيقيّ وجزءٍ تخيّليّ معطيين. أمّا لإيجاد المقدار والزاوية، أو لبناء عددٍ مركّبٍ بمقدارٍ وزاويةٍ معطيين، فإنّه يستخدم العلاقات المثلثيّة
التي تربط الجزأين الحقيقيّ والتخيّليّ بالمقدار والزاوية .[44] ولذلك، يتعيّن تمثيل بن بالمُنتقِيّات والبواني الآتية:
(define (real-part z) (car z))
(define (imag-part z) (cdr z))

(define (magnitude z)
  (sqrt (+ (square (real-part z))
           (square (imag-part z)))))

(define (angle z)
  (atan (imag-part z) (real-part z)))

(define (make-from-real-imag x y)
  (cons x y))

(define (make-from-mag-ang r a)
  (cons (* r (cos a)) (* r (sin a))))
أمّا أليسا، فعلى العكس، تختار تمثيل الأعداد المركّبة بالتمثيل القطريّ. فبالنسبة لها، يكون انتقاء المقدار والزاوية مباشرًا، لكنّها مضطرة إلى استخدام العلاقات المثلثيّة للحصول على الجزأين الحقيقيّ والتخيّليّ. وتمثيل أليسا هو:
(define (real-part z)
  (* (magnitude z) (cos (angle z))))

(define (imag-part z)
  (* (magnitude z) (sin (angle z))))

(define (magnitude z) (car z))
(define (angle z) (cdr z))

(define (make-from-real-imag x y)
  (cons (sqrt (+ (square x) (square y)))
        (atan y x)))

(define (make-from-mag-ang r a)
  (cons r a))
يضمن انضباط تجريد البيانات أنّ التنفيذ نفسه للإجراءات add-complex وsub-complex وmul-complex وdiv-complex سيعمل مع تمثيل بن أو مع تمثيل أليسا.
2.4.2 البيانات المَوْسومة
إحدى طرائق النظر إلى تجريد البيانات هي النظر إليه بوصفه تطبيقًا لـ«مبدأ أقلّ التزام». فعند تنفيذ نظام الأعداد المركّبة في 2.4.1، يمكننا استخدام إمّا تمثيل بن المستطيل وإمّا تمثيل أليسا القطريّ. وحاجز التجريد المُقام بالمُنتقِيّات والبواني يسمح لنا بتأجيل اختيار تمثيلٍ ملموسٍ لكائنات بياناتنا إلى آخر لحظةٍ ممكنة، وبذلك نحتفظ بأقصى مرونةٍ ممكنةٍ في تصميم نظامنا.
ويمكن التوسّع في مبدأ أقلّ الالتزام إلى حدودٍ أشدّ حتّى من ذلك. فإن أردنا، فيمكننا الحفاظ على غموض التمثيل حتّى بعد أن نُصمّم المُنتقِيّات والبواني، ونختار استخدام تمثيل بن وتمثيل أليسا معًا. غير أنّ ضَمّ التمثيلين في نظامٍ واحدٍ يتطلّب منّا طريقةً ما للتمييز بين البيانات ذات التمثيل القطريّ والبيانات ذات التمثيل المستطيل. وإلّا، فلو طُلب منّا، مثلًا، إيجاد magnitude الزوج (3, 4)، فلن نعرف هل نُجيب بـ5 (بقراءة العدد بالتمثيل المستطيل) أم بـ3 (بقراءة العدد بالتمثيل القطريّ). وطريقةٌ مباشرةٌ لإنجاز هذا التمييز هي إدراج وسم نوع (type tag) - وهو الرمز rectangular أو polar - كجزءٍ من كلّ عددٍ مركّب. وحين نحتاج حينئذٍ إلى معالجة عددٍ مركّبٍ، يمكننا استخدام الوسم لتحديد أيّ المُنتقِيّات نطبّق.
لكي نتعامل مع البيانات المَوْسومة، سنفترض أنّ لدينا إجراءين، type-tag وcontents، يستخرجان من كائن البيانات الوسم والمحتويات الفعليّة (الإحداثيّات القطريّة أو المستطيلة، في حالة العدد المركّب). وسنفترض أيضًا وجود إجراءٍ attach-tag يأخذ وسمًا ومحتويات ويُنتج كائن بياناتٍ موسومًا. وأحد الطرق المباشرة لتنفيذ ذلك هو استخدام بنية القوائم الاعتياديّة:
(define (attach-tag type-tag contents)
  (cons type-tag contents))

(define (type-tag datum)
  (if (pair? datum)
      (car datum)
      (error "Bad tagged datum:
              TYPE-TAG" datum)))

(define (contents datum)
  (if (pair? datum)
      (cdr datum)
      (error "Bad tagged datum:
              CONTENTS" datum)))
باستخدام هذه الإجراءات، يمكننا تعريف مُسَيِّمَين، rectangular? وpolar?، يتعرّفان على الأعداد المستطيلة والأعداد القطريّة على الترتيب:
(define (rectangular? z)
  (eq? (type-tag z) 'rectangular))

(define (polar? z)
  (eq? (type-tag z) 'polar))
وباستخدام أوسمة الأنواع، يمكن لبن وأليسا الآن تعديل شيفرتيهما بحيث يتعايش تمثيلاهما المختلفان في النظام نفسه. فكلّما يبني بن عددًا مركّبًا، فإنّه يوسمه بأنّه مستطيل. وكلّما تبني أليسا عددًا مركّبًا، فإنّها توسمه بأنّه قطريّ. وبالإضافة إلى ذلك، يجب على بن وأليسا أن يضمنا ألّا تتعارض أسماء إجراءاتهما. وإحدى طرائق فعل ذلك هي أن يُلحق بن اللاحقة rectangular باسم كلّ إجراءٍ من إجراءات تمثيله، وأن تُلحق أليسا اللاحقة polar بأسماء إجراءاتها. وهذه هي نسخة بن المُعدَّلة من التمثيل المستطيل الواردة في 2.4.1:
(define (real-part-rectangular z) (car z))
(define (imag-part-rectangular z) (cdr z))

(define (magnitude-rectangular z)
  (sqrt (+ (square (real-part-rectangular z))
           (square (imag-part-rectangular z)))))

(define (angle-rectangular z)
  (atan (imag-part-rectangular z)
        (real-part-rectangular z)))

(define (make-from-real-imag-rectangular x y)
  (attach-tag 'rectangular (cons x y)))

(define (make-from-mag-ang-rectangular r a)
  (attach-tag
   'rectangular
   (cons (* r (cos a)) (* r (sin a)))))
وهذه هي نسخة أليسا المُعدَّلة من التمثيل القطريّ:
(define (real-part-polar z)
  (* (magnitude-polar z)
     (cos (angle-polar z))))

(define (imag-part-polar z)
  (* (magnitude-polar z)
     (sin (angle-polar z))))

(define (magnitude-polar z) (car z))
(define (angle-polar z) (cdr z))

(define (make-from-real-imag-polar x y)
  (attach-tag
   'polar
   (cons (sqrt (+ (square x) (square y)))
         (atan y x))))

(define (make-from-mag-ang-polar r a)
  (attach-tag 'polar (cons r a)))
يُنفَّذ كلّ مُنتقٍ عامّ (generic selector) بإجراءٍ يفحص وسم (tag) معطاه ويستدعي الإجراء المناسب لمعالجة البيانات من ذلك النوع. فمثلًا، للحصول على الجزء الحقيقيّ لعددٍ مركّب، يفحص real-part الوسم ليحدّد هل يستخدم real-part-rectangular الذي كتبه بن أم real-part-polar الذي كتبته أليسا. وفي كلتا الحالتين، نستخدم contents لاستخراج البيان المجرّد غير الموسوم ونرسله إلى الإجراء المستطيل أو القطبيّ بحسب الحاجة:
(define (real-part z)
  (cond ((rectangular? z)
         (real-part-rectangular (contents z)))
        ((polar? z)
         (real-part-polar (contents z)))
        (else (error "Unknown type:
               REAL-PART" z))))

(define (imag-part z)
  (cond ((rectangular? z)
         (imag-part-rectangular (contents z)))
        ((polar? z)
         (imag-part-polar (contents z)))
        (else (error "Unknown type:
               IMAG-PART" z))))

(define (magnitude z)
  (cond ((rectangular? z)
         (magnitude-rectangular (contents z)))
        ((polar? z)
         (magnitude-polar (contents z)))
        (else (error "Unknown type:
               MAGNITUDE" z))))

(define (angle z)
  (cond ((rectangular? z)
         (angle-rectangular (contents z)))
        ((polar? z)
         (angle-polar (contents z)))
        (else (error "Unknown type:
               ANGLE" z))))
ولتنفيذ عمليّات الحساب على الأعداد المركّبة، يمكننا استخدام الإجراءات نفسها add-complex وsub-complex وmul-complex وdiv-complex الواردة في 2.4.1، إذ المُنتقِيّات التي تستدعيها عامّة، وبذلك ستعمل مع أيّ من التمثيلين. فمثلًا، ما زال الإجراء add-complex كما هو:
(define (add-complex z1 z2)
  (make-from-real-imag
   (+ (real-part z1) (real-part z2))
   (+ (imag-part z1) (imag-part z2))))
وأخيرًا، يجب أن نختار هل نُبنِي الأعداد المركّبة باستخدام تمثيل بن أم تمثيل أليسا. وأحد الخيارات المعقولة هو بناء الأعداد المستطيلة كلّما توفّر لدينا الجزء الحقيقيّ والجزء التخيّليّ، وبناء الأعداد القطبيّة كلّما توفّر لدينا المقدار والزاوية:
(define (make-from-real-imag x y)
  (make-from-real-imag-rectangular x y))

(define (make-from-mag-ang r a)
  (make-from-mag-ang-polar r a))
إنّ نظام الأعداد المركّبة الناتج له البنية الموضحة في الشكل 2.21. وقد فُكِّك النظام إلى ثلاثة أجزاءٍ مستقلّةٍ نسبيًّا: عمليّات الحساب على الأعداد المركّبة، وتنفيذ أليسا للتمثيل القطبيّ، وتنفيذ بن للتمثيل المستطيل. وكان يمكن كتابة التنفيذين القطبيّ والمستطيل على يد بن وأليسا عاملين كلٌّ على حدة، ويمكن استخدام كلٍّ منهما بوصفه تمثيلًا أساسيًّا من قِبل مبرمجٍ ثالثٍ يُنفّذ إجراءات الحساب على الأعداد المركّبة بدلالة واجهة البواني والمُنتقِيّات المجرّدة.
الشكل 2.21: بنية نظام الحساب العامّ على الأعداد المركّبة.
لأنّ كلّ كائن بياناتٍ مَوْسومٌ بنوعه، فإنّ المُنتقِيّات تشتغل على البيانات بصورةٍ عامّة. أي أنّ كلّ مُنتقٍ مُعرَّفٌ بأنّ له سلوكًا يتوقّف على النوع الخاصّ للبيانات التي يُطبَّق عليها. ولاحِظ الآليّة العامّة لربط التمثيلات المتفرّقة: فداخل تنفيذ تمثيلٍ معيّن (مثلًا حزمة أليسا القطبيّة) يكون العدد المركّب زوجًا غير موسوم (مقدار، زاوية). وحين يعمل مُنتقٍ عامّ على عددٍ من نوع polar، فإنّه ينزع الوسم ويمرّر المحتويات إلى شيفرة أليسا. وبالعكس، حين تبني أليسا عددًا للاستخدام العامّ، فإنها توسمه بنوعٍ حتّى يتعرّف عليه الإجراءات ذات المستوى الأعلى كما ينبغي. وهذا النظام في نزع الأوسمة وإلحاقها كلّما انتقلت كائنات البيانات من مستوى إلى آخر قد يكون استراتيجيّةً تنظيميّةً مهمّة، كما سنرى في 2.5.
2.4.3 البرمجة الموجَّهة بالبيانات والجمعيّة
تُسمّى الاستراتيجيّة العامّة المتمثّلة في فحص نوع البيان واستدعاء إجراءٍ مناسب التوجيه بحسب النوع (dispatching on type). وهذه استراتيجيّة قويّة لتحقيق الوحدانيّة في تصميم النظم. ومن ناحية أخرى، فإنّ تنفيذ التوجيه كما في 2.4.2 له نقطتا ضعفٍ مهمّتان. والضعف الأوّل أنّ إجراءات الواجهة العامّة (real-part وimag-part وmagnitude وangle) يجب أن تعرف جميع التمثيلات المختلفة. فمثلًا، لنفترض أنّنا أردنا إدخال تمثيلٍ جديدٍ للأعداد المركّبة في نظام الأعداد المركّبة لدينا. فسنحتاج إلى ربط هذا التمثيل بنوع، ثمّ إضافة بندٍ إلى كلّ واحدٍ من إجراءات الواجهة العامّة ليفحص النوع الجديد ويطبّق المُنتقِي المناسب لذلك التمثيل.
والضعف الآخر في التقنيّة أنّنا ورغم إمكان تصميم التمثيلات الفرديّة كلٌّ على حدة، يجب أن نضمن ألّا يحمل إجراءان في النظام بأكمله الاسم نفسه. ولهذا اضطرّ بن وأليسا إلى تغيير أسماء إجراءاتهما الأصليّة الواردة في 2.4.1.
والمسألة الكامنة وراء هذين الضعفين هي أنّ التقنيّة المستخدمة في تنفيذ الواجهات العامّة ليست جمعيّة (additive). فالشخص الذي يُنفّذ إجراءات المُنتقِي العامّة يجب أن يُعدّل تلك الإجراءات في كلّ مرّةٍ يُثبَّت فيها تمثيلٌ جديد، والناس الذين يربطون التمثيلات الفرديّة يجب أن يُعدّلوا شيفراتهم لتفادي تعارض الأسماء. وفي كلٍّ من هاتين الحالتين، فإنّ التعديلات الواجب إجراؤها على الشيفرة مباشرة، لكن لا بدّ من إجرائها مع ذلك، وهذا مصدرٌ للإزعاج والخطأ. وهذا ليس مشكلةً كبيرةً في نظام الأعداد المركّبة في وضعه الحاليّ، لكن لنفترض أنّ هناك ليس تمثيلين بل مئاتٍ من التمثيلات المختلفة للأعداد المركّبة. ولنفترض أيضًا أنّ هناك مُنتقِيّات عامّة كثيرة يجب صيانتها في واجهة البيانات المجرّدة. ولنفترض، في الحقيقة، أنّ أحدًا من المبرمجين لا يعرف جميع إجراءات الواجهة ولا جميع التمثيلات. فالمشكلة حقيقيّة ويجب مواجهتها في برامج مثل نظم إدارة قواعد البيانات واسعة النطاق.
ما نحتاجه هو وسيلةٌ لوحدنة تصميم النظم إلى حدٍّ أبعد. وتوفّرها تقنيّة البرمجة المعروفة بـالبرمجة الموجَّهة بالبيانات (data-directed programming). ولتفهّم كيف تعمل البرمجة الموجَّهة بالبيانات، ابدأ بالملاحظة أنّنا كلّما تعاملنا مع مجموعةٍ من العمليّات العامّة المشتركة بين مجموعةٍ من الأنواع المختلفة، فإنّنا في الواقع نتعامل مع جدولٍ ثنائيّ الأبعاد يحتوي العمليّات الممكنة على أحد المحورين والأنواع الممكنة على المحور الآخر. ومدخلات الجدول هي الإجراءات التي تُنفّذ كلّ عمليّةٍ لكلّ نوعٍ من المعطيات المقدَّمة. وفي نظام الأعداد المركّبة المطوَّر في القسم السابق، فإنّ المطابقة بين اسم العمليّة ونوع البيانات والإجراء الفعليّ كانت موزّعةً على البنود الشرطيّة المختلفة في إجراءات الواجهة العامّة. لكنّ المعلومات نفسها كان يمكن تنظيمها في جدول، كما هو موضح في الشكل 2.22.
Figure 2.22: Table of operations for the complex-number system.
إنّ البرمجة الموجَّهة بالبيانات هي تقنيّة تصميم البرامج للعمل مع مثل هذا الجدول مباشرةً. فقد نُفّذنا سابقًا الآليّة التي تربط شيفرة الحساب على الأعداد المركّبة بحزمتَي التمثيل بوصفها مجموعةً من الإجراءات يؤدّي كلٌّ منها توجيهًا صريحًا بحسب النوع. وهنا سنُنفّذ الواجهة بإجراءٍ واحدٍ يبحث في الجدول عن تركيبة اسم العمليّة ونوع المعطى ليجد الإجراء الصحيح الذي ينبغي تطبيقه، ثمّ يطبّقه على محتويات المعطى. فإذا فعلنا ذلك، فحتّى نُضيف حزمة تمثيلٍ جديدةٍ إلى النظام فإنّنا لا نحتاج إلى تغيير أيّ إجراءٍ قائم؛ فكلّ ما نحتاجه هو إضافة مدخلاتٍ جديدةٍ إلى الجدول.
ولتنفيذ هذه الخطة، افترض أنّ لدينا إجراءين، put وget، للتلاعب بجدول العمليّات والأنواع:
(put ⟨op⟩ ⟨type⟩ ⟨item⟩)يُثبّت⟨item⟩في الجدول، مفهرَسًا بـ⟨op⟩و⟨type⟩.(get ⟨op⟩ ⟨type⟩)يبحث عن⟨op⟩و⟨type⟩في الجدول ويعيد العنصر الذي يجده هناك. فإن لم يُعثر على عنصر، فإنّgetيعيد القيمة false.
وفي الوقت الحاليّ، يمكننا الافتراض أنّ put وget مُدمَجَان في لغتنا. وفي الفصل 3 (3.3.3) سنرى كيف نُنفّذ هذه العمليّات وغيرها من عمليّات التلاعب بالجداول.
وهكذا يمكن استخدام البرمجة الموجَّهة بالبيانات في نظام الأعداد المركّبة. فأمّا بن، الذي طوّر التمثيل المستطيل، فيُنفّذ شيفرته تمامًا كما فعل في الأصل. فهو يُعرّف مجموعةً من الإجراءات، أو حزمة (package)، ويربطها ببقيّة النظام بإضافة مدخلاتٍ إلى الجدول تُخبر النظام كيف يعمل على الأعداد المستطيلة. وهذا يتحقّق باستدعاء الإجراء الآتي:
(define (install-rectangular-package)
  ;; internal procedures
  (define (real-part z) (car z))
  (define (imag-part z) (cdr z))
  (define (make-from-real-imag x y)
    (cons x y))
  (define (magnitude z)
    (sqrt (+ (square (real-part z))
             (square (imag-part z)))))
  (define (angle z)
    (atan (imag-part z) (real-part z)))
  (define (make-from-mag-ang r a)
    (cons (* r (cos a)) (* r (sin a))))
  ;; interface to the rest of the system
  (define (tag x)
    (attach-tag 'rectangular x))
  (put 'real-part '(rectangular) real-part)
  (put 'imag-part '(rectangular) imag-part)
  (put 'magnitude '(rectangular) magnitude)
  (put 'angle '(rectangular) angle)
  (put 'make-from-real-imag 'rectangular
       (lambda (x y)
         (tag (make-from-real-imag x y))))
  (put 'make-from-mag-ang 'rectangular
       (lambda (r a)
         (tag (make-from-mag-ang r a))))
  'done)
لاحِظ أنّ الإجراءات الداخليّة هنا هي الإجراءات نفسها الواردة في 2.4.1 التي كتبها بن عندما كان يعمل منفردًا. ولا يلزم أيّ تغييرٍ لربطها ببقيّة النظام. وبالإضافة إلى ذلك، فبما أنّ تعريفات الإجراءات هذه داخليّةٌ في إجراء التثبيت، فإنّ بن لا يقلق من تعارض الأسماء مع إجراءاتٍ أخرى خارج الحزمة المستطيلة. ولربط هذه الإجراءات ببقيّة النظام، يُثبِّت بن إجراء real-part الخاصّ به تحت اسم العمليّة real-part والنوع (rectangular)، وكذلك الحال بالنسبة إلى المُنتقِيّات الأخرى.[45] وتُعرّف الواجهة أيضًا البواني التي سيستخدمها النظام الخارجيّ.[46] وهذه مطابقةٌ للبواني التي عرّفها بن داخليًّا، فيما عدا أنّها تُلحق الوسم.
وحزمة أليسا القطبيّة مماثلة:
(define (install-polar-package)
  ;; internal procedures
  (define (magnitude z) (car z))
  (define (angle z) (cdr z))
  (define (make-from-mag-ang r a) (cons r a))
  (define (real-part z)
    (* (magnitude z) (cos (angle z))))
  (define (imag-part z)
    (* (magnitude z) (sin (angle z))))
  (define (make-from-real-imag x y)
    (cons (sqrt (+ (square x) (square y)))
          (atan y x)))
  ;; interface to the rest of the system
  (define (tag x) (attach-tag 'polar x))
  (put 'real-part '(polar) real-part)
  (put 'imag-part '(polar) imag-part)
  (put 'magnitude '(polar) magnitude)
  (put 'angle '(polar) angle)
  (put 'make-from-real-imag 'polar
       (lambda (x y)
         (tag (make-from-real-imag x y))))
  (put 'make-from-mag-ang 'polar
       (lambda (r a)
         (tag (make-from-mag-ang r a))))
  'done)
ورغم أنّ بن وأليسا كلًّا منهما لا يزالان يستخدمان إجراءاتهما الأصليّة المعرّفةً بالأسماء نفسها التي يستخدمها كلٌّ منهما للآخر (مثل real-part)، فإنّ هذه التعريفات أصبحت داخليّةً في إجراءاتٍ مختلفة (انظر 1.1.8)، فلا يقع تعارضٌ في الأسماء.
تَصِل مُنتقِيّات الحساب على الأعداد المركّبة إلى الجدول بوساطة إجراء «عمليّة» عامّ يُسمّى apply-generic، وهو يُطبّق عمليّةً عامّةً على بعض المعطيات. وapply-generic يبحث في الجدول تحت اسم العمليّة وأنواع المعطيات ويطبّق الإجراء الناتج إن كان موجودًا:[47]
(define (apply-generic op . args)
  (let ((type-tags (map type-tag args)))
    (let ((proc (get op type-tags)))
      (if proc
          (apply proc (map contents args))
          (error
            "No method for these types:
             APPLY-GENERIC"
            (list op type-tags))))))
وباستخدام apply-generic، يمكننا تعريف مُنتقِيّاتنا العامّة كما يأتي:
(define (real-part z)
  (apply-generic 'real-part z))
(define (imag-part z)
  (apply-generic 'imag-part z))
(define (magnitude z)
  (apply-generic 'magnitude z))
(define (angle z)
  (apply-generic 'angle z))
ولاحِظ أنّ هذه لا تتغيّر إطلاقًا إن أُضيف تمثيلٌ جديدٌ إلى النظام.
ويمكننا أيضًا استخراج البواني التي ستستخدمها البرامج الخارجيّة عن الحزم من الجدول، وذلك لبناء أعدادٍ مركّبةٍ من الأجزاء الحقيقيّة والتخيّليّة ومن المقادير والزوايا. فكما في 2.4.2، نُبنِي الأعداد المستطيلة كلّما توفّر لدينا الجزء الحقيقيّ والجزء التخيّليّ، والأعداد القطبيّة كلّما توفّر لدينا المقدار والزاوية:
(define (make-from-real-imag x y)
  ((get 'make-from-real-imag
        'rectangular)
   x y))

(define (make-from-mag-ang r a)
  ((get 'make-from-mag-ang
        'polar)
   r a))
التمرين 2.73: وصفت 2.3.2 برنامجًا يُؤدّي الاشتقاق الرمزيّ:
(define (deriv exp var)
  (cond ((number? exp) 0)
        ((variable? exp)
         (if (same-variable? exp var) 1 0))
        ((sum? exp)
         (make-sum (deriv (addend exp) var)
                   (deriv (augend exp) var)))
        ((product? exp)
         (make-sum
           (make-product
            (multiplier exp)
            (deriv (multiplicand exp) var))
           (make-product
            (deriv (multiplier exp) var)
            (multiplicand exp))))
        ⟨more rules can be added here⟩
        (else (error "unknown expression type:
                      DERIV" exp))))
يمكننا اعتبار هذا البرنامج مؤدّيًا توجيهًا بحسب نوع التعبير المطلوب اشتقاقه. وفي هذا الموقف، يكون «وسم النوع» الخاصّ بالبيان هو رمز المؤثّل الجبريّ (مثل +) والعمليّة التي تُؤدّى هي deriv. ويمكننا تحويل هذا البرنامج إلى النمط الموجَّه بالبيانات بإعادة كتابة إجراء الاشتقاق الأساسيّ كما يأتي:
(define (deriv exp var)
   (cond ((number? exp) 0)
         ((variable? exp)
           (if (same-variable? exp var)
               1
               0))
         (else ((get 'deriv (operator exp))
                (operands exp)
                var))))

(define (operator exp) (car exp))
(define (operands exp) (cdr exp))
اشرح ما جرى أعلاه. فلماذا لا نستطيع استيعاب المُسَيِّمَين number? وvariable? في التوجيه الموجَّه بالبيانات؟ واكتب الإجراءات الخاصّة باشتقاق المجاميع والجداءات، والشيفرة المساعدة اللازمة لتثبيتها في الجدول الذي يستخدمه البرنامج أعلاه. واختر أيّ قاعدة اشتقاقٍ إضافيّةٍ تحبّها، مثل القاعدة الخاصّة بالأسّ (التمرين 2.56)، وثبّتها في هذا النظام الموجَّه بالبيانات. وفي هذه المُعالِجة الجبريّة البسيطة، يكون نوع التعبير هو المؤثّل الجبريّ الذي يربطه معًا. لكن لنفترض أنّنا فهرسنا الإجراءات بالعكس، بحيث صار سطر التوجيه في deriv كالآتي:
((get (operator exp) 'deriv)
 (operands exp) var)
فما التعديلات المقتضاة في نظام الاشتقاق؟
التمرين 2.74: شركة «Insatiable Enterprises, Inc.» هي شركةٌ عملاقةٌ لامركزيّةٌ للغاية، تتكوّن من عددٍ كبيرٍ من الأقسام المستقلّة المنتشرة في أنحاء العالم. وقد رُبطت تسهيلات الشركة الحاسوبيّة للتوّ بعضها ببعض بوساطة نظامٍ ذكيّ للواجهة مع الشبكة يجعل الشبكة بأكملها تبدو لأيّ مستخدمٍ حاسوبًا واحدًا. ورئيسة شركة Insatiable، في محاولتها الأولى لاستغلال قدرة الشبكة على استخراج المعلومات الإداريّة من ملفّات الأقسام، تفزع حين تكتشف أنّ جميع ملفّات الأقسام - وإن كانت قد نُفّذت كبنيات بياناتٍ في Scheme - تختلف بنية البيانات الخاصّة المستخدمة من قسمٍ إلى آخر. ويُدعى مديرو الأقسام على عجلٍ إلى اجتماعٍ للبحث عن استراتيجيّةٍ لدمج الملفّات تُلبّي احتياجات المقرّ الرئيسيّ مع الحفاظ على الاستقلاليّة القائمة للأقسام. وأرِ كيف يمكن تنفيذ مثل هذه الاستراتيجيّة بالبرمجة الموجَّهة بالبيانات. فعلى سبيل المثال، لنفترض أنّ سجلّات العاملين في كلّ قسمٍ تتكوّن من ملفٍّ واحدٍ يحتوي مجموعةً من السجلّات مفهرسةً بأسماء العاملين. وبنية المجموعة تختلف من قسمٍ إلى آخر. وبالإضافة إلى ذلك، فإنّ سجلّ كلّ عاملٍ هو بذاته مجموعةٌ (ذات بنيةٍ مختلفة من قسمٍ إلى آخر) تحتوي معلوماتٍ مفهرسةً تحت معرّفاتٍ مثل
addressوsalary. وبالتحديد: نُنفّذ للمقرّ الرئيسيّ إجراءget-recordيسترجع سجلّ عاملٍ محدَّدٍ من ملفّ عمالٍ محدَّد. وينبغي أن يكون الإجراء قابلًا للتطبيق على ملفّ أيّ قسم. واشرح كيف ينبغي بنيّة ملفّات الأقسام الفرديّة. وبالتحديد، ما معلومات النوع التي يجب توفيرها؟نُنفّذ للمقرّ الرئيسيّ إجراء
get-salaryيعيد معلومات الراتب من سجلّ عاملٍ معطىً من ملفّ عمالٍ في أيّ قسم. فكيف ينبغي بنيّة السجلّ حتّى تعمل هذه العمليّة؟ نُنفّذ للمقرّ الرئيسيّ إجراءfind-employee-record. وينبغي أن يبحث هذا الإجراء في ملفّات جميع الأقسام عن سجلّ عاملٍ معطىً ويعيد ذلك السجلّ. وافترض أنّ هذا الإجراء يأخذ كمعطياتٍ اسم العامل وقائمةً بملفّات جميع الأقسام. عندما تستحوذ Insatiable على شركةٍ جديدة، فأيّ تغييراتٍ يجب إجراؤها لإدماج معلومات العاملين الجديدة في النظام المركزيّ؟
تمرير الرسائل
الفكرة المحوريّة في البرمجة الموجَّهة بالبيانات هي معالجة العمليّات العامّة في البرامج بالتصرّف صراحةً مع جداول العمليّات والأنواع، مثل الجدول في الشكل 2.22. وقد نظّم نمط البرمجة الذي استخدمناه في 2.4.2 التوجيه المطلوب بحسب النوع بجعل كلّ عمليّةٍ تتولّى توجيهها بنفسها. وهذا يفكّك في الواقع جدول العمليّات والأنواع إلى صفوف، بحيث يمثّل كلّ إجراء عمليّةٍ عامّة صفًّا من الجدول.
أمّا الاستراتيجيّة البديلة في التنفيذ فهي تفكيك الجدول إلى أعمدة، وبدلًا من استخدام «عمليّات ذكيّة» توجّه بحسب أنواع البيانات، العمل مع «كائنات بيانات ذكيّة» توجّه بحسب أسماء العمليّات. ويمكننا فعل ذلك بترتيب الأمور بحيث يُمثَّل كائن البيانات - مثل العدد المستطيل - بإجراءٍ يأخذ اسم العمليّة المطلوبة مدخلًا ويؤدّي العمليّة المُشار إليها. وفي نظامٍ مثل هذا، يمكن كتابة make-from-real-imag على النحو الآتي:
(define (make-from-real-imag x y)
  (define (dispatch op)
    (cond ((eq? op 'real-part) x)
          ((eq? op 'imag-part) y)
          ((eq? op 'magnitude)
           (sqrt (+ (square x) (square y))))
          ((eq? op 'angle) (atan y x))
          (else
           (error "Unknown op:
            MAKE-FROM-REAL-IMAG" op))))
  dispatch)
أمّا إجراء apply-generic المطابق، وهو يُطبّق عمليّةً عامّةً على معطىً، فإنّه الآن يغذّي كائن البيانات باسم العمليّة ويترك الكائن يقوم بالعمل:[48]
(define (apply-generic op arg) (arg op))
لاحِظ أنّ القيمة التي يعيدها make-from-real-imag هي إجراء - وهو إجراء dispatch الداخليّ. وهذا هو الإجراء الذي يُستدعى حين يطلب apply-generic أداء عمليّةٍ ما.
يُسمّى هذا النمط من البرمجة تمرير الرسائل (message passing). واسمه مستمدٌ من تصوّر كائن البيانات ككيانٍ يستقبل اسم العمليّة المطلوبة بوصفه «رسالة». وقد رأينا مثلًا على تمرير الرسائل سابقًا في 2.1.3، حيث رأينا كيف يمكن تعريف cons وcar وcdr دون أيّ كائنات بياناتٍ بل بإجراءاتٍ فقط. وهنا نرى أنّ تمرير الرسائل ليس خُدعةً رياضيّةً بل تقنيّةً مفيدةً لتنظيم النظم ذات العمليّات العامّة. وفي بقية هذا الفصل سنواصل استخدام البرمجة الموجَّهة بالبيانات، لا تمرير الرسائل، لمناقشة عمليّات الحساب العامّة. وفي الفصل 3 سنعود إلى تمرير الرسائل، وسنرى أنّه قد يكون أداةً قويّةً لبناء برامج المحاكاة.
التمرين 2.75: نُنفّذ الباني
make-from-mag-angبنمط تمرير الرسائل. وينبغي أن يكون هذا الإجراء مماثلًا لإجراءmake-from-real-imagالمعطى أعلاه.
التمرين 2.76: مع تطوّر نظامٍ كبيرٍ ذي عمليّاتٍ عامّة، قد تصير هناك حاجةٌ إلى أنواعٍ جديدةٍ من كائنات البيانات أو إلى عمليّاتٍ جديدة. وبالنسبة إلى كلٍّ من الاستراتيجيّات الثلاث - العمليّات العامّة ذات التوجيه الصريح، والنمط الموجَّه بالبيانات، ونمط تمرير الرسائل - صِف التعديلات التي يجب إجراؤها على نظامٍ ما لإضافة أنواعٍ أو عمليّاتٍ جديدة. فأيّ تنظيمٍ يكون أنسب لنظامٍ يجب إضافة أنواعٍ جديدةٍ إليه كثيرًا؟ وأيّها يكون أنسب لنظامٍ يجب إضافة عمليّاتٍ جديدةٍ إليه كثيرًا؟
2.5 أنظمة ذات عمليّات عامّة
في القسم السابق، رأينا كيف نصمّم نظمًا يمكن تمثيل كائنات البيانات فيها بأكثر من طريقةٍ واحدة. والفكرة المحوريّة هي ربط الشيفرة التي تحدّد عمليّات البيانات بالتمثيلات المتعدّدة بوساطة إجراءات واجهةٍ عامّة. والآن سنرى كيف نستخدم هذه الفكرة نفسها لا لتحديد عمليّاتٍ عامّةٍ على تمثيلاتٍ مختلفةٍ فحسب، بل أيضًا لتحديد عمليّاتٍ عامّةٍ على أنواعٍ مختلفةٍ من المعطيات. فقد رأينا سابقًا عدّة حزمٍ مختلفةٍ لعمليّات الحساب: الحساب الأوّليّ (+ و- و* و/) المدمج في لغتنا، والحساب على الأعداد الكسريّة (add-rat وsub-rat وmul-rat وdiv-rat) الوارد في 2.1.1، والحساب على الأعداد المركّبة الذي نُفّذناه في 2.4.3. وسنستخدم الآن تقنيّات البرمجة الموجَّهة بالبيانات لبناء حزمةٍ من عمليّات الحساب تُدمج جميع حزم الحساب التي بنيناها سابقًا.
يُظهر الشكل 2.23 بنية النظام الذي سنبنيه. ولاحِظ حواجز التجريد. فمن منظور من يستخدم «الأعداد»، هناك إجراءٌ واحدٌ هو add يعمل على أيّ أعدادٍ تُعطى له. وadd جزءٌ من واجهةٍ عامّةٍ تسمح بالنفاذ الموحّد إلى حزم الحساب الاعتياديّ والحساب الكسريّ والحساب المركّب المتفرّقة من قِبل البرامج التي تستخدم الأعداد. وأيّ حزمة حسابٍ فرديّة (مثل الحزمة المركّبة) قد يُنفَذ إليها هي نفسها بوساطة إجراءاتٍ عامّة (مثل add-complex) تجمع حزمًا صُمّمت لتمثيلاتٍ مختلفة (مثل المستطيلة والقطبيّة). وبالإضافة إلى ذلك، فإنّ بنية النظام جمعيّة، بحيث يمكن تصميم حزم الحساب الفرديّة كلٌّ على حدة ثمّ جمعها لإنتاج نظام حسابٍ عامّ.
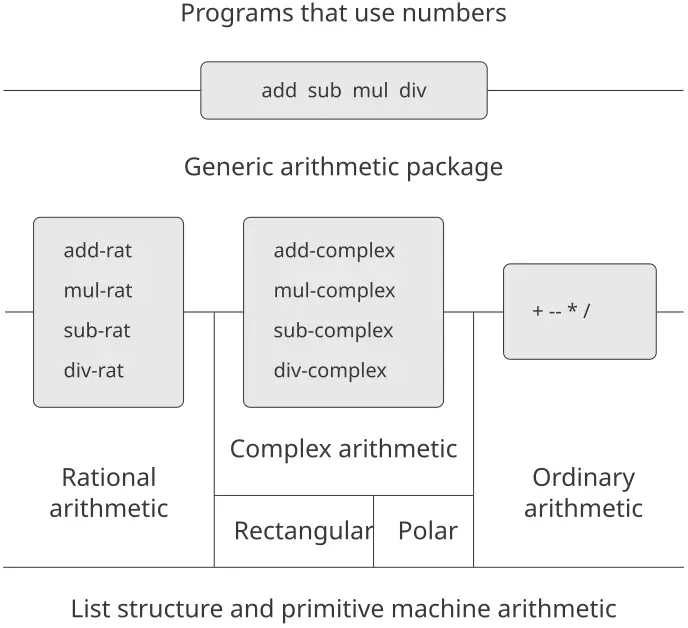
الشكل 2.23: نظام حسابيّ عامّ.
2.5.1 عمليّات الحساب العامّة
إنّ مهمّة تصميم عمليّات الحساب العامّة مماثلةٌ لمهمّة تصميم العمليّات العامّة على الأعداد المركّبة. فنودّ - مثلًا - أن يكون لدينا إجراء جمعٍ عامّ هو add يتصرّف كالجمع الأوّليّ الاعتياديّ + على الأعداد الاعتياديّة، وكـadd-rat على الأعداد الكسريّة، وكـadd-complex على الأعداد المركّبة. ويمكننا تنفيذ add، وسائر عمليّات الحساب العامّة، باتّباع الاستراتيجيّة نفسها التي استخدمنها في 2.4.3 لتنفيذ المُنتقِيّات العامّة للأعداد المركّبة. فسنُلحق وسم نوعٍ بكلّ نوعٍ من الأعداد ونجعل الإجراء العامّ يوجّه إلى الحزمة المناسبة بحسب نوع بيانات معطياته.
وتُعرَّف إجراءات الحساب العامّة كما يأتي:
(define (add x y) (apply-generic 'add x y))
(define (sub x y) (apply-generic 'sub x y))
(define (mul x y) (apply-generic 'mul x y))
(define (div x y) (apply-generic 'div x y))
نبدأ بتثبيت حزمةٍ لمعالجة الأعداد الاعتياديّة، أي الأعداد الأوّليّة في لغتنا. وسَنَوسم هذه بالرمز scheme-number. وعمليّات الحساب في هذه الحزمة هي إجراءات الحساب الأوّليّة (فلا حاجة إلى تعريف إجراءاتٍ إضافيّةٍ لمعالجة الأعداد غير الموسومة). وبما أنّ كلًّا من هذه العمليّات يأخذ معطيين، فإنّها تُثبَّت في الجدول مفهرسةً بالقائمة (scheme-number scheme-number):
(define (install-scheme-number-package)
  (define (tag x)
    (attach-tag 'scheme-number x))
  (put 'add '(scheme-number scheme-number)
       (lambda (x y) (tag (+ x y))))
  (put 'sub '(scheme-number scheme-number)
       (lambda (x y) (tag (- x y))))
  (put 'mul '(scheme-number scheme-number)
       (lambda (x y) (tag (* x y))))
  (put 'div '(scheme-number scheme-number)
       (lambda (x y) (tag (/ x y))))
  (put 'make 'scheme-number
       (lambda (x) (tag x)))
  'done)
سيُنشئ مستخدمو حزمة Scheme-number أعدادًا اعتياديّةً موسومةً (tagged) بواسطة الإجراء:
(define (make-scheme-number n)
  ((get 'make 'scheme-number) n))
وبعد أن صار هيكل نظام الحساب العامّ في مكانه، يمكننا بسهولةٍ إدخال أنواعٍ جديدةٍ من الأعداد. وهذه حزمةٌ تؤدّي الحساب الكسريّ. ولاحِظ أنّنا، بفضل الجمعيّة، نستطيع استخدام شيفرة الأعداد الكسريّة الواردة في 2.1.1 دون تعديلٍ بوصفها الإجراءات الداخليّة في الحزمة:
(define (install-rational-package)
  ;; internal procedures
  (define (numer x) (car x))
  (define (denom x) (cdr x))
  (define (make-rat n d)
    (let ((g (gcd n d)))
      (cons (/ n g) (/ d g))))
  (define (add-rat x y)
    (make-rat (+ (* (numer x) (denom y))
                 (* (numer y) (denom x)))
              (* (denom x) (denom y))))
  (define (sub-rat x y)
    (make-rat (- (* (numer x) (denom y))
                 (* (numer y) (denom x)))
              (* (denom x) (denom y))))
  (define (mul-rat x y)
    (make-rat (* (numer x) (numer y))
              (* (denom x) (denom y))))
  (define (div-rat x y)
    (make-rat (* (numer x) (denom y))
              (* (denom x) (numer y))))
  ;; interface to rest of the system
  (define (tag x) (attach-tag 'rational x))
  (put 'add '(rational rational)
       (lambda (x y) (tag (add-rat x y))))
  (put 'sub '(rational rational)
       (lambda (x y) (tag (sub-rat x y))))
  (put 'mul '(rational rational)
       (lambda (x y) (tag (mul-rat x y))))
  (put 'div '(rational rational)
       (lambda (x y) (tag (div-rat x y))))
  (put 'make 'rational
       (lambda (n d) (tag (make-rat n d))))
  'done)

(define (make-rational n d)
  ((get 'make 'rational) n d))
ويمكننا تثبيت حزمةٍ شبيهةٍ للتعامل مع الأعداد المركّبة باستخدام الوسم complex. وعند إنشاء الحزمة نستخرج من الجدول العمليّتين make-from-real-imag وmake-from-mag-ang اللتين عرّفتهما الحزمتان المستطيلة والقطبيّة. وتسمح لنا الجمعيّة باستخدام الإجراءات add-complex وsub-complex وmul-complex وdiv-complex ذاتها الواردة في 2.4.1 بوصفها العمليّات الداخليّة.
(define (install-complex-package)
  ;; imported procedures from rectangular
  ;; and polar packages
  (define (make-from-real-imag x y)
    ((get 'make-from-real-imag
          'rectangular)
     x y))
  (define (make-from-mag-ang r a)
    ((get 'make-from-mag-ang 'polar)
     r a))
  ;; internal procedures
  (define (add-complex z1 z2)
    (make-from-real-imag
     (+ (real-part z1) (real-part z2))
     (+ (imag-part z1) (imag-part z2))))
  (define (sub-complex z1 z2)
    (make-from-real-imag
     (- (real-part z1) (real-part z2))
     (- (imag-part z1) (imag-part z2))))
  (define (mul-complex z1 z2)
    (make-from-mag-ang
     (* (magnitude z1) (magnitude z2))
     (+ (angle z1) (angle z2))))
  (define (div-complex z1 z2)
    (make-from-mag-ang
     (/ (magnitude z1) (magnitude z2))
     (- (angle z1) (angle z2))))
  ;; interface to rest of the system
  (define (tag z) (attach-tag 'complex z))
  (put 'add '(complex complex)
       (lambda (z1 z2)
         (tag (add-complex z1 z2))))
  (put 'sub '(complex complex)
       (lambda (z1 z2)
         (tag (sub-complex z1 z2))))
  (put 'mul '(complex complex)
       (lambda (z1 z2)
         (tag (mul-complex z1 z2))))
  (put 'div '(complex complex)
       (lambda (z1 z2)
         (tag (div-complex z1 z2))))
  (put 'make-from-real-imag 'complex
       (lambda (x y)
         (tag (make-from-real-imag x y))))
  (put 'make-from-mag-ang 'complex
       (lambda (r a)
         (tag (make-from-mag-ang r a))))
  'done)
وتستطيع البرامج الواقعة خارج حزمة الأعداد المركّبة بناء أعدادٍ مركّبةٍ إمّا من الأجزاء الحقيقيّة والتخيّليّة وإمّا من المقادير والزوايا. ولاحِظ كيف تُصدَّر الإجراءات الكامنة، المعرَّفة أصلًا في الحزمتين المستطيلة والقطبيّة، إلى حزمة الأعداد المركّبة، ثم تُصدَّر من هناك إلى العالم الخارجيّ.
(define (make-complex-from-real-imag x y)
  ((get 'make-from-real-imag 'complex) x y))
(define (make-complex-from-mag-ang r a)
  ((get 'make-from-mag-ang 'complex) r a))
ما لدينا هنا هو نظام وسمٍ من مستويين. فالعدد المركّب النموذجيّ، مثل في الصيغة المستطيلة، سيُمثَّل كما هو موضّح في الشكل 2.24. ويُستخدم الوسم الخارجيّ (complex) لتوجيه العدد إلى حزمة الأعداد المركّبة. وحالما يصير داخل حزمة الأعداد المركّبة، يُستخدم الوسم التالي (rectangular) لتوجيه العدد إلى الحزمة المستطيلة. وفي نظامٍ كبيرٍ ومعقّدٍ قد تكون هناك مستوياتٌ عديدةٌ، تتصل كلٌّ منها بما يليها بواسطة عمليّاتٍ عامّة. وحين يُمرَّر كائن البيانات «إلى الأسفل»، يُجرَّد الوسم الخارجيّ المستخدم في توجيهه إلى الحزمة المناسبة (بتطبيق contents) ويصير مستوى الوسم التالي (إن وُجد) مرئيًّا ليُستخدم في مزيدٍ من التوزيع.
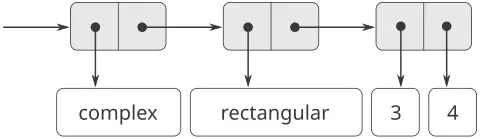
الشكل 2.24: تمثيل في الصيغة المستطيلة.
في الحزمتين أعلاه، استخدمنا add-rat وadd-complex وسائر الإجراءات الحسابيّة تمامًا كما كُتبت أصلًا. غير أنّ هذه التعريفات، متى صارت داخليّةً في إجراءات تثبيتٍ مختلفة، فإنّها لم تعُد تحتاج إلى أسماءٍ متمايزةٍ بعضها عن بعض: فيمكننا تسميتها ببساطةٍ add وsub وmul وdiv في الحزمتين معًا.
التمرين 2.77: يحاول لويس ريزنر تقييم التعبير (magnitude z) حيث z هو الكائن الموضّح في الشكل 2.24. وإلى حدّ دهشته، فبدلًا من الجواب 5 يحصل على رسالة خطأٍ من apply-generic تقول إنّه لا توجد طريقة للعمليّة magnitude على الأنواع (complex). فيعرض هذا التفاعل على أليسا بي. هاكر التي تقول: «المشكلة هي أنّ محدِّدات الأعداد المركّبة لم تُعرَّف قطّ من أجل الأعداد complex، بل من أجل الأعداد polar وrectangular فقط. وكلّ ما عليك فعله ليعمل هذا هو إضافة الآتي إلى حزمة complex:»
(put 'real-part '(complex) real-part)
(put 'imag-part '(complex) imag-part)
(put 'magnitude '(complex) magnitude)
(put 'angle '(complex) angle)
صُف بتفصيلٍ سبب نجاح هذا. ومثلًا، تعقّب جميع الإجراءات المستدعاة في تقييم التعبير (magnitude z) حيث z هو الكائن الموضّح في الشكل 2.24. وعلى وجه الخصوص، كم مرّةً يُنادى apply-generic؟ وما الإجراء الذي يُوزَّع إليه في كلّ حالة؟
التمرين 2.78: إنّ الإجراءات الداخليّة في حزمة
scheme-numberليست في جوهرها إلّا نداءاتٍ للإجراءات الأوّليّة+و-ونحوها. ولم يكن ممكنًا استخدام أوّليّات اللغة مباشرةً لأنّ نظام وسم النوع الذي لدينا يتطلّب أن يكون لكلّ كائن بياناتٍ نوعٌ ملحقٌ به. لكنّ جميع تنفيذات Lisp تملك في الحقيقة نظام أنواعٍ تستخدمه داخليًّا. والمسيّمات الأوّليّة مثلsymbol?وnumber?تحدّد ما إذا كانت كائنات البيانات تنتمي إلى أنواعٍ معيّنة. فعَدّل تعريفاتtype-tagوcontentsوattach-tagالواردة في 2.4.2 بحيث يستفيد نظامنا العامّ من نظام أنواع Scheme الداخليّ. أي أنّ النظام ينبغي أن يعمل كما كان يعمل، إلّا أنّ الأعداد الاعتياديّة ينبغي أن تُُمثَّل ببساطةٍ كأرقام Scheme بدلًا من أزواجٍ يكونcarكلٍّ منها هو الرمزscheme-number.
التمرين 2.79: عرّف مسيّمًا عامًّا للمساواة هو
equ?يختبر تساوي عددين، وثبّته في حزمة الحساب العامّ. وينبغي أن تعمل هذه العمليّة مع الأعداد الاعتياديّة والكسريّة والمركّبة.
التمرين 2.80: عرّف مسيّمًا عامًّا هو
=zero?يختبر ما إذا كان معطاه صفرًا، وثبّته في حزمة الحساب العامّ. وينبغي أن تعمل هذه العمليّة مع الأعداد الاعتياديّة والكسريّة والمركّبة.
2.5.2 الجمع بين بيانات من أنواع مختلفة
رأينا كيف نُعرّف نظامًا حسابيًّا موحّدًا يشمل الأعداد الاعتياديّة والمركّبة والكسريّة وأيّ نوع عددٍ آخر قد نُقدّر اختراعه، لكنّنا أهمَلنا مسألةً مهمّة. فالعمليّات التي عرّفناها حتّى الآن تعامل أنواع البيانات المختلفة باعتبارها مستقلّةً تمامًا. وهكذا، توجد حزمٌ منفصلةٌ لجمع عددين اعتياديّين، مثلًا، أو عددين مركّبين. وما لم نفكّر فيه بعد هو أنّ من ذي المعنى تعريف عمليّاتٍ تتجاوز حدود الأنواع، كإضافة عددٍ مركّبٍ إلى عددٍ اعتياديّ. وقد بذلنا جهدًا كبيرًا في إدخال حواجزَ بين أجزاء برامجنا حتّى يُمكن تطويرها وفهمها كلٌّ على حدة. ونودّ أن نُدخل العمليّات العابرة للأنواع بطريقةٍ محكومةٍ بعنايةٍ، حتّى نتمكّن من دعمها دون انتهاك حدود وحدانيّتنا انتهاكًا جسيمًا.
إحدى طرائق التعامل مع العمليّات العابرة للأنواع هي تصميم إجراءٍ مختلفٍ لكلّ تركيبةٍ ممكنةٍ من الأنواع التي تكون العمليّة صالحةً لها. فمثلًا، يمكننا توسيع حزمة الأعداد المركّبة بحيث تُوفّر إجراءً لجمع الأعداد المركّبة مع الأعداد الاعتياديّة وتُثبّته في الجدول باستخدام الوسم (complex scheme-number):[49]
(define (add-complex-to-schemenum z x)
  (make-from-real-imag (+ (real-part z) x)
                       (imag-part z)))

(put 'add
     '(complex scheme-number)
     (lambda (z x)
       (tag (add-complex-to-schemenum z x))))
هذه التقنيّة تُجدي، لكنّها متعثّرة. فمع نظامٍ كهذا، لا تقتصر كلفة إدخال نوعٍ جديد على بناء حزمة الإجراءات الخاصّة بذلك النوع، بل تشمل أيضًا بناء الإجراءات التي تُنفّذ العمليّات العابرة للأنواع وتثبيتها. ويمكن أن تكون هذه بسهولةٍ شيفرةً أكثر كثيرًا ممّا يلزم لتعريف العمليّات على النوع ذاته. وهذه الطريقة تُضعف أيضًا قدرتنا على دمج حزمٍ منفصلةٍ جمعًا، أو على الأقلّ تحدّ المدى الذي يحتاج معه منفّذو الحزم الفرديّة إلى مراعاة الحزم الأخرى. فمثلًا، في المثال أعلاه، يبدو من المعقول أن تكون معالجة العمليّات المختلطة على الأعداد المركّبة والأعداد الاعتياديّة من مسؤوليّة حزمة الأعداد المركّبة. أمّا جمع الأعداد الكسريّة والأعداد المركّبة فيمكن أن تنجزه حزمة الأعداد المركّبة، أو حزمة الأعداد الكسريّة، أو حزمةٌ ثالثةٌ تستخدم عمليّاتٍ مستخرجةً من هاتين الحزمتين. وقد تكون صياغة سياسيّاتٍ متناسقةٍ لتقسيم المسؤوليّة بين الحزم مهمّةً ساحقةً في تصميم أنظمةٍ كثيرة الحزم والعمليّات العابرة للأنواع.
الإكراه
في الحالة العامّة المتمثّلة في عمليّاتٍ غير مترابطةٍ إطلاقًا تعمل على أنواعٍ غير مترابطةٍ إطلاقًا، فإنّ تنفيذ عمليّاتٍ صريحةٍ عابرةٍ للأنواع، على رغم تعثّره، هو أفضلُ ما يمكن للمرء أن يأمله. لكنّنا نستطيع لحسن الحظّ أن نأتي بأفضلَ من ذلك عادةً بالاستفادة من بنيةٍ إضافيّةٍ قد تكون كامنةً في نظام أنواعنا. فكثيرًا ما لا تكون أنواع البيانات مختلفة الاستقلال تمامًا، وقد توجد طرائقٌ يمكن بها النظر إلى كائنات نوعٍ ما على أنّها من نوعٍ آخر. وتُسمّى هذه العمليّة الإكراه (coercion). فمثلًا، إذا طُلب منّا أن نجمع حسابيًّا عددًا اعتياديًّا مع عددٍ مركّبٍ، فيمكننا النظر إلى العدد الاعتياديّ بوصفه عددًا مركّبًا جزءه التخيّليّ صفر. وهذا يحوّل المسألة إلى جمع عددين مركّبين، وهو ما يمكن التعامل معه بالطريقة المعتادة بواسطة حزمة الحساب المركّب.
وبصورةٍ عامّة، يمكننا تنفيذ هذه الفكرة بتصميم إجراءات إكراهٍ تحوّل كائنًا من نوعٍ ما إلى كائنٍ مكافئٍ من نوعٍ آخر. وهذا إجراء إكراهٍ نموذجيّ، يحوّل عددًا اعتياديًّا معطىً إلى عددٍ مركّبٍ جزؤه الحقيقيّ هو ذلك العدد وجزؤه التخيّليّ صفر:
(define (scheme-number->complex n)
  (make-complex-from-real-imag
   (contents n) 0))
نُثبّت إجراءات الإكراه هذه في جدول إكراهٍ خاصّ، مُفهرَسٍ باسمَي النوعين:
(put-coercion 'scheme-number 'complex
              scheme-number->complex)
(ونحن نفترض توفّر إجراءَي put-coercion وget-coercion للتلاعب بهذا الجدول.) وبصورةٍ عامّة، ستكون بعض خانات الجدول فارغة، لأنّه ليس ممكنًا على العموم إكراه كائن بياناتٍ اعتباطيّ من كلّ نوعٍ إلى جميع الأنواع الأخرى. فمثلًا، لا توجد طريقة لإكراه عددٍ مركّبٍ اعتباطيّ إلى عددٍ اعتياديّ، فلن يكون هناك إجراء complex->scheme-number عامٌّ مُدرَجٌ في الجدول.
وبمجرّد إعداد جدول الإكراه، يمكننا التعامل مع الإكراه بطريقةٍ موحّدةٍ بتعديل إجراء apply-generic الوارد في 2.4.3. وحين يُطلَب تطبيق عمليّةٍ ما، نتحقّق أوّلًا ممّا إذا كانت العمليّة معرَّفةً لأنواع المعطيات، تمامًا كما قبل. فإن كانت كذلك، نُوزّع إلى الإجراء الموجود في جدول العمليّات والأنواع. وإلّا فنجرّب الإكراه. وللتبسيط، لن نفكّر إلّا في حالة وجود مُدخَلين.[50] فنفحص جدول الإكراه لنرى ما إذا كانت كائنات النوع الأوّل يمكن إكراهها إلى النوع الثاني. فإن كان ممكنًا، فنُكرِه المعطى الأوّل ونُعيد تجريب العمليّة. وإن كانت كائنات النوع الأوّل لا يمكن إكراهها على العموم إلى النوع الثاني، فنجرّب الإكراه بالاتجاه المعاكس لنرى هل توجد طريقة لإكراه المعطى الثاني إلى نوع المعطى الأوّل. وأخيرًا، إن لم تكن هناك طريقةٌ معروفةٌ لإكراه أيّ النوعين إلى النوع الآخر، فإنّنا نستسلم. وهذا هو الإجراء:
(define (apply-generic op . args)
  (let ((type-tags (map type-tag args)))
    (let ((proc (get op type-tags)))
      (if proc
          (apply proc (map contents args))
          (if (= (length args) 2)
              (let ((type1 (car type-tags))
                    (type2 (cadr type-tags))
                    (a1 (car args))
                    (a2 (cadr args)))
                (let ((t1->t2
                       (get-coercion type1
                                     type2))
                      (t2->t1
                       (get-coercion type2
                                     type1)))
                  (cond (t1->t2
                         (apply-generic
                          op (t1->t2 a1) a2))
                        (t2->t1
                         (apply-generic
                          op a1 (t2->t1 a2)))
                        (else
                         (error
                          "No method for
                           these types"
                          (list
                           op
                           type-tags))))))
              (error
               "No method for these types"
               (list op type-tags)))))))
لهذا المخطّط الإكراهيّ مزايا كثيرة على طريقة تعريف عمليّاتٍ صريحةٍ عابرةٍ للأنواع، كما بُيّن أعلاه. فرغم أنّنا ما نزال نحتاج إلى كتابة إجراءات إكراهٍ لربط الأنواع (وربّما إجراءً لنظامٍ فيه أنواع)، فإنّنا نحتاج إلى كتابة إجراءٍ واحدٍ فقط لكلّ زوجٍ من الأنواع بدلًا من إجراءٍ مختلفٍ لكلّ مجموعةٍ من الأنواع ولكلّ عمليّةٍ عامّة.[51] وما نعتمد عليه هنا هو حقيقة أنّ التحويل المناسب بين الأنواع يعتمد على الأنواع ذاتها وحدها، لا على العمليّة المطلوب تطبيقها.
ومن ناحية أخرى، قد توجد تطبيقاتٌ لا يكون مخطّط الإكراه الذي لدينا عامًّا بالقدر الكافي من أجلها. فإنّه حتّى حين لا يمكن تحويل أيّ من الكائنين المطلوب جمعهما إلى نوع الآخر، فقد يظلّ أداء العمليّة ممكنًا بتحويل الكائنين معًا إلى نوعٍ ثالث. ولكي نتعامل مع هذا القدر من التعقيد مع الحفاظ على وحدانيّة برامجنا، فإنّه من الضروريّ عادةً بناء أنظمةٍ تستفيد من بنيةٍ أبعدَ في العلاقات بين الأنواع، كما سنناقش تاليًا.
تسلسلات الأنواع
اعتمد مخطّط الإكراه المعروض أعلاه على وجود علاقاتٍ طبيعيّةٍ بين أزواج الأنواع. وكثيرًا ما تكون هناك بنيةٌ أكثر «شموليّةً» في كيفية ارتباط الأنواع المختلفة بعضها ببعض. فمثلًا، لنفترض أنّنا نبني نظام حسابٍ عامّ للتعامل مع الأعداد الصحيحة والكسريّة والحقيقيّة والمركّبة. وفي نظامٍ كهذا، فمن الطبيعيّ جدًّا اعتبار العدد الصحيح نوعًا خاصًّا من العدد الكسريّ، وهو بدوره نوعٌ خاصٌّ من العدد الحقيقيّ، وهو بدوره نوعٌ خاصٌّ من العدد المركّب. وما لدينا فعلًا هو ما يُسمّى تسلسل أنواع (hierarchy of types)، تكون فيه، مثلًا، الأعداد الصحيحة نوعًا فرعيًّا (subtype) من الأعداد الكسريّة (أي أنّ أيّ عمليّةٍ يمكن تطبيقها على عددٍ كسريٍّ يمكن تطبيقها تلقائيًّا على عددٍ صحيح). وبالعكس، نقول إنّ الأعداد الكسريّة تُشكّل نوعًا أعلى (supertype) من الأعداد الصحيحة. والتسلسل المعيّن الذي لدينا هنا هو من نوعٍ بالغ البساطة، يكون فيه لكلّ نوعٍ نوعٌ أعلى واحدٌ على الأكثرّ ونوعٌ فرعيٌّ واحدٌ على الأكثرّ. وهذه البنية، التي تُسمّى برجًا (tower)، موضّحةٌ في الشكل 2.25.
الشكل 2.25: برج من الأنواع.
فإن كان لدينا بنية برجٍ، فإنّنا نستطيع تبسيط مسألة إضافة نوعٍ جديدٍ إلى التسلسل تبسيطًا كبيرًا، إذ ما علينا إلّا أن نُحدّد كيف يُدَمَج النوع الجديد في النوع الأعلى التالي له وكيف يكون هو النوع الأعلى للنوع الذي تحته. فمثلًا، إذا أردنا جمع عددٍ صحيحٍ مع عددٍ مركّبٍ، فليس علينا أن نُعرّف صراحةً إجراء إكراهٍ خاصًّا integer->complex. وبدلًا من ذلك، نُعرّف كيف يمكن تحويل عددٍ صحيحٍ إلى عددٍ كسريّ، وكيف يُحوَّل العدد الكسريّ إلى عددٍ حقيقيّ، وكيف يُحوَّل العدد الحقيقيّ إلى عددٍ مركّب. ثمّ نسمح للنظام بتحويل العدد الصحيح إلى عددٍ مركّبٍ عبر هذه الخطوات، ثمّ نجمع العددين المركّبين.
ويمكننا إعادة تصميم إجراء apply-generic على النحو الآتي: فمن أجل كلّ نوعٍ، نحتاج إلى توفير إجراء raise «يرفع» كائنات ذلك النوع مستوىً واحدًا في البرج. وحين يلزم أن يعمل النظام على كائناتٍ من أنواعٍ مختلفة، فإنّه يستطيع رفع الأنواع الأدنى تباعًا حتّى تصير جميع الكائنات في المستوى ذاته داخل البرج. (والتمرين 2.83 والتمرين 2.84 يتناولان تفاصيل تنفيذ استراتيجيّةٍ كهذه.)
وميزةٌ أخرى للبرج هي أنّنا نستطيع تنفيذ فكرة أنّ كلّ نوعٍ «يَرِث» جميع العمليّات المعرَّفة على نوعٍ أعلى منه. فمثلًا، إن لم نُوفّر إجراءً خاصًّا لإيجاد الجزء الحقيقيّ لعددٍ صحيحٍ، فينبغي أن نتوقّع مع ذلك أنّ real-part سيُعرَّف للأعداد الصحيحة بحقيقة أنّ الأعداد الصحيحة نوعٌ فرعيٌّ من الأعداد المركّبة. وفي البرج، يمكننا ترتيب الأمر ليحدث هذا بطريقةٍ موحّدةٍ بتعديل apply-generic. فإن لم تكن العمليّة المطلوبة معرَّفةً مباشرةً لنوع الكائن المعطى، نرفع الكائن إلى نوعه الأعلى ونُعيد المحاولة. وهكذا نصعد البرج زحفًا، محوّلين معطانا أثناء ذلك، حتّى نجد إمّا مستوىً يمكن أداء العمليّة المطلوبة عنده، وإمّا نصطدم بالقمة (وحينها نستسلم).
وثمّة ميزةٌ أخرى للبرج على تسلسلٍ أكثر عموميّةً، وهي أنّه يُتيح لنا طريقةً بسيطةً لـ«إنزال» كائن بياناتٍ إلى أبسط تمثيلٍ له. فمثلًا، إذا أضفنا إلى ، فسيكون من الجميل الحصول على الجواب كالعدد الصحيح 6 بدلًا من العدد المركّب . ويناقش التمرين 2.85 طريقةً لتنفيذ عمليّة إنزالٍ كهذه. (والحيلة هي أنّنا نحتاج إلى طريقةٍ عامّةٍ للتمييز بين تلك الكائنات التي يمكن إنزالها، مثل ، وتلك التي لا يمكن إنزالها، مثل .)
أوجه القصور في التسلسلات
فإن كانت أنواع البيانات في نظامنا قابلةً للترتيب في برجٍ ترتيبًا طبيعيًّا، فإنّ ذلك يُبسّط مسائل التعامل مع العمليّات العامّة على الأنواع المختلفة تبسيطًا كبيرًا، كما رأينا. لكنّ ذلك، للأسف، ليس هو الحال عادةً. ويوضّح الشكل 2.26 ترتيبًا أكثر تعقيدًا لأنواعٍ مختلطة، يُظهر هذا الترتيب العلاقات بين أنواعٍ مختلفةٍ من الأشكال الهندسيّة. فنرى أنّ النوع، بصورةٍ عامّة، قد يكون له أكثر من نوعٍ فرعيٍّ واحد. فالمثلّثات والرباعيّات، مثلًا، كلاهما نوعان فرعيّان من المضلّعات. وبالإضافة إلى ذلك، قد يكون للنوع أكثر من نوعٍ أعلى واحدٍ. فمثلًا، يمكن النظر إلى المثلّث القائم متساوي الساقين إمّا بوصفه مثلّثًا متساوي الساقين وإمّا بوصفه مثلّثًا قائمًا. وهذه المسألة المتعلّقة بتعدّد الأنواع العليا شائكةٌ بصورةٍ خاصّة، إذ تعني أنّه لا توجد طريقةٌ وحيدةٌ لـ«رفع» نوعٍ في التسلسل. وقد يتطلّب إيجاد النوع الأعلى «الصحيح» الذي تُطبَّق فيه عمليّةٌ على كائنٍ بحثًا واسعًا في شبكة الأنواع بأكملها من جانب إجراءٍ مثل apply-generic. وبما أنّ للنوع أنواعٌ فرعيّةٌ متعدّدةٌ عمومًا، فهناك مسألةٌ مماثلةٌ في إكراه قيمةٍ «إلى الأسفل» في تسلسل الأنواع. فالتعامل مع أعدادٍ كبيرةٍ من الأنواع المترابطة مع الحفاظ في الوقت نفسه على وحدانيّة تصميم الأنظمة الكبيرة أمرٌ صعبٌ جدًّا، وهو مجالٌ لكثيرٍ من الأبحاث الجارية.[52]
الشكل 2.26: العلاقات بين أنواع الأشكال الهندسيّة.
التمرين 2.81: لاحَظ لويس ريزنر أنّ apply-generic قد يحاول إكراه المعطيات إلى نوع بعضها بعضًا حتّى ولو كانت من النوع ذاته أصلًا. ولذلك، بحسب منطقه، فإنّ علينا وضع إجراءاتٍ في جدول الإكراه تُكرِهُ مُدخلات كلّ نوعٍ إلى نوعها هي نفسها. فمثلًا، بالإضافة إلى إكراه scheme-number->complex الموضّح أعلاه، سيفعل الآتي:
(define (scheme-number->scheme-number n) n)
(define (complex->complex z) z)

(put-coercion 'scheme-number 'scheme-number
              scheme-number->scheme-number)

(put-coercion 'complex 'complex
              complex->complex)
ومع تثبيت إجراءات إكراه لويس، فماذا يحدث إذا نُودي apply-generic بمعطيّن من نوع scheme-number أو بمعطيّن من نوع complex من أجل عمليّةٍ غير موجودةٍ في الجدول لتلك الأنواع؟ فمثلًا، لنفترض أنّنا عرّفنا عمليّة أُسٍّ عامّة:
(define (exp x y)
  (apply-generic 'exp x y))
ووضعنا إجراءً للأُسّ في حزمة Scheme-number، ولكن ليس في أيّ حزمةٍ أخرى:
;; following added to Scheme-number package
(put 'exp
     '(scheme-number scheme-number)
     (lambda (x y)
       (tag (expt x y))))
       ; using primitive expt
فماذا يحدث إذا نادينا exp بعددين مركّبين كمعطيّن؟
فهل لويس محقٌّ في أنّه كان لا بدّ من فعل شيءٍ بشأن الإكراه مع معطياتٍ من النوع ذاته، أم أنّ apply-generic يعمل صحيحًا كما هو؟ عَدّل apply-generic كي لا يُحاول الإكراه إذا كان المعطيّان من النوع ذاته.
التمرين 2.82: أظهِر كيف تُعمّم
apply-genericللتعامل مع الإكراه في الحالة العامّة للمعطيات المتعدّدة. وإحدى الاستراتيجيّات هي محاولة إكراه جميع المعطيات إلى نوع المعطى الأوّل، ثمّ إلى نوع المعطى الثاني، وهكذا. وأعطِ مثالًا لحالةٍ لا تكون فيها هذه الاستراتيجيّة (وكذلك النسخة الثنائيّة المعطاة أعلاه) عامّةً بالقدر الكافي. (تلميح: انظر في الحالة التي توجد فيها بعض عمليّات الأنواع المختلطة المناسبة في الجدول والتي لن تُجرَّب.)
التمرين 2.83: لنفترض أنّك تصمّم نظام حسابٍ عامّ للتعامل مع برج الأنواع الموضّح في الشكل 2.25: صحيح، وكسريّ، وحقيقيّ، ومركّب. فمن أجل كلّ نوعٍ (عدا المركّب)، صمّم إجراءً يرفع كائنات ذلك النوع مستوىً واحدًا في البرج. وأظهِر كيف تُثبّت عمليّة
raiseعامّةً تعمل من أجل كلّ نوعٍ (عدا المركّب).
التمرين 2.84: باستخدام عمليّة
raiseالواردة في التمرين 2.83، عَدّل إجراءapply-genericبحيث يُكرِه معطيّيه ليكونا من النوع ذاته بطريقة الرفع المتتالي، كما نُوقش في هذا القسم. وستحتاج إلى ابتكار طريقةٍ لاختبار أيّ النوعين أعلى في البرج. وافعل ذلك بطريقةٍ «متوافقة» مع بقيّة النظام ولا تؤدّي إلى مشاكلَ عند إضافة مستوياتٍ جديدةٍ إلى البرج.
التمرين 2.85: ذكر هذا القسم طريقةً لـ«تبسيط» كائن بياناتٍ بإنزاله في برج الأنواع إلى أدنى حدٍّ ممكن. صمّم إجراء
dropيُنجز ذلك من أجل البرج الموصوف في التمرين 2.83. والمفتاح هو أن تقرّر، بطريقةٍ عامّةٍ ما، ما إذا كان الكائن يمكن إنزاله أم لا. فمثلًا، يمكن إنزال العدد المركّب إلىreal، ويمكن إنزال العدد المركّب إلىinteger، أمّا العدد المركّب فلا يمكن إنزاله إطلاقًا. وهذه خطةٌ لتحديد ما إذا كان الكائن يمكن إنزاله: ابدأ بتعريف عمليّة عامّةٍproject«تُسقِط» كائنًا إلى الأسفل في البرج. فمثلًا، إنّ إسقاط عددٍ مركّبٍ ينطوي على إلقاء الجزء التخيّليّ بعيدًا. وبعدها يمكن إنزال عددٍ متى كان، حين نُسقِطه بـprojectونرفع النتيجة بـraiseعودةً إلى النوع الذي بدأنا به، ننتهي إلى شيءٍ مساوٍ لما بدأنا به. وأظهِر كيف تُنفَّذ هذه الفكرة بالتفصيل، بكتابة إجراءdropيُنزّل كائنًا إلى أدنى حدٍّ ممكن. وستحتاج إلى تصميم عمليّات الإسقاط المختلفة[53] وتثبيتprojectبوصفها عمليّةً عامّةً في النظام. وستحتاج أيضًا إلى الاستفادة من مسيّم مساواةٍ عامّ، كالموصوف في التمرين 2.79. وأخيرًا، استخدمdropلإعادة كتابةapply-genericالوارد في التمرين 2.84 بحيث «يُبسّط» أجوبته.
التمرين 2.86: لنفترض أنّنا نريد التعامل مع أعدادٍ مركّبةٍ يمكن أن تكون أجزاؤها الحقيقيّة، وأجزاؤها التخيّليّة، ومقاديرها، وزواياها إمّا أعدادًا اعتياديّةً أو أعدادًا كسريّةً أو أعدادًا أخرى قد نرغب في إضافتها إلى النظام. صُغ ونفّذ التغييرات اللازمة في النظام لاستيعاب ذلك. وستكون مضطرًّا إلى تعريف عمليّاتٍ مثل
sineوcosineتكون عامّةً على الأعداد الاعتياديّة والكسريّة.
2.5.3 مثال: الجبر الرمزيّ
إنّ التلاعب بالتعبيرات الجبريّة الرمزيّة عمليّةٌ معقّدةٌ تُبيّن كثيرًا من أصعب المسائل التي تقع في تصميم الأنظمة واسعة النطاق. فأيّ تعبيرٍ جبريّ، بصورةٍ عامّة، يمكن النظر إليه بوصفه بنيةً هرميّةً، شجرةً من المشغّلات المطبَّقة على العوامل. ونستطيع بناء التعبيرات الجبريّة بالانطلاق من مجموعةٍ من الكائنات الأوّليّة، كالثوابت والمتغيّرات، وتركيب هذه بعضها إلى بعضٍ بواسطة مشغّلاتٍ جبريّةٍ، كالجمع والضرب. وكما في اللغات الأخرى، فإنّنا نُشكّل تجريداتٍ تُمكّننا من الإشارة إلى الكائنات المركّبة بعباراتٍ بسيطة. والتجريدات النموذجيّة في الجبر الرمزيّ هي أفكارٌ مثل التركيب الخطّيّ، وكثير الحدود، والدالّة النسبيّة، والدالّة المثلّثاتيّة. ونستطيع اعتبار هذه «أنواعًا» مركّبةً، وهي مفيدةٌ غالبًا في توجيه معالجة التعبيرات. فمثلًا، يمكننا وصف التعبير بوصفه كثيرةَ حدودٍ في معاملاتها دوالّ مثلّثاتيّةٌ لكثيرات حدودٍ في معاملاتها أعدادٌ صحيحة.
لن نحاول تطوير نظامٍ كاملٍ للتلاعب الجبريّ هنا. فإنّ مثل هذه الأنظمة برامجٌ بالغة التعقيد، تجسّد معرفةً جبريّةً عميقةً وخوارزميّاتٍ أنيقة. وما سنفعله هو النظر إلى جزءٍ بسيطٍ لكنّه مهمٌّ من التلاعب الجبريّ: حساب كثيرات الحدود. وسنُبيّن أنواع القرارات التي يواجهها مصمّم نظامٍ كهذا، وكيف يُطبّق أفكار البيانات المجرّدة والعمليّات العامّة للمساعدة في تنظيم هذا الجهد.
الحساب على كثيرات الحدود
أوّل مهمّةٍ في تصميم نظامٍ لأداء الحساب على كثيرات الحدود هي أن نقرّر ما هو كثيرة الحدود تمامًا. فكثيرات الحدود تُعرَّف عادةً نسبةً إلى متغيّراتٍ معيّنةٍ (وهي المجاهيل (indeterminates) للكثيرة). وللتبسيط، سنقصر أنفسنا على كثيرات حدودٍ لها مجهولٌ واحدٌ فقط (كثيرات حدودٍ أحاديّة المجهول (univariate polynomials)).[54] وسنُعرِّف كثيرة الحدود بوصفها مجموعَ حدودٍ، كلٌّ منها إمّا معامل، وإمّا قوّةٌ للمجهول، وإمّا جداءَ معاملٍ وقوّةٍ للمجهول. والمعامل يُعرَّف بوصفه تعبيرًا جبريًّا لا يعتمد على مجهول كثيرة الحدود. فمثلًا، إنّ كثيرةَ حدودٍ بسيطةٌ في ، وإنّ كثيرةَ حدودٍ في معاملاتها كثيرات حدودٍ في .
إنّنا نتجنّب منذ الآن بعض المسائل الشائكة. فهل أوّل هاتين الكثريتين هي نفسها كثيرة الحدود ، أم لا؟ وقد يكون الجواب المعقول «نعم، إذا كنّا ننظر إلى كثيرة الحدود بوصفها دالّةً رياضيّةً محضة، لكن لا، إذا كنّا ننظر إليها بوصفها صيغةً نحويّة.» والكثيرة الثانية مكافئةٌ جبريًّا لكثيرة حدودٍ في معاملاتها كثيرات حدودٍ في . فهل ينبغي لنظامنا أن يتعرّف على ذلك، أم لا؟ وبالإضافة إلى ذلك، هناك طرائق أخرى لتمثيل كثيرة الحدود—فمثلًا، بوصفها جداءَ عواملٍ، أو (من أجل كثيرة حدودٍ أحاديّة المجهول) بوصفها مجموعة الجذور، أو بوصفها قائمةً بقيم كثيرة الحدود في مجموعةٍ محدَّدةٍ من النقاط.[55] ونستطيع تجاوز هذه الأسئلة بالحكم بأنّ «كثيرة الحدود» في نظام التلاعب الجبريّ الذي لدينا ستكون صيغةً نحويّةً معيّنةً، لا معناها الرياضيّ الكامن.
والعلينا الآن أن ننظر في كيفية أداء الحساب على كثيرات الحدود. ففي هذا النظام البسيط، لن ننظر إلّا في الجمع والضرب. وبالإضافة إلى ذلك، سنُصرّ على أن يكون لكثيرتَي الحدود المطلوب دمجهما المجهول ذاته.
سنتناول تصميم نظامنا باتّباع نظام البيانات المجرّدة المألوف. وسنمثّل كثيرات الحدود باستخدام بنية بياناتٍ تُسمّى كثيرةَ حدود (poly)، تتكوّن من متغيّرٍ ومجموعةٍ من الحدود. ونحن نفترض أنّ لدينا مُنتقيَين (selectors) variable وterm-list يستخرجان هذين الجزأين من كثيرة الحدود، وبانٍ (constructor) make-poly يُجمّع كثيرةَ حدودٍ من متغيّرٍ معطى وقائمة حدود. والمتغيّر لن يكون إلّا رمزًا، فيمكننا استخدام إجراء same-variable? الوارد في 2.3.2 لمقارنة المتغيّرات. والإجراءات الآتية تُعرِّف جمع كثيرات الحدود وضربها:
(define (add-poly p1 p2)
  (if (same-variable? (variable p1)
                      (variable p2))
      (make-poly
       (variable p1)
       (add-terms (term-list p1)
                  (term-list p2)))
      (error "Polys not in same var:
              ADD-POLY"
             (list p1 p2))))

(define (mul-poly p1 p2)
  (if (same-variable? (variable p1)
                      (variable p2))
      (make-poly
       (variable p1)
       (mul-terms (term-list p1)
                  (term-list p2)))
      (error "Polys not in same var:
              MUL-POLY"
             (list p1 p2))))
ولإدخال كثيرات الحدود في نظام الحساب العامّ خاصّتنا، نحتاج إلى تزويدها بأوسمة أنواع. وسنستخدم الوسم polynomial، وسنُثبّت العمليّات المناسبة على كثيرات الحدود الموسومة في جدول العمليّات. وسنُضمّن جميع شيفرتنا في إجراء تثبيتٍ من أجل حزمة كثيرات الحدود، شبيهٍ بتلك الواردة في 2.5.1:
(define (install-polynomial-package)
  ;; internal procedures
  ;; representation of poly
  (define (make-poly variable term-list)
    (cons variable term-list))
  (define (variable p) (car p))
  (define (term-list p) (cdr p))
  ⟨procedures same-variable?
   and variable? from section 2.3.2⟩

  ;; representation of terms and term lists
  ⟨procedures adjoin-term … coeff
  from text below⟩

  (define (add-poly p1 p2) …)
  ⟨procedures used by add-poly⟩
  (define (mul-poly p1 p2) …)
  ⟨procedures used by mul-poly⟩

  ;; interface to rest of the system
  (define (tag p) (attach-tag 'polynomial p))
  (put 'add '(polynomial polynomial)
       (lambda (p1 p2)
         (tag (add-poly p1 p2))))
  (put 'mul '(polynomial polynomial)
       (lambda (p1 p2)
         (tag (mul-poly p1 p2))))
  (put 'make 'polynomial
       (lambda (var terms)
         (tag (make-poly var terms))))
  'done)
يُجرى جمع كثيرات الحدود (polynomials) حدًّا حدًّا. فيجب جمع الحدود من الرتبة ذاتها (أيّ ذات القوة ذاتها في المجهول) بعضها إلى بعضٍ. ويتمّ ذلك بتكوين حدٍّ جديدٍ من الرتبة ذاتها يكون معاملُه مجموع معامِلي الحدود المُضَافة. وأمّا الحدود في أحد الحدّين المضافَين التي لا يقابلها في الآخر حدٌّ من الرتبة ذاتها فهي تُتراكم ببساطةٍ في كثير الحدود الحاصل الجاري بنائه.
لكي نعالج قوائم الحدود، سنفترض أنّ لدينا بانٍ (constructor) هو the-empty-termlist يعيد قائمة حدود فارغة، وبانٍ هو adjoin-term يُلحق حدًّا جديدًا بقائمة حدود. وسنفترض أيضًا أنّ لدينا مُسَيِّمًا هو empty-termlist? يخبرنا عمّا إذا كانت قائمة حدود معيّنة فارغة، ومُنتقيًا (selector) هو first-term يستخرج الحدّ ذا الرتبة الأعلى من قائمة حدود، ومُنتقيًا هو rest-terms يعيد كلّ الحدود عدا ذي الرتبة الأعلى. ولكي نعالج الحدود، سنفترض أنّ لدينا بانٍ هو make-term يبني حدًّا له رتبةٌ ومعاملٌ مُعطَيان، ومُنتقيين هما order وcoeff يعيدان، على الترتيب، رتبة الحدّ ومعاملَه. وتتيح لنا هذه العمليّات اعتبار الحدود وقوائم الحدود جميعًا تجريداتٍ للبيانات (data abstractions)، يمكننا الاشتغال بتمثيلاتها الملموسة كلًّا على حدة.
وهذا هو الإجراء الذي يبني قائمة الحدود الخاصّة بمجموع كثيرَي حدود:[56]
(define (add-terms L1 L2)
  (cond ((empty-termlist? L1) L2)
        ((empty-termlist? L2) L1)
        (else
         (let ((t1 (first-term L1))
               (t2 (first-term L2)))
           (cond ((> (order t1) (order t2))
                  (adjoin-term
                   t1
                   (add-terms (rest-terms L1)
                              L2)))
                 ((< (order t1) (order t2))
                  (adjoin-term
                   t2
                   (add-terms
                    L1
                    (rest-terms L2))))
                 (else
                  (adjoin-term
                   (make-term
                    (order t1)
                    (add (coeff t1)
                         (coeff t2)))
                   (add-terms
                    (rest-terms L1)
                    (rest-terms L2)))))))))
وأهمّ ما ينبغي ملاحظته هنا أنّنا استخدمنا إجراء الجمع العامّ add في جمع معامِلي الحدود التي تُجمَع بعضها إلى بعضٍ. ولهذا عواقب جسيمة، كما سنرى أدناه.
لكي نضرب قائمتَي حدود، نضرب كلّ حدّ من القائمة الأولى بجميع حدود القائمة الأخرى، مستخدمين بشكلٍ متكرّرٍ mul-term-by-all-terms الذي يضرب حدًّا معيّنًا بجميع حدود قائمة حدود معيّنة. وتُتراكم قوائم الحدود الناتجة (واحدةٌ لكلّ حدّ من القائمة الأولى) في مجموع. وأمّا ضرب حدّين فينتج عنه حدٌّ رتبتُه مجموع رتبتَي العاملين ومعاملُه حاصل ضرب معاملَي العاملين:
(define (mul-terms L1 L2)
  (if (empty-termlist? L1)
      (the-empty-termlist)
      (add-terms
       (mul-term-by-all-terms
        (first-term L1) L2)
       (mul-terms (rest-terms L1) L2))))

(define (mul-term-by-all-terms t1 L)
  (if (empty-termlist? L)
      (the-empty-termlist)
      (let ((t2 (first-term L)))
        (adjoin-term
         (make-term
          (+ (order t1) (order t2))
          (mul (coeff t1) (coeff t2)))
         (mul-term-by-all-terms
          t1
          (rest-terms L))))))
وهذا في الحقيقة كلّ ما يتعلّق بجمع كثيرات الحدود وضربها. ولاحِظ أنّنا، بما أنّنا نعالج الحدود باستخدام إجراءَي الجمع والضرب العامّين add وmul، فإنّ حزمة كثيرات الحدود خاصّتنا قادرةٌ تلقائيًّا على معالجة أيّ نوعٍ من المعاملات تعرفه حزمة الحساب العامّ. فإذا أدرجنا آلية إكراه مثل إحدى الآليّات المناقشة في 2.5.2، صرنا قادرين تلقائيًّا كذلك على معالجة العمليّات على كثيرات حدود ذات أنواع معاملات مختلفة، مثل وبما أنّنا ثبّتنا إجراءَي جمع كثيرات الحدود وضربها add-poly وmul-poly في نظام الحساب العامّ بوصفهما عمليتَي add وmul للنوع polynomial، فإنّ نظامنا قادرٌ تلقائيًّا كذلك على معالجة عمليّاتٍ على كثيرات الحدود مثل والسبب أنّ النظام، حين يحاول جمع المعاملات بعضها إلى بعضٍ، يوحّد عبر add وmul. وبما أنّ المعاملات هي نفسها كثيرات حدود (في )، فإنّها ستُجمَع باستخدام add-poly وmul-poly. والنتيجة نوعٌ من «التعاود الموجّه بالبيانات (data-directed recursion)» فيه، مثلًا، يؤدّي نداءٌ إلى mul-poly إلى نداءاتٍ تعاوديّةٍ إلى mul-poly لكي تُضرب المعاملات. ولو كانت معاملات المعاملات هي نفسها كثيرات حدود (كما قد يُستخدم لتمثيل كثيرات الحدود في ثلاثة متغيّرات)، لكان اتّجاه البيانات يضمن أنّ النظام يتابع مستوى آخر من النداءات التعاوديّة، وهكذا عبر ما يمتدّ إليه البناء بحسب ما تملي به بنية البيانات.[57]
تمثيل قوائم الحدود
وأخيرًا، لا بدّ لنا من مواجهة مهمّة تنفيذ تمثيلٍ حسنٍ لقوائم الحدود. فإنّ قائمة الحدود هي في الواقع مجموعةٌ من المعاملات مُفتاحها رتبة الحدّ. وبالتالي، يمكن تطبيق أيّ من طرائق تمثيل المجموعات، كما نُوقشت في 2.3.3، على هذه المهمّة. ومن جهة أخرى، فإنّ إجراءَي add-terms وmul-terms ينفذان إلى قوائم الحدود تسلسليًّا دائمًا من الرتبة الأعلى إلى الأدنى. وعليه، فسوف نستخدم نوعًا ما من تمثيل القائمة المرتّبة.
وكيف ينبغي لنا أن نُبنّي القائمة التي تمثّل قائمة الحدود؟ وأحد الاعتبارات هو «كثافة» كثيرات الحدود التي ننوي معالجتها. فيُقال عن كثير الحدود إنّه كثيف (dense) إذا كانت له معاملات غير صفرية في الحدود ذات معظم الرتب. وأمّا إذا كانت له حدودٌ صفريةٌ كثيرة فيُقال عنه إنّه متناثر (sparse). فمثلًا، كثير حدود كثيف، بينما متناثر.
إنّ قوائم حدود كثيرات الحدود الكثيفة تُُمثَّل بأقصى كفاءةٍ كقوائم من المعاملات. فمثلًا، يمكن تمثيل أعلاه تمثيلًا حسنًا بالقائمة (1 2 0 3 -2 -5). ورتبة الحدّ في هذا التمثيل هي طول القائمة الفرعيّة التي تبدأ بمعامل ذلك الحدّ، ناقصًا واحدًا.[58] وسيكون هذا تمثيلًا فظيعًا لكثير حدود متناثرٍ مثل : إذ سيكون هناك قائمةٌ عملاقةٌ من الأصفار تتخلّلها حدود غير صفرية وحيدةٌ قليلة. وأمّا التمثيل الأكثر معقوليّةً لقائمة حدود كثير الحدود المتناثر فهو قائمةٌ بالحدود غير الصفرية، حيث كلّ حدّ قائمةٌ تحتوي رتبة الحدّ ومعاملَ تلك الرتبة. وفي هذا المخطّط، يُُمثَّل كثير الحدود بكفاءةٍ بالقائمة ((100 1) (2 2) (0 1)). وبما أنّ معظم عمليّات معالجة كثيرات الحدود تُجرى على كثيرات الحدود المتناثرة، فإنّنا سنستخدم هذه الطريقة. وسنفترض أنّ قوائم الحدود مُمثَّلةٌ كقوائمٍ من الحدود، مرتّبةٍ من الحدّ ذي الرتبة الأعلى إلى الحدّ ذي الرتبة الأدنى. وبمجرّد اتّخاذنا هذا القرار، يصبح تنفيذ المُنتقيات والبانِياء الخاصّين بالحدود وبقوائم الحدود مباشرًا:[59]
(define (adjoin-term term term-list)
  (if (=zero? (coeff term))
      term-list
      (cons term term-list)))
(define (the-empty-termlist) '())
(define (first-term term-list) (car term-list))
(define (rest-terms term-list) (cdr term-list))
(define (empty-termlist? term-list)
  (null? term-list))
(define (make-term order coeff)
  (list order coeff))
(define (order term) (car term))
(define (coeff term) (cadr term))
حيث =zero? كما عُرِّف في التمرين 2.80. (انظر أيضًا التمرين 2.87 أدناه.)
وسينشئ مستخدمو حزمة كثيرات الحدود كثيرات حدود (موسومة) بالإجراء:
(define (make-polynomial var terms)
  ((get 'make 'polynomial) var terms))
التمرين 2.87: ثبّت
=zero?لكثيرات الحدود في حزمة الحساب العامّ. سيتيح ذلك لـadjoin-termالعمل مع كثيرات حدود معاملاتها هي نفسها كثيرات حدود.
التمرين 2.88: وسّع نظام كثيرات الحدود ليضمّ طرح كثيرات الحدود. (تلميح: قد تجد من المفيد تعريف عمليّة نفي عامّة.)
التمرين 2.89: عرّف إجراءات تنفّذ تمثيل قوائم الحدود الموصوف أعلاه بصورةٍ مناسبةٍ لكثيرات الحدود الكثيفة.
التمرين 2.90: لنفترض رغبتنا في امتلاك نظامٍ لكثيرات الحدود يعمل جيّدًا مع المتناثرة والكثيفة على حدٍّ سواء. وإحدى طرائق فعل ذلك هي السماح بنوعَي تمثيل قوائم الحدود في نظامنا. والحالة شبيهة بمثال العدد المركّب الوارد في 2.4، حيث سمحنا بكلٍّ من التمثيلين المستطيّل والقطبيّ. ولكي نفعل ذلك، ينبغي لنا أن نميّز أنواع قوائم الحدود المختلفة وأن نجعل العمليّات على قوائم الحدود عامّة. فأعِد تصميم نظام كثيرات الحدود لتنفيذ هذا التعميم. وهذا جهدٌ كبير، لا تغييرٌ موضعيّ.
التمرين 2.91: يمكن قسمة كثير الحدود أحاديّ المتغيّر على آخر لإنتاج حاصلٍ كثيرة حدود وباقٍ كثيرة حدود. فمثلًا، ويمكن أداء القسمة بالقسمة المطوّلة. أي أنّنا نقسم الحدّ ذا الرتبة الأعلى من المقسوم على الحدّ ذا الرتبة الأعلى من المقسوم عليه. والنتيجة هي الحدّ الأوّل من الحاصل. ثمّ نضرب النتيجة في المقسوم عليه، ونطرح ذلك من المقسوم، وننتج بقيّة الجواب بالقسمة التعاوديّة للفارق على المقسوم عليه. ونتوقّف عندما تتجاوز رتبة المقسوم عليه رتبة المقسوم ونعلن المقسوم باقيًا. وكذلك، إذا صار المقسوم صفرًا في أيّ حين، نعيد صفرًا حاصلًا وباقيًا.
يمكننا تصميم إجراء div-poly على نمط add-poly وmul-poly. ويفحص الإجراء ما إذا كان كثيرا الحدود لهما المتغيّر ذاته. فإن كان الأمر كذلك، فإنّ div-poly ينزع المتغيّر ويمرّر المسألة إلى div-terms الذي يؤدّي عمليّة القسمة على قوائم الحدود. وأخيرًا، يعيد Div-poly إلحاق المتغيّر بالنتيجة التي يزوّده بها div-terms. ومن الملائم تصميم div-terms ليحتسب الحاصل والباقي معًا. ويمكن أن يأخذ Div-terms قائمتَي حدود كمعطيات ويعيد قائمةً بقائمة الحدود الحاصلة وقائمة الحدود الباقية.
أكمل التعريف التالي لـdiv-terms بملء التعابير الناقصة. واستخدم ذلك لتنفيذ div-poly الذي يأخذ كثيرَي حدود كمعطيات ويعيد قائمةً بالحاصل والباقي.
(define (div-terms L1 L2)
  (if (empty-termlist? L1)
      (list (the-empty-termlist)
            (the-empty-termlist))
      (let ((t1 (first-term L1))
            (t2 (first-term L2)))
        (if (> (order t2) (order t1))
            (list (the-empty-termlist) L1)
            (let ((new-c (div (coeff t1)
                              (coeff t2)))
                  (new-o (- (order t1)
                            (order t2))))
              (let ((rest-of-result
                     ⟨compute rest of result
                     recursively⟩ ))
                ⟨form complete result⟩ ))))))
تسلسلات الأنواع في الجبر الرمزيّ
يُبيّن نظام كثيرات الحدود خاصّتنا كيف أنّ كائنات نوعٍ واحدٍ (كثيرات الحدود) قد تكون في الحقيقة كائنات مركّبة لها كائنات من أنواعٍ عدّة مختلفةٍ أجزاءً. ولا يطرح هذا صعوبة حقيقيّةً في تعريف العمليّات العامّة. فكلّ ما نحتاجه هو تثبيت عمليّات عامّة مناسبةٍ لإجراء المعالجات اللازمة لأجزاء الأنواع المركّبة. وقد رأينا في الحقيقة أنّ كثيرات الحدود تشكّل نوعًا من «تجريد البيانات التعاوديّ»، إذ قد تكون أجزاء كثير الحدود هي نفسها كثيرات حدود. ويمكن لعمليّاتنا العامّة وأسلوبنا في البرمجة الموجّهة بالبيانات أن يتعامل مع هذا التعقيد دون عناءٍ كبير.
ومن جهة أخرى، فإنّ جبر كثيرات الحدود نظامٌ لا يمكن ترتيب أنواع بياناته ترتيبًا طبيعيًّا في برج. فمثلًا، من الممكن أن تكون هناك كثيرات حدود في معاملاتها كثيرات حدود في . ومن الممكن أيضًا أن تكون هناك كثيرات حدود في معاملاتها كثيرات حدود في . ولا أيٌّ من هذين النوعين «أعلى» من الآخر بأيّ نحوٍ طبيعيّ، مع أنّ الجمع بين عناصر من كلّ مجموعةٍ لازمٌ في أغلب الأحيان. وهناك طرائق عدّة لفعل ذلك. وأحد الاحتمالات تحويل أحد كثيرَي الحدود إلى نوع الآخر بفكّه وإعادة ترتيب حدوده بحيث يكون لكثيرَي الحدود المتغيّر الرئيس ذاته. ويمكننا فرض بنيةٍ شبيهة بالبرج على هذا بترتيب المتغيّرات، وبالتالي تحويل أيّ كثير حدود دائمًا إلى «صيغة نموذجيّة» يكون فيها المتغيّر ذو الأولويّة الأعلى مسيطرًا والمتغيّرات ذوات الأولويّة الأدنى مدفونةً في المعاملات. وهذه الاستراتيجيّة تنجح نجاحًا حسنًا إلى حدّ ما، إلّا أنّ التحويل قد يفكّ كثير الحدود بغير حاجةٍ، فيصعب قراءته وربّما تقلّ كفاءته في المعالجة. وأمّا استراتيجيّة البرج فليست طبيعيّةً قطعًا لهذا المجال ولا لأيّ مجالٍ يستطيع المستخدم فيه أن يبتكر أنواعًا جديدةً ديناميكيًّا باستخدام أنواعٍ قديمةٍ في صيغ تركيبٍ مختلفة، كالدوالّ المثلثيّة ومتسلسلات القوى والتكاملات.
ولا ينبغي أن يكون مفاجئًا أنّ التحكّم في الإكراه مسألة جدّيّة في تصميم أنظمة الجبر الرمزيّ واسعة النطاق. فإنّ الكثير من تعقيد مثل هذه الأنظمة يتعلّق بالعلاقات بين أنواعٍ متنوّعة. والحقّ أنّ من العدل القول إنّنا لا نفهم الإكراه فهمًا تامًّا بعد. في الحقيقة، إنّنا لا نفهم مفهوم نوع البيانات فهمًا تامًّا بعد. ومع ذلك، فإنّ ما نعرفه يزوّدنا بمبادئ قويّة للهيكلة والوحدانية تدعم تصميم الأنظمة الكبرى.
التمرين 2.92: بفرض ترتيبٍ على المتغيّرات، وسّع حزمة كثيرات الحدود بحيث يعمل جمع كثيرات الحدود وضربها مع كثيرات الحدود في متغيّراتٍ مختلفة. (وهذا ليس بالسهل!)
تمرين موسّع: الدوالّ النسبيّة
يمكننا توسيع نظام الحساب العامّ خاصّتنا ليضمّ الدوالّ النسبيّة (rational functions). وهذه «كسور» بسطُها ومقامُها كثيرات حدود، مثل وينبغي للنظام أن يكون قادرًا على جمع الدوالّ النسبيّة وطرحها وضربها وقسمتها، وعلى أداء احتساباتٍ مثل (وهنا بُسِّط المجموع بإزالة العوامل المشتركة. أمّا «الضرب التصافيّ» الاعتيادي لأنتج كثير حدود من الدرجة الرابعة على كثير حدود من الدرجة الخامسة.)
فإذا عدّلنا حزمة الحساب الكسريّ خاصّتنا بحيث تستخدم العمليّات العامّة، فإنّها ستفعل ما نريده، إلّا فيما يخصّ مسألة اختزال الكسور إلى أدنى حدود.
التمرين 2.93: عدّل حزمة الحساب الكسريّ لتستخدم العمليّات العامّة، لكن غيّر make-rat بحيث لا تحاول اختزال الكسور إلى أدنى حدود. واختبر نظامك بنداء make-rational على كثيرَي حدود لإنتاج دالّة نسبيّة:
(define p1 (make-polynomial 'x '((2 1) (0 1))))
(define p2 (make-polynomial 'x '((3 1) (0 1))))
(define rf (make-rational p2 p1))
والآن أضف rf إلى نفسه باستخدام add. ستلاحظ أنّ إجراء الجمع هذا لا يختزل الكسور إلى أدنى حدود.
يمكننا اختزال كسور كثيرات الحدود إلى أدنى حدود باستخدام الفكرة ذاتها التي استخدمناها مع الأعداد الصحيحة: تعديل make-rat بحيث يقسم البسط والمقام على القاسم المشترك الأكبر لهما. ومفهوم «القاسم المشترك الأكبر» مفهومٌ ذو معنىً لكثيرات الحدود. في الحقيقة، يمكننا احتساب القاسم المشترك الأكبر (GCD) لكثيرَي حدود باستخدام خوارزميّة أقليدس مماثلةٍ في الجوهر لتلك التي تعمل مع الأعداد الصحيحة.[60] وأمّا النسخة الخاصّة بالأعداد الصحيحة فهي
(define (gcd a b)
  (if (= b 0)
      a
      (gcd b (remainder a b))))
وباستخدام هذا، يمكننا إجراء التعديل البديهي لتعريف عمليّة القاسم المشترك الأكبر التي تعمل على قوائم الحدود:
(define (gcd-terms a b)
  (if (empty-termlist? b)
      a
      (gcd-terms b (remainder-terms a b))))
حيث ينتقي remainder-terms مكوّن الباقي من القائمة التي تعيدها عمليّة قسمة قوائم الحدود div-terms والتي نُفّذت في التمرين 2.91.
التمرين 2.94: باستخدام div-terms، نفّذ الإجراء remainder-terms واستخدم ذلك لتعريف gcd-terms كما أعلاه. والآن اكتب إجراء gcd-poly يحتسب القاسم المشترك الأكبر لكثيرَي حدود. (وينبغي للإجراء أن يشير بخطأٍ إذا لم يكن كثيرا الحدود في المتغيّر ذاته.) وثبّت في النظام عمليّة عامّة greatest-common-divisor تُختزل إلى gcd-poly لكثيرات الحدود وإلى gcd الاعتياديّة للأعداد الاعتياديّة. وكاختبار، جرّب
(define p1
  (make-polynomial
   'x '((4 1) (3 -1) (2 -2) (1 2))))

(define p2
  (make-polynomial
   'x '((3 1) (1 -1))))

(greatest-common-divisor p1 p2)
وتحقّق من نتيجتك يدويًّا.
التمرين 2.95: عرّف و و بحيث تكون كثيرات الحدود والآن عرّف بحيث يكون حاصل ضرب في ، و بحيث يكون حاصل ضرب في ، واستخدم
greatest-common-divisor(التمرين 2.94) لاحتساب القاسم المشترك الأكبر لـ و . ولاحِظ أنّ الجواب ليس هو . وهذا المثال يُدخل عمليّاتٍ على أعدادٍ غير صحيحةٍ في الاحتساب، مسبّبةً صعوباتٍ لخوارزميّة القاسم المشترك الأكبر.[61] ولتفهم ما يحدث، جرّب تتبّعgcd-termsأثناء احتساب القاسم المشترك الأكبر، أو جرّب أداء القسمة يدويًّا.
يمكننا حلّ المسألة التي أظهرها التمرين 2.95 إذا استخدمنا التعديل التالي لخوارزميّة القاسم المشترك الأكبر (وهي التي تعمل حقًّا في حالة كثيرات الحدود ذات المعاملات الصحيحة فقط). فقبل أداء أيّ قسمةٍ لكثيرات الحدود في احتساب القاسم المشترك الأكبر، نضرب المقسوم في عامل ثابتٍ صحيحٍ، مُختارٍ ليضمن ألّا تنشأ كسورٌ أثناء عمليّة القسمة. وسيختلف جوابنا عن القاسم المشترك الأكبر الحقيقيّ بعاملٍ ثابتٍ صحيحٍ، لكنّ هذا لا يهمّ في حالة اختزال الدوالّ النسبيّة إلى أدنى حدود؛ إذ سيُستخدم القاسم المشترك الأكبر في قسمة البسط والمقام، فيلغي عامل الثابت الصحيح.
وبأكثر دقّة، إذا كان و كثيرَي حدود، فلتجعل رتبة (أي رتبة الحدّ الأكبر في ) وليكن رتبة . وليكن المعامل الأوّل لـ . فيمكن إثبات أنّنا، إذا ضربنا في عامل التصحيح (integerizing factor) ، فإنّ كثير الحدود الناتج يمكن قسمته على باستخدام خوارزميّة div-terms من دون إدخال أيّ كسور. وعمليّة ضرب المقسوم في هذا الثابت ثمّ القسمة تُسمّى أحيانًا القسمة الكاذبة (pseudodivision) لـ على . وأمّا باقي القسمة فيُسمّى الباقي الكاذب (pseudoremainder).
التمرين 2.96: نفّذ الإجراء
pseudoremainder-terms، الذي هو تمامًا مثلremainder-termsإلّا أنّه يضرب المقسوم في عامل التصحيح الموصوف أعلاه قبل نداءdiv-terms. وعدّلgcd-termsليستخدمpseudoremainder-terms، وتأكّد أنّgreatest-common-divisorينتج الآن جوابًا بمعاملاتٍ صحيحةٍ على المثال الوارد في التمرين 2.95.أصبح للقاسم المشترك الأكبر الآن معاملاتٌ صحيحة، لكنّها أكبر من معاملات . عدّل
gcd-termsبحيث يزيل العوامل المشتركة من معاملات الجواب بقسمة جميع المعاملات على قاسمها المشترك الأكبر (الصحيح).
وهكذا، هذه هي طريقة اختزال الدالّة النسبيّة إلى أدنى حدود:
- احتسب القاسم المشترك الأكبر للبسط والمقام، باستخدام نسخة
gcd-termsالواردة في التمرين 2.96. - عندما تحصل على القاسم المشترك الأكبر، اضرب البسط والمقام في عامل التصحيح ذاته قبل القسمة على القاسم المشترك الأكبر، بحيث لا تُدخل القسمة على القاسم المشترك الأكبر أيّ معاملاتٍ غير صحيحة. وبوصفه عاملًا، يمكنك استخدام المعامل الأوّل للقاسم المشترك الأكبر مرفوعًا إلى القوة ، حيث رتبة القاسم المشترك الأكبر و هو أكبر رتبتين للبسط والمقام. وهذا سيضمن أنّ قسمة البسط والمقام على القاسم المشترك الأكبر لن تُدخل أيّ كسور.
- وستكون نتيجة هذه العمليّة بسطًا ومقامًا ذوي معاملاتٍ صحيحة. وغالبًا ما ستكون المعاملات كبيرةً جدًّا بسبب كلّ عوامل التصحيح، لذا فإنّ الخطوة الأخيرة هي إزالة العوامل الزائدة باحتساب القاسم المشترك الأكبر (الصحيح) لجميع معاملات البسط والمقام والقسمة على هذا العامل.
التمرين 2.97:
نفّذ هذه الخوارزميّة كإجراءٍ reduce-terms يأخذ قائمتَي حدود n وd كمعطيات ويعيد قائمتَي nn وdd، وهما n وd مختزلتان إلى أدنى حدودٍ وفقًا للخوارزميّة المعطاة أعلاه. واكتب أيضًا إجراء reduce-poly، شبيهًا بـadd-poly، يفحص ما إذا كان كثيرا الحدود لهما المتغيّر ذاته. فإن كان الأمر كذلك، فإنّ reduce-poly ينزع المتغيّر ويمرّر المسألة إلى reduce-terms، ثمّ يعيد إلحاق المتغيّر بقائمتَي الحدود التي يزوّده بها reduce-terms. وعرّف إجراءً شبيهًا بـreduce-terms يؤدّي ما كان make-rat الأصليّ يؤدّيه للأعداد الصحيحة:
(define (reduce-integers n d)
(let ((g (gcd n d)))
(list (/ n g) (/ d g))))
وعرّف reduce كعمليّةٍ عامّةٍ تنادي apply-generic لتوحّد إلى reduce-poly (لمعطيات polynomial) أو إلى reduce-integers (لمعطيات scheme-number). ويمكنك الآن أن تجعل حزمة الحساب الكسريّ تختزل الكسور إلى أدنى حدودٍ بسهولةٍ بجعل make-rat ينادي reduce قبل أن يجمّع البسط والمقام المعطيين لتكوين عددٍ كسريّ. والنظام الآن يتعامل مع التعابير النسبيّة في الأعداد الصحيحة أو في كثيرات الحدود. ولتختبر برنامجك، جرّب المثال الوارد في بداية هذا التمرين الموسّع:
(define p1
(make-polynomial 'x '((1 1) (0 1))))
(define p2
(make-polynomial 'x '((3 1) (0 -1))))
(define p3
(make-polynomial 'x '((1 1))))
(define p4
(make-polynomial 'x '((2 1) (0 -1))))
(define rf1 (make-rational p1 p2))
(define rf2 (make-rational p3 p4))
(add rf1 rf2)
وانظر إن كنت ستحصل على الجواب الصحيح، مختزلًا إلى أدنى حدودٍ اختزالًا صحيحًا.
إنّ احتساب القاسم المشترك الأكبر هو قلب أيّ نظامٍ يؤدّي عمليّاتٍ على الدوالّ النسبيّة. فالخوارزميّة المستخدمة أعلاه، على مباشرة رياضيّتها، بطيئةٌ للغاية. ويعود البطء جزئيًّا إلى العدد الكبير من عمليّات القسمة، وجزئيًّا إلى الحجم الهائل للمعاملات الوسيطة التي تولّدها القسمات الكاذبة. وأحد المجالات الفعّالة في تطوير أنظمة الجبر الرمزيّ هو تصميم خوارزميّاتٍ أفضل لاحتساب القواسم المشتركة الكبرى لكثيرات الحدود.[62]
إنّ القدرة على معالجة الإجراءات مباشرةً توفّر زيادةً مماثلةً في القوّة التعبيريّة للغة البرمجة. فمثلًا، في 1.3.1 قدّمنا الإجراء
sumالذي يأخذ إجراءً هوtermكمعطىً ويحتسب مجموع قيمtermعلى مدىً معيّنٍ. ولكي نعرّفsum، فمن الجوهريّ أن نكون قادرين على التحدّث عن إجراءٍ مثلtermبوصفه كيانًا قائمًا بذاته، دون اعتبارٍ لكيفيّة التعبير عنtermبعمليّاتٍ أكثر أوّليّة. في الحقيقة، لو لم يكن لدينا مفهوم «الإجراء»، لمشكوكٌ فيه أنّنا كنا سنفكّر حتّى في إمكانيّة تعريف عمليّةٍ مثلsum. وفوق ذلك، فإنّ تفاصيل كيفيّة بناءtermمن عمليّاتٍ أكثر أوّليّة لا صلة لها بالأمر، بالقدر الذي يتعلّق بأداء الجمع. ↩︎الاسم
consاختصارٌ لـ«construct»، أي البناء. وأمّا الاسمانcarوcdrفيشتقّان من التنفيذ الأصليّ لـLisp على IBM 704. وكان لتلك الآلة مخطّط عنونةٍ يسمح بالإشارة إلى جزأي «العنوان» و«النقص» في موضع الذاكرة. وCarاختصارٌ لـ«Contents of Address part of Register»، أي محتويات جزء العنوان من المسجّل، وcdr(وتُنطق «could-er») اختصارٌ لـ«Contents of Decrement part of Register»، أي محتويات جزء النقص من المسجّل. ↩︎هناك طريقة أخرى لتعريف المُنتقيات والبانيء، وهي
scheme (define make-rat cons) (define numer car) (define denom cdr)↩︎إنّ
Displayهو الأوّليّة في Scheme لطباعة البيانات. والأوّليّةnewlineفي Scheme تبدأ سطرًا جديدًا للطباعة. ولا يعيد أيٌّ من هذين الإجراءين قيمةً مفيدة، لذا فإنّنا في استخداماتprint-ratأدناه نُظهر ما تطبعهprint-ratفقط، لا ما يطبعه المفسّر قيمةً معادةً منprint-rat. ↩︎ومن المدهش أنّ هذه الفكرة يصعب صياغتها صياغةً دقيقة. وهناك منهجان لتقديم مثل هذه الصياغة. أحدهما، الذي ابتكره C. A. R. هوير (1972)، يُعرَف بطريقة النماذج المجرّدة. وهو يُصاغ «مواصفات الإجراءات زائد الشروط» صياغةً رسميّةً على النحو المبيَّن في مثال العدد الكسريّ أعلاه. ولاحِظ أنّ الشرط على تمثيل العدد الكسريّ قد قيل بدلالة حقائق عن الأعداد الصحيحة (المساواة والقسمة). وعمومًا، فإنّ النماذج المجرّدة تعرّف أنواعًا جديدةً من كائنات البيانات بدلالة أنواعٍ من كائنات البيانات عُرِّفَت سابقًا. وبالتالي، يمكن فحص التأكيدات عن كائنات البيانات باختزالها إلى تأكيداتٍ عن كائنات بياناتٍ عُرِّفَت سابقًا. وأمّا المنهج الآخر، الذي قدّمه زايلاس في MIT، وگوجوين وثاتشر وواغنر ورايت في IBM (انظر ثاتشر وآخرون 1978)، وغوتاغ في تورونتو (انظر غوتاغ 1977)، فيُسمّى المواصفة الجبريّة. وهو يعتبر «الإجراءات» عناصرَ في نظامٍ جبريٍّ مجرّدٍ سلوكُه محدَّدٌ بمسلّماتٍ تقابل «شروطنا»، ويستخدم تقنيّات الجبر المجرّد لفحص التأكيدات عن كائنات البيانات. أمّا المنهجان معًا فمبحوثان في الورقة التي كتبها ليسكوف وزايلاس (1975). ↩︎
إنّ استخدام كلمة «الإغلاق (closure)» هنا مستمدٌّ من الجبر المجرّد، حيث يُقال عن مجموعةٍ من العناصر إنّها مغلقةٌ تحت عمليّةٍ إذا كانت تطبيق العمليّة على عناصر المجموعة ينتج عنصرًا هو من عناصر المجموعة مرّةً أخرى. ومجتمع Lisp أيضًا (للأسف) يستخدم كلمة «closure» لوصف مفهومٍ لا صلة له بتاتًا: فالإغلاق هناك تقنيّةُ تنفيذٍ لتمثيل الإجراءات ذات المتغيّرات الحرّة. ونحن لا نستخدم كلمة «closure» بهذا المعنى الثاني في هذا الكتاب. ↩︎
إنّ فكرة أنّ وسيلة التركيب ينبغي أن تحقّق الانغلاق فكرةٌ يسيرة. ولسوء الحظّ، فإنّ أدوات تركيب البيانات التي توفّرها لغات البرمجة الشعبيّة الكثيرة لا تحقّق الانغلاق، أو تجعل استغلاله شاقًّا. ففي Fortran أو Basic، يتركّب المرء عادةً عناصر البيانات بتجميعها في مصفوفات — لكن لا يمكن تكوين مصفوفاتٍ عناصرها هي نفسها مصفوفات. أمّا Pascal وC فتسمحان ببنياتٍ عناصرها بنيات. لكنّ هذا يتطلّب من المبرمج أن يعالج المؤشّرات صراحةً، وأن يلتزم بالقييد أنّ كلّ حقلٍ من بنيةٍ يمكن أن يحتوي إلّا على عناصرٍ من صيغةٍ محدّدةٍ سابقًا. وبخلاف Lisp بأزواجها، فإنّ هذه اللغات لا تملك أيّ مادّة لاصقة عامّة الغرض مدمجة تجعل معالجة البيانات المركّبة على نحوٍ موحّدٍ أمرًا يسيرًا. وهذا القيد يكمن خلف ملاحظة آلان بيرليس في تقديمه لهذا الكتاب: «في Pascal، فإنّ وفرة بنيات البيانات القابلة للتعريف تُحدث تخصّصًا داخل الدوالّ يُعيق التعاون العارض ويعاقبه. فالأفضل أن تعمل 100 دالّة على بنية بياناتٍ واحدةٍ من أن تعمل 10 دوالٍ على 10 بنيات بيانات.» ↩︎
في هذا الكتاب، نستخدم القائمة (list) للدلالة على سلسلةٍ من الأزواج تنتهي بعلامة نهاية القائمة. وعلى النقيض، فإنّ مصطلح بنية القائمة (list structure) يشير إلى أيّ بنية بياناتٍ مصنوعةٍ من الأزواج، لا إلى القوائم وحدها. ↩︎
بما أنّ تطبيقات
carوcdrالمتداخلة متعبةٌ في الكتابة، فإنّ لهجات Lisp توفّر اختصاراتٍ لها — فمثلًا،scheme (cadr ⟨arg⟩) = (car (cdr ⟨arg⟩))↩︎ومن المدهش كمٍّ هائل من الطاقة تبدّد في توحيد لهجات Lisp في جدالاتٍ هي حرفيًّا لا حول ولا قوّة: فهل ينبغي أن يكون
nilاسمًا اعتياديًّا؟ وهل ينبغي أن تكون قيمةnilرمزًا؟ وهل ينبغي أن تكون قائمة؟ وهل ينبغي أن تكون زوجًا؟ في Scheme، يكونnilاسمًا اعتياديًّا، نستخدمه في هذا القسم متغيّرًا قيمتُه علامة نهاية القائمة (تمامًا كما أنّtrueمتغيّرٌ اعتياديّ قيمتُه قيمة صحيحة). وأمّا لهجات Lisp الأخرى، ومنها Common Lisp، فتعاملnilمعاملة رمزٍ خاصّ. ومؤلّفا هذا الكتاب، الذين احتملوا من جدالات توحيد اللغات أكثر من اللازم، يحبّان تجنّب المسألة برمّتها. وبمجرّد أن نُنشئ الاقتباس في 2.3، فإنّا سنُرمّز القائمة الفارغة بـ'()ونتخلّص نهائيًّا من المتغيّرnil. ↩︎لتعريف
fوgباستخدامlambda، نكتبscheme (define f (lambda (x y . z) ⟨body⟩)) (define g (lambda w ⟨body⟩))↩︎توفّر Scheme قياسيًّا إجراء
mapأعمّ من ذلك الموصوف هنا. وهذاmapالأعمّ يأخذ إجراءً ذا معطى، مع قائمة، ويطبّق الإجراء على جميع العناصر الأولى للقوائم، وجميع العناصر الثانية للقوائم، وهكذا، معيدًا قائمةً بالنتائج. فمثلًا:scheme (map + (list 1 2 3) (list 40 50 60) (list 700 800 900)) (741 852 963) (map (lambda (x y) (+ x (* 2 y))) (list 1 2 3) (list 4 5 6)) (9 12 15)↩︎إنّ ترتيب البندين الأوّلين في
condمهمّ، إذ إنّ القائمة الفارغة تُرضيnull?وهي ليست زوجًا أيضًا. ↩︎هذا في الحقيقة هو بالضبط الإجراء
fringeالوارد في التمرين 2.28. وقد أعدنا هنا تسميته لإبراز أنّه جزءٌ من عائلة إجراءاتٍ عامّةٍ لمعالجة التسلسلات. ↩︎طوّر ريتشارد ووترز (1979) برنامجًا يحلّل تحليلًا آليًّا برامج Fortran التقليديّة، نظرةً إليها من حيث التطبيقات والترشيحات والتراكمات. فقد وجد أنّ 90 بالمئة كاملةً من الشيفرة في حزمة Fortran Scientific Subroutine Package تتّسق اتّساقًا تامًّا مع هذا النموذج. وأحد أسباب نجاح Lisp لغةً للبرمجة هو أنّ القوائم توفّر وسطًا قياسيًّا للتعبير عن المجموعات المرتّبة بحيث يمكن معالجتها باستخدام عمليّاتٍ من رتبةٍ أعلى. وتَدِين لغة البرمجة APL بكثير من قوّتها وجاذبيّتها إلى اختيارٍ مشابه. ففي APL، جميع البيانات مُمثَّلةٌ بمصفوفات، وهناك مجموعةٌ شاملةٌ ومريحةٌ من المشغّلات العامّة لجميع أنواع عمليّات المصفوفات. ↩︎
وفقًا لـكنوث 1981، فقد صاغ هذه القاعدة W. G. هورنر في أوائل القرن التاسع عشر، لكنّ الطريقة استُخدمت فعلًا على يد نيوتن منذ أكثر من مئة سنةٍ قبل ذلك. وتُقيّم قاعدة هورنر كثير الحدود باستخدام عددٍ من الجمعات والضروبات أقلّ من الطريقة المباشرة التي تحتسب أوّلًا ثمّ تجمع وهكذا. في الحقيقة، يمكن إثبات أنّ أيّ خوارزميّةٍ لتقييم كثريات الحدود الاعتباطيّة ينبغي أن تستخدم عددًا من الجمعات والضروبات لا يقلّ عمّا تستخدمه قاعدة هورنر، وبالتالي فإنّ قاعدة هورنر خوارزميّةٌ أمثل لتقييم كثيرات الحدود. وقد أُثبت هذا (بالنسبة لعدد الجمعات) على يد A. M. أوستروفسكي في ورقةٍ عام 1954 أرست دراسة الخوارزميّات الأمثل دراسةً حديثة. أمّا القول المماثل بالنسبة للضروبات فقد أثبته V. Y. بان عام 1966. ويقدّم كتاب بورودين ومونرو (1975) نظرةً عامّة على هذه النتائج وغيرها من النتائج عن الخوارزميّات الأمثل. ↩︎
يستخدم هذا التعريف النسخة الممدودة من
mapالموصوفة في الحاشية 78. ↩︎لقد أُرينا هذا المنهج في التطبيقات المتداخلة على يد ديفيد تيرنر، الذي توفّر لغتاه KRC وMiranda صياغاتٍ رسميّةً أنيقةً للتعامل مع هذه البنى. وأمّا الأمثلة في هذا القسم (انظر أيضًا التمرين 2.42) فمقتبسةٌ من تيرنر 1981. وفي 3.5.3، سوف نرى كيف يعمّم هذا المنهج على التسلسلات اللانهائيّة. ↩︎
نحن نمثّل الزوج هنا كقائمةٍ من عنصرين بدلًا من زوج Lisp. وبالتالي، فإنّ «الزوج» مُمثَّلٌ بالقائمة
(list i j)، لا بـ(cons i j). ↩︎المجموعة هي مجموعة جميع عناصر ، مستثنىً منها . ↩︎
تُستخدم الفاصلة المنقوطة في شيفرة Scheme لإدخال التعليقات (comments). وكلّ شيءٍ من الفاصلة المنقوطة إلى نهاية السطر يتجاهله المفسّر. ونحن في هذا الكتاب لا نستخدم تعليقاتٍ كثيرة؛ فإنّا نحاول أن نجعل برامجنا موثّقةً لذاتها باستخدام أسماءٍ وصفيّة. ↩︎
لغة الرسم مستندةٌ إلى اللغة التي أنشأها بيتر هندرسون لبناء صورٍ مثل نقش «Square Limit» الخشبيّ لـM.C. إيشر (انظر هندرسون 1982). ويتضمّن هذا النقش نقشًا متكرّرًا مُكيّفًا بالمقياس، شبيهًا بالترتيبات المرسومة باستخدام الإجراء
square-limitفي هذا القسم. ↩︎كان وليام بارتون روجرز (1804-1882) مؤّسس MIT ورئيسها الأوّل. وكان جيولوجيًّا ومعلّمًا موهوبًا، درس في كلّيّة وليام وماري وفي جامعة فيرجينيا. وفي عام 1859 انتقل إلى بوسطن، حيث أمضى وقتًا أطول في البحث، وعمل على خطّةٍ لإقامة «معهد متعدّد الاختصاصات»، وخدم بوصفه أوّل مفتشٍ للعدادات الغازيّة في ولاية ماساتشوستس. وحين أُقيم MIT في عام 1861، انتُخب روجرز رئيسًا أوّل له. ودافع روجرز عن مثُلِ «التعلّم النافع» التي تختلف عن التعليم الجامعيّ في ذلك الوقت، بإفراطه في التركيز على الكلاسيكيّات التي قال عنها إنّها «تقف في طريق التعليم والتأديب الأوسع والأسمى والأكثر عمليّةً في العلوم الطبيعيّة والاجتماعيّة». وكان من المفروض أن يكون هذا التعليم مختلفًا أيضًا عن التعليم الضيّق في المدارس التجاريّة. وبكلمات روجرز: > إنّ التمييز الذي يفرضه العالم بين العامل العمليّ والعامل العلميّ تباطُلٌ عبثيّ، وقد أظهرت تجربة العصر الحديث برمّتها تفاهته التامّة. وخدم روجرز رئيسًا لـMIT حتّى عام 1870، حين استقال بسبب تدهور صحّته. وفي عام 1878، استقال رئيس MIT الثاني، جون رانكل، تحت ضغط أزمة ماليّة أثقلتها حمى عام 1873 ووطأة صدّ محاولات جامعة هارفارد للاستيلاء على MIT. وعاد روجرز ليتولّى منصب الرئيس حتّى عام 1881. وانهار روجرز ومات وهو يخاطب الدفعة المتخرّجة من MIT في حفل تخرّج عام 1882. ونقل رانكل كلمات روجرز الأخيرة في خطاب تأبينٍ ألقاه في العام نفسه: > «وأنا واقفٌ اليومَ أرى ما صار إليه المعهد، … فإنّي أستحضر بدايات العلم. وأتذكّر منذ مئة وخمسين سنةً نشر ستيفن هيلز كرّاسةً في موضوع غاز الإضاءة، ذكر فيها أنّ بحوثه قد أظهرت أنّ 128 حبّةً من الفحم القاري — » «الفحم القاري»، كانت هذه آخر كلماته على الأرض. وهنا مال إلى الأمام، كأنّه يستشير بعض الأوراق الموضوعة أمامه على الطاولة، ثمّ عاد واقفًا منتصبًا على استقامته ببطءٍ، ورفع يديه، ونُقل من مسرح أعماله وانتصاراته الأرضيّة إلى «غد الموت»، حيث تُحلّ ألغاز الحياة، ويجد الروح المنفصّ سعادةً لا تنتهي في التأمّل في ألغاز المستقبل اللانهائيّة الجديدة التي لم تُفهم بعد. وبكلمات فرانسيس أ. ووكر (رئيس MIT الثالث): > لقد تحمّل طوال حياته بأوفى إخلاصٍ وأسمى بطولة، ومات كما لَ ودّ فارسٌ صالحٌ أن يموت: في عتاده، في موقعه، وفي ذروة مباشرته واجبه العامّ. ↩︎
وعلى نحوٍ مكافئ، كان بوسعنا أن نكتب
scheme (define flipped-pairs (square-of-four identity flip-vert identity flip-vert))↩︎يُدير
Rotate180الرسّام 180 درجة (انظر التمرين 2.50). وبدلًا منrotate180، كان بوسعنا أن نقول(compose flip-vert flip-horiz)، باستخدام الإجراءcomposeالوارد في التمرين 1.42. ↩︎يستخدم
Frame-coord-mapعمليّات المتجهات الموصوفة في التمرين 2.46 أدناه، والتي نفترض أنّها نُفّذت باستخدام تمثيلٍ ما للمتجهات. وبسبب تجريد البيانات، فلا يهمّ أيّ تمثيلٍ للمتجهات يكون هو، طالما أنّ عمليّات المتجهات تسلك سلوكًا صحيحًا. ↩︎يستخدم
Segments->painterتمثيل مقاطع الخطوط الموصوف في التمرين 2.48 أدناه. كما يستخدم الإجراءfor-eachالموصوف في التمرين 2.23. ↩︎فمثلًا، بُني رسّام
rogersالوارد في الشكل 2.11 من صورةٍ بدرجات الرماديّ. فلكلّ نقطةٍ في إطارٍ معطى، يحدّد رسّامrogersالنقطة في الصورة التي تُخطَّط إليها تحت خريطة إحداثيّات الإطار، ويُظلّلها وفقًا لذلك. وبالسماح بأنواعٍ مختلفة من الرسّامين، فإنّا نستثمر فكرة تجريد البيانات المناقشة في 2.1.3، حيث أثبتنا أنّ تمثيل العدد الكسريّ يمكن أن يكون أيّ شيءٍ على الإطلاق يُرضي شرطًا مناسبًا. وهنا نستخدم الحقيقة أنّ الرسّام يمكن تنفيذه بأيّ طريقةٍ على الإطلاق، طالما أنّه يرسم شيئًا ما في الإطار المعيّن. كما أظهر 2.1.3 كيف يمكن تنفيذ الأزواج كإجراءات. والرسّامون هم مثالنا الثاني على التمثيل الإجرائيّ للبيانات. ↩︎إنّ
Rotate90دورانٌ خالصٌ فقط بالنسبة للإطارات المربّعة، لأنّه يمدّ الصورة ويقلّصها أيضًا لتلائم الإطار المدوَّر. ↩︎أُنشئت الصور على شكل المعيّن في الشكل 2.10 والشكل 2.11 باستخدام
squash-inwardsمطبَّقًا علىwaveوrogers. ↩︎إنّ السمح بالاقتباس في لغةٍ يُحدث خللًا في القدرة على الاستدلال على اللغة بشروطٍ يسيرة، لأنّه يدمّر فكرة أنّ المتماثل يمكن أن يُبدَّل بالمتماثل. فمثلًا، الثلاثة هو واحد زائد اثنان، لكنّ كلمة «ثلاثة» ليست العبارة «واحد زائد اثنان». والاقتباس قويّ لأنّه يمنحنا طريقةً لبناء تعابيرَ تعالج تعابيرَ أخرى (كما سنرى حين نكتب مفسّرًا في الفصل 4). لكن السماح بعباراتٍ في لغةٍ تتحدّث عن عباراتٍ أخرى في تلك اللغة يجعل من الصعب جدًّا المحافظة على أيّ مبدأٍ متماسكٍ لمعنى «المتماثل يمكن أن يُبدَّل بالمتماثل». فمثلًا، إذا عرفنا أنّ نجم المساء هو نجم الصباح، فمن العبارة «نجم المساء هو كوكب الزهرة» يمكننا استنتاج «نجم الصباح هو كوكب الزهرة». لكن بناءً على أنّ «يوحنا يعلم أنّ نجم المساء هو كوكب الزهرة»، لا نستطيع أن نستنتج أنّ «يوحنا يعلم أنّ نجم الصباح هو كوكب الزهرة». ↩︎
إنّ علامة التنصيص المفردة مختلفة عن علامة التنصيص المزدوجة التي كنّا نستخدمها لإحاطة مقاطع الحروف المراد طباعتها. فبينما يمكن استخدام علامة التنصيص المفردة للدلالة على القوائم أو الرموز، فإنّ علامة التنصيص المزدوجة تُستخدم فقط مع مقاطع الحروف. وفي هذا الكتاب، الاستخدام الوحيد لمقاطع الحروف هو بوصفها عناصرَ تُطبع. ↩︎
على وجه الدقّة، فإنّ استخدامنا علامة التنصيص يخالف القاعدة العامّة التي تقول إنّ جميع التعابير المركّبة في لغتنا ينبغي أن تُحدَّد بالأقواس وتبدو قوائم. ويمكننا استعادة هذا الاتّساق بإدخال صيغةٍ خاصّةٍ
quoteتؤدّي الغرض نفسه الذي تؤدّيه علامة التنصيص. وبالتالي، فسنكتب(quote a)بدلًا من'a، وسنكتب(quote (a b c))بدلًا من'(a b c). وهذا هو بالضبط كيف يعمل المفسّر. فعلامة التنصيص ما هي إلّا اختصارٌ بحرفٍ واحدٍ لإحاطة التعبير التالي الكامل بـquoteلتكوين(quote ⟨expression⟩). وهذا مهمّ لأنّه يحافظ على المبدأ القائل إنّ أيّ تعبيرٍ يراه المفسّر يمكن معالجته ككائنٍ من كائنات البيانات. فمثلًا، أمكننا بناء التعبير(car '(a b c))، الذي هو نفسه(car (quote (a b c)))، بتقييم(list 'car (list 'quote '(a b c))). ↩︎يمكننا اعتبار رمزين «متطابقين» إذا تكوّنا من الحروف ذاتها بالترتيب ذاته. ومثل هذا التعريف يحاذي مسألةً عميقةً لسنا مستعدّين بعد لمعالجتها: ألا وهي معنى «التطابق» في لغة البرمجة. وسوف نعود إلى هذا في الفصل 3 (3.1.3). ↩︎
في الممارسة، يستخدم المبرمجون
equal?لمقارنة قوائمَ تحتوي أعدادًا بالإضافة إلى رموز. والأعداد لا تُعتبر رموزًا. وأمّا المسألة المتعلّقة بما إذا كان عددان متساويان عدديًّا (كما يختبرهما=) هما أيضًاeq?فهي مسألةٌ تعتمد إلى حدٍّ كبيرٍ على التنفيذ. وأمّا تعريفٌ أفضل لـequal?(مثل الذي يأتي كأوّليّةٍ في Scheme) فيقرّر أيضًا أنّaوb، إذا كانا عددين، فإنّaوbهماequal?إذا كانا متساويين عدديًّا. ↩︎إذا أردنا أن نكون أكثر رسميّةً، فيمكننا تحديد «متوافقٍ مع التأويلات المعطاة أعلاه» بمعنى أنّ العمليّات تُرضي مجموعةً من القواعد كهذه: - لأيّ مجموعة
Sوأيّ كائنx، فإنّ(element-of-set? x (adjoin-set x S))صحيح (بصورةٍ غير رسميّة: «إلحاق كائن بمجموعةٍ ينتج مجموعةً تحتوي هذا الكائن»). - ولأيّ مجموعتينSوTوأيّ كائنx، فإنّ(element-of-set? x (union-set S T))يساوي(or (element-of-set? x S) (element-of-set? x T))(بصورةٍ غير رسميّة: «عناصر(union S T)هي العناصر الموجودة فيSأو فيT»). - ولأيّ كائنx، فإنّ(element-of-set? x '())خاطئ (بصورةٍ غير رسميّة: «لا كائن يكون عنصرًا في المجموعة الفارغة»). ↩︎إنّ تنصيف حجم المسألة عند كلّ خطوةٍ هو السمة المميّزة للنموّ اللوغاريتميّ، كما رأينا مع خوارزميّة الأسّ السريع الواردة في 1.2.4 وطريقة البحث بنصف الفترة الواردة في 1.3.3. ↩︎
نحن نمثّل المجموعات بأشجار، والأشجار بقوائم — تجريد بياناتٍ مبنيٌّ في الواقع على تجريد بياناتٍ آخر. ويمكننا النظر إلى الإجراءات
entryوleft-branchوright-branchوmake-treeعلى أنّها طريقةٌ لعزل تجريد «الشجرة الثنائيّة» عن الطريقة الخاصّة التي قد نرغب في تمثيل شجرةٍ كهذه ببنية القوائم. ↩︎إنّ أمثلة مثل هذه البنى تشمل أشجار B وأشجار الأحمر-الأسود. وهناك أدبيّاتٌ غزيرةٌ عن بنيات البيانات مخصّصةٌ لهذه المسألة. انظر كورمن وآخرون 1990. ↩︎
إنّ التمرين 2.63 إلى التمرين 2.65 من وضع بول هيلفينغر. ↩︎
انظر هامينغ 1980 لمناقشة الخصائص الرياضيّة لشيفرات هوفمان. ↩︎
في أنظمة الحساب الفعليّة، فإنّ الصيغة المستطيلة مفضّلةٌ على الصيغة القطبيّة في معظم الأحيان بسبب أخطاء التقريب في التحويل بين الصيغتين. ولهذا فإنّ مثال العدد المركّب غير واقعيّ. ومع ذلك، فإنّه يوفّر توضيحًا واضحًا لتصميم نظامٍ باستخدام العمليّات العامّة، ومدخلًا جيّدًا إلى الأنظمة الأكثر أهمّيّة التي ستُطوّر لاحقًا في هذا الفصل. ↩︎
أمّا دالّة ظلّ الزاوية المعنيّة هنا، والتي يحتسبها إجراء
atanفي Scheme، فمُعرَّفةٌ بحيث تأخذ معطيين و وتعيد الزاوية التي ظلّها هو . وإشارات المعطيات هي التي تحدّد الربع الذي تقع فيه الزاوية. ↩︎نستخدم القائمة
(rectangular)بدلًا من الرمزrectangularللسماح بإمكانيّة عمليّاتٍ ذات معطياتٍ متعدّدةٍ ليست كلّها من النوع ذاته. ↩︎ليس من الضروريّ أن يكون النوع الذي تُثبَّت تحته البواني (constructors) قائمةً، إذ يُستخدم البانيّ دائمًا لصنع كائن من نوعٍ واحدٍ معيّن. ↩︎
يستخدم
Apply-genericالترميز بالذيل المنقّط الموصوف في التمرين 2.20، لأنّ العمليّات العامّة المختلفة قد تأخذ أعدادًا مختلفة من المعطيات. ففيapply-generic، تكونopقيمتها المعطى الأوّل لـapply-generic، وتكونargsقيمتها قائمةٌ ببقيّة المعطيات. كما يستخدمApply-genericالإجراء الأوّليّapplyالذي يأخذ معطيين: إجراءً وقائمة. وApplyيطبّق الإجراء باستخدام عناصر القائمة كمعطيات. فمثلًا،scheme (apply + (list 1 2 3 4))↩︎وأحد قيود هذا التنظيم أنّه لا يسمح إلّا بإجراءاتٍ عامّةٍ ذات معطىً واحد. ↩︎
ويتعيّن علينا أيضًا تزويد إجراءٍ شبه مطابقةٍ للتعامل مع النوعين
(scheme-number complex). ↩︎انظر التمرين 2.82 للتعميمات. ↩︎
إذا نحن بارعون، فيمكننا العيش عادةً بعددٍ أقلّ من إجراء إكراه. فمثلًا، إذا عرفنا كيف نحوّل من النوع 1 إلى النوع 2 ومن النوع 2 إلى النوع 3، فيمكننا استخدام هذه المعرفة للتحويل من النوع 1 إلى النوع 3. وهذا يستطيع أن يُقلّل إلى حدٍّ كبيرٍ عدد إجراءات الإكراه التي يتعيّن علينا تزويدها صراحةً حين نضيف نوعًا جديدًا إلى النظام. فإذا كنّا على استعدادٍ لبناء القدر المطلوب من التطوّر في نظامنا، أمكننا له أن يبحث في «الرسم البيانيّ» للعلاقات بين الأنواع ويولّد تلقائيًّا إجراءات الإكراه التي يمكن استنتاجها من تلك المزوَّدة صراحةً. ↩︎
هذا القول، الذي يظهر أيضًا في الطبعة الأولى من هذا الكتاب، صحيحٌ الآن كما كان حين كتبناه منذ اثنتَي عشرة سنة. ويبدو أنّ تطوير إطارٍ مفيدٍ وعامٍّ للتعبير عن العلاقات بين كياناتٍ من أنواعٍ مختلفة (وهو ما يسمّيه الفلاسفة «الأنطولوجيا (ontology)») عسيرٌ عسرًا مستعصيًا. وأمّا الفرق الرئيسيّ بين الالتباس الذي كان قائمًا منذ عشر سنوات والالتباس القائم اليوم فهو أنّ نظريّاتٍ أنطولوجيّةً متعدّدةً ناقصةً قد تجسّدت في وفرةٍ من لغات البرمجة الناقصة المقابلة لها. فمثلًا، يتمحور الكثير من تعقيد لغات البرمجة كائنيّة التوجّه — والاختلافات الخفيّة والمربكة بين لغات البرمجة كائنيّة التوجّه المعاصرة — حول معالجة العمليّات العامّة على الأنواع المترابطة. أمّا مناقشتنا نحن للكائنات الحسابيّة في الفصل 3 فهي تتجنّب هذه المسائل تمامًا. وسيلاحظ القرّاء الملمّون بالبرمجة كائنيّة التوجّه أنّ لدينا الكثير لتقوله في الفصل 3 عن الحالة المحليّة، لكنّنا لا نذكر حتّى «الأصناف» ولا «الوراثة». في الحقيقة، إنّنا نشكّ في أنّ هذه المسائل لا يمكن معالجتها معالجةً كافيةً من حيث تصميم لغات الحاسوب وحده، دون الاعتماد أيضًا على أعمالٍ في تمثيل المعرفة والاستدلال الآلي. ↩︎
يمكن إسقاط العدد الحقيقيّ على عددٍ صحيحٍ باستخدام الأوّليّة
roundالتي تعيد أقرب عددٍ صحيحٍ لمعطاها. ↩︎ومن جهة أخرى، فإنّنا سنسمح بكثيرات حدودٍ معاملاتها هي نفسها كثيرات حدودٍ في متغيّراتٍ أخرى. وهذا سيمنحنا في الأساس القدرة التمثيليّة ذاتها التي يمنحها نظامٌ متعدّد المتغيّرات كامل، رغم أنّه يؤدّي إلى مسائل إكراهٍ، كما سنناقش أدناه. ↩︎
أمّا في كثريات الحدود أحاديّة المتغيّر، فقد يكون إعطاء قيمة كثير الحدود عند مجموعةٍ معيّنةٍ من النقاط تمثيلًا جيّدًا بصفةٍ خاصّة. وهذا يجعل حساب كثيرات الحدود بالغ البساطة. فللحصول، مثلًا، على مجموع كثيرَي حدودٍ مُمثَّلين بهذه الطريقة، لا يحتاج إلّا أن نجمع قيمتَي كثيرَي الحدود عند النقاط المقابلة. وللتحويل رجعةً إلى تمثيلٍ أكثر ألفةً، يمكننا استخدام صيغة استكمال لاغرانج (Lagrange interpolation)، التي تُظهر كيف نستعيد معاملات كثير الحدود ذي الدرجة بمعلوميّة قيم كثير الحدود عند نقطة. ↩︎
هذه العمليّة تشبه إلى حدٍّ بعيدٍ عمليّة
union-setالمرتّبة التي طوّرناها في التمرين 2.62. في الحقيقة، إذا فكّرنا في حدود كثير الحدود على أنّها مجموعةٌ مرتّبةٌ وفقًا لقوّة المجهول، فإنّ البرنامج الذي ينتج قائمة الحدود الخاصّة بمجموعٍ يكاد يكون مطابقًا لـunion-set. ↩︎ولكي يعمل هذا بسلاسةٍ تامّة، ينبغي لنا أيضًا أن نضيف إلى نظام الحساب العامّ خاصّتنا القدرة على إكراه «العدد» إلى كثير حدود باعتباره كثير حدودٍ من الدرجة صفرٍ معاملُه ذلك العدد. وهذا لازمٌ إذا كنّا سنؤدّي عمليّاتٍ مثل التي تتطلّب جمع المعامل إلى المعامل 2. ↩︎
في أمثلة كثيرات الحدود هذه، نفترض أنّنا نفّذنا نظام الحساب العامّ باستخدام آليّة الأنواع المقترحة في التمرين 2.78. وبالتالي، فإنّ المعاملات التي هي أعدادٌ اعتياديّة ستُُمثَّل بالأعداد نفسها بدلًا من الأزواج التي
carفيها هو الرمزscheme-number. ↩︎رغم أنّنا نفترض أنّ قوائم الحدود مرتّبة، فإنّنا نفّذنا
adjoin-termبحيث يربط (cons) ببساطةٍ الحدّ الجديد على قائمة الحدود القائمة. ويمكننا الإفلات من هذا طالما نضمن أنّ الإجراءات (مثلadd-terms) التي تستخدمadjoin-termتناديه دائمًا بحدٍّ ذي رتبةٍ أعلى ممّا يظهر في القائمة. ولو كنّا لا نريد تقديم مثل هذا الضمان، لأمكننا تنفيذadjoin-termبحيث يكون شبيهًا ببانيّadjoin-setالخاصّ بتمثيل المجموعات بالقوائم المرتّبة (التمرين 2.61). ↩︎أمّا حقيقة أنّ خوارزميّة أقليدس تعمل مع كثيرات الحدود فتُصاغ رسميًّا في الجبر بالقول إنّ كثيرات الحدود تشكّل نوعًا من المجالات الجبريّة يُسمّى الحلقة الإقليديّة (Euclidean ring). والحلقة الإقليديّة مجالٌ يقبل الجمع والطرح والضرب التبادليّ، مع طريقةٍ لإسناد «قياس» لكلّ عنصرٍ من الحلقة عددٌ صحيحٌ موجبٌ له الخصائص أنّ لأيّ غير الصفريّ و وأنّه، لأيّ و معطيين، هناك بحيث وإمّا أو . ومن وجهة نظرٍ مجرّدة، هذا هو ما يلزم لإثبات أنّ خوارزميّة أقليدس تعمل. وأمّا في مجال الأعداد الصحيحة، فالقياس لعددٍ صحيحٍ هو القيمة المطلقة للعدد نفسه. وأمّا في مجال كثيرات الحدود، فقياس كثير الحدود هو درجته. ↩︎
في تنفيذٍ مثل MIT Scheme، ينتج هذا كثير حدودٍ هو بالفعل قاسمٌ لـ و ، لكن بمعاملاتٍ نسبيّة. وفي أنظمة Scheme عدّة أخرى، حيث يمكن لقسمة الأعداد الصحيحة أن تنتج أعدادًا عشريّة بدقّةٍ محدودة، قد نفشل في الحصول على قاسمٍ صالح. ↩︎
اكتشف ريتشارد زيبل (1979) طريقةً بالغة الكفاءة والأناقة لاحتساب القواسم المشتركة الكبرى لكثيرات الحدود. وهذه الطريقة خوارزميّة احتماليّة، شأنها شأن الاختبار السريع لأوليّة العدد الذي ناقشناه في الفصل 1. ويصف كتاب زيبل (زيبل 1993) هذه الطريقة، مع طرائق أخرى لاحتساب القواسم المشتركة الكبرى لكثيرات الحدود. ↩︎