بناء التجريدات بالإجراءات
أفعال العقل، حين يبسط سلطانه على الأفكار البسيطة، هي ثلاثةٌ أساسًا: 1. الجمع: تركيب عدّة أفكار بسيطة في فكرةٍ مركّبةٍ واحدة، وبذلك تُصنَع جميع الأفكار المركّبة. 2. الثاني: إحضار فكرتين، بسيطةً كانتا أو مركّبتين، ووضعهما إحداهما إلى جانب الأخرى بحيث يرى العقلُهما معًا بلمحةٍ واحدة، دون أن يوحّدهما في فكرةٍ واحدة، وبذلك يحصل على جميع أفكاره عن العلاقات. 3. الثالث: فصلها عن جميع الأفكار الأخرى التي ترافقها في وجودها الحقيقيّ؛ وهذا ما يُسمّى التجريد، وبذلك تُصنَع جميع أفكاره العامّة. —John Locke, An Essay Concerning Human Understanding (1690)
نحن على وشك دراسة فكرة العمليّة الحسابيّة (computational process). فالعمليّات الحسابيّة كائناتٌ مجرّدةٌ تسكن الحواسيب. وبينما تتطوّر، تُعالج العمليّات كائناتٍ مجرّدةً أخرى تُسمّى البيانات (data). وتطوّر العمليّة يوجّهه نمطٌ من القواعد يُسمّى البرنامج (program). والناس يُنشئون البرامج لتوجيه العمليّات. في الحقيقة، إنّا نستحضر أرواح الحاسوب بتعاويذنا.
والعمليّة الحسابيّة تشبه حقًّا فكرة الساحر عن الرّوح. فلا يمكن رؤيتها أو لمسها، وهي ليست مركّبةً من المادّة إطلاقًا. لكنّها واقعيّةٌ للغاية. فهي قادرة على أداء عملٍ فكريّ. وقادرة على الإجابة عن الأسئلة. وقادرة على التأثير في العالم بإنفاق المال في مصرفٍ أو بالتحكّم في ذراع روبوتٍ في مصنع. والبرامج التي نستخدمها لاستحضار العمليّات تشبه تعاويذ الساحر. وهي مركّبةٌ بعنايةٍ من تعبيراتٍ رمزيّةٍ في لغات البرمجة (programming languages) الغامضة والأسرارية التي تُحدّد المهام التي نريد من عمليّاتنا أداءها.
والعمليّة الحسابيّة، في حاسوبٍ يعمل على نحوٍ صحيح، تُنفّذ البرامج بدقّةٍ وإحكام. وهكذا، وعلى غرار تلميذ الساحر، ينبغي على المبرمجين المبتدئين أن يتعلّموا فهم عواقب استحضارهم وتوقّعها. فحتّى الأخطاء الصغيرة (المسماة عادةً العلل (bugs) أو الخلل (glitches)) في البرامج يمكن أن تكون لها عواقبُ معقّدةٌ وغير متوقّعة.
ومن حسن الحظّ، فإنّ تعلّم البرمجة أقلّ خطرًا بكثيرٍ من تعلّم السحر، لأنّ الأرواح التي نتعامل معها محتجزةٌ بطريقةٍ مريحةٍ في مكانٍ آمن. أمّا البرمجة في العالم الواقعيّ، فهي تتطلّب عنايةً وخبرةً وحكمة. فإنّ خللًا صغيرًا في برنامجٍ للتصميم بمساعدة الحاسوب، مثلًا، يمكن أن يؤدّي إلى انهيارٍ كارثيٍّ لطائرةٍ أو لسدٍّ أو إلى تدمير روبوت صناعيّ لنفسه.
يمتلك مهندسو البرمجيّات المتمكّنون قدرةً على تنظيم البرامج بحيث يمكنهم أن يكونوا على يقينٍ معقولٍ بأنّ العمليّات الناتجة ستؤدّي المهام المقصودة. وهم قادرون على تصوّر سلوك أنظمتهم مسبقًا. ويعرفون كيف يُبنون البرامج حتّى لا يؤدّي ظهور المسائل غير المتوقّعة إلى عواقبَ كارثيّة، وحين تنشأ المسائل فعلًا فإنّهم يُصحّحون (debug) برامجهم. فإنّ الأنظمة الحسابيّة المصمّمة تصميمًا حسنًا، كالسيّارات المصمّمة تصميمًا حسنًا أو المفاعلات النوويّة، تُصمَّم على نحوٍ وحدانيّ، بحيث يمكن بناء أجزائها واستبدالها وتصحيحها كلًّا على حدة.
البرمجة بلغة Lisp
نحتاج إلى لغةٍ ملائمةٍ لوصف العمليّات، وسنستخدم لهذا الغرض لغة البرمجة Lisp. فكما تُعبَّر أفكارنا اليوميّة عادةً بلغتنا الطبيعيّة (كالإنجليزيّة أو الفرنسيّة أو اليابانيّة)، وكما تُعبَّر أوصاف الظواهر الكمّيّة بالترميزات الرياضيّة، فإنّ أفكارنا الإجرائيّة ستُعبَّر عنها بـLisp. وقد اختُرعت Lisp في أواخر خمسينيّات القرن العشرين كصياغةٍ رسميّةٍ للاستدلال على استخدام أنواعٍ معيّنةٍ من التعبيرات المنطقيّة، المسماة معادلات التعاود (recursion equations)، كنموذجٍ للاحتساب. وقد تصوّرها جون مكارثي وهي مستندةٌ إلى ورقته «الدوالّ العودية والتعابير الرمزيّة وحوسبتها بالآلة» (مكارثي 1960).
رغم نشأتها كصياغةٍ رياضيّة، فإنّ Lisp لغةُ برمجةٍ عمليّة. والمفسّر (interpreter) آلةٌ تنفّذ العمليّات الموصوفة بلغة Lisp. وقد نُفّذ أوّل مفسّر Lisp على يد مكارثي بمساعدة زملائه وطلابه في مجموعة الذكاء الاصطناعي في مختبر أبحاث الإلكترونيات وفي مركز الحوسبة، وكلاهما في MIT. واسم Lisp مشتقٌ من عبارة LISt Processing، أي معالجة القوائم، وقد صُمّمت لتوفير قدرات معالجة الرموز لمهاجمة مسائل برمجةٍ كالتفاضل والتكامل الرمزيّين للتعبيرات الجبريّة. وقد أُضيفت لهذا الغرض كائناتُ بياناتٍ جديدة تُعرف بالذرّات والقوائم، وهي التي ميّزتها تمييزًا باهرًا عن جميع لغات ذلك العهد.
ولم تكن Lisp نتاجَ جهدٍ تصميميٍّ منظّم، بل تطوّرت تطوّرًا غير رسميٍّ وتجريبيًّا استجابةً لاحتياجات المستخدمين ولاعتبارات التنفيذ العمليّة. واستمرّ تطوّر Lisp غير الرسميّ على مرّ السنين، ولمجتمع مستخدمي Lisp مقاومةٌ تقليديّةٌ لمحاولات إصدار أيّ تعريف «رسميّ» للغة. وقد مكّن هذا التطوّر، مع المرونة والأناقة في التصوّر الأوّل، Lisp - وهي ثاني أقدم لغةٍ شائعة الاستخدام اليوم (ولا تزيد عليها في العمر إلّا Fortran) - من التكيّف باستمرارٍ لاستيعاب أحدث الأفكار عن تصميم البرامج. وهكذا، صارت Lisp الآن عائلةً من اللهجات، تتشابه في معظم الخصائص الأصليّة وقد تختلف اختلافًا جوهريًّا في نواحٍ عدّة. ولهجة Lisp المستخدمة في هذا الكتاب تُسمّى Scheme.
وبسبب طابعها التجريبيّ وتأكيدها على معالجة الرموز، كانت Lisp غير كفؤةٍ على الإطلاق في الحسابات العدديّة في بادئ الأمر، على الأقلّ بالمقارنة مع Fortran. وعلى مرّ السنين، مع ذلك، طُوّرت مُصرّفات Lisp تترجم البرامج إلى شيفرة آليّة قادرة على أداء الحسابات العدديّة بكفاءةٍ معقولة. وللتطبيقات الخاصّة، استُخدمت Lisp بفعّيّةٍ كبيرة. ورغم أنّ Lisp لم تتغلّب بعد على سمعتها القديمة كلغةٍ ميؤوس من كفاءتها، فإنّها تُستخدم اليوم في تطبيقاتٍ كثيرةٍ ليس الهمّ المركزيّ فيها هو الكفاءة. فقد صارت Lisp - مثلًا - لغةً مختارةً لأغلفة نظم التشغيل (shell) ولغات التوسعة للمحرّرات ونظم التصميم بمساعدة الحاسوب.
فإن لم تكن Lisp لغةً سائدةً، فلماذا نستخدمها إطارًا لمناقشتنا للبرمجة؟ لأنّ اللغة تمتلك خصائص فريدة تجعلها وسطًا ممتازًا لدراسة بنيات البرمجة وبنيات البيانات المهمّة، ولربطها بالخصائص اللغويّة التي تدعمها. وأهمّ هذه الخصائص أنّ أوصاف Lisp للعمليّات، المسماة الإجراءات (procedures)، يمكن أن تُُمثَّل وتُعالَجَ بذاتها كبيانات Lisp. وأهمّيّة هذا أنّ هناك تقنيّاتٍ قويّةً لتصميم البرامج تعتمد على القدرة على طمس التمييز التقليديّ بين البيانات «السلبيّة» والعمليّات «النشطة». فكما سنكتشف، فإنّ مرونة Lisp في معاملة الإجراءات كبياناتٍ تجعلها إحدى أكثر اللغات ملاءمةً الموجودة لاستكشاف هذه التقنيّات. والقدرة على تمثيل الإجراءات كبيانات تجعل Lisp أيضًا لغةً ممتازةً لكتابة البرامج التي يجب أن تعالج برامجًا أخرى كبيانات، كالمفسّرات والمُصرّفات التي تدعم لغات الحاسوب. وفوق هذه الاعتبارات كلّها، فإنّ البرمجة بـLisp متعةٌ عظيمة.
1.1 عناصر البرمجة
لغة البرمجة القويّة أكثر من مجرّد وسيلةٍ لتكليف الحاسوب بأداء المهام. فإنّ اللغة تخدم أيضًا بوصفها إطارًا نُنظّم داخله أفكارنا عن العمليّات. لذلك، حين نصف لغةً، ينبغي أن نُعير اهتمامًا خاصًّا للوسائل التي توفّرها اللغة لدمج الأفكار البسيطة لتكوين أفكار أكثر تعقيدًا. ولكلّ لغةٍ قويّةٍ ثلاث آليّاتٍ لإنجاز ذلك:
- التعابير الأوّليّة (primitive expressions)، التي تمثّل أبسط الكيانات التي تعنى بها اللغة،
- وسائل التركيب (means of combination)، التي تُبنى بها العناصر المركّبة من عناصر أبسط منها، و
- وسائل التجريد (means of abstraction)، التي تُسمّى بها العناصر المركّبة وتُعالَج كوحداتٍ.
في البرمجة، نتعامل مع نوعين من العناصر: الإجراءات والبيانات. (وسنكتشف لاحقًا أنّها ليست متمايزةً بهذا القدر حقًّا.) فبصورةٍ غير رسميّة، البيانات هي «المادّة» التي نريد معالجتها، والإجراءات هي أوصاف القواعد لمعالجة البيانات. لذلك، ينبغي لأيّ لغة برمجةٍ قويّةٍ أن تكون قادرة على وصف البيانات الأوّليّة والإجراءات الأوّليّة، وأن تكون لها طرائقٌ لتركيب الإجراءات والبيانات ولتجريدهما.
في هذا الفصل سنتعامل مع بيانات عدديّة بسيطة فقط، حتّى نتمكّن من التركيز على قواعد بناء الإجراءات.[1] وفي الفصول اللاحقة سنرى أنّ هذه القواعد ذاتها تسمح لنا ببناء إجراءاتٍ تعالجة البيانات المركّبة كذلك.
1.1.1 التعابير
وهناك طريقةٌ سهلةٌ للانطلاق في البرمجة، وهي أن نفحص بعض التفاعلات النموذجيّة مع مفسّرٍ للهجة Scheme من Lisp. فتخيّل أنّك جالسٌ أمام طرفيّة حاسوب. فتكتب تعبيرًا (expression)، فيستجيب المفسّر بعرض نتيجة تقييمه (evaluating) لذلك التعبير.
أحد أنواع التعبيرات الأوّليّة التي قد تكتبها هو العدد. (وبأكثر دقّة، التعبير الذي تكتبه يتكوّن من الأرقام التي تمثّل العدد في الأساس 10.) فإن قدّمت لـLisp عددًا
486
فسيستجيب المفسّر بالطباعة[2]
486
والتعابير التي تمثّل الأعداد يمكن أن تُدمج بتعبيرٍ يمثّل إجراءً أوّليًّا (كـ+ أو *) لتكوين تعبيرٍ مركّبٍ يمثّل تطبيق الإجراء على تلك الأعداد. على سبيل المثال:
(+ 137 349)
486

(- 1000 334)
666

(* 5 99)
495

(/ 10 5)
2

(+ 2.7 10)
12.7
والتعابير كهذه، المشكّلة بتحديد قائمةٍ من التعابير داخل قوسين للإشارة إلى تطبيق الإجراء، تُسمّى التركيبات (combinations). ويُسمّى العنصر الأيسر في القائمة المشغّل (operator)، وتُسمّى العناصر الأخرى العوامل (operands). وقيمة التركيب تُحصَل بتطبيق الإجراء الذي يُحدّده المشغّل على المعطيات (arguments) التي هي قيم العوامل.
ويُعرف اصطلاح وضع المشغّل إلى يسار العوامل باسم الترميز البادئ (prefix notation)، وقد يكون مربكًا بعض الشيء في البداية لأنّه يبتعد ابتعادًا جوهريًّا عن الاصطلاح الرياضيّ المعتاد. غير أنّ الترميز البادئ له عدّة مزايا، منها أنّه يقبل إجراءاتٍ قد تأخذ عددًا اعتباطيًّا من المعطيات، كما في الأمثلة التالية:
(+ 21 35 12 7)
75

(* 25 4 12)
1200
فلا يمكن أن ينشأ التباس، لأنّ المشغّل هو دائمًا العنصر الأيسر، والتركيبَ كلّه محدَّدٌ بالأقواس.
وميزةٌ ثانية للترميز البادئ هي أنّه يمتدّ امتدادًا مباشرًا ليسمح بأن تكون التركيبات متداخلة (nested)، أي أن تكون عناصر التركيب تركيبًا بذاته:
(+ (* 3 5) (- 10 6))
19
ولا يوجد حدّ (من حيث المبدأ) لعمق هذا التداخل وللتعقيد الكلّيّ للتعابير التي يقدر مفسّر Lisp على تقييمها. ونحن البشر الذين نضلّل بتعابيرَ ما تزال بسيطةً نسبيًّا مثل
(+ (* 3
      (+ (* 2 4)
         (+ 3 5)))
   (+ (- 10 7)
      6))
والتي سيقيّمها المفسّر دون تردّدٍ فتُعطي 57. ويمكننا أن نساعد أنفسنا بكتابة تعبيرٍ كهذا في الصيغة
(+ (* 3
(+ (* 2 4)
(+ 3 5)))
(+ (- 10 7)
6))
اتّباعًا لاصطلاح تنسيقٍ يُعرف بـالطبع الأنيق (pretty-printing)، وفيه تُكتب كلّ تركيبةٍ طويلةٍ بحيث تُحاذى العوامل رأسيًّا. فتظهر الإزاحات الناتجة بنية التعبير بيانًا واضحًا.[3]
وحتّى مع التعابير المعقّدة، يعمل المفسّر دائمًا في الدورة الأساسيّة ذاتها: فيقرأ تعبيرًا من الطرفيّة، ويقيّم التعبير، ويطبع النتيجة. وهذا النمط من التشغيل يُعبَّر عنه غالبًا بالقول إنّ المفسّر يعمل في حلقة القراءة والتقييم والطباعة (read-eval-print loop). ولاحِظ على وجه الخصوص أنّه ليس ضروريًّا أن تُعطي المفسّر تعليماتٍ صريحةً بطبع قيمة التعبير.[4]
1.1.2 التسمية والبيئة
وجانبٌ بالغ الأهمّيّة في لغة البرمجة هو ما توفّره من وسائل لاستخدام الأسماء للإشارة إلى الكائنات الحاسوبيّة. فنحن نقول إنّ الاسم يدلّ على متغيّر (variable) قيمتُهُ (value) هي الكائن.
في لهجة Scheme من Lisp، نُسمّي الأشياء بـdefine. فبكتابة
(define size 2)
فإنّ المفسّر (interpreter) يربط القيمة 2 بالاسم size.[5] وحين يُربط الاسم size بالعدد 2، يمكننا أن نشير إلى القيمة 2 بالاسم:
size
2

(* 5 size)
10
وهذه أمثلةٌ إضافيّةٌ على استخدام define:
(define pi 3.14159)
(define radius 10)

(* pi (* radius radius))
314.159

(define circumference (* 2 pi radius))

circumference
62.8318
فـDefine أبسط وسائل التجريد في لغتنا، إذ يسمح لنا باستخدام أسماءٍ بسيطة للإشارة إلى نتائج عمليّاتٍ مركّبة، كـcircumference المحسوبة أعلاه. وبصورةٍ عامّة، قد تكون للكائنات الحاسوبيّة بنى معقّدةٌ جدًّا، وكان من غير الملائم للغاية أن نحتفظ بتفاصيلها ونعيدها في كلّ مرّةٍ نريد استخدامها. فحقًّا، إنّ البرامج المعقّدة تُبنى خطوةً بخطوة، من كائناتٍ حاسوبيّةٍ بتعقيدٍ متزايد. ويجعل المفسّر هذا البناء المتدرّج للبرنامج ملائمًا على وجه الخصوص، لأنّه يمكن إنشاء روابط الاسم-الكائن تدريجيًّا في تفاعلاتٍ متعاقبة. وهذه الميزة تشجّع على التطوير والاختبار التدريجيّين للبرامج، وهي مسؤولةٌ إلى حدٍّ كبيرٍ عن حقيقة أنّ برنامج Lisp يتكوّن عادةً من عددٍ كبيرٍ من الإجراءات البسيطة نسبيًّا.
وينبغي أن يكون واضحًا أنّ إمكان ربط القيم بالرموز واسترجاعها لاحقًا يعني أنّ المفسّر يجب أن يحتفظ بنوعٍ من الذاكرة التي تتابع أزواج الاسم-الكائن. وهذه الذاكرة تُسمّى البيئة (environment) (وبأكثر دقّة البيئة العامّة (global environment)، إذ سنرى لاحقًا أنّ الاحتساب قد يشمل عددًا من البيئات المختلفة).[6]
1.1.3 تقييم التركيبات
وأحد أهدافنا في هذا الفصل هو عزل القضايا المتعلّقة بالتفكير الإجرائيّ. وعلى سبيل المثال، لنفترض أنّ المفسّر نفسه يُتْبِع إجراءً عند تقييمه التركيبات.
ولتقييم تركيبةٍ، افعل ما يلي: قيّم التعابير الجزئيّة للتركيبة.
طبّق الإجراء الذي هو قيمة التعبير الجزئيّ الأيسر (المشغّل) على المعطيات التي هي قيم التعبيرات الجزئيّة الأخرى (العوامل).
حتّى هذه القاعدة البسيطة تُبرز بعض النقاط المهمّة عن العمليّات بصورةٍ عامّة. فأوّلًا، لاحظ أنّ الخطوة الأولى تقضي بأنّه لإنجاز عمليّة تقييم تركيبةٍ ما، يجب أن نؤدّي أوّلًا عمليّة التقييم على كلّ عنصرٍ من عناصر التركيبة. وبذلك، فقاعدة التقييم تعاوديّة (recursive) بطبيعتها؛ أي أنّها تتضمّن، كإحدى خطواتها، الحاجة إلى استحضار القاعدة نفسها.[7]
ولاحظ كيف يمكن أن تُستخدم فكرة التعاود باختصارٍ للتعبير عمّا كان سيُنظر إليه، في حالة تركيبةٍ متداخلةٍ بعمق، على أنّه عمليّةٌ معقّدةٌ إلى حدٍّ ما. فمثلًا، تقييم
(* (+ 2 (* 4 6)) (+ 3 5 7))
يتطلّب تطبيق قاعدة التقييم على أربع تركيباتٍ مختلفة. ويمكننا الحصول على صورةٍ عن هذه العمليّة بتمثيل التركيبة في شكل شجرة، كما هو موضّح في الشكل 1.1. فكلّ تركيبةٍ تُصوَّر بعقدةٍ لها أفرعٌ تقابل المشغّل وعوامل التركيبة الآتية منها. وتمثّل العُقَد النهائيّة (أي العُقَد التي لا تأتي منها أفرع) إمّا مشغّلاتٍ وإمّا أعداد. وبالنظر إلى التقييم من منظور الشجرة، يمكننا أن نتخيّل أنّ قيم العوامل تتسرّب إلى الأعلى، بدءًا من العُقَد النهائيّة ثم تجتمع عند مستوياتٍ أعلى فأعلى. وبصورةٍ عامّة، سنرى أنّ التعاود تقنيّةٌ بالغة القوّة للتعامل مع الكائنات الهرميّة الشبيهة بالأشجار. وفي الواقع، فإنّ صيغة «تسرّب القيم إلى الأعلى» من قاعدة التقييم مثالٌ على نوعٍ عامّ من العمليّات يُعرف بـالتراكم الشجريّ (tree accumulation).
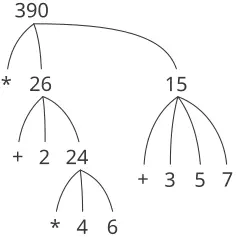
الشكل 1.1: تمثيل شجريّ، يُظهر قيمة كلّ تركيبةٍ جزئيّة.
تاليًا، لاحظ أنّ التطبيق المتكرّر للخطوة الأولى يصل بنا إلى النقطة التي نحتاج فيها إلى تقييم، لا تركيباتٍ، بل تعابيرَ أوّليّةً كالأعداد والمشغّلات المدمجة أو أسماءٍ أخرى. ونتعامل مع الحالات الأوّليّة بالنصّ على أنّ
- قيم الأعداد هي الأعداد التي تُسمّيها،
- قيم المشغّلات المدمجة هي تسلسلات تعليمات الآلة التي تؤدّي العمليّات المقابلة، و
- قيم الأسماء الأخرى هي الكائنات المرتبطة بتلك الأسماء في البيئة.
ويمكننا اعتبار القاعدة الثانية حالةً خاصّة من الثالثة بالنصّ على أنّ رموزًا مثل + و* مُدرجةٌ أيضًا في البيئة العامّة، ومرتبطةٌ بتسلسلات تعليمات الآلة التي هي «قيمُها». والنقطة الجوهريّة التي ينبغي ملاحظتها هي دور البيئة في تحديد معنى الرموز في التعابير. ففي لغةٍ تفاعليّةٍ مثل Lisp، لا معنى للكلام عن قيمة تعبيرٍ مثل (+ x 1) دون تحديد أيّ معلوماتٍ عن البيئة التي تمنح معنىً للرمز x (أو حتّى للرمز +). فكما سنرى في الفصل 3، فإنّ المفهوم العامّ للبيئة بوصفها سياقًا تجري فيه عمليّة التقييم سيؤدّي دورًا مهمًّا في فهمنا لتنفيذ البرنامج.
ولاحظ أنّ قاعدة التقييم المعطاة أعلاه لا تتعامل مع التعريفات. فمثلًا، تقييم (define x 3) لا يطبّق define على معطيين، أحدهما قيمة الرمز x والآخر هو 3، إذ إنّ غرض define هو بالضبط ربط x بقيمة. (أي أنّ (define x 3) ليس تركيبةً.)
وتُسمّى هذه الاستثناءات على قاعدة التقييم العامّة الصيغ الخاصّة (special forms). وDefine هي المثال الوحيد على صيغةٍ خاصّةٍ رأيناها حتّى الآن، لكنّنا سنقابل أخرى قريبًا. ولكلّ صيغةٍ خاصّةٍ قاعدة تقييمٍ خاصّة بها. وأنواع التعابير المختلفة (كلٌّ مع قاعدة التقييم المرافقة لها) تُشكّل صياغة لغة البرمجة. وبالمقارنة مع معظم لغات البرمجة الأخرى، فإنّ Lisp ذات صياغةٍ بسيطةٍ جدًّا؛ أي أنّ قاعدة تقييم التعابير يمكن وصفها بقاعدة عامّة بسيطة مع قواعد متخصّصة لعددٍ صغيرٍ من الصيغ الخاصّة.[8]
1.1.4 الإجراءات المركّبة
لقد حدّدنا في Lisp بعض العناصر التي يجب أن تظهر في كلّ لغة برمجةٍ قويّة:
- الأعداد والعمليّات الحسابيّة بيانات وإجراءات أوّليّة.
- تداخل التركيبات يُوفّر وسيلةً لتركيب العمليّات.
- التعريفات التي تربط الأسماء بالقيم تُوفّر وسيلةً محدودةً للتجريد.
والآن سنتعلّم عن تعريفات الإجراءات (procedure definitions)، وهي تقنيّة تجريدٍ أكثر قوّةٍ بكثيرٍ تُعطى بها للعمليّة المركّبة اسمٌ ثم يُشار إليها كوحدةٍ.
نبدأ بفحص كيف نُعبّر عن فكرة «التربيع». فقد نقول: «لكي تُربّع شيئًا، اضربه في نفسه». ويُعبَّر عن هذا في لغتنا كما يلي
(define (square x) (* x x))
ويمكننا فهم هذا على النحو التالي:
(define (square x)    (*       x       x))
  |      |      |      |       |       |
 To square something, multiply it by itself.
فلدينا هنا إجراءٌ مركّب (compound procedure)، وقد أُعطي الاسم square. فالإجراء يمثّل عمليّة ضرب شيءٍ في نفسه. وأُعطي الشيء الذي سيُضرب اسمٌ محلّيٌّ، x، يلعب الدور نفسه الذي يلعبه الضمير في اللغة الطبيعيّة. وتقييم التعريف يُنشئ هذا الإجراء المركّب ويربطه بالاسم square.[9]
والصورة العامّة لتعريف الإجراء هي
(define (⟨name⟩ ⟨formal parameters⟩) ⟨body⟩)
والـ⟨الاسم⟩ رمزٌ يُربط بتعريف الإجراء في البيئة، و⟨الوسائط الشكلية⟩ هي الأسماء المستخدمة داخل ⟨الجسم⟩ للإشارة إلى الوسائط المطابقة للإجراء، و⟨الجسم⟩ تعبيرٌ سيُنتج قيمة تطبيق الإجراء حين تُستبدل الوسائط الشكلية بالمعطيات الفعليّة التي يُطبَّق عليها الإجراء. ويُجمَّع ⟨الاسم⟩ و⟨الوسائط الشكلية⟩ بين قوسين، تمامًا كما هما في نداءٍ فعليّ للإجراء المعرَّف.
وبعد تعريف square، يمكننا الآن استخدامه:
(square 21)
441

(square (+ 2 5))
49

(square (square 3))
81
ويمكننا أيضًا استخدام square كوحدة بناءٍ في تعريف إجراءاتٍ أخرى. فمثلًا، يمكن التعبير عنه بـ
(+ (square x) (square y))
ويمكننا بسهولةٍ تعريف إجراءٍ sum-of-squares يُعطي، لأيّ عددين كمعطيات، مجموع مربّعيهما:
(define (sum-of-squares x y)
  (+ (square x) (square y)))

(sum-of-squares 3 4)
25
والآن يمكننا استخدام sum-of-squares كوحدة بناءٍ في بناء إجراءاتٍ أخرى:
(define (f a)
  (sum-of-squares (+ a 1) (* a 2)))

(f 5)
136
والإجراءات المركّبة تُستخدم بالطريقة ذاتها تمامًا كالإجراءات الأوّليّة. فحقًّا، لا يمكن للمرء أن يعرف - بالنظر إلى تعريف sum-of-squares المعطى أعلاه - ما إذا كان square مدمجًا في المفسّر، مثل + و*، أو معرَّفًا كإجراءٍ مركّب.
1.1.5 نموذج الاستبدال لتطبيق الإجراء
ولتقييم تركيبةٍ مشغّلها إجراءٌ مركّب، يتبع المفسّر العمليّةَ ذاتها التي يتبعها من أجل التركيبات التي مشغّلاتها إجراءات أوّليّة، والتي وصفناها في 1.1.3. أي أنّ المفسّر يقيّم عناصر التركيبة ثم يطبّق الإجراء (وهو قيمة مشغّل التركيبة) على المعطيات (وهي قيم عوامل التركيبة).
ويمكننا أن نفترض أنّ آليّة تطبيق الإجراءات الأوّليّة على المعطيات مدمجةٌ في المفسّر. وأمّا بالنسبة للإجراءات المركّبة، فعملية التطبيق تكون كما يلي:
ولتطبيق إجراءٍ مركّب على معطياتٍ، قيّم جسم الإجراء باستبدال كلّ وسيطٍ شكليّ بالمعطى المطابق له.
ولتوضيح هذه العمليّة، لنُقيّم التركيبة
(f 5)
حيث f هو الإجراء المعرَّف في 1.1.4. نبدأ باسترجاع جسم f:
(sum-of-squares (+ a 1) (* a 2))
ثم نستبدل الوسيط الشكليّ a بالمعطى 5:
(sum-of-squares (+ 5 1) (* 5 2))
وبذلك، تنحلّ المسألة إلى تقييم تركيبةٍ ذات عاملين ومشغّلٍ هو sum-of-squares. وتقييم هذا التركيب يشمل ثلاث مسائل جزئيّة. فيجب أن نقيّم المشغّل للحصول على الإجراء الذي سيُطبَّق، ويجب أن نقيّم العوامل للحصول على المعطيات. فإنّ (+ 5 1) يُنتج 6 و(* 5 2) يُنتج 10، فيجب أن نطبّق الإجراء sum-of-squares على 6 و10. وهذه القيم تُستبدل بالوسائط الشكلية x وy في جسم sum-of-squares، فتنحلّ التعبير إلى
(+ (square 6) (square 10))
فإن استخدمنا تعريف square، انحلّ هذا إلى
(+ (* 6 6) (* 10 10))
والذي ينحلّ بالضرب إلى
(+ 36 100)
وأخيرًا إلى
136
والعمليّة التي وصفناها للتوّ تُسمّى نموذج الاستبدال (substitution model) لتطبيق الإجراءات. ويمكن اعتبارها نموذجًا تحدّد «معنى» تطبيق الإجراء، بالقدر الذي تخصّ فيه الإجراءات الواردة في هذا الفصل. غير أنّ هناك نقطتين ينبغي التشديد عليهما:
- والغرض من الاستبدال هو مساعدتنا على التفكير في تطبيق الإجراء، لا توفير وصفٍ لكيفية عمل المفسّر فعليًّا. فالمفسّرات النموذجيّة لا تُقيّم تطبيقات الإجراءات بمعالجة نصّ الإجراء لاستبدال القيم بالوسائط الشكليّة. وفي الممارسة، يُنْجَز «الاستبدال» باستخدام بيئةٍ محلّيّةٍ للوسائط الشكليّة. وسنناقش هذا بتوسّعٍ أكبر في الفصل 3 والفصل 4 حين نفحص تنفيذ مفسّرٍ بتفصيلٍ أكبر.
- وعلى مدى هذا الكتاب، سنُقدّم سلسلةً من النماذج المتعاقبة في تعقيدها لكيفية عمل المفسّرات، تتوّج بتنفيذٍ كاملٍ لمفسّرٍ ومُصرِّفٍ في الفصل 5. فنموذج الاستبدال هو أوّل هذه النماذج فقط - طريقةٌ للانطلاق في التفكير رسميًّا في عمليّة التقييم. وبصورةٍ عامّة، حين نُنمذج الظواهر في العلم والهندسة، نبدأ بنماذج مبسّطة غير كاملة. وحين نفحص الأشياء بتفصيلٍ أكبر، تصبح هذه النماذج البسيطة غير كافية ويجب استبدالها بنماذج أكثر دقّة. ونموذج الاستبدال ليس استثناءً من ذلك. وعلى وجه الخصوص، حين نتناول في الفصل 3 استخدام الإجراءات مع «البيانات القابلة للتغيير»، فسنرى أنّ نموذج الاستبدال يتعطّل ويجب استبداله بنموذجٍ أكثر تعقيدًا لتطبيق الإجراءات.[10]
الترتيب التطبيقيّ مقابل الترتيب الاعتياديّ
فبحسب وصف التقييم المعطى في 1.1.3، يُقيّم المفسّر المشغّل والعوامل أوّلًا ثم يطبّق الإجراء الناتج على المعطيات الناتجة. وهذه ليست الطريقة الوحيدة لأداء التقييم. فنموذج تقييمٍ بديلٍ لن يقيّم العوامل حتّى تحتاج قيمُها. بل سيستبدل أوّلًا تعبيرات العوامل بالوسائط حتّى يحصل على تعبيرٍ يتضمّن مشغّلاتٍ أوّليّةً فقط، ثم يُجرى التقييم. فإن كنّا قد استخدمنا هذه الطريقة، لسار تقييم (f 5) تبعًا لتسلسل التوسّعات
(sum-of-squares (+ 5 1) (* 5 2))

(+ (square (+ 5 1))
   (square (* 5 2)))

(+ (* (+ 5 1) (+ 5 1))
   (* (* 5 2) (* 5 2)))
تتبعه الاحتسابات (reductions)
(+ (* 6 6)
   (* 10 10))

(+ 36 100)

136
وهذا يُعطي الجواب نفسه الذي أعطاه نموذج التقييم السابق، لكنّ العمليّة مختلفة. وعلى وجه الخصوص، فإنّ تقييم (+ 5 1) و(* 5 2) يُجرى مرّتين هنا، مقابلًا لاختزال التعبير (* x x) باستبدال x على التوالي بـ(+ 5 1) و(* 5 2).
وتُعرف طريقة التقييم البديلة هذه - «التوسيع الكامل ثم الاحتساب» - باسم التقييم بالترتيب الاعتياديّ (normal-order evaluation)، بخلاف طريقة «تقييم المعطيات ثم التطبيق» التي يستخدمها المفسّر فعلًا، والتي تُسمّى التقييم بالترتيب التطبيقيّ (applicative-order evaluation). ويمكن إثبات أنّ هذين الأسلوبين يُنتجان القيمة نفسها، من أجل تطبيقات الإجراءات التي يمكن نمذجتها باستخدام الاستبدال (بما في ذلك جميع الإجراءات في الفصلين الأولين من هذا الكتاب) والتي تُنتج قيمًا مشروعة. (انظر التمرين 1.5 لمثالٍ على قيمةٍ «غير مشروعة» لا يُعطي فيها التقييم بالترتيب الاعتياديّ والتقييم بالترتيب التطبيقيّ النتيجة نفسها.)
تستخدم Lisp التقييم بالترتيب التطبيقيّ، جزئيًّا بسبب الكفاءة الإضافيّة المتحصّلة من تجنّب التقييم المتكرّر لتعبيراتٍ مثل (+ 5 1) و(* 5 2) المذكورين أعلاه، والأهمّ من ذلك، لأنّ التقييم بالترتيب الاعتياديّ يصبح أعقدَ بكثيرٍ في التعامل حين نترك عالم الإجراءات التي يمكن نمذجتها بالاستبدال. ومن جهةٍ أخرى، قد يكون التقييم بالترتيب الاعتياديّ أداةً بالغة القيمة، وسنفحص بعض تبعاته في الفصل 3 والفصل 4.[11]
1.1.6 التعابير الشرطيّة والمسندات
والقوّة التعبيريّة لصنف الإجراءات التي يمكننا تعريفها في هذه المرحلة محدودةٌ جدًّا، لأنّه ليس لدينا طريقةٌ لإجراء الاختبارات ولأداء عمليّاتٍ مختلفة بحسب نتيجة الاختبار. فنحن لا نستطيع، مثلًا، تعريف إجراءٍ يحسب القيمة المطلقة لعددٍ باختبار ما إذا كان العدد موجبًا أو سالبًا أو صفرًا واتّخاذ إجراءاتٍ مختلفة في الحالات المختلفة وفقًا للقاعدة وهذا البناء يُسمّى تحليل الحالات (case analysis)، وهناك صيغةٌ خاصّةٌ في Lisp لترميز تحليل حالاتٍ كهذا. وتُسمّى cond (وهو اختصارٌ لـ«conditional»)، وتُستخدم كما يلي:
(define (abs x)
  (cond ((> x 0) x)
        ((= x 0) 0)
        ((< x 0) (- x))))
الصيغة العامّة للتعبير الشرطيّ هي
(cond (⟨p₁⟩ ⟨e₁⟩)
      (⟨p₂⟩ ⟨e₂⟩)
      …
      (⟨pₙ⟩ ⟨eₙ⟩))
وهي تتألّف من الرمز cond متبوعًا بأزواجٍ من التعابير محاطةً بأقواس
(⟨p⟩ ⟨e⟩)
تُسمّى بنودًا (clauses). أوّل تعبيرٍ في كلّ زوجٍ هو مُسَيِّم (predicate) — أيّ تعبيرٌ تُفَسَّر قيمته على أنّها إمّا صحيحة أو خاطئة.[12]
تُقيَّم التعابير الشرطيّة على النحو الآتي. يُقيَّم المسيّم أوّلًا. فإن كانت قيمته خاطئة، قُيِّم . فإن كانت قيمة خاطئة هي أيضًا، قُيِّم . ويستمرّ هذا الإجراء حتّى يُعثَر على مُسَيِّمٍ قيمته صحيحة، وحينئذٍ يعيد المفسّر قيمة التعبير الناتج المقابل في البند، قيمةً للتعبير الشرطيّ. فإن لم يُعثَر على أيّ ذي قيمةٍ صحيحة، كانت قيمة cond غير محدّدة.
تُستخدَم كلمة مُسَيِّم للإجراءات التي تعيد قيمة صحيحة أو خاطئة، وكذلك للتعبيرات التي تُقيَّم إلى قيمة صحيحة أو خاطئة. ويستخدم إجراء القيمة المطلقة abs المسيّمات الأوّليّة > و< و=.[13] وهي تأخذ عددين كمعطىين وتختبر ما إذا كان العدد الأوّل، على الترتيب، أكبر من العدد الثاني أو أصغر منه أو مساويًا له، فتعيد القيمة صحيحة أو خاطئة وفقًا لذلك.
وهناك طريقة أخرى لكتابة إجراء القيمة المطلقة، وهي
(define (abs x)
  (cond ((< x 0) (- x))
        (else x)))
ويمكن التعبير عنها بالإنجليزيّة قولًا: «إذا كان أصغر من صفر فأعِد ؛ وإلّا فأعِد .» والرمز else رمزٌ خاصّ يمكن استخدامه بدلًا من في البند الأخير من cond. وهذا يجعل cond يعيد قيمة المقابلة كلّما تمّ تجاوز جميع البنود السابقة. وفي الحقيقة، يمكن استخدام أيّ تعبيرٍ يُقيَّم دائمًا إلى قيمةٍ صحيحة في موضع هنا.
وهذه طريقة أخرى بعد لكتابة إجراء القيمة المطلقة:
(define (abs x)
  (if (< x 0)
      (- x)
      x))
تستخدم هذه الصيغة الصيغة الخاصّة if، وهو نوعٌ مقيَّد من الشرطيّ يمكن استخدامه حين توجد حالتان بالضبط في تحليل الحالات. والصيغة العامّة لتعبير if هي
(if ⟨predicate⟩ ⟨consequent⟩ ⟨alternative⟩)
ولتقييم تعبير if، يبدأ المفسّر بتقييم الجزء ⟨predicate⟩ من التعبير. فإن قُيّم ⟨predicate⟩ إلى قيمة صحيحة، قيّم المفسّر حينها ⟨consequent⟩ وأعاد قيمته. وإلّا قيّم ⟨alternative⟩ وأعاد قيمته.[14]
وبالإضافة إلى المسيّمات الأوّليّة مثل ``، هناك عمليّات التركيب المنطقيّ التي تتيح لنا بناء مسيّماتٍ مركّبة. وأكثرها استخدامًا هي:
(and ⟨e₁⟩ … ⟨eₙ⟩)يقيّم المفسّر التعبيرات⟨e⟩واحدًا واحدًا، من اليسار إلى اليمين. فإن قُيّم أيّ⟨e⟩إلى القيمة خاطئة، كانت قيمة تعبيرandخاطئة، ولم تُقيَّم بقيّة⟨e⟩. فإن قُيّمت جميع⟨e⟩إلى قيمٍ صحيحة، كانت قيمة تعبيرandقيمة آخرها.(or ⟨e₁⟩ … ⟨eₙ⟩)يقيّم المفسّر التعبيرات⟨e⟩واحدًا واحدًا، من اليسار إلى اليمين. فإن قُيّم أيّ⟨e⟩إلى قيمة صحيحة، أُعيدت تلك القيمة قيمةً لتعبيرor، ولم تُقيَّم بقيّة⟨e⟩. فإن قُيّمت جميع⟨e⟩إلى القيمة خاطئة، كانت قيمة تعبيرorخاطئة.(not ⟨e⟩)قيمة تعبيرnotصحيحة عندما يُقيَّم التعبير⟨e⟩إلى القيمة خاطئة، وخاطئة فيما عدا ذلك.
لاحِظ أنّ and وor صيغتان خاصّتان، لا إجراءان، لأنّ التعابير الفرعيّة لا تُقيَّم كلّها بالضرورة. وأمّا not فإجراءٌ اعتياديّ.
ومثالٌ على كيفية استخدام هذه العمليّات، يمكن التعبير عن شرط كون العدد في المدى بـ
(and (> x 5) (< x 10))
ومثالٌ آخر، يمكننا تعريف مُسَيِّمٍ لاختبار ما إذا كان عددٌ أكبر من أو يساوي عددًا آخر بـ
(define (>= x y)
  (or (> x y) (= x y)))
أو بدلًا من ذلك بـ
(define (>= x y)
  (not (< x y)))
التمرين 1.1: فيما يلي تتاليٌ من التعبيرات. فما هي النتيجة التي يطبعها المفسّر استجابةً لكلّ تعبير؟ وافترض أنّ التتالي يُقيَّم بالترتيب الذي قُدّم به.
10
(+ 5 3 4)
(- 9 1)
(/ 6 2)
(+ (* 2 4) (- 4 6))
(define a 3)
(define b (+ a 1))
(+ a b (* a b))
(= a b)
(if (and (> b a) (< b (* a b)))
    b
    a)
(cond ((= a 4) 6)
      ((= b 4) (+ 6 7 a))
      (else 25))
(+ 2 (if (> b a) b a))
(* (cond ((> a b) a)
         ((< a b) b)
         (else -1))
   (+ a 1))
التمرين 1.2: حوّل التعبير الآتي إلى صيغةٍ سابقة (prefix form):
التمرين 1.3: عرّف إجراءً يأخذ ثلاثة أعداد كمعطياتٍ ويعيد مجموع مربّعي العددين الأكبر.
التمرين 1.4: لاحِظ أنّ نموذجنا للتقييم يسمح بتركيباتٍ معاملاتها تعابير مركّبة. واستخدم هذه الملاحظة لوصف سلوك الإجراء الآتي:
(define (a-plus-abs-b a b)
  ((if (> b 0) + -) a b))
التمرين 1.5: ابتكر بن بيتدِل اختبارًا لتحديد ما إذا كان المفسّر الذي يواجهه يستخدم التقييم بالترتيب التطبيقيّ أم التقييم بالترتيب الاعتياديّ. وهو يُعرّف الإجراءين الآتيين:
(define (p) (p))

(define (test x y)
  (if (= x 0)
      0
      y))
ثمّ يُقيّم التعبير
(test 0 (p))
فأيّ سلوك سيلاحظه بن مع مفسّر يستخدم التقييم بالترتيب التطبيقيّ؟ وأيّ سلوك سيلاحظه مع مفسّر يستخدم التقييم بالترتيب الاعتياديّ؟ فسّر إجابتك. (وافترض أنّ قاعدة تقييم الصيغة الخاصّة if هي ذاتها سواء استخدم المفسّر الترتيب الاعتياديّ أم الترتيب التطبيقيّ: يُقيَّم تعبير المُسَيِّم أوّلًا، والنتيجة تحدّد ما إذا كان سيُقيَّم التعبير الناتج أم التعبير البديل.)
1.1.7 مثال: الجذور التربيعيّة بطريقة نيوتن
الإجراءات، كما قُدِّمت أعلاه، أشبه كثيرًا بالدوالّ الرياضيّة الاعتياديّة. فهي تحدّد قيمةً تتحدّد بوسيطٍ واحد أو أكثر. لكن هناك فرقًا مهمًّا بين الدوالّ الرياضيّة وإجراءات الحاسوب. فالإجراءات يجب أن تكون فعّالة.
وبوصفها مثالًا على ذلك، تأمّل مسألة احتساب الجذور التربيعيّة. فيمكننا تعريف دالّة الجذر التربيعيّ بأنّها وهذا يصف دالّةً رياضيّةً مشروعةً تمامًا. فيمكننا استخدامها للتعرّف على ما إذا كان عددٌ هو الجذر التربيعيّ لعددٍ آخر، أو لاستنتاج حقائق عن الجذور التربيعيّة عمومًا. ومن جانبٍ آخر، فإنّ هذا التعريف لا يصف إجراءً. بل إنّه لا يخبرنا بشيءٍ تقريبًا عن كيفيّة إيجاد الجذر التربيعيّ لعددٍ معطًى فعليًّا. ولن يفيد الأمر في شيءٍ إعادة صياغة هذا التعريف بما يشبه Lisp:
(define (sqrt x)
  (the y (and (>= y 0)
              (= (square y) x))))
وهذا لا يفعل سوى إثارة المسألة من جديد.
والتناقض بين الدالّة والإجراء انعكاسٌ للتمييز العامّ بين وصف خصائص الأشياء ووصف كيفيّة فعل الأشياء، أو - كما يُشار إليه أحيانًا - التمييز بين المعرفة الإعلانيّة والمعرفة الأمرة. ففي الرياضيّات نعنى عادةً بالأوصاف الإعلانيّة (ما هو)، بينما نعنى في علوم الحاسوب عادةً بالأوصاف الأمرة (كيف).[15]
وكيف يحتسب المرء الجذور التربيعيّة؟ أكثر الطرق شيوعًا هو استخدام طريقة نيوتن في التقريبات المتعاقبة، التي تقول إنّه كلّما كان لدينا تخمينٌ لقيمة الجذر التربيعيّ لعددٍ ، فيمكننا إجراء معالجةٍ بسيطة للحصول على تخمينٍ أفضل (أقرب إلى الجذر التربيعيّ الحقيقيّ) بحساب متوسّط مع .[16] فعلى سبيل المثال، يمكننا احتساب الجذر التربيعيّ للعدد 2 على النحو الآتي. وليكن تخميننا الأوّل 1:
Guess     Quotient      Average

1         (2/1)  = 2    ((2 + 1)/2)  = 1.5

1.5       (2/1.5)       ((1.3333 + 1.5)/2)
            = 1.3333      = 1.4167

1.4167    (2/1.4167)    ((1.4167 + 1.4118)/2)
            = 1.4118      = 1.4142

1.4142    ...           ...
وبمواصلة هذا الإجراء، نحصل على تقريباتٍ أفضل فأفضل للجذر التربيعيّ.
والآن لنُصغِ الإجراء بمصطلحات الإجراءات. فنبدأ بقيمةٍ للعدد تحت الجذر (العدد الذي نحاول احتساب جذره التربيعيّ) وبقيمةٍ للتخمين. فإن كان التخمين جيّدًا بما يكفي لأغراضنا، فقد انتهينا؛ وإلّا فعلينا تكرار الإجراء بتخمينٍ مُحسَّن. ونكتب هذه الاستراتيجيّة الأساسيّة كإجراء:
(define (sqrt-iter guess x)
  (if (good-enough? guess x)
      guess
      (sqrt-iter (improve guess x) x)))
وقد حُسِّن التخمين بحساب متوسّطه مع حاصل قسمة العدد تحت الجذر على التخمين القديم:
(define (improve guess x)
  (average guess (/ x guess)))
حيث
(define (average x y)
  (/ (+ x y) 2))
وعلينا أيضًا أن نقول ما نعنيه بـ«جيّد بما يكفي». فالصيغة الآتية تفي بالغرض للتوضيح، لكنّها ليست اختبارًا جيّدًا حقًّا. (انظر التمرين 1.7.) والفكرة هي تحسين الإجابة حتّى تصير قريبةً بالقدر الذي يقلّ فيه مربّعها عن العدد تحت الجذر بأقلّ من تسامحٍ محدّدٍ مسبقًا (هنا 0.001):[17]
(define (good-enough? guess x)
  (< (abs (- (square guess) x)) 0.001))
وأخيرًا، نحتاج إلى طريقةٍ للانطلاق. فعلى سبيل المثال، يمكننا دائمًا التخمين بأنّ الجذر التربيعيّ لأيّ عدد هو 1:[18]
(define (sqrt x)
  (sqrt-iter 1.0 x))
فإذا أدخلنا هذه التعريفات إلى المفسّر، أمكننا استخدام sqrt تمامًا كما نستخدم أيّ إجراء:
(sqrt 9)
3.00009155413138

(sqrt (+ 100 37))
11.704699917758145

(sqrt (+ (sqrt 2) (sqrt 3)))
1.7739279023207892

(square (sqrt 1000))
1000.000369924366
ويُظهر برنامج sqrt أيضًا أنّ اللغة الإجرائيّة البسيطة التي قدّمناها حتى الآن تكفي لكتابة أيّ برنامجٍ رقميٍّ خالصٍ يمكن للمرء كتابته بـC أو Pascal مثلًا. وقد يبدو هذا مفاجئًا، إذ لم نُدرج في لغتنا أيّ بنية تكرارية (حلقات) تُوجّه الحاسوب لفعل شيءٍ ما مرارًا وتكرارًا. ومن جانبٍ آخر، يُظهر sqrt-iter كيف يمكن تحقيق التكرار دون أيّ بنيةٍ خاصّة سوى القدرة الاعتياديّة على نداء إجراء.[19]
التمرين 1.6: لا ترى أليسا بي. هاكر لماذا ينبغي توفير if كصيغةٍ خاصّة. «فلماذا لا أُنشئها كإجراءٍ اعتياديّ بدلالة cond؟» كما تسأل. وتؤكّد صديقتها إيفا لو أتور أنّ ذلك ممكن فعلًا، وهي تُعرّف نسخةً جديدة من if:
(define (new-if predicate
                then-clause
                else-clause)
  (cond (predicate then-clause)
        (else else-clause)))
وتُظهر إيفا البرنامج لأليسا:
(new-if (= 2 3) 0 5)
5

(new-if (= 1 1) 0 5)
0
مسرورةً، تستخدم أليسا new-if لإعادة كتابة برنامج الجذر التربيعيّ:
(define (sqrt-iter guess x)
  (new-if (good-enough? guess x)
          guess
          (sqrt-iter (improve guess x) x)))
ماذا يحدث عندما تحاول أليسا استخدام هذا لاحتساب الجذور التربيعيّة؟ فسّر.
التمرين 1.7: الاختبار
good-enough?المستخدم في احتساب الجذور التربيعيّة لن يكون فعّالًا جدًّا في إيجاد جذور الأعداد الصغيرة جدًّا. أيضًا، في الحواسيب الحقيقيّة، تُجرى العمليّات الحسابيّة شبه دائمًا بدقّةٍ محدودة. وهذا يجعل اختبارنا غير كافٍ للأعداد الكبيرة جدًّا. فسّر هذين القولين، مع أمثلة تُظهر كيف يفشل الاختبار للأعداد الصغيرة والكبيرة. والاستراتيجيّة البديلة لتنفيذgood-enough?هي مراقبة كيف يتغيّرguessمن دورة تكرارٍ إلى التالية والتوقّف عندما يكون التغيّر جزءًا صغيرًا جدًّا من التخمين. صمّم إجراءً للجذر التربيعيّ يستخدم هذا النوع من اختبار النهاية. فهل يعمل هذا عملًا أفضل للأعداد الصغيرة والكبيرة؟
التمرين 1.8: طريقة نيوتن للجذور التكعيبيّة تقوم على حقيقة أنّّه إذا كان تقريبًا للجذر التكعيبيّ لـ ، فإنّ تقريبًا أفضل يُعطى بالقيمة
استخدم هذه الصيغة لتنفيذ إجراءٍ للجذر التكعيبيّ مماثلٍ لإجراء الجذر التربيعيّ. (وفي 1.3.4 سنرى كيف نُنفّذ طريقة نيوتن بصورةٍ عامّةٍ بوصفها تجريدًا لإجراء الجذر التربيعيّ وإجراء الجذر التكعيبيّ.)
1.1.8 الإجراءات كتجريداتٍ على هيئة صناديق سوداء
sqrt هو أوّل مثالٍ لدينا عن إجراءٍ مُعرَّف بمجموعةٍ من الإجراءات مُعرَّفة بعضها بدلالة بعض. لاحِظ أنّ تعريف sqrt-iter تعاوديّ؛ أيّ أنّ الإجراء مُعرَّف بدلالة ذاته. وقد تكون فكرة القدرة على تعريف إجراءٍ بدلالة ذاته مقلقة؛ فقد يبدو من غير الواضح كيف يمكن لمثل هذا التعريف «الدائريّ» أن يكون مفهومًا أصلًا، ناهيك عن أن يحدّد إجراءً محدّدًا تحديدًا حسنًا ينفّذه الحاسوب. وسيُناقَش هذا بعنايةٍ أكبر في 1.2. لكن دعنا أوّلًا نأخذ بنظر الاعتبار بعض النقاط المهمّة الأخرى التي يُظهرها مثال sqrt.
لاحِظ أنّ مسألة احتساب الجذور التربيعيّة تنقسم انقسامًا طبيعيًّا إلى عددٍ من المسائل الفرعيّة: كيف نحدّد ما إذا كان التخمين جيّدًا بما يكفي، وكيف نحسّن تخمين، وهكذا. وتُنجَز كلٌّ من هذه المهامّ بإجراءٍ منفصل. ويمكن النظر إلى برنامج sqrt بأكمله بوصفه عنقودًا من الإجراءات (كما هو موضّح في الشكل 1.2) يعكس تفكيك المسألة إلى مسائلَ فرعيّة.
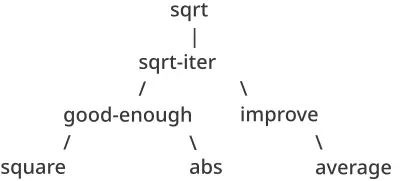
الشكل 1.2: التفكيك الإجرائيّ لبرنامج sqrt.
وأهمّيّة استراتيجيّة التفكيك هذه ليست في تقسيم البرنامج إلى أجزاءٍ فحسب. ففي النهاية، يمكننا أخذ أيّ برنامجٍ كبيرٍ وتقسيمه إلى أجزاء — الأسطر العشرة الأولى، ثمّ الأسطر العشرة التالية، وهكذا. بل المهمّ هو أنّ كلَّ إجراءٍ ينجز مهمّةً قابلةً للتحديد يمكن استخدامها كوحدةٍ (module) في تعريف إجراءاتٍ أخرى. فعلى سبيل المثال، عندما نُعرّف الإجراء good-enough? بدلالة square، فإنّنا نستطيع اعتبار إجراء square «صندوقًا أسود». فنحن في تلك اللحظة غير معنيّين بكيفيّة احتساب الإجراء لنتيجته، بل بحقيقة أنّه يحتسب المربّع فقط. ويمكن حجز تفاصيل كيفيّة احتساب المربّع للنظر فيها في وقتٍ لاحق. وبالفعل، بقدر ما يخصّ الإجراء good-enough?، فإنّ square ليس إجراءً بالمعنى الدقيق بل هو تجريدٌ لإجراء، ما يُسمّى تجريدًا إجرائيًّا. وعلى مستوى التجريد هذا، فإنّ أيّ إجراء يحتسب المربّع جيّدٌ بالقدر ذاته.
وبالتالي، إذا نظرنا إلى القيم التي تعيدها فحسب، فإنّ الإجراءين الآتيين لتربيع عددٍ يجب أن يكونا غير قابلين للتمييز. فكلٌّ منهما يأخذ معطًى عدديًّا ويُنتج مربّع ذلك العدد قيمةً له.[20]
(define (square x) (* x x))

(define (square x)
  (exp (double (log x))))

(define (double x) (+ x x))
إذن، يجب أن يكون تعريف الإجراء قادرًا على حجب التفاصيل. فقد لا يكون مستخدمو الإجراء هم الذين كتبوه، بل ربّما حصلوا عليه من مبرمجٍ آخر بوصفه صندوقًا أسود. ولا ينبغي أن يحتاج المستخدم إلى معرفة كيفيّة تنفيذ الإجراء لكي يستخدمه.
الأسماء المحليّة
وأحد تفاصيل تنفيذ الإجراء التي لا ينبغي أن تهمّ مستخدم الإجراء هو اختيار المُنفِّذ لأسماء الوسائط الشكليّة للإجراء. وبالتالي، يجب ألّا يكون الإجراءان الآتيان قابلين للتمييز:
(define (square x) (* x x))
(define (square y) (* y y))
وهذا المبدأ — أنّ معنَى الإجراء يجب أن يكون مستقلًّا عن أسماء الوسائط التي استخدمها مؤلّفه — يبدو في ظاهره بديهيًّا، لكنّ نتائجه عميقة. وأبسط نتيجة هي أنّ أسماء وسائط الإجراء يجب أن تكون محليّة لجسم الإجراء. فعلى سبيل المثال، لقد استخدمنا square في تعريف good-enough? في إجراء الجذر التربيعيّ:
(define (good-enough? guess x)
  (< (abs (- (square guess) x)) 0.001))
وقصد مؤلّف good-enough? هو تحديد ما إذا كان مربّع الوسيط الأوّل يقع ضمن تسامحٍ معطى من الوسيط الثاني. ونرى أنّ مؤلّف good-enough? استخدم الاسم guess للإشارة إلى الوسيط الأوّل والاسم x للإشارة إلى الوسيط الثاني. ووسيط square هو guess. فإن استخدم مؤلّف square الاسم x (كما أعلاه) للإشارة إلى ذلك الوسيط، نرى أنّ x في good-enough? يجب أن يكون x مغايرًا لذاك الموجود في square. فيجب ألّا يؤثّر تشغيل الإجراء square في قيمة x التي يستخدمها good-enough?، لأنّ good-enough? قد يحتاج إلى تلك القيمة من x بعد أن ينتهي square من الاحتساب.
فلو لم تكن الوسائط محليّة لأجسام إجراءاتها فإنّ الوسيط x في square يمكن أن يُخَلَط بالوسيط x في good-enough?، وسيعتمد سلوك good-enough? على أيّ نسخة من square نستخدمها. وعندها لن يكون square الصندوق الأسود الذي أردناه.
وللوسيط الشكليّ للإجراء دورٌ خاصّ للغاية في تعريف الإجراء، إذ لا يهمّ أيّ اسم يحمله الوسيط الشكليّ. ويُسمّى مثل هذا الاسم متغيّرًا مُقيَّدًا، ونقول إنّ تعريف الإجراء يُقيِّد وسائطه الشكليّة. ولا يتغيّر معنى تعريف الإجراء إذا أُعيد تسمية متغيّرٍ مُقيَّدٍ تسميةً متّسقةً في جميع أنحاء التعريف.[21] فإن كان المتغيّر غير مُقيَّد، نقول إنّه حرّ. ومجموعة التعابير التي يحدّد الربط اسمًا لها تُسمّى نطاق ذلك الاسم. وفي تعريف الإجراء، فإنّ المتغيّرات المُقيَّدة المُعلَنة كوسائط شكليّة للإجراء لها جسم الإجراء نطاقًا.
في تعريف good-enough? أعلاه، فإنّ guess وx متغيّران مُقيَّدان ولكن *capturing* المتغيّرabs. لكنّه كان سيتغيّر من حرّ إلى مُقيَّد.) ومع ذلك، فمعنى good-enough?ليس مستقلًّا عن أسماء متغيّراته الحرّة. فهو يعتمد حتمًا على الحقيقة (الخارجة عن هذا التعريف) أنّ الرمزabsيُسمّي إجراءً لاحتساب القيمة المطلقة لعدد. وسيحسبgood-enough?دالّةً مختلفة إذا استبدلناcos بـabs` في تعريفه.
التعريفات الداخليّة والبنية الكتليّة
ولدينا نوعٌ واحد من عزل الأسماء متاحٌ لنا حتى الآن: الوسائط الشكليّة للإجراء محليّة لجسم الإجراء. ويُظهر برنامج الجذر التربيعيّ طريقة أخرى نرغب بها في التحكّم في استخدام الأسماء. فالبرنامج القائم يتألّف من إجراءاتٍ منفصلة:
(define (sqrt x)
  (sqrt-iter 1.0 x))

(define (sqrt-iter guess x)
  (if (good-enough? guess x)
      guess
      (sqrt-iter (improve guess x) x)))

(define (good-enough? guess x)
  (< (abs (- (square guess) x)) 0.001))

(define (improve guess x)
  (average guess (/ x guess)))
ومشكلة هذا البرنامج أنّ الإجراء الوحيد المُهمّ لمستخدمي sqrt هو sqrt. أمّا الإجراءات الأخرى (sqrt-iter، وgood-enough?، وimprove) فإنّها تُشوّش أذهانهم فحسب. فقد لا يُعرّفون أيّ إجراءٍ آخر اسمه good-enough? كجزءٍ من برنامجٍ آخر ليعمل مع برنامج الجذر التربيعيّ، لأنّ sqrt يحتاج إليه. والمشكلة بالغة الحدّة بشكلٍ خاصّ في بناء النظمّ الكبيرة بواسطة مبرمجين منفصلين كثيرين. فعلى سبيل المثال، في بناء مكتبةٍ كبيرةٍ من الإجراءات العدديّة، تُحتسب كثير من الدوالّ العدديّة بتقريباتٍ متعاقبة، وبالتالي قد يكون لها إجراءاتٌ مساعدةٌ تُسمّى good-enough? وimprove. ونحن نرغب في توطين الإجراءات الفرعيّة، بإخفائها داخل sqrt حتّى يتمكّن sqrt من التعايش مع تقريباتٍ متعاقبة أخرى، لكلٍّ منها إجراء good-enough? خاصّ بها. ولتمكين هذا، نسمح للإجراء بأن يكون له تعريفات داخليّة محليّة لذلك الإجراء. فعلى سبيل المثال، في مسألة الجذر التربيعيّ يمكننا كتابة
(define (sqrt x)
  (define (good-enough? guess x)
    (< (abs (- (square guess) x)) 0.001))
  (define (improve guess x)
    (average guess (/ x guess)))
  (define (sqrt-iter guess x)
    (if (good-enough? guess x)
        guess
        (sqrt-iter (improve guess x) x)))
  (sqrt-iter 1.0 x))
وهذا التداخل للتعريفات، الذي يُسمّى البنية الكتليّة (block structure)، هو في الأساس الحلّ الصحيح لأبسط مسألةٍ في تحزيم الأسماء. لكن هناك فكرة أفضل تختبئ هنا. فبالإضافة إلى إدخال تعريفات الإجراءات المساعدة إلى الداخل، يمكننا تبسيطها. وبما أنّ x مُقيَّد في تعريف sqrt، فإنّ الإجراءات good-enough? وimprove وsqrt-iter، المُعرَّفة داخليًّا في sqrt، تقع في نطاق x. وبالتالي، فليس من الضروريّ تمرير x صراحةً إلى كلٍّ من هذه الإجراءات. وبدلًا من ذلك، نسمح لـx بأن يكون متغيّرًا حرًّا في التعريفات الداخليّة، كما هو موضّح أدناه. وحينها تأخذ x قيمتها من المعطى الذي يُنادى به الإجراء المحيط sqrt. ويُسمّى هذا النظام النطاق المعجميّ (lexical scoping).[22]
(define (sqrt x)
  (define (good-enough? guess)
    (< (abs (- (square guess) x)) 0.001))
  (define (improve guess)
    (average guess (/ x guess)))
  (define (sqrt-iter guess)
    (if (good-enough? guess)
        guess
        (sqrt-iter (improve guess))))
  (sqrt-iter 1.0))
وسنستخدم بنية الكتل على نطاق واسع لمساعدتنا في تقسيم البرامج الكبيرة إلى أجزاء قابلة للمعالجة.[23] وقد نشأت فكرة بنية الكتل مع لغة البرمجة Algol 60. وهي تظهر في معظم لغات البرمجة المتقدمة، وتُعدّ أداة مهمة للمساعدة في تنظيم بناء البرامج الكبيرة.
1.2 الإجراءات والعمليات التي تولّدها
لقد نظرنا حتى الآن في عناصر البرمجة: استخدمنا عمليات حسابية أولية، وركّبنا هذه العمليات، وجرّدنا هذه العمليات المركّبة بتعريفها كإجراءات مركّبة. لكن ذلك لا يكفي لنقول إننا نعرف كيف نبرمج. ووضعنا مماثل لوضع من تعلّم قواعد حركة القطع في الشطرنج لكنه لا يعرف شيئًا عن الافتتاحيات أو التكتيكات أو الاستراتيجية النموذجية. وكما هو حال لاعب الشطرنج المبتدئ، لا نعرف بعد الأنماط الشائعة للاستخدام في هذا المجال. تنقصنا المعرفة بأي النقلات جديرة بأن تُلعب (أي الإجراءات جديرة بأن تُعرَّف). وتنقصنا الخبرة للتنبؤ بعواقب القيام بنقلة (تنفيذ إجراء).
إن القدرة على تصوّر عواقب الأفعال قيد النظر أمر بالغ الأهمية لأن يصبح المرء مبرمجًا خبيرًا، تمامًا كما هو الحال في أي نشاط تركيبي إبداعي. فعند أن يصبح المرء مصوّرًا فوتوغرافيًا خبيرًا، مثلًا، عليه أن يتعلّم كيف ينظر إلى مشهد ويعرف مقدار عتمة كل منطقة عند طباعتها لكل اختيار ممكن لظروف التعريض والتحميض. وعندها فقط يستطيع أن يستدلّ عكسيًا، فيخطّط للتأطير والإضاءة والتعريض والتحميض للحصول على التأثيرات المرغوبة. وكذلك الأمر في البرمجة، حيث نخطّط لمسار الفعل الذي ستسلكه عملية، وحيث نتحكم في العملية عن طريق برنامج. ولكي نصبح خبراء، علينا أن نتعلّم تصوّر العمليات التي تولّدها أنماط مختلفة من الإجراءات. وفقط بعد أن نطوّر مثل هذه المهارة نستطيع أن نتعلّم بناء برامج تُظهر السلوك المرغوب على نحو موثوق.
الإجراء نمط للتطور المحلّي لعملية حسابية. وهو يحدّد كيف يُبنى كل طور من أطوار العملية على الطور السابق. ونودّ أن نتمكن من إصدار عبارات عن السلوك الكلي، أو الشامل، لعملية حُدِّد تطورها المحلّي بإجراء. وهذا أمر صعب جدًا عمومًا، لكن يمكننا على الأقل أن نحاول وصف بعض الأنماط النمطية لتطور العملية.
في هذا القسم سنفحص بعض «الأشكال» الشائعة للعمليات التي تولّدها إجراءات بسيطة. وسنبحث أيضًا في المعدلات التي تستهلك بها هذه العمليات موارد الحساب المهمة: الزمن والمساحة. والإجراءات التي سننظر فيها بسيطة جدًا. ودورها مثل دور أنماط الاختبار في التصوير الفوتوغرافي: أنماط نماذج مبسَّطة بإفراط، لا أمثلة عملية بحد ذاتها.
1.2.1 التعاود الخطي والتكرار
نبدأ بالنظر في دالة العاملي، المعرَّفة بـ هناك طرق كثيرة لحساب العوامل. وإحدى الطرق هي الاستفادة من الملاحظة أن يساوي مضروبًا في لأي عدد صحيح موجب : وهكذا، يمكننا حساب بحساب وضرب النتيجة في . وإذا أضفنا الشرط أن 1! يساوي 1، فإن هذه الملاحظة تُترجم مباشرة إلى إجراء:
(define (factorial n)
  (if (= n 1)
      1
      (* n (factorial (- n 1)))))
يمكننا استخدام نموذج الاستبدال من 1.1.5 لمشاهدة هذا الإجراء أثناء عمله في حساب 6!، كما هو مبيَّن في الشكل 1.3.
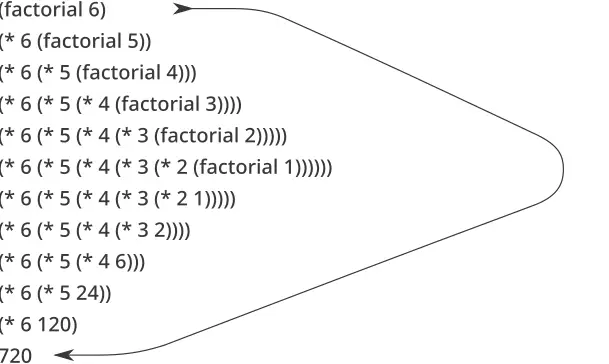
الشكل 1.3: عملية تعاودية خطية لحساب 6!.
والآن لنأخذ منظورًا مختلفًا حول حساب العوامل. يمكننا وصف قاعدة لحساب بتحديد أننا نضرب 1 في 2 أولًا، ثم نضرب النتيجة في 3، ثم في 4، وهكذا حتى نصل إلى . وبصورة أكثر رسمية، نحتفظ بجداء جارٍ، إلى جانب عدّاد يعدّ من 1 حتى . ويمكننا وصف الحساب بالقول إن العدّاد والجداء يتغيران في الوقت نفسه من خطوة إلى التي تليها وفقًا للقاعدة
product  $←$  counter * product
counter  $←$  counter + 1
ونشترط أن هو قيمة الجداء عندما يتجاوز العدّاد .
ومرة أخرى، يمكننا إعادة صياغة وصفنا في صورة إجراء لحساب العوامل:[24]
(define (factorial n)
  (fact-iter 1 1 n))

(define (fact-iter product counter max-count)
  (if (> counter max-count)
      product
      (fact-iter (* counter product)
                 (+ counter 1)
                 max-count)))
وكما في السابق، يمكننا استخدام نموذج الاستبدال لتصوّر عملية حساب 6!، كما هو مبيَّن في الشكل 1.4.
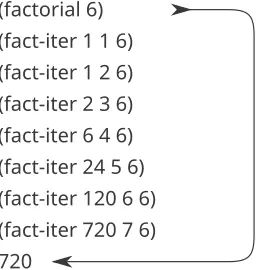
الشكل 1.4: عملية تكرارية خطية لحساب 6!.
قارن بين العمليتين. فمن وجهة نظر ما، يبدوان متشابهين إلى حدّ يعسر معه التمييز بينهما. فكلتاهما تحسب الدالة الرياضية نفسها على المجال نفسه، وكلٌّ منهما تتطلب عددًا من الخطوات يتناسب مع لحساب . بل إن كلتا العمليتين تنفّذان حتى المتتالية نفسها من الضرب، فتحصلان على المتتالية نفسها من الجداءات الجزئية. ومن ناحية أخرى، عندما ننظر في «أشكال» العمليتين، نجد أنهما تتطوران على نحو مختلف تمامًا.
تأمل العملية الأولى. يكشف نموذج الاستبدال شكلًا من التوسّع يعقبه انقباض، كما يدل عليه السهم في الشكل 1.3. ويحدث التوسّع بينما تبني العملية سلسلة من العمليات المؤجَّلة (وهي في هذه الحالة سلسلة من الضرب). ويحدث الانقباض عند تنفيذ العمليات فعليًا. وهذا النوع من العمليات، الذي يتميّز بسلسلة من العمليات المؤجَّلة، يُسمى عملية تعاودية. ويتطلب تنفيذ هذه العملية أن يتعقّب المفسّر العمليات التي ستنفَّذ لاحقًا. وفي حساب ، ينمو طول سلسلة الضرب المؤجَّل، ومن ثمّ مقدار المعلومات اللازمة لتعقّبها، خطيًا مع (أي يتناسب مع )، تمامًا كعدد الخطوات. وتُسمى مثل هذه العملية عملية تعاودية خطية.
وعلى النقيض، لا تنمو العملية الثانية ولا تتقلّص. وفي كل خطوة، كل ما نحتاج إلى تعقّبه، لأي ، هو القيم الحالية للمتغيّرات product وcounter وmax-count. ونسمي هذه عملية تكرارية. وعمومًا، العملية التكرارية هي التي يمكن تلخيص حالتها بعدد ثابت من متغيّرات الحالة، إلى جانب قاعدة ثابتة تصف كيف ينبغي تحديث متغيّرات الحالة بينما تنتقل العملية من حالة إلى حالة، واختبار انتهاء (اختياري) يحدّد الشروط التي ينبغي أن تنتهي عندها العملية. وفي حساب ، ينمو عدد الخطوات المطلوبة خطيًا مع . وتُسمى مثل هذه العملية عملية تكرارية خطية.
ويمكن رؤية التباين بين العمليتين بطريقة أخرى. في الحالة التكرارية، تقدّم متغيّرات البرنامج وصفًا كاملًا لحالة العملية في أي نقطة. فلو أوقفنا الحساب بين الخطوات، لما احتجنا لاستئناف الحساب سوى تزويد المفسّر بقيم متغيّرات البرنامج الثلاثة. وليس الأمر كذلك مع العملية التعاودية. فهنا توجد بعض المعلومات «الخفيّة» الإضافية، التي يحتفظ بها المفسّر ولا تحتوي عليها متغيّرات البرنامج، والتي تدلّ على «موضع العملية» في أثناء تعاملها مع سلسلة العمليات المؤجَّلة. وكلما طالت السلسلة، وجب الاحتفاظ بمعلومات أكثر.[25]
وعند المقابلة بين التكرار والتعاود، يجب أن نحرص على عدم الخلط بين فكرة العملية التعاودية وفكرة الإجراء التعاودي. فعندما نصف إجراءً بأنه تعاودي، فإننا نشير إلى الحقيقة النحوية القائلة إن تعريف الإجراء يشير (مباشرةً أو غير مباشرة) إلى الإجراء نفسه. لكن عندما نصف عملية بأنها تتبع نمطًا، لنقل، تعاوديًا خطيًا، فإننا نتحدّث عن كيفية تطور العملية، لا عن النحو الذي كُتب به الإجراء. وقد يبدو مُقلقًا أن نشير إلى إجراء تعاودي مثل fact-iter بأنه يولّد عملية تكرارية. غير أن العملية تكرارية فعلًا: فحالتها تُلتقط بالكامل بمتغيّرات حالتها الثلاثة، ولا يحتاج المفسّر إلى تعقّب سوى ثلاثة متغيّرات لتنفيذ العملية.
إنّ سببًا من أسباب الالتباس في التمييز بين العمليّة والإجراء هو أنّ معظم تنفيذات اللغات الشائعة (بما فيها Ada وPascal وC) مُصمَّمة على نحوٍ يجعل تفسير أيّ إجراءٍ تعاوديّ يستهلك مقدارًا من الذاكرة ينمو بعدد نداءات الإجراء، حتّى عندما تكون العمليّة الموصوفة، من حيث المبدأ، تكراريّة. ونتيجةً لذلك، لا تستطيع هذه اللغات وصف العمليّات التكراريّة إلّا باللجوء إلى «بنى حلقات» ذات أغراض خاصّة مثل do وrepeat وuntil وfor وwhile. أمّا تنفيذ Scheme الذي سننظر فيه في الفصل 5 فلا يشاركنا هذا الخلل. فسوف ينفّذ العمليّة التكراريّة في مساحةٍ ثابتة، حتّى إذا كانت العمليّة التكراريّة موصوفةً بإجراءٍ تعاوديّ. ويُسمّى التنفيذ ذو هذه الخاصّيّة تعاوديًّا ذيليًّا. وبتنفيذ تعاوديّ ذيليّ، يمكن التعبير عن التكرار باستخدام آليّة نداء الإجراءات المعتادة، بحيث تصير بنى التكرار الخاصّة ذا فائدةٍ كسُكَرٍ نحويّ.[26]
تمرين 1.9: يحدّد كلٌّ من الإجراءين التاليين طريقةً لجمع عددين صحيحين موجبين بدلالة الإجراء inc، الذي يزيد وسيطه بمقدار 1، والإجراء dec، الذي ينقص وسيطه بمقدار 1.
(define (+ a b)
  (if (= a 0)
      b
      (inc (+ (dec a) b))))

(define (+ a b)
  (if (= a 0)
      b
      (+ (dec a) (inc b))))
باستخدام نموذج الاستبدال، صُوّر العمليّة التي يولّدها كلٌّ من الإجراءين عند تقييم (+ 4 5) . فهل هاتان العمليّتان تكراريّتان أم تعاوديّتان؟
تمرين 1.10: يحسب الإجراء التالي دالّةً رياضيّةً تُسمّى دالّة Ackermann.
(define (A x y)
  (cond ((= y 0) 0)
        ((= x 0) (* 2 y))
        ((= y 1) 2)
        (else (A (- x 1)
                 (A x (- y 1))))))
ما قيم التعبيرات التالية؟
(A 1 10)
(A 2 4)
(A 3 3)
تأمّل الإجراءات التالية، حيث A هو الإجراء المُعرَّف أعلاه:
(define (f n) (A 0 n))
(define (g n) (A 1 n))
(define (h n) (A 2 n))
(define (k n) (* 5 n n))
أعطِ تعريفات رياضيّة موجزة للدوالّ التي تحسبها الإجراءات f وg وh لقيم العدد الصحيح الموجبة . فعلى سبيل المثال، يحسب (k n) القيمة .
1.2.2 التعاود الشجريّ
هناك نمطٌ شائعٌ آخر من الاحتساب يُسمّى التعاود الشجريّ. فخذ مثلًا احتساب متتالية أعداد فيبوناتشي، التي يكون فيها كلّ عددٍ مجموع العددين السابقين:
0، 1، 1، 2، 3، 5، 8، 13، 21، ....
وبصورة عامّة، يمكن تعريف أعداد فيبوناتشي بالقاعدة ويمكننا ترجمة هذا التعريف مباشرةً إلى إجراءٍ تعاوديٍّ لاحتساب أعداد فيبوناتشي:
(define (fib n)
  (cond ((= n 0) 0)
        ((= n 1) 1)
        (else (+ (fib (- n 1))
                 (fib (- n 2))))))
تأمّل نمط هذا الاحتساب. فلاحتساب (fib 5)، نحتسب (fib 4) و(fib 3). ولاحتساب (fib 4)، نحتسب (fib 3) و(fib 2). وبصورة عامّة، تبدو العمليّة المتطوّرة كأنّها شجرة، كما هو مبيَّن في الشكل 1.5. ولاحِظ أنّ الفروع تتشعّب إلى فرعين في كلّ مستوى (إلّا في الأسفل)؛ وهذا يعكس حقيقة أنّ الإجراء fib يُنادي نفسه مرّتين في كلّ مرّةٍ يُستدعى فيها.
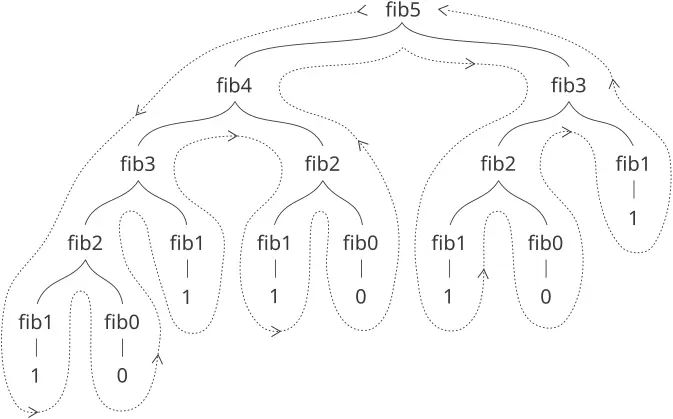
الشكل 1.5: العمليّة التعاوديّة الشجريّة المتولّدة عند احتساب (fib 5).
هذا الإجراء تعليميٌّ بوصفه تعاودًا شجريًّا نموذجيًّا، لكنّه طريقةٌ فظيعةٌ لاحتساب أعداد فيبوناتشي لأنّه يؤدي إلى قدرٍ كبيرٍ من الاحتساب المُكرَّر. فلاحِظ في الشكل 1.5 أنّ احتساب (fib 3) بكامله - وهو قرابة نصف العمل - مُكرَّر. وفي الحقيقة، ليس من الصعب إظهار أنّ عدد المرّات التي سيحتسب فيها الإجراء (fib 1) أو (fib 0) (وهو عدد الأوراق في الشجرة أعلاه، بصورة عامّة) هو بالضبط . ولمعرفة مدى سُوء هذا الأمر، يمكن إظهار أنّ قيمة تنمو أسّيًّا مع . وبشكلٍ أدقّ (انظر تمرين 1.13)، فإنّ هو أقرب عددٍ صحيحٍ إلى ، حيث هي النسبة الذهبيّة، التي تحقّق المعادلة وبالتالي، فإنّ العمليّة تستخدم عددًا من الخطوات ينمو أسّيًّا مع المدخلات. ومن ناحية أخرى، فإنّ المساحة المطلوبة تنمو خطّيًّا فقط مع المدخلات، لأنّنا لا نحتاج إلى تعقّب إلّا العُقد التي تعلونا في الشجرة في أيّ نقطةٍ من الاحتساب. وبصورة عامّة، فإنّ عدد الخطوات التي تتطلّبها العمليّة التعاوديّة الشجريّة سيتناسب مع عدد العُقد في الشجرة، بينما ستتناسب المساحة المطلوبة مع أقصى عمقٍ للشجرة.
يمكننا أيضًا صياغة عمليّةٍ تكراريّةٍ لاحتساب أعداد فيبوناتشي. والفكرة هي استخدام زوجٍ من الأعداد الصحيحة و ، مُهيَّأٍ على و ، وتطبيق التحويلات المتزامنة مرارًا وتكرارًا
ليس من الصعب إظهار أنّ، بعد تطبيق هذا التحويل مرّة، سيصبح و مساويين على الترتيب لـ و . وبالتالي، يمكننا احتساب أعداد فيبوناتشي تكرارًا باستخدام الإجراء
(define (fib n)
  (fib-iter 1 0 n))

(define (fib-iter a b count)
  (if (= count 0)
      b
      (fib-iter (+ a b) a (- count 1))))
هذه الطريقة الثانية لاحتساب تكرارٌ خطّيّ. والفرق في عدد الخطوات الذي تتطلّبه الطريقتان - إحداهما خطّيّة في ، والأخرى تنمو بسرعة نفسها - هائل، حتّى بالنسبة للمدخلات الصغيرة.
لا يجوز أن نستنتج من ذلك أنّ العمليّات التعاوديّة الشجريّة غير مفيدة. فعندما ننظر في العمليّات التي تعمل على بياناتٍ مهيكلةٍ هرميًّا بدلًا من الأعداد، سنجد أنّ التعاود الشجريّ أداةٌ طبيعيّةٌ وقويّة.[27] ولكن حتّى في العمليّات العدديّة، يمكن أن تكون العمليّات التعاوديّة الشجريّة مفيدةً في مساعدتنا على فهم البرامج وتصميمها. فعلى سبيل المثال، وعلى الرغم من أنّ الإجراء fib الأوّل أقلّ كفاءةً بكثيرٍ من الثاني، فإنّه أكثر مباشرةً، إذ ليس سوى ترجمةً إلى Lisp لتعريف متتالية فيبوناتشي. وقد استلزمت صياغة الخوارزميّة التكراريّة ملاحظة أنّ الاحتساب يمكن إعادة صياغته تكرارًا بثلاثة متغيّرات حالة.
مثال: عدّ طرق إبدال النقود
لا يتطلّب الأمر إلّا القليل من الذكاء للتوصل إلى الخوارزميّة التكراريّة لأعداد فيبوناتشي. وعلى النقيض من ذلك، تأمّل المسألة التالية: كم طريقةً مختلفةً يمكننا بها إبدال مبلغ $1.00، إذا كانت العملات المتاحة هي أنصاف الدولار والربع دولار والدايمات والنيكلات والبنسات؟ وبصورةٍ أعمّ، فهل يمكننا كتابة إجراءٍ لحساب عدد طرق إبدال أيّ مبلغٍ معطى من النقود؟
لهذه المسألة حلٌّ بسيطٌ في صورة إجراءٍ تعاوديّ. فلنفترض أنّنا ننظر إلى أنواع العملات المتاحة كأنّها مرتّبةٌ في ترتيبٍ ما. وعندئذٍ يسري العلاقة التالية:
يساوي عدد طرق إبدال المبلغ باستخدام أنواعٍ من العملات
- عدد طرق إبدال المبلغ باستخدام كلّ أنواع العملات عدا النوع الأوّل، زائدًا
- عدد طرق إبدال المبلغ باستخدام كلّ أنواع العملات ، حيث هو فئة النوع الأوّل من العملات.
ولنرَ سبب صحّة ذلك، لاحِظ أنّ طرق إبدال النقود يمكن تقسيمها إلى مجموعتين: تلك التي لا تستخدم أيّ عملةٍ من النوع الأوّل، وتلك التي تستخدمه. وبالتالي، فإنّ العدد الكلّيّ لطرق إبدال مبلغٍ ما يساوي عدد طرق إبدال المبلغ دون استخدام أيّ عملةٍ من النوع الأوّل، زائدًا عدد طرق الإبدال على افتراض أنّنا نستخدم عملةً من النوع الأوّل. وهذا العدد الأخير يساوي عدد طرق إبدال المبلغ المتبقّي بعد استخدام عملةٍ من النوع الأوّل.
وبالتالي، يمكننا تقليص مسألة إبدال مبلغٍ معطى تقليصًا تعاوديًّا إلى مسألة إبدال مبالغ أصغر باستخدام أنواعٍ أقلّ من العملات. تأمّل قاعدة التقليص هذه بعناية، وأقنع نفسك بأنّنا نستطيع استخدامها لوصف خوارزميّةٍ إذا حدّدنا الحالات المنحطّة التالية:[28]
- إذا كان يساوي 0 بالضبط، فينبغي أن نعدّ ذلك طريقةً واحدةً لإبدال النقود.
- إذا كان أقلّ من 0، فينبغي أن نعدّ ذلك صفر طريقةٍ لإبدال النقود.
- إذا كان يساوي 0، فينبغي أن نعدّ ذلك صفر طريقةٍ لإبدال النقود.
يمكننا بسهولةٍ ترجمة هذا الوصف إلى إجراءٍ تعاوديّ:
(define (count-change amount)
  (cc amount 5))

(define (cc amount kinds-of-coins)
  (cond ((= amount 0) 1)
        ((or (< amount 0)
             (= kinds-of-coins 0))
         0)
        (else
         (+ (cc amount (- kinds-of-coins 1))
            (cc (- amount (first-denomination
                           kinds-of-coins))
                kinds-of-coins)))))

(define (first-denomination kinds-of-coins)
  (cond ((= kinds-of-coins 1) 1)
        ((= kinds-of-coins 2) 5)
        ((= kinds-of-coins 3) 10)
        ((= kinds-of-coins 4) 25)
        ((= kinds-of-coins 5) 50)))
(يأخذ الإجراء first-denomination مدخلًا عدد أنواع العملات المتاحة ويعيد فئة النوع الأوّل. وهنا نحن ننظر إلى العملات كأنّها مرتّبةٌ من الأكبر إلى الأصغر، ولكن أيّ ترتيبٍ آخر يكفي كذلك.) ويمكننا الآن الإجابة عن سؤالنا الأصليّ حول إبدال الدولار الواحد:
(count-change 100)
292
يولّد الإجراء count-change عمليّةً تعاوديّةً شجريّةً ذات تكراراتٍ زائدةٍ شبيهةٍ بتلك التي في تنفيذنا الأوّل لـfib. (وسوف يستغرق احتساب ذلك العدد 292 وقتًا طويلًا.) ومن ناحية أخرى، فليس من الواضح كيف نُصمّم خوارزميّةً أفضل لاحتساب النتيجة، ونحن نترك هذه المسألة تحدّيًا. وقد دفعت الملاحظة القائلة إنّ العمليّة التعاوديّة الشجريّة قد تكون غير كفؤةٍ للغاية لكنّها غالبًا ما تكون سهلة التحديد والفهم، الناسَ إلى الاقتراح بأنّ المرء يمكن أن يجمع بين أفضل ما في العالمين بتصميم «مصرِّف ذكيّ» يستطيع تحويل الإجراءات التعاوديّة الشجريّة إلى إجراءاتٍ أكثر كفاءةً تحسب النتيجة ذاتها.[29]
تمرين 1.11: دالّةٌ مُعرَّفةٌ بالقاعدة أنّ إذا كان و إذا كان . اكتب إجراءً يحسب بواسطة عمليّةٍ تعاوديّة. واكتب إجراءً يحسب بواسطة عمليّةٍ تكراريّة.
تمرين 1.12: يُسمّى نمط الأعداد التالي مثلّث باسكال.
         1
       1   1
     1   2   1
   1   3   3   1
 1   4   6   4   1
       . . .
الأعداد عند حافّة المثلّث كلّها 1، وكلّ عددٍ داخل المثلّث هو مجموع العددين الواقعين فوقه.[30] واكتب إجراءً يحسب عناصر مثلّث باسكال بواسطة عمليّةٍ تعاوديّة.
تمرين 1.13: أثبت أنّ هو أقرب عددٍ صحيحٍ إلى ، حيث . تلميح: ليكن . استخدم الاستقراح وتعريف أعداد فيبوناتشي (انظر 1.2.2) لتُثبت أنّ .
1.2.3 رُتب النموّ
توضّح الأمثلة السابقة أنّ العمليّات يمكن أن تختلف اختلافًا كبيرًا في المعدّلات التي تستهلك بها الموارد الاحتسابيّة. وإحدى الطرائق الملائمة لوصف هذا الاختلاف هي استخدام مفهوم رتبة النموّ للحصول على قياسٍ إجماليٍّ للموارد التي تتطلّبها العمليّة مع كِبَر المدخلات.
لتكن مُعاملًا يقيس حجم المسألة، ولتكن مقدار الموارد التي تتطلّبها العمليّة لمسألةٍ حجمها . وفي أمثلتنا السابقة أخذنا العدد الذي يُحتسب لأجله دالّةٌ معيّنة، ولكن ثمّة إمكانيّاتٍ أخرى. فعلى سبيل المثال، إذا كان هدفنا هو احتساب تقريبٍ للجذر التربيعيّ لعددٍ ما، فقد نأخذ عدد الأرقام المطلوبة في الدقّة. وفي ضرب المصفوفات قد نأخذ عدد الصفوف في المصفوفات. وبصورة عامّة، ثمّة عددٍ من خصائص المسألة التي يكون من المرغوب تحليل عمليّةٍ معيّنةٍ بالنسبة إليها. وبالمثل، قد تقيس عدد مسجّلات التخزين الداخليّ المستخدمة، وعدد عمليّات الآلة الأوليّة المنفَّذة، وكذلك غير ذلك. وفي الحواسيب التي تؤدّي عددًا ثابتًا من العمليّات في الوقت نفسه، سيكون الزمن المطلوب متناسبًا مع عدد عمليّات الآلة الأوليّة المنفَّذة.
نقول إنّ ذات رتبة نموّ ، وتُكتب (وتُنطق «ثيتا التابعة لـ »)، إذا وجدت ثابتتان موجبتان و مستقلّتان عن بحيث يتحقّق لأيّ قيمةٍ كبيرةٍ بما يكفي من . (وبعبارةٍ أخرى، من أجل الكبيرة، تكون القيمة محصورةً بين و .)
فعلى سبيل المثال، فإنّ عدد الخطوات في العمليّة التعاوديّة الخطّيّة لاحتساب العامليّات الموصوفة في 1.2.1 ينمو تناسبًا مع مدخل . وبالتالي، فإنّ الخطوات التي تتطلّبها هذه العمليّة تنمو على الصورة . ورأينا أيضًا أنّ المساحة المطلوبة تنمو على الصورة . وأمّا في حالة العامليّات التكراريّة، فإنّ عدد الخطوات لا يزال ولكن المساحة هي - أي ثابتة.[31] ويتطلّب احتساب فيبوناتشي التعاوديّ الشجريّ خطوةً ومساحة ، حيث هي النسبة الذهبيّة الموصوفة في 1.2.2.
إنّ رُتب النموّ لا تقدّم سوى وصفٍ خشنٍ لسلوك العمليّة. فعلى سبيل المثال، فإنّ العمليّة التي تتطلّب خطوةً، والعمليّة التي تتطلّب خطوةً، والعمليّة التي تتطلّب خطوةً، كلّها ذات رتبة نموّ . ومن ناحية أخرى، فإنّ رتبة النموّ تقدّم إشارةً مفيدةً حول كيف نتوقّع أن يتغيّر سلوك العمليّة بتغيّرنا حجم المسألة. ففي العمليّة (الخطّيّة)، سيؤدّي مضاعفة الحجم إلى مضاعفة مقدار الموارد المستخدمة تقريبًا. وفي العمليّة الأسّيّة، ستؤدّي كلّ زيادةٍ في حجم المسألة إلى ضرب استخدام الموارد في عاملٍ ثابت. وفي الجزء المتبقّي من 1.2 سنفحص خوارزميّتين رتبة نموّهما لوغاريتميّة، بحيث تؤدّي مضاعفة حجم المسألة إلى زيادة متطلّب الموارد بمقدارٍ ثابت.
تمرين 1.14: ارسم الشجرة التي توضّح العمليّة التي يولّدها الإجراء
count-changeالمذكور في 1.2.2 عند إبدال 11 سنتًا. فما رُتب نموّ المساحة وعدد الخطوات التي تستخدمها هذه العمليّة بازدياد المبلغ المطلوب إبداله؟
تمرين 1.15: يمكن احتساب جيب زاويةٍ (محدَّدةٍ بالراديان) بالاستفادة من التقريب إذا كان صغيرًا بما يكفي، ومن المتطابقة المثلّثاتيّة لتقليص حجم وسيط الجيب. (ولأغراض هذا التمرين، تُعتبر الزاوية «صغيرةً بما يكفي» إذا كان مقدارها لا يزيد على 0.1 راديان.) وهذه الأفكار مُدمجةٌ في الإجراءات التالية:
(define (cube x) (* x x x))
(define (p x) (- (* 3 x) (* 4 (cube x))))
(define (sine angle)
   (if (not (> (abs angle) 0.1))
       angle
       (p (sine (/ angle 3.0)))))
- كم مرّةً يُطبَّق الإجراء
pعند تقييم(sine 12.15)؟ - فما رتبة النموّ في المساحة وعدد الخطوات (كدالّةٍ في ) التي تستخدمها العمليّة التي يولّدها الإجراء
sineعند تقييم(sine a)؟
1.2.4 الأسّ
تأمّل مسألة احتساب أسّ عددٍ معطى. فنحن نريد إجراءً يأخذ وسيطَين أساسًا وأُسًّا عددًا صحيحًا موجبًا، ويحسب . وإحدى الطرائق لفعل ذلك هي التعريف التعاوديّ الذي يترجم بسهولةٍ إلى الإجراء
(define (expt b n)
  (if (= n 0)
      1
      (* b (expt b (- n 1)))))
وهذه عمليّةٌ تعاوديّةٌ خطّيّة، تتطلّب خطوةً و مساحة. وتمامًا كما في حالة العامليّات، يمكننا بصياغةٍ سهلةٍ صياغة تكرارٍ خطّيٍّ مكافئ:
(define (expt b n)
  (expt-iter b n 1))

(define (expt-iter b counter product)
  (if (= counter 0)
      product
      (expt-iter b
                 (- counter 1)
                 (* b product))))
تتطلّب هذه النسخة خطوةً و مساحة.
يمكننا احتساب الأسس بخطواتٍ أقلّ باستخدام التربيع المتكرّر. فعلى سبيل المثال، بدلًا من احتساب على الصورة يمكننا احتسابها بثلاث عمليّات ضرب: وهذه الطريقة تنجح على نحوٍ حسنٍ مع الأسس التي هي قوى للعدد 2. ونستطيع أيضًا الاستفادة من التربيع المتكرّر في احتساب الأسس بصورة عامّة إذا استخدمنا القاعدة ويمكننا التعبير عن هذه الطريقة في صورة إجراء:
(define (fast-expt b n)
  (cond ((= n 0)
         1)
        ((even? n)
         (square (fast-expt b (/ n 2))))
        (else
         (* b (fast-expt b (- n 1))))))
حيث يُعرَّف المسند الذي يختبر كون عددٍ صحيحٍ زوجيًّا بدلالة الإجراء الأوّليّ remainder بواسطة
(define (even? n)
  (= (remainder n 2) 0))
تنمو العمليّة التي يتطوّرها الإجراء fast-expt لوغاريتميًّا مع في كلّ من المساحة وعدد الخطوات. ولرؤية ذلك، لاحِظ أنّ احتساب باستخدام fast-expt لا يتطلّب سوى عمليّة ضربٍ إضافيّةٍ واحدةً مقارنةً باحتساب . وبالتالي، فإنّ حجم الأُسّ الذي نستطيع احتسابه يتضاعف (تقريبًا) مع كلّ عمليّة ضربٍ جديدةٍ يُتاح لنا أداؤها. وهكذا، فإنّ عدد عمليّات الضرب المطلوبة لأُسٍّ قيمته ينمو بسرعةٍ تقارب سرعة لوغاريتم للأساس 2. وللعمليّة نموٌّ من رتبة .[32]
يصبح الفرق بين نموّ ونموّ لافتًا مع كِبَر . فعلى سبيل المثال، يتطلّب fast-expt من أجل = 1000 أربع عشرة عمليّة ضربٍ فقط.[33] ومن الممكن أيضًا استخدام فكرة التربيع المتكرّر لاستنباط خوارزميّةٍ تكراريّةٍ تحسب الأسس بعددٍ لوغاريتميٍّ من الخطوات (انظر تمرين 1.16)، على الرغم من أنّ ذلك، كما هو الحال في الغالب مع الخوارزميّات التكراريّة، لا يُكتب على نحوٍ مباشرٍ كالخوارزميّة التعاوديّة.[34]
تمرين 1.16: صمّم إجراءً يتطوّر فيه أسٌّ بعمليّةٍ تكراريّةٍ تستخدم التربيع المتكرّر وتستخدم عددًا لوغاريتميًّا من الخطوات، كما يفعل
fast-expt. (تلميح: باستخدام الملاحظة أنّ ، أبقِ، إلى جانب الأُسّ والأساس ، متغيّر حالةٍ إضافيًّا ، وعرّف تحويل الحالة بحيث يبقى الجداء دون تغييرٍ من حالةٍ إلى أخرى. وفي بداية العمليّة يُؤخذ قيمته 1، وتُعطى الإجابة بقيمة في نهاية العمليّة. وبصورة عامّة، فإنّ تقنيّة تعريف مقدارٍ ثابتٍ يبقى دون تغييرٍ من حالةٍ إلى أخرى طريقةٌ قويّةٌ للتفكير في تصميم الخوارزميّات التكراريّة.)
تمرين 1.17: تستند خوارزميّات الأسّ الواردة في هذا القسم على أداء الأسّ عن طريق الضرب المتكرّر. وبطريقةٍ مشابهة، يمكن أداء ضرب الأعداد الصحيحة عن طريق الجمع المتكرّر. والإجراء الضربي التالي (الذي يُفترض فيه أنّ لغتنا تستطيع الجمع فقط لا الضرب) نظيرٌ للإجراء expt:
(define (* a b)
  (if (= b 0)
      0
      (+ a (* a (- b 1)))))
تتطلّب هذه الخوارزميّة عددًا من الخطوات خطّيًّا في b. والآن فلنفترض أنّنا نُدرج، إلى جانب الجمع، عمليّتَي double ، التي تضاعف عددًا صحيحًا، وhalve ، التي تقسم عددًا صحيحًا (زوجيًّا) على 2. وباستخدام هاتين العمليّتين، صمّم إجراءً ضربيًّا نظيرًا لـfast-expt يستخدم عددًا لوغاريتميًّا من الخطوات.
تمرين 1.18: باستخدام نتيجتَي تمرين 1.16 وتمرين 1.17، استنبط إجراءً يولّد عمليّةً تكراريّةً لضرب عددين صحيحين بدلالة الجمع والمضاعفة والتنصيف، ويستخدم عددًا لوغاريتميًّا من الخطوات.[35]
تمرين 1.19: ثمّة خوارزميّةٌ ذات حيلةٍ لاحتساب أعداد فيبوناتشي بعددٍ لوغاريتميٍّ من الخطوات. تذكّر تحويل متغيّري الحالة و في عمليّة fib-iter المذكورة في 1.2.2: و . ووسِم هذا التحويل بالرمز ، ولاحِظ أنّ تطبيق مرارًا وتكرارًا مرّةً، بدءًا من 1 و0، يُنتج الزوج و . وبعبارةٍ أخرى، فإنّ أعداد فيبوناتشي تُنتَج بتطبيق ، أي الأُسّ للتحويل ، بدءًا بالزوج (1, 0). والآن فكّر في كأنّه الحالة الخاصّة من و في عائلةٍ من التحويلات ، حيث يحوّل الزوج وفقًا للقاعدتين و . وأظهر أنّه إذا طبّقنا تحويلًا من نوع مرّتين، فإنّ الأثر هو نفسُه أثر استخدام تحويلٍ وحيدٍ من الشكل ، واحسب و بدلالة و . وهذا يمنحنا طريقةً صريحةً لتربيع هذه التحويلات، وبالتالي نستطيع احتساب باستخدام التربيع المتكرّر، كما في الإجراء fast-expt . واجمع كلّ هذا معًا لتُكمل الإجراء التالي، الذي يعمل بعددٍ لوغاريتميٍّ من الخطوات:[36]
(define (fib n)
  (fib-iter 1 0 0 1 n))

(define (fib-iter a b p q count)
  (cond ((= count 0)
         b)
        ((even? count)
         (fib-iter a
                   b
                   ⟨??⟩  ;compute p'
                   ⟨??⟩  ;compute q'
                   (/ count 2)))
        (else
         (fib-iter (+ (* b q)
                      (* a q)
                      (* a p))
                   (+ (* b p)
                      (* a q))
                   p
                   q
                   (- count 1)))))
1.2.5 القواسم المشتركة الكبرى
القاسم المشترك الأكبر (GCD) لعددين صحيحين و يُعرَّف بأنه أكبر عددٍ صحيحٍ يقسم كلاً من و دون باقٍ. فعلى سبيل المثال، فإنّ القاسم المشترك الأكبر للعددين 16 و28 هو 4. وفي الفصل 2، عندما نبحث في كيفيّة تنفيذ الحساب على الأعداد الكسريّة، سنحتاج إلى القدرة على احتساب القواسم المشتركة الكبرى بغرض اختزال الأعداد الكسريّة إلى أبسط صورة. (ولاختزال عددٍ كسريٍّ إلى أبسط صورة، ينبغي أن نقسم كلًّا من البسط والمقام على قاسمهما المشترك الأكبر. فعلى سبيل المثال، فإنّ 16/28 يُختزل إلى 4/7.) وإحدى طرائق إيجاد القاسم المشترك الأكبر لعددين صحيحين هي تحليل كلٍّ منهما إلى عوامل والبحث عن عوامل مشتركة، ولكن ثمّة خوارزميّة مشهورة أكفأُ من ذلك بكثير.
تقوم فكرة الخوارزميّة على الملاحظة أنّهُ، إذا كان هو الباقي عند قسمة على ، فإنّ القواسم المشتركة للعددين و هي بالضبط القواسم المشتركة نفسها للعددين و . وبالتالي، فيمكننا استخدام المعادلة
GCD(a,b) = GCD(b,r)
لاختزال مسألة احتساب GCD إلى مسألة احتساب GCD لأزواجٍ من الأعداد الصحيحة أصغرَ فأصغر اختزالًا متتاليًّا. فعلى سبيل المثال،
GCD(206,40) = GCD(40,6)
            = GCD(6,4)
            = GCD(4,2)
            = GCD(2,0) = 2
يُختزل GCD(206, 40) إلى GCD(2, 0)، وهو 2. ويمكن إظهار أنّ الانطلاق بأيّ عددين صحيحين موجبين وأداء اختزالاتٍ متكرّرة سيُنتج دائمًا في النهاية زوجًا ثاني عدديه هو 0. وحينئذٍ يكون GCD هو العدد الآخر في الزوج. وتُعرَف هذه الطريقة في احتساب GCD بـخوارزميّة إقليدس.[37]
من السهل التعبير عن خوارزميّة إقليدس في صورة إجراء:
(define (gcd a b)
  (if (= b 0)
      a
      (gcd b (remainder a b))))
يولّد هذا عمليّةً تكراريّةً، ويتناسب عدد خطواتها مع لوغاريتم الأعداد الداخلة فيه.
إنّ كون عدد الخطوات التي تتطلّبها خوارزميّة إقليدس ينمو نموًّا لوغاريتميًّا يحمل علاقةً مثيرةً للاهتمام بأعداد فيبوناتشي:
مبرهنة لامي: إذا تطلّبت خوارزميّة إقليدس خطواتٍ لاحتساب GCD زوجٍ ما، فإنّ العدد الأصغر في الزوج لا بدّ أن يكون أكبر من أو مساويًا للعدد الفيبوناتشيّ .[38]
يمكننا استخدام هذه المبرهنة للحصول على تصوّرٍ لرتبة نموّ خوارميّة إقليدس. فليكن هو الأصغر من مدخلَي الإجراء. فإن استغرقت العمليّة خطواتٍ، فإنّه لا بدّ أنّ . وبالتالي، فإنّ عدد الخطوات ينمو بسرعةٍ تناسب سرعة لوغاريتم للأساس . ومن ثمّ، فإنّ رتبة النموّ هي .
تمرين 1.20: إنّ العمليّة التي يولّدها إجراءٌ ما تابعةٌ بطبيعة الحال لقواعد التي يستخدمها المفسّر. فكمثالٍ على ذلك، تأمّل إجراء
gcdالتكراريّ المعطى أعلاه. فلنفترض أنّنا كنّا سنفسّر هذا الإجراء باستخدام التقييم بالترتيب الاعتياديّ، كما نُوقش في 1.1.5. (وقاعدة التقييم بالترتيب الاعتياديّ من أجلifموصوفةٌ في التمرين 1.5.) وباستخدام نموذج الاستبدال (للترتيب الاعتياديّ)، صُوّر العمليّة المتولّدة عند تقييم(gcd 206 40)وأشِر إلى عمليّاتremainderالتي تُؤدّى فعلًا. فكم عمليّةremainderتُؤدّى فعلًا في التقييم بالترتيب الاعتياديّ لـ(gcd 206 40)؟ وفي التقييم بالترتيب التطبيقيّ؟
1.2.6 مثال: اختبار الأوّليّة
يصف هذا القسم طريقتين للتحقّق من أوّليّة عددٍ صحيحٍ ، إحداهما برتبة نموّ ، وأخرى «احتماليّة» برتبة نموّ . وتقترح التمارين في نهاية هذا القسم مشاريع برمجيّةً تقوم على هذه الخوارميّات.
البحث عن القواسم
منذ القديم، أثار الرياضيّون إعجابهم مسائل تتعلّق بالأعداد الأوّليّة، وعمل كثيرٌ من الناس على مسألة تحديد طرائق لاختبار ما إذا كانت الأعداد أوّليّة. وإحدى طرائق اختبار أوّليّة عددٍ ما هي إيجاد قواسم ذلك العدد. والبرنامج التالي يجد أصغر قاسمٍ صحيحٍ (أكبر من 1) لعددٍ معطى . وهو يفعل ذلك على نحوٍ مباشر، باختبار قابلية قسمة على أعدادٍ صحيحةٍ متتاليةٍ بدءًا من 2.
(define (smallest-divisor n)
  (find-divisor n 2))

(define (find-divisor n test-divisor)
  (cond ((> (square test-divisor) n)
         n)
        ((divides? test-divisor n)
         test-divisor)
        (else (find-divisor
               n
               (+ test-divisor 1)))))

(define (divides? a b)
  (= (remainder b a) 0))
يمكننا اختبار ما إذا كان عددٌ ما أوّليًّا على النحو التالي: عددٌ أوّليّ إذا وفقط إذا كان هو أصغر قاسمٍ له.
(define (prime? n)
  (= n (smallest-divisor n)))
إنّ اختبار الانتهاء في find-divisor يقوم على حقيقة أنّهُ إذا لم يكن أوّليًّا فإنّه لا بدّ أن يكون له قاسمٌ أصغر من أو مساوٍ لـ .[39] وهذا يعني أنّ الخوارزميّة لا تحتاج إلى اختبار إلّا القواسم بين 1 و . ونتيجةً لذلك، فإنّ عدد الخطوات اللازم لتحديد أنّ أوّليّ ستكون له رتبة نموّ .
اختبار فيرما
إنّ اختبار الأوّليّة ذا الرتبة يقوم على نتيجةٍ من نظريّة الأعداد تُعرَف بالمبرهنة الصغرى لفيرما.[40]
المبرهنة الصغرى لفيرما: إذا كان عددًا أوّليًّا وكان أيّ عددٍ صحيحٍ موجبٍ أصغر من ، فإنّ رفع إلى القوّة يُنتج عددًا مطابقًا لـ بقياس .
((ويُقال عن عددين إنّهما مطابقان بقياس إذا كان لهما الباقي نفسه عند قسمتهما على . ويُشار أيضًا إلى باقي عددٍ عند قسمته على بـباقي بقياس ، أو ببساطةٍ بـ بقياس .))
فإذا لم يكن أوّليًّا، فإنّ معظم الأعداد عمومًا لن تحقّق العلاقةَ أعلاه. وهذا يؤدّي إلى الخوارزميّة التالية لاختبار الأوّليّة: بُعطى عددٍ ، انتقِ عددًا عشوائيًّا واحتسب باقي بقياس . فإن لم تكن النتيجة مساويةً لـ ، فإنّ ليس أوّليًّا بيقين. وإذا كانت هي ، فإنّ الاحتمالات تُرجّح أنّ أوّليّ. والآن انتقِ عددًا عشوائيًّا آخر واختبره بالطريقة ذاتها. فإن حقّق المعادلة كذلك، أمكننا الاطمئنان أكثر إلى أنّ أوّليّ. وبمحاولة قيمٍ أكثر فأكثر من ، يمكننا أن نزيد اطمئناننا إلى النتيجة. وتُعرَف هذه الخوارزميّة باختبار فيرما.
ولتنفيذ اختبار فيرما، نحتاج إلى إجراءٍ يحتسب أُسّ عددٍ بقياس عددٍ آخر:
(define (expmod base exp m)
  (cond ((= exp 0) 1)
        ((even? exp)
         (remainder
          (square (expmod base (/ exp 2) m))
          m))
        (else
         (remainder
          (* base (expmod base (- exp 1) m))
          m))))
هذا يشبه إلى حدٍّ بعيد إجراء fast-expt في 1.2.4. فهو يستخدم التربيع المتتالي، بحيث ينمو عدد الخطوات نموًّا لوغاريتميًّا مع الأُسّ.[41]
ويُؤدّى اختبار فيرما بانتقاء عشوائيٍّ عددٍ بين 1 و ضِمنًا، والتحقّق من كون باقي القوّة للعدد بقياس مساويًا لـ . ويُنتقى العدد العشوائيّ باستخدام الإجراء random، الذي نفترض أنّه مُضمَّنٌ كأوّليّةٍ في Scheme. ويُعيد random عددًا صحيحًا غير سالب أصغرَ من مُدخله الصحيح. وبالتالي، فلكي نحصل على عددٍ عشوائيٍّ بين 1 و ، ننادي random بمُدخلٍ قيمته ونضيف 1 إلى النتيجة:
(define (fermat-test n)
  (define (try-it a)
    (= (expmod a n n) a))
  (try-it (+ 1 (random (- n 1)))))
الإجراء التالي يؤدّي الاختبار عددًا معطى من المرّات، كما يحدّده وسيطٌ له. وقيمتُه صحيحة إذا نجح الاختبار في كلّ مرّة، وخاطئة إلّا ذلك.
(define (fast-prime? n times)
  (cond ((= times 0) true)
        ((fermat-test n)
         (fast-prime? n (- times 1)))
        (else false)))
الطرائق الاحتماليّة
يختلف اختبار فيرما في طابعه عن معظم الخوارزميات المألوفة، التي يُحتسب فيها جوابٌ مضمونٌ صحّتُهُ. فأمّا هنا، فالجواب المحصَل عليه صحيحٌ على الأرجح فقط. وبأدقّ من ذلك، فإنّه إذا أخفق في اختبار فيرما مرّةً ما، فيمكننا أن نتيقّن أنّ ليس أوّليًّا. ولكن حقيقة نجاح في الاختبار، مع كونها دلالةً قويّةً للغاية، لا تزال ليست ضمانًا بأنّ أوّليّ. وما نحبّ أن نقوله هو أنّه من أجل أيّ عددٍ ، إذا أدّينا الاختبار عددًا كافيًا من المرّات ووجدنا أنّ ينجح فيه دائمًا، فإنّ احتمال الخطأ في اختبارنا للأوّليّة يمكن أن يُجعَل صغيرًا كما نشاء.
للأسف، هذا الادّعاء ليس صحيحًا تمامًا. فثمّة أعدادٌ تُخدع اختبار فيرما فعلًا: أعدادٌ غير أوّليّة ومع ذلك تحمل الخاصيّة أنّ مطابقٌ لـ بقياس لجميع الأعداد الصحيحة . وهذه الأعداد نادرةٌ للغاية، لذا فإنّ اختبار فيرما موثوقٌ إلى حدٍّ كبيرٍ في الممارسة.[42]
ثمّة تنويعاتٌ من اختبار فيرما لا يمكن خداعها. وفي هذه الاختبارات، كما في طريقة فيرما، يُختبر كون عددٍ صحيحٍ أوّليًّا بانتقاء عددٍ صحيحٍ عشوائيٍّ والتحقّق من شرطٍ ما يعتمد على و . (انظر التمرين 1.28 لمثالٍ على اختبارٍ كهذا.) ومن ناحية أخرى، وعلى خلاف اختبار فيرما، يمكن للمرء أن يُثبت أنّه، من أجل أيّ ، فإنّ الشرط لا يتحقّق لمعظم الأعداد الصحيحة إلّا إذا كان أوّليًّا. وبالتالي، فإنّه إذا نجح في الاختبار من أجل اختيارٍ عشوائيٍّ ما لـ ، فإنّ الاحتمالات تُرجّح أنّ أوّليّ. وإذا نجح في الاختبار من أجل اختيارين عشوائيَّين لـ ، فإنّ الاحتمالات تُرجّح أنّ أوّليّ بثلاثة أرباعٍ أو تزيد. وبأداء الاختبار بقيمٍ منتقاةٍ عشوائيًّا أكثر فأكثر من يمكننا أن نجعل احتمال الخطأ صغيرًا كما نشاء.
إنّ وجود اختباراتٍ يمكن للمرء أن يُثبت أنّ احتمال الخطأ فيها يصير صغيرًا بغير حدّ، قد أثار اهتمامًا بخوارزميات من هذا النوع، التي صارت تُعرَف بـالخوارزميات الاحتماليّة. وثمّة نشاطٌ بحثيٌّ كبيرٌ في هذا المجال، وقد طُبِّقت الخوارزميات الاحتماليّة بإثمارٍ في حقولٍ كثيرة.[43]
تمرين 1.21: استخدم إجراء
smallest-divisorلإيجاد أصغر قاسمٍ لكلّ عددٍ من الأعداد التالية: 199، و1999، و19999.
تمرين 1.22: تتضمّن معظم تنفيذات Lisp أوّليّةً تُسمّى runtime تُعيد عددًا صحيحًا يُحدّد مقدار الزمن الذي كان النظام يعمل فيه (مقيسًا، مثلًا، بالميكروثواني). وإجراء timed-prime-test التالي، عند مناداته بعددٍ صحيحٍ ، يطبع ويفحص ما إذا كان أوّليًّا. فإن كان أوّليًّا، يطبع الإجراء ثلاث نجماتٍ متبوعةً بمقدار الزمن المستخدم في أداء الاختبار.
(define (timed-prime-test n)
  (newline)
  (display n)
  (start-prime-test n (runtime)))
(define (start-prime-test n start-time)
  (if (prime? n)
      (report-prime (- (runtime)
                       start-time))))
(define (report-prime elapsed-time)
  (display " *** ")
  (display elapsed-time))
وباستخدام هذا الإجراء، اكتب إجراءً search-for-primes يفحص أوّليّة أعدادٍ صحيحةٍ فرديّةٍ متتاليةٍ في مدىً محدّد. واستخدم إجراءك لإيجاد أصغر ثلاثة أعدادٍ أوّليّةٍ أكبر من 1000؛ وأكبر من 10.000؛ وأكبر من 100.000؛ وأكبر من 1.000.000. ولاحِظ الزمن اللازم لاختبار كلّ عددٍ أوّليّ. وبما أنّ خوارزميّة الاختبار لها رتبة نموّ ، فينبغي أن تتوقّع أنّ اختبار الأعداد الأوّليّة حول 10.000 ينبغي أن يستغرق نحو أضعاف ما يستغرقه اختبار الأعداد الأوّليّة حول 1000. فهل تؤكّد بيانات التوقيت التي حصلتَها ذلك؟ وإلى أيّ مدى تؤكّد بيانات 100.000 و1.000.000 تنبّؤ ؟ وهل نتيجتك متوافقةٌ مع الفكرة القائلة إنّ البرامج على حاسوبك تعمل في زمنٍ يتناسب مع عدد الخطوات التي يتطلّبها الاحتساب؟
تمرين 1.23: إنّ إجراء
smallest-divisorالمبيَّن في بداية هذا القسم يؤدّي كثيرًا من الاختبارات غير الضروريّة: فبعد أن يتحقّق من قابلية العدد للقسمة على 2، لا فائدة من التحقّق من قابلية العدد للقسمة على أيّ عددٍ زوجيٍّ أكبر منه. وهذا يُشير إلى أنّ القيم التي تُستخدم لـtest-divisorينبغي ألّا تكون 2، و3، و4، و5، و6، و…، بل 2، و3، و5، و7، و9، و…. ولتنفيذ هذا التغيير، عرّف إجراءًnextيُعيد 3 إذا كان مُدخله مساويًا لـ2 ويُعيد مُدخله زائد 2 وإلّا. وعَدّل إجراءsmallest-divisorليستخدم(next test-divisor)بدلًا من(+ test-divisor 1). ومع إدخال هذه النسخة المعدّلة منsmallest-divisorفيtimed-prime-test، أدِّ الاختبار لكلّ عددٍ من الأعداد الـ 12 الأوّليّة التي وُجِدت في التمرين 1.22 . وبما أنّ هذا التعديل يُنصّف عدد خطوات الاختبار، فينبغي أن تتوقّع أن يعمل أسرع بنحو مرّتين. فهل يتأكّد هذا التوقّع؟ فإن لم يكن كذلك، فما النسبة المرصودة لسرعتَي الخوارزميّتين، وكيف تُفسّر حقيقة أنّها مختلفة عن 2؟
تمرين 1.24: عَدّل إجراء
timed-prime-testمن التمرين 1.22 ليستخدمfast-prime?(طريقة فيرما)، واختبر كلّ عددٍ من الأعداد الـ 12 الأوّليّة التي وجدتَها في ذلك التمرين. وبما أنّ اختبار فيرما له نموّ ، فكيف تتوقّع أن يُقارن زمن اختبار الأعداد الأوّليّة قرب 1.000.000 بالزمن اللازم لاختبار الأعداد الأوّليّة قرب 1000؟ فهل تؤكّد بياناتك ذلك؟ وهل يمكنك تفسير أيّ تباينٍ تجده؟
تمرين 1.25: تشكو أليسا بي. هاكر من أنّنا بذلنا جهدًا إضافيًّا كثيرًا في كتابة expmod . فهي تقول، في النهاية، بما أنّنا نعرف سلفًا كيف نحتسب الأسّات، كان بوسعنا أن نكتب ببساطةٍ
(define (expmod base exp m)
  (remainder (fast-expt base exp) m))
أفهي محقّة؟ أوسيخدم هذا الإجراء مُختبِرَ الأعداد الأوّليّة السريع لدينا خدمةً حسنةً بالقدر نفسه؟ فسّر.
تمرين 1.26: يجد لويس ريزنر صعوبةً كبيرةً في أداء التمرين 1.24 . فيبدو أنّ اختباره fast-prime? يعمل أبطأ من اختباره prime? . فيستدعي لويس صديقته إيفا لو أتور لتساعده. وعندما يفحصان شيفرة لويس، يجدان أنّه قد أعاد كتابة إجراء expmod ليستخدم ضربًا صريحًا، بدلًا من مناداة square :
(define (expmod base exp m)
  (cond ((= exp 0) 1)
        ((even? exp)
         (remainder
          (* (expmod base (/ exp 2) m)
             (expmod base (/ exp 2) m))
          m))
        (else
         (remainder
          (* base
             (expmod base (- exp 1) m))
          m))))
«لا أرى أيّ فرقٍ يمكن أن يُحدِثه ذلك»، يقول لويس. «وأنا أرى»، تقول إيفا. «بكتابتك الإجراء على ذلك النحو، فإنّك قد حوّلت العمليّة إلى عمليّة .» فسّر.
تمرين 1.27: أظهِر أنّ أعداد كارميكل المسرودة في الحاشية 47 تُخدع اختبار فيرما فعلًا. أي اكتب إجراءً يأخذ عددًا صحيحًا ويختبر ما إذا كان مطابقًا لـ بقياس لكلّ ، وجرّب إجراءك على أعداد كارميكل المعطاة.
تمرين 1.28: إحدى تنويعات اختبار فيرما التي لا يمكن خداعها تُسمّى اختبار ميلر-رابين (Miller 1976; Rabin 1980). وهذا يبدأ من صورةٍ بديلةٍ للمبرهنة الصغرى لفيرما، التي تنصّ على أنّه إذا كان عددًا أوّليًّا وكان أيّ عددٍ صحيحٍ موجبٍ أصغر من ، فإنّ رفع إلى القوّة -st يُنتج عددًا مطابقًا لـ1 بقياس . ولاكتشاف أوّليّة عددٍ باختبار ميلر-رابين، ننتقي عددًا عشوائيًّا ونرفع إلى القوّة -st بقياس باستخدام إجراء
expmod. ولكن كلّما أدّينا خطوة التربيع فيexpmod، نتحقّق مما إذا كنّا قد كشفنا عن «جذرٍ تربيعيٍّ غير تافهٍ للعدد 1 بقياس »، أي عددٍ لا يساوي 1 أو ومربّعه يساوي 1 بقياس . ويمكن إثبات أنّه إذا وُجِد جذرٌ تربيعيٌّ غير تافهٍ للعدد 1، فإنّ ليس أوّليًّا. ويمكن كذلك إثبات أنّه إذا كان عددًا فرديًّا غير أوّليّ، فإنّ احتساب بهذه الطريقة سيكشف عن جذرٍ تربيعيٍّ غير تافهٍ للعدد 1 بقياس من أجل نصف أعداد على الأقلّ. (وهذا هو السبب في أنّ اختبار ميلر-رابين لا يمكن خداعه.) وعَدّل إجراءexpmodليُشير إذا كشف عن جذرٍ تربيعيٍّ غير تافهٍ للعدد 1، واستخدم هذا لتنفيذ اختبار ميلر-رابين بإجراءٍ نظيرٍ لـfermat-test. وتحقّق من إجراءك باختبار أعدادٍ أوّليّةٍ وغير أوّليّةٍ معروفةٍ مختلفة. تلميح: إحدى الطرائق الملائمة لجعلexpmodيُشير هي أن يُعيد 0.
1.3 صياغة التجريدات بإجراءات عليا الرتبة
لقد رأينا أنّ الإجراءات هي في الحقيقة تجريداتٌ تصف عمليّاتٍ مركّبةً على الأعداد، مستقلّةً عن الأعداد المعنيّة بعينها. فعلى سبيل المثال، عندما نكتب
(define (cube x) (* x x x))
فإنّنا لا نتحدّث عن مكعّب عددٍ معيّن، بل عن طريقةٍ للحصول على مكعّب أيّ عدد. وبالطبع كان بوسعنا أن نستغني عن تعريف هذا الإجراء تمامًا، بكتابة تعابيرَ مثل
(* 3 3 3)
(* x x x)
(* y y y)
وبلا ذكرٍ صريحٍ لـcube . وهذا من شأنه أن يضعنا في موقفٍ ضعيفٍ للغاية، إذ يُجبِرنا على العمل دائمًا على مستوى العمليّات المعنيّة بعينها التي يتّفق أنّها أوّليّةٌ في اللغة (الضرب، في هذه الحالة) بدلًا من العمل بدلالة عمليّاتٍ ذات مستوى أعلى. فبرامجنا كانت ستكون قادرةً على احتساب المكعّبات، ولكن لغتنا كانت ستفتقر إلى القدرة على التعبير عن مفهوم التكعيب. وأحد الأشياء التي ينبغي أن نطالب بها من لغةٍ برمجيّةٍ قويّةٍ هو القدرة على بناء التجريدات بتسمية الأنماط الشائعة ثمّ العمل بدلالة التجريدات مباشرةً. والإجراءات تُوفّر هذه القدرة. ولهذا السبب فإنّ جميع لغات البرمجة، إلّا الأكثر أوّليّةً منها، تتضمّن آليّاتٍ لتعريف الإجراءات.
حتّى في المعالجة العدديّة، ستكون قدرتنا على إبداع التجريدات محدودةً بشدّةٍ إذا كنّا مقيّدين بإجراءاتٍ ينبغي أن تكون وسائطها أعدادًا. فكثيرًا ما يُستخدم النمط البرمجيّ ذاته مع عددٍ من الإجراءات المختلفة. ولكي نعبّر عن أنماطٍ كهذه كمفاهيم، سنحتاج إلى بناء إجراءاتٍ تستطيع أن تقبل الإجراءات كوسائط أو أن تُعيد الإجراءات كقيم. والإجراءات التي تُعالج الإجراءات تُسمّى إجراءات عليا الرتبة. ويُظهر هذا القسم كيف يمكن أن تكون الإجراءات عليا الرتبة آليّات تجريدٍ قويّة، تزيد القوّة التعبيريّة للغتنا زيادةً هائلة.
1.3.1 الإجراءات كوسائط
تأمّل الإجراءات الثلاثة التالية. يحسب الأوّل مجموع الأعداد الصحيحة من a إلى b :
(define (sum-integers a b)
  (if (> a b)
      0
      (+ a (sum-integers (+ a 1) b))))
ويحسب الثاني مجموع مكعّبات الأعداد الصحيحة في المدى المعطى:
(define (sum-cubes a b)
  (if (> a b)
      0
      (+ (cube a)
         (sum-cubes (+ a 1) b))))
ويحسب الثالث مجموع متتاليةٍ من الحدود في المتسلسلة التي تتقارب إلى (ببطءٍ شديد):[44]
(define (pi-sum a b)
  (if (> a b)
      0
      (+ (/ 1.0 (* a (+ a 2)))
         (pi-sum (+ a 4) b))))
من الواضح أنّ هذه الإجراءات الثلاثة تتشارك نمطًا كامنًا مشتركًا. فهي متطابقةٌ في معظمها، ولا تختلف إلّا في اسم الإجراء، وفي دالّة a المستخدمة لاحتساب الحدّ المُراد إضافته، وفي الدالّة التي تُوفّر القيمة التالية لـa . وكان بوسعنا أن نُولّد كلًّا من الإجراءات بسدّ خاناتٍ في القالب ذاته:
(define (⟨name⟩ a b)
  (if (> a b)
      0
      (+ (⟨term⟩ a)
         (⟨name⟩ (⟨next⟩ a) b))))
إنّ وجود نمطٍ مشتركٍ كهذا دليلٌ قويٌّ على أنّ ثمّة تجريدًا مفيدًا ينتظر أن يُستخرج إلى السطح. ففي الحقيقة، حدّد الرياضيّون منذ زمنٍ بعيد تجريد جمع متسلسلة واخترعوا «صيغة سيجما»، على سبيل المثال للتعبير عن هذا المفهوم. وقوّة صيغة سيجما هي أنّها تسمح للرياضيّين بالتعامل مع مفهوم الجمع ذاته بدلًا من التعامل مع مجاميعَ معيّنةٍ فقط - على سبيل المثال، بصياغة نتائجَ عامّةٍ عن المجاميع مستقلّةً عن المتسلسلة المعنيّة بعينها التي تُجمع.
وبالمثل، وبوصفنا مصمّمي برامج، نحبّ أن تكون لغتنا قويّةً بالقدر الذي يمكّننا من كتابة إجراءٍ يُعبّر عن مفهوم الجمع ذاته بدلًا من إجراءاتٍ تحسب مجاميعَ معيّنةٍ فقط. ويمكننا فعل ذلك بسهولةٍ في لغتنا الإجرائيّة بأخذ القالب المشترك المبيَّن أعلاه وتحويل «الخانات» إلى وسائط شكلّيّة:
(define (sum term a next b)
  (if (> a b)
      0
      (+ (term a)
         (sum term (next a) next b))))
لاحِظ أنّ sum يأخذ كوسائطه الحدّين الأدنى والأعلى a وb إلى جانب الإجراءين term وnext . وبوسعنا أن نستخدم sum تمامًا كما نستخدم أيّ إجراء. فعلى سبيل المثال، يمكننا استخدامه (مع إجراءٍ inc يزيد وسيطه بمقدار 1) لتعريف sum-cubes :
(define (inc n) (+ n 1))

(define (sum-cubes a b)
  (sum cube a inc b))
وباستخدام هذا، يمكننا احتساب مجموع مكعّبات الأعداد الصحيحة من 1 إلى 10:
(sum-cubes 1 10)
3025
وبمساعدة إجراءٍ الهويّة لاحتساب الحدّ، يمكننا تعريف sum-integers بدلالة sum :
(define (identity x) x)

(define (sum-integers a b)
  (sum identity a inc b))
ومن ثمّ يمكننا جمع الأعداد الصحيحة من 1 إلى 10:
(sum-integers 1 10)
55
ويمكننا كذلك تعريف pi-sum بالطريقة ذاتها:[45]
(define (pi-sum a b)
  (define (pi-term x)
    (/ 1.0 (* x (+ x 2))))
  (define (pi-next x)
    (+ x 4))
  (sum pi-term a pi-next b))
وباستخدام هذه الإجراءات، يمكننا احتساب تقريبٍ للعدد :
(* 8 (pi-sum 1 1000))
3.139592655589783
وبمجرّد أن يصير لدينا sum ، يمكننا استخدامه لبنةً في صياغة مفاهيمَ لاحقة. فعلى سبيل المثال، يمكن تقريب التكامل المحدّد لدالّةٍ بين الحدّين و عدديًّا باستخدام الصيغة من أجل قيمٍ صغيرةٍ من . ويمكننا التعبير عن هذا مباشرةً في صورة إجراء:
(define (integral f a b dx)
  (define (add-dx x) (+ x dx))
  (* (sum f (+ a (/ dx 2.0)) add-dx b)
     dx))

(integral cube 0 1 0.01)
.24998750000000042

(integral cube 0 1 0.001)
.249999875000001
(والقيمة المضبوطة لتكامل cube بين 0 و1 هي 1/4.)
تمرين 1.29: إنّ قاعدة سيمبسون طريقةٌ للتكامل العدديّ أدقّ من الطريقة الموضّحة أعلاه. وباستخدام قاعدة سيمبسون، يُقارَب تكامل دالّةٍ بين و على الصورة
حيث ، من أجل عددٍ صحيحٍ زوجيٍّ ما ، و . (فزيادة تزيد دقّة التقريب.) عرّف إجراءً يأخذ و و و كوسائط ويُعيد قيمة التكامل، محتسبةً باستخدام قاعدة سيمبسون. واستخدم إجراءك لتكامل
cubeبين 0 و1 (مع و )، وقارن النتائج بتلك التي يعطيها إجراءintegralالمبيَّن أعلاه.
تمرين 1.30: إنّ إجراء sum أعلاه يُولّد تعاودًا خطّيًّا. ويمكن إعادة كتابة الإجراء بحيث يُؤدّى الجمع تكرارًا. وأظهِر كيف يمكن فعل ذلك بسدّ التعابير الناقصة في التعريف التالي:
(define (sum term a next b)
  (define (iter a result)
    (if ⟨??⟩
        ⟨??⟩
        (iter ⟨??⟩ ⟨??⟩)))
  (iter ⟨??⟩ ⟨??⟩))
تمرين 1.31: إنّ إجراء
sumليس سوى أبسط عددٍ هائلٍ من التجريدات المشابهة التي يمكن التعبير عنها كإجراءاتٍ عليا الرتبة.[46] اكتب إجراءً نظيرًا يُسمّىproductيُعيد حاصل ضرب قيم دالّةٍ عند نقاطٍ في مدىً معطى. وأظهِر كيف تُعرَّفfactorialبدلالةproduct. واستخدمproductكذلك لاحتساب تقريباتٍ للعدد باستخدام الصيغة[47]فإن كان إجراء
productلديك يُولّد عمليّةً تعاوديّةً، فاكتب واحدًا يُولّد عمليّةً تكراريّةً. وإن كان يُولّد عمليّةً تكراريّةً، فاكتب واحدًا يُولّد عمليّةً تعاوديّةً.
تمرين 1.32:
أظهِر أنّ sum وproduct (التمرين 1.31) كلاهما حالتان خاصّتان من مفهومٍ أعمّ يُسمّى accumulate يجمع مجموعةً من الحدود، باستخدام دالّة تجميعٍ عامّةٍ ما:
(accumulate
 combiner null-value term a next b)
يأخذ Accumulate كوسائطَ مواصفاتِ الحدّ والمدى نفسها التي يأخذها sum و product، إلى جانب إجراء combiner (ذي وسيطين) يُحدِّد كيف يُدمَج الحدّ الحاليّ في تراكم الحدود السابقة، وقيمة null-value تُحدِّد ما القيمة الأساسيّة الواجب استخدامها عند نفاد الحدود. اكتب accumulate، وبيّن كيف يمكن تعريف كلٍّ من sum و product بوصفه نداءً بسيطًا لـ accumulate.
إذا ولّد إجراؤك accumulate عمليّةً تعاوديّةً، فاكتب إجراءً يولّد عمليّةً تكراريّةً. وإذا ولّد عمليّةً تكراريّةً، فاكتب إجراءً يولّد عمليّةً تعاوديّةً.
تمرين 1.33: يمكنك الحصول على نسخةٍ أعمّ من
accumulate(التمرين 1.32) بإدخال فكرة مرشّح على الحدود المراد دمجها. أي لا تُدمَج إلّا تلك الحدود المشتقّة من قيمٍ في المدى تحقّق شرطًا محدّدًا. ويأخذ التجريد الناتجfiltered-accumulateالوسائط نفسها التي يأخذهاaccumulate، مع مسيّمٍ (predicate) إضافيّ من وسيطٍ واحد يحدّد المرشّح. اكتبfiltered-accumulateكإجراء. وبيّن كيف تُعبِّر عمّا يلي باستخدامfiltered-accumulate: مجموع مربّعات الأعداد الأوّليّة في الفترة من إلى (بافتراض أنّ لديك مسيّمprime?مكتوبًا سلفًا)حاصل ضرب جميع الأعداد الصحيحة الموجبة الأصغر من والأوليّة نسبيًّا لـ (أي جميع الأعداد الصحيحة الموجبة التي تحقّق ).
1.3.2 إنشاء الإجراءات باستخدام Lambda
عند استخدام sum كما في 1.3.1، يبدو من الأخرق للغاية أن نضطرّ إلى تعريف إجراءاتٍ تافهةٍ مثل pi-term و pi-next لمجرّد أن نستخدمها كوسائط لإجرائنا عالي الرتبة. وبدلًا من تعريف pi-next و pi-term، سيكون من الأنسب أن تتاح لنا طريقةٌ لتحديد «الإجراء الذي يُعيد مُدخله مزيدًا بمقدار 4» و«الإجراء الذي يُعيد مقلوب مُدخله مضروبًا في مُدخله زائد 2» مباشرةً. ويمكننا فعل ذلك بإدخال الصيغة الخاصّة lambda، التي تُنشئ الإجراءات. وباستخدام lambda يمكننا وصف ما نريد كما يلي
(lambda (x) (+ x 4))
و
(lambda (x) (/ 1.0 (* x (+ x 2))))
ومن ثَمّ يمكن التعبير عن إجرائنا pi-sum من دون تعريف أيّ إجراءاتٍ مساعدةٍ كما يلي
(define (pi-sum a b)
  (sum (lambda (x) (/ 1.0 (* x (+ x 2))))
       a
       (lambda (x) (+ x 4))
       b))
وباستخدام lambda مجددًا، يمكننا كتابة الإجراء integral من دون الحاجة إلى تعريف الإجراء المساعد add-dx:
(define (integral f a b dx)
  (* (sum f (+ a (/ dx 2.0))
            (lambda (x) (+ x dx))
            b)
     dx))
وعمومًا، يُستخدم lambda لإنشاء الإجراءات بالطريقة نفسها التي يُستخدم بها define، إلّا أنّه لا يُحدَّد اسمٌ للإجراء:
(lambda (⟨formal-parameters⟩) ⟨body⟩)
والإجراء الناتج هو إجراءٌ بالقدر الذي يكون به الإجراء المُنشأ باستخدام define. والفرق الوحيد أنّه لم يُقرَن بأيّ اسمٍ في البيئة. بل إنّ
(define (plus4 x) (+ x 4))
يكافئ
(define plus4 (lambda (x) (+ x 4)))
يمكننا قراءة تعبير lambda كما يلي:
(lambda                     (x)     (+   x     4))
    |                        |       |   |     |
the procedure of an argument x that adds x and 4
وكأيّ تعبيرٍ تكون قيمته إجراءً، يمكن استخدام تعبير lambda كمعاملٍ في تركيبٍ مثل
((lambda (x y z) (+ x y (square z))) 1 2 3)
12
أو، بشكلٍ أعمّ، في أيّ سياقٍ نستخدم فيه عادةً اسم إجراء.[48]
استخدام let لإنشاء متغيّرات محلّيّة
وثمة استخدام آخر لـ lambda في إنشاء المتغيّرات المحليّة. فغالبًا ما نحتاج في إجراءاتنا إلى متغيّراتٍ محلّيّةٍ غير تلك المقيّدة كوسائط صوريّة. فمثلًا، افترض أنّنا نريد حساب الدالّة التي يمكننا التعبير عنها أيضًا بصيغة وعند كتابة إجراءٍ لحساب ، نودّ أن نُضمّن متغيّراتٍ محلّيّةٍ لا تقتصر على و بل تشمل أيضًا أسماء الكميّات الوسيطة مثل و . ومن طرق تحقيق ذلك استخدام إجراءٍ مساعدٍ لربط المتغيّرات المحليّة:
(define (f x y)
  (define (f-helper a b)
    (+ (* x (square a))
       (* y b)
       (* a b)))
  (f-helper (+ 1 (* x y))
            (- 1 y)))
وبالطبع، يمكننا استخدام تعبير lambda لتحديد إجراءٍ مجهولٍ لربط متغيّراتنا المحليّة. ويصبح متن f من ثَمّ نداءً واحدًا لذلك الإجراء:
(define (f x y)
  ((lambda (a b)
     (+ (* x (square a))
        (* y b)
        (* a b)))
   (+ 1 (* x y))
   (- 1 y)))
وهذا البناء مفيدٌ إلى حدّ أنّ ثمّة صيغةً خاصّةً تُدعى let لتيسير استخدامه. وباستخدام let، يمكن كتابة إجراء f كما يلي
(define (f x y)
  (let ((a (+ 1 (* x y)))
        (b (- 1 y)))
    (+ (* x (square a))
       (* y b)
       (* a b))))
والصيغة العامّة لتعبير let هي
(let ((⟨var₁⟩ ⟨exp₁⟩)
      (⟨var₂⟩ ⟨exp₂⟩)
      …
      (⟨varₙ⟩ ⟨expₙ⟩))
  ⟨body⟩)
ويمكن النظر إلى ذلك على أنّه يقول
let ⟨var₁⟩ have the value ⟨exp₁⟩ and
    ⟨var₂⟩ have the value ⟨exp₂⟩ and
    …
    ⟨varₙ⟩ have the value ⟨expₙ⟩
  in ⟨body⟩
الجزء الأوّل من تعبير let قائمةٌ من أزواج الاسم-التعبير. وحين يُقيَّم let، يُربط كلّ اسمٍ بقيمة التعبير المقابل. ويُقيَّم متن let وهذه الأسماء مقيّدةً متغيّراتٍ محلّيّةً. والطريقة التي يحدث بها ذلك هي أنّ تعبير let يُفسَّر باعتباره صياغةً بديلةً لِـ
((lambda (⟨var₁⟩ … ⟨varₙ⟩)
   ⟨body⟩)
 ⟨exp₁⟩
 …
 ⟨expₙ⟩)
ولا يلزم أيّ آليّةٍ جديدةٍ في المفسّر لتوفير المتغيّرات المحليّة. وتعبير let ما هو إلّا سكرٌ صياغيّ لتطبيق lambda الكامن.
ويمكننا أن نرى من هذه المكافأة أنّ نطاق متغيّرٍ يحدّده تعبير let هو متن let. وهذا يعني أنّ:
Let يسمح بربط المتغيّرات في أقرب موضعٍ ممكنٍ من الموضع الذي ستُستخدم فيه. فمثلًا، إذا كانت قيمة x هي 5، فإنّ قيمة التعبير
(+ (let ((x 3))
     (+ x (* x 10)))
   x)
هي 38. فهنا، الـ x في متن let هو 3، ومن ثَمّ قيمة تعبير let هي 33. ومن جانبٍ آخر، فإنّ الـ x الذي هو الوسيط الثاني للـ + الخارجيّ ما زال 5.
وتُحسب قيم المتغيّرات خارج let. وهذا يهمّ عندما تتوقّف التعبيرات التي تُوفّر قيم المتغيّرات المحليّة على متغيّراتٍ تحمل الأسماء نفسها التي تحملها المتغيّرات المحليّة نفسها. فمثلًا، إذا كانت قيمة x هي 2، فإنّ التعبير
(let ((x 3)
      (y (+ x 2)))
  (* x y))
ستكون قيمته 12 لأنّ x سيكون 3 و y سيكون 4 داخل متن let (أي الـ x الخارجيّ زائد 2).
وأحيانًا يمكننا استخدام تعريفاتٍ داخليّةٍ للحصول على الأثر نفسه الذي نحصل عليه مع let. فمثلًا، كان يمكننا تعريف الإجراء f أعلاه كما يلي
(define (f x y)
  (define a
    (+ 1 (* x y)))
  (define b (- 1 y))
  (+ (* x (square a))
     (* y b)
     (* a b)))
أمّا نحن فنفضّل استخدام let في مواضع مثل هذه، واستخدام define الداخليّ للإجراءات الداخليّة فقط.[49]
التمرين 1.34: لنفترض أنّنا نُعرّف الإجراء
(define (f g) (g 2))
عندها يكون لدينا
(f square)
4

(f (lambda (z) (* z (+ z 1))))
6
ماذا يحدث إذا طلبنا (بمنطقٍ معكوس) من المفسّر تقييم التركيب (f f)؟ فسّر.
1.3.3 الإجراءات بوصفها طرقًا عامّة
قدّمنا الإجراءات المركّبة في 1.1.4 كآليّةٍ لتجريد أنماط العمليّات العدديّة بحيث تصير مستقلّةً عن الأعداد المعنيّة بعينها. ومع الإجراءات عالية الرتبة، مثل إجراء integral في 1.3.1، بدأنا نرى نوعًا أقوى من التجريد: إجراءاتٌ تُستخدم للتعبير عن طرقٍ عامّةٍ للاحتساب، مستقلّةً عن الدوالّ المعنيّة بعينها. وفي هذا القسم نناقش مثالَين أكثر تفصيلاً—طرائق عامّة لإيجاد أصفار الدوالّ ونقاطها الثابتة—ونُظهر كيف يمكن التعبير عن هذه الطرق مباشرةً كإجراءات.
إيجاد جذور المعادلات بطريقة نصف الفترة
طريقة نصف الفترة (half-interval method) تقنيّةٌ بسيطةٌ لكنّها قويّة لإيجاد جذور معادلةٍ ، حيث دالّةٌ متّصلة. والفكرة هي أنّنا، إذا أُعطينا نقطتَين و بحيث ، فإنّ لا بدّ أن يكون لها صفرٌ واحدٌ على الأقلّ بين و . ولتحديد موضع صفر، فلنجعل متوسّط و ، ولنحسب . فإن كان ، فإنّ لا بدّ أن يكون لها صفرٌ بين و . وإن كان ، فإنّ لا بدّ أن يكون لها صفرٌ بين و . وبمواصلة ذلك على هذا النحو، يمكننا تحديد فتراتٍ أصغرَ فأصغرَ تكون ملزمةً بصفرٍ عليها. وحين نبلغ موضعًا تكون الفترة فيه صغيرةً بما يكفي، تتوقّف العمليّة. وبما أنّ فترة عدم التيقُّن تُنصَّف في كلّ خطوةٍ من العمليّة، فإنّ عدد الخطوات المطلوبة ينمو وفقًا لـ ، حيث هو طول الفترة الأصليّة و هي سماحيّة الخطأ (أي حجم الفترة التي سنعتبرها «صغيرةً بما يكفي»). وفيما يلي إجراءٌ ينفّذ هذه الاستراتيجيّة:
(define (search f neg-point pos-point)
  (let ((midpoint
         (average neg-point pos-point)))
    (if (close-enough? neg-point pos-point)
        midpoint
        (let ((test-value (f midpoint)))
          (cond
           ((positive? test-value)
            (search f neg-point midpoint))
           ((negative? test-value)
            (search f midpoint pos-point))
           (else midpoint))))))
ونحن نفترض أنّنا أُعطينا في البدء الدالّة مع نقطتَين، قيمة الأولى منهما سالبة وقيمة الثانية موجبة. ونحسب أوّلًا نقطة منتصف النقطتين المعطاتين. ثمّ نتحقّق لمعرفة ما إذا كانت الفترة المعطاة صغيرةً بما يكفي، فإن كانت كذلك أعَدنا ببساطةٍ نقطة المنتصف جوابًا. وإلّا، نحسب قيمة عند نقطة المنتصف قيمةً اختباريّة. فإن كانت القيمة الاختباريّة موجبة، نواصل العمليّة بفترةٍ جديدةٍ تمتدّ من النقطة السالبة الأصليّة إلى نقطة المنتصف. وإن كانت القيمة الاختباريّة سالبة، نواصل بالفترة الممتدّة من نقطة المنتصف إلى النقطة الموجبة. وأخيرًا، ثمّة احتمالٌ أن تكون القيمة الاختباريّة مساويةً لـ 0، وفي هذه الحالة تكون نقطة المنتصف هي نفسها الجذر الذي نبحث عنه.
ولاختبار ما إذا كانت الطرفيّتين «قريبتَين بما يكفي» يمكننا استخدام إجراءٍ مشابهٍ للإجراء المستخدم في 1.1.7 لحساب الجذور التربيعيّة:[50]
(define (close-enough? x y)
  (< (abs (- x y)) 0.001))
إنّ search غير مريحٍ للاستعمال المباشر، لأنّنا قد نُعطيه من غير قصدٍ نقاطًا لا تكون قيم عندها ذات الإشارة المطلوبة، وفي هذه الحالة نحصل على جوابٍ خاطئ. وبدلًا من ذلك سنستخدم search بواسطة الإجراء التالي، الذي يتحقّق لمعرفة أيّ الطرفيّتين قيمتها الدالّيّة سالبة وأيّهما قيمتها موجبة، ويستدعي الإجراء search وفقًا لذلك. فإن كانت الدالّة تحمل الإشارة نفسها على النقطتين المعطاتين، فلا يمكن استخدام طريقة نصف الفترة، وفي هذه الحالة يُشير الإجراء إلى وقوع خطأ.[51]
(define (half-interval-method f a b)
  (let ((a-value (f a))
        (b-value (f b)))
    (cond ((and (negative? a-value)
                (positive? b-value))
           (search f a b))
          ((and (negative? b-value)
                (positive? a-value))
           (search f b a))
          (else
           (error "Values are not of
                   opposite sign" a b)))))
ويستخدم المثال التاليّ طريقة نصف الفترة لتقريب بوصفه الجذر بين 2 و 4 للمعادلة :
(half-interval-method sin 2.0 4.0)
3.14111328125
وهذا مثالٌ آخر، يستخدم طريقة نصف الفترة للبحث عن جذرٍ للمعادلة بين 1 و 2:
(half-interval-method
 (lambda (x) (- (* x x x) (* 2 x) 3))
 1.0
 2.0)
1.89306640625
إيجاد النقاط الثابتة للدوالّ
يُسمّى العدد نقطةً ثابتة (fixed point) لدالّةٍ إذا حقّق المعادلة . وبالنسبة لبعض الدوالّ يمكننا تحديد نقطةٍ ثابتةٍ بالبدء بتخمينٍ أوّليّ وتطبيق مرارًا وتكرارًا، إلى أن لا تتغيّر القيمة تغيّرًا كبيرًا. وباستخدام هذه الفكرة، يمكننا ابتكار إجراءٍ fixed-point يأخذ دالّةً وتخمينًا أوّليًّا بوصفهما مُدخلين، ويُنتج تقريبًا لنقطةٍ ثابتةٍ للدالّة. ونطبّق الدالّة مرارًا حتّى نجد قيمتين متتاليتين يكون فرقهما أقلّ من سماحيّةٍ محدّدةٍ سلفًا:
(define tolerance 0.00001)

(define (fixed-point f first-guess)
  (define (close-enough? v1 v2)
    (< (abs (- v1 v2))
       tolerance))
  (define (try guess)
    (let ((next (f guess)))
      (if (close-enough? guess next)
          next
          (try next))))
  (try first-guess))
فمثلًا، يمكننا استخدام هذه الطريقة لتقريب النقطة الثابتة لدالّة جيب التمام، بالبدء بالعدد 1 كتقريبٍ أوّليّ:[52]
(fixed-point cos 1.0)
.7390822985224023
وعلى نحو مماثل، يمكننا إيجاد حلٍّ للمعادلة :
(fixed-point (lambda (y) (+ (sin y) (cos y)))
             1.0)
1.2587315962971173
تُذكّرنا عمليّة النقطة الثابتة بالعمليّة التي استخدمناها لإيجاد الجذور التربيعيّة في 1.1.7. فكلتاهما تقومان على فكرة تحسين تخمينٍ مرارًا وتكرارًا حتّى تحقّق النتيجة معيارًا ما. بل إنّه يمكننا بسهولةٍ صياغة احتساب الجذر التربيعيّ بوصفه بحثًا عن نقطةٍ ثابتة. فاحتساب الجذر التربيعيّ لعددٍ ما يقتضي إيجاد بحيث . وبوضع هذه المعادلة في الصورة المكافئة ، ندرك أنّنا نبحث عن نقطةٍ ثابتةٍ للدالّة[53] ، ومن ثَمّ يمكننا محاولة احتساب الجذور التربيعيّة كما يلي
(define (sqrt x)
  (fixed-point (lambda (y) (/ x y))
               1.0))
وللأسف، فإنّ بحث النقطة الثابتة هذا لا يتقارب. فلننظر في تخمينٍ أوّليّ . فإنّ التخمين التالي هو والتخمين الذي يليه هو . وينجم عن ذلك حلقةٌ لا نهائيّةٌ يكرّر فيها التخمينَان و نفسيهما مرارًا وتكرارًا، متأرجحَين حول الجواب.
ومن طرق ضبط مثل هذه التأرجحات منع التخمينات من التغيّر بهذا القدر. وبما أنّ الجواب دائمًا ما يكون بين تخميننا و ، فيمكننا عمل تخمينٍ جديدٍ لا يبعد عن بمقدار ما يبعد ، بحساب متوسّط مع ، بحيث يكون التخمين التالي بعد هو بدلًا من . وعمليّة إجراء متتاليةٍ من التخمينات كهذه ما هي إلّا عمليّة البحث عن نقطةٍ ثابتةٍ لِـ :
(define (sqrt x)
  (fixed-point
   (lambda (y) (average y (/ x y)))
   1.0))
(لاحِظ أنّ تحويلٌ بسيط للمعادلة ولكي نستنبطها، أضِف إلى طرفَي المعادلة ثمّ اقسم على 2.)
وبهذا التعديل، يعمل إجراء الجذر التربيعيّ. بل إنّه، إذا فكّكنا التعريفات، يمكننا أن نرى أنّ متتالية التقريبات للجذر التربيعيّ المتولّدة هنا هي نفسها تمامًا المتولّدة عن إجراء الجذر التربيعيّ الأصليّ لدينا في 1.1.7. وهذا النهج القائم على حساب متوسّط تقريباتٍ متتاليةٍ لحلٍّ، وهو تقنيّةٌ نسمّيها التخميد المتوسط (average damping)، كثيرًا ما يساعد على تقارب عمليات البحث عن نقطةٍ ثابتة.
التمرين 1.35: بيّن أنّ النسبة الذهبيّة (1.2.2) نقطةٌ ثابتةٌ للتحويل ، واستخدم هذه الحقيقة لحساب بواسطة الإجراء
fixed-point.
التمرين 1.36: عدّل
fixed-pointبحيث يطبع متتالية التقريبات التي يولّدها، باستخدام الأوّليّتينnewlineوdisplayالموضّحتين في التمرين 1.22. ثمّ جد حلًّا للمعادلة بإيجاد نقطةٍ ثابتةٍ للدالّة . (استخدم إجراءlogالأوليّ في Scheme، الذي يحسب اللوغاريتمات الطبيعيّة.) وقارن عدد الخطوات التي يستغرقها هذا مع التخميد المتوسط وبدونه. (لاحِظ أنّك لا يمكنك بدءfixed-pointبتخمينٍ قيمته 1، لأنّ ذلك سيتسبّب في القسمة على .)
التمرين 1.37:
والكسر المستمرّ اللانهائيّ (continued fraction) تعبيرٌ من الشكل وكمثالٍ على ذلك، يمكن البرهان على أنّ مفكوك الكسر المستمرّ اللانهائيّ الذي تكون فيه جميع و مساويةً لـ 1 يُنتج ، حيث هي النسبة الذهبيّة (الموصوفة في 1.2.2). ومن طرق تقريب كسرٍ مستمرٍّ لانهائيّ اقتطاع المفكوك بعد عددٍ معطىً من الحدود. ومثل هذا الاقتطاع—وهو ما يُسمّى كسرًا مستمرًّا منتهيًا k-حد كسر مستمر منتهٍ—له الشكل ولنفترض أنّ n و d إجراءان من وسيطٍ واحد (فهرس الحدّ ) يُعيدان و لحدود الكسر المستمرّ. عرّف إجراءً cont-frac بحيث يحسب تقييم (cont-frac n d k) قيمة الكسر المستمرّ المنتهي من حدّ. وتحقّق من إجرائك بتقريب باستخدام
(cont-frac (lambda (i) 1.0)
           (lambda (i) 1.0)
           k)
لقيمٍ متتاليةٍ من k. فما أكبر مقدارٍ يلزم أن تجعله لـ k كي تحصل على تقريبٍ دقيقٍ إلى 4 منازل عشريّة؟
إذا ولّد إجراؤك cont-frac عمليّةً تعاوديّةً، فاكتب إجراءً يولّد عمليّةً تكراريّةً. وإذا ولّد عمليّةً تكراريّةً، فاكتب إجراءً يولّد عمليّةً تعاوديّةً.
التمرين 1.38: في عام 1737، نشر الرياضياتيّ السويسريّ لونهارد أويلر مذكّرةً بعنوان De Fractionibus Continuis، تضمّنت مفكوكًا لكسرٍ مستمرٍّ من أجل ، حيث هو أساس اللوغاريتمات الطبيعيّة. وفي هذا الكسر، جميع تساوي 1، و تأتي على التوالي 1، 2، 1، 1، 4، 1، 1، 6، 1، 1، 8، …. اكتب برنامجًا يستخدم إجراءك
cont-fracمن التمرين 1.37 لتقريب ، استنادًا إلى مفكوك أويلر.
التمرين 1.39: نشر الرياضياتيّ الألمانيّ ج. هـ. لامبرت، عام 1770، تمثيلًا لدالّة الظلّ بكسرٍ مستمرٍّ:
حيث بالراديان. عرّف إجراءً
(tan-cf x k)يحسب تقريبًا لدالّة الظلّ استنادًا إلى صيغة لامبرت. ويحدّدkعدد الحدود المراد حسابها، كما في التمرين 1.37.
1.3.4 الإجراءات كقيمٍ مُعادة
وتُبيّن الأمثلة أعلاه كيف تعزّز القدرة على تمرير الإجراءات بوصفها وسائط قوّة التعبير في لغة البرمجة لدينا تعزيزًا كبيرًا. ويمكننا تحقيق قوّة تعبيرٍ أكبر بإنشاء إجراءاتٍ تكون قيمها المُعادة إجراءاتٍ بذاتها.
يمكننا توضيح هذه الفكرة بالنظر مرّةً أخرى إلى مثال النقطة الثابتة الموصوف في نهاية 1.3.3. فقد صُغنا نسخةً جديدةً من إجراء الجذر التربيعيّ بوصفها بحثًا عن نقطةٍ ثابتة، بدءًا من ملاحظة أنّ نقطةٌ ثابتةٌ للدالّة . ثمّ استخدمنا التخميد المتوسط لجعل التقريبات تتقارب. والتخميد المتوسط تقنيّةٌ عامّةٌ مفيدةٌ بحدّ ذاتها. وهي، على وجه التحديد، أنّه بمعلوبيّة دالّةٍ ، ننظر إلى الدالّة التي تساوي قيمتها عند متوسّط و .
ويمكننا التعبير عن فكرة التخميد المتوسط بواسطة الإجراء التالي:
(define (average-damp f)
  (lambda (x)
    (average x (f x))))
Average-damp هو إجراءٌ يأخذ إجراءً هو f وسيطًا له، ويعيد قيمةً هي إجراء (ينتجه lambda) ينتج - حين يُطبَّق على عدد x - متوسط x و(f x). فمثلًا، تطبيق average-damp على الإجراء square ينتج إجراءً قيمته عند عددٍ ما هي متوسط و . وتطبيق هذا الإجراء الناتج على 10 يعيد متوسط 10 و100، أي 55:[54]
((average-damp square) 10)
55
وباستخدام average-damp، يمكننا إعادة صياغة إجراء الجذر التربيعيّ على النحو التالي:
(define (sqrt x)
  (fixed-point
   (average-damp
    (lambda (y) (/ x y)))
   1.0))
لاحِظ كيف تُضفي هذه الصياغة وضوحًا صريحًا على الأفكار الثلاثة في الطريقة: البحث عن النقطة الثابتة، والتخميد المتوسط (average damping)، والدالّة . ومن المفيد مقارنة هذه الصياغة لطريقة الجذر التربيعيّ بالنسخة الأصليّة المعطاة في 1.1.7. وخُذ في الحسبان أنّ هذه الإجراءات تعبّر عن العمليّة ذاتها، ولاحِظ كم يصير الفكر أوضح حين نعبّر عن العمليّة بدلالة هذه التجريدات. وبصورة عامّة، ثمّة طرائق كثيرة لصياغة عمليّةٍ في صورة إجراء. ويعرف المبرمجون الخبراء كيف ينتخبون الصياغ الإجرائيّة البديعةَ بشكلٍ خاصّ، وحيث تُكشَف العناصر المفيدة من العمليّة ككياناتٍ منفصلةٍ يمكن إعادة استخدامها في تطبيقات أخرى. وبوصفه مثالًا بسيطًا على إعادة الاستخدام، لاحِظ أنّ الجذر التكعيبيّ لـ نقطةٌ ثابتة للدالّة ، فيمكننا تعميم إجراء الجذر التربيعيّ تعميمًا فوريًّا إلى إجراءٍ يستخرج الجذور التكعيبيّة:[55]
(define (cube-root x)
  (fixed-point
   (average-damp
    (lambda (y)
      (/ x (square y))))
   1.0))
طريقة نيوتن
حين قدّمنا أوّل مرّة إجراء الجذر التربيعيّ، في 1.1.7، ذكرنا أنّه كان حالةً خاصّةً من طريقة نيوتن. فإذا كانت دالّةً قابلةً للاشتقاق، فإنّ حلّ المعادلة نقطةٌ ثابتة للدالّة حيث وأنّ هي مشتقّة مُقيَّمةً عند . وطريقة نيوتن هي استخدام طريقة النقطة الثابتة التي رأيناها أعلاه لتقريب حلّ المعادلة بإيجاد نقطةٍ ثابتةٍ للدالّة .[56]
فلكثيرٍ من الدوالّ ، ومع تقديراتٍ أوّليّةٍ جيّدةٍ بما يكفي لـ ، تتقارب طريقة نيوتن بسرعةٍ فائقةٍ نحو حلٍّ للمعادلة .[57]
لكي نُنفِّذ طريقة نيوتن كإجراء، لا بدّ أن نعبّر أوّلًا عن فكرة المشتقّة. ولاحِظ أنّ «المشتقّة» - شأنها شأن التخميد المتوسط - شيءٌ يحوّل دالّةً إلى دالّةٍ أخرى. فمثلًا، مشتقّة الدالّة هي الدالّة . وبصورة عامّة، إذا كانت دالّةً وكان عددًا صغيرًا، فإنّ المشتقّة للدالّة هي الدالّة التي قيمتها عند أيّ عدد تُعطى (في حدّ الصغير) بالعلاقة وعلى هذا، يمكننا التعبير عن فكرة المشتقّة (بأخذ مساويًا، مثلًا، 0.00001) بالإجراء
(define (deriv g)
  (lambda (x)
    (/ (- (g (+ x dx)) (g x))
       dx)))
مع التعريف
(define dx 0.00001)
شأنها شأن average-damp، فإنّ deriv إجراءٌ يأخذ إجراءً وسيطًا ويعيد إجراءً قيمةً. فمثلًا، لتقريب مشتقّة عند 5 (وقيمتها المضبوطة 75) يمكننا أن نقوّم
(define (cube x) (* x x x))

((deriv cube) 5)
75.00014999664018
وبمعونة deriv، يمكننا التعبير عن طريقة نيوتن كعمليّة نقطةٍ ثابتة:
(define (newton-transform g)
  (lambda (x)
    (- x (/ (g x)
            ((deriv g) x)))))

(define (newtons-method g guess)
  (fixed-point (newton-transform g)
               guess))
إنّ الإجراء newton-transform يعبّر عن الصيغة الواردة في بداية هذا القسم، أمّا newtons-method فمُعرَّفٌ بسهولةٍ بدلالة ذلك. وهو يأخذ وسيطَين: إجراءً يحسب الدالّة التي نريد إيجاد صفرٍ لها، مع تقديرٍ أوّليّ. فمثلًا، لإيجاد الجذر التربيعيّ لـ ، يمكننا استخدام طريقة نيوتن لإيجاد صفرٍ للدالّة بالانطلاق من تقديرٍ أوّليٍّ قيمته 1.[58]
وهذا يوفّر صورةً أخرى لإجراء الجذر التربيعيّ:
(define (sqrt x)
  (newtons-method
   (lambda (y)
     (- (square y) x))
   1.0))
التجريدات والإجراءات من الرتبة الأولى
لقد رأينا طريقتين للتعبير عن احتساب الجذر التربيعيّ بوصفه حالةً من طريقةٍ أكثر عموميّة: مرّةً كبحثٍ عن نقطةٍ ثابتة، ومرّةً باستخدام طريقة نيوتن. وبما أنّ طريقة نيوتن عُبِّر عنها هي نفسها كعمليّة نقطةٍ ثابتة، فإنّنا رأينا في الواقع طريقتين لاحتساب الجذور التربيعيّة كنقاطٍ ثابتة. فكلّ طريقةٍ تبدأ بدالّةٍ وتجد نقطةً ثابتةً لتحويلٍ ما من الدالّة. ويمكننا التعبير عن هذه الفكرة العامّة نفسها كإجراء:
(define (fixed-point-of-transform
         g transform guess)
  (fixed-point (transform g) guess))
يأخذ هذا الإجراء بالغ العموميّة ثلاثة وسائط: إجراءً هو g يحسب دالّةً ما، وإجراءً يحوّل g، وتقديرًا أوّليًّا. والنتيجة المعادة هي نقطةٌ ثابتة للدالّة المحوَّلة.
وباستخدام هذا التجريد، يمكننا إعادة صياغة احتساب الجذر التربيعيّ الأوّل من هذا القسم (حيث نبحث عن نقطةٍ ثابتةٍ للنسخة المُخمَّدة متوسطيًّا من ) بوصفه حالةً من هذه الطريقة العامّة:
(define (sqrt x)
  (fixed-point-of-transform
   (lambda (y) (/ x y))
   average-damp
   1.0))
وعلى نحو مماثل، يمكننا التعبير عن احتساب الجذر التربيعيّ الثاني من هذا القسم (وهي حالةٌ من طريقة نيوتن تجد نقطةً ثابتةً للتحويل النيوتونيّ من ) على الصورة
(define (sqrt x)
  (fixed-point-of-transform
   (lambda (y) (- (square y) x))
   newton-transform
   1.0))
بدأنا القسم 1.3 بملاحظةٍ مفادها أنّ الإجراءات المركّبة آليّة تجريدٍ حاسمة، لأنّها تسمح لنا بالتعبير عن طرائق عامّة للاحتساب كعناصر صريحةٍ في لغة البرمجة لدينا. أمّا الآن فقد رأينا كيف تسمح لنا الإجراءات من الرتبة العليا بالتحكّم في هذه الطرائق العامّة لإبداع تجريداتٍ إضافيّة.
وبوصفنا مبرمجين، ينبغي أن نكون متيقّظين للفرص التي تُتيح لنا تمييز التجريدات الكامنة في برامجنا، والبناء عليها، وتعميمها، لإبداع تجريداتٍ أكثر قوّة. وهذا لا يعني وجوب كتابة البرامج دائمًا بأكثر الطرق تجريدًا؛ فالمبرمجون الخبراء يعرفون كيف ينتخبون مستوى التجريد الملائم لمهمّتهم. ولكن المهمّ هو القدرة على التفكير بدلالة هذه التجريدات، حتّى نكون على استعدادٍ لتطبيقها في سياقاتٍ جديدة. وأهمّيّة الإجراءات من الرتبة العليا أنّها تُمكّننا من تمثيل هذه التجريدات تمثيلًا صريحًا كعناصر في لغة البرمجة لدينا، فيمكن التعامل معها تمامًا مثل غيرها من العناصر الاحتسابيّة.
وبصورة عامّة، تفرض لغات البرمجة قيودًا على الطرق التي يمكن بالتحكّم في العناصر الاحتسابيّة فيها. ويُقال إنّ العناصر الأقلّ خضوعًا للقيود تتمتّع بمكانة من الرتبة الأولى (first-class). ومن «الحقوق والامتيازات» التي تتمتّع بها العناصر من الرتبة الأولى:[59]
- يجوز أن تُسمّى بواسطة متغيّرات.
- يجوز أن تُمرَّر كمعطياتٍ إلى الإجراءات.
- يجوز أن تُعاد كنتائج للإجراءات.
- يجوز أن تُضمَّن في بنيات البيانات.[60]
إنّ Lisp - بخلاف لغات البرمجة الشائعة الأخرى - يمنح الإجراءات مكانة الرتبة الأولى الكاملة. وهذا يطرح تحدّياتٍ في التنفيذ الكفء، ولكن المكسب الناتج في القوّة التعبيريّة هائل.[61]
تمرين 1.40: عرّف إجراءً هو cubic يمكن استخدامه مع الإجراء newtons-method في تعبيراتٍ على الصورة
(newtons-method (cubic a b c) 1)
لتقريب أصفار الدالّة التكعيبيّة .
تمرين 1.41: عرّف إجراءً هو double يأخذ إجراءً ذا وسيطٍ واحدٍ كوسيطٍ له ويعيد إجراءً يطبّق الإجراء الأصليّ مرّتين. فمثلًا، إذا كان inc إجراءً يضيف 1 إلى وسيطه، فإنّ (double inc) ينبغي أن يكون إجراءً يضيف 2. فما القيمة التي تعيدها
(((double (double double)) inc) 5)
تمرين 1.42: لتكن و دالّتين أحاديّتي الوسيط. ويُعرَّف التركيب بعد بوصفه الدالّة . عرّف إجراءً هو compose يُنفِّذ التركيب. فمثلًا، إذا كان inc إجراءً يضيف 1 إلى وسيطه،
((compose square inc) 6)
49
تمرين 1.43: إذا كانت دالّةً عدديّةً وكان عددًا صحيحًا موجبًا، فبوسعنا تكوين التطبيق المكرّر للمقدار للدالّة ، وهو مُعرَّفٌ بوصفه الدالّة التي قيمتها عند هي . فمثلًا، إذا كانت هي الدالّة ، فإنّ التطبيق المكرّر للمقدار للدالّة هو الدالّة . وإذا كانت هي عمليّة تربيع عدد، فإنّ التطبيق المكرّر للمقدار للدالّة هو الدالّة التي ترفع وسيطها إلى القوّة . اكتب إجراءً يأخذ مُدخلَين: إجراءً يحسب وعددًا صحيحًا موجبًا ، ويعيد الإجراء الذي يحسب التطبيق المكرّر للمقدار للدالّة . وينبغي أن يكون إجراءك صالحًا للاستخدام على النحو التالي:
((repeated square 2) 5)
625
تلميح: قد تجد ملاءمةً في استخدام compose من التمرين 1.42.
تمرين 1.44: إنّ فكرة تنعيم دالّةٍ مفهومٌ مهمّ في معالجة الإشارة. إذا كانت دالّةً وكان عددًا صغيرًا ما، فإنّ النسخة المُنعَّمة من هي الدالّة التي قيمتها عند نقطةٍ هي متوسط ، و ، و . اكتب إجراءً هو
smoothيأخذ مُدخلًا إجراءً يحسب ويعيد إجراءً يحسب المُنعَّمة. ومن المفيد أحيانًا تنعيم دالّةٍ تكرارًا (أي تنعيم الدالّة المُنعَّمة، وهلمّ جرًّا) للحصول على الدالّة المُنعَّمة *n-ضعف. وبيّن كيف تُولَّد الدالّة المُنعَّمة n-ضعف أيّ دالّةٍ معطاة باستخدامsmoothوrepeatedمن التمرين 1.43.
تمرين 1.45: رأينا في 1.3.3 أنّ محاولة احتساب الجذور التربيعيّة بإيجاد نقطةٍ ثابتةٍ لـ إيجادًا ساذجًا لا تتقارب، وأنّ هذا يمكن تداركه بالتخميد المتوسط. والطريقة ذاتها تصلح لإيجاد الجذور التكعيبيّة كنقاطٍ ثابتةٍ للدالّة المُخمَّدة متوسطيًّا. ولكن للأسف، لا تصلح العمليّة للجذور الرباعيّة—فإنّ التخميد المتوسط الواحد غير كافٍ لجعل بحث النقطة الثابتة عن يتقارب. ومن ناحية أخرى، إذا خمّدنا متوسطيًّا مرّتين (أي إذا استخدمنا التخميد المتوسط للتخميد المتوسط لـ ) فإنّ بحث النقطة الثابتة يتقارب فعلًا. فأجرِ بعض التجارب لتحديد كم تخميدًا متوسطيًّا يلزم لاحتساب جذور المقدار كبحثٍ عن نقطةٍ ثابتةٍ قائمٍ على التخميد المتوسط المتكرّر لـ . واستخدم هذا لتنفيذ إجراءٍ بسيطٍ لاحتساب جذور المقدار باستخدام
fixed-pointوaverage-dampوإجراءrepeatedمن التمرين 1.43. وافترض أنّ أيّ عمليّات حسابيّةٍ تحتاجها متاحةٌ كأوّليّات.
تمرين 1.46: إنّ جملةً من الطرائق العدديّة الموصوفة في هذا الفصل هي حالاتٌ من استراتيجيّة احتسابيّةٍ بالغة العموميّة تُعرف بـالتحسين التكراريّ (iterative improvement). ويقول التحسين التكراريّ إنّه لكي نحسب شيئًا، نبدأ بتقديرٍ أوّليّ للجواب، ونختبر ما إذا كان التقدير جيّدًا بما يكفي، وإلّا نحسّن التقدير ونواصل العمليّة باستخدام التقدير المُحسَّن تقديرًا جديدًا. اكتب إجراءً هو
iterative-improveيأخذ إجراءَين كوسيطَين: طريقةً للحكم بما إذا كان تقديرٌ ما جيّدًا بما يكفي، وطريقةً لتحسين التقدير. وينبغي أن يعيدIterative-improveقيمةً هي إجراءٌ يأخذ تقديرًا كوسيطٍ له ويواصل تحسين التقدير حتّى يصير جيّدًا بما يكفي. وأعِد كتابة إجراءsqrtمن 1.1.7 وإجراءfixed-pointمن 1.3.3 بدلالةiterative-improve.
إنّ توصيف الأعداد بأنّها «بيانات بسيطة» مُبالغةٌ صارخة. فالواقع، إنّ معاملة الأعداد هي واحدة من أعقد القضايا إرباكًا في أيّ لغة برمجة. ومن القضايا النمطيّة المُتورّطة في ذلك ما يلي: تتميّز بعض أنظمة الحاسوب بين الأعداد الصحيحة، مثل 2، والأعداد الحقيقيّة، مثل 2.71. فهل العدد الحقيقيّ 2.00 يختلف عن العدد الصحيح 2؟ وهل العمليّات الحسابيّة المستخدمة للأعداد الصحيحة هي ذاتها المستخدمة للأعداد الحقيقيّة؟ وهل يُنتج قسمةُ 6 على 2 العددَ 3، أم 3.0؟ فما أكبر عددٍ يمكننا تمثيله؟ وكم منزلةً عشريّةً من الدقّة يمكننا تمثيلها؟ فهل مدى الأعداد الصحيحة هو ذاته مدى الأعداد الحقيقيّة؟ وفوق هذه الأسئلة كلّها، يقع بالطبع مجموعةٌ من القضايا المتعلّقة بأخطاء التقريب والاقتطاع—وهو علم التحليل العدديّ برمّته. وبما أنّ تركيزنا في هذا الكتاب ينصرف إلى تصميم البرامج واسعة النطاق بدلًا من التقنيّات العدديّة، فإنّنا سنتجاهل هذه المشكلات. والأمثلة العدديّة في هذا الفصل ستبدي السلوك التقريبيّ المعتاد الذي يُلاحَظ عند استخدام عمليّات حسابيّةٍ تحافظ على عددٍ محدودٍ من المنازل العشريّة للدقّة في العمليّات غير الصحيحة. ↩︎
وعلى امتداد هذا الكتاب، حين نرغب في إبراز التمييز بين المُدخَل الذي يطبعه المستخدم والاستجابة التي يطبعها المفسّر، فإنّنا سنُظهر الأخيرة بحروفٍ مائلة. ↩︎
تُوفّر أنظمة Lisp عادةً ميزاتٍ لمساعدة المستخدم على تنسيق التعابير. وأكثر الميزتَين نفعةً هما واحدةٌ تُزحزح تلقائيًّا إلى موضع الطباعة الجميلة الصحيح كلّما بُدِئ سطرٌ جديد، وأخرى تُبرز القوس الأيسر المطابق كلّما طُبع قوسٌ أيمن. ↩︎
تتّبع Lisp الاصطلاح القائل إنّ لكلّ تعبيرٍ قيمة. وهذا الاصطلاح، إلى جانب السمعة القديمة لـLisp بوصفها لغةً غير كفء، هو مصدر العبارة الساخرة لآلان بيرليس (بمعارضةٍ لأوسكار وايلد) بأنّ «مبرمجي Lisp يعرفون قيمة كلّ شيءٍ ولكنّهم لا يعرفون ثمن لا شيء». ↩︎
في هذا الكتاب، لا نُظهر استجابة المفسّر لتقييم التعريفات، لأنّ ذلك يعتمد بدرجةٍ كبيرةٍ على التنفيذ. ↩︎
سيُظهر الفصل 3 أنّ مفهوم البيئة هذا حاسم، سواءً لفهم كيفيّة عمل المفسّر أم لتنفيذ المفسّرات. ↩︎
قد يبدو غريبًا أنّ قاعدة التقييم تقول، كجزءٍ من الخطوة الأولى، إنّه ينبغي تقييم العنصر الأيسر في التركيب، إذ إنّ ذلك لا يمكن أن يكون عند هذه النقطة إلّا عاملًا مثل
+أو*يمثّل إجراءً أوّيًّا مبنيًّا كالجمع أو الضرب. وسنرى لاحقًا أنّ من المفيد القدرة على التعامل مع تركيباتٍ تكون عواملها هي ذاتها تعبيراتٍ مركّبة. ↩︎الصيغ النحويّة الخاصّة التي هي مجرّد بنيات سطحيّة بديلةٍ مناسبةٍ لأشياء يمكن كتابتها بطرائق أكثر انتظامًا تُسمّى أحيانًا سكّرًا نحويًّا (syntactic sugar)، بمعارضة العبارة التي اشتقّها بيتر لاندين. وبمقارنة مستخدمي اللغات الأخرى، فإنّ مبرمجي Lisp - كقاعدةٍ عامّة - أقلّ اهتمامًا بشؤون النحو. (وعلى النقيض، افحص أيّ دليلٍ لـPascal ولاحِظ كم منه مخصّصٍ لأوصاف النحو.) وهذا الاحتقار للنحو يرجع جزئيًّا إلى مرونة Lisp، التي تُسهّل تغيير النحو السطحيّ، وجزئيًّا إلى الملاحظة أنّ كثيرًا من البنى النحويّة «المناسبة»، التي تجعل اللغة أقلّ انتظامًا، تنتهي إلى التسبّب في متاعبَ أكثرَ ممّا تستحقّ حين تصير البرامج كبيرة ومعقّدة. وبكلام آلان بيرليس، «السكّر النحويّ يُسبّب سرطان الفاصلة المنقوطة». ↩︎
لاحِظ أنّ ثمّة عمليّتين مختلفتين تُجمعان هنا: نحن نُنشيء الإجراء، ونحن نُسمّيه
square. فمن الممكن - والمهمّ فعلًا - القدرة على فصل المفهومين: إنشاء الإجراءات دون تسميتها، وإعطاء أسماءٍ لإجراءاتٍ أُنشئت سلفًا. وسنرى كيف نفعل ذلك في 1.3.2. ↩︎وعلى رغم بساطة فكرة الإحلال، فإنّها تتبيّن أعقدَ ممّا يُتصوّر إعطاءً لتعريفٍ رياضيّ دقيق لعمليّة الإحلال. وتنشأ المشكلة من إمكان الالتباس بين الأسماء المستخدمة لوسائط الإجراء الشكليّة وبين الأسماء (وقد تكون متطابقةً) المستخدمة في التعابير التي يُطبَّق عليها الإجراء. والحقّ إنّ ثمّة تاريخًا طويلًا من التعريفات الخاطئة لـالإحلال في أدبيّات المنطق ودلالات البرمجة. انظر Stoy 1977 لمناقشةٍ وافيةٍ للإحلال. ↩︎
سنُقدّم في الفصل 3 معالجة المجاري (stream processing)، وهي طريقةٌ للتعامل مع بنيات بياناتٍ «لا نهائيّة» ظاهريًّا بإدخال شكلٍ محدودٍ من التقييم بالترتيب الاعتياديّ. وسنُعدّل في 4.2 مفسّر Scheme لإنتاج صيغةٍ من Scheme ذات ترتيبٍ اعتياديٍّ. ↩︎
إنّ «تُفسَّر بأنّها إمّا صادقة أو كاذبة» يعني ما يلي: في Scheme، ثمّة قيمتان مميّزتان يُشار إليهما بالثابتتين
#tو#f. وحين يتحقّق المفسّر من قيمة مُقوِّمٍ، فإنّه يُفسّر#fبالكذب. وأيّ قيمةٍ أخرى تُعامَل معاملة الصدق. (وعليه، فإنّ إعطاء#tغير لازمٍ منطقيًّا، ولكنّه مريح.) وفي هذا الكتاب سنستخدم الاسمينtrueوfalse، اللذين يُربطان بالقيمتين#tو#fعلى الترتيب. ↩︎يستخدم
Absأيضًا العامل «السالب»-، الذي - إذا استُخدم بمعاملٍ واحدٍ، كما في(- x)- يدلّ على النفي. ↩︎وأحد الفروق الطفيفة بين
ifوcondهو أنّ جزء⟨e⟩من كلّ بندٍ فيcondقد يكون تسلسلًا من التعابير. فإذا وُجد أنّ⟨p⟩المقابل صادقة، فإنّ التعابير⟨e⟩تُقيَّم بالتتابع، وتُعاد قيمة التعبير الأخير في التسلسل قيمةً للبندcond. أمّا في تعبيرif، فإنّ⟨consequent⟩و⟨alternative⟩يجب أن يكونا تعبيرَين منفردَين. ↩︎إنّ الوصفين التصريحيّ والإمريّ مترابطان ترابطًا وثيقًا، كما الرياضيّات وعلوم الحاسوب. فمثلًا، القول إنّ الجواب الذي يُنتجه برنامجٌ ما «صحيح» هو إفادةٌ تصريحيّةٌ عن البرنامج. وثمّة مقدارٌ كبيرٌ من البحث الرامي إلى إرساء تقنيّاتٍ لإثبات صحّة البرامج، ومعظم الصعوبة التقنيّة في هذا الموضوع تتعلّق بالتفاوض على الانتقال بين الإفادات الإمريّة (التي تُبنى منها البرامج) والإفادات التصريحيّة (التي يمكن استنتاج أمورٍ بها). وفي السياق ذاته، فإنّ مجالًا مهمًّا حاليًّا في تصميم لغات البرمجة هو استكشاف ما يُسمّى «لغات عالية المستوى جدًّا» (very high-level languages)، التي يبرمج فيها المرء فعلًا بدلالة الإفادات التصريحيّة. والفكرة هي جعل المفسّرات متطوّرةً بالقدر الكافي بحيث إنّه - إذا ما حدّد المبرمج معرفةَ «ما هو» - أمكنها توليد معرفة «كيف» تلقائيًّا. ولا يمكن فعل ذلك بصورة عامّة، ولكن ثمّة مجالاتٍ مهمّةٍ أُحرز فيها تقدّم. وسنعود إلى هذه الفكرة في الفصل 4. ↩︎
إنّ خوارزميّة الجذر التربيعيّ هذه هي في الحقيقة حالةٌ خاصّة من طريقة نيوتن، وهي تقنيّة عامّة لإيجاد جذور المعادلات. وقد طُوِّرت خوارزميّة الجذر التربيعيّ ذاتها على يد هيرون الإسكندريّ في القرن الأوّل الميلاديّ. وسنرى كيف نُعبّر عن طريقة نيوتن العامّة كإجراءٍ في Lisp في 1.3.4. ↩︎
سنُعطي المُقوِّمات عادةً أسماءً تنتهي بعلامة استفهام، لتُعيننا على تذكّر أنّها مُقوِّمات. وهذا مجرّد اصطلاحٍ أسلوبيّ. فأمّا المفسّر فلا يعني علامة الاستفهام سوى حرفٍ عاديّ. ↩︎
لاحِظ أنّنا نُعبّر عن تقديرنا الأوّليّ بالعدد 1.0 بدلًا من 1. ولن يُحدِث ذلك فرقًا في كثيرٍ من تنفيذات Lisp. إلّا أنّ MIT Scheme تميّز بين الأعداد الصحيحة المضبوطة والقيم العشريّة، وقسمة عددين صحيحين تُنتج عددًا كسريًّا بدلًا من عددٍ عشريّ. فمثلًا، قسمة 10 على 6 تُنتج 5/3، بينما قسمة 10.0 على 6.0 تُنتج 1.6666666666666667. (وسنتعلّم كيف نُنفّذ الحساب على الأعداد الكسريّة في 2.1.1.) فإذا بدأنا بتقديرٍ أوّليٍّ قيمته 1 في برنامج الجذر التربيعيّ، وكان عددًا صحيحًا مضبوطًا، فإنّ جميع القيم التالية التي يُنتجها احتساب الجذر التربيعيّ ستكون أعدادًا كسريّةً بدلًا من الأعداد العشريّة. والعمليّات المختلطة على الأعداد الكسريّة والعشريّة تُنتج دائمًا أعدادًا عشريّة، وعلى هذا فإنّ الانطلاق بتقديرٍ أوّليٍّ قيمته 1.0 يُجبِر جميع القيم التالية على أن تكون عشريّة. ↩︎
أمّا القارئون الذين يقلقهم مسائل الكفاءة المُتورّطة في استخدام نداءات الإجراءات لتنفيذ التكرار فينبغي لهم أن يلاحظوا الملاحظات المتعلّقة بـ«التعاود الذيليّ» في 1.2.1. ↩︎
ليس واضحًا حتّى أيّ هذين الإجراءَين هو التنفيذ الأكفء. وهذا يعتمد على العتاد المتاح. فثمّة آلاتٌ يكون فيها التنفيذ «البديهيّ» هو الأقلّ كفاءة. فتأمّل آلةً تحتوي جداولَ واسعةً للوغاريتمات والمُعاكسات مخزَّنةً بأسلوبٍ بالغ الكفاءة. ↩︎
إنّ مفهوم إعادة التسمية المُتّسقة مفهومٌ دقيقٌ في الواقع ويصعب تعريفه رسميًّا. وقد اقترف منطقيّون مشهورون أخطاءً مُحرجةً هنا. ↩︎
يقتضي النطاق المعجميّ أنّ المتغيّرات الحرّة في إجراءٍ يُفترض أنّها تُشير إلى روابطَ أُنشئت بتعريفات الإجراءات المُحاطة؛ أي أنّه يُبحث عنها في البيئة التي عُرِّف الإجراء فيها. وسنرى كيف يعمل ذلك بالتفصيل في الفصل 3 حين ندرس البيئات والسلوك التفصيليّ للمفسّر. ↩︎
يجب أن تأتي التعريفات المُضمَّنة أوّلًا في جسم الإجراء. والإدارة غير مسؤولة عن عواقب تشغيل برامجَ تُشابك بين التعريف والاستخدام. ↩︎
في برنامجٍ حقيقيّ، نستخدم على الأرجح بنية الكتل المقدَّمة في القسم الأخير لإخفاء تعريف
fact-iter:scheme (define (factorial n) (define (iter product counter) (if (> counter n) product (iter (* counter product) (+ counter 1)))) (iter 1 1))↩︎حين نناقش تنفيذ الإجراءات على آلات المسجّلات في الفصل 5، سنرى أنّ أيّ عمليّة تكراريّة يمكن تحقيقها «عتاديًّا» كآلةٍ لها مجموعة ثابتة من المسجّلات وبلا ذاكرة مساعدة. أمّا تحقيق عمليّة تعاوديّة فيتطلّب آلةً تستخدم بنية بيانات مساعدةً تُعرف بـمكدس (stack). ↩︎
لُقّبت التعاوبة الذيليّة منذ زمنٍ بعيد بخُدعة تحسينٍ في المصرّفات. وقد أرسى كارل Hewitt (1977) أساسًا دلاليًّا متماسكًا للتعاوبة الذيليّة، إذ فسّرها بدلالة نموذج «تمرير الرسائل» للاحتساب الذي سنناقشه في الفصل 3. واستلهامًا من ذلك، بنى جيرالد جاي سوسمان وغاي لويس ستيل الابن (انظر Steele and Sussman 1975) مفسّرًا ذا تعاوبةٍ ذيليّةٍ لـScheme. وأبان ستيل لاحقًا كيف أنّ التعاوبة الذيليّة نتيجةٌ للطريق الطبيعيّ لتصريف نداءات الإجراءات (Steele 1977). ويقتضي معيار IEEE لـScheme أن تكون تنفيذات Scheme ذات تعاوبةٍ ذيليّة. ↩︎
أُشيرَ إلى مثالٍ من هذا في 1.1.3. والمفسّر نفسه يُقيّم التعابير باستخدام عمليّةٍ ذات تعاوبةٍ شجريّة. ↩︎
فمثلًا، اشرح بالتفصيل كيف تُطبَّق قاعدة الاختزال على مشكلة إيجاد باقي عملةٍ معدنيّةٍ بقيمة 10 سنتات باستخدام البنسات (pennies) والنيكل (nickels). ↩︎
إحدى المقاربات لمواجهة الاحتسابات الزائدة هي ترتيب الأمور بحيث نُبنّي تلقائيًّا جدولَ قيمٍ عند احتسابها. فكلّما طُلب منّا تطبيق الإجراء على معطىً ما، ننظر أوّلًا لمعرفة ما إذا كانت القيمة مخزَّنةً في الجدول سلفًا، وفي هذه الحالة نتفادى أداء الاحتساب الزائد. وهذه الاستراتيجيّة، المعروفة بـالجدولة أو حفظ النتائج (memoization)، يمكن تنفيذها بأسلوبٍ مباشر. ويمكن للجدولة أن تُستخدم أحيانًا لتحويل عمليّاتٍ تتطلّب عددًا أسّيًّا من الخطوات (مثل
count-change) إلى عمليّاتٍ تنمو متطلّباتها المكانيّة والزمنيّة خطيًّا مع المُدخَل. انظر التمرين 3.27. ↩︎إنّ عناصر مثلّث باسكال تُسمّى المُعامِلات ذات الحدّين، لأنّ الصفّ يتألّف من مُعامِلات الحدود في التوسيع . وقد ظهر هذا النمط لاحتساب المُعامِلات في العمل الأساسيّ الذي أنجزه بليز باسكال في نظريّة الاحتمالات عام 1653، وهو بعنوان Traité du triangle arithmétique. وطبقًا لـKnuth (1973)، فإنّ النمط ذاته يظهر في Szu-yuen Yü-chien («المرآة الثمينة للعناصر الأربعة»)، الذي نشره الرياضيّ الصينيّ تشو شيه-تشيه عام 1303، وفي أعمال الشاعر والرياضيّ الفارسيّ عمر الخيّام في القرن الثاني عشر، وفي أعمال الرياضيّ الهنديّ بهاسكارا أشاريا في القرن الثاني عشر. ↩︎
إنّ هذه الإفادات تُخفي مقدارًا كبيرًا من التبسيط المُفرِط. فمثلًا، إذا عُدّنا خطوات العمليّة «عمليّات آليّة» فإنّنا نُقدّر أنّ عدد العمليّات الآليّة اللازمة لأداء ضربٍ - مثلًا - مستقلّ عن مقادير الأعداد المُراد ضربها، وهو زائفٌ إذا كانت الأعداد كبيرةً بالقدر الكافي. وتنطبق ملاحظاتٌ مماثلةٌ على تقديرات المكان. وشأن تصميم عمليّةٍ ووصفها، فإنّ تحليل العمليّة يمكن استقصاؤه على مستوياتٍ مختلفةٍ من التجريد. ↩︎
وبدقّةٍ أكثر، فإنّ عدد الضروب المطلوب يساوي ما يقلّ بواحد عن اللوغاريتم للأساس 2 للقيمة مضافًا إليه عدد الآحاد في التمثيل الثنائيّ لـ . وهذا المجموع أقلّ دائمًا من ضعف اللوغاريتم للأساس 2 لـ . وإنّ الثابتين الاعتباطيّين و في تعريف صياغة الرتبة يعنيان أنّ العمليّة اللوغاريتميّة لا يهمّ الأساس الذي تُجرى عليه اللوغاريتمات، وعلى هذا فجميع هذه العمليّات توصف بأنّها . ↩︎
ولعلك تتساءل لماذا يهتمّ أحدٌ برفع الأعداد إلى القوّة الألف. انظر 1.2.6. ↩︎
وهذه الخوارزميّة التكراريّة قديمة. وهي تظهر في Chandah-sutra للمؤلّف أشاريا بينغالا، المكتوب قبل عام 200 ق.م. انظر Knuth 1981، القسم 4.6.3، لمناقشةٍ وافيةٍ لهذه الطريقة وغيرها من طرق الأسّ. ↩︎
وهذه الخوارزميّة، التي تُعرف أحيانًا بـ«طريقة الفلاح الروسيّ» (Russian peasant method) في الضرب، قديمة. وأمثلة استخدامها موجودة في بردية ريند، وهي إحدى الوثيقتين الرياضيّتين الأقدم وجودًا، المكتوبة نحو عام 1700 ق.م. (والمنسوخة من وثيقةٍ أقدم منها) على يد كاتبٍ مصريّ يُدعى أحموسي. ↩︎
لقد اقترح علينا هذا التمرين جو ستوي، بناءً على مثالٍ في Kaldewaij 1990. ↩︎
إنّ خوارزميّة إقليدس تُسمّى كذلك لأنّها تظهر في «العناصر» لإقليدس (الكتاب 7، نحو عام 300 ق.م.). وطبقًا لـKnuth (1973)، فإنّه يمكن اعتبارها أقدم خوارزميّة غير تافهةٍ معروفة. وإنّ طريقة الضرب المصريّة القديمة (التمرين 1.18) لأقدم منها بلا شكّ، ولكنّ Knuth يفسّر أنّ خوارزميّة إقليدس هي الأقدم التي قُدّمت كخوارزميّةٍ عامّة، لا كمجموعةٍ من الأمثلة التوضيحيّة. ↩︎
أُثبتت هذه المبرهنة في عام 1845 على يد غابرييل لامي، وهو رياضيّ ومهندس فرنسيّ يُعرف أساسًا بمساهماته في الفيزياء الرياضيّة. ولإثبات المبرهنة، نُنظر في أزواج ، حيث ، والتي تنتهي عندها خوارزميّة إقليدس في خطوات. ويقوم البرهان على الادّعاء بأنّه، إذا كانت ثلاثة أزواج متتاليةٍ في عمليّة الاختزال، فإنّه لا بدّ أنّ . وللتحقّق من الادّعاء، اعتبر أنّ خطوة الاختزال تُعرَّف بتطبيق التحويل ، حيث باقي قسمة على . والمعادلة الثانية تعني أنّ لعددٍ صحيحٍ موجبٍ ما هو . وبما أنّ لا بدّ أن تكون 1 على الأقلّ فإنّ . ولكن في خطوة الاختزال السابقة لدينا . وعلى ذلك فإنّ . وهذا يتحقّق من الادّعاء. والآن يمكننا إثبات المبرهنة بالاستقراء على ، عدد الخطوات التي تتطلّبها الخوارزميّة حتّى تنتهي. والنتيجة صحيحة من أجل ، إذ إنّ هذا لا يتطلّب إلّا أن تكون بالغةً في الكبر بمقدار على الأقلّ. والآن، افترض أنّ النتيجة صحيحة لجميع الأعداد الصحيحة الأصغر من أو المساوية لها، وأثبت النتيجة من أجل . ولتكن أزواجًا متتاليةً في عمليّة الاختزال. فبفرضيّات الاستقراء لدينا، نتوصّل إلى و . وعلى هذا، فإنّ تطبيق الادّعاء الذي أثبتناه للتوّ مع تعريف أعداد فيبوناتشي يُعطينا ، وهو ما يُكمل برهان مبرهنة لامي. ↩︎
إذا كان قاسمًا لـ ، فإنّ كذلك. ولكنّ و لا يمكن أن يكونا كلَيْهما أكبرَين من . ↩︎
يُعتبر بيير دي فيرما (1601-1665) مُؤسّس نظريّة الأعداد الحديثة. وقد حصل على العديد من النتائج المهمّة في نظريّة الأعداد، ولكنّه كان يُعلن النتائج وحدها عادةً دون تقديم براهينها. وقد ذُكرت المبرهنة الصغرى لفيرما في رسالةٍ كتبها عام 1640. وأوّل برهانٍ منشورٍ أعطاه أويلر عام 1736 (وقد اكتُشف برهانٌ أوّليّ مطابقٌ في مخطوطات لايبنيز غير المنشورة). وأشهر نتائج فيرما - والمعروفة بمبرهنة فيرما الأخيرة - حُفِظت في عام 1637 في نسخته من كتاب «الحساب» (للرياضيّ اليونانيّ ديوفانتس في القرن الثالث) مع الملاحظة التالية: «لقد اكتشفتُ برهانًا رائعًا حقًّا، ولكنّ هذا الهامش ضيّقٌ جدًّا بحيث لا يتّسع له». وصار إيجاد برهانٍ لمبرهنة فيرما الأخيرة أحد أشهر التحدّيات في نظريّة الأعداد. وقد أُعطيت حلولٌ كاملةٌ أخيرًا عام 1995 على يد أندرو وايلز من جامعة برينستون. ↩︎
إنّ خطوات الاختزال في الحالات التي يكون فيها الأسّ أكبر من 1 تقوم على الحقيقة التي مفادها أنّنا - من أجل أيّ أعدادٍ صحيحةٍ و و - نستطيع إيجاد باقي ضرب بقياس باحتساب باقي بقياس وباقي بقياس على حدة، وضرب هذين، ثمّ أخذ باقي النتيجة بقياس . فمثلًا، في الحالة التي يكون فيها زوجيًّا، نحسب باقي بقياس ، ونربّع ذلك، ونأخذ باقيه بقياس . وهذه التقنيّة مفيدةٌ لأنّها تعني أنّنا نستطيع أداء احتسابنا دون الاضطرار أبدًا إلى التعامل مع أعدادٍ أكبر بكثيرٍ من . (قارن التمرين 1.25.) ↩︎
إنّ الأعداد التي تخدع اختبار فيرما تُسمّى أعداد كارميكل (Carmichael numbers)، ولا يُعرف عنها إلّا القليل، غير أنّها نادرةً للغاية. فثمّة 255 عددًا من أعداد كارميكل تحت 100.000.000. وأصغرها القليل هي 561، و1105، و1729، و2465، و2821، و6601. وعند اختبار أوّليّة أعدادٍ كبيرةٍ جدًّا منتقاةٍ عشوائيًّا، فإنّ احتمال الوقوع في قيمةٍ تخدع اختبار فيرما أقلّ من احتمال أن تُسبِّب الأشعّة الكونيّة خطأً في أداء الحاسوب لخوارزميّةٍ «صحيحة». واعتبار خوارزميّةٍ غير ملائمةٍ للسبب الأوّل دون الثاني يُظهر الفرق بين الرياضيّات والهندسة. ↩︎
إنّ أحد أبرز تطبيقات اختبار الأوّليّة الاحتماليّ كان في مجال التشفير. فعلى الرغم من أنّ تحليل عددٍ اعتباريٍّ مكوّنٍ من 200 رقمٍ إلى عوامل أوّليّة قد صار غير ممكنٍ احتسابيًّا، فإنّه يمكن التحقّق من أوّليّة عددٍ كهذا في بضع ثوانٍ باستخدام اختبار فيرما. وهذه الحقيقة تُشكّل أساس تقنيّةٍ لبناء «شيفراتٍ غير قابلةٍ للكسر» اقترحها Rivest et al. (1977). وقد صارت خوارزميّة RSA تقنيّةً واسعة الاستخدام لتعزيز أمن الاتّصالات الإلكترونيّة. وبسبب هذا التطوّر وما اتّصل به، فإنّ دراسة الأعداد الأوّليّة - التي كانت تُعتبر يومًا مثال الموضوع في الرياضيّات «النظريّة» التي تُدرس من أجل ذاتها فقط - تتبيّن الآن ذات تطبيقاتٍ عمليّةٍ مهمّةٍ في التشفير، وتحويل الأموال الإلكترونيّ، واسترجاع المعلومات. ↩︎
هذه المتسلسلة، التي تُكتب عادةً في الصيغة المكافئة ، ترجع إلى لايبنيز. وسنرى كيف نستخدم ذلك أساسًا لبعض الحِيَل العدديّة الأنيقة في 3.5.3. ↩︎
لاحِظ أنّنا استخدمنا بنية الكتل (1.1.8) لتضمين تعريفَي
pi-nextوpi-termداخلpi-sum، إذ إنّه من غير المرجّح أن تكون هذه الإجراءات مفيدةً لأيّ غرضٍ آخر. وسنرى كيف نستغني عنها كلّيًّا في 1.3.2. ↩︎إنّ المقصد من التمرين 1.31 إلى التمرين 1.33 هو إظهار القوّة التعبيريّة التي تُدرَك باستخدام تجريدٍ ملائمٍ لتوحيد كثيرٍ من العمليّات التي يبدو بينها تباعد. ولكن، وعلى رغم أنّ التجميع والترشيح فكرتان أنيقتان، فإنّ أيدينا مقيَّدةٌ نوعًا ما في استخدامهما في هذه المرحلة، إذ ليس لدينا بعدُ بنيات بياناتٍ لتوفير وسائل تجميعٍ ملائمةٍ لهذين التجريدين. وسنعود إلى هذه الأفكار في 2.2.3 حين نُظهر كيف نستخدم التسلسلات كواجهاتٍ لتجميع المرشّحات والمُجمِّعات لبناء تجريداتٍ أكثر قوّةً. وسنرى هناك كيف تتبلور هذه الطرائق فعلًا كمقاربةٍ قويّةٍ وأنيقةٍ لتصميم البرامج. ↩︎
اكتشف هذه الصيغة الرياضيّ الإنجليزيّ جون واليس في القرن السابع عشر. ↩︎
سيكون الأمر أوضح وأقلّ إرهابًا للناس الذين يتعلّمون Lisp لو استُخدم اسمٌ أوضح من
lambda، مثلmake-procedure. ولكن الاصطلاح راسخٌ رسوخًا متينًا. وقد أُخذت الترميز من حساب اللامدا (λ-calculus)، وهو صياغةٌ رياضيّةٌ أدخلها عالم المنطق الرياضيّ ألونزو Church (1941). وقد طوّر Church حساب اللامدا ليُوفّر أساسًا دقيقًا لدراسة مفهومَي الدالّة وتطبيق الدالّة. وقد صار حساب اللامدا أداةً أساسيّةً في البحوث الرياضيّة حول دلالات لغات البرمجة. ↩︎إنّ فهم التعريفات الداخليّة فهمًا حسنًا بما يكفي لأن نكون على يقينٍ من أنّ برنامجًا يعني ما نُنشده له أن يعني، يقتضي نموذجًا أكثر تفصيلًا لعمليّة التقييم ممّا قدّمناه في هذا الفصل. غير أنّ هذه الفروق الدقيقة لا تنشأ مع التعريفات الداخليّة للإجراءات. وسنعود إلى هذه القضيّة في 4.1.6، بعد أن نتعلّم المزيد عن التقييم. ↩︎
استخدمنا 0.001 عددًا «صغيرًا» نموذجيًّا للإشارة إلى تفاوتٍ للخطأ المقبول في عملية حسابية. والتفاوت الملائم لعملية حسابية حقيقية يعتمد على المشكلة المطلوب حلّها وعلى حدود الحاسوب والخوارزمية. وهذا غالبًا اعتبارٌ دقيقٌ للغاية، يقتضي مساعدةً من محلّل عدديّ أو نوعٍ آخر من السَحَرة. ↩︎
يمكن عمل ذلك باستخدام
error، التي تأخذ كوسائط عددًا من العناصر التي تُطبع كرسائل خطأ. ↩︎جرّب هذا في أثناء محاضرةٍ مملة: اضبط حاسبتك على وضع الراديانات، ثمّ اضغط زرّ
cosتكرارًا حتّى تحصل على النقطة الثابتة. ↩︎(يُنطق «يُقابل») هو طريق الرياضيّ في كتابة
lambda. و يعني(lambda (y) (/ x y))، أي الدالّة التي قيمتها عند هي . ↩︎لاحِظ أنّ هذا تركيبٌ عامله هو نفسه تركيب. وقد أبان التمرين 1.4 من قبل القدرة على تكوين تركيباتٍ كهذه، ولكن ذلك لم يكن إلّا مثالًا لعبة. وهنا نبدأ في رؤية الحاجة الحقيقيّة إلى مثل هذه التركيبات - عند تطبيق إجراءٍ يُحصَل عليه قيمةً معادةً من إجراءٍ من الرتبة العليا. ↩︎
انظر التمرين 1.45 لتعميمٍ إضافيّ. ↩︎
تُصفّ طريقة نيوتن في كتب الحساب الأساسيّة عادةً بدلالة تسلسل التقريبات . وإنّ امتلاك لغةٍ للحديث عن العمليّات واستخدام فكرة النقاط الثابتة يُبسّط وصف الطريقة. ↩︎
إنّ طريقة نيوتن لا تتقارب دائمًا نحو جواب، ولكن يمكن إظهار أنّ الحالات المواتية يُضاعِف كلّ تكرارٍ فيها عدد الأرقام الدقيقة في التقريب نحو الحلّ. وفي هذه الحالات، ستتقارب طريقة نيوتن تقاربًا أسرع بكثيرٍ من طريقة نصف الفترة. ↩︎
فمن أجل إيجاد الجذور التربيعيّة، تتقارب طريقة نيوتن بسرعةٍ نحو الحلّ الصحيح انطلاقًا من أيّ نقطة بداية. ↩︎
إنّ مفهوم مكانة الرتبة الأولى لعناصر لغة البرمجة يرجع إلى عالم الحاسوب البريطانيّ كريستوفر ستراشي (1916-1975). ↩︎
سنرى أمثلةً على ذلك بعد أن نُقدّم بنيات البيانات في الفصل 2. ↩︎
إنّ كلفة التنفيذ الرئيسة للإجراءات من الرتبة الأولى هي أنّ السّماح بإعادة الإجراءات كقيمٍ يقتضي حجز تخزينٍ للمتغيّرات الحرّة في إجراءٍ حتّى أثناء عدم تنفيذه للإجراء. وفي تنفيذ Scheme الذي سنهتمّ به في 4.1، تُخزَّن هذه المتغيّرات في بيئة الإجراء. ↩︎