الملحق: اشتقاق صيغ حساب التباين
A.1. اشتقاق صيغ حساب التباين
A.1.1. اشتقاق طريقة يونغز وكرامر
طريقة يونغز وكرامر (Youngs and Cramer method) تحسينٌ لطريقة وِلفورد المتّصلة. ولِفهم اشتقاق (derivation) طريقة يونغز وكرامر، نتفحّص طريقة وِلفورد (Welford method) أولًا.
طريقة وِلفورد:
تُعرَّف طريقة وِلفورد (Welford’s method) لحساب التباين (variance) بعلاقة الاستدعاء الذاتي (recurrence relation) التالية:
ويكون اشتقاق هذه العلاقة كما يلي:
طريقة يونغز وكرامر:
تُعدّل طريقة يونغز وكرامر طريقة وِلفورد باستبدال المتوسط (mean) بالمجموع لتحسين كفاءة الحساب والاستقرار العددي.
وتُشتق علاقة الاستدعاء الذاتي كما يلي:
A.1.2. اشتقاق صيغ التباين أحادي المرور / المتوازي
في معالجة الاستعلامات المتوازية (parallel query processing)، عند حساب التباين، تجمع عملية القائد (leader process) النتائج الجزئية التي حسبتها عمليات العمال (worker processes) لتوليد النتيجة النهائية.
ويمكن التعبير عن تباين مجموعة البيانات كاملة، ، بدلالة و و و كما يلي:
حيث:
- مجموعة البيانات (dataset):
- المتوسط الإجمالي:
- مجموع الجزء الأول من مجموعة البيانات:
- تباين الجزء الأول:
- مجموع الجزء الثاني من مجموعة البيانات:
- تباين الجزء الثاني:
البرهان:
A.2. أمثلة على io_uring
إلمام بأمثلة تنفيذ io_uring يوضّح الإدخال/الإخراج غير المتزامن (Asynchronous I/O أو AIO) في PostgreSQL. وفيما يلي مثالان بسيطان.
وهما يقدّمان نموذجًا مبسّطًا (toy model) لمدير مخزن مؤقت (buffer manager)، إذ يقرآن البيانات من ملف بشكل غير متزامن إلى فتحات في الذاكرة (الشكل A2.1).
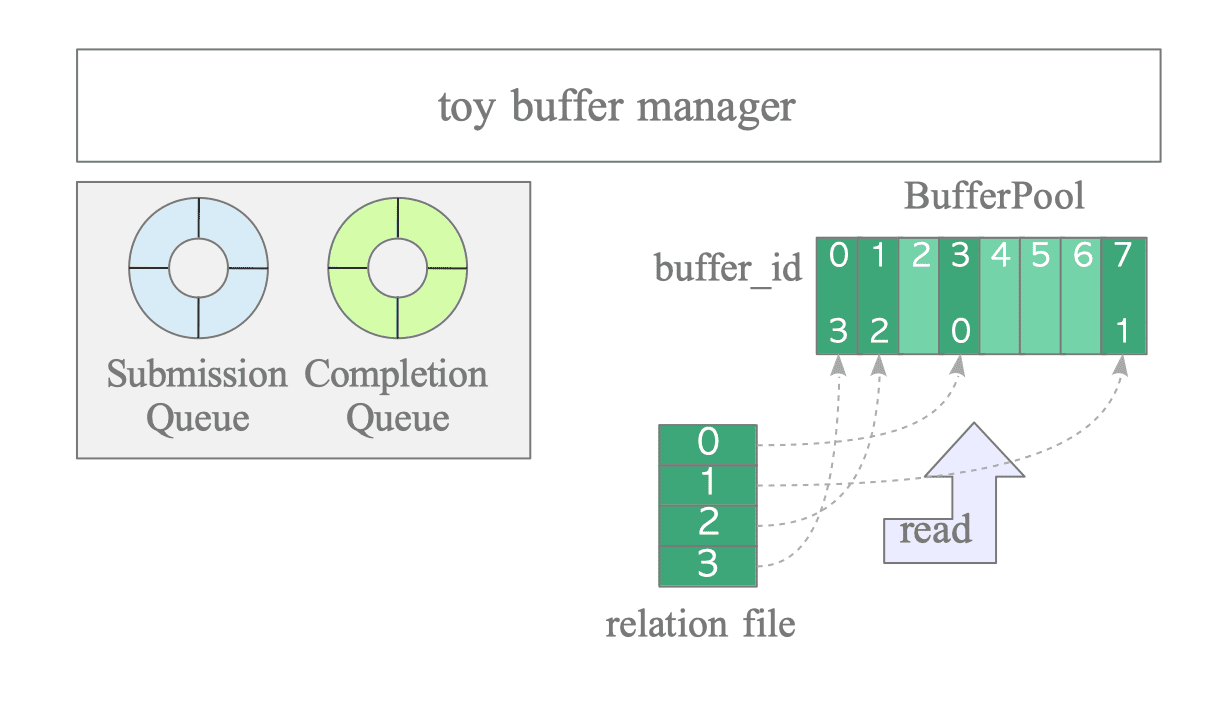
الشكل A2.1. نموذج مبسّط لمدير المخزن المؤقت.
تقرأ البرامج ملفًا بحجم 32 بايت (rel.data) بشكل غير متزامن إلى مصفوفة BufferPool مستخدمةً أربعة طلبات قراءة بحجم 8 بايت لكل منها.
$ cat rel.data
A0000000B0000001C0000010D0000011
#define BUFFER_SIZE 8
#define PAGE_SIZE 8

char BufferPool[BUFFER_SIZE][PAGE_SIZE + 1];
في هذين المثالين، توضع الكتل المنطقية الأربع من rel.data في فتحات BufferPool أرقام 3 و7 و1 و0.
/*
 * Mapping Table: Logical Block -> Physical Buffer Slot
 * Defines the destination slot in BufferPool for each sequential file block.
 * - Block 0 (Bytes 0-7)   -> BufferPool[3]
 * - Block 1 (Bytes 8-15)  -> BufferPool[7]
 * - Block 2 (Bytes 16-23) -> BufferPool[1]
 * - Block 3 (Bytes 24-31) -> BufferPool[0]
 */
#define QUEUE_SIZE 4

int dest[QUEUE_SIZE] = { 3, 7, 1, 0 };
A.2.1. أسلوب القراءة المتعددة
يوضّح المثال التالي برنامج io_uring بسيطًا.
الشيفرة المصدرية الكاملة معروضة فيما يلي: ** ** aio_read.c
$ cat rel.data
A0000000B0000001C0000010D0000011
$ cat aio_read.c
#include <liburing.h>
#include <stdio.h>
#include <string.h>
#include <unistd.h>
#define BUFFER_SIZE 8
#define PAGE_SIZE 8
#define QUEUE_SIZE 4
#define REL_FILE "rel.data"
int
main()
{
int fd;
struct io_uring ring;
char BufferPool[BUFFER_SIZE][PAGE_SIZE+1];
/*
* Mapping Table: Logical Block -> Physical Buffer Slot
* Defines the destination slot in BufferPool for each sequential file block.
* - Block 0 (Bytes 0-7) -> BufferPool[3]
* - Block 1 (Bytes 8-15) -> BufferPool[7]
* - Block 2 (Bytes 16-23) -> BufferPool[1]
* - Block 3 (Bytes 24-31) -> BufferPool[0]
*/
int dest[QUEUE_SIZE] = { 3, 7, 1, 0 };
/* Initialize io_uring environment and open target relation file */
io_uring_queue_init(QUEUE_SIZE, &ring, 0);
if ((fd = open(REL_FILE, O_RDONLY)) < 0)
return 1;
memset(BufferPool, 0, sizeof(BufferPool));
/*
* Prepare and submit read requests
*/
for (int i = 0; i < QUEUE_SIZE; i++) {
struct io_uring_sqe* sqe = io_uring_get_sqe(&ring);
int buff_id = dest[i];
io_uring_prep_read(sqe, fd, BufferPool[buff_id], PAGE_SIZE, i * PAGE_SIZE);
sqe->user_data = i;
}
io_uring_submit(&ring);
/*
* Wait for completion events
*/
for (int i = 0; i < QUEUE_SIZE; i++) {
int blockNum;
int buff_id;
struct io_uring_cqe* cqe;
/* Wait for one io_uring completion event */
io_uring_wait_cqe(&ring, &cqe);
/* Mark io_uring completion event as consumed */
io_uring_cqe_seen(&ring, cqe);
/* Output the results */
blockNum = (int)cqe->user_data;
buff_id = dest[blockNum];
printf("CQ[%d]: BlockNum_%d -> BufferPool[%d] offset=%3d bytes=%2d: [%s]\n",
i+1, blockNum, buff_id, blockNum * PAGE_SIZE, PAGE_SIZE, BufferPool[buff_id]);
}
close(fd);
io_uring_queue_exit(&ring);
return 0;
}
$ gcc -o aio_read aio_read.c -luring
$ ./aio_read
CQ[1]: BlockNum_0 -> BufferPool[3] offset= 0 bytes= 8: [A0000000]
CQ[2]: BlockNum_1 -> BufferPool[7] offset= 8 bytes= 8: [B0000001]
CQ[3]: BlockNum_2 -> BufferPool[1] offset= 16 bytes= 8: [C0000010]
CQ[4]: BlockNum_3 -> BufferPool[0] offset= 24 bytes= 8: [D0000011]
أولًا، يفتح البرنامج الملف ويهيّئ نسخة io_uring.
#define REL_FILE "rel.data"

int fd;
struct io_uring ring;

if ((fd = open(REL_FILE, O_RDONLY)) < 0)
    return 1;

io_uring_queue_init(QUEUE_SIZE, &ring, 0);
يوضّح الشكل A2.2 التدفق اللاحق لمعالجة طلبات قراءة متعددة.
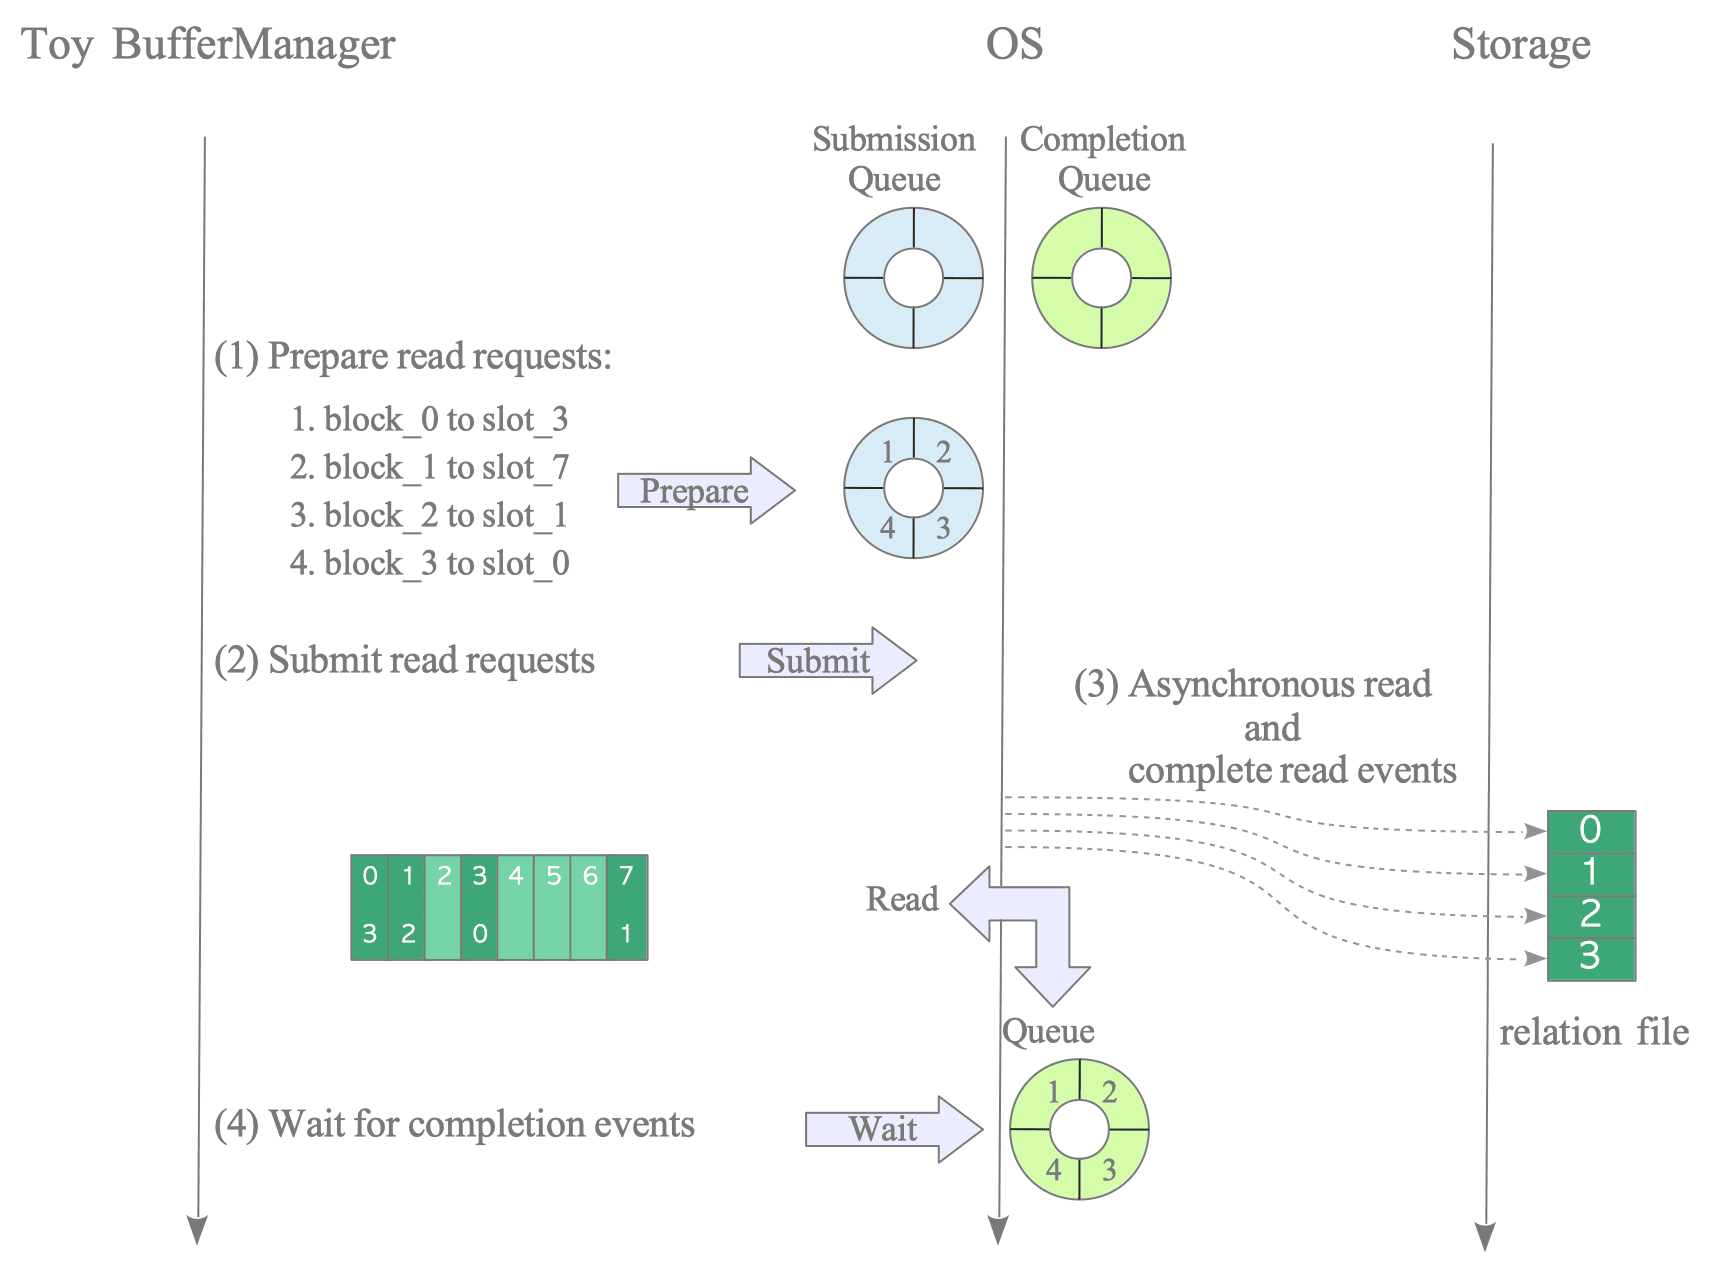
الشكل A2.2. تدفق معالجة طلبات قراءة متعددة.
(1) تحضير طلبات القراءة: يوفّر io_uring_get_sqe() مدخلًا واحدًا في طابور الإرسال (Submission Queue Entry أو SQE) لكل طلب قراءة. ثم يملأ io_uring_prep_read() كل مدخل SQE بطلب قراءة، محددًا المخزن الهدف وحجم القراءة وإزاحة الملف. ويخزّن الحقل user_data رقم الكتلة لربط كل حدث إتمام بالطلب المقابل له لاحقًا.
for (int i = 0; i < QUEUE_SIZE; i++) {
    struct io_uring_sqe* sqe = io_uring_get_sqe(&ring);
    int buff_id = dest[i];
    io_uring_prep_read(sqe, fd, BufferPool[buff_id], PAGE_SIZE, i * PAGE_SIZE);
    sqe->user_data = i;
}
(2) إرسال طلبات القراءة: بعد جهوزية طلبات القراءة الأربعة كلها، يرسلها io_uring_submit() معًا.
io_uring_submit(&ring);
(3) قراءة الكتل وإدراج أحداث الإتمام: تقرأ النواة الكتل المطلوبة من جهاز التخزين. وبمجرد اكتمال كل قراءة، تدرج النواة حدث إتمام في طابور الإتمام (Completion Queue أو CQ).
(4) انتظار أحداث الإتمام: ينتظر البرنامج أحداث الإتمام باستدعاء io_uring_wait_cqe() مرارًا وتكرارًا. ويصبح المخزن المؤقت المقابل آمنًا للوصول كلما وصل حدث إتمام. وأخيرًا، يضع io_uring_cqe_seen() علامة على مدخل طابور الإتمام باعتباره مستهلَكًا.
for (int i = 0; i < QUEUE_SIZE; i++) {
int blockNum;
int buff_id;
struct io_uring_cqe* cqe;
/* Wait for one io_uring completion event */
io_uring_wait_cqe(&ring, &cqe);
/* Mark io_uring completion event as consumed */
io_uring_cqe_seen(&ring, cqe);
/* Output the results */
blockNum = (int)cqe->user_data;
buff_id = dest[blockNum];
printf("CQ[%d]: BlockNum_%d -> BufferPool[%d] offset=%3d bytes=%2d: [%s]\n",
i+1, blockNum, buff_id, blockNum * PAGE_SIZE, PAGE_SIZE, BufferPool[buff_id]);
}
أنتجت إحدى عمليات تنفيذ البرنامج الخرج التالي.
$ ./aio_read
CQ[1]: BlockNum_0 -> BufferPool[3] offset=  0 bytes= 8: [A0000000]
CQ[2]: BlockNum_1 -> BufferPool[7] offset=  8 bytes= 8: [B0000001]
CQ[3]: BlockNum_2 -> BufferPool[1] offset= 16 bytes= 8: [C0000010]
CQ[4]: BlockNum_3 -> BufferPool[0] offset= 24 bytes= 8: [D0000011]
A.2.2. أسلوب القراءة المتجهة
يدعم io_uring الإدخال/الإخراج المتجهي (Vector I/O) أو الإدخال/الإخراج بالتجميع-التفريق (Scatter-Gather I/O)، ما يتيح قراءة صفحات متتالية متعددة بكفاءة عبر طلب قراءة واحد.
يوضّح المثال التالي كيفية عمل io_uring على صفحات متتالية متعددة.
الشيفرة المصدرية الكاملة معروضة فيما يلي: ** ** aio_readv.c
$ cat rel.data
A0000000B0000001C0000010D0000011
$ cat aio_readv.c
#include <fcntl.h>
#include <liburing.h>
#include <stdio.h>
#include <string.h>
#include <unistd.h>
#define BUFFER_SIZE 8
#define PAGE_SIZE 8
#define QUEUE_SIZE 4
#define REL_FILE "rel.data"
int
main()
{
int fd;
struct io_uring ring;
char BufferPool[BUFFER_SIZE][PAGE_SIZE + 1];
struct iovec iov[QUEUE_SIZE];
/*
* Mapping Table: Logical Block -> Physical Buffer Slot
* Defines the destination slot in BufferPool for each sequential file block.
* - Block 0 (Bytes 0-7) -> BufferPool[3]
* - Block 1 (Bytes 8-15) -> BufferPool[7]
* - Block 2 (Bytes 16-23) -> BufferPool[1]
* - Block 3 (Bytes 24-31) -> BufferPool[0]
*/
int dest[QUEUE_SIZE] = { 3, 7, 1, 0 };
/* Initialize io_uring environment and open target relation file */
io_uring_queue_init(QUEUE_SIZE, &ring, 0);
if ((fd = open(REL_FILE, O_RDONLY)) < 0)
return 1;
memset(BufferPool, 0, sizeof(BufferPool));
/* Set up iovec array to bind scattered buffer pool addresses to the read stream */
for (int blockNum = 0; blockNum < QUEUE_SIZE; blockNum++) {
int buff_id = dest[blockNum];
iov[blockNum].iov_base = BufferPool[buff_id];
iov[blockNum].iov_len = PAGE_SIZE;
}
/*
* Prepare and submit a single scatter-read request (readv)
*/
struct io_uring_sqe* sqe = io_uring_get_sqe(&ring);
io_uring_prep_readv(sqe, fd, iov, QUEUE_SIZE, 0 /* file offset */);
io_uring_submit(&ring);
/*
* Wait until the single CQE (representing the entire readv completion) returns
*/
struct io_uring_cqe* cqe;
io_uring_wait_cqe(&ring, &cqe);
/* Mark the completion event as consumed */
io_uring_cqe_seen(&ring, cqe);
/* Output the results scattered into the buffer pool */
printf("CQ: readv completed: %d bytes read\n", cqe->res);
for (int blockNum = 0; blockNum < QUEUE_SIZE; blockNum++) {
int buff_id = dest[blockNum];
printf("\tBlockNum_%d -> BufferPool[%d] offset=%3d bytes=%2d: [%s]\n",
blockNum, buff_id, blockNum * PAGE_SIZE, PAGE_SIZE, BufferPool[buff_id]);
}
close(fd);
io_uring_queue_exit(&ring);
return 0;
}
$ gcc -o aio_readv aio_readv.c -luring
$ ./aio_readv
CQ: readv completed: 32 bytes read
BlockNum_0 -> BufferPool[3] offset= 0 bytes= 8: [A0000000]
BlockNum_1 -> BufferPool[7] offset= 8 bytes= 8: [B0000001]
BlockNum_2 -> BufferPool[1] offset= 16 bytes= 8: [C0000010]
BlockNum_3 -> BufferPool[0] offset= 24 bytes= 8: [D0000011]
لاستخدام ميزة الإدخال/الإخراج المتجهي، ينشئ البرنامج مصفوفة iov ويضبط عناوين فتحات BufferPool.
struct iovec iov[QUEUE_SIZE];

/* Set up iovec array to bind scattered buffer pool addresses to the read stream */
for (int blockNum = 0; blockNum < QUEUE_SIZE; blockNum++) {
    int buff_id = dest[blockNum];
    iov[blockNum].iov_base = BufferPool[buff_id];
    iov[blockNum].iov_len = PAGE_SIZE;
}
يوضّح الشكل A2.3 التدفق اللاحق لمعالجة طلب قراءة متجهة.
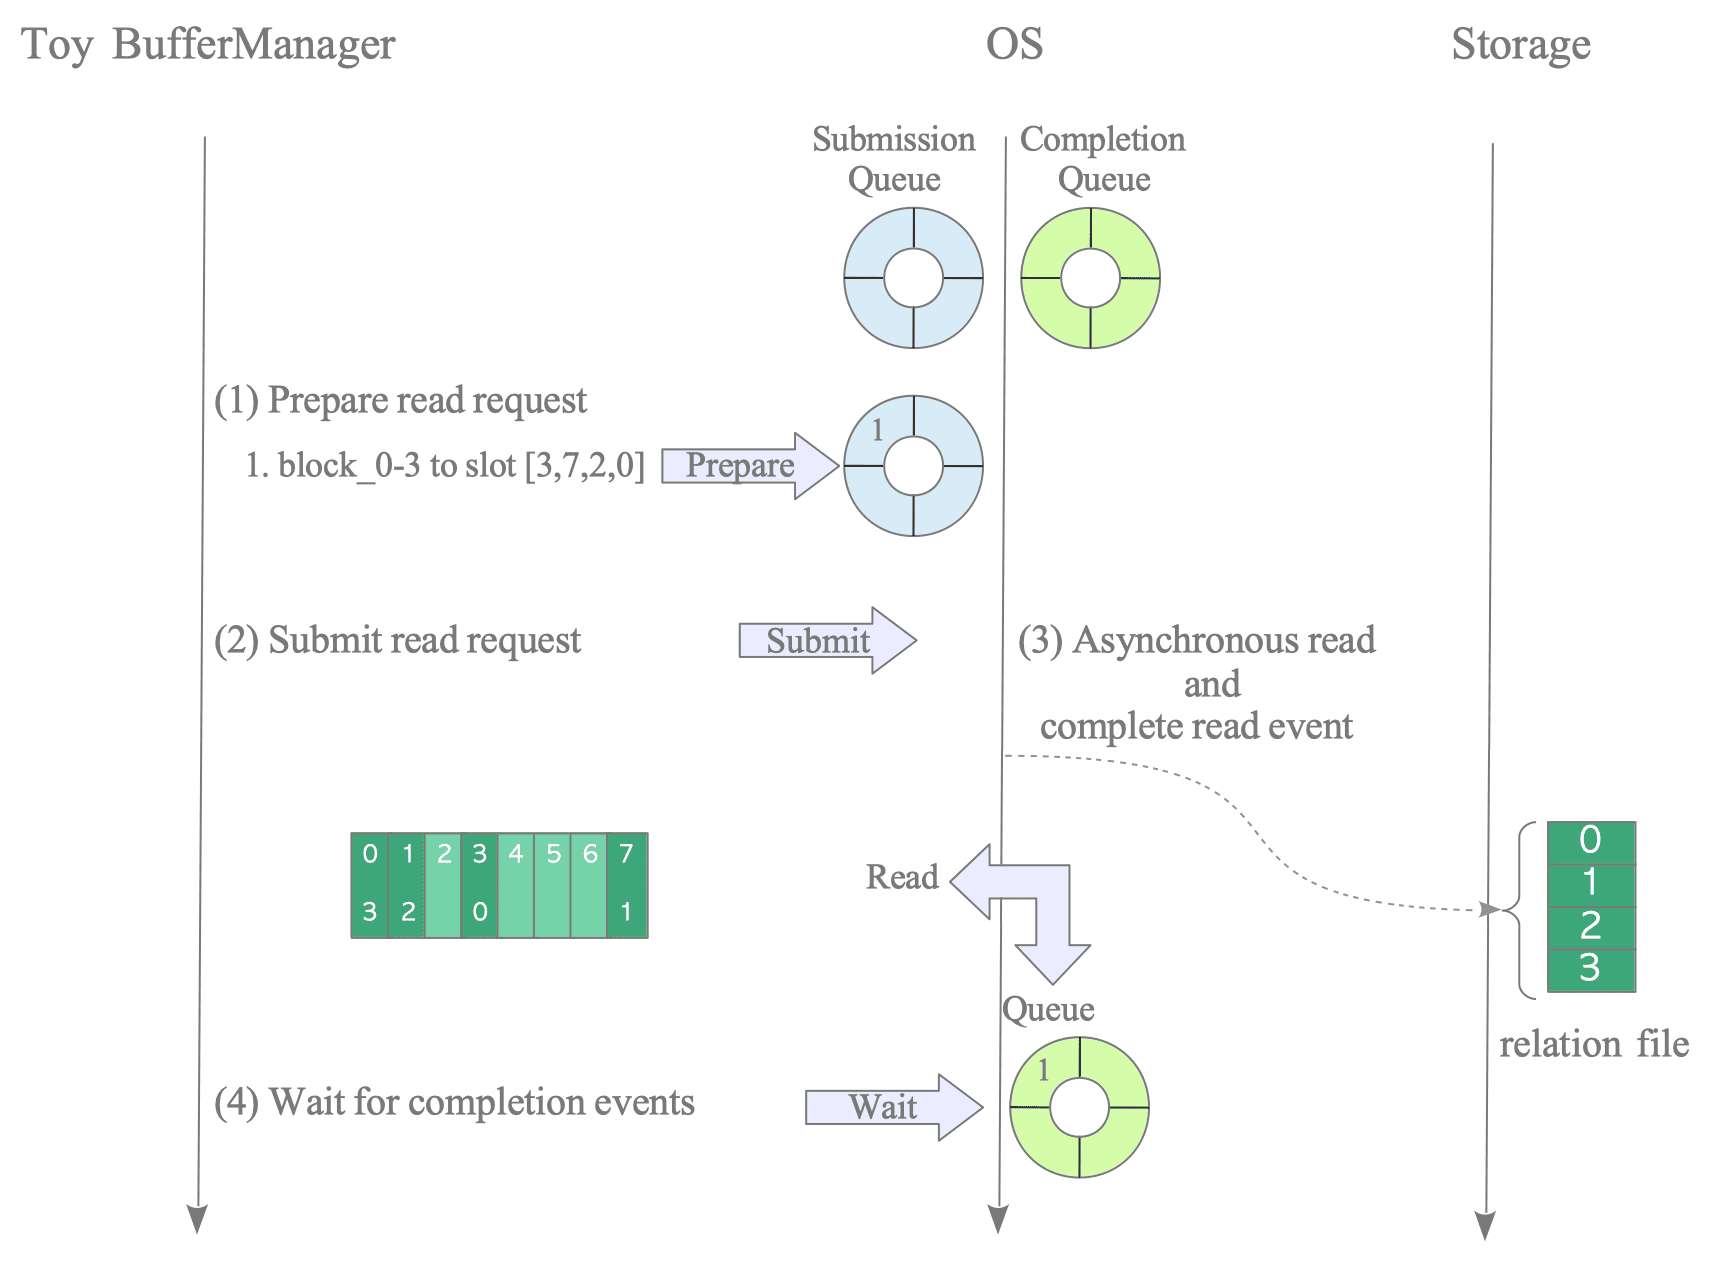
الشكل A2.3. تدفق معالجة طلب قراءة متجهة.
(1) تحضير طلب القراءة: يجهّز البرنامج طلب قراءة واحدًا. وخلافًا للمثال السابق، يقرأ هذا الطلب الواحد أربع كتل متتالية إلى فتحات BufferPool المتفّرقة المحددة في مصفوفة iov.
struct io_uring_sqe* sqe = io_uring_get_sqe(&ring);
io_uring_prep_readv(sqe, fd, iov, QUEUE_SIZE, 0 /* file offset */);
(2) إرسال طلب القراءة: يرسل io_uring_submit() طلب القراءة.
io_uring_submit(&ring);
(3) قراءة الكتل وإدراج حدث الإتمام: تقرأ النواة الكتل المتتالية الأربع كلها من الملف. وعند اكتمال عملية القراءة المتجهة بأكملها، تدرج النواة حدث إتمام واحدًا في طابور الإتمام CQ.
(4) انتظار حدث الإتمام: ينتظر البرنامج حدث إتمام طلب القراءة. وخلافًا للمثال السابق، ومع أن البرنامج طلب أربع كتل، تدرج النواة حدثًا واحدًا فقط في طابور الإتمام CQ لأنه لا يوجد سوى طلب قراءة واحد.
struct io_uring_cqe* cqe;
/* Wait for a completion event */
io_uring_wait_cqe(&ring, &cqe);
/* Mark the completion event as consumed */
io_uring_cqe_seen(&ring, cqe);
/* Output the results scattered into the buffer pool */
printf("CQ: readv completed: %d bytes read\n", cqe->res);
for (int blockNum = 0; blockNum < QUEUE_SIZE; blockNum++) {
int buff_id = dest[blockNum];
printf("\tBlockNum_%d -> BufferPool[%d] offset=%3d bytes=%2d: [%s]\n",
blockNum, buff_id, blockNum * PAGE_SIZE, PAGE_SIZE, BufferPool[buff_id]);
}
أنتجت إحدى عمليات تنفيذ البرنامج الخرج التالي.
$ ./aio_readv
CQ: readv completed: 32 bytes read
	BlockNum_0 -> BufferPool[3] offset=  0 bytes= 8: [A0000000]
	BlockNum_1 -> BufferPool[7] offset=  8 bytes= 8: [B0000001]
	BlockNum_2 -> BufferPool[1] offset= 16 bytes= 8: [C0000010]
	BlockNum_3 -> BufferPool[0] offset= 24 bytes= 8: [D0000011]
يؤدي استخدام ميزة الإدخال/الإخراج المتجهي إلى تجميع قراءة الكتل المتتالية في طلب قراءة واحد.