5. جداول التجزئة
جداول التجزئة (hash tables) طريقةٌ كفؤة لتخزين عددٍ صغير، ، من الأعداد الصحيحة المأخوذة من مدى واسع . ويشمل مصطلح «جدول التجزئة» مدىً واسعًا من بنى البيانات. يركّز الجزء الأول من هذا الفصل على أكثر تنفيذين شيوعًا لجداول التجزئة: التجزئة بالتسلسل (hashing with chaining) والاستكشاف الخطي (linear probing). وكثيرًا ما تخزّن جداول التجزئة أنواعًا من البيانات ليست أعدادًا صحيحة. وفي هذه الحالة يُسنَد إلى كل عنصر بيانات رمز تجزئة (hash code) صحيح يُستخدَم في جدول التجزئة. ويناقش الجزء الثاني من هذا الفصل كيفية توليد رموز التجزئة هذه. وتتطلب بعض الطرق المستخدَمة في هذا الفصل اختيار أعداد صحيحة عشوائية ضمن مدى محدّد. وفي نماذج الشيفرة تكون بعض هذه الأعداد «العشوائية» ثوابت مكتوبة على نحو صريح (hard-coded). وقد جُمِعت هذه الثوابت باستخدام بتّات عشوائية مولَّدة من ضجيج جوي.
الأقسام الفرعية
5.1 ChainedHashTable: التجزئة بالتسلسل
الأقسام الفرعية
5.1 ChainedHashTable: التجزئة بالتسلسل
تستخدم بنية بيانات ChainedHashTable التجزئة بالتسلسل لتخزين البيانات في صورة مصفوفة، ، من القوائم (lists). ويحتفظ عدد صحيح، ، بمجموع عدد العناصر في جميع القوائم (انظر الشكل 5.1):
    List<T>[] t;
    int n;
قيمة تجزئة عنصر البيانات ، والمشار إليها بـ ، هي قيمة ضمن المدى . وتُخزَّن جميع العناصر ذات قيمة التجزئة في القائمة عند . ولمنع أن تصير القوائم طويلة أكثر من اللازم، نُبقي على الشرط الثابت (invariant)
بحيث يكون متوسط عدد العناصر المخزَّنة في إحدى هذه القوائم هو . ولإضافة عنصر إلى جدول التجزئة، نتحقّق أولًا مما إذا كان طول يحتاج إلى زيادة، فإن كان ذلك فإننا نُنمّي . وبعد أن نُنهي ذلك نجزّئ لنحصل على عدد صحيح، ، ضمن المدى ، ثم نُلحق بالقائمة :
    boolean add(T x) {
        if (find(x) != null) return false;
        if (n+1 > t.length) resize();
        t[hash(x)].add(x);
        n++;
        return true;
    }
ينطوي نموُّ الجدول، عند الضرورة، على مضاعفة طول وإعادة إدراج جميع العناصر في الجدول الجديد. وهذه الاستراتيجية هي نفسها تمامًا المستخدَمة في تنفيذ ArrayStack، وينطبق عليها النتيجة نفسها: ف تكلفة النموّ ثابتة فقط عند الاحتساب بمعدل (amortized) على تسلسل من عمليات الإدراج (انظر المتراجمة 2.1 في الصفحة  ). وإلى جانب النموّ، فإن العمل الوحيد الآخر الذي يجري عند إضافة قيمة جديدة إلى ChainedHashTable هو إلحاق بالقائمة . ولكلٍّ من تنفيذي القوائم الموصوفين في الفصلين 2 أو 3، لا يستغرق هذا سوى زمن ثابت. ولإزالة عنصر من جدول التجزئة، نمرّ على القائمة حتى نجد لنتمكن من إزالته:
    T remove(T x) {
        Iterator<T> it = t[hash(x)].iterator();
        while (it.hasNext()) {
            T y = it.next();
            if (y.equals(x)) {
                it.remove();
                n--;
                return y;
            }
        }
        return null;
    }
يستغرق هذا زمنًا قدره ، حيث يشير إلى طول القائمة المخزَّنة عند . والبحث عن العنصر في جدول تجزئة مشابه. فنجري بحثًا خطيًا في القائمة :
    T find(Object x) {
        for (T y : t[hash(x)])
            if (y.equals(x))
                return y;
        return null;
    }
ومرة أخرى، يستغرق هذا زمنًا متناسبًا مع طول القائمة .
يعتمد أداء جدول التجزئة اعتمادًا حاسمًا على اختيار دالة التجزئة (hash function). فدالة التجزئة الجيدة توزّع العناصر بالتساوي على القوائم الـ ، بحيث يكون الحجم المتوقَّع للقائمة هو . وعلى النقيض، فإن دالة التجزئة السيئة تجعل جميع القيم (بما فيها ) تُجزَّأ إلى موضع الجدول نفسه، وعندها يكون حجم القائمة هو . وفي القسم التالي نصف دالة تجزئة جيدة. 5.1.1 التجزئة الضربية (multiplicative hashing) التجزئة الضربية طريقةٌ كفؤة لتوليد قيم التجزئة بالاعتماد على الحساب النمطي (modular arithmetic) (المُناقَش في القسم 2.3) والقسمة الصحيحة. وهي تستخدم المعامل الذي يحسب الجزء الصحيح من ناتج القسمة مع تجاهل الباقي. وصيغته: لأي عددين صحيحين و ، فإن . وفي التجزئة الضربية نستخدم جدول تجزئة حجمه مهما كان العدد الصحيح (ويسمى البُعد (dimension)). وصيغة تجزئة العدد الصحيح هي
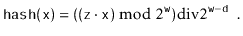
هنا عددٌ صحيح فردي يُختار عشوائيًا من . ويمكن تنفيذ دالة التجزئة هذه بكفاءة بالغة بمجرد ملاحظة أن عمليات الأعداد الصحيحة تُنفَّذ افتراضيًا بمقياس حيث عدد البتّات في العدد الصحيح.5.1 (انظر الشكل 5.2.) وإضافةً إلى ذلك، فإن القسمة الصحيحة على تعادل إسقاط البتّات الأخيرة في التمثيل الثنائي (وهذا يُنفَّذ بإزاحة البتّات إلى اليمين بمقدار باستخدام المعامل ). وبهذه الطريقة تكون الشيفرة التي تنفّذ الصيغة أعلاه أبسط من الصيغة نفسها:
    int hash(Object x) {
        return (z * x.hashCode()) >>> (w-d);
    }
الشكل 5.2: تشغيل دالة التجزئة الضربية مع و . 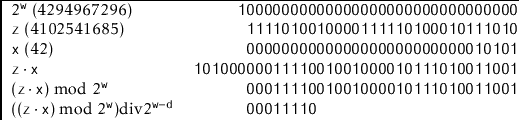 وتبيّن المتراجمة التالية (Lemma)، إن كان برهانها مؤجَّلًا إلى ما بعد في هذا القسم، أن التجزئة الضربية تحسن التخلّص من التصادمات (collisions): المتراجمة 5.1 ليكن و أي قيمتين في بحيث . وعندئذ .
بالمتراجمة 5.1، يصبح تحليل أداء و سهلًا: المتراجمة 5.2 لكل قيمة بيانات ، يكون الطول المتوقَّع للقائمة هو على الأكثر، حيث هو عدد تكرارات في جدول التجزئة.
إثبات. ليكن المجموعة (متعددة العناصر) للعناصر المخزَّنة في جدول التجزئة التي لا تساوي . ولكل عنصر ، عرّف المتغيّر الإشاري (indicator variable)
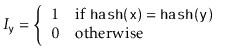
ولاحظ أن، بحسب المتراجمة 5.1، . ويعطى الطول المتوقَّع للقائمة بـ
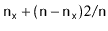 |
|||
كما هو مطلوب.
الآن نريد إثبات المتراجمة 5.1، لكننا نحتاج أولًا إلى نتيجة من نظرية الأعداد (number theory). وفي البرهان التالي نستخدم الترميز للدلالة على ، حيث كل بتّ قيمته 0 أو 1. بمعنى آخر، هو العدد الصحيح الذي تمثيله الثنائي هو . ونستخدم للدلالة على بتّ مجهول القيمة. المتراجمة 5.3 ليكن مجموعة الأعداد الفردية في ؛ وليكن و أي عنصرين في . وعندئذ توجد قيمة واحدة بالضبط تحقق .
إثبات. بما أن عدد الاختيارات لـ و هو نفسه، فإنّه يكفي إثبات وجود قيمة واحدة على الأكثر تحقق .
ولنفرض، طلبًا للتناقض، وجود قيمتين من هذا النوع و ، بحيث . عندئذ
إذن
لكن هذا يعني أن
لبعض العدد الصحيح . وبالتفكير في مصطلحات الأعداد الثنائية، لدينا
بحيث تكون البتّات اللاحقة في التمثيل الثنائي لـ كلها أصفارًا.
وفوق ذلك ، لأن و . وبما أن فردي، فلا توجد عنده أصفار لاحقة في تمثيله الثنائي:
ولأن ، فإن يملك عددًا من الأصفار اللاحقة في تمثيله الثاني أقل من :
لذلك يملك حاصل الضرب عددًا من الأصفار اللاحقة في تمثيله الثاني أقل من :
لذلك لا يمكن أن يحقّق الشرط (5.1)، فينشأ تناقض ويكتمل البرهان.
تنبع فائدة المتراجمة 5.3 من الملاحظة التالية: إذا اختير عشوائيًا بانتظام من ، فإن يتوزّع بانتظام على . وفي البرهان التالي من المفيد التفكير في التمثيل الثنائي لـ ، وهو يتكوّن من بتّ عشوائي يليه بتّ بقيمة 1.
إثبات. [إثبات المتراجمة 5.1] نلاحظ أولًا أن الشرط يعادل القول «أن البتّات ذات الرتبة العليا في والبتّات ذات الرتبة العليا في متساوية.» والشرط الضروري لهذا القول هو أن تكون البتّات ذات الرتبة العليا في التمثيل الثنائي لـ إمّا كلها أصفارًا أو كلها آحادًا. أي:
عندما أو
عندما . لذلك لا علىّ سوى تقييد احتمال أن يبدو على هيئة (5.2) أو (5.3).
ليكن العدد الفردية الفريد بحيث لبعض العدد الصحيح . وبالمتراجمة 5.3، فإن التمثيل الثنائي لـ يحتوي بتّ عشوائي يليه بتّ بقيمة 1:
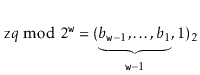
لذلك، فإن التمثيل الثنائي لـ 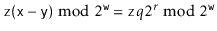 يحتوي بتّ عشوائي، يليه بتّ بقيمة 1، يليه من الأصفار:
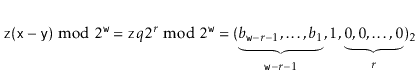
يمكننا الآن إكمال البرهان: إذا كان ، فالبتّات ذات الرتبة العليا في تحتوي أصفارًا وآحادًا معًا، ومن ثمّ فإن احتمال أن يبدو على هيئة (5.2) أو (5.3) هو 0. وإذا كان ، فإن احتمال الظهور على هيئة (5.2) هو 0، لكن احتمال الظهور على هيئة (5.3) هو (لأننا يجب أن يكون ). وإذا كان ، فيجب أن يكون أو . احتمال كلٍّ من هذين الحالتين هو وهما متعارضتان تبادليًا، ومن ثمّ فإن احتمال إحداهما هو . وبهذا يكتمل البرهان.
5.1.2 خلاصة تلخّص النظرية التالية أداء بنية بيانات ChainedHashTable: نظرية 5.1 *تنفّذ ChainedHashTable واجهة USet. وتجاهلًا لتكلفة استدعاءات ، يدعم ChainedHashTable العمليات و و في زمن متوقَّع قدره لكل عملية. * وفضًا عن ذلك، فإن البدء من ChainedHashTable فارغ وأي تسلسل عدده من عمليات و ينتج عنهما زمن كلي قدره مُنفَقًا خلال جميع استدعاءات .
حواشٍ
... عدد صحيح.5.1 ينطبق هذا على معظم لغات البرمجة ومنها C و C# و C++ و Java. ومن أبرز الاستثناءات Python و Ruby، إذ إن نتيجة عملية على عدد صحيح بطول ثابت قدره بت يفيض عن هذا الطول تُرقَّى إلى تمثيل بطول متغيّر. opendatastructures.org
5.2 LinearHashTable: الاستكشاف الخطي
الأقسام الفرعية
5.2 LinearHashTable: الاستكشاف الخطي
تستخدم بنية بيانات ChainedHashTable مصفوفة من القوائم، حيث تخزّن القائمة رقم جميع العناصر التي تتحقق . وهناك بديل يُسمّى العنونة المفتوحة (open addressing) هو تخزين العناصر مباشرةً في مصفوفة، ، بحيث يخزّن كل موضع في قيمة واحدة على الأكثر. وهذا هو المنهج الذي يتبعه LinearHashTable الموصوف في هذا القسم. وتُسمّى هذه البنية في بعض المواضع «عنونة مفتوحة مع استكشاف خطي». وتتمثّل الفكرة الأساسية خلف LinearHashTable في أننا نودّ، مثاليًا، تخزين العنصر ذي قيمة التجزئة في موضع الجدول . وإذا تعذّر ذلك (لأن عنصرًا ما مخزَّن هناك بالفعل) نحاول تخزينه عند الموضع ؛ وإذا لم يكن ذلك ممكنًا، نحاول وهكذا، حتى نجد مكانًا لـ . وهناك ثلاثة أنواع من المداخل المخزَّنة في :
- قيم البيانات: القيم الفعلية في USet التي نمثّلها؛
- قيم : عند المواضع التي لم تُخزَّن فيها أي بيانات من قبل؛ و
- قيم : عند المواضع التي خُزِّنت فيها بيانات في وقت ما ثم حُذفت منذ ذلك الحين.
إلى جانب العدّاد الذي يتتبّع عدد العناصر في LinearHashTable، فإن عدّادًا آخر، ، يتتبّع عدد عناصر النوعين 1 و3. أي أن يساوي مضافًا إليه عدد قيم في . ولجعل هذا يعمل بكفاءة نحتاج إلى أن يكون أكبر بكثير من ، بحيث تتوفّر في قيَم كثيرة. وتحافظ عمليات LinearHashTable بالتالي على الشرط الثابت . وباختصار، يحتوي LinearHashTable على مصفوفة، ، تخزّن عناصر البيانات، وعلى عددين صحيحين و يتتبّعان على التوالي عدد عناصر البيانات وعدد القيم غير في . ولأن كثيرًا من دوال التجزئة لا تعمل إلا مع أحجام جداول تكون قوة للعدد 2، فنحن نحتفظ أيضًا بعدد صحيح ونحافظ على الشرط الثابت .
    T[] t;   // the table
    int n;   // the size
    int d;   // t.length = 2^d
    int q;   // number of non-null entries in t
عملية في LinearHashTable بسيطة. نبدأ عند المدخل في المصفوفة حيث ، ونفحص المداخل و و وهكذا، حتى نجد فهرسًا بحيث إمّا أو . في الحالة الأولى نُرجع . وفي الحالة الثانية نستنتج أن غير موجود في جدول التجزئة ونُرجع .
    T find(T x) {
        int i = hash(x);
        while (t[i] != null) {
            if (t[i] != del && x.equals(t[i])) return t[i];
            i = (i == t.length-1) ? 0 : i + 1; // increment i
        }
        return null;
    }
عملية سهلة التنفيذ أيضًا. وبعد التحقق من أن غير مخزَّن بالفعل في الجدول (باستخدام )، نفحص و و وهكذا، حتى نجد أو فنخزّن عند ذلك الموضع، ونزيد و بحسب ما يناسب.
    boolean add(T x) {
        if (find(x) != null) return false;
        if (2*(q+1) > t.length) resize(); // max 50% occupancy
        int i = hash(x);
        while (t[i] != null && t[i] != del)
            i = (i == t.length-1) ? 0 : i + 1; // increment i
        if (t[i] == null) q++;
        n++;
        t[i] = x;
        return true;
    }
والآن أصبح تنفيذ عملية واضحًا. نفحص و و وهكذا حتى نجد فهرسًا بحيث أو . في الحالة الأولى نضبط ونُرجع . وفي الحالة الثانية نستنتج أن لم يكن مخزَّنًا في الجدول (وبالتالي لا يمكن حذفه) ونُرجع .
    T remove(T x) {
        int i = hash(x);
        while (t[i] != null) {
            T y = t[i];
            if (y != del && x.equals(y)) {
                t[i] = del;
                n--;
                if (8*n < t.length) resize(); // min 12.5% occupancy
                return y;
            }
            i = (i == t.length-1) ? 0 : i + 1;  // increment i
        }
        return null;
    }
صحة الدوال و و سهلة التحقّق، وإن كانت تعتمد على استخدام قيم . ولاحظ أن أيًّا من هذه العمليات لا تضبط مدخلًا غير ليصبح أبدًا. لذلك، عندما نصل إلى فهرس بحيث ، فإن هذا برهان على أن العنصر الذي نبحث عنه غير مخزَّن في الجدول؛ فمدخل كان دائمًا، فلا يوجد سبب يجعل عملية سابقة أن تتجاوز الفهرس . وتُستدعى الدالة من عندما يتجاوز عدد المداخل غير القيمة ، أو من عندما يصبح عدد مداخل البيانات أقل من . وتعمل الدالة كما تعمل دوال في بنى البيانات الأخرى المعتمدة على المصفوفات. فنجد أصغر عدد صحيح غير سالب بحيث . ثم نعيد تخصيص المصفوفة لتصبح ذات حجم ، وبعدها نُدرج جميع عناصر النسخة القديمة من في النسخة المعاد تحجيمها من . وأثناء ذلك نعيد ضبط مساويةً لـ ، لأن المعاد تخصيصه لا يحتوي على قيم .
    void resize() {
        d = 1;
        while ((1<<d) < 3*n) d++;
        T[] told = t;
        t = newArray(1<<d);
        q = n;
        // insert everything from told
        for (int k = 0; k < told.length; k++) {
            if (told[k] != null && told[k] != del) {
                int i = hash(told[k]);
                while (t[i] != null)
                    i = (i == t.length-1) ? 0 : i + 1;
                t[i] = told[k];
            }
        }
    }
5.2.1 تحليل الاستكشاف الخطي لاحظ أن كل عملية، أو أو ، تنتهي بمجرد اكتشافها (أو قبل ذلك) أول مدخل في . والبديهية الكامنة خلف تحليل الاستكشاف الخطي هي أن نصف عناصر على الأقل تساوي ، وبالتالي فلا ينبغي أن تستغرق العملية وقتًا طويلًا لإتمامها لأنها ستصطدم سريعًا جدًا بمدخل . ومع ذلك فلا ينبغي أن نعتمد على هذه البديهية كثيرًا، لأنها ستقودنا إلى استنتاج (خاطئ) بأن عدد المواضع المتوقَّع في التي تفحصها عملية ما هو 2 على الأكثر. وفي بقية هذا القسم سنفترض أن جميع قيم التجزئة موزَّعة بشكل مستقل وموحَّد على . وهذا افتراض غير واقعي، لكنه سيمكّننا من تحليل الاستكشاف الخطي. وسنصف لاحقًا في هذا القسم طريقة تُسمّى التجزئة بالجداول (tabulation hashing) تُنتج دالة تجزئة «جيدة بما يكفي» للاستكشاف الخطي. وسنفترض كذلك أن جميع الفهارس المستخدَمة في مواضع محسوبة بمقياس ، بحيث يكون اختصارًا فعليًا لـ . نقول إن مقطعًا (run) طوله يبدأ عند يقع عندما تكون جميع مداخل الجدول غير و . وعدد العناصر غير في هو بالضبط ، وتضمن الدالة في كل الأوقات أن . وهناك عنصرًا أُدرجت في منذ آخر عملية . وافتراضنا، فإن لكلٍّ منها قيمة تجزئة، ، موزَّعة بانتظام ومستقلة عن البقية. ومع هذا الإعداد يمكننا إثبات المتراجمة الرئيسية اللازمة لتحليل الاستكشاف الخطي. المتراجمة 5.4 ثبّت قيمة . عندئذ يكون احتمال أن مقطعًا طوله يبدأ عند هو حيث ثابت.
إثبات. إذا وقع مقطع طوله يبدأ عند ، فإن هناك بالضبط عنصرًا بحيث . واحتمال حدوث ذلك هو بالضبط
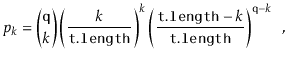
إذ إن كل اختيار لـ عنصرًا يفرض أن تُجزَّأ هذه عناصر إلى أحد مواضع ، وأن تُجزَّأ العناصر الـ الباقية إلى بقية مواضع الجدول وعددها .5.2
في الاشتقاق التالي سنحتال قليلًا ونستبدل بـ . فتقريب ستيرلنغ (Stirling's Approximation) (القسم 1.3.2) يبيّن أن هذا لا يبتعد عن الحقيقة إلا بعامل قدره . وقد لجأنا إلى ذلك لمجرّد تبسيط الاشتقاق؛ إذ يطلب التمرين 5.4 من القارئ إعادة الحساب بمنتهى الدقة باستخدام تقريب ستيرلنغ كاملًا. وقيمة تبلغ عظمىها عندما تكون أصغر ما يمكن، وبنية البيانات تحافظ على الشرط الثابت ، إذن
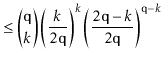 |
||||
|---|---|---|---|---|
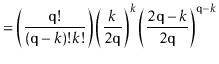 |
||||
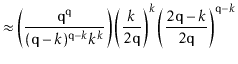 |
||||
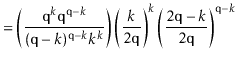 |
||||
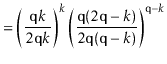 |
||||
(في الخطوة الأخيرة نستخدم المتراجحة ، التي تتحقّق لكل .) وبما أن ، فقد اكتمل البرهان.
أصبح استخدام المتراجمة 5.4 لإثبات الحدود العليا لزمن التشغيل المتوقَّع للدوال و و سهلًا إلى حدٍّ ما. لنفحص أبسط حالة: أن نُنفّذ لقيمة لم تُخزَّن قط في LinearHashTable. في هذه الحالة تكون قيمة عشوائية في مستقلة عن محتوى . وإذا كان جزءًا من مقطع طوله ، فإن الزمن اللازم لتنفيذ عملية هو على الأكثر. ومن ثمّ يمكن تحديد حدّ أعلى لزمن التشغيل المتوقَّع بـ
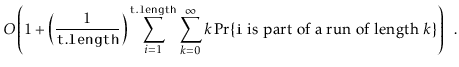
لاحظ أن كل مقطع طوله يساهم في المجموع الداخلي مرة، أي بمساهمة إجمالية قدرها ، ومن ثمّ يمكن إعادة كتابة المجموع أعلاه على الصورة
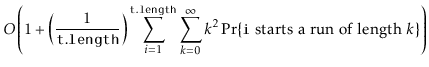 |
||
|---|---|---|
تأتي الخطوة الأخيرة في هذا الاشتقاق من أن متتالية متناقصة أُسّيًا.5.3لذلك نستنتج أن زمن التشغيل المتوقَّع لعملية على قيمة غير الموجودة في LinearHashTable هو .
إذا تجاهلنا تكلفة عملية ، فإن التحليل أعلاه يمكّننا من كل ما نحتاجه لتحليل تكلفة العمليات على LinearHashTable. أولًا، فإن تحليل أعلاه ينطبق على عملية عندما لا يكون موجودًا في الجدول. ولتحليل عملية عندما يكون موجودًا في الجدول، يكفي أن نلاحظ أن ذلك هو نفسه تكلفة عملية التي كانت قد أضافت إلى الجدول. وأخيرًا، تكلفة عملية هي نفسها تكلفة عملية . وباختصار، إذا تجاهلنا تكلفة استدعاءات ، فإن جميع العمليات على LinearHashTable تعمل بزمن متوقَّع قدره . ويمكن احتساب تكلفة إعادة التحجيم (resize) باستخدام التحليل المُستهلَك (amortized analysis) نفسه الذي أُجري لبنية بيانات ArrayStack في القسم 2.1. 5.2.2 خلاصة تلخّص النظرية التالية أداء بنية بيانات LinearHashTable: نظرية 5.2 *تنفّذ LinearHashTable واجهة USet. وتجاهلًا لتكلفة استدعاءات ، يدعم LinearHashTable العمليات و و في زمن متوقَّع قدره لكل عملية. * وفضًا عن ذلك، فإن البدء من LinearHashTable فارغ وأي تسلسل عدده من عمليات و ينتج عنهما زمن كلي قدره مُنفَقًا خلال جميع استدعاءات .
5.2.3 التجزئة بالجداول
أثناء تحليل بنية LinearHashTable، أتينا بافتراض قوي جدًا: أن قيم التجزئة لأي مجموعة عناصر ، أي ، موزَّعة بشكل مستقل وموحَّد على المجموعة . وإحدى طرق تحقيق ذلك هي تخزين مصفوفة ضخمة، ، طولها ، يكون فيها كل مدخل عددًا صحيحًا عشوائيًا بطول بت مستقلًا عن جميع المداخل الأخرى. وبهذه الطريقة يمكننا تنفيذ باستخراج عدد صحيح بطول بت من :
    int idealHash(T x) {
        return tab[x.hashCode() >>> w-d];
    }
للأسف، فإن تخزين مصفوفة بحجم مكلف جدًا من حيث استهلاك الذاكرة. والأسلوب الذي تعتمده التجزئة بالجداول هو، بدلًا من ذلك، معاملة الأعداد الصحيحة بطول بت كأنها مكوَّنة من عددًا صحيحًا، كل واحد منها بطول بت فقط. وبهذه الطريقة، لا تحتاج التجزئة بالجداول إلا إلى مصفوفة، كلٌّ منها بطول . وكل المداخل في هذه المصفوفات أعداد صحيحة عشوائية مستقلة بطول بت. وللحصول على قيمة نقسّم إلى عددًا صحيحًا بطول بت ونستخدمها كفهارس في هذه المصفوفات. ثم ندمج كل هذه القيم بمعامل XOR على مستوى البتات للحصول على . ويبيّن الشيفرة التالية كيف يعمل هذا عندما و :
    int hash(T x) {
        int h = x.hashCode();
        return (tab[0][h&0xff]
                 ^ tab[1][(h>>>8)&0xff]
                 ^ tab[2][(h>>>16)&0xff]
                 ^ tab[3][(h>>>24)&0xff])
                  >>> (w-d);
    }
في هذه الحالة يكون مصفوفة ثنائية الأبعاد بأربعة أعمدة و صفًا. ويمكن التحقّق بسهولة من أن كل قيمة لها رمز تجزئة موزَّع بانتظام على . وجهدٍ قليل يمكن حتى التحقّق من أن قيم التجزئة لأي زوج من القيم مستقلة. وهذا يعني أن في وسعنا استخدام التجزئة بالجداول بدلًا من التجزئة الضربية في تنفيذ ChainedHashTable. غير أنه ليس صحيحًا أن أي مجموعة من قيم متمايزة تعطي مجموعة من قيم تجزئة مستقلة. ومع ذلك، فعند استخدام التجزئة بالجداول يظل حدّ النظرية 5.2 ساريًا. أما المراجع اللازمة فتوجد في نهاية هذا الفصل.
حواشٍ
... المواضع.5.2 لاحظ أن أكبر من احتمال أن مقطعًا طوله يبدأ عند ، لأن تعريف لا يتضمّن اشتراط . ... المتتالية.5.3 ولغة كثير من كتب التفاضل والتكامل، تُجتاز هذه المتتالية اختبار النسبة: يوجد عدد صحيح موجب بحيث إن كان فإن . opendatastructures.org
5.3 رموز التجزئة
الأقسام الفرعية
5.3 رموز التجزئة
تُستخدم جداول التجزئة التي ناقشناها في القسم السابق لربط البيانات بمفاتيح صحيحة مكوَّنة من بت. وفي كثير من الحالات تكون لدينا مفاتيح ليست أعدادًا صحيحة؛ قد تكون نصوصًا (strings) أو كائنات (objects) أو مصفوفات أو بنى مركّبة أخرى. ولاستخدام جداول التجزئة مع أنواع البيانات هذه، علينا ربطها برموز تجزئة (hash codes) بطول بت. وينبغي أن توفّر ربطات رموز التجزئة الخصائص التالية: إذا كان و متساويين، فإن و متساويان. وإذا كان و غير متساويين، فيجب أن يكون احتمال صغيرًا (قريبًا من ). والخاصية الأولى تضمن أنه إذا خزّنّا في جدول تجزئة ثم بحثنا لاحقًا عن قيمة مساوية لـ ، فسنجد -- كما ينبغي. أما الخاصية الثانية فتُقلّل الخسارة الناتجة عن تحويل كائناتنا إلى أعداد صحيحة. فهي تضمن أن الكائنات غير المتساوية تملك عادةً رموز تجزئة مختلفة، ومن ثمّ يُرجَّح أن تُخزَّن في مواضع مختلفة في جدول التجزئة لدينا. 5.3.1 رموز التجزئة لأنواع البيانات البدائية عادةً ما يكون إيجاد رموز تجزئة للأنواع البدائية الصغيرة مثل و و و سهلًا. فلهذه الأنواع تمثيل ثنائي دائمًا، وهذا التمثيل الثنائي يتكوّن عادةً من بت أو أقل. (على سبيل المثال، في Java، نوع بطول 8 بت و نوع بطول 32 بت.) وفي هذه الحالات، نتعامل مع هذه البتّات بوصفها تمثيلًا لعدد صحيح ضمن المدى . فإذا اختلفت قيمتان فستحصلان على رمزي تجزئة مختلفين، وإذا تساوتا فستحصلان على رمز التجزئة نفسه. وهناك القليل من أنواع البيانات البدائية المكوَّنة من أكثر من بت، عادةً بت حيث عدد صحيح ثابت. (ومن أمثلتها نوعا و في Java مع .) ويمكن التعامل مع أنواع البيانات هذه بوصفها كائنات مركّبة من أجزاء، كما سيأتي في القسم التالي. 5.3.2 رموز التجزئة للكائنات المركّبة بالنسبة إلى كائن مركّب، نريد إنشاء رمز تجزئة بدمج رموز التجزئة الفردية لأجزاء الكائن المكوّنة له. وهذا ليس بالأمر السهل كما يبدو. فعلى الرغم من وجود طرق كثيرة — بل متناهية — للقيام بذلك (مثلًا دمج رموز التجزئة بعمليات XOR على مستوى البتات)، إلا أن كثيرًا من هذه الحيل يسهل إبطالها (انظر التمارين 5.7-5.9). لكن إذا كان المرء مستعدًا لإجراء عمليات حسابية بدقة بت، فإن هناك طرقًا بسيطة ومتينة متاحة. لنفترض لدينا كائن مكوَّن من عدة أجزاء رموز تجزئتها . عندئذ يمكننا اختيار أعداد صحيحة عشوائية مستقلة متبادلة بطول بت هي ، وعددًا صحيحًا فرديًا عشوائيًا بطول بت هو ، ثم نحسب رمز تجزئة لكائننا بمعادلة
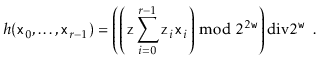
لاحظ أن رمز التجزئة هذا يتضمّن خطوة أخيرة (الضرب في والقسمة على ) تستخدم دالة التجزئة الضربية من القسم 5.1.1 لتحويل النتيجة الوسيطة ذات بت واختصارها إلى نتيجة نهائية ذات بت. وفيما يلي مثال على تطبيق هذه الطريقة على كائن مركّب بسيط من ثلاثة أجزاء و و :
    int hashCode() {
        // random numbers from rand.org
        long[] z = {0x2058cc50L, 0xcb19137eL, 0x2cb6b6fdL};
        long zz = 0xbea0107e5067d19dL;

        // convert (unsigned) hashcodes to long
        long h0 = x0.hashCode() & ((1L<<32)-1);
        long h1 = x1.hashCode() & ((1L<<32)-1);
        long h2 = x2.hashCode() & ((1L<<32)-1);

        return (int)(((z[0]*h0 + z[1]*h1 + z[2]*h2)*zz)
                     >>> 32);
    }
تبيّن النظرية التالية أن هذه الطريقة، إلى جانب بساطة تنفيذها، جيدة ويمكن إثبات ذلك:
نظرية 5.3 ليكن و كلٌّ منهما تسلسلًا من الأعداد الصحيحة بطول بت ضمن ، ولنفترض أن لفهرس واحد على الأقل . عندئذ
إثبات. سنتجاهل أولًا خطوة التجزئة الضربية الأخيرة، ونرى لاحقًا كيف تساهم تلك الخطوة. نعرّف:
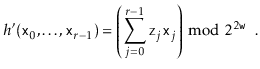
لنفترض أن . ويمكن إعادة كتابة ذلك على الصورة:
حيث
إذا افترضنا، دون حدّ من العمومية، أن ، فإن (5.4) يصير
إذ إن كلًا من و هو على الأكثر، فإن حاصل ضربهما هو على الأكثر. ويفترض أن ، ومن ثمّ يكون للمعادلة (5.5) حل واحد على الأكثر في . لذلك، وبما أن و مستقلان ( مستقلة متبادلة)، فإن احتمال اختيار بحيث هو على الأكثر.
الخطوة الأخيرة في دالة التجزئة هي تطبيق التجزئة الضربية لاختصار نتيجتنا الوسيطة ذات بت، أي ، إلى نتيجة نهائية ذات بت، أي . وبالنظرية 5.3، إذا كان ، فإن 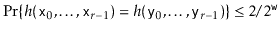 . وباختصار،
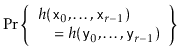 |
||
|---|---|---|
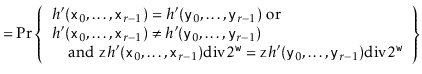 |
||
5.3.3 رموز التجزئة للمصفوفات والنصوص تنجح طريقة القسم السابق جيدًا مع الكائنات التي لها عدد ثابت من المكوّنات. غير أنها تنهار عندما نريد استخدامها مع كائنات ذات عدد متغيّر من المكوّنات، لأنها تتطلّب عددًا صحيحًا عشوائيًا بطول بت هو لكل مكوّن. يمكننا استخدام تسلسل شبه عشوائي لتوليد أكبر عدد نحتاجه من ، لكن عندئذٍ لا تكون مستقلة متبادلة، ويصعب عندئذٍ إثبات أن الأعداد شبه العشوائية لا تتفاعل بصورة ضارة مع دالة التجزئة التي نستخدمها. وعلى وجه التحديد، لا تعود قيمتا و في برهان النظرية 5.3 مستقلتين. وهناك نهج أدقّ هو بناء رموز التجزئة على متعددات الحدود (polynomials) فوق الحقول الأولية (prime fields)؛ وهذه ليست سوى متعددات حدود عادية تُقَيَّم بمقياس عدد أولي ما، . ويقوم هذا النهج على النظرية التالية التي تقول إن متعددات الحدود فوق الحقول الأولية تتصرف إلى حدٍّ كبير كالمتعددات الحدود المعتادة: نظرية 5.4 ليكن عددًا أوليًا، وليكن 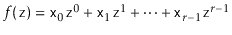 متعدد حدود غير تافه معاملات . عندئذ تكون للمعادلة حلول عددها على الأكثر من أجل .
لاستخدام النظرية 5.4، نجزّئ تسلسلًا من الأعداد الصحيحة ، حيث كل ، باستخدام عدد صحيح عشوائي عبر الصيغة
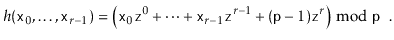
لاحظ الحدّ الإضافي في نهاية الصيغة. ومن المفيد التفكير في بوصفه العنصر الأخير، ، في التسلسل . ولاحظ أن هذا العنصر يختلف عن كل عنصر آخر في التسلسل (وكلٌّ منها يقع في المجموعة ). ويمكننا أن نرى في علامة نهاية تسلسل. وتبيّن النظرية التالية، التي تتناول حالة تسلسلين بالطول نفسه، أن دالة التجزئة هذه تحقّق عائدًا جيدًا بالمقابل مع مقدار التوزيع العشوائي المحدود اللازم لاختيار : نظرية 5.5 ليكن عددًا أوليًا، وليكن و كلٌّ منهما تسلسلًا من الأعداد الصحيحة بطول بت ضمن ، ولنفترض أن لفهرس واحد على الأقل . عندئذ
إثبات. يمكن إعادة كتابة المعادلة على الصورة
بما أن ، فإن هذا المتعدد غير تافه. لذلك، وبالنظرية 5.4، فإن له حلولًا عددها على الأكثر في . ومن ثمّ فإن احتمال أن نختار ليكون أحد هذه الحلول هو على الأكثر.
لاحظ أن دالة التجزئة هذه تتعامل أيضًا مع الحالة التي يكون فيها التسلسلان مختلفي الطول، حتى عندما يكون أحد التسلسلين بادئةً (prefix) للآخر. وذلك لأن هذه الدالة تُجزّئ فعليًا التسلسل اللانهائي
وهذا يضمن أنه إذا كان لدينا تسلسلان بطول و مع ، فإن هذين التسلسلين يختلفان عند الفهرس . وفي هذه الحالة، تصير (5.6)
والتي، بحسب النظرية 5.4، لها حلول عددها على الأكثر في . وهذا مقترنًا بالنظرية 5.5 يكفي لإثبات النظرية الأكثر عمومية التالية:
نظرية 5.6 ليكن عددًا أوليًا، وليكن و تسلسلين متمايزين من الأعداد الصحيحة بطول بت ضمن . عندئذ
تبيّن شيفرة المثال التالية كيف تُطبَّق دالة التجزئة هذه على كائن يحتوي على مصفوفة، ، من القيم:
    int hashCode() {
        long p = (1L<<32)-5;   // prime: 2^32 - 5
        long z = 0x64b6055aL;  // 32 bits from random.org
        int z2 = 0x5067d19d;   // random odd 32 bit number
        long s = 0;
        long zi = 1;
        for (int i = 0; i < x.length; i++) {
            // reduce to 31 bits
            long xi = (x[i].hashCode() * z2) >>> 1;
            s = (s + zi * xi) % p;
            zi = (zi * z) % p;
        }
        s = (s + zi * (p-1)) % p;
        return (int)s;
    }
تقدّم الشيفرة السابقة بعضًا من احتمال التصادم مقابل سهولة التنفيذ. وعلى وجه التحديد، فهي تطبّق دالة التجزئة الضربية من القسم 5.1.1، مع ، لاختصار إلى قيمة بطول 31 بت. وذلك حتى يمكن تنفيذ الجمعيات والضربيات التي تُجرى بمقياس العدد الأولي باستخدام حساب غير موقَّع بدقة 63 بت. ومن ثمّ فإن احتمال تسلسلين مختلفين، أحدهما أطول وطوله ، أن يكون لهما رمز التجزئة نفسه هو
بدلًا من المحدَّد في النظرية 5.6. opendatastructures.org
5.4 مناقشة وتمارين
تمثّل جداول التجزئة ورموز التجزئة حقلًا بحثيًا هائلًا ونشطًا لم يقتصر هذا الفصل على إلماح سريع به. تحتوي «ببليوغرافيا التجزئة» (Bibliography on Hashing) على الإنترنت [10] على نحو 2000 مدخل. وتوجد تنوّعات كثيرة من تنفيذي جداول التجزئة. والتنفيذ الموصوف في القسم 5.1 معروف بالتجزئة بالتسلسل (hashing with chaining) (يحتوي كل مدخل في المصفوفة على سلسلة (List) من العناصر). وتعود التجزئة بالتسلسل إلى مذكرة داخلية من IBM كتبها H. P. Luhn وتاريخها يناير 1953. ويبدو أن هذه المذكرة أيضًا إحدى أقدم الإشارات إلى القوائم المترابطة (linked lists). والبديل عن التجزئة بالتسلسل هو ما تعتمده مخططات العنونة المفتوحة، حيث تُخزَّن جميع البيانات مباشرةً في مصفوفة. ومن هذه المخططات بنية LinearHashTable في القسم 5.2. وقد اقتُرح هذه الفكرة أيضًا، بشكل مستقل، من مجموعة في IBM في خمسينيات القرن الماضي. ويجب أن تتعامل مخططات العنونة المفتوحة مع مسألة معالجة التصادم (collision resolution): الحالة التي تُجزَّأ فيها قيمتان إلى موضع المصفوفة نفسه. وتوجد استراتيجيات مختلفة لمعالجة التصادم؛ وهي تقدّم ضمانات أداء مختلفة، وغالبًا ما تتطلّب دوال تجزئة أكثر تطوّرًا من تلك الموصوفة هنا. وهناك فئة أخرى من تنفيذي جداول التجزئة هي ما تُسمّى طرائق التجزئة التامّة (perfect hashing). وهذه طرائق تستغرق فيها عمليات زمنًا قدره في أسوأ الحالات. وبالنسبة لمجموعات البيانات الساكنة، يمكن تحقيق ذلك بإيجاد دوال تجزئة تامّة (perfect hash functions) للبيانات؛ وهذه دوال تربط كل قطعة بيانات بموضع فريد في المصفوفة. أما البيانات التي تتغيّر مع الزمن، فتشمل طرائق التجزئة التامّة جداول التجزئة ثنائية المستوى من نوع FKS [31,24] وتجزئة cuckoo [57]. ومن المرجّح أن دوال التجزئة المقدَّمة في هذا الفصل من بين أكثر الأساليب العملية المعروفة اليوم التي يمكن إثبات أنها تعمل جيدًا مع أي مجموعة بيانات. وهناك أساليب أخرى جيدة يمكن إثباتها تعود إلى العمل الرائد لـ Carter و Wegman اللذين أدخلا مفهوم التجزئة الشاملة (universal hashing) ووصفا عدة دوال تجزئة لسيناريوهات مختلفة [14]. أمّا التجزئة بالجداول الموصوفة في القسم 5.2.3 فينسبها Carter و Wegman [14]، لكن تحليلها عند تطبيقها على الاستكشاف الخطي (وعدة مخططات أخرى لجداول التجزئة) فينسبه إلى P  tra
 cu و Thorup [60]. وفكرة التجزئة الضربية قديمة جدًا ويبدو أنها جزء من التراث المتعلق بالتجزئة [48, Section 6.4]. لكن فكرة اختيار المُضاعِف عددًا فرديًا عشوائيًا، وكذلك التحليل في القسم 5.1.1، فينسبها إلى Dietzfelbinger وآخرون [23]. وهذه النسخة من التجزئة الضربية من أبسط النسخ، لكن احتمال التصادم فيها البالغ أكبر بمعامل اثنين مما يمكن توقّعه مع دالة عشوائية من . وتستخدم طريقة التجزئة بالضرب-والجمع (multiply-add hashing) الدالة
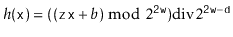
حيث و يُختار كلٌّ منهما عشوائيًا من . وتجزئة الضرب-والجمع (multiply-add hashing) ذات احتمال تصادم يبلغ فقط [21]، لكنها تتطلّب حسابًا بدقة بت.
توجد عدة طرق للحصول على رموز تجزئة من تسلسلات ثابتة الطول من الأعداد الصحيحة بطول بت. ومن أسرعها على الإطلاق [11] هي الدالة
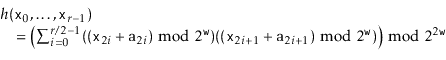
حيث زوجي و تُختار عشوائيًا من . وينتج عن ذلك رمز تجزئة بطول بت احتمال تصادمه . ويمكن اختصاره إلى رمز تجزئة بطول بت باستخدام التجزئة الضربية (أو التجزئة بالضرب-والجمع). وهذه الطريقة سريعة لأنها تتطلّب فقط من الضربيات ذات بت، في حين تتطلّب الطريقة الموصوفة في القسم 5.3.2 ما مقداره ضربة. (وتحدث عمليات ضمنيًا باستخدام حساب بطول للجمعيات وبحساب بطول للضربيات على التوالي.)
طريقة القسم 5.3.3، أي استخدام متعددات الحدود فوق الحقول الأولية لتجزئة المصفوفات والنصوص متغيّرة الطول، ترجع إلى Dietzfelbinger وآخرون [22]. ولأنها تستخدم المعامل الذي يعتمد على تعليمة آليّة مكلفة، فإنها للأسف ليست سريعة جدًا. وتختار بعض صيغ هذه الطريقة العدد الأولي من الشكل ، وعندها يمكن استبدال المعامل بعمليتي الجمع ( ) و AND على مستوى البتات ( ) [47, Section 3.6]. ومن الخيارات الأخرى تطبيق إحدى الطرق السريعة للنصوص ثابتة الطول على كتل بطول حيث ثابت، ثم تطبيق طريقة الحقل الأولي على التسلسل الناتج من رموز التجزئة وعددها . تمرين 5.1 تمنح جامعةٌ معيّنة كلًا من طلابها رقمًا جامعيًا عند أول تسجيل له في أي دورة. وهذه الأعداد أعداد صحيحة متتابعة بدأت من 0 قبل سنوات طويلة واليوم تقع في الملايين. لنفترض لدينا صفٌّ من مئة طالب في السنة الأولى ونريد إسناد رموز تجزئة إليهم بالاستناد إلى أرقامهم الجامعية. فهل استخدام الرقم الأولين من الرقم الجامعي أم آخر رقمين فيه أكثر منطقية؟ برّر إجابتك.
تمرين 5.2 تأمّل مخطّط التجزئة في القسم 5.1.1، ولنفرض و . بيّن أن لكل اختيار للمُضاعِف، ، توجد قيمة كلها تملك رمز التجزئة نفسه. (تلميح: هذا سهل ولا يحتاج إلى نظرية الأعداد.) وبمعطى المُضاعِف، ، صِف قيمة كلها تملك رمز التجزئة نفسه. (تلميح: هذا أصعب ويحتاج إلى بعض أساسيات نظرية الأعداد.)
تمرين 5.3 أثبت أن الحدّ في المتراجمة 5.1 هو أفضل حدّ ممكن، ببيّن أنه إذا كان و ، فإن . (تلميح: انظر إلى التمثيلين الثنائيين لـ و واستخدم الحقيقة .)
تمرين 5.4 أعد إثبات المتراجمة 5.4 باستخدام الصيغة الكاملة لتقريب ستيرلنغ المعطاة في القسم 1.3.2.
تمرين 5.5 تأمّل الصيغة المبسّطة التالية لشيفرة إضافة عنصر إلى LinearHashTable، وهي ببساطة تخزّن في أول مدخل في المصفوفة تجده. واشرح لماذا قد تكون بطيئة جدًا، مع إعطاء مثالٍ لتسلسل من من عمليات و و يستغرق زمنًا من المرتبة في التنفيذ.
    boolean addSlow(T x) {
        if (2*(q+1) > t.length) resize(); // max 50% occupancy
        int i = hash(x);
        while (t[i] != null) {
            if (t[i] != del && x.equals(t[i])) return false;
            i = (i == t.length-1) ? 0 : i + 1; // increment i
        }
        t[i] = x;
        n++; q++;
        return true;
    }
تمرين 5.6 عملت الإصدارات المبكِّرة من دالة Java لصنف String على عدم استخدام كل المحارف الموجودة في النصوص الطويلة. فمثلًا، كان رمز التجزئة لنص من ستة عشر محرفًا يُحسب باستخدام المحارف ذات الفهارس الزوجية الثمانية فقط. واشرح لماذا كانت فكرة سيئة جدًا، مع إعطاء مثال لمجموعة كبيرة من النصوص كلها تملك رمز التجزئة نفسه.
تمرين 5.7 لنفترض لديك كائن مكوَّن من عددين صحيحين بطول بت، و . بيّن لماذا لا يصلح رمز تجزئة لكائنك. وأعطِ مثالًا لمجموعة كبيرة من الكائنات جميعها تملك رمز التجزئة 0.
تمرين 5.8 لنفترض لديك كائن مكوَّن من عددين صحيحين بطول بت، و . بيّن لماذا لا يصلح رمز تجزئة لكائنك. وأعطِ مثالًا لمجموعة كبيرة من الكائنات جميعها تملك رمز التجزئة نفسه.
تمرين 5.9 لنفترض لديك كائن مكوَّن من عددين صحيحين بطول بت، و . ولنفترض أن رمز التجزئة لكائنك معرَّف بدالة حتمية تُنتج عددًا صحيحًا واحدًا بطول بت. أثبت وجود مجموعة كبيرة من الكائنات تملك رمز التجزئة نفسه.
تمرين 5.10 ليكن حيث عدد صحيح موجب. اشرح لماذا، بالنسبة إلى عدد صحيح موجب
(وهذا يعطي خوارزمية لحساب عبر إعادة الضبط المتكرر لـ
حتى .)
تمرين 5.11 اعثر على أحد تنفيذي جداول التجزئة الشائعة الاستخدام، مثل HashMap في Java Collection Framework أو تنفيذَي HashTable و LinearHashTable في هذا الكتاب، وصمّم برنامجًا يخزّن أعدادًا صحيحة في بنية البيانات هذه بحيث توجد أعداد صحيحة، ، يكون فيها زمنيًا خطيًا. أي بعبارة أخرى، ابحث عن مجموعة من عدد صحيح يوجد فيها عنصر تُجزَّأ إلى موضع الجدول نفسه. وبحسب جودة التنفيذ، قد تتمكّن من ذلك بمجرد فحص شيفرة التنفيذ، أو قد تضطر إلى كتابة شيفرة تجرّب عمليات الإدراج والبحث، وتقيس الزمن اللازم لإضافة قيم بعينها وإيجادها. (وقد استُخدم هذا، وما زال يُستخدم، في إطلاق هجمات حجب الخدمة على خوادم الويب [17].)