4. قوائم التخطّي
في هذا الفصل، نناقش بنية بيانات (data structure) جميلة: قائمة التخطي (skiplist)، ولها تطبيقات متنوعة. وباستخدام قائمة التخطي يمكننا تنفيذ واجهة List تمتلك تنفيذات بزمن للدوال ، ، ، و . ويمكن أيضًا تنفيذ مجموعة SSet تعمل فيها جميع العمليات بزمن متوقع قدره . وتعتمد كفاءة قوائم التخطي على استخدامها للعشوائية. فعندما يُضاف عنصر جديد إلى قائمة تخطٍ، تستخدم قائمة التخطي رميات عملة عشوائية لتحديد ارتفاع العنصر الجديد. ويُعبَّر عن أداء قوائم التخطي في أزمنة التشغيل المتوقعة وأطوال المسارات. ويُؤخذ هذا التوقع على رميات العملة العشوائية التي تستخدمها قائمة التخطي. وفي التنفيذ، تُحاكى رميات العملة العشوائية المستخدمة في قائمة التخطي بواسطة مولّد أرقام (أو بتات) شبه عشوائي.
الأقسام الفرعية
4.1 البنية الأساسية
من الناحية المفاهيمية، قائمة التخطي هي تسلسل من القوائم المترابطة أحادية الاتجاه . تحتوي كل قائمة على مجموعة جزئية من العناصر الموجودة في . نبدأ بالقائمة المُدخلة التي تحتوي على عنصر، ونبني من ، ثم من ، وهكذا. تُحصل عناصر برمي عملة مقابل كل عنصر في وإدراج في إذا ظهر وجه العملة. وتنتهي هذه العملية عند إنشاء قائمة فارغة. ويظهر مثال على قائمة تخطٍ في الشكل 4.1. الشكل 4.1: قائمة تخطٍ تحتوي على سبعة عناصر. 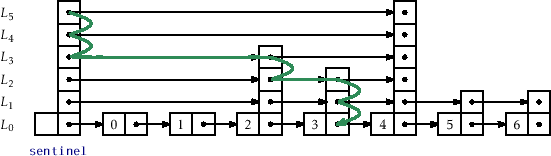 وفيما يلي النتيجة التي سنثبتها في القسم 4.4، والتي تُظهر أن مسار البحث قصير إلى حد كبير: المُلَم 4.1 الطول المتوقع لمسار البحث عن أي عقدة في لا يتجاوز .
إحدى الطرق الموفِّرة للمساحة لتنفيذ قائمة تخطٍ هي تعريف العقدة (Node) على أنها تتكوّن من قيمة بيانات ومصفوفة من المؤشرات، حيث يشير إلى العنصر اللاحق لـ في القائمة . بهذه الطريقة، لا تتم الإشارة إلى البيانات داخل العقدة إلا مرة واحدة، حتى لو ظهر في عدة قوائم.
    class Node<T> {
        T x;
        Node<T>[] next;
        Node(T ix, int h) {
            x = ix;
            next = (Node<T>[])Array.newInstance(Node.class, h+1);
        }
        int height() {
            return next.length - 1;
        }
    }
يناقش القسمان التاليان من هذا الفصل تطبيقين مختلفين لقوائم التخطي. في كلٍّ منهما، تخزّن البنية الأساسية (قائمة عناصر أو مجموعة عناصر مرتبة). والفرق الرئيسي بين هاتين البنيتين يكمن في كيفية التنقّل عبر مسار البحث؛ وبخاصة، يختلفان في كيفية تحديد ما إذا كان ينبغي أن ينزل مسار البحث إلى أم أن يتحرك إلى اليمين ضمن . opendatastructures.org
4.2 SkiplistSSet: مجموعة SSet فعّالة
الأقسام الفرعية
4.2 SkiplistSSet: مجموعة SSet فعّالة
تستخدم SkiplistSSet بنية قائمة التخطي لتنفيذ واجهة SSet. وعند استخدامها بهذه الطريقة، تخزّن القائمة عناصر مجموعة SSet مرتبة. وتعمل الدالة باتباع مسار البحث عن أصغر قيمة بحيث :
    Node<T> findPredNode(T x) {
        Node<T> u = sentinel;
        int r = h;
        while (r >= 0) {
            while (u.next[r] != null && compare(u.next[r].x,x) < 0)
                u = u.next[r];   // go right in list r
            r--;               // go down into list r-1
        }
        return u;
    }
    T find(T x) {
        Node<T> u = findPredNode(x);
        return u.next[0] == null ? null : u.next[0].x;
    }
اتباع مسار البحث عن سهل: عندما نقع عند عقدة ما في ، ننظر إلى اليمين إلى . فإذا كان ، فإننا نتحرك خطوة إلى اليمين في ؛ وإلا فإننا ننزل إلى . وكل خطوة (يمينًا أو هبوطًا) في هذا البحث تستغرق زمنًا ثابتًا فقط؛ وبالتالي، وبموجب المُلم 4.1، فإن زمن التشغيل المتوقع للدالة هو . وقبل أن نتمكن من إضافة عنصر إلى SkipListSSet، نحتاج إلى دالة تحاكي رمي العملات لتحديد ارتفاع العقدة الجديدة . ونفعل ذلك باختيار عدد صحيح عشوائي وعدّ البتات المتتابعة في التمثيل الثنائي لـ :4.1
    int pickHeight() {
        int z = rand.nextInt();
        int k = 0;
        int m = 1;
        while ((z & m) != 0) {
            k++;
            m <<= 1;
        }
        return k;
    }
لتنفيذ الدالة في SkiplistSSet، نبحث عن ثم ندرج (splice) في بضعة قوائم ,..., ، حيث يُختار باستخدام الدالة . وأبسط طريقة للقيام بذلك هي استخدام مصفوفة تتابع العقد عندها ينزل مسار البحث من قائمة ما إلى . وبأدق عبارة، هي العقدة في عندها نزل مسار البحث إلى . والعقد التي نعدّلها لإدراج هي بالضبط العقد . ويطبّق الشيفرة التالية هذه الخوارزمية على :
    boolean add(T x) {
        Node<T> u = sentinel;
        int r = h;
        int comp = 0;
        while (r >= 0) {
            while (u.next[r] != null
                   && (comp = compare(u.next[r].x,x)) < 0)
                u = u.next[r];
            if (u.next[r] != null && comp == 0) return false;
            stack[r--] = u;          // going down, store u
        }
        Node<T> w = new Node<T>(x, pickHeight());
        while (h < w.height())
            stack[++h] = sentinel;   // height increased
        for (int i = 0; i < w.next.length; i++) {
            w.next[i] = stack[i].next[i];
            stack[i].next[i] = w;
        }
        n++;
        return true;
    }
يتم حذف عنصر بطريقة مماثلة، إلا أنه لا حاجة إلى لمتابعة مسار البحث. ويمكن إجراء الحذف أثناء اتباع مسار البحث. نبحث عن ، وكلما تحرّك البحث إلى الأسفل من عقدة \ensuremath{\mathtt{u.next.x}}=\ensuremath{\mathtt{x}} \mathtt{u}$ من القائمة (splice):
    boolean remove(T x) {
        boolean removed = false;
        Node<T> u = sentinel;
        int r = h;
        int comp = 0;
        while (r >= 0) {
            while (u.next[r] != null
                   && (comp = compare(u.next[r].x, x)) < 0) {
                u = u.next[r];
            }
            if (u.next[r] != null && comp == 0) {
                removed = true;
                u.next[r] = u.next[r].next[r];
                if (u == sentinel && u.next[r] == null)
                    h--;  // height has gone down
            }
            r--;
        }
        if (removed) n--;
        return removed;
    }
الشكل 4.4: إزالة العقدة التي تحتوي على من قائمة تخطٍ. 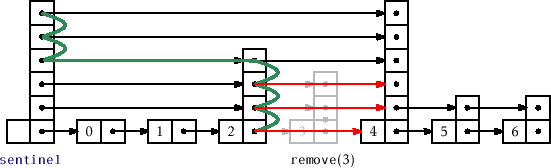 4.2.1 ملخص تلخّص المبرهنة التالية أداء قوائم التخطي عند استخدامها لتنفيذ المجموعات المرتبة: المبرهنة 4.1 تنفّذ SkiplistSSet واجهة SSet. تدعم SkiplistSSet العمليات ، ، و بزمن متوقع قدره لكل عملية.
الحواشي
...:4.1 لا تُحاكي هذه الدالة تجربة رمي العملة تمامًا، لأن قيمة ستكون دائمًا أقل من عدد البتات في . غير أن لهذا تأثيرًا مهمَلًا ما لم يكن عدد العناصر في البنية أكبر بكثير من . opendatastructures.org
4.3 SkiplistList: قائمة فعّالة ذات وصول عشوائي
الأقسام الفرعية
4.3 SkiplistList: قائمة فعّالة ذات وصول عشوائي
تنفّذ SkiplistList واجهة List باستخدام بنية قائمة التخطي. وفي SkiplistList، تحتوي على عناصر القائمة بالترتيب الذي تظهر به في القائمة. وكما في SkiplistSSet، يمكن إضافة العناصر وحذفها والوصول إليها في زمن . ولتحقيق ذلك، نحتاج إلى وسيلة لاتباع مسار البحث عن العنصر ذي الفهرس في . وأبسط طريقة للقيام بذلك هي تعريف مفهوم طول الحافة (edge) في قائمة ما . نعرّف طول كل حافة في بأنه 1. ويُعرَّف طول الحافة في ، ، بأنه مجموع أطوال الحواف الواقعة أسفل في . وبالمثل، فإن طول هو عدد الحواف في الواقعة أسفل . انظر الشكل 4.5 لمثال على قائمة تخطٍ معروضة فيها أطوال حوافها. وبما أن حواف قوائم التخطي مخزّنة في مصفوفات، فيمكن تخزين الأطوال بالطريقة نفسها:
    class Node {
        T x;
        Node[] next;
        int[] length;
        @SuppressWarnings("unchecked")
        Node(T ix, int h) {
            x = ix;
            next = (Node[])Array.newInstance(Node.class, h+1);
            length = new int[h+1];
        }
        int height() {
            return next.length - 1;
        }
    }
الخاصية المفيدة لهذا التعريف للطول هي أنه، إذا كنا حاليًا عند عقدة تقع في الموضع في واتبعنا حافة طولها ، فإننا ننتقل إلى عقدة يكون موضعها في هو . وبهذه الطريقة، أثناء اتباع مسار البحث، يمكننا متابعة الموضع للعقدة الحالية في . وعندما نقع عند عقدة في ، فإننا نتحرك إلى اليمين إذا كان مضافًا إليه طول الحافة أصغر من . وإلا فإننا ننزل إلى .
    Node findPred(int i) {
        Node u = sentinel;
        int r = h;
        int j = -1;   // index of the current node in list 0
        while (r >= 0) {
            while (u.next[r] != null && j + u.length[r] < i) {
                j += u.length[r];
                u = u.next[r];
            }
            r--;
        }
        return u;
    }
    T get(int i) {
        if (i < 0 || i > n-1) throw new IndexOutOfBoundsException();
        return findPred(i).next[0].x;
    }
    T set(int i, T x) {
        if (i < 0 || i > n-1) throw new IndexOutOfBoundsException();
        Node u = findPred(i).next[0];
        T y = u.x;
        u.x = x;
        return y;
    }
ولأن أصعب جزء في العمليتين و هو العثور على العقدة ذات الفهرس في ، فإن هاتين العمليتين تعملان في زمن . وإضافة عنصر إلى SkiplistList عند الموضع أمر بسيط إلى حد ما. وخلافًا لحالة SkiplistSSet، نحن نتيقن أن عقدة جديدة ستُضاف بالفعل، لذا يمكننا إجراء الإضافة في الوقت نفسه الذي نبحث فيه عن موضع العقدة الجديدة. نختار أولًا الارتفاع للعقدة المُدخلة حديثًا ، ثم نتبع مسار البحث عن . وكلما نزل مسار البحث من مع ، فإننا ندرج (splice) في . والاهتمام الإضافي الوحيد الضروري هو التأكد من تحديث أطوال الحواف تحديثًا صحيحًا. انظر الشكل 4.6.
لاحظ أن كلما نزل مسار البحث عند عقدة في ، يزداد طول الحافة بمقدار واحد، لأننا نضيف عنصرًا أسفل تلك الحافة عند الموضع . وإدراج العقدة (splice) بين عقدتين و يتم بالطريقة المبيّنة في الشكل 4.7. وأثناء اتباعنا مسار البحث، فإننا نتابع بالفعل الموضع للعقدة في . ومن ثم نعرف أن طول الحافة من إلى هو . كما يمكننا استنتاج طول الحافة من إلى من الطول للحافة من إلى . ومن ثم يمكننا إدراج وتحديث أطوال الحواف في زمن ثابت.
يبدو هذا أكثر تعقيدًا مما هو عليه، فالشيفرة في الواقع بسيطة إلى حد كبير:
    void add(int i, T x) {
        if (i < 0 || i > n) throw new IndexOutOfBoundsException();
        Node w = new Node(x, pickHeight());
        if (w.height() > h)
            h = w.height();
        add(i, w);
    }
    Node add(int i, Node w) {
        Node u = sentinel;
        int k = w.height();
        int r = h;
        int j = -1; // index of u
        while (r >= 0) {
            while (u.next[r] != null && j+u.length[r] < i) {
                j += u.length[r];
                u = u.next[r];
            }
            u.length[r]++; // accounts for new node in list 0
            if (r <= k) {
                w.next[r] = u.next[r];
                u.next[r] = w;
                w.length[r] = u.length[r] - (i - j);
                u.length[r] = i - j;
            }
            r--;
        }
        n++;
        return u;
    }
والآن، ينبغي أن يكون تنفيذ العملية في SkiplistList واضحًا. فنتبع مسار البحث عن العقدة عند الموضع . وكلما أخذ مسار البحث خطوة إلى الأسفل من عقدة عند المستوى ، فإننا ننقص واحدًا من طول الحافة الخارجة من عند ذلك المستوى. ونتحقق أيضًا مما إذا كانت هي العنصر ذو الرتبة ، وإذا كان الأمر كذلك فإننا نزعها من القائمة عند ذلك المستوى. ويظهر مثال في الشكل 4.8.
    T remove(int i) {
        if (i < 0 || i > n-1) throw new IndexOutOfBoundsException();
        T x = null;
        Node u = sentinel;
        int r = h;
        int j = -1; // index of node u
        while (r >= 0) {
            while (u.next[r] != null && j+u.length[r] < i) {
                j += u.length[r];
                u = u.next[r];
            }
            u.length[r]--;  // for the node we are removing
            if (j + u.length[r] + 1 == i && u.next[r] != null) {
                x = u.next[r].x;
                u.length[r] += u.next[r].length[r];
                u.next[r] = u.next[r].next[r];
                if (u == sentinel && u.next[r] == null)
                    h--;
            }
            r--;
        }
        n--;
        return x;
    }
4.3.1 ملخص تلخّص المبرهنة التالية أداء بنية البيانات SkiplistList: المبرهنة 4.2 تنفّذ SkiplistList واجهة List. تدعم SkiplistList العمليات ، ، ، و بزمن متوقع قدره لكل عملية.
4.4 تحليل قوائم التخطي
في هذا القسم، نحلّل الارتفاع والحجم وطول مسار البحث المتوقعة في قائمة تخطٍ. ويتطلب هذا القسم خلفية في الاحتمالات الأساسية. وتستند عدة براهين إلى الملاحظة الأساسية التالية حول رمي العملات. المُلَم 4.2 لنفترض أن هو عدد مرات رمي عملة عادلة، حتى المرة الأولى التي يأتي فيها وجه العملة وشاملًا تلك الرمية. عندئذ .
البرهان. نفترض أننا نتوقف عن رمي العملة أول مرة يأتي فيها وجهها. ولنفعرّف المتغير المؤشّر (indicator variable)
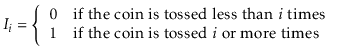
لاحظ أن إذا وفقط إذا كانت أول رمية من رميات العملة قد جاءت بظهر العملة، لذا . ولاحظ أن ، وهو إجمالي عدد رميات العملة، يمكن كتابته على النحو . لذلك،
يخبرنا المُلَمان التاليان أن قوائم التخطي ذات حجم خطي: المُلَم 4.3 العدد المتوقع للعقد في قائمة تخطٍ تحتوي على عنصرًا، لا بما في ذلك ورودات الحارس، هو .
البرهان. احتمال أن يُدرَج عنصر معيّن في القائمة هو ، لذا فإن العدد المتوقع للعقد في هو .4.2 ومن ثم فإن إجمالي العدد المتوقع للعقد في جميع القوائم هو
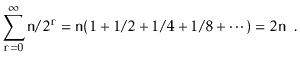
المُلَم 4.4 الارتفاع المتوقع لقائمة تخطٍ تحتوي على عنصرًا لا يتجاوز .
البرهان. لكل ، عرّف متغيرًا عشوائيًا مؤشّرًا
وعليه فإن ارتفاع قائمة التخطي يُعطى بـ
لاحظ أن لا يتجاوز أبدًا الطول للقائمة ، لذا
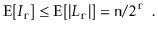
لذلك لدينا
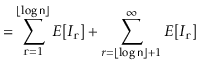 |
||
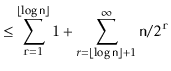 |
||
المُلَم 4.5 العدد المتوقع للعقد في قائمة تخطٍ تحتوي على عنصرًا، بما في ذلك جميع ورودات الحارس، هو .
البرهان. وبموجب المُلم 4.3، فإن العدد المتوقع للعقد، لا بما في ذلك الحارس، هو . وعدد ورودات الحارس يساوي ارتفاع قائمة التخطي ، لذا فإن بالجُلم 4.4 يكون العدد المتوقع لورودات الحارس لا يتجاوز .
المُلَم 4.6 الطول المتوقع لمسار البحث في قائمة تخطٍ لا يتجاوز .
البرهان. أسهل طريقة لرؤية ذلك هي النظر في مسار البحث العكسي لعقدة . يبدأ هذا المسار من السابقة (predecessor) للعقدة في . وفي أي لحظة، إذا كان بإمكان المسار الصعود مستوى، فإنه يفعل ذلك. وإذا لم يستطع الصعود مستوى، فإنه يذهب إلى اليسار. التفكير في هذا الأمر لدقائق قليلة سيقنعنا بأن مسار البحث العكسي للعقدة مطابق لمسار البحث عن ، إلا أنه معكوس.
يرتبط عدد العقد التي يزورها مسار البحث العكسي عند مستوى معيّن بالتجربة التالية: ارمِ عملة. فإذا جاءت العملة بوجهها، فارتقِ مستوى واحدًا وتوقّف. وإلا فارتح إلى اليسار وكرّر التجربة. ويمثّل عدد رميات العملة قبل ظهور الوجه عدد الخطوات إلى اليسار التي يخطوها مسار البحث العكسي عند مستوى معيّن.4.3 ويخبرنا المُلم 4.2 أن العدد المتوقع لرميات العملة قبل أول ظهور للوجه هو 1. ولنفترض أن تدل على عدد الخطوات التي يتخذها مسار البحث الأمامي عند المستوى ويتحرك بها إلى اليمين. وقد رجّحنا للتو أن . كذلك ، إذ لا يمكننا اتخاذ خطوات في أكثر من طول ، لذا
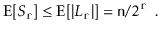
ويمكننا الآن أن نُتمّ كما في برهان المُلم 4.4. ولنفترض أن هو طول مسار البحث لعقدة ما في قائمة تخطٍ، وأن هو ارتفاع قائمة التخطي. عندئذ
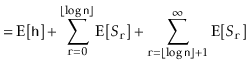 |
||
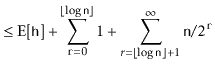 |
||
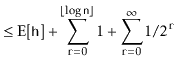 |
||
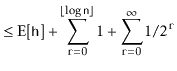 |
||
تلخّص المبرهنة التالية نتائج هذا القسم: المبرهنة 4.3 لقائمة تخطٍ تحتوي على عنصرًا، الحجم المتوقع هو ، والطول المتوقع لمسار البحث عن أي عنصر بعينه لا يتجاوز .
الحواشي
....4.2 انظر القسم 1.3.4 لترى كيف يُشتق ذلك باستخدام المتغيرات المؤشّرة وخطية التوقع. ... مستوى.4.3 لاحظ أن هذا قد يُفرط في عدّ عدد الخطوات إلى اليسار، لأن التجربة ينبغي أن تنتهي إما عند أول ظهور للوجه أو عند وصول مسار البحث إلى الحارس، أيهما أسبق. وهذه ليست مشكلة لأن المُلم يقرّر حدًا أعلى فقط. opendatastructures.org
4.5 نقاش وتمارين
قدَّم Pugh [62] قوائم التخطي، وعرض أيضًا عددًا من تطبيقاتها وتوسيعاتها [61]. ومنذ ذلك الحين يجري دراستها على نطاق واسع. وقام عدة باحثين بإجراء تحليلات دقيقة إلى حد كبير للطول المتوقع وتباين طول مسار البحث عن العنصر في قائمة تخطٍ [45,44,58]. وقد طُوّرت نسخ حتمية (deterministic) [53]، ونسخ مُتحيّزة (biased) [8,26]، ونسخ ذاتية الضبط (self-adjusting) [12] من قوائم التخطي. وقد كُتبت تنفيذات لقوائم التخطي بلغات وأطر عمل مختلفة، واستُخدمت في أنظمة قواعد بيانات مفتوحة المصدر [71,63]. ويُستخدم أحد صيغ قوائم التخطي في هياكل إدارة العمليات في نواة نظام التشغيل HP-UX [42]. بل إن قوائم التخطي جزء من واجهة API في Java 1.6 [55]. التمرين 4.1 ارسم مساري البحث عن 2.5 و 5.5 على قائمة التخطي في الشكل 4.1.
التمرين 4.2 ارسم إضافة القيمة 0.5 (بارتفاع 1) ثم القيمة 3.5 (بارتفاع 2) إلى قائمة التخطي في الشكل 4.1.
التمرين 4.3 ارسم حذف القيمة 1 ثم القيمة 3 من قائمة التخطي في الشكل 4.1.
التمرين 4.4 ارسم تنفيذ على SkiplistList في الشكل 4.5.
التمرين 4.5 ارسم تنفيذ على SkiplistList في الشكل 4.5. افترض أن يختار ارتفاعًا قدره 4 للعقدة المنشأة حديثًا.
التمرين 4.6 بيّن أن العدد المتوقع للمؤشرات في SkiplistSet التي تتغيّر أثناء عملية أو هو عدد ثابت.
التمرين 4.7 افترض أنه بدلاً من ترقية عنصر من إلى استنادًا إلى رمية عملة، فإننا نرقّيه باحتمال ما ، حيث . بيّن أن مع هذا التعديل يكون الطول المتوقع لمسار البحث لا يتجاوز . ما قيمة التي تُصغّر التعبير السابق إلى أدنى حد؟ وما الارتفاع المتوقع لقائمة التخطي؟ وما العدد المتوقع للعقد في قائمة التخطي؟
التمرين 4.8 تنفّذ الدالة في SkiplistSet أحيانًا مقارنات زائدة (redundant)، وتحدث هذه عندما يُقارن بالقيمة نفسها أكثر من مرة. ويمكن أن تحدث عندما تكون، عند بعض العقد ، . بيّن كيف تحدث هذه المقارنات الزائدة، وعدّل بحيث تُتجنَّب. وحلّل العدد المتوقع من المقارنات التي تنفّذها الدالة بعد تعديلها.
التمرين 4.9 صمّم ونفّذ صيغة من قائمة التخطي تنفّذ واجهة SSet، لكنها تسمح أيضًا بالوصول السريع إلى العناصر حسب الرتبة. أي أنها تدعم أيضًا الدالة التي تُعيد العنصر الذي رتبته في زمن متوقع قدره . (رتبة العنصر في مجموعة SSet هي عدد العناصر في مجموعة SSet الأقل من .)
التمرين 4.10 الإصبع (finger) في قائمة التخطي هو مصفوفة تخزّن تسلسل العقد الموجودة على مسار البحث عندها ينزل مسار البحث. (المتغير في شيفرة في صفحة  هو إصبع؛ وتُظهر العقد المظلَّلة في الشكل 4.3 محتوى الإصبع.) ويمكن تخيّل الإصبع على أنه يشير إلى المسار المؤدّي إلى عقدة في أدنى القوائم، . وينفّذ البحث بالإصبع (finger search) الدالة باستخدام إصبع، بأن يصعد في القائمة مستخدمًا الإصبع حتى يبلغ عقدة بحيث و أو ، ثم يُجري بحثًا عاديًا عن بدءًا من . ومن الممكن إثبات أن العدد المتوقع من الخطوات اللازمة للبحث بالإصبع هو ، حيث هو عدد القيم في الواقعة بين والقيمة التي يشير إليها الإصبع. نفّذ صنفًا فرعيًا (subclass) من Skiplist باسم SkiplistWithFinger ينفّذ عمليات باستخدام إصبع داخلي. يخزّن هذا الصنف الفرعي إصبعًا يُستخدم بعد ذلك بحيث تُنفَّذ كل عملية على هيئة بحث بالإصبع. وأثناء كل عملية يُحدَّث الإصبع بحيث تستخدم كل عملية ، كنقطة انطلاق، إصبعًا يشير إلى نتيجة عملية السابقة.
التمرين 4.11 اكتب دالة تقتطع SkiplistList عند الموضع . وبعد تنفيذ هذه الدالة يصبح حجم القائمة ، وتحتوي على العناصر ذات الفهارس فقط. وقيمة الإعادة هي SkiplistList أخرى تحتوي على العناصر ذات الفهارس . وينبغي أن تعمل هذه الدالة في زمن .
التمرين 4.12 اكتب دالة في SkiplistList اسمها ، تأخذ كوسيط SkiplistList باسم ، ثم تفرغه وتُلحق محتوياته بالترتيب بالمستقبِل. فمثلًا، إذا كان يحتوي على وكان يحتوي على ، فإن بعد استدعاء سيحتوي على وسيكون فارغًا. وينبغي أن تعمل هذه الدالة في زمن .
التمرين 4.13 باستخدام الأفكار من القائمة الموفِّرة للمساحة، SEList، صمّم ونفّذ مجموعة SSet موفِّرة للمساحة، SESSet. ولتحقيق ذلك، خزّن البيانات بالترتيب في SEList، وخزّن كتل هذه SEList في مجموعة SSet. فإذا كان تنفيذ مجموعة SSet الأصلي يستخدم مساحة مقدارها لتخزين عنصرًا، فإن SESSet ستستخدم مساحة كافية لـ عنصرًا زائدًا مساحة مهدورة.
التمرين 4.14 باستخدام مجموعة SSet كبنية أساسية، صمّم ونفّذ تطبيقًا يقرأ ملفًا نصيًا (كبيرًا) ويسمح لك بالبحث، تفاعليًا، عن أي سلسلة جزئية (substring) واردة في النص. ومع أن يكتب المستخدم استعلامه، ينبغي أن يظهر الجزء المطابق من النص (إن وُجد) كنتيجة. تلميح 1: كل سلسلة جزئية هي بادئة لبعض اللاحقة (suffix)، لذا يكفي تخزين جميع لواحق الملف النصي. تلميح 2: يمكن تمثيل أي لاحقة على نحو مضغوط كعدد صحيح واحد يشير إلى موضع بدايتها في النص. اختبر تطبيقك على بعض النصوص الكبيرة، مثل بعض الكتب المتاحة في Project Gutenberg [1]. وإذا نُفِّذ بشكل صحيح، فإن تطبيقك سيكون سريع الاستجابة إلى حد كبير؛ فلا ينبغي أن يكون هناك تأخير ملحوظ بين ضغط ضغطات المفاتيح ورؤية النتائج.
التمرين 4.15 (ينبغي أن يُنجز هذا التمرين بعد قراءة شجرة البحث الثنائي في القسم 6.2.) قارن بين قوائم التخطي وأشجار البحث الثنائي على النحو التالي: اشرح كيف يؤدي حذف بعض حواف قائمة تخطٍ إلى بنية تبدو كشجرة ثنائية وتتشابه مع شجرة بحث ثنائي. تستخدم قوائم التخطي وأشجار البحث الثنائي كلٌّ منها عددًا متقاربًا من المؤشرات (مؤشران لكل عقدة). لكن قوائم التخطي تستغل تلك المؤشرات استغلالًا أفضل. اشرح السبب.