3. القوائم المترابطة
في هذا الفصل نواصل دراسة تنفيذات واجهة List، وهذه المرة باستخدام بنى بيانات قائمة على المؤشرات (pointer-based) بدلًا من المصفوفات. تتكوَّن البنى في هذا الفصل من عقد (nodes) تحتوي على عناصر القائمة. وتُربط العقد معًا في متسلسلة (sequence) بواسطة المراجع (المؤشرات). نبدأ بدراسة القوائم المترابطة أحادية الوصل (singly-linked lists)، التي تستطيع تنفيذ عمليات Stack وQueue (بترتيب FIFO) في زمن ثابت لكل عملية، ثم ننتقل إلى القوائم المترابطة ثنائية الوصل (doubly-linked lists)، التي تستطيع تنفيذ عمليات Deque في زمن ثابت. وللقوائم المترابطة مزايا وعيوب مقارنةً بتنفيذات واجهة List القائمة على المصفوفات. والعيب الأساسي هو فقدان القدرة على الوصول إلى أي عنصر بواسطة أو في زمن ثابت. وبدلًا من ذلك علينا أن نمرّ في القائمة عنصرًا تلو الآخر حتى نصل إلى العنصر . أما الميزة الأساسية فهي أنها أكثر ديناميكية: فبناءً على مرجع إلى أي عقدة في القائمة ، يمكننا حذف أو إدراج عقدة مجاورة لـ في زمن ثابت. وهذا صحيح أينما كانت في القائمة.
الأقسام الفرعية
3.1 SLList: قائمة مترابطة أحادية الوصل
الأقسام الفرعية
3.1 SLList: قائمة مترابطة أحادية الوصل
إن SLList (قائمة مترابطة أحادية الوصل) هي متسلسلة من عقد Node. وتخزّن كل عقدة قيمة بيانات ومرجعًا إلى العقدة التالية في المتسلسلة. أما العقدة الأخيرة في المتسلسلة فيكون
    class Node {
        T x;
        Node next;
    }
ولكفاءة التنفيذ، تستخدم SLList المتغيّرات و لمتابعة العقدة الأولى والعقدة الأخيرة في المتسلسلة، وكذلك عددًا صحيحًا لمتابعة طول المتسلسلة:
    Node head;
    Node tail;
    int n;
يوضّح الشكل 3.1 متسلسلة من عمليات Stack وQueue على SLList.
تستطيع SLList تنفيذ عمليتَي Stack، وهما و، بكفاءة عبر إضافة العناصر وحذفها عند رأس المتسلسلة. إن عملية ببساطة تنشئ عقدة جديدة بقيمة البيانات ، وتضبط على الرأس القديم للقائمة، وتجعل هو الرأس الجديد للقائمة. وأخيرًا هي تزيد بمقدار واحد لأن حجم SLList قد ازداد بمقدار واحد:
    T push(T x) {
        Node u = new Node();
        u.x = x;
        u.next = head;
        head = u;
        if (n == 0)
            tail = u;
        n++;
        return x;
    }
أما عملية ، بعد التحقق من أن SLList ليست فارغة، فتزيل الرأس عبر ضبط وإنقاص . وتحدث حالة خاصة عند إزالة العنصر الأخير، وعندئذ يُضبط على :
    T pop() {
        if (n == 0)    return null;
        T x = head.x;
        head = head.next;
        if (--n == 0) tail = null;
        return x;
    }
من الواضح أن عمليتَي و تعملان في زمن .
3.1.1 عمليات الطابور
تستطيع SLList كذلك تنفيذ عمليتَي الطابور من نوع FIFO، وهما و ، في زمن ثابت. يتم الحذف من رأس القائمة، وهو مطابق تمامًا لعملية :
    T remove() {
        if (n == 0)    return null;
        T x = head.x;
        head = head.next;
        if (--n == 0) tail = null;
        return x;
    }
أما الإضافة، على النقيض، تتم عند ذيل القائمة. وفي معظم الحالات يتم ذلك عبر ضبط ، حيث هي العقدة المُنشأة حديثًا التي تحتوي على . غير أن حالة خاصة تحدث عندما ، وعندئذ يكون . في هذه الحالة يُضبط كلٌّ من و على .
    boolean add(T x) {
        Node u = new Node();
        u.x = x;
        if (n == 0) {
            head = u;
        } else {
            tail.next = u;
        }
        tail = u;
        n++;
        return true;
    }
من الواضح أن كلتا العمليتين و تستغرقان زمنًا ثابتًا. 3.1.2 الملخّص تلخّص المبرهنة التالية أداء SLList: مبرهنة 3.1 يطبِّق SLList واجهتَي Stack وQueue (بترتيب FIFO). وتعمل العمليات و و و في زمن لكل عملية.
يطبِّق SLList تقريبًا المجموعة الكاملة لعمليات Deque. والعملية الوحيدة المفقودة هي الحذف من ذيل SLList. والحذف من ذيل SLList صعب لأنه يتطلب تحديث قيمة بحيث يشير إلى العقدة التي تسبق في SLList؛ وهذه هي العقدة بحيث . وللأسف، الطريقة الوحيدة للوصول إلى هي اجتياز SLList بدءًا من مع أخذ خطوة. opendatastructures.org
3.2 DLList: قائمة مترابطة ثنائية الوصل
الأقسام الفرعية
3.2 DLList: قائمة مترابطة ثنائية الوصل
إن DLList (قائمة مترابطة ثنائية الوصل) مشابهة جدًا لـ SLList، إلا أن كل عقدة في DLList لها مراجع إلى العقدة التي تليها وإلى العقدة التي تسبقها.
    class Node {
        T x;
        Node prev, next;
    }
وحينما نفّذنا SLList لاحظنا أنه كانت هناك دائمًا عدة حالات خاصة يجب الاهتمام بها. فمثلًا، إزالة العنصر الأخير من SLList أو إضافة عنصر إلى SLList فارغة تتطلب عنايةً لضمان تحديث و بشكل صحيح. وفي DLList يزداد عدد هذه الحالات الخاصة بدرجة كبيرة. ولعل أنظف طريقة للاهتمام بكل هذه الحالات الخاصة في DLList هي إدخال عقدة . وهذه عقدة لا تحتوي على أي بيانات، لكنها تعمل كعنصر نائب (placeholder) بحيث لا توجد عقد خاصة؛ فكل عقدة لديها و ، مع كون هي العقدة التي تلي آخر عقدة في القائمة وتسبق أول عقدة فيها. وبهذه الطريقة تُربط عقد القائمة بترابط ثنائي في دورة (cycle)، كما يوضّح الشكل 3.2.
    int n;
    Node dummy;
    DLList() {
        dummy = new Node();
        dummy.next = dummy;
        dummy.prev = dummy;
        n = 0;
    }
العثور على العقدة ذات الفهرس معيّن في DLList سهل؛ فإما أن نبدأ من رأس القائمة ( ) ونتقدّم إلى الأمام، أو نبدأ من ذيل القائمة ( ) ونتراجع إلى الخلف. وهذا يتيح لنا الوصول إلى العقدة في زمن :
    Node getNode(int i) {
        Node p = null;
        if (i < n / 2) {
            p = dummy.next;
            for (int j = 0; j < i; j++)
                p = p.next;
        } else {
            p = dummy;
            for (int j = n; j > i; j--)
                p = p.prev;
        }
        return p;
    }
أصبحت العمليتان و سهلتين أيضًا. فنبدأ بالعثور على العقدة ثم نجلب قيمتها أو نضبطها:
    T get(int i) {
        if (i < 0 || i > n - 1) throw new IndexOutOfBoundsException();
        return getNode(i).x;
    }
    T set(int i, T x) {
        if (i < 0 || i > n - 1) throw new IndexOutOfBoundsException();
        Node u = getNode(i);
        T y = u.x;
        u.x = x;
        return y;
    }
ويُهيمن على زمن تنفيذ هذه العمليات الوقت اللازم للعثور على العقدة ، ويكون .
3.2.1 الإضافة والحذف
إذا كان لدينا مرجع إلى عقدة في DLList أردنا إدراج عقدة قبل ، فلا{amsر سوى ضبط و ثم تعديل و . (انظر الشكل 3.3.) وبفضل عقدة dummy، لا حاجة للقلق بشأن غياب أو .
    Node addBefore(Node w, T x) {
        Node u = new Node();
        u.x = x;
        u.prev = w.prev;
        u.next = w;
        u.next.prev = u;
        u.prev.next = u;
        n++;
        return u;
    }
والآن أصبح تنفيذ عملية القائمة بسيطًا تامًّا. فنجد العقدة في DLList ونُدرِج عقدة جديدة تحتوي على قبلها مباشرة.
    void add(int i, T x) {
        if (i < 0 || i > n) throw new IndexOutOfBoundsException();
        addBefore(getNode(i), x);
    }
الجزء الوحيد غير الثابت في زمن تنفيذ هو الوقت اللازم للعثور على العقدة (باستخدام ). ولذلك تعمل في زمن . أما حذف عقدة من DLList فسهل. فنحن بحاجة فقط إلى تعديل المؤشرين عند و بحيث يتجاوزان . ومرة أخرى، يُلغي استخدام عقدة dummy الحاجة إلى اعتبار أي حالات خاصة:
    void remove(Node w) {
        w.prev.next = w.next;
        w.next.prev = w.prev;
        n--;
    }
والآن أصبحت عملية بسيطة تامًّا. فنجد العقدة ذات الفهرس ونحذفها:
    T remove(int i) {
        if (i < 0 || i > n - 1) throw new IndexOutOfBoundsException();
        Node w = getNode(i);
        remove(w);
        return w.x;
    }
ومرة أخرى، الجزء الوحيد المكلف في هذه العملية هو العثور على العقدة باستخدام ، ولذلك تعمل في زمن . 3.2.2 الملخّص تلخّص المبرهنة التالية أداء DLList: مبرهنة 3.2 يطبِّق DLList واجهة List. وفي هذا التنفيذ، تعمل العمليات و و و في زمن لكل عملية.
من المفيد ملاحظة أنه، إذا تجاهلنا تكلفة عملية ، فإن جميع العمليات على DLList تستغرق زمنًا ثابتًا. وبالتالي فإن الجزء الوحيد المكلف في العمليات على DLList هو العثور على العقدة المطلوبة. وبمجرد أن نتوفّر لدينا على العقدة المطلوبة، فإن الإضافة أو الحذف أو الوصول إلى البيانات في تلك العقدة لا يستغرق سوى زمن ثابت. وهذا في تناقض حادّ مع تنفيذات List القائمة على المصفوفات في الفصل 2؛ ففي تلك التنفيذات يمكن العثور على عنصر المصفوفة المطلوب في زمن ثابت. غير أن الإضافة أو الحذف تتطلّب إزاحة عناصر داخل المصفوفة، وهي عمومًا تستغرق زمنًا غير ثابت. ولهذا السبب فإن بنى القوائم المترابطة تناسب التطبيقات التي يمكن فيها الحصول على مراجع عقد القائمة بطرق خارجية. ومن أمثلتها بنية بيانات LinkedHashSet الموجودة في Java Collections Framework، حيث تُخزَّن مجموعة عناصر في قائمة مترابطة ثنائية الوصل وتُخزَّن عقد تلك القائمة في جدول تجزئة (hash table) (يُناقش في الفصل 5). وعندما تُزال العناصر من LinkedHashSet، يُستخدم جدول التجزئة للعثور على عقدة القائمة المطلوبة في زمن ثابت ثم تُحذف عقدة القائمة (أيضًا في زمن ثابت). opendatastructures.org
3.3 SEList: قائمة مترابطة موفّرة للمساحة
الأقسام الفرعية
3.3 SEList: قائمة مترابطة موفّرة للمساحة
أحد عيوب القوائم المترابطة (بخلاف الوقت اللازم للوصول إلى العناصر الموجودة في أعماق القائمة) هو استهلاكها للمساحة. تتطلّب كل عقدة في DLList مرجعين إضافيين إلى العقدة التالية والعقدة السابقة في القائمة. وحقلان من حقول Node مخصّصان لصيانة القائمة، ولا يبقى سوى حقل واحد لتخزين البيانات! ويقلّل SEList (قائمة موفّرة للمساحة) هذه المساحة المهدرة باستخدام فكرة بسيطة: فبدلًا من تخزين العناصر المفردة في DLList، نخزّن كتلة (block) تحتوي على عدة عناصر. وبعبارة أدق، يُعاير SEList بحجم الكتلة . وتخزّن كل عقدة مفردة في SEList كتلة يمكن أن تتّسع حتى عنصرًا. ولأسباب ستتضح لاحقًا، من المفيد أن نتمكّن من تنفيذ عمليات Deque على كل كتلة. وبنية البيانات التي نختارها لهذا هي BDeque (طابور مزدوج مقيَّد)، المشتق من بنية ArrayDeque الموصوفة في القسم 2.4. ويختلف BDeque عن ArrayDeque في فرق بسيط واحد: فعند إنشاء BDeque جديد، يكون حجم المصفوفة المؤسِّسة ثابتًا عند ولا يتزايد ولا يتناقص أبدًا. والخاصية المهمة في BDeque هي أنها تسمح بإضافة العناصر أو حذفها عند المقدّمة أو المؤخّرة في زمن ثابت. وسيكون هذا مفيدًا عند إزاحة العناصر من كتلة إلى أخرى.
    class BDeque extends ArrayDeque<T> {
        BDeque() {
            super(SEList.this.type());
            a = newArray(b+1);
        }
        void resize() { }
    }
يصبح SEList إذن قائمة مترابطة ثنائية الوصل من الكتل:
    class Node {
        BDeque d;
        Node prev, next;
    }
    int n;
    Node dummy;
3.3.1 متطلبات المساحة يفرض SEList قيودًا شديدة على عدد العناصر في الكتلة: فمالم تكن الكتلة هي الكتلة الأخيرة، فإن تلك الكتلة تحتوي على عنصرًا على الأقل و عنصرًا على الأكثر. وهذا يعني أنه إذا كان SEList يحتوي على عنصرًا، فإنه يحتوي على
كتلة كحد أقصى. يحتوي BDeque الخاص بكل كتلة على مصفوفة طولها ، لكن في كل كتلة عدا الأخيرة، لا يُهدَر في هذه المصفوفة سوى قدر ثابت من المساحة. والذاكرة المتبقية المستخدَمة بواسطة الكتلة هي أيضًا ثابتة. وهذا يعني أن المساحة المهدرة في SEList هي فقط. وباختيار قيمة لـ ضمن معامل ثابت من ، يمكننا أن نجعل الحمل الزائد للمساحة في SEList يقترب من الحدّ الأدنى المذكور في القسم 2.6.2.
3.3.2 العثور على العناصر
التحدّي الأول الذي نواجهه مع SEList هو العثور على عنصر القائمة ذي الفهرس . ولاحظ أن موقع العنصر يتكوّن من جزأين:
- العقدة التي تحتوي على الكتلة التي تحتوي على العنصر ذو الفهرس ؛ و
- الفهرس للعنصر داخل كتلته.
    class Location {
        Node u;
        int j;
        Location(Node u, int j) {
            this.u = u;
            this.j = j;
        }
    }
وللعثور على الكتلة التي تحتوي على عنصر معيّن، نتصرّف بالطريقة نفسها التي نتصرّف بها في DLList. فإما أن نبدأ من مقدّمة القائمة ونجتاز في الاتجاه الأمامي، أو من ذيل القائمة ونجتاز إلى الخلف حتى نصل إلى العقدة التي نريدها. والاختلاف الوحيد هو أنه، كلما انتقلنا من عقدة إلى التي تليها، نتخطى فوق كتلة كاملة من العناصر.
    Location getLocation(int i) {
        if (i < n/2) {
            Node u = dummy.next;
            while (i >= u.d.size()) {
                i -= u.d.size();
                u = u.next;
            }
            return new Location(u, i);
        } else {
            Node u = dummy;
            int idx = n;
            while (i < idx) {
                u = u.prev;
                idx -= u.d.size();
            }
            return new Location(u, i-idx);
        }
    }
تذكّر أن، باستثناء كتلة واحدة على الأكثر، تحتوي كل كتلة على عنصرًا على الأقل، لذا تقربنا كل خطوة في بحثنا عنصرًا من العنصر الذي نبحث عنه. وإذا كنا نبحث إلى الأمام، فهذا يعني أننا نصل إلى العقدة التي نريدها بعد خطوة. وإذا كنا نبحث إلى الخلف، فنصل إلى العقدة التي نريدها بعد خطوة. وتأخذ الخوارزمية الأصغر من هاتين القيمتين تبعًا لقيمة ، لذا فإن الزمن اللازم لتحديد موقع العنصر ذي الفهرس هو . وبمجرد أن نعرف كيفية تحديد موقع العنصر ذي الفهرس ، تتحوّل العمليتان و إلى جلب فهرس معيّن داخل الكتلة الصحيحة أو ضبطه:
    T get(int i) {
        if (i < 0 || i > n - 1) throw new IndexOutOfBoundsException();
        Location l = getLocation(i);
        return l.u.d.get(l.j);
    }
    T set(int i, T x) {
        if (i < 0 || i > n - 1) throw new IndexOutOfBoundsException();
        Location l = getLocation(i);
        T y = l.u.d.get(l.j);
        l.u.d.set(l.j,x);
        return y;
    }
ويُهيمن على زمن تنفيذ هذه العمليات الوقت اللازم لتحديد موقع العنصر، لذا فهي تعمل أيضًا في زمن .
3.3.3 إضافة عنصر
إضافة العناصر إلى SEList أعقد قليلًا. وقبل النظر في الحالة العامة، نبحث عن العملية الأسهل، وهي ، حيث يُضاف إلى نهاية القائمة. وإذا كانت الكتلة الأخيرة ممتلئة (أو غير موجودة لعدم وجود كتل بعد)، فإننا نخصّص كتلة جديدة أولًا ونُلحقها بقائمة الكتل. وبمجرد أن نتيقّن من وجود الكتلة الأخيرة وعدم امتلائها، نُلحق بالكتلة الأخيرة.
    boolean add(T x) {
        Node last = dummy.prev;
        if (last == dummy || last.d.size() == b+1) {
            last = addBefore(dummy);
        }
        last.d.add(x);
        n++;
        return true;
    }
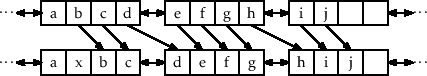
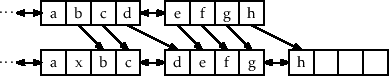
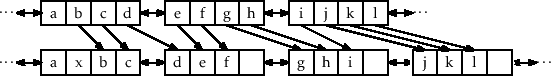
يصبح الأمر أكثر تعقيدًا عندما نضيف إلى داخل القائمة باستخدام . فنحن أولًا نحدّد موقع للحصول على العقدة التي تحتوي كتلتها على عنصر القائمة ذي الفهرس . والمشكلة أننا نريد إدراج في كتلة ، لكن علينا الاستعداد لحالة تكون فيها كتلة تحتوي بالفعل على عنصرًا، بحيث تكون ممتلئة ولا يوجد متّسع لها لـ . لنرمز بـ إلى و و وهكذا. ونستكشف بحثًا عن عقدة تستطيع توفير مساحة لـ . ويمكن أن تحدث ثلاث حالات أثناء استكشافنا للمساحة (انظر الشكل 3.4):
 |
||
|---|---|---|
 |
||
 |
- نجد بسرعة (في خطوة) عقدة كتلتها ليست ممتلئة. في هذه الحالة، نُجري إزاحة لعنصر من كتلة إلى التي تليها، بحيث تصبح المساحة الحرة في مساحة حرة في . يمكننا بعدها إدراج في كتلة .
- نتجاوز بسرعة (في خطوة) نهاية قائمة الكتل. في هذه الحالة، نضيف كتلة فارغة جديدة إلى نهاية قائمة الكتل ونتصرّف كما في الحالة الأولى.
- بعد خطوات لا نجد أي كتلة ليست ممتلئة. في هذه الحالة، يكون متسلسلة من كتل تحتوي كل منها على عنصرًا. نُدرِج كتلة جديدة في نهاية هذه المتسلسلة ونوزّع العناصر الـ الأصلية بحيث تحتوي كل كتلة من على عنصرًا بالضبط. والآن كتلة تحتوي على عناصر فقط، لذا يتّسع لها لإدراج .
    void add(int i, T x) {
        if (i < 0 || i > n) throw new IndexOutOfBoundsException();
        if (i == n) {
            add(x);
            return;
        }
        Location l = getLocation(i);
        Node u = l.u;
        int r = 0;
        while (r < b && u != dummy && u.d.size() == b+1) {
            u = u.next;
            r++;
        }
        if (r == b) {      // b blocks each with b+1 elements
            spread(l.u);
            u = l.u;
        }
        if (u == dummy) {  // ran off the end - add new node
            u = addBefore(u);
        }
        while (u != l.u) { // work backwards, shifting elements
            u.d.add(0, u.prev.d.remove(u.prev.d.size()-1));
            u = u.prev;
        }
        u.d.add(l.j, x);
        n++;
    }
يعتمد زمن تنفيذ عملية على أيّ من الحالات الثلاث السابقة تحدث. وتتضمّن الحالتان 1 و2 فحص العناصر وإزاحتها عبر كتل كحد أقصى وتستغرقان زمن . أما الحالة 3 فتتضمّن استدعاء الطريقة ، التي تحرّك عنصرًا وتستغرق زمن . وإذا تجاهلنا تكلفة الحالة 3 (والتي سنحسبها لاحقًا بالتحليل المُلبَّد) فإن هذا يعني أن زمن التنفيذ الكلي لتحديد موقع وإدراج هو .
3.3.4 حذف عنصر
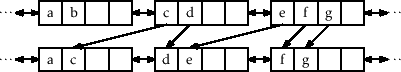
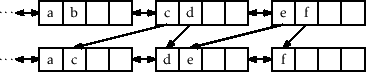
حذف عنصر من SEList شبيه بإضافة عنصر. فنحن أولًا نحدّد موقع العقدة التي تحتوي على العنصر ذي الفهرس . والآن علينا الاستعداد للحالة التي لا يمكننا فيها حذف عنصر من دون أن تصبح كتلة أصغر من . ومرة أخرى، لنرمز بـ إلى و و وهكذا. ونفحص بالترتيب بحثًا عن عقدة نستطيع أن نستعير منها عنصرًا لجعل حجم كتلة على الأقل . وهناك ثلاث حالات يجب اعتبارها (انظر الشكل 3.5):
 |
|---|
 |
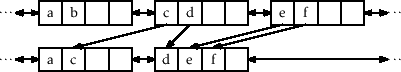 |
- نجد بسرعة (في خطوة) عقدة كتلتها تحتوي على أكثر من عنصرًا. في هذه الحالة، نُجري إزاحة لعنصر من كتلة إلى السابقة لها، بحيث يصبح العنصر الزائد في عنصرًا زائدًا في . يمكننا بعدها حذف العنصر المناسب من كتلة .
- نتجاوز بسرعة (في خطوة) نهاية قائمة الكتل. في هذه الحالة، تكون هي الكتلة الأخيرة، ولا حاجة لأن تحتوي كتلة على عنصرًا على الأقل. ولذلك نتصرّف كما سبق، مستعيرين عنصرًا من ليكون عنصرًا زائدًا في . وإذا أدّى هذا إلى أن تصبح كتلة فارغة، فإننا نحذفها.
- بعد خطوات، لا نجد أي كتلة تحتوي على أكثر من عنصرًا. في هذه الحالة، يكون متسلسلة من كتل تحتوي كل منها على عنصرًا. نجمع العناصر الـ هذه في بحيث تحتوي كل واحدة من هذه الـ كتلة على عنصرًا بالضبط، ونحذف التي صارت فارغة. والآن كتلة تحتوي على عنصرًا، ونتمكن بعدها من حذف العنصر المناسب منها.
    T remove(int i) {
        if (i < 0 || i > n - 1) throw new IndexOutOfBoundsException();
        Location l = getLocation(i);
        T y = l.u.d.get(l.j);
        Node u = l.u;
        int r = 0;
        while (r < b && u != dummy && u.d.size() == b-1) {
            u = u.next;
            r++;
        }
        if (r == b) {  // b blocks each with b-1 elements
            gather(l.u);
        }
        u = l.u;
        u.d.remove(l.j);
        while (u.d.size() < b-1 && u.next != dummy) {
            u.d.add(u.next.d.remove(0));
            u = u.next;
        }
        if (u.d.isEmpty()) remove(u);
        n--;
        return y;
    }
وكما في عملية ، فإن زمن تنفيذ عملية هو إذا تجاهلنا تكلفة الطريقة التي تحدث في الحالة 3.
3.3.5 التحليل المُلبَّد للتوزيع والجمع
بعد ذلك، نبحث في تكلفة الطريقتين و اللتين قد تنفَّذان بواسطة الطريقتين و . ولأجل الاكتمال، إليك إياهما:
    void spread(Node u) {
        Node w = u;
        for (int j = 0; j < b; j++) {
            w = w.next;
        }
        w = addBefore(w);
        while (w != u) {
            while (w.d.size() < b)
                w.d.add(0,w.prev.d.remove(w.prev.d.size()-1));
            w = w.prev;
        }
    }
    void gather(Node u) {
        Node w = u;
        for (int j = 0; j < b-1; j++) {
            while (w.d.size() < b)
                w.d.add(w.next.d.remove(0));
            w = w.next;
        }
        remove(w);
    }
ويُهيمن على زمن تنفيذ كلٍّ من هاتين الطريقتين على الحلقتين المتداخلتين. وكلٌّ من الحلقة الداخلية والخارجية تُنفَّذ في أقصاه مرة، لذا فإن زمن التنفيذ الكلي لكلٍّ من هاتين الطريقتين هو . غير أن الملمّة التالية تبيّن أن هاتين الطريقتين لا تُنفَّذان إلا في حالة واحدة على الأكثر من كل استدعاءات لـ أو . ملمّة 3.1 إذا أُنشئ SEList فارغ ونُفِّذت أي متسلسلة من استدعاءات لـ و ، فإن الزمن الكلي المُقضى في جميع استدعاءات و هو .
البرهان. سنستخدم طريقة الجهد (potential method) في التحليل المُلبَّد. نقول إن العقدة هشّة (fragile) إذا كانت كتلة لا تحتوي على عناصر (بحيث تكون إما العقدة الأخيرة، أو تحتوي على أو عنصرًا). وأي عقدة كتلتها تحتوي على عناصر هي متينة (rugged). ونعرّف جهد SEList بأنه عدد العقد الهشّة التي يحتويها. وسنعتبر عملية فقط وعلاقتها بعدد استدعاءات . وتحليل و مطابق.
لاحظ أنه، إذا وقعت الحالة 1 أثناء الطريقة ، فإن عقدة واحدة فقط، وهي ، يتغيّر حجم كتلتها. لذلك تنتقل عقدة واحدة على الأكثر، وهي ، من حالة المتانة إلى حالة الهشاشة. وإذا وقعت الحالة 2، فإن عقدة جديدة تُنشأ، وهذه العقدة هشّة، لكن أحجام أي عقدة أخرى لا تتغيّر، لذا يزداد عدد العقد الهشّة بمقدار واحد. وبالتالي، سواء في الحالة 1 أو الحالة 2، يزداد جهد SEList بمقدار واحد على الأكثر. وأخيرًا، إذا وقعت الحالة 3، فذلك لأن كلها عقد هشّة. عندئذٍ يُستدعى وتُستبدل هذه العقد الـ الهشّة بعقد متينة عددها . وأخيرًا يُضاف إلى كتلة مما يجعل هشّة. إجمالًا، ينخفض الجهد بمقدار . وباختصار، يبدأ الجهد من 0 (لا توجد عقد في القائمة). وكلما وقعت الحالة 1 أو الحالة 2، يزداد الجهد بمقدار 1 على الأكثر. وكلما وقعت الحالة 3، ينخفض الجهد بمقدار . الجهد (الذي يعدّ عدد العقد الهشّة) لا يقل أبدًا عن 0. ونستنتج أنه، لكل وقوع للحالة 3، هناك على الأقل وقوع للحالة 1 أو الحالة 2. وبالتالي، لكل استدعاء لـ هناك على الأقل استدعاءً لـ . وهذا يُتمّ البرهان.
3.3.6 الملخّص تلخّص المبرهنة التالية أداء بنية بيانات SEList: مبرهنة 3.3 يطبِّق SEList واجهة List. ومع تجاهل تكلفة استدعاءات و ، يدعم SEList ذو حجم الكتلة العمليتين * و في زمن لكل عملية؛ و و في زمن لكل عملية. * وفوق ذلك، بدءًا من SEList فارغ، فإن أي متسلسلة من عملية و ينتج عنها زمن كلي مقداره يُقضى في جميع استدعاءات و . * * والمساحة (مقيسة بالكلمات)3.1 التي يستخدمها SEList الذي يخزّن عنصرًا هي .
إن SEList هو حلّ وسط (trade-off) بين ArrayList وDLList، حيث يعتمد المزيج النسبي بين هذين البنيتين على حجم الكتلة . وفي الطرف المتطرّف ، تخزّن كل عقدة في SEList ثلاث قيم كحد أقصى، وهو ما لا يختلف كثيرًا عن DLList. وفي الطرف المتطرّف الآخر، ، تُخزَّن جميع العناصر في مصفوفة واحدة، تمامًا كما في ArrayList. وبين هذين الطرفين المتطرفين يقع حلّ وسط بين الزمن اللازم لإضافة عنصر قائمة أو حذفه والزمن اللازم لتحديد موقع عنصر قائمة معيّن.
الحواشي
... words)3.1 راجع القسم 1.4 لمناقشة كيفية قياس الذاكرة. opendatastructures.org
3.4 مناقشة والتمارين
كلتا القائمتين المترابطتين أحادية الوصل وثنائية الوصل هما أسلوبان راسخان، استُخدما في البرامج لأكثر من 40 عامًا. وقد ناقشهما، على سبيل المثال، نوت [46، الأقسام 2.2.3-2.2.5]. وحتى بنية بيانات SEList تبدو تمرينًا معروفًا في بنى البيانات. ويُشار إلى SEList أحيانًا بأنه قائمة مترابطة غير ملفوفة (unrolled linked list) [69]. وطريقة أخرى لتوفير المساحة في قائمة مترابطة ثنائية الوصل هي استخدام ما يُعرف بقوائم XOR. في قائمة XOR، تحتوي كل عقدة، ، على مؤشر واحد فقط، يُدعى ، يحمل قيمة OR الحصري على مستوى البِتّات (bitwise exclusive-or) لـ و . وتحتاج القائمة نفسها إلى تخزين مؤشرين، أحدهما إلى عقدة والآخر إلى (العقدة الأولى، أو إذا كانت القائمة فارغة). وتستخدم هذه التقنية الحقيقة التالية: إذا كان لدينا مؤشرات إلى و ، يمكننا استخراج باستخدام الصيغة
(وهنا يحسب ^ قيمة OR الحصري على مستوى البِتّات لمِرَّعيه.) وتُعقِّد هذه التقنية الشيفرة قليلًا ولا يمكن تطبيقها في بعض اللغات مثل Java وPython التي تملك جمع القمامة، لكنها تقدّم تنفيذًا لقائمة مترابطة ثنائية الوصل يحتاج إلى مؤشر واحد فقط لكل عقدة. انظر مقالة Sinha في المجلة [70] لمناقشة تفصيلية لقوائم XOR.
تمرين 3.1 لماذا لا يمكن استخدام عقدة dummy في SLList لتجنّب جميع الحالات الخاصة التي تحدث في العمليات و و و ؟
تمرين 3.2 صمّم ونفّذ طريقة SLList اسمها تُعيد العنصر الثاني من الأخير في SLList. افعل ذلك دون استخدام متغيّر العضو الذي يتتبّع حجم القائمة.
تمرين 3.3 نفّذ عمليات List و و و على SLList. وينبغي أن تعمل كل واحدة من هذه العمليات في زمن .
تمرين 3.4 صمّم ونفّذ طريقة SLList اسمها تعكس ترتيب العناصر في SLList. وينبغي أن تعمل هذه الطريقة في زمن ، وألا تستخدم التعاود، وألا تستخدم أي بنى بيانات ثانوية، وألا تنشئ أي عقد جديدة.
تمرين 3.5 صمّم ونفّذ طريقتي SLList وDLList اسمهما . تسيران هاتان الطريقتان في القائمة وتحسبان عدد العقد للتأكد مما إذا كان يطابق القيمة المخزّنة في القائمة. ولا تعيد هاتان الطريقتان أي شيء، لكنهما تُلقيان استثناءً إذا كان الحجم الذي تحسبانه لا يطابق قيمة .
تمرين 3.6 حاول أن تعيد إنشاء الشيفرة الخاصة بعملية التي تنشئ عقدة وتضيفها في DLList قبل العقدة مباشرة. لا ترجع إلى هذا الفصل. حتى لو لم تطابق شيفرك تمامًا الشيفرة المعطاة في هذا الكتاب، فقد تكون صحيحة على أي حال. اختبرها وشاهد إن كانت تعمل.
التمارين التالية القليلة تنطوي على إجراء عمليات تعديل على قوائم DLList. وينبغي أن تُنجزها دون تخصيص أي عقد أو مصفوفات مؤقتة جديدة. ويمكن إنجازها جميعًا بتغيير قيمتي و في العقد الموجودة فقط. تمرين 3.7 اكتب طريقة DLList اسمها تعيد إذا كانت القائمة متناظرة (palindrome)، أي أن العنصر في الموضع يساوي العنصر في الموضع لكل . وينبغي أن تعمل شيفرك في زمن .
تمرين 3.8 نفّذ طريقة اسمها «تدوّر» DLList بحيث يصبح عنصر القائمة هو عنصر القائمة . وينبغي أن تعمل هذه الطريقة في زمن وألا تعدّل أي عقد في القائمة.
تمرين 3.9 اكتب طريقة اسمها تقتطع DLList عند الموضع . وبعد تنفيذ هذه الطريقة سيكون حجم القائمة هو وستحتوي فقط على العناصر ذات الفهارس . وقيمة الإعادة هي DLList أخرى تحتوي على العناصر ذات الفهارس . وينبغي أن تعمل هذه الطريقة في زمن .
تمرين 3.10 اكتب طريقة DLList اسمها تأخذ كوسيط DLList، وهي ، وتُفرغها ثم تلحق محتواها بالترتيب في القائمة المستقبِلة. فمثلًا، إذا كانت تحتوي على و تحتوي على ، فعند استدعاء ، ستحتوي على وستكون فارغة.
تمرين 3.11 اكتب طريقة اسمها تزيل جميع العناصر ذات الفهارس الفردية من DLList وتعيد DLList تحتوي على هذه العناصر. فمثلًا، إذا كانت تحتوي على العناصر ، فعند استدعاء ، ينبغي أن تحتوي على وأن تُعاد قائمة تحتوي على .
تمرين 3.12 اكتب طريقة اسمها تعكس ترتيب العناصر في DLList.
تمرين 3.13 يقودك هذا التمرين خطوة بخطوة إلى تنفيذ خوارزمية الفرز بالدمج (merge-sort) لفرز DLList، كما نوقش في القسم 11.1.1. وفي تنفيذك، قارن بين العناصر باستخدام الطريقة بحيث يصبح التنفيذ الناتج قادرًا على فرز أي DLList يحتوي على عناصر تنفّذ واجهة Comparable. اكتب طريقة DLList اسمها . تأخذ هذه الطريقة أول عقدة من وتلحقها بالقائمة المستقبِلة. وهذا يعادل ، باستثناء أنها لا ينبغي أن تنشئ عقدة جديدة. اكتب طريقة DLList ساكنة اسمها ، تأخذ قائمتين مرتّبتين و ، وتدمجهما، وتعيد قائمة مرتّبة جديدة تحتوي على النتيجة. ويؤدي هذا إلى تفريغ و أثناء العملية. فمثلًا، إذا كانت تحتوي على و تحتوي على ، فإن هذه الطريقة تعيد قائمة جديدة تحتوي على . اكتب طريقة DLList اسمها ترتّب العناصر الموجودة في القائمة باستخدام خوارزمية الفرز بالدمج. وتعمل هذه الخوارزمية التعاودية على النحو التالي: إذا كانت القائمة تحتوي على 0 أو 1 عنصر فلا يوجد ما يُفعل. بخلاف ذلك، باستخدام الطريقة ، قسّم القائمة إلى قائمتين متساويتي الطول تقريبًا، و ; رتّب تعاوديًا ; رتّب تعاوديًا ; وأخيرًا، ادمج و في قائمة مرتّبة واحدة.
التمارين التالية القليلة أكثر تقدّمًا وتتطلب فهمًا واضحًا لما يحدث للقيمة الدنيا المخزّنة في Stack أو Queue عند إضافة العناصر وإزالتها. تمرين 3.14 صمّم ونفّذ بنية بيانات MinStack تستطيع تخزين عناصر قابلة للمقارنة وتدعم عمليات المكدس و و ، وكذلك عملية التي تعيد أصغر قيمة مخزّنة حاليًا في بنية البيانات. وينبغي أن تعمل جميع العمليات في زمن ثابت.
تمرين 3.15 صمّم ونفّذ بنية بيانات MinQueue تستطيع تخزين عناصر قابلة للمقارنة وتدعم عمليات الطابور و و ، وكذلك عملية التي تعيد أصغر قيمة مخزّنة حاليًا في بنية البيانات. وينبغي أن تعمل جميع العمليات في زمن ثابت مُلبَّد.
تمرين 3.16 صمّم ونفّذ بنية بيانات MinDeque تستطيع تخزين عناصر قابلة للمقارنة وتدعم جميع عمليات الطابور المزدوج و و و ، وعملية التي تعيد أصغر قيمة مخزّنة حاليًا في بنية البيانات. وينبغي أن تعمل جميع العمليات في زمن ثابت مُلبَّد.
التمارين التالية مصمَّمة لاختبار فهم القارئ لتنفيذ وتحليل SEList الموفّر للمساحة: تمرين 3.17 أثبت أنه، إذا استُخدم SEList كمكدس Stack (بحيث تقتصر التعديلات الوحيدة على SEList على تنفيذ و )، فإن هذه العمليات تعمل في زمن ثابت مُلبَّد، بغضّ النظر عن قيمة .
تمرين 3.18 صمّم ونفّذ نسخة من SEList تدعم جميع عمليات Deque في زمن ثابت مُلبَّد لكل عملية، بغضّ النظر عن قيمة .
تمرين 3.19 اشرح كيفية استخدام معامل OR الحصري على مستوى البِتّات، ^، لتبديل قيم متغيّري دون استخدام متغيّر ثالث.