1. مقدّمة
يتضمّن كل منهج في علوم الحاسوب حول العالم دورة في بنى البيانات (data structures) والخوارزميات. بنى البيانات بالغة الأهمية؛ فهي تحسّن جودة حياتنا بل وتنقذ الأرواح بانتظام. بُنيت شركات لا تحصى بقيمة ملايين الدولارات، بل مليارات الدولارات، حول بنى البيانات. كيف يكون ذلك ممكنًا؟ إذا توقفنا للتفكير في الأمر، ندرك أننا نتعامل مع بنى البيانات باستمرار.
- فتح ملف: تُستخدم بنى بيانات نظام الملفات (file system) لتحديد موقع أجزاء ذلك الملف على القرص حتى يمكن استرجاعها. هذا ليس بالأمر السهل؛ إذ تحتوي الأقراص على مئات الملايين من الكتل. وقد يكون محتوى ملفك مخزَّنًا في أي منها.
- البحث عن جهة اتصال في هاتفك: تُستخدم بنية بيانات للبحث عن رقم هاتف في قائمة جهات اتصالك استنادًا إلى معلومات جزئية، قبل أن تنتهي من الاتصال/الكتابة أصلًا. هذا ليس بالأمر السهل؛ فقد يحتوي هاتفك على معلومات عن كثير من الأشخاص--كل من تعاملت معه عبر الهاتف أو البريد الإلكتروني--دون أن يكون معالجه سريعًا جدًا أو ذا ذاكرة كبيرة.
- تسجيل الدخول إلى شبكتك الاجتماعية المفضلة: تستخدم خوادم الشبكة معلومات تسجيل دخولك للبحث عن معلومات حسابك. هذا ليس بالأمر السهل؛ فالشبكات الاجتماعية الأكثر شعبية لديها مئات الملايين من المستخدمين النشطين.
- إجراء بحث على الويب: يستخدم محرك البحث بنى بيانات للعثور على صفحات الويب التي تحتوي على كلمات بحثك. هذا ليس بالأمر السهل؛ فهناك أكثر من 8.5 مليار صفحة ويب على الإنترنت، وتحتوي كل صفحة على عدد كبير من كلمات البحث المحتملة.
- الاتصال بخدمات الطوارئ (9-1-1): تبحث شبكة خدمات الطوارئ عن رقم هاتفك في بنية بيانات تربط أرقام الهواتف بالعناوين، حتى يمكن إرسال سيارات الشرطة أو الإسعاف أو شاحنات الإطفاء إلى هناك دون تأخير. وهذا مهم؛ فقد لا يستطيع الشخص المُجري للمكالمة أن يحدد العنوان الذي يتصل منه بدقة، والتأخير قد يعني الفرق بين الحياة والموت.
الأقسام الفرعية
1.1 الحاجة إلى الكفاءة
في القسم التالي، نتناول العمليات التي تدعمها أكثر بنى البيانات شيوعًا. وسيرى أي شخص لديه بعض الخبرة في البرمجة أن تنفيذ هذه العمليات على نحو صحيح ليس صعبًا. يمكننا تخزين البيانات في مصفوفة (array) أو قائمة مترابطة (linked list)، ويمكن تنفيذ كل عملية بمرور على جميع عناصر المصفوفة أو القائمة، مع إضافة عنصر أو إزالته على الأرجح. هذا النوع من التنفيذ سهل، لكنه ليس فعّالًا جدًا. هل لهذا أهمية فعلًا؟ فالحواسيب تصبح أسرع وأسرع. وربما كان التنفيذ البديهي كافيًا. لنجرِ بعض الحسابات التقريبية لنتعرّف.
1.1.0.0.1 عدد العمليات:
تخيّل تطبيقًا له مجموعة بيانات متوسطة الحجم، ولنقل بمليون ( ) عنصر. ومن المعقول في معظم التطبيقات أن نفترض أن التطبيق سيرغب في البحث عن كل عنصر مرة واحدة على الأقل. أي أننا نتوقع أن ننفّذ ما لا يقل عن مليون ( ) عملية بحث على هذه البيانات. وإذا فحص كل بحث من عمليات الـ كل عنصر من عناصر الـ ، فإن ذلك يعطي إجمالي (ألف مليار) عملية فحص.
1.1.0.0.2 سرعات المعالجات:
عند وقت الكتابة، لا يستطيع حتى حاسوب مكتبي سريع جدًا تنفيذ أكثر من مليار ( ) عملية في الثانية.1.1وهذا يعني أن هذا التطبيق سيستغرق ما لا يقل عن ثانية، أي نحو 16 دقيقة و40 ثانية. وست عشرة دقيقة تعني حقبةً كاملة في زمن الحاسوب، لكن ربما يقبل الإنسان ذلك (إذا كان ذاهبًا لاستراحة قهوة).
1.1.0.0.3 مجموعات بيانات أكبر:
الآن خُذ شركة مثل Google، التي تفهرس أكثر من 8.5 مليار صفحة ويب. ووفق حساباتنا، فإن تنفيذ أي نوع من الاستعلامات على هذه البيانات سيستغرق 8.5 ثانية على الأقل. ونحن نعرف أصلًا أن الأمر ليس كذلك؛ فالبحث على الويب يكتمل في زمن أقل بكثير من 8.5 ثانية، كما أنه يُجري استعلامات أعقد بكثير من مجرد السؤال عمّا إذا كانت صفحة معينة ضمن قائمة صفحاته المفهرسة. وعند وقت الكتابة، يستقبل Google نحو استعلامًا في الثانية، ما يعني أنه سيحتاج إلى ما لا يقل عن خادمًا سريعًا جدًا لمجرد اللحاق بالركب.
1.1.0.0.4 الحل:
تخبرنا هذه الأمثلة بأن التنفيذات البديهية لبنى البيانات لا تتوسّع جيدًا عندما يكون عدد العناصر، ، في بنية البيانات وعدد العمليات، ، المنفَّذة عليها كبيرين معًا. وفي هذه الحالات، يكون الزمن (المقاس، مثلًا، بتعليمات الآلة) تقريبًا . والحل، بالطبع، هو تنظيم البيانات داخل بنية البيانات بعناية بحيث لا تتطلب كل عملية فحص كل عنصر من عناصر البيانات. ورغم أن ذلك يبدو مستحيلًا في البداية، سنرى بنى بيانات تكون فيها عملية البحث لا تتطلب سوى النظر في عنصرين فقط في المتوسط، بغضّ النظر عن عدد العناصر المخزَّنة في بنية البيانات. وفي حاسوبنا الذي ينفّذ مليار تعليمة في الثانية، لا يستغرق البحث في بنية بيانات تحتوي على مليار عنصر (أو تريليون، أو كوادريليون، بل حتى كوينتليون عنصر) سوى ثانية. وسنرى أيضًا تنفيذات لبنى البيانات تحتفظ بعناصرها مرتبة، حيث ينمو عدد العناصر المفحوصة أثناء أي عملية ببطء شديد كدالة في عدد عناصر بنية البيانات. فمثلًا، يمكننا الحفاظ على مجموعة مرتبة من مليار عنصر مع فحص 60 عنصرًا كحد أقصى أثناء أي عملية. وفي حاسوبنا الذي ينفّذ مليار تعليمة في الثانية، تستغرق هذه العمليات ثانية لكل منها. ويراجع بقية هذا الفصل بإيجاز بعض المفاهيم الرئيسية المستخدمة في بقية الكتاب. ويصف القسم 1.2 الواجهات (interfaces) التي تنفّذها جميع بنى البيانات الموصوفة في هذا الكتاب، وينبغي اعتباره قراءة إلزامية. وتناقش الأقسام الباقية:
- مراجعة رياضية تشمل الأسّيات (exponentials) واللوغاريتمات (logarithms) والمُعاملات (factorials) والترميز التقريبي (big-Oh) والاحتمال والعشوائية (randomization)؛
- نموذج الحساب (model of computation)؛
- الصحة، وزمن التنفيذ، والمكان؛
- نظرة عامة على بقية الفصول؛ و
- الشيفرة النموذجية واتفاقيات التنضيد (typesetting).
ويمكن للقارئ، سواء كان لديه خلفية في هذه المجالات أو لم تكن لديه، أن يتخطّاها الآن ويعود إليها لاحقًا عند الحاجة.
الحواشي
... ثانية.1.1 وسرعة المعالجات تبلغ بضعة غيغاهرتز كحد أقصى (مليارات الدورات في الثانية)، وتستغرق كل عملية عادةً بضع دورات. opendatastructures.org
1.2 الواجهات
الأقسام الفرعية
1.2 الواجهات
عند مناقشة بنى البيانات، من المهم فهم الفرق بين واجهة (interface) بنية البيانات وتنفيذها (implementation). فالواجهة تصف ما تفعله بنية البيانات، بينما يصف التنفيذ كيف تفعله بنية البيانات.
الواجهة، وتُسمى أحيانًا أيضًا بنوع بيانات مجرّد (abstract data type)، تعرّف مجموعة العمليات التي تدعمها بنية البيانات ودلالات تلك العمليات، أي معناها. ولا تخبرك الواجهة بشيء عن كيفية تنفيذ بنية البيانات لهذه العمليات؛ فهي تقدّم فقط قائمة بالعمليات المدعومة، إضافة إلى مواصفات تحدد أنواع الوسائط التي تقبلها كل عملية والقيمة التي تعيدها كل عملية. وفي المقابل، يشمل تنفيذ بنية البيانات التمثيل الداخلي لبنية البيانات، وكذلك تعريفات الخوارزميات التي تنفّذ العمليات التي تدعمها بنية البيانات. وبالتالي، يمكن أن توجد تنفيذات كثيرة لواجهة واحدة. فعلى سبيل المثال، سنرى في الفصل 2 تنفيذات لواجهة List باستخدام المصفوفات، وسنرى في الفصل 3 تنفيذات لواجهة List باستخدام بنى بيانات قائمة على المؤشرات. وينفّذ كل منها الواجهة نفسها، List، لكن بطرق مختلفة. 1.2.1 واجهات Queue و Stack و Deque تمثّل واجهة Queue مجموعة عناصر يمكننا إضافة عناصر إليها وإزالة العنصر التالي منها. وبدقة أكبر، فإن العمليات التي تدعمها واجهة Queue هي : أضف القيمة إلى الـ Queue : أزل القيمة التالية (المضافة سابقًا)، ، من الـ Queue وأعِد لاحظ أن العملية لا تأخذ أي وسيط. ونظام الانتظار الخاص بـ Queue هو ما يقرر أي عنصر ينبغي إزالته. وهناك أنظمة انتظار كثيرة ممكنة، أكثرها شيوعًا يشمل FIFO والأولوية و LIFO. ويزيل طابور FIFO (أول داخل أول خارج)، المبيَّن في الشكل 1.1، العناصر بالترتيب نفسه الذي أُضيفت به، تمامًا كما يعمل الطابور (أو الصف) عند الدفع في صندوق نقدية في متجر بقالة. وهذا هو أكثر أنواع Queue شيوعًا، لذا يُكتفى عادةً بموصفة FIFO. وفي النصوص الأخرى، تُسمّى العمليتان و على طابور FIFO غالبًا و على التوالي. الشكل 1.1: طابور FIFO. 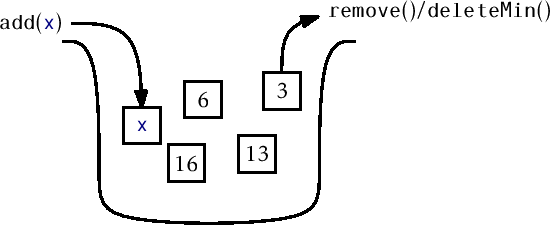 ومن أنظمة الانتظار الشائعة جدًا نظام LIFO (آخر داخل أول خارج)، المبيَّن في الشكل 1.3. وفي طابور LIFO، يكون العنصر المضاف آخرًا هو العنصر التالي الذي يُزال. ويمكن تصوّر ذلك على أفضل نحو في صورة كومة من الأطباق؛ فالأطباق توضع على قمة الكومة وتُزال أيضًا من قمتها. وهذه البنية شائعة لدرجة أنها تأخذ اسمًا خاصًا بها: Stack. وغالبًا ما، عند مناقشة Stack، تُغيَّر أسماء و إلى و ؛ وذلك لتفادي الخلط بين نظامي الانتظار LIFO و FIFO. الشكل 1.3: مكدس.
 ورغم أننا لن نناقش عادةً واجهات Stack و Deque وطابور FIFO في الفصول اللاحقة، فإن مصطلحي Stack و Deque يُستخدمان أحيانًا في أسماء بنى البيانات التي تنفّذ واجهة List. وعند حدوث ذلك، فإنه يبرز أن هذه البنى يمكن استخدامها لتنفيذ واجهة Stack أو Deque بكفاءة عالية جدًا. فعلى سبيل المثال، صنف ArrayDeque هو تنفيذ لواجهة List ينفّذ جميع عمليات Deque في زمن ثابت لكل عملية. 1.2.3 واجهة USet: مجموعات غير مرتبة تمثّل واجهة USet مجموعة غير مرتبة من عناصر فريدة، تحاكي مجموعة رياضية. ويحتوي الـ USet على عنصرًا متمايزًا؛ فلا يظهر أي عنصر أكثر من مرة؛ والعناصر ليست في أي ترتيب معين. ويدعم الـ USet العمليات التالية: : أعِد العدد، ، للعناصر في المجموعة : أضف العنصر إلى المجموعة إن لم يكن حاضرًا بالفعل؛ أضف إلى المجموعة شريطة ألّا يوجد عنصر في المجموعة بحيث يساوي . أعِد إن أُضيف إلى المجموعة و خلاف ذلك. : أزل من المجموعة؛ اعثر على عنصر في المجموعة بحيث يساوي وأزل . أعِد ، أو إن لم يوجد عنصر كهذا. : اعثر على في المجموعة إن وُجد؛ اعثر على عنصر في المجموعة بحيث يساوي . أعِد ، أو إن لم يوجد عنصر كهذا. وهذه التعريفات متحفظة في تمييز ، وهو العنصر الذي نزاله أو نبحث عنه، عن ، وهو العنصر الذي قد نزيله أو نجده. والسبب في ذلك أن و قد يكونان كائنين مختلفين فعليًا إلا أنهما يُعامَلان على أنهما متساويان.1.2وهذا التمييز مفيد لأنه يسمح بإنشاء قواميس (dictionaries) أو خرائط (maps) تربط المفاتيح بالقيم. ولإنشاء قاميس/خريطة، نشكّل كائنات مركّبة تسمى Pairs، كل منها يحتوي على مفتاح وقيمة. ويعامل اثنان من الـ Pairs على أنهما متساويان إذا كان مفتاحاهما متساويين. فإن خزّنّا زوجًا ما في USet ثم استدعينا لاحقًا الطريقة مستخدمين الزوج ، تكون النتيجة . بمعنى آخر، من الممكن استرجاع القيمة، ، انطلاقًا من المفتاح وحده. 1.2.4 واجهة SSet: مجموعات مرتبة تمثّل واجهة SSet مجموعة مرتبة من العناصر. ويخزّن الـ SSet عناصر من ترتيب كلي (total order)، بحيث يمكن مقارنة أي عنصرين و . وفي أمثلة الشيفرة، سيُجرى ذلك بطريقة اسمها يتم فيها
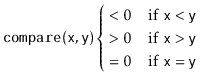
ويدعم الـ SSet الطرق و و بدلالات مطابقة تمامًا لتلك الموجودة في واجهة USet. ويكمن الفرق بين USet و SSet في الطريقة :
- : حدّد موقع في المجموعة المرتبة؛ اعثر على أصغر عنصر في المجموعة بحيث . أعِد أو إن لم يوجد عنصر كهذا.
وتُسمّى هذه الصيغة من العملية أحيانًا بحث الخلف (successor search). وهي تختلف جوهريًا عن لأنها تعيد نتيجة ذات معنى حتى عندما لا يوجد في المجموعة عنصر مساوٍ لـ . والفرق بين عمليتي في USet و SSet بالغ الأهمية وكثيرًا ما يُغفل. أما الوظيفة الإضافية التي يوفرها الـ SSet فعادةً ما تأتي بثمن يشمل زيادة في زمن التنفيذ وزيادة في تعقيد التنفيذ. فعلى سبيل المثال، معظم تنفيذات SSet المتناولة في هذا الكتاب لديها عمليات يكون زمن تنفيذها لوغاريتميًا في حجم المجموعة. وفي المقابل، فإن تنفيذ USet بوصفه ChainedHashTable في الفصل 5 لديه عملية تعمل في زمن ثابت متوقع. وعند الاختيار بين هذه البنى، ينبغي دائمًا استخدام USet ما لم تكن الوظيفة الإضافية التي يقدمها SSet مطلوبة فعلًا.
الحواشي
... متساويين.1.2 في Java، يتم ذلك بتجاوز طريقتي الصنف و . opendatastructures.org
1.3 الخلفية الرياضية
الأقسام الفرعية
1.3 الخلفية الرياضية
في هذا القسم، نراجع بعض الرموز والأدوات الرياضية المستخدمة في هذا الكتاب، بما فيها اللوغاريتمات وترميز big-Oh ونظرية الاحتمال. وستكون هذه المراجعة موجزة ولا يُقصد بها أن تكون مقدمة. ويُشجّع القراء الذين يشعرون بأن هذه الخلفية ناقصة لديهم على قراءة الأقسام المناسبة من الكتاب النصي الجيد جدًا (والمجاني) في الرياضيات لعلوم الحاسوب [50] وعلى حل تمارينه. 1.3.1 الأسّيات واللوغاريتمات يعبّر التعبير عن العدد مرفوعًا إلى الأس . فإذا كان عددًا صحيحًا موجبًا، فإن هذه هي ببساطة قيمة مضروبة في نفسها مرة:
وعندما يكون عددًا صحيحًا سالبًا، فإن . وعندما ، فإن . أما عندما لا يكون عددًا صحيحًا، فيمكننا مع ذلك تعريف الرفع إلى القوة بدلالة الدالة الأسية (انظر أدناه)، وهي بدورها معرَّفة بدلالة المتسلسلة الأسية، لكن الأفضل ترك هذا لكتاب حساب تفاضل وتكامل.
في هذا الكتاب، يعبّر التعبير عن اللوغاريتم الأساسي للعدد . أي أنه القيمة الفريدة التي تحقّق
معظم اللوغاريتمات في هذا الكتاب أساسها 2 (لوغاريتمات ثنائية). وللأساس 2 نُهمل الأساس، بحيث يكون اختصارًا لـ .
ومن طرائق التفكير غير الرسمية، وإن كانت مفيدة، في اللوغاريتمات: أن نتخيل بوصفه عدد المرات التي يجب أن نقسم فيها على قبل أن تصبح النتيجة أصغر من 1 أو مساوية لها. فعلى سبيل المثال، عند إجراء بحث ثنائي (binary search)، يخفض كل مقارنة عدد الإجابات المحتملة بمعامل 2. ويُعاد هذا حتى يبقى باقٍ إجابة محتملة واحدة على الأكثر. ولذلك فإن عدد المقارنات التي ينفذها البحث الثنائي عندما يكون عدد الإجابات المحتملة في البداية على الأكثر يساوي على الأكثر. وهناك لوغاريتم آخر يتكرر ذكره في هذا الكتاب عدة مرات هو اللوغاريتم الطبيعي. وهنا نستخدم الرمز للإشارة إلى ، حيث -- ثابت أويلر -- معطى بـ
ويتكرر اللوغاريتم الطبيعي كثيرًا لأنه قيمة تكامل شائع إلى حد كبير:
ومن اثنتين من أكثر المعالجات شيوعًا للوغاريتمات، إخراجه من الأس:
وتغيير أساس اللوغاريتم:
فعلى سبيل المثال، يمكننا استخدام هاتين العمليتين للمقارنة بين اللوغاريتم الطبيعي واللوغاريتم الثنائي
1.3.2 المُعاملات يُستخدم في موضع أو موضعين من هذا الكتاب دالة المُعامل (factorial). وللعدد الصحيح غير السالب ، يُعرَّف الرمز (يُنطق « factorial») بأنه
وتظهر المُعاملات لأن يَعُدّ عدد التبديلات المتمايزة، أي ترتيبات عنصرًا متمايزًا. وفي الحالة الخاصة ، يُعرَّف بأنه 1.
ويمكن تقريب الكمية باستخدام تقريب ستيرلنغ (Stirling's Approximation):
حيث
كما يقرّب تقريب ستيرلنغ قيمة :
(وف الواقع، يُثبَت تقريب ستيرلنغ على نحو أسهل تقريبًا باقتراض بالتكامل .)
وذات صلة بدالة المُعامل هي معاملات ثنائية القطع (binomial coefficients). وللعدد الصحيح غير السالب والعدد الصحيح ، يعبّر الرمز عن:
ومعامل ثنائي القطع (يُنطق « choose ») يَعُدّ عدد المجموعات الجزئية في مجموعة من عنصرًا ذات الحجم ، أي عدد طرق اختيار عددًا صحيحًا متمايزًا من المجموعة .
1.3.3 الترميز التقريبي عند تحليل بنى البيانات في هذا الكتاب، نريد الحديث عن أزمنة تنفيذ العمليات المختلفة. وبالطبع تختلف أزمنة التنفيذ الدقيقة من حاسوب إلى آخر، بل ومن تشغيل إلى آخر على حاسوب بعينه. وحين نتحدث عن زمن تنفيذ عملية، فإننا نشير إلى عدد تعليمات الحاسوب المنفَّذة أثناء تلك العملية. وحتى في حالة الشيفرة البسيطة قد يصعب حساب هذه الكمية بدقة. لذلك، بدلًا من تحليل أزمنة التنفيذ بدقة، سنستخدم ما يسمى ترميز big-Oh: فبالنسبة إلى دالة ، تشير إلى مجموعة من الدوال،
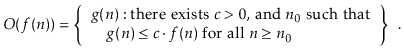
وبالتفكير بيانيًا، تتكوّن هذه المجموعة من الدوال حيث تبدأ بالسيطرة على عندما يصبح كبيرًا بما يكفي.
ونستخدم عادةً الترميز التقريبي لتبسيط الدوال. فمثلًا، بدلًا من يمكننا كتابة . وقد ثبت ذلك على النحو التالي:
ويُظهر هذا أن الدالة تنتمي إلى المجموعة باستخدام الثابتين و .
ويمكن تطبيق عدد من الاختصارات المفيدة عند استخدام الترميز التقريبي. أولًا:
لكل . ثانيًا: لأي الثوابت ،
ويمكن ضرب علاقات الاحتواء هذه بأي قيمة موجبة، وتظل قائمة. فمثلًا، الضرب في يعطي:
متابعةً لتقليد عريق ومتميز، سنُسيء استعمال هذا الرمز بكتب أشياء مثل بينما ما نقصده حقًا هو . وسنقول أيضًا عبارات مثل «زمن تنفيذ هذه العملية هو » بينما المقصود هو «زمن تنفيذ هذه العملية عنصر في .» هذه الاختصارات موجودة أساسًا لتفادي اللغة المربكة ولتسهيل استخدام الترميز التقريبي داخل سلاسل المعادلات. ويحدث مثال غريب بشكل خاص من هذا النوع حين نكتب عبارات مثل
ومرة أخرى، ينبغي كتابة هذا على نحو أدق هكذا:
كما يثير التعبير مسألة أخرى. فبينما لا يوجد متغيّر في هذا التعبير، قد لا يكون واضحًا أي المتغيّرات هو الذي يصبح كبيرًا بشكل عشوائي. وبدون سياق لا سبيل إلى معرفة ذلك. وفي المثال أعلاه، بما أن المتغيّر الوحيد في بقية المعادلة هو ، يمكننا أن نفترض أن هذا يُقرأ على أنه ، حيث . وترميز big-Oh ليس جديدًا ولا خاصًا بعلوم الحاسوب. فقد استخدمه عالم نظر الأعداد Paul Bachmann في عام 1894، وهو مفيد للغاية في وصف أزمنة تنفيذ خوارزميات الحاسوب. خُذ الشيفرة التالية في الاعتبار:
    void snippet() {
        for (int i = 0; i < n; i++)
            a[i] = i;
    }
ينطوي تنفيذ واحد لهذه الطريقة على
- إسنادًا ( )،
- مقارنة ( )،
- عملية زيادة ( )،
- حساب إزاحة في المصفوفة ( )، و
- إسنادًا غير مباشر ( ).
ويمكننا كتابة زمن التنفيذ هذا على النحو
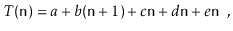
حيث و و و و ثوابت تعتمد على الآلة التي تشغّل الشيفرة، وتمثل زمن تنفيذ عمليات الإسناد والمقارنة والزيادة وحساب إزاحة المصفوفة والإسناد غير المباشر على التوالي. لكن إذا كان هذا التعبير يمثّل زمن تنفيذي سطرين من الشيفرة، فمن الواضح أن هذا النوع من التحليل لن يكون ممكنًا مع الشيفرة أو الخوارزميات المعقدة. وباستخدام ترميز big-Oh يمكن تبسيط زمن التنفيذ إلى
وليس هذا أكثر اختصارًا فحسب، بل إنه يعطي أيضًا قدرًا تقريبًا مماثلًا من المعلومات. فكون زمن التنفيذ يعتمد على الثوابت و و و و في المثال أعلاه يعني عمومًا أنه لن يكون بإمكاننا مقارنة زمنَي تنفيذ لمعرفة أيهما أسرع دون معرفة قيم هذه الثوابت. وحتى لو بذلنا جهدًا لتحديد هذه الثوابت (مثلًا عبر اختبارات التوقيت)، فإن استنتاجنا سيكون صالحًا فقط للآلة التي شغّلنا عليها اختباراتنا.
يسمح ترميز big-Oh لنا بالتفكير على مستوى أعلى بكثير، مما يجعل تحليل الدوال الأكثر تعقيدًا ممكنًا. فإذا كانت لخوارزميتين زمنا التنفيذ نفسيهما في ترميز big-Oh، فلن نعرف أيهما أسرع، وقد لا يوجد فائز واضح. فقد تكون إحداهما أسرع على آلة وتكون الأخرى أسرع على آلة مختلفة. لكن إذا كان لخوارزميتَي زمنا تنفيذ مختلفان في ترميز big-Oh يمكن إثباته، فسنكون على يقين أن ذا زمن التنفيذ الأصغر سيكون أسرع عندما تكون قيم كبيرة بما يكفي. ويبيّن الشكل 1.5 مثالًا على كيفية إتاحة ترميز big-Oh مقارنة دالتين مختلفتين، إذ يقارن فيه معدل نمو مقابل . وقد يكون هو زمن تنفيذ خوارزمية خطية معقدة، في حين يكون هو زمن تنفيذ خوارزمية أبسط بكثير تعتمد على نموذج القسمة والتغلب (divide-and-conquer). ويوضح هذا أنه، رغم أن أكبر من عند قيم الصغيرة، فإن العكس هو الصحيح عند قيم الكبيرة. وفي النهاية تتفوق بفارق يزداد اتساعًا. وقد أخبرنا التحليل باستخدام ترميز big-Oh أن هذا سيحدث، لأن . الشكل 1.5: رسوم بيانية لـ مقابل .  وفي قليل من الحالات، سنستخدم الترميز التقريبي على دوال لها أكثر من متغيّر واحد. ولا يبدو أنه يوجد معيار قياسي لذلك، لكن لأغراضنا يكون التعريف التالي كافيًا:
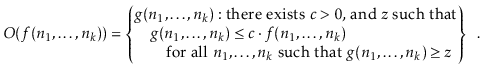
ويلتقط هذا التعريف الحالة التي نهتم بها فعلًا: عندما تجعل الوسائط الدالة تاخذ قيمًا كبيرة. ويتفق هذا التعريف أيضًا مع تعريف أحادي المتغيّر عندما تكون دالة متزايدة في . وينبغي تنبيه القارئ إلى أن، رغم أن هذا ينفع لأغراضنا، فإن نصوصًا أخرى قد تعامل الدوال متعددة المتغيرات والترميز التقريبي بطريقة مختلفة.
1.3.4 العشوائية والاحتمال بعض بنى البيانات المعروضة في هذا الكتاب عشوائية؛ فهي تتخذ خيارات عشوائية مستقلة عن البيانات المخزَّنة فيها أو عن العمليات المنفَّذة عليها. ولهذا السبب، فإن تنفيذ مجموعة العمليات نفسها أكثر من مرة باستخدام هذه البنى قد يؤدي إلى أزمنة تنفيذ مختلفة. وحين نحلّل هذه البنى فإننا مهتمون بأزمنة تنفيذها المتوسطة أو المتوقعة. ورسميًا، فإن زمن تنفيذ عملية على بنية بيانات عشوائية هو متغيّر عشوائي، ونريد دراسة قيمته المتوقعة. وبالنسبة إلى متغيّر عشوائي متقطّع يأخذ قيمًا في مجموعة قابلة للعدّ ، فإن القيمة المتوقعة لـ ، ويُشار إليها بـ ، تُعطى بالصيغة
وهنا تشير إلى احتمال وقوع الحدث . وفي جميع الأمثلة في هذا الكتاب، ترجع هذه الاحتمالات إلى الخيارات العشوائية التي تتخذها بنية البيانات العشوائية فحسب؛ ولا يوجد افتراض بأن البيانات المخزَّنة في البنية، ولا تسلسل العمليات المنفَّذة عليها، عشوائي.
ومن أهم خصائص القيم المتوقعة الخطية (linearity of expectation). فبالنسبة إلى أي متغيّرَي عشوائي و ،
وبشكل أعم، بالنسبة إلى أي متغيّرات عشوائية ،
تتيح الخطية للتوقع تفكيك المتغيّرات العشوائية المعقدة (مثل الطرف الأيسر للمعادلات أعلاه) إلى مجاميع متغيّرات عشوائية أبسط (الطرف الأيمن).
ومن الحيل المفيدة التي سنستخدمها مرارًا تعريف متغيّرات المؤشر (indicator random variables). فهذه المتغيّرات الثنائية مفيدة عندما نريد عدّ شيء ما، وأفضل طريقة لتوضيحها هي مثال. لنفترض أننا نرمي عملة عادلة مرة ونريد معرفة العدد المتوقع لمرات خروج الوجه (heads). ومن البديهي أن نعرف أن الإجابة هي ، لكن إذا حاولنا إثبات ذلك باستخدام تعريف القيمة المتوقعة، نحصل على
ويتطلب هذا أن نعرف ما يكفي لحساب ، وأن نعرف المتطابقات الثنائية و .
واستخدام متغيّرات المؤشر وخطية التوقع يجعل الأمور أسهل بكثير. فلكل ، نعرّف متغيّر المؤشر
ثم
والآن، ، لذا
وهذا أطول قليلًا، لكنه لا يتطلب منا معرفة أي متطابقات سحرية أو حساب أي احتمالات غير بديهية. والأفضل أنه يتوافق مع الحدس بأننا نتوقع أن تخرج نصف العملات وجهًا بالضبط لأن كل عملة منفردة تخرج وجهًا باحتمال . opendatastructures.org
1.4 نموذج الحساب
في هذا الكتاب، سنحلل أزمنة التنفيذ النظرية للعمليات على بنى البيانات التي ندرسها. ولإجراء ذلك بدقة، نحتاج إلى نموذج حساب رياضي. ونستخدم هنا نموذج word-RAM ذي بت. واختصار RAM يعني آلة الوصول العشوائي (Random Access Machine). وفي هذا النموذج، لدينا وصول إلى ذاكرة وصول عشوائي مكوّنة من خلايا، تخزّن كل منها كلمة (word) بطول بت. وهذا يعني أن خلية الذاكرة تستطيع أن تمثّل، مثلًا، أي عدد صحيح في المجموعة . وفي نموذج word-RAM، تستغرق العمليات الأساسية على الكلمات زمنًا ثابتًا. ويشمل ذلك العمليات الحسابية ( ، ، ، ، )، والمقارنات ( ، ، ، ، )، وعمليات المنطق البوليانية على البتات (AND و OR و exclusive-OR). ويمكن قراءة أي خلية أو كتابتها في زمن ثابت. وتُدار ذاكرة الحاسوب بواسطة نظام إدارة ذاكرة (memory management system) يمكننا منه تخصيص كتلة ذاكرة أو تحريرها بأي حجم نرغب فيه. ويستغرق تخصيص كتلة ذاكرة بحجم زمنًا قدره ويعيد مرجعًا (مؤشرًا) إلى كتلة الذاكرة المخصصة حديثًا. وهذا المرجع صغير بما يكفي لأن يُمثَّل بكلمة واحدة. وحجم الكلمة معامل مهم جدًا في هذا النموذج. والافتراض الوحيد الذي سنفرضه على هو الحد الأدنى ، حيث هو عدد العناصر المخزَّنة في أي من بنى بياناتنا. وهذا افتراض متواضع إلى حد ما، إذ لولا ذلك لما كانت الكلمة كبيرة بما يكفي حتى لعدّ عدد العناصر المخزَّنة في بنية البيانات. ويُقاس المكان بالكلمات، بحيث حين نتحدث عن مقدار المكان المستخدم في بنية بيانات، فإننا نشير إلى عدد كلمات الذاكرة التي تستخدمها البنية. وتخزّن جميع بنى بياناتنا قيمًا من نوع عام ، ونفترض أن عنصرًا من النوع يشغل كلمة واحدة من الذاكرة. (وفي الواقع، نحن نخزّن مراجع لكائنات من النوع ، وهذه المراجع تشغل كلمة واحدة فقط من الذاكرة.) ويتطابق نموذج word-RAM ذي بت إلى حد كبير مع آلة Java الافتراضية (JVM) ذات 32 بت عندما يكون . ولا تستخدم بنى البيانات المعروضة في هذا الكتاب أي حيل خاصة غير قابلة للتنفيذ على JVM وعلى معظم البنى الأخرى. opendatastructures.org
1.5 الصحة والتعقيد الزمني والتعقيد المكاني
عند دراسة أداء بنية بيانات، هناك ثلاثة أمور هي الأهم: الصحة: ينبغي أن تنفّذ بنية البيانات واجهتها على نحو صحيح. التعقيد الزمني: ينبغي أن تكون أزمنة تنفيذ العمليات على بنية البيانات أصغر ما يمكن. التعقيد المكاني: ينبغي أن تستخدم بنية البيانات أقل قدر ممكن من الذاكرة. وفي هذا النص التمهيدي سنعتبر الصحة أمرًا مفترضًا؛ فلن ننظر في بنى بيانات تعطي إجابات خاطئة على الاستعلامات أو لا تنفّذ التحديثات على الوجه الصحيح. لكننا سنرى مع ذلك بنى بيانات تبذل جهدًا إضافيًا للحد من استهلاك المكان. ولن يؤثر ذلك عادةً في أزمنة التنفيذ (التقريبية) للعمليات، لكنه قد يجعل بنى البيانات أبطأ قليلًا في الممارسة العملية. وعند دراسة أزمنة التنفيذ في سياق بنى البيانات، نميل إلى مواجهة ثلاثة أنواع مختلفة من ضمانات زمن التنفيذ: أزمنة التنفيذ في أسوأ الحالات: وهذه أقوى أنواع ضمانات زمن التنفيذ. فإذا كان لعملية ما على بنية بيانات زمن تنفيذ في أسوأ الحالات قدره ، فإن إحدى هذه العمليات لا تستغرق أبدًا زمنًا يتجاوز . أزمنة التنفيذ المُستهلكة (amortized): فإذا قلنا إن زمن التنفيذ المُستهلك لعملية ما على بنية بيانات هو ، فإن هذا يعني أن تكلفة العملية المعتادة هي على الأكثر . وبدقة أكبر، إذا كانت بنية بيانات ذات زمن تنفيذ مستهلك هو ، فإن سلسلة من عمليات تستغرق زمنًا لا يتجاوز . وقد تستغرق بعض العمليات الفردية أكثر من لكن المتوسط، على كامل سلسلة العمليات، هو على الأكثر . أزمنة التنفيذ المتوقعة: فإذا قلنا إن زمن التنفيذ المتوقع لعملية ما على بنية بيانات هو ، فإن هذا يعني أن زمن التنفيذ الفعلي هو متغيّر عشوائي (انظر القسم 1.3.4) وأن القيمة المتوقعة لهذا المتغيّر العشوائي هي على الأكثر . والعشوائية هنا تتعلق بالخيارات العشوائية التي تتخذها بنية البيانات. وللفهم الفرق بين أزمنة التنفيذ في أسوأ الحالات والمُستهلكة والمتوقعة، من المفيد النظر في مثال مالي. خُذ تكلفة شراء منزل: 1.5.0.0.1 أسوأ الحالات مقابل التكلفة المُستهلكة: لنفترض أن المنزل يكلف $120000. ولشراء هذا المنزل، قد نأخذ رهنًا عقاريًا لمدة 120 شهرًا (10 سنوات) بدفعات شهرية قدرها $1200 شهريًا. وفي هذه الحالة، فإن تكلفة سداد هذا الرهن في أسوأ الحالات شهريًا هي $1200 شهريًا. وإذا كان لدينا
شهرًا شهريًا
فإن ذلك أقل بكثير من $1200 شهريًا مما كان علينا دفعه لو أخذنا رهنًا عقاريًا.
1.5.0.0.2 أسوأ الحالات مقابل التكلفة المتوقعة:
الآن، خُذ مسألة التأمين على الحريق لمنزلنا الذي تبلغ قيمته $120000. ومن خلال دراسة مئات الآلاف من الحالات، حددت شركات التأمين أن المبلغ المتوقع من أضرار الحريق على منزل مثل منزلك هو $10 شهريًا. وهذا رقم صغير جدًا، لأن معظم المنازل لا تحترق أبدًا، وقد تشتعل في بعض المنازل حرائق صغيرة تسبب قدرًا من ضرر الدخان، وتحترق أعداد ضئيلة جدًا من المنازل حتى الأساسات. واستنادًا إلى هذه المعلومات، تفرض شركة التأمين $15 شهريًا مقابل التأمين على الحريق. والآن حان وقت القرار. فهل ندفع تكلفة أسوأ الحالات البالغة $15 شهريًا مقابل التأمين على الحريق، أم نراهن ونؤمّن على أنفسنا بتكلفة متوقعة قدرها $10 شهريًا؟ من الواضح أن $10 شهريًا أقل كلفة في التوقع، لكن علينا أن نتقبل احتمال أن التكلفة الفعلية قد تكون أعلى بكثير. وفي الحدث غير المحتمل بأن يحترق المنزل بأكمله، ستكون التكلفة الفعلية $120000. وتقدّم هذه الأمثلة المالية أيضًا رؤية حول لماذا نكتفي أحيانًا بزمن تنفيذ مستهلك أو متوقع بدلًا من زمن تنفيذ في أسوأ الحالات. فغالبًا ما يمكن الحصول على زمن تنفيذ متوقع أو مستهلك أقل من زمن التنفيذ في أسوأ الحالات. وعلى أقل تقدير، من الممكن غالبًا جدًا الحصول على بنية بيانات أبسط بكثير إذا رغب أحد في الاكتفاء بزمن تنفيذ مستهلك أو متوقع. opendatastructures.org
1.6 نماذج الشيفرة
نماذج الشيفرة في هذا الكتاب مكتوبة بلغة البرمجة Java. لكن، وحرصًا على جعل الكتاب متاحًا للقراء غير الملمسين بكل تركيبات Java وكلماتها المفتاحية، فقد بُسطت نماذج الشيفرة. فمثلًا، لن يجد القارئ أيًا من الكلمات المفتاحية أو أو أو . ولن يجد القارئ أيضًا نقاشًا مطوّلًا حول تسلسلات الأصناف (class hierarchies). وأي الواجهات تنفّذها صنف بعينه أو أي صنف يمتد إليه، إن كان ذلك ذا صلة بالنقاش، ينبغي أن يكون واضحًا من النص المرافق. وينبغي أن تجعل هذه الاتفاقيات نماذج الشيفرة مفهومة لكل من لديه خلفية في أي من لغات تقليد ALGOL، بما فيها B و C و C++ و C# و Objective-C و D و Java و JavaScript وغيرها. ويُشجّع القراء الراغبين في التفاصيل الكاملة لجميع التنفيذات على النظر في شيفرة Java المصدرية المصاحبة لهذا الكتاب. ويخلط هذا الكتاب بين التحليلات الرياضية لأزمنة التنفيذ وشيفرة Java الخاصة بالخوارزميات التي يجري تحليلها. وهذا يعني أن بعض المعادلات تحتوي متغيّرات موجودة أيضًا في الشيفرة المصدرية. وتُنسَّق هذه المتغيّرات تنسيقًا متسقًا، سواء داخل الشيفرة المصدرية أو داخل المعادلات. وأكثر هذه المتغيّرات شيوعًا هو المتغيّر الذي، بلا استثناء، يشير دائمًا إلى عدد العناصر المخزَّنة حاليًا في بنية البيانات. opendatastructures.org
1.7 قائمة بنى البيانات
يلخّص الجدولان 1.1 و1.2 أداء بنى البيانات في هذا الكتاب التي تنفّذ كل واجهة من الواجهات، List و USet و SSet، الموصوفة في القسم 1.2. ويبيّن الشكل 1.6 التبعيات بين الفصول المختلفة في هذا الكتاب. ويشير السهم المتقطع إلى تبعية ضعيفة فقط، حيث يعتمد جزء صغير من الفصل على فصل سابق أو تعتمد النتائج الرئيسية للفصل السابق فقط.
1.8 المناقشة والتمارين
تتأثر واجهات List و USet و SSet الموصوفة في القسم 1.2 بإطار مجموعات Java (Java Collections Framework) [54]. وهذه في جوهرها نسخ مبسّطة من واجهات List و Set و Map و SortedSet و SortedMap الموجودة في إطار مجموعات Java. وتتضمن الشيفرة المصدرية المرافقة أصناف غلاف (wrapper classes) لتحويل تنفيذات USet و SSet إلى تنفيذات Set و Map و SortedSet و SortedMap. ولمعالجة راقية (ومجانية) للرياضيات المتناولة في هذا الفصل، بما في ذلك الترميز التقريبي واللوغاريتمات والمُعاملات وتقريب ستيرلنغ والاحتمال الأساسي والكثير غير ذلك، انظر الكتاب النصي لـ Leyman و Leighton و Meyer [50]. ولكتاب حساب تفاضل وتكامل سهل يتضمن تعريفات رسمية للأسّيات واللوغاريتمات، انظر النص الكلاسيكي (المتاح مجانًا) لـ Thompson [73]. ولمزيد من المعلومات عن الاحتمال الأساسي، ولا سيما ما يتعلق منه بعلوم الحاسوب، انظر الكتاب النصي لـ Ross [65]. ومرجع جيد آخر، يغطي كلاً من الترميز التقريبي والاحتمال، هو الكتاب النصي لـ Graham و Knuth و Patashnik [37]. ويمكن للقراء الذين يريدون تنشيط مهاراتهم في برمجة Java العثور على دروس Java كثيرة عبر الإنترنت [56]. التمرين 1.1 صُمم هذا التمرين لمساعدة القارئ على التأقلم مع اختيار بنية البيانات المناسبة للمشكلة المناسبة. وإذا كان تنفيذ هذا التمرين، فينبغي أن تُنجز أجزاؤه بالاستعانة بتنفيذ للواجهة المعنية (Stack أو Queue أو Deque أو USet أو SSet) يوفّره إطار مجموعات Java. حل المسائل التالية بقراءة ملف نصي سطرًا واحدًا في كل مرة وتنفيذ عمليات على كل سطر في بنية البيانات المناسبة. ينبغي أن تكون تنفيذاتك سريعة بما يكفي بحيث يمكن معالجة الملفات التي تحتوي على مليون سطر في بضع ثوانٍ. اقرأ المدخلات سطرًا واحدًا في كل مرة، ثم اكتب السطور بترتيب معكوس، بحيث يُطبع آخر سطر من المدخلات أولًا، ثم ما قبله من سطر، وهكذا. اقرأ أول 50 سطرًا من المدخلات ثم اكتبها بترتيب معكوس. اقرأ السطور الـ 50 التالية ثم اكتبها بترتيب معكوس. افعل ذلك حتى لا تبقى سطور لقراءتها، وعندها تُخرَج أي سطور متبقية بترتيب معكوس. بمعنى آخر، سيبدأ مخرجاتك بالسطر الخمسين، ثم التاسع والأربعين، ثم الثامن والأربعين، وهكذا نزولًا إلى السطر الأول. يتبع ذلك السطر المئة، ثم التسعة والتسعين، وهكذا نزولًا إلى السطر الحادي والخمسين. وهكذا. ولا ينبغي أن تحتاج شيفرتك في أي لحظة إلى تخزين أكثر من 50 سطرًا. اقرأ المدخلات سطرًا واحدًا في كل مرة. عند أي نقطة بعد قراءة أول 42 سطرًا، إن كان أحد السطور فارغًا (أي سلسلة طولها 0)، فأخرِج السطر الذي وقع قبله بـ 42 سطرًا. فمثلًا، إذا كان السطر 242 فارغًا، فينبغي لبرنامجك أن يخرِج السطر 200. وينبغي تنفيذ هذا البرنامج بحيث لا يخزّن أكثر من 43 سطرًا من المدخلات في أي لحظة. اقرأ المدخلات سطرًا واحدًا في كل مرة واكتب كل سطر إلى المخرجات إذا لم يكن نسخة مكررة من بعض سطور المدخلات السابقة. خذ عناية خاصة بحيث لا يستخدم ملف يحتوي على سطور مكررة كثيرة ذاكرة أكثر مما يلزم لعدد السطور الفريدة. اقرأ المدخلات سطرًا واحدًا في كل مرة واكتب كل سطر إلى المخرجات فقط إذا كنت قد قرأت هذا السطر من قبل. (والنتيجة النهائية أنك تزيل أول ظهور لكل سطر.) خذ عناية خاصة بحيث لا يستخدم ملف يحتوي على سطور مكررة كثيرة ذاكرة أكثر مما يلزم لعدد السطور الفريدة. اقرأ كامل المدخلات سطرًا واحدًا في كل مرة. ثم أخرِج كل السطور مرتبة حسب الطول، بحيث تسبق السطور الأقصر. وفي حال تساوي طولَي سطرين، فُض ترتيبهما وفق «الترتيب المرتَّب» المعتاد. وينبغي أن تُطبع السطور المكررة مرة واحدة فقط. افعل كما في السؤال السابق، إلا أن السطور المكررة ينبغي أن تُطبع بعدد مرات ظهورها في المدخلات. اقرأ كامل المدخلات سطرًا واحدًا في كل مرة ثم أخرِج السطور ذات الأرقام الزوجية (بدءًا من السطر الأول، السطر 0) يليها السطور ذات الأرقام الفردية. اقرأ كامل المدخلات سطرًا واحدًا في كل مرة ثم رتّب السطور عشوائيًا قبل إخراجها. وللتوضيح: لا ينبغي أن تعدّل محتوى أي سطر. بل ينبغي أن تُطبع المجموعة نفسها من السطور، لكن بترتيب عشوائي.
التمرين 1.2 الكلمة الدايكية (Dyck word) هي تسلسل من +1 و -1 بحيث يكون مجموع أي بادئة من التسلسل غير سالب أبدًا. فمثلًا، كلمة دايكية، في حين أن ليست كلمة دايكية لأن البادئة . صِف أي علاقة بين الكلمات الدايكية وعمليتَي Stack و .
التمرين 1.3 السلسلة المتطابقة (matched string) هي تسلسل من الأحرف { و } و ( و ) و [ و ] تكون متطابقة على الوجه الصحيح. فمثلًا، {{()[]}}'' سلسلة متطابقة، في حين أن {{()]}'' ليست كذلك، لأن { الثانية تُطابَق مع ]. وبيّن كيف يمكن استخدام مكدس بحيث، عندما يكون طول السلسلة ، تستطيع تحديد ما إذا كانت سلسلة متطابقة في زمن .
التمرين 1.4 لنفترض لديك Stack، ، يدعم فقط عمليتَي و . بيّن كيف، باستخدام طابور FIFO واحد فقط، ، يمكنك عكس ترتيب جميع عناصر .
التمرين 1.5 باستخدام USet، نفّذ Bag. وBag يشبه USet-- فهو يدعم الطريقتين و و --لكنه يسمح بتخزين عناصر مكررة. وتعيد عملية في Bag بعض العناصر (إن وُجدت) التي تساوي . وبالإضافة إلى ذلك، يدعم Bag عملية التي تعيد قائمة بجميع عناصر Bag التي تساوي .
التمرين 1.6 اكتب من الصفر ونفّذ اختبارات لتطبيقات واجهات List و USet و SSet. ولا يلزم أن تكون هذه فعّالة. ويمكن استخدامها لاحقًا لاختبار صحة وأداء التطبيقات الأكثر فعالية. (والأسهل تنفيذًا لذلك هو تخزين العناصر في مصفوفة.)
التمرين 1.7 اعمل على تحسين أداء تطبيقاتك من السؤال السابق باستخدام أي حيل يخطر لك. جرّب وفكّر في كيفية تحسين أداء و في تطبيق List لديك. وفكّر في كيفية تحسين أداء عملية في تطبيقات USet و SSet لديك. صُمم هذا التمرين لتمنحك إحساسًا بمقدار صعوبة الحصول على تطبيقات فعّالة لهذه الواجهات.