13. بنى بيانات الأعداد الصحيحة
في هذا الفصل، نعود إلى مسألة تنفيذ مجموعة مرتَّبة (SSet). والفرق الآن أننا نفترض أنّ العناصر المخزَّنة في SSet أعدادٌ صحيحة بطول بت. أي أننا نريد تنفيذ و و حيث . ومن السهل إلى حدٍّ ما أن نتخيّل تطبيقاتٍ كثيرة تكون فيها البيانات — أو على الأقلّ المفتاح الذي نستعمله في ترتيب البيانات — عددًا صحيحًا. وسنناقش ثلاث بنى بيانات، كلٌّ منها تبني على أفكار سابقتها. البنية الأولى، BinaryTrie، تنفّذ عمليات SSet الثلاث جميعها بزمن . وهذا ليس لافتًا للنظر، إذ إنّ أي مجموعة جزئية من لها حجم ، بحيث إنّ . وكل تنفيذات SSet الأخرى التي ناقشناها في هذا الكتاب تنفّذ جميع العمليات بزمن ، فهي كلّها على الأقلّ بسرعة BinaryTrie. أمّا البنية الثانية، XFastTrie، فتُسرّع البحث في BinaryTrie باستعمال التجزئة (hashing). ومع هذا التسريع تعمل العملية بزمن . غير أنّ عمليتَي و في XFastTrie لا تزالان تستغرقان بزمن ، والمساحة التي يستعملها XFastTrie هي . أمّا البنية الثالثة، YFastTrie، فتستعمل XFastTrie لتخزين عيّنة فقط، تقارب عنصرًا واحدًا من كلّ عناصر، وتخزّن بقية العناصر في بنية SSet معيارية. وتُنزل هذه الحيلة زمن تنفيذ و إلى وتُنزل المساحة إلى . أمّا التنفيذات المستعملة أمثلةً في هذا الفصل فيمكنها تخزين أيّ نوعٍ من البيانات، ما دام بإمكاننا إسناد عددٍ صحيحٍ إليها. وفي نماذج الشيفرة، يكون المتغيّر دائمًا القيمة الصحيحة المسنَدة إلى ، وتحوّل الدالة القيمة إلى العدد الصحيح المسنَد إليها. أمّا في النصّ فسنكتفي بمعاملة كما لو كانت عددًا صحيحًا.
الأقسام الفرعية
13.1 BinaryTrie: شجرة بحث رقمية
يشفّر BinaryTrie مجموعةً من الأعداد الصحيحة بطول بت في شجرة ثنائية. فجميع الأوراق في الشجرة على العمق ، ويُشفَّر كلّ عدد صحيح في صورة مسارٍ يمتدّ من الجذر إلى ورقة. ويتّجه مسار العدد الصحيح إلى اليسار عند المستوى إذا كان البت th الأكثر أهميةً في يساوي 0، وإلى اليمين إذا كان يساوي 1. ويعرض الشكل 13.1 مثالًا للحالة ، حيث تخزّن شجرة البادئات (trie) الأعداد الصحيحة 3(0011) و9(1001) و12(1100) و13(1101).
لأنّ مسار البحث عن قيمةٍ ما، ، يعتمد على بتات نفسها، من المفيد أن نسمّي أبناء عقدةٍ ما، ، بالاسمين ( ) و ( ). وفي الواقع، تخدم مؤشّرات الأبناء هذين غرضين معًا. ولأنّ أوراق شجرة البادئات الثنائية لا أبناء لها، تُستعمل هذه المؤشّرات لوصل الأوراق ببعضها في قائمة مترابطة ثنائية الوصل (doubly-linked list). أمّا الورقة في شجرة البادئات الثنائية، ( ) فهي العقدة التي تسبق في القائمة، و ( ) هي العقدة التي تلي في القائمة. وتُستعمل عقدةٌ خاصة، ، قبل أوّل عقدةٍ في القائمة وبعد آخر عقدةٍ فيها معًا (انظر القسم 3.2). وتحتوي كلّ عقدة، ، كذلك على مؤشّرٍ إضافي هو . فإن كان الابن الأيسر لـ مفقودًا، فإنّ يشير إلى أصغر ورقةٍ في الشجرة الفرعية لـ . وإن كان الابن الأيمن لـ مفقودًا، فإنّ يشير إلى أكبر ورقةٍ في الشجرة الفرعية لـ . ويعرض الشكل 13.2 مثالًا على BinaryTrie يُظهر مؤشّرات والقائمة المترابطة ثنائية الوصل عند الأوراق.
العملية في BinaryTrie بسيطةٌ إلى حدٍّ ما. فنحن نحاول اتّباع مسار البحث عن في شجرة البادئات. فإذا بلغنا ورقة، فقد وجدنا . وإذا بلغنا عقدةً لا يمكننا المتابعة عندها (لأنّ تفتقر إلى ابن)، فإنّنا نتبع ، الذي ينقلنا إمّا إلى أصغر ورقةٍ أكبر من أو إلى أكبر ورقةٍ أصغر من . وأيّ من هاتين الحالتين يقع يتوقّف على ما إذا كانت تفتقر إلى ابنها الأيسر أم إلى ابنها الأيمن، على التوالي. وفي الحالة الأولى ( تفتقر إلى ابنها الأيسر) فقد وجدنا العقدة التي نريدها. وفي الحالة الثانية ( تفتقر إلى ابنها الأيمن) يمكننا استعمال القائمة المترابطة للوصول إلى العقدة التي نريدها. ويوضّح الشكل 13.3 كلَّ واحدةٍ من هاتين الحالتين.
    T find(T x) {
        int i, c = 0, ix = it.intValue(x);
        Node u = r;
        for (i = 0; i < w; i++) {
            c = (ix >>> w-i-1) & 1;
            if (u.child[c] == null) break;
            u = u.child[c];
        }
        if (i == w) return u.x;  // found it
        u = (c == 0) ? u.jump : u.jump.child[next];
        return u == dummy ? null : u.x;
    }
يغلب على زمن تنفيذ الدالة الزمن اللازم لاتّباع مسارٍ من الجذر إلى ورقة، ولذلك تعمل بزمن . أمّا العملية في BinaryTrie فبسيطةٌ هي الأخرى، لكنّ عليها عملٌ كثير:
- يتّبع مسار البحث عن حتى يبلغ عقدةً لم يعد في وسعه المتابعة.
- ينشئ بقيّة مسار البحث من إلى ورقةٍ تحوي .
- يضيف العقدةَ ، التي تحوي ، إلى القائمة المترابطة للأوراق (ويستطيع الوصول إلى السابقة لـ في القائمة المترابطة من مؤشّر لآخر عقدٍ، ، صادفها في الخطوة 1.)
- يصعد عائدًا في مسار البحث عن ، ويعدّل مؤشّرات عند العقد التي ينبغي أن يشير مؤشّر فيها الآن إلى .
ويوضّح الشكل 13.4 مثالًا على إضافة عنصر.
    boolean add(T x) {
        int i, c = 0, ix = it.intValue(x);
        Node u = r;
        // 1 - search for ix until falling out of the trie
        for (i = 0; i < w; i++) {
            c = (ix >>> w-i-1) & 1;
            if (u.child[c] == null) break;
            u = u.child[c];
        }
        if (i == w) return false; // already contains x - abort
        Node pred = (c == right) ? u.jump : u.jump.child[0];
        u.jump = null;  // u will have two children shortly
        // 2 - add path to ix
        for (; i < w; i++) {
            c = (ix >>> w-i-1) & 1;
            u.child[c] = newNode();
            u.child[c].parent = u;
            u = u.child[c];
        }
        u.x = x;
        // 3 - add u to linked list
        u.child[prev] = pred;
        u.child[next] = pred.child[next];
        u.child[prev].child[next] = u;
        u.child[next].child[prev] = u;
        // 4 - walk back up, updating jump pointers
        Node v = u.parent;
        while (v != null) {
            if ((v.child[left] == null
                    && (v.jump == null || it.intValue(v.jump.x) > ix))
            || (v.child[right] == null
                    && (v.jump == null || it.intValue(v.jump.x) < ix)))
                v.jump = u;
            v = v.parent;
        }
        n++;
        return true;
    }
تُجري هذه الدالة نزولًا واحدًا في مسار البحث عن وصعودًا واحدًا عائدًا. وتستغرق كلّ خطوةٍ من خطوتي الصعود والنزول زمنًا ثابتًا، ولذلك تعمل الدالة بزمن . أمّا العملية فتلغي عمل . ومثل ، عليها عملٌ كثير:
- يتّبع مسار البحث عن حتى يبلغ الورقةَ ، التي تحوي .
- يزيل من القائمة المترابطة ثنائية الوصل.
- يحذف ثمّ يصعد عائدًا في مسار البحث عن ، محذفًا العقد، حتى يبلغ عقدةً لها ابنٌ ليس على مسار البحث عن .
- يصعد من إلى الجذر، محدِّثًا أيّ مؤشّرات التي تشير إلى .
ويوضّح الشكل 13.5 مثالًا على إزالة عنصر.
    boolean remove(T x) {
        // 1 - find leaf, u, containing x
        int i, c, ix = it.intValue(x);
        Node u = r;
        for (i = 0; i < w; i++) {
            c = (ix >>> w-i-1) & 1;
            if (u.child[c] == null) return false;
            u = u.child[c];
        }
        // 2 - remove u from linked list
        u.child[prev].child[next] = u.child[next];
        u.child[next].child[prev] = u.child[prev];
        Node v = u;
        // 3 - delete nodes on path to u
        for (i = w-1; i >= 0; i--) {
            c = (ix >>> w-i-1) & 1;
            v = v.parent;
            v.child[c] = null;
            if (v.child[1-c] != null) break;
        }
        // 4 - update jump pointers
        c = (ix >>> w-i-1) & 1;
        v.jump = u.child[1-c];
        v = v.parent;
        i--;
        for (; i >= 0; i--) {
            c = (ix >>> w-i-1) & 1;
            if (v.jump == u)
                v.jump = u.child[1-c];
            v = v.parent;
        }
        n--;
        return true;
    }
المبرهنة 13.1 يُنفِّذ BinaryTrie واجهة SSet للأعداد الصحيحة بطول بت. ويدعم BinaryTrie العمليات و و في زمن لكل عملية. والمساحة التي يستعملها BinaryTrie يخزّن قيمةً هي .
13.2 XFastTrie: البحث في زمن لوغاريتمي مزدوج
أداء بنية BinaryTrie ليس لافتًا للنظر. فعدد العناصر، ، المخزَّنة في البنية لا يتجاوز ، ولذلك فإنّ . بمعنى آخر، أيّ بنيةٍ من بنى SSet المبنيّة على المقارنات الموصوفة في أجزاءٍ أخرى من هذا الكتاب لا تقلّ كفاءةً عن BinaryTrie، وهي غير مقيّدة بتخزين الأعداد الصحيحة وحدها. ثمّ نصف الآن XFastTrie، وهي مجرّد BinaryTrie مع من جداول التجزئة (hash tables) — جدولٌ لكلّ مستوىٍ من مستويات شجرة البادئات. وتُستعمل جداول التجزئة هذه لتسريع العملية إلى زمن . ولنتذكّر أنّ العملية في BinaryTrie تكاد تكون منتهيةً بمجرد وصولنا إلى عقدة، ، يكون فيها مسار البحث عن راغبًا في الانتقال إلى (أو ) بينما ليس له ابنٌ أيمن (على سبيل المقابل، ابنٌ أيسر). وعند هذه النقطة، يقفز البحث بواسطة إلى ورقةٍ، ، من أوراق BinaryTrie، ثمّ إمّا يعيد أو خليفتها في القائمة المترابطة للأوراق. ويُسرّع XFastTrie عملية البحث باستعمال البحث الثنائي (binary search) على مستويات شجرة البادئات لتحديد موضع العقدة . ولاستعمال البحث الثنائي، نحتاج طريقةً لمعرفة ما إذا كانت العقدة التي نبحث عنها فوق مستوىٍ معيّن، ، أم أنّ عند المستوى أو تحته. وتقدّم هذه المعلومة البتات الأعلى رتبةً في التمثيل الثنائي لـ ; فهذه البتات تحدّد مسار البحث الذي يسلكه من الجذر إلى المستوى . ولمثالٍ ما، راجع الشكل 13.6؛ ففي هذا الشكل، آخر عقدة، ، على مسار البحث عن 14 (الذي تمثيله الثنائي هو 1110) هي العقدة الموسومة عند المستوى 2، لأنّه لا توجد عقدةٌ موسومة عند المستوى 3. وبذلك، يمكننا وسم كلّ عقدةٍ عند المستوى بعددٍ صحيحٍ من بت. وعندئذٍ تكون العقدة التي نبحث عنها عند المستوى أو تحته إذا وفقط إذا وُجدت عقدةٌ عند المستوى يطابق وسمها البتات الأعلى رتبةً في .
في XFastTrie، نخزّن، لكلّ ، جميع العقد عند المستوى في مجموعة غير مرتَّبة (USet)، هي ، منفَّذةً في صورة جدول تجزئة (hash table) (الفصل 5). ويتيح لنا استعمال هذا USet أن نتحقّق بزمنٍ ثابتٍ متوقَّع ممّا إذا كانت هناك عقدةٌ عند المستوى يطابق وسمها البتات الأعلى رتبةً في . بل إنّنا نستطيع أصلًا أن نجد هذه العقدة باستعمال تتيح لنا جداول التجزئة استعمال البحث الثنائي للعثور على . وفي البداية نعرف أنّ عند مستوىٍ ما، ، مع . لذلك نُهيّئ و ، وننظر تكرارًا في جدول التجزئة ، حيث . فإذا كان يحوي عقدةً يطابق وسمها البتات الأعلى رتبةً، أي البتات ، فإنّنا نضع ( عند المستوى أو تحته )؛ وإلّا فإنّنا نضع ( فوق المستوى ). وتنتهي هذه العملية حين يصبح ، وعندئذٍ نحدّد أنّ عند المستوى . ثمّ نُكمل العملية باستعمال والقائمة المترابطة ثنائية الوصل للأوراق.
    T find(T x) {
        int l = 0, h = w+1, ix = it.intValue(x);
        Node v, u = r, q = newNode();
        while (h-l > 1) {
            int i = (l+h)/2;
            q.prefix = ix >>> w-i;
            if ((v = t[i].find(q)) == null) {
                h = i;
            } else {
                u = v;
                l = i;
            }
        }
        if (l == w) return u.x;
        Node pred = (((ix >>> w-l-1) & 1) == 1)
                 ? u.jump : u.jump.child[0];
        return (pred.child[next] == dummy)
                     ? null : pred.child[next].x;
    }
تُنقص كلّ دورةٍ من دورات حلقة في الطريقة أعلاه بنحو النصف، ولذلك تجد هذه الحلقة بعد دورة. وتُجري كلّ دورة عملًا ثابت المقدار وعملية واحدة في USet، وهي عملية تستغرق زمنًا متوقَّعًا ثابتًا. ولا يستغرق العمل المتبقّي سوى زمنٍ ثابت، ولذلك لا تستغرق الطريقة في XFastTrie سوى زمنًا متوقَّعًا.
الدالتان و في XFastTrie متطابقتان تقريبًا مع الدالتين ذواتهما في BinaryTrie. والتعديلات الوحيدة هي الخاصة بإدارة جداول التجزئة و... و . وخلال العملية ، حين تُنشأ عقدةٌ جديدة عند المستوى ، تُضاف هذه العقدة إلى . وخلال العملية ، حين تُزال عقدةٌ من المستوى ، تُزال هذه العقدة من . ولأنّ الإضافة والإزالة في جدول التجزئة تستغرقان زمنًا متوقَّعًا ثابتًا، فإنّ هذا لا يزيد زمنَي تنفيذ و إلّا بعاملٍ ثابت. ونُهمل عرض شيفرة و لأنّ الشيفرة تكاد تكون مطابقةً لشيفرة العرض (الطويلة) التي سبق أن قدّمناها للدالتين ذواتهما في BinaryTrie. وتُلخّص المبرهنة التالية أداء XFastTrie: المبرهنة 13.2 يُنفِّذ XFastTrie واجهة SSet للأعداد الصحيحة بطول بت. ويدعم XFastTrie العمليات * و في زمن متوقَّع لكل عملية، والعملية في زمن متوقَّع لكل عملية. * والمساحة التي يستعملها XFastTrie يخزّن قيمةً هي .
13.3 YFastTrie: مجموعة مرتَّبة بزمن لوغاريتمي مزدوج
يُعدّ XFastTrie تحسينًا هائلًا — بل أُسّيّ — على BinaryTrie من حيث زمن الاستعلام، لكنّ عمليتَي و لا تزالان بطيئتين نوعًا ما. وإضافةً إلى ذلك، فإنّ استهلاك المساحة، ، أعلى من تنفيذات SSet الأخرى الموصوفة في هذا الكتاب، التي تشغل جميعها من المساحة. وهذان المشكلتان مترابطتان؛ فإذا كانت عملية تبني بنيةً بحجم ، فإنّ عملية تتطلّب على الأقلّ زمنًا (ومساحةً) من رتبة لكل عملية. أمّا YFastTrie، الذي سنناقشه تاليًا، فيحسّن المساحة والسرعة معًا. ويستعمل YFastTrie بنية XFastTrie، ، لكنّه لا يخزّن سوى قيمةً في . وبهذه الطريقة، لا تتجاوز المساحة الإجمالية المستعملة في حدود . وإضافةً إلى ذلك، فإنّ واحدةً فقط من كلّ عمليات أو في YFastTrie تؤدّي إلى عملية أو في . وبهذا، لا يتجاوز متوسّط الكلفة التي يتحمّلها استدعاءُ — أي عمليتَي و — قيمةً ثابتة. والسؤال الواضح يصبح: إذا كان يخزّن / عنصرًا فقط، فإلى أين تذهب بقية العناصر ؟ تنتقل هذه العناصر إلى بنى ثانوية، وهي في هذه الحالة نسخةٌ موسَّعة من Treap (القسم 7.2). وهناك نحو / من هذه البنى الثانوية، لذا يخزّن كلٌّ منها في المتوسّط عنصرًا. وتدعم Treap عمليات SSet بزمنٍ لوغاريتمي، ولذلك ستعمل العمليات على هذه الـTreap بزمن ، كما هو مطلوب. وبنحوٍ أكثر تحديدًا، يحتوي YFastTrie على XFastTrie، ، يحوي عيّنةً عشوائية من البيانات، حيث يظهر كلّ عنصر في العيّنة باستقلالٍ واحتمال . وللراحة، القيمة محتواةٌ دائمًا في . ولنفرض أنّ تصف العناصر المخزَّنة في . ومرتبطةً بكلّ عنصر، ، Treap، ، تخزّن جميع القيم في المدى . ويوضّح هذا الشكل 13.7.
العملية في YFastTrie سهلةٌ إلى حدٍّ ما. فنحن نبحث عن في ، ونجد قيمةً ما مرتبطةً بالـTreap . ثمّ نستعمل الدالة الخاصة بالـTreap على للردّ على الاستعلام. والدالة بأكملها سطرٌ واحد:
    T find(T x) {
        return xft.find(new Pair<T>(it.intValue(x))).t.find(x);
    }
العملية الأولى (على ) تستغرق زمن . أمّا العملية الثانية (على Treap) فتستغرق زمن ، حيث هو حجم الـTreap. وفيما بعد من هذا القسم سنبيّن أنّ الحجم المتوقَّع للـTreap هو ، بحيث تستغرق هذه العملية زمن .13.1 وإضافة عنصرٍ إلى YFastTrie بسيطةٌ هي الأخرى في معظم الأحيان. تستدعي الدالة الدالة لتحديد الـTreap، ، التي ينبغي أن يُدرج فيها. ثمّ تستدعي لإضافة إلى . وعند هذه النقطة، ترمي عملةً بميل، تأتي وجوهًا باحتمال وظهرًا باحتمال . فإذا جاءت هذه العملة وجوهًا، فسيُضاف إلى . وهنا تبدأ الأمورقليلاً في التعقيد. وحين يُضاف إلى ، لا بدّ من تقسيم الـTreap إلى Treapَين، و . ويحتوي الـTreap على جميع القيم الأصغر من أو المساوية لها؛ أمّا فهو الـTreap الأصلي، ، بعد إزالة عناصر منه. وبعد إتمام ذلك، نضيف الزوج إلى . ويعرض الشكل 13.8 مثالًا على ذلك.
    boolean add(T x) {
        int ix = it.intValue(x);
        STreap<T> t = xft.find(new Pair<T>(ix)).t;
        if (t.add(x)) {
            n++;
            if (rand.nextInt(w) == 0) {
                STreap<T> t1 = t.split(x);
                xft.add(new Pair<T>(ix, t1));
            }
            return true;
        }
        return false;
    }
تستغرق إضافة إلى زمن . ويبيّن التمرين 7.12 أنّ تقسيم إلى و يمكن أن يتمّ أيضًا في زمن متوقَّع. أمّا إضافة الزوج ( ، ) إلى فتستغرق زمن ، لكنها لا تحدث إلّا باحتمال . لذلك فإنّ زمن التشغيل المتوقَّع للعملية هو
تلغي الدالة العمل الذي أدّته . فنحن نستعمل للعثور على الورقة، ، في التي تحوي جواب . ومن ، نحصل على الـTreap، ، التي تحوي ونزيل من . فإذا كان مخزَّنًا أيضًا في (و لا يساوي )، فإنّنا نزيل من ونضيف عناصر الـTreap الخاصة بـ إلى الـTreap، ، التي يخزّنها خَلِفُ في القائمة المترابطة. ويوضّح هذا الشكل 13.9.
    boolean remove(T x) {
        int ix = it.intValue(x);
        Node<T> u = xft.findNode(ix);
        boolean ret = u.x.t.remove(x);
        if (ret) n--;
        if (u.x.x == ix && ix != 0xffffffff) {
            STreap<T> t2 = u.child[1].x.t;
            t2.absorb(u.x.t);
            xft.remove(u.x);
        }
        return ret;
    }
يستغرق العثور على العقدة في زمنًا متوقَّعًا قدره . ويستغرق إزالة من زمنًا متوقَّعًا قدره . ومرةً أخرى، يبيّن التمرين 7.12 أنّ دمج جميع عناصر في يمكن أن يتمّ في زمن . وإن كان ذلك ضروريًا، فإنّ إزالة من تستغرق زمن ، لكنّ لا يكون محتوًى في إلّا باحتمال . لذلك فإنّ الزمن المتوقَّع لإزالة عنصرٍ من YFastTrie هو .
في النقاش السابق، أجّلنا البحت في أحجام الـTreap في هذه البنية إلى وقتٍ لاحق. وقبل أن نختم هذا الفصل، نبرهن النتيجة التي نحتاجها. الملاحظة 13.1 ليكن عددًا صحيحًا مخزَّنًا في YFastTrie، وليكن يدلّ على عدد العناصر في الـTreap، ، التي تحوي . عندئذٍ .
إثبات. راجع الشكل 13.10. ولنفرض أنّ 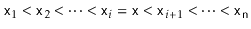 تصف العناصر المخزَّنة في YFastTrie. ويحتوي الـTreap على بعض العناصر الأكبر من أو المساوية لها. وهذه هي ، حيث هو العنصر الوحيد من هذه العناصر الذي جاءت رمية العملة بميل في الدالة فيه وجوهًا. بمعنى آخر، يساوي العدد المتوقَّع لرمي العملة بميل اللازم للحصول على أول وجوه.13.2 وكلّ رمية العملة مستقلّة وتأتي وجوهًا باحتمال ، ولذلك فإنّ . (راجع الملاحظة 4.2 لتحليل هذا في الحالة .)
وبالمثل، فإنّ عناصر الأصغر من هي حيث تأتي كلّ رميات العملة الـ هذه ظهرًا، وتأتي رمية العملة الخاصة بـ وجوهًا. لذلك فإنّ ، لأنّها تجربة رمي العملة عينها التي نظرنا إليها في الفقرة السابقة، غير أنّ الرمية الأخيرة لا تُحتسب فيها. وباختصار،
، إذًا
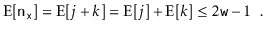
كانت الملاحظة 13.1 هي القطعة الأخيرة في برهان المبرهنة التالية، التي تلخّص أداء YFastTrie: المبرهنة 13.3 يُنفِّذ YFastTrie واجهة SSet للأعداد الصحيحة بطول بت. ويدعم YFastTrie العمليات و و في زمن متوقَّع لكل عملية. والمساحة التي يستعملها YFastTrie يخزّن قيمةً هي .
حدّ في متطلّب المساحة يأتي من أنّ يخزّن دائمًا القيمة . ويمكن تعديل التنفيذ (على حساب إضافة بعض الحالات الإضافية إلى الشيفرة) بحيث يصبح تخزين هذه القيمة غير لازم. وعندئذٍ يصبح متطلّب المساحة في المبرهنة .
حواشٍ
... زمن.13.1 وهذا تطبيقٌ لمتراجحة جِنسن (Jensen's Inequality): إذا كان ، فإنّ . ... وجوهًا.13.2 وهذا التحليل يتجاهل أنّ لا يتجاوز أبدًا . غير أنّ هذا يقلّل فقط، ولذلك يبقى الحدّ الأعلى قائمًا. opendatastructures.org
13.4 مناقشة وتمارين
أوّل بنية بيانات توفّر عمليات بزمن هي عمليات و و التي اقترحها van Emde Boas وصارت معروفة منذ ذلك الحين باسم شجرة van Emde Boas (أو الشجرة المتدرّجة (stratified)) [74]. وكانت بنية van Emde Boas الأصلية ذات حجم ، ممّا يجعلها غير عمليةٍ للأعداد الصحيحة الكبيرة. واكتشف Willard [77] بنيتَي البيانات XFastTrie وYFastTrie. وترتبط بنية XFastTrie ارتباطًا وثيقًا بأشجار van Emde Boas؛ فمثلًا، تحلّ جداول التجزئة في XFastTrie محلَّ المصفوفات في شجرة van Emde Boas. أي إنّ شجرة van Emde Boas تخزّن، بدلًا من جدول التجزئة ، مصفوفةً طولها . وبنية أخرى لتخزين الأعداد الصحيحة هي أشجار الدمج (fusion trees) لفريدمان وويلارد [32]. ويمكن لهذه البنية أن تخزّن عددًا صحيحًا بطول بت في مساحة بحيث تعمل العملية بزمن . وباستعمال شجرة دمج حين و YFastTrie حين ، نحصل على بنية بيانات تشغل من المساحة وتستطيع تنفيذ العملية بزمن . وتبيّن نتائج الحدود الدنيا الحديثة لـ P  tra
 cu و Thorup [59] أنّ هذه النتائج مثلى إلى حدٍّ كبير، على الأقلّ بالنسبة إلى البنى التي لا تشغل إلّا من المساحة. التمرين 13.1 صمّم ونفّذ نسخةً مبسَّطة من BinaryTrie لا تملك قائمة مترابطة ولا مؤشّرات قفز (jump pointers)، لكنّ العملية تظلّ تعمل فيها بزمن .
التمرين 13.2 صمّم ونفّذ تنفيذًا مبسَّطًا لـ XFastTrie لا يستعمل شجرة بادئات ثنائية إطلاقًا. وبدلًا من ذلك، ينبغي أن يخزّن تنفيذك كلّ شيء في قائمة مترابطة ثنائية الوصل وفي من جداول التجزئة.
التمرين 13.3 يمكننا التفكير في BinaryTrie على أنها بنية تخزّن سلاسلَ بتاتٍ بطول بحيث يُمثَّل كلُّ سلسلة بتاتٍ بمسارٍ من الجذر إلى ورقة. ووسِّع هذه الفكرة إلى تنفيذ SSet يخزّن سلاسل متغيّرة الطول وينفّذ و و بزمن متناسب مع طول . تلميح: ينبغي أن تخزّن كلُّ عقدةٍ في بنية بياناتك جدول تجزئة مفهرسًا بقيم المحارف.
التمرين 13.4 بالنسبة إلى العدد الصحيح ، ليكن يدلّ على الفرق بين والقيمة التي تعيدها [وإذا أعادت القيمة ، فإننا نعرّف بأنّه ]. فمثلًا، إذا أعادت القيمة 43، فإنّ . صمّم ونفّذ نسخةً معدَّلة من العملية في XFastTrie تعمل بزمن متوقَّع. تلميح: يحتوي جدول التجزئة على جميع القيم، ، التي تحقّق ، ولذلك سيكون ذلك نقطة بدايةٍ جيدة. صمّم ونفّذ نسخةً معدَّلة من العملية في XFastTrie تعمل بزمن متوقَّع.