12. الرسوم البيانية
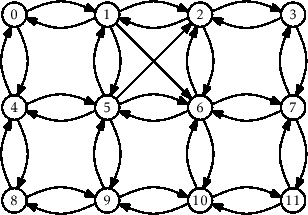
في هذا الفصل، ندرس تمثيلين للرسوم البيانية (graphs) وخوارزمياتٍ أساسية تستعمل هذه التمثيلات. رياضيًّا، الرسم البياني (الموجَّه) زوجٌ حيث مجموعة رؤوس (vertices) و مجموعة أزواجٍ مرتَّبة من الرؤوس تُسمَّى أضلاعًا (edges). الضلع موجَّه من إلى ؛ ويُسمَّى مصدر الضلع (source) ويُسمَّى هدفه (target). المسار (path) في هو تتابعٌ من الرؤوس بحيث، لكلّ ، يكون الضلع في . ويكون المسار دورةً (cycle) إذا، إضافةً إلى ذلك، كان الضلع في . ويكون المسار (أو الدورة) بسيطًا (simple) إذا كانت جميع رؤوسه فريدة. وإذا كان هناك مسار من رأسٍ ما إلى رأسٍ ما ، فإننا نقول إنّ يمكن الوصول إليه من (reachable). ويُعرض مثالٌ على رسمٍ بياني في الشكل 12.1.
بفضل قدرتها على نمذجة عددٍ هائل من الظواهر، تمتلك الرسوم البيانية عددًا كبيرًا جدًّا من التطبيقات. وهناك أمثلةٌ واضحة كثيرة. ويمكن نمذجة شبكات الحاسوب (computer networks) في صورة رسوم بيانية، حيث تقابل الرؤوس الحواسيب وتقابل الأضلاع روابط الاتصال (الموجَّهة) بين تلك الحواسيب. ويمكن نمذجة شوارع المدينة في صورة رسوم بيانية، حيث تمثّل الرؤوس التقاطعات (intersections) وتمثّل الأضلاع الشوارع التي تصل بين تقاطعاتٍ متتالية. وتظهر أمثلةٌ أقلّ وضوحًا متى ندرك أنّ الرسوم البيانية تستطيع نمذجة أيّ علاقاتٍ ثنائية ضمن مجموعة. فمثلًا، في بيئةٍ جامعية قد لدينا رسمٌ بياني لتعارض الجداول الدراسية (timetable conflict graph) تمثّل رؤوسه المقرّرات المقدَّمة في الجامعة، ويكون فيه الضلع حاضرًا إذا وفقط إذا كان هناك طالبٌ واحدٌ على الأقلّ يأخذ الصفَّ والصفَّ معًا. أي إنّ الضلع يشير إلى أنّ اختبار الصفَّ لا ينبغي أن يُجدوَل في الوقت نفسه الذي يُجدوَل فيه اختبار الصفَّ . وفي هذا القسم، سنستعمل للإشارة إلى عدد رؤوس و للإشارة إلى عدد أضلاع . أي إنّ و . وفوق ذلك، سنفترض أنّ . ويمكن تخزين أيّ بياناتٍ أخرى نرغب في ربطها بعناصر في مصفوفة (array) طولها . ومن العمليات النموذجية التي تُجرى على الرسوم البيانية:
- : إضافة الضلع إلى .
- : إزالة الضلع من .
- : التحقّق ممّا إذا كان الضلع
- : إعادة List تضمّ جميع الأعداد الصحيحة بحيث
- : إعادة List تضمّ جميع الأعداد الصحيحة بحيث
لاحظ أنّ هذه العمليات ليست صعبة التنفيذ بكفاءة عالية. فمثلًا، يمكن تنفيذ العمليات الثلاث الأولى مباشرةً باستعمال USet، ولذلك يمكن تنفيذها بزمنٍ ثابتٍ متوقَّع (constant expected time) باستعمال جداول التجزئة (hash tables) التي ناقشناها في الفصل 5. ويمكن تنفيذ العمليتين الأخيرتين بزمنٍ ثابت بتخزين قائمةٍ برؤوس كلّ رأس المجاورة (adjacent) إليه. لكنّ تطبيقات الرسوم البيانية المختلفة لها متطلّبات أداءٍ مختلفة لهذه العمليات، ومن ثمّ فإنّنا نفضّل، مبدئيًّا، استعمال أبسط تنفيذٍ يحقّق جميع متطلّبات التطبيق. ولهذا السبب، سنناقش فئتين عريضتين من تمثيلات الرسوم البيانية.
الأقسام الفرعية
12.1 AdjacencyMatrix: تمثيل الرسم البياني بمصفوفة
مصفوفة التجاور (adjacency matrix) طريقةٌ لتمثيل رسمٍ بياني من رأس، ، بمصفوفة أبعادها ، ، تكون مداخلها قيمًا منطقية (boolean).
    int n;
    boolean[][] a;
    AdjacencyMatrix(int n0) {
        n = n0;
        a = new boolean[n][n];
    }
يُعرَّف مدخل المصفوفة على أنه
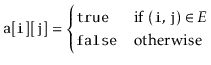
تُعرض مصفوفة التجاور للرسم البياني في الشكل 12.1 في الشكل 12.2. وفي هذا التمثيل، لا تتضمّن العمليات و و سوى تعيين مدخل المصفوفة أو قراءته:
    void addEdge(int i, int j) {
        a[i][j] = true;
    }
    void removeEdge(int i, int j) {
        a[i][j] = false;
    }
    boolean hasEdge(int i, int j) {
        return a[i][j];
    }
من الواضح أنّ هذه العمليات تستغرق زمنًا ثابتًا لكل عملية.
 |
0 | 1 | 2 | 3 | 4 | 5 | 6 | 7 | 8 | 9 | 10 | 11 |
|---|---|---|---|---|---|---|---|---|---|---|---|---|
| 0 | 0 | 1 | 0 | 0 | 1 | 0 | 0 | 0 | 0 | 0 | 0 | 0 |
| 1 | 1 | 0 | 1 | 0 | 0 | 1 | 1 | 0 | 0 | 0 | 0 | 0 |
| 2 | 1 | 0 | 0 | 1 | 0 | 0 | 1 | 0 | 0 | 0 | 0 | 0 |
| 3 | 0 | 0 | 1 | 0 | 0 | 0 | 0 | 1 | 0 | 0 | 0 | 0 |
| 4 | 1 | 0 | 0 | 0 | 0 | 1 | 0 | 0 | 1 | 0 | 0 | 0 |
| 5 | 0 | 1 | 1 | 0 | 1 | 0 | 1 | 0 | 0 | 1 | 0 | 0 |
| 6 | 0 | 0 | 1 | 0 | 0 | 1 | 0 | 1 | 0 | 0 | 1 | 0 |
| 7 | 0 | 0 | 0 | 1 | 0 | 0 | 1 | 0 | 0 | 0 | 0 | 1 |
| 8 | 0 | 0 | 0 | 0 | 1 | 0 | 0 | 0 | 0 | 1 | 0 | 0 |
| 9 | 0 | 0 | 0 | 0 | 0 | 1 | 0 | 0 | 1 | 0 | 1 | 0 |
| 10 | 0 | 0 | 0 | 0 | 0 | 0 | 1 | 0 | 0 | 1 | 0 | 1 |
| 11 | 0 | 0 | 0 | 0 | 0 | 0 | 0 | 1 | 0 | 0 | 1 | 0 |
أمّا الموضع الذي يظهر فيه أداءُ مصفوفة التجاور سيّئًا فهو العمليتان و . ولتنفيذهما، يتعيّن أن نمسح كلّ المداخل في الصفّ أو العمود المقابل من ، وأن نجمع كلّ الفهارس التي يكون فيها ، أو على التوالي ، قيمةً منطقية (true).
    List<Integer> outEdges(int i) {
        List<Integer> edges = new ArrayList<Integer>();
        for (int j = 0; j < n; j++)
            if (a[i][j]) edges.add(j);
        return edges;
    }
    List<Integer> inEdges(int i) {
        List<Integer> edges = new ArrayList<Integer>();
        for (int j = 0; j < n; j++)
            if (a[j][i]) edges.add(j);
        return edges;
    }
من الواضح أنّ هذه العمليات تستغرق زمنًا لكل عملية.
ومن عيوب تمثيل مصفوفة التجاور أنّها كبيرة الحجم. فهي تخزّن مصفوفةً منطقية أبعادها ، ولذلك تتطلّب بت على الأقلّ من الذاكرة. ويستخدم التنفيذ هنا مصفوفةً من قيم ، فهو يستهلك فعليًا من رتبة بايت من الذاكرة. أمّا تنفيذٌ أكثر عناية، يَحزِم قيمةً منطقية في كلّ كلمة ذاكرة، فيمكنه خفض استهلاك هذه المساحة إلى كلمة ذاكرة. المبرهنة 12.1 تنفّذ بنية بيانات AdjacencyMatrix واجهة Graph. ويدعم AdjacencyMatrix العمليات * و و بزمنٍ ثابت لكل عملية؛ والعمليتين و في زمن لكل عملية. * والمساحة التي يستعملها AdjacencyMatrix هي .
ورغم متطلّباتها المرتفعة للذاكرة وأدائها السيّئ في العمليتين و ، لا يزال AdjacencyMatrix مفيدًا لبعض التطبيقات. وبخاصة، عندما يكون الرسم البياني كثيفًا (dense)، أي عندما يحتوي على ما يقارب ضلعًا، يكون استهلاك ذاكرةٍ مقداره مقبولًا. كما تُستعمل بنية بيانات AdjacencyMatrix على نطاقٍ واسع، لأنّ العمليات الجبرية على المصفوفة يمكن استعمالها لحساب خصائص الرسم البياني بكفاءة. وهذا موضوع مقررٍ في الخوارزميات، لكنّنا نُشِر هنا إلى إحدى هذه الخصائص: إذا تعاملنا مع مداخل بوصفها أعدادًا صحيحة (القيمة 1 مقابل والقيمة 0 مقابل ) وضربنا في نفسها باستعمال ضرب المصفوفات، فإنّنا نحصل على المصفوفة . تذكّر، من تعريف ضرب المصفوفات، أنّ
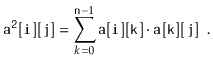
إذا فسّرنا هذا المجموع في ضوء الرسم البياني ، فإنّ هذه الصيغة تعدّ عدد الرؤوس، ، التي يحتوي على الضلعين و معًا. أي إنّها تعدّ عدد المسارات من إلى (عبر رؤوسٍ وسيطة، ) التي طولها يساوي اثنين بالضبط. وهذه الملاحظة هي أساس خوارزميةٍ تحسب المسارات الأقصر (shortest paths) بين كلّ زوجٍ من الرؤوس في باستعمال ضربات مصفوفاتٍ لا تتجاوز . opendatastructures.org
12.2 AdjacencyLists: رسمٌ بياني في صورة مجموعة قوائم
تتخذ تمثيلات قوائم التجاور (adjacency lists) للرسوم البيانية منهجًا أكثر تركيزًا على الرؤوس. وهناك إمكاناتٌ كثيرة لتنفيذ قوائم التجاور. وفي هذا القسم نقدّم واحدةً بسيطة منها. وفي نهاية القسم سنناقش إمكاناتٍ مختلفة. وفي تمثيل قوائم التجاور، يُمثَّل الرسم البياني في صورة مصفوفة، ، من القوائم. وتحتوي القائمة على قائمةٍ بجميع الرؤوس المجاورة للرأس . أي إنّها تحتوي كلّ فهرس بحيث .
    int n;
    List<Integer>[] adj;
    AdjacencyLists(int n0) {
        n = n0;
        adj = (List<Integer>[])new List[n];
        for (int i = 0; i < n; i++)
            adj[i] = new ArrayStack<Integer>(Integer.class);
    }
(يُعرض مثالٌ في الشكل 12.3.) وفي هذا التنفيذ بعينه، نمثّل كلّ قائمة في في صورة ArrayStack، لأنّنا نرغب في الوصول بحسب الموضع بزمنٍ ثابت. والخيارات الأخرى ممكنة أيضًا. وبخاصة، كان يمكن أن ننفّذ بوصفه DLList.
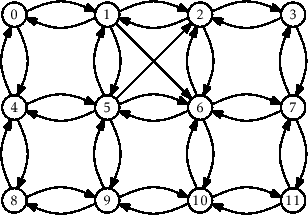 0 |
1 | 2 | 3 | 4 | 5 | 6 | 7 | 8 | 9 | 10 | 11 | |
|---|---|---|---|---|---|---|---|---|---|---|---|---|
| 1 | 0 | 1 | 2 | 0 | 1 | 5 | 6 | 4 | 8 | 9 | 10 | |
| 4 | 2 | 3 | 7 | 5 | 2 | 2 | 3 | 9 | 5 | 6 | 7 | |
| 6 | 6 | 8 | 6 | 7 | 11 | 10 | 11 | |||||
| 5 | 9 | 10 | ||||||||||
| 4 |
لا تفعل العملية سوى إلحاق القيمة بالقائمة :
    void addEdge(int i, int j) {
        adj[i].add(j);
    }
يستغرق هذا زمنًا ثابتًا. وتبحث العملية في القائمة حتى تجد ثمّ تحذفها:
    void removeEdge(int i, int j) {
        Iterator<Integer> it = adj[i].iterator();
        while (it.hasNext()) {
            if (it.next() == j) {
                it.remove();
                return;
            }
        }
    }
يستغرق هذا زمنًا، حيث إنّ (درجة الرأس ) تعدّ عدد الأضلاع في التي يكون مصدرًا لها. والعملية مشابهة؛ فهي تبحث في القائمة حتى تجد (وتُعيد true)، أو تبلغ نهاية القائمة (وتُعيد false):
    boolean hasEdge(int i, int j) {
        return adj[i].contains(j);
    }
يستغرق هذا أيضًا زمنًا. أمّا العملية فبسيطةٌ جدًّا؛ فهي تُعيد القائمة :
    List<Integer> outEdges(int i) {
        return adj[i];
    }
من الواضح أنّ هذا يستغرق زمنًا ثابتًا. أمّا العملية فعملٌ أكبر بكثير. فهي تمسح كلّ رأس للتحقّق ممّا إذا كان الضلع موجودًا، وعندئذٍ تضيف إلى قائمة المخرجات:
    List<Integer> inEdges(int i) {
        List<Integer> edges = new ArrayStack<Integer>(Integer.class);
        for (int j = 0; j < n; j++)
            if (adj[j].contains(i))    edges.add(j);
        return edges;
    }
هذه العملية بطيئةٌ جدًّا. فهي تمسح قائمة التجاور لكلّ رأس، ولذلك تستغرق زمنًا.
تلخّص المبرهنة التالية أداء بنية البيانات أعلاه: المبرهنة 12.2 تنفّذ بنية بيانات AdjacencyLists واجهة Graph. ويدعم AdjacencyLists العمليات * بزمنٍ ثابت لكل عملية؛ و و في زمن لكل عملية؛ و بزمنٍ ثابت لكل عملية؛ و في زمن لكل عملية. * والمساحة التي يستعملها AdjacencyLists هي .
كما أَلمَحْنا سابقًا، هناك خياراتٌ كثيرة مختلفة يجب اتخاذها عند تنفيذ رسمٍ بياني في صورة قائمة تجاور. ومن الأسئلة التي تُطرح:
- ما نوع المجموعة (collection) التي ينبغي استعمالها لتخزين كلّ عنصر من ؟ يمكن استعمال قائمةٍ مبنيةٍ على مصفوفة، أو قائمة مترابطة (linked list)، أو حتى جدول تجزئة (hashtable).
- هل ينبغي وجود قائمة تجاور ثانية، ، تخزّن لكلّ قائمة الرؤوس، ، بحيث ؟ ويمكن أن يخفض هذا كثيرًا زمن تشغيل العملية ، لكنه يتطلّب عملًا إضافيًّا طفيفًا عند إضافة الأضلاع أو حذفها.
- هل ينبغي أن يُربط مدخلُ الضلع في بمرجعٍ إلى المدخل المقابل في ؟
- هل ينبغي أن تكون الأضلاع كائناتٍ من المرتبة الأولى (first-class objects) لها بياناتها المرتبطة بها؟ بهذه الطريقة، سيحتوي على قوائم أضلاع بدلًا من قوائم رؤوس (أعداد صحيحة).
معظم هذه الأسئلة ينحصر في مفاضلة (tradeoff) بين تعقيد التنفيذ (والمساحة) وميزات أداء التنفيذ. opendatastructures.org
12.3 اجتياز الرسوم البيانية
الأقسام الفرعية
12.3 اجتياز الرسوم البيانية
في هذا القسم نقدّم خوارزميتين لاستكشاف رسمٍ بياني، تنطلقان من إحدى رؤوسه، ، وتجدان جميع الرؤوس التي يمكن الوصول إليها من . وكلتا الخوارزميتين أنسب للرسوم البيانية الممثَّلة في صورة قائمة تجاور (adjacency list). ولذلك، عند تحليل هاتين الخوارزميتين سنفترض أنّ التمثيل الأساسي هو AdjacencyLists.
12.3.1 البحث بالعرض أوّلًا (Breadth-First Search)
تبدأ خوارزمية البحث بالعرض أوّلًا (breadth-first search) من رأس وتزور، أوّلًا، جيران ، ثمّ جيران جيران ، ثمّ جيران جيران جيران ، وهكذا. وهذه الخوارزمية تعميمٌ لخوارزمية اجتياز الأشجار الثنائية بالعرض أوّلًا (القسم 6.1.2)، وهي مشابهة لها إلى حدٍّ كبير؛ فهي تستعمل طابورًا (queue)، ، يحتوي في البدء على وحده. ثمّ تستخرج عنصرًا من على التوالي وتضيف جيرانه إلى ، ما دام أنّ هؤلاء الجيران لم يكونوا في من قبل. والفرق الجوهري الوحيد بين خوارزمية البحث بالعرض أوّلًا للرسوم البيانية وبين نظيرتها للأشجار هو أنّ خوارزمية الرسوم البيانية عليها أن تتأكّد من أنّها لا تضيف الرأس نفسه إلى أكثر من مرّة. وهي تفعل ذلك باستعمال مصفوفةٍ منطقية مساعدة (auxiliary)، ، تتتبّع الرؤوس التي اكتُشِفت بالفعل.
    void bfs(Graph g, int r) {
        boolean[] seen = new boolean[g.nVertices()];
        Queue<Integer> q = new SLList<Integer>();
        q.add(r);
        seen[r] = true;
        while (!q.isEmpty()) {
            int i = q.remove();
            for (Integer j : g.outEdges(i)) {
                if (!seen[j]) {
                    q.add(j);
                    seen[j] = true;
                }
            }
        }
    }
يُعرض في الشكل 12.4 مثالٌ على تشغيل على الرسم البياني في الشكل 12.1. وتختلف عمليات التنفيذ بحسب ترتيب قوائم التجاور؛ إذ يستعمل الشكل 12.4 قوائم التجاور الواردة في الشكل 12.3.
الشكل 12.4: مثالٌ على البحث بالعرض أوّلًا انطلاقًا من العقدة 0. العقدُ موسومةٌ بترتيب إضافتها إلى . والأضلاع التي أدّت إلى إضافة العُقد إلى مرسومةٌ بالأسود، أمّا بقية الأضلاع فمرسومةٌ بالرمادي. 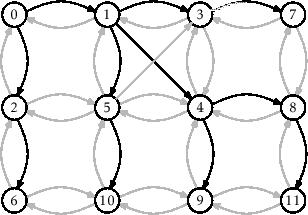 وتحليل زمن تشغيل الإجراء مباشر إلى حدٍّ كبير. ويضمن استعمال مصفوفة ألّا يُضاف أيّ رأس إلى أكثر من مرّة. وتستغرق إضافة كلّ رأس إلى (وحذفه لاحقًا) زمنًا ثابتًا لكلّ رأس، أي زمنًا في المجموع. وبما أنّ الحلقة الداخلية تعالج كلّ رأسٍ مرّةً واحدة على الأكثر، تُعالَج كلّ قائمة تجاورٍ مرّةً واحدة على الأكثر، ومن ثمّ تُعالَج كلّ ضلعٍ من أضلاع مرّةً واحدة على الأكثر. وهذه المعالجة، التي تجري في الحلقة الداخلية، تستغرق زمنًا ثابتًا في كلّ دورة، أي زمنًا في المجموع. ولذلك تعمل الخوارزميةُ كاملةً في زمن. وتلخّص المبرهنة التالية أداء خوارزمية . المبرهنة 12.3 إذا قُدِّم لها كمدخل رسمٌ بياني (Graph)، ، منفَّذ ببنية بيانات AdjacencyLists، فإنّ خوارزمية تعمل في زمن.
للاجتياز بالعرض أوّلًا بعض الخصائص شديدة التخصّص. فاستدعاء سيؤدي في نهاية المطاف إلى إدخال (وفي نهاية المطاف إخراج) كلّ رأس يوجد مسارٌ موجَّه من إلى . وفوق ذلك، تدخل الرؤوس الواقعة على مسافة 0 من (أي نفسه) في قبل الرؤوس الواقعة على مسافة 1، وهذه تدخل في قبل الرؤوس الواقعة على مسافة 2، وهكذا. ولذلك تزور الدالة الرؤوس بحسب تصاعد المسافة عن ، أمّا الرؤوس التي لا يمكن الوصول إليها من فلا تُزار البتّة. ومن هنا فإنّ أحد أكثر تطبيقات خوارزمية البحث بالعرض أوّلًا نفعًا هو حساب المسارات الأقصر. ولحساب المسار الأقصر من إلى كلّ رأسٍ آخر، نستعمل صيغةً معدَّلة من تستعمل مصفوفةً مساعدة، ، طولها . وحين يُضاف رأسٌ جديد، ، إلى ، نضبط . وبهذه الطريقة، تصبح هي العقدة ما قبل الأخيرة في مسارٍ أقصر من إلى . وبتكرار ذلك بأخذ و وهكذا، يمكننا إعادة بناء (انعكاس) مسارٍ أقصر من إلى .
12.3.2 البحث بالعمق أوّلًا (Depth-First Search)
خوارزمية البحث بالعمق أوّلًا (depth-first search) مشابهة للخوارزمية القياسية لاجتياز الأشجار الثنائية؛ فهي تستكشف أوّلًا شجرةً فرعية (subtree) بالكامل قبل العودة إلى العقدة الحالية ثمّ استكشاف الشجرة الفرعية الأخرى. وهناك طريقةٌ أخرى للفهم هي القول إنّ البحث بالعمق أوّلًا يشبه البحث بالعرض أوّلًا ما لمّ أنّه يستعمل مكدسًا (stack) بدلًا من طابور. وأثناء تنفيذ خوارزمية البحث بالعمق أوّلًا يُسنَد إلى كلّ رأس، ، لون (colour)، : القيمة إذا كنّا لم نرَ الرأس من قبل، والقيمة إذا كنّا نزور ذلك الرأس حاليًّا، والقيمة إذا كنا قد فرغنا من زيارته. وأيسر طريقةٍ لفهم البحث بالعمق أوّلًا هي اعتباره خوارزميةً تعاودية (recursive). فهي تبدأ بزيارة . وعند زيارة رأسٍ ، نضع أوّلًا على أنّها . بعد ذلك، نمسح قائمة تجاور ونسري بزيارة كلّ رأسٍ أبيض (white) نجده في هذه القائمة. وأخيرًا، نكتمل معالجة ، فنلوّن باللون الأسود ونعود.
    void dfs(Graph g, int r) {
        byte[] c = new byte[g.nVertices()];
        dfs(g, r, c);
    }
    void dfs(Graph g, int i, byte[] c) {
        c[i] = grey;  // currently visiting i
        for (Integer j : g.outEdges(i)) {
            if (c[j] == white) {
                c[j] = grey;
                dfs(g, j, c);
            }
        }
        c[i] = black; // done visiting i
    }
يُعرض في الشكل 12.5 مثالٌ على تنفيذ هذه الخوارزمية.
ولعلّ الأفضل تصوّر البحث بالعمق أوّلًا بوصفه خوارزميةً تعاودية، فإنّ التعاود ليس أفضل طريقةٍ لتنفيذه. فبالحقّ، ستُعاني الشيفرة أعلاه في كثيرٍ من الرسوم البيانية الكبيرة بسبب حدوث فيض المكدس (stack overflow). ويكمن تنفيذٌ بديل في استبدال مكدس التعاود بمكدسٍ صريح (explicit stack)، . والتنفيذ التالي يفعل ذلك بالضبط:
    void dfs2(Graph g, int r) {
        byte[] c = new byte[g.nVertices()];
        Stack<Integer> s = new Stack<Integer>();
        s.push(r);
        while (!s.isEmpty()) {
            int i = s.pop();
            if (c[i] == white) {
                c[i] = grey;
                for (int j : g.outEdges(i))
                    s.push(j);
            }
        }
    }
في الشيفرة السابقة، عند معالجة الرأس التالي، ، يُلوَّن باللون ثمّ يُستبدل على المكدس برؤوسه المجاورة. وخلال التكرار التالي، ستُزار إحدى هذه الرؤوس.
وليس مفاجئًا أنّ زمنَي تشغيل و هما نفسه زمن تشغيل : المبرهنة 12.4 إذا قُدِّم لهما كمدخل رسمٌ بياني (Graph)، ، منفَّذ ببنية بيانات AdjacencyLists، فإنّ خوارزميتَي و تعمل كلٌّ منهما في زمن.
وكما في خوارزمية البحث بالعرض أوّلًا، ترتبط بكلّ تنفيذٍ للبحث بالعمق أوّلًا شجرةٌ ضمنية. فحين تنتقل عقدة، ، من إلى ، فإنّ ذلك لأنّ استُدعيت تعاوديًّا أثناء معالجة عقدةٍ ما . (وفي حالة خوارزمية ، تكون إحدى العقد التي استبدلت على المكدس.) فإذا نظرنا إلى بوصفها الأمّ (parent) لـ ، نحصل على شجرةٍ مجذَّرة عند . وفي الشكل 12.5، تكون هذه الشجرة مسارًا من الرأس 0 إلى الرأس 11. وإليك خاصيةً مهمّة لخوارزمية البحث بالعمق أوّلًا: نفترض أنّه حين تُلوَّن عقدة، ، باللون ، يوجد مسارٌ من إلى عقدةٍ أخرى ما، ، يستعمل رؤوسًا بيضاءً فقط. عندئذٍ ستُلوَّن أوّلًا باللون ثمّ قبل أن تُلوَّن باللون . (ويمكن إثبات ذلك بالتناقض، بالنظر في أيّ مسار، ، من إلى .) ومن تطبيقات هذه الخاصية كشف الدورات (cycles). راجع الشكل 12.6. خُذ دورةً ما، ، يمكن الوصول إليها من . ولنفرض أنّ هي أوّل عقدةٍ في تُلوَّن باللون ، وأنّ هي العقدة التي تسبق في الدورة . عندئذٍ، وبموجب الخاصية أعلاه، ستُلوَّن باللون ، وستنظر الخوارزمية في الضلع ما دام ما تزال بلون . إذًا تستطيع الخوارزمية أن تستنتج أنّه يوجد مسار، ، من إلى في شجرة البحث بالعمق أوّلًا، وأنّ الضلع موجود. ولذلك فإنّ هي أيضًا دورة.
12.4 نقاشٌ وتمارين
تضخّم المبرهنتان 12.3 و12.4 نوعًا ما تقديرَ زمن تشغيل خوارزميتَي البحث بالعمق أوّلًا والبحث بالعرض أوّلًا. عرِّف بأنّه عدد الرؤوس، ، في التي يوجد مسارٌ من إلى . وعرِّف بأنّه عدد الأضلاع التي تكون هذه الرؤوس مصادرَ لها. عندئذٍ تكون المبرهنة التالية بيانًا أدقّ لزمن تشغيل خوارزميتَي البحث بالعرض أوّلًا والبحث بالعمق أوّلًا. (وهذه الصياغةُ الأدقّ لزمن التشغيل مفيدةٌ في بعض التطبيقات لهاتين الخوارزميتين المبيَّنة في التمارين.) المبرهنة 12.5 إذا قُدِّم لها كمدخل رسمٌ بياني (Graph)، ، منفَّذ ببنية بيانات AdjacencyLists، فإنّ خوارزميات و و تعمل كلٌّ منها في زمن.
يبدو أنّ البحث بالعرض أوّلًا قد اُكتشف بصورةٍ مستقلّة على يد Moore [52] وLee [49] في سياقَي استكشاف المتاهات وتوجيه الدوائر الإلكترونية على التوالي. وقد قدّم Hopcroft وTarjan [40] تمثيلات قوائم التجاور للرسوم البيانية بوصفها بديلًا عن تمثيل مصفوفة التجاور (الذي كان أكثر شيوعًا آنذاك). وقد لعب هذا التمثيل، وكذلك البحث بالعمق أوّلًا، دورًا رئيسيًّا في خوارزمية Hopcroft-Tarjan الشهيرة لاختبار المستوية (planarity)، التي تستطيع تحديد، في زمن، ما إذا كان رسمٌ بياني يمكن رسمه في المستوَى، بحيث لا يتقاطع أيّ زوجٍ من الأضلاع [41]. وفي التمارين التالية، يكون الرسم البياني غير الموجَّه (undirected) رسمًا يكون فيه، لكلّ و ، الضلع حاضرًا إذا وفقط إذا كان الضلع حاضرًا. التمرين 12.1 ارسم تمثيل قائمة التجاور وتمثيل مصفوفة التجاور للرسم البياني في الشكل 12.7.
الشكل 12.7: مثالٌ على رسمٍ بياني. 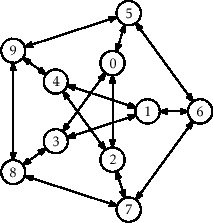 التمرين 12.2 تمثيل مصفوفة الورودية (incidence matrix) لرسمٍ بياني، ، هو مصفوفة أبعادها ، ، حيث
- ارسم تمثيل مصفوفة الورودية للرسم البياني في الشكل 12.7.
- صمّم وحلّل ونفّذ تمثيلًا بمصفوفة الورودية لرسمٍ بياني. واحرص على تحليل المساحة، وتكلفة و و و و .
التمرين 12.3 بيّن تنفيذ و على الرسم البياني، ، في الشكل 12.7.
التمرين 12.4 ليكن رسمًا بيانيًا غير موجَّه. نقول إنّ متّصل (connected) إذا، لكلّ زوجٍ من الرؤوس و في ، كان هناك مسارٌ من إلى (ولأنّ غير موجَّه، فهناك أيضًا مسارٌ من إلى ). بيّن كيف تختبر ما إذا كان متّصلًا في زمن.
التمرين 12.5 ليكن رسمًا بيانيًا غير موجَّه. تسمية المكوّنات المتّصلة (connected-component labelling) لـ تقسّم رؤوس إلى مجموعات قصوى، كلٌّ منها يشكّل رسمًا بيانيًا فرعيًّا متّصلًا. بيّن كيف تحسب تسمية المكوّنات المتّصلة لـ في زمن.
التمرين 12.6 ليكن رسمًا بيانيًا غير موجَّه. الغابة الممتدّة (spanning forest) لـ هي مجموعة أشجار، واحدةٌ لكلّ مكوّن، أضلاعُها أضلاعٌ من ورؤوسُها تضمّ كلّ رؤوس . بيّن كيف تحسب غابةً ممتدّة لـ في زمن.
التمرين 12.7 نقول إنّ الرسم البياني متّصلٌ بشدّة (strongly-connected) إذا، لكلّ زوجٍ من الرؤوس و في ، كان هناك مسارٌ من إلى . بيّن كيف تختبر ما إذا كان متّصلًا بشدّة في زمن.
التمرين 12.8 معطًى رسمٌ بياني، ، ورأسٌ خاصّ، ، بيّن كيف تحسب طول المسار الأقصر من إلى لكلّ رأس، .
التمرين 12.9 أعطِ مثالًا (بسيطًا) تزور فيه شيفرة عقدَ رسمٍ بياني بترتيبٍ يخالف ترتيب شيفرة . واكتب صيغةً من تزور العقدَ دائمًا بالترتيب نفسه تمامًا الذي تزور به . (تلميح: يكفي أن تبدأ بتتبّع تنفيذ كلّ خوارزمية على رسمٍ بيانيٍّ ما يكون فيه مصدرَ أكثر من ضلعٍ واحد.)
التمرين 12.10 البالعة الشاملة (universal sink) في رسمٍ بياني، ، هي رأسٌ يكون هدفًا لـ ضلعًا ومصدرًا لأيّ ضلع.12.1 صمّم ونفّذ خوارزمية تختبر ما إذا كان رسمٌ بياني، ، ممثَّلًا في صورة AdjacencyMatrix، يملك بالعةً شاملة. وينبغي أن تعمل خوارزميتك في زمن.
الحواشي
... الأضلاع.12.1 تُسمّى البالعة الشاملة، ، أحيانًا «شخصيةً مشهورة» (celebrity): كلُّ من في الغرفة يعرف ، لكنّ لا يعرف أيّ شخصٍ آخر في الغرفة. opendatastructures.org