11. خوارزميات الترتيب
يناقش هذا الفصل الخوارزميات اللازمة لترتيب مجموعة من عنصرًا. قد يبدو هذا موضوعًا غريبًا في كتاب عن بنى البيانات، غير أن هناك عدة أسباب وجيهة لإدراجه هنا. وأوضح هذه الأسباب أن خوارزميتين من هذه الخوارزميات (الترتيب السريع quicksort، والترتيب بالكومة heap-sort) ترتبطان ارتباطًا وثيقًا ببنيتي بيانات درسناهما من قبل (شجرة البحث الثنائية العشوائية random binary search tree، والكومة heap على التوالي). يناقش الجزء الأول من هذا الفصل خوارزميات للترتيب لا تستعمل إلا المقارنات، ويقدّم ثلاث خوارزميات تعمل في زمن . ويبيّن في النهاية أن هذه الخوارزميات الثلاث كلها مثلى سلوكًا تقاربيًا؛ فلا توجد خوارزمية تعتمد على المقارنات فحسب، ولا تستطيع تفادي إجراء نحو مقارنة في أسوأ الحالات بل وحتى في الحالة المتوسطة. وقبل أن نُكمل، يجدر بنا أن نلاحظ أن أيًّا من تنفيذات SSet أو طابور الأولوية priority queue التي عرضناها في الفصول السابقة يمكن أن يُستعمل أيضًا للحصول على خوارزمية ترتيب في زمن . فمثلًا، يمكننا ترتيب عنصرًا بتنفيذ عملية من نوع يتبعها عملية من نوع على BinaryHeap أو MeldableHeap. وبدلًا من ذلك، يمكننا استعمال عملية من نوع على أي بنية من بنى بيانات شجرة البحث الثنائية، ثم تنفيذ اجتياز بالترتيب الوسطي in-order traversal (التمرين 6.8) لاستخراج العناصر بالترتيب المرتَّب. غير أن في الحالتين نتحمّل عبءً كبيرًا لبناء بنية لا تُستعمل بالكامل أبدًا. والترتيب مشكلة بالغة الأهمية، وبه يستحق أن نضع له طرقًا مباشرة تكون بأقصى ما يمكن من السرعة والبساطة وكفاءة المساحة. ويبيّن الجزء الثاني من هذا الفصل أن ما إن نسمح بعمليات أخرى إلى جانب المقارنات حتى تصير تلك الحدود لا محل سريان. وفعلًا، وباستعمال فهرسة المصفوفات، يمكن ترتيب مجموعة من عددًا صحيحًا ضمن المدى في زمن .
الأقسام الفرعية
11.1 الترتيب المبني على المقارنات
الأقسام الفرعية
11.1 الترتيب المبني على المقارنات
نقدّم في هذا القسم ثلاث خوارزميات للترتيب: الترتيب بالدمج (merge-sort)، والترتيب السريع (quicksort)، والترتيب بالكومة (heap-sort). تأخذ كل واحدة من هذه الخوارزميات مصفوفة إدخال وترتّب عناصر في ترتيب غير متناقص خلال زمن (متوقَّع). وجميع هذه الخوارزميات مبنية على المقارنات. أمّا وسيطها الثاني، ، فهو Comparator يُنفّذ الطريقة . ولا تُعنى هذه الخوارزميات بنوع البيانات التي يجري ترتيبها؛ فالعملية الوحيدة التي تجريها على البيانات هي المقارنات بالاستعانة بالطريقة . وتذكّر، كما ورد في القسم 1.2.4، أن تُعيد قيمة سالبة إذا كان ، وقيمة موجبة إذا كان ، وصفرًا إذا كان .
11.1.1 الترتيب بالدمج
خوارزمية الترتيب بالدمج مثال كلاسيكي على «القسمة والتغلب» (divide and conquer) التعاودي: فإذا كان طول لا يتجاوز 1، فإن مرتَّب أصلًا، فلا نفعل شيئًا. وإلّا فسنقسّم إلى نصفين، هما و . نرتّب و تعايديًا، ثم ندمج (بعد أن صارا مرتَّبين) و للحصول على مصفوفتنا المرتَّبة تمامًا :
    <T> void mergeSort(T[] a, Comparator<T> c) {
        if (a.length <= 1) return;
        T[] a0 = Arrays.copyOfRange(a, 0, a.length/2);
        T[] a1 = Arrays.copyOfRange(a, a.length/2, a.length);
        mergeSort(a0, c);
        mergeSort(a1, c);
        merge(a0, a1, a, c);
    }
يعرض الشكل 11.1 مثالًا على ذلك.
وبالمقارنة مع الترتيب، فإن دمج المصفوفتين المرتَّبتين و أمر يسير إلى حدٍّ ما. فنضيف العناصر إلى واحدًا تلو الآخر. فإن كانت أو فارغة، أضفنا العنصر التالي من المصفوفة الأخرى (غير الفارغة). وإلّا أخذنا الأصغر بين العنصر التالي في والعنصر التالي في وأضفناه إلى :
    <T> void merge(T[] a0, T[] a1, T[] a, Comparator<T> c) {
        int i0 = 0, i1 = 0;
        for (int i = 0; i < a.length; i++) {
            if (i0 == a0.length)
                a[i] = a1[i1++];
            else if (i1 == a1.length)
                a[i] = a0[i0++];
            else if (compare(a0[i0], a1[i1]) < 0)
                a[i] = a0[i0++];
            else
                a[i] = a1[i1++];
        }
    }
لاحظ أن خوارزمية تجري ما لا يزيد على مقارنة قبل أن تنفد عناصر إحدى أو .
لفهم زمن تشغيل الترتيب بالدمج، أسهل ما يكون النظر إليه في ضوء شجرة تعاوده (recursion tree). لنفترض الآن أن قوة للعدد 2، بحيث يكون ، وأن عددًا صحيحًا. راجع الشكل 11.2. يحوّل الترتيب بالدمج مسألة ترتيب عنصرًا إلى مسألتين، كل واحدة منهما ترتيب عنصرًا. ثم تُحوَّل هاتان المسئلتان الفرعيتان كلٌّ منهما إلى مسألتين، أي إلى أربعة مسائل فرعية في المجمل، حجم كلٍّ منها . ثم تصير هذه المسائل الفرعية الأربع ثماني مسائل فرعية، حجم كلٍّ منها ، وهكذا. وفي قاع هذه العملية، تُحوَّل مسألة فرعية، حجم كلٍّ منها اثنان، إلى مسألة، حجم كلٍّ منها واحد. ولكل مسألة فرعية حجم ، فإن الزمن الذي يُستغرق في دمج البيانات ونسخها هو . وبما أنه يوجد مسألة فرعية حجم كلٍّ منها ، فإن الزمن الكلي المستغرق في العمل على المسائل ذات الحجم ، باستثناء الاستدعاءات التعاودية، هو
وعليه، فإن الزمن الكلي الذي يستغرقه الترتيب بالدمج هو
الشكل 11.2: شجرة التعاود في الترتيب بالدمج. 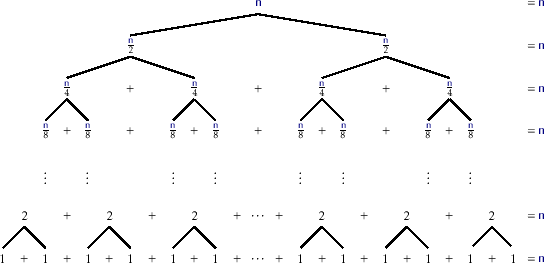 يقوم برهان المبرهنة التالية على التحليل السابق، لكنه يحتاج إلى قدر من العناية الإضافية للتعامل مع الحالات التي لا يكون فيها قوة للعدد 2. المبرهنة 11.1 تعمل خوارزمية في زمن وتجري ما لا يزيد على مقارنة.
البرهان. البرهان بالاستدلال (induction) على . الحالة الأساسية، أي ، بديهية؛ فحين تُعرض على الخوارزمية مصفوفة طولها 0 أو 1 فإنها تعود فورًا دون إجراء أي مقارنة.
يتطلب دمج قائمتين مرتَّبتين مجموع طولهما ما لا يزيد على مقارنة. وليتكن رمزًا لأقصى عدد من المقارنات التي تجريها على مصفوفة طولها . فإذا كان زوجيًا، طبّقنا فرضية الاستدلال على المسألتين الفرعيتين وحصلنا على
أما الحالة التي يكون فيها فرديًا فهي أعقد قليلًا. ونستخدم في هذه الحالة متساويتين يسهل التحقق منهما:
لكل و
لكل . وتأتي المتساوية (11.1) من الحقيقة ، فيما تنبع (11.2) من كون دالة مقعرة (concave). ومع هذين الأداتين في متناول اليد، ينتج لنا، لأجل الفردي،
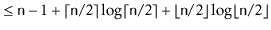 |
||
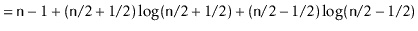 |
||
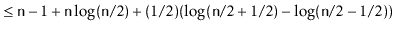 |
||
11.1.2 الترتيب السريع
خوارزمية الترتيب السريع خوارزمية «قسمة وتغلب» كلاسيكية أخرى. وبخلاف الترتيب بالدمج الذي يقوم بالدمج بعد حل المسألتين الفرعيتين، فإن الترتيب السريع ينجز كل عمله مقدمًا. ووصفة الترتيب السريع بسيطة: اختر عنصرًا محوريًا (pivot) عشوائيًا، هو ، من ؛ وقسّم إلى مجموعة العناصر الأصغر من ، ومجموعة العناصر المساوية لـ ، ومجموعة العناصر الأكبر من ؛ وأخيرًا رتّب تعايديًا المجموعة الأولى والثالثة من هذا التقسيم. ويعرض الشكل 11.3 مثالًا على ذلك.
    <T> void quickSort(T[] a, Comparator<T> c) {
        quickSort(a, 0, a.length, c);
    }
    <T> void quickSort(T[] a, int i, int n, Comparator<T> c) {
        if (n <= 1) return;
        T x = a[i + rand.nextInt(n)];
        int p = i-1, j = i, q = i+n;
        // a[i..p]<x,  a[p+1..q-1]??x, a[q..i+n-1]>x
        while (j < q) {
            int comp = compare(a[j], x);
            if (comp < 0) {       // move to beginning of array
                swap(a, j++, ++p);
            } else if (comp > 0) {
                swap(a, j, --q);  // move to end of array
            } else {
                j++;              // keep in the middle
            }
        }
        // a[i..p]<x,  a[p+1..q-1]=x, a[q..i+n-1]>x
        quickSort(a, i, p-i+1, c);
        quickSort(a, q, n-(q-i), c);
    }
كل هذا يجري في الموضع نفسه (in place)، بحيث لا تصنع الطريقة نسخًا من المصفوفات الجزئية التي يجري ترتيبها، بل لا تكتفي إلا بترتيب المصفوفة الجزئية . ويُستدعى هذا في البداية بالمعطيات .
وفي قلب خوارزمية الترتيب السريع تقع خوارزمية التقسيم في الموضع نفسه. وهذه الخوارزمية، دون استعمال أي مساحة إضافية، تبدّل العناصر في وتحسب الدليلين و بحيث
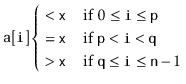
ينفذ هذا التقسيم، الذي تتولاه حلقة في الشيفرة، بزيادة وإنقاص تكرارًا مع الحفاظ على الشرطين الأول والأخير من هذه الشروط. وفي كل خطوة، إمّا أن يُنقل العنصر الكائن عند الموضع إلى المقدّمة، أو يُترك مكانه، أو يُنقل إلى المؤخرة. وفي الحالتين الأوليين تُزاد قيمة ، أما في الحالة الأخيرة فلا تُزاد ، لأن العنصر الجديد الموجود عند الموضع لم يجرِ معالجته بعد.
يرتبط الترتيب السريع ارتباطًا وثيقًا جدًا بأشجار البحث الثنائية العشوائية random binary search trees التي درسناها في القسم 7.1. وفي الواقع، إذا كان مدخل الترتيب السريع مؤلَّفًا من عنصرًا متمايزًا، فإن شجرة تعاود الترتيب السريع هي شجرة بحث ثنائية عشوائية. ولرؤية ذلك، تذكّر أن أول ما نفعله عند بناء شجرة بحث ثنائية عشوائية هو اختيار عنصر عشوائي وجعله جذر الشجرة. وبعد ذلك، سيُقارَن كل عنصر في النهاية بـ ، إذ تذهب العناصر الأصغر إلى الشجرة الفرعية اليسرى والأكبر منها إلى اليمنى. أما في الترتيب السريع فنختار عنصرًا عشوائيًا ونقارن كل شيء به فورًا، فوضع العناصر الأصغر في بداية المصفوفة والعناصر الأكبر في نهايتها. ثم يرتّب الترتيب السريع تعايديًا بداية المصفوفة ونهايتها، في حين تُدرج شجرة البحث الثنائية العشوائية تعايديًا العناصر الأصغر في الشجرة الفرعية اليسرى للجذر والعناصر الأكبر في الشجرة الفرعية اليمنى للجذر. ويقابل هذا التطابق بين أشجار البحث الثنائية العشوائية والترتيب السريع أن باستطاعتنا نقل الملاحظة 7.1 إلى عبارة عن الترتيب السريع: الملاحظة 11.1 حين يُستدعى الترتيب السريع لترتيب مصفوفة تحتوي الأعداد الصحيحة ، يكون العدد المتوقَّع لمرات مقارنة العنصر بعنصر محوري ما لا يزيد على .
ومن خلال جمع يسير للأعداد التوافقية (harmonic numbers) نحصل على المبرهنة التالية بشأن زمن تشغيل الترتيب السريع: المبرهنة 11.2 حين يُستدعى الترتيب السريع لترتيب مصفوفة تحتوي عنصرًا متمايزًا، يكون عدد المقارنات المتوقَّع ما لا يزيد على .
البرهان. وليكن عدد المقارنات التي يجريها الترتيب السريع عند ترتيب عنصرًا متمايزًا. وباستعمال الملاحظة 11.1 وخطية التوقّع، لدينا:
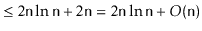 |
تصف المبرهنة 11.3 الحالة التي تكون فيها العناصر المرتَّبة كلها متمايزة. أما إذا كانت مصفوفة الإدخال تحوي عناصر مكرَّرة، فإن زمن التشغيل المتوقَّع للترتيب السريع ليس أسوأ، بل قد يكون أفضل؛ فكلما اختير عنصر مكرَّر محورًا، جُمِّعت كل ورودات معًا ولم تشارك في أيٍّ من المسألتين الفرعيتين. المبرهنة 11.3 تعمل الطريقة في زمن متوقَّع قدره ، وعدد المقارنات المتوقَّع الذي تجريه ما لا يزيد على .
11.1.3 الترتيب بالكومة
خوارزمية الترتيب بالكومة خوارزمية ترتيب أخرى تعمل في الموضع نفسه. وهي تستعمل الأكوام الثنائية (binary heaps) التي ناقشناها في القسم 10.1. وتذكّر أن بنية البيانات BinaryHeap تمثّل كومة باستعمال مصفوفة واحدة. تحوّل خوارزمية الترتيب بالكومة مصفوفة الإدخال إلى كومة، ثم تستخرج القيمة الأصغر تكرارًا. وبعبارة أدق، تخزّن الكومة عنصرًا في مصفوفة، ، عند مواقع المصفوفة مع تخزين أصغر قيمة عند الجذر، وهو . وبعد تحويل إلى BinaryHeap، تبدّل خوارزمية الترتيب بالكومة بين و تكرارًا، وتخفض ، وتستدعي بحيث تصير مجددًا تمثيلًا صالحًا للكومة. وعندما تنتهي هذه العملية (لأن ) تكون عناصر مخزَّنة بترتيب متناقص، فنعكس للحصول على الترتيب المرتَّب النهائي.11.1يعرض الشكل 11.4 مثالًا على تنفيذ .
    <T> void sort(T[] a, Comparator<T> c) {
        BinaryHeap<T> h = new BinaryHeap<T>(a, c);
        while (h.n > 1) {
            h.swap(--h.n, 0);
            h.trickleDown(0);
        }
        Collections.reverse(Arrays.asList(a));
    }
تتمثل إحدى الدوال الفرعية (subroutines) الجوهرية في الترتيب بالكومة في المُنشئ (constructor) الذي يحوّل مصفوفة غير مرتَّبة إلى كومة. ومن السهل إنجاز ذلك في زمن عبر استدعاء طريقة BinaryHeap مرارًا، لكننا نستطيع فعل ما هو أفضل باستعمال خوارزمية تصاعدية (bottom-up). وتذكّر أن أبناء في الكومة الثنائية يُخزَّنون عند المواضع و . ويترتب على ذلك أن عناصر ليس لها أبناء. وبعبارة أخرى، كلٌّ من كومة جزئية (sub-heap) بحجم 1. الآن، وإذا عملنا في الاتجاه المعاكس، يمكننا استدعاء لكل . وهذا يعمل، ذلك أنه بحلول اللحظة التي نستدعي فيها يكون كلٌّ من أبناء جذرًا لكومة جزئية، لذا فإن استدعاء يجعل جذرًا لكومته الجزئية الخاصة.
    BinaryHeap(T[] a, Comparator<T> c) {
        this.c = c;
        this.a = a;
        n = a.length;
        for (int i = n/2-1; i >= 0; i--) {
            trickleDown(i);
        }
    }
والأمر اللافت في هذه الاستراتيجية التصاعدية أنها أكثر كفاءة من استدعاء مرة. ولرؤية ذلك، لاحظ أن عددًا قدره من العناصر لا يحتاج إلى أي عمل، وأن من العناصر نستدعي فيها على كومة جزئية جذرها وارتفاعها واحد، و من العناصر نستدعي فيها على كومة جزئية ارتفاعها اثنان، وهكذا. وبما أن العمل الذي تجريه متناسب مع ارتفاع الكومة الجزئية التي جذرها ، فإن إجمالي العمل المنجز هو على الأكثر
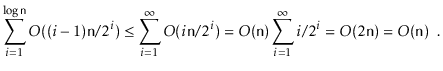
أما المساواة قبل الأخيرة فتُفَهَّم بالاعتراف بأن المجموع يساوي، بحسب تعريف القيمة المتوقَّعة، عدد مرات رمي عملة (بما فيها الرمية التي تخرج فيها الوجه أولًا)؛ ثم بتطبيق الملاحظة 4.2.
تصف المبرهنة التالية أداء . المبرهنة 11.4 تعمل الطريقة في زمن وتجري ما لا يزيد على مقارنة.
البرهان. تعمل الخوارزمية في ثلاث خطوات: (1) تحويل إلى كومة، (2) استخراج العنصر الأصغر من تكرارًا، و(3) عكس عناصر . وقد برهنا للتو أن الخطوة 1 تستغرق زمنًا قدره وتجري مقارنة. أما الخطوة 3 فتستغرق زمنًا قدره ولا تجري أي مقارنة. وتُجري الخطوة 2 عددًا قدره من الاستدعاءات لـ . ويعمل الاستدعاء رقم من هذه الاستدعاءات على كومة حجمها ويجري ما لا يزيد على مقارنة. وبجمع ذلك على نحصل على
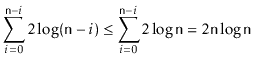
بجمع عدد المقارنات التي تجريها كل واحدة من الخطوات الثلاث يكتمل البرهان.
11.1.4 حدٌّ أدنى (lower bound) للترتيب المبني على المقارنات لقد رأينا الآن ثلاث خوارزميات ترتيب مبنية على المقارنات، كل منها تعمل في زمن . وإلى هذا الحد، ينبغي أن نتساءل إن كانت هناك خوارزميات أسرع. والجواب المختصر على هذا السؤال هو لا. فإذا كانت العمليات الوحيدة المسموح بها على عناصر هي المقارنات، فلا يمكن لأي خوارزمية أن تتجنب إجراء نحو مقارنة. وإثبات ذلك ليس صعبًا، لكنه يتطلب قدرًا من الخيال. وفي المحصلة، فإنه ينبع من الحقيقة أن
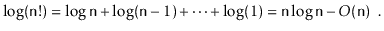
( وترك إثبات هذه الحقيقة كتمرين 11.11.)
وسنبدأ بتركيز انتباهنا على الخوارزميات الحتمية (deterministic) مثل الترتيب بالدمج والترتيب بالكومة، وعلى قيمة ثابتة بعينها لـ . تخيّل خوارزمية من هذا النوع مستعملة لترتيب عنصرًا متمايزًا. ومفتاح إثبات هذا الحد الأدنى هو ملاحظة أن الخوارزمية الحتمية، عند ثبات قيمة ، تقارن أولًا دائمًا الزوج نفسه من العناصر. فمثلًا، في ، عندما يكون زوجيًا، يكون أول استدعاء لـ هو ، وتكون أول مقارنة بين العنصرين و . وبما أن جميع عناصر الإدخال متمايزة، فإن هذه المقارنة الأولى لها نتيجتان محتملتان فقط. وقد تعتمد المقارنة الثانية التي تجريها الخوارزمية على نتيجة المقارنة الأولى. وقد تعتمد المقارنة الثالثة على نتيجتي المقارنتين الأوليين، وهكذا. وبهذه الطريقة، يمكن النظر إلى أي خوارزمية ترتيب حتمية مبنية على المقارنات على أنها شجرة مقارنات ثنائية الجذر. وكل عقدة داخلية، ، في هذه الشجرة موسومة بزوج من الدلالين و . فإذا كان انتقلت الخوارزمية إلى الشجرة الفرعية اليسرى، وإلّا انتقلت إلى الشجرة الفرعية اليمنى. وكل ورقة في هذه الشجرة موسومة بتبادل لـ . ويمثّل هذا التبادل التبادلَ المطلوب لترتيب إذا بلغت شجرة المقارنات هذه الورقة. أي أن:
يعرض الشكل 11.5 مثالًا على شجرة مقارنات لمصفوفة حجمها .
تخبرنا شجرة المقارنات الخاصة بخوارزمية الترتيب بكل شيء عن تلك الخوارزمية. فهي تخبرنا بدقة بتسلسل المقارنات التي ستُجرى لأي مصفوفة إدخال، ، ذات عنصرًا متمايزًا، وتخبرنا بكيفية إعادة الخوارزمية ترتيب بغية ترتيبه. وعليه، يجب أن تملك شجرة المقارنات ما لا يقل عن ورقة؛ وإلّا فهناك تباديلان مختلفان يقودان إلى الورقة نفسها، وبالتالي لا ترتّب الخوارزمية أحد هذين التباديل ترتيبًا صحيحًا. فمثلًا، لا تملك شجرة المقارنات في الشكل 11.6 سوى ورقة. وبفحص هذه الشجرة نرى أن مصفوفتي الإدخال و توصلان كلتاهما إلى الورقة واقفة أقصى اليمين. ففي الإدخال تُخرج هذه الورقة بصورة صحيحة . غير أن في الإدخال تُخرج هذه العقدة بصورة خاطئة . ويقودنا هذا النقاش إلى الحد الأدنى الأساسي للخوارزميات المبنية على المقارنات. الشكل 11.6: شجرة مقارنات لا ترتّب كل تباديل الإدخال ترتيبًا صحيحًا. 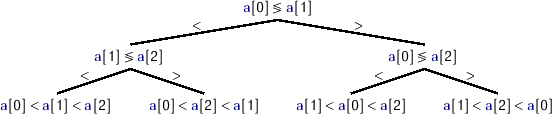 المبرهنة 11.5 لأي خوارزمية ترتيب حتمية مبنية على المقارنات وأي عدد صحيح ، توجد مصفوفة إدخال طولها بحيث تجري عددًا من المقارنات يبلغ على الأقل عند ترتيب .
البرهان. ووفق المناقشة السابقة، يجب أن تملك شجرة المقارنات المعرَّفة بواسطة ما لا يقل عن ورقة. ويبيّن برهان استدلالي سهل أن ارتفاع أي شجرة ثنائية ذات ورقة هو على الأقل . وعليه، فإن شجرة المقارنات الخاصة بـ فيها ورقة، ، عمقها على الأقل ، وهناك مصفوفة إدخال تقود إلى هذه الورقة. ومصفوفة الإدخال هذه هي مدخل تجري فيه عددًا من المقارنات يبلغ على الأقل .
تتناول المبرهنة 11.5 خوارزميات حتمية مثل الترتيب بالدمج والترتيب بالكومة، لكنها لا تخبرنا بشيء عن الخوارزميات العشوائية مثل الترتيب السريع. فهل يمكن لخوارزمية عشوائية أن تتجاوز الحد الأدنى على عدد المقارنات؟ والجواب، مرة أخرى، هو لا. والطريقة لإثبات ذلك هي التفكير، بطريقة مختلفة، فيما تعنيه الخوارزمية العشوائية. وفي النقاش التالي، سنفترض أن أشجار قرارنا «نُظِّفت» بالطريقة التالية: تُحذف أي عقدة لا يمكن بلوغها بواسطة مصفوفة إدخال ما، هي . وهذه التنظيفية تعني أن الشجرة فيها بالضبط ورقة. وفيها ما لا يقل عن ورقة، لأن ما عدا ذلك لما استطاعت أن ترتّب ترتيبًا صحيحًا. وفيها ما لا يزيد عن ورقة، لأن كل واحد من التباديل المحتملة لعدد من العناصر المتمايزة يسلك مسارًا واحدًا بالضبط من الجذر إلى الورقة في شجرة القرار. ويمكننا النظر إلى خوارزمية ترتيب عشوائية، ، على أنها خوارزمية حتمية تأخذ مدخلين: مصفوفة الإدخال التي يفترض ترتيبها، ومتوالية طويلة من أعداد حقيقية عشوائية ضمن المدى . وتوفّر هذه الأعداد العشوائيةَ ما يلزم من عشوائيةٍ في الخوارزمية. وحين تريد الخوارزمية أن ترمي عملة أو تجري اختيارًا عشوائيًا، فإنها تفعل ذلك باستعمال عنصر ما من . فمثلًا، ولحساب دليل أول عنصر محوري في الترتيب السريع، يمكن للخوارزمية أن تستعمل الصيغة . والآن، لاحظ أن إذا ثبّتنا على متتالية بعينها ، فإن تصير خوارزمية ترتيب حتمية، ، لها شجرة مقارنات مقابلة، . ثم لاحظ أن إذا اخترنا لتكون تبادلًا عشوائيًا لـ ، فإن هذا يعادل اختيار ورقة عشوائية، ، من ورقة في . ويطلب منك التمرين 11.13 أن تثبت أن إذا اخترنا ورقة عشوائية من أي شجرة ثنائية ذات ورقة، فإن عمق هذه الورقة المتوقَّع هو على الأقل . وعليه، فإن عدد المقارنات المتوقَّع الذي تجريه الخوارزمية (الحتمية) حين تُعطى مصفوفة إدخال تحوي تبادلًا عشوائيًا لـ هو على الأقل . وأخيرًا، لاحظ أن هذا صحيح لكل اختيار لـ ، لذا فهو يصح حتى في حالة . وبهذا يكتمل برهان الحد الأدنى للخوارزميات العشوائية. المبرهنة 11.6 لأي عدد صحيح وأي خوارزمية ترتيب مبنية على المقارنات (حتمية كانت أو عشوائية)، ، يكون عدد المقارنات المتوقَّع الذي تجريه عند ترتيب تبادل عشوائي لـ على الأقل .
الحواشي
... بالترتيب.11.1 كان بإمكان الخوارزمية، على نحو بديل، أن تعيد تعريف الدالة بحيث يخزّن الترتيب بالكومة العناصر مباشرةً بالترتيب التصاعدي. opendatastructures.org
11.2 الترتيب العدّي (counting sort) والترتيب الجذري (radix sort)
الأقسام الفرعية
11.2 الترتيب العدّي (counting sort) والترتيب الجذري (radix sort)
ندرس في هذا القسم خوارزميتَي ترتيب ليستا مبنيتين على المقارنات. ومتخصصتان في ترتيب الأعداد الصحيحة الصغيرة، فإن هاتين الخوارزميتين تتجاوزان الحدود الدنيا للمبرهنة 11.5 باستعمال (أجزاء من) عناصر كدلالَين داخل مصفوفة. ولنفترض عبارة من الشكل
تُنفَّذ هذه العبارة في زمن ثابت، لكن لها نواتج مختلفة محتملة، بحسب قيمة . وهذا يعني أن تنفيذ خوارزمية تجري مثل هذه العبارة لا يمكن نمذجته على شكل شجرة ثنائية. وفي المحصلة، فهذه هي سبب قدرة خوارزميات هذا القسم على الترتيب أسرع من الخوارزميات المبنية على المقارنات.
11.2.1 الترتيب العدّي
لنفترض لدينا مصفوفة إدخال مؤلَّفة من عدد صحيح، كلٌّ منها ضمن المدى . ترتّب خوارزمية الترتيب العدّي المصفوفة باستعمال مصفوفة مساعدة من العدادات. وتُخرج نسخة مرتَّبة من في مصفوفة مساعدة . والفكرة وراء الترتيب العدّي بسيطة: لكل ، عُدّ عدد مرات ورود في واحفظ هذا العدد في . الآن، بعد الترتيب، سيبدو المخرج على النحو التالي: ورودة من 0، تليها ورودة من 1، تليها ورودة من 2،...، تليها ورودة من . والشيفرة التي تقوم بذلك في غاية النحت والإيجاز، ويوضّح الشكل 11.7 تنفيذها:
    int[] countingSort(int[] a, int k) {
        int c[] = new int[k];
        for (int i = 0; i < a.length; i++)
            c[a[i]]++;
        for (int i = 1; i < k; i++)
            c[i] += c[i-1];
        int b[] = new int[a.length];
        for (int i = a.length-1; i >= 0; i--)
            b[--c[a[i]]] = a[i];
        return b;
    }
الشكل 11.7: عمل الترتيب العدّي على مصفوفة طولها تخزّن الأعداد الصحيحة . 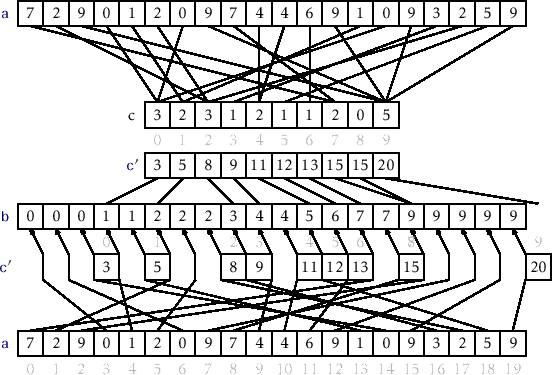 تضبط حلقة الأولى في هذه الشيفرة كل عدّاد بحيث يعدّ عدد ورودات في . وباستعمال قيم كدلالَين، يمكن حساب جميع هذه العدادات في زمن بحلقة for واحدة. وعند هذه النقطة كان بإمكاننا استعمال لملء مصفوفة المخرجات مباشرة. غير أن هذا لن ينجح إذا كانت عناصر مرتبطة ببيانات مرافقة. ولذلك نبذل جهدًا إضافيًا يسيرًا لنسخ عناصر إلى . أمّا حلقة التالية، التي تستغرق زمنًا قدره ، فتحسب مجموعًا تراكميًا للعدادات بحيث تصير عدد العناصر في التي تكون أصغر من أو مساوية لها. وبخاصة، فلكل ، سيكون لدى مصفوفة المخرجات، ، ما يلي
وأخيرًا، تفحص الخوارزمية في الاتجاه العكسي لتضع عناصرها بالترتيب في مصفوفة مخرجات . وأثناء الفحص، يوضع العنصر عند الموضع وتُنقص قيمة .
المبرهنة 11.7 يمكن للطريقة أن ترتّب مصفوفة التي تحوي عددًا صحيحًا من المجموعة في زمن .
ولخوارزمية الترتيب العدّي خاصية حسنة؛ فهي ثابتة (stable)، أي أنها تحافظ على الترتيب النسبي للعناصر المتساوية. فإذا كان عنصران و لهما القيمة نفسها، وكان ، فإن سيظهر قبل في . وسيكون هذا مفيدًا في القسم التالي.
11.2.2 الترتيب الجذري
الترتيب العدّي شديد الكفاءة في ترتيب مصفوفة من الأعداد الصحيحة عندما لا يقلّ طول المصفوفة، ، كثيرًا عن القيمة القصوى، ، التي تظهر في المصفوفة. أما خوارزمية الترتيب الجذري التي نصفها الآن، فهي تستعمل عدة تمريرات (passes) من الترتيب العدّي لتسمح بمدى أكبر بكثير من القيم القصوى. يرتّب الترتيب الجذري الأعداد الصحيحة ذات بت باستعمال تمريرة من الترتيب العدّي لترتيب هذه الأعداد الصحيحة بت في كل مرة.11.2 وبعبارة أدق، يرتّب الترتيب الجذري أولًا الأعداد الصحيحة حسب بت الأقل أهمية، ثم حسب بت التالية في الأهمية، وهكذا حتى أنه في التمريرة الأخيرة تُرتَّب الأعداد الصحيحة حسب بت الأعلى أهمية.
    int[] radixSort(int[] a) {
        int[] b = null;
        for (int p = 0; p < w/d; p++) {
            int c[] = new int[1<<d];
            // the next three for loops implement counting-sort
            b = new int[a.length];
            for (int i = 0; i < a.length; i++)
                c[(a[i] >> d*p)&((1<<d)-1)]++;
            for (int i = 1; i < 1<<d; i++)
                c[i] += c[i-1];
            for (int i = a.length-1; i >= 0; i--)
                b[--c[(a[i] >> d*p)&((1<<d)-1)]] = a[i];
            a = b;
        }
        return b;
    }
(في هذه الشيفرة، يستخرج التعبير العددَ الصحيح الذي يُعطى تمثيله الثنائي بتات من .) ويعرض الشكل 11.8 مثالًا على خطوات هذه الخوارزمية.
الشكل 11.8: استعمال radixsort لترتيب أعداد صحيحة ذات بت باستعمال 4 تمريرات من الترتيب العدّي على أعداد صحيحة ذات بت. 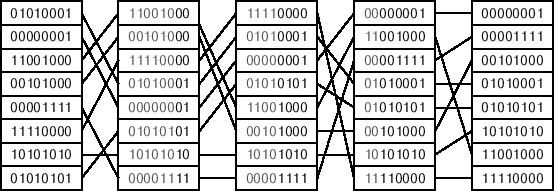 ترتّب هذه الخوارزمية اللافتة تصحيحًا لأن الترتيب العدّي خوارزمية ترتيب ثابتة. فإذا كان عنصرين من ، وكان البت الأعلى أهمية الذي يختلف عنده عن فهرسه ، فإن سيُوضع قبل أثناء التمريرة ولن تغيّر التمريرات التالية الترتيب النسبي بين و . ويؤدي الترتيب الجذري تمريرة من الترتيب العدّي. وتحتاج كل تمريرة إلى زمن . وعليه، فإن أداء الترتيب الجذري تحدده المبرهنة التالية. المبرهنة 11.8 لأي عدد صحيح ، يمكن للطريقة أن ترتّب مصفوفة تحوي عددًا صحيحًا ذا بت في زمن .
وإن فكّرنا بدلًا من ذلك في أن عناصر المصفوفة تقع ضمن المدى ، وآخذنا ، نحصل على الصيغة التالية للمبرهنة 11.8. النتيجة 11.1 يمكن للطريقة أن ترتّب مصفوفة تحوي قيمة عددية ضمن المدى في زمن .
الحواشي
... زمنيًا.11.2 نفترض أن يقسم ، وإلا يمكننا دائمًا زيادة إلى . opendatastructures.org
11.3 مناقشة وتمارين
الترتيب هو المسألة الخوارزمية الأساسية في علم الحاسوب، وله تاريخ طويل. ويُنسب Knuth [48] خوارزمية الترتيب بالدمج إلى von Neumann (1945). أما الترتيب السريع فينسب إلى Hoare [39]. وخوارزمية الترتيب بالكومة الأصلية تنسب إلى Williams [78]، غير أن النسخة المعروضة هنا (والتي تُبنى فيها الكومة تصاعديًا في زمن ) تنسب إلى Floyd [28]. أما الحدود الدنيا للترتيب المبني على المقارنات فتبدو من جهل المعرفة (folklore). ويُلخّص الجدول التالي أداء خوارزميات الترتيب المبنية على المقارنات هذه: المقارنات، في الموضع نفسه: الترتيب بالدمج أسوأ حالة، لا؛ الترتيب السريع متوقَّع، نعم؛ الترتيب بالكومة أسوأ حالة، نعم. ولكل واحدة من خوارزميات الترتيب المبنية على المقارنات هذه مزاياها وعيوبها. فالترتيب بالدمج يجري أقل عدد من المقارنات ولا يعتمد على العشوائية. وللأسف، فهو يستعمل مصفوفة مساعدة في مرحلة الدمج. وتخصيص هذه المصفوفة قد يكون مكلفًا، وهو نقطة فشل محتملة إذا كانت الذاكرة محدودة. أما الترتيب السريع فهو خوارزمية تعمل في الموضع نفسه، ويأتي في مرتبة ثانية قريبة من حيث عدد المقارنات، لكنه عشوائي، لذا فإن زمن التشغيل هذا غير مضمون دائمًا. والترتيب بالكومة يجري أكبر عدد من المقارنات، لكنه يعمل في الموضع نفسه وهو حتمي. وهناك إعداد واحد يتفوق فيه الترتيب بالدمج بوضوح؛ هو ترتيب قائمة مترابطة (linked list). ففي هذه الحالة لا حاجة إلى المصفوفة المساعدة؛ إذ يمكن دمج قائمتين مترابطتين مرتَّبتين بسهولة شديدة في قائمة مترابطة واحدة مرتَّبة عبر التلاعب بالمؤشرات (راجع التمرين 11.2). أما خوارزميتا الترتيب العدّي والترتيب الجذري الموصوفتان هنا فينسبان إلى Seward [68, Section 2.4.6]. غير أن أشكالًا من الترتيب الجذري استُعملت منذ العشرينيات من القرن الماضي لترتيب بطاقات الثقب بواسطة آلات ترتيب بطاقات مثقّبة (punched card sorting machines). تستطيع هذه الآلات ترتيب حزمة من البطاقات إلى كومتين استنادًا إلى وجود ثقب (أو عدمه) في موضع محدّد على البطاقة. وتكرار هذه العملية لمواضع ثقب مختلفة يعطي تنفيذًا للترتيب الجذري. وأخيرًا، نلاحظ أن الترتيب العدّي والترتيب الجذري يمكن أن يُستعملا لترتيب أنواع أخرى من الأعداد غير الأعداد الصحيحة غير السالبة. فبتعديلات مباشرة على الترتيب العدّي يمكن ترتيب الأعداد الصحيحة، في أي مدى ، في زمن . وبالمثل، يمكن للترتيب الجذري أن يرتّب الأعداد الصحيحة في المدى نفسه في زمن . وأخيرًا، يمكن أيضًا لخوارزميتَي الترتيب هاتين أن تُستعملا لترتيب الأعداد العشرية العائمة بصيغة IEEE 754 العشرية العائمة. وذلك لأن صيغة IEEE مصمَّمة لتتيح مقارنة عددين عشريين عائمين بمقارنة قيمتيهما كأنهما عددان صحيحان بترميز ثنائي بإشارة-مقدار (signed-magnitude) [2]. التمرين 11.1 بيّن تنفيذ الترتيب بالدمج والترتيب بالكومة على مصفوفة إدخال تحتوي . وقدّم نموذجًا توضيحيًا لتنفيذ واحد ممكن للترتيب السريع على المصفوفة نفسها.
التمرين 11.2 نفّذ نسخة من خوارزمية الترتيب بالدمج ترتّب DLList دون استعمال مصفوفة مساعدة. (راجع التمرين 3.13.)
التمرين 11.3 تستعمل بعض تنفيذات دائمًا كعنصر محوري. أعطِ مثالًا لمصفوفة إدخال طولها تجري فيها هذه النسخة عددًا من المقارنات يبلغ .
التمرين 11.4 تستعمل بعض تنفيذات دائمًا كعنصر محوري. أعطِ مثالًا لمصفوفة إدخال طولها تجري فيها هذه النسخة عددًا من المقارنات يبلغ .
التمرين 11.5 بيّن أن أي تنفيذ لـ يختار عنصرًا محوريًا بشكل حتمي، دون النظر أولًا في أي قيم ضمن ، توجد مصفوفة إدخال طولها تجعل هذا التنفيذ يجري مقارنة.
التمرين 11.6 صمّم Comparator، هو ، يمكنك تمريره كوسيط إلى ويجعل الترتيب السريع يجري مقارنة. (تلميح: لا يحتاج المقارن (comparator) لديك فعليًا إلى النظر في القيم قيد المقارنة.)
التمرين 11.7 حلّل عدد المقارنات المتوقَّع الذي يجريه الترتيب السريع بعناية أكبر قليلًا مما فعل برهان المبرهنة 11.3. وبخاصة، بيّن أن عدد المقارنات المتوقَّع هو .
التمرين 11.8 صِف مصفوفة إدخال تجعل الترتيب بالكومة يجري عددًا من المقارنات يبلغ على الأقل . وبرّر إجابتك.
التمرين 11.9 تنفيذ الترتيب بالكومة الموصوف هنا يرتّب العناصر في ترتيب معكوس ثم يعكس المصفوفة. ويمكن تفادي هذه الخطوة الأخيرة بتعريف Comparator جديد ينفي نتائج Comparator الإدخال، وهو . اشرح لماذا لا يكون هذا تحسينًا جيدًا. (تلميح: تأمّل كم عدد عمليات النفي التي يلزم إجراؤها مقابل الزمن الذي يستغرقه عكس المصفوفة.)
التمرين 11.10 أوجد زوجًا آخر من تباديل لا ترتّبها شجرة المقارنات في الشكل 11.6 ترتيبًا صحيحًا.
التمرين 11.11 اثبت أن .
التمرين 11.12 اثبت أن الشجرة الثنائية ذات ورقة ارتفاعها على الأقل .
التمرين 11.13 اثبت أنه إذا اخترنا ورقة عشوائية من شجرة ثنائية ذات ورقة، فإن ارتفاع هذه الورقة المتوقَّع هو على الأقل .
التمرين 11.14 التنفيذ المعطى هنا لـ يعمل عندما تحوي مصفوفة الإدخال، ، على أعداد صحيحة غير سالبة فقط. وسّع هذا التنفيذ بحيث يعمل أيضًا تصحيحًا عندما يحوي على أعداد صحيحة سالبة وغير سالبة معًا.