الصحة
8. الصحة
عندما نكتب شيفرة، نأمل دائمًا أن نكتبها على نحو صحيح. إننا نأمل أن تكون شيفرتنا صحيحة. لكن كيف يمكننا أن نعلم أنها صحيحة؟ سندرس في هذا الفصل ثلاثة أجوبة ممكنة: التوثيق والاختبار والبرهان.
ولنكن صادقين: لقد ظننا جميعًا في وقت أو آخر أن التوثيق أو الاختبار مهمة مملة ومضنية وقابلة للتأجيل تمامًا. لكن المبرمجين، مع النضج، يدركون أن كليهما ضروري لكتابة شيفرة صحيحة. فكلاهما يصل إلى حقيقة ما تفعله الشيفرة فعلًا.
التوثيق هو الحقيقة الأساسية لما قصده المبرمج، في مقابل ما نفّذه فعلًا. وهو ينقل إلى البشر الآخرين الأفكار التي كانت في ذهن المؤلف. وفي كثير من الأحيان (حتى في هذا الكتاب!) نفشل في إيصال الأفكار كما قصدناها. وقد يقع الفشل في الشيفرة، أو في التوثيق. لكن كتابة التوثيق تجبرنا على التفكير مرة ثانية (أعني، نأمل أن تكون ثانية) في مقاصدنا. فالمهمة الذهنية المتمثلة في شرح أفكارنا لبشر آخرين مختلفة بالتأكيد عن شرحها للحاسوب. وقد يكشف ذلك عن مواضع خلل في تفكيرنا.
والأهم من ذلك أن التوثيق رسالة في كبسولة زمن. تخيّل هذا: شخص بعيد وغير قابل للوصول الآن قد أرسل تلك الرسالة إليك، أيها المبرمج. أنت تحتاج تلك الرسالة لتفسير الأدلة الأثرية المعروضة أمامك الآن—أي الشيفرة المصدرية التي ورثتها وغير المفهومة لولا ذلك. وأملك الوحيد أن المؤلف الأصلي، منذ زمن بعيد، كان لديه من التعاطف ما دفعه إلى تدوين أفكاره بالكلمات.
والآن تخيّل هذا: ذلك المؤلف من الماضي السحيق؟ ماذا لو كنت أنت؟ فقد يكون أنت من قبل أسبوعين، أو شهرين، أو سنتين. فذاكرة الإنسان سريعة الزوال. وإذا كنت أنت نفسك لم تبرمج إلا بضع سنوات، فقد يصعب عليك فهم ذلك، لكن جرّب أن تتقبله بسخاء: ستأتي يومًا تعود فيه إلى الشيفرة التي تكتبها اليوم ولا يكون لديك أي فكرة عن معناها. وأملك الوحيد أن تترك لنفسك بعض الفتات في وقت كتابتها. وإلا فستضيع عندما تعود إليها.
الاختبار هو الحقيقة الأساسية لما يفعله البرنامج فعلًا، في مقابل ما قصده المبرمج. وهو يوفر دليلًا على أن المبرمج أصاب. والعلماء الجيدون يطلبون الدليل. وذلك الطلب لا ينبع من الغرور بل من التواضع. فنحن البشر بارعون بصورة مذهلة في خداع أنفسنا. (تأمل غرف الصدى في وسائل التواصل الاجتماعي الحديثة.) يمكنك كتابة شيفرة تظن أنها صحيحة. لكن يمكنك بعد ذلك كتابة حالة اختبار تُبرهن على أنها صحيحة. ثم يمكنك كتابة عشر حالات أخرى. ويتراكم الدليل، ويصير في النهاية كافيًا للإقناع. فهل هو مطلق؟ بالطبع لا. فربما توجد حالة اختبار لم تكن بارعًا بما يكفي لاختراعها. تلك هي العلم: تأتي أفكار جديدة لتتحدى القديمة.
والأهم من ذلك أن الاختبار علم قابل للتكرار. فالقدرة على تكرار التجارب جوهرية للحقيقة التي تثبتها. وبالتقاط الاختبارات كتجارب قابلة للتكرار تلقائيًا في صورة مجموعات اختبار وحدة، يمكننا أن نبرهن لأنفسنا وللآخرين، الآن وفي المستقبل، على أن شيفرتنا صحيحة. وعلاوة على ذلك، يضمن ذلك بقاء الشيفرة صحيحة مع الوقت، حتى مع إجراء التغييرات — سواء من الآخرين أو منا.
التحدي في التوثيق والاختبار هو الانضباط. فمن المُغري جدًا، ومن السهل جدًا، أن نهتم بكتابة الشيفرة وحدها. «فهذا هو الجزء الممتع»، أليس كذلك؟ لكن الأمر كأننا نحذف ثلث الرسالة التي قصدنا كتابتها. فجزء من الرسالة إلى الآلة، عن كيفية الحساب. وجزء آخر إلى البشر الآخرين، عن ما أردنا حسابه. وجزء آخر إلى الآلات والبشر معًا، عن ما تمكنا فعلًا من حسابه. ولن تنتهي مهمتك حتى تُكتب الأجزاء الثلاثة كلها.
وإن لم تكن مقتنعًا بعد بأهمية التوثيق والاختبار، فلا تقلق. ستقتنع في المستقبل، إن ثابرت على حرفة البرمجة مدة كافية. وفي هذه الأثناء، لنمضِ في تعلم كيف نفعل ذلك على نحو أفضل. وسنتعلم في هذا الفصل بعض التقنيات الناجحة (ونرجو أن تكون جديدة عليك) في كل منهما.
وأخيرًا، علاوة على التوثيق والاختبار، يوجد برهان رياضي على الصحة. ويمكن استخدام تقنيات من المنطق والرياضيات المتقطعة لإثبات أن برنامجًا ما صحيح وفق مواصفة، إثباتًا صوريًا. وليست هذه البراهين بالضرورة سهلة—بل تتطلب انضباطًا وتدريبًا بشريين أكثر حتى من التوثيق والاختبار. لكن قد يكون من المنطقي تطبيقها عندما تُستخدم البرامج في مهام حرجة للسلامة تكون فيها أرواح البشر على المحك.
8.1. المواصفات
المواصفة (specification) عقد بين عميل (client) وحدة شيفرة ما ومنفّذ (implementer) تلك الشيفرة. وأكثر موضع نجد فيه المواصفات هو التعليقات في ملفات الواجهة (.mli) لوحدة ما. وهناك يوضح منفّذ الوحدة ما يجوز للعميل افتراضه وما لا يجوز افتراضه بشأن سلوك الوحدة. ويجعل هذا العقد واضحًا من يُلام إذا ساء شيء: هل أساء العميل استخدام الوحدة؟ أم فشل المنفّذ في تقديم الوظيفة الموعودة؟
تتضمن المواصفات عادةً شروطًا مسبقة وشروطًا لاحقة. فالشرط المسبق (precondition) يخبر بما يجب على العميل ضمانه بشأن المدخلات التي يمررها، وما يجوز للمنفّذ افتراضه بشأن تلك المدخلات. والشرط اللاحق (postcondition) يخبر بما يجوز للعميل افتراضه بشأن المخرجات التي يتلقاها، وما يجب على المنفّذ ضمانه بشأن تلك المخرجات.
وتحقق المواصفة تنفيذٌ لها إذا قدّم السلوك الموصوف في المواصفة. وقد توجد تنفيذات ممكنة كثيرة لمواصفة معينة. ولا يجوز للعميل أن يفترض شيئًا عن أيّ من تلك التنفيذات يُقدَّم فعلًا. أما المنفّذ فيحق له تقديم أحدها باختياره.
تؤدي المواصفات الواضحة وظائف مهمة كثيرة في فرق تطوير البرمجيات. ومن الوظائف المهمة أنه عندما يسوء شيء ما، يتفق الجميع على من تقع عليه مسؤولية إصلاح المشكلة: فإما أن المنفّذ لم يفِ بالمواصفة ويحتاج إلى إصلاح التنفيذ، وإما أن العميل كتب شيفرة تفترض شيئًا غير مضمون في المواصفة، ومن ثمّ يحتاج إلى إصلاح الشيفرة المستخدِمة. أو ربما تكون المواصفة نفسها خاطئة، وحينها يحتاج العميل والمنفّذ إلى الاتفاق على مواصفة جديدة. وهذه القدرة على تحديد من تقع عليه مسؤولية العيب تمنع المشكلات من التسرب عبر الشقوق.
كتابة المواصفات. يجب أن توازن المواصفات الجيدة بين هدفين متعارضين؛ فيجب أن تكون
- مقيّدة بما يكفي، بحيث تستبعد التنفيذات التي لا تنفع العملاء، و
- عامة بما يكفي، بحيث لا تستبعد التنفيذات التي تنفع العملاء.
ومن الأخطاء الشائعة عدم ذكر ما يكفي في الشروط المسبقة، والفشل في تحديد متى ستُرفع الاستثناءات، والفشل في تحديد السلوك في الحالات الحدّية، وكتابة مواصفات إجرائية بدلًا من تعريفية، وذكر الكثير في الشروط اللاحقة.
كتابة المواصفات الجيدة صعبة لأن اللغة والمصرّف لا يفعلان شيئًا للتحقق من صحة المواصفة: فلا يوجد نظام أنواع لها، ولا تحذيرات، وما إلى ذلك. (وإن كان ثمة بحث جارٍ عن كيفية تحسين المواصفات وكتابتها.) وستقرأ مواصفاتك بشر آخرون، وقد يأتي مع القراءة سوء فهم. وتتطلب قراءة المواصفات انتباهًا دقيقًا للتفاصيل.
وينبغي أن تُكتب المواصفات مبكرًا جدًا. فبمجرد اتخاذ قرار تصميمي، وثّقه في مواصفة. وينبغي أن تستمر المواصفات في التحديث طوال التنفيذ. ولا تصبح المواصفة قديمة إلا عندما تصبح الشيفرة التي تصفها قديمة وتُزال من قاعدة الشيفرة.
التجريد بالمواصفة. يتيح التجريد البرمجة النمطية بإخفاء تفاصيل التنفيذ. والمواصفات جزء من ذلك النوع من التجريد: فهي تكشف معلومات معينة عن سلوك الوحدة دون الإفصاح عن كل تفاصيل تنفيذها.
ومن فوائد التجريد بالمواصفة المحلية (locality). فيمكن فهم وحدة ما دون الحاجة إلى فحص تنفيذها. وهذه المحلية جوهرية في تنفيذ البرامج الكبيرة، بل في تنفيذ البرامج الأصغر ضمن فرق. فلا يستطيع شخص واحد أن يحتفظ بالنظام كله في ذهنه في وقت واحد.
ومن الفوائد الأخرى القابلية للتعديل (modifiability). فيمكن إعادة تنفيذ الوحدات دون تغيير تنفيذ وحدات أو دوال أخرى. وتعتمد مكتبات البرمجيات على ذلك لتحسين وظائفها دون إجبار جميع عملائها على إعادة كتابة الشيفرة كلما حُدِّثت المكتبة. وتتيح القابلية للتعديل أيضًا تحسينات الأداء: فيمكننا كتابة تنفيذات بسيطة بطيئة أولًا، ثم تحسين عنق الزجاجة حسب الحاجة.
ولا ينبغي للعميل أن يفترض في التنفيذ أكثر مما هو مذكور في المواصفة، لأن ذلك يتيح تغيير التنفيذ. فتشكّل المواصفة حاجز تجريد (abstraction barrier) يحمي المنفّذ من العميل والعكس. وتُعرف افتراضات التنفيذ غير المضمونة بالمواصفة بأنها خرق للحاجز التجريدي. ويفرض الحاجز التجريدي الاستدلال المحلي. كما يعزز الترابط غير المحكم (loose coupling) بين وحدات الشيفرة المختلفة. فإذا تغيّرت وحدة ما، قلّ احتمال اضطرار الوحدات الأخرى إلى التغير لتطابقها.
8.2. توثيق الدوال
يواصل هذا القسم النقاش حول التوثيق، الذي بدأناه في الفصل 2.
تُكتب المواصفة ليقرأها البشر، لا الآلات. وقد تستغرق «المواصفات» وقتًا لتُكتب جيدًا، وهو وقت يُستثمر جيدًا. والهدف الرئيسي هو الوضوح. ومن المهم أيضًا الإيجاز، لأن المبرمجين العملاء لن يبذلوا دائمًا جهدًا لقراءة مواصفة طويلة. وكما في أي شيء نكتبه، علينا أن نراعي جمهورنا عند كتابة المواصفات. فقد يحتاج بعض القراء إلى مواصفة أكثر إسهابًا من غيرهم.
تتألف المواصفة الجيدة عادةً من أجزاء عدة تنقل أنواعًا مختلفة من المعلومات عن الشيء الموصوف. وإذا عرفنا المكونات المعتادة للمواصفة، قلّ احتمال نسيان كتابة شيء مهم. ولننظر الآن في وصفة لكتابة المواصفات.
8.2.1. جملة الإعادة
كيف قد نكتب مواصفة للدالة sqr، وهي دالة جذر تربيعي؟ أولًا، نحتاج إلى وصف نتيجتها. وسنسمي هذا الوصف جملة الإعادة (returns clause) لأنه جزء من المواصفة يصف نتيجة استدعاء الدالة. ويُعرف أيضًا بالـ شرط اللاحق (postcondition): فهو يصف شرطًا يصح بعد استدعاء الدالة. وإليك مثالًا على جملة إعادة:
(** Returns: [sqr x] is the square root of [x]. *)
لكننا عادةً نحذف returns: ونكتب جملة الإعادة ببساطة كالجملة الأولى من التعليق:
(** [sqr x] is the square root of [x]. *)
وفي البرمجة العددية، ينبغي على الأرجح أن نضيف بعض المعلومات عن مدى دقتها.
(** [sqr x] is the square root of [x]. Its relative accuracy is no worse than
    [1.0e-6]. *)
وبالمثل، إليك كيف قد نكتب جملة إعادة لدالة find:
(** [find lst x] is the index of [x] in [lst], starting from zero. *)
المواصفة الجيدة موجزة لكن واضحة—ينبغي أن تقول ما يكفي ليفهم القارئ ما تفعله الدالة، لكن دون حشو إضافي يضطر القارئ إلى خوضه وقد يجعله يفوّت المقصود. وأحيانًا يجب الموازنة بين الإيجاز والوضوح.
وتستخدم هاتان المواصفتان حيلة مفيدة لجعلهما أكثر إيجازًا: فهما تتحدثان عن نتيجة تطبيق الدالة الموصوفة على وسائط اعتباطية. ونفهم ضمنًا أن الشرط اللاحق المذكور يصح لجميع القيم الممكنة لأي متغيرات غير مرتبطة (وهي متغيرات الوسائط).
8.2.2. جملة المتطلبات
لا تكون مواصفة sqr منطقية تمامًا لأن الجذر التربيعي غير موجود لبعض قيم x من النوع real. فدالة الجذر التربيعي الرياضية دالة جزئية (partial) معرّفة على جزء من مجالها فقط. والمواصفة الجيدة للدالة تكون كاملة بالنسبة إلى المدخلات الممكنة؛ فهي تمنح العميل فهمًا للمدخلات المسموح بها وللنتائج التي ستحدث للمدخلات المسموح بها.
ولدينا عدة طرق للتعامل مع الدوال الجزئية. ومن المقاربات المباشرة تقييد المجال بحيث يكون واضحًا أنه لا يجوز استخدام الدالة استخدامًا مشروعًا على بعض المدخلات. وتستبعد المواصفة المدخلات السيئة بـ جملة متطلبات (requires clause) تحدد متى يجوز استدعاء الدالة. وتُسمى هذه الجملة أيضًا الشرط المسبق (precondition) لأنها تصف شرطًا يجب أن يصح قبل استدعاء الدالة. وإليك جملة متطلبات لـ sqr:
(** [sqr x] is the square root of [x]. Its relative accuracy is no worse
    than [1.0e-6].  Requires: [x >= 0]. *)
لا تقول هذه المواصفة ما يحدث عندما x < 0، وليس عليها أن تقول. تذكّر أن المواصفة عقد. ويصادف أن هذا العقد يلقي عبء إثبات وجود الجذر التربيعي على العميل. فإذا لم يتحقق الشرط المسبق، يُسمح للتنفيذ بفعل أي شيء يشاء: مثلًا، الدخول في حلقة لا نهائية أو رفع استثناء. وميزة هذه المقاربة أن المنفّذ حرّ في تصميم الخوارزمية دون قيد التحقق من وسائط المدخلات غير الصحيحة، وهو أمر قد يكون مضنيًا ويبطئ البرنامج. وعيبها أنه قد يصعب التنقيح إذا استُدعيت الدالة استدعاءً غير سليم، لأن الدالة قد تسلك سلوكًا سيئًا وليس لدى العميل أي فهم لكيفية ذلك السلوك السيئ.
8.2.3. جملة الرفع
ومن الطرق الأخرى للتعامل مع الدوال الجزئية تحويلها إلى دوال كاملة (أي دوال معرّفة على مجالها كله). وهذه المقاربة أسهل على العميل بحسب الظاهر، لأن سلوك الدالة معرّف دائمًا؛ فليس لها شرط مسبق. لكنها تلقي عملًا على المنفّذ وقد تؤدي إلى تنفيذ أبطأ.
فكيف يمكننا تحويل sqr إلى دالة كاملة؟ من المقاربات المتبعة (أكثر مما ينبغي) تعريف قيمة ما تُعاد في الحالات التي كانت جملة المتطلبات ستستبعدها؛ مثلًا:
(** [sqr x] is the square root of [x] if [x >= 0],
    with relative accuracy no worse than 1.0e-6.
    Otherwise, a negative number is returned. *)
ولا يُوصى بهذه الممارسة لأنها تميل إلى تشجيع شيفرة عميلة معطوبة وصعبة القراءة. فمعظم العملاء الصحيحين لهذا التجريد سيكتبون شيفرة كهذه إذا تعذر إثبات صحة الشرط المسبق:
if sqr(a) < 0.0 then ... else ...
فالخطأ يجب التعامل معه مع ذلك في تعبير if، لذا فمهمة عميل هذا التجريد ليست أسهل من مهمته مع جملة متطلبات: فلا يزال العميل بحاجة إلى تغليف الاستدعاء باختبار صريح في الحالات التي قد يفشل فيها. وإذا أُغفل الاختبار، فلن يشتكي المصرّف، وستُعامَل النتيجة السالبة بصمت كما لو كانت جذرًا تربيعيًا صالحًا، مما يسبب على الأرجح أخطاء لاحقًا أثناء تنفيذ البرنامج. وقد كان نمط الكتابة هذا مصدرًا لأخطاء لا تُحصى ومشكلات أمنية في أنظمة تشغيل Unix وورثتها (مثل Linux).
والطريقة الأفضل لجعل الدوال كاملة هي أن ترفع استثناءً عندما لا يتحقق شرط المدخل المتوقع. فالاستثناءات تُغني عن الحاجة إلى منطق معالجة أخطاء مشتت في شيفرة العميل. وإذا أُريد للدالة أن تكون كاملة، فيجب أن تقول المواصفة ما الاستثناء الذي يُرفع ومتى. فمثلًا، يمكننا جعل دالة الجذر التربيعي كاملة كما يلي:
(** [sqr x] is the square root of [x], with relative accuracy no worse
    than 1.0e-6. Raises: [Negative] if [x < 0]. *)
لاحظ أن تنفيذ دالة sqr هذه يجب أن يتحقق مما إذا كان x >= 0، حتى في النسخة الإنتاجية من الشيفرة، لأن بعض العملاء قد يعتمدون على رفع الاستثناء.
8.2.4. جملة الأمثلة
قد يكون من المفيد تقديم مثال توضيحي كجزء من المواصفة. فمهما كانت المواصفة واضحة ومكتوبة جيدًا، فالمثال مفيد غالبًا للعملاء.
(** [find lst x] is the index of [x] in [lst], starting from zero.
    Example: [find ["b","a","c"] "a" = 1]. *)
8.2.5. لعبة المواصفة
عند تقييم المواصفات، قد يكون من المفيد تخيّل لعبة تُلعب بين شخصين: كاتب المواصفة (specifier) ومبرمج ماكر (devious programmer).
لنفترض أن كاتب المواصفة كتب المواصفة التالية:
(** Returns a list. *)
val reverse : 'a list -> 'a list
هذه المواصفة ناقصة بوضوح. فمثلًا، يمكن لمبرمج ماكر أن يفي بالمواصفة بتنفيذ يعطي المخرج التالي:
# reverse [1; 2; 3];;
- : int list = []
وعندما يدرك كاتب المواصفة ذلك، ينقّح المواصفة كما يلي:
(** [reverse lst] returns a list that is the same length as [lst]. *)
val reverse : 'a list -> 'a list
لكن المبرمج الماكر يكتشف أن المواصفة ما زالت تسمح بتنفيذات معطوبة:
# reverse [1; 2; 3];;
- : int list = [0; 0; 0]
وأخيرًا، يستقر كاتب المواصفة على مواصفة ثالثة:
(** [reverse lst] returns a list [m] satisfying the following conditions:
    - [length lst = length m],
    - for all [i], [nth m i = nth lst (n - i - 1)],
      where [n] is the length of [lst].
    For example, [reverse [1; 2; 3]] is [[3; 2; 1]], and [reverse []] is [[]]. *)
val reverse : 'a list -> 'a list
وبهذه المواصفة، يُضطر المبرمج الماكر إلى تقديم تنفيذ عامل ليفي بها، فيكون كاتب المواصفة قد نجح في كتابة مواصفته.
والغرض من لعب هذه اللعبة تحسين قدرتك على كتابة المواصفات. ومن الواضح أننا لا ندعوك إلى محاولة خرق مقصود المواصفة والإفلات من العقاب. فعند قراءة مواصفة شخص آخر، اقرأها بأكبر قدر من حسن الظن. لكن كن صارمًا في تحسين مواصفاتك أنت.
8.2.6. التعليقات
علاوة على كتابة مواصفات الدوال، يحتاج المبرمجون إلى تقديم تعليقات في جسم الدوال. بل إن المبرمجين عادةً لا يكتبون تعليقات كافية في شيفرتهم. (ولمثال كلاسيكي، ألقِ نظرة على التعليق الفعلي في السطر 561 من محرّك لعبة Quake 3 Arena.)
لكن هذا لا يعني أن إضافة مزيد من التعليقات أفضل دائمًا. فالتعليقات الخاطئة لن تزيد الشيفرة إلا غموضًا. وكوم التعليقات في الشيفرة بأكبر قدر ممكن يجعلها أسوأ عادةً! فالشيفرة والتعليقات معًا أدوات دقيقة للتواصل (مع الحاسوب ومع المبرمجين الآخرين) وينبغي استخدامها بحذر.
ومن المزعج بشكل خاص قراءة شيفرة تحتوي تعليقات كثيرة متناثرة (قيمتها موضع شك عادةً)، مثل:
let y = x + 1 (* make y one greater than x *)
وبالنسبة إلى الخوارزميات المعقدة، قد تكون بعض التعليقات ضرورية لشرح كيفية عمل الشيفرة المنفّذة للخوارزمية. وكثيرًا ما يميل المبرمجون إلى كتابة تعليقات عن الخوارزمية متناثرة في الشيفرة. لكن القارئ للشيفرة سيجد هذه التعليقات مربكة غالبًا لأنه لا يملك صورة عالية المستوى عن الخوارزمية. ومن الأفضل عادةً كتابة تعليق على شكل فقرة في بداية الدالة يشرح كيفية عمل تنفيذها. ويمكن بعد ذلك وسم مواضع محددة في الشيفرة تحتاج إلى الربط بتلك الفقرة بتعليقات قصيرة جدًا، مثل (* case 1 *).
ومن الأخطاء الشائعة أيضًا، وإن كانت حسنة النية، إعطاء المتغيرات أسماء طويلة ووصفية، كما في الشيفرة المسهبة التالية:
let number_of_zeros the_list =
  List.fold_left (fun (accumulator : int) (list_element : int) ->
    accumulator + (if list_element = 0 then 1 else 0)) 0 the_list
val number_of_zeros : int list -> int = <fun>
الشيفرة التي تستخدم أسماء طويلة كهذه مسهبة وصعبة القراءة. وبدلًا من محاولة تضمين وصف كامل للمتغير في اسمه، استخدم اسمًا قصيرًا وموحيًا (مثل zeros)، وأضف عند الحاجة تعليقًا عند إعلانه يشرح غرض المتغير.
let zeros lst =
  let is0 = function 0 -> 1 | _ -> 0 in
  List.fold_left (fun zs x -> zs + is0 x) 0 lst
val zeros : int list -> int = <fun>
ومن الممارسات السيئة المشابهة تضمين نوع المتغير في اسمه، مثل تسمية متغير i_count لبيان أنه عدد صحيح. فنظام الأنواع سيضمن ذلك لك، ويمكن لمحرّرك أن يعرض النوع عند المرور فوق المتغير. وإن أردت حقًا التأكيد على النوع في الشيفرة، فأضف تعليقًا نوعيًا عند الموضع الذي يدخل فيه المتغير في النطاق.
8.3. توثيق الوحدات
يمكن العثور على مواصفات الدوال التي توفرها وحدة ما في واجهتها، وهي ما سيرجع إليه العملاء. لكن ماذا عن التوثيق الداخلي، وهو المتعلق بمن ينفّذون الوحدة ويصونونها؟ الغرض من تعليقات التنفيذ هذه أن تشرح للقارئ كيف ينفّذ التنفيذ واجهته على نحو صحيح.
تذكير
من غير المناسب نسخ مواصفات الدوال الموجودة في واجهة الوحدة إلى تنفيذ الوحدة. فالنسخ ينطوي على خطر إدخال تناقض مع تطور البرنامج، لأن المبرمجين لا يبقون النسخ متزامنة. ونسخ الشيفرة والمواصفات مصدر رئيسي (إن لم يكن المصدر الرئيسي) لأخطاء البرامج. وفي كل الأحوال، يمكن للمنفّذين دائمًا الاطلاع على الواجهة لمعرفة المواصفة.
تنقسم تعليقات التنفيذ إلى فئتين. تنشأ الفئة الأولى لأن تنفيذ الوحدة قد يعرّف أنواعًا ودوالًا جديدة داخلية بحتة. وإذا لم يكن معناها جليًا، فينبغي توثيق هذه الأنواع والدوال بالأسلوب نفسه الذي اقترحناه لتوثيق الواجهات. وغالبًا ما يتبين، مع كتابة الشيفرة، أن الأنواع والدوال الجديدة المعرّفة في الوحدة تشكّل تجريد بيانات داخليًا أو على الأقل مجموعة وظائف يكون من المنطقي أن تكون وحدة قائمة بذاتها. وهذه إشارة إلى أنه قد يُنقل تجريد البيانات الداخلي إلى وحدة منفصلة ولا يُتعامل معه إلا عبر عملياته.
أما الفئة الثانية من تعليقات التنفيذ فتتعلق باستخدام تجريد البيانات (data abstraction). لنفترض أننا ننفّذ تجريدًا لمجموعة من عناصر من النوع 'a. وقد تبدو الواجهة كما يلي:
(** A set is an unordered collection in which multiplicity is ignored. *)
module type Set = sig
  (** ['a t] represents a set whose elements are of type ['a]. *)
  type 'a t
  (** [empty] is the set containing no elements. *)
  val empty : 'a t
  (** [mem x s] is whether [x] is a member of set [s]. *)
  val mem : 'a -> 'a t -> bool
  (** [add x s] is the set containing all the elements of [s]
      as well as [x]. *)
  val add : 'a -> 'a t -> 'a t
  (** [rem x s] is the set containing all the elements of [s],
      minus [x]. *)
  val rem : 'a -> 'a t -> 'a t
  (** [size s] is the cardinality of [s]. *)
  val size: 'a t -> int
  (** [union s1 s2] is the set containing all the elements that
      are in either [s1] or [s2]. *)
  val union: 'a t -> 'a t -> 'a t
  (** [inter s1 s2] is the set containing all the elements that
      are in both [s1] and [s2]. *)
  val inter: 'a t -> 'a t -> 'a t
end
module type Set =
  sig
    type 'a t
    val empty : 'a t
    val mem : 'a -> 'a t -> bool
    val add : 'a -> 'a t -> 'a t
    val rem : 'a -> 'a t -> 'a t
    val size : 'a t -> int
    val union : 'a t -> 'a t -> 'a t
    val inter : 'a t -> 'a t -> 'a t
  end
في توقيع حقيقي للمجموعات، سنريد أيضًا عمليات مثل map وfold، لكن سنغفلها الآن للتبسيط. وهناك طرق كثيرة لتنفيذ هذا التجريد.
وكما رأينا سابقًا، من الطرق السهلة تمثيلها كقائمة:
(** Implementation of sets as lists with duplicates. *)
module ListSet : Set = struct
  type 'a t = 'a list
  let empty = []
  let mem = List.mem
  let add = List.cons
  let rem x = List.filter (( <> ) x)
  let size lst = List.(lst |> sort_uniq Stdlib.compare |> length)
  let union lst1 lst2 = lst1 @ lst2
  let inter lst1 lst2 = List.filter (fun h -> mem h lst2) lst1
end
module ListSet : Set
يتميز هذا التنفيذ بالبساطة. وبالنسبة إلى المجموعات الصغيرة التي لا تميل إلى احتواء عناصر مكررة، سيكون خيارًا جيدًا. أما أداؤه فسيكون ضعيفًا للمجموعات الكبيرة أو التطبيقات ذات التكرار الكثير، لكن ذلك ليس مشكلة في بعض التطبيقات.
لاحظ أن أنواع الدوال لا يلزم كتابتها في التنفيذ. فهي غير مطلوبة لأنها موجودة بالفعل في التوقيع، تمامًا كما أن المواصفات الموجودة أيضًا في التوقيع لا يلزم تكرارها في البنية.
وإليك تنفيذًا آخر للوحدة Set يستخدم أيضًا 'a list لكنه يشترط ألا تحتوي القوائم عناصر مكررة. وهذا التنفيذ صحيح أيضًا (وبطيء أيضًا للمجموعات الكبيرة). ولاحظ أننا نستخدم نوع التمثيل نفسه، ومع ذلك تختلف بعض الجوانب المهمة في التنفيذ (add وsize وunion) اختلافًا كبيرًا.
(** Implementation of sets as lists without duplicates. *)
module UniqListSet : Set = struct
  type 'a t = 'a list
  let empty = []
  let mem = List.mem
  let add x lst = if mem x lst then lst else x :: lst
  let rem x = List.filter (( <> ) x)
  let size = List.length
  let union lst1 lst2 = lst1 @ lst2 |> List.sort_uniq Stdlib.compare
  let inter lst1 lst2 = List.filter (fun h -> mem h lst2) lst1
end
module UniqListSet : Set
كان أحد الأسباب المهمة لاستحداث كتابة مواصفات الدوال تمكين الاستدلال المحلي (local reasoning): فبمجرد أن تكون للدالة مواصفة، يمكننا الحكم على ما إذا كانت الدالة تفعل ما يفترض بها دون النظر إلى بقية البرنامج. ويمكننا أيضًا الحكم على عمل بقية البرنامج دون النظر إلى شيفرة الدالة. غير أننا لا نستطيع الاستدلال محليًا على الدوال الفردية في تنفيذات الوحدات الثلاثة المذكورة للتو. والمشكلة أننا لا نملك معلومات كافية عن العلاقة بين النوع الملموس (int list) والنوع المجرّد المقابل (set). ويمكن معالجة هذا النقص في المعلومات بإضافة نوعين جديدين من التعليقات إلى التنفيذ: دالة التجريد (abstraction function) وثابت التمثيل (representation invariant) لنوع البيانات المجرّد. وسننتقل إلى مناقشتهما بعد ذلك.
8.3.1. دوال التجريد
ينبغي ألا يستطيع عميل أي تنفيذ للوحدة Set تمييزه عن أي تنفيذ آخر بناءً على سلوكه الوظيفي. وبقدر ما يستطيع العميل معرفته، تعمل العمليات كعمليات على المثال الرياضي المثالي للمجموعة. ففي التنفيذ الأول، تكون القوائم [3; 1] و[1; 3] و[1; 1; 3] قابلة للتمييز عند المنفّذ، لكن ليس عند العميل. فالعميل يراها كلها تمثل المجموعة المجرّدة {1, 3} ولا يمكن تمييزها بأي من عمليات توقيع Set. ومن وجهة نظر العميل، يصف نوع البيانات المجرّد مجموعة من القيم المجرّدة والعمليات المرتبطة بها. ويعلم المنفّذ أن هذه القيم المجرّدة تمثلها قيم ملموسة قد تحتوي معلومات إضافية غير مرئية من منظور العميل. ويوصف هذا الفقدان للمعلومات بـ دالة التجريد، وهي تطبيق من فضاء القيم الملموسة إلى الفضاء المجرّد. وتبدو دالة التجريد لتنفيذ ListSet هكذا:
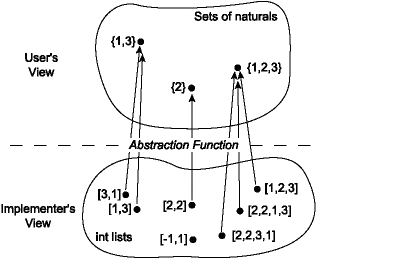
لاحظ أن عدة قيم ملموسة قد تُطبَّق على قيمة مجرّدة واحدة؛ أي أن دالة التجريد قد تكون متعددة إلى واحد (many-to-one). ومن الممكن أيضًا ألا تُطبَّق بعض القيم الملموسة على أي قيمة مجرّدة؛ فقد تكون دالة التجريد جزئية (partial). وهذا ليس حال ListSet، لكنه قد يكون حال تنفيذات أخرى.
ودالة التجريد مهمة للحكم على صحة التنفيذ، لذا فهي من التعليقات التي تنتمي إلى تنفيذ أي نوع بيانات مجرّد. فمثلًا، في وحدة ListSet، يمكننا توثيق دالة التجريد كما يلي:
module ListSet : Set = struct
  (** Abstraction function: The list [[a1; ...; an]] represents the
      set [{b1, ..., bm}], where [[b1; ...; bm]] is the same list as
      [[a1; ...; an]] but with any duplicates removed. The empty list
      [[]] represents the empty set [{}]. *)
  type 'a t = 'a list
  ...
end
يشير هذا التعليق صراحةً إلى أن القائمة قد تحتوي عناصر مكررة، وهو أمر مفيد لتعزيز الجملة الأولى. وبالمثل، ذُكرت حالة القائمة الفارغة صراحةً للوضوح، وإن كان بعضهم قد يعتبرها زائدة.
أما دالة التجريد للتنفيذ الثاني، الذي لا يسمح بالتكرار، فهي تومئ إلى فرق مهم. ويمكننا كتابة دالة التجريد لهذا التمثيل الثاني بصورة أبسط قليلًا لأننا نعلم أن العناصر متمايزة.
module UniqListSet : Set = struct
  (** Abstraction function: The list [[a1; ...; an]] represents the set
      [{a1, ..., an}]. The empty list [[]] represents the empty set [{}]. *)
  type 'a t = 'a list
  ...
end
8.3.2. تنفيذ دالة التجريد
ماذا يعني تنفيذ دالة التجريد الخاصة بـ ListSet؟ سنريد دالة تأخذ مدخلًا من النوع 'a ListSet.t. لكن ما ينبغي أن يكون نوع مخرجها؟ فالقيم المجرّدة مجموعات رياضية، لا أنواع OCaml. ولو افترضنا جدلًا أن لدينا نوعًا 'a set يمكن لدالة التجريد أن تعيده، لما كان لتطوير ListSet كبير معنى؛ إذ كنا سنستخدم ذلك النوع 'a set دون القيام بأي عمل من عندنا.
وفي المقابل، قد ننفّذ شيئًا قريبًا من دالة التجريد بتحويل مدخل من النوع 'a ListSet.t إلى نوع مدمج في OCaml أو نوع من المكتبة القياسية:
- يمكننا التحويل إلى
string. ويكون في ذلك ميزة سهولة القراءة البشرية في المستوى الأعلى أو في مخرجات التنقيح. ويستخدم مبرمجو JavatoString()لأغراض مشابهة. - يمكننا التحويل إلى
'a list. (وفي الواقع لا يبقى إلا تحويل قليل). وبالنسبة إلى تجميعات البيانات يعد ذلك خيارًا مريحًا، لأن القوائم يمكنها على الأقل أن تمثل تمثيلًا تقريبيًا بنى بيانات كثيرة: المكدسات والطوابير والقواميس والمجموعات والأكوام، وما إلى ذلك.
وتنفّذ الدوال التالية هاتين الفكرتين. لاحظ أن to_string يجب أن تأخذ وسيطًا إضافيًا string_of_val من العميل لتحويل 'a إلى string.
module ListSet : Set = struct
  ...
  let uniq lst = List.sort_uniq Stdlib.compare lst
  let to_string string_of_val lst =
    let interior =
      lst |> uniq |> List.map string_of_val |> String.concat ", "
    in
    "{" ^ interior ^ "}"
  let to_list = uniq
end
كما يمكن فهم تثبيت منسّق مخصص، كما نوقش في قسم التغليف، على أنه تنفيذ لدالة التجريد. لكنه في تلك الحالة لا يكون قابلًا للاستخدام إلا بواسطة البشر في المستوى الأعلى، لا بواسطة شيفرة أخرى برمجيًا.
8.3.3. المخططات التبديلية
باستخدام دالة التجريد، يمكننا الآن الحديث عما يعنيه أن يكون تنفيذ تجريد ما صحيحًا. فهو صحيح بالضبط عندما تكون كل عملية تجري في الفضاء الملموس ذات معنى عند تطبيق دالة التجريد عليها إلى الفضاء المجرّد. ويمكن تصوّر ذلك بـ مخطط تبديلي (commutative diagram):
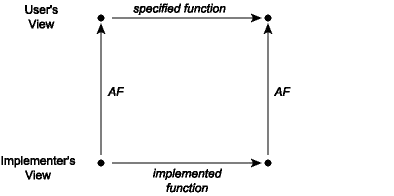
ويعني المخطط التبديلي أننا إذا سلكنا المسارين حول المخطط، وجب أن نصل إلى الموضع نفسه. لنفترض أننا نبدأ من قيمة ملموسة ونطبّق عليها التنفيذ الفعلي لبعض العمليات لنحصل على قيمة ملموسة جديدة أو قيم جديدة. فعند النظر إليها مجرّدةً، ينبغي أن تكون النتيجة الملموسة قيمة مجرّدة ممكنة ناتجة من تطبيق الدالة كما هي موصوفة في مواصفتها على الصورة المجرّدة للمدخلات الفعلية. فمثلًا، تأمل دالة union من تنفيذ المجموعات كقوائم بعناصر متكررة الذي تناولناه سابقًا. فعندما تُطبَّق هذه الدالة على الزوج الملموس [1; 3] و[2; 2]، يقابل ذلك الركن الأيسر السفلي من المخطط. ونتيجة هذه العملية هي القائمة [2; 2; 1; 3]، التي تقابلها القيمة المجرّدة {1, 2, 3}. ولاحظ أننا إذا طبّقنا دالة التجريد AF على قائمتي المدخلات [1; 3] و[2; 2]، حصلنا على المجموعتين {1, 3} و{2}. ويقتضي المخطط التبديلي في هذه الحالة أن يكون اتحاد {1, 3} و{2} هو {1, 2, 3}، وهذا صحيح بالطبع.
8.3.4. ثوابت التمثيل
تشرح دالة التجريد كيف تُرى المعلومات داخل الوحدة مجرّدةً من منظور عملاء الوحدة. لكن هذا ليس كل ما نحتاج معرفته لضمان صحة التنفيذ. تأمل دالة size في كل من التنفيذين. فبالنسبة إلى ListSet، الذي يسمح بالتكرار، نحتاج إلى التأكد من عدم عدّ العناصر المكررة مرتين:
let size lst = List.(lst |> sort_uniq Stdlib.compare |> length)
لكن بالنسبة إلى UniqListSet، الذي لا تحتوي قوائمه عناصر مكررة، فإن الحجم ليس إلا طول القائمة:
let size = List.length
فكيف نعلم أن التنفيذ الأخير صحيح؟ أي كيف نعلم أن «القوائم لا تحتوي عناصر مكررة»؟ إن اسم الوحدة يلمّح إلى ذلك، ويمكن استنتاجه من تنفيذ add، لكننا لم نوثقه توثيقًا دقيقًا قط. فالآن، لا تقول الشيفرة صراحةً إنه لا توجد عناصر مكررة.
في تمثيل UniqListSet، لا تمثل كل عناصر البيانات الملموسة عناصر بيانات مجرّدة. أي أن مجال دالة التجريد لا يشمل جميع القوائم الممكنة. فهناك بعض القوائم، مثل [1; 1; 2]، تحتوي عناصر مكررة ويجب ألا تظهر أبدًا في تمثيل مجموعة في تنفيذ UniqListSet؛ ودالة التجريد غير معرّفة على مثل هذه القوائم. ونحتاج إلى تضمين قطعة معلومات ثانية، هي ثابت التمثيل (representation invariant) (أو ثابت التمثيل، أو RI)، لتحديد عناصر البيانات الملموسة الصالحة لتمثيل عناصر البيانات المجرّدة. وبالنسبة إلى المجموعات الممثلة كقوائم بلا تكرار، نكتب ذلك كجزء من التعليق مع دالة التجريد:
module UniqListSet : Set = struct
  (** Abstraction function: the list [[a1; ...; an]] represents the set
      [{a1, ..., an}].  The empty list [[]] represents the empty set [{}].
      Representation invariant: the list contains no duplicates. *)
  type 'a t = 'a list
  ...
end
وإذا فكرنا في هذه المسألة من منظور المخطط التبديلي، نرى أن هناك خاصية جوهرية ضرورية لضمان الصحة: وهي أن تحافظ جميع العمليات الملموسة على ثابت التمثيل. فإذا خُرق هذا القيد، فلن تعيد دوال مثل size الجواب الصحيح. وتوضح هذه الصورة العلاقة بين ثابت التمثيل ودالة التجريد:
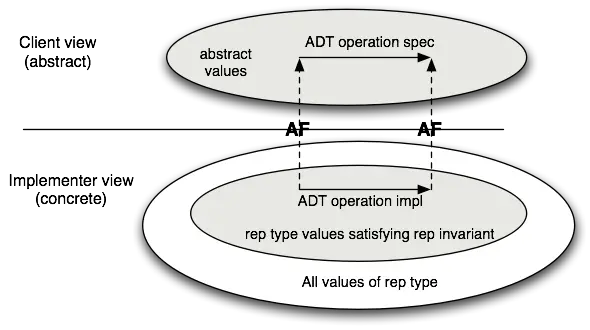
ويمكننا استخدام ثابت التمثيل ودالة التجريد للحكم على صحة تنفيذ عملية واحدة بمعزل عن بقية دوال الوحدة. وتكون الدالة صحيحة إذا كان هذان الشرطان:
- الشروط المسبقة للدالة تصح على قيم الوسائط.
- التمثيلات الملموسة للوسائط تحقق ثابت التمثيل.
يستلزمان هذين الشرطين:
- جميع قيم التمثيل الجديدة المنشأة تحقق ثابت التمثيل.
- المخطط التبديلي يصح.
ويجعل ثابت التمثيل كتابة شيفرة قابلة للإثبات أسهل، لأنه يعني أننا لا نضطر إلى كتابة شيفرة تعمل لجميع التمثيلات الملموسة الواردة الممكنة—بل فقط لتلك التي تحقق ثابت التمثيل. فمثلًا، في تنفيذ UniqListSet، لا يهمنا ما تفعله الشيفرة بالقوائم التي تحتوي عناصر مكررة. لكن يجب أن يهمنا ألا ننتج عند الإعادة إلا قيمًا تحقق ثابت التمثيل. وكما تشير الصورة أعلاه، إذا صح ثابت التمثيل على قيم المدخلات، فينبغي أن يصح على قيم المخرجات، ولهذا نسميه ثابتًا (invariant).
8.3.5. تنفيذ ثابت التمثيل
عند تنفيذ نوع بيانات مجرّد معقد، كثيرًا ما يكون من المفيد كتابة دالة داخلية يمكن استخدامها للتحقق من أن ثابت التمثيل يصح على عنصر بيانات معين. وسنسمي هذه الدالة، بحسب العرف، rep_ok. وإذا كانت الوحدة تقبل قيمًا من النوع المجرّد منشأة خارجها، مثلًا بكشف تنفيذ النوع في التوقيع، فينبغي تطبيق rep_ok عليها لضمان تحقق ثابت التمثيل. وعلاوة على ذلك، إذا أنشأ التنفيذ أي قيم جديدة من النوع المجرّد، فيمكن تطبيق rep_ok عليها كفحص سلامة. وبهذه المقاربة تُلتقط الأخطاء مبكرًا، ويقل احتمال أن يوهم خطأ في دالة ما بوجود خطأ في دالة أخرى.
وطريقة مريحة لكتابة rep_ok هي جعلها دالة هوية تعيد قيمة المدخل فحسب إذا صح ثابت التمثيل، وترفع استثناءً إذا فشل.
(* Checks whether x satisfies the representation invariant. *)
let rep_ok x =
  if (* check the RI holds of x *) then x else failwith "RI violated"
وإليك تنفيذًا للوحدة Set يستخدم تمثيل البيانات نفسه الذي لـ UniqListSet، لكنه يتضمن فحوص rep_ok كثيرة. لاحظ أن rep_ok تُطبَّق على جميع المجموعات المدخلة وعلى أي مجموعة تُنشأ. وهذا يضمن أنه إذا أُنشئ تمثيل مجموعة سيئ، فسيُكتشف فورًا. وفي حال فوّتنا فحصًا عند الإنشاء، نطبّق rep_ok أيضًا على وسائط المجموعات الواردة. وإذا وُجد خطأ، فستساعدنا هذه الفحوص على تحديد موضع خرق ثابت التمثيل بسرعة.
(** Implementation of sets as lists without duplicates. *)
module UniqListSet : Set = struct
  (** Abstraction function: The list [[a1; ...; an]] represents the
      set [{a1, ..., an}]. The empty list [[]] represents the empty set [{}].
      Representation invariant: the list contains no duplicates. *)
  type 'a t = 'a list
  let rep_ok lst =
    let u = List.sort_uniq Stdlib.compare lst in
    match List.compare_lengths lst u with 0 -> lst | _ -> failwith "RI"
  let empty = []
  let mem x lst = List.mem x (rep_ok lst)
  let add x lst = rep_ok (if mem x (rep_ok lst) then lst else x :: lst)
  let rem x lst = rep_ok (List.filter (( <> ) x) (rep_ok lst))
  let size lst = List.length (rep_ok lst)
  let union lst1 lst2 =
    rep_ok
      (List.fold_left
         (fun u x -> if mem x lst2 then u else x :: u)
         (rep_ok lst2) (rep_ok lst1))
  let inter lst1 lst2 = rep_ok (List.filter (fun h -> mem h lst2) (rep_ok lst1))
end
module UniqListSet : Set
قد يكون استدعاء rep_ok على كل وسيطة مكلفًا أكثر مما ينبغي للنسخة الإنتاجية من البرنامج. فـ rep_ok أعلاه، مثلًا، يتطلب زمنًا بترتيب n log n، وهو ما يدمّر كفاءة جميع العمليات التي كانت سابقًا ثابتة الزمن أو خطية الزمن. وبالنسبة إلى شيفرة الإنتاج، قد يكون من الأنسب استخدام نسخة من rep_ok تتحقق فقط من الأجزاء الرخيصة الفحص من ثابت التمثيل. وعندما تكون هناك حاجة إلى ألا تكون هناك كلفة وقت تشغيل، يمكن تغيير rep_ok إلى دالة هوية (أو ماكرو) بحيث يحسّن المصرّف الاستدعاءات إليها فيزيلها. لكن من الجيد الاحتفاظ بالشيفرة الكاملة لـ rep_ok حتى يمكن إعادتها بسهولة في التنقيح المستقبلي:
let rep_ok lst = lst
let rep_ok_expensive =
  let u = List.sort_uniq Stdlib.compare lst in
  match List.compare_lengths lst u with 0 -> lst | _ -> failwith "RI"
وتوفر بعض اللغات دعمًا للتصريف الشرطي (conditional compilation)، وهو نوع من الدعم لتصريف أجزاء من قاعدة الشيفرة دون غيرها. ويدعم مصرّف OCaml علمًا باسم noassert يعطّل فحص التأكيدات. لذا يمكنك تنفيذ فحص ثابت التمثيل بـ assert، وتعطيله بـ noassert. والمشكلة في ذلك أن بعض أجزاء قاعدة شيفرتك قد تحتاج إلى تشغيل فحص التأكيدات لتعمل بصورة صحيحة.
8.4. الاختبار والتنقيح
البرامج الصحيحة تسلك السلوك الذي نقصده. والتحقق من الصلاحية (validation) هو عملية بناء ثقتنا في سلوك البرنامج الصحيح.
8.4.1. التحقق من الصلاحية
هناك طرق كثيرة لزيادة تلك الثقة. والطرق الاجتماعية والطرق الصورية والاختبار ثلاث منها. والأخير هو محور اهتمامنا الرئيسي، لكن لننظر أولًا في الطريقتين الأخريين.
الطرق الاجتماعية تتضمن تطوير البرامج مع آخرين، والاعتماد على مساعدتهم لتحسين الصحة. ومن التقنيات الجيدة ما يلي:
- الاستعراض البرمجي (Code walkthrough). في مقاربة الاستعراض، يعرض المبرمج التوثيق والشيفرة على فريق مراجعة، ويقدم الفريق تعليقاته. وهذه عملية غير رسمية. والتركيز فيها على الشيفرة لا على كاتبها، لذا يسهل تفادي جرح المشاعر. غير أن الفريق قد لا يحصل على قدر كبير من الطمأنينة إلى صحة الشيفرة.
- فحص الشيفرة (Code inspection). هنا يقود فريق المراجعة عملية مراجعة الشيفرة. ومن المفيد أن يكون للفريق بعض التحضير المسبق، وإن لم يكن كثيرًا بالضرورة. ويحدد الفريق أهداف عملية المراجعة ويتفاعل مع كاتب الشيفرة أو الكتّاب لفهم مواضع مشكلات الجودة المحتملة. ومرة أخرى، من المهم جعل العملية خالية من اللوم قدر الإمكان.
- البرمجة الثنائية (Pair programming). أكثر مقاربات مراجعة الشيفرة عدمية الرسمية هي البرمجة الثنائية، حيث يطوّر الشيفرة مهندسان: القائد الذي يكتب الشيفرة، والمراقب الذي يشاهد. ودور المراقب أن يكون ناقدًا، يفكر في الأخطاء المحتملة، ويساعد في التنقل بين قضايا التصميم الأكبر. ومن الأفضل عادةً أن يكون المراقب المهندس الأكثر خبرة بمهمة البرمجة المطروحة. ويراجع المراقب الشيفرة، ليكون محامي الشيطان الذي يجب على القائد إقناعه. وعندما يطوّر الثنائي المواصفات، يفكر المراقب في كيفية جعل المواصفات أوضح أو أقصر. وللبرمجة الثنائية فوائد أخرى. فالعمل مع شريك أكثر متعة وتعليمًا في الغالب، ويساعد على تركيز الشريكين معًا على المهمة. وإذا كنت بدأت للتو العمل مع مبرمج آخر، فالبرمجة الثنائية طريقة جيدة لفهم طريقة تفكير شريكك وتأسيس مفردات مشتركة. ومن الجيد أن يتبادل الشريكان الأدوار أيضًا.
وقد تكون هذه التقنيات الاجتماعية لـ مراجعة الشيفرة فعالة بشكل ملحوظ. فقد وجدت دراسة أجريت في IBM (Jones, 1991) أن فحص الشيفرة اكتشف 65% من أخطاء البرمجة المعروفة و25% من أخطاء التوثيق المعروفة، بينما لم يكتشف الاختبار إلا 20% من أخطاء البرمجة ولا شيء من أخطاء التوثيق. وقد تكون عملية فحص الشيفرة أكثر فعالية من الاستعراضات. ووجدت دراسة (Fagan, 1976) أن فحوص الشيفرة أدت إلى شيفرة أقل حالات فشل بنسبة 38% مقارنة بالاستعراضات.
غير أن مراجعة الشيفرة الشاملة قد تكون مكلفة. فقد وجد Jones أن التحضير لفحص الشيفرة استغرق ساعة لكل 150 سطرًا من الشيفرة، وأن الفحص الفعلي غطى 75 سطرًا من الشيفرة في الساعة. ووجود ما يصل إلى ثلاثة أشخاص في فريق الفحص يحسّن جودة الفحص؛ أما أكثر من ذلك فلا يبدو أن مزيدًا من الفاحصين يفيد. ولم يبدُ أن قضاء وقت طويل في التحضير للفحص مفيد أيضًا. ولعل السبب في ذلك أن قدرًا كبيرًا من قيمة الفحص يكمن في التفاعل مع كاتبي الشيفرة.
الطرق الصورية تستخدم قوة الرياضيات والمنطق للتحقق من صلاحية سلوك البرنامج. ويستخدم الإثبات الصوري (verification) شيفرة البرنامج ومواصفاته لبناء برهان على أن البرنامج يسلك سلوكًا صحيحًا على جميع المدخلات الممكنة. وتوجد أدوات بحثية للمساعدة في الإثبات الصوري للبرامج، تقوم غالبًا على مبرهنات آلية، كما توجد لغات بحثية مصممة للإثبات الصوري. ويميل الإثبات الصوري إلى أن يكون مكلفًا وأن يتطلب تفكيرًا دقيقًا وفهمًا عميقًا للشيفرة المراد إثباتها. لذا فهو عمليًا يُميَّل إلى تطبيقه على الشيفرة المهمة والقيرة نسبيًا. والإثبات الصوري ذو قيمة خاصة في الأنظمة الحرجة التي يكون فيها الاختبار أقل فعالية. ولأن تنفيذ البرامج المتزامنة غير حتمي، يصعب اختبارها، وأحيانًا لا يمكن العثور على أخطاء خفية إلا بمحاولة إثبات الشيفرة صوريًا. بل إن أدوات المساعدة على إثبات صحة البرامج صارت تزداد فعالية، وقد أُثبتت بعض الأنظمة الكبيرة إثباتًا كاملًا، منها المصرّفات والمعالجات ومحاكيات المعالجات وأجزاء أساسية من أنظمة التشغيل.
أما الاختبار فيتضمن التنفيذ الفعلي للبرنامج على مدخلات عيّنة لمعرفة ما إذا كان السلوك كما هو متوقع. وبمقارنة النتائج الفعلية للبرنامج بالنتائج المتوقعة، نعرف ما إذا كان البرنامج يعمل فعلًا على المدخلات المعينة التي نجربه عليها. ولا يمكن للاختبار أن يوفر الضمانات المطلقة التي توفرها الطرق الصورية، لكنه أسهل وأرخص بكثير. وهو أيضًا منهجية التحقق من الصلاحية التي تعرفها على الأرجح أكثر من غيرها. فالاختبار طريقة جيدة وفعالة الكلفة لبناء الثقة في سلوك البرنامج الصحيح.
8.4.2. التنقيح
عندما يكشف الاختبار عن خطأ، نقول عادةً إن البرنامج «مصاب بعُقدة/خطأ». لكن كلمة «خطأ» توحي بشيء تسلّل إلى البرنامج. والتسمية الأفضل أن هناك
- عيوبًا (faults)، وهي نتاج أخطاء بشرية في أنظمة البرمجيات، و
- إخفاقات (failures)، وهي خروق للمتطلبات.
وقد لا تظهر بعض العيوب أبدًا لمستخدم النظام النهائي، أما الإخفاقات فهي تلك العيوب التي تظهر. وقد ينشأ العيب لأن التنفيذ لا يطابق التصميم، أو لأن التصميم لا يطابق المتطلبات.
التنقيح (Debugging) هو عملية اكتشاف العيوب وإصلاحها. والاختبار بوضوح هو جزء «الاكتشاف»، لكن الإصلاح قد يكون أعقد. بل قد تكون مهمة التنقيح مستهلكة للوقت أكثر من التنفيذ الأصلي نفسه! لذا يحسن بك أن تجعل تنقيح برامجك سهلًا منذ البداية. اكتب مواصفات جيدة لكل دالة. ووثّق دالة التجريد وثابت التمثيل لكل تجريد بيانات. وأبقِ الوحدات صغيرة، واختبرها بصورة مستقلة.
لكنك ستكتشف عيوبًا في برامجك حتمًا. وعندما تفعل، تعامل معها كعالِم مستخدمًا المنهج العلمي:
- قيّم البيانات المتاحة؛
- صُغ فرضية قد تفسر البيانات؛
- صمّم تجربة قابلة للتكرار لاختبار تلك الفرضية؛ و
- استخدم نتيجة تلك التجربة لتنقيح فرضيتك أو دحضها.
وغالبًا ما يكون محور هذه العملية إيجاد أبسط وأصغر مدخل يُثير العيب. وذلك ليس عادةً المدخل الأصلي الذي اكتشفنا فيه العيب. لذا قد يلزم بعض التجريب الأولي لإيجاد حالة اختبار دنيا (minimal test case).
ولا تخشَ أبدًا كتابة شيفرة إضافية، بل شيفرة إضافية كثيرة، لمساعدتك في العثور على العيوب. فدوال مثل to_string أو format قد تكون عظيمة القيمة في فهم الحسابات، لذا فكتابتها مسبقًا قبل اكتشاف أي عيوب أمر يستحق العناء تمامًا.
وعندما تكتشف مصدر العيب فعلًا، توخَّ حذرًا خاصًا في إصلاحه. فمن المُغري أن تلصق إصلاحًا سريعًا في الشيفرة وتمضي. وهذا خطير جدًا. ففي كثير من الأحيان لا يؤدي إصلاح العيب إلا إلى إدخال عيب جديد (ومجهول)! وإذا صعب العثور على خطأ، فغالبًا لأن منطق البرنامج معقد وصعب الاستدلال. فكّر بعناية في سبب إدخال العيب من الأساس، وفي كيفية منع عيوب مشابهة في المستقبل.
8.5. اختبار الصندوق الأسود والصندوق الزجاجي
نريد أن نعلم أن برنامجًا ما يعمل على جميع المدخلات الممكنة. والمشكلة في الاختبار أنه يتعذر عادةً تجربة جميع المدخلات الممكنة. فمثلًا، لنفترض أننا ننفّذ وحدة توفر نوع بيانات مجرّدًا للأعداد الكسرية. وقد تكون إحدى عملياتها دالة جمع plus، مثل:
module type RATIONAL = sig
  (** A [t] is a rational. *)
  type t
  (** [create p q] is the rational number [p/q].
      Raises: [Invalid_argument "0"] if [q] is 0. *)
  val create : int -> int -> t
  (** [plus r1 r2] is [r1 + r2]. *)
  val plus : t -> t -> t
end
module Rational : RATIONAL = struct
  (** AF: [(p, q)] represents the rational number [p/q].
      RI: [q] is not 0. *)
  type t = int * int
  let create p q =
    if q = 0 then invalid_arg "0" else (p, q)
  let plus (p1, q1) (p2, q2) =
    (p1 * q2 + p2 * q1, q1 * q2)
end
module type RATIONAL =
  sig type t val create : int -> int -> t val plus : t -> t -> t end
module Rational : RATIONAL
ماذا يتطلب اختبار هذه الدالة الواحدة اختبارًا شاملًا؟ سنريد تجربة جميع الأعداد الكسرية الممكنة في الوسيطين r1 وr2 معًا. والعدد الكسري يتكوّن من عددين صحيحين، ويوجد عددًا صحيحًا في تنفيذ حديث لـ OCaml. لذا توجد تقريبًا مدخلًا ممكنًا للدالة plus. وحتى لو اختبرنا عملية جمع واحدة كل نانو ثانية، فسيستغرق اختبار هذه الدالة الواحدة نحو سنة حتى يكتمل.
من الواضح أننا لا نستطيع اختبار البرمجيات اختبارًا شاملًا. لكن ذلك لا يعني أن نتخلى عن الاختبار. إنه يعني فقط أننا نحتاج إلى التفكير بعناية في حالات الاختبار التي ينبغي أن نختارها بحيث تكون فعالة قدر الإمكان في إقناعنا بأن الشيفرة تعمل.
تأمل دالة create أعلاه. فهي تأخذ عددين صحيحين p وq كوسيطين. فكيف نختار عددًا صغيرًا نسبيًا من حالات الاختبار التي ستقنعنا بأن الدالة تعمل بصورة صحيحة على جميع المدخلات الممكنة؟ يمكننا تصوّر فضاء جميع المدخلات الممكنة كمربع كبير:
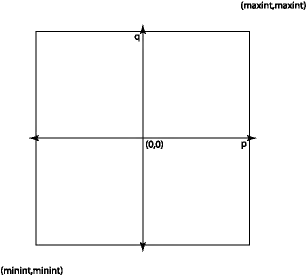
يوجد في هذا المربع نحو نقطة، لذا لا يمكننا تحمّل كلفة اختبارها كلها. واختبارها كلها سيكون في معظمه مضيعة للوقت—فمعظم المدخلات الممكنة لا يقدم شيئًا جديدًا. نحتاج إلى طريقة لإيجاد مجموعة نقاط في هذا الفضاء تستحق الاختبار وستعطي تصورًا جيدًا عن سلوك البرنامج في الفضاء كله.
يتألف فضاء المدخلات عمومًا من عدد من المجموعات الجزئية التي يكون سلوك الشيفرة فيها متشابهًا بصورة جوهرية في المجموعة الجزئية كلها. ولا نحصل على أي معلومات إضافية باختبار أكثر من مدخل واحد من كل مجموعة كهذه.
وإذا اختبرنا جميع المناطق المثيرة للاهتمام في فضاء المدخلات، نكون قد حققنا تغطية (coverage) جيدة. ونريد اختبارات تغطي، بمعنى مفيد ما، فضاء مدخلات البرنامج الممكنة.
ومن الطرق الجيدة لتحقيق التغطية اختبار الصندوق الأسود (black-box testing) واختبار الصندوق الزجاجي (glass-box testing). وسنناقشهما بعد ذلك.
8.5.1. اختبار الصندوق الأسود
عند اختيار حالات الاختبار لتحقيق تغطية جيدة، قد نريد النظر في كل من المواصفة والتنفيذ للبرنامج أو الوحدة المراد اختبارها. ويتبين أننا نستطيع غالبًا اختيار حالات اختبار جيدة جدًا بالنظر إلى المواصفة وحدها وإغفال التنفيذ. ويُعرف ذلك بـ اختبار الصندوق الأسود. والفكرة أننا نعتبر الشيفرة صندوقًا أسود لا نرى منه إلا سطحه: مواصفته. ونختار حالات الاختبار بالنظر إلى الطريقة التي تُدخل بها المواصفة ضمنًا حدودًا تقسم فضاء المدخلات الممكنة إلى مناطق مختلفة.
وعند كتابة حالات اختبار الصندوق الأسود، نسأل أنفسنا أي مجموعة من حالات الاختبار ستُنتج سلوكًا مميزًا كما تتوقعه المواصفة. ومن المهم تجربة كل من المدخلات النمطية والمدخلات التي تكون حالات حدّية (boundary cases) أو حالات ركنية أو حالات طرفية. ومن الأخطاء الشائعة اختبار المدخلات النمطية فقط، فتكون النتيجة أن البرنامج يعمل عادةً لكنه يفشل في المواقف الأقل شيوعًا. ومن المهم أيضًا تحديد الطرق التي تُنشئ بها المواصفة أصنافًا من المدخلات ينبغي أن تستدعي سلوكًا مشابهًا من الدالة، واختبار تلك المسارات عبر المواصفة (paths through the specification). وإليك بعض الأمثلة.
المثال 1.
إليك بعض الأفكار لاختبار دالة create:
- بالنظر إلى المربع أعلاه، نرى أن له حدودًا عند
min_intوmax_int. ونريد أن نحاول إنشاء أعداد كسرية عند أركان المربع وعلى جوانبه، مثلcreate min_int min_intوcreate max_int 2، وما إلى ذلك. - الخط
p=0مهم لأنp/qيساوي صفرًا على امتداده كله. وينبغي أن نجرّب(0, q)لقيم مختلفة منq. - ينبغي أن نجرّب بعض الأزواج النمطية
(p, q)في الأرباع الأربعة كلها من الفضاء. - ينبغي أن نجرّب كلا نوعي الأزواج
(p, q): تلك التي يقسم فيهاqعلىpقسمة تامة، وتلك التي لا يقسم فيهاqعلىp. - وقد تكون أزواج من الشكل
(1, q)و(-1, q)و(p, 1)و(p, -1)لقيم مختلفة منpوqمثيرة للاهتمام أيضًا بالنظر إلى خواص الأعداد الكسرية.
وتقول المواصفة أيضًا إن الشيفرة ستتحقق من أن q ليس صفرًا. وينبغي أن نبني بعض حالات الاختبار لضمان إجراء هذا التحقق كما هو معلن. وتجربة (1, 0) و(max_int, 0) و(min_int, 0) و(-1, 0) و(0, 0) للتأكد من أنها كلها ترفع الاستثناء المحدد ستكون على الأرجح مجموعة كافية من اختبارات الصندوق الأسود.
المثال 2.
تأمل الدالة list_max:
(** Return the maximum element in the list. *)
val list_max: int list -> int
ما مجموعة حالات اختبار الصندوق الأسود الجيدة؟ فضاء المدخلات هنا هو مجموعة جميع القوائم الممكنة من الأعداد الصحيحة. ونحتاج إلى تجربة بعض المدخلات النمطية والنظر أيضًا في الحالات الحدّية. وبناءً على هذه المواصفة، تشمل الحالات الحدّية ما يلي:
- قائمة تحتوي عنصرًا واحدًا. بل إن القائمة الفارغة هي على الأرجح أول حالة حدّية تخطر ببالنا. وبالنظر إلى المواصفة أعلاه، ندرك أنها لا تحدد ما يحدث في حالة القائمة الفارغة. وهكذا فإن التفكير في الحالات الحدّية مفيد أيضًا في تحديد أخطاء المواصفة.
- قائمة تحتوي عنصرين.
- قائمة يكون فيها العنصر الأقصى هو الأول. أو الأخير. أو في موضع ما وسط القائمة.
- قائمة تكون جميع عناصرها متساوية.
- قائمة تكون عناصرها مرتبة تصاعديًا، وأخرى تكون مرتبة تنازليًا.
- قائمة يكون عنصرها الأقصى
max_int، وقائمة يكون عنصرها الأقصىmin_int.
المثال 3.
تأمل الدالة sqrt:
(** [sqrt x n] is the square root of [x] computed to an accuracy of [n]
    significant digits.
    Requires: [x >= 0] and [n >= 1]. *)
val sqrt : float -> int -> float
يحدد الشرط المسبق احتمالين لـ x (إما أن يكون 0 أو أكبر) واحتمالين لـ n (إما أن يكون 1 أو أكبر). ويؤدي ذلك إلى أربعة «مسارات عبر المواصفة»، أي حالات تمثيلية وحدّية لتحقيق الشرط المسبق، ينبغي اختبارها:
xيساوي 0 وnيساوي 1xأكبر من 0 وnيساوي 1xيساوي 0 وnأكبر من 1xأكبر من 0 وnأكبر من 1.
8.5.2. اختبار الصندوق الأسود لتجريدات البيانات
حتى الآن كنا نفكر في اختبار دالة واحدة في كل مرة. لكن تجريدات البيانات تحتوي عادةً عمليات كثيرة، ونحتاج إلى اختبار كيفية تفاعل تلك العمليات بعضها مع بعض. ومن المفيد التمييز بين المستهلكات (consumers) والمنتجات (producers) في تجريد البيانات:
- المستهلك عملية تأخذ قيمة من تجريد البيانات كمدخل.
- المنتج عملية تعيد قيمة من تجريد البيانات كمخرج.
فمثلًا، تأمل تجريد المجموعة هذا:
module type Set = sig
  (** ['a t] is the type of a set whose elements have type ['a]. *)
  type 'a t
  (** [empty] is the empty set. *)
  val empty : 'a t
  (** [size s] is the number of elements in [s]. *
      [size empty] is [0]. *)
  val size : 'a t -> int
  (** [add x s] is a set containing all the elements of
      [s] as well as element [x]. *)
  val add : 'a -> 'a t -> 'a t
  (** [mem x s] is [true] iff [x] is an element of [s]. *)
  val mem : 'a -> 'a t -> bool
end
module type Set =
  sig
    type 'a t
    val empty : 'a t
    val size : 'a t -> int
    val add : 'a -> 'a t -> 'a t
    val mem : 'a -> 'a t -> bool
  end
الدالتان empty وadd منتجتان؛ والدوال size وadd وmem مستهلكات.
وعند اختبار تجريد بيانات اختبار صندوق أسود، ينبغي أن نختبر كيف يتعامل كل مستهلك لتجريد البيانات مع كل مسار عبر كل منتج من منتجاته. وفي مثال Set، يعني ذلك اختبار ما يلي:
- كيف تتعامل
sizeمع المجموعةempty؛ - كيف تتعامل
sizeمع مجموعة أنتجتهاadd، في كل من حالتي تركaddللمجموعة دون تغيير وزيادتها للمجموعة؛ - كيف تتعامل
addمع المجموعات التي أنتجتهاemptyوكذلكaddنفسها؛ - كيف تتعامل
memمع المجموعات التي أنتجتهاemptyوكذلكadd، بما في ذلك المسارات التي تُستدعى فيهاmemعلى عناصر أُضيفت وعلى عناصر لم تُضف.
8.5.3. اختبار الصندوق الزجاجي
اختبار الصندوق الأسود نقطة بداية جيدة عند كتابة حالات الاختبار، لكنه لا يكفي في النهاية. وبوجه خاص، لا يمكن تحديد مقدار التغطية التي تحققها مجموعة اختبارات الصندوق الأسود فعلًا—إذ نحتاج في الحقيقة إلى معرفة الشيفرة المصدرية للتنفيذ. ويُعرف الاختبار القائم على تلك الشيفرة بـ اختبار الصندوق الزجاجي أو الصندوق الأبيض. ويمكن لاختبار الصندوق الزجاجي أن يتفوق على الصندوق الأسود باختبار مسارات التنفيذ (execution paths) عبر شيفرة التنفيذ: أي سلسلة التعبيرات التي تُقيَّم تقييمًا شرطيًا بناءً على تعبيرات if وتعبيرات match وتطبيقات الدوال. ويُقال إن حالات الاختبار التي تمارس جميع المسارات مجتمعةً كاملة المسارات (path-complete). وتقتضي كمال المسارات في الحد الأدنى أن توجد لكل سطر شيفرة، بل لكل تعبير في البرنامج، حالة اختبار تجعله يُنفَّذ. وأي شيفرة لم تُنفَّذ قد تحتوي خطأً إذا لم تُختبر قط.
ولتحقيق كمال المسارات الحقيقي، يجب أن ننظر في جميع مسارات التنفيذ الممكنة من بداية كل دالة إلى نهايتها، وأن نحاول ممارسة كل مسار متمايز. وهذا متعذر عمومًا، لأن المسارات كثيرة جدًا. ومن المقاربات الجيدة التفكير في مجموعة المسارات كأنها الفضاء الذي نحاول استكشافه، وتحديد الحالات الحدّية ضمن هذا الفضاء التي تستحق الاختبار.
فمثلًا، تأمل التنفيذ التالي لدالة تجد الأقصى بين وسائطها الثلاثة:
let max3 x y z =
  if x > y then
    if x > z then x else z
  else
    if y > z then y else z
val max3 : 'a -> 'a -> 'a -> 'a = <fun>
قد يقودنا اختبار الصندوق الأسود إلى اختراع اختبارات كثيرة، لكن النظر إلى التنفيذ يكشف أن هناك أربعة مسارات فقط عبر الشيفرة—المسارات التي تعيد x أو z أو y أو z (مرة أخرى). ويمكننا اختبار كل من تلك المسارات بمدخلات تمثيلية مثل: max3 3 2 1 وmax3 3 2 4 وmax3 1 2 1 وmax3 1 2 3.
وعند إجراء اختبار الصندوق الزجاجي، ينبغي أن نضمّن حالات اختبار لكل فرع من فروع كل تعبير if (متضمَّن)، ولكل فرع من فروع كل مطابقة أنماط (متضمَّنة). وإذا وُجدت دوال تعاودية، ينبغي أن نضمّن حالات اختبار للحالات الأساسية وكذلك لكل استدعاء تعاودي. كما ينبغي أن نضمّن حالات اختبار لإثارة كل موضع قد يُرفع فيه استثناء.
وبالطبع، لا يضمن الاختبار كامل المسارات غياب الأخطاء. فلا نزال بحاجة إلى الاختبار مقابل المواصفة، أي إجراء اختبار الصندوق الأسود. فمثلًا، إليك تنفيذًا معطوبًا لـ max3:
let max3 x y z = x
فالاختبار max3 2 1 1 كامل المسارات، لكنه لا يكشف الخطأ.
8.5.4. اختبار الصندوق الزجاجي لتجريدات البيانات
انظر إلى دالة التجريد وثابت التمثيل بحثًا عن تلميحات عن الحدود التي قد توجد في فضاء القيم التي تتعامل معها تجريدات البيانات. وثابت التمثيل أداة فعالة بوجه خاص لبناء حالات اختبار مفيدة. وبالنظر إلى ثابت التمثيل لتجريد البيانات Rational أعلاه، نرى أنه يشترط أن يكون q غير صفري. لذا ينبغي أن نبني حالات اختبار لنرى إن كان من الممكن إحداث خرق لذلك الثابت.
8.5.5. الصندوق الأسود مقابل الصندوق الزجاجي
لاختبار الصندوق الأسود مزايا مهمة:
- لا يشترط أن نرى الشيفرة التي نختبرها. فأحيانًا لا تكون الشيفرة متاحة في صورة مصدرية، ومع ذلك نستطيع بناء حالات اختبار مفيدة دونها. ولا يحتاج كاتب حالات الاختبار إلى فهم التنفيذ.
- لا تعتمد حالات الاختبار على التنفيذ. فيمكن كتابتها بالتوازي مع التنفيذ أو قبله. وعلاوة على ذلك، لا تحتاج حالات اختبار الصندوق الأسود الجيدة إلى التغيير، حتى لو أُعيد كتابة التنفيذ بالكامل.
- يؤدي بناء حالات اختبار الصندوق الأسود إلى أن يفكر المبرمج بعناية في المواصفة وتداعياتها. وتُكتشف أخطاء مواصفات كثيرة بهذه الطريقة.
وعيب اختبار الصندوق الأسود أن تغطيته قد لا تكون عالية كما نريد، لأنه مضطر إلى العمل دون التنفيذ.
8.5.6. أداة Bisect
يمكن الاستعانة في اختبار الصندوق الزجاجي بـ أدوات تغطية الشيفرة (code-coverage tools) التي تقيّم مقدار الشيفرة التي مارستها مجموعة اختبارات. وتستطيع أداة bisect_ppx لـ OCaml أن تخبرك أي التعبيرات في برنامجك اختُبرت وأيها لم يُختبر. وإليك كيف تعمل:
- تصرّف شيفرتك باستخدام Bisect_ppx (وسنقول Bisect للاختصار من الآن فصاعدًا) كجزء من عملية التصريف. فهي تجهّز (instruments) شيفرتك، أساسًا بإدراج تعبيرات إضافية تُقيَّم.
- تنفّذ شيفرتك. ويجعل التجهيز الذي أدرجته Bisect برنامجك يفعل شيئًا إضافيًا علاوة على أي وظيفة برمجتها بنفسك: سيسجّل البرنامج الآن أي التعبيرات من الشيفرة المصدرية تُنفَّذ فعلًا في وقت التشغيل وأيها لا يُنفَّذ. كما سينتج البرنامج الآن ملف مخرجات يحتوي تلك المعلومات.
- تشغّل أداة تُسمى
bisect-ppx-reportعلى ملف المخرجات ذلك. فتُنتج HTML يبين لك أي أجزاء شيفرتك نُفِّذت وأيها لم يُنفَّذ.
فكيف يساعد ذلك في حساب تغطية مجموعة اختبارات؟ إذا شغّلت مجموعة اختبارات OUnit، فستؤدي حالات الاختبار فيها إلى تنفيذ الشيفرة في الدوال التي تختبرها. وإذا لم تكن لديك حالات اختبار كافية، فلن تُنفَّذ بعض الشيفرة في دوالك أبدًا. وسيوضح لك التقرير الذي تنتجه Bisect ما تلك الشيفرة بالضبط. ويمكنك بعد ذلك تصميم حالات اختبار صندوق زجاجي جديدة لتنفيذ تلك الشيفرة، وإضافتها إلى مجموعة OUnit، وإنشاء تقرير Bisect جديد لتأكيد أن الشيفرة نُفِّذت فعلًا.
درس تعليمي على Bisect.
نزّل الملف sorts.ml. وستجد فيه تنفيذًا لترتيب الإدراج وترتيب الدمج.
ونزّل الملف test_sorts.ml. فهو يحتوي الهيكل العظمي لمجموعة اختبارات OUnit.
وأنشئ ملف dune لتنفيذ test_sorts:
(executable
 (name test_sorts)
 (libraries ounit2)
 (instrumentation
  (backend bisect_ppx)))
ونفّذ:
$ dune exec --instrument-with bisect_ppx ./test_sorts.exe
سيُنفّذ ذلك مجموعة الاختبارات مع تمكين تغطية Bisect، مما ينتج بعض الملفات المسماة bisectNNNN.coverage.
ونفّذ:
$ bisect-ppx-report html
لإنشاء تقرير Bisect من تنفيذ مجموعة اختباراتك. ويوجد التقرير في دليل أُنشئ حديثًا يُسمى _coverage.
وافتح الملف _coverage/index.html في متصفح ويب. وانظر إلى التغطية لكل ملف؛ وسترى أننا تمكنا من اختبار نسبة قليلة من أسطر sorts.ml بمجموعة اختباراتنا حتى الآن. وانقر على الرابط الخاص بـ sorts.ml في ذلك التقرير. وسترى أننا تمكنا من تغطية سطر واحد فقط من الشيفرة المصدرية.
وتوجد بعض الاختبارات الإضافية في ملف الاختبار. جرّب إلغاء التعليق عنها، كما هو موضح في ملف الاختبار، وزيادة تغطية شيفرتك. وبين كل تشغيل وآخر، ستحتاج إلى حذف ملفات bisectNNNN.coverage، وإلا فسيحتوي التقرير معلومات من تلك التشغيلات السابقة:
$ rm bisect*.coverage
وعندما تنتهي من إلغاء التعليقات عن الاختبارات المقدمة، ينبغي أن تكون عند تغطية 25%، بما في ذلك تنفيذ ترتيب الإدراج كله. وللمتعة، جرّب إضافة اختبارات أكثر للوصول إلى تغطية 100% لترتيب الدمج.
التوازي. سيحاول OUnit افتراضيًا تشغيل بعض الاختبارات بالتوازي، وهو ما يقلل الوقت اللازم لتشغيل مجموعة اختبارات كبيرة، مقابل جعل ترتيب تشغيل الاختبارات غير حتمي. وقد يؤثر ذلك في التغطية إذا كنت تختبر شيفرة أمرية. ولجعل الاختبارات تعمل واحدًا تلو الآخر بالترتيب، يمكنك تمرير العلم -runner sequential إلى الملف التنفيذي. وسيرى OUnit ذلك العلم ويتوقف عن التوازي:
$ dune exec --instrument-with bisect_ppx ./test_sorts.exe -- -runner sequential
8.6. الاختبار العشوائي باستخدام QCheck
الاختبار العشوائي (randomized testing) أو اختبار التعتيم (fuzz testing) هو عملية توليد مدخلات عشوائية وتغذية برنامج أو دالة بها لمعرفة ما إذا كان البرنامج يسلك سلوكًا صحيحًا. والمشكلة الفورية هي كيفية تحديد المخرج الصحيح لمدخل معين. فإذا توفر تنفيذ مرجعي (reference implementation)—أي تنفيذ يُعتقد أنه صحيح لكنه لا يكفي من وجه آخر (مثلًا أداؤه بطيء جدًا، أو أنه بلغة أخرى)—أمكن مقارنة مخرجات التنفيذين. وإلا فقد نتحقق من خاصية (property) ما في المخرج. فمثلًا،
- «عدم الانهيار» خاصية مهمة في واجهات المستخدم؛
- إضافة عنصرًا إلى تجميع بيانات ثم إزالة تلك العناصر والانتهاء بتجميع فارغ خاصية مهمة في بنى البيانات؛ و
- تشفير سلسلة بمفتاح ثم فك تشفيرها بالمفتاح نفسه والحصول على السلسلة الأصلية خاصية مهمة في مخطط تشفير مثل Enigma.
الاختبار العشوائي تقنية بالغة القوة. ويُستخدم غالبًا في اختبار البرامج بحثًا عن الثغرات الأمنية. وتدعم حزمة qcheck لـ OCaml الاختبار العشوائي. وسننظر فيها بعد ذلك، بعد أن نناقش توليد الأعداد العشوائية.
8.6.1. توليد الأعداد العشوائية
لفهم الاختبار العشوائي، نحتاج إلى استطراد موجز في توليد الأعداد العشوائية.
توفر معظم اللغات وسيلة لتوليد أعداد عشوائية. وفي الحقيقة، هذه المولّدات ليست عشوائية حقًا في الغالب (بمعنى أنها غير قابلة للتنبؤ تمامًا) بل هي في الواقع شبه عشوائية (pseudorandom): فسلسلة الأعداد التي تولّدها تجتاز اختبارات إحصائية جيدة لضمان عدم وجود نمط ظاهر فيها، لكن السلسلة نفسها دالة حتمية لقيمة بذرة (seed) أولية. (تذكّر أن السابقة pseudo أصلها من اليونانية pseudēs بمعنى «زائف».) وتوفر كل من Java وPython مولّدات أعداد شبه عشوائية (PRNGs). وكذلك تفعل OCaml في وحدة Random في المكتبة القياسية.
تجربة. ابدأ جلسة جديدة من utop وأدخل ما يلي:
# Random.int 100;;
# Random.int 100;;
# Random.int 100;;
ستكون كل استجابة عددًا صحيحًا بحيث .
والآن اخرج من utop وابدأ جلسة جديدة أخرى. وأدخل العبارات نفسها مرة أخرى. وستحصل على الاستجابات نفسها التي حصلت عليها سابقًا. بل إنك، ما لم يكن تنصيب OCaml لديك مختلفًا بطريقة ما عن التنصيب المستخدم لإنتاج هذا الكتاب، ستحصل على الأعداد نفسها المذكورة أدناه:
Random.int 100;;
Random.int 100;;
Random.int 100;;
- : int = 54
- : int = 62
- : int = 10
ليست غير قابلة للتنبؤ تمامًا، أليس كذلك؟
مولّدات الأعداد الشبه العشوائية (PRNGs). صحيح أن مولّد الأعداد الشبه العشوائية يؤدي إلى ثغرات فظيعة في أغراض الأمن والتشفير، لكنه لأغراض أخرى—منها الاختبار والمحاكاة—جيد تمامًا. بل إن قابلية التنبؤ به قد تكون مفيدة: فبالنظر إلى البذرة الأولية نفسها، سيولّد دائمًا السلسلة نفسها من الأعداد الشبه العشوائية، مما يتيح إعادة سلسلة اختبارات معينة أو محاكاة معينة.
وطريقة عمل مولّد الأعداد الشبه العشوائية عمومًا أنه يهيئ حالة (state) يحتفظ بها داخليًا انطلاقًا من البذرة الأولية. ومن ثمّ، كل مرة يولّد فيها قيمة جديدة، يحدّث تلك الحالة تحديثًا أمريًا. وتتيح وحدة Random التعامل مع تلك الحالة بطرق محدودة. فمثلًا يمكنك
- الحصول على الحالة الحالية بـ
Random.get_state، - نسخ الحالة الحالية بـ
Random.State.copy، - طلب عدد صحيح عشوائي مولَّد من حالة معينة بـ
Random.State.int، و - تهيئة الحالة بنفسك. وستختار الدالتان
Random.self_initوRandom.State.make_self_initبذرة «عشوائية» لتهيئة الحالة. وهما تفعلان ذلك بالمعاينة من ملف Unix خاص يُسمى/dev/urandom، المقصود منه توفير أعلى قدر ممكن من العشوائية الحقيقية على الحاسوب.
إعادة التجربة. ابدأ جلسة جديدة من utop. وأدخل ما يلي:
# Random.self_init ();;
# Random.int 100;;
# Random.int 100;;
# Random.int 100;;
والآن افعل ذلك مرة ثانية (لا يهم إن خرجت من utop بينهما أم لا). وستلاحظ أنك تحصل على سلسلة مختلفة من القيم. ومع احتمال كبير، سيكون ما تحصل عليه مختلفًا عن القيم أدناه:
Random.self_init ();;
Random.int 100;;
Random.int 100;;
Random.int 100;;
- : unit = ()
- : int = 76
- : int = 48
- : int = 98
8.6.2. تجريدات QCheck
لـ QCheck ثلاثة تجريدات نحتاج إلى تغطيتها قبل استخدامها في الاختبار: المولّدات، والخواص، والقيم الاعتباطية. وإذا أردت أن تتابع في utop، فحمّل QCheck بهذا التوجيه:
#require "qcheck";;
المولّدات (Generators). من أهم الوظائف التي توفرها QCheck القدرة على توليد قيم شبه عشوائية من أنواع مختلفة. وإليك بعض توقيع الوحدة التي تفعل ذلك:
module QCheck : sig
  ...
  module Gen :
  sig
    type 'a t = Random.State.t -> 'a
    val int : int t
    val generate : ?rand:Random.State.t -> n:int -> 'a t -> 'a list
    val generate1 : ?rand:Random.State.t -> 'a t -> 'a
    ...
  end
  ...
end
يكون 'a QCheck.Gen.t دالة تأخذ حالة مولّد أعداد شبه عشوائية وتستخدمها لإنتاج قيمة شبه عشوائية من النوع 'a. لذا ينتج QCheck.Gen.int أعدادًا صحيحة شبه عشوائية. وتتولى الدالة generate1 فعلًا توليد قيمة شبه عشوائية واحدة. وهي تأخذ وسيطًا اختياريًا هو حالة المولّد؛ وإن لم يُمرَّر ذلك الوسيط، استخدمت حالة المولّد الافتراضية. وتنتج الدالة generate قائمة من n قيم شبه عشوائية.
تنفّذ QCheck منتجات كثيرة للقيم الشبه العشوائية. وإليك بعضها الآخر:
module QCheck : sig
  ...
  module Gen :
  sig
    val int : int t
    val small_int : int t
    val int_range : int -> int -> int t
    val list : 'a t -> 'a list t
    val list_size : int t -> 'a t -> 'a list t
    val string : ?gen:char t -> string t
    val small_string : ?gen:char t -> string t
    ...
  end
  ...
end
ويمكنك قراءة توثيق هذه الدوال وكثير غيرها.
الخواص (Properties). من المُغري أن نعتقد أن QCheck ستمكّننا من اختبار دالة بتوليد مدخلات شبه عشوائية كثيرة لها، وتشغيل الدالة عليها، ثم التحقق من صحة المخرجات. لكن تظهر مشكلة فورًا: كيف يمكن لـ QCheck أن تعرف المخرج الصحيح لكل من تلك المدخلات؟ وبما أنها مولّدة عشوائيًا، فلا يستطيع مهندس الاختبار أن يثبّت المخرجات الصحيحة كتابةً.
لذا، بدلًا من ذلك، تتيح لنا QCheck التحقق من تحقق خاصية (property) معينة في كل مخرج. والخاصية دالة من النوع t -> bool، لنوع t ما، تخبرنا ما إذا كانت القيمة من النوع t تُبدي خاصية مرغوبة ما. وهنا، على سبيل المثال، خاصيتان؛ إحداهما تحدد ما إذا كان عدد صحيح زوجيًا، والأخرى تحدد ما إذا كانت قائمة مرتبة ترتيبًا غير تنازلي وفق العامل المدمج <=:
let is_even n = n mod 2 = 0
let rec is_sorted = function
  | [] -> true
  | [_] -> true
  | h1 :: (h2 :: t as t') -> h1 <= h2 && is_sorted t'
val is_even : int -> bool = <fun>
val is_sorted : 'a list -> bool = <fun>
القيم الاعتباطية (Arbitraries). الطريقة التي نعرض بها على QCheck المخرجات التي نريد فحصها هي قيمة من النوع 'a QCheck.arbitrary. وهذا النوع يمثل قيمة «اعتباطية» من النوع 'a—أي أنها اختيرت اختيارًا شبه عشوائي كقيمة نريد فحصها، وبوجه أدق، نريد فحص ما إذا كانت تحقق خاصية ما.
ويمكننا إنشاء قيم اعتباطية من المولّدات باستخدام الدالة QCheck.make : 'a QCheck.Gen.t -> 'a QCheck.arbitrary. (وهي في الواقع تأخذ بعض الوسائط الاختيارية التي نغفلها هنا.) وهذه ليست الطريقة المعتادة لإنشاء القيم الاعتباطية في الواقع، لكنها طريقة بسيطة ستساعدنا على فهمها؛ وسنصل إلى الطريقة المعتادة بعد قليل. فمثلًا، يمثل التعبير التالي عددًا صحيحًا اعتباطيًا:
QCheck.make QCheck.Gen.int
- : int QCheck.arbitrary =
{QCheck.gen = <fun>; print = None; small = None; shrink = None;
 collect = None; stats = []}
8.6.3. اختبار الخواص
لبناء اختبار QCheck، ننشئ قيمة اعتباطية وخاصية، ونمررهما إلى QCheck.Test.make، الذي يمكن تبسيط نوعه إلى:
QCheck.Test.make : 'a QCheck.arbitrary -> ('a -> bool) -> QCheck.Test.t
وفي الواقع، تأخذ تلك الدالة أيضًا عدة وسائط اختيارية نغفلها هنا. وسيولّد الاختبار عددًا من القيم الاعتباطية ويتحقق من تحقق الخاصية في كل منها. فمثلًا، تنشئ الشيفرة التالية اختبار QCheck يتحقق مما إذا كان عدد صحيح اعتباطي زوجيًا:
let t = QCheck.Test.make (QCheck.make QCheck.Gen.int) is_even
val t : QCheck.Test.t = QCheck2.Test.Test <abstr>
وإذا أردنا تغيير عدد القيم الاعتباطية التي تُفحص، يمكننا تمرير وسيط صحيح اختياري ~count إلى QCheck.Test.make.
ويمكننا تشغيل ذلك الاختبار بـ QCheck_runner.run_tests : QCheck.Test.t list -> int. (ومرة أخرى، تأخذ تلك الدالة بعض الوسائط الاختيارية التي نغفلها هنا.) والعدد الصحيح الذي تعيده هو 0 إذا نجحت جميع الاختبارات في القائمة، و1 في غير ذلك. وبالنسبة إلى الاختبار أعلاه، سيُخرج تشغيله 1 مع احتمال كبير، لأنه سيولّد عددًا صحيحًا فرديًا واحدًا على الأقل.
QCheck_runner.run_tests [t]
random seed: 68606218
--- Failure --------------------------------------------------------------------
Test anon_test_1 failed (0 shrink steps):
<no printer>
================================================================================
failure (1 tests failed, 0 tests errored, ran 1 tests)
- : int = 1
لكن ذلك المخرج ليس مفيدًا كثيرًا للأسف؛ فهو لا يخبرنا ما القيم المعينة التي فشلت في تحقيق الخاصية! وسنصلح تلك المشكلة بعد قليل.
وإذا أردت إنشاء برنامج OCaml يشغّل اختبارات QCheck ويطبع النتائج، فهناك دالة QCheck_runner.run_tests_main تعمل كثيرًا مثل OUnit2.run_test_tt_main: فقط استدعها كالتعبير الأخير في ملف اختبار. فمثلًا:
let tests = (* code that constructs a [QCheck.Test.t list] *)
let _ = QCheck_runner.run_tests_main tests
ولتصريف شيفرة QCheck، ما عليك إلا إضافة مكتبة qcheck إلى ملف dune:
(executable
 ...
 (libraries ... qcheck))
ويمكن تحويل اختبارات QCheck إلى اختبارات OUnit وإدراجها في نوع مجموعات اختبارات OUnit المعتاد الذي كنا نكتبه طوال الوقت. والدالة التي تفعل ذلك هي:
QCheck_runner.to_ounit2_test
- : ?rand:Random.State.t -> QCheck2.Test.t -> OUnit2.test = <fun>
8.6.4. مخرجات مفيدة من QCheck
لاحظنا أعلاه أن مخرجات QCheck حتى الآن لم تخبرنا إلا هل حققت بعض القيم الاعتباطية خاصية ما، لا أيّ القيم الاعتباطية فشلت في تحقيقها. فلنصلح تلك المشكلة.
والمشكلة في طريقة إنشائنا قيمة اعتباطية مباشرةً من مولّد. فالقيمة الاعتباطية أكبر في الحقيقة من مجرد مولّد. فمكتبة QCheck تحتاج إلى معرفة كيفية طباعة قيم المولّد، وإلى بضعة أمور أخرى كذلك. ويمكنك رؤية ذلك في تعريف 'a QCheck.arbitrary:
#show QCheck.arbitrary;;
type 'a arbitrary = private {
gen : 'a QCheck.Gen.t;
print : 'a QCheck.Print.t option;
small : ('a -> int) option;
shrink : 'a QCheck.Shrink.t option;
collect : ('a -> string) option;
stats : 'a QCheck.stat list;
}
فإضافة إلى حقل المولّد gen، يوجد حقل يحتوي دالة اختيارية لطباعة قيم المولّد، وبضعة حقول اختيارية أخرى كذلك. ولحسن الحظ، لا نضطر عادةً إلى إيجاد طريقة لإكمال تلك الحقول بأنفسنا؛ فوحدة QCheck توفر قيمًا اعتباطية كثيرة تقابل المولّدات الموجودة في QCheck.Gen:
module QCheck :
  sig
    ...
  val int : int arbitrary
  val small_int : int arbitrary
  val int_range : int -> int -> int arbitrary
  val list : 'a arbitrary -> 'a list arbitrary
  val list_of_size : int Gen.t -> 'a arbitrary -> 'a list arbitrary
  val string : string arbitrary
  val small_string : string arbitrary
    ...
  end
وباستخدام تلك القيم الاعتباطية، يمكننا الحصول على رسائل أخطاء محسّنة:
let t = QCheck.Test.make ~name:"my_test" QCheck.int is_even;;
QCheck_runner.run_tests [t];;
val t : QCheck.Test.t = QCheck2.Test.Test <abstr>
--- Failure --------------------------------------------------------------------
Test my_test failed (87 shrink steps):
-3
================================================================================
failure (1 tests failed, 0 tests errored, ran 1 tests)
- : int = 1
ويخبرنا المخرج بأن my_test فشل، ويعرض لنا المدخل الذي تسبب في الفشل.
8.6.5. اختبار الدوال باستخدام QCheck
القطعة الأخيرة في أحجية QCheck هي استخدام مدخل مولَّد عشوائيًا لاختبار ما إذا كان مخرج دالة يحقق خاصية ما. فمثلًا، إليك اختبار QCheck لمعرفة ما إذا كان مخرج double صحيحًا:
let double x = 2 * x;;
let double_check x = double x = x + x;;
let t = QCheck.Test.make ~count:1000 QCheck.int double_check;;
QCheck_runner.run_tests [t];;
val double : int -> int = <fun>
val double_check : int -> bool = <fun>
val t : QCheck.Test.t = QCheck2.Test.Test <abstr>
================================================================================
success (ran 1 tests)
- : int = 0
في الأعلى، double هي الدالة التي نختبرها. والخاصية التي نختبرها، double_check، هي أن double x تساوي دائمًا x + x. ونفعل ذلك بجعل QCheck تنشئ 1000 عدد صحيح اعتباطي وتختبر تحقق الخاصية في كل منها.
وإليك مثالين آخرين مأخوذين من توثيق QCheck نفسه. يتحقق الأول من أن List.rev دالة إرجاعية (involution)، أي أن تطبيقها مرتين يعيدك إلى القائمة الأصلية. وهذه خاصية ينبغي أن تصح على تنفيذ صحيح لعكس القوائم.
let rev_involutive lst = List.(lst |> rev |> rev = lst);;
let t = QCheck.(Test.make ~count:1000 (list int) rev_involutive);;
QCheck_runner.run_tests [t];;
val rev_involutive : 'a list -> bool = <fun>
val t : QCheck.Test.t = QCheck2.Test.Test <abstr>
================================================================================
success (ran 1 tests)
- : int = 0
وفعلًا، يكشف تشغيل 1000 اختبار عشوائي أن أيا منها لا يفشل. والمولّد int المستخدم أعلاه يولّد أعدادًا صحيحة موزّعة بانتظام على مدى أعداد OCaml الصحيحة كله. أما المولّد list فينشئ قوائم تُولَّد عناصرها فردًا فردًا بواسطة int. ووفقًا لتوثيق list، يُولَّد طول كل قائمة عشوائيًا بمولّد آخر هو nat، الذي يولّد «أعدادًا طبيعية صغيرة». وماذا يعني ذلك؟ لم يُحدَّد. لكن إذا قرأنا الشيفرة المصدرية الحالية، نرى أنها أعداد صحيحة من 0 إلى 10,000، مع تحيّز نحو الأعداد الأصغر في ذلك المدى.
ويتحقق المثال الثاني من أن جميع القوائم مرتبة. وبالطبع، ليست جميع القوائم مرتبة! لذا ينبغي أن نتوقع فشل هذا الاختبار.
let is_sorted lst = lst = List.sort Stdlib.compare lst;;
let t = QCheck.(Test.make ~count:1000 (list small_nat) is_sorted);;
QCheck_runner.run_tests [t];;
val is_sorted : 'a list -> bool = <fun>
File "[14]", line 2, characters 44-53:
2 | let t = QCheck.(Test.make ~count:1000 (list small_nat) is_sorted);;
^^^^^^^^^
Alert deprecated: QCheck.small_nat
Use [nat_small] instead
val t : QCheck.Test.t = QCheck2.Test.Test <abstr>
--- Failure --------------------------------------------------------------------
Test anon_test_4 failed (11 shrink steps):
[1; 0]
================================================================================
failure (1 tests failed, 0 tests errored, ran 1 tests)
- : int = 1
ويُظهر المخرج مثالًا لقائمة غير مرتبة، ومن ثمّ تخالف الخاصية. والمولّد small_nat يشبه nat لكن مداه من 0 إلى 100.
8.7. إثبات الصحة
يوفر الاختبار دليلًا على الصحة، لا طمأنينة كاملة. فحتى بعد اختبار مكثف بالصندوق الأسود والصندوق الزجاجي، قد توجد بعد حالة اختبار فشل المبرمج في اختراعها، وكانت ستكشف عيبًا في البرنامج.
يمكن استخدام اختبار البرامج لإظهار وجود الأخطاء، لكن ليس لإظهار غيابها أبدًا. —Edsger W. Dijkstra
والمقصود ليس أن الاختبار عديم الفائدة! فهو قد يكون فعالًا جدًا. لكنه نوع من الاستدلال الاستقرائي (inductive reasoning)، حيث يتراكم الدليل (أي اجتياز الاختبارات) دعمًا لاستنتاج (أي صحة البرنامج) دون ضمان مطلق لصحة ذلك الاستنتاج. (لاحظ أن كلمة «استقرائي» تُستخدم هنا بمعنى مختلف عن تقنية البرهان المعروفة بالاستقراء.) وللحصول على ذلك الضمان، نلجأ إلى الاستدلال الاستنباطي (deductive reasoning)، حيث نمضي من مقدمات وقواعد منطقية إلى استنتاج صحيح. وبعبارة أخرى، نبرهن صحة البرنامج. وهدفنا بعد ذلك هو تعلم بعض تقنيات براهين الصحة هذه. وتُعرف هذه التقنيات بـ الطرق الصورية (formal methods) لاستخدامها الصورية المنطقية.
وتعني الصحة هنا أن البرنامج ينتج المخرج الصحيح وفق مواصفة (specification). وتُقدم المواصفات عادةً في توثيق الدالة (ومن هنا اسم «تعليق المواصفة»): فهي تصف الشرط المسبق للبرنامج والشرط اللاحق. والشرط اللاحق، كما كنا نكتبه، يكون بالشكل [f x] is "...a description of the output in terms of the input [x]...". فمثلًا، قد تكون مواصفة دالة العاملي:
(** [fact n] is [n!]. Requires: [n >= 0]. *)
let rec fact n = ...
فالشرط اللاحق يؤكد تساويًا بين مخرج الدالة ووصف إنجليزي ما لحساب على المدخل. والإثبات الصوري (Formal verification) هو مهمة البرهان على أن تنفيذ الدالة يحقق مواصفته.
والتساويات من الطرق الجوهرية التي نفكر بها في صحة البرامج الوظيفية. فغياب الحالة القابلة للتغيير يتيح الاستدلال مباشرةً على ما إذا كان تعبيران متساويين. ويصعب فعل ذلك في لغة أمرية، لأن تلك التعبيرات قد تحدث تأثيرات جانبية تغيّر الحالة.
8.7.1. التساوي
متى يكون تعبيران متساويين؟ ثمة جوابان ممكنان:
- عندما يكونان متطابقين نحويًا.
- عندما يكونان متكافئين دلاليًا: أي ينتجان القيمة نفسها.
فمثلًا، هل 42 و41+1 متساويان؟ سيقول الجواب النحوي إنهما ليسا كذلك، لأنهما يتضمنان رمزين مختلفين. وسيقول الجواب الدلالي إنهما متساويان: فكلاهما ينتج القيمة 42.
وماذا عن الدوال: هل fun x -> x وfun y -> y متساويتان؟ هما مختلفتان نحويًا. لكنهما دلاليًا تنتجان قيمة هي دالة الهوية: فعند تطبيقهما على مدخل، ستنتجان المخرج نفسه. أي أن (fun x -> x) z = z و(fun y -> y) z = z. وإذا كان الحال أن دالتين تنتجان المخرج نفسه لجميع المدخلات، فسنعتبرهما متساويتين:
if (forall x, f x = g x), then f = g.
ويُعرف تعريف التساوي هذا للدوال بـ مسلّمة الامتداد (Axiom of Extensionality) في بعض فروع الرياضيات؛ وسنشير إليه من الآن فصاعدًا بـ «الامتداد» فحسب.
وسنتبنى هنا المقاربة الدلالية. فإذا قُيِّم e1 وe2 إلى القيمة نفسها v، كتبنا e1 = e2. ونستخدم = هنا بمعناها الرياضي، لا كعامل التساوي متعدد الأشكال في OCaml. فمثلًا، نسمح بـ (fun x -> x) = (fun y -> y)، مع أن عامل OCaml سيرفع استثناءً ويرفض مقارنة الدوال.
وسنقتصر أيضًا على التعبيرات الجيدة الأنواع، والنقية (أي التي لا تأثيرات جانبية لها)، والكاملة (أي التي لا استثناءات لها ولا حلقات لا نهائية).
8.7.2. الاستدلال المعادلي
تأمل هاتين الدالتين:
let twice f x = f (f x)
let compose f g x = f (g x)
val twice : ('a -> 'a) -> 'a -> 'a = <fun>
val compose : ('a -> 'b) -> ('c -> 'a) -> 'c -> 'b = <fun>
نعلم من قواعد تقييم OCaml أن twice h x = h (h x)، وبالمثل compose h h x = h (h x). ومن ثمّ لدينا:
twice h x = h (h x) = compose h h x
لذا يمكننا أن نستنتج أن twice h x = compose h h x. وبالامتداد يمكننا تبسيط تلك المساواة: فبما أن twice h x = compose h h x تصح لجميع x، يمكننا أن نستنتج twice h = compose h h.
ومثال آخر: لنفترض أننا عرّفنا عاملًا بينيًا لتركيب الدوال:
let ( << ) = compose
حينئذٍ يمكننا أن نبرهن أن التركيب تجميعي، باستخدام الاستدلال المعادلي:
Theorem: (f << g) << h  =  f << (g << h)

Proof: By extensionality, we need to show
  ((f << g) << h) x  =  (f << (g << h)) x
for an arbitrary x.

  ((f << g) << h) x
= (f << g) (h x)
= f (g (h x))

and

  (f << (g << h)) x
= f ((g << h) x)
= f (g (h x))

So ((f << g) << h) x = f (g (h x)) = (f << (g << h)) x.

QED
جميع الخطوات في البرهان المعادلي أعلاه تتبع من التقييم. وهناك صيغة أخرى لكتابة البرهان تقدم تلميحات عن سبب صحة كل خطوة:
  ((f << g) << h) x
=   { evaluation of << }
  (f << g) (h x)
=   { evaluation of << }
  f (g (h x))

and

  (f << (g << h)) x
=   { evaluation of << }
  f ((g << h) x)
=   { evaluation of << }
  f (g (h x))
8.7.3. الاستقراء على الأعداد الطبيعية
تجمع الدالة التالية الأعداد الصحيحة غير السالبة حتى n:
let rec sumto n =
  if n = 0 then 0 else n + sumto (n - 1)
val sumto : int -> int = <fun>
قد تتذكر أن المجموع نفسه يمكن التعبير عنه بصيغة مغلقة هي n * (n + 1) / 2. ولإثبات أن forall n >= 0, sumto n = n * (n + 1) / 2، سنحتاج إلى الاستقراء الرياضي (mathematical induction).
تذكّر أن الاستقراء على الأعداد الطبيعية (أي الأعداد الصحيحة غير السالبة) يُصاغ كما يلي:
forall properties P,
  if P(0),
  and if forall k, P(k) implies P(k + 1),
  then forall n, P(n)
ويُسمى ذلك مبدأ الاستقراء (induction principle) للأعداد الطبيعية. والحالة الأساسية (base case) هي إثبات P(0)، والحالة الاستقرائية (inductive case) هي إثبات أن P(k + 1) تصح بافتراض الفرضية الاستقرائية (inductive hypothesis) P(k).
ولنستخدم الاستقراء لإثبات صحة sumto.
Claim: sumto n = n * (n + 1) / 2

Proof: by induction on n.
P(n) = sumto n = n * (n + 1) / 2

Base case: n = 0
Show: sumto 0 = 0 * (0 + 1) / 2

  sumto 0
=   { evaluation }
  0
=   { algebra }
  0 * (0 + 1) / 2

Inductive case: n = k + 1
Show: sumto (k + 1) = (k + 1) * ((k + 1) + 1) / 2
IH: sumto k = k * (k + 1) / 2

  sumto (k + 1)
=   { evaluation }
  k + 1 + sumto k
=   { IH }
  k + 1 + k * (k + 1) / 2
=   { algebra }
  (k + 1) * (k + 2) / 2

QED
لاحظ أننا حرصنا في كل حالة على كتابة ما نحتاج إلى إثباته، وكذلك على تدوين الفرضية الاستقرائية. ومن المهم إظهار هذا العمل كله.
ولنفترض الآن أننا عرّفنا:
let sumto_closed n = n * (n + 1) / 2
val sumto_closed : int -> int = <fun>
حينئذٍ، كنتيجة تالية من دعوانا السابقة، يمكننا بالامتداد أن نستنتج
sumto_closed = sumto
تقنيًا، تصح تلك المساواة على المدخلات التي هي أعداد طبيعية فقط. لكن بما أن جميع أمثلتنا من الآن فصاعدًا ستكون للأعداد الطبيعية، لا للأعداد الصحيحة بمعناها المطلق، فسنغفل ذكر أي شروط مسبقة أو قيود تتعلق بالأعداد الطبيعية.
8.7.4. البرامج كمواصفات
برهنا للتو على صحة تنفيذ فعّال بالنسبة إلى تنفيذ غير فعّال. فالتنفيذ غير الفعّال، sumto، يعمل كمواصفة للتنفيذ الفعّال، sumto_closed.
وتلك التقنية شائعة في الإثبات الصوري للبرامج الوظيفية: اكتب تنفيذًا صحيحًا بوضوح لكنه يفتقر إلى خاصية مرغوبة ما، مثل الكفاءة، ثم برهن أن تنفيذًا أفضل يساوي التنفيذ الأصلي.
ولنأت بمثال آخر على هذا النوع من الإثبات. وسنستخدم هذه المرة دالة العاملي.
التنفيذ البسيط الصحيح بوضوح لدالة العاملي سيكون:
let rec fact n =
  if n = 0 then 1 else n * fact (n - 1)
val fact : int -> int = <fun>
أما التنفيذ التعاودي الذيلي فسيكون أكثر كفاءة في مساحة المكدس:
let rec facti acc n =
  if n = 0 then acc else facti (acc * n) (n - 1)
let fact_tr n = facti 1 n
val facti : int -> int -> int = <fun>
val fact_tr : int -> int = <fun>
حرف i في الاسم facti يرمز إلى تكرارية (iterative). ونسمي هذا تنفيذًا تكراريًا لأنه يشبه بقوة الطريقة التي سيُعبَّر بها عن الحساب نفسه باستخدام حلقة (أي بناء تكرار) في لغة أمرية. فمثلًا، قد نكتب في Java:
int facti (int n) {
  int acc = 1;
  while (n != 0) {
    acc *= n;
    n--;
  }
  return acc;
}
يشترك تنفيذ facti في OCaml و Java في هذه السمات:
- يبدآن
accعند1 - يتحققان مما إذا كان
nهو0 - يضربان
accفيn - ينقصان
n - يعيدان المُراكِم
acc
ولنحاول أن نبرهن أن fact_tr ينفّذ الحساب نفسه الذي ينفّذه fact تنفيذًا صحيحًا.
Claim: forall n, fact n = fact_tr n

Since fact_tr n = facti 1 n, it suffices to show fact n = facti 1 n.

Proof: by induction on n.
P(n) = fact n = facti 1 n

Base case: n = 0
Show: fact 0 = facti 1 0

  fact 0
=   { evaluation }
  1
=   { evaluation }
  facti 1 0

Inductive case: n = k + 1
Show: fact (k + 1) = facti 1 (k + 1)
IH: fact k = facti 1 k

  fact (k + 1)
=   { evaluation }
  (k + 1) * fact k
=   { IH }
  (k + 1) * facti 1 k

  facti 1 (k + 1)
=   { evaluation }
  facti (1 * (k + 1)) k
=   { evaluation }
  facti (k + 1) k

Unfortunately, we're stuck.  Neither side of what we want to show
can be manipulated any further.

ABORT
نعلم أن facti (k + 1) k و(k + 1) * facti 1 k ينبغي أن يعطيا القيمة نفسها. لكن الفرضية الاستقرائية تتيح لنا استخدام 1 فقط كوسيط ثانٍ لـ facti، بدلًا من وسيط أكبر مثل k + 1. لذا ضلّ برهاننا في اللحظة التي استخدمنا فيها الفرضية الاستقرائية. نحتاج إلى فرضية استقرائية أقوى!
فلنقوِّ الدعوى التي نقدمها إذن. فبدلًا من إثبات أن fact n = facti 1 n، سنحاول إثبات forall p, p * fact n = facti p n. وهذا يعمّم الكمية k + 1 التي علقنا عليها إلى كمية اعتباطية p.
Claim: forall n, forall p . p * fact n = facti p n

Proof: by induction on n.
P(n) = forall p, p * fact n = facti p n

Base case:  n = 0
Show: forall p,  p * fact 0 = facti p 0

  p * fact 0
=   { evaluation and algebra }
  p
=   { evaluation }
  facti p 0

Inductive case: n = k + 1
Show: forall p,  p * fact (k + 1) = facti p (k + 1)
IH: forall p,  p * fact k = facti p k

  p * fact (k + 1)
=   { evaluation }
  p * (k + 1) * fact k
=   { IH, instantiating its p as p * (k + 1) }
  facti (p * (k + 1)) k

  facti p (k + 1)
=   { evaluation }
  facti (p * (k + 1)) k

QED

Claim: forall n, fact n = fact_tr n

Proof:

  fact n
=   { algebra }
  1 * fact n
=   { previous claim }
  facti 1 n
=   { evaluation }
  fact_tr n

QED
وبذلك يكتمل برهاننا على أن الدالة الفعّالة التعاودية الذيلية fact_tr مكافئة للدالة البسيطة التعاودية fact. وجوهر الأمر أننا برهنا على صحة fact_tr باستخدام fact كمواصفة لها.
8.7.5. التعاود مقابل التكرار
أضفنا مُراكِمًا كوسيط إضافي لجعل دالة العاملي تعاودية ذيلية. وتلك حيلة رأيناها سابقًا. ولنجرّدها ونرَ كيف نفعلها عمومًا.
لنفترض أن لدينا دالة تعاودية على الأعداد الصحيحة:
let rec f_r n =
  if n = 0 then i else op n (f_r (n - 1))
هنا، يُقصد بالحرف r في f_r الإشارة إلى أن f_r دالة تعاودية. أما i وop فجزآن من الدالة مقصود بهما أن يُستبدلا بقيمة ملموسة i وعامل op. فمثلًا، مع دالة العاملي لدينا:
f_r = fact
i = 1
op = ( * )
ويمكن جعل دالة كهذه تعاودية ذيلية بإعادة كتابتها كما يلي:
let rec f_i acc n =
  if n = 0 then acc
  else f_i (op acc n) (n - 1)
let f_tr = f_i i
هنا، يُقصد بالحرف i في f_i الإشارة إلى أن f_i دالة تكرارية، وi وop هما نفسهما في النسخة التعاودية من الدالة. فمثلًا، مع دالة العاملي لدينا:
f_i = fact_i
i = 1
op = ( * )
f_tr = fact_tr
يمكننا أن نبرهن أن f_r وf_tr تحسبان الدالة نفسها. وسنكتشف أثناء البرهان التالي شروطًا معينة يجب أن تصح على i وop ليكون التحويل إلى التعاود الذيلي صحيحًا.
Theorem: f_r = f_tr

Proof:  By extensionality, it suffices to show that forall n, f_r n = f_tr n.

As in the previous proof for fact, we will need a strengthened induction
hypothesis. So we first prove this lemma, which quantifies over all accumulators
that could be input to f_i, rather than only i:

  Lemma: forall n, forall acc, op acc (f_r n) = f_i acc n

  Proof of Lemma: by induction on n.
  P(n) = forall acc, op acc (f_r n) = f_i acc n

  Base: n = 0
  Show: forall acc, op acc (f_r 0) = f_i acc 0

    op acc (f_r 0)
  =   { evaluation }
    op acc i
  =   { if we assume forall x, op x i = x }
    acc

    f_i acc 0
  =   { evaluation }
    acc

  Inductive case: n = k + 1
  Show: forall acc, op acc (f_r (k + 1)) = f_i acc (k + 1)
  IH: forall acc, op acc (f_r k) = f_i acc k

    op acc (f_r (k + 1))
  =   { evaluation }
    op acc (op (k + 1) (f_r k))
  =   { if we assume forall x y z, op x (op y z) = op (op x y) z }
    op (op acc (k + 1)) (f_r k)

    f_i acc (k + 1)
  =   { evaluation }
    f_i (op acc (k + 1)) k
  =   { IH, instantiating acc as op acc (k + 1)}
    op (op acc (k + 1)) (f_r k)

  QED

The proof then follows almost immediately from the lemma:

  f_r n
=   { if we assume forall x, op i x = x }
  op i (f_r n)
=   { lemma, instantiating acc as i }
  f_i i n
=   { evaluation }
  f_tr n

QED
وقد افترضنا في الطريق ثلاثة افتراضات عن i و op:
forall x, op x i = xop x (op y z) = op (op x y) zforall x, op i x = x
يقول الافتراضان الأول والثالث إن i محايد (identity) لـ op: فاستخدامه على الجهة اليسرى أو اليمنى يترك الوسيط الآخر x دون تغيير. ويقول الثاني إن op تجميعي (associative). وقد صح الافتراضان معًا على القيم التي استخدمناها في دوال العاملي:
opهو الضرب، وهو تجميعي.iهو1، وهو محايد للضرب: فالضرب في 1 يترك الوسيط الآخر دون تغيير.
إذن فتحويلنا من دالة تعاودية إلى دالة تعاودية ذيلية صحيح ما دام العامل المطبَّق في الاستدعاء التعاودي تجميعيًا، والقيمة المعادة في الحالة الأساسية محايدًا لذلك العامل.
وبالعودة إلى الدالة sumto، يمكننا تطبيق المبرهنة التي برهناها للتو للحصول فورًا على نسخة تعاودية ذيلية:
let rec sumto_r n =
  if n = 0 then 0 else n + sumto_r (n - 1)
val sumto_r : int -> int = <fun>
هنا، العامل هو الجمع، وهو تجميعي؛ والحالة الأساسية هي الصفر، وهو محايد للجمع. لذا تنطبق مبرهنتنا، ويمكننا استخدامها لإنتاج النسخة التعاودية الذيلية دون حاجة إلى التفكير حتى:
let rec sumto_i acc n =
  if n = 0 then acc else sumto_i (acc + n) (n - 1)
let sumto_tr = sumto_i 0
val sumto_i : int -> int -> int = <fun>
val sumto_tr : int -> int = <fun>
نعلم بالفعل أن sumto_tr صحيحة، بفضل مبرهنتنا.
8.7.6. الانتهاء
تُقسَّم صحة البرامج أحيانًا كذلك إلى:
- الصحة الجزئية (partial correctness): بمعنى أنه إذا انتهى تنفيذ البرنامج، فمخرجه صحيح؛ و
- الصحة الكلية (total correctness): بمعنى أن البرنامج ينتهي فعلًا، ومخرجه صحيح.
فالصحة الكلية إذن اقتران الصحة الجزئية بالانتهاء. وقد كنا حتى الآن نبرهن الصحة الجزئية.
والبرهان على أن برنامجًا ينتهي أمر صعب. بل إنه مستحيل عمومًا على أي خوارزمية أن تفعل ذلك: فلا يستطيع الحاسوب أن يقرر بدقة ما إذا كان برنامج سينتهي. (ابحث عن «مسألة التوقف» لمزيد من التفاصيل.) لكن الإنسان الذكي قد يستطيع ذلك أحيانًا.
وثمة قاعدة استرشادية بسيطة يمكن استخدامها لإظهار أن دالة تعاودية تنتهي:
- جميع الاستدعاءات التعاودية تكون على مدخل «أصغر»، و
- جميع الحالات الأساسية منتهية.
فمثلًا، تأمل دالة العاملي:
let rec fact n =
  if n = 0 then 1
  else n * fact (n - 1)
val fact : int -> int = <fun>
الحالة الأساسية، 1، منتهية بوضوح. والاستدعاء التعاودي على n - 1، وهو مدخل أصغر من n الأصلي. لذا تنتهي fact دائمًا (ما دام مدخلها عددًا طبيعيًا).
وينطبق الاستدلال نفسه على جميع الدوال الأخرى التي ناقشناها أعلاه.
ولجعل ذلك أدق، نحتاج إلى تصور لمعنى أن يكون العنصر «أصغر». لنفترض أن لدينا علاقة ثنائية x1 > x2 > x3 ... للعناصر باستخدام هذه العلاقة. (حيث a > b بالطبع إذا وفقط إذا كان b < a.) أي أنه لا توجد سلاسل هبوط لا نهائية من العناصر: فبمجرد أن تختار عنصر بداية x0، لا يمكن أن يكون هناك إلا عدد منتهٍ من «الهبوطات» وفق علاقة < قبل أن تصل إلى القاع وتصطدم بحالة أساسية. وهذه الخاصية لـ < تجعله علاقة جيدة الأساس (well-founded relation).
لذا تنتهي الدالة التعاودية إذا كانت جميع استدعاءاتها التعاودية على عناصر أصغر وفق <. ولماذا؟ لأن عدد الاستدعاءات لا يمكن أن يتجاوز عددًا منتهيًا قبل الوصول إلى حالة أساسية، والحالات الأساسية يجب أن تنتهي.
العلاقة المعتادة -2 > -3 > ....
وإليك دالة مثيرة للاهتمام لا تكفي العلاقة المعتادة < لإثبات انتهائها:
let rec ack = function
  | (0, n) -> n + 1
  | (m, 0) -> ack (m - 1, 1)
  | (m, n) -> ack (m - 1, ack (m, n - 1))
val ack : int * int -> int = <fun>
وهذه تُعرف بـ دالة أكرمان (Ackermann’s function). وهي تنمو أسرع من أي دالة أسية. جرّب تشغيل ack (1, 1) وack (2, 1) وack (3, 1) ثم ack (4, 1) لتأخذ فكرة عن ذلك. وهي أيضًا مثال مشهور على دالة يمكن تنفيذها بحلقات while لا بحلقات for. ومع ذلك، فهي تنتهي.
ولإظهار ذلك، الحالة الأساسية سهلة: فعندما يكون المدخل (0, _)، تنتهي الدالة. لكنها في الحالات الأخرى تُجري استدعاءً تعاوديًا، ونحتاج إلى تعريف علاقة < مناسبة. ويتبين أن الترتيب المعجمي (lexicographic ordering) على الأزواج ينجح في ذلك. عرّف (a, b) < (c, d) إذا:
- `a
a = cو`b
ورتبة < في هاتين الحالتين هي < المعتادة على الأعداد الطبيعية.
في الاستدعاء التعاودي الأول، (m - 1, 1) < (m, 0) بالحالة الأولى من تعريف <، لأن m - 1 < m. وفي الاستدعاء التعاودي المتضمَّن ack (m - 1, ack (m, n - 1))، نحتاج إلى الحالتين معًا:
- `(m, n - 1)
- `(m - 1, _)
8.8. الاستقراء البنيوي
برهنا حتى الآن صحة دوال تعاودية على الأعداد الطبيعية. ويمكننا أيضًا إجراء براهين صحة لدوال تعاودية على الأنواع المتغايرة. ويقتضي ذلك أن نكتشف كيف يعمل الاستقراء على الأنواع المتغايرة. وسنفعل ذلك بعد ذلك، بدءًا بنوع متغاير لتمثيل الأعداد الطبيعية، ثم نعمّم إلى القوائم والأشجار وغيرها من الأنواع المتغايرة. وتُعرف تقنية البرهان الاستقرائي هذه أحيانًا بـ الاستقراء البنيوي (structural induction) بدلًا من الاستقراء الرياضي. لكن ذلك مجرد مصطلح؛ فلا تتشبث به. فالفكرة الجوهرية هي نفسها تمامًا.
8.8.1. الاستقراء على الأعداد الطبيعية
استخدمنا نوع int في OCaml لتمثيل الأعداد الطبيعية. وبالطبع، ذلك النوع غير مطابق تمامًا: فقيم int السالبة لا تمثل أعدادًا طبيعية، وهناك حد أعلى لما يمكننا تمثيله من الأعداد الطبيعية بـ int.
فلنصلح هاتين المشكلتين بتعريف نوع متغاير خاص بنا لتمثيل الأعداد الطبيعية:
type nat = Z | S of nat
type nat = Z | S of nat
يمثل المنشئ Z الصفر؛ ويمثل المنشئ S لاحق عدد طبيعي آخر. لذا،
- يمثل
Zالعدد 0، - ويمثل
S Zالعدد 1، - ويمثل
S (S Z)العدد 2، - ويمثل
S (S (S Z))العدد 3،
وهكذا. فهذا النوع المتغاير تمثيل أحادي (unary) (في مقابل الثنائي أو العشري) للأعداد الطبيعية: فعدد مرات ظهور S في قيمة n : nat هو العدد الطبيعي الذي تمثله n.
ويمكننا تعريف الجمع على الأعداد الطبيعية بالدالة التالية:
let rec plus a b =
  match a with
  | Z -> b
  | S k -> S (plus k b)
val plus : nat -> nat -> nat = <fun>
ويمكننا فورًا أن نبرهن الدعوى التافهة إلى حد ما التالية:
Claim:  plus Z n = n

Proof:

  plus Z n
=   { evaluation }
  n

QED
لكن لنفترض أننا نريد أن نبرهن هذه الدعوى التي تبدو تافهة أيضًا:
Claim:  plus n Z = n

Proof:

  plus n Z
=
  ???
لا يمكننا مجرد تقييم plus n Z، لأن plus تطابق على وسيطها الأول لا الثاني. ومن الاحتمالات إجراء تحليل حالات: ماذا لو كان n هو Z، أو S k لبعض k؟ فلنجرّب ذلك.
Proof:

By case analysis on n, which must be either Z or S k.

Case:  n = Z

  plus Z Z
=   { evaluation }
  Z

Case:  n = S k

  plus (S k) Z
=   { evaluation }
  S (plus k Z)
=
  ???
وقد علقنا مرة أخرى، وللسبب نفسه: فمرة أخرى لا يمكن تقييم plus أكثر من ذلك.
وعندما تجد نفسك بحاجة إلى حل المسألة الجزئية نفسها في البرمجة، تستخدم التعاود. وعندما يحدث ذلك في برهان، تستخدم الاستقراء!
سنحتاج إلى مبدأ استقراء لـ nat. وها هو:
forall properties P,
  if P(Z),
  and if forall k, P(k) implies P(S k),
  then forall n, P(n)
قارن ذلك بمبدأ الاستقراء الذي استخدمناه للأعداد الطبيعية سابقًا، عندما كنا نستخدم int بدلًا من الأعداد الطبيعية:
forall properties P,
  if P(0),
  and if forall k, P(k) implies P(k + 1),
  then forall n, P(n)
لا فرق جوهريًا بين الاثنين: نستخدم Z بدلًا من 0، وS k بدلًا من k + 1.
وباستخدام مبدأ الاستقراء ذلك، يمكننا إجراء البرهان:
Claim:  plus n Z = n

Proof: by induction on n.
P(n) = plus n Z = n

Base case: n = Z
Show: plus Z Z = Z

  plus Z Z
=   { evaluation }
  Z

Inductive case: n = S k
IH: plus k Z = k
Show: plus (S k) Z = S k

  plus (S k) Z
=   { evaluation }
  S (plus k Z)
=   { IH }
  S k

QED
8.8.2. الاستقراء على القوائم
يتبين أن الأعداد الطبيعية والقوائم متشابهة إلى حد كبير، عند النظر إليها كأنواع بيانات. وإليك تعريف كليهما، مصفوفين للمقارنة:
type    nat  = Z  | S      of nat
type 'a list = [] | ( :: ) of 'a * 'a list
للنوعين معًا منشئ يمثل مفهوم «لا شيء». وللنوعين معًا أيضًا منشئ يمثل «واحدًا أكثر» من قيمة أخرى من النوع: فـ S n واحد أكثر من n، وh :: t قائمة فيها عنصر واحد أكثر من t.
ومبدأ الاستقراء للقوائم شبيه إلى حد كبير بمبدأ الاستقراء للأعداد الطبيعية. وها هو مبدأ الاستقراء للقوائم:
forall properties P,
  if P([]),
  and if forall h t, P(t) implies P(h :: t),
  then forall lst, P(lst)
ولذا يكون للبرهان الاستقرائي على القوائم البنية التالية:
Proof: by induction on lst.
P(lst) = ...

Base case: lst = []
Show: P([])

Inductive case: lst = h :: t
IH: P(t)
Show: P(h :: t)
ولنجرّب مثالًا على هذا النوع من البراهين. تذكّر تعريف عامل الإلحاق:
let rec append lst1 lst2 =
  match lst1 with
  | [] -> lst2
  | h :: t -> h :: append t lst2
let ( @ ) = append
val append : 'a list -> 'a list -> 'a list = <fun>
val ( @ ) : 'a list -> 'a list -> 'a list = <fun>
سنبرهن أن الإلحاق تجميعي.
Theorem: forall xs ys zs, xs @ (ys @ zs) = (xs @ ys) @ zs

Proof: by induction on xs.
P(xs) = forall ys zs, xs @ (ys @ zs) = (xs @ ys) @ zs

Base case: xs = []
Show: forall ys zs, [] @ (ys @ zs) = ([] @ ys) @ zs

  [] @ (ys @ zs)
=   { evaluation }
  ys @ zs
=   { evaluation }
  ([] @ ys) @ zs

Inductive case: xs = h :: t
IH: forall ys zs, t @ (ys @ zs) = (t @ ys) @ zs
Show: forall ys zs, (h :: t) @ (ys @ zs) = ((h :: t) @ ys) @ zs

  (h :: t) @ (ys @ zs)
=   { evaluation }
  h :: (t @ (ys @ zs))
=   { IH }
  h :: ((t @ ys) @ zs)

  ((h :: t) @ ys) @ zs
=   { evaluation of inner @ }
  (h :: (t @ ys)) @ zs
=   { evaluation of outer @ }
  h :: ((t @ ys) @ zs)

QED
8.8.3. مبرهنة عن الطي
عندما درسنا List.fold_left وList.fold_right، ناقشنا كيف أنهما يحسبان الدالة نفسها أحيانًا، لكنهما لا يفعلان ذلك عمومًا. فمثلًا،
  List.fold_left ( + ) 0 [1; 2; 3]
= (((0 + 1) + 2) + 3
= 6
= 1 + (2 + (3 + 0))
= List.fold_right ( + ) [1; 2; 3] 0
but
  List.fold_left ( - ) 0 [1; 2; 3]
= (((0 - 1) - 2) - 3
= -6
<> 2
= 1 - (2 - (3 - 0))
= List.fold_right ( - ) [1; 2; 3] 0
وبناءً على المعادلات أعلاه، يبدو أن كون + تبديليًا وتجميعيًا، بينما - ليس كذلك، يفسر هذا الفرق في متى تعطي دالتا الطي الجواب نفسه. فلنبرهن ذلك!
أولًا، تذكّر تعريفي دالتي الطي:
let rec fold_left f acc lst =
  match lst with
  | [] -> acc
  | h :: t -> fold_left f (f acc h) t
let rec fold_right f lst acc =
  match lst with
  | [] -> acc
  | h :: t -> f h (fold_right f t acc)
val fold_left : ('a -> 'b -> 'a) -> 'a -> 'b list -> 'a = <fun>
val fold_right : ('a -> 'b -> 'b) -> 'a list -> 'b -> 'b = <fun>
ثانيًا، تذكّر ما يعنيه أن تكون دالة f : 'a -> 'a تبديلية وتجميعية:
Commutative:  forall x y, f x y = f y x
Associative:  forall x y z, f x (f y z) = f (f x y) z
قد تبدو هذه مختلفة قليلًا عن الصيغ المعتادة لتلك الخواص، لأننا نستخدم f كعامل سابق. ولو كتبنا f بدلًا من ذلك كعامل بيني op، لبدت مألوفة أكثر:
Commutative:  forall x y, x op y = y op x
Associative:  forall x y z, x op (y op z) = (x op y) op z
وعندما تكون f تبديلية وتجميعية معًا، تكون لدينا هذه المُبرهنة المساعدة الصغيرة للتبادل التي تتيح لنا مبادلة وسيطين:
Lemma (interchange): f x (f y z) = f y (f x z)
Proof:
  f x (f y z)
=   { associativity }
  f (f x y) z
=   { commutativity }
  f (f y x) z
=   { associativity }
  f y (f x z)
QED
والآن نحن جاهزون لصوغ المبرهنة والبرهان عليها.
Theorem: If f is commutative and associative, then
  forall lst acc,
    fold_left f acc lst = fold_right f lst acc.

Proof: by induction on lst.
P(lst) = forall acc,
  fold_left f acc lst = fold_right f lst acc

Base case: lst = []
Show: forall acc,
  fold_left f acc [] = fold_right f [] acc

  fold_left f acc []
=   { evaluation }
  acc
=   { evaluation }
  fold_right f [] acc

Inductive case: lst = h :: t
IH: forall acc,
  fold_left f acc t = fold_right f t acc
Show: forall acc,
  fold_left f acc (h :: t) = fold_right f (h :: t) acc

  fold_left f acc (h :: t)
=   { evaluation }
  fold_left f (f acc h) t
=   { IH with acc := f acc h }
  fold_right f t (f acc h)

  fold_right f (h :: t) acc
=   { evaluation }
  f h (fold_right f t acc)
والآن قد يبدو أننا علقنا: فالطرفان الأيسر والأيمن من المساواة التي نريد إثباتها لم يتلاقيا «في المنتصف». لكننا في الواقع في موقف مشابه لحالتنا عندما برهنا صحة facti سابقًا: فهناك شيء (تطبيق f على h وعلى وسيط آخر) نريد دفعه إلى داخل مُراكِم السطر الأخير (بحيث يصبح لدينا f acc h).
ولنحاول البرهان على ذلك بمُبرهنة مساعدة خاصة به:
Lemma: forall lst acc x,
  f x (fold_right f lst acc) = fold_right f lst (f acc x)

Proof: by induction on lst.
P(lst) = forall acc x,
  f x (fold_right f lst acc) = fold_right f lst (f acc x)

Base case: lst = []
Show: forall acc x,
  f x (fold_right f [] acc) = fold_right f [] (f acc x)

  f x (fold_right f [] acc)
=   { evaluation }
  f x acc

  fold_right f [] (f acc x)
=   { evaluation }
  f acc x
=   { commutativity of f }
  f x acc

Inductive case: lst = h :: t
IH: forall acc x,
  f x (fold_right f t acc) = fold_right f t (f acc x)
Show: forall acc x,
  f x (fold_right f (h :: t) acc) = fold_right f (h :: t) (f acc x)

  f x (fold_right f (h :: t) acc)
=  { evaluation }
  f x (f h (fold_right f t acc))
=  { interchange lemma }
  f h (f x (fold_right f t acc))
=  { IH }
  f h (fold_right f t (f acc x))

  fold_right f (h :: t) (f acc x)
=   { evaluation }
  f h (fold_right f t (f acc x))

QED
والآن بعد أن اكتملت المُبرهنة المساعدة، يمكننا استئناف برهان المبرهنة. وسنبدأ من جديد عند بداية الحالة الاستقرائية:
Inductive case: lst = h :: t
IH: forall acc,
  fold_left f acc t = fold_right f t acc
Show: forall acc,
  fold_left f acc (h :: t) = fold_right f (h :: t) acc

  fold_left f acc (h :: t)
=   { evaluation }
  fold_left f (f acc h) t
=   { IH with acc := f acc h }
  fold_right f t (f acc h)

  fold_right f (h :: t) acc
=   { evaluation }
  f h (fold_right f t acc)
=   { lemma with x := h and lst := t }
  fold_right f t (f acc h)

QED
لقد احتجنا إلى استقراءين لإثبات المبرهنة، لكننا نجحنا! والآن نعلم أن السلوك الذي لاحظناه مع + لم يكن مصادفة: فأي عامل تبديلي وتجميعي يجعل fold_left وfold_right يعطيان الجواب نفسه.
8.8.4. الاستقراء على الأشجار
القوائم والأشجار الثنائية متشابهة عند النظر إليها كأنواع بيانات. وإليك تعريف كليهما، مصفوفين للمقارنة:
type 'a list = []   | ( :: ) of           'a * 'a list
type 'a tree = Leaf | Node   of 'a tree * 'a * 'a tree
type 'a list = [] | (::) of 'a * 'a list
type 'a tree = Leaf | Node of 'a tree * 'a * 'a tree
لكل منهما منشئ يمثل «الفراغ»، ولكل منهما منشئ يجمع قيمة من النوع 'a مع نسخة أخرى من نوع البيانات. والفرق الحقيقي الوحيد أن ( :: ) تأخذ قائمة واحدة فحسب، بينما تأخذ Node شجرتين.
ولذا فمبدأ الاستقراء للأشجار الثنائية شبيه جدًا بمبدأ الاستقراء للقوائم، إلا أننا نحصل مع الأشجار الثنائية على فرضيتين استقرائيتين، واحدة لكل شجرة فرعية:
forall properties P,
  if P(Leaf),
  and if forall l v r, (P(l) and P(r)) implies P(Node (l, v, r)),
  then forall t, P(t)
ولذا يكون للبرهان الاستقرائي على الأشجار الثنائية البنية التالية:
Proof: by induction on t.
P(t) = ...

Base case: t = Leaf
Show: P(Leaf)

Inductive case: t = Node (l, v, r)
IH1: P(l)
IH2: P(r)
Show: P(Node (l, v, r))
ولنجرّب مثالًا على هذا النوع من البراهين. إليك دالة تنشئ الصورة المرآتية لشجرة، بتبديل شجرتيها الفرعيتين اليسرى واليمنى في جميع المستويات:
let rec reflect = function
  | Leaf -> Leaf
  | Node (l, v, r) -> Node (reflect r, v, reflect l)
val reflect : 'a tree -> 'a tree = <fun>
فمثلًا، هاتان الشجرتان انعكاسان لبعضهما:
     1               1
   /   \           /   \
  2     3         3     2
 / \   / \       / \   / \
4   5 6   7     7   6 5   4
إذا أخذت الصورة المرآتية لصورة مرآتية، فينبغي أن تعود إلى الأصل. وهذا يعني أن الانعكاس إرجاعي (involution)، وهو أي دالة f بحيث f (f x) = x. ومن الأمثلة الأخرى على الدوال الإرجاعية الضرب في سالب واحد على الأعداد الصحيحة.
ولنبرهن أن reflect دالة إرجاعية.
Claim: forall t, reflect (reflect t) = t

Proof: by induction on t.
P(t) = reflect (reflect t) = t

Base case: t = Leaf
Show: reflect (reflect Leaf) = Leaf

  reflect (reflect Leaf)
=   { evaluation }
  reflect Leaf
=   { evaluation }
  Leaf

Inductive case: t = Node (l, v, r)
IH1: reflect (reflect l) = l
IH2: reflect (reflect r) = r
Show: reflect (reflect (Node (l, v, r))) = Node (l, v, r)

  reflect (reflect (Node (l, v, r)))
=   { evaluation }
  reflect (Node (reflect r, v, reflect l))
=   { evaluation }
  Node (reflect (reflect l), v, reflect (reflect r))
=   { IH1 }
  Node (l, v, reflect (reflect r))
=   { IH2 }
  Node (l, v, r)

QED
الاستقراء على الأشجار ليس في الحقيقة أصعب من الاستقراء على القوائم أو الأعداد الطبيعية. فقط تتبّع الفرضيات الاستقرائية، مستخدمًا رمز البرهان المنسَّق الذي نتبناه، فلن يكون صعبًا على الإطلاق.
8.8.5. مبادئ الاستقراء لجميع الأنواع المتغايرة
رأينا الآن مبادئ الاستقراء لـ nat وlist وtree. وبتعميم ما رأيناه، يولّد كل منشئ من منشئات النوع المتغاير إما حالة أساسية للبرهان الاستقرائي وإما حالة استقرائية. وإذا كان المنشئ نفسه يحمل قيمًا من نوع البيانات ذلك، فكل قيمة من تلك القيم تولّد فرضية استقرائية. فمثلًا:
Zو[]وLeafولّدت كلها حالات أساسية.Sو::وNodeولّدت كلها حالات استقرائية.Sو::ولّدت كل واحدة فرضية استقرائية واحدة، لأن كلًا منهما تحمل قيمة واحدة من نوع البيانات.Nodeولّدت فرضيتين استقرائيتين، لأنها تحمل قيمتين من نوع البيانات.
ومثالًا على مبدأ استقراء لنوع أعقد، لننظر في نوع يمثل صياغة تعبير رياضي. قد تتذكر من مقرر سابق في بنى البيانات أن الأشجار يمكن استخدامها لذلك الغرض.
لنفترض أن لدينا نوع expr التالي، وهو نوع من الأشجار، لتمثيل تعبيرات بالأعداد الصحيحة والقيم المنطقية والعوامل الأحادية والعوامل الثنائية:
type uop =
  | UMinus
type bop =
  | BPlus
  | BMinus
  | BLeq
type expr =
  | Int of int
  | Bool of bool
  | Unop of uop * expr
  | Binop of expr * bop * expr
type uop = UMinus
type bop = BPlus | BMinus | BLeq
type expr =
    Int of int
  | Bool of bool
  | Unop of uop * expr
  | Binop of expr * bop * expr
فمثلًا، يُمثَّل التعبير 5 < 6 بـ Binop (Int 5, BLeq, Int 6). وسنرى أمثلة أكثر على هذا النوع من التمثيل لاحقًا في الكتاب عندما ندرس المفسّرات.
ومبدأ الاستقراء لـ expr هو:
forall properties P,
  if forall i, P(Int i)
  and forall b, P(Bool b)
  and forall u e, P(e) implies P(Unop (u, e))
  and forall b e1 e2, (P(e1) and P(e2)) implies P(Binop (e1, b, e2))
  then forall e, P(e)
هناك حالتان أساسيتان، تقابلان المنشئين اللذين لا يحملان expr. وهناك حالتان استقرائيتان، تقابلان المنشئين اللذين يحملان expr. وتحصل Unop على فرضية استقرائية واحدة، بينما تحصل Binop على فرضيتين، بسبب عدد expr التي تحملها كل منهما.
8.8.6. الاستقراء والتعاود
بين البراهين الاستقرائية والبرامج التعاودية تشابه لافت. فبالبرهان الاستقرائي هو، بمعنى ما، برنامج تعاودي يوضح كيفية بناء دليل على مبرهنة تتضمن نوع بيانات جبري (ADT). وتحدد بنية النوع الجبري بنية البراهين والبرامج:
- منشئات النوع الجبري هي مبدأ التنظيم في البراهين والبرامج معًا. ففي البرهان، لدينا حالة أساسية أو استقرائية لكل منشئ. وفي البرنامج، لدينا حالة مطابقة أنماط لكل منشئ.
- ويحدد استخدام الأنواع التعاودية في النوع الجبري موضع التعاود في البراهين والبرامج معًا. ونعني بـ «النوع التعاودي» ظهور النوع في تعريفه نفسه، مثل
'a listالثانية فيtype 'a list = [] | ( :: ) 'a * 'a list. وتؤدي هذه الظهورات إلى ظهور قيم «أصغر» من نوع ما داخل قيم أكبر. وفي البرهان، نطبّق الفرضية الاستقرائية عند الوصول إلى قيمة أصغر كهذه. وفي البرنامج، نُجري التعاود على القيمة الأصغر.
8.9. المواصفة المعادلية
لنواجه بعد ذلك تحديًا أكبر: إثبات صحة بنية بيانات، مثل مكدس أو طابور أو مجموعة.
تحتاج براهين الصحة دائمًا إلى مواصفات. ففي إثبات صحة العاملي التكراري، استخدمنا العاملي التعاودي كمواصفة. وبالقياس، يمكننا تقديم تنفيذين لبنية بيانات—أحدهما بسيط والآخر معقد وفعّال—وإثبات أن الاثنين متكافئان. ويقتضي ذلك استحداث طرق للترجمة بين التنفيذين. فمثلًا، يمكننا إثبات صحة خريطة منفَّذة بشجرة بحث ثنائية متوازنة فعّالة بالنسبة إلى تنفيذ كقائمة ترابطية غير فعّالة، بتعريف دوال لتحويل الأشجار إلى قوائم. ومثل هذه المقاربة صحيحة بالتأكيد، لكنها لا تقودنا إلى أفكار جديدة في الإثبات الصوري لنتمكن من دراستها.
بدلًا من ذلك، سنتبع مقاربة مختلفة قائمة على المواصفات المعادلية (equational specifications)، وتُعرف أيضًا بـ المواصفات الجبرية (algebraic specifications). والفكرة فيها أن
- نعرّف أنواع عمليات بنية البيانات، و
- نكتب مجموعة من المعادلات تحدد كيفية تفاعل العمليات بعضها مع بعض.
وسبب ظهور كلمة «جبر» هنا هو (جزئيًا) أن هذه المقاربة القائمة على الأنواع والمعادلات شيء تعلمناه في جبر المدرسة الثانوية. فمثلًا، إليك مواصفة لبعض العوامل:
0 : int
1 : int
- : int -> int
+ : int -> int -> int
* : int -> int -> int
(a + b) + c = a + (b + c)
a + b = b + a
a + 0 = a
a + (-a) = 0
(a * b) * c = a * (b * c)
a * b = b * a
a * 1 = a
a * 0 = 0
a * (b + c) = a * b + a * c
إن أنواع تلك العوامل، والمعادلات المرتبطة بها، حقائق نتعلمها عند دراسة الجبر.
وهدفنا الآن أن نكتب مواصفات مشابهة لبنى البيانات، وأن نستخدمها للاستدلال على صحة التنفيذات.
8.9.1. مثال: المكدسات
إليك بعض العمليات المألوفة على المكدسات مع أنواعها.
module type Stack = sig
  type 'a t
  val empty : 'a t
  val is_empty : 'a t -> bool
  val peek : 'a t -> 'a
  val push : 'a -> 'a t -> 'a t
  val pop : 'a t -> 'a t
end
module type Stack =
  sig
    type 'a t
    val empty : 'a t
    val is_empty : 'a t -> bool
    val peek : 'a t -> 'a
    val push : 'a -> 'a t -> 'a t
    val pop : 'a t -> 'a t
  end
وكما اعتدنا، هناك خيار تصميمي يجب اتخاذه بشأن peek وما شابهها حول ما تفعله بالمكدس الفارغ. وهنا لم نستخدم option، وهو ما يوحي بأن peek سترفع استثناءً على المكدس الفارغ. لذا فنحن نخفف بحذر حظرنا على الاستثناءات.
وقد كنا في الماضي نعطي هذه العمليات مواصفات بالإنجليزية، مثل
  (** [push x s] is the stack [s] with [x] pushed on the top. *)
  val push : 'a -> 'a stack -> 'a stack
لكننا سنكتب الآن بعض المعادلات لوصف كيفية عمل العمليات:
1. is_empty empty = true
2. is_empty (push x s) = false
3. peek (push x s) = x
4. pop (push x s) = s
(وسنعود لاحقًا إلى مسألة كيفية تصميم مثل هذه المعادلات.) والمتغيرات الظاهرة في هذه المعادلات محدودة كليًا ضمنًا. وإليك كيفية قراءة كل معادلة:
is_empty empty = true. المكدس الفارغ فارغ.is_empty (push x s) = false. المكدس الذي دُفع إليه للتو ليس فارغًا.peek (push x s) = x. الدفع ثم النظر مباشرةً يعطي القيمة التي دُفعت.pop (push x s) = s. الدفع ثم السحب مباشرةً يعطي المكدس الأصلي.
وبهذه المعادلات وحدها، يمكننا بالفعل أن نستنبط الكثير عن كيفية عمل أي متتالية من عمليات المكدس. فمثلًا،
  peek (pop (push 1 (push 2 empty)))
=   { equation 4 }
  peek (push 2 empty)
=   { equation 3 }
  2
ولا يساوي peek empty أي قيمة وفق المعادلات، لأنه لا توجد معادلة بالشكل peek empty = .... وكل ذلك صحيح بصرف النظر عن تنفيذ المكدس المختار: فأي تنفيذ صحيح يجب أن يجعل المعادلات تصح.
لنفترض أننا نفّذنا المكدسات كقوائم، كما يلي:
module ListStack = struct
  type 'a t = 'a list
  let empty = []
  let is_empty = function [] -> true | _ -> false
  let peek = List.hd
  let push = List.cons
  let pop = List.tl
end
module ListStack :
  sig
    type 'a t = 'a list
    val empty : 'a list
    val is_empty : 'a list -> bool
    val peek : 'a list -> 'a
    val push : 'a -> 'a list -> 'a list
    val pop : 'a list -> 'a list
  end
وبعد ذلك يمكننا أن نبرهن أن كل معادلة تصح على التنفيذ. وجميع هذه البراهين سهلة الآن، وتجري كلها بالتقييم. فمثلًا، إليك برهان المعادلة 3:
  peek (push x s)
=   { evaluation }
  peek (x :: s)
=   { evaluation }
  x
8.9.2. مثال: الطوابير
كانت المكدسات سهلة. وماذا عن الطوابير؟ إليك المواصفة:
module type Queue = sig
  type 'a t
  val empty : 'a t
  val is_empty : 'a t -> bool
  val front : 'a t -> 'a
  val enq : 'a -> 'a t -> 'a t
  val deq : 'a t -> 'a t
end
module type Queue =
  sig
    type 'a t
    val empty : 'a t
    val is_empty : 'a t -> bool
    val front : 'a t -> 'a
    val enq : 'a -> 'a t -> 'a t
    val deq : 'a t -> 'a t
  end
1.  is_empty empty = true
2.  is_empty (enq x q) = false
3a. front (enq x q) = x            if is_empty q = true
3b. front (enq x q) = front q      if is_empty q = false
4a. deq (enq x q) = empty          if is_empty q = true
4b. deq (enq x q) = enq x (deq q)  if is_empty q = false
إن أنواع عمليات الطابور مطابقة في الواقع لأنواع عمليات المكدس. وها هي، جنبًا إلى جنب للمقارنة:
module type Stack = sig            module type Queue = sig
  type 'a t                          type 'a t
  val empty : 'a t                   val empty : 'a t
  val is_empty : 'a t -> bool        val is_empty : 'a t -> bool
  val peek : 'a t -> 'a              val front : 'a t -> 'a
  val push : 'a -> 'a t -> 'a t      val enq : 'a -> 'a t -> 'a t
  val pop : 'a t -> 'a t             val deq : 'a t -> 'a t
end                                end
انظر إلى كل سطر: فرغم أن العملية قد يكون لها اسم مختلف، فنوعها هو نفسه. ومن الواضح أن الأنواع وحدها لا تخبرنا ما يكفي عن العمليات. لكن المعادلات تفعل ذلك! وإليك كيفية قراءة كل معادلة:
- الطابور الفارغ فارغ.
- الإدراج في الطابور يجعله غير فارغ.
- إدراج
xفي طابور فارغ يجعلxعنصر المقدمة. أما إذا لم يكن الطابور فارغًا، فالإدراج لا يغيّر عنصر المقدمة. - الإدراج ثم الإخراج من طابور فارغ يترك الطابور فارغًا. أما إذا لم يكن الطابور فارغًا، فيمكن مبادلة عمليتي الإدراج والإخراج.
فمثلًا،
  front (deq (enq 1 (enq 2 empty)))
=   { equations 4b and 2 }
  front (enq 1 (deq (enq 2 empty)))
=   { equations 4a and 1 }
  front (enq 1 empty)
=   { equations 3a and 1 }
  1
ولا يساوي front empty أي قيمة وفق المعادلات.
وينتج عن تنفيذ الطابور كقائمة تنفيذ يسهل إثباته بالتقييم فحسب.
module ListQueue : Queue = struct
  type 'a t = 'a list
  let empty = []
  let is_empty q = q = []
  let front = List.hd
  let enq x q = q @ [x]
  let deq = List.tl
end
module ListQueue : Queue
فمثلًا، يمكن التحقق من 4a كما يلي:
  deq (enq x empty)
=   { evaluation of empty and enq}
  deq ([] @ [x])
=   { evaluation of @ }
  deq [x]
=   { evaluation of deq }
  []
=   { evaluation of empty }
  empty
و4b كما يلي:
  deq (enq x q)
=  { evaluation of enq and deq }
  List.tl (q @ [x])
=  { lemma, below, and q <> [] }
  (List.tl q) @ [x]

  enq x (deq q)
=  { evaluation }
  (List.tl q) @ [x]
وإليك المُبرهنة المساعدة:
Lemma: if xs <> [], then List.tl (xs @ ys) = (List.tl xs) @ ys.
Proof: if xs <> [], then xs = h :: t for some h and t.

  List.tl ((h :: t) @ ys)
=   { evaluation of @ }
  List.tl (h :: (t @ ys))
=   { evaluation of tl }
  t @ ys

  (List.tl (h :: t)) @ ys
=   { evaluation of tl }
  t @ ys

QED
لاحظ كيف يضمن الشرط المسبق في 3b و4b، وهو ألا يكون q فارغًا، ألا نضطر أبدًا إلى التعامل مع استثناء يُرفع في البراهين المعادلية.
8.9.3. مثال: الطوابير المُدفوعة على دفعات
تذكّر أن الطوابير المُدفوعة على دفعات تمثل طابورًا بقائمتين:
module BatchedQueue = struct
  (* AF: [(o, i)] represents the queue [o @ (List.rev i)].
     RI: if [o] is empty then [i] is empty. *)
  type 'a t = 'a list * 'a list
  let empty = ([], [])
  let is_empty (o, i) = if o = [] then true else false
  let enq x (o, i) = if o = [] then ([x], []) else (o, x :: i)
  let front (o, _) = List.hd o
  let deq (o, i) =
    match List.tl o with
    | [] -> (List.rev i, [])
    | t -> (t, i)
end
module BatchedQueue :
  sig
    type 'a t = 'a list * 'a list
    val empty : 'a list * 'b list
    val is_empty : 'a list * 'b -> bool
    val enq : 'a -> 'a list * 'a list -> 'a list * 'a list
    val front : 'a list * 'b -> 'a
    val deq : 'a list * 'a list -> 'a list * 'a list
  end
يختلف هذا التنفيذ ظاهريًا عن التنفيذ السابق الذي قدمناه، فهو يستخدم الأزواج بدلًا من السجلات، ويرفع الاستثناء المدمج Failure بدلًا من استثناء مخصص هو Empty.
فهل هذا التنفيذ صحيح؟ لا نحتاج إلا إلى التحقق من المعادلات لنعرف.
أولًا، مُبرهنة مساعدة:
Lemma:  if is_empty q = true, then q = empty.
Proof:  Since is_empty q = true, it must be that q = (f, b) and f = [].
By the RI, it must also be that b = [].  Thus q = ([], []) = empty.
QED
التحقق من المعادلة 1:
  is_empty empty
=   { eval empty }
  is_empty ([], [])
=   { eval is_empty }
  [] = []
=   { eval = }
  true
التحقق من المعادلة 2:
  is_empty (enq x q) = false
=   { eval enq }
  is_empty (if f = [] then [x], [] else f, x :: b)

case analysis: f = []

  is_empty (if f = [] then [x], [] else f, x :: b)
=   { eval if, f = [] }
  is_empty ([x], [])
=   { eval is_empty }
  [x] = []
=   { eval = }
  false

case analysis: f = h :: t

  is_empty (if f = [] then [x], [] else f, x :: b)
=   { eval if, f = h :: t }
  is_empty (h :: t, x :: b)
=   { eval is_empty }
  h :: t = []
=   { eval = }
  false
التحقق من المعادلة 3a:
  front (enq x q) = x
=   { emptiness lemma }
  front (enq x ([], []))
=   { eval enq }
  front ([x], [])
=   { eval front }
  x
التحقق من المعادلة 3b:
  front (enq x q)
=   { rewrite q as (h :: t, b), because q is not empty }
  front (enq x (h :: t, b))
=   { eval enq }
  front (h :: t, x :: b)
=   { eval front }
  h

  front q
=   { rewrite q as (h :: t, b), because q is not empty }
  front (h :: t, b)
=   { eval front }
  h
التحقق من المعادلة 4a:
  deq (enq x q)
=   { emptiness lemma }
  deq (enq x ([], []))
=   { eval enq }
  deq ([x], [])
=   { eval deq }
  List.rev [], []
=   { eval rev }
  [], []
=   { eval empty }
  empty
التحقق من المعادلة 4b:
Show: deq (enq x q) = enq x (deq q)  assuming is_empty q = false.
Proof: Since is_empty q = false, q must be (h :: t, b).

Case analysis:  t = [], b = []

  deq (enq x q)
=   { rewriting q as ([h], []) }
  deq (enq x ([h], []))
=   { eval enq }
  deq ([h], [x])
=   { eval deq }
  List.rev [x], []
=   { eval rev }
  [x], []

  enq x (deq q)
=   { rewriting q as ([h], []) }
  enq x (deq ([h], []))
=   { eval deq }
  enq x (List.rev [], [])
=   { eval rev }
  enq x ([], [])
=   { eval enq }
  [x], []

Case analysis:  t = [], b = h' :: t'

  deq (enq x q)
=   { rewriting q as ([h], h' :: t') }
  deq (enq x ([h], h' :: t'))
=   { eval enq }
  deq ([h], x :: h' :: t')
=   { eval deq }
  (List.rev (x :: h' :: t'), [])

  enq x (deq q)
=   { rewriting q as ([h], h' :: t') }
  enq x (deq ([h], h' :: t'))
=   { eval deq }
  enq x (List.rev (h' :: t'), [])
=   { eval enq }
  (List.rev (h' :: t'), [x])

STUCK
انتظر، لقد علقنا للتو! فـ (List.rev (x :: h' :: t'), []) و(List.rev (h' :: t'), [x]) مختلفان. لكنهما، مجرّدين، يمثلان الطابور نفسه: (List.rev t') @ [h'; x].
ولحل هذه المشكلة، سنتبنى المعادلة التالية لأنواع التمثيل:
e = e' if AF(e) = AF(e')
وتتيح لنا تلك المعادلة أن نستنتج أن التعبيرين المختلفين متساويان:
  AF((List.rev (h' :: t'), [x]))
=   { apply AF }
  List.rev (h' :: t') @ List.rev [x]
=   { rev distributes over @, an exercise in the previous lecture }
  List.rev ([x] @ (h' :: t'))
=   { eval @ }
  List.rev (x :: h' :: t')

  AF((List.rev (x :: h' :: t'), []))
=   { apply AF }
  List.rev (x :: h' :: t') @ List.rev []
=   { eval rev }
  List.rev (x :: h' :: t') @ []
=   { eval @ }
  List.rev (x :: h' :: t')
وبهذا نخرج من المأزق:
  (List.rev (h' :: t'), [x])
=   { AF equation }
  (List.rev (x :: h' :: t'), [])
تبقى تحليل حالات واحد آخر لإكمال البرهان:
Case analysis:  t = h' :: t'

  deq (enq x q)
=   { rewriting q as (h :: h' :: t', b) }
  deq (enq x (h :: h' :: t', b))
=   { eval enq }
  deq (h :: h' :: t, x :: b)
=   { eval deq }
  h' :: t, x :: b

  enq x (deq q)
=   { rewriting q as (h :: h' :: t', b) }
  enq x (deq (h :: h' :: t', b))
=   { eval deq }
  enq x (h' :: t', b)
=   { eval enq }
  h' :: t', x :: b

QED
وبذلك يختتم تحققنا من الطابور المُدفوع على دفعات. لاحظ أننا اضطررنا إلى إضافة معادلة إضافية تتضمن دالة التجريد حتى تجتاز البراهين:
e = e' if AF(e) = AF(e')
وأننا استفدنا من ثابت التمثيل أثناء البرهان. فدالة التجريد وثابت التمثيل مهمان حقًا!
8.9.4. تصميم المواصفات المعادلية
قدّمنا لكل من المكدسات والطوابير بعض المعادلات كمواصفة. وتصميم تلك المعادلات مسألة تفكير عميق في بنية البيانات، جزئيًا. لكن الأمر أكثر من ذلك.
فكل قيمة في بنية البيانات تُبنى ببعض العمليات. وفي المكدس، تلك العمليات هي empty وpush. وقد تكون هناك بعض عمليات pop متضمنة، لكن يمكن إزالتها. فمثلًا، pop (push 1 (push 2 empty)) هو في الحقيقة المكدس نفسه الذي push 2 empty. وهذا الأخير هو الصيغة القانونية (canonical form) لذلك المكدس: فهناك طرق أخرى كثيرة لبنائه، لكن تلك هي الأبسط. بل إن كل قيمة مكدس ممكنة يمكن بناؤها بـ empty وpush فحسب. وبالمثل، كل قيمة طابور ممكنة يمكن بناؤها بـ empty وenq فحسب: فإذا كانت هناك عمليات deq متضمنة، أمكن إزالتها.
ولنصنّف عمليات بنية البيانات كما يلي:
- المولّدات (Generators) هي العمليات المتضمنة في إنشاء الصيغة القانونية. وهي تعيد قيمة من نوع بنية البيانات. مثل
emptyوpushوenq. - المعالِجات (Manipulators) عمليات تنشئ قيمة من نوع بنية البيانات، لكنها غير مطلوبة لإنشاء الصيغ القانونية. مثل
popوdeq. - الاستعلامات (Queries) لا تعيد قيمة من نوع بنية البيانات. مثل
is_emptyوpeekوfront.
وبالنظر إلى هذا التصنيف، يمكننا تصميم المواصفة المعادلية لبنية بيانات بتطبيق غير المولّدات على المولّدات. فمثلًا: ماذا تعيد is_empty على empty؟ وعلى push؟ وماذا تعيد front على enq؟ وماذا تعيد deq على enq؟ وما إلى ذلك.
لذا إذا كان في بنية البيانات n من المولّدات وm من غير المولّدات، فسنبدأ بمحاولة إنشاء n*m معادلة، واحدة لكل زوج من مولّد وغير مولّد. وستوضح كل معادلة كيفية تبسيط تعبير. وقد نحتاج في بعض الحالات إلى معادلتين، حسب نتيجة بعض المقارنات. فمثلًا، في مواصفة الطابور لدينا المعادلات التالية:
is_empty empty = true: هذا غير مولّد هوis_emptyمطبَّق على مولّد هوempty. وهو يختزل ببساطة إلى قيمة منطقية، لا تتضمن نوع بنية البيانات (الطوابير) إطلاقًا.is_empty (enq x q) = false: غير مولّد هوis_emptyمطبَّق على مولّد هوenq. وهو مرة أخرى يختزل ببساطة إلى قيمة منطقية.- هناك حالتان فرعيتان.
front (enq x q) = x، إذا كانis_empty q = true. وغير مولّد هوfrontمطبَّق على مولّد هوenq. وهو يختزل إلىx، وهو تعبير أصغر منfront (enq x q)الأصلي. front (enq x q) = front q،if is_empty q = false. وهذا يختزل كذلك إلى تعبير أصغر.- ومرة أخرى، هناك حالتان فرعيتان.
deq (enq x q) = empty، إذا كانis_empty q = true. وهذا يبسّط التعبير الأصلي باختزاله إلىempty. deq (enq x q) = enq x (deq q)، إذا كانis_empty q = false. وهذا يبسّط التعبير الأصلي باختزاله إلى مولّد مطبَّق على وسيط أصغر، هوdeq qبدلًا منdeq (enq x q).
ولا نصمم عادةً معادلات تتضمن أزواجًا من غير المولّدات. لكن قد يلزم أحيانًا زوجان من المولّدات، كما سنرى في المثال التالي.
مثال: المجموعات. إليك واجهة صغيرة للمجموعات:
module type Set = sig
  type 'a t
  val empty : 'a t
  val is_empty : 'a t -> bool
  val add : 'a -> 'a t -> 'a t
  val mem : 'a -> 'a t -> bool
  val remove : 'a -> 'a t -> 'a t
end
module type Set =
  sig
    type 'a t
    val empty : 'a t
    val is_empty : 'a t -> bool
    val add : 'a -> 'a t -> 'a t
    val mem : 'a -> 'a t -> bool
    val remove : 'a -> 'a t -> 'a t
  end
المولّدان هما empty وadd. والمعالِج الوحيد هو remove. وأخيرًا، is_empty وmem استعلامان. لذا ينبغي أن نتوقع 2 × 3 = 6 معادلات على الأقل، واحدة لكل زوج من مولّد وغير مولّد. وإليك مواصفة معادلية:
1.  is_empty empty = true
2.  is_empty (add x s) = false
3.  mem x empty = false
4a. mem y (add x s) = true                    if x = y
4b. mem y (add x s) = mem y s                 if x <> y
5.  remove x empty = empty
6a. remove y (add x s) = remove y s           if x = y
6b. remove y (add x s) = add x (remove y s)   if x <> y
لكن تأمل هاتين المجموعتين:
add 0 (add 1 empty)add 1 (add 0 empty)
فهما بديهيًا تمثلان المجموعة {0,1}. ومع ذلك لا يمكننا أن نبرهن أن هاتين المجموعتين متساويتان باستخدام المواصفة أعلاه. فتنقصنا معادلة تتضمن مولّدين:
7. add x (add y s) = add y (add x s)
8.10. الخلاصة
التوثيق والاختبار ضروريان لإثبات حقيقة ما يفعله البرنامج الصحيح. فالتوثيق ينقل إلى البشر الآخرين مقصد المبرمج. والاختبار ينقل دليلًا على نجاح المبرمج.
ويوفر التوثيق الجيد عدة مكونات: ملخصًا، وشروطًا مسبقة، وشروطًا لاحقة (تشمل الأخطاء)، وأمثلة. ويُكتب التوثيق لجمهورين مختلفين: العملاء والصّوان. ويحتاج الصّوان إلى معرفة دوال التجريد وثوابت التمثيل.
وتشمل منهجيات الاختبار اختبارات الصندوق الأسود والصندوق الزجاجي والاختبارات العشوائية. وهذه مقاربات متكاملة، لا متعامدة، لتطوير شيفرة صحيحة.
والطرق الصورية حلقة مهمة بين الرياضيات وعلم الحاسوب. فيمكننا استخدام تقنيات من الرياضيات المتقطعة، مثل الاستقراء، لإثبات صحة البرامج الوظيفية. والاستدلال المعادلي يجعل البراهين ممتعة نسبيًا.
وقد يكون إثبات صحة البرامج الأمرية أكثر تحديًا، بسبب الحاجة إلى الاستدلال على الحالة القابلة للتغيير. وقد يخرّب ذلك الاستدلال المعادلي. وبدلًا من ذلك، تُعتبر منطق هور (Hoare logic)، المنسوب إلى Tony Hoare، طريقة صورية شائعة للبرامج الأمرية. وحساب أضعف شرط مسبق (weakest precondition) عند Dijkstra طريقة أخرى.
8.10.1. المصطلحات والمفاهيم
- قيمة مجرّدة (abstract value)
- التجريد بالمواصفة (abstraction by specification)
- دالة التجريد (abstraction function)
- مواصفة جبرية (algebraic specification)
- تأكيد (asserting)
- تجميعي (associative)
- الحالة الأساسية (base case)
- صندوق أسود (black box)
- حالة حدّية (boundary case)
- عيب (bug)
- صيغة قانونية (canonical form)
- عميل (client)
- فحص الشيفرة (code inspection)
- مراجعة الشيفرة (code review)
- استعراض الشيفرة (code walkthrough)
- تعليقات (comments)
- تبديلي (commutative)
- مخطط تبديلي (commutative diagram)
- قيمة ملموسة (concrete value)
- تصريف شرطي (conditional compilation)
- مستهلك (consumer)
- الصحة (correctness)
- تجريد البيانات (data abstraction)
- التنقيح بالمنهج العلمي (debugging by scientific method)
- البرمجة الدفاعية (defensive programming)
- معادلة (equation)
- الاستدلال المعادلي (equational reasoning)
- جملة الأمثلة (example clause)
- الامتداد (extensionality)
- إخفاق (failure)
- عيب (fault)
- طرق صورية (formal methods)
- مولّد (generator)
- صندوق زجاجي (glass box)
- محايد (identity)
- منفّذ (implementer)
- استقراء (induction)
- فرضية استقرائية (induction hypothesis)
- مبدأ الاستقراء (induction principle)
- حالة استقرائية (inductive case)
- مدخلات لأصناف من المخرجات (inputs for classes of output)
- مدخلات تحقق الشرط المسبق (inputs that satisfy precondition)
- مدخلات تثير الاستثناءات (inputs that trigger exceptions)
- تكراري (iterative)
- محلية (locality)
- معالِج (manipulator)
- متعدد إلى واحد (many to one)
- حالة اختبار دنيا (minimal test case)
- قابلية التعديل (modifiability)
- أعداد طبيعية (natural numbers)
- البرمجة الثنائية (pair programming)
- جزئي (partial)
- الصحة الجزئية (partial correctness)
- دالة جزئية (partial function)
- تغطية المسارات (path coverage)
- مسارات عبر التنفيذ (paths through implementation)
- مسارات عبر المواصفة (paths through specification)
- شرط لاحق (postcondition)
- شرط مسبق (precondition)
- منتج (producer)
- استعلام (query)
- جملة الرفع (raises clause)
- اختبار عشوائي (randomized testing)
- اختبار الانحدار (regression testing)
- يعتمد على (rely)
- ثابت التمثيل سليم (rep ok)
- ثابت التمثيل (representation invariant)
- نوع التمثيل (representation type)
- مدخلات تمثيلية (representative inputs)
- جملة المتطلبات (requires clause)
- جملة الإعادة (returns clause)
- تحقق (satisfaction)
- طرق اجتماعية (social methods)
- مواصفة (specification)
- اختبار (testing)
- الصحة الكلية (total correctness)
- دالة كاملة (total function)
- مدخل نمطي (typical input)
- التحقق من الصلاحية (validation)
- الإثبات الصوري (verification)
- جيد الأساس (well-founded)
8.10.2. قراءات إضافية
- Program Development in Java: Abstraction, Specification, and Object-Oriented Design، الفصول 3 و5 و9، لباربرا ليسكوف مع جون غوتاغ.
- The Functional Approach to Programming، القسم 3.4. Guy Cousineau و Michel Mauny. Cambridge، 1998.
- ML for the Working Programmer، الطبعة الثانية، الفصل 6. L.C. Paulson. Cambridge، 1996.
- Thinking Functionally with Haskell، الفصل 6. Richard Bird. Cambridge، 2015.
- Software Foundations، المجلد 1، فصول Basic وInduction وLists وPoly. Benjamin Pierce وآخرون. https://softwarefoundations.cis.upenn.edu/
- «Algebraic Specifications»، Robert McCloskey، https://www.cs.scranton.edu/~mccloske/courses/se507/alg_specs_lec.html.
- Software Engineering: Theory and Practice، الطبعة الثالثة، القسم 4.5. Shari Lawrence Pfleeger و Joanne M. Atlee. Prentice Hall، 2006.
- «Algebraic Semantics»، الفصل 12 من Formal Syntax and Semantics of Programming Languages، Kenneth Slonneger و Barry L. Kurtz، Addison-Wesley، 1995.
- «Algebraic Semantics»، Muffy Thomas. الفصل 6 في Programming Language Syntax and Semantics، David Watt، Prentice Hall، 1991.
- Fundamentals of Algebraic Specification 1: Equations and Initial Semantics. H. Ehrig و B. Mahr. Springer-Verlag، 1985.
8.10.3. شكر وتقدير
استمدت معالجتنا للطرق الصورية إلهامها من مواد مقرر Princeton COS 326 لـ David Walker وآخرين، وهي مدينة لها.
وتستند مواصفاتنا الجبرية المثالية إلى McCloskey. ويستند مصطلح «مولّد» و«معالِج» و«استعلام» إلى Pfleeger و Atlee.
ومعظم تماريننا في الطرق الصورية مستوحاة من Software Foundations، المجلد 1.
8.11. التمارين
حلول معظم التمارين متاحة. ويسعدنا إضافة الحلول أو تصحيحها. فيرجى المساهمة عبر GitHub.
تمرين: لعبة المواصفة [★★★]
اتفق مع مبرمج آخر والعبا لعبة المواصفة معًا. وتبادلا الأدوار بين كاتب المواصفة والمبرمج الماكر. وإليك بعض الدوال المقترحة التي يمكنكما استخدامها:
num_vowels : string -> intis_sorted : 'a list -> boolsort : 'a list -> 'a listmax : 'a list -> 'ais_prime : int -> boolis_palindrome : string -> boolsecond_largest : int list -> intdepth : 'a tree -> int
تمرين: مواصفة كثيرات الحدود [★★★]
لننشئ تجريد بيانات لكثيرات حدود صحيحة بمتغير واحد بالشكل
ولنفترض أن كثيرات الحدود كثيفة (dense)، بمعنى أنها تحتوي معاملات صفرية قليلة جدًا. وإليك واجهة غير مكتملة لكثيرات الحدود:
(** [Poly] represents immutable polynomials with integer coefficients. *)
module type Poly = sig
  (** [t] is the type of polynomials. *)
  type t
  (** [eval x p] is [p] evaluated at [x]. Example: if [p] represents
      $3x^3 + x^2 + x$, then [eval 10 p] is [3110]. *)
  val eval : int -> t -> int
end
أكمل تصميم Poly بإضافة مزيد من العمليات إلى الواجهة. وفكّر في العمليات التي ستكون مفيدة لعميل التجريد:
- كيف ينشئ كثيرات الحدود؟
- كيف يدمج كثيرات الحدود للحصول على كثيرات حدود جديدة؟
- كيف يستعلم عن كثيرة حدود لمعرفة ما تمثله؟
واكتب تعليقات مواصفة للعمليات التي تخترعها. وضع لعبة المواصفة في ذهنك وأنت تكتبها: فهل يستطيع مبرمج ماكر أن يخرّب مقاصدك؟
تمرين: تنفيذ كثيرات الحدود [★★★]
نفّذ مواصفتك لـ Poly. وسيكون عليك، كجزء من تنفيذك، اختيار نوع تمثيل t. تلميح: تذكّر أن كثيرات حدودنا كثيفة قد يرشدك إلى اختيار نوع تمثيل يجعل التنفيذ أسهل.
تمرين: حساب الفترات [★★★★]
اكتب مواصفة ونفّذ تجريد بيانات لـ حساب الفترات (interval arithmetic). واحرص على تضمين دالة التجريد وثابت التمثيل وrep_ok. ونفّذ أيضًا دالة to_string ودالة format يمكن تثبيتها في المستوى الأعلى بـ #install_printer.
تمرين: خرائط الدوال [★★★★]
نفّذ بنية بيانات خريطة (أو قاموس) بنوع مجرّد ('k, 'v) t. واستخدم 'k -> 'v كنوع التمثيل. أي أن الخريطة تُمثَّل بدالة OCaml من المفاتيح إلى القيم. ووثّق دالة التجريد. ولست بحاجة إلى ثابت تمثيل. وسيستخدم حلك دوال عالية الرتبة استخدامًا مكثفًا. ووفّر على الأقل هذه القيم والعمليات: empty وmem وfind وadd وremove.
تمرين: صندوق أسود للمجموعات [★★★]
عُد إلى تنفيذ المجموعات بالقوائم في الفصل السابق. وبناءً على تعليقات مواصفة Set، اكتب مجموعة اختبارات OUnit للوحدة ListSet تجري اختبار صندوق أسود لجميع عملياتها.
تمرين: صندوق زجاجي للمجموعات [★★★]
حقّق أقرب ما يمكن إلى تغطية شيفرة 100% بأداة Bisect للوحدة ListSet وUniqListSet.
تمرين: قوائم عشوائية [★★★]
استخدم QCheck.Gen.generate1 لتوليد قائمة طولها بين 5 و10، وعناصرها أعداد صحيحة بين 0 و100. ثم استخدم QCheck.Gen.generate لتوليد قائمة من 3 عناصر، كل عنصر منها قائمة من النوع الذي أنشأته للتو بـ generate1.
ثم استخدم QCheck.make لإنشاء قيمة اعتباطية تمثل قائمة طولها بين 5 و10، وعناصرها أعداد صحيحة بين 0 و100. وينبغي أن يكون نوع قيمتك الاعتباطية int list QCheck.arbitrary.
وأخيرًا، أنشئ اختبار QCheck وشغّله ليتحقق مما إذا كان عنصر واحد على الأقل من قائمة اعتباطية (من 5 إلى 10 عناصر، كل منها بين 0 و100) زوجيًا. وستحتاج إلى «ترقية» الخاصية is_even لتعمل على قائمة أعداد صحيحة بدلًا من عدد صحيح واحد.
وتذكّر أن الاختبار في كل مرة تشغّله سيولّد 100 قائمة ويتحقق من الخاصية فيها. وإذا شغّلت الاختبار مرات كثيرة، فسترى على الأرجح بعض النجاحات وبعض الإخفاقات.
تمرين: القاسم الفردي في QCheck [★★★]
إليك دالة معطوبة:
(** [odd_divisor x] is an odd divisor of [x].
    Requires: [x >= 0]. *)
let odd_divisor x =
  if x < 3 then 1 else
    let rec search y =
      if y >= x then y  (* exceeded upper bound *)
      else if x mod y = 0 then y  (* found a divisor! *)
      else search (y + 2) (* skip evens *)
    in search 3
اكتب اختبار QCheck لتحديد ما إذا كان مخرج تلك الدالة (على عدد صحيح موجب، وفق شرطها المسبق؛ تلميح: توجد قيمة اعتباطية تولّد أعدادًا صحيحة موجبة) فرديًا وكذلك قاسمًا للمدخل. وستكتشف أن في الدالة عيبًا. فما أصغر عدد صحيح يُثير ذلك العيب؟
تمرين: المتوسط في QCheck [★★★★]
إليك دالة معطوبة:
(** [avg [x1; ...; xn]] is [(x1 + ... + xn) / n].
     Requires: the input list is not empty. *)
let avg lst =
  let rec loop (s, n) = function
    | [] -> (s, n)
    | [ h ] -> (s + h, n + 1)
    | h1 :: h2 :: t -> if h1 = h2 then loop (s + h1, n + 1) t
      else loop (s + h1 + h2, n + 2) t
  in
  let (s, n) = loop (0, 0) lst
  in float_of_int s /. float_of_int n
اكتب اختبار QCheck يكشف العيب. وللخاصية التي تتحقق منها، ابنِ تنفيذًا مرجعيًا خاصًا بك للمتوسط—أي نسخة أقل تحسينًا من avg صحيحة بوضوح.
تمرين: exp [★★]
برهن أن exp x (m + n) = exp x m * exp x n، حيث
let rec exp x n =
  if n = 0 then 1 else x * exp x (n - 1)
امضِ بالاستقراء على m.
تمرين: fibi [★★★]
برهن أن forall n >= 1, fib n = fibi n (0, 1)، حيث
let rec fib n =
  if n = 1 then 1
  else if n = 2 then 1
  else fib (n - 2) + fib (n - 1)
let rec fibi n (prev, curr) =
  if n = 1 then curr
  else fibi (n - 1) (curr, prev + curr)
امضِ بالاستقراء على n، بدلًا من محاولة تطبيق المبرهنة المتعلقة بتحويل التعاود إلى تكرار.
تمرين: expsq [★★★]
برهن أن expsq x n = exp x n، حيث
let rec expsq x n =
  if n = 0 then 1
  else if n = 1 then x
  else (if n mod 2 = 0 then 1 else x) * expsq (x * x) (n / 2)
امضِ بـ الاستقراء القوي (strong induction) على n. وتنفّذ الدالة expsq الرفع إلى قوة بالتربيع المتكرر (exponentiation by repeated squaring)، وهو ما يؤدي إلى حساب أكثر كفاءة من exp.
تمرين: expsq مبسّطة [★★★]
أعد التمرين السابق، لكن بهذه النسخة المبسّطة من الدالة. فالنسخة المبسّطة تتطلب شيفرة أقل، لكنها تتطلب استدعاءً تعاوديًا إضافيًا.
let rec expsq' x n =
  if n = 0 then 1
  else (if n mod 2 = 0 then 1 else x) * expsq' (x * x) (n / 2)
تمرين: mult [★★]
برهن أن forall n, mult n Z = Z بالاستقراء على n، حيث:
let rec mult a b =
  match a with
  | Z -> Z
  | S k -> plus b (mult k b)
تمرين: إلحاق القائمة الفارغة [★★]
برهن أن forall lst, lst @ [] = lst بالاستقراء على lst.
تمرين: توزيع rev على الإلحاق [★★★]
برهن أن العكس يوزّع على الإلحاق، أي أن forall lst1 lst2, rev (lst1 @ lst2) = rev lst2 @ rev lst1، حيث:
let rec rev = function
  | [] -> []
  | h :: t -> rev t @ [h]
(وهذا بالطبع تنفيذ غير فعّال لـ rev.) ستحتاج إلى اختيار القائمة التي ستجري الاستقراء عليها. وستحتاج إلى التمرين السابق كمُبرهنة مساعدة، وإلى تجميعية الإلحاق التي برهناها في الملاحظات أعلاه.
تمرين: إرجاعية rev [★★★]
برهن أن العكس دالة إرجاعية، أي أن forall lst, rev (rev lst) = lst. وامضِ بالاستقراء على lst. وستحتاج إلى التمرين السابق كمُبرهنة مساعدة.
تمرين: حجم الانعكاس [★★★]
برهن أن forall t, size (reflect t) = size t بالاستقراء على t، حيث:
let rec size = function
  | Leaf -> 0
  | Node (l, v, r) -> 1 + size l + size r
let rec reflect = function
  | Leaf -> Leaf
  | Node (l, v, r) -> Node (reflect r, v, reflect l)
تمرين: مبرهنة الطي 2 [★★★★]
برهنا أن fold_left وfold_right يعطيان النتائج نفسها إذا كانت وسيطهما الدالي تجميعيًا وتبديلًا. لكن ذلك لا يفسر لماذا يعطي تنفيذا concat هذان النتيجتين نفسها، لأن ( ^ ) ليس تبديليًا:
let concat_l lst = List.fold_left ( ^ ) "" lst
let concat_r lst = List.fold_right ( ^ ) lst ""
صُغ وبرهن مبرهنة جديدة عن متى يعطي fold_left وfold_right النتائج نفسها، تحت الافتراض المخفف بأن وسيطهما الدالي تجميعي لكنه ليس تبديليًا بالضرورة. تلميح: اطرح افتراضًا جديدًا عن القيمة الأولية للمُراكِم.
تمرين: القضايا المنطقية [★★★★]
في المنطق القضوي، لدينا قضايا ذرية ونفي وعطف وفصل واستلزام. فمثلًا، raining /\ snowing /\ cold قضية تقول إن الجو ممطر ومثلج وبارد في آن واحد (وهي حالة جوية تُعرف بـ Ithacating).
عرّف نوعًا في OCaml لتمثيل القضايا. ثم صُغ مبدأ الاستقراء لذلك النوع.
تمرين: مواصفة القوائم [★★★]
صمّم واجهة OCaml للقوائم فيها عمليات nil وcons وappend وlength. وصمّم المواصفة المعادلية. تلميح: ستبدو المعادلات شبيهة بشكل لافت بتطبيقات OCaml لـ @ وList.length.
تمرين: مواصفة الحقيبة [★★★★]
الحقيبة (bag) أو المجموعة المتعددة (multiset) مزيج من قائمة ومجموعة: فهي مثل المجموعة لا يهم فيها الترتيب؛ ومثل القائمة قد يتكرر عنصرها أكثر من مرة. وعدد مرات ظهور العنصر هو تعدديته (multiplicity). والعنصر الذي لا يظهر في الحقيبة تعدديته 0. وإليك توقيعًا في OCaml للحقائب:
module type Bag = sig
  type 'a t
  val empty : 'a t
  val is_empty : 'a t -> bool
  val insert : 'a -> 'a t -> 'a t
  val mult : 'a -> 'a t -> int
  val remove : 'a -> 'a t -> 'a t
end
صنّف العمليات في واجهة Bag كمولّدات أو معالِجات أو استعلامات. ثم صمّم مواصفة معادلية للحقائب. وبالنسبة إلى العملية remove، ينبغي أن تجعل مواصفتك إزالة ظهور واحد على الأكثر من العنصر. أي أن تعددية تلك القيمة ينبغي أن تنقص بمقدار واحد على الأكثر.