خوارزميات الترتيب
12. خوارزميات الترتيب
يعرض هذا الفصل عدة خوارزميات للترتيب (sorting algorithms) على القوائم والمصفوفات.
نفترض أن العناصر المطلوب ترتيبها من النوع elt، مزوّدة بترتيب كلي يُعطى في صورة دالة
compare من النوع elt->elt->int. وستكون لدوال الترتيب على القوائم والمصفوفات
على التوالي النوعان eltlist->eltlist وeltarray->unit. ونفترض أننا نرتّب القوائم
والمصفوفات ترتيبًا تصاعديًا. وللتيسير، نعرّف الدالتين lt وle على
النحو التالي:
  let lt x y = compare x y < 0
  let le x y = compare x y <= 0
في هذا الفصل كله، سنرمز بـ N إلى عدد العناصر المطلوب ترتيبها. ولكل خوارزمية ترتيب معروضة، نبيّن تعقيدها لا من حيث عدد المقارنات المُنفّذة فحسب، بل أيضًا من حيث عدد التخصيصات (allocations) الأساسية في حالة القوائم وعدد الإسنادات (assignments) في حالة المصفوفات. ولكل واحدة منها، نعطي التعقيد في أفضل الحالات وأسوئها ومتوسطها. وفي الحالة المتوسطة، نفترض أن العناصر المطلوب ترتيبها متمايزة وأن التباديل (permutations) الممكنة N! للمُدخل كلها متساوية الاحتمال. وذكّر أن التعقيد الأمثل لخوارزمية ترتيب لا تُجري إلا مقارنات بين العناصر هو O(N log N) (انظر القسم 12.5).
12.1 الترتيب بالإدراج (insertion sort)
يتمثل الترتيب بالإدراج في إدراج كل عنصر تباعًا ضمن مجموعة العناصر المرتّبة بالفعل. وهذا ما نفعله، على سبيل المثال، عند ترتيب رزمة من البطاقات.
12.1.1 القوائم
يتمثل الترتيب بالإدراج على قائمة في اجتيازها مع إدراج كل عنصر تباعًا
في الجزء المرتّب بالفعل. لذلك نبدأ بكتابة دالة insert تُدرج عنصرًا x
في قائمة مفترض أنها مرتّبة. ويكون الرمز على النحو
التالي:
  let rec insert x = function
    | y :: l when lt y x -> y :: insert x l
    | l -> x :: l
تقابل الحالة الأولى من مطابقة الأنماط إدراجًا عوديًا عندما يكون العنصر الأول
من القائمة أصغر من x. وتقابل الحالة الثانية من مطابقة الأنماط
الحالة التي يكون فيها x أصغر من جميع عناصر l، سواء كانت l فارغة أم
لا.
عندئذٍ يتمثل الترتيب في اجتياز القائمة باستعمال List.fold_left، مع اتخاذ
الجزء المرتّب بالفعل من القائمة مركمًا (accumulator).
  let insertion_sort l =
    List.fold_left (fun acc x -> insert x acc) [] l
قد يثبت هذا الرمز مشكلةً في القوائم الطويلة: فلأن الدالة insert ليست
عودية ذيلية (tail recursive)، فإنها قد تتجاوز سعة المكدس (stack overflow). ومع ذلك، من السهل تعديل الدالة insert
لجعلها عودية ذيلية. ويمكننا فعل ذلك بإضافة مركم يحوي القائمة،
بترتيب معكوس، للعناصر الأصغر من x التي فُحصت بالفعل. وإذا
أسمينا هذا المركم acc، تصبح لدينا الحالة التالية عندما نحاول إدراج
x في l:
بمجرد تحديد موضع x، يكفي عكس المركم
acc وربط (concatenate) النتيجة بـ l. وتفعل الدالة List.rev_append
هذا بالضبط، وهي عودية ذيلية. ويُعطى الرمز النهائي للترتيب بالإدراج في
البرنامج 89.
التعقيد
عندما تُدرج الدالة insert عنصرًا x في الموضع k ضمن l، فإنها تُجري k
مقارنة و2k تخصيصًا (k لبناء المركم وk في
List.rev_append). وفي أفضل الحالات يكون k دائمًا مساويًا 1، وفي أسوئها
يساوي طول القائمة، ما يعطي في النهاية الجدول في الشكل 12.1.
الشكل 12.1: تعقيد الترتيب بالإدراج على القوائم.
| أفضل الحالات | الحالة المتوسطة | أسوأ الحالات | |
|---|---|---|---|
| مقارنات | N | N2∕4 | N2∕2 |
| تخصيصات | N | N2∕2 | N2 |
12.1.2 المصفوفات
يُنفَّذ الترتيب بالإدراج على مصفوفة a في المكان. ويتمثل في إدراج
كل عنصر a.(i) تباعًا في الجزء المرتّب بالفعل من المصفوفة a[0..i-1]، وهو ما
يقابل الحالة التالية:
0 i-1 |
||
|---|---|---|
| … مرتّب بالفعل … | a.(i) |
… بحاجة إلى ترتيب … |
نبدأ بحلقة for لاجتياز المصفوفة:
  let insertion_sort a =
    for i = 1 to Array.length a - 1 do
      let v = a.(i) in
لإدراج العنصر a.(i) في الموضع الصحيح، نستعمل حلقة while تُزيح
العناصر نحو اليمين ما دامت أكبر من a.(i).
      let j = ref i in
      while 0 < !j && lt v a.(!j - 1) do
        a.(!j) <- a.(!j - 1);
        decr j
      done;
وبمجرد الخروج من الحلقة، لم يبقَ سوى وضع a.(i) في موضعه.
       a.(!j) <- v
    done
ويُعطى الرمز الكامل للترتيب بالإدراج على المصفوفات في البرنامج 90.
التعقيد
لاحظ أن الدالة insertion_sort تُجري من المقارنات مثل ما تُجريه من
الإسنادات. وعندما تُدرج حلقة while العنصر a.(i) في الموضع i− k، فإنها
تُجري k + 1 مقارنة. وفي أفضل الحالات يساوي k الصفر، وفي أسوئها يساوي i، ما يعطي
في النهاية الجدول في الشكل 12.2.
الشكل 12.2: تعقيد الترتيب بالإدراج على المصفوفات.
| أفضل الحالات | الحالة المتوسطة | أسوأ الحالات | |
|---|---|---|---|
| مقارنات | N | N2∕4 | N2∕2 |
| إسنادات | N | N2∕4 | N2∕2 |
12.2 الترتيب السريع (quicksort)
يعتمد الترتيب السريع على طريقة تقسيم وتغلّب (divide and conquer): تُقسَّم العناصر المطلوب ترتيبها إلى مجموعتين جزئيتين، تكون فيهما جميع عناصر الأولى أصغر من عناصر الثانية. ثم نرتّب كل مجموعة جزئية عوديًا. وعمليًا، يُنفَّذ التقسيم بمساعدة عنصر اعتباطي p من المجموعة، يُسمّى المحور (pivot). وعندئذٍ تكون المجموعتان الجزئيتان على التوالي العناصر الأصغر من أو المساوية لـ p، والعناصر الأكبر من p.
12.2.1 القوائم
لتطبيق الترتيب السريع على القوائم، نبدأ بكتابة دالة partition تُقسّم
قائمة عند محور معطى p. ولضمان العودية الذيلية، نستعمل مركمًا
يتألف من زوج من القوائم. ولذلك تأخذ الدالة partition الشكل
التالي:
let rec partition ((left, right) as acc) p = function
تمثّل القائمتان left وright العناصر الأصغر من أو المساوية لـ p والأكبر من p على التوالي. وعندما
نبلغ القائمة الفارغة، يكفي إعادة المركم.
| [] -> acc
وإلا، نأخذ العنصر الأول x ونقارنه بالمحور p. فإذا كان x
أصغر من أو مساويًا لـ p، أضفناه إلى left واستدعينا partition عوديًا على بقية
القائمة، s.
    | x :: s when le x p ->
        partition (x :: left, right) p s
ومن ناحية أخرى، إذا كان x أكبر من p، أضفناه إلى right واستدعينا
partition عوديًا بالمثل.
    | x :: s ->
        partition (left, x :: right) p s
يتخذ الترتيب السريع صورة دالة عودية quicksort. والحالة الأساسية هي
حالة القائمة الفارغة.
  let rec quicksort = function
    | [] ->
        []
وإذا لم تكن القائمة فارغة، نختار عنصرها الأول محورًا p ونُقسّم
العناصر المتبقية باستعمال الدالة partition.
    | p :: s ->
        let (left, right) = partition ([], []) p s in
وأخيرًا، نرتّب left وright عوديًا ونربط النتيجتين، مع تذكّر
إدراج المحور p في الوسط.
(quicksort left) @ (p :: quicksort right)
ويُعطى الرمز الكامل للترتيب السريع على القوائم في البرنامج 91.
من المهم ملاحظة أن كلا الاستدعاءين العوديين للدالة
quicksort ليس عوديًا ذيليًا. ولذلك يكون تجاوز سعة المكدس ممكنًا. ويناقش التمرين 12.4
حلًا لهذه المشكلة.
التعقيد
تُجري الدالة partition من المقارنات والتخصيصات بقدر عدد
العناصر في القائمة الممرَّرة كوسيطة. ولتكن C(N) عدد المقارنات
المُنفّذة في الدالة quicksort من أجل قائمة طولها N.
إذا أعادت partition قائمة طولها K وقائمة طولها N − 1 − K،
نستنتج:
تقابل أسوأ الحالات K = 0، وهو ما يعطي C(N) = N − 1 + C(N − 1)، ومن ثم C(N) ∼. وتقابل أفضل الحالات قائمة مقسّمة إلى نصفين متساويين، أي K = N∕2. ومن ذلك نستنتج بسهولة C(N) ∼ N log N. وفي ما يتعلق بعدد المقارنات في المتوسط، نعتبر أن المواضع النهائية الممكنة N للمحور كلها متساوية الاحتمال، وهو ما يعطي:
وبعد قليل من الجبر، نتركه للقارئ، نحصل على:
وهذا مجموع متداخل، يقودنا إلى استنتاج ما يلي:
وبذلك يكون لدينا C(N) ∼ 2N log N. وفي ما يتعلق بعدد التخصيصات A(N)، نسير على نحو مشابه، بمعادلة مختلفة قليلًا:
وفي النهاية نحصل على النتائج المعطاة في جدول الشكل 12.3.
الشكل 12.3: تعقيد الترتيب السريع على القوائم.
| أفضل الحالات | الحالة المتوسطة | أسوأ الحالات | |
|---|---|---|---|
| مقارنات | N log N | 2N log N | N2∕2 |
| تخصيصات | N log N | 4N log N | N2 |
12.2.2 المصفوفات
يُنفَّذ الترتيب السريع على المصفوفات في المكان. وتأخذ دالتا التقسيم والترتيب
كوسيطتين المصفوفة وفهرسين يحدّان الجزء الواجب اعتباره. ونحتفظ
بفكرة دالة partition تنظّم العناصر حول محور،
ودالة ترتيب تسير عوديًا.
تأخذ الدالة partition مصفوفة a كوسيطة، وفهرسين l وr،
يحدّان جزءًا من المصفوفة. ويقابل هذا الجزء العناصر الواقعة بين
الفهرسين l (شاملًا) وr (غير شامل). ونبدأ باختيار a.(l)
محورًا.
  let partition a l r =
    let p = a.(l) in
هذا الاختيار اعتباطي ويمكن أن يؤثر في الأداء. ويقترح التمرين 12.8 طريقة أفضل لاختيار المحور.
تتمثل الفكرة في اجتياز المصفوفة من اليسار إلى اليمين، بين الفهرسين l
(شاملًا) وr (غير شامل)، بحلقة for. وفي كل تكرار من تكرارات الحلقة،
تكون الحالة على النحو التالي:
يعطي فهرس الحلقة i موضع العنصر التالي الواجب اعتباره. ويُقسّم
الفهرس m الجزء الذي جرى اجتيازه بالفعل. وبتعبير أدق، هو
فهرس آخر خلية تحوي قيمة أصغر من أو مساوية لـ p. ونمثّله
بمرجع.
    let m = ref l in
    for i = l + 1 to r - 1 do
إذا كان a.(i) أكبر تمامًا من p، تركناه في موضعه. وإلا، فحفاظًا على ثابت
الحلقة (loop invariant)، يكفي زيادة m وتبديل a.(i) وa.(!m).
      if le a.(i) p then begin incr m; swap a i !m end
    done;
ويُعطى رمز الدالة swap في البرنامج 92 أدناه. وبمجرد اجتياز جميع العناصر،
نُجري تبديلًا آخر لوضع المحور في موضعه، أي في
الموضع !m، ونُعيد هذا الفهرس.
    if l <> !m then swap a l !m;
    !m
نكتب الدالة الرئيسية للترتيب السريع في صورة دالة عودية quick_rec تأخذ
الوسيطات نفسها التي تأخذها الدالة partition. وإذا كان l ≥ r-1، فإن عدد العناصر
المطلوب ترتيبها إما صفر أو واحد، ولا شيء هناك لفعله.
  let rec quick_rec a l r =
    if l < r - 1 then begin
وإلا، نُقسّم العناصر بين l وr.
let m = partition a l r in
بعد هذا الاستدعاء، يكون المحور a.(m) في موضعه النهائي. ثم نُجري استدعاءين
عوديين لترتيب العناصر الأصغر من المحور والعناصر الأكبر منه
على التوالي.
      quick_rec a l m;
      quick_rec a (m + 1) r
    end
ولترتيب مصفوفة، يكفي استدعاء quick_rec على جميع عناصرها.
let quicksort a = quick_rec a 0 (Array.length a)
ويُعطى الرمز الكامل في البرنامج 92.
وكما في حالة الترتيب السريع على القوائم، قد يحدث تجاوز لسعة المكدس. فبالفعل، الاستدعاء الأول لـ
quick_rec ليس عوديًا ذيليًا، وفي أسوأ الحالات قد يساوي عدد هذه الاستدعاءات
طول المصفوفة. ويناقش التمرين 12.6 حلًا لهذه
المشكلة.
التعقيد
تُجري الدالة partition دائمًا ما مجموعه بالضبط (r−l) − 1 مقارنة. ولذلك يكون
التعقيد من حيث عدد المقارنات هو نفسه كما في حالة الترتيب السريع
على القوائم. أما من حيث عدد الإسنادات، نلاحظ أن
الدالة partition تُجري من الاستدعاءات لـ swap بقدر ما تزيد
m. وتحدث أفضل الحالات عندما يبقى المحور، في كل مرحلة،
في الموضع الأول. عندئذٍ لا يُنفَّذ أي إسناد. ومن المهم
ملاحظة أن هذه الحالة لا تقابل أفضل تعقيد من حيث
المقارنات، وهو تربيعي في هذه الحالة. وهكذا، في المتوسط، وبافتراض
أن جميع المواضع النهائية للمحور متساوية الاحتمال، يكون لدينا أقل من
(r−l) + 1 إسناد، مع إجراء كل استدعاء لـ swap إسنادين. ويؤدي هذا
إلى حساب مماثل لحساب المتوسط لعدد المقارنات.
وقد أجرينا هذا الحساب بالفعل للقوائم وحصلنا على 2N log N.
وفي أسوأ الحالات، يوجد المحور دائمًا في الموضع r-1. وعندئذٍ تُجري الدالة
partition ما مجموعه 2(r−l) إسناد. ويوجد، بالتالي، ما مجموعه N2
إسناد. وفي النهاية نحصل على النتائج المعطاة في جدول الشكل
12.4.
الشكل 12.4: تعقيد الترتيب السريع على المصفوفات.
| أفضل الحالات | الحالة المتوسطة | أسوأ الحالات | ||
|---|---|---|---|---|
| مقارنات | N log N | - | 2N log N | N2∕2 |
| إسنادات | - | 0 | 2N log N | N2 |
ولتفادي أسوأ الحالات، قدر الإمكان، يجب تنفيذ التحسينين المقترحين في التمرينين 12.8 و12.9.
12.3 الترتيب بالدمج (merge sort)
كما في حالة الترتيب السريع، يطبّق الترتيب بالدمج أيضًا مبدأ تقسيم وتغلّب. فهو يقسّم العناصر المطلوب ترتيبها إلى جزأين متساويين في الحجم، دون محاولة مقارنة عناصرهما. ثم يرتّب الجزأين عوديًا ويدمجهما؛ ومن هنا جاء اسم الترتيب بالدمج (merge sort). وبذلك تُتفادى أسوأ حالات الترتيب السريع، التي يكون فيها للجزأين حجمان غير متناسبين.
12.3.1 القوائم
نبدأ بكتابة دالة split تُقسّم قائمة إلى قائمتين يختلف طولاهما
بواحد على الأكثر. ولضمان العودية الذيلية، نمرّر قائمتين l1 و
l2 كمركمين. وعندما نبلغ نهاية القائمة، نُعيد الزوج
(l1,l2).
  let rec split l1 l2 = function
    | [] -> (l1, l2)
وإلا، نأخذ العنصر الأول x ونضعه بالتناوب في l1 أو l2. وأبسط
طريقة لتحقيق ذلك هي تبادل l1 وl2 عند كل استدعاء.
| x :: l -> split (x :: l2) l1 l
تتمثل الخطوة الثانية في كتابة دالة merge تدمج قائمتين مرتّبتين.
ولهذا، نُجري الاجتياز على القائمتين في آنٍ واحد.
let rec merge l1 l2 = match l1, l2 with
وإذا كانت إحداهما فارغة، أعدنا الأخرى.
    | [], l | l, [] ->
        l
وإلا، نقارن العنصرين الأولين x1 وx2 في كل قائمة. فإذا كان x1 أصغر، وُضع
في رأس النتيجة، ودمجنا عوديًا الباقي s1 من l1 مع
l2. ونسير على نحو متناظر إذا كان x2 أصغر.
    | x1 :: s1, x2 :: s2 ->
        if le x1 x2 then x1 :: merge s1 l2 else x2 :: merge l1 s2
ملاحظة: نلاحظ أن merge ليست عودية ذيلية. ويمكننا إصلاح ذلك بسهولة بإضافة
وسيطة إضافية نُراكم فيها العناصر الأصغر.
وأخيرًا، نكتب دالة mergesort تُطبّق الترتيب بالدمج على قائمة l. وإذا
كانت القائمة تحوي عنصرًا واحدًا على الأكثر، أعدناها مباشرة.
  let rec mergesort l = match l with
    | [] | [_] ->
        l
وإلا، نُقسّم القائمة l إلى قائمتين باستعمال الدالة split:
    | _ ->
        let l1, l2 = split [] [] l in
ثم نرتّب القائمتين l1 وl2 عوديًا، وندمج النتيجتين باستعمال
merge.
merge (mergesort l1) (mergesort l2)
وعلى خلاف الدالة merge، لا تخاطر الدالة mergesort بإحداث تجاوز
لسعة المكدس: فلأن القائمة l تُقسَّم إلى نصفين متساويين، يكون حجم المكدس
لوغاريتميًا. ويحوي البرنامج 93 أدناه الرمز الكامل، مع الدالة merge
في نسختها العودية الذيلية.
يمكننا تفادي تخصيص القائمتين l1 وl2 بإعادة استعمال القائمة l نفسها ببراعة.
ويقترح التمرين 12.10 تحسينًا من هذا القبيل. وتُستعمل هذه الفكرة على وجه الخصوص في
الدالة List.sort من المكتبة المعيارية لـ OCaml.
التعقيد
تُجري الدالة split عددًا مقداره N من التخصيصات ولا تُجري أي مقارنة. وتُجري الدالة merge
من التخصيصات ضعف ما تُجريه من المقارنات: ففي الفرع الثاني من مطابقة
الأنماط، يوجد من المقارنات بقدر ما يوجد من التخصيصات، وفي الفرع
الأول، يساوي عدد التخصيصات التي تُجريها List.rev_append طول
acc، وهو نفسه مساوٍ لعدد التخصيصات/المقارنات المُنفّذة
في الجزء العودي. ولتكن C(N) (على التوالي f(N)) العدد الكلي
للمقارنات التي تُجريها mergesort (على التوالي merge). عندئذٍ تكون لدينا
المعادلة التالية:
فبالفعل، يُجرى الاستدعاءان العوديان على قائمتين لهما الطول نفسه N∕2. وفي
أفضل الحالات، لا تفحص الدالة merge إلا عناصر إحدى القائمتين، لأنها
جميعًا أصغر من عناصر القائمة الأخرى. وفي هذه الحالة f(N) = N∕2 ومن
ثم C(N) ∼N log N. وفي أسوأ الحالات، تفحص merge كل عنصر، بحيث
f(N) = N − 1؛ ومن ثم C(N) ∼ N log N. والتحليل في
الحالة المتوسطة أدقّ (انظر [15، المثال 2 ص. 646]) ويعطي f(N) = N + O(1)؛ ومن ثم
C(N) ∼ N log N أيضًا. ويُستنتج عدد الإسنادات بسهولة من عدد المقارنات. وفي النهاية نحصل على النتائج المعطاة في جدول الشكل 12.5.
الشكل 12.5: تعقيد الترتيب بالدمج على القوائم.
| أفضل الحالات | الحالة المتوسطة | أسوأ الحالات | |
|---|---|---|---|
| مقارنات | N log N | N log N | N log N |
| تخصيصات | 2N log N | 3N log N | 3N log N |
12.3.2 المصفوفات
فكرة الترتيب بالدمج على المصفوفات هي نفسها كما في القوائم: نقسّم العناصر المطلوب
ترتيبها إلى نصفين متساويين. ونرتّب النصفين، ثم ندمجهما. ونحدّ
الجزء المطلوب ترتيبه بفهرسين l (شاملًا) وr (غير شامل). وللتقسيم،
يكفي حساب الفهرس الأوسط m =. ثم نرتّب عوديًا
الجزأين المحدودين بـ l وm من جهة، وm وr من جهة أخرى. ولم يبقَ لنا
سوى دمجهما. ويثبت أن القيام بذلك في المكان بالغ الصعوبة. والأبسط
هو استعمال مصفوفة ثانية، تُخصَّص مرة واحدة وللأبد في بداية
الترتيب.
نبدأ بكتابة الدالة merge التي تُطبّق الدمج. وهي تأخذ كوسيطتين
مصفوفتين، a1 وa2، والفهارس الثلاثة l وm وr. والجزآن
a1[l..m[ وa1[m..r[ مرتّبان. والهدف هو دمجهما في a2[l..r[. ولهذا
نُجري الاجتياز على جزأي a1 (بمرجعين i وj) وعلى الجزء من a2
الواجب تعبئته (بحلقة for).
  let merge a1 a2 l m r =
    let i = ref l in
    let j = ref m in
    for k = l to r - 1 do
وفي كل تكرار من تكرارات الحلقة، تكون الحالة على النحو التالي:
يجب أن نحدّد القيمة التالية التي سنضعها في a2.(k). وهي أصغر القيمتين
a1.(!i) وa1.(!j). ومن المهم، مع ذلك، معالجة
الحالة التي لم يبقَ فيها عناصر في أحد النصفين. ونحدّد
ما إذا كان العنصر سيُؤخذ من النصف الأيسر بالاختبار
التالي:
if !i < m && (!j = r || le a1.(!i) a1.(!j)) then begin
يفحص هذا الاختبار ما إذا كان النصف الأيسر غير فارغ وعنصره الأول أصغر
من العنصر الأول للنصف الأيمن، إن وُجد عنصر كهذا. وفي كلتا
الحالتين، ننسخ العنصر إلى a2.(k) ونزيد الفهرس
المقابل.
        a2.(k) <- a1.(!i); incr i
      end else begin
        a2.(k) <- a1.(!j); incr j
      end
    done
بعد ذلك، نطبّق الترتيب بالدمج في صورة دالة mergesort. نبدأ بتخصيص
مصفوفة مؤقتة tmp ناتجة عن نسخ المصفوفة المطلوب ترتيبها.
  let mergesort a =
    let tmp = Array.copy a in
ويُجسَّد الجزء العودي من الترتيب بالدمج عبر دالة عودية mergesort_rec
تأخذ كوسيطتين الفهرسين l وr اللذين يحدّان الجزء المطلوب
ترتيبه.
let rec mergesort_rec l r =
وإذا كان المقطع يحوي عنصرًا واحدًا على الأكثر، أي إذا كان l ≥ r-1، فلا شيء
آخر هناك لفعله.
if l < r - 1 then begin
وإلا، نقسّم المجال إلى نصفين متساويين بحساب الموضع
الأوسط m، ثم نرتّب عوديًا a[l..m[ وa[m..r[.
        let m = (l + r) / 2 in
        mergesort_rec l m;
        mergesort_rec m r;
لاحظ أن حساب (l+r)/2 لا يمكن أن يُحدث تجاوزًا للعدد
الصحيح (integer overflow)، لأن الحجم الأقصى لمصفوفة OCaml أصغر بكثير من أكبر
عدد صحيح قابل للتمثيل (انظر القسم 3.2 نموذج التنفيذ لمزيد من التفاصيل).
ويبقى تنفيذ الدمج. ولهذا ننسخ الجزء a[l..r[ كاملًا إلى
المصفوفة tmp ثم نستدعي الدالة merge.
        Array.blit a l tmp l (r - l);
        merge tmp a l m r
      end
وأخيرًا، نرتّب المصفوفة a كاملة باستدعاء mergesort على جميع عناصرها.
    in
    mergesort_rec 0 (Array.length a)
ويحوي البرنامج 94 الرمز الكامل. ويمكن تحسين كفاءته أكثر: فكما في
حالة الترتيب السريع، يمكننا التحوّل إلى الترتيب بالإدراج عندما يصبح الجزء المطلوب
ترتيبه صغيرًا بدرجة كافية (انظر التمرين 12.7). وتتمثل فكرة أخرى في تفادي نسخ a
إلى tmp، وهو ما يستعمل Array.blit (انظر التمرين 12.12).
التعقيد
عدد المقارنات هو نفسه تمامًا كما في حالة القوائم. وعدد
الإسنادات هو نفسه أيضًا: N إسناد في الدالة merge (حيث يُنسخ كل عنصر
من a1 إلى a2) وN إسناد تُجريها Array.blit.
ولتكن A(N) العدد الكلي للإسنادات في mergesort. عندئذٍ
يكون لدينا:
أي ما مجموعه 2N log N إسناد. وفي النهاية نحصل على نتائج الشكل 12.6.
الشكل 12.6: تعقيد الترتيب بالدمج على المصفوفات.
| أفضل الحالات | الحالة المتوسطة | أسوأ الحالات | |
|---|---|---|---|
| مقارنات | N log N | N log N | N log N |
| إسنادات | 2N log N | 2N log N | 2N log N |
12.4 الترتيب بالكومة (heapsort)
يعتمد الترتيب بالكومة على استعمال طابور أولوية (priority queue). وتتيح بنية كهذه إضافة العناصر واستخراج أصغر عنصر فيها. والفكرة الكامنة وراء الترتيب بالكومة هي التالية: نبني طابور أولوية يحوي جميع العناصر المطلوب ترتيبها ثم نستخرج العناصر واحدًا واحدًا. ولأن عملية الاستخراج تُعيد أصغر عنصر في كل مرة، تخرج العناصر بترتيب تصاعدي.
من حيث المبدأ، يمكن استعمال أي بنية لطابور الأولوية. غير أن بنية تكون فيها عمليتا الإضافة والاستخراج بتكلفة O(log N) تُعطي خوارزمية ترتيب مثلى في O(N log N). وكلا بنيتَي الكومة المعروضتين في الفصل 6 لهما تعقيد كهذا.
12.4.1 القوائم
نفترض أننا نملك دالة تصنيفية (functor) PriorityQueue تُطبّق بنية طابور أولوية.
ومن حيث المبدأ، يمكننا الاختيار بين بنيتين أمرية (imperative) ودائمة (persistent).
غير أنه لا فائدة من اختيار بنية دائمة هنا. ولذلك
نستعمل بنية الكومة الأمرية الموصوفة في القسم 6.3 طوابير الأولوية الأمرية.
وتُعطى واجهتها مجددًا في البرنامج 95.
نُطبّق الدالة التصنيفية PriorityQueue بتمرير وحدة (module) تقارن العناصر
بـ compare كوسيطة. ولتفادي الاضطرار إلى عكس القائمة في النهاية، نرتّب
العناصر بترتيب تنازلي، أي أن العنصر ذا الأولوية الأعلى في طابور الأولوية
سيكون أكبر عنصر بالنسبة إلى علاقة الترتيب lt. ولذلك نكتب:
  module Heap = PriorityQueue(struct
                  type t = elt
                  let compare x y = compare y x
                end)
تأخذ الدالة heapsort قائمة l من العناصر المطلوب ترتيبها وتبدأ
بإنشاء كومة فارغة h.
  let heapsort l =
    let h = Heap.create () in
ثم تُضيف الدالة جميع عناصر القائمة l إلى الكومة.
List.iter (fun x -> Heap.add x h) l;
بعد ذلك، نُنشئ مرجعًا res سيستقبل النتيجة المرتّبة. ونستخرج
العناصر من الكومة بمساعدة حلقة while.
    let res = ref [] in
    while not (Heap.is_empty h) do
وإذا لم تكن الكومة فارغة، نستخرج أصغر عنصر فيها x باستعمال Heap.get_min ثم
نحذفه من الكومة باستعمال Heap.remove_min.
      let x = Heap.get_min h in
      Heap.remove_min h;
نُضيف x في رأس القائمة الموجودة في res ثم نُعيد الكرّة.
      res := x :: !res
    done;
وبمجرد أن تصبح الكومة فارغة، يكفي إعادة محتوى res.
!res
لاحظ أن عكس علاقة الترتيب في بنية الكومة يعني أننا
لا نضطر إلى عكس القائمة !res في نهاية heapsort. ويحوي البرنامج 96
الرمز الكامل.
التعقيد
يعتمد تعقيد الترتيب بالكومة على تعقيد بنية الكومة المستعملة. وكما
ذكرنا في مقدمة هذا القسم، إذا كانت عمليتا add و
remove_min في بنية الكومة بتكلفة لوغاريتمية على الأكثر، فإن الترتيب نفسه
تكون تكلفته O(N log N) في أسوأ الحالات، وهو الأمثل. وإذا افترضنا الآن أن
بنية الكومة المستعملة هي بنية القسم 6.3 طوابير الأولوية الأمرية، يمكننا إعطاء
نتيجة أدقّ. فبالفعل، نعلم حينئذٍ أن add وremove_min تُجري كل منهما
2log k مقارنة على الأكثر لإضافة عنصر إلى كومة تحوي
k عنصر أو لحذفه منها، بحيث يكون العدد الكلي للمقارنات في أسوأ الحالات على الأكثر:
بل سنرى في القسم التالي أن بناء الكومة تكلفته خطية فحسب، بحيث يكون المجموع مكافئًا لـ 2N log N.
12.4.2 المصفوفات
لتطبيق الترتيب بالكومة على مصفوفة a، سنبني بنية الكومة
مباشرة داخل هذه المصفوفة. وتنظيم الكومة في المصفوفة هو تمامًا
نفسه كما في القسم 6.3 طوابير الأولوية الأمرية: يُخزَّن الابنان الأيسر والأيمن
لعقدة مخزّنة في الفهرس i على التوالي في الفهرسين 2i + 1 و
2i + 2. وكما في القسم السابق، نبني كومة لعلاقة الترتيب المعكوسة،
أي كومة يوجد فيها أكبر عنصر في الجذر.
ولبناء الكومة، نأخذ عناصر المصفوفة من اليمين إلى اليسار. وفي كل تكرار، تكون لدينا الحالة التالية:
يحوي الجزء a[k+1..n[ قاعدة الكومة قيد البناء، أي
أنه غابة من أكوام تقع جذورها في فهارس i بحيث k < i < 2k + 3.
ثم نُنزل القيمة a.(k) إلى موضعها في الكومة ذات الجذر k.
وبمجرد اجتياز جميع العناصر، تصبح لدينا كومة واحدة جذرها
0.
وتتمثل الخطوة الثانية في تفكيك الكومة. ولهذا نستبدل جذرها
r في a.(0) بالعنصر v في a.(n-1). وتكون القيمة r حينئذٍ في
موضعها النهائي. ثم نُعيد إنشاء بنية الكومة على a[0..n-1[ بإنزال
v إلى موضعه في الكومة ذات الحجم n-1 والجذر 0. ونُكرّر العملية
على المواضع n-1 وn-2 وهكذا. وفي كل تكرار k، تكون لدينا الحالة
التالية:
توجد كومة في الجزء a[0..k[، تكون جميع عناصرها أصغر من عناصر
الجزء a[k..n[ المرتّب بالفعل.
تستعمل خطوتا الخوارزمية أعلاه العملية نفسها المتمثلة في إنزال
قيمة حتى تبلغ موضعها في كومة. ويُطبَّق ذلك باستعمال دالة
عودية move_down تأخذ كوسيطات مصفوفة a وفهرسًا k وقيمة
v وحدًّا أعلى للفهارس، n.
let rec move_down a k v n =
نفترض أن لدينا بالفعل كومة h1 جذرها 2k+1، بحيث 2k+1 < n، وبالمثل
كومة h2 جذرها 2k+2، بحيث 2k+2 < n. والهدف هو بناء كومة جذرها k،
تحوي v وجميع عناصر h1 وh2. ونبدأ بتحديد ما إذا كانت الكومة ذات الجذر k
ستُختزل إلى ورقة، أي ما إذا كانت الكومة h1 فارغة. فإذا كان الأمر كذلك،
نُسند القيمة v إلى a.(k)، وينتهي الأمر.
    let r = 2 * k + 1 in
    if r >= n then
      a.(k) <- v
وإلا، نحدّد الفهرس rmax لأكبر الجذرين في h1 وh2،
مع معالجة الحالة التي تكون فيها h2 فارغة بعناية.
    else
      let rmax =
        if r+1 < n then if lt a.(r) a.(r+1) then r+1 else r
        else r in
وإذا كانت القيمة v أكبر من أو مساوية لـ a.(rmax)، فقد اكتمل الإنزال، ويكفي
إسناد v إلى a.(k).
if le a.(rmax) v then a.(k) <- v
وإلا، نرفع a.(rmax) إلى الأعلى ونواصل إنزال v عوديًا عند
الموضع rmax.
else begin a.(k) <- a.(rmax); move_down a rmax v n end
وتأخذ دالة الترتيب مصفوفة a كوسيطة:
  let heapsort a =
    let n = Array.length a in
نبدأ ببناء الكومة من الأسفل إلى الأعلى باستدعاء move_down. ونتفادى
الاستدعاءات غير الضرورية للأكوام المختزلة إلى أوراق وحيدة بالبدء بالحلقة عند ⌊⌋− 1.
(فبالفعل، من أجل كل فهرس k أكبر تمامًا، يكون لدينا 2k+1 ≥ n.)
for k = n/2 - 1 downto 0 do move_down a k a.(k) n done;
وبمجرد أن تُبنى الكومة بالكامل، نستخرج عناصرها واحدًا واحدًا، بترتيب تنازلي.
وكما شُرح أعلاه، من أجل كل فهرس k، نستبدل a.(0) بالقيمة v في a.(k)
ثم نُنزل v إلى موضعها في الكومة.
    for k = n-1 downto 1 do
      let v = a.(k) in a.(k) <- a.(0); move_down a 0 v k
    done
لاحظ أن مواصفة move_down تتيح لنا تفادي إسناد v إلى a.(0) قبل
بدء الإنزال. ويحوي البرنامج 97 أدناه الرمز الكامل.
التعقيد
لنعتبر أولًا تكلفة استدعاء واحد لـ move_downakvn. عدد الاستدعاءات
العودية محدود بـ log n لأن قيمة k تتضاعف عند كل استدعاء. وعلاوة على ذلك،
تُجري move_down مقارنتين على الأكثر وإسنادًا واحدًا في كل استدعاء.
وهكذا، في أسوأ الحالات، يكون لدينا ما مجموعه 2log n مقارنة وlog n
إسناد.
وفي ما يتعلق بالترتيب نفسه، يمكننا أن نحدّ تقريبيًا عدد المقارنات C(N) في
كل استدعاء لـ move_down بـ 2log N، أي ما مجموعه في أسوأ الحالات 3N log N مقارنة
(N log N مقارنة للخطوة الأولى و2N log N للثانية). وبالمثل، يكون
العدد الكلي للإسنادات، في أسوأ الحالات، N log N.
بل يمكننا أن نكون أدقّ ونبيّن أن الخطوة الأولى من الخوارزمية، أي بناء الكومة، تكلفتها خطية. (انظر على سبيل المثال [7، القسم 7.3].) ويترتب على ذلك أن الجزء الثاني من الخوارزمية فحسب يسهم في التعقيد المقارب، بحيث C(N) ∼ 2N log N. ولتحليل متوسط للترتيب بالكومة، يُحال القارئ إلى فن البرمجة الحاسوبية [15، المجلد 3، ص. 152].
لاحظ أن الترتيب بالكومة يُنفَّذ في ذاكرة ثابتة. فبالفعل، لا تُجري الدالة move_down
إلا استدعاءات عودية ذيلية، وعلاوة على ذلك، تُنفَّذ جميع الحسابات
في المكان داخل المصفوفة a.
12.5 التعقيد الأمثل
نعرض هنا برهانًا موجزًا على أن التعقيد الأمثل لخوارزمية ترتيب لا تُجري إلا مقارنات بين العناصر يقع في O(N log N).
يمكننا أن نتصوّر خوارزمية كهذه في صورة شجرة ثنائية. ويرمز كل عقدة داخلية إلى مقارنة أُجريت، ويمثّل الشجران الجزئيان الأيسر (على التوالي الأيمن) بقية الخوارزمية عندما يكون الاختبار موجبًا (على التوالي سالبًا). وكل
ورقة تشكّل نتيجة ممكنة، أي تبديلًا أُجري على المتتالية الابتدائية. وإذا افترضنا وجود N عنصرًا متمايزًا، فإن هناك N! تبديلًا ممكنًا، ومن ثم N! ورقة على الأقل في هذه الشجرة. وبالتالي يكون ارتفاعها على الأقل log N!. والآن، يقابل أطول مسار من الجذر إلى ورقة أكبر عدد من المقارنات التي تُجريها الخوارزمية على مُدخل. ويوجد، بالتالي، مُدخل يكون فيه عدد المقارنات على الأقل log N!. وبصيغة ستيرلينغ (Stirling’s formula)، نعلم أن log N! ∼ N log N. ولبرهان أكثر تفصيلًا، يُحال القارئ إلى فن البرمجة الحاسوبية [15، القسم 5.3].
12.6 التقييم التجريبي (experimental evaluation)
في هذا القسم، نقارن تجريبيًا بين خوارزميات الترتيب المختلفة المعروضة في هذا الفصل.
بروتوكول التقييم
من أجل قائمة أو مصفوفة معطاة، نُقيّم أداء عدة خوارزميات على المدخل نفسه على النحو التالي. نُنفّذ كل خوارزمية ترتيب خمس مرات، مع قياس زمن الحساب في كل حالة. ونستبعد أصغر القيم وأكبرها، ونأخذ متوسط القيم الثلاث المتبقية.
وبالنسبة إلى القوائم، نأخذ قوائم مبنية عشوائيًا وكذلك قوائم مرتّبة بالفعل، بأطوال 2i × 1000 حيث i يتراوح من 0 إلى 10. وبالنسبة إلى المصفوفات، نأخذ مصفوفات معبّأة عشوائيًا وكذلك مصفوفات مرتّبة بالفعل، بأطوال 2i × 1000 حيث i يتراوح من 0 إلى 12. ومن المهم اعتبار حالة البيانات المرتّبة بالفعل لأنها تمثّل وضعًا واقعيًا نرغب في التحقق فيه من كفاءة خوارزميات الترتيب لدينا.
التقييم على القوائم
نقارن الخوارزميات المدرجة في الشكل 12.7. ويعرض الشكلان 12.8 و12.9 النتائج.
الشكل 12.7: خوارزميات الترتيب على القوائم.
insertion |
الترتيب بالإدراج من البرنامج 89 |
|---|---|
quicksort |
الترتيب السريع من البرنامج 91 |
quicksort (log stack) |
الترتيب السريع مع إجراء الاستدعاء الأول على أصغر |
| القائمتين بعد التقسيم (انظر التمرين 12.4) | |
quicksort (rand) |
الترتيب السريع مع محور مختار عشوائيًا (انظر |
| التمرين 12.5) | |
mergesort |
الترتيب بالدمج من البرنامج 93 |
mergesort (reuse) |
الترتيب بالدمج مع تحسين يتمثل في عدم |
| إنشاء قوائم وسيطة عند التقسيم | |
| (انظر التمرين 12.10) | |
List.sort |
الدالة List.sort من المكتبة المعيارية لـ OCaml |
| (الإصدار 3.11.2) | |
heapsort (arrays) |
الترتيب بالكومة من البرنامج 96، باستعمال البنية المعتمدة |
| على المصفوفات المعروضة في القسم 6.3 | |
heapsort (trees) |
الترتيب بالكومة من البرنامج 96، باستعمال البنية المعتمدة |
| على الأشجار الثنائية المعروضة في القسم 6.4 |
بالنسبة إلى القوائم العشوائية (الشكل 12.8)، نلاحظ ما يلي: لا يمكن استعمال الترتيب بالإدراج
(insertion) إلا في حالة القوائم الصغيرة، نظرًا إلى تعقيده التربيعي.
(لا نعطي زمن الحساب للقوائم الأطول من 16,000.) وقد أحدثت اثنتان من خوارزميات
الترتيب السريع الثلاث، (quicksort وquicksort (rand)) تجاوزًا لسعة المكدس
على قوائم طولها 210. وتُعاق خوارزمية heapsort (trees)، التي تستعمل الأشجار الثنائية،
بسبب بناء الأشجار، حتى وإن كان تعقيدها أمثل. أما
خوارزميات الترتيب الأخرى فكفاءتها متقاربة، وأسرعها هي خوارزمية المكتبة
المعيارية لـ OCaml.
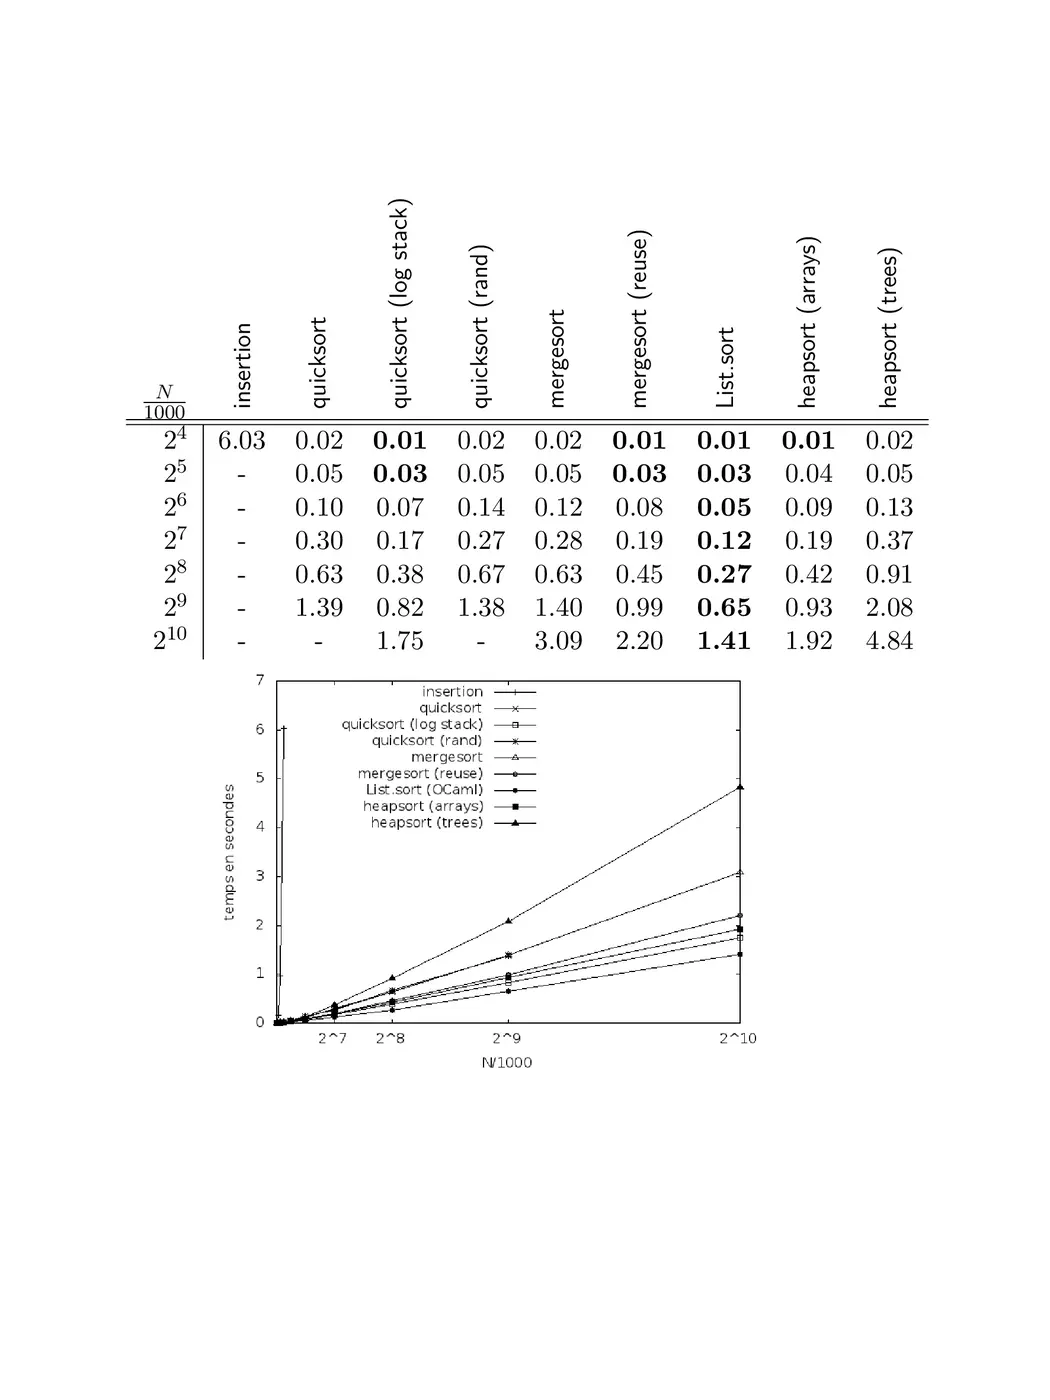
الشكل 12.8: مقارنة خوارزميات الترتيب على القوائم العشوائية.
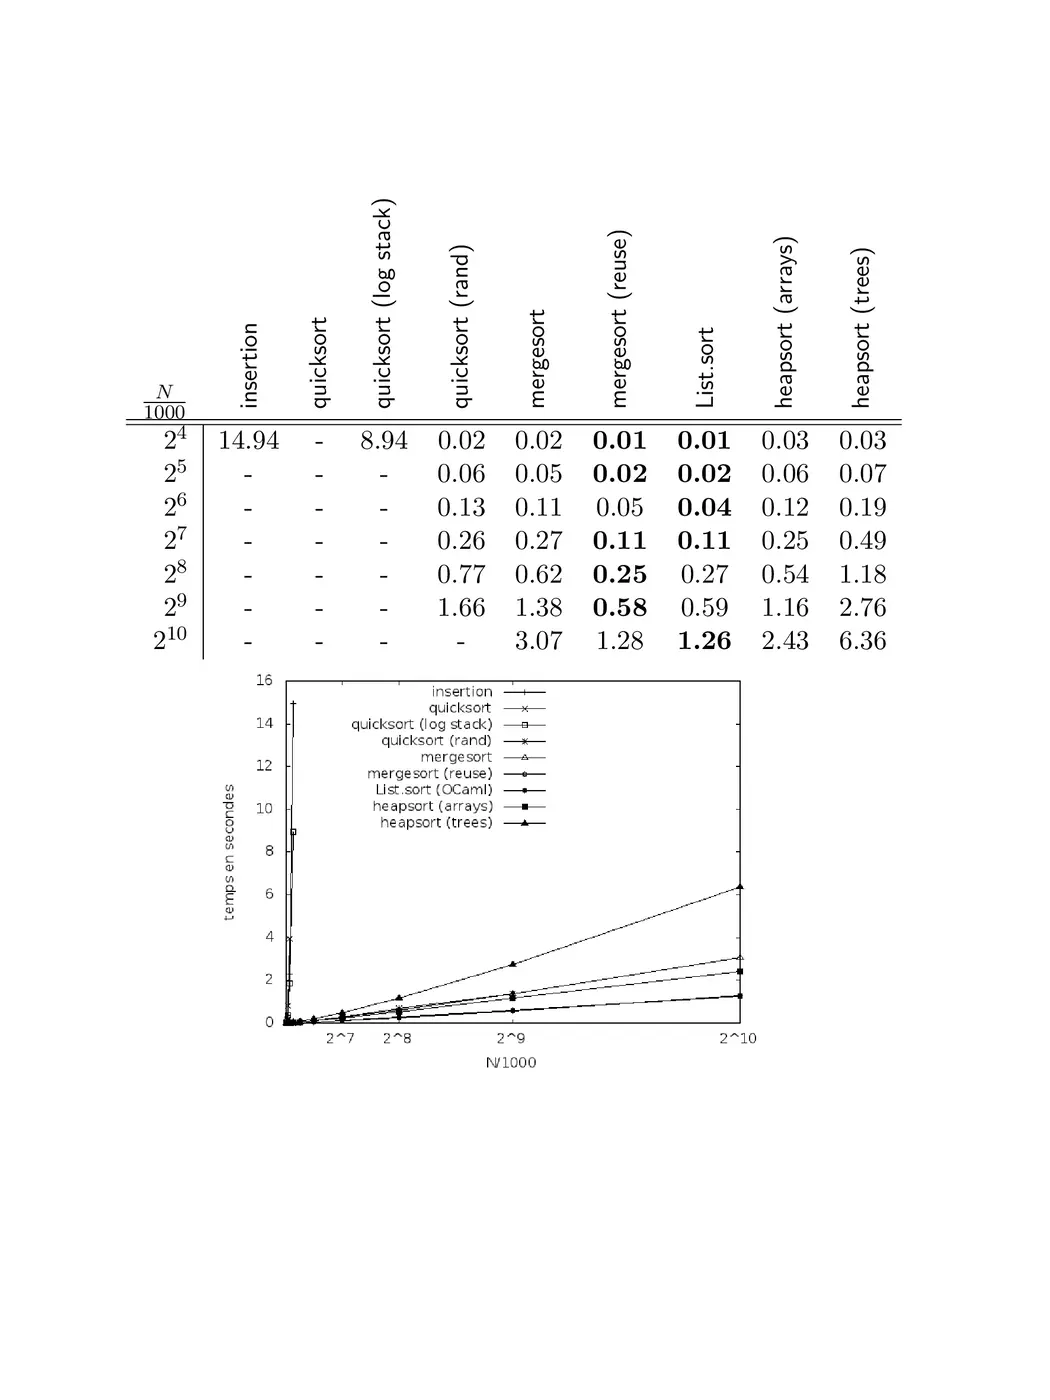
الشكل 12.9: مقارنة خوارزميات الترتيب على القوائم المرتّبة بالفعل.
وفي حالة القوائم المرتّبة بالفعل (الشكل 12.9)، نلاحظ ما يلي: للترتيب بالإدراج
(insertion) تعقيد تربيعي. (كانت الحالة المواتية ستكون
حالة قائمة مرتّبة ترتيبًا تنازليًا.) ولخوارزميتَي الترتيب السريع الأوليين،
quicksort وquicksort (log stack)، تعقيد تربيعي، وهو ما
يُفسَّر بالاختيار الاعتباطي للعنصر الأول من القائمة محورًا. (لا نعطي
زمن الحساب للقوائم التي يتجاوز طولها 16,000.) أما
خوارزمية الترتيب السريع الثالثة، quicksort (rand)، فتَسلُك سلوكًا جيدًا لكنها تُحدث
تجاوزًا لسعة المكدس على قوائم بحجم 210 × 1000. وتبقى خوارزمية heapsort (trees)
مُعاقة بسبب بناء الأشجار، كما في حالة القوائم العشوائية.
يمكننا أن نستخلص الاستنتاجات التالية: الترتيب بالدمج هو الأفضل في الجمع بين البساطة والكفاءة. حتى أبسط نسخة منه لها كفاءة مقاربة للنسخة المحسّنة من المكتبة المعيارية لـ OCaml. والترتيب بالكومة يؤدي دائمًا أداءً جيدًا، لكن تطبيقه أعقد بكثير من تطبيق الترتيب بالدمج. وأخيرًا، نلاحظ أن استعمال الترتيب السريع على القوائم ليس بالأمر المباشر لأننا يجب، في الحد الأدنى، أن نجمع التحسينين الواردين في التمرينين 12.4 و12.5، لتفادي تجاوز سعة المكدس والحالة غير المواتية ذات التعقيد التربيعي معًا.
التقييم على المصفوفات
نقارن الآن التقنيات المختلفة لترتيب مصفوفات من الأعداد الصحيحة استنادًا إلى الخوارزميات المدرجة في الشكل 12.10. ويعرض الشكلان 12.11 و12.12 النتائج.
الشكل 12.10: خوارزميات الترتيب على مصفوفات من الأعداد الصحيحة.
insertion |
الترتيب بالإدراج من البرنامج 90 |
|---|---|
quicksort |
الترتيب السريع من البرنامج 92 |
quicksort (insertion) |
الترتيب السريع باستعمال ترتيب بالإدراج على |
| مقاطع صغيرة (انظر التمرين 12.7) | |
quicksort (log stack) |
الترتيب السريع مع إجراء الاستدعاء الأول على أصغر |
| المقطعين (انظر التمرين 12.6) | |
quicksort (rand) |
الترتيب السريع مع محور مختار عشوائيًا (انظر |
| التمرين 12.8) | |
mergesort |
الترتيب بالدمج من البرنامج 94 |
merge sort (swap) |
الترتيب بالدمج مع التحسين المتمثل |
في تفادي استعمال Array.blit (انظر |
|
| التمرين 12.12) | |
Array.stable_sort |
الدالة Array.stable_sort من المكتبة |
| المعيارية لـ OCaml (الإصدار 3.11.2) | |
heapsort |
الترتيب بالكومة من البرنامج 97 |
Array.sort |
الترتيب بالكومة من المكتبة المعيارية لـ OCaml |
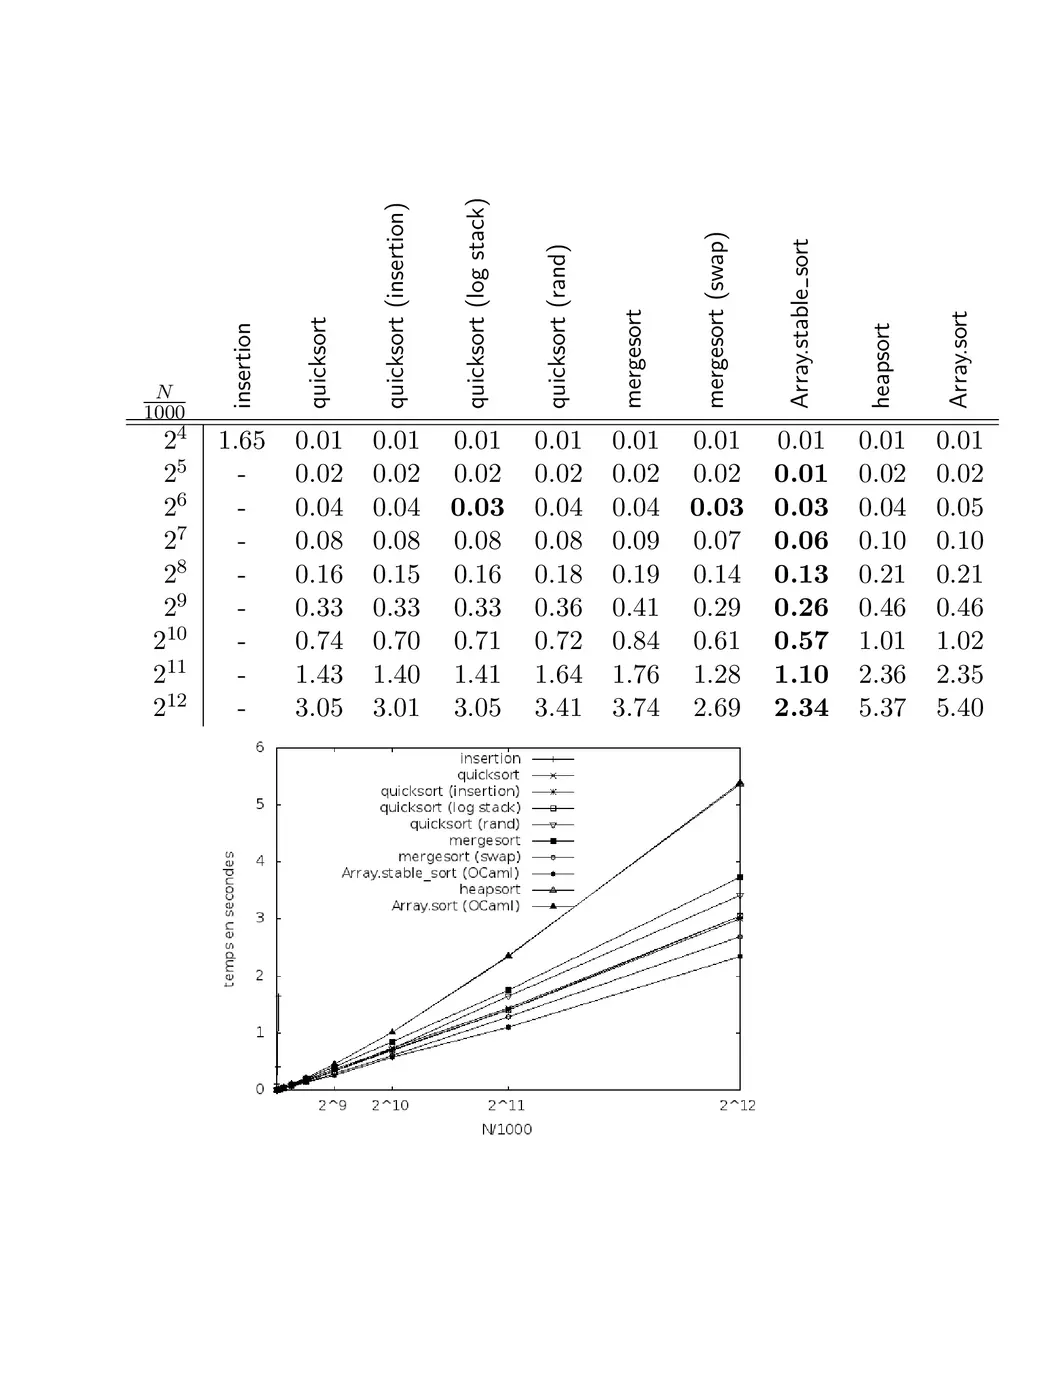
الشكل 12.11: مقارنة الترتيب على المصفوفات العشوائية.
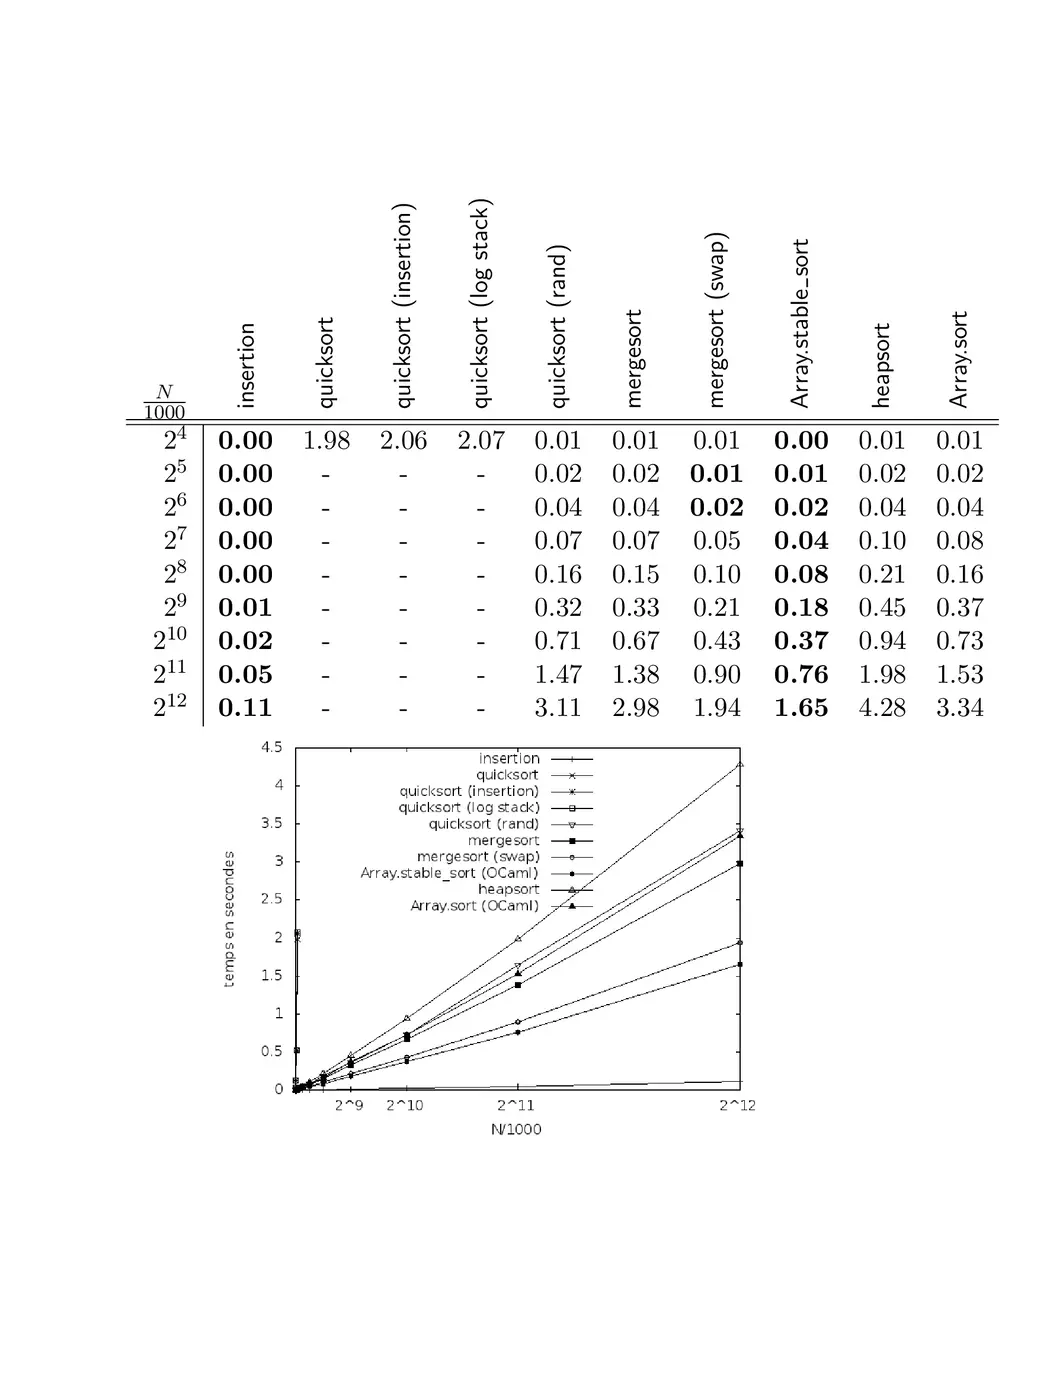
الشكل 12.12: مقارنة الترتيب على المصفوفات المرتّبة بالفعل.
بالنسبة إلى المصفوفات العشوائية (الشكل 12.11)، نلاحظ ما يلي: كما في حالة القوائم،
لا يمكن استعمال الترتيب بالإدراج إلا من أجل مصفوفات صغيرة. وخوارزميتا
الترتيب بالكومة، heapsort وArray.sort، أقل كفاءة بقليل من الترتيب بالدمج والترتيب السريع.
وأكثر الخوارزميتين كفاءة هما كلتاهما من خوارزميات
الترتيب بالدمج.
وبالنسبة إلى المصفوفات المرتّبة بالفعل (الشكل 12.12)، نلاحظ ما يلي: هنا تكون خوارزميات
الترتيب السريع الثلاث الأولى، quicksort وquicksort (insertion) وquicksort (log stack)، في أكثر حالاتها غير المواتية، وهو ما قد يُفسَّر
بالاختيار الاعتباطي لأقصى عنصر يسارًا محورًا. (لا نعطي زمن الحساب
للمصفوفات التي يتجاوز طولها 16,000.) أما نسخة الترتيب السريع ذات
المحور المختار عشوائيًا فتحقق كفاءة جيدة، مقارِبة لكفاءة
mergesort.
من بين جميع خوارزميات الترتيب في O(N log N)، يُعدّ الترتيب بالكومة من الأقل كفاءة
بينما يُعدّ الترتيب بالدمج من الأكثر كفاءة. وهنا يكون الترتيب بالإدراج (insertion)
الأكثر كفاءة، لأننا في الحالة المواتية ذات التعقيد الخطي.
(كانت الحالة غير المواتية ستكون حالة مصفوفة مرتّبة ترتيبًا تنازليًا.)
يمكننا أن نستخلص الاستنتاجات التالية: إذا كان مسموحًا لنا بتخصيص مصفوفة وسيطة، بعبارة أخرى، بمضاعفة استعمال الذاكرة مؤقتًا، فإن الترتيب بالدمج هو الخيار الأفضل. وكما في حالة القوائم، فهو يجمع بين البساطة والكفاءة. أما إذا أردنا ترتيب مصفوفة في المكان، فيجب علينا إما استعمال الترتيب بالكومة أو الترتيب السريع، مع الحرص على جمعه بالتحسينين الواردين في التمرينين 12.6 و12.8، لتفادي تجاوز سعة المكدس والسلوك التربيعي الناجم عن اختيار سيئ للمحور معًا.
12.7 التمارين
12.1 اكتب دالة two_way_sort:boolarray->unit ترتّب مصفوفة من القيم المنطقية
في المكان، بإجراء تبديلات للعناصر فحسب، مع الاصطلاح على أن
false < true. وينبغي أن يكون التعقيد متناسبًا مع عدد
العناصر.
12.2 (مسألة العلم الهولندي لديكسترا) اكتب دالة ترتّب مصفوفة في المكان. وتحوي المصفوفة قيمًا تمثّل ألوان العلم الهولندي الثلاثة، وهي:
type color = Blue | White | Red
لا يجوز إجراء سوى تبديلات للعناصر في المصفوفة. وينبغي أن يكون التعقيد متناسبًا مع عدد العناصر.
12.3 وبشكل أعم، نأخذ حالة مصفوفة تحوي k قيمة متمايزة. وللتبسيط، نفترض أننا نتعامل مع الأعداد الصحيحة 0,…,k − 1. اكتب دالة ترتّب مصفوفة كهذه في زمن O(max(k,N))، حيث N هو حجم المصفوفة.
الترتيب السريع
12.4 من طرق تفادي تجاوز محتمل لسعة المكدس في الدالة quicksort على القوائم
أن نُجري أولًا استدعاءً غير عودي ذيلي لترتيب أصغر القائمتين،
يتبعه استدعاء عودي ذيلي لترتيب الأكبر منهما. إرشاد: من أجل الاستدعاء العودي الذيلـي،
عمّم الدالة quicksort بحيث تأخذ كوسيطتين إضافيتين القائمتين
left وright، بحيث تُعيد quicksortleftlright الربط، بهذا
الترتيب، لـ left والقائمة المرتّبة l وright. وبيّن أن حجم المكدس يبقى
لوغاريتميًا حتى في أسوأ الحالات.
12.5 عدّل الدالة partition على القوائم بحيث تستعمل عنصرًا مختارًا عشوائيًا من
القائمة محورًا. والهدف هو تفادي الحالة غير المواتية لقائمة مرتّبة، حيث
سيكون للترتيب السريع حينئذٍ تعقيد تربيعي.
12.6 من طرق تفادي تجاوز محتمل لسعة المكدس في الدالة quick_rec على
المصفوفات أن نبدأ بإجراء الاستدعاء العودي على أصغر
الجزأين. وبيّن أن حجم المكدس يبقى لوغاريتميًا حتى في أسوأ
الحالات.
12.7 من الأفكار الكلاسيكية لتسريع خوارزميات الترتيب التحوّل إلى الترتيب
بالإدراج عندما يكون عدد العناصر المطلوب ترتيبها صغيرًا، أي أقل من ثابت
محدَّد مسبقًا (مثلًا 5). عدّل تطبيق الترتيب السريع على المصفوفات
آخذًا هذه الفكرة في الحسبان. استعمل الدالة insertion_sort على المصفوفات
(البرنامج 90) وعمّمها بتمرير فهرسين، l وr، لتحديد الجزء
المطلوب ترتيبه من المصفوفة.
12.8 عدّل تطبيق الترتيب السريع على المصفوفات بحيث يستعمل محورًا مختارًا عشوائيًا
في المقطع a[l..r[. وكما في حالة القوائم، تتمثل الفكرة في تفادي الحالة غير المواتية
لمصفوفة مرتّبة بالفعل، حيث سيكون للترتيب السريع حينئذٍ تعقيد تربيعي. وأحد
الحلول البسيطة هو خلط المصفوفة قبل ترتيبها، مثلًا باستعمال
التمرين 2.11.
12.9 عندما تكون عناصر المصفوفة كثيرة التكافؤ، لا يكفي التمرين السابق دائمًا
لضمان اختيار جيد للمحور. عدّل الدالة partition
بحيث تفصل العناصر الأصغر تمامًا من المحور (إلى
اليسار)، والعناصر المساوية للمحور (في الوسط)، والعناصر الأكبر تمامًا
من المحور (إلى اليمين). وبدلًا من فهرسين m وi يقسمان
مقطع المصفوفة إلى ثلاثة أجزاء، كما هو موضّح في الشكل ??، سوف
نستعمل ثلاثة فهارس لتقسيم مقطع المصفوفة إلى أربعة أجزاء. وعلى
الدالة الجديدة partition الآن أن تُعيد فهرسين. عدّل الدالة
quick_rec وفقًا لذلك. ويشكّل التقسيم إلى ثلاثة أجزاء بهذه الطريقة موضوع
التمرين 12.2.
الترتيب بالدمج
12.10 من مصادر عدم كفاءة الترتيب بالدمج على القوائم الدالة split. فبالنظر إلى
قائمة l تحوي n عنصرًا، تُنشئ splitl قائمتين جديدتين تمامًا، l1 وl2،
تحويان جميع عناصر l. ويمكننا تفادي هذا البناء باستعمال القائمة
l وحدها، دون تخصيص أي قائمة جديدة. وبدلًا من أخذ كل عنصر ثانٍ من l لبناء
l1 وl2، نختار لـ l1 العناصر ⌊n∕2⌋ الأولى من l ولـ l2 العناصر
⌈n∕2⌉ الأخيرة. ولبناء l2، اكتب دالة chop:int->’alist->’alist
بحيث تُعيد chopn1l لاحقة l الناتجة عن حذف عناصرها n1 الأولى.
أما l1، فيكفي تمثيلها بادئةً من l، أي إضافة وسيطة n1 إلى
الدالة mergesort، تشير إلى وجوب ترتيب العناصر n1 الأولى من l.
أعد كتابة الدالة mergesort باستعمال هذه الفكرة. وأعد استعمال الدالة merge من
البرنامج 93. واحسب التعقيد من حيث عدد التخصيصات للدالة
mergesort.
12.11 من طرق تحسين الدالة mergesort على المصفوفات شبه المرتّبة
تفادي الدمج عندما تكون، بعد الاستدعاءين العوديين،
جميع عناصر النصف الأيسر أصغر من عناصر النصف الأيمن. ويمكننا
اختبار ذلك بسهولة بمقارنة أقصى عنصر يمينًا في النصف الأيسر بـ
أقصى عنصر يسارًا في النصف الأيمن. عدّل الدالة mergesort باستعمال هذه
الفكرة.
12.12 لتفادي نسخ a إلى tmp بـ Array.blit في الدالة mergesort على
المصفوفات، أحد الاحتمالات هو ترتيب نصفي المصفوفة a مع نقلِهما في الوقت نفسه
إلى المصفوفة tmp، ثم دمج tmp مرة أخرى في a كما يُفعل بالفعل.
غير أن ترتيب عناصر a في tmp يقتضي، على العكس، أن يُرتَّب النصفان
في المكان، ثم يُدمجا في tmp. ولذلك نحتاج إلى دالتي ترتيب
متعاودتين (mutually recursive). ويمكننا الاكتفاء بواحدة بتمرير
وسيطة إضافية تشير إلى ما إذا كان الترتيب واجب التنفيذ في المكان أم
في tmp. عدّل الدالتين mergesort وmergesort_rec وفقًا لهذه
الفكرة.
12.13 في الترتيب بالدمج، كما في الترتيب السريع، يمكننا التحوّل إلى الترتيب بالإدراج عندما يكون
عدد العناصر المطلوب ترتيبها صغيرًا (انظر التمرين 12.7).