المجموعات والقواميس
5. المجموعات والقواميس
المجموعات والقواميس هي أكثر بنى المعطيات استخدامًا. يعرض هذا الفصل عدة طرق لتنفيذ المجموعات (sets). وفي كل حالة نناقش كيف يمكن تكييفها لتمثيل القواميس (dictionaries). يمكن استخدام بعض بنى المعطيات مع عناصر من أي نوع، بينما بعضها الآخر أكثر تخصصًا، إذ يصلح لعناصر ذات شكل معين (مثل القوائم) أو نوع معين (مثل الأعداد الصحيحة).
تُعرض بعض هذه بنى المعطيات بصيغة دائمة (persistent) وبعضها بصيغة أمرية (imperative). وهذا اختيار اعتباطي، وغالبًا ما تكون الخيارات الأخرى ممكنة، مثل جداول التجزئة الدائمة أو أشجار AVL الأمرية. وتُقترح بعض هذه الصيغ في التمارين.
لا يعتمد اختيار بنية المعطيات على كونها دائمة أو أمرية فحسب، بل تحكمه معايير أخرى، مثل العمليات المتاحة على العناصر (مثل وجود ترتيب كلي)، والعمليات التي توفرها بنية المعطيات نفسها (مثل عملية الاتحاد)، وتكلفتها النسبية (مثل إمكانية بناء مجموعة في زمن خطي).
5.1 أشجار البحث الثنائية
في هذا القسم ننفذ مجموعات دائمة. ترد توقيعة (signature) دنيا لهذه المجموعات، وهي
PersistentSet، في البرنامج 32. نوع العناصر هو elt ونوع المجموعات هو t.
وتمثل المجموعة الفارغة بالقيمة empty. وتضيف العمليتان add وmem على التوالي عنصرًا
وتختبران انتماء عنصر إلى مجموعة. وتُرجع الدالة min_elt أصغر عنصر في مجموعة إن وُجد،
وترفع الاستثناء Not_found في غير ذلك. وتزيل الدالة remove عنصرًا من مجموعة إن كان
موجودًا، وتُرجع المجموعة نفسها في غير ذلك. وأخيرًا تُرجع العملية cardinal عدد عناصر
المجموعة. وبالطبع فإن توقيعة أكثر واقعية ستضم عمليات إضافية، مثل الاتحاد والتقاطع
والفرق.
بنية المعطيات المختارة هنا لتنفيذ هذه التوقيعة هي شجرة البحث الثنائية (binary search tree)، أي شجرة
ثنائية يكون فيها كل عنصر في عقدة أكبر من كل عنصر في شجرتها الفرعية اليسرى وأصغر من كل عنصر في
شجرتها الفرعية اليمنى. ويسمح هذا التنظيم بالبحث عن عنصر في زمن يتناسب مع ارتفاع الشجرة.
غير أن بنية الشجرة هذه تفترض إمكانية مقارنة العناصر بعضها ببعض. ولهذا نطلب دالة مقارنة
compare:elt->elt->int على النحو التالي:
نجمع النوع elt وتصريح الدالة compare في توقيعة Ordered الواردة في البرنامج 33.
وتُكتب الشيفرة بعد ذلك على شكل مُمَيِّز (functor) يُوسَّم بوحدة ذات التوقيعة Ordered:
  module Make(X : Ordered) : PersistentSet with type elt = X.t =
  struct
توقيعة الوحدة التي يُرجعها هذا المُمَيِّز هي PersistentSet، حيث نحدد أن النوع elt للعناصر هو النوع X.t.
تبعًا لذلك، نبدأ في جسم المُمَيِّز بتعريف النوع elt كمرادف للنوع X.t.
type elt = X.t
ثم نعرّف النوع t للمجموعات بأنه نوع الأشجار الثنائية التي تحتوي عقدها الداخلية على قيمة من النوع elt:
type t = Empty | Node of t * elt * t
لنتأمل القيمة التالية بلغة OCaml:
  Node (Node (Node (Empty, ’B’, Empty), ’D’, Empty),
        ’E’,
        Node (Empty, ’F’, Empty))
وهي تقابل الشجرة اليسرى في الشكل 5.1، حيث تُعرض فقط القيمة من النوع elt
في كل عقدة، وحيث يُمثَّل Empty بالرمز ⊥.
في ما يلي لن نرسم أبناء العقدة عندما يكونان فارغين معًا، على النحو المبين في الشجرة اليمنى من الشكل.
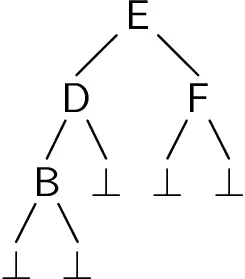
الشكل 5.1: تمثيلان لشجرة البحث الثنائية نفسها.
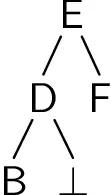
القيمة empty، التي تدل على المجموعة الفارغة، ليست سوى مرادف للباني
Empty، أي الشجرة الفارغة.
let empty = Empty
أصغر عنصر
يسهّل تركيب شجرة البحث الثنائية استرجاع أصغر عنصر فيها، إذ يكفي النزول على طول الفرع الأيسر
أطول مسافة ممكنة. وتنفذ الدالة min_elt هذا الاجتياز.
  let rec min_elt = function
    | Empty -> raise Not_found
    | Node (Empty, v, _) -> v
    | Node (l, _, _) -> min_elt l
كان بإمكاننا، بدلًا من الاستثناء المعرّف مسبقًا Not_found، أن نعرّف ونستخدم استثناءً خاصًا
بأشجار البحث الثنائية.
البحث عن عنصر
يجري البحث عن عنصر x في شجرة بحث ثنائية على نحو تعاودي كما يلي: إذا كانت الشجرة فارغة
نُرجع false.
  let rec mem x = function
    | Empty ->
        false
وإلا فإننا نقارن x بالعنصر v الموجود في جذر الشجرة. وإذا تساويا انتهى البحث بنجاح. وإذا كان x < v
واصلنا تعاوديًا في الشجرة الفرعية اليسرى، وإلا واصلنا في الشجرة الفرعية اليمنى.
    | Node (l, v, r) ->
        let c = X.compare x v in
        c = 0 || if c < 0 then mem x l else mem x r
إدراج عنصر
يتلخص إدراج عنصر x في شجرة بحث ثنائية t في إيجاد موضع x في t وفق المبدأ نفسه المتبع
عند البحث عن عنصر. وإذا كانت t فارغة كفى بناء شجرة تحتوي على x وحده.
  let rec add x t =
    match t with
    | Empty ->
        Node (Empty, x, Empty)
وإلا فإننا نقارن العنصر x بالجذر v للشجرة t. وإذا تساويا أعدنا الشجرة t كما هي تفاديًا لإدخال تكرار.
    | Node (l, v, r) ->
        let c = X.compare x v in
        if c = 0 then t
وإلا واصلنا الإدراج تعاوديًا إلى اليسار أو إلى اليمين بحسب نتيجة المقارنة.
        else if c < 0 then Node (add x l, v, r)
        else Node (l, v, add x r)
من الطبيعي أن يؤدي هذا التنفيذ لدالة الإدراج إلى أشجار شديدة الاختلال. فمثلًا إذا أضفنا تباعًا
F وE وD وB إلى الشجرة الفارغة حصلنا على «المشط» المبين في الشكل 5.2.
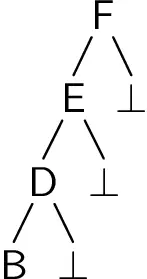
الشكل 5.2: شجرة بحث ثنائية على شكل مشط.
تُضعف هذه الأشكال كفاءة عمليات البحث والإدراج اللاحقة. وتقابل أسوأ حالة حالةَ المشط حيث لا تملك كل عقدة داخلية، كما يبين المثال، سوى شجرة فرعية واحدة غير فارغة. وعندئذ تتناسب العمليات في مثل هذه الأشجار مع عدد العناصر. وسنرى في القسم التالي أنه يمكن تحديد ارتفاع شجرة البحث الثنائية بحيث يظل لوغاريتميًا بالنسبة إلى عدد العناصر. وترد الشيفرة الكاملة لدالة الإدراج في البرنامج 34.
إزالة عنصر
لإزالة عنصر x من شجرة بحث ثنائية t نسير بالطريقة نفسها التي نتبعها عند البحث أو الإدراج، أي
بالنزول التعاودي نحو الموضع المحتمل لـ x. وإذا كانت t فارغة كفى إرجاع الشجرة الفارغة.
  let rec remove x = function
    | Empty ->
        Empty
وإلا فإننا نقارن x بالجذر v للشجرة t. وإذا تساويا واجهتنا مشكلة: إذ يجب إزالة v، أي
بناء شجرة انطلاقًا من الشجرتين الفرعيتين اليسرى واليمنى للشجرة t. ولتنفيذ هذه العملية نفترض أننا
كتبنا دالة merge تتولى هذا الدمج.
    | Node (l, v, r) ->
        let c = X.compare x v in
        if c = 0 then merge l r
وإذا كان x مختلفًا عن v نزلنا تعاوديًا في الشجرة الفرعية اليسرى أو اليمنى لإزالة x. والشيفرة
مماثلة لشيفرة الإدراج.
        else if c < 0 then Node (remove x l, v, r)
        else Node (l, v, remove x r)
تبقى دالة merge، التي تدمج شجرتين l وr، بحاجة إلى كتابة. وتكمن الصعوبة في تحديد جذر
للشجرة الناتجة. وتتمثل إحدى الطرق في اختيار أصغر عنصر في r، وتُحصَّل قيمته باستخدام الدالة
min_elt المكتوبة سابقًا. ثم يجب إزالة هذا العنصر من r، لكن هذه هي بالضبط العملية التي نحاول
تنفيذها.
لحسن الحظ، إن إزالة أصغر عنصر في شجرة بحث ثنائية أبسط بكثير في التنفيذ من إزالة عنصر عشوائي. ولنكتب
الدالة remove_min_elt لهذا الغرض. وإذا كانت الشجرة فارغة فليس هناك ما يُفعل.
  let rec remove_min_elt = function
    | Empty -> Empty
وإلا، وإذا لم توجد شجرة فرعية يسرى، فإن الجذر هو أصغر عنصر، ونُرجع الشجرة الفرعية اليمنى.
| Node (Empty, _, r) -> r
وإلا فإننا نزيل أصغر عنصر من الشجرة الفرعية اليسرى تعاوديًا.
| Node (l, v, r) -> Node (remove_min_elt l, v, r)
أصبحنا الآن جاهزين لكتابة الدالة merge. وإذا كانت إحدى وسيطتيها فارغة أعدنا الأخرى. وإلا
استخدمنا min_elt وremove_min_elt وطبقنا الفكرة المذكورة سابقًا.
  let merge t1 t2 = match t1, t2 with
    | Empty, t | t, Empty -> t
    | _ -> Node (t1, min_elt t2, remove_min_elt t2)
ترد الشيفرة الكاملة لإزالة عنصر في البرنامج 35. ويقترح التمرين 5.7
تحسينًا طفيفًا يتمثل في تجنب إعادة بناء الشجرة عندما لا يكون العنصر المراد إزالته موجودًا فعلًا.
وينطبق هذا التحسين أيضًا على الدالة add.
القواميس
لا نوضح هنا كيفية تكييف بنية المعطيات هذه لتنفيذ القواميس، لأن ذلك سيُفعل في القسم التالي بشأن الأشجار الثنائية المتوازنة.
5.2 أشجار AVL
كما رأينا في القسم السابق، يمكن أن يبلغ ارتفاع شجرة البحث الثنائية عدد عناصرها، كما هي حال المشط. وتتأثر كفاءة كل عملية بهذا مباشرة. ويمكن حلّ المشكلة بموازنة شجرة البحث الثنائية، أي بمحاولة جعل ارتفاعها صغيرًا قدر الإمكان. ومن الناحية العملية نبحث عن حل لا يكون مكلفًا جدًا عند البناء، لكنه يضمن أن تحتوي الشجرتان الفرعيتان لكل عقدة على العدد نفسه من العناصر ضمن عامل مضاعف صغير. والحل المعروض هنا هو حل أشجار AVL، حيث لا يُسمح أبدًا لاختلاف الارتفاعين بين الشجرتين الفرعيتين اليسرى واليمنى لكل عقدة أن يتجاوز 1.
نبدأ بتعديل نوع أشجار البحث الثنائية لتخزين ارتفاع الشجرة كوسيط رابع للباني Node.
type t = Empty | Node of t * elt * t * int
لنتأمل الشجرة التالية BDEF:
وهي ممثَّلة بالقيمة التالية بلغة OCaml:
  Node (Node (Node (Empty, ’B’, Empty, 1), ’D’, Empty, 2),
        ’E’,
        Node (Empty, ’F’, Empty, 1),
        3)
للتعامل مع ارتفاع شجرة AVL، من الملائم تعريف دالة لاسترجاعه:
  let height = function
    | Empty -> 0
    | Node (_, _, _, h) -> h
ومن المفيد بالمثل تعريف دالة تنشئ عقدة جديدة وتحسب ارتفاعها في الوقت نفسه:
  let node l v r =
    Node (l, v, r, 1 + max (height l) (height r))
تُسمى دالة كهذه بانيًا ذكيًا (smart constructor). وسنستخدمها في ما يلي بدلًا من الباني
Node. وبالطبع لا يكون الارتفاع الذي تحسبه node صحيحًا إلا إذا كان الارتفاعان المخزنان في
l وr صحيحين أيضًا. وسنضمن ذلك بجعل نوع أشجار AVL مجرّدًا (abstract).
أصغر عنصر واختبار الانتماء
بما أن شجرة AVL شجرة بحث ثنائية، تبقى الدالتان min_elt وmem مطابقتين لما في البرنامج
34 (انظر الصفحة 395). والفرق الوحيد أنهما تتجاهلان الوسيط الرابع للباني
Node.
الموازنة
نوضح موازنة شجرة AVL بمثال. فإذا أدرجنا العنصر A في الشجرة BDEF حصلنا على الشجرة
التالية ABDEF:
هذه الشجرة غير متوازنة لأن فرق الارتفاع بين الشجرتين الفرعيتين اليسرى واليمنى للعقدة E
يساوي اثنين. ومع ذلك يسهل استعادة توازن الشجرة، ويمكن فعل ذلك بإجراء تحويلات محلية تحافظ
على خاصية شجرة البحث الثنائية. ومن أمثلة هذه العمليات الدوران الأيمن (right rotation) المبين
في الشكل 5.3.
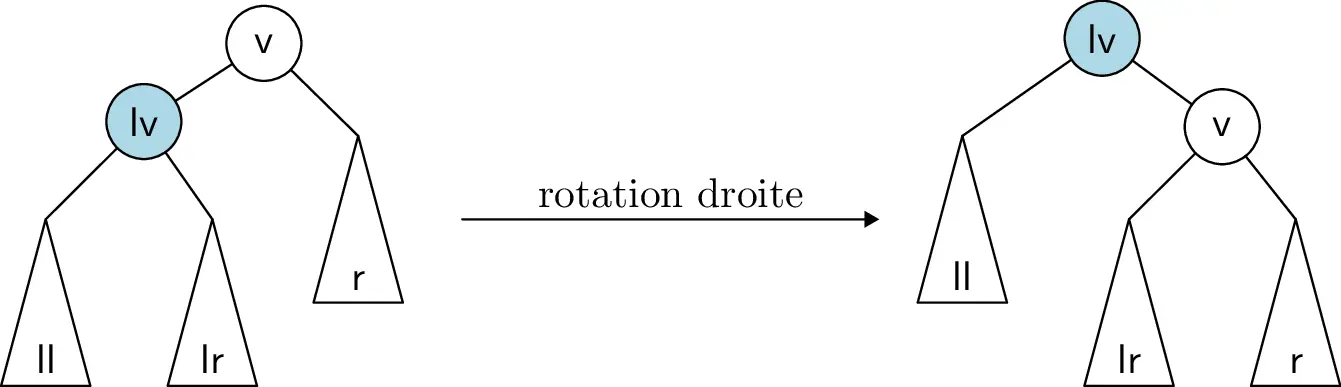
الشكل 5.3: دوران أيمن في شجرة AVL.
تحل هذه العملية الجذر v محل الجذر lv للشجرة الفرعية اليسرى، وتنقل الشجرة الفرعية lr
التي تحتوي على العناصر الواقعة بين lv وv. ولاحظ أن هذه العملية تعدّل عقدتين فقط في بنية
الشجرة. وتُحفظ خاصية شجرة البحث الثنائية: فتبقى الشجرة الفرعية ll على يسار lv؛ وتبقى
الشجرة الفرعية r على يمين v؛ وتبقى الشجرة الفرعية lr على يمين lv وعلى يسار v.
ويمكن إجراء دوران أيسر على نحو متناظر.
وبذلك يمكن إعادة موازنة الشجرة ABDEF بإجراء دوران أيمن عند الشجرة الفرعية ذات الجذر D.
فنحصل عندئذ على الشجرة التالية، التي تحقق شرط AVL.
لا يكفي دوران أيسر أو أيمن بسيط بالضرورة لإعادة موازنة الشجرة. فمثلًا إذا أدرجنا C حصلنا
على الشجرة التالية، وهي ليست شجرة AVL.
ويمكننا حينئذ أن نحاول إجراء دوران أيمن عند الجذر E أو دوران أيسر عند العقدة B. غير أن
أيا من العمليتين لا يعطي شجرة AVL.
ومع ذلك يمكن إعادة موازنة الشجرة اليمنى بسهولة بإجراء دوران أيمن إضافي عند الجذر E. فنحصل
على شجرة AVL التالية:
وتسمى هذه العملية المزدوجة الدوران الأيسر-الأيمن (left-right rotation). وغني عن القول إن هناك أيضًا دورانًا متناظرًا يمينًا-يسارًا.
تكفي هذه العمليات الأربع، أي الدورانين البسيطين والدورانين المزدوجين، لإعادة موازنة أي شجرة
AVL بعد عملية إدراج. ونجمع شيفرة إعادة الموازنة في باني ذكي balance بالنوع التالي:
val balance : t -> elt -> t -> t
وهو يتصرف تمامًا كالدالة node، إلا أنه يضمن أيضًا أن تكون النتيجة متوازنة.
نبدأ بحساب الارتفاعين hl وhr للشجرتين الفرعيتين اليسرى واليمنى، وننظر أولًا في الحالة التي
يكون فيها الاختلال ناتجًا عن الشجرة الفرعية اليسرى l:
  let balance l v r =
    let hl = height l in
    let hr = height r in
    if hl > hr + 1 then begin
كما هو مبين في الشكل 5.4، يكفي دوران أيمن بسيط إذا كانت الشجرة الفرعية اليسرى ll
للشجرة l لا تقل ارتفاعًا عن الشجرة الفرعية اليمنى lr:
      match l with
        | Node(ll, lv, lr, _) when height ll >= height lr ->
            node ll lv (node lr v r)
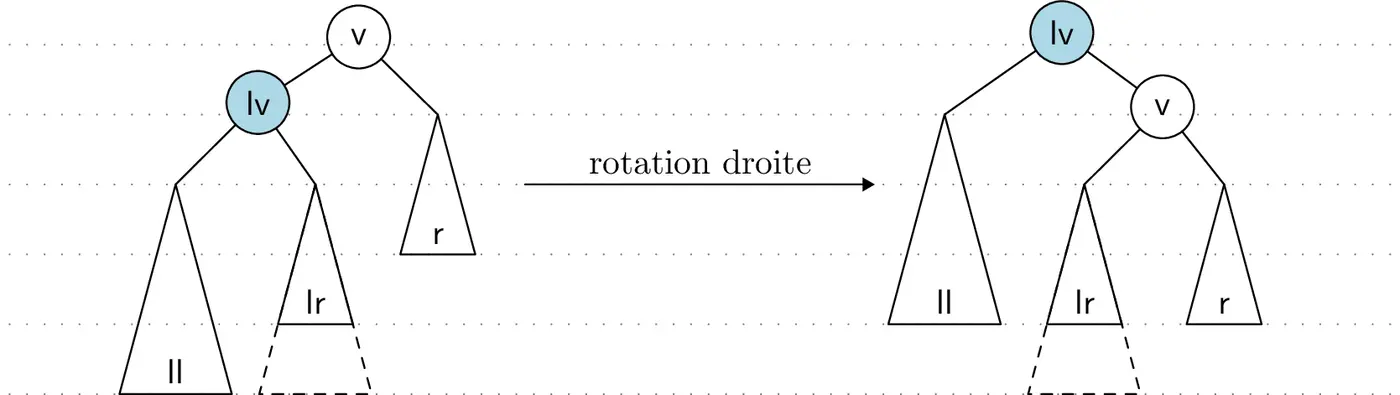
الشكل 5.4: دوران بسيط في شجرة AVL.
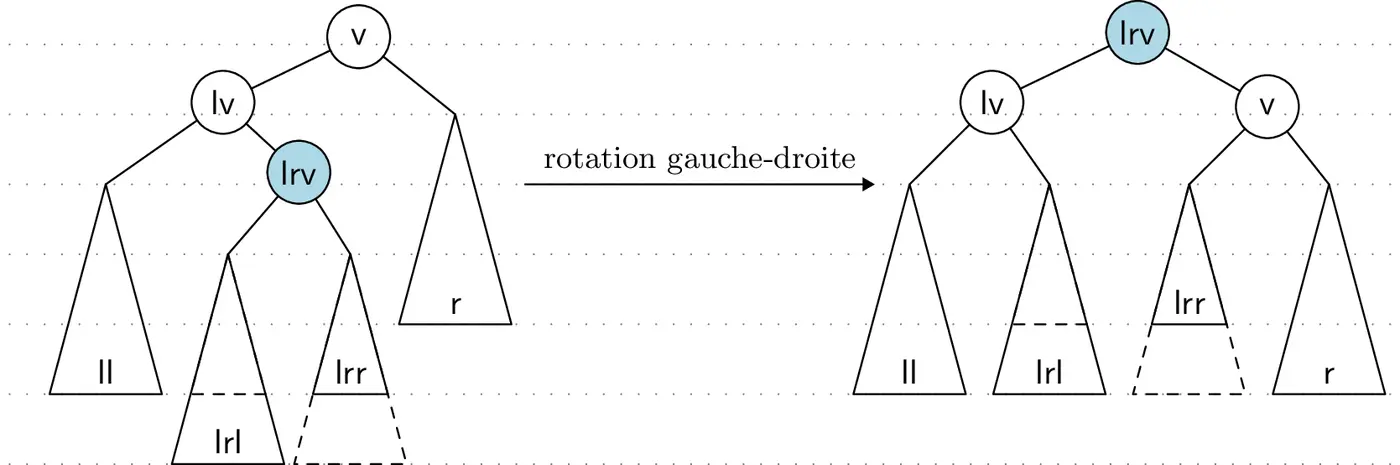
الشكل 5.5: دوران مزدوج في شجرة AVL.
ومن جهة أخرى، إذا كانت ll أقصر من lr، وجب إجراء دوران مزدوج أيسر-أيمن، كما هو مبين في
الشكل 5.5.
        | Node(ll, lv, Node(lrl, lrv, lrr, _),_)->
            node (node ll lv lrl) lrv (node lrr v r)
وهنا أيضًا يُضمن شرط AVL. ولاحظ أن الاختلال قد يكون ناتجًا عن lrl أو عن lrr، وأن دورانًا
مزدوجًا أيسر-أيمن يكفي في الحالتين لاستعادة التوازن.
وبما أن l وr يفترض أن تكونا شجرتي AVL، فلا يوجد سبب آخر محتمل للاختلال عندما تكون l
أطول من r. وبذلك تكتمل مطابقة الأنماط:
| _ -> assert false
وتُعالج الحالة التي يكون فيها الاختلال ناتجًا عن r على نحو متناظر:
    end else if hr > hl + 1 then begin
      match r with
        | Node (rl, rv, rr, _) when height rr >= height rl ->
            node (node l v rl) rv rr
        | Node (Node(rll, rlv, rlr, _), rv, rr, _) ->
            node (node l v rll) rlv (node rlr rv rr)
        |  _ ->
            assert false
وأخيرًا، إذا اختلف ارتفاعا l وr بواحد على الأكثر، فإننا نبني العقدة دون إعادة موازنة:
    end else
      node l v r
ترد الشيفرة الكاملة للدالة balance في البرنامج 36.
الإدراج والإزالة
يمكننا الآن تكييف شيفرة إدراج عنصر (الدالة add في البرنامج 34)، باستبدال
كل تطبيق للباني Node بتطبيق للدالة balance. وبالمثل يمكننا تكييف شيفرة إزالة عنصر (الدوال
remove_min_elt وmerge وremove)، بإجراء التعديل نفسه.
وترد الشيفرة المحصَّلة بهذه الطريقة في البرنامج 37.
نؤكد أن التكييفات المذكورة أعلاه لا تتضمن سوى استبدالات بسيطة.
مقارنة المجموعات
تنفيذ ترتيب كلي على المجموعات مهم، وهو من النوع التالي:
val compare : t -> t -> int
ويتيح لنا ذلك على وجه الخصوص بناء مجموعات من المجموعات بسهولة بتجسيد المُمَيِّز Make عدة
مرات متتالية، كما يلي:
  module Int = struct
    type t = int
    let compare = Stdlib.compare
  end
  module IntSet = Make(Int)
  module IntSetSet = Make(IntSet)
لا يمكن إجراء المقارنة على المجموعات ببساطة باستخدام Stdlib.compare. فالواقع أن شجرتي بحث
ثنائيتين قد تحتويان العناصر نفسها دون أن يكون لهما التركيب نفسه. ويتمثل حل بسيط في بناء قائمة
عناصر كل شجرة بالترتيب الداخلي ثم مقارنتها. غير أن ذلك غير فعّال البتة: فمن جهة يتطلب بناء
القائمة ذاكرة كبيرة، ومن جهة أخرى قد يكون هذا البناء مضيعة إذا اختلفت القائمتان قرب البداية.
ويقترح الفصل 9 حلًا فعّالًا لهذه المسألة.
التعقيد
لتبرير القول بأن أشجار AVL متوازنة، نبين الآن أن ارتفاع شجرة كهذه لوغاريتمي دائمًا بالنسبة إلى عدد العناصر.
لنأخذ شجرة AVL ارتفاعها h، ولنحاول تقدير عدد عناصرها n.
إذا كانت الشجرة متوازنة تمامًا فإن n = 2h − 1. غير أن لدينا في الحالة العامة n ≤ 2h − 1 فقط. وتُحصَّل أصغر قيمة ممكنة لـ n في شجرة تحتوي إحدى شجرتيها الفرعيتين على ارتفاع h − 1 والأخرى على ارتفاع h − 2. (والسبب أنه لولا ذلك لأمكننا إزالة عناصر من إحدى الشجرتين الفرعيتين مع الحفاظ على خاصية AVL.) وهكذا، إذا دللنا بـ Nh على أصغر عدد من العناصر في شجرة AVL ارتفاعها h، كان لدينا Nh = 1 + Nh−1 + Nh−2، ويمكن إعادة كتابة ذلك على الصورة Nh + 1 = (Nh−1 + 1) + (Nh−2 + 1). وبشكل مكافئ، إذا وضعنا Gh = Nh + 1 كان لدينا Gh = Gh−1 + Gh−2. وهنا نتعرف على العلاقة التعاودية التي تعرّف متتالية فيبوناتشي. وبما أن لدينا أيضًا N0 = 0 وN1 = 1، أي G0 = 1 وG1 = 2، نستنتج أن Gh = Fh+2، حيث (Fi) هي متتالية فيبوناتشي.
تخبرنا نتيجة رياضية أن Fi > ϕi∕ − 1، حيث ϕ = هي النسبة الذهبية. ومن ثَمّ:
أي:
وبأخذ اللوغاريتم ذي الأساس 2 لهذه المتباينة، نستنتج الحد المطلوب لارتفاع h بدلالة عدد العناصر n:
ومن ثَمّ يكون ارتفاع شجرة AVL لوغاريتميًا بالنسبة إلى عدد العناصر. ويضمن ذلك على وجه الخصوص تعقيدًا O(log n) لعمليات البحث والإدراج والإزالة. كما يضمن ألا تسبب هذه العمليات طفحًا في المكدس (stack overflow).
القاموس
ترد توقيعة دنيا لقاموس دائم في البرنامج 38. وهي شديدة الشبه بتوقيعة المجموعة
(البرنامج 32، في بداية الفصل). والنوع key للمفاتيح يحل محل النوع elt للعناصر
لمزيد من الوضوح. والنوع t أصبح متعدد الصور (polymorphic)، ووسيطه من النوع ’a هو نوع القيم
المقترنة بالمفاتيح. وتأخذ الدالة add وسيطًا إضافيًا. وأخيرًا تُرجع دالة جديدة find القيمة
المقترنة بمفتاح، وترفع الاستثناء Not_found في غير ذلك.
يتلخص تكييف بنية أشجار AVL للقواميس في إضافة القيمة المقترنة بالمفتاح إلى كل عقدة، أي:
type ’a t = Empty | Node of ’a t * key * ’a * ’a t * int
الدالة mem لا تتغير. وتتبع الدالة find المخطط نفسه تمامًا الذي تتبعه mem، إلا أنها ترفع
الاستثناء Not_found إذا لم يكن المفتاح موجودًا في القاموس. وترد شيفرتها في البرنامج 39.
وجميع الدوال الأخرى على أشجار AVL (balance، add، إلخ) لا تتغير، إلا أن العناصر تُستبدل
بأزواج مفتاح/قيمة.
الوحدتان Set وMap
توفر المكتبة القياسية لـ OCaml الوحدتين Set وMap، المنفذتين باستخدام أشجار AVL، وهما شبه
مطابقتين لما عرضناه في هذا القسم. والفرق الوحيد أن الشرط المفروض على ارتفاع الشجرتين الفرعيتين
مخفف (2 في OCaml مقابل 1 هنا). وهذا الاختيار حل وسط بين تكلفة البناء وكفاءة العمليات. وتوفر
هاتان المكتبتان جميع العمليات المجموعاتية (set-theoretic)، مثل الاتحاد والتقاطع واختبار
التضمين، إلخ.
5.3 جداول التجزئة
يمكن تنفيذ بنية معطيات أمرية (imperative) للمجموعات باستخدام مصفوفة من القيم المنطقية
بحجم n إذا كانت العناصر أعدادًا صحيحة بين 0 و n − 1. غير أن هذه الفكرة لا تصلح لأنواع أخرى من العناصر، مثل أعداد صحيحة في مجال مختلف، أو عناصر من نوع مختلف، أو إذا كان عدد العناصر غير محدود. ويمكننا أيضًا استخدام قائمة، لكن البحث يصبح حينئذ مكلفًا.
نعرض هنا بنية المعطيات المسماة جدول التجزئة (hash table)، التي تجمع بين هذين المقاربتين. وتتلخص الفكرة في استخدام دالة f تربط كل عنصر بعدد صحيح بين 0 و n − 1. ومن الصعب عمومًا إيجاد دالة f تكون تباينية (injective). وسيتعين علينا تبعًا لذلك معالجة التصادمات (collisions)، أي الحالات التي تُسند فيها عدة عناصر إلى القيمة نفسها بموجب f. وبدلًا من استخدام مصفوفة من القيم المنطقية، سنستخدم مصفوفة تحتوي كل خلية فيها على «دلو» (bucket) من العناصر ممثَّل بقائمة. وهكذا ينتمي عنصر x إلى المجموعة إذا وفقط إذا انتمى إلى الدلو ذي الفهرس f(x). وإذا كانت الدالة f توزع العناصر بانتظام على مختلف الدلاء، كانت عملية البحث فعّالة.
لنأخذ، على سبيل المثال، جدول تجزئة يمثل مجموعة السلاسل النصية التالية:
لنفترض أن الجدول يحتوي على n = 7 دلاء. ولنفترض أيضًا وجود دالة h، تسمى دالة التجزئة (hash function)، تربط بكل عنصر عددًا صحيحًا موجبًا (أو صفرًا). ويمكننا عندئذ تعريف الدالة f كما يلي:
تضمن العملية الباقي (modulo) أن قيمة f تقع فعلًا في المجال 0..n− 1. وفي حالة السلاسل النصية
يمكننا أن نأخذ h مطابقًا لطول السلسلة. وإذا استخدمنا القوائم لتمثيل الدلاء حصلنا على البنية
المبينة في الشكل 5.6. وهكذا، على سبيل المثال، يحتوي الدلو 2 على
السلسلتين "the codes" و"in"، اللتين طولهما على التوالي 9 و2.
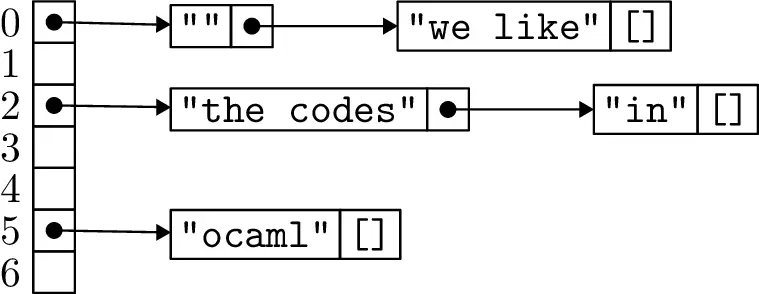
الشكل 5.6: جدول تجزئة يحتوي سلاسل نصية.
يُعدّ اختيار عدد الدلاء n ودالة التجزئة h أمرًا مهمًا. فمثلًا إذا أردنا تمثيل مجموعة الكلمات الـ 80000 في القاموس الفرنسي، وجب علينا اختيار قيمة n كبيرة بما يكفي، من الرتبة نفسها لعدد العناصر، بغية الحصول على دلاء صغيرة. كما يجب اختيار دالة h أكثر دقة من مجرد طول السلسلة، وإلا فسيُستخدم عدد قليل من الدلاء فقط.
سننفذ الآن جداول تجزئة ذات التوقيعة الواردة في البرنامج 40. والنوع elt هو نوع
العناصر والنوع t هو نوع جداول التجزئة. وتُرجع الدالة create جدولًا جديدًا فارغًا في البداية.
وتضيف الدالة add عنصرًا وتزيل الدالة remove عنصرًا. وتختبر الدالة mem وجود عنصر وتُرجع
cardinal عدد العناصر في المجموعة.
لإضافة عنصر إلى جدول تجزئة تجب الاستعانة بدالة تجزئة hash من النوع elt->int. وللبحث عن
عنصر تجب أيضًا الاستعانة بدالة تساوٍ equal من النوع elt->elt->bool. وبدلًا من استخدام عامل
التساوي = في OCaml، نفضل أن نترك للمستخدمين اختيار دالة المقارنة الخاصة بهم. ويجب أن تحقق
الدالتان hash وequal الشرط التالي:
لذلك من الطبيعي أن نكتب جداول التجزئة على شكل مُمَيِّز يُوسَّم بوحدة من النوع HashType،
تحتوي توقعيتها على هاتين الدالتين (انظر البرنامج 41 أدناه).
يتخذ المُمَيِّز عندئذ الشكل التالي:
module Make(X: HashType): ImperativeSet with type elt = X.t = struct
  type elt = X.t
كان يمكن تعريف النوع t لجداول التجزئة كما يلي:
type t = (elt list) array
غير أنه يُفضَّل أيضًا تخزين عدد العناصر في المجموعة حتى نتمكن من تنفيذ الدالة cardinal
بكفاءة. ولذلك نستخدم نوع سجل (record) يحتوي، من جهة، على عدد العناصر في الحقل size، ومن
جهة أخرى، على مصفوفة الدلاء في الحقل buckets
  type t = {
    mutable size : int;
    buckets : (elt list) array;
  }
وتكون الدالة cardinal عندئذ فورية.
  let cardinal h =
    h.size
لإنشاء جدول تجزئة جديد يجب اختيار حجم n للمصفوفة. ويُستحسن أن يكون هذا الحجم من الرتبة نفسها
لعدد العناصر التي ستُخزَّن في الجدول. ويمكن للمستخدم تقديم هذه المعلومة، مثلًا على شكل وسيط
إضافي للدالة create، لكن ذلك غير ممكن دائمًا. ولنفترض الآن حالة مبسطة يكون فيها الحجم ثابتًا
اعتباطيًا.
let array_length = 5003
سنرى لاحقًا كيف نتخلص من الحاجة إلى هذا الاختيار الاعتباطي. ويتلخص إنشاء جدول تجزئة فارغ في
إنشاء مصفوفة بحجم array_length تحتوي على قوائم فارغة فقط، وفي تهيئة الحقل size بالقيمة 0.
  let create () =
    { size = 0;
      buckets = Array.make array_length []; }
البحث عن عنصر
للبحث عن عنصر x داخل جدول تجزئة h، نبدأ بكتابة دالة bucket_of تُرجع الدلو المقابل لـ x
في h.
  let bucket_of x h =
    (X.hash x land max_int) mod (Array.length h.buckets)
بما أن نتيجة mod تحمل الإشارة نفسها التي تحملها وسيطتها الأولى، فإننا نتأكد من أن هذه
الأخيرة ليست سالبة بإزالة بت الإشارة[^1].
للبحث عن عنصر x في جدول h، نبدأ بتحديد فهرس i للدلو الذي يحتوي x باستخدام الدالة
bucket_of.
  let mem x h =
    let i = bucket_of x h in
بعد ذلك نبحث عن x في القائمة h.buckets.(i). ولهذا نستخدم دالة التساوي على النوع elt، أي
X.equal.
List.exists (X.equal x) h.buckets.(i)
ترد الشيفرة الكاملة للدالة mem أدناه في البرنامج 42.
بما أن عملية البحث داخل دلو تُستخدم عدة مرات لاحقًا، فسنحوّلها إلى دالة mem_bucket.
إدراج عنصر
لإدراج عنصر x في جدول h، نبدأ باسترجاع القائمة b الخاصة بالدلو الذي قد يحتوي x.
  let add x h =
    let i = bucket_of x h in
    let b = h.buckets.(i) in
إذا كان x موجودًا في الدلو فليس هناك ما يُفعل. وإلا فإننا نزيد الحقل size ونضيف x في رأس
القائمة b.
    if not (mem_bucket x b) then begin
      h.size <- h.size + 1;
      h.buckets.(i) <- x :: b
    end
ترد الشيفرة الكاملة للدالة add أدناه في البرنامج 43.
ملاحظة: كان بإمكاننا إضافة x مباشرة إلى القائمة b دون التحقق من وجوده مسبقًا. ولن يغيّر
ذلك محتوى المجموعة (من وجهة نظر mem)، وكان الإدراج سيحدث عندئذ في زمن O(1). ومن جهة أخرى،
كان سيصبح من المستحيل تتبع الحقل size، وكانت العملية cardinal ستصبح أكثر كلفة. علاوة على
ذلك، كانت الإدراجات المتكررة للعنصر نفسه ستشغل حيزًا متزايدًا في جدول التجزئة، مما يقلل كفاءة
عمليات البحث. وبدلًا من ذلك، لمنع التكرارات، يمكن تمثيل الدلاء باستخدام بنية معطيات أكثر كفاءة
من القوائم؛ فيمكننا مثلًا استخدام أشجار AVL المعروضة في القسم السابق. غير أن ذلك سيتطلب دالة
مقارنة إضافية على النوع elt.
إزالة عنصر
تسير إزالة عنصر من جدول تجزئة كما في عملية الإدراج. وترد شيفرة remove في البرنامج 44.
عندما يكون x موجودًا في الدلو b، يجب إنقاص الحقل size وحذف وقوع x في b. ولهذه
العملية الأخيرة نستخدم الدالة List.filter بحيث لا نبقي إلا على عناصر الدلو المختلفة
عن x.
تغيير حجم المصفوفة ديناميكيًا
تكون كفاءة الشيفرة المعروضة أعلاه مرضية عندما يكون ترتيب حجم عدد عناصر المجموعة معروفًا مسبقًا. غير أن بنيتنا أبسط مما ينبغي إذا أمكن لعدد العناصر أن يزداد على نحو اعتباطي. وتنخفض الكفاءة بسرعة بمجرد أن يكبر عامل الحمولة (load factor) لجدول التجزئة، أي النسبة بين عدد العناصر في الجدول وحجم المصفوفة. ولعلاج ذلك يجب تغيير حجم المصفوفة ديناميكيًا بحسب عامل الحمولة. ويمكننا، مثلًا، مضاعفة حجم المصفوفة بمجرد أن يتجاوز عامل الحمولة 1∕2.
ولفعل ذلك يجب تعديل تعريف النوع t تعديلًا طفيفًا، بحيث يُجعل الحقل buckets من النوع
mutable.
  type t = {
    mutable size : int;
    mutable buckets : elt list array;
  }
تبقى القيمة الأولية للثابت array_length اعتباطية لكنها لن تؤثر بعد ذلك في كفاءة العمليات.
غير أنه يمكن للمستخدم أن يستمر في الإشارة إلى ترتيب حجم مناسب تجنبًا لكثرة عمليات تغيير
الحجم.
يتمثل التعديل الرئيسي في الدالة add، حيث يجب تغيير حجم المصفوفة عندما يصبح عامل الحمولة
كبيرًا جدًا.
  let add x h =
    let n = Array.length h.buckets in
    ...
    if not (mem_bucket x b) then begin
      ...
      if h.size > n/2 then resize h
    end
يُجرى الاختبار h.size>n/2 مباشرة بعد إدراج x. وإذا تحقق الشرط نستدعي دالة resize تتولى
تغيير حجم المصفوفة. وتسير هذه الدالة كما في القسم 4.1Resizeable Arrays. وتبدأ بتخصيص مصفوفة جديدة a، من
حجم m = 2 × n.
  let resize h =
    let n = Array.length h.buckets in
    let m = 2 * n in
    let a = Array.make m [] in
بما أن حجم المصفوفة تغير، فإن رقم دلو العنصر لم يعد بالضرورة هو نفسه بسبب تغير المقاس
(modulus). ولذلك من الضروري إعادة تعيين كل عنصر من عناصر h إلى دلوّه الجديد. ولهذا
نعرّف دالة rehash تضيف العنصر x إلى دلوّه الجديد.
    let rehash x =
      let i = (X.hash x land max_int) mod m in
      a.(i) <- x :: a.(i)
    in
ثم يكفي تنفيذ rehash على جميع دلاء المصفوفة السابقة h.buckets:
Array.iter (List.iter rehash) h.buckets;
وأخيرًا نستبدل المصفوفة h.buckets بالمصفوفة a.
h.buckets <- a
ترد الشيفرة الكاملة للدالة resize في البرنامج 45.
بما أن حجم المصفوفات محدد بـ Sys.max_array_length، فمن الجيد التحقق من أن طول المصفوفة
التي تنشئها الدالة resize ليس كبيرًا جدًا (انظر التمرين 5.11).
التعقيد
يعتمد تعقيد العمليات على جدول التجزئة على دالة التجزئة بالطبع. فإذا كانت هذه الدالة تُرجع
دائمًا القيمة نفسها، مثلًا، تحول الجدول إلى قائمة بسيطة، وتكون لعمليات mem وadd وremove
تكلفة O(N) إذا كان الجدول يحتوي N عنصرًا. وعلى النقيض، إذا كانت دالة التجزئة توزع العناصر
بانتظام على مختلف الدلاء، وكان عدد الدلاء كبيرًا بما يكفي، أمكننا أن نأمل أن يكون حجم كل دلو
محصورًا بثابت صغير. وفي هذه الحالة يكون تعقيد كل عملية O(1).
يُضبط اختيار دالة التجزئة تجريبيًا، بقياس الحد الأقصى والمتوسط لحجوم الدلاء مثلًا. وبالنسبة
إلى قيم مثل الأعداد الصحيحة والسلاسل النصية أو حتى مصفوفات الأعداد الصحيحة، يمكننا استخدام
دالة التجزئة متعددة الصور Hashtbl.hash المتوفرة في مكتبة OCaml، والتي تعطي نتائج جيدة.
وسنرى في القسم 11.4 Hash-consing كيف
نعرّف دالة تجزئة فعّالة لقيم أكثر تعقيدًا، مثل القوائم أو الأشجار.
للحفاظ على عامل حمولة محدود، بيّنا أعلاه كيفية تغيير حجم جدول التجزئة ديناميكيًا. ومن الواضح
أن لكل عملية تستدعي تغيير الحجم تكلفة O(N)، لأن كل عنصر يجب إعادة إدراجه على حدة في
المصفوفة الجديدة. غير أنه إذا اتبعنا الاستراتيجية أعلاه المتمثلة في مضاعفة حجم المصفوفة في كل
مرة، فإن التكلفة تكون مطفأة (amortized) على تسلسل العمليات بأكمله، تمامًا كما في القسم
4.1 Resizeable Arrays. وعليه تكون
لعمليات mem وadd وremove تكلفة مطفأة O(1). وبناءً عليه يعد جدول التجزئة بنية معطيات
فعّالة للغاية.
القاموس
لتكييف بنية جدول التجزئة لتمثيل القواميس، نضيف القيم المقترنة بالمفاتيح إلى الدلاء. فتصبح
القوائم قوائم إقران (association lists) ويصبح النوع t:
  type ’a t = {
    mutable size : int;
    mutable buckets : (key * ’a) list array;
  }
للتحقق من وجود مفتاح في قائمة من النوع (key*’a)list، نعدل الدالة mem_bucket تعديلًا
طفيفًا، كما يلي:
  let mem_bucket x b =
    List.exists (fun (y,_) -> X.equal x y) b
تخضع جميع الدوال الأخرى لتعديلات طفيفة مماثلة. والدالة الجديدة الوحيدة التي يجب إضافتها هي
find، إذ تبحث عن القيمة المقترنة بمفتاح في الدلو المقابل، وهو ما يختزل إلى البحث في قائمة
إقران. ولا يمكننا استخدام الدالة المعرّفة مسبقًا List.assoc، لأنه يجب علينا هنا استخدام
المسند بالتساوي X.equal. لذلك نكتب لهذا الغرض دالة خاصة lookup. وترد شيفرة find في
البرنامج 46.
الوحدة Hashtbl
توفر المكتبة القياسية لـ OCaml قواميس منفذة كجداول تجزئة في شكل مُمَيِّز Hashtbl.Make،
مماثل للمُمَيِّز الذي كتبناه للتو.
يمكن استخدام بنية المعطيات هذه لإقران عدة قيم بمفتاح واحد. وبشكل أدق، تتيح لنا استدعاء الدالة
add عدة مرات بالمفتاح نفسه دون أن نفقد القيم التي كان المفتاح مقترنًا بها سابقًا. فمثلًا، إذا
نفذنا الإضافتين addhxv1 وaddhxv2 تباعًا لمفتاح x في جدول h، فإن findhx سيرجع v2.
ثم إذا نفذنا removehx، كان لأثر ذلك حذف آخر إقران لـ x، وسيرجع findhx حينئذ v1. ومن
جهة أخرى، إذا أردنا استبدال القيمة v1 بالقيمة v2، يمكننا استخدام العملية replace.
توفر الوحدة Hashtbl أيضًا بنية معطيات جدول تجزئة متعدد الصور تعتمد على دالة التجزئة
متعددة الصور Hashtbl.hash من النوع ’a->int، وهي متوافقة مع عملية التساوي التركيبي =.
وبهذه الطريقة نتجنب الاضطرار إلى استخدام المُمَيِّز Hashtbl.Make عندما تكون المفاتيح، مثلًا،
قيمًا من النوع int أو string.
5.4 أشجار البادئة
نعنى في هذا القسم ببنية معطيات تُستعمل لتمثيل مجموعات من الكلمات. ونقصد بالكلمة هنا
أي قيمة من قيم OCaml يمكن النظر إليها بوصفها متتالية من الحروف. ونوع المعطيات الأول
الذي يتبادر إلى الذهن لهذه القيم هو بطبيعة الحال النوع string الخاص بالسلاسل النصية،
حيث تكون الحروف قيمًا من النوع char. غير أن قيمًا أخرى قد تُعد أيضًا كلمات. فعلى سبيل
المثال، يمكن فهم عدد صحيح مكتوب على الأساس 2 بوصفه كلمة مؤلفة من الحرفين 0 و1.
وبشكل أعم، سنفترض أن الكلمات من النوع L.tlist، حيث أن L وحدة من توقيع Letter،
ترد في البرنامج 47، وتحتوي على نوع t يمثل الحروف. وبصرف النظر عن
هذا النوع t، يفترض هذا التوقيع وجود دالة مقارنة سنحتاج إليها فيما يلي.
نستخدم هذا التحليل إلى حروف لتمثيل مجموعات الكلمات بمساعدة بنية معطيات تسمى شجرة
البادئة (prefix tree)، وتعرف أيضًا باسم trie[^2].
في هذه الأشجار، تُوسم كل حافة بحرف، وتحتوي كل عقدة على قيمة منطقية تبين ما إذا كانت
متتالية الحروف الواصلة من جذر الشجرة إلى هذه العقدة كلمة تنتمي إلى المجموعة. فعلى سبيل
المثال، الشجرة السابقة المقابلة لمجموعة الكلمات {if,in,do,done} ممثَّلة في
الشكل 5.7.
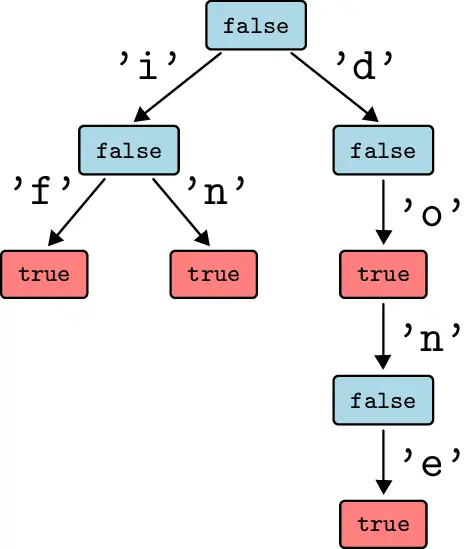
الشكل 5.7: شجرة بادئة لمجموعة {if,in,do,done}.
هذه البنية مفيدة لتحديد الزمن اللازم للبحث عن كلمة في مجموعة بطول الكلمة، بصرف النظر عن عدد الكلمات في المجموعة.
تجنبًا للاعتماد على تنفيذ خاص للوحدة L، نعرّف بنية معطيات شجرة البادئة على شكل مُمَيِّز
يُوسَّم بوحدة L ويُرجع مجموعة دائمة تكون توقعيتها، PersistentSet، واردة في البرنامج
48.
  module Make(L: Letter): PersistentSet with type elt = L.t list =
  struct
    type elt = L.t list
كما ذكرنا سابقًا، يُعرَّف النوع elt للعناصر بأنه قائمة من الحروف، أي قائمة من النوع
L.tlist.
تتلخص الفكرة وراء أشجار البادئة في تمثيل كل عقدة بقاموس يربط الحروف بأشجار فرعية، أي
بعقد أخرى. ونبدأ بتقديم قاموس M، مفاتيحه حروف، بتطبيق المُمَيِّز Map.Make على الوحدة
L.
module M = Map.Make(L)
ويمكننا عندئذ تعريف النوع t للعقد كما يلي:
type t = { word : bool; branches : t M.t }
يحتوي الحقل word على القيمة المنطقية الدالة على وجود كلمة في المجموعة. ويحتوي الحقل
branches على أبناء العقدة.
وتمثل المجموعة الفارغة بشجرة empty تتكون من عقدة واحدة، يكون فيها الحقل word هو
false، وbranches هو القاموس الفارغ:
let empty = { word = false; branches = M.empty }
وترد الشيفرة في البرنامج 49 مع دالة is_empty تختبر ما إذا كانت مجموعة
فارغة.
البحث عن عنصر
يجري البحث عن عنصر x على نحو تعاودي كما يلي: إذا كانت الكلمة x هي القائمة الفارغة،
انتهى البحث معيدًا القيمة المنطقية الموجودة في جذر الشجرة t.
  let rec mem x t =
    match x with
    | [] -> t.word
وإلا واصلنا البحث تعاوديًا داخل الشجرة الفرعية المقترنة بالحافة الموسومة بالحرف الأول i من
الكلمة x. وإذا لم توجد هذه الحافة، انتهى البحث فورًا بالفشل.
    | i :: l ->
        try mem l (M.find i t.branches)
        with Not_found -> false
ترد شيفرة الدالة mem في البرنامج 49.
إدراج عنصر
يتلخص إدراج كلمة x في شجرة بادئة t في النزول على طول الحواف الموسومة بحروف x، كما
فُعل عند البحث عن عنصر.
وإذا كانت x هي الكلمة الفارغة، انتهى الإدراج معيدًا شجرة t يكون فيها الحقل word مضبوطًا
على true، دلالة على أن x تنتمي الآن إلى المجموعة.
  let rec add x t =
    match x with
    | [] ->
        if t.word then t else { t with word = true }
ونتجنب إعادة بناء العقدة عندما يكون t.word هو true مسبقًا.
وإذا كانت x قائمة غير فارغة من الشكل i::l، ندرج l تعاوديًا في الشجرة الفرعية b
المقترنة بالحرف i في t. وإذا لم توجد b نجري الإدراج انطلاقًا من شجرة فارغة. وينتهي
الإدراج بإنشاء عقدة جديدة نربط فيها الحرف i بالشجرة الفرعية المحصَّلة تعاوديًا.
    | i :: l ->
        let b = try M.find i t.branches with Not_found -> empty in
        { t with branches = M.add i (add l b) t.branches }
ترد شيفرة الدالة add في البرنامج 50.
إزالة عنصر
تسير إزالة عنصر x في شجرة t، مرة أخرى، بالاجتياز التعاودي نفسه. غير أن ثمة دقة.
إذ يمكن للإزالة أن تترك الشجرة في حالة تكون فيها إحدى الحواف فارغة تمامًا، أي حيث تكون كل
حقول word مساوية لـfalse. وتفاديًا لإهدار الحيز على هذا النحو، نفرض الخاصية القاضية
بأن جميع أوراق شجرة البادئة يجب أن تمثل كلمة تنتمي إلى المجموعة. بعبارة أخرى، يجب أن تكون
القيمة المنطقية word للورقة مساوية دائمًا لـtrue، باستثناء، بالطبع، المجموعة الفارغة
الممثَّلة بعقدة واحدة تكون فيها القيمة المنطقية word مضبوطة على false.
ولنكتب الآن شيفرة الدالة remove. وإذا كانت الوسيطة x هي القائمة الفارغة، حُذفت من t
بتحويل الحقل word إلى false.
  let rec remove x t =
    match x with
      | [] ->
          { t with word = false }
وإلا تكون x من الشكل i::l، ونبدأ بحذف بقية الكلمة l تعاوديًا من الشجرة الفرعية المقترنة
بـ i. وإذا لم توجد هذه الشجرة الفرعية، تنتهي الدالة معيدة t مباشرة.
      | i :: l ->
          try
            let s = remove l (M.find i t.branches) in
            ...
          with Not_found -> t
بعد ذلك، إذا وُجدت الشجرة s وكانت فارغة، نزيل الحافة المقترنة بـ i في t. وإلا أنشأنا
إقرانًا جديدًا بين i وs.
            let new_branches =
              if is_empty s then M.remove i t.branches
              else M.add i s t.branches
            in
يضمن هذا ألا تشير أي حافة من حواف t إلى شجرة فارغة. وأخيرًا تنتهي الدالة بتحديث t
بالحواف الجديدة.
{ t with branches = new_branches }
ترد شيفرة الدالة remove أعلاه في البرنامج 50.
تقاطع أشجار البادئة
يُنفَّذ تقاطع شجرتي بادئة بمساعدة دالتين متعاودتين تبادليًا (mutually recursive) هما inter
وinter_branches. فتحسب الدالة inter تقاطع شجرتين t1 وt2 يفترض أنهما تقابلان البادئة
نفسها p. وتنتمي الكلمة p إلى التقاطع إذا احتوى جذرا t1 وt2 معًا الكلمة p. وتحسب حواف
التقاطع الدالة inter_branches.
  let rec inter t1 t2 =
    { word = t1.word && t2.word ;
      branches = inter_branches t1.branches t2.branches }
تنفذ الدالة inter_branches تقاطع قاموسين m1 وm2. وتتلخص الفكرة في تعداد حواف m1 مع
التحقق، لكل حافة، مما إذا كانت حافة مناظرة موجودة في m2. ولهذا نستخدم الدالة M.fold،
انطلاقًا من قاموس فارغ وبالنظر إلى كل إقران i↦ti من m1 تباعًا.
  and inter_branches m1 m2 =
    M.fold
      (fun i ti m -> ... )
      m1 M.empty
ولكل إقران نحسب تعاوديًا التقاطع t للشجرة ti مع الشجرة المقيدة بـ i في m2، إن وُجدت.
ونضيف الإقران i↦t إلى m، متحققين من أن t ليست فارغة. وإذا لم تحتوِ m2 على الحافة
i، يكون التقاطع فارغًا ويُترك m دون تغيير.
      (fun i ti m ->
         try
           let t = inter ti (M.find i m2) in
           if is_empty t then m else M.add i t m
         with Not_found -> m)
ترد الشيفرة الكاملة لدالة التقاطع في البرنامج 51. ويُترك تنفيذ عملية الاتحاد (union) كتمرين للقارئ.
المقارنة
يمكن مقارنة أشجار البادئة بسهولة. لمقارنة شجرتين t1 وt2، نبدأ بمقارنة القيمتين
المنطقيتين t1.word وt2.word. وفي حالة التساوي، يلزم مقارنة القاموسين t1.branches
وt2.branches. ولهذا الغرض نستعمل دالة المقارنة التي توفرها الوحدة M. وتأخذ هذه
الدالة وسيطة هي دالة لمقارنة القيم في القاموسين، وهو ما يطابق تمامًا الدالة compare
التي نسعى إلى تعريفها. ومن ثم تكون هذه الدالة تعاودية.
  let rec compare t1 t2 =
    let c = Stdlib.compare t1.word t2.word in
    if c<>0 then c else M.compare compare t1.branches t2.branches
التعقيد
لنأخذ شجرة بادئة s تحتوي N كلمة بالمجموع، واعتبر كلمة x من الطول M. لا يتطلب البحث
عن x في s أكثر من M استدعاءً تعاوديًا للدالة mem، لكل منها التكلفة نفسها التي تتطلبها
عملية البحث في قاموس branches للعقدة المناظرة. وبما أن قواميسنا تستعمل الوحدة Map
من المكتبة القياسية لـ OCaml، فإن تكلفة البحث لوغاريتمية بالنسبة إلى عدد العناصر.
وعليه تكون التكلفة الكلية متناسبة مع ∑
log(Bi)، حيث Bi هي أحجام القواميس التي
تُصادَف أثناء البحث. ويمكننا حصر كل Bi بالعدد N، ذلك أن الخاصية القاضية بأن كل ورقة
تنتهي بـtrue تضمن أن العقدة التي تحوي قاموسًا من الحجم B تتضمن على الأقل B كلمات
مختلفة. ومن ثم يكون التعقيد في أسوأ الحالات O(M log N). غير أنه قد يكون أقل من ذلك
بكثير. فإذا كان كل Bi مساويًا لاثنين، فإن التعقيد سيكون O(M)، بينما يمكن أن يبلغ N حد
2M. وبشكل أعم، إذا كانت مجموعة الحروف المدروسة محدودة الحجم، كما هو الحال مع
الحروف الـ26 للأبجدية مثلًا، فإن البحث له تعقيد O(M). ولعمليتي الإدراج والحذف تعقيد
مماثل.
أما بالنسبة لتقاطع شجرتي بادئة تحتويان على التوالي على N1 وN2 عنصرًا من الطول الأصغر من M، فيمكننا بالمثل حصر التعقيد بـ O(N1M log N2). وإذا كان عدد الحروف محدودًا، ينخفض التعقيد إلى O(N1M).
القواميس
ترمّز شجرة البادئة إلى وجود عنصر بقيمة منطقية موجودة في كل عقدة. ويتلخص تكييف هذه البنية لتمثيل القواميس في استبدال القيمة المنطقية بقيمة اختيارية (optional). ولذلك نعرّف النوع التالي:
type ’a t = { value : ’a option ; branches : ’a t M.t }
يحل الحقل value محل الحقل المنطقي word. والتكييفات اللازمة فورية: فهي تتحقق في الدالة mem
بفحص ما إذا كان الحقل value مختلفًا عن None؛ وتستبدل الدالة add القيمة الحالية (إن
وُجدت) بقيمة جديدة؛ وهكذا. وترد شيفرة الدالة find في البرنامج 52.
5.5 أشجار باتريشيا
عرضنا في القسم السابق أشجار البادئة. ويمكن استعمال بنية المعطيات هذه لتمثيل مجموعات من الأعداد الصحيحة بأن نطابق العدد الصحيح مع الكلمة المكونة من أرقامه الثنائية. ونسمي هذا بنية شجرة باتريشيا (Patricia tree). وهكذا يمكن النظر إلى المجموعة {4,5,17} على أنها المجموعة التالية المكونة من ثلاث كلمات ثنائية:
يمكننا بناء شجرة بادئة لهذه الكلمات الثلاث. ولدينا شجرتا باتريشيا محتملتان، بحسب ما إذا بدأنا القراءة من بت الترتيب الأعلى أو الأدنى. وفي الحالة الأولى نتحدث عن أشجار باتريشيا كبيرة الطرف (big-endian)، وفي الثانية عن أشجار باتريشيا صغيرة الطرف (little-endian)[1]. وفي ما يلي نكتفي بالنظر في أشجار باتريشيا صغيرة الطرف فقط، أي أننا نفحص البتات بدءًا من البت الأقل دلالة، أي من اليمين إلى اليسار. وباعتماد الاصطلاح القاضي بأن بت 0 يقود إلى الشجرة الفرعية اليسرى بينما يقود بت 1 إلى الشجرة الفرعية اليمنى، فإن شجرة البادئة المحصَّلة للأعداد الصحيحة {4,5,17} ممثلة في الشكل 5.8.
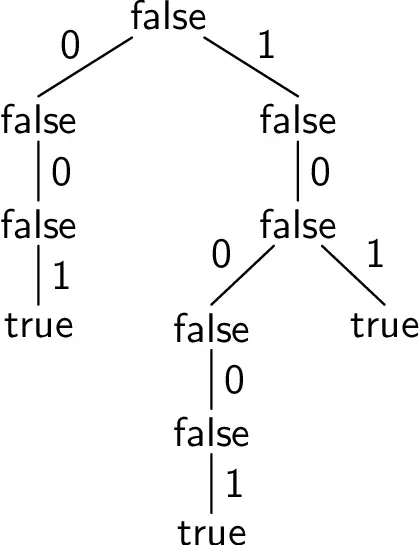
الشكل 5.8: شجرة بادئة للأعداد الصحيحة {4,5,17}.
نلاحظ فورًا وجود كثير من المعلومات المكررة. فعلى سبيل المثال، تكون البتة الثانية من الأعداد الصحيحة الثلاثة صفرًا دائمًا. ومع ذلك تحتوي شجرة البادئة على عقدة فرعية عند هذا المستوى. وهذا هو الحال أيضًا بالنسبة للبتة الرابعة في الشجرة الفرعية اليمنى. ونلاحظ بالمثل أنه لا جدوى من إنشاء فرع عندما لا يبقى في الشجرة سوى عنصر واحد. وللحصول على تمثيل أكثر إحكامًا، سنضيف عقدة فرعية إلى الشجرة عند الضرورة فقط، أي عندما يكون ثمة اختلاف في بتات المجموعتين الجزئيتين من العناصر. وبصيغة أدق، ستحتوي العقدة على البتة التي يتعين فحصها وكذلك جميع البتات الواقعة إلى يمينها. وهكذا نحصل على الشجرة المعروضة في الشكل 5.9، حيث البتة التي يتعين فحصها مسطَّر تحتها.
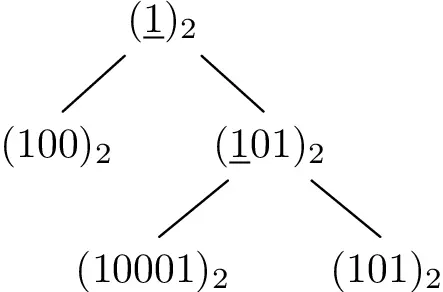
الشكل 5.9: شجرة باتريشيا للمجموعة {4,5,17}.
تدل هذه الشجرة على أنه يمكننا البدء بفحص البتة الأولى. وإذا كانت 0، نتجه إلى الشجرة الفرعية اليسرى التي تحتوي عنصرًا واحدًا، ألا وهو 4 = (100)2. وإذا كانت 1، نتجه إلى الشجرة الفرعية اليمنى التي تشير إلى أن البتة الثالثة يتعين فحصها، وأن البتتين الأدنى ترتيبًا هما (01)2 بالنسبة لهذه الشجرة الفرعية بأكملها. وإذا كانت البتة الثالثة 0، نبلغ الشجرة الفرعية التي لا تحتوي إلا على 17 = (10001)2. وإذا كانت 1، نبلغ الشجرة الفرعية التي لا تحتوي إلا على 5 = (101)2. ولاحظ أن ترتيب العناصر غير محفوظ في بنية الشجرة. (وسيكون الأمر كذلك، مع ذلك، في أشجار باتريشيا كبيرة الطرف التي تحتوي أعدادًا صحيحة غير موقَّعة).
من المهم ملاحظة أن عقدة فرعية مثل (101)2 تحتوي معلومتين متميزتين: البتة التي يتعين فحصها (وهنا الثالثة) والبتات الواقعة إلى يمينها (وهنا (01)2). وليس ضروريًا للبحث عن عنصر في الشجرة سوى المعلومة الأولى. غير أن الإدراج يتطلب المعلومة الثانية أيضًا. وسنستعمل عددين صحيحين لتمثيل عقدة فرعية مثل (101)2: قوة لعدد اثنين لتمثيل البتة التي يتعين فحصها (وهنا (100)2) وعددًا صحيحًا يمثل البادئة، أي البتات ذات الترتيب الأصغر من هذه القوة (وهنا (01)2). وقد يكفي عدد صحيح واحد وحده (وهنا (101)2)، لكن بما أنه ليس من السهل استخراج بتة الرتبة العليا، فمن الأبسط الاحتفاظ بالمعلومتين منفصلتين. ونعتمد لذلك النوع التالي لتمثيل أشجار باتريشيا:
  type t =
    | Empty
    | Leaf of int
    | Node of int * int * t * t
ويمثل المُنشئ Empty الشجرة الفارغة؛ وLeafx ورقة تحتوي عنصرًا x؛ وأخيرًا، يمثل
Node(p,b,l,r) نقطة تفرع، حيث p هي البادئة، وb البتة الواجب فحصها (قوة لعدد
اثنين)، وl وr الشجرتان الفرعيتان. وفي ما يلي سنضمن الثابتة التالية المسماة ثابتة حسن
التكوين (well-formedness): شجرة من الشكل Node لا تحتوي شجرة فرعية من الشكل
Empty.
البحث عن عنصر
للبحث عن عنصر x في شجرة باتريشيا، يكفي النزول على طول الشجرة وفقًا لبتات التفرع،
حتى بلوغ ورقة. نبدأ بكتابة دالة zero_bit تختبر ما إذا كانت البتة b من x تساوي 0،
باستعمال وٍمنطقي (logical and) وبافتراض أن العدد الصحيح b قوة لعدد اثنين.
  let zero_bit x b =
    x land b == 0
يمكننا الآن كتابة الدالة mem. فتعريفها واضح إذا كانت الشجرة فارغة.
  let rec mem x = function
    | Empty -> false
وإذا بلغنا ورقة j، نتحقق مما إذا كانت x تساوي j.
| Leaf j -> x = j
وأخيرًا، عند عقدة تفرع، يكفي تحديد ما إذا كانت البتة المقابلة لـ x تساوي 0 أو 1 باستعمال
الدالة zero_bit.
| Node (_, b, l, r) -> mem x (if zero_bit x b then l else r)
ترد شيفرة الدالة mem في البرنامج 53.
لاحظ أن هذه الشيفرة تنزل بشكل منهجي حتى بلوغ ورقة، رغم أنها قد تتوقف أحيانًا قبل ذلك
إذا لم تتوفر في العنصر x البادئة التي تتوقعها العقدة الفرعية. وقد اخترنا هنا مقاربة
تجري فحوصًا أقل، ما يخدم المواقف التي تنتهي فيها أغلبية عمليات البحث بنتيجة إيجابية.
ويتناول التمرين 5.22 الاحتمال الآخر.
إدراج عنصر
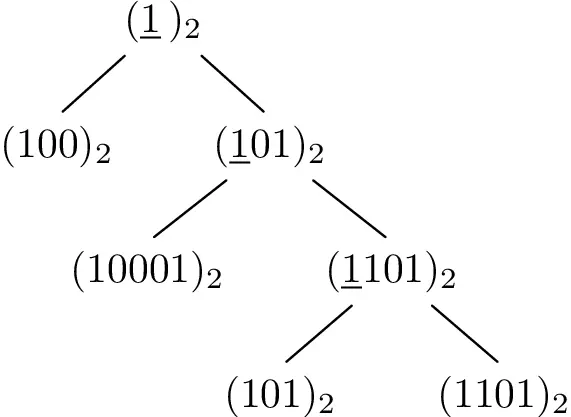
يتلخص إدراج عنصر في شجرة باتريشيا في النزول على طول الشجرة حتى إيجاد موضع الإدراج. ونستعمل مثالًا لتوضيح الحالتين اللتين قد تطرآن. لنفترض أننا ندرج 7 = (111)2 في الشجرة المعروضة في الشكل 5.9. تقود العقدة الفرعية الأولى إلى الشجرة الفرعية اليمنى، لأن البتة الأدنى ترتيبًا هي 1. غير أن البادئة لا تتطابق في العقدة الفرعية الثانية، أي (101)2: فهي (11)2 في العنصر المزمع إدراجه و(10)2 في الشجرة الفرعية. ومن ثم يلزم إنشاء عقدة فرعية جديدة، ألا وهي (11)2، مع وضع الشجرة الفرعية السابقة إلى اليسار والورقة 7 إلى اليمين. وفي النهاية نحصل على الشجرة اليسرى في الشكل 5.10. ومن جهة أخرى، إذا أدرجنا لا 7 بل 13 = (1101)2، فإننا نبلغ الورقة المحتوية على 5، والتي يجب فصلها إلى ورقتين متميزتين، تحتويان على 5 و13، وهو ما يعطي الشجرة على اليمين في الشكل 5.10.
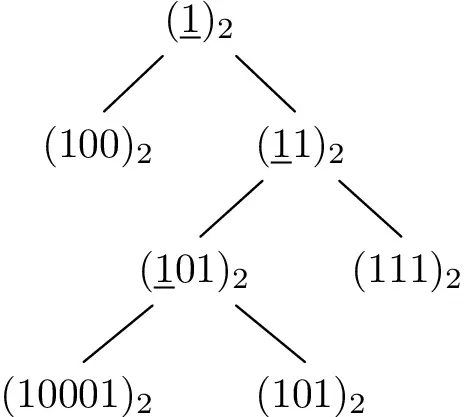
الشكل 5.10: إدراج 7 = (111)2 (على اليسار) أو 13 = (1101)2 (على اليمين) في شجرة باتريشيا في الشكل 5.9.
نبدأ بتنفيذ دالة branch تأخذ شجرتين t1 وt2 كوسيطتين، وتنشئ العقدة الفرعية
المناظرة. ويفترض أن تكون بادئتا الشجرتين، p1 وp2، مختلفتين. ومن ثم يلزم تحديد
البتة الأدنى ترتيبًا التي يختلف عندها p1 وp2. ولهذا نعمل على خطوتين: نبدأ بتحديد
جميع البتات المختلفة، باستعمال العملية p1lxorp2. ثم نستخرج البتة الأدنى ترتيبًا
المضبوطة على 1، والتي يجب أن توجد. وقد رأينا سابقًا كيف نفعل ذلك باستعمال وٍمنطقي
بين x و-x في القسم 4.2 متجهات البتات. وبناءً عليه، نقدم دالة
rightmost_1_bit لهذا الغرض.
  let rightmost_1_bit x =
    x land -x
لنكتب الآن الدالة branch. نبدأ بحساب بتة التفرع باستعمال rightmost_1_bit.
  let branch p1 t1 p2 t2 =
    let b = rightmost_1_bit (p1 lxor p2) in
ثم نحسب البادئة المشتركة p لكل من p1 وp2. وهي مجموعة البتات ذات الترتيب الأصغر
من b، التي نستخرجها باستعمال وٍمنطقي مع القناع b-1.
let p = p1 land (b-1) in
نستعمل هنا p1 لتحديد هذه البادئة، لكن كان يمكننا أيضًا استعمال p2. ولم يبقَ الآن سوى
تحديد أيّ من الشجرتين، t1 أو t2، يجب وضعه في اليسار، وفقًا لقيمة البتة b.
    if zero_bit p1 b then
      Node (p, b, t1, t2)
    else
      Node (p, b, t2, t1)
لنتناول مثالًا يوضح طريقة عمل الدالة branch مع p1 = (011101)2 وp2 = (110101)2.
فنتيجة p1lxorp2 هي (101000)2. والبتة b المستخرجة باستعمال rightmost_1_bit هي إذن
(001000)2. والقناع b-1 هو عندئذ (000111)2، مما يعطي البادئة p = (000101)2.
نعرّف بعد ذلك دالة matches_prefix تحدد ما إذا كان لعدد صحيح x البادئة المعرفة بـ p
وb.
  let matches_prefix x p b =
    x land (b-1) == p
أصبحنا الآن قادرين على كتابة الدالة add التي تدرج عنصرًا x في شجرة باتريشيا. فحالة
الشجرة الفارغة واضحة.
  let rec add x = function
    | Empty ->
        Leaf x
وفي حالة ورقة j، نبدأ بالتحقق مما إذا كانت j تساوي x. وإذا كان الأمر كذلك، فلا
ثمة شيء آخر ينبغي فعله. وإلا، يجب إنشاء عقدة فرعية للورقتين، باستعمال branch.
    | Leaf j as t ->
        if j == x then t else branch x (Leaf x) j t
وأخيرًا، في حالة Node، نحدد ما إذا كانت x تملك بادئة هذه الشجرة.
    | Node (p, b, l, r) as t ->
        if matches_prefix x p b then
وإذا كان الأمر كذلك، نواصل الإدراج تعاوديًا في الشجرة الفرعية اليسرى أو اليمنى، وفقًا
لما إذا كانت بتة x المعرفة بـb تساوي 0 أو 1.
          if zero_bit x b then
            Node (p, b, add x l, r)
          else
            Node (p, b, l, add x r)
وإذا لم تكن x، من جهة أخرى، تملك البادئة p، فمن الضروري إنشاء عقدة فرعية بشجرتين
فرعيتين، t والورقة x. وقد أُنشئت الدالة branch لهذا الغرض تحديدًا.
        else
          branch x (Leaf x) p t
وبهذا تكتمل الدالة add. وترد الشيفرة الكاملة في البرنامج 54 (انظر
الصفحة 497).
إزالة عنصر
تتم إزالة عنصر في شجرة باتريشيا تمامًا كما هو الحال في الإدراج، والفرق الوحيد هو ضرورة
الحفاظ على ثابتة حسن التكوين. ولهذا الغرض، يكفي إدخال منشئ ذكي (smart constructor)
node يتصرف مثل Node عندما لا تكون وسيطاته Empty ويجري تبسيطًا في الحالة
المعاكسة.
  let node = function
    | (_, _, Empty, t)
    | (_, _, t, Empty) -> t
    | (p, b, l, r) -> Node (p, b, l, r)
وباستعمال الدالة node بدل المنشئ Node، يكون تعريف remove واضحًا. وهو وارد في
البرنامج 55.
الاتحاد
من مزايا أشجار باتريشيا مقارنة بأشجار AVL أن الأولى تصلح بيسر أكبر للعمليات المجموعاتية مثل الاتحاد (union). ففي الواقع، تملك شجرتا باتريشيا تتشاطران عناصر كثيرة عادةً بنى تفرع متماثلة أو متشابهة، مما يسمح بمقاربة تقوم على النزول التعاودي. وهذا يتناقض مع أشجار AVL، حيث يعتمد الجذر اعتمادًا كبيرًا على الطريقة التي بُنيت بها الشجرة.
لننفذ اتحاد شجرتي باتريشيا، t1 وt2. نبدأ بالنظر في الحالات البديهية. وأبسطها هي
الحالة التي تكون فيها إحدى الشجرتين فارغة.
  let rec union t1 t2 = match t1, t2 with
    | Empty, t | t, Empty  ->
        t
وبالمثل، يمكننا معالجة الحالة التي تكون فيها إحدى الشجرتين ورقة بسهولة، باستدعاء
الدالة add.
    | Leaf x, t | t, Leaf x ->
        add x t
ثم يجب علينا النظر في الحالة العامة، حيث تكون t1 وt2 معًا عقدتي تفرع.
| Node (p1, b1, l1, r1), Node (p2, b2, l2, r2) ->
ثمة ثلاثة سيناريوهات ممكنة. وأبسط الحالات هي التي تتطابق فيها بادئتا t1 وt2
تطابقًا تامًا. وفي هذه الحالة، يكفي إجراء الاتحاد تعاوديًا على الشجرتين الفرعيتين اليسرى
واليمنى على التوالي.
        if b1 == b2 && p1 = p2 then
          Node (p1, b1, union l1 l2, union r1 r2)
في الحالة الثانية، تكون إحدى البادئتين مضمنة في الأخرى. لنفترض مثلًا أن بادئة t1
مضمنة في بادئة t2. وهذا يعني أن t1 تختبر بتة ترتيبها أدنى من بتة t2، أي أن
b1<b2، وأن بتات p2 الواقعة دون b1 تطابق p1. وفي هذه الحالة، يجب دمج t2
بأكملها تعاوديًا مع الشجرة الفرعية اليسرى أو اليمنى من t1، وفقًا للبتة b1 من البادئة
p2.
        else if b1 < b2 && matches_prefix p2 p1 b1 then
          if zero_bit p2 b1 then
            Node (p1, b1, union l1 t2, r1)
          else
            Node (p1, b1, l1, union r1 t2)
ونعالج الحالة المتناظرة، عندما تكون بادئة t2 مضمنة في بادئة t1، بطريقة مماثلة.
        else if b1 > b2 && matches_prefix p1 p2 b2 then
          ...
الحالة الأخيرة هي التي تختلف فيها البادئتان اختلافًا كاملًا، دون أن تتضمن إحداهما
الأخرى. وهذا يعني أن عناصر t1 منفصلة عن عناصر t2، ويكفي إنشاء عقدة فرعية جديدة
مع t1 في جانب وt2 في الجانب الآخر، وهو ما تقوم به الدالة branch تحديدًا.
        else
          branch p1 t1 p2 t2
ترد الشيفرة الكاملة للدالة union أدناه في البرنامج 56.
تُكتب عمليات التقاطع والفرق واختبار الاحتواء (inclusion) بطريقة مماثلة (انظر التمرين 5.23).
المقارنة
يمكن مقارنة أشجار باتريشيا بسهولة. ففي الواقع، يجب أن تملك شجرتا باتريشيا تحتويان
العناصر نفسها البنية نفسها. ومن ثم يمكن استعمال دوال المقارنة البنيوية في OCaml مباشرة
على أشجار باتريشيا. وبهذه الطريقة نحصل على مساواة وترتيب كلي على النوع t مع
العامل = والدالة Stdlib.compare.
التعقيد
تكون تكلفة البحث عن العناصر وإدراجها وإزالتها في أشجار باتريشيا متناسبة مع عدد بتات العدد الصحيح المدروس. وبذلك تكون التكلفة ثابتة. ولاحظ، مع ذلك، أن هذه التكلفة قد تصل إلى 64 مقارنة على جهاز ذي 64 بتًا، وهو ما يقابل، في حالة شجرة AVL، بنية تحتوي من العناصر أكثر مما يمكن تمثيله في ذاكرة الحاسوب. ومن ثم لا يمكننا أن نستنتج من هذا أن شجرة باتريشيا أفضل من شجرة AVL بشكل عام. فقد تقتضي شجرة باتريشيا مقارنات أكثر من شجرة AVL. ففي الواقع، يمكن لشجرة باتريشيا تحتوي 30 عنصرًا أن تتخذ بنية مشطية (comb) بينما تكون شجرة AVL المناظرة متوازنة. ومع ذلك، تبقى أشجار باتريشيا بنية مثيرة للاهتمام عندما يتعين علينا تنفيذ عمليات مثل الاتحاد أو التقاطع أو المقارنة.
القواميس
من السهل تكييف نوع أشجار باتريشيا لصنع قواميس منها. ففي الواقع، يكفي إضافة وسيطة
ثانية إلى المُنشئ Leaf.
  type key = int
  type ’a t =
    | Empty
    | Leaf of key * ’a
    | Node of int * int * ’a t * ’a t
والتكييفات اللازمة للدوال المختلفة واضحة. ويقترح التمرين 5.27 كتابة الدالة
find.
5.6 التمارين
أشجار البحث الثنائية
5.1 اكتب دالة height تحسب ارتفاع شجرة.
5.2 اكتب دالة cardinal:t->int تُرجع عدد عناصر شجرة البحث الثنائية.
5.3 اكتب دالة max_elt:t->elt مماثلة لدالة min_elt.
5.4 اكتب دالة floor:elt->t->elt تُرجع أكبر عنصر في شجرة البحث الثنائية يكون أصغر
من أو يساوي عنصرًا معطى، إن وُجد، وتُطلق الاستثناء Not_found في الحالة المعاكسة.
5.5 اكتب دالة iter:(elt->unit)->t->unit تجتاز عناصر شجرة البحث الثنائية بترتيب
تصاعدي.
5.6 اكتب دالة elements:t->eltlist تُرجع عناصر شجرة البحث الثنائية بترتيب تصاعدي.
5.7 عندما تُستدعى add بعنصر موجود مسبقًا، أو remove بعنصر غير موجود، يمكن
تحسين كفاءة الدالتين بإرجاع الشجرة الممررة كوسيطة مباشرة. أعد كتابة الدالتين add
وremove باستعمال هذه الفكرة. ويمكنك إطلاق استثناء للإشارة إلى أن الشجرة لم تتغير،
مع الحرص على عدم التقاطه عند كل استدعاء تعاودي، بل فقط على مستوى الاستدعاء
الأولي.
5.8 إذا استعملت فكرة التمرين السابق، يصبح من السهل تتبع أصل (cardinal) شجرة
البحث الثنائية. يمكنك، مثلًا، استعمال سجل (record) يخزن الأصل بجانب الشجرة. أعد
كتابة النوع t، والدالتين add وremove بهذه الطريقة.
أشجار AVL
يمكن إعادة تناول جميع التمارين السابقة حول أشجار البحث الثنائية مع أشجار AVL.
5.9 اكتب الدالة add لقواميس مطبقة بشجرة AVL. وما الذي ينبغي فعله إذا كان مفتاح
مقترنًا مسبقًا بقيمة؟
جداول التجزئة
5.10 سيكون حساب (X.hashx)mod(Array.lengthh.buckets) غير صحيح إذا أرجع
X.hashx قيمة سالبة، لأن النتيجة ستكون سالبة. اشرح لماذا ليست
(abs(X.hashx))mod(Array.lengthh.buckets) حلًا.
5.11 عدّل الدالة resize بحيث لا يتجاوز حجم m المصفوفة الجديدة
Sys.max_array_length.
5.12 في حالة القاموس، بدلًا من استعمال قائمة اقترانات من النوع (key*’a)list لتمثيل
الدلاء، يمكنك استعمال نوع أكثر إحكامًا، ألا وهو:
type ’a bucket = Nil | Cons of key * ’a * ’a bucket
بيّن أنك ستوفر بذلك ثلث كلمات الذاكرة. أعد كتابة الدوال الخاصة بجداول التجزئة باستعمال
النوع ’abucket.
5.13 باستعمال المصفوفات الدائمة (persistent arrays)، نفذ بنية معطيات لجداول تجزئة دائمة.
أشجار البادئة
5.14 اكتب الدالة cardinal على أشجار البادئة.
5.15 اكتب دالة min_elt تُرجع أصغر عنصر في شجرة بادئة بالنسبة للترتيب المعجمي
المشتق من L.compare. يمكنك استعمال حقيقة أن مكررات الوحدة Map تجتاز الاقترانات
بترتيب تصاعدي للمفاتيح.
5.16 حسّن كفاءة الدالتين add وremove باستعمال فكرة التمرين
5.7.
5.17 الدالة mem ليست تعاودية الذيل (tail recursive) لأن الاستدعاء التعاودي موجود
داخل try-with. عالج هذه المشكلة بالتقاط الاستثناء Not_found فقط في أعلى الدالة.
5.18 بدلًا من استعمال الوحدة Map من المكتبة القياسية لـ OCaml، يمكن للمميّز
Make أن يأخذ وسيطة إضافية M من التوقيع
Map.S with type key = L.t
أعد كتابة المميّز Make بهذه الطريقة.
5.19 اكتب الدالة union على أشجار البادئة. يمكنك استعمال دالتين تعاوديتين تبادليًا
كما فعلنا في حالة الدالة inter.
5.20 اكتب نسخة مختلفة من أشجار البادئة حيث يُطبق القاموس branches بمصفوفة، على
سبيل المثال، عندما تتكون الكلمات من المحارف ’a’..’z’.
5.21 تسهّل طريقة الإدخال T9 في الهواتف المحمولة القديمة كتابة النصوص على
لوحات مفاتيحها الرقمية: فبدلًا من الضغط على مفتاح عدة مرات لإنتاج كل حرف، يكفي
ضغطة واحدة، ويقترح الهاتف الكلمات التي تقابل متتالية المفاتيح المضغوطة، استنادًا إلى
قاموس بحوزة الهاتف في ذاكرته.
فعلى سبيل المثال، عندما تضغط على المفاتيح 2، 6، 6، 7، 8، 8، 3، 7 تباعًا، تحصل على الكلمة computer، بافتراض المراسلة التالية من المفاتيح إلى الحروف،
قد تقابل متتالية من المفاتيح أكثر من كلمة واحدة. على سبيل المثال، تقابل المتتالية 2، 2، 5، 3، 7 كلا الكلمتين baker وcakes، وتقابل المتتالية 3، 3، 2، 7 كلا الكلمتين dear وfear.
يمكنك استعمال أشجار البادئة لتمثيل مثل هذه القواميس. وهكذا يكون لدينا بنية معطيات تسمح لنا بالبحث بكفاءة عن جميع الكلمات في قاموس الهاتف التي تقابل متتالية معطاة من ضغطات المفاتيح.
ولهذا الغرض، يلزم تعديل بنية المعطيات المعروضة في هذا الفصل تعديلًا طفيفًا. أولًا، يجب علينا أن نفترض أن تحليل الكلمات ليس حقنيًا (injective) بالضرورة. بعبارة أخرى، قد يُمثَّل الآن كلمتان مختلفتان بنفس متتالية الحروف. وسنفترض وجود وحدة تنفذ هذا التحليل، بالتوقيع التالي:
  module type Word = sig
   type t
   type letter
   val decomposition: t -> letter list
   val compare : t -> t -> int
  end
بعد ذلك، لتخزين جميع الكلمات التي يقابل تحليلها البادئة نفسها، يجب استبدال الحقل
المنطقي word، الذي يدل على كلمة مكتملة، بحقل يحتوي مجموعة من الكلمات المتطابقة.
وعليه ستأخذ بداية الوحدة Make الشكل التالي:
  module Make(L : Letter)(W : Word with type letter = L.t)
  :  PersistentSet with type elt = W.t =
  struct
    module S = Set.Make(W)
    module M = Map.Make(L)

    type elt = W.t
    type t = { words : S.t ; branches : t M.t }
أكمل شيفرة المميّز Make.
أشجار باتريشيا
5.22 عدّل الدالة mem على أشجار باتريشيا (البرنامج 53) بحيث تفشل
بمجرد أن لا تملك x البادئة المقابلة للعقدة Node.
5.23 اكتب الدوال inter وdiff وsubset على أشجار باتريشيا، منفذة على التوالي
التقاطع والفرق واختبار الاحتواء، متخذًا الدالة union نموذجًا.
5.24 اكتب جميع عمليات أشجار باتريشيا كبيرة الطرف (big-endian)، أي تلك التي
تُفحص فيها البتات من اليسار إلى اليمين بدلًا من اليمين إلى اليسار. والصعوبة الرئيسية
هي كتابة الدالة leftmost_1_bit التي ليست ببساطة rightmost_1_bit.
5.25 اكتب مكتبة لأشجار باتريشيا، بصرف النظر عن طبيعتها صغيرة الطرف أو كبيرة الطرف، بوصفها مميّزًا (functor) مُعاملًا بالعناصر التي تختلف بين التنفيذين.
5.26 حسّن تمثيل أشجار البادئة بإخراج البادئات المشتركة عاملًا مشتركًا كما يحدث في
أشجار باتريشيا. وهكذا، سيكون لمجموعة الكلمات {do, doing, dominate, domino}
التمثيل التالي:
يشير الجذر إلى أن الحرفين الأولين يجب أن يكونا do وأن الكلمة المقابلة، do، موجودة
في المجموعة. وننزل في الشجرة وفقًا لقيمة الحرف الثالث. بالنسبة لـ i، نبلغ ورقة
تحتوي الكلمة doing. وبالنسبة لـ m، نبلغ عقدة فرعية جديدة تشير إلى أن الحرفين
التاليين يجب أن يكونا in وأن الكلمة المقابلة، domin، غير موجودة في المجموعة.
ووفقًا لقيمة الحرف السادس، نحصل إما على الورقة dominate أو الورقة domino.
5.27 اكتب الدالة find للقواميس الممثلة باستعمال أشجار باتريشيا.
البرنامج
seqأداة Unix تعرض جميع الأعداد الصحيحة من 1 إلى n، عددًا صحيحًا في كل سطر. وهو أبسط طريقة للحصول على n سطرًا من النص بالضبط. ↩︎