المخزن المزدوج
^title المخزن المزدوج ^section أنماط التسلسل
النية
تجنّب العمل غير الضروري بتأجيله حتى تصبح النتيجة مطلوبة.
الدافع
في باطنها، الحاسوب مخلوق تسلسلي (sequential). قوّته تأتي من قدرته على تفكيك أكبر المهام إلى خطوات صغيرة يمكن تنفيذها واحدة تلو الأخرى. لكن غالباً ما يحتاج مستخدمونا إلى رؤية الأشياء تحدث في خطوة فورية واحدة، أو رؤية عدة مهام تُنفَّذ في وقت واحد.
المثال النموذجي، والذي يجب على كل محرّك ألعاب معالجته، هو العرض (rendering). عندما ترسم اللعبة العالم الذي يراه المستخدمون، فإنها تفعل ذلك جزءاً بعد جزء -- الجبال في البعيد، والتلال المتدرّجة، والأشجار، كلٌّ منها دوره. لو شاهد المستخدم ذلك المشهد يُرسم تدريجياً على هذا النحو، لانهار وهم العالم المتّسق. يجب أن يتحدّث المشهد بسلاسة وسرعة، معروضاً سلسلة من الإطارات (frames) الكاملة، كلٌّ منها يبدو فورياً.
المخزن المزدوج (double buffer) يحلّ هذه المشكلة، لكن لفهم كيف يفعل ذلك نحتاج أولاً إلى مراجعة كيفية عرض الحاسوب للرسوميات.
كيف تعمل رسوم الحاسوب (باختصار)
تفرض شاشة العرض، مثل شاشة حاسوب، بكسلاً واحداً في كل مرة. فهي تمسح كل صف من البكسلات من اليسار إلى اليمين ثم تنزل إلى الصف التالي. وعندما تصل إلى الركن السفلي الأيمن، تمسح عائدةً إلى الأعلى الأيسر وتبدأ من جديد. وهي تفعل ذلك بسرعة -- نحو ستّين مرة في الثانية -- حتى لا تستطيع أعيننا رؤية عملية المسح. بالنسبة إلينا، إنها حقل ثابت واحد من البكسلات الملوّنة -- صورة.
يمكنك التفكير في هذه العملية كخرطوم صغير يوجّه البكسلات إلى الشاشة. تدخل الألوان الفردية إلى مؤخرة الخرطوم، فيرشّها عبر الشاشة، بت واحد من البكسلات إلى كل بكسل دوره. إذاً كيف يعرف الخرطوم أي الألوان تذهب إلى أين؟
في معظم الحواسيب، الجواب أنه يسحبها من إطار التخزين (framebuffer). إطار التخزين مصفوفة من البكسلات في الذاكرة، أي جزء من الذاكرة العشوائية (RAM) حيث يمثّل كل زوج من بايتات لون بكسل واحد. وبينما يرشّ الخرطوم عبر الشاشة، يقرأ قيم الألوان من هذه المصفوفة، بايتاً في كل مرة.
في النهاية، كي تظهر لعبتنا على الشاشة، لا نفعل شيئاً سوى الكتابة في تلك المصفوفة. كل خوارزميات الرسوميات المتطوّرة التي لدينا تنحصر في ذلك: تعيين قيم بايتات داخل إطار التخزين. لكن هناك مشكلة صغيرة.
قلتُ في وقت سابق إن الحاسوب تسلسلي. إذا كانت الآلة تنفّذ جزءاً من شيفرة العرض لدينا، فلا نتوقّع منها أن تفعل أي شيء آخر في الوقت نفسه. هذا صحيح إلى حدٍّ كبير، لكن هناك أمران قد يحدّثان في منتصف تشغيل برنامجنا. أحدهما أن شاشة العرض تقرأ من إطار التخزين بشكل مستمر بينما تعمل لعبتنا. ويمكن أن يسبّب هذا لنا مشكلة.
لنفترض أننا نريد لوجه مبتسم أن يظهر على الشاشة. يبدأ برنامجنا في المرور على إطار التخزين، يلوّن البكسلات. وما لا ندركه هو أن سائق الفيديو يسحب من إطار التخزين في اللحظة ذاتها التي نكتب فيها إليه. وبينما يمسح البكسلات التي كتبناها، يبدأ وجهنا بالظهور، ثم يسبقه لاحقاً ويتقدّم إلى بكسلات لم نكتبها بعد. النتيجة هي التمزّق (tearing)، وهو خلل بصري فظيع ترى فيه نصف شيء مرسوماً على الشاشة.
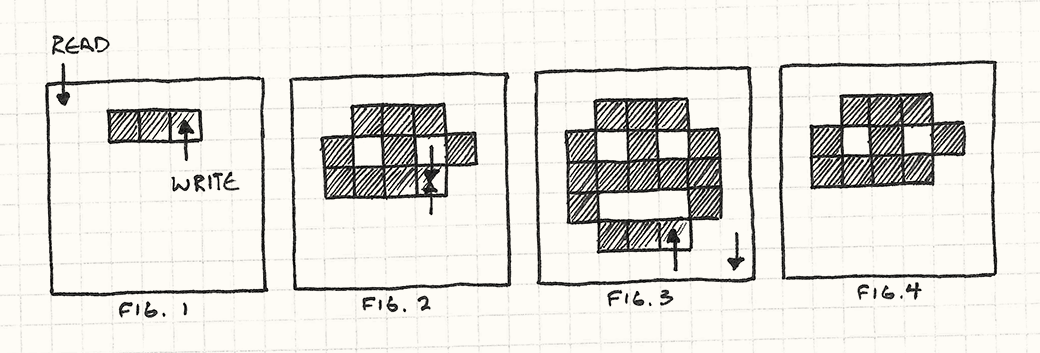
هذا هو سبب حاجتنا إلى هذا النمط. يرسم برنامجنا البكسلات واحداً تلو الآخر، لكننا نحتاج إلى أن يراها سائق العرض كلها دفعةً واحدة -- في إطار واحد الوجه غير موجود، وفي الإطار التالي أصبح موجوداً. المخزن المزدوج يحلّ هذا الأمر. وسأشرح كيف يحدث ذلك عن طريق تشبيه.
الفصل الأول، المشهد الأول
تخيّل أن مستخدمنا يشاهد مسرحية أنتجناها بأنفسنا. عندما ينتهي المشهد الأول ويبدأ المشهد الثاني، نحتاج إلى تغيير ديكور المسرح. لو سمحنا لعمّال المسرح أن يركضوا إلى المسرح بعد انتهاء المشهد ويبدأون في سحب الأدوات والأثاث، لانهار وهم المكان المتّسق. يمكننا أن نخفّف الأضواء أثناء ذلك (وهو بالطبع ما تفعله المسارح الحقيقية)، لكن الجمهور يبقى يعرف أن هناك شيئاً يجري. نريد ألّا تكون هناك أي فجوة زمنية بين المشاهد.
مع بعض المساحة الإضافية، نصل إلى هذا الحلّ المبدع: نبني مسرحين معدّين بحيث يستطيع الجمهور رؤية كليهما. لكلٍّ منهما مجموعة أضواء خاصة به. لنسمّيهما المسرح A والمسرح B. يُعرض المشهد الأول على المسرح A. وفي الوقت نفسه، يظل المسرح B مظلماً بينما يهيّئ عمّال المسرح المشهد الثاني. حالما ينتهي المشهد الأول، نطفئ أضواء المسرح A ونشعل أضواء المسرح B. ينظر الجمهور إلى المسرح الجديد، فيبدأ المشهد الثاني فوراً.
وفي الوقت نفسه، يكون عمّال المسرح في المسرح A الذي أصبح مظلماً، ويمسحون المشهد الأول ويهيّئون المشهد الثالث. وحالما ينتهي المشهد الثاني، نعيد تبديل الأضواء إلى المسرح A. ونواصل هذه العملية طوال العرض، مستخدمين المسرح المظلماً كمنطقة عمل نهيّئ فيها المشهد التالي. عند كل انتقال بين المشاهد، لا نفعل سوى تبديل الأضواء بين المسرحين. يحصل جمهورنا على عرض متّصل بلا أي تأخير بين المشاهد. لا يرون أبداً عاملاً من عمّال المسرح.
العودة إلى الرسوميات
هذا هو بالضبط كيف يعمل المخزن المزدوج، وهذه العملية هي التي تقوم عليها منظومة العرض في كل لعبة شاهدتها تقريباً. بدلاً من إطار تخزين واحد، لدينا اثنان. أحدهما يمثّل الإطار الحالي، وهو المسرح A في تشبيهنا. وهو الإطار الذي تقرأ منه عتاد الفيديو. ويمكن لوحدة معالجة الرسوميات (GPU) أن تمسحه بقدر ما تشاء متى شاء.
وفي الوقت نفسه، تكتب شيفرة العرض لدينا في إطار التخزين الآخر. هذا هو المسرح B المظلماً. وعندما تنتهي شيفرة العرض لدينا من رسم المشهد، فإنها تبدّل الأضواء عبر تبديل (swap) المخازن. هذا يخبر عتاد الفيديو بأن يبدأ القراءة من المخزن الثاني الآن بدلاً من الأول. ما دمنا نوقّت هذا التبديل في نهاية إحدى دورات التحديث، فلن نحصل على أي تمزّق، وسيظهر المشهد بأكمله دفعةً واحدة.
وفي الوقت نفسه، أصبح إطار التخزين القديم متاحاً للاستخدام. نبدأ برسم الإطار التالي عليه. Voilà!
النمط
يغلّف صنف مُخزَّن (buffered class) ما يُسمّى مخزناً (buffer): وهو جزء من الحالة يمكن تعديله. يُعدَّل هذا المخزن بشكل تدريجي، لكننا نريد أن يرى كل الشيفرة الخارجية هذا التعديل على أنه تغيير ذرّي واحد. ولتحقيق ذلك، يحتفظ الصنف بنسختين من المخزن: مخزناً تالياً (next buffer) ومخزناً حالياً (current buffer).
حين تُقرأ المعلومات من مخزن، فإنها تُقرأ دائماً من المخزن الحالي. وحين تُكتب المعلومات إلى مخزن، فإن ذلك يحدث في المخزن التالي. وعندما تكتمل التغييرات، تُبدّل عملية تبديل (swap) المخزنين التالي والحالي بصورة فورية بحيث يصبح المخزن الجديد ظاهراً الآن للجميع. ويصبح المخزن الحالي القديم متاحاً الآن لإعادة الاستخدام بوصفه المخزن التالي الجديد.
متى تستخدمه
هذا النمط واحد من تلك الأنماط التي ستعرف حين تحتاجه. إن كان لديك نظام يفتقر إلى المخزن المزدوج، فسيبدو على الأرجح خاطئاً بشكل واضح (تمزّق، إلخ) أو سيتصرف تصرفاً خاطئاً. لكن قول «ستعرف حين تحتاجه» لا يمنحك الكثير لتبني عليه. وبشكل أكثر تحديداً، هذا النمط مناسب حين يتحقق كل ما يلي:
-
لدينا حالة ما يجري تعديلها بشكل تدريجي.
-
من الممكن الوصول إلى الحالة ذاتها في منتصف التعديل.
-
نريد منع الشيفرة التي تصل إلى الحالة من رؤية العمل الجاري.
-
نريد أن نتمكن من قراءة الحالة، ولا نريد الانتظار ريثما تُكتب.
في بالك
على خلاف الأنماط المعمارية الأكبر، يوجد المخزن المزدوج عند مستوى تنفيذ أدنى. ولهذا، آثاره على بقية قاعدة الشيفرة أقل -- معظم اللعبة لن تلاحظ الفرق أصلاً. لكن هناك تحفّظات يجب ذكرها.
عملية التبديل نفسها تستغرق وقتاً
يتطلب المخزن المزدوج خطوة تبديل (swap) بعد انتهاء تعديل الحالة. يجب أن تكون تلك العملية ذرّية -- لا يمكن لأي شيفرة أن تصل إلى أيٍّ من الحالتين أثناء تبديلهما. غالباً ما يكون ذلك أسرع بقدر إسناد مؤشر، لكن إن استغرق التبديل وقتاً أطول من تعديل الحالة في أصله، فلن نكون قد استفدنا شيئاً على الإطلاق.
علينا الاحتفاظ بمخزنين
النتيجة الأخرى لهذا النمط هي زيادة استهلاك الذاكرة. وكما يوحي اسمه، يتطلب النمط أن تحتفظ دائماً بنسختين من حالتك في الذاكرة. وفي الأجهزة محدودة الذاكرة، قد يكون هذا ثمناً باهظاً. وإن كنت لا تستطيع تحمل مخزنين، فعليك أن تبحث عن طرق أخرى تضمن ألّا يتم الوصول إلى حالتك أثناء تعديلها.
شيفرة نموذجية
بعد أن توفّر لنا النظرية، فلنرَ كيف يعمل هذا في الممارسة العملية. سنكتب نظام رسوميات شديد البساطة يتيح لنا رسم بكسلات على إطار تخزين. في معظم الأجهزة الطرفية والحاسوبات الشخصية، يوفّر سائق الفيديو هذا الجزء منخفض المستوى من نظام الرسوميات، لكن تنفيذ ذلك يدوياً هنا سيتيح لنا رؤية ما يجري. وأول ما نبدأ به هو المخزن نفسه:
^code 1
يملك عمليات أساسية لمسح المخزن بالكامل إلى لون افتراضي، ولتعيين لون بكسل فردي.
ويملك أيضاً دالة getPixels() تكشف المصفوفة الخام من الذاكرة التي تحمل بيانات
البكسلات. لن نرى هذا في المثال، لكن سائق الفيديو سيستدعي تلك الدالة كثيراً لبثّ
الذاكرة من المخزن إلى الشاشة.
نغلّف هذا المخزن الخام في صنف Scene. مهمّته هنا هي رسم شيء ما عبر إجراء مجموعة
من الاستدعاءات draw() على مخزنه:
^code 2
في كل إطار، تطلب اللعبة من المشهد أن يرسم. يمسح المشهد المخزن ثم يرسم مجموعة
من البكسلات، واحداً تلو الآخر. كما يوفّر الوصول إلى المخزن الداخلي عبر
getBuffer() ليتمكّن سائق الفيديو من الوصول إليه.
يبدو هذا مباشراً إلى حدٍّ كبير، لكن إن تركناه على حاله سنواجه مشكلات. المشكلة
أن سائق الفيديو يستطيع استدعاء getPixels() على المخزن في أي لحظة من الزمن،
حتى هنا:
^code 3
عندما يحدث ذلك، سيرى المستخدم عينَي الوجه، لكن الفم سيختفي في إطار واحد فقط. وفي الإطار التالي، قد يتوقف عند نقطة أخرى. والنتيجة النهائية هي رسوميات ترتعش بشكل مروّع. سنصلح هذا بالمخزن المزدوج:
^code 4
أصبح لدى Scene الآن مخزنان، مخزَّنان في المصفوفة buffers_. لا نشيران إليهما
مباشرةً من المصفوفة. بدلاً من ذلك، هناك عضوان، next_ وcurrent_، يشيران إلى
داخل المصفوفة. عندما نرسم، نرسم على المخزن التالي، الذي يشير إليه next_.
وعندما يحتاج سائق الفيديو إلى الحصول على البكسلات، فإنه يصل دائماً إلى المخزن
الآخر عبر current_.
بهذه الطريقة، لا يرى سائق الفيديو أبداً المخزن الذي نعمل عليه. والقطعة الأخيرة
المتبقّية من اللغز هي الاستدعاء إلى swap() عندما ينتهي المشهد من رسم الإطار.
وهو يبدّل المخزنين بمجرد تبديل مرجعيَّ next_ وcurrent_. وفي المرة التالية
التي يستدعي فيها سائق الفيديو getBuffer()، سيحصل على المخزن الجديد الذي أكملنا
رسمه للتو، ويضع مخزننا الذي رُسم مؤخراً على الشاشة. لا تمزّق بعد ولا اختلالات
قبيحة.
ليس للرسوميات فقط
المشكلة الجوهرية التي يحلّها المخزن المزدوج هي الوصول إلى الحالة ريثما يجري تعديلها. وهناك سببان شائعان لذلك. وقد غطّينا السبب الأول بمثالنا الخاص بالرسوميات -- أي أن الحالة يُصل إليها مباشرةً من شيفرة تعمل على خيط آخر أو من معالج مقاطعة.
لكن هناك سبب آخر شائع بالقدر نفسه: أن تكون الشيفرة القيام بالتعديل هي نفسها تصل إلى الحالة التي تعدّلها. وهذا قد يظهر في مواضع متنوعة، وخاصة في الفيزياء والذكاء الاصطناعي حيث تتفاعل الكيانات مع بعضها. غالباً ما يكون المخزن المزدوج مفيداً هنا أيضاً.
غباءً اصطناعياً
لنفترض أننا نبني النظام السلوكي للعبة، تخيّل، قائمة على كوميديا حارجة عن الحد. لدى اللعبة مسرح يحتوي على مجموعة من الممثلين الذين يركضون هنا وهناك ويوقعون مختلف المقالب والمشاغب. إليك ممثلنا الأساسي:
^code 5
في كل إطار، تكون اللعبة مسؤولة عن استدعاء update() على
الممثل ليتمكّن من إجراء بعض المعالجة. والأمر الحاسم، من منظور المستخدم، هو أن
جميع الممثلين يجب أن يبدوا وكأنهم يتحدّثون في وقت واحد.
يستطيع الممثلون أيضاً التفاعل مع بعضهم، إن كان المقصود بـ«التفاعل» هو «أنهم
يستطيعون صفع بعضهم». وعند التحديث، يستطيع الممثل استدعاء slap() على ممثل آخر
ليصفعه، واستدعاء wasSlapped() ليعرف ما إذا كان قد صُفع.
يحتاج الممثلون إلى مسرح يتفاعلون فيه، فلنبنِ ذلك:
^code 6
يتيح لنا Stage إضافة الممثلين، ويوفّر استدعاء update() واحداً يحدّث كل ممثل.
أمام المستخدم، يبدو الممثلون وكأنهم يتحركون في وقت واحد، لكن داخلياً يتم تحديثهم
واحداً تلو الآخر.
النقطة الوحيدة الأخرى التي تستحق الذكر هي أن حالة «صُفع» لكل ممثل تُمسح فوراً بعد التحديث. وذلك كي يستجيب الممثل لصفعة معيّنة مرّة واحدة فقط.
لنُشغّل الأمور، ونعرّف صنف ممثل ملموس. المهرج هنا بسيط جداً. إنه يواجه ممثلاً واحداً. ومتى ما صُفع -- من أي أحد -- يستجيب بصفع الممثل الذي يواجهه.
^code 7
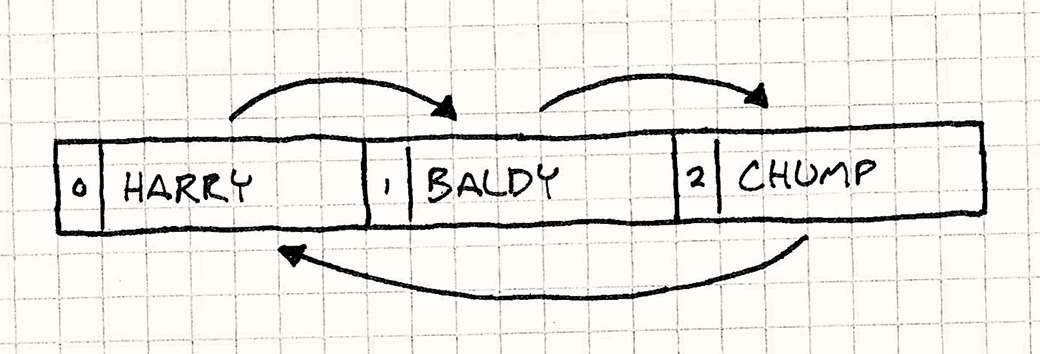
الآن، لنضع بعض المهرجين على مسرح ونرَ ما سيحدث. سنهيّئ ثلاثة مهرجين، كلٌّ منهم يواجه التالي. وسيواجه الأخير الأول، في دائرة كبيرة:
^code 8
يكون المسرح الناتج معدّاً كما يوضّح الصورة التالية. تُظهر الأسهم إلى من يواجه كل ممثل، والأرقام تُظهر فهرسهم في مصفوفة المسرح.
سنصفع هاري لبدء الأمور، ونرى ما يحدث عندما نبدأ المعالجة:
^code 9
تذكّر أن الدالة update() في Stage تحدّث كل ممثل بالترتيب، فإذا شرذمنا الشيفرة
خطوةً خطوة، فسنجد أن ما يلي يحدث:
يحدّث المسرح الممثل 0 (هاري)
  صُفع هاري، فصفع أصلع
يحدّث المسرح الممثل 1 (أصلع)
  صُفع أصلع، فصفع غبي
يحدّث المسرح الممثل 2 (غبي)
  صُفع غبي، فصفع هاري
ينتهي تحديث المسرح
في إطار واحد، انتشرت صفعتنا الأولى على هاري بين كل المهرجين. والآن، لنخلط الأمور قليلاً، ولنفترض أننا نعيد ترتيب المهرجين داخل مصفوفة المسرح لكن نتركهم يواجهون بعضهم بالطريقة نفسها.
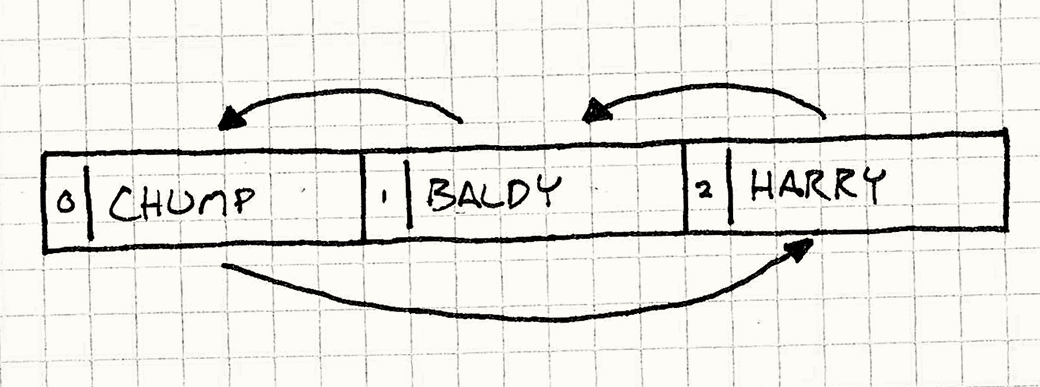
سنترك بقية إعداد المسرح كما هو، لكننا سنستبدل الجزء من الشيفرة الذي يضيف الممثلين إلى المسرح بما يلي:
^code 10
لنرَ ما يحدث عندما نعيد تشغيل تجربتنا:
يحدّث المسرح الممثل 0 (غبي)
  لم يُصفع غبي، فلا يفعل شيئاً
يحدّث المسرح الممثل 1 (أصلع)
  لم يُصفع أصلع، فلا يفعل شيئاً
يحدّث المسرح الممثل 2 (هاري)
  صُفع هاري، فصفع أصلع
ينتهي تحديث المسرح
يا إلهي. مختلف تماماً. المشكلة واضحة. عندما نحدّث الممثلين، فإننا نعدّل حالات «صُفع» لديهم، وهي الحالة نفسها التي نقرأها أيضاً أثناء التحديث. ولهذا، تؤثر التغييرات التي تحدث في تلك الحالة في وقت مبكر من التحديث في أجزاء لاحقة من خطوة التحديث نفسها.
النتيجة النهائية هي أن الممثل قد يستجيب لصفحته إما في الإطار نفسه الذي وقعت فيه الصفعة أو في الإطار التالي، وذلك كلياً بحسب كيفية ترتيب الممثلَين على المسرح. هذا يخالف شرطنا بأن يبدوا الممثلون وكأنهم يعملون على التوازي -- فترتيبهم داخل الإطار الواحد يجب ألّا يهم.
صفعات مخزَّنة
لحسن الحظ، يمكن لنمط المخزن المزدوج أن يساعدنا. لكن هذه المرة، بدلاً من الاحتفاظ بنسختين من كائن «مخزن» أحادي متماسك، سنخزّن بدقة أدق بكثير: حالة «صُفع» لكل ممثل:
^code 11
بدلاً من حالة واحدة slapped_، صار لكل ممثل حالتان. تماماً مثل مثال الرسوميات
السابق، تُستخدم الحالة الحالية للقراءة، وتُستخدم الحالة التالية للكتابة.
استُبدلت الدالة reset() بالدالة swap(). الآن، قبل مسح حالة التبديل مباشرةً،
تنسخ الدالة swap() الحالة التالية إلى الحالة الحالية، فتصبح هي الحالة الحالية
الجديدة. وهذا يتطلب أيضاً تغييراً بسيطاً في Stage:
^code 12
صارت الدالة update() تحدّث جميع الممثلين ثم تبدّل كل حالاتهم. والنتيجة
النهائية لذلك هي أن الممثل لن يرى الصفعة إلا في الإطار الذي بعد الإطار الذي صُفع
فيه فعلاً. وبهذه الطريقة، سيتصرف الممثلون بالطريقة نفسها بغضّ النظر عن ترتيبهم في
مصفوفة المسرح. وبقدر ما يستطيع المستخدم أو أي شيفرة خارجية أن تعرف، فإن جميع
الممثلين يتحدّثون في وقت واحد ضمن الإطار.
قرارات التصميم
المخزن المزدوج بسيط إلى حدٍّ كبير، والأمثلة التي رأيناها حتى الآن تغطي معظم التنويعات التي من المحتمل أن تصادفها. وهناك قراران رئيسيان يطرآن عند تنفيذ هذا النمط.
كيف تُبدَّل المخازن؟
عملية التبديل هي الخطوة الأكثر أهمية في العملية، إذ يجب أن نمنع كل قراءة وتعديل للمخزنين طوال حدوثها. وللحصول على أفضل أداء، نريد أن يحدث ذلك بأسرع ما يمكن.
-
تبديل المؤشرات أو المراجع إلى المخزن:
هذا هو ما يفعله مثال الرسوميات لدينا، وهو الحلّ الأكثر شيوعاً لتخزين الرسوميات المزدوج.
-
سريع. بغضّ النظر عن حجم المخزن، فإن التبديل هو ببساطة إسناد مؤشرَين. يصعب هزيمة ذلك في السرعة والبساطة.
-
لا يمكن للشيفرة الخارجية أن تخزّن مؤشرات دائمة إلى المخزن. وهذه هي القيد الرئيس. بما أننا لا ننقل البيانات فعلياً، فالأمر الذي نفعله هو في الأساس إخبار بقية قاعدة الشيفرة دورياً بأن تبحث عن المخزن في مكان آخر، كما في تشبيه المسرح الأصلي. وهذا يعني أن بقية قاعدة الشيفرة لا تستطيع تخزين مؤشرات مباشرةً إلى البيانات داخل المخزن -- فقد تكون في اللحظة التالية تشير إلى المخزن الخطأ.
قد يكون هذا مزعجاً بشكل خاص في نظام يتوقّع فيه سائق الفيديو أن يكون إطار التخزين دائماً في موقع ثابت في الذاكرة. في تلك الحالة، لن نتمكّن من استخدام هذا الخيار.
-
البيانات الموجودة على المخزن ستكون من إطارين مضيَين، لا من الإطار الأخير. تُرسم الإطارات المتتالية على مخازن متبادلة دون نسخ أي بيانات بينهما، كالتالي:
:::text
الإطار 1 مرسوم على المخزن A
الإطار 2 مرسوم على المخزن B
الإطار 3 مرسوم على المخزن A
...
لاحظ أنه عندما نذهب لرسم الإطار الثالث، فالبيانات الموجودة على المخزن هي من الإطار الأول، لا من الإطار الثاني الأحدث. في معظم الحالات، ليست هذه مشكلة -- فنحن عادة ما نمسح المخزن بالكامل قبل الرسم بوقت قليل. لكن إن كنا نعتزم إعادة الاستخدام لبعض البيانات الموجودة على المخزن، فمن المهم أن نأخذ في الحسبان أن تلك البيانات ستكون أقدم بإطار مما قد نتوقع.
-
-
نسخ البيانات بين المخازن:
إن لم نتمكن من إعادة توجيه المستخدمين إلى المخزن الآخر، فالخيار الوحيد المتبقي هو نسخ البيانات فعلياً من الإطار التالي إلى الإطار الحالي. هذا هو ما يفعله مهرجو الكوميديا لدينا. في تلك الحالة اخترنا هذه الطريقة لأن الحالة -- وهي علم منطقي مفرد (Boolean) -- لا تستغرق وقتاً أطول في النسخ مما يستغرقه المؤشر إلى المخزن.
-
البيانات الموجودة على المخزن التالي قديمة بإطار واحد فقط. هذا هو الشيء اللطيف في نسخ البيانات بدلاً من التأرجح ذهاباً وإياباً بين المخزنين. إن احتجنا الوصول إلى بيانات المخزن السابق، فسنحصل على بيانات أحدث للعمل بها.
-
قد يستغرق التبديل وقتاً أطول. وهذه بالطبع هي النقطة السلبية الكبرى. تعني عملية التبديل لدينا الآن نسخ المخزن بالكامل في الذاكرة. وإذا كان المخزن كبيراً، كإطار تخزين كامل، فقد يستغرق ذلك جزءاً معتبراً من الوقت. وبما أن لا شيء يستطيع القراءة أو الكتابة في أيٍّ من المخزنين أثناء حدوث ذلك، فهذه قيدة كبيرة.
-
ما دقّة المخزن؟
السؤال الآخر هو كيف يُنظَّم المخزن نفسه -- هل هو كتلة بيانات أحادية متماسكة واحدة، أم موزّع بين مجموعة من الكائنات؟ يستخدم مثالنا للرسوميات الخيار الأول، بينما يستخدم الممثلون الخيار الثاني.
في معظم الأحيان، تقود طبيعة ما تخزّنه إلى الإجابة، لكن هناك بعض المرونة. مثلاً، يمكننا أن يكون لدى جميع ممثلينا رسائل مخزَّنة في كتلة رسائل واحدة يشير إليها جميعهم بفهارسهم.
-
إذا كان المخزن أحادياً متماسكاً:
-
*التبديل أبسط.* بما أنه لا وجود إلا لزوج واحد من المخازن، فإن تبديلاً واحداً يكفي. وإذا استطعت التبديل بتغيير المؤشرات، لتبديل المخزن بأكمله، مهما كان حجمه، بإسنادَين فقط.
-
-
إذا كان لدى كائنات كثيرة جزء من البيانات:
-
التبديل أبطأ. من أجل التبديل، نحتاج إلى المرور على المجموعة الكاملة من الكائنات وإخبار كل واحد منها بأن يبدّل.
في مثال المهرج، كان ذلك مقبولاً لأننا كنا بحاجة إلى مسح حالة الصفعة التالية على أي حال -- كل جزء من الحالة المخزَّنة كان يحتاج إلى اللمس في كل إطار. وإن لم نكن بحاجة إلى لمس المخزن القديم على أي حال، فهناك تحسين بسيط يمكننا إجراءه للحصول على أداء مخزن أحادي متماسك مع توزيع المخزن على كائنات متعددة.
الفكرة هي أخذ مفهوم «المؤشر الحالي» و«المؤشر التالي» وتطبيقه على كل كائناتنا عبر تحويلهما إلى إزاحات (offsets) نسبية للكائن. كالتالي:
^code 13
يصل الممثلون إلى حالة صفعهم الحالية باستخدام
current_كفهرس داخل مصفوفة الحالة. والحالة التالية هي دائماً الفهرس الآخر في المصفوفة، فيمكننا حسابها بـnext(). وتبديل الحالة يكفيه أن نبدّل قيمة الفهرسcurrent_. الجزء الذكي هو أنswap()صارت الآن دالة ساكنة (static) -- لا يلزم استدعاؤها إلا مرّة واحدة، وستُبدَّل حالة كل ممثل.
-
انظر أيضاً
-
تجد نمط المخزن المزدوج مستخدَماً في كل واجهة رسوميات تقريباً. على سبيل المثال، لدى OpenGL الدالة `swapBuffers()`، ولدى Direct3D ما يُسمّى «سلاسل التبديل» (swap chains)، ويبدّل إطار XNA من مايكروسوفت مخازن التخزين داخل دالة `endDraw()`.