15. نظرة إلى الأمام: أنظمة التوازي الأخرى ونماذج البرمجة المتوازية
ناقشنا في الفصل السابق التوازي بالذاكرة المشتركة والبرمجة متعددة الخيوط. ونقدّم في هذا الفصل نماذج ولغات برمجة متوازية أخرى لفئات مختلفة من المعماريات. وتحديدًا، نقدّم التوازي من أجل مسرّعات العتاد مع التركيز على وحدات معالجة الرسوميات (GPUs) والحوسبة عامة الغرض على وحدات معالجة الرسوميات (حوسبة GPGPU)، باستخدام CUDA كمثال؛ وأنظمة الذاكرة الموزّعة وتمرير الرسائل، باستخدام MPI كمثال؛ والحوسبة السحابية، باستخدام MapReduce وApache Spark كمثالين.
عالم جديد بالكامل: تصنيف فلين للمعماريات
يُستخدم تصنيف فلين (Flynn's taxonomy) عادةً لوصف منظومة معماريات الحوسبة الحديثة (الشكل 1).
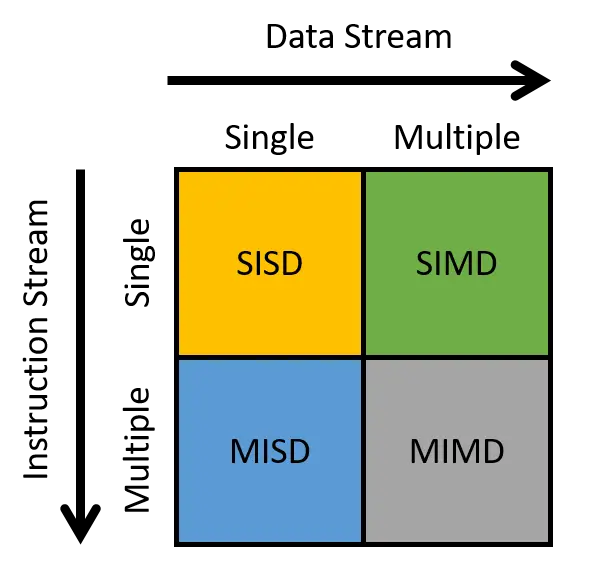 الشكل 1. يصنّف تصنيف فلين الطرق التي يطبّق بها المعالج التعليمات.
يشير المحور الأفقي إلى تدفق البيانات، بينما يشير المحور الرأسي إلى تدفق التعليمات. والتدفق (stream) في هذا السياق هو سيل من البيانات أو التعليمات. ويُصدر التدفق الواحد عنصرًا واحدًا في وحدة الزمن، شأنه شأن الصف. وفي المقابل، تُصدر التدفقات المتعددة عادةً عناصر كثيرة في وحدة الزمن (فكّر في صفوف متعددة). وهكذا، يُصدر تدفق التعليمات الواحد (SI) تعليمة واحدة في وحدة الزمن، بينما يُصدر تدفق التعليمات المتعدد (MI) تعليمات كثيرة في وحدة الزمن. وبالمثل، يُصدر تدفق البيانات الواحد (SD) عنصر بيانات واحد في وحدة الزمن، بينما يُصدر تدفق البيانات المتعدد (MD) عناصر بيانات كثيرة في وحدة الزمن.
ويمكن تصنيف المعالج في واحدة من أربع فئات بناءً على أنواع التدفقات التي يستخدمها:
- SISD: تحتوي أنظمة التعليمات الواحدة/البيانات الواحدة على وحدة تحكم واحدة تعالج تدفقًا واحدًا من التعليمات، ما يسمح لها بتنفيذ تعليمة واحدة في المرة. وبالمثل، لا يستطيع المعالج معالجة سوى تدفق واحد من البيانات أو معالجة وحدة بيانات واحدة في المرة. وكانت معظم المعالجات المتاحة تجاريًا قبل منتصف الألفينيات من أجهزة SISD.
- MISD: تحتوي أنظمة التعليمات المتعددة/البيانات الواحدة على وحدات تعليمات متعددة تعمل على تدفق بيانات واحد. وقد صُمّمت أنظمة MISD عادةً لتضمين تحمّل الأخطاء في الأنظمة الحرجة، مثل برامج التحكم في الطيران لمكوكات NASA. ومع ذلك، نادرًا ما تُستخدم أجهزة MISD في الممارسة العملية اليوم.
- SIMD: تنفّذ أنظمة التعليمات الواحدة/البيانات المتعددة التعليمة نفسها على بيانات متعددة في الوقت نفسه وبطريقة متزامنة الخطى. وأثناء التنفيذ "متزامن الخطى" (lockstep)، تُوضع جميع التعليمات في صف، بينما تُوزَّع البيانات على وحدات حسابية مختلفة. وأثناء التنفيذ، تنفّذ كل وحدة حسابية التعليمة الأولى في الصف في الوقت نفسه، قبل أن تنفّذ في الوقت نفسه التعليمة التالية في الصف، ثم التالية، وهكذا. وأشهر مثال على معمارية SIMD هو وحدة معالجة الرسوميات. وقد اتبعت الحواسيب الفائقة الأولى معمارية SIMD أيضًا. ونناقش وحدات GPU بمزيد من التفصيل في القسم التالي.
- MIMD: تمثّل أنظمة التعليمات المتعددة/البيانات المتعددة فئة المعماريات الأكثر استخدامًا. وهي مرنة للغاية وقادرة على العمل على تعليمات متعددة أو تدفقات بيانات متعددة. وبما أن جميع الحواسيب الحديثة تقريبًا تستخدم معالجات متعددة الأنوية (multicore CPUs)، فإن معظمها يُصنَّف كأجهزة MIMD. ونناقش فئة أخرى من أنظمة MIMD، هي أنظمة الذاكرة الموزّعة، في القسم 15.2.
الحوسبة غير المتجانسة (heterogeneous computing) هي الحوسبة باستخدام وحدات معالجة متعددة ومختلفة موجودة في الحاسوب. وغالبًا ما تكون لهذه الوحدات بنى ISA مختلفة، بعضها يديره نظام التشغيل وبعضها لا. وعادةً تعني الحوسبة غير المتجانسة دعم الحوسبة المتوازية باستخدام أنوية المعالج في الحاسوب وواحدة أو أكثر من وحدات التسريع فيه مثل وحدات معالجة الرسوميات (GPUs) أو مصفوفات البوابات القابلة للبرمجة ميدانيًا (FPGAs)1.
يزداد شيوع قيام المطورين بتطبيق حلول الحوسبة غير المتجانسة للمسائل الكبيرة كثيفة البيانات والحساب. وتنتشر هذه الأنواع من المسائل في الحوسبة العلمية، وكذلك في مجموعة أكثر تنوعًا من التطبيقات المتعلقة بمعالجة البيانات الضخمة وتحليلها واستخراج المعلومات. وبالاستفادة من قدرات المعالجة لكل من وحدة المعالجة المركزية ووحدات التسريع المتاحة في الحاسوب، يستطيع المبرمج زيادة درجة التنفيذ المتوازي في تطبيقه، ما يؤدي إلى تحسين الأداء وقابلية التوسع.
نقدّم في هذا القسم الحوسبة غير المتجانسة باستخدام مسرّعات العتاد لدعم الحوسبة المتوازية عامة الغرض. ونركّز على وحدات GPU ولغة البرمجة CUDA.
15.1.1. مسرّعات العتاد
إلى جانب وحدة المعالجة المركزية، تحتوي الحواسيب على وحدات معالجة أخرى مصمّمة لأداء مهام محدّدة. وهذه الوحدات ليست وحدات معالجة عامة الغرض مثل وحدة المعالجة المركزية، بل عتاد متخصّص محسَّن لتنفيذ وظائف خاصة بأجهزة معينة أو تُستخدم لأداء أنواع متخصّصة من المعالجة في النظام. وتُعدّ مصفوفات FPGA ومعالجات Cell ووحدات GPU ثلاثة أمثلة على هذه الأنواع من وحدات المعالجة.
FPGAs
مصفوفة FPGA دارة متكاملة تتكوّن من بوابات وذاكرة ومكوّنات ترابط. وهي قابلة لإعادة البرمجة، أي يمكن إعادة تهيئتها لتنفيذ وظائف محدّدة في العتاد، وغالبًا ما تُستخدم لنمذجة الدوائر المتكاملة الخاصة بالتطبيقات (ASICs) أوليًا. وتحتاج مصفوفات FPGA عادةً إلى طاقة أقل للتشغيل من وحدة معالجة مركزية كاملة، ما يؤدي إلى تشغيل موفّر للطاقة. ومن الأمثلة على طرق دمج مصفوفات FPGA في نظام حاسوبي استخدامها كمتحكمات أجهزة، ولمعالجة بيانات المستشعرات، وللتشفير، ولاختبار تصاميم عتاد جديدة (فبما أنها قابلة لإعادة البرمجة، يمكن تنفيذ التصاميم وتصحيحها واختبارها على FPGA). ويمكن تصميم مصفوفات FPGA كدارة فيها عدد كبير من وحدات المعالجة البسيطة. كما أن مصفوفات FPGA أجهزة منخفضة زمن الاستجابة يمكن توصيلها مباشرة بنواقل النظام. ونتيجة لذلك، استُخدمت لتنفيذ حسابات متوازية سريعة جدًا تتكوّن من أنماط منتظمة من المعالجة المتوازية المستقلة على عدة قنوات إدخال بيانات. غير أن إعادة برمجة مصفوفات FPGA تستغرق وقتًا طويلًا، ويقتصر استخدامها على دعم التنفيذ السريع لأجزاء محدّدة من أحمال العمل المتوازية أو لتشغيل حمل عمل برنامج ثابت2.
وحدات GPU ومعالجات Cell
معالج Cell معالج متعدد الأنوية يتكوّن من معالج عام الغرض واحد ومعالجات مساعدة متعددة متخصّصة في تسريع نوع معيّن من الحسابات، مثل معالجة الوسائط المتعددة. وكان نظام الألعاب Sony PlayStation 3 أول معمارية Cell، إذ استخدم المعالجات المساعدة Cell لرسوميات سريعة.
تنفّذ وحدات GPU حسابات رسوميات الحاسوب — فهي تعمل على بيانات الصور لتمكين العرض الرسومي ومعالجة الصور بسرعة عالية. وتكتب وحدة GPU نتائجها في مخزن إطارات (frame buffer) يوصل البيانات إلى شاشة الحاسوب. ومدفوعةً بتطبيقات ألعاب الحاسوب، أصبحت وحدات GPU المتطورة اليوم قياسية في أنظمة الحواسيب المكتبية والمحمولة.
في منتصف الألفينيات، أدرك باحثو الحوسبة المتوازية إمكانات استخدام المسرّعات بالاشتراك مع أنوية المعالج في الحاسوب لدعم الحوسبة المتوازية عامة الغرض.
15.1.2. نظرة عامة على معمارية GPU
صُمّم عتاد GPU لرسوميات الحاسوب ومعالجة الصور. وتاريخيًا، دفعت صناعة ألعاب الفيديو تطوير وحدات GPU. ولدعم رسوميات أكثر تفصيلًا وعرض إطارات أسرع، يتكوّن جهاز GPU من آلاف المعالجات المتخصّصة المصمّمة تحديدًا لمعالجة بيانات الصور بكفاءة وبشكل متوازٍ، مثل قيم البكسلات الفردية لصورة ثنائية الأبعاد.
نموذج التنفيذ العتادي الذي تطبّقه وحدات GPU هو التعليمة الواحدة/الخيوط المتعددة (single instruction/multiple thread, SIMT)، وهو تنويع على SIMD. ويشبه SIMT نموذج SIMD متعدد الخيوط، حيث تُنفَّذ تعليمة واحدة بتزامن الخطى بواسطة خيوط متعددة تعمل على وحدات المعالجة. وفي SIMT، قد يكون العدد الإجمالي للخيوط أكبر من العدد الإجمالي لوحدات المعالجة، ما يستلزم جدولة مجموعات متعددة من الخيوط على المعالجات لتنفيذ التسلسل نفسه من التعليمات.
وكمثال، تتكوّن وحدات NVIDIA GPU من عدة معالجات متعددة التدفقات (streaming multiprocessors, SMs)، لكل منها وحدات تحكم في التنفيذ وفضاء ذاكرة خاص بها (سجلات وذاكرة مؤقتة L1 وذاكرة مشتركة). ويتكوّن كل SM من عدة أنوية معالجة قياسية (scalar processor, SP). ويتضمّن SM مُجدوِل الحُزم (warp scheduler) الذي يجدول الحُزم (warps)، أي مجموعات من خيوط التطبيق، لتنفيذها بتزامن الخطى على أنوية SP الخاصة به. وفي التنفيذ بتزامن الخطى، ينفّذ كل خيط في الحزمة التعليمة نفسها في كل دورة لكن على بيانات مختلفة. فمثلًا، إذا كان تطبيق يحوّل صورة ملوّنة إلى تدرجات رمادية، فإن كل خيط في الحزمة ينفّذ التسلسل نفسه من التعليمات في الوقت نفسه لضبط قيمة RGB لبكسل ما على ما يقابلها بالتدرج الرمادي. وينفّذ كل خيط في الحزمة هذه التعليمات على قيمة بيانات بكسل مختلفة، ما يؤدي إلى تحديث بكسلات متعددة من الصورة بالتوازي. وبما أن الخيوط تُنفَّذ بتزامن الخطى، يمكن تبسيط تصميم المعالج بحيث تتشارك أنوية متعددة وحدات التحكم نفسها في التعليمات. وتحتوي كل وحدة على ذاكرة مؤقتة وسجلات متعددة تستخدمها لحمل البيانات أثناء معالجتها بتزامن الخطى بواسطة أنوية المعالجة المتوازية.
يعرض الشكل 1 معمارية GPU مبسّطة تتضمّن عرضًا تفصيليًا لإحدى وحدات SM فيها. ويتكوّن كل SM من عدة أنوية SP، ومُجدوِل حُزم، ووحدة تحكم في التنفيذ، وذاكرة مؤقتة L1، وفضاء ذاكرة مشتركة.
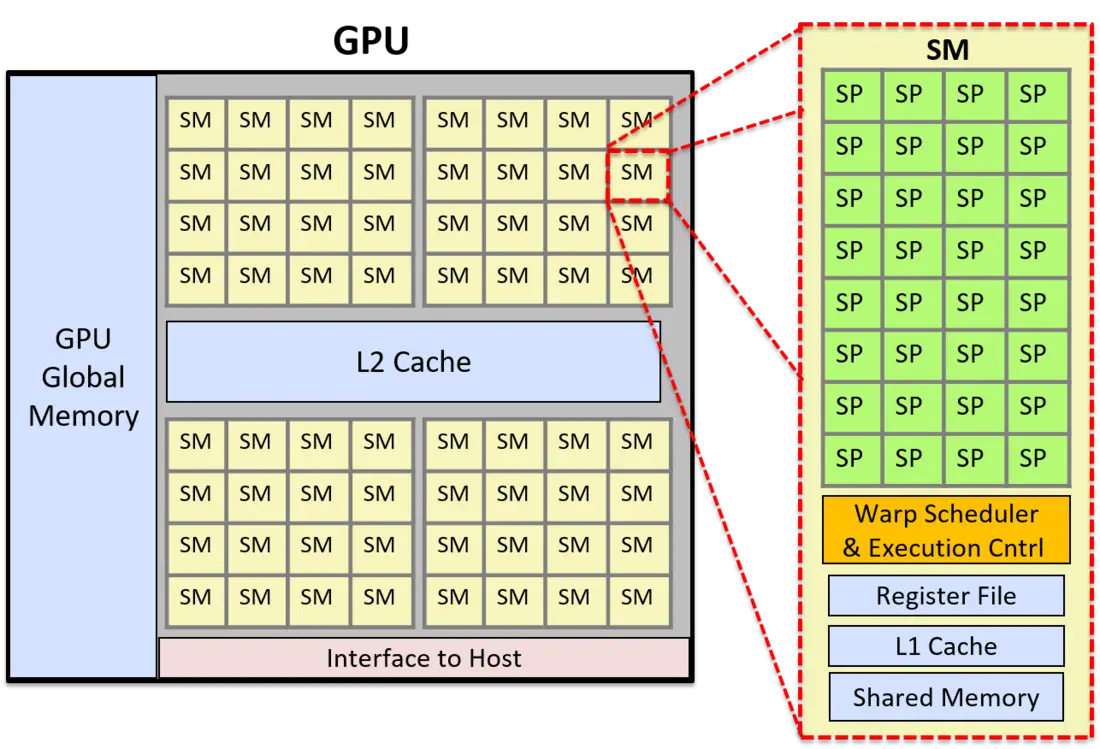 الشكل 1. مثال على معمارية GPU مبسّطة بـ2,048 نواة. يوضّح هذا تقسيم GPU إلى 64 وحدة SM، وتفاصيل وحدة SM واحدة تتكوّن من 32 نواة SP. ويجدول مُجدوِل الحُزم في SM حُزم الخيوط على أنوية SP الخاصة به. وتنفّذ حزمة من الخيوط بتزامن الخطى على أنوية SP.
15.1.3. حوسبة GPGPU
تعني حوسبة GPU عامة الغرض (General Purpose GPU, GPGPU) تطبيق معالجات GPU المتخصّصة على مهام الحوسبة المتوازية عامة الغرض. وتجمع حوسبة GPGPU بين الحساب على أنوية المعالج المضيف والحساب بتقنية SIMT على معالجات GPU. وتؤدي حوسبة GPGPU أفضل أداء في التطبيقات المتوازية (أو أجزاء من التطبيقات) التي يمكن بناؤها كحساب معالجة تدفقات على شبكة من البيانات متعددة الأبعاد.
لا يدير نظام التشغيل المضيف معالجات GPU ولا ذاكرتها. ونتيجة لذلك، يجب على المبرمج حجز مساحة بيانات البرنامج على GPU ونسخ البيانات بين ذاكرة المضيف وذاكرة GPU. وعادةً توفّر لغات ومكتبات برمجة GPGPU واجهات برمجية لذاكرة GPU تخفي عن المبرمج بعض صعوبة إدارة ذاكرة GPU صراحةً أو كلها. فمثلًا، في CUDA يمكن للمبرمج تضمين استدعاءات لدوال مكتبة CUDA لحجز ذاكرة CUDA على GPU صراحةً ونسخ البيانات بين ذاكرة CUDA على GPU وذاكرة المضيف. ويمكن لمبرمج CUDA أيضًا استخدام الذاكرة الموحّدة في CUDA (CUDA unified memory)، وهي تجريد CUDA لفضاء ذاكرة واحد فوق ذاكرة المضيف وذاكرة GPU. وتخفي الذاكرة الموحّدة في CUDA ذاكرتي GPU والمضيف المنفصلتين، وعمليات النسخ بينهما، عن مبرمج CUDA.
توفّر وحدات GPU أيضًا دعمًا محدودًا لمزامنة الخيوط، ما يعني أن الحوسبة المتوازية بـGPGPU تؤدي أداءً جيدًا بشكل خاص في التطبيقات المتوازية التي تكون إما متوازية بشكل سهل (embarrassingly parallel) وإما ذات امتدادات كبيرة من حسابات تدفقية متوازية مستقلة بنقاط مزامنة قليلة جدًا. ووحدات GPU معالجات متوازية هائلة، وأي برنامج ينفّذ تسلسلات طويلة من خطوات حسابية متطابقة (أو شبه متطابقة) مستقلة على البيانات قد يؤدي أداءً جيدًا كتطبيق GPGPU متوازٍ. كما تؤدي حوسبة GPGPU أداءً جيدًا عندما تكون عمليات النسخ بين ذاكرة المضيف وذاكرة الجهاز قليلة. وإذا كان نقل البيانات بين GPU وCPU يسيطر على زمن التنفيذ، أو إذا تطلّب تطبيق مزامنة دقيقة الحبيبات، فقد لا تؤدي حوسبة GPGPU أداءً جيدًا أو قد لا تقدّم مكسبًا كبيرًا، إن قدّمت أي مكسب، على نسخة متعددة الخيوط من البرنامج تعمل على CPU.
15.1.4. CUDA
CUDA (Compute Unified Device Architecture)3 هي الواجهة البرمجية من NVIDIA لحوسبة GPGPU على أجهزتها الرسومية. وقد صُمّمت CUDA للحوسبة غير المتجانسة التي تُنفَّذ فيها بعض دوال البرنامج على المعالج المضيف وتُنفَّذ أخرى على جهاز GPU. ويكتب المبرمجون عادةً برامج CUDA بلغة C أو C++ مع شروح تحدّد دوال نواة CUDA (kernel)، ويستدعون دوال مكتبة CUDA لإدارة ذاكرة جهاز GPU. ودالة النواة (kernel function) في CUDA دالة تُنفَّذ على GPU، والخيط (thread) في CUDA هو وحدة التنفيذ الأساسية في برنامج CUDA. وتُجدول خيوط CUDA في حُزم تُنفَّذ بتزامن الخطى على وحدات SM في GPU، فتنفّذ شيفرة نواة CUDA على حصتها من البيانات المخزّنة في ذاكرة GPU. وتُوسَم دوال النواة بـglobal لتمييزها عن دوال المضيف. ودوال device في CUDA دوال مساعدة يمكن استدعاؤها من دالة نواة CUDA.
ينقسم فضاء ذاكرة برنامج CUDA إلى ذاكرة المضيف وذاكرة GPU. ويجب على البرنامج حجز مساحة ذاكرة GPU وتحريرها صراحةً لتخزين بيانات البرنامج التي تعالجها أنوية CUDA. ويجب على مبرمج CUDA إما نسخ البيانات من ذاكرة المضيف وذاكرة GPU وإليهما صراحةً، وإما استخدام الذاكرة الموحّدة في CUDA التي تقدّم عرضًا لفضاء ذاكرة يتشاركه GPU والمضيف مباشرةً. وإليك مثالًا على دوال CUDA الأساسية لحجز الذاكرة وتحريرها والنسخ الصريح للذاكرة:
/* "returns" through pass-by-pointer param dev_ptr GPU memory of size bytes
 * returns cudaSuccess or a cudaError value on error
 */
cudaMalloc(void **dev_ptr, size_t size);

/* free GPU memory
 * returns cudaSuccess or cudaErrorInvalidValue on error
 */
cudaFree(void *data);

/* copies data from src to dst, direction is based on value of kind
 *   kind: cudaMemcpyHosttoDevice is copy from cpu to gpu memory
 *   kind: cudaMemcpyDevicetoHost is copy from gpu to cpu memory
 * returns cudaSuccess or a cudaError value on error
 */
cudaMemcpy(void *dst, const void *src, size_t count, cudaMemcpyKind kind);
تُنظَّم خيوط CUDA في كتل (blocks)، وتُنظَّم الكتل في شبكة (grid). ويمكن تنظيم الشبكات في تجميعات أحادية أو ثنائية أو ثلاثية الأبعاد من الكتل. وبالمثل، يمكن تنظيم الكتل في تجميعات أحادية أو ثنائية أو ثلاثية الأبعاد من الخيوط. ويُعرَّف كل خيط بشكل فريد بموضع الخيط (x،y،z) داخل الكتلة الحاوية له وموضع تلك الكتلة (x،y،z) في الشبكة. فمثلًا، يمكن للمبرمج تعريف أبعاد كتلة وشبكة ثنائية الأبعاد كما يلي:
dim3 blockDim(16,16);  // 256 threads per block, in a 16x16 2D arrangement
dim3 gridDim(20,20);   // 400 blocks per grid, in a 20x20 2D arrangement
عند استدعاء نواة، يُحدَّد تخطيط الكتل/الشبكة والخيوط/الكتل في الاستدعاء. فمثلًا، هذا استدعاء لدالة نواة اسمها do_something يحدّد تخطيط الشبكة والكتلة باستخدام gridDim وblockDim المعرّفين أعلاه (ويمرّر المعاملين dev_array و100):
ret = do_something<<<gridDim,blockDim>>>(dev_array, 100);
يعرض الشكل 2 مثالًا على ترتيب ثنائي الأبعاد لكتل الخيوط. وفي هذا المثال، الشبكة مصفوفة 3 × 2 من الكتل، وكل كتلة مصفوفة 4 × 3 من الخيوط.
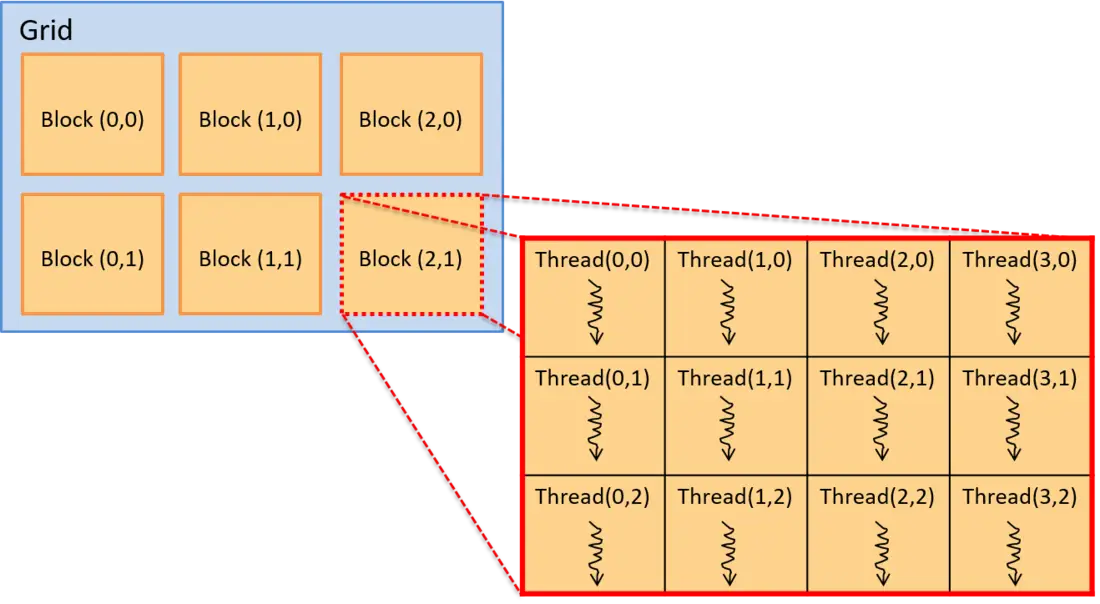 الشكل 2. نموذج خيوط CUDA. شبكة من كتل الخيوط. يمكن تنظيم الكتل والخيوط في تخطيطات أحادية أو ثنائية أو ثلاثية الأبعاد. ويعرض هذا المثال شبكة من كتل ثنائية الأبعاد، 3 × 2 كتلة في الشبكة، ولكل كتلة مجموعة ثنائية الأبعاد من الخيوط، 4 × 3 خيطًا في الكتلة).
يُعطى موضع الخيط في هذا التخطيط بالإحداثي (x،y) في الكتلة الحاوية له (threadId.x وthreadId.y) وبالإحداثي (x،y) لكتلته في الشبكة (blockIdx.x وblockIdx.y). لاحظ أن إحداثيات الكتل والخيوط قائمة على (x،y)، حيث يكون المحور x أفقيًا والمحور y رأسيًا. والعنصر (0,0) في أعلى اليسار. وتملك نواة CUDA أيضًا متغيرات معرّفة لأبعاد الكتلة (blockDim.x وblockDim.y). وبالتالي، لأي خيط ينفّذ النواة، يمكن تحديد موضعه (صف، عمود) في المصفوفة ثنائية الأبعاد من الخيوط داخل المصفوفة ثنائية الأبعاد من الكتل منطقيًا كما يلي:
int row = blockIdx.y * blockDim.y + threadIdx.y;
int col = blockIdx.x * blockDim.x + threadIdx.x;
مع أن ذلك ليس ضروريًا بالمعنى الدقيق، غالبًا ما ينظّم مبرمجو CUDA الكتل والخيوط لتطابق التنظيم المنطقي لبيانات البرنامج. فمثلًا، إذا كان برنامج يعالج مصفوفة ثنائية الأبعاد، فمن المنطقي غالبًا تنظيم الخيوط والكتل في ترتيب ثنائي الأبعاد. وبهذه الطريقة، يمكن استخدام (x،y) كتلة الخيط و(x،y) الخيط داخل كتلته لربط موضع الخيط في الكتل ثنائية الأبعاد من الخيوط بقيمة بيانات واحدة أو أكثر في المصفوفة ثنائية الأبعاد.
مثال برنامج CUDA: الضرب القياسي
وكمثال، تأمّل برنامج CUDA ينفّذ ضربًا قياسيًا لمتجه:
x = a * x // where x is a vector and a is a scalar value
بما أن بيانات البرنامج تتكوّن من مصفوفات أحادية البعد، فإن استخدام تخطيط أحادي البعد للكتل/الشبكة والخيوط/الكتل يعمل جيدًا. وهذا ليس ضروريًا، لكنه يسهّل ربط الخيوط بالبيانات.
وعند التشغيل، ستفعل الدالة main في هذا البرنامج ما يلي:
- تحجز ذاكرة على جانب المضيف للمتجه
xوتهيّئه. - تحجز ذاكرة على جانب الجهاز للمتجه
xوتنسخه من ذاكرة المضيف إلى ذاكرة GPU. - تستدعي دالة نواة CUDA لتنفيذ ضرب المتجه القياسي بالتوازي، وتمرّر كوسائط عنوان الجهاز للمتجه
xوالقيمة القياسيةa. - تنسخ النتيجة من ذاكرة GPU إلى المتجه
xفي ذاكرة المضيف.
في المثال التالي، نعرض برنامج CUDA ينفّذ هذه الخطوات لتطبيق ضرب المتجه القياسي. وقد أزلنا بعض معالجة الأخطاء والتفاصيل من سرد الشيفرة، لكن الحل الكامل متاح هنا: scalar_multiply_cuda.cu.
تنفّذ الدالة main في برنامج CUDA3 الخطوات الأربع المذكورة أعلاه:
#include <cuda.h>

#define BLOCK_SIZE       64     /* threads per block */
#define N              10240    /* vector size */

// some host-side init function
void init_array(int *vector, int size, int step);

// host-side function: main
int main(int argc, char **argv) {

  int *vector, *dev_vector, scalar;

  scalar = 3;     // init scalar to some default value
  if(argc == 2) { // get scalar's value from a command line argument
    scalar = atoi(argv[1]);
  }

  // 1. allocate host memory space for the vector (missing error handling)
  vector = (int *)malloc(sizeof(int)*N);

  // initialize vector in host memory
  // (a user-defined initialization function not listed here)
  init_array(vector, N, 7);

  // 2. allocate GPU device memory for vector (missing error handling)
  cudaMalloc(&dev_vector, sizeof(int)*N);

  // 2. copy host vector to device memory (missing error handling)
  cudaMemcpy(dev_vector, vector, sizeof(int)*N, cudaMemcpyHostToDevice);

  // 3. call the CUDA scalar_multiply kernel
  // specify the 1D layout for blocks/grid (N/BLOCK_SIZE)
  //    and the 1D layout for threads/block (BLOCK_SIZE)
  scalar_multiply<<<(N/BLOCK_SIZE), BLOCK_SIZE>>>(dev_vector, scalar);

  // 4. copy device vector to host memory (missing error handling)
  cudaMemcpy(vector, dev_vector, sizeof(int)*N, cudaMemcpyDeviceToHost);

  // ...(do something on the host with the result copied into vector)

  // free allocated memory space on host and GPU
  cudaFree(dev_vector);
  free(vector);

  return 0;
}
ينفّذ كل خيط CUDA دالة النواة scalar_multiply. وتُكتب دالة نواة CUDA من منظور خيط فردي. وتتكوّن عادةً من خطوتين رئيسيتين: (1) يحدّد الخيط المستدعي الجزء الذي يتحمّل مسؤوليته من البيانات بناءً على موضع خيطه في الكتلة الحاوية له وموضع كتلته في الشبكة؛ (2) وينفّذ الخيط المستدعي حسابات خاصة بالتطبيق على حصته من البيانات. وفي هذا المثال، كل خيط مسؤول عن حساب الضرب القياسي لعنصر واحد بالضبط في المصفوفة. وتحسب شيفرة دالة النواة أولًا قيمة فهرس فريدة بناءً على معرّف الكتلة والخيط للخيط المستدعي. ثم تستخدم هذه القيمة كفهرس في مصفوفة البيانات لتنفيذ الضرب القياسي على عنصر المصفوفة الخاص به (array[index] = array[index] * scalar). وتحسب خيوط CUDA العاملة على وحدات SM في GPU كلٌّ قيمة فهرس مختلفة لتحديث عناصر المصفوفة بالتوازي.
/*
 * CUDA kernel function that performs scalar multiply
 * of a vector on the GPU device
 *
 * This assumes that there are enough threads to associate
 * each array[i] element with a signal thread
 * (in general, each thread would be responsible for a set of data elements)
 */
__global__ void scalar_multiply(int *array, int scalar) {

  int index;

  // compute the calling thread's index value based on
  // its position in the enclosing block and grid
  index = blockIdx.x * blockDim.x + threadIdx.x;

  // the thread's uses its index value is to
  // perform scalar multiply on its array element
  array[index] = array[index] * scalar;
}
جدولة خيوط CUDA ومزامنتها
تُشغَّل كل كتلة خيوط CUDA بوحدة SM في GPU. ويجدول SM حزمة من الخيوط من كتلة الخيوط نفسها لتشغيل أنوية معالجاته. وتنفّذ جميع الخيوط في الحزمة المجموعة نفسها من التعليمات بتزامن الخطى، على بيانات مختلفة عادةً. وتتشارك الخيوط خط أنابيب التعليمات لكنها تحصل على سجلاتها الخاصة ومساحة مكدّس للمتغيرات المحلية والمعاملات.
وبما أن كتل الخيوط تُجدول على وحدات SM فردية، فإن زيادة عدد الخيوط في الكتلة تزيد درجة التنفيذ المتوازي. وبما أن SM يجدول حُزم الخيوط لتشغيلها على وحدات معالجاته، فإذا كان عدد الخيوط في الكتلة من مضاعفات حجم الحزمة، فلن تُهدر أي من أنوية SM في الحساب. ومن الناحية العملية، يُجدّ استخدام عدد خيوط في الكتلة يكون مضاعفًا صغيرًا لعدد أنوية المعالجة في SM.
تضمن CUDA أن تكتمل جميع الخيوط من استدعاء نواة واحد قبل جدولة أي خيوط من استدعاء نواة لاحق. وبالتالي، توجد نقطة مزامنة ضمنية بين استدعاءات الأنوية المنفصلة. أما داخل استدعاء نواة واحد، فتُجدول كتل الخيوط لتشغيل شيفرة النواة بأي ترتيب على وحدات SM في GPU. ونتيجة لذلك، لا ينبغي للمبرمج افتراض أي ترتيب للتنفيذ بين خيوط في كتل خيوط مختلفة. وتوفّر CUDA بعض الدعم لمزامنة الخيوط، لكن للخيوط التي في كتلة الخيوط نفسها فقط.
15.1.5. لغات أخرى لبرمجة GPGPU
توجد لغات برمجة أخرى لحوسبة GPGPU. وتعدّ OpenCL وOpenACC وOpenHMPP ثلاثة أمثلة على لغات يمكن استخدامها لبرمجة أي جهاز رسومي (فهي ليست خاصة بأجهزة NVIDIA). وتملك OpenCL (Open Computing Language) نموذج برمجة مشابهًا لنموذج CUDA؛ وكلاهما ينفّذ نموذج برمجة أدنى مستوى (أو ينفّذ تجريدًا برمجيًا أرقّ) فوق المعماريات الهدف. وتستهدف OpenCL مجموعة واسعة من منصات الحوسبة غير المتجانسة التي تشمل معالج مضيف مقترنًا بوحدات حسابية أخرى، قد تتضمّن معالجات CPUs أو مسرّعات مثل وحدات GPU ومصفوفات FPGA. وOpenACC (Open Accelerator) نموذج برمجة بتجريد أعلى مستوى من CUDA أو OpenCL. وقد صُمّم لقابلية النقل وسهولة المبرمج. ويضع المبرمج شروحًا على أجزاء من شيفرته للتنفيذ المتوازي، ويولّد المترجم شيفرة متوازية يمكن تشغيلها على وحدات GPU. وOpenHMPP (Open Hybrid Multicore Programming) لغة أخرى توفّر تجريدًا برمجيًا أعلى مستوى للبرمجة غير المتجانسة.
15.1.6. المراجع
- "A Survey Of Techniques for Architecting and Managing Asymmetric Multicore Processors"، Sparsh Mittal، في ACM Computing Surveys 48(3)، فبراير 2016
- "FPGAs and the Road to Reprogrammable HPC"، inside HPC، يوليو 2019 (https://insidehpc.com/2019/07/fpgas-and-the-road-to-reprogrammable-hpc/)
- توثيق CUDA Toolkit: https://docs.nvidia.com/cuda/index.html
- "GPU Programming"، من CSinParallel: https://csinparallel.org/csinparallel/modules/gpu_programming.html، ولدى CSinParallel وحدات أخرى لبرمجة GPU: https://csinparallel.org
يصف الفصل 14 آليات مثل Pthreads وOpenMP تستخدمها البرامج للاستفادة من أنوية CPU المتعددة في نظام ذاكرة مشتركة. وفي مثل هذه الأنظمة، تتشارك كل نواة عتاد الذاكرة الفيزيائي نفسه، ما يسمح لها بتبادل البيانات ومزامنة سلوكها بالقراءة من عناوين الذاكرة المشتركة والكتابة فيها. ومع أن أنظمة الذاكرة المشتركة تجعل التواصل سهلًا نسبيًا، فإن قابليتها للتوسع محدودة بعدد أنوية CPU في النظام.
حتى عام 2019، كانت معالجات الخواديم التجارية الراقية توفّر عمومًا 64 نواة كحد أقصى. غير أن بعض المهام تحتاج حتى إلى بضع مئات من أنوية CPU كحد أدنى. فمثلًا، تخيّل محاولة محاكاة ديناميكيات السوائل لمحيطات الأرض أو فهرسة المحتوى الكامل للشبكة العنكبوتية العالمية لبناء تطبيق بحث. وتتطلب هذه المهام الضخمة ذاكرة فيزيائية ومعالجات أكثر مما يستطيع أي حاسوب واحد توفيره. وبالتالي، تعمل التطبيقات التي تحتاج إلى عدد كبير من أنوية CPU على أنظمة تتخلى عن الذاكرة المشتركة. وبدلًا من ذلك، تنفَّذ على أنظمة مبنية من حواسيب متعددة، لكل منها معالجه وذاكرته، تتواصل عبر شبكة لتنسيق سلوكها.
وتُعرف مجموعة الحواسيب العاملة معًا بـنظام الذاكرة الموزّعة (distributed memory system) (وكثيرًا ما يُقال النظام الموزّع فقط).
ملاحظة — ملاحظة عن التسلسل الزمني
رغم الترتيب الذي عُرضت به في هذا الكتاب، بنى مصمّمو الأنظمة الأنظمة الموزّعة قبل وجود آليات مثل الخيوط أو OpenMP بوقت طويل.
تُدمج بعض أنظمة الذاكرة الموزّعة العتاد بعضه ببعض بشكل أوثق من غيرها. فمثلًا، الحاسوب الفائق (supercomputer) نظام عالي الأداء ترتبط فيه العديد من عقد الحساب ارتباطًا وثيقًا (تكاملًا قريبًا) بشبكة ترابط سريعة. وتحتوي كل عقدة حساب على معالجها ووحدات GPU وذاكرتها الخاصة، لكن عقدًا متعددة قد تتشارك موارد مساعدة مثل التخزين الثانوي ومصادر الطاقة. ويتفاوت المستوى الدقيق لتشارك العتاد من حاسوب فائق إلى آخر.
وفي الطرف الآخر من الطيف، قد يعمل تطبيق موزّع على مجموعة متراخية الترابط (أقل تكاملًا) من حواسيب مستقلة تمامًا (عقد) متصلة بتقنية شبكة محلية تقليدية (LAN) مثل Ethernet. وتُعرف هذه المجموعة من العقد بـعنقود المنتجات الجاهزة التجارية (commodity off-the-shelf, COTS). وتستخدم عناقيد COTS عادةً معمارية لا شيء مشترك (shared-nothing architecture) التي تحتوي فيها كل عقدة على مجموعة عتاد الحساب الخاصة بها (معالجات CPU ووحدات GPU وذاكرة وتخزين). ويوضّح الشكل 1 نظامًا موزّعًا لا شيء مشترك يتكوّن من حاسوبين بذاكرة مشتركة.
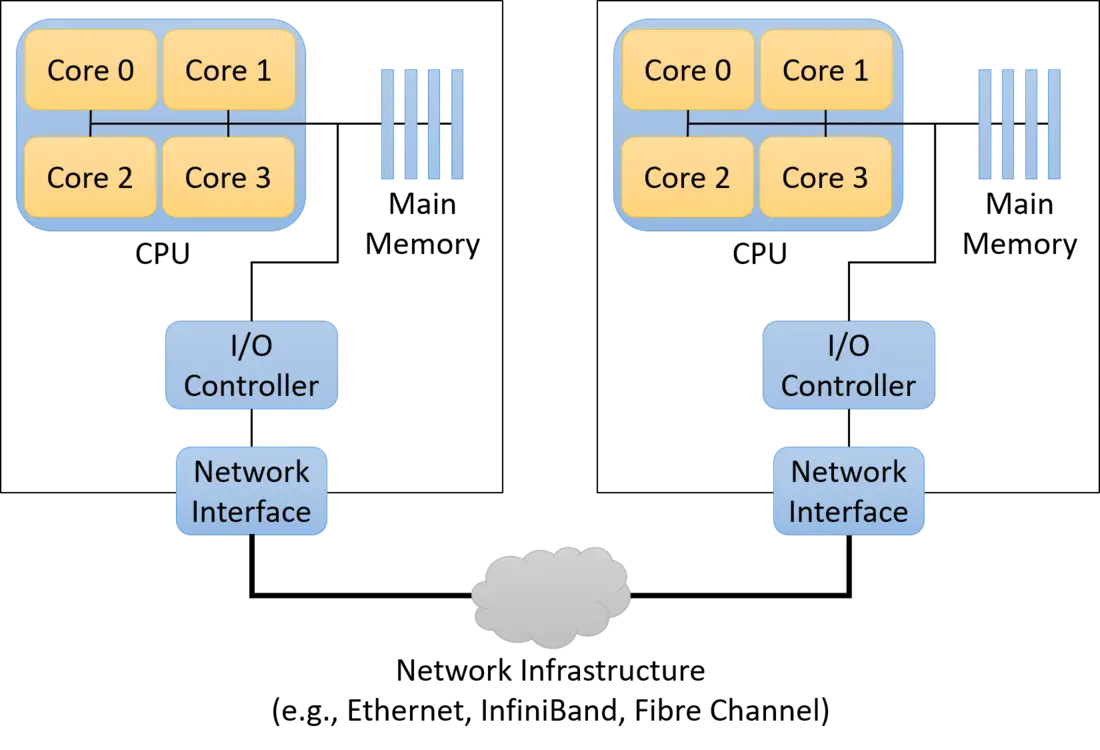 الشكل 1. المكوّنات الرئيسية لمعمارية ذاكرة موزّعة لا شيء مشترك مبنية من عقدتي حساب
15.2.1. نماذج المعالجة المتوازية والموزّعة
غالبًا ما ينظّم مصمّمو التطبيقات التطبيقات الموزّعة باستخدام تصاميم مجرّبة وموثوقة. ويساعد تبنّي نماذج تطبيقات كهذه المطورين على التفكير في التطبيق لأن سلوكه سيتوافق مع معايير مفهومة جيدًا. ولكل نموذج فوائده وعيوبه الفريدة — فلا يوجد حل واحد يناسب الجميع. ونوصف بإيجاز بعض النماذج الأكثر شيوعًا أدناه، مع التنبيه إلى أننا لا نقدّم قائمة شاملة.
العميل/الخادم
نموذج العميل/الخادم (client/server model) نموذج تطبيقات شائع للغاية يوزّع مسؤوليات التطبيق على طرفين: عمليات العميل وعمليات الخادم. وتوفّر عملية الخادم خدمة للعملاء الذين يطلبون إنجاز شيء ما. وتنتظر عمليات الخادم عادةً عند عناوين معروفة لتستقبل الاتصالات الواردة من العملاء. وعند إنشاء اتصال، يرسل العميل طلبات إلى عملية الخادم، التي إما تستجيب لتلك الطلبات (مثلًا بجلب ملف مطلوب) وإما تبلّغ بخطأ (مثلًا عدم وجود الملف أو تعذّر مصادقة العميل بشكل صحيح).
ومع أنك قد لا تكون قد فكّرت في ذلك، فقد وصلت إلى الكتاب الذي تقرأه الآن عبر نموذج العميل/الخادم! فقد اتصل متصفح الويب لديك (العميل) بموقع ويب (الخادم) عند عنوان عام (diveintosystems.org) لاسترجاع محتويات الكتاب.
خط الأنابيب
يقسّم نموذج خط الأنابيب (pipeline model) التطبيق إلى تسلسل مميّز من الخطوات تتدفق فيه البيانات من خطوة إلى أخرى. وتعالج كل مكوّنة داخل خط الأنابيب بياناتها بشكل مستقل ومتزامن. ويعمل هذا النموذج جيدًا في التطبيقات التي يتضمّن سير عملها مهام خطية متكررة على مدخلات بيانات كبيرة. فمثلًا، تأمّل إنتاج أفلام الرسوم المتحركة بالحاسوب. فيجب معالجة كل إطار من الفيلم عبر تسلسل من الخطوات التي تحوّل الإطار (مثل إضافة الأنسجة أو تطبيق الإضاءة). وبما أن كل خطوة تحدث بشكل مستقل في تسلسل، يستطيع الرسامون المتحركون تسريع العرض بمعالجة الإطارات بالتوازي عبر عنقود كبير من الحواسيب.
الرئيس/العامل
في نموذج الرئيس/العامل (boss/worker model)، تعمل عملية واحدة كمنسّق مركزي وتوزّع العمل على العمليات في العقد الأخرى. ويعمل هذا النموذج جيدًا في المسائل التي تتطلب معالجة مدخلات كبيرة قابلة للتقسيم. ويقسّم الرئيس المدخلات إلى أجزاء أصغر ويخصّص للعامل الواحد جزءًا واحدًا أو أكثر. وفي بعض التطبيقات، قد يخصّص الرئيس لكل عامل جزءًا واحدًا بالضبط من المدخلات تخصيصًا ساكنًا. وفي حالات أخرى، قد يُكمل العاملون جزءًا من المدخلات مرارًا ثم يعودون إلى الرئيس لاسترجاع الجزء التالي من المدخلات ديناميكيًا. وسنعرض لاحقًا في هذا القسم برنامجًا نموذجيًا يقسّم فيه رئيس مصفوفة على عمال كثيرين لتنفيذ ضرب قياسي على مصفوفة.
لاحظ أن هذا النموذج يُسمّى أحيانًا بأسماء أخرى، مثل "السيد/العامل" أو تنويعات أخرى، لكن الفكرة الأساسية هي نفسها.
النظير إلى النظير
وخلافًا لنموذج الرئيس/العامل، يتجنّب تطبيق النظير إلى النظير (peer-to-peer) الاعتماد على عملية تحكم مركزية. وبدلًا من ذلك، تنظّم عمليات الأقران التطبيق ذاتيًا في بنية يتحمّل فيها كل منها مسؤوليات متساوية تقريبًا. فمثلًا، في بروتوكول مشاركة الملفات BitTorrent، يتبادل كل نظير أجزاء من ملف مع الآخرين مرارًا حتى يستقبل الجميع الملف كاملًا.
ولأنها تفتقر إلى مكوّن مركزي، تكون تطبيقات النظير إلى النظير متينة عمومًا في وجه أعطال العقد. ومن جهة أخرى، تتطلب تطبيقات النظير إلى النظير عادةً خوارزميات تنسيق معقّدة، ما يجعل بنائها واختبارها بدقة أمرًا صعبًا.
15.2.2. بروتوكولات الاتصال
سواء كانت جزءًا من حاسوب فائق أو عنقود COTS، تتواصل العمليات في نظام الذاكرة الموزّعة عبر تمرير الرسائل (message passing)، حيث ترسل عملية ما رسالة صراحةً إلى عمليات على عقدة أخرى أو أكثر، فتستقبلها. ويعود إلى التطبيقات العاملة على النظام تحديد كيفية استخدام الشبكة — فبعض التطبيقات يتطلب تواصلًا متكررًا لتنسيق سلوك العمليات عبر عقد كثيرة تنسيقًا وثيقًا، بينما تتواصل تطبيقات أخرى لتقسيم مدخلات كبيرة على العمليات ثم تعمل بعد ذلك باستقلالية في الغالب.
ويصوغ التطبيق الموزّع توقعاته التواصلية بتعريف بروتوكول (protocol) اتصال يصف مجموعة من القواعد التي تحكم استخدامه للشبكة، ومنها:
- متى ينبغي للعملية إرسال رسالة
- إلى أي عملية أو عمليات ينبغي إرسال الرسالة
- كيفية تنسيق الرسالة
وبدون بروتوكول، قد يفشل التطبيق في تفسير الرسائل تفسيرًا صحيحًا أو قد يقع في جمود حتى. فمثلًا، إذا تكوّن تطبيق من عمليتين، وكانت كل عملية تنتظر الأخرى لترسل لها رسالة، فلن تحرز أي من العمليتين أي تقدم أبدًا. وتضيف البروتوكولات بنية إلى التواصل لتقليل احتمال حدوث مثل هذه الإخفاقات.
ولتنفيذ بروتوكول اتصال، تحتاج التطبيقات إلى وظائف أساسية لمهام مثل إرسال الرسائل واستقبالها، وتسمية العمليات (العنونة)، ومزامنة تنفيذ العمليات. وتتوجه تطبيقات كثيرة إلى واجهة تمرير الرسائل (Message Passing Interface) للحصول على هذه الوظائف.
15.2.3. واجهة تمرير الرسائل (MPI)
تعرّف واجهة تمرير الرسائل (Message Passing Interface, MPI) (لكنها لا تنفّذها بنفسها) واجهة معيارية يمكن للتطبيقات استخدامها للتواصل في نظام ذاكرة موزّعة. وباتباع معيار اتصال MPI، تصبح التطبيقات قابلة للنقل (portable)، أي يمكن ترجمتها وتنفيذها على أنظمة مختلفة كثيرة. وبعبارة أخرى، ما دام أحد تنفيذات MPI مثبّتًا، يمكن للتطبيق القابل للنقل الانتقال من نظام إلى آخر وتوقّع التنفيذ السليم، حتى لو كانت للأنظمة خصائص أساسية مختلفة.
تتيح MPI للمبرمج تقسيم التطبيق إلى عمليات متعددة. وتخصّص لكل عملية من عمليات التطبيق معرّفًا فريدًا يُعرف بـالرتبة (rank)، وتتراوح من 0 إلى N-1 لتطبيق فيه N عملية. ويمكن للعملية معرفة رتبتها باستدعاء الدالة [MPI_Comm_rank](https://www.open-mpi.org/doc/v4.0/man3/MPI_Comm_rank.3.php)، ومعرفة عدد العمليات العاملة في التطبيق باستدعاء [MPI_Comm_size](https://www.open-mpi.org/doc/v4.0/man3/MPI_Comm_size.3.php). ولإرسال رسالة، تستدعي العملية [MPI_Send](https://www.open-mpi.org/doc/v4.0/man3/MPI_Send.3.php) وتحدّد رتبة المستلم المقصود. وبالمثل، تستدعي العملية [MPI_Recv](https://www.open-mpi.org/doc/v4.0/man3/MPI_Recv.3.php) لاستقبال رسالة، وتحدّد ما إذا كانت ستنتظر رسالة من عقدة محددة أو ستستقبل رسالة من أي مرسل (باستخدام الثابت MPI_ANY_SOURCE كرتبة).
إلى جانب دالتي الإرسال والاستقبال الأساسيتين، تعرّف MPI أيضًا مجموعة متنوعة من الدوال التي تسهّل على عملية واحدة توصيل البيانات إلى مستلمين متعددين. فمثلًا، تتيح [MPI_Bcast](https://www.open-mpi.org/doc/v4.0/man3/MPI_Bcast.3.php) لعملية واحدة إرسال رسالة إلى كل عملية أخرى في التطبيق باستدعاء دالة واحد فقط. كما تعرّف زوجًا من الدوال، [MPI_Scatter](https://www.open-mpi.org/doc/v4.0/man3/MPI_Scatter.3.php) و[MPI_Gather](https://www.open-mpi.org/doc/v4.0/man3/MPI_Gather.3.php)، يتيح لعملية واحدة تقسيم مصفوفة وتوزيع الأجزاء على العمليات (التوزيع)، والعمل على البيانات، ثم استرجاع جميع البيانات لاحقًا لدمج النتائج (التجميع).
ولأن MPI يحدّد فقط مجموعة من الدوال وكيف ينبغي أن تتصرف، يستطيع كل مصمّم نظام تنفيذ وظائف MPI بطريقة تلائم قدرات نظامه الخاص. فمثلًا، قد يتمكن نظام فيه شبكة ترابط تدعم البث (إرسال نسخة واحدة من رسالة إلى مستلمين متعددين في الوقت نفسه) من تنفيذ دالة [MPI_Bcast](https://www.open-mpi.org/doc/v4.0/man3/MPI_Bcast.3.php) في MPI بكفاءة أكبر من نظام لا يوفّر هذا الدعم.
15.2.4. برنامج MPI hello world
كمقدمة لبرمجة MPI، تأمّل برنامج "hello world" (hello_world_mpi.c) المعروض هنا:
#include <stdio.h>
#include <unistd.h>
#include "mpi.h"

int main(int argc, char **argv) {
    int rank, process_count;
    char hostname[1024];

    /* Initialize MPI. */
    MPI_Init(&argc, &argv);

    /* Determine how many processes there are and which one this is. */
    MPI_Comm_size(MPI_COMM_WORLD, &process_count);
    MPI_Comm_rank(MPI_COMM_WORLD, &rank);

    /* Determine the name of the machine this process is running on. */
    gethostname(hostname, 1024);

    /* Print a message, identifying the process and machine it comes from. */
    printf("Hello from %s process %d of %d\n", hostname, rank, process_count);

    /* Clean up. */
    MPI_Finalize();

    return 0;
}
عند بدء هذا البرنامج، تنفّذ MPI عدة نسخ منه في الوقت نفسه كعمليات مستقلة عبر حاسوب واحد أو أكثر. وتستدعي كل عملية دوال MPI لتحديد العدد الإجمالي للعمليات العاملة (بـ[MPI_Comm_size](https://www.open-mpi.org/doc/v4.0/man3/MPI_Comm_size.3.php)) وأي عملية هي بين تلك العمليات (رتبة العملية، بـ[MPI_Comm_rank](https://www.open-mpi.org/doc/v4.0/man3/MPI_Comm_rank.3.php)). وبعد البحث عن هذه المعلومات، تطبع كل عملية رسالة قصيرة تحتوي على الرتبة واسم الحاسوب (hostname) الذي تعمل عليه قبل أن تنتهي.
ملاحظة — تشغيل شيفرة MPI
لتشغيل أمثلة MPI هذه، ستحتاج إلى تنفيذ MPI مثل OpenMPI أو MPICH مثبّتًا على نظامك.
لترجمة هذا المثال، استدعِ برنامج المترجم mpicc، الذي ينفّذ إصدارًا مدركًا لـMPI من gcc لبناء البرنامج وربطه بمكتبات MPI:
$ mpicc -o hello_world_mpi hello_world_mpi.c
لتنفيذ البرنامج، استخدم أداة mpirun لبدء عدة عمليات متوازية بـMPI. ويجب إخبار الأمر mpirun بالحواسيب التي سيشغّل العمليات عليها (--hostfile) وبعدد العمليات التي سيشغّلها على كل حاسوب (-np). وهنا نزوّده بملف اسمه hosts.txt يخبر mpirun بإنشاء أربع عمليات عبر حاسوبين، أحدهما اسمه lemon والآخر اسمه orange:
$ mpirun -np 8 --hostfile hosts.txt ./hello_world_mpi
Hello from lemon process 4 of 8
Hello from lemon process 5 of 8
Hello from orange process 2 of 8
Hello from lemon process 6 of 8
Hello from orange process 0 of 8
Hello from lemon process 7 of 8
Hello from orange process 3 of 8
Hello from orange process 1 of 8
تحذير — ترتيب تنفيذ MPI
ينبغي ألا تفترض أبدًا أي شيء عن ترتيب تنفيذ عمليات MPI. فتبدأ العمليات العمل على حواسيب متعددة، لكل منها نظام تشغيله ومجدول عملياته. وإذا كانت صحة برنامجك تتطلب تشغيل العمليات بترتيب معيّن، فيجب أن تضمن حدوث الترتيب الصحيح — مثلًا بإجبار عمليات معينة على التوقف حتى تستقبل رسالة.
15.2.5. الضرب القياسي بـMPI
لمثال MPI أكثر جوهرية، تأمّل تنفيذ ضرب قياسي على مصفوفة. يتبنّى هذا المثال نموذج الرئيس/العامل — إذ تقسم عملية واحدة المصفوفة إلى أجزاء أصغر وتوزّعها على عمليات العمال. لاحظ أن عملية الرئيس في هذا التطبيق للضرب القياسي تتصرف أيضًا كعامل وتضرب جزءًا من المصفوفة بعد توزيع الأقسام على العمال الآخرين.
للاستفادة من العمل بالتوازي، تضرب كل عملية جزءها المحلي فقط من المصفوفة في القيمة القياسية، ثم يرسل جميع العمال النتائج إلى عملية الرئيس لتكوين النتيجة النهائية. وفي مواضع عدة من البرنامج، تتحقق الشيفرة مما إذا كانت رتبة العملية صفرًا:
if (rank == 0) {
    /* This code only executes at the boss. */
}
يضمن هذا التحقق أن عملية واحدة فقط (ذات الرتبة 0) تؤدي دور الرئيس. وحسب الاصطلاح، تختار تطبيقات MPI غالبًا الرتبة 0 لتنفيذ المهام التي تحدث مرة واحدة، لأنه مهما كان عدد العمليات، ستُمنح واحدة دائمًا الرتبة 0 (حتى لو كانت عملية واحدة فقط قيد التنفيذ).
تواصل MPI
تبدأ عملية الرئيس بتحديد القيمة القياسية ومصفوفة الإدخال الأولية. وفي تطبيق حوسبة علمية حقيقي، من المرجّح أن يقرأ الرئيس هذه القيم من ملف إدخال. ولتبسيط هذا المثال، يستخدم الرئيس قيمة قياسية ثابتة (10) ويولّد مصفوفة بسيطة من 40 عنصرًا (تحتوي التسلسل من 0 إلى 39) لأغراض التوضيح.
يتطلب هذا البرنامج تواصلًا بين عمليات MPI لثلاث مهام مهمة:
- يرسل الرئيس القيمة القياسية وحجم المصفوفة إلى جميع العمال.
- يقسّم الرئيس المصفوفة الأولية إلى أجزاء ويرسل جزءًا إلى كل عامل.
- تضرب كل عملية في جزءها من المصفوفة القيم في القيمة القياسية ثم ترسل القيم المحدَّثة عائدة إلى الرئيس.
بث القيم المهمة
لإرسال القيمة القياسية إلى العمال، يستخدم البرنامج المثال دالة [MPI_Bcast](https://www.open-mpi.org/doc/v4.0/man3/MPI_Bcast.3.php)، التي تتيح لعملية MPI واحدة إرسال القيمة نفسها إلى جميع عمليات MPI الأخرى باستدعاء دالة واحد:
/* Boss sends the scalar value to every process with a broadcast. */
MPI_Bcast(&scalar, 1, MPI_INT, 0, MPI_COMM_WORLD);
يرسل هذا الاستدعاء عددًا صحيحًا واحدًا (MPI_INT) بدءًا من عنوان المتغير scalar من العملية ذات الرتبة 0 إلى كل عملية أخرى (MPI_COMM_WORLD). وتستقبل جميع عمليات العمال (ذات الرتب غير الصفرية) البث في نسختها المحلية من المتغير scalar، فعندما يكتمل هذا الاستدعاء، تعرف كل عملية القيمة القياسية التي ستستخدمها.
ملاحظة — سلوك MPI_Bcast
تنفّذ كل عملية
MPI_Bcast، لكنها تتصرف بشكل مختلف حسب رتبة العملية المستدعية. وإذا طابقت الرتبة رتبة الوسيط الرابع، تتولى العملية المستدعية دور المرسل. وتعمل جميع العمليات الأخرى التي تستدعيMPI_Bcastكمستقبلات.
وبالمثل، يبثّ الرئيس الحجم الإجمالي للمصفوفة إلى كل عملية أخرى. وبعد معرفة الحجم الإجمالي للمصفوفة، تضبط كل عملية متغير local_size بقسمة الحجم الإجمالي للمصفوفة على عدد عمليات MPI. ويمثّل المتغير local_size عدد العناصر التي سيحتوي عليها جزء كل عامل من المصفوفة. فمثلًا، إذا كانت مصفوفة الإدخال تحتوي 40 عنصرًا ويتكوّن التطبيق من ثماني عمليات، فكل عملية مسؤولة عن جزء من خمسة عناصر من المصفوفة (40 / 8 = 5). ولإبقاء المثال بسيطًا، يُفترض أن عدد العمليات يقسم حجم المصفوفة قسمة تامة:
/* Each process determines how many processes there are. */
MPI_Comm_size(MPI_COMM_WORLD, &process_count);

/* Boss sends the total array size to every process with a broadcast. */
MPI_Bcast(&array_size, 1, MPI_INT, 0, MPI_COMM_WORLD);

/* Determine how many array elements each process will get.
 * Assumes the array is evenly divisible by the number of processes. */
local_size = array_size / process_count;
توزيع المصفوفة
الآن بعد أن تعرف كل عملية القيمة القياسية وعدد القيم المسؤولة عن ضربها، يجب على الرئيس تقسيم المصفوفة إلى أجزاء وتوزيعها على العمال. لاحظ أن الرئيس (الرتبة 0) يشارك أيضًا كعامل في هذا التطبيق. فمثلًا، مع مصفوفة من 40 عنصرًا وثماني عمليات (الرتب 0-7)، ينبغي أن يحتفظ الرئيس بعناصر المصفوفة 0-4 لنفسه (الرتبة 0)، ويرسل العناصر 5-9 إلى الرتبة 1، والعناصر 10-14 إلى الرتبة 2، وهكذا. ويعرض الشكل 2 كيفية تخصيص الرئيس أجزاء المصفوفة لكل عملية MPI.
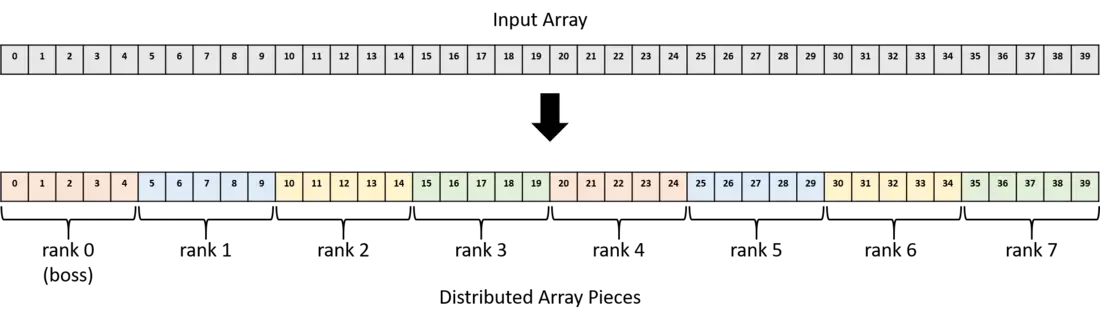 الشكل 2. توزيع مصفوفة من 40 عنصرًا على ثماني عمليات MPI (الرتب 0-7)
يتضمن أحد خيارات توزيع أجزاء المصفوفة على كل عامل الجمع بين استدعاءات [MPI_Send](https://www.open-mpi.org/doc/v4.0/man3/MPI_Send.3.php) عند الرئيس واستدعاء [MPI_Recv](https://www.open-mpi.org/doc/v4.0/man3/MPI_Recv.3.php) عند كل عامل:
if (rank == 0) {
    int i;

    /* For each worker process, send a unique chunk of the array. */
    for (i = 1; i < process_count; i++) {
        /* Send local_size ints starting at array index (i * local_size) */
        MPI_Send(array + (i * local_size), local_size, MPI_INT, i, 0,
                 MPI_COMM_WORLD);
    }
} else {
    MPI_Recv(local_array, local_size, MPI_INT, 0, 0, MPI_COMM_WORLD,
             MPI_STATUS_IGNORE);
}
في هذه الشيفرة، ينفّذ الرئيس حلقة تُنفَّذ مرة واحدة لكل عملية عامل، يرسل فيها إلى العامل جزءًا من المصفوفة. ويبدأ إرسال البيانات من عنوان array بإزاحة (i * local_size) لضمان حصول كل عامل على جزء فريد من المصفوفة. أي أن العامل ذا الرتبة 1 يحصل على جزء من المصفوفة يبدأ عند الفهرس 5، والرتبة 2 تحصل على جزء يبدأ عند الفهرس 10، وهكذا، كما هو معروض في الشكل 2.
يرسل كل استدعاء لـ[MPI_Send](https://www.open-mpi.org/doc/v4.0/man3/MPI_Send.3.php) بيانات مقدارها local_size (5) من الأعداد الصحيحة (20 بايت) إلى العملية ذات الرتبة i. ويمثّل الوسيط 0 القريب من النهاية وسم رسالة، وهو ميزة متقدمة لا يحتاجها هذا البرنامج — فتحديده على 0 يعامل جميع الرسائل بالتساوي.
تستدعي جميع العمال [MPI_Recv](https://www.open-mpi.org/doc/v4.0/man3/MPI_Recv.3.php) لاسترجاع جزءهم من المصفوفة، فيخزّنونه في الذاكرة عند العنوان الذي يشير إليه local_array. ويستقبلون بيانات مقدارها local_size (5) من الأعداد الصحيحة (20 بايت) من العقدة ذات الرتبة 0. لاحظ أن [MPI_Recv](https://www.open-mpi.org/doc/v4.0/man3/MPI_Recv.3.php) استدعاء حاجب (blocking)، أي أن العملية التي تستدعيه تتوقف حتى تستقبل بيانات. ولأن استدعاء [MPI_Recv](https://www.open-mpi.org/doc/v4.0/man3/MPI_Recv.3.php) حاجب، لن يتقدم أي عامل حتى يرسل الرئيس جزأه من المصفوفة.
التنفيذ المتوازي
بعد أن يستقبل العامل جزأه من المصفوفة، يمكنه البدء بضرب كل قيمة من قيم المصفوفة في القيمة القياسية. وبما أن كل عامل يحصل على مجموعة فرعية فريدة من المصفوفة، فيمكنهم التنفيذ باستقلالية وبالتوازي دون حاجة إلى التواصل.
تجميع النتائج
وأخيرًا، بعد أن يكمل العمال عمليات الضرب، يرسلون قيم المصفوفة المحدَّثة عائدة إلى الرئيس الذي يجمع النتائج. وباستخدام [MPI_Send](https://www.open-mpi.org/doc/v4.0/man3/MPI_Send.3.php) و[MPI_Recv](https://www.open-mpi.org/doc/v4.0/man3/MPI_Recv.3.php)، تشبه هذه العملية شيفرة توزيع المصفوفة أعلاه، إلا أن دوري المرسل والمستقبل معكوسان:
if (rank == 0) {
    int i;

    for (i = 1; i < process_count; i++) {
        MPI_Recv(array + (i * local_size), local_size, MPI_INT, i, 0,
                 MPI_COMM_WORLD, MPI_STATUS_IGNORE);
    }
} else {
    MPI_Send(local_array, local_size, MPI_INT, 0, 0, MPI_COMM_WORLD);
}
تذكّر أن [MPI_Recv](https://www.open-mpi.org/doc/v4.0/man3/MPI_Recv.3.php) تحجب التنفيذ أو توقفه مؤقتًا، لذا يتسبب كل استدعاء في حلقة for في انتظار الرئيس حتى يستقبل جزءًا من المصفوفة من العامل i.
التوزيع/التجميع
مع أن حلقات for في المثال السابق توزّع البيانات بشكل صحيح باستخدام [MPI_Send](https://www.open-mpi.org/doc/v4.0/man3/MPI_Send.3.php) و[MPI_Recv](https://www.open-mpi.org/doc/v4.0/man3/MPI_Recv.3.php)، فإنها لا تجسّد القصد الكامن وراءها بإيجاز. أي أنها تظهر لـMPI كسلسلة من استدعاءات الإرسال والاستقبال دون الهدف الواضح المتمثل في توزيع مصفوفة على عمليات MPI. ولأن التطبيقات المتوازية تحتاج كثيرًا إلى توزيع البيانات وجمعها كما في مصفوفة هذا المثال، توفّر MPI دوالّ لهذا الغرض بالتحديد: [MPI_Scatter](https://www.open-mpi.org/doc/v4.0/man3/MPI_Scatter.3.php) و[MPI_Gather](https://www.open-mpi.org/doc/v4.0/man3/MPI_Gather.3.php).
وتوفّر هاتان الدالتان فائدتين رئيسيتين:
- تتيح التعبير عن كل كتلة شيفرة كاملة من الكتل أعلاه باستدعاء دالة MPI واحد، ما يبسّط الشيفرة.
- تعبّر عن قصد العملية لتنفيذ MPI الأساسي، الذي قد يكون قادرًا على تحسين أدائه بشكل أفضل.
لاستبدال الحلقة الأولى أعلاه، يمكن لكل عملية استدعاء [MPI_Scatter](https://www.open-mpi.org/doc/v4.0/man3/MPI_Scatter.3.php):
/* Boss scatters chunks of the array evenly among all the processes. */
MPI_Scatter(array, local_size, MPI_INT, local_array, local_size, MPI_INT,
            0, MPI_COMM_WORLD);
توزّع هذه الدالة تلقائيًا محتويات الذاكرة بدءًا من array في أجزاء تحتوي local_size من الأعداد الصحيحة إلى المتغير الهدف local_array. ويحدّد الوسيط 0 أن العملية ذات الرتبة 0 (الرئيس) هي المرسل، فتقرأ المصدر array وتوزّعه على العمليات الأخرى (بما في ذلك إرسال جزء واحد إلى نفسها). وتعمل كل عملية أخرى كمستقبل وتستقبل البيانات في هدفها local_array.
بعد هذا الاستدعاء الواحد، يمكن للعمال كلٌّ ضرب المصفوفة بالتوازي. وعندما ينتهون، تستدعي كل عملية [MPI_Gather](https://www.open-mpi.org/doc/v4.0/man3/MPI_Gather.3.php) لتجميع النتائج عائدة في متغير array الخاص بالرئيس:
/* Boss gathers the chunks from all the processes and coalesces the
 * results into a final array. */
MPI_Gather(local_array, local_size, MPI_INT, array, local_size, MPI_INT,
           0, MPI_COMM_WORLD);
يتصرف هذا الاستدعاء عكس [MPI_Scatter](https://www.open-mpi.org/doc/v4.0/man3/MPI_Scatter.3.php): فهذه المرة، يحدّد الوسيط 0 أن العملية ذات الرتبة 0 (الرئيس) هي المستقبل، فيحدّث متغير array، ويرسل العمال كلٌّ local_size من الأعداد الصحيحة من متغيرات local_array الخاصة بهم.
الشيفرة الكاملة لضرب MPI القياسي
وفيما يلي سرد كامل لشيفرة ضرب MPI القياسي تستخدم MPI_Scatter وMPI_Gather (scalar_multiply_mpi.c):
#include <stdio.h>
#include <stdlib.h>
#include "mpi.h"

#define ARRAY_SIZE (40)
#define SCALAR (10)

/* In a real application, the boss process would likely read its input from a
 * data file.  This example program produces a simple array and informs the
 * caller of the size of the array through the array_size pointer parameter.*/
int *build_array(int *array_size) {
    int i;
    int *result = malloc(ARRAY_SIZE * sizeof(int));

    if (result == NULL) {
        exit(1);
    }

    for (i = 0; i < ARRAY_SIZE; i++) {
        result[i] = i;
    }

    *array_size = ARRAY_SIZE;
    return result;
}

/* Print the elements of an array, given the array and its size. */
void print_array(int *array, int array_size) {
    int i;
    for (i = 0; i < array_size; i++) {
        printf("%3d ", array[i]);
    }
    printf("\n\n");
}

/* Multiply each element of an array by a scalar value. */
void scalar_multiply(int *array, int array_size, int scalar) {
    int i;
    for (i = 0; i < array_size; i++) {
        array[i] = array[i] * scalar;
    }
}

int main(int argc, char **argv) {
    int rank, process_count;
    int array_size, local_size;
    int scalar;
    int *array, *local_array;

    /* Initialize MPI */
    MPI_Init(&argc, &argv);

    /* Determine how many processes there are and which one this is. */
    MPI_Comm_size(MPI_COMM_WORLD, &process_count);
    MPI_Comm_rank(MPI_COMM_WORLD, &rank);

    /* Designate rank 0 to be the boss.  It sets up the problem by generating
     * the initial input array and choosing the scalar to multiply it by. */
    if (rank == 0) {
        array = build_array(&array_size);
        scalar = SCALAR;

        printf("Initial array:\n");
        print_array(array, array_size);
    }

    /* Boss sends the scalar value to every process with a broadcast.
     * Worker processes receive the scalar value by making this MPI_Bcast
     * call. */
    MPI_Bcast(&scalar, 1, MPI_INT, 0, MPI_COMM_WORLD);

    /* Boss sends the total array size to every process with a broadcast.
     * Worker processes receive the size value by making this MPI_Bcast
     * call. */
    MPI_Bcast(&array_size, 1, MPI_INT, 0, MPI_COMM_WORLD);

    /* Determine how many array elements each process will get.
     * Assumes the array is evenly divisible by the number of processes. */
    local_size = array_size / process_count;

    /* Each process allocates space to store its portion of the array. */
    local_array = malloc(local_size * sizeof(int));
    if (local_array == NULL) {
        exit(1);
    }

    /* Boss scatters chunks of the array evenly among all the processes. */
    MPI_Scatter(array, local_size, MPI_INT, local_array, local_size, MPI_INT,
                0, MPI_COMM_WORLD);

    /* Every process (including boss) performs scalar multiplication over its
     * chunk of the array in parallel. */
    scalar_multiply(local_array, local_size, scalar);

    /* Boss gathers the chunks from all the processes and coalesces the
     * results into a final array. */
    MPI_Gather(local_array, local_size, MPI_INT, array, local_size, MPI_INT,
               0, MPI_COMM_WORLD);

    /* Boss prints the final answer. */
    if (rank == 0) {
        printf("Final array:\n");
        print_array(array, array_size);
    }

    /* Clean up. */
    if (rank == 0) {
        free(array);
    }
    free(local_array);
    MPI_Finalize();

    return 0;
}
في الدالة main، يهيّئ الرئيس المسألة وينشئ مصفوفة. ولو كان هذا حلًّا لمسألة حقيقية (مثل تطبيق حوسبة علمية)، فمن المرجّح أن يقرأ الرئيس بياناته الأولية من ملف إدخال. وبعد تهيئة المصفوفة، يحتاج الرئيس إلى إرسال معلومات عن حجم المصفوفة والقيمة القياسية المستخدمة في الضرب إلى جميع عمليات العمال الأخرى، فيبثّ هذين المتغيرين إلى كل عملية.
الآن بعد أن تعرف كل عملية حجم المصفوفة وعدد العمليات، يمكن لكل منها إجراء القسمة لتحديد عدد عناصر المصفوفة المسؤولة عن ضربها. وللتبسيط، تفترض هذه الشيفرة أن المصفوفة قابلة للقسمة قسمة تامة على عدد العمليات.
ثم يستخدم الرئيس دالة [MPI_Scatter](https://www.open-mpi.org/doc/v4.0/man3/MPI_Scatter.3.php) لإرسال جزء متساوٍ من المصفوفة إلى كل عملية عامل (بما فيها نفسها). والآن يملك العمال كل المعلومات التي يحتاجونها، فينفّذ كل منهم الضرب على حصته من المصفوفة بالتوازي. وأخيرًا، بينما يكمل العمال عمليات الضرب، يجمع الرئيس جزء كل عامل من المصفوفة باستخدام [MPI_Gather](https://www.open-mpi.org/doc/v4.0/man3/MPI_Gather.3.php) لإعلان النتائج النهائية.
وترجمة هذا البرنامج وتنفيذه تبدوان كما يلي:
$ mpicc -o scalar_multiply_mpi scalar_multiply_mpi.c

$ mpirun -np 8 --hostfile hosts.txt ./scalar_multiply_mpi
Initial array:
  0   1   2   3   4   5   6   7   8   9  10  11  12  13  14  15  16  17  18  19
 20  21  22  23  24  25  26  27  28  29  30  31  32  33  34  35  36  37  38  39

Final array:
  0  10  20  30  40  50  60  70  80  90 100 110 120 130 140 150 160 170 180 190
200 210 220 230 240 250 260 270 280 290 300 310 320 330 340 350 360 370 380 390
15.2.6. تحديات الأنظمة الموزّعة
بشكل عام، يُعرف تنسيق سلوك عمليات متعددة في الأنظمة الموزّعة بأنه صعب للغاية. فإذا تعطّل مكوّن عتادي (مثل CPU أو مصدر طاقة) في نظام ذاكرة مشتركة، يصبح النظام كله غير قابل للتشغيل. أما في نظام موزّع، فيمكن للعقد المستقلة أن تتعطل كلٌّ على حدة. فمثلًا، يجب أن يقرر التطبيق كيف يتصرف إذا اختفت عقدة واحدة وبقيت الأخريات قيد التشغيل. وبالمثل، قد تتعطل شبكة الترابط، فيبدو لكل عملية كأن جميع العمليات الأخرى قد تعطلت.
تواجه الأنظمة الموزّعة أيضًا تحديات بسبب غياب عتاد مشترك، وتحديدًا الساعات. فنظرًا لتأخيرات نقل الشبكة غير المتوقعة، لا تستطيع العقد المستقلة تحديد الترتيب الذي أُرسلت به الرسائل بسهولة. وحلّ هذه التحديات (وغيرها الكثير) يتجاوز نطاق هذا الكتاب. ولحسن الحظ، بنى مصمّمو البرمجيات الموزّعة عدة أطر عمل تسهّل تطوير التطبيقات الموزّعة. ونصف بعض هذه الأطر في القسم التالي.
موارد MPI
MPI كبيرة ومعقّدة، وهذا القسم لا يكاد يلامس السطح. ولمزيد من المعلومات عن MPI، نقترح:
- الدرس التعليمي عن MPI من مختبر Lawrence Livermore الوطني، بقلم Blaise Barney.
- أنماط MPI من CSinParallel.
أتاحت التطورات التقنية للبشرية إنتاج البيانات بمعدل لم يُرَ من قبل. وتنتج الأدوات العلمية مثل التلسكوبات وأجهزة التسلسل البيولوجي والمستشعرات بيانات علمية عالية الدقة بتكلفة منخفضة. وبينما يكافح العلماء لتحليل هذا "طوفان البيانات"، يتزايد اعتمادهم على حواسيب فائقة متقدمة متعددة العقد تشكّل أساس الحوسبة عالية الأداء (high-performance computing, HPC).
تُكتب تطبيقات HPC عادةً بلغات مثل C أو C++ أو Fortran، مع تمكين تعدد الخيوط وتمرير الرسائل بمكتبات مثل خيوط POSIX وOpenMP وMPI. وقد وصف القسم الأكبر من هذا الكتاب حتى الآن سمات معمارية ولغات ومكتبات تُستفاد منها عادةً في أنظمة HPC. وتستخدم الشركات والمختبرات الوطنية وغيرها من المنظمات المهتمة بتقدم العلم أنظمة HPC عادةً، وتشكّل نواة منظومة العلوم الحاسوبية.
وفي الوقت نفسه، أدى انتشار الأجهزة المتصلة بالإنترنت وشيوع وسائل التواصل الاجتماعي إلى أن تنتج البشرية بسهولة كميات كبيرة من الوسائط المتعددة على الإنترنت، في هيئة صفحات ويب وصور ومقاطع فيديو وتغريدات ومنشورات على وسائل التواصل. ويُقدَّر أن 90% من جميع البيانات على الإنترنت أُنتجت في العامين الماضيين، وأن المجتمع ينتج 30 تيرابايت من بيانات المستخدمين في الثانية (أو 2.5 إكسابايت يوميًا). ويقدّم طوفان بيانات المستخدمين للشركات والمنظمات ثروة من المعلومات عن عادات مستخدميها واهتماماتهم وسلوكهم، ويسهّل بناء ملفات عملاء غنية بالبيانات لتخصيص المنتجات والخدمات التجارية بشكل أفضل. ولتحليل بيانات المستخدمين، تعتمد الشركات عادةً على مراكز بيانات متعددة العقد تتشارك كثيرًا من مكوّنات معمارية العتاد في الحواسيب الفائقة النموذجية. غير أن مراكز البيانات هذه تعتمد على حزمة برمجيات مختلفة مصمّمة خصيصًا للبيانات القائمة على الإنترنت. وتُشار أحيانًا إلى الأنظمة الحاسوبية المستخدمة لتخزين وتحليل البيانات القائمة على الإنترنت واسعة النطاق بـأنظمة تحليل البيانات الراقية (high-end data analysis, HDA). وللشركات مثل Amazon وGoogle وMicrosoft وFacebook مصلحة راسخة في تحليل بيانات الإنترنت، وتشكّل نواة منظومة تحليلات البيانات. وقد بدأت ثورة HDA وتحليلات البيانات حوالي عام 2010، وهي الآن مجال مهيمن في أبحاث الحوسبة السحابية.
يبرز الشكل 1 الفروق الرئيسية في البرمجيات التي يستخدمها مجتمعا HDA وHPC. لاحظ أن كلا المجتمعين يستخدم عتاد عناقيد متشابهًا يتبع نموذج الذاكرة الموزّعة، حيث تحتوي كل عقدة حساب عادةً على معالج متعدد الأنوية واحد أو أكثر، وغالبًا على GPU. ويضمّ عتاد العنقود عادةً نظام ملفات موزّعًا يتيح للمستخدمين والتطبيقات وصولًا مشتركًا إلى الملفات المقيمة محليًا على عقد متعددة في العنقود.
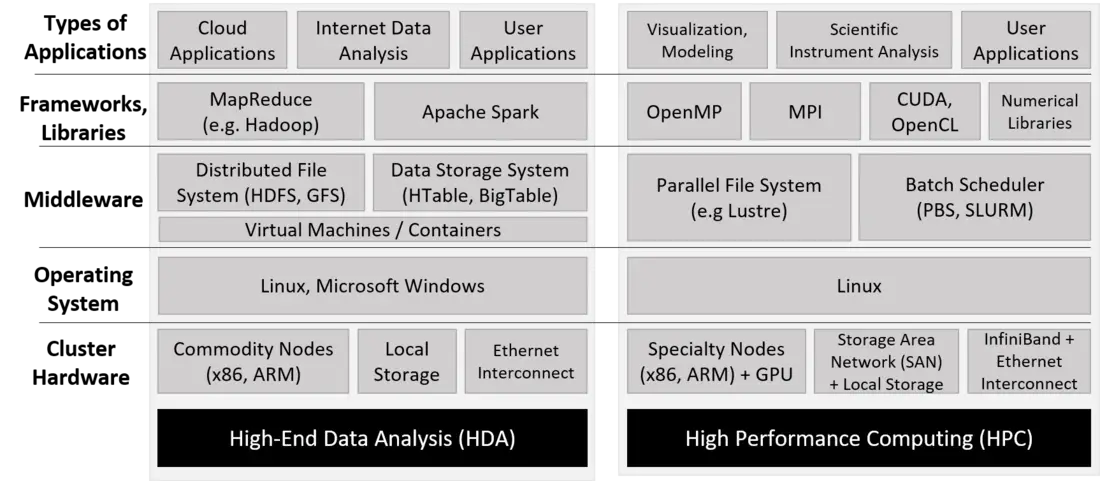 الشكل 1. مقارنة بين أطر HDA وHPC. استنادًا إلى شكل من إعداد Jack Dongarra وDaniel Reed.8
وخلافًا للحواسيب الفائقة، المصمّمة والمحسَّنة عادةً لاستخدام HPC، يعتمد مجتمع HDA على مراكز البيانات، التي تتكوّن من مجموعة كبيرة من عقد الحساب عامة الغرض المتصلة عادةً معًا عبر Ethernet. وعلى المستوى البرمجي، تستخدم مراكز البيانات عادةً أجهزة ظاهرية وقواعد بيانات موزّعة كبيرة وأطر عمل تمكّن من تحليل بيانات الإنترنت بمعدل إنتاجية عالٍ. ويشير مصطلح السحابة (cloud) إلى مكوّنات تخزين البيانات وقدرة الحوسبة في مراكز بيانات HDA.
نلقي في هذا القسم نظرة موجزة على الحوسبة السحابية، وبعض البرمجيات الشائعة المستخدمة لتمكينها (تحديدًا MapReduce)، وبعض التحديات المستقبلية. ويرجى ملاحظة أن هذا القسم ليس مقصودًا به التعمق في هذه المفاهيم؛ ونشجّع القراء المهتمين على استكشاف المصادر المشار إليها لمزيد من التفصيل.
15.3.1. الحوسبة السحابية
الحوسبة السحابية هي استخدام السحابة أو استئجارها لمجموعة متنوعة من الخدمات. وتمكّن الحوسبة السحابية البنية التحتية الحاسوبية من العمل كـ"مرفق عام": إذ يمنح عدد قليل من المزوّدين المركزيين المستخدمين والمنظمات إمكانية الوصول إلى قدرة حوسبة (تبدو غير محدودة) عبر الإنترنت، بحيث يختار المستخدمون والمنظمات استخدام ما يشاؤون منه ويدفعون حسب مستوى استخدامهم. وللحوسبة السحابية ثلاث ركائز رئيسية: البرمجيات كخدمة (SaaS)، والبنية التحتية كخدمة (IaaS)، والمنصة كخدمة (PaaS)1.
البرمجيات كخدمة
تشير البرمجيات كخدمة (Software as a service, SaaS) إلى البرمجيات المقدَّمة مباشرةً للمستخدمين عبر السحابة. ويستخدم معظم الناس هذه الركيزة من الحوسبة السحابية دون أن يدركوا ذلك حتى. فالتطبيقات التي يستخدمها كثيرون يوميًا (مثل البريد الإلكتروني عبر الويب ووسائل التواصل الاجتماعي وبث الفيديو) تعتمد على البنية التحتية السحابية. تأمّل التطبيق الكلاسيكي للبريد الإلكتروني عبر الويب. فيستطيع المستخدمون تسجيل الدخول والوصول إلى بريدهم الإلكتروني من أي جهاز، وإرسال البريد واستقباله، ويبدو أن مساحة التخزين لا تنفد أبدًا. ويمكن للمنظمات المهتمة بدورها "استئجار" خدمات البريد الإلكتروني السحابية لتوفير البريد لعملائها وموظفيها، دون تحمّل تكلفة العتاد والصيانة لتشغيل الخدمة بنفسها. وتُدار الخدمات في ركيزة SaaS بالكامل بواسطة مزوّدي السحابة؛ فلا تدير المنظمات والمستخدمون (ربما عدا ضبط بعض الإعدادات) أي جزء من التطبيق أو البيانات أو البرمجيات أو البنية التحتية للعتاد، وكل ذلك سيكون ضروريًا لو حاولوا إعداد الخدمة على عتادهم الخاص. وقبل ظهور الحوسبة السحابية، كانت المنظمات المهتمة بتوفير البريد الإلكتروني عبر الويب لمستخدميها تحتاج إلى بنيتها التحتية الخاصة وفريق دعم تقنية معلومات مخصّص لصيانتها. ومن الأمثلة الشائعة على مزوّدي SaaS: G Suite من Google وOffice 365 من Microsoft.
البنية التحتية كخدمة
تتيح البنية التحتية كخدمة (Infrastructure as a service, IaaS) للأفراد والمنظمات "استئجار" موارد حسابية لتلبية احتياجاتها، وذلك عادةً في هيئة الوصول إلى أجهزة ظاهرية إما عامة الغرض وإما مهيّأة مسبقًا لتطبيق معيّن. ومن الأمثلة الكلاسيكية خدمة Elastic Compute Cloud (EC2) من Amazon Web Services (AWS). وتمكّن EC2 المستخدمين من إنشاء أجهزة ظاهرية قابلة للتخصيص بالكامل. ويشير مصطلح elastic (مرن) في EC2 إلى قدرة المستخدم على توسيع طلبات موارده الحسابية أو تقليصها حسب الحاجة، مع الدفع حسب الاستخدام. فمثلًا، قد تستخدم منظمة مزوّد IaaS لاستضافة موقعها أو نشر سلسلة من تطبيقاتها المخصصة للمستخدمين. وتستخدم بعض المختبرات البحثية والفصول الدراسية خدمات IaaS بدلًا من أجهزة المختبر، فتشغّل التجارب في السحابة أو تقدّم منصة افتراضية ليتعلم طلابها. وفي جميع الحالات، الهدف هو إلغاء الصيانة ورأس المال اللازمين للحفاظ على عنقود أو خادم شخصي لأغراض مشابهة. وخلافًا لحالات الاستخدام في ركيزة SaaS، تتطلب حالات الاستخدام في ركيزة IaaS من العملاء تهيئة التطبيقات والبيانات، وفي بعض الحالات نظام تشغيل الجهاز الظاهري نفسه. غير أن نظام التشغيل المضيف والبنية التحتية للعتاد يعدّهما مزوّد السحابة ويديرهما. ومن مزوّدي IaaS الشائعين: Amazon AWS وGoogle Cloud Services وMicrosoft Azure.
المنصة كخدمة
تتيح المنصة كخدمة (Platform as a service, PaaS) للأفراد والمنظمات تطوير تطبيقات الويب الخاصة بهم ونشرها للسحابة، ما يلغي الحاجة إلى التهيئة أو الصيانة المحلية. وتمكّن معظم مزوّدي PaaS المطورين من كتابة تطبيقاتهم بلغات متنوعة وتقدّم اختيارًا من واجهات API لاستخدامها. فمثلًا، تتيح خدمة Microsoft Azure للمستخدمين كتابة تطبيقات الويب في بيئة تطوير Visual Studio ونشر تطبيقاتهم على Azure للاختبار. وتمكّن Google App Engine المطورين من بناء تطبيقات محمولة مخصصة واختبارها في السحابة بلغات متنوعة. ويُعدّ Heroku وCloudBees مثالين بارزين آخرين. لاحظ أن المطورين يتحكمون في تطبيقاتهم وبياناتهم فقط؛ بينما يتحكم مزوّد السحابة في بقية البنية التحتية للبرمجيات وفي كامل البنية التحتية للعتاد الأساسي.
15.3.2. MapReduce
لعلّ أشهر نموذج برمجي مستخدم على الأنظمة السحابية هو MapReduce3. ومع أن أصول MapReduce تعود إلى عمليتي Map وReduce في البرمجة الوظيفية، كانت Google أول من طبّق هذا المفهوم على تحليل كميات كبيرة من بيانات الويب. وقد مكّن MapReduce شركة Google من تنفيذ استعلامات الويب بسرعة أكبر من منافسيها، ومكّن صعودها الصاروخي لتصبح مزوّد خدمة الويب المفضّل وعملاق الإنترنت الذي هي عليه اليوم.
فهم عمليتي Map وReduce
تستند الدالتان map وreduce في نموذج MapReduce إلى العمليتين الرياضيتين Map وReduce من البرمجة الوظيفية. ونناقش في هذا القسم بإيجاز كيفية عمل هاتين العمليتين الرياضيتين بالعودة إلى بعض الأمثلة المقدَّمة سابقًا في الكتاب.
تُطبّق عملية Map عادةً الدالة نفسها على جميع العناصر في مجموعة. وقد يتعرّف القراء الملمّون بـPython على هذه الوظيفة بوضوح أكبر في ميزة استيعاب القوائم (list comprehension) في Python. فمثلًا، مقطعا الشيفرة التاليان في الجدول 1 ينفّذان الضرب القياسي في Python:
الجدول 1. مقارنة الضرب القياسي باستخدام الحلقة واستيعاب القوائم.
الضرب القياسي العادي
'''
    The typical way to perform
    scalar multiplication
'''

# array is an array of numbers
# s is an integer
def scalarMultiply(array, s):

    for i in range(len(array)):
        array[i] = array[i] * s

    return array

# call the scalarMultiply function:
myArray = [1, 3, 5, 7, 9]
result = scalarMultiply(myArray, 2)

#prints [2, 6, 10, 14, 18]
print(result)
الضرب القياسي باستخدام استيعاب القوائم
'''
    Equivalent program that
    performs scalar multiplication
    with list comprehension
'''

# multiplies two numbers together
def multiply(num1, num2):
    return num1 * num2

# array is an array of numbers
# s is an integer
def scalarMultiply(array, s):

    # using list comprehension
    return [multiply(x, s) for x in array]

# call the scalarMultiply function:
myArray = [1, 3, 5, 7, 9]
result = scalarMultiply(myArray, 2)

# prints [2, 6, 10, 14, 18]
print(result)
ويطبّق استيعاب القوائم الدالة نفسها (في هذه الحالة ضرب عنصر المصفوفة في القيمة القياسية s) على كل عنصر x في array.
تأخذ عملية Reduce الواحدة مجموعة من العناصر وتدمجها معًا في قيمة واحدة باستخدام دالة مشتركة ما. فمثلًا، تعمل دالة sum في Python على نحو مشابه لعملية Reduce، إذ تأخذ مجموعة (قائمة Python عادةً) وتدمج جميع العناصر معًا بالجمع. لذا، وعلى سبيل المثال، فإن تطبيق الجمع على جميع العناصر في مصفوفة result المُعادة من دالة scalarMultiply في الجدول 1 يعطي مجموعًا مدموجًا مقداره 50.
نموذج برمجة MapReduce
من السمات الرئيسية لـMapReduce نموذج برمجته المبسّط. فلا يحتاج المطورون إلى تنفيذ سوى نوعين من الدوال، map وreduce؛ بينما يؤتمت إطار MapReduce الأساسي بقية العمل.
تأخذ دالة map المكتوبة من المبرمج زوج (مفتاح،قيمة) مدخلًا وتُخرج سلسلة من أزواج (مفتاح،قيمة) وسيطة تُكتب في نظام ملفات موزّع يتشاركه جميع العقد. ثم تُجمّع أداة دمج (combiner) يعرّفها إطار MapReduce عادةً أزواج (مفتاح،قيمة) حسب المفتاح، لتنتج أزواج (مفتاح،list(قيمة)) تُمرَّر إلى دالة reduce المعرّفة من المبرمج. ثم تأخذ دالة reduce كمدخل زوج (مفتاح،list(قيمة)) وتدمج جميع القيم معًا عبر عملية يعرّفها المبرمج لتكوين زوج نهائي (مفتاح،قيمة)، حيث تقابل القيمة في هذا الخرج نتيجة عملية الاختزال. ويُكتب خرج دالة reduce في نظام الملفات الموزّع وعادةً ما يُخرج إلى المستخدم.
لتوضيح كيفية استخدام نموذج MapReduce لتوازي برنامج، نناقش برنامج تكرار الكلمات (Word Frequency). وهدف هذا البرنامج تحديد تكرار كل كلمة في مجموعة نصوص كبيرة.
قد ينفّذ مبرمج C دالة map التالية لبرنامج تكرار الكلمات:3
void map(char *key, char *value) {
    // key is document name
    // value is string containing some words (separated by spaces)
    int i;
    int numWords = 0; // number of words found: populated by parseWords()

    // returns an array of numWords words
    char *words[] = parseWords(value, &numWords);
    for (i = 0; i < numWords; i++) {
        // output (word, 1) key-value intermediate to file system
        emit(words[i], "1");
    }
}
تستقبل دالة map هذه كمدخل سلسلة (key) تقابل اسم الملف، وسلسلة منفصلة (value) تحتوي مكوّنًا من بيانات الملف. ثم تحلّل الدالة الكلمات من المدخل value وتُصدر كل كلمة (words[i]) منفصلة مع القيمة النصية "1". ودالة emit يوفّرها إطار MapReduce وتكتب أزواج (مفتاح،قيمة) الوسيطة في نظام الملفات الموزّع.
لإكمال برنامج تكرار الكلمات، قد ينفّذ المبرمج دالة reduce التالية:
void reduce(char *key, struct Iterator values) {
    // key is individual word
    // value is of type Iterator (a struct that consists of
    // a items array (type char **), and its associated length (type int))
    int numWords = values.length();  // get length
    char *counts[] = values.items(); // get counts
    int i, total = 0;
    for (i = 0; i < numWords; i++) {
        total += atoi(counts[i]); // sum up all counts
    }
    char *stringTotal = itoa(total); // convert total to a string
    emit(key, stringTotal); // output (word, total) pair to file system
}
تستقبل دالة reduce هذه كمدخل سلسلة (key) تقابل كلمة معيّنة، وبنية Iterator (يوفّرها إطار MapReduce أيضًا) تتكوّن من مصفوفة مجمَّعة من العناصر المرتبطة بالمفتاح (items)، وطول تلك المصفوفة (length). وفي تطبيق تكرار الكلمات، يقابل items قائمة بالعددات (counts). ثم تستخرج الدالة عدد الكلمات من الحقل length في بنية Iterator، ومصفوفة العددات من الحقل items. ثم تتكرر على جميع العددات، وتجمع القيم في المتغير total. وبما أن دالة emit تتطلب معاملات من نوع char *، تحوّل الدالة total إلى سلسلة قبل استدعاء emit.
بعد تنفيذ map وreduce، تنتهي مسؤولية المبرمج. فيؤتمت إطار MapReduce بقية العمل، بما في ذلك تقسيم المدخل، وتوليد العمليات التي تشغّل دالة map وإدارتها (مهام map)، وتجميع أزواج (مفتاح،قيمة) الوسيطة وفرزها، وتوليد العمليات المنفصلة التي تشغّل دالة reduce وإدارتها (مهام reduce)، وتوليد ملف خرج نهائي.
وللتبسيط، نوضّح في الشكل 2 كيف يوازي MapReduce الأسطر الأولى من أغنية "Code Monkey" الشهيرة لجوناثان كولتون: code monkey get up get coffee, code monkey go to job.
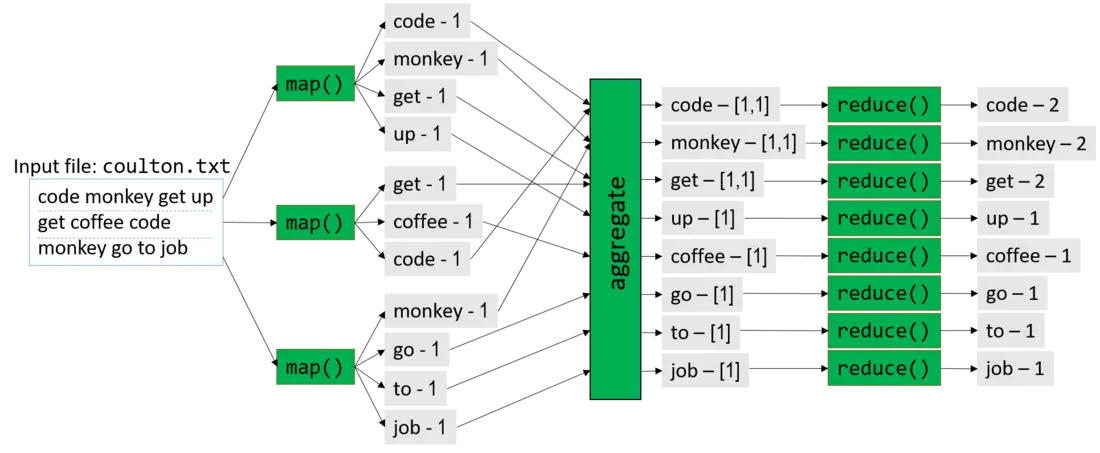 الشكل 2. توازي الأسطر الأولى من أغنية "Code Monkey" باستخدام إطار MapReduce
يعطي الشكل 2 نظرة عامة على هذه العملية. وقبل التنفيذ، تقسم عقدة الرئيس المدخل أولًا إلى M جزءًا، حيث يقابل M عدد مهام map. وفي الشكل 2، M = 3، ويُقسَّم ملف الإدخال (coulton.txt) إلى ثلاثة أجزاء. وأثناء مرحلة map، توزّع عقدة الرئيس مهام map على عقدة عاملة واحدة أو أكثر، وتنفّذ كل مهمة map باستقلالية وبالتوازي. فمثلًا، تحلّل مهمة map الأولى المقتطف code monkey get up إلى كلمات منفصلة وتُصدر أزواج (مفتاح،قيمة) الأربعة التالية: (code,1) و(monkey,1) و(get,1) و(up,1). ثم تُصدر كل مهمة map قيمها الوسيطة إلى نظام ملفات موزّع يشغل قدرًا معيّنًا من التخزين على كل عقدة.
وقبل بدء مرحلة reduce، يجمع الإطار أزواج (مفتاح،قيمة) الوسيطة ويدمجها في أزواج (مفتاح،list(قيمة)). وفي الشكل 2، على سبيل المثال، يُصدر زوج (مفتاح،قيمة) (get,1) بواسطة مهمتي map منفصلتين. ويجمع إطار MapReduce زوجي (مفتاح،قيمة) المنفصلين في زوج (مفتاح،list(قيمة)) الواحد (get,[1,1]). وتُكتب الأزواج الوسيطة المجمَّعة في نظام الملفات الموزّع على القرص.
بعد ذلك، يوجّه إطار MapReduce عقدة الرئيس لتوليد R مهمة reduce. وفي الشكل 2، R = 8. ثم يوزّع الإطار المهام على عقد العمل الخاصة به. ومرة أخرى، تنفّذ كل مهمة reduce باستقلالية وبالتوازي. وفي مرحلة reduce من هذا المثال، يُختزل زوج (مفتاح،list(قيمة)) (get,[1,1]) إلى زوج (مفتاح،قيمة) (get,2). وتضيف كل عقدة عاملة خرج مجموعة مهام reduce الخاصة بها إلى ملف نهائي يكون متاحًا للمستخدم عند الاكتمال.
تحمّل الأخطاء
تحتوي مراكز البيانات عادةً على آلاف العقد. وبالتالي، يكون معدل الأعطال مرتفعًا؛ فتأمّل أنه إذا كان احتمال تعطّل العتاد في عقدة فردية داخل مركز بيانات 2%، فإن احتمال تعطّل بعض العقد في مركز بيانات من 1,000 عقدة يتجاوز 99.99%. ولذلك يجب أن تكون البرمجيات المكتوبة لمراكز البيانات متينة في وجه الأخطاء (fault tolerant)، أي أن تكون قادرة على مواصلة العمل في وجه أعطال العتاد (أو أن تتعطل بلطف على الأقل).
صُمّم MapReduce مع مراعاة تحمّل الأخطاء. ففي أي تشغيل لـMapReduce، توجد عقدة رئيس واحدة وربما آلاف العقد العاملة. لذا يكون احتمال تعطّل عقدة عاملة مرتفعًا. ولمعالجة ذلك، تتحقق عقدة الرئيس من العقد العاملة فرديةً دوريًا (ping). وإذا لم تستقبل عقدة الرئيس ردًّا من عقدة عاملة، تعيد الرئيس توزيع عبء العمل المخصّص للعاملة على عقدة أخرى وتعيد تنفيذ المهمة3. وإذا تعطلت عقدة الرئيس (احتمال منخفض نظرًا لأنها عقدة واحدة فقط)، تُجهض مهمة MapReduce ويجب إعادة تشغيلها على عقدة منفصلة. لاحظ أن العقدة العاملة قد تفشل أحيانًا في الرد على تحققات عقدة الرئيس لأن العاملة غارقة في المهام. ولذلك يستخدم MapReduce استراتيجية التحقق وإعادة توزيع العمل نفسها للحد من أثر العقد العاملة البطيئة (أو المتخلفة).
Hadoop وApache Spark
أحدث تطوير MapReduce ضجة في عالم الحوسبة. غير أن تنفيذ Google لـMapReduce مغلق المصدر. ونتيجة لذلك، طوّر مهندسون في Yahoo! نظام Hadoop، وهو تنفيذ مفتوح المصدر لـMapReduce، تبنّته مؤسسة Apache لاحقًا. ويتكوّن مشروع Hadoop من منظومة أدوات لـApache Hadoop، منها نظام ملفات Hadoop الموزّع (HDFS) (بديل مفتوح المصدر لنظام Google File System)، وHBase (المستوحى من BigTable من Google).
ولـHadoop بعض القيود الرئيسية. أولًا، يصعب ربط مهام MapReduce المتعددة معًا في سير عمل أكبر. ثانيًا، تبيّن أن كتابة البيانات الوسيطة في HDFS عنق زجاجة، خصوصًا في المهام الصغيرة (أصغر من جيجابايت واحد). وقد صُمّم Apache Spark لمعالجة هذه المسائل من بين أمور أخرى. وبفضل تحسيناته وقدرته على معالجة البيانات الوسيطة في الذاكرة إلى حد كبير، يكون Apache Spark أسرع من Hadoop بما يصل إلى 100 مرة في بعض التطبيقات4.
15.3.3. النظر نحو المستقبل: الفرص والتحديات
رغم الابتكارات في مجتمع تحليلات بيانات الإنترنت، لا تزال كمية البيانات التي تنتجها البشرية تنمو. وتُنتَج معظم البيانات الجديدة في ما يُسمى بيئات الحافة (edge environments)، أو بالقرب من المستشعرات وغيرها من الأدوات المولّدة للبيانات التي تكون بحكم تعريفها في الطرف الآخر من الشبكة بعيدًا عن مزوّدي السحابة التجاريين وأنظمة HPC. وتقليديًا، يجمع العلماء والممارسون البيانات ويحلّلونها باستخدام عنقود محلي، أو ينقلونها إلى حاسوب فائق أو مركز بيانات للتحليل. ولم تعد هذه الرؤية "المركزية" للحوسبة استراتيجية قابلة للاستمرار، إذ فاقمت التحسينات في تقنية المستشعرات طوفان البيانات.
أحد أسباب هذا النمو الانفجاري هو انتشار الأجهزة الصغيرة المتصلة بالإنترنت التي تحتوي على مجموعة متنوعة من المستشعرات. وقد أدت هذه الأجهزة، أي أجهزة إنترنت الأشياء (Internet of Things, IoT)، إلى توليد مجموعات بيانات كبيرة ومتنوعة في بيئات الحافة. ويصعب نقل مجموعات البيانات الكبيرة من الحافة إلى السحابة، لأن المجموعات الأكبر تستهلك وقتًا وطاقة أكبر في النقل. وللتخفيف من المسائل اللوجستية لما يسمى "البيانات الضخمة"، بدأ مجتمع البحث في إنشاء تقنيات تلخّص البيانات بقوة عند كل نقطة نقل بين الحافة والسحابة2. ويوجد اهتمام شديد في مجتمع أبحاث الحوسبة بإنشاء بنية تحتية قادرة على معالجة البيانات وتخزينها وتلخيصها في بيئات الحافة في منصة موحّدة؛ وتُعرف هذه المجال بـحوسبة الحافة (edge) (أو الضباب، fog). وتقلب حوسبة الحافة نموذج التحليل التقليدي للبيانات الضخمة؛ فبدلًا من حدوث التحليل في الحاسوب الفائق أو مركز البيانات ("الميل الأخير")، يحدث التحليل في مصدر إنتاج البيانات ("الميل الأول")2.
إلى جانب لوجستيات نقل البيانات، فإن الشاغل الشامل الآخر لتحليل البيانات الضخمة هو إدارة الطاقة. فالموارد الكبيرة المركزية مثل الحواسيب الفائقة ومراكز البيانات تستهلك طاقة كثيرة؛ وتحتاج الحواسيب الفائقة الحديثة إلى عدة ميغاواط (مليون واط) للتشغيل والتبريد. ويقول قول قديم في مجتمع الحوسبة الفائقة إن "الميغاواط يكلّف مليون دولار"؛ وبعبارة أخرى، يكلّف الحفاظ على متطلب الطاقة لميغاواط واحد نحو مليون دولار سنويًا5. وتساعد المعالجة المحلية للبيانات في بيئات الحافة على تخفيف المسألة اللوجستية لنقل مجموعات البيانات الكبيرة، لكن البنية التحتية الحاسوبية في مثل هذه البيئات يجب أن تستخدم أقل طاقة ممكنة بالمثل2. وفي الوقت نفسه، فإن زيادة كفاءة الطاقة في الحواسيب الفائقة ومراكز البيانات الكبيرة أمر بالغ الأهمية5.
يوجد أيضًا اهتمام بإيجاد سبل لتقريب منظومتي HPC والحوسبة السحابية لإنشاء مجموعة مشتركة من الأطر والبنية التحتية والأدوات لتحليل البيانات على نطاق واسع. وفي السنوات الأخيرة، استخدم كثير من العلماء تقنيات وأدوات طوّرها باحثون في مجتمع الحوسبة السحابية لتحليل مجموعات بيانات HPC التقليدية، والعكس صحيح. وسيتيح تقريب هاتين المنظومتين البرمجيتين التلقيح المتبادل للأبحاث ويؤدي إلى تطوير نظام موحّد يمكّن المجتمعين من مواجهة الطوفان القادم من البيانات، وربما تقاسم الموارد. وترى مجموعة عمل Big Data Exascale Computing (BDEC) أنه بدلًا من النظر إلى HPC والحوسبة السحابية كنموذجين مختلفين جذريًا، ربما يكون من المفيد أكثر اعتبار الحوسبة السحابية مرحلة "ممكّنة رقميًا" من الحوسبة العلمية، تتولّد فيها مصادر البيانات بشكل متزايد عبر الإنترنت2. علاوة على ذلك، يلزم تقارب في الثقافة والتدريب والأدوات لدمج مجتمعي برمجيات وأبحاث HPC والحوسبة السحابية دمجًا كاملًا. وتقترح BDEC أيضًا نموذجًا تكون فيه الحواسيب الفائقة ومراكز البيانات "عقدًا" في شبكة ضخمة جدًا من الموارد الحاسوبية، تعمل جميعها بتناغم للتعامل مع تدفق البيانات من مصادر متعددة2. وتلخّص كل عقدة البيانات المتدفقة إليها بقوة، ولا تطلقها إلى عقدة موارد حسابية أكبر إلا عند الضرورة.
وبينما تبحث منظومتا الحوسبة السحابية وHPC عن التوحيد وتشددان أحزمتهما في وجه الطوفان المتزايد من البيانات، يفيض مستقبل الأنظمة الحاسوبية باحتمالات مثيرة. فالمجالات الجديدة مثل الذكاء الاصطناعي والحوسبة الكمومية تؤدي إلى إنشاء معماريات خاصة بالمجال (domain-specific architectures, DSAs) ودوائر متكاملة خاصة بالتطبيقات (ASICs) ستكون قادرة على التعامل مع سير عمل مخصص بكفاءة طاقة أعلى من قبل (انظر TPU6 كمثال). علاوة على ذلك، سيصبح أمن هذه المعماريات، الذي أهمله المجتمع طويلًا، أمرًا حاسمًا مع تزايد أهمية البيانات التي تحلّلها. وستؤدي المعماريات الجديدة أيضًا إلى لغات جديدة لبرمجتها، وربما حتى أنظمة تشغيل جديدة لإدارة واجهاتها المتنوعة. ولمعرفة المزيد عن الشكل المحتمل لمستقبل معمارية الحاسوب، نشجّع القراء على تصفّح هذه المقالة بقلم الفائزين بجائزة ACM Turing لعام 2017 وعملاقي معمارية الحاسوب، John Hennessy وDavid Patterson7.
المراجع:
- Armbrust et. al. "A view of cloud computing". CACM 53(4). 2010.
- Asch et. al. "Big data and extreme-scale computing: Pathways to Convergence-Toward a shaping strategy for a future software and data ecosystem for scientific inquiry". The International Journal of High Performance Computing Applications 32(4), 435–479. 2018.
- Dean and Ghemawat. "MapReduce: Simplified Data Processing on Large Clusters". USENIX. 2004.
- DataBricks. "Apache Spark". https://databricks.com/spark/about
- M. Halper. "Supercomputing’s Super Energy Needs, and What to Do About Them". CACM News: https://cacm.acm.org/news/192296-supercomputings-super-energy-needs-and-what-to-do-about-them/fulltext
- Jouppi et. al. "In-datacenter performance analysis of a tensor processing unit". 2017 ACM/IEEE 44th Annual International Symposium on Computer Architecture (ISCA), الصفحات 1-12. 2017.
- J. Hennessy and D. Patterson. "A New Golden Age for Computer Architecture". CACM 62(2), 48-60. 2019.
- D. A. Reed and J. Dongarra. "Exascale computing and big data". CACM 58(7), 56–68. 2015.