14. استغلال الذاكرة المشتركة في عصر تعدد الأنوية
تغيّر العالم.
أشعر به في السيليكا.
أشعر به في الترانزستور.
أراه في النواة.
~ مع الاعتذار إلى Galadriel (سيد الخواتم: رفقة الخاتم)
حتى الآن، ركّزت مناقشتنا للمعمارية على عالم أحادي المعالج خالص. لكن العالم تغيّر. فمعالجات اليوم تملك أنوية متعددة، أي وحدات حساب. ونناقش في هذا الفصل المعماريات متعددة الأنوية، وكيفية استغلالها لتسريع تنفيذ البرامج.
ملاحظة — المعالجات ووحدات المعالجة المركزية والأنوية
في مواضع كثيرة من هذا الفصل، يُستخدم المصطلحان معالج ووحدة معالجة مركزية بالتبادل. وعلى المستوى الأساسي، المعالج أي دائرة تجري بعض الحساب على بيانات خارجية. وبناءً على هذا التعريف، فإن وحدة المعالجة المركزية (CPU) مثال على معالج. ويُشار إلى معالج أو وحدة معالجة مركزية بعدة أنوية حسابية بـمعالج متعدد الأنوية أو وحدة معالجة مركزية متعددة الأنوية. أما النواة فوحدة حساب تحتوي كثيرًا من المكوّنات التي تتألف منها وحدة المعالجة المركزية الكلاسيكية: وحدة حساب ومنطق، وسجلات، وقليل من الذاكرة المؤقتة. ومع أن النواة تختلف عن المعالج، فليس غريبًا رؤية هذه المصطلحات مستخدمة بالتبادل في الأدبيات (خصوصًا إذا كانت الأدبيات قد نشأت في وقت كانت فيه المعالجات متعددة الأنوية ما زالت تُعدّ جديدة).
في عام 1965، قدّر مؤسس Intel، Gordon Moore، أن عدد الترانزستورات في الدارة المتكاملة سيتضاعف كل سنة. وقد نُقّح تنبؤه، المعروف الآن بـقانون Moore، لاحقًا ليصبح تضاعف عدد الترانزستورات كل سنتين. ومع أن المفاتيح الإلكترونية تطوّرت من ترانزستور Bardeen إلى ترانزستورات الشرائح الصغيرة المستخدمة حاليًا في الحواسيب الحديثة، ظل قانون Moore صحيحًا على مدى الخمسين سنة الماضية. لكن مطلع الألفية شهد اصطدام تصميم المعالجات بعدة جدران أداء حرجة:
- جدار الذاكرة: لم تواكب التحسينات في تقنية الذاكرة التحسينات في سرعة الساعة، فصارت الذاكرة عنق زجاجة للأداء. ونتيجة لذلك، لم يعد التسريع المستمر لتنفيذ وحدة المعالجة المركزية يحسّن أداء النظام الكلي.
- جدار الطاقة: تؤدي زيادة عدد الترانزستورات في المعالج بالضرورة إلى زيادة حرارته واستهلاكه للطاقة، ما يزيد بدوره الكلفة اللازمة لتغذية النظام وتبريده. ومع انتشار الأنظمة متعددة الأنوية، صارت الطاقة الشغل الشاغل المهيمن في تصميم أنظمة الحاسوب.
دفع جدارا الطاقة والذاكرة معماريي الحواسيب إلى تغيير طريقة تصميمهم للمعالجات. فبدلًا من إضافة مزيد من الترانزستورات لزيادة سرعة تنفيذ وحدة المعالجة المركزية لتدفق تعليمات واحد، بدأ المعماريون بإضافة عدة أنوية حسابية إلى وحدة المعالجة المركزية. والأنوية الحسابية وحدات معالجة مبسّطة تحتوي ترانزستورات أقل من وحدات المعالجة المركزية التقليدية وتكون عمومًا أسهل في الإنشاء. ويسمح دمج عدة أنوية في وحدة معالجة مركزية واحدة بتنفيذ عدة تدفقات مستقلة من التعليمات دفعة واحدة.
تحذير — أنوية أكثر لا تعني أفضل
قد يغريك افتراض أن جميع الأنوية متساوية وأن الحاسوب كلما زاد عدد أنويته كان أفضل. وهذا ليس صحيحًا بالضرورة! فمثلًا، تحتوي أنوية وحدة معالجة الرسوميات (graphics processing unit أو GPU) ترانزستورات أقل حتى من أنوية المعالج، وهي متخصصة في مهام معينة تتعلق بالمتجهات. وقد تملك وحدة معالجة رسوميات نموذجية 5,000 نواة GPU أو أكثر. لكن أنوية GPU محدودة في أنواع العمليات التي تستطيع تنفيذها، وليست مناسبة دائمًا للحوسبة عامة الغرض مثل نواة المعالج. وتُعرف الحوسبة باستخدام وحدات معالجة الرسوميات بـالحوسبة متعددة الأنوية بكثافة (manycore). ونركّز في هذا الفصل على الحوسبة متعددة الأنوية (multicore). انظر الفصل 15 لمناقشة الحوسبة متعددة الأنوية بكثافة.
نظرة أقرب: كم عدد الأنوية؟
تملك جميع أنظمة الحاسوب الحديثة تقريبًا أنوية متعددة، بما في ذلك الأجهزة الصغيرة مثل Raspberry Pi. وتحديد عدد الأنوية في النظام جوهري لقياس أداء البرامج متعددة الأنوية قياسًا دقيقًا. وفي حواسيب Linux وmacOS، يقدّم الأمر lscpu ملخصًا لمعمارية النظام. وفي المثال التالي، نعرض مخرجات الأمر lscpu عند تشغيله على آلة نموذجية (حُذفت بعض المخرجات لإبراز السمات الرئيسية):
$ lscpu

Architecture:          x86_64
CPU op-mode(s):        32-bit, 64-bit
Byte Order:            Little Endian
CPU(s):                8
On-line CPU(s) list:   0-7
Thread(s) per core:    2
Core(s) per socket:    4
Socket(s):             1
Model name:            Intel(R) Core(TM) i7-3770 CPU @ 3.40GHz
CPU MHz:               1607.562
CPU max MHz:           3900.0000
CPU min MHz:           1600.0000
L1d cache:             32K
L1i cache:             32K
L2 cache:              256K
L3 cache:              8192K
...
يقدّم الأمر lscpu كثيرًا من المعلومات المفيدة، منها نوع المعالجات وسرعة النواة وعدد الأنوية. ولحساب عدد الأنوية الفيزيائية (أو الفعلية) في نظام، اضرب عدد المقابس في عدد الأنوية لكل مقبس. وتُظهر مخرجات lscpu النموذجية أعلاه أن للنظام مقبسًا واحدًا فيه أربع أنوية لكل مقبس، أي أربع أنوية فيزيائية إجمالًا.
تعدد الخيوط الفائق
للوهلة الأولى، قد يبدو أن النظام في المثال السابق يملك ثمانية أنوية إجمالًا. فهذا ما يبدو أن حقل "CPU(s)" يعنيه. لكن ذلك الحقل يدل فعلًا على عدد الأنوية الفائقة الخيوط (المنطقية)، لا عدد الأنوية الفيزيائية. ويتيح تعدد الخيوط الفائق، أو تعدد الخيوط المتزامن (SMT)، المعالجة الكفؤة لخيوط متعددة على نواة واحدة. ومع أن تعدد الخيوط الفائق قد يقلل زمن التشغيل الكلي لبرنامج، فإن الأداء على الأنوية الفائقة الخيوط لا يتوسع بالمعدل نفسه الذي يتوسع به على الأنوية الفيزيائية. لكن إذا خملت مهمة ما (مثلًا بسبب خطر تحكم)، تستطيع مهمة أخرى استخدام النواة. وباختصار، أُدخل تعدد الخيوط الفائق لتحسين إنتاجية العمليات (التي تقيس عدد العمليات التي تكتمل في وحدة زمنية معينة) بدلًا من تسريع العملية (الذي يقيس مقدار التحسن في زمن تشغيل عملية فردية). وسيركّز كثير من مناقشتنا للأداء في الفصل القادم على التسريع.
أنوية الأداء وأنوية الكفاءة
في بعض المعماريات الأحدث (مثل معالجات Intel من الجيل الثاني عشر وما بعده)، يعطي ضرب عدد المقابس في أعداد الأنوية وخيوط العتاد عددًا مختلفًا (أصغر عادةً) من المعروض في حقل "CPU(s)". فما الذي يجري؟ تكمن الإجابة في المعماريات غير المتجانسة الجديدة التي تطوّرها شركات تصنيع الشرائح. فمثلًا، بدءًا من معالجاتها من الجيل الثاني عشر، قدّمت Intel معمارية تتألف من مزيج من أنوية «الأداء» (P-cores) وأنوية «الكفاءة» (E-cores). وهدف هذا التصميم الهجين تفويض المهام الخلفية الأصغر إلى أنوية E الأصغر قليلة الاستهلاك للطاقة، وتحرير أنوية P الأكبر كثيفة الاستهلاك للمهام الحسابية. ويقود مبدأ مشابه تصميم معمارية big.LITTLE المتنقلة الأسبق التي قدّمتها Arm. وفي المعماريات غير المتجانسة، تُظهر المخرجات الافتراضية لـ lscpu أنوية P المتاحة فقط؛ ويمكن عادةً حساب عدد أنوية E بطرح عدد أنوية P من إجمالي الأنوية المعروض في حقل "CPU(s)". واستدعاء الأمر lscpu بعلميه --all و--extended سيعرض خريطة كاملة لأنوية P وE في النظام، حيث يمكن تمييز نواة E بسرعات معالجها الأدنى.
أُنشئت معظم اللغات الشائعة التي يعرفها المبرمجون اليوم قبل عصر تعدد الأنوية. ونتيجة لذلك، لا تستطيع لغات كثيرة استخدام المعالجات متعددة الأنوية ضمنيًا (أو تلقائيًا) لتسريع تنفيذ البرنامج. بل يجب على المبرمجين كتابة برمجيات تحديدًا للاستفادة من الأنوية المتعددة في النظام.
14.1.1. أثر الأنظمة متعددة الأنوية في تنفيذ العمليات
تذكّر أن العملية يمكن التفكير فيها كتجريد لبرنامج عامل. وتنفّذ كل عملية في فضاء عنوانها الافتراضي الخاص. ويجدول نظام التشغيل العمليات للتنفيذ على المعالج؛ ويحدث تبديل السياق عندما يغيّر المعالج العملية التي ينفّذها حاليًا.
ويوضح الشكل 1 كيف يمكن لخمس عمليات نموذجية أن تنفّذ على معالج أحادي النواة.
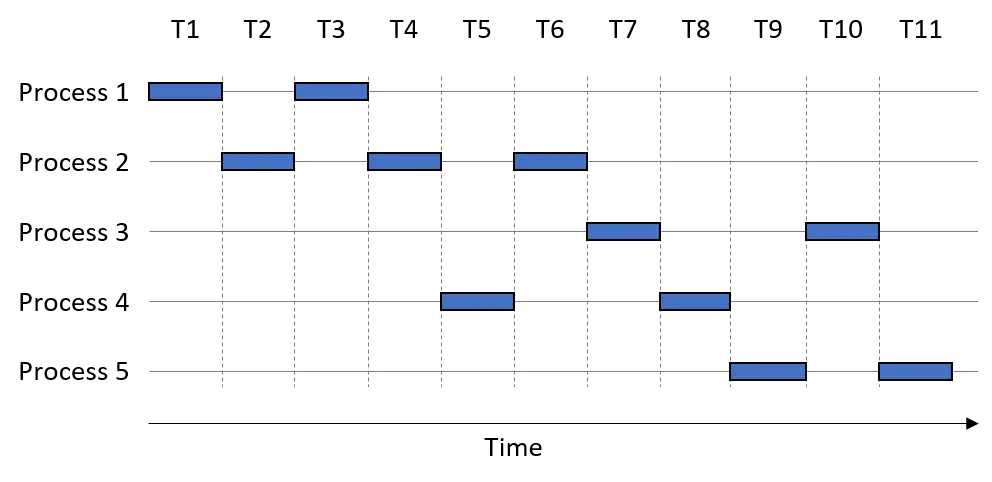 الشكل 1. تسلسل زمني للتنفيذ لخمس عمليات بينما تتشارك نواة معالجة مركزية واحدة
المحور الأفقي هو الزمن، وتستغرق كل شريحة زمنية وحدة زمن واحدة. ويمثّل المربع وقت استخدام العملية للمعالج أحادي النواة. لنفترض أن كل عملية تنفّذ شريحة زمنية كاملة قبل حدوث تبديل السياق. فعملية 1 تستخدم المعالج خلال الخطوتين الزمنيتين T1 وT3.
في هذا المثال، ترتيب تنفيذ العمليات هو P1، P2، P1، P2، P4، P2، P3، P4، P5، P3، P5. ونستغرق لحظة هنا للتمييز بين مقياسين للزمن. فـزمن المعالج (CPU time) يقيس مقدار الوقت الذي تستغرقه العملية في التنفيذ على المعالج. وفي المقابل، يقيس الزمن الحائطي (wall-clock time) مقدار الوقت الذي يتصور فيه الإنسان أن العملية استغرقته لتكتمل. وكثيرًا ما يكون الزمن الحائطي أطول بكثير من زمن المعالج بسبب تبديلات السياق. فمثلًا، يحتاج زمن المعالج لعملية 1 إلى وحدتي زمن، بينما زمنها الحائطي ثلاث وحدات زمن.
وعندما يتداخل زمن التنفيذ الكلي لعملية مع أخرى، تكون العمليات عاملة بالتزامن مع بعضها. وقد استخدمت أنظمة التشغيل التزامن في عصر النواة الواحدة لإعطاء وهم بأن الحاسوب يستطيع تنفيذ أشياء كثيرة دفعة واحدة (مثلًا، يمكن أن يكون لديك برنامج آلة حاسبة ومتصفح ويب ومستند معالجة نصوص مفتوحة كلها في الوقت نفسه). وفي الحقيقة، كل عملية تنفّذ تتابعيًا، ويحدد نظام التشغيل ترتيب تنفيذ العمليات واكتمالها (وهو ترتيب يختلف غالبًا في التشغيلات اللاحقة).
وبالعودة إلى المثال، لاحظ أن العملية 1 والعملية 2 تعملان بالتزامن مع بعضهما، لأن تنفيذهما يتداخل عند النقاط الزمنية T2-T4. وبالمثل، تعمل العملية 2 بالتزامن مع العملية 4، لأن تنفيذهما يتداخل عند النقاط T4-T6. وفي المقابل، لا تعمل العملية 2 بالتزامن مع العملية 3، لأنه لا تداخل بين تنفيذهما؛ فالعملية 3 تبدأ العمل فقط عند الزمن T7، بينما تكتمل العملية 2 عند الزمن T6.
وتتيح وحدة المعالجة المركزية متعددة الأنوية لنظام التشغيل جدولة عملية مختلفة لكل نواة متاحة، ما يتيح للعمليات التنفيذ في الوقت نفسه. ويُشار إلى التنفيذ المتزامن لتعليمات من عمليات تعمل على أنوية متعددة بـالتنفيذ المتوازي (parallel execution). ويعرض الشكل 2 كيف يمكن لعملياتنا المثال أن تنفّذ على نظام ثنائي الأنوية.
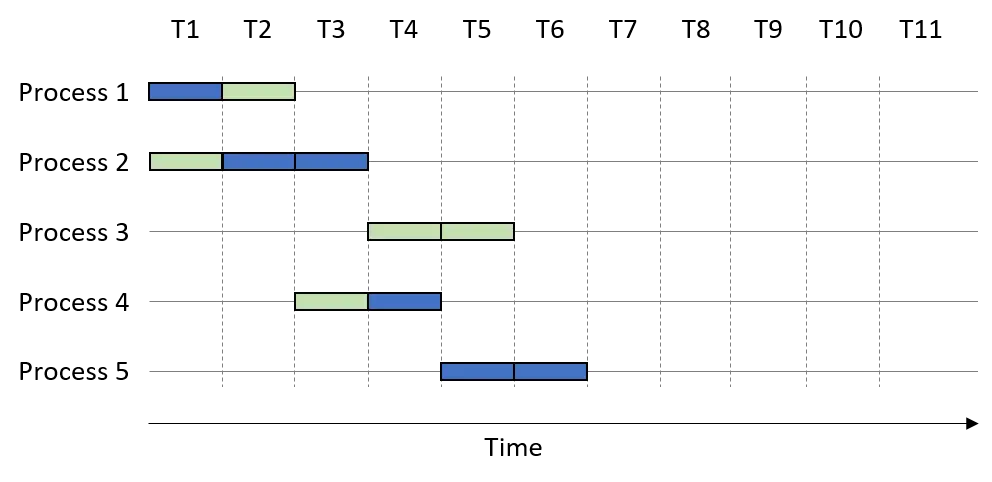 الشكل 2. تسلسل زمني للتنفيذ لخمس عمليات، ممتد ليشمل نواتَي معالجة مركزية (إحداهما باللون الأزرق الداكن والأخرى بالأخضر الفاتح).
في هذا المثال، تُلوَّن نواتا المعالج بلونين مختلفين. لنفترض أن ترتيب تنفيذ العمليات هو مرة أخرى P1، P2، P1، P2، P4، P2، P3، P4، P5، P3، P5. ويتيح وجود أنوية متعددة لبعض العمليات التنفيذ مبكرًا. فمثلًا، خلال الوحدة الزمنية T1، تنفّذ النواة الأولى العملية 1 بينما تنفّذ النواة الثانية العملية 2. وعند الزمن T2، تنفّذ النواة الأولى العملية 2 بينما تنفّذ الثانية العملية 1. وبذلك تكمل العملية 1 تنفيذها بعد الزمن T2، بينما تكمل العملية 2 تنفيذها عند الزمن T3.
لاحظ أن التنفيذ المتوازي لعمليات متعددة يزيد فقط عدد العمليات التي تنفّذ في أي لحظة. وفي الشكل 2، تكمل جميع العمليات التنفيذ بحلول الوحدة الزمنية T7. لكن كل عملية فردية ما زالت تحتاج المقدار نفسه من زمن المعالج لتكتمل كما يظهر في الشكل 1. فمثلًا، تحتاج العملية 2 ثلاث وحدات زمن سواء نُفّذت على نظام أحادي النواة أم متعدد الأنوية (أي أن زمن معالجها يبقى كما هو). ويزيد المعالج متعدد الأنوية إنتاجية تنفيذ العمليات، أي عدد العمليات التي يمكن أن تكتمل في فترة زمنية معينة. وبذلك، بينما يبقى زمن المعالج لعملية فردية دون تغيير، قد ينخفض زمنها الحائطي.
14.1.2. تعجيل تنفيذ العمليات بالخيوط
من طرق تسريع تنفيذ عملية واحدة تفكيكها إلى تدفقات تنفيذ مستقلة خفيفة تُسمى الخيوط (threads). ويعرض الشكل 3 كيف يتغير فضاء العنوان الافتراضي للعملية عندما تصبح متعددة الخيوط بخيطين. ومع أن لكل خيط تخصيصه الخاص لمساحة مكدّس النداء، فإن جميع الخيوط تتشارك بيانات البرنامج وتعليماته والكومة المخصصة للعملية متعددة الخيوط.
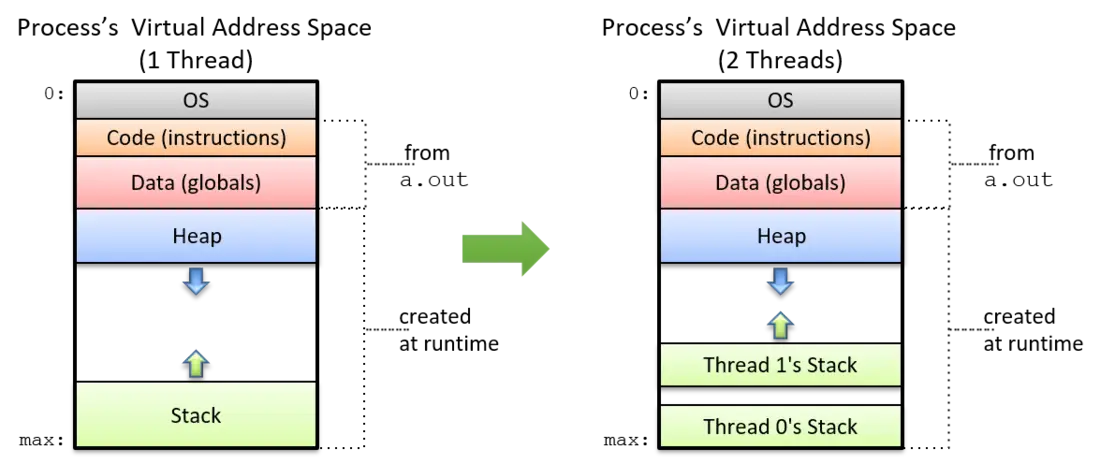 الشكل 3. مقارنة فضاء العنوان الافتراضي لعملية أحادية الخيط وعملية متعددة الخيوط بخيطين
ويجدول نظام التشغيل الخيوط بالطريقة نفسها التي يجدول بها العمليات. وعلى معالج متعدد الأنوية، يستطيع نظام التشغيل تسريع تنفيذ برنامج متعدد الخيوط بجدولة خيوطه المختلفة للعمل على أنوية منفصلة. ويساوي الحد الأقصى لعدد الخيوط التي يمكن أن تنفّذ على التوازي عدد الأنوية الفيزيائية في النظام. وإذا تجاوز عدد الخيوط عدد الأنوية الفيزيائية، وجب على الخيوط الباقية انتظار دورها للتنفيذ (على غرار طريقة تنفيذ العمليات على نواة واحدة).
مثال: الضرب القياسي
وكمثال أولي على كيفية استخدام تعدد الخيوط لتسريع تطبيق، فكّر في مسألة إجراء ضرب قياسي لمصفوفة array في عدد صحيح ما s. وفي الضرب القياسي، يُقاس كل عنصر في المصفوفة بضربه في s.
وتطبيق تتابعي لدالة الضرب القياسي كما يلي:
void scalar_multiply(int * array, long length, int s) {
    int i;
    for (i = 0; i < length; i++) {
      array[i] = array[i] * s;
    }
}
لنفترض أن array يحتوي N عنصرًا إجمالًا. ولإنشاء نسخة متعددة الخيوط من هذا التطبيق بـt من الخيوط، يلزم:
- إنشاء t خيوط.
- إسناد كل خيط مجموعة جزئية من مصفوفة الإدخال (أي N/t عنصرًا).
- تكليف كل خيط بضرب العناصر في مجموعته الجزئية من المصفوفة في
s.
لنفترض أن التطبيق التتابعي لـ scalar_multiply يستغرق 60 ثانية لضرب مصفوفة إدخال من 100 مليون عنصر. ولبناء نسخة تنفّذ بـt= 4 خيوط، نُسند إلى كل خيط ربع مصفوفة الإدخال الكلية (25 مليون عنصر).
ويعرض الشكل 4 ما يحدث عند تشغيل أربعة خيوط على نواة واحدة. وكما سبق، يُترك ترتيب التنفيذ لنظام التشغيل. وفي هذا السيناريو، افترض أن ترتيب تنفيذ الخيوط هو الخيط 1، الخيط 3، الخيط 2، الخيط 4. وعلى معالج أحادي النواة (تمثله المربعات)، ينفّذ كل خيط تتابعيًا. وبذلك، ستستغرق العملية متعددة الخيوط العاملة على نواة واحدة 60 ثانية أيضًا (وربما أطول قليلًا بسبب كلفة إنشاء الخيوط).
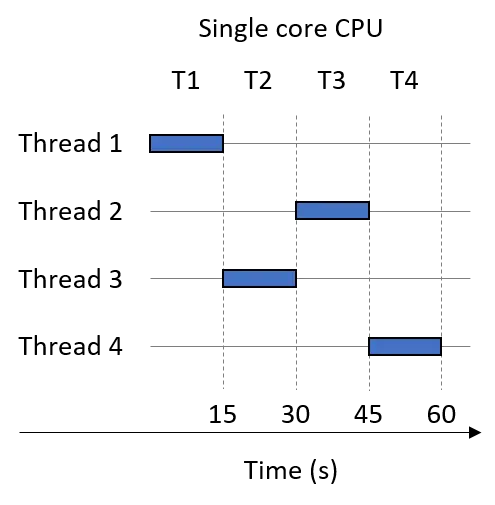 الشكل 4. تشغيل أربعة خيوط على معالج أحادي النواة
والآن لنفترض أننا نشغّل عمليتنا متعددة الخيوط على نظام ثنائي الأنوية. ويعرض الشكل 5 النتيجة. ومرة أخرى، افترض t = 4 خيوط، وأن ترتيب تنفيذ الخيوط هو الخيط 1، الخيط 3، الخيط 2، الخيط 4. ونواتانا تمثلهما مربعات مظللة. ولأن النظام ثنائي الأنوية، ينفّذ الخيطان 1 و3 على التوازي خلال الخطوة الزمنية T1. ثم ينفّذ الخيطان 2 و4 على التوازي خلال الخطوة الزمنية T2. وبذلك، صارت العملية متعددة الخيوط التي كانت تستغرق 60 ثانية تعمل في 30 ثانية.
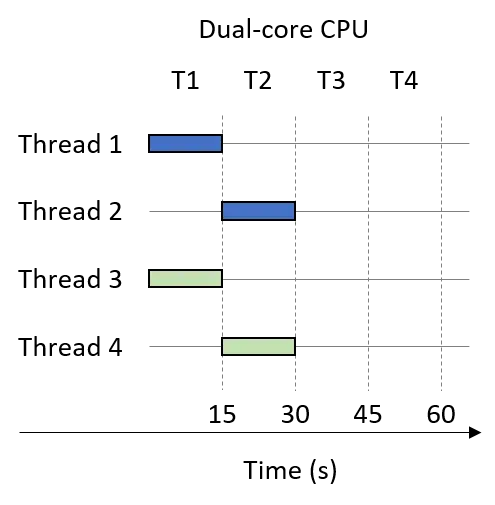 الشكل 5. تشغيل أربعة خيوط على معالج ثنائي النواة
وأخيرًا، لنفترض أن العملية متعددة الخيوط (t = 4) تُشغَّل على معالج رباعي الأنوية. ويعرض الشكل 6 أحد تسلسلات التنفيذ هذه. وتظلَّل كل نواة من الأنوية الأربع في الشكل 6 بلون مختلف. وعلى النظام رباعي الأنوية، ينفّذ كل خيط على التوازي خلال الشريحة الزمنية T1. وبذلك، على معالج رباعي الأنوية، صارت العملية متعددة الخيوط التي كانت تستغرق 60 ثانية تعمل في 15 ثانية.
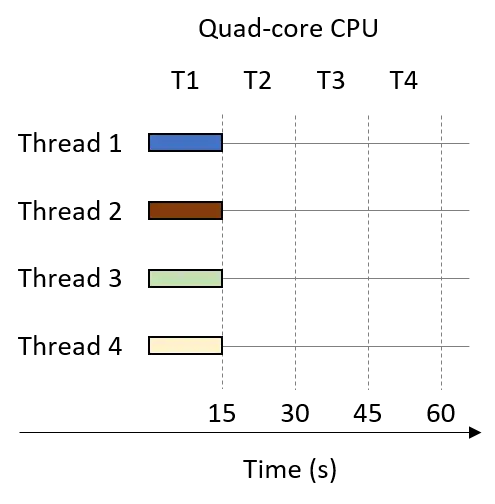 الشكل 6. تشغيل أربعة خيوط على معالج رباعي النواة
وبصفة عامة، إذا طابق عدد الخيوط عدد الأنوية (c) وجدول نظام التشغيل كل خيط للعمل على نواة منفصلة على التوازي، فمن المفترض أن تعمل العملية متعددة الخيوط في نحو 1/c من الزمن. وهذا التسريع الخطي مثالي، لكنه لا يُلاحظ كثيرًا في الواقع العملي. فمثلًا، إذا كانت هناك عمليات أخرى كثيرة (أو عمليات متعددة الخيوط) تنتظر استخدام المعالج، فستتنافس كلها على العدد المحدود من الأنوية، ما يؤدي إلى تنازع الموارد (resource contention) بين العمليات. وإذا تجاوز عدد الخيوط المحددة عدد أنوية المعالج، وجب على كل خيط انتظار دوره للعمل. وسنستكشف عوامل أخرى كثيرًا ما تمنع التسريع الخطي لاحقًا في هذا الفصل.
نفحص في هذا القسم مكتبة الخيوط الشائعة POSIX، أي Pthreads. وPOSIX اختصار لـ Portable Operating System Interface. وهو معيار من IEEE يحدد شكل أنظمة UNIX وسلوكها وإحساسها. وتتوافر واجهة برمجة خيوط POSIX على جميع أنظمة التشغيل الشبيهة بـ UNIX تقريبًا، وكل منها يستوفي المعيار بكامله أو بدرجة كبيرة. لذلك، إذا كتبت شيفرة متوازية باستخدام خيوط POSIX على آلة Linux، فستعمل بالتأكيد على آلات Linux أخرى، ويُرجَّح أن تعمل على آلات تشغّل macOS أو متغيرات UNIX أخرى.
لنبدأ بتحليل برنامج Pthreads نموذجي لـ«Hello World» (hellothreads.c). وللإيجاز، استبعدنا معالجة الأخطاء من القائمة، مع أن النسخة القابلة للتنزيل تحتوي معالجة أخطاء نموذجية.
#include <stdio.h>
#include <stdlib.h>
#include <pthread.h>

/* The "thread function" passed to pthread_create.  Each thread executes this
 * function and terminates when it returns from this function. */
void *HelloWorld(void *id) {

    /* We know the argument is a pointer to a long, so we cast it from a
     * generic (void *) to a (long *). */
    long *myid = (long *) id;

    printf("Hello world! I am thread %ld\n", *myid);

    return NULL; // We don't need our threads to return anything.
}

int main(int argc, char **argv) {
    int i;
    int nthreads; //number of threads
    pthread_t *thread_array; //pointer to future thread array
    long *thread_ids;

    // Read the number of threads to create from the command line.
    if (argc !=2) {
        fprintf(stderr, "usage: %s <n>\n", argv[0]);
        fprintf(stderr, "where <n> is the number of threads\n");
        return 1;
    }
    nthreads = strtol(argv[1], NULL, 10);

    // Allocate space for thread structs and identifiers.
    thread_array = malloc(nthreads * sizeof(pthread_t));
    thread_ids = malloc(nthreads * sizeof(long));

    // Assign each thread an ID and create all the threads.
    for (i = 0; i < nthreads; i++) {
        thread_ids[i] = i;
        pthread_create(&thread_array[i], NULL, HelloWorld, &thread_ids[i]);
    }

    /* Join all the threads. Main will pause in this loop until all threads
     * have returned from the thread function. */
    for (i = 0; i < nthreads; i++) {
        pthread_join(thread_array[i], NULL);
    }

    free(thread_array);
    free(thread_ids);

    return 0;
}
لنفحص هذا البرنامج في مكوّنات أصغر.
- لاحظ تضمين ملف الترويسة
pthread.hالذي يعرّف أنواعpthreadودوالها. - بعد ذلك، تعرّف الدالة
HelloWorldدالة الخيط التي نمرّرها لاحقًا إلىpthread_create. ودالة الخيط مماثلة لدالةmainبالنسبة إلى خيط عامل (منشأ) — فيبدأ الخيط تنفيذه عند بداية دالة خيطه وينتهي عند وصوله إلى نهايتها. وينفّذ كل خيط دالة الخيط باستخدام حالة تنفيذه الخاصة (أي ذاكرة مكدّسه وقيم سجلاته الخاصة). لاحظ أيضًا أن دالة الخيط من النوعvoid*. وتحديد مؤشر مجهول في هذا السياق يتيح للمبرمجين كتابة دوال خيوط تتعامل مع وسائط وقيم إرجاع من أنواع مختلفة. - وأخيرًا، في الدالة
main، يهيّئ الخيط الرئيسي حالة البرنامج قبل إنشاء خيوط العمل وضمّها.
14.2.1. إنشاء الخيوط وضمّها
يبدأ البرنامج أولًا كعملية أحادية الخيط. وأثناء تنفيذه الدالة main، يقرأ عدد الخيوط المراد إنشاؤها، ويخصص ذاكرة لمصفوفتين: thread_array وthread_ids. وتحتوي المصفوفة thread_array مجموعة عناوين كل خيط مُنشأ. وتخزّن المصفوفة thread_ids مجموعة الوسائط التي تُمرَّر إلى كل خيط. وفي هذا المثال، يُمرَّر إلى كل خيط عنوان رتبته (أو معرّفه، الممثَّل بـ thread_ids[i]).
وبعد تخصيص جميع المتغيرات الأولية وتهيئتها، ينفّذ الخيط الرئيسي خطوتي تعدد الخيوط الرئيستين:
- خطوة الإنشاء، وفيها يولّد الخيط الرئيسي خيط عمل واحدًا أو أكثر. وبعد توليده، يعمل كل خيط عمل داخل سياق تنفيذه الخاص بالتزامن مع الخيوط والعمليات الأخرى في النظام.
- خطوة الضم (join)، وفيها ينتظر الخيط الرئيسي اكتمال جميع خيوط العمل قبل المتابعة كعملية أحادية الخيط. وضم خيط انتهى يحرّر سياق تنفيذ الخيط وموارده. ومحاولة ضم خيط لم ينتهِ تحجب المستدعي حتى ينتهي الخيط، على غرار دلالات دالة wait للعمليات.
وتوفّر مكتبة Pthreads دالة pthread_create لإنشاء الخيوط ودالة pthread_join لضمّها. وتوقيع الدالة pthread_create كما يلي:
pthread_create(pthread_t *thread, const pthread_attr_t *attr,
               void *(*thread_function)(void *), void *thread_args)
وتأخذ الدالة مؤشرًا إلى بنية خيط (من النوع pthread_t)، ومؤشرًا إلى بنية سمات (تُضبط عادةً على NULL)، واسم الدالة التي ينبغي أن ينفّذها الخيط، ومصفوفة الوسائط التي ستُمرَّر إلى دالة الخيط عند بدئه.
ويستدعي برنامج Hello World الدالة pthread_create في الدالة main بالشكل:
pthread_create(&thread_array[i], NULL, HelloWorld, &thread_ids[i]);
وهنا:
- يحتوي
&thread_array[i]عنوان الخيط i. وتخصص الدالةpthread_createكائن خيطpthread_tوتخزّن عنوانه في هذا الموقع، ما يتيح للمبرمج الإشارة إلى الخيط لاحقًا (مثلًا عند ضمّه). - يحدد
NULLأنه ينبغي إنشاء الخيط بسمات افتراضية. وفي معظم البرامج، من الآمن ترك هذا المُعامِل الثانيNULL. - يسمّي
HelloWorldدالة الخيط التي ينبغي أن ينفّذها الخيط المنشأ. وتتصرف هذه الدالة مثل دالة «main» للخيط. وبالنسبة إلى دالة خيط اعتباطية (مثلfunction)، يجب أن يطابق نموذجها الشكلvoid * function(void *). - يحدد
&thread_ids[i]عنوان الوسائط التي ستُمرَّر إلى الخيط i. وفي هذه الحالة، يحتويthread_ids[i]عددًا واحدًا من النوعlongيمثل معرّف الخيط. ولأن المُعامِل الأخير لـpthread_createيجب أن يكون مؤشرًا، نمرّر عنوان معرّف الخيط.
ولتوليد عدة خيوط تنفّذ دالة الخيط HelloWorld، يُسند البرنامج إلى كل خيط معرّفًا فريدًا وينشئ كل خيط داخل حلقة for:
for (i = 0; i < nthreads; i++) {
    thread_ids[i] = i;
    pthread_create(&thread_array[i], NULL, HelloWorld, &thread_ids[i]);
}
ويجدول نظام التشغيل تنفيذ كل خيط مُنشأ؛ ولا يستطيع المستخدم افتراض أي شيء عن ترتيب تنفيذ الخيوط.
وتوقف دالة pthread_join تنفيذ مستدعيها حتى ينتهي الخيط الذي تشير إليه. وتوقيعها:
pthread_join(pthread_t thread, void **return_val)
تأخذ pthread_join مدخلًا بنية pthread_t تدل على الخيط الذي ستنتظره، ومُعامِل مؤشر اختياريًا يحدد أين تُخزَّن قيمة إرجاع الخيط.
ويستدعي برنامج Hello World الدالة pthread_join في main بالشكل:
pthread_join(thread_array[t], NULL);
يدل هذا السطر على أن على الخيط الرئيسي انتظار انتهاء الخيط t. وتمرير NULL مُعامِلًا ثانيًا يدل على أن البرنامج لا يستخدم قيمة إرجاع الخيط.
وفي البرنامج السابق، يستدعي main الدالة pthread_join في حلقة لأن جميع خيوط العمل تحتاج إلى الانتهاء قبل أن تتابع الدالة main تنظيف الذاكرة وإنهاء العملية:
for (i = 0; i < nthreads; i++) {
    pthread_join(thread_array[i], NULL);
}
14.2.2. دالة الخيط
في البرنامج السابق، يطبع كل خيط مُنشأ Hello world! I am thread n، حيث n معرّف الخيط الفريد. وبعد أن يطبع الخيط رسالته، ينتهي. لنلقِ نظرة أقرب على الدالة HelloWorld:
void *HelloWorld(void *id) {
    long *myid = (long*)id;

    printf("Hello world! I am thread %ld\n", *myid);

    return NULL;
}
تذكّر أن pthread_create تمرّر الوسائط إلى دالة الخيط عبر المُعامِل thread_args. وفي الدالة pthread_create في main، حدد برنامج Hello World أن هذا المُعامِل هو في الواقع معرّف الخيط. لاحظ أن المُعامِل في HelloWorld يجب أن يُعلَن كمؤشر عام أو مؤشر مجهول (void *). وتستخدم مكتبة Pthreads void * لجعل pthread_create أكثر عمومية بعدم فرض نوع مُعامِل. وبالنسبة إلى المبرمج، يكون void * غير مريح قليلًا لأنه يجب إعادة صبه قبل استخدامه. وهنا نعرف أن المُعامِل من النوع long * لأن ذلك ما مرّرناه إلى pthread_create في main. ولذلك يمكننا صب القيمة بأمان كـ long * وإلغاء الإشارة عن المؤشر للوصول إلى قيمة long. وتتبع برامج متوازية كثيرة هذه البنية.
وعلى غرار مُعامِل دالة الخيط، تتجنّب مكتبة Pthreads فرض نوع إرجاع دالة الخيط بتحديد void * آخر — فالمبرمج حر في إعادة أي مؤشر من دالة الخيط. وإذا احتاج البرنامج إلى الوصول إلى قيمة إرجاع الخيط، فيمكنه استرجاعها عبر المُعامِل الثاني لـ pthread_join. وفي مثالنا، لا حاجة للخيط إلى إعادة قيمة، فيعيد ببساطة مؤشر NULL.
14.2.3. تشغيل الشيفرة
يوضح الأمر التالي كيفية استخدام GCC لتصريف hellothreads.c. ويتطلب بناء تطبيق Pthreads تمرير علم الربط -pthread إلى GCC لضمان إتاحة دوال Pthreads وأنواعها:
$ gcc -o hellothreads hellothreads.c -pthread
وينتج عن تشغيل البرنامج من دون وسيطة سطر أوامر رسالة استخدام:
$ ./hellothreads
usage: ./hellothreads <n>
where <n> is the number of threads
وينتج عن تشغيل البرنامج بأربعة خيوط المخرجات التالية:
$ ./hellothreads 4
Hello world! I am thread 1
Hello world! I am thread 2
Hello world! I am thread 3
Hello world! I am thread 0
لاحظ أن كل خيط يطبع رقم معرّفه الفريد. وفي هذا التشغيل، تظهر مخرجات الخيط 1 أولًا، ثم الخيوط 2 و3 و0. وإذا شغّلنا البرنامج مرة أخرى، فقد نرى المخرجات معروضة بترتيب مختلف:
$ ./hellothreads 4
Hello world! I am thread 0
Hello world! I am thread 1
Hello world! I am thread 2
Hello world! I am thread 3
تذكّر أن مجدول نظام التشغيل هو الذي يحدد ترتيب تنفيذ الخيوط. ومن منظور المستخدم، الترتيب عشوائي فعليًا لأنه يتأثر بعوامل كثيرة تتفاوت خارج سيطرته (مثل موارد النظام المتاحة، أو تلقّي النظام مدخلات، أو جدولة نظام التشغيل). ولأن جميع الخيوط تعمل بالتزامن مع بعضها وكل خيط ينفّذ نداءً إلى printf (التي تطبع إلى stdout)، فإن أول خيط يطبع إلى stdout ستظهر مخرجاته أولًا. وقد تؤدي التشغيلات اللاحقة (أو لا تؤدي) إلى مخرجات مختلفة.
تحذير — ترتيب تنفيذ الخيوط
ينبغي ألا تفترض أبدًا أي شيء عن ترتيب تنفيذ الخيوط. وإذا كانت صحة برنامجك تتطلب عمل الخيوط بترتيب معين، فيجب أن تضيف تزامنًا إلى برنامجك لمنع الخيوط من العمل عندما لا ينبغي لها ذلك.
14.2.4. إعادة النظر في الضرب القياسي
لنستكشف كيفية إنشاء تطبيق متعدد الخيوط لبرنامج الضرب القياسي من القسم السابق. تذكّر أن استراتيجيتنا العامة لجعل scalar_multiply متوازية هي:
- إنشاء خيوط متعددة،
- إسناد كل خيط مجموعة جزئية من مصفوفة الإدخال،
- تكليف كل خيط بضرب العناصر في مجموعته الجزئية من المصفوفة في
s.
وفيما يلي دالة خيط تنجز هذه المهمة. لاحظ أننا نقلنا array وlength وs إلى النطاق العام للبرنامج.
long *array; //allocated in main
long length; //set in main (1 billion)
long nthreads; //number of threads
long s; //scalar

void *scalar_multiply(void *id) {
    long *myid = (long *) id;
    int i;

    //assign each thread its own chunk of elements to process
    long chunk = length / nthreads;
    long start = *myid * chunk;
    long end  = start + chunk;
    if (*myid == nthreads - 1) {
        end = length;
    }

    //perform scalar multiplication on assigned chunk
    for (i = start; i < end; i++) {
        array[i] *= s;
    }

    return NULL;
}
لنفصّل ذلك إلى أجزاء. تذكّر أن الخطوة الأولى هي إسناد مكوّن من المصفوفة إلى كل خيط. وتنجز الأسطر التالية هذه المهمة:
long chunk = length / nthreads;
long start = *myid * chunk;
long end  = start + chunk;
يخزّن المتغير chunk عدد العناصر المسندة إلى كل خيط. ولضمان حصول كل خيط على كمية عمل متقاربة تقريبًا، نضبط حجم القطعة أولًا على عدد العناصر مقسومًا على عدد الخيوط، أو length / nthreads.
بعد ذلك، نُسند إلى كل خيط مجالًا مميزًا من العناصر لمعالجته. ويحسب كل خيط فهرسي start وend لمجاله باستخدام حجم chunk ومعرّف خيطه الفريد.
فمثلًا، مع أربعة خيوط (بمعرّفات 0-3) تعمل على مصفوفة من 100 مليون عنصر، يكون كل خيط مسؤولًا عن معالجة chunk من 25 مليون عنصر. وإدراج معرّف الخيط يُسند إلى كل خيط مجموعة جزئية فريدة من الإدخال.
ويعالج السطران التاليان حالة عدم قابلية length للقسمة على عدد الخيوط بالتساوي:
if (*myid == nthreads - 1) {
    end = length;
}
لنفترض أننا حددنا ثلاثة خيوط بدلًا من أربعة. سيكون حجم القطعة الاسمي 33,333,333 عنصرًا، فيتبقى عنصر واحد غير محسوب. وستسند الشيفرة في المثال السابق العنصر المتبقي إلى الخيط الأخير.
ملاحظة — إنشاء إدخال متوازن
شيفرة التقطيع المعروضة للتو غير مثالية. فعندما لا يقسم عدد الخيوط الإدخال بالتساوي، يُسند الباقي إلى الخيط الأخير. فكّر في تشغيل نموذجي تكون فيه المصفوفة من 100 عنصر ويُحدَّد 12 خيطًا. سيكون حجم القطعة الاسمي 8 والباقي 4. ومع شيفرة المثال، سيكون لكل من الخيوط الأحد عشر الأولى 8 عناصر مسندة، بينما يُسند إلى الخيط الأخير 12 عنصرًا. ونتيجة لذلك، ينفّذ الخيط الأخير عملًا أكثر بنسبة 50% من الخيوط الأخرى. وربما تكون الطريقة الأفضل لتقطيع هذا المثال أن يعالج كل من الخيوط الأربعة الأولى 9 عناصر، بينما يعالج كل من الخيوط الثمانية الأخيرة 8 عناصر. وسينتج عن ذلك موازنة حمل (load balancing) أفضل للإدخال بين الخيوط.
وبعد حساب فهرسي start وend المحليين المناسبين، يصبح كل خيط جاهزًا لإجراء الضرب القياسي على مكوّنه من المصفوفة. وينجز الجزء الأخير من دالة scalar_multiply ذلك:
for (i = start; i < end; i++) {
    array[i] *= s;
}
14.2.5. تحسين الضرب القياسي: وسائط متعددة
من أوجه الضعف الرئيسية في التطبيق السابق الاستخدام الواسع للمتغيرات العامة. وقد أظهرت مناقشتنا الأصلية لـالمتغيرات العامة أنه مع فائدتها، ينبغي تجنّب المتغيرات العامة عمومًا في C. ولتقليل عدد المتغيرات العامة في البرنامج، يتمثل أحد الحلول في تعريف بنية t_arg كما يلي في النطاق العام:
struct t_arg {
    int *array; // pointer to shared array
    long length; // num elements in array
    long s; //scaling factor
    long numthreads; // total number of threads
    long id; //  logical thread id
};
وستخصص دالتنا main، إضافةً إلى تخصيص array وضبط المتغيرات المحلية length وnthreads وs (عامل القياس لدينا)، مصفوفة من سجلات t_arg:
long nthreads = strtol(argv[1], NULL, 10); //get number of threads
long length = strtol(argv[2], NULL, 10); //get length of array
long s = strtol( argv[3], NULL, 10 ); //get scaling factor

int *array = malloc(length*sizeof(int));

//allocate space for thread structs and identifiers
pthread_t *thread_array = malloc(nthreads * sizeof(pthread_t));
struct t_arg *thread_args = malloc(nthreads * sizeof(struct t_arg));

//Populate thread arguments for all the threads
for (i = 0; i < nthreads; i++){
    thread_args[i].array = array;
    thread_args[i].length = length;
    thread_args[i].s = s;
    thread_args[i].numthreads = nthreads;
    thread_args[i].id = i;
}
لاحقًا في main، عند استدعاء pthread_create، تُمرَّر بنية t_args المرتبطة بالخيط كوسيطة:
for (i = 0; i < nthreads; i++){
    pthread_create(&thread_array[i], NULL, scalar_multiply, &thread_args[i]);
}
وأخيرًا، ستبدو دالتنا scalar_multiply كما يلي:
void * scalar_multiply(void* args) {
    //cast to a struct t_arg from void*
    struct t_arg * myargs = (struct t_arg *) args;

    //extract all variables from struct
    long myid =  myargs->id;
    long length = myargs->length;
    long s = myargs->s;
    long nthreads = myargs->numthreads;
    int * ap = myargs->array; //pointer to array in main

    //code as before
    long chunk = length/nthreads;
    long start = myid * chunk;
    long end  = start + chunk;
    if (myid == nthreads-1) {
        end = length;
    }

    int i;
    for (i = start; i < end; i++) {
        ap[i] *= s;
    }

    return NULL;
}
وتنفيذ هذا البرنامج تنفيذًا كاملًا تمرين نتركه للقارئ. يرجى ملاحظة أن معالجة الأخطاء حُذفت للإيجاز.
في الأمثلة التي نظرنا إليها حتى الآن، ينفّذ كل خيط من دون تشارك بيانات مع أي خيوط أخرى. وفي برنامج الضرب القياسي، مثلًا، يكون كل عنصر في المصفوفة مستقلًا تمامًا عن جميع العناصر الأخرى، فلا حاجة إلى تشارك الخيوط بيانات.
غير أن قدرة الخيط على تشارك البيانات مع الخيوط الأخرى بسهولة من سماته الرئيسية. تذكّر أن جميع خيوط العملية متعددة الخيوط تتشارك الكومة المشتركة للعملية. وفي هذا القسم، ندرس آليات تشارك البيانات والحماية المتاحة للخيوط بالتفصيل.
يشير تزامن الخيوط (thread synchronization) إلى إجبار الخيوط على التنفيذ بترتيب معين. ومع أن تزامن الخيوط قد يضيف إلى زمن تشغيل البرنامج، فإنه ضروري غالبًا لضمان صحة البرنامج. ونناقش في هذا القسم أساسًا كيف تساعد بنية تزامن واحدة (وهي قفل التبادل المتبادل) في ضمان صحة برنامج ذي خيوط. ونختم القسم بمناقشة بعض بنى التزامن الشائعة الأخرى: السيمافورات والحواجز ومتغيرات الشرط.
CountSort
لندرس مثالًا أعقد قليلًا يُسمى CountSort. وخوارزمية CountSort خوارزمية ترتيب خطية بسيطة (O(N)) لترتيب مجال صغير معروف من R قيمة، حيث R أصغر بكثير من N. ولتوضيح كيفية عمل CountSort، فكّر في مصفوفة A من 15 عنصرًا، تحتوي جميعها قيمًا عشوائية بين 0 و9 (10 قيم ممكنة):
A = [9, 0, 2, 7, 9, 0, 1, 4, 2, 2, 4, 5, 0, 9, 1]
وبالنسبة إلى مصفوفة معينة، يعمل CountSort كما يلي:
- يحصي تكرار كل قيمة في المصفوفة.
- يكتب فوق المصفوفة الأصلية بذكر كل قيمة بحسب تكرارها.
وبعد الخطوة 1، يُوضع تكرار كل قيمة في مصفوفة counts بطول 10، حيث قيمة counts[i] هي تكرار القيمة i في المصفوفة A. فمثلًا، بما أن هناك ثلاثة عناصر قيمتها 2 في المصفوفة A، فإن counts[2] تساوي 3.
وتبدو مصفوفة counts المقابلة للمثال السابق كما يلي:
counts = [3, 2, 3, 0, 2, 1, 0, 1, 0, 3]
لاحظ أن مجموع جميع عناصر مصفوفة counts يساوي طول A، أي 15.
وتستخدم الخطوة 2 مصفوفة counts للكتابة فوق A، مستخدمةً أعداد التكرار لتحديد مجموعة الفهارس في A التي تخزّن كل قيمة متعاقبة بترتيب مفروز. ولأن مصفوفة counts تدل على وجود ثلاثة عناصر قيمتها 0 وعنصرين قيمتهما 1 في المصفوفة A، ستكون العناصر الثلاثة الأولى من المصفوفة النهائية 0، والعنصران التاليان 1.
وبعد تشغيل الخطوة 2، تبدو المصفوفة النهائية كما يلي:
A = [0, 0, 0, 1, 1, 2, 2, 2, 4, 4, 5, 7, 9, 9, 9]
وفيما يلي تطبيق تتابعي لخوارزمية CountSort، مع تمييز دالتي count (الخطوة 1) وoverwrite (الخطوة 2) بوضوح. وللإيجاز، لا نعيد إدراج البرنامج كاملًا هنا، لكن يمكنك تنزيل الشيفرة المصدرية (countSort.c).
#define MAX 10 //the maximum value of an element. (10 means 0-9)

/*step 1:
 * compute the frequency of all the elements in the input array and store
 * the associated counts of each element in array counts. The elements in the
 * counts array are initialized to zero prior to the call to this function.
*/
void countElems(int *counts, int *array_A, long length) {
    int val, i;
    for (i = 0; i < length; i++) {
      val = array_A[i]; //read the value at index i
      counts[val] = counts[val] + 1; //update corresponding location in counts
    }
}

/* step 2:
 * overwrite the input array (array_A) using the frequencies stored in the
 *  array counts
*/
void writeArray(int *counts, int *array_A) {
    int i, j = 0, amt;

    for (i = 0; i < MAX; i++) { //iterate over the counts array
        amt = counts[i]; //capture frequency of element i
        while (amt > 0) { //while all values aren't written
            array_A[j] = i; //replace value at index j of array_A with i
            j++; //go to next position in array_A
            amt--; //decrease the amount written by 1
        }
    }
}

/* main function:
 * gets array length from command line args, allocates a random array of that
 * size, allocates the counts array, the executes step 1 of the CountSort
 * algorithm (countsElem) followed by step 2 (writeArray).
*/
int main( int argc, char **argv ) {
    //code ommitted for brevity -- download source to view full file

    srand(10); //use of static seed ensures the output is the same every run

    long length = strtol( argv[1], NULL, 10 );
    int verbose = atoi(argv[2]);

    //generate random array of elements of specified length
    int *array = malloc(length * sizeof(int));
    genRandomArray(array, length);

    //print unsorted array (commented out)
    //printArray(array, length);

    //allocate counts array and initializes all elements to zero.
    int counts[MAX] = {0};

    countElems(counts, array, length); //calls step 1
    writeArray(counts, array); //calls step2

    //print sorted array (commented out)
    //printArray(array, length);

    free(array); //free memory

    return 0;
}
وينتج عن تشغيل هذا البرنامج على مصفوفة بحجم 15 المخرجات التالية:
$ ./countSort 15 1
array before sort:
5 8 8 5 8 7 5 1 7 7 3 3 8 3 4
result after sort:
1 3 3 3 4 5 5 5 7 7 7 8 8 8 8
والمُعامِل الثاني لهذا البرنامج هو علم الإسهاب (verbose) الذي يدل على ما إذا كان البرنامج يطبع مخرجات. وهذا خيار مفيد للمصفوفات الأكبر التي قد نريد تشغيل البرنامج عليها من دون بالضرورة طباعة المخرجات.
جعل countElems متوازية: محاولة أولية
يتألف CountSort من خطوتين رئيسيتين، تستفيد كل منهما من جعلها متوازية. وفي ما تبقى من الفصل، نركّز أساسًا على جعل الخطوة 1، أي الدالة countElems، متوازية. وتُترك موازاة الدالة writeArray تمرينًا للقارئ.
ويوضح مقطع الشيفرة التالي محاولة أولى لإنشاء دالة countElems بخيوط. وقد حُذفت أجزاء من الشيفرة (تحليل الوسائط ومعالجة الأخطاء) في هذا المثال للإيجاز، لكن الشيفرة المصدرية الكاملة يمكن تنزيلها من هنا (countElems_p.c). وفي الشيفرة التالية، يحاول كل خيط إحصاء تكرار عناصر المصفوفة في مكوّنه المسند من المصفوفة العامة ويحدّث مصفوفة عدّ عامة بالأعداد المكتشفة:
/*parallel version of step 1 (first cut) of CountSort algorithm:
 * extracts arguments from args value
 * calculates the portion of the array that thread is responsible for counting
 * computes the frequency of all the elements in assigned component and stores
 * the associated counts of each element in counts array
*/
void *countElems( void *args ) {
    struct t_arg * myargs = (struct t_arg *)args;
    //extract arguments (omitted for brevity)
    int *array = myargs->ap;
    long *counts = myargs->countp;
    //... (get nthreads, length, myid)

    //assign work to the thread
    long chunk = length / nthreads; //nominal chunk size
    long start = myid * chunk;
    long end = (myid + 1) * chunk;
    long val;
    if (myid == nthreads-1) {
        end = length;
    }

    long i;
    //heart of the program
    for (i = start; i < end; i++) {
        val = array[i];
        counts[val] = counts[val] + 1;
    }

    return NULL;
}
وتبدو الدالة main شبه مطابقة لبرامجنا النموذجية السابقة:
int main(int argc, char **argv) {

    if (argc != 4) {
        //print out usage info (ommitted for brevity)
        return 1;
    }

    srand(10); //static seed to assist in correctness check

    //parse command line arguments
    long t;
    long length = strtol(argv[1], NULL, 10);
    int verbose = atoi(argv[2]);
    long nthreads = strtol(argv[3], NULL, 10);

    //generate random array of elements of specified length
    int *array = malloc(length * sizeof(int));
    genRandomArray(array, length);

    //specify counts array and initialize all elements to zero
    long counts[MAX] = {0};

    //allocate threads and args array
    pthread_t *thread_array; //pointer to future thread array
    thread_array = malloc(nthreads * sizeof(pthread_t)); //allocate the array
    struct t_arg *thread_args = malloc( nthreads * sizeof(struct t_arg) );

    //fill thread array with parameters
    for (t = 0; t < nthreads; t++) {
        //ommitted for brevity...
    }

    for (t = 0; t < nthreads; t++) {
        pthread_create(&thread_array[t], NULL, countElems, &thread_args[t]);
    }

    for (t = 0; t < nthreads; t++) {
        pthread_join(thread_array[t], NULL);
    }

    free(thread_array);
    free(array);

    if (verbose) {
        printf("Counts array:\n");
        printCounts(counts);
    }
    return 0;
}
ولأغراض قابلية إعادة الإنتاج، تُهيَّأ مولّد الأعداد العشوائية بقيمة ساكنة (10) لضمان احتواء array (وبالتالي counts) دائمًا المجموعة نفسها من الأعداد. وتطبع دالة إضافية (printCounts) محتويات مصفوفة counts العامة. والتوقع أن تظل محتويات مصفوفة counts هي نفسها دائمًا، أيًا كان عدد الخيوط المستخدم. وللإيجاز، أُزيلت معالجة الأخطاء من القائمة.
وينتج عن تصريف البرنامج وتشغيله بخيط واحد وخيطين وأربعة خيوط على 10 ملايين عنصر ما يلي:
$ gcc -o countElems_p countElems_p.c -pthread

$./countElems_p 10000000 1 1
Counts array:
999170 1001044 999908 1000431 999998 1001479 999709 997250 1000804 1000207

$./countElems_p 10000000 1 2
Counts array:
661756 661977 657828 658479 657913 659308 658561 656879 658070 657276

$./countElems_p 10000000 1 4
Counts array:
579846 580814 580122 579772 582509 582713 582518 580917 581963 581094
لاحظ أن النتائج المطبوعة تتغير تغيرًا كبيرًا في كل تشغيل. وعلى وجه الخصوص، تبدو متغيرة كلما غيّرنا عدد الخيوط! ولا ينبغي أن يحدث هذا، لأن استخدامنا للبذرة الساكنة يضمن المجموعة نفسها من الأعداد في كل تشغيل. وتناقض هذه النتائج إحدى القواعد الأساسية للبرامج ذات الخيوط: ينبغي أن يكون إخراج البرنامج صحيحًا ومتسقًا بغض النظر عن عدد الخيوط المستخدم.
ولأن محاولتنا الأولى لجعل countElems متوازية لا تبدو ناجحة، لنغص أعمق في ما يفعله هذا البرنامج ونفحص كيف يمكن إصلاحه.
حالات سباق البيانات
لفهم ما يجري، لنفكّر في تشغيل نموذجي بخيطين على نواتين منفصلتين في نظام متعدد الأنوية. تذكّر أن تنفيذ أي خيط يمكن أن يُستبق في أي وقت بواسطة نظام التشغيل، ما يعني أن كل خيط قد ينفّذ تعليمات مختلفة من دالة معينة في أي لحظة (أو ربما التعليمة نفسها). ويعرض الجدول 1 مسارًا ممكنًا للتنفيذ عبر دالة countElems. ولتوضيح ما يجري توضيحًا أفضل، ترجمنا السطر counts[val] = counts[val] + 1 إلى التسلسل التالي من التعليمات المكافئة:
- اقرأ
counts[val]وضعها في سجل. - عدّل السجل بزيادته بمقدار واحد.
- اكتب محتويات السجل إلى
counts[val].
ويُعرف هذا بـنمط القراءة-التعديل-الكتابة (read-modify-write). وفي المثال المعروض في الجدول 1، ينفّذ كل خيط على نواة منفصلة (الخيط 0 على النواة 0، والخيط 1 على النواة 1). ونبدأ فحص تنفيذ العملية عند الخطوة الزمنية i، حيث يكون لدى كلا الخيطين val تساوي 1.
| الزمن | الخيط 0 | الخيط 1 |
|---|---|---|
| i | اقرأ counts[1] وضعها في سجل النواة 0 | … |
| i+1 | زد السجل بمقدار 1 | اقرأ counts[1] وضعها في سجل النواة 1 |
| i+2 | اكتب فوق counts[1] محتويات السجل | زد السجل بمقدار 1 |
| i+3 | … | اكتب فوق counts[1] محتويات السجل |
لنفترض أن counts[1] كانت تحتوي القيمة 60 قبل تسلسل التنفيذ في الجدول 1. وفي الخطوة الزمنية i، يقرأ الخيط 0 القيمة counts[1] ويضع القيمة 60 في سجل النواة 0. وفي الخطوة الزمنية i+1، بينما يزيد الخيط 0 سجل النواة 0 بمقدار واحد، تُقرأ القيمة الحالية في counts[1] (وهي 60) إلى سجل النواة 1 بواسطة الخيط 1. وفي الخطوة الزمنية i+2، يحدّث الخيط 0 القيمة counts[1] إلى 61 بينما يزيد الخيط 1 القيمة المخزَّنة في سجله المحلي (60) بمقدار واحد. والنتيجة النهائية أن القيمة counts[1] يُكتب فوقها في الخطوة الزمنية i+3 بواسطة الخيط 1 بالقيمة 61، لا 62 كما كنا نتوقع! ويؤدي هذا إلى أن counts[1] «تفقد» زيادة!
ونشير إلى السيناريو الذي يحاول فيه خيطان الكتابة إلى موقع الذاكرة نفسه بـحالة سباق البيانات (data race). وبصفة أعم، تشير حالة السباق (race condition) إلى أي سيناريو يعطي فيه التنفيذ المتزامن لعمليتين نتيجة غير صحيحة. لاحظ أن القراءة المتزامنة لموقع counts[1] لا تشكّل في حد ذاتها حالة سباق، لأن القيم يمكن قراءتها عمومًا من الذاكرة وحدها من دون مشكلة. وقد كان الجمع بين هذه الخطوة والكتابات في counts[1] هو ما سبب النتيجة غير الصحيحة. ونمط القراءة-التعديل-الكتابة هذا مصدر شائع لنوع معين من حالات السباق يُسمى حالة سباق البيانات في معظم البرامج ذات الخيوط. وفي مناقشتنا لحالات السباق وكيفية إصلاحها، نركّز على حالات سباق البيانات.
ملاحظة — العمليات الذرية
تُعرَّف العملية بأنها ذرية (atomic) إذا رأى خيط أنها تنفّذ من دون انقطاع (وبعبارة أخرى، كإجراء «كل شيء أو لا شيء»). وفي بعض المكتبات، تُستخدم كلمة مفتاحية أو نوع لتحديد أن كتلة حساب يجب أن تُعامل كذرية. وفي المثال السابق، السطر
counts[val] = counts[val] + 1(حتى لو كُتب بالشكلcounts[val]++) ليس ذريًا، لأن هذا السطر يقابل فعلًا عدة تعليمات على مستوى الآلة. ويلزم بنية تزامن مثل الاستبعاد المتبادل لضمان عدم وجود حالات سباق بيانات. وبصفة عامة، ينبغي افتراض أن جميع العمليات غير ذرية إلا إذا فُرض الاستبعاد المتبادل صراحةً.
تذكّر أن ليس كل تسلسلات تنفيذ الخيطين تسبب حالة سباق. فكّر في تسلسل التنفيذ النموذجي للخيطين 0 و1 في الجدول 2.
| الزمن | الخيط 0 | الخيط 1 |
|---|---|---|
| i | اقرأ counts[1] وضعها في سجل النواة 0 | … |
| i+1 | زد السجل بمقدار 1 | … |
| i+2 | اكتب فوق counts[1] محتويات السجل | … |
| i+3 | … | اقرأ counts[1] وضعها في سجل النواة 1 |
| i+4 | … | زد السجل بمقدار 1 |
| i+5 | … | اكتب فوق counts[1] محتويات السجل |
في تسلسل التنفيذ هذا، لا يقرأ الخيط 1 من counts[1] إلا بعد أن يحدّثها الخيط 0 بقيمته الجديدة (61). والنتيجة النهائية أن الخيط 1 يقرأ القيمة 61 من counts[1] ويضعها في سجل النواة 1 خلال الخطوة الزمنية i+3، ويكتب القيمة 62 إلى counts[1] في الخطوة الزمنية i+5.
ولإصلاح حالة سباق بيانات، يجب أولًا عزل القسم الحرج (critical section)، أي المجموعة الجزئية من الشيفرة التي يجب أن تنفّذ ذرّيًا (بمعزل) لضمان سلوك صحيح. وفي البرامج ذات الخيوط، تُحدَّد عادةً كتل الشيفرة التي تحدّث موردًا مشتركًا كأقسام حرجة.
وفي الدالة countElems، ينبغي وضع تحديثات مصفوفة counts في قسم حرج لضمان عدم فقدان قيم بسبب تحديث خيوط متعددة الموقع نفسه في الذاكرة:
long i;
for (i = start; i < end; i++) {
    val = array[i];
    counts[val] = counts[val] + 1; //this line needs to be protected
}
ولأن المشكلة الجوهرية في countElems هي الوصول المتزامن إلى counts من خيوط متعددة، تلزم آلية تضمن ألا ينفّذ داخل القسم الحرج إلا خيط واحد في المرة. واستخدام بنية تزامن (مثل قفل التبادل المتبادل الذي يُغطّى في القسم التالي) سيجبر الخيوط على دخول القسم الحرج تتابعيًا.
ما هو قفل التبادل المتبادل؟ الجواب هناك في الخارج، وهو يبحث عنك، وسيجدك إن أردت ذلك.
~Trinity وهي تشرح أقفال التبادل المتبادل لـ Neo (مع الاعتذار إلى The Matrix)
ولإصلاح حالة سباق البيانات، لنستخدم بنية تزامن تُعرف بقفل الاستبعاد المتبادل، أو قفل التبادل المتبادل (mutex). وأقفال التبادل المتبادل نوع من عناصر التزامن الأولية تضمن ألا يدخل وينفّذ الشيفرة داخل القسم الحرج إلا خيط واحد في أي لحظة.
وقبل استخدام قفل التبادل المتبادل، يجب على البرنامج أولًا:
- تعريف القفل في ذاكرة تتشاركها الخيوط (غالبًا كمتغير عام).
- تهيئة القفل قبل أن تحتاج الخيوط إلى استخدامه (عادةً في الدالة
main).
وتعرّف مكتبة Pthreads نوع pthread_mutex_t لأقفال التبادل المتبادل. ولتعريف متغير قفل، أضف هذا السطر:
pthread_mutex_t mutex;
وتهيئة القفل باستخدام الدالة pthread_mutex_init التي تأخذ عنوان قفل وبنية سمات تُضبط عادةً على NULL:
pthread_mutex_init(&mutex, NULL);
وعندما لا تعود الحاجة إلى القفل (عادةً في نهاية الدالة main بعد pthread_join)، ينبغي للبرنامج تحرير بنية القفل باستدعاء الدالة pthread_mutex_destroy:
pthread_mutex_destroy(&mutex);
قفل التبادل المتبادل: مقفل وجاهز
الحالة الأولية لقفل التبادل المتبادل غير مقفلة، أي أنه قابل للاستخدام فورًا من أي خيط. ولدخول قسم حرج، يجب على الخيط أولًا حيازة القفل. ويتحقق ذلك باستدعاء الدالة pthread_mutex_lock. وبعد أن يحوز الخيط القفل، لا يستطيع أي خيط آخر دخول القسم الحرج حتى يحرّره الخيط الحائز للقفل. وإذا استدعى خيط آخر pthread_mutex_lock وكان القفل مقفلًا بالفعل، فسيُحجب الخيط (أو ينتظر) حتى يصبح القفل متاحًا. تذكّر أن الحجب يعني أن الخيط لن يُجدول لاستخدام المعالج حتى يتحقق الشرط الذي ينتظره (أي توافر القفل).
وعند خروج الخيط من القسم الحرج، يجب أن يستدعي الدالة pthread_mutex_unlock لتحرير القفل وجعله متاحًا لخيط آخر. وبذلك يمكن لخيط واحد على الأكثر حيازة القفل ودخول القسم الحرج في المرة، ما يمنع خيوطًا متعددة من التسابق لقراءة المتغيرات المشتركة وتحديثها.
وبعد تعريف قفل وتهيئته، يصبح السؤال التالي أين ينبغي وضع دالتي القفل وفتح القفل لفرض القسم الحرج فرضًا أفضل. وإليك محاولة أولية لتعزيز الدالة countElems بقفل تبادل متبادل (يمكن تنزيل الشيفرة الكاملة من countElems_p_v2.c):
pthread_mutex_t mutex; //global declaration of mutex, initialized in main()

/*parallel version of step 1 of CountSort algorithm (attempt 1 with mutexes):
 * extracts arguments from args value
 * calculates component of the array that thread is responsible for counting
 * computes the frequency of all the elements in assigned component and stores
 * the associated counts of each element in counts array
*/
void *countElems( void *args ) {
    //extract arguments
    //ommitted for brevity
    int *array = myargs->ap;
    long *counts = myargs->countp;

    //assign work to the thread
    long chunk = length / nthreads; //nominal chunk size
    long start = myid * chunk;
    long end = (myid + 1) * chunk;
    long val;
    if (myid == nthreads - 1) {
        end = length;
    }
    long i;

    //heart of the program
    pthread_mutex_lock(&mutex); //acquire the mutex lock
    for (i = start; i < end; i++) {
        val = array[i];
        counts[val] = counts[val] + 1;
    }
    pthread_mutex_unlock(&mutex); //release the mutex lock

    return NULL;
}
وتُوضع دالتا تهيئة القفل وتدميره في main حول دالتي إنشاء الخيوط وضمّها:
//code snippet from main():

pthread_mutex_init(&mutex, NULL); //initialize the mutex

for (t = 0; t < nthreads; t++) {
    pthread_create( &thread_array[t], NULL, countElems, &thread_args[t] );
}

for (t = 0; t < nthreads; t++) {
    pthread_join(thread_array[t], NULL);
}
pthread_mutex_destroy(&mutex); //destroy (free) the mutex
لنعد تصريف هذا البرنامج الجديد ونشغّله مع تغيير عدد الخيوط:
$ ./countElems_p_v2 10000000 1 1
Counts array:
999170 1001044 999908 1000431 999998 1001479 999709 997250 1000804 1000207

$ ./countElems_p_v2 10000000 1 2
Counts array:
999170 1001044 999908 1000431 999998 1001479 999709 997250 1000804 1000207

$ ./countElems_p_v2 10000000 1 4
Counts array:
999170 1001044 999908 1000431 999998 1001479 999709 997250 1000804 1000207
ممتاز، صارت المخرجات أخيرًا متسقة بغض النظر عن عدد الخيوط المستخدم!
تذكّر أن من الأهداف الرئيسية الأخرى لتعدد الخيوط تقليل زمن تشغيل البرنامج كلما زاد عدد الخيوط (وبعبارة أخرى، تسريع تنفيذ البرنامج). لنقِس أداء الدالة countElems. ومع أن استخدام أداة سطر أوامر مثل time -p قد يغريك، تذكّر أن استدعاء time -p يقيس الزمن الحائطي للبرنامج كله (بما في ذلك توليد العناصر العشوائية) لا تشغيل الدالة countElems وحدها. وفي هذه الحالة، الأفضل استخدام نداء نظام مثل gettimeofday يتيح للمستخدم قياس الزمن الحائطي لقسم معين من الشيفرة قياسًا دقيقًا. وينتج عن قياس countElems على 100 مليون عنصر أزمنة التشغيل التالية:
$ ./countElems_p_v2 100000000 0 1
Time for Step 1 is 0.368126 s

$ ./countElems_p_v2 100000000 0 2
Time for Step 1 is 0.438357 s

$ ./countElems_p_v2 100000000 0 4
Time for Step 1 is 0.519913 s
إضافة مزيد من الخيوط تجعل البرنامج أبطأ! وهذا يناقض هدف جعل البرامج أسرع بالخيوط.
ولفهم ما يجري، فكّر في مكان وضع الأقفال في الدالة countsElems:
//code snippet from the countElems function from earlier
//the heart of the program
pthread_mutex_lock(&mutex); //acquire the mutex lock
for (i = start; i < end; i++){
    val = array[i];
    counts[val] = counts[val] + 1;
}
pthread_mutex_unlock(&mutex); //release the mutex lock
في هذا المثال، وضعنا القفل حول حلقة for بالكامل. ومع أن هذا الوضع يحل مشكلات الصحة، فهو قرار بالغ السوء من منظور الأداء — فالقسم الحرج يشمل الآن جسم الحلقة كله. ووضع الأقفال بهذه الطريقة يضمن ألا ينفّذ الحلقة إلا خيط واحد في المرة، ما يجعل البرنامج تتابعيًا فعليًا!
قفل التبادل المتبادل: النسخة المحمَّلة
لنجرّب مقاربة أخرى ونضع دالتي قفل القفل وفتحه داخل كل تكرار من تكرارات الحلقة:
/*modified code snippet of countElems function:
 *locks are now placed INSIDE the for loop!
*/
//the heart of the program
for (i = start; i < end; i++) {
    val = array[i];
    pthread_mutex_lock(&m); //acquire the mutex lock
    counts[val] = counts[val] + 1;
    pthread_mutex_unlock(&m); //release the mutex lock
}
قد يبدو هذا في البداية حلًا أفضل لأن كل خيط يستطيع دخول الحلقة على التوازي، ولا يتسلسل إلا عند وصوله إلى القفل. والقسم الحرج صغير جدًا، إذ يشمل السطر counts[val] = counts[val] + 1 فقط.
لنجرِ أولًا فحص صحة على هذه النسخة من البرنامج:
$ ./countElems_p_v3 10000000 1 1
Counts array:
999170 1001044 999908 1000431 999998 1001479 999709 997250 1000804 1000207

$ ./countElems_p_v3 10000000 1 2
Counts array:
999170 1001044 999908 1000431 999998 1001479 999709 997250 1000804 1000207

$ ./countElems_p_v3 10000000 1 4
Counts array:
999170 1001044 999908 1000431 999998 1001479 999709 997250 1000804 1000207
حتى الآن، كل شيء جيد. وتنتج هذه النسخة من البرنامج أيضًا مخرجات متسقة بغض النظر عن عدد الخيوط المستخدمة.
والآن، لننظر إلى الأداء:
$ ./countElems_p_v3 100000000 0 1
Time for Step 1 is 1.92225 s

$ ./countElems_p_v3 100000000 0 2
Time for Step 1 is 10.9704 s

$ ./countElems_p_v3 100000000 0 4
Time for Step 1 is 9.13662 s
وينتج عن تشغيل هذه النسخة من الشيفرة (والمثير للعجب) زمن تشغيل أبطأ بدرجة كبيرة!
وتبيّن أن قفل قفل التبادل المتبادل وفتحه عمليتان مكلفتان. تذكّر ما غُطّي في مناقشة تحسينات نداء الدوال: استدعاء دالة بتكرار (وبلا داعٍ) في حلقة يمكن أن يكون سببًا رئيسيًا لإبطاء البرنامج. وفي استخدامنا السابق لأقفال التبادل المتبادل، كان كل خيط يقفل القفل ويفتحه مرة واحدة بالضبط. وفي الحل الحالي، يقفل كل خيط القفل ويفتحه n/t مرة، حيث n حجم المصفوفة وt عدد الخيوط وn/t حجم مكوّن المصفوفة المسند إلى كل خيط بعينه. ونتيجة لذلك، تؤدي كلفة عمليات القفل الإضافية إلى إبطاء تنفيذ الحلقة بدرجة كبيرة.
قفل التبادل المتبادل: إعادة النظر
إضافةً إلى حماية القسم الحرج لتحقيق سلوك صحيح، سيستخدم الحل المثالي دالتي القفل وفتح القفل بأقل قدر ممكن، ويقلل القسم الحرج إلى أصغر حجم ممكن.
يحقق التطبيق الأصلي الشرط الأول، بينما يحاول التطبيق الثاني إنجاز الثاني. وللوهلة الأولى، يبدو الشرطان غير متوافقين. فهل من طريقة لإنجاز كليهما فعلًا (وبينما نفعل ذلك، تسريع تنفيذ برنامجنا)؟
في المحاولة التالية، يحتفظ كل خيط بمصفوفة عدّ خاصة محلية على مكدّسه. ولأن المصفوفة محلية لكل خيط، يستطيع الخيط الوصول إليها من دون قفل — فلا خطر لحدوث حالة سباق على بيانات غير مشتركة بين الخيوط. ويعالج كل خيط مجموعته الجزئية المسندة من المصفوفة المشتركة ويملأ مصفوفة عدّه المحلية. وبعد إحصاء جميع القيم ضمن مجموعته الجزئية، يقوم كل خيط بما يلي:
- يقفل القفل المشترك (دخول قسم حرج).
- يضيف القيم من مصفوفة عدّه المحلية إلى مصفوفة العدّ المشتركة.
- يفتح القفل المشترك (خروج من القسم الحرج).
وتقييد كل خيط بتحديث مصفوفة العدّ المشتركة مرة واحدة فقط يقلل بدرجة كبيرة تنافس المتغيرات المشتركة ويقلل عمليات القفل المكلفة.
وفيما يلي دالتنا المعدّلة countElems. ويمكن الوصول إلى الشيفرة المصدرية الكاملة لهذا البرنامج النهائي في (countElems_p_v3.c):
/*parallel version of step 1 of CountSort algorithm (final attempt w/mutexes):
 * extracts arguments from args value
 * calculates component of the array that thread is responsible for counting
 * computes the frequency of all the elements in assigned component and stores
 * the associated counts of each element in counts array
*/
void *countElems( void *args ) {
    //extract arguments
    //ommitted for brevity
    int *array = myargs->ap;
    long *counts = myargs->countp;

    //local declaration of counts array, initializes every element to zero.
    long local_counts[MAX] = {0};

    //assign work to the thread
    long chunk = length / nthreads; //nominal chunk size
    long start = myid * chunk;
    long end = (myid + 1) * chunk;
    long val;
    if (myid == nthreads-1)
        end = length;

    long i;

    //heart of the program
    for (i = start; i < end; i++) {
        val = array[i];

        //updates local counts array
        local_counts[val] = local_counts[val] + 1;
    }

    //update to global counts array
    pthread_mutex_lock(&mutex); //acquire the mutex lock
    for (i = 0; i < MAX; i++) {
        counts[i] += local_counts[i];
    }
    pthread_mutex_unlock(&mutex); //release the mutex lock

    return NULL;
}
ولهذه النسخة سمات إضافية قليلة:
- وجود
local_counts، وهي مصفوفة خاصة بنطاق كل خيط (أي مخصصة على مكدّس الخيط). ومثلcounts، تحتويlocal_countsعناصرMAX، حيثMAXأقصى قيمة يمكن أن يحملها أي عنصر في مصفوفة إدخالنا. - يجري كل خيط تحديثات على
local_countsبوتيرته الخاصة، من دون أي تنافس على متغيرات مشتركة. - نداء واحد إلى
pthread_mutex_lockيحمي تحديث كل خيط للمصفوفة العامةcounts، وهو تحديث يحدث مرة واحدة فقط في نهاية تنفيذ كل خيط.
وبهذه الطريقة، نقلل الوقت الذي يقضيه كل خيط في قسم حرج إلى تحديث مصفوفة العدّ المشتركة فقط. ومع أنه لا يستطيع دخول القسم الحرج إلا خيط واحد في المرة، فالوقت الذي يقضيه كل خيط فيه يتناسب مع MAX لا مع n، طول المصفوفة العامة. ولأن MAX أصغر بكثير من n، ينبغي أن نرى تحسنًا في الأداء.
لنقِس الآن أداء هذه النسخة من شيفرتنا:
$ ./countElems_p_v3 100000000 0 1
Time for Step 1 is 0.334574 s

$ ./countElems_p_v3 100000000 0 2
Time for Step 1 is 0.209347 s

$ ./countElems_p_v3 100000000 0 4
Time for Step 1 is 0.130745 s
يا للفرق! فبرنامجنا لا يحسب الإجابات الصحيحة فحسب، بل ينفّذ أيضًا أسرع كلما زدنا عدد الخيوط.
والدرس المستفاد هنا هو: لتقليل القسم الحرج بفعالية، استخدم متغيرات محلية لتجميع القيم الوسيطة. وبعد انتهاء العمل الشاق الذي يتطلب التوازي، استخدم قفل تبادل متبادل لتحديث أي متغير (متغيرات) مشتركة بأمان.
التجمّد
في بعض البرامج، تعتمد الخيوط المنتظرة على بعضها. وقد تنشأ حالة تُسمى التجمّد (deadlock) عند تطبيق عناصر تزامن متعددة مثل أقفال التبادل المتبادل تطبيقًا خاطئًا. فخيط المتجمّد يُحجب عن التنفيذ بواسطة خيط آخر محجوب هو نفسه على خيط محجوب. والازدحام التام (الذي لا تستطيع فيه السيارات من جميع الاتجاهات التقدم بسبب انسدادها بسيارات أخرى) مثال واقعي شائع على التجمّد يحدث عند تقاطعات المدن المزدحمة.
ولتوضيح سيناريو تجمّد في الشيفرة، لنفكّر في مثال يُستخدم فيه تعدد الخيوط لتنفيذ تطبيق مصرفي. وتُعرَّف كل حساب مستخدم برصيد وقفل تبادل متبادل خاص به (يضمن عدم حدوث حالات سباق عند تحديث الرصيد):
struct account {
    pthread_mutex_t lock;
    int balance;
};
لنفكّر في التطبيق الساذج التالي لدالة Transfer التي تنقل مالًا من حساب مصرفي إلى آخر:
void *Transfer(void *args){
    //argument passing removed to increase readability
    //...

    pthread_mutex_lock(&fromAcct->lock);
    pthread_mutex_lock(&toAcct->lock);

    fromAcct->balance -= amt;
    toAcct->balance += amt;

    pthread_mutex_unlock(&fromAcct->lock);
    pthread_mutex_unlock(&toAcct->lock);

    return NULL;
}
لنفترض أن الخيطين 0 و1 ينفّذان بالتزامن ويمثلان المستخدمين A وB على الترتيب. ولنفكّر الآن في الوضع الذي يريد فيه A وB تحويل مال أحدهما للآخر: يريد A تحويل 20 دولارًا إلى B، بينما يريد B تحويل 40 إلى A.
وفي مسار التنفيذ المميز في الشكل 1، ينفّذ الخيطان بالتزامن الدالة Transfer. فيحوز الخيط 0 قفل acctA بينما يحوز الخيط 1 قفل acctB. والآن فكّر في ما يحدث. لمواصلة التنفيذ، يحتاج الخيط 0 إلى حيازة قفل acctB الذي يحوزه الخيط 1. وبالمثل، يحتاج الخيط 1 إلى حيازة قفل acctA لمواصلة التنفيذ، وهو محجوز للخيط 0. ولأن كلا الخيطين محجوبان على الآخر، فهما في تجمّد.
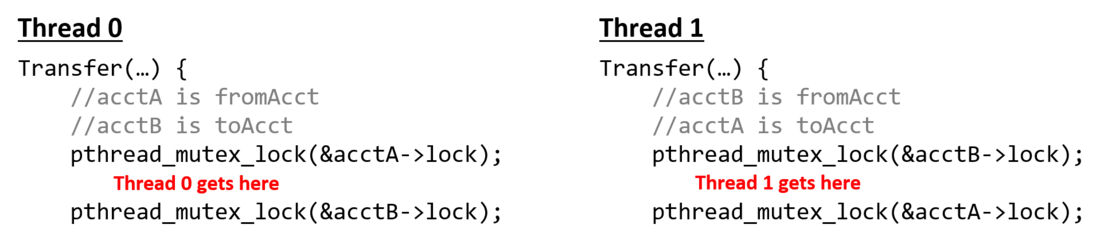 الشكل 1. مثال على التجمّد
ومع أن نظام التشغيل يوفّر بعض الحماية من التجمّد، ينبغي للمبرمجين الانتباه إلى كتابة شيفرة تزيد احتمال التجمّد. فمثلًا، كان يمكن تجنّب السيناريو السابق بإعادة ترتيب الأقفال بحيث يحيط كل زوج قفل/فتح قفل بعبارة تحديث الرصيد المرتبطة به فقط:
void *Transfer(void *args){
    //argument passing removed to increase readability
    //...

    pthread_mutex_lock(&fromAcct->lock);
    fromAcct->balance -= amt;
    pthread_mutex_unlock(&fromAcct->lock);

    pthread_mutex_lock(&toAcct->lock);
    toAcct->balance += amt;
    pthread_mutex_unlock(&toAcct->lock);

    return NULL;
}
والتجمّد ليس حالة خاصة بالخيوط. فالعمليات (خصوصًا تلك التي تتواصل مع بعضها) يمكن أن تتجمد مع بعضها. وينبغي للمبرمجين الانتباه إلى عناصر التزامن الأولية التي يستخدمونها وعواقب استخدامها استخدامًا خاطئًا.
تُستخدم السيمافورات عادةً في أنظمة التشغيل والبرامج المتزامنة التي يكون الهدف فيها إدارة الوصول المتزامن إلى مجموعة موارد. وعند استخدام سيمافور، ليس الهدف من يملك ماذا، بل كم من الموارد لا يزال متاحًا. وتختلف السيمافورات عن أقفال التبادل المتبادل في عدة أوجه:
- لا يلزم أن تكون السيمافورات في حالة ثنائية (مقفلة أو غير مقفلة). فنوع خاص من السيمافورات يُسمى سيمافور العدّ يمكن أن تتراوح قيمته من 0 إلى عدد ما r، حيث r عدد الموارد الممكنة. وكلما أُنتج مورد، يزداد السيمافور. وكلما استُخدم مورد، ينقص السيمافور. وعندما تكون قيمة سيمافور العدّ 0، فهذا يعني عدم توافر أي موارد، ويجب على أي خيوط أخرى تحاول حيازة مورد أن تنتظر (أي تُحجب).
- يمكن أن تكون السيمافورات مقفلة افتراضيًا.
ومع أن قفل التبادل المتبادل ومتغيرات الشرط يمكنهما محاكاة وظيفة السيمافور، فقد يكون استخدام سيمافور أبسط وأكفأ في بعض الحالات. وللسيمافورات أيضًا ميزة أن أي خيط يمكنه فتح السيمافور (خلافًا لقفل التبادل المتبادل حيث يجب أن يفتحه الخيط المستدعي).
والسيمافورات ليست جزءًا من مكتبة Pthreads، لكن هذا لا يعني أنه لا يمكنك استخدامها. وفي أنظمة Linux وmacOS، يمكن الوصول إلى عناصر السيمافور الأولية من semaphore.h الموجود عادةً في /usr/include. ولأنه لا يوجد معيار، قد تختلف نداءات الدوال على أنظمة مختلفة. ومع ذلك، فللمكتبة السيمافور تصريحات مشابهة لتصريحات أقفال التبادل المتبادل:
- عرّف سيمافورًا (النوع
sem_t، مثلsem_t semaphore). - هيّئ سيمافورًا باستخدام
sem_init(عادةً فيmain). وللدالةsem_initثلاثة مُعامِلات: الأول عنوان سيمافور، والثاني حالته الأولية (مقفل أو غير مقفل)، والمُعامِل الثالث يدل على ما إذا كان ينبغي تشارك السيمافور مع خيوط عملية (مثلًا بالقيمة 0) أو بين العمليات (مثلًا بالقيمة 1). وهذا مفيد لأن السيمافورات تُستخدم عادةً لتزامن العمليات. فمثلًا، تهيئة سيمافور بالنداءsem_init(&semaphore, 1, 0)تدل على أن سيمافورنا مقفل ابتدائيًا (المُعامِل الثاني هو 1)، وأنه سيُتشارك بين خيوط عملية مشتركة (المُعامِل الثالث هو 0). وفي المقابل، تبدأ أقفال التبادل المتبادل دائمًا غير مقفلة. ومن المهم ملاحظة أن الدالة المكافئة في macOS هيsem_open. - دمّر سيمافورًا باستخدام
sem_destroy(عادةً فيmain). وتأخذ هذه الدالة مؤشرًا إلى السيمافور فقط (sem_destroy(&semaphore)). لاحظ أن الدالة المكافئة في macOS قد تكونsem_unlinkأوsem_close. - تدل الدالة
sem_waitعلى أن موردًا قيد الاستخدام، وتنقص السيمافور. وإذا كانت قيمة السيمافور أكبر من 0 (دلالةً على توافر موارد)، تعود الدالة فورًا ويُسمح للخيط بالمتابعة. وإذا كانت قيمة السيمافور 0 بالفعل، يُحجب الخيط حتى يتوافر مورد (أي تصبح للسيمافور قيمة موجبة). ويبدو نداءsem_waitعادةً بالشكلsem_wait(&semaphore). - تدل الدالة
sem_postعلى تحرير مورد، وتزيد السيمافور. وتعود هذه الدالة فورًا. وإذا كان هناك خيط منتظر على السيمافور (أي كانت قيمة السيمافور 0 سابقًا)، فسيأخذ الخيط الآخر ملكية المورد المحرَّر. ويبدو نداءsem_postبالشكلsem_post(&semaphore).
وأقفال التبادل المتبادل والسيمافورات ليست المثال الوحيد على عناصر التزامن التي يمكن استخدامها في سياق البرامج متعددة الخيوط. وفي هذا القسم الفرعي سنناقش بإيجاز عنصرَي التزامن الحاجز ومتغير الشرط، وكلاهما جزء من مكتبة Pthreads.
الحواجز
الحاجز (barrier) نوع من عناصر التزامن يجبر جميع الخيوط على الوصول إلى نقطة مشتركة في التنفيذ قبل إطلاق الخيوط لمتابعة التنفيذ بالتزامن. وتوفّر Pthreads عنصر تزامن أولي للحاجز. ولاستخدام حواجز Pthreads، يلزم فعل ما يلي:
- تعريف متغير حاجز عام (مثل
pthread_barrier_t barrier) - تهيئة الحاجز في
main(pthread_barrier_init(&barrier)) - تدمير الحاجز في
mainبعد الاستخدام (pthread_barrier_destroy(&barrier)) - استخدام الدالة
pthread_barrier_waitلإنشاء نقطة تزامن.
ويعرض البرنامج التالي استخدام حاجز في دالة تُسمى threadEx:
void *threadEx(void *args){
    //parse args
    //...
    long myid = myargs->id;
    int nthreads = myargs->numthreads;
    int *array = myargs->array

    printf("Thread %ld starting thread work!\n", myid);
    pthread_barrier_wait(&barrier); //forced synchronization point
    printf("All threads have reached the barrier!\n");
    for (i = start; i < end; i++) {
        array[i] = array[i] * 2;
    }
    printf("Thread %ld done with work!\n", myid);

    return NULL;
}
في هذا المثال، لا يستطيع أي خيط بدء معالجة جزئه المسند من المصفوفة حتى يُطبع في كل خيط الرسالة الدالة على بدء العمل. ومن دون الحاجز، من الممكن أن يكون خيط قد أنهى عمله قبل أن تطبع الخيوط الأخرى رسالتها عن بدء العمل! لاحظ أنه ما زال ممكنًا أن يطبع خيط رسالة انتهائه من العمل قبل أن ينتهي خيط آخر.
متغيرات الشرط
تجبر متغيرات الشرط خيطًا على الحجب حتى بلوغ شرط معين. ويفيد هذا العنصر في السيناريوهات التي يجب فيها بلوغ شرط قبل أن يؤدّي الخيط عملًا ما. وفي غياب متغيرات الشرط، سيتعين على الخيط فحص بلوغ الشرط مرارًا بتكرار، مستهلكًا المعالج باستمرار. وتُستخدم متغيرات الشرط دائمًا مقترنة بقفل تبادل متبادل. وفي هذا النوع من عناصر التزامن، يفرض القفل الاستبعاد المتبادل، بينما يضمن متغير الشرط بلوغ شروط معينة قبل أن يحوز الخيط القفل.
لمتغيرات الشرط في POSIX النوع pthread_cond_t. وكما في عنصرَي القفل والحاجز، يجب تهيئة متغيرات الشرط قبل استخدامها وتدميرها بعده.
ولتهيئة متغير شرط، استخدم الدالة pthread_cond_init. ولتدمير متغير شرط، استخدم الدالة pthread_cond_destroy.
والدالتان الشائع استدعاؤهما عند استخدام متغيرات الشرط هما pthread_cond_wait وpthread_cond_signal. وتحتاج كلتا الدالتين عنوان قفل تبادل متبادل إضافةً إلى عنوان متغير الشرط:
- تأخذ الدالة
pthread_cond_wait(&cond, &mutex)عنواني متغير شرطcondوقفلmutexكمُعامِلَيها. وتسبب حجب الخيط المستدعي على متغير الشرطcondحتى يشير إليه خيط آخر (أو «يوقظه»). - تسبب الدالة
pthread_cond_signal(&cond)إلغاء حجب (أو إشعار) خيط آخر منتظر على متغير الشرطcond(بحسب أولوية الجدولة). وإذا لم تكن هناك خيوط محجوبة حاليًا على الشرط، فلا أثر للدالة. وخلافًا لـpthread_cond_wait، يمكن استدعاء الدالةpthread_cond_signalمن خيط سواء كان يملك القفل الذي يُستدعى فيهpthread_cond_waitأم لا.
مثال على متغير الشرط
تقليديًا، تكون متغيرات الشرط أكثر فائدة عندما تنتظر مجموعة جزئية من الخيوط مجموعة أخرى لإكمال إجراء ما. وفي المثال التالي، نستخدم خيوطًا متعددة لمحاكاة مجموعة مزارعين يجمعون البيض من مجموعة دجاجات. ويمثّل «Chicken» و«Farmer» صنفين منفصلين من الخيوط. ويمكن تنزيل الشيفرة الكاملة لهذا البرنامج (layeggs.c). لاحظ أن القائمة تستبعد كثيرًا من التعليقات ومعالجة الأخطاء للإيجاز.
تنشئ الدالة main متغيرًا مشتركًا num_eggs (يدل على العدد الإجمالي للبيض المتاح في أي لحظة)، وmutex مشتركًا (يُستخدم كلما وصل خيط إلى num_eggs)، ومتغير شرط مشتركًا eggs. ثم تنشئ خيطَي Chicken وخيطَي Farmer:
int main(int argc, char **argv){
    //... declarations omitted for brevity

    // these will be shared by all threads via pointer fields in t_args
    int num_eggs;           // number of eggs ready to collect
    pthread_mutex_t mutex;  // mutex associated with cond variable
    pthread_cond_t  eggs;   // used to block/wake-up farmer waiting for eggs

    //... args parsing removed for brevity

    num_eggs = 0; // number of eggs ready to collect
    ret = pthread_mutex_init(&mutex, NULL); //initialize the mutex
    pthread_cond_init(&eggs, NULL); //initialize the condition variable

    //... thread_array and thread_args creation/filling omitted for brevity

    // create some chicken and farmer threads
    for (i = 0; i < (2 * nthreads); i++) {
        if ( (i % 2) == 0 ) {
            ret = pthread_create(&thread_array[i], NULL,
                                 chicken, &thread_args[i]);
        }
        else {
            ret = pthread_create(&thread_array[i], NULL,
                                 farmer, &thread_args[i] );
        }
    }

    // wait for chicken and farmer threads to exit
    for (i = 0; i < (2 * nthreads); i++)  {
        ret = pthread_join(thread_array[i], NULL);
    }

    // clean-up program state
    pthread_mutex_destroy(&mutex); //destroy the mutex
    pthread_cond_destroy(&eggs);   //destroy the cond var

    return 0;
}
وكل خيط Chicken مسؤول عن وضع عدد معين من البيض:
void *chicken(void *args ) {
    struct t_arg *myargs = (struct t_arg *)args;
    int *num_eggs, i, num;

    num_eggs = myargs->num_eggs;
    i = 0;

    // lay some eggs
    for (i = 0; i < myargs->total_eggs; i++) {
        usleep(EGGTIME); //chicken sleeps

        pthread_mutex_lock(myargs->mutex);
        *num_eggs = *num_eggs + 1;  // update number of eggs
        num = *num_eggs;
        pthread_cond_signal(myargs->eggs); // wake a sleeping farmer (squawk)
        pthread_mutex_unlock(myargs->mutex);

        printf("chicken %d created egg %d available %d\n",myargs->id,i,num);
    }
    return NULL;
}
لوضع بيضة، ينام خيط Chicken مدة، ثم يحوز القفل ويحدّث العدد الإجمالي للبيض المتاح بواحد. وقبل تحرير القفل، «يوقظ» خيط Chicken مزارعًا نائمًا (بصياحه على الأرجح). ويكرر خيط Chicken الدورة حتى يضع كل البيض الذي يعتزم وضعه (total_eggs).
وكل خيط Farmer مسؤول عن جمع total_eggs بيضة من مجموعة الدجاجات (لإفطاره على الأرجح):
void *farmer(void *args ) {
    struct t_arg * myargs = (struct t_arg *)args;
    int *num_eggs, i, num;

    num_eggs = myargs->num_eggs;

    i = 0;

    for (i = 0; i < myargs->total_eggs; i++) {
        pthread_mutex_lock(myargs->mutex);
        while (*num_eggs == 0 ) { // no eggs to collect
            // wait for a chicken to lay an egg
            pthread_cond_wait(myargs->eggs, myargs->mutex);
        }

        // we hold mutex lock here and num_eggs > 0
        num = *num_eggs;
        *num_eggs = *num_eggs - 1;
        pthread_mutex_unlock(myargs->mutex);

        printf("farmer %d gathered egg %d available %d\n",myargs->id,i,num);
    }
    return NULL;
}
يحوز كل خيط Farmer القفل قبل فحص المتغير المشترك num_eggs لمعرفة ما إذا كان هناك بيض متاح (*num_eggs == 0). وما دام لا يوجد بيض متاح، يُحجب خيط Farmer (أي يأخذ قسطًا من النوم).
وبعد أن «يستيقظ» خيط Farmer بسبب إشارة من خيط Chicken، يتحقق من أن بيضة لا تزال متاحة (فقد يلتقطها مزارع آخر أولًا)، وإن كان الأمر كذلك «يجمع» المزارع بيضة (منقصًا num_eggs بواحد) ويحرر القفل.
وبهذه الطريقة، يعمل Chicken وFarmer معًا لوضع/جمع البيض. وتضمن متغيرات الشرط ألا يجمع أي خيط Farmer بيضة حتى تضعها دجاجة.
البث
من الدوال الأخرى المستخدمة مع متغيرات الشرط pthread_cond_broadcast، وهي مفيدة عندما تكون خيوط متعددة محجوبة على شرط معين. ويؤدي استدعاء pthread_cond_broadcast(&cond) إلى إيقاظ جميع الخيوط المحجوبة على الشرط cond. وفي المثال التالي، نوضح كيف يمكن لمتغيرات الشرط تنفيذ عنصر الحاجز المناقش سابقًا:
// mutex (initialized in main)
pthread_mutex_t mutex;

// condition variable signifying the barrier (initialized in main)
pthread_cond_t barrier;

void *threadEx_v2(void *args){
    // parse args
    // ...

    long myid = myargs->id;
    int nthreads = myargs->numthreads;
    int *array = myargs->array

    // counter denoting the number of threads that reached the barrier
    int *n_reached = myargs->n_reached;

    // start barrier code
    pthread_mutex_lock(&mutex);
    *n_reached++;

    printf("Thread %ld starting work!\n", myid)

    // if some threads have not reached the barrier
    while (*n_reached < nthreads) {
        pthread_cond_wait(&barrier, &mutex);
    }
    // all threads have reached the barrier
    printf("all threads have reached the barrier!\n");
    pthread_cond_broadcast(&barrier);

    pthread_mutex_unlock(&mutex);
    // end barrier code

    // normal thread work
    for (i = start; i < end; i++) {
        array[i] = array[i] * 2;
    }
    printf("Thread %ld done with work!\n", myid);

    return NULL;
}
للدالة threadEx_v2 الوظيفة نفسها التي لـ threadEx. وفي هذا المثال، يُسمى متغير الشرط barrier. وعندما يحوز كل خيط القفل، يزيد n_reached، أي عدد الخيوط التي وصلت إلى تلك النقطة. وما دام عدد الخيوط التي وصلت إلى الحاجز أقل من العدد الإجمالي للخيوط، ينتظر الخيط على متغير الشرط barrier والقفل mutex.
لكن عندما يصل الخيط الأخير إلى الحاجز، يستدعي pthread_cond_broadcast(&barrier) التي تحرّر جميع الخيوط الأخرى المنتظرة على متغير الشرط barrier، فتتيح لها متابعة التنفيذ.
هذا المثال مفيد لتوضيح الدالة pthread_cond_broadcast؛ لكن من الأفضل استخدام عنصر الحاجز الأولي في Pthreads كلما لزمت الحواجز في برنامج.
ومن الأسئلة التي يميل الطلاب إلى طرحها: هل يمكن استبدال حلقة while حول نداء pthread_cond_wait في شيفرة farmer وthreadEx_v2 بعبارة if؟ في الواقع، حلقة while هذه ضرورية تمامًا لسببين رئيسيين. أولًا، قد يتغير الشرط قبل أن يصل الخيط المستيقظ لمتابعة التنفيذ. وتفرض حلقة while إعادة اختبار الشرط اختبارًا أخيرًا. وثانيًا، الدالة pthread_cond_wait عرضة لـالاستيقاظات الكاذبة (spurious wakeups)، حيث يُوقظ خيط خطأً حتى لو لم يكن الشرط متحققًا. وحلقة while في الواقع مثال على حلقة محمول (predicate loop) تفرض فحصًا أخيرًا لمتغير الشرط قبل تحرير القفل. ولذلك فإن استخدام حلقات المحمول ممارسة صحيحة عند استخدام متغيرات الشرط.
حتى الآن، استخدمنا الدالة gettimeofday لقياس مقدار الوقت الذي تستغرقه البرامج في التنفيذ. ونناقش في هذا القسم كيفية قياس مدى أداء برنامج متوازٍ مقارنةً ببرنامج تتابعي، فضلًا عن موضوعات أخرى مرتبطة بقياس أداء البرامج المتوازية.
نغطي أولًا بعض الأساسيات المتعلقة بالأداء المتوازي:
ومع أن قانون Amdahl والتسريع مفهومان مهمان جدًا مرتبطان بالأداء، فإن الفهم الجيد للموضوعين التاليين سيكمل فهم القارئ للأداء:
وتحديدًا، يعطي قانون Gustafson-Barsis فهمًا أفضل لحدود قانون Amdahl.
التسريع
لنفترض أن برنامجًا يستغرق زمن Tc للتنفيذ على c من الأنوية. وبذلك تستغرق النسخة التتابعية من البرنامج زمن T1.
ويعبَّر عن تسريع البرنامج على c من الأنوية بالمعادلة:
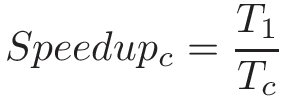
إذا استغرق برنامج تتابعي 60 ثانية للتنفيذ، بينما تستغرق نسخته المتوازية 30 ثانية على نواتين، فالتسريع المقابل هو 2. وبالمثل، إذا استغرق ذلك البرنامج 15 ثانية على أربع أنوية، فالتسريع 4. وفي سيناريو مثالي، يكون تسريع برنامج يعمل على n من الأنوية بـn من الخيوط الإجمالية مساويًا n.
وإذا كان تسريع برنامج أكبر من 1، فهو يدل على أن التوازي حقق بعض التحسن. وإذا كان التسريع أقل من 1، فالحل المتوازي في الواقع أبطأ من الحل التتابعي. ومن الممكن أن يكون تسريع برنامج أكبر من n (مثلًا كأثر جانبي لوجود ذاكرات مؤقتة إضافية تقلل الوصول إلى الذاكرة). وتُشار إلى هذه الحالات بـالتسريع فوق الخطي (superlinear speedup).
الكفاءة
لا يأخذ التسريع عدد الأنوية في الحسبان — فهو ببساطة نسبة الزمن التتابعي إلى الزمن المتوازي. فمثلًا، إذا استغرق برنامج تتابعي 60 ثانية، لكن برنامجًا متوازيًا استغرق 30 ثانية على أربع أنوية، فسيظل تسريعه 2. غير أن هذا المقياس لا يجسّد حقيقة أنه عمل على أربع أنوية.
ولقياس التسريع لكل نواة، استخدم الكفاءة:
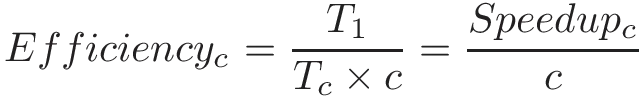
تتفاوت الكفاءة عادةً من 0 إلى 1. وتدل كفاءة 1 على أن الأنوية تُستخدم استخدامًا مثاليًا. وإذا كانت الكفاءة قريبة من 0، فللتوازي فائدة ضئيلة أو معدومة، إذ لا تحسّن الأنوية الإضافية الأداء. وإذا كانت الكفاءة أكبر من 1، فهي تدل على تسريع فوق خطي.
لنعد إلى المثال السابق الذي يستغرق فيه برنامج تتابعي 60 ثانية. فإذا استغرقت النسخة المتوازية 30 ثانية على نواتين، فكفاءتها 1 (أو 100%). وإذا استغرق البرنامج بدلًا من ذلك 30 ثانية على أربع أنوية، تهبط الكفاءة إلى 0.5 (أو 50%).
الأداء المتوازي في العالم الواقعي
في عالم مثالي، يكون التسريع خطيًا. فلكل وحدة حساب إضافية، ينبغي أن يحقق البرنامج المتوازي مقدارًا متناسبًا من التسريع. لكن هذا السيناريو نادر الحدوث في العالم الواقعي. فمعظم البرامج تحتوي مكوّنًا تتابعيًا ضروريًا وُجد بسبب تبعيات متأصلة في الشيفرة. وتُشار إلى أطول مجموعة من التبعيات في برنامج بـالمسار الحرج (critical path). وتقليل طول المسار الحرج للبرنامج خطوة أولى مهمة في جعله متوازيًا. ونقاط تزامن الخيوط و(بالنسبة إلى البرامج التي تعمل على عقد حسابية متعددة) الكلفة الإضافية للتواصل بين العمليات مكوّنات أخرى في الشيفرة يمكن أن تحدّ من الأداء المتوازي للبرنامج.
تحذير — ليست كل البرامج مرشحة جيدة للتوازي!
يمكن أن يجعل طول المسار الحرج بعض البرامج عسيرة التوازي تمامًا. وكمثال، فكّر في مسألة توليد عدد فيبوناتشي رقم n. ولأن كل عدد فيبوناتشي يعتمد على العددين السابقين له، فمن الصعب جدًا جعل هذا البرنامج متوازيًا بكفاءة!
لننظر في موازاة الدالة countElems من خوارزمية CountSort من وقت سابق في هذا الفصل. في عالم مثالي، كنا نتوقع أن يكون تسريع البرنامج خطيًا بالنسبة إلى عدد الأنوية. لكن لنقِس زمن تشغيله (وفي هذه الحالة على نظام رباعي الأنوية بثمانية خيوط منطقية):
$ ./countElems_p_v3 100000000 0 1
Time for Step 1 is 0.331831 s

$ ./countElems_p_v3 100000000 0 2
Time for Step 1 is 0.197245 s

$ ./countElems_p_v3 100000000 0 4
Time for Step 1 is 0.140642 s

$ ./countElems_p_v3 100000000 0 8
Time for Step 1 is 0.107649 s
ويعرض الجدول 1 التسريع والكفاءة لهذه التشغيلات متعددة الخيوط:
| عدد الخيوط | 2 | 4 | 8 |
|---|---|---|---|
| التسريع | 1.68 | 2.36 | 3.08 |
| الكفاءة | 0.84 | 0.59 | 0.39 |
ومع أن لدينا كفاءة 84% بنواتين، تهبط كفاءة الأنوية إلى 39% بثماني أنوية. لاحظ أن التسريع المثالي البالغ 8 لم يتحقق. وأحد أسباب ذلك أن الكلفة الإضافية لإسناد العمل إلى الخيوط والتحديث التتابعي لمصفوفة counts تبدأ بالسيطرة على الأداء عند أعداد أكبر من الخيوط. وثانيًا، يقلل تنازع الموارد بين الخيوط الثمانية (تذكّر أن هذا معالج رباعي الأنوية) كفاءة الأنوية.
قانون Amdahl
في عام 1967، تنبأ Gene Amdahl، وهو معماري حواسيب بارز في IBM، بأن التسريع الأقصى الذي يمكن أن يحققه برنامج حاسوبي محدود بحجم مكوّنه التتابعي الضروري (المعروف الآن بقانون Amdahl). وبصفة أعم، ينص قانون Amdahl على أنه يوجد في كل برنامج مكوّن يمكن تسريعه (أي الجزء من البرنامج الذي يمكن تحسينه أو جعله متوازيًا، P)، ومكوّن لا يمكن تسريعه (أي الجزء من البرنامج التتابعي بطبيعته، S). وحتى لو انخفض الوقت اللازم لتنفيذ المكوّن القابل للتحسين أو التوازي P إلى الصفر، فسيظل المكوّن التتابعي S موجودًا، وسيسيطر على الأداء في نهاية الأمر. ولأن S وP كسران، لاحظ أن S + P = 1.
فكّر في برنامج ينفّذ على نواة واحدة في زمن T1. عندئذٍ يستغرق الجزء التتابعي الضروري من تنفيذ البرنامج زمن S × T1 للعمل، ويستغرق الجزء القابل للتوازي من تنفيذ البرنامج (P = 1 - S) زمن P × T1 للعمل.
وعندما ينفّذ البرنامج على c من الأنوية، ما زال الجزء التتابعي من الشيفرة يستغرق زمن S × T1 للعمل (مع بقاء جميع الشروط الأخرى على حالها)، لكن الجزء القابل للتوازي يمكن تقسيمه على c من الأنوية. وبذلك يكون التحسن الأقصى للمعالج المتوازي بـc من الأنوية لتنفيذ المهمة نفسها هو:
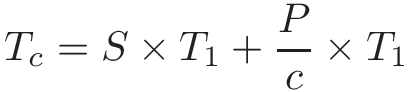
وكلما زاد c، صار زمن التنفيذ على المعالج المتوازي مسيطرًا عليه بالجزء التتابعي من البرنامج.
ولفهم أثر قانون Amdahl، فكّر في برنامج 90% منه قابل للتوازي وينفّذ في 10 ثوانٍ على نواة واحدة. وفي معادلتنا، المكوّن القابل للتوازي (P) هو 0.9، بينما المكوّن التتابعي (S) هو 0.1. ويعرض الجدول 2 الزمن الكلي المقابل على c من الأنوية (Tc) وفق قانون Amdahl، والتسريع المرتبط به.
| عدد الأنوية | الزمن التتابعي (ث) | الزمن المتوازي (ث) | الزمن الكلي (Tc ث) | التسريع (مقارنةً بنواة واحدة) |
|---|---|---|---|---|
| 1 | 1 | 9 | 10 | 1 |
| 10 | 1 | 0.9 | 1.9 | 5.26 |
| 100 | 1 | 0.09 | 1.09 | 9.17 |
| 1000 | 1 | 0.009 | 1.009 | 9.91 |
لاحظ أنه مع مرور الوقت، يبدأ المكوّن التتابعي من البرنامج بالسيطرة، ويبدو أن أثر إضافة مزيد من الأنوية ضئيل أو معدوم.
وثمة طريقة أكثر رسمية للنظر إلى ذلك تتطلب إدماج حساب Amdahl لـ Tc في معادلة التسريع:
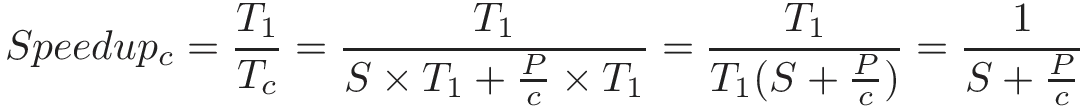
ويُظهر أخذ نهاية هذه المعادلة أنه كلما اقترب عدد الأنوية (c) من اللانهاية، اقترب التسريع من 1/S. وفي المثال المعروض في الجدول 2، يقترب التسريع من 1/0.1، أي 10.
وكمثال آخر، فكّر في برنامج حيث P = 0.99. وبعبارة أخرى، 99% من البرنامج قابل للتوازي. وكلما اقترب c من اللانهاية، بدأ الزمن التتابعي بالسيطرة على الأداء (وفي هذا المثال S = 0.01). وبذلك يقترب التسريع من 1/0.01، أي 100. وبعبارة أخرى، حتى بمليون نواة، فإن التسريع الأقصى الذي يمكن أن يحققه هذا البرنامج هو 100 فقط.
لم يضع كل شيء: حدود قانون Amdahl
عند تعلّم قانون Amdahl، من المهم مراعاة مقاصد واضعه، Gene Amdahl. وبكلماته هو، اقترح القانون لبيان «استمرار صلاحية مقاربة المعالج الواحد، وضعف مقاربة المعالجات المتعددة من حيث تطبيقها على المسائل الحقيقية وما يصاحبها من تفاوتات1». وفي ورقته عام 1967، وسّع Amdahl هذا المفهوم قائلًا: «على مدى أكثر من عقد، أكد الأنبياء أن تنظيم الحاسوب الواحد بلغ حدوده، وأن التقدم الجوهري لا يمكن أن يتحقق إلا بربط عدد كبير من الحواسيب بطريقة تتيح حلًا تعاونيًا1».
وقد تحدّث أعمال لاحقة عن بعض الافتراضات الرئيسية التي بنى عليها Amdahl. اقرأ عن قانون Gustafson-Barsis لمناقشة حدود قانون Amdahl وحجة مختلفة حول كيفية التفكير في فوائد التوازي.
المراجع
- جين أمهدال. «Validity of the single processor approach to achieving large scale computing capabilities»، Proceedings of the April 18-20, 1967, Spring Joint Computer Conference. ص. 483—485. ACM. 1967.
قانون Gustafson-Barsis
في عام 1988، كتب John L. Gustafson، وهو عالم حاسوب وباحث في مختبرات Sandia الوطنية، ورقة بعنوان "Reevaluating Amdahl’s Law1". ويُبرز Gustafson في هذه الورقة افتراضًا جوهريًا كان قد وُضع حول تنفيذ البرنامج المتوازي ولا يصح دائمًا.
وتحديدًا، يعني قانون Amdahl أن عدد أنوية الحساب c والجزء القابل للتوازي من البرنامج P مستقلان عن بعضهما. ويلاحظ Gustafson أن هذا «لا يحدث فعليًا أبدًا تقريبًا»1. ومع أن قياس أداء برنامج بتغيير عدد الأنوية على مجموعة بيانات ثابتة تمرين أكاديمي مفيد، فإنه في العالم الواقعي تُضاف أنوية (أو معالجات، كما بحثنا في مناقشة الذاكرة الموزعة) كلما كبرت المسألة. ويكتب Gustafson1: «قد يكون الأكثر واقعية افتراض ثبات زمن التشغيل، لا حجم المسألة».
وبالتالي، ووفق Gustafson، فالأدق أن نقول إن «مقدار العمل القابل للتنفيذ على التوازي يتغير خطيًا مع عدد المعالجات»1.
فكّر في برنامج متوازٍ يستغرق زمن Tc للعمل على نظام بـc من الأنوية. ولتمثّل S الجزء التتابعي الضروري من تنفيذ البرنامج الذي يستغرق زمن S × Tc للعمل. وبذلك يستغرق الجزء القابل للتوازي من تنفيذ البرنامج، P = 1 - S، زمن P × Tc للعمل على c من الأنوية.
وعندما يعمل البرنامج نفسه على نواة واحدة فقط، ما زال الجزء التتابعي من الشيفرة يستغرق S x Tc (بافتراض بقاء جميع الشروط الأخرى على حالها). لكن الجزء القابل للتوازي (الذي كان مقسومًا على c من الأنوية) يجب الآن أن تنفّذه نواة واحدة فقط ليعمل تتابعيًا، فيستغرق زمن P × Tc × c. وبعبارة أخرى، سيستغرق المكوّن المتوازي c ضعف المدة على نظام أحادي النواة. ويترتب على ذلك أن التسريع المعياري سيكون:
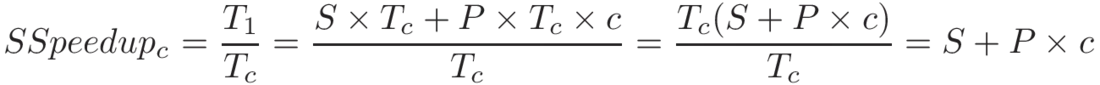
وهذا يدل على أن التسريع المعياري يزداد خطيًا مع عدد وحدات الحساب.
فكّر في مثالنا السابق الذي كان 99% منه قابلًا للتوازي (أي P = 0.99). وبتطبيق معادلة التسريع المعياري، سيكون التسريع النظري على 100 معالج 99.01. وعلى 1,000 معالج سيكون 990.01. لاحظ أن الكفاءة تبقى ثابتة عند P.
وكما يستنتج Gustafson، «ينبغي قياس التسريع بقياس المسألة إلى عدد المعالجات، لا بتثبيت حجم المسألة»1. وتُعدّ نتيجة Gustafson جديرة بالملاحظة لأنها تُظهر إمكانية الحصول على تسريع متزايد بتحديث عدد المعالجات. وكم باحث يعمل في منشأة حوسبة فائقة وطنية، كان اهتمام Gustafson أكبر بأداء عمل أكثر في مقدار ثابت من الزمن. وفي عدة مجالات علمية، تؤدي القدرة على تحليل بيانات أكثر إلى دقة أو إتقان أعلى في النتائج عادةً. وقد أظهر عمل Gustafson إمكانية الحصول على تسريعات كبيرة على أعداد كبيرة من المعالجات، وأعاد إحياء الاهتمام بالمعالجة المتوازية2.
قابلية التوسع
نصف برنامجًا بـقابل للتوسع (scalable) إذا رأينا أداءً متحسنًا (أو ثابتًا) كلما زدنا عدد الموارد (الأنوية والمعالجات) أو حجم المسألة. وثمة مفهومان مرتبطان هما التوسع القوي (strong scaling) والتوسع الضعيف (weak scaling). ومن المهم ملاحظة أن «الضعيف» و«القوي» في هذا السياق لا يدلان على جودة قابلية توسع البرنامج، بل هما مجرد طريقتين مختلفتين لقياس قابلية التوسع.
نقول إن برنامجًا قابل للتوسع بقوة إذا أدت زيادة عدد الأنوية/وحدات المعالجة على حجم مسألة ثابت إلى تحسن في الأداء. ويُظهر البرنامج قابلية توسع قوية خطية إذا كان تسريعه على n من الأنوية مساويًا n أيضًا. وبالطبع، يضمن قانون Amdahl أنه بعد نقطة ما تصبح إضافة أنوية إضافية بلا معنى تقريبًا.
ونقول إن برنامجًا قابل للتوسع بضعف إذا أدت زيادة حجم البيانات بالمعدل نفسه الذي يزداد به عدد الأنوية (أي إذا كان هناك حجم بيانات ثابت لكل نواة/معالج) إلى أداء ثابت أو متحسن. ونقول إن برنامجًا يُظهر قابلية توسع ضعيفة خطية إذا رأينا تحسنًا بمقدار n عند زيادة العمل لكل نواة بمعامل n.
نصائح عامة بشأن قياس الأداء
نختم مناقشتنا للأداء ببعض الملاحظات عن القياس المرجعي والأداء على الأنوية الفائقة الخيوط.
شغّل البرنامج مرات متعددة عند القياس المرجعي.
في كثير من الأمثلة المعروضة حتى الآن في هذا الكتاب، نشغّل برنامجًا مرة واحدة فقط للإحساس بزمن تشغيله. لكن هذا لا يكفي للقياسات المرجعية الرسمية. فتشغيل البرنامج مرة واحدة ليس أبدًا مقياسًا دقيقًا لزمن تشغيله الحقيقي! فقد تؤدي تبديلات السياق والعمليات الأخرى العاملة إلى تذبذب زمن التشغيل جذريًا مؤقتًا. ولذلك من الأفضل دائمًا تشغيل البرنامج عدة مرات والإبلاغ عن زمن تشغيل متوسط مع أكبر قدر ممكن من التفاصيل، بما في ذلك عدد التشغيلات وتغير القياسات الملاحظ (مثل أشرطة الخطأ والحد الأدنى والحد الأقصى والوسيط والانحراف المعياري) والظروف التي أُخذت فيها القياسات.
كن حذرًا في موضع قياس التوقيت.
تفيد الدالة gettimeofday في المساعدة على قياس الوقت الذي يستغرقه البرنامج قياسًا دقيقًا. لكن يمكن أيضًا إساءة استخدامها. ومع أن وضع نداء gettimeofday حول مكوّن إنشاء الخيوط وضمّها فقط في main قد يغريك، فمن المهم التفكير فيما تريد قياسه بالضبط. فمثلًا، إذا قرأ برنامج ملف بيانات خارجيًا كجزء ضروري من تنفيذه، فيُرجَّح أن يُدرج زمن قراءة الملف في قياس البرنامج.
كن منتبهًا لأثر الأنوية الفائقة الخيوط.
كما نوقش في مقدمة هذا الفصل وقسم تعدد خيوط العتاد، تستطيع الأنوية الفائقة الخيوط (المنطقية) تنفيذ خيوط متعددة على نواة واحدة. وفي نظام رباعي الأنوية بخيطين منطقيين لكل نواة، نقول إن في النظام ثمانية أنوية فائقة الخيوط. وينتج عن تشغيل برنامج على التوازي على ثمانية أنوية منطقية في كثير من الحالات زمن حائطي أفضل من تشغيله على أربع أنوية. لكن بسبب تنازع الموارد الذي يحدث عادةً مع الأنوية الفائقة الخيوط، قد ترى انخفاضًا في كفاءة الأنوية وتسريعًا غير خطي.
احترس من تنازع الموارد.
عند القياس المرجعي، من المهم دائمًا مراعاة العمليات والتطبيقات المتعددة الخيوط الأخرى العاملة على النظام. وإذا بدت نتائج أدائك غريبة بعض الشيء، فمن الجدير تشغيل top بسرعة لرؤية ما إذا كان هناك مستخدمون آخرون يشغّلون أيضًا مهام كثيفة الموارد على النظام نفسه. وإن كان الأمر كذلك، فحاول استخدام نظام مختلف للقياس المرجعي (أو انتظر حتى لا يكون النظام مستخدمًا بكثافة).
المراجع
- جون غوستافسون. «Reevaluating Amdahl’s law». Communications of the ACM 31(5)، ص. 532—533. ACM. 1988.
- كارولين كونور. «Movers and Shakers in HPC: John Gustafson». HPC Wire. http://www.hpcwire.com/hpcwire/2010-10-20/movers_and_shakers_in_hpc_john_gustafson.html
قد يكون لذاكرات التخزين المؤقت في الأنظمة متعددة الأنوية آثار عميقة في أداء برنامج متعدد الخيوط. لكن أولًا، لنراجع سريعًا بعض المفاهيم الأساسية المرتبطة بتصميم الذاكرة المؤقتة:
- لا تُنقل البيانات/التعليمات إلى الذاكرة المؤقتة منفردةً. بل تُنقل البيانات في كتل، وتميل أحجام الكتل إلى الكبر في المستويات الأدنى من هرم الذاكرة.
- تُنظَّم كل ذاكرة مؤقتة في سلسلة من المجموعات، ولكل مجموعة عدد من الأسطر. ويحمل كل سطر كتلة بيانات واحدة.
- تُستخدم بتات عنوان الذاكرة الفردية لتحديد أي مجموعة ووسم وإزاحة كتلة في الذاكرة المؤقتة تُكتب فيها كتلة بيانات.
- تحدث إصابة في الذاكرة المؤقتة عندما توجد كتلة البيانات المطلوبة في الذاكرة المؤقتة. وإلا تحدث إخفاق في الذاكرة المؤقتة، ويُجرى بحث في المستوى الأدنى التالي من هرم الذاكرة (الذي قد يكون ذاكرة مؤقتة أو الذاكرة الرئيسية).
- يدل بت الصلاحية على ما إذا كانت الكتلة عند سطر معين في الذاكرة المؤقتة آمنة للاستخدام. وإذا كان بت الصلاحية 0، فلا يمكن استخدام كتلة البيانات عند ذلك السطر (مثلًا، قد تحتوي الكتلة بيانات من عملية منتهية).
- تُكتب المعلومات في الذاكرة المؤقتة/الذاكرة وفق استراتيجيتين رئيسيتين. في استراتيجية الكتابة المباشرة، تُكتب البيانات في الذاكرة المؤقتة والذاكرة الرئيسية في الوقت نفسه. وفي استراتيجية الكتابة المرتجعة، تُكتب البيانات في الذاكرة المؤقتة فقط، وتُكتب إلى المستويات الأدنى من الهرم بعد إخلاء الكتلة من الذاكرة المؤقتة.
14.5.1. الذاكرات المؤقتة في الأنظمة متعددة الأنوية
تذكّر أنه في معماريات الذاكرة المشتركة يمكن أن تملك كل نواة ذاكرتها المؤقتة الخاصة، ويمكن أن تتشارك أنوية متعددة ذاكرة مؤقتة مشتركة. ويعرض الشكل 1 مثالًا على وحدة معالجة مركزية ثنائية الأنوية. ومع أن كل نواة تملك ذاكرتها المؤقتة L1 المحلية، فإن الأنوية تتشارك ذاكرة L2 مؤقتة مشتركة.
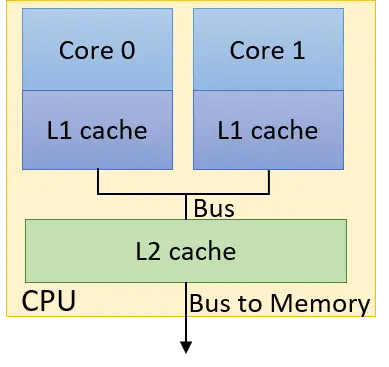 الشكل 1. مثال على معالج ثنائي الأنوية بذاكرتين مؤقتيتين L1 منفصلتين وذاكرة مؤقتة L2 مشتركة
قد تنفّذ خيوط متعددة في ملف تنفيذي واحد دوال منفصلة. ومن دون استراتيجية تماسك الذاكرة المؤقتة تضمن أن كل ذاكرة مؤقتة تحافظ على رؤية متسقة للذاكرة المشتركة، يمكن تحديث المتغيرات المشتركة تحديثًا غير متسق. وكمثال، فكّر في المعالج ثنائي الأنوية في الشكل 1، حيث تكون كل نواة مشغولة بتنفيذ خيوط منفصلة بالتزامن. وللخيط المسند إلى النواة 0 متغير محلي x، وللخيط المنفّذ على النواة 1 متغير محلي y، ولكلا الخيطين وصول مشترك إلى متغير عام g. ويعرض الجدول 1 مسارًا ممكنًا للتنفيذ.
| الزمن | النواة 0 | النواة 1 |
|---|---|---|
| 0 | g = 5 | (عمل آخر) |
| 1 | (عمل آخر) | y = g*4 |
| 2 | x += g | y += g*2 |
لنفترض أن القيمة الأولية لـ g هي 10، والقيمتين الأوليتين لـ x وy كلتاهما 0. ما القيمة النهائية لـ y في نهاية هذا التسلسل من العمليات؟ من دون تماسك الذاكرة المؤقتة، يصعب جدًا الإجابة عن هذا السؤال، بما أن هناك ثلاث قيم مخزَّنة لـ g على الأقل: واحدة في ذاكرة L1 المؤقتة للنواة 0، وواحدة في ذاكرة L1 المؤقتة للنواة 1، ونسخة منفصلة من g مخزَّنة في ذاكرة L2 المشتركة.
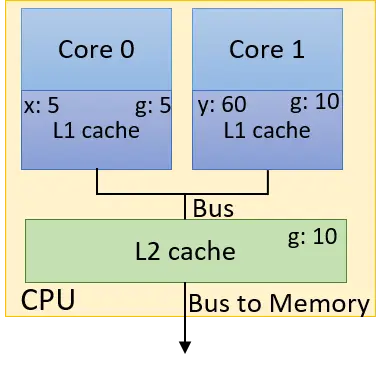 الشكل 2. تحديث مشكلل للذاكرات المؤقتة التي لا تستخدم تماسك الذاكرة المؤقتة
ويعرض الشكل 2 نتيجة خاطئة ممكنة بعد اكتمال تسلسل العمليات في الجدول 1. لنفترض أن ذاكرات L1 المؤقتة تنفّذ سياسة الكتابة المرتجعة. فعندما يكتب الخيط المنفّذ على النواة 0 القيمة 5 في g، لا يحدّث إلا قيمة g في ذاكرة L1 المؤقتة للنواة 0. وتبقى قيمة g في ذاكرة L1 المؤقتة للنواة 1 مساوية 10، وكذلك النسخة في ذاكرة L2 المشتركة. وحتى لو نُفّذت سياسة الكتابة المباشرة، فلا ضمان أن تُحدَّث نسخة g المخزَّنة في ذاكرة L1 المؤقتة للنواة 1! وفي هذه الحالة، ستكون القيمة النهائية لـ y هي 60.
وتُبطل استراتيجية تماسك الذاكرة المؤقتة النسخ المخزَّنة مؤقتًا للقيم المشتركة في الذاكرات المؤقتة الأخرى أو تحدّثها عندما تُجرى كتابة في القيمة المشتركة في ذاكرة مؤقتة واحدة. وبروتوكول المعدَّلة المشتركة غير الصالحة (MSI) (المناقش بالتفصيل في الفصل 11.6) مثال على بروتوكول تماسك ذاكرة مؤقتة بالإبطال.
ومن التقنيات الشائعة لتنفيذ MSI التجسّس. وتتجنّس الذاكرة المؤقتة المتجسّسة (snoopy cache) كهذه على ناقل الذاكرة بحثًا عن إشارات كتابة محتملة. وإذا اكتشفت الذاكرة المؤقتة المتجسّسة كتابة في كتلة ذاكرة مؤقتة مشتركة، أُبطلت سطرها الحاوي تلك الكتلة. والنتيجة النهائية أن النسخة الصالحة الوحيدة من الكتلة تكون في الذاكرة المؤقتة التي كُتب فيها، بينما تُوسم جميع النسخ الأخرى من الكتلة في الذاكرات المؤقتة الأخرى غير صالحة.
ومن شأن استخدام بروتوكول MSI مع التجسّس أن يعطي الإسناد النهائي الصحيح للقيمة 30 إلى المتغير y في المثال السابق.
14.5.2. المشاركة الزائفة
يضمن تماسك الذاكرة المؤقتة الصحة، لكنه قد يضر بالأداء. تذكّر أنه عندما يحدّث الخيط g على النواة 0، تُبطل الذاكرة المؤقتة المتجسّسة ليس g فقط، بل سطر الذاكرة المؤقتة كله الذي يقع فيه g.
فكّر في محاولتنا الأولية لجعل الدالة countElems من خوارزمية CountSort متوازية. وللتيسير، أُعيد إدراج الدالة هنا:
/*parallel version of step 1 (first cut) of CountSort algorithm:
 * extracts arguments from args value
 * calculates portion of the array this thread is responsible for counting
 * computes the frequency of all the elements in assigned component and stores
 * the associated counts of each element in counts array
*/
void *countElems(void *args){
    //extract arguments
    //ommitted for brevity
    int *array = myargs->ap;
    long *counts = myargs->countp;

    //assign work to the thread
    //compute chunk, start, and end
    //ommited for brevity

    long i;
    //heart of the program
    for (i = start; i < end; i++){
        val = array[i];
        counts[val] = counts[val] + 1;
    }

    return NULL;
}
في مناقشتنا السابقة لهذه الدالة، أشرنا إلى كيف يمكن لحالات سباق البيانات أن تمنع امتلاء مصفوفة counts بالمجموعة الصحيحة من الأعداد. لنرَ ما يحدث إذا حاولنا قياس زمن هذه الدالة. نضيف شيفرة قياس إلى main باستخدام getimeofday بالطريقة نفسها المعروضة في countElems_p_v3.c. وينتج عن القياس المرجعي للنسخة الأولية من countElems كما هي معروضة للتو على 100 مليون عنصر الأزمنة التالية:
$ ./countElems_p 100000000 0 1
Time for Step 1 is 0.336239 s

$ ./countElems_p 100000000 0 2
Time for Step 1 is 0.799464 s

$ ./countElems_p 100000000 0 4
Time for Step 1 is 0.767003 s
حتى من دون أي عناصر تزامن، فإن هذه النسخة من البرنامج تصبح أبطأ كلما زاد عدد الخيوط!
ولفهم ما يجري، لنعد إلى مصفوفة counts. تحمل مصفوفة counts تكرار حدوث كل عدد في مصفوفة إدخالنا. ويتحدد الحد الأقصى بالمتغير MAX. وفي برنامجنا المثال، MAX مضبوط على 10. وبعبارة أخرى، تشغل مصفوفة counts مساحة 40 بايتًا.
تذكّر أن تفاصيل الذاكرة المؤقتة في نظام Linux موجودة في الدليل /sys/devices/system/cpu/. ولكل نواة منطقية دليلها الفرعي الخاص المسمى cpuk حيث k يدل على النواة المنطقية kth. ولكل دليل فرعي cpu بدوره أدلة index منفصلة تدل على الذاكرات المؤقتة المتاحة لتلك النواة.
وتحتوي أدلة index ملفات فيها تفاصيل كثيرة عن الذاكرات المؤقتة لكل نواة منطقية. وتُعرض محتويات دليل index0 نموذجي هنا (index0 يقابل عادةً ذاكرة L1 المؤقتة في نظام Linux):
$ ls /sys/devices/system/cpu/cpu0/cache/index0
coherency_line_size      power            type
level                    shared_cpu_list  uevent
number_of_sets           shared_cpu_map   ways_of_associativity
physical_line_partition  size
ولمعرفة حجم سطر الذاكرة المؤقتة L1، استخدم هذا الأمر:
$ cat /sys/devices/system/cpu/cpu0/cache/index0/coherency_line_size
64
وتكشف المخرجات أن حجم سطر ذاكرة L1 المؤقتة للآلة هو 64 بايتًا. وبعبارة أخرى، فإن مصفوفة counts البالغة 40 بايتًا تتسع داخل سطر ذاكرة مؤقتة واحد.
تذكّر أنه مع بروتوكولات تماسك الذاكرة المؤقتة بالإبطال مثل MSI، في كل مرة يحدّث فيها برنامج متغيرًا مشتركًا، يُبطل سطر الذاكرة المؤقتة كله في الذاكرات المؤقتة الأخرى التي تخزّن المتغير. لنفكّر فيما يحدث عندما ينفّذ خيطان الدالة السابقة. ويُعرض مسار تنفيذ ممكن في الجدول 2 (بافتراض أن كل خيط مسند إلى نواة منفصلة، وأن المتغير x محلي لكل خيط).
| الزمن | الخيط 0 | الخيط 1 |
|---|---|---|
| i | يقرأ array[x] (1) | … |
| i+1 | يزيد counts[1] (يبطل سطر الذاكرة المؤقتة) | يقرأ array[x] (4) |
| i+2 | يقرأ array[x] (6) | يزيد counts[4] (يبطل سطر الذاكرة المؤقتة) |
| i+3 | يزيد counts[6] (يبطل سطر الذاكرة المؤقتة) | يقرأ array[x] (2) |
| i+4 | يقرأ array[x] (3) | يزيد counts[2] (يبطل سطر الذاكرة المؤقتة) |
| i+5 | يزيد counts[3] (يبطل سطر الذاكرة المؤقتة) | … |
- خلال الخطوة الزمنية i، يقرأ الخيط 0 القيمة عند
array[x]في جزئه من المصفوفة، وهي 1 في هذا المثال. - وخلال الخطوات الزمنية i + 1 إلى i + 5، يقرأ كل خيط قيمة من
array[x]. لاحظ أن كل خيط ينظر إلى مكوّنات مختلفة من المصفوفة. وليس هذا فحسب، بل تعطي كل قراءة منarrayفي تنفيذنا النموذجي قيمًا فريدة (فلا حالات سباق في هذا التسلسل التنفيذي النموذجي!). وبعد قراءة القيمة منarray[x]، يزيد كل خيط القيمة المرتبطة بها فيcounts. - تذكّر أن مصفوفة
countsتتسع في سطر ذاكرة مؤقتة واحد في ذاكرة L1 المؤقتة لدينا. ونتيجة لذلك، تُبطل كل كتابة فيcountsالسطر كله في كل ذاكرة L1 مؤقتة أخرى. - والنتيجة النهائية أنه رغم تحديث مواقع ذاكرة مختلفة في
counts، فإن أي سطر ذاكرة مؤقتة يحتويcountsيُبطل مع كل تحديث لـcounts!
ويجبر الإبطال جميع ذاكرات L1 المؤقتة على تحديث السطر بنسخة «صالحة» من L2. والتكرار المتواصل لإبطال أسطر من ذاكرة L1 والكتابة فوقها مثال على الخبط (thrashing)، حيث تسبب التعارضات المتكررة في الذاكرة المؤقتة سلسلة من الإخفاقات.
وتزيد إضافة مزيد من الأنوية المشكلة سوءًا، بما أن ذاكرات L1 مؤقتة أكثر تُبطل السطر الآن. ونتيجة لذلك، تؤدي إضافة خيوط إضافية إلى إبطاء زمن التشغيل، رغم أن كل خيط يصل إلى عناصر مختلفة من مصفوفة counts! وهذا مثال على المشاركة الزائفة (false sharing)، أو الوهم بأن عناصر فردية يتشاركها عدة أنوية. وفي المثال السابق، يبدو أن جميع الأنوية تصل إلى العناصر نفسها من counts، حتى لو لم يكن الأمر كذلك.
14.5.3. إصلاح المشاركة الزائفة
من طرق إصلاح حالة مشاركة زائفة حشو المصفوفة (في حالتنا counts) بعناصر إضافية بحيث لا تتسع في سطر ذاكرة مؤقتة واحد. لكن الحشو قد يهدر الذاكرة، وقد لا يزيل المشكلة من جميع المعماريات (فكّر في سيناريو تكون فيه آلتان مختلفتان بأحجام ذاكرة L1 مؤقتة مختلفة). وفي معظم الحالات، لا تستحق كتابة شيفرة تدعم أحجام ذاكرات مؤقتة مختلفة المكسب في الأداء.
والحل الأفضل أن يكتب الخيوط في تخزين محلي كلما أمكن. والتخزين المحلي في هذا السياق يشير إلى ذاكرة محلية لخيط. ويقلل الحل التالي المشاركة الزائفة باختيار إجراء تحديثات على نسخة معلنة محليًا من counts تُسمى local_counts.
لنعد إلى النسخة النهائية من دالتنا countElems (معادة من countElems_p_v3.c):
/*parallel version of CountSort algorithm step 1 (final attempt with mutexes):
 * extracts arguments from args value
 * calculates the portion of the array this thread is responsible for counting
 * computes the frequency of all the elements in assigned component and stores
 * the associated counts of each element in counts array
*/
void *countElems( void *args ){
    //extract arguments
    //omitted for brevity
    int *array = myargs->ap;
    long *counts = myargs->countp;

    long local_counts[MAX] = {0}; //local declaration of counts array

    //assign work to the thread
    //compute chunk, start, and end values (omitted for brevity)

    long i;

    //heart of the program
    for (i = start; i < end; i++){
        val = array[i];
        local_counts[val] = local_counts[val] + 1; //update local counts array
    }

    //update to global counts array
    pthread_mutex_lock(&mutex); //acquire the mutex lock
    for (i = 0; i < MAX; i++){
        counts[i] += local_counts[i];
    }
    pthread_mutex_unlock(&mutex); //release the mutex lock

    return NULL;
}
واستخدام local_counts لتجميع التكرارات بدلًا من counts هو المصدر الرئيسي لتقليل المشاركة الزائفة في هذا المثال:
for (i = start; i < end; i++){
    val = array[i];
    local_counts[val] = local_counts[val] + 1; //updates local counts array
}
ولأن تماسك الذاكرة المؤقتة يهدف إلى الحفاظ على رؤية متسقة للذاكرة المشتركة، فلا تُفعَّل عمليات الإبطال إلا على الكتابات في القيم المشتركة في الذاكرة. ولأن local_counts غير مشتركة بين الخيوط المختلفة، فإن الكتابة فيها لن تبطل سطر الذاكرة المؤقتة المرتبط بها.
وفي المكوّن الأخير من الشيفرة، يفرض القفل الصحة بضمان ألا يحدّث مصفوفة counts المشتركة إلا خيط واحد في المرة:
//update to global counts array
pthread_mutex_lock(&mutex); //acquire the mutex lock
for (i = 0; i < MAX; i++){
    counts[i] += local_counts[i];
}
pthread_mutex_unlock(&mutex); //release the mutex lock
ولأن counts تقع على سطر ذاكرة مؤقتة واحد، فسيظل يُبطل مع كل كتابة. والفرق أن العقوبة هنا MAX × t كتابة على الأكثر مقابل n كتابة، حيث n طول مصفوفة إدخالنا وt عدد الخيوط المستخدمة.
حتى الآن، غطينا عناصر التزامن التي يمكن للمبرمجين استخدامها لضمان اتساق برامجهم متعددة الخيوط وصحتها بغض النظر عن عدد الخيوط المستخدم. لكن ليس من الآمن دائمًا افتراض أن دوال مكتبة C القياسية يمكن استخدامها «كما هي» في سياق أي تطبيق متعدد الخيوط. فليست كل الدوال في مكتبة C آمنة للخيوط (thread safe)، أو قادرة على التشغيل بواسطة خيوط متعددة مع ضمان نتيجة صحيحة بلا آثار جانبية غير مقصودة. ولضمان أن البرامج التي نكتبها آمنة للخيوط، من المهم استخدام عناصر التزامن الأولية مثل أقفال التبادل المتبادل والحواجز لفرض اتساق البرامج متعددة الخيوط وصحتها بغض النظر عن تغير عدد الخيوط.
وثمة مفهوم آخر وثيق الصلة بأمان الخيوط هو إعادة الدخول. فجميع الشيفرة الآمنة للخيوط قابلة لإعادة الدخول؛ لكن ليست كل شيفرة قابلة لإعادة الدخول آمنة للخيوط. وتكون الدالة قابلة لإعادة الدخول (re-entrant) إذا أمكن إعادة تنفيذها/تنفيذها جزئيًا بواسطة دالة من دون إحداث مشكلة. وبحكم التعريف، تضمن الشيفرة القابلة لإعادة الدخول أن تؤدي عمليات الوصول إلى الحالة العامة للبرنامج دائمًا إلى بقاء تلك الحالة العامة متسقة. ومع أن إعادة الدخول تُستخدم كثيرًا (استخدامًا خاطئًا) كمرادف لأمان الخيوط، فثمة حالات خاصة تكون فيها الشيفرة القابلة لإعادة الدخول غير آمنة للخيوط.
عند كتابة شيفرة متعددة الخيوط، تحقق من أن دوال مكتبة C المستخدمة آمنة للخيوط فعلًا. لحسن الحظ، قائمة دوال مكتبة C غير الآمنة للخيوط صغيرة نسبيًا. وتحتفظ The Open Group مشكورةً بـقائمة بالدوال غير الآمنة للخيوط.
14.6.1. إصلاح مشكلات أمان الخيوط
عناصر التزامن الأولية هي الطريقة الأكثر شيوعًا لإصلاح المشكلات المرتبطة بأمان الخيوط. لكن استخدام دوال مكتبة C غير الآمنة للخيوط من دون علم قد يسبب مشكلات دقيقة. لننظر في نسخة معدّلة قليلًا من دالتنا countsElem تُسمى countElemsStr، تحاول إحصاء تكرار الأرقام في سلسلة نصية معينة، حيث يُفصل بين كل رقم ورقم بمسافات. وقد حُرّر البرنامج التالي للإيجاز؛ والشيفرة الكاملة لهذا البرنامج متاحة في: countElemsStr.c.
/* computes the frequency of all the elements in the input string and stores
 * the associated counts of each element in the array called counts. */
void countElemsStr(int *counts, char *input_str) {
    int val, i;
    char *token;
    token = strtok(input_str, " ");
    while (token != NULL) {
        val = atoi(token);
        counts[val] = counts[val] + 1;
        token = strtok(NULL, " ");
    }
}

/* main function:
 * calls countElemsStr on a static string and counts up all the digits in
 * that string. */
int main( int argc, char **argv ) {
    //lines omitted for brevity, but gets user defined length of string

    //fill string with n digits
    char *inputString = calloc(length * 2, sizeof(char));
    fillString(inputString, length * 2);

    countElemsStr(counts, inputString);

    return 0;
}
الدالة countElemsStr تستخدم الدالة strtok (كما نظرنا في نقاشنا عن السلاسل) لتحليل كل رقم (المخزَّن في token) في السلسلة، قبل تحويله إلى عدد صحيح وإجراء التحديثات المرتبطة به في مصفوفة counts.
يُنتج تصريف وتشغيل هذا البرنامج على 100,000 عنصر المخرجات التالية:
$ gcc -o countElemsStr countElemsStr.c

$ ./countElemsStr 100000 1
contents of counts array:
9963 9975 9953 10121 10058 10017 10053 9905 9915 10040
والآن، لننظر إلى نسخة متعددة الخيوط من countElemsStr (المصدر الكامل للبرنامج متاح هنا):
/* parallel version of countElemsStr (First cut):
 * computes the frequency of all the elements in the input string and stores
 * the associated counts of each element in the array called counts
*/
void *countElemsStr(void *args) {
    //parse args
    struct t_arg *myargs = (struct t_arg *)args;
    //omitted for brevity

    //local variables
    int val, i;
    char *token;
    int local_counts[MAX] = {0};

    //compute local start and end values and chunk size:
    //omitted for brevity

    //tokenize values
    token = strtok(input_str + start, " ");
    while (token != NULL) {
        val = atoi(token); //convert to an int
        local_counts[val] = local_counts[val] + 1; //update associated counts
        token = strtok(NULL, " ");
    }

    pthread_mutex_lock(&mutex);
    for (i = 0; i < MAX; i++) {
        counts[i] += local_counts[i];
    }
    pthread_mutex_unlock(&mutex);

    return NULL;
}
في هذه النسخة من البرنامج، تعالج كل خيط قسمًا منفصلًا من السلسلة المرجَّة بـinput_str. تضمن مصفوفة local_counts أن تقع معظم عمليات الكتابة على التخزين المحلي. ويُستخدم قفل التبادل المتبادل لضمان عدم كتابة خيطين اثنين إلى المتغير المشترك counts.
ومع ذلك، يُنتج تصريف وتشغيل هذا البرنامج النتائج التالية:
$ gcc -o countElemsStr_p countElemsStr_p.c -pthread

$ ./countElemsStr_p 100000 1 1
contents of counts array:
9963 9975 9953 10121 10058 10017 10053 9905 9915 10040

$ ./countElemsStr_p 100000 1 2
contents of counts array:
498 459 456 450 456 471 446 462 450 463

$ ./countElemsStr_p 100000 1 4
contents of counts array:
5038 4988 4985 5042 5056 5013 5025 5035 4968 5065
على الرغم من استخدام أقفال قفل التبادل المتبادل حول الوصولات إلى مصفوفة counts، فإن نتائج التشغيلات المنفصلة تختلف جذريًا. ينشأ هذا الأمر لأن الدالة countsElemsStr ليست آمنة للخيوط، لأن دالة مكتبة السلاسل strtok ليست آمنة للخيوط! يؤكد زيارة موقع OpenGroup أن strtok مدرجة في قائمة الدوال غير الآمنة للخيوط.
ولإصلاح هذا الأمر، يكفي استبدال strtok بالبديل الآمن للخيوط strtok_r. وفي الدالة الأخيرة، يُستخدم مؤشر معامل أخير لمساعدة الخيط على تتبّع موقعه في السلسلة أثناء تحليلها. وإليك الدالة المصحَّحة بـstrtok_r (المصدر الكامل هنا (countsElemsStr_p_v2.c):
/* parallel version of countElemsStr (First cut):
 * computes the frequency of all the elements in the input string and stores
 * the associated counts of each element in the array called counts */
void* countElemsStr(void* args) {
    //parse arguments
    //omitted for brevity

    //local variables
    int val, i;
    char * token;
    int local_counts[MAX] = {0};
    char * saveptr; //for saving state of strtok_r

    //compute local start and end values and chunk size:
    //omitted for brevity

    //tokenize values
    token = strtok_r(input_str+start, " ", &saveptr);
    while (token != NULL) {
        val = atoi(token); //convert to an int
        local_counts[val] = local_counts[val]+1; //update associated counts
        token = strtok_r(NULL, " ", &saveptr);
    }

    pthread_mutex_lock(&mutex);
    for (i = 0; i < MAX; i++) {
        counts[i]+=local_counts[i];
    }
    pthread_mutex_unlock(&mutex);

    return NULL;
}
التغيير الوحيد في هذه النسخة من الشيفرة هو إعلان مؤشر الأحرف saveptr واستبدال جميع حالات strtok بـstrtok_r. يُنتج إعادة تشغيل الشيفرة بهذه التغييرات المخرجات التالية:
$ gcc -o countElemsStr_p_v2 countElemsStr_p_v2.c -pthread

$ ./countElemsStr_p_v2 100000 1 1
contents of counts array:
9963 9975 9953 10121 10058 10017 10053 9905 9915 10040

$ ./countElemsStr_p_v2 100000 1 2
contents of counts array:
9963 9975 9953 10121 10058 10017 10053 9905 9915 10040

$ ./countElemsStr_p_v2 100000 1 4
contents of counts array:
9963 9975 9953 10121 10058 10017 10053 9905 9915 10040
الآن يُنتج البرنامج النتيجة نفسها في كل تشغيل. تضمن استخدام saveptr بالاشتراك مع strtok_r أن يكون كل خيط قادرًا على تتبّع موقعه باستقلالية أثناء تحليل السلسلة.
الفكرة الأساسية من هذا القسم هي أنه ينبغي دائمًا الاطلاع على قائمة الدوال غير الآمنة للخيوط في C عند كتابة تطبيقات متعددة الخيوط. فهذا يمكن أن يوفّر على المبرمج كثيرًا من الألم والإحباط عند كتابة تطبيقات الخيوط وتصحيح أخطائها.
حتى الآن، قدّمنا البرمجة بالذاكرة المشتركة باستخدام خيوط POSIX. ومع أن Pthreads ممتازة للتطبيقات البسيطة، إلا أنها تصبح صعبة الاستخدام بشكل متزايد كلما أصبحت البرامج نفسها أكثر تعقيدًا. وتمثل خيوط POSIX مثالًا على البرمجة التوازية الصريحة للخيوط، إذ تلزم المبرمج بتحديد بدقة ما يجب أن ينفّذه كل خيط ومتى يبدأ كل خيط ومتى يتوقف.
مع Pthreads، قد يكون من الصعب أيضًا إضافة التوازي تدريجيًا إلى برنامج تتابعي موجود. أي أنه يلزم إعادة كتابة البرنامج بالكامل غالبًا لاستخدام الخيوط، وهو ما ليس مرغوبًا غالبًا عند محاولة موازاة قاعدة شيفرة كبيرة موجودة.
تنفّذ مكتبة Open Multiprocessing (OpenMP) بديلًا ضمنيًا لـPthreads. وOpenMP مدمجة في GCC وغيرها من المترجمات الشائعة مثل LLVM وClang، ويمكن استخدامها مع لغات البرمجة C وC++ وFortran. ومن ميزة أساسية لـOpenMP أنها تمكن المبرمجين من موازاة مكوّنات شيفرة C موجودة وتتابعة بإضافة توجيهات (pragmas) (وهي توجيهات مترجم خاصة) إلى أجزاء من الشيفرة. وتبدأ التوجيهات الخاصة بـOpenMP بـ#pragma omp.
التغطية التفصيلية لـOpenMP خارج نطاق هذا الكتاب، لكننا نغطي بعض التوجيهات الشائعة، ونُظهر كيف يمكن استخدام عدة منها في سياق بعض التطبيقات النموذجية.
14.7.1. التوجيهات الشائعة (pragmas)
وإليكم بعض التوجيهات الأكثر استخدامًا في برامج OpenMP:
#pragma omp parallel
ينشئ هذا التوجيه فريقًا من الخيوط ويُكلِّف كل خيط بتشغيل شيفرة نطاقه (وهي عادة نداء دالة) على كل خيط. ونداء هذا التوجيه يعادل عادةً نداء زوج الدالتين pthread_create وpthread_join الذي ناقشناه في مناقشتنا الأصلية لـPthreads. وقد يحتوي التوجيه على عدد من العبارات (clauses)، بما في ذلك ما يلي:
num_threadsيحدد عدد الخيوط المراد إنشاؤها.privateقائمة من المتغيرات التي ينبغي أن تكون خاصة (أو محلية) بكل خيط. ويمكن أيضًا إعلان المتغيرات التي ينبغي أن تكون خاصة بخيط داخل نطاق التوجيه (انظر أدناه لمثال). ويحصل كل خيط على نسخته الخاصة من كل متغير.sharedقائمة بالمتغيرات التي ينبغي أن تتشاركها الخيوط. فتوجد نسخة واحدة من المتغير تتشاركها جميع الخيوط.defaultيشير إلى ما إذا كان تحديد المتغيرات التي ينبغي أن تكون مشتركة متروكًا للمترجم. وفي معظم الحالات، نريد استخدامdefault(none)وتحديد صراحةً أي المتغيرات ينبغي أن تكون مشتركة وأيّها ينبغي أن يكون خاصًا.
#pragma omp for
يحدد أن ينفّذ كل خيط مجموعة جزئية من تكرارات حلقة for. ومع أن جدولة الحلقات متروكة للنظام، فالافتراض عادةً هو طريقة «التقطيع» (chunking) التي ناقشناها أولًا في مثال الضرب القياسي. وهذا شكل ثابت من الجدولة: يحصل كل خيط على كتلة مُسندة إليه، ثم يعالج التكرارات في كتلته. غير أن OpenMP يجعل الجدولة الديناميكية أيضًا سهلة. وفي الجدولة الديناميكية، يحصل كل خيط على عدد من التكرارات، ويطلب مجموعة جديدة عند إتمام معالجة تكراراته. ويمكن ضبط سياسة الجدولة باستخدام العبارة التالية:
schedule(dynamic): يحدد أنه ينبغي استخدام شكل ديناميكي من الجدولة. ومع أن هذا مفيد في بعض الحالات، فإن الشكل الثابت (الافتراضي) من الجدولة عادةً أسرع.
#pragma omp parallel for
هذا التوجيه مزيج من التوجيهين omp parallel وomp for. وعلى عكس التوجيه omp for، يُنشئ التوجيه omp parallel for فريقًا من الخيوط أيضًا قبل إسناد مجموعة من تكرارات الحلقة إلى كل خيط.
#pragma omp critical
يُستخدم هذا التوجيه لتحديد أن ينبغي التعامل مع شيفرة نطاقه كـقسم حرج — أي أنه ينبغي لخيط واحد فقط أن ينفّذ قسم الشيفرة في وقت واحد لضمان سلوك صحيح.
وهناك أيضًا عدة دوال يستطيع الخيط الوصول إليها تفيد كثيرًا أثناء التنفيذ. فمثلًا:
omp_get_num_threads
تُعيد عدد الخيوط في الفريق الحالي قيد التنفيذ.
omp_set_num_threads
تضبط عدد الخيوط الذي ينبغي أن يمتلكه فريق.
omp_get_thread_num
تُعيد معرّف الخيط النداء.
تحذير — التوجيه omp parallel for يعمل مع حلقات for فقط!
تذكّر أن التوجيه
omp parallel forيعمل فقط مع حلقاتfor. ولا تُدعم أنواع حلقات أخرى، مثل حلقاتwhileوحلقاتdo-while.
14.7.2. مرحّبا بالتعدد الخيطي: بأسلوب OpenMP
لنعد إلى برنامج «Hello World» (hellothreads.c)، هذه المرة باستخدام OpenMP بدلًا من Pthreads:
#include <stdio.h>
#include <stdlib.h>
#include <omp.h>

void HelloWorld( void ) {
    long myid = omp_get_thread_num();
    printf( "Hello world! I am thread %ld\n", myid );
}

int main( int argc, char** argv ) {
    long nthreads;

    if (argc !=2) {
        fprintf(stderr, "usage: %s <n>\n", argv[0]);
        fprintf(stderr, "where <n> is the number of threads\n");
        return 1;
    }

    nthreads = strtol( argv[1], NULL, 10 );

    #pragma omp parallel num_threads(nthreads)
        HelloWorld();

    return 0;
}
لاحظ أن برنامج OpenMP أقصر بكثير من نسخة Pthreads. وللوصول إلى دوال مكتبة OpenMP، نُضمّن ملف الترويسة omp.h. ينشئ التوجيه omp parallel num_threads(nthreads) في main مجموعة من الخيوط، ينادي كل خيط منها الدالة HelloWorld. وتحدد العبارة num_threads(nthreads) إجمالي عدد الخيوط المراد توليدها. كما يضمّ التوجيه كل خيط مُنشأ عائدًا إلى عملية أحادية الخيط. وبعبارة أخرى، تُجسَّد جميع أعمال المستوى المنخفض لإنشاء الخيوط وضمّها بعيدًا عن المبرمج وتُنجَّز بتضمين توجيه واحد فقط. ولهذا السبب تُعدّ OpenMP مكتبة تعدد خيوط ضمني.
كما تجسّد OpenMP الحاجة إلى إدارة معرّفات الخيوط صراحةً. وفي سياق HelloWorld، تستخرج الدالة omp_get_thread_num المعرّف الفريد المرتبط بالخيط الذي ينفّذها.
تصريف الشيفرة
لنصريف وتشغيل هذا البرنامج، نمرّر الخيار -fopenmp إلى المصرّف، ما يشير إلى أننا نصرّف باستخدام OpenMP:
$ gcc -o hello_mp hello_mp.c -fopenmp

$ ./hello_mp 4
Hello world! I am thread 2
Hello world! I am thread 3
Hello world! I am thread 0
Hello world! I am thread 1
وبما أن تنفيذ الخيوط قد يتغير في التشغيلات اللاحقة، تُنتج إعادة تشغيل هذا البرنامج تسلسلًا مختلفًا من الرسائل:
$ ./hello_mp 4
Hello world! I am thread 3
Hello world! I am thread 2
Hello world! I am thread 1
Hello world! I am thread 0
هذا السلوك متسق مع مثالنا مع Pthreads.
14.7.3. مثال أعقد: CountSort في OpenMP
من مزايا OpenMP القوية أنها تمكن المبرمجين من موازاة شيفرتهم تدريجيًا. ولرؤية ذلك عمليًا، لنوازِ خوارزمية CountSort الأعقد التي ناقشناها سابقًا في هذا الفصل (الشيفرة التتابعية موجودة هنا: countSort.c). وتذكّر أن هذه الخوارزمية ترتيب مصفوفات تحتوي مجالًا صغيرًا من القيم. ويبدو الدالة الرئيسية للبرنامج التتابعي كالتالي:
int main( int argc, char **argv ) {
    //parse args (omitted for brevity)

    srand(10); //use of static seed ensures the output is the same every run

    //generate random array of elements of specified length
    //(omitted for brevity)

    //allocate counts array and initializes all elements to zero.
    int counts[MAX] = {0};

    countElems(counts, array, length); //calls step 1
    writeArray(counts, array); //calls step2

    free(array); //free memory

    return 0;
}
تنادي الدالة main، بعد إجراء بعض تحليل سطر الأوامر وتوليد مصفوفة عشوائية، الدالة countsElems يليها نداء الدالة writeArray.
موازاة CountElems باستخدام OpenMP
هناك عدة طرق لموازاة البرنامج أعلاه. إحدى الطريقتين (المعروضة في المثال التالي) تستخدم التوجيه omp parallel في سياق الدالتين countElems وwriteArray. ونتيجة لذلك، لا حاجة إلى إجراء أي تغييرات على الدالة main. ونسخة البرنامج الكاملة متاحة هنا: countSort_mp.c.
أولًا، لنفحص كيفية موازاة الدالة countElems باستخدام OpenMP:
void countElems(int *counts, int *array, long length) {

    #pragma omp parallel default(none) shared(counts, array, length)
    {
        int val, i, local[MAX] = {0};
        #pragma omp for
        for (i = 0; i < length; i++) {
            val = array[i];
            local[val]++;
        }

       #pragma omp critical
       {
           for (i = 0; i < MAX; i++) {
               counts[i] += local[i];
           }
       }
   }
}
في هذه النسخة من الشيفرة، تُستخدم ثلاثة توجيهات:
- يشير التوجيه
#pragma omp parallelإلى أنه ينبغي إنشاء فريق من الخيوط. يضبط السطرomp_set_num_threads(nthreads)فيmainالحجم الافتراضي لفريق الخيوط ليكونnthreads. وإذا لم تُستخدم الدالةomp_set_num_threads، فسيساوي عدد الخيوط المُسندة عدد الأنوية في النظام. وللتذكير، يُنشئ التوجيهomp parallelالخيوط ضمنيًا في بداية الكتلة ويضمّها في نهاية الكتلة. وتُستخدم الأقواس ({}) لتحديد النطاق. وتنشيء العبارةsharedالمتغيراتcountsوarrayوlengthمشتركة (عالمية) بين جميع الخيوط. وبذلك، تُعلن المتغيراتvalوiوlocal[MAX]محلية في كل خيط. - التوجيه التالي هو
#pragma omp for، الذي يوازي حلقةforبتقسيم عدد التكرارات على عدد الخيوط. تحسب OpenMP كيف تُقسَّم تكرارات الحلقة بأفضل طريقة. وكما ذُكر سابقًا، تكون الاستراتيجية الافتراضية عادةً طريقة التقطيع، حيث يحصل كل خيط على عدد متساوٍ تقريبًا من التكرارات لحسابها. وبذلك، يقرأ كل خيط مكوّنًا من المصفوفة المشتركةarrayويُراكم عدّاداته في مصفوفته المحليةlocal. - يشير التوجيه
#pragma omp criticalإلى أنه ينبغي لخيط واحد بالضبط أن ينفّذ شيفرة نطاق القسم الحرج في وقت واحد. وهذا يعادل قفل التبادل المتبادل الذي استُخدم في نسخة Pthreads من هذا البرنامج. وهنا، يزيد كل خيط من مصفوفةcountsالمشتركة واحدًا تلو الآخر.
لنحصل على فكرة عن أداء هذه الدالة بتشغيلها على 100 مليون عنصر:
$ ./countElems_mp 100000000 1
Run Time for Phase 1 is 0.249893

$ ./countElems_mp 100000000 2
Run Time for Phase 1 is 0.124462

$ ./countElems_mp 100000000 4
Run Time for Phase 1 is 0.068749
هذا أداء ممتاز، إذ حققت دالتنا تسريعًا قدره 2 بخيطين، وتسريعًا قدره 3.63 بأربعة خيوط. بل نحصل على أداء أفضل حتى من تنفيذ Pthreads!
الدالة writeArray في OpenMP
موازاة الدالة writeArray أصعب بكثير. وتُظهر الشيفرة التالية حلًا واحدًا ممكنًا:
void writeArray(int *counts, int *array) {
    int i;

    //assumed the number of threads is no more than MAX
    #pragma omp parallel for schedule(dynamic)
    for (i = 0; i < MAX; i++) {
        int j = 0, amt, start = 0;
        for (j = 0; j < i; j++) {  //calculate the "true" start position
            start += counts[j];
        }

        amt = counts[i]; //the number of array positions to fill

        //overwrite amt elements with value i, starting at position start
        for (j = start; j < start + amt; j++) {
            array[j] = i;
        }
    }
}
قبل الموازاة، أجرينا تغييرًا على هذه الدالة، لأن النسخة القديمة من writeArray جعلت j تعتمد على التكرارات السابقة للحلقة. وفي هذه النسخة، يحسب كل خيط قيمة start الفريدة له بناءً على مجموع جميع العناصر السابقة في counts.
وعند إزالة هذه التبعية، تصبح الموازاة بسيطة إلى حد كبير. يُنشئ التوجيه #pragma omp parallel for فريقًا من الخيوط ويوازي حلقة for بإسناد مجموعة جزئية من تكرارات الحلقة إلى كل خيط. وللتذكير، هذا التوجيه مزيج من التوجيهين omp parallel وomp for (الذين استُخدما في موازاة countElems).
لا تلائم طريقة التقطيع لجدولة الخيوط (كما في الدالة countElems أعلاه) هنا، لأن من المحتمل أن يكون لكل عنصر في counts تكرار جذريًا مختلف. وبذلك لن يتساوى حجم عمل الخيوط، ما يؤدي إلى إسناد عمل أكثر إلى بعض الخيوط من غيرها. ولذلك تُستخدم العبارة schedule(dynamic)، بحيث يُكمل كل خيط التكرار المُسند إليه قبل أن يطلب تكرارًا جديدًا من مدير الخيوط.
وبما أن كل خيط يكتب إلى مواقع مصفوفة متمايزة، فلا حاجة للاستبعاد المتبادل في هذه الدالة.
لاحظ كيف أن شيفرة OpenMP أنظف بكثير من تنفيذ خيوط POSIX. فالشيفرة مقروءة جدًا واحتاجت إلى تعديلات قليلة جدًا. وهذا أحد قوى التجريد، حيث تُخفى تفاصيل التنفيذ عن المبرمج.
غير أن التنازل اللازم عن التجريد هو التحكم. يفترض المبرمج أن المترجم «ذكي» بما يكفي للعناية بتفاصيل الموازاة، وبذلك يكون أسهل في موازاة تطبيقه. غير أن المبرمج لم يعد يتخذ قرارات مفصلة عن تفاصيل تلك الموازاة. وبدون فكرة واضحة حول كيفية تنفيذ توجيهات OpenMP في الخلفية، قد يكون من الصعب تصحيح أخطاء تطبيق OpenMP أو معرفة التوجيه الأنسب لاستخدامه في وقت معين.
14.7.4. معرفة المزيد عن OpenMP
مناقشة أعمق لـOpenMP تتجاوز نطاق هذا الكتاب، لكن توجد موارد مجانية مفيدة1,2 لتعلم OpenMP.
المراجع:
- بلايس بارني. «OpenMP». https://hpc.llnl.gov/tuts/openMP/
- ريتشارد براون وليبي شوب. «Multicore Programming with OpenMP». CSinParallel: Parallel Computing in the Computer Science curriculum. http://selkie.macalester.edu/csinparallel/modules/MulticoreProgramming/build/html/index.html
قدّم هذا الفصل نظرة عامة على المعالجات متعددة الأنوية وكيفية البرمجة لها. وتحديدًا، غطينا مكتبة خيوط POSIX (أو Pthreads) وكيفية استخدامها لإنشاء برامج صحيحة متعددة الخيوط تسرّع أداء برنامج أحادي الخيط. وتستخدم مكتبات مثل POSIX وOpenMP نموذج الاتصال بالذاكرة المشتركة، إذ تتشارك الخيوط بيانات في مساحة ذاكرة مشتركة.
النقاط الرئيسية
الخيوط هي الوحدة الأساسية للبرامج المتزامنة
لموازاة برنامج تتابعي، يستخدم المبرمجون بنى خفيفة تُسمى الخيوط (threads). ففي عملية متعددة خيوط بعينها، لكل خيط تخصيصه الخاص لمساحة مكدّس الذاكرة، لكنه يتشارك بيانات البرنامج وكومة تعليمات العملية. ووكما في العمليات، تعمل الخيوط على المعالج بشكل عشوائي غير حتمي (أي أن ترتيب التنفيذ يتغير بين التشغيلات، وأن إسناد كل خيط إلى أي نواة متروك لنظام التشغيل).
بنى التزامن تضمن عمل البرامج بشكل صحيح
من نتائج الذاكرة المشتركة أن تستطيع الخيوط الكتابة فوق البيانات الموجودة في الذاكرة المشتركة عن غير قصد. ويمكن أن تحدث حالة سباق (race condition) كلما حدّثت عمليتان قيمة مشتركة بشكل غير صحيح. وعندما تكون القيمة المشتركة بيانات، قد تنشأ حالة سباق خاصة تُسمى سباق بيانات (data race). وتساعد بنى التزامن (القفل المتبادل والسيمافورات وغيرها) على ضمان صحة البرنامج بضمان تنفيذ الخيوط واحدًا تلو الآخر عند تحديث المتغيرات المشتركة.
انتبه عند استخدام بنى التزامن
يُحدث التزامن بطبعه نقاطًا من الحساب التتابعي في برنامج خلاف ذلك متوازي. ومن المهم لذلك أن يكون المرء مدركًا لكيفية استخدام مفاهيم التزامن. ويُشار إلى مجموعة العمليات التي يجب أن تنفَّذ ذريةً بـالقسم الحرج (critical section). وإذا كان القسم الحرج كبيرًا جدًا، ستتنفّذ الخيوط تتابعيًا دون أي تحسن في زمن التشغيل. واستخدام بنى التزامن بطريقة رعوية قد يؤدي إلى مواقف مثل التجمّد عن غير قصد. واستراتيجية جيدة أن تستخدم الخيوط المتغيرات المحلية قدر الإمكان ولا تحدّث المتغيرات المشتركة إلا عند الضرورة.
ليس كل مكوّنات البرنامج قابلة للموازاة
بعض البرامج بالضرورة تحتوي مكوّنات تتابعة كبيرة يمكن أن تعيق أداء برنامج متعدد الخيوط على أنوية متعددة (مثلًا، قانون Amdahl). وحتى عندما تكون نسبة كبيرة من البرنامج قابلة للتوازي، نادرًا ما يكون التسريع خطيًا. ويشجَّع القراء أيضًا على النظر إلى مقاييس أخرى مثل الكفاءة وقابلية التوسع عند تقييم أداء برامجهم.
قراءات إضافية
يهدف هذا الفصل إلى منح القارئ نموذجًا أوليًا لمواضيع التزامن بالخيوط؛ وليس هو شاملًا بأي حال. ولمعرفة المزيد عن البرمجة بخيوط POSIX وOpenMP، راجع الدروس الممتازة عن Pthreads وOpenMP من Blaise Barney في مختبرات لورنس ليفرمور الوطنية. أما بالنسبة للأدوات الآلية لتصحيح أخطاء البرامج المتوازية، فيُشجَّع القراء على تجربة أداتي Valgrind وهما Helgrind وDRD.
وفي الفصل الأخير من الكتاب، نعطي نظرة عامة عالية المستوى على معماريات توازية شائعة أخرى وكيفية البرمجة لها. تابع القراءة لمعرفة المزيد.
- تمارين الفصل 14 (قيد الإعداد)
تمارين إضافية
- نفّذ برنامج scalar_multiply بالكامل. قِس زمن شيفرتك باستخدام الدالة
gettimeofday()و100 مليون عنصر. كيف يتغير الزمن كلما زددت عدد الخيوط؟ وماذا لو زددت عدد العناصر إلى مليار؟ 2 مليار؟ - حسّن دالة الخيط الأصلية
scalar multiplyبوضع جميع المعاملات فيstructوتمريرها عبر main. قِس أداء هذه النسخة من الشيفرة. هل ثمة فرق؟ (الحل) - حسّن دالة الخيط
scalar_multiplyبتنفيذ إجراء أفضل لتوزيع الحِمل. وبعبارة أخرى، نفّذ إجراء توزيع الحِمل المذكور في الملاحظة أعلاه. - باستخدام ما تعلمته، حاول تنفيذ برنامج يُجري ضرب مصفوفة في متجه. وفي ضرب المصفوفة في المتجه، يُضرب كل صف في المصفوفة في متجه معين من العناصر.
- نفّذ نسخة متوازية من الخطوة 2 من خوارزمية CountSort. قِس أداءك.
- حاول دمج الخطوة 1 والخطوة 2 من برنامج CountSort في برنامج واحد. ولفعل ذلك، ستحتاج إلى إضافة دورة أخرى من
pthread_create()وpthread_join()إلى برنامجك. - قِس الأداء الكلي لبرنامج CountSort الجديد.
- OpenMP: تفترض الدالة
writeElems()أن المستخدم يدخل عددًا من الخيوط أقل منMAX. هل من طريقة لإعادة كتابة هذه الشيفرة بحيث تعمل بصرف النظر عن عدد الخيوط؟