جلب المعلومات من ملف بيانات عبر SQL
من أكثر أيامي إنتاجية ذلك اليوم الذي تخلصت فيه من 1000 سطر من الشيفرة. —Ken Thompson
مجموعات البيانات الموجودة
رأينا في الفصل السابق كيفية إضافة بياناتك الخاصة إلى جدول عبر INSERT INTO. وفي المثال التمهيدي أخذنا بيانات مقررات من دليل البرنامج باستخدام أوراق ECTS الخاصة ببرنامجنا في علوم الحاسوب. غير أن البيانات تُجمع أحيانًا على يد أشخاص آخرين ويمكن العثور عليها في مواقع الويب. ونتحدث عندئذ عن مجموعات البيانات (datasets).
وكمثال، نأخذ مجموعة بيانات تقدّم بعض البيانات المتعلقة باستخدام الإنترنت حسب البلد. اطّلع على صفحة Kaggle: https://www.kaggle.com/datasets/ ramjasmaurya/1-gb-internet-price. وفي هذه الصفحة يقدّم المستخدم "Ram Jas Maurya" بيانات عن "أسعار الإنترنت في أكثر من 200 بلد في عام 2022". والبيانات متاحة في الملكية العامة (بلا حقوق نشر). لذا يجوز لك استخدام مجموعة البيانات هذه دون أي مشكلة.
لكن ما لا نجده للأسف هو المصادر. وينبغي أن يكون ردّ الفعل الطبيعي هو البحث عن المصادر دائمًا. فمن أين أتت البيانات التي جمعها هذا المؤلف في مجموعة البيانات هذه؟ لنجرِ فحصًا سريعًا برقم يسهل التحقق منه. سيكون في بلجيكا (وفق ويكيبيديا، والمصدر Statbel) في 1 يناير 2022 نحو 11.6 مليون نسمة. وتعطي مجموعة البيانات هذه عدد السكان 11.5 مليون. وهذا قريب جدًا. أما من أين أُخذت المعلومة عن رسوم بيانات الإنترنت لـ 1 جيجابايت فلا تعلم. وبالمناسبة، تقرأ تعليقات مشابهة في تعليقات هذه المجموعة على Kaggle.
غير أننا نريد في هذا الفصل أن نؤكد الاستخدام التعليمي لمجموعة بيانات CSV ثم يمكن أن يخدم هذا الغرض. ما دمنا لا نريد استنتاج أي "حقائق مطلقة" من هذا...
وعند كتابة هذا الفصل (14 أغسطس 2022)، كانت هناك أربع مجموعات بيانات متاحة. ونحن مهتمون بشكل خاص بـ "all_csv sorted.csv" (الإصدار 7 وقت الكتابة). وتجمع مجموعة البيانات هذه مجموعات البيانات الثلاث الأخرى في مجموعة أكبر تضم 200 صف و13 عمودًا. ويحتوي الملف على بيانات عن المتوسط والحد الأدنى والحد الأعلى لسعر 1 جيجابايت من البيانات في عام 2022 والمتوسطات في العامين السابقين (إن توفّرت). وستجد أيضًا عدد مستخدمي الإنترنت والسكان في كل بلد ومتوسط سرعة الاتصال بالميغابت في الثانية. وكما ذُكر بالفعل ويبقى مهمًا: لا علم لنا بمصدر البيانات، لذا استخدم هذه البيانات بحذر.
نزّل مجموعة البيانات هذه عبر رابط التنزيل المباشر لملف CSV هذا.
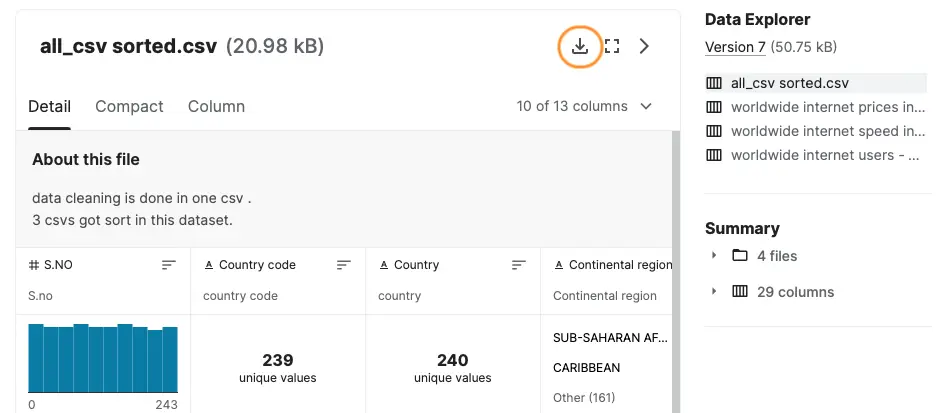
وربما تُفتح مجموعة البيانات هذه مباشرة في نافذة متصفحك. فإما أن تأمر صراحةً بتنزيل الملف المرتبط، وإما أن تحدد كامل محتوى نافذة متصفحك (ويندوز: CTRL + A، وماك: CMD + A) وتنسخ هذا المحتوى وتلصقه في ملف نصي جديد.
احفظ الملف باسم "internetprices.csv".
ملفات CSV
ملف CSV ("Comma Separated Values") هو ملف نصي عادي مفيد لتبادل البيانات بين تطبيقات مختلفة. فمثلًا، يمكنك تصدير ملف Excel بهذه الصيغة. ويوجد بين كل قيمة عمود فاصل (يمكنك غالبًا اختياره بنفسك) مثل فاصلة أو فاصلة منقوطة ونحو ذلك. ويبدأ كل صف في سطر جديد. ويبدو الملف المنزّل هكذا:
S.NO,Country code,Country,Continental region,NO. OF Internet Plans,Average price of 1GB (USD),Cheapest 1GB for 30 days (USD),Most expensive 1GB (USD),Average price of 1GB (USD at the start of 2021),Average price of 1GB (USD â€" at start of 2020),Internet users,Population, "Avg
(Mbit/s)Ookla"
0,IL,Israel,NEAR EAST,27,0.05,0.02,20.95,0. 11,0.9,"6,788,737","8,381,516",28.01
1,KG,Kyrgyzstan,CIS (FORMER USSR),20,0.15,0.1,7.08,0.21,0.27,"2,309,235","6,304,030",16.3
2,FJ,Fiji,OCEANIA,18,0. 19,0.05,0.85,0.59,3.57,"452,479","883,483",25.99
3,IT,Italy,WESTERN EUROPE,29,0.27,0.09,3.54,0.43,1.73,"50,540,000","60,627,291",37.15
…
عادةً ما يحتوي السطر الأول من ملف CSV على نوع من ترويسة الأعمدة، وهي في هذه الحالة:
- رقم (نوع الرقم التسلسلي)،
- رمز البلد المكوّن من حرفين،
- اسم البلد،
- المنطقة،
- عدد صيغ الإنترنت المختلفة،
- متوسط سعر 1 جيجابايت،
- أرخص سعر للشيء نفسه،
- أغلى سعر،
- المتوسطان للسنتين السابقتين،
- عدد مستخدمي الإنترنت،
- عدد السكان،
- متوسط معدل البيانات.
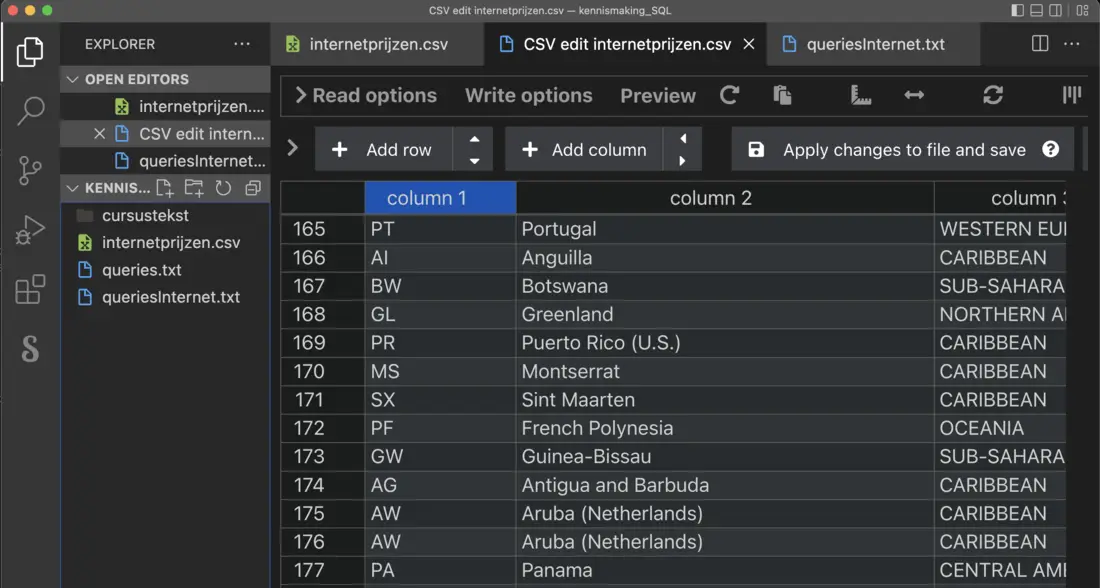
وبما أن هذا ملف نصي، يمكنك فتحه وعرضه ومعالجته بواسطة محرر. وتختار أنت المحرر الذي تستخدمه لذلك، لكننا سنستخدم في هذا المثال Visual Studio Code ("VS Code")، وهو محرر تستخدمه بلا شك في دورات أخرى (الواجهة الأمامية والبرمجة...). واقتراحنا: ثبّت في VS Code إضافة "Edit CSV" التي أنشأها شخص يُدعى janisdd. وتتيح لك هذه الإضافة العمل بعرض شبيه بجداول البيانات بصفوف وأعمدة لعرض البيانات ومعالجتها.
وهناك إضافة ثانية مفيدة لملفات CSV هي "Rainbow CSV". وهي تعطي الأعمدة المختلفة لونًا مختلفًا وبالتالي يسهل تمييزها بعضها عن بعض. ثبّت هذه الإضافة أيضًا في VS Code.
ويوضح اللقطتان أدناه ملف CSV الأصلي بدون إضافة "Rainbow CSV" ومعها. النسخة الملوّنة أسهل قراءة بكثير، أليس كذلك؟
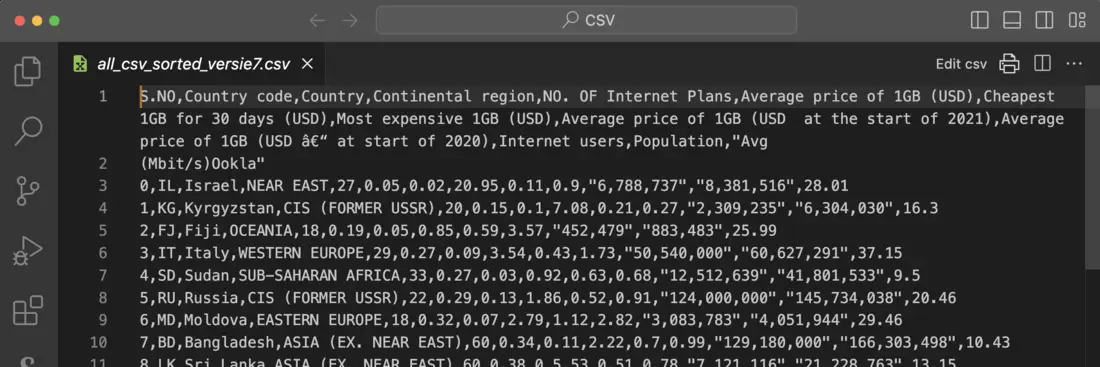
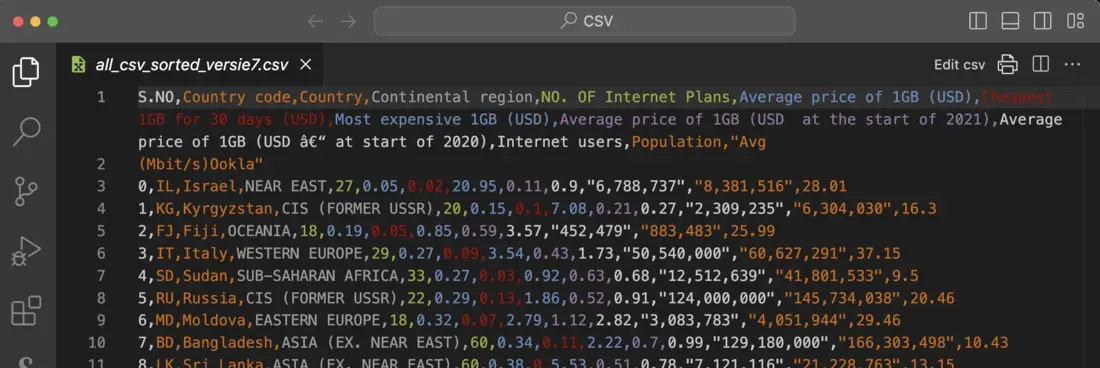
تنبيه: يوجد خطأ صغير لأن هناك "إدخالًا" (Enter) بين "Avg" و"(Mbit/s)Ookla". واحرص على إزالته حتى تكون الترويسة الكاملة في السطر الأول فقط!
وبمجرد تثبيت هذه الإضافات، افتح ملف csv وانقر على "Edit CSV" في الزاوية العلوية اليمنى. وستحصل الآن على العرض التالي للملف:
تنظيف البيانات
نادرًا ما تكون مجموعة البيانات قابلة للاستخدام دون تعديل. وتحتوي مجموعة البيانات هذه أيضًا بعض الأمور المزعجة التي تجعل تحميلها في جدول صعبًا.
أعمدة غير ضرورية
لا يمكنك تحميل بيانات CSV إلا في جدول موجود. لذا عليك أن تنشئ جدولًا جديدًا أولًا. وأنت تعرف بالفعل أن لكل جدول مفتاحًا أساسيًا: حقلًا (أو مجموعة حقول) فريدًا لكل صف. ويحتوي العمود الأول من مجموعة البيانات هذه على عدد صحيح متزايد (سنسميه لاحقًا "مفتاحًا تقنيًا"). ويمكن أن يفي هذا الغرض بالتأكيد، لكن لننظر أبعد.
يحتوي العمود الثاني على رمز بلد مكوّن من حرفين. وهذا الرمز فريد بشكل مضمون إذا اتبع المعيار. وفي الواقع، من الأفضل عندئذ استخدام هذا العمود الثاني مفتاحًا أساسيًا لجدولنا.
والعمود الأول يحتوي في الواقع على معلومات لا فائدة منها. والأفضل إزالته من الملف. وتسهّل إضافة "Edit CSV" التي ثبّتها في VS Code ذلك. فإن لم تكن فعلت ذلك من قبل، فانقر فقط على "Edit CSV" في الزاوية العلوية اليمنى. وستحصل عندئذ على عرض أعمدة للملف. ومرّر المؤشر فوق الترويسة "column 1". وسيظهر رمز سلة مهملات. انقر عليه لحذف هذا العمود.
ترميز المحارف
مرّر إلى الصف 35. لا أعرف كيف سيبدو على شاشتك، لكنني أقرأ على جهاز Mac اسم البلد "Réunion". وهذه مشكلة نمطية في ترميز المحارف. ولو أردنا اختصار القصة: فقد اتفق مصنّعو الحواسيب (منذ زمن طويل) على أي تركيبات البتات تقابل أي حرف أو رقم أو محرف. وإذا لم تستخدم ترميز المحارف نفسه المستخدم لهذا الملف، فستُفسَّر بعض الحروف تفسيرًا خاطئًا.
وترميز المحارف الأكثر استخدامًا هو UTF-8. وهو الترميز القياسي لمتصفحك ومن VS Code... وفي خادم قاعدة البيانات أيضًا يمكنك اختيار ترميز المحارف. ولنتفق على أن نختار دائمًا UTF-8. وهناك بعض أسماء البلدان التي تحتوي محارف خاصة مثل é وô وغيرها. ولنعدّلها يدويًا. وإذا واجهت صعوبة في العثور على تلك المحارف على لوحة مفاتيحك، فيمكنك دائمًا نسخها من ملف يحتوي هذه المحارف بشكل صحيح.
عدّل ما يلي (ما لم يكن صحيحًا بالفعل):
- الصف 35: Réunion
- الصف 125: Saint Barthélemy (St. Barts)
- الصف 131: Côte d'Ivoire
- الصف 139: حالة صعبة، حرف كبير سويدي: Åland Islands (والأسهل على الأرجح نسخ الحرف من هنا)
- الصف 199: Curaçao
- وأخيرًا الأصعب في الصف 229: São Tomé and Príncipe.
وبهذا انتهى هذا الجزء من "تنظيف البيانات". ويمكننا أن نتساءل بعد ذلك إن كنا نحتاج الصف الأول. من حيث المبدأ لا نحتاجه، لكنه يحتوي معلومات مفيدة تلزم لتعريف الجدول لاحقًا. علاوة على ذلك، يمكننا لاحقًا أثناء الاستيراد أن نبيّن أنه لا ينبغي استيراد الصف الأول.
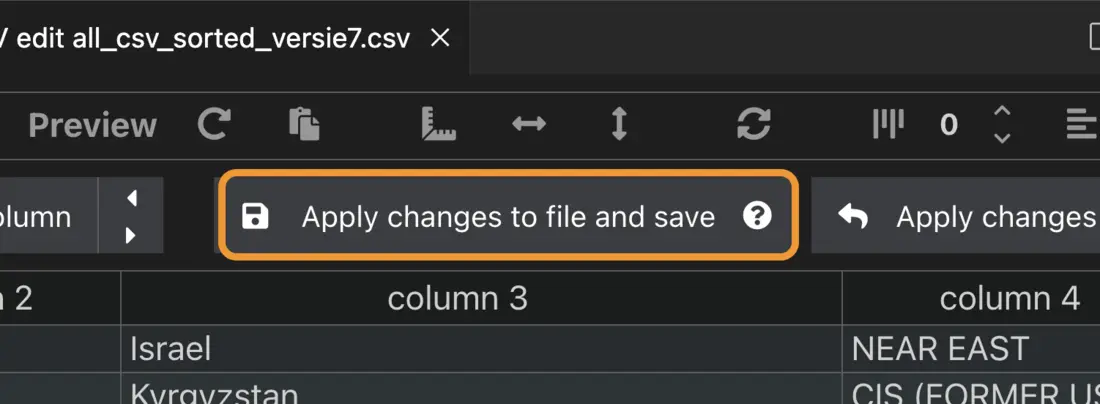
وللاحتياط، احفظ هذه التغييرات في VS Code: "Apply changes to file and save" (انظر اللقطة أدناه).
معلومات ناقصة
ابتداءً من الصف 233 ("Christmas Island") تنقص معلومات كثيرة: فإما أنه لا يوجد مزوّدون، وإما أن العملة التي تُعبَّر بها التكاليف غير مستقرة لدرجة يتعذّر معها تحويلها إلى الدولار. ولنحذف كل هذه الصفوف (أي من "Christmas Island" إلى "Zimbabwe") من هذا المثال. ويمكنك فعل ذلك في عرض الأعمدة، لكن الأسهل في الواقع هو في نسخة النص لأنك في تخطيط الأعمدة تضطر إلى فعل ذلك صفًا صفًا.
راجع كل شيء مرة أخرى. ويبرز هنا وهناك الوصف "NO PACKAGES". وهذه غالبًا بلدان صغيرة جدًا. ولنحذف صفوفًا من مجموعة البيانات أيضًا. وبشكل أكثر تحديدًا يمكن حذف البلدان الخمسة التالية (الصفوف): "Cook Islands" و"Vanuatu" و"Tuvalu" و"Cuba" (وهو أمر مؤسف بعض الشيء لأنها بلد كبير في النهاية) و"Cocos (Keeling) Islands". احذف الآن هذه الصفوف (والأفضل في نسخة النص، وابحث عن "PACK") واحفظ الملف مرة أخيرة.
وأريد أن أضيف هنا كلمة تحذير. في الحالات الواقعية، قد يكون لحذف البيانات أو تعديلها عواقب وخيمة على صلاحية دراستك. فمثلًا، تخيّل أنك تحلل متوسط الدخل في بلجيكا. فقد يكون أصحاب الدخول الأدنى أقل استعدادًا للإفصاح عن رواتبهم الشهرية. وإذا حذفت تلك الإجابات الناقصة ببساطة، فقد تُظهر نتائجك متوسط دخل أعلى بكثير من الواقع. وستتعلم استراتيجيات أخرى للتعامل مع البيانات الناقصة في فصول قادمة. وأما الآن فتذكّر: عند العمل ببيانات حقيقية لعميل حقيقي، اطرح الأسئلة دائمًا قبل حذف البيانات أو تعديلها..
تدوين مختلف للأعداد
لاحظ أن الأعداد الكبيرة الممثلة للسكان والمستخدمين تستخدم التدوين الأمريكي: تُفصل الآلاف بفاصلة، بينما الفاصل بين الوحدات والكسور العشرية هنا نقطة وليس فاصلة. وهذه النقطة ليست مشكلة، لكن الفاصلة بين الأعداد ستكون مشكلة عند استيراد البيانات. فنحن نريد الأعداد فقط بلا فاصل للآلاف والملايين ونحو ذلك.
ويتعقد ذلك لأننا لا نستطيع ببساطة حذف جميع الفواصل، لأن تلك الفاصلة هي أيضًا الفاصل بين الأعمدة المختلفة. ويجب أن أعترف بصراحة بأنني أمضيت وقتًا طويلًا في العبث بـ Excel أثناء إعداد هذا النص التعليمي. كانت تلك خطتي الأولى: استيراد هذه البيانات إلى Excel وتعديلها هناك ثم تصديرها مرة أخرى بصيغة CSV. يبدو ذلك بسيطًا جدًا، لكن العملية كانت محبطة إلى حد كبير.
أفضل ما يمكنك فعله إذا لم ينجح الأمر هو أن تذهب في نزهة...
وعندما عدت رأيت فجأة أن الأمر يمكن فعلًا بسهولة داخل VS Code نفسه. فالدافع إلى الحل موجود في إحدى الفقرات السابقة. ونفّذ الآن الخطوات التالية في VS Code:
الفاصل بين الأعمدة هو الفاصلة. غير أن ملف CSV يمكن أن يستخدم محارف أخرى فواصل. ويمكننا ضبط ذلك عبر إضافة VS Code. فاختر مرة أخرى "Edit CSV". وفي أعلى النافذة لديك "Write options". وفي خيارات الكتابة اختر الفاصلة المنقوطة ";" فاصلًا ("Delimiter"). ثم طبّق واحفظ عبر زر "Apply changes to file and save". وأغلق ملفي .csv كليهما (الأصلي و"edit CSV") في VS Code وافتح ملف .csv الأصلي مرة أخرى لعرض التعديل. ويستخدم ملف CSV الآن الفاصلة المنقوطة ; بين عمودين:
Country code;Country;Continental region;NO. OF Internet Plans;Average price of 1GB (USD);Cheapest 1GB for 30 days (USD);Most expensive 1GB (USD);Average price of 1GB (USD at the start of 2021);Average price of 1GB (USD at start of 2020);Internet users;Population; "Avg (Mbit/s)Alsola" Israel;NEAR EAST;27;0. 05;0.02;20.95;0.11;0.9;6,788,737;8,381,516;"28.01"
KG;Kyrgyzstan;CIS (FORMER USSR);20;0.15;0.1;7.08;0.21;0. 27;2,309,235;6,304,030;"16.3"
FJ;Fiji;OCEANIA;18;0.19;0.05;0.85;0.59;3.57;452,479;883,483;"25.99"
…
والفواصل الوحيدة المتبقية الآن هي تلك بين الآلاف والملايين ونحو ذلك. لذا يمكن إزالتها بـأمر بحث/استبدال في VS Code (انظر الشكل أدناه).
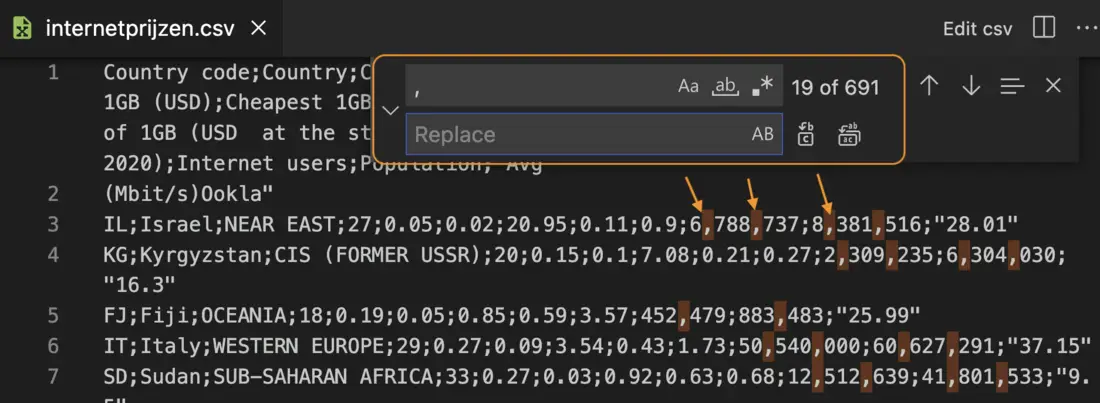
في حقل البحث أدخل الفاصلة، واترك حقل الاستبدال فارغًا (ولا حتى مسافة). وتتيح لك الأزرار على الجانب الأيمن الاستبدال واحدًا واحدًا أو دفعة واحدة. وفي النص نفسه يمكنك رؤية جميع الفواصل التي ستُزال. ويبدو ذلك جيدًا، لذا نفّذ الاستبدال دفعة واحدة. وإذا ساء الأمر فلا تهلع: تراجع!
وينبغي أيضًا إزالة علامات الاقتباس المزدوجة ("...") حول بعض الأعداد. ففي النهاية نريد قراءة هذه البيانات في قاعدة البيانات كأعداد لأننا نريد إجراء حسابات بهذه الأعداد. فلا ينبغي قراءتها كنصوص.
أزل جميع علامات الاقتباس المزدوجة بأمر بحث/استبدال في VS Code عبر Edit > Replace.
وبعد إزالة هذين المحرفين، تبدو النتيجة النهائية هكذا:
Country code;Country;Continental region;NO. OF Internet Plans;Average price of 1GB (USD);Cheapest 1GB for 30 days (USD);Most expensive 1GB (USD);Average price of 1GB (USD at the start of 2021);Average price of 1GB (USD at the start of 2020);Internet users;Population;Avg (Mbit/s)AlsolaNIL;Israel;NEAR EAST;27;0. 05;0.02;20.95;0.11;0.9;6788737;8381516;28.01
KG;Kyrgyzstan;CIS (FORMER USSR);20;0.15;0.1;7.08;0.21;0.27;2309235;6304030;16. 3
FJ;Fiji;OCEANIA;18;0.19;0.05;0.85;0.59;3.57;452479;883483;25.99
IT;Italy;WESTERN EUROPE;29;0.27;0.09;3.54;0.43;1.73;50540000;60627291;37.15
SD;Sudan;SUB-SAHARAN AFRICA;33;0.27;0.03;0.92;0. 63;0.68;12512639;41801533;9.5
RU;Russia;CIS (FORMER USSR);22;0.29;0.13;1.86;0.52;0.91;124000000;145734038;20.46
MD;Moldova;EASTERN EUROPE;18;0.32;0.07;2.79;1.12;2.82;3083783;4051944;29.46
…
والملف الآن جاهز للاستيراد إلى جدول. فلننشئ ذلك الجدول الآن.
إنشاء المخطط والجدول عبر pgAdmin
عبر pgAdmin لديك بالفعل إمكانية الوصول إلى مخطط باسم رقم طالبك "rxxxxxxxx" في قاعدة البيانات الخاصة بصفك. وسننشئ في هذا المخطط الآن جدولًا جديدًا باسم "internet prices" (ويمكنك إنشاء أي عدد تريده من الجداول في مخططك). ولنستعرض جميع الأعمدة:
- رمز البلد (العمود 1) سلسلة من محرفين، لذا
char(2). وهو مطلوب لأنه سيكون مفتاحنا الأساسي. - اسم البلد (العمود 2) والمنطقة (العمود 3) غير محددَي الطول. لذا سيلزم أن يكونا
varchar(). واختر بنفسك عدد المحارف لكل منهما بما يكفي لتخزين جميع الأسماء (ابحث عن أطول سلسلة). وكلاهما إلزامي. - عدد صيغ الإنترنت (العمود 4) عدد صحيح صغير. ويكفي نوع البيانات
smallintبالتأكيد. وهو حقل مطلوب أيضًا. - والأعمدة الثلاثة التالية هي متوسط السعر والحد الأدنى للسعر والحد الأعلى للسعر لـ 1 جيجابايت من البيانات. وهي حقول مطلوبة تمثل مبلغًا بالدولار. ونوع البيانات المناسب لذلك هو
numeric(5,2). وفي هذا، 5 هو العدد الإجمالي للأرقام و2 هو عدد الأرقام بعد الفاصلة العشرية (أي مبلغ مقرّب إلى سنت واحد). وتُشار إلى القيم الثلاث كلها في كل مرة في مجموعة البيانات. - والعمودان 8 و9 هما متوسطا سعري السنتين السابقتين. وهنا أيضًا يكون اختيار
numeric(5,2)مناسبًا. وتوجد مشكلة صغيرة إذا نظرت إلى مجموعة البيانات. فهذه الأعداد غير محددة لكل صف. لذا لن نضيف هنا شرطNOT NULL. فقد تُترك هذه الحقول فارغة عند استيراد البيانات. - والعمودان 10 و11 هما عدد مستخدمي الإنترنت وعدد السكان. وهما عددان صحيحان كبيران، لذا يصلح
integerنوع بيانات مناسبًا. وتحقق مما إذا كانت جميع الصفوف تحتوي هذه المعلومة. فإن كانت كذلك، فيمكنك أن تشترط ألا تُترك هذه الحقول فارغة. - وأخيرًا، العمود الأخير عمود آخر لا يكون معروفًا دائمًا، ألا وهو متوسط معدل البيانات. ومرة أخرى، يمكن أن يكون
numeric(5,2)على الأرجح.
والآن، كتمرين، أنشئ هذا الجدول بجملة CREATE. وبعض الأخطاء النمطية التي تتكرر كثيرًا:
- أنت تعمل عن طريق الخطأ في المخطط "Public" (التفسيرات والحلول).
- تستخدم أسماء أعمدة فيها مسافات: فكرة سيئة. في حد ذاتها يمكن فعل ذلك، لكن يجب أن تُحيط الاسم عندئذ دائمًا بعلامات اقتباس مزدوجة ("..."). والحل الأفضل هو كتابة الكلمات معًا أو استخدام شرطة سفلية (underscore).
- نسيت تعريف مفتاح أساسي.
الحل
CREATE SCHEMA u0012047; -- probably unnecessary because this schema exists already
SET search_path to u0012047; -- otherwise you're working in schema public!
CREATE TABLE internet_prices (
  country_code         char(2) NOT NULL,
  name                 varchar(60) NOT NULL,
  region               varchar(50) NOT NULL,
  number               smallint NOT NULL,
  avg_price            numeric(5,2) NOT NULL,
  min_price            numeric(5,2) NOT NULL,
  max_price            numeric(5,2) NOT NULL,
  avg_21_price         numeric(5,2),
  avg_20_price         numeric(5,2),
  internet_users       integer,
  residents            integer,
  avg_data_rate        numeric(5,2),
  CONSTRAINT pk_internet_prices PRIMARY KEY ( country_code )
);
استيراد CSV عبر pgAdmin
غالبًا ما يُستخدم CSV لـتبادل البيانات بين التطبيقات. لذا من البديهي أن يستطيع خادم قاعدة بيانات PostgreSQL العمل بملفات CSV. ويتيح لنا العميل الذي نستخدمه (pgAdmin) إجراء هذه العملية بسهولة.
وعن كلمة "سهل" هذه ربما تحذير صغير... فعند استيراد ملف CSV إلى جدول ستصطدم بالتأكيد تقريبًا ببعض الأخطاء. فأحيانًا لا يكون تعريف عمود متوافقًا تمامًا مع البيانات، أو يحتوي ملف CSV على أخطاء صغيرة، ونحو ذلك. ونأمل أن تكفي عملية التنظيف التي أجريناها أعلاه لنجاح الاستيراد.
أمل زائف، كما سنرى قريبًا...
ويُجرى الاستيراد في pgAdmin كما يلي. انقر بزر الفأرة الأيمن على اسم الجدول المنشأ حديثًا واختر "Import/Export Data...". وفي مربع الحوار (علامة التبويب "General") تضبط الآن ما يلي:
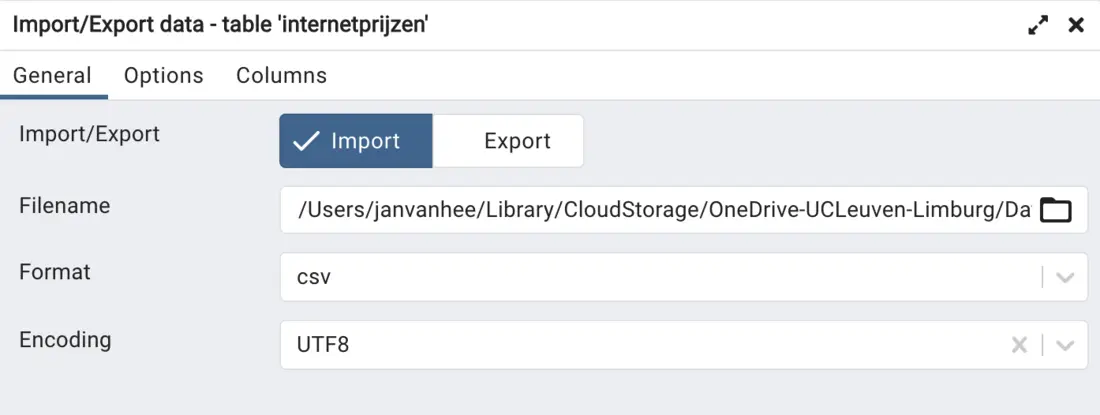
- Import/Export: اختر Import؛
- Filename: رابط ملف .csv الذي تريد استيراده ("internetprices.csv")؛
- Format: csv؛
- Encoding: UTF8؛
وفي علامة التبويب الثانية "Options" (الشكل أدناه)، عدّل ما يلي:
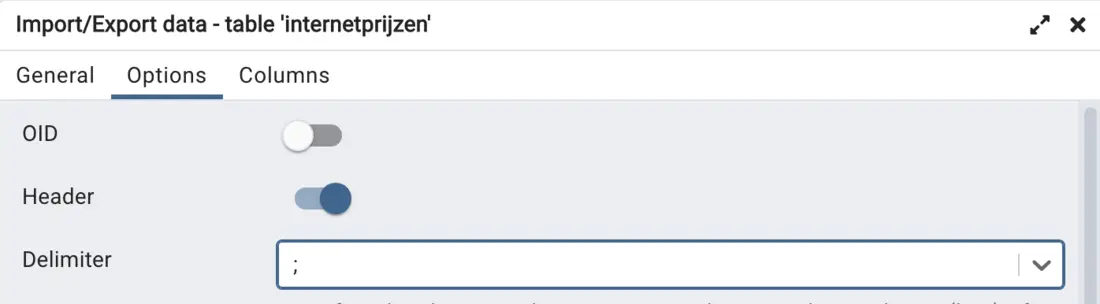
- Header: ضع علامة (حتى يُتخطى الصف الأول)؛
- Delimiter: اختر ";" فاصلًا؛
- لا تحتاج إلى تغيير بقية الخيارات.
وأكّد بزر OK. وإذا سار كل شيء على ما يرام، تُقرأ الآن جميع صفوف ملف CSV في صفوف الجدول.
لكن كما ذُكر... نادرًا ما تسير الأمور كما هو مخطط لها تمامًا في المرة الأولى. فقد ظنّنا أن "تنظيف بياناتنا" نجح، لكنك لا تزال تحصل على رسالة خطأ. ولرؤية رسالة الخطأ هذه، عليك أولًا الدخول إلى المربع الأحمر حيث توجد رسالة خطأ، والنقر على "View Processes". وستحصل حينئذ على جدول بسطر من المعلومات عن عملية الاستيراد الفاشلة. وفي ذلك السطر، وقبل عمود "PID" مباشرة، يوجد رمز "View Details". انقر عليه لرؤية الخطأ الصحيح. وقد تحتاج إلى تكبير النافذة لقراءة رسالة الخطأ كاملة. وستبدو رسالة الخطأ كهذه:
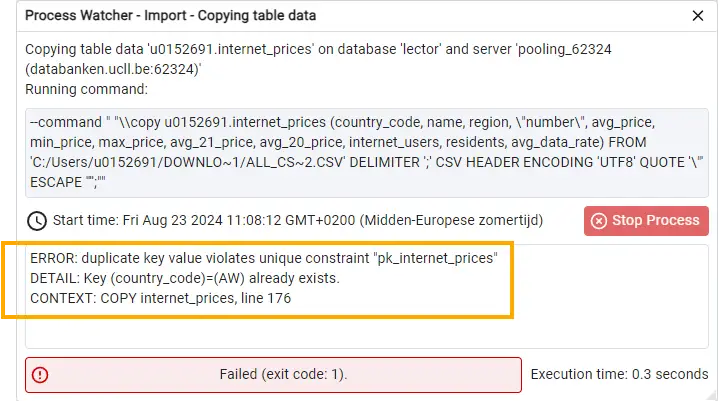
يبدو أن رمز البلد AW (مفتاحنا الأساسي!) يظهر مرتين قرب السطر 176 من ملف CSV. وبما أن المفتاح الأساسي يجب أن يكون فريدًا، يعطي خادم قاعدة البيانات رسالة خطأ عن حق، ويُلغى الاستيراد. ولذلك لا يُستورد أي شيء.
انظر قرب ذلك السطر في الشيفرة:
...
AG;Antigua and Barbuda;CARIBBEAN;39;4.44;1.48;42.18;7.17;12.7;77529;96286;
AW;Aruba (Netherlands);CARIBBEAN;17;4.44;0.74;8.96;9.11;5.56;15877494;17059560;108. 33
AW;Aruba (Netherlands);CARIBBEAN;17;4.44;0.74;8.96;9.11;5.56;102285;105845;108.33
PA;Panama;CENTRAL AMERICA;8;4.49;2;7.48;6.69;4.69;2371852;4176869;17.03
...
إذن هناك بلدان رمز بلدهما AW والاسم نفسه Aruba. وتكشف زيارة سريعة إلى ويكيبيديا أن عدد سكان Aruba يزيد قليلًا على 100000 نسمة. وهذا العدد يوافق السطر الثاني. أما السطر الأول فيوافق على الأرجح هولندا، إذ يبلغ عدد سكانها نحو 17 مليون نسمة. ولننظر في بيانات هولندا في ملف CSV لتأكيد ما فكرنا فيه. وعبر بحث في VS Code نجد ما يلي:
NL;The Netherlands;WESTERN EUROPE;24;3.11;0.77;15.97;2.98;4.62;;;
إذن ينقص هذا السطر عدد مستخدمي الإنترنت وعدد السكان ومتوسط السرعة. وقد حذّرنا مقدمًا من غياب الاستشهاد الواضح بالمصدر لمجموعة البيانات هذه. وتبيّن الآن أيضًا وجود أخطاء في الملف. ويفضَّل على الأرجح تصحيح الخطأ بنقل البيانات من مدخل AW الأول، Aruba... إلى السطر الخاص بهولندا ثم حذف ذلك السطر الأول من Aruba من الملف.
NL;The Netherlands;WESTERN EUROPE;24;3.11;0.77;15.97;2.98;4.62;15877494;17059560;108.33
...
AG;Antigua and Barbuda;CARIBBEAN;39;4.44;1.48;42.18;7.17;12. 7;77529;96286;
AW;Aruba (Netherlands);CARIBBEAN;17;4.44;0.74;8.96;9.11;5.56;102285;105845;108.33
PA;Panama;CENTRAL AMERICA;8;4.49;2;7.48;6.69;4.69;2371852;4176869;17.03
...
المحاولة التالية. كرّر خطوات الاستيراد. ويسوء الأمر هذه المرة أيضًا لأن رمز البلد LB يظهر مرتين. ويقرأ ملف CSV:
LB;Lebanon;NEAR EAST;15;4.81;1.21;77.7;3.82;5.84;4755187;6859408;16.38
LB;Lebanon;NEAR EAST;15;4.81;1.21;77.7;3.82;5.84;4755187;6859408;16.38
وهذا الخطأ سهل التصحيح: احذف أيًّا من السطرين في VS Code. ولا تنسَ حفظ ملفك بعد ذلك!
محاولة جديدة. ولحسن الحظ، نحصل هذه المرة على رسالة تفيد بنجاح الاستيراد عبر نافذة خضراء فيها "Process completed".
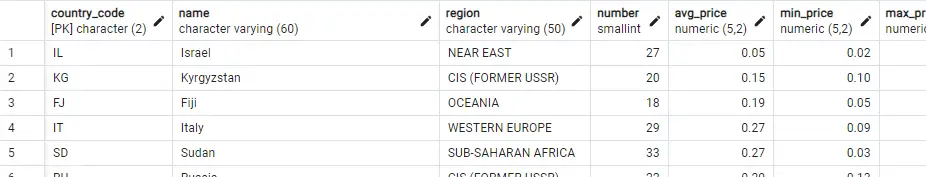
اطلب نظرة عامة كاملة بواسطة SELECT * FROM internet_prices:
من البيانات إلى المعلومات
وضعنا البيانات (مجموعة وقائع) في جدول. ويمكننا الآن استخدام SQL لهيكلة هذه البيانات ودمجها وتنظيمها بشكل مختلف... وتذكّر أننا نتحدث عن تحويل البيانات إلى معلومات.
وعلى سبيل المثال، لنبحث عن إجابة عن سؤال: كيف تقارن بلجيكا بغيرها من البلدان من حيث تكلفة (في عام 2022) 1 جيجابايت من البيانات على الإنترنت؟ ويمكن إيجاد ذلك بالاستعلام البسيط التالي:
SELECT name, avg_price
FROM internet_prices
ORDER BY 2; --so from cheap to expensive
اختبر هذا الاستعلام والاستعلامات التالية بنفسك!
وتأتي بلجيكا في المرتبة 186 وفق هذه البيانات. فاتصالات الإنترنت لدينا غالية!
فأين نقف مقارنة بجيراننا في أوروبا الغربية؟ هناك أيضًا لا نبدو جيدًا. فلا تجاوزنا في الغلاء إلا ثلاثة بلدان (النرويج وأندورا واليونان)، كما يوضح الاستعلام التالي:
SELECT name, region, avg_price
FROM internet_prices
WHERE region ='WESTERN EUROPE'
ORDER By 3;
تمارين على مجموعة البيانات هذه
أفضل طريقة لتعلّم مجموعة بيانات هي اللعب بها. اختبر استعلامات مختلفة. وحاول حل التمارين التالية.
ترتيب حسب سرعة الإنترنت
أنشئ ترتيبًا لجميع البلدان حسب متوسط معدل البيانات. وينبغي أن يكون البلد ذو الاتصال الأسرع في الأعلى. واعرض العمودين "name" و"avg_data_rate" فقط. وفي نسخة ثانية من هذا الاستعلام اعرض فقط البلدان المعطى لها معدل.
الحل
يمكن أن تكون النسخة الأولى من الاستعلام هكذا:
SELECT name, avg_data_rate
FROM internet_prices
ORDER BY avg_data_rate DESC;
ستلاحظ أمرًا خاصًا في الناتج: تُعرض جميع الصفوف التي تحتوي NULL في عمود المعدل أولًا. وسبب ذلك أن PostgreSQL يعتبر قيم NULL أكبر من جميع القيم غير NULL. ويتوقف هذا السلوك على قاعدة البيانات: فـ Oracle تفعل الشيء نفسه، لكن SQLite وMySQL تفعلان العكس. فهذان الخادمان يعتبران NULL قيمة أصغر من جميع القيم الأخرى.
ولعرض الصفوف التي يوجد لها معدل معطى فعليًا فقط، يمكنك الترشيح بالقيمة NOT NULL:
SELECT name, avg_data_rate
FROM internet_prices
WHERE avg_data_rate IS NOT NULL
ORDER BY avg_data_rate DESC;
البلد ذو أغلى متوسط سعر
أي بلد لديه أغلى متوسط سعر لـ 1 جيجابايت من البيانات؟
الحل
SELECT *
FROM internet_prices
ORDER by avg_price desc;
أكبر فرق في السعر
في SELECT يمكنك أيضًا الحساب بالأعمدة. وسنستفيد من ذلك في هذا التمرين.
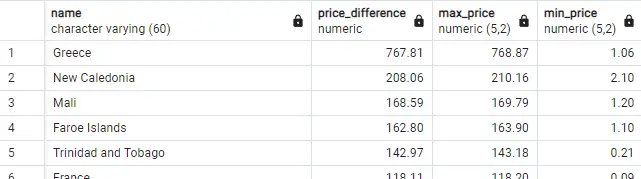
في أي بلد يكون فرق السعر بين أغلى عرض وأرخصه الأكبر؟ (الجواب: اليونان، حيث الفرق كبير لدرجة تجعلك تتساءل إن كانت هذه الأعداد صحيحة...). وينبغي أن تحصل على لقطة الشاشة في الشكل أدناه.
الحل
SELECT name, max_price - min_price AS price_difference, max_price, min_price
FROM internet_prices
ORDER BY 2 desc;
البلد ذو أسرع إنترنت في الأمريكتين
أي بلد في القارة الأمريكية (سواء في أمريكا الشمالية أو الجنوبية) لديه أسرع سرعة إنترنت؟ أنشئ استعلام SQL يولّد قائمة يمكنك أن تجد فيها الإجابة.
الحل
هذا تركيب موسّع بالفعل من AND وOR. لا تقلق إن وجدت ذلك صعبًا، فسنعود إليه في الفصل التالي.
SELECT name, avg_data_rate, region
FROM internet_prices
WHERE (region = 'SOUTH AMERICA' OR region = 'NORTHERN AMERICA') AND avg_data_rate is not null
ORDER BY avg_data_rate desc;
نسبة مستخدمي الإنترنت
هذا تمرين صعب!
احسب نسبة مستخدمي الإنترنت في كل بلد ورتّبها بحيث يكون البلد ذو النسبة الأكبر في الأعلى. وإذا كنت قد فكرت حتى الآن "أليس كل شخص في بلدنا لديه بالتأكيد إمكانية الوصول إلى الإنترنت؟": فنسبة بلجيكا 87%... وتجد أدناه في الحل بعض النصائح، لكن جرّب التمرين أولًا بدون النصائح!
الحل
النسبة هي العدد مقسومًا على المجموع مضروبًا في 100.
وتوجد مشكلة في قسمة عددين صحيحين. جرّب الشيفرة التالية:
SELECT 1 / 2;
تنتج هذه القسمة نتيجة مفاجئة: 0. والسبب أنها قسمة صحيحة. فالعدد 2 يدخل في 1 صفر مرة. وجرّب تركيبات أعداد أخرى حتى تفهم كيف تعمل قسمة الأعداد الصحيحة. وإذا أردت الحصول على عدد عشري (float) نتيجةً، فعليك استخدام المعامل CAST ... AS .... واكتب استعلام SELECT التالي:
SELECT cast(1 AS float) / cast(2 AS float);
يحسب هذا الاستعلام قسمة عددين عشريين. والنتيجة الآن عدد عشري أيضًا، ويُسمى في قاعدة البيانات float.
ولا نريد قيم NULL في الناتج. واستخدم اسمًا مستعارًا (بـ AS) في SELECT.
هذه الشيفرة حل جيد:
SELECT name, cast(internet_users as float) / cast(residents as float) * 100 AS percentage
FROM internet_prices
WHERE internet_users / residents is not null
ORDER BY 2 desc;
تجميع البيانات بواسطة GROUP BY
وبعد أن أصبحت لدينا مجموعة بيانات كبيرة بما يكفي، يمكننا تجميع البيانات (أو بعبارة تقنية "تجميعها") بطريقة ذات معنى، مثلًا حسب المنطقة. ونقدّم GROUP BY لهذا الغرض. وسيأتي تناول وافٍ في فصل "GROUP BY / HAVING".
ترتيب تنفيذ الاستعلام
يمكنك بحلول الآن إنشاء استعلامات بسيطة. ويُنجز خادم قاعدة البيانات تلك الاستعلامات بهذا الترتيب:
FROM: ما الجداول التي نحتاجها وينبغي تحميلها في الذاكرة؟WHERE: ما صفوف هذه الجداول التي نختارها؟SELECT: ما الأعمدة التي نعرضها في الناتج؟ORDER BY: حسب أي عمود (أو أعمدة) تُرتَّب الصفوف في الناتج؟
ولاحظ أن ذلك يختلف عن الترتيب الذي تكتب به الاستعلام!
تجميع البيانات
أحيانًا لا تريد بعد الآن استرجاع تفاصيل فردية، بل تهتم فقط بـمعلومات عن مجموعة معينة. وبعض الأمثلة على جدول أسعار الإنترنت:
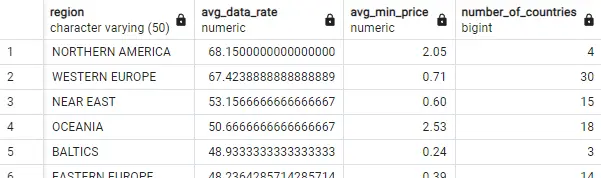
- ما متوسط سرعة الإنترنت ومتوسط الحد الأدنى للسعر وعدد البلدان في كل منطقة (انظر الشكل)؟
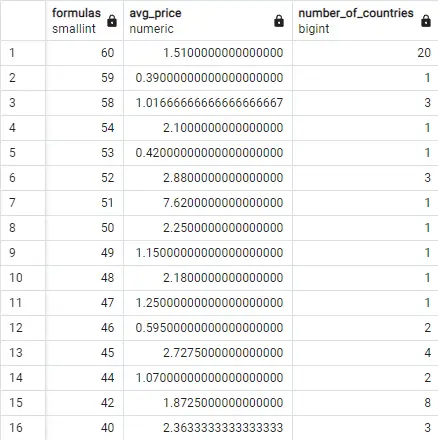
- اسرد البلدان حسب عدد صيغ الإنترنت (من 40 صيغة على الأقل) وأعطِ متوسط السعر:
ولنحل سؤال المثال الأول: "لكل منطقة، اسرد عدد البلدان في تلك المنطقة ومتوسط سرعة الإنترنت ومتوسط الحد الأدنى للسعر.". نحتاج إلى تقديم بعض المعلومات حسب المنطقة، لذا نستخدم GROUP BY region. وفي هذه المرحلة لا يمكننا استرجاع سوى المنطقة نفسها والأعداد الملخّصة (دوال التجميع المطبقة على أعمدة معينة). وهذا يعطي الاستعلام التالي:
SELECT region, AVG(avg_data_rate), AVG(min_price), COUNT(*)
FROM internet_prices
GROUP BY region
ORDER BY 2 DESC;
ولنستعرض تنفيذ هذا الاستعلام خطوة بخطوة بالترتيب الصحيح (أي لا بالترتيب الذي كُتب به الاستعلام!):
FROM internet_prices: يُحمَّل جدول internet_prices بأكمله في الذاكرة.- لا يوجد
WHERE، لذا لا تُسقَط أي صفوف. - ثم يأتي
GROUP BY region: تذهب جميع الصفوف ذات المنطقة نفسها إلى صندوق واحد. ويظهر على كل صندوق اسم المنطقة. لذا سيكون عدد الصناديق بعدد المناطق المختلفة في الجدول. - وعندها فقط يُنفَّذ
SELECT. والشيء الوحيد الذي يمكننا استرجاعه الآن هو تسمية كل صندوق (المنطقة) ومعلومات ملخّصة عن كل البيانات الواردة في كل صندوق باستخدام دوال تجميع مثلAVG(avg_data_rate)(المتوسط الحسابي لجميع المعدلات في كل صندوق)، وAVG(min_price)(المتوسط الحسابي لجميع الأسعار الدنيا في كل صندوق)، وCOUNT(*)(عدد الصفوف في كل صندوق). - وأخيرًا، تُرتَّب صفوف الناتج النهائي (
ORDER BY 2 DESC) من الأكبر إلى الأصغر حسب العمود الثاني، بحيث يكون صف أكبر متوسط سرعة في الأعلى.
خطأ كلاسيكي مع GROUP BY
ألقِ نظرة على الاستعلام البسيط التالي. سيفشل هذا الاستعلام لأنه يحتوي أخطاء. فما الخطأ فيه؟
SELECT *
FROM internet_prices
GROUP by region;
الحل
اقرأ رسالة الخطأ التي تحصل عليها بتعمّن:
ERROR: column "internet_prices.country_code" must appear in the GROUP BY clause
  or be used in an aggregate function
LINE 2: select *
               ^
SQL state: 42803
 Character: 39
باستخدام GROUP BY تُوضع جميع الصفوف ذات القيمة نفسها للحقل "region" في صندوق واحد. ومن هذا الصندوق يمكنك أن تختار فقط الاسم ("region") والمتوسطات والحدود العليا والدنيا والعدد والمجموع** (دوال التجميع الخمس) لبعض الأعمدة. أما مع SELECT * فإنك تستعلم عن جميع الأعمدة، وهو ما لا يمكن فعله. ويفشل الأمر فورًا مع العمود الأول ("country_code")، ومن هنا الرسالة التي تفيد بأن هذا العمود يجب أن يكون في GROUP BY.
HAVING
في استعلام يحتوي GROUP BY، ستواجه أيضًا بانتظام HAVING. وهي تشبه WHERE إلى حد ما من حيث إنها تجري أيضًا اختيارًا وربما تُسقط بيانات. تأمّل المثال التالي:
SELECT region, COUNT(*), AVG(avg_data_rate)
FROM internet_prices
GROUP BY region
ORDER BY 2 DESC;
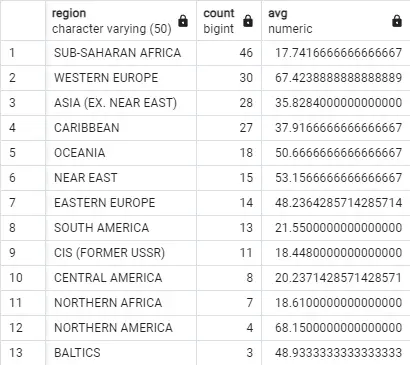
يسرد هذا الاستعلام حسب المنطقة عدد البلدان في تلك المنطقة ومتوسط سرعة الإنترنت فيها. ويوضح الشكل التالي النتائج الكاملة مرتبة تنازليًا حسب العمود الثاني:
ويمكننا الآن إضافة HAVING إلى الشيفرة:
SELECT region, COUNT(*), AVG(avg_data_rate)
FROM internet_prices
GROUP BY region
HAVING COUNT(*) > 16 --has to come after the GROUP BY clause
ORDER BY 2 DESC;
وإضافة HAVING COUNT(*) > 16 تعني "أبقِ فقط الصناديق (المناطق) التي تحتوي أكثر من 16 صفًا فرديًا". ويتكوّن ناتج الاستعلام الآن من صفوف أقل بكثير:
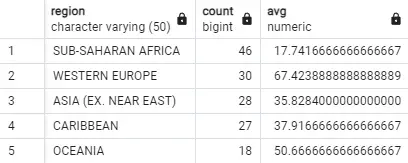
فما أكبر فرق عن WHERE؟ يُنفَّذ WHERE مباشرة بعد FROM وقبل أن يدخل GROUP BY حيز التنفيذ. ويختار الشرط الذي بعد WHERE صفوفًا معينة من الجدول (ويطرح البقية). وعندها فقط تُجمع هذه الصفوف في صناديق بواسطة GROUP BY. وعندما يصبح كل صف في صندوق، يبدأ HAVING الذي يبقي صناديق معينة ويزيل غيرها.
وتُنفَّذ الجمل المختلفة في الاستعلام بهذا الترتيب:
FROM: ما الجداول التي تحتوي المعلومة؟WHERE: ما الصفوف التي تحقق الشرط؟ أبقِ تلك الصفوف فقط.GROUP BY: هل نضع المعلومات معًا في صناديق...؟HAVING: ... تحقق شرطًا معينًا؟SELECT: ما الأعمدة التي نعرضها؟ORDER BY: كيف تُرتَّب الصفوف؟