الاو الحصري (XOR)
الاو الحصري
الوصف
الاو الحصري (exclusive or)، الذي يُسمّى عادةً «XOR»، هو معامِل ثنائي (binary operator) منطقي (Boolean) يكون صحيحًا عندما يكون أحد المدخلين — الأول أو الثاني، لكن ليس كلاهما — صحيحًا.
وهناك طريقة أخرى للتفكير في XOR بوصفه شيئًا يُسمّى «مُقلِبًا قابلًا للبرمجة» (programmable inverter): فبتّ واحد من المدخلين يقرّر هل نعكس بتّ المدخل الآخر، أم نمرّره كما هو دون تغيير. وتُسمّى عملية «عكس» البتّات بصورة غير رسمية «قلب» البتّات (flipping bits)، وهو مصطلح سنستعمله كثيرًا في هذا الكتاب كلّه.
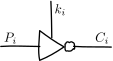
في الرياضيات وفي أبحاث التشفير، يُمثَّل الاو الحصري عادةً على شكل صليب داخل دائرة:
\xor. وسنستعمل في هذا الكتاب الترميز نفسه:
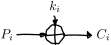
المدخلات والمخرج هنا مُسمّاة كأنّنا نستعمل XOR كعملية تشفير. على اليسار لدينا البتّ
الخاص بالنصّ الصريح (plaintext) وهو P_i. أمّا i فمجرد فهرس (index)، لأنّنا عادةً
نتعامل مع أكثر من بتّ واحد من هذا النوع. وفي الأعلى لدينا بتّ المفتاح (key) k_i الذي
يقرّر ما إذا كنّا سنعكس P_i أم لا. وعلى اليمين لدينا البتّ الخاص بالنصّ المشفَّر
(ciphertext) وهو C_i، وهو ناتج عملية XOR.
لا يستعمل إلّا «true» و«false» كقيمتَي دخل وخروج.
يأخذ مُعاملين.
بعض خصائص XOR
لأنّنا سنتعامل مع XOR كثيرًا في هذا الكتاب، سنُلقي النظر عن قرب على بعض خصائصه. وإن كنت ملمًّا أصلًا بكيفية عمل XOR، فلا تتردّد في تخطّي هذا القسم.
لقد رأينا أنّ خرج XOR يساوي 1 عندما يكون أحد المدخلين — لا كلاهما — يساوي 1:
ومنه يمكننا استخراج بعض الحيل الحسابية المفيدة.
#. يمكن تطبيق XOR بأيّ ترتيب:
a \xor (b \xor c) = (a \xor b) \xor c
#. يمكن قلب ترتيب المعاملين: a \xor b = b \xor a
#. أيّ بتّ يُعامَل بـXOR مع نفسه يساوي 0: a \xor a = 0. فإن كان a يساوي 0،
فإنّ 0 \xor 0 = 0؛ وإن كان a يساوي 1، فإنّ 1 \xor 1 = 0.
#. أيّ بتّ يُعامَل بـXOR مع 0 يساوي ذلك البتّ نفسه: a \xor 0 = a. فإن كان a
يساوي 0، فإنّ 0 \xor 0 = 0؛ وإن كان a يساوي 1، فإنّ
1 \xor 0 = 1.
وتنقض هذه القواعد أنّ a \xor b \xor a = b:
نستعمل هذه الخاصية في تشفير XOR. ويمكن اعتبار أوّل XOR — وهو a — عملية تشفير،
والثاني عملية فكّ تشفير.
XOR على مستوى البتّ
إنّ XOR، كما عرّفناه توًّا، لا يعمل إلّا على البتّات المفردة أو القيم المنطقية (Boolean). ولأنّنا نتعامل عادةً مع قيم مكوّنة من بتّات كثيرة، توفّر معظم لغات البرمجة معامِل «XOR على مستوى البتّ» (bitwise XOR): وهو معامِل يُجري عملية XOR على البتّات المتناظرة في القيمة.
على سبيل المثال، توفّر Python المعامِل ^ (caret) الذي يؤدّي XOR على مستوى البتّ
للأعداد الصحيحة. فهو أوّلًا يكتب عددين صحيحين بالترميز الثنائي [1]،
ثمّ يجري عملية XOR على بتّاتهما المتناظرة. ومن هنا جاء اسم «XOR على مستوى البتّ»
(bitwise XOR).
وسادات المرّة الواحدة
قد يبدو XOR معامِلًا بسيطًا إلى حدٍّ مثير للسخرية، بل تافهًا. ومع ذلك فهناك نظام تشفير قائم على ذلك. يُسمّى وسادة المرّة الواحدة (one-time pad)، وهو يتكوّن من معامِل واحد مع تسلسل («وسادة») من البتّات العشوائية. ويعتمد أمان هذا النظام على استعمال الوسادة مرّة واحدة فقط. ويُلَقَّب هذا التسلسل بـ«وسادة» لأنّه كان في الأصل يُدوَّن على وسادة ورقية مادّية.
هذا النظام فريد لا بساطته فحسب، بل إنّ له أعلى ضمان أمان ممكن. فإذا كانت البتّات عشوائية حقًّا فإنّها تصير غير قابلة للتنبّؤ بالنسبة إلى المهاجم. وإضافةً إلى ذلك، فإنّ استعمال الوسادة مرّة واحدة فقط يعني أنّ المهاجم لا يكتسب أيّ معلومة عن النصّ الصريح عند اطّلاعه على نصّ مشفَّر.
يكتسب المهاجم مع ذلك علمًا بأنّ الرسالة موجودة وبطولها في هذا النظام البسيط. ومع أنّ هذا لا يهمّ عادةً إلى حدٍّ كبير، فهناك حالات يهمّ فيها الأمر. فالأنظمة التشفيرية الآمنة موجودة لإخفاء وجود الرسالة وطولها معًا. لنفترض أنّنا نستطيع ترجمة نصّنا الصريح إلى تسلسل من البتّات. ولدينا أيضًا وسادة من البتّات العشوائية يتقاسمها المُرسِل مع المستقبِل (أو المستقبِلين). يمكننا حساب النصّ المشفَّر بأخذ XOR على مستوى البتّ بين تسلسلي البتّات.
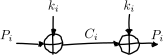
إذا رأى المهاجم النصّ المشفَّر، يمكننا إثبات أنّه لا يكتسب أيّ معلومة عن النصّ الصريح دون المفتاح. وتُسمَّى هذه الخاصية السرّية التامّة (perfect secrecy). ويمكن فهم البرهان بطريقة حدسية. تخيّل XOR بوصفه مُقلِبًا قابلًا للبرمجة، وأنظر إلى بتّ بعينه اعترضته إيف المستقِعة (eavesdropper).
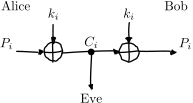
لنفترض أنّ إيف ترى أنّ البتّ c_i من النصّ المشفَّر يساوي 1. فإنّها لا تعرف هل كان
البتّ المقابل في النصّ الصريح p_i يساوي 0 أم 1، لأنّها لا تعرف هل كان بتّ
المفتاح k_i يساوي 0 أم 1. وبما أنّ جميع بتّات المفتاح عشوائية حقًّا، فإنّ
الاحتمالين متساويان تمامًا.
هجمات على «وسادات المرّة الواحدة»
لا يتحقّق ضمان أمان وسادة المرّة الواحدة إلّا إذا استُعملت على الوجه الصحيح. أوّلًا، يجب أن تتكوّن وسادة المرّة الواحدة من بيانات عشوائية حقًّا. ثانيًا، لا يمكن استعمال وسادة المرّة الواحدة إلّا مرّة واحدة (ولهذا اسمها). وللأسف فإنّ معظم المنتجات التجارية التي تدّعي أنّها «وسادات مرّة واحدة» هي زيتُ ثعابين (snake oil) [2] ولا تستوفي خاصية واحدة على الأقلّ من هاتين الخاصيتين.
عدم استعمال بيانات عشوائية حقًّا
المشكلة الأولى هي أنّ تركيبات حتميّة (deterministic) مختلفة تُنتج وسادة المرّة الواحدة بدلًا من استعمال بيانات عشوائية حقًّا. وليس هذا بالضرورة غير آمن: فريث أنّ أبرز مثال على ذلك، وهو شيفرة تيار متزامنة (synchronous stream cipher)، سنراه لاحقًا في هذا الكتاب. لكنّه يُبطل خاصية الأمان «التي لا تُكسر» التي توفّرها وسادات المرّة الواحدة. فالمستخدم النهائي يُقدَّم له على نحو أفضل نظام تشفير أكثر أمانة، لا نظام يكذب بشأن خصائصه الأمنية.
إعادة استعمال وسادة «المرّة الواحدة»
المشكلة الأخرى هي إعادة استعمال المفتاح، وهي أخطر بكثير. فلنفترض أنّ مهاجمًا حصل على نصّين مشفَّرين بالوسادة «ذات المرّة الواحدة». عندئذٍ يستطيع المهاجم أن يجري عملية XOR على النصّين المشفَّرين، وهي أيضًا XOR للنصّين الصريحين:
للوهلة الأولى، قد لا يبدو ذلك مشكلة. فلكي تستخرج p_1 أو p_2، ستحتاج إلى إلغاء
عملية XOR، أي إنّك تحتاج إلى معرفة النصّ الصريح الآخر. والمشكلة هي أنّ ناتج عملية
XOR على نصّين صريحين يحوي نفسه قدرًا لا بأس به من المعلومات عن النصّين الصريحين
أنفسهما. سنوضّح ذلك بصريًّا عبر بعض الصور من عمليّة وسادة «مرّة واحدة» مكسورة، بدءًا
من fig-multitimepad.
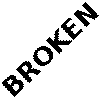
النصّ الصريح الأوّل.
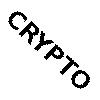
النصّ الصريح الثاني.
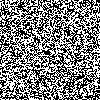
النصّ المشفَّر الأوّل.
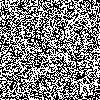
النصّ المشفَّر الثاني.
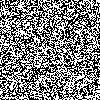
المفتاح المُعاد استعماله.
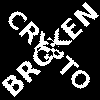
XOR للنصّين المشفَّرين.
نصّان صريحان، والمفتاح المُعاد استعماله، والنصّان المشفَّر الموافق لهما، وXOR للنصّين المشفَّرين. ومن واضح أنّ معلومات عن النصّ الصريح تتسرّب عند إجراء XOR على النصّين المشفَّرين.
جرّ الحثّات
أسلوب كلاسيكي لكسر أنظمة الوسادات متعدّدة المرّات هو «جرّ الحثّات» (crib-dragging). ويعتمد جرّ الحثّات على تسلسلات صغيرة يُتوقّع أن ترد بكثرة. وتُسمَّى هذه التسلسلات «حثّات» (cribs). ويعود اسم جرّ الحثّات إلى أنّ هذه «الحثّات» الصغيرة تُسحَب من اليسار إلى اليمين عبر كلّ نصّ مشفَّر، ومن الأعلى إلى الأسفل عبر النصّين المشفَّرين، أملًا في إيجاد تطابق. وتُشكّل التطابقات مواضع بداية، أو «حثّة» إن شئت، لعملية فكّ تشفير إضافية.
الفكرة بسيطة إلى حدٍّ معقول. فلنفترض أنّ لدينا عدّة رسائل مشفَّرة C_i مشفَّرة
بالوسادة «ذات المرّة الواحدة» نفسها K [3]. فلو استطعنا تخمين النصّ
الصريح لأحد الرسائل، ولنفقل C_j، لانكشف لنا K:
وبما أنّ K هو السرّ المشترك، يمكننا استعماله لفكّ تشفير جميع الرسائل الأخرى كما لو
كنّا المستقبِل:
عادةً لا ينجح هذا لأنّنا لا نستطيع تخمين رسالة كاملة. لكنّنا نستطيع تخمين أجزاء من رسالة.
إن خمّنت بعض بتّات النصّ الصريح p_i على وجه الصحيح في أيّ من الرسائل، فإنّ ذلك
يكشف بتّات المفتاح في ذلك الموضع في جميع الرسائل، لأنّ k = c_i \xor p_i.
وبالتالي تنكشف جميع بتّات النصّ الصريح في ذلك الموضع. وباستعمال تلك القيمة بوصفها
k، يمكننا حساب بتّات النصّ الصريح p_i = c_i \xor k في جميع الرسائل الأخرى.
تخمين أجزاء من النصّ الصريح أسهل من تخمين النصّ الصريح بأسره. فلنفترض أنّنا نعرف
أنّ النصّ الصريح بالإنجليزية. فهناك تسلسلات ترد بكثرة جدًّا. على سبيل المثال (يرمز
الرمز \verb*| | إلى مسافة):
\verb*| the |واشتقاقات مثل\verb*|. The |\verb*| of |واشتقاقاته\verb*| to |واشتقاقاته\verb*| and |(لا اشتقاقات له؛ لا يرد إلّا في منتصف الجملة)\verb*| a |واشتقاقاته
ويمكننا أن نخمّن أفضل إن كنّا نعرف معلومات أكثر عن النصّ الصريح. فمثلًا، إذا قُدِّم
HTML فوق HTTP، فإنّنا نتوقّع أن نرى Content-Type و<a> وهكذا.
وهذا لا يخبرنا إلّا بتسلسلات النصّ الصريح المحتملة، فيعطينا تخمينات محتملة. وكيف نعرف ما إذا كانت تخميناتنا صحيحة؟ إن كان تخميننا صحيحًا، فإنّنا نعرف جميع النصوص الصريحة في ذلك الموضع بالاستناد إلى التقنية الموصوفة سابقًا. ويمكننا ببساطة النظر في تلك النصوص الصريحة ونقرّر ما إذا كانت تبدو صحيحة.
عمليًا، تحتاج هذه العملية إلى الأتمتة بسبب كثرة التخمينات المحتملة. ولحسن الحظّ فالأمر سهل. فمثلًا، إحدى الطرائق البسيطة والفعّالة هي عدّ مدى تكرار الرموز المختلفة في النصوص الصريحة المخمَّنة: فإذا كانت الرسائل تحوي نصًّا إنجليزيًّا، فإنّنا نتوقّع أن نرى حروفًا كثيرة مثل e وt وa وo وi وn. وإن رأينا بدلًا منها ترميزًا ثنائيًّا بلا معنى، فإنّنا نعرف أنّ التخمين على الأرجح خاطئ، أو ربّما أنّ تلك الرسالة هي في الواقع بيانات ثنائية.
تُسمَّى هذه التسلسلات الصغيرة المرجّحة جدًّا «حثّات» (cribs) لأنّها بداية عملية فكّ
تشفير أكبر. فلنفترض أنّ حثّتك the نجحت ووجدت التسلسل الخماسي t thr في رسالة
أخرى. يمكنك استعمال قاموس للعثور على كلمات شائعة تبدأ بـthr، مثل through. فإذا
كان ذلك تخمينًا صحيحًا، فإنّه يكشف أربعة بايتات إضافية في جميع النصوص المشفَّرة.
ويمكن أن تكون هذه المعلومات مفيدة لكشف المزيد. وعلى نحو مماثل، يمكنك استعمال القاموس
للعثور على كلمات تنتهي بالحرف t.
وتصبح هذه الطريقة شديدة الفعالية مع النصوص الصريحة التي نعرف عنها معلومات أكثر.
فإذا احتوت بيانات HTTP على النصّ الصريح ent-Len، يمكننا توسيعه إلى
Content-Length:. بسهولة تُكشف بايتات إضافية.
على الرغم من أنّ هذه التقنية تنجح ما دام رسالتان مشفَّرتان بالمفتاح نفسه، فإنّ من الواضح أنّ العملية تصير أسهل كلّما استُعمل المفتاح نفسه في نصوص مشفَّرة أكثر. وبما أنّ كلّ الخطوات تصير أكثر فعالية، فإنّنا نربح:
- مواضع أكثر لصناعة الحثّات.
- كشف بايتات نصّ صريح أكثر مع كلّ حثّة ناجحة وتخمين. ويؤدي هذا إلى خيارات تخمين أكثر في مواضع أخرى.
- نصوص مشفَّرة أكثر متاحة لأيّ موضع بعينه. وهذا يبسّط التحقّق من التخمينات ويزيد الدقّة أحيانًا.
لقد راجعنا أفكارًا بسيطة لكسر الوسادات متعدّدة المرّات. ومع أنّها فعّالة إلى حدٍّ
كبير بالفعل، فإنّ الناس يخترعون طرائق أكثر فعالية عبر تطبيق نماذج إحصائية متقدّمة
تستعمل تحليل اللغة الطبيعية. وهذا يوضّح أكثر من أيّ شيء مدى انهيار الوسادات متعدّدة
المرّات. mason:nltwotimepads
المشكلات المتبقّية
وسادات المرّة الواحدة الحقيقية، إن نُفِّذت على الوجه الصحيح، توفّر ضمان أمان شديد القوة. ويبدو عندئذٍ أنّ التشفير قد انتهى: فالتشفير مسألة محلولة، ويمكننا جميعًا أن نذهب إلى بيوتنا. ومن الواضح أنّ الأمر ليس كذلك.
نادرًا ما تُستعمل وسادات المرّة الواحدة لأنّها غير عملية إلى حدٍّ فظيع. فالمفتاح لا يقلّ حجمًا عن كامل المعلومات التي تودّ إرسالها، مجتمعةً. وإضافةً إلى ذلك، يجب تبادل المفاتيح بشكل آمن، مسبقًا، مع كلّ من تودّ التواصل معه. ونحن نودّ التواصل بأمان مع كلّ شخص على الإنترنت، وهذا عدد كبير جدًّا. وعلاوةً على ذلك، بما أنّ المفاتيح يجب أن تتكوّن من بيانات عشوائية حقًّا كي يتحقّق خاصية الأمان، فإنّ توليد المفاتيح صعب ومستهلك للوقت من دون عتاد متخصّص.
تفرض وسادات المرّة الواحدة مقايضة (trade-off). فأحد مزاياها أنّها خوارزمية ذات ضمان أمان معلوماتي (information-theoretic) متين. وهذا الضمان غير متاح في أيّ نظام آخر. وعلى الجهة المقابلة، فإنّ متطلّبات تبادل المفاتيح فيها غير عملية إلى حدٍّ متطرّف. لكنّنا سنرى، في هذا الكتاب كلّه، أنّ خوارزميات التشفير المتماثل الآمنة ليست نقطة الألم في الأنظمة التشفيرية الحديثة. فقد صمّم خَبَراء التشفير كثيرًا من هذه الخوارزميات. أمّا الإدارة العملية للمفاتيح، فإحدى أصعب التحديات التي تواجه التشفير الحديث. قد تحلّ وسادات المرّة الواحدة مشكلة، لكنّها المشكلة الخاطئة.
قد تكون لوسادات المرّة الواحدة استخدامات عملية، لكنّها ليست بطبيء الحال دواءً شافيًا (panacea). فنحن بحاجة إلى نظام يجمع بين أحجام مفاتيح قابلة للإدارة والقدرة على صيانة السرّية (maintaining secrecy) في آنٍ واحد. وإضافةً إلى ذلك، نحتاج إلى نظام للتفاوض على المفاتيح عبر الإنترنت مع غرباء تامّين.
عادةً تُخزَّن الأعداد داخليًّا بالترميز الثنائي، لذا لا يستغرق هذا أيّ عمل. وإذا كان عدد ما مسبوقًا بـ«0b» فإنّ ذلك يعني أنّ الأرقام المتبقّية تمثّل ترميزًا ثنائيًّا. ↩︎
«زيت الثعابين» (snake oil) مصطلح يُطلق على المنتجات المشكوك فيها التي تدّعي فوائد وميزات استثنائية، ثمّ لا تحقّق منها شيئًا. ↩︎
نستعمل الأحرف الكبيرة عند الإشارة إلى رسالة كاملة، في مقابل الإشارة إلى بتّات رسالة فحسب. ↩︎