التحسين
أمسي المساء هو أفضل جزء في اليوم. لقد أدّيتَ عملك النهاري. والآن تستطيع أن ترتاح وتستمتع به.
كازو إيشيغورو، بقايا اليوم
لو كنتُ ما زلت أعيش في نيو أورلينز، لكنت أسميّ هذا الفصل lagniappe، أي شيءٍ إضافي صغير يُعطى مجانًا للزبون. فلديك كتاب كامل وآلة افتراضية مكتملة بالفعل، لكنني أريد أن تحصل على مزيد من المتعة وأنت تختبث في clox. لكن هذه المرّة، ذهبنا إلى الأداء الخالص. سنطبّق تحسينين مختلفين تمامًا على آلتنا الافتراضية. وفي أثناء ذلك، ستحصل على إحساس بكيفية قياس أداء تنفيذ لغة وتحسينه -- أو أيّ برنامج، في الحقيقة.
قياس الأداء
التحسين (optimization) يعني أخذ تطبيق عامل وتحسين أدائه. البرنامج المُحسَّن يفعل الشيء نفسه، إنّه يستخدم فقط موارد أقلّ لإنجازه. والموارد التي نفكّر فيها عادةً عند التحسين هي سرعة التشغيل، لكنّه قد يكون مهمًّا أيضًا تقليل استهلاك الذاكرة، أو زمن بدء التشغيل، أو حجم التخزين الدائم، أو عرض نطاق الشبكة. ولكلّ الموارد المادية تكلفةٌ ما -- حتى لو كانت التكلفة في الوقت البشري الضائع في الغالب -- لذا فإنّ عمل التحسين كثيرًا ما يؤتي ثماره.
كان هناك زمن في الأيام الأولى للحاسوب يستطيع فيه مبرمج ماهر أن يحمل في ذهنه بنية العتاد كاملة وخطّ أنابيب المصرّف، وأن يفهم أداء برنامج بمجرّد التفكير الجادّ. تلك الأيام راحت منذ زمن طويل، وفصل بين الحاضر والماضي شيفرة الميكروكود وأسطر الذاكرة المخبّأة وتوقّعات الفروع وخطوط الأنابيب العميقة في المصرّف ومجموعات التعليمات الضخمة. نحن نحبّ أن نتظاهر بأنّ C لغة "منخفضة المستوى"، لكنّ طبقة التقنيات بين
printf("Hello, world!");
وظهور تحيّة على الشاشة أصبحت طويلة بشكل خطير.
التحسين اليوم علم تجريبي. برنامجنا كلبُ حدود جارٍ يعدو في مسار العتاد. فإن أردنا أن تصل إلى النهاية أسرع، لا يمكننا أن نجلس نفكّر في فسيولوجيا الكلاب حتى يطرقنا الوحي. وبدلًا من ذلك، نحتاج إلى أن نلاحظ أداءها، ونرى أين تتعثّر، ثمّ نجد لها مسارات أسرع تسلكها.
وكما أنّ تدريب الرشاقة خاصّ بكلبٍ ودورة عائق بعينها، لا يمكننا أن نفترض إنّ تحسينات آلتنا الافتراضية ستجعل كلّ برامج Lox تعمل أسرع على كلّ العتاد. فبرامج Lox المختلفة تضغط على جوانب مختلفة من الآلة، ولكلّ بنية معمارية نقاط قوّتها وضعفها.
مقاييس الأداء
حين نضيف ميزات جديدة، فإنّنا نتحقّق من صحّة العمل بكتابة اختبارات -- برامج Lox تستخدم ميزة وتتحقّق من سلوك الآلة الافتراضية. فالاختبارات تثبّت الدلالات وتضمن ألّا نكسر الميزات القائمة حين نضيف جديدًا. ولدينا احتياجات مشابهة حين يأتي الأمر إلى الأداء:
-
كيف نتحقّق من أنّ تحسينًا ما قد حسّن الأداء، وبمقدار كم؟
-
كيف نضمن أنّ التغييرات الأخرى غير المرتبطة لا تُتراجع بالأداء؟
برامج Lox التي نكتبها لتحقيق تلك الأهداف تُسمّى مقاييس الأداء (benchmarks). وهذه برامج مصمَّمة بعناية تضغط على جزء ما من تنفيذ اللغة. فهي تقيس ليس ما يفعله البرنامج، بل كم يستغرق وقتًا لإنجازه.
بقياس أداء مقياس أداء قبل تغيير وبعده، يمكنك أن ترى ما يفعله تغييرك. حين تُدرج تحسينًا، ينبغي أن تتصرف كلّ الاختبارات تمامًا كما كانت من قبل، لكن يُرجى أن تعمل مقاييس الأداء أسرع.
ومتى كان لديك مجموعة كاملة من مقاييس الأداء، تستطيع أن تقيس ليس مجرد أنّ التحسين يغيّر الأداء، بل على أيّ أنواع من الشيفرة. وغالبًا ما ستجد أن بعض المقاييس تصبح أسرع بينما تصبح أخرى أبطأ. وعندها عليك أن تتّخذ قرارات صعبة حول أنواع الشيفرة التي يُحسّن تنفيذ لغتك من أجلها.
ومجموعة مقاييس الأداء التي تختار كتابتها جزءٌ رئيسي من ذلك القرار. فبالطريقة نفسها التي تُشفّر بها اختباراتك اختياراتك حول شكل السلوك الصحيح، فإنّ مقاييس الأداء لديك هي تجسيد أولوياتك حين يأتي الأمر إلى الأداء. ستوجّه التحسينات التي تنفّذها، لذا اختر مقاييسك بعناية، ولا تنسَ أن تعيد بين حين وآخر التفكير فيما إذا كانت تساعدك على بلوغ أهدافك الأكبر.
قياس الأداء فنّ دقيق. فكما في الاختبارات، عليك أن توازن بين ألّا تفرط في المواءمة لتنفيذك، وبين التأكّد من أنّ المقياس بالفعل يحرّك مسارات الشيفرة التي تهمّك. وحين تقيس الأداء، عليك أن تعوّض التغيّرات النسبية الناتجة عن خنق المعالج (throttling)، والتخزين المؤقّت، وسائر غرائب العتاد ونظام التشغيل الغريبة. لن أخوض هنا في وعظ طويل، لكن تعامل مع قياس الأداء كمهارة قائمة بذاتها تتحسّن بالتدرّب.
التنميط
حسنًا، صار لديك بضع مقاييس أداء. وتريد جعلها تعمل أسرع. وماذا الآن؟ أولًا، لنفترض أنّك أنجزت كل العمل الواضح السهل. فأنت تستخدم الخوارزميات وبنى البيانات الصحيحة -- أو، على الأقلّ، لست تستخدم أخرى خاطئة بشكل صارخ. أنا لا أعتبر استخدام جدول تجزئة بدل البحث الخطّي في مصفوفة ضخمة غير مرتّبة "تحسينًا" بقدر ما أعتبره "هندسة برمجيات جيّدة".
ولأنّ العتاد معقّد أكثر من أن نستطيع استنتاج أداء برنامجنا منه من المبادئ الأولى، علينا أن نخرج إلى الميدان. وهذا يعني التنميط (profiling). والمُنمِّط (profiler)، إن لم تكن قد استخدمت واحدًا من قبل، هو أداة تشغّل برنامجك وتتتبّع استهلاك موارد العتاد أثناء تنفيذ الشيفرة. والأدوات البسيطة تُظهر لك كمّ من الوقت قُضي في كلّ دالة في برنامجك. والأدوات المتطوّرة تُسجّل إخفاقات ذاكرة البيانات، وإخفاقات ذاكرة التعليمات، وتوقّعات الفروع الخاطئة، وخصائص الذاكرة، وكلّ أنواع المقاييس الأخرى.
هناك مُنمِّطات كثيرة هناك لمختلف أنظمة التشغيل واللغات. وعلى أيّ منصّة تبرمج فيها، فإنّ التعرّف على مُنمِّط جيّد يستحقّ الوقت. ولا تحتاج أن تكون خبيرًا. لقد تعلّمتُ أمورًا خلال دقائق من رمي برنامج على مُنمِّط، كانت ستأخذ مني أيامًا لاكتشافها وحدي بالتجربة والخطأ. المُنمِّطات أدوات رائعة سحرية.
سبر أسرع في جدول التجزئة
كفانا عن الخطب، لنُطلق بعض الرسوم البيانية للأداء صعودًا وإلى اليمين. Optimization الأول الذي سنفعله، كما اتّضح، يتعلّق بأصغر تغيير ممكن على آلتنا الافتراضية.
حين جعلت آلة شيفرة البايت الافتراضية التي نحدّ من clox تعمل أول مرّة، فعلت ما يفعله أيّ مختبِر آلة افتراضية يحترم نفسه. فجمّعت بضع مقاييس أداء، وأشعلت مُنمِّطًا، وشغّلت تلك السكربتات عبر مفسّري. وفي لغة مُنمَّطة ديناميكيًّا مثل Lox، فإنّ نسبة كبيرة من شيفرة المستخدم عبارة عن وصول إلى حقول واستدعاء طرق، لذا بدا أحد مقاييسي كالتالي:
class Zoo {
  init() {
    this.aardvark = 1;
    this.baboon   = 1;
    this.cat      = 1;
    this.donkey   = 1;
    this.elephant = 1;
    this.fox      = 1;
  }
  ant()    { return this.aardvark; }
  banana() { return this.baboon; }
  tuna()   { return this.cat; }
  hay()    { return this.donkey; }
  grass()  { return this.elephant; }
  mouse()  { return this.fox; }
}

var zoo = Zoo();
var sum = 0;
var start = clock();
while (sum < 100000000) {
  sum = sum + zoo.ant()
            + zoo.banana()
            + zoo.tuna()
            + zoo.hay()
            + zoo.grass()
            + zoo.mouse();
}

print clock() - start;
print sum;
إن لم ترَ مقياس أداء من قبل، فقد يبدو هذا سخيفًا. ما الذي يحدث هنا؟ البرنامج نفسه لا يقصد أن يفعل أيّ شيء مفيد. ما يفعله هو استدعاء مجموعة من الطرق والوصول إلى مجموعة من الحقول، لأنّ تلك هي أجزاء اللغة التي نهمّنا. والحقول والطرق تعيش في جداول تجزئة، لذا حريص حريص على ملء بضعة مفاتيح مثيرة على الأقلّ في تلك الجداول. وكل ذلك مغلّف في حلقة كبيرة كي يضمن لمُنمِّطنا وقت تنفيذ كافيًا ليتوغّل ويرى أين تذهب الدورات.
قبل أن أخبرك بما أظهره لي مُنمِّطي، خصّص دقيقة لطرح بضعة تخمينات. أين في شيفرة clox تظنّ أنّ الآلة الافتراضية قضت أكثر وقتها؟ وهل هناك شيفرة كتبناها في الفصول السابقة تشكّ في أنّها بطيئة بشكل خاص؟
وهذا ما وجدته: طبيعيًّا، فإنّ الدالة ذات أكبر وقت شامل هي run(). (الوقت الشامل يعني
الوقت الكلّي المُقضى في دالة ما وفي جميع الدوالّ الأخرى التي تستدعيها -- أي الوقت الكلّي من لحظة
دخولك الدالة إلى لحظة عودتك.) وبما أنّ run() هي حلقة تنفيذ شيفرة البايت الرئيسة، فإنّها تقود كل
شيء.
وداخل run()، هناك كتل صغيرة من الوقت موزّعة في حالات مختلفة في مفتاح شيفرة البايت الخاص
بالتعليمات الشائعة مثل OP_POP وOP_RETURN وOP_ADD. والتعليمات الثقيلة هي OP_GET_GLOBAL
بنسبة 17% من زمن التنفيذ، وOP_GET_PROPERTY بنسبة 12%، وOP_INVOKE التي تستهلك 42% من إجمالي
زمن التشغيل.
إذن لدينا ثلاث نقاط اختناق يجب تحسينها؟ في الواقع، لا. لأنّ هذه التعليمات الثلاث تُنفق كلّ وقتها
تقريبًا داخل استدعاءات الدالة نفسها: tableGet(). فتلك الدالة تستعيد 72% من زمن التنفيذ (مرة
أخرى، الوقت الشامل). والآن، في لغة مُنمَّطة ديناميكيًّا، نتوقّع أن ننفق قدرًا لا بأس به من الوقت
في البحث في جداول التجزئة -- إنّه نوعًا ما ثمن الديناميكية. لكن، مع ذلك، يا لها من مفاجأة.
لفّ المفاتيح البطيء
إن نظرتَ إلى tableGet()، فسترى أنّها في معظمها غلاف حول استدعاء findEntry() حيث يجري البحث
الفعلّي في جدول التجزئة. ولتذكير ذاكرتك، إليك إياه كاملًا:
static Entry* findEntry(Entry* entries, int capacity,
                        ObjString* key) {
  uint32_t index = key->hash % capacity;
  Entry* tombstone = NULL;

  for (;;) {
    Entry* entry = &entries[index];
    if (entry->key == NULL) {
      if (IS_NIL(entry->value)) {
        // Empty entry.
        return tombstone != NULL ? tombstone : entry;
      } else {
        // We found a tombstone.
        if (tombstone == NULL) tombstone = entry;
      }
    } else if (entry->key == key) {
      // We found the key.
      return entry;
    }

    index = (index + 1) % capacity;
  }
}
عند تشغيل ذلك المقياس السابق -- على جهازي على الأقلّ -- تُنفق الآلة الافتراضية 70% من إجمالي زمن التنفيذ في سطر واحد في هذه الدالة. أيّ تخمينات حول أيّ سطر؟ لا شيء؟ إنه هذا:
uint32_t index = key->hash % capacity;
تلك العملية الفكّية للمؤشّر ليست هي المشكلة. المشكلة هي ذاك % الصغير. يتبيّن أنّ مشغّل الباقي
(remainder) بطيء حقًّا. أبطأ بكثير من مشغّلات العمليات الحسابية
الأخرى. هل يمكننا أن نفعل شيئًا أفضل؟
في الحالة العامّة، من الصعب حقًّا إعادة تنفيذ مشغّل حسابي أساسي في شيفرة المستخدم بطريقة أسرع ممّا يستطيع المعالج نفسه إنجازه. فبعد كلّ شيء، شيفرتنا في C تترجم في النهاية إلى عمليات المعالج الحسابية نفسها. ولو كانت هناك حيل نستطيع استخدامها لتكون أسرع، لكانت الشريحة تستخدمها بالفعل.
لكن، يمكننا أن نستغلّ الحقيقة بأنّنا نعرف عن مشكلتنا أكثر مما يعرفه المعالج. فنحن نستخدم الباقي هنا لأخذ رمز تجزئة سلسلة مفتاح والالتفاف به ليناسب حدود مصفوفة مُدخلات الجدول. وتبدأ تلك المصفوفة بثمانية عناصر وتنمو بمعامل اثنين في كلّ مرّة. ونحن نعرف -- والمعالج ومصرّف C لا يعرفان -- أنّ حجم جدولنا دائمًا قوة للعدد 2.
ولأنّنا نلاعب بالبتات بذكاء، فإنّنا نعرف طريقة أسرع لحساب باقي قسمة عدد على قوة للعدد 2: قناع البتات (bit masking). لنقل إنّنا نريد حساب 229 mod 64. الجواب 37، وهو ليس واضحًا على نحو خاصّ في النظام العشري، لكنّه أوضح حين ننظر إلى تلك الأعداد في النظام الثنائي:
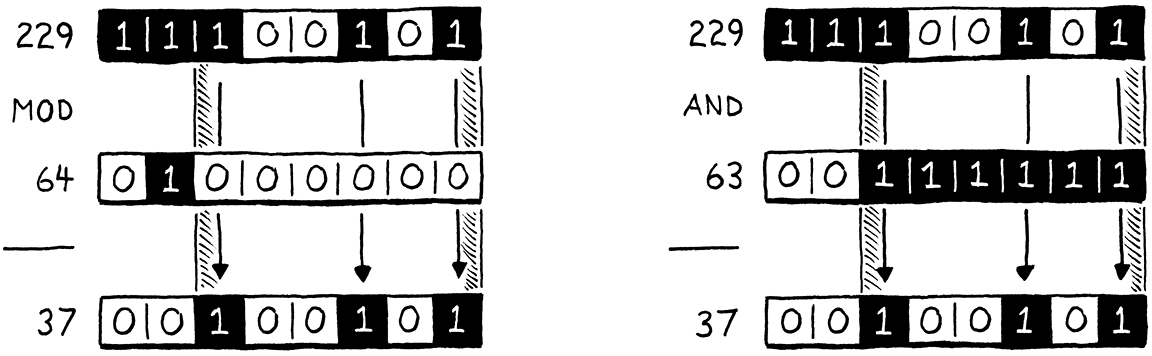
على الجانب الأيسر من الرسم، لاحظ كيف أنّ النتيجة (37) هي ببساطة المقسوم (229) وقد قُصّت منه أعلى بتّين؟ هذان البتّان الأعلى هما البتّان عند بت القاسمة الواحدة أو إلى يسارها.
وعلى الجانب الأيمن، نحصل على النتيجة نفسها بأخذ 229 وعمل AND على مستوى البتّات مع 63، وهو أقلّ بواحد من قاسمنا الأصلي الذي هو قوة للعدد 2. وطرح الواحد من قوة للعدد 2 يعطيك سلسلة من بتات 1. وهذا هو بالضبط القناع الذي نحتاجه من أجل نزع بتّين أقصى اليسار.
بعبارة أخرى، يمكنك حساب أيّ عدد بأخذ باقي القسمة على أيّ قوة للعدد 2 بمجرّد عمل AND معه على واحد من تلك القوة. ولستُ رياضيًّا بما يكفي لأثبت لك أنّ هذا يعمل، لكن إن فكّرت فيه فلا بدّ أنّ المعنى سيتّضح. يمكننا أن نستبدل مشغّل الباقي البطيء ذلك بطرح سريع جدًّا وعمل AND على مستوى البتّات. فنكتفي بتغيير سطر الشيفرة المعيب إلى هذا:
^code initial-index (2 before, 1 after)
تحبّ المعالجات المشغّلات البتّية، لذا من الصعب تحسين ذلك.
قد يحتاج بحثنا بالسبر الخطّي إلى الالتفاف حول نهاية المصفوفة، لذا يوجد باقي آخر في findEntry()
للتحديث.
^code next-index (4 before, 1 after)
لم يظهر هذا السطر في المُنمِّط لأنّ معظم عمليات البحث لا تلتفّ.
ولدى دالة findEntry() أخت تُسمّى tableFindString() تجري بحثًا في جدول تجزئة لتدويل النصوص.
فلا بأس بأن نطبّق فيها التحسينات ذاتها أيضًا. وهذه الدالة لا تُستدعى إلّا عند تدويل النصوص، وهو ما لم
يُضغط عليه في مقيسنا كثيرًا. لكن برنامج Lox يُنشئ نصوصًا كثيرة قد يستفيد بوضوح من هذا التغيير.
^code find-string-index (2 before, 2 after)
وأيضًا حين يلتفّ السبر الخطّي حول النهاية.
^code find-string-next (3 before, 1 after)
ولنرَ إن كانت إصلاحاتنا تستحقّ. عدّلت ذلك المقياس الحيواني ليعدّ كمّ دفعة من 10,000 استدعاء يستطيع إنجازها في عشر ثوانٍ. والمزيد من الدفعات يعني أداءً أسرع. على جهازي باستخدام الشيفرة غير المُحسَّنة، يتجاوز المقياس 3,192 دفعة. وبعد هذا التحسين، يقفز الرقم إلى 6,249.
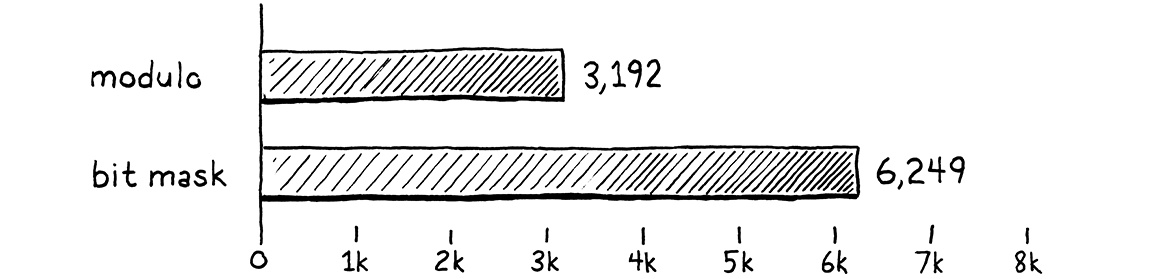
ذلك يكاد بالضبط ضعف كمّ العمل في الوقت نفسه. جعلنا الآلة الافتراضية أسرع مرّتين (مع التحفّظ المعتاد: على هذا المقياس). وهذه مكسب هائل حين يأتي الأمر إلى التحسين. فعادةً تشعر بالارتياح إن استطعت انتزاع بضعة نقاط مئوية هنا وهناك. وبما أنّ الطرق والحقول والمتغيّرات العامة شديدة الشيوع في برامج Lox، فإنّ هذا التحسين الضئيل يحسّن الأداء في كلّ الجوانب. فكلّ برنامج Lox تقريبًا يستفيد منها.
والآن، المقصد من هذا القسم ليس أنّ مشغّل الباقي شرير بعمق وينبغي أن تطرده من كلّ برنامج تكتبه. وليس أنّ تحسين الأجزاء الدقيقة مهارة هندسية حيوية. فنادرًا ما يكون لمشكلة أداء حلٌّ بهذه الدرجة والفاعلية بهذا الشكل. لقد حظينا بالحظّ.
والمقصد هو أنّنا لم نكن نعرف أنّ مشغّل الباقي استنزاف للأداء حتى أخبرنا مُنمِّطنا بذلك. فلو تجوّلنا في شيفرة آلتنا الافتراضية عشوائيًا نخمّن نقاط الاختناق، لما لاحظناه على الأرجح. وما أريد أن تأخذه عن هذا هو مدى أهمية وجود مُنمِّط في صندوق أدواتك.
ولتأكيد هذه النقطة، لنشغّل المقياس الأصلي في آلتنا الافتراضية الآن المُحسَّنة ولنرَ ما يُظهره
المُنمِّط. على جهازي، ما زالت tableGet() تحتلّ قدرًا كبيرًا من زمن التنفيذ. وهذا متوقَّع في لغة
مُنمَّطة ديناميكيًّا. لكنها انخفضت من 72% من إجمالي زمن التنفيذ إلى 35%. وهذا أقرب بكثير إلى ما
نودّ رؤيته، ويُظهر أنّ تحسيننا لم يجعل البرنامج أسرع فحسب، بل جعله أسرع بالطريقة التي توقعناها.
والمُنمِّطات مفيدة للتحقّق من الحلول كما هي مفيدة لاكتشاف المشكلات.
صندوق NaN
هذا التحسين التالي له إحساس مختلف إلى حدٍّ كبير. ولحسن الحظ، وعلى رغم الاسم الغريب، فإنّه لا يتضمّن ضرب جدّتك. فهو مختلف، لكن ليس، يعني، مختلفًا إلى هذا الحدّ. ففي تحسيننا السابق، قال لنا المُنمِّط أين المشكلة، ولم نكن بحاجة سوى إلى بعض الذكاء لنأتي بحلّ.
وهذا التحسين أدقّ، وآثاره على الأداء أكثر تشتّتًا عبر الآلة الافتراضية. ولن يساعدنا المُنمِّط على إيجاد حلّ له. وبدلًا من ذلك، اخترعه شخصٌ ما يفكّر بعمق في أدنى مستويات بنية الآلة.
وكما يقول العنوان، فإنّ هذا التحسين يُسمّى صندوق NaN (NaN boxing) أو أحيانًا وسم NaN (NaN tagging). وأنا شخصيًّا أُحبّ الاسم الثاني لأنّ "boxing" يميل إلى الامتناع عن تمثيل مخصَّص في الكومة، لكنّ الأول يبدو المصطلح الأكثر استخدامًا على نطاق واسع. وهذه التقنية تغيّر كيفية تمثيلنا للقيم في الآلة الافتراضية.
على آلة من 64 بتًّا، يشغل نوع Value لدينا 16 بايت. للبنية حقلان: وسم نوع واتّحاد (union) للحمولة. وأكبر حقول الاتّحاد هي مؤشّر Obj وdouble، وكلاهما 8 بايتات. ولإبقاء حقل الاتّحاد محاذيًا لحدّ 8 بايتات، يضيف المصرّف حشوًا بعد الوسم أيضًا:
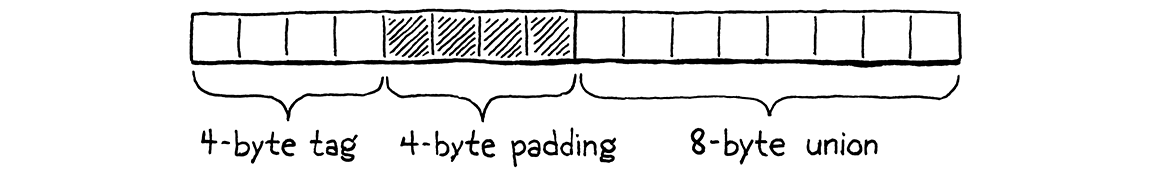
ذلك كبير إلى حدٍّ ما. فلو استطعنا تقليصه، لأمكن للآلة الافتراضية حزم قيم أكثر في المقدار نفسه من الذاكرة. ومعظم الحواسيب لديها ذاكرة عشوائية وفيرة اليوم، لذا فإنّ توفير الذاكرة المباشر ليس أمرًا كبيرًا. لكنّ تمثيلًا أصغر يعني اتّساعَ عدد القيم التي تتّسع في سطر واحد من الذاكرة المخبّأة. وهذا يعني إخفاقات أقلّ في الذاكرة المخبّأة، وهو يؤثّر في السرعة.
إذا كانت القيم تحتاج إلى محاذاة على حجم حمولتها الأكبر، وكان رقم Lox أو مؤشّر Obj يحتاج إلى 8 بايتات كاملة، فكيف يمكننا أن نصغر؟ في لغة مُنمَّطة ديناميكيًّا مثل Lox، تحتاج كلّ قيمة إلى أن تحمل حمولتها فحسب، بل تحمل معلومات إضافية كافية لتحديد نوع القيمة وقت التشغيل. فإذا كان رقم Lox يستخدم الثمانية بايتات كاملة، فأين يمكننا أن نُخفي بيتين إضافيين من البتّات لنقول لوقت التشغيل "هذا رقم"؟
هذه إحدى المسائل الدائمة لمختبري اللغات الديناميكية. وهي تؤرّقهم على وجه الخصوص لأنّ اللغات المُنمَّطة ساكنًا ليس لديها هذه المشكلة عمومًا. فنوع كلّ قيمة معروف وقت التجميع، لذا لا حاجة إلى ذاكرة إضافية وقت التشغيل لتتبّعه. وحين يترجم مصرّف C عددًا صحيحًا من 32 بتًّا، فإنّ المتغيّر الناتج يحصل على بالضبط 32 بتًّا من التخزين.
ويكره أهل اللغات الديناميكية أن يخسروا أرضًا أمام معسكر الساكن، لذا ابتكرا عددًا من الطرق الذكيّة جدًّا لحزم معلومات النوع والحمولة في عدد قليل من البتات. وصندوق NaN إحدى تلك الطرق. وهو ملائم بصورة خاصة للّغات مثل JavaScript وLua حيث كلّ الأعداد أعداد عشرية مزدوجة الدقة. وLox في القارب نفسه.
ما هو العدد (وما ليس عددًا)؟
قبل أن نبدأ التحسين، نحتاج إلى فهم حقيقي لكيفية تمثيل صديقنا المعالج للأعداد العشرية المتحرّكة (floating point). فمعظم الآلات اليوم تستخدم المخطط نفسه، المُرمَّز في اللفافة المقدسة IEEE 754، المعروف للبشر بـ"المعيار IEEE للعمليات الحسابية بالأعداد العشرية المتحرّكة".
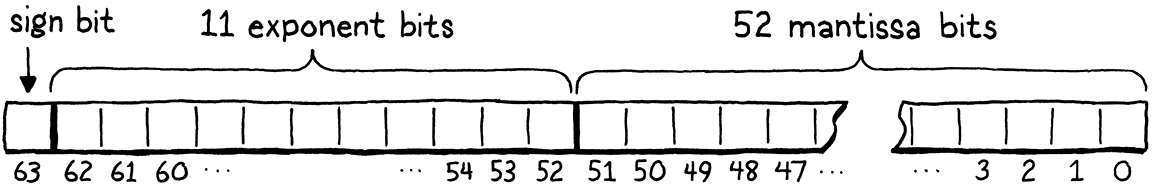
في عيني حاسوبك، يبدو الرقم العشري المتحرك من 64 بتًّا، بدقة مزدوجة، من نوع IEEE هكذا:
-
بدءًا من اليمين، البتّات الخمسة والخمسون الأولى هي بتات الكسر أو المانتيسا أو الخانات المعنوية. وهي تمثّل الخانات المهمة من الرقم، كعدد صحيح ثنائي.
-
وبجانبها إحدى عشرة بتّة الأس (exponent). وهذه تخبرك بمدى إزاحة المانتيسا عن النقطة العشرية (أو الثنائية).
-
وأعلى بتّة هي بتّة الإشارة، وهي تدلّ على ما إذا كان الرقم موجبًا أم سالبًا.
أعرف أنّ ذلك غامض بعض الشيء، لكنّ هذا الفصل ليس غوصًا عميقًا في تمثيل الأعداد العشرية المتحركة. فإذا أردت أن تعرف كيف يتعاون الأس والمانتيسا، فهناك شروح أفضل بكثير هناك ممّا أستطيع كتابته.
الجزء المهمّ لأغراضنا هو أنّ المواصفة تُخصيص حالة خاصة للأس. فحين تكون كلّ بتات الأس مضبوطة، فإنّ القيمة لا تمثّل عددًا كبيرًا فحسب، بل تكتسب معنًى مختلفًا. وهذه القيم هي قيم "ليس عددًا" (NaN). فهي تمثّل مفاهيم مثل اللانهاية أو ناتج القسمة على صفر.
أيّ double تكون بتّات أسّه مضبوطة بالكامل هو NaN، بغضّ النظر عن بتات المانتيسا. وهذا يعني أنّ هناك الكثير والكثير من أنماط بتات NaN المختلفة. ويقسّم IEEE 754 تلك إلى فئتين. فالقيم التي تكون فيها أعلى بتّة مانتيسا مساوية للصفر تُسمّى NaN المُنبِّهة (signalling NaNs)، والبقية هي NaN الهادئة (quiet NaNs). والـ NaN المُنبِّهة مقصودة أن تكون نتيجة عمليات خاطئة، مثل القسمة على صفر. ويمكن للشريحة أن تكتشف حين يُنتَج أحد هذه القيم وتُنهي البرنامج تمامًا. وقد تدمّر نفسها إن حاولت قراءة واحدة.
من المفترض أن تكون NaN الهادئة أكثر أمانًا في الاستخدام. فهي لا تمثّل قيمًا عددية مفيدة، لكنّها على الأقلّ لا ينبغي أن تُشعل يدك إن لمستَها.
كلّ double تكون كلّ بتات أسّه مضبوطة وأعلى بتّة مانتيسا فيه مضبوطة هو قيمة NaN هادئة. وهذا يترك 51 بتّة دون حساب. وسنتجنّب واحدة من تلك حتى لا نقع على قيمة "QNaN Floating-Point Indefinite" الخاصة بـ Intel، فيتبقّى لنا 51 بتّة. ويمكن أن تكون تلك البتّات المتبقّية أيّ شيء. ونحن نتكلّم عن 2,251,799,813,685,248 نمط بتّات فريد من NaN الهادئة.
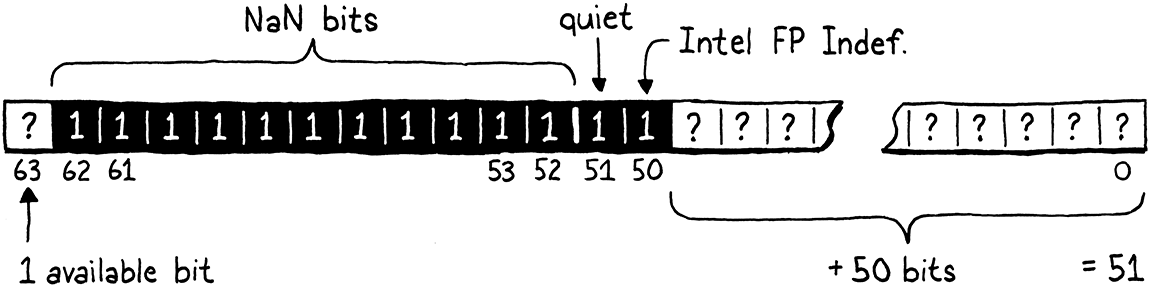
وهذا يعني أنّ double من 64 بتًّا فيه متّسع كافٍ لتخزين كلّ قيم الأعداد العشرية المتحركة المختلفة، و
أيضًا فيه متّسع لـ 51 بتّة إضافية من البيانات يمكننا استخدامها كيفما نشاء. وهذا متّسع وافٍ
لأن نُخصّص بضعة أنماط بتّات لتمثيل قيم nil وtrue وfalse في Lox. لكن ماذا عن مؤشّرات Obj؟ ألست
المؤشّرات تحتاج إلى 64 بتًّا كاملة أيضًا؟
ولحسن الحظ، لدينا خدعة أخرى في جيبنا الآخر. فنعم، تقنيًّا تكون المؤشّرات على معمارية 64 بتًّا ذات 64 بتًّا. لكن لا توجد أيّ معمارية أعرفها تستخدم فعلًا ذلك الفضاء الكامل من العناوين. وبدلًا من ذلك، فإنّ معظم الشرائح المستخدمة على نطاق واسع اليوم لا تستخدم إلّا البتّات 48 الدنيا أبدًا. أمّا البتّات الستّ عشرة المتبقّية فإمّا غير محدّدة أو تكون دائمًا صفرًا.
إن كان لدينا 51 بتّة، يمكننا حشر مؤشّر من 48 بتّة فيها مع ثلاث بتّات فائضة. وتلك البتّات الثلاث
تكفي بالضبط لتخزين وسوم أنواع صغيرة للتمييز بين nil، والقيم المنطقية، ومؤشّرات Obj.
تلك هي صندوق NaN. فداخل double واحد من 64 بتًّا، يمكنك تخزين كلّ قيم الأعداد العشرية المتحركة المختلفة، أو مؤشّرًا، أو أيّ قيمة حارسة خاصة أخرى. أي نصف استهلاك الذاكرة لبنية Value الحالية، مع الاحتفاظ بكامل Fidelity.
والجذاب بصفة خاصة في هذا التمثيل هو أنّه لا حاجة إلى تحويل قيمة عددية من نوع double إلى شكل "معلَّب". فأعداد Lox هي مجرد أعداد double عادية من 64 بتًّا. ولا يزال علينا التحقّق من نوعها قبل استخدامها، بما أنّ Lox مُنمَّطة ديناميكيًّا، لكنّنا لا نحتاج إلى أيّ إزاحة بتّات أو استدلال عبر مؤشّرات للانتقال من "قيمة" إلى "عدد".
أمّا أنواع القيم الأخرى، فهناك خطوة تحويل بالطبع. لكن لحسن الحظ، تُخفي آلتنا الافتراضية كلّ آلية الانتقال من القيم إلى الأنواع الخام خلف حفنة من الماكروهات. أعد كتابة تلك لتُنفّذ صندوق NaN، وستعمل بقيّة الآلة الافتراضية كما هي.
الدعم الشرطي
أعرف أنّ تفاصيل هذا التمثيل الجديد ليست واضحة في ذهنك بعد. لا تقلق، فستتجسّد مع تقدّمنا في التنفيذ. وقبل أن نصل إلى ذلك، سنضع بعض الهياكل وقت التجميع في مكانها.
ففي تحسيننا السابق، أعدنا كتابة الشيفرة البطيئة السابقة ووجدنا ذلك كافيًا. وهذا مختلف قليلًا. فصندوق NaN يعتمد على بعض التفاصيل منخفضة المستوى جدًّا لكيفية تمثيل الشريحة للأعداد العشرية المتحركة والمؤشّرات. وهو يرجح أن يعمل على معظم المعالجات التي من المرجّح أن تصادفها، لكنّك لا تستطيع أن تكون متأكّدًا تمامًا.
سيكون سيئًا لو فقدت آلتنا الافتراضية دعم معمارية بأكملها لمجرّد تمثيل قيمها. ولتفادي ذلك، سنُبقي دعمًا لـكلا التطبيقين: اتّحاد الوسم القديم لنوع Value والشكل الجديد المعلَّب بـ NaN. ونختار التمثيل الذي نريده وقت التجميع باستخدام هذا العَلَم:
^code define-nan-boxing (2 before, 1 after)
إن كان ذلك معرَّفًا، تستخدم الآلة الافتراضية الشكل الجديد. وإلا، فإنّها تعود إلى النمط القديم. والقطع القليلة من الشيفرة التي تهتمّ بتفاصيل تمثيل القيمة -- وهي بضع ماكروهات للّفّ وإلغاء لفّ القيم -- تختلف بحسب ما إذا كان ذلك العَلَم مضبوطًا. أمّا بقيّة الآلة الافتراضية فلا يزال بإمكانها أن تواصل طريقها المرح.
يقع معظم العمل في وحدة "value" حيث نضيف قسمًا للنوع الجديد.
^code nan-boxing (2 before, 1 after)
وحين يكون صندوق NaN مفعّلًا، فإنّ النوع الفعلي لقيمة Value يكون عددًا صحيحًا مسطّحًا غير سالب من 64 بتًّا. يمكننا استخدام double بدلًا منه، وهو ما سيجعل الماكروهات الخاصة بالتعامل مع أعداد Lox أبسط قليلًا. لكنّ جميع الماكروهات الأخرى تحتاج إلى تنفيذ عمليات بتّية، وuint64_t نوعٌ أكثر ملاءمة بكثير لذلك. وخارج هذه الوحدة، لا تهتمّ بقيّة الآلة الافتراضية بأيّ من الأمرين.
وقبل أن نبدأ في إعادة تنفيذ تلك الماكروهات، نغلق فرع #else من #ifdef في نهاية تعريفات التمثيل
القديم.
^code end-if-nan-boxing (1 before, 2 after)
ومهمّتنا المتبقّية هي ببساطة ملء ذلك قسم #ifdef الأوّل بتنفيذات جديدة لكلّ ما هو موجود في جانب
#else. وسنعمل عليه نوع قيمة تلو الآخر، من الأسهل إلى الأصعب.
الأعداد
سنبدأ بالأعداد لأنّ لها التمثيل الأكثر مباشرةً تحت صندوق NaN. فـ"تحويل" double في C إلى قيمة clox معلَّبة بـ NaN لا يحتاج إلى مسّ بتّة واحدة -- فالتمثيل هو نفسه بالضبط. لكنّنا نحتاج إلى إقناع مصرّف C بذلك، وهو ما جعلناه أصعب بتعريف Value على أنّه uint64_t.
نحتاج إلى جعل المصرّف يأخذ مجموعة بتّات يظنّ أنّها double ويستخدم البتّات نفسها على أنّها uint64_t، أو العكس. وتُسمّى هذه ثنائية الأنواع (type punning). والمبرمجون في C وC++ يفعلون هذا منذ أيام بنّاطيس الأبواب وأشرطة 8 المسجّلة، لكنّ مواصفات اللغة تردّدت في أن تذكر أيّ الطرق العديدة لهذا هو المعتمد رسميًّا.
أعرف طريقة واحدة لتحويل double إلى Value والعكس أعتقد أنّ مواصفتَي C وC++ تدعمانها. لكنّها لا
تتّسع في تعبير واحد، لذا اضطرّ ماكروهات التحويل إلى استدعاء دوالّ مساعِدة. وهذه هي الماكرو الأولى:
^code number-val (1 before, 2 after)
يمرّر ذلك الماكرو الـ double إلى هنا:
^code num-to-value (1 before, 2 after)
أعرف، غريب، صحيح؟ الطريقة للتعامل مع سلسلة بايتات على أنّ لها نوعًا مختلفًا دون تغيير قيمتها إطلاقًا
هي memcpy()؟ يبدو هذا بطيئًا بشكل مرعب: أنشئ متغيّرًا محلّيًا. ومرّر عنوانه إلى نظام التشغيل عبر
استدعاء نظام لنسخ بضعة بايتات. ثمّ أعد النتيجة، وهي البتّات نفسها تمامًا كالمُدخَل. ولحسن الحظ،
ولأنّ هذا هو المصطلح المدعوم لثنائية الأنواع، فإنّ معظم المصرّفات تتعرّف على النمط وتُلغي
memcpy() بالكامل.
"إلغاء لفّ" رقم Lox هو الصورة المعكوسة.
^code as-number (1 before, 2 after)
يستدعي ذلك الماكرو هذه الدالة:
^code value-to-num (1 before, 2 after)
إنّها تعمل تمامًا بنفس الطريقة لكن مع تبديل النوعين. ومجدّدًا، سيُلغي المصرّف كلّ ذلك. فرغم أنّ تلك
الاستدعاءات لـ memcpy() ستختفي، فما زلنا بحاجة إلى أن نُظهر للمصرّف أيّ memcpy() نستدعيه،
لذا نحتاج أيضًا إلى include.
^code include-string (1 before, 2 after)
كان ذلك كثيرًا من الشيفرة، لكنّ الغاية في النهاية لم تكن سوى إسكات فاحص أنواع C. وإجراء اختبار نوع وقت التشغيل على رقم Lox أكثر إثارة للاهتمام. فإذا كان كلّ ما لدينا هو البتّات الخاصة بـ double بالضبط، فكيف نعرف أنّه هو double؟ حان وقت للّعب بالبتّات.
^code is-number (1 before, 2 after)
نعرف أنّ كلّ قيمة ليست عددًا ستستخدم تمثيل quiet NaN خاصًّا. ونفترض أنّنا قد تجنّبنا على نحو صحيح أيّ من تمثيلات NaN ذات المعنى التي قد تنتجها فعلًا عمليات حسابية على الأعداد.
فإذا كانت الـ double تملك كلّ بتّات NaN مضبوطة، وبتّة quiet NaN مضبوطة، وبتّة إضافية احتياطًا، ف يمكننا أن نكون موقنين إلى حدٍّ كبير أنّها أحد أنماط البتّات التي خصّصناها بأنفسنا لأنواع أخرى. للتحقّق من ذلك، فإنّنا نقنّع كلّ البتّات عدا بتّات quiet NaN التي اخترناها. فإن كانت كلّ تلك البتّات مضبوطة، فلا بدّ أنّها قيمة معلَّبة بـ NaN من نوع آخر في Lox. وإلا، فإنّها في الواقع عدد.
وتُعلَن مجموعة بتّات quiet NaN هكذا:
^code qnan (1 before, 2 after)
كان من الجميل لو دعمت C القيم الثنائية. لكن إن حوّلتَ، فسترى أنّ القيمة نفسها:
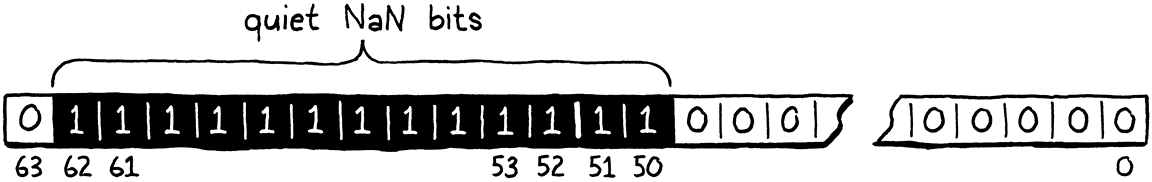
وهذا هو بالضبط كلّ بتّات الأس، مضافًا إليها بتّة quiet NaN، مضافًا إليها بتّة إضافية لتفادي قيمة Intel تلك.
nil و true و false
النوع التالي الذي نتعامل معه هو nil. وهذا بسيط إلى حدٍّ ما لأنّ هناك قيمة nil واحدة فحسب، لذا
نحتاج إلى نمط بتّات واحد فقط لتمثيله. وهناك قيمتان أخريان وحيدتان، وهما القيمتان المنطقيتان
true وfalse. وهذا يستدعي ثلاثة أنماط بتّات فريدة إجمالًا.
بتّتان تعطيان أربع تركيبات مختلفة، وهو ما يكفي تمامًا. فنحجز أدنى بتّتين في فراغ المانتيسا المهمل بوصفهما "وسم نوع" لتحديد أيّ من هذه القيم الثلاث وحيدة نبحث عنها. وتُعرَّف وسوم الأنواع الثلاثة هكذا:
^code tags (1 before, 2 after)
وتمثيلنا لـ nil هو إذن كلّ البتّات المطلوبة لتعريف تمثيل quiet NaN لدينا إلى جانب بتّات وسم النوع
nil:
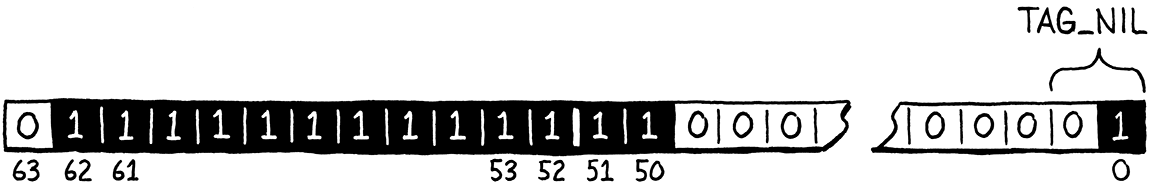
وفي الشيفرة، نتحقّق من البتّات هكذا:
^code nil-val (2 before, 1 after)
نكتفي بعمل OR على مستوى البتّات بين بتّات quiet NaN ووسم النوع، ثمّ نفعل بعض رقصات التحويل (CAST) لتُعلم مصرّف C بما نريد أن تعنيه تلك البتّات.
وبما أنّ nil له تمثيل بتّات واحد فحسب، يمكننا استخدام المساواة على uint64_t لمعرفة ما إذا كانت
قيمة ما هي nil.
^code is-nil (2 before, 1 after)
ويمكنك أن تخمّن كيف نعرّف قيمتَي true وfalse.
^code false-true-vals (2 before, 1 after)
وتبدو البتّات هكذا:
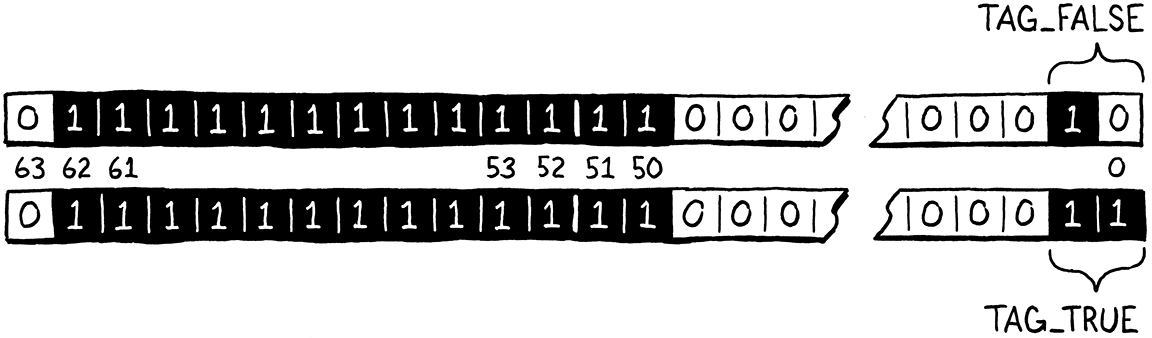
ولتحويل bool في C إلى قيمة منطقية في Lox، فإنّنا نعتمد على قيمتي وحيدتَي هاتين والمُعامل الشرطي القديم الطرّاز.
^code bool-val (2 before, 1 after)
ربما هناك طريقة أذكى على مستوى البتّات لإنجاز ذلك، لكنّ حدسي هو أنّ المصرّف يستطيع اكتشاف طريقة أسرع مني. والاتجاه المعاكس أبسط.
^code as-bool (2 before, 1 after)
وبما أنّنا نعرف أنّه في Lox يوجد تمثيلان بالضبط للقيم المنطقية على مستوى البتّات -- بخلاف C حيث يمكن
اعتبار أيّ قيمة غير صفرية "صادقة" -- فإنّ ما ليس true لا بدّ أن يكون false. وهذا الماكرو يفترض
طبعًا أنّك لا تستدعيه إلّا على قيمة تعرف أنّها قيمة منطقية في Lox. وللتحقّق من ذلك، هناك
ماكرو آخر.
^code is-bool (2 before, 1 after)
يبدو ذلك غريبًا قليلًا. وماكرو أكثر وضوحًا هكذا:
#define IS_BOOL(v) ((v) == TRUE_VAL || (v) == FALSE_VAL)
للأسف، ذلك غير آمن. فالتوسيع يذكر v مرّتين، ما يعني أنّه إن كان ذلك التعبير له أيّ آثار جانبية،
فستُنفَّذ مرّتين. يمكننا أن نجعل الماكرو يستدعي دالة منفصلة، لكنّ آه، أيّ عبء.
وبدلًا من ذلك، فإنّنا نعمل OR على مستوى البتّات مع 1 على القيمة لدمج نمطي البتّات المنطقيَّين الصالحَين الوحيدَين. وهذا يترك ثلاث حالات محتملة يمكن أن تكون القيمة فيها:
-
كانت
FALSE_VALوقد تحوّلت الآن إلىTRUE_VAL. -
كانت
TRUE_VALولم يفعل| 1شيئًا وما زالتTRUE_VAL. -
إنّها قيمة أخرى غير منطقية.
وعند تلك النقطة، يمكننا ببساطة مقارنة النتيجة بـ TRUE_VAL لمعرفة إن كنّا في الحالتين الأولى أو
الثانية أم في الثالثة.
الكائنات
نوع القيمة الأخير هو الأصعب. فخلافًا للقيم الوحيدة، هناك مليارات قيم المؤشّرات المختلفة التي نحتاج إلى تعلّبها داخل NaN. وهذا يعني أنّنا نحتاج إلى نوع من الوسم يشير إلى أنّ هذه NaNs تحديدًا هي مؤشّرات Obj، وإلى متّسع للعناوين نفسها.
بتّات الوسم التي استخدمناها للقيم الوحيدة تقع في المنطقة التي قرّرتُ فيها تخزين المؤشّر نفسه، لذا لا يمكننا بسهولة استخدام بتّة مختلفة هناك للدلالة على أنّ القيمة إشارة مرجعية لكائن. لكن هناك بتّة أخرى لا نستخدمها. وبما أنّ كلّ قيم NaN لدينا ليست أعدادًا -- إنّه مكتوب في الاسم نفسه -- فإنّ بتّة الإشارة لا تُستخدم لأيّ شيء. سنستخدمها بوصفها وسم النوع للكائنات. فإن كان أحد قِيَم quiet NaN لدينا تضع بتّة إشارة مضبوطة، فإنّه مؤشّر Obj. وإلا، فلا بدّ أنّه إحدى قيم وحيدة السابقة.
إذا كانت بتّة الإشارة مضبوطة، فإنّ البتّات الدنيا المتبقّية تخزّن المؤشّر إلى Obj:
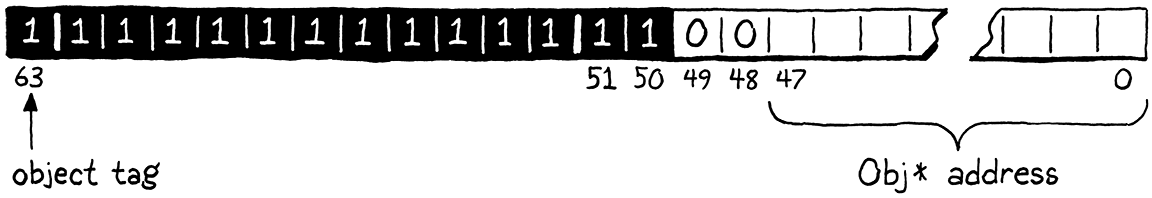
ولتحويل مؤشّر Obj خام إلى Value، نأخذ المؤشّر ونضبط كلّ بتّات quiet NaN وبتّة الإشارة.
^code obj-val (1 before, 2 after)
المؤشّر نفسه 64 بتًّا كاملًا، ومن حيث المبدأ، يمكنه إذن أن يتداخل مع بعض بتّات quiet NaN وبتّات الإشارة تلك. لكن في الممارسة، على الأقلّ في المعماريات التي اختبرتها، فإنّ كلّ ما فوق البتّة 48 في المؤشّر يكون دائمًا صفرًا. وهناك كثير من التحويلات هنا، وقد وجدتُ أنّها ضرورية لإرضاء بعض أكثر مصرّفات C تدخّلًا، لكنّ النتيجة النهائية هي مجرّد ضمّ بعض البتّات معًا.
ونُعرّف بتّة الإشارة هكذا:
^code sign-bit (2 before, 2 after)
ولإخراج مؤشّر Obj مرّة أخرى، فإنّنا نكتفي بقنّاع كلّ تلك البتّات الزائدة.
^code as-obj (1 before, 2 after)
والعلامة (~)، إن لم تكن قد مارست بما يكفي التلاعب بالبتّات من قبل، فهي NOT على مستوى البتّات. فهي تقلب كلّ الآحاد والأصفار في مُعاملها. وبقنّاع القيمة مع النافذ السلبي البتّي لبتّات
quiet NaN وبتّة الإشارة، فإنّنا نمسح تلك البتّات ونترك بتّات المؤشّر باقية.
ماكرو أخير:
^code is-obj (1 before, 2 after)
القيمة التي تخزّن مؤشّر Obj تكون بتّة إشارتها مضبوطة، لكنّ أيّ عدد سالب كذلك. لمعرفة ما إذا كانت قيمة ما مؤشّر Obj، نحتاج إلى التحقّق من أنّ بتّة الإشارة وكلّ بتّات quiet NaN مضبوطة. وهذا مشابه لطريقة اكتشافنا لنوع القيم الوحيدة، لكنّنا هنا نستخدم بتّة الإشارة كوسم.
دوالّ القيم
تمرّ بقيّة الآلة الافتراضية عادةً عبر الماكروهات عند العمل مع القيم، لذا فقد أوشكنا على الانتهاء. لكنّ هناك بضع دوالّ في وحدة "value" تختلس النظر داخل صندوق Value الأسود على أيّ حال وتعمل مع ترميزه مباشرة. ونحتاج إلى إصلاح تلك أيضًا.
الأولى هي printValue(). ولديها شيفرة منفصلة لكلّ نوع قيمة. لم يعد لدينا تعداد أنواع صريح نستطيع
التبديل عليه، لذا نستخدم بدلًا منه سلسلة من اختبارات الأنواع للتعامل مع كلّ نوع قيمة.
^code print-value (1 before, 1 after)
وهذا من الناحية التقنية أبطأ قليلًا من جملة switch، لكنّه بالمقارنة مع الحِمل الزائد للكتابة الفعلية إلى مجرى، فهو لا يُذكر.
وما زلنا ندعم تمثيل الاتّحاد الموسوم الأصلي، لذا نُبقي الشيفرة القديمة ونحيطها بقسم #else الشرطي.
^code end-print-value (1 before, 1 after)
والعملية الأخرى هي اختبار قيمتين بالمساواة.
^code values-equal (1 before, 1 after)
لا يمكن أن تكون أبسط من ذلك بكثير! فإذا كان تمثيلا البتّات متطابقَين، فإنّ القيم متساوية. وذلك يفعل الشّيء الصحيح مع القيم الوحيدة لأنّ لكلٍّ منها تمثيل بتّات فريد ولا تساوي إلا نفسها. وهو أيضًا يفعل الشّيء الصحيح مع مؤشّرات Obj، لأنّ الكائنات تستخدم الهوية (identity) في المساواة -- فإشيرا Obj متساويان فقط إنّهما يشيران إلى الكائن نفسه بالضبط.
وهو إلى حدٍّ كبير صحيح أيضًا للأعداد. فمعظم الأعداد العشرية المتحركة ذات تمثيلات بتّات مختلفة هي قيم عددية متميّزة. لكن للأسف، يحتوي IEEE 754 على حفرة تُوقعنا في مشكلة. فلأسباب ليست واضحة لي تمامًا، تُوجب المواصفة على أنّ قيم NaN لا تساوي نفسها. وهذا ليس مشكلة مع قيم quiet NaN الخاصة التي نستخدمها لأغراضنا. لكن من الممكن إنتاج NaN "حقيقية" حسابية في Lox، وإن أردنا تنفيذ أرقام IEEE 754 على نحو صحيح، فلا يُفترض بالقيمة الناتجة أن تساوي نفسها. وبشكل أكثر تحديدًا:
var nan = 0/0;
print nan == nan;
يقول IEEE 754 إنّ هذا البرنامج من المفترض أن يطبع "false". وهو يفعل الشّيء الصحيح مع تمثيلنا القديم
بالاتّحاد الموسوم، لأنّ حالة VAL_NUMBER تطبّق == على قيمتين يعرف مصرّف C أنّهما double. ومن ثمّ
يولّد المصرّف تعليمة المعالج الصحيحة لتنفيذ مساواة عشرية متحركة وفق IEEE.
ويكسر تمثيلنا الجديد ذلك بتعريف Value على أنّه uint64_t. وإن أردنا الامتثال لـ IEEE 754 بالكامل، نحتاج إلى معالجة هذه الحالة.
^code nan-equality (1 before, 1 after)
أعرف، إنّه غريب. وهناك تكلفة أداء لعمل هذا الاختبار في كلّ مرّة نتحقّق فيها من مساواة قيمتَي Lox. فإن كنا مستعدّين للتضحية ببعض التوافق -- فمَن حقًّا يهتمّ إن كان NaN لا يساوي نفسه؟ -- يمكننا ترك ذلك. وسأترك لك القرار في مدى التحرّف الذي تريد أن تكون عليه.
وأخيرًا، نغلق قسم الترجمة الشرطي حول التنفيذ القديم.
^code end-values-equal (1 before, 1 after)
وهذا كل شيء. Optimization مكتمل، وكذلك آلتنا الافتراضية clox. وكان ذلك آخر سطر شيفرة جديد في الكتاب.
تقييم الأداء
انتهت الشيفرة، لكنّنا ما زلنا بحاجة إلى معرفة ما إذا كنّا قد جعلنا أيّ شيء أفضل حقًّا بهذه التغييرات. وتقييم تحسين كهذا يختلف كثيرًا عن السابق. فهناك كان لدينا نقطة اختناق واضحة في المُنمِّط. وقد أصلحنا ذلك الجزء من الشيفرة ورأينا فورًا نقطة الاختناق تصير أسرع.
أمّا آثار تغيير تمثيل القيم فهي أكثر انتشارًا. فالماكروهات يتمدّد في مكانها أينما استُخدمت، لذا فإنّ تغييرات الأداء موزّعة عبر قاعدة الشيفرة بطريقة يصعب على كثير من المُنمِّطات تتبّعها جيدًا، ولا سيّما في بناء مُحسَّن.
كما يمكننا صعوبة استنتاج آثار تغييرنا. فقد جعلنا القيم أصغر، ما يقلّل إخفاقات الذاكرة المخبّأة في كلّ أنحاء الآلة الافتراضية. لكنّ الأثر الفعلي في العالم الحقيقي لهذا التغيير يعتمد بشدّة على استهلاك الذاكرة في برنامج Lox الجاري تشغيله. فقد لا يحتوي مقياس Lox دقيق صغير على ما يكفي من القيم الموزّعة في الذاكرة ليكون الأثر ملحوظًا، وحتى أمور مثل العناوين التي يمنحها إياها مخصّص ذاكرة C يمكن أن تؤثّر في النتائج.
إن أدّينا عملنا على نحو صحيح، فإنّ كلّ شيء تقريبًا يصبح أسرع قليلًا، ولا سيّما في برامج Lox الأكبر والأكثر تعقيدًا. لكن من الممكن أن تُبطل عمليات البتّات الإضافية التي نجريها عند تعلّب قيم بـ NaN إنّ عمل الأداء بهذا الشكل مُقلِق لأنّك لا تستطيع بسهولة إثبات أنّك جعلت الآلة الافتراضية أفضل. فلا يمكنك أن تشير إلى مقياس أداء دقيق واحد مستهدَف بالجراحة وتقول: "ها، انظر!"
والمثاليّ، ينبغي أن تكون مستخلَصة من تطبيقات العالم الحقيقي -- وهو أمر غير موجود بالطبع للغة لعب مثل Lox. عندئذٍ يمكننا قياس تغييرات الأداء الإجمالية عبرها جميعًا. وقد أبذلتُ قصارى جهدي لتجميع حفنة من برامج Lox الأكبر. وعلى جهازي، يبدو أنّ تمثيل القيم الجديد يجعل كلّ شيء أسرع بنحو 10% بشكل عام.
وليست هذه تحسينات هائلة، ولا سيّما بالمقارنة مع الأثر العميق لجعل البحث في جداول التجزئة أسرع. وقد أضفتُ هذا التحسين إلى حدٍّ كبير لأنّه مثال جيّد لنوعٍ معيّن من عمل الأداء قد تكتشفه، وبصراحة، لأنّني أظنّ أنّه رائع تقنيًّا. قد لا يكون أوّل ما ألجأ إليه لو كنت أحاول بجدّ جعل clox أسرع. وهناك على الأرجح ثمار أخرى أسهل .
لكن إن وجدتَ نفسك تعمل على برنامج نُفدت فيه كلّ المكاسب السهلة، فقد ترغب عند بعض النقاط في التفكير في ضبط تمثيل قيمك. وآمل أن يكون هذا فصلا قد أضاء على بعض الخيارات المتاحة لك في ذلك المجال.
إلى أين بعد ذلك
سنقف هنا مع لغة Lox ومفسّرينا الاثنين. يمكننا أن نستمرّ في العبث بها إلى الأبد، مضافين ميزات لغة جديدة وتحسينات سرعة ذكيّة. لكنّنا، في هذا الكتاب، أظنّ أنّنا وصلنا إلى مكانٍ طبيعيّ لنُتمّ فيه عملنا. لن أعيد سرد كلّ ما تعلّمناه في الصفحات الماضية العديدة. فقد كنت معي وتذكر. وبدلًا من ذلك، أودّ أن آخذ دقيقة للتحدّث عن يمكنك أن تذهب من هنا. فما الخطوة التالية في رحلتك مع لغات البرمجة؟
معظمكم على الأرجح لن يقضي جزءًا مهمًّا من مسيرته المهنية في العمل على المصرّفات أو المفسّرات. فذاك قطعة صغيرة إلى حدٍّ ما من فطيرة أكاديمية علوم الحاسوب، وهي قطعة أصغر بعد في هندسة البرمجيات في الصناعة. وهذا مقبول. فحتى لو لم تعمل أبدًا على مصرّف في حياتك، فستستخدم واحدًا بالتأكيد، وآمل أن يكون هذا الكتاب قد زوّدك بفهم أفضل لكيفية تصميم لغات البرمجة التي تستخدمها وتنفيذها.
لقد تعلّمتَ أيضًا حفنة من بنى البيانات المهمّة والأساسية، واكتسبتَ بعض التدريب على عمل التنميط والتحسين منخفض المستوى. وذلك النوع من الخبرة مفيد مهما كان المجال الذي تبرمج فيه.
وأنا أيضًا آمل أنني منحتك طريقة جديدة في النظر إلى المشكلات وحلّها. فحتى لو لم تعمل على لغة أبدًا، فقد تندهش عند اكتشاف كمّ من مشكلات البرمجة يمكن رؤيتها على أنّها شبيهة بـاللغات. ربما يستطيع مولّد التقارير الذي تحتاج إلى كتابته أن يُنمذَج كسلسلة من "تعليمات" قائمة على المكدّس "ينفّذها" ذلك المولّد. وواجهة المستخدم التي تحتاج إلى عرضها تبدو إلى حدٍّ كبير شبيهة بعبور شجرة تحليل مجرّد.
أبعد في هذا الاتجاه، إليك بعض الاقتراحات لأيّ الفروع في النفق تستكشف:
-
دفعنا مصرّف شيفرة البايت البسيط أحادي التمريرة إلى حدّ كبير نحو التحسين وقت التشغيل. وفي تنفيذ لغة ناضج، يكون التحسين وقت التجميع أهمّ عمومًا، ومجال تحسينات المصرّفات غنيّ إلى حدٍّ لا يُصدَّق. خُذ كتابًا كلاسيكيًّا في المصرّفات، وأعد بناء واجهة clox أو jlox الأمامية لتكون خطّ أنابيب تجميع متطوّرًا يتمثّل بعض التمثيلات الوسيطة المثيرة وتمريرات التحسين.
وستضع الأنواع الديناميكية بعض القيود على مدى وصولك، لكنّ هناك الكثير مما تستطيع فعله. أو ربما تريد أن تأخذ قفزة كبيرة وتضيف أنواعًا ساكنة وفاحص أنواع إلى Lox. وسيمنح ذلك واجهتك الأمامية الكثير مما تعالجه بالتأكيد.
-
في هذا الكتاب، أهدف إلى أن أكون صحيحًا، لكن ليس دقيقًّا على نحو خاصّ. هدفي الأساسي هو منحك حدسًا وإحساسًا بعمل في مجال اللغات. وإن كنتَ تفضّل المزيد من الدقة، فإنّ عالم لغات البرمجة الأكاديميّ كلّه في انتظارك. فاللغات والمصرّفات دُرست رسميًّا منذ ما قبل أن نمتلك حواسيب، لذا فلا نقص في الكتب والأوراق البحثية حول نظريّة المحلّلات وأنظمة الأنواع والدلالات والمنطق الرسمي. والذهاب في هذا الاتجاه سيعلّمك أيضًا كيف تقرأ أوراق علوم الحاسوب، وهي مهارة ثمينة بذاتها.
-
أو، إن كنتَ تستمتع فعلًا بالعبث بلغات البرمجة وصناعتها، فيمكنك أن تأخذ Lox وتحوّلها إلى لعبتك الخاصة. غيّر الصياغة إلى شيء يُبسط عينيك. أضف ميزات ناقصة أو أزل ميزات لا تعجبك. وأضِف تحسينات جديدة.
وقد تصل في النهاية إلى نقطة تجد فيها عندك شيئًا تظنّ أنّ الآخرين يمكنهم الاستفادة منه أيضًا. وذلك يأخذك إلى عالم شعبية لغات البرمجة المميّز تمامًا. توقّع أن تقضي وقتًا طويلًا في كتابة التوثيق وبرامج المثال والأدوات والمكتبات المفيدة. والمجال مزدحم بلغات تتنافس على المستخدمين. وللانتقال في ذلك الفضاء، عليك أن تضع قبّعة التسويق وتبيع. لا يستمتع الجميع بهذا النوع من العمل الموجّه للجمهور، لكن إن فعلت، فيمكن أن يكون رؤية الناس يستخدمون لغتك للتعبير عن أنفسهم مجزية إلى حدٍّ لا يُصدَّق.
وربما يكون هذا الكتاب قد أشبع شهيتك وستتوقّف هنا. وأيًّا كان المسار الذي تسلكه أو لا تسلكه، فهناك مثلي، قد تكون قد واجهتَ لغات البرمجة بخوف في البداية. لكن في هذه الفصول، رأيت أنّ حتى المواد الصعبة حقًّا يمكن أن نعالجها نحن البشر العاديّون إذا أدخلنا أيدينا واتّخذناها خطوةً خطوة. فإن استطعتَ التعامل مع المصرّفات والمفسّرات، فبإمكانك فعل أيّ شيء تضع له عقلك.
التحدّيات
إسناد واجب في اليوم الأخير من المدرسة يبدو قاسيًا، لكن إن أردت حقًّا شيئًا تفعله خلال إجازتك الصيفية:
-
أشعل مُنمِّطك، وشغّل بضع مقاييس أداء، وابحث عن نقاط اختناق أخرى في الآلة الافتراضية. هل ترى أيّ شيء في وقت التشغيل يمكنك تحسينه؟
-
النصوص في برامج المستخدم من العالم الحقيقي صغيرة، غالبًا بحرف أو حرفين فقط. وهذا أقلّ سبب للقلق في clox لأنّنا نُدوِّل النصوص، لكنّ معظم الآلات الافتراضية لا تفعل. أمّا تلك التي تفعل، فإنّ تخصيص مصفوفة محارف صغيرة في الكومة لكلّ تلك النصوص الصغيرة ثمّ تمثيل القيمة كمؤشّر إلى تلك المصفوفة هدرٌ للوقت. والحيلة الكلاسيكية هي وجود تمثيل قيمة منفصل للنصوص الصغيرة يخرّز المحارف داخل القيمة نفسها.
بدءًا من تمثيل الاتّحاد الموسوم الأصلي في clox، نفّذ ذلك التحسين. واكتب بضع مقاييس أداء ذات صلة وشاهد إن كان يساعد.
-
تأمّل في تجربتك مع هذا الكتاب. ما الأجزاء التي نجحت معك؟ وما التي لم تنجح؟ هل كان من الأسهل أن تتعلّم من الأسفل إلى الأعلى أم من الأعلى إلى الأسفل؟ هل ساعدتك الرسوم التوضيحية أم شتّتك؟ هل وضّحت التشبيهات أم ارتبكتك؟
وكلّما فهمتَ أسلوب تعلّمك الشخصي أكثر، كنتَ تستطيع أكثر فعاليةً في إدخال المعرفة إلى ذهنك. ويمكنك استهداف المواد التي تعلّمك بالطريقة التي تتعلّم بها على نحو أفضل.