خريطة الإقليم
عليك أن تملك خريطة، مهما كانت خشنة. وإلّا فقد تاهت في كلّ مكان. في سيد الحلقات لم أسمح لأحدٍ أن يبتعد أكثر ممّا يستطيع في يومٍ بعينه.
جي. آر. آر. تولكين
لا نريد أن نتاهى في كلّ مكان، لذا قبل أن نتحرّك، فلنفحص الإقليم الذي رسمه من سبقونا من منفّذي اللّغات. سيُعيننا ذلك على فهم إلى أين نحن ذاهبون، وما هي الطرق البديلة التي سلكها غيرنا.
أولاً، دعني أضع اختصاراً. فالموضوع الأعظم في هذا الكتاب هو التنفيذ (implementation) للّغة، وهو شيءٌ متمايز عن اللّغة نفسها بصيغةٍ ما من المثالية الأفلاطونية. فأشياء مثل "مكدّس" و"شيفرة بايت" (bytecode) و"النزول التكرّاري" (recursive descent) هي مسامير وصواميل قد يستعملها تطبيقٌ بعينه. ومن منظور المستخدم، ما دامت الآلية الناتجة تتبع مواصفة اللّغة بإخلاص، فكلّ ذلك تفاصيلُ تنفيذ.
وسنقضي وقتاً طويلاً في تلك التفاصيل، لذا إن اضطررتُ إلى كتابة "تنفيذ اللّغة" في كلّ مرّةٍ أُشير فيها إليها، سأُبلي أصابع يدي. ولن ألتزم بذلك. بل سأستعمل "اللّغة" للإشارة إلى اللّغة أو إلى تنفيذها، أو إلى كليهما، ما لم يكن التمييز بينهما مهمّاً.
أجزاء اللّغة
يبني المهندسون لغات البرمجة منذ العصور المظلمة للحاسوب. وكما أمكننا التحدّث إلى الحاسوب، اكتشفنا أنّ ذلك صعبٌ جداً، فاستأجرنا مساعدته. وأجده مثيراً للاهتمام أنّ آلات اليوم -- رغم أنّها أسرع بمليون مرّة حرفياً، ولديها مخزّن بتفوق رتب المقادير -- فإنّ الطريقة التي نبني بها لغات البرمجة لم تتغيّر عملياً.
ولرغم أنّ المجال الذي يستكشفه مصمّمو اللّغات واسع، فإنّ المسارات التي حفروها فيه قليلة. فليست كلّ لغة تسلك المسار نفسه تماماً -- فبعضها يسلك اختصاراً أو آخر -- لكنّها عدا ذلك متشابهة إلى حدٍّ يطمئن، من أوّل مصرّف COBOL الذي كتبته العقيلة غريس هوبار وصولاً إلى لغةٍ ساخنة وجديدة تُترجَم إلى JavaScript، و"توثيقها" كلّه مكوّن من ملفّ README واحد رديء التحرير في مستودع git ما.
أتخيّل شبكةَ المسارات التي قد يختارها التطبيق كتسلّق جبل. تبدأ من الأسفل ومعك البرنامج كنصّ مصدري خام، أي مجرّد سلسلة من المحارف. وكلّ مرحلة تحلّل البرنامج وتحوّله إلى تمثيلٍ أعلى مستوى، حيث تصبح الدلالة -- أي ما يريد مؤلّف البرنامج أن يفعله الحاسوب -- أكثر وضوحاً.
نصل في النهاية إلى القمّة. لدينا نظرة من علوّ على برنامج المستخدم، ويمكننا رؤية ما تعنيه شيفرتُه بمعنى. نبدأ هبوطنا على الجانب الآخر من الجبل. نحوّل هذا التمثيل الأعلى مستوى نزولاً إلى صور أدنى مستوى تِباعاً، لنقترب أكثر فأكثر ممّا نعرف كيف نجعل المعالج ينفّذه فعلاً.
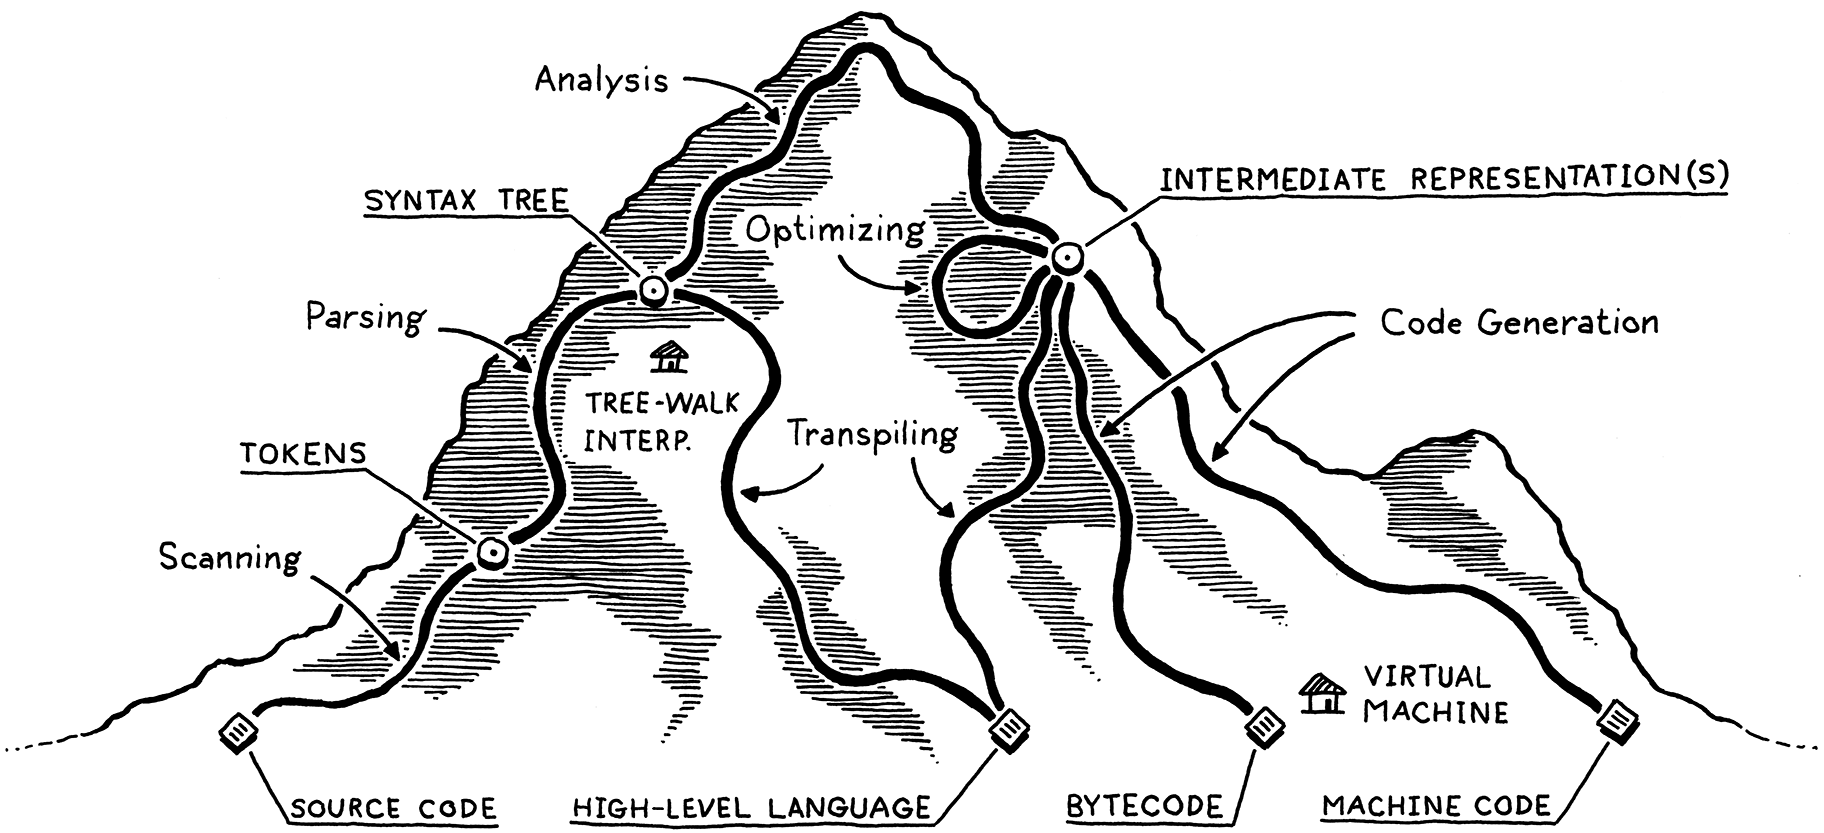
لنمرّ على كلّ تلك الممرّات والمعالم. تبدأ رحلتنا على اليسار بالنصّ المجرّد لشيفرة المستخدم المصدرية:
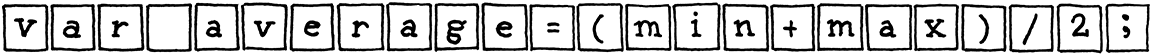
المسح المعجمي
الخطوة الأولى هي المسح المعجمي (scanning)، وتُسمّى أيضاً التحليل المعجمي (lexing)، أو -- إن كنتَ تحاول إبهار أحدهم -- التحليل المعجمي الصريح. جميعها تعني نفس الشيء تقريباً. وأنا أحبّ كلمة "lexing" لأنّها تبدو شيئاً قد يفعله شرّيرٌ خارق، لكنّني سأستعمل "scanning" لأنّها تبدو أكثر شيوعاً بدرجةٍ يسيرة.
يستقبل المُحلِّل المعجمي (scanner أو lexer) تدفّق المحارف
الخطّي ويجمعها في قطعٍ أقرب ما تكون إلى "كلمات".
وفي لغات البرمجة، تُسمّى كلّ واحدة من تلك الكلمات رمزاً
(token). فبعض الرموز محرفٌ واحد، مثل ( و ,. وبعضها قد
يطول عدّة محارف، مثل الأرقام (123)، وثوابت النصوص ("hi!")،
والمعرّفات (min).
بعض المحارف في الملفّ المصدري لا تعني شيئاً فعلياً. فالمسافات البيضاء غالباً لا أثر لها، والتعليقات -- بحكم تعريفها -- مُهمَلة من اللّغة. ويطرحها المُحلِّل المعجمي عادةً، تاركاً تسلسلاً نظيفاً من الرموز ذات المعنى.

التحليل النحوي
الخطوة التالية هي التحليل النحوي (parsing). هنا تكتسب صياغتنا قواعد (grammar) -- أي القدرة على تأليف تعبيراتٍ وجملٍ أكبر من أجزاء أصغر. هل كنتَ ترسم مخطّطات جُملٍ في صفّ اللّغة الإنجليزية؟ إن كان كذلك، فقد فعلتَ ما يفعله المحلّل النحوي، إلّا أنّ الإنجليزية فيها آلاف وآلاف من "الكلمات المفتاحية" وفيضٌ هائل من الغموض. أمّا لغات البرمجة فأبسط بكثير.
يستقبل المحلل النحوي (parser) تسلسل الرموز المسطّح ويبني بنية شجرية تعكس طبيعة قواعد اللّغة المتداخلة. ولبهذه الأشجار عدّة أسماء مختلفة -- شجرة التحليل (parse tree) أو شجرة الصياغة المجرّدة (abstract syntax tree) -- بحسب مدى قربها من البنية الصرفيّة المجرّدة للّغة المصدرية. وعملياً، يدعو قراصنة اللّغات إليها عادةً أشجار الصياغة (syntax trees) أو الأشجار المجرّدة (ASTs)، أو غالباً مجرّد الأشجار (trees).
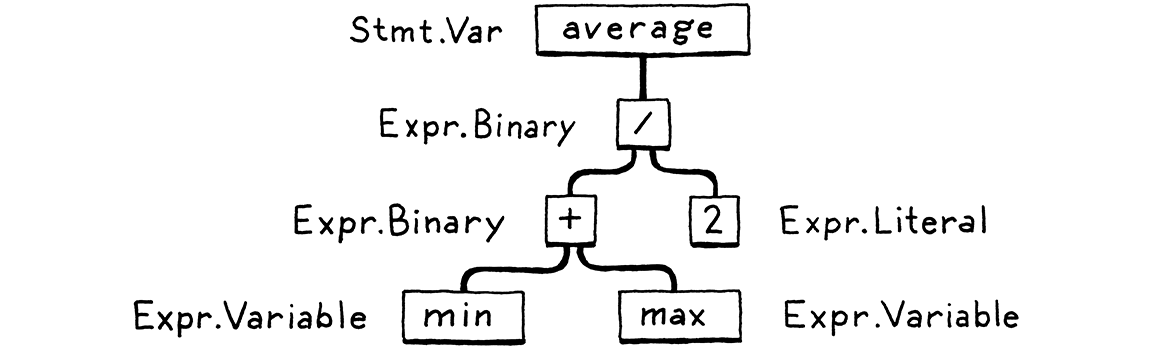
للتحليل النحوي تاريخٌ طويلٌ وغنيّ في علوم الحاسوب، وهو مرتبط بإحكام بمجتمع الذكاء الاصطناعي. فالخبرات العديدة المستعملة اليوم في تحليل لغات البرمجة صاغها في الأصل باحثو الذكاء الاصطناعي لتحليل اللّغات البشرية، وهم يحاولون جعل الحاسوب يتحدث إلينا.
وتبيّن أنّ اللّغات البشرية كانت فوضويةً أكثر من اللازم بالنسبة للقواعد الجامدة التي كانت تلك المحلّلات قادرة على معالجتها، لكنّها كانت ملائمةً تماماً للقواعد الاصطناعية الأبسط في لغات البرمجة. وللأسف، ما زال نحن البشر المعطوبون ننجح في استعمال تلك القواعد البسيطة استعمالاً خاطئاً، لذا فإنّ عمل المحلل النحوي يشمل أيضاً أن يخبرنا متى نفعل ذلك عبر الإبلاغ عن أخطاء الصياغة (syntax errors).
التحليل الساكن
المرحلتان الأولى والثانيتان متشابهتان إلى حدٍّ كبير عبر جميع التطبيقات. أمّا الآن فتبدأ الخصائص الفردية لكلّ لغة في الظهور. عند هذه النقطة، نعرف البنية الصرفيّة للشيفرة -- أمور مثل أيّ تعبيراتٍ متداخلة داخل أيّها -- لكنّنا لا نعرف أكثر من ذلك بكثير.
في تعبيرٍ مثل a + b، نعرف أنّنا نجمع a و b، لكنّنا لا
نعرف إلى ماذا تشير هذه الأسماء. هل هي متغيّرات محلّية؟ عامّة؟
أين عُرّفت؟
يُسمّى أوّل جزء من التحليل تقوم به معظم اللّغات الربط (binding) أو الحَلّ (resolution). فلكلّ معرّف (identifier)، نكتشف أين عُرّف هذا الاسم ونوصّل بين الاثنين. وهنا يظهر النطاق (scope) -- وهو منطقة من الشيفرة المصدرية يمكن فيها استخدام اسمٍ معيّن للإشارة إلى تصريحٍ معيّن.
وإذا كانت اللّغة مُنمَّطة ساكناً، فهنا
نجري فحص الأنواع. فبعد أن نعرف أين صُرّح a و b، يمكننا
كذلك أن نستنتج نوعَيهما. ثمّ إن لم تكن تلك الأنواع تدعم
إضافتهما إلى بعضهما، نُبلّغ عن خطأ نوع (type error).
خذ نفساً عميقاً. لقد بلغنا قمة الجبل، ونحصل على منظرٍ شامل لبرنامج المستخدم. وكلّ هذه البصيرة الدلالية التي نراها من التحليل تحتاج إلى تخزين في مكانٍ ما. وهناك عدّة أماكن يمكن أن نخبّئها فيها:
-
غالباً ما تُخزَّن مجدداً بوصفها سمات (attributes) على شجرة الصياغة نفسها -- أي حقولٌ إضافية في العقد لا تُهيّأ أثناء التحليل النحوي بل تُملأ لاحقاً.
-
وأحياناً، قد نخزّن البيانات في جدول بحثٍ جانبي. وعادةً ما تكون مفاتيح هذا الجدول معرّفات -- أسماء متغيّرات وتصريحات. وفي هذه الحالة نسمّيه جدول الرموز (symbol table)، وتخبرنا القيم التي يربطها بكلّ مفتاح عمّ يشير إليه ذلك المعرّف.
-
وأقوى أداة محاسبة هي تحويل الشجرة إلى بنية بياناتٍ جديدة تماماً تعبّر عن دلالة الشيفرة تعابيرَ أكثر مباشرة. وهذا هو القسم التالي.
كلّ ما حتى هذه النقطة يُعدّ الواجهة الأماميّة (front end) للتطبيق. وقد تخمّن أنّ كلّ ما بعدها هو الواجهة الخلفيّة (back end)، لكن ليس كذلك. ففي عهد صياغة مصطلحي "الواجهة الأماميّة" و"الواجهة الخلفيّة" كانت المصرّفات أبسط بكثير. واخترع باحثون لاحقاً مراحل جديدة احتواها بين النصفين. وبدلاً من التخلّص من المصطلحين القديمين، جمع وليم ولف ورفاقه تلك المراحل الجديدة في اسمٍ جذّاب لكنّه متناقض مكانياً: الواجهة الوسطى (middle end).
التمثيلات الوسيطة
يمكنك أن تفكر في المصرّف كخطّ إنتاج، تكون مهمّة كلّ مرحلة فيه هي تنظيم البيانات الممثِّلة لشيفرة المستخدم بحيث تصبح المرحلة التالية أسهل في التنفيذ. والواجهة الأماميّة من خطّ الإنتاج خاصّةٌ بلغة المصدر التي كُتب البرنامج بها. أمّا الواجهة الخلفيّة فتخصّ البنية النهائية التي سيُشغَّل البرنامج عليها.
وفي الوسط، قد يُخزَّن الشيفرة في تمثيلٍ وسيط (IR) لا يرتبط ارتباطاً محكماً لا بصيغة المصدر ولا بصيغة الوجهة (ولهذا سُمّي "وسيطاً"). بل يؤدّي التمثيل الوسيط دور الواجهة (interface) بين هاتين اللّغتين.
يتيح لك ذلك دعم عدّة لغات مصدرية وعدّة منصّاتِ هدفٍ بجهدٍ أقلّ. لنفترض أنّك تريد تنفيذ مصرّفات Pascal و C و Fortran، وأن تستهدف x86 و ARM، و -- لا أدري -- SPARC. عادةً ما يعني ذلك أنّك تلتزم بكتابة تسعة مصرّفات كاملة: Pascal→x86 و C→ARM وكلّ التوافيق الأخرى.
ويقلّل التمثيل الوسيط المشترك (shared) ذلك بدرجةٍ هائلة. فأنت تكتب واجهة أماميّة واحدة لكلّ لغة مصدرية تُنتج التمثيل الوسيط. ثمّ واجهة خلفية واحدة لكلّ بنية هدف. والآن يمكنك المزج والمطابقة بينهما للحصول على كلّ التوافيق.
وهناك سببٌ كبير آخر قد نرغب معه في تحويل الشيفرة إلى صورة تجعل الدلالة أكثر وضوحاً...
التحسين
بمجرد أن نفهم ما يعنيه برنامج المستخدم، نكون أحراراً في استبداله ببرنامجٍ آخر له الدلالة نفسها لكن ينفّذها بكفاءة أعلى -- أي يمكننا أن نُحسّن (optimize) الشيفرة.
ومثالٌ بسيط هو طيّ الثوابت (constant folding): فإذا كان تعبيرٌ ما يُقيَّم دائماً إلى القيمة نفسها تماماً، يمكننا إجراء التقييم وقت التصريف واستبدال شيفرة التعبير بنتيجته. فإذا كتب المستخدم:
pennyArea = 3.14159 * (0.75 / 2) * (0.75 / 2);
فيمكننا أن نُجري كلّ تلك العمليات الحسابية داخل المصرّف ونغيّر الشيفرة إلى:
pennyArea = 0.4417860938;
والتحسين جزءٌ ضخم من تجارة لغات البرمجة. فكثير من قراصنة اللّغات يقضون حياتهم المهنية كلّها هنا، يضغطون كلّ قطرة أداءٍ يستطيعون استخراجها من مصرّفاتهم ليحصلوا على نتائج قياسية أسرع بنسبة جزءٍ من المئة. وقد يتحوّل الأمر إلى نوعٍ من الهوس.
وسنقفز في هذا الكتاب إلى حدٍّ كبيرٍ فوق تلك الفجوة. فكثير من اللّغات الناجحة تملك عدداً مدهشاً من تحسينات وقت التصريف. فمثلاً، تُنتج Lua و CPython شيفرةً غير مُحسَّنة نسبياً، وتركّز معظم جهدها في الأداء على وقت التشغيل.
توليد الشيفرة
لقد طبّقنا كلّ التحسينات التي نستطيع تخيّلها على برنامج المستخدم. والخطوة الأخيرة هي تحويله إلى صورة تستطيع الآلة تنفيذها فعلاً. بكلّماتٍ أخرى، توليد الشيفرة (code generation أو code gen)، حيث تشير "الشيفرة" هنا عادةً إلى نوع التعليمات الأوّلية الشبيهة بتعليمات التجميع (assembly) التي ينفّذها المعالج، وليس إلى نوع "الشيفرة المصدرية" التي قد يريد إنسانٌ قراءتها.
وأخيراً، نحن في الواجهة الخلفيّة (back end)، نُنزل في الجانب الآخر من الجبل. ومن هنا فصاعداً، يصير تمثيلنا للشيفرة أكثر وأكثر أوّلياً، كأنّ التطوّر ينكشف في اتجاهه المعاكس، كلّما اقتربنا ممّا تستطيع آلتنا البسيطة فهمه.
ولنا قرارٌ نتخّذه. هل نولّد تعليماتٍ لمعالجٍ حقيقيّ أم لمعالجٍ افتراضيّ؟ فإذا ولّدنا شيفرة آلة حقيقية، نحصل على ملفٍّ تنفيذي يستطيع نظام التشغيل تحميله مباشرةً على الشريحة. أمّا الشيفرة الأصلية (native code) فهي أسرع البرق، لكن توليدها عملٌ كبير. وتبني البنى (architectures) اليوم أكواماً من التعليمات، ومسارات معالجةٍ معقّدة (pipelines)، وحقيبةً من الأثقال التاريخية تكفي لملء حجرة أمتعة طائرة 747.
وتحدّثك بلغة الشريحة يعني أيضاً أنّ مصرّفك مربوط ببنيةٍ معيّنة. فإذا كان مصرّفك يستهدف x86، فلن يعمل على جهاز ARM. وفي العودة إلى الستينيات، خلال الانفجار الكمبري لمعماريات الحاسوب، كان انعدام قابلية النقل هذا عائقاً حقيقياً.
وللتجاوز ذلك، جعل قراصنةٌ مثل مارتن ريتشاردز ونيكلوس فيرت -- صاحبَي شهرة BCPL و Pascal على التوالي -- مصرّفاتهم تُنتج شيفرة آلةٍ افتراضية. فبدلاً من تعليماتٍ لشريحةٍ ما حقيقية، أنتجوا شيفرةً لآلةٍ افتراضية متخيَّلة ومثالية. وسمّى فيرت هذا p-code أي قابلاً للنقل (portable)، لكنّنا اليوم نسمّيه عموماً شيفرة بايت (bytecode) لأنّ كلّ تعليمةٍ فيها يبلغ طوله بايتاً واحداً في الغالب.
وهذه التعليمات الاصطناعية مصمَّمة لتُطابق دلالة اللّغة تطابقاً أدقّ قليلاً، ولا تكون مربوطةً إلى خصوصيّات بنية حاسوبٍ بعينها وحطامها التاريخي المتراكم. ويمكنك أن تفكّر فيها بوصفها ترميزاً كثيفاً ثنائيّاً للعمليات منخفضة المستوى في اللّغة.
الآلة الافتراضية
إذا كان مصرّفك يُنتج شيفرة بايت، فإنّ عملك لم ينتهِ بانتهاء ذلك. ولأنّه لا توجد شريحة تتحدّث بهذه الشيفرة، فمهمّتك هي الترجمة. ومرةً أخرى، أمامك خياران. يمكنك كتابة مصرّفٍ مصغّر لكلّ بنية هدف يحوّل شيفرة البايت إلى شيفرة أصلية لتلك الآلة. وما زال عليك أن تعمل من أجل كلّ شريحة تدعمها، لكنّ هذه المرحلة الأخيرة بسيطةٌ إلى حدٍّ كبير، وتتمكّن من إعادة استعمال بقيّة خطّ إنتاج المصرّف عبر كلّ الآلات التي تدعمها. فأنت عملياً تستعمل شيفرة البايت بوصفها تمثيلاً وسيطاً.
أو يمكنك كتابة آلة افتراضية (VM)، وهي برنامج يحاكي شريحةً افتراضية متخيَّلة تدعم بنيةَك الافتراضية في وقت التشغيل. فتشغيل شيفرة البايت داخل آلة افتراضية أبطأ من ترجمتها مسبقاً إلى شيفرة أصلية، لأنّ كلّ تعليمةٍ يجب أن تُحاكى في وقت التشغيل في كلّ مرّة تُنفَّذ فيها. وفي المقابل، تكسب البساطة وقابلية النقل. فنفّذ آلتك الافتراضية، مثلاً، بـC، وتستطيع تشغيل لغتك على أيّ منصّة فيها مصرّف C. وهكذا يعمل المفسّر الثاني الذي سنبنيه في هذا الكتاب.
وقت التشغيل
نجحنا أخيراً في طرق برنامج المستخدم حتى صار صورةً نستطيع تنفيذها. والخطوة الأخيرة هي تشغيله. فإن صرّفناه إلى شيفرة آلة، فقط نأمر نظام التشغيل بتحميل الملفّ التنفيذي فينطلق. أما إن صرّفناه إلى شيفرة بايت، فنحتاج إلى تشغيل الآلة الافتراضية وتحميل البرنامج فيها.
وفي الحالتين، باستثناء أكثر اللّغات انخفاضاً في المستوى، نحتاج عادةً إلى بعض الخدمات التي تقدّمها لغتنا أثناء تشغيل البرنامج. فمثلاً، إذا كانت اللّغة تُدير الذاكرة تلقائياً، فنحتاج إلى جامع نفايات (garbage collector) يعمل لاستعادة البتات غير المستعملة. وإذا كانت لغتنا تدعم اختبارات "instance of" لتعرف نوع الكائن الذي لديك، فنحتاج إلى بعض التمثيل لتتبّع نوع كلّ كائن أثناء التنفيذ.
وكلّ هذا يجري في وقت التشغيل، لذا يُسمّى -- على وجه الأنسب -- بيئة التشغيل (runtime). وفي اللّغة المصرَّفة بالكامل، تُدرَج الشيفرة المنفِّذة لبيئة التشغيل مباشرةً في الملفّ التنفيذي الناتج. ففي Go مثلاً، لكلّ تطبيقٍ مصرَّف نسخته الخاصة من بيئة تشغيل Go مضمّنةً فيه مباشرةً. أمّا إذا كانت اللّغة تُشغَّل داخل مفسّر أو آلة افتراضية، فإنّ بيئة التشغيل تقطن هناك. وهكذا تعمل معظم تطبيقات لغاتٍ مثل Java و Python و JavaScript.
الاختصارات والطرق البديلة
هذا هو الطريق الطويل الذي يغطّي كلّ مرحلةٍ قد تنفّذها. فكثير من اللّغات تسلك المسار كلّه فعلاً، لكنّ هناك بضعة اختصارات وطرقٍ بديلة.
المصرّفات ذات المرور الواحد
تتداخل بعض المصرّفات البسيطة بين التحليل النحوي والتحليل وتوليد الشيفرة، بحيث تُنتج شيفرة المخرجات مباشرةً داخل المحلّل النحوي دون أن تخصّص أيّ أشجار صياغة أو تمثيلات وسيطة أخرى. وتقيّد هذه المصرّفات ذات المرور الواحد (single-pass compilers) تصميم اللّغة. فليس لديك بنى بيانات وسيطة تخزّن فيها معلوماتٍ عامة عن البرنامج، ولا تعود إلى أيّ جزءٍ سبق تحليله من الشيفرة. وهذا يعني أنّه ما إن ترى تعبيراً ما حتى تحتاج إلى معرفة كافية لتصريفه على نحو صحيح.
صُمّمت Pascal و C حول هذا القيد. ففي ذلك الحين كانت الذاكرة بكلّ غالٍ، لعلّ المصرّف لا يستطيع حتى أن يحتفظ في ذاكرته بملفّ مصدري (source file) كامل، فضلاً عن البرنامج كلّه. ولهذا تشترط قواعد Pascal أن تظهر تصريحات الأنواع أولاً في الكتلة. ولهذا لا يمكنك في C استدعاء دالةٍ فوق الشيفرة التي تعرّفها، إلا إذا كان لديك تصريحٌ أمامي صريح (forward declaration) يخبر المصرّف بما يحتاج معرفته ليولّد شيفرة الاستدعاء لتلك الدالة اللاحقة.
مفسّرات المشي على الشجرة
تبدأ بعض لغات البرمجة بتنفيذ الشيفرة فور تحليلها النحوي إلى شجرة صياغة مجرّدة (AST) (مع ربما قدرٍ يسير من التحليل الساكن). ولتشغيل البرنامج، يمرّ المفسّر على شجرة الصياغة فرعاً وفرعاً وورقةً وورقةً، مُقيِّماً كلّ عقدة أثناء ذلك.
وهذا النمط من التنفيذ شائع في مشاريع الطلاب واللّغات الصغيرة، لكنّه غير مستخدَم على نطاقٍ واسع في اللّغات عامة الغرض (general-purpose) لأنّه يميل إلى البطء. فبعضهم يستعمل "مفسّراً" بمعنى هذه الأنواع من التنفيذ وحدها، بينما يعرّف آخرون تلك الكلمة على نحوٍ أوسع، لذا سأستعمل مفسّر المشي على الشجرة (tree-walk interpreter) الصريح وغير القابل للجدال للإشارة إلى هذه. ومفسّرنا الأوّل يسير على هذا النحو.
المصرّفات المُترجِمة (transpilers)
قد يكون كتابة واجهة خلفية كاملة للغة عملٌ كبيراً. فإذا كان لديك تمثيلٌ وسيطٌ عامّ قائم للاستهداف، فيمكنك تثبيت واجهتك الأماميّة عليه. وإن لم يكن كذلك، فيبدو أنك محتجز. لكن ماذا لو تعاملتَ مع لغة مصدرية أخرى وكأنّها تمثيلٌ وسيط؟
فأنت تكتب واجهةً أماميّة للّغتك. ثمّ في الواجهة الخلفية، بدلاً من إنفاق العمل على خفض دلالات الشيفرة إلى لغةٍ هدف أوّلية، أنت تُنتج سلسلةً من الشيفرة المصدرية الصالحة للّغة أخرى التي ارتفاعها يقارب ارتفاع لغتك. ثمّ تستعمل أدوات التصريف القائمة لـتلك اللّغة كطريق هروبك من الجبل والنزول إلى شيءٍ تستطيع تنفيذه.
كانوا يسمّون هذا مصرّفاً من مصدرٍ إلى مصدر (source-to-source compiler) أو مصرّفاً عابراً للّغات (transcompiler). وبعد ظهور اللّغات التي تُصرَّف إلى JavaScript كي تعمل في المتصفّح، أخذت اللقبة العصرية transpiler في الانتشار.
ولما كان أوّل مصرّفٍ عابر يترجم لغة تجميعٍ إلى أخرى، فإنّ معظم الـtranspilers اليوم تعمل على لغاتٍ أعلى مستوى. وبعد أن انتشرت UNIX انتشاراً واسعاً في الآلات، بدأت تقليدٌ طويل من المصرّفات التي تنتج C كلغة مخرجات. فقد كانت مصرّفات C متوفّرة في كلّ مكان توجد فيه UNIX وتُنتج شيفرةً كفؤة، لذا كان استهداف C طريقةً جيّدة لجعل لغتك تعمل على كثير من البنى.
ومتصفّحات الويب هي "الآلات" اليوم، و"شيفرتها الآلية" هي JavaScript، لذا يبدو أنّ كلّ لغةٍ تقريباً موجودة اليوم صار لها مصرّف يستهدف JS، لأنّ ذلك هو الطريقة الرئيسية للحصول على شيفرتك عاملةٍ في متصفّح.
وتبدو الواجهة الأماميّة للمصرّف العابر -- المُحلِّل المعجمي والمحلّل النحوي -- كغيرها من المصرّفات. ثمّ إذا كانت اللّغة المصدرية مجرّد جلدٍ نحويّ بسيط فوق اللّغة الهدف، فقد يتخطّى التحليل تماماً وينتقل مباشرةً إلى إخراج الصياغة المكافئة في اللّغة الوجهة.
وإذا كانت اللّغتان مختلفتين أكثر على مستوى الدلالة، فسترى المزيد من المراحل النموذجية للمصرّف الكامل، بما فيها التحليل وربما حتى التحسين. ثمّ عند توليد الشيفرة، بدلاً من إخراج لغةٍ ثنائية كشيفرة الآلة، تُنتج سلسلةً من شيفرة مصدرية (بل وجهة) نحوياً صحيحة في اللّغة الهدف.
وفي الحالتين، تمرّر بعد ذلك تلك الشيفرة الناتجة عبر خطّ إنتاج التصريف القائم في اللّغة الهدف، فتصبح جاهزاً للانطلاق.
التصريف في آخر لحظة (Just-in-time)
هذا الأخير أقلّ ما يكون اختصاراً وأكثره تسلّقاً جبلياً خطيراً يُحتفظ به للخبراء وحدهم. فأسرع طريقة لتنفيذ الشيفرة هي تصريفها إلى شيفرة آلة، لكنّك قد لا تعرف أيّ بنيةٍ يدعمها جهاز المستخدم النهائي. فما العمل؟
يمكنك أن تفعل ما تفعله آلة Java الافتراضية HotSpot (JVM)، وبيئة التشغيل (CLR) من مايكروسوفت، ومعظم مفسّرات JavaScript. فعلى جهاز المستخدم النهائي، حين يُحمَّل البرنامج -- إمّا من مصدرٍ في حالة JS، أو من شيفرة بايتٍ مستقلّة عن المنصّة في حالتي JVM و CLR -- تصرفه إلى شيفرةٍ أصلية لبنية حاسوبه. ومن البديهي أنّ هذا يُسمّى التصريف في آخر لحظة (just-in-time compilation). ويكتفي معظم القراصنة بقول "JIT"، منطوقةً كما لو كانت تنطق على قافية "fit".
وتُدرج أكثر JITs تطوّراً خطّافات تنميط (profiling hooks) في الشيفرة المُولَّدة لترى أيّ المناطق هي الأكثر حسّاسية للأداء وأيّ نوعٍ من البيانات يجري فيها. ثمّ مع مرور الوقت يعيدون تصريف تلك النقاط الساخنة (hot spots) تلقائياً بتحسيناتٍ أكثر تقدّماً.
المصرّفات والمفسّرات
بعد أن ملأتَ رأسك بمقدار معجمٍ كامل من مصطلحات لغات البرمجة، يمكننا أخيراً أن نعالج سؤالاً ما يلاحق المبرمجين منذ عصور ما قبل التاريخ: ما الفرق بين المصرّف والمفسّر؟
وتبيّن أنّ هذا أشبه بالسؤال عن الفرق بين الفاكهة والخضراوات. يبدو خياراً ثنائياً إما/أو، لكنّ "فاكهة" مصطلح نباتيّ (botanical) بينما "خضراوت" مصطلح طبخيّ (culinary). فالأولى لا تستلزم نفي الثانية، بالمعنى الصارم. فهناك فواكه ليست خضراوات (التفاح) وخضراوات ليست فواكه (الجزر)، لكنّ هناك نباتاتٍ تؤكل هي فواكه وخضراوات معاً، مثل الطماطم.
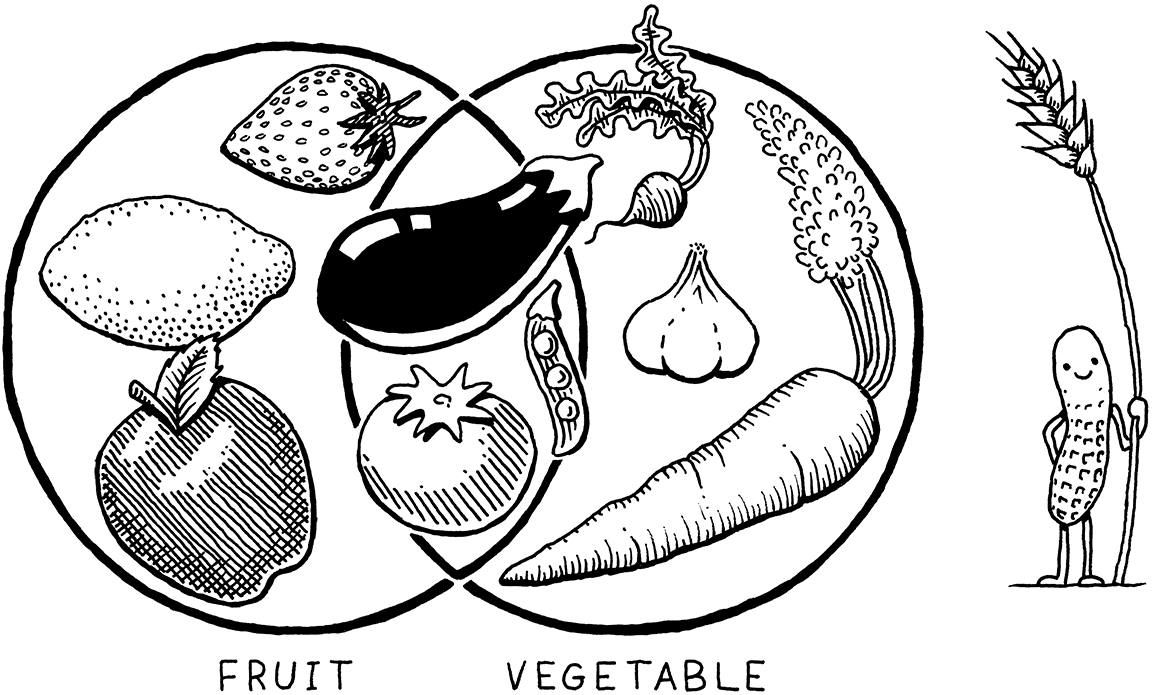
إذن، عدنا إلى اللّغات:
-
التصريف (compiling) هو تقنية تنفيذ تنطوي على ترجمة لغةٍ مصدرية إلى صورةٍ أخرى -- عادةً أدنى مستوى. فحين تولّد شيفرة بايت أو شيفرة آلة، فأنت تصرّف. وحين تُترجم إلى لغةٍ عالية المستوى أخرى، فأنت تصرّف أيضاً.
-
وحين نقول إنّ تطبيق لغةٍ ما "مصرّف" (compiler)، فنعني أنّه يترجم الشيفرة المصدرية إلى صورةٍ أخرى لكنّه لا ينفّذها. على المستخدم أن يأخذ المخرجات الناتجة ويشغّلها بنفسه.
-
وبالمقابل، حين نقول إنّ تطبيقاً ما "مفسّر" (interpreter)، فنعني أنّه يأخذ الشيفرة المصدرية وينفّذها فوراً. فهو يشغّل البرامج "من المصدر".
وكالتفاح والبرتقال، هناك تطبيقاتٌ واضحة أنّها مصرّفات وليست مفسّرات. فـGCC و Clang يأخذان شيفرتك المكتوبة بـC ويصرّفانها إلى شيفرة آلة. والمستخدم النهائي يشغّل ذلك الملفّ التنفيذي مباشرةً، وقد لا يعرف حتّى أيّ أداة استُعملت في تصريفه. فهما إذن مصرّفان للّغة C.
وفي الإصدارات الأقدم من التطبيق المرجعي لماتز الخاص بـRuby، كان المستخدم يشغّل Ruby من المصدر. فكان التطبيق يحلّله نحوياً وينفّذه مباشرةً بتمريره على شجرة الصياغة. ولم يحدث أيّ ترجمة أخرى، لا داخلياً ولا في أيّ صورةٍ يراها المستخدم. فهذا كان بالتأكيد مفسّراً للّغة Ruby.
لكنّ ماذا عن CPython؟ حين تشغّل برنامج Python باستخدامه، تُحلَّل الشيفرة نحوياً وتُحوَّل إلى صيغة شيفرة بايت داخلية، ثمّ تُنفَّذ تلك داخل الآلة الافتراضية. فمن منظور المستخدم، هذا مفسّر بوضوح -- فهو يشغّل برنامجه من المصدر. لكنّك إن رفعت جلد CPython المتفشّر، فسترى أنّ ثمّة تصريفاً يجري بالتأكيد في الداخل.
والجواب أنّه كلاهما معاً. فـCPython مفسّر، وله مصرّف أيضاً. وعملياً، تعمل معظم لغات النصوص بهذه الطريقة، كما ترى:
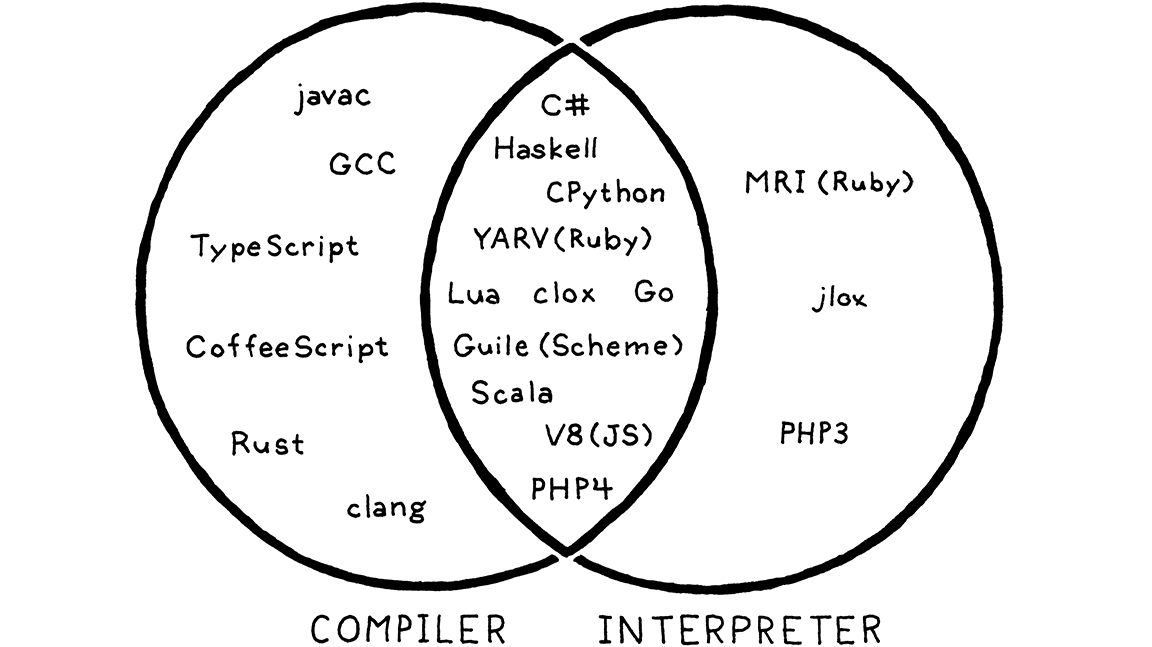
وتقع المنطقة المتداخلة في الوسط هناك أيضاً حيث يقيم مفسّرنا الثاني، لأنّه يصرّف داخلياً إلى شيفرة بايت. فبينما يكون هذا الكتاب اسمياً عن المفسّرات، سنتناول بعض التصريف أيضاً.
رحلتنا
هذا كلٌّه كثيرٌ لابتلاعه دفعةً واحدة. لا تقلق. هذا ليس الفصل الذي يُتوقَّع منك فيه أن تفهم كلّ هذه القطع والقطع. كلّ ما أريده هو أن تعرف أنّها موجودة، وتعرف تقريباً كيف تتّسق بعضها ببعض.
وستخدمك هذه الخريطة جيّداً وأنت تستكشف الإقليم خارج المسار الموجّه الذي نسلكه في هذا الكتاب. وأريد أن أتركك متلهّفاً لأن تنطلق بمفردك وتتهادى في ذلك الجبل كلّه.
لكنّ الوقت الآن هو وقت بدء رحلتنا نحن. اربط رباط حذائك، وشدّ حقيبتك على ظهرك، وتعال معنا. من هنا فصاعداً، كلّ ما تحتاج إلى التركيز عليه هو الطريق الذي أمامك.
التحديات
-
اختر تطبيقاً مفتوح المصدر للّغة تحبها. نزّل الشيفرة المصدرية وتنقّل فيها. حاول أن تجد الشيفرة التي تنفّذ المُحلِّل المعجمي والمحلّل النحوي. هل هي مكتوبةٌ بيد البشر أم مولّدةٌ بأدوات مثل Lex و Yacc؟ (ملفات
.lأو.yتدلّ عادةً على الثاني.) -
يُعدّ التصريف في آخر لحظة أسرع طريقة لتنفيذ اللّغات المُنمَّطة ديناميكياً، لكنّ ليس كلّها يستعمله. ما الأسباب التي تجعل عدم استعمال JIT خياراً؟
-
معظم تطبيقات Lisp التي تُصرَّف إلى C تحتوي أيضاً على مفسّر يسمح لها بتنفيذ شيفرة Lisp أثناء التشغيل أيضاً. لماذا؟