ZeroMQ
بنية تطبيقات المصادر المفتوحة (المجلد الثاني)ZeroMQ
بنية تطبيقات المصادر المفتوحة (المجلد الثاني) ZeroMQ
Martin Süstrik
إن كنت تستمتع بهذه الكتب، فقد يعجبك أيضًا تصميم البرمجيات بالأمثلة في Python وتصميم البرمجيات بالأمثلة في JavaScript.
ØMQ هو نظام مراسلة، أو «برمجيات وسيطة موجَّهة بالرسائل» (message-oriented middleware) إن شئت المصطلح. إنه يُستخدم في بيئات متباينة كالخدمات المالية، وتطوير الألعاب، والأنظمة المدمجة، والبحث الأكاديمي، وصناعة الفضاء.
تعمل أنظمة المراسلة في جوهرها كالمراسلة الفورية (instant messaging) لكن للتطبيقات. فيقرّر تطبيقٌ ما أن يبلّغ تطبيقًا آخر (أو عدة تطبيقات) بحدث ما، فيجمّع البيانات المراد إرسالها، ثم يضغط زر «إرسال»، وانتهى الأمر—يتولى نظام المراسلة الباقي.
على خلاف المراسلة الفورية، لا تمتلك أنظمة المراسلة واجهة رسومية (GUI)، ولا تفترض وجود بشر في نقطتي الطرف قادرين على التدخل الذكي عندما يسوء شيء ما. لذلك يجب أن تكون أنظمة المراسلة متسامحة مع الأعطال (fault-tolerant) وأسرع بكثير من المراسلة الفورية المعتادة.
صُمّم ØMQ في الأصل كنظام مراسلة فائق السرعة لتداول الأسهم، ولذلك كان التركيز على التحسين المتطرف (extreme optimization). أمضى العام الأول من المشروع في وضع منهجية قياس الأداء (benchmarking) ومحاولة تعريف بنية أكثرها كفاءة ممكنة.
ثم إننا، في العام الثاني من التطوير تقريبًا، نقلنا التركيز إلى توفير نظام عام (generic) لبناء التطبيقات الموزّعة ودعم أنماط مراسلة اعتباطية، وآليات نقل متنوعة، وربط بلغات برمجية اعتباطية، إلخ.
وفي العام الثالث ركّز العمل أساسًا على تحسين سهولة الاستخدام وتسطيح منحنى التعلم. لقد تبنّينا واجهة BSD Sockets البرمجية (API)، وحاولنا تنقية دلالات أنماط المراسلة الفردية، وهكذا.
نأمل أن يمنح هذا الفصل رؤوسة حول كيفية انعكاس الأهداف الثلاثة أعلاه في البنية الداخلية لـ ØMQ، وأن يقدّم بعض النصائح للذين يصارعون المشكلات ذاتها.
منذ عامه الثالث تجاوز ØMQ حدود شيفرته الأصلية؛ وهناك مبادرة لتوحيد معايير بروتوكولات السلك (wire protocols) التي يستخدمها، وتنفيذ تجريبي لنظام مراسلة شبيه بـ ØMQ داخل نواة لينكس، إلخ. ولا يغطي هذا الكتاب هذه الموضوعات. غير أنك يمكنك مراجعة موارد متاحة على الإنترنت لمزيد من التفاصيل: http://www.250bpm.com/concepts، وhttp://groups.google.com/group/sp-discuss-group، وhttp://www.250bpm.com/hits.
24.1. التطبيق مقابل المكتبة
ØMQ مكتبة، لا خادم مراسلة. استغرقنا عدة سنوات في العمل على بروتوكول AMQP، وهو محاولة من قطاع التمويل لتوحيد بروتوكول السلك الخاص بمراسلة الأعمال—كنا نكتب له تنفيذًا مرجعيًا ونشارك في عدة مشاريع كبيرة تعتمد بعمق على تقنية المراسلة—حتى أدركنا أن في النموذج الكلاسيكي عميل/خادم، أي خادم مراسلة ذكي (broker) مع عملاء مراسلة غبّاء، أمرًا خاطئًا.
كان شاغلنا الأساسي في ذلك الوقت هو الأداء: فإذا كان هناك خادم في المنتصف، فلا بد أن تعبر كل رسالة الشبكة مرتين (من المرسل إلى الوسيط، ومن الوسيط إلى المستقبل)، مما يفرض عقوبة في كل من زمن الاستجابة (latency) ونسبة الإرسال (throughput). علاوة على ذلك، إذا مرَّت جميع الرسائل عبر الوسيط، فمن المؤكد أنه سيصبح عنق الزجاجة (bottleneck) في وقت ما.
أما شاغلنا الثانوي فكان يتعلق بالنشرات (deployments) واسعة النطاق: فحين يتجاوز النشر حدود المؤسسات، لم تعد فكرة سلطة مركزية تُدير كامل تدفّق الرسائل صالحة. لا شركة مستعدة للتنازل عن السيطرة إلى خادم في شركة أخرى؛ فهناك أسرار تجارية ومسؤولية قانونية. والنتيجة عمليًا أن يكون لكل شركة خادم مراسلة واحد، مع جسور مكتوبة يدويًا لربطه بأنظمة المراسلة في الشركات الأخرى. ومن ثمّ يكون النظام البيئي كله مجزّأً إلى حد كبير، وصيانة هذا العدد الكبير من الجسور لكل شركة مشاركة لا تحسّن الحال. لحل هذه المشكلة نحتاج إلى بنية موزّعة بالكامل، بنية قد تخضع كل مكوّناتها لكيان تجاري مختلف. وبما أن وحدة الإدارة في البنية المعتمدة على الخوادم هي الخادم، يمكننا حل المشكلة بتثبيت خادم منفصل لكل مكوّن. وفي هذه الحالة يمكننا كذلك تحسين التصميم أكثر من ذلك بجعل الخادم والمكوّن يتشاركان العمليات (processes) نفسها. والنتيجة في النهاية هي مكتبة مراسلة.
بدأ ØMQ حين تطرّحنا فكرة كيفية جعل المراسلة تعمل دون خادم مركزي. تطلّب ذلك قلب مفهوم المراسلة رأسًا على عقب، واستبدال نموذج مخزن مركزي مستقل للرسائل في منتصف الشبكة ببنية «طرف طرف ذكي، شبكة غبّاء» قائمة على مبدأ الطرف إلى الطرف (end-to-end). وكانت النتيجة الفنية لهذا القرار أن ØMQ، منذ البداية الأولى، كان مكتبة لا تطبيقًا.
وفي الوقت نفسه تمكّنّا من إثبات أن هذه البنية أكثر كفاءة (زمن استجابة أدنى ونسبة إرسال أعلى) وأكثر مرونة (فمن السهل بناء طوبولوجيات معقدة كيفما شئت بدل الارتباط بالنموذج الكلاسيكي «مركزي ذو أذرع» (hub-and-spoke)).
غير أن إحدى النتائج غير المقصودة كانت أن اختيار نموذج المكتبة حسّن سهولة استخدام المنتج. ومرّة تلو الأخرى عبّر المستخدمون عن سعادتهم لكونهم لا يحتاجون إلى تثبيت خادم مراسلة مستقل وإدارته. وتبيّن أن عدم وجود خادم خيار مفضَّل، لأنه يخفض تكلفة التشغيل (لا حاجة إلى مدير لخادم المراسلة) ويحسّن زمن الإطلاق إلى السوق (لا حاجة إلى التفاوض مع فريق العميل أو الإدارة أو العمليات حول ضرورة تشغيل الخادم).
الدرس المستفاد هو أنه عند بدء مشروع جديد، ينبغي أن تختار تصميم المكتبة إن أمكن ذلك مطلقًا. فمن السهل جدًا إنشاء تطبيق من مكتبة بمجرد استدعائها من برنامج بسيط؛ أما إنشاء مكتبة من ملف تنفيذي قائم فشبه مستحيل. وتقدّم المكتبة للمستخدمين مرونة أكبر بكثير، وفي الوقت نفسه تعفيهم من جهد إداري غير بسيط.
24.2. الحالة العامة
المتغيرات العامة لا تتعايش مع المكتبات. قد تُحمَّل المكتبة عدة مرات في العملية الواحدة، لكن يبقى لدى النظام مجموعة واحدة فقط من المتغيرات العامة. يعرض الشكل 24.1 مكتبة ØMQ مستخدَمة من مكتبتين مختلفتين ومستقلتين، ثم يستخدم التطبيق كلتا المكتبتين.
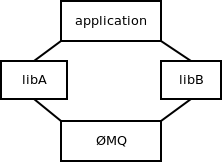 الشكل 24.1: استخدام ØMQ من مكتبات مختلفة
وعند حدوث مثل هذه الحالة، فإن نسختَي ØMQ تصلان إلى المتغيرات نفسها، مما ينتج حالات تسابق (race conditions) وأعطالًا غريبة وسلوكًا غير معرَّف.
ولمنع هذه المشكلة، لا تحتوي مكتبة ØMQ على أي متغيرات عامة. وبدلًا من ذلك، يتحمل مستخدم المكتبة مسؤولية إنشاء الحالة العامة صراحةً. ويُسمّى الكائن الذي يحتوي على الحالة العامة السياق (context). فمن منظور المستخدم يبدو السياق أشبه بمجموعة (pool) من خيوط العمل، أما من منظور ØMQ فهو مجرد كائن لتخزين أي حالة عامة نرغب فيها. وفي الصورة أعلاه، لدى libA سياقه الخاص، وكذلك libB. ولا سبيل لأحدهما إلى إفساد الآخر أو اختراقه.
الدرس هنا واضح إلى حد كبير: لا تستخدم حالة عامة في المكتبات. فإن فعلت ذلك، فمن المرجح أن تتعطل المكتبة حين تُنشأ مرتين في العملية نفسها.
24.3. الأداء
عند بدء ØMQ كان هدفه الأولي هو تحسين الأداء. ويُعبَّر عن أداء أنظمة المراسلة بمقياسين: نسبة الإرسال (throughput)—أي كم رسالة يمكن تمريرها خلال مدة زمنية محددة؛ وزمن الاستجابة (latency)—أي كم يستغرق وصول الرسالة من طرف إلى الطرف الآخر.
أي المقياسين ينبغي أن نركّز عليه؟ وما العلاقة بينهما؟ أليس الأمر بديهيًا؟ شغّل الاختبار، واقسم الزمن الكلي للاختبار على عدد الرسائل المارّة، لتحصل على زمن الاستجابة. واقسم عدد الرسائل على الزمن، لتحصل على نسبة الإرسال. بمعنى آخر، زمن الاستجابة هو القيمة المقلوبة لنسبة الإرسال. أمر بديهي، أليس كذلك؟
بدلًا من الانطلاق في البرمجة مباشرة، أمضينا بضعة أسابيع في بحث مقاييس الأداء بالتفصيل، فوجدنا أن العلاقة بين نسبة الإرسال وزمن الاستجابة أدقّ بكثير من ذلك، وأن هذه المقاييس غالبًا ما تكون مخالفة للتوقع البديهي.
تخيّل أن A ترسل رسائل إلى B. (انظر الشكل 24.2.) الزمن الكلي للاختبار 6 ثوانٍ. وقد عبرت 5 رسائل. إذن نسبة الإرسال 0.83 رسالة/ثانية (5/6) وزمن الاستجابة 1.2 ثانية (6/5)، صحيح؟
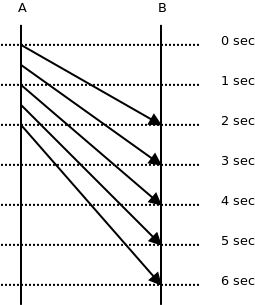 الشكل 24.2: إرسال الرسائل من A إلى B
انظر إلى المخطط من جديد. تستغرق كل رسالة وقتًا مختلفًا للانتقال من A إلى B: ثانيتان، و2.5 ثانية، و3 ثوانٍ، و3.5 ثانية، و4 ثوانٍ. والمعدل 3 ثوانٍ، وهو بعيد كل البعد عن حسابنا الأصلي الذي أعطى 1.2 ثانية. ويوضح هذا المثال سوء الفهم الذي يميل الناس بطبيعيتهم إلى ارتكابه بشأن مقاييس الأداء.
والآن انظر إلى نسبة الإرسال. الزمن الكلي للاختبار 6 ثوانٍ. غير أن إرسال كل الرسائل لا يستغرق عند A سوى ثانيتين. فمن منظور A تكون نسبة الإرسال 2.5 رسالة/ثانية (5/2). أما عند B فيستغرق استقبال كل الرسائل 4 ثوانٍ. فمن منظور B تكون نسبة الإرسال 1.25 رسالة/ثانية (5/4). ولا يطابق أيٌّ من الرقمين حسابنا الأصلي البالغ 1.2 رسالة/ثانية.
ولاختصار القصة، فإن زمن الاستجابة ونسبة الإرسال مقياسان مختلفان؛ وهذا واضح بذاته. والمهم هو فهم الفرق بينهما وعلاقتهما المتبادلة. فلا يُقاس زمن الاستجابة إلا بين نقطتين مختلفتين في النظام؛ فليس ثمّة زمن استجابة عند النقطة A. ولكل رسالة زمن استجابة خاص بها. ويمكنك حساب المتوسط لأزمنة استجابة عدة رسائل؛ لكن لا معنى لـ«زمن استجابة تدفّق من الرسائل».
أما نسبة الإرسال، على النقيض، فلا تُقاس إلا عند نقطة واحدة في النظام. فهناك نسبة إرسال عند المرسل، ونسبة إرسال عند المستقبل، ونسبة إرسال عند أي نقطة وسيطة بينهما، لكن لا وجود لنسبة إرسال كلية للنظام كله. ولا معنى لنسبة الإرسال إلا بالنسبة إلى مجموعة رسائل؛ فليس هناك نسبة إرسال لرسالة مفردة.
أما العلاقة بين نسبة الإرسال وزمن الاستجابة، فسنجد أن هناك علاقة فعلًا؛ لكن الصيغة تتضمّن التكاملات (integrals) ولا نتناولها هنا. ولمزيد من المعلومات، راجع مراجع نظرية الطوابير (queueing theory).
وهناك كثير من المزالق الأخرى في قياس أداء أنظمة المراسلة لن نتعمق فيها. والأولى أن نركّز بدلًا من ذلك على الدرس المستفاد: تأكّد أنك تفهم المشكلة التي تحلّها. فحتى مشكلة بسيطة مثل «اجعله سريعًا» تحتاج إلى جهد كبير لفهمها على نحو صحيح. والأهم أنك إن لم تفهم المشكلة، فأنت على الأرجح أن تبني في شيفرتك افتراضات ضمنية وخرافات شائعة، مما يجعل الحل إما معيبًا أو على الأقل أعقد بكثير أو أقل فائدة بكثير مما كان يمكن أن يكون عليه.
24.4. المسار الحرج
اكتشفنا أثناء عملية التحسين أن ثلاثة عوامل لها تأثير حاسم في الأداء:
- عدد عمليات تخصيص الذاكرة
- عدد استدعاءات النظام
- نموذج التزامن
لكن ليس كل تخصيص ذاكرة ولا كل استدعاء نظام له الأثر نفسه على الأداء. فالأداء الذي يهمّنا في أنظمة المراسلة هو عدد الرسائل التي يمكننا نقلها بين طرفين خلال مدة محددة. أو على نحو بديل، قد يهمّنا الوقت الذي تستغرقه رسالة للانتقال من طرف إلى آخر.
غير أنه بما أن ØMQ مصمَّم للسيناريوهات ذات الاتصالات طويلة العمر، فإن الوقت اللازم لإنشاء اتصال أو لمعالجة خطأ في اتصال يكاد لا يهم. فهذه الأحداث نادرة جدًا، ومن ثمّ فإن أثرها على الأداء الكلي مهمَل.
يُسمّى الجزء من قاعدة الشيفرة الذي يُستخدم بكثرة، مرّة تلو الأخرى، المسار الحرج (critical path)؛ وعلى التحسين أن يركّز على المسار الحرج.
لننظر إلى مثال: لا يحسّن ØMQ على نحو متطرف فيما يخص تخصيص الذاكرة. فمثلًا، عند التعامل مع النصوص (strings) كثيرًا ما يخصص سلسلة جديدة لكل مرحلة وسيطة من مراحل التحويل. لكن إذا نظرنا بصرامة إلى المسار الحرج—أي تمرير الرسائل نفسه—فسنجد أنه لا يكاد يستخدم أي تخصيص ذاكرة. فإذا كانت الرسائل صغيرة، فلا نكاد نحتاج إلى تخصيص واحد لكل 256 رسالة (تُحفظ هذه الرسائل في كتلة ذاكرة واحدة كبيرة مُخصَّصة). وإذا كان تدفّق الرسائل مستقرًا، بلا قمم هائلة في الحمل، فإن عدد عمليات تخصيص الذاكرة على المسار الحرج ينعدم (لا تُعاد كتل الذاكرة المُخصَّصة إلى النظام، بل تُعاد استخدامها مرّة تلو الأخرى).
الدرس المستفاد: حسّن حيثما كان للأمر فرق. فتحسين أجزاء الشيفرة غير الموجودة على المسار الحرج جهد ضائع.
24.5. تخصيص الذاكرة
بافتراض أن البنية التحتية كلها قد أُهيِّئ وأن اتصالًا بين طرفين قد أُنشئ، فلا يوجد سوى شيء واحد يحتاج إلى التخصيص عند إرسال رسالة: الرسالة نفسها. وعليه، لتحسين المسار الحرج كان علينا النظر في كيفية تخصيص الرسائل وتمريرها صعودًا ونزولًا في المكدّس (stack).
ومن المعارف الشائعة في مجال الشبكات عالية الأداء أن أفضل أداء يتحقق عند الموازنة بعناية بين كلفة تخصيص الرسالة وكلفة نسخها (انظر على سبيل المثال http://hal.inria.fr/docs/00/29/28/31/PDF/Open-MX-IOAT.pdf: لاحظ المعالجة المختلفة للرسائل «الصغيرة» و«المتوسطة» و«الكبيرة»). فالرسائل الصغيرة، يكون النسخ أرخص بكثير من تخصيص الذاكرة. ومن المنطقي ألّا تخصَّص أي كتل ذاكرة جديدة، بل أن تُنسخ الرسالة إلى ذاكرة مُخصَّصة مسبقًا كلما احتجنا إليها. أما الرسائل الكبيرة، على النقيض، فالنسخ أغلى بكثير من تخصيص الذاكرة. ومن المنطقي أن تُخصَّص الرسالة مرة واحدة ويُمرَّر مؤشر إلى الكتلة المُخصَّصة بدلًا من نسخ البيانات. وتُسمّى هذه المقاربة «النسخ الصفري» (zero-copy).
يتعامل ØMQ مع الحالتين على نحو شفاف. فالرسالة في ØMQ ممثَّلة بمقبض (handle) معتم. ومحتوى الرسائل الصغيرة جدًا مُرمَّز مباشرةً في المقبض. لذا فإن نسخ المقبض ينسخ بيانات الرسالة فعليًا. أما إذا كانت الرسالة أكبر فتُخصَّص في مخزن مؤقت (buffer) منفصل، ولا يحتوي المقبض سوى مؤشر إلى ذلك المخزن. ونسخ المقبض لا ينتج نسخًا لبيانات الرسالة، وهو أمر منطقي عندما يبلغ طول الرسالة ملايين البايتات (الشكل 24.3). وينبغي الإشارة إلى أن المخزن المؤقت في الحالة الأخيرة مُدار بعدّ مراجع (reference-counted) بحيث يمكن الإشارة إليه من عدة مقابض دون الحاجة إلى نسخ البيانات.
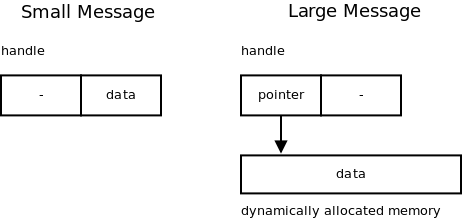 الشكل 24.3: نسخ الرسالة (أو عدم نسخها)
الدرس المستفاد: حين تفكر في الأداء، لا تفترض أن ثمّة حلًا واحدًا أفضل. فالأمر قد يكون أن للمشكلة عدة أصناف فرعية (مثلًا: الرسائل الصغيرة مقابل الكبيرة)، لكل منها خوارزميته المثلى الخاصة.
24.6. التجميع في دفعات
سبق أن ذكرنا أن العدد الهائل من استدعاءات النظام في نظام مراسلة قد يؤدي إلى عنق زجاجة في الأداء. والحقيقة أن المشكلة أعمّ من ذلك بكثير. فهناك عقوبة أداء غير تافهة مرتبطة بعبور مكدّس الاستدعاءات، وعليه فإن بناء تطبيقات عالية الأداء يقتضي تجنّب أكبر قدر ممكن من العبور عبر المكدّس.
تأمّل الشكل 24.4. لإرسال أربع رسائل عليك أن تعبر كامل مكدّس الشبكة أربع مرات (أي: ØMQ، وglibc، وحدود فضاء المستخدم/النواة، وتنفيذ TCP، وتنفيذ IP، وطبقة إيثرنت، وبطاقة الشبكة نفسها NIC، ثم الصعود عبر المكدّس من جديد).
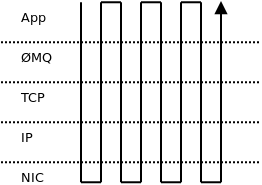 الشكل 24.4: إرسال أربع رسائل
غير أن إذا قرّرت دمج تلك الرسائل في دفعة واحدة، فلن يكون هناك سوى عبور واحد عبر المكدّس (الشكل 24.5). والأثر في نسبة إرسال الرسائل قد يكون هائلًا: حتى مرّتين من الرتبة (order of magnitude)، ولا سيما إذا كانت الرسائل صغيرة وأمكن حشر مئات منها في دفعة واحدة.
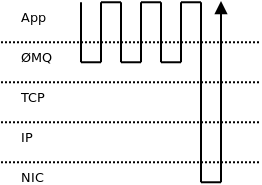 الشكل 24.5: تجميع الرسائل في دفعات
على النقيض، قد يكون للتجميع في دفعات أثر سلبي في زمن الاستجابة. ولنأخذ، مثلًا، خوارزمية نَغل المعروفة اسمًا والمطبَّقة في TCP. فهي تؤخّر الرسائل الصادرة مدةً محددة وتدمج كل البيانات المتراكمة في حزمة واحدة. ومن البديهي أن زمن الاستجابة من طرف إلى طرف للرسالة الأولى في الحزمة أسوأ بكثير منه للرسالة الأخيرة. ومن ثمّ فإن من الشائع للتطبيقات التي تحتاج إلى زمن استجابة منخفض بشكل ثابت أن تعطّل خوارزمية نَغل. بل ومن الشائع تعطيل التجميع في الدفعات على جميع مستويات المكدّس (مثل ميزة دمج المقاطعات في بطاقة الشبكة NIC).
لكن بالمقابل، فإن عدم التجميع يعني عبورًا مكثّفًا عبر المكدّس ويؤدي إلى انخفاض نسبة إرسال الرسائل. يبدو أننا ندور في حلقة مفرغة بين نسبة الإرسال وزمن الاستجابة.
يحاول ØMQ تحقيق أزمنة استجابة منخفضة باستمرار مع نسبة إرسال عالية عبر الاستراتيجية التالية: عندما يكون تدفّق الرسائل متقطّعًا ولا يتجاوز عرض نطاق (bandwidth) مكدّس الشبكة، يعطّل ØMQ كل عمليات التجميع لتحسين زمن الاستجابة. والمقايضة هنا هي استهلاك أعلى نسبيًا للمعالج—فلا يزال علينا العبور عبر المكدّس كثيرًا. غير أن ذلك لا يُعدّ مشكلة في معظم الحالات.
وعندما يتجاوز معدل الرسائل عرض نطاق مكدّس الشبكة، لا بدّ من وضع الرسائل في طابور—تخزينها في الذاكرة حتى يصبح المكدّس قادرًا على استقبالها. ووضع الرسائل في الطابور يعني أن زمن الاستجابة سيزداد. فإذا أمضت الرسالة ثانية واحدة في الطابور، فإن زمن الاستجابة من طرف إلى طرف سيكون ثانية واحدة على الأقل. والأسوأ من ذلك أن أزمنة الاستجابة ستزداد تدريجيًا مع نمو حجم الطابور. وإذا لم يكن لحجم الطابور حدّ أقصى، فيمكن أن يتجاوز زمن الاستجابة أي حد.
وقد لوحظ أنه، رغم ضبط مكدّس الشبكة لأدنى زمن استجابة ممكن (خوارزمية نَغل معطّلة، ودمج مقاطعات بطاقة الشبكة معطّل، إلخ)، فإن أزمنة الاستجابة قد تظلّ سيئة بسبب أثر الطابور، على النحو الموصوف أعلاه.
وفي مثل هذه الحالات يكون من المنطقي البدء بالتجميع بقوة (aggressive batching). فلا شيء يمكن خسارته إذ إن أزمنة الاستجابة عالية أصلًا. وعلى النقيض، فإن التجميع القوي يحسّن نسبة الإرسال ويستطيع تفريغ طابور الرسائل المعلّقة—مما يعني بدوره أن زمن الاستجابة سينخفض تدريجيًا مع خفض تأخير الطابور. وحالما لا تعود هناك رسائل معلّقة في الطابور، يمكن تعطيل التجميع لتحسين زمن الاستجابة أكثر.
وثمة ملاحظة إضافية: لا ينبغي إجراء التجميع إلا في أعلى مستوى. فإذا جُمِّعت الرسائل هناك، فلا يكون لدى الطبقات الأدنى ما تُجمِّعه على أي حال، ومن ثمّ فإن كل خوارزميات التجميع في الأسفل لا تفعل شيئًا سوى إدخال زمن استجابة إضافي.
الدرس المستفاد: للحصول على نسبة إرسال مثلى مع زمن استجابة مثلى في نظام غير متزامن (asynchronous)، عطّل كل خوارزميات التجميع في الطبقات الدنيا من المكدّس واجمع الدفعات في أعلى مستوى. ولا تجمع إلا عندما تصل البيانات الجديدة أسرع من قدرتها على المعالجة.
24.7. نظرة عامة على البنية
حتى الآن ركّزنا على المبادئ العامة التي تجعل ØMQ سريعًا. ومن الآن فصاعدًا سننظر في البنية الفعلية للنظام (الشكل 24.6).
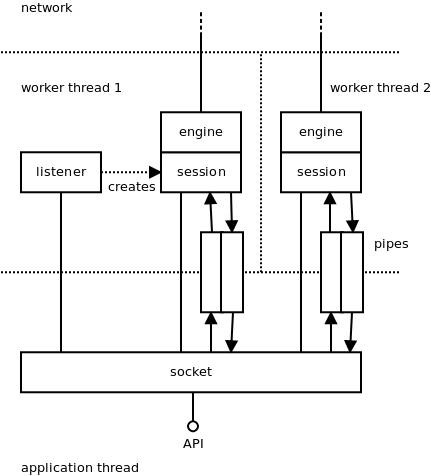 الشكل 24.6: بنية ØMQ
يتفاعل المستخدم مع ØMQ باستخدام ما يُسمّى «المقابس» (sockets). وهي مشابهة جدًا لمقابس TCP، والفرق الرئيسي أن كل مقبس يستطيع التعامل مع اتصالات عدة أقران، على نحو ما تفعله مقابس UDP غير المربوطة (unbound).
يعيش كائن المقبس في خيط المستخدم (راجع مناقشة نماذج خيوط التنفيذ في القسم التالي). وبخلاف ذلك، يشغّل ØMQ عددًا من خيوط العمل التي تتولى الجزء غير المتزامن من الاتصال: قراءة البيانات من الشبكة، ووضع الرسائل في الطوابير، وقبول الاتصالات الواردة، إلخ.
هناك كائنات مختلفة تعيش في خيوط العمل. ويملك كل كائن منها كائنًا أبًا واحدًا بالضبط (فالملكية يبيّنها خط متصل بسيط في المخطط). وقد يعيش الأب في خيط مختلف عن الابن. معظم الكائنات يملكها المقابس مباشرةً؛ غير أن هناك بعض الحالات التي يملك فيها كائنٌ كائنًا آخر يملكه المقبس. وما نحصل عليه هو شجرة من الكائنات، شجرة واحدة لكل مقبس. وتُستخدم هذه الشجرة أثناء الإيقاف (shutdown)؛ فلا يستطيع أي كائن أن يوقف نفسه قبل أن يغلق جميع أبنائه. وبهذه الطريقة نضمن أن عملية الإيقاف تعمل كما هو متوقع؛ مثلًا أن تُدفع الرسائل الصادرة المعلّقة إلى الشبكة قبل إنهاء عملية الإرسال.
وبشكل تقريبي، هناك نوعان من الكائنات غير المتزامنة: كائنات لا تشارك في تمرير الرسائل، وكائنات تشارك فيه. أما الأولى فتسعى غالبًا إلى إدارة الاتصالات. فمثلًا، كائن مستمع TCP (listener) يستمع إلى اتصالات TCP الواردة وينشئ كائن محرك/جلسة (engine/session) لكل اتصال جديد. وبالمثل، يحاول كائن موصّل TCP (connector) الاتصال بالأقران TCP، وعندما ينجح ينشئ كائن محرك/جلسة لإدارة الاتصال. وإذا فشل هذا الاتصال، يحاول كائن الموصّل إعادة إنشائه.
أما الثانية فهي الكائنات التي تتولى نقل البيانات نفسها. وهي مكوّنة من جزأين: كائن الجلسة (session object) المسؤول عن التفاعل مع مقبس ØMQ، وكائن المحرك (engine object) المسؤول عن الاتصال بالشبكة. وهناك نوع واحد فقط من كائنات الجلسة، لكن لكل بروتوكول سُلمي يدعمه ØMQ نوع محرك مختلف. ومن ثمّ لدينا محركات TCP، ومحركات IPC (التواصل بين العمليات)، ومحركات PGM (بروتوكول بث متعدد موثوق، انظر RFC 3208)، إلخ. ومجموعة المحركات قابلة للتوسعة—فقد نقرر مستقبلًا تنفيذ محرك WebSocket أو محرك SCTP مثلًا.
تتبادل الجلسات الرسائل مع المقابس. وهناك اتجاهان لتمرير الرسائل، ويتولى كل اتجاه كائن أنبوب (pipe). وكل أنبوب هو في الأساس طابور خالٍ من الأقفال (lock-free) محسَّن لتمرير الرسائل بسرعة بين الخيوط.
وأخيرًا، هناك كائن سياق (context) (ناقشناه في الأقسام السابقة لكنه غير ظاهر في المخطط) يحمل الحالة العامة ويمكن الوصول إليه من جميع المقابس وجميع الكائنات غير المتزامنة.
24.8. نموذج التزامن
كان أحد متطلبات ØMQ هو الاستفادة من الأجهزة متعددة الأنوية؛ بمعنى آخر، زيادة نسبة الإرسال خطيًا مع عدد أنوية المعالج المتاحة.
أظهرت تجاربنا السابقة مع أنظمة المراسلة أن استخدام خيوط متعددة بالطريقة الكلاسيكية (الأقسام الحرجة، والإشارات (semaphores)، إلخ) لا يحقق تحسنًا كبيرًا في الأداء. وفي الواقع، قد تكون النسخة متعددة الخيوط من نظام المراسلة أبطأ من النسخة أحادية الخيط، حتى لو قِيست على جهاز متعدد الأنوية. فالخيوط المنفردة تكتفي ببساطة بقضاء وقت طويل في انتظار بعضها بعضًا، فيما تثير في الوقت نفسه تبديلًا كبيرًا في السياق (context switching) يُبطئ النظام.
ونظرًا لهذه المشكلات، قررنا الانتقال إلى نموذج مختلف. وكان الهدف هو تجنّب الأقفال (locking) تمامًا والسماح لكل خيط أن يعمل بأقصى سرعته. وكان الاتصال بين الخيوط سيُوفَّر عبر رسائل (أحداث) غير متزامنة تُمرَّر بين الخيوط. وهذا، كما يعرف أهل الخبرة، هو نموذج الفاعلين الكلاسيكي (actor model).
كانت الفكرة أن نشغّل خيط عمل واحدًا لكل نواة معالج—فلو تشارك خيطان النواة نفسها لما كان ذلك سوى تبديل كبير في السياق دون أي ميزة تذكر. وكل كائن داخلي في ØMQ، مثل محرك TCP مثلًا، يكون مربوطًا ارتباطًا محكمًا بخيط عمل بعينه. وهذا بدوره يعني أنه لا حاجة إلى الأقسام الحرجة، ولا إلى كائنات التزامن (mutexes)، ولا إلى الإشارات (semaphores) وما شابهها. علاوة على ذلك، لن تُنقل كائنات ØMQ هذه بين أنوية المعالج، ومن ثمّ تتجنب الأثر السلبي في الأداء الذي يسبّبه إتلاف الذاكرة المخبأة (cache pollution) (الشكل 24.7).
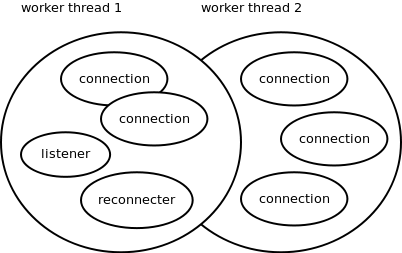 الشكل 24.7: عدة خيوط عمل
يؤدي هذا التصميم إلى زوال كثير من مشكلات البرمجة متعددة الخيوط التقليدية. غير أن هناك حاجة إلى مشاركة خيط العمل بين كائنات كثيرة، وهذا بدوره يعني وجود نوع ما من المهام التعاونية (cooperative multitasking). أي أننا نحتاج إلى مجدول (scheduler)؛ وتحتاج الكائنات إلى أن تكون مدفوعة بالأحداث (event-driven) بدلًا من أن تكون مسيطرة على حلقة الأحداث كاملة؛ ويتعين علينا التعامل مع تسلسلات أحداث اعتباطية، حتى النادرة منها؛ والتأكد من أن لا كائن يحتجز المعالج مدة أطول مما ينبغي؛ إلخ.
باختصار، لا بدّ أن يصبح النظام كله غير متزامن تمامًا. فلا يستطيع أي كائن أن ينفّذ عملية حاجبة (blocking)، لأنها ستحجبه هو بالدرجة الأولى، وتحجب كذلك سائر الكائنات التي تتشارك خيط العمل ذاته. ويجب أن يتحول جميع الكائنات، صراحةً أو ضمنًا، إلى آلات حالات (state machines). ومع وجود مئات أو آلاف آلات الحالات التي تعمل بالتوازي، عليك أن تعتني بكل التفاعلات الممكنة بينها، والأهم—بعملية الإيقاف (shutdown).
يتبيّن أن إيقاف نظام غير متزامن تمامًا بصورة نظيفة مهمة معقدة إلى حدٍّ مرعب. فمحاولة إيقاف ألف قطعة متحركة، بعضها يعمل وبعضها خامل وبعضها في طور التهيئة وبعضها يوقف نفسه بالفعل، عرضة لكل أنواع حالات التسابق (race conditions) وتسريبات الموارد وما شابه. ونظام الإيقاف الفرعي (shutdown subsystem) هو بالتأكيد أعقد أجزاء ØMQ. ويكشف فحص سريع لمتعقّب الأخطاء (bug tracker) أن نحو 30--50% من الأخطاء المبلَّغ عنها تتعلق بالإيقاف بشكل أو بآخر.
الدرس المستفاد: عند السعي إلى أداء وقابلية توسّع متطرفين، فكّر في نموذج الفاعلين (actor model)؛ فهو في مثل هذه الحالات الخيار الوحيد تقريبًا. لكن إن لم تكن تستخدم نظامًا متخصصًا مثل Erlang أو ØMQ نفسه، فسيتعين عليك كتابة كثير من البنية التحتية وتصحيح أخطاءها يدويًا. وإضافة إلى ذلك، فكّر منذ البداية في إجراء إيقاف النظام. فسيكون ذلك أعقد جزء في قاعدة الشيفرة، وإذا لم تكن لديك فكرة واضحة عن كيفية تنفيذه، فلا بد أنك ستعيد التفكير في استخدام نموذج الفاعلين من الأساس.
24.9. الخوارزميات الخالية من الأقفال
راحت الخوارزميات الخالية من الأقفال (lock-free) في الآونة الأخيرة. وهي آليات بسيطة للاتصال بين الخيوط لا تعتمد على أدوات التزامن التي توفرها النواة، ككائنات التزامن (mutexes) والإشارات (semaphores)؛ بل تنفّذ التزامن باستخدام عمليات معالج ذرّية، مثل المقارنة والتبديل الذرّيين (atomic compare-and-swap, CAS). وينبغي أن يُفهم أنها ليست خالية من الأقفال بالمعنى الحرفي—بل إن القفل يتم في الخلفية على مستوى العتاد (hardware).
يستخدم ØMQ طابورًا خاليًا من الأقفال في كائنات الأنابيب لتمرير الرسائل بين خيوط المستخدم وخيوط عمل ØMQ. وهناك جانبان مثيران للاهتمام في طريقة استخدام ØMQ للطابور الخالي من الأقفال.
أولًا، لكل طابور خيط كاتب واحد بالضبط وخيط قارئ واحد بالضبط. وإذا لزم وجود اتصال من واحد إلى N، فسيجري إنشاء عدة طوابير (الشكل 24.8). وبما أن الطابور بهذا الشكل لا يحتاج إلى مزامنة الكاتبين (فالكاتب واحد) ولا مزامنة القارئين (فالقارئ واحد)، فإنه يمكن تنفيذه بكفاءة استثنائية.
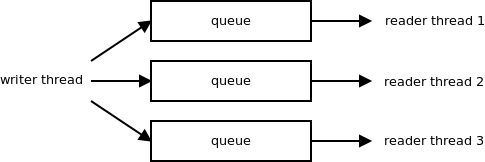 الشكل 24.8: الطوابير
ثانيًا، أدركنا أن الخوارزميات الخالية من الأقفال، وإن كانت أكثر كفاءة من الخوارزميات الكلاسيكية القائمة على كائنات التزامن (mutex)، فإن عمليات المعالج الذرّية لا تزال باهظة إلى حد ما (ولا سيما عند وجود تنافس بين أنوية المعالج)، وأن تنفيذ عملية ذرّية لكل رسالة تُكتب و/أو لكل رسالة تُقرأ كان أبطأ مما كنا مستعدين لقبوله.
كانت طريقة تسريع ذلك—ومرة أخرى—هي التجميع في دفعات. تخيّل أن لديك 10 رسائل يجب كتابتها في الطابور. وقد يحدث ذلك، مثلًا، حين تستقبل حزمة شبكة تحتوي على 10 رسائل صغيرة. فاستقبال الحزمة حدث ذرّي؛ ولا يمكنك أن تحصل على نصفها. وهذا الحدث الذرّي يستلزم كتابة 10 رسائل في الطابور الخالي من الأقفال. وليس ثمّة فائدة كبيرة من تنفيذ عملية ذرّية لكل رسالة. وبدلًا من ذلك يمكنك تراكم الرسائل في جزء «ما قبل الكتابة» (pre-write) من الطابور لا يطاله سوى خيط الكاتب، ثم تفريغها إلى الطابور باستخدام عملية ذرّية واحدة.
وينطبق الأمر نفسه على القراءة من الطابور. تخيّل أن الرسائل العشر السابقة فُرِّغت بالفعل إلى الطابور. فيمكن لخيط القارئ استخراج كل رسالة من الطابور باستخدام عملية ذرّية. غير أن ذلك مبالَغ فيه؛ وبدلًا من ذلك يمكنه نقل جميع الرسائل المعلّقة إلى جزء «ما قبل القراءة» (pre-read) من الطابور باستخدام عملية ذرّية واحدة. وبعد ذلك يمكنه استرجاع الرسائل من مخزن «ما قبل القراءة» واحدة تلو الأخرى. و«ما قبل القراءة» يملكه خيط القارئ وحده ولا يطاله سواه، ومن ثمّ لا يلزم أي مزامنة في هذه المرحلة البتة.
يبيّن السهم على يسار الشكل 24.9 كيف يمكن تفريغ مخزن ما قبل الكتابة إلى الطابور بمجرد تعديل مؤشر واحد. ويبيّن السهم على اليمين كيف يمكن نقل محتوى الطابور كله إلى ما قبل القراءة، بمجرد تعديل مؤشر آخر.
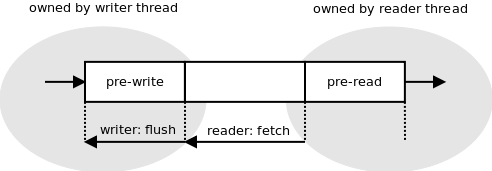 الشكل 24.9: طابور خالٍ من الأقفال
الدرس المستفاد: الخوارزميات الخالية من الأقفال صعبة الاختراع ومتعثرة التنفيذ وشبه مستحيلة التصحيح. فاستخدم خوارزمية مجرَّبة موجودة إن أمكن ذلك بدلًا من اختراع واحدة خاصة بك. وإذا كان الأداء المتطرف مطلوبًا فلا تعتمد على الخوارزميات الخالية من الأقفال وحدها. فرغم سرعتها يمكن تحسين الأداء بصورة ملحوظة بإضافة تجميع ذكي فوقها.
24.10. API
واجهة المستخدم هي أهم جزء في أي منتج. فهي الجزء الوحيد من برنامجك الذي يراه العالم الخارجي، وإن أخطأت فيها فسينتقم منك العالم. وفي المنتجات الموجّهة للمستخدم النهائي تكون إما الواجهة الرسومية (GUI) أو واجهة سطر الأوامر. أما في المكتبات فهي واجهة البرمجة (API).
في الإصدارات المبكرة من ØMQ كانت واجهة البرمجة قائمة على نموذج AMQP للتبادلات (exchanges) والطوابير. (انظر مواصفة AMQP.) ومن منظور تاريخي من المثير للاهتمام الاطلاع على الورقة البيضاء لعام 2007 التي تحاول التوفيق بين AMQP ونموذج مراسلة بلا وسيط (brokerless). وقد أمضيت نهاية عام 2009 في إعادة كتابتها تقريبًا من الصفر لتستخدم واجهة BSD Sockets البرمجية بدلاً من ذلك. وكانت تلك نقطة التحوّل؛ ومنذ ذلك الحين قفز تبنّي ØMQ ارتفاعًا. فقبلها كان منتجًا متخصصًا (niche) يستخدمه نفر من خبراء المراسلة، وبعدها أصبح أداة عملية مألوفة متاحة للجميع. وخلال عام أو نحوه تضاعف حجم المجتمع عشرة أضعاف، ونُفِّذ نحو 20 ربطًا (binding) بلغات مختلفة، إلخ.
تحدّد واجهة المستخدم تصوّر الناس للمنتج. فرغم أن الوظيفة لم تتغيّر تقريبًا—بتغيير واجهة البرمجة فحسب—تحوّل ØMQ من منتج «مراسلة مؤسسية» إلى منتج «شبكات». بمعنى آخر، تغيّر التصوّر من «قطعة بنية تحتية معقدة للبنوك الكبرى» إلى «يا سلام، هذا يساعدني في إرسال رسالتي التي طولها 10 بايت من التطبيق A إلى التطبيق B».
الدرس المستفاد: افهم ما تريد أن يكون عليه مشروعك، وصمّم واجهة المستخدم تبعًا لذلك. فوجود واجهة مستخدم لا تتوافق مع رؤية المشروع ضمانٌ مطلقٌ للفشل.
كان أحد الجوانب المهمة للانتقال إلى واجهة BSD Sockets أنها لم تكن واجهة ثورية مخترعة حديثًا، بل واجهة قائمة ومعروفة جيدًا. وفي الواقع، تُعدّ واجهة BSD Sockets من أقدم الواجهات البرمجية التي ما تزال مستخدمة حتى اليوم؛ فهي تعود إلى عام 1983 وإلى 4.2BSD Unix. وقد استُخدمت على نطاق واسع وبقيت مستقرة حرفيًا لعقود.
وتأتي هذه الحقيقة بعدد كبير من المزايا. أولًا، إنها واجهة يعرفها الجميع، لذا فإن منحنى التعلم مسطّح إلى حدّ ساخر. فرّ حتى إن لم تكن سمعت بـ ØMQ من قبل، يمكنك بناء تطبيقك الأول في دقائق قليلة بفضل قدرتك على إعادة استخدام معرفتك بواجهة BSD Sockets.
ثانيًا، استخدام واجهة برمجية منفَّذة على نطاق واسع يتيح دمج ØMQ مع التقنيات القائمة. فمثلًا، إخراج كائنات ØMQ بوصفها «مقابس» أو «واصفات ملفات» (file descriptors) يتيح معالجة أحداث TCP وUDP والأنابيب والملفات وأحداث ØMQ كلها في حلقة الأحداث نفسها. ومثال آخر: المشروع التجريبي لإدخال وظيفة شبيهة بـ ØMQ إلى نواة لينكس تبيّن أنه بسيط التنفيذ إلى حد كبير. وبمشاركة الإطار المفاهيمي نفسه يمكنه إعادة استخدام كثير من البنية التحتية الموجودة بالفعل.
ثالثًا، وهو على الأرجح الأهم، فإن بقاء واجهة BSD Sockets البرمجية نحو ثلاثة عقود رغم محاولات استبدالها العديدة يعني أن في التصميم شيئًا صحيحًا بطبيعته. فقد اتّخذ مصمّمو واجهة BSD Sockets القرارات التصميمية الصحيحة—سواء عن قصد أو مصادفة. وبتبنّي هذه الواجهة نشارك تلك القرارات التصميمية تلقائيًا، حتى دون أن نعرف ما كانت عليه ولا أي مشكلة كانت تحلّها.
الدرس المستفاد: رُوِّج لإعادة استخدام الشيفرة منذ قديم الزمان، ثم انضم إليها لاحقًا إعادة استخدام الأنماط، ومن المهم التفكير في إعادة الاستخدام بصورة أكثر عمومية. فعند تصميم منتج، اطّلع على منتجات مشابهة. وتحقّق أيّها فشل وأيّها نجح، وتعلّم من المشاريع الناجحة. ولا تستسلم لمتلازمة «غير مُبتكَر هنا» (Not Invented Here). أعد استخدام الأفكار، وواجهات البرمجة، والأطر المفاهيمية، وكل ما تراه مناسبًا. وبذلك تتيح للمستخدمين إعادة استخدام معرفتهم القائمة. وفي الوقت نفسه، قد تتجنّب مزالق تقنية لا تعي وجودها أصلًا.
24.11. أنماط المراسلة
في أي نظام مراسلة، تتمثل أهم مسألة تصميمية في كيفية توفير وسيلة للمستخدم كي يحدد أي الرسائل تُوجَّه إلى أي الوجهات. وهناك نهجان رئيسيان، وأعتقد أن هذا الانقسام عام إلى حد كبير وينطبق إلى حد بعيد على أي مشكلة في مجال البرمجيات.
أحد النهجين هو تبنّي فلسفة يونكس «افعل شيئًا واحدًا وأتقنه». ويعني ذلك أن مجال المشكلة ينبغي تقييده عمدًا بمجال صغير مفهوم جيدًا. ثم ينبغي للبرنامج أن يحلّ هذه المشكلة المقيّدة حلًا صحيحًا وشاملًا. ومن أمثلة هذا النهج في مجال المراسلة بروتوكول MQTT. فهو بروتوكول لتوزيع الرسائل على مجموعة من المستهلكين. ولا يصلح لأي شيء آخر (قل استدعاء الإجراءات عن بُعد RPC مثلًا)، لكنه سهل الاستخدام ويؤدي توزيع الرسائل على نحو ممتاز.
أما النهج الآخر فيركّز على العمومية ويوفّر نظامًا قويًا وعالي القابلية للتهيئة. وAMQP مثال على مثل هذا النظام. فنموذجه القائم على الطوابير والتبادلات يتيح للمستخدم الوسائل البرمجية ليعرّف برمجيًا أي خوارزمية توجيه تخطر له. والمقايضة، بالطبع، هي كثرة الخيارات التي عليك مراعاتها.
يختار ØMQ النموذج الأول لأنه يتيح استخدام المنتج الناتج من قِبل أي شخص تقريبًا، في حين يتطلب النموذج العام خبراء في المراسلة لاستخدامه. ولتوضيح هذه النقطة، فلننظر في كيفية تأثير النموذج في تعقيد واجهة البرمجة. وفيما يلي تنفيذ عميل RPC فوق نظام عام (AMQP):
connect ("192.168.0.111")
exchange.declare (exchange="requests", type="direct", passive=false,
    durable=true, no-wait=true, arguments={})
exchange.declare (exchange="replies", type="direct", passive=false,
    durable=true, no-wait=true, arguments={})
reply-queue = queue.declare (queue="", passive=false, durable=false,
    exclusive=true, auto-delete=true, no-wait=false, arguments={})
queue.bind (queue=reply-queue, exchange="replies",
    routing-key=reply-queue)
queue.consume (queue=reply-queue, consumer-tag="", no-local=false,
    no-ack=false, exclusive=true, no-wait=true, arguments={})
request = new-message ("Hello World!")
request.reply-to = reply-queue
request.correlation-id = generate-unique-id ()
basic.publish (exchange="requests", routing-key="my-service",
    mandatory=true, immediate=false)
reply = get-message ()
على النقيض، يقسّم ØMQ مشهد المراسلة إلى ما يُسمّى «أنماط المراسلة». ومن أمثلة هذه الأنماط «النشر/الاشتراك» (publish/subscribe)، و«الطلب/الرد» (request/reply)، و«خط الأنابيب المتوازي» (parallelised pipeline). وكل نمط مراسلة متعامد تمامًا مع الأنماط الأخرى، ويمكن تخيّله أداة منفصلة.
وفيما يلي إعادة تنفيذ التطبيق أعلاه باستخدام نمط الطلب/الرد في ØMQ. لاحظ كيف ينحسر ضبط كل الخيارات في خطوة واحدة: اختيار نمط المراسلة المناسب (REQ):
s = socket (REQ)
s.connect ("tcp://192.168.0.111:5555")
s.send ("Hello World!")
reply = s.recv ()
حتى الآن كنا ندّعي أن الحلول المتخصصة أفضل من الحلول العامة. نريد أن يكون حلّنا متخصصًا قدر الإمكان. لكننا نريد في الوقت نفسه أن نوفّر لعملائنا أوسع نطاق ممكن من الوظائف. فكيف نحلّ هذا التناقض الظاهري؟
يتكوّن الجواب من خطوتين:
- حدّد طبقة في المكدّس تتعامل مع مجال مشكلة بعينه (مثل النقل، أو التوجيه، أو العرض، إلخ).
- وفّر تنفيذات متعددة لتلك الطبقة. وينبغي أن يكون لكل حالة استخدام تنفيذ منفصل لا يتقاطع مع غيره.
لننظر إلى مثال طبقة النقل في مكدّس الإنترنت. فمقصود منها تقديم خدمات مثل نقل تدفّقات البيانات، وتطبيق التحكم في التدفّق، وتوفير الموثوقية، إلخ، فوق طبقة الشبكة (IP). وتؤدي ذلك عبر تعريف حلول متعددة لا يتقاطع بعضها في بعض: TCP لنقل تدفّق موثوق موجَّه بالاتصال، وUDP لنقل حزم غير موثوق بلا اتصال، وSCTP لنقل تدفّقات متعددة، وDCCP لاتصالات غير موثوقة، وهكذا.
لاحظ أن كل تنفيذ متعامد تمامًا: فلا يستطيع طرف UDP أن يتحدث إلى طرف TCP. ولا يستطيع طرف SCTP أن يتحدث إلى طرف DCCP. وهذا يعني أنه يمكن إضافة تنفيذات جديدة إلى المكدّس في أي لحظة دون التأثير في الأجزاء القائمة منه. وبالمقابل، يمكن نسيان التنفيذات الفاشلة والتخلص منها دون المساس بجدوى طبقة النقل ككل.
ينطبق المبدأ نفسه على أنماط المراسلة كما يعرّفها ØMQ. فأنماط المراسلة تشكّل طبقة (المسماة «طبقة قابلية التوسّع») فوق طبقة النقل (TCP ورفقتها). وأنماط المراسلة الفردية هي تنفيذات لهذه الطبقة. وهي متعامدة تمامًا—فطرف النشر/الاشتراك لا يستطيع أن يتحدث إلى طرف الطلب/الرد، إلخ. والفصل الصارم بين الأنماط يعني بدوره أنه يمكن إضافة أنماط جديدة عند الحاجة، وأن التجارب الفاشلة مع أنماط جديدة لن تضرب الأنماط القائمة.
الدرس المستفاد: عند حل مشكلة معقدة ومتعددة الأوجه، قد يتبيّن أن الحل الأحادي العام الغرض ليس بالضرورة أفضل طريق. وبدلًا من ذلك يمكننا النظر إلى مجال المشكلة بوصفه طبقة مجرّدة، وتوفير تنفيذات متعددة لهذه الطبقة، كل منها مركّز على حالة استخدام محددة المعالم. وعندئذٍ، حدّد حالة الاستخدام بعناية. واحرص على معرفة ما داخل النطاق وما خارجه. فالتقييد المفرط لحالة الاستخدام قد يحدّ من مجالات استخدام برمجيتك. أما إذا عرّفت المشكلة تعريفًا واسعًا أكثر من اللازم، فقد يصبح المنتج معقدًا وضبابيًا ومربكًا للمستخدمين.
24.12. الخاتمة
مع امتلاء عالمنا بالحواسيب الصغيرة المتصلة عبر الإنترنت—الهواتف المحمولة، وقارئات RFID، والأجهزة اللوحية والمحمولة، وأجهزة GPS، إلخ—لم تعد مسألة الحوسبة الموزّعة حكرًا على العلم الأكاديمي، بل أصبحت مسألة يومية شائعة يواجهها كل مطوّر. لكن الحلول، للأسف، في معظمها حِيَل خاصة بكل مجال (domain-specific hacks). يلخّص هذا المقال تجربتنا في بناء نظام موزّع واسع النطاق بأسلوب منهجي. وهو يركّز على مشكلات ممتعة من منظور هندسة البرمجيات، ونأمل أن يجده مصمّمو البرمجيات والمبرمجون في مجتمع المصادر المفتوحة مفيدًا.